导读更新于 2026-11-11:补齐指令跟随、目标导航、Agentic 导航、户外导航及传统导航的阅读入口,并补充户外方法的机制对照与评测边界。本次不是全篇论文或排行榜重新核验;历次技术核验范围见第 9.4 节。
这组文章怎么读
| 文章 | 主要回答的问题 |
|---|---|
| 本篇:VLN 综述 | 如何理解任务、方法机制、数据集与评测?适合作为总入口。 |
| 指令跟随篇 | 如何遵循路线指令?查代表方法与同设定性能表。 |
| 目标导航篇 | 给定对象、图像等目标,如何搜索并到达?查目标导航及相关扩展任务。 |
| Agentic 导航篇 | 如何组织工具、记忆、计划与执行反馈? |
| 户外导航篇 | 如何结合地图、视觉和语言,在街道、园区与步道执行任务? |
| 传统导航综述 | 定位、建图、规划和控制怎样支撑实际执行? |
这四篇精读是阅读分类,不是互斥的算法分类:户外方法也可能使用 Agent 编排,指令跟随也可能依赖传统规划器。先用本篇确认任务与评价口径,再到对应精读查实现和证据;底层执行不清楚时,回看传统导航综述。
阅读导航
本文回答三个问题:VLN 在解决什么任务,模型靠什么完成导航,以及怎样证明改进有效。 阅读时可沿着“任务设定 → 状态与动作接口 → 训练信号 → 闭环评测”这条线展开;数据集目录和模拟器细节适合在确定实验目标后按需查阅。
| 你现在的问题 | 本文入口 | 配套论文阅读 |
|---|---|---|
| 指令如何变成机器人动作? | 任务与系统闭环、策略架构 | StreamVLN、DualVLN |
| 长历史应该留在上下文还是写进地图? | 空间表征与历史记忆 | MapNav、AdaGeoVLN |
| 像素目标、动作 token 和轨迹有何不同? | 动作表示与空间落地 | GroundingVLN、LightNav-0 |
| 怎么判断指令进度,何时需要补看或恢复? | 进度、主动感知与恢复 | Route2Step、SeekVLN |
| 架构之外,还能怎样训练策略? | 数据扩展与闭环训练 | CorrectNav、MacroAction-VLN |
| 强化学习怎样改善纠错、停止与路线跟随? | RL 反馈层级、奖励设计、PPO / GRPO | ActiveVLN、ETP-R1 |
| 应该选什么数据与实验环境? | 数据集、模拟器 | 先确定观测、动作和划分,再查同设定结果 |
| SR 提高是否意味着导航更好? | 评测体系 | 分任务性能表与原论文实验协议 |
| 方法之间的真正差异是什么? | 方法组合与证据比较 | 按状态、接口、训练和预算比较机制 |
| 哪些问题仍未解决? | 证据与开放问题 | 区分论文结论和本文研究建议 |
| 怎样从论文走到可复现实验? | 实验与部署流程 | 按论文版本固定代码、权重和数据配置 |
先记住四点:到达终点与遵循沿途指令是两种能力;连续环境与完整机器人动力学是两个层次;缓存计算状态与记忆空间经验有不同用途;模型的推理速度需要放到完整控制闭环中评估。
1. 引言
视觉语言导航(Vision-Language Navigation, VLN)研究的是:智能体如何依据自然语言,在持续变化的第一视角观测中完成空间定位、路径决策与动作执行。它不是简单的“看图选方向”,而是一个典型的部分可观测长时序问题:智能体必须记住已经走过的区域,判断指令执行进度,在局部观测与全局目标之间反复对齐,并在偏航、遮挡或碰撞后恢复。
2018 年 R2R 奠定了“自然语言指令 + 真实扫描室内环境 + 未见场景泛化”的经典任务。此后,研究对象从离散全景导航扩展到连续控制、多语言指令、目标搜索、对话协作、动态人群、空中导航和真实机器人。2024 年以后,VLM/VLA 基础模型进一步改变了研究重心:问题不再只是如何设计一个任务专用策略,而是如何把通用视觉语言知识、空间记忆、高层推理和低层控制组织成一个可实时运行的具身系统。
截至 2026 年,更准确的判断不是“端到端模型已经取代模块化系统”,而是两者正在融合:统一模型负责获得可扩展的通用能力,结构化地图、快慢分层、技能调用和安全控制则为长时序可靠性提供约束。本文据此重新梳理 VLN 的概念边界、方法演进、基准体系与仍未解决的问题。
2. VLN 基本概述
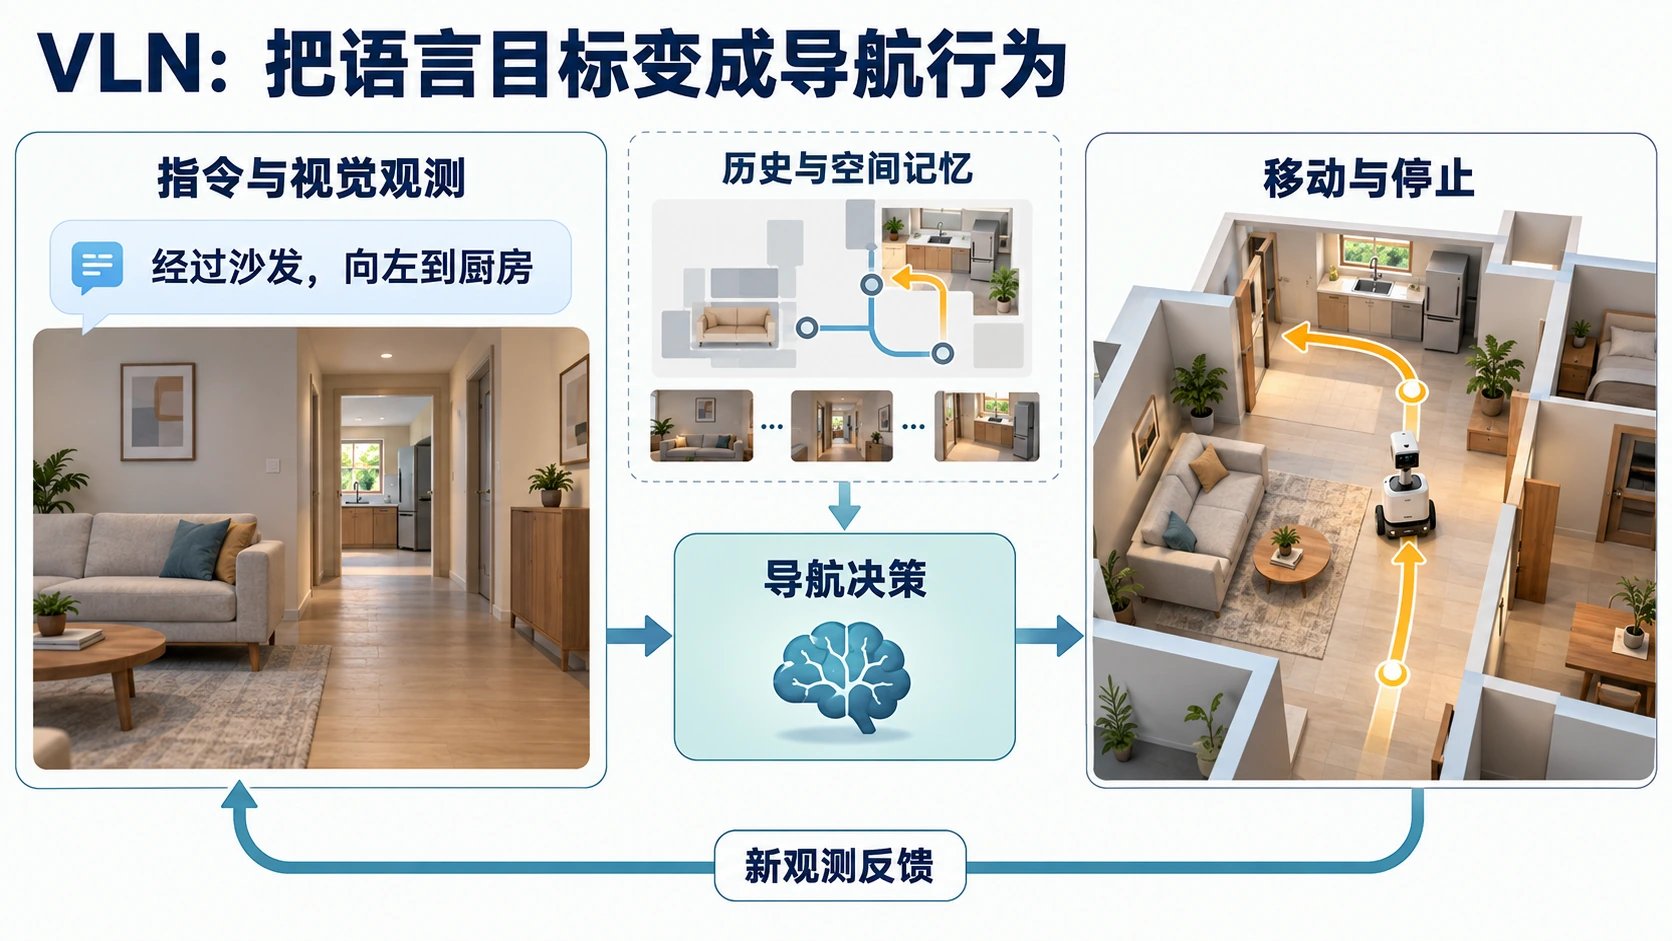
VLN 的核心不是“看懂一句话”,而是在部分可观测环境中持续完成 语言落地、空间定位、历史记忆、动作决策和停止判断。智能体每移动一步,视觉输入和指令进度都会变化,因此导航是一个闭环过程,而不是一次性的视觉问答。
2.1 任务定义
给定自然语言指令 $I$,智能体在时刻 $t$ 接收当前观测 $o_t$,并结合历史状态 $h_t$ 预测动作 $a_t$:
\[a_t \sim \pi(a_t \mid I, o_t, h_t)\]flowchart LR
I["自然语言指令"] --> G["语言与场景对齐"]
O["当前视觉观测"] --> G
H["历史轨迹与空间记忆"] --> G
G --> D["下一步决策"]
D --> S{"是否应当停止"}
S -->|否| A["动作或局部目标"]
A --> E["环境状态变化"]
E --> O
E --> H
S -->|是| Z["结束轨迹并评估是否成功"]
style I fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
style O fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
style H fill:#fff4e6,stroke:#e67700,stroke-width:2px
style G fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
style D fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
style A fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
style Z fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
离散环境通常输出相邻视点或 STOP;连续环境则可能输出前进/转向动作、二维路点、轨迹片段或底层控制量。动作接口不同会改变感知范围、控制难度和成功条件,因此不能仅凭“都使用 R2R 指令”就直接比较结果。
2.2 如何看懂 VLN 基准
| 维度 | 需要确认的问题 | 常见设定 | 对结果的影响 |
|---|---|---|---|
| 目标表达 | 智能体究竟要理解什么? | 路线指令、目标类别、目标图像、场景描述、对话 | 决定是否需要逐步语言落地或开放词汇搜索 |
| 观测配置 | 智能体能看到什么? | 全景、单目、多目、RGB、RGB-D、里程计 | 决定可见范围与几何先验强度 |
| 动作空间 | 智能体如何移动? | 离散视点、低层动作、路点、速度、轨迹 | 决定是否真正考察避障与控制 |
| 环境模型 | 环境是否具有物理约束? | 导航图、可导航表面、刚体碰撞、机器人动力学 | 决定是否会碰撞、跌倒或卡住 |
| 交互协议 | 指令能否被澄清或修正? | 单轮、对话、主动问询、人类反馈 | 决定智能体能否消解歧义和请求帮助 |
2.2.1 VLN、ObjectNav 与 VLA
| 范式 | 主要输入 | 主要考察能力 | 典型输出 |
|---|---|---|---|
| 指令跟随 VLN | 路线级自然语言指令 | 指令进度、地标对齐、路径忠实度 | 视点、动作或路点 |
| ObjectNav / ImageNav | 目标类别或目标图像 | 目标搜索、探索效率、目标定位(是否开放词汇依协议而定) | 探索方向或局部目标 |
| 通用 VLA | 图像/视频、语言目标、机器人状态 | 多任务迁移与动作生成 | 动作 token、轨迹或控制量 |
ObjectNav 可以为 VLN 提供语义探索模块,VLA 也可以成为 VLN 的策略底座,但它们的成绩不能自动并入标准 VLN 榜单。公平比较必须固定任务输入、传感器、动作接口、数据划分与额外训练数据。
2.3 现代 VLN 系统
早期模型常把 VLN 描述为“视觉编码器 + 语言编码器 + 动作分类器”。2026 年更实用的系统视图是:感知提供语义与几何证据,状态层维护指令进度和空间记忆,规划层选择子目标,执行层将子目标转化为安全动作,并由真实观测持续纠偏。
flowchart TB
    subgraph input["输入与观测"]
        I["自然语言指令"]
        V["第一视角视觉流"]
        R["深度 里程计 机器人状态"]
    end

    subgraph cognition["语义与空间状态"]
        P["视觉语言感知"]
        M["拓扑图 BEV 记忆缓存"]
        T["指令进度与失败状态"]
    end

    subgraph decision["规划与决策"]
        Q["子目标分解与候选生成"]
        W["候选评估与重规划"]
    end

    subgraph control["动作与控制"]
        L["局部路点或轨迹策略"]
        C["控制器与安全约束"]
        A["机器人动作"]
    end

    I --> P
    V --> P
    R --> M
    P --> M
    P --> T
    M --> Q
    T --> Q
    Q --> W
    W --> L
    L --> C
    C --> A
    A -.->|新观测| V
    A -.->|位姿更新| R
    C -.->|碰撞或卡住| T

    style P fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style M fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style T fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style Q fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style W fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
    style L fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style A fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
这张图不是要求所有方法都显式实现每个模块。端到端模型会把多个方框折叠进统一网络;双系统、地图方法和 Agent 方法则会把部分接口显式化。判断架构时,应看信息流和训练目标,而不是只看论文使用了哪个名称。
2.4 核心难点
| 难点 | 典型失败 | 为什么难 | 需要观察的证据 |
|---|---|---|---|
| 动态语言落地 | 把后半句地标提前执行,或错过转向点 | 指令进度随位移变化 | 细粒度轨迹对齐、错误指令测试 |
| 部分可观测与长记忆 | 重复探索、忘记已访问区域、无法回退 | 单帧看不到全局结构 | 长路径表现、回溯和记忆消融 |
| 语义推理与几何可达性 | VLM 选择语义正确但不可到达的目标 | 互联网知识不等于三维几何 | 深度/地图消融、可达性验证 |
| 高层规划与低层控制 | 子目标正确但轨迹碰撞或振荡 | 两个时间尺度和接口误差叠加 | 控制频率、延迟、碰撞与重规划次数 |
| 开放世界与真实部署 | 仿真成功、真机失效 | 视角、传感器、动力学和场景分布变化 | 跨场景、跨构型和真实机器人评测 |
| 失败检测与恢复 | 到过目标附近却没有停下,偏航后持续累积错误 | 模型缺少不确定性和自我诊断 | OSR–SR 差距、恢复成功率、人工介入次数 |
2.5 走向导航基础模型
%%{init: {"themeVariables": {"fontSize": "20px"}, "flowchart": {"nodeSpacing": 24, "rankSpacing": 28}}}%%
flowchart TB
    A["2018–2019<br/>序列建模<br/>Seq2Seq · Speaker-Follower"]
    B["2020–2021<br/>跨模态预训练<br/>PREVALENT · VLN-BERT · HAMT"]
    C["2021–2023<br/>图规划与长历史<br/>DUET · ETPNav · ScaleVLN"]
    D["2023–2024<br/>VLM 与视频策略<br/>NaVid · NavGPT-2"]
    E["2025<br/>快慢系统与规模化数据<br/>StreamVLN · DualVLN<br/>NavFoM · OmniNav"]
    F["2026<br/>Agent 与统一导航持续探索<br/>AgentVLN · Qwen-RobotNav<br/>NavWAM"]

    A --> B --> C --> D --> E --> F

    style A fill:#f8f9fa,stroke:#868e96,stroke-width:2px
    style B fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style C fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style D fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style E fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style F fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
这条演进线包含多个持续交汇的问题:预训练提供语义先验,空间表征与记忆支持长期状态,分层控制协调规划和执行,进度判断与主动感知帮助持续核对指令。Agent 编排、纠偏训练和未来预测又可以组合到这些系统中,分别改善能力调用、错误恢复与动作决策。
2.6 研究问题地图
| 研究层 | 当前常用方案 | 仍缺少的关键证据 |
|---|---|---|
| 表征 | VLM 预训练、视频上下文、三维 token | 是否真正理解沿途约束,而不是只预测终点? |
| 状态 | 拓扑图、BEV、3D Gaussian、缓存与检索记忆 | 记忆错误何时发生,如何遗忘与修正? |
| 规划 | 子目标分解、CoT、候选轨迹打分 | 更长的推理是否稳定改善闭环控制? |
| 执行 | 路点策略、动作块、扩散轨迹、MPC | 不同机器人形态和控制频率下能否迁移? |
| 数据 | 合成轨迹、多任务联合训练、自动进度描述 | 数据量、场景多样性和标注质量谁更关键? |
| 部署 | 量化、缓存、边缘推理、安全控制器 | 仿真 SR / SPL 能否预测真实可靠性? |
2.7 近期研究的交汇点
近期工作的交汇点既包括统一策略与分层控制,也包括几何表征、历史记忆、空间动作接口、进度判断和主动感知。Agent 编排、预测学习与闭环训练可以作用于多种架构。第 3 节因此按研究问题组织方法,同一论文可用于解释多个机制;这种组织方式是本文的分析框架,不是互斥分类,也不意味着这些思想都始于 2026 年。证据边界见第 9.3 节。
3. 方法范式与关键机制
理解一个 VLN 方法,需要分别回答:策略怎样组织,历史怎样表示,决策怎样落到动作,指令进度怎样跟踪,以及模型从什么反馈中学习。 本节按这些问题讨论统一策略、分层控制、空间记忆、任务编排与未来预测,并单独展开动作接口、主动感知和训练机制。同一方法可以同时采用多项设计,这些小节不构成互斥的论文类别,也不代表统一条件下的性能排序。
| 分析维度 | 核心问题 | 本节入口 |
|---|---|---|
| 策略架构 | 统一策略负责到哪一级,规划与执行如何分工? | 3.2 策略架构 |
| 状态表示 | 如何保留空间关系、历史证据与访问经验? | 3.3 空间表征与历史记忆 |
| 动作接口 | 输出的是原子动作、像素目标、路点还是轨迹? | 3.4 动作表示与空间落地 |
| 任务进度 | 正在执行哪段指令,何时补看、回退或停止? | 3.5 进度、主动感知与恢复 |
| 系统编排 | 谁调用工具,执行反馈如何改变后续决策? | 3.6 Agent 编排 |
| 预测机制 | 预测只用于训练,还是参与运行时决策? | 3.7 预测学习与世界模型 |
| 学习信号 | 使用示范、纠偏轨迹、辅助监督还是环境奖励? | 3.8 数据扩展与闭环训练 |
下图按照信息流展示这些职责的关系。空间记忆、进度判断和未来预测可以在统一网络内部实现,也可以作为独立模块;Agent 编排是可选的上层组织方式。
flowchart TB
    I["指令与当前观测"] --> S["空间表征与历史记忆"]
    I --> P["指令进度与证据判断"]
    S --> D["策略决策:统一策略或分层规划"]
    P --> D
    D --> A["动作接口:原子动作 像素 路点 轨迹"]
    A --> C["局部执行与控制"]
    C --> E["环境与新观测"]
    E -.->|反馈与纠偏| I
    P -.->|需要补充证据| O["主动观察"]
    O --> E
    G["可选 Agent:任务编排与工具调用"] -.-> D
    E -.->|执行结果| G
    W["可选未来预测"] -.->|运行时辅助决策| D
    T["训练:示范 数据扩展 纠偏 RL 预测监督"] -.->|学习策略与表征| D

    style S fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style P fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style D fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style A fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
    style G fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style W fill:#f3d9fa,stroke:#862e9c,stroke-width:2px
    style E fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
3.1 方法演进
| 研究重心 | 模型内部状态 | 典型动作接口 | 训练信号 | 代表方法 |
|---|---|---|---|---|
| 序列策略 | RNN 隐状态 | 离散视点 / 动作 | 行为克隆、强化学习 | Seq2Seq、Speaker-Follower |
| 预训练 Transformer | 跨模态 token 与历史特征 | 离散候选点 | 掩码建模、指令—轨迹对齐 | PREVALENT、VLN-BERT、HAMT |
| 图规划与显式记忆 | 拓扑图、语义图、局部地图 | 全局节点 + 局部动作 | 图监督、路径与进度目标 | DUET、ETPNav、MapNav |
| 视频 VLM / VLA | 视频上下文、KV cache、动作 token | 离散动作、路点或动作块 | 视觉语言数据 + 导航轨迹 | NaVid、StreamVLN、NavFoM |
| 多任务导航模型 | 共享上下文与可配置观测 | 多任务模式、空间目标或轨迹 | 联合训练、指令微调及可选 RL | OmniNav、OneVLA、Qwen-RobotNav、LightNav-0 |
| 进度推理与证据获取 | 活动子指令、地标证据、恢复状态 | 导航动作、补充观察或子任务 | 进度对齐、纠偏与观察收益 | AwareVLN、Route2Step、SeekVLN |
| Agent 编排 | 工具反馈与任务记忆 | 工具调用或子任务 | 依实现使用提示、监督或环境反馈 | AgentVLN、HarnessVLN |
| 预测表征与世界动作模型 | 预测的未来特征、视觉状态或联合表示 | 原有动作接口、轨迹或动作块 | 未来预测与动作监督 | PROSPECT、AstraNav-World |
这些重心在时间上相互交叠:图结构可以继续服务于 VLM 策略,统一模型可以使用空间记忆,强化学习也可以优化不同的动作接口。现代方法的提升还常伴随更大的基模、更多轨迹或额外传感器,阅读时应把机制改动和资源增加分开归因。
3.2 策略架构
架构首先决定各层负责什么。统一策略在同一个主干中结合语言、观测和历史,预测下一步动作或轨迹;分层系统显式传递子目标,由另一层完成局部执行。模型数量、是否联合训练、是否维护地图、是否高低频分工是不同属性。 使用统一策略仍可能需要轨迹跟踪器,分层网络也可能联合优化;“端到端”应说明监督或梯度覆盖到哪一级接口。
3.2.1 统一策略
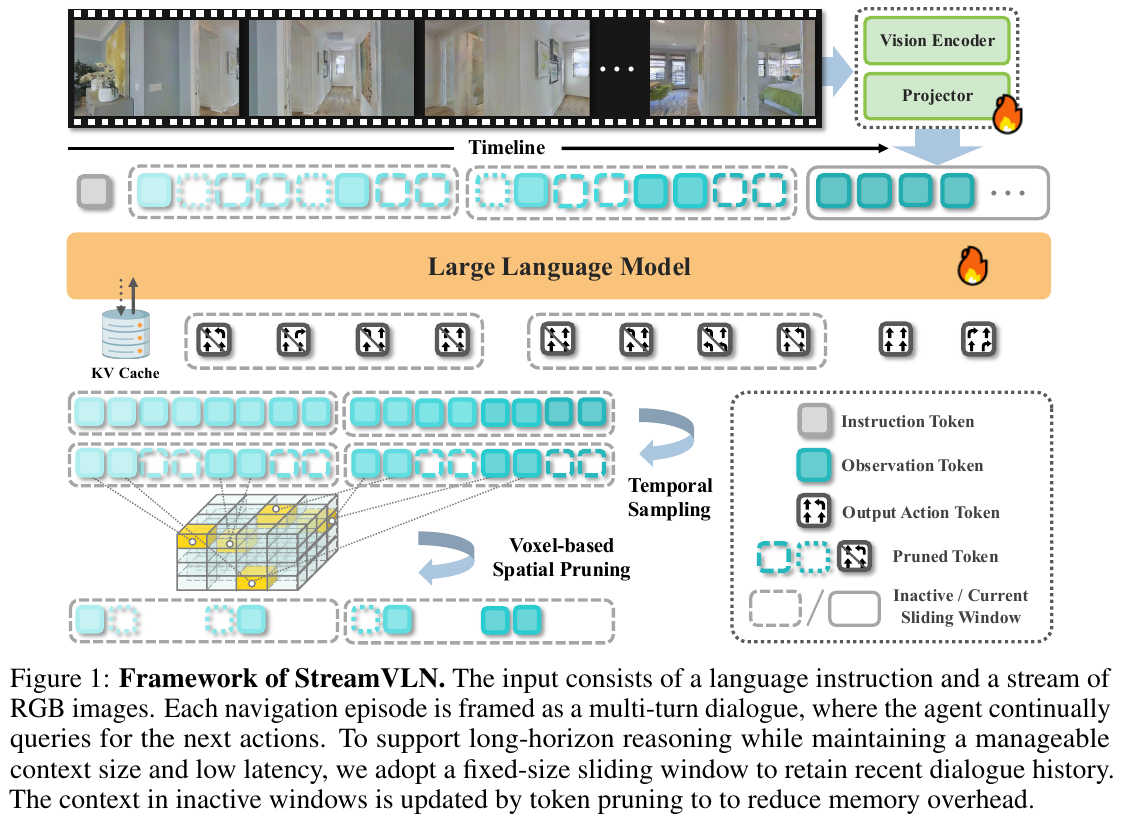
NaVid和StreamVLN将视频历史与语言用于动作生成;NavFoM、Qwen-RobotNav等工作进一步探索多任务共享策略。讨论这一类方法时,重点是输入与输出如何统一,以及训练数据能否支持迁移,而不是要求模型完全没有外部模块。
| 关键设计 | 解决的问题 | 代表工作 |
|---|---|---|
| 观测—动作交错与流式上下文 | 长视频输入下的持续决策与计算复用 | StreamVLN |
| 多任务共享策略 | 让不同导航目标共享表征与动作能力 | NavFoM、OneVLA |
| 可配置观测上下文 | 按任务调整历史、相机与 token 预算 | Qwen-RobotNav |
| 统一空间与动作 token | 在模型词表中表达空间意图和轨迹 | LightNav-0 |
3.2.2 分层控制
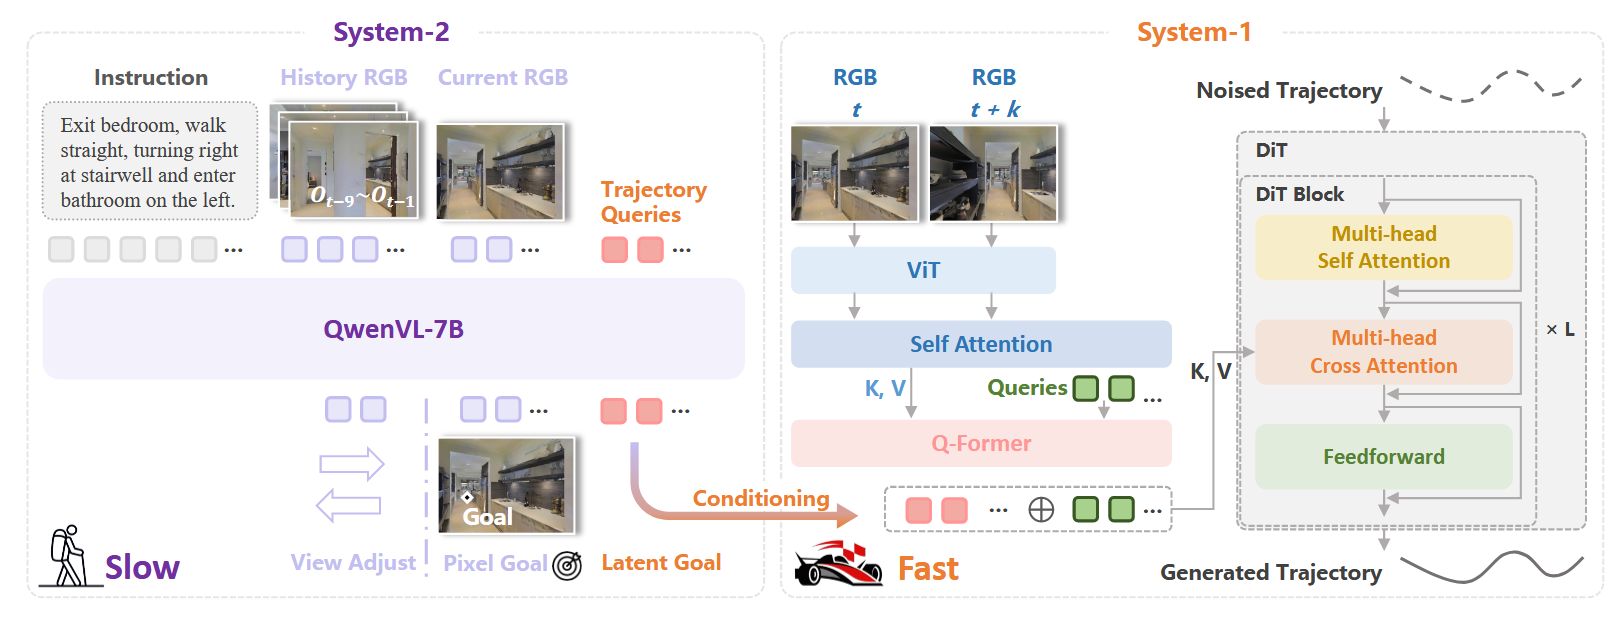
快慢系统是分层控制的一种实现:慢系统低频理解指令并产生子目标,快系统利用最新观测持续生成局部动作。低层既可以是学习到的策略,也可以是几何规划器;应检查它是否闭环执行、何时请求新目标,以及上层延迟和错误如何传递。
flowchart LR
    I["指令与历史"] --> S2["高层:进度判断与子目标"]
    S2 --> G["像素目标 路点 子指令"]
    O["当前观测与机器人状态"] --> S1["低层:策略或几何规划器"]
    G --> S1
    S1 --> T["局部动作或轨迹"]
    T --> C["跟踪控制与机器人执行"]
    C -.->|新观测| O
    C -.->|完成 受阻 偏航| S2

    style S2 fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style G fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style S1 fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style C fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
DualVLN、OmniNav、ABot-N1和Robostral Navigate提供了不同的规划—执行分工实例。Route2Step则把语义进度与动作生成分开,提醒我们区分“职责分层”和“控制频率分层”,不能仅凭存在两个模块就认定为快慢系统。
同名机制需要看具体含义。 StreamVLN 的 SlowFast 主要描述上下文与记忆的更新节奏;DualVLN 的快慢分工发生在目标推理与轨迹执行之间。前者应评估历史保留和计算效率,后者还要评估控制频率、轨迹平滑性和异步目标更新。
3.3 空间表征与记忆
空间表征回答“环境中的对象和可通行区域是什么关系”,历史记忆回答“过去哪些信息应当影响现在的决策”。二者可以结合在地图中,也可以由几何特征、隐状态、关键帧或检索库共同承担。仅从 RGB 提取三维几何特征,不等于已经建立可供规划器查询的全局地图。
| 表示与记忆方式 | 主要作用 | 代表工作 | 需要检查的代价 |
|---|---|---|---|
| 拓扑图 | 保存连通关系,支持全局选点和回溯 | DUET、ETPNav、DGNav | 建图先验、候选点和连接误差 |
| 语义地图 / BEV | 将空间布局压缩成可定位、可聚合的状态 | MapNav、GA-VLN | 深度、位姿依赖与更新误差 |
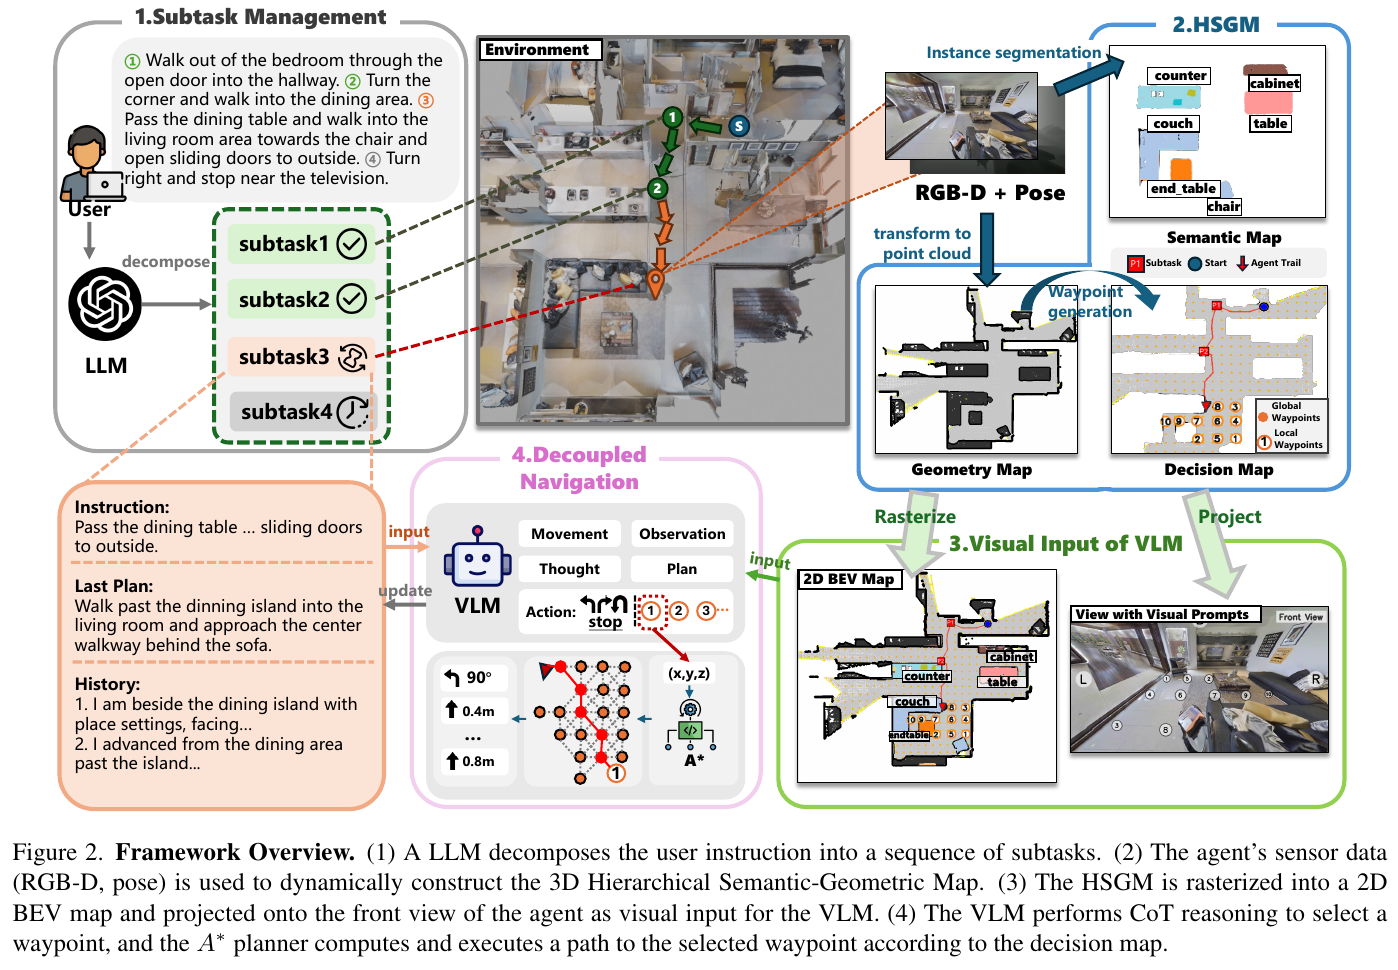
| 分层场景图 / 三维场景记忆 | 组织房间、对象与多视角空间关系 | HSGM、GSMem | 感知质量、建图成本与动态场景更新 |
| 几何基础模型特征与隐式记忆 | 在神经表征中保留几何和跨帧证据 | JanusVLN、AdaGeoVLN | 尺度一致性、显存与历史选择 |
| 历史帧、关键帧与压缩上下文 | 用有限预算保存任务相关观测 | StreamVLN、MemVLN、DecoVLN | 是否遗漏早期地标和转折点 |
| 任务事件与经验检索 | 保存已完成步骤、失败条件和执行证据 | HarnessVLN | 错误写入、经验过时与检索开销 |
户外场景图的阅读入口。 CausalNav将语义地图、目标检索与动态环境导航连接起来,可对照理解场景图如何服务真实户外任务;它不是路线指令基准上的直接性能证据,比较时需固定目标形式、建图信息与动态障碍条件。
几何融合与历史选择可以共同优化。 AdaGeoVLN将几何模型不同深度的特征接入策略,并按指令相关性、几何置信度和转移新颖度保留历史 KV 状态。这个例子说明,压缩不只是减少 token;保留什么也会改变下一时刻的空间推理依据。
计算复用与任务记忆应按用途区分,而不只看是否使用 KV cache。 VLN-Cache主要复用跨帧计算以降低成本;JanusVLN、AdaGeoVLN 等方法还用历史神经状态承担语义或几何记忆。前者应报告加速与精度损失,后者还需要检验长程地标保留、回溯与错误修正。
地图和记忆都可能出错。评价时应说明如何写入、更新、处理冲突和遗忘;使用目标导航中的记忆方法作参考时,还需固定任务输入和跨回合信息权限。
3.4 动作表示与空间落地
动作接口决定高层模型需要预测什么,以及执行端还需完成哪些工作。“向左转”“走向画面里的门”“到达某个三维路点”和“一段可跟踪轨迹”具有不同的精度、时间跨度和几何要求。它们不能仅按输出是文本还是数字来区分。
| 输出接口 | 怎样转化为移动 | 代表工作 | 主要限制 |
|---|---|---|---|
| 原子动作 / 离散动作块 | 将动作符号映射为前进、转向与停止 | NaVid、StreamVLN、SeekVLN | 决策序列长,执行粒度与动作语义依平台而定 |
| 像素目标 / 图像区域 | 由深度反投影、几何规划或目标条件策略执行 | Goal2Pixel、TAMP-Nav、GroundingVLN | 二维点本身不保证深度、可达性或安全 |
| 拓扑节点 / 前沿宏动作 | 选择图节点或前沿点;离散环境按图转移,连续环境交给低层执行 | DUET、MacroAction-VLN | 候选集合与图质量限制高层选择 |
| 连续路点 / 轨迹块 | 由控制器跟踪回归、扩散等方式生成的轨迹 | DualVLN、OmniNav | 需要明确坐标系、轨迹时域与执行约束 |
| 量化轨迹 token | 先解码为轨迹,再交给执行端 | LightNav-0 | 需要检查量化误差和跨构型适配 |
户外方向指令也需要几何落地。 DA-Nav把方向指令与视觉历史转为图像网格轨迹,再经深度或平地 IPM 投影交给控制器。网格位置不是米制航点,RGB 策略输入也不意味着完整系统无需深度、标定或地面假设。
视觉落地同时影响推理与执行。 GroundingVLN把推理中的视觉证据绑定到图像位置,再输出与任务进度对齐的像素目标,交给几何规划器执行。可测量的中间接口便于分别检查“认对了什么”“目标在哪里”和“实际走到了哪里”,也为执行感知奖励提供依据。
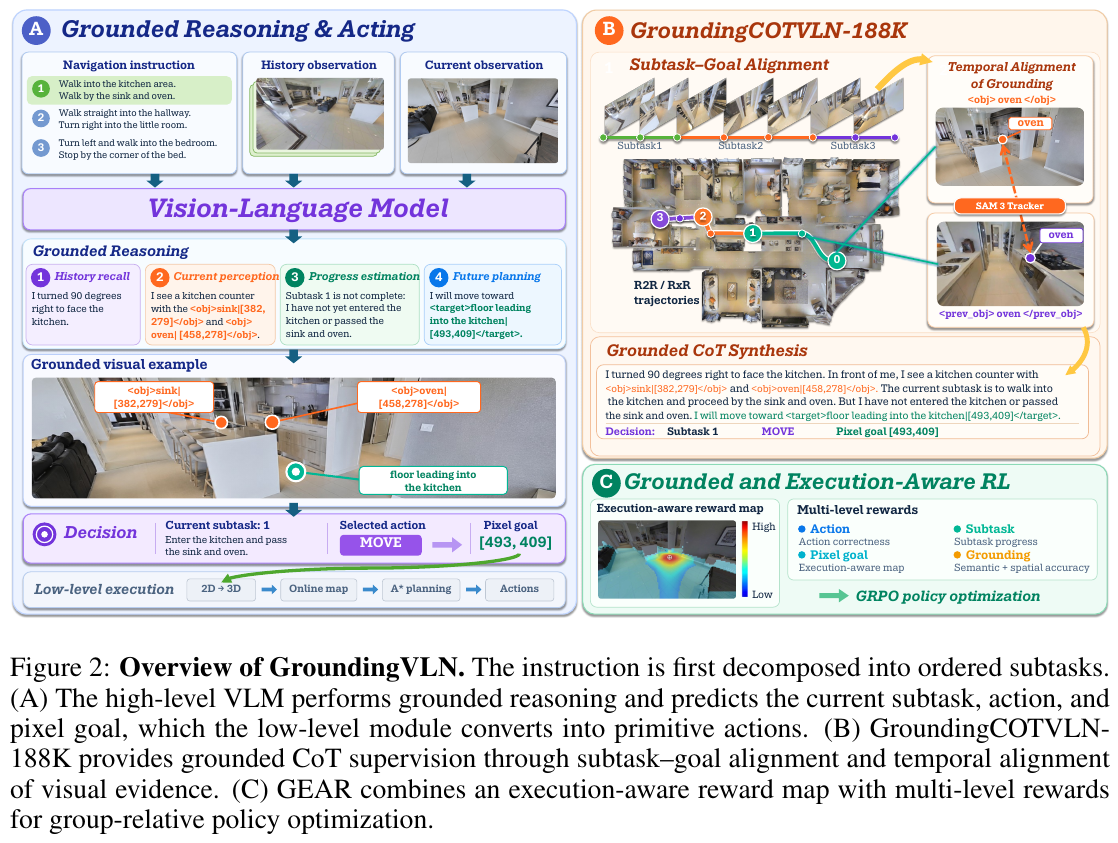
token 化不等于原子离散控制。 LightNav-0使用统一 token 接口表达 pointing 与量化轨迹;其动作 token 解码后具有轨迹含义,不能与“左转一次”的动作分类混为一谈。反过来,像素目标也不必搭配神经连续动作头,几何规划器同样可以把它变成移动。
比较接口时,应固定可用的 RGB、深度、位姿与地图,报告完整执行链的闭环结果。模型输出离散符号并不妨碍在连续环境中评测,模型输出连续坐标也不自动代表机器人满足动力学约束。
3.5 进度、主动感知与恢复
长程导航需要持续判断“已完成哪段指令、下一步还缺什么证据”。选错活动子指令和未能执行正确子指令,会产生不同的错误;只给出一个纠正动作,未必能修复内部进度状态。
| 研究问题 | 典型机制 | 代表工作 | 应观察的证据 |
|---|---|---|---|
| 何时需要推理? | 按需触发场景描述、进度判断与计划 | AwareVLN、TAMP-Nav | 推理频率、调用开销与收益 |
| 正在执行哪条子指令? | 显式任务清单、进度状态与地标约束 | Dual-Anchoring、Route2Step | 状态对齐、偏航后的进度修正 |
| 现有观测够不够? | 把补充观察纳入策略选择 | SeekVLN | 观察次数、额外视角与后续行动收益 |
| 走偏后怎样恢复? | 纠偏数据、状态监督或反思反馈 | CorrectNav、BudVLN、ReflectVLN | 恢复成功率、额外路径与重复失败 |
Route2Step通过步级接口拆开语义进度与动作生成,使错误进度能够获得状态监督。它提供的启发是:同一次偏航,可能需要先修正“我在做什么”,再修正“怎样移动”,而非把所有问题都交给动作预测。
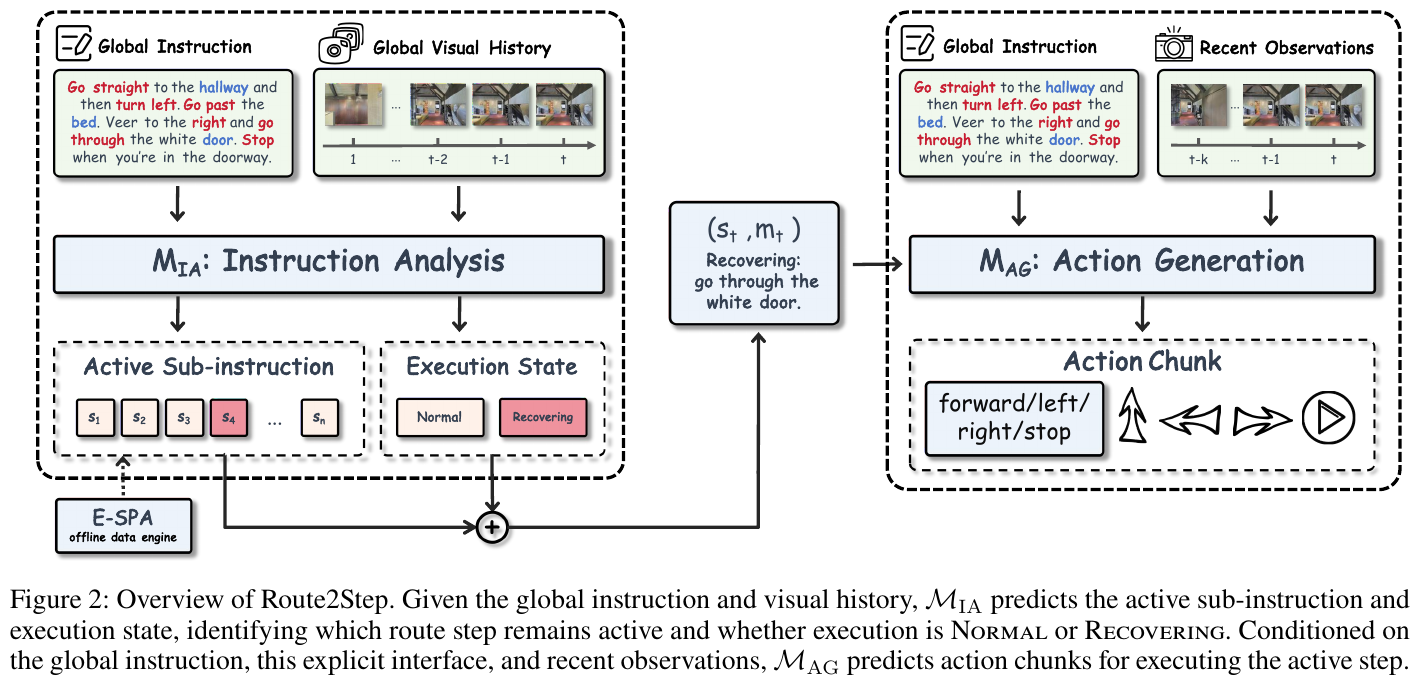
SeekVLN进一步研究“现有画面不足以支持进度判断”的情形:策略可选择直接导航或补充观察,再利用新增证据继续决策。其训练比较同状态下补看与直接导航的后续进展。这里需要单独报告额外观察成本,不能把按需增加视角的收益全部归因于更强推理,也不能仅凭模式切换就将其归为工具编排或快慢控制。
例如,指令要求“经过沙发后左转,在第二扇门前停下”。看不到侧面的门时,补充观察可能更有帮助;已经错过路口时,需要回退并修正进度;到达后仍继续前进,则需要分析停止条件。这三类错误应分开统计,再检查恢复行为是否真正保留了沿途指令约束。
DA-Nav 的恢复数据提供了另一种训练路径:在仿真采集阶段主动制造偏航,丢弃扰动段、保留恢复示范,再监督学习偏航状态、纠正动作与轨迹。这不等于在线强化学习;评测也要将偏航事件的纠正成功率与整条任务的成功率分开。
恢复是一种能力,获得它的机制并不唯一。 CorrectNav从模型偏离轨迹中生成纠错数据并继续训练,属于训练机制;Agent 系统也可以在运行时利用工具反馈恢复。两者都应以实际轨迹验证,不能仅凭出现“反思”文本就认定恢复有效,或推断部署时发生了权重更新。
3.6 Agent 编排与工具执行
本节将 Agent 编排限定为:上层依据任务状态选择和调用感知、记忆、规划或导航能力,并读取执行结果以更新后续决策。它可以调用统一导航策略,也可以接入分层控制系统。评价时应区分“工具本身能做什么”和“上层何时调用工具带来什么收益”。
| 组织方式 | 代表工作 | 主要接口 | 应单独验证什么 |
|---|---|---|---|
| VLM 与可调用技能协作 | Open-Nav、AgentVLN | 感知、候选点、规划与局部执行 | 工具选择相对固定流程的收益 |
| 导航封装为工具调用 | AgenticNav | 观测、决策与执行反馈 | 交互协议、调用成本与失败处理 |
| 统一管理工具、记忆和执行校验 | HarnessVLN | 任务进度、空间证据与结构化返回 | 校验、记忆及恢复各自的贡献 |
| 上层规划器调用共享导航基模 | Qwen-RobotNav 系统 | 任务模式与可配置观测上下文 | 动态配置相对固定配置的收益 |
HarnessVLN将感知、记忆和执行工具纳入共享接口,并在派发前检查证据、几何可行性与子目标一致性。这个例子说明,Agent 编排与空间记忆常同时存在;把一篇论文只归入其中一类,会丢掉另一部分设计。
3.6.1 基模与 Agent 分开评测
Qwen-RobotNav 是可用于 Agent 系统的导航模型。评价时应区分底层导航成绩与加入上层编排后的系统成绩:前者反映模型及其输入配置,后者还包含任务分解、模式切换和运行时反馈。不能把整个系统的收益全部记在基模或规划器任一方上。
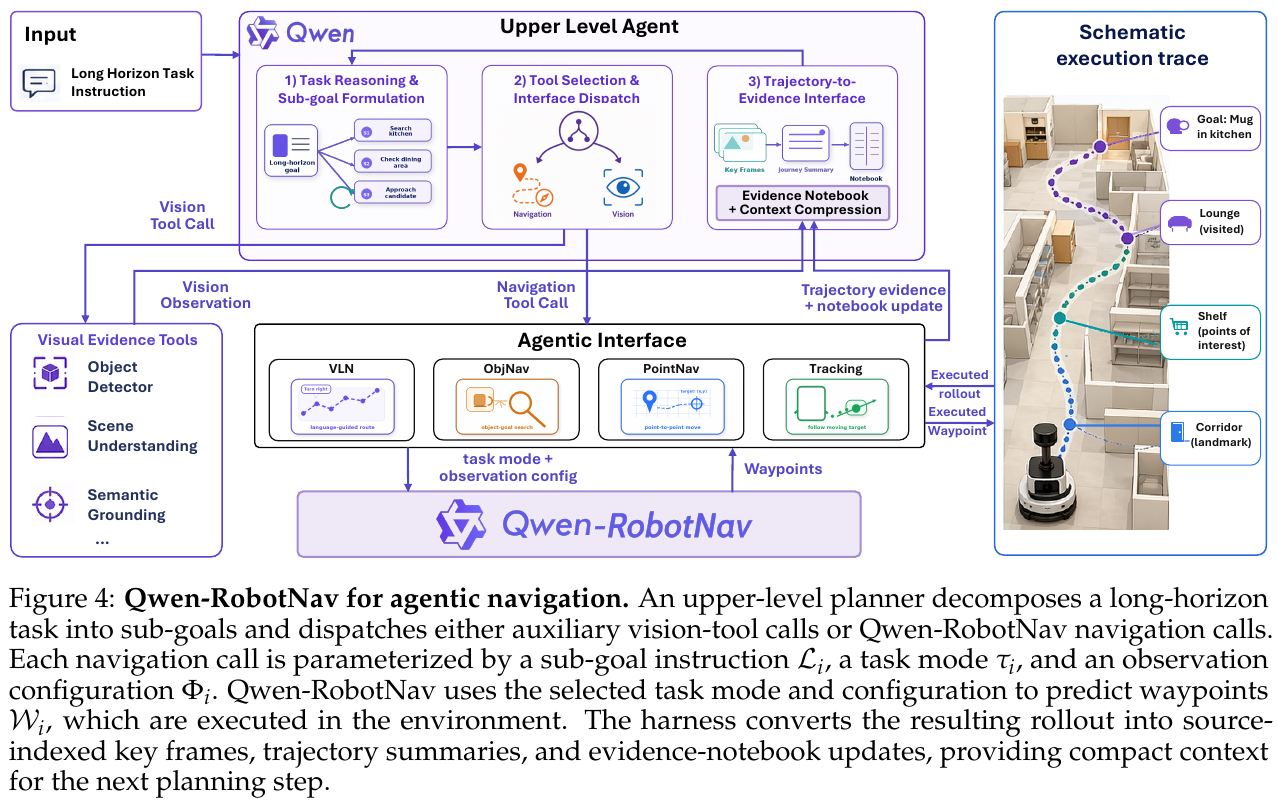
3.6.2 可检查的 Agent 闭环
本文采用的分析框架是:任务状态 → 选择子任务与工具 → 执行 → 读取结果 → 更新任务状态。每个转换都应能在日志中检查:工具失败是否被识别、是否换了策略、是否重复调用无效动作,以及何时终止。下图是系统职责示意,不要求所有论文实现同名模块。
sequenceDiagram
    participant Planner as 任务规划器
    participant Memory as 状态与记忆
    participant Navigator as 导航策略
    participant Env as 环境与执行器
    Planner->>Memory: 查询已完成子任务与已探索区域
    Memory-->>Planner: 返回状态及其观测依据
    Planner->>Navigator: 下发当前子目标与约束
    Navigator->>Env: 执行动作或局部轨迹
    Env-->>Navigator: 新观测、位姿或执行反馈
    Navigator-->>Planner: 子目标进展与失败证据
    alt 证据支持子目标完成
        Planner->>Memory: 记录完成状态与关键观测
    else 未完成或执行受阻
        Planner->>Memory: 记录尝试与失败条件
        Planner->>Navigator: 调整子目标或重试策略
    end
例如,“穿过走廊去厨房找杯子”至少包含到达厨房与确认杯子两个判定。检测到杯子不能证明房间条件已满足;日志需要关联到实际观测、工具调用和之后的轨迹,才能定位任务拆解、空间记忆或执行层的失败。
3.6.3 编排收益与恢复成本
建议在相同底层技能、模型和预算下,比较固定执行流程与自适应编排,并分别统计任务成功、恢复率、工具调用、延迟及人工介入。若更多重试带来更高成功率,需要同时呈现成本。导航模型是否训练过也应单独记录,Agent 不等于免训练系统。
3.7 预测学习与世界模型
预测机制需要先区分预测目标是什么、预测发生在训练还是执行时、预测结果怎样影响动作。未来图像、潜特征和价值都可以提供监督或决策依据,但辅助预测损失、运行时想象规划与世界—动作联合生成具有不同的成本和证据要求。
| 使用方式 | 预测怎样发挥作用 | 代表工作 | 应验证的收益 |
|---|---|---|---|
| 训练时的潜空间预测 | 用未来特征监督策略表征,执行时移除预测分支 | PROSPECT | 在相同部署接口下是否优于无预测监督 |
| 视觉想象与未来预测辅助决策 | 生成视觉线索,或预测候选动作后果供策略 / 规划器使用 | VLN-Imagine、NWM | 额外预测相对同预算直接决策的收益 |
| 视觉—动作联合生成 | 在共同条件下耦合未来视觉与动作 | AstraNav-World | 一致性与闭环控制是否同时改善 |
| 从预测状态生成动作 | 预测短时域潜状态,再解码成可执行路点 | WorldVLN(航空 VLN) | 状态误差、执行结果与真实观测校正 |
| 联合观测、价值与动作块 | 将未来观测、目标进度和动作放入共享表示 | NavWAM(图像目标导航) | 相对预测加外部搜索的控制收益与成本 |
PROSPECT预测下一步语义与空间潜特征,预测分支在推理时移除。因此它属于预测表征学习,不能据此声称运行时会展开候选未来或搜索动作。其“无额外预测开销”只针对被移除的分支,完整系统仍包含感知融合和流式策略计算。
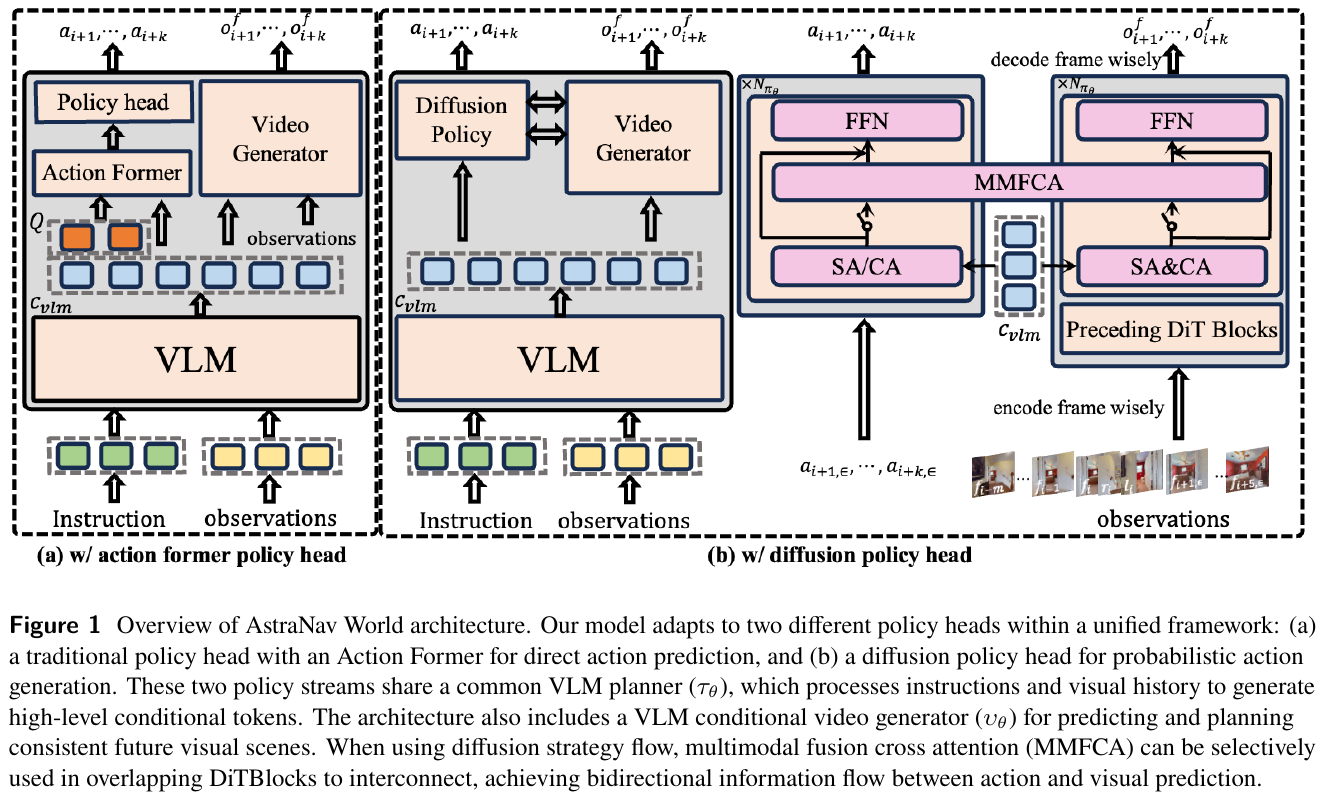
flowchart LR
    subgraph train["训练时的预测监督"]
        H["观测与历史"] --> Z["策略表征"]
        Z --> A["动作预测"]
        Z --> F["未来特征预测"]
        T["后续真实观测的教师特征"] -.->|监督| F
    end
    subgraph run["预测参与运行时决策"]
        O["当前观测与目标"] --> W["预测与决策模块"]
        W --> P["动作或轨迹"]
        P --> R["环境执行"]
        R -.->|真实观测校正| O
    end

    style Z fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style F fill:#f3d9fa,stroke:#862e9c,stroke-width:2px
    style W fill:#f3d9fa,stroke:#862e9c,stroke-width:2px
    style R fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
两侧是不同使用方式的示意,可以分别采用,也可以组合。右侧的预测与决策模块可能采用候选评估或联合生成,不要求每种方法都进行显式树搜索。
名称不能替代预测方向的检查。 Dual-Anchoring的地标辅助分支重建历史证据,主要用于约束记忆;即使使用了 world model 一词,也不宜直接归为前瞻规划。视觉想象生成的语义线索也不自动等价于动作条件的环境动力学。
任务边界与闭环收益仍需分别确认。 WorldVLN面向航空语言导航,NavWAM评估图像目标导航。后者和 NWM 可作预测—控制机制的参考,不能直接并入路线指令 VLN 榜单。预测质量应结合 SR / SPL、碰撞率、长程误差与推理成本解释,生成帧逼真本身不足以证明导航改善。
3.8 数据扩展与闭环训练
架构与机制决定系统如何使用信息,训练范式决定它从什么反馈中学习。两者应分别描述:统一策略、分层控制和带记忆的模型都可以使用示范、数据增强或强化学习;同一个模型也可能先监督微调,再收集纠偏样本或进行 RL 后训练。
3.8.1 从示范到闭环 RL
| 训练方式 | 学习信号与作用 | 代表工作 | 需要单独验证的问题 |
|---|---|---|---|
| 行为克隆 / 监督微调 | 从专家轨迹建立指令—动作映射 | NaVid、StreamVLN | 离开专家访问状态后能否恢复? |
| 联合训练与任务扩展 | 共享导航、图文或视频表征 | NavFoM、Qwen-RobotNav | 收益来自数据量、任务多样性还是模型设计? |
| 合成场景、指令与轨迹 | 扩展环境与语言覆盖 | ScaleVLN、Image2Sim / Image2Nav | 指令是否可执行,场景是否泄漏,仿真是否可靠? |
| 策略采样与纠偏数据 | 在模型实际访问的错误状态上提供纠正 | CorrectNav、DecoVLN | 专家信息权限与纠偏指令是否一致? |
| 进度与证据监督 | 让中间状态对应活动子指令和真实观测 | Route2Step、SeekVLN | 更准的进度和证据判断是否改善轨迹? |
| 强化学习后训练 | 用任务完成、几何执行或观察收益优化策略 | Robostral Navigate、GroundingVLN、MacroAction-VLN | 奖励是否鼓励捷径,比较是否固定交互预算? |
| 辅助预测监督 | 用未来状态或历史重建约束表征 | PROSPECT、Dual-Anchoring | 辅助损失与额外编码器各贡献多少? |
纠偏数据需要区分语义状态错误和执行错误。 CorrectNav 利用偏离轨迹构造感知与动作纠错数据;Route2Step 为错误进度提供状态监督,并将直接动作监督用于相应的恢复情形。它们关注的是模型在哪些状态上学习、接受什么监督,不能仅由最终架构名称解释。
行为克隆 / SFT 学习“在专家经过的状态上,下一步应该怎么走”。测试时,一次转弯不足就会改变后续画面,策略可能进入示范没有覆盖的状态。DAgger让策略访问自己的状态,再查询专家纠正动作,缓解这种分布变化;闭环 RL 则根据自主执行的后果,优化整段任务的回报。 两者可以组合,交互采样本身不能决定一次训练属于模仿学习还是强化学习。
用两个目标可以看出反馈来源的区别:
\[\begin{aligned} \mathcal L_{BC}&=-\mathbb E_{(I,h_t,a_t^*)\sim D} \log\pi_\theta(a_t^*\mid I,h_t),\\ J_{RL}(\theta)&=\mathbb E_{\tau\sim\pi_\theta} \left[\sum_{t=0}^{T-1}\gamma^t r_t\right]. \end{aligned}\]这里 $I$ 是指令,$h_t$ 表示截至当前的观测与动作历史,$a_t^*$ 是专家动作,$\tau$ 是实际执行轨迹,$r_t$ 是奖励,$\gamma$ 是折扣因子。前者提高专家动作的概率,后者提高自主轨迹的期望回报。任务允许多种有效走法时,奖励可以接受不同但符合指令的路径;相应地,奖励遗漏沿途要求时,也可能鼓励错误的捷径。
RL 在 VLN 中值得优化的是关键决策的后果。 偏航后是否重新观察或回头、到达附近后何时 STOP、为了正确转弯是否应暂时远离终点,都难以用平均动作准确率充分衡量。长程信用分配需要把最终成功或失败关联到更早的决策;过程奖励、价值估计和分段回报提供不同的信号。感知、深度尺度或执行器本身有错误时,仍需先确认系统瓶颈,不能把增加 RL 当作通用修复。
这条研究路线早于大模型后训练:RCM用跨模态 matching critic 奖励指令与轨迹的匹配;EnvDrop结合环境特征 dropout、回译、行为克隆与 Advantage Actor-Critic。大模型阶段扩展了策略规模和动作生成接口,数据增强、记忆设计与 RL 的贡献仍应分别分析。
3.8.2 奖励作用的粒度
“使用 GRPO”只说明优化器的一部分,不能说明模型是否在环境中自主完成整段导航。以下按训练时被评分的对象区分代表方法;这是对原文机制的归纳,同一方法可能结合多种奖励。
| 工作与核查版本 | 被评分的对象与主要奖励 | 能支持的机制判断 |
|---|---|---|
| VLN-R1,v1 | 固定历史下生成六步动作,用时间衰减的专家逐位匹配奖励做 GRPO | 局部动作后训练;不能由此推断学会自主偏航后的整段恢复 |
| JOP-VLN,v1 | 在 DAgger 状态上采样至多四步动作块,以格式、oracle 匹配和位姿 / 位移反馈评分,联合纠错 IL | 局部动作块优化,含短程执行反馈;不同于整段任务成功奖励 |
| GroundingVLN / GEAR,v3 | 在固定决策 anchor 上采样输出,按视觉落地、子任务、可通行性与执行端点奖励评分 | 执行感知后训练;奖励图反映物理后果,但不等于每个候选都重新 rollout 整个 episode |
| ActiveVLN,v1 | 生成动作、执行、追加观测,按完整多轮轨迹的任务结果做 GRPO | 闭环轨迹优化,策略动作会改变后续训练输入 |
| ETP-R1,v1 | 图式策略经预训练和 DAgger 后,按完整 episode 的到达、效率与路线指标做 GRPO | 闭环高层规划优化,奖励随 R2R / RxR 的任务要求调整 |
| NavGRPO,v1 | 在离散导航图上采样多条轨迹,以目标距离、路径效率和步级信号比较,结合困难任务回放 | 完整轨迹与恢复学习;动作和观测权限须与 VLN-CE 原子动作策略区分 |
局部答案奖励主要回答“这段动作是否符合专家”,执行感知奖励回答“这个目标是否可走、执行后落在哪里”,完整闭环回报回答“反复观察与行动后是否完成任务”。三者可能都改善最终 SR,但训练成本、错误状态覆盖和能够证明的能力不同。尤其是固定历史的动作优化,后续输入不会随当前采样动作自然改变,不能直接当作长程探索的证据。
动作粒度也影响学习:MacroAction-VLN在拓扑前沿宏动作上进行闭环 RL,减少高层决策次数;SeekVLN 则根据补充观察相对直接导航的后续进展分配奖励。使用几何奖励并不要求输出连续坐标,关键是评分对象、实际执行和新观测之间的关系是否明确。
3.8.3 奖励设计
如果指令是“先穿过厨房,再沿走廊进入卧室”,绕过厨房的捷径可能得到更高的终点成功与最短路效率,却违反了沿途要求。到达终点、忠实执行指令、安全高效地移动,是相关但不同的优化目标。 奖励应先明确任务要求,再选择指标。
| 奖励项 | 希望学到什么 | 容易出现的偏差 |
|---|---|---|
| 成功 / 正确 STOP | 在满足成功条件时结束任务 | 终点奖励稀疏;经过目标但不停与成功停止应区分 |
| 距离进展 | 为中途决策提供密集反馈 | 必要转向、回退或绕行未必立即缩短距离 |
| nDTW / SDTW、顺序地标完成 | 遵循中间地标与路线顺序 | 参考路径未必是唯一合理走法;地标事件应避免重复计奖 |
| SPL 或与参考路线匹配的效率项 | 成功后少绕路 | 最短路效率本身不保证满足沿途指令 |
| 碰撞、步数或时间成本 | 改善可执行性和效率 | 代价过大可能鼓励提前放弃或过早 STOP |
| 格式 / 动作合法性 | 产生可解析的控制输出 | 格式正确不能代替任务完成 |
nDTW 原始研究通过有序路径匹配衡量路线忠实度,SDTW 再加入成功约束;定义见第 8.3 节。例如 ETP-R1 的 R2R 奖励结合 success@1.5m、SPL 与终点距离,RxR 则采用 nDTW、SDTW、以参考路线长度计算的 gSPL 及终点距离。gSPL 调整的是效率参照,沿途一致性仍需路线项共同约束;奖励中的 1.5m 也不能代替其他评测协议的成功阈值。原文 Eq.5
下面仅展示回报可包含的分项,不是某篇论文的固定配方,也不是经验证的通用权重:
\[\begin{aligned} R(\tau)&=w_s\mathbf 1[\mathrm{success}] +w_f\mathrm{nDTW}(\tau,\tau^*)+w_p\mathrm{SPL}(\tau)\\ &\quad-c_c N_{\mathrm{collision}}-c_t T -w_e\mathbf 1[\mathrm{wrong\ STOP}]. \end{aligned}\]其中 $\tau^*$ 是参考路线,$N_{\mathrm{collision}}$ 是碰撞次数,$T$ 在此表示执行步数;各权重控制不同目标的相对影响,距离进展等密集信号可另按步骤发放。长程任务要按整段累计量校准成本,避免数百步惩罚压过成功奖励。奖励落地前,可先比较专家、捷径、绕路、碰撞和提前停止轨迹的分项得分,确认排序符合任务要求。
奖励可用的训练信息与策略可见的信息要分开。 仿真可用目标真值、导航网格和参考路线评分,部署 actor 应只读取协议允许的观测、指令和记忆。若 critic 使用特权状态辅助训练,也应单独说明。否则,靠真实目标坐标获得的收益不能作为仅凭视觉与语言导航的证据。
3.8.4 PPO 与 GRPO
策略梯度通过提高高优势动作的概率更新策略。这里的优势表示“这次选择的后续回报,比当前条件下的比较基准好多少”;PPO 与 GRPO 的一个核心差别,是这个比较基准如何得到。
PPO:用价值估计辅助分配步骤级信用。 常见 actor-critic 实现训练价值函数 $V(I,h_t)$,结合回报估计每一步的优势 $A_t$,再限制新旧策略概率比的更新幅度。其裁剪目标为:
\[\begin{aligned} L_{\mathrm{clip}}&=\mathbb E_t\left[ \min\left(\rho_t A_t, \operatorname{clip}(\rho_t,1-\epsilon,1+\epsilon)A_t\right)\right],\\ \rho_t&=\frac{\pi_\theta(a_t\mid I,h_t)} {\pi_{\mathrm{old}}(a_t\mid I,h_t)}. \end{aligned}\]$\pi_{\mathrm{old}}$ 是采样该批轨迹的行为策略,$\epsilon$ 是裁剪范围。价值基线帮助判断早期路口、回退和停止决策的贡献,也引入价值估计误差。critic 可以是共享表示上的小 value head,不必复制一个同规模模型;PPO 也可以使用终局奖励,并非必须有密集过程奖励。PPO 原论文
GRPO:用同一条件下的多个结果形成比较基准。 不单独训练 critic,而是为同一输入采样一组输出并比较奖励。若评分单位是完整导航轨迹,同组应固定指令、起点、朝向和环境条件。常见的组归一化优势为:
\[\hat A_i=\frac{R(\tau_i)-\operatorname{mean}_{j=1}^{G}R(\tau_j)} {\operatorname{std}_{j=1}^{G}R(\tau_j)+\varepsilon}.\]这里 $G$ 是组大小,$\varepsilon$ 是防止分母为零的小量,与 PPO 的裁剪范围不同。随后将优势用于对应轨迹的动作或策略生成 token,并采用裁剪更新及相应参考约束。这个式子是常见形式;NavGRPO 使用 Dr.GRPO,归一化和长度聚合不能一概照搬。GRPO 来源:DeepSeekMath、NavGRPO 算法说明
| 比较项 | 常见 PPO 实现 | 轨迹级 GRPO 实现 |
|---|---|---|
| 优势基准 | 学到的价值函数与回报 | 同任务多个采样结果的组内比较 |
| 长程信用 | 可估计逐步优势,质量依赖 critic | 仅用终局回报时,整条轨迹可能共享同一优势,局部归因较粗 |
| 额外成本 | 价值学习、概率重算与环境交互 | 多条完整轨迹的视觉推理与环境交互 |
| 主要信号风险 | 价值估计不准、终止 / 截断处理错误 | 同组奖励相同导致零优势、采样质量差异不足 |
| 适合比较的条件 | 希望逐步诊断决策,且可训练价值头 | 任务回报可靠,且同任务重复采样吞吐足够 |
省去 critic 不等于总训练更便宜。 若成功奖励只有 0 / 1,全失败或全成功组都可能没有相对优势;密集评分、课程与困难任务监督能改变信号,但各有额外设计成本。GRPO 的完整轨迹回报也不能自动准确定位导致失败的那次转弯。参考策略 KL 与辅助 BC / IL 可用于保留原有能力,属于可选择的约束,应与主要任务奖励分别报告。
3.8.5 闭环训练实践
对已有导航模型,一条便于定位收益来源的实验路线是:SFT / DAgger 初始化 → 自主采样 → 回报与优势计算 → 策略更新 → 未见场景验证。 下图是训练流程示意,PPO 与完整轨迹 GRPO 均可采用;具体方案仍需按动作接口和采样预算选择。
flowchart TB
    B["SFT 或 DAgger 初始化"] --> S["固定训练任务与行为策略版本"]
    S --> P["读取指令、当前观测与历史"]
    P --> A["采样动作并记录行为概率"]
    A --> E["环境执行并返回新观测"]
    E -->|任务继续| P
    E -->|结束或截断| R["保存成功与失败,计算回报"]
    R --> V["PPO 价值优势或 GRPO 组内优势"]
    V --> U["重建采样历史并更新策略"]
    U --> T["独立验证:到达、路线、恢复与成本"]
    T -.->|下一轮训练| S

    style B fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style E fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
    style R fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style V fill:#f3d9fa,stroke:#862e9c,stroke-width:2px
    style U fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style T fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
落实这条流程时,有三个容易影响结论的细节:
- 自主行为与专家纠正分开记账。 专家接管后的转移不能直接配上模型原先被拒绝动作的概率。纠正样本可走 IL 通道,自主 RL 则应保留失败、错误 STOP、碰撞和超时,不能只筛成功轨迹;任务终止与采样截断也需区分。
- 采样概率与重算概率对应同一历史。 对 StreamVLN 一类流式模型,要保存观测、历史选帧、记忆更新和动作 token,使新旧策略在相同条件下评分。参数更新后,旧参数产生的 KV cache 不能直接当作精确的新策略历史;可先在权重不变时核对概率重放是否一致。
- 生成动作块与实际执行步数对齐。 STOP 或碰撞可能截断动作块,未执行后缀如何参与优化应明确。长块减少模型调用,短块提供更快的新观测反馈;改变块长或重观察频率后,应增加同接口监督基线,才能判断收益来自 RL 还是更多决策机会。
这些是从闭环目标和策略概率比推导出的实施检查,不表示必须照用某个项目的训练器。选型上,可把 PPO 作为有价值头的步骤级对照,把轨迹级 GRPO 作为组采样对照,并固定奖励、动作接口和环境交互预算。只有专家轨迹、无法交互时,应先确认离线 RL 所需的奖励、转移与失败覆盖;轨迹偏好优化则需保留各分支真实产生的视觉历史。
3.8.6 RL 收益的归因
同一论文、同一基座和协议下的前后对照,比跨论文最终成绩更接近回答“后训练增加了什么”。下表数字均为作者报告,未独立复现;SR / SPL 单位为百分数,增量是绝对百分点。每一行只在本行协议内解读,包含联合训练或特定奖励组件时,也不等于只替换优化器的收益。
| 工作与原文表号 | 数据与 split | 对照 → 后训练 | SR | SPL | SR / SPL 增量 |
|---|---|---|---|---|---|
| VLN-R1,Table 1 | R2R-CE Val-Unseen | Qwen2-VL-7B SFT → SFT + RFT | 24.9 → 30.2 | 17.5 → 21.8 | +5.3 / +4.3 |
| ActiveVLN,Table IV | R2R-CE Val-Unseen | 多轮 IL → 多轮 IL + RL | 38.5 → 50.1 | 33.7 → 43.7 | +11.6 / +10.0 |
| ActiveVLN,Table IV | R2R-CE Val-Unseen | 单轮 IL → 单轮 IL + RL | 39.7 → 40.3 | 35.3 → 37.0 | +0.6 / +1.7 |
| ETP-R1,Table I | R2R-CE Val-Unseen | DAgger → GRPO | 63 → 65 | 54 → 56 | +2 / +2,原表取整 |
| ETP-R1,Table I | RxR-CE Val-Unseen | DAgger → GRPO | 58.26 → 59.92 | 48.19 → 48.97 | +1.66 / +0.78 |
| JOP-VLN,Table II | R2R-CE Val-Unseen | Stage 3 纯 IL → 联合训练 | 68.1 → 69.9 | 60.7 → 64.9 | +1.8 / +4.2 |
| NavGRPO,Table 7 | 离散 R2R Val-Unseen | SFT → 完整 GRPO 方法 | 79.40 → 81.88 | 69.97 → 72.65 | +2.48 / +2.68 |
| GroundingVLN,Table 3 | R2R-CE Val-Unseen | w/o GEAR → 完整方法 | 57.2 → 69.9 | 49.5 → 64.1 | +12.7 / +14.6 |
这些结果支持奖励驱动后训练可以改善 VLN,但收益依赖反馈层级、初始化和任务协议。ActiveVLN 的单轮 / 多轮对照说明交互组织方式值得单独研究;ETP-R1 的 DAgger → RL 增量提醒读者,不能把整个系统相对旧模型的提升都算给 RL。JOP-VLN 同表的纯 GRPO 为 SR / SPL 67.5 / 62.8,相比纯 IL 的 68.1 / 60.7,成功率与效率并非同时提高,联合纠错监督在该实验更有效。ActiveVLN 消融、ETP-R1 对照、JOP-VLN Table II
复现实验还应核查奖励定义:ActiveVLN v1 的 Eq.8 写成成功指示乘终点距离,与“越近越好”的文字解释存在方向矛盾,不能直接抄作实现。NavGRPO 的 PPO 对照使用步级进度 / 朝向奖励,完整 GRPO 方法使用不同的轨迹奖励,因此该比较不能推出 GRPO 普遍优于 PPO;GroundingVLN 的 GEAR 增量也应放在其视觉落地、像素目标与几何执行接口内理解。ActiveVLN Eq.8、NavGRPO §4.4、GroundingVLN §3.5 / Table 3
评估时,除 SR / SPL,还应检查 nDTW / SDTW、错误 STOP、偏航恢复率、碰撞和任务耗时;未见场景评估与允许测试时探索的适应协议需分开。奖励上升而 SR 下降,可能意味着奖励排序、任务难度或执行接口出了问题,不能只看训练曲线。模型规模、数据、传感器、动作空间、训练交互与测试推理预算应逐项固定或报告,恢复能力还需要受控偏航实验。
配套论文篇的要素打勾矩阵可以帮助检查数据、相机、控制接口、RL 与纠偏数据是否共同出现。但矩阵仅覆盖特定基准和筛选条件下的条目,采纳率不等于因果贡献;模型大小、观测范围和额外训练数据仍需逐项核对。
建议用三个层次组织消融:先固定数据和基模比较机制,再固定架构比较数据与监督,最后在相同硬件和推理预算下比较完整系统。对于“预训练后零样本迁移”和“不做导航专项训练”,也应分开说明,避免把两种零样本口径混在一起。
3.9 方法选型
3.9.1 多维度描述方法
下表展示怎样从论文机制出发描述组合。“需要验证”是本文提出的比较建议,不表示已有统一对照实验,也不是模型总排名。
| 工作 | 组合的主要机制 | 容易混淆的边界 | 需要验证的证据 |
|---|---|---|---|
| MapNav | 统一 VLM 策略 + 标注语义地图 | 使用地图与端到端动作预测可以共存 | 同输入权限下,地图相对历史帧的收益 |
| StreamVLN | 流式策略 + 快慢上下文 + 缓存复用 | 上下文更新节奏不等于高低频控制分层 | 同历史和计算预算下的地标保留 |
| DualVLN | 高层目标 + 像素 / 潜在接口 + 低层扩散轨迹 | 分层规划与执行需要分别评测 | 上层目标偏差、延迟与低层适应能力 |
| GroundingVLN | 视觉证据落地 + 像素目标 + 几何执行 + RL | 可解释接口、执行器与训练同时变化 | 固定接口或训练信号后的分项消融 |
| SeekVLN | 统一动作策略 + 进度推理 + 主动观察 + RL | 按需观察不等于工具编排,且有额外感知成本 | 同视角与调用预算下的观察收益 |
| HarnessVLN | 工具编排 + 事件记忆 / 时空图 + 执行校验 | 系统成绩同时包含基模和工具能力 | 固定基模、技能与重试预算后的收益 |
| PROSPECT | 流式策略 + 语义几何融合 + 训练时潜预测 | 推理时不运行预测分支 | 几何融合和预测监督各自的贡献 |
| MacroAction-VLN | 拓扑图 + 分层宏动作 + 闭环 RL | 状态、动作粒度和训练方式共同改变 | 固定图与控制器后,动作粒度对学习的作用 |
3.9.2 从失败类型选择机制
以下是基于系统职责的研究建议,应先用失败轨迹确认瓶颈,再进行有预算约束的对照实验。
| 当前瓶颈 | 优先检查 | 可比较的机制 | 重点报告 |
|---|---|---|---|
| 语义目标正确,但走不稳或响应慢 | 动作接口、更新频率与执行器 | 像素 / 轨迹接口、分层控制、缓存复用 | 完整闭环延迟、碰撞与轨迹稳定性 |
| 长程中忘记地标、重复探索 | 历史保留与空间一致性 | 关键帧、隐式几何记忆、拓扑图与检索 | 长路径结果、回溯收益、位姿误差与显存 |
| 错认任务进度或漏看路口 | 活动子指令与证据充分性 | 进度监督、按需推理与主动观察 | 进度错误、观察成本、沿途指令保真度 |
| 偏航后持续累积错误 | 失败状态是否被识别并覆盖 | 纠偏数据、状态监督、闭环 RL | 恢复率、额外路径、停止错误与交互预算 |
| 多步骤任务需要切换能力 | 工具边界、任务状态与返回结果 | Agent 编排、共享导航基模与执行校验 | 工具调用、重复失败、人工介入与路径效率 |
| 希望利用动作后果改善决策 | 预测在哪个阶段产生价值 | 训练时预测、候选评估或世界—动作联合生成 | 同预算闭环收益、预测误差与延迟 |
3.9.3 读新论文的四个检查
- 协议是否一致:传感器、动作空间、数据划分和成功阈值是否相同?按需观察、额外地图和目标真值是否单独说明?
- 资源是否一致:收益来自机制,还是更大的基模、更多数据或额外几何先验?训练样本、环境交互与推理预算是否可比?
- 闭环是否受益:进度、记忆或预测是否真正改善导航,是否有相应消融与失败轨迹?
- 部署代价是否透明:是否报告完整执行链的延迟、显存、控制频率和真实机器人测试?
配套文章 VLN 论文精读:指令跟随篇按基准维护 R2R-CE、RxR-CE、离散 R2R / REVERIE 结果,并区分训练式、免训练与验证集子集;目标导航维护目标导航结果。综述用于解释机制与证据,具体实现、论文版本和同设定成绩可继续查阅配套精读。
4. VLN 任务类型
任务名称相近并不意味着结果可比。第 2.2 节已经给出理解一个 VLN 基准所需的五个维度(目标表达、观测配置、动作空间、环境模型、交互协议),本节在此基础上从 推理复杂度、交互方式、动作与物理真实性 三个角度给出常用的任务分类,并标出每类的代表性基准。需要特别留意具身形态:无动力学的虚拟智能体、轮式、四足、人形与无人机在碰撞、跌倒、卡住和 6-DoF 控制上的难度完全不同,同名任务在不同具身下的结果也不应直接比较。
4.1 按推理复杂度
1. 指令跟随型 VLN(Instruction-Following VLN)
该类任务要求智能体根据给定的自然语言指令,在环境中完成从起点到目标位置的导航,不必额外执行开放目标搜索,但仍可能要求地标消歧、顺序推理与长期记忆。此类任务的重点是把沿途语言约束落到轨迹上。
代表性数据集:Room-to-Room(R2R)、Room-for-Room(R4R)
2. 语义推理驱动的 VLN(Reasoning-Oriented VLN)
该类任务在导航过程中引入目标物体搜索或语义约束,智能体需要将语言指令与环境中的语义信息进行推理匹配,从而完成导航与定位任务。
代表性数据集:REVERIE、SOON
3. 长时序与组合式 VLN(Long-Horizon VLN)
该类任务强调长距离导航和复杂指令组合,要求智能体具备长期规划、记忆和错误恢复能力,是评估 VLN 系统长期决策能力的重要设定。
代表性数据集:LHPR-VLN,以及 R4R / RxR 中的长路径设定
4.2 按交互方式
1. 非交互式 VLN
智能体在接收到初始指令后独立完成导航任务,过程中不与用户进行额外交互。这是当前最常见的 VLN 评测设定。
2. 交互式与对话式 VLN
该类任务允许智能体在导航过程中与用户进行多轮交互,通过提问或反馈不断优化导航目标,更接近真实人机协作场景。
代表性数据集:CVDN(须区分已有对话历史与在线问询协议)
4.3 按动作与物理真实性
1. 离散全景导航
智能体在预定义的可通行视点图上移动,通常每个节点提供 360° 全景特征。该设定弱化了局部控制与碰撞问题,适合研究语言—地标对齐、全局规划和历史建模。
代表性基准:R2R、R4R、RxR、REVERIE
2. 连续环境导航
智能体通过前进、转向或局部路点在可导航表面运动,不再沿人工导航图“瞬移”。连续设定需要处理可通行空间和停止控制;视角限制、定位噪声与动力学是否启用,取决于具体配置。
代表性基准:R2R-CE、RxR-CE;其他移植设定须注明具体实现
3. 物理具身导航
机器人受动力学、形态和控制频率约束,需要处理跌倒、打滑、卡住与不同相机安装位置。此类任务更接近部署,但也更难与经典 VLN 结果对齐。
代表性基准:VLN-PE、VLNVerse,以及真实机器人评测
比较原则:R2R、R2R-CE、RxR-CE、ObjectNav 与真实机器人测试必须分表报告。即使都使用 SR / SPL,它们的输入、动作空间和成功条件也可能不同。
5. VLN 的应用场景
应用场景决定了传感器配置、动作空间、地图先验与安全约束,也决定了应选用哪一类数据集与模拟器。下表先给出三类场景的整体对照,随后分别展开。
| 场景 | 典型平台 | 主要观测与先验 | 核心难点 | 代表基准 | 常用模拟器 |
|---|---|---|---|---|---|
| 室内 | 轮式 / 四足 / 人形机器人 | 单目或全景 RGB-D、里程计 | 多房间拓扑、遮挡、家具级语义、精确停止 | R2R / RxR / VLN-CE / REVERIE / VLN-PE | Matterport3D Simulator、Habitat、Isaac Sim |
| 室外街景 | 轮式配送机器人、辅助出行设备 | 街景全景、GPS、OpenStreetMap 地图 | 尺度大、地标稀疏且相似、动态交通与天气 | Touchdown / StreetLearn / map2seq | Street View 图节点环境、CARLA(语言条件驾驶) |
| 空中 | 多旋翼无人机 | 斜视 / 俯视 RGB、高度计、GPS | 三维运动、高度与视角变化、地标消歧、飞行安全约束 | AerialVLN / CityNav / OpenFly | AirSim、Unreal Engine、Isaac Sim |
5.1 室内场景
室内 VLN 主要关注家庭、办公与公共建筑内部的导航。环境由多个房间和大量家具构成,指令通常以房间与物体作为地标(”穿过厨房,在沙发旁停下”),因此对房间级拓扑理解、物体级语义落地与精确停止能力的要求最高。室内也是数据与基准最成熟的场景:第 6 节中绝大多数数据集都建立在 Matterport3D、HM3D 等真实扫描或 ProcTHOR、GRScenes 等合成场景之上。
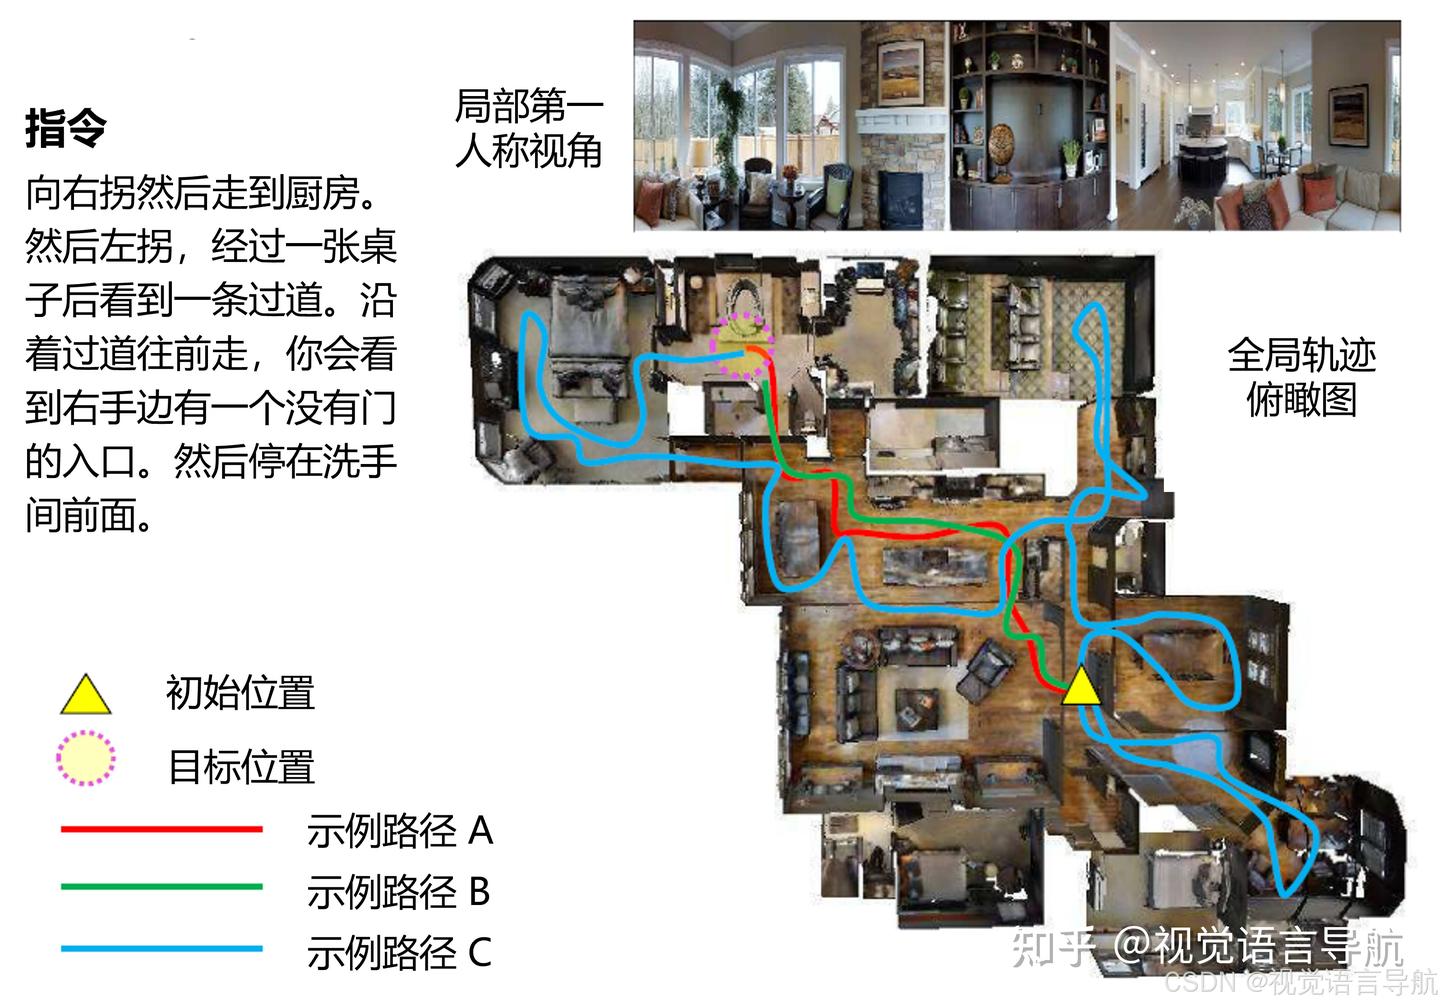
应用示例:家庭服务机器人、室内物流配送、医院与商场导览、四足 / 人形机器人巡检。
5.2 室外场景
室外 VLN 面临更大的空间尺度与更强的环境不确定性:地标在数百米尺度上稀疏分布且外观相似,光照、天气和动态交通持续变化,GPS 与地图先验的可用性也因场景而异。Touchdown(Chen et al., CVPR 2019)研究街景中的语言导航与空间定位;StreetLearn 提供街景学习环境,本身不应等同于路线指令数据集;map2seq 则涉及地图辅助的导航指令。这一分支正与自动驾驶中的语言条件规划、户外服务机器人的语义导航逐步汇合。
从街景图导航到真实机器人执行。 街景全景图节点上的语言导航、地图方向驱动的地面导航、开放语义目标导航具有不同输入与执行条件,不能合并为一个排行榜。户外导航篇按各自协议记录结果:
跨方法阅读时,先核对地图与定位权限、方向更新来源、控制接口和人工接管条件,再比较任务完成与安全性。地面户外执行也应与下一节的航空任务、自动驾驶任务区分。
应用示例:园区与城市配送机器人、导盲与辅助出行、语言条件的自动驾驶规划。
5.3 空中场景
空中 VLN 面向多旋翼无人机等飞行平台。与地面导航相比,它需要同时控制水平位置与高度,观测视角在俯视与斜视之间连续变化,同一地标在不同高度下的外观差异极大;飞行安全约束(禁飞区、最低高度、避障)也必须在动作层显式处理。第 6.6 节的 AerialVLN、CityNav 与 OpenFly 分别代表了仿真城市、真实航拍与多引擎大规模数据三条路线。
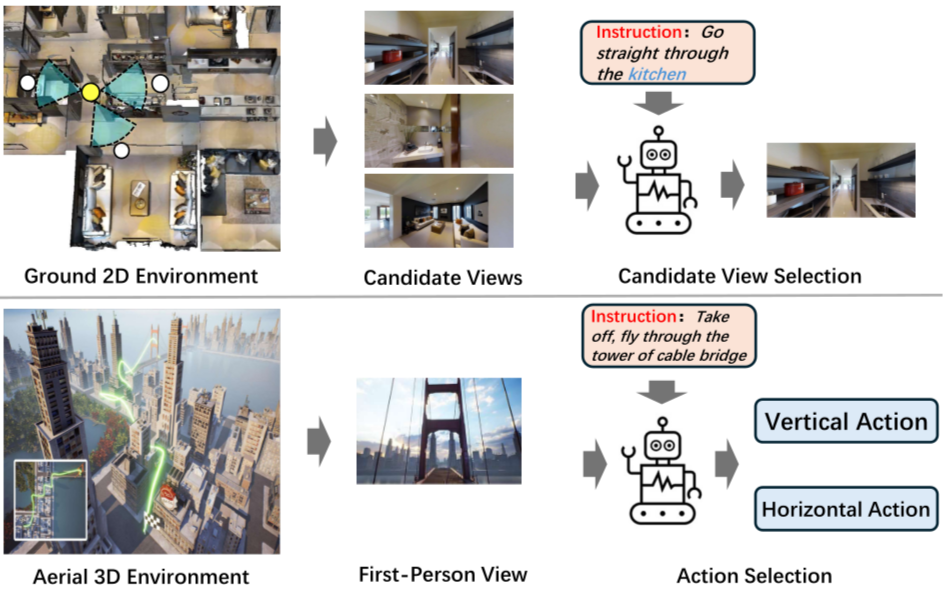
应用示例:无人机巡检与测绘、空中搜救、城市低空物流、语言指挥的航拍取景。
6. VLN 主流数据集
选择基准时先确定要验证的能力,再看规模。场景资产、任务数据、训练增强数据是三种不同对象:Matterport3D 提供环境,R2R 提供指令与路径,ScaleVLN 提供合成训练样本。共享环境不代表共享动作接口或评测协议。
6.1 数据集总览
| 研究问题 | 代表基准 | 必须区分的设定 | 主要评测维度 |
|---|---|---|---|
| 路线指令跟随 | R2R / R4R / RxR | 短路径、组合路径、多语言 | 到达、效率、路径忠实度 |
| 连续环境执行 | R2R-CE / RxR-CE | 观测视场、低层动作或路点、滑动设置 | 到达、停止、实际行走路径 |
| 目标指代与搜索 | REVERIE / SOON | 到达目标附近与正确识别目标 | 导航成功 + 目标定位 |
| 长时序多子任务 | LHPR-VLN | 独立子任务成功与连续执行成功 | 子任务完成、错误传播 |
| 对话协作 | CVDN / TEACh | 对话历史输入与在线问答;导航与操作 | 任务进度、交互与执行 |
| 社交与物理约束 | HA-VLN 2.0 / VLN-PE / VLNVerse | 人群、形态、动力学及任务子集 | 到达 + 社交或具身失败 |
| 需求推理 | DDN | 需求满足与固定类别搜索 | 找到满足需求的物体 |
| 空中语言导航 | AerialVLN / CityNav / OpenFly | 地图输入、飞行自由度、环境来源 | 到达、三维路径、执行约束 |
下表仅列有明确计数对象的规模。年份采用首次公开年份;会议年份另注。路径、指令、对话与 episode 不能互换,转换到连续环境后的样本数也不能直接照搬离散版本。
| 数据资源 | 可核对的规模 | 统计口径与来源 |
|---|---|---|
| R2R(2018) | 7,189 条路径,21,567 条指令 | 每条路径 3 条指令;原论文 |
| RxR(2020) | 约 126k 条指令及约 126k 条跟随示范 | 英语、印地语、泰卢固语;Guide 与 Follower 分开发布;官方数据仓库 |
| CVDN(2019) | 2,000 余段对话 | 对话数不是从历史切出的导航实例数;原论文 |
| TEACh(2021;AAAI 2022) | 3,000 余段对话 | 家务任务交互对话,派生评测实例另计;论文 v3 |
| AerialVLN(2023) | 25 个场景,8,446 条路径,25,338 条指令 | 标准版本每路径 3 条指令;原论文表 1 |
| ScaleVLN(2023) | 1,200 余环境,约 490 万指令—轨迹对 | 合成训练增强数据;论文 v2 |
| LHPR-VLN(2024;CVPR 2025) | 3,260 个任务,平均约 150 个任务步 | “平均”不能写成所有任务的最小长度;论文 v3 |
| CityNav(2024;ICCV 2025) | 32,637 条人类示范轨迹 | 覆盖 Cambridge / Birmingham 两座城市;论文 v3 |
| OpenFly(2025;ICLR 2026) | 18 个场景,100k 条轨迹 | 多引擎数据,不能由轨迹量推出语言多样性;论文 v7 |
| HA-VLN 2.0(2025;IROS 2026) | 16,844 条社交情境指令 | 以版本化协议确认离散/连续子集;论文 v5 |
| InternData-N1 | 240k 余轨迹、3,000 余场景 | 数据卡汇总口径,包含多个子集;官方数据卡,查阅于 2026-09-26 |
6.2 指令导向与连续导航
6.2.1 R2R (Room-to-Room)
R2R 在 Matterport3D 扫描环境的导航图上,将自然语言与起终点间的参考路径配对。它适合研究地标对齐与跨场景泛化;图上的可通行边已经简化了局部避障问题,因而不能用 R2R 成功率代表机器人控制能力。参见 原论文 与 官方模拟器。
如何理解一个样本:指令描述沿途地标和转向,参考路径由离散视点组成。智能体从初始视点与朝向出发,逐步选择相邻可达视点,最终决定停止。路径本身不是逐帧视频,同一路径的不同指令也不能当成不同建筑中的独立样本。
研究价值与局限:R2R 适合作为语言对齐和规划方法的共同起点。解释 Val-Unseen 成绩时,应检查训练视觉特征和额外数据是否涉及测试环境;解释真实部署能力时,则需要另外验证窄视场观测、定位误差和低层执行。
展开:R2R 原始字段与数据读取要点
以下是原始任务数据中常见字段的阅读指南,具体格式以 R2R 官方任务目录 为准。
| 字段 | 含义 | 读取时容易混淆的地方 |
|---|---|---|
scan |
场景标识 | 场景资产需另行获取 |
path_id |
参考路径标识 | 不是单条语言指令的唯一标识 |
path |
有序视点 ID 列表 | 不是三维坐标列表 |
heading |
初始朝向 | 保留原始单位和坐标约定 |
instructions |
同一路径的指令列表 | 训练器可能将列表展开为多个实例 |
连通关系来自独立的 connectivity 数据;图像特征也是另一层输入。复现时分别固定任务标注、连通图与视觉特征版本,不应把某个模型整理后的缓存目录当成 R2R 的统一标准。
6.2.2 R4R (Room-for-Room)
R4R 拼接 R2R 路径与指令,使“按描述走完路线”和“直接到达终点”的差异更加明显。适合研究沿途约束与长路径跟随,需结合 CLS / nDTW,而不能仅报告 SR。原论文同时提出了 CLS。
为什么需要更长的参考路线:教学示例中,指令要求“经过餐厅,再绕回客厅”,终点却离起点很近。直接走到客厅可能获得很高的终点成功率,却没有遵循中间约束。R4R 把这种矛盾显式化:最短到达路径与语言要求的路线不一定相同。
分析结果时可同时记录终点成功、沿途覆盖和访问顺序。长路径还会放大错误积累,但仅增加历史窗口不足以证明模型能处理任务状态;需要观察它是否知道哪些路段已完成、哪些地标尚未经过。
6.2.3 RxR (Room-across-Room)
RxR 提供多语言指令及与观测关联的时空标注。复现时应明确语言子集、Guide / Follower 使用方式及测试划分;只在英语子集上评测,不能称为验证了多语言能力。官方数据与字段说明。
标注机制:Guide 描述路线,Follower 根据描述实际跟随。两者轨迹可能不同,这使数据不仅能用于模仿参考路径,也能用于分析语言歧义及人类跟随误差。词语时间信息与相机姿态提供了更细的视觉—语言对齐线索。官方标注说明。
展开:RxR 四类数据、关联键与对齐边界
| 组成 | 主要用途 | 关联与检查 |
|---|---|---|
| Guide annotations | 指令与参考路径 | instruction_id、language、path |
| Follower annotations | 实际跟随示范 | demonstration_id;用 instruction_id 关联 Guide |
| Pose traces | 相机姿态和时间序列 | 区分 Guide 与 Follower,核对时间基准 |
| Text features | 预计算语言表示 | 核对语言、分词器及特征版本 |
timed_instruction 记录词语及时间区间,但少量词没有起止时间,不能假设每个词都能直接配到图像帧。基础导航实验可只使用 Guide 标注;一旦加入 Follower、稠密对齐或合成指令,应在训练数据说明中列出。
6.2.4 VLN-CE
VLN-CE 将指令导航移到 Habitat 的可导航空间中,取消沿导航图边移动的限制。连续的是环境位置,策略动作仍可采用有限集合,例如前进和转向。它增加执行难度,但并不自动包含腿足动力学。原论文。
原始基线仓库推荐 R2R_VLNCE_v1-3,并固定了对应 Habitat 版本。论文模型若使用不同传感器、路点控制器或修改过的模拟器,必须重新检查协议;数据名称相同不足以证明实验可比。
数据与代码:官方 VLN-CE 仓库 · R2R-CE 数据下载与目录说明 · 数据格式与版本记录。下载入口提供 R2R_VLNCE_v1-3 基础包和预处理包。
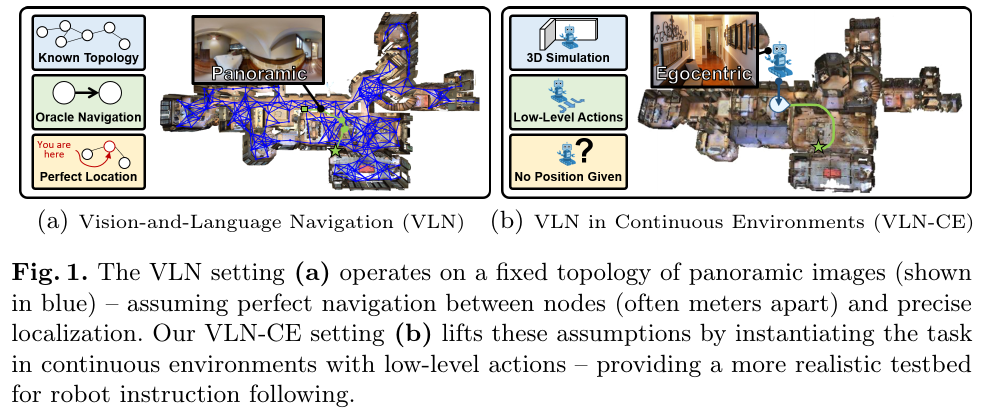
从“选对节点”到“走到位置”:在离散图上,一个合法邻接节点通常意味着可以直接转移;在连续环境中,即使高层选对门口,局部执行仍可能偏航、卡住或越过停止位置。因此,路点预测器、控制器和导航策略应分别记录,不能把整条系统的提升都归因于语言模型。
| 层面 | 离散图导航 | VLN-CE 常见设置 |
|---|---|---|
| 位置表示 | 预定义视点 ID | 场景中的位置与朝向 |
| 可行动作 | 邻接节点选择、停止 | 前进、转向、停止,或经控制器执行路点 |
| 可通行性 | 导航图预先约束 | 受可导航表面、碰撞与滑动配置影响 |
| 典型额外失败 | 选错路径或停止点 | 窄门执行、局部偏差、连续动作累积误差 |
展开:R2R_VLNCE_v1-3 的划分与字段示意
官方数据页列出的 v1-3 基础划分为 train 10,819、val_seen 778、val_unseen 1,839、test 3,408 个 episode。预处理包中的 EnvDrop 增强集另计。v1-3 修正了初始朝向,不能仅根据同名任务混用旧版本缓存。
以下为字段类型示意:场景名、文本及坐标均为教学占位值,省略词表与部分字段,不能作为可运行 episode。旋转采用该格式的 [x, y, z, w] 四元数表示,示例为单位旋转。
{
  "episode_id": 1,
  "trajectory_id": 4,
  "scene_id": "mp3d/SCENE/SCENE.glb",
  "instruction": {"instruction_text": "Walk forward to the doorway."},
  "start_position": [0.0, 0.0, 0.0],
  "start_rotation": [0.0, 0.0, 0.0, 1.0],
  "goals": [{"position": [0.0, 0.0, -4.0], "radius": 3.0}],
  "reference_path": [[0.0, 0.0, 0.0], [0.0, 0.0, -4.0]]
}
reference_path 是三维点列表;训练/验证包的 {split}_gt.json.gz 另存动作和位置监督。测试集隐藏目标与参考真值,不能按训练样本的可见字段假定测试输入。goals.radius 也不能代替对实际成功评测器的检查。
6.2.5 RxR-CE
RxR 的连续环境移植随 VLN-CE 发布。RxR-Habitat 挑战赛对 RGB-D 观测和动作步长、转角作了明确限制,采用全景观测的结果不能直接当作同一挑战赛成绩。官方挑战赛配置说明。
数据与代码:官方 VLN-CE 仓库 · RxR-CE 数据下载与目录说明。RxR-CE 与 R2R-CE 共用该仓库;此入口提供 RxR_VLNCE_v0 数据包及文本特征下载说明。
多语言与执行误差需要分开看:某语言上的下降可能来自语义理解,也可能来自较长路径引发的动作误差。本文建议按语言、路径长度和终点误差分组,并在相同相机与控制器下比较。若加入机器翻译或额外文本特征,应说明模型直接理解原语言,还是借助翻译系统完成导航。
6.2.6 VLN-PE
VLN-PE 支持人形、四足和轮式机器人,研究相机视角、光照、碰撞和跌倒等因素造成的具身差距。这里的“真实物理”指更接近机器人约束的仿真评测,并不表示全部数据来自真机。应按机器人形态和控制器分别报告结果。论文 v2。
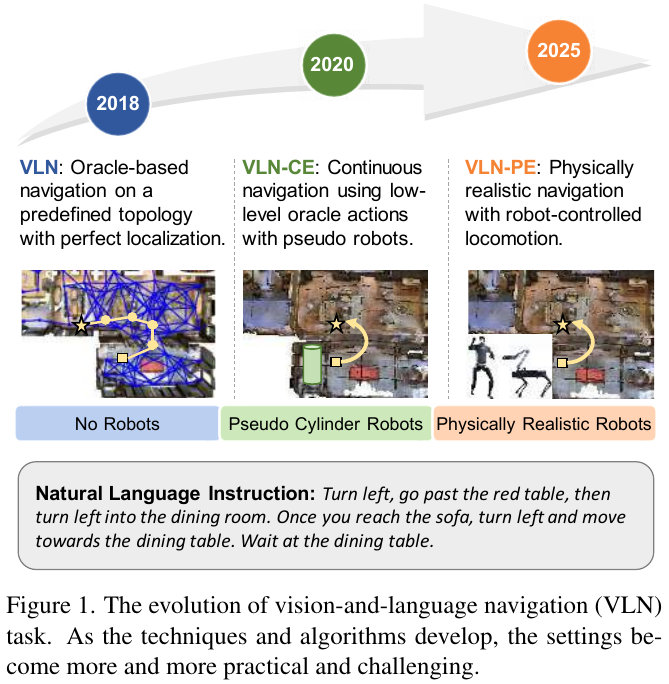
物理具身带来的新变量:相同语义子目标不保证对所有机器人都可执行。相机高度会改变可见地标,机身尺寸会改变门口通过条件,运动控制器则影响跟踪和稳定性。分析时应将“理解了目的地但没有走过去”与“目标理解错误”分开。
本文建议保留三层日志:高层目标与路点、低层实际轨迹、碰撞或姿态异常。跨机器人比较除 SR 外,还应报告所用控制器与失效类别;若同时换了相机、控制器和策略,结果不能单独解释为形态泛化。
6.2.7 ScaleVLN
ScaleVLN 的作用是扩充训练覆盖,而非提供一个可与 R2R 并列排名的新任务。其结果说明扩大环境与合成监督可能显著改变既有模型表现;比较架构时需列明是否用了此类额外数据。原论文。
数据扩容改变了什么:更多场景有助于扩大视觉和几何覆盖,更多合成指令则增加监督样本,两种作用应分别讨论。合成语言也可能重复模板,路径采样可能偏向容易走的区域,因此“样本更多”不自动等于“任务更丰富”。
本文建议用相同模型比较原始数据、增加场景、增加指令和完整增强四种条件;同时报告训练步数或算力预算。这样才能判断增益主要来自数据覆盖、语言变化还是更多优化计算。
6.2.8 InternData-N1
InternData-N1 将 VLN-CE、VLN-PE、VLN-N1 子集统一为 LeRobot 格式。统一存储格式便于训练,但不会消除原任务的观测、动作和成功标准差异;取用时需记录子集、筛选和采样配比。官方数据卡。
统一格式之后仍需统一语义:视频、状态与动作可以共享存储接口,但不同子集的动作尺度、相机设置和机器人状态未必相同。混合训练应明确如何归一化动作、如何编码任务条件,以及如何避免大子集在采样时压过小子集。
展开:InternData-N1 子集目录与数据版本记录
下图概括官方数据卡中的 CE 轨迹目录,省略场景级压缩包与其他子集,不是所有版本共有的完整清单。下载前固定分支或 revision;数据卡列有 full / mini 等版本。
vln_ce/
├── raw_data/                 # 原任务标注
└── traj_data/
    └── <场景数据集>/<场景>/
        ├── data/chunk-000/   # episode 的 Parquet 数据
        ├── meta/            # info、tasks、episodes 等元数据
        └── videos/          # 按相机和模态组织的观测
取一个 episode,先核对表格时间索引、视频帧、相机名称与动作字段能否对应,再开始批量训练。目录能读取不代表动作已被正确解释;应将一次动作解码和轨迹回放纳入数据接入检查。VLN-PE、VLN-N1 的内容与目录以各自子集说明为准。
6.2.9 VLNVerse
VLNVerse 将多种任务、具身仿真和评测置于统一框架。它适合检查跨任务能力,但“使用同一平台”仍不等于“所有任务可合成一个 SR”。应展开各任务及各具身设置,而不是仅给总体均值。原论文。
统一基准应怎样读:共同平台便于复用传感器和执行器,但任务成功可能分别指到达、目标确认或多阶段完成。本文建议同时给出“任务 × 具身设置”的结果矩阵,标明哪些模型共享权重、哪些进行了任务微调。仅有综合均值时,很难判断系统是否在部分任务上失效。
6.3 目标导向与长程规划
6.3.1 REVERIE
REVERIE 要求依据高层描述导航并识别目标物体。到达可见目标的位置与正确完成物体指代是不同结果,因此需区分导航指标与远程指代定位指标。原论文。
原论文统计为 90 栋建筑中的 10,567 个全景视点、4,140 个目标物体和 21,702 条众包指令(平均 18 词);指令通常只描述目标所在区域和物体,不逐段描述路线。导航成功要求停在能观察到目标物体的视点(物体在 3 m 内视为可见)。原论文附录用输出框与真值框 IoU ≥ 0.5 判定指代成功;后续工作通常在给定物体候选中做选择,并报告 RGS(Remote Grounding Success,选中正确目标的比例)与按路径长度加权的 RGSPL。比较 REVERIE 结果时,应确认使用的是哪种定位判据和候选来源。
两个阶段、两类错误:以“去楼上卧室找到窗边的台灯”为教学例子,智能体先要探索到能够观察目标的位置,再从候选物体中选择符合描述的实例。抵达正确房间但选错台灯,是指代错误;一直未进入可观察区域,则需要检查搜索与导航。
这也解释了为什么目标检测器、候选框与物体特征属于实验设置的一部分。比较导航策略时,如果一方获得更好的目标候选,不能把最终指代成功率的全部差异都归于规划能力。
6.3.2 REVERIE-CE
REVERIE-CE 是一类连续环境移植设定的统称,目前没有找到像 VLN-CE 那样由原作者维护、固定版本与规模的统一官方协议,因此本文不给出发布年份和样本数。引用此类结果时,应直接给出论文、转换脚本、样本过滤和物体成功判据,不沿用离散 REVERIE 的统计数。
连续移植至少涉及三项额外工作:将离散目标映射到连续场景、明确可观察目标的位置集合、定义停止后如何提交物体预测。本文建议报告过滤了多少原始样本,以及过滤原因。未经核对的转换不能默认保持原基准的难度和目标分布。
6.3.3 SOON
SOON 根据目标及周围场景描述,从不同起点搜索并定位目标。它将路径级指令跟随转为场景条件下的探索,适合研究语义搜索与图规划;所用 FAO 数据中的描述、目标与起点组合不应混算成一种样本数。原论文。
与路线跟随的不同:路线指令告诉智能体“怎么走”,场景描述更多告诉它“去哪里找什么”。缺少逐段路线监督时,系统必须决定先搜索哪些区域、什么时候放弃一个假设,以及如何依据新观测更新搜索方向。
本文建议将未找到目标区域、目标已可见但未识别、识别后停止失败分别统计。这样能区分语义先验是否有效,以及探索预算究竟花在了哪些区域。
6.3.4 LHPR-VLN
LHPR-VLN 关注连续子任务中的规划一致性。除总体完成情况,还使用 ISR、CSR、CGT 等指标分析子任务成功与前序失败的影响。与 R4R 的区别在于,多阶段执行需要跟踪任务状态,不能只用总路径长度刻画难度。论文 v3。
长程失败会传播:若前一阶段停在错误位置,下一阶段就不再从预设状态开始;单独重置后测试每个子任务,会掩盖这种累积效应。本文建议同时保留独立子任务评测和连续执行评测,记录首次失败阶段、已完成进度与恢复开销。
记忆机制也应围绕任务状态验证:模型是否记住已经完成的目标,是否重复访问已排除区域,执行失败后是否错误地把子任务标为完成。这些证据比单纯展示更长的上下文窗口更能说明长程能力。
6.4 对话式与社交导航
6.4.1 CVDN
CVDN 的人类数据采集包含 Navigator 与 Oracle 对话;其 Navigation from Dialog History 任务是依据已有对话历史继续导航。使用对话历史不等于允许模型在线向人求助,评测主动提问能力须另行明确交互协议。原论文。
历史理解与主动交互是两个问题:给定“刚才那个门口左转”的历史回复,模型需要把它与已走路径对齐;允许实时询问“是红色门还是白色门”,还需要设计何时提问、如何使用回答及交互代价。两种设置的输入信息不同,应分别报告结果。
若研究主动求助,本文建议增加提问次数、有效回答比例与每次交互后的导航改善;若只做 NDH,则重点分析历史长度、指代消解与下一段路径的完成情况。
6.4.2 TEACh
TEACh 包含对话、导航和物体交互,属于更广义的具身任务。其 EDH 等派生任务有不同输入和完成条件,应与纯导航基准分开讨论。论文 v3还说明了测试集评估对象的修订。
为什么不能只看走到哪里:教学例子“拿一个干净的杯子放到桌上”涉及物体定位、状态判断和操作后条件。智能体即使走到杯子附近,也没有完成任务。
EDH(Execution from Dialog History)研究从给定交互历史继续执行,TfD(Trajectory from Dialog)则依据对话推断并执行任务轨迹;两者的起始信息不同。阅读论文时要先确定评测任务,再比较任务成功与目标条件完成情况。TEACh 论文。
6.4.3 HA-VLN 2.0
HA-VLN 2.0 将动态多人交互与个人空间约束纳入导航评测。到达与社交合规需要同时观察,并固定人群行为及运行种子;单次成功视频不能反映多次遇人情况下的稳定性。论文 v5。
动态环境下的成功有条件:遇到行人时,等待、绕行与紧贴人群穿过可能都到达同一目标,却具有不同的社交后果。仅用 SPL 可能把合理等待或绕行表现为效率下降,因此需要与碰撞、个人空间侵犯及任务时限共同解释。
本文建议固定或配对运行种子,重复测试不同人群交互情形;报告成功样本中的社交违规,以及失败样本是否因超时、碰撞或迷路结束。不要仅展示最顺利的一次轨迹。
6.5 需求导向与常识推理
6.5.1 DDN
DDN 从用户需求推断满足需求的物体,例如将“我需要清洁”映射为具有合适用途的目标。原工作在 AI2-THOR / ProcTHOR 上研究这一问题,属于需求条件的目标导航;它不要求逐段遵循路线描述。原论文。
需求到目标存在多解:同一需求可能由多个物体满足,但可接受答案取决于任务标注和场景。教学例子“我想坐下休息”可能引出椅子或沙发,不能只凭语言常识就判定任意候选都成功。
本文建议把需求推断与空间搜索分开诊断:模型是否提出了可接受目标,目标是否在当前环境可用,随后是否找到并正确停止。将需求预先改写成固定物体类别再导航时,也应说明这一步使用了什么额外模型或监督。
6.6 空中与特殊场景
6.6.1 AerialVLN
AerialVLN 使用 UE4 / AirSim 城市场景,增加高度和空间关系推理。原论文表 1 将标准任务列为 4 DoF,不应笼统称为完整 6-DoF 飞控。原论文。
高度改变语言参照:“绕过楼顶再下降”同时包含水平路径和垂直关系;俯视观测中的地标尺度也随高度变化。分析模型时应说明可控自由度、相机方向和飞行步长,并检查是否依赖训练城市中特定建筑外观。
本文建议分开记录水平偏差、高度偏差和停止位置,不能仅凭二维地图上的投影接近目标就判断三维导航成功。
6.6.2 CityNav
CityNav 使用真实城市地理环境及语言配对的人类示范,研究视觉与地理信息结合的空中导航。“真实城市数据”不能直接等同于真实无人机的自主飞行测试;比较时还需说明地理信息和地图是否可用。论文 v3。
地图信息是一种额外输入:地理坐标、地图或先验位置可能显著改变搜索问题。本文建议对比视觉与语言输入、加入地理信息、加入地图的不同条件,并报告城市划分。跨城市评测更能检验空间语义能否迁移,但也需控制资产和数据重叠。
6.6.3 OpenFly
OpenFly 将多种渲染引擎、自动采集工具链与空中导航基准结合。研究价值在于数据生产和环境覆盖;跨引擎泛化仍需要隔离训练与测试引擎、场景和资产来验证。论文 v7。
跨引擎不只是换画面风格:渲染、坐标系、深度定义和动作执行都可能变化。本文建议先对齐这些接口,再区分同场景换渲染、同引擎换场景和跨引擎跨场景三类实验。自动生成大量轨迹后,还应抽查语言是否描述了实际可见地标及真正执行的路线。
6.7 复现需记录的数据口径
保留原始数据版本、场景清单、episode 数与唯一指令数、语言子集、Guide/Follower 类型,以及丢弃样本的规则。说明额外训练数据是否接触测试建筑或其衍生资产。对私有预训练数据无法确认的重叠,应标注“未披露”,不能自动视为无重叠。
上文将数据字段与目录说明折叠在对应基准下,方便按需查阅。下面补充跨数据集的实验记录模板;官方格式、本文示意与实际运行配置应分开保存。下载和安装命令以所用版本的官方仓库为准。
展开:实验数据与评测配置记录模板
这是本文建议的记录模板,不是 Habitat、LeRobot 或任何基准可直接加载的配置。null 表示待填写,不能作为实验默认值。
dataset:
  name: null
  revision: null
  split: null
  episode_count_after_filtering: null
  scene_list_hash: null
  languages: []
  extra_training_sources: []
environment:
  simulator_commit: null
  scene_assets_version: null
  robot_and_controller: null
  camera_modalities_and_fov: null
  action_space_and_units: null
  collision_and_sliding: null
evaluation:
  evaluator_commit: null
  distance_definition: null
  success_threshold_and_stop_rule: null
  max_steps_or_time: null
  trajectory_sampling: null
  seeds: []
保存过滤前后数量及原因,避免把“不支持加载”“没有可行路径”“模型执行失败”混成同一类丢弃。评测失败的 episode 应按协议计入统计,不能从结果文件中静默删除。
7. VLN 主流模拟器
模拟器决定观测如何生成、动作怎样执行和成功如何判定。比较时应分别考虑渲染、碰撞、动力学、任务实现和数据资产;画面逼真或物理引擎功能丰富,都不能单独证明某个 VLN 协议更接近真实部署。
7.1 Matterport3D Simulator
以扫描全景和导航图为核心,适合复现 R2R、R4R、RxR 等离散任务。图节点之间的合法连接为策略提供了可通行性约束,不能据此评价真实机器人避障。环境安装与图像资产获取分别遵循 官方仓库及数据许可。
工作机制与优势:策略在扫描视点构成的图上观察和移动,便于固定视觉输入并复用经典基准。预计算视觉特征能将研究重点集中到语言对齐、历史建模和图搜索。
局限与选型:视点间的转移隐藏了中间路段的控制过程;高层规划成功不代表机器人能穿过窄门或处理碰撞。若研究问题主要是离散规划,可以先用它建立基线;若关心动作误差,应在连续环境中另外验证。
7.2 Habitat
Habitat-Sim 提供仿真后端,Habitat-Lab 组织任务、传感器、动作和评测。经典 VLN-CE 使用其中的导航配置;平台后来支持的交互、物理或人机共存功能,并不自动存在于旧基准中。参见 Habitat-Sim 与 Habitat-Lab。
复现论文优先匹配它指定的版本。升级引擎可能改变碰撞与滑动行为;应先确认基线结果,再将升级后的实验作为单独配置报告。
工作机制与优势:通过传感器观测、导航空间和任务评测器组成实验闭环,适合研究 RGB-D 输入、局部路点和连续空间中的指令执行。场景资产、导航网格与任务代码需要共同固定。
局限与选型:默认导航代理不等同于完整动力学机器人。相机高度、视场、转角、步长与滑动行为会改变结果;先对齐论文配置,再讨论模型差异。新增物理或交互功能后,应把它视为新的实验条件。
7.3 Isaac Sim / Isaac Lab
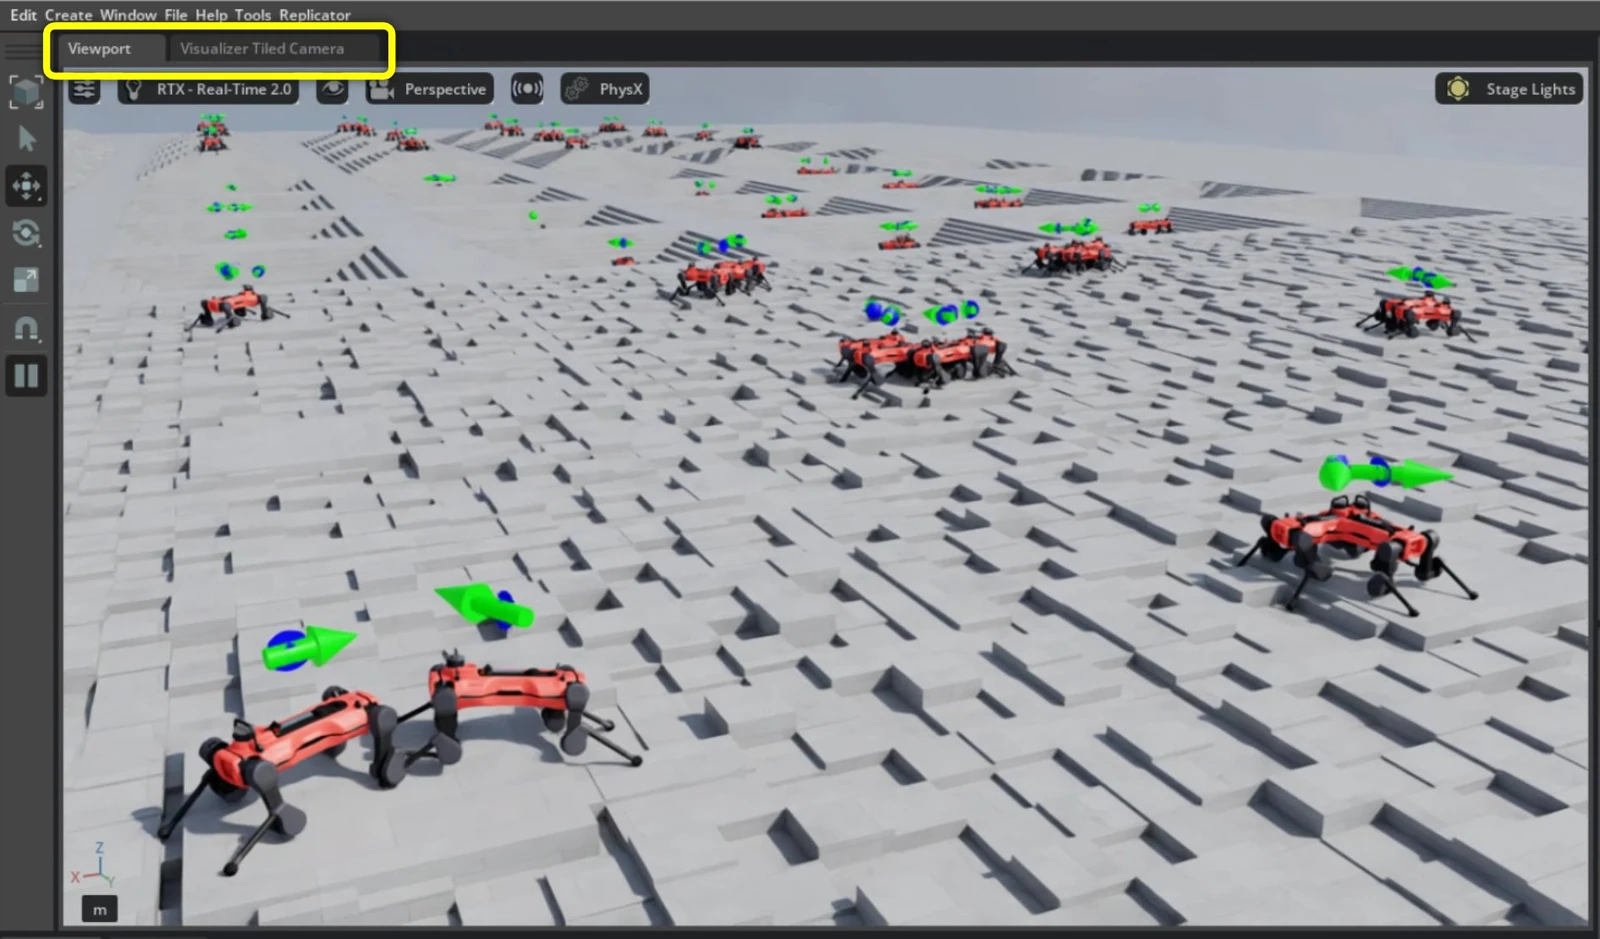
Isaac Sim 提供机器人仿真与传感器环境,Isaac Lab 在其上提供机器人学习工作流。适合显式研究机器人形态、接触和控制,但需额外实现或接入 VLN 数据与任务。官方提供 Windows / Linux 安装路径;Python、驱动与 Isaac Sim 版本须配套。官方安装文档。
工作机制与优势:机器人本体、关节、接触、传感器与控制器共同决定执行结果,适合研究从导航目标到真实运动约束的衔接。可以把高层导航与底层运动控制分层分析。
局限与选型:资产导入、碰撞体、惯性参数和控制接口都会影响结果;高质量渲染也会增加资源开销。先验证一个机器人在一个场景中的观测与动作闭环,再扩大并行环境数量;不要把物理步吞吐当作多模态系统吞吐。
7.4 MuJoCo / MJX
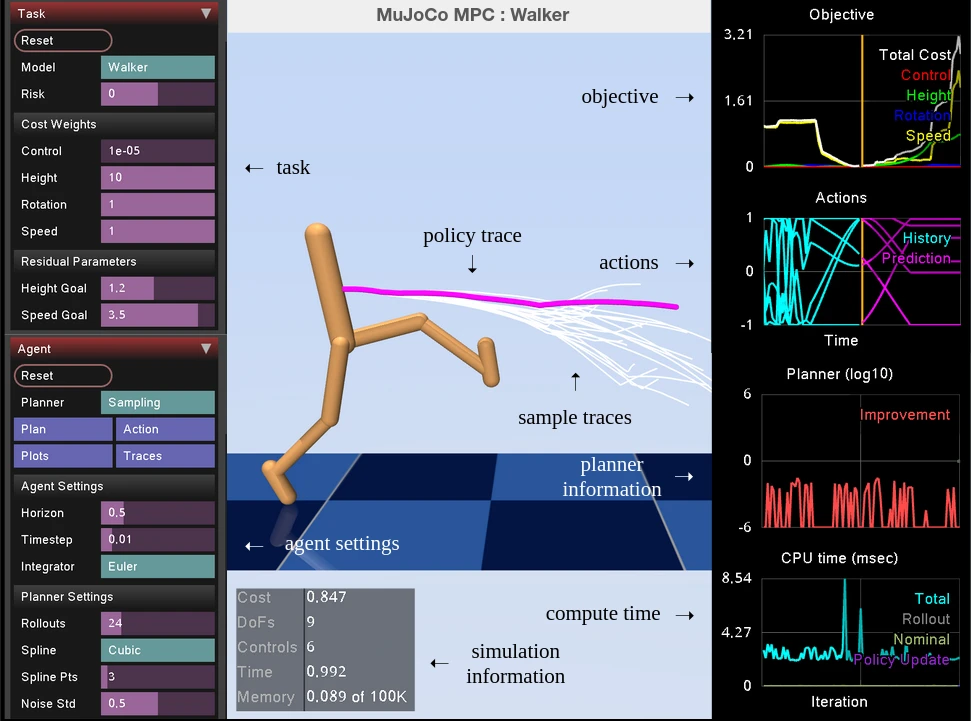
MuJoCo 适合接触动力学和控制研究;MJX 提供加速器上的批量物理计算。它们可以承载 VLN 系统的运动执行层,但不会自动提供语言指令、室内资产和导航评测器。批量物理步吞吐与包含图像渲染、VLM 推理的训练吞吐应分开测量。MuJoCo / MJX 文档。
工作机制与优势:显式建模运动状态和接触,适合检验局部控制器、轨迹跟踪及稳定性。对于分层 VLN,可将上层输出的目标或速度交给运动层执行,再把实际到达误差反馈给上层。
局限与选型:要构成视觉语言导航实验,还需要场景资产、语言任务、相机观测及评测器。MJX 的批量计算收益受模型和硬件配置影响;需要单独测量物理、渲染和策略推理各部分耗时。
7.5 AI2-THOR
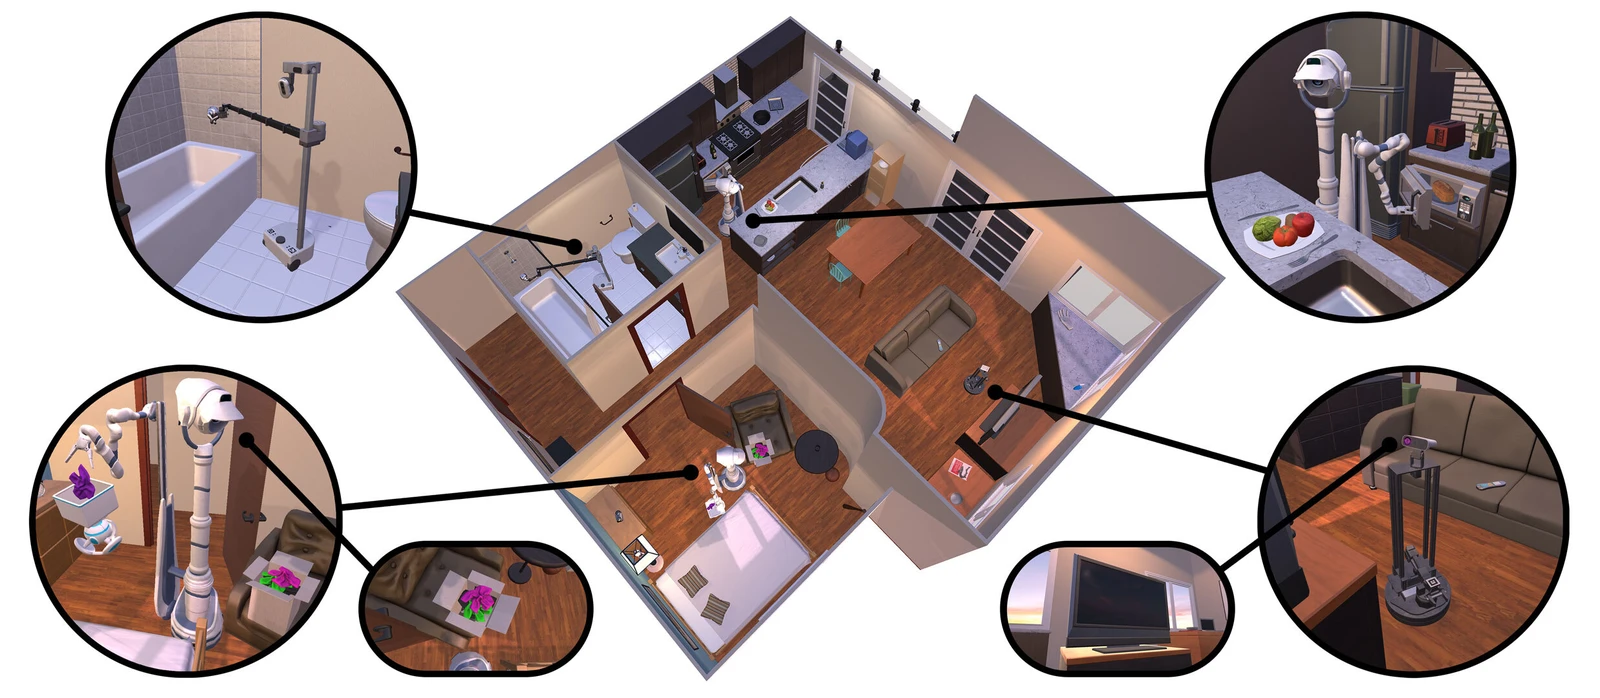
AI2-THOR 的重点是可交互物体和环境状态变化,适合导航与操作结合的任务。其官方 README 列出的系统要求为 macOS / Ubuntu,不能从底层 Unity 可跨平台推出 Python 仿真栈原生支持 Windows。部署以目标版本的构建与渲染后端要求为准。官方仓库。
工作机制与优势:可交互对象及其状态使“走到物体旁”和“完成操作条件”能够在同一环境中衔接。适合讨论导航、物体搜索与任务执行之间的关系。
局限与选型:可见、可达和可交互是不同状态;靠近物体不一定满足交互前提。分析 TEACh 等任务时,应同时记录导航失败和操作失败,并固定对象状态与任务初始化,避免只用终点距离评价整个任务。
7.6 Gibson / iGibson
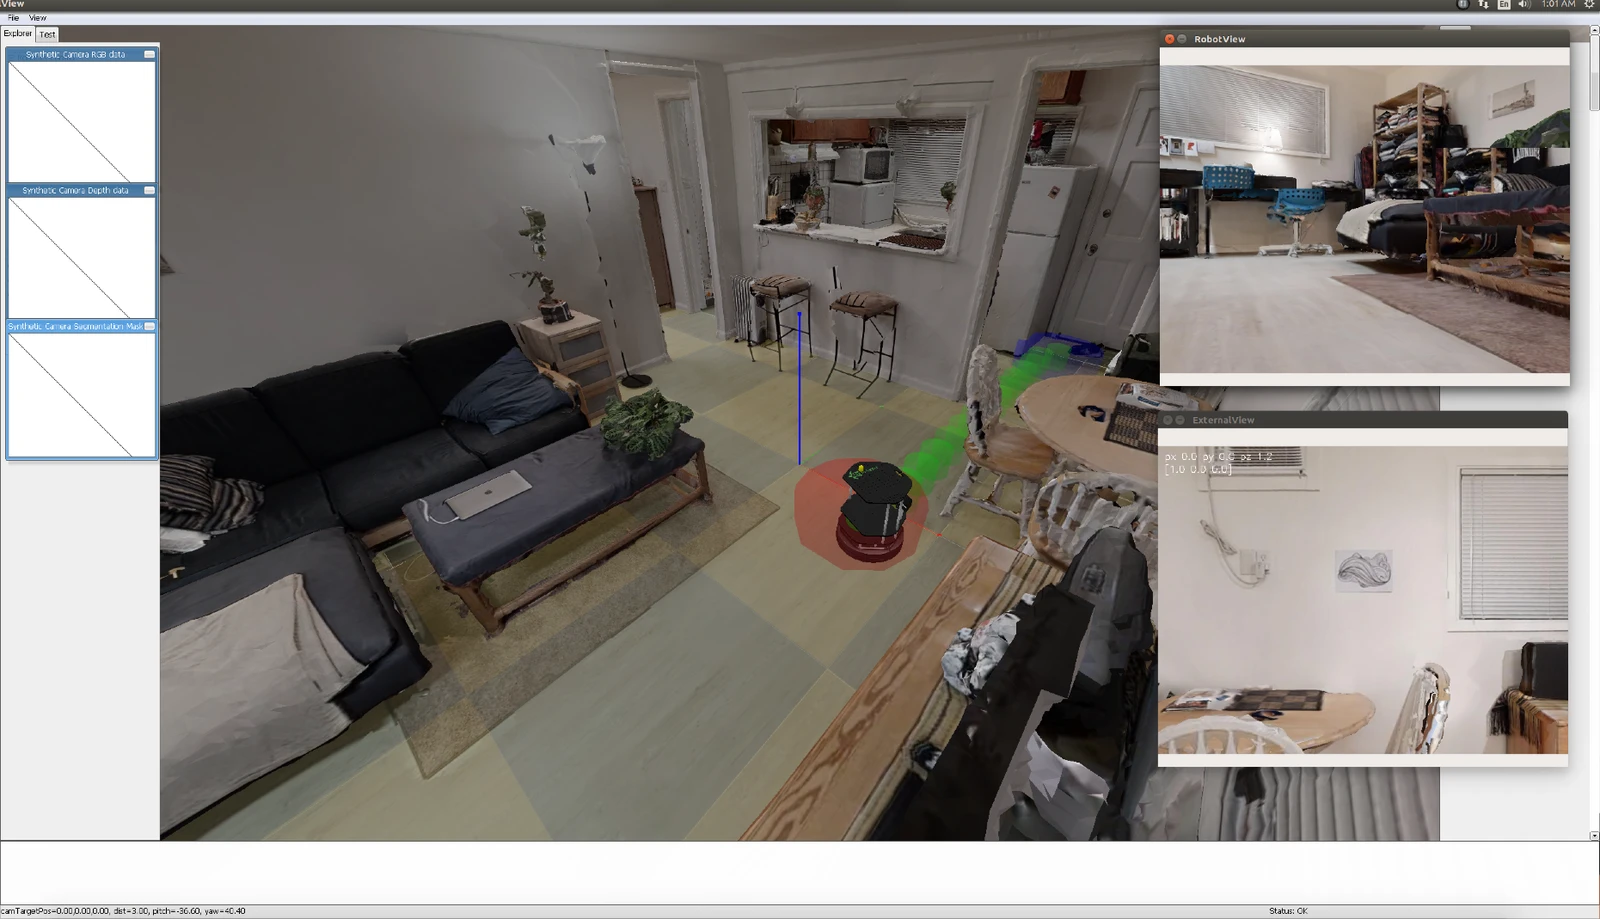
Gibson、iGibson 与 OmniGibson 相关但不等同:使用扫描场景资产与使用交互式物理平台是不同选择。涉及家务任务和对象状态时,应确认使用的具体平台、资产版本与行为定义;OmniGibson 的入口现位于 BEHAVIOR-1K 项目,iGibson 另见 官方仓库。
工作机制与优势:交互式环境允许把家具、物体和机器人接触纳入任务,适合研究导航与家务操作的联动。具体可用能力取决于使用的是 Gibson、iGibson 还是 OmniGibson。
局限与选型:这些项目的资产、依赖和任务定义不能直接互换。先确认论文所依赖的平台,再验证物体状态与成功条件;从另一平台迁移场景时,需要重新检查碰撞和交互语义。
7.7 AirSim
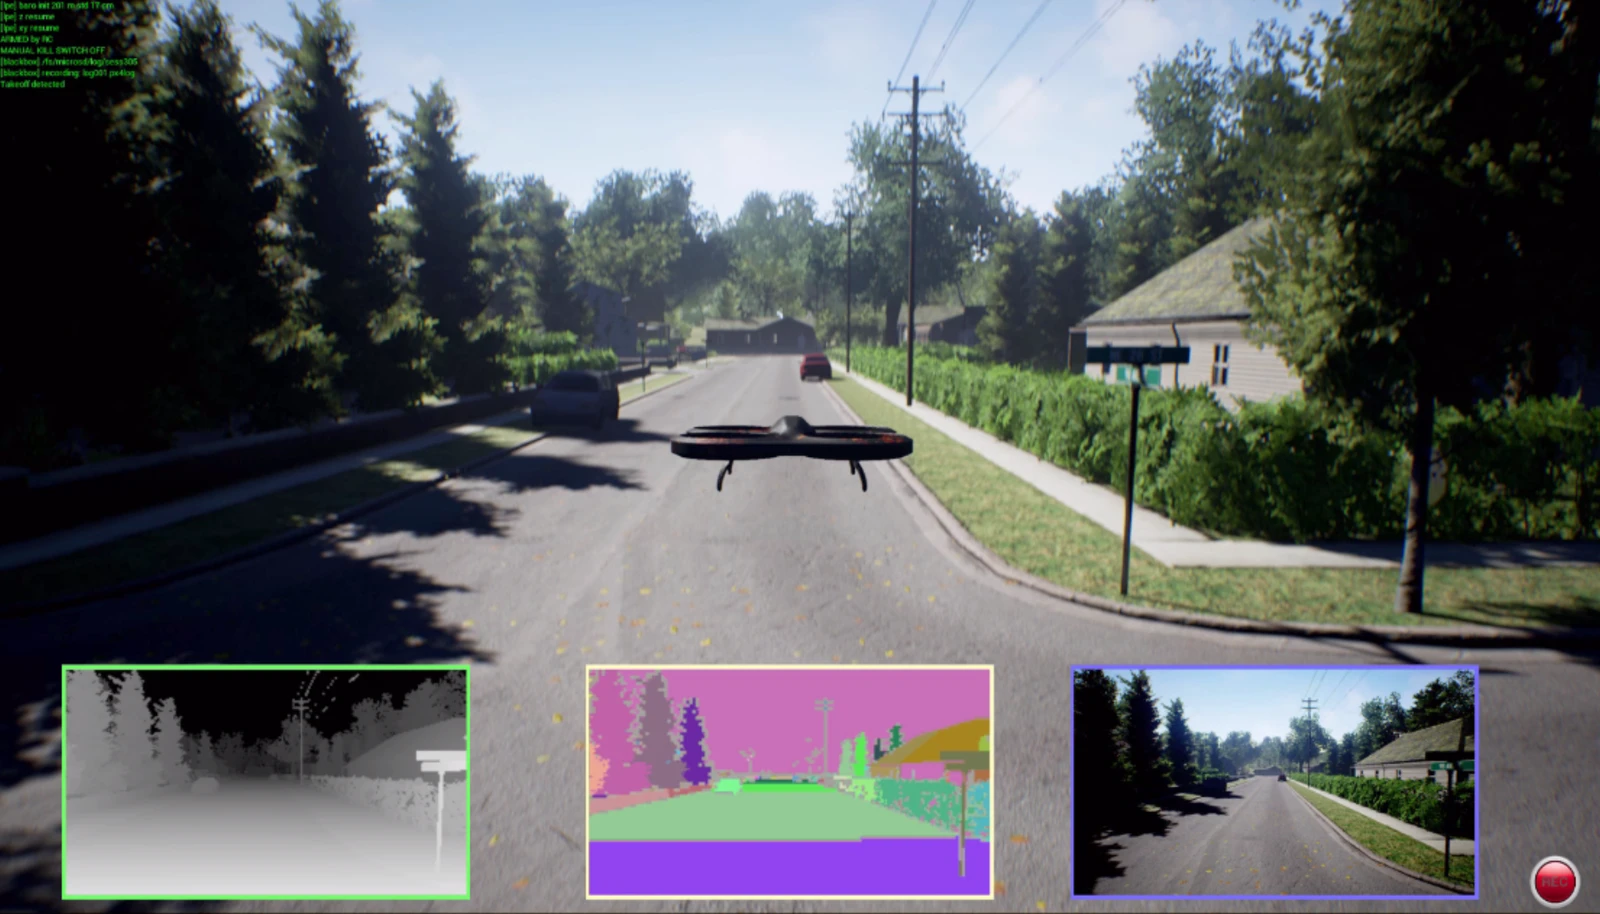
AirSim 用于无人机与车辆仿真,也是部分空中 VLN 项目的底层依赖。复现时固定 Unreal / AirSim 及项目场景版本;迁移到社区分支后,需要重新验证控制接口和评测行为,不能默认为同一环境。原始仓库。
工作机制与优势:飞行状态、相机观测与动作接口能支持空中路线执行,便于检查高度变化和城市尺度导航。用于 VLN 时,语言数据和成功评测通常由上层研究工程提供。
局限与选型:调用位姿或路点接口,与在底层控制约束下飞行,是不同难度的任务。复现时应写清是否存在瞬移、速度限制、碰撞终止及超时条件,同时固定场景地图和引擎版本。
7.8 InternUtopia
InternUtopia 在 Isaac Sim 上组织场景、机器人与具身任务。查阅时,官方安装前提列出 Ubuntu 20.04 / 22.04 与 Isaac Sim 4.5.0;因此不能沿用 Isaac Sim 的跨平台说明,直接宣称整套 InternUtopia 支持 Windows。具体要求见 官方安装前提(查阅于 2026-09-26)。
工作机制与优势:在统一环境组织中接入场景、机器人与不同任务,有利于比较高层能力在多种具身设置下的表现。具体实验仍由所选任务配置与机器人控制器决定。
局限与选型:框架支持某类任务,不表示任意机器人和场景组合都已完成评测。本文建议先运行官方最小示例,确认任务重置、观测、执行和成功判定,再移植自己的导航策略。
7.9 模拟器对比
| 目标 | 常见入口 | 还需补齐的部分 |
|---|---|---|
| 复现离散语言导航 | Matterport3D Simulator | 指令划分、图连接与特征版本 |
| 复现连续 VLN | Habitat + 对应 VLN-CE 实现 | 相机、动作、滑动与停止协议 |
| 研究多具身执行 | Isaac Sim / Isaac Lab / InternUtopia | 机器人控制器、形态参数、VLN 任务 |
| 研究局部运动与接触 | MuJoCo / MJX | 视觉环境、上层策略、语言评测 |
| 研究导航与操作 | AI2-THOR / iGibson / OmniGibson | 对象状态、任务完成条件与交互成本 |
| 复现空中 VLN | 论文指定 AirSim 或其他引擎 | 飞行接口、城市资产、地理输入和划分 |
7.10 选型建议
7.10.1 按操作系统选型
先核对完整论文工程的支持平台,再核对底层引擎。Windows 用户可选择原生提供支持的 Isaac Sim / Isaac Lab;其他工程应按官方配置使用 Linux 主机、容器或经过验证的 WSL 环境。WSL 能运行 Linux 程序并不保证 EGL、Vulkan、CUDA、窗口系统和仿真资产均可直接工作。
7.10.2 按研究任务选型
本文建议:复现已有结果时使用原任务环境;研究动力学时才增加机器人形态和接触模型;研究交互时增加可操作对象。每多一层仿真能力,都应明确它对应哪个研究问题,并为新增变量建立基线。不要用跨硬件、跨场景的“快/慢”标签排列平台优劣。
展开:开始大规模实验前的最小仿真检查
| 检查项 | 建议保存的证据 | 能排除的问题 |
|---|---|---|
| 加载一个固定场景 | 场景版本与加载日志 | 资产缺失、路径错误 |
| 获取一帧观测 | RGB / 深度样本和相机参数 | 相机朝向、深度单位或视场不一致 |
| 执行一次前进和转向 | 动作前后位姿 | 坐标轴、角度单位或动作尺度错误 |
| 在障碍前执行动作 | 碰撞与实际位移记录 | 滑动、穿透或接触行为不一致 |
| 执行一次停止 | 停止标志与评测器输出 | 将超时或接近目标误当成功 |
| 固定种子重复运行 | 轨迹与结果差异 | 未控制的环境或策略随机性 |
吞吐测试记录硬件、并行环境数、图像分辨率、传感器数量和是否包含策略推理。实时部署还应报告端到端延迟及尾部延迟,不能用单独渲染 FPS 代替。
8. 评估指标与评测体系
一次导航至少有四个评价维度:是否完成目标、付出了多少路径成本、是否遵循指令、执行是否可靠。前三者在经典 VLN 中已有常用指标,最后一项需要结合机器人与场景补充定义。不存在一个能够替代全部维度的通用分数。
只盯住一个维度,策略就可能用另一个维度的退化来换分:只看 SR,可能靠大范围试探“碰”到终点;只看 SPL,可能忽略指令要求的绕行而走最短路;只看途中是否接近目标,会掩盖不会停下的问题;只在无接触仿真中评测,则看不到碰撞、跌倒与卡住。因此下面的指标应按维度成组报告。
flowchart TB
    Q["一次导航需要回答的四个问题"]

    subgraph D1["目标达成"]
        SR["SR 终点成功率"]
        NE["NE 终点误差"]
        OSR["OSR 途中是否进入成功范围"]
    end

    subgraph D2["路径成本"]
        SPL["SPL 路径长度加权成功率"]
        TL["TL 实际轨迹长度"]
        ST["步数或耗时"]
    end

    subgraph D3["指令忠实"]
        CLS["CLS 覆盖与长度匹配"]
        NDTW["nDTW 顺序对齐"]
        SDTW["SDTW 成功加权对齐"]
    end

    subgraph D4["执行可靠"]
        CR["碰撞 环境或行人"]
        FS["跌倒与卡住 如 VLN-PE 的 FR StR"]
        HI["人工介入与端到端延迟"]
    end

    Q --> D1
    Q --> D2
    Q --> D3
    Q --> D4

    style Q fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style D1 fill:#f1f8ff,stroke:#339af0,stroke-width:2px
    style D2 fill:#f0fbf2,stroke:#40c057,stroke-width:2px
    style D3 fill:#fff8f0,stroke:#ff922b,stroke-width:2px
    style D4 fill:#fff5f5,stroke:#fa5252,stroke-width:2px
前三组指标的定义在各基准间较为统一;第四组的计数单位、阈值和是否中断 episode 依基准而定,见第 8.4 节。
8.1 评测协议与指标解读
记录任务与划分、传感器和视场、深度/位姿/地图权限、动作接口、停止与超时规则、距离函数、成功阈值、额外训练数据以及推理预算。R2R 的导航图、Habitat 的可导航表面与空中场景不是同一种距离空间。
| 想证明什么 | 至少报告 | 不能由此直接推出 |
|---|---|---|
| 更容易到达目标 | SR、NE、OSR | 是否遵循了沿途指令 |
| 行走更高效 | SR、SPL、实际路径长度 | 推理更快或能耗更低 |
| 更忠实地执行指令 | nDTW / SDTW,必要时 CLS | 语言理解的全部能力 |
| 更准确地找到物体 | 导航指标 + 对应目标定位指标 | 一般 ObjectNav 与指代导航同等困难 |
| 更适合真实机器人 | 真机完成率、碰撞、介入、延迟与失败类型 | 在其他机器人和环境同样可靠 |
8.1.1 轨迹形态与指标响应
以下是用于理解指标的示意,不是某篇论文的实验结果。设指令要求经过地标后再到终点:
| 执行情况 | SR | SPL | nDTW / CLS | 应如何解读 |
|---|---|---|---|---|
| 按指令到达并正确结束 | 成功 | 取决于与最短路的差异 | 通常较高 | 完成了路径与终点要求 |
| 绕开地标,走捷径到达 | 仍可能成功 | 可能较高 | 通常下降 | 到达不等于路径忠实 |
| 反复进出多个房间后才到达 | 仍可能成功 | 明显偏低 | 通常下降 | 成功可能由过量探索换来,需结合 TL 看代价 |
| 遵循大部分路线但终点失败 | 失败 | 为 0 | 仍可能较高 | 路径相似不等于完成;SDTW 为 0 |
| 路过目标后继续远离 | 可能失败 | 失败时为 0 | 依轨迹而定 | OSR 与 SR 的差距提示检查停止与执行 |
8.1.2 场景化指标选型
路线跟随优先同时看终点和路径;目标搜索优先看搜索成功与目标验证;对话任务还需说明是否允许主动提问;物理机器人需额外报告执行失败。不同任务的成功判据应沿用各自官方定义,不能把“离终点 3 米”套用于全部 VLN。
下图帮助确定指标组合。分支可以同时成立,例如物理环境中的指代导航既需要目标识别,也需要执行安全评测。
flowchart TB
    Q["任务要求验证什么能力?"]
    Q --> G["到达指定位置"]
    Q --> R["遵循沿途路线"]
    Q --> O["识别或操作目标"]
    Q --> E["物理与社交执行"]
    G --> GM["SR、NE、OSR<br/>结合 SPL 看行走效率"]
    R --> RM["CLS 看软覆盖<br/>nDTW / SDTW 看顺序对齐"]
    O --> OM["导航结果 + 目标定位<br/>或任务后条件完成"]
    E --> EM["到达 + 碰撞 / 跌倒 / 违规<br/>结合时间与控制延迟"]
    classDef metric fill:#e8f1fb,stroke:#426a91,color:#18354f;
    class GM,RM,OM,EM metric;
选完指标后,还要保存逐 episode 结果。总体均值可能掩盖长路径、多语言、特定机器人或特定失败条件下的显著退化。
8.1.3 核心指标总览
| 指标 | 主要问题 | 方向 | 关键限制 |
|---|---|---|---|
| SR | 最终是否成功 | ↑ | 成功条件依任务而定 |
| NE | 停止时距离目标多远 | ↓,通常为米 | 必须说明距离函数 |
| OSR | 途中是否曾进入目标成功范围 | ↑ | 是到达机会的诊断量,不是可实现策略的保证 |
| SPL | 成功时路径是否高效 | ↑,0–1 或百分数 | 最短路效率不等于指令忠实度 |
| CLS | 对参考路径的覆盖与长度匹配如何 | ↑,0–1 或百分数 | 不显式做顺序对齐 |
| nDTW | 轨迹在顺序约束下多接近参考路线 | ↑,0–1 或百分数 | 受采样、距离函数与参考标注影响 |
| SDTW | 是否成功且与参考路线接近 | ↑,0–1 或百分数 | 失败轨迹记 0,需搭配 nDTW 分析 |
| TL | 实际走了多长 | 无固定优劣方向,通常为米 | 需结合 SR 与参考路径长度解读,过短可能是过早停止 |
| RGS / RGSPL | 是否选中了指令所指的目标物体 | ↑ | REVERIE 类任务专用;需说明候选物体来源与判定方式 |
8.1.4 指标反差排查
| 观察 | 可能原因 | 用什么验证 |
|---|---|---|
| OSR 明显高于 SR | 停止判断、目标验证、控制漂移、超时 | 回放首次进入成功范围后的行为 |
| SR 提升但 SPL 下降 | 更充分的探索换来更长路径 | 配对比较成功集合与实际路径长度 |
| SPL 高而 nDTW 低 | 捷径或沿途地标被忽略 | 查看参考路径是否故意偏离最短路 |
| Seen 与 Unseen 差距大 | 场景过拟合或任务分布差异 | 按路径长度、指令类型和场景难度分组 |
| 仿真好、真机差 | 感知、时间同步、动力学或环境偏移 | 分层测量感知、规划与执行误差 |
这些是待验证的解释。某个指标反差可以由多个机制产生,不应直接给模型下“缺乏推理”或“只会记忆”的结论。
8.2 目标达成指标
8.2.1 Success Rate (SR)
设第 $i$ 个 episode 的官方成功指示为 $S_i\in{0,1}$,共 $N$ 条评测轨迹:
\[\mathrm{SR}=\frac{1}{N}\sum_{i=1}^{N}S_i.\]成功条件可能包含终点距离、主动停止、目标可见性或物体识别。报告时保留这些条件;被超时截断是否算成功,也由评测器决定。
8.2.2 Navigation Error (NE)
设 $x_i^{\mathrm{end}}$ 为终止位置,$g_i$ 为目标,$d$ 为基准的距离函数:
\[\mathrm{NE}=\frac{1}{N}\sum_{i=1}^{N}d(x_i^{\mathrm{end}},g_i).\]经典图导航一般采用最短图距离,连续导航的目标距离通常采用可导航表面的测地距离,不能统一改写成欧氏距离。存在多个有效目标位置时,还须说明目标集合的处理方式。RxR 官方指标说明。
8.2.3 Oracle Success Rate (OSR)
对于使用目标距离阈值 $\tau$ 的任务,OSR 检查轨迹中是否曾进入成功范围:
\[\mathrm{OSR}=\frac{1}{N}\sum_{i=1}^{N}\mathbb{1}\!\left[\min_t d(x_i^t,g_i)<\tau\right].\]严格或非严格阈值遵循官方实现。OSR 不能替代真实停止策略:途中偶然经过终点也可能提高 OSR。SR 与 OSR 的距离与采样口径一致时,两者差距可用于定位停止相关问题。
教学示例:路过目标与正确停止不同。 下图假设成功只取决于停止时到目标的距离,阈值为 3 m;所有距离采用同一评测定义。
flowchart LR
    A["起点"] --> B["途中距目标 1 m<br/>已进入成功范围"]
    B --> C["继续走,最终距目标 5 m<br/>此处停止"]
    B -.-> D["该轨迹 Oracle success = 1"]
    C -.-> E["该轨迹 Success = 0"]
    classDef pass fill:#e4f2e8,stroke:#548565,color:#21452e;
    classDef fail fill:#fbe9e5,stroke:#b66b58,color:#612f25;
    class B,D pass;
    class C,E fail;
这个差距提示检查停止判断、目标识别和路径回退,但不能仅凭 OSR 高就断言模型“定位准确”。轨迹可能偶然路过目标,或者模型根本没有意识到目标已被看到。
8.3 路径效率与保真度
8.3.1 SPL
设 $l_i$ 为起点到目标的最短可行路径长度,$p_i$ 为实际行走长度,则:
\[\mathrm{SPL}=\frac{1}{N}\sum_{i=1}^{N}S_i\frac{l_i}{\max(l_i,p_i)}.\]分数逐轨迹计算后平均,不能写成 SR 乘以全体轨迹的平均效率。零长度等退化情况遵循基准实现。SPL 原始评测建议。
例如两条轨迹中,一条成功且效率为 0.5,另一条失败,则 SR 为 0.5、SPL 为 0.25。SPL 衡量行走效率,额外生成 token、网络等待或原地计算时间不会自动进入它的分母。
四类轨迹的计算例子:设同一直走廊中,起点到精确目标的最短距离为 10 m,成功阈值为 3 m,均主动停止。下图表示行为类别,不按空间比例绘制。
flowchart TB
    S["共同起点:到精确目标最短距离 10 m"]
    S --> A["直接到目标<br/>行走 10 m,终点误差 0 m"]
    S --> B["绕行后到目标<br/>行走 20 m,终点误差 0 m"]
    S --> C["进入成功范围后停止<br/>行走 8 m,终点误差 2 m"]
    S --> D["过早停止<br/>行走 6.5 m,终点误差 3.5 m"]
    A --> AS["成功,SPL = 1"]
    B --> BS["成功,SPL = 0.5"]
    C --> CS["成功,SPL = 1"]
    D --> DS["失败,SPL = 0"]
    classDef pass fill:#e4f2e8,stroke:#548565,color:#21452e;
    classDef fail fill:#fbe9e5,stroke:#b66b58,color:#612f25;
    class AS,BS,CS pass;
    class DS fail;
| 行为 | $S_i$ | 效率项 $l_i / \max(l_i,p_i)$ | 单条 SPL |
|---|---|---|---|
| 直接到达 | 1 | $10/10=1$ | 1 |
| 绕行到达 | 1 | $10/20=0.5$ | 0.5 |
| 在目标前 2 m 停止 | 1 | $10/10=1$ | 1 |
| 在目标前 3.5 m 停止 | 0 | $10/10=1$ | 0 |
四条一起评测时,SR 为 0.75,SPL 为 0.625。第三条的行走长度小于到精确目标的最短距离,是因为在成功范围内提前停止,不是走出了比同一几何中的最短路径更短的路线;max 将效率上限限制为 1。若基准把 $l_i$ 定义到目标区域,应按其实现重新计算。
SPL 对失败轨迹直接计零,对成功但过长的路径施加反比惩罚。它不要求遵循指令的所有中间地标:当指令要求绕行时,忠实执行可能反而降低 SPL,因此还需路径保真度指标。
8.3.2 CLS
给定参考路径 $R$ 和预测路径 $P$,定义节点到路径的距离 $d(r,P)=\min_{p\in P}d(r,p)$。CLS 结合软覆盖与长度匹配:
\[\mathrm{PC}=\frac{1}{|R|}\sum_{r\in R}\exp\!\left(-\frac{d(r,P)}{d_{th}}\right),\qquad \mathrm{EPL}=\mathrm{PC}\cdot L(R),\] \[\mathrm{CLS}=\mathrm{PC}\cdot\frac{\mathrm{EPL}}{\mathrm{EPL}+|\mathrm{EPL}-L(P)|}.\]其中 $L$ 表示路径长度,$d_{th}$ 是距离尺度。它鼓励覆盖沿途节点,但没有显式约束访问顺序;评估先后次序时还需看 nDTW。CLS 原论文。
把公式拆成两步:PC 问“参考路线各处离实际走过的地方有多远”,长度项 LS 问“实际长度是否与已覆盖部分相称”。节点到路径取最小距离,因此仅靠 PC 不会检查访问顺序。
flowchart TB
    R["参考路径中的每个节点"] --> D["计算到预测路径的最近距离"]
    D --> PC["距离经指数衰减后取平均<br/>得到软覆盖 PC"]
    PC --> EPL["EPL = PC × 参考路径长度"]
    EPL --> LS["比较 EPL 与实际路径长度<br/>得到长度得分 LS"]
    PC --> C["CLS = PC × LS"]
    LS --> C
    classDef score fill:#e8f1fb,stroke:#426a91,color:#18354f;
    class PC,LS,C score;
| 教学算例:$L(R)=20$ m | 假设 PC | $L(P)$ | EPL | LS | CLS |
|---|---|---|---|---|---|
| 完整覆盖且长度匹配 | 1 | 20 m | 20 m | 1 | 1 |
| 完整覆盖但有额外绕行 | 1 | 30 m | 20 m | $2/3$ | $2/3$ |
| 软覆盖不足但长度与 EPL 匹配 | 0.5 | 10 m | 10 m | 1 | 0.5 |
表中 PC 为便于演算设定的值,不是从某张路线图测得,也不表示“恰好走了半数节点”。即使每个参考点都在距离尺度 $d_{th}$ 内,PC 也不必接近 1:距离恰好为 $d_{th}$ 的点,其贡献只有 $e^{-1}\approx0.368$。
CLS 可以揭示“到达终点却漏掉沿途路线”,但相同覆盖集合仍可能对应不同访问顺序;这正是下面引入 DTW 对齐的原因。
8.3.3 nDTW 与 SDTW
DTW 寻找满足顺序约束的路径对齐,允许两条轨迹具有不同采样点数。常见归一化与成功加权形式为:
\[\mathrm{nDTW}(R,P)=\exp\!\left(-\frac{\mathrm{DTW}(R,P)}{|R|d_{th}}\right),\qquad \mathrm{SDTW}=\frac{1}{N}\sum_{i=1}^{N}S_i\,\mathrm{nDTW}(R_i,P_i).\]数据集 nDTW 同样逐 episode 计算后平均。其顺序对齐比单纯路径覆盖更适合检查沿途约束,但仍依赖参考轨迹质量。nDTW 原论文。
实现边界:用于 NE 的目标距离与 DTW 的点对距离不应想当然地视为相同。连续环境实现还涉及轨迹采样、去重、近似 DTW 等选择;复现应固定评测代码,而非只复制公式。参见 VLN-CE 指标实现。
为什么不直接逐步相减:参考序列为 A→B→C,预测序列为 A→A→B→C。若按相同下标比较,第二步会把 B 与 A 错配;DTW 允许在保持顺序的前提下,让多个采样点对应同一个参考点。
flowchart TB
    subgraph Ref["参考路径"]
        direction LR
        R1["A"] --> R2["B"] --> R3["C"]
    end
    subgraph Pred["预测路径"]
        direction LR
        P1["A"] --> P2["A"] --> P3["B"] --> P4["C"]
    end
    R1 -. "对齐" .-> P1
    R1 -. "对齐" .-> P2
    R2 -. "对齐" .-> P3
    R3 -. "对齐" .-> P4
在这个重复位置完全相同的教学例子中,对齐代价可以为零;真实轨迹中的位移、采样方式和噪声仍会改变 DTW,不能泛化为“对速度与采样完全不敏感”。如果改走 A→C→B→C,即使访问过同样地标,也通常无法获得同样的零代价顺序对齐。
DTW 累积代价可以写为下列递推,其中 $D(a,b)$ 是两条路径前缀的最小对齐代价,边界按标准 DTW 初始化:
\[D(a,b)=d(r_a,p_b)+\min\{D(a-1,b),D(a,b-1),D(a-1,b-1)\}.\]例如 $\lvert R\rvert=4$、$d_{th}=3$ m、DTW 为 6 m,则 nDTW 为 $e^{-0.5}\approx0.607$;若最终失败,该条 SDTW 为 0。另一条成功且 nDTW 为 0.8 时,两条轨迹的平均 nDTW 约 0.704,而 SDTW 为 0.4。成功加权必须先作用于每条轨迹,不能用总体 SR 乘总体 nDTW 替代。
8.4 安全与部署指标
8.4.1 避障与社交安全
户外评测不能只报走了多远。 DA-Nav 的评测记录区分 CARLA 混合城镇、未见城镇与实机闭环:任务 SR、按偏航事件统计的 CSR、单动作成功率和公里级展示不是同一种证据。跨论文还应记录人工接管、重试、碰撞和网络依赖;没有干预日志,不能把长距离展示解释为无人监督可靠运行。
碰撞可以按动作步、接触事件或 episode 计数,三者分母不同。报告 Collision Rate / Human Collision Rate 时写出定义,并同时给出任务完成情况,避免“原地不动所以碰撞少”的误读。个人空间侵犯也不能简化为身体接触。
8.4.2 动力学稳定性
跌倒、卡住、急停与人工复位应分别记录。需要给出姿态或时间阈值、恢复预算,以及复位是否中断 episode。不同机器人形态的失败模式不同,不能合并为一个不带条件的具身成功率。
8.4.3 系统效率与实时性
报告相机到动作执行的端到端延迟,注明均值与尾部延迟、硬件、批大小、输入分辨率、历史长度和模型调用方式。另列控制频率、显存、调用/token 成本、任务耗时与人工介入。模型单次前向 FPS 不等于机器人的有效控制频率。
8.5 评测协议规范
8.5.1 Val-Seen 与 Val-Unseen
Seen / Unseen 通常按基准场景划分,衡量同一任务内的场景泛化。它不自动保证大规模预训练时从未见过同源建筑、图像或衍生资产,也不等价于跨机器人、跨语言或真机泛化。
8.5.2 公平对比清单
- 输入相同:相机数量、视场、深度、位姿与地图权限。
- 任务相同:数据版本、语言子集、episode、目标与停止判据。
- 执行相同:动作空间、控制器、步数与时间预算、滑动和碰撞配置。
- 资源透明:额外训练数据、基模、工具调用、搜索/重试次数与计算预算。
- 统计可检查:报告成功数与总数;随机任务给出多次运行或置信区间,并说明采样方法。
8.5.3 可复现证据
先确认结果属于论文哪个版本和哪张表,再核对官方评测器。VLN-CE 官方仓库曾明确说明,同一基线在论文与榜单上的 SPL 差异与硬件和 Habitat 构建有关;这说明协议与实现本身也是实验的一部分。官方复现说明。
配套论文篇用于检索候选方法和原始结果。跨文章、跨版本的成绩在完成上述核对前,只能作为阅读索引,不能直接用于架构优劣的因果结论。
9. 学习资源与框架
建议按“经典任务 → 连续环境 → 基础模型 → 真实部署”的顺序学习:先复现 R2R / VLN-CE 基线,熟悉 Habitat 的 episode、传感器与指标;再阅读流式 VLA、快慢系统和空间记忆方法;最后再进入 Agent、世界模型和真实机器人部署。直接从最新大模型开始,往往会掩盖数据协议和动作接口带来的差异。
站内配套资源:
- 指令跟随篇:路线指令执行、代表方法与同设定性能表。
- 目标导航篇:对象、图像等目标的搜索与到达,以及相关扩展任务。
- Agentic 导航篇:工具调用、空间记忆、计划与执行反馈。
- 户外导航篇:地图指引、语义目标与偏航恢复;按各自协议记录结果,不跨任务混排。
- 空间智能综述:补充 3D 表征、地图与空间推理基础。
- 世界模型综述:补充预测模型、世界动作模型与数据引擎。
- 传统导航综述:补充 SLAM、全局 / 局部规划与控制器基础,对应第 3.2 节的分层控制、第 3.4 节的动作接口与第 8.4 节的部署指标。
- VLA 综述:补充视觉-语言-动作模型的训练范式与动作接口设计。
VLN-Survey-with-Foundation-Models
- 类型:GitHub 资源仓库
- 重点:专注于 LLM/VLM 时代的 VLN 方法(2023-至今),持续更新最新论文
- 适合:想了解大模型如何革新 VLN 领域的研究者
- 类型:全栈资源合集
- 重点:涵盖 VLN、VLA、机器人操作等完整具身智能技术栈
- 适合:系统学习具身 AI 全貌的研究者
- 类型:入门教程 + 实践指南
- 重点:提供代码实践、论文解读、学习路径规划
- 适合:零基础入门或需要结构化学习路径的新人
Vision-and-Language Navigation: A Survey of Tasks, Methods, and Future Directions
- 类型:综述论文(Gu et al., ACL 2022)
- 重点:系统梳理 VLN 发展脉络,覆盖 2018–2022 年的任务、方法与评测
- 适合:需要全面了解 VLN 历史演进的研究者
Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models
- 类型:综述论文(Zhang et al., 2024,与上方 VLN-Survey-with-Foundation-Models 仓库配套)
- 重点:以基础模型为主线重新组织 VLN 方法,讨论世界模型、人类模型与 VLA 的交汇
- 适合:从大模型视角切入 VLN 的研究者
9.1 重要会议与研讨会
具身智能专项会议:
- Embodied AI Workshop - CVPR 官方 Workshop,最新趋势和挑战赛发布地
- CoRL (Conference on Robot Learning) - VLN 向真实机器人迁移的主要阵地
- RSS (Robotics: Science and Systems) - 顶级机器人会议,强调 Sim-to-Real
主流会议分布:
| 会议 | 常见侧重点 |
|---|---|
| CVPR / ICCV / ECCV | 视觉语言建模、空间表征、数据集与基准 |
| NeurIPS / ICLR | 基础模型、强化学习、生成模型与规模化训练 |
| CoRL / RSS | 机器人学习、真实部署与跨具身泛化 |
| ICRA / IROS | 导航系统、控制、仿真平台与工程验证 |
9.2 可复现的实施路径
以下流程是本文的实验组织建议,适合将配套论文中的方法落实为可比较的系统。
| 阶段 | 先完成什么 | 应留下的可检查产物 |
|---|---|---|
| 固定任务 | 确定指令类型、观测、动作接口、具身形态与成功条件 | 配置表,包含数据版本、划分、传感器与停止规则 |
| 跑通基线 | 使用论文对应版本的代码和权重,复现标准验证集 | 逐 episode 结果、配置、代码版本与汇总指标 |
| 定位短板 | 回看失败轨迹,区分理解、记忆、规划、执行和停止错误 | 失败分类及代表轨迹,避免只记录平均 SR |
| 验证改动 | 每次控制一个变量;保持 episode 集合与预算一致 | 配对结果、模块消融、不同运行种子下的波动 |
| 检查泛化 | 在未见场景与明确指定的扰动条件下评测 | 分场景、分路径长度及分扰动类型的结果 |
| 接入机器人 | 检查坐标系、时间戳、动作尺度、轨迹有效期与执行反馈 | 端到端延迟、碰撞、恢复、介入次数及真机失败记录 |
推理完成不等于动作仍然有效。 相机采集、编码、模型生成、通信和控制执行共同决定闭环延迟。慢系统返回子目标时,机器人可能已经离开对应视点,因此需要明确旧目标何时失效、何时重新规划,以及快系统在等待期间采取什么行为。报告模型 FPS 时,应同时说明测量边界、硬件、批大小与控制频率。
选择研究切入点时,从失败证据反推方法。 长路径上反复访问同一区域,适合检查记忆与地图更新;到过目标附近却未成功,适合检查停止判定与目标验证;语义目标正确却经常碰撞,适合检查可达性、动作接口和控制器。指标差距只提供线索,最终仍要用轨迹回放和受控实验验证原因。
9.3 开放问题与研究判断
从本文讨论的工作可以得到几条有明确适用范围的结论:R4R 与路径指标说明到达和指令忠实度需要分别衡量;ETPNav、DualVLN 展示了规划与执行分工的具体实现;ScaleVLN 说明训练资源是解释性能的重要变量;VLN-PE 则提供了视觉与物理差距会影响导航表现的实验证据。这些结论分别来自路径跟随研究、连续图规划、双系统设计、数据扩展和物理具身评测,尚不足以推出一种通用于所有任务的最优架构。
下表是本文据此归纳的开放问题与建议验证方式,属于研究判断,不是领域已形成的统一结论。
| 开放问题 | 为什么现有结果还不足 | 更有区分力的验证 |
|---|---|---|
| 何时值得显式建图? | 地图模型与隐式模型常使用不同传感器和位姿先验 | 固定输入,在路径长度、遮挡、位姿噪声上分组比较 |
| 模型究竟使用了哪些语言信息? | 高 SR 可能主要来自终点线索 | 保持目标不变,改动沿途顺序、否定和转向约束,检查轨迹响应 |
| 记忆能否修正自身错误? | 静态环境上的长期保存不代表动态更新能力 | 移动物体、阻断通路、注入错误观测,检查纠正与遗忘 |
| 反思是否带来可靠恢复? | 更长推理和更多重试可能同时增加成功率 | 固定调用预算和失败注入,比较恢复率、额外路径及失败升级 |
| 世界模型何时优于直接策略? | 生成质量和真实执行收益不等价 | 同预算比较无预测、候选排序和联合生成,报告长滚动失真 |
| “通用”能力能迁移多远? | 同一平台的多任务成绩不代表跨形态迁移 | 留出语言、资产、机器人与控制接口,分别报告适配量 |
| 仿真进步能否预测部署收益? | 真机试验环境和介入规则常不统一 | 固定任务集、起点与恢复预算,公开失败轨迹和介入记录 |
本文的研究建议是优先建立可回放、可归因的失败分析,再选择模型改动。若已有系统主要失败于局部执行,扩大语言模型未必是最直接的路径;若停止和沿途约束是主要问题,单看平均 SR 又可能遮蔽有效改进。值得追求的进展,是能够说明“在什么条件下、解决了哪类失败、付出了多少代价”。
9.4 本文覆盖范围与维护方式
本文是按问题组织的叙述性综述,覆盖路线指令导航及与之相关的目标导航、交互和具身控制工作,不是具有穷尽检索与排除流程的系统综述。不同任务作为机制参考时已注明边界;通用 VLA 与操作论文不作为标准 VLN 的直接性能证据。
2026-11-11 导读更新:补齐四篇精读与传统导航的入口,加入 CausalNav、DA-Nav 的机制对照和户外评测边界,检查站内链接并同步英文版;不代表重审全部论文事实、数据集或排行榜。
数据口径、平台支持和核心指标集中核验于 2026-09-26;2026-10-07 结合配套论文篇重组第 3 节,并补充核对动作接口、进度与主动感知、预测学习等代表方法的机制说明;2026-10-09 扩充第 3.8 节,按原论文指定版本核对 RL 的反馈层级、奖励与同基座消融。本次方法章节修订不代表重新核验了全部数据集、平台或排行榜。正文为易变数据注明论文版本或数据卡来源;无法确认独立协议的条目保留不确定性说明。其余工作通过配套论文篇供进一步阅读,本文不声称已独立复现所有实验或验证全部排行榜结果。
10. 参考资料
论文精读:按阅读问题进入指令跟随篇、目标导航篇、Agentic 导航篇或户外导航篇。本节只收录正文直接涉及的数据集、方法、模拟器与综述,按主题分组、全文连续编号;预印本的发表状态与榜单数字以论文主页及配套论文页为准。
10.1 数据集与基准
10.1.1 指令导向与连续环境
- R2R — Anderson et al., Vision-and-Language Navigation: Interpreting Visually-Grounded Navigation Instructions in Real Environments, CVPR 2018. [Paper]
- R4R — Jain et al., Stay on the Path: Instruction Fidelity in Vision-and-Language Navigation, ACL 2019. [Paper]
- RxR — Ku et al., Room-Across-Room: Multilingual Vision-and-Language Navigation with Dense Spatiotemporal Grounding, EMNLP 2020. [Paper]
- VLN-CE — Krantz et al., Beyond the Nav-Graph: Vision-and-Language Navigation in Continuous Environments, ECCV 2020. [Paper]
- RxR-CE — RxR 在 Habitat 连续环境中的移植,随 VLN-CE 代码库发布,用于 RxR-Habitat 挑战赛(CVPR Embodied AI Workshop)。[Code]
- ScaleVLN — Wang et al., Scaling Data Generation in Vision-and-Language Navigation, ICCV 2023. [Paper]
- VLN-PE — Wang et al., Rethinking the Embodied Gap in Vision-and-Language Navigation: A Holistic Study of Physical and Visual Disparities, ICCV 2025. [Paper]
- InternData-N1 — InternRobotics(上海人工智能实验室),面向 InternVLA-N1 的大规模合成导航数据(LeRobot 格式),2025. [Dataset] [Code]
- VLNVerse — Lin et al., VLNVerse: A Benchmark for Vision-Language Navigation with Versatile, Embodied, Realistic Simulation and Evaluation, arXiv 2025. [Paper]
10.1.2 目标导向与长程规划
- REVERIE — Qi et al., REVERIE: Remote Embodied Visual Referring Expression in Real Indoor Environments, CVPR 2020. [Paper]
- REVERIE-CE — 连续环境移植设定的统称,尚无统一官方协议;引用时以具体论文的转换实现为准,参见第 6.3.2 节。
- SOON — Zhu et al., SOON: Scenario Oriented Object Navigation with Graph-based Exploration, CVPR 2021. [Paper]
- LHPR-VLN — Song et al., Towards Long-Horizon Vision-Language Navigation: Platform, Benchmark and Method, CVPR 2025. [Paper]
10.1.3 对话式与社交感知
- CVDN — Thomason et al., Vision-and-Dialog Navigation, CoRL 2019. [Paper]
- TEACh — Padmakumar et al., TEACh: Task-driven Embodied Agents that Chat, AAAI 2022. [Paper]
- HA-VLN — Li et al., Human-Aware Vision-and-Language Navigation: Bridging Simulation to Reality with Dynamic Human Interactions, NeurIPS 2024 Datasets and Benchmarks Track. [Paper]
- HA-VLN 2.0 — Dong et al., HA-VLN 2.0: An Open Benchmark and Leaderboard for Human-Aware Navigation in Discrete and Continuous Environments, IROS 2026(arXiv 首发 2025;核对 v5). [Paper]
10.1.4 需求导向、街景与空中
- DDN — Wang et al., Find What You Want: Learning Demand-conditioned Object Attribute Space for Demand-driven Navigation, NeurIPS 2023. [Paper]
- Touchdown — Chen et al., Touchdown: Natural Language Navigation and Spatial Reasoning in Visual Street Environments, CVPR 2019. [Paper]
- StreetLearn — Mirowski et al., The StreetLearn Environment and Dataset, arXiv 2019. [Paper]
- AerialVLN — Liu et al., AerialVLN: Vision-and-Language Navigation for UAVs, ICCV 2023. [Paper]
- CityNav — Lee et al., CityNav: A Large-Scale Dataset for Real-World Aerial Navigation, ICCV 2025(arXiv 2024). [Paper]
- OpenFly — Gao et al., OpenFly: A Comprehensive Platform for Aerial Vision-Language Navigation, ICLR 2026(arXiv 首发 2025;核对 v7). [Paper]
10.2 核心模型与方法
10.2.1 跨模态对齐与预训练
- PREVALENT — Hao et al., Towards Learning a Generic Agent for Vision-and-Language Navigation via Pre-training, CVPR 2020. [Paper]
- VLN-BERT — Majumdar et al., Improving Vision-and-Language Navigation with Image-Text Pairs from the Web, ECCV 2020. [Paper]
- Recurrent VLN-BERT — Hong et al., A Recurrent Vision-and-Language BERT for Navigation, CVPR 2021. [Paper]
- HAMT — Chen et al., History Aware Multimodal Transformer for Vision-and-Language Navigation, NeurIPS 2021. [Paper]
10.2.2 拓扑图与空间记忆
- DUET — Chen et al., Think Global, Act Local: Dual-scale Graph Transformer for Vision-and-Language Navigation, CVPR 2022. [Paper]
- ETPNav — An et al., ETPNav: Evolving Topological Planning for Vision-Language Navigation in Continuous Environments, IEEE TPAMI 2024. [Paper]
- LagMemo — Zhou et al., LagMemo: Language 3D Gaussian Splatting Memory for Multi-modal Open-vocabulary Multi-goal Visual Navigation, arXiv 2025. [Paper]
10.2.3 快慢双系统
- DualVLN — Wei et al., Ground Slow, Move Fast: A Dual-System Foundation Model for Generalizable Vision-and-Language Navigation, arXiv 2025. [Paper]
- NaVILA — Cheng et al., NaVILA: Legged Robot Vision-Language-Action Model for Navigation, RSS 2025. [Paper]
- NavDP — Cai et al., NavDP: Learning Sim-to-Real Navigation Diffusion Policy with Privileged Information Guidance, arXiv 2025. [Paper]
- InternVLA-N1 — InternRobotics(上海人工智能实验室),InternVLA-N1: An Open Dual-System Vision-Language Navigation Foundation Model with Learned Latent Plans, 2025. [Code]
- OmniNav — Xue et al., OmniNav: A Unified Framework for Prospective Exploration and Visual-Language Navigation, arXiv 2025. [Paper]
- Qwen-RobotNav — Zhang et al., Qwen-RobotNav Technical Report: A Scalable Navigation Model Designed for an Agentic Navigation System, arXiv 2026. [Paper]
10.2.4 视频 VLM 与连续策略
- Waypoint Models — Krantz et al., Waypoint Models for Instruction-guided Navigation in Continuous Environments, ICCV 2021. [Paper]
- NaVid — Zhang et al., NaVid: Video-based VLM Plans the Next Step for Vision-and-Language Navigation, RSS 2024. [Paper]
- StreamVLN — Wei et al., StreamVLN: Streaming Vision-and-Language Navigation via SlowFast Context Modeling, ICRA 2026(arXiv 首发 2025;核对 v2). [Paper]
10.2.5 底层视觉导航策略
- DD-PPO — Wijmans et al., DD-PPO: Learning Near-Perfect PointGoal Navigators from 2.5 Billion Frames, ICLR 2020. [Paper]
- GNM — Shah et al., GNM: A General Navigation Model to Drive Any Robot, ICRA 2023. [Paper]
- ViNT — Shah et al., ViNT: A Foundation Model for Visual Navigation, CoRL 2023. [Paper]
- NoMaD — Sridhar et al., NoMaD: Goal Masked Diffusion Policies for Navigation and Exploration, ICRA 2024. [Paper]
- ViPlanner — Roth et al., ViPlanner: Visual Semantic Imperative Learning for Local Navigation, ICRA 2024. [Paper]
10.2.6 世界模型
- Navigation World Models (NWM) — Bar et al., Navigation World Models, CVPR 2025. [Paper] [Project]
- Dynam3D — Wang et al., Dynam3D: Dynamic Layered 3D Tokens Empower VLM for Vision-and-Language Navigation, NeurIPS 2025. [Paper]
- WMNav — Nie et al., WMNav: Integrating Vision-Language Models into World Models for Object Goal Navigation, IROS 2025. [Paper] [Project]
- AstraNav-World — Chen et al., AstraNav-World: World Model for Foresight Control and Consistency, arXiv 2025. [Paper]
- NavWAM — Azuma et al., NavWAM: A Navigation World Action Model for Goal-Conditioned Visual Navigation, arXiv 2026. [Paper]
- DreamVLA — Zhang et al., DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge, NeurIPS 2025. [Paper] [Project]
- NVIDIA Cosmos — NVIDIA, Cosmos World Foundation Model Platform for Physical AI, arXiv 2025. [Paper] [Project]
10.2.7 Agent 与通用 VLA
- AgentVLN — Xin et al., AgentVLN: Towards Agentic Vision-and-Language Navigation, arXiv 2026. [Paper] [Code]
- SE-VLN — Dong et al., SE-VLN: A Self-Evolving Vision-Language Navigation Framework Based on Multimodal Large Language Models, arXiv 2025. [Paper]
- RT-2 — Brohan et al., RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, CoRL 2023. [Paper]
- OpenVLA — Kim et al., OpenVLA: An Open-Source Vision-Language-Action Model, CoRL 2024. [Paper]
10.3 模拟器与场景资产
- Matterport3D Simulator — Anderson et al., CVPR 2018(随 R2R 发布). [GitHub]
- Habitat — Savva et al., Habitat: A Platform for Embodied AI Research, ICCV 2019 [Paper];Szot et al., Habitat 2.0: Training Home Assistants to Rearrange their Habitat, NeurIPS 2021 [Paper];Puig et al., Habitat 3.0: A Co-Habitat for Humans, Avatars and Robots, ICLR 2024 [Paper]. [GitHub]
- AI2-THOR / ProcTHOR — Kolve et al., AI2-THOR: An Interactive 3D Environment for Visual AI, arXiv 2017 [Paper];Deitke et al., ProcTHOR: Large-Scale Embodied AI Using Procedural Generation, NeurIPS 2022 [Paper]. [Website]
- Gibson / iGibson / OmniGibson — Xia et al., Gibson Env: Real-World Perception for Embodied Agents, CVPR 2018 [Paper];Li et al., iGibson 2.0: Object-Centric Simulation for Robot Learning of Everyday Household Tasks, CoRL 2021 [Paper];Li et al., BEHAVIOR-1K, CoRL 2022(arXiv 2024 扩展版)[Paper]. [GitHub]
- AirSim — Shah et al., AirSim: High-Fidelity Visual and Physical Simulation for Autonomous Vehicles, FSR 2017. [GitHub](维护与兼容性以仓库说明为准)/ [Colosseum]
- Isaac Sim / Isaac Lab — NVIDIA;Mittal et al., Orbit: A Unified Simulation Framework for Interactive Robot Learning Environments(Isaac Lab 前身), IEEE RA-L 2023 [Paper]. [Docs]
- MuJoCo / MJX — Todorov et al., MuJoCo: A Physics Engine for Model-based Control, IROS 2012;Google DeepMind 维护. [GitHub] / [Docs]
- InternUtopia (GRUtopia) — Wang et al., GRUtopia: Dream General Robots in a City at Scale, arXiv 2024. [Paper] [GitHub]
10.4 综述论文
- Gu et al., Vision-and-Language Navigation: A Survey of Tasks, Methods, and Future Directions, ACL 2022. [Paper]
- Zhang et al., Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models, arXiv 2024. [Paper] [GitHub]
10.5 强化学习与后训练
- DAgger — Ross et al., A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning, AISTATS 2011. [Paper]
- RCM — Wang et al., Reinforced Cross-Modal Matching and Self-Supervised Imitation Learning for Vision-Language Navigation, CVPR 2019. [Paper]
- EnvDrop — Tan et al., Learning to Navigate Unseen Environments: Back Translation with Environmental Dropout, NAACL 2019. [Paper]
- PPO — Schulman et al., Proximal Policy Optimization Algorithms, arXiv 2017. [Paper]
- GRPO / DeepSeekMath — Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, arXiv 2024. [Paper]
- nDTW / SDTW — Ilharco et al., General Evaluation for Instruction Conditioned Navigation using Dynamic Time Warping, NeurIPS ViGIL Workshop 2019. [Paper]
- VLN-R1 — Vision-Language Navigation via Reinforcement Fine-Tuning, arXiv 2025(核查 v1). [Paper]
- ActiveVLN — Towards Active Exploration via Multi-Turn RL in Vision-and-Language Navigation, arXiv 2025(核查 v1). [Paper]
- ETP-R1 — Evolving Topological Planning with Reinforcement Fine-tuning for Vision-Language Navigation in Continuous Environments, arXiv 2025(核查 v1). [Paper]
- JOP-VLN — Joint On-and-Off Policy Learning for Vision-and-Language Navigation, arXiv 2026(核查 v1). [Paper]
- NavGRPO — Trajectory-Diversity-Driven Robust Vision-and-Language Navigation, arXiv 2026(核查 v1). [Paper]
- GroundingVLN / GEAR — Reasoning and Acting with Grounding for Vision-Language Navigation, arXiv 2026(核查 v3). [Paper]