- 目标导航性能排行榜
- 目标导航论文精读
- 相关策略、世界模型与评测
- 14. NAVCON (2024)
- 15. LoGoPlanner (2025)
- 16. Skill-Nav (2025)
- 17. FantasyVLN (2026)
- 18. SparseVideoNav (2026)
- 19. WorldVLN (2026)
- 20. CONDVLN (2026)
- 21. Qwen-Drive (2026)
- 22. LookStep (2026)
- 23. OccPlanner (2026)
- 24. EgoPathBench (2026)
- 25. VLingNav (2026)
- 26. X-NavDP (2026)
- 参考资料
- 已迁移的 Agentic 导航精读
本篇收录 26 篇目标导航及支撑研究。目标导航给定物体类别、描述、图像或坐标,要求机器人寻找并到达目标;下文先列目标导航方法,再单列相关策略、世界模型与评测工作。
工具调用、主动交互、持久空间记忆与持续决策系统已独立整理为 Agentic 导航篇;指令跟随方法见指令跟随篇。交叉工作的精读按研究重点分篇,目标导航排行榜仍在本页统一维护,并链接至对应论文所在篇目。
目标导航性能排行榜
⚠️ 不同基准不可直接混比:目标导航只给目标(物体类别、目标图像或坐标),不给路线描述,与主篇的指令跟随 VLN 是两类任务,指令跟随的排行榜见主篇 性能排行榜。本篇按目标形式分表,编号接主篇指令跟随的 ①–③:④ 封闭类别物体目标、⑤ 开放词汇物体目标、⑥ 图像目标、⑦ 点目标、⑧ 多模态目标与自建基准。表内再按基准分组,组间以粗线分隔,各组的场景、类别与成功判定不同(HM3D v1 与 v2 也不同),SR 只在组内比较;ObjectNav 类基准不定义 NE / OSR。
读表:「范式」列中,训练指在导航数据上训练或微调过模型;免训练指不训练任何导航模型,由现成的大模型、检测分割模型与规则 / 规划模块组合而成(调用现成的点目标低层控制器不影响归类)。闭源 API 角标标出推理时调用 GPT / Gemini / Claude 等闭源大模型 API 的方法,与范式是两回事:训练过的模型也可能在推理时调用(如 SuperNav-Learned),只在构造训练数据或离线预处理时用到大模型的不算(如 AECNav 用 DeepSeek 离线生成干扰类别);图视图中条的颜色按是否调用闭源 API 区分。灰色行是非标准口径(如只评测了验证集子集),不参与加粗;加粗为同一基准内非灰色行的最优值,只有一行的基准不加粗。筛选栏可按范式、推理方式、输入配置、是否开源筛选,也可以隐藏灰色行。
EvoLife 评测条件:EvoLife 的灰色行使用抽样任务和具有目标、路线特权信息的向导,属于辅助导航;不能与无向导、全量验证集成绩直接比较。GOAT-Bench 的 SR 列为子任务成功率 99.3%,完整序列成功率为 94%;LHPR-VLN 的 98% 是完整序列成功率,VL-LN / CoIN 则是交互实例导航。
④ 封闭类别物体目标 · ObjectNav(HM3D · MP3D · Gibson)
封闭类别物体导航:给出物体类别,在未见过的场景中找到任一实例并在其附近停下
| 模型 | 年份 | 基准 | 范式 | 基模 | SR ↑ | SPL ↑ | 开源 |
|---|---|---|---|---|---|---|---|
| EvoLife (四视角) 闭源 API 100 条子集、特权向导 | 2026 | HM3D-v2 | 免训练 | GPT-6 Astra (ultra) | 100 | 64.3 | – |
| SuperNav-Geo (四视角) 闭源 API 1 m,协议差异 | 2026 | HM3D-v2 | 免训练 | GPT-5.6 Terra (high) | 86.50 | 36.38 | – |
| SuperNav-Learned (四视角) 闭源 API 1 m,协议差异 | 2026 | HM3D-v2 | 训练 | GPT-5.6 Terra (high) | 85.40 | 13.83 | – |
| Hydra-Nav (单目) | 2026 | HM3D-v2 | 训练 | Qwen2.5-VL-7B | 84.8 | 41.1 | 否 |
| AECNav (单目) | 2026 | HM3D-v2 | 免训练 | DeepSeek-V4-Flash | 84.7 | 45.3 | 否 |
| VLingNav (单目) | 2026 | HM3D-v2 | 训练 | LLaVA-Video-7B | 83.0 | 40.5 | 否 |
| SysNav (单目) 闭源 API | 2026 | HM3D-v2 | 免训练 | Gemini-2.5-Flash | 80.8 | 37.2 | 是 |
| SuperNav-Geo (四视角) 闭源 API 0.2 m,协议差异 | 2026 | HM3D-v2 | 免训练 | GPT-5.6 Terra (high) | 80.30 | 33.38 | – |
| SuperNav-Learned (四视角) 闭源 API 0.2 m,协议差异 | 2026 | HM3D-v2 | 训练 | GPT-5.6 Terra (high) | 79.00 | 12.88 | – |
| LightNav-0 (单目) | 2026 | HM3D-v2 | 训练 | Qwen3-VL-4B | 77.2 | 41.5 | 是 |
| HarnessVLN (单目) 闭源 API | 2026 | HM3D-v2 | 免训练 | GPT-5.6-luna | 76.0 | 37.9 | 否 |
| Qwen-RobotNav (单目) | 2026 | HM3D-v2 | 训练 | Qwen3-VL-4B | 75.6 | 30.6 | 否 |
| NavGPT-3 (四视角 · Opus 5) 闭源 API 500 条子集,面向目标停止 | 2026 | HM3D-v2 | 训练 | Claude Opus 5 + Qwen3-VL-8B | 75.3 | 40.8 | 是 |
| 3DGSNav (单目) 闭源 API | 2026 | HM3D-v2 | 免训练 | Gemini 3 Pro + GLM-4.5V | 75.0 | 44.2 | 否 |
| Qwen-RobotNav (单目) | 2026 | HM3D-v2 | 训练 | Qwen3-VL-8B | 71.2 | 33.0 | 否 |
| EvoMemNav (单目) | 2026 | HM3D-v2 | 免训练 | Qwen-8B | 63.8 | 39.4 | 否 |
| 3DGSNav (单目) 闭源 API | 2026 | HM3D-v1 | 免训练 | Gemini 3 Pro + GLM-4.5V | 80.0 | 51.8 | 否 |
| VLingNav (单目) | 2026 | HM3D-v1 | 训练 | LLaVA-Video-7B | 79.1 | 42.9 | 否 |
| SysNav (单目) 闭源 API | 2026 | HM3D-v1 | 免训练 | Gemini-2.5-Flash | 63.7 | 30.5 | 是 |
| EvoMemNav (单目) | 2026 | HM3D-v1 | 免训练 | Qwen-8B | 59.2 | 33.6 | 否 |
| VLFM (单目) | 2023 | HM3D-v1 | 免训练 | – | 52.5 | 30.4 | 是 |
| PanoNav (全景) 200 条子集 | 2025 | HM3D(未注明版本) | 免训练 | Qwen2.5-VL + DeepSeek-V3 | 43.5 | 23.7 | 否 |
| Hydra-Nav (单目) | 2026 | MP3D | 训练 | Qwen2.5-VL-7B | 64.0 | 29.6 | 否 |
| NavGPT-3 (四视角 · Opus 5) 闭源 API 500 条子集,面向目标停止 | 2026 | MP3D | 训练 | Claude Opus 5 + Qwen3-VL-8B | 59.2 | 25.2 | 是 |
| VLingNav (单目) | 2026 | MP3D | 训练 | LLaVA-Video-7B | 58.9 | 26.5 | 否 |
| Qwen-RobotNav (单目) | 2026 | MP3D | 训练 | Qwen3-VL-4B | 52.2 | 16.0 | 否 |
| AECNav (单目) | 2026 | MP3D | 免训练 | DeepSeek-V4-Flash | 51.3 | 25.9 | 否 |
| SysNav (单目) 闭源 API | 2026 | MP3D | 免训练 | Gemini-2.5-Flash | 50.7 | 18.1 | 是 |
| Qwen-RobotNav (单目) | 2026 | MP3D | 训练 | Qwen3-VL-8B | 48.8 | 17.7 | 否 |
| 3DGSNav (单目) 闭源 API | 2026 | MP3D | 免训练 | Gemini 3 Pro + GLM-4.5V | 43.6 | 21.3 | 否 |
| VLFM (单目) | 2023 | MP3D | 免训练 | – | 36.4 | 17.5 | 是 |
| VLFM (单目) | 2023 | Gibson | 免训练 | – | 84.0 | 52.2 | 是 |
注:HM3D-v1 为 Habitat 2022 挑战赛的 val(2000 条 / 20 场景 / 6 类),HM3D-v2 为 2023 挑战赛的 val(1000 条 / 36 场景 / 6 类),两者场景与标注不同。VLFM 原文只写 HM3D,但给出的 2000 条 / 20 场景 / 6 类与 v1 一致;Hydra-Nav 原文也未写版本,但其 Table 2 的基线 WMNav 取 72.2,与 WMNav 原文的 HM3D-v2 成绩一致,据此归入 v2;PanoNav 原文未写明版本,单列一组。PanoNav 只从 HM3D val 随机抽取 200 条评测,列为灰色。Hydra-Nav 取原文 Table 2 的 IRFT(Stage 3)结果。Qwen-RobotNav 取 arXiv v3,4B / 8B 两个尺寸分列;LightNav-0 取 arXiv v2 数字(v1 的 HM3D-v2 为 79.5 / 43.7)。
补充:SuperNav-Geo 使用深度与导航几何执行移动,按免训练归类;SuperNav-Learned 的底层运动策略用导航专家轨迹训练,按训练归类,两者的上层 MLLM 均不做导航专用微调。其 HM3D-v2 两个成功阈值分别列行;论文说明外部方法的预算、STOP 规则与执行资源存在差异,因此这些行以灰色保留,不参与最优值加粗。SuperNav 的 SPL 已从原文的 0–1 数值换算为本表使用的百分数,开源列“–”表示摘要未提供可核实的代码仓库链接。
补充:NavGPT-3 使用 Claude Opus 5 Planner + 8B VLA,MP3D 与 HM3D-v2 各评测 500 条验证子集,成功还要求停止时面向目标,因此灰显且不参与加粗。附录表 16 在完全相同的子集与协议下重评 Qwen-RobotNav 8B,其 MP3D SR/SPL 为 47.8/17.5、HM3D-v2 为 72.4/33.1;表内 Qwen-RobotNav 的历史行仍为原论文全量结果,不能直接当作这个匹配对照。完整系统尚无对应的 ObjectNav 全量结果。
⑤ 开放词汇物体目标 · HM3D-OVON
开放词汇物体导航;除注明外均为 val-unseen,标 † 的行原文未写明划分
| 模型 | 年份 | 范式 | 基模 | SR ↑ | SPL ↑ | 开源 |
|---|---|---|---|---|---|---|
| EvoLife (四视角) 闭源 API 100 条子集、特权向导 | 2026 | 免训练 | GPT-6 Astra (ultra) | 100 | 71.4 | – |
| SuperNav-Geo-Astra (四视角) 闭源 API 120 条子集,1 m | 2026 | 免训练 | GPT-6 Astra (medium) | 79.17 | 49.74 | – |
| SuperNav-Geo (四视角) 闭源 API 120 条子集,1 m | 2026 | 免训练 | GPT-5.6 Terra (high) | 73.33 | 41.05 | – |
| SuperNav-Geo-Astra (四视角) 闭源 API 120 条子集,0.25 m | 2026 | 免训练 | GPT-6 Astra (medium) | 71.67 | 45.79 | – |
| SuperNav-Learned (四视角) 闭源 API 120 条子集,1 m | 2026 | 训练 | GPT-5.6 Terra (high) | 70.83 | 14.43 | – |
| SuperNav-Geo (四视角) 闭源 API 120 条子集,0.25 m | 2026 | 免训练 | GPT-5.6 Terra (high) | 68.33 | 38.37 | – |
| Hydra-Nav (单目) | 2026 | 训练 | Qwen2.5-VL-7B | 66.3 | 37.4 | 否 |
| SuperNav-Learned (四视角) 闭源 API 120 条子集,0.25 m | 2026 | 训练 | GPT-5.6 Terra (high) | 65.00 | 13.55 | – |
| HarnessVLN (单目) 闭源 API | 2026 | 免训练 | GPT-5.6-luna | 59.3 | 36.6 | 否 |
| OmniNav (多目) | 2026 | 训练 | Qwen2.5-VL-3B | 59.2 | 33.2 | 是 |
| AECNav (单目) | 2026 | 免训练 | DeepSeek-V4-Flash | 57.3 | 30.5 | 否 |
| SysNav (单目) 闭源 API† | 2026 | 免训练 | Gemini-2.5-Flash | 54.9 | 26.1 | 是 |
| Qwen-RobotNav (单目) | 2026 | 训练 | Qwen3-VL-4B | 53.1 | 20.9 | 否 |
| Qwen-RobotNav (单目) | 2026 | 训练 | Qwen3-VL-8B | 51.2 | 24.0 | 否 |
| VLingNav (单目) | 2026 | 训练 | LLaVA-Video-7B | 50.1 | 24.6 | 否 |
| LightNav-0 (单目) | 2026 | 训练 | Qwen3-VL-4B | 47.0 | 24.2 | 是 |
| AstraNav-World (多目)† | 2025 | 训练 | Qwen2.5-VL-3B | 45.7 | 28.7 | 是 |
| NavFoM (多目) | 2025 | 训练 | Qwen2-7B | 45.2 | 31.9 | 否 |
| JanusVLN (单目)† | 2026 | 训练 | Janus-Pro-7B | 44.9 | 31.7 | 是 |
| LocalNav-Claude (单目) 闭源 API | 2026 | 免训练 | Claude Sonnet 4.6 | 39.7 | 19.7 | 否 |
| LocalNav-Qwen (单目) | 2026 | 训练 | Qwen3.5-4B | 34.5 | 17.2 | 否 |
注:† SysNav、AstraNav-World 与 JanusVLN 原文只给出一列 HM3D-OVON 结果,未写明划分;NavFoM 为四视角设定(单视角为 43.6 / 31.3);OmniNav 为启用慢思考系统的 OmniNav*。LocalNav-Claude 是直接用 Claude Sonnet 4.6 做决策的免训练版本,LocalNav-Qwen 是用 Claude 轨迹做 SFT 蒸馏的 Qwen3.5-4B。
补充:SuperNav 使用 120 条 val-unseen 子集,分别报告 0.25 m 与 1 m 阈值,均列为灰色行;评测不额外要求 Habitat STOP,各配置中两项指定的不可达目标任务按采用的规则贡献 SR 与 SPL 为 1。SuperNav-Geo-Astra 为相同几何后端与完整框架上的 GPT-6 Astra(medium)配置,其余 SuperNav 行使用 GPT-5.6 Terra(high);模型与推理设置同时变化。
⑥ 图像目标 · HM3D-IIN / Image-Goal
以一张图像给出目标:HM3D-IIN 为实例图像导航(给出目标物体的照片,找到同一个实例),Image-Goal 给出在目标位置拍摄的图像
| 模型 | 年份 | 基准 | 范式 | 基模 | SR ↑ | SPL ↑ | 开源 |
|---|---|---|---|---|---|---|---|
| GaussNav (单目) | 2025 | HM3D-IIN | 训练 | – | 72.5 | 57.8 | 是 |
| VLingNav (单目) | 2026 | HM3D-IIN | 训练 | LLaVA-Video-7B | 60.8 | 37.4 | 否 |
| WAM-Nav (单目) | 2026 | Clutter/Intern (Image-Goal) | 训练 | – | 50.2 | 48.2 | 否 |
| NavDP (单目) | 2025 | Clutter/Intern (Image-Goal) | 训练 | – | 43.4 | 41.4 | 是 |
注:Clutter/Intern 为 ClutterScenes(Easy / Hard)与 InternScenes(Home / Commercial)四组场景的平均;WAM-Nav 与 NavDP 均为端到端扩散 / 世界模型策略,高频输出轨迹。NavDP 的行取自 WAM-Nav 原文(arXiv v2)Table 3 的基线复现,NavDP 原文未报告该基准。
⑦ 点目标 · Point-Goal
以相对起点的坐标给出目标,不涉及语义识别,主要考察避障与局部路径规划
| 模型 | 年份 | 基准 | 范式 | 基模 | SR ↑ | SPL ↑ | 开源 |
|---|---|---|---|---|---|---|---|
| WAM-Nav (单目) | 2026 | Clutter/Intern (Point-Goal) | 训练 | – | 80.4 | 78.0 | 否 |
| NavDP (单目) | 2025 | Clutter/Intern (Point-Goal) | 训练 | – | 77.8 | 74.8 | 是 |
注:Clutter/Intern 的场景构成与 NavDP 行的来源同表 ⑥。只有一篇论文报告的点目标基准(IsaacLab 40-Scenes、ABotN-PointBench)列在表 ⑧。
⑧ 多模态目标与自建基准
多模态长程目标(GOAT-Bench)、交互实例与连续多阶段任务,以及目前只有一篇论文报告的自建基准
| 模型 | 年份 | 基准 | 范式 | 基模 | SR ↑ | SPL ↑ | 开源 |
|---|---|---|---|---|---|---|---|
| EvoLife (四视角) 闭源 API 50 条序列、特权向导 | 2026 | GOAT-Bench | 免训练 | GPT-6 Astra (ultra) | 99.3 | 81.9 | – |
| HSGNav (单目) 闭源 API | 2026 | GOAT-Bench | 免训练 | GPT-4o | 71.2 | 50.3 | 否 |
| GSMem (单目) 闭源 API | 2025 | GOAT-Bench | 免训练 | GPT-4o | 67.2 | 46.9 | 否 |
| EvoMemNav (单目) | 2026 | GOAT-Bench | 免训练 | Qwen-8B | 59.6 | 38.9 | 否 |
| X-NavDP (单目) | 2026 | IsaacLab 40-Scenes (Point-Goal) | 训练 | – | 84.28 | 77.19 | 是 |
| ABot-N1 (三相机) | 2026 | ABotN-PointBench (Indoor) | 训练 | Qwen-3.5-4B + 2B | 95.4 | 93.7 | 否 |
| ABot-N1 (三相机) | 2026 | ABotN-PointBench (Outdoor) | 训练 | Qwen-3.5-4B + 2B | 92.9 | 91.4 | 否 |
| ABot-N1 (三相机) | 2026 | Short-Horizon OVON | 训练 | Qwen-3.5-4B + 2B | 84.9 | 51.8 | 否 |
| ABot-N1 (三相机) | 2026 | ABotN-POIBench | 训练 | Qwen-3.5-4B + 2B | 77.3 | 72.6 | 否 |
| VNT-PA (单目) | 2026 | HM3D (Point-Goal, 先验探索帧) | 训练 | – | 93.3 | 90.4 | 否 |
| SuperNav-Geo (四视角) 闭源 API | 2026 | InteriorGS (Single-Object) | 免训练 | GPT-5.6 Terra (high) | 78.00 | 41.27 | – |
| SuperNav-Learned (四视角) 闭源 API | 2026 | InteriorGS (Single-Object) | 训练 | GPT-5.6 Terra (high) | 68.00 | 20.59 | – |
| SuperNav-Geo (四视角) 闭源 API | 2026 | InteriorGS (Ordered Multi-Object) | 免训练 | GPT-5.6 Terra (high) | 34.00 | 13.88 | – |
| SuperNav-Learned (四视角) 闭源 API | 2026 | InteriorGS (Ordered Multi-Object) | 训练 | GPT-5.6 Terra (high) | 34.00 | 8.62 | – |
| SuperNav-Geo (四视角) 闭源 API | 2026 | Demand-Bench (Ordered Navigation) | 免训练 | GPT-5.6 Terra (high) | 59.50 | 18.01 | – |
| SuperNav-Learned (四视角) 闭源 API | 2026 | Demand-Bench (Ordered Navigation) | 训练 | GPT-5.6 Terra (high) | 45.00 | 16.03 | – |
| EvoLife (四视角) 闭源 API 100 条子集、特权向导 | 2026 | VL-LN | 免训练 | GPT-6 Astra (ultra) | 99 | 76.2 | – |
| EvoLife (四视角) 闭源 API 100 条子集、特权向导 | 2026 | CoIN | 免训练 | GPT-6 Astra (ultra) | 100 | 73.5 | – |
| EvoLife (四视角) 闭源 API 50 条序列、特权向导 | 2026 | LHPR-VLN | 免训练 | GPT-6 Astra (ultra) | 98 | – | – |
注:GOAT-Bench 为 val-unseen,一个 episode 内依次给出类别、文字描述或图像形式的多个目标。IsaacLab 40-Scenes 为 X-NavDP 的点目标评测;ABotN-PointBench、Short-Horizon OVON 与 ABotN-POIBench 为 ABot-N1 的自建设定,PointBench 室内用零碰撞成功率(SR<1col),室外用三次碰撞内成功率(SR<3col),两者判定不同;POIBench 以到达入口 2 m 内为成功。HM3D (Point-Goal, 先验探索帧) 为 VNT-PA 的设定:规划器只读取一段先验探索轨迹的深度帧与位姿,不看当前视图,以停在目标 0.2 m 内为成功。仅有一行的基准不加粗;自建基准的结果不宜与其他表的数字比较。
SuperNav 的 InteriorGS (Single-Object) 与 InteriorGS (Ordered Multi-Object) 是 Habitat-GS 中各 150 项的自建实例导航任务;多目标包含 2–5 个目标,要求按序到达批准视点的可导航距离 1 m 内并显式 STOP。Demand-Bench (Ordered Navigation) 使用 200 项需求驱动任务的改编协议,要求按序进入相关物体水平包围盒的 2 m 范围、不重复使用物体并显式 STOP,没有额外可见性检查;其数字不能直接与 DemandAgent 原协议比较,也不代表完成搬运或整理活动。同组两行比较 SuperNav 的几何与学习式后端,底层几何资源不同。
目标导航论文精读
1. VLFM (2023)
——Vision-Language Frontier Maps for Zero-Shot Semantic Navigation
📄 Paper: arXiv:2312.03275 · 🏛️ ICRA 2024
研究背景/问题 零样本语义导航要求机器人在未见环境中高效定位目标对象,现有方法(如ESC、SemUtil)依赖物体检测器将视觉线索转化为文本后再用LLM/BERT进行语义推理,存在计算瓶颈且无法充分利用视觉-语言联合表征。如何直接从RGB观测中提取语义价值以指导前沿探索成为关键挑战。
主要方法/创新点
VLFM提出语言驱动的前沿价值图框架,实现端到端视觉-语义推理:
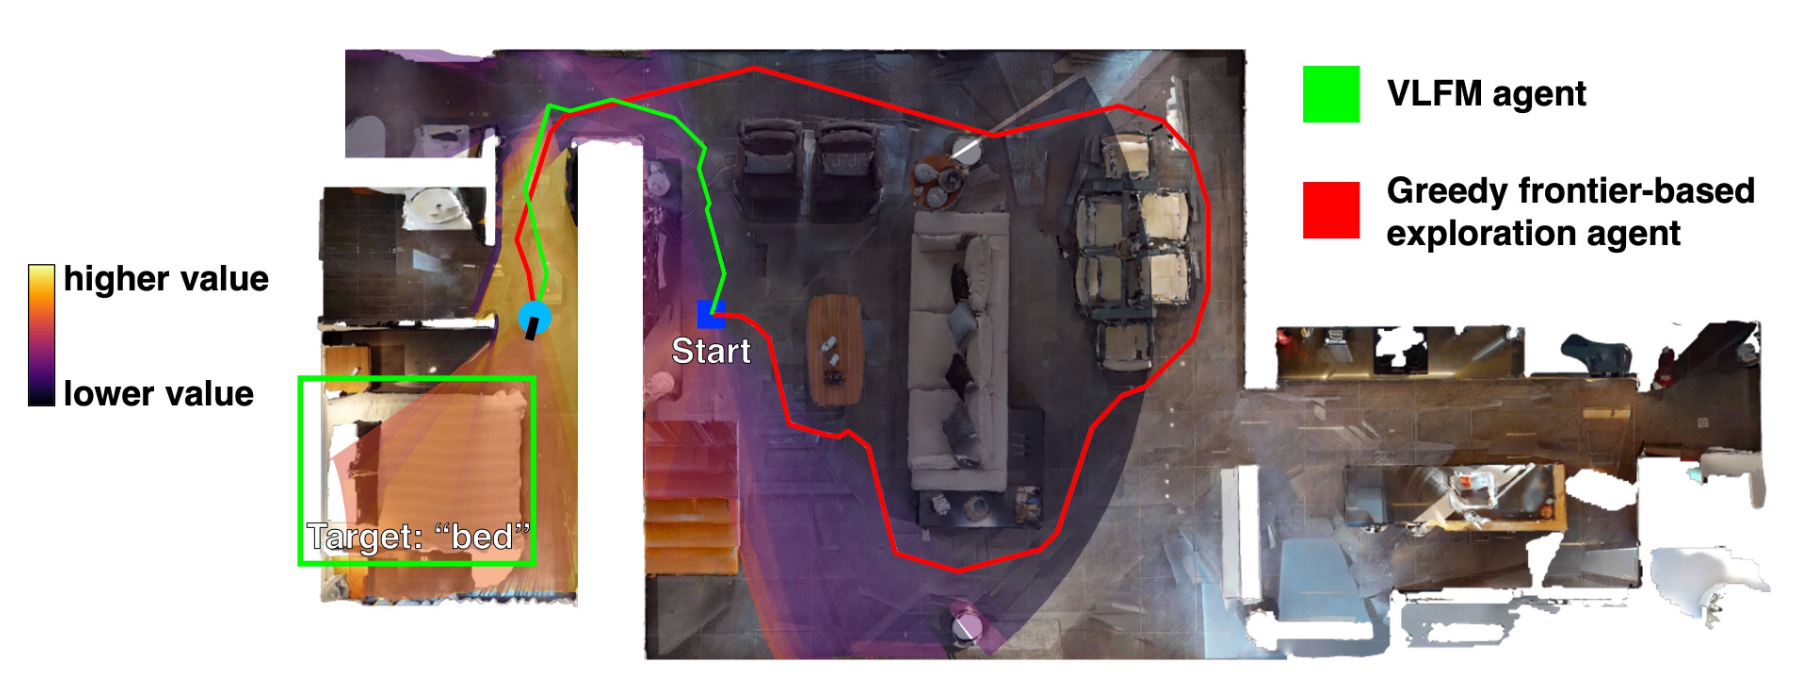
核心机制:
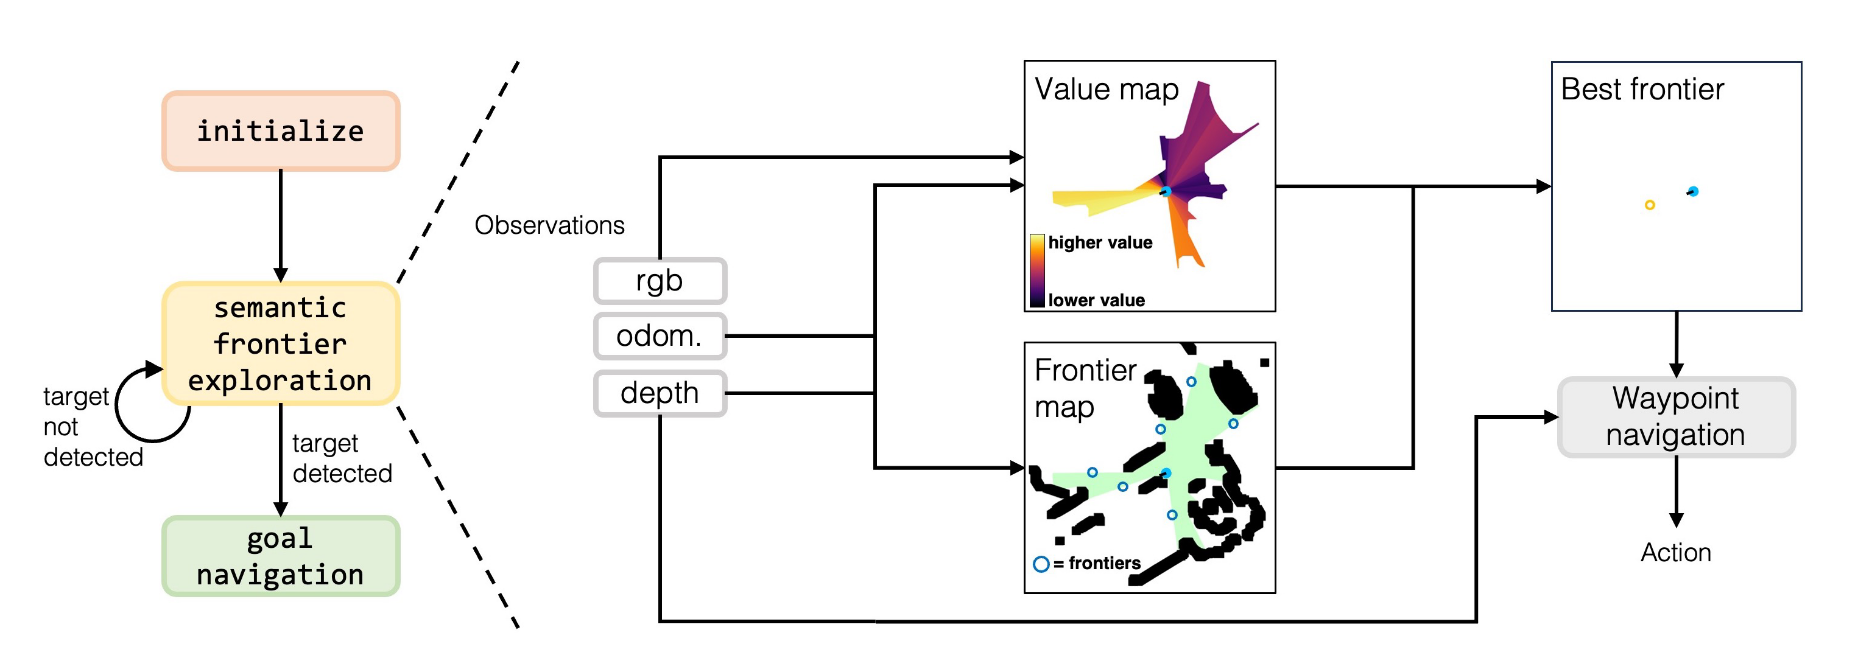
- 前沿航点生成(Frontier Waypoint Generation)
- 利用深度和里程计构建2D占用地图,识别已探索与未探索区域边界作为前沿候选点
- 每个前沿中点作为潜在导航航点
- 价值图生成(Value Map Generation)
- 使用预训练BLIP-2视觉-语言模型直接从RGB图像计算语义价值分数
- 文本提示:”Seems like there is a
ahead" - 输出余弦相似度分数并投影到俯视图价值图(双通道:语义分数+置信度分数)
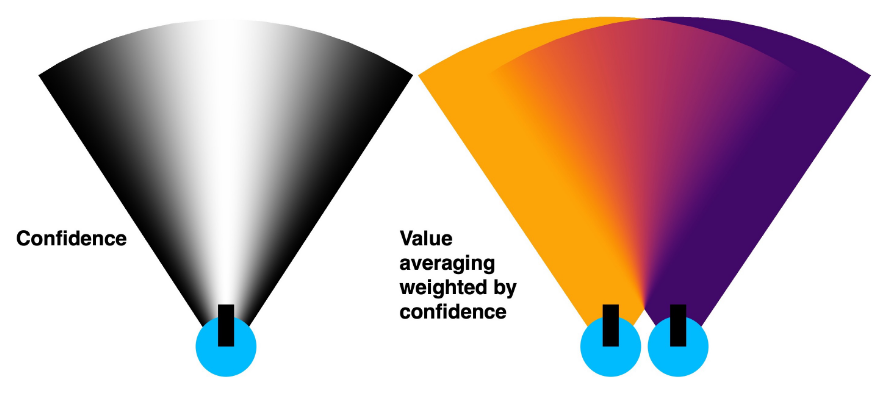
- 置信度加权更新(Confidence-Weighted Averaging)
- 置信度分数基于像素相对光轴位置:$c_{i,j} = \cos^2(\theta/(\theta_{fov}/2) \times \pi/2)$
- 重叠区域的语义值更新:$v_{i,j}^{new} = (c_{i,j}^{curr}v_{i,j}^{curr} + c_{i,j}^{prev}v_{i,j}^{prev})/(c_{i,j}^{curr} + c_{i,j}^{prev})$
- 置信度更新偏向高置信值:$c_{i,j}^{new} = ((c_{i,j}^{curr})^2 + (c_{i,j}^{prev})^2)/(c_{i,j}^{curr} + c_{i,j}^{prev})$
- 物体检测与导航
- YOLOv7用于COCO类别,Grounding-DINO用于开放词汇检测
- Mobile-SAM提取目标轮廓,确定最近点作为目标航点
- 使用VER训练的PointNav策略执行航点导航(纯几何理解,不依赖语义)
关键创新:
- 直接视觉-语义推理:绕过物体检测器,BLIP-2直接从RGB生成语义分数
- 空间化价值表征:将语义价值映射到俯视图网格,支持前沿选择
- 置信度驱动融合:动态平衡当前观测与历史信息
核心结果/发现
- 基准测试表现:在Gibson、HM3D、MP3D三个数据集上均达到SOTA零样本性能
- Gibson:SPL 52.2%、SR 84.0%(相比SemUtil提升+11.7% SPL、+14.7% SR)
- HM3D:SPL 30.4%、SR 52.5%(相比ESC提升+8.1% SPL、+13.3% SR)
- MP3D:SPL 17.5%、SR 36.4%(相比ESC提升+3.3% SPL、+7.7% SR)
- 超越部分有监督方法:在Gibson和MP3D数据集上优于SemExp、PONI等ObjectNav训练方法
- 消融实验:置信度加权平均(Weighted avg.)在所有数据集上均优于简单替换(Replacement)和无权平均(Unweighted avg.)
- 真实世界部署:成功在Boston Dynamics Spot机器人上部署,在办公楼环境中高效导航至未见目标对象,所有模型(BLIP-2、GroundingDINO、MobileSAM、ZoeDepth)实时运行于RTX 4090 MaxQ笔记本
局限性 仅支持单层楼导航(缺少z坐标里程计导致价值图重置困难),HM3D和MP3D中14.6%和9.6%的跨楼层任务失败;假定目标物体在默认相机高度可见,未来可探索主动相机控制、操作式搜索(如打开抽屉)及可复用的语义地图表征以支持长时程多任务规划。
2. NoMaD (2023)
——目标掩码扩散策略实现统一导航
📄 Paper: arXiv:2310.07896 · 🏛️ ICRA 2024
研究背景/问题
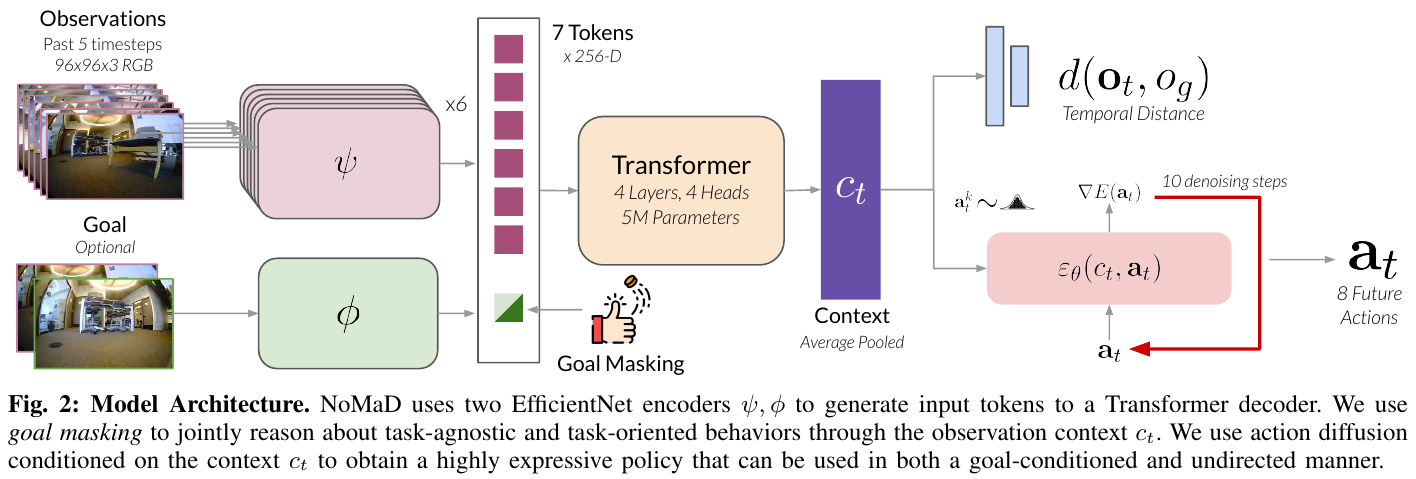
传统机器人导航系统通常为探索(exploration)和目标导航(goal-conditioned navigation)分别训练独立的策略模型,这不仅增加了系统复杂度,也限制了跨任务的知识共享和泛化能力。NoMaD(Nomadic Multi-task Agent with Diffusion,伯克利,ICRA2024 Best Paper)提出通过统一的扩散策略框架,使用目标掩码机制同时建模任务特定行为(目标导向)和任务无关行为(探索),实现单一策略胜任多种导航任务。
主要方法/创新点
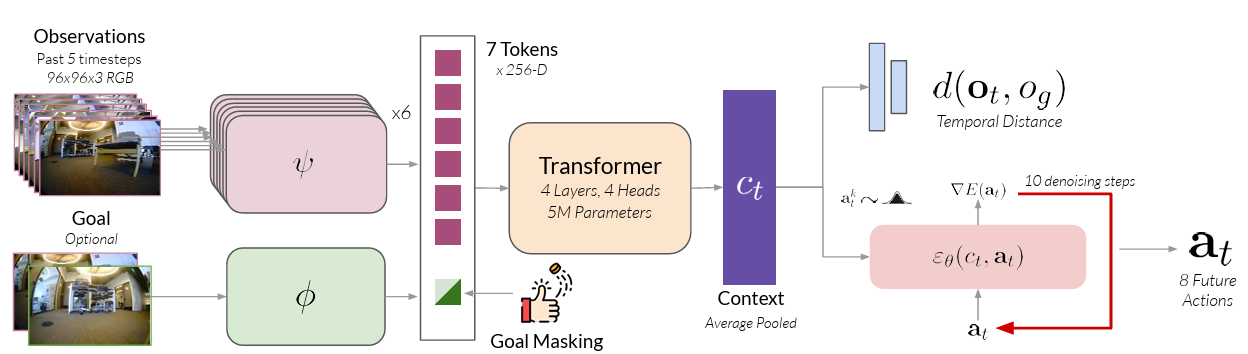
核心思路
通过统一的扩散策略,同时建模任务特定和任务无关行为
两个关键组件
目标掩码(Goal Masking)
- 通过二值掩码控制策略是否关注目标图像,实现任务条件的灵活切换
- 训练时:目标掩码以50%概率随机设置,使模型同时学习目标导向行为和探索行为
- 推理时:根据任务需要设置掩码(探索时掩盖目标,导航时提供目标)
扩散策略(Diffusion Policy)
- 利用扩散模型生成多模态、无碰撞的动作序列
- 从随机噪声逐步迭代生成预测动作序列
- 动作分布既可在无目标条件下表达探索行为,也可在提供目标条件下收敛到目标导向行为
统一框架设计
- 通过Transformer编码视觉观测并结合扩散模型生成未来动作序列
- 同时支持任务特定行为(目标导向)和任务无关行为(探索)
- 使用大规模多样化数据集(GNM和SACSoN)进行端到端监督训练
核心结果/发现
- 探索未知环境:成功率达到98%,平均碰撞数仅0.2,超过最优基线Subgoal Diffusion约25%,且参数量仅为其1/15
- 目标导航:在已知环境的目标导航任务中,成功率与最优基线相当,但计算资源需求更少
- 计算效率:比现有方法计算效率提升约15倍,是首个成功在物理机器人上部署的目标条件动作扩散模型
- 统一策略优势:联合训练能够学习共享表示和环境可操作性,单一策略即可胜任多种行为
- 编码器选择:ViNT编码器配合注意力目标掩码效果最佳,成功率98%,碰撞数最少
- 多场景验证:在6个复杂的室内外环境中表现优异
局限性
NoMaD的视觉编码器选择对性能影响较大,需要仔细调优以达到最佳效果。虽然ViT编码器具有更大的容量和表达能力,但其训练优化难度较高,收敛速度相对较慢。此外,目标掩码机制的随机采样比例(训练时50%)是一个关键超参数,在不同场景下可能需要针对性调整。尽管在多个室内外环境中表现优异,但在极端复杂、高度动态的场景(如密集人流、快速变化的障碍物)下的鲁棒性仍有进一步提升空间。
3. VL-Nav (2025)
——实时零样本 Vision-Language 导航系统,融合像素级视觉-语言特征与启发式空间推理
📄 Paper: arXiv:2502.00931 · 🏛️ IROS 2026
精华
这篇论文展示了如何将像素级 vision-language 特征与启发式探索策略结合,实现高效的零样本导航。值得借鉴的核心思想包括:(1) 使用 Gaussian 混合模型将像素级 VL 特征转换为空间分布,而非依赖单一图像级相似度分数;(2) 引入 instance-based target points 模拟人类搜索行为,允许机器人接近并验证潜在目标;(3) 通过 rolling occupancy grid 和 partial frontier detection 优化计算开销,使系统能在低功耗平台上实时运行;(4) 结合 distance weighting 和 unknown-area heuristic 避免反复移动,提升大规模环境中的导航效率;(5) 证明了模块化方法在真实世界中的泛化能力优于端到端学习方法。
研究背景/问题
当前的 vision-language navigation 系统面临三大挑战:难以解释像素级 vision-language 特征、在不同环境中泛化能力差、无法在低功耗平台上实时运行。现有方法如 VLFM 依赖计算密集型模型且仅使用单一图像级相似度分数进行目标选择,限制了其利用细粒度 vision-language 线索的能力。
主要方法/创新点
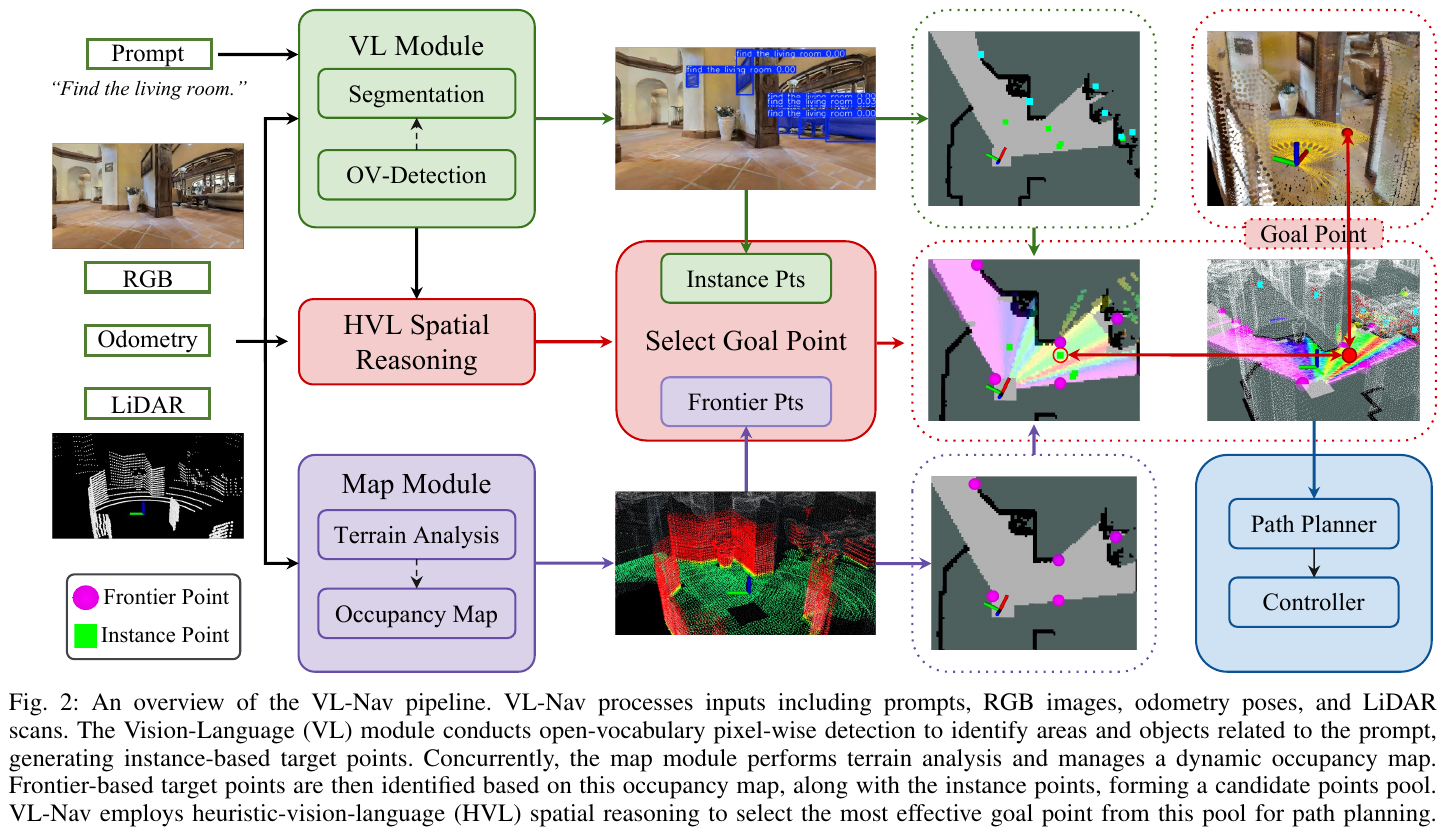
VL-Nav 提出了一个针对低功耗机器人优化的 vision-language navigation 框架,在 Jetson Orin NX 上实现 30 Hz 实时性能。核心创新在于 Heuristic-Vision-Language (HVL) 空间推理,将像素级 vision-language 特征与启发式探索策略相结合。
Rolling Occupancy Map:系统维护一个动态 2D 占用栅格地图,每个单元格标记为 free (0)、unknown (-1) 或 occupied (100)。与传统固定大小全局栅格不同,VL-Nav 采用 rolling grid,仅在新传感器数据需要时动态扩展,降低内存使用和 BFS/cluster 计算开销。更新过程包括:(1) 根据需要扩展地图;(2) 清除前向 FOV 内的过时障碍物;(3) 膨胀新障碍物;(4) 使用 raycasting 将 unknown cells 标记为 free。
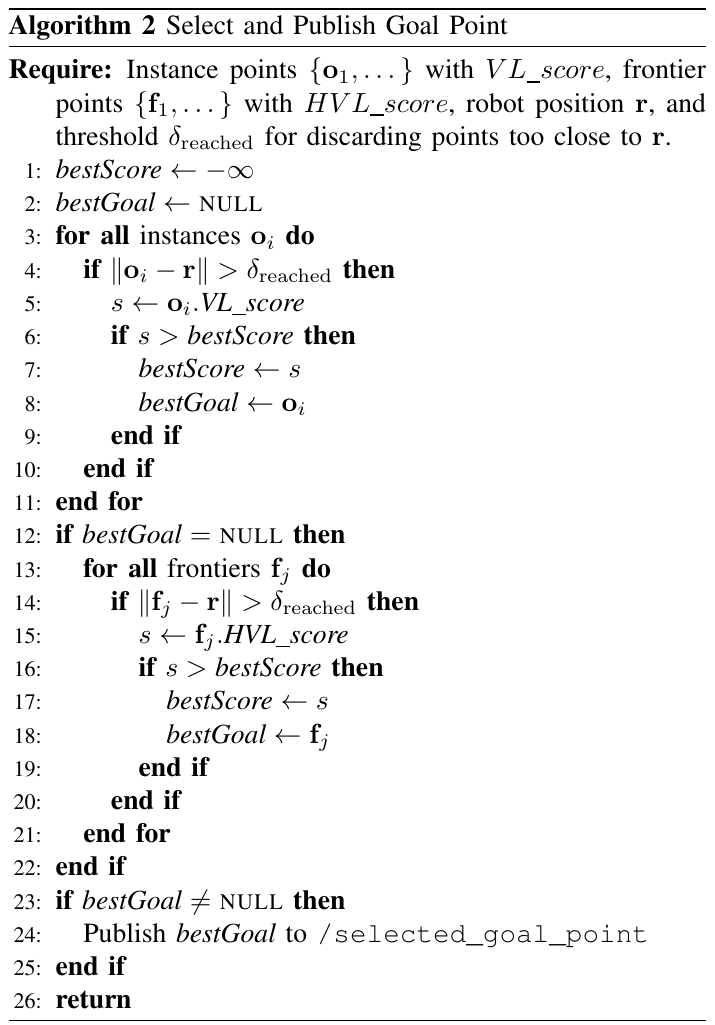
Frontier-based 与 Instance-based Target Points:系统生成两类候选目标点。Frontier-based points 通过 partial frontier detection 在前向楔形区域内识别,仅测试满足角度和距离约束的单元格,并使用 BFS 聚类。Instance-based target points (IBTP) 来自 vision-language 检测器周期性报告的候选实例中心,保留置信度高于阈值 τdet 的检测结果。IBTP 模拟人类搜索行为:看到可能匹配的目标时会靠近确认,而非忽略中间检测结果。
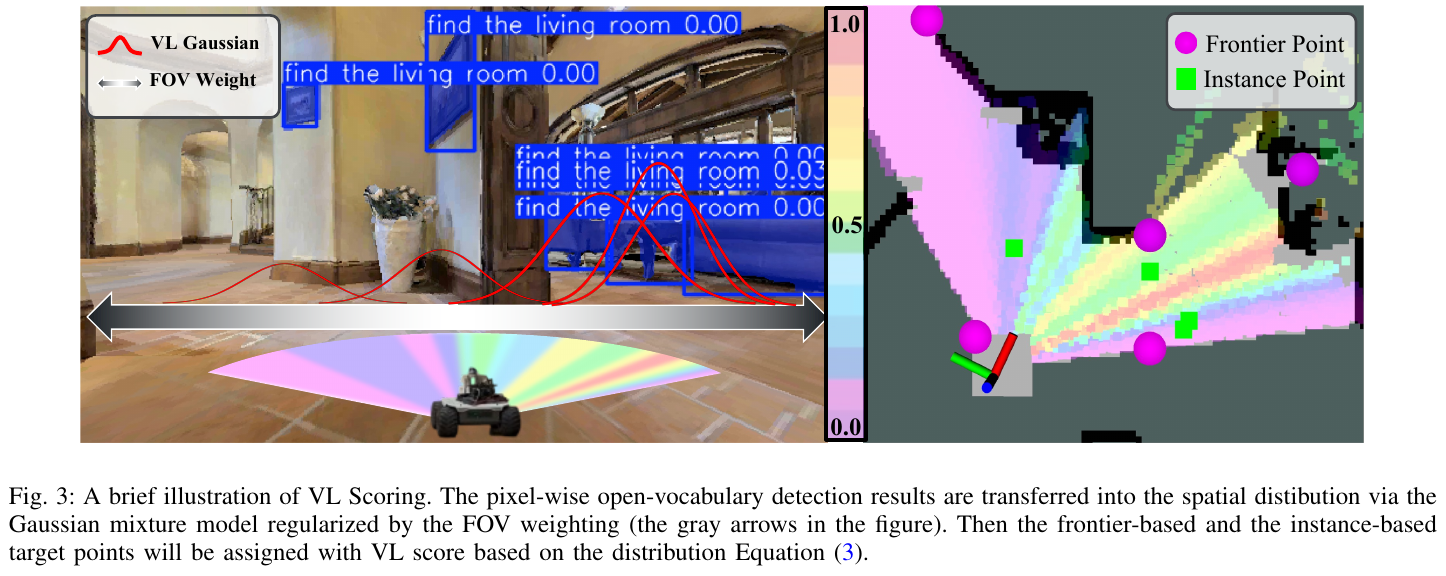
HVL 空间推理:这是 VL-Nav 的核心创新。对每个候选目标 g,系统计算 HVL score。VL Score 使用 Gaussian 混合模型将像素级 vision-language 特征转换为机器人水平 FOV 上的分布。假设开放词汇检测模型识别出 K 个可能方向,每个由 (μk, σk, αk) 参数化,其中 μk 表示 FOV 内的平均偏移角度,σk 编码检测的角度不确定性(固定为 0.1),αk 是基于置信度的权重。VL score 计算为:
S_VL(g) = Σ(k=1 to K) αk * exp(-1/2 * ((Δθ - μk)/σk)²) * C(Δθ)
其中 C(Δθ) = cos²(Δθ/(θ_fov/2) * π/2) 是视野置信度项,降低大角度偏移检测的权重。
Heuristic Cues 包括两个启发式项:(1) Distance Weighting: S_dist(g) = 1/(1+d(xr,g)),使较近目标获得更高分数,减少能量消耗和不必要的徘徊;(2) Unknown-Area Weighting: S_unknown(g) = 1 - exp(-k*ratio(g)),其中 ratio(g) 是局部 BFS 中 unknown cells 与可达 cells 的比率,鼓励探索可能揭示大量未知空间的目标。
最终 HVL score 为:S_HVL(g) = w_dist * S_dist(g) + w_VL * S_VL(g) * S_unknown(g)。系统优先选择 instance-based goals(基于 VL score),若无则选择得分最高的 frontier goal(基于 HVL score)。
Path Planning:选定 HVL goal 后,系统使用 FAR Planner 进行 point-goal 路径规划,以多边形表示障碍物并实时更新可见性图,支持部分未知环境中的高效重规划。局部规划器将 FAR Planner 的路径点细化为短时域速度命令,确保对新障碍物的快速反应。
核心结果/发现
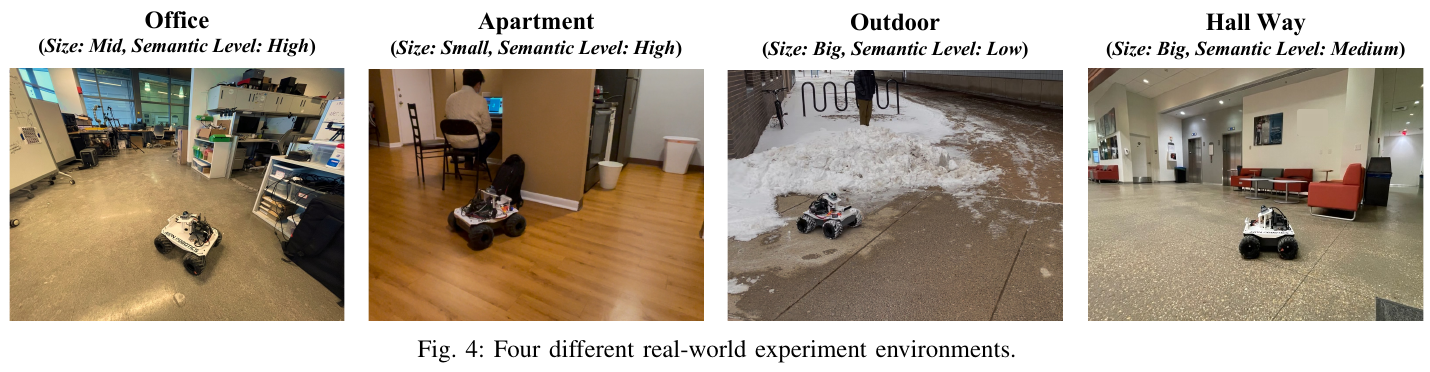
VL-Nav 在四个真实世界环境(Hallway、Office、Apartment、Outdoor)上进行了全面评估,每个环境具有不同的语义复杂度(High、Medium、Low)和规模(Big、Mid、Small)。主要发现包括:
- 整体性能:VL-Nav 达到 86.3% 的总体成功率 (SR),比先前方法提升 44.15%。在所有四个环境中,VL-Nav 的 SR 和 SPL(Success weighted by Path Length)均为最高。
- Instance-based Target Points 的影响:去除 IBTP 后性能显著下降,特别是在复杂环境(Apartment 和 Office)中,证明了允许机器人接近并验证潜在检测结果的重要性。
- Heuristics 的贡献:去除启发式项后 SR 和 SPL 均下降,特别是在大规模环境中,表明 distance weighting 和 unknown-area heuristic 对提升效率至关重要。
- 相比 VLFM:VL-Nav 在所有环境中均超越 VLFM,特别是在语义复杂(Apartment)和开放区域(Outdoor)环境中,优势更加明显,证明了像素级 VL 特征和 HVL 空间推理的有效性。
- 环境规模影响:经典 Frontier Exploration 在大规模环境中性能急剧下降(Big 环境中 SR 仅 36.7%),而 VL-Nav 保持鲁棒(82.3% SR),证明了其在各种规模环境中的适应能力。
- 语义复杂度影响:所有方法在语义更丰富的环境中表现更好,因为结构化室内空间提供了更强的检测和分割线索。VL-Nav 能够充分利用语义上下文,在高复杂度环境中获得更显著的优势。
- 实时性能:VL-Nav 在 Jetson Orin NX 上以 30 Hz 运行,通过选择高效的 YOLO-World 模型变体(256×320 输入,标准 GPU runtime)和 rolling occupancy grid 实现了真实世界部署的可行性。
局限性
系统在处理包含隐藏对象引用和特定文本注释的复杂语言描述时存在困难。此外,系统依赖于手动定义的阈值(如光照条件等),这些阈值可能无法在不同环境和场景中很好地泛化,需要进一步研究自适应或基于学习的阈值调整方法。
4. GaussNav (2025)
——Gaussian Splatting for Visual Navigation
📄 Paper: arXiv:2403.11625 · 🏛️ IEEE TPAMI 2025
研究背景/问题
Instance ImageGoal Navigation (IIN)要求智能体在未探索环境中定位并导航至目标图像所描绘的特定对象实例,需要跨视角识别目标对象同时忽略干扰物。现有基于BEV地图的导航方法缺乏详细纹理表示,难以胜任实例级任务,无法保留场景的实例感知特征,不足以区分同类别的多个对象。
主要方法/创新点
GaussNav首次将3D Gaussian Splatting(3DGS)引入具身视觉导航,提出语义高斯地图表示:
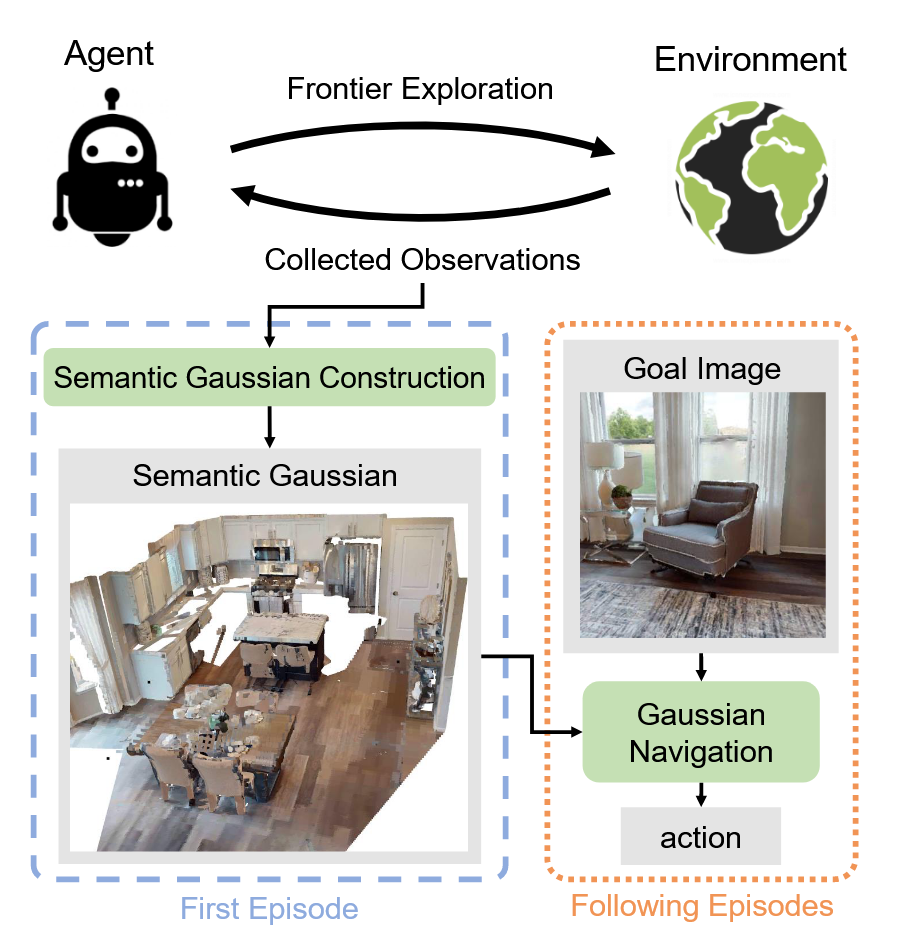
前沿探索(Frontier Exploration):
- 智能体同时维护探索地图和障碍地图,探索地图标记已探索区域,障碍地图标记场景中的障碍物
- 检测探索地图轮廓并排除障碍地图区域,将最近的前沿点设为路径点,迭代覆盖整个环境
语义高斯构建(Semantic Gaussian Construction):
几何重建:
- 3DGS简化表示:每个高斯由9个参数特征化:RGB颜色向量c、质心µ∈R³、半径r、不透明度o∈[0,1]、类别标签l
- 可微渲染:通过alpha合成渲染RGB、深度和轮廓图像,支持新视角合成(NVS)
- 关键帧检索机制:针对导航场景帧间重叠有限问题,存储历史帧并周期性渲染评估PSNR,优先优化低保真帧,采用两阶段优化(p1=30迭代新视点,p2=60迭代关键帧视点)
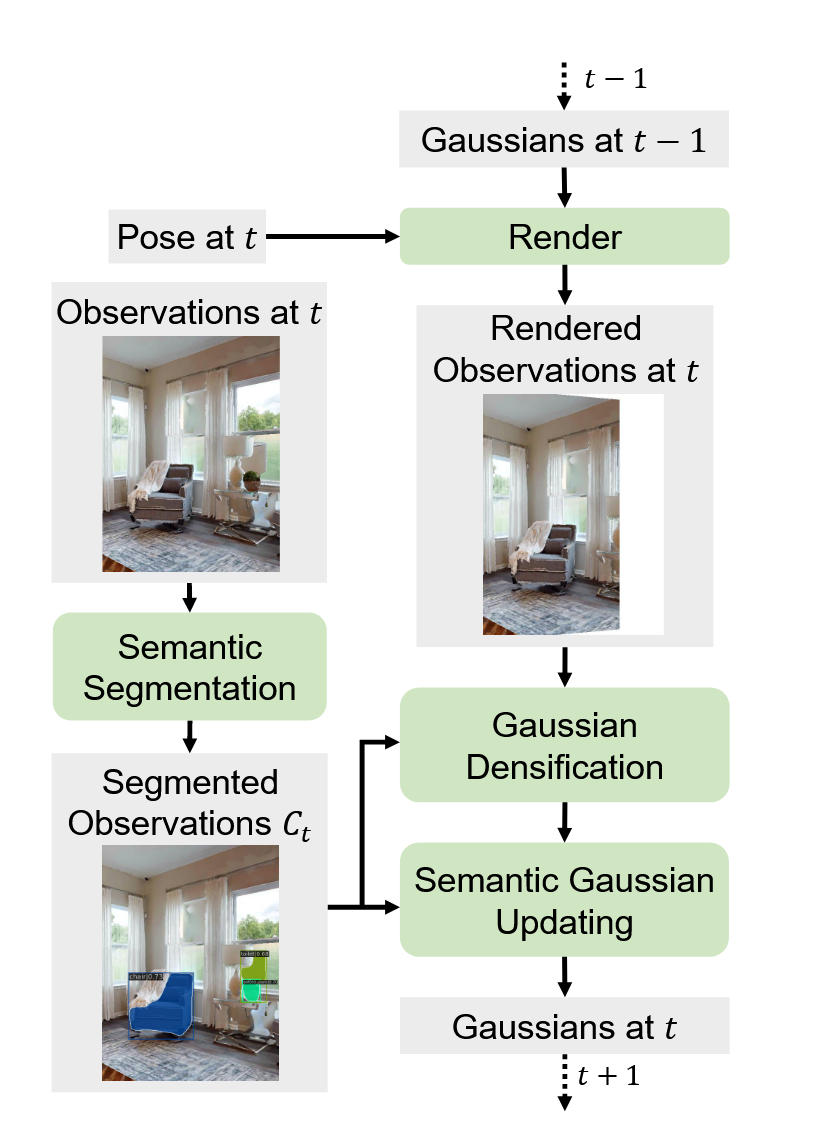
语义特征注入:
- 实例分割:使用Mask-RCNN为每个高斯分配语义标签
- 特征优化:通过特征splatting渲染逐像素语义特征,优化特征损失以鼓励实例内一致性和实例间可分性
- 高斯聚类:基于语义标签和3D位置聚类高斯,将场景中的对象分割为不同语义类别下的不同实例
高斯导航(Gaussian Navigation):
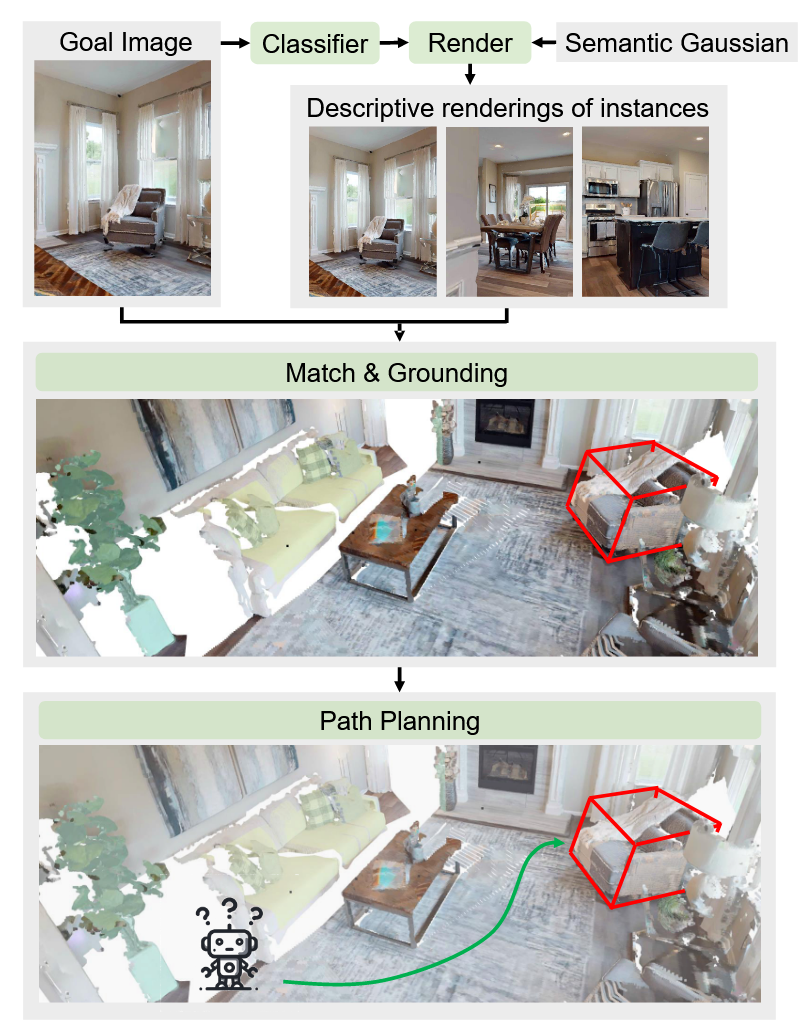
- 分类器:使用ResNet50对目标图像分类预测语义标签ˆlg,显著缩小搜索空间(如场景CrMo8WxCyVb从648个潜在观测减少到33个)
- 匹配与定位:
- 为每个候选实例通过NVS生成描述性图像(nv=1/3/5,θ=±15°/±30°水平和垂直旋转)
- 使用DISK提取关键点和特征描述符,通过LightGlue匹配,选择匹配关键点数最多的候选对象
- 使用DBSCAN聚类去除语义分割误差导致的离群点,精确定位目标实例
- 路径规划:将语义高斯转换为点云并体素化投影到2D BEV网格,使用FMM生成最短距离场并规划路径
创新要点:
- 统一几何、语义和实例感知特征的地图表示,首次将3DGS应用于具身视觉导航
- 通过渲染描述性图像直接定位目标对象,无需额外探索或验证步骤
- 关键帧检索机制有效缓解导航场景中的遗忘和表面空洞问题
核心结果/发现
- HM3D数据集性能:SPL从0.347大幅提升至0.578(提升66.6%),成功率达72.5%,显著超越所有基线方法
- 效率优势:运行帧率超过20 FPS,在模块化方法中效率最高,搜索空间优化显著(如CrMo8WxCyVb场景从648个观测点减少至33个)
- 消融实验验证:
- 移除分类器导致Success降至37.5%,SPL降至29.1%,但使用分类器后匹配时间减少2.5倍
- 移除匹配模块Success降至44.4%,SPL降至35.3%
- NVS对识别成功率有益,GT NVS可进一步提升性能(Success从72.3%升至74.7%)
- 使用GT匹配模块Success提升至85.0%,GT目标定位Success达94.6%
- 渲染质量分析:在HM3D验证集上PSNR最高可达40,深度渲染误差接近零,但部分高纹理场景重建质量欠佳
- 跨场景泛化:在36个验证场景中表现稳定,语义高斯可视化展示了对多种场景复杂度和对象组成的鲁棒性
局限性
当前方法在高纹理环境中重建质量欠佳,导致NVS可能产生孔洞等伪影。错误源分析显示匹配失败和目标定位不准确仍有改进空间。语义高斯不适合直接路径规划,需转换为2D BEV网格,增加了计算开销。
5. NavDP (2025)
——只用仿真数据训练,零样本迁移到真实机器人的导航扩散策略
📄 Paper: arXiv:2505.08712 · 🏛️ ICRA 2026 · Code
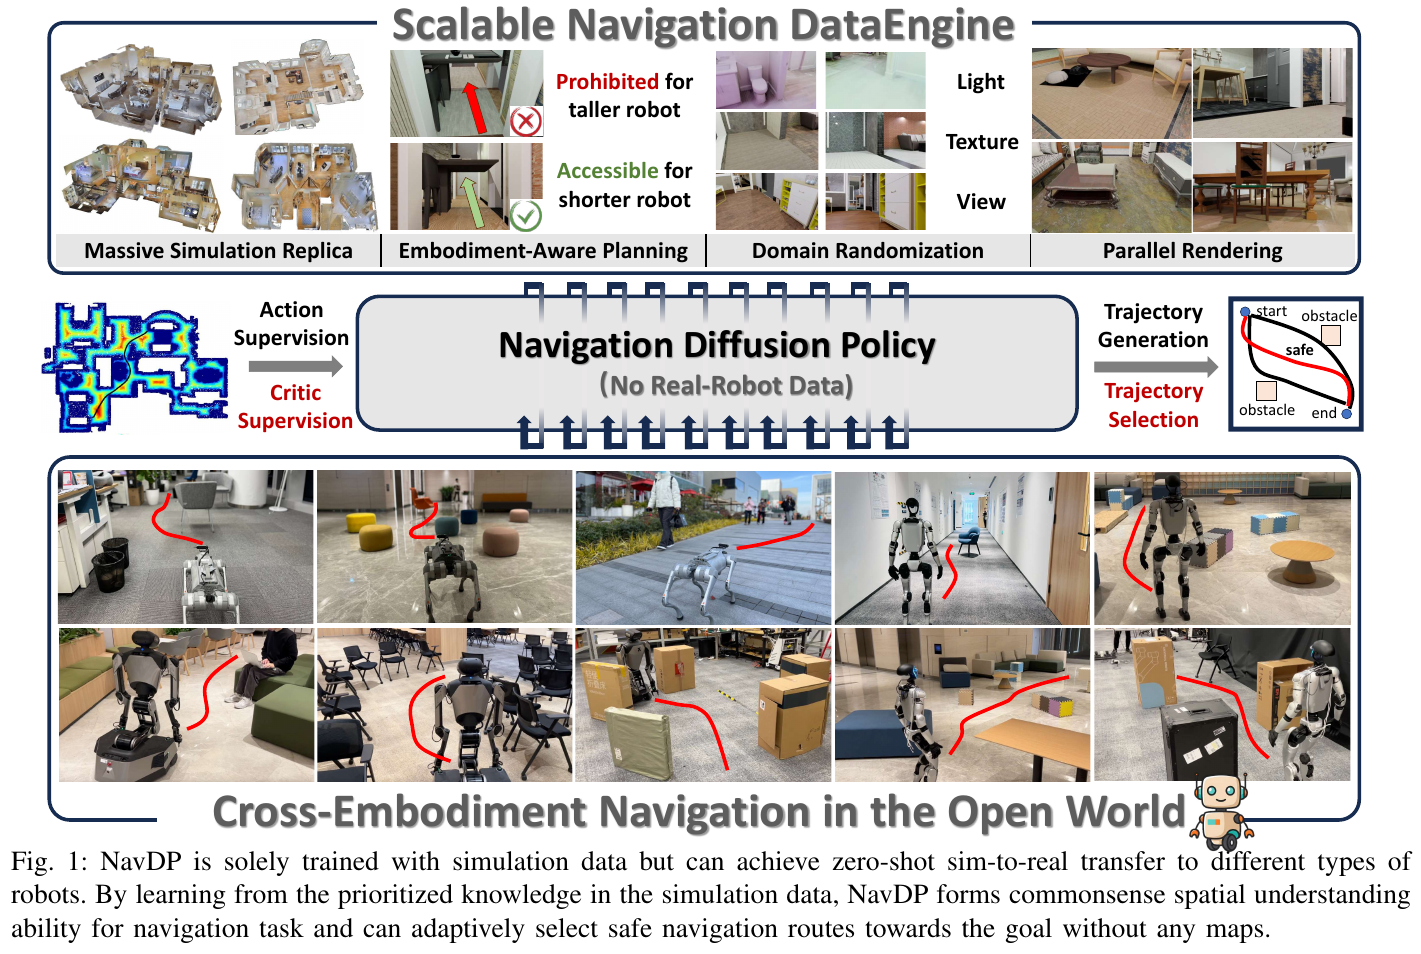
一句话概括:NavDP 用纯仿真数据训练一个端到端导航网络,靠”扩散模型生成多条候选轨迹 + Critic 打分选最安全的一条“这一组合,做到零样本 sim-to-real、并能直接换装到 TurtleBot / Unitree Go2 / G1 / Galaxea R1 等不同形态的机器人上,全程不需要地图、不需要任何真机训练数据。
研究背景/问题
机器人要在动态、非结构化的开放世界里导航,理想状态是”换个机器人、换个场景都能直接用”。但现有两条路线都有硬伤:
- 传统模块化方法(感知 → 建图 → 定位 → 规划):系统延迟大、模块间误差层层累积,且要反复手调超参数;
- 学习型方法:受限于真实数据稀缺。靠真机遥操作采数据又慢又贵,难以 scale up。
NavDP(上海 AI Lab)的破题思路是全面拥抱仿真数据——仿真场景可以无限生成、自带”上帝视角”的特权信息(全局最优路径、全局 ESDF 距离场)。导航任务的物理交互远少于机械臂操作(manipulation),sim-to-real gap 本就更小,配合域随机化与高真实感渲染就能进一步弥合。问题随之变成两点:(1) 如何把仿真里的特权信息有效”蒸馏”进策略?(2) 如何保证策略在没见过的真实场景里安全?NavDP 的答案分别是模仿学习生成轨迹和对比式 Critic 评估轨迹。
NavDP 在双系统框架中的定位:NavDP 扮演快慢双系统(Fast-Slow System)里的 System 1——负责高频、实时的局部避障与路径规划,可无缝挂到 VLM 驱动的 System 2(负责语义理解、任务分解、长期记忆)之下,构成完整的开放世界导航能力。本文专注 System 1。
主要方法/创新点
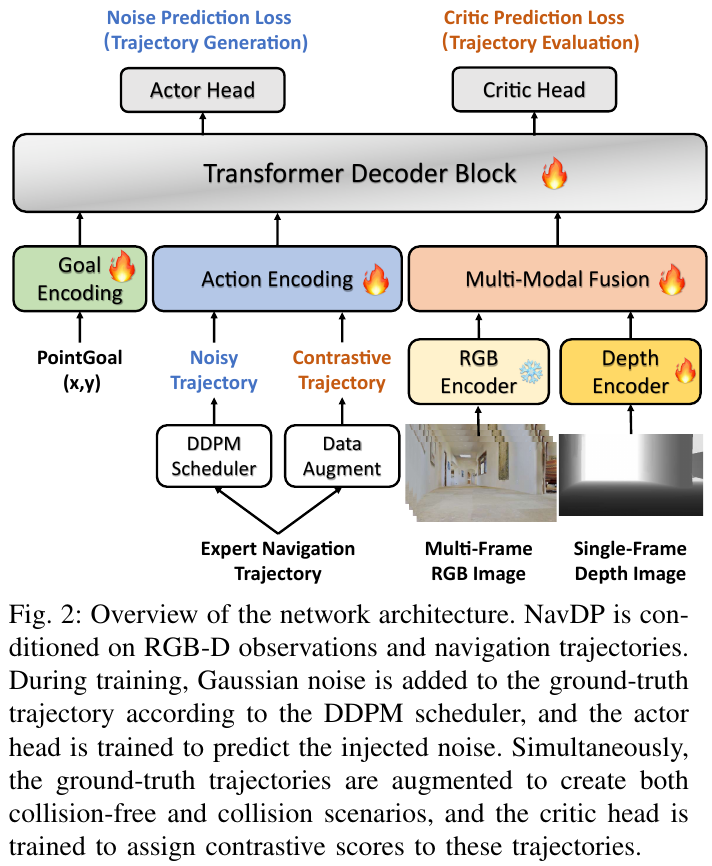
NavDP 由两大支柱组成:(A) 可扩展的仿真数据引擎,负责高效造数据;(B) 统一的策略 Transformer,在一个共享网络里同时学”生成轨迹”(Actor 头)和”评估轨迹安全性”(Critic 头)。下面逐一拆解。
(A) 可扩展仿真数据引擎(DataEngine)
目标是把”造导航数据”做到又快又多样。流程是:
- 场景与本体建模:机器人简化为半径 $r_b=0.25\text{m}$ 的圆柱 + 两轮差速模型;为模拟不同机器人,随机化机器人高度(0.25–1.25 m)与相机俯仰角(−30°–0°),并提供两套相机 FOV(RealSense D435i 与 Zed 2)。高于相机配置高度的物体不计为障碍——这让”矮机器人能钻、高机器人要绕”成为数据里天然存在的常识。
- 生成无碰撞轨迹:把场景网格体素化(0.05 m)算出可通行区的 ESDF(欧氏符号距离场);A* 规划初始路径后,对每个路径点在局部做贪心搜索把它推离障碍更远,最后用三次样条插值平滑成连续轨迹。
- 域随机化 + 并行渲染:用 BlenderProc 渲染照片级 RGB-D,并施加光照 / 纹理 / 视角三类随机化提升多样性。
效率上达到 2500 条轨迹 / GPU / 天,比真机采集快约 20×;最终数据集覆盖 3154 个场景、约 1627 km、452 小时、4000 万张图片(见论文 Table I),在规模与多样性上全面超越以往导航数据集。
(B) 统一策略 Transformer(一个网络,两个任务)
① 多模态编码(输入怎么进网络)
- RGB:取最近 $N=8$ 帧,用预训练并冻结的 DepthAnything 编码器,每帧抽 256 个 patch token(带入时序信息)。
- 深度:只取单帧深度,用一个从零训练的 ViT 编码(为对齐绝对物理尺度,利于轨迹生成);因深度图有 sim-to-real gap,只保留 (0.1 m, 5 m) 范围。
- 融合压缩:用带可学习 query 的轻量 transformer decoder,把 $(N+1)\times 256$ 个 token 压缩成 $N\times 16$ 个紧凑 token,降低后续计算量。
- 目标编码:遵循 PointGoal 定义,目标是相对当前位姿的 2D 坐标 $(x_g, y_g)$,经 MLP 投影到同一维度;无目标(NoGoal)探索任务则用全零张量当目标嵌入。
② Actor 头——扩散式轨迹生成 把专家轨迹按 DDPM 加噪,网络学习预测被注入的噪声,推理时从高斯噪声反复去噪得到一条由 $M=24$ 个密集路径点构成的轨迹。扩散过程天然能建模专家演示的多模态分布(同一处可能有”左绕”和”右绕”两条都对的路)。训练同时覆盖 PointGoal 与 NoGoal 两种目标,损失为两者噪声预测 MSE 的加权和(默认各 0.5)。
③ Critic 头——对比式轨迹评估(本文最关键创新) 这是 NavDP 区别于普通扩散策略的灵魂。纯模仿学习只见过”正确轨迹”,无法判断一条轨迹有多危险。NavDP 借用强化学习里的 Critic 价值函数思想:利用仿真里现成的全局 ESDF,给任意轨迹打一个”安全分”。具体地,对增广后的轨迹 $\hat\tau$,其在第 $m$ 个路径点上的 ESDF 值记作 \(d_{\hat\tau}^{m}\),标签价值定义为:
\[V(\hat\tau) = \gamma \cdot \sum_{m=0}^{M}(d_{\hat\tau}^{m+1} - d_{\hat\tau}^{m}) + \lambda \cdot \frac{1}{M}\sum_{m=0}^{M}\mathbb{I}(d_{\hat\tau}^{m} < d_{safe})\]直观理解:第一项奖励”越走离障碍越远”的趋势,第二项惩罚”靠得太近(小于安全阈值 $d_{safe}=0.5\text{m}$)”的路径点。训练时把专家轨迹做随机旋转增广,人为造出”碰撞 / 不碰撞”的对比样本喂给 Critic,让它学会区分安全与危险行为。
关键 insight:仿真专家轨迹因超参难调,常有轻微”贴边”现象。Critic 的真正价值不只是过滤碰撞,而是从一批候选里挑出安全裕度最大的那条,从而系统性提升 sim-to-real 的鲁棒性。
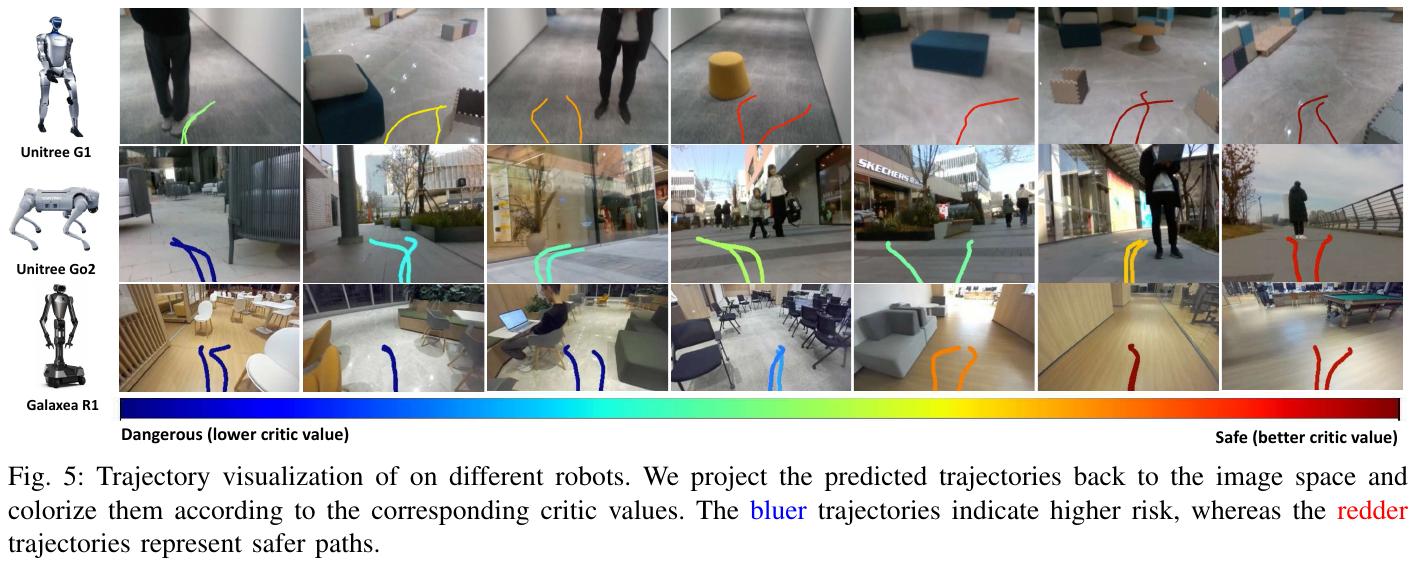
④ 推理流程:先生成、再选择 推理时 NavDP 先用 Actor 头一次性生成一批候选轨迹,再用 Critic 头给每条打分,选出价值最高(最安全)的一条执行。这就是”扩散生成多样性 + Critic 把关安全性”的两阶段闭环。下图把预测轨迹投影回图像、按 Critic 分值上色,蓝色=危险、红色=安全,直观展示 Critic 学到的空间常识:
训练配置:整个网络单阶段联合训练 Actor + Critic 两个损失之和;扩散步数 10、预测路径点 $M=24$、RGB 历史 $N=8$、安全阈值 0.5 m,用 32 张 A100、batch 2048 训练。
核心结果/发现
- PointGoal 点目标导航:仿真中 SR 67.2 / SPL 62.6,比此前最强的 ViPlanner(60.9 / 58.6)高 +6.3% SR;真机跨本体平均 SR 76.7%,比 ViPlanner(53.3%)高 +23.4%,在 TurtleBot 9/10、Go2 7/10、G1 7/10 上全面领先。
- NoGoal 无目标探索:仿真平均无碰撞时长是 NoMaD 的 2.9×、探索面积 3.1×;真机探索时长达 3.8×,展现极强的零样本泛化与避障一致性。
- 三类失败模式对比(Fig. 4):iPlanner/ViPlanner 用单帧输入导致时序不一致(相机过了障碍但机体没过,路径突变引发碰撞)、对深度噪声敏感、被带洞的不规则障碍几何”骗”而试图穿墙;NavDP 凭多帧时序 + Critic 把关都能稳健处理。
- 消融实验(Table V,验证三组因素):
- RGB-D 融合不可或缺:去掉深度 −10.3% SR,去掉 RGB −5.1% SR,单帧替代多帧 −2.8% SR。
- Critic 是安全性的关键:同权重下改用随机选轨迹(去掉 Critic 选择)−7.8% SR;去掉对比轨迹增广 −3.0% SR(家居场景)。
- NoGoal 是有用的辅助任务:联合训练 NoGoal 让 PointGoal 反而 +2.1% SR / +1.8% SPL。
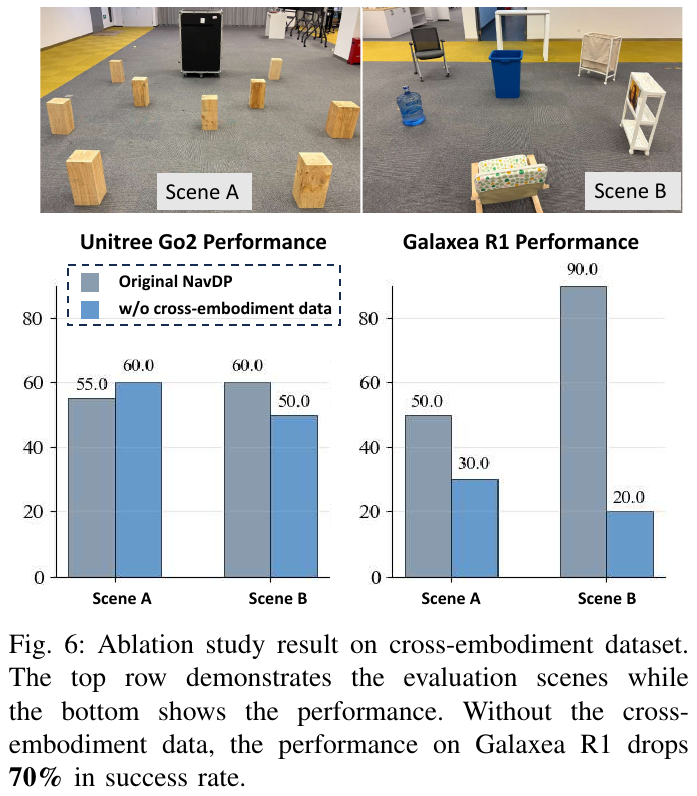
- 域随机化对跨本体至关重要(Q5 / Fig. 6):若只用矮机器人(< 0.5 m)数据训练,高个子 Galaxea R1 学不会”绕开桌子”的策略,成功率从 90% 暴跌到 20%(−70%),而矮个子 Go2 基本不受影响——证明跨本体数据的多样性才是泛化的根本。
局限性与未来方向
NavDP 性能高度依赖高质量仿真数据;扩散模型多步去噪虽带来轨迹多样性,但相比直接回归计算开销更大。作者点明三个未来方向:
- 显式本体信息编码:当前仅从数据分布隐式学习运动约束,无法明确感知自身体型;理想系统应能判断”这条缝我过不去”,即把机器人几何参数作为显式条件引入决策。
- 运动技能与路径规划联合设计:当前避障默认”只能行走绕行”;在极端地形(需跳跃 / 跨越)下,规划器应结合自身运动能力上限做更合理的通过 / 绕行决策。
- 高效后训练 + 语言目标 + 全局记忆:探索后训练策略提升真机表现,把目标扩展到自然语言指令,并引入全局记忆支持长时探索。
6. NavWAM (2026)
———首个将未来预测、价值评估与动作决策集成于单一具身世界模型的导航模型
📄 Paper: arXiv:2606.13494 · Project Page
精华
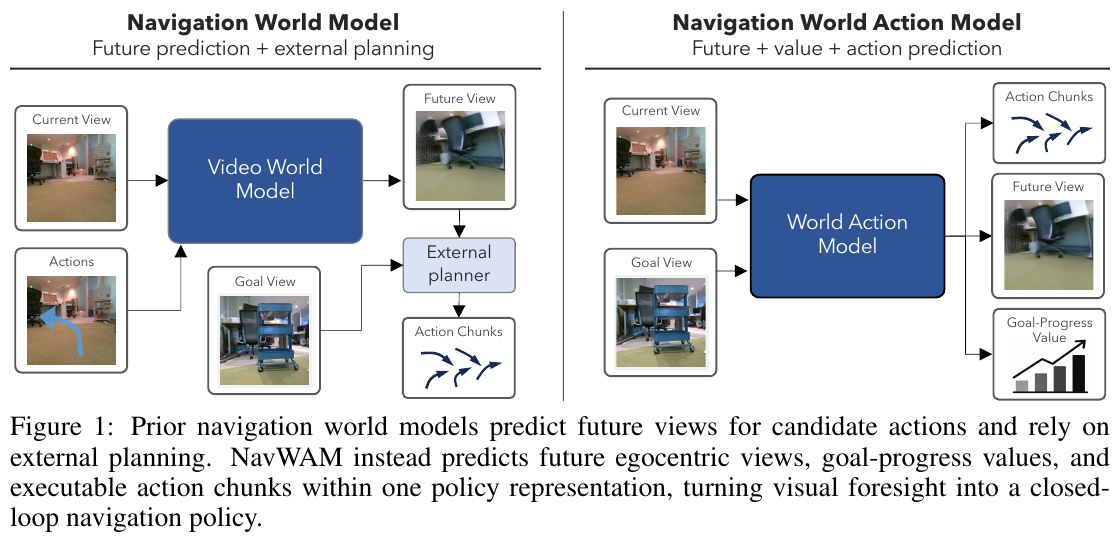
- 一体化整合:NavWAM 将传统导航世界模型(NWM)中分离的“未来预测”与“动作规划(如 CEM 搜索)”整合进单一的视频扩散 Transformer 网络中。
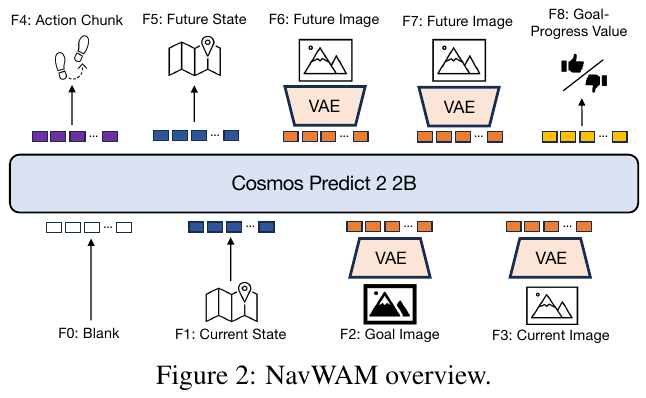
- 共享 Latent Canvas:将当前状态、目标图像、当前视觉观测、可执行动作 Chunk、未来状态、未来视觉预测和进度价值评估(Value)统一表征为固定 9 帧的潜在画布(Latent Canvas)序列,通过联合去噪实现多任务输出。
- 消除在线规划开销:在测试时直接以 Policy 模式进行单次推理去噪即可输出动作 Chunk,避免了传统世界模型繁重的在线轨迹采样与优化,控制频率可达 5Hz,计算量降低数千倍。
- 提升表征质量:通过引入未来视觉预测的 dense 自监督重构损失,为动作选择提供了强有力的“未来观测锚定”,显著降低了局部可观测下的策略漂移。
1. 研究背景/问题
在局部可观测的图像目标导航中,传统的基于规划的导航世界模型(NWM)通过预测动作序列条件下的未来视觉变化来辅助决策。然而,这些方法通常将“世界预测”和“动作选择”分为两个独立的步骤:模型仅作为一个单纯的预测器,而在推理时必须依靠外在的规划算法(如交叉熵方法 CEM)在大量的随机候选动作序列中进行耗时的闭环生成与评分。这导致了巨大的在线计算开销(通常低至 sub-Hz 级别)。为了消除这一瓶颈,本研究致力于构建一个世界动作模型,将未来感知预测、价值估计和连续动作生成直接统一在单个网络表征中。
2. 主要方法/创新点
整体框架
NavWAM 使用预训练的视频世界模型 Cosmos Predict2 (2B) 作为网络底座,将当前观测、图像目标、机器人状态、未来动作序列(Action Chunk)、未来视觉观测和目标进度价值(Goal-Progress Value)融合成一个统一的 9 帧“世界-动作潜在画布(World-Action Latent Canvas)”。通过这种表征,导航任务被建模为在潜在画布上的联合去噪问题。
Latent Canvas 帧布局
画布中的 9 个帧被定义如下:
- 帧 0 (Observed):Causal VAE temporal pad(全零帧),为时空 VAE 压缩提供边界。
- 帧 1 (Observed):当前机器人状态 $s_t = [x_t/100, y_t/100, \psi_t/\pi] \in \mathbb{R}^3$,在局部坐标系中标准化。
- 帧 2 (Observed):目标图像 $g$(Image Goal)。
- 帧 3 (Observed):当前第一人称视觉观测 $o_t$。
- 帧 4 (Predicted):待预测的可执行动作 Chunk $a_{t:t+H-1} \in \mathbb{R}^{3H}$,其中 $H=4$(表示局部航向点增量 $[\Delta x_i, \Delta y_i, \Delta \psi_i]$)。
- 帧 5 (Predicted):未来状态预测 $s_{t+H} \in \mathbb{R}^3$。
- 帧 6 & 7 (Predicted):未来的两个自车视角图像预测 $o_{t+H-1}, o_{t+H}$。
- 帧 8 (Predicted):目标进度估计值 $v_{t+H} \in [0, 1]$。
对于动作、状态、价值等非图像标量/向量,NavWAM 首先对其进行归一化,然后将其在空间网格(Spatial Grid)上进行广播(Broadcast)填充为整帧;解码时则通过空间平均(Spatial Averaging)将对应通道的去噪特征恢复为标量/向量值。
训练目标与混合模式
网络损失函数基于潜在画布上的加权去噪得分匹配: \(\mathcal{L}_{\text{diff}} = \mathbb{E}_{\sigma, \epsilon} \left[ w(\sigma) \lVert x_0 - F_\theta(x_\sigma, \sigma, c) \rVert_2^2 \right]\) 为了防止低维的动作信号淹没在图像重构的高维像素损失中,动作帧损失被乘以权重系数 $\lambda = 5$ 进行了上采样增强。
在训练阶段,样本被划分为三种不同的条件模式以促使网络联合学习不同的导航子任务(比例为 50/25/25):
- Policy 模式 (50%):给定观测帧 0–3,预测帧 4–8。
- World-Model 模式 (25%):给定观测帧 0–4,预测帧 5–8。训练模型在动作条件下的物理演化预测。
- Value 模式 (25%):给定观测帧 0–7,预测帧 8(当前轨迹下的目标进度价值)。
目标进度价值设计
价值目标 $v_{t+H}$ 被显式定义为反映机器人局部到终点精度的归一化距离进度: \(v_{t+H} = \text{clip}\left( 1 - \frac{\lVert p_{\text{end}} - p_t \rVert_2}{d_{\text{max}}}, 0, 1 \right)\) 其中 $p_t$ 为当前 2D 位置,$p_{\text{end}}$ 为目标 2D 位置,$d_{\text{max}}$ 为轨迹最大长度上限。
推理流程
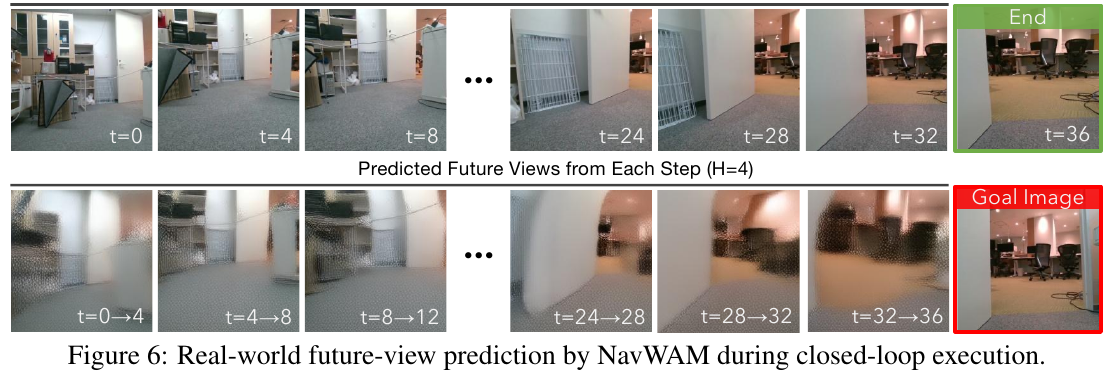
在部署阶段,机器人获取当前图像 $o_t$ 和目标 $g$,在 Policy 模式下运行,通过单次去噪过程直接输出 \(\hat{a}_{t:t+H-1}\)。随后以 Receding-Horizon 的方式执行这组动作 Chunk,执行完毕后重新请求网络,实现大约 5Hz 的高频闭环响应。
3. 核心结果/发现
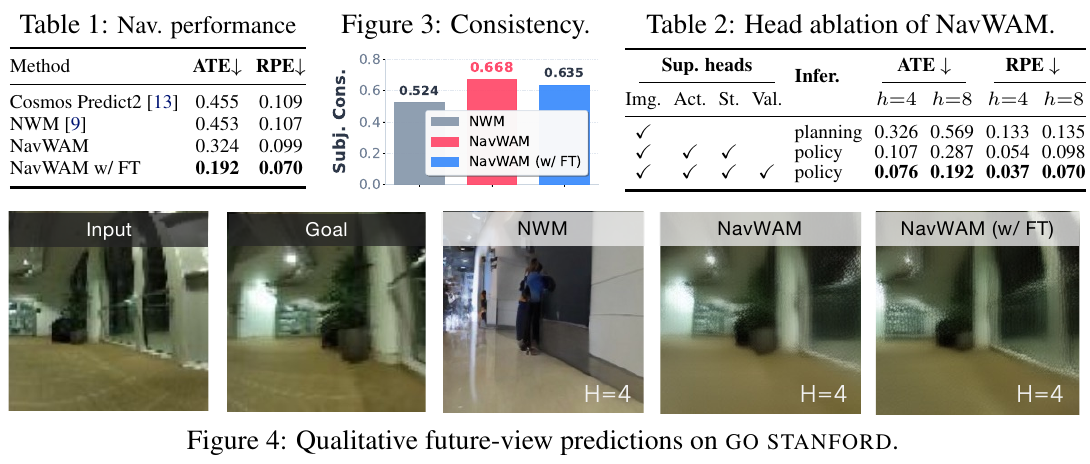
- 更优的导航表现:在 GO STANFORD 离线图像目标导航上,NavWAM 在无需推理时 CEM 动作搜索的前提下,其 zero-shot(ATE 0.324)和微调版(ATE 0.192 / RPE 0.070)均优于传统的 NWM(ATE 0.453)。同时,模型保持了卓越的未来视觉预测一致性(Consistency 达 0.635–0.668,明显好于 NWM 的 0.524)。
- 极其低廉的推理开销:单次去噪推理代替 CEM 轨迹优化,使得 NavWAM 的 FLOPs 仅为 4.45 TF,推理延迟仅为 205.7 ms,而同底座的 NWM 延迟达 233.8 秒,FLOPs 高达 14,521 TF,推理成本相差数千倍。
- 多任务监督的作用:消融实验证明,未来视觉预测监督能够为决策系统带来长程路标锚定,是不可或缺的自监督信号(相比去掉未来图像的策略,ATE 从 0.090 降低到 0.076)。
- ** Diablo 机器人实机闭环成功率**:在真实室内环境(Office, Storage, Meeting, Hallway)的 24 次部署测试中,NavWAM 取得了 79.2% 的高成功率,远超 OmniVLA (58.3%) 和传统 NWM (16.7%),证明了极强的鲁棒性。
4. 局限性
- 测试场景局限:实机评估主要集中在静态的室内环境中,面对含有行人和移动物体的动态障碍物场景未做验证。
- 目标形态局限:主要针对图像目标导航(Image-Goal Navigation),对于自然语言指令导航、物体类别导航(Object-Goal)以及具身问答尚未开展系统验证。
- 长程瓶颈:面对跨楼层、多房间的大范围、极长程导航场景(需要频繁的子任务规划与重规划),由于上下文帧数限制,依然存在表现衰退的风险。
7. CanonNav (2026)
——— 解耦相机几何与导航行为的跨平台视觉扩散导航策略
📄 Paper: arXiv:2608.30242
精华
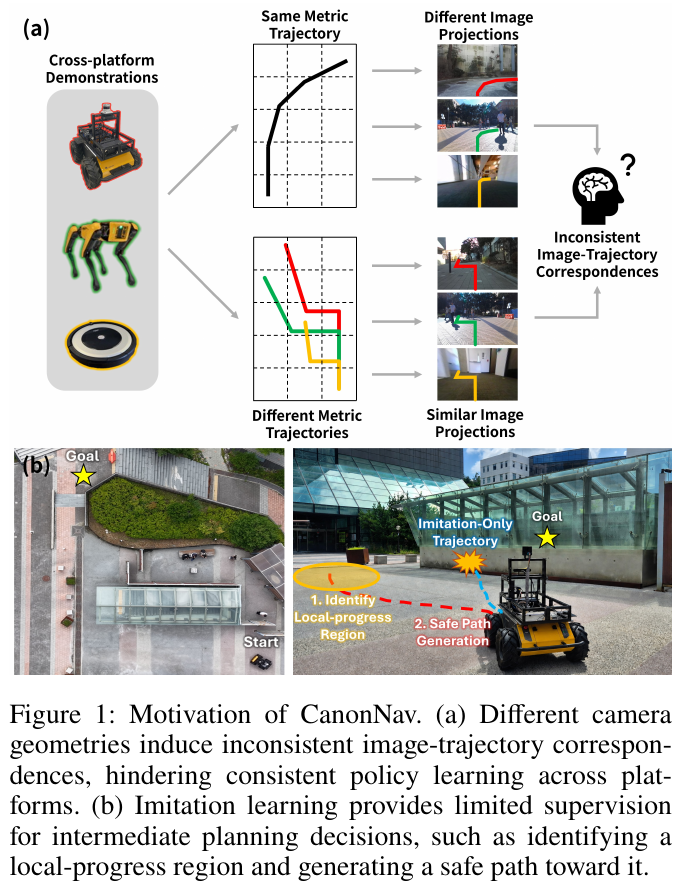
- 相机几何与行为解耦:提出相机几何规范化(Canonicalization),通过单应重投影消除相机内参和俯仰角差异,并通过安装高度归一化将物理轨迹映射至视角不变空间,彻底解决了跨机器人平台演示数据中视觉观测与轨迹映射纠缠的病态问题。
- 显式局部规划监督(Scope-of-Reach, SoR):针对传统模仿学习只学到专家动作却遗漏中间规划意图的缺陷,提出局部可达范围(SoR)表征,利用离线生成的 BEV 伪标签显式监督智能体在被遮挡或复杂地形下”往何处推进”。
- 碰撞感知流形约束:利用离线可通行性估计器构建度量符号距离场(SDF),在扩散策略的去噪轨迹上直接反向传播碰撞惩罚损失与航点可行性损失,实现端到端安全轨迹生成。
- 单目 RGB 匹敌并超越深度图方案:仅依靠单目 RGB 输入进行推理,在 CitySim 室外与 AWS Hospital 室内多相机配置下大幅超越 ViNT、NoMaD、LiMo 等 RGB 基线,并在长距离复杂拐弯场景下成功率反超依赖实时 RGB-D 深度输入的 NavDP。
1. 研究背景/问题
利用离散跨平台专家示范进行大规模模仿学习(Imitation Learning)是推动机器人自主视觉导航的重要路线。然而,充分利用跨平台异构数据面临两大根本症结:
- 相机几何的病态纠缠:不同机器人底盘(如四足机器狗、低矮扫地机、轮式移动车)搭载的相机高度、内参及俯仰倾角各异。相同的图像投影可能对应截然不同的地面物理轨迹;若强行让策略从 RGB 隐式推断相机几何,在数学上属于严重不适定的欠约束问题。
- 专家示范中规划意图的隐式性:专家轨迹仅展示了最终执行的平滑路径,而没有解释”为什么选择向该局部空旷区域过渡”以及”两侧边缘有多危险”。纯模仿学习在遇到障碍物遮挡、必须转弯绕行等未直达目标的复杂场景时,极易退化或发生撞击。
2. 主要方法/创新点
① 整体框架概述
CanonNav 提出了由相机几何规范化(Canonicalization)、多任务扩散策略网络(Policy Inference)以及离线规划安全监督(Training-Time Planning Supervision)构成的闭环系统。在训练阶段利用预训练可通行性模型离线提取 BEV 伪标签提供密集监督;在部署阶段无需任何离线模型与深度传感器,仅凭单目 RGB 图像和相对目标即可输出无碰撞轨迹。
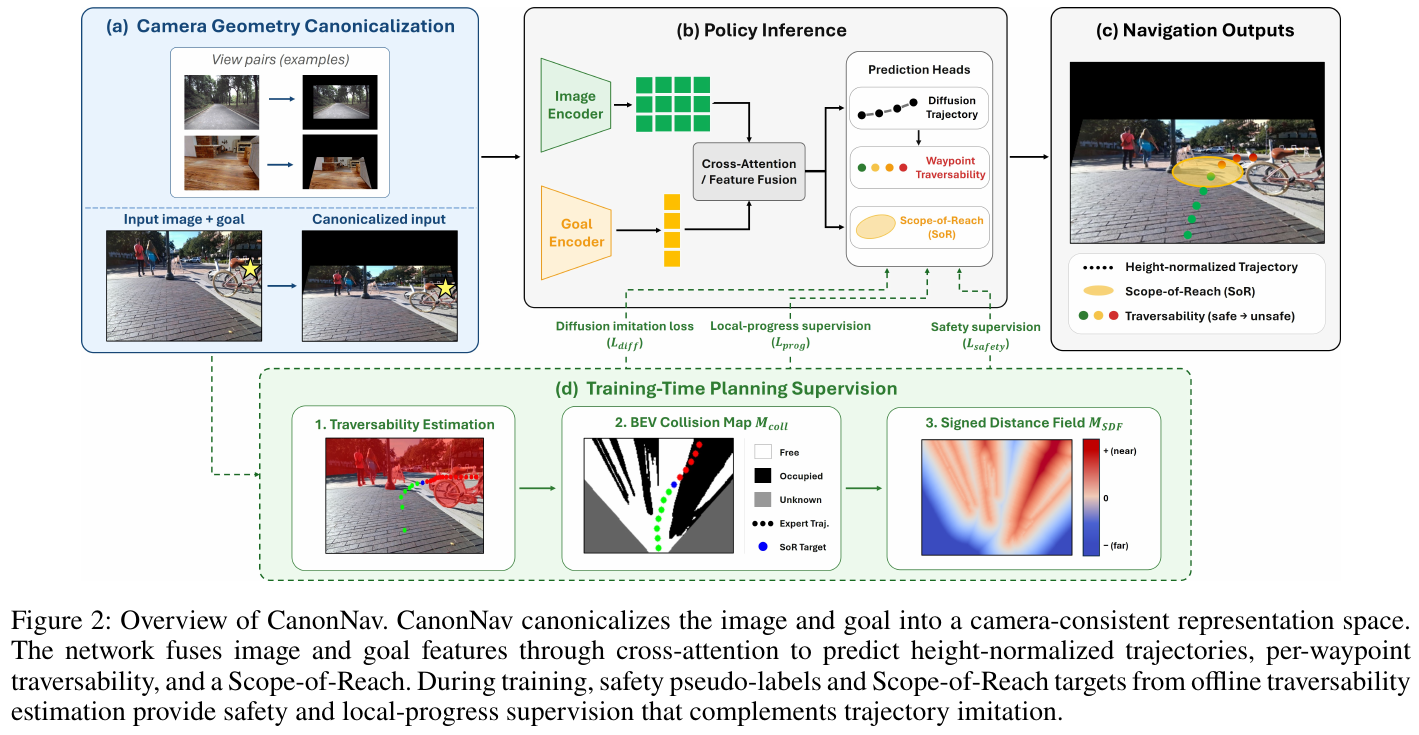
② 逐模块讲解
1. 相机几何规范化(Camera Geometry Canonicalization)
- 内参与俯仰角消除:设相机外参简化为安装高度 $h$ 与俯仰角 $R_{pitch}$,内参为 $K$。给定预设的正向基准虚拟相机内参 $\tilde{K}$,将原始图像 $I_t$ 投影重映射至无倾角正向视野 \(\tilde{I}_t\): \((\tilde{u}, \tilde{v}, 1)^\top \propto \tilde{K} R_{pitch}^{-1} K^{-1} (u, v, 1)^\top\)
- 高度归一化轨迹(Height-Normalized Trajectory):在正向基准相机下,地面物理点 $(x, y)$ 投影为 \(\tilde{u} = \tilde{c}_x - \tilde{f}_x \frac{y}{x}\),\(\tilde{v} = \tilde{c}_y - \tilde{f}_y \frac{h}{x}\)。可以看出像素位置完全取决于横纵比 $y/x$ 与高距比 $h/x$。将物理轨迹点 $(x, y)$ 归一化为 $(\tilde{x}, \tilde{y}) = (x/h, y/h)$,投影公式转化为: \(\tilde{u} = \tilde{c}_x - \tilde{f}_x \frac{\tilde{y}}{\tilde{x}}, \quad \tilde{v} = \tilde{c}_y - \tilde{f}_y \frac{1}{\tilde{x}}\) 该归一化彻底剥离了相机高度 $h$ 的干扰,使所有平台的轨迹分布在同一视锥几何下对齐。
举个例子(卡点降维装置 A:为什么高度归一化能消除底盘差异?): 设基准虚拟相机焦距 \(\tilde{f}_y = 500\),主点 \(\tilde{c}_y = 250\):
- 低矮扫地机器人:相机高度 $h_1 = 0.2\text{ m}$,前方 $1.0\text{ m}$ 处的路面障碍物($x_1 = 1.0\text{ m}$),其高距比为 $h_1 / x_1 = 0.2 / 1.0 = 0.2$;
- 高大巡检轮式车:相机高度 $h_2 = 1.0\text{ m}$,前方 $5.0\text{ m}$ 处的路面障碍物($x_2 = 5.0\text{ m}$),其高距比为 $h_2 / x_2 = 1.0 / 5.0 = 0.2$。
在两个机器人的正向图像中,这两个物理距离完全不同的地面点,计算出的像素行位置 $\tilde{v} = 250 - 500 \times 0.2 = 150$ 完全一模一样! 若直接模仿米制坐标,策略网络面对相同的视觉外观却要预测 $1.0\text{ m}$ 和 $5.0\text{ m}$ 的矛盾动作。而经过高度归一化后,两者的无量纲目标距离均为 $\tilde{x} = x/h = 5.0$!策略网络只需要学习这一统一分布,控制时再乘以各自的物理安装高度 $h$,即可无缝泛化。
2. 规划监督与 Scope-of-Reach (SoR)
- SoR 局部可达范围建模:将局部推进区域建模为 2D 鸟瞰图高斯分布 $\mathcal{S} = \mathcal{N}(\mu, \operatorname{diag}(\sigma^2))$,网络预测其高度归一化参数 $(\tilde{\mu}, \tilde{\sigma}) = (\mu/h, \sigma/h)$。
- 离线安全伪标签生成:
- 使用预训练 ViTA 在离线训练集中提取图像可通行掩码;
- 投影到地面生成局部 BEV 碰撞图 $M_{coll}$,并转换为度量符号距离场 $M_{sdf}$;
- 将专家轨迹进入碰撞区或视野边界前的最后一个可行航点提取为局部推进目标 \(s^*\)。
- 三重 SoR 损失函数:
\(L_{prog} = \lambda_{pred} L_{pred} + \lambda_{neg} L_{neg} + \lambda_{cons} L_{cons}\)
- $L_{pred}$:负对数似然结合 Smooth-L1 拟合目标点 \(\tilde{s}^*\);
- $L_{neg} = \iint M_{coll}(x, y) \mathcal{S}(x, y) dx dy$:对高斯概率落入碰撞障碍区的积分惩罚;
- $L_{cons}$:采用 Soft-min 约束生成轨迹的去噪航点至少有一个穿越预测的 SoR 区域。
3. 连续碰撞感知安全损失(Safety Supervision)
- 从加噪轨迹 \(\tilde{\tau}_k\) 经过单步反解得到无噪航点估计 \(\hat{\tau}_0 = \{\hat{p}_i\}\);
- 度量碰撞惩罚损失 $L_{coll}$: \(c_i = \operatorname{softplus}\left(\frac{d_{safe} - M_{sdf}(h \hat{p}_i)}{\eta}\right), \quad L_{coll} = \frac{1}{\gamma} \log \sum_{i=1}^N \exp(\gamma c_i)\)
- 航点可通行性分支 $L_{trav}$:双线性采样图像特征预测航点生存概率 \(\hat{q}_i\)。
③ 读者视角:数据流与训练/推理分离图(卡点降维装置 B)
graph TD
    subgraph "训练阶段: 离线伪标签与规划引导"
        T1["训练图像 + 已知几何参数 (K, Rpitch, h)"] --> T2["ViTA 预测通行掩码"]
        T2 --> T3["反投影生成 BEV 碰撞图 Mcoll 与 SDF"]
        T3 --> T4["截取安全转折点作为 SoR 目标点 s*"]
        T3 --> T5["SDF 碰撞惩罚 Lcoll + 负样本压制 Lneg"]
    end

    subgraph "核心网络: 规范化扩散策略"
        N1["输入 RGB 观测 + 相对目标"] --> N2["相机几何规范化 (重投影 + 高度归一化)"]
        N2 --> N3["DINOv3 ViT-S+ 特征编码与 Cross-Attention"]
        N3 --> N4["扩散去噪头 ϵθ -> 生成候选轨迹"]
        N3 --> N5["SoR 预测头 -> 输出局部可行高斯分布"]
        N3 --> N6["可通行性预测头 -> 评估航点生存率"]
    end

    subgraph "推理部署阶段: 单目 RGB 纯闭环"
        P1["实时单目 RGB + 目标"] --> N2
        N4 --> P2["输出 B 条高度归一化轨迹候选"]
        P2 --> P3["乘以自身相机高度 h 恢复物理米级尺度"]
        P3 & N6 --> P4["航点生存率折现 + 目标推进量综合比选"]
        P4 --> P5["执行最优平滑无碰撞轨迹"]
    end

    T4 -.-> N5
    T5 -.-> N4
④ 核心机制对比:CanonNav vs 主流导航基线(卡点降维装置 C)
| 机制维度 | 传统纯模仿基线 (ViNT / NoMaD) | 深度图规划基线 (ViPlanner / NavDP) | 本文 CanonNav |
|---|---|---|---|
| 跨平台几何处理 | 强行输入原图,靠海量随机增强隐式适配 | 需精确配准的 RGB-D 几何对齐 | 显式重投影 + 高度归一化空间解耦 |
| 中间规划意图 | 纯轨迹扩散去噪,缺失局部转折引导 | 依赖实时深度图重构代价地图 | 提出 SoR 显式建模局部推进分布 |
| 碰撞回避机制 | 缺乏显式负反馈,易切内弯刮蹭障碍物 | 需在线高帧率深度传感器计算碰撞 | 离线 SDF 反向梯度约束生成轨迹 |
| 部署传感器门槛 | 单目 RGB(但抗几何扰动极差) | 强依赖实时稠密 RGB-D 传感器 | 纯单目 RGB 即可达到超高安全性 |
3. 核心结果/发现
在 CitySim(室外复杂园区) 与 AWS Hospital(室内复杂走廊病房) 两个极具代表性的高难度仿真环境,以及真实物理车(Clearpath Husky 差速轮式车)上进行评测:
- 跨相机几何泛化断层领先:在相机高度从 $0.4\text{ m}$ 变化至 $1.0\text{ m}$、俯仰角从 $-15^\circ$ 变化至 $+15^\circ$ 的剧烈配置偏移下,ViNT 与 NoMaD 的成功率普遍暴跌 20%~40%,而 CanonNav 在所有几何扰动下的成功率下降幅度($\Delta\text{SR}$)均控制在极小区间内。
- 长距离复杂拐角超越 RGB-D 方案:在 $20\text{ m}$ 超长子目标导航任务中,即便面对遮挡严重的 U 形拐弯,CanonNav 仅使用单目 RGB 就取得了 86.4% 的成功率与 0.89 次碰撞率,显著超越了搭载实时稠密深度的 NavDP(SR 71.2%,碰撞率 2.21)和 ViPlanner(SR 39.3%)。
- 真实世界零样本迁移零事故:在包含反光玻璃幕墙、狭窄树丛台阶和户外异形走廊的实机测试中,CanonNav 在所有测试中均保持零碰撞,轨迹曲率与人类示教路径吻合度极高。
4. 局限性
- 几何规范化依赖机器人自身已知的安装参数(相机内参 $K$、静态安装高度 $h$ 与俯仰角 $R_{pitch}$),若机器人在越野颠簸路面上发生剧烈动态俯仰震荡,静态规范化假设会引入瞬时投影误差。
- 离线伪标签质量受限于 ViTA 可通行性分割模型在极端光照(如暴雨、强逆光)下的初始分割精度。
8. Hydra-Nav (2026)
——Object Navigation via Adaptive Dual-Process Reasoning
📄 Paper: arXiv:2602.09972
精华
Hydra-Nav 最值得借鉴的核心思想是:将”慢思考”(CoT 推理)与”快行动”(低级反应控制)统一在单个 VLM 内,避免了多模型架构的碎片化问题。其关键创新在于通过 Iterative Rejection Fine-Tuning (IRFT) 让模型自主学习”何时触发推理”,而非固定频率触发,从而在成功率与推理开销之间取得最优平衡。三阶段课程训练(空间-动作对齐 → 记忆-推理集成 → 自适应推理)的渐进式设计,为构建具身导航智能体提供了可复用的训练范式。新提出的 SOT 指标(Success weighted by Operation Time)将推理延迟纳入评估,比 SPL 更贴近实际部署需求,值得在其他具身任务中推广使用。
研究背景/问题
Object goal navigation 要求机器人仅凭自我中心感知在真实环境中主动探索并定位目标物体。当前 VLM-based 方法存在两大核心缺陷:(1)时空推理能力不足,导致对已探索区域的记忆维护失效,引发重复探索;(2)在每步推理(chain-of-thought)的做法带来大量不必要的计算开销,而在关键”停滞点”又未能及时触发推理。现有双系统架构(slow-fast paradigm)依赖独立模型,存在架构割裂和切换灵活性不足的问题。
主要方法/创新点
Hydra-Nav 将高层规划与低层元动作统一在单一 VLM(基于 Qwen2.5-VL-7B)内,通过输出特殊 transition token obs 自主触发从快系统到慢系统的切换。
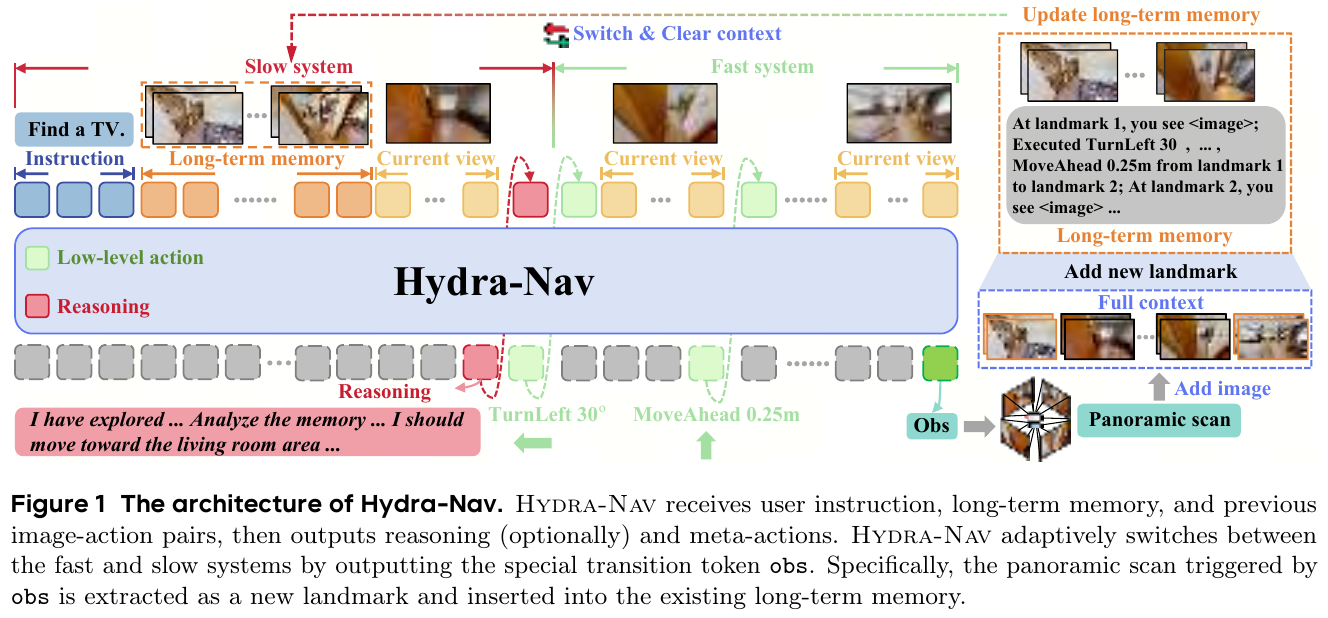
双过程系统(Dual-process System)
- 慢系统(Slow system):接收目标指令、当前全景观测(4 张 90° 间隔 RGB 图)和结构化长期记忆,生成 CoT 推理文本与高层计划,随后输出第一个元动作。
- 快系统(Fast system):基于上一慢系统的对话历史,利用 KV-caching 仅编码最新自我中心帧,自回归解码低级原子动作(MoveAhead 0.25m、TurnLeft/Right 30°),避免重复处理完整历史上下文。
- 自适应切换机制:当智能体完成子目标或当前观测与现有计划矛盾时,输出
obs触发全景扫描,构建新的地标节点并更新长期记忆,随后重新进入慢系统。
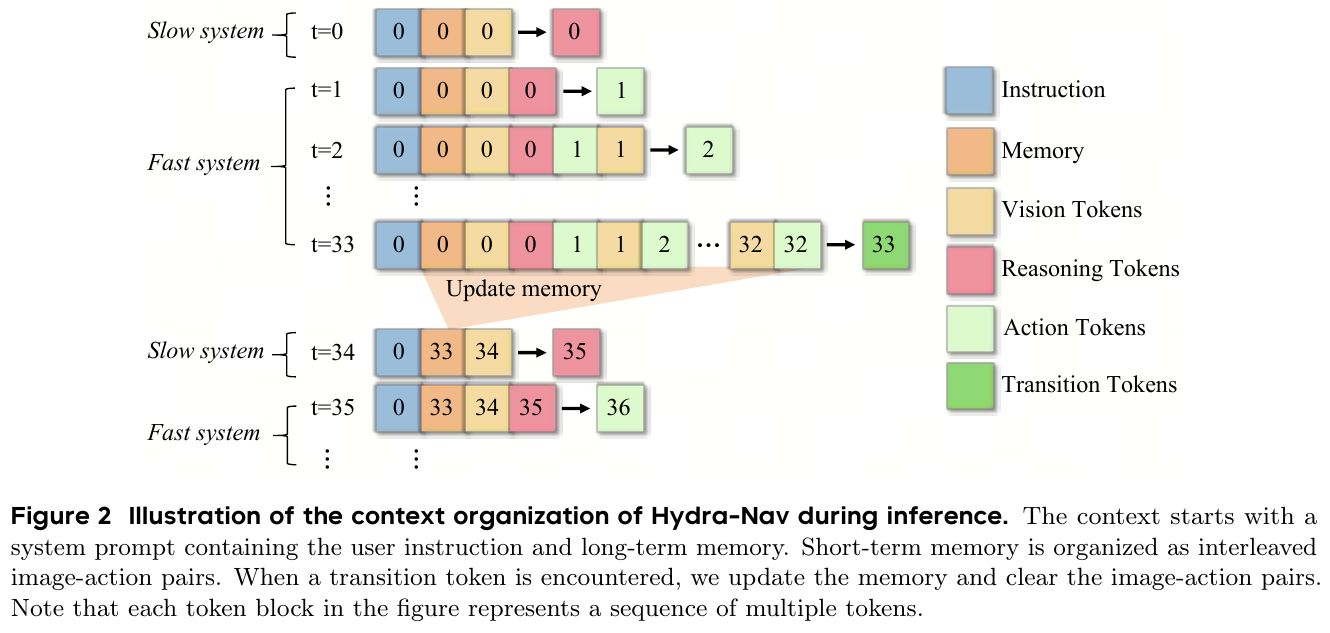
三阶段课程训练(Curriculum Training Pipeline)
Stage 1 — 空间-动作对齐(Spatial-Action Alignment)
使用 A* planner 在 HM3D、MP3D、OVON 训练集上生成 500K 条轨迹(20.1B tokens),训练 Qwen2.5-VL-7B 学习基本导航动作执行。每条轨迹格式化为多轮对话,通过单次前向-反向传播完成梯度计算。
Stage 2 — 推理-记忆集成(Reasoning-Memory Integration)
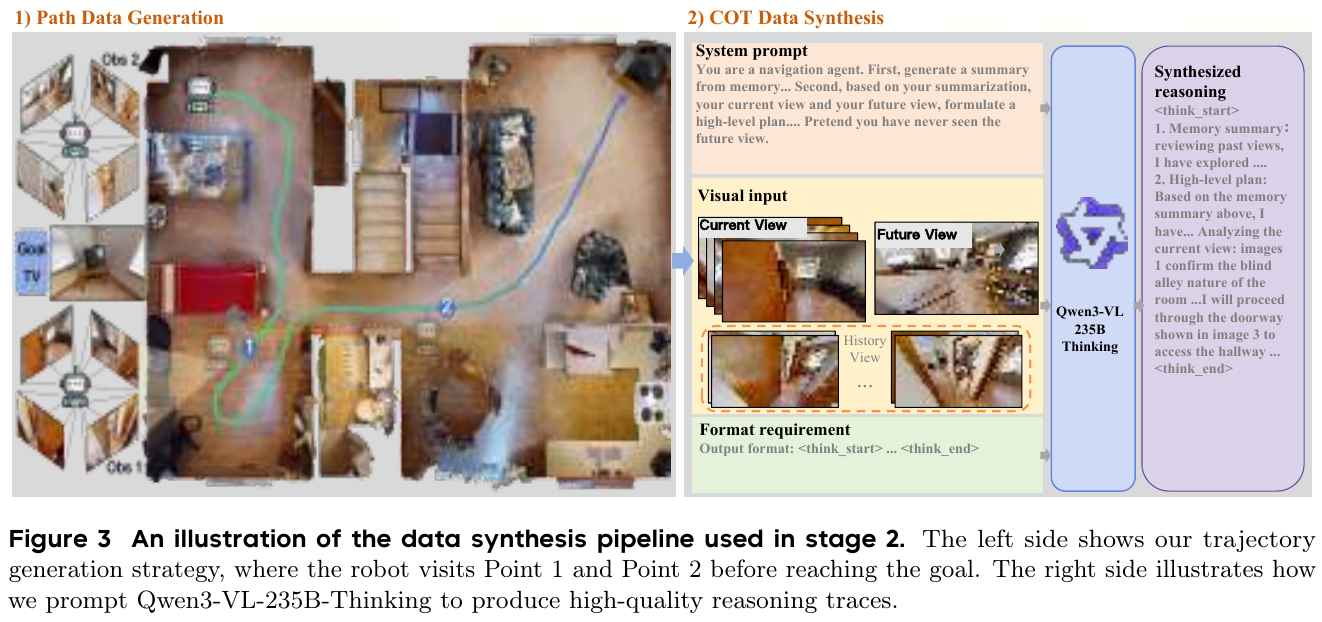
- 使用启发式路点选择策略生成包含探索行为的轨迹(而非仅最短路径),每条轨迹选取分数最高的两个探索路点。
- 将轨迹分段(固定长度 16 步),在每段开头插入长期记忆和推理文本,段尾插入
obstoken。 - 推理文本合成:先用 Qwen3-VL-235B-Thinking 对历史图像进行记忆摘要,再结合当前视图与”未来正确视图”(信息泄漏防止)生成前瞻性规划文本。
- 共生成 565K 条混合样本(8.3B tokens),同时混入 VQA 数据防止过拟合。
Stage 3 — 自适应推理(Adaptive Reasoning via IRFT)
定义两类停滞点(Stagnation Points):
- 重复探索:智能体在过去 $T_{stag}=20$ 步内回到距离 $\delta_{stag}=0.5$m 内的位置。
- 缺乏进展:在随机时间窗口 $\Delta t \sim \mathcal{U}(20,35)$ 内到目标距离未缩短。
IRFT 流程:在快系统模式下运行,于停滞点触发慢系统;对失败轨迹(超时或目标误识别)进行”拒绝-修复”——找到干预时间戳 \(t^*\),用 A* 最优路径替换后续轨迹,重新合成修正段的推理文本;使用最新 checkpoint 迭代执行,每轮生成约 60K 条轨迹(4.5B tokens)。
核心结果/发现
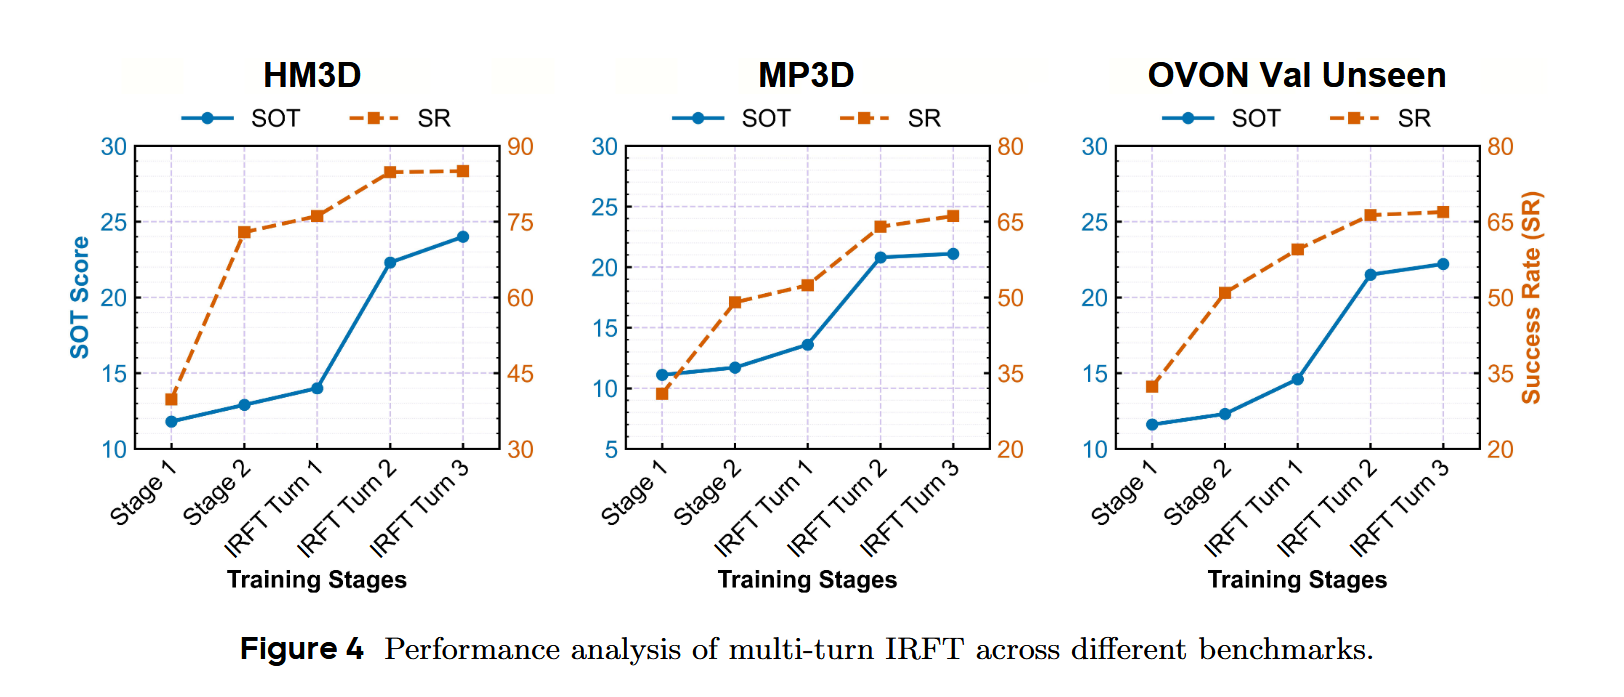
与 SOTA 对比(Table 2):
| Benchmark | 指标 | Hydra-Nav-IRFT | 第二名 | 提升 |
|---|---|---|---|---|
| HM3D Val | SR | 84.8% | 73.7% | +11.1% |
| MP3D Val | SR | 64.0% | 46.6% | +17.4% |
| OVON Val-Unseen | SR | 66.3% | 45.2% | +21.1% |
SOT 指标分析(Table 5):
- Hydra-Nav-IRFT 推理触发比例仅 3.0%(HM3D),而 VLMnav/Nav-R²/WMNav 均为 100%。
- SOT 得分:Hydra-Nav-IRFT 24.0(HM3D)vs Nav-R² 1.9(最高 SR 竞争者),提升约 12×。
- 说明频繁推理虽提高 SR,但严重拖累效率;自适应推理是实际部署的关键。
消融实验关键发现:
- 记忆模块对 SPL 提升显著(无记忆 SPL=13.9 vs 有记忆 28.8),说明长期空间记忆是路径效率的核心。
- 探索性轨迹数据 vs 最短路径数据:SR 下降 25.4%(HM3D),说明探索能力对高成功率不可或缺。
- Co-training with VQA 防止导航专有数据过拟合,维持泛化性(SR: 69.1→72.9,HM3D)。
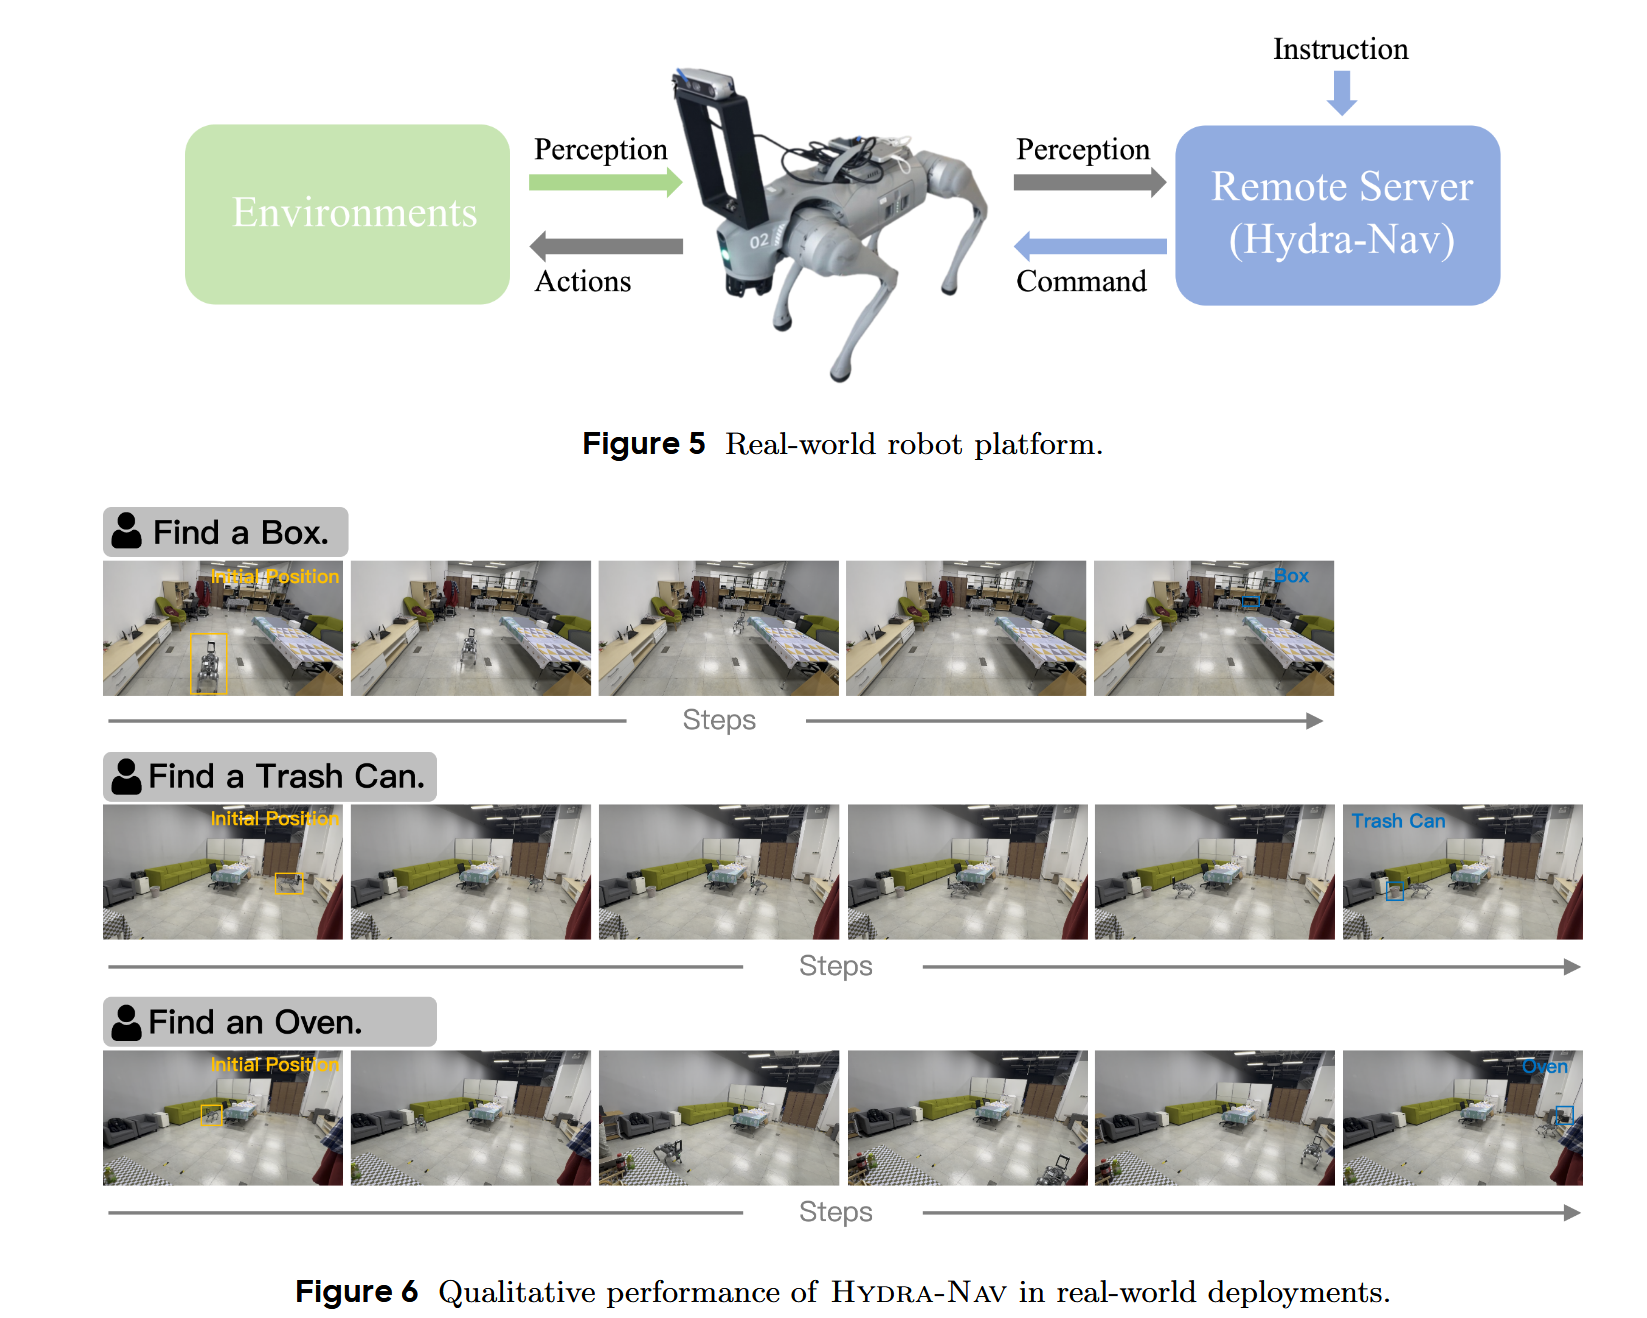
局限性
评估仅在 Habitat 模拟器(HM3D/MP3D/OVON)中进行,缺乏在 Isaac Sim 等更高保真度仿真环境中的验证;当前框架专为 object navigation 设计,向移动操作等更复杂具身任务的扩展有待探索。
9. 3DGSNav (2026)
———用主动 3DGS 记忆增强 VLM 空间推理,实现零样本目标导航
📄 Paper: arXiv:2602.12159
精华
3DGSNav 最值得借鉴的核心思想:
- 将 3DGS 作为持久记忆替代语义地图/文字描述,让 VLM 直接”看”到几何连续的场景,而非依赖中间抽象层,从而释放 VLM 本身的视觉空间推理能力。
- 主动感知(Active Perception)+ 自由视角优化:代理不被动旋转扫描,而是通过不透明度场(opacity field)主动定位视觉盲区,再利用 3DGS Novel View Synthesis 渲染最优视角——这种”按需生成观测”的模式可推广到其他需要视角控制的具身任务。
- 结构化视觉提示(Structured Visual Prompts)+ CoT 融合:在渲染图像上叠加注释(gaze point、未探索区域标注),配合 Chain-of-Thought,让 VLM 的长程规划推理能力得到充分激活,无需额外训练。
- 实时检测 + VLM 重验证(Re-verification):先用轻量检测器初筛候选目标,再用 VLM 主动切换视角确认——分两阶段解耦效率与可靠性,是目标确认模块的通用设计范式。
研究背景/问题
现有零样本目标导航(ZSON)方法通常将环境转换为语义地图或文字描述,导致高层决策被低层感知精度所制约,VLM 的视觉空间推理能力无法充分发挥。如何让 VLM 直接基于高质量视觉观测进行空间推理,而非依赖降维后的语义抽象,是本文解决的核心问题。
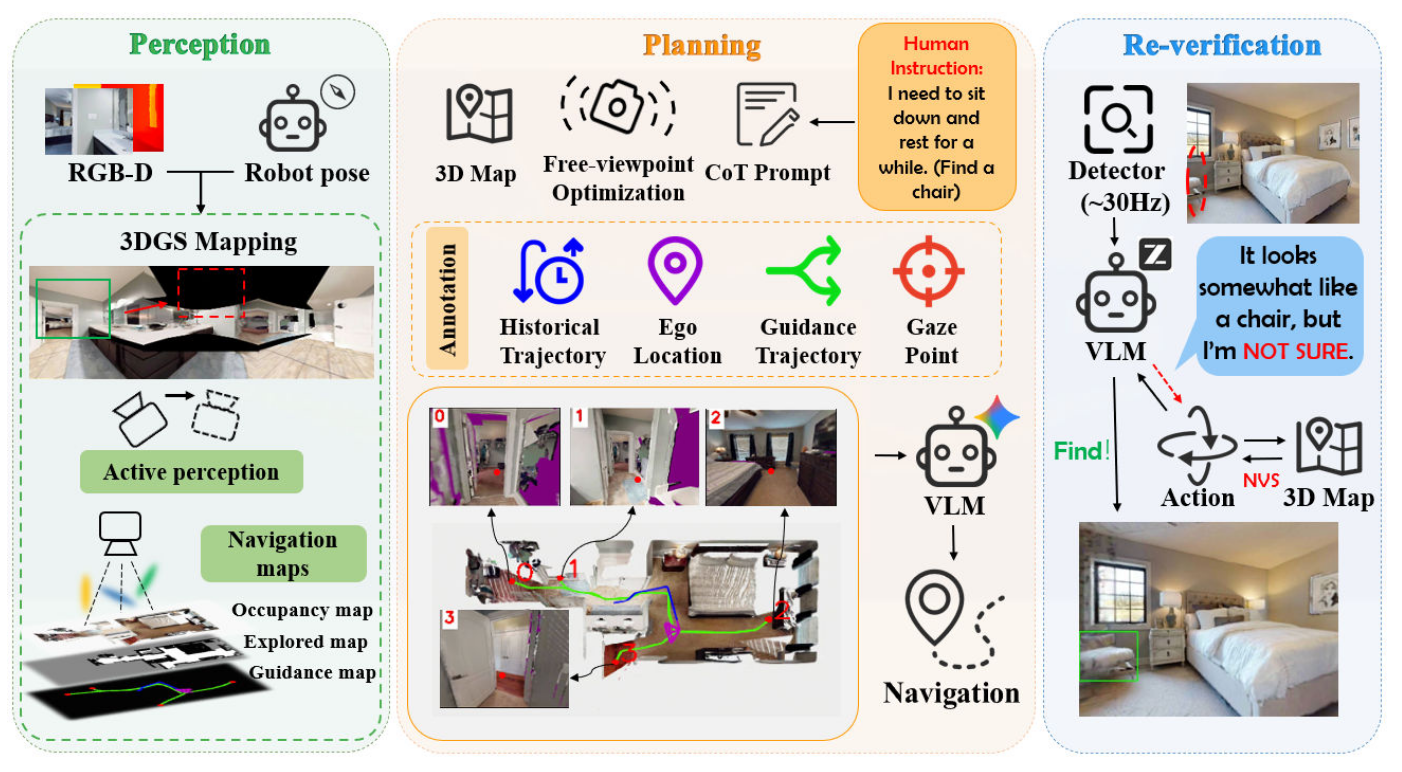
主要方法/创新点
3DGSNav 是一个基于 3D Gaussian Splatting 的 ZSON 框架,核心由三个模块组成:
1. 主动感知(Active Perception)模块
- 使用虚拟相机渲染全景不透明度场(panoramic opacity field),定量估计当前观测完整性
- 利用 DBSCAN 聚类低不透明度区域,识别视觉盲区,计算最优俯仰角 θ* 和偏航角 ϕ*,驱动真实相机主动补偿缺失视角
- 避免机械旋转带来的定位误差与冗余观测
2. 自由视角规划(Free-Viewpoint Planning)模块
- 前沿点提取与聚类:在 3DGS 空间构建探索地图,提取 frontier points(已探索与未探索边界),通过距离场 + 分水岭分割(watershed segmentation)自适应聚类冗余前沿点,选代表性点降低 VLM 分析开销
- 引导轨迹(Guidance Trajectory):基于 Dijkstra + 指数惩罚障碍物距离的代价函数,为每个前沿点生成安全路径,作为自由视角优化的参考基准
- 虚拟视角初始化:利用轨迹曲率 κ 和距离 d 加权得分选最优初始位置,确保既不过近(优化不稳定)也不过远(信息量低)
- 多约束视角优化:最小化复合损失函数 ℒ = λ_opa·ℒ_opa + λ_vis·ℒ_vis + λ_cos·ℒ_cos + λ_traj·ℒ_traj,包含:
- Opacity Loss:控制可见/不可见区域比例
- Ray Occlusion Loss:确保虚拟相机视线直达前沿点(无遮挡)
- Cosine Loss:约束视角方向与前沿点方向一致
- Trajectory Loss:约束相机位置在轨迹附近
3. 结构化视觉提示 + VLM 推理
- 渲染 Bird’s-Eye View(BEV)+ 多个前沿点的 First-Person Views(FPVs)
- 在图像上叠加结构化注释:注视点(gaze point)、未观测区域表示(unobserved region)
- 配合 Chain-of-Thought(CoT)提示,驱动 planner VLM(Gemini 3)对候选前沿点进行空间语义推理,选择最优探索目标
4. 实时检测 + VLM 主动重验证(Re-verification)
- 导航过程中使用轻量实时检测器(YOLOE)初步筛选候选目标
- 当检测置信度不足时,action-decision VLM(GLM-4.1V-Thinking)主动切换视角——将所选动作投影回 3DGS 渲染新视角,获取更具判别力的观测,完成目标二次确认
- 有效降低漏检率和误停率
核心结果/发现
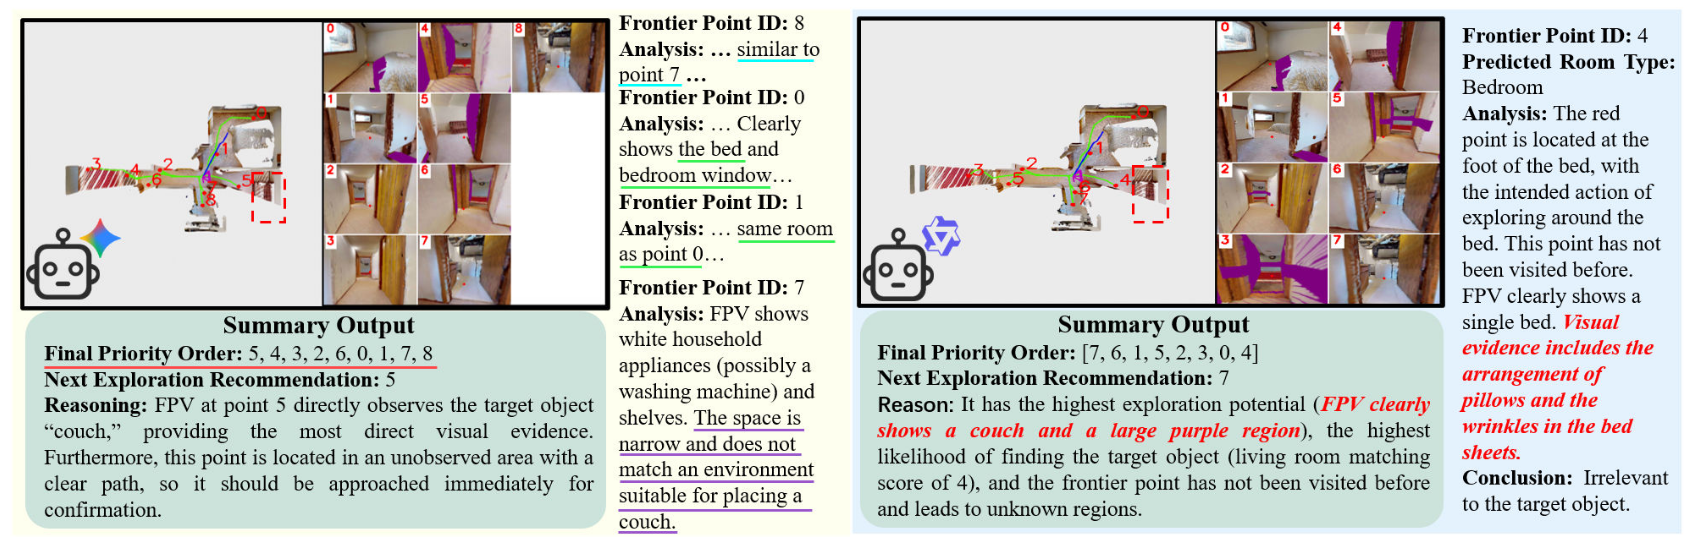
- 在 HM3D、MP3D、Gibson 等多个 ObjectNav 标准 benchmark 上取得 SOTA 或竞争性性能
- 消融实验验证:自由视角优化、结构化注释、CoT、Re-verification 模块均对最终 Success Rate 有显著贡献
- 不同 VLM(Gemini 3、GPT-4V、GLM-4.1V 等)可灵活替换,框架具备良好兼容性
- 在四足机器人真实环境实验中成功复现(定位厕所等目标),验证了 sim-to-real 迁移能力
- Runtime 分析显示主动感知显著优于被动旋转扫描,探索效率更高
局限性
3DGS 的在线增量重建和自由视角优化带来一定计算开销,在计算资源受限的嵌入式平台上实时性仍有挑战;此外,真实场景的动态物体、运动模糊和视觉感知噪声会影响 3DGS 质量,进而影响导航可靠性。
10. WAM-Nav (2026)
———非对称隐空间「世界-动作」联合建模,用一个 DiT 统一三类视觉导航
📄 Paper: arXiv:2606.04907 — WAM-Nav: Asymmetric Latent World-Action Modeling for Unified Visual Navigation
精华
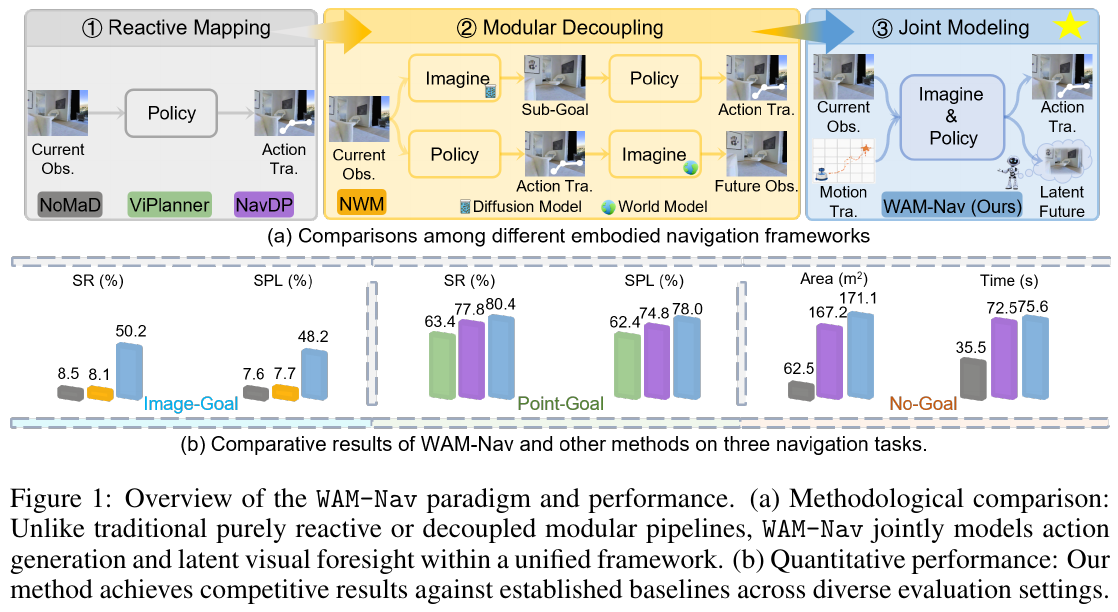
- 把”想象未来画面”与”生成动作”塞进同一个共享 DiT 里联合扩散,而不是先想象再用逆动力学解算动作的解耦式 pipeline,从根上消除了模块间的状态-动作错配与误差累积。
- 核心 insight 是非对称视界(asymmetric horizon):动作用长视界($H_{act}=24$)保证轨迹连续,视觉前瞻只用极短视界($H_{vis}=1$)。因为导航的视角变化剧烈,长自回归视觉 rollout 既慢又容易误差爆炸,短视界恰好提供可靠的近未来几何约束。
- 视觉前瞻全部在 Stable Diffusion VAE 的隐空间里预测(不解码成像素),让”未来感知”以低成本反过来约束动作生成(视觉速度匹配损失惩罚动作-场景不一致)。
- 双流上下文条件(DSCC):视觉记忆流管空间避障,自我运动历史流管运动学动量(平滑性),用运动 token 去 query 视觉空间,兼顾几何安全与轨迹顺滑。
- 统一目标对齐:把 Image-Goal / Point-Goal / No-Goal 都编码成”视觉语义查询 $g_V$ + 几何查询 $g_G$”两路互补 embedding,一个策略零样本支持三类任务且性能均衡,无需切换架构。
1. 研究背景/问题
视觉导航要在复杂几何与物理约束下生成平滑、无碰撞的轨迹。现有范式各有硬伤:反应式端到端策略(GNM/ViNT/NoMaD)直接把观测映射到动作,缺乏预测性推理,在杂乱环境里容易陷入局部最优和碰撞;模块化解耦的世界模型方法(先想象未来子目标,再用逆动力学/轨迹打分)虽有前瞻能力,但预测与决策分离训练,带来高延迟和累积误差。已有的「世界-动作模型」在机器人操作上验证了联合建模的价值,但其自回归生成范式在导航大视角变化下实时性差、误差累积严重。此外多数方法只支持单一目标类型,换任务就得重新设计训练;即便 NavDP 支持多目标,其单模态对齐也导致跨任务性能不均衡。
2. 主要方法/创新点
① 整体框架概述
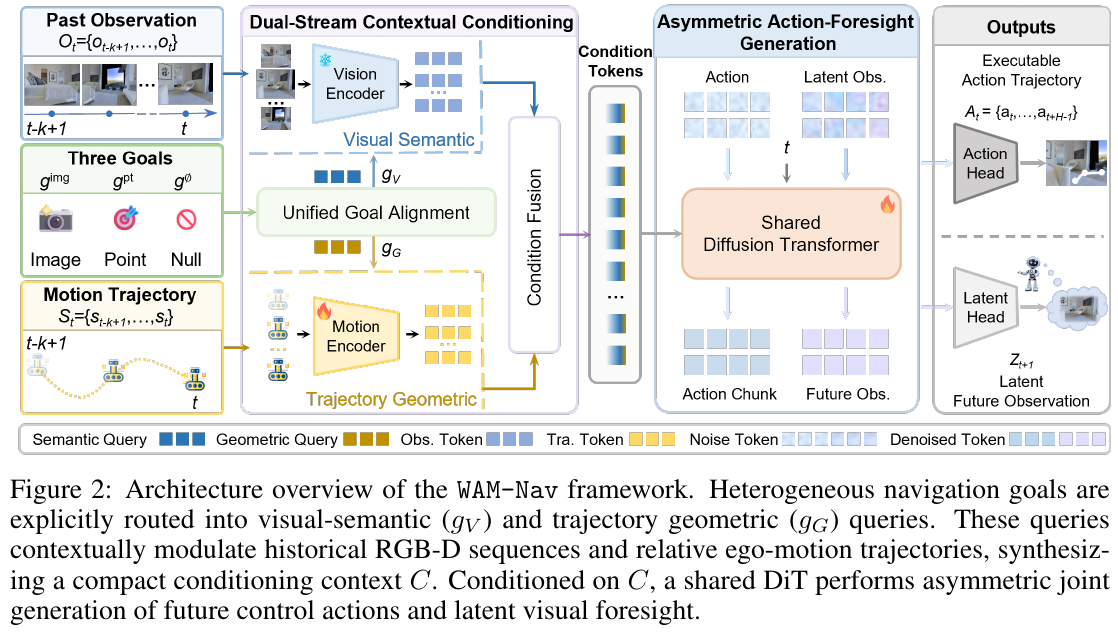
如图 2,WAM-Nav 由三个核心组件构成:(1) 统一目标对齐(Unified Goal Alignment),把异构目标投影到统一空间,产出视觉语义查询 $g_V$ 与几何查询 $g_G$;(2) 双流上下文条件(DSCC),分别编码序列视觉观测和自我运动历史,经目标调制后融合成紧凑条件上下文 $C$;(3) 非对称动作-前瞻生成(Asymmetric Action-Foresight Generation),以 $C$ 为条件,用一个共享 DiT 通过非对称去噪同时生成未来动作轨迹与隐空间视觉前瞻。
② 逐模块讲解
模块一:统一目标对齐(Unified Goal Alignment)
- 输入:一个目标 $g$,可能是目标图像(Image-Goal)、相对坐标(Point-Goal)或空目标(No-Goal)。
- 处理:先用模态专属特征提取器 $E_\phi(\cdot)$ 把 $g$ 转成基础 embedding $e_g$(图像目标用从零训练的 ViT,相对坐标用正弦位置编码,无目标用 masked 零状态);再通过两个可学习线性映射 $\psi_V,\psi_G$ 投到两路功能 token 空间:$g_V=\psi_V(e_g)$、$g_G=\psi_G(e_g)$。
- 输出:视觉语义查询 $g_V$(用于视觉记忆检索)与几何查询 $g_G$(用于轨迹级方向引导)。
- 设计动机:与 NavDP 等”把所有任务都重写成 point-goal”的做法不同,本设计保留模态特异性信息,又提供统一接口,从而在三类目标上性能均衡。
模块二:双流上下文条件 DSCC(Dual-Stream Contextual Conditioning) 仅靠视觉条件会因缺乏显式动量约束而生成抖动、运动学不一致的轨迹。DSCC 在 $t-k+1$ 到 $t$ 的滑动窗口上融合两条流:
- 目标调制视觉记忆流:历史 RGB 观测 $O_t$ 经 DINOv2 编码成记忆张量 $V$;用视觉查询 $g_V$ 对每个 patch token 算缩放点积相关性分数 \(\alpha=\sigma\!\left(\tfrac{g_V V^\top}{\sqrt D}\right)\),再残差强化与目标相关的空间 token:\(\tilde V = V + \alpha \odot V\)。输出:被目标”点亮”的视觉空间记忆。
- 轨迹感知运动历史流:把执行过的位姿序列 $S_t$ 转成坐标无关的相对位移与朝向变化 \(\tilde S_t=\{(\Delta x_i,\Delta y_i,\Delta\theta_i)\}\)(在当前自我中心坐标系下,见 Algorithm 1),经因果 Transformer 编码为 $H$;再用几何目标 $g_G$ 通过 cross-attention query 出一个浓缩的运动学向量 \(o_{kin}=\mathrm{CrossAttn}(g_G,H,H)\)。输出:相对目标方向的历史运动连续性摘要。
- 跨注意力条件融合:用运动学 token $o_{kin}$ 去偏置一组可学习 query $Q_c$,再用多层 Transformer Decoder 让”运动动量”主动 query “目标调制后的视觉空间”:\(C=\mathrm{TransformerDecoder}\big(Q_c+\phi(o_{kin}),\,\tilde V,\,\tilde V\big)\)。输出:统一条件上下文 $C$,同时编码几何安全(避障)与执行平滑(动量)。
模块三:非对称动作-前瞻生成(Asymmetric Action-Foresight Generation) 这是全文最关键的设计。在 $C$ 条件下,模型联合建模:长视界动作轨迹 $A_t={a_t,\dots,a_{t+H_{act}-1}}$ 与短视界隐空间视觉前瞻 \(Z_{t+1:t+H_{vis}}=\{z_{t+1},\dots,z_{t+H_{vis}}\}\),其中 $H_{vis}\le H_{act}$。未来视觉状态 $z_i=\mathcal E(o_i)$ 由预训练 SD-VAE 压成 $N$ 个隐 patch 的紧凑网格。
- 训练用 flow-matching:把高斯先验 $(A_0,Z_0)$ 到数据流形的概率路径建成直线,任意流时刻 $\tau$ 的插值态为 $A_\tau=(1-\tau)A_0+\tau A_1$、$Z_\tau=(1-\tau)Z_0+\tau Z_1$,目标速度场 $u_A=A_1-A_0$、$u_Z=Z_1-Z_0$。
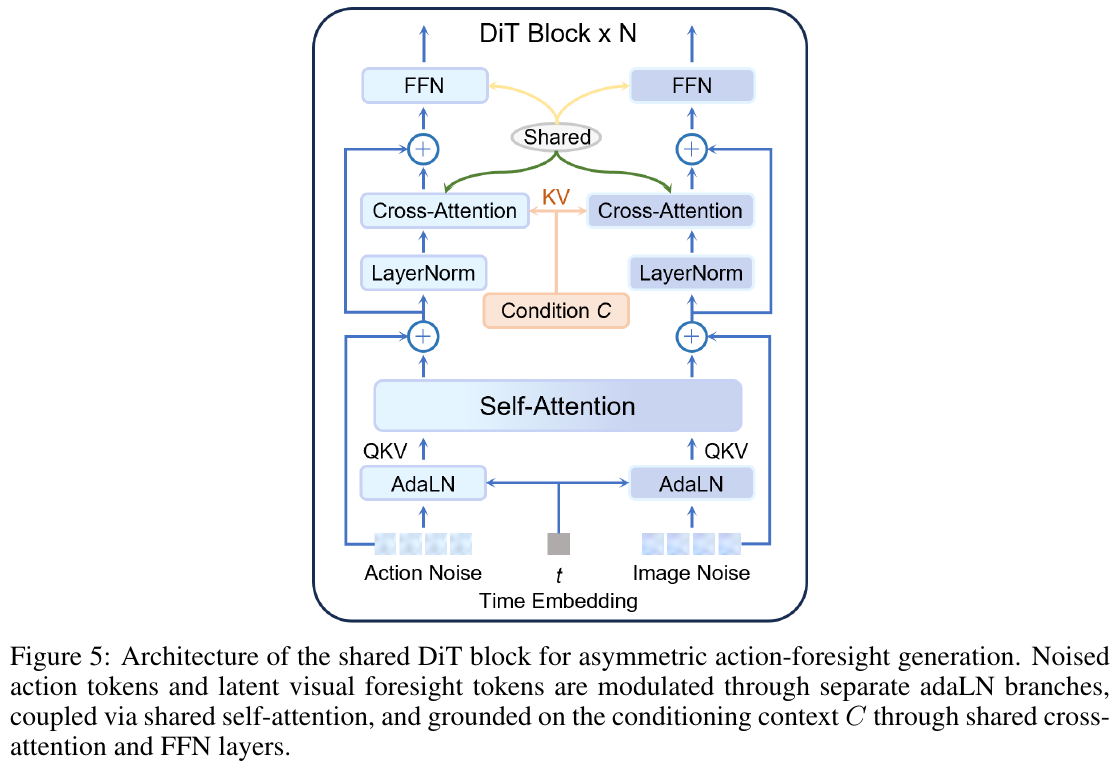
- 共享 DiT:$A_\tau$ 与 $Z_\tau$ 被 token 化后拼接,送入多层 DiT。每个 block 内两类异构 token 先做共享 self-attention(让动作路径与视觉表征逐层交换时空约束),再各自 cross-attend 到条件 $C$,时间步 $\tau$ 经 adaLN 注入,回归联合速度场 $\hat u_A,\hat u_Z=f_\theta(A_\tau,Z_\tau,\tau,C)$。共享参数让隐空间前瞻成为”感知接地”的约束,通过视觉速度匹配损失惩罚动作-场景不一致。
- 为何非对称:操作类 WAM 的未来视觉变化局部、以物体为中心;而导航涉及大幅自我中心视角变化,长自回归视觉 rollout 会同时带来推理延迟和累积视觉误差,反而误导动作。故采用”动作长视界保连续 + 视觉短视界给可靠近未来几何约束”的非对称设计。
③ 端到端数据流:单步样本流经路径为——目标 $g$ → 对齐成 $g_V,g_G$;历史观测 $O_t$、运动历史 $S_t$ → 经 DSCC 双流调制融合成 $C$;高斯噪声 $(A_0,Z_0)$ → 在 $C$ 条件下经共享 DiT 的 10 步 Euler 积分去噪 → 输出执行动作轨迹 $A_t$ 与隐空间未来观测 $Z_{t+1}$。
④ 训练目标:端到端最小化联合损失 \(\mathcal L_{total}=\mathbb E\big[\lVert\hat u_A-u_A\rVert_2^2+\lambda_{img}\lVert\hat u_Z-u_Z\rVert_2^2\big]+\lambda_{align}\mathcal L_{align}\) 其中第一项为动作流速度回归,第二项为视觉前瞻速度匹配($\lambda_{img}=0.25$),第三项 $\mathcal L_{align}$ 为对称对比 InfoNCE 损失($\lambda_{align}=0.1$),通过最大化跨空间投影的互信息保证多目标模态一致性。训练时 DINOv2 ViT-S/14 与 SD-VAE 冻结,目标图像编码器、融合解码器、因果运动编码器与共享 DiT 从零训练。
⑤ 推理流程:采用 receding-horizon 控制循环。与 NavDP 一致,每步在当前 $C$ 下采样 16 条候选轨迹,按 NoMaD 做法选第一条执行;flow-matching ODE 求解器跑 10 步 Euler 积分,平衡生成质量与实时性。
3. 核心结果/发现
主结果(零样本,IsaacSim,ClutterScenes + InternScenes,6000 episodes):WAM-Nav 在三类任务上平均最优——Image-Goal 达 50.2% SR / 48.2% SPL(较 NavDP 提升 15.7% SR),Point-Goal 80.4% SR / 78.0% SPL(提升 3.3%),No-Goal 探索面积 171.1 m²。
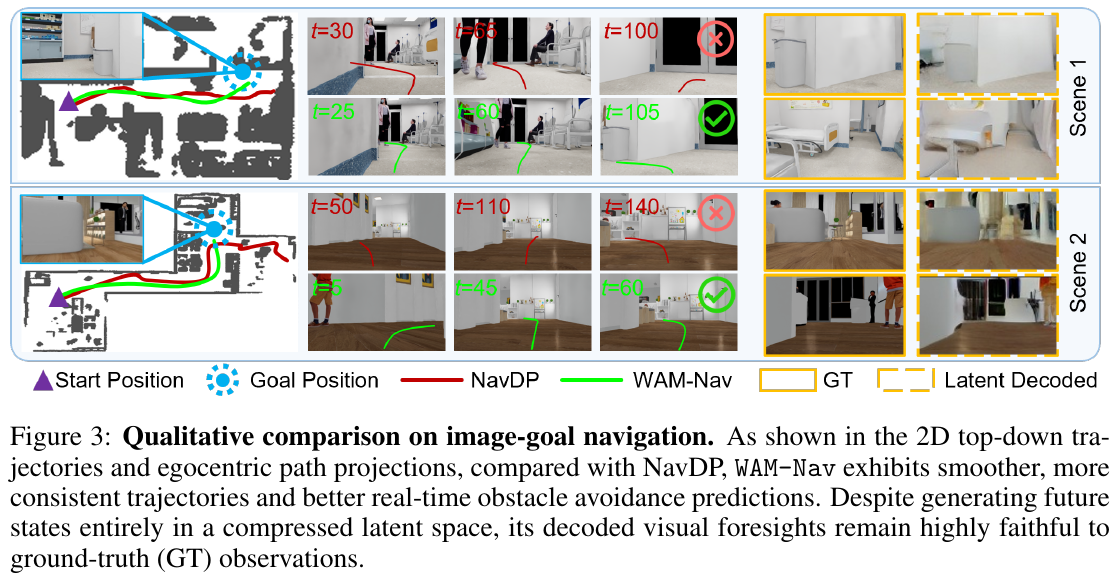
- 效率(Q3):推理延迟 0.26s,每决策仅 0.7 TFLOPs(NavDP 1.3、NWM 8.3),可训练参数与 NavDP 相当;避免了 NWM 那种 1.43s 的多候选视觉 rollout,满足实时导航。
- 消融(Q4):纯隐空间前瞻把 SR 从 42.1%→45.7%;纯运动轨迹在 ClutterScenes 有益但在语义更复杂的 InternScenes 反而下降;两者结合最佳(50.2% SR)——印证 DSCC 设计:运动历史稳定轨迹生成、隐空间前瞻提供安全所需几何约束。
- 非对称视界验证:$H_{vis}=1$ 最佳(50.2 SR),随视觉视界拉长(4/8/24)性能单调下降(直至 30.4 SR),强力支撑”视觉前瞻应给近未来约束而非长自回归 rollout”的核心动机。
- 耦合架构:完全共享 DiT 优于解耦/部分共享变体,说明隐空间前瞻在直接通过共享表征正则化动作生成时最有用。
- 跨本体 & 真实世界:单策略零样本迁移到 Dingo 轮式、Unitree G1/H2 人形机器人均稳定领先 NavDP;真实部署(G1 + RealSense D455,会议室/仓库/大厅/停车场四场景)平均 85% 成功率,验证有效的 sim-to-real 零样本迁移。难度越高(长程)相对 NavDP 优势越大(Hard 子集 +7.6% SR)。
4. 局限性
真实部署发现两类失败:(1) 相机高度与视野受限,对近场低矮障碍感知弱,易漏看导致碰撞或避障延迟;(2) 当前策略未显式建模机器人本体形状,轨迹规划只保证相机能通过,导致身体与侧方障碍碰撞。未来方向:自适应视角控制、以及融入多形态本体的 embodiment-aware 训练。
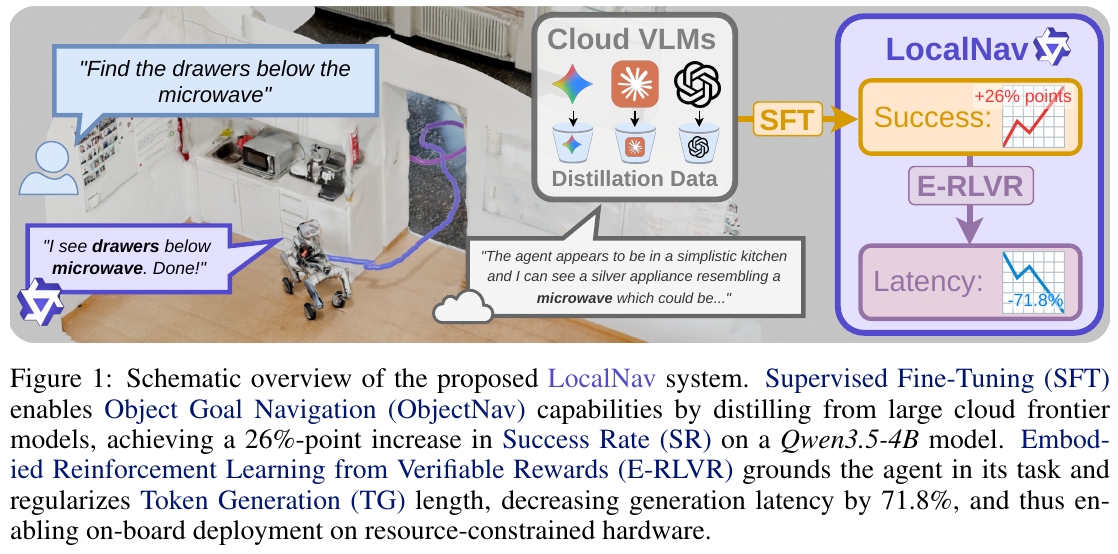
11. LocalNav (2026)
———基于知识蒸馏与具身强化学习的端侧轻量化三维场景图目标导航框架
📄 Paper: arXiv:2606.27871
精华
- 本文提出了 LocalNav,一个将前沿云端大模型(如 Claude 3.5 Sonnet)的复杂空间-语义推理能力蒸馏到端侧轻量化 4B VLM(Qwen3.5-4B)的框架,实现完全本地化运行,摆脱云端依赖。
- 在在线构建的三维拓扑场景图(Scene Graph)基础上,采用仅 500 条高质量云端模型导航轨迹进行监督微调(SFT),将 4B 小模型的导航成功率(SR)大幅度提升。
- 引入具身可验证奖励强化学习(E-RLVR)与 Token 生成长度正则化奖励,对小模型的输出动作 and CoT 链长度进行压缩与规范,减少了 72.1% 的输出 Token 冗余。
- 结合 llama.cpp 的 4-bit 量化(IQ4-XS),在 Jetson Orin AGX 边缘计算平台上实现了累计 82.8% 的推理延迟降低,将单回合运行时间从 305.2 秒压缩至 52.5 秒。
- 整个系统是模块化解耦的,高层 VLM 负责语义推理和宏观决策,低层 PointGoal 导航策略负责避障与运动控制,并在 Unitree 机器狗和手持设备上进行了实车验证。
1. 研究背景/问题
- 开放词汇目标导航(Open-Vocabulary ObjectNav):传统的导航算法通常局限于训练时定义的封闭类群,而引入视觉语言模型(VLM)可以利用其强大的开集感知和语义推理能力,指导机器人进行复杂目标搜索。
- 云端依赖与高延迟问题:目前性能优异 VLM 导航方案(如基于 GPT-4o 或 Claude 3.5 Sonnet)多依赖云端 API 交互。这不仅对网络连接提出了严苛要求,还引入了巨大的通信延迟和隐私泄露风险。
- 本地部署与自回归生成的计算瓶颈:尽管 2B-7B 级别的轻量级 VLM 理论上可在端侧(如英伟达 Jetson 平台)部署,但其零样本的语义导航能力极差(SR 仅 21%)。此外,小模型在生成高层决策指令时常伴随大量的思维链(CoT)冗余,使得自回归解码(Token Generation)成为端侧运行的主要延迟瓶颈(占 93.3% 运行时间)。
2. 主要方法/创新点
① 整体框架概述
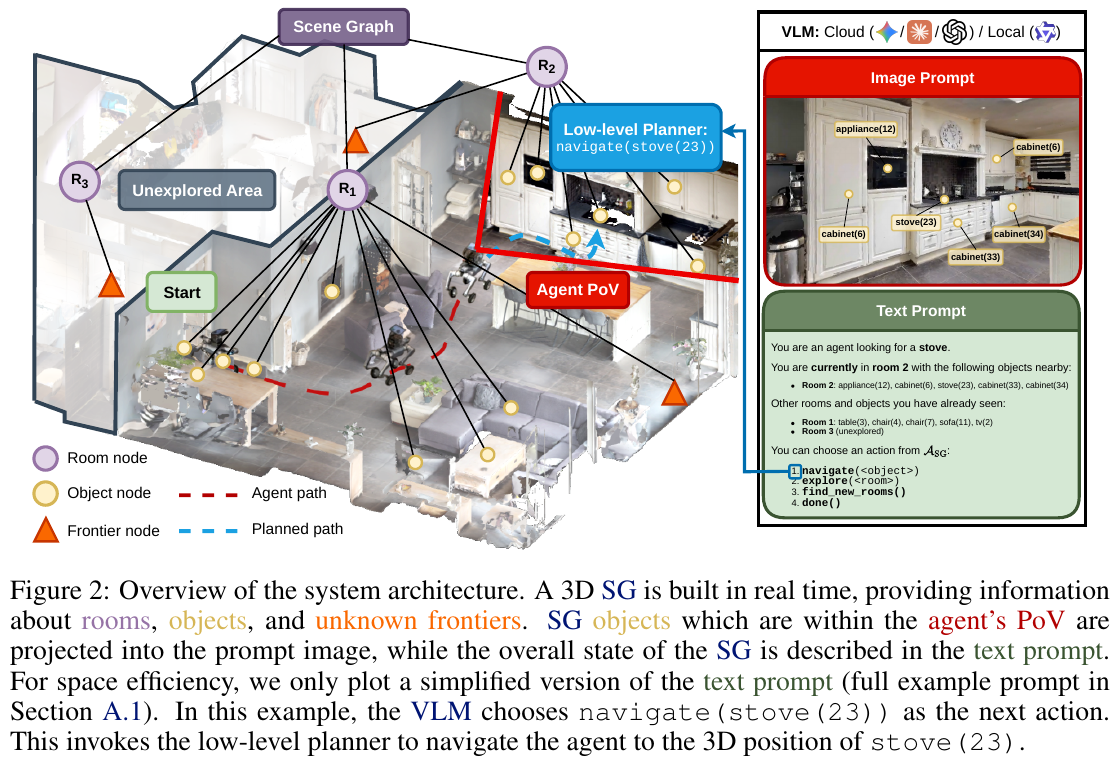
LocalNav 系统由三维拓扑场景图(Scene Graph)构建模块、高层 VLM 决策规划器以及低层 PointGoal 运动规划策略三大核心模块构成。高层 VLM 通过结合环境 360° 拼接全景图(含物体 ID 投影)与文本形式的场景图节点列表,选择宏观语义动作(导航、探索、寻找新房间或停止);低层运动策略则负责执行点对点三维路径规划与运动避障。
② 逐模块讲解
- 3D 拓扑场景图(Scene Graph)构建
- 输入:传感器获取的 RGB-D 深度图、机器人里程计(Odometry),以及预训练的目标检测分割模型(如 Mask2Former)提供的物体类别标签(或仿真环境中的真实标注)。
- 处理:利用开源 Hydra 框架在线构建和维护一个包含 Room 节点和 Object 节点的三维场景拓扑图。该图提供明确的拓扑连接结构和物体空间位置,充当机器人的显式空间记忆。
- 输出:在决策点为 VLM 组装两种模态的信息:
- 文本 Prompt:当前所在 Room、已探索/未探索 Room 列表、已知物体类别与空间 ID。
- 图像 Prompt:将当前视场角(PoV)内场景图物体 ID 直接投影叠加在 360° 全景图上(类似于 Set-of-Mark 提示),完成符号 ID 与像素区域的对齐锚定。
- 设计动机:显式三维场景图提供了非连续的抽象状态空间,能将机器人高频运动与 VLM 的低频决策解耦,降低计算开销,并具有极佳的可解释性。
- 监督微调(SFT)知识蒸馏
- 输入:在 Habitat 仿真器环境(HM3D OVON 数据集)中使用 privileged action space(特权最短路径导航)获取的、由 Claude 3.5 Sonnet、GPT-4o/5.4、Gemini 3.1 Pro 引导并成功完成任务的原始推理轨迹日志(包含图像对和拓扑状态),约 500 条样本。
- 处理:将高层前沿 VLM(Teacher)的推理决策行为作为标签,对本地轻量级 VLM 学生模型(Qwen3.5-4B)进行监督微调。
- 输出:微调后的 Local VLM,初步具备在当前三维拓扑图上选择合理宏观动作的能力。
- 设计动机:小模型直接在 ObjectNav 上表现差。利用前沿模型的推理痕迹进行行为克隆(Behavior Cloning),能以极小的数据量(~500 样本)快速赋予小模型开集场景推理与决策的常识。
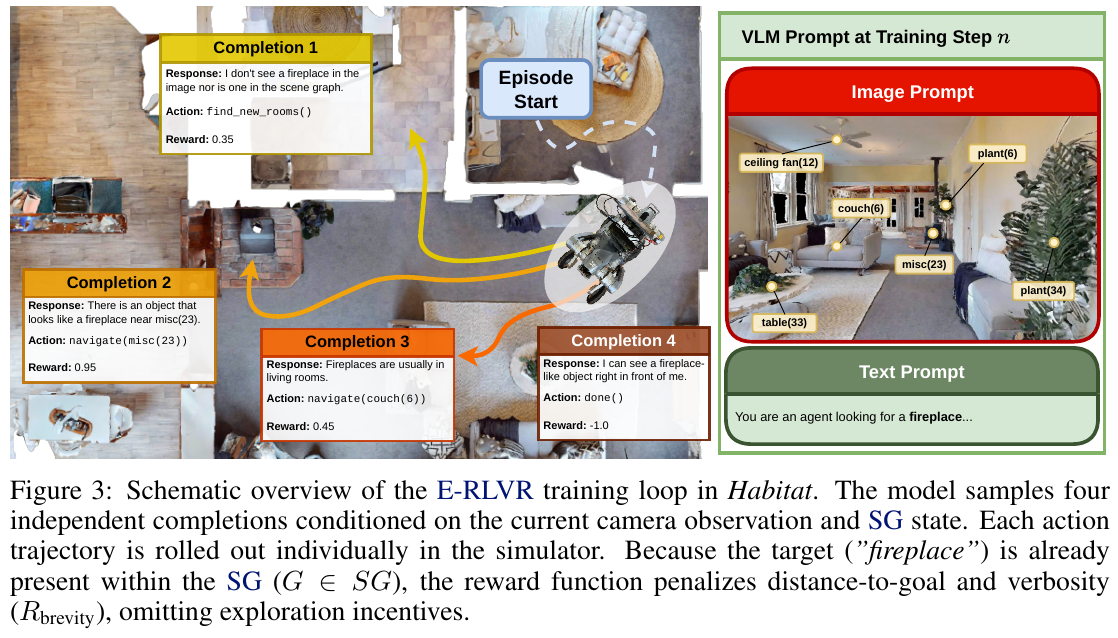
- 具身可验证奖励强化学习(E-RLVR)动作优化
- 输入:SFT 后的小 VLM 模型,在 Habitat 仿真环境中的闭环交互回放轨迹。
- 处理:基于 LoRA 参数高效微调,应用 Group Relative Policy Optimization (GRPO) 算法。在每个决策点,生成
N = 4个独立的动作补全并复制当前仿真环境状态进行并行轨迹 rollout。 - 输出:优化动作准确率并压缩了 CoT 冗余的 Local VLM 权重。
- 设计动机:SFT 训练的模型输出字数较多,且在推理时可能会出现空间记忆幻觉或无用的重复打转。E-RLVR 采用“实践中学习”的方法,结合仿真环境中的可验证反馈来调整模型行为。
③ 训练目标与损失函数
在 E-RLVR 阶段,模型通过并行 rollout 轨迹的相对优势更新,所采用的累加奖励函数定义如下: \(R_{tot} = R_{done} + R_{nav} + R_{exp} + R_{brev}\) 其中各项公式的定义及作用为:
- 终点可验证奖励 \(R_{done}\): \(R_{done} = \begin{cases} 1.0 & \text{若执行 done() 且机器人距离目标物体符合成功阈值} \\ -1.0 & \text{若执行 done() 但未成功(误报)} \\ 0.0 & \text{执行其他动作} \end{cases}\) 用于惩罚妄动终止和奖励正确归航。
- 导航进步奖励 \(R_{nav}\):
\(R_{nav} = \begin{cases} \Delta d & \text{当目标物体已被收入场景图且机器人向其靠近} \\ 0 & \text{其他情况} \end{cases}\)
\Delta d代表向目标移动的归一化距离增量,鼓励快速缩短与目标的距离。 - 探索拓展奖励 \(R_{exp}\): \(R_{exp} = \begin{cases} 0.0 & \text{若目标 G 已在场景图中} \\ \lambda_{found} & \text{当目标 G 首次被收入场景图} \\ \Delta n & \text{发现新拓扑节点的归一化增量} \end{cases}\) 激励机器人在目标未知时探索未知区域。
- 输出长度惩罚(Brevity Reward)\(R_{brev}\):
\(R_{brev} = \begin{cases} 1.0 & L \le L_t \\ 1 - 2 \frac{L - L_t}{L_m - L_t} & L_t < L < L_m \\ -1.0 & L \ge L_m \end{cases}\)
其中
L为生成动作的 Token 字符长度,L_t为目标理想短字数,L_m为最大字数。该惩罚以线性惩罚模型过度长篇大论,迫使其精简 CoT 思维链,只保留最核心的空间推理,在保障 SR 的同时极大削减 Token 生成的计算量。
④ 推理与量化部署流程
为了在低算力移动机器人平台上运行,作者将 E-RLVR 微调后的模型通过 llama.cpp 进行量化。经 Pareto 前沿评估,选择了 IQ4-XS(4-bit 量化)格式,使 Token 生成速度从 17.68 tok/s 提升至 39.43 tok/s,在保留模型推理精确性的同时,突破了端侧 GPU 的内存和带宽限制。
3. 核心结果/发现
- SFT 蒸馏来源评估:在 HM3D OVON 测试集上,采用不同前沿模型作为教师,微调后的 Qwen3.5-4B 表现出差异。使用 Claude 3.5 Sonnet 蒸馏 of 4B 模型最为优秀,SR 从 Base 的 21% 跃升至 47%,甚至超过了混合源蒸馏(41%)。
- E-RLVR 的双重优化作用:SFT 训练后的模型虽强但冗余较多(平均输出 535.2 个 Token,单回合耗时 305.2 秒)。叠加 E-RLVR 训练后,输出 Token 数直降 72.1% 至 149.36,使得在 Jetson Orin AGX 上的物理推理延迟降低 71.8%(下降至 86.0 秒),且成功率甚至微幅上升至 49%。
- 量化联合提速:最终“SFT + E-RLVR + 4-bit 量化 (IQ4-XS)”的完整路线,使推理吞吐量翻倍(~39.43 tok/s),在 Jetson Orin AGX 端侧将物理运行时间大幅缩减 82.8%(仅耗时 52.5 秒),而成功率仅微弱损耗 2% 左右。
- Benchmark 对比:在 HM3D OVON 标准评测(含低层 PointGoal 执行误差)中,基于云端 Claude 3.5 Sonnet 的高层方案取得了 39.7% SR,而完全本地化运行的 Qwen3.5-4B-Claude 学生模型取得了 34.5% SR,与前沿云端模型的性能差距缩窄至仅 5.2%,处于端侧部署方案的业界领先水平。
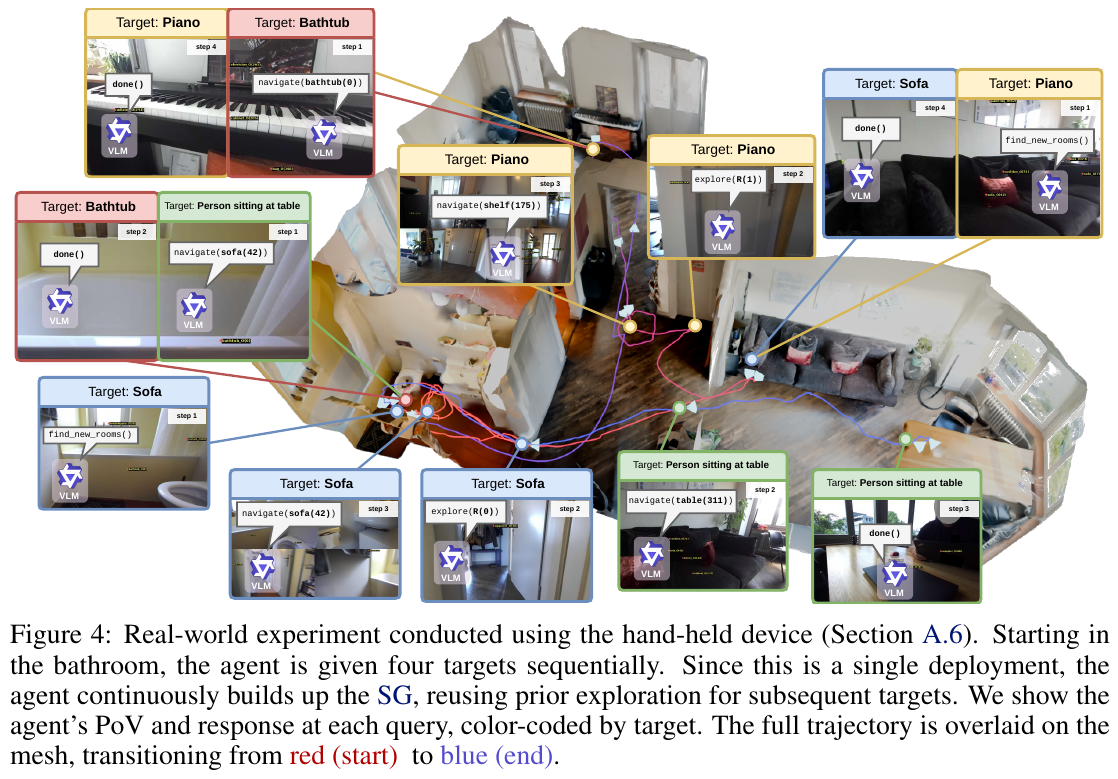
4. 局限性
- 时空语义局限性:拓扑场景图目前难以融合动态/瞬时或具有多重语义组合的属性(例如无法区分“普通椅子”与“坐了人的椅子”),必须依赖机器人反复触发 VLM 进行稠密视觉验证。
- 三维感知依赖:对于物体分割检测的精度(如 Mask2Former)和三维重建算法(如 Hydra)的鲁棒性高度敏感,感知模块的误检或漏检会直接导致场景图拓扑结构崩塌,进而引发 VLM 决策链错误。
12. AECNav (2026)
———把”找物体”改写成”攒证据”:一次编码、按需分割、对数几率累积信念
📄 Paper: arXiv:2608.10817 · Project Page
精华
- 目标确认不该是”单帧分数过阈值就停”,而应是”多视角证据的累加”:借用占据栅格的 log-odds 加法更新,让一致的观测能把置信度推高到任何单帧都达不到的水平。
- 负证据和正证据同样重要:相似干扰物(confuser)得分更高、以及”该看到却没看到”(miss),都应主动扣减信念,而不只是”不加分”。
- 一个共享骨干(C-RADIOv4)同时服务场景打分、patch 定位与实例分割,既消除多模型语义不一致,又省去重复编码;昂贵的分割头再用几乎免费的 patch 相似度做门控。
- 前沿选择要同时考虑”方向对不对 + 沿途能看到多少新区域 + 走过去要多远”;信息增益若没有路程代价约束,会把机器人引向空旷大区域白白消耗步数。
- 训练-free 管线在精度上反超训练方法的同时,单 episode 耗时比 VLFM 还快 2.2 倍,说明”少做无用功”本身就是精度来源。
1. 研究背景/问题
零样本开放词汇物体导航(ZSON)要求机器人在陌生环境中找到任意语言描述的物体。现有基于价值地图的方法存在三个瓶颈:前沿选择与目标确认使用互不相干的多套视觉模型(CLIP/BLIP-2 + GroundingDINO/MobileSAM),造成重复编码与高延迟;目标确认靠单帧阈值或”平均化”融合,难以区分真目标与外观相似的干扰物;前沿选择只看语义相关度,忽略到达代价与可获得的新信息量,在语义线索弱时容易在远处低收益前沿之间来回摆动。
2. 主要方法/创新点
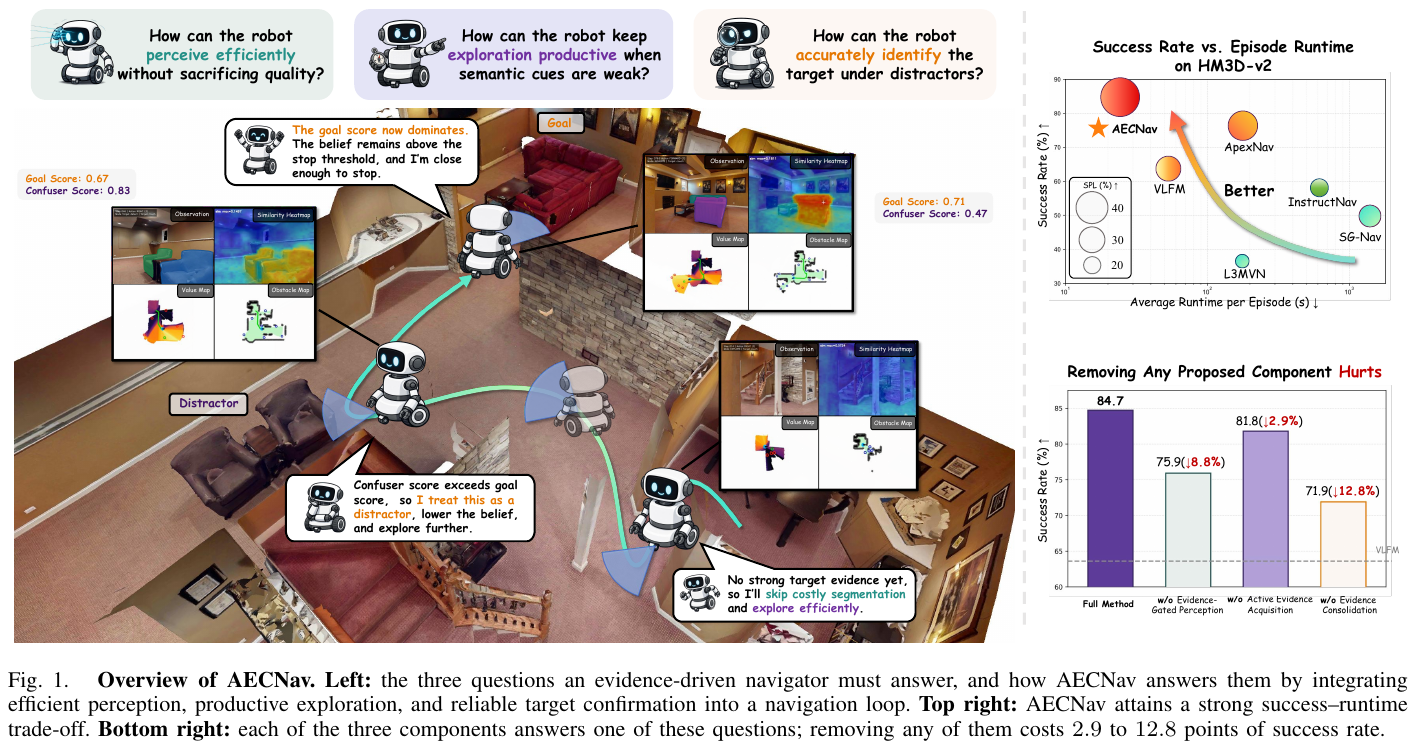
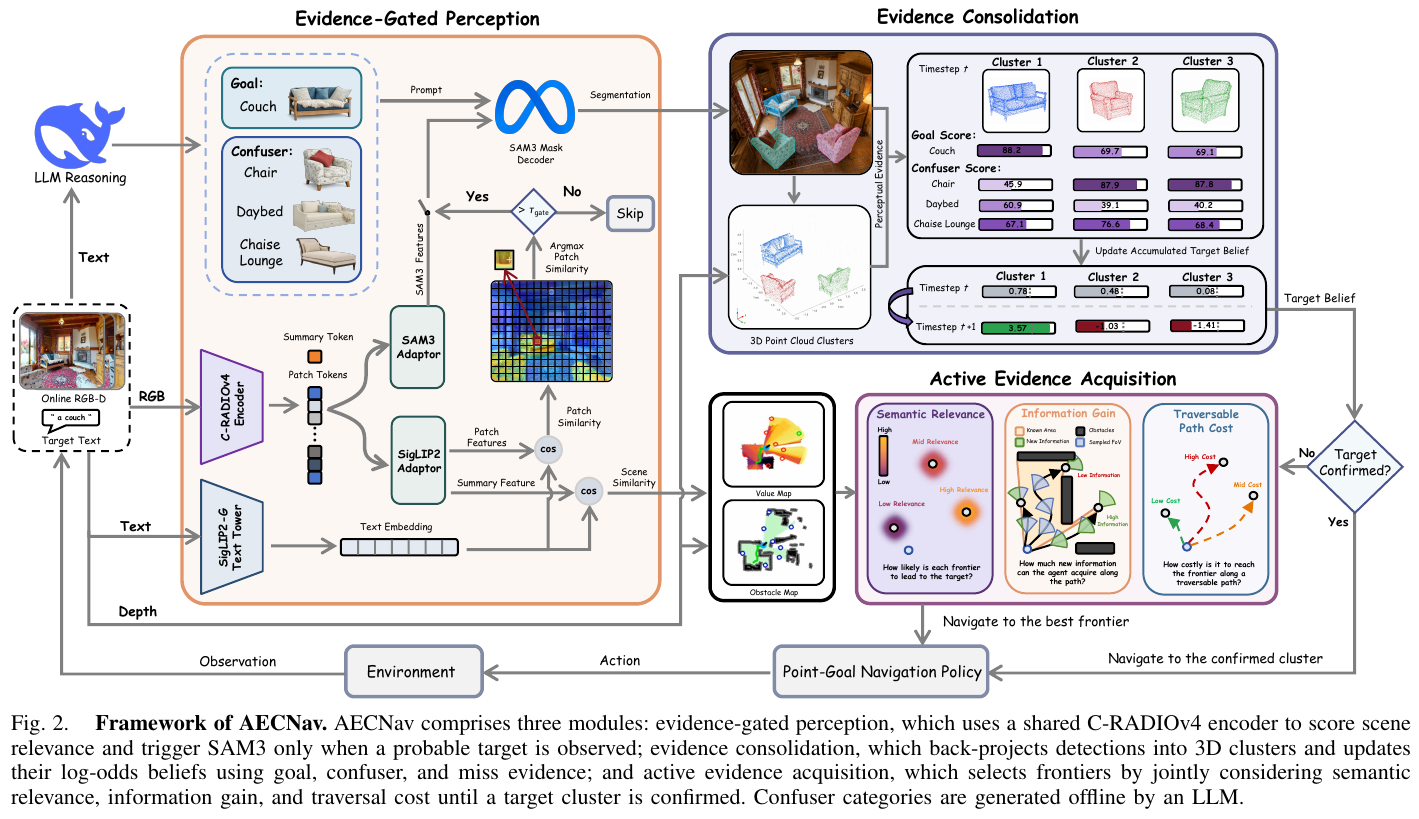
① 整体框架概述
AECNav 把 ZSON 重新表述为”证据驱动的感知→决策”问题,由三个模块闭环构成:证据门控感知(Evidence-Gated Perception)负责用一次前向提取所有语义线索,并决定要不要跑昂贵的分割;证据整合(Evidence Consolidation)把分割结果变成 3D 候选簇,并为每个簇维护一个”它是不是目标”的累积信念;主动证据获取(Active Evidence Acquisition)在信念不足以停下时,挑选”最值得去看一眼”的前沿。底层运动交给 VLFM 同款预训练 PointNav 策略。
下面是读者版的数据流(一次决策循环):
graph TD
    A["RGB-D 观测 + 目标文本"] --> B["C-RADIOv4 单次前向: summary token + patch tokens"]
    B --> C["场景相似度写入价值地图"]
    B --> D{"最大 patch 相似度 > 门控阈值?"}
    D -- "否 (约 62% 的步)" --> G["跳过分割"]
    D -- "是" --> E["SAM3 同时分割目标与干扰类别"]
    E --> F["反投影成 3D 簇, 按 log-odds 更新信念"]
    G --> H{"某簇信念稳定超过停止阈值且足够近?"}
    F --> H
    H -- "是" --> I["STOP"]
    H -- "否" --> J["按 语义+信息增益-路程代价 选前沿"]
    C --> J
    J --> K["PointNav 执行动作, 获得新观测"]
    K --> A
② 逐模块讲解
模块 1:证据门控感知
- 输入:当前 RGB 图像 $I_t$、目标类别名 $g$。
- 处理:C-RADIOv4 编码器 $E$ 一次前向输出 summary token $z_t^{\text{sum}}$(整幅图的全局语义)与 $N$ 个 patch token $z_t^{\text{patch}}$(每个局部区域的语义)。目标名只用 SigLIP2 文本塔编码一次得到 $e_g$ 并缓存整个 episode。
- 场景相关度:summary token 经 SigLIP2 adaptor $f$ 对齐到文本空间,$\sigma_t^{\text{scene}} = \cos(f(z_t^{\text{sum}}), e_g)$,再按深度和位姿投影到俯视价值地图 $V_t$,作为”哪个方向可能有目标”的持久先验。
- 局部目标指示:同一个 adaptor 作用到每个 patch 上,取最大值 $\sigma_t^{\text{patch}} = \max_i \cos(f(z_{t,i}^{\text{patch}}), e_g)$——直觉上就是”画面里最像目标的那一小块有多像”。
- 门控:只有 $\sigma_t^{\text{patch}} > \tau_{\text{gate}}$(取 0.08)时,才把已算好的特征送进 SAM3 mask decoder 做实例分割,否则整步跳过分割。
- 输出:价值地图更新;以及(可能有的)带目标分与干扰分的实例分割结果。
- 设计动机:旧方法用 BLIP-2 打场景分、YOLO/GroundingDINO 做检测、MobileSAM 做分割,三套编码语义不一致且重复计算。共享骨干让所有阶段”看同一份表征”;而门控判断复用已算好的 patch 相似度,几乎零成本,却能跳过 60% 以上的 SAM3 调用。
模块 2:证据整合(核心卡点)
- 输入:SAM3 输出的实例 mask、深度、位姿;每个实例带目标分 $s_g$ 与最高干扰分 $s_{\text{conf}}$(干扰类别由 LLM 离线为每个目标生成至多 3 个,如 couch 的干扰物为 chair / daybed / chaise lounge,并跨 episode 缓存)。低于 $\tau_{\text{det}}=0.4$ 的检测直接丢弃。
- 处理:实例反投影成 3D 点云,若与最近观测到的某簇距离小于 0.75 m 就融合进去,否则新建簇。每个簇 $C_k$ 维护一个标量对数几率信念——可以理解为”支持它是目标的证据分”,0 表示中立,正数偏向是目标,负数偏向不是:
每次观测按加法更新并截断在 $[-4, 4]$ 内:
\[l(C_k) \leftarrow l(C_k) + \Delta l^{\text{sem}}(C_k) + \Delta l^{\text{miss}}(C_k)\]- 语义项(对被检测命中的簇):比较目标分与干扰分,谁明显占优就朝谁的方向推,差距在中性边界 $\delta=0.10$ 内则不动:
其中 $\tilde s_g, \tilde s_{\text{conf}}$ 是重标定后的分数(保证过了 $\tau_{\text{det}}$ 的检测 logit 非负),$\rho_k \in [0,1]$ 是新实例与簇的空间重叠度,$\alpha_{\text{sem}}=0.7$。
- 缺失项(对信念为正、且落在视野内却没被检测到的簇):”该看见却没看见”本身就是反证:
$v_k$ 是簇的 3D 点落在当前视锥内的比例,$s_{\text{miss}}=0.2083$ 是由统计估计的单帧漏检率,$\alpha_{\text{miss}}=0.3$。视野外的簇不受影响。
- 输出:每个簇的累积信念。当某簇信念超过 $\tau_{\text{stop}}=1.0$,机器人朝它走并持续更新;只有在连续 5 帧中至少 2 帧超过阈值、且距离簇 0.5 m 以内时才真正 STOP。
- 设计动机:ApexNav 也做时序融合,但它是平均——置信度永远不会超过最强那一帧,而且模糊视角和决定性视角权重相同。log-odds 的加法让一致观测复利累积;干扰项和缺失项则让错误假设被主动”撤销”。
举个例子(取 $\rho_k = 1$,假设重标定后分数即为下文数值):
- 真目标:连续 3 帧看到同一把沙发,每帧 $\tilde s_g = 0.8$,$\text{logit}(0.8) = \ln 4 \approx 1.39$,每帧加 $0.7 \times 1.39 \approx 0.97$。3 帧后信念 $\approx 2.91$,稳稳超过 $\tau_{\text{stop}} = 1.0$。若用平均法,置信度始终停在 0.8,”看得再多也不会更确定”。
- 干扰物:找 chair 时看到沙发,目标分 0.47、干扰分 0.86(Fig. 4 真机数据),干扰分高出 $\delta$ 以上,若 $\tilde s_{\text{conf}} = 0.8$ 则该簇扣 0.97,直接变成负信念,机器人不会被它吸走。
- 误检撤回:某帧把远处杂物误检成垃圾桶,信念升到 +0.97。走近后它完整落在视野内($v_k = 1$)却连续没被检测到,每帧扣 $0.3 \times \text{logit}(0.79) \approx 0.3 \times 1.34 \approx 0.40$;仅 1 帧后信念就降到 0.57、跌破停止阈值,机器人被”释放”回去继续探索;3 帧后变为 −0.23。
模块 3:主动证据获取
- 输入:价值地图 $V_t$、占据栅格(1000×1000,0.05 m/格)、当前前沿集合。
- 处理:对每个前沿 $f$ 计算复合效用(三项先在当前前沿集合内做 min-max 归一化,使尺度可比):
- $S_t$:与 VLFM 相同,聚合前沿附近的价值地图值——”这个方向像不像有目标”。
- $G_t$:在占据栅格上用 BFS 求到前沿的最短可通行路径 $\pi_t(f)$,沿路径每 0.75 m 采样一个视点(朝向沿路径切线,终点朝向附近未知区域),在 79° 水平视场内每 5° 射一条光线、最远 5 m,碰到已知障碍即停;所有光线扫过的未知格子并集就是信息增益 $G_t(f) = \lvert U_t \cap \text{Vis}(\pi_t(f)) \rvert$。关键在于它统计的是”一路上能看到多少新东西”,而不只是终点。
- $C_t$:路径长度 $\lvert \pi_t(f) \rvert$。
- 输出:效用最高的前沿,交给 PointNav 执行。
- 设计动机:纯语义排序只说明”往哪边可能有”,不管”去那里能新看到多少、要走多远”。弱语义线索时,这正是来回摆动、步数浪费的根源。
| 维度 | 传统做法(VLFM / ApexNav 等) | AECNav |
|---|---|---|
| 视觉编码 | 场景打分、检测、分割各用一套模型 | 一个 C-RADIOv4 前向,多个 adaptor 头共享 |
| 分割调用 | 每步都跑 | patch 相似度门控,跳过约 62.5% |
| 目标确认 | 单帧阈值,或多帧平均 | 3D 簇级 log-odds 累加,含干扰物与漏检负证据 |
| 前沿选择 | 语义价值(ApexNav 弱线索时退回几何) | 语义 + 沿途信息增益 − 路径代价 |
③ 端到端数据流
一步决策的完整路径为:RGB-D 进入 C-RADIOv4 → summary token 更新价值地图、patch 相似度决定是否触发 SAM3 → 若触发,SAM3 以”目标 + LLM 生成的干扰类别”为提示分割 → 实例反投影并入 3D 簇、更新 log-odds 信念(视野内未命中的正信念簇扣 miss 分)→ 若某簇满足”稳定 + 足够近”则 STOP,若只是超阈值则朝它导航,否则按复合效用选前沿 → PointNav 输出 MOVE_FORWARD(0.25 m)/ TURN(30°)等离散动作 → 新观测回到开头。
④ 训练目标
完全 training-free:没有任何损失函数或微调,所有组件(C-RADIOv4 + SigLIP2/SAM3 adaptor、DeepSeek-V4-Flash 生成的干扰类别、预训练 PointNav)均直接复用,只有少量阈值与权重超参。
⑤ 推理流程
默认超参:$\tau_{\text{gate}}=0.08$,$\tau_{\text{det}}=0.4$,信念范围 $[-4,4]$,$(\alpha_{\text{sem}}, \alpha_{\text{miss}})=(0.7, 0.3)$,$\lambda_{\text{info}}=\lambda_{\text{dist}}=1.0$,C-RADIOv4(SO400M)输入 672×672。LLM 只在离线阶段为每个目标类别生成一次干扰类别,推理时没有在线 LLM 调用,这是它比 SG-Nav / InstructNav 快一到两个数量级的原因之一。
3. 核心结果/发现
主结果(全部为 training-free,与训练方法同表比较):
| 基准 | AECNav SR / SPL | 此前最佳 | 提升 |
|---|---|---|---|
| HM3D-v2 | 84.7 / 45.3 | TrajRAG 78.1 / 40.2 | SR +6.6,SPL +5.1 |
| MP3D | 51.3 / 25.9 | WMNav 45.4 / 17.2 | SR +5.9,SPL +8.7 |
| HM3D-OVON | 57.3 / 30.5 | MSGNav 48.3 / 27.0 | SR +9.0 |
开放词汇最难的 HM3D-OVON 上提升最大,与”类别越多、相似干扰物越多,log-odds 抗干扰越有用”的设计相吻合。
效率(HM3D-v2 前 100 个 episode):AECNav 平均 108.63 步、24.39 s/episode;VLFM 53.36 s,ApexNav 177.97 s,SG-Nav 超过 1400 s。步数比第二名 ASCENT 少 33%,耗时比 VLFM 快 2.2 倍。
感知管线分析:把 BLIP-2 + YOLOv7 + MobileSAM 换成 C-RADIO,SR 从 75.9 升到 84.7、延迟从 0.402 降到 0.248 s/step;再加门控($\tau_{\text{gate}}=0.08$)跳过 62.5% 的 SAM3 调用,延迟降到 0.178 s/step 且精度不掉,整体比多模型基线快 2.3 倍。
消融:
- 去掉证据整合(检测到就直接走过去)掉得最多:SR −12.8。
- 仅保留目标分的 log-odds 累积就已达 81.9 SR(比无累积高 10 个点)——累积本身是主要收益来源;干扰项再 +1.8,缺失项再 +1.3,两者修复的是互不重叠的错误类型,合计到 84.7。
- 去掉主动证据获取:SR −2.9,SPL −3.5。
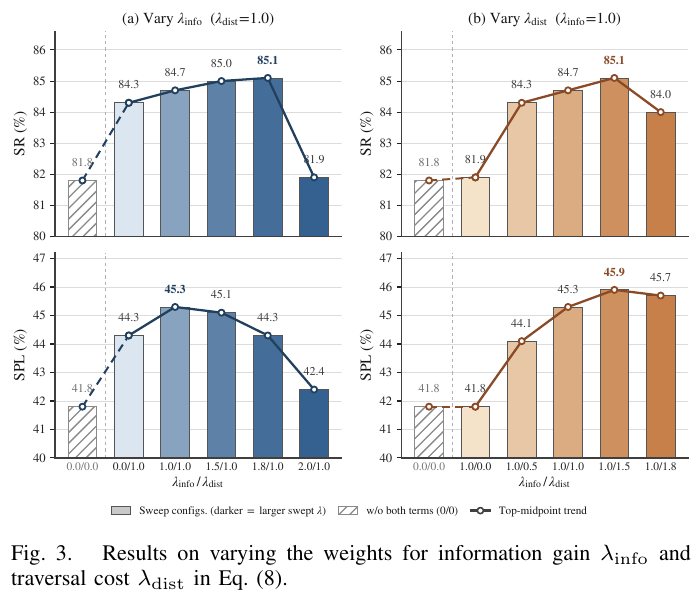
一个反直觉的发现:信息增益单独使用几乎没用。没有代价约束时,它总偏爱视野开阔的大区域,把机器人派去长途远行,既耗步数又偏离语义有希望的区域;只有与路径代价配对,它才成为有效的”性价比”信号。
真机:Unitree Go2 + RealSense D455,4 个室内场景、8 个开放词汇目标(含”饮水机”“咖啡机”等标准词表外类别,椅子实验刻意放了沙发和长凳作干扰),40 次中成功 38 次(95%),单次决策 197.4 ms(约 5 Hz)。
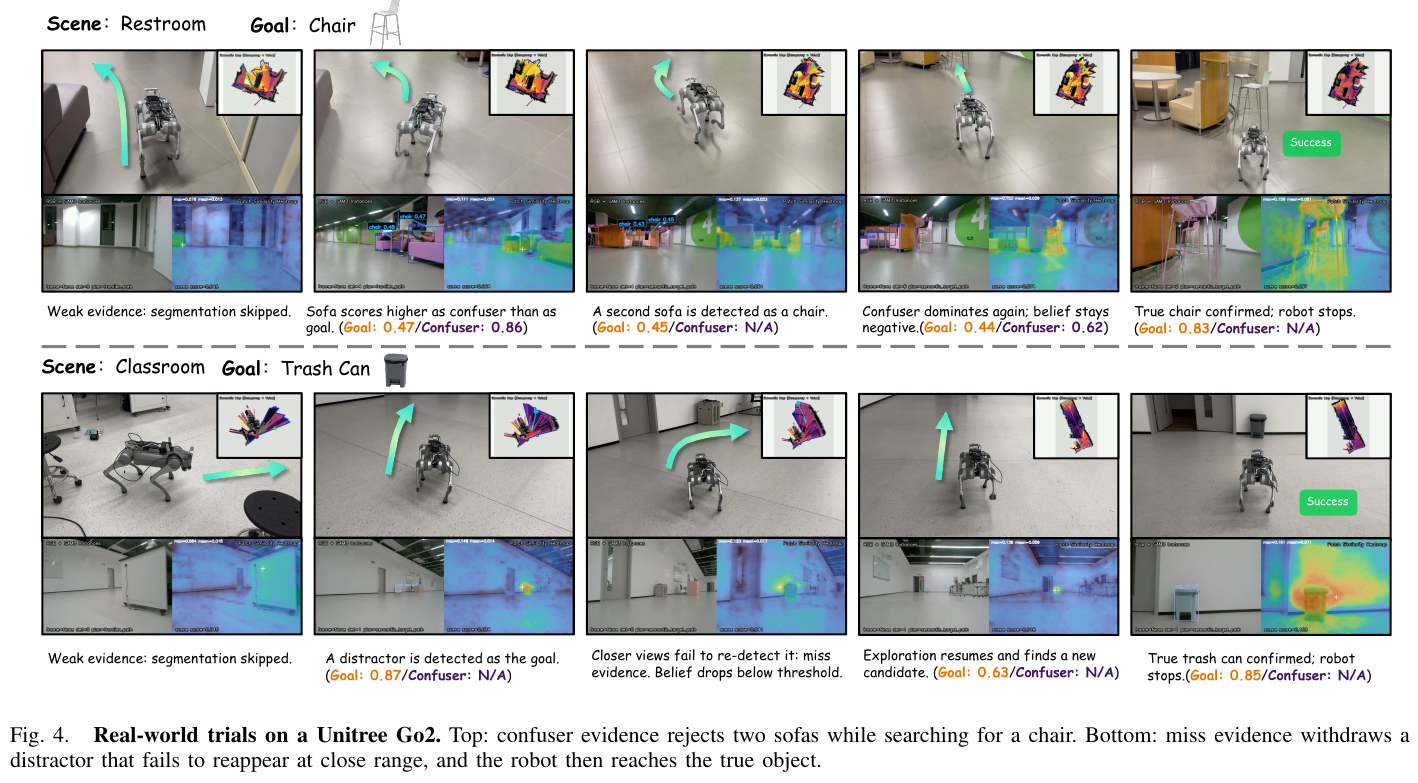
4. 局限性
干扰类别依赖 LLM 离线生成的固定小集合(至多 3 个),若真实干扰物不在列表中,负证据就无法生效;方法大量依赖手调阈值与权重(门控阈值、漏检率先验、停止窗口等)。真机实验规模较小(40 次),两次失败分别来自前视相机从未看到的角落和大空旷区域的步数耗尽,说明探索策略在这两类场景仍有盲区。
13. VNT-PA (2026)
———把”在哪看到的”而不是”什么时候看到的”作为位置编码:无显式地图的 Transformer 规划器
📄 Paper: arXiv:2609.21212
精华
- 记忆按”在哪”组织比按”何时”组织更适合表示环境:一组带相机位姿的深度关键帧本身就能充当规划用的环境表示,不需要显式建图。
- 把相机位姿当作 RoPE 位置编码,注意力就只依赖两帧之间的位姿差,天然与帧的时间顺序无关、与世界坐标原点无关。
- 同样的架构只换位置编码(时间 → 位姿),长距离 episode 的 SPL 差距最高达 17.1 个点,训练收敛也快 4 倍以上——归纳偏置比模型容量更重要。
- 上下文是无序集合,所以测试时可以随意并入其他轨迹、其他时间的帧,无需重训;关键帧过滤让上下文规模只随”看过的空间”增长,而不随轨迹长度增长。
- 相比先把噪声位姿”写死”进栅格地图的 OctoMap + A*,隐式表示在定位误差下退化得平缓得多。
1. 研究背景/问题
学习型导航策略几乎都把历史观测当作时间序列处理(时间索引 token、滑动窗口或循环隐状态)。这种记忆无法自然地放入”上一次来这里时”或”另一台机器人”看到的观测,成本也随历史长度增长。真正复用长期经验的系统则另建一套度量/拓扑地图用于规划,同一环境维护两份表示。作者要回答:能否让学习型规划器直接以带位姿的经验作为环境表示,而不经过显式地图?
2. 主要方法/创新点
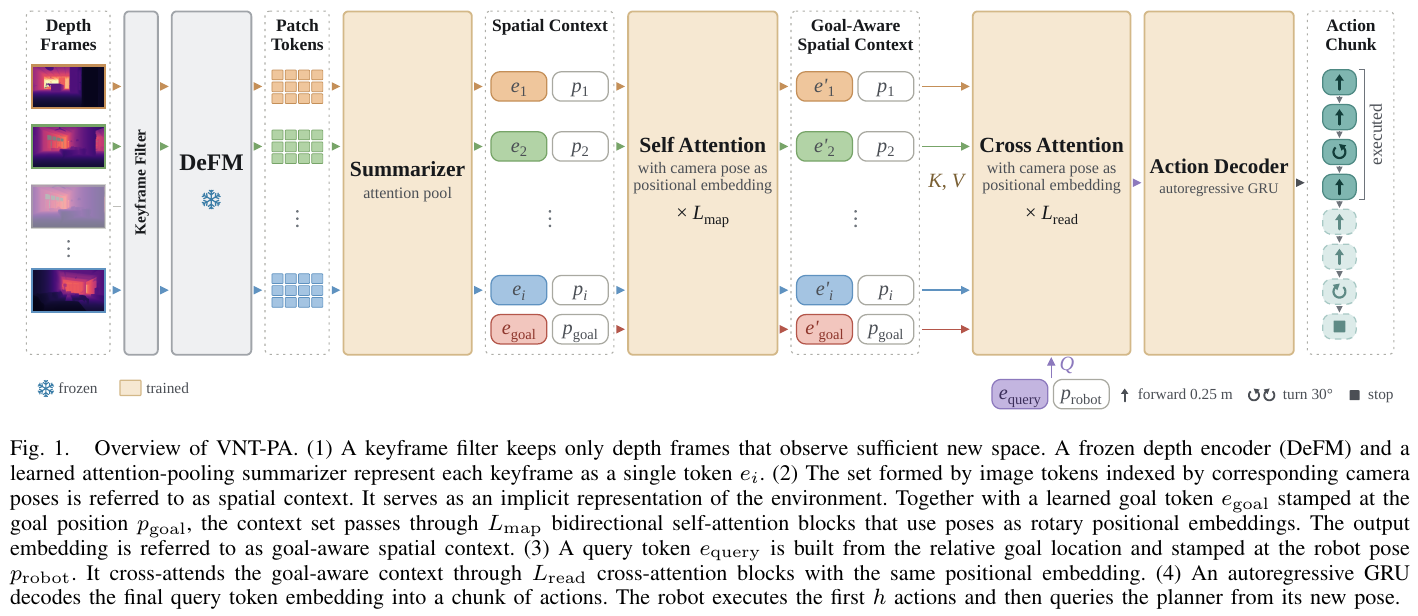
问题设定:与 PointGoal 类似,机器人已知自身位姿与目标位置,执行 FORWARD(0.25 m)/ TURN-LEFT / TURN-RIGHT(30°)/ STOP。不同之处在于:机器人还拿到此前探索时记录的深度帧 $I_1, \dots, I_N$ 及其位姿,而且规划时不看当前视图,只靠这些旧帧、机器人位姿和目标来决策——旧帧必须承担”地图”的职责。
① 整体框架概述
VNT-PA 由四段组成:关键帧过滤与编码把大量深度帧精简并各压成一个 token;空间上下文 + 位姿 RoPE 自注意力让各帧与目标通过位姿差互相关联,形成隐式地图;机器人位姿锚定的查询通过交叉注意力从隐式地图中读出决策信息;GRU 动作解码器输出一段动作。
| 维度 | 时间上下文(序列模型) | 空间上下文(VNT-PA) |
|---|---|---|
| 每帧的索引 | 第几帧(时间步 $t$) | 相机位姿 $(x, y, \psi)$ |
| 注意力依赖 | 两帧的时间间隔 | 两帧的位姿差 |
| 并入其他轨迹的帧 | 没有自然的插入位置 | 带位姿即可直接加入 |
| 上下文规模 | 随历史长度增长 | 随观测到的空间大小增长 |
② 逐模块讲解
关键帧过滤(Keyframe Filter)
- 输入:按顺序到来的深度帧及位姿
- 处理:把每帧划为 $G \times G$ 个 patch,取每个 patch 的中值深度沿中心射线反投影,量化到”体素 + 视角方向”标签,得到该帧观测到的集合 $C(I_i, p_i)$;若该帧新观测到的体素数不少于 $\eta$,则保留:
- 输出:关键帧集合($G = 16$、$\eta = 10$ 时平均保留 21% 的帧,每条轨迹约 67 帧)
- 设计动机:注意力的代价随条目数增长,相邻位姿的帧高度重叠;而且在集合里删掉一个条目不影响其他条目的索引,这在时间序列中做不到
帧编码(Frame Embedding)
- 输入:224×224 深度图
- 处理:冻结的深度基础模型 DeFM(ViT-S/14)得到 16×16 个 384 维 patch token,再由可学习的注意力池化汇总器压成一个向量 $e_i$
- 输出:空间上下文 $\mathcal S = {(e_i, p_i)}$
- 设计动机:导航决策只依赖几何,所以用深度而非 RGB
位姿 RoPE(核心卡点)
标准 RoPE 把 query/key 向量的每两维看作一个平面,按”位置 × 频率”旋转对应角度。由于两个旋转矩阵满足 $R(a)^\top R(b) = R(b - a)$,旋转后的点积只取决于位置之差。VNT-PA 把这个”位置”从时间步换成相机位姿的三个分量:
\[R(p) = R_\omega(x) \oplus R_\omega(y) \oplus R_\nu(\psi)\]于是位姿 $p_i$ 处的 query 与位姿 $p_j$ 处的 key 之间的注意力分数为:
\[\langle R(p_i) q_i,\ R(p_j) k_j \rangle = q_i^\top R(p_j - p_i) k_j\]举个例子(只看 $x$ 分量、只取一个频率,设每米旋转 1 弧度): 查询在 $x = 2$ m,键在 $x = 5$ m。查询向量旋转 2 弧度,键向量旋转 5 弧度,二者点积只剩下相对旋转 $5 - 2 = 3$ 弧度的效果。 如果把世界坐标原点平移 10 m,两者变为 12 m 和 15 m,相对旋转仍是 3 弧度,注意力分数完全不变。 如果换成时间 RoPE,同样两帧可能是第 7 帧和第 40 帧,间隔 33——这个数字取决于探索路线怎么走,与两帧在空间上是否相邻毫无关系。
频率设计的几个细节:
- 位置频率:$\omega_m = s^{-1} b^{-(m-1)/n}$,最高频率每 $s$ 米转 1 弧度。$s$ 越小越能区分相近位姿,但对定位误差更敏感
- 防止绕回:最低频率对应最长波长 $\lambda_{max} = 2\pi s\, b^{(n-1)/n}$,位移超过 $\lambda_{max}/2$ 时旋转会与反方向的短位移混淆。取 $s = 0.25$ m、$b = 100$、$n = 16$,得 $\lambda_{max} \approx 2\pi \times 0.25 \times 75 \approx 118$ m,超过多数训练场景尺寸的两倍
- 朝向频率:朝向是周期量,取整数频率 $\nu_m = m$,保证转一整圈结果不变;朝向部分的注意力因此成为 $\psi_j - \psi_i$ 的傅里叶级数
- 旋转增强:这种编码对世界坐标平移不变、对旋转不变性不成立,所以训练时把整个世界坐标系随机旋转 $\gamma \sim U[0, 2\pi)$,让模型从数据中学到旋转不变性
目标感知上下文(Goal-Aware Context)
- 输入:空间上下文 + 一个可学习的目标 token $e_{goal}$,标记在目标位置 $p_{goal}$(目标没有朝向,其朝向子空间置零)
- 处理:$L_{map} = 6$ 层双向自注意力,全部使用位姿 RoPE
- 输出:每个条目都已通过位姿差与其他帧、与目标建立关联的上下文
- 设计动机:在做任何决策之前,先让”地图”内部完成信息整合,类似隐式建图
查询与读出(Query)
- 输入:目标在机器人坐标系下的位置 $\Delta p = (\Delta x, \Delta y)$,夹角 $\alpha = \mathrm{atan2}(\Delta y, \Delta x)$
- 处理:查询 token 为 $f(\lVert \Delta p \rVert, \cos\alpha, \sin\alpha)$,标记在机器人位姿处,经 $L_{read} = 4$ 层交叉注意力读取目标感知上下文
- 输出:查询 token 的输出嵌入 $z$
- 设计动机:查询里刻意不放当前或过去的观测,迫使每次决策都基于空间上下文,行为上类似传统的”地图 + 规划器”
动作解码器(Action Decoder)
- 输入:$z$
- 处理:GRU 自回归解码 $H = 8$ 个动作;训练时以专家动作为条件,执行时以实际动作为条件
- 输出:动作块,执行前 $h = 4$ 个后从新位姿重新查询
- 设计动机:$h$ 越小重规划越频繁,越大动作越连贯
③ 端到端数据流
graph TD
    A["探索轨迹的深度帧 + 位姿"] --> B["关键帧过滤: 只留看到足够新空间的帧"]
    B --> C["DeFM + 注意力池化: 每帧一个 token"]
    C --> D["空间上下文 + 目标 token"]
    D --> E["6 层自注意力 (位姿 RoPE): 目标感知上下文"]
    F["机器人位姿 + 目标相对位置"] --> G["查询 token"]
    G --> H["4 层交叉注意力 (位姿 RoPE)"]
    E --> H
    H --> I["GRU 解码 8 个动作, 执行前 4 个"]
    I --> F
④ 训练目标
模仿 Habitat-Sim 在真值网格上的最短路径规划器,对动作块做交叉熵:
\[\mathcal L(\theta) = -\mathbb E\left[ \sum_{\ell=1}^{H} \log \pi_\theta\left( a_\ell^* \mid \tilde S, \tilde p_{robot}, p_{goal}, a_{1:\ell-1}^* \right) \right]\]其中 $\tilde S$、$\tilde p_{robot}$ 是加了噪声的上下文位姿与机器人位姿(每轴 ±0.1 m、±0.2 rad),用于模拟定位误差。训练时对几乎直线的样本(绕行比 $\kappa < 1.1$)按概率丢弃,以突出需要绕行的难样本。模型共 74.3M 可训练参数,单张 L40S 训练约 4 小时;300 帧上下文下单步推理 14 ms。
3. 核心结果/发现
HM3D 验证场景闭环导航(2,220 条 episode,三个随机种子):
| 方法 | 总体 SR | 总体 SPL | 距离 ≥15 m SR | 距离 ≥15 m SPL |
|---|---|---|---|---|
| LSTM | 31.9 | 28.5 | 5.7 | 5.1 |
| SRU | 30.3 | 27.3 | 7.8 | 7.1 |
| Causal Transformer | 90.3 | 87.3 | 80.4 | 77.4 |
| VNT-TA(时间 RoPE) | 87.1 | 83.9 | 67.7 | 64.9 |
| VNT-PF(位姿作输入特征) | 89.5 | 86.5 | 73.6 | 70.8 |
| VNT-PA(仅位姿,无深度特征) | 66.4 | 62.8 | 41.7 | 39.5 |
| VNT-PA | 93.3 | 90.4 | 85.4 | 82.0 |
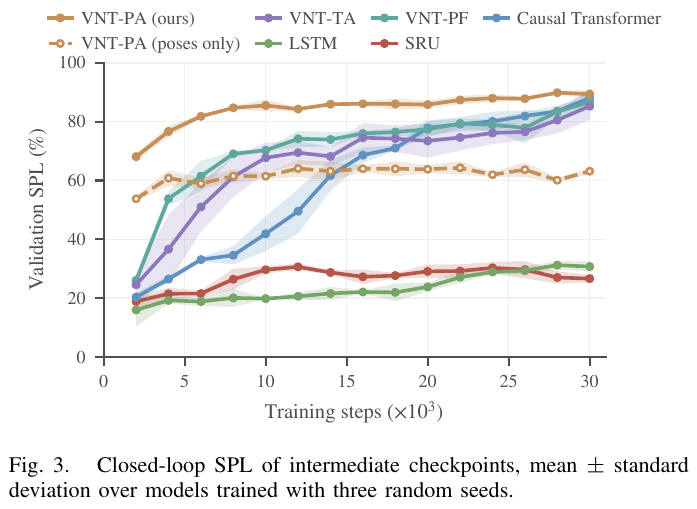
- 与 VNT-TA 架构完全相同、只差位置编码,随距离增长 SPL 差距从 4.6 扩大到 17.1 个点,说明优势来自位姿 RoPE 本身
- 循环网络在绕行比 $\kappa \ge 1.5$ 的 episode 上成功率仅约 11%,固定大小的隐状态难以承担环境表示
- 仅用位姿就有 66.4%(关键帧位姿本身就标出了可通行位置),其余提升来自深度特征携带的几何
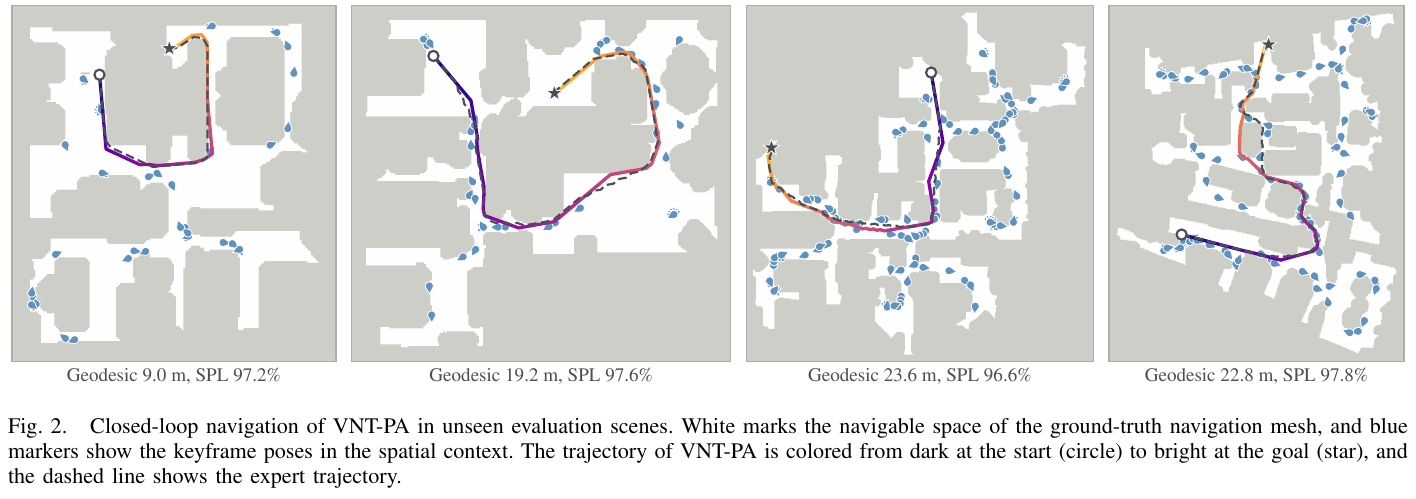
测试时扩展上下文(单种子,无需重训):加入被过滤掉的帧(平均 67 → 313 帧)、或每次查询时加入当前视图,均能提升成功率;≥15 m 的 episode 从 87.7% 最高升至 96.3%。
训练效率:VNT-PA 在 5,000 步内三个种子均达到 80% SPL,Causal Transformer、VNT-PF、VNT-TA 需要 20,000 步以上。
定位误差鲁棒性(关键帧上下文):
| 方法 | 精确位姿 SR | 噪声位姿 SR |
|---|---|---|
| OctoMap + A* | 96.2 | 54.1(−42.1) |
| VNT-PA | 94.6 | 86.6(−8.0) |
显式地图会把每帧按噪声位姿写入栅格,把通畅的走廊误标为障碍;VNT-PA 的失败多是”在成功半径外一点点就 STOP”。改用全部帧建图时 OctoMap 恢复到 78.1%,仍低于 VNT-PA 的 88.0%。
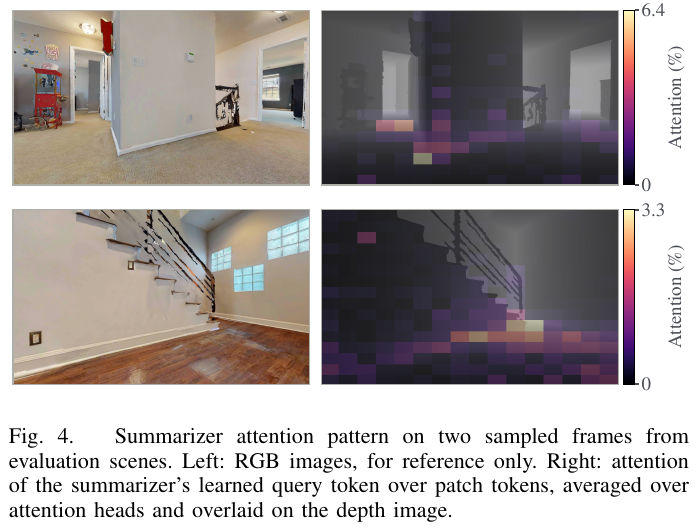
4. 局限性
只做 2D 平面规划并假设相机高度恒定;动作是离散的,定位误差被建模为每步独立扰动,而非沿轨迹累积的真实里程计漂移;任务是纯几何的 PointGoal,尚未接入语义或语言特征。此外,方法需要事先有一次覆盖场景的探索轨迹,且与 OctoMap + A* 的鲁棒性对比只用了单一噪声水平。
相关策略、世界模型与评测
14. NAVCON (2024)
——— 认知启发与语言落地的首个大规模 Vision-Language Navigation 概念数据集
📄 Paper: arXiv:2412.13026
精华
- 提出了首个基于认知科学与语言学理论的视觉语言导航(VLN)概念数据集 NAVCON,包含对 R2R 和 RxR 约 30,000 条指令的 23.6 万个高层导航概念标注。
- 定义了四种核心导航概念:定位自身(SIT)、移动路径(MOVE)、改变方向(CD)和改变区域(CR),构成了完备的导航语言原语。
- 利用 RxR 的时间戳信息,通过 Habitat 模拟器实现了 270 万帧图像/视频片段与导航概念词组的跨模态时间对齐。
- 基于该语料库微调的轻量级序列标注模型 NCC,达到了 96.53% 的概念和文本跨度预测准确率,展现出极强的泛化与落地潜力。
- 这一工作为打破 VLN 端到端黑盒设计提供了结构化的语义解析工具,有助于提高跨模态对齐的可解释性与实时运行效率。
1. 研究背景/问题
传统的视觉语言导航(VLN)模型多采用黑盒端到端架构,存在视觉与文本 token 对齐不平衡、缺乏可解释性等问题。此外,现有的句法解析方法过于依赖外部嘈杂的依存句法分析器,导致在下游机器人导航任务中泛化性能差、可解释性低。因此,如何定义完备的导航概念并实现低成本、高精度的细粒度文本-视频对齐,是实现可信、透明且高效的具身智能体导航的关键瓶颈。
2. 主要方法/创新点
NAVCON 提出了一套完整的视觉-语言导航概念自动化构建与标注流水线,实现了自然语言指令到核心导航概念(标签 + 文本跨度)以及视频片段的端到端对齐。
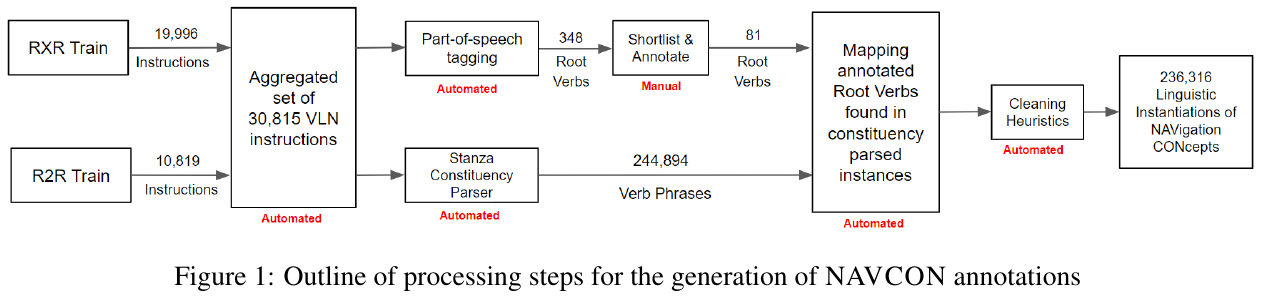
① 整体框架概述
整个构建框架由导航概念定义、语言概念提取与人工评估以及视频剪辑对齐与时序窗口微调三个核心阶段组成。它通过自然语言处理管线提取指令中的动作谓词及修饰词组,并与 Habitat 模拟器导出的智能体第一视角视频流进行多模态时序关联。
② 逐模块讲解
- 导航概念定义模块:
- 输入:无标注的导航指令文本。
- 处理:基于动物与人类大脑空间建图的认知科学研究(如海马区位置细胞、边缘系统头部方向细胞、内嗅皮层边界细胞和自主运动系统),系统定义了四种核心导航概念:
- 定位自身(Situate Yourself, SIT):标识当前所处的位置与环境特征(如 “standing in front of that pillar”)。
- 移动路径(Move along a Path, MOVE):表示沿特定物理通道的位移(如 “step into this area with a large pool”)。
- 改变方向(Change Direction, CD):描述朝向的转动(如 “turn around from the bench”)。
- 改变区域(Change Region, CR):刻画越过物理边界进入新空间的动作(如 “enter the room that is in front of you”)。
- 输出:导航概念的分类体系。
- 设计动机:提供符合认知科学、且覆盖主流 VLN 指令所需的完备导航语言原语。
- 语言概念提取管线:
- 输入:来自 R2R 和 RxR 数据集的 30,815 条训练指令。
- 处理:利用 Stanza constituency parser 等 NLP 工具进行分词、词干化、词性标注与句法分析。首先检索出 348 个候选根动词,通过人工筛选保留 81 个无歧义映射到上述四大概念的导航根动词;然后提取这 81 个根动词的所有句法子节点,形成代表导航概念的完整谓词短语。
- 输出:236,316 个自动生成的“银标(silver)”导航概念短语标注(包含概念类别与对应的文本跨度)。
- 设计动机:降低人工标注的成本,同时利用 constituency trees 保证提取出的概念词组的句法完整性(包含修饰语和地标名词)。
- 视频剪辑对齐与微调模块:
- 输入:带有单词级时间戳的 RxR 导航指令、 Matterport 3D 场景以及智能体运动轨迹姿态(pose traces)。
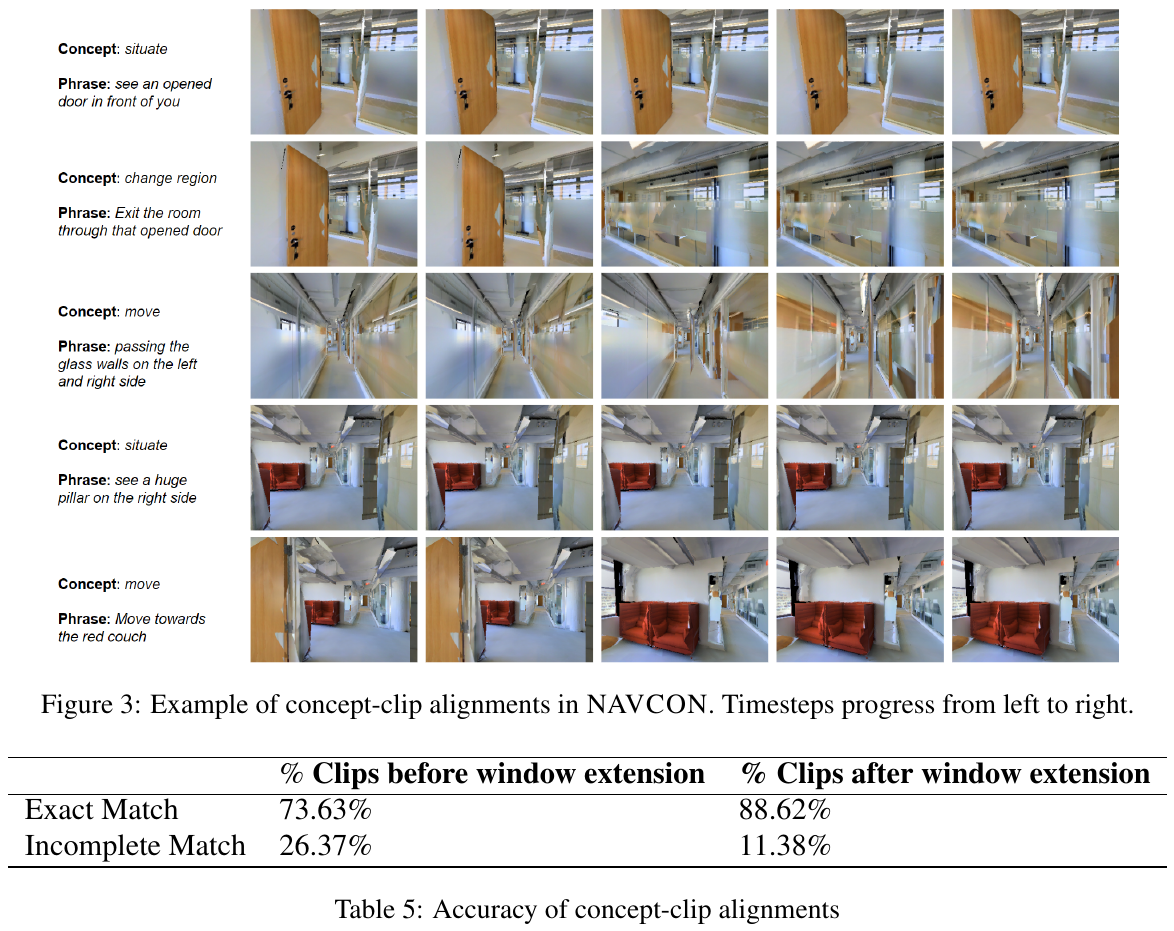
- 处理:利用 Habitat 模拟器以 10 倍下采样率渲染智能体视角图像(320x240 像素),提取了 760 万帧图像。通过 RxR 词级时间戳,将提取的语言概念短语在时序上投影到对应的智能体运动视频剪辑中。针对 RxR 部分单词时间戳不准导致动作未开始或已结束的对齐偏移问题,引入了时序窗口微调策略:将每个剪辑的提取时间窗口向后延伸视频总长度的 5%。
- 输出:270 万帧已实现概念-视频对齐的图像数据,覆盖 19,074 条指令。
- 设计动机:解决跨模态细粒度对齐的时间错位问题,提供大规模的高质量视频-语言导航原语对齐数据。
③ 训练目标与分类器
基于生成的银标数据集,论文训练了一个导航概念分类器 (Navigation Concept Classifier, NCC)。模型基于轻量级的 distilbert-base-uncased,在输入端接收分词后的指令,在输出端使用 BIO 格式进行 Token 级别分类(共 5 类:SIT、MOVE、CD、CR 的 B/I 标记,以及 O 外部词)。训练采用标准的交叉熵损失函数进行序列标注:
\(\mathcal{L} = -\sum_{i=1}^{N} \sum_{j=1}^{C} y_{i,j} \log p_{i,j}\)
其中 $N$ 为序列长度,$C$ 为分类类别数($C=9$,包括 B- 和 I- 标记及 O),$y_{i,j}$ 为真实标签,$p_{i,j}$ 为预测概率。
3. 核心结果/发现
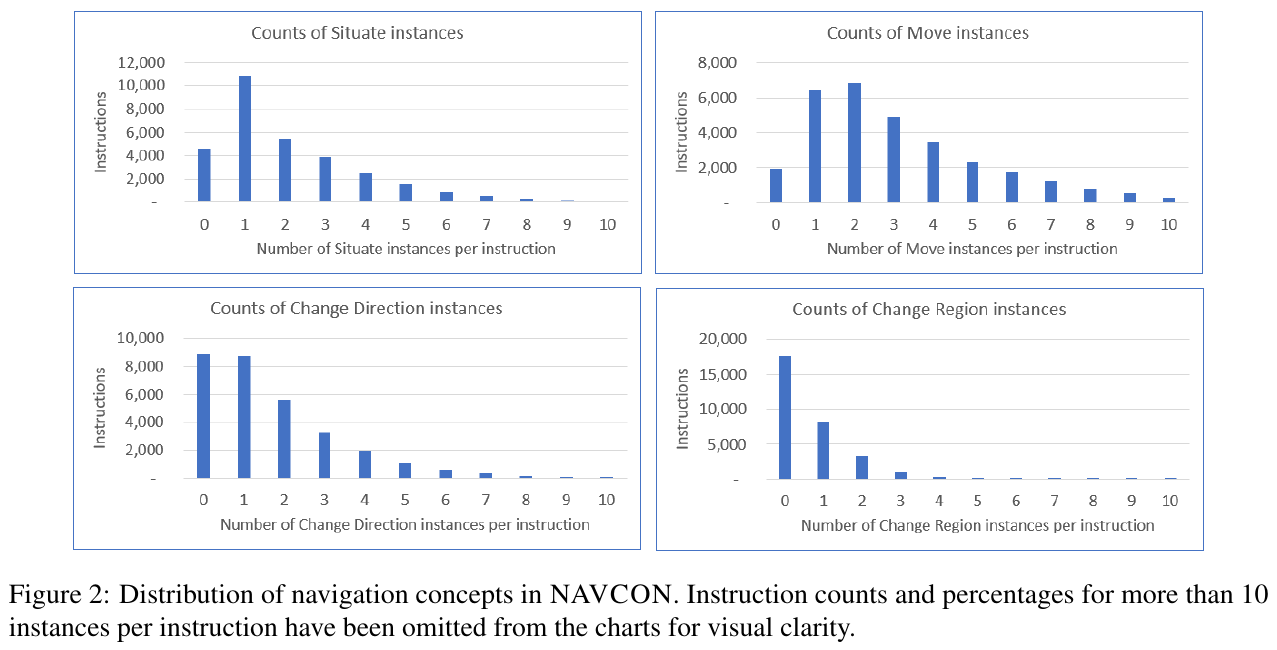
- 数据集特征:NAVCON 概念分布中,MOVE(移动路径)占比最大,达 42%;SIT(定位自身)占 28%;CD(改变方向)占 22%;CR(改变区域)占 9%。
- 标注质量评估:人工评估表明,银标概念分类正确率达 95.82%,对应的文本跨度覆盖正确率达 95.49%,漏检率低于 4%。在引入时序窗口延伸 5% 后,视频剪辑的精确对齐率从 73.63% 大幅提升至 88.62%。
- NCC 分类器表现:NCC 分类器在 unseen 测试集上表现极佳,实现概念类别与文本跨度 100% 完美匹配(Exact Match)的比例高达 96.53%。
- LLM 少样本泛化能力:使用 GPT-4o 进行 3-shot 上下文学习(In-Context Learning)进行概念提取,在 unseen 数据上实现了 82.12% 的 Exact Match,说明该导航概念对 LLM 具有高度的可学习性与泛化性。
4. 局限性
- 解析器依赖性:对语言概念的提取极度依赖 Stanza constituency parser 的句法解析准确率,句法树错误会直接导致概念跨度提取不完整。
- 多模态对齐误差:视频-文本对齐质量受限于原始 RxR 数据集 word-timestamp 标注的准确性,尽管采用了窗口延展,仍有约 11% 的视频片段对齐不完整。
15. LoGoPlanner (2025)
——定位接地的端到端导航策略:把度量尺度的视觉几何”植入”规划
📄 Paper: arXiv:2512.19629 · 🏛️ ICRA 2026
研究背景/问题
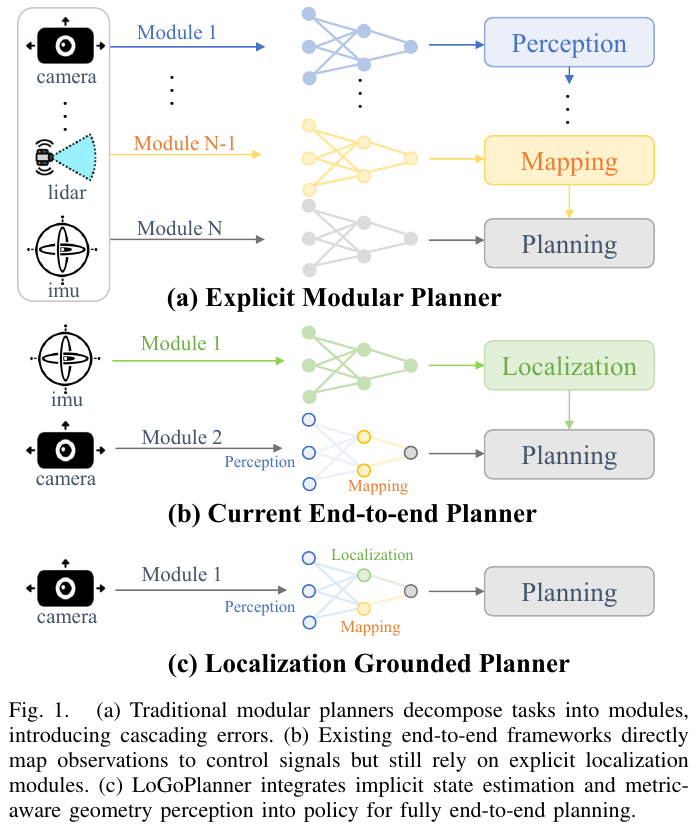
现有”端到端”导航虽把感知、建图、规划合并,却仍依赖独立的定位模块(SLAM / 视觉里程计)做自状态估计,而定位模块需要精确的相机-底盘外参标定,泛化性差、在足式机器人抖动场景尤其不稳定。根因在于这些规划器大多只处理单帧或短片段,缺乏对长时序历史的总结能力,短期估计会随时间累积漂移;单帧感知也缺乏稳健度量推理所需的几何记忆,重建往往是局部或尺度模糊的。本文目标:仅用 RGB-D 观测,实现无需任何外部定位模块的点目标(point-goal)导航。
主要方法/创新点
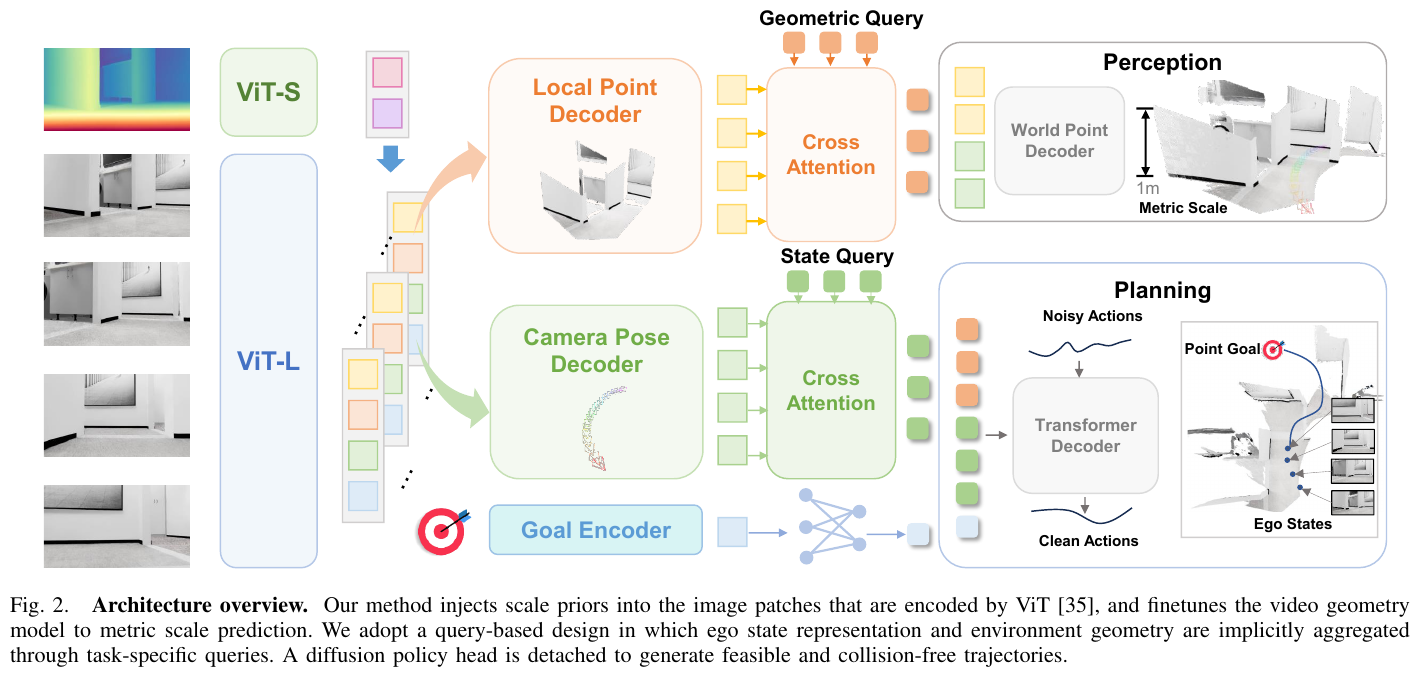
LoGoPlanner 在一个统一网络里端到端协同三大部分:(A) 度量感知视觉几何学习——以预训练视频几何骨干 VGGT 为底,注入深度尺度先验,通过局部点 / 相机位姿两个 auxiliary head 产生世界点嵌入;(B) 定位接地的导航策略——解耦相机与底盘位姿,用 state query / geometric query 通过 cross-attention 把隐式状态与几何聚合成统一规划上下文;(C) Diffusion 策略头——以规划上下文为条件对噪声动作迭代去噪,输出无碰撞轨迹。整条链路把”定位”和”建图”从显式模块降格为网络内部的隐式特征,规划误差是唯一最终优化目标。
-
度量尺度注入(Metric-aware Geometry):VGGT 原生只给相对尺度重建,无法对齐规划轨迹。作者用一个轻量 ViT 把深度图编码成几何 token,在 patch 级与语义 token 融合,经带 RoPE 的 transformer decoder 得到带度量尺度的逐帧特征:
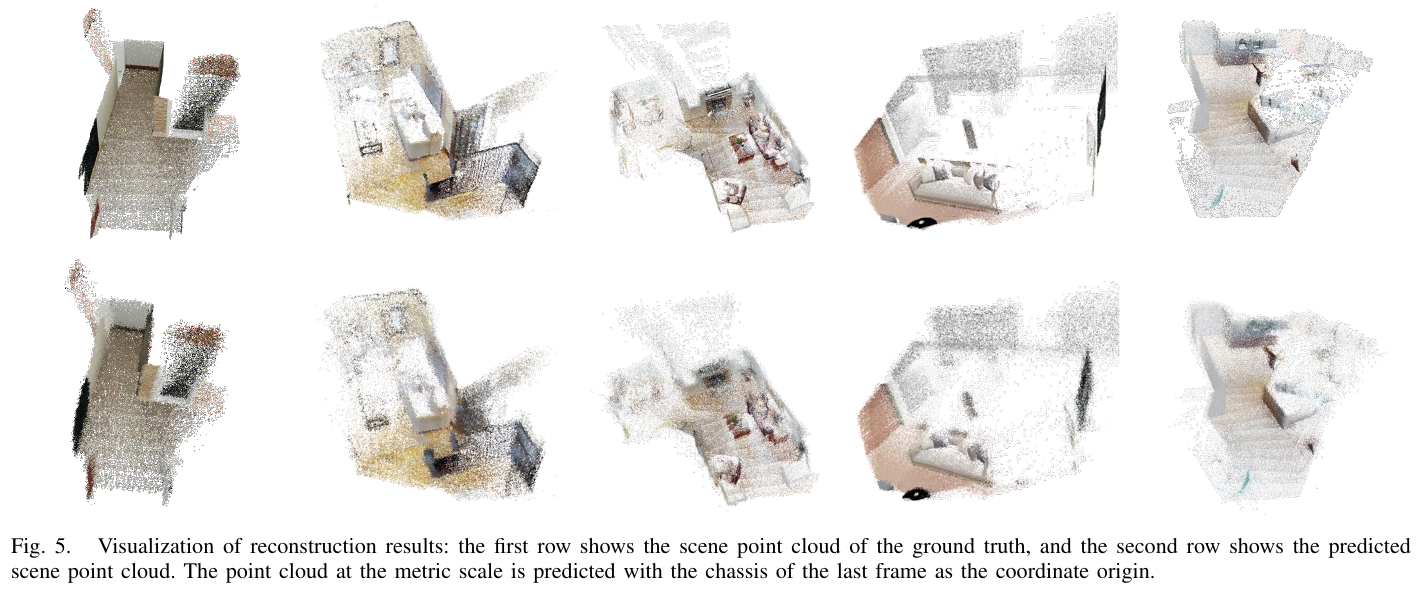
\[t_i^{metric} = \text{Attention}_{\text{RoPE}}((t_i^I, t_i^D), pos)\]再分支到局部点 head(由针孔模型监督相机系 3D 点)与相机位姿 head(解码相机到世界变换,世界系定义在最后一帧底盘系)。两个 head 的中间特征拼接后经 context fusion 与点云解码器,输出以机器人当前位置为原点的稠密度量尺度点云,覆盖被遮挡与后视区域。
-
相机/底盘外参解耦:感知绑定相机视角、控制执行在底盘坐标系。把相机位姿与底盘位姿拆成两个独立预测任务,假设相机相对底盘无 yaw 旋转,由位姿特征额外预测底盘位姿与当前帧相对目标,相机位姿经固定外参 \(T_{b,i}=T_{c,i}\cdot T_{ext}\) 换算。训练时在任意相机高度(0.25–1.25 m)与俯仰角(0°–30°)下构造数据,赋予跨本体鲁棒性。
-
Query-based 隐式聚合(借鉴 UniAD):state query 从位姿 token 抽自状态、geometric query 从世界点 token 抽环境几何,与目标 embedding 拼接送 transformer decoder 得规划上下文 query \(Q_P\)。关键:不把上游预测的外参/点云显式喂下游,避免级联误差,最终优化目标始终是轨迹规划误差。
-
Diffusion 策略头:以 \(Q_P\) 为条件,从高斯噪声对动作块 \(\{(\Delta x_t,\Delta y_t,\Delta\theta_t)\}\) 迭代去噪,生成可行、无碰撞轨迹。
训练采用两阶段:阶段一微调几何模型 decoder 与 task head(注入深度尺度先验,监督度量点云与外参);阶段二冻结骨干 decoder,联合训练 diffusion head 与 task head。
核心结果/发现
- 仿真(InternScenes 40 个未见场景):在完全无外部定位条件下,Home SR 57.3 / SPL 52.4、Commercial SR 67.1 / SPL 63.9,超过使用 oracle 定位的 ViPlanner——相对 ViPlanner,Home SR 提升 27.3 个百分点、SPL 提升 21.3%。
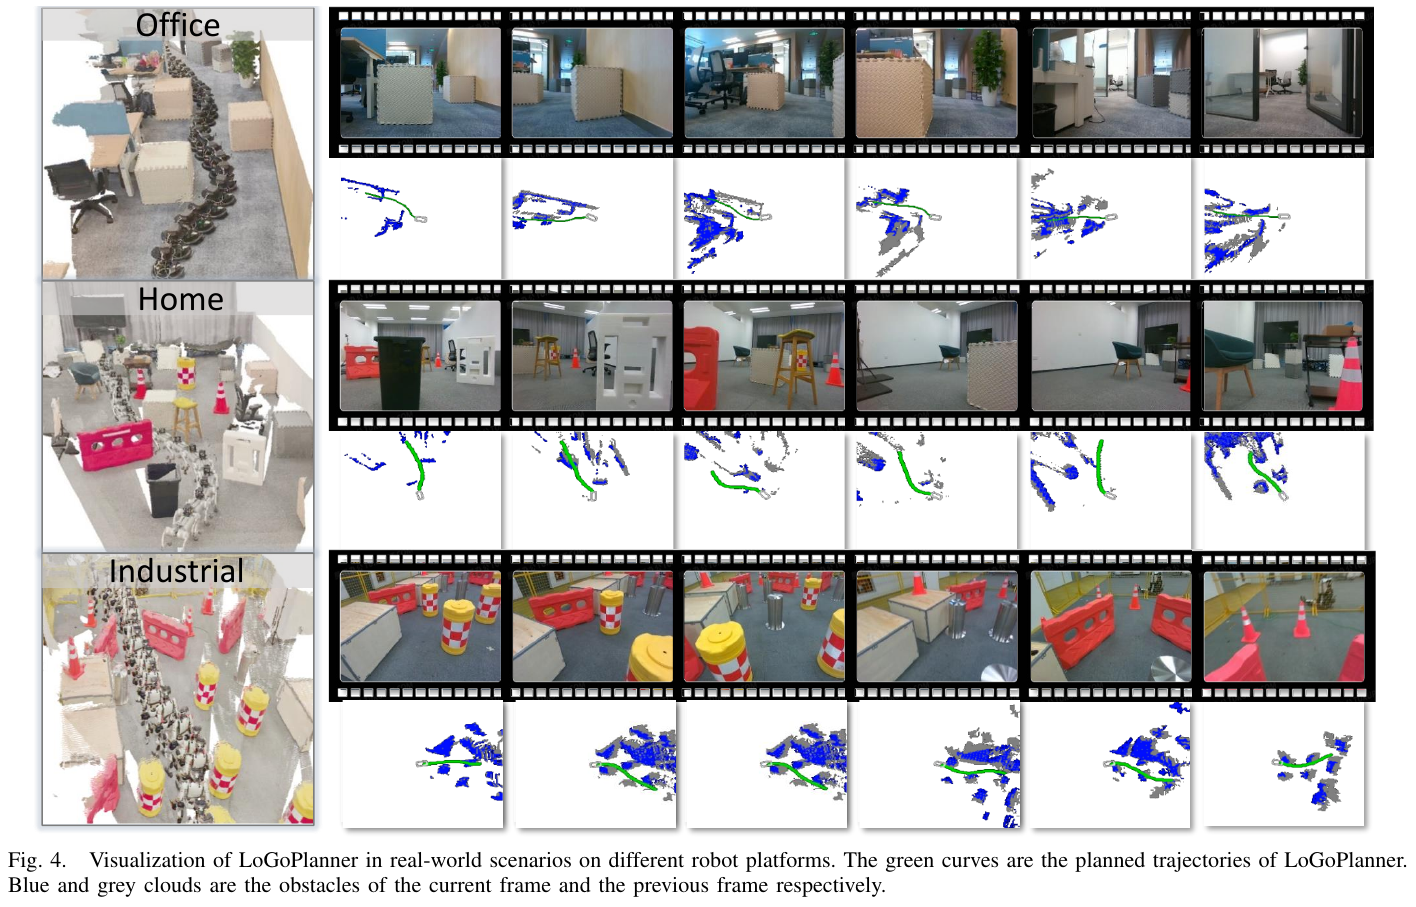
- 真实世界(3 平台 × 各 20 条轨迹,免 VO/SLAM 直接部署):TurtleBot(办公)SR 85% (17/20)、Unitree Go2(家居)70% (14/20)、Unitree G1(工业)50% (10/20),全面优于 iPlanner(10/15/0%)与 ViPlanner(50/45/0%);四足平台相机抖动下仍能准确自定位并避障。
- 消融(关键模块):Odometry / Goal / Point Cloud 三个 auxiliary task 逐项叠加,Home SR 从纯端到端的 49.5 提升到 51.3 → 52.4 → 57.3,证明点云监督带来超出 2D 语义的空间关系、显著提升避障。
- 消融(几何骨干):DepthAnything(单帧)→ Video DepthAnything → VGGT†(无度量尺度)→ VGGT(注入尺度先验)逐级提升;注入尺度先验后 PE 从 0.87 降到 0.55(Home),说明度量尺度监督对真实部署是必需的。
关键创新:
- 把”定位”吸收进网络:用长时序视觉几何骨干做隐式自状态估计,免标定、免外部 SLAM/VO,跨本体跨视角直接部署。
- 相对尺度→绝对度量尺度:注入深度先验校正 VGGT 的尺度模糊,得到可对齐规划坐标系的稠密点云。
- 隐式特征条件化而非显式传递:用 auxiliary task 把几何/位姿能力蒸馏成隐式特征供 diffusion 头条件化,切断级联误差,以规划误差为唯一优化目标。
局限性
受限于可用导航场景数量较少(约 2k),真实环境下的重建质量仍不理想;作者正在度量尺度的真实世界数据集上继续训练,以提升实际部署性能。
16. Skill-Nav (2025)
———Enhanced Navigation with Versatile Quadrupedal Locomotion via Waypoint Interface
📄 Paper: arXiv:2506.21853 · 🏛️ Vicinagearth (Springer) 2025
精华
Skill-Nav 的核心贡献在于用 waypoint(路标点) 作为高层规划器与低层运动控制器之间的接口,相比速度命令接口,waypoint 对追踪误差更不敏感,且天然兼容 LLM 和经典路径规划算法。两阶段训练策略(WP-Fixed 先学技能、WP-Random 再强化泛化)解决了单阶段训练的跌步或过度跳跃问题,值得在其他层级化机器人控制任务中借鉴。Teacher-Student 蒸馏架构通过在 Student 训练时引入膨胀虚拟障碍(inflated virtual obstacles),使 Student 策略在不接触特权信息的条件下保持安全导航能力。
1. 研究背景/问题
四足机器人通过 RL 已能完成极限 parkour 等高难度运动,但将丰富的运动技能集成到长距离导航任务中仍未充分探索。现有方法大多以速度命令为接口,高层规划器难以精确跟踪,且与多样化通用规划工具(LLM、A*)耦合困难。
2. 主要方法/创新点
Waypoint 接口设计
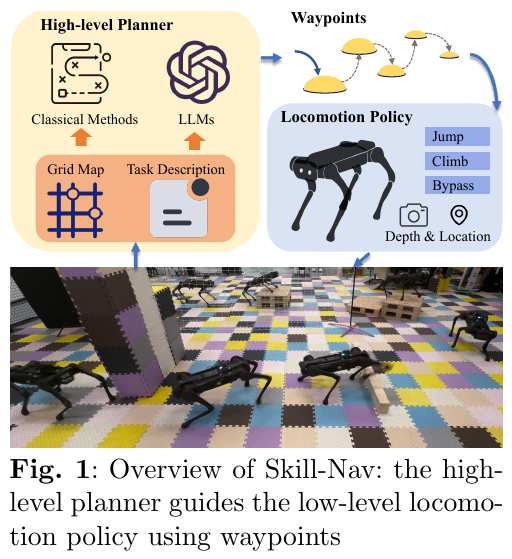
Skill-Nav 以 2D 相对位置(相对于机器人 base frame 的坐标)作为 waypoint 命令替代速度命令。高层规划器通过 $\mathcal{W} = \mathcal{H}(\mathbf{M}, p_e, p_s)$ 生成从起点到终点的 waypoint 序列,$\mathcal{H}$ 可以是 A* 算法或 LLM,$\mathbf{M}$ 为粗粒度环境信息(如占用地图或房间布局)。
两阶段训练策略
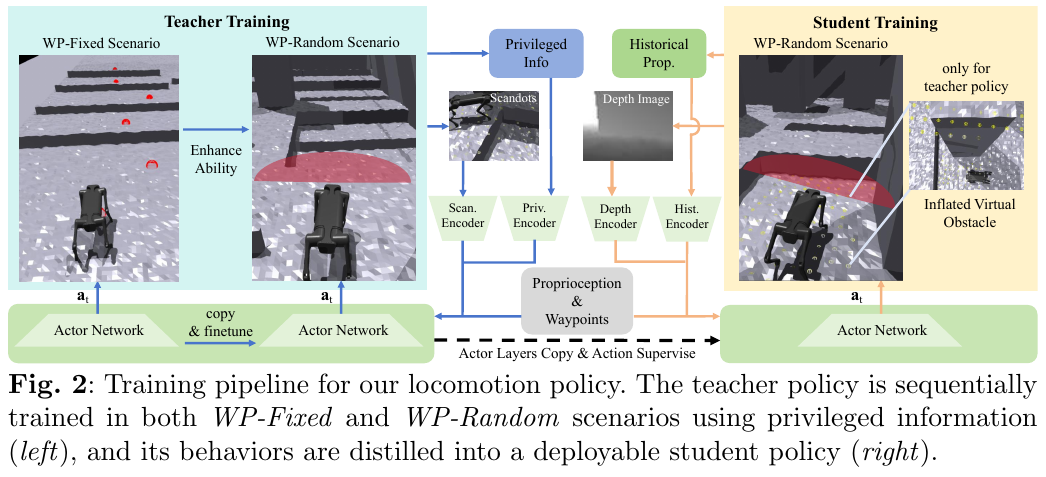
-
WP-Fixed 场景(技能学习):障碍物按行排列,waypoint 预置。策略从零开始学习攀爬箱体、跨越间隙、越过护栏等基础运动技能。设计 $r_{\text{reach}} = n_p/(t + \epsilon)$ 鼓励机器人快速到达更多 waypoint,同时引入 $r_{\text{stay}}$ 使机器人在到达 waypoint 后等待下一条指令。
-
WP-Random 场景(泛化增强):障碍物以矩阵形式随机分布,waypoint 根据机器人位置和偏航角动态选取。引入修改后的 $r_{\text{track}}$,当速度方向与 waypoint 方向余弦相似度 $< 0.1$ 时给予 $-1$ 惩罚,鼓励机器人向目标前进。Student 训练时在深度图中加入虚拟膨胀障碍,使学生策略保持安全距离。
双规划器高层架构
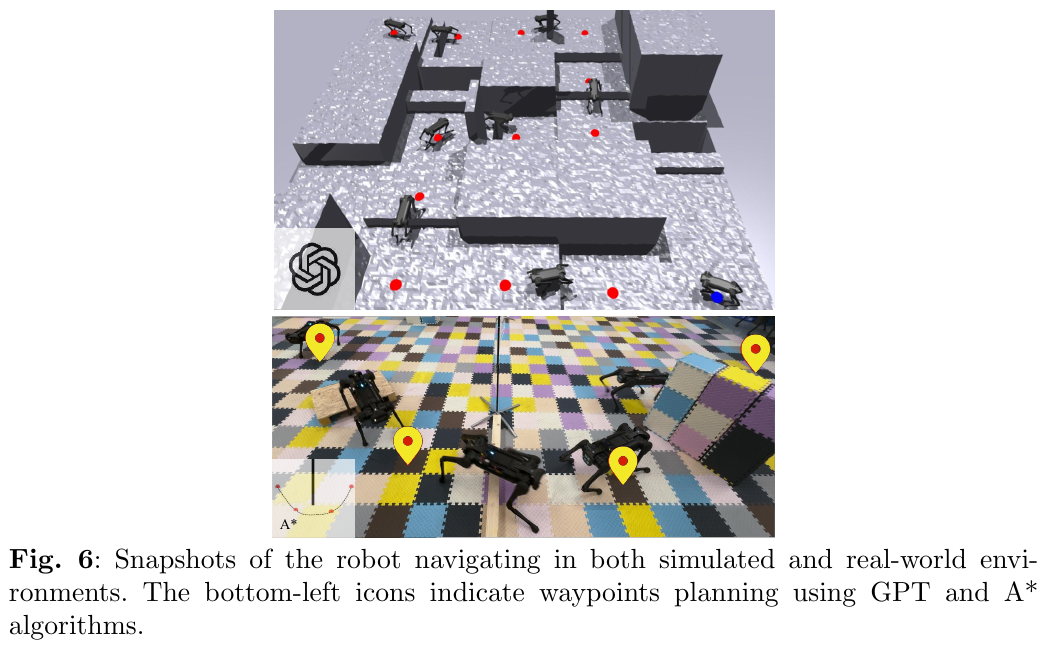
- 经典规划(A*):输入仅含墙体标注的占用地图,输出连续路径点序列,以 0.5–3m 间隔采样为 waypoint 输入低层控制器。
- LLM 规划:向 LLM 提供任务描述、粗粒度地形图、机器人运动能力(最高攀爬 0.45m、最大跨越 0.7m 间隙)等信息,由 LLM 生成 waypoint 索引序列(以 GPT-4 验证)。
3. 核心结果/发现
- Single-traverse 任务:在有无高障碍物场景中,Skill-Nav 均达到 SR=1.00、ATD=15.8m,是唯一在两种条件下均成功的方法。
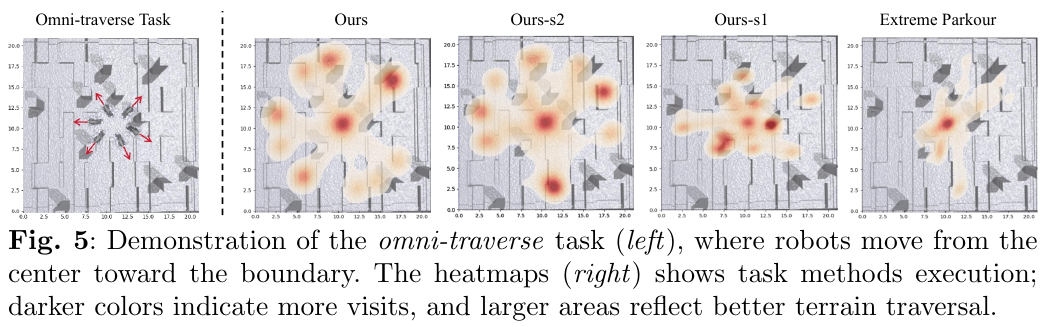
- Omni-traverse 任务:SR=0.89、ATD=8.2m,超越所有对比方法(RMA SR=0.00,Extreme Parkour SR=0.44/0.28)。
- 消融分析:仅 WP-Fixed 训练(Ours-s1)因 waypoint 分布规则,泛化能力差;仅 WP-Random 训练(Ours-s2)导致过度跳跃步态,实际部署困难;两阶段结合效果最优。
- 真实机器人部署:在 Unitree AlienGo 上成功验证,可应对深度相机未检测到的低矮障碍,并在受到外力干扰后恢复平衡继续导航。
4. 局限性
高层规划器(尤其是 LLM)可能生成位于间隙中央或箱体边缘等异常 waypoint,低层控制器难以从这类极端位置恢复;未来工作将设计边缘无碰撞低层控制器,并探索运动与导航的端到端统一策略。
17. FantasyVLN (2026)
———统一多模态Chain-of-Thought推理用于视觉-语言导航
📄 Paper: arXiv:2601.13976
精华 这篇论文展示了如何通过统一框架整合文本、视觉和多模态CoT推理模式,值得借鉴的点包括:(1) 训练时使用CoT监督、推理时直接预测的隐式推理范式,避免了显式CoT的token膨胀问题;(2) 使用预训练VAR模型将想象的视觉观测压缩到紧凑潜在空间,大幅降低序列长度;(3) 通过跨模态对齐约束统一不同推理模式,学习模态不变的推理表示;(4) 门控机制实现单一模型灵活切换多种推理模式。这种设计在保持推理能力的同时实现了实时导航,为具身智能任务提供了实用的解决方案。
研究背景/问题 现有VLN方法面临关键挑战:纯文本CoT缺乏空间理解且容易过拟合稀疏标注;多模态CoT通过生成想象的视觉观测引入严重的token膨胀,导致推理延迟增加数个数量级,无法实现实时导航。这在长时域、多阶段导航场景中尤为突出。
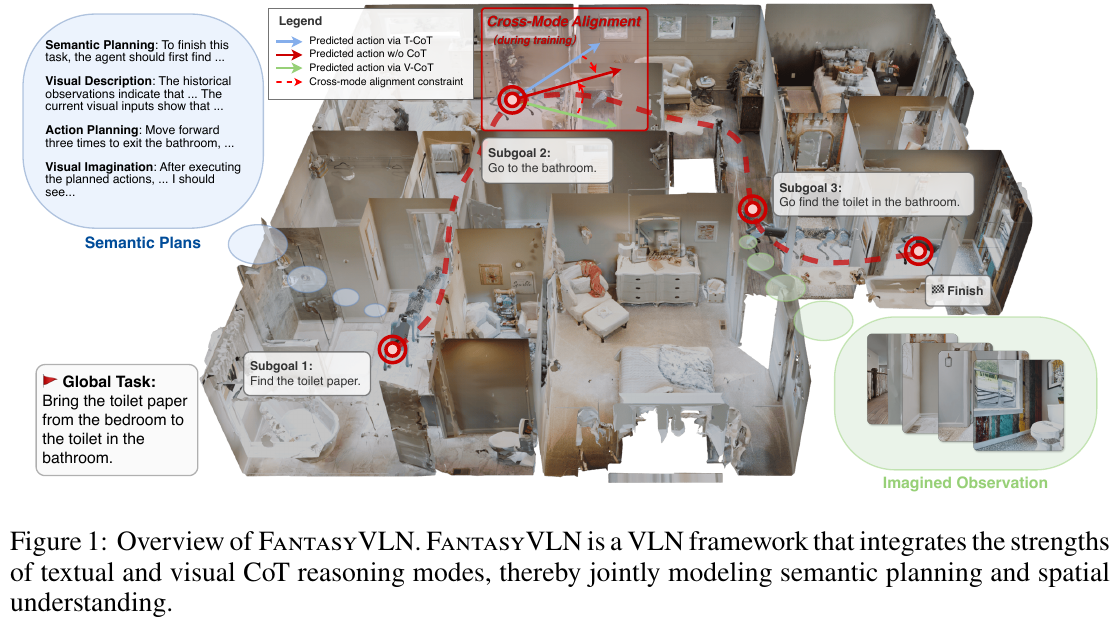
主要方法/创新点
FantasyVLN提出了统一的隐式推理框架,核心创新包括:
1. Compact Visual CoT (CompV-CoT)
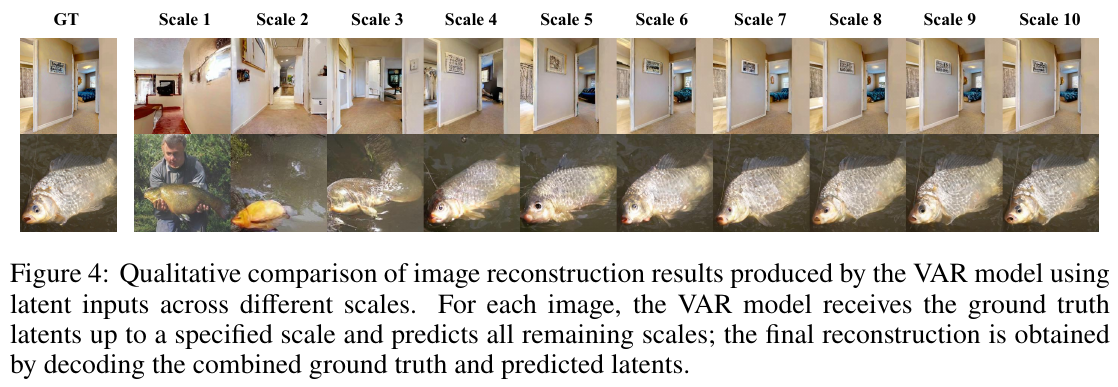
- 使用预训练的Visual AutoRegressor (VAR)模型将想象的视觉观测编码到紧凑潜在空间
- VAR采用next-scale预测范式,256×256图像仅需30个视觉token即可精确重建,压缩比达1/2185
- 训练时VLM直接生成VAR潜在表示,推理时无需显式VAR解码,大幅提升效率
2. 统一多模态CoT (UM-CoT)框架
- 通过二元门控信号 gT 和 gV 控制文本和视觉推理的激活
- 四种推理模式:(a) Non-CoT (gT=0, gV=0) 直接预测动作;(b) T-CoT (gT=1, gV=0) 生成文本推理步骤;(c) V-CoT (gT=0, gV=1) 生成压缩视觉想象;(d) MM-CoT (gT=1, gV=1) 联合生成文本-视觉推理
- 单一模型共享参数,通过数据混合实现端到端联合训练
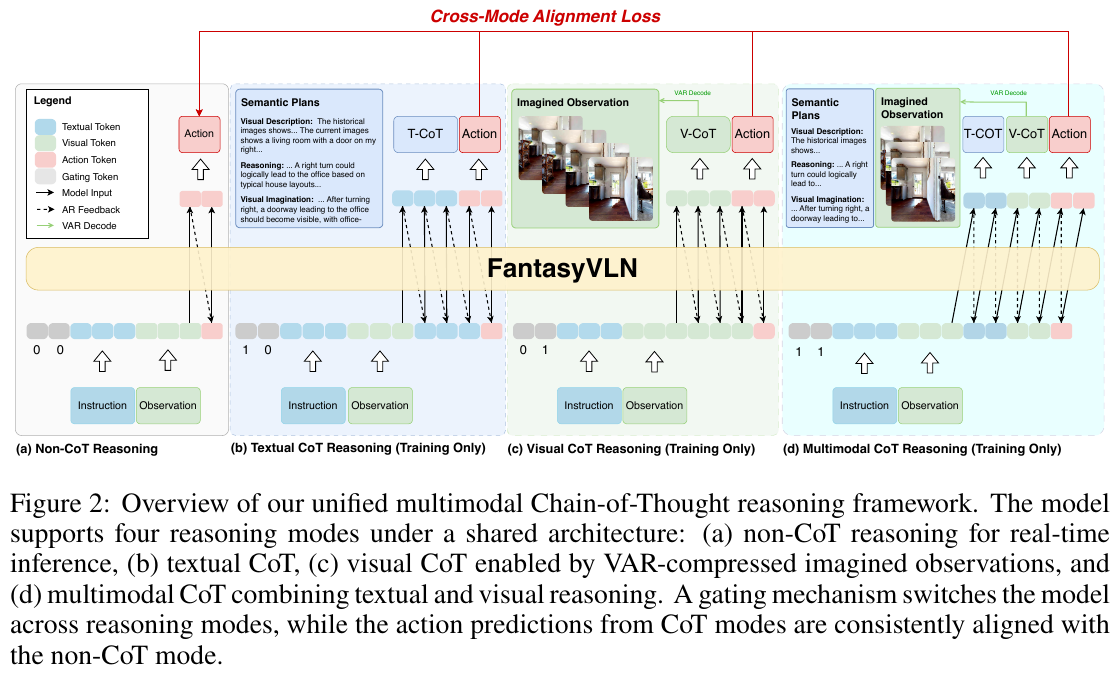
3. 跨模态对齐约束 (Cross-Mode Alignment)
- 将Non-CoT模式的动作预测作为软监督信号,对齐所有CoT变体的动作输出
- 交替优化Non-CoT目标和跨模态对齐的联合目标,嵌入多样化推理模式到统一潜在策略
- 防止不同推理模式间的冲突,学习一致的模态不变表示
4. 隐式推理机制
- 训练时:联合学习文本、视觉和多模态CoT模式
- 推理时:采用Non-CoT模式直接指令到动作映射,无需生成显式CoT序列
- 借鉴Aux-Think的”train-with-CoT, infer-without-CoT”范式,模型隐式保留推理感知表示
训练细节
- 基础模型:Qwen2.5-VL (7B参数)
- 数据:LH-VLN训练集18,554个导航轨迹切片(每5步一个切片)
- T-CoT标注:使用Qwen-VL-Max生成,包含语义规划、视觉描述、动作规划和视觉想象四部分
- 优化:LoRA微调,AdamW优化器,学习率1e-4,64×H20 GPUs,DeepSpeed ZeRO-2
核心结果/发现
导航精度 (LH-VLN benchmark)
- SR (成功率): 2.44% (所有基线中最佳)
- ISR (独立成功率): 11.01% (显著优于所有方法)
- CSR (条件成功率): 9.64%
- CGT (加权CSR): 8.99%
- 显著超越次优方法Aux-Think (仅T-CoT): SR提升3.75×,ISR提升3.5×
推理效率
- APS (每秒动作数): 1.03,与WorldVLA (1.02)和Aux-Think (0.97)相当
- 比显式CoT方法CoT-VLA (0.19 APS)快5.4×,推理延迟降低一个数量级
- 隐式推理每次预测仅解码单个token,而显式CoT需生成3k-5k个token
训练效率
- FantasyVLN在few thousand迭代内快速收敛,token预测准确率达到1.0
- WorldVLA (像素级V-CoT)需10k+迭代才能达到0.5准确率,且训练不稳定
- CompV-CoT通过潜在空间推理提供更强梯度信号和更稳定的学习动态
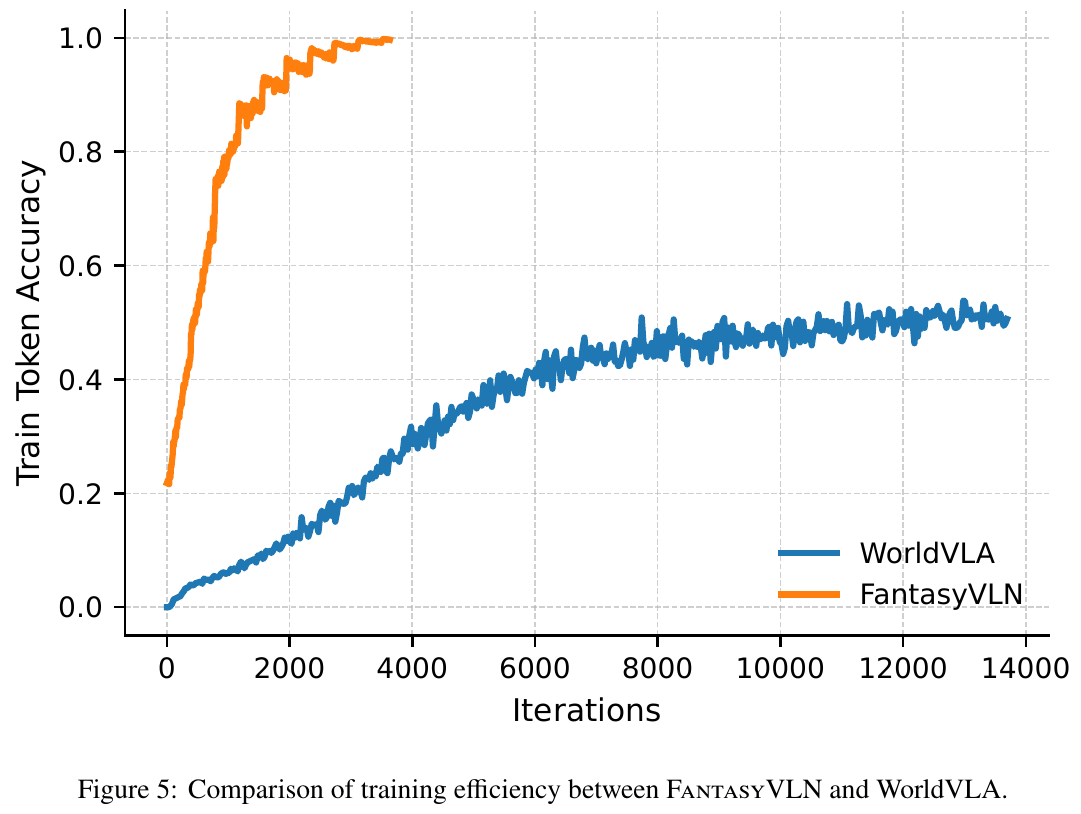
消融实验
- 各推理模式贡献:结合任何CoT模式与Non-CoT都能提升性能,四模式联合训练效果最佳
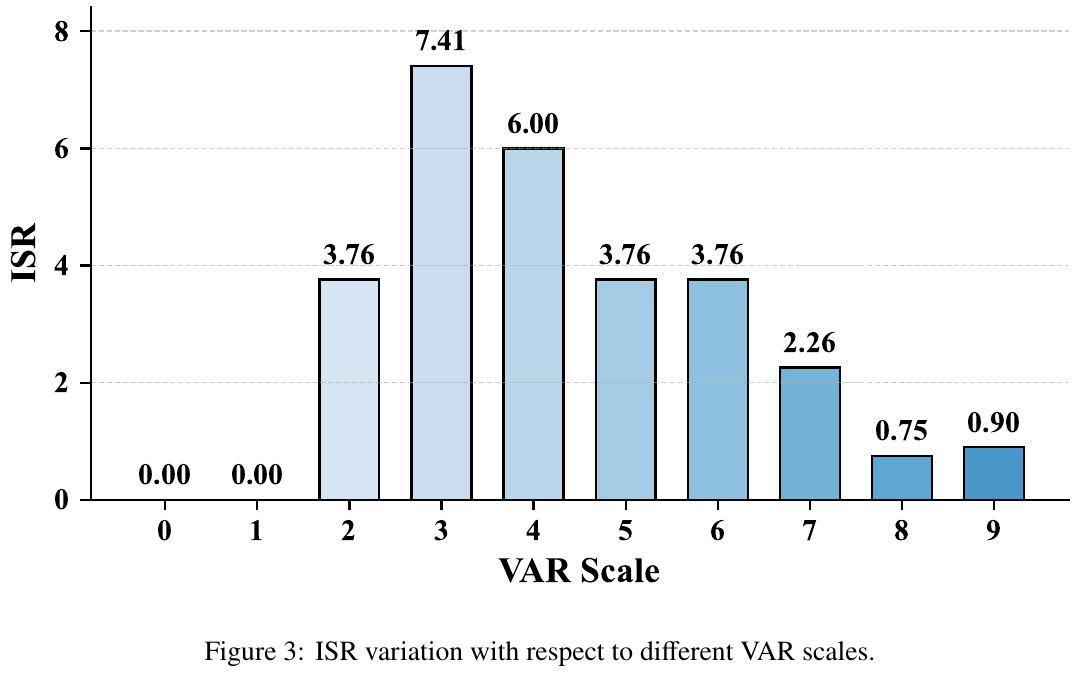
- VAR scale选择:scale 4最优(ISR 7.41%),更小scale信息不足,更大scale冗余
- 跨模态对齐:关键组件,移除后SR从2.44%降至0,ISR从11.01%降至2.39%
- 显式vs隐式推理:隐式推理在多模态设置下表现最佳(MM-CoT隐式:SR 2.44 vs 显式0.98)
局限性 该方法在LH-VLN这种小规模数据集(18k轨迹切片)上训练,显式CoT容易过拟合并产生累积误差;在更大规模数据集上的表现有待验证。此外,绝对成功率仍较低(SR 2.44%),表明长时域多阶段导航仍是极具挑战性的任务。
18. SparseVideoNav (2026)
———用稀疏未来视频为视野之外的导航提供长程预见
📄 Paper: arXiv:2602.05827v1 · Code
版本说明:本文依据论文 v1 PDF(2026 年 2 月 5 日)整理;PDF 未注明正式发表会议或期刊。
精华
- 把未来画出来,再决定怎么走:将语言条件的视频生成模型作为长程预见模块,帮助导航策略在目标尚未出现时维持方向与任务意图。
- 近处密、远处疏:保留近期连续片段保障动作精度,对较远未来间隔采样,用有限的生成预算覆盖更长时间,而不是追求完整连续视频。
- 逐步迁移预训练能力:通过图像条件适配、历史注入、扩散蒸馏、动作学习四阶段,把通用视频生成模型转成可部署的导航系统。
- 动作标签必须匹配生成的未来:生成视频与真实录像的运动可能不同,因此重新估计生成视频的动作,比直接复用原录像动作标签更合理。
- 效率与成功率需要一起看:最终模型在 RTX 4090 上报告 0.79 秒推理、BVN 成功率 25.0%,优于最佳 LLM 基线的 10.0%,但低于计算更昂贵的长程连续生成变体。
1. 研究背景/问题
视野之外的导航(Beyond-the-View Navigation,BVN)要求机器人仅凭“寻找桌子并停在旁边”这类高层指令,在陌生环境中寻找当前看不到的目标,而无需沿途逐步指引。论文认为,所比较的 LLM 导航方法依赖较短动作序列监督,容易在长距离搜索时意外转向、原地旋转或困在死路;视频生成模型的长程语言条件预测能力提供了另一种预见方式。问题在于生成几十秒连续视频耗时过高,必须同时解决预测范围、历史输入和推理延迟的问题。
2. 主要方法/创新点
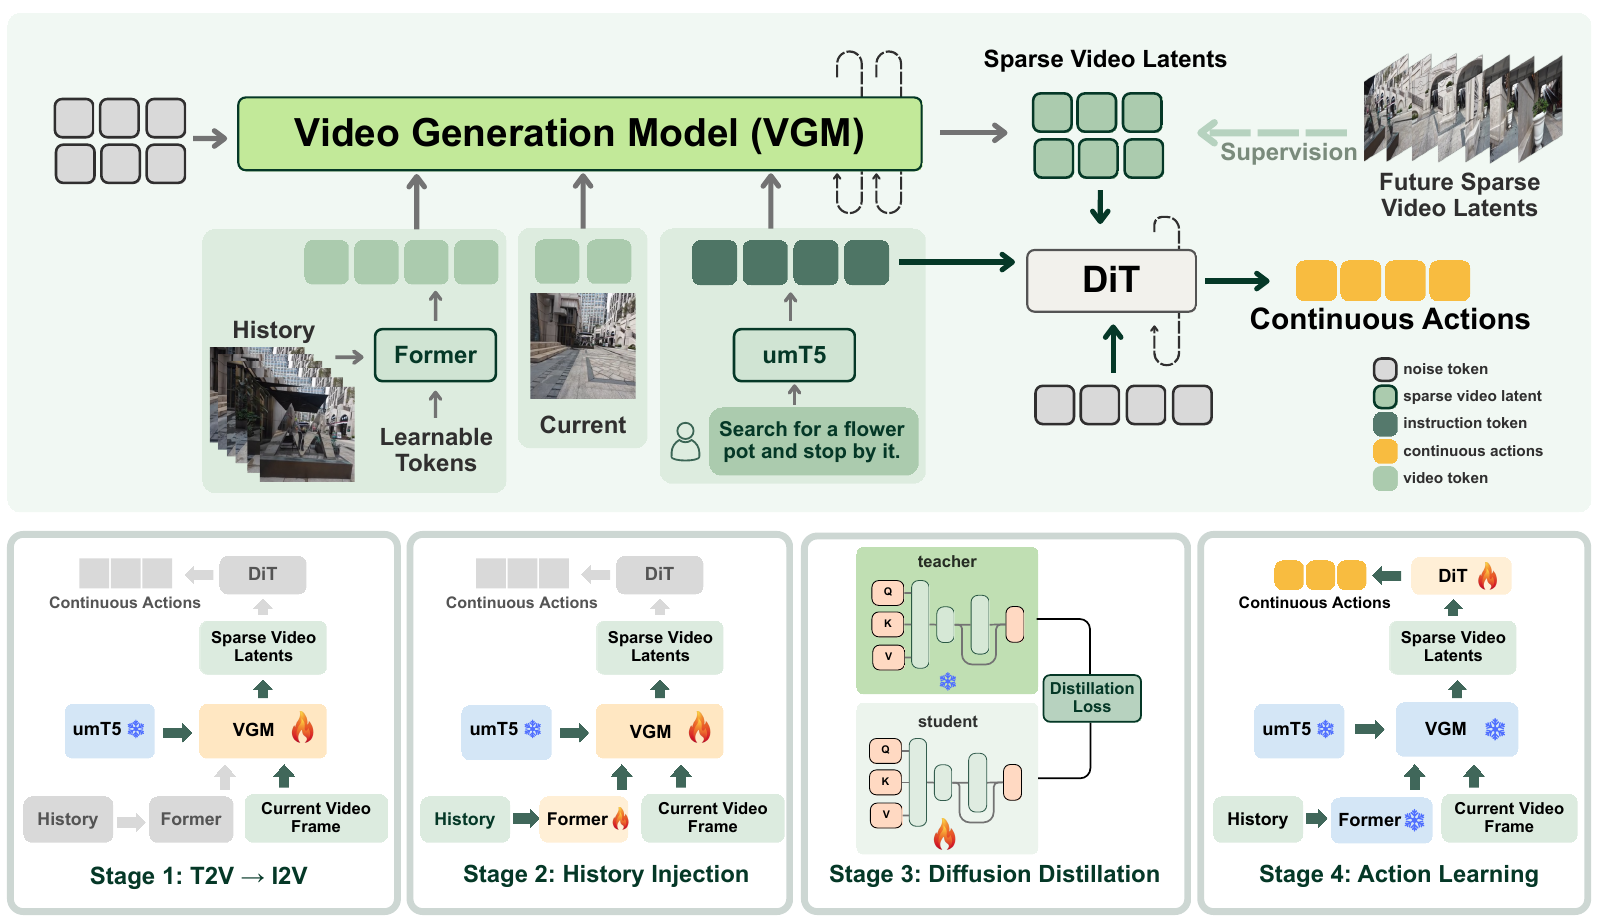
2.1 整体框架与模块数据流
系统由 Wan2.1 视频生成主干、历史压缩模块、逆动力学动作头 三部分组成:视频主干预测“未来可能看见什么”,历史模块提供“之前经过哪里”的上下文,动作头根据预测未来输出“接下来怎么移动”。
- 视频生成主干:当前 RGB 观测经 Wan 的 3D 因果 VAE 编码,语言指令经 umT5 编码,再与历史嵌入一起输入 Wan2.1 T2V-1.3B 适配后的图像到视频模型(I2V);输出稀疏未来视频潜变量,用视觉动态承载长程导航意图。
- 历史压缩模块:历史观测特征先经 Q-Former 压缩时间维度的冗余,再经 Video-Former 做 4 倍空间下采样,得到 2,560 个历史潜在 token;这些特征通过主干每个 Transformer 块新增的交叉注意力层注入,使模型利用过去的观测,同时控制历史上下文带来的计算负担。
- 动作头:动作侧的 Video-Former 聚合生成未来的时空特征,得到 640 个条件 token;这些特征与语言指令通过交叉注意力输入 Diffusion Transformer(DiT),以扩散去噪方式预测 8 步连续动作轨迹,动作表示为平面位移与转角 $(\Delta x,\Delta y,\Delta\theta)$。
下面是只保留部署信息流的读者版示意图:
graph LR
    A["当前 RGB 观测"] --> E["视频生成主干"]
    B["历史观测"] --> C["Q-Former 与 Video-Former 压缩"]
    C --> E
    D["语言指令"] --> E
    E --> F["稀疏未来潜变量"]
    F --> G["Video-Former 与 DiT 动作头"]
    D --> G
    G --> H["8 步连续动作轨迹"]
    H --> I["机器人执行并获取新观测"]
    I --> A
2.2 稀疏未来:生成数量与预测范围分开设计
稀疏生成的直觉是:近期要看得细,远期只需在几个时间点看清道路与目标变化。论文的采样单位主要是 VAE 压缩后的片段(chunk),不能把 8 个未来片段误读成 8 张原始图像。
Wan-VAE 将输入的 $(1+F)$ 帧视频压缩为 $(1+F/4)$ 个潜在片段,同时将空间尺寸从 $H\times W$ 压缩至 $H/8\times W/8$,每个位置为 16 维潜变量。除初始帧的特殊处理外,未来每个片段对应 4 个原始时间步;在 4 FPS 数据上,一个片段约对应 1 秒。
论文选取未来片段索引:
\[[T+1,T+2,T+5,T+8,T+11,T+14,T+17,T+20].\]最初两个片段保持连续,保障最近 8 个原始时间步的动作信息;之后每隔 3 个片段选取一个,将预测范围延伸至约 20 秒。
举个例子:把未来每秒看作一个片段,要连续预测到第 8 秒,需要生成 8 个片段;如果只保留第 1、2、5、8 秒,就用 4 个片段覆盖相同终点。论文把这一设计延伸为第 1、2、5、8、11、14、17、20 秒附近的 8 个片段,用相近的生成数量看得更远;它并不是逐帧生成整段 20 秒视频。
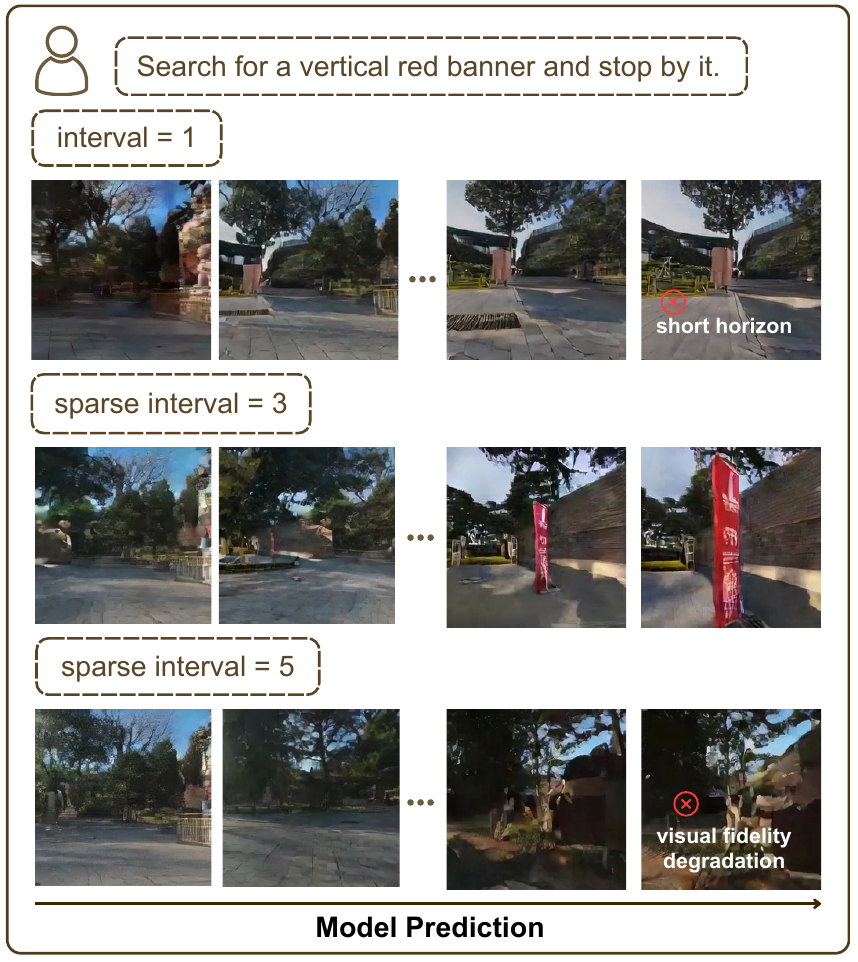
| 设计维度 | 连续视频生成 | 本文稀疏生成 |
|---|---|---|
| 未来监督 | 连续相邻片段 | 近期连续、远期间隔采样 |
| 长程预测成本 | 看得更远需要生成更多片段 | 用较少片段覆盖远期变化 |
| 动作依据 | 完整连续未来 | 稀疏视觉预见与近期细节 |
2.3 四阶段训练
Stage 1:T2V → I2V 适配。 输入当前图像、语言指令和带噪的稀疏未来潜变量,在保留 Wan 的流匹配(flow matching)目标下微调主干;输出以当前视角为起点、与指令一致的未来生成模型,使文本到视频先验适应导航的视觉条件。
Stage 2:历史注入。 输入压缩历史嵌入,在主干每个 Transformer 块中增加历史交叉注意力;新增块的末端线性层零初始化,降低刚加入历史通道时对已有生成能力的扰动;输出同时利用当前画面与历史的 I2V 模型。
Stage 3:扩散蒸馏。 用第二阶段模型作为教师,以相同结构和权重初始化学生,把噪声日程划为 4 个阶段;采用分阶段一致性模型(Phased Consistency Models,PCM),让学生学习教师概率流 ODE 轨迹上的各阶段终点,并通过相邻时刻的一致性约束,将视频生成去噪从 50 步压缩至 4 步。
Stage 4:动作学习。 冻结蒸馏后的 I2V 主干,学习“从预测的视觉变化反推出动作”的逆动力学(inverse dynamics)动作头;输入生成的稀疏未来与指令,输出 8 步连续动作。
这里的关键不是直接把原录像动作附到生成视频上,而是先用 Depth Anything 3(DA3)重新标注生成未来的运动,避免视觉变化与动作监督错位。
举个例子:假设真实录像对应“直行 1 米”,生成视频却表现为“直行后右转”,仍给它“只直行”的标签就会产生冲突。论文重新估计生成视频的相机运动,再据此形成动作标签;例子中的距离仅用于解释标签对齐,不是论文测量值。
2.4 核心训练目标
视频生成的流匹配损失。 设 $x_1$ 是真实稀疏未来潜变量,$x_0$ 是高斯噪声,$t$ 是流匹配时间,则输入和目标速度为:
\[x_t=t x_1+(1-t)x_0,\qquad v_t=x_1-x_0.\]两个生成阶段可统一写为:
\[\mathcal L_{\mathrm{FM}} =\mathbb E\left[\lVert u_\theta(x_t,l,c_T,h_T,t)-v_t\rVert_2^2\right].\]其中 $l$ 是语言嵌入,$c_T$ 是当前观测潜变量,$h_T$ 是历史嵌入;Stage 1 不使用 $h_T$,Stage 2 使用它,目标都是学习把噪声推进到稀疏未来的速度场。
蒸馏的一致性目标。 Stage 3 约束同一阶段内相邻噪声时刻的预测对应教师轨迹上的同一解点,使少步推理保留教师生成能力;论文正文未展开完整 PCM 损失公式。
动作重建损失。 按论文式(5),将重新标注的干净动作 $a_0$ 加噪得到 $a_k$,动作头在指令 $l$ 和生成未来 $V$ 的条件下重建 $a_0$:
\[\mathcal L_{\mathrm{action}} =\mathbb E\left[\lVert D_\psi(a_k,l,V)-a_0\rVert_2^2\right].\]这里直接监督的是干净动作重建,推理采用 DDIM;视频预测范围为 20 秒,动作头输出长度为 8 步,两者不是同一个时间尺度。
2.5 数据构建与推理
作者用配备 RockSteady+ 稳像的手持 DJI Osmo Action 4 收集 140 小时真实导航视频,处理为约 13,000 条轨迹,平均每条 140 帧、采样率 4 FPS,并人工标注语言指令。DA3 估计每帧 6 自由度相机位姿,再将相邻位姿变化投影到局部平面,生成 $(\Delta x,\Delta y,\Delta\theta)$ 标签;静止片段、极端俯仰角和影响位姿估计的正面动态行人片段被过滤。
推理时,机器人把新 RGB 观测发送至远程工作站,模型结合指令与压缩历史,先经 4 步视频去噪得到稀疏未来,再由动作头预测连续轨迹并发回机器人执行;后续观测参与闭环更新,而不是一次性执行完整 20 秒预测。DA3 重标注用于训练准备,论文没有将其列为在线导航推理模块;附录报告完整四阶段训练使用 32 张 H200,约耗时 64 小时。
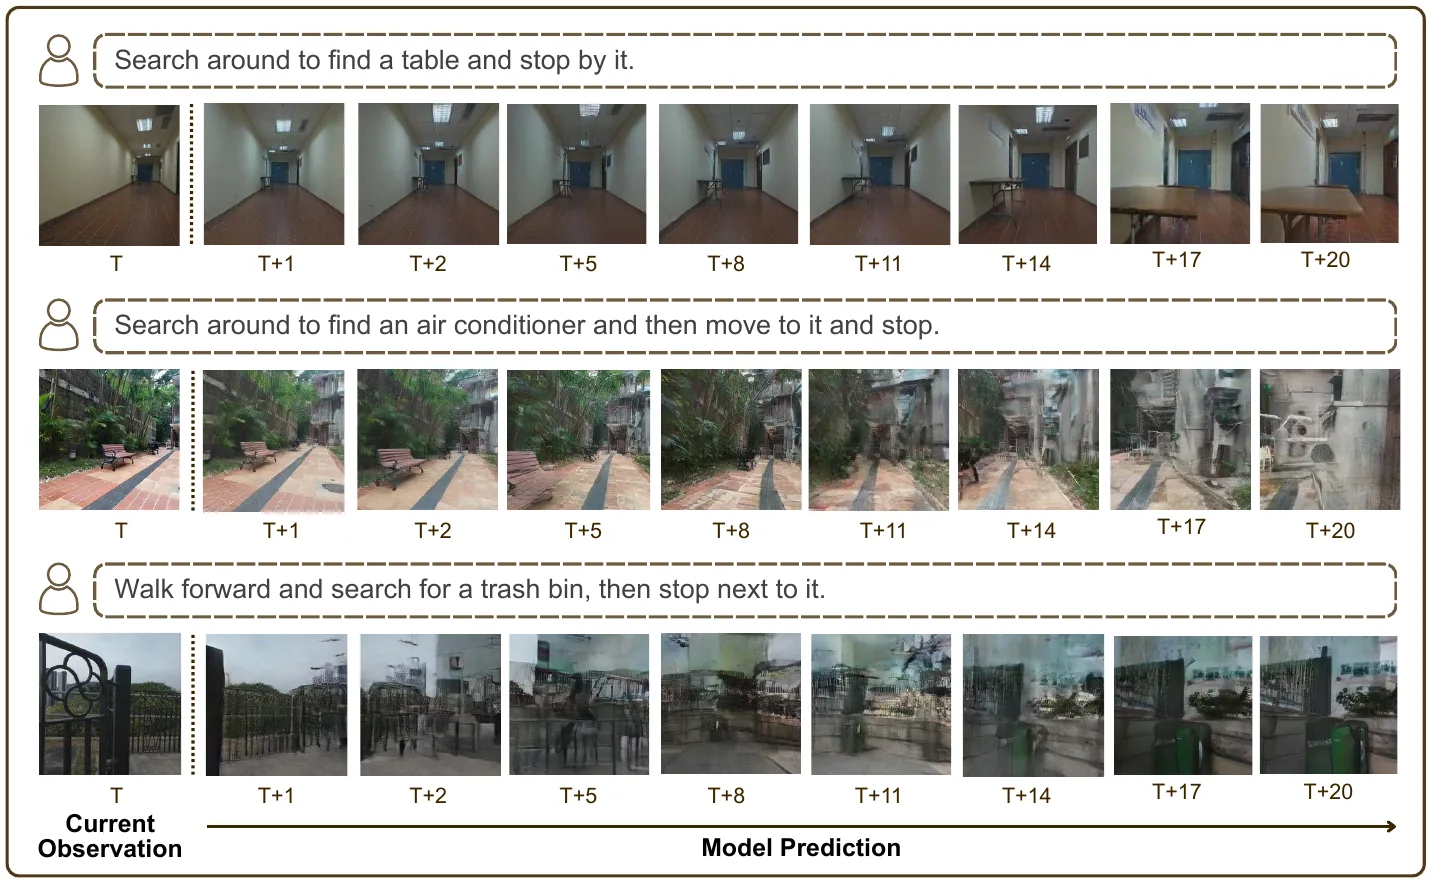
3. 核心结果/发现
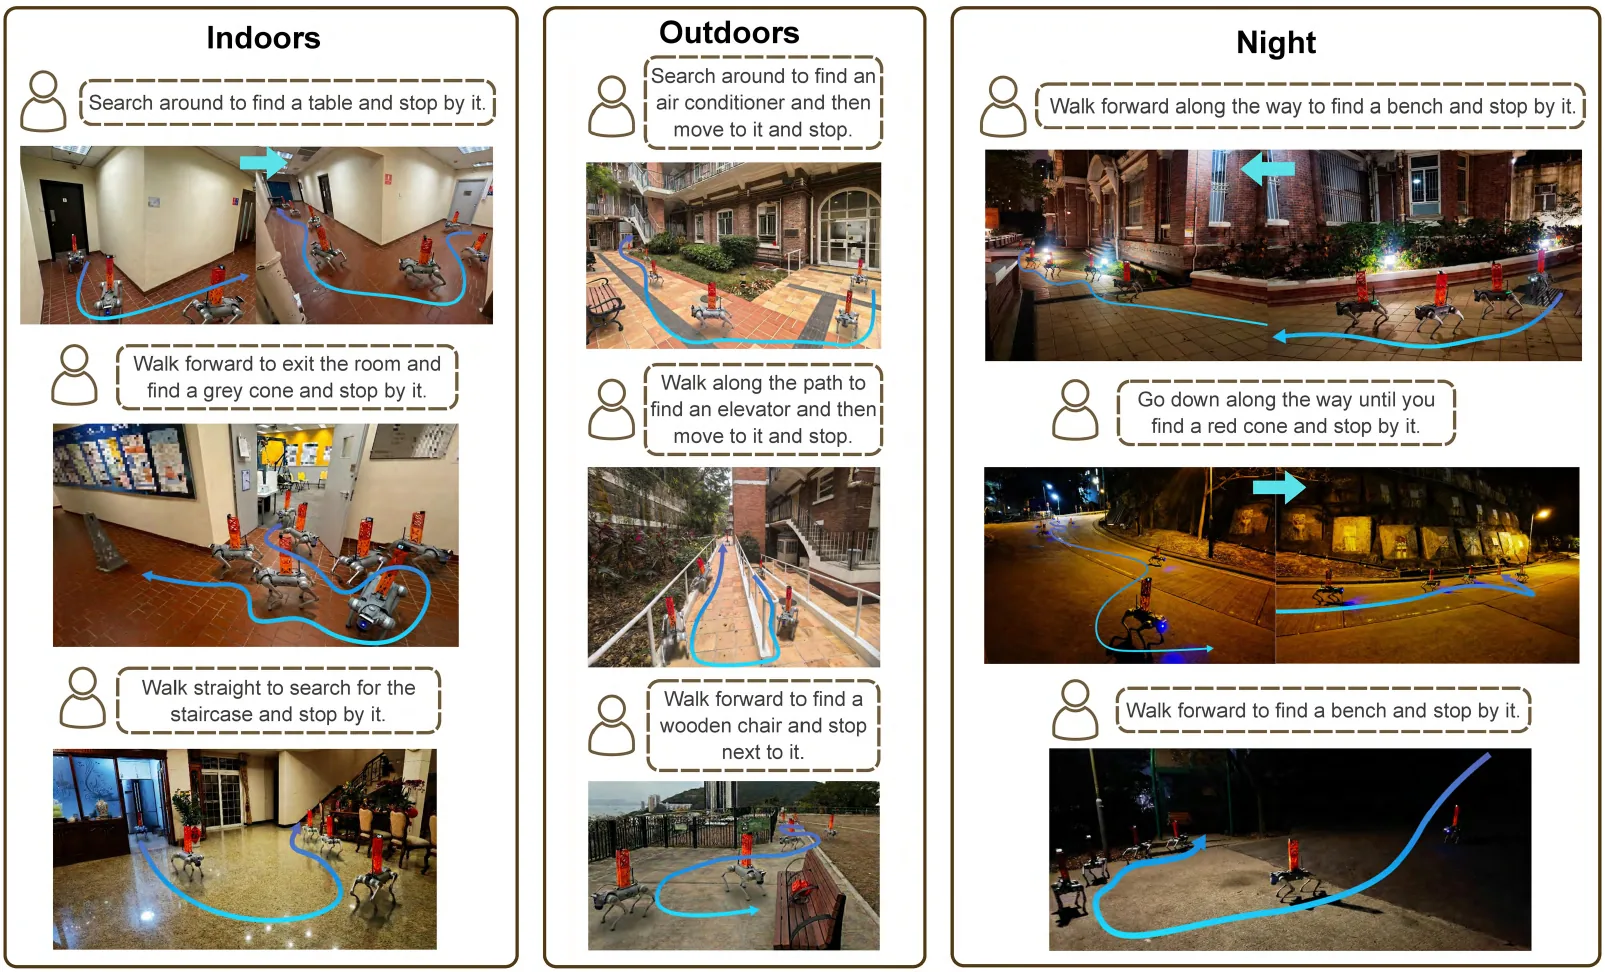
评测条件。 在 Unitree Go2 上测试 6 个未见真实场景:室内 Room、Lab Building,室外 Yard、Park,夜间 Square、Mountain;每场景 2 个 IFN 任务和 2 个 BVN 任务,每任务重复 10 次,共 240 次试验/方法。成功标准为机器人停在目标 1.5 米以内,不要求朝向目标;模型部署在远程 RTX 4090 工作站上,不能将报告延迟直接等同于机器人端完整通信与控制周期。
主结果(表 I,成功率 %)。
| 方法 | IFN 平均 | BVN 平均 |
|---|---|---|
| Uni-NaVid | 10.0 | 2.5 |
| StreamVLN | 35.0 | 10.0 |
| InternVLA-N1 | 17.5 | 8.3 |
| SparseVideoNav | 50.0 | 25.0 |
相对最佳基线 StreamVLN,两类任务均提升 15 个百分点;BVN 的 25.0% / 10.0% = 2.5 倍。夜间两个场景的 BVN 成功率分别为 20% 和 15%,平均 17.5%,所测三个基线均为 0%;这不意味着任意夜间环境都能成功导航。
预测范围与成功率的取舍(表 I)。
| 变体 | IFN(%) | BVN(%) |
|---|---|---|
| 4 步去噪,连续生成 2 个片段 | 15.8 | 2.5 |
| 4 步去噪,连续生成 10 个片段 | 36.7 | 11.7 |
| 本文:4 步去噪,稀疏未来覆盖 20 秒 | 50.0 | 25.0 |
| 50 步去噪,连续生成 20 个片段 | 62.5 | 35.8 |
| 本文移除历史压缩模块 | 45.0 | 22.5 |
长程连续生成变体成功率更高,表明稀疏化与蒸馏获得效率收益时存在性能代价;这组消融支持本文的实用折中,并不证明稀疏预测在相同终点下必然比连续预测更准确。
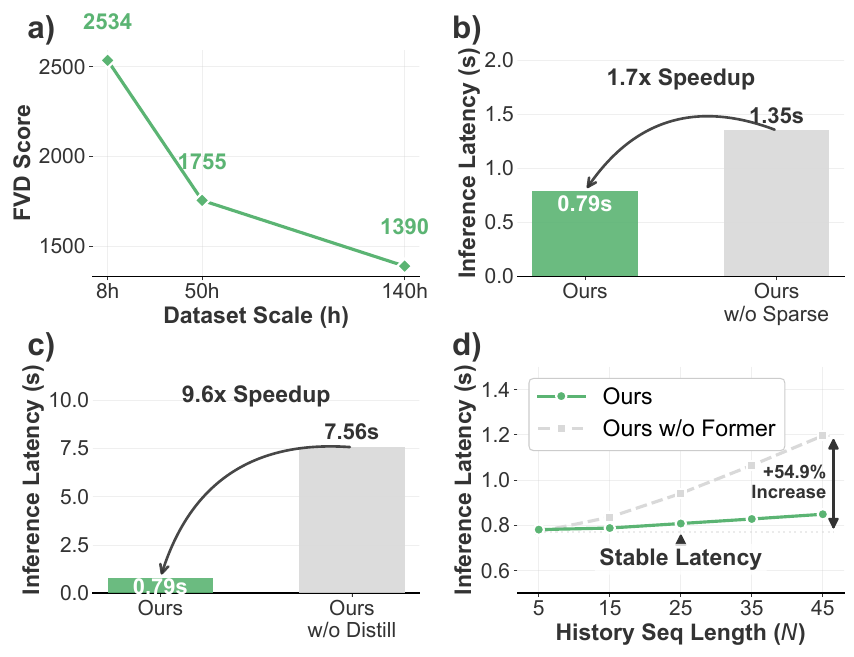
- 效率:图 6 报告最终推理 0.79 秒;去掉稀疏设计为 1.35 秒(约 1.7 倍差异),去掉蒸馏为 7.56 秒(约 9.6 倍差异),稀疏设计也带来 Stage 1+2 约 1.4 倍训练加速;摘要另报告相对完整未优化系统 27 倍加速,它与上述单项消融的对比设置不同,不能直接相乘或混用。
- 历史与初始化:不使用 Former 时,历史长度 $N=45$ 的延迟增加 54.9%;先完成 Stage 1 再进行历史注入,可把生成适配训练的收敛时间从直接训练 Stage 2 的 64 小时降为 32 小时,这不同于四阶段总训练耗时。
- 数据扩展:训练数据从 8 / 50 / 140 小时增加时,3 小时未见验证集上的 FVD 从 2534 / 1755 / 1390下降,显示视频分布拟合改善;论文没有在这一实验中报告导航成功率随数据规模的对应曲线。
- 定性泛化:展示了动态行人避让,以及训练相机高度约 1 米、部署高度 50 厘米时的成功案例,但没有给出这两项能力的独立量化成功率。
4. 局限性
140 小时数据仍有限,困难场景会出现生成模式坍塌并导致导航失败,最终 BVN 成功率也仅为 25.0%;效率优化牺牲部分成功率,且作者指出推理仍比现有 LLM 导航方法略慢。评测覆盖 6 个场景、24 个任务并依赖远程 GPU,相机高度变化与动态避障主要以定性案例支撑,因此本文结果尚不足以证明广泛场景下的稳定自主导航。
19. WorldVLN (2026)
———Autoregressive World Action Model for Aerial Vision-Language Navigation
📄 Paper: arXiv:2605.15964
精华
WorldVLN 将航空 VLN 重新定义为”预测驱动的世界-动作”问题:Agent 不直接从观测映射到动作,而是先在隐空间预测世界状态演化,再从预测的隐表示解码出可执行路径点。其核心启发是:空间导航本质上是预期性的,如同人脑预测移动后的状态变化。将视频生成模型的时序先验迁移至导航,并通过 Action-aware GRPO 强化学习直接优化动作后果而非视觉合成质量,这两个设计使 WAM 范式在有限训练步数下超越 VLA 基线 12+ 个百分点。闭环自回归更新(用真实观测替换模型生成的隐状态)解决了长程隐预测的漂移问题。零样本迁移到真实无人机验证了隐式预测架构的潜在泛化能力。
1. 研究背景/问题
现有 VLA 模型将 VLN 视为从指令和观测到动作的条件映射,虽具备语义理解能力,但缺乏对”Agent 自身动作如何改变世界状态”的显式时序因果建模,导致在空间推理和几何精度上存在明显短板。视频生成模型虽拥有强大的时空先验,但其生成目标(视觉真实性)与 VLN 目标(动作导向的状态预测)之间存在结构性错配:大多数视频骨干以双向方式生成整段视频,而 VLN 需要因果性的”观测—行动—更新”闭环;此外,生成模型的隐表示未被优化为可动作解码的形式。
2. 主要方法/创新点
整体框架: WorldVLN 由三大模块构成——(1)潜空间时空自回归 Transformer(世界骨干)负责预测短时域世界状态转变;(2)动作解码器(Action Decoder)将隐状态转变解码为可执行路径点;(3)两阶段训练框架,先通过监督学习对齐视频先验与导航动态,再通过 Action-aware GRPO 强化学习优化动作后果。
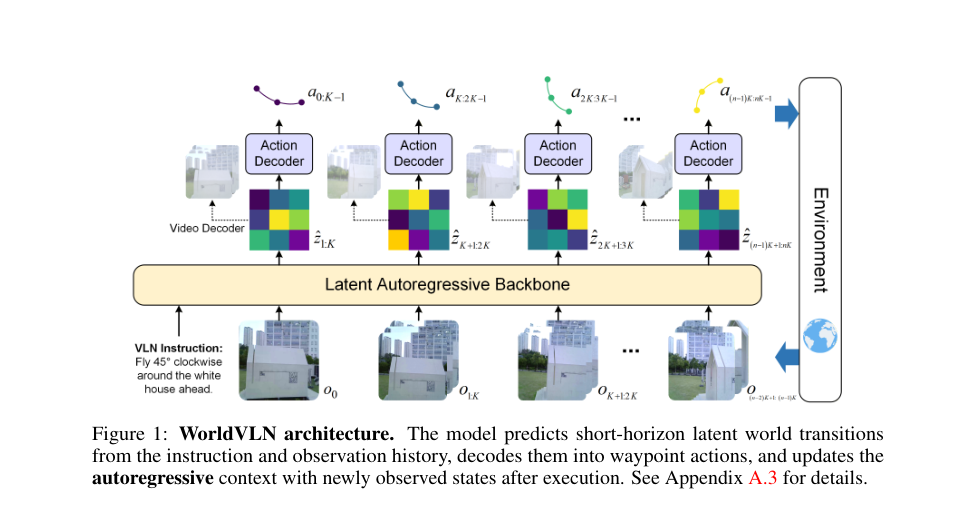
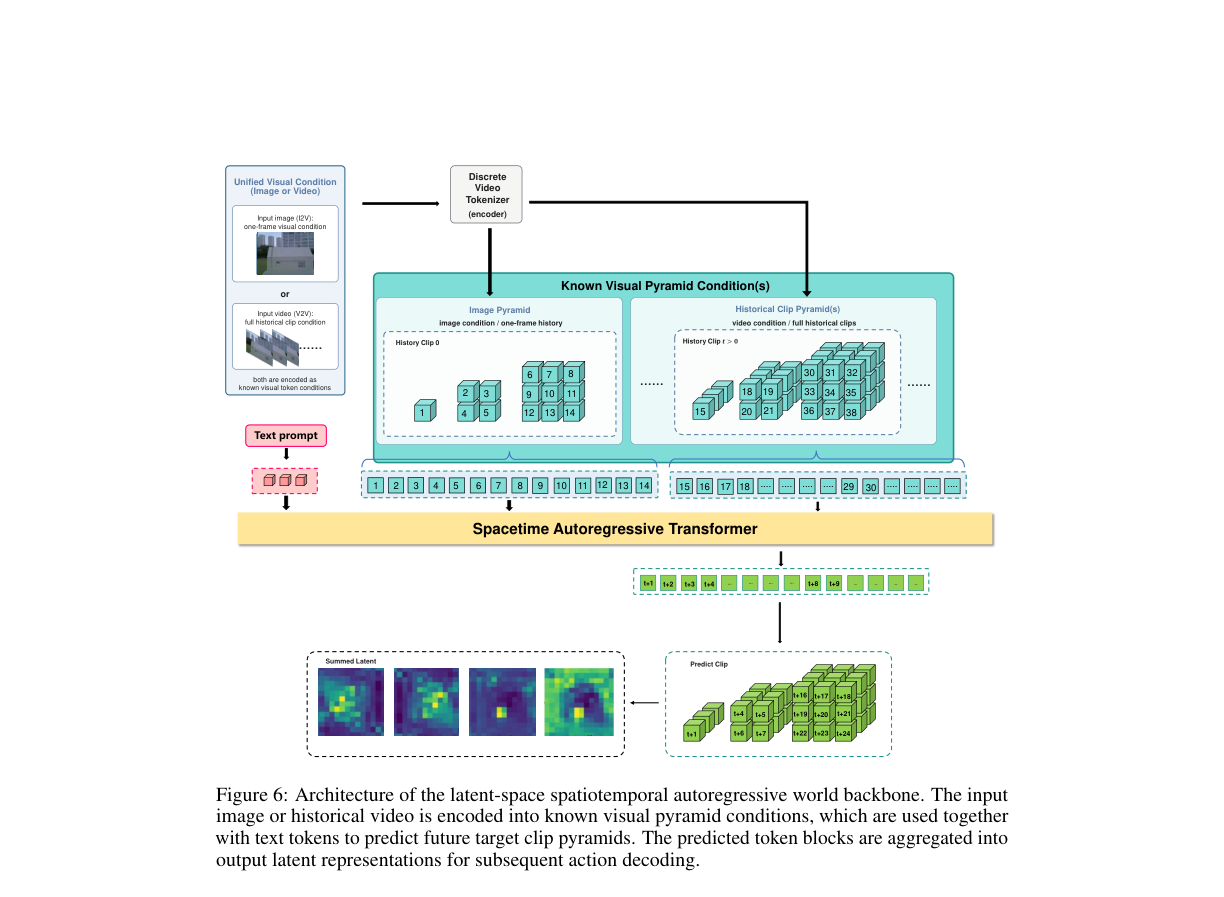
① 世界骨干(Latent Autoregressive Video Transformer)
- 输入:文本编码器输出指令嵌入 $e_\ell = \psi(\ell)$,以及历史真实自中心观测编码后的隐状态序列 $z_{\leq t}$
- 处理:时空自回归 Transformer 按从粗到细的尺度预测多尺度 token 块(先全局低分辨率,再局部高分辨率),并沿时间维度按片段顺序自回归生成
- 输出:短时域隐状态预测 \(\hat{z}_{t+1:t+K} \sim p_\theta(\cdot \mid e_\ell, z_{\leq t})\)
- 设计动机:借用视频生成模型的时序先验而非从头学习,同时将生成架构改造为因果自回归以支持闭环
② 动作解码器(Action Decoder)
- 输入:世界骨干输出的未来隐表示 \(\hat{z}_{t+1:t+K}\)(紧凑时空表示,编码了视角变化、空间结构变化和运动趋势)
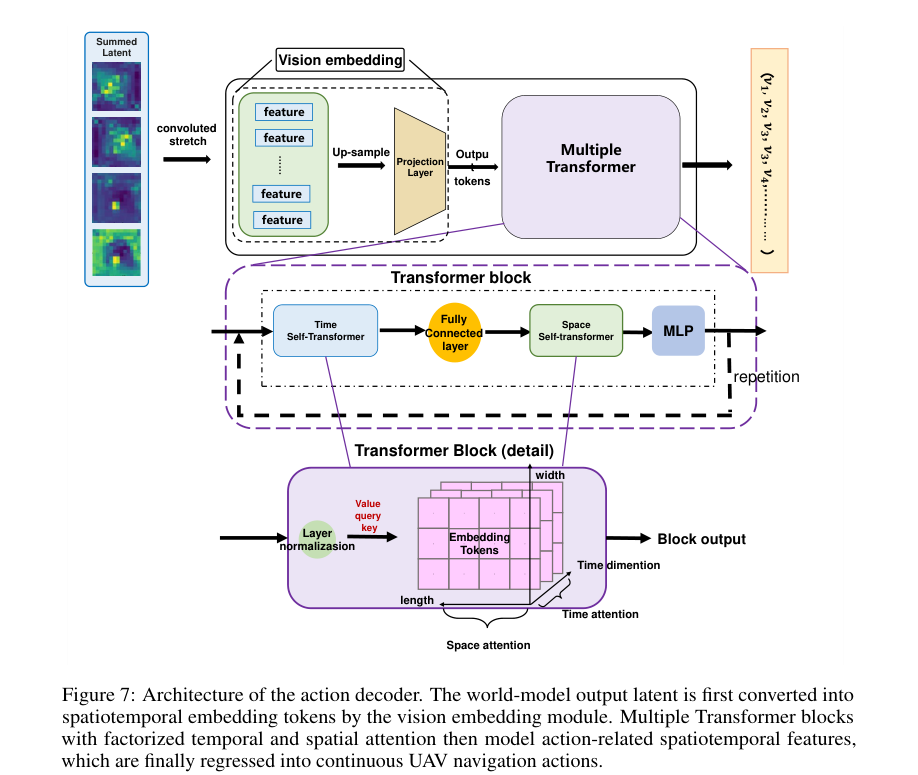
- 处理:Vision Embedding 模块将隐表示转换为时空嵌入 token;多层 Transformer Block 采用分解时空注意力——时间注意力捕捉跨帧运动演化,空间注意力建模每帧内的几何结构;MLP 动作头将聚合特征回归到连续动作向量
- 输出:连续路径点动作 \(a_{t:t+K-1} = D_\phi(\hat{z}_{t+1:t+K})\),对应 UAV 的相对 3D 位移和偏航角变化
- 设计动机:避免将隐状态解码为视频帧再估计运动(有误差累积),直接从隐表示推理动作更简洁高效
③ 闭环自回归更新
完整推理循环为: \((e_\ell, z_0) \to \hat{z}_{1:K} \to a_{0:K-1} \to o_{1:K} \to z_{1:K} \to \hat{z}_{K+1:2K} \to \cdots\) 关键在于执行动作后,将真实观测重新编码 $z_{t+1:t+K} = E_\text{vid}(o_{t+1:t+K})$ 替换模型预测的隐状态,防止隐预测漂移积累。
④ 两阶段训练框架
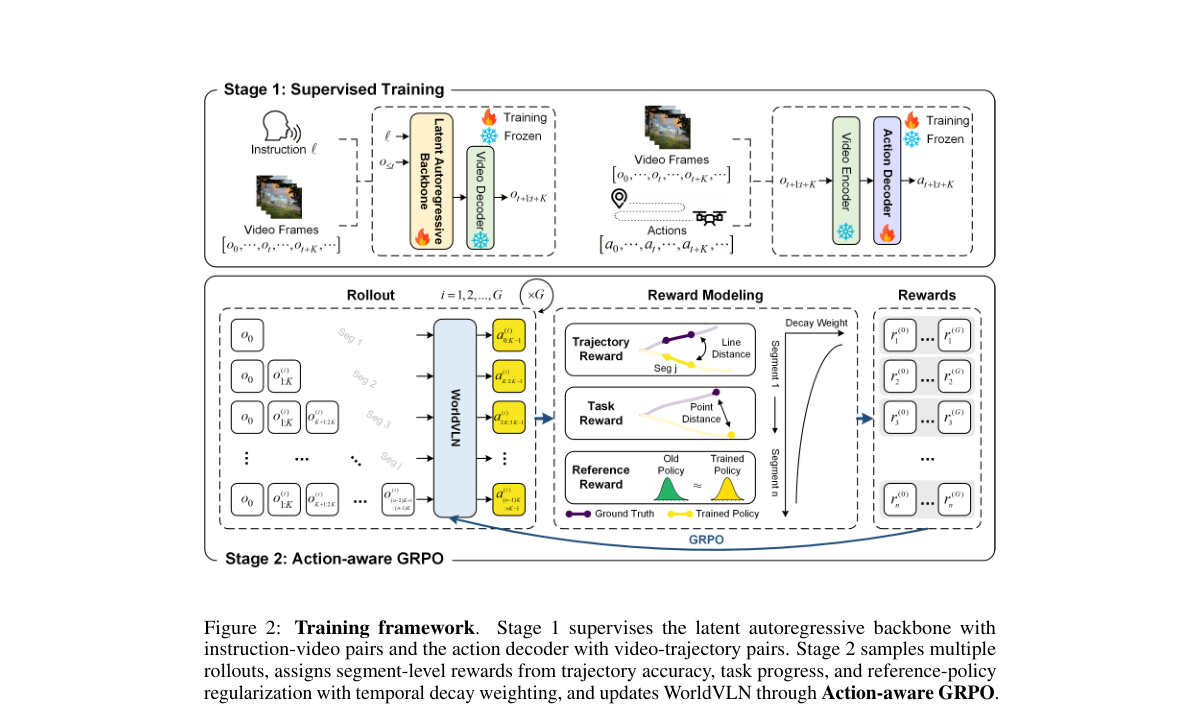
Stage 1 — 监督训练(世界先验对齐)
世界骨干目标: \(\mathcal L_\text{wm} = -\sum \log p_\theta(z_{t+1:t+K} \mid e_\ell, z_{\leq t})\)
动作解码器目标(通过视频-动作教师模型蒸馏初始化): \(\mathcal L_\text{act} = \sum \lVert D_\phi(E_\text{vid}(o_{t+1:t+K})) - a^*_{t:t+K-1} \rVert\)
Stage 2 — Action-aware GRPO(动作后果对齐)
对每条导航案例采样 $G$ 条在线轨迹,每条包含 $n$ 个自回归决策段,对第 $j$ 段分配奖励:
\[r^{(i)}_j = \gamma^{j-1}\left(\lambda_\text{traj} r^{(i)}_{\text{traj},j} + \lambda_\text{task} r^{(i)}_{\text{task},j} + \lambda_\text{ref} r^{(i)}_{\text{ref},j}\right)\]- 轨迹奖励 $r_\text{traj}$:局部几何监督,衡量预测动作与专家动作的接近程度
- 任务奖励 $r_\text{task}$:全局终点评估,衡量轨迹终点与目标的距离
- 参考奖励 $r_\text{ref}$:KL 正则化,保持更新策略与参考策略(Stage 1 产物)的一致性,防止世界先验退化
- 时序衰减 $\gamma^{j-1}$($\gamma=0.9$):早期决策权重更大,因其影响后续更长的动作链
优势归一化后以 GRPO 截断目标更新策略。
3. 核心结果/发现
UAV-Flow-Sim(室外):WorldVLN 达到 79.12% / 78.02% 平均 SR(固定/开放语言模板),分别比最强基线提升 13.51 / 12.24 个百分点。在 Approach(97.62%)、Land(98.15%)、Move(100%)等精细动作上表现尤为突出。
IndoorUAV-VLA(室内):Full-set SR 达 41.76%,比最强基线(π0,27.16%)提升 14.60 个百分点;Hard 难度下 SR 从 7.55% 提升至 41.19%,显示对复杂多步动作组合的强适应能力。
消融分析:
- 与 OpenVLA 对比:相同步数下,Stage 1 后的 WorldVLN 已超越 OpenVLA-SFT,表明 WAM 范式学习效率更高
- 自回归 vs 全序列预测:自回归提升 SR 5.7+ 个百分点,隐预测可视化显示全序列预测存在语义漂移,而自回归因持续融合真实观测保持了连贯的视觉空间表示
- Action-aware GRPO:在 Stage 1 接近饱和后额外提升 10+ 个百分点,轨迹可视化显示 RL 后模型能正确执行”环绕”等几何精确动作
零样本真实机器部署:在仅用仿真数据训练的情况下,WorldVLN 在 250 mm 轴距四旋翼无人机上实现室内和室外的语言指令跟随,机载 Jetson Orin NX + 远程服务器推理架构验证了实际可部署性。
4. 局限性
当前实验主要针对短程低时域导航,长距离多阶段 VLN 尚未充分验证;受骨干计算量限制,真实部署仍依赖服务器端推理,无法完全机载运行。
20. CONDVLN (2026)
———首个基于分层3D场景图的视觉语言导航条件分支诊断基准与神经符号探针
📄 Paper: arXiv:2608.17318
精华
- 研究痛点:传统视觉语言导航(VLN)评测高度依赖“固定目标点的线性路径跟随”,无法评估现实中极其普遍的条件分支决策(如“若厨房有花则去客厅,否则去卧室”),导致感知、空间定位与符号逻辑推理的失败原因相互混淆。
- 核心构建:提出首个基于分层 3D 场景图的程序化条件基准 CONDVLN,跨 AI2-THOR、Matterport3D、Gibson 和 ReplicaCAD 四大环境生成了超 11,500 条真值可验证、复杂度可控(逻辑深度 $d$ 与分支链长 $\ell$)的条件导航任务。
- 诊断指标:设计分支选择准确率(BSA)与条件成功率(CSR),克服了传统成功率(SR)对“走错分支但误打误撞到达某处”无法甄别的盲区,支持对中间子目标完成度的细粒度归因。
- 评测发现:SOTA 视觉语言模型(如 NaVid、NaVILA)在条件分支任务中几乎崩溃(CSR 接近 0%),而具显式推理结构的 Open-Nav 与 VLN-Zero 表现更佳,表明端到端黑盒训练在结构化条件决策上存在严重缺陷。
- 解耦探针:提出神经符号 Oracle 诊断探针,将条件判定与底层动作执行解耦,在复杂嵌套与长分支链场景下带来高达 2 倍的性能提升,为神经符号与具身导航的结合指明了方向。
1. 研究背景/问题
现有的具身视觉语言导航基准(如 R2R、RxR 等)主要关注智能体能否根据指令到达单一且固定的目标位置。然而,在真实的家庭与物理环境中,人类的导航指令往往强依赖于环境状态的动态观测(例如:“如果餐桌上有咖啡杯,就走到洗碗机旁的吧台凳;否则走到浴室水槽下方的照明灯处”)。现有评测不仅缺乏对条件分支结构的显式控制,也无法厘清智能体在失败时究竟是卡在视觉感知、目标定位、空间运动还是高层逻辑决策上。
2. 主要方法/创新点
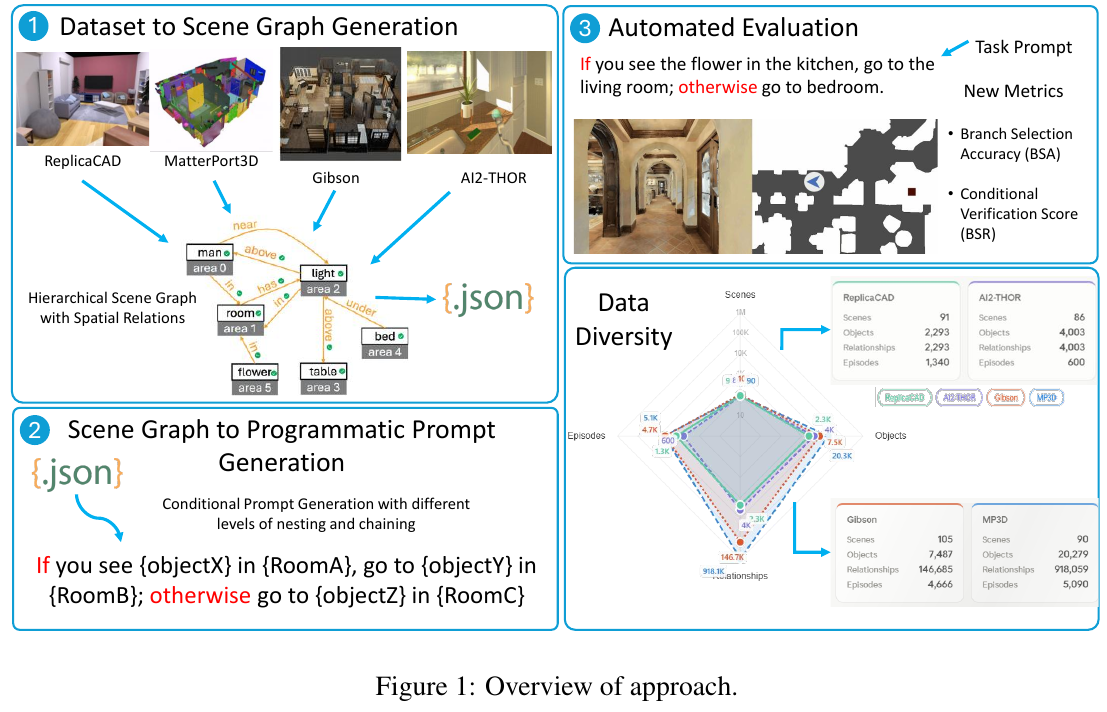
CONDVLN 框架由分层 3D 场景图构建、程序化条件指令合成、VLN-CE 兼容仿真适配、细粒度诊断指标(BSA/CSR)以及神经符号 Oracle 诊断探针五大核心模块组成,整体实现了逻辑复杂度可控、真值可溯源的端到端评估闭环。
模块一:多源环境统一与分层 3D 场景图构建(Scene Hierarchy & Spatial-Semantic Graph)
- 输入:来自 AI2-THOR、ReplicaCAD(合成仿真数据)以及 Matterport3D、Gibson(真实物理扫描数据)的异构几何与语义标注。
- 处理:
- 统一房间层级抽象:将不同数据源统一解析为以房间为顶层、包含物体实例集合的符号化层级结构。每个物体 $o_i$ 记录语义标签 $\ell_i$ 与 3D 中心坐标 $c_i = (x_i, y_i, z_i)$,并优先提取 3D 轴对齐包围盒(AABB),缺失时以包围球半径作为几何兜底。
- 回退几何距离计算:计算同房间内物体对 $(o_i, o_j)$ 的空间位移 $\delta_{i \to j} = c_j - c_i$,并按优先级回退选择距离度量: \(d_{ij}^{\text{used}} \in \{ d_{ij}^{\text{AABB}}, d_{ij}^{\text{sphere}}, d_{ij}^{\text{center}} \}\) 其中 AABB 表面距离 $d_{ij}^{\text{AABB}} = \sqrt{\Delta_x^2 + \Delta_y^2 + \Delta_z^2}$ 能精确捕捉物体的表面外轮廓,包围球表面距离 $d_{ij}^{\text{sphere}} = \max(0, \lVert \delta_{i \to j} \rVert_2 - (r_i + r_j))$ 作为平滑近似,中心点欧氏距离 $d_{ij}^{\text{center}} = \lVert \delta_{i \to j} \rVert_2$ 作为最终兜底。
- 规范方位与语义谓词生成:将水平方位角离散化为 8 个罗盘扇区(东、东北、北等),俯仰角离散化为 3 个垂直区间(上、平级、下),组合生成三维相对方位谓词;同时基于硬阈值生成贴近自然语言的语义空间谓词(如
near、far from、higher than、lower than、above、below)。
- 输出:带可追溯几何属性(包含中心距、AABB 距离、方位扇区等)的有向空间语义场景图。
- 设计动机:消除各模拟器之间坐标系与标注粒度的壁垒,为后续逻辑生成提供唯一、可精确判真伪的客观物理事实底座。
模块二:程序化条件指令合成与对象采样(Programmatic Conditional Instruction Synthesis)
- 输入:已构建的 3D 场景图与其空间谓词。
- 处理:
- 正负条件采样机制:从场景图中采样有效实体作为真实分支的参考物体;同时从该场景其他房间中采样存在、但当前参考房间中缺失的物体类别,构造具有明确客观真伪的负分支条件(False Branch)。
- 同名物体空间消歧:当房间内存在多个同类物体(如多盏台灯)时,自动引入场景图关系谓词限定(如“床边的台灯”)实现唯一指向,无法消除歧义的样本直接滤除。
- 逻辑模板实例化:将场景图谓词映射进
IF [condition] THEN [action] ELSE [action]的基础骨架中,并支持多层级嵌套与多分支串联。
- 输出:自然语言条件指令文本及其对应的先验真值分支、目标点与子目标序列。
- 设计动机:确保每条指令在 3D 空间中都有明确无误的真值,使评测系统完全掌握地面真值(Ground Truth)决策路径。
模块三:复杂度分类与 VLN-CE 仿真适配(Complexity Taxonomy & Episode Realization)
为了系统化诊断不同维度的推理瓶颈,CONDVLN 沿逻辑深度(Depth $d$)和分支链长(Chain Length $\ell$)两个正交维度定义了 6 种指令复杂度层级:
| 复杂度类别 | 逻辑深度 $d$ | 分支链长 $\ell$ | 逻辑结构形式 | 典型示例 |
|---|---|---|---|---|
| Simple | 1 | 1 | 单层 IF-ELSE | 若厨房有花则去客厅,否则去卧室 |
| Nested | 2 | 1 | IF 内部嵌套 IF | 若厨房有花,(若花在桌上则去客厅,否则去阳台);否则去卧室 |
| Deep Nested | 3 | 1 | 三级深度嵌套 | 多层条件逐级判定深入 |
| Chain | 1 | 2 | IF / ELSE IF / ELSE | 若厨房有花去客厅,否则若有咖啡机去书房,否则去卧室 |
| Long Chain | 1 | 3 | 多分支串联链 | 3 个以上顺序排他条件分支 |
| Nested Chain | 2 | 2 | 嵌套 + 链式组合 | 复合高层复杂决策 |
降维装置:条件指令的状态机流转
graph TD
    Start["起始观测"] --> Q1{"条件 A: 厨房是否有花?"}
    Q1 -- "True (分支1)" --> Q2{"条件 B (深度 d=2): 花是否在桌上?"}
    Q1 -- "False (分支2)" --> Q3{"条件 C (链长 l=2): 是否有咖啡机?"}
    Q2 -- "True" --> T1["目标1: 客厅沙发"]
    Q2 -- "False" --> T2["目标2: 阳台花架"]
    Q3 -- "True" --> T3["目标3: 书房书桌"]
    Q3 -- "False" --> T4["目标4: 卧室床头"]
所有任务均被转换为标准 VLN-CE / Habitat-Sim 的 JSON 格式,包含起点坐标、朝向、真值测地线最短路径(Geodesic Shortest Path)与多阶段子目标航点,现有模型无需改造仿真环境即可直接评测。
模块四:条件推理诊断指标(BSA & CSR)
传统的成功率(SR)只在乎最终停靠点是否接近目标,无法辨别智能体是“正确理解了条件并前往目标”还是“由于感知漂移误打误撞停在了某个目标附近”。为此,CONDVLN 提出了两个专用诊断指标:
- 分支选择准确率(Branch Selection Accuracy, BSA): 衡量智能体沿着正确条件分支前进了多远。设当前真值分支对应的有序子目标序列为 $G_i = (g_{i,1}, \dots, g_{i,m_i})$,智能体按序在容差半径 $\tau$ 内到达的最长前缀长度为 $k_i$,则单样本得分为: \(BSA_i = \frac{k_i}{m_i} \quad (m_i > 0)\) 整体评测集得分为所有样本的平均值 $BSA = \frac{1}{\lvert I \rvert} \sum_{i \in I} BSA_i$。该指标允许给出部分完成的分数。
- 条件成功率(Conditional Success Rate, CSR): 衡量严格意义上的条件导航完成度。要求智能体不仅要完整经历分支的所有子目标($BSA_i = 1$),还必须在最终目标点取得 Habitat 标准导航成功($\text{Success}(i) = 1$): \(CSR_i = \mathbf{1}[BSA_i = 1 \land \text{Success}(i) = 1]\) 整体评测集得分为 $CSR = \frac{1}{\lvert I \rvert} \sum_{i \in I} CSR_i$。
举个例子: 设某任务真值分支包含 2 个顺序航点(走廊拐角 $g_1$、客厅门 $g_2$)和终点(沙发 $g_3$),即 $m_i = 2$。
- 情况 A(完全正确):智能体依次经过 $g_1, g_2$ 并停在 $g_3$,则 $k_i=2, BSA_i=1.0, \text{Success}(i)=1 \implies CSR_i=1, SR_i=1$;
- 情况 B(半途迷失):智能体经过 $g_1$ 后迷路未到 $g_2$ 且未到 $g_3$,则 $k_i=1, BSA_i=0.5, CSR_i=0, SR_i=0$;
- 情况 C(误打误撞/走错分支):智能体直接走错走向卧室分支,但卧室里恰好有一张同名沙发,智能体停在卧室沙发旁——此时传统 $SR_i=1$ 会误判为成功,但由于其完全未访问正确分支的子目标($k_i=0, BSA_i=0$),新指标精确诊断出 $CSR_i=0$!
模块五:神经符号 Oracle 诊断探针(Neurosymbolic Branch-Selection Oracle Model)
为了探究现有智能体究竟是受阻于“前段条件逻辑推理”还是“后段空间运动导航”,作者构建了一个神经符号 Oracle 探针:
| 对比维度 | 端到端黑盒智能体(NaVid / NaVILA 等) | 神经符号 Oracle 探针(Oracle + VLN-Zero) |
|---|---|---|
| 指令输入形式 | 原始条件文本(含 IF-ELSE / 嵌套 / 链式逻辑) | 由真值元数据线性化重写后的纯路径指令(如“先到 $g_1$,再到 $g_2$,最后到 $g_b$”) |
| 条件分支决策 | 由神经网络隐式端到端猜测与判断 | 符号化先验自动解析,剥离分支选择负担 |
| 底层执行器 | 保持不变 | 保持完全不变(使用相同的 VLN 导航模型) |
| 诊断作用 | 测量包含逻辑、感知与控制的混合表现 | 作为理论上限探针,严格量化逻辑分支选择错误导致的性能损失 |
3. 核心结果/发现
论文在 AI2-THOR、ReplicaCAD、Gibson 和 Matterport3D 四个数据集上评测了四类主流 VLN 模型(NaVid、NaVILA、Open-Nav、VLN-Zero)以及 Oracle 探针,得出以下关键结论:
- 端到端大模型在条件分支上性能普遍崩溃:
- 通用端到端 VLM 导航模型(如 NaVid、NaVILA)在各大环境中的条件成功率极低(NaVILA 在所有数据集上的 CSR 均为 0.0%,NaVid 在 Gibson 与 MP3D 上 CSR 也接近 0%)。这表明目前单纯依靠预训练视觉语言模型的隐式端到端微调,根本无法泛化到具备显式逻辑分支的 3D 决策任务。
- 显式结构与大语言模型推理带来显著优势:
- 具备显式推理架构的模型表现大幅领先:Open-Nav 凭借 LLM 零样本思维链(Chain-of-Thought)规划,在 ReplicaCAD 上取得了 33.3% 的 CSR 和 39.2% 的 BSA;VLN-Zero 依托显式 3D 场景图表征,在 AI2-THOR 上取得了 21.0% 的 CSR 和 31.5% 的 BSA。这证实结构化表征与符号规划对条件具身决策至关重要。
- 逻辑深度与分支链长扩展造成持续性能衰减:
- 随着嵌套深度从 $d=1$ 增加到 $d=3$,或分支链长从 $\ell=1$ 扩展到 $\ell=3$,所有端到端模型的 BSA 与 CSR 均单调骤降。
- 神经符号 Oracle 探针在高复杂度下优势尤为明显:在 $d=3, \ell=1$ 和 $d=1, \ell=2$ 等高难度配置下,Oracle 相比未解耦的基线模型展现出超过 2 倍的性能提升(例如在 $d=1, \ell=2$ 下 Oracle 取得 24.63% CSR,而 Open-Nav 仅为 11.51%),证明将符号条件判定与底层导航动作正交解耦是攻克复杂任务的有效路径。
4. 局限性
CONDVLN 目前仅支持 VLN-CE 兼容的室内离散/连续仿真环境,评测质量受限于原始点云扫描与几何标注的噪点;此外,几何谓词生成依赖固定的人工阈值,且 Oracle 探针使用的是真值元数据而非在线感知构建的场景图。
21. Qwen-Drive (2026)
———首个不改动 VLM 架构、统一 3D 感知/问答/轨迹规划的端到端自动驾驶基础模型
📄 Paper: arXiv:2609.00111 · Code · Model
精华
- 无侵入架构统一三大驾驶能力:在完全冻结且不修改通用视觉语言模型(VLM)主干的前提下,通过外挂轻量化 BEV 感知头与基于扩散变换器(DiT)的规划专家,首次在一套框架内原生统一 3D 感知、驾驶视觉问答与未来运动轨迹规划。
- 解耦感知探针与隐式空间表征倒逼:提出双流特征融合的 BEV 感知头,低层通过深度网络将图像投影构建 3D 体素空间,高层抽取 VLM 语义特征并经由 BEV Transformer 融合,作为探针不仅输出可解释的 3D 检测、占用与矢量地图,更通过双流反向传播驱动通用 VLM 掌握精确 3D 几何常识。
- GQA 键值缓存驱动的连续流匹配规划:规划专家无需将轨迹离散化为自回归文本 Token,而是直接跨模块复用 VLM 内部 8 层分组查询注意力(GQA)的 Key-Value 缓存作为交叉条件,借助流匹配(Flow Matching)在连续空间内一步到位解码平滑且符合动力学物理特性的时空航点。
- 首创连续流匹配策略梯度强化学习:突破传统扩散/流模型难以接入不可微驾驶环境指标的瓶颈,在最后 3 步积分区间引入正交低频余弦子空间扰动与分数恢复项(Restoring Score),结合组内无评论家相对优势,在连续扩散流形上直接优化碰撞、通行规则与体感舒适度指标。
- 零灾难性遗忘且多基准登顶:通过混合驾驶与通用图文数据的四阶段递进式训练,模型在获得行业领先 3D 几何与规划能力(NAVSIM PDMS 达 90.7,WOD-E2E RFS 达 7.91)的同时,通用多模态问答基准分毫未损。
1. 研究背景/问题
现有的自动驾驶视觉语言模型(VLM)面临两难困境:若直接改造大模型主干去输出离散坐标或自回归生成决策,往往导致严重的灾难性遗忘并破坏其原生的通用视觉推理与指令遵循能力;而若仅依靠多模态大模型输出高层文本解释,又缺乏对 3D 物理环境的精确几何感知与可执行的连续运动学控制。
为此,阿里云 Qwen 团队与华中科技大学联合推出了 Qwen-Drive-1.0,旨在探索兼顾“通用多模态理解能力”与“专用端到端自动驾驶几何规划能力”的统一基座。其核心动机在于:在完全不改动预训练 VLM 架构与参数格式的前提下,利用外挂探针模块抽取通用特征中的 3D 空间结构,并通过连续流匹配与强化学习,实现端到端 3D 感知、常识推理与闭环轨迹规划的深度协同。
2. 主要方法/创新点
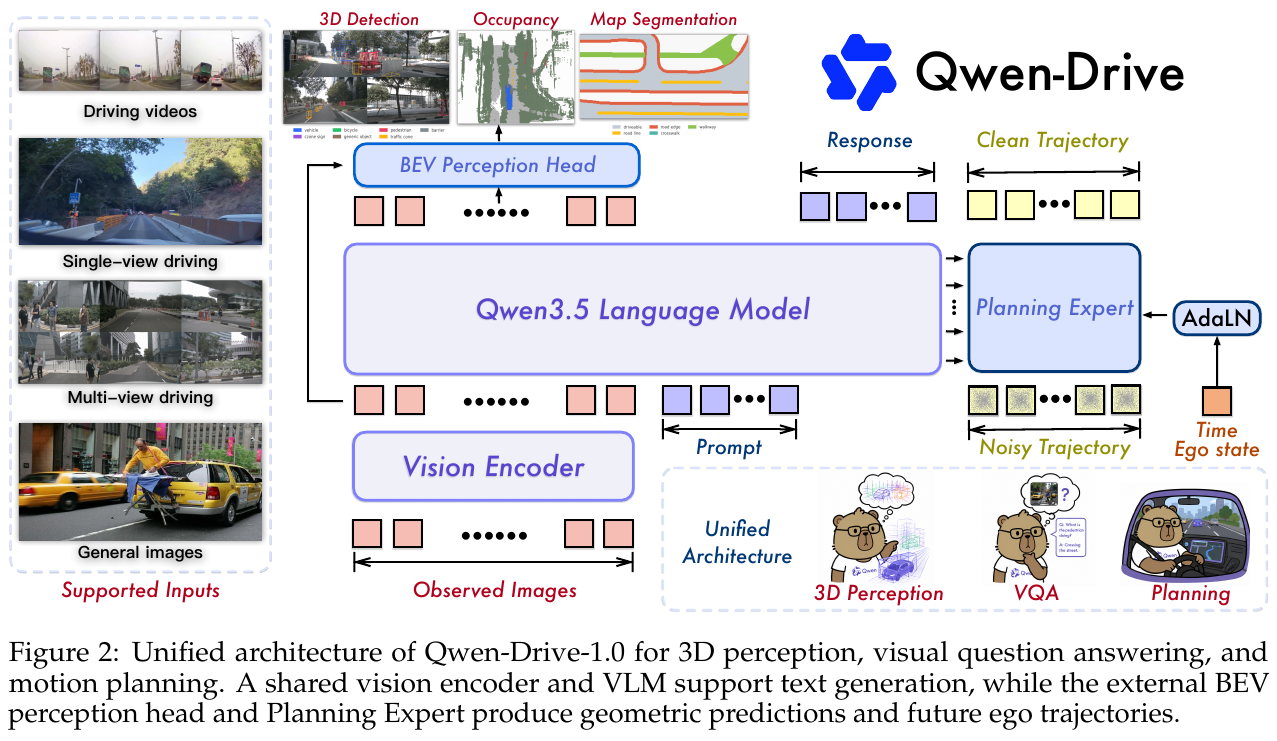
2.1 整体框架概述
Qwen-Drive-1.0 整体由三个核心协同模块构成:
- 共享多模态骨干(Shared VLM Backbone):采用标准 Qwen3.5-4B 架构与原生 Vision Encoder,接收多视角环视图像、连续视频帧或单张通用图像,负责场景语义表征与多轮对话问答;
- BEV 感知探针(BEV Perception Head):外挂轻量化空间解码模块,融合视觉编码器底层纹理特征与 VLM 顶层语义特征,显式解码自车坐标系下的 3D 目标检测、3D 语义占用(Semantic Occupancy)及高精矢量地图分割;
- 规划专家(Planning Expert):包含 11 亿参数(32 层)的扩散变换器(Diffusion Transformer, DiT),跨模块直接读取 VLM 中缓存的键值表征(KV Cache)作为先验条件,通过流匹配生成未来 5 秒(10Hz,共 50 个航点)的平滑自车轨迹。
在输入序列化上,模型依据下游任务特性设计了两种无冗余标签排序策略:
- 问答任务(帧优先,Frame-Major):按时步遍历视角,即
frame: 0 <FRONT VIEW> <image> ... frame: 1 ...,便于大模型跨视角对齐单帧全局环境; - 规划任务(视角优先,View-Major):按视角遍历时步,即
<FRONT VIEW> frame: 0 <image> frame: 1 <image> ...,将同一摄像头的连续历史观测紧密相邻排列,显著增强对动态障碍物时序速度与运动变化的感知。
2.2 外挂双流 BEV 感知探针与自制架构解析
为验证预训练 VLM 内部是否已内隐具备 3D 空间结构,并为驾驶决策提供可显式质检的几何输出,论文设计了不修改大模型主干的 BEV 感知头。
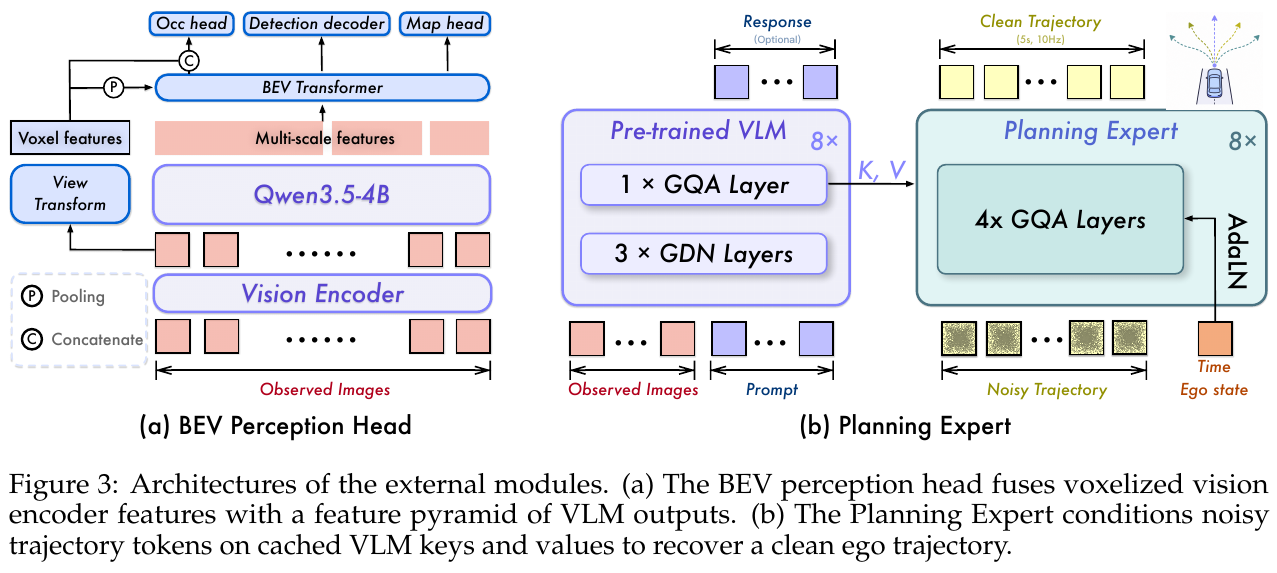
模块内部的数据流向与空间投影机制如下:
- 输入:当前时刻 $N_v$ 个环视相机画面(如 6 视角或 8 视角)及内外参标定矩阵。
- 处理过程(双流融合):
- 低层几何流:从 Vision Encoder 提取尚未进入大模型的低层图像特征 $F_v$。通过轻量化深度子网络预测沿视线的离散深度分布 $D_i$,按经典视线投射原理将特征分散到 3D 空间中,构建带有高度维度的 3D 体素特征体 $V(p) = \sum_{i \in \Omega(p)} D_i(u_i, v_i, d_i) F_v^i(u_i, v_i)$;
- 高层语义流:图像 Token 完整经过 VLM 运算后,抽取顶层富含全图上下文语义的特征 $F_m$。经由特征金字塔(FPN)上采样生成多尺度语义图;
- BEV 平面聚合:将 3D 体素 $V$ 沿高度坍缩压平作为几何先验查询 $\bar{V}$,送入 BEV Transformer。通过在 BEV 网格上交替执行自注意力与对多尺度 $F_m$ 的可变形跨注意力(Deformable Cross-Attention),输出融合了几何深度与高层语义的自车坐标系 BEV 表征 $B$。
- 输出:三路专用解码头并行输出——DETR 风格的可变形注意力解码器预测 3D 目标检测框;三维 UNet 结合初始体素 $V$ 预测体素级 3D 语义占用;轻量卷积头输出局部 $400 \times 200$ 网格的栅格化矢量地图元素。
graph TD
    A["多视角环视图像 (Nv 视角)"] --> B["Vision Encoder 提取低层特征 Fv"]
    A --> C["Qwen3.5 VLM 主干提取高层语义 Fm"]
    B --> D["深度网络预测视线深度分布 Di"]
    D --> E["外推并聚合成 3D 体素表征 V"]
    E --> F["沿高度坍缩生成几何先验 V_bar"]
    C --> G["特征金字塔 FPN 构建多尺度语义"]
    F --> H["BEV Transformer 交叉注意力融合"]
    G --> H
    H --> I["统一自车 BEV 特征 B"]
    I --> J["3D 目标检测 (DETR 查询解码)"]
    I --> K["语义占用预测 (结合 3D 体素 V)"]
    I --> L["高精地图矢量分割 (BEV UNet)"]
- 感知目标函数:总感知损失联合监督检测、占用与地图分割: \(L_{perc} = L_{det} + L_{occ} + L_{map}\) 其中 $L_{det}$ 采用匈牙利匹配下的 Focal 损失与 $\ell_1$ 边界框回归;$L_{occ}$ 结合类别平衡 Focal、几何/语义亲和度损失与 Lovász-softmax 损失;$L_{map}$ 采用 Focal 与 Lovász 损失。在反向传播时,感知损失不仅更新 BEV 头,更通过 $F_m$ 为 VLM 与视觉编码器注入强大的 3D 空间监督信号。
2.3 基于流匹配(Flow Matching)的规划专家
传统自动驾驶方案要么采用级联感知预测模块,信息瓶颈严重;要么强行让语言模型输出离散的轨迹 Token,不仅推理缓慢,而且容易违反车辆物理运动学约束。
| 维度 | 传统端到端感知规划 (如 UniAD) | 纯自回归语言模型规划 (如 DriveVLM / EMMA) | 本文 Qwen-Drive-1.0 架构 |
|---|---|---|---|
| 主干模型架构 | 专用 CNN/BEV 网络,无通用推理与常识理解能力 | 修改或全量微调 VLM,易出现灾难性遗忘与泛化退化 | 冻结原生预训练 VLM 架构,无侵入式外挂扩展 |
| 规划轨迹表示 | 稠密感知结果级联输入二次低层轨迹优化器 | 文本或离散网格 Token 自回归逐点解码 | 32 层连续扩散变换器(DiT)结合流匹配解码 |
| 几何常识交互机制 | 仅依赖预测框几何交互,缺乏深层语义推理 | 纯靠离散语言提示推导坐标,动力学平滑度差 | 跨模块直接复用 VLM 8 层 GQA 键值缓存与动力学状态 |
| 策略后训练能力 | 仅支持模仿学习或简单的代价函数打分 | 离散强化学习(PPO)难以平滑探索连续控制流形 | 连续流匹配策略梯度(低频余弦子空间扰动与分数恢复) |
- 输入与条件注入: 规划目标建模为条件连续轨迹生成: \(\tau \sim p(\tau \mid s, \ell, \tau_{hist}, n, e, r)\) 其中 \(\tau = \{ (x_k, y_k, \theta_k) \} _{k=1}^{50}\) 为未来 5 秒内 50 个时间步的纵向位置、横向位置及朝向角。输入的传感器图像经过 VLM 主干计算后,模型提取 VLM 中全部 8 个分组查询注意力(GQA)层中带有旋转位置编码(RoPE)的 Key 和 Value 缓存(KV Cache)。DiT 的 32 层分为 8 组(每组 4 层),每组直接与对应 GQA 层的 KV 拼接执行联合跨注意力交互;自车历史轨迹 \(\tau_{hist}\)、导航意图 $n$(如左转、直行)、当前自车物理状态 $e$(速度与加速度)及流时间步 $t$ 则通过自适应层归一化(AdaLN)注入到每个 DiT 块中。
- 流匹配训练目标: 采用端点预测形式的流匹配(Flow Matching),并引入一阶与二阶时间差分惩罚抑制轨迹抖动: \(L_{plan} = L_{fm} + 0.1 L_{\Delta 1} + 0.05 L_{\Delta 2}\) 其中 $L_{fm}$ 为预测流场速度与真实流速度之间的均方误差;$L_{\Delta 1}$ 和 $L_{\Delta 2}$ 为 Huber 正则项,分别惩罚轨迹速度与加速度的突变,确保输出轨迹严格满足车辆乘坐舒适性与动力学连续性。推理时仅需 10 步欧拉积分器即可快速解出确定性平滑轨迹。
2.4 连续流匹配的策略梯度强化学习(Flow Matching RL)
难点剖析:基于模仿学习(SFT)训练的规划专家只能逼近人类单条演示轨迹,但人类驾驶演示可能存在次优解,且无法直接感知碰撞风险、越界率与行车通行效率等不可微环境指标。然而,标准的策略梯度强化学习(如 PPO/GRPO)依赖动作概率 $\log \pi(a \mid s)$,而流匹配在推理时使用的是确定性的 10 步常微分方程(ODE)欧拉积分,不存在可以直接求导的似然分布。
针对该挑战,Qwen-Drive-1.0 提出了一套作用于连续扩散/流积分过程的平滑策略梯度优化算法:
- 尾部注入受控随机性:10 步欧拉积分(步长 $\Delta t = 0.1$)中,前 7 步保持纯确定性积分以锁定大局决策;仅在最后 3 个积分时步 $W = {7, 8, 9}$ 引入受控随机扰动。因为终点处的扰动能直接映射到轨迹形变上,既保证了探索的多样性,又避免了前期扰动被后续积分衰减抵消;
- 正交余弦低频子空间投影:若在 50 个航点上添加独立高斯噪声,会产生杂乱无章的高频震颤毛刺,使模型学不到有意义的规避行为。因此,扰动被严格限制在前 $M=6$ 阶正交余弦基底 $\Phi \in \mathbb{R}^{50 \times 6}$ 构成的平滑低频子空间内($\Phi^\top \Phi = I_M$),使得随机变动表现为平滑的变道微调或前后纵向车距拉伸;
- 分数恢复机制(Restoring Score):随机探索可能导致中间轨迹偏离高概率密度流形,算法利用高斯条件概率推导解析恢复分数项: \(s_\theta(\tau^{(k)}, t_k) = -\frac{\tau^{(k)} - t_k \hat{\tau} _1^{(k)}}{(1 - t_k)^2}\) 并将单步均值修正为 $\mu^{(k)} = \tau^{(k)} + v_\theta \Delta t + \frac{\sigma_k^2}{2} s_\theta$,像虚拟阻尼器一样将轨迹状态持续拉向预训练流场中心;
- 组内相对优势折扣优化:同一个环境并发采样 $G=8$ 条轨迹候选,依据不可微指标(NAVSIM 的 PDMS、Waymo 的 RFS 及位移误差 ADE)计算奖励,通过组内标准化优势值 $A_i = \frac{R_i - \bar{R}}{\sigma_R + \epsilon_R}$ 结合时间折扣因子 $\gamma = 0.6$ 进行策略梯度回传: \(L_{rl} = -\frac{1}{G \lvert W \rvert} \sum_{i=1}^G \sum_{w=0}^{\lvert W \rvert - 1} \gamma^{\lvert W \rvert - 1 - w} A_i \log \pi_\theta\left(\tau_i^{(k_w+1)} \,\middle\vert\, \tau_i^{(k_w)}\right)\)
举个例子:假设规划专家用 10 步欧拉积分($K=10$)从纯噪声去噪生成 5 秒(50 个航点)的轨迹。
- 前 7 步(时步 0 到 6):完全遵循确定性流场速度积分滑行,不引入任何额外噪声,保留预训练学到的宏观驾驶意图;
- 后 3 步(时步 7 到 9,集合 $W={7,8,9}$):由于越靠近终点微小扰动对实际轨迹影响越直接,此时注入探索随机性。但为了防止 50 个航点各自随机抖动变成”锯齿折线”,扰动被严格限制在 6 个平滑的正交余弦波形基底($\Phi \in \mathbb{R}^{50 \times 6}$)构成的低频子空间内;
- 防漂移拉回:注入高斯扰动后,中间状态可能会偏离预训练流线,算法通过条件高斯分布反推一个恢复分数项 $s_\theta = -\frac{\tau - t \hat{\tau} _1}{(1-t)^2}$,像一根橡皮筋把扰动点稳稳拽回安全流形中心;
- 无价值网络优势估计:同一个驾驶场景并发采样 $G=8$ 组完整轨迹,每条轨迹根据驾驶表现计算非可微奖励(如 NAVSIM 的碰撞与合规综合得分 PDMS),通过组内相对优势 $A_i = \frac{R_i - \bar{R}}{\sigma_R}$ 计算折扣策略梯度,实现针对连续扩散流的强化学习更新。
2.5 四阶段递进式训练配方
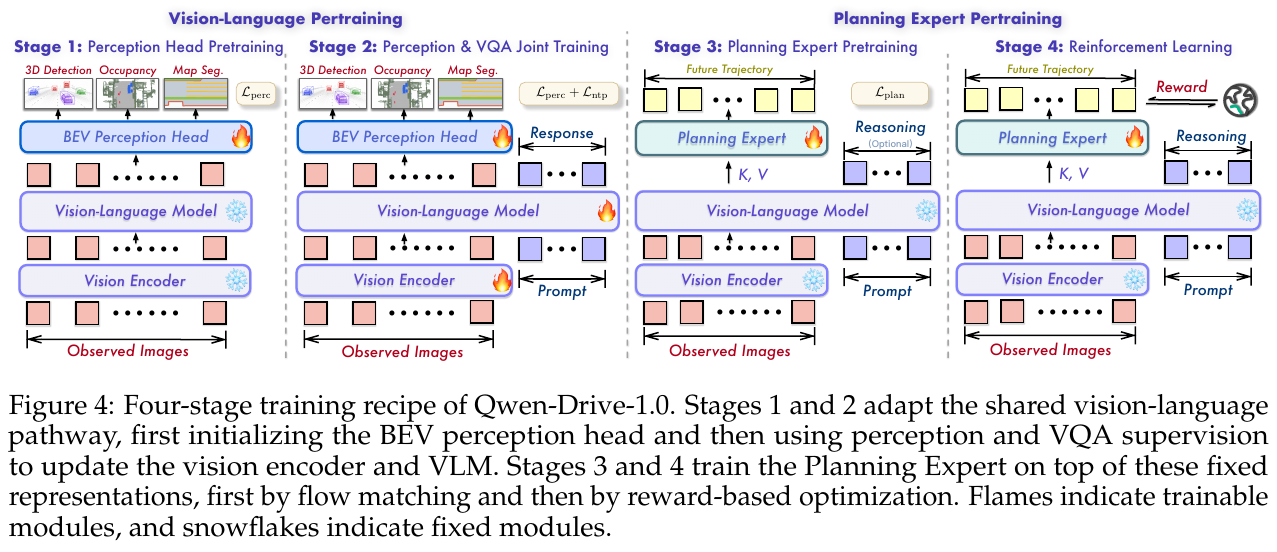
为了平衡多任务学习冲突并避免灾难性遗忘,论文提出了清晰的四阶段递进式训练流程:
- Stage 1(感知头预训练):完全冻结视觉编码器与 VLM 主干,仅以感知损失 $L_{perc}$ 预训练外挂的 BEV 感知头,使其快速建立从图像到 3D 体素与 BEV 坐标系的投影与解码先验;
- Stage 2(感知与 VQA 联合对齐微调):解冻视觉编码器、VLM 与 BEV 感知头,将 3D 感知数据、309 万驾驶图文数据(多视角图文、视频时序数据)与通用视觉语言数据按比例混合,以 $L_{perc} + L_{ntp}$ 联合训练。BEV 头学习率设为 VLM 的 20 倍,既让大模型表征融入 3D 物理空间理解,又牢固锁死通用问答与常识推理能力;
- Stage 3(规划专家预训练,SFT):冻结 Stage 2 训练完毕的全部多模态表征,仅训练外挂的 11 亿参数规划专家 DiT,以端到端流匹配损失 $L_{plan}$ 学习各驾驶数据集的演示轨迹;
- Stage 4(规划专家强化学习,RL):在 NAVSIM、Waymo E2E 与 PhysicalAI-AV 上构建多源混合奖励,通过上述流匹配策略梯度直接后训练优化规划专家,最终得到性能优异的 Qwen-Drive-1.0-RL。
3. 核心结果/发现
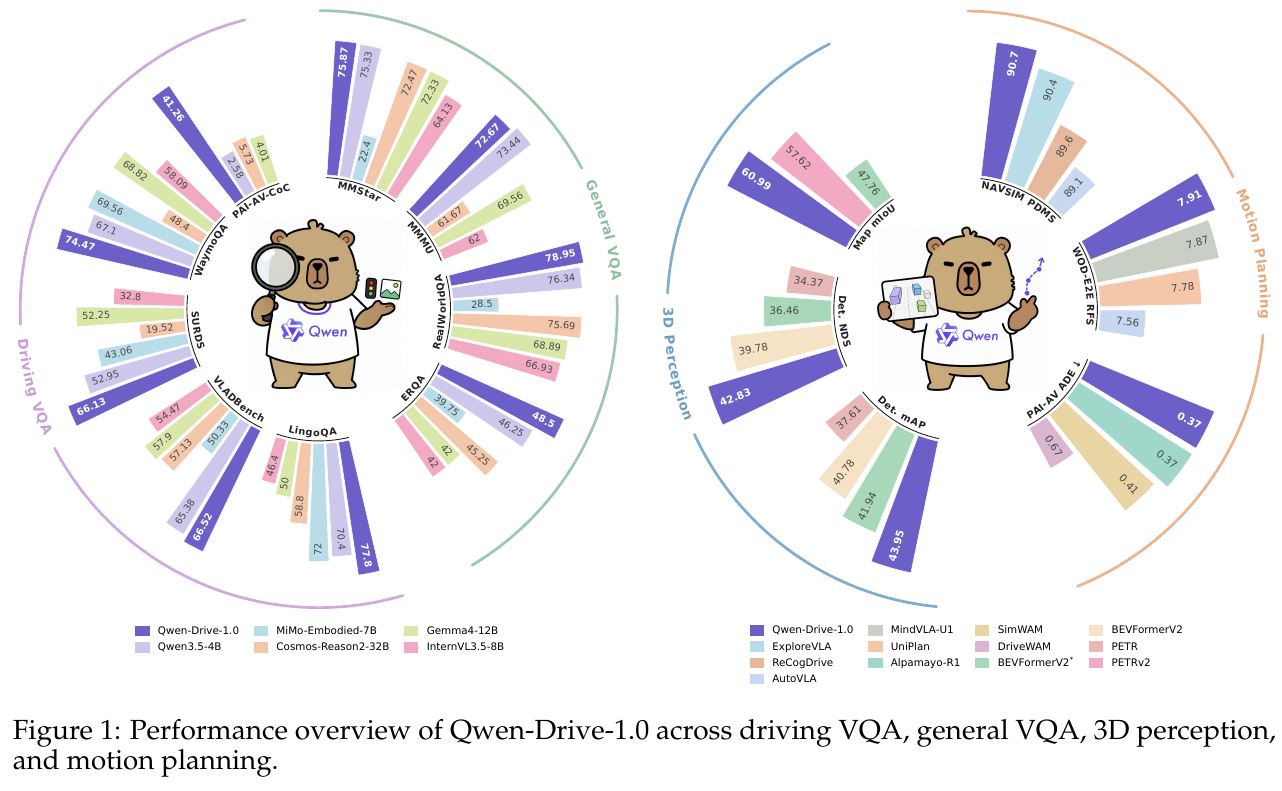
3.1 3D 感知性能探测
在 nuScenes 与 OpenScene 验证集上的多任务统一评测表明:
- 3D 目标检测与地图分割领先:在 nuScenes 上取得 43.95% mAP 与 42.83% NDS,BEV 矢量地图分割 mIoU 达到 60.99%;在跨城市、跨时段的 OpenScene 验证集上,检测 mAP 达到 38.65%,地图分割 mIoU 达 57.07%;
- 空间表征隐式激发:消融实验显示,如果不在 Stage 2 进行联合训练(仅在 Stage 1 冻结主干训练外挂头),感知指标会大幅落后(nuScenes mAP 仅 36.46%),证明通用 VLM 本身并未直接暴露显式 3D 坐标,而 Stage 2 的联合反向传播成功将 3D 几何特征注入到了 VLM 的深层表征中。
3.2 通用视觉理解零遗忘与驾驶场景问答登顶
- 通用能力分毫未损:在包含 MMBench(87.07%)、MMStar(75.87%)、MMMU(72.67%)、RealWorldQA(78.95%)等 11 个通用多模态基准评测中,Qwen-Drive-1.0-SFT 平均得分达到 66.82%,与未经驾驶微调的原生通用 Qwen3.5-4B 基座(67.40%)基本持平,成功攻克了具身驾驶微调中常见的灾难性遗忘难题;
- 驾驶 VQA 全面超越行业大模型:在 LingoQA 上达到 77.80%(大幅领先 32B 参数的 Cosmos-Reason2 的 72.00%),在 VLADBench 上达到 66.52%(领先 InternVL3.5-8B 的 54.47%),在 WaymoQA(74.47%)和 SURDS(66.13%)上也均位列榜首。
3.3 运动规划全场景领先(开环、伪闭环与仿真闭环)
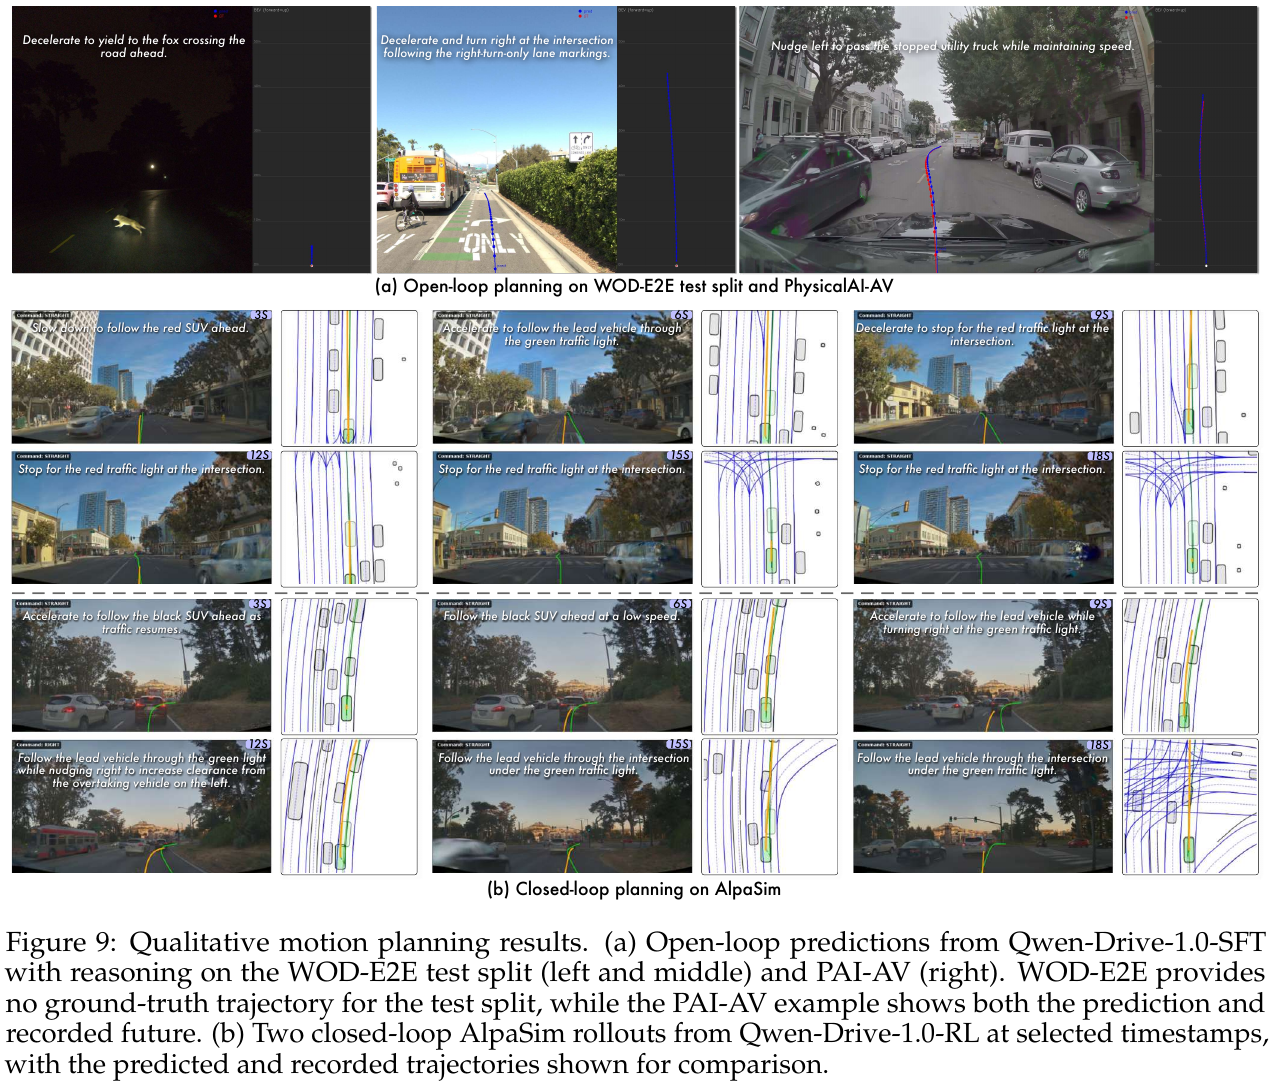
- NAVSIM 伪闭环测试刷新纪录:在 NAVSIM v1.1 navtest 榜单上,Qwen-Drive-1.0-RL 的驾驶综合评分(PDMS)达到 90.7(无碰撞率 98.3%,可行驶区域合规率 96.8%,舒适度满分 100.0%),显著领先 TransFuser(84.0)、DRAMA(85.5)和 Hydra-MDP(86.5);强化学习后训练相比纯模仿学习(86.8)带来高达 +3.9 分的质的飞跃;
- Waymo E2E 测试集登顶:在权威的 Waymo 真实世界端到端规划基准(WOD-E2E)测试集上,Qwen-Drive-1.0-RL 取得 7.91 的评分官反馈得分(RFS,接近人类真实驾驶员的 8.13 分),3 秒与 5 秒平均位移误差(ADE)分别低至 1.19 米与 2.67 米,在公开排行榜中击败了 MindVLA-U1(7.87)和 AutoVLA(7.56);在验证集上 RFS 更达 8.45,超越人类基准分;
- AlpaSim 闭环多场景长时程仿真验证:在英伟达 916 个复杂长时程闭环场景评测中,Qwen-Drive-1.0-RL 的出险率(Close Encounter Rate)与冲出道路率(Off-Road Rate)均维持在低位,最终 AlpaSim 得分达 0.37,验证了模型在动态交互博弈中的闭环安全性与敏捷避障能力。
4. 局限性
虽然 Qwen-Drive-1.0 在多任务统一上取得了突破,但其 BEV 感知头与规划专家目前仍作为外挂分支独立接入 VLM,感知输出的显式几何图元(如 3D 边界框与占用网格)未能反向作为结构化提示直接反馈给大语言模型进行多步思维链符号推理;此外,闭环仿真在面对密集动态博弈长尾极端工况时,对突发侵入车辆的让行决策仍存在偶发保守倾向。
22. LookStep (2026)
——— 基于语言前瞻推演与事件驱动记忆的高效端到端视觉语言导航
📄 Paper: arXiv:2609.02350 · Code
精华
- 语言中心未来状态前瞻(LC-FSM):打破传统 VLN 仅监督下一步单一专家动作(Next-step prediction)的范式,通过轻量级语言标签显式预测所有候选动作的前瞻后果(如提前撞墙、完成转向、错误路线),以极高的数据利用率实现反事实决策推演。
- 事件驱动自适应滚动记忆(EDRM):无需外部复杂的 3D 几何建图或占用庞大显存的全量历史堆叠,由多模态大模型在推理过程中自主判断当前观测是否构成关键事件(
<memory_write>keep/drop</memory_write>)并赋予语义角色,以有界内存实现长程上下文维护。 - 极高显存与数据利用效率:在不依赖外部几何工具或海量额外预训练数据的情况下,推理显存控制在 19.7 GB(约为同类方法的一半),显存利用效率(SR/GB)达到 2.52,显著领先 JanusVLN(1.19)与 StreamVLN(1.95)。
- 同等设定下刷新连续环境 SOTA:在最具挑战性的连续环境视觉语言导航基准 R2R-CE 未见验证集(Val-Unseen)上取得 49.7% 的成功率,全面超越了使用相同数据量与训练预算的现有主流方法。
1. 研究背景/问题
连续环境视觉语言导航(VLN-CE)要求具身智能体仅凭自然语言长程指令和连续车载相机观测到达指定目的地。基于多模态大语言模型(MLLM)的现有导航策略主要受制于两大效率瓶颈:
- 训练层面的数据饥渴与弱监督:传统行为克隆(Behavior Cloning)仅将专家当前执行的单一动作作为监督信号,模型无法知晓”为什么不选择其他动作”以及”备选动作会导致何种危险后果”,导致训练需要数百万级的大规模专家轨迹支持。
- 推理层面的显存爆炸与关键帧遗失:长程导航必须依赖历史状态;但全量保存历史视频帧会导致显存线性暴增,而固定窗口截断或均匀抽帧容易漏掉”推开房门”、”走下楼梯”等决定性的转折事件;引入外部 3D 建图工具又大幅增加了计算延迟与部署复杂度。
2. 主要方法/创新点
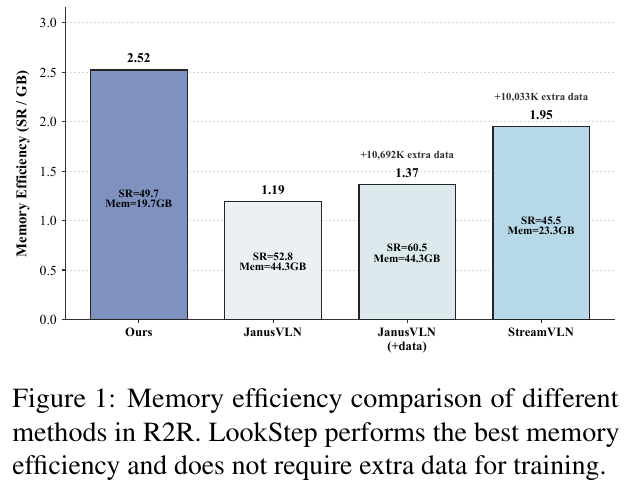
① 整体框架概述
LookStep 是一个统一的端到端 MLLM 导航框架,不依赖外部 3D 传感器或独立建图模块。系统通过统一的结构化文本生成序列,在自回归解码中同步完成三大核心任务:事件驱动记忆管理(Event-Driven Memory Management)、语言中心未来状态建模(Language-Centric Future State Modeling)与最终动作下发(Action Prediction)。
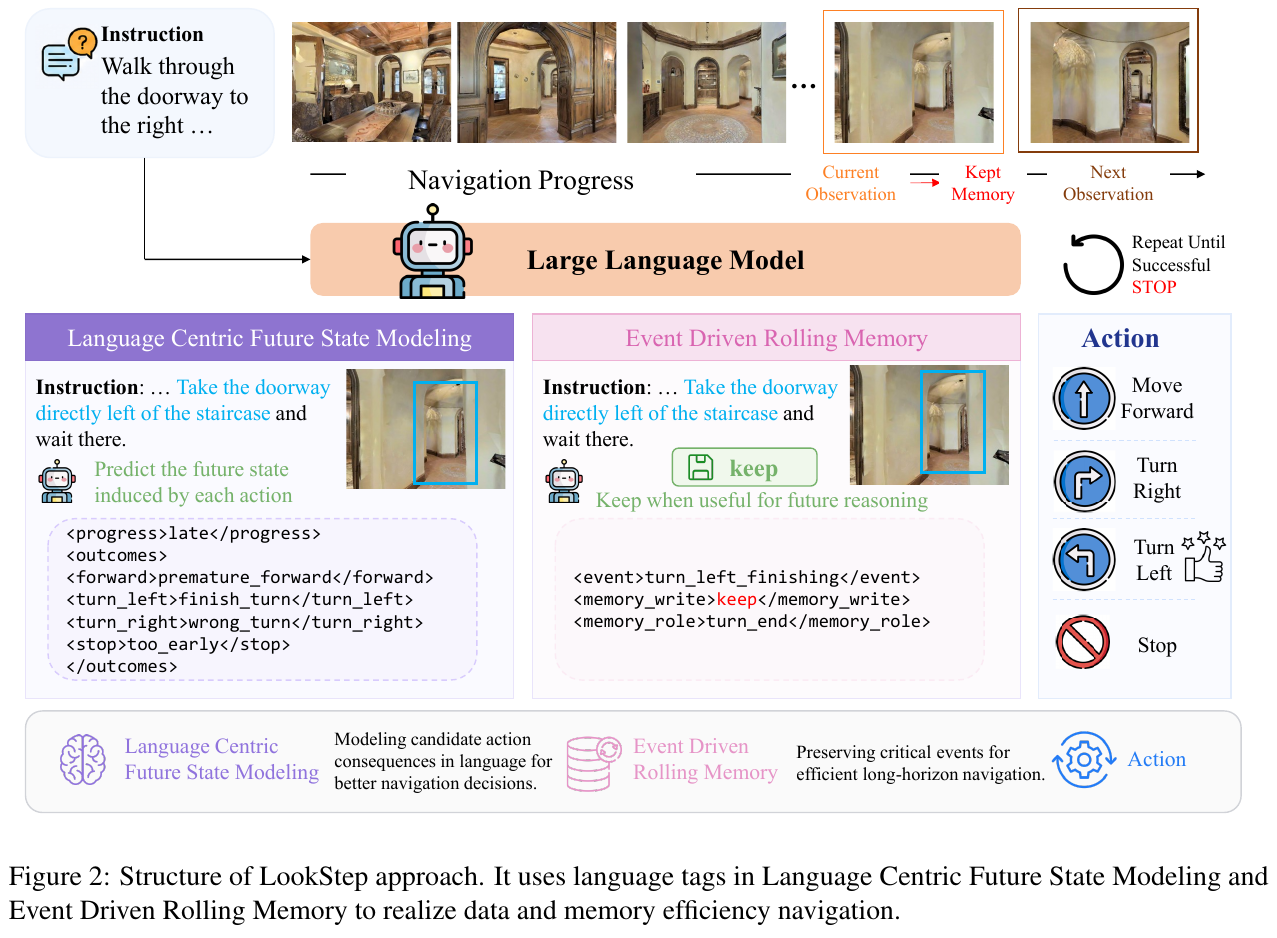
② 逐模块讲解
1. 语言中心未来状态建模(Language Centric Future State Modeling, LC-FSM)
- 输入:自然语言导航指令 $I$、当前相机观测 $x_t$ 以及有界历史记忆 $O_{t-1}$。
- 结构化推演标签设计:
- 宏观导航进度:
<progress>early / mid / late</progress>,令模型对当前所处指令阶段具备显式感知; - 候选动作后果全集:对当前可用的离散候选动作(如前进、左转、右转、停止),分别生成粗粒度的自然语言后果标签:
\(\langle \mathrm{outcomes} \rangle \; \langle \mathrm{forward} \rangle \dots \langle /\mathrm{forward} \rangle \; \langle \mathrm{turn\_left} \rangle \dots \langle /\mathrm{turn\_left} \rangle \dots \langle /\mathrm{outcomes} \rangle\)
例如:
<forward>premature_forward</forward>(过早前进,撞墙)、<turn_left>finish_turn</turn_left>(完成转向,正对门洞)、<stop>too_early</stop>(过早停止)。
- 宏观导航进度:
- 信息论设计动机:作者在理论上证明,引入专家未来状态标签能够显著提升观测与专家动作之间的条件互信息下界;通过反事实后果语言建模,使单个样本提供多维度的对抗性判别监督。
举个例子(卡点降维装置 A:候选动作反事实推演): 设指令为:”穿过楼梯左侧的门洞并在那里等待”。 机器人目前刚走到楼梯前,面临 4 个动作候选:
- 传统 BC 监督:标签为
turn_left。损失函数仅惩罚这一项的负对数似然,模型对于”为什么不能右转”没有任何梯度反馈;- LookStep 语言前瞻:模型自回归生成:
<progress>late</progress>
<outcomes>
  <forward>premature_forward</forward> <!-- 警示:此时直行将撞到楼梯扶手 -->
  <turn_left>finish_turn</turn_left>    <!-- 确认:左转可正对目标门洞 -->
  <turn_right>wrong_turn</turn_right>   <!-- 警示:右转将进入死胡同走廊 -->
  <stop>too_early</stop>                <!-- 警示:尚未穿过门洞,不可停下 -->
</outcomes>
模型在推理下一步动作前,已在语言语义空间内完成了对环境物理约束的”沙盒推演”,极大降低了盲目试错率。
2. 事件驱动滚动记忆(Event Driven Rolling Memory, EDRM)
- 输入:当前帧与全局任务上下文。
- 处理:将历史状态的维护转化为在线免微调的测试时记忆自适应(Test-Time Adaptation):
<event>:识别当前帧所发生的关键具身事件(如turn_left_finishing、doorway_crossing);<memory_write>:自主裁决是否写入历史记忆缓冲区(keep写入,drop丢弃);<memory_role>:指定该帧的长期索引角色(如turn_end转向结束锚点、landmark关键地标)。
- 有界滚动更新:记忆队列保持固定长度 $K$(仅容纳极少数关键帧),新关键帧写入时若队列溢出,则遵循先进先出或基于角色优先级的滚动替换,将长程轨迹的显存占用严格锁定在常量上限。
③ 读者视角:单步推理与记忆流转自制流程图(卡点降维装置 B)
graph TD
    A["输入: 导航指令 I + 历史关键帧 Ot-1 + 当前视点 xt"] --> B["MLLM 多模态大模型统一自回归生成"]

    subgraph "步骤 1: 记忆诊断与自适应写入"
        B --> M1["生成当前事件 <event>"]
        M1 --> M2{"决策: 是否保留当前帧 <memory_write>"}
        M2 -- "keep" --> M3["标记语义角色 <memory_role> -> 写入有界队列 Ot"]
        M2 -- "drop" --> M4["丢弃冗余过渡帧,保持原记忆 Ot = Ot-1"]
    end

    subgraph "步骤 2: 语言中心未来状态前瞻"
        B --> P1["预测宏观进度 <progress>"]
        P1 --> P2["推演全部候选动作后果 <outcomes>"]
        P2 --> P3["语义判别: 剔除危险/偏离动作,锁定成功候选"]
    end

    subgraph "步骤 3: 动作下发与环境交互"
        P3 --> ACT["生成最终动作 at+1 (Forward / Turn / Stop)"]
        ACT --> ENV["底层控制器执行,推进至新位姿"]
    end

    M3 -.-> A
    M4 -.-> A
    ENV -.-> A
④ 机制对比:LookStep vs 主流连续环境 VLN 方案(卡点降维装置 C)
| 机制维度 | 传统视频帧堆叠方案 (如 StreamVLN) | 外置建图方案 (如 MapNav / g3D-LF) | 本文 LookStep |
|---|---|---|---|
| 历史记忆维护 | 滑动窗口截断或均匀固定间隔抽帧 | 维护稠密 2D/3D 拓扑图或体素网格 | 模型自主按事件触发写入并标注角色 |
| 动作监督信号 | 仅监督单一专家离散动作 | 依赖地图启发式几何航点规划 | 结构化语言推演所有候选动作的未来后果 |
| 运行时显存 | 随轨迹长度增加,或高达 40 GB+ | 需额外运行 SLAM/3D 模块,显存与计算重 | 严格恒定限制在 19.7 GB,消费级显卡可跑 |
| 额外训练数据 | 普遍依赖数百万额外多模态轨迹 | 需预先离线抽取 3D 几何特征 | 0 额外预训练数据,纯标准数据集训练 |
⑤ 训练与推理细节
- 骨干网络:采用统一的开源视觉-语言模型架构,在标准 R2R-CE / RxR-CE 训练集上使用标准自回归因果语言建模损失(Cross-Entropy)端到端微调。
- 测试期推理:单步推理中,模型顺次吐出记忆标签、前瞻标签与最终动作,随后直接解析动作 token 驱动机器人移动,无需调用外部渲染器或几何求解器。
3. 核心结果/发现
在连续环境视觉语言导航的核心基准 R2R-CE 与 RxR-CE 未见验证集(Val-Unseen)上进行了全面对比评估:
- 同等训练设定下夺冠 SOTA:在不借助任何额外训练数据(0 External Data)的前提下:
- R2R-CE Val-Unseen 成功率(SR)达到 49.7%,路径长度加权成功率(SPL)达到 45.5%;
- 全面碾压了传统模型(如 HPN+DN 36.0%、CMA 41.0%、VLN-BERT 44.0%、Sim2Sim 43.0%);
- 性能匹敌甚至逼近了使用了千万级额外无监督轨迹预训练的超大模型方案(如 NaVILA 49.7%)。
- 极高的单位显存效率:如图 1 所示,LookStep 运行显存仅为 19.7 GB,其内存效率指标(SR / GB)达到 2.52,大幅高于同类先进 MLLM 方法 JanusVLN(1.19)和 StreamVLN(1.95)。
- 真实物理机部署验证:在室内复杂多房间真实机器人实验中(图 3 与图 7),即使遇到指令描述与实际光照视角不完全匹配的情况,智能体依靠准确的角色记忆与动作前瞻,依然展现出了平滑进出房门、准确识别转弯终点的稳健能力。
4. 局限性
- 候选动作的前瞻状态目前采用离散化语言标签(如
premature_forward、wrong_turn)进行粗粒度描述,难以刻画毫米级的连续角速度与线速度动力学细节。 - 记忆的写入和剔除完全依赖 MLLM 自身的语义判断,当遇到极端视觉退化(如全黑暗光、强反光)导致误判事件角色时,可能会错误丢弃关键帧。
23. OccPlanner (2026)
———把一个没有深度的像素,”顶”回局部 3D 占用栅格里再规划
📄 Paper: arXiv:2608.14160
精华
- 像素目标只有方向、没有深度和可通行性,OccPlanner 的解法是两段式条件注入——先让目标与时序视觉上下文对齐拿到粗方向,再与局部 3D 占用几何对齐落到可行点位;消融显示单独注入占用特征几乎无增益,补上顺序交互后 cluttered-hard 的 SR 从 75.55% 跳到 84.92%。
- 显式的局部 3D 占用不是当地图用的,而是作为几何先验的中间监督,让扩散策略在吐轨迹之前先”知道”哪里是墙。
- L3ROcc 的核心洞察是把体素分成 occupied / observed-free / unknown 三态而非二值——”没看见”和”确实是空的”必须分开,否则策略会把遮挡区当通路。
- 因此单目 RGB 视频就能反向生成占用监督,数据来源从”必须有 3D 标注的仿真器”放宽到”任何导航视频”,真机仅用 829 条样本微调即见效。
- 开环指标与闭环成功率不同向——base model 开环 IoU/FDE 最好,闭环却明显低于完整模型,提醒别拿开环 proxy 选模型。
1. 研究背景/问题
导航目标的指定方式有度量坐标(PointGoal)、语义类别(ObjectGoal)、目标照片(ImageGoal)和自然语言(VLN)几种,而像素目标直接在当前相机视野里点一个点作为终点,不需要预建地图、也不需要度量坐标——对真机部署最友好。
但一个像素既不含深度、也不含可通行性:策略必须同时完成”这个点在 3D 里的哪个位置”和”怎么绕开障碍走过去”两件事。现有像素目标方法(PixNav、SSM-PixNav)直接在图像空间做条件,Goal2Pixel 预测可导航像素再反投影成航点;另一边的学习型局部规划器(iPlanner、ViPlanner、NavDP、LoGoPlanner)则从度量目标出发生成轨迹。两条线是断开的——连续的像素目标规划始终没有和显式的局部 3D 占用推理结合起来。
2. 主要方法/创新点
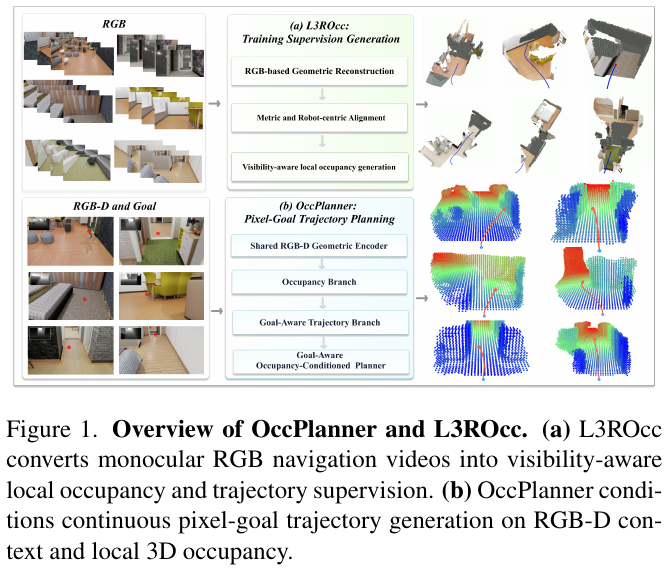
① 卡点降维:像素目标到底难在哪
先把四种目标形式摆在一起,就能看清 PixelGoal 的”便宜”是拿什么换的:
| 目标形式 | 给了什么 | 缺了什么 | 代价 |
|---|---|---|---|
| PointGoal(度量坐标) | 精确的 3D 位置 | — | 需要预建地图或全局定位 |
| ObjectGoal(”找沙发”) | 语义类别 | 具体实例与位置 | 需要语义地图 + 探索 |
| ImageGoal(一张目标照片) | 目标外观 | 目标在哪、有多远 | 跨视角匹配,长程易失败 |
| PixelGoal(像素坐标) | 目标在当前视野里的方向 | 深度、可通行性 | 不用地图,但要自己把像素顶回 3D |
最后一行就是这篇论文要付的那笔账:省掉了地图,就得把”深度 + 可通行性”这两样东西从模型内部补出来。OccPlanner 的答案是——用一个学出来的局部 3D 占用分支来补。
② 整体框架
系统由两半组成:L3ROcc 是离线数据生成流水线,负责把单目 RGB 导航视频变成局部占用监督;OccPlanner 是在线策略,由三个模块构成——共享 RGB-D 几何编码器负责抽时空上下文,占用分支负责显式预测局部 3D 占用并压成紧凑 token,目标感知轨迹分支负责把像素目标依次与上下文、与占用几何对齐,最后交给扩散去噪生成连续轨迹。
③ L3ROcc:从单目视频反向生成占用监督
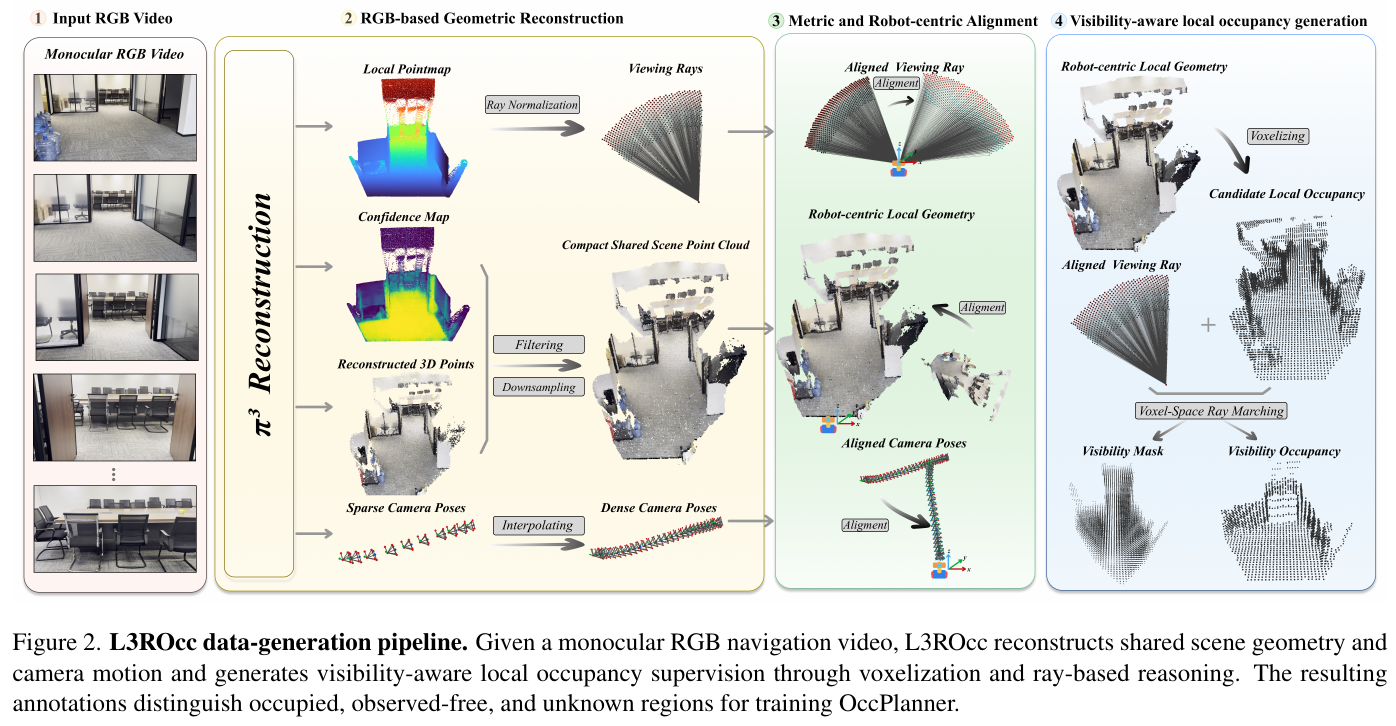
输入:一段单目 RGB 导航视频。
处理分四步:
- RGB 几何重建——均匀采样 K 帧送进 π³,得到共享坐标系 3D 点、局部 pointmap、稀疏相机位姿和置信度图。滤掉低置信点、用局部 pointmap 去掉深度边缘伪影,再体素下采样得到紧凑的共享场景点云。稀疏位姿用三次样条插值平移、SLERP 插值旋转,补齐到每一个视频时间戳。
- 度量与机器人中心对齐——单目重建天然尺度不确定。有参考位姿时,用重建轨迹与参考轨迹对齐恢复场景级尺度;没有参考位姿时直接换用具备度量能力的 π³ 变体。每个时刻把缩放后的共享几何变换到当前局部坐标系,再用相机到底盘的外参对齐机器人朝向,得到机器人中心几何与对齐后的视线射线。
- 可见性感知占用生成——把机器人中心几何体素化成候选占用栅格,然后沿射线做 ray marching(借鉴 Occ3D)。
- 输出:稀疏可见占用 + 打包的可见性掩码 + 对齐的轨迹元数据。
卡点降维 —— 三态标注为什么是关键:
举个例子:把一条射线上的体素排成一列,编号 1→6,机器人在 0 处往前看,假设第 3 个体素被桌子占住了。ray marching 走一遍的结果是:
- 体素 1、2 → observed free(射线确实穿过去了,是空的)
- 体素 3 → visible occupied(第一个命中点,这才是真障碍)
- 体素 4、5、6 → unknown(被桌子挡住,压根没看见)
关键在第三行。朴素做法会把 4~6 标成自由空间——因为点云里那儿本来就没有点——策略学完就会以为桌子后面能走。三态标注把”没看见”和”确实是空的”分开,模型才不会把遮挡区当通路。如果射线一路没有命中,则整条路径上的体素全部标为 observed free。
设计动机:占用监督传统上依赖带 3D 真值的仿真器。L3ROcc 把门槛降到”一段 RGB 视频 + 相机外参”,这正是后面真机只靠 829 条样本就能微调的前提。
④ OccPlanner 主架构
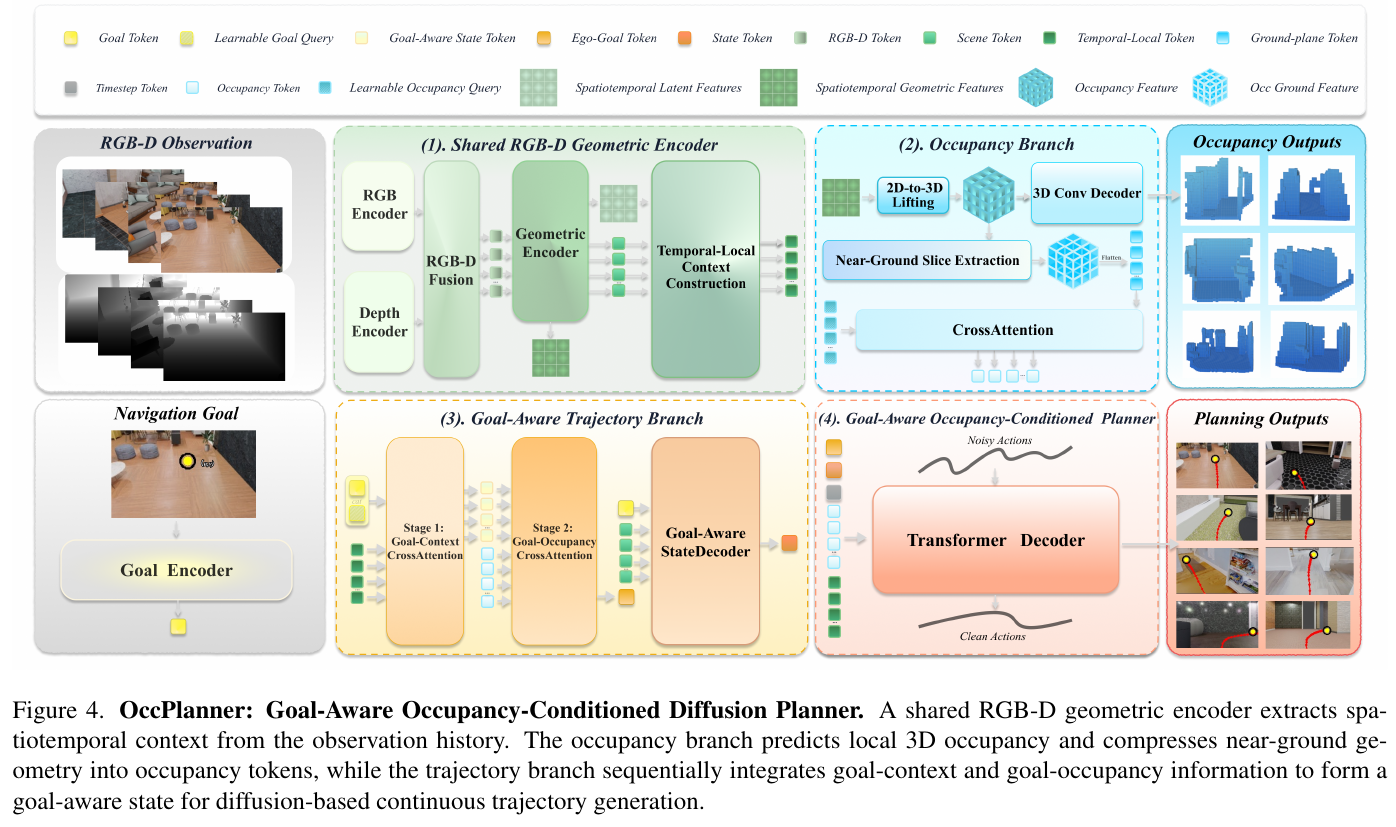
模块 1 · 共享 RGB-D 几何编码器
- 输入:RGB-D 观测历史,共 8 帧 224×224。
- 处理:RGB 流用 π³ 自带的 DINOv2 编码器,深度流沿用 LoGoPlanner 的做法,只取 DepthAnythingV2 的 ViT-S 骨干(轻量)。两路 patch 对齐后拼接、线性投影成融合的 RGB-D token,再经过 π³ 的”视角内自注意力 / 全局自注意力”交替堆叠,产出每帧潜特征,解码成时空几何特征。
- 输出:时空几何特征同时供占用分支和轨迹分支使用——两个分支共享同一套几何底座,这是参数效率的来源。
- 每帧几何特征被压成一个场景 token,最新一帧的潜特征额外压成当前观测 token,合起来构成时序局部上下文 \(U_{ctx}\)。
模块 2 · 占用分支
- 输入:最新一帧的几何特征。
- 处理:按主流 3D 占用方法的套路,先做 2D-to-3D lifting,再过 3D 卷积解码器,得到体素 logits 与稠密占用特征体。由于避障主要取决于近地面几何,从占用特征体里切出近地面切片投影成特征图,展平成地面平面记忆 \(M_{gnd}\),再用可学习的占用 query 做 cross-attention 抽成紧凑占用 token:
- 输出:占用 token(供轨迹分支条件化)+ 体素 logits(受 L3ROcc 的可见性感知监督)。
- 设计动机:不把整个占用体直接塞给规划器——那既贵又稀释信号;只留避障真正要用的近地面几何。
模块 3 · 目标感知轨迹分支
- 目标编码:与 NavDP 的掩码式像素目标表示不同,这里把归一化像素坐标用多频 Fourier 特征编码投影成目标 token,再加到可学习的 goal query 上。
- 两段式目标条件化(本文核心):
- 目标感知状态解码:把目标 token、场景 token 序列、ego-goal 表征一起送进状态解码器,得到目标感知状态 token。
卡点降维 —— 为什么非得分两步?
一次性把目标、上下文、占用全拼在一起喂给 Transformer,直觉上信息量是一样的。但消融说明不是:
graph LR
    G["像素目标 (u,v)<br/>Fourier 编码"] --> Q["可学习 goal query"]
    CTX["时序视觉上下文<br/>场景 token + 当前观测 token"] --> S1
    Q --> S1["Stage 1<br/>目标 × 上下文 CrossAttn"]
    S1 --> ZE1["粗定位:目标大概在哪个方向"]
    OCC["占用 token<br/>近地面几何切片"] --> S2
    ZE1 --> S2["Stage 2<br/>目标 × 占用 CrossAttn"]
    S2 --> ZE["ego-goal 表征<br/>带辅助回归监督"]
    ZE --> DEC["目标感知状态解码器"]
    DEC --> DIFF["扩散去噪 → 24 个航点"]
顺序的意义在于:Stage 1 先把”目标在哪”定下来,Stage 2 才问”那条路能不能走”。反过来或者并行,占用特征不知道该关注哪片区域,就退化成一堆无差别的几何信息。表中 w/o Occ. Feature(单阶段、只有 ego-goal)在 cluttered-hard 上是 81.57%,而 w/o Two-Stage(单阶段、ego-goal 与占用都有)反而掉到 75.55%——占用特征在缺少顺序交互时是负收益。补上两段式后回到 84.92%。
⑤ 训练目标
三项联合优化:
\[L = \lambda_{occ} L_{occ} + \lambda_{traj} L_{traj} + \lambda_{ego} L_{ego}\]- \(L_{occ}\):体素 logits 与 L3ROcc 标注之间的 focal loss,提供显式几何监督。
- \(L_{traj}\):DDPM / Diffusion Policy 框架下的去噪损失。给定真值动作序列 \(A_0\),第 $\ell$ 步的带噪序列为
条件上下文由扩散时间步 token、目标感知状态、时序上下文、ego-goal 表征、占用 token 拼成,去噪网络预测注入噪声,用 SmoothL1 对齐。
- \(L_{ego}\):辅助 ego-goal 回归——从 ego-goal 表征预测目标在机器人坐标系下的位置,只在训练时用。这一项是把”像素顶回 3D”这件事显式教给模型的地方,消融里它是单阶段条件下增益最大的组件(cluttered-easy/hard 分别 +20.23 和 +15.30 个百分点)。
⑥ 推理流程
8 帧 RGB-D + 一个像素目标进去,几何编码器与占用分支各跑一次,轨迹分支构造条件上下文后做 10 步反向去噪,输出 24 个未来航点组成的连续轨迹。闭环执行时世界坐标系下的目标固定不变,每步重新投影回当前相机视野作为新的像素目标。
3. 核心结果/发现
评测设置:训练用 InternData-N1(20 万+ 条轨迹,差速底盘 + 顶置 RGB-D,机器人高度与相机俯仰随机化)。评测在 InternScenes 的 60 个未见场景(20 home、20 commercial、10 cluttered-easy、10 cluttered-hard),每场景采 50 对 3–5 m 与 50 对 5–8 m 起止点,共 6000 条闭环 episode。成功判据是停在目标 0.5 m 以内。对比 NavDP(适配到同一像素目标接口)与 PixNav。
闭环成功率(SR %)
| 方法 | 距离 | Home | Commercial | Cluttered-Easy | Cluttered-Hard |
|---|---|---|---|---|---|
| NavDP | 3–5 m | 35.79 | 29.58 | 32.61 | 33.72 |
| PixNav | 3–5 m | 21.23 | 21.91 | 24.89 | 21.31 |
| OccPlanner | 3–5 m | 71.29 | 47.47 | 92.97 | 92.82 |
| NavDP | 5–8 m | 24.98 | 19.07 | 19.43 | 19.77 |
| PixNav | 5–8 m | 19.63 | 11.90 | 14.20 | 14.44 |
| OccPlanner | 5–8 m | 69.90 | 45.17 | 86.20 | 84.92 |
几个值得注意的点:
- 5–8 m 四类场景平均 SR 从 NavDP 的 20.81% 提到 71.55%,且在 cluttered 场景增益最大(19.43→86.20、19.77→84.92),说明显式局部占用在复杂几何下的收益最明显。
- 长程几乎不掉点:OccPlanner 从 3–5 m 到 5–8 m 只掉 1~8 个百分点,而 PixNav 掉得很厉害——论文查了失败案例,PixNav 成功的 episode 几乎全是近似直线的路径,需要大幅绕行的基本都失败,这也解释了它的 SR 与 SPL 为何在报告精度下完全重合。
- Commercial 是短板(45.17%),明显低于其他三类。
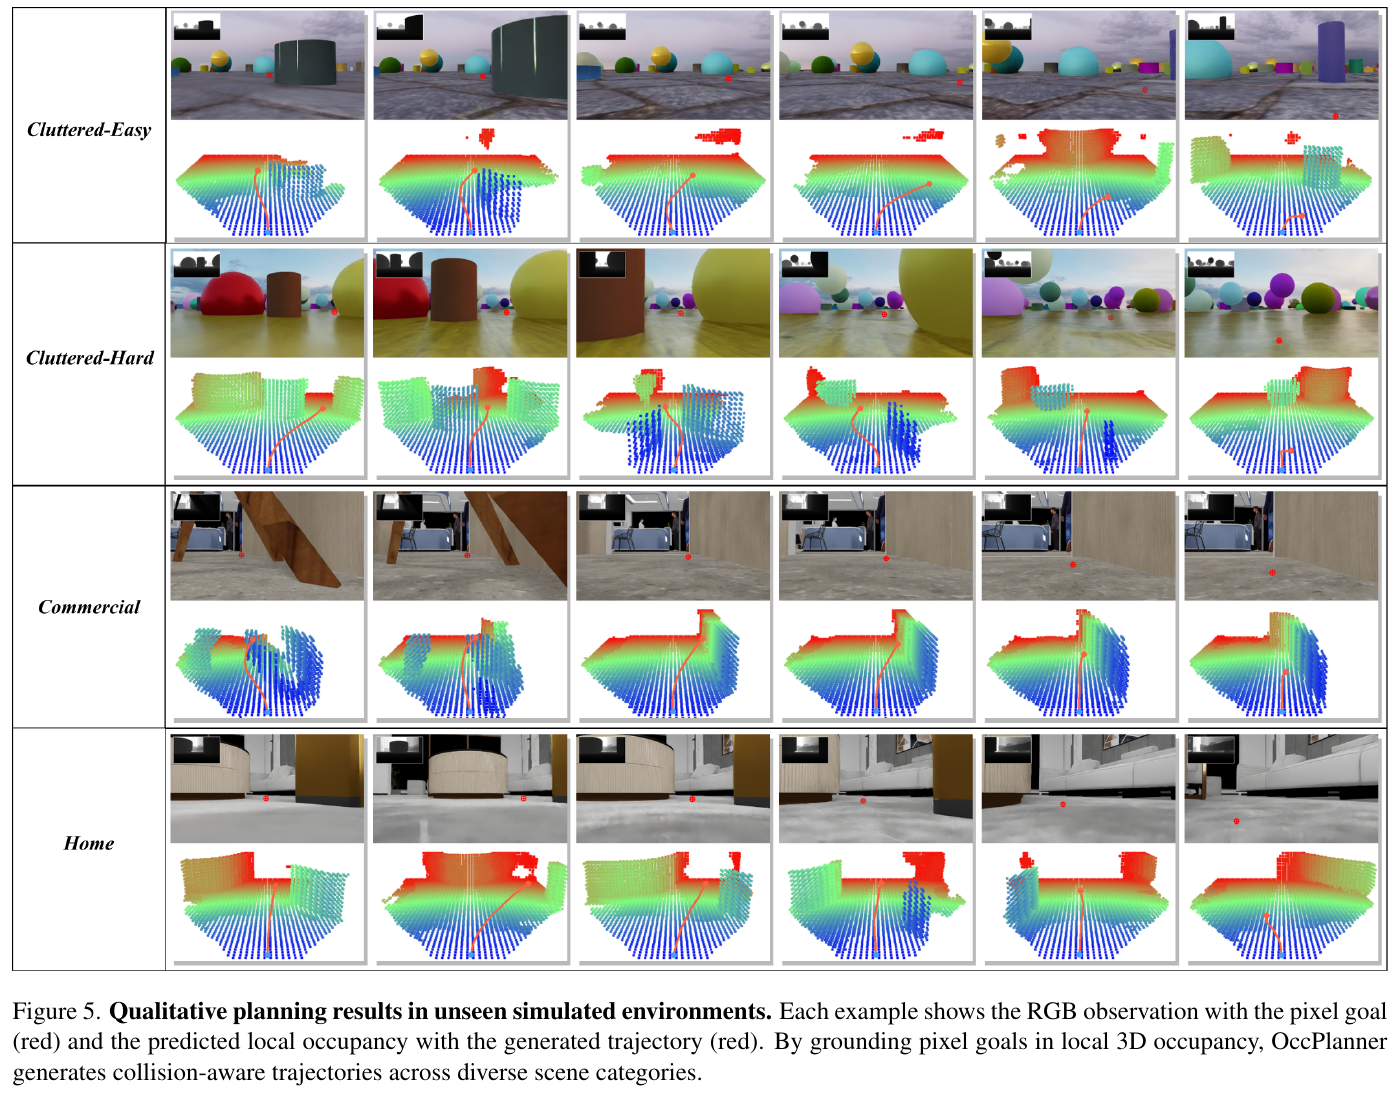
消融(5–8 m,cluttered 场景;开环用 1496 条 InternData-N1 留出样本)
| 变体 | 两段式 | Ego-Goal | 占用特征 | C-Easy SR | C-Hard SR | IoU | FDE |
|---|---|---|---|---|---|---|---|
| Base Model | — | — | — | 66.60 | 72.42 | 50.79 | 0.18 |
| w/o Two-Stage | — | ✓ | ✓ | 84.34 | 75.55 | 43.61 | 0.28 |
| w/o Ego-Goal | — | — | ✓ | 64.11 | 60.25 | 45.60 | 0.24 |
| w/o Occ. Feature | — | ✓ | — | 79.88 | 81.57 | 38.03 | 0.23 |
| Full Model | ✓ | ✓ | ✓ | 86.20 | 84.92 | 46.01 | 0.19 |
- Ego-Goal 是单阶段下增益最大的组件(+20.23 / +15.30 个百分点)。
- 两段式交互把 cluttered-hard 从 75.55% 推到 84.92%,DTG 从 0.87 m 降到 0.56 m。
- 开环指标会骗人:Base Model 的 IoU (50.79) 和 FDE (0.18) 都是全场最好,闭环 SR 却落后完整模型近 20 个百分点。开环 proxy 不能代表闭环导航能力。
真机(Unitree Go2,开环)
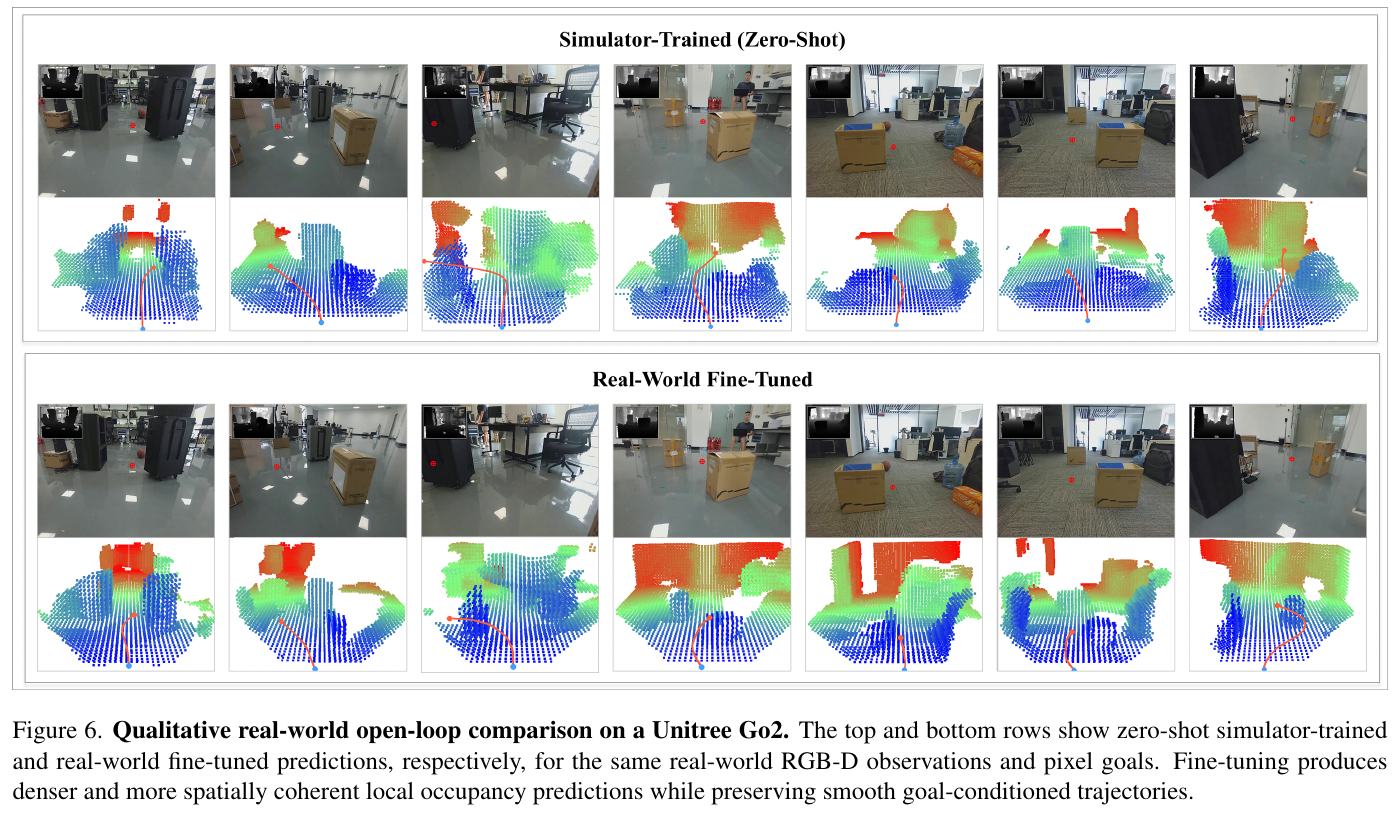
在堆满箱子、椅子、柜子和窄通道的办公室里录 RGB-D 序列。零样本的仿真训练模型已能捕捉粗略障碍几何、生成朝向目标的轨迹;用 L3ROcc 处理额外录制的机器人视频得到 829 条真实样本微调后,占用预测在家具与通道边界处明显更稠密、更连贯。
实现细节:4×H100 训练 30 epoch,Adam,单卡 batch 8(全局 32),bfloat16 混合精度,梯度裁剪 1.0;学习率在前 10000 步从 $1\times10^{-4}$ 线性衰减到 $5\times10^{-5}$ 后固定,约 48 小时。
4. 局限性
真机评测只做了开环定性对比,没有闭环物理部署,且局限于静态室内场景——动态障碍推理完全没有涉及。此外 commercial 场景的 SR(45.17%)明显落后于 cluttered 场景,说明大空间、弱几何约束的环境下,近地面占用提供的信号不足以支撑长程目标定位。
24. EgoPathBench (2026)
———把「导航决策」压成第一人称图上的一串编号,对错交给场景几何裁定
📄 Paper: arXiv:2609.16610
精华
把「整合式空间智能」这个虚概念落成一个可判定的动作:在当前第一人称图上,从编号好的可见路点里挑出一条有序路线,对错由场景几何直接判,不需要跑完整导航系统。关键设计是「同图、同编号、两套可行性图」——质点 agent 与 0.6 m 机身 agent 共享观测和动作词表,只换可通行图,从而把「具身约束」这一个变量单独隔离出来测量。评测不比对是否模仿专家轨迹,而看所选动作的几何后果(候选是否可行、每条相邻边是否合法、末点是否落进目标域),参考路线只用来证明「有解」,不是唯一答案。五个诊断口径拆开后暴露出真正的瓶颈既不是输出格式也不是第一步,而是中间边——首步合法率 88–96%,整条路线合法率在具身任务上掉到 5–7%。同一套几何标注顺手产出 31,852 条带 Spatial CoT 的训练数据,微调 Qwen3.5-4B 后本榜 3.9→38.9,三个外部空间基准也全部上涨。
1. 研究背景/问题
现有空间智能基准(SpatialVLM、VSI-Bench、3DSRBench、EmbSpatial-Bench 等)测的是孤立判断:两个物体谁左谁右、距离多远、什么朝向。但导航决策要求把目标识别、动作后果评估、距离估计、路径规划同时做对,这些孤立能力加起来不等于整合能力。另一端,完整导航系统的成败又被建图、定位、记忆、控制、重规划层层稀释,测不出基础 VLM 本身的空间决策水平。
EgoPathBench 卡在中间:给一张第一人称 RGB、一个自然语言目标、一组画在图上的编号路点,问 VLM 能不能直接输出一条几何上可行、目标上一致的路线。
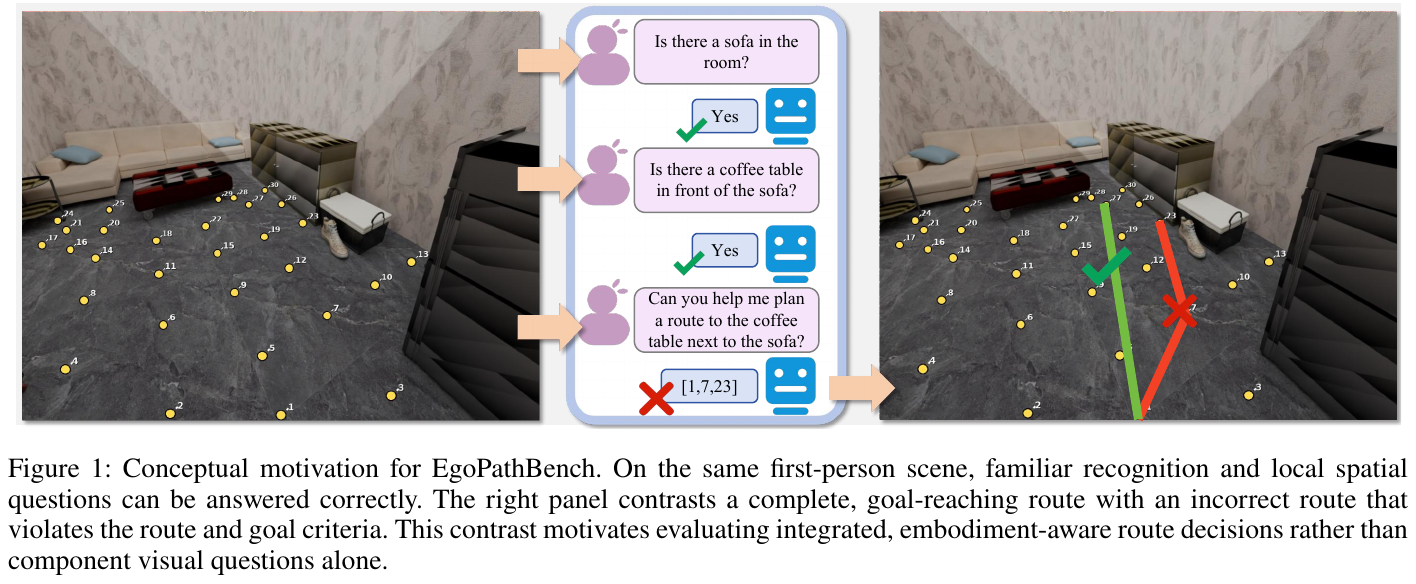
2. 主要方法/创新点
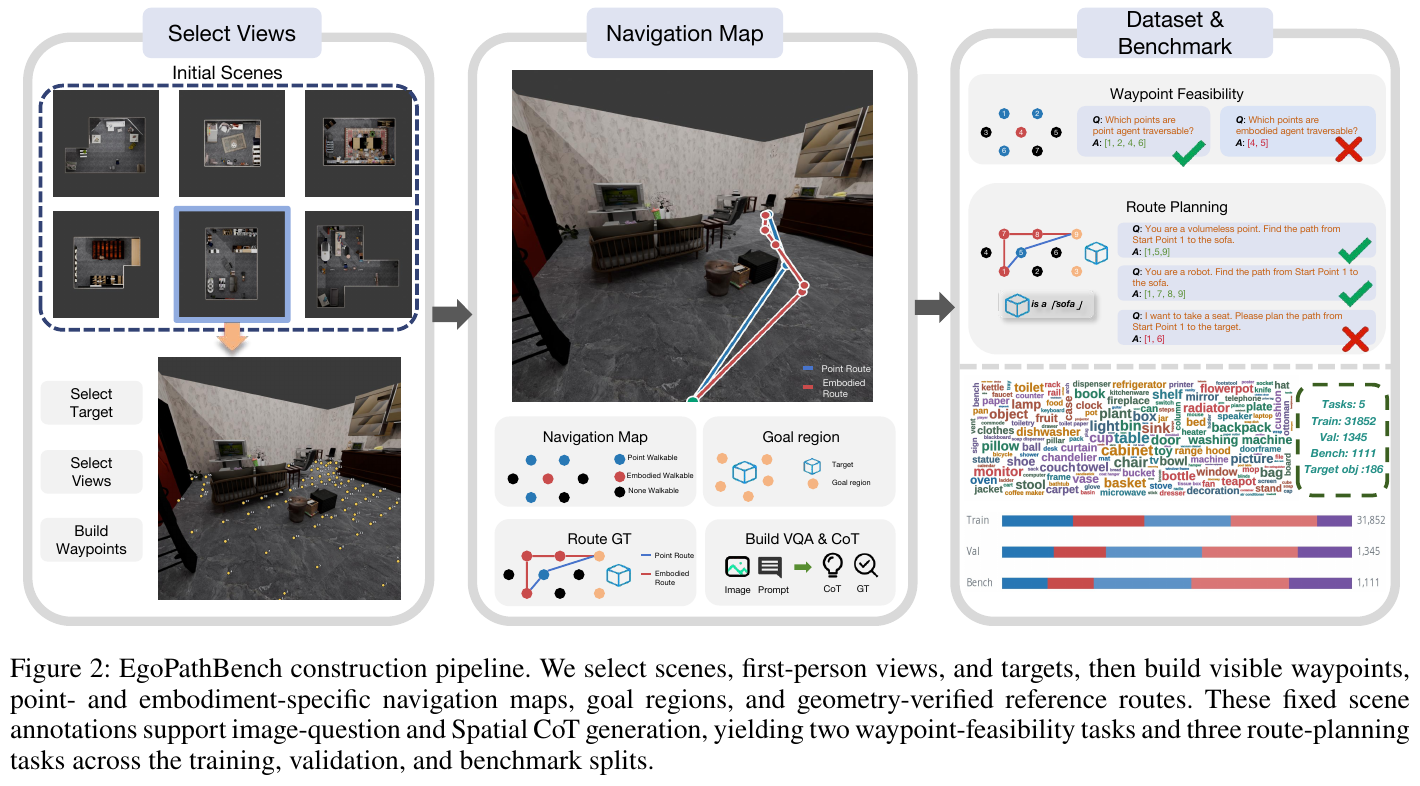
① 整体框架概述
EgoPathBench 由三件东西组成:一个统一的动作接口(图像 + 编号路点 + 语言目标 → 一个 JSON 编号数组)、一套离线固化的场景标注(可见路点、两套可行性图、目标域、参考路线)、一个按顺序执行的几何判定器。模型全程只看得到 RGB 图和提示词,判分却发生在与这张图配准的 3D 场景里——这就是所谓「动作有明确后果」。
② 逐模块讲解
模块 1:任务接口与动作词表
- 输入:一张第一人称 RGB,上面叠了编号圆点;一段自然语言任务。
- 处理:模型要把显示 ID 与场景位置对应起来,判断哪些能走、怎么串成一条路。
- 输出:一个 JSON 数组。两个可通行性任务输出无序集合,三个路线任务输出从指定起点出发的有序序列。
- 设计动机:五个任务共用一套输入输出协议,差异只来自目标规格、agent 几何、评分约束,因此跨任务、跨模型可以直接比。
五个任务的分工:
| 任务 | 目标规格 | Agent | 输出 | 评分约束 | 基准题数 |
|---|---|---|---|---|---|
| Point Traversability | 无 | 质点 | ID 集合 | 逐候选可通行分类 | 146 |
| Embodied Traversability | 无 | 0.6 m 机身 | ID 集合 | 逐候选机身可行分类 | 146 |
| Point Path | 显式物名 | 质点 | 有序路线 | 合法 ID、指定起点、合法边、可接受终点 | 309 |
| Embodied Path | 显式物名 | 0.6 m 机身 | 有序路线 | 上面全部 + 机身宽度下的边合法性 | 309 |
| Intent Path | 意图 + 视觉线索 | 0.6 m 机身 | 有序路线 | 意图消歧后的终点 + 具身路线合法性 | 201 |
模块 2:场景、视角与目标筛选
- 输入:InternScenes 归一化后的可仿真室内资产(原始扫描来自 3RScan、ScanNet、ARKitScenes、Matterport3D)。
- 处理:在可通行空间里采样第一人称相机,剔除镜头紧邻处被挡住的视角;再用视锥投影、观测距离、投影尺寸、可见表面证据四道过滤筛目标实例,把出画、太小、被重度遮挡的目标去掉。
- 输出:一条「场景–视角」记录,绑定相机参数、场景几何、保留的目标与 RGB 观测。
- 设计动机:后面所有路点和路线标注都挂在这条记录上,保证图像里看到的和几何里算的是同一件事。
模块 3:路点与几何标签
- 输入:保留下来的视角。
- 处理:往图里投两类标记——地面动作候选,以及选中的物体/结构表面位置(作为不可通行负样本)。用深度、射线可见性、标记间距三重检查,保证每个显示 ID 对应一个独立的场景位置,且不会互相重叠或被前景挡住。
- 输出:每个候选带 ID、图像投影坐标、场景三维坐标。
- 设计动机:负样本的存在让「把所有编号都选上」这种偷懒策略失效——可通行性任务混了可行地面点、对宽度敏感的地面点、可见表面负样本三类。
模块 4:成对路线构造(本文最核心的控制变量设计)
- 输入:一条场景–视角记录 + 一个目标。
- 处理:起点锚在图像底部附近的可见地面;在目标足迹周围生成可行终点区域;然后分别在质点自由空间和具身自由空间里搜索,把连续路径稀疏化成路点,再投影回当前图像。
- 输出:一对共享目标、起点、视角、候选空间,但分别通过各自 agent 几何校验的参考路线。
- 设计动机:Point Path 和 Embodied Path 之间只差 agent 几何这一个变量。模型在两者上的差距,就是纯粹的「具身约束理解能力」。
卡点降维 · 两套可行性图到底差在哪
同一张图、同一组编号、同一个目标,为什么标签会不一样?
| 维度 | Point Agent(质点) | Embodied Agent(0.6 m 直径机身) |
|---|---|---|
| 观测与编号 | 一张 RGB,一套显示 ID | 完全相同,不换图也不换编号 |
| 节点可行性 | 只要落在几何连通的自由空间 | 还要求该点周围有足够 clearance 容下机身 |
| 边合法性 | 两点之间几何直连即可 | 用 0.30 m 名义半径做扫掠走廊检查,整条走廊不能撞 |
| 典型后果 | 家具之间的窄缝、半开的门算可通行 | 同一批点被判不可行,路线必须绕远 |
| 榜单落差 | Point Path 最高 SR 35.9% | Embodied Path 最高 SR 2.9% |
一句话:同一个视觉上看着合理的动作,在两种 agent 模型下后果完全不同——这就是论文反复强调的「相同的视觉选择,几何后果不同」。
模块 5:问题文本与 Spatial CoT
- 输入:已经固定下来的目标身份、可见路点、目标域、参考路线。
- 处理:显式目标任务直接点名物体;Intent Path 则先从当前视角可见物体里构造候选宇宙,用关系、属性、颜色、距离线索生成描述,再回代验证这段描述在当前视角下能唯一锁定那个固定目标,否则丢弃。训练集额外由 GPT-5.5 把「目标 + 候选 + 可行性标签 + 合法边 + 参考路线」口语化成 Spatial CoT 推理文本,导出前再与形式化标注对账。
- 设计动机:语言生成始终在几何真值下游,改措辞不会改目标和路线几何。Intent Path 就是从已接受的 Embodied Path 实例派生的,只换语言规格。
③ 端到端数据流
整条流水线最反直觉的一点是顺序:几何先固化,语言最后长上去。
graph TD
    A["InternScenes 室内资产"] --> B["采样第一人称相机, 剔除被遮挡视角"]
    B --> C["筛目标: 视锥 + 距离 + 投影尺寸 + 可见表面"]
    C --> D["投可见路点: 地面候选 + 表面负样本"]
    D --> E["构建两套可行性图: 质点 / 0.6m 机身"]
    E --> F["搜索成对参考路线, 稀疏化并投回图像"]
    F --> G{"连通性 / 可行性 / 到达目标域 / 路点可显示"}
    G -- "任一不过" --> H["丢弃该路线单元"]
    G -- "全过" --> I["目标 / 路点 / 目标域 / 参考路线就此冻结"]
    I --> J["生成问题文本与 Spatial CoT, 回代校验"]
    J --> K["质量审计 + 难度选样, 得到 31852 / 1345 / 1111"]
④ 评测指标(这篇论文的「损失函数」)
没有训练损失,但有一套严格的打分定义。可通行性用平衡准确率和 F1:
\[\mathrm{BA} = \frac{\mathrm{TPR} + \mathrm{TNR}}{2}, \qquad F_1 = \frac{2PR}{P + R}\]路线任务用三个逐级收紧的口径。记 $V_i$ 表示第 i 条预测可解析、ID 合法、起点正确、且每条相邻边都合法;$S_i$ 在此之上再要求终点可接受:
\[\mathrm{VPR} = \frac{1}{N}\sum_i V_i, \qquad \mathrm{SR} = \frac{1}{N}\sum_i S_i, \qquad \mathrm{SPL} = \frac{1}{N}\sum_i S_i \cdot \frac{\ell_i}{\max(\ell_i,\, p_i)}\]其中 $\ell_i$ 是到可接受目标的最短合法参考长度,$p_i$ 是预测路线长度——失败路线 SPL 直接记 0。总分是五个任务的等权宏平均:
\[\mathrm{EgoPathScore} = \frac{100}{5}\Big[ (2\mathrm{BA}_{PT} - 1) + (2\mathrm{BA}_{ET} - 1) + \mathrm{SR}_{PP} + \mathrm{SR}_{EP} + \mathrm{SR}_{IP} \Big]\]卡点降维 · 为什么 BA 要写成 2BA − 1
举个例子:假设一个模型对「这个点能不能走」完全瞎猜,可行类和不可行类各命中一半,那么 BA = 0.5。 如果直接把 BA 平均进总分,这个瞎猜模型白拿 50 分;而三个路线任务上真实模型的成功率普遍只有 0–5%,两项「送分题」会把总分整个带偏,榜单就变成了在比谁的可通行性分类更准。 换成 2BA − 1 之后:瞎猜 → 2×0.5 − 1 = 0,全对 → 2×1.0 − 1 = 1。这叫 chance-adjusted,把随机基线拉回零点,和成功率(瞎猜几乎必然是 0,全对是 1)统一了量纲。 代回榜首 Gemini 3.1 Pro 手算一遍:(2×0.765 − 1) + (2×0.727 − 1) + 0.359 + 0.029 + 0.040 = 1.412,再 ÷5 ×100 = 28.2,就是表里的 28.3。
⑤ 判定流程(评测器怎么一步步扣分)
卡点降维 · VPR、SR、SPL 究竟卡在哪一环
这三个指标不是三个独立分数,而是同一条判定链上的三个不同深度。评测器严格按顺序走,一旦某一环失败就直接判负,后面的检查不再执行:
graph TD
    A["模型返回的 JSON 编号数组"] --> B{"可解析, 且 ID 全部可见合法"}
    B -- "否" --> X1["判负: 格式错误 / 非法 ID"]
    B -- "是" --> C{"首个 ID 等于指定起点"}
    C -- "否" --> X2["判负: 起点错误"]
    C -- "是" --> D{"每对相邻点都是该 agent 的合法直连边"}
    D -- "否" --> X3["判负: 非法边"]
    D -- "是" --> E["VPR 计入: 这是一条完全合法的路线"]
    E --> F{"末点落在可接受目标域内"}
    F -- "否" --> X4["判负: 走得合法但没到目标"]
    F -- "是" --> G["SR 计入, 再按最短参考长度折算 SPL"]
所以 VPR 减 SR 的差值 = 路走得合法但走错了地方,而 1 减 VPR = 路线本身就不合法。论文后面全部的诊断分析都建立在这个分解上。
顺带说明提示词协议:所有任务的用户提示都会明确「图中是编号候选点」「从显示 ID 1 出发」「机身直径 0.6 m」,并要求只返回一个 JSON 数组。每次评测用 8,192 token 完成预算、temperature 0、top-p 1。
3. 核心结果/发现
(1)九个基础 VLM 的榜单:最高分只有 28.3
| 模型 | EgoPath Score | Point Trav. BA/F1 | Embodied Trav. BA/F1 | Point Path VPR/SR/SPL | Embodied Path VPR/SR/SPL | Intent Path VPR/SR/SPL |
|---|---|---|---|---|---|---|
| Gemini 3.1 Pro | 28.3 | 76.5 / 79.0 | 72.7 / 56.2 | 63.7 / 35.9 / 28.7 | 9.1 / 2.9 / 2.4 | 10.4 / 4.0 / 3.3 |
| GPT-5.5 | 27.3 | 74.1 / 77.1 | 77.3 / 62.5 | 60.5 / 31.1 / 24.8 | 5.5 / 1.3 / 1.3 | 9.0 / 1.5 / 1.4 |
| Claude Opus 4.8 | 25.6 | 77.9 / 74.3 | 73.5 / 59.6 | 66.0 / 21.0 / 16.7 | 12.0 / 1.6 / 1.5 | 14.4 / 2.5 / 2.2 |
| MiniMax M3 | 21.8 | 77.0 / 76.2 | 68.7 / 52.8 | 50.8 / 13.3 / 8.7 | 5.5 / 1.9 / 1.7 | 9.0 / 2.5 / 2.3 |
| Qwen 3.6 | 16.4 | 67.4 / 72.1 | 64.8 / 49.1 | 49.2 / 15.2 / 10.9 | 2.6 / 1.0 / 0.9 | 5.0 / 1.5 / 1.3 |
| Mistral L3 | 15.8 | 65.2 / 70.8 | 68.5 / 52.5 | 35.6 / 11.0 / 5.8 | 0.3 / 0.0 / 0.0 | 3.5 / 0.5 / 0.5 |
| Llama 4 | 14.9 | 66.8 / 66.5 | 66.0 / 49.8 | 36.2 / 8.7 / 5.9 | 1.9 / 0.0 / 0.0 | 2.0 / 0.0 / 0.0 |
| Kimi K2.6 | 9.7 | 60.2 / 69.8 | 57.8 / 44.2 | 40.5 / 11.7 / 8.2 | 1.3 / 0.7 / 0.5 | 1.5 / 0.5 / 0.4 |
| Grok 4.3 | 1.4 | 52.3 / 58.4 | 50.0 / 35.8 | 18.4 / 2.6 / 1.2 | 5.2 / 0.0 / 0.0 | 3.5 / 0.0 / 0.0 |
两个读法:逐点判断远强于整体成图——可通行性 BA 都在 60–78%,但 Point Path SR 最高只有 35.9%;具身约束是断崖——同一个模型从 Point Path 到 Embodied Path,SR 从 35.9% 掉到 2.9%,直接掉一个数量级。
(2)失败到底发生在哪一步
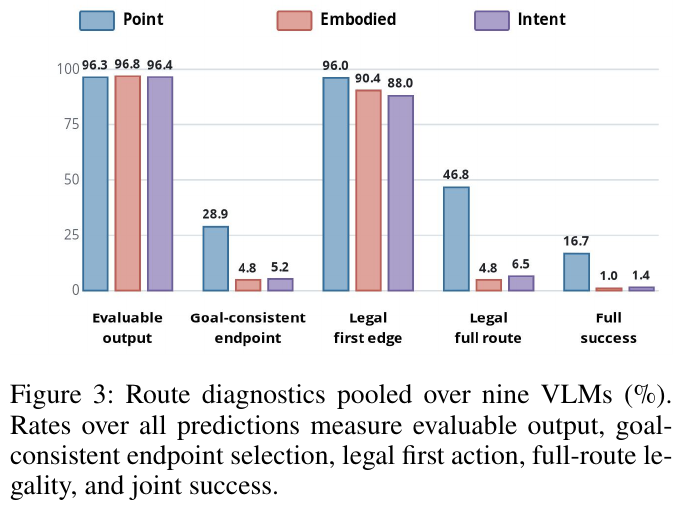
拆开来看非常清楚:
- 输出协议不是瓶颈:96.3–96.8% 的输出都是可评测的路线。
- 首步不是瓶颈:96.0% / 90.4% / 88.0% 的预测第一条边是合法的。
- 终点定位很弱:目标一致的终点率只有 28.9%(Point)、4.8%(Embodied)、5.2%(Intent)。模型可能认出了目标物在哪,却找不到一个紧邻它且对该 agent 可行的终端路点。
- 真正的病灶是中间边:整条路线合法率掉到 46.8% / 4.8% / 6.5%。在「首边合法」的预测里,有 51.3% / 94.7% / 92.7% 在后面某条边上违规。
更狠的一组控制实验:即使同时限定首边合法且终点正确,仍有 42.2%(Point)、75.8%(Embodied)、69.4%(Intent)的路线中间挂掉。把题目减半到路点更稀疏的一半上,比例几乎不变(42.8% / 76.6% / 67.3%),说明不是「图上点太密看花眼」。而且在只需一条边的具身/意图题上违规率已经是 90.6% / 88.4%,三条边以上才升到 94.0% / 92.4%——问题不在长程累积,而在对 agent 几何的基本理解。
(3)人类参照
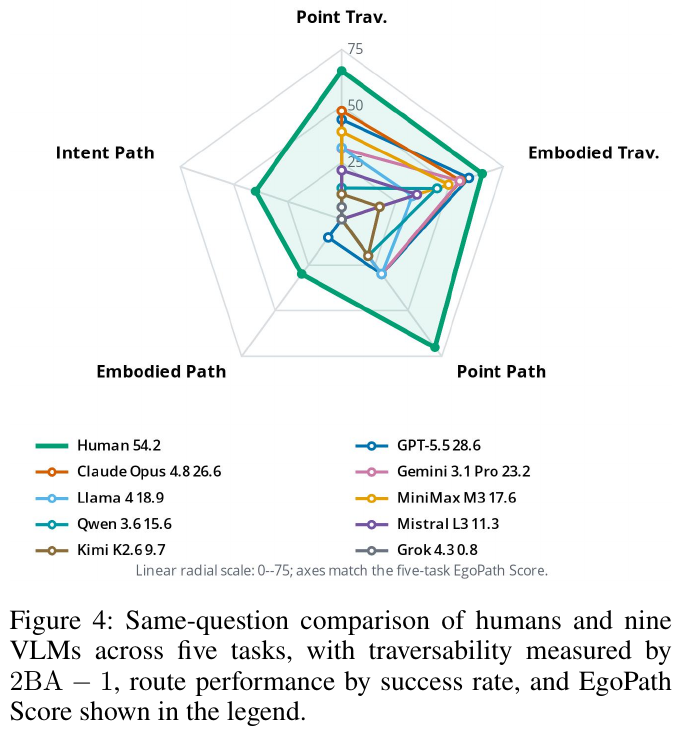
在随机抽取的 50 题(每任务 10 题)同接口对照上,人类 EgoPath Score 54.2 对最强 VLM 的 28.6;三个路线任务的平均有效路径率 70.0% 对 26.7%,平均成功率 46.7% 对 13.3%。论文明确说明这是探索性同接口参照,不是人类天花板估计。
(4)基准本身是否可信
- 依赖配对视觉输入:去掉图像或换成不匹配的路点叠加层,路线 SR 全面塌到接近 0(GPT-5.5 的 Point Path SR 从 30.0% 掉到 0.0% / 10.0%),说明模型确实在看图而不是只靠提示词猜。
- 非法边有真实几何后果:对 5,563 条含非法边的预测各抽一条边,沿 0.30 m 扫掠走廊按 0.05 m 采样查深度与物体索引渲染,88.7% 能找到明确注册的障碍物证据。
- 结论对离散化不敏感:改机身半径(0.25 / 0.35 m)、占据栅格(0.04 / 0.06 m)、目标环(0.05 / 0.15 m),九模型排序的 Spearman ρ 全部等于 1.0。把总分里的 SR 换成 SPL、或先按任务族内平均再等权,排序同样不变。
(5)训练资源确实有用
用 LoRA(rank 8、alpha 16、冻结视觉塔、两阶段 1e-4 到 5e-5)在 31,852 条带 Spatial CoT 的训练集上微调 Qwen3.5-4B:
| 设置 | Score | Point Trav. BA/F1 | Emb. Trav. BA/F1 | Point Path VPR/SR/SPL | Emb. Path VPR/SR/SPL | Intent Path VPR/SR/SPL |
|---|---|---|---|---|---|---|
| Qwen3.5-4B base | 3.9 | 54.6 / 55.6 | 54.9 / 33.1 | 9.1 / 0.7 / 0.1 | 0.3 / 0.0 / 0.0 | 0.0 / 0.0 / 0.0 |
| + EgoPathBench SFT | 38.9 | 89.3 / 89.2 | 83.4 / 71.2 | 77.0 / 31.4 / 28.6 | 34.9 / 7.1 / 6.9 | 44.8 / 10.4 / 10.0 |
一个 4B 模型微调后拿到 38.9 分,超过了榜首的 Gemini 3.1 Pro(28.3),且 Embodied Path SR 7.1% 是全表最高。更值得注意的是外部迁移全部为正:
| 外部基准 | 设置 | Base | SFT | Δ |
|---|---|---|---|---|
| VSI-Bench Route Planning | Full | 29.38 | 33.51 | +4.13 |
| VSI-Bench Route Planning | Debiased | 20.18 | 24.56 | +4.38 |
| SpatialEval-VTQA | Full | 61.8 | 71.4 | +9.6 |
| 3DSRBench | Full | 58.0 | 59.4 | +1.4 |
说明学到的不是「刷这个榜的输出格式」,而是可迁移的空间决策能力。
4. 局限性
人类参照只有 50 题、单名志愿者,论文自己定性为探索性对照而非人口层面的能力上限;场景全部来自 InternScenes 归一化的重建资产并经 Blender 渲染,与真实相机噪声、动态障碍、光照变化之间仍有分布差距。此外,任务形态是单张静态第一人称图上的一次性决策,不涉及探索、记忆与重规划,因此高分并不直接等价于闭环导航能力;场景后果审计中还有 11.3% 的非法边在辅助渲染下给不出明确障碍证据(论文认为这是证据不足而非标签错误)。
25. VLingNav (2026)
——Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic Memory
📄 Paper: arXiv:2601.08665
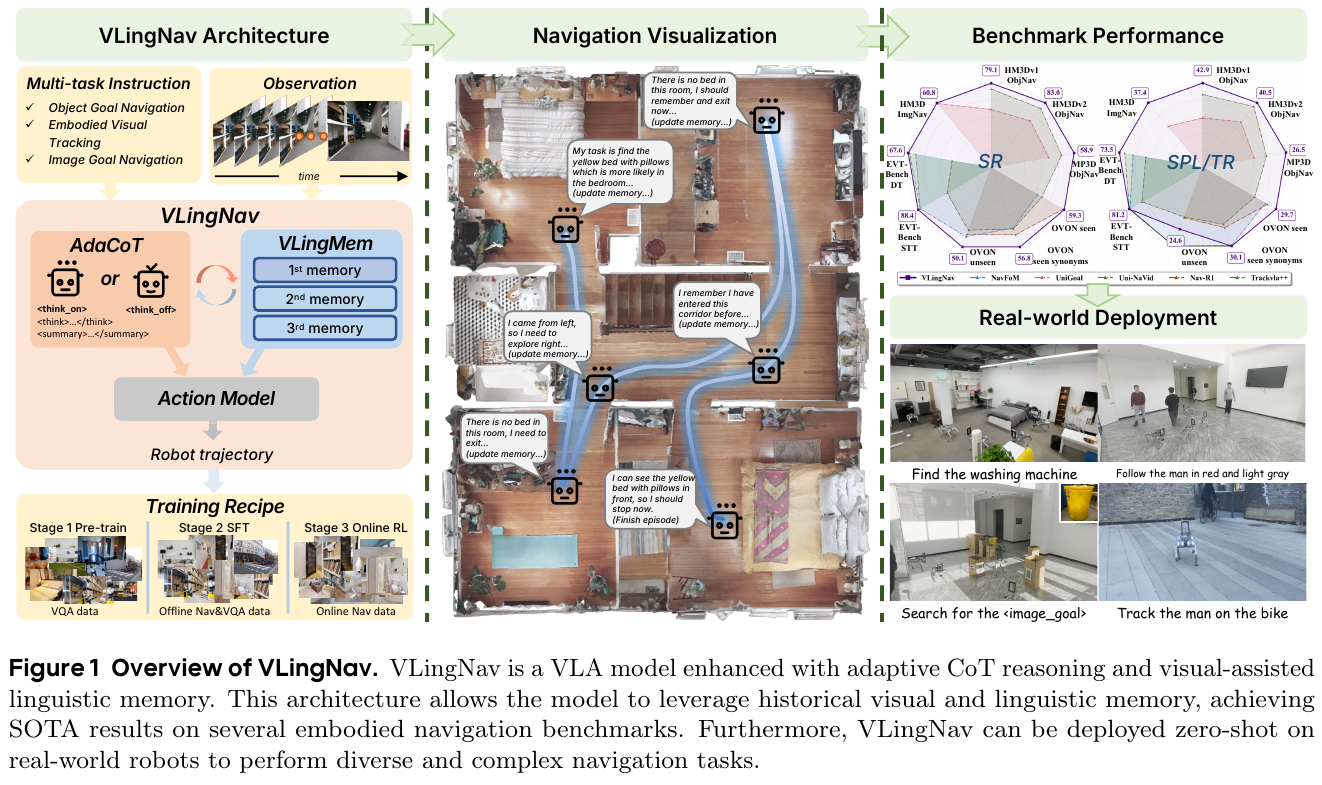
精华
该论文提出了VLingNav框架,通过自适应链式思考(AdaCoT)和视觉辅助语言记忆(VLingMem)赋予具身智能体认知能力,实现了高效且可解释的具身导航。其核心亮点在于动态推理机制和跨模态记忆,使其在各种具身导航基准测试中达到SOTA性能,并展示了强大的零样本迁移能力和跨任务泛化能力,为资源受限机器人平台上的智能导航提供了启发。
研究背景/问题
当前的具身导航VLA模型在复杂、长周期任务中缺乏明确的推理能力和持久性记忆,难以泛化到不同环境和任务变体。现有模型多为被动式系统,缺少自适应推理机制,并且依赖有限的上下文窗口,导致在复杂场景下无法有效规划和避免重复探索。
主要方法/创新点
本文提出了VLingNav,一个以语言驱动的VLA框架,旨在通过两个核心组件赋予具身智能体认知能力:
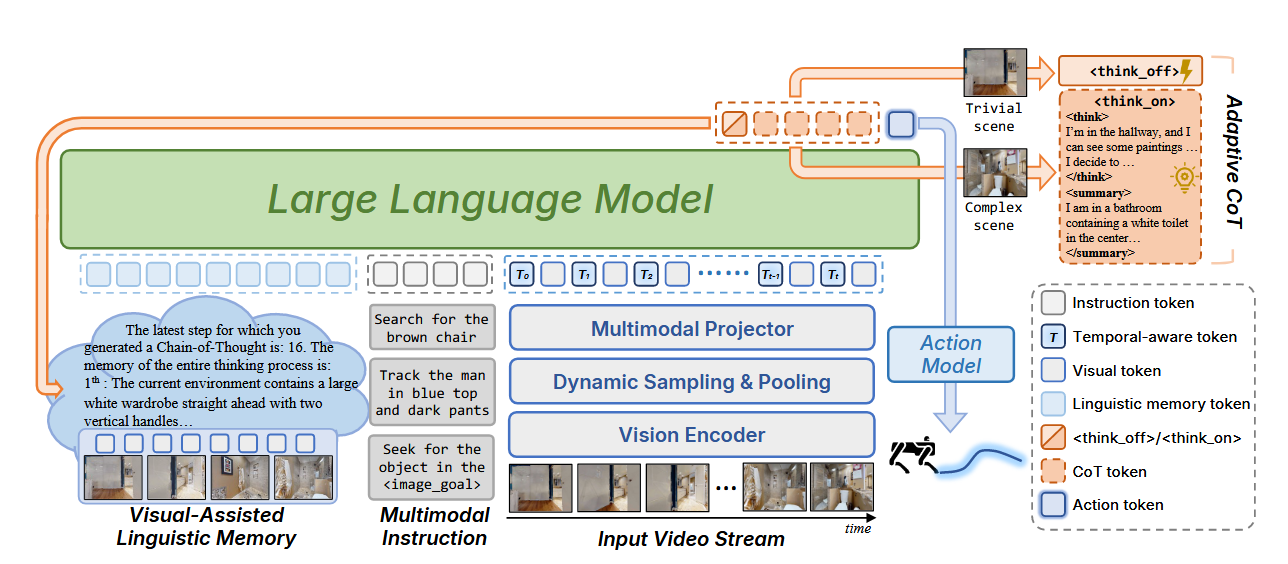
- 自适应链式思考 (Adaptive Chain-of-Thought, AdaCoT): 受人类双进程理论启发,AdaCoT机制在必要时动态触发显式推理,使智能体能够根据任务复杂性在快速、直观执行和缓慢、深思熟虑的规划之间灵活切换。这解决了现有CoT方法中推理频率固定导致效率低下的问题。
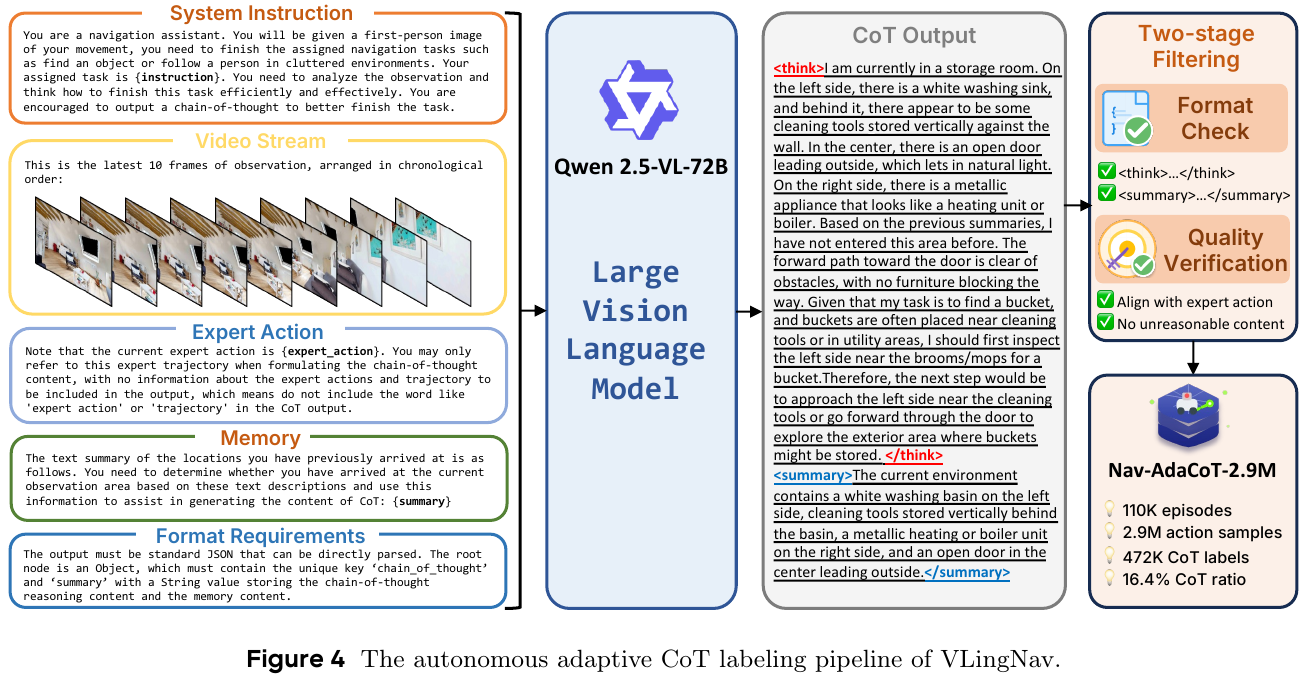
- 视觉辅助语言记忆 (Visual-Assisted Linguistic Memory, VLingMem): 为了处理长周期的空间依赖性,VLingMem构建了一个持久的、跨模态的语义记忆,使智能体能够回忆过去的观察结果,防止重复探索,并推断动态环境中的移动趋势,从而确保在长时间交互中的连贯决策。
训练数据和策略:
- Nav-AdaCoT-2.9M数据集:构建了目前最大的具身导航数据集,包含推理标注和自适应CoT标注。
- 在线专家引导强化学习 (Online Expert-guided RL):在模仿学习(SFT)之后引入了在线专家引导RL阶段,使模型能够获得更鲁棒、自探索的导航行为,超越监督演示的局限性。
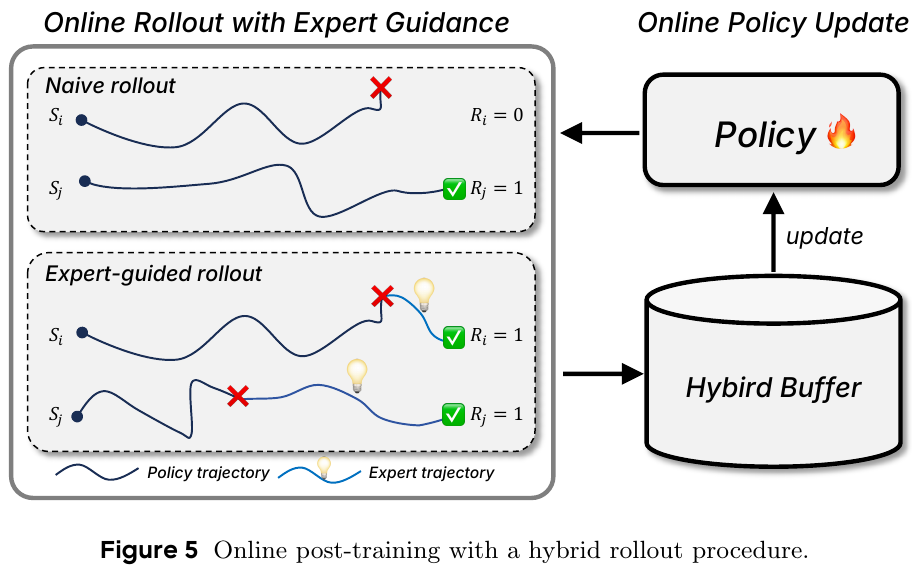
核心结果/发现
- VLingNav在多项具身导航基准测试(如ObjectNav, EVT, ImageNav)上实现了最先进的性能。
- 在HM3Dv1 ObjectNav上,SR和SPL显著优于Uni-NaVid,展现了强大的探索和记忆能力。
- 在HM3D OVON上,VLingNav在所有测试拆分中均表现最佳,证明了其强大的跨领域泛化能力。
- 在EVT-Bench上,VLingNav在单目标跟踪和分心跟踪任务中均达到SOTA性能,尤其在复杂混乱场景中优势明显。
- 在Image Goal Navigation上,VLingNav的成功率和导航效率显著高于UniGoal,表明其先进的推理和规划能力。
- 在真实世界机器人平台上实现了零样本迁移,成功执行了未见过的导航任务,展示了强大的真实世界泛化和实用性。
局限性
- 当前模型主要依赖单目自我中心观测,这限制了其感知能力。未来工作可以探索多视角观测以提高导航效率。
- 模型采用单系统架构,限制了预测频率,可能影响在高度动态环境中的快速决策和障碍物处理。未来可升级为双系统结构以支持高频动作输出。
- 当前方法仅使用基于MPC的路点控制器,缺乏更灵活的运动模型,未来可集成更多运动能力。
26. X-NavDP (2026)
———多构型机器人通用视觉导航的组内 Q 值重加权 Diffusion RL 强化学习微调框架
📄 Paper: arXiv:2607.28560 · 🏛️ CoRL 2026 · Code
💻 Code: InternRobotics/NavDP
精华
- 解决核心痛点:传统扩散导航策略依赖全局特权规划器模仿学习,缺乏局部视场下的自救探索与多构型适应能力,而常规 RL 算法在扩散策略微调中易面临似然计算不稳定或高斯探索破坏轨迹平滑性的难题。
- 自引导轨迹扰动:利用预训练模型内部的无目标(Goal-Agnostic)预测分支与坐标翻转组合,在保留扩散模型先验与时间平滑性的同时生成侧向、倒车与绕行等高多样性探索动作。
- 组内 Q 值重加权(GQRM):提出在同状态(Same-State)候选动作组内归一化 Q 值,解决了全局 Minibatch 归一化在困难低收益状态下梯度信号被掩盖的问题,实现高效稳健的扩散 actor 更新。
- 轻量化构型 FiLM 调制:通过在 Transformer 解码器输入与输出特征层注入构型 Embedding,用单套网络权重统一控制轮式、四足与人形(Dingo、Unitree Go2、G1)三种异构机器人。
- 大幅提升性能:在 40 个未见模拟场景中成功率由 61.20% 提升至 84.28%,并在真实世界死胡同自救等困难场景中将成功率由 10% 提升至 65%,仅需 12 小时并行 RL 训练。
1. 研究背景/问题
基于大规模数据预训练的扩散视觉导航策略(如 NavDP、NoMaD)具备极强的零样本泛化能力。然而,现有方法主要采用模仿学习(Imitation Learning),监督数据由全局全知规划器生成。这种训练范式存在两大天然缺陷:
- 决策歧义与无自救能力:真实部署时机器人仅能获取局部 Visual RGB-D 观测,全局最优轨迹与局部视觉的失配严重抑制了策略的自主探索,导致机器人面对死胡同(Dead-End)或长障碍物时无法后退或绕行自救。
- 构型盲目性(Embodiment-Blind):数据生成未考虑不同机器人的物理运动约束与动力学差异,难以直接跨机器人平台迁移。
虽然强化学习(RL)是解决交互试错与构型适用的有效途径,但扩散策略的 RL 微调存在极高的技术瓶颈:
- 基于策略梯度的微调方法(如 DPPO)需要穿透长扩散去噪链计算似然,导致训练极不稳定;
- 基于隐空间的微调方法(如 DSRL)冻结去噪核心参数,极大限制了探索能力;
- 基于重加权分段匹配的方法(如 DPMD)虽然稳定,但在全局 Minibatch 归一化下,困难状态的低绝对收益导致梯度失真。
2. 主要方法/创新点
X-NavDP 构建了一套高性能的扩散策略强化学习后训练框架。系统由三大核心模块构成:构型 FiLM 条件调制模块负责跨构型感知,自引导轨迹扰动模块生成兼具先验与多样性的探索候选,组内 Q 值重加权匹配(GQRM)在同状态组内精确计算策略改进方向,最后通过闭环时域引导(RTC)保障部署推演的连续平滑。
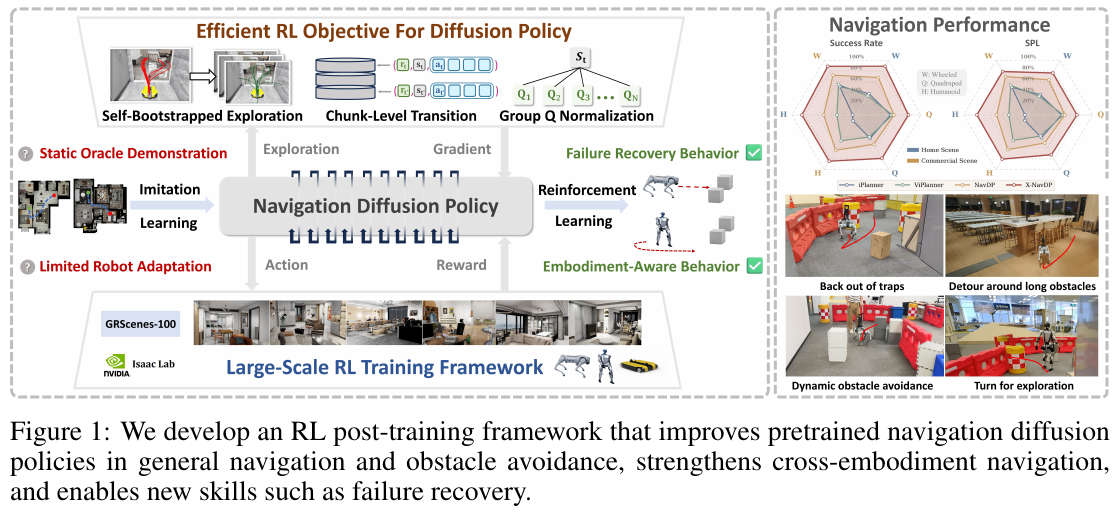
① 整体框架与分层控制
X-NavDP 采用分层控制架构:
- 高层导航策略:输入局部 RGB-D 图像与 PointGoal 目标坐标,扩散模型输出 $H$ 步未来航点轨迹 Chunk(如 3 秒轨迹);
- 低层控制栈:统一的 MPC 控制器将航点 Chunk 转化为底盘速度指令,再由机器人特定的低层足行/轮运动控制策略(25 Hz)执行。
- 并行训练环境:在 IsaacLab 中并行运行 500+ 个涉及轮式(Dingo)、四足(Unitree Go2)、人形(Unitree G1)机器人的仿真环境,高层策略按 3 秒宏观步(Macro-Step)收集 Replay Buffer。
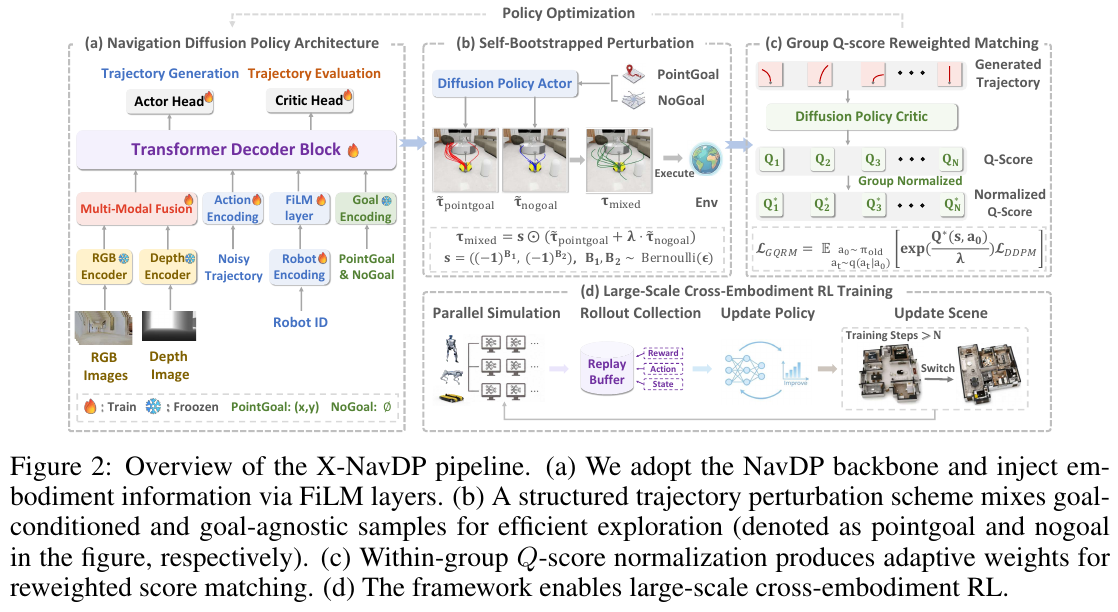
② 自引导轨迹扰动(Self-Bootstrapped Perturbation)
直观上,直接给轨迹添加高斯噪声会破坏航点的时间连续性与动力学可行性。X-NavDP 发现:预训练策略在无目标(Goal-Agnostic)条件下的输出天然保持场景一致性且探索更激进。
因此,对同一视觉观测,算法同时采样有目标轨迹 \(\tilde{\tau}_{\text{pointgoal}}\) 与无目标轨迹 \(\tilde{\tau}_{\text{nogoal}}\),并进行带符号外推混合:
\[\tau_{\text{mixed}} = \mathbf{s} \odot \left( \tilde{\tau}_{\text{pointgoal}} + \lambda \tilde{\tau}_{\text{nogoal}} \right)\]其中 $\mathbf{s} = ((-1)^{B_1}, (-1)^{B_2})$ 是由伯努利分布生成的随机符号向量,对整体 Chunk 的 $x, y$ 坐标独立按概率 $\epsilon$ 进行翻转。这种设计能够原生地生成平滑的倒车、侧向避障与侧退自救轨迹。
举个例子(自引导扰动数据流): 假设机器人陷入死胡同,有目标预测 \(\tilde{\tau}_{\text{pointgoal}}\) 给出向前微动 $[+0.2, 0.0]$,单纯加高斯噪声可能得到 $[+0.2+\mathcal N, 0.0+\mathcal N]$(机器人剧烈抖动碰撞); 而无目标预测 \(\tilde{\tau}_{\text{nogoal}}\) 给出大范围探索航点 $[+0.5, +0.6]$。通过外推和符号翻转 $\mathbf s = (-1, -1)$,合成轨迹变为 $[-0.2, -0.6]$——产生了一条极其平滑且符合物理约束的倒车绕行轨迹!
③ 组内 Q 值重加权匹配(Group Q-Score Reweighted Matching, GQRM)
为解决标准 DPMD 在 Minibatch 全局归一化时“简单状态高收益掩盖困难状态低收益”的缺陷,GQRM 强制在同一状态下的候选动作组 $G(s)$ 内计算统计量:
组内均值与标准差公式: \(\bar{Q}_G(s) = \mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s)} [Q(s, a_0)], \quad \sigma_G(s) = \sqrt{\mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s)} [(Q(s, a_0) - \bar{Q}_G(s))^2]}\)
组内归一化优势值: \(\tilde{Q}_G(s, a_0) = \text{clip}\left( \frac{c (Q(s, a_0) - \bar{Q}_G(s))}{\sigma_G(s) + \varepsilon}, -h, h \right)\)
GQRM 的 Actor 优化目标: \(\mathcal L_{\text{GQRM}}(\theta; s, t) = \mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s), a_t \sim q_{t \mid 0}(\cdot \mid a_0)} \left[ \exp(\tilde{Q}_G(s, a_0) / \lambda) \left\lVert s_\theta(a_t; s, t) - \nabla_{a_t} \log q_{t \mid 0}(a_t \mid a_0) \right\rVert^2 \right]\)
在实践中,每次仅保留同状态候选组中优势值大于零前 $k$ 个候选动作(Top-$k$ Positive Advantage),既削减了低质量样本噪声,又大幅节省了计算开销。
| 维度 | 传统 DPMD 做法 | 本文 GQRM 做法 |
|---|---|---|
| 归一化范围 | 跨 Minibatch 内不同状态混合归一化 | 仅在同一状态采样的候选动作组内归一化 |
| 困境表现 | 简单状态的大 positive return 掩盖困难状态的相对优劣 | 即使绝对 return 全为负,也能区分出局部更优的倒车自救动作 |
| 梯度权重 | 困难状态样本权重接近于 0,无法学习自救 | 困难状态的局部相对优胜者获得指数级强化权重 |
④ 构型 FiLM 调制与闭环时域引导
- 构型 FiLM 调制(Embodiment Modulation):将机器人 ID 转换为 Embedding $\mathbf z_e = E_{\text{emb}}(e)$,一方面作为 Action Token 前的偏置 $\mathbf u_e = \mathbf u + f_\Delta(\mathbf z_e)$,另一方面通过 FiLM 生成缩放与偏移参数 $[\Delta \gamma_e, \Delta \beta_e] = f_{\text{FiLM}}(\mathbf z_e)$ 调制解码器输出特征 $\mathbf h_e = (1 + \Delta \gamma_e) \odot \mathbf h + \Delta \beta_e$,使得单套主干模型能感知不同机器人的宽度、转弯半径及推力特性。
- 闭环时域引导(RTC Guidance):推理部署时,在 DDPM 反向去噪步骤中引入前一预测轨迹的时域平滑梯度,更新公式为 \(\mathbf x_t^{(k-1)} = \boldsymbol \mu_k + \sigma_k \mathbf z + \sqrt{\bar{\alpha}_k} \eta_{\text{guide}} \mathbf g\),有效消除了滚动时域预测中的轨迹抖动。
graph TD
    A["输入: 局部 RGB-D + PointGoal + 机器人 ID"] --> B["构型 FiLM 模块注入 Robot Embedding"]
    B --> C["自引导扰动策略采样同状态候选组 G(s)"]
    C --> D["Twin Critics 评估候选组轨迹 Q(s, a0)"]
    D --> E["同状态组内归一化计算优势值 Q_tilde_G"]
    E --> F["保留 Top-k 正优势动作指数重加权"]
    F --> G["优化 Diffusion Score Network 去噪目标"]
    G --> H["MPC 追踪执行 + RTC 闭环平滑引导"]
3. 核心结果/发现
- 仿真基准全方位超越:在 IsaacLab 40 个未见测试场景中,X-NavDP 相比预训练基线 NavDP,平均成功率(SR)从 61.20% 提升至 84.28%,SPL 从 58.95% 提升至 77.19%。特别是在人形机器人(Unitree G1)上,Home 场景成功率从 50.70% 骤升至 84.50%。
- 真机硬核困境自救:在无真机微调(Zero-Shot Sim-to-Real)情况下部署于 Turtlebot、Unitree Go2 和 Unitree G1,在死胡同、长墙绕行等硬核测试集中,成功率从基线的 10% 飙升至 65%。
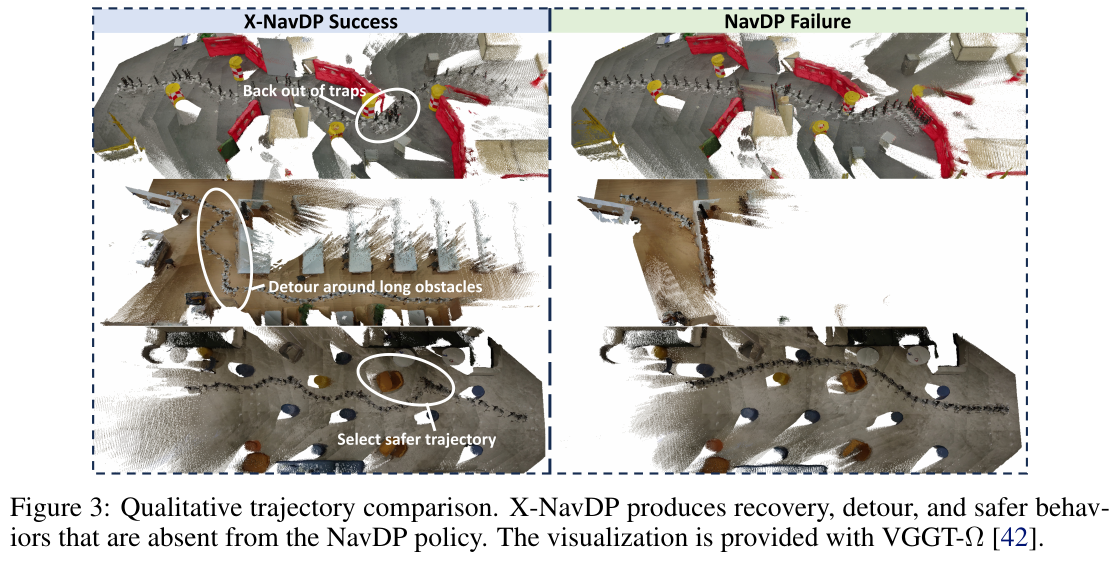
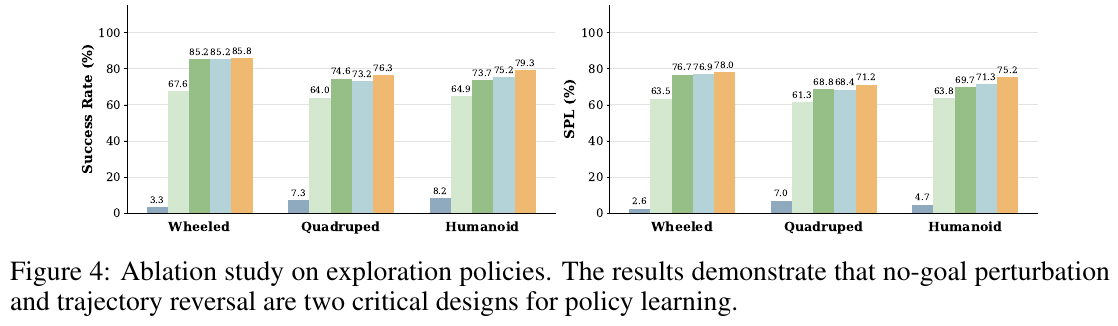
- 消融实验关键发现:
- 移除自引导扰动与轨迹反向会导致 RL 训练直接崩溃(SR 跌至 6.23%);
- 相比于 Soft-Prompt 拼接,FiLM 构型调制在多场景扩展时展现出更强的跨构型适应性;
- 相比于 DPPO 和 DSRL,GQRM 展现出极高的训练稳定性和数据效率(仅需 12 小时后训练)。
4. 局限性
- 短时域上下文依赖:策略当前主要依赖短时域视觉上下文,缺少长期拓扑记忆,在极长的墙体绕行中可能因记忆消退出现重复打转。
- 低层控制器依赖:跨构型泛化依赖于预先训练好的低层足行/轮式控制器,在非常规构型上的扩展需要先具备对应的基底控制器。
- 透明与空洞障碍物感知:对玻璃隔断、网格孔洞面板等透明/高穿透力障碍物的 RGB-D 深度测量易失效,需引入更强语义感知。
参考资料
论文引用
- VLFM (2023). Vision-Language Frontier Maps for Zero-Shot Semantic Navigation. arXiv: 2312.03275 · ICRA 2024 · Code: rai-opensource/vlfm
- NoMaD (2023). 目标掩码扩散策略实现统一导航. arXiv: 2310.07896 · ICRA 2024
- VL-Nav (2025). 实时零样本 Vision-Language 导航系统,融合像素级视觉-语言特征与启发式空间推理. arXiv: 2502.00931 · IROS 2026
- GaussNav (2025). Gaussian Splatting for Visual Navigation. arXiv: 2403.11625 · IEEE TPAMI 2025
- NavDP (2025). 只用仿真数据训练,零样本迁移到真实机器人的导航扩散策略. arXiv: 2505.08712 · ICRA 2026 · Code: InternRobotics/NavDP
- NavWAM (2026). 首个将未来预测、价值评估与动作决策集成于单一具身世界模型的导航模型. arXiv: 2606.13494
- CanonNav (2026). 解耦相机几何与导航行为的跨平台视觉扩散导航策略. arXiv: 2608.30242
- Hydra-Nav (2026). Object Navigation via Adaptive Dual-Process Reasoning. arXiv: 2602.09972
- 3DGSNav (2026). 用主动 3DGS 记忆增强 VLM 空间推理,实现零样本目标导航. arXiv: 2602.12159
- WAM-Nav (2026). 非对称隐空间「世界-动作」联合建模,用一个 DiT 统一三类视觉导航. arXiv: 2606.04907
- LocalNav (2026). 基于知识蒸馏与具身强化学习的端侧轻量化三维场景图目标导航框架. arXiv: 2606.27871
- AECNav (2026). 把”找物体”改写成”攒证据”:一次编码、按需分割、对数几率累积信念. arXiv: 2608.10817
- VNT-PA (2026). 把”在哪看到的”而不是”什么时候看到的”作为位置编码:无显式地图的 Transformer 规划器. arXiv: 2609.21212
- NAVCON (2024). 认知启发与语言落地的首个大规模 Vision-Language Navigation 概念数据集. arXiv: 2412.13026
- LoGoPlanner (2025). 定位接地的端到端导航策略:把度量尺度的视觉几何”植入”规划. arXiv: 2512.19629 · ICRA 2026
- Skill-Nav (2025). Enhanced Navigation with Versatile Quadrupedal Locomotion via Waypoint Interface. arXiv: 2506.21853 · Vicinagearth (Springer) 2025
- FantasyVLN (2026). 统一多模态 Chain-of-Thought 推理用于视觉-语言导航. arXiv: 2601.13976
- SparseVideoNav (2026). Sparse Video Generation Propels Real-World Beyond-the-View Vision-Language Navigation. arXiv: 2602.05827v1
- WorldVLN (2026). Autoregressive World Action Model for Aerial Vision-Language Navigation. arXiv: 2605.15964
- CONDVLN (2026). 首个基于分层 3D 场景图的视觉语言导航条件分支诊断基准与神经符号探针. arXiv: 2608.17318
- Qwen-Drive (2026). 首个不改动 VLM 架构、统一 3D 感知/问答/轨迹规划的端到端自动驾驶基础模型. arXiv: 2609.00111
- LookStep (2026). 基于语言前瞻推演与事件驱动记忆的高效端到端视觉语言导航. arXiv: 2609.02350
- OccPlanner (2026). 把一个没有深度的像素,”顶”回局部 3D 占用栅格里再规划. arXiv: 2608.14160
- EgoPathBench (2026). 把「导航决策」压成第一人称图上的一串编号,对错交给场景几何裁定. arXiv: 2609.16610
- VLingNav (2026). Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic Memory. arXiv: 2601.08665 · Project Page: wsakobe/VLingNav-web
- X-NavDP (2026). 多构型机器人通用视觉导航的组内 Q值重加权 Diffusion RL 强化学习微调框架. arXiv: 2607.28560 · CoRL 2026 · Code: InternRobotics/NavDP