本文是 VLN综述:基于视觉语言的导航 的配套论文精读,收录 VLN 经典论文与依赖基础工作。
本篇收录 55 篇工作,均已发表于会议期刊或进入了指令跟随排行榜;目标导航排行榜与其余论文见扩展篇 VLN 论文精读(扩展篇)。
性能排行榜
⚠️ 不同基准不可直接混比:本篇只收指令跟随类基准,按基准分表——① R2R-CE 与 ② RxR-CE 是连续环境(机器人第一视角逐步控制),③ R2R / REVERIE 是离散导航图上的全景决策。各表任务定义或传感器设定不同,SR 不可跨表比较。目标导航(ObjectNav、HM3D-OVON、图像 / 点目标等)的排行榜在扩展篇:目标导航性能排行榜。
读表:「范式」列中,训练指在导航数据上训练或微调过模型(含跨任务零样本迁移的导航基础模型);免训练指不训练任何导航模型,由现成的大模型、检测分割模型与规则 / 规划模块组合而成(调用现成的点目标低层控制器不影响归类)。灰色行是非标准口径(如只评测了验证集子集),不参与加粗;加粗为同一基准内非灰色行的最优值。表格上方的筛选栏可按范式、输入配置、是否开源筛选,也可以隐藏灰色行。
① R2R-CE
连续环境 · 英文指令 · val-unseen(全量 1839 条)
| 模型 | 年份 | 范式 | 基模 | SR ↑ | SPL ↑ | NE ↓ | OSR ↑ | 开源 |
|---|---|---|---|---|---|---|---|---|
| GPT-6-Astra (单目 · ultra) 100 条子集 | 2026 | 免训练 | GPT-6-Astra | 79.0 | 69.5 | 3.0 | 82.0 | 否 |
| Robostral Navigate (单目) | 2026 | 训练 | Mistral-8B | 77.4 | 74.2 | 3.20 | 81.3 | 否 |
| GPT-6-Astra (单目 · medium) 100 条子集 | 2026 | 免训练 | GPT-6-Astra | 76.0 | 67.9 | 2.7 | 83.0 | 否 |
| Qwen-RobotNav (全景) | 2026 | 训练 | Qwen3-VL-8B | 72.1 | 66.6 | 3.53 | 78.5 | 否 |
| ABot-N1 (三相机) | 2026 | 训练 | Qwen-3.5-4B + 2B | 70.9 | 67.5 | 3.32 | 75.2 | 否 |
| Image2Nav (180° FOV) | 2026 | 训练 | Qwen3-VL-4B | 70.3 | 65.6 | 3.71 | 76.1 | 是 |
| GroundingVLN (三相机) | 2026 | 训练 | Qwen3.5-4B | 69.9 | 64.1 | 3.66 | 74.8 | 否 |
| OmniNav (多目) | 2026 | 训练 | Qwen2.5-VL-3B | 69.5 | 66.1 | 3.74 | 74.6 | 是 |
| LightNav-0 (单目) | 2026 | 训练 | Qwen3-VL-4B | 68.5 | 62.8 | 3.91 | 73.7 | 是 |
| AstraNav-World (多目) | 2025 | 训练 | Qwen2.5-VL-3B | 67.9 | 65.4 | 3.86 | 73.9 | 是 |
| SEDualVLN (单目) | 2026 | 训练 | LLaVA-Video-7B | 67.3 | 62.5 | 3.75 | 73.7 | 否 |
| AgentVLN (单目) | 2026 | 训练 | Qwen2.5-VL-3B | 67.2 | 64.7 | 3.88 | 73.5 | 是 |
| Qwen-RobotNav (单目) | 2026 | 训练 | Qwen3-VL-4B | 66.9 | 60.5 | 4.22 | 73.6 | 否 |
| TAMP-Nav (多目) | 2026 | 训练 | Qwen2.5-VL-7B | 66.2 | 58.8 | 3.85 | 74.5 | 是 |
| Dual-Anchoring (单目) | 2026 | 训练 | LLaVA-Video-7B | 65.6 | 62.1 | – | – | 否 |
| AwareVLN (单目) | 2026 | 训练 | Vicuna-7B | 65.4 | 55.1 | 4.02 | 73.5 | 是 |
| CorrectNav (单目) | 2025 | 训练 | – | 65.1 | 62.3 | 4.24 | 67.5 | 是 |
| DualVLN (单目) | 2025 | 训练 | Qwen2.5-VL-7B | 64.3 | 58.5 | 4.05 | 70.7 | 是 |
| VLN-Cache (单目) | 2026 | 训练 | Qwen2.5-VL-7B | 63.1 | 57.6 | – | – | 否 |
| ReflectVLN (单目) | 2026 | 训练 | Qwen2.5-VL-3B | 62.8 | 58.5 | 4.19 | 67.3 | 否 |
| NavFoM (多目) | 2025 | 训练 | Qwen2-7B | 61.7 | 55.3 | 4.61 | 72.1 | 否 |
| GA-VLN (单目) | 2026 | 训练 | LLaVA-Video-7B | 61.0 | 55.2 | 4.80 | 67.6 | 是 |
| HarnessVLN (单目) | 2026 | 免训练 | GPT-5.5 | 60.8 | 43.5 | 4.01 | 72.7 | 否 |
| JanusVLN (单目) | 2026 | 训练 | Janus-Pro-7B | 60.5 | 56.8 | 4.78 | 65.2 | 是 |
| RynnBrain-Nav (单目) | 2026 | 训练 | – | 58.6 | 49.6 | 4.92 | 71.6 | 是 |
| DGNav (全景) | 2026 | 训练 | – | 58.56 | 50.08 | 4.66 | 64.82 | 是 |
| MemVLN-8B (单目) | 2026 | 训练 | Qwen3-VL-8B | 58.4 | 51.2 | 4.98 | 65.3 | 否 |
| BudVLN (单目) | 2026 | 训练 | LLaVA-1.5-7B | 57.6 | 51.1 | – | – | 否 |
| StreamVLN (单目) | 2025 | 训练 | LLaVA-Video-7B | 56.4 | 50.2 | 4.90 | 63.6 | 是 |
| DecoVLN (单目) | 2026 | 训练 | LLaVA-Video-7B | 56.3 | 50.5 | 5.01 | 63.5 | 否 |
| AgenticNav (全景) 100 条子集 | 2026 | 免训练 | GPT-5.5 | 55.0 | 48.41 | 5.19 | 65.0 | 否 |
| Goal2Pixel (单目) | 2025 | 训练 | LLaVA-1.5-7B | 54.1 | 52.5 | 4.85 | 59.9 | 否 |
| HSGM (单目) | 2026 | 免训练 | – | 47.9 | 32.8 | 5.42 | 58.7 | 是 |
| MapNav (单目) | 2025 | 训练 | LLaVA-Onevision-7B | 39.7 | 37.2 | 5.43 | 53.0 | 是 |
| NaVid (单目) | 2024 | 训练 | – | 37.4 | 35.9 | 5.47 | 49.1 | 是 |
| VLN-R1 (单目) | 2025 | 训练 | Qwen2-VL-7B | 30.2 | 21.8 | 7.0 | 41.2 | 否 |
| VLN-R1 (单目) | 2025 | 训练 | Qwen2-VL-2B | 25.6 | 20.5 | 10.2 | 37.5 | 否 |
| OneVLA (单目) | 2026 | 训练 | Qwen2.5-VL-3B | – | – | – | 68.6 | 是 |
注:NavFoM 为四视角结果(单视角为 SR 56.2 / SPL 51.2);DGNav 沿用 ETPNav 的全景 RGB-D 输入;DualVLN 与 StreamVLN 为同口径单视角对比;VLN-Cache 为对 DualVLN 的加速方案,几乎无损(基线 64.3 / 58.5)。 StreamVLN 取 arXiv v2(ICRA 2026 版)的 StreamVLN† 数字(用了 ScaleVLN 子集等额外数据),v1 为 56.9 / 51.9,其他论文作为基线引用的多是 v1 数字。 Qwen-RobotNav 取 arXiv v3:全景行是 8B(底座 Qwen3-VL-8B),单目行是 4B(单目下 4B 的 66.9 高于 8B 的 65.7;8B 单目为 65.7 / 59.6)。灰色的 GPT-6-Astra 与 AgenticNav 三行只在 R2R-CE-100 上评测:这是 Open-Nav 从 val-unseen 中固定抽取的 100 条 episode(覆盖 10 个场景),免训练方法为控制大模型调用成本普遍只报这一子集。1 条 episode 就是 1 个百分点,SR 在 79% 附近时标准误约 4 个点(95% 区间约 71–87),全量 1839 条时约 1 个点;GPT-6-Astra 每档推理强度又只跑一次。这几行按 SR 排在表里、不参与加粗,与全量行的高低只作参考。
② RxR-CE
连续环境 · 多语言指令(英语 / 印地语 / 泰卢固语)· val-unseen
| 模型 | 年份 | 范式 | 基模 | SR ↑ | SPL ↑ | NE ↓ | OSR ↑ | 开源 |
|---|---|---|---|---|---|---|---|---|
| Qwen-RobotNav (全景) | 2026 | 训练 | Qwen3-VL-8B | 76.5 | 65.7 | 3.58 | – | 否 |
| Robostral Navigate (单目) | 2026 | 训练 | Mistral-8B | 75.1 | 68.7 | 3.47 | – | 否 |
| GroundingVLN (三相机) | 2026 | 训练 | Qwen3.5-4B | 75.1 | 62.0 | 3.54 | – | 否 |
| ABot-N1 (三相机) | 2026 | 训练 | Qwen-3.5-4B + 2B | 73.9 | 63.9 | 3.13 | – | 否 |
| OmniNav (多目) | 2026 | 训练 | Qwen2.5-VL-3B | 73.6 | 62.0 | 3.77 | – | 是 |
| LightNav-0 (单目) | 2026 | 训练 | Qwen3-VL-4B | 73.6 | 64.5 | 3.66 | – | 是 |
| Qwen-RobotNav (单目) | 2026 | 训练 | Qwen3-VL-8B | 73.4 | 63.5 | 4.16 | – | 否 |
| AstraNav-World (多目) | 2025 | 训练 | Qwen2.5-VL-3B | 72.9 | 61.5 | 3.82 | – | 是 |
| Image2Nav (180° FOV) | 2026 | 训练 | Qwen3-VL-4B | 70.7 | 59.1 | 3.74 | – | 是 |
| AgentVLN (单目) | 2026 | 训练 | Qwen2.5-VL-3B | 69.5 | 61.3 | 3.92 | – | 是 |
| CorrectNav (单目) | 2025 | 训练 | – | 69.3 | 63.3 | 4.09 | – | 是 |
| AwareVLN (单目) | 2026 | 训练 | Vicuna-7B | 67.6 | 56.1 | 3.95 | – | 是 |
| MemVLN-4B (单目) | 2026 | 训练 | Qwen3-VL-4B | 66.5 | 57.4 | 4.22 | – | 否 |
| ReflectVLN (单目) | 2026 | 训练 | Qwen2.5-VL-3B | 66.0 | 57.2 | 3.98 | – | 否 |
| TAMP-Nav (多目) | 2026 | 训练 | Qwen2.5-VL-7B | 65.7 | 56.9 | 4.32 | – | 是 |
| NavFoM (多目) | 2025 | 训练 | Qwen2-7B | 64.4 | 56.2 | 4.74 | – | 否 |
| SEDualVLN (单目) | 2026 | 训练 | LLaVA-Video-7B | 63.9 | 52.4 | 4.12 | – | 否 |
| Dual-Anchoring (单目) | 2026 | 训练 | LLaVA-Video-7B | 61.7 | 53.3 | – | – | 否 |
| DualVLN (单目) | 2025 | 训练 | Qwen2.5-VL-7B | 61.4 | 51.8 | 4.58 | – | 是 |
| JanusVLN (单目) | 2026 | 训练 | Janus-Pro-7B | 56.2 | 47.5 | 6.06 | – | 是 |
| RynnBrain-Nav (单目) | 2026 | 训练 | – | 56.1 | 49.6 | 6.20 | – | 是 |
| GA-VLN (单目) | 2026 | 训练 | LLaVA-Video-7B | 55.4 | 45.2 | 5.88 | 67.0 | 是 |
| StreamVLN (单目) | 2025 | 训练 | LLaVA-Video-7B | 54.4 | 45.4 | 5.65 | – | 是 |
| DecoVLN (单目) | 2026 | 训练 | LLaVA-Video-7B | 54.2 | 46.3 | 5.73 | – | 否 |
| HarnessVLN (单目) | 2026 | 免训练 | GPT-5.5 | 53.9 | 38.0 | 6.42 | – | 否 |
| DGNav (全景) | 2026 | 训练 | – | 53.78 | 44.37 | 6.00 | – | 是 |
| Goal2Pixel (单目) | 2025 | 训练 | LLaVA-1.5-7B | 43.8 | 40.4 | 7.50 | – | 否 |
| HSGM (单目) | 2026 | 免训练 | – | 41.8 | 25.1 | 7.43 | – | 是 |
| MapNav (单目) | 2025 | 训练 | LLaVA-Onevision-7B | 32.6 | 27.7 | 7.62 | – | 是 |
| NaVid (单目) | 2024 | 训练 | – | 23.8 | 21.2 | 8.41 | 34.5 | 是 |
| VLN-R1 (单目) | 2025 | 训练 | Qwen2-VL-7B | 22.7 | 17.6 | 9.1 | 30.4 | 否 |
| VLN-R1 (单目) | 2025 | 训练 | Qwen2-VL-2B | 20.7 | 16.9 | 10.2 | 30.1 | 否 |
| OneVLA (单目) | 2026 | 训练 | Qwen2.5-VL-3B | – | – | – | 58.2 | 是 |
注:StreamVLN 取 arXiv v2 数字(v1 为 52.9 / 46.0);Dual-Anchoring 与 StreamVLN 基线(52.9%)对比来自 Dual-Anchoring 原文。 Qwen-RobotNav 两行均为 8B(单目下 8B 的 73.4 高于 4B 的 71.3)。
③ R2R · REVERIE
离散导航图 · 全景观测;含 GSA-R2R 的住宅(ID)/ 非住宅(OOD)场景划分
| 模型 | 年份 | 基准 | 范式 | 基模 | SR ↑ | SPL ↑ | NE ↓ | OSR ↑ | 开源 |
|---|---|---|---|---|---|---|---|---|---|
| UAGM (全景) | 2026 | R2R | 训练 | – | 78.3 | 66 | – | – | 否 |
| R³ (全景) | 2026 | R2R | 训练 | GPT-4o | 77 | 66 | 2.76 | – | 否 |
| CA-VLN (全景) | 2026 | R2R | 训练 | LLaVA-7B | 73.3 | 62.0 | 3.03 | – | 否 |
| VLN-Imagine (DUET) (全景) | 2025 | R2R | 训练 | – | 72.12 | 60.48 | 3.19 | – | 是 |
| NavGPT-2 (全景) | 2024 | R2R | 训练 | Vicuna-7B | 71 | 60 | 3.18 | 80 | 是 |
| DUET (全景) | 2022 | R2R (Test-Unseen) | 训练 | – | 69.0 | 59.0 | 3.65 | – | 是 |
| R2R (全景) | 2018 | R2R (Test-Unseen) | 训练 | – | 20.4 | 18.0 | 7.85 | 26.6 | 否 |
| Slow4fast-VLN (全景) | 2026 | GSA-R2R (ID) | 训练 | – | 70.8 | 65.0 | 2.9 | – | 是 |
| GR-DUET (全景) | 2025 | GSA-R2R (ID) | 训练 | – | 69.3 | 64.3 | 3.1 | – | 是 |
| Slow4fast-VLN (全景) | 2026 | GSA-R2R (OOD) | 训练 | – | 58.4 | 52.9 | 4.2 | – | 是 |
| GR-DUET (全景) | 2025 | GSA-R2R (OOD) | 训练 | – | 56.6 | 51.5 | 4.4 | – | 是 |
| CA-VLN (全景) | 2026 | REVERIE | 训练 | LLaVA-7B | 51.0 | 35.5 | – | 56.3 | 否 |
| DUET (全景) | 2022 | REVERIE (Test-Unseen) | 训练 | – | 52.51 | 36.06 | – | 56.91 | 是 |
注:VLN-Imagine 为 DUET-Imagine 的 R2R val-unseen 结果(DUET 基线 71.52 / 60.41)。GSA-R2R 区分住宅(ID,Test-R-Basic)与非住宅(OOD,Test-N-Basic)场景,Slow4fast-VLN 相对 GR-DUET 性能有所提升。REVERIE 基准另用 RGS / RGSPL 指标:R³ 为 53.76 / 42.14 / 37.94 / 29.86(SR/SPL/RGS/RGSPL),Uncertainty-Aware Gaussian Map 的 RGS / RGSPL 为 37.65 / 27.01。 连续环境版 REVERIE-CE 目前只有 Image2Nav(180° FOV)报告:SR 53.7 / SPL 42.7 / NE 5.08 / OSR 59.5(val-unseen),动作空间与离散 REVERIE 不同,不并入本表。
说明:以下论文因评测于真实世界 / 自建或非标准基准(如 Open-Nav、SparseVideoNav、CausalNav、VL-Nav 等),或属运动控制 / 操作 / 生成等非导航指标任务(Skill-Nav、RoboClaw、ABot-Claw 等),或为依赖性基础工作,未列入本篇与扩展篇的排行榜。详见各自章节。
前列模型技术方案分析
要素打勾矩阵
为了清晰揭示 R2R-CE SR ≥ 60% 前列模型的技术 Recipe(解法组合),下表对排行榜 ① 中 SR ≥ 60% 的全部 24 个条目(22 个模型,Qwen-RobotNav 的全景 / 单目配置与 GPT-6-Astra 的 ultra / medium 推理强度各分两行)逐篇核对原文后打勾(✓)。
打勾口径:按取得该 R2R-CE 成绩的那套配置判定,论文未披露的一律记为 –。
| 要素 | 判定标准 |
|---|---|
| 堆数据 | 训练样本 / 轨迹 ≥ 1M(含与导航数据联合训练的通用视觉语言数据) |
| 堆相机 | 每步输入多目或全景(含 180° 超广角);单目 RGB / RGB-D 不计 |
| 快慢双系统 | 高层 VLM 只给子目标(像素 / 航点 / 前沿点),由独立的低层策略或几何规划器以更高频率闭环执行 |
| Agentic | VLM / MLLM 作为调度中枢调用建图、感知、规划等外部工具或技能模块,而非端到端直接出动作 |
| 像素 Grounding | 导航目标以图像坐标或图像区域给出,再经深度反投影或低层策略落地 |
| 连续动作头 | 用回归头、扩散或流匹配直接输出连续航点 / 控制量,而非离散文本动作 |
| 强化学习 | SFT 之后有 GRPO / CISPO 等在线或离线 RL 后训练 |
| DAgger / 纠偏数据 | 用策略自身 rollout 采集纠偏样本(DAgger、自纠错飞轮、失败反思数据) |
| 上下文压缩 | 显式的历史 Token 压缩、KV 复用或前缀共享(含训练期) |
| 开源 | 代码或权重已公开 |
| 排名 | 模型 | R2R-CE SR ↑ | 堆数据 (≥1M) | 堆相机 (多目/全景) | 快慢双系统 | Agentic | 像素 Grounding | 连续动作头 (回归/扩散/流匹配) | 强化学习 (GRPO/CISPO) | DAgger / 纠偏数据 | 上下文压缩 (KV/Token/前缀) | 开源代码 / 权重 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | GPT-6-Astra (单目 · ultra) | 79.0% | – | – | – | – | – | – | – | – | – | – |
| 2 | Robostral Navigate (单目) | 77.4% | ✓ | – | ✓ | – | ✓ | ✓ | ✓ | – | ✓ | – |
| 3 | GPT-6-Astra (单目 · medium) | 76.0% | – | – | – | – | – | – | – | – | – | – |
| 4 | Qwen-RobotNav (全景) | 72.1% | ✓ | ✓ | – | – | – | ✓ | – | – | ✓ | – |
| 5 | ABot-N1 (三相机) | 70.9% | ✓ | ✓ | ✓ | – | ✓ | ✓ | ✓ | ✓ | – | – |
| 6 | Image2Nav (180° FOV) | 70.3% | ✓ | ✓ | – | – | – | – | – | ✓ | ✓ | ✓ |
| 7 | GroundingVLN (三相机) | 69.9% | – | ✓ | ✓ | – | ✓ | – | ✓ | – | – | – |
| 8 | OmniNav (多目) | 69.5% | ✓ | ✓ | – | – | – | ✓ | – | – | ✓ | ✓ |
| 9 | LightNav-0 (单目) | 68.5% | ✓ | – | – | – | ✓ | – | ✓ | ✓ | ✓ | ✓ |
| 10 | AstraNav-World (多目) | 67.9% | – | ✓ | – | – | – | ✓ | – | – | – | ✓ |
| 11 | SEDualVLN (单目) | 67.3% | – | – | ✓ | ✓ | – | – | – | ✓ | ✓ | – |
| 12 | AgentVLN (单目) | 67.2% | – | – | ✓ | ✓ | ✓ | – | – | – | – | ✓ |
| 13 | Qwen-RobotNav (单目) | 66.9% | ✓ | – | – | – | – | ✓ | – | – | ✓ | – |
| 14 | TAMP-Nav (多目) | 66.2% | – | ✓ | ✓ | – | ✓ | – | ✓ | – | ✓ | ✓ |
| 15 | Dual-Anchoring (单目) | 65.6% | ✓ | – | – | – | – | – | – | ✓ | ✓ | – |
| 16 | AwareVLN (单目) | 65.4% | – | – | – | – | – | – | – | ✓ | – | ✓ |
| 17 | CorrectNav (单目) | 65.1% | ✓ | – | – | – | – | – | – | ✓ | – | ✓ |
| 18 | DualVLN (单目) | 64.3% | ✓ | – | ✓ | – | ✓ | ✓ | – | ✓ | ✓ | ✓ |
| 19 | VLN-Cache (单目) | 63.1% | ✓ | – | ✓ | – | ✓ | ✓ | – | ✓ | ✓ | – |
| 20 | ReflectVLN (单目) | 62.8% | ✓ | – | ✓ | – | – | ✓ | – | ✓ | – | – |
| 21 | NavFoM (多目) | 61.7% | ✓ | ✓ | – | – | – | ✓ | – | – | ✓ | – |
| 22 | GA-VLN (单目) | 61.0% | – | – | – | – | – | – | – | – | ✓ | ✓ |
| 23 | HarnessVLN (单目 RGB-D) | 60.8% | – | – | ✓ | ✓ | ✓ | – | – | – | ✓ | – |
| 24 | JanusVLN (单目) | 60.5% | ✓ | – | – | – | – | – | – | ✓ | ✓ | ✓ |
| 统计 | 各要素采纳频次 | 最高 79.0% | 14/24 (58%) | 8/24 (33%) | 10/24 (42%) | 3/24 (12%) | 9/24 (38%) | 10/24 (42%) | 5/24 (21%) | 11/24 (46%) | 15/24 (62%) | 11/24 (46%) |
注:VLN-Cache 是套在 DualVLN 上的免训练 Token 缓存层,其余要素随 DualVLN 继承;OmniNav 的 R2R / RxR 评测只走快系统(VLM + 航点回归头),慢系统的前沿探索只用于 OVON,故双系统记 –;Qwen-RobotNav 与上层规划 Agent 的协作只用于 EQA 等长程任务,R2R-CE 成绩来自模型本体;Dual-Anchoring 与 SEDualVLN 的系统 1 均以 StreamVLN 为骨干,继承其滑动窗口 KV 与体素剪枝;HarnessVLN 是表中唯一在全量 val-unseen 上评测的免训练方法(另一个免训练条目 GPT-6-Astra 只跑了 R2R-CE-100),其像素 Grounding 指 ground_target 工具把子目标落到图像区域后再查深度。ABot-N1 的 30M 预训练样本与 DAgger rollout、Image2Nav 的离散动作输出与在线 DAgger,均依据各自 arXiv 原文补充。GPT-6-Astra 两行是同一闭源模型在 ultra / medium 两档推理强度下的 R2R-CE-100 成绩(100 条子集、每档单次运行),不做任何导航微调;它的 observe() / step() 只是原始观测与原语动作接口,不调用建图、感知或规划工具,故 Agentic 记 –;训练数据未披露,堆数据、强化学习等列也记 –。
统计研判
以 68% 为界把 24 个条目分成两档,比较各要素的采纳率:
| 要素 | 第一梯队(SR ≥ 68%,9 个) | 第二梯队(60%–68%,15 个) | 合计(24 个) |
|---|---|---|---|
| 堆数据 | 6/9 (67%) | 8/15 (53%) | 14/24 (58%) |
| 堆相机 | 5/9 (56%) | 3/15 (20%) | 8/24 (33%) |
| 快慢双系统 | 3/9 (33%) | 7/15 (47%) | 10/24 (42%) |
| Agentic | 0/9 (0%) | 3/15 (20%) | 3/24 (12%) |
| 像素 Grounding | 4/9 (44%) | 5/15 (33%) | 9/24 (38%) |
| 连续动作头 | 4/9 (44%) | 6/15 (40%) | 10/24 (42%) |
| 强化学习 | 4/9 (44%) | 1/15 (7%) | 5/24 (21%) |
| DAgger / 纠偏数据 | 3/9 (33%) | 8/15 (53%) | 11/24 (46%) |
| 上下文压缩 | 5/9 (56%) | 10/15 (67%) | 15/24 (62%) |
| 开源 | 3/9 (33%) | 8/15 (53%) | 11/24 (46%) |
以下是前列模型内部的采纳率对比,只能说明相关性;某个要素能带来多少增益,要以各论文的消融为准。
- 先说特例:GPT-6-Astra 十列全空,却排在最前(须按子集口径看):
- GPT-6-Astra 的两档推理强度分别以 79.0% 与 76.0% 进入第一梯队,但矩阵的十个要素它一个都没有:单目 RGB、原语离散动作、不做任何导航微调,也不调用建图、感知或规划工具,模型闭源、训练数据未披露。
- 这说明矩阵刻画的是”训练一个导航模型”的 Recipe,足够强的通用基础模型本身可能已覆盖其中不少作用。但它的成绩来自 R2R-CE-100(100 条、单次运行,1 条即 1 个百分点,标准误约 4 个点),与其他条目的全量 val-unseen 不同口径,领先 Robostral 的 1.6 个点谈不上排名意义。
- 下文比例都把这两行算在内;结论只针对训练式模型时,同时给出第一梯队 7 个训练式条目的比例。
- 强化学习是两档之间最清晰的分界线(44% vs 7%;只算训练式条目为 57% vs 7%):
- 第一梯队 9 个里有 4 个做了 RL 后训练——Robostral (77.4%) 的 CISPO 在线 RL、ABot-N1 (70.9%) 带安全净空惩罚的 GRPO、GroundingVLN (69.9%) 的执行感知 GRPO(GEAR)、LightNav-0 (68.5%) 基于 RVQ 动作 Token 的 GRPO;没做 RL 的 5 个里有 2 个是不做导航训练的 GPT-6-Astra。第二梯队 15 个里只有 TAMP-Nav (66.2%) 一个。
- 消融给出了因果证据:GroundingVLN 去掉 GEAR,SR 从 69.9% 掉到 57.2%;把执行感知奖励图换成朴素 2D 像素距离也会掉到 66.2%。
- 这些奖励几乎都是几何量:像素 L2 距离与安全净空(ABot-N1)、横向偏离 / 路线进度差 / 执行端点误差(GroundingVLN)、截断目标距离(Robostral)。能这样设计奖励,前提是模型输出本身可度量,这正好引出下一条。
- 训练式模型的输出接口从离散文本动作转向可度量的空间目标:
- 第一梯队 7 个训练式条目里有 6 个输出像素目标(Robostral、ABot-N1、GroundingVLN、LightNav-0)或连续航点(Qwen-RobotNav、OmniNav),唯一的离散动作模型 Image2Nav 靠的是 10M 合成轨迹加 180° 视场。第一梯队另外两个离散动作条目是 GPT-6-Astra,它直接输出 0.25 m / 15° 的原语动作,靠的是基础模型本身而不是导航训练。
- 第二梯队这一比例降到 9/15:其余 6 个都是离散动作模型(SEDualVLN、Dual-Anchoring、AwareVLN、CorrectNav、GA-VLN、JanusVLN),最高的 SEDualVLN 为 67.3%,没有一个进入第一梯队。
- 像素目标与 RL 经常同时出现:可度量的接口让奖励从”动作对 / 错”升级为”离目标差多少米”。
- 堆数据是训练式模型高分的常见条件,但不是必要条件:
- 第一梯队 7 个训练式条目中有 6 个用了 ≥ 1M 样本(算上训练数据未披露、记为 – 的 GPT-6-Astra 两行为 6/9):ABot-N1 30M、Qwen-RobotNav 15.6M、Image2Nav 10M、OmniNav 9.2M、Robostral 2.4M、LightNav-0 4K+ 小时仿真数据。Image2Sim 的 Scaling 曲线也显示 35K → 10M 时 SR 从 46.1% 升到 66.3%,仍未饱和。
- 新进前列的 GroundingVLN 是反例:只用 188K 样本(约为 ABot-N0 的 0.9%)拿到 69.9%,只用 R2R 训练直接迁移到 RxR-CE 仍有 59.9%;TAMP-Nav 也仅凭 90K 合成轨迹冷启动加两级 GRPO 达到 66.2%。时序对齐的 grounding 监督加执行感知奖励,能替代相当一部分数据量。
- 多相机有稳定增益,但单目照样能登顶:
- 两组同模型对照给出了增量:Qwen-RobotNav-8B 全景 72.1% vs 单目 65.7%(+6.4;4B 为 69.5% vs 66.9%,+2.6),NavFoM 四视角 61.7% vs 单视角 56.2%(+5.5)。矩阵里 Qwen-RobotNav 的两行取各自设定下的最好成绩,全景行是 8B、单目行是 4B,两行相减不是同模型增量。第一梯队中 5/9 使用多目或全景(训练式条目 5/7),第二梯队只有 3/15。
- 但 SR 最高的两个条目都只用单目 RGB:GPT-6-Astra ultra(79.0%,R2R-CE-100)与 Robostral(77.4%,全量 val-unseen),LightNav-0 单目也有 68.5%——视野上的缺口可以用更好的训练与输出接口,或更强的基础模型补回来。
- 快慢双系统与 Agentic 不决定 SR 档位:
- 快慢双系统并不偏向高分档:第一梯队 3/9(33%;训练式条目 3/7,即 43%),第二梯队 7/15(47%)。它更多服务于部署时延,而不是 SR 本身:ABot-N1 慢系统异步决策、快系统 10Hz 控制;GroundingVLN 只在约 33% 的决策步调用 VLM,其余交给 A* 规划器。
- Agentic 只有 3/24,且都在第二梯队。HarnessVLN 用 GPT-5.5 加一层”派发前校验”的 Harness,以训练无关方式跨过 60%(SR 60.8%),但 SPL 只有 43.5,比同一 SR 段的训练式模型(NavFoM 55.3、GA-VLN 55.2、JanusVLN 56.8)低 11–13 个点。同为训练无关的 GPT-6-Astra 只有”看”和”动”两个工具,在 R2R-CE-100 上的 SPL 却有 69.5,仅次于 Robostral(74.2)——训练无关路线的路径效率短板,看来更多取决于基座模型,而不是外围工具链的多少(两者基座与评测集都不同,只作参考)。
- DAgger 与上下文压缩已成为入场标配,不再拉开档位:
- DAgger / 纠偏数据(46%)与上下文压缩(62%)在两档中都很普遍,第二梯队的 DAgger 采纳率(53%)甚至高于第一梯队(33%;训练式条目为 43%)。
- 上下文压缩的具体形式正在分化:JanusVLN 的初始窗口加滑动窗口 KV、GA-VLN 的 BEV 网格池化(每步约 4000 → 514 Token)、TAMP-Nav 的关键帧锚点加定长 STI Token、LightNav-0 的慢快历史压缩、NavFoM 按遗忘曲线采样历史帧,以及 HarnessVLN 的有界工作记忆加图检索 top-K。
- 第一梯队多数未开源,可复现的前列基线在 68%–70% 一带:
- 开源率第一梯队反而低于第二梯队(3/9 vs 8/15):Robostral (77.4%)、Qwen-RobotNav (72.1%)、ABot-N1 (70.9%)、GroundingVLN (69.9%) 截至 2026 年 9 月都没有公开模型代码或权重,ABot-N1 只开源了评测基准;GPT-6-Astra 本身是闭源通用模型。
- 想在开源代码上复现或做对比,目前最高的起点是 Image2Nav (70.3%)、OmniNav (69.5%) 与 LightNav-0 (68.5%)。
小结:从这 24 个条目看,训练式模型冲进 68%+ 的共性是”可度量的输出接口(像素目标 / 连续航点)+ 基于几何量的 RL 后训练”,数据规模与多相机是放大器;快慢双系统、DAgger 与上下文压缩更像是工程上的入场条件。GPT-6-Astra 则在不采用任何上述要素的情况下,在 R2R-CE-100 子集上拿到了最高的 SR——全量 val-unseen 上的同条件结果出来之前,它更适合被读作”通用基础模型的导航能力已逼近专用训练”的信号,而不是新的榜首。
具身导航经典论文
1. R2R (2018)
📄 Paper: arXiv:1711.07280 · 🏛️ CVPR 2018 (Spotlight)
精华
- 提出了视觉-语言导航(Vision-and-Language Navigation, VLN)任务,要求智能体在真实 3D 室内环境中根据自然语言指令进行多步视觉连续导航。
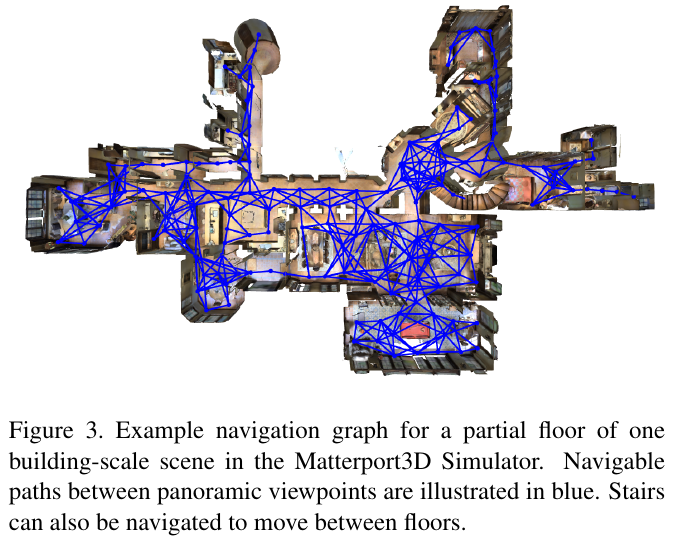
- 基于 Matterport3D 数据集构建了第一个真实场景大规模 VLN 基准 Room-to-Room (R2R),包含 21,567 条众包人类自然语言指令与高精度 3D 视点导航图。
- 提出了基于注意力机制的 Sequence-to-Sequence (Seq2Seq) Baseline 模型,实现语言指令与视觉观察之间的动态对齐。
- 比较了 Teacher-forcing 与 Student-forcing(在线采样/DAgger 变体)两种训练机制,证明 Student-forcing 能有效缓解分布偏移并提升鲁棒性。
- 揭示了 VLN 模型在未见(Unseen)场景中的严重泛化瓶颈,为后续具身导航研究指明了泛化性与表征学习的核心方向。
1. 研究背景/问题
将自然语言理解与物理世界视觉感知相结合的具身视觉导航(Embodied Navigation),是智能体在真实人居环境中执行复杂任务的核心前提。在此之前,相关研究存在以下两大局限:
- 任务设定局限:传统导航研究主要基于人工合成环境或仅依赖结构化目标点坐标(如 PointGoal),而视觉问答(VQA)与图像描述(Image Captioning)仅针对静态单张图像,缺乏具身交互与连续多步决策。
- 基准与模拟器缺失:缺乏兼具高真实度 3D 视觉场景、自然语言指令以及交互式导航物理拓扑图的大规模开源平台。
为了填补这一空白,本文提出了 Vision-and-Language Navigation (VLN) 任务,并配套开发了 Matterport3D 模拟器 与 Room-to-Room (R2R) 数据集。
2. 主要方法/创新点
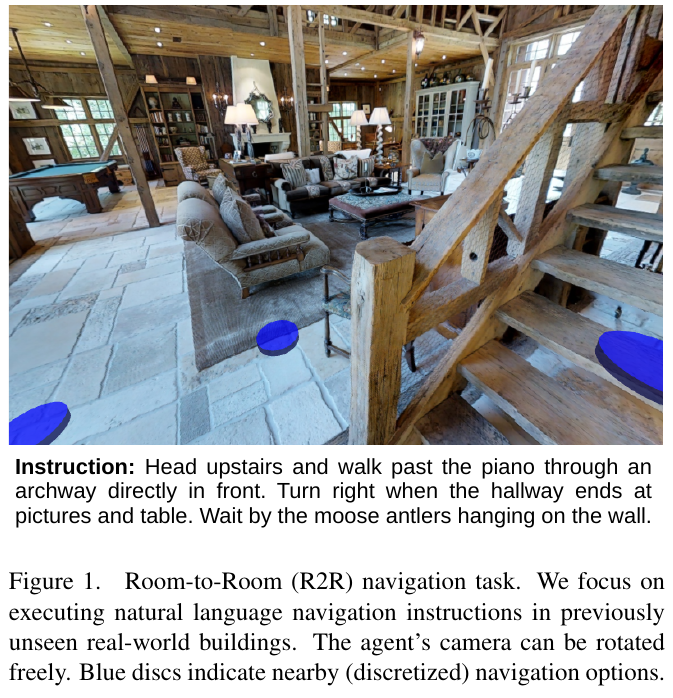
① 整体框架概述
VLN 任务要求智能体在无先验全局地图的 3D 环境中,仅依靠局部 RGB 视觉观察 $o_t$ 和自然语言指令 $\bar{x}$,生成一系列离散导航动作到达目标位置。模型整体由 语言指令编码器(Instruction Encoder)、视觉与动作特征嵌入模块(Image & Action Embeddings)、带注意力机制的解码器 LSTM(Decoder LSTM with Attention) 以及 动作预测分布产生器 四大核心组件构成。
② 逐模块讲解
- 语言指令编码器 (Language Instruction Encoder):
- 输入:自然语言指令 token 序列 $\bar{x} = \langle x_1, x_2, \dots, x_L \rangle$。
- 处理:将词嵌入向量逆序(Reverse order)依次送入单层编码器 LSTM,计算隐状态 \(h_i = \text{LSTM}_{\text{enc}}(x_i, h_{i-1})\)。
- 输出:生成编码上下文序列 $\bar{h} = {h_1, h_2, \dots, h_L}$,供后续注意力机制对齐。
- 设计动机:逆序输入语言序列能在处理序列开头时保持较短的记忆梯度距离,提升早期导航决策质量。
- 视觉与动作特征嵌入 (Image and Action Embedding):
- 输入:当前时刻全景图像观察 $o_t$ 与上一时刻采取的动作 $a_{t-1}$。
- 处理:利用预训练的 ResNet-152 CNN 提取 $o_t$ 的均值池化特征向量,与可学习的动作嵌入向量拼接,得到综合状态向量 $q_t$。
- 输出:将 $q_t$ 送入解码器 LSTM 更新隐状态: \(h'_t = \text{LSTM}_{\text{dec}}(q_t, h'_{t-1})\)
- 设计动机:使解码器 LSTM 维持对智能体历史轨迹与视觉观察的全程内部记忆,适应部分可观察环境(POMDP)。
- 注意力机制与动作预测 (Attention & Action Prediction):
- 输入:解码器隐状态 $h’_t$ 与语言编码上下文 $\bar{h}$。
- 处理:使用 Luong 全局注意力计算文本上下文向量 $c_t = f(h’_t, \bar{h})$,进而合成注意力隐状态: \(\tilde{h}_t = \tanh(W_c [c_t; h'_t])\)
- 输出:通过 Softmax 预测离散动作分布 \(a_t = \text{softmax}(\tilde{h}_t)\)。
- 动作空间:在简化模型中包含 6 种离散动作:
left(左转 30°)、right(右转 30°)、up(仰角 +30°)、down(俯角 -30°)、forward(沿视角中央最近相邻视点前进)与stop(终止导航)。
③ 训练目标与损失函数
训练采用多步交叉熵损失(Cross-Entropy Loss),最大化真值动作序列的似然度:
\[L = -\sum_{t=1}^T \log P(a_t^* \mid s_0, a_0, \dots, s_t)\]其中真值目标动作 \(a_t^*\) 为智能体当前状态 $s_t = \langle v_t, \psi_t, \theta_t \rangle$ 到目标视点 \(v^*\) 在拓扑图 $G$ 上的最短路径下一步动作。
④ 训练范式对比 (Teacher-Forcing vs. Student-Forcing)
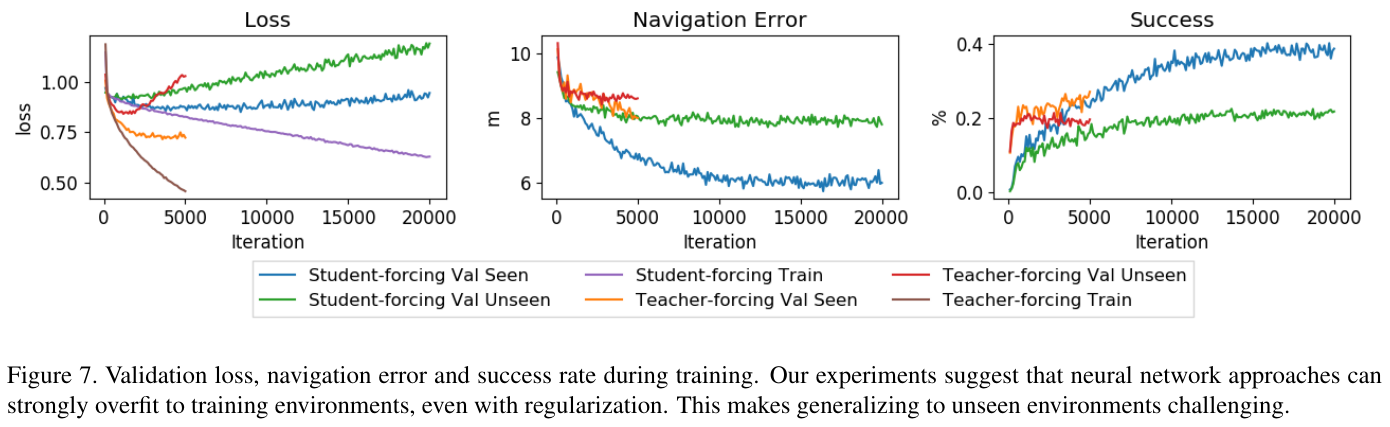
- Teacher-forcing:在训练阶段每一步强行使用真值动作 \(a_t^*\) 作为下一步输入。模型仅能在真值最短路径状态上训练,一旦推理中偏离路径即产生暴露偏差(Exposure Bias)。
- Student-forcing(在线采样 / DAgger 变体):训练阶段从模型预测的分布中采样动作 $a_t$ 并让智能体实际移动。若偏离原路径,系统在线重新计算当前位置到目标的最新最短路径动作作为 \(a_t^*\) 继续监督。实验表明该范式能显著提升模型对导航偏差的自愈能力。
3. 核心结果/发现
本文在 R2R 数据集上评估了不同 Baseline 与 Seq2Seq 模型的导航性能:
| 模型 / 评估设定 | 轨迹长度 (m) | 导航误差 (m) | 成功率 (%) | Oracle 成功率 (%) |
|---|---|---|---|---|
| Val Seen (已见验证集) | ||||
| RANDOM Baseline | 9.58 | 9.45 | 15.9 | 21.4 |
| Teacher-forcing | 10.95 | 8.01 | 27.1 | 36.7 |
| Student-forcing | 11.33 | 6.01 | 38.6 | 52.9 |
| Val Unseen (未见验证集) | ||||
| RANDOM Baseline | 9.77 | 9.23 | 16.3 | 22.0 |
| Teacher-forcing | 10.67 | 8.61 | 19.6 | 29.1 |
| Student-forcing | 8.39 | 7.81 | 21.8 | 28.4 |
| Test Unseen (未见测试集) | ||||
| Human (人类测试) | 11.90 | 1.61 | 86.4 | 90.2 |
| Student-forcing | 8.13 | 7.85 | 20.4 | 26.6 |
核心发现:
- Student-forcing 优势显著:在 Val Seen 上成功率达到 38.6%,在 Test Unseen 上达到 20.4%,均大幅超越随机基线 (13.2%) 和 Teacher-forcing。
- 泛化瓶颈巨大:模型在已见环境(Val Seen 38.6%)与未见环境(Val Unseen 21.8%)存在巨大差距。如图 7 所示,即便添加 Dropout 与 Weight Decay 正则化,模型仍会快速过拟合于已见房间的特定视觉特征。
- 人机差距显著:人类测试者达到了 86.4% 的成功率与 1.61m 的低误差,说明数据集指令清晰有效,但机器在跨场景泛化与指令-视觉精准对齐上仍面临重大挑战。
4. 局限性
- 视点拓扑限制:依赖预先连线的离散 3D 视点图(Navigation Graph),而非真实连续物理空间的自由碰撞与平滑控制。
- 跨场景泛化能力弱:标准 Seq2Seq + ResNet 特征难以建立泛化性强的视觉-语言底层语义关联,易过拟合特定场景纹理。
- 动作空间离散简化:将转向与前进离散化为 6 个固定动作,无法直接无缝部署于物理机器人的低层控制接口。
2. VLN-CE (2020)
——Beyond the Nav-Graph: 在连续环境中的视觉-语言导航
📄 Paper: arXiv:2004.02857 · 🏛️ ECCV 2020
精华
这篇论文通过将 VLN 任务从离散导航图迁移到连续 3D 环境,揭示了基于导航图的设定中隐含的强假设对性能的巨大影响。值得借鉴的核心思想包括:批判性地审视任务设定中的隐含假设、通过消除不现实的简化来提高任务的实际应用价值、深度信息在具身导航中的关键作用、以及端到端学习与低层控制结合的必要性。这种”去简化”的研究思路对构建更接近真实机器人应用的 AI 系统具有重要指导意义。
研究背景/问题
现有的 Vision-and-Language Navigation (VLN) 任务基于导航图 (nav-graph) 表示,引入了三个不现实的假设:已知环境拓扑、短距离 oracle 导航、以及完美的智能体定位。这些假设使得任务本质上退化为视觉引导的图搜索问题,与真实机器人导航场景存在巨大差距,限制了向实际机器人平台迁移的可能性。
主要方法/创新点
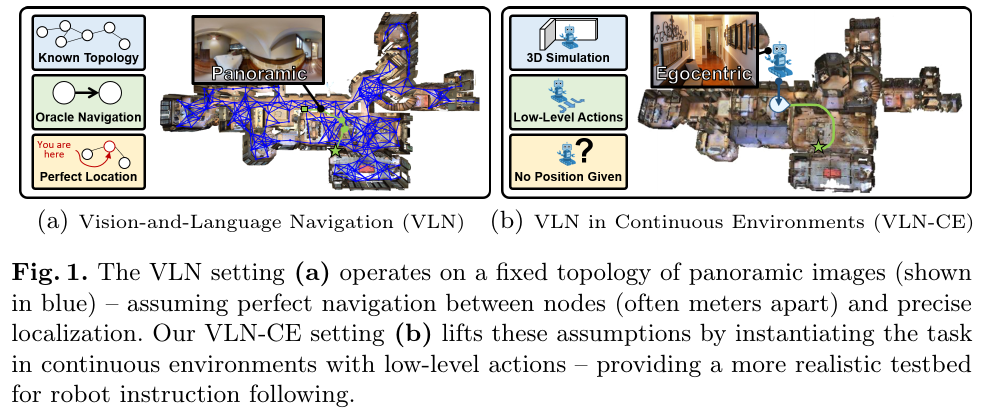
论文提出了 Vision-and-Language Navigation in Continuous Environments (VLN-CE) 任务,在 Habitat 模拟器中实例化连续的 Matterport3D 环境。主要创新包括:
-
连续环境设定:智能体通过低层动作(前进 0.25m、左转/右转 15°、停止)在连续 3D 空间中自由导航,而非在固定节点间传送。
-
轨迹迁移方法:设计了将 Room-to-Room (R2R) 数据集的导航图轨迹转换为连续环境路径的算法。通过向下投射射线找到最近的可导航点,并使用 A* 算法验证路径可达性,成功转换了 77% 的 R2R 轨迹(4475 条)。
- 模型架构:
- Seq2Seq Baseline: 使用 GRU 处理 RGB 和 Depth 观察的均值池化特征以及 LSTM 编码的指令
- Cross-Modal Attention Model: 采用双 GRU 架构,一个处理视觉观察,另一个基于注意力机制融合指令和视觉特征进行决策。使用预训练的 ResNet50 (ImageNet) 提取 RGB 特征,使用预训练的 ResNet50 (Point-Goal Navigation) 提取深度特征。
- 训练策略:
- 基础模仿学习 with inflection weighting
- DAgger 应对 exposure bias
- Progress Monitor 辅助损失
- Speaker 模型生成的合成数据增强(~150k 条轨迹)
核心结果/发现
-
任务难度显著增加:VLN-CE 中平均轨迹长度为 55.88 个动作,而 VLN 仅需 4-6 个节点跳转。最佳模型在 val-unseen 上达到 32% 成功率 (SR) 和 0.30 SPL,显著低于 VLN 中的表现。
-
深度信息至关重要:移除深度输入导致模型性能崩溃(成功率 ≤1%),而移除 RGB 或指令的影响相对较小。深度使智能体能够快速学会有效遍历环境(避免碰撞),是引导学习的关键信号。
-
训练技术的混合效果:Cross-Modal Attention 优于 Seq2Seq;DAgger 带来 3-5% SPL 提升;但 Progress Monitor 和数据增强单独使用时效果不佳,需要组合使用(预训练 + DAgger 微调)才能达到最佳性能。
-
导航图的强先验:将 VLN-CE 训练的智能体路径转换回导航图并在 VLN 测试集上评估,SPL 为 0.21,远低于利用导航图训练的 SOTA 方法(0.47 SPL)。这表明现有 VLN 结果可能因导航图的强先验而被高估。
-
单模态消融:无指令模型达到 17% SR,无图像模型也达到 17% SR,表明轨迹存在共同的规律性;但完整多模态模型(20% SR)仍明显优于单模态基线。
局限性
约 23% 的 R2R 轨迹无法在连续环境中导航(环境重建的不连续性、物体移动等)。当前端到端方法的绝对性能仍较低,未来需要探索模块化方法,如将学习到的智能体与运动控制器集成。论文未详细探索所有可能改善 VLN-CE 性能的技术(如更多应对 exposure bias 和数据稀疏性的方法)。
3. DUET (2022)
📄 Paper: arXiv:2202.11742 · 🏛️ CVPR 2022 · Code
精华
- 针对视觉语言导航(VLN)中“细尺度局部决策缺乏全局视角易困在局部”与“粗尺度地图决策缺乏细粒度物体基元”的矛盾,提出了双尺度拓扑图 Transformer 框架(DUET)。
- 在粗尺度拓扑地图上引入图感知自注意力机制(GASA),将图拓扑测地线距离显示注入 Transformer 注意力计算,高效规划全局航向与回溯节点。
- 提出粗/细尺度动态融合策略(Dynamic Fusion),基于当前状态自适应平衡全局探索与细粒度视觉/目标定位。
- 引入伪交互演示器(PID)解决行为克隆中的分布偏移(Exposure Bias),在 REVERIE、SOON 和 R2R 等数据集上实现 SOTA 导航与目标定位性能。
1. 研究背景/问题
在视觉与语言导航(VLN)任务中,智能体需要根据自然语言指令在未见的真实三维环境中导航到目标位置(如 REVERIE 任务中还需要定位特定物体)。传统方法主要面临两大瓶颈:
- 细尺度与粗尺度表示的天然矛盾:基于一步一预测的细尺度(fine-scale)局部方法只能感知当前视点周边的局域环境,缺乏全局地图表示,遇到死胡同或偏离路线时极难高效回溯;而现有的粗尺度(coarse-scale)拓扑地图方法虽然记录了历史轨迹与未探索边界节点,但由于映射抽象度高,缺失细粒度的视觉图像与目标物体特征,难以完成需精确定位具体物体的复杂指令。
- 训练中的分布偏移(Distribution Shift):纯行为克隆(Behavior Cloning)仅在专家示范路径上训练,推理阶段一旦偏离路线就会产生严重的累积误差。
针对上述难题,DUET 提出了联合粗尺度拓扑图与细尺度局部视点的双尺度 Transformer 架构,并利用图拓扑距离引导全局规划与伪交互演示算法进行策略学习。
2. 主要方法/创新点
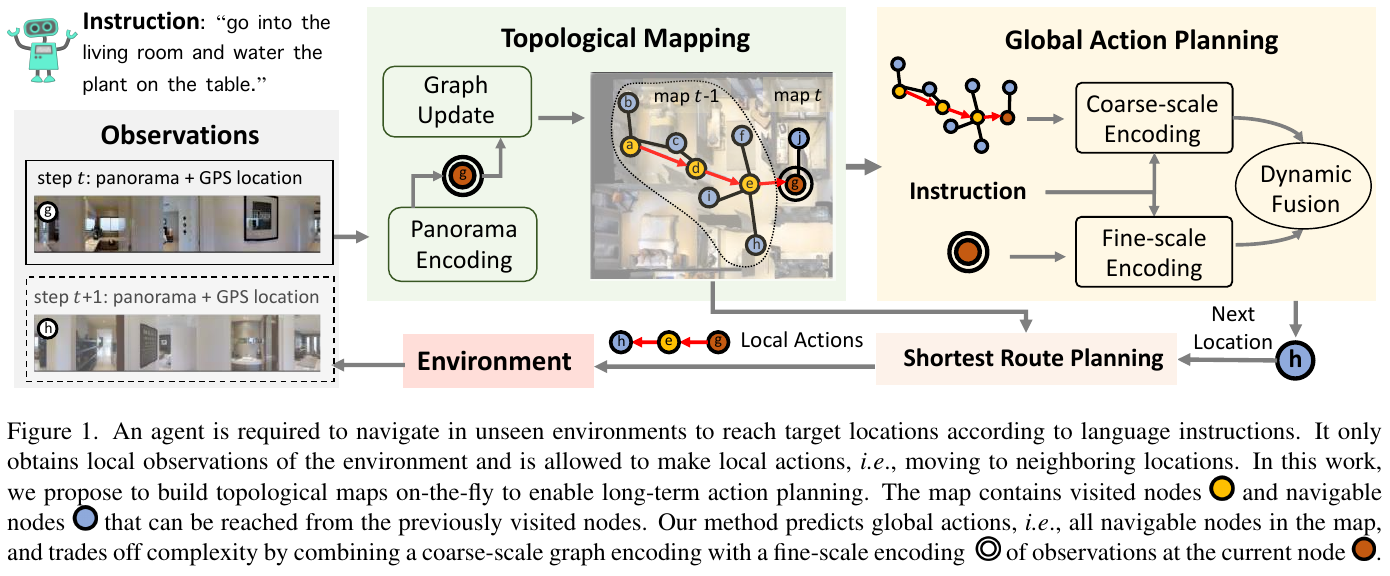
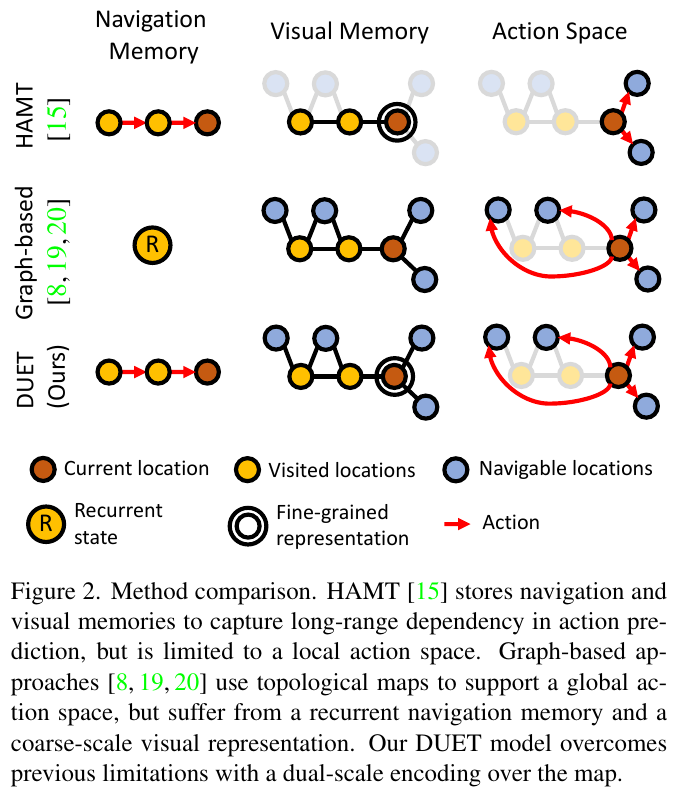
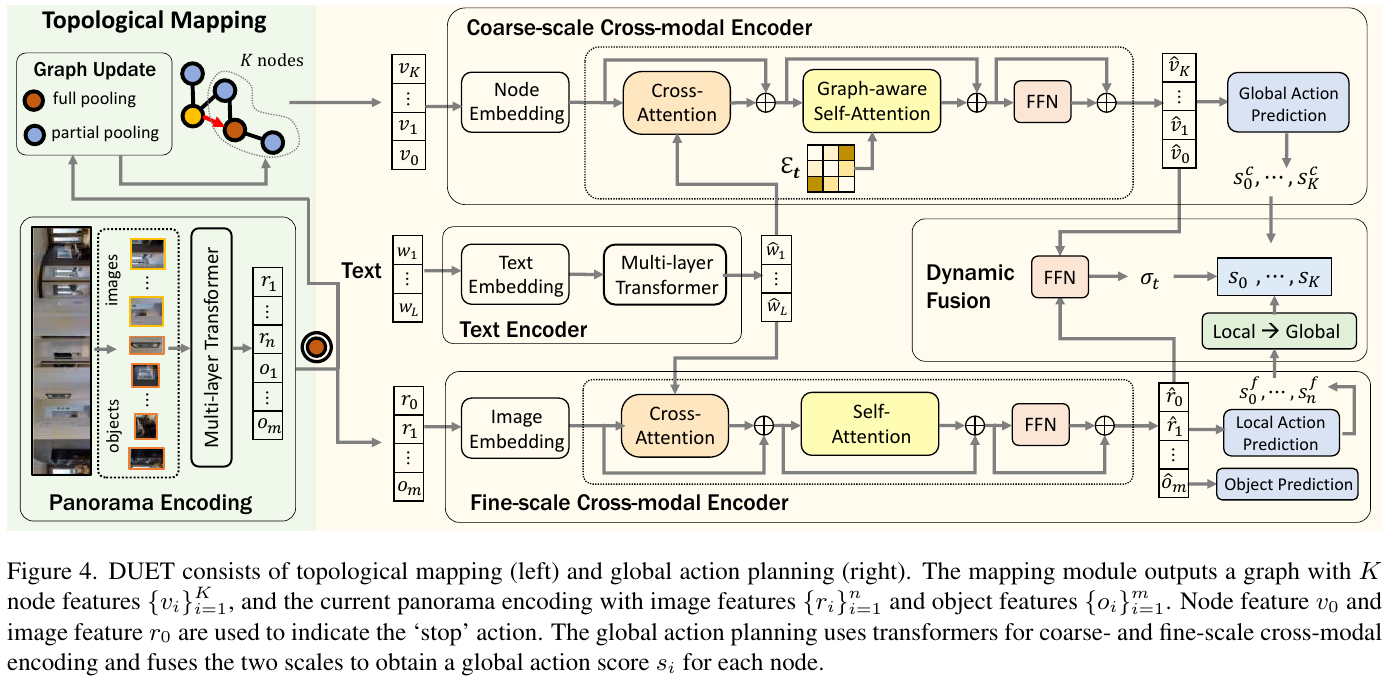
① 整体框架概述
DUET 架构由四大核心模块构成:
- 在线拓扑地图构建模块(Topological Mapping):增量式维护粗尺度拓扑图 \(G_t\) 和当前全景细尺度视觉/物体表征。
- 粗尺度跨模态编码器(Coarse-scale Cross-modal Encoder):利用图感知自注意力在全局拓扑图上推理探索与回溯候选节点。
- 细尺度跨模态编码器(Fine-scale Cross-modal Encoder):聚焦当前视点视线范围内的图像与物体,完成细粒度语言-视觉关联与目标定位。
- 动态融合预测模块(Dynamic Fusion):自适应融合全局与局部动作预测得分,输出全局动作空间上的下一步决策。
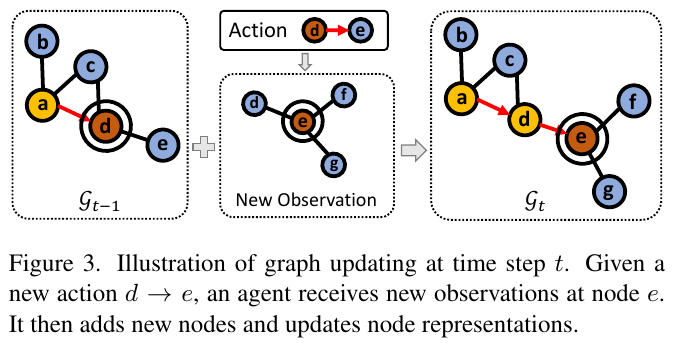
② 拓扑地图构建与图更新
在线拓扑图定义为 \(G_t = (V_t, E_t)\)。节点集合包含已访问节点(保存了历史全景特征与访问时间步 \(t\))与可导航的未探索边界节点(Frontier Nodes)。此外,在图中显式加入一个特殊的“停止”节点 \(v_0\),并与所有节点相连。
③ 粗尺度跨模态编码器与图感知自注意力(GASA)
粗尺度编码器接收拓扑图 \(G_t\) 和文本指令编码 \(\hat{W}\)。节点视觉特征结合了以自我为中心的相对位置编码(方位角、仰角和距离)以及最近访问时间步编码。
为了让 Transformer 能够感知图的拓扑空间结构,提出了图感知自注意力(Graph-Aware Self-Attention, GASA): \(\text{GASA}(X) = \text{Softmax}\left( \frac{X W_q (X W_k)^T}{\sqrt{d}} + M \right) X W_v\) 其中 \(M = E W_e + b_e\),\(E\) 为节点间的最短路径测地线距离矩阵,\(W_e, b_e\) 为可学习参数。粗尺度编码器为全局图中所有可导航边界节点和停止节点输出全局动作得分 \(s_i^c\)。
④ 细尺度跨模态编码器
细尺度编码器仅对当前视点 \(V_t\) 的全景图像块 \(R_t\) 和检测到的候选物体 \(O_t\) 进行交叉注意力编码,引入全局坐标与局部相对方位编码。输出当前视点局部邻近节点 \(N(V_t)\) 的局部动作得分 \(s_i^f\) 以及候选物体的预测定位得分。
⑤ 粗细尺度动态融合(Dynamic Fusion)
由于细尺度动作空间限制在局部邻居节点 \(N(V_t)\),无法直接与全局节点评分比对。DUET 将非邻居节点的细尺度得分统一映射为回溯得分 \(s_{\text{back}} = \sum_{v \in N(V_t)} s_v^f\),将其转换为全局动作空间下的评分 \(s_i'^f\)。
系统拼接粗尺度停止节点嵌入 \(\hat{v}_0\) 和细尺度停止节点嵌入 \(\hat{r}_0\),通过 FFN 计算自适应融合权重: \(\sigma_t = \text{Sigmoid}(\text{FFN}([\hat{v}_0; \hat{r}_0]))\) 最终各节点的选择概率评分为: \(s_i = \sigma_t s_i^c + (1 - \sigma_t) s_i'^f\)
⑥ 训练目标与伪交互演示器(PID)
- 预训练阶段:使用专家示范轨迹,联合优化单步动作预测损失 \(L_{\text{SAP}}\)、目标定位损失 \(L_{\text{OG}}\)、掩码语言建模 \(L_{\text{MLM}}\) 与掩码区域分类 \(L_{\text{MRC}}\): \(L_{\text{SAP}} = \sum_{t=1}^T -\log p(a_t^* \mid W, P_{<t}^*)\) \(L_{\text{OG}} = -\log p(o^* \mid W, P_T)\)
- 策略微调阶段(PID):在完整地图图结构已知的前提下,构造伪交互演示器(Pseudo Interactive Demonstrator, PID)\(\pi^*\)。在智能体自采样轨迹 \(P\) 上,PID 根据当前拓扑图计算到达终点的最短路径节点作为伪专家监督标签,通过 DAgger 范式微调策略: \(L_{\text{PID}} = \sum_{t=1}^T -\log p(a_t^{\pi^*} \mid W, P_{<t})\)
3. 核心结果/发现
DUET 在 REVERIE、SOON 和 R2R 三大视觉语言导航基准上均刷新了 SOTA 记录:
- REVERIE 远距离物体导航:
- 在 Val Unseen 分割上,成功率 SR 达到 46.98%,SPL 达到 33.73%,遥遥领先之前的 SOTA 模型 HAMT(SR 32.95%, SPL 30.20%)。
- 在 Test Unseen 分割上,SR 达到 52.51%、SPL 达到 36.06%,SR 相比 HAMT 提升了 22.11%。
- SOON 复杂目标导航:
- 在 Test Unseen 分割上,SR 达到 33.44%,SPL 达到 21.42%,显著优于传统的图搜索 baseline GBE(SR 12.90%, SPL 9.23%)。
- R2R 细粒度指令导航:
- 在 Val Unseen 和 Test Unseen 分割上的 SR 分别达到 72% 和 69%(领先 HAMT 6% 和 4%)。
- 消融实验关键结论:
- 单独粗尺度模型具备高探索能力(High OSR),但缺乏目标定位精度;单独细尺度模型容易陷于局部;双尺度动态融合(Dynamic Fusion)取得了最优的综合表现(SPL 提升 1.79%)。
- 引入 GASA 图拓扑距离显著优化了导航路径长度(SPL 提升)。
- PID 相比传统 RL 微调更高效地缓解了偏离轨迹时的分布偏移问题。
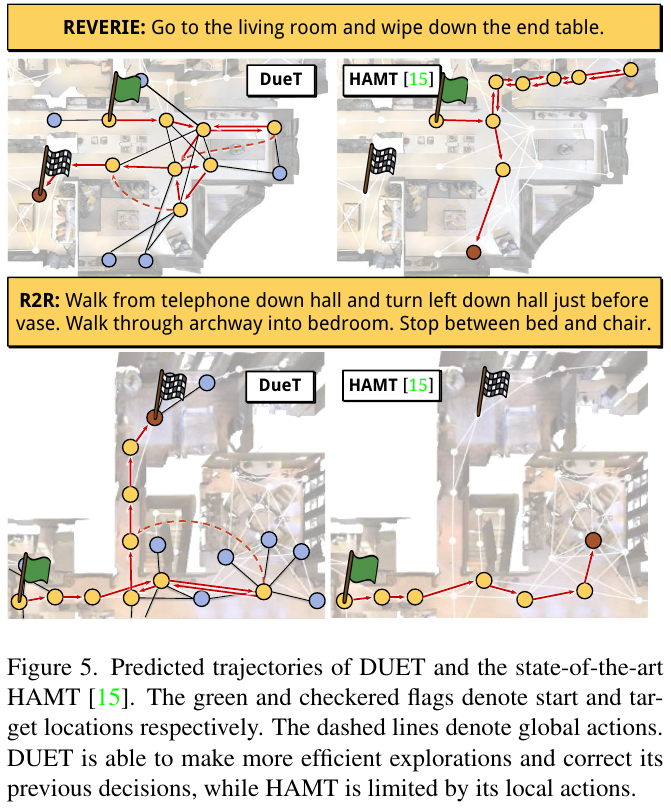
4. 局限性
- 未见环境泛化差距:在已见环境(Seen)与未见环境(Unseen)之间仍存在一定性能差距,提示模型对未见场景泛化能力仍有提升空间。
- 仅限于离散拓扑图:当前 DUET 依赖离散拓扑导航图(如 Matterport3D 模拟器中的离散节点与边),难以直接无缝迁移到连续无拓扑先验的真实物理机器人导航环境中。
- 隐私与安全考量:在真实室内部署时需考虑视觉采集与实时建图带来的隐私泄漏及碰撞安全风险。
4. NoMaD (2023)
——目标掩码扩散策略实现统一导航
📄 Paper: arXiv:2310.07896 · 🏛️ ICRA 2024
研究背景/问题
传统机器人导航系统通常为探索(exploration)和目标导航(goal-conditioned navigation)分别训练独立的策略模型,这不仅增加了系统复杂度,也限制了跨任务的知识共享和泛化能力。NoMaD(Nomadic Multi-task Agent with Diffusion,伯克利,ICRA2024 Best Paper)提出通过统一的扩散策略框架,使用目标掩码机制同时建模任务特定行为(目标导向)和任务无关行为(探索),实现单一策略胜任多种导航任务。
主要方法/创新点
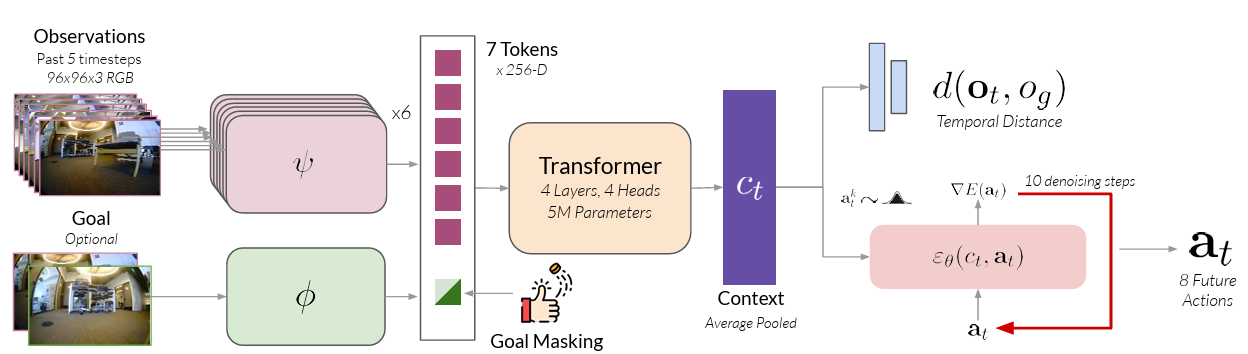
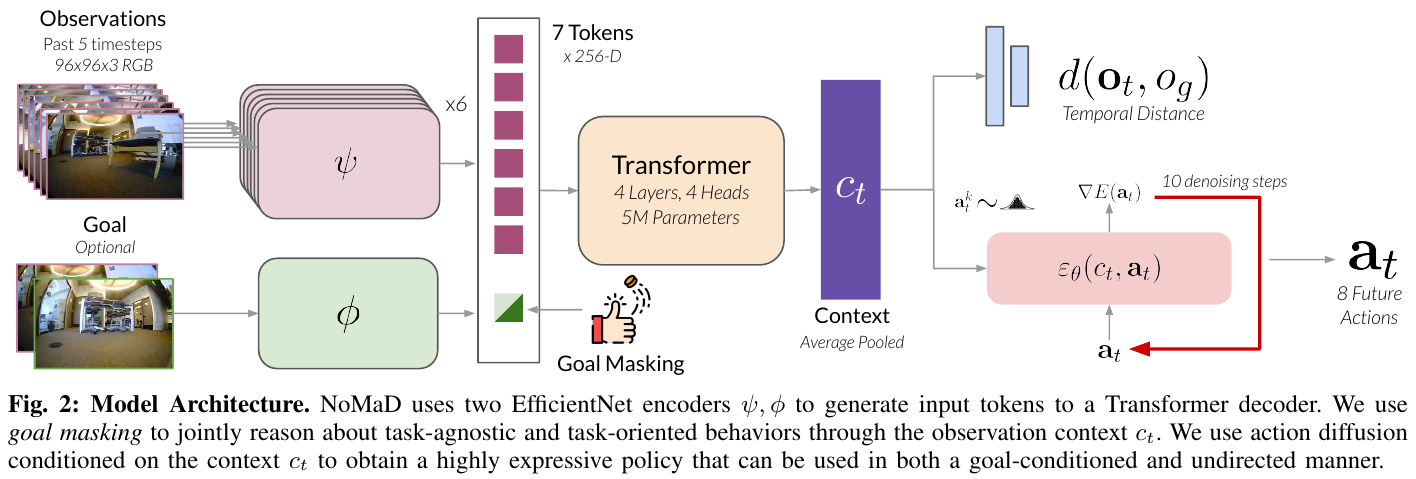
核心思路
通过统一的扩散策略,同时建模任务特定和任务无关行为
两个关键组件
目标掩码(Goal Masking)
- 通过二值掩码控制策略是否关注目标图像,实现任务条件的灵活切换
- 训练时:目标掩码以50%概率随机设置,使模型同时学习目标导向行为和探索行为
- 推理时:根据任务需要设置掩码(探索时掩盖目标,导航时提供目标)
扩散策略(Diffusion Policy)
- 利用扩散模型生成多模态、无碰撞的动作序列
- 从随机噪声逐步迭代生成预测动作序列
- 动作分布既可在无目标条件下表达探索行为,也可在提供目标条件下收敛到目标导向行为
统一框架设计
- 通过Transformer编码视觉观测并结合扩散模型生成未来动作序列
- 同时支持任务特定行为(目标导向)和任务无关行为(探索)
- 使用大规模多样化数据集(GNM和SACSoN)进行端到端监督训练
核心结果/发现
- 探索未知环境:成功率达到98%,平均碰撞数仅0.2,超过最优基线Subgoal Diffusion约25%,且参数量仅为其1/15
- 目标导航:在已知环境的目标导航任务中,成功率与最优基线相当,但计算资源需求更少
- 计算效率:比现有方法计算效率提升约15倍,是首个成功在物理机器人上部署的目标条件动作扩散模型
- 统一策略优势:联合训练能够学习共享表示和环境可操作性,单一策略即可胜任多种行为
- 编码器选择:ViNT编码器配合注意力目标掩码效果最佳,成功率98%,碰撞数最少
- 多场景验证:在6个复杂的室内外环境中表现优异
局限性
NoMaD的视觉编码器选择对性能影响较大,需要仔细调优以达到最佳效果。虽然ViT编码器具有更大的容量和表达能力,但其训练优化难度较高,收敛速度相对较慢。此外,目标掩码机制的随机采样比例(训练时50%)是一个关键超参数,在不同场景下可能需要针对性调整。尽管在多个室内外环境中表现优异,但在极端复杂、高度动态的场景(如密集人流、快速变化的障碍物)下的鲁棒性仍有进一步提升空间。
5. VLFM (2023)
——Vision-Language Frontier Maps for Zero-Shot Semantic Navigation
📄 Paper: arXiv:2312.03275 · 🏛️ ICRA 2024
研究背景/问题 零样本语义导航要求机器人在未见环境中高效定位目标对象,现有方法(如ESC、SemUtil)依赖物体检测器将视觉线索转化为文本后再用LLM/BERT进行语义推理,存在计算瓶颈且无法充分利用视觉-语言联合表征。如何直接从RGB观测中提取语义价值以指导前沿探索成为关键挑战。
主要方法/创新点
VLFM提出语言驱动的前沿价值图框架,实现端到端视觉-语义推理:
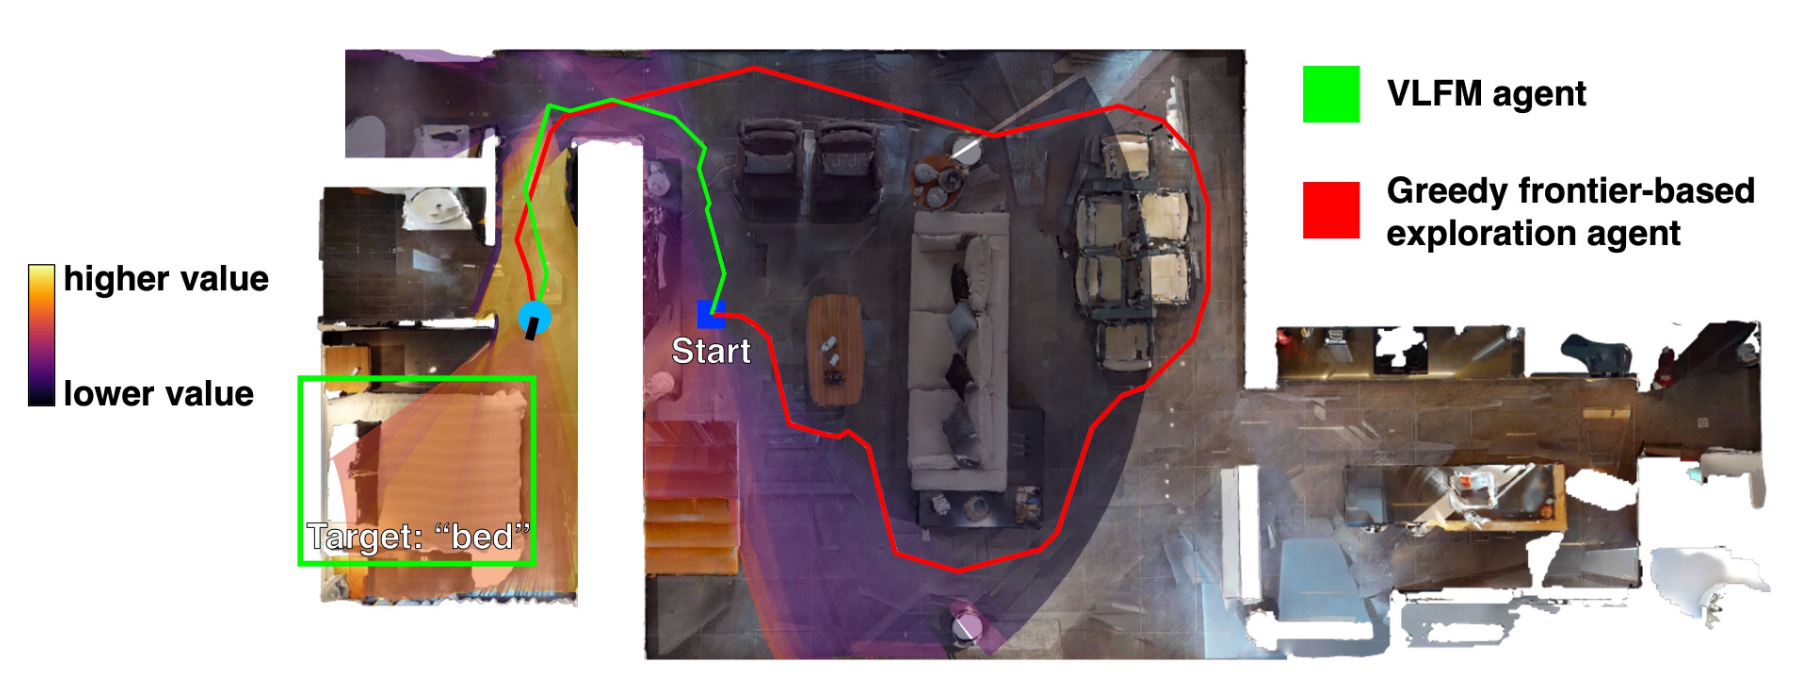
核心机制:
- 前沿航点生成(Frontier Waypoint Generation)
- 利用深度和里程计构建2D占用地图,识别已探索与未探索区域边界作为前沿候选点
- 每个前沿中点作为潜在导航航点
- 价值图生成(Value Map Generation)
- 使用预训练BLIP-2视觉-语言模型直接从RGB图像计算语义价值分数
- 文本提示:”Seems like there is a
ahead" - 输出余弦相似度分数并投影到俯视图价值图(双通道:语义分数+置信度分数)
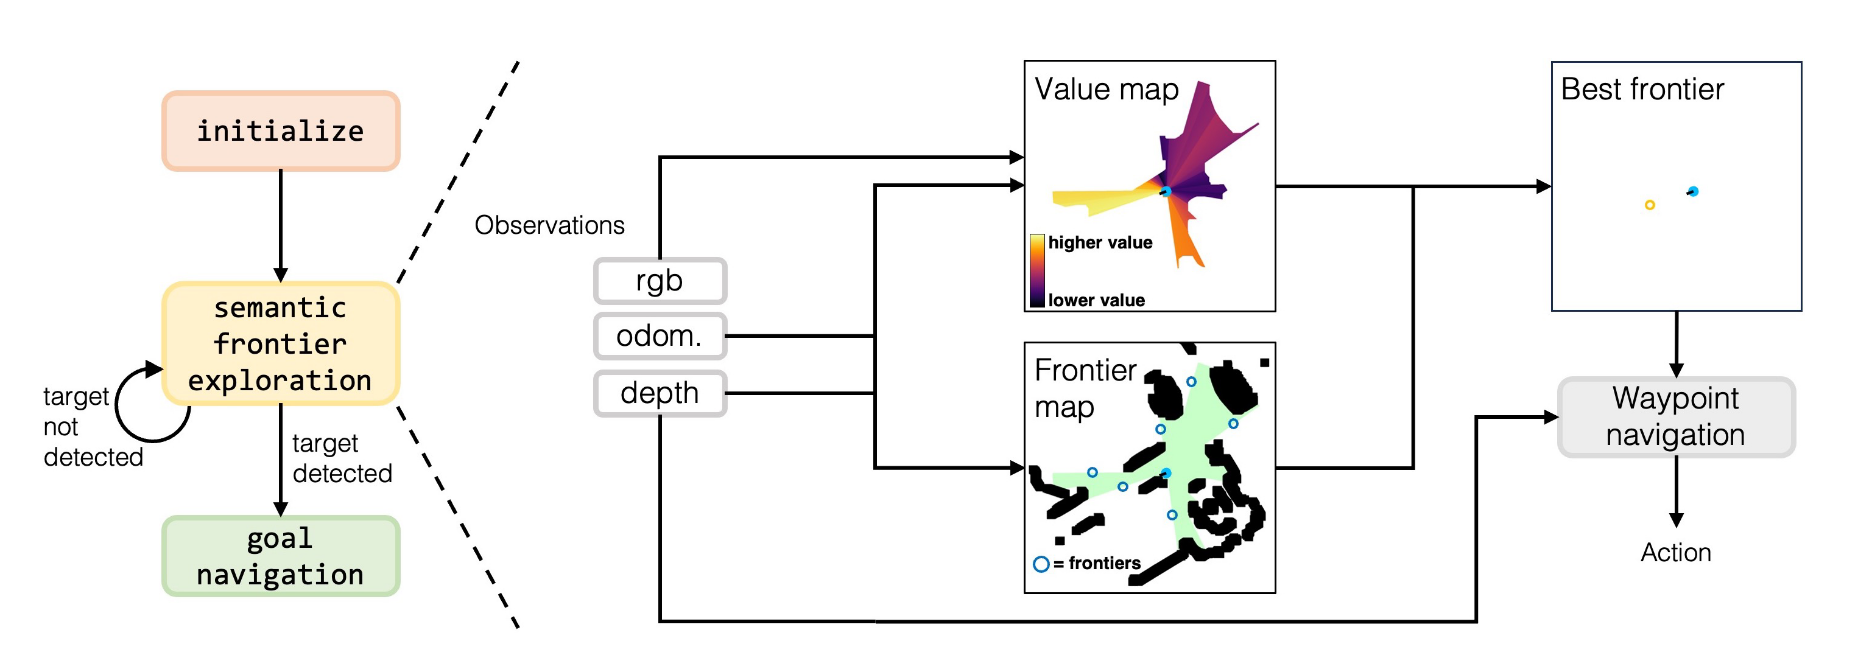
- 置信度加权更新(Confidence-Weighted Averaging)
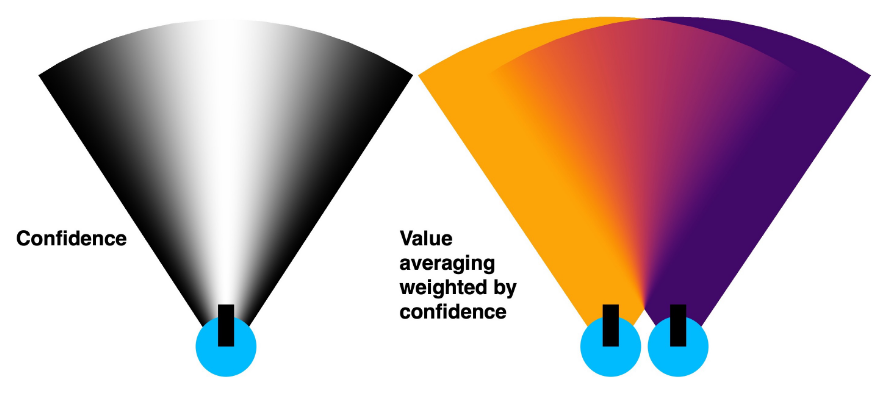
- 置信度分数基于像素相对光轴位置:$c_{i,j} = \cos^2(\theta/(\theta_{fov}/2) \times \pi/2)$
- 重叠区域的语义值更新:$v_{i,j}^{new} = (c_{i,j}^{curr}v_{i,j}^{curr} + c_{i,j}^{prev}v_{i,j}^{prev})/(c_{i,j}^{curr} + c_{i,j}^{prev})$
- 置信度更新偏向高置信值:$c_{i,j}^{new} = ((c_{i,j}^{curr})^2 + (c_{i,j}^{prev})^2)/(c_{i,j}^{curr} + c_{i,j}^{prev})$
- 物体检测与导航
- YOLOv7用于COCO类别,Grounding-DINO用于开放词汇检测
- Mobile-SAM提取目标轮廓,确定最近点作为目标航点
- 使用VER训练的PointNav策略执行航点导航(纯几何理解,不依赖语义)
关键创新:
- 直接视觉-语义推理:绕过物体检测器,BLIP-2直接从RGB生成语义分数
- 空间化价值表征:将语义价值映射到俯视图网格,支持前沿选择
- 置信度驱动融合:动态平衡当前观测与历史信息
核心结果/发现
- 基准测试表现:在Gibson、HM3D、MP3D三个数据集上均达到SOTA零样本性能
- Gibson:SPL 52.2%、SR 84.0%(相比SemUtil提升+11.7% SPL、+14.7% SR)
- HM3D:SPL 30.4%、SR 52.5%(相比ESC提升+8.1% SPL、+13.3% SR)
- MP3D:SPL 17.5%、SR 36.4%(相比ESC提升+3.3% SPL、+7.7% SR)
- 超越部分有监督方法:在Gibson和MP3D数据集上优于SemExp、PONI等ObjectNav训练方法
- 消融实验:置信度加权平均(Weighted avg.)在所有数据集上均优于简单替换(Replacement)和无权平均(Unweighted avg.)
- 真实世界部署:成功在Boston Dynamics Spot机器人上部署,在办公楼环境中高效导航至未见目标对象,所有模型(BLIP-2、GroundingDINO、MobileSAM、ZoeDepth)实时运行于RTX 4090 MaxQ笔记本
局限性 仅支持单层楼导航(缺少z坐标里程计导致价值图重置困难),HM3D和MP3D中14.6%和9.6%的跨楼层任务失败;假定目标物体在默认相机高度可见,未来可探索主动相机控制、操作式搜索(如打开抽屉)及可复用的语义地图表征以支持长时程多任务规划。
6. R2RIE-CE & IEDL (2024)
——— 首个连续导航指令错误基准测试,以及结合指令-轨迹兼容性的多模态错误检测与定位框架
📄 Paper: arXiv:2403.10700 · Project Page · 🏛️ ROMAN 2024
精华
- 指令容错新视角:首次指出现有 Vision-and-Language Navigation (VLN-CE) 研究默认指令完全正确的假设在现实中极易失效,人类常因记忆模糊或混淆给出带错指令。
- 基准测试构建:构建了首个包含指令错误的连续导航基准测试 R2RIE-CE,涵盖方向、房间、物体、复合及全错误五类扰动。
- 脆弱性验证:实验表明,指令中仅注入至多3个错误就会导致 SOTA 导航模型的 Success Rate (SR) 发生高达 25%–30.64% 的断崖式下跌。
- 定位与检测框架:提出 IEDL 框架,通过跨模态 Transformer 融合视觉轨迹与文本指令特征,实现高效的错误检测(AUC 0.79)与词级定位。
- 标注纠错价值:作为半自动数据清洗工具,成功在经典的 R2R-CE 和 RxR-CE 验证集中筛查出 8 个 and 10 个存在真值标注错误或歧义的路径样本。
1. 研究背景/问题
现有的视觉语言导航(VLN)方法均建立在“人类给出的指令是 100% 正确”的理想假设之上。然而在实际的人机交互中,由于人类记忆不精确、空间概念混淆(如左右不分)或认知障碍,给出的导航指令往往包含错误。
如果在这种情况下智能体盲目服从指令,会导致严重的导航失败。目前缺乏在连续三维环境(VLN-CE)下评估智能体对“错误指令”鲁棒性的基准测试。因此,本文提出了以下核心问题:
- 现有的 SOTA 导航模型在面对带有错误的人类指令时有多脆弱?
- 如何有效地检测输入指令中是否包含错误,并精确定位错误发生的单词位置,以便后续采取容错或澄清机制?
2. 主要方法/创新点
A. R2RIE-CE 基准测试构建
本文基于 R2R-CE 验证集(Val Unseen),通过人工引入具有常识先验和人类混淆特征的错误,构建了 R2RIE-CE (R2R with Instruction Errors in Continuous Environments) 基准测试。
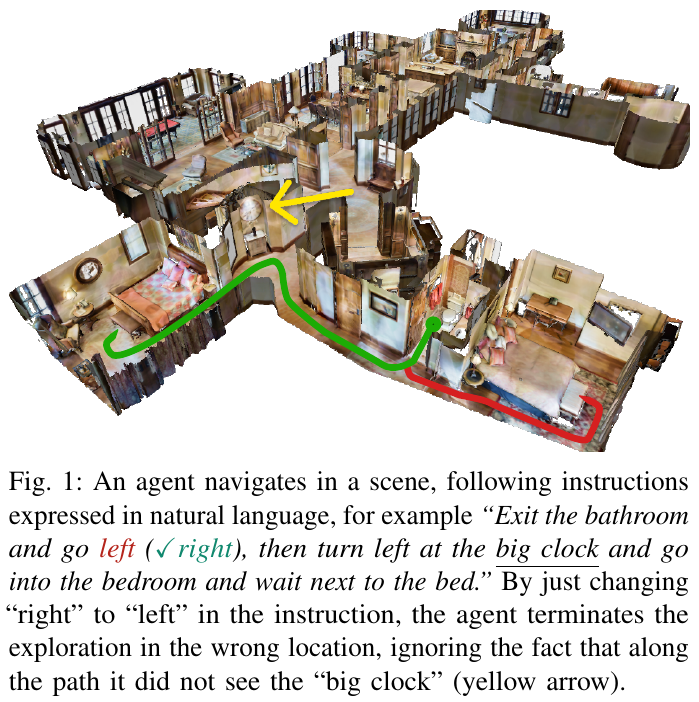
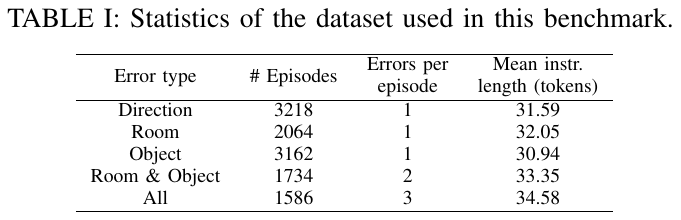
错误类型分为以下五类:
- Direction Error (方向错误):将高频方向词(如 left/right、go down/go up、forward/backward 等)替换为其反义词。
- Object Error (物体错误):考虑常识共现性,将指令中的物体词(如 sofa)随机替换为通常在同个房间共现的另一物体(如 chair)。
- Room Error (房间错误):根据房间邻接先验,将目标房间(如 bathroom)随机替换为相邻的房间类型(如 bedroom)。
- Room & Object Error (房间与物体双重错误):在指令中同时注入房间错误和物体错误。
- All Error (全类型错误):在指令中同时引入方向、房间和物体三类错误(平均每个样本包含3个错误)。
B. IEDL 错误检测与定位框架
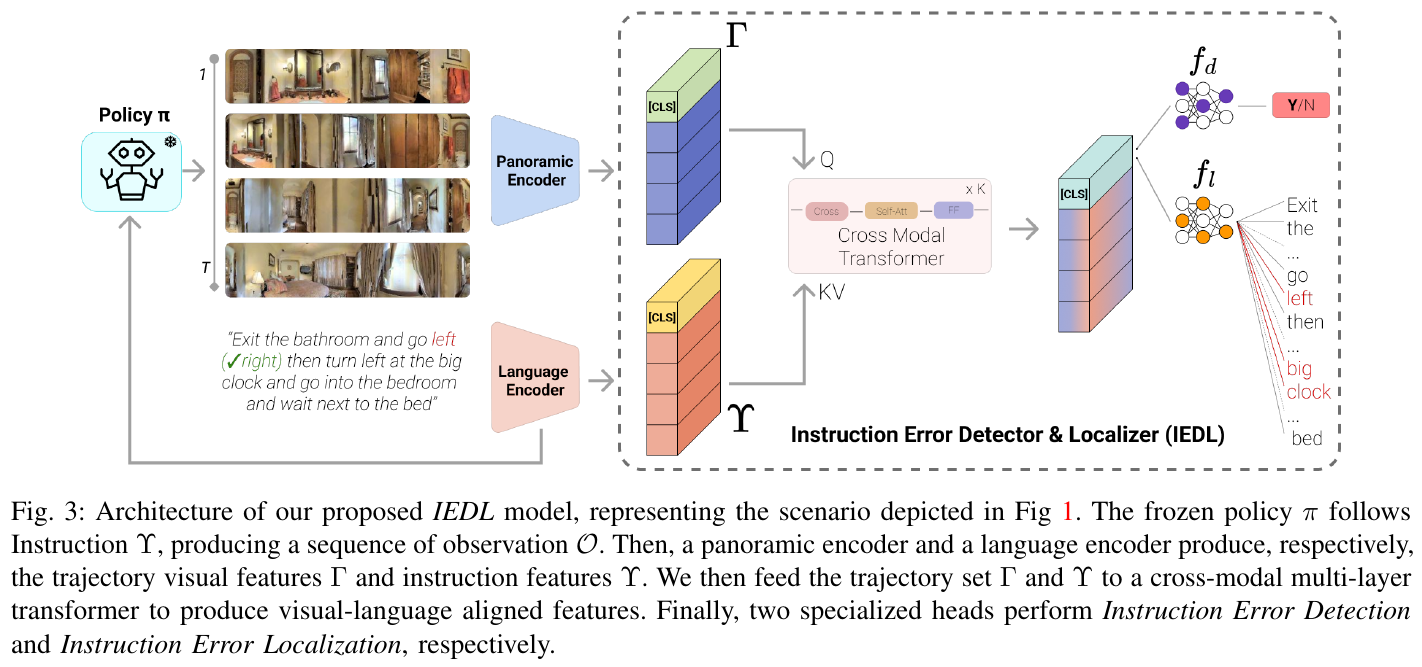
为了解决上述挑战,本文提出了 IEDL (Instruction Error Detector & Localizer) 框架。该框架是一个与底层导航策略解耦的模块,其核心思路是通过对比智能体执行导航后的“轨迹视觉特征”与“输入文本指令”的语义兼容性来捕捉不一致的错误。
-
整体框架概述: IEDL 模型由指令编码器、全景轨迹编码器、跨模态融合 Transformer,以及两个并行的分类预测头构成。它利用智能体的动作历史和视觉观测序列作为真值轨迹,去检验指令的语义是否与其吻合。
- 逐模块讲解:
- 指令编码器 (Language Encoder):接收包含 $W$ ($W=80$) 个词的自然语言指令 $\mathcal{I}$。利用分词与填充后,送入预训练的 BERT 模型提取其词嵌入特征 $\Upsilon \in \mathbb{R}^{W \times D}$。
- 轨迹编码器 (Trajectory Encoder):导航智能体基于某策略 $\pi$ 在环境中导航 $T$ 步,得到图像观测序列 $\mathcal{O} = {O_1, …, O_T}$。每个 $O_t$ 提取 ViT-B/16-CLIP 全景特征,再经过 Panoramic Encoder 进行时空建模,得到轨迹表示 $\Gamma = {V_1, …, V_T} \in \mathbb{R}^{T \times D}$。为了引入轨迹时序,对 $\Gamma$ 加入 sine/cosine 位置编码,并在其头部拼接一个可学习的
[CLS]embedding。 - 跨模态多层 Transformer (Cross-Modal Transformer):包含 $k$ ($k=4$) 个堆叠层。在每一层,轨迹特征 $\Gamma$ 作为 Query ($Q$),文本指令嵌入 $\Upsilon$ 作为 Key-Value ($KV$) 进行交叉注意力 (cross-attention) 计算,将视觉特征对齐到文本;接着用 Self-Attention 和 FFN 充分交互以融合多模态特征。
- 轨迹-指令匹配预测头 (Trajectory-Instruction Matching Head, $f_d$):输入融合后的
[CLS]token,通过一个多层感知机(MLP,由 $\mathbb{R}^D \to \mathbb{R}$)和 Sigmoid 函数输出匹配概率 \(d_{\pi} \in [0, 1]\),用以识别当前指令是否包含错误。 - 错误定位预测头 (Error Localization Head, $f_l$):输入融合后的文本 token 序列,利用独立的 MLP(由 $\mathbb{R}^D \to \mathbb{R}^W$)预测每一个 token 为错误词的概率,实现细粒度的错误词定位。
- 训练目标 / 损失函数: 采用多任务联合训练,损失函数由匹配分类损失 \(\mathcal{L}_d\)(采用二元交叉熵损失)与词级定位损失 \(\mathcal{L}_l\)(对指令中每个 token 计算标准交叉熵并求和)加权组成: \(\mathcal{L} = \lambda_1 \mathcal{L}_d + \frac{\lambda_2}{E} \sum_{i=1}^{E} \mathcal{L}_l\) 其中 $E$ 是指令中实际含有的错误词数量,$\lambda_1$ 和 $\lambda_2$ 为平衡权重参数(实验中均设为 1)。
3. 核心结果/发现
A. 现有导航模型在错误指令下的脆弱性
研究人员在 R2RIE-CE 基准上测试了六种主流 VLN-CE 模型(包括 BEVBert, ETPNav 等 SOTA 算法)。
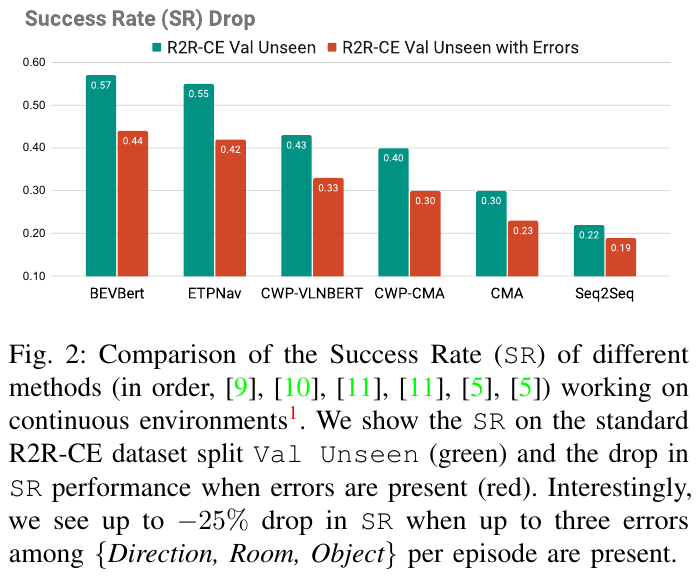
- 性能大跌:当指令中混入错误时,所有模型的 Success Rate (SR) 均有明显的断崖式下降。在 Room & Object 错误类型下,各模型表现平均下降约 11.47%;在包含所有错误的 All 模式下,SR 下降达到 30.64%。
- 错误类型敏感度差异:方向错误 (Direction) 对导航的负面影响最大,会导致 SR 平均相对大跌 18.64%。智能体对方向词(如 left/right)极度依赖,一旦方向写反,智能体会迅速走偏并提前终止。
B. IEDL 的检测与定位表现
作者将 IEDL 与 Random (随机预测) 和 CLIP Alignment (基于词组匹配的零样本对齐基准) 进行了比较:
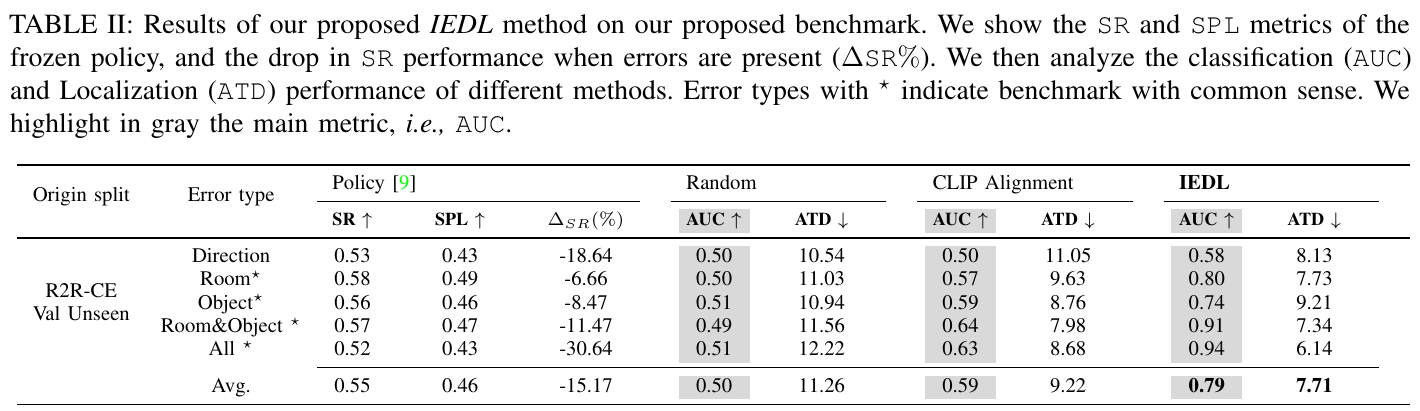
- SOTA 级的检测与定位:在所有类型下,IEDL 均显著优于基线模型。尤其在全类型错误 (All) 下,IEDL 的检测 AUC 达到了 0.94,平均定位距离 (ATD) 缩短至 6.14 个 token。
- 数据集纠错的实用价值:作者将训练好的 IEDL 应用于经典的 R2R-CE 和 RxR-CE 原始验证集,在分类置信度超过 0.99 的样本中,通过人工复核成功识别出 8个 R2R-CE 样本 和 10个 RxR-CE 样本 的地面真值(Ground-Truth)指令本身就存在明显的人类标注错误。
4. 局限性
- 离线检测限制:目前 IEDL 属于离线(Post-hoc)检测器,即必须等到智能体导航策略执行完毕、生成完整轨迹后才能进行错误检测。未来需要探索如何在导航执行过程中进行在线(Online)实时错误识别与纠偏。
- 纠错后的闭环策略缺失:论文主要聚焦于“检测”与“定位”错误,但未详细构建智能体发现错误后,如何主动向人类用户发起交互澄清或自主尝试重新规划路线的闭环控制策略。
7. NaVid (2024)
📄 Paper: arXiv:2402.15852 · 🏛️ RSS 2024 · Project Page · Code
精华
- 免地图与传感器噪声依赖的新范式:NaVid 是首个仅依赖单目 RGB 视频流、无需深度图、拓扑/度量地图或里程计输入的视觉语言导航(VLN)大模型,从根本上消除了里程计漂移与 Sim-to-Real 传感器鸿沟。
- 动态时空 Token 编码:基于 LLaMA-VID 架构,当前帧分配 64 个指令无关 token 以保留高分辨率几何结构,历史帧大幅压缩至 4 个 token,结合特殊标识符
<HIS>、<OBS>、<NAV>高效表征长时间序列上下文。 - 混合导航数据与指令推理协同训练:结合 320k Oracle 轨迹、180k Dagger 非 Oracle 探索轨迹与 10k 路径指令推理数据,并与 763k 大规模 Web 多模态数据联合微调,保持大模型泛化能力的同时注入机器人控制能力。
- 卓越的跨数据集与真实机器人部署表现:在 RxR 零样本迁移测试中,SPL 指标超越现有 SOTA 方法 236.5%(自 6.3% 提升至 21.2%);在真实场景实车测试中实现了 84% 的简单指令与 48% 的复杂指令导航成功率。
1. 研究背景/问题
连续环境视觉语言导航(VLN-CE)要求智能体在未知的真实物理世界中根据自然语言指令进行低层级动作控制。现有方法主要存在两大瓶颈:
- 传感器与地图依赖性:绝大多数传统及基于 LLM 的导航系统依赖拓扑/度量地图构建、深度相机点云或精确里程计姿态估计。在真实世界部署时,传感器噪声、点云缺失和里程计累计漂移会导致系统迅速失效。
- Sim-to-Real 跨域泛化差:仿真环境中的完美深度图与无误差定位在真实世界中难以复现,极大地阻碍了导航策略从仿真向实车的迁移。
NaVid 的核心动机在于模仿人类导航的本能——人类导航仅依靠眼前的单目视觉流和大脑中的历史记忆即可完成路径推理。因此,NaVid 探索纯单目 RGB 视频流驱动的 VLM 端到端导航范式。
2. 主要方法/创新点
① 整体框架概述
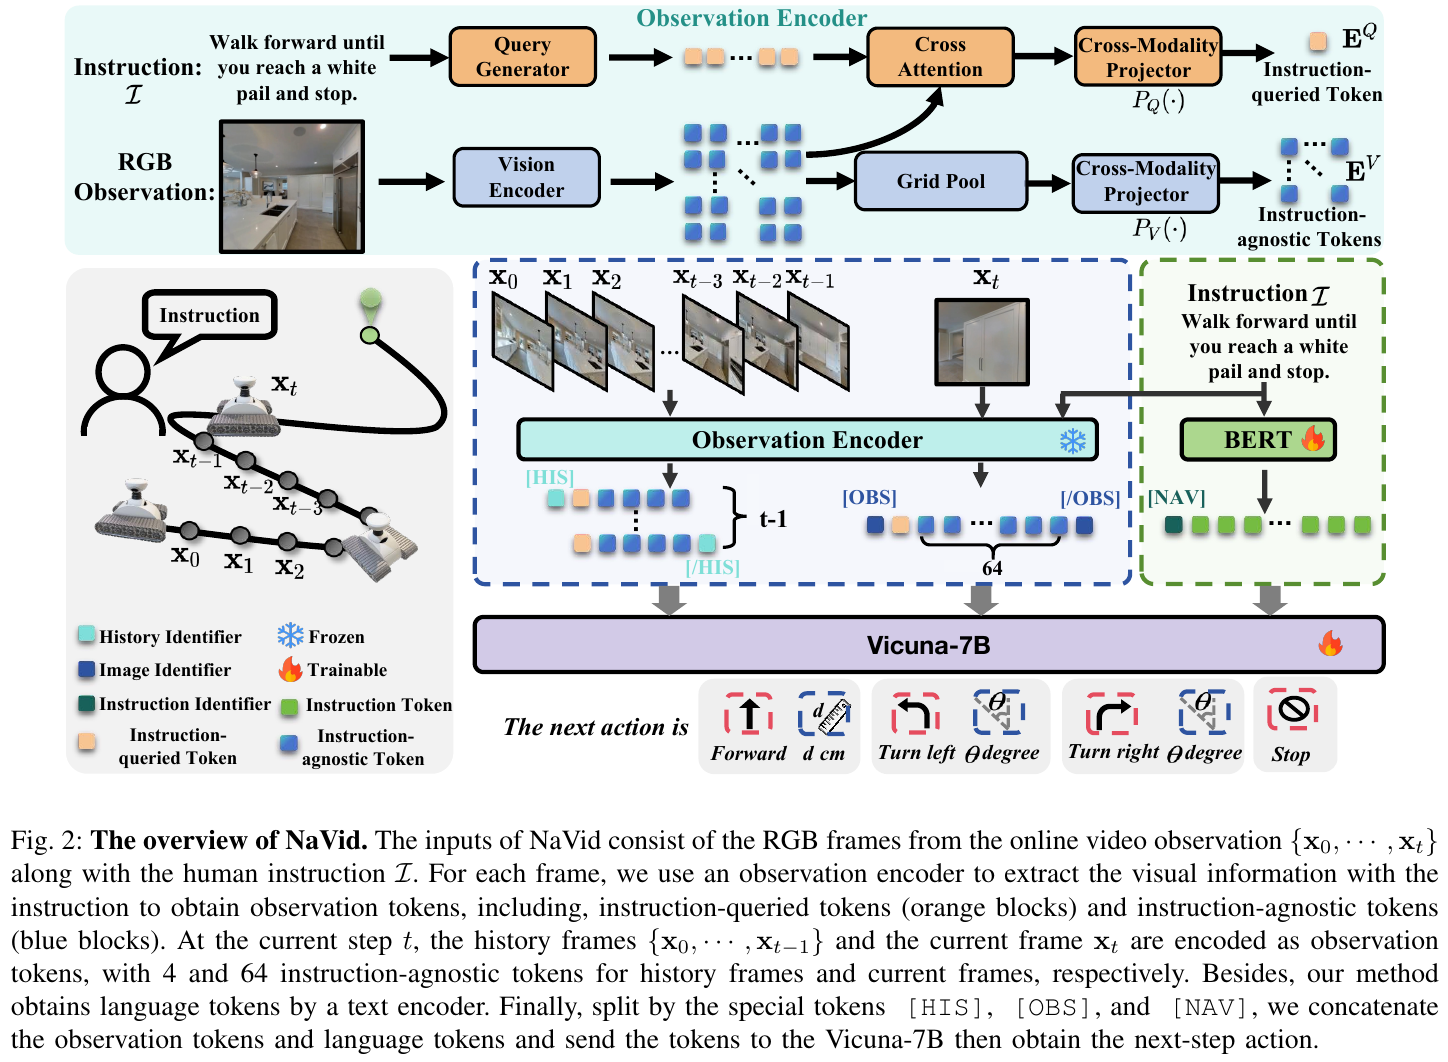
NaVid 建立在通用视频语言大模型 LLaMA-VID 框架之上,由视觉编码器(EVA-CLIP)、查询生成器(Q-Former-based Query Generator)、双模态投影器以及大语言模型骨干(LLM, 如 Vicuna-7B)组成。系统接收机器人的历史观察视频流与当前单目 RGB 图像,经过指令相关与指令无关的双路 Token 编码后,直接生成包含动作类型及定量参数(如前进距离、旋转角度)的文本动作指令。
② 逐模块讲解
- 视觉编码器与双路 Observation Token 编码
- 输入:从起始时刻 $0$ 到当前时刻 $t$ 的单目 RGB 视频帧序列 \(\mathcal{O}_t = \{x_0, x_1, \dots, x_t\}\)。每帧输入视觉编码器 EVA-CLIP 提取 patch 嵌入 $X_t \in \mathbb{R}^{N_x \times C}$(其中 $N_x = 256$)。
- 处理过程:
- 指令相关 Token(Instruction-Queried Tokens $E_t^Q$):利用 Q-Former 查询生成器 $G_Q$ 结合文本指令 $I$ 与图像特征 $X_t$ 生成指令感知 Query $Q_t$,通过 Cross-Attention 交叉注意力与均值池化(Pool)压缩为单 token 表达 $E_t^Q \in \mathbb{R}^{1 \times C}$。
- 指令无关 Token(Instruction-Agnostic Tokens $E_t^V$):对图像特征 $X_t$ 执行 Grid Pooling 网格池化,将 $N_x$ 个特征压缩为 $N_v$ 个几何 token。为了兼顾计算效率与空间几何保留,当前帧 $x_t$ 设置 $N_v = 64$,而历史帧 $x_{0..t-1}$ 大幅压缩至每帧 $N_v = 4$。
- 输出:当前帧与历史帧的多模态视觉 Token 序列。
- 设计动机:当前帧需要高密度的几何细节来预测精确的动作定量参数(移动距离/旋转角度),而历史帧主要提供时空轨迹上下文,低密度 Token 既减轻了大模型的长上下文负担,又保留了关键轨迹记忆。
- 特殊标识符与 Token 格式化(Special Token Formatting)
- 输入:历史帧 Token 序列、当前帧 Token 序列、语言指令 Token 序列。
- 处理过程:引入专用界定标识符
<HIS>/</HIS>(界定历史观察)、<OBS>/</OBS>(界定当前观察)以及<NAV>(触发导航动作预测)。 - 输出格式: \(\text{Input}: \text{<HIS>} \{\text{historical frames}\} \text{</HIS>} \text{<OBS>} \{\text{current frame}\} \text{</OBS>} \text{<NAV>} \{\text{instruction content}\}\) \(\text{Output}: \{\text{action reasoning \& text action}\}\)
- 设计动机:显式区分动作推理所需的不同模态与时空属性,引导 LLM 正确区分导航历史记忆与当前决策环境。
- 定量动作预测(Quantitative Action Planning)
- 输出格式:NaVid 采用离散动作类型 + 连续定量参数的文本组合输出,动作集合 $\mathcal{A} \in {\text{FORWARD}, \text{TURN-LEFT}, \text{TURN-RIGHT}, \text{STOP}}$。例如:
The next action is move forward 75 cm或turn left 30 degrees。 - 解析机制:推理阶段通过正则匹配解析器(Regular Expression Parser)直接提取动作类型与数值参数并发送至机器人底盘执行。
- 输出格式:NaVid 采用离散动作类型 + 连续定量参数的文本组合输出,动作集合 $\mathcal{A} \in {\text{FORWARD}, \text{TURN-LEFT}, \text{TURN-RIGHT}, \text{STOP}}$。例如:
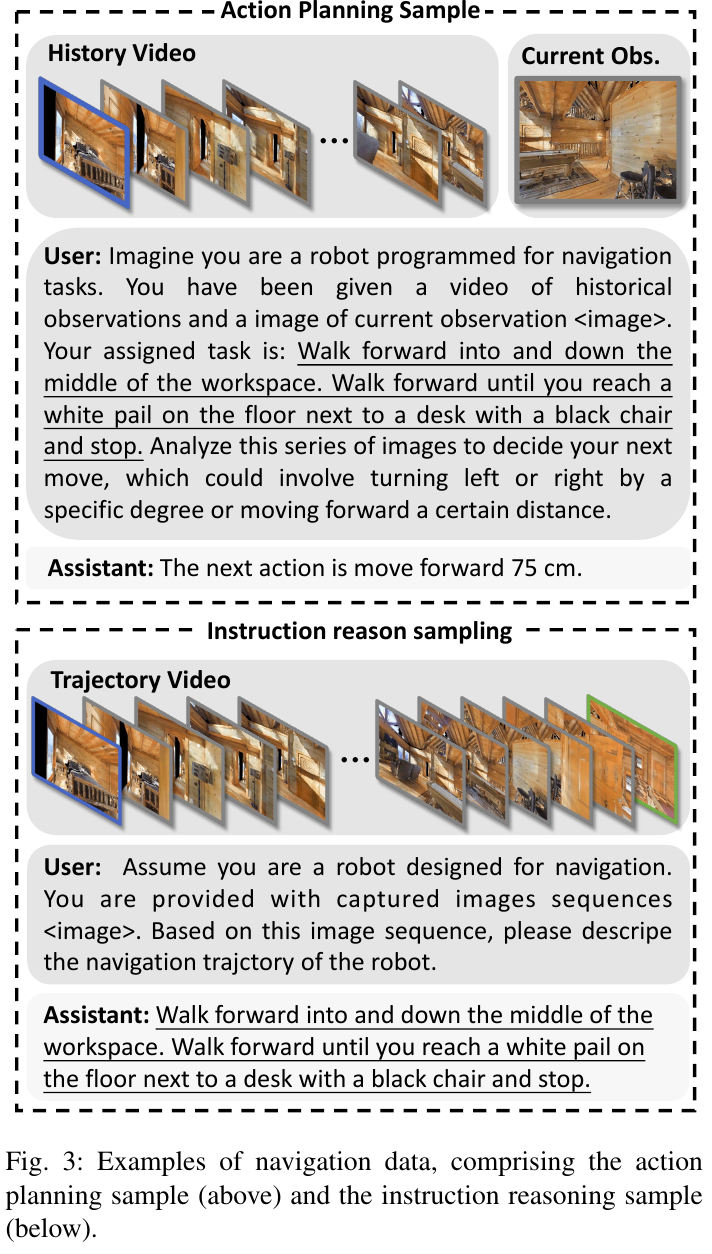
③ 混合训练策略与辅助任务(Hybrid Training Strategy)
- Non-Oracle 轨迹采集(Dagger-like Trajectory Collection):首先在 61 个 MP3D 室内场景中基于 Oracle 轨迹生成 320k 步骤样本;随后将初始模型部署到 VLN-CE 环境中,采集偏离正确路径的 180k 步骤非 Oracle 探索轨迹,大幅增强模型的自我纠错与鲁棒性。
- 多任务协同微调(Co-training of VLN-CE & Auxiliary Tasks):
- 动作规划(Action Planning):500k 步级导航动作预测样本。
- 指令推理(Instruction Reasoning):10k 路径反向描述样本,输入历史视频序列,要求模型反推对应的自然语言导航指令,增强图文对齐。
- Web 大规模数据预训练:融合 763k 来自 LLaMA-VID 的通用 Video-QA / Image-QA Web 数据,保持通用 VLM 的常识与推理能力,防止灾难性遗忘。
④ 训练目标 / 损失函数
NaVid 采用标准自回归交叉熵损失(Autoregressive Cross-Entropy Loss)进行端到端微调: \(\mathcal{L}_{CE} = -\sum_{i=1}^N \log P\left(y_i \mid y_{<i}, \mathbf{X}_{obs}, \mathbf{X}_{inst}\right)\) 其中 $y_i$ 表示输出文本序列(包含推理过程与定量动作命令)的第 $i$ 个 token,\(\mathbf{X}_{obs}\) 为编码后的视频观察 token,\(\mathbf{X}_{inst}\) 为指令 token。
⑤ 推理流程
在在线导航过程中,机器人单目 RGB 相机实时采集视频流。系统维护滑动观察缓冲区,抽取历史帧(每帧 4 token)与当前帧(64 token),拼接文本指令后送入 NaVid。大模型自回归解码输出动作文本,经正则解析器直接转化为底层控制命令(如前进 75cm),无需构建任何显式地图。
3. 核心结果/发现
- 仿真环境 SOTA 表现(VLN-CE R2R & RxR):
- 在 R2R Val-Unseen 验证集上,NaVid 取得 37.4% 的成功率(SR)与 35.9% 的路径长度加权成功率(SPL),显著超越现有的纯视觉与深度图基线。
- 在 RxR Val-Unseen 零样本跨数据集测试中(未在 RxR 上训练),NaVid 的 SR 达到 23.8%,SPL 达到 21.2%,相比此前 SOTA 方法 A2Nav(SR 16.8%, SPL 6.3%)在 SPL 上提升了 236.5%。
- 基座大模型对比(LLM Baseline Comparison):
- 在 100 个随机采样的 R2R Val-Unseen 子集测试中,未针对导航数据微调的 GPT-4V 仅达到 5.0% 的 SR,且频繁输出与动作无关的描述文本;而经过导航微调的 NaVid 成功率达到 38.0%(SPL 35.4%)。
- 历史轨迹表示消融(History Representation Ablation):
- 相比于纯文本历史描述(Text-based, SPL 0.0%)、俯视 2D 地图+文本(Map-text, SPL 8.97%)以及第一视角图像+文本(Ego-view-text, SPL 20.8%),NaVid 的纯 Video-based 视频流表征实现了最高的 SPL(35.9%),且推理延迟显著降低(无需频繁调用额外的 Captioning 模型)。
- 真实物理世界部署(Real-World Sim-to-Real Transfer):
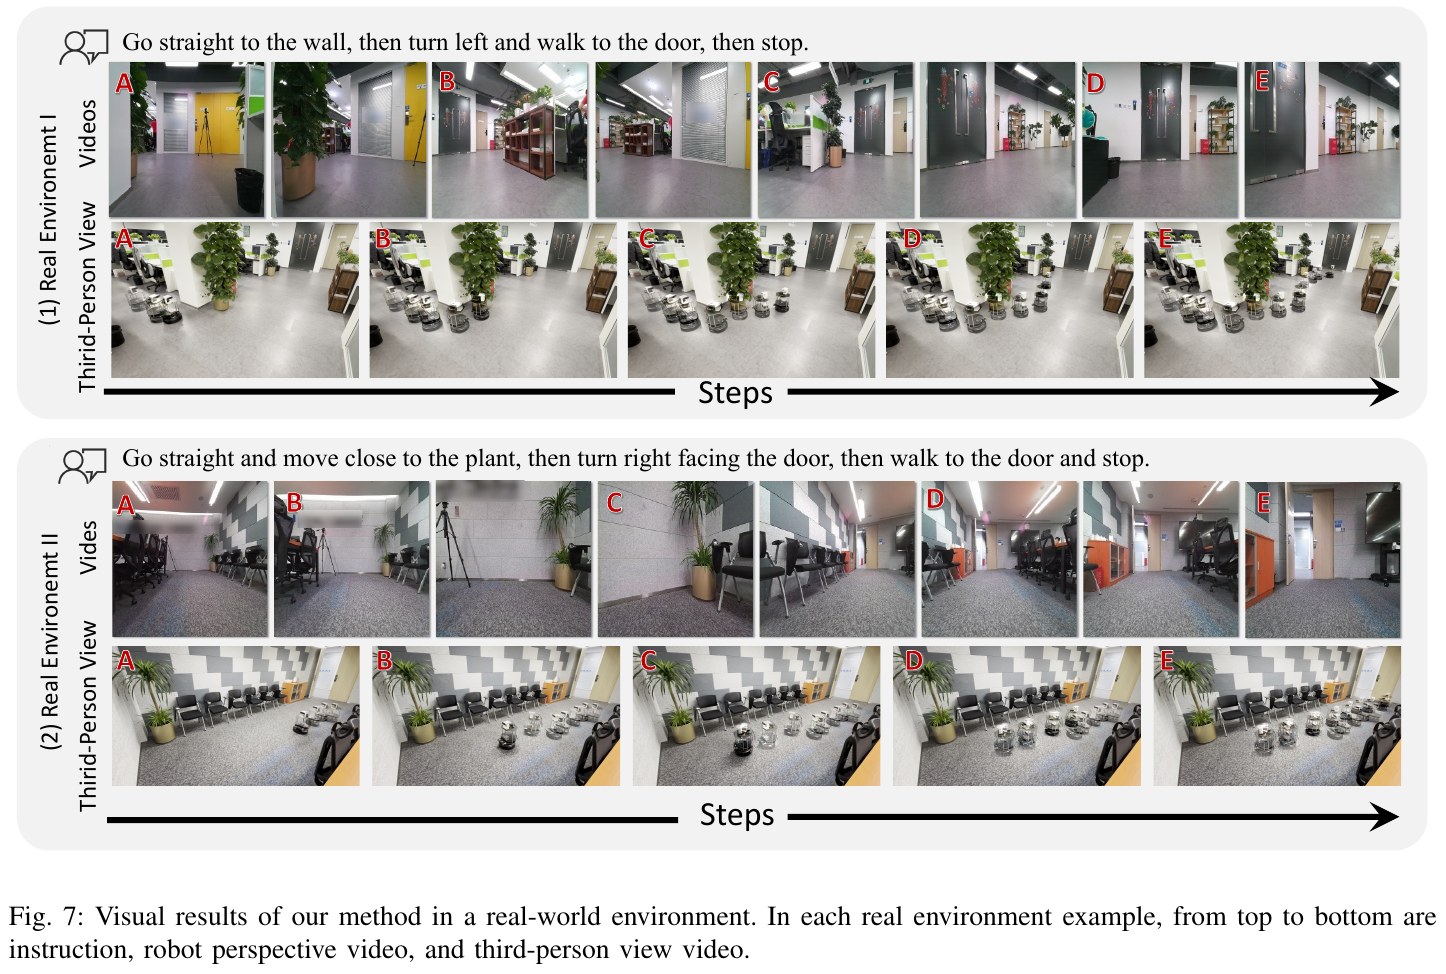
- 在会议室(Meeting Room)、办公室(Office)、实验室(Lab)和休息室(Lounge)四个真实物理场景下,NaVid 在简单指令上的平均完成率达到 84%,在需要避开混淆物(如类似椅子)的复杂多步指令上达到 48%,远超 Seq2Seq(0%)、CMA(2%)及基于语义地图的 WS-MGMap(20%-32%)。
4. 局限性
- 长距离导航计算开销:随着导航步数增加,历史视频帧数量积累会增加大模型上下文长度。虽然历史帧已压缩至 4 token/帧,但在上百步的长路径中仍会增加显存与推理耗时。
- 缺乏显式回溯能力:由于采用纯自回归文本动作预测且无显式拓扑/度量地图记录,智能体在陷入死胡同或误入歧途时,难以像显式建图方法那样进行精确的全局路径重规划(Re-planning)。
8. NavGPT-2 (2024)
——释放大型视觉语言模型的导航推理能力
📄 Paper: arXiv:2407.12366 · 🏛️ ECCV 2024
研究背景/问题
虽然有将LLMs集成到VLN任务的努力,但存在两个极端方法的局限:(1)零样本方法依赖复杂的提示工程,存在信息损失且性能差距大(约40% SR);(2)微调方法虽然使用大规模LLMs,但性能仍落后于VLN专用模型,且丧失了LLMs的语言能力和可解释性。研究目标是在保持LLMs解释能力的同时,消除LLM-based agents与SOTA VLN专用模型之间的性能差距。
主要方法/创新点
NavGPT-2采用冻结LLM + 导航策略网络的混合架构,分两阶段训练:
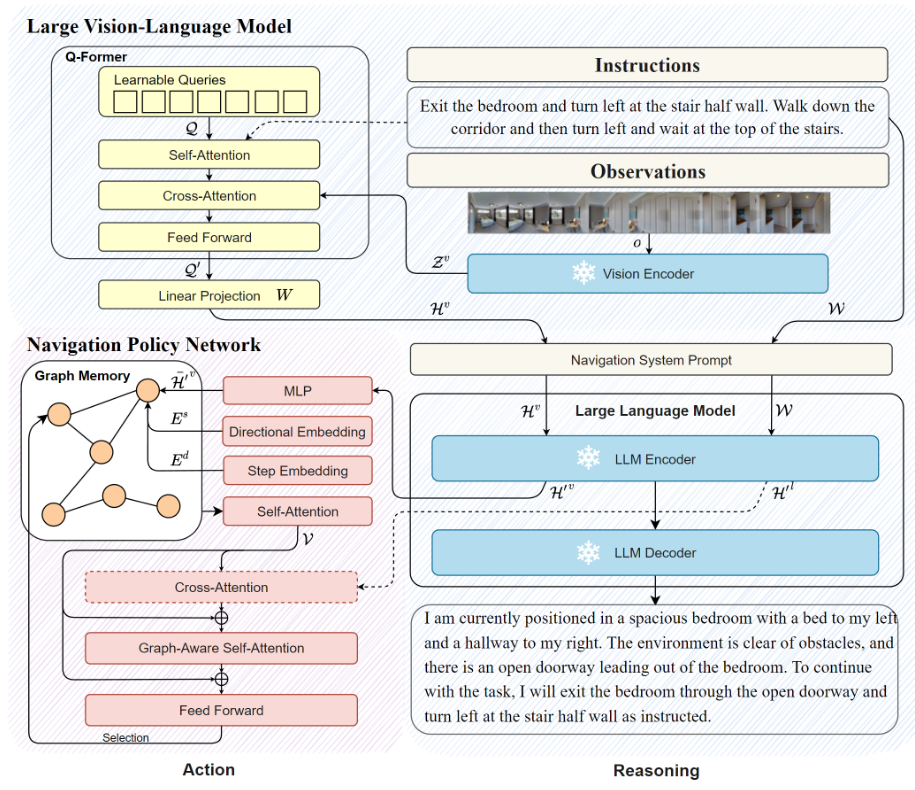
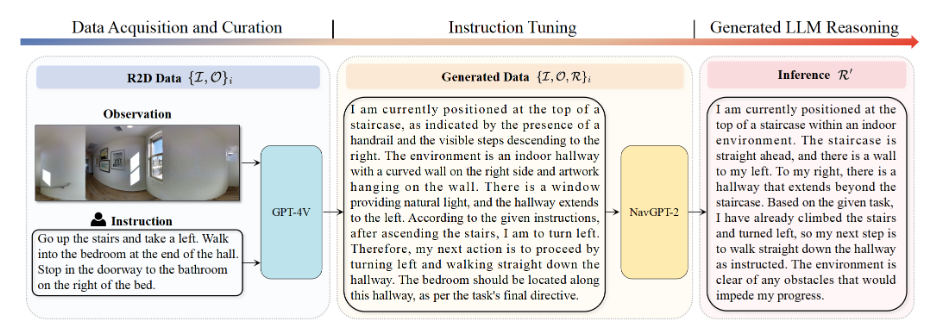
阶段一:视觉指令调优(Visual Instruction Tuning)
- 基于InstructBLIP架构,使用Q-former将多视图图像编码为固定长度的视觉tokens
- 使用GPT-4V自动生成10K导航推理数据
- 仅微调Q-former和投影层,保持LLM和视觉编码器(EVA-CLIP ViT-g/14)冻结
阶段二:图基础导航策略学习
- 提取LLM隐藏层表示作为视觉-语言表征
- 采用拓扑图导航策略网络(源自DUET),包含:
- 节点嵌入(Node Embedding):整合视觉特征、方向嵌入、步数嵌入
- 跨模态编码(Cross-Modal Encoding):图感知自注意力(GASA)机制
- 全局动作预测(Global Action Prediction):从整个构建的图中选择下一步
- 使用DAgger损失训练,保持VLM冻结
关键创新点:
- VLM隐表示作为视觉-语言表征:将视觉特征投影到LLM的语言空间,实现更强的跨环境对齐
- 数据高效:利用LLM预训练权重,在50%数据量下即可达到DUET全量数据的性能
- 保留语言能力:冻结LLM使其保持生成导航推理和与人类交互的能力
核心结果/发现
在R2R数据集上的性能(NavGPT-2FlanT5-XXL, 5B参数):
| Split | SR | SPL | NE | OSR |
|---|---|---|---|---|
| Val Unseen | 71% | 60% | 3.18 | 80% |
| Test Unseen | 72% | 60% | 3.33 | 80% |
主要发现:
- 消除性能差距:在相同训练规模下,超越所有LLM-based方法,与DUET(SOTA VLN专用模型)性能相当
- 数据效率:使用50% R2R数据即可达到DUET使用全量数据的性能
- 泛化能力:
- RxR数据集(细粒度指令):SR提升3.67%
- HM3D数据集(未见环境):SR提升21.6%(47.2% vs 25.6%)
- 可解释性:能够生成描述周围环境、识别导航进度、规划下一步的自然语言推理
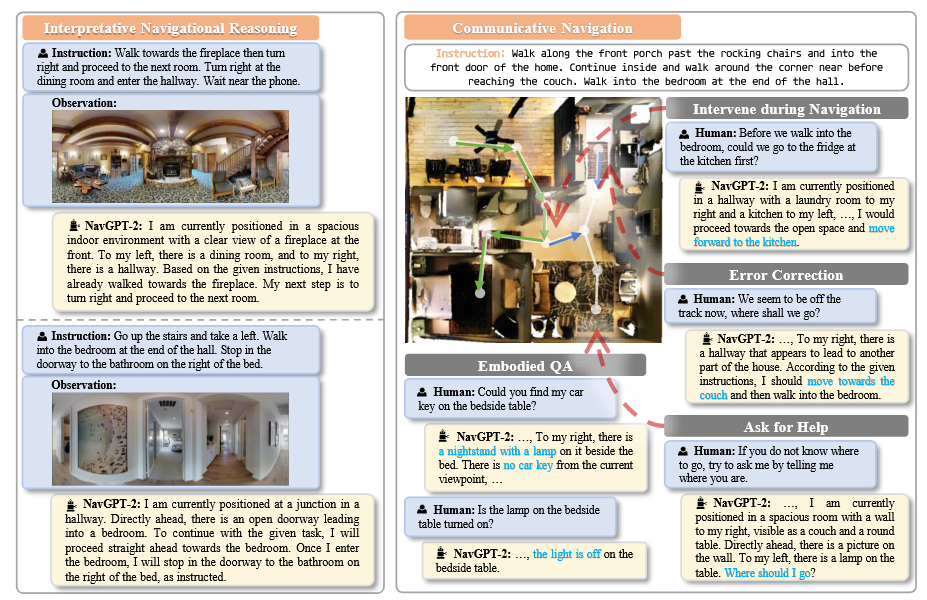
消融实验表明:
- 移除导航策略网络后性能大幅下降(SR从68%降至21%)
- FlanT5系列模型优于Vicuna系列(编码器-解码器架构优于纯解码器架构)
- 更强的视觉编码器对性能提升有限,主要增益来自LLM隐表示
局限性
(1)导航推理基于局部观察,未在VLM中建模历史,一致性有待提高;(2)推理与动作预测未严格同步;(3)存在幻觉问题(识别不存在的物体或误判方向);(4)交互能力未经充分评估。未来工作应聚焦于推理-动作同步机制、历史建模以及交互导航能力的开发。
系列对比总结
| 维度 | NavGPT (AAAI-2024) | NavGPT-2 (ECCV-2024) |
|---|---|---|
| 核心思路 | 纯LLM零样本导航 | 冻结LLM + 微调导航策略 |
| 训练方式 | 无需训练(零样本) | 两阶段训练(VLM微调+策略学习) |
| 性能(R2R SR) | 34% | 72% (test unseen) |
| 推理能力 | 显式,基于提示工程 | 显式,基于指令调优 |
| 主要贡献 | 揭示LLM导航推理能力 | 消除LLM-agent与SOTA的性能差距 |
| 局限 | 性能差距大,信息损失严重 | 推理-动作同步不足,存在幻觉 |
两篇工作共同展示了LLMs在具身导航中的巨大潜力,从探索性的零样本方法发展到实用的混合架构,为构建可解释、可交互的通用导航智能体指明了方向。
9. DualVLN/InternVLN (2025)
——Ground Slow, Move Fast: 具备快慢双系统的端到端连续具身导航大模型
📄 Paper: arXiv:2512.08186 · 🏛️ ICLR 2026 · 💻 Code & Models: InternRobotics/InternNav
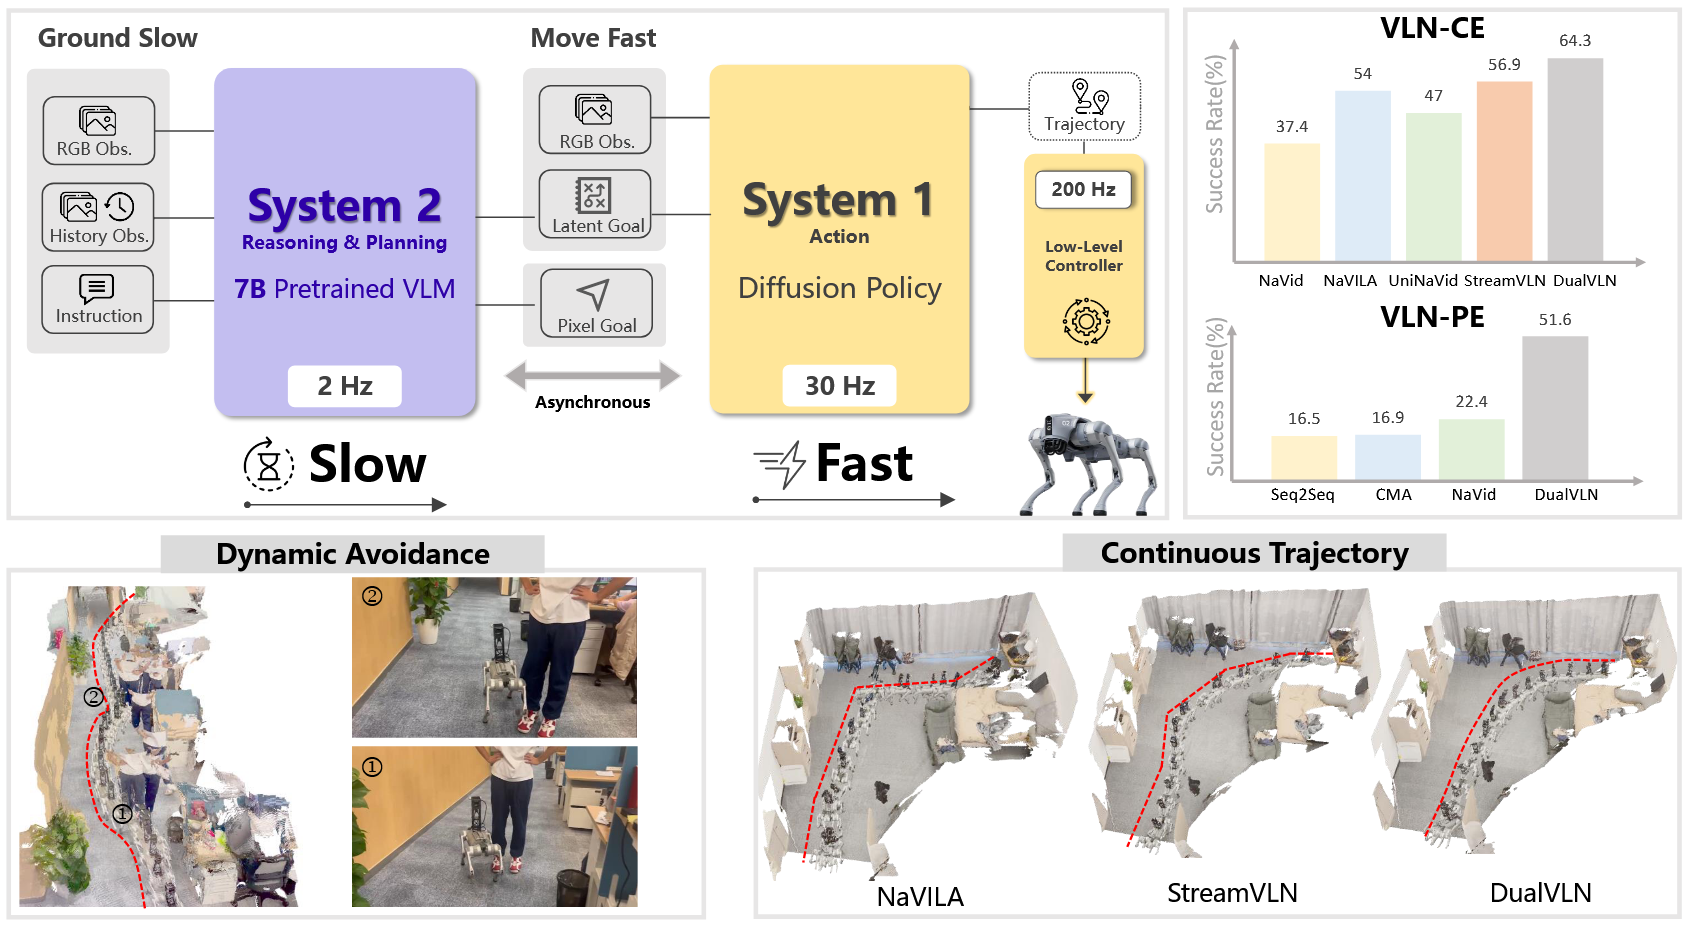
一句话概括:DualVLN(上海人工智能实验室 InternNav 团队)首创具身导航领域的快慢双系统(Dual-System)基础模型。将“慢思考”的高层 VLM 规划器(System 2,~2Hz,Qwen-VL)与“快反应”的轻量扩散 Transformer 策略(System 1,30Hz,DiT)进行物理级解耦,通过“显式像素目标 + 隐式语义潜在表征”协同衔接,以纯单目 RGB 在 VLN-CE(64.3% SR)与 RxR(61.4% SR)双双登顶,并零样本跨具身部署至轮式、四足(Go2)与人形(G1)真实机器人。
精华
- 快慢双系统物理级解耦:借鉴认知科学的“双过程理论(Dual-Process Theory)”,将高层多模态语义推理(2Hz 全局规划)与底层高频连续运动控制(30Hz 轨迹生成)解耦,从根本上终结了传统端到端 VLA“步步问大模型”造成的严重运动碎片化与高延迟卡顿。
- “显式几何像素点 + 隐式语义 Latent”双重桥梁:System 2 不仅自回归输出当前视角下最远可见路径点的 2D 像素坐标(显式引导,保障可解释性),还通过 4 个可学习的
<TRAJ>查询向量从 VLM 最后一层提取富含任务上下文的潜在表征(隐式特征,保障抗扰与动态适应),两者互补使 System 1 能够忠实生成平滑轨迹。 - 渐进式两阶段解耦训练范式(Progressive Two-Stage Decoupled Training):Stage 1 全量微调 Qwen-VL-2.5(统一学习视角微调、像素点定位与 STOP 判停,结合 67% 导航 + 33% 通用多模态数据保全泛化);Stage 2 冻结 VLM,仅端到端训练轻量潜在查询与 DiT 策略(Flow Matching 监督)。底层策略收敛极快,仅需 10% 轨迹数据即可达到性能上限。
- 全异步多速率高频闭环:System 2(2Hz,利用 KV Cache 复用压至 0.7s/次)负责选定航向与像素落脚点;System 1(30Hz,TensorRT 加速仅需 30ms)基于最新双时步 RGB 实时生成 32 步无碰撞世界坐标轨迹;底层 MPC(200Hz)实现超高频电机控制,具备毫秒级动态避障响应。
- 全基准 SOTA 与多形态真实部署:在仿真基准 VLN-CE(R2R SR 64.3%)、多语言 RxR(SR 61.4%)创下纯单目 RGB 最优表现;在物理仿真基准 VLN-PE 上展现 51.6% 的强悍零样本跨越能力;并引入首个动态行人交互基准 Social-VLN,在轮式、四足、人形真实机器人上完成了无场景特定微调的通用落地。
1. 研究背景与核心矛盾
在连续环境视觉语言导航(VLN-CE)中,智能体既需要理解复杂长程指令、在三维人居场景中识别拓扑地标,又必须与真实的连续物理世界高频交互并避开动态障碍物。然而,现有的端到端方法面临难以调和的三大瓶颈:
- 动作碎片化(Action Fragmentation):现有 VLA 模型(如 NaVid、StreamVLN)倾向于每走一步都调用一次大模型,输出离散的“原子短动作”(如“前进 0.25m”、“左转 15°”),导致机器人频繁出现“停顿—思考—急转—再停顿”的顿挫行为,无法形成流畅平滑的运动轨迹。
- 感知-动作响应高延迟(High Control Latency):7B 级以上的视觉语言大模型(VLM)单次自回归生成耗时通常在 0.5s~1.2s 以上,根本无法满足动态场景下 20~30Hz 的高频闭环控制需求。一旦环境中出现行走的行人或突发障碍,大模型往往来不及反应便发生碰撞。
- 高低层任务耦合与语义退化(Coupling Dilemma):如果强行把高层语义理解、全局规划与底层局部避障揉进单个端到端网络,底层避障的细粒度几何调整往往会破坏高层长程指令的语义对齐;而单纯追求语义则牺牲了局部轨迹的几何平滑度。
为打破这一死结,DualVLN 提出了 “Ground Slow, Move Fast” 的双系统范式:让大模型专注于低频的宏观语义解构与视觉落脚点(慢思考),让轻量扩散模型专注于高频的局部避障与平滑轨迹生成(快行动)。
2. 核心架构与双系统协同机制
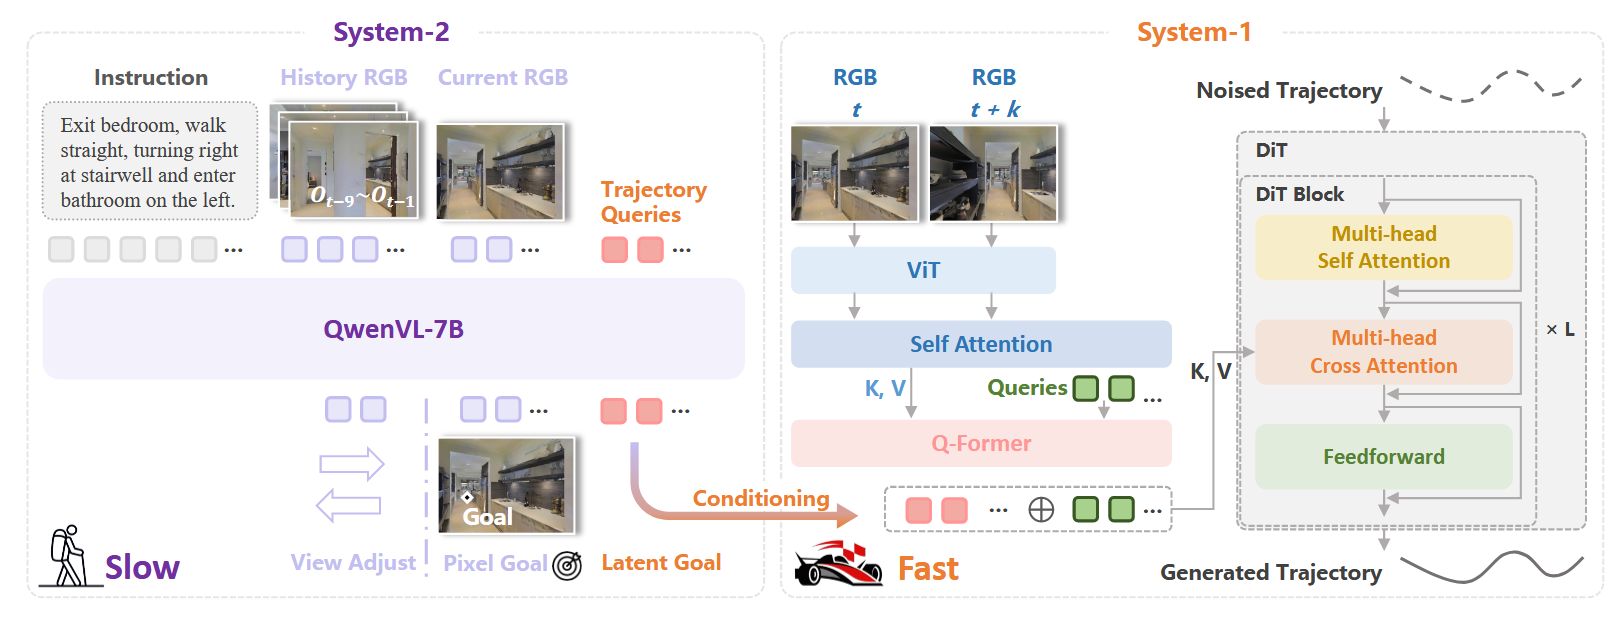
① 系统 2(System 2 - Ground Slow):慢思考的高层全局规划器
- 核心定位:基于 Qwen-VL-2.5-7B 构建的高层规划器,以约 2 Hz(每 0.5 秒)的频率异步运行。它接收自然语言指令、历史时序视觉观测序列以及当前单目 RGB 画面,输出导航意图。
- 三类统一建模的自回归输出:System 2 在统一的多轮对话序列中自回归预测三种行为,由模型自主决断当前应当“转向观察”、“给出导航路标”还是“终止任务”:
| 输出类型 | 触发条件 | 监督与执行机制 |
|---|---|---|
| 视角调整(View Adjustment) | 预期未来轨迹落入当前相机视场(FOV)之外(如遇到直角急转弯或原地调头) | 自回归输出离散转向动作序列(Turn Left/Right 15°、Look Up/Down 15°),每个分块(Action Chunk)最多包含 4 个连续转向(单次最多转动 60°) |
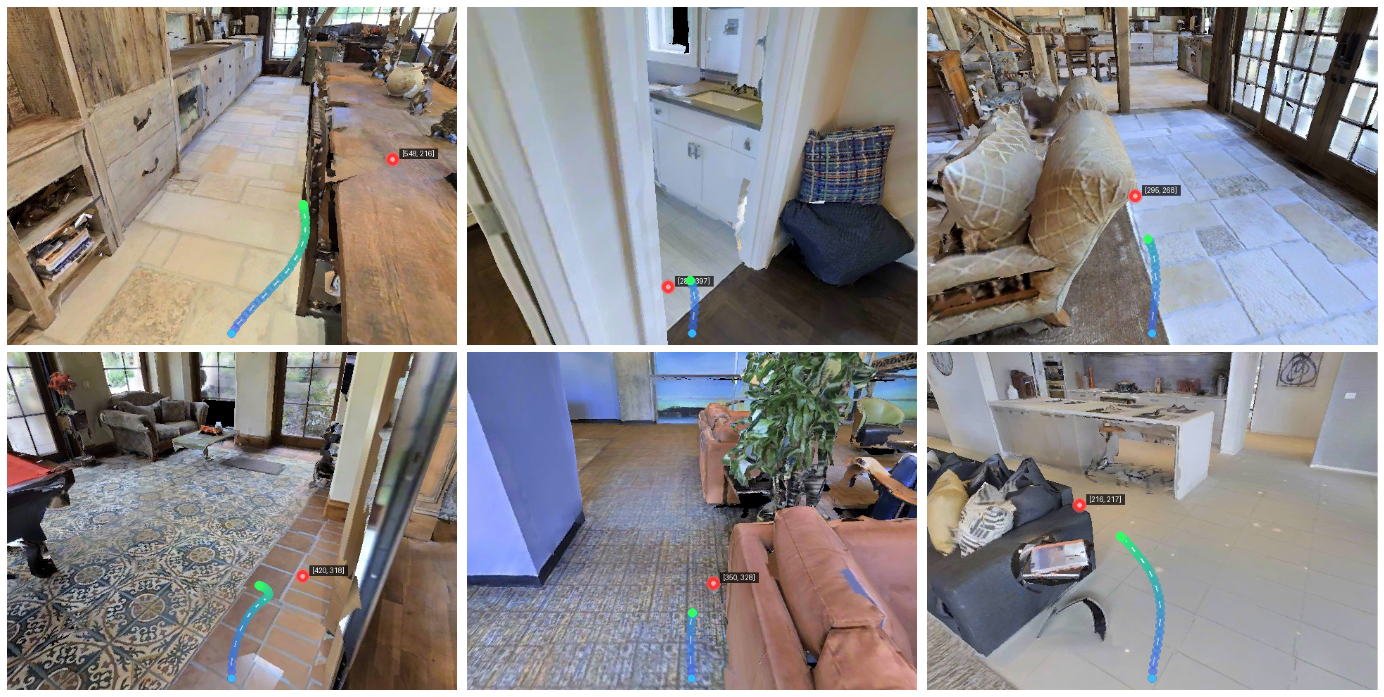
| 像素目标定位(Pixel-Goal Grounding) | 当前视野中至少存在一个可见的未来真实轨迹路径点 | 输出最远可见路径点在当前图像坐标系下的 2D 像素坐标文本(如 234 447) |
| 任务终止(STOP) | 智能体判断已到达自然语言指令描述的终点区域 | 输出离散文本标记 STOP |
- 对话模板格式(见原文附录 A.1):
User: You are an autonomous navigation assistant. Your task is <instruction>. ... These are your historical observations: <history>. Your current observation is <image>. Assistant: → → → → # ① 视角调整:4 个连续右转动作(未来路点不在 FOV 内时先调头) Assistant: 234 447 # ② 像素目标:最远可见路点的图像像素坐标文本 Assistant: STOP # ③ 终止判停:判定到达目标区域 - 关键设计权衡:为什么是“最远可见路点”与“最多 4 次连续转向”?
- 最远可见(Farthest Visible):利用 3D 轨迹向当前相机平面的投影,并借助深度图过滤掉“距离 > 深度测量值”的遮挡点(确保路点绝不落在墙后或障碍物后),取其中最远的一个可见点作为像素目标。这赋予了底层 System 1 尽可能长的前瞻视界(Look-ahead Horizon),使 System 2 的高层规划调用尽可能稀疏(2Hz 即可满足),同时避免了把虚空/遮挡点反投影时引发的几何深度歧义。
- 转向分块与 4 次封顶(Chunked & Capped Turning):沿用了 StreamVLN 的动作分块设计(单次推理生成一组离散动作)。4 个 15° 动作(累计 60°)既足以将大多数弯道死角的下一路点重新纳入 FOV,又设立了严格的安全阈值,防止智能体在未见新视觉证据前盲目过度旋转或原地打转,强制模型在转动 60° 后必须重新观测环境再做决策。
② 系统 1(System 1 - Move Fast):快行动的高频连续轨迹生成器
- 核心定位:轻量级 Diffusion Transformer (DiT) 连续轨迹策略,以 30 Hz(约每 33ms 一次)的超高频率运行,专门负责从高频单目 RGB 观测中实时规划局部平滑无碰撞轨迹。
- 双模态条件融合(Conditioning):
- 显式像素目标(Explicit Pixel Goal):System 2 预测的 $(u, v)$ 坐标,为低层策略提供确定性、可解释的宏观几何引导;
- 隐式潜在目标(Implicit Latent Goal):在 System 2 的像素坐标文本后追加 4 个可学习的特殊 Token
<TRAJ>。通过 Prompt Tuning,这 4 个 Token 穿过冻结的 Qwen-VL,在最后一层引出隐藏状态并投影至 768 维作为pixel_goal_latents,为 System 1 注入包含复杂物体语义和全局上下文的先验信息; - 双时步高频 RGB 融合:使用预训练的 DepthAnythingV2-Small ViT 分别抽取上一高层更新时刻 $t$ 与当前时刻 $t+k$ 的视觉特征,经自注意力融合时序动态,并通过轻量 Q-Former 压缩为 32 个视觉 Token。
- 基于 Flow Matching 的连续轨迹生成: System 1 放弃了离散动作词表,采用连续流匹配(Flow Matching)建模轨迹生成。对真值平滑轨迹 $X_0$ 施加时步 $u \in [0, 1]$ 的线性高斯插值: \(X_u = (1 - (1 - \sigma_{min})u) X_0 + u \epsilon, \quad \epsilon \sim \mathcal{N}(0, I)\) 网络 $f_\theta$ 负责预测速度向量场,并以最小化流匹配损失进行训练: \(\mathcal{L}_{flow} = \mathbb{E}_{u, X_0, \epsilon} \left[ \left\| f_\theta(X_u, u, Z' \oplus F) - \dot{X}_u \right\|_2^2 \right]\) 单次去噪前向传播即可直接生成包含 32 个密集路点的机器人局部坐标系轨迹(Horizon 约 2~3 米),无缝交付给底层 200Hz MPC 控制器完成电机差速/足端控制。
③ 异步流水线与推理加速机制
- 全异步多频率调度:
- System 2(2 Hz / 0.5s):低频刷新高层像素与语义 Latent;
- System 1(30 Hz / 0.033s):高频消化实时图像流,重规划局部避障路径;
- MPC 控制器(200 Hz / 0.005s):以毫秒级刷新电机控制量,保证动力学稳定性。
- 推理延迟极限压榨:
- KV-Cache 跨轮复用:System 2 采用流式 KV 缓存,将长序列自回归预填充耗时从 1.1s 大幅降至 0.7s(提速 36%);
- TensorRT 并行推理:轻量级 DiT(12 层,隐藏层维度 384)经 TensorRT 编译后,单次并行生成 32 个轨迹点仅耗时 0.03s,使纯单目 30Hz 控制在主流边缘/工控 GPU(如 RTX 4090)上成为现实。
3. 渐进式两阶段解耦训练范式
DualVLN 摒弃了将高低层网络端到端联合优化的常规做法,提出渐进式两阶段解耦训练(Progressive Two-Stage Decoupled Training):
flowchart LR
    subgraph Stage1["Stage 1: 高层规划器全量微调 (Qwen-VL-2.5)"]
        D1["67% VLA 导航数据<br/>(MP3D, HM3D, DAgger 纠错)"] --> M1["全参数解冻 SFT<br/>(1 Epoch, 14,000 步)"]
        D2["33% 通用多模态<br/>(LLaVA-Video, MMC4)"] --> M1
        M1 --> S2["已微调的 System 2 规划器<br/>(输出视角调整 / 像素点 / STOP)"]
    end

    subgraph Stage2["Stage 2: 低层扩散策略参数高效训练"]
        S2 -->|完全冻结权重| Freeze["冻结 VLM"]
        Q["4 个可学习 <TRAJ> Query"] --> Freeze
        Freeze -->|提取潜码| LG["Latent Goal (768d)"]
        LG --> DiT["训练 DiT 策略 (12层)<br/>(Flow Matching 监督, 15,000 步)"]
        RGB["双时步 RGB (DepthAnything ViT)"] --> DiT
        DiT --> Traj["32 步密集连续轨迹"]
    end

    Stage1 ==> Stage2
① Stage 1:高层规划器协同微调(Co-Training)
- 训练机制:全量微调视觉编码器与 LLM 骨干(全参数解冻,1 个 epoch,AdamW 学习率 2e-5,Batch Size 128,共 14,000 步)。
- 多源协同数据配方(Co-Training Recipe,总量 147 万样本):
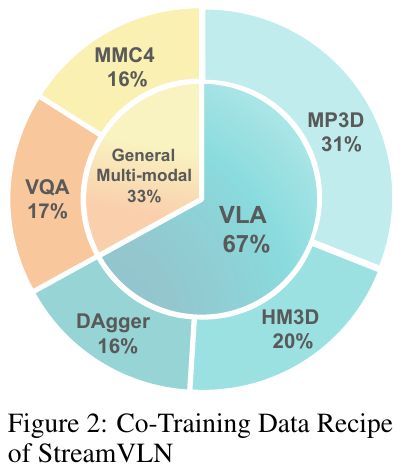
- VLA 导航专业数据(67%):MP3D 场景(450K,31%)、HM3D 多样化场景(300K,20%)以及 Habitat 最短路径专家采集的 DAgger 偏航纠错示范(240K,16%),赋予模型极强的航向偏离自愈能力;
- 通用视觉语言数据(33%):VQA(LLaVA-Video + ScanQA,248K,17%)与 MMC4 图文交错集(230K,16%),严防导航微调引发的通用视觉推理灾难性遗忘。
| 大类 | 子集 | 占比 | 规模 | 来源与关键作用 |
|---|---|---|---|---|
| VLA 导航(67%) | MP3D | 31% | 450K | R2R / R2R-EnvDrop / RxR,覆盖 60 个室内场景 |
| HM3D | 20% | 300K | ScaleVLN 子集,700 个高质量人居场景,强化跨环境泛化 | |
| DAgger | 16% | 240K | Habitat 最短路径专家在模型探索 Rollout 上采集的动态纠错轨迹 | |
| 通用多模态(33%) | VQA | 17% | 248K | LLaVA-Video-178K + ScanQA,注入 3D 空间理解与常识几何推理 |
| MMC4 | 16% | 230K | 图文交错长文档样本,强化长程多轮视觉语言对齐能力 |
② Stage 2:扩散策略的参数高效微调(PEFT)
- 训练机制:完全冻结 System 2 的全部权重,仅对 4 个
<TRAJ>的 Embedding 及 DiT 策略模块计算梯度(AdamW 学习率 1e-4,Batch Size 128,共 15,000 步)。 - 潜在表征提取机制(见原文附录 A.2):通过在 Prompt 尾部添加 4 个专用 Token,将文本输出与连续控制空间相耦合:
inputs_embeds = QwenVL.embed_tokens(input_ids) traj_idx = (input_ids == TRAJ_TOKEN) # 锁定 4 个 <TRAJ> 位置 inputs_embeds[traj_idx] = latent_queries # 替换为可学习 Query (Prompt Tuning) with torch.no_grad(): hidden = QwenVL.forward(inputs_embeds) # 冻结的 VLM 前向传播 pixel_goal_latents = hidden[-1][:, -4:, :] # 抽取末层最后 4 个位置特征 noise_pred = DiT(traj_encoder(gt_poses), timestep, pixel_goal_latents, rgb_feats) - 纯净样本过滤:Stage 2 仅使用包含有效像素目标的样本进行轨迹拟合,完全剔除纯转向样本,保证扩散策略专注学习“向目标平滑巡航与避障”。
③ 为什么必须解耦训练?(方法学核心思考)
- 数据规模与收敛速度的本质不对称:System 2 作为 7B 级通用 VLM 具有显著的“数据饥饿(Data-Hungry)”特征,需要百万级混合数据磨砺语义常识;而底层 System 1 的局部轨迹跟踪任务结构高度受限,实验表明仅需 System 2 约 10% 的轨迹数据,System 1 性能即达饱和。解耦训练大幅节约了昂贵的端到端计算资源。
- 避免表征塌陷(Representation Collapse):消融实验证实,若将两者端到端联合训练(w/o Sys.2 Train),强烈的扩散梯度震荡会导致 VLM 的高层泛化能力严重退化,在 R2R-CE 上的成功率暴跌 9.1%。解耦训练以显式像素点为几何针脚,完美兼顾了高层泛化与底层敏捷。
4. 核心实验结果与分析
① 经典单目视觉仿真基准(VLN-CE)
在仅输入单目纯 RGB 图像(无深度图、无全景环视、无里程计先验)的标准评测下,DualVLN 在 R2R 与 RxR 上均刷新了业界最优成绩:
R2R Val-Unseen 评测结果(单目 RGB): | 模型 | 成功率 SR ↑ | 加权成功率 SPL ↑ | 导航误差 NE ↓ | 航向重合率 OS ↑ | |:—|:—:|:—:|:—:|:—:| | NaVid (2024) | 37.4% | 35.9% | – | – | | NaVILA (2025) | 54.0% | 48.0% | – | – | | StreamVLN (前SOTA) | 56.9% | 51.9% | 4.98m | 64.2% | | DualVLN | 64.3% | 58.5% | 4.05m | 70.7% | | 提升幅度 | +7.4% | +6.6% | -0.93m | +6.5% |
RxR Val-Unseen 评测结果(细粒度多语言指令): | 模型 | 成功率 SR ↑ | 加权成功率 SPL ↑ | 导航误差 NE ↓ | 归一化动态对齐 nDTW ↑ | |:—|:—:|:—:|:—:|:—:| | NaVILA (前SOTA) | 49.3% | 44.0% | 6.77m | 58.8% | | DualVLN | 61.4% | 51.8% | 4.58m | 70.0% | | 提升幅度 | +12.1% | +7.8% | -2.19m | +11.2% |
结论:在更长、语言更多样的 RxR 任务上,DualVLN 的领先优势扩大到 +12.1% SR,且大幅超越了依赖“全景 RGB + 深度 + 里程计”的传统图搜索方法(如 ETPNav 的 57.0% SR),确立了端到端纯视觉双系统的统治级表现。
② 真实物理仿真评测(VLN-PE)
VLN-PE 在物理引擎中模拟了真实的人形机器人(Unitree H1)运动动力学与跌倒碰撞风险。DualVLN 在完全未在 VLN-PE 上进行任何微调(零样本迁移)的情况下,展现出极佳的控制鲁棒性:
| 模型 | 训练状态 | SR ↑ | SPL ↑ | NE ↓ | 跌倒率 FR ↓ | 卡死率 StR ↓ |
|---|---|---|---|---|---|---|
| NaVid | 零样本迁移 | 22.42% | 18.58% | 5.94m | 8.61% | 0.45% |
| RDP | 在 VLN-PE 上微调 | 25.24% | 17.73% | 6.72m | 24.57% | 3.11% |
| DualVLN | 零样本迁移 | 51.60% | 42.49% | 4.66m | 12.32% | 2.23% |
结论:成功率达到基准模型的 2 倍以上(51.60% vs 22.42%),连续平滑的轨迹有效抑制了人形机器人在离散急停时产生的高惯性跌倒。
③ 动态行人交互新基准:Social-VLN
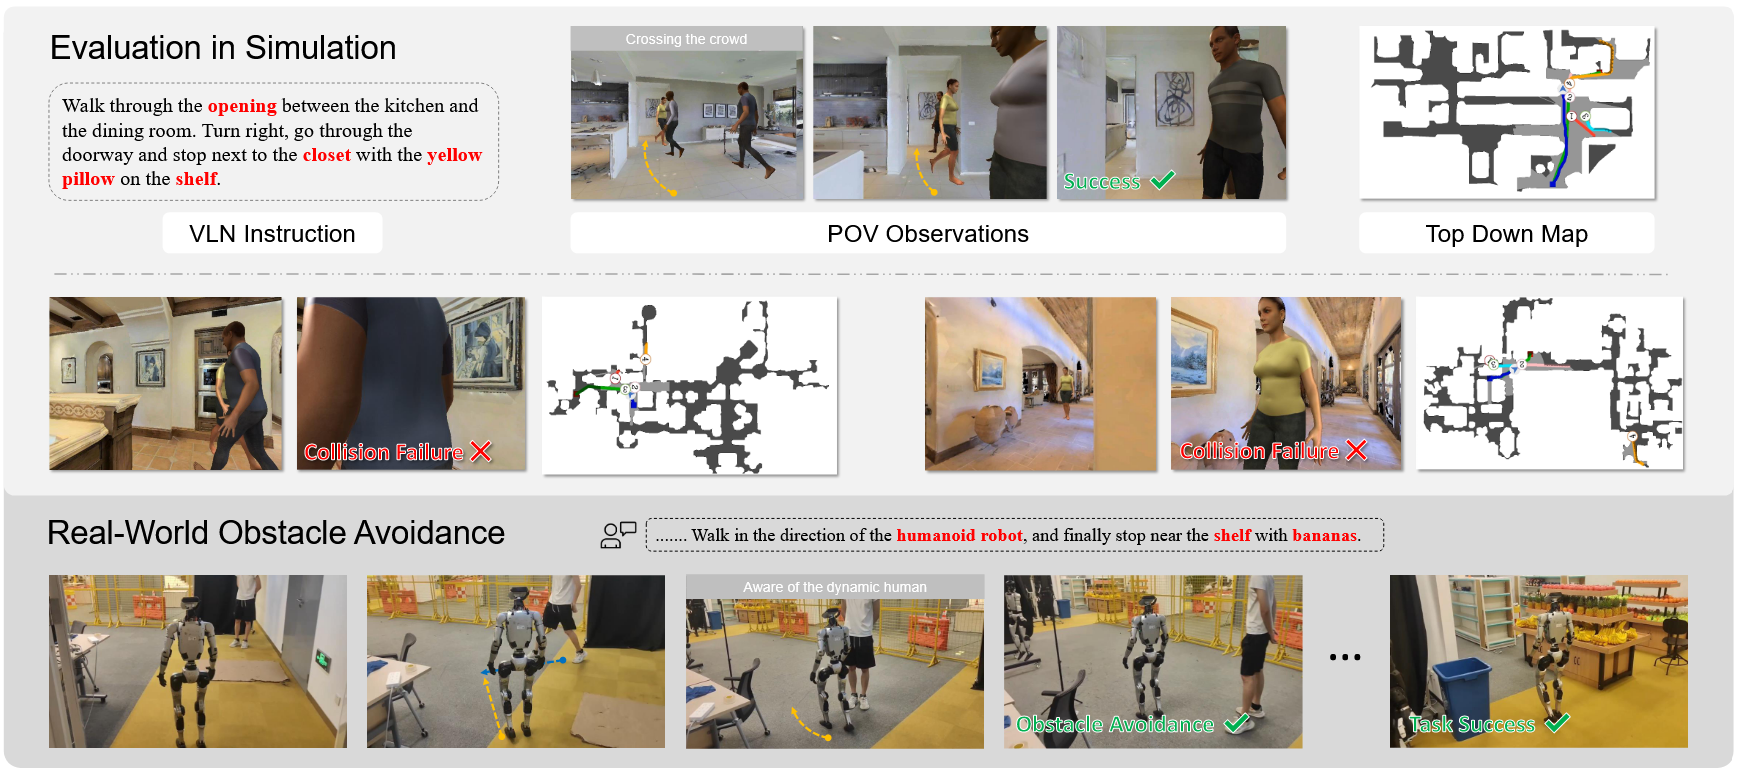
- 基准设立:论文指出静态建图与离散动作模型在面对动态行人时极为脆弱。因此在 Habitat 3.0 中沿真值路径注入动态行走行人,构建包含 763K 交互样本的 Social-VLN 基准,并提出人类碰撞率(Human Collision Rate, HCR)指标。
- 评测表现:静态到动态环境下,所有模型成功率普遍暴跌约 26%,证明了动态具身导航的严苛难度;但 DualVLN 凭借 30Hz 的局部重规划能力保持了 37.2% SR(领先 StreamVLN 5.8%),且碰撞率显著更低(HCR 35.4%)。
| 模型 | 静态环境 SR | Social-VLN 动态 SR | SR 降幅 ↓ | 人类碰撞率 HCR ↓ |
|---|---|---|---|---|
| StreamVLN | 56.9% | 31.4% | -25.5% | 36.4% |
| DualVLN | 64.3% | 37.2% | -27.1% | 35.4% |
④ 真实世界跨形态机器人部署
- 硬件配置:测试覆盖三种异构形态机器人:轮式(Turtlebot4)、四足(Unitree Go2) 与 人形(Unitree G1)。机载单目 Intel RealSense D455(下俯 15°),通过 Wi-Fi 流式传输图像至配有一块 RTX 4090 的远端服务器进行异步双系统推理,MPC 控制器部署于机载工控机。
- 实测表现(3 种跨房间难度场景,每场景 20 次测试):
- 走廊(简单):DualVLN 达到 100% SR(平均误差 0.2m,基线仅 25%~80%);
- 单间卧室(中等):DualVLN 达到 100% SR(平均误差 0.3m,基线仅 0%~70%);
- 跨房间长程办公室(困难):DualVLN 达到 85% SR(平均误差 0.4m,基线仅 0%~60%)。
- 各场景导航误差(NE)横向对比:
| 场景难度 | CMA | NaVid | NaVILA | StreamVLN | DualVLN |
|---|---|---|---|---|---|
| 走廊(简单) | 3.2m | 0.9m | 0.3m | 0.2m | 0.2m |
| 卧室(中等) | 5.3m | 2.5m | 0.6m | 0.3m | 0.3m |
| 跨房间办公室(困难) | 15.4m | 10.1m | 2.2m | 0.5m | 0.4m |
- 各基线典型失效模式对比:
- NaVid:长距离误差累积严重,在多弯道场景下极易直接撞墙;
- NaVILA:能执行宏观转向,但在跨房间终点定位上频繁发生“过门而不入”的漏判;
- StreamVLN:动作低延迟使其能躲开静态障碍物,但往往以大幅偏离原本指令路径为代价;
- DualVLN:高层 System 2 稳定锁死目标路标,底层 System 1 动态绕行,兼顾全局保真与局部避障。
5. 核心消融与机理解析
① 目标表征与解耦训练的必要性(R2R-CE Val-Unseen)
| 架构变体 | SR ↑ | SPL ↑ | OS ↑ | NE ↓ | 核心结论 | |:—|:—:|:—:|:—:|:—:|:—| | DualVLN(完整) | 64.3% | 58.5% | 70.7% | 4.05m | 显隐协同表现最佳 | | w/o Sys.2 Train(端到端联合训练) | 55.2% | 51.5% | 60.9% | 4.98m | 性能断崖下跌 9.1%,联合优化导致表征退化与收敛停滞 | | w/o Pixel Goal(移除显式像素点) | 62.2% | 55.8% | 68.0% | 4.22m | 失去显式几何锚点,低层轨迹漂移增加(-2.1% SR) | | w/o Latent Goal(移除隐式语义潜码) | 60.9% | 55.1% | 67.7% | 4.26m | 仅靠 2D 坐标无法传递场景拓扑语义(-3.4% SR) |
② 对比 SOTA 传统点目标规划器(VLN-PE Unseen)
如果把 System 2 预测的像素点借助 Oracle 深度图强制投影到 3D 空间,替换为成熟的局部点目标策略(PointGoal Policy):
| 局部规划器 | Seen SR ↑ | Seen SPL ↑ | Unseen SR ↑ | Unseen SPL ↑ | Unseen NE ↓ |
|---|---|---|---|---|---|
| iPlanner (Yang et al., 2023) | 58.66% | 49.43% | 47.07% | 41.09% | 4.91m |
| NavDP (Cai et al., 2025) | 66.11% | 56.26% | 58.72% | 50.98% | 4.22m |
| System 1(完整版) | 73.25% | 64.00% | 63.62% | 56.49% | 3.90m |
深层机理:传统 PointGoal 规划器对投影误差与深度噪点极其敏感;而 System 1 具备高频单目 RGB 上下文感知与 Latent 调节,即便高层预测的像素点略有偏差,低层扩散策略也能依靠视觉流自主修正轨迹。
③ 扩散策略的数据扩展律(Data Scaling Law)
在 System 2 轨迹数据上截取不同比例训练 System 1:
- 1% 数据:SR ~54%,已展现可用避障能力;
- 10% 数据:SR ~62%,曲线迅速逼近饱和点;
- 50%~100% 数据:SR ~64.3%,边际收益显著递减。 启示:轨迹生成本质是一个低维几何流形映射,对样本规模的需求远低于大语言模型。解耦训练让工程团队可以用极低成本微调不同的下游机器人执行器。
④ 注意力逐层精化机理(Attention Map Analysis)
分析 Qwen-VL 在自回归生成时的逐层注意力权重变化:
- 浅层(Layer 6):注意力广泛弥散于整张图像的全局空间轮廓与指令方向词;
- 中层(Layer 15):注意力逐渐收拢至与指令匹配的关键物体(如门、长桌、走廊接口);
- 深层(Layer 24):注意力极端聚焦在最终的最远可见像素目标坐标区域,并在任务到达时向
STOPToken 集中激活。这证明了模型实现了从“宏观场景语义理解”到“精细空间几何落脚点”的逐级提炼。
6. 局限性与未来演进
- 单向通信瓶颈(缺乏底层向上反馈):目前双系统架构为单向级联(System 2 $\rightarrow$ System 1)。若机器人遭遇突发死胡同或物理碰撞阻挡,底层执行受阻的状态无法实时反哺给 System 2 触发即时重规划,未来需引入自下而上的动态中断与重触发机制。
- 极端动态社交场景的避障上限:在 Social-VLN 中,智能体成功率虽居首位但仍只有 37.2%,高密度人流下的碰撞率依然偏高,缺乏博弈层面的显式人机运动意图推断。
- 边缘算力与部署门槛:System 2 依赖 7B 级多模态底座,全精度加载需约 20GB 显存,目前仍需依赖板载之外的工作站串流。探索 2B~3B 边缘级端侧视觉模型的量化蒸馏是实现完全离线自主导航的关键一步。
10. ODYSSEY (2025)
——Open-World Quadrupeds Exploration and Manipulation for Long-Horizon Tasks
📄 Paper: arXiv:2508.08240 · 🏛️ AAAI 2026
研究背景/问题
在动态、非结构化环境中,机器人需要将移动性、操作和实时感知紧密结合才能执行复杂任务。现有研究大多局限于桌面场景,未能解决移动平台特有的感知受限和执行器范围有限的问题,且在开放世界环境中的泛化能力不足。
主要方法/创新点
ODYSSEY提出了一个统一的移动操作框架,包含分层规划和全身控制两大核心模块:
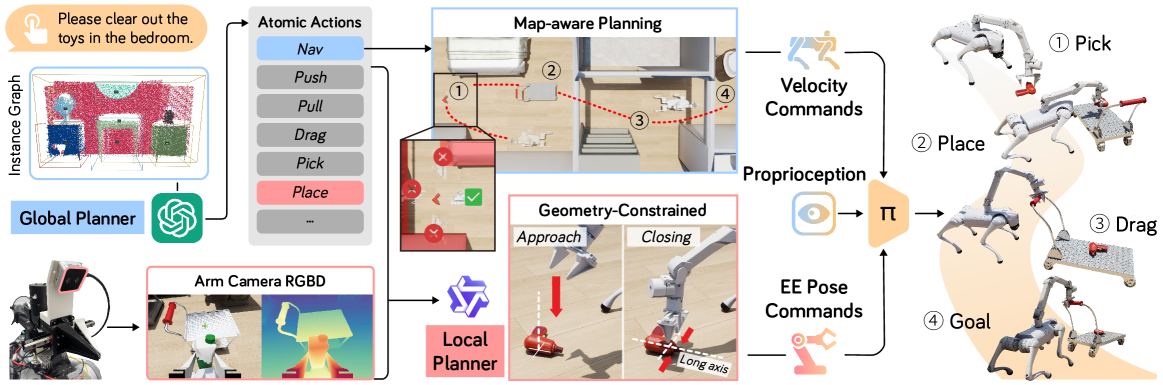
长期任务规划器:
- 全局任务级规划:融合RGB和LiDAR流构建场景的空-语义表示,利用预训练基础模型将实例图映射到场景中
- 使用GPT-4.1将自然语言指令分解为原子动作序列(导航、抓取、放置等),并输出粗略目标航路点
- 航路点投影到2D占用图,通过局部搜索确定无碰撞目标姿态
局部操作:
- 使用腕部安装的深度观测数据指导视觉-语言模型生成精确末端执行器姿态
- Qwen2.5-VL-72B-Instruct模型根据RGB观测和文本描述推断任务相关接触点
- 根据目标物体主轴和表面法线施加几何约束,确定末端执行器朝向
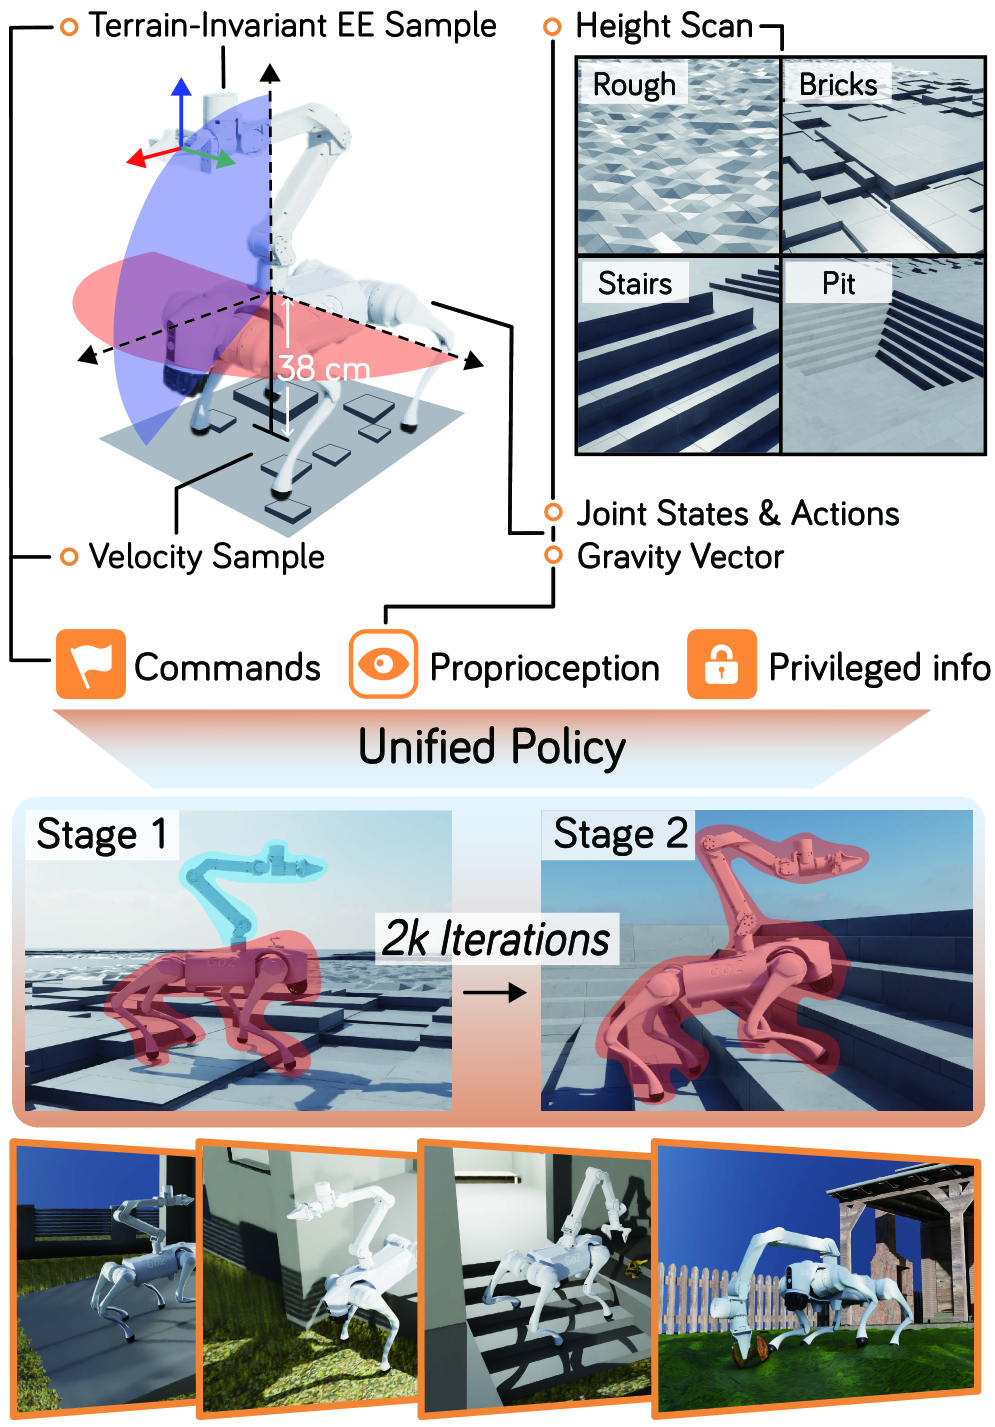
全身控制策略:
- 单一网络将观测向量(运动指令、末端执行器目标、地面高度图、重力向量、本体感知状态等)映射到目标动作
- 两阶段训练:第一阶段固定机械臂关节训练运动;第二阶段控制全部18个关节,采用地形不变末端执行器采样策略
- 引入步态奖励、频率奖励和末端执行器跟踪项,运用领域随机化增强适应性
模拟基准测试:
- 构建包含50个刚体物体、15个容器、30个关节结构、10个可拖动物体的多样化资产库
- 基准测试包括10个真实场景(室内家居、超市、餐厅、室外庭院等)
- 长期任务包含246个室内和58个室外变化,涉及抓取、重新定向、容器放置、关节操作等多种技能
核心结果/发现
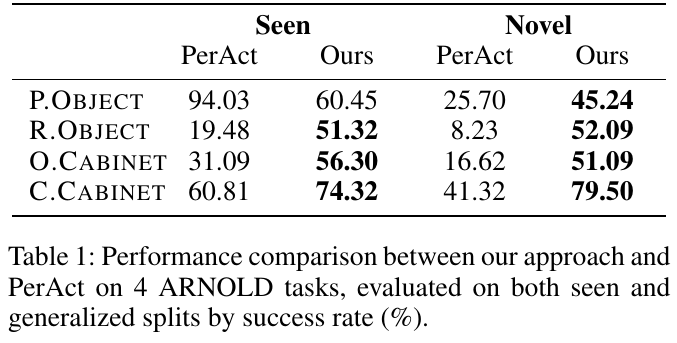
- 短期任务:在ARNOLD基准测试上优于PerAct基线,仅依赖单个自我中心摄像头实现更强的泛化能力,在未见数据集上性能保持稳定
- 长期任务:在8个长期移动操作任务上实现40%以上整体成功率,每个原子技能类别保持60%以上成功率,展现出可靠的协调能力
- 低层策略:在基座速度跟踪方面优于RoboDuet基线,末端执行器姿态跟踪性能相当,且在不同地形上具有更强的适应性
- Sim-to-Real迁移:成功在Unitree Go2+Arx5平台上实现现实世界部署,在”导航到抓取”和”抓取和放置”任务中验证了框架的实用性
局限性
模型在物体几何形状的空间推理方面存在局限,导致夹爪对齐不佳和细长手柄或部分遮挡物品的定位不准确。此外,抓取小物体时偶尔失败,主要由于末端执行器跟踪和视觉感知精度不足。
11. PanoNav (2025)
——Mapless Zero-Shot Object Navigation
📄 Paper: arXiv:2511.06840 · 🏛️ AAAI 2026 (Poster)
研究背景/问题
现有目标导航方法大多依赖深度传感器或预建地图来构建2.5D场景表示,限制了在真实环境中的适用性和泛化能力。零样本目标导航要求机器人识别和导航到超出预定义类别范围的对象,现有方法在开放词汇场景中表现有限。无地图方法通常只基于当前观测进行决策,忽略历史轨迹信息,容易陷入局部死锁。
主要方法/创新点
PanoNav是一个无地图、仅使用RGB图像的零样本目标导航框架,包含两个核心模块:
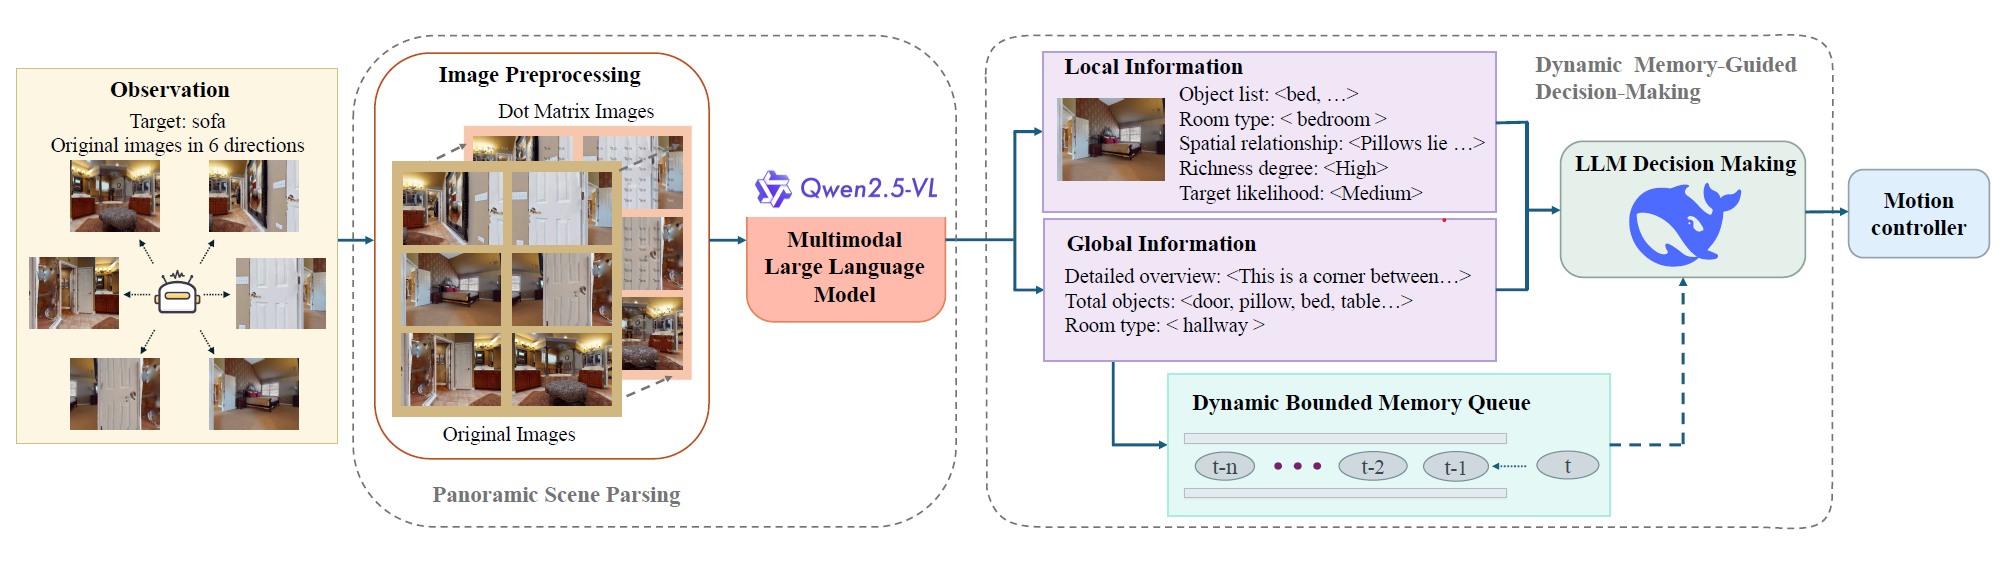
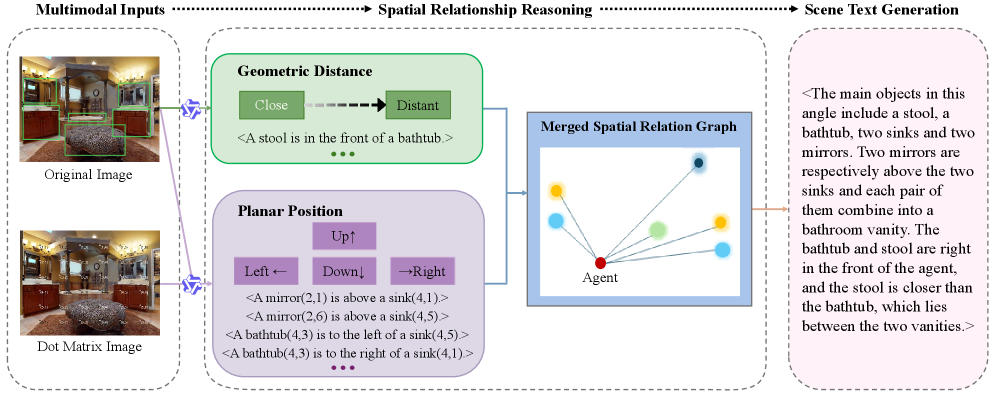
全景场景解析(Panoramic Scene Parsing):
局部方向解析:
- 点阵图像增强:将每个RGB图像转换为点阵图像,通过Scaffold方法增强平面位置理解,与RGB图像共同作为MLLM输入
- 空间关系图构建:MLLM利用几何距离关系和平面位置关系,构建空间关系图,生成每个方向的详细描述(物体存在、空间关系、房间类型等)
全局全景总结:
- 环境整体感知:对机器人周围环境进行整体分析,识别环境中存在的物体类型和当前房间类型(如厨房、走廊)
- 隐式自我定位:通过全局总结提供隐式自我定位信息,帮助机器人理解其在更大环境中的位置
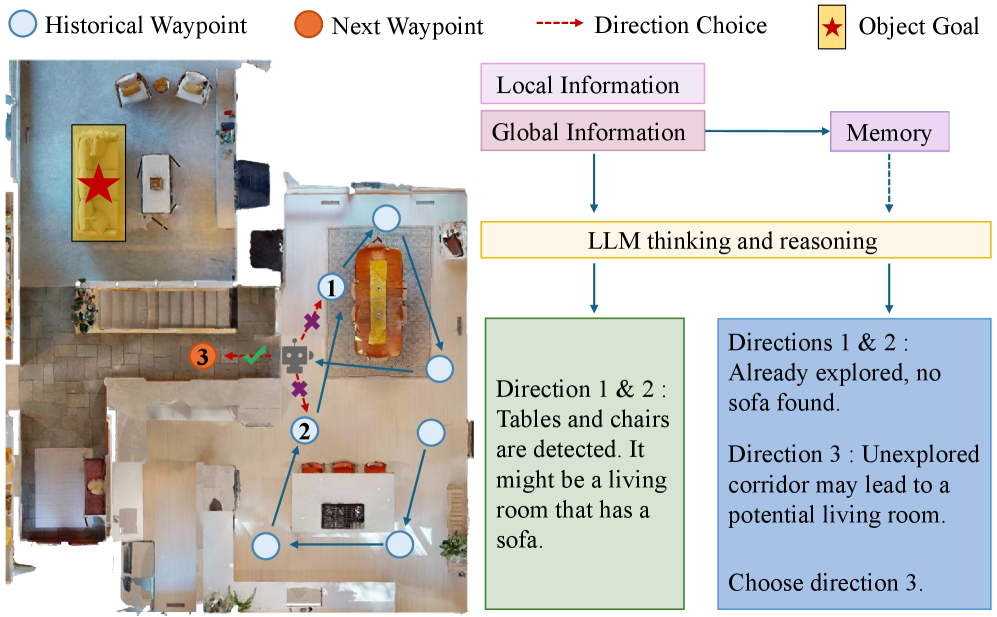
动态记忆引导决策(Dynamic Memory-guided Decision-Making):
- 动态有界记忆队列:存储最近的全局场景总结,队列长度固定,当队列满时新元素加入会移除最旧元素
- 决策过程:
- 记忆队列未满时:决策仅基于当前的局部描述和全局总结
- 记忆队列满时:决策结合当前信息和历史记忆信息,避免重复探索已访问区域
- 动作选择:决策结果包括导航方向和是否找到目标的标志,由运动控制器执行相应动作
任务设置:
- 观测数据:每个时间步获取六个方向的RGB图像(间隔60度),形成全景视图,不依赖深度传感器或GPS
- 动作空间:停止、前进(0.25米)、左转/右转(30度)、抬头/低头
- 任务目标:在未见过的环境中根据语言指令找到目标对象,并导航至目标位置
核心结果/发现
- 性能优势:在HM3D数据集上,PanoNav的成功率(SR)达到43.5%,SPL达到23.7%,显著优于PixNav(SR=37.9%,SPL=20.5%)和ZSON(SR=25.5%,SPL=12.6%),甚至超过部分依赖地图和闭词汇表的方法
- 死锁避免:在高度欺骗性环境中,通过动态记忆机制实现48.0%成功率和19.2% SPL,逃离局部区域的逃逸率达82.0%
- 消融实验验证:
- 全景视图的重要性:仅使用三视图时性能显著下降(SR=19.5%,SPL=9.97%)
- 解耦解析与决策的优势:解耦方法(SR=43.5%,SPL=23.7%)优于直接从MLLM输出决策(SR=38.5%,SPL=22.57%)
- 动态记忆的关键作用:移除动态记忆后性能大幅下降(SR=38.5%,SPL=22.57%)
局限性
虽然PanoNav显著提升了无地图零样本导航性能,但未来仍需探索利用多模态信息(如语音、手势等)构建更强大的记忆队列,以进一步提高无地图目标导航的鲁棒性和泛化能力。
12. VLN-R1 (2025)
——基于GRPO与Time-Decayed Reward的端到端导航
📄 Paper: arXiv:2506.17221
研究背景/问题
VLN是具身人工智能领域的一项核心挑战,要求智能体根据自然语言指令在真实世界环境中进行导航。传统的导航方法通常依赖离散的拓扑图和预定义的节点连接,限制了智能体在连续环境中的泛化能力。
主要方法/创新点
VLN-R1提出了一种创新的端到端框架,利用大型视觉-语言模型(LVLM)直接处理自我中心视频流,生成连续的导航动作。
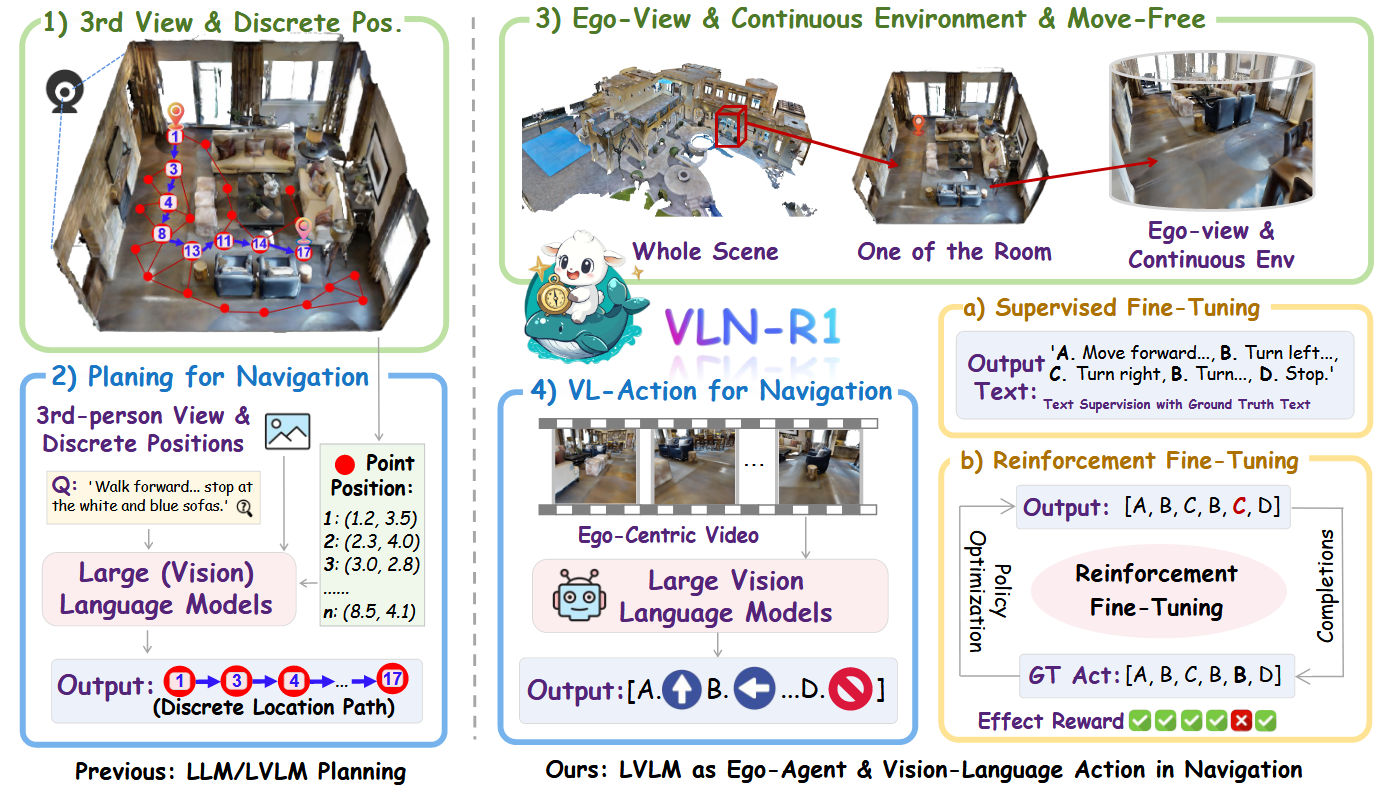
核心设计理念:
- 构建能够实时处理自我中心视频流并生成连续导航动作的端到端框架
- 与传统方法依赖导航图或额外传感器不同,VLN-R1直接将视觉输入和自然语言指令转化为动作输出
- 提高系统通用性,增强在未见过环境中的适应能力
主要组件:
VLN-Ego数据集:
- 数据生成:通过Habitat模拟器生成,包含自我中心视频流与未来动作预测的配对数据
- 三部分文本注释:
- 指令部分:自然语言导航指令(如”走到客厅的沙发旁”)
- 视觉部分:包括历史帧和当前观察,提供自我中心的视觉信息
- 动作部分:未来动作选择(前进、左转、右转、停止四种基本动作)
- 数据规模:
- 从Room-to-Room生成了60K个训练样本
- 从Room-Across-Room生成了1.2M个训练样本
- 覆盖了61个训练场景
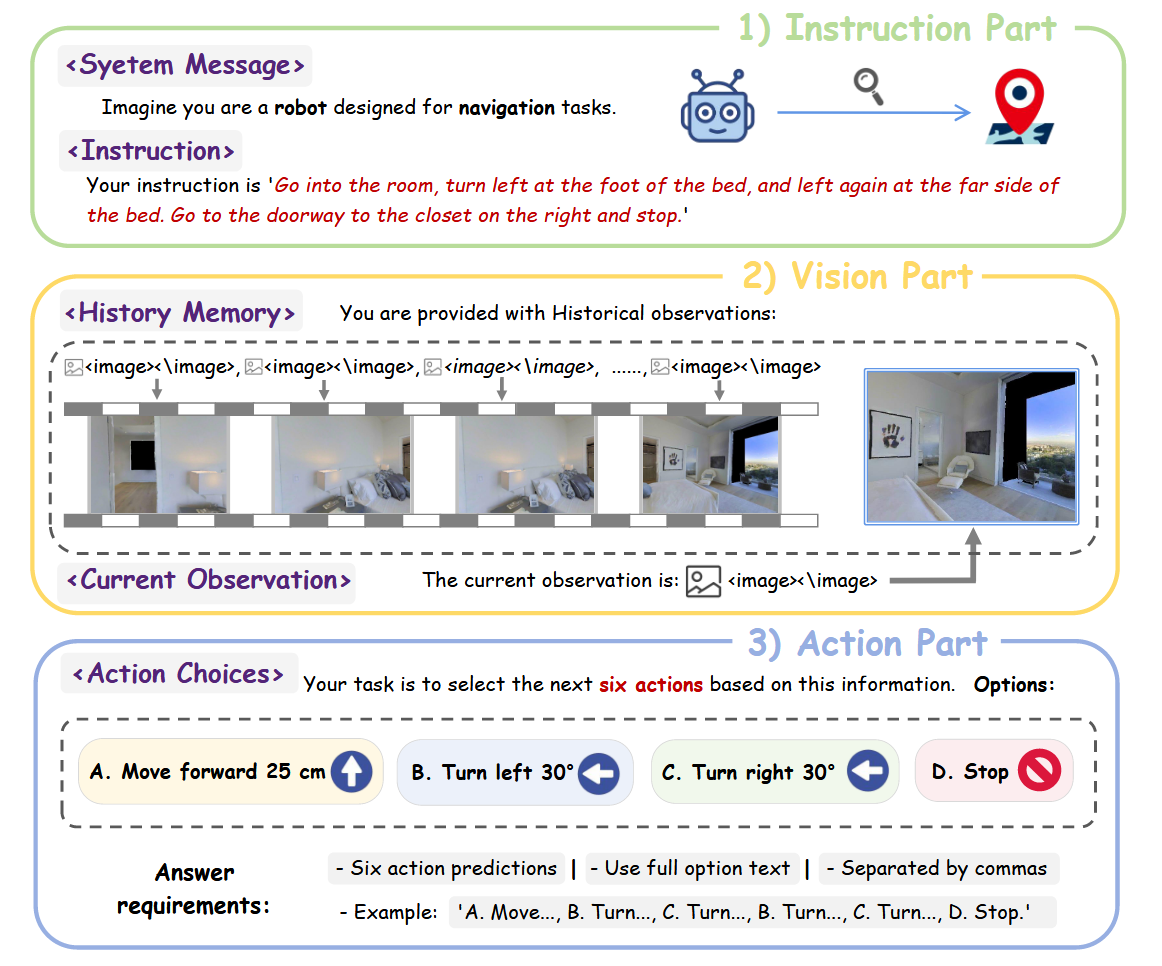
长短期记忆采样:
- 新颖的视频输入处理策略,用于动态平衡历史帧的重要性与当前观察的实时性
- 确保模型既能利用历史信息,又能快速响应当前环境变化
- 相比单一动作预测,多步动作预测结合历史上下文显著提升性能
两阶段训练策略:
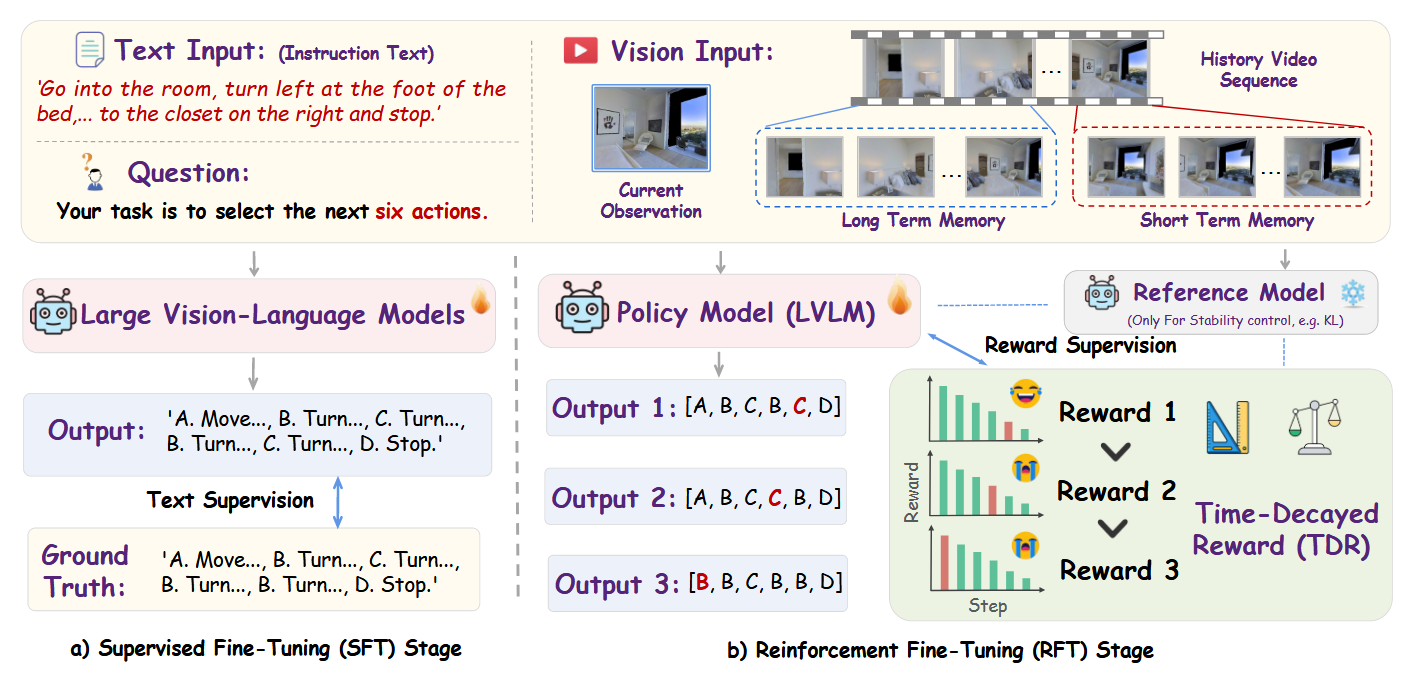
监督微调(SFT)阶段:
- 模型的动作序列预测与专家演示对齐,通过监督学习优化输出文本
- 模型生成的多步动作序列文本与地面真值对齐,通过交叉熵损失进行优化
- 给定历史观察序列H_t、指令Z和当前观察O_t,模型预测n步未来动作序列
强化微调(RFT)阶段:
- 引入基于GRPO(Group Relative Policy Optimization)的强化学习方法
- 结合时间衰减奖励机制(TDR),进一步优化模型在长时程导航中的性能
- 超参数经过消融实验确定,生成次数选择8作为默认值
时间衰减奖励机制(TDR):
- 核心思想:通过引入衰减因子,平衡短期和长期奖励
- 作用机制:使模型能够更关注近期的动作,同时考虑长期目标
- 优势:用于评估多步动作预测的长期效果,优化长时程导航性能
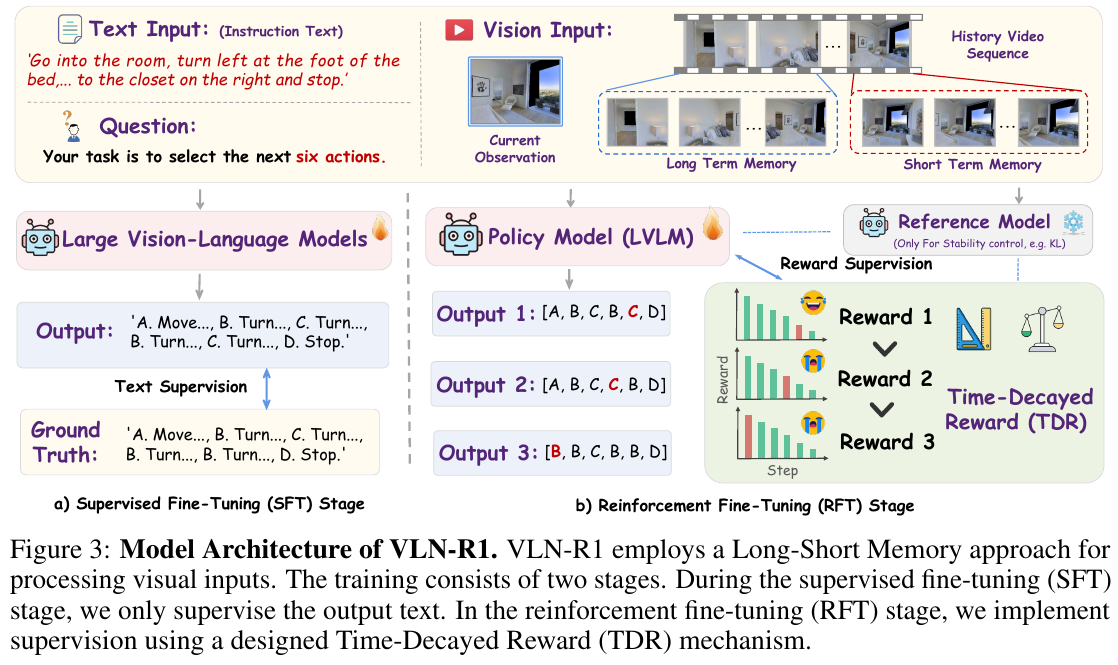
模型架构:
- 输入:自我中心视频流和指令
- 输出:多步未来动作序列
- 端到端设计:消除了对导航图的依赖,使其在连续环境中表现出色
核心结果/发现
VLN-R1在VLN-CE(视觉-语言导航连续环境)基准上进行了全面测试:
测试平台:
- Room-to-Room(R2R):要求智能体在单个房间内导航
- Room-Across-Room(R4R):要求智能体跨房间导航,任务更具挑战性
性能表现:
- R2R数据集:展现了高效的导航能力和准确的任务完成率
- R4R数据集:通过强化微调显著提升了跨域适应性,小型2B模型的性能甚至接近7B模型
- 模型可扩展性:证明了端到端框架在不同模型规模下的有效性
消融实验验证:
- 长短期记忆采样:多步动作预测结合历史上下文显著提升性能,优于单一动作预测
- TDR机制:与传统奖励函数相比,TDR显著提高了长时程任务的成功率
- 生成次数:从6增加到8时性能提升有限,因此选择8作为默认值
技术优势:
- 端到端设计实现了实时导航
- 结合LVLM的视觉-语言理解能力和强化学习的优化策略
- 展示了在任务特定推理中的潜力
局限性
论文内容相对简短,未详细说明具体的性能指标数值(如SR、SPL等)和与其他SOTA方法的详细对比。此外,对于Real-world部署的讨论较少,主要集中在仿真环境(Habitat)测试,缺乏真实机器人平台上的验证实验。
13. StreamVLN (2025)
——— 通过慢-快上下文建模实现流式视觉-语言导航
📄 Paper: arXiv:2507.05240 · 🏛️ ICRA 2026
精华
这篇论文提出了一个适用于真实世界部署的流式 VLN 框架,值得借鉴的核心思想包括:(1) 采用慢-快双通道上下文建模策略,平衡全局场景理解和实时响应能力;(2) 利用 3D 几何信息进行智能 token 剪枝,在保持性能的同时显著降低计算开销;(3) 通过 KV cache 复用机制利用时间连贯性,支持长视频流的高效推理;(4) 将上下文大小和推理成本控制在有界范围内,为 embodied AI 的实际部署提供了可行方案;(5) 采用多源数据联合训练策略(VLA数据+通用VL数据+DAgger数据),同时保持通用推理能力和导航专业性能。这些设计思路可以迁移到其他需要处理长序列多模态输入的具身智能任务中。
研究背景/问题
现有的 Vision-and-Language Navigation 方法在处理真实世界连续环境时面临关键挑战:如何在长视频流中高效进行多模态推理,同时保持低延迟以支持实时交互。现有 Video-LLM 基于的 VLN 方法往往在细粒度视觉理解、长期上下文建模和计算效率之间存在权衡。本文旨在设计一个既能捕捉全局场景理解,又能快速响应的流式导航框架。
主要方法/创新点
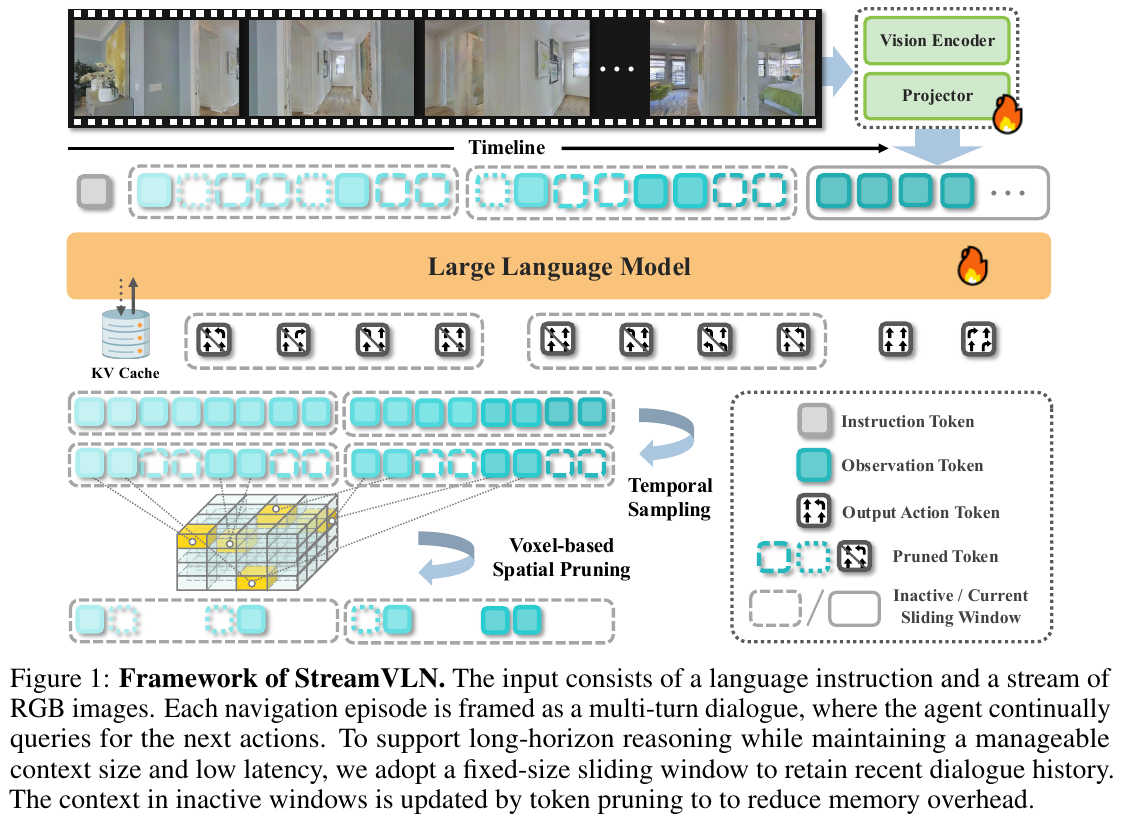
论文提出了 StreamVLN,一个基于慢-快上下文建模的流式视觉-语言导航框架,将 Video-LLM 扩展为交错的 vision-language-action 模型。
1. 连续多轮自回归生成
VLN 的多轮对话会话由一系列交错的观测和动作组成。在每个对话 $d_i = (o_i, a_i)$ 中,VLN 模型接收新观测 $o_i$ 并生成动作响应 $a_i$,条件于当前输入和对话历史。完整输入序列构造为:$o_1a_1o_2a_2…o_{i-1}a_{i-1}$。Transformer 基于 LLM 首先执行 prefill 阶段(预填充阶段)编码输入 token 并缓存 key/value(KV)状态,然后在 decoding 阶段使用缓存的 KV 对生成新 token。
2. 快速流式对话上下文 (Fast-Streaming Dialogue Context)
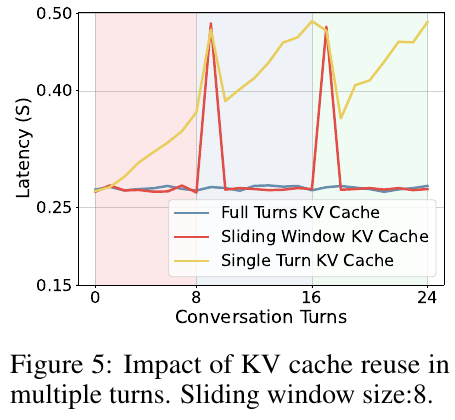
虽然跨轮次复用 KV cache 可以消除超过 99% 的 prefilling 时间,但会引入巨大的内存开销。随着对话数量增加,KV cache 呈线性增长(例如 2K token 可能消耗约 5GB 内存),使长会话变得不切实际。此外,现有 Video-LLM 在处理过长上下文时推理性能会下降。
StreamVLN 采用 滑动窗口 KV cache 管理对话上下文,保留固定数量 $N$ 的最近对话在活跃窗口中:$W_j = [o_{(i-N+1)}a_{(i-N+1)}…o_ia_i]$。当窗口达到容量时,key/value 状态从 LLM 中卸载,非观测对话 token(如提示词和生成的动作)的状态立即丢弃。对于新的滑动窗口,来自过去窗口的 token 状态被处理为记忆 token 状态 ${M_0, …, M_j}$。
3. 慢速更新记忆上下文 (Slow-Updating Memory Context)
在有限的上下文长度内平衡时间分辨率和细粒度空间感知仍然是 Video-LLM 的关键挑战。StreamVLN 不在特征层面压缩视频 token(如通过平均池化),而是保留高图像分辨率的同时选择性地丢弃空间和时间冗余 token,以更好地保持 Video-LLM 的可迁移性。
- 时间采样: 采用简单的固定数量采样策略,避免不同长度的记忆 token 引入时间持续偏差
- 体素化空间剪枝 (Voxel-based Spatial Pruning): 使用深度信息将视频流中的 2D 图像patches 反投影到共享 3D 空间,离散化为均匀体素。通过跟踪 patch token 在时间上的体素索引,如果给定时长内的多个 token 投影到同一体素,仅保留最新观测的 token。该剪枝掩码用于选择保留的 token 状态(详见 Algorithm 1)。
4. 多源数据联合训练
- Vision-Language Action (VLA) 数据:
- 使用 Habitat 模拟器收集 450K 样本(来自 60 个 Matterport3D 环境的 R2R、R2R-EnvDrop 和 RxR 数据集)
- 额外 300K 样本来自 ScaleVLN(涵盖 700 个 HM3D 场景)以提高场景多样性
- 采用 DAgger 算法收集 240K 纠正示范样本以增强鲁棒性和错误恢复能力
- 通用Vision-Language数据: 为保持预训练 Video-LLM 的通用推理能力,引入:
- 248K 视频基础 VQA 样本(来自 LLaVA-Video-178K 和 ScanQA)
- 230K 交错图像-文本样本(来自 MMC4)以增强多轮视觉-语言交互能力
主要创新点:
- 首次提出针对实时 VLN 的慢-快上下文建模策略
- 设计了基于 3D 几何的智能 token 剪枝方法,优于通用的均匀剪枝
- 实现了低延迟、可扩展的流式多模态推理框架,支持 KV cache 高效复用
- 通过交错 vision-language-action 建模支持连贯的多轮对话
- 有界的上下文大小和推理成本,适合长视频流处理
核心结果/发现
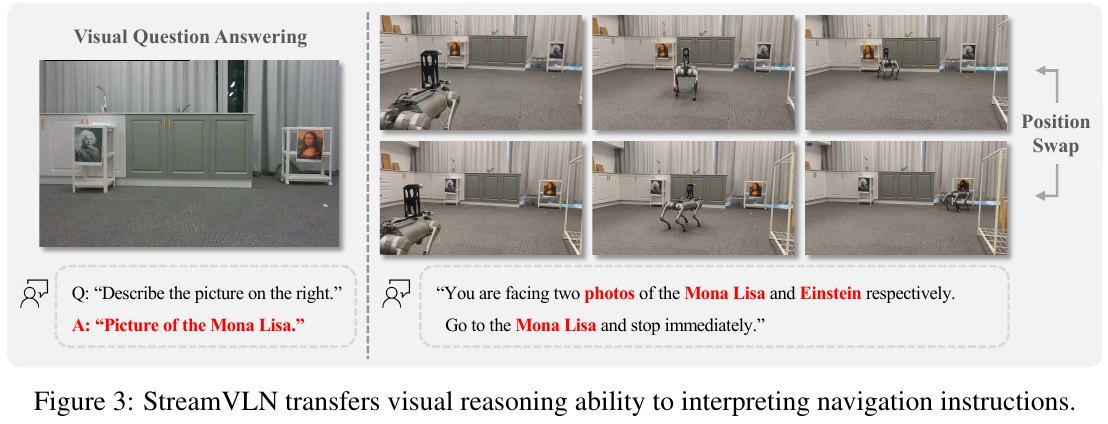
- VLN-CE 基准测试上取得 state-of-the-art 性能:
- R2R Val-Unseen: SR 56.4%, SPL 50.2%(StreamVLN†,加入 ScaleVLN 子集等额外训练数据;只用 R2R / RxR 时为 52.8% / 47.2%)
- RxR Val-Unseen: SR 54.4%, SPL 45.4%, nDTW 63.7%(以上为 arXiv v2 / ICRA 2026 版数字;v1 为 R2R 56.9 / 51.9、RxR 52.9 / 46.0)
- 性能与 ETPNav 相当,但不依赖全景视图或航点监督
-
ScanQA 3D 问答基准测试:超越 NaVILA 和 NaviLLM,Exact Match达到 28.8%
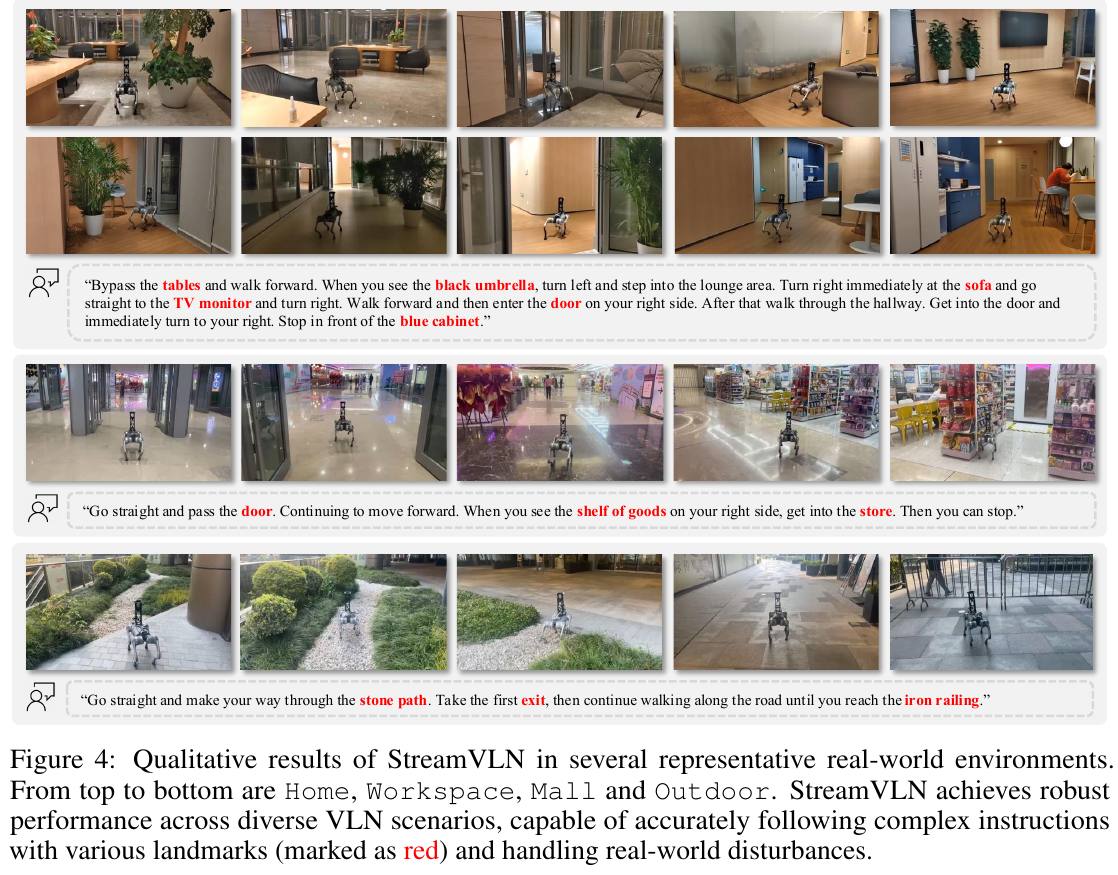
- 真实世界部署验证:
- 在 Unitree Go2 机器狗上成功部署
- 平均推理延迟 0.27s(4个动作)+ 通信延迟 0.2s(室内)/ 1.0s(室外)
- 支持实时物理部署
- 关键消融实验发现:
- KV cache 复用在多轮对话中消除超过 99% 的 prefilling 时间
- 滑动窗口大小为 8 个对话轮次时实现最佳平衡
- 记忆上下文大小从 2×196 增加到 8×196 tokens 时,SR 从 37.3% 提升到 45.5%
- 体素化空间剪枝减少约 20% 的输入 token,同时提升性能(R2R +1.2% SR,RxR +1.1% SR)
- DAgger 数据对性能提升至关重要(+5.5% SR / +3.8% SPL)
- 通用 VL 数据(VideoQA + MMC4)的联合训练带来显著增益(+7.3% SR / +5.6% SPL)
局限性
- 直接从原始视觉观测生成低级动作对视点和遮挡变化的鲁棒性较弱,在真实世界环境中可能导致次优控制
- 当前的混合上下文建模策略在更长视野的导航场景中仍然面临挑战,保持扩展序列上的一致推理较为困难
- 依赖显式动作历史作为对话上下文的一部分,为异步推理和部署带来额外复杂性,需要同步过去的动作以保持对话连贯性
14. NavFoM (2025)
——Embodied Navigation Foundation Model
📄 Paper: arXiv:2509.12129 · 🏛️ ICLR 2026
精华
这篇论文展示了如何构建跨任务、跨具身体的导航基础模型,值得借鉴的核心思想包括:(1) 引入 Temporal-Viewpoint Indicator (TVI) tokens 来统一编码不同相机配置和时间信息,使模型能够处理多视角输入;(2) 提出 Budget-Aware Temporal Sampling (BATS) 策略,通过遗忘曲线动态采样历史帧,平衡性能和推理速度;(3) 在 8.02M 导航样本(包括四足机器人、无人机、轮式机器人、汽车等多种具身体)上联合训练,展示了大规模多任务训练对泛化能力的提升;(4) 采用视觉特征缓存机制加速训练 2.9 倍;(5) 证明了无需针对特定任务微调即可在多个基准测试上达到 SOTA 或竞争性能。
研究背景/问题
当前导航系统主要聚焦于特定任务设定和具身体架构,缺乏跨任务和跨具身体的泛化能力。现有 VLM 虽然在零样本任务上表现出色,但导航任务仍然局限于狭窄的任务领域、固定的相机配置和特定的具身体平台。本文旨在构建一个统一的导航基础模型,能够处理来自不同具身体(四足机器人、无人机、轮式机器人、汽车)的多视角输入,并跨越多个导航任务(VLN、目标搜索、目标追踪、自动驾驶)。
主要方法/创新点
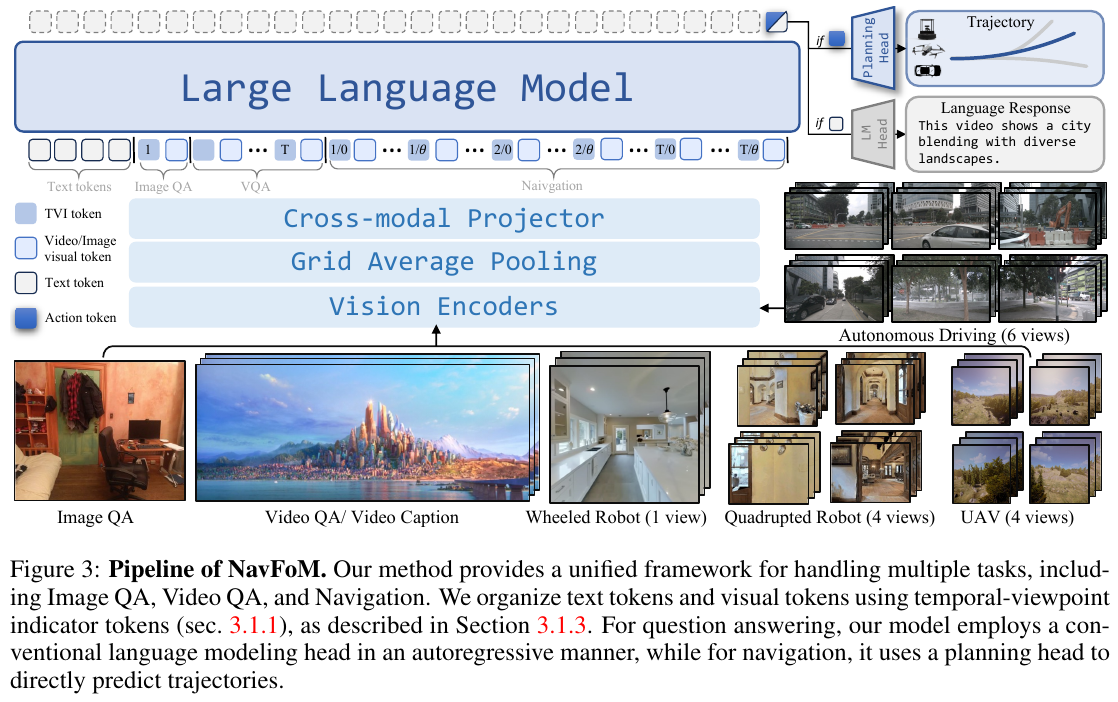
NavFoM 基于 Vision-Language Model 架构,扩展为双分支系统:一个用于导航,一个用于问答。核心创新包括:
1. Temporal-Viewpoint Indicator (TVI) Tokens
- 引入特殊 indicator tokens 来编码相机视角和时间信息,每个 TVI token 由三部分组成:
- 可学习的 base embedding (E_Base)
- 时间编码 (Time PE): 使用正弦位置编码标识帧的时间顺序
- 视角编码 (Angle PE): 使用正弦/余弦编码保持方位角的循环连续性
- 对于导航任务,使用: E_TVI = E_Base + Time PE + Angle PE
- 对于 Video QA,仅使用时间信息;对于 Image QA,仅使用 base embedding
- TVI tokens 使 LLM 能够区分不同时间步和不同视角的 tokens,实现多视角导航
2. Budget-Aware Temporal Sampling (BATS)
- 解决在线导航时视觉 tokens 数量激增的问题
- 基于遗忘曲线(exponential decay)的采样概率: P(t) = (1 - ε)e^(k(t-T)/T) + ε
- 动态调整历史帧采样,越近的帧采样概率越高
- 在 token budget 约束下,平衡短期上下文和长期历史信息
- 相比 Uniform Sampling,BATS 在保持性能的同时显著降低推理时间
3. 观测编码
- 使用预训练 vision encoders (DINOv2, SigLIP) 提取视觉特征
- 采用 Grid Average Pooling 策略生成两种分辨率的视觉 tokens:
- Fine-grained (64×C): 用于当前最新观测和 Image QA
- Coarse-grained (4×C): 用于导航历史和 Video QA
- 通过 cross-modality projector 将视觉特征映射到 LLM latent space
4. Token 组织策略
- 不同任务采用不同的 token 组织方式:
- Image QA: fine-grained visual tokens + base TVI embedding
- Video QA: coarse-grained visual tokens + base + time embedding
- Navigation: coarse-grained + fine-grained tokens + base + time + angle embedding
- 这种设计实现了导航和 QA 数据的联合训练
5. 轨迹预测
- 使用三层 MLP 作为 planning head 从 LLM 隐藏状态预测轨迹
- 轨迹归一化到 [-1, 1] 分布,针对不同具身体(室内导航 vs 户外驾驶)采用不同的 scaling factor
- 对于室内机器人,预测 8 个航点;对于汽车和无人机,预测更长的轨迹
6. 数据规模与来源
- 导航数据 (8.02M): VLN-CE R2R/RxR (2.94M), OpenUAV (429K), 目标导航 (1.02M), 主动视觉追踪 (897K), 自动驾驶 (681K), Web 导航伪标签 (2.03M)
- QA 数据 (4.76M): Image QA (3.15M) + Video QA (1.61M)
- 总计 12.7M 训练样本,覆盖四足机器人、无人机、轮式机器人、汽车等多种具身体
7. 训练优化
- 视觉特征缓存: 预先计算并缓存 coarse-grained visual tokens,训练加速 2.9 倍,GPU 内存减少 1.8 倍
- 使用 Qwen2-7B 作为 LLM backbone
- 单次训练所有参数(仅 designated trainable parameters),无需多阶段训练
核心结果/发现
VLN 性能:
- VLN-CE R2R: 单视角 SR 56.2%、SPL 51.2%(NE 5.01、OSR 64.9);四视角 SR 61.7%、SPL 55.3%(NE 4.61、OSR 72.1),无需任务特定微调
- VLN-CE RxR: 单视角 SR 57.4%、SPL 49.4%;四视角 SR 64.4%、SPL 56.2%,超越所有基线方法
- OpenUAV (四视角,UM split): SR 6.38% → 14.05%, OSRL 5.68% → 18.65%,显著优于 TravelUAV
目标搜索:
- HM3D-OVON (zero-shot): VAL SEEN SR 55.0%, VAL UNSEEN SR 45.2%,超越 MTU3D baseline
主动视觉追踪:
- EVT-Bench (four-view, zero-shot): Single Target SR 85.1%/TR 80.5%, Distracted Target SR 62.0%/TR 67.9%
自动驾驶:
- NAVSIM (eight-view): PDMS 84.3%, 与 SOTA 方法竞争性能
- nuScenes (six-view): CR 93%, 接近 SOTA
Ablation 研究:
- 多任务训练带来显著增益:联合训练使 VLN SR 从 57.3% 提升到 64.4%
- 相机数量对性能的影响:从单视角到四视角,SR 从 58.3% 提升到 65.8%,但增加到六视角略有下降
- BATS 相比 Uniform Sampling,在 RxR 上 nDTW 仅下降 1.4%,但保持稳定推理速度
- TVI tokens 相比其他替代方案(learned special tokens, handcraft tokens)显著提升性能
实际部署:
- 在 110 个真实世界测试场景(50 VLN + 30 搜索 + 30 追踪)中验证,成功率达到 72%~93%
- 支持跨具身体部署:四足机器人(Unitree Go2)、类人机器人、无人机、轮式机器人
- 0.5 秒内生成 8 航点轨迹(1600 token budget)
局限性
该方法在训练时需要大量计算资源(56 NVIDIA H100 GPUs,72 小时)。尽管引入了视觉特征缓存等优化策略,大规模训练仍然是资源密集型任务。此外,在需要遍历 300 米复杂邻域的 Unseen-Map 场景中表现较差,表明模型在大规模环境探索和长距离规划方面仍有改进空间。作者也指出 NavFoM 只是一个起点,未来需要更高质量的数据、更先进的技术以及新一代基准测试来推动泛化导航研究的发展。
15. MapNav (2025)
———A Novel Memory Representation via Annotated Semantic Maps for Vision-and-Language Navigation
📄 Paper: arXiv:2502.13451 · 🏛️ ACL 2025
精华
MapNav 的核心创新在于用轻量级的 Annotated Semantic Map (ASM) 替代传统的历史 RGB 帧序列作为记忆表示,实现了恒定 0.17MB 的内存占用(与步数无关),推理速度提升 79.5%。值得借鉴的关键思想:将语义地图与自然语言标注相结合,使 VLM 能够直接理解空间信息,而无需额外的解码器;用结构化的 top-down 地图取代时序帧,把”历史信息”从时间维度转移到空间维度,大幅降低计算开销。这种”语言化地图”的思路为 VLM 赋能导航提供了一个清晰且高效的范式。
研究背景/问题
Vision-and-Language Navigation (VLN-CE) 要求 agent 在连续三维环境中跟随自然语言指令导航。现有方法大量依赖历史 RGB 帧作为时序上下文,导致内存随轨迹长度线性增长(Navid 在 300 步时高达 276MB),且无法充分利用 VLM 对语言的理解能力。设计一种高效的记忆表示以替代历史帧,成为本工作的核心动机。
主要方法/创新点
MapNav 提出一个端到端的 VLM-based VLN 框架,核心组件是在线更新的 Annotated Semantic Map (ASM)。
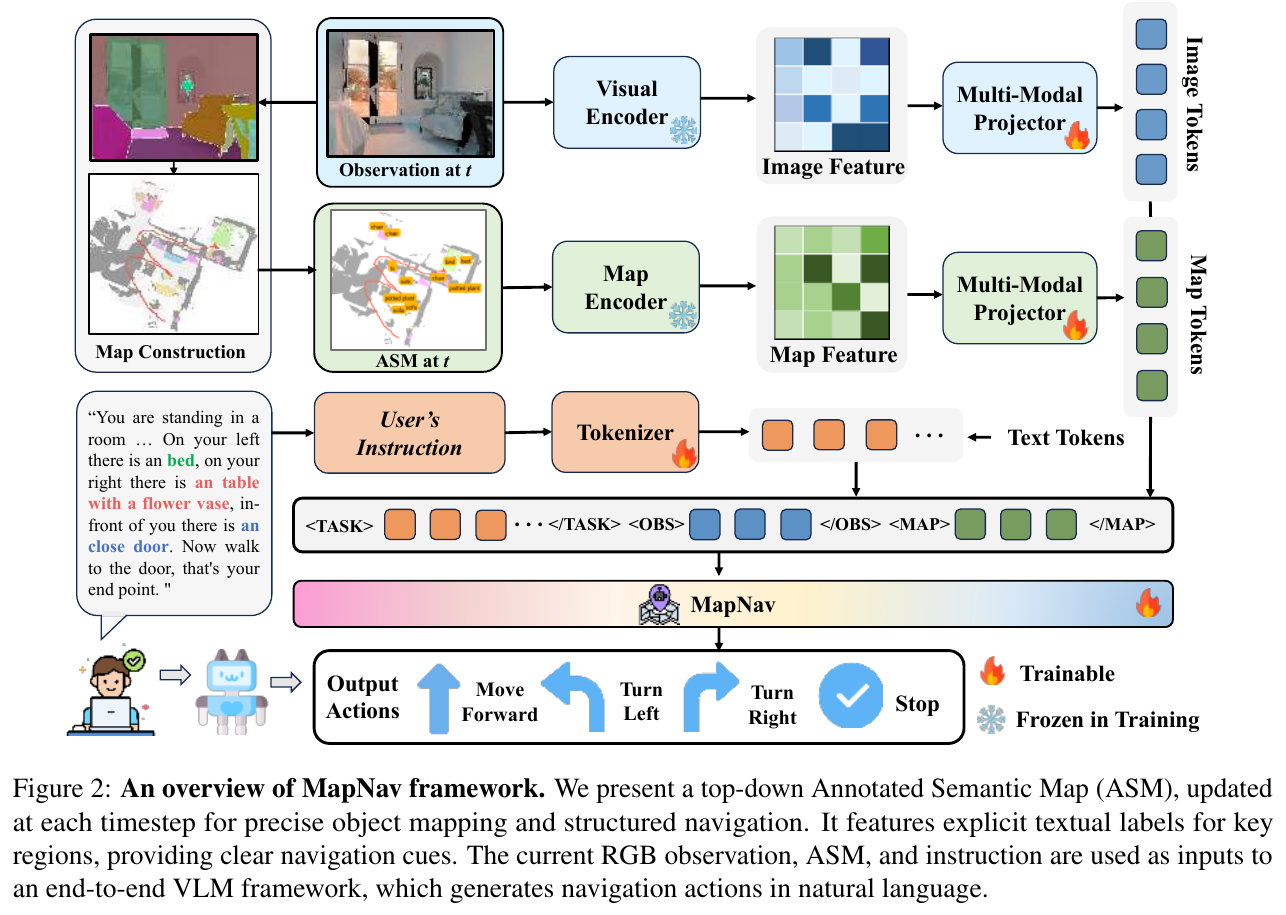
ASM 生成流程
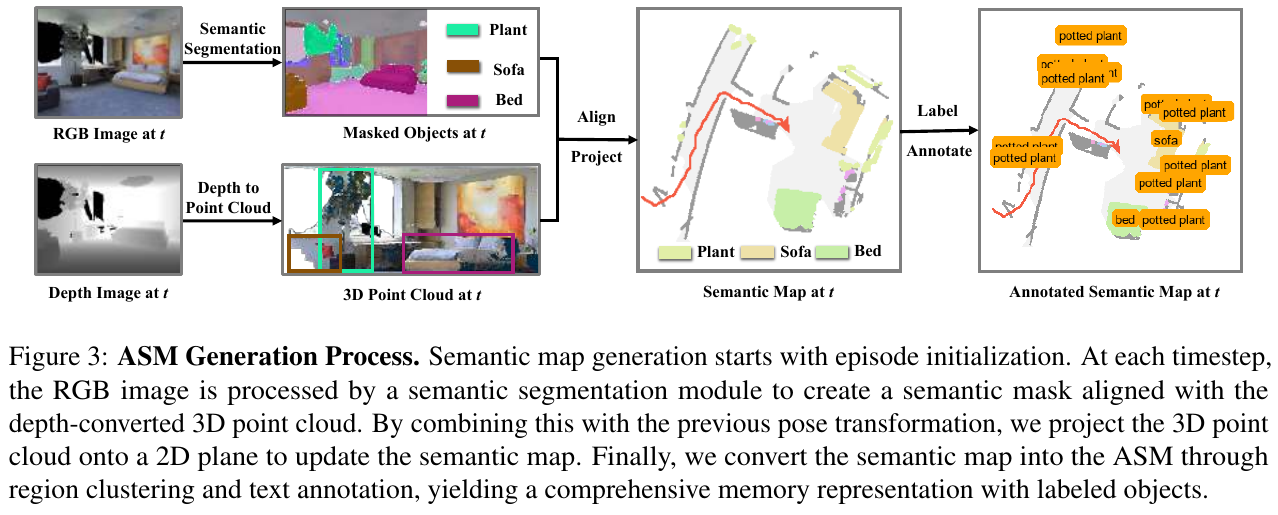
ASM 是一个多通道张量 M(维度 $C \times W \times H$,$C = C_n + 4$),其中:
- 基础通道(1-4):编码障碍物分布、已探索区域、agent 当前位置、历史轨迹
- 语义通道(n个):存储各目标物体的空间分布
生成流程:
- 用 Mask2Former 对当前 RGB 帧做语义分割,提取目标 mask
- 结合深度图将 3D 点云投影到 2D 俯视平面,对齐语义 mask
- 对每个语义区域做连通分量分析,计算区域质心并在地图上添加文字标签(如 “chair”、”potted plant”)
- 生成最终 ASM,包含物体位置、轨迹、障碍物等结构化信息
为什么 ASM 优于普通语义地图?
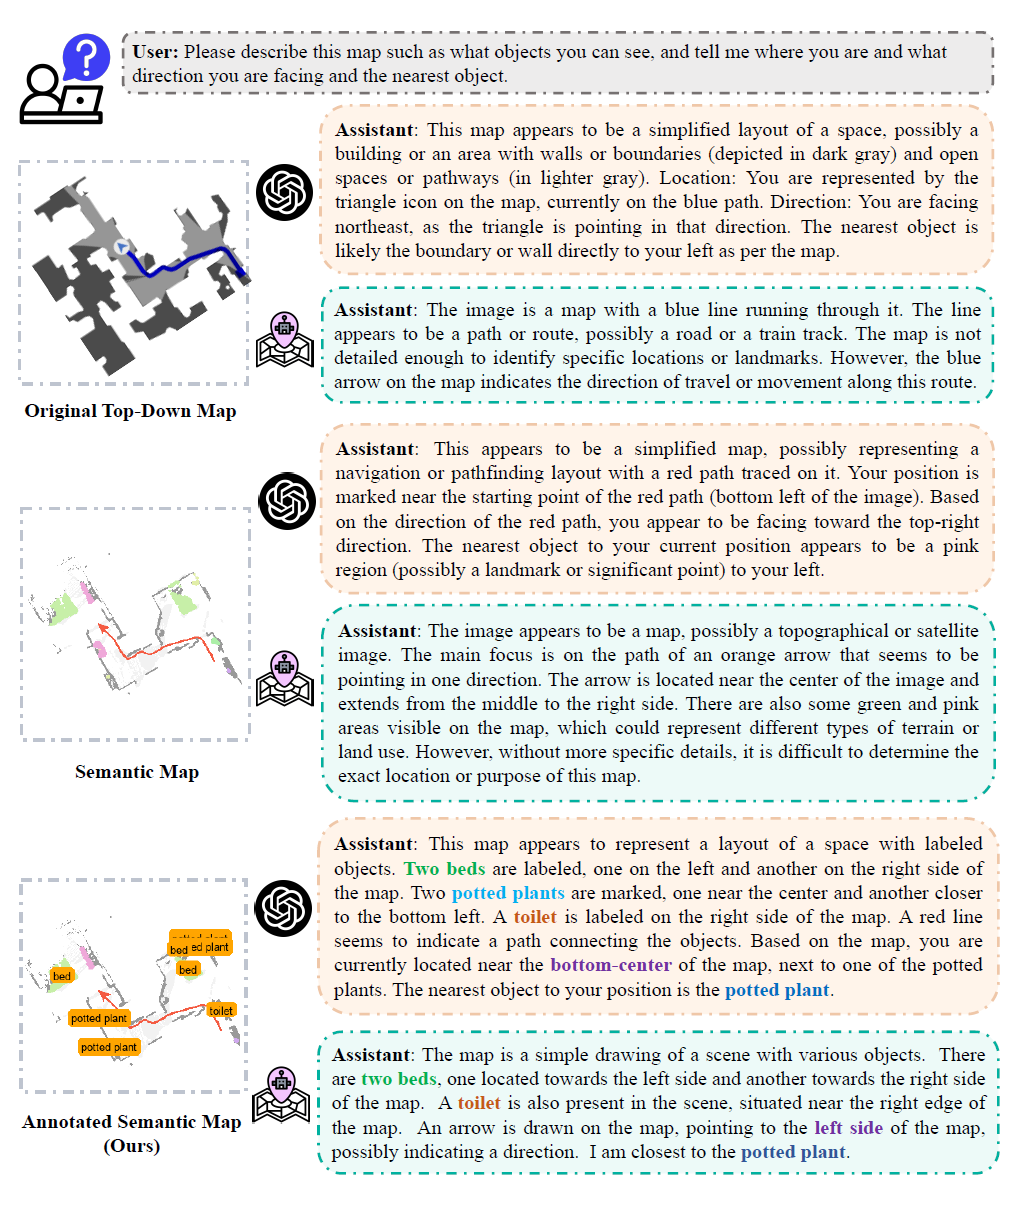
实验证明,VLM(GPT-4o 和 MapNav)处理 ASM 时表现出对物体位置的精准理解(注意力峰值 > 0.8),而处理原始 top-down 地图(峰值 < 0.3)或语义地图(峰值 < 0.4)时注意力极为分散。ASM 通过显式文字标注将抽象语义转化为语言基础,充分激活 VLM 预训练的语言理解能力。
双流编码器架构
MapNav 基于 LLaVA-Onevision 框架,使用 SigLIP-so400m 视觉编码器:
\[\mathbf{F}_t = \Phi_{spatial}(\mathbf{X}_t, \mathcal{G}), \quad \mathbf{F}_t^M = \Phi_{spatial}(\mathbf{X}_t^M, \mathcal{G})\]两路特征分别通过 MLP 投影对齐到语言空间,最终拼接为统一表示:
\[\mathbf{V}_t = [\text{TASK}; \mathbf{E}_t; \text{OBS}; \mathbf{E}_t^M; \text{MAP}]\]动作预测
VLM 直接输出自然语言动作,通过正则表达式匹配解析为 {前进, 左转, 右转, 停止} 四类动作,无需额外动作解码器。
训练数据(~1M 样本)
三阶段数据收集:
- Phase I:来自 R2R + RxR 的 GT 轨迹(~300k × 2)
- Phase II:DAgger 在线交互采集(~200k × 2)
- Phase III:碰撞恢复专项数据(~25k × 2)
历史帧数量的消融
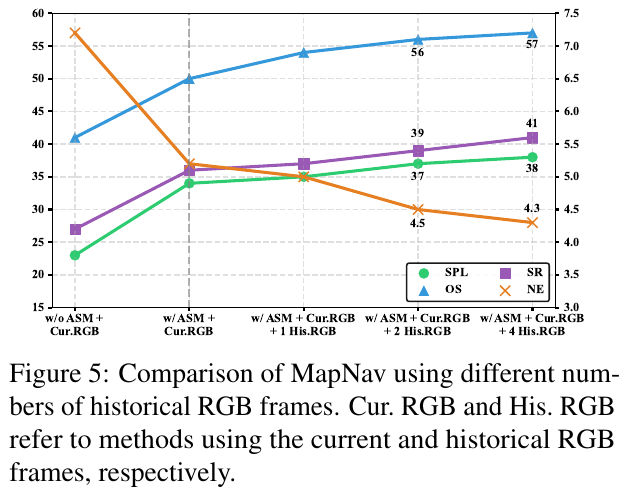
加入 ASM 后,SR 从 27% 提升至 36%,SPL 从 23% 提升至 34%;继续增加历史 RGB 帧带来的提升则相当有限,说明核心增益来自 ASM 的空间表示能力,而非时序帧累积。
核心结果/发现
模拟环境(R2R-CE & RxR-CE Val-Unseen)
| 方法 | R2R SR↑ | R2R SPL↑ | RxR SR↑ | RxR SPL↑ |
|---|---|---|---|---|
| NaVid (All RGB Frames) | 49.1 | 37.4 | 23.8 | 21.2 |
| MapNav (w/o ASM + Cur. RGB) | 41.2 | 27.1 | 15.6 | 12.2 |
| MapNav (w/ ASM + Cur. RGB) | 50.3 | 36.5 | 22.1 | 20.2 |
| MapNav (w/ ASM + Cur. + 2 His. RGB) | 53.0 | 39.7 | 32.6 | 27.7 |
- 仅用 ASM + 单帧 RGB,性能即可媲美使用全部历史帧的 NaVid
- 加入 2 帧历史 RGB 后超越所有 SOTA,R2R SPL 提升 1.3%,RxR SPL 提升 6.5%
效率对比(关键优势)
| 方法 | 1步 | 10步 | 100步 | 300步 | 平均推理时间 |
|---|---|---|---|---|---|
| Navid | 0.92MB | 9.2MB | 92MB | 276MB | 1.22s |
| MapNav | 0.17MB | 0.17MB | 0.17MB | 0.17MB | 0.25s |
- 内存占用恒定 0.17MB,与轨迹长度完全解耦
- 推理速度提升 79.5%(1.22s → 0.25s)
真实世界(5种室内场景)
在 Office、Meeting Room、Lecture Hall、Tea Room、Living Room 中,MapNav 在简单指令和语义指令下均全面超越 WS-MGMAP 和 Navid,SR 提升最高达 30%。
局限性
语义分割模块在遮挡或光照变化等复杂条件下可能产生不准确的物体标签,从而影响 ASM 质量。未来计划扩展到更复杂的具身 AI 任务(如交互导航和操作),需将物体可供性和物理交互能力整合进 ASM 表示。
16. Open-Nav (2025)
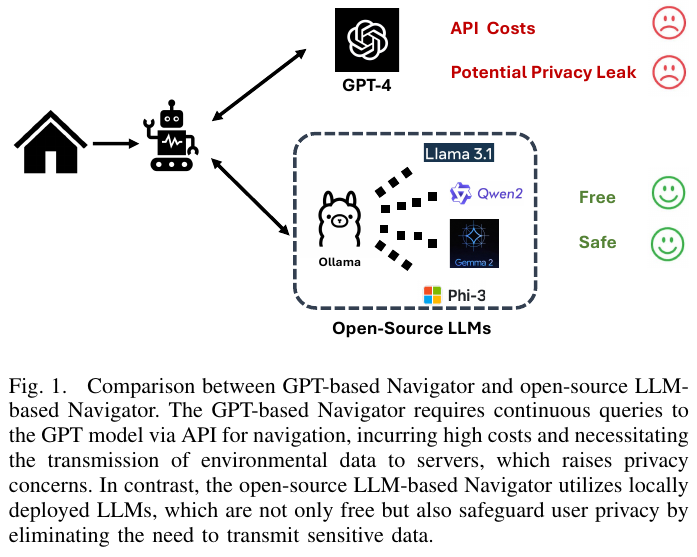
———Zero-Shot VLN in Continuous Environment with Open-Source LLMs
📄 Paper: arXiv:2409.18794 · 🏛️ ICRA 2025
精华
Open-Nav 的核心贡献在于将昂贵的 GPT-4 API 替换为本地部署的开源 LLM,同时维持竞争力性能,这对隐私敏感的真实场景机器人部署有重要意义。论文设计的三阶段空间-时序 CoT(指令理解 → 进度估计 → 决策制定)是一种可复用的 LLM 导航推理框架,值得借鉴。用 SpatialBot + RAM 联合增强视觉感知的思路——一个负责空间关系理解,一个负责细粒度目标识别——有效弥补了开源 LLM 相比 GPT-4 在视觉感知上的差距。真实世界评估结果显示,无训练的 Open-Nav 甚至超越了有监督训练的 SOTA 方法,说明 LLM 的泛化能力在分布外场景中优势显著。
1. 研究背景/问题
Vision-and-Language Navigation in Continuous Environments (VLN-CE) 要求 agent 在未见过的 3D 室内环境中,根据自然语言指令进行导航。现有基于 LLM 的零样本方法(如 NavGPT、DiscussNav)严重依赖 GPT-4 API,存在高昂 token 费用和用户环境数据隐私泄露风险,且主要在离散环境中验证,难以直接应用于连续真实场景。
2. 主要方法/创新点
Open-Nav 框架由三个核心模块组成:
1. Waypoint Prediction 模块
使用基于 Transformer 的路径点预测模型,融合 RGB 和深度图像特征(两个专用 ResNet50 分支):
\[v_i^{rgbd} = W_m(f_{\text{ResNet-RGB}}(I_i^{rgb}) \| f_{\text{ResNet-Depth}}(I_i^d))\]经 Transformer 处理后生成候选路径点热力图,再通过 NMS 筛选出 K 个候选方向点 \(\Delta W = \{\Delta w_i\}_{i=1}^K\),每个候选点由角度和距离表示。
2. Scene Perception 模块
针对连续环境中需要精确空间理解的挑战,使用两个互补模型增强场景描述:
- SpatialBot:空间理解 VLM,输入 RGB+深度图,输出包含物体间距离和空间关系的文本描述
- RAM(Recognize Anything Model):细粒度目标检测,识别场景中所有物体的类别和三维位置
两者输出合并为统一的文本化场景观测 $O_{text} = \langle D_{spatial}, {o_i}\rangle$,为 LLM 提供丰富的空间语境。
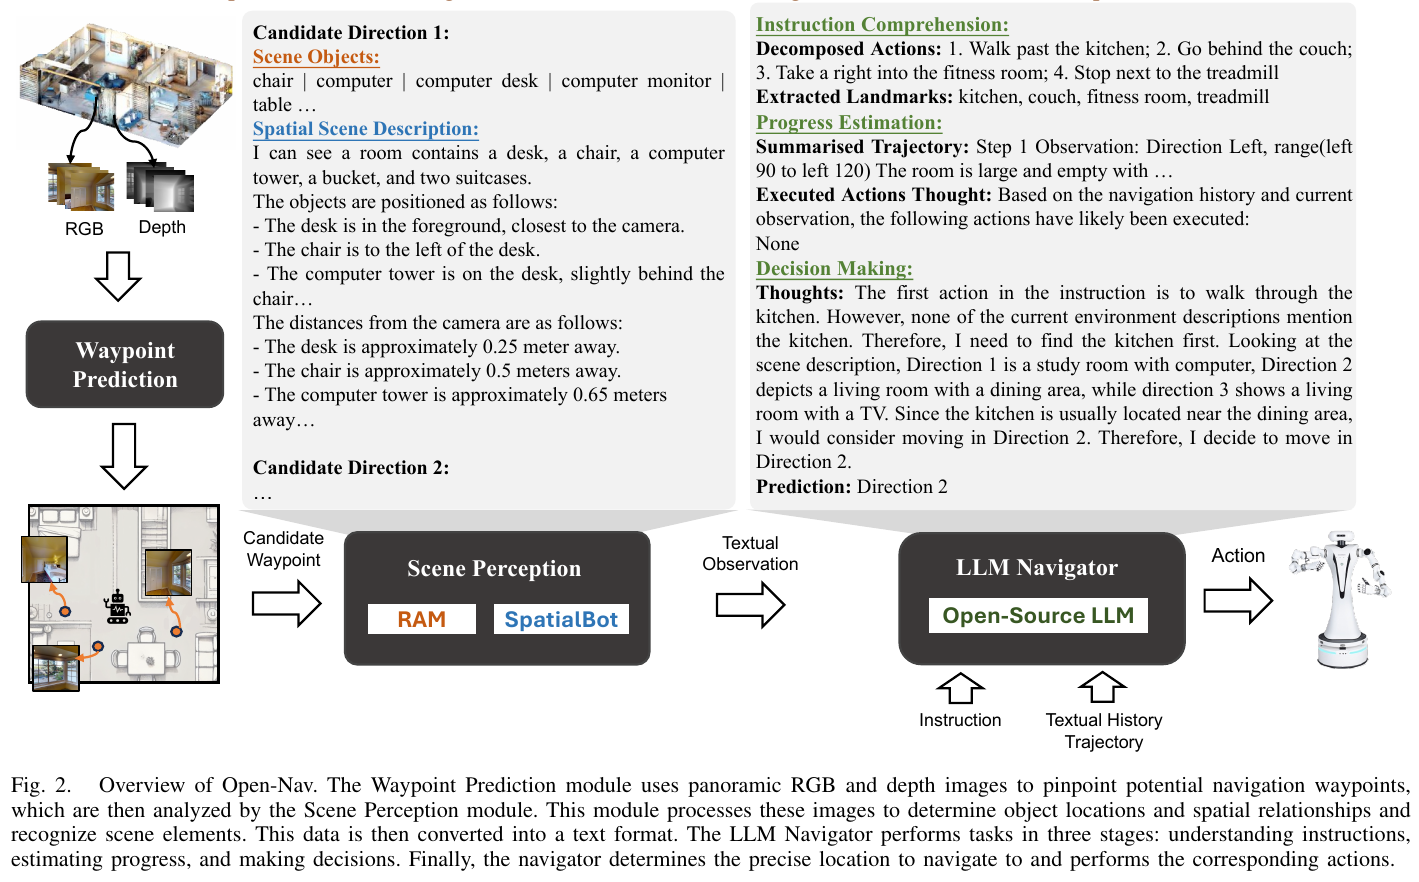
3. LLM Navigator:三阶段空间-时序 Chain-of-Thought
这是 Open-Nav 的核心创新。每个导航步骤,LLM 按顺序完成三个推理阶段:
- 指令理解(Instruction Comprehension):将导航指令分解为动作序列和地标列表,使用专用 prompt 提取结构化信息
- 进度估计(Progress Estimation):综合历史轨迹和当前观测,通过地标验证、方向分析、动作完成度评估四步判断已完成哪些子任务
- 决策制定(Decision Making):整合当前候选路径点的空间描述、历史轨迹摘要和进度估计结果,生成推理过程并选择最优方向点
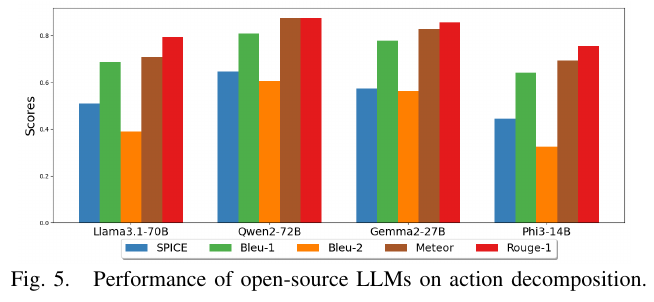
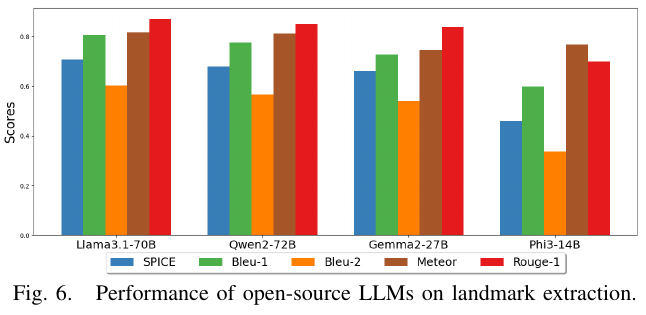
框架通过 Ollama 在本地部署四种开源 LLM:Llama3.1-70B、Qwen2-72B、Gemma2-27B、Phi3-14B。
3. 核心结果/发现
模拟环境(R2R-CE 数据集):
| 方法 | SR↑ | SPL↑ | nDTW↑ |
|---|---|---|---|
| DiscussNav-GPT4 | 15 | 10.51 | 42.87 |
| Open-Nav-Llama3.1(本文) | 16 | 12.90 | 44.99 |
| Open-Nav-GPT4(本文) | 19 | 16.10 | 45.79 |
Open-Nav 使用开源 LLM 在 SR 和 SPL 上均超过 DiscussNav-GPT4,证明开源 LLM 配合良好的感知增强可媲美闭源方案。
真实世界环境(Office / Lab / Game Room):
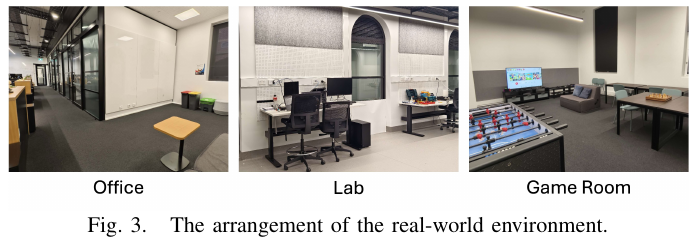
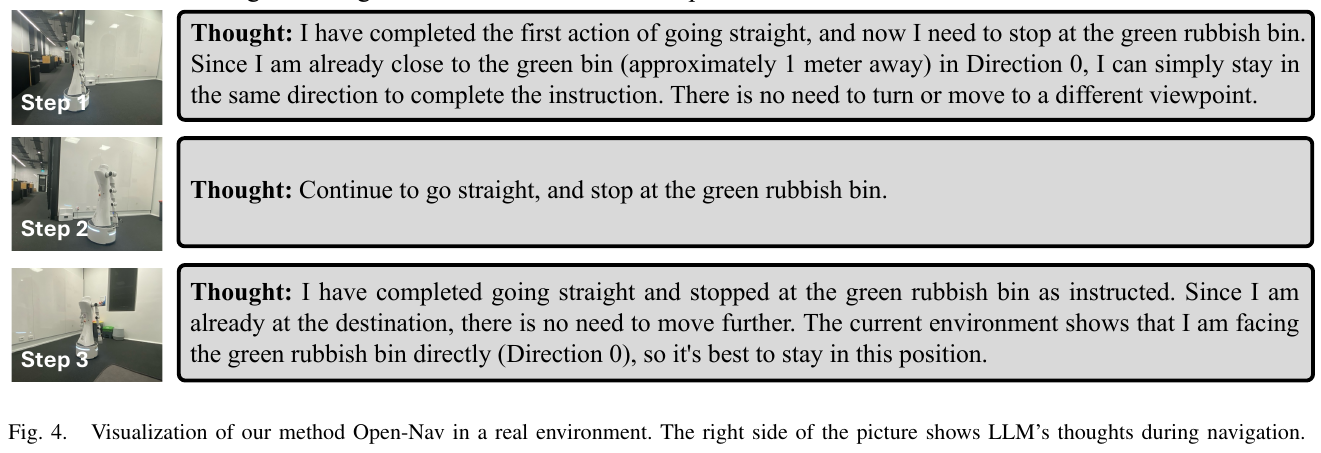
在全部真实场景中:Open-Nav-Llama3.1 达到 SR=35, NE=2.39,超越有监督训练的 CMA(SR=23)、RecBERT(SR=27)、BEVBert(SR=20),验证了 LLM 泛化能力在分布外场景的优越性。
不同开源 LLM 对比(模拟环境导航性能):
4. 局限性
当前开源 LLM 的推理速度较慢,在真实环境中计算效率仍有待提升;论文未探索针对导航任务微调开源 LLM 的潜力,未来可进一步缩小与 GPT-4 的性能差距。
17. Skill-Nav (2025)
———Enhanced Navigation with Versatile Quadrupedal Locomotion via Waypoint Interface
📄 Paper: arXiv:2506.21853 · 🏛️ Vicinagearth (Springer) 2025
精华
Skill-Nav 的核心贡献在于用 waypoint(路标点) 作为高层规划器与低层运动控制器之间的接口,相比速度命令接口,waypoint 对追踪误差更不敏感,且天然兼容 LLM 和经典路径规划算法。两阶段训练策略(WP-Fixed 先学技能、WP-Random 再强化泛化)解决了单阶段训练的跌步或过度跳跃问题,值得在其他层级化机器人控制任务中借鉴。Teacher-Student 蒸馏架构通过在 Student 训练时引入膨胀虚拟障碍(inflated virtual obstacles),使 Student 策略在不接触特权信息的条件下保持安全导航能力。
1. 研究背景/问题
四足机器人通过 RL 已能完成极限 parkour 等高难度运动,但将丰富的运动技能集成到长距离导航任务中仍未充分探索。现有方法大多以速度命令为接口,高层规划器难以精确跟踪,且与多样化通用规划工具(LLM、A*)耦合困难。
2. 主要方法/创新点
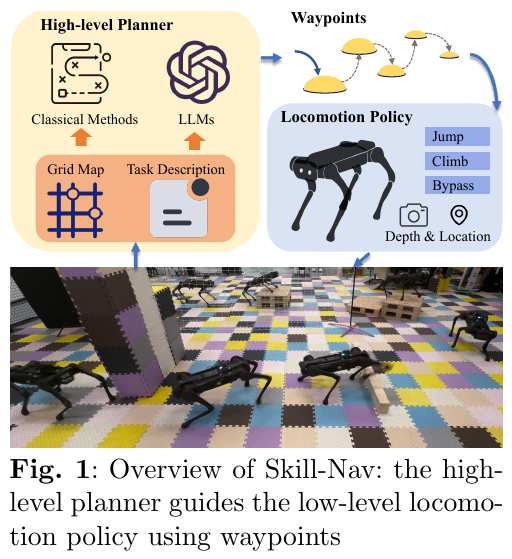
Waypoint 接口设计
Skill-Nav 以 2D 相对位置(相对于机器人 base frame 的坐标)作为 waypoint 命令替代速度命令。高层规划器通过 $\mathcal{W} = \mathcal{H}(\mathbf{M}, p_e, p_s)$ 生成从起点到终点的 waypoint 序列,$\mathcal{H}$ 可以是 A* 算法或 LLM,$\mathbf{M}$ 为粗粒度环境信息(如占用地图或房间布局)。
两阶段训练策略
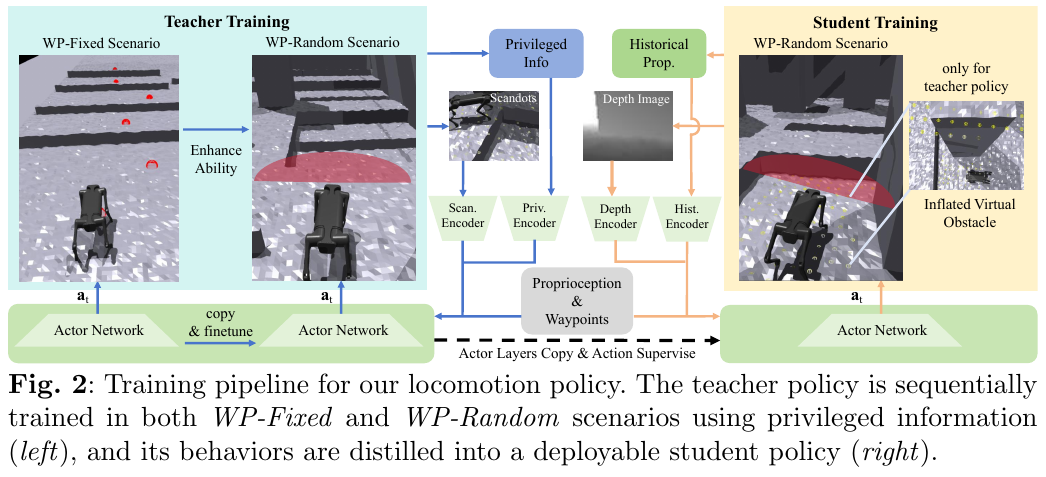
-
WP-Fixed 场景(技能学习):障碍物按行排列,waypoint 预置。策略从零开始学习攀爬箱体、跨越间隙、越过护栏等基础运动技能。设计 $r_{\text{reach}} = n_p/(t + \epsilon)$ 鼓励机器人快速到达更多 waypoint,同时引入 $r_{\text{stay}}$ 使机器人在到达 waypoint 后等待下一条指令。
-
WP-Random 场景(泛化增强):障碍物以矩阵形式随机分布,waypoint 根据机器人位置和偏航角动态选取。引入修改后的 $r_{\text{track}}$,当速度方向与 waypoint 方向余弦相似度 $< 0.1$ 时给予 $-1$ 惩罚,鼓励机器人向目标前进。Student 训练时在深度图中加入虚拟膨胀障碍,使学生策略保持安全距离。
双规划器高层架构
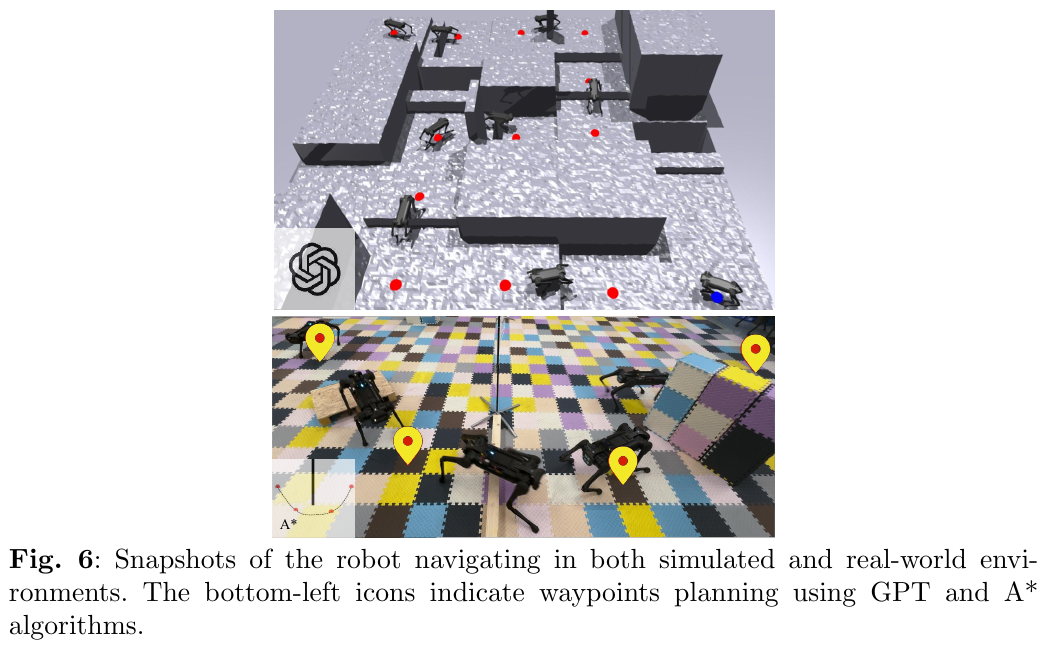
- 经典规划(A*):输入仅含墙体标注的占用地图,输出连续路径点序列,以 0.5–3m 间隔采样为 waypoint 输入低层控制器。
- LLM 规划:向 LLM 提供任务描述、粗粒度地形图、机器人运动能力(最高攀爬 0.45m、最大跨越 0.7m 间隙)等信息,由 LLM 生成 waypoint 索引序列(以 GPT-4 验证)。
3. 核心结果/发现
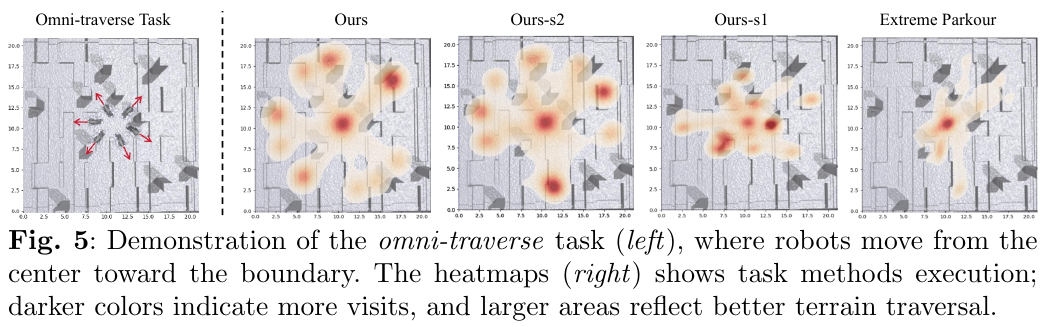
- Single-traverse 任务:在有无高障碍物场景中,Skill-Nav 均达到 SR=1.00、ATD=15.8m,是唯一在两种条件下均成功的方法。
- Omni-traverse 任务:SR=0.89、ATD=8.2m,超越所有对比方法(RMA SR=0.00,Extreme Parkour SR=0.44/0.28)。
- 消融分析:仅 WP-Fixed 训练(Ours-s1)因 waypoint 分布规则,泛化能力差;仅 WP-Random 训练(Ours-s2)导致过度跳跃步态,实际部署困难;两阶段结合效果最优。
- 真实机器人部署:在 Unitree AlienGo 上成功验证,可应对深度相机未检测到的低矮障碍,并在受到外力干扰后恢复平衡继续导航。
4. 局限性
高层规划器(尤其是 LLM)可能生成位于间隙中央或箱体边缘等异常 waypoint,低层控制器难以从这类极端位置恢复;未来工作将设计边缘无碰撞低层控制器,并探索运动与导航的端到端统一策略。
18. VLN-Imagine (2025)
———用文本生成图像模型为导航智能体构建”视觉想象”
📄 Paper: arXiv:2503.16394 · 🏛️ CVPR 2025
精华
- 利用现成的 text-to-image 扩散模型(SDXL)为导航指令中的地标名词短语生成”视觉想象”,将跨模态对齐从隐式学习转化为显式的图像-图像匹配,思路简洁且可迁移。
- 方法设计为 model-agnostic:通过独立的 imagination encoder + 辅助对齐损失即可嵌入任意 VLN 模型,无需修改原有架构。
- 子指令过滤策略(FG-R2R 分割 + 名词短语黑名单)有效控制了生成图像的质量与相关性,是低成本数据增强的好范例。
- 实验表明 imagination 在训练和推理阶段均有增益,且训练阶段的正则化效应独立于推理时的输入增益,说明多模态辅助信号可提升模型泛化。
- cosine similarity 辅助损失足以对齐 imagination 与指令表征,无需更复杂的对比损失(InfoNCE),体现了”够用即可”的工程哲学。
1. 研究背景/问题
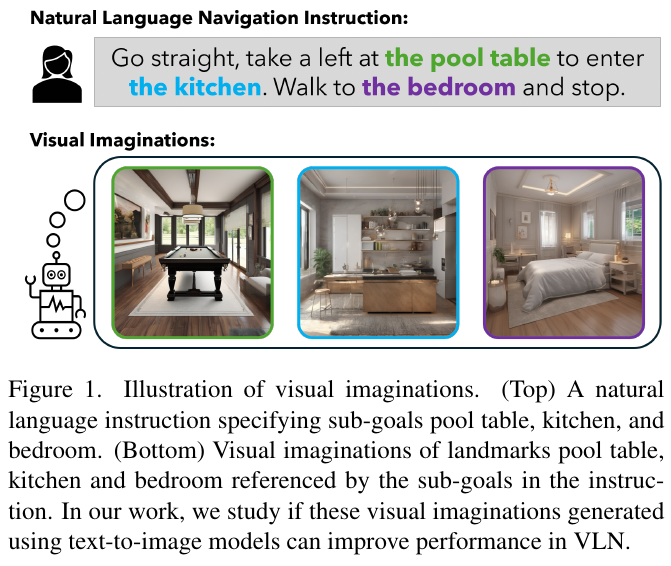
Vision-and-Language Navigation(VLN)任务中,智能体需要根据自然语言指令在未见过的环境中导航。指令常引用视觉地标(如”pool table”“kitchen”),但现有方法依赖隐式跨模态对齐来关联名词短语与实际观察。本文探索是否可以在导航前先用 text-to-image 模型为地标生成”视觉想象”,将语言-视觉对齐转化为更容易的图像-图像匹配任务。
2. 主要方法/创新点
2.1 Visual Imagination 生成管线
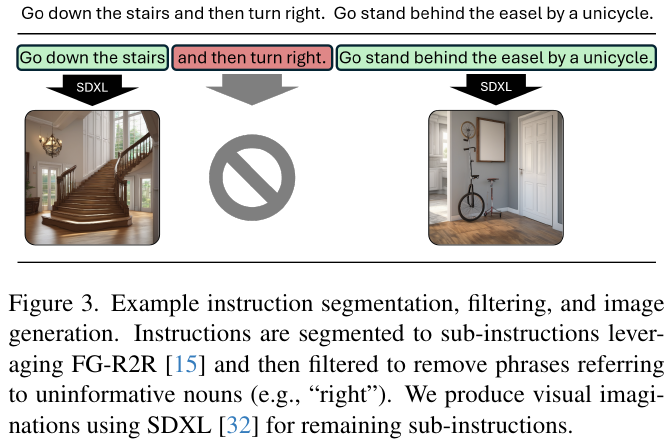
- 指令分割:使用 FG-R2R 将完整导航指令分割为子指令序列 $S = (S_0, \cdots, S_m)$,R2R 训练集平均每条指令 3.66 个子指令。
- 子指令过滤:通过 SpaCy 过滤无名词短语的子指令,再用黑名单排除非视觉名词(如计数词、方向词、代词),保留有效子指令集 $S’ \subset S$。
- 图像生成:使用 SDXL 扩散模型,以正向提示词(indoor, house, realistic, real estate)和负向提示词(outdoor, text, humans 等)引导生成室内场景图像。最终构建 R2R-Imagine 数据集,包含超过 41k 张 1024×1024 想象图像。
2.2 Model-Agnostic 集成方法
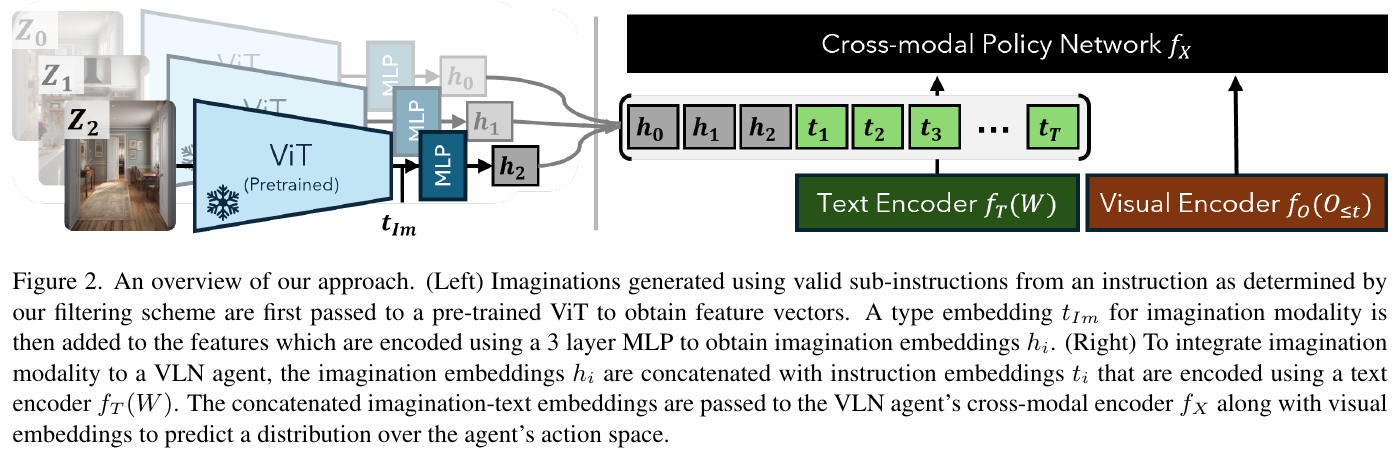
- Imagination Encoder:使用预训练 ViT-B/16 编码想象图像,加上 imagination modality 的类型嵌入 $t_{Im}$,再通过三层 MLP(768→512→768,ReLU + Dropout 0.15)得到 imagination embedding $h_i = \text{MLP}(\text{ViT}(Z_i) + t_{Im})$。
- 模态融合:imagination embedding 与指令的文本编码拼接后,一起送入 VLN 智能体的跨模态编码器。本文在 HAMT 和 DUET 两个代表性模型上验证了该方法。
- 辅助对齐损失:计算 imagination embedding $h_i$ 与对应子指令名词短语的平均文本嵌入 \(\bar{S}_i\) 之间的 cosine similarity 损失 $\mathcal L_{cos}$,总损失为 $\mathcal L_{\text{base}} + \lambda \mathcal L_{cos}$($\lambda=0.5$)。
- 三阶段微调:为缓解灾难性遗忘,先训练 MLP + 类型嵌入(25% 迭代)→ 联合训练所有模块(25%)→ 统一学习率训练(50%),总计 100k 迭代。
3. 核心结果/发现
- R2R 数据集:HAMT-Imagine 在 val-unseen 上提升 1.0 SR / 0.5 SPL(66.24 → 67.26 / 61.51 → 62.02);DUET-Imagine 提升 0.6 SR / 0.07 SPL(71.52 → 72.12 / 60.41 → 60.48),test split 上 SR 从 69 提升到 71。
- REVERIE 数据集:DUET-Imagine 在粗粒度指令设置下 SR 提升 1.3 点,RGS 提升 0.82 点,说明想象对目标定位也有帮助。
- 训练与推理双重增益:即使在推理时 nullify imagination(置零注意力掩码),模型仍优于 baseline,暗示 imagination-based 训练具有正则化效果。
- 对齐是关键:随机 imagination 反而降低性能;正确对齐的 imagination 才能带来提升。
- 视觉优于文本:用子指令文本嵌入代替 imagination embedding 效果不如视觉想象,说明视觉表征与语言起互补作用。
- Imagination 高保真度:通过 LangSAM 开放词汇检测器验证,98.78% 的子指令至少有一个名词短语被检测到。
4. 局限性
生成和编码想象图像增加了计算开销,对实际机器人部署尤为不利(H100 上单张 3.2 秒,微调需 V100 约 1.5 天)。此外,想象图像无法捕捉环境中物体和位置的个性化命名,终身学习的持久化视觉 grounding 仍是开放问题。
19. VLN-PE (2025)
———重新思考视觉-语言导航中的具身化差距:物理和视觉差异的全面研究
📄 Paper: arXiv:2507.13019 · 🏛️ ICCV 2025
精华
这篇论文通过构建物理真实的VLN平台,系统性地揭示了理想化仿真与物理部署之间的巨大差距。核心启示包括:(1) 跨具身数据融合训练可以显著提升模型泛化能力,为统一的跨机器人导航模型奠定基础;(2) 多模态感知(RGB+Depth)比单一RGB更鲁棒,尤其在光照变化环境下;(3) 物理控制器的引入对于腿足机器人至关重要,训练和评估阶段的控制器一致性直接影响性能;(4) 现有MP3D风格数据集的泛化能力有限,小规模域内数据微调即可超越大模型零样本性能;(5) diffusion policy作为连续路径点预测的新范式在VLN任务中展现潜力。
研究背景/问题
现有的VLN方法在理想化仿真环境中表现优异,但在部署到真实物理机器人时面临巨大挑战。主要问题包括:当前VLN平台忽视了机器人的物理具身特性(如视点高度、运动动力学、碰撞和跌倒等),并且缺乏对不同机器人类型(轮式、人形、四足)的跨具身支持。研究核心问题是:物理具身约束和视觉环境变化对现有VLN方法的性能影响究竟有多大?
主要方法/创新点
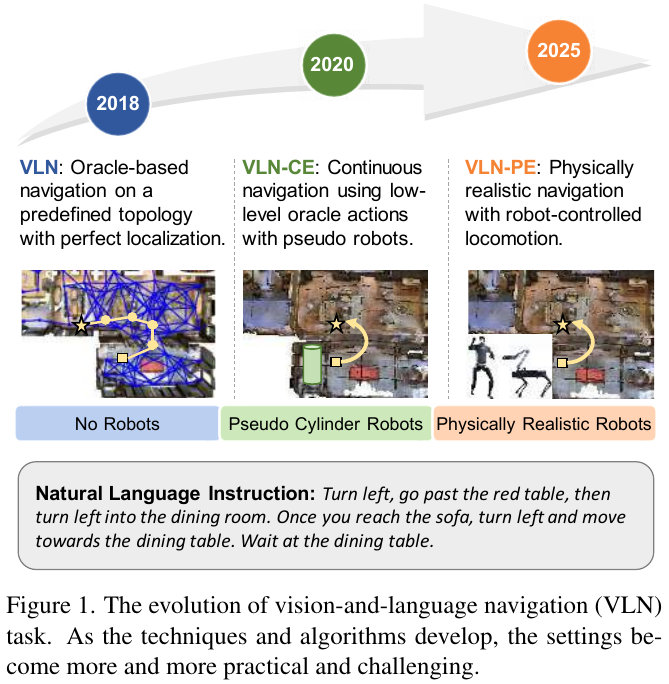
论文提出了VLN-PE平台,一个基于GRUTopia构建的物理真实VLN基准测试平台,具有以下核心特性:
-
跨具身支持:支持人形机器人(Unitree H1, G1)、四足机器人(Unitree Aliengo)和轮式机器人(Jetbot),并提供基于RL的物理控制器API,实现真实的运动动力学模拟
-
场景多样性:除了90个MP3D场景外,新增10个高质量合成家居场景(GRScenes)和3DGS在线渲染实验室场景,支持无缝集成更多环境
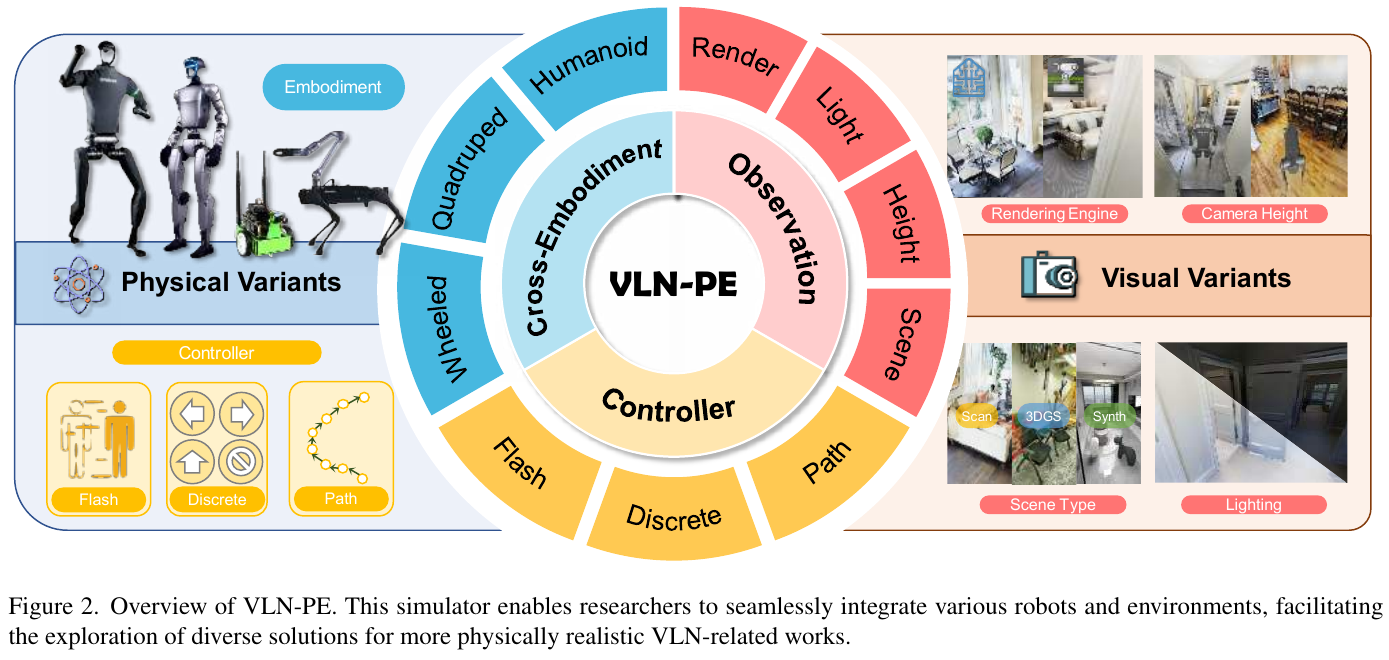
- 系统性评估框架:评估三类ego-centric VLN方法
- 单步端到端方法:Seq2Seq、CMA(约36M参数)和NaVid(7B参数的视频MLLM)
- 多步端到端方法:首次提出RDP(Recurrent Diffusion Policy),使用transformer-based diffusion模块预测连续轨迹路径点
- 地图基零样本方法:改进的VLMaps,结合LLM和语义地图进行路径规划
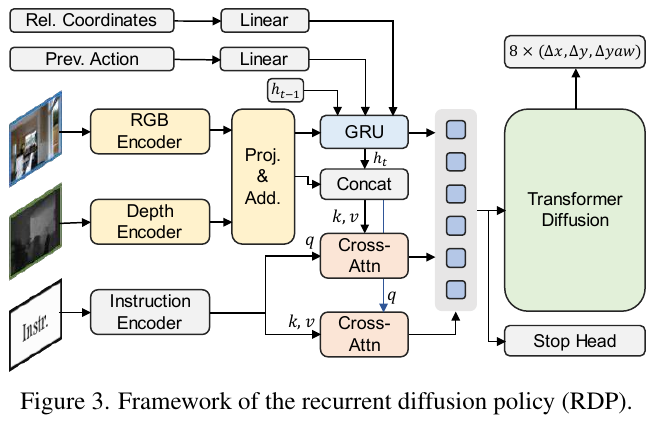
- 新数据集:
- R2R-filtered:过滤楼梯场景后保留8,679/658/1,347个训练/val-seen/val-unseen episodes
- GRU-VLN10:10个合成场景,441/111/1,287个episodes
- 3DGS-Lab-VLN:3DGS渲染实验室环境,160训练/640评估episodes
- 新评估指标:除了传统的TL、NE、SR、OS、SPL外,新增Fall Rate (FR)和Stuck Rate (StR)来衡量物理真实性挑战
核心结果/发现
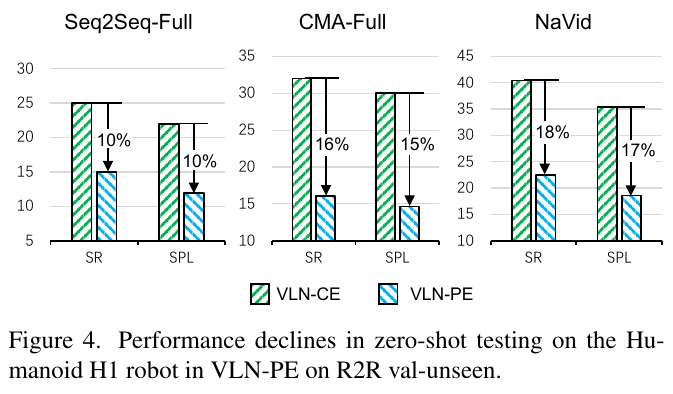
零样本迁移性能大幅下降:
- VLN-CE模型直接迁移到VLN-PE时,SR相对下降约34%
- Seq2Seq-Full、CMA-Full和NaVid的SR分别下降10%、16%和18%
- 这表明现有模型严重过拟合特定仿真平台
域内微调显著提升:
- 在VLN-PE上从头训练的CMA(无数据增强)超越了使用175K增强数据训练的CMA-Full
- 小模型CMA+经过微调后,在val-seen上达到SR 28.72,SPL 24.24,超越NaVid的零样本性能
跨具身敏感性:
- 四足机器人(相机高度约0.5m)在迁移时几乎完全失败
- 调整相机高度到1.8m可改善人形机器人的迁移性能
- 跨具身联合训练使单一模型在所有机器人类型上达到SoTA性能
物理控制器的重要性:
- 训练和评估使用相同控制器时性能最佳
- 使用物理控制器收集数据可降低Fall Rate和Stuck Rate
多模态鲁棒性:
- 仅RGB的NaVid在低光照下SR下降12.47%
- RGB+Depth的CMA和RDP受光照影响较小(下降约1-2%)
MP3D数据集泛化能力有限:
- 在GRU-VLN10上,RDP用6M参数仅441个训练样本,零样本超越NaVid大模型
- 在3DGS-Lab-VLN上,NaVid完全失败(SR仅5.81),可能是3DGS渲染噪声导致
扩散策略的潜力:
- RDP作为首个VLN扩散策略基线,在从头训练时优于Seq2Seq和CMA
- 预测连续密集路径点,可与MPC等控制理论方法结合
真机实验验证:
- 使用Unitree Go2机器人进行14个室内场景测试
- VLN-PE微调模型在真实环境中OS达到57.14,SR达到28.57,显著优于VLN-CE训练模型
局限性
当前RL-based运动控制器无法可靠处理复杂环境中的楼梯导航,需要过滤相关场景。论文主要聚焦ego-centric视角,未评估panoramic VLN方法。MLLM在精确目标识别和停止决策上仍存在挑战。3DGS渲染引入的像素级噪声可能干扰纯RGB模型,需要进一步研究图像扰动的鲁棒性。
20. Goal2Pixel (2025)
———将导航目标接地到图像像素,以像素预测统一 VLN-CE 的决策空间
📄 Paper: arXiv:2606.01621
精华
- 图像平面即决策空间:将 VLN-CE 的高层决策从离散动作预测重新定义为像素预测——VLM 只需输出一个像素坐标,消除了动作标签的歧义性,并与 VLM 的原生输出空间对齐。
- 辅助指令区域设计:将转向/停止等非前进动作编码为图像平面扩展区域中的像素,使所有决策在同一坐标空间内统一处理,无需两阶段切换。
- ViKeyMem 以可见性驱动关键帧:以”未来路点可见性变化”为关键帧选取标准,仅需 3–4 帧即可编码 100+ 步轨迹,训练成本从 156 降至 70 H100 GPU 小时。
- 减少 VLM 调用次数:像素预测粒度更粗(一次预测对应 5 步低层动作),使 VLM 调用次数从 46.62 降至 7.75,同时性能从 32.9% SR 提升至 54.1% SR。
- 跨平台可迁移性:像素输出将高层 VLM 推理与机器人底层控制器解耦,同一模型可跨不同硬件平台复用。
1. 研究背景/问题
VLN-CE(连续环境视觉语言导航)中,现有 VLM-based 方法多以低层动作预测(前进/左转/右转/停止)为输出接口,存在三个缺陷:监督信号模糊(同一空间目标对应多个合法动作序列)、决策视野短(每步只移动 25cm)、VLM 调用次数过多(每集需 30–47 次)。如何为 VLM 推理与机器人执行之间找到更合适的接口,成为核心问题。
2. 主要方法/创新点
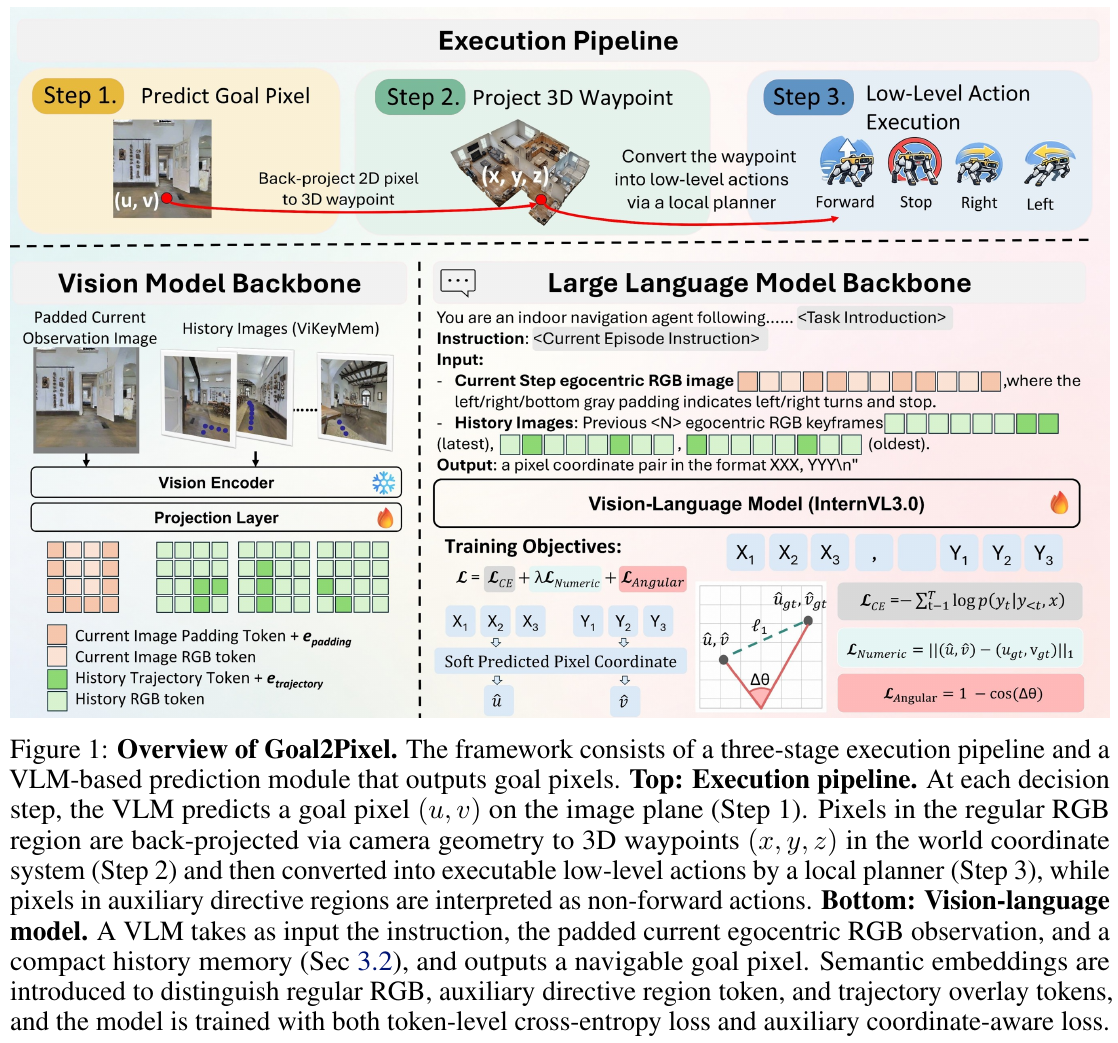
① 整体框架概述
Goal2Pixel 由三个核心部分构成:像素预测 VLM(InternVL3 微调)、几何反投影模块、本地规划器。VLM 输出坐标字符串 → 反投影为 3D 路径点 → 规划器执行至多 5 步低层动作后再次查询 VLM,形成闭环。
② 纯像素输出接口(Pure Pixel Paradigm)
- 输入:正方形填充的当前 RGB 图像(含三侧辅助指令区域)+ 语言指令 + ViKeyMem 历史(最多 8 帧)
- 处理:VLM 自回归生成 “XXX,YYY” 格式坐标字符串,坐标归一化至 [000, 999]
- 输出判断:坐标落在 RGB 区域 → 经相机内参反投影为 3D 路径点,由本地规划器跟踪执行;坐标落在辅助区域 → 直接执行 Turn_Left / Turn_Right / Stop
- 设计动机:像素坐标是 VLM 的原生输出空间,监督信号更明确;所有决策统一在同一接口,无需两阶段 action-then-pixel 切换
辅助指令区域规则:
- 底部区域 → Stop(距终点 ≤1m 时,GT 像素指向此区域)
- 左/右区域 → Turn_Left / Turn_Right(当前进路点不可见时,根据接下来 5 个路点的平均自中心方向决定)
GT 像素定义:沿 oracle 轨迹,当前帧中最远可见可行驶像素——鼓励更长视野决策,去除短程动作的模糊歧义。
③ ViKeyMem 关键帧历史记忆
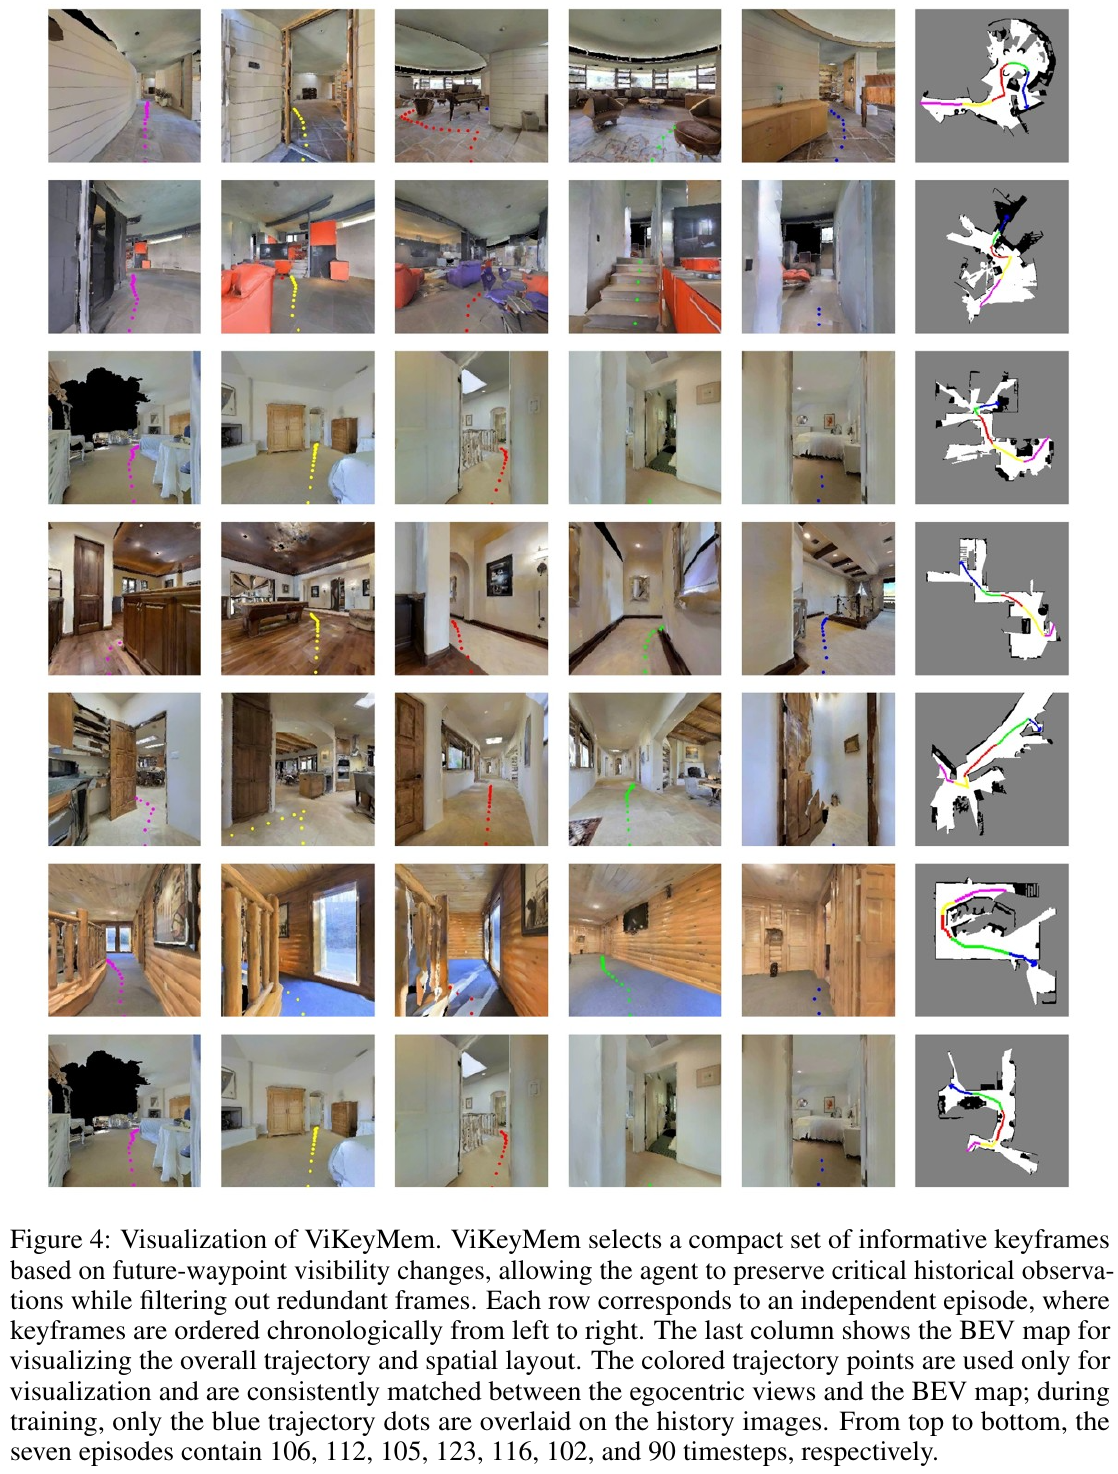
ViKeyMem 以未来路点可见性变化为关键帧选取标准,候选帧满足以下三个条件时加入关键帧集合:
- 候选帧视点不再被最近关键帧覆盖(核心可见性条件)
- 候选帧自中心图像中至少有一个后续路点可见
- 至少两个不同后续路点落在候选帧 45° 前向视场内
每个选取的关键帧上叠加蓝色轨迹点(trajectory overlay),提供轻量级过去运动提示。R2R-CE 上平均每 100 步仅选 3–4 帧,推理时间从 0.224s 降至 0.121s,训练时间从 156 H100 小时降至 70 小时。
④ 视觉语义嵌入(Visual Semantic Embeddings)
预训练 VLM 对导航特有的视觉模式(辅助指令区域、轨迹叠加点)识别能力不足,因此引入两类可学习嵌入:
- 指令区域嵌入(directive embedding):叠加在与辅助指令区域重叠的当前帧 visual token 上
- 轨迹嵌入(trajectory embedding):叠加在含蓝色轨迹点的历史帧 visual token 上
- 普通 RGB token 保持不变,参数量极小
⑤ 训练目标与坐标感知损失
\[\mathcal{L} = \mathcal{L}_{CE} + \lambda_{num}\mathcal{L}_{num} + \lambda_{ang}\mathcal{L}_{ang}\]- \(\mathcal{L}_{CE}\):标准 token 级交叉熵,主要监督信号;\(\lambda_{CE}=1\)
- \(\mathcal{L}_{num}\):数值损失,通过 softmax logits 推导可微 soft 坐标,鼓励预测数值接近 GT;\(\lambda_{num}=0.3\)
- \(\mathcal{L}_{ang}\):角度损失,鼓励预测像素保持与 GT 相同的自中心方向;\(\lambda_{ang}=0.03\)
⑥ 推理流程
每次 VLM 调用后,本地规划器最多执行 t=5 步低层动作;若出现连续 20 步左右震荡,自动 fallback 到固定前进像素 (500,970) 以脱困。
3. 核心结果/发现
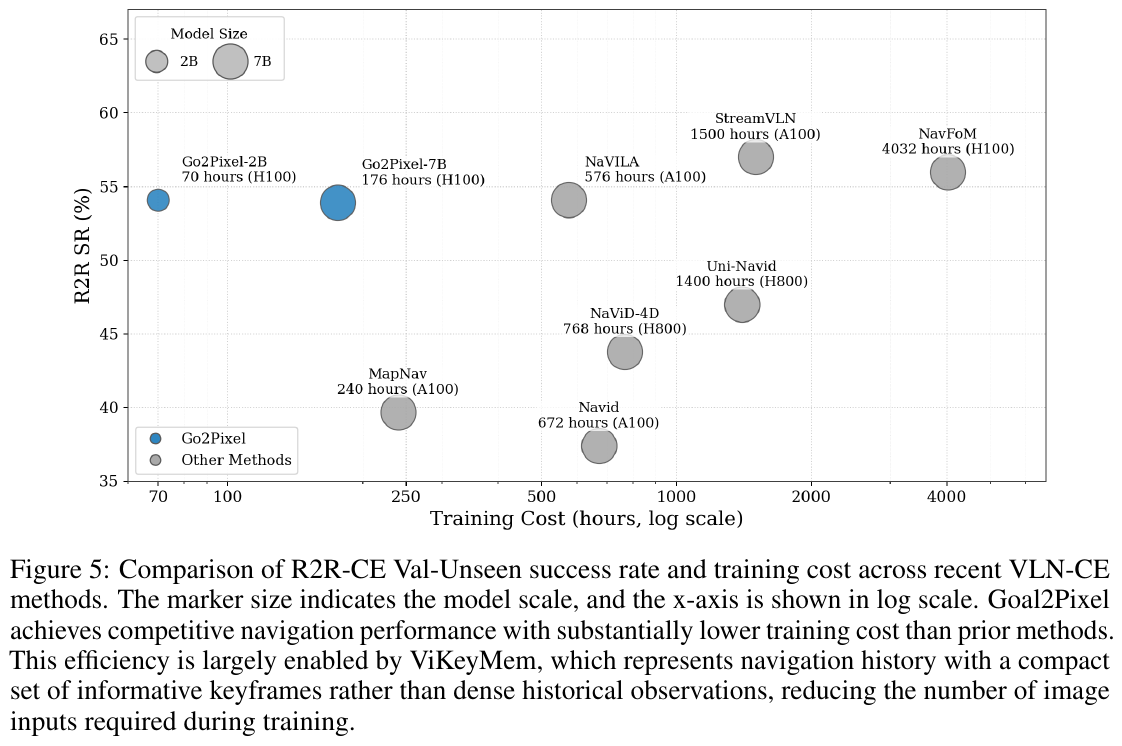
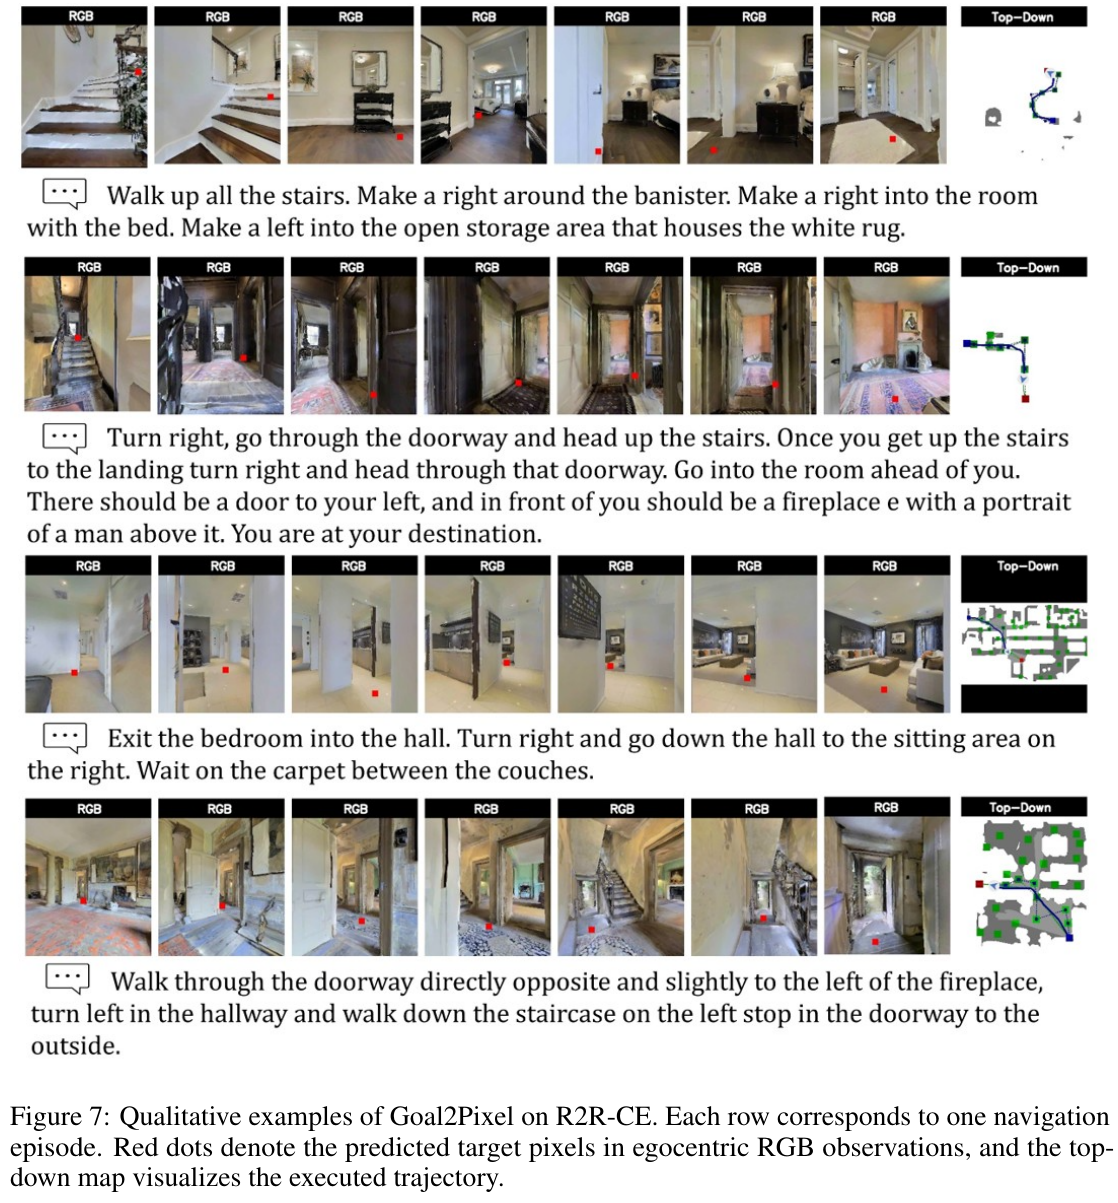
R2R-CE Val-Unseen 主要结果(2B 模型,零外部数据):
- SR 54.1%,SPL 52.5%,每集仅需 7.75 次 VLM 调用
- 直接动作预测:SR 32.9%,需 46.62 次调用(SR 差 21.2 点,调用多 6×)
- 与 JanusVLN 7B(SR 52.8%)相比,2B Goal2Pixel SR 高 1.3 点,参数规模仅 2/7
输出范式消融(Table 2):
| 输出范式 | SR | SPL | # VLM Calls |
|---|---|---|---|
| 1 动作预测 | 32.9% | 31.5% | 46.62 |
| 4 动作预测 | 37.0% | 36.0% | 15.77 |
| 混合 Action-Pixel (Seq) | 43.7% | — | ~10 |
| 纯 Pixel(本文) | 54.1% | 52.5% | 7.55 |
ViKeyMem 消融(Table 3a):
- 对比 5-step 固定间隔采样:SR/SPL +8.0/+7.4(R2R),+5.1/+5.0(RxR)
- 推理时间:0.243s → 0.121s(−50%);训练时间:173h → 70h(−60%)
RxR-CE Val-Unseen(2B):SR 43.8%,SPL 40.4%,nDTW 61.1%
实物机器人:16 次室内导航测试,Goal2Pixel 能将语言指令(门、沙发、冰箱、楼梯等)接地到有意义的像素目标,并通过本地控制器完成实际导航。
4. 局限性
ViKeyMem 以可见性为标准可能遗漏短暂出现或远距低分辨率的细粒度地标;soft 坐标期望值在多峰数字分布下可靠性有限(但主监督仍为 token 级 CE loss,已起缓解作用)。
21. AstraNav-World (2025)
———将”想象未来”与”规划未来”统一进同一个生成式概率框架
📄 Paper: arXiv:2512.21714 · Code
精华
- 把”先想象未来场景、再据此规划动作”的松耦合 envision-then-plan 范式,改造为视觉预测与动作生成在同一概率框架内联合建模、同步 rollout 的紧耦合范式,从根本上抑制误差累积。
- VLM 不再只做语言理解,而是同时作为视频生成器和动作策略头的统一条件编码器,用同一份”语言-视觉嵌入”驱动两条分支。
- 双向约束是关键:动作要以可执行的未来视觉证据为依据,预测的未来画面也要被动作意图反向约束,两者互相校正而不是单向传递误差。
- 引入 Sparse Foresight Scheduling,按固定间隔而非逐帧触发”视觉预测+动作生成”的联合推理,在几乎不掉点的情况下把推理速度提升一个数量级。
- 消融证明:性能提升主要来自世界模型的双向约束机制,而非单纯堆参数量(3B 联合模型优于纯放大到 7B 的 VLA-only 基线)。
1. 研究背景/问题
具身导航失败的一个核心原因是模型缺乏对物理规律和时间动态的建模:微小的预测偏差会随时间累积,最终破坏全局规划的有效性。现有方法通常把”想象未来”(world model 生成未来画面)和”规划未来”(VLA 输出动作)做成两个松耦合的串行模块,这种 envision-then-plan 流水线会放大物理不确定性和因果歧义,导致视觉预测和实际动作彼此不一致。
2. 主要方法/创新点
① 整体框架概述:AstraNav-World 由三个核心模块构成——VLM 规划器(高层语义推理)、基于 DiT 的视频生成器(预测未来视觉观测)、动作策略头(生成未来动作序列,有 Action Former 和 Diffusion Policy 两种实现)。VLM 编码指令和历史/当前多视角观测,生成统一的视觉-语言嵌入,同时作为视频生成器和策略头的条件输入,取代了传统视频扩散模型里的文本编码器。
② 逐模块讲解
- VLM 规划器(τθ):输入是自然语言指令 I 和历史观测序列 O_hist;内部用 Qwen2.5-VL-3B 做全参数微调;输出是 C ∈ R^(L×D)(D=2048)的视觉-语言嵌入,同时包含”目标导向语义特征”(指令编码)和”空间上下文特征”(历史/当前视觉语义与空间信息)。这一表示让模型既能保持对长时序任务的整体理解,又能灵活响应环境的即时变化。
- VLM 条件视频生成器:基础架构是 Wan2.2-TI2V-5B(ST-VAE + 30 层 DiT),用 LoRA(rank=128)微调。把 VLM 的视觉-语言嵌入通过 cross-attention 注入 DiT,替代原本的 umT5 文本编码器,使生成的未来帧在语义上与 VLM 的高层规划保持一致。训练时对历史/当前帧加极小噪声(σ_obs≈0.05)当作”干净”条件,对未来帧用 Flow Matching 方式加噪并学习速度场 u_t=ϵ−z_future,损失只在未来帧上计算(L_VG,式 4)。
- 3D-RoPE 重排:为了把当前时刻的 left/front/right 三个视角和历史帧统一编码进同一套 3D 旋转位置编码,作者把三个视角沿宽度轴”虚拟拼接”——front 保持原坐标,right 在宽度上偏移 W,left 偏移 2W,同时共享相同的时间和高度索引(式 1–3),从而显式编码多视角间的空间-时间关系,而不打乱时序对齐。
- 动作策略头(两种实现):
- Action Former:用一组可学习 query 向量通过若干层 Transformer 与 VLM 嵌入交互,再经 MLP 输出确定性动作序列 A=(X,Y,cosθ,sinθ,α),分别用 L1 位置损失、余弦角度损失、二元到达损失加权组合(式 5–8)。
- Diffusion Policy:用 Flow Matching 在噪声动作序列上做去噪生成,提供概率化的动作预测。关键创新是 Multimodal Fusion Cross-Attention(MMFCA):在 Diffusion Policy 和视频生成器最后 8 个重叠的 DiT 块之间引入双向 cross-attention——动作表征作 query 去 attend 视频隐表征(确保动作以可信的未来视觉为依据),同时视频隐表征也作 query 去 attend 动作表征(确保生成画面与已规划动作保持因果一致)。MMFCA 受二元开关 γ 控制:γ=1 时两路双向融合、同步 rollout;γ=0 时两路独立运行,推理时甚至可以完全跳过视频生成器只跑策略头,大幅降低算力开销。
- 设计动机:核心 gap 是松耦合流水线里视觉预测和动作规划互不感知,容易各自漂移。MMFCA 和共享 VLM 条件正是为了让两条分支在训练和推理阶段都能”互相看见对方”,把误差互相校正而不是单向累积。
③ 端到端数据流:一条样本先经 VLM 编码指令+历史/当前三视角观测得到统一嵌入;该嵌入同时条件化视频生成器(预测未来 N 步前视帧)和策略头(预测未来 N 步动作);若启用 MMFCA,两路在重叠 DiT 块内做双向 cross-attention 实现同步 rollout;最终输出未来视觉帧序列和对应的动作(路径点)序列。
④ 训练目标:总损失 L_Total = L_VG + λ·L_PH(λ=1.0,式 10),L_VG 是视频生成的 Flow Matching 损失(式 4),L_PH 根据策略头类型为式 8(Action Former 的位置+角度+到达损失组合)或式 9(Diffusion Policy 的 Flow Matching 损失)。训练分两阶段:Stage 1 冻结 VLM,先独立预训练视频生成器(L_VG)、再独立预训练策略头(L_PH),避免两个模块过早互相干扰;Stage 2 解冻全部组件用 L_Total 联合微调,对 Diffusion Policy 以 50% 概率随机启用 MMFCA,防止策略头过度依赖视觉反馈,保证视频生成器关闭时策略头仍能独立工作。
⑤ 推理流程(Sparse Foresight Scheduling, SFS):视频生成是推理速度的瓶颈,因此不在每一步都联合生成”未来帧+动作”,而是按固定间隔触发联合生成——大量导航场景里直行等简单一致行为并不需要逐帧更新世界模型。使用 Action Former 时,推理阶段直接完全关闭视频生成器,只用 query Transformer 出动作;使用 Diffusion Policy 时,视频生成器仅在固定间隔步(实现中每 10 步)激活一次,中间步骤保持关闭,在预测精度和推理速度间取得最优折中。
3. 核心结果/发现
- 在 R2R-CE / RxR-CE Val-Unseen 上,AstraNav-World 全面超越此前 SOTA:Action Former 版本相对此前最佳方法 SR 绝对提升 2.1%(R2R-CE)/1.1%(RxR-CE);Diffusion Policy + MMFCA 版本进一步在 Action Former 基础上再提升 0.7%(R2R-CE)/2.5%(RxR-CE),最终 R2R-CE SR=67.9%、SPL=65.4%,RxR-CE SR=72.9%。
- 在 HM3D-OVON 开放词表物体导航上,Diffusion Policy 相对此前最佳 MTU3D 提升 SR 4.9% 绝对值(45.7% vs 40.8%)。
- 去掉视频生成器分支会在 R2R、RxR、OVON 三个数据集上一致地降低 SR,证明显式预测未来观测确实为规划提供了关键的视觉引导,并非冗余分支。
- 缩放 vs. 世界建模:把 VLA-only(无视频生成)基线的 VLM 从 3B 放大到 7B,R2R-CE SR 几乎不变(66.5%→66.6%),已触及参数缩放的天花板;而 3B 模型加上视频生成分支(L_VG 正则化)就能把 SR 推到 67.9%,说明性能增益主要来自世界模型的双向约束机制,而不是单纯堆参数。
- 一致性分析:用开源 VGGT 模型估计生成图像序列的相对相机位姿变化,与仿真器真实渲染的相对位姿对比,角度差 δ_a 的分布显示生成的未来视觉预测与规划动作具有很高的几何一致性。
- 真实世界零样本迁移:未做任何真实世界数据微调,AstraNav-World 直接部署在物理机器人上完成自然语言指令导航任务,在过门、转角等关键过渡场景上表现出对未来场景的预判能力,显著优于通常需要域适应的现有方法,验证了世界模型学到的是可迁移的物理/导航规律而非仅过拟合仿真数据分布。
4. 局限性
视频生成本身的推理延迟和复杂场景下的算力开销仍是瓶颈(尽管 SFS 已大幅缓解);论文也指出未来工作需要扩展到更长时间跨度和更难的任务,进一步加强物理与因果一致性建模,并提升闭环一致性与实时推理/规划能力。
22. CorrectNav (2025)
——— 自纠错飞轮赋能的单目 RGB 视觉-语言-动作导航模型
📄 Paper: arXiv:2508.10416 · 🏛️ AAAI 2026 · Code · Project Page
精华
- 变废为宝的数据范式:不同于传统方法将模型在训练集上的预测偏差视为无效错误,CorrectNav 提出自纠错飞轮(Self-correction Flywheel)后训练范式,将模型评估产生的偏离轨迹转化为极具价值的自纠错训练数据。
- 感知与动作双重隐式纠错:联合构建动作纠错轨迹(通过轨迹规划器 $\Gamma$ 重新打通至终点的路径)与基于多模态大模型的关键帧感知分析(描述地标与生成细节 QA),无需增加额外的推理模块或引入极耗时的思维链(CoT),将自纠错能力直接隐式内化于模型参数中。
- 闭环飞轮多轮迭代:采用”模型评估 ➔ 偏离检测 ➔ 动作/感知自纠错数据自动生成 ➔ 持续训练”的闭环机制。训练后新模型产生的偏离模式会触发下一轮飞轮,性能随迭代轮次提升显著。
- 单目 RGB 端到端 SOTA:仅依赖单目 RGB 视频输入与语言指令,在 R2R-CE 和 RxR-CE Val-Unseen 连续环境基准上成功率分别达到 65.1% 和 69.3%,大幅超越 prior SOTA 导航大模型 StreamVLN(+8.2% 与 +16.4%)。
- 强鲁棒的实机落地:结合域随机化与通用多模态数据回放防遗忘策略,在 AgiBot 灵汐 D1 四足机器人上实现了室内外复杂场景、长指令跟随与动态避障自纠正的高成功率部署。
1. 研究背景/问题
在视觉-语言导航(Vision-and-Language Navigation, VLN)任务中,机器人需要根据自然语言指令在未探索的连续环境中进行路径探索。然而,现有的视觉-语言-动作(VLA)导航模型在执行指令时,不可避免地会由于感知失误或指令理解偏差产生单步预测错误。
这种单步错误在连续空间中会迅速累积,导致机器人严重偏离预定路线(如指令要求”向前走并右转进客厅”,若提前右转则会误入厨房)。传统模型由于缺乏自纠错(Self-correction)与自恢复能力,一旦偏离路径便无法重新定位,导致导航失败。先前部分研究(如 SmartWay、EnvolveNav)尝试引入闭源大模型进行回溯反思或生成长思维链,但这引入了巨大的推理延迟与复杂的外部模块,难以满足实机导航的实时性要求。
2. 主要方法/创新点
CorrectNav 构建了一个基于单目 RGB 图像输入的 VLA 导航模型,并通过自纠错飞轮后训练范式隐式内化了高效的路径偏离纠正能力。
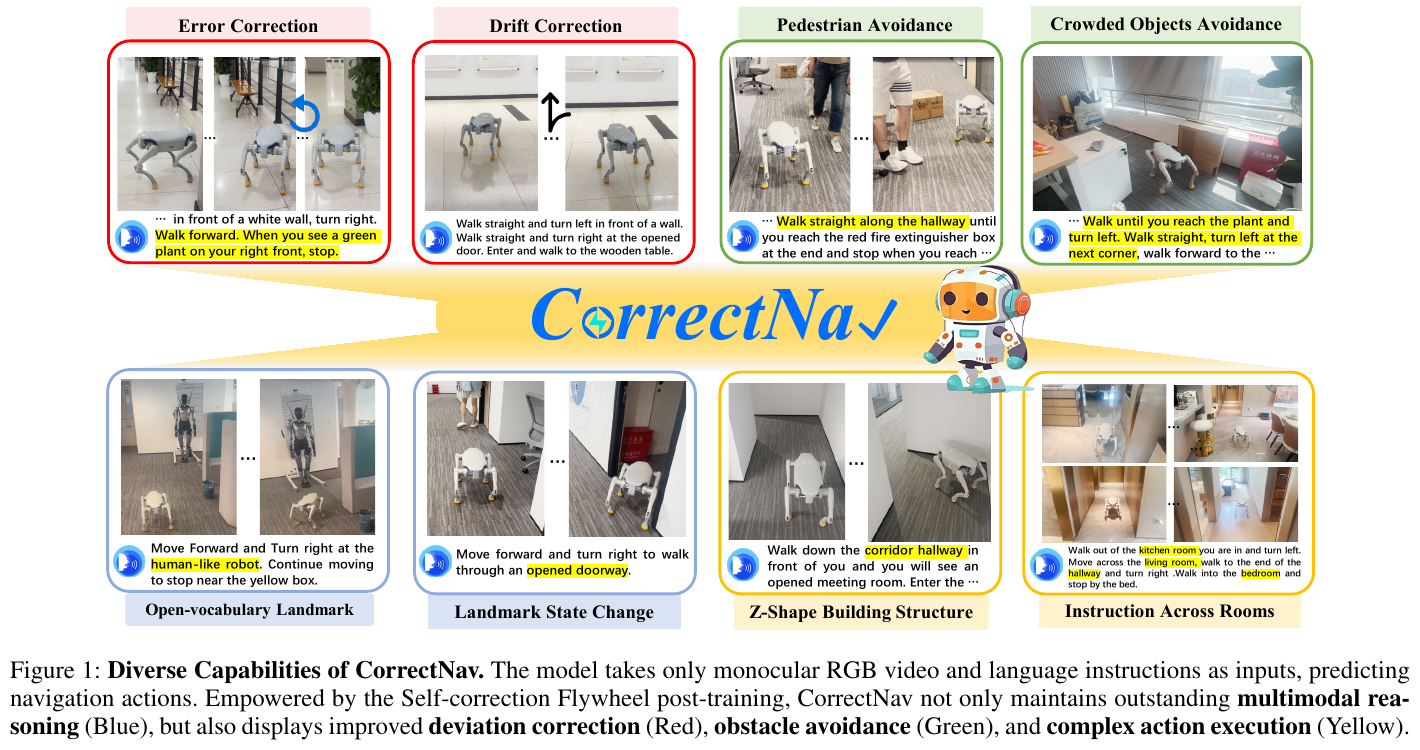
① 整体框架概述
CorrectNav 系统由 Vision Encoder(SigLIP)、Projector(2层 MLP)与 Large Language Model Backbone(Qwen2 7B,初始化自 LLaVA-Video 7B)三个模块构成。Vision Encoder 负责抽取输入 RGB 视频多帧的视觉特征 $Z_v$,Projector 将视觉特征映射至 LLM 语义空间 $H_v$,LLM 结合语言指令文本 token 自回归预测长度为 $m=4$ 的动作块(Action Chunk ${a_{t+1}, \dots, a_{t+m}}$)。
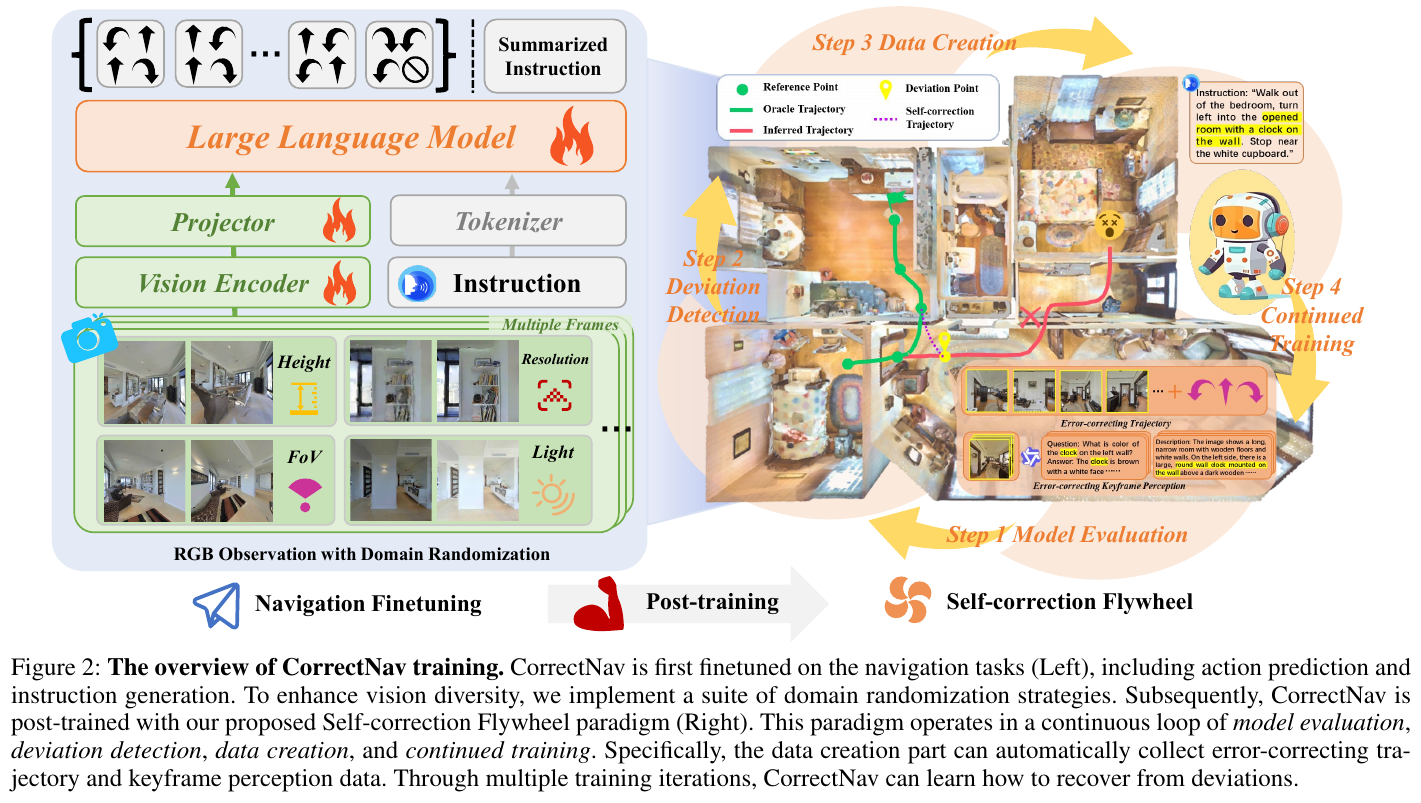
② 基础导航微调(Navigation Fine-tuning)与三大数据策略
在开启自纠错飞轮前,CorrectNav 首先在标准导航任务上进行多任务微调:
- 动作预测任务(Action Prediction):基于 MP3D 场景提取的 R2R-CE(527K)和 RxR-CE(1.58M)共计 210 万+ 步级标准轨迹进行动作预测训练。为了大幅提升视觉鲁棒性,引入了域随机化策略(涵盖随机相机高度、视场角 FoV、分辨率缩放与光照条件变换)。
- 轨迹逆向指令生成(Instruction Generation):利用 30K 条完整 oracle 轨迹,训练 CorrectNav 根据观测历史生成对应的导航语言指令,强化跨模态表达能力。
- 通用多模态数据回放(General Multimodal Data Recall):为防止在专用导航数据集上连续训练导致通用多模态理解能力退化(Catastrophic Forgetting),按比例混入 240K 来自 LLaVA-Video(ActivityNet-QA 和 NextQA)的视频 QA 数据,保持时空感知能力。
③ 自纠错飞轮后训练范式(Self-correction Flywheel Post-training)
为了使 CorrectNav 具备自恢复能力,作者设计了四步闭环飞轮:
-
Step 1: 训练集评估与偏离轨迹采集
虽然 CorrectNav 已在训练集上接受过监督训练,但在训练集上重新评估模型时,模型依然会产生导航错误轨迹 $T_m = (M_1, M_2, \dots, M_m)$。这些包含错误的轨迹正是最宝贵的自纠错训练数据来源。 -
Step 2: 轨迹偏离检测(Deviation Detection)
对真实参考轨迹 $T_g$ 进行均匀插值得到 $T’_g$。计算机器人位置 $M_i$ 到参考轨迹的垂距: \(h_i = \min_{x \in T'_g} \lVert M_i - x \rVert_2\) 对应在 $T’_g$ 上的垂足定位为: \(P_i = \arg\min_{P \in T'_g} \lVert M_i - P \rVert_2\) 当存在时间步 $t$ 满足垂距超过距离阈值 $S$(即 $h_t > S$,且之前步骤 $h_i \le S, \forall i < t$),则判定模型在 $M_t$ 处发生了偏离,并将 $M_t$ 附近的观测帧标记为纠错关键帧。 - Step 3: 动作与感知自纠错数据构建
- 动作纠错轨迹(Action Correction Trajectory):若垂足 $P_t$ 位于参考线段 $G_k G_{k+1}$ 上,说明机器人正确经过了 $G_k$,但在前往 $G_{k+1}$ 时发生偏离。调用轨迹规划器 $\Gamma$ 重新生成一条从偏离点 $M_t$ 出发、经过后续参考点并最终到达终点的修补轨迹 \(T_e = (M_t, G_{k+1}, \dots, G_n)\)。在训练时,偏离点前的历史只提供观测上下文,仅在 $T_e$ 上计算动作预测损失。
- 关键帧感知分析(Keyframe Perception Analysis):抽取偏离点 $M_t$ 及其前后关键帧 ${K_1, K_2, K_3}$,利用多模态大模型 Qwen-VL-Plus 自动生成两类感知数据:
- 地标描述 \(C_i = \text{MLLM}(K_i, L_{\text{cap}})\):描述图像中出现的家具、建筑结构等关键地标;
- 细节 QA 对 \(\{(Q_j, A_j)\}_{j=1}^x = \text{MLLM}(K_i, L_{\text{qa}})\):聚焦于物体相对位置、颜色及机器人当前朝向等关键视觉元素。通过感知数据训练,引导模型不仅知晓”怎么纠偏”,更理解”为何偏离”。
- Step 4: 模型持续训练与多轮飞轮迭代(Continued Training & Multi-Round Iteration)
按比例采样 $50\%$ 的自纠错轨迹/感知数据与 $25\%$ 的原始标准轨迹组合进行持续训练。当经过一轮纠错训练的模型再次在训练集上评估时,又会暴露新的偏离模式,从而驱动飞轮开启下一轮(Loop)。随着多轮迭代推进,模型的自纠错能力持续攀升。
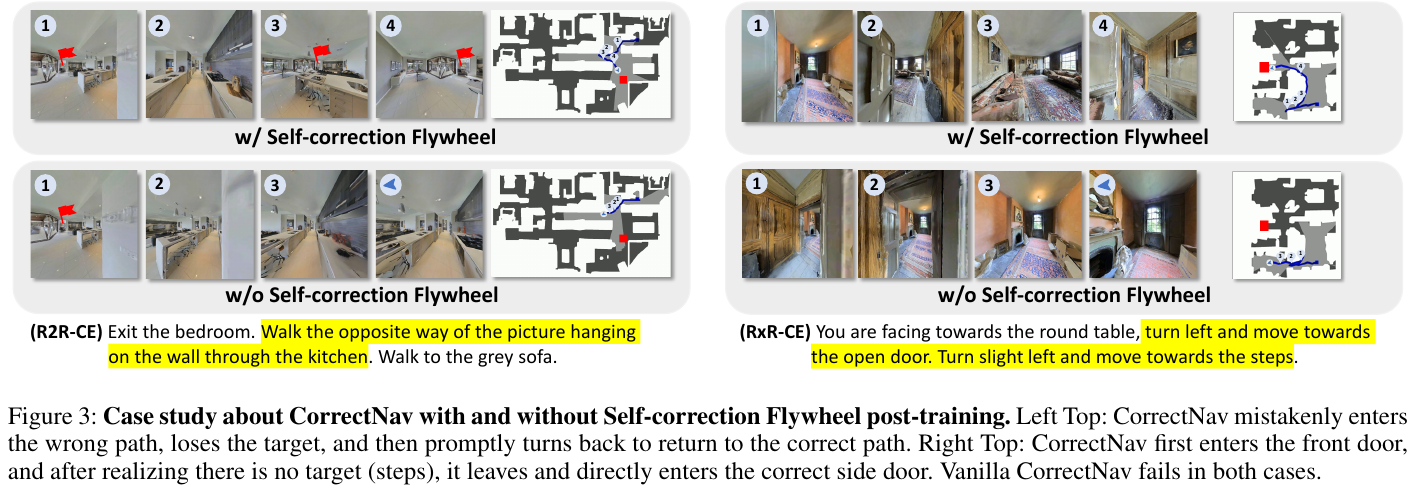
3. 核心结果/发现
① VLN-CE 连续基准定量对比
在 Habitat 3.0 仿真器中,对 R2R-CE 和 RxR-CE 的 Val-Unseen 拆分集进行了全面评估(仅输入单目 RGB):
| 模型 | 输入模态 | R2R-CE NE↓ | R2R-CE SR↑ | R2R-CE SPL↑ | RxR-CE NE↓ | RxR-CE SR↑ | RxR-CE SPL↑ | RxR-CE nDTW↑ |
|---|---|---|---|---|---|---|---|---|
| BEVBert | RGB-D + Pano | 4.57 | 59.0% | 50.0% | - | - | - | - |
| ETPNav | RGB-D + Pano | 4.71 | 57.0% | 49.0% | 5.64 | 54.7% | 44.8% | 61.9% |
| HNR | RGB-D + Pano | 4.42 | 61.0% | 51.0% | 5.50 | 56.3% | 46.7% | 63.5% |
| NaVid | 单目 RGB | 5.47 | 37.0% | 35.0% | - | - | - | - |
| Uni-NaVid | 单目 RGB | 5.58 | 47.0% | 42.7% | 6.24 | 48.7% | 40.9% | - |
| NaVILA | 单目 RGB | 5.22 | 54.0% | 49.0% | 6.77 | 49.3% | 44.0% | 58.8% |
| StreamVLN | 单目 RGB | 4.98 | 56.9% | 51.9% | 6.22 | 52.9% | 46.0% | 61.9% |
| CorrectNav (Ours) | 单目 RGB | 4.24 | 65.1% | 62.3% | 4.09 | 69.3% | 63.3% | 75.2% |
CorrectNav 在仅使用单目 RGB 的前提下,不仅刷新了单目 VLA 模型的最高纪录(R2R-CE SR 65.1%,RxR-CE SR 69.3%),甚至全面超越了依赖深度图(Depth)、全景图(Pano)和路点预测器(Waypoint Predictor)的传统拓扑地图方法(如 HNR、ETPNav)。
② 飞轮迭代与消融实验
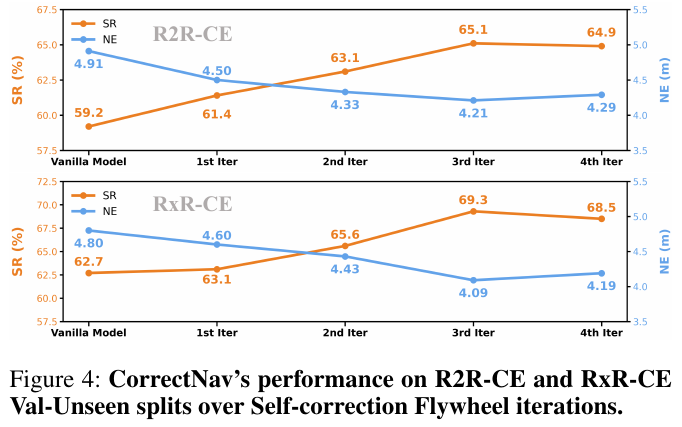
- 飞轮迭代效应:随着自纠错飞轮迭代从 Iter 0 推进至 Iter 3,R2R-CE 和 RxR-CE 的成功率均表现出持续的增长,证明了自纠错数据闭环迭代的有效性。在第 4 轮出现轻微回落时止盈。
- 关键模块消融:移除动作纠错轨迹生成会导致成功率最显著的下降(R2R 降至 59.2%);移除关键帧感知分析则导致成功率降至 60.1%,验证了感知引导纠错的必要性。
③ 真实机器人实测(AgiBot 灵汐 D1 四足机器人)
在 AgiBot 灵汐 D1 四足机器人平台(配备单目 RGB 摄像头及 remote A100 GPU)上进行了 Office、Home、Campus 三大场景的定量测试:
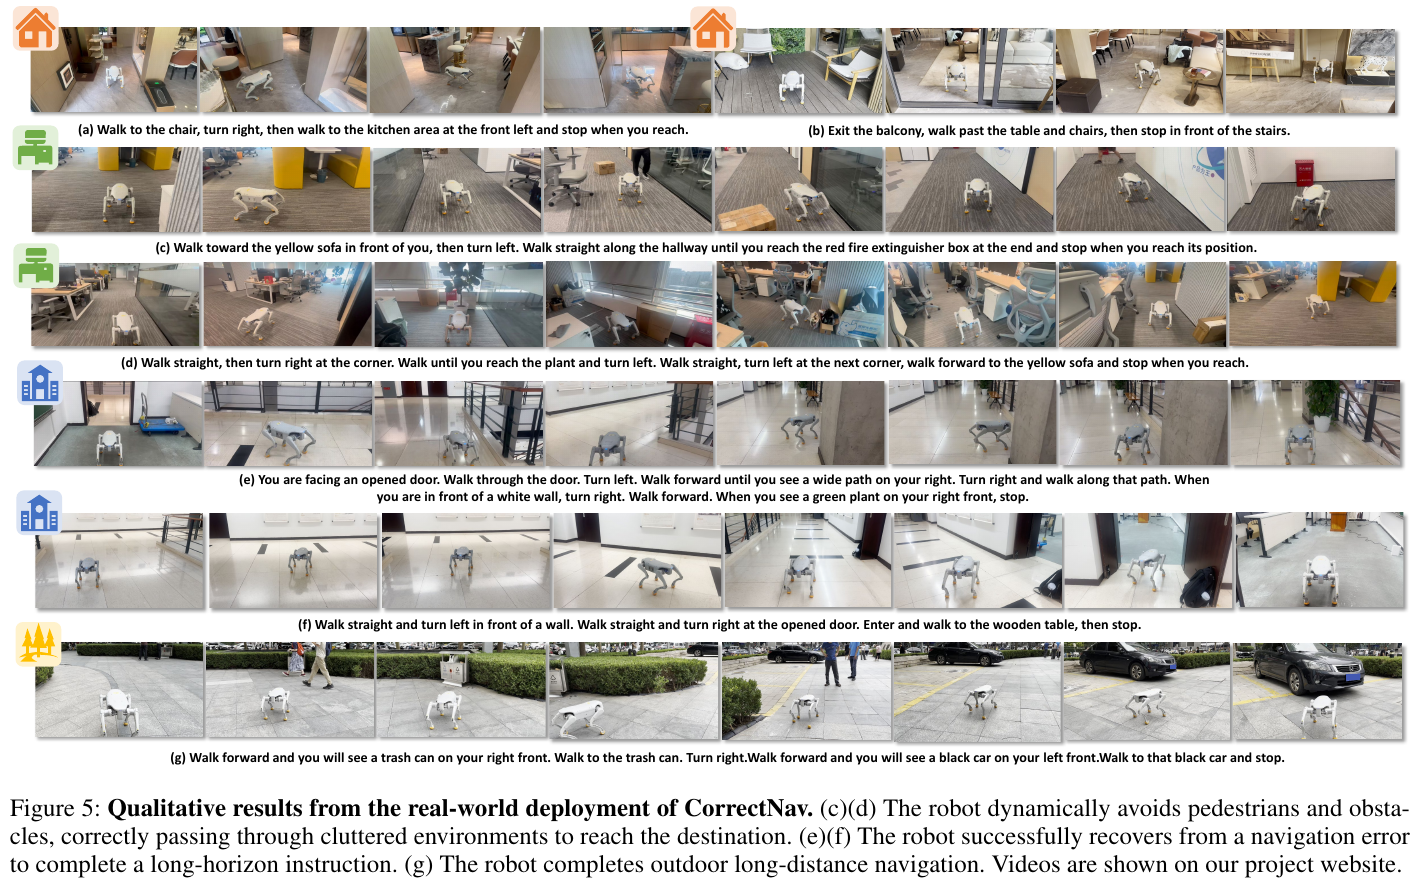
- 在复杂的室内外长指令测试中,CorrectNav 的成功率(SR)显著优于 Baseline(如在 Office Complex 指令下 SR 达 75%,而 NaVid 仅为 30%,NaVILA 为 20%)。
- 具备强劲的动态避障(动态避让行人与黄色箱子)以及偏离后自折返恢复能力。
4. 局限性
- 几何相对位置感知精度有限:单目 RGB 缺乏精确深度信息,模型对机器人本体与周围障碍物之间的相对空间物理距离感知尚不够精确。
- 机体碰撞擦碰风险:在四足机器人等具有复杂几何轮廓的平台上,当贴紧障碍物转弯时,机器人的后腿可能存在轻微擦碰障碍物的风险。作者指出未来需将机器人本体尺寸与状态先验融合入推理模型中。
23. Slow4fast-VLN (2026)
——General Vision-Language Navigation via Fast-Slow Interactive Reasoning
📄 Paper: arXiv:2601.09111 · 🏛️ CVPR 2026 · Code
精华
这篇论文的核心借鉴价值在于其提出的动态交互式快慢脑(Fast-Slow Interactive Reasoning)导航框架。它通过模拟人类的“快思考”(直觉决策)和“慢思考”(深度反思),实现导航策略的持续优化。其亮点在于,慢脑系统能够从历史经验中提炼出可泛化的“导航知识”,并用其“赋能”快脑,从而有效提升了智能体在未知环境(OOD场景)中的泛化能力和决策效率,解决了传统方法中快慢系统割裂、经验无法沉淀的问题。
1. 研究背景/问题
传统的视觉-语言导航(VLN)方法在封闭环境下表现良好,但在面对环境和指令风格多变的开放世界时,其泛化能力严重不足。GSA-VLN任务通过引入多样化的场景和指令,对模型的场景适应性提出了更高要求。当前方法的主要挑战在于如何让智能体在导航过程中动态生成可泛化的策略,以应对前所未见的场景和指令。
2. 主要方法/创新点 (Core content, most detailed)
论文提出了一个名为 slow4fast-VLN 的动态交互式快慢推理框架,以应对开放环境下的视觉语言导航挑战。该框架包含快慢两个核心模块:
-
快推理模块 (Fast Reasoning):这是一个端到端的策略网络(基于DUET),负责根据实时的视觉和指令输入,快速生成导航动作。同时,它会记录导航过程中的所有执行记录(如观测、动作、度量等),形成历史记忆(History Repository)。
-
慢推理模块 (Slow Reasoning):该模块是整个框架的核心创新点。它利用大语言模型(LLM)对快推理模块产生的历史记忆进行深度“反思”(Reflection),从中提取出结构化、可泛化的导航经验(Structured Experience),并存入一个经验库(Experience Library)。这些经验包含了场景类型、空间上下文、空间规则、导航策略等关键信息。
-
快慢交互机制 (Interaction):这是区别于以往工作的关键。在导航决策时,快推理模块会从经验库中检索与当前场景最相关的经验,并将这些经验特征与实时视觉特征进行融合(通过Attention机制),从而“赋能”快脑,使其做出更精准、更泛化的决策。这种交互使得慢脑提炼的经验能够持续优化快脑的性能。
-
指令风格转换 (Instruction Style Conversion):为了应对多样的指令风格(如场景化、用户个性化),论文还设计了一个基于LLM的指令转换模块,通过CoT提示工程,将不同风格的指令实时转换为统一的“基础风格”指令,降低了模型对指令变化的敏感度。
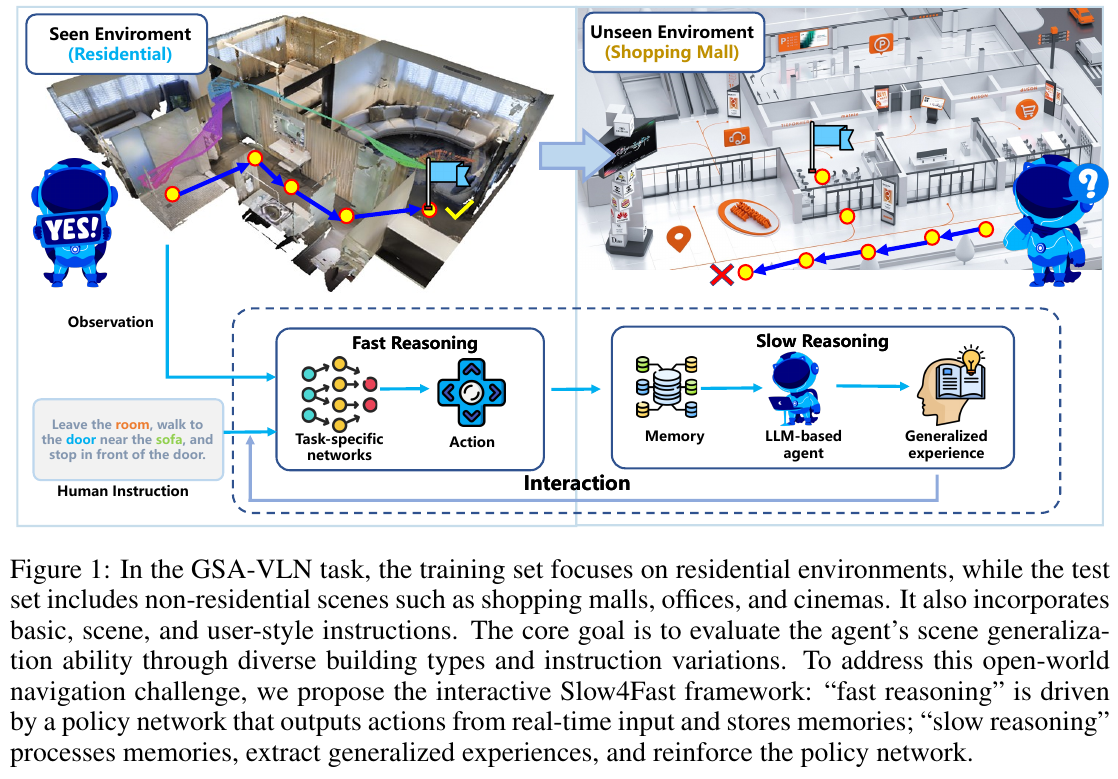
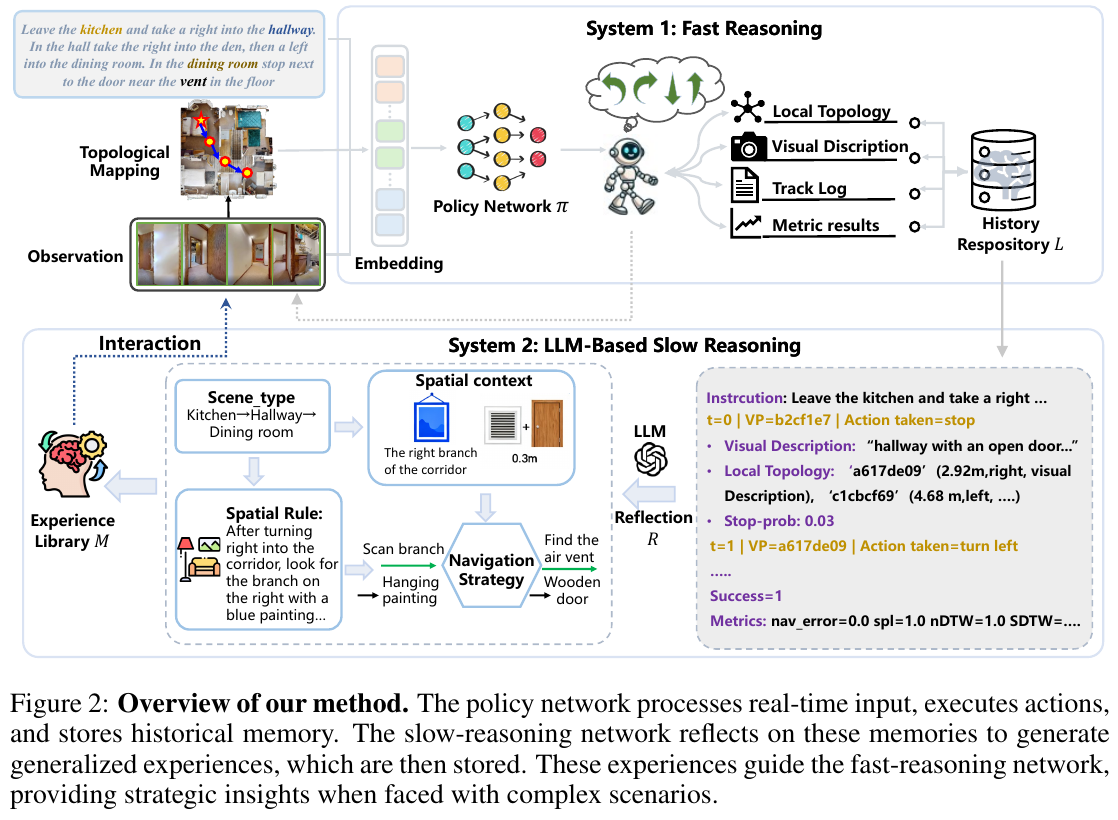
3. 核心结果/发现 (Key findings)
- 环境适应性:在GSA-R2R数据集上,使用基础指令进行测试时,slow4fast-VLN在住宅(ID)和非住宅(OOD)场景中的成功率(SR)分别比基线方法GR-DUET提升了1.5%和2.2%,证明了快慢交互框架对于提升场景泛化能力的有效性。
- 指令适应性:在面对用户个性化指令和场景化指令时,该方法同样全面优于基线。例如,在用户指令测试中,其SR和SPL指标在多种角色(如Child, Keith, Moira等)下均达到SOTA水平。这得益于其指令风格转换模块和动态经验反馈循环。
- 消融实验:实验证明,快慢推理(FSR)框架和指令风格转换(ISC)模块都是有效的。当两者协同工作时,模型在最具挑战的Test-N-Scene任务上达到了最佳性能。
- 案例研究:通过可视化导航轨迹,论文展示了在引入慢脑反思后,智能体能够修正初始的错误路径,并基于经验(如“寻找蓝色画作”作为线索)更高效、更准确地完成导航任务,避免了不必要的探索。
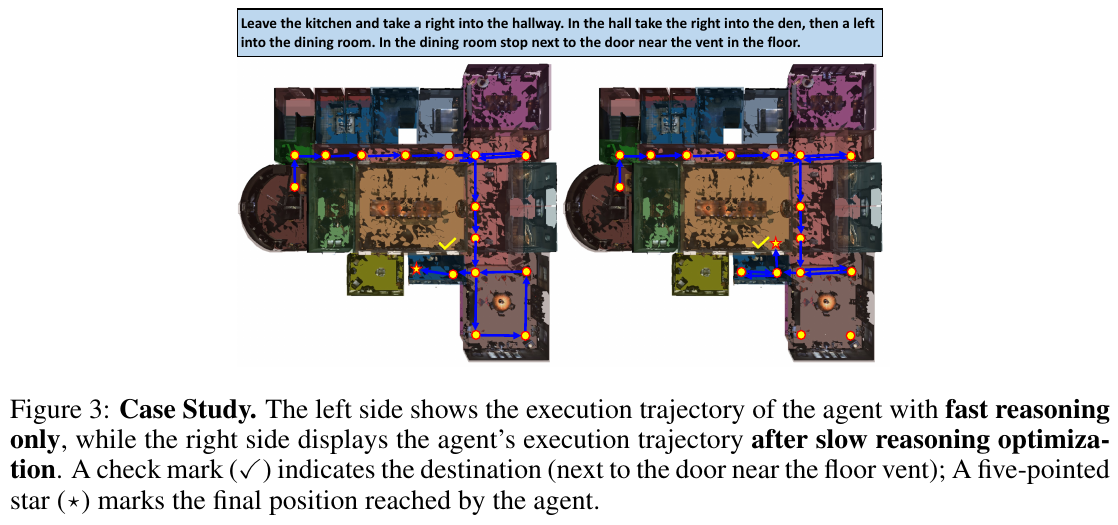
4. 局限性 (Brief, 1-2 sentences)
论文指出的一个局限是,慢脑推理产生的知识是隐式地编码在策略网络的权重中,这种“黑盒”形式使得学习到的经验难以解释和直接干预。未来的一个研究方向是让慢脑生成显式的、结构化的知识库(如语义地图或知识图谱),以供快脑在导航时直接查询。
24. DGNav (2026)
———动态拓扑感知:打破视觉-语言导航中的粒度刚性
📄 Paper: arXiv:2601.21751
精华
这篇论文解决了 VLN-CE 中的”粒度刚性”问题,值得借鉴的核心思想:
- 自适应结构调整:不仅调整模型参数,还动态调整数据结构本身(拓扑图的节点密度),实现”简单场景保效率、复杂场景保安全”的自适应平衡,这一思路可迁移到其他需要精度/效率权衡的规划任务(如 SLAM、点云处理)。
- 条件干预设计:引入”稳定性门槛”(中位数离散度 σ_med),只在高不确定性场景触发动态调整,而非全局自适应,有效避免了在简单场景引入不必要的噪声——这是一种极具工程实用性的设计思想。
- 多模态软硬约束融合:将几何硬约束(物理可达性)与视觉语义和语言指令软约束通过可学习权重动态融合,使图连接从”物理近邻关系”升级为”语义近邻关系”,为多约束优化提供了优雅解法。
- 线性映射的理论优越性:基于信息论论证了线性映射是保持最大熵属性的最优一阶近似,既优于 Sigmoid 的梯度饱和,又优于 Exponential 的保守偏差——理论驱动设计的典范。
- 结构与训练解耦:Scene-Aware Adaptive Strategy 仅在推理阶段激活,训练阶段使用固定阈值,实现了稳定的特征学习与灵活的测试时推理之间的解耦。
1. 研究背景/问题
VLN-CE(连续环境中的视觉-语言导航)中,现有拓扑规划方法(如 ETPNav)依赖固定的图构建阈值 γ 和静态欧式距离边权重,导致”粒度刚性”问题:在简单低不确定性区域产生大量冗余节点,在复杂高不确定性区域图过于稀疏导致导航失败。更严重的是,纯几何边权重使智能体优先连接物理距离近但语义无关的节点(”导航性近视” Navigational Myopia),无法遵从指令中的语义意图。
主要方法/创新点
论文提出 DGNav (Dynamic Graph Navigation) 框架,包含两大核心模块:
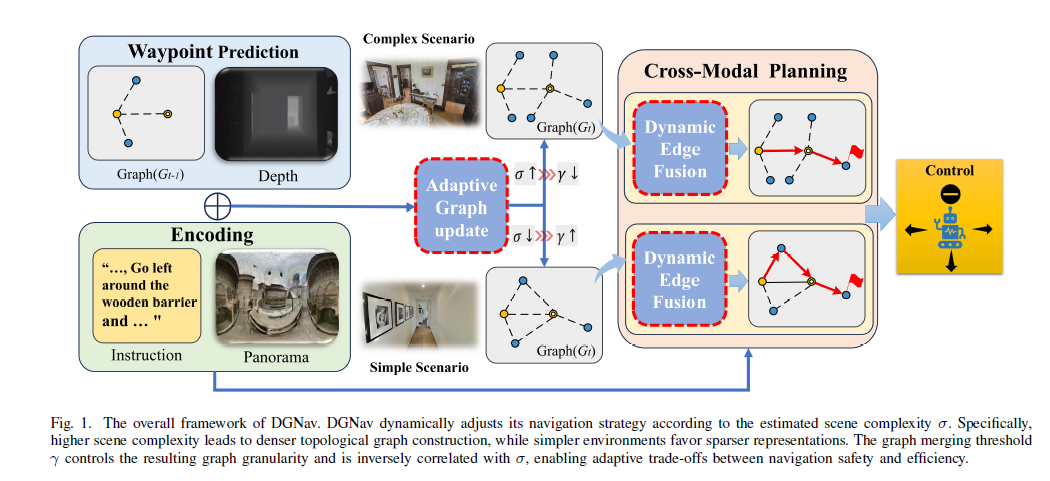
1. 场景感知自适应策略 (Scene-Aware Adaptive Strategy)
针对物理结构层面的粒度刚性问题,提出动态调整图构建阈值的方法:
- 场景复杂度度量:通过分析预测路径点的角度离散度 (angular dispersion) σ 来量化局部场景复杂度:
σ_t = sqrt(1/N_c * Σ(θ_i - θ̄)²)其中 θ_i 是候选节点相对于智能体朝向的角度。高 σ 表示复杂决策边界(如交叉路口),低 σ 表示简单几何结构(如走廊)。
- 条件线性映射控制律:基于统计校准的高斯分布特性,采用线性映射动态调整合并阈值 γ:
γ_t = γ_fix                                        if σ_t ≤ σ_med
γ_t = γ_fix - (σ_t - σ_med)/(σ_max - σ_med) * (γ_fix - γ_min)   if σ_t > σ_med
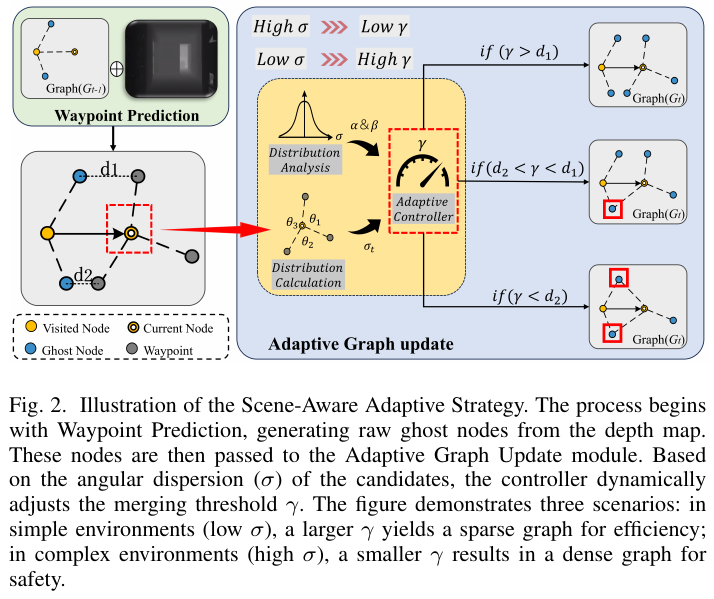
- 理论依据:选择线性映射而非 Sigmoid/指数映射的原因是线性变换保持高斯源分布的最大熵特性。非线性映射会在分布尾部引入饱和区域(梯度消失),导致高不确定状态的信息丢失。条件映射策略仅在 σ > σ_med 时激活自适应机制,在稳定场景中保持拓扑稳定性。
2. 动态图 Transformer (Dynamic Graph Transformer)
针对语义逻辑层面的导航近视问题,融合多模态线索动态重构图连接性:
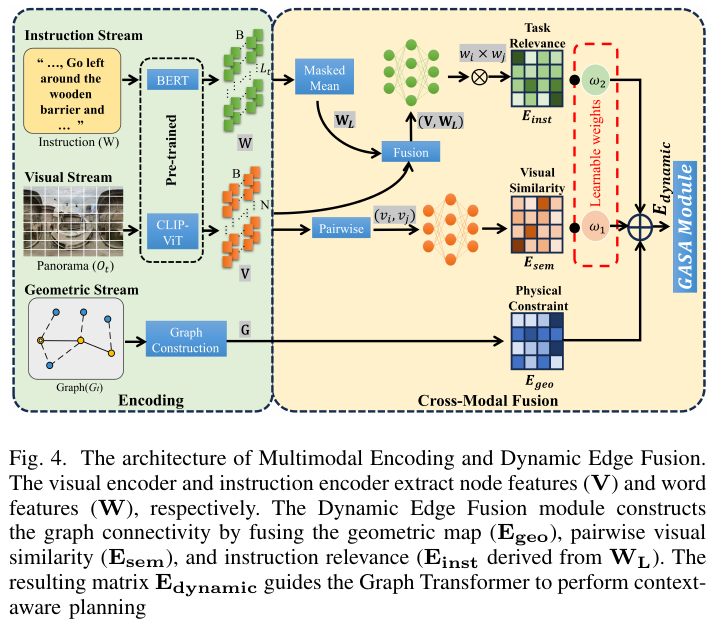
1.Scene-Aware Adaptive Strategy(场景感知自适应策略)
通过计算当前时刻候选节点的角度离散度 $\sigma_t$ 来量化场景复杂度:
\[\sigma_t = \sqrt{\frac{1}{N_c} \sum_{i=1}^{N_c} (\theta_i - \bar{\theta})^2}\]基于 $\sigma_t$,采用条件线性映射动态调整图合并阈值 $\gamma_t$:
\[\gamma_t = \begin{cases} \gamma_{fix} & \text{if } \sigma_t \leq \sigma_{med} \\ \gamma_{fix} - \dfrac{\sigma_t - \sigma_{med}}{\sigma_{max} - \sigma_{med}}(\gamma_{fix} - \gamma_{min}) & \text{if } \sigma_t > \sigma_{med} \end{cases}\]- 简单场景($\sigma_t \leq \sigma_{med}$):$\gamma_t = \gamma_{fix} = 0.5\text{m}$,保持稀疏效率
- 复杂场景($\sigma_t > \sigma_{med}$):线性降低 $\gamma_t$(最低至 $\gamma_{min} = 0.1\text{m}$),生成密集拓扑
$\sigma_{med}$ 和 $\sigma_{max}$ 通过在 ETPNav 基线模型上统计推断得到(数据驱动校准),线性函数的选择基于信息论证明其是保最大熵的最优一阶近似。
2.Dynamic Graph Transformer(动态图 Transformer)
Dynamic Edge Fusion:融合三种信息流构造动态邻接矩阵:
\[\mathbf{E}_{dynamic} = \mathbf{E}_{geo} + \omega_1 \cdot \mathbf{E}_{sem} + \omega_2 \cdot \mathbf{E}_{inst}\]- \(\mathbf{E}_{geo}\):归一化欧式距离(物理可达性硬约束)
- \(\mathbf{E}_{sem}\):CLIP-ViT 提取的视觉特征通过 MLP 计算的成对相似度
- \(\mathbf{E}_{inst}\):节点特征与全局指令 token \(\mathbf{W}_L\) 的外积相关性分数,即 \(w_i = \text{MLP}([v_i; \mathbf{W}_L])\),$E_{inst}^{(i,j)} = w_i \cdot w_j$
Graph-Aware Self-Attention (GASA):
\[\text{GASA}(\mathbf{H}^l, \mathbf{E}_{dynamic}) = \text{Softmax}\!\left(\frac{(\mathbf{H}^l \mathbf{W}_Q)(\mathbf{H}^l \mathbf{W}_K)^\top}{\sqrt{d_k}} + \mathbf{E}_{dynamic}\right)\!(\mathbf{H}^l \mathbf{W}_V)\]将 \(\mathbf{E}_{dynamic}\) 直接叠加到注意力分数上,强制模型关注语义相关(\(\omega_1 \cdot \mathbf{E}_{sem}\))且指令对齐(\(\omega_2 \cdot \mathbf{E}_{inst}\))的节点,同时 \(\mathbf{E}_{geo}\) 保证物理约束不被完全忽略,实现从纯几何到语义驱动的平滑过渡。
训练策略:采用两阶段训练,Adaptive Strategy 仅在推理阶段激活,训练阶段固定 $\gamma = 0.5\text{m}$ 确保稳定的特征学习。
3. 核心结果/发现
R2R-CE 数据集:
- Val-Unseen:SR 58.56%,SPL 50.08%(OSR 64.82%,NE 4.66),高于 ETPNav 基线的 SR 57% / SPL 49%
- Test-Unseen:SR 64%(+1% vs ETPNav),SPL 47%,NE 下降 0.2m
- 超越所有 End-to-End 方法和显式地图方法(含 GridMM, Safe-VLN, OVL-MAP)
RxR-CE 数据集(多语言,更长路径):
- Val-Unseen:SR 53.78%,nDTW 62.04%(+0.55%),SDTW 44.49%(+0.57%)
- 路径保真度指标全面超越 ETPNav,证明在长时域细粒度指令遵从上的优越性
消融实验关键发现:
- 条件线性映射 vs 全局线性映射:SR +1.52%(稳定性门槛机制的贡献)
- 动态 $\gamma$ vs 固定 $\gamma$(0.25/0.40/0.50m):SR 最高提升 +1.63%,且计算开销仅增加 0.4 个节点
- 完整 \(\mathbf{E}_{dynamic}\) vs 仅几何:SR 大幅提升,验证语义软约束的关键作用
- 定性分析(Fig.9):在”绕过木质围栏”场景中,仅几何模型因物理距离过近而提前错误转向,DGNav 正确识别指令语义并忽略了几何干扰,成功到达目标
4. 局限性
自适应策略的核心参数($\gamma_{fix}, \gamma_{min}, \sigma_{med}, \sigma_{max}$)通过在 R2R-CE 训练集上进行统计校准获得,在分布外场景(如户外环境、高度动态场景)中的泛化能力尚未验证;同时,随着导航轨迹增长,拓扑图规模持续膨胀,论文未讨论图压缩和历史节点管理策略,在超长路径任务中可能面临内存和计算的挑战。
25. CausalNav (2026)
———First Scene Graph-based Semantic Navigation for Dynamic Outdoor Environments
📄 Paper: arXiv:2601.01872 · 🏛️ IEEE RA-L
精华
CausalNav 的核心亮点在于将多层级场景图(Embodied Graph)与 RAG 机制深度结合,实现了支持开放词汇查询的长程语义导航——”图即知识库”的设计范式值得借鉴。其次,层次化 Embodied Graph 构建策略(从细粒度对象节点到粗粒度建筑物与聚类节点)展示了如何在多空间尺度上统一语义表示与检索。第三,基于时空走廊(Spatial-Temporal Corridor)的动态对象过滤机制,无需额外标注即可区分静态、准静态与动态障碍物,是处理室外动态场景的实用方案。第四,使用本地开源 LLM 替代商业 API 完成层次语义检索,证明了在自主平台上脱离云端仍可实现高质量语义推理。
1. 研究背景/问题
室外大规模动态环境中的自主语义导航面临三大挑战:开放词汇的语义理解、动态环境适应(行人、车辆等移动障碍物)以及长期稳定性。现有 VLN 研究主要聚焦于静态室内场景,依赖高精度地图或大规模训练数据,在真实室外动态场景中的长程导航鲁棒性未得到充分验证。
2. 主要方法/创新点
CausalNav 提出了一个由三个核心模块构成的语义导航框架:
模块一:开放词汇目标跟踪与自我运动估计
使用 YOLO-World 从 RGB 图像中提取开放词汇的 2D 检测框和分割掩码,通过 ByteTrack 进行多目标跟踪。结合 LiDAR 点云将 2D 检测投影至 3D 空间,获得目标的 3D 姿态 \(^w\mathbf{T}_{obj}\)。自车运动通过 LiDAR-IMU 里程计(FAST-LIO2)估计,提供精确的定位与坐标变换基础。
模块二:动态对象过滤与 Embodied Graph 构建
-
时空走廊过滤:将每个目标的历史轨迹编码为时空走廊 \(\mathcal{T} = \{^w\mathbf{T}^n_{obj}, \text{3DBBox}_i, t_i\}_{i=1}^n\)。若目标在 $k$ 步内位移超过阈值,则认定为动态目标并从图中移除,有效消除运动引起的虚假节点。
-
Embodied Graph 层次构建:静态环境由两类节点组成——建筑物节点 $\nu_i^{build}$ 来自离线地图,对象节点 $\nu_i^{obj}$ 来自实时感知。使用 LLM 对节点进行层次聚类(spatial-semantic similarity),形成多级抽象:对象层(Level $L-1$)→ 建筑物/Place 层(Level $L$)→ 聚类节点(Clustering Node)。每次自车移动超过距离阈值 $d$,新增自车节点 $\nu_i^l$ 记录历史轨迹。
-
RAG 语义检索:基于 LLM 打分的层次化检索,结合空间相似性 $\kappa^{spatial}$ 和语义相似性 $\kappa^{semantic}$,在图中逐层选择最匹配查询的节点路径,支持开放词汇目标定位。
模块三:Embodied Graph 动态更新与自然语言导航
-
全局规划:解析自然语言指令,通过 RAG 检索 Embodied Graph 推断目标位置,优先使用历史轨迹中的 Dijkstra 最短路径;若目标不可达,则调用离线地图或 Google Maps 生成粗粒度路线,结果表示为路点序列 $\mathcal{W} = {w_1, w_2, \ldots, w_n}$。
-
局部规划:采用 RH-Map 进行实时动态局部地图构建,通过 Informed-RRT* 生成初始轨迹,再使用 NMPC-CBF(Nonlinear Model Predictive Control with Control Barrier Function)进行轨迹跟踪与动态避障,保证对移动行人/车辆的安全性。
3. 核心结果/发现
仿真实验(对比 ViNT、NoMaD、GNM、CityWalker):
- Small 任务:SR 100%,SPL 88.9%,CC 0.2(所有方法中最优)
- Medium 任务:SR 92%,SPL 82.2%
- Large 任务:SR 80%,SPL 66.0%,CC 1.2,TL 141.82m
真实世界实验:
- 短程(130m):ViNT 和 CausalNav 均成功,其他方法失败
- 长程(512m):仅 CausalNav 成功完成任务,其他方法因碰撞失败
- CityWalker 在真实世界表现显著差于仿真,对光照变化和动态障碍物敏感
消融实验:
- 启用 Embodied Graph 动态更新:SR 从 78% 提升至 90%,SPL 从 54.7% 提升至 80.1%
- 最优超参数:$\alpha=\beta=0.5$,$\gamma=1.5$(空间-语义平衡点)
- 运行时延:105ms/cycle(10Hz),比 NoMaD 仅多 11% 开销
4. 局限性
CausalNav 在极端光照/天气条件下的鲁棒性有待提升,且长程图记忆的压缩与遗忘机制尚未完善,可能在超长时间运行后出现图膨胀和检索精度下降问题。
26. AgentVLN (2026)
———Towards Agentic Vision-and-Language Navigation
📄 Paper: arXiv:2603.17670 · 🏛️ ECCV 2026 · Project Page · Code
精华
AgentVLN 最值得借鉴的思想是 VLM-as-Brain 范式:将 VLM 作为大脑纯做高层语义推理与技能调度,把感知、规划、控制等低层能力封装成模块化、即插即用的技能库,彻底解耦了认知与执行。跨空间表示映射(将 3D 拓扑路点反投影为像素对齐的 2D 视觉提示)是一个无需额外参数就能弥合 2D VLM 与 3D 物理世界之间鸿沟的精妙设计。QD-PCoT 展示了如何赋予模型元认知能力:当面对空间歧义时主动提问、调用感知技能获取深度信息,而非盲目输出坐标。3B 参数量在 R2R/RxR 双榜均超越 7B+ 的先前 SOTA,证明结构化分层推理远比暴力扩参数更高效。该框架可直接部署于 Jetson 嵌入式边缘平台,具备极强的落地价值。
1. 研究背景/问题
Vision-and-Language Navigation (VLN) 要求具身智能体将复杂自然语言指令转化为长时域、连续空间的导航行为。当前 VLN 系统面临三大核心瓶颈:VLM 固有的 2D 语义理解与 3D 几何感知之间的跨空间失配;单目 RGB 图像引起的尺度歧义导致局部目标定位失败;以及大参数量模型无法满足边缘设备实时推理需求。
2. 主要方法/创新点
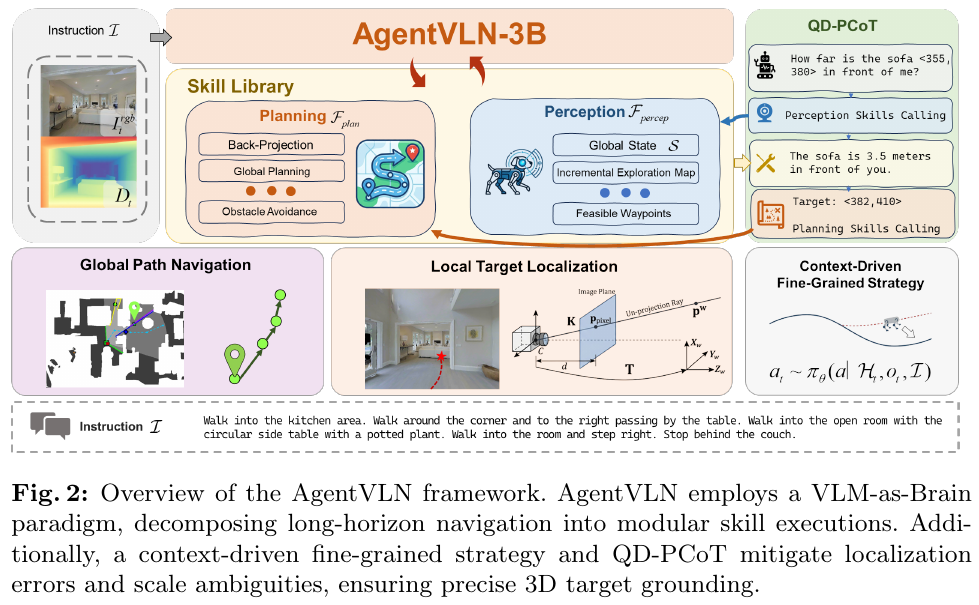
VLM-as-Brain 范式与 POSMDP 建模
AgentVLN 将 VLN 任务形式化为 Partially Observable Semi-Markov Decision Process (POSMDP) $\mathcal{M} = \langle \mathcal{S}, \mathcal{O}, \mathcal{F}, \mathcal{T}, \mathcal{I}, \mathcal{H} \rangle$。VLM 作为中央控制器,在每个决策步 $t$ 基于历史上下文 \(\mathcal{H}_t\)、视觉观测 $o_t$ 和自然语言指令 $\mathcal{I}$ 生成技能调用指令:
\[c_k \sim \pi_\theta(f \mid \mathcal{H}_{t_k}, o_{t_k}, \mathcal{I}), \quad f \in \mathcal{F}\]技能库 $\mathcal{F}$ 分为两类:感知技能 $\mathcal F_{percep}$($\tau=0$,无延时地从环境提取几何/语义特征,更新全局状态 $\mathcal{S}$)和规划技能 $\mathcal F_{plan}$($\tau>0$,执行多步物理动作序列)。具体包括:Back-Projection、Global Planning、Obstacle Avoidance、Incremental Exploration Map、Feasible Waypoints 等模块。这种分层设计使 VLM 完全不接触低层运动细节,专注高层语义-空间匹配。
跨空间表示映射(Cross-Space Representation Mapping)
为解决 VLM 无法直接感知 3D 几何的问题,AgentVLN 设计了一套逆透视投影机制。感知技能首先将 RGB-D 观测通过反投影构建全局占据栅格地图,生成三维路点 $\mathbf{P}^w_{path} = [X_{path}, Y_{path}, 0]^T$;随后通过相机内参矩阵 $K$ 和当前位姿 $T_t$ 将 3D 路点投影回像素坐标:
\[s \cdot \mathbf{p}^{img}_{path} = KR_t^{-1}(\mathbf{P}^w_{path} - \mathbf{t}_t)\]这样 VLM 只需在 2D 像素空间中根据语义选择最匹配的路点,再由规划技能将其恢复为 3D 控制信号,实现了 2D 视觉语义与 3D 物理结构的无缝桥接。
上下文感知的细粒度自校正与主动探索
当当前观测 $o_t$ 中不存在满足指令语义的可行路点时(如遮挡、盲区、轨迹偏差),AgentVLN 不强制执行长距离盲位移,而是输出细粒度原子动作 \(a_t \sim \pi_\theta(a \mid \mathcal{H}_t, o_t, \mathcal{I})\),$a \in {\text{Forward, Left, Right}}$,自主环顾恢复可见路点后切回宏观技能调用,有效抑制长轨迹误差累积。
Query-Driven Perceptual Chain-of-Thought (QD-PCoT)
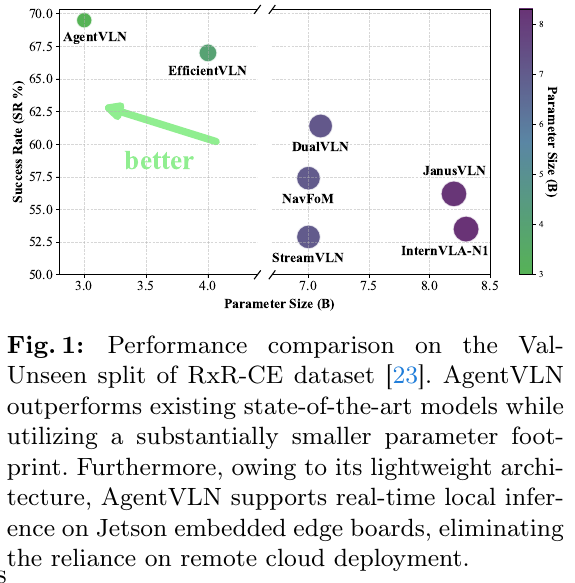
针对局部目标定位阶段的单目尺度歧义,AgentVLN 引入 QD-PCoT 机制。当模型检测到空间歧义时,不盲目回归像素坐标,而是生成中间自然语言查询(如 “How many meters is the chair in front of me?”)并调用感知技能 $\mathcal F_{percep}$ 获取精确深度反馈。该反馈以增量文本提示形式注入上下文,引导模型最终输出准确的目标像素坐标 $\mathbf p_{target}^{img} = [u_{target}, v_{target}, 1]^T$,再经深度图反投影转换为 3D 目标坐标 $\mathbf{P}^w_{target}$,实现精准对接。
AgentVLN-Instruct 数据集
构建了大规模指令调优数据集 AgentVLN-Instruct(基于 Habitat 仿真器),包含四个关键组件:目标可见性驱动的动态阶段路由机制(模拟人类”先粗导航、再精定位”的认知模式)、可泛化技能调用标注、局部化推理数据,以及主动问答交互对。基础模型为 Qwen2.5-VL-3B,训练时冻结视觉编码器,以 AdamW 优化,使用 32 块 NVIDIA A100 GPU。
3. 核心结果/发现
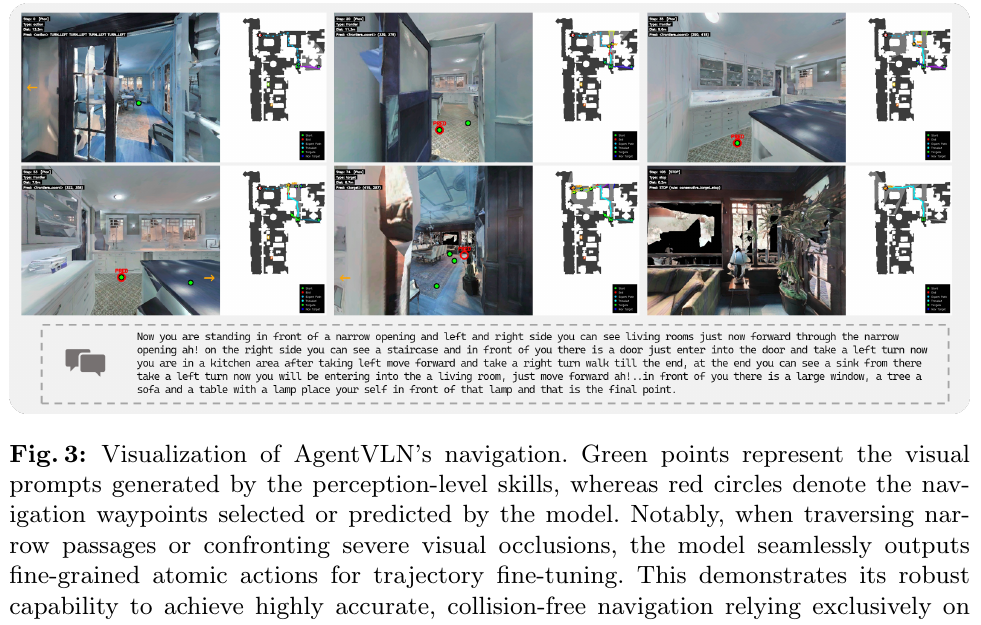
- R2R-CE Val-Unseen: AgentVLN-3B 达到 SR=67.2%, SPL=64.7%,超越同类 SOTA InternVLA-N1-8.3B(SR+9.0%,SPL+10.7%),以不到一半的参数量实现全面超越
- RxR-CE Val-Unseen: SR=69.5%, SPL=61.3%, nDTW=74.6%,同样刷新 SOTA
- 消融分析:仅引入 VLM-as-Brain + 跨空间映射,SR 从基线 38.6% 提升至 59.7%;加入 CDFG 细粒度自校正后达 65.6%;最终集成 QD-PCoT 达 67.2%
- 时序上下文:最优历史帧数 K=8(SR=67.2%,SPL=64.7%),过短则短视,过长则注意力稀释
- 真实世界部署:基于 Unitree Go2 四足机器人 + Intel RealSense D455,结合 RTAB-Map SLAM,在室内外场景均实现准确导航,支持 Jetson 边缘实时推理
4. 局限性
AgentVLN 当前依赖深度传感器(RGB-D)支持精确的 3D 反投影,在纯 RGB 单目场景下的尺度歧义处理能力仍受限;此外,技能库的扩展和维护需要一定的工程成本,对全新场景的零样本适配能力尚待系统评估。
27. VLN-Cache (2026)
———Enabling Token Caching for VLN Models with Visual/Semantic Dynamics Awareness
📄 Paper: arXiv:2603.07080
精华
VLN-Cache 的核心洞见是:现有 token caching 方案在 VLN 场景下失效的根本原因有两个相互独立的维度——视觉动态(视角偏移导致空间位置错配)和语义动态(任务阶段推进导致缓存 token 语义过时)。将 “视图对齐重映射” 与 “任务相关性语义门控” 分别针对这两种动态进行正交设计是本文最值得借鉴的思路:先用几何对应恢复可复用集合,再用语义相关性做一票否决,二者缺一不可。层自适应熵策略(layer-adaptive entropy policy)将每层的复用预算与注意力分布的不确定性挂钩,也为其他需要跨层差异化处理的 inference 优化工作提供了参考范式。整个框架训练自由、无需架构修改,可作为即插即用的推理加速包裹层,具有很强的实用价值。
1. 研究背景/问题
现代 VLN 系统依赖大型视觉-语言模型(VLM)作为规划器,每个导航步骤都需完整的前向推理,导致每步延迟成为实时部署的瓶颈。Token caching 是一种无需训练的推理加速策略,通过复用帧间稳定 token 的 KV 表示来跳过冗余计算;然而现有方法基于静态相机和固定语义的假设,在 Agent 连续平移旋转的 VLN 场景下会出现两类系统性失效:视角偏移导致位置对齐失效,任务阶段推进导致语义相关性突变,使得缓存 token 在视觉上”看起来稳定”但语义上已经过时。
2. 主要方法/创新点
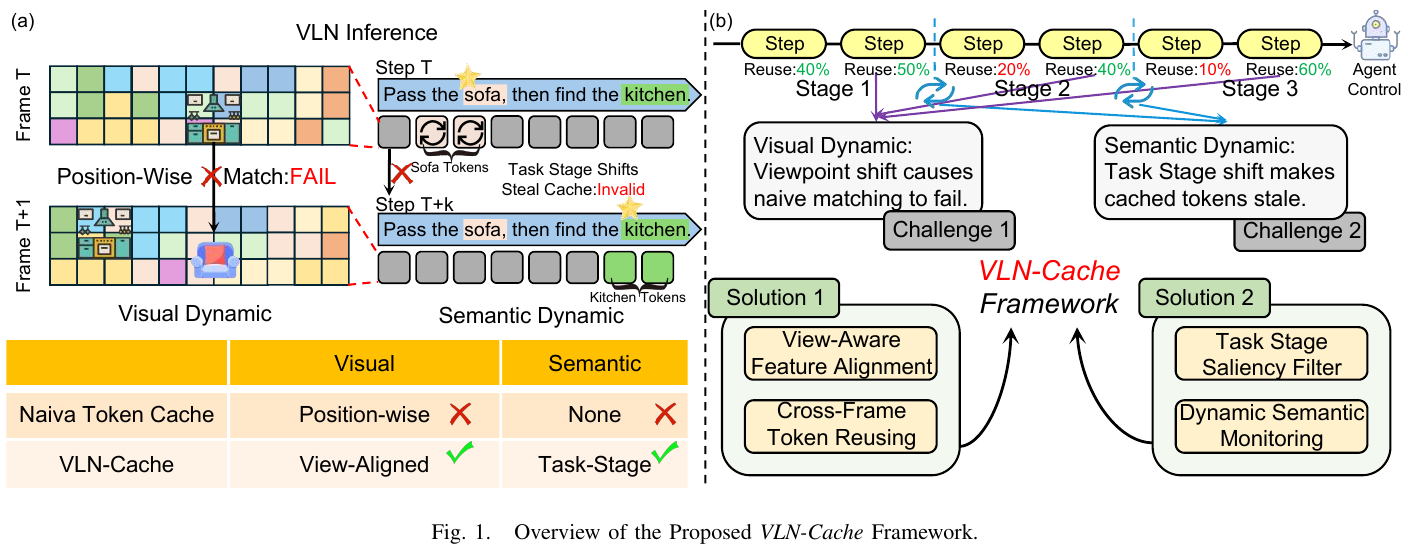
VLN-Cache 是一个双感知 token caching 框架,针对视觉动态和语义动态分别设计了正交的处理机制:
A. 视觉动态感知 Token Caching
由于 Agent 连续移动,帧 t 中位置 i 的 token 对应的物理表面与帧 t-1 中同一位置 i 的表面完全不同。VLN-Cache 通过 视图对齐重映射(View-Aligned Remapping) 解决这一问题:
- 利用深度图将每个 token 中心 $u_t^{(i)}$ 反投影到 3D 空间,结合相机相对位姿变换矩阵 $T_{t \to t-1}$,重新投影到上一帧图像平面,得到对应位置 $\pi_t(i)$
- 通过 3×3 邻域细化($\mathcal{N}$)处理连续坐标到离散 patch 索引的量化误差
- 仅当重映射后的 token 对余弦相似度超过阈值 $\tau_{vis}$ 且在有效视野内时才标记为可复用
B. 语义动态感知 Token Caching
即便两帧间 token 在几何上完美对齐、视觉上高度相似,若 Agent 已完成当前子目标并转向下一阶段,该区域的任务相关性可能已骤降,复用其缓存状态会向语言解码器注入过时的注意力模式。VLN-Cache 引入 任务阶段显著性过滤器(Task-Stage Saliency Filter):
- 为每个 token 计算指令条件相关性分数 $s_t^{(i)}$(top-k 注意力集中区域的 Jaccard 距离衡量语义转变幅度 $D_t^{sem}$)
- 满足以下任一条件则强制刷新:当前相关性过高($s_t^{(i)} > \tau_{abs}$,缓存版本无法代表该区域重要性)或相关性快速变化($\lvert s_t^{(i)} - s_{t-1}^{(i)} \rvert > \tau_\Delta$,正在经历语义转变)
- 语义门控为 一票否决(hard veto):视觉稳定性是复用的必要条件但不充分,语义过时则无条件刷新
C. 双感知融合与层自适应缓存策略
最终复用掩码采用乘法形式 $m_t^{(i)} = m_{vis,t}^{(i)} \cdot (1 - m_{sem,t}^{(i)})$,仅当几何稳定且无语义转变时才复用。
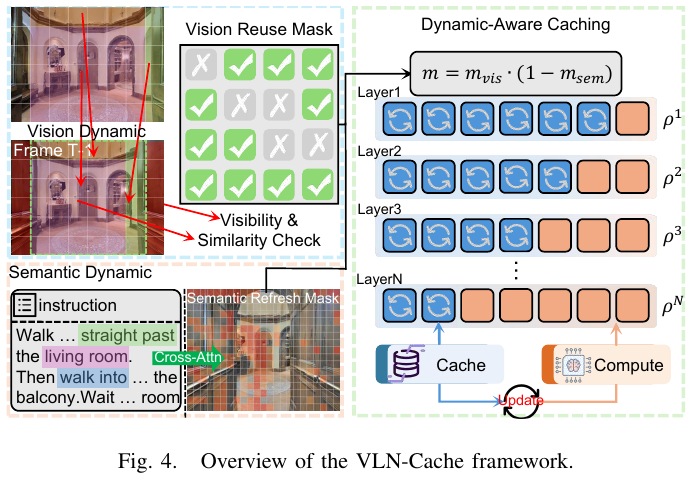
对于 Transformer 不同层,早期层处理低层次视觉特征(变化较慢),深层编码任务相关表示(在指令转变时变化更剧烈)。VLN-Cache 通过 层自适应熵策略 调节每层复用预算: \(\rho_t^\ell = \text{clip}(\rho_{max} - \alpha H_t^\ell, \rho_{min}, \rho_{max})\) 其中 $H_t^\ell$ 是从现有注意力 softmax 读取的层熵代理,高熵层(不确定层)分配更保守的复用预算,低熵层可更激进地复用。
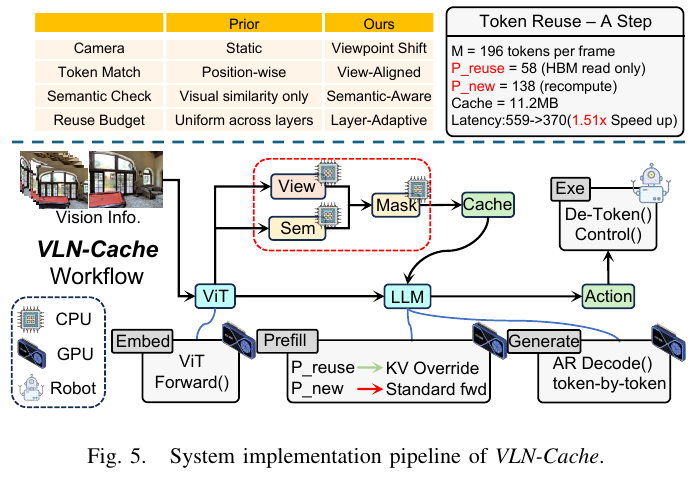
在系统实现上,VLN-Cache 不修改模型权重或注意力核,作为 drop-in 包裹层集成到任意基于 Transformer 的 VLA backbone:复用 token 从视图对齐缓存位置 $\pi_t(i)$ 直接拼接 KV 状态,新 token 经标准投影;RoPE 位置编码仅对新 token 更新,复用 token 继承原有编码。每帧缓存占用约 85.8 MB(A100 VRAM 的 0.21%),无需 CPU 卸载。
3. 核心结果/发现
在 R2R-CE val_unseen 基准(1,839 个 episode,基于 InternVLA-N1 / QwenVL-2.5 7B backbone)上:
- 推理加速:每步延迟从 637 ms 降至 419 ms,实现 1.52× 步级加速,episode 级别同样达到 1.52× 加速(114.7s → 75.5s)
- 导航精度保持:SR = 63.1(vs. 基线 64.3),SPL = 57.6(vs. 基线 58.5),SR 下降仅 1.2%
- Token 复用率:平均每步 31% 的 VLA token 从缓存复用;83% 的帧完全绕过 ViT 视觉编码器
- 消融分析:移除视图对齐重映射后 SR/SPL 显著下降(回退到位置对齐方案),移除语义门控后精度下降(视觉相似但语义过时的 token 被错误复用),二者均为不可或缺的正交贡献
- 效率-精度帕累托最优:在所有 RGB-only VLN 方法(NaVid, MapNav, UniNaVid, NaVILA, StreamVLN, DualVLN)中,VLN-Cache 达到最低 NE(3.93)和最高 OS(71.4),同时具备最快推理速度
4. 局限性
VLN-Cache 目前仅针对 RGB-based 连续 VLN,不支持深度传感器或地图导航设置;四个超参数($\tau_v, \tau_s, k, \rho_{max}$)缺乏自动调节方法,需在小型保留轨迹集上手动校准,自动超参确定方案留作未来工作。
28. R³: Run, Ruminate, and Regulate (2026)
———一个面向视觉语言导航的双过程思考框架
📄 Paper: arXiv:2511.14131 · Code(待发布) · 🏛️ AAAI 2026
精华
- 将 Kahneman 双过程理论落到 VLN:Runner(快系统)处理常规导航,Ruminator(慢系统)处理异常情境,Regulator在两者间做监督切换——解决 “LLM 方法慢但泛化强 vs. 专家模型快但迁移差” 的取舍。
- Runner 用轻量级 transformer VLN 专家(~160 M 参数、沿用 GridMM)做反应式高频动作预测;Ruminator 用 GPT-4o + CoT 做感知-规划-预测三步推理;二者共享一个grid-based topological memory bank,使慢系统能直接继承快系统的历史上下文。
- Regulator 的切换信号来自三路critical evaluation(looping 视点重访阈值 + scoring GNN 对轨迹图做自监督打分 + ending 对 STOP 的校验),切换后进入critical formulation清空误导性历史,避免 LLM 被错误上下文污染。
- Scoring 的自监督标注策略值得借鉴:以”是否最终到达目的地 / 路径是否属于 GT 子集”作为二分类伪标签,GNN 用图注意力做消息传递,从而无需人工标注就能早期识别失败前兆。
- R³ 在 REVERIE Val-Unseen 上 SPL/RGSPL 比 SOTA 高 3.28 / 3.30,推理时间仅为其他 LLM-assisted 方法的 1/5(1.10 s vs. 5~11 s),展示了”大部分步数走快系统、异常步数才调 LLM”这一思路在效率与性能上的双赢。
1. 研究背景/问题
VLN 需要智能体根据自然语言指令在复杂 3D 环境中动态导航。两条主流路线各有短板:(1)基于 BC 的 VLN 专家(DUET、GridMM 等)效率高但常识缺失、对未见环境泛化差;(2)LLM-assisted 零样本方法(NavGPT、MapGPT、DiscussNav 等)泛化好但每步调 LLM 导致延迟高(5~11 s/step),且对空间几何与场景布局的理解不够精确。作者目标是把两者的长处糅合在同一框架下——而不是简单地把 LLM 插进每一步。
2. 主要方法/创新点
2.1 整体思想:双过程思考
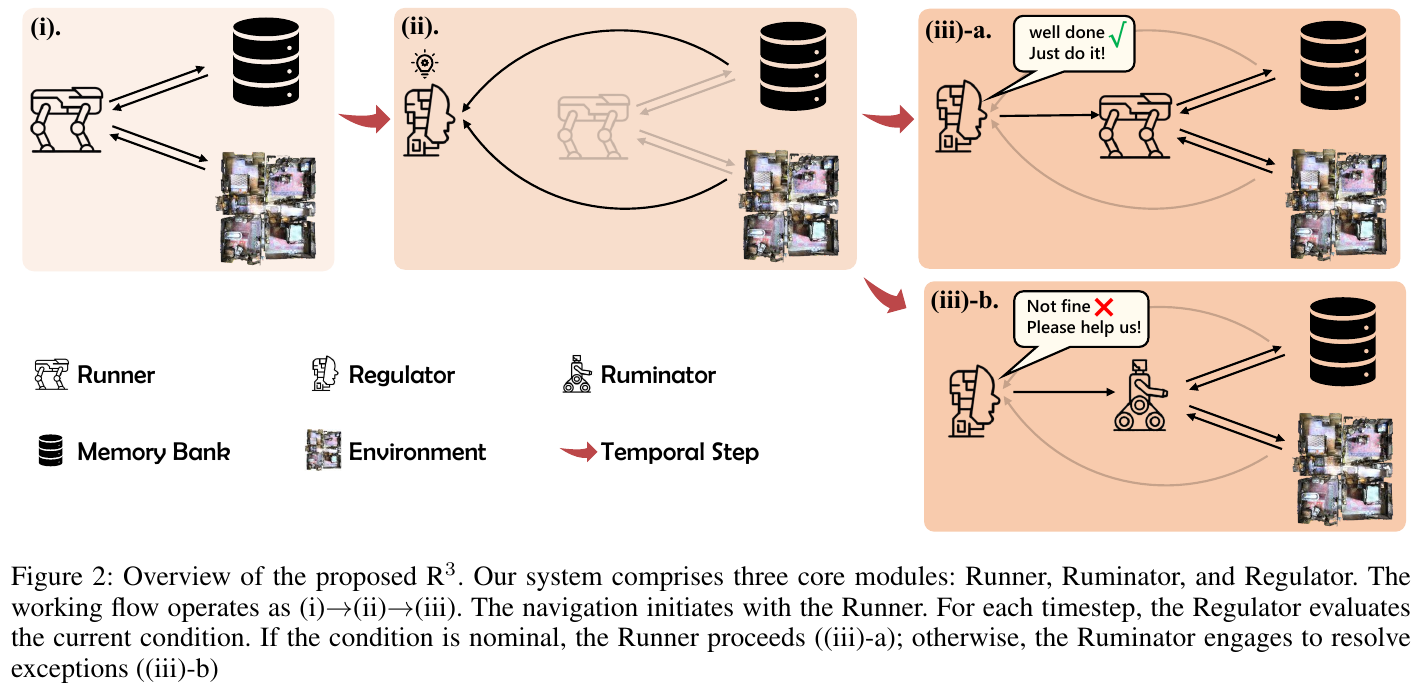
R³ 由三个模块组成:
- Runner(快系统):反应式 VLN 专家,常规步骤下主导。
- Ruminator(慢系统):多模态 LLM + CoT,仅在检测到异常时激活,接管直到该异常消除或片段结束。
- Regulator(监督者):每个时间步评估当前状态,决定是否切换到 Ruminator,并在切换时清洗历史。
2.2 整体 Pipeline
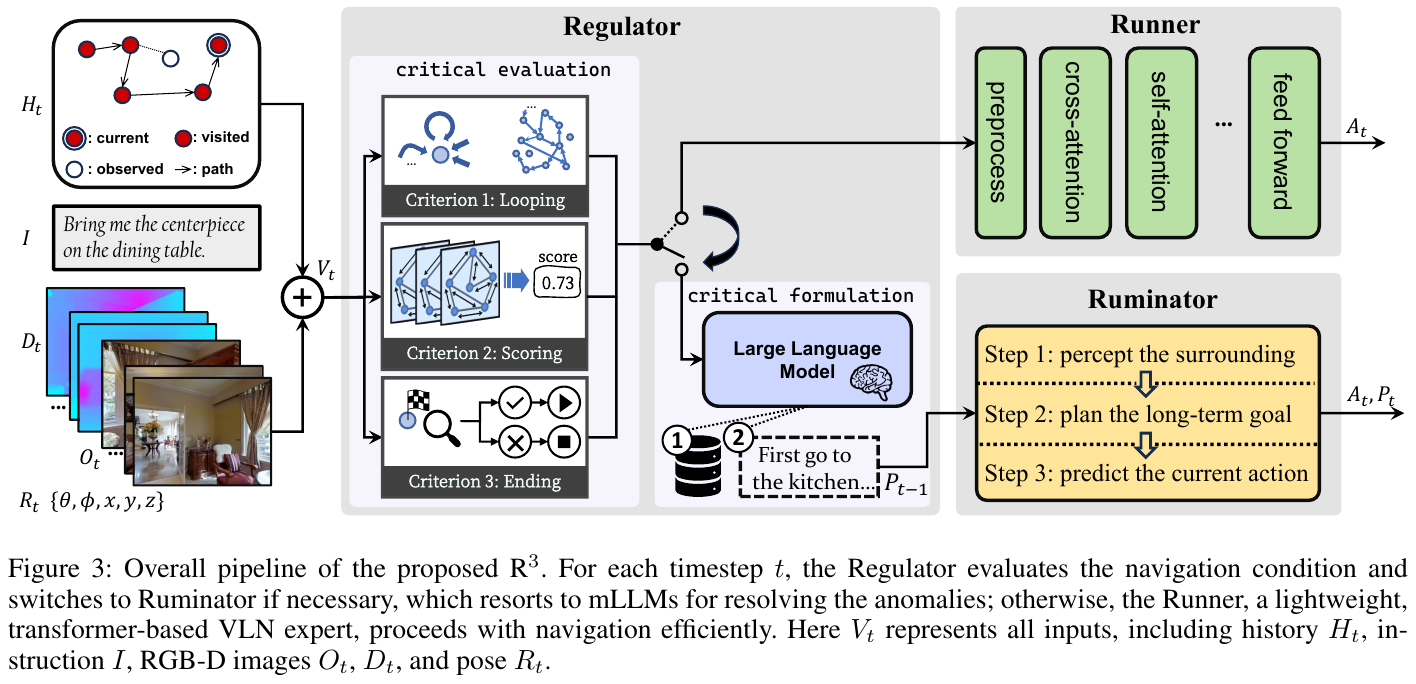
问题形式化:VLN 建模为 POMDP,智能体在时刻 $t$ 观察到位姿 $R_t$ 与全景 \(O_t=\{o_t^i\}_{i=1}^{36}\)(36 个相对 heading/elevation 的透视图),从可导航视点集合中选一个作为动作 $A_t$。策略 $\pi(A_t \mid I, O_t, H_t; \Theta)$ 基于指令 $I$、历史 $H_t={O_0, A_0, …, O_{t-1}, A_{t-1}}$ 与当前观察预测动作,直到智能体输出 [STOP] 或超步数上限。
2.3 Runner:轻量 transformer 快速响应
Runner 接收 RGB-D $O_t, D_t$ 与位姿 $R_t$,通过投影提取细粒度特征并写入egocentric grid memory;随后与指令嵌入一起走 cross-modal transformer encoder,最终由两层 FFN 预测动作。Runner 仅 160 M 参数,保证实时推理。其实现直接复用 GridMM 官方仓库。作者指出 Runner 的两类固有缺陷:(1)训练 teacher-forcing 分布有限导致未见场景下容易出现短视决策(aimless wandering / 重复徘徊);(2)BC 学习使其进入错误视点后难以自我纠错——这正是 Ruminator 要补的。
2.4 Ruminator:GPT-4o + CoT 三步慎思
Ruminator 的输入通过一段结构化文本模板拼接(论文 Fig. 4):Instruction + 36 张全景 Observation + Trajectory(”你从 $id_0$ 出发看到 $M_0$;step 1 到 $id_1$ 看到 $M_1$…“)+ Map(视点连通关系)+ Option(候选动作)。这种系统化格式化让 LLM 能显式感知环境拓扑与历史。
Ruminator 以 GPT-4o 为底座,用 CoT 组织三步:
- Perception:根据指令 $I$ 与全景 $O_t$ 生成细粒度环境文字描述,突出指令涉及的对象。
- Planning:结合历史 $H_t$、上一步规划 $P_{t-1}$ 做长视野重规划,生成新 plan $P_t$。历史在 Ruminator 状态下以”taken action + target destination“形式表达——动作从
{go forward to, turn left to, turn right to, turn back to}根据当前朝向与目标视点的夹角生成。 - Prediction:基于 $I, P_t, O’_t$(可导航视点的子集)从候选中选动作。执行后更新 $H_t$ 与相邻视点。
2.5 Regulator:双阶段切换机制
Stage 1 — Critical Evaluation(何时切换) 三条互补准则:
- Looping:当任一视点的重访次数超过 $\tau_r$,或轨迹长度超过 $\tau_l$,判定为陷入循环。
- Scoring:用 GNN(两层 graph attention + edge encoding)给当前轨迹打分,输入是以”位置 / 最后到达时间戳 / 视觉 embedding”为节点特征、视点连通关系为边的拓扑图,未访问节点用邻居视觉嵌入均值近似。训练用自监督伪标签——成功到达或所有视点都属于 GT 路径的 $\mathcal T_t$ 标 0,否则标 1。推理时分数 $>\tau_g=0.35$ 触发切换。
- Ending:Runner 预测
[STOP]时再由 GPT-4o 根据 $I, O_t$ 判断是否真的到达目的地,避免早停。
Stage 2 — Critical Formulation(如何切换) 切换到 Ruminator 前,Regulator 额外用 LLM 判断”从起点重启是否更可取”——这一步重置 memory bank以模拟真实部署;同时在其它触发下也会剔除 Runner 积累的误导历史,再让 Ruminator 重新推理,避免错误上下文污染 LLM。
2.6 共享 Memory Bank
这是效率关键:Runner 的 grid-based topological memory 不仅服务快系统的长上下文决策,在切换时也直接继承给 Ruminator,使 LLM 无需从零重建历史(消融显示 w/o memory bank 时 SR 下降 0.87)。
3. 核心结果/发现
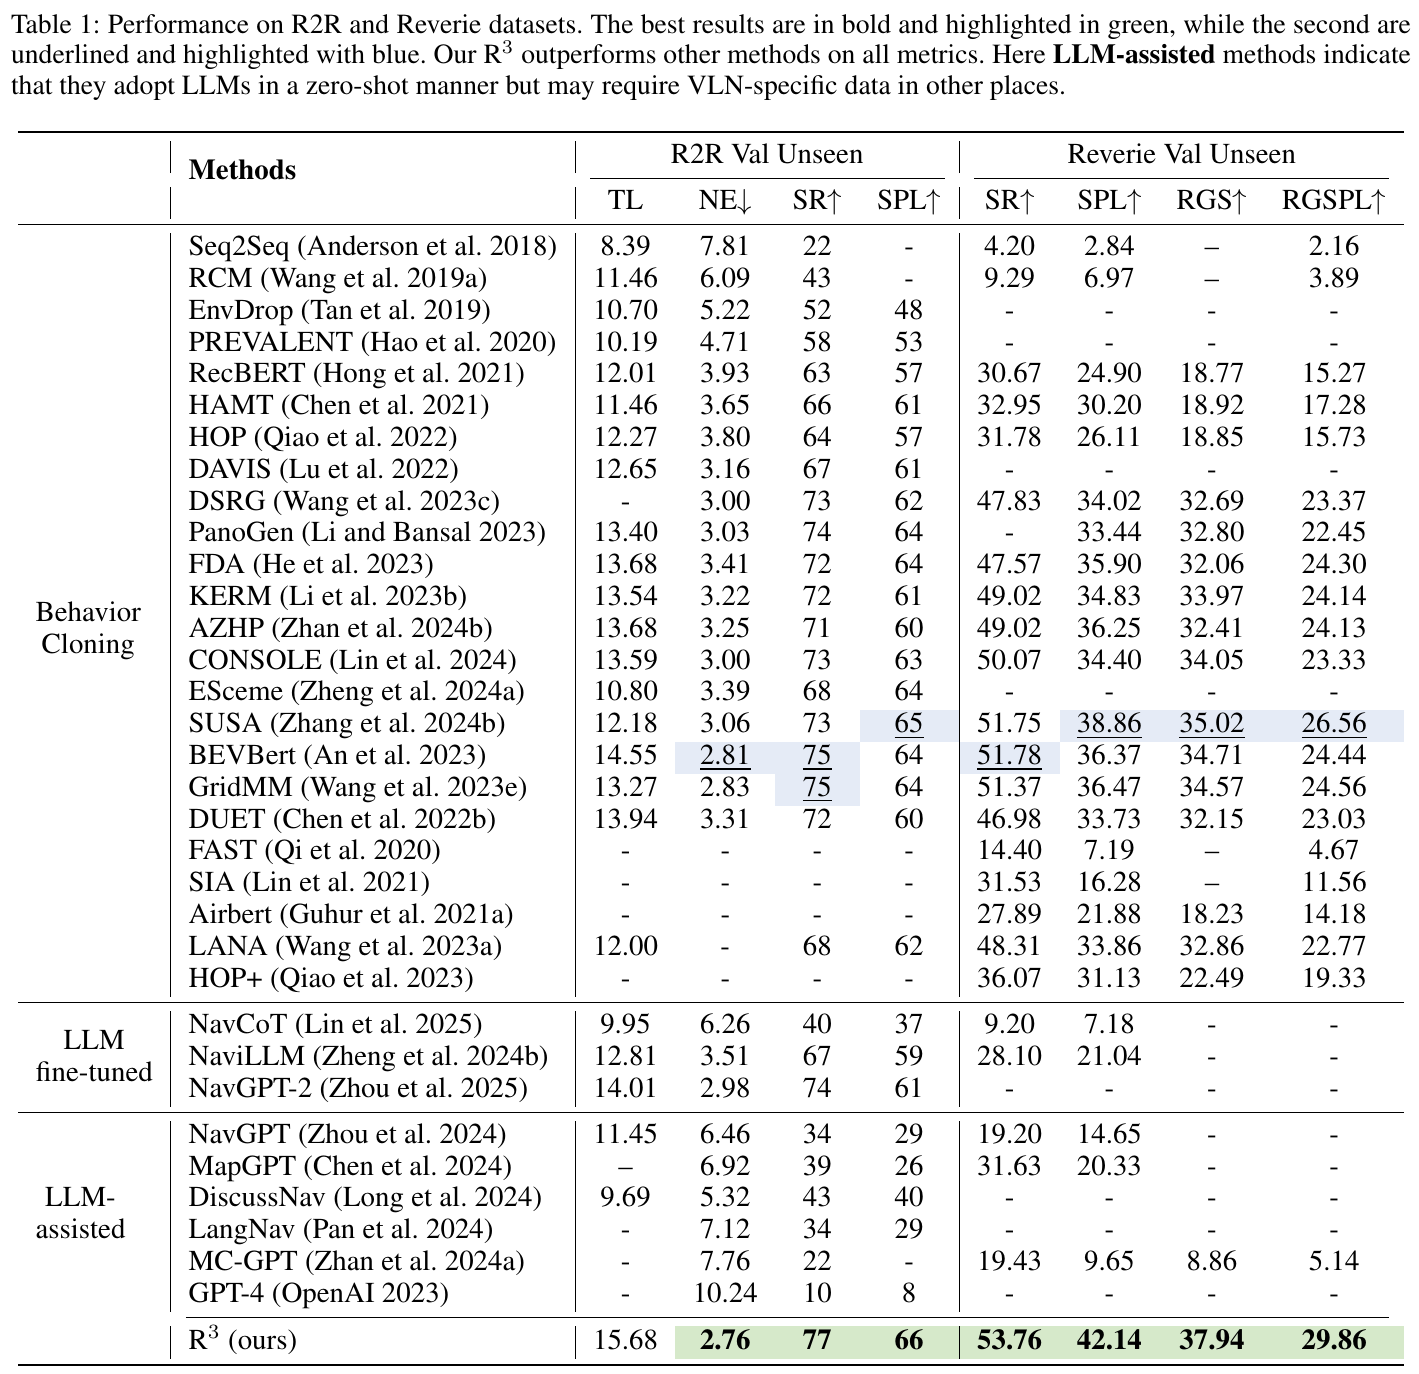
- R2R Val-Unseen:SR 77 / SPL 66,较最佳 BC 基线(GridMM 75 / 64、BEVBert 75 / 64)提升 2 / 1.5 个点;NE 2.76(最低)。
- REVERIE Val-Unseen:SR 53.76 / SPL 42.14 / RGS 37.94 / RGSPL 29.86,较次优方法(SUSA 51.75 / 38.86 / 35.02 / 26.56)分别 +2.01 / +3.28 / +2.92 / +3.30;REVERIE 上提升显著大于 R2R,表明 R³ 对高层语义理解与慎思分析要求更高的”粗粒度”指令更有优势。
- 效率(Fig. 1):R³ 1.10 s/step vs. 其他 LLM-assisted 方法 5~11 s,约 1/5;且 SR 77 远超所有 LLM-assisted 基线(最高 DiscussNav 40)。证明”异常步才调 LLM”的策略可同时获得效率与性能。
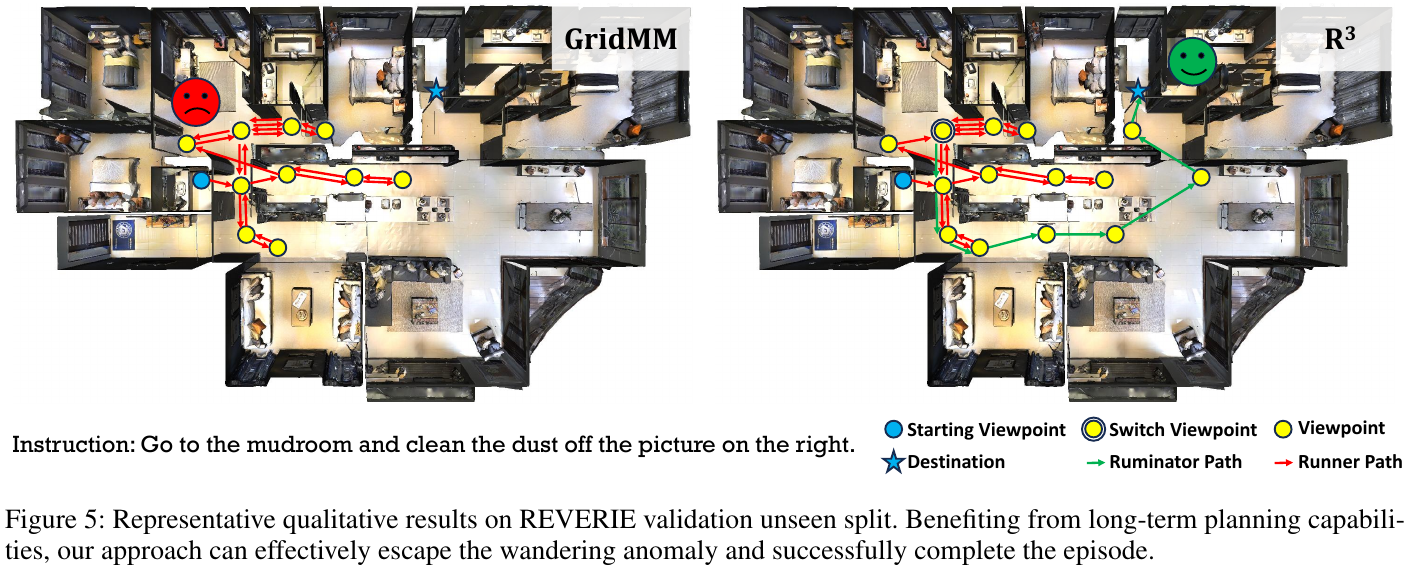
消融要点(Table 2/3,略图):
- Regulator 三准则互补:去掉 Scoring 掉 SR 2.05 / SPL 2.76(最大降幅),说明 GNN 打分是主要的失败早期信号;去掉 Ending 掉 RGS 2.33 / RGSPL 4.01(RGS/RGSPL 最大降幅),对物体定位影响最大;去掉 Looping 与 Critical Formulation 也都有 0.37~0.39 的 SR 下降,全部非冗余。
- LLM 能力 × 性能正相关:GPT-4o > GPT-3.5 Turbo » MiniGPT-4;有趣的是不接 Ruminator(w/o LLM)的 R³ 仍比接 MiniGPT-4 好 1.98 SR,说明能力不足的 LLM 会破坏系统,预示未来更强 LLM 可直接放大 R³ 收益。
- 共享 memory 的必要性:w/o memory bank 时 SR 52.89(-0.87)、RGSPL 28.06(-1.80),说明 Ruminator 真的依赖 Runner 积累的上下文。
4. 局限性
- Ruminator 依赖 GPT-4o API,部署成本与网络延迟仍是瓶颈(Fig. 1 中 NavGPT-2 本地部署效率更好);在真实机器人上需要等价的本地 MLLM。
- 仅在 Matterport3D(R2R / REVERIE)上评测,连续动作空间(R2R-CE、RxR-CE)与真实机器人泛化尚未验证。
- Scoring GNN 的自监督伪标签依赖”GT 路径子集”这一先验,迁移到无明确路径标注的任务(如 ObjectNav)可能需要重新设计。
29. AwareVLN (2026)
———Reasoning with Self-awareness for Vision-Language Navigation
📄 Paper: arXiv:2605.22816 · Project Page · 🏛️ CVPR 2026
精华
- 现有 VLM-based VLN 方法把 VLM 当成”指令→动作”的端到端映射器,浪费了 VLM 本身的推理能力,导致导航过程不可解释、缺乏纠错能力。
- AwareVLN 的核心思想是自我感知(self-awareness)推理:让 agent 在导航中显式分析”自己当前在哪、任务完成到哪、是否偏离了指令”,而不仅仅预测下一步动作。
- 关键设计是稀疏触发的结构化推理——用一个 special token(
[REASON]/[ACT])让模型自主决定”何时该想一想”,只在子任务边界、路径偏离、停止误差这些关键节点触发推理,兼顾效率与有效性。 - 推理采用固定的三元结构:场景描述 → 进度评估 → 下一步规划,并把上一次推理结果回灌给模型,形成因果链式的自我对话。
- 配套一个全自动数据引擎:利用模拟器的房间级语义 + ground-truth 路点自动定位关键推理节点,再用通用 VLM(Qwen-VL-Max)生成结构化推理监督,无需人工标注即可规模化造数据。
1. 研究背景/问题
VLN(Vision-Language Navigation)要求 agent 在未知环境中跟随自然语言指令导航。传统方法依赖显式拓扑图 + SLAM/3D 传感器做规划,部署受限;近期端到端 VLM-based 方法(NaVid、NaVILA、StreamVLN 等)直接把指令和 RGB 观测映射为动作,摆脱了对深度/位姿的依赖。但这些方法只”驯化 VLM 去预测动作”,忽视了 VLM 的内在推理能力,导致导航过程像黑盒、缺乏自我感知,难以做精确的子任务规划和错误纠正。已有的 Nav-R1 虽尝试以固定间隔的双系统机制做推理,但其监督数据来自通用 VLM 对历史观测的泛化查询,缺乏真正的自我感知知识,推理只是文本输出而无法指导后续动作。核心问题是:如何根据观测历史准确推理 agent 当前状态与任务进度,并让推理真正服务于行动?
2. 主要方法/创新点
AwareVLN 在一个统一的 VLM 中同时承担动作预测与自反思推理。相比用两个独立模型,统一架构让”推理”和”行动”两个维度的知识在模型内部相互交互、彼此增强。
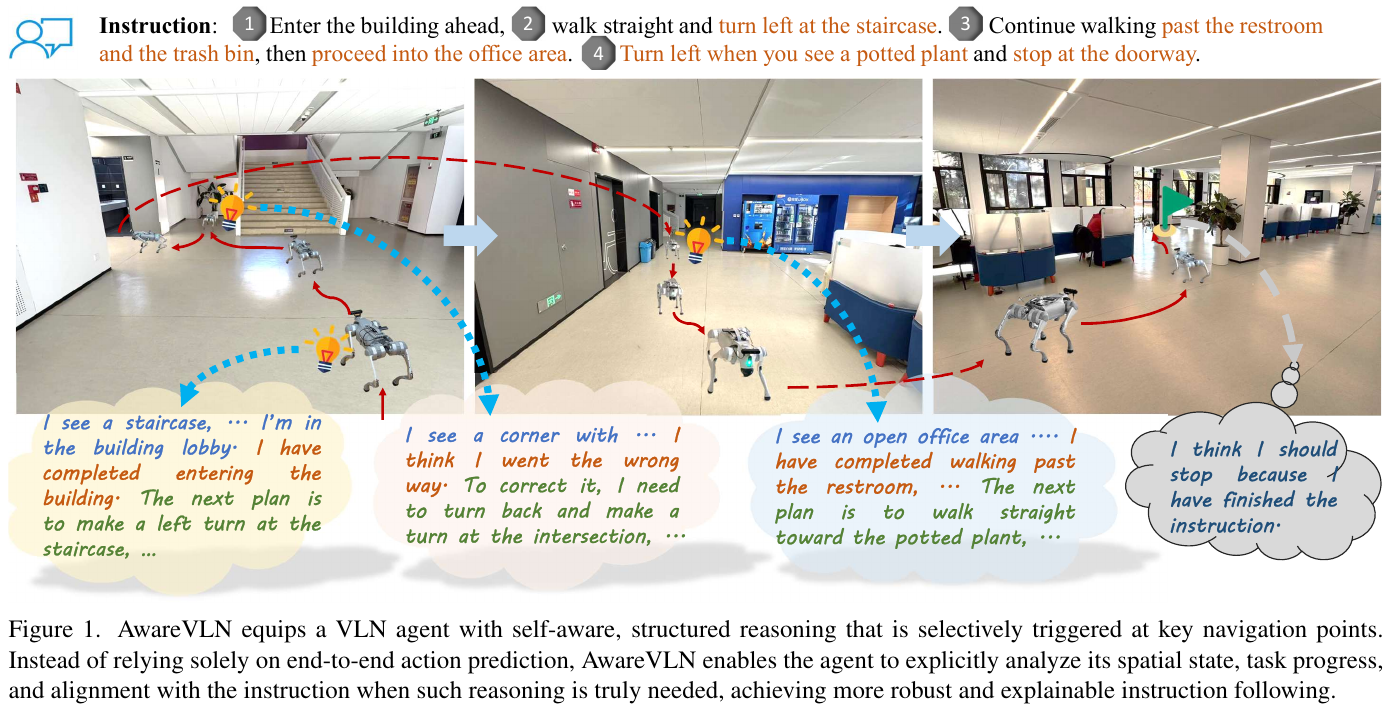
① 整体框架概述
AwareVLN 由三大部分构成:(a) 统一的 Reason-Act 框架(一个 VLM 同时输出动作和推理)、(b) 结构化的三元推理格式(场景描述 / 进度评估 / 下一步规划)、以及 (c) 稀疏触发机制(由 special token 在关键节点决定是否推理)。视觉观测经 Vision Encoder & Projector 编码,与指令、上一次推理文本一起送入 LLM,模型先输出一个 special token 决定进入”行动模式”还是”推理模式”,再生成相应的文本。
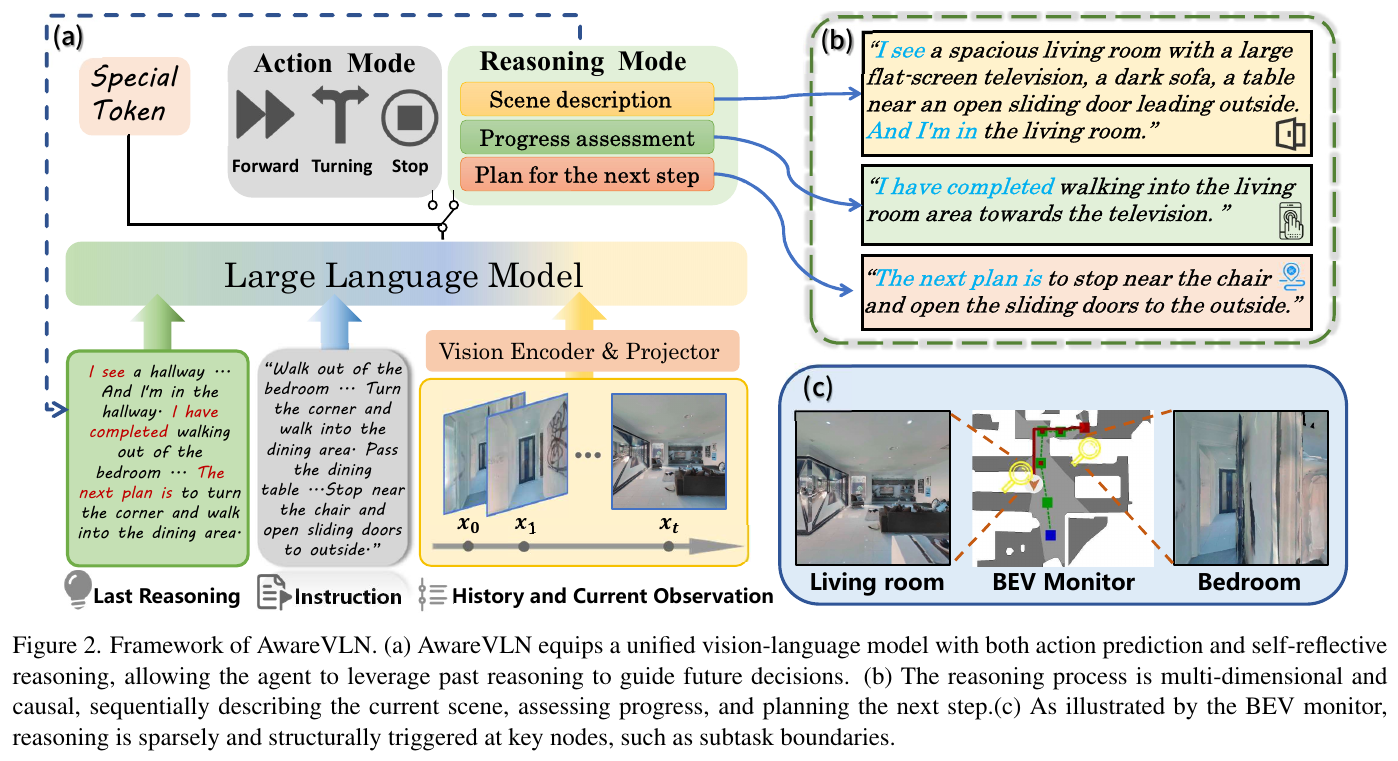
② 逐模块讲解
统一 Reason-Act 框架(Unified Reason-act Framework)
- 输入:导航指令 $I={w_1,\dots,w_l}$、视觉观测序列 $O_t={x_0,\dots,x_t}$(为效率均匀采样 8 帧),以及最近一次推理输出 $R$。
- 处理:tokenizer $f_{tok}(\cdot)$ 把指令和上次推理转成 token,vision encoder $f_{vis}(\cdot)$ 提取视觉嵌入。一个关键细节是把”当前帧与上次推理帧之间的步数差”作为相对位置线索编码进去,与推理文本融合以提供显式的时间上下文:
其中 $t_{prev}$ 是上一次推理输出的时间步。统一策略 $\pi_\theta$ 基于该上下文产生一个 logit $d$(决定 special token)和文本输出 $y_t$:
\[d, y_t = \pi_\theta\big(f_{tok}(I), f_{tok}(R'), f_{vis}(O_t)\big)\]special token 的选择规则为:当 $d_{[\text{REASON}]} > d_{[\text{ACT}]}$ 时取 [REASON],否则取 [ACT]。
- 输出:若为
[REASON],模型进入推理模式,产生总结自身理解与进度的文本,并更新 $R$、记录 $t_{prev}$;若为[ACT],进入行动模式,生成动作命令(如”move forward 75 cm”),经 PARSE 解析为底层离散动作 $a_{t+1:t+k}$(动作集 $A={$FORWARD, TURN-LEFT, TURN-RIGHT, STOP$}$)执行。 - 设计动机:这种”语言驱动”的统一形式让感知、推理、控制无缝衔接;通过递归地以上一次推理和相对步数为条件,模型在长程导航中保持时间感知与自适应决策。
结构化自我感知推理(Structural Reasoning for Self-awareness)
- 触发时机(关键节点):不在每一步都推理,而只在三类关键状态触发——(i) 子任务完成:检测到某条子指令(如”走到门口”)已完成时,总结进度、确认子目标、规划下一步;(ii) 路径偏离:发现期望与观测的视觉线索不一致(地标缺失、空间错位)时,进入推理分析错误并提出纠正动作;(iii) 停止误差:导航末段当前视觉上下文与目标描述不符时,触发推理分析偏差、调整后续计划以精确定位终点。
- 三元推理格式:每次推理强制产出三个组件——(1) Scene description(对关键节点视觉上下文的简洁描述)、(2) Progress assessment(分析指令完成到哪、是否偏离)、(3) Plan for the next step(下一阶段的高层意图/策略)。这套结构在统一语言空间里把感知、推理、规划连成一体,为模型提供显式的自我感知。
③ 自动数据引擎(Automatic Data Engine)
为规模化获得高质量推理监督且不依赖人工标注,AwareVLN 设计了一个全自动数据引擎。
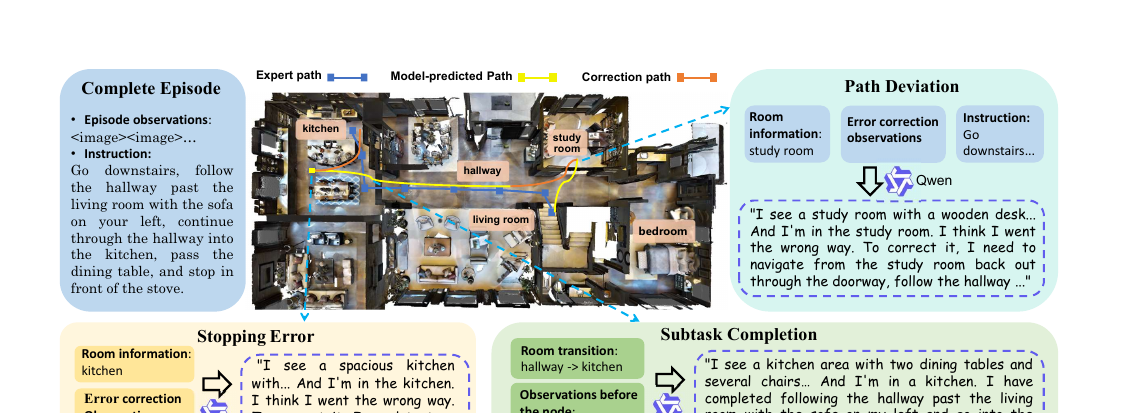
- 轨迹采集:两种互补策略。其一是 ground-truth following(严格跟随参考轨迹,得到指令对齐的”正确推理”样本);其二是 DAgger-based collection(用早期模型执行预测动作,一旦偏离 ground-truth 就纠正回下一个路点,产生含真实预测错误与纠正行为的轨迹,对训练”错误识别与恢复”推理尤为宝贵)。
- 关键节点识别:利用模拟器场景语义 + 数据集标注路点自动定位。子任务完成通过轨迹上房间类别的变化判定(并把纠正过程的完成也当作子任务边界);路径偏离/停止误差通过计算执行轨迹与 ground-truth 路点的空间偏差,超过阈值即标记为偏离节点并记录后续纠正观测。
- 推理监督生成:用通用 VLM(Qwen-VL-Max)以多轮对话流水线把上下文转成结构化推理。第一轮输入完整 episode 观测序列 + 指令,让 VLM 建立全局理解;后续每个关键节点再输入节点类型、节点前的降采样观测、房间转移信息、估计的导航进度(已行进距离/总路径长度);对偏离节点额外提供纠正过程观测,使 VLM 能推断”错误—恢复”的因果关系。最终为每个节点生成上述三元结构的推理文本。
④ 训练与推理
- 训练:分两阶段。预训练遵循 NaVILA,纳入常规导航数据 + 大规模 VQA 数据;微调使用数据引擎产出的”推理增强导航轨迹”,并混入无推理监督的人类视频以提升泛化。这使模型在获得自我感知推理能力的同时保留强视觉对齐与语言对齐。训练在 4 节点 NVIDIA H20 GPU 上完成。
- 推理:见 Algorithm 1——循环中先融合相对步数与上次推理 $R’ = R \oplus (t-t_{prev})$,再由 $\pi_\theta$ 输出首个 logit 与文本;据 special token 决定更新推理(
[REASON])还是解析并执行动作([ACT]),然后追加新帧。单卡 NVIDIA RTX 4090 上推理速度约 1 FPS。
3. 核心结果/发现
- 仿真主结果(R2R-CE / RxR-CE Val-Unseen,纯单目 RGB 输入):AwareVLN 在 R2R-CE 上 SR 65.4、SPL 55.1、OS 73.5、NE 4.02;RxR-CE 上 SR 67.6、SPL 56.1、nDTW 65.7,全面超越所有不依赖模拟器预训练 waypoint predictor 的方法(包括 NaVILA、StreamVLN、Uni-NaVid、OctoNav 等),甚至优于很多使用深度、全景、里程计等额外输入的方法。例如相比 StreamVLN,R2R-CE SR 从 56.9 提升到 65.4,OS 从 64.2 提升到 73.5。
- 真实世界评测:在 Corridor / Home / Office 三类环境、简单与复杂任务共 18 条指令上,AwareVLN 的 NE 和 SR 一致优于 NaVid、NaVILA,复杂任务下优势尤为明显(多个复杂场景 SR 从 0.33 提升到 0.67–1.00),验证了自我感知推理对 sim-to-real 泛化的增益。
- 消融——数据引擎关键节点(Table 3):去掉任一节点都会掉点;去掉 Subtask Completion 掉点最严重(R2R SR 65.4→52.3),因为模型失去对整体指令进度的跟踪;去掉 Path Deviation 削弱纠错能力,去掉 Stopping Error 影响终点判定。
- 消融——架构与推理调度(Table 4):去掉 special token 强迫模型直接预测会掉点(结构化输出对任务分解很关键);”每帧都密集推理 + 动作”(Reason with action densely)反而明显变差,证明稀疏推理既更有效又更高效(昂贵的推理只在必要时触发)。
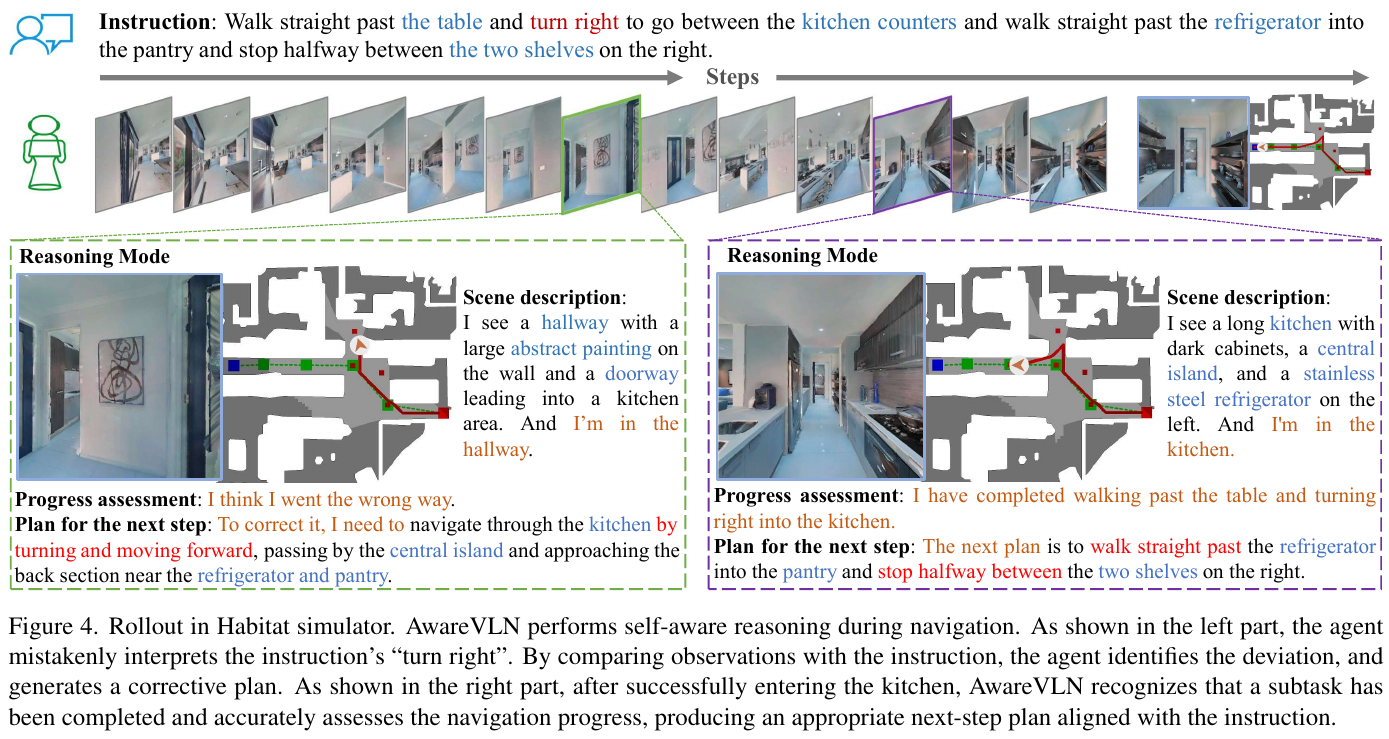
4. 局限性
推理监督的质量受限于通用 VLM(Qwen-VL-Max)和模拟器语义/路点标注的准确性;关键节点的检测依赖房间级语义与阈值规则,迁移到无此类标注的开放环境时数据引擎的可用性有待验证。此外约 1 FPS 的推理速度对高动态实时场景仍有压力。
30. Dual-Anchoring (2026)
———用”指令进度”与”地标记忆”双重锚定,对抗 VLN 中的状态漂移(State Drift)
📄 Paper: arXiv:2604.17473v2
精华
- 提出 State Drift(状态漂移) 概念:基于 Video-LLM 的 VLN agent 在长程任务中,内部状态会逐渐脱离真实任务状态,表现为进度漂移(Progress Drift,搞不清走到指令哪一步)和记忆漂移(Memory Drift,忘记已经过的地标)。
- 核心洞见:纯 next-action prediction 是”结果导向”的弱监督,只保证局部动作正确,却不约束内部认知过程,长程下必然与物理现实解耦。解法是给内部状态加显式锚点。
- 双锚定框架两条互补支路:① 指令进度锚定——让 agent 在动作前先用结构化文本写出”已完成 vs 未完成”的子目标清单(语义稳定器);② 记忆地标锚定——用 Landmark-Centric World Model 回溯重建最近经过地标的 SAM 特征(视觉”后视镜”)。
- 方法论启发:用”语言化心智清单”显式表征任务进度,用”回溯式(hindsight)而非前瞻式(foresight)世界模型”锚定历史记忆——两者都是给隐状态加可监督的显式约束,且推理时可丢弃辅助头,零额外开销。
- 配套构建两个大规模数据集(360 万进度描述 + 93.7 万地标 SAM 特征),在 R2R-CE / RxR-CE 上达到 SOTA,长程轨迹 SPL 相对提升高达 +33.2%。
1. 研究背景/问题
VLN 要求 agent 在未见 3D 环境中按自然语言指令导航。主流 perception-to-action 流水线对短指令有效,但在长、组合性指令下脆弱:随导航推进,agent 的任务状态逐渐不可靠,丧失对”我在指令的哪一步”和”我去过哪里”的一致感知,即 State Drift。近期 Video-LLM 虽借助强预训练表征推进了 VLN,但其 next-action prediction 目标只约束局部动作、不约束内部状态,长程下内部表征不可避免地与物理现实解耦。作者将其归因为两种耦合的失败模式:Progress Drift(指令阶段误判,已完成/未完成边界模糊)与 Memory Drift(历史表征退化,丢失已访问地标)。
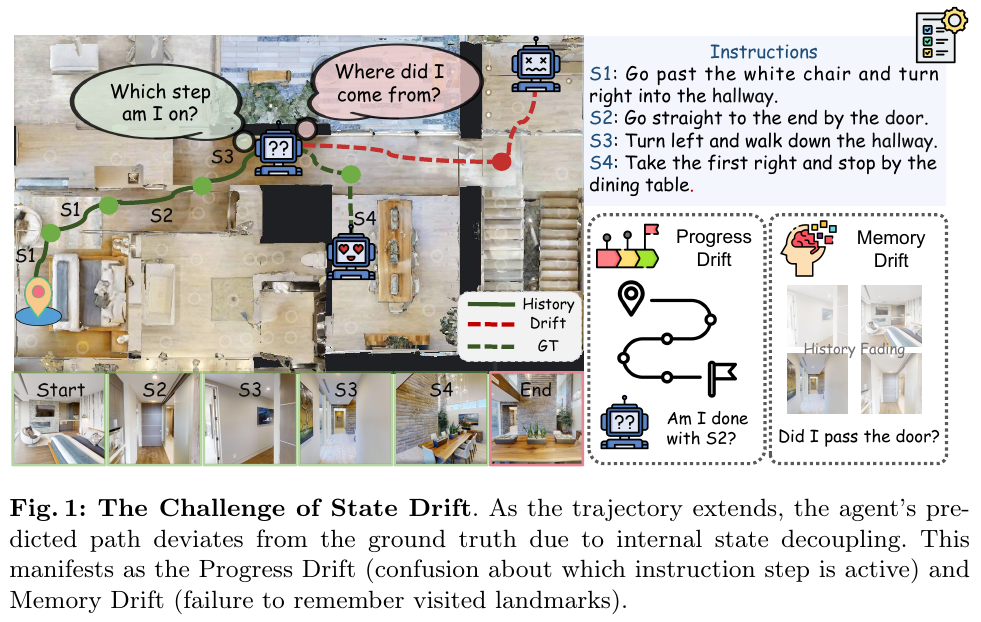
2. 主要方法/创新点
① 整体框架概述
Dual-Anchoring Framework 以 StreamVLN(LLaVA-Video 为骨干的流式 Video-LLM)为 backbone,在标准动作预测之外,叠加两个仅训练期生效的辅助任务来正则化内部状态:Instruction Progress Anchoring(指令进度锚定,作为 Co-Training 任务) 负责语义对齐,Memory Landmark Anchoring(记忆地标锚定,作为辅助头) 负责视觉记忆锚定。两个辅助头在部署时被丢弃,对推理零额外计算开销。
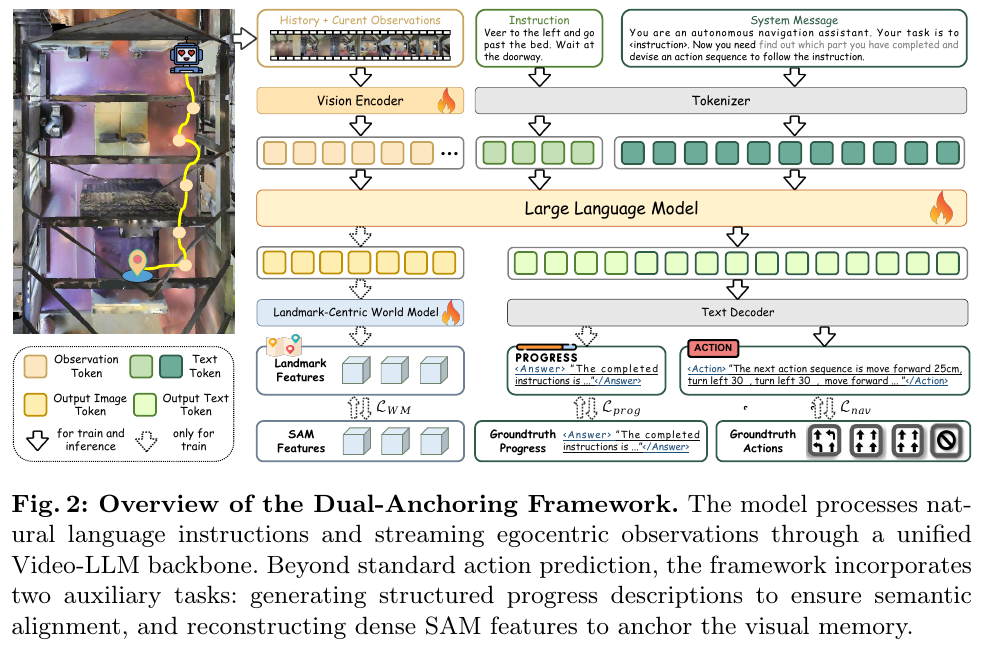
② 逐模块讲解
模块一:Instruction Progress Anchoring(指令进度锚定)
- 目标:缓解 Progress Drift,让 agent 显式维护一份”已完成 vs 待完成”的心智清单(mental checklist),而非依赖隐式 attention 推断进度。
- 数据生成(Progress Annotation Generation):用 Qwen3-VL 作离线标注器,给定 GT 轨迹与指令,按四步流水线合成 360 万条进度描述:
- Visual Kinematics Prompting:把帧序号与已执行动作文本(如 “Turn Left 15°”)叠印到每帧左上角,弥合静态帧与动态导航的鸿沟,让标注器感知帧间运动学。
- Interval Sampling:以步长 n 沿轨迹间隔采样。
- Dual-Step Reasoning:先让模型对比视觉证据与指令做分析(CoT),再用原文措辞总结”已完成子目标”。
- Instruction-Aligned Refinement:把分析蒸馏成一句话,严格约束输出为指令的逐字前缀(verbatim prefix),消除中间推理与幻觉。
- 输入 → 处理 → 输出:输入指令 + 历史观测 → 模型先输出结构化进度文本,再输出动作序列。
- 训练(Instruction-Aware Co-training):把 GT 动作前缀以合成的进度描述,并在 Prompt 中加入”find out which part you have completed”。目标改为最大化 \(P(y^{prog}_t, a_t \mid \mathcal I, \mathcal H_t)\),强制 agent 在执行任何控制前先用语言articulate自身状态。
模块二:Memory Landmark Anchoring(记忆地标锚定)
- 目标:缓解 Memory Drift(遗忘地标、感知混淆 perceptual aliasing),强制 Retrospective Grounding(回溯式接地)。
- 数据生成(Landmark Frame Mining):两阶段挖掘 93.7 万条地标数据:
- Decomposition:用 Qwen3 把复杂指令拆成原子子目标 \(\mathcal S = \{s_1, \dots, s_K\}\),每个 \(s_k\) 含一个动作或地标。
- Temporal Grounding:把完整视频 + \(\mathcal S\) 喂给 Qwen3-VL,定位每个地标首次出现的帧 \(t^{(k)}_{lm}\);并施加严格递增约束(\(t^{(i)}_{lm} < t^{(j)}_{lm}\) 对 \(i<j\)),违反时序逻辑的标注被过滤以消除幻觉。
- 对任意导航时刻 \(t\),可检索最近经过的地标帧 \(t^*\)(\(t^* \le t\)),用 SAM 抽取其高分辨率空间特征图 \(F_{SAM}(o_{t^*})\) 作为回溯监督的 ground truth。
- Landmark-Centric World Model(回溯式世界模型):用 Learnable Spatial Query Decoder 让 agent 重建最近经过地标的稠密空间特征。
- 输入:Video-LLM 在第 \(t\) 步的输出序列 \(X_t \in \mathbb R^{N \times d_{llm}}\)(含历史与当前视觉语义)。
- 处理:先经线性层 + LayerNorm 投影到紧凑潜空间 \(\hat X_t = \text{LayerNorm}(X_t W_{in})\);初始化一组可学习空间查询 \(Q_{spa}\)(每个 query 是对应 \(H\times W\) 分辨率的像素级锚点),通过 cross-attention 从 \(\hat X_t\) 检索局部空间线索:\(Z = \text{Softmax}(Q_{spa}\hat X_t^T / \sqrt{d_{attn}})\hat X_t\);再线性投影到 \(d_{sam}\) 维并 reshape 成 2D 特征图 \(F_t\)。
- 输出:预测特征图 \(F_t\),与冻结的 SAM 特征做 MSE 对齐。
- 设计动机:充当”后视镜(rear-view mirror)”,逼迫内部状态保留过去轨迹的稠密、可区分的物体信息,防止记忆衰减;区别于 NWM 等前瞻式(foresight)像素级世界模型(计算昂贵、且忽视历史维护),本文是回溯式(hindsight)特征级,更适合实时 onboard 推理。
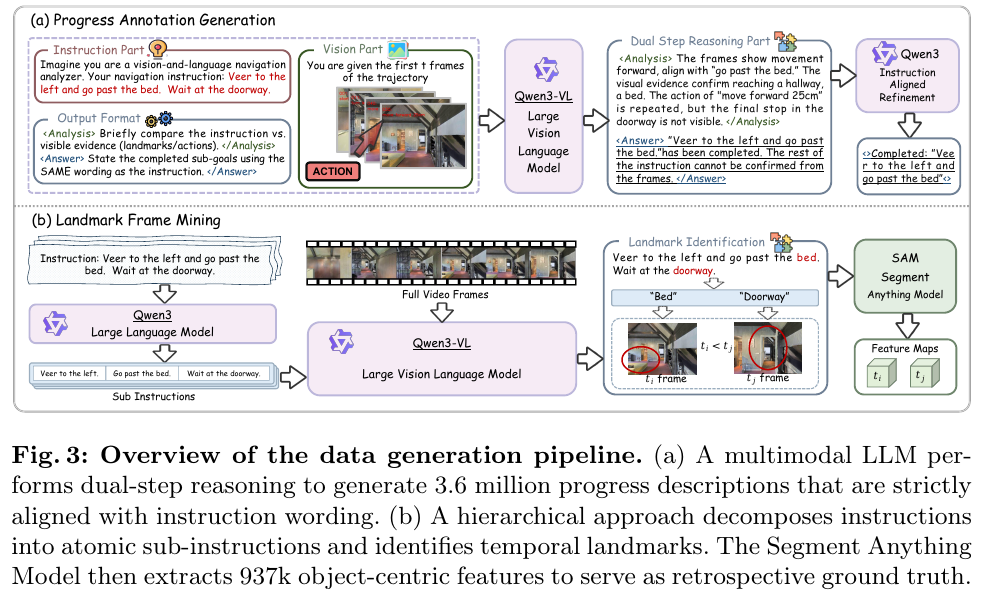
③ 训练目标 / 损失函数
Stage 1(导航数据预训练) 的总损失是三项加权和:
\[\mathcal{L}_{Stage1} = \mathcal{L}_{nav} + \lambda_{prog}\mathcal{L}_{prog} + \lambda_{WM}\mathcal{L}_{WM}\]- \(\mathcal L_{nav}\):标准导航动作损失。
- \(\mathcal L_{prog}\):进度描述生成损失。
- 世界模型 MSE 损失:\(\mathcal{L}_{WM} = \lVert F_t - F_{SAM}(o_{t^*}) \rVert_2^2\)。
④ 两阶段训练与数据组成
- 数据组成:Base Navigation(R2R/RxR/EnvDrop 180K + ScaleVLN HM3D 子集 155K)+ State Anchoring(360 万进度描述 + 93.7 万地标 SAM 特征)+ 240K DAgger rollouts + 400K VideoQA + 230K 图文对(MMC4,保留通用 VL 能力)。
- Stage 1:在导航数据 + 双锚定目标上预训练。
- Stage 2(DAgger + Generalist Fine-tuning):用 Stage 1 策略采样轨迹、收集纠正性专家动作构成 ~240K DAgger 数据,混合导航数据与通用 VL 数据共训以缓解 exposure bias 并防灾难性遗忘;双锚定目标(\(\mathcal L_{prog}\)、\(\mathcal L_{WM}\))在所有导航批次上保持激活。
3. 核心结果/发现
仿真 SOTA(R2R-CE / RxR-CE val unseen):仅用单目 RGB(S-RGB),在 R2R-CE 上 SR 从 StreamVLN 基线的 56.9% → 65.6%、SPL 51.9% → 62.1%;RxR-CE 上 SR 52.9% → 61.7%(绝对 +8.8%),SPL → 53.3%。相比同期强方法 DualVLN,SR/SPL 多项指标领先。
长程增益尤为显著:按轨迹测地距离分 Short/Medium/Long 三档,基线随距离增大急剧退化;本文方法的相对增益随轨迹变长而扩大——SR 相对提升从 Short 的 +10.7% 升到 Long 的 +24.7%,SPL 相对提升从 +12.6% 升到 Long 的 +33.2%,验证显式状态锚定对长程导航的关键作用。
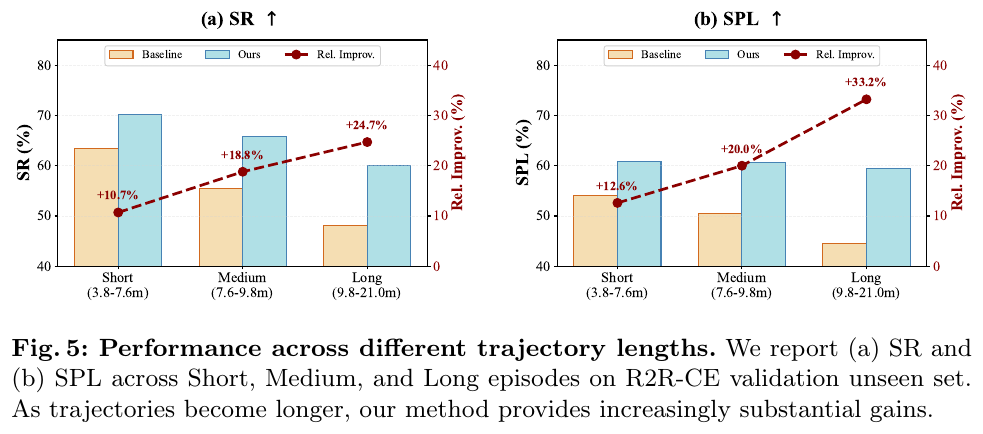
消融(Table 3):在两种数据规模下,IPA 单独把 SR 从 40.8%→45.4%(语义对齐有效);MLA 单独显著提升 SPL 并降低 NE(6.49→6.01,回溯重建抑制轨迹漂移);二者组合(双锚定)在所有设置下最优,证明两种正则互补且在数据扩展后依然有效。
数据质量(Table 4,参考无关指标):Visual Kinematics Prompting 使进度描述的 Logical Consistency Score 从 1.71→4.26(+149%)、Hallucination Rate 8.13%→6.04%(-25.7%);地标挖掘相对随机采样,Landmark Presence Rate 从 13.9%→75.6%(+444%)。
定性与真机:仿真中(图4)面对欺骗性开口,基线因 Progress Drift 提前左转失败,而本文 agent 的进度锚定明确指示”go straight 仍在进行”以抑制干扰动作,记忆锚定回溯重建出发”bathroom”特征接地当前位置。真机部署在 Unitree Go2 + RealSense D435i 上,纯 Matterport3D 仿真训练、零微调直接迁移,实时生成的进度描述准确反映完成状态。
4. 局限性
- 仍依赖自采集合成数据(Qwen3-VL/SAM 标注),其质量与覆盖度受标注器能力限制(进度描述仍有 ~6% 幻觉率);地标锚定假设可从指令显式分解出离散地标,对缺乏明确地标的指令收益可能受限。
31. JanusVLN (2026)
——— 解耦语义与空间:使用双隐式神经内存的视觉语言导航
📄 Paper: arXiv:2509.22548v2 · 🏛️ ICLR 2026
精华
- 脑区分工启发:首次将人类左右脑的语义理解和空间认知分工应用到具身智能导航中,解耦视觉语义与 3D 空间几何信息。
- 双隐式神经内存:抛弃显式文本认知地图或历史帧图片缓存,使用 Transformer 的深层 KV cache 缓存,并结合初始窗口(全局锚点)与滑动窗口(局部细节)进行混合增量更新。
- 强大的 3D 几何特征:引入在像素-3D 点云对上预训练的 3D 几何模型 VGGT,仅通过单目 RGB 输入即可推断隐式 3D 几何,极大地增强了纯 2D 模型的空间推理能力。
- 低延迟与高效率:增量内存更新方式规避了传统方法随时间增长的内存和计算复杂度膨胀,在测试中将单帧推理延迟从 268ms 大幅降低至最少 82ms。
- 多基准 SOTA:在 VLN-CE(R2R-CE, RxR-CE)和更复杂的 HM3D-OVON 开放词汇导航上均刷新了成功率与路径效率 of SOTA 记录。
1. 研究背景/问题
近年来,基于多模态大语言模型(MLLMs)的具身导航(VLN)系统取得了很大进展。然而,现有模型大多面临两大痛点:
- 显式语义记忆的局限性:许多方法通过构建基于文本的显式语义地图或直接保存历史观察帧来做决策。这不仅造成 3D 空间物理信息的丢失,而且会导致随着时间序列增长,模型出现严重的计算冗余和内存膨胀(Memory Bloat),在长程任务中推理效率低下。
- 缺乏 3D 几何结构理解:现有视觉语言动作模型(VLA)几乎完全继承了以 CLIP 为代表的 2D 图像-文本预训练视觉编码器。由于 2D 训练数据的性质,这些编码器非常擅长高层语义识别,但对三维空间物理结构、景深、透视以及遮挡关系的理解却极为匮乏。而这正是 3D 实地导航所必需的。
2. 主要方法/创新点
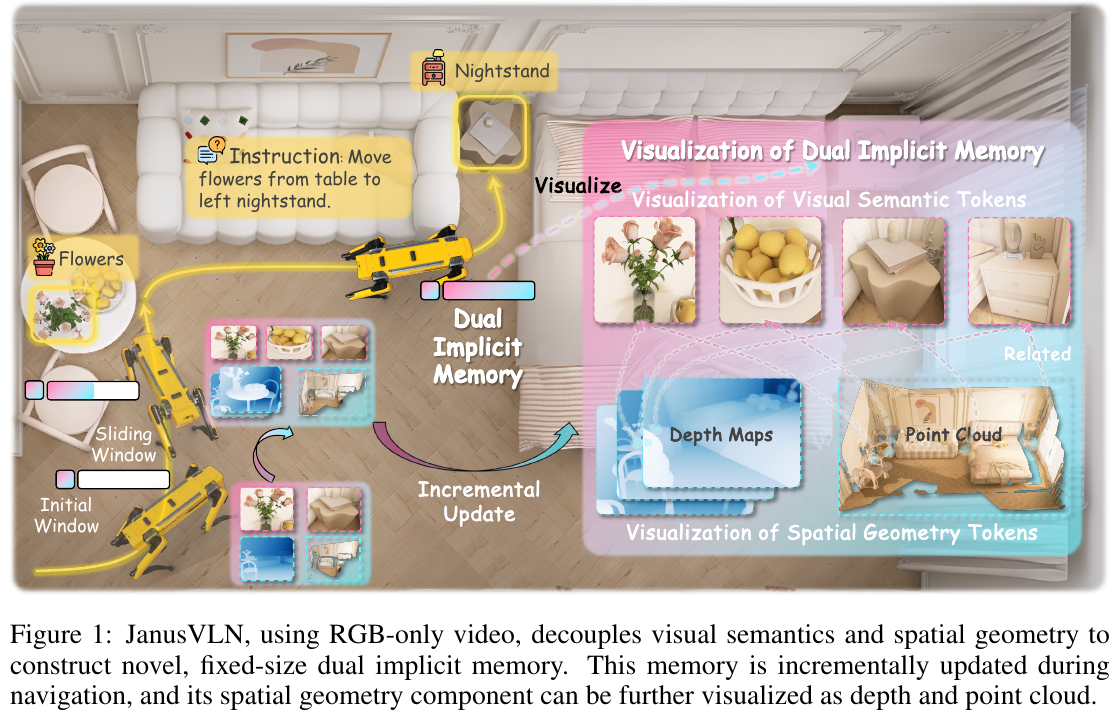
整体框架概述
针对上述局限性,论文提出了 JanusVLN 框架。它利用双隐式神经内存,将 3D 空间几何信息(负责“在哪里,如何关联”)与 2D 视觉语义信息(负责“是什么”)进行分离编码,并使用混合增量策略对神经内存进行高效更新。系统主要由 2D 视觉语义编码器、3D 空间几何编码器、双隐式神经内存以及空间感知特征融合模块组成,最后将多模态表征输入大语言模型以预测离散动作。
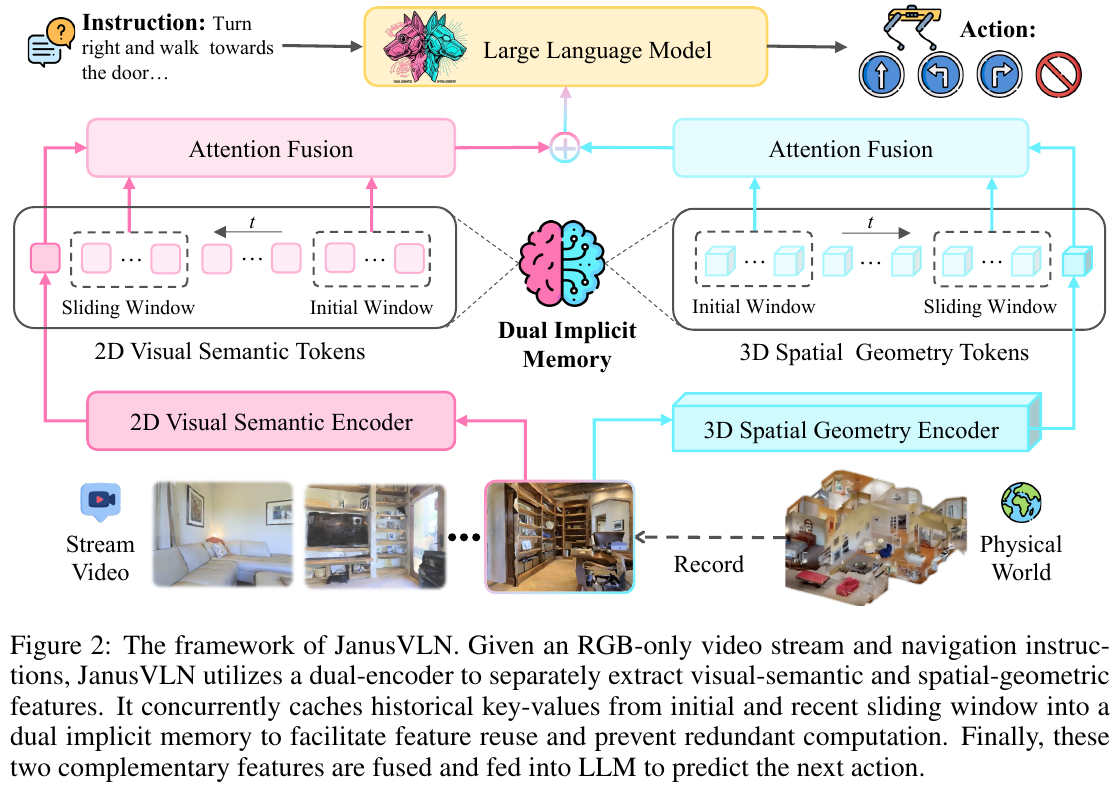
逐模块讲解
① 2D 视觉语义编码器 (Visual-Semantic Encoder)
- 输入:当前帧 RGB 图像 $x_t \in \mathbb{R}^{3 \times H \times W}$。
- 处理:直接采用多模态大语言模型(Qwen2.5-VL)的原始视觉编码器,提取输入图像的二维语义特征。为了减少视觉标记(Tokens)带来的计算量,Qwen2.5-VL 将空间上相邻 of $2 \times 2$ 特征小块(Patches)进行级联融合,形成单个语义标记。
- 输出:降采样后的 2D 视觉语义标记 $S’_t \in \mathbb{R}^{\lfloor \frac{H}{2p} \rfloor \times \lfloor \frac{W}{2p} \rfloor \times C}$,其中 $p$ 为 patch 大小。
- 设计动机:负责提取场景中强有力的语义物体感知(例如床、台灯、拐角的位置与语义属性)。
② 3D 空间几何编码器 (Spatial-Geometric Encoder)
- 输入:当前帧 RGB 图像 $x_t$。
- 处理:引入预训练的 3D 视觉几何基础模型 VGGT 的编码器部分。VGGT 在大量“像素-3D 点云”对上进行过训练,因此蕴含了极强的 3D 空间深度感知和三维布局先验。VGGT 将输入图像提取的初始特征与 3D 几何隐式内存中的历史 KV 缓存相结合,再输入到 Fusion Decoder 中进行跨帧交互处理。
- 输出:包含了 3D 空间结构的几何 Token 序列 $G_t \in \mathbb{R}^{\lfloor \frac{H}{p} \rfloor \times \lfloor \frac{W}{p} \rfloor \times C}$。这些 Token 也可以用一个轻量级的小头部重建高保真的单目深度图和局部 3D 点云。
- 设计动机:直接从纯 RGB 视频流中,以在线和流式(Online & Streaming)的方式获取 3D 深度、几何和空间关系,避免了对昂贵且难以获取的 3D 实地数据(如激光雷达、实时 RGB-D 相机)的硬件依赖。
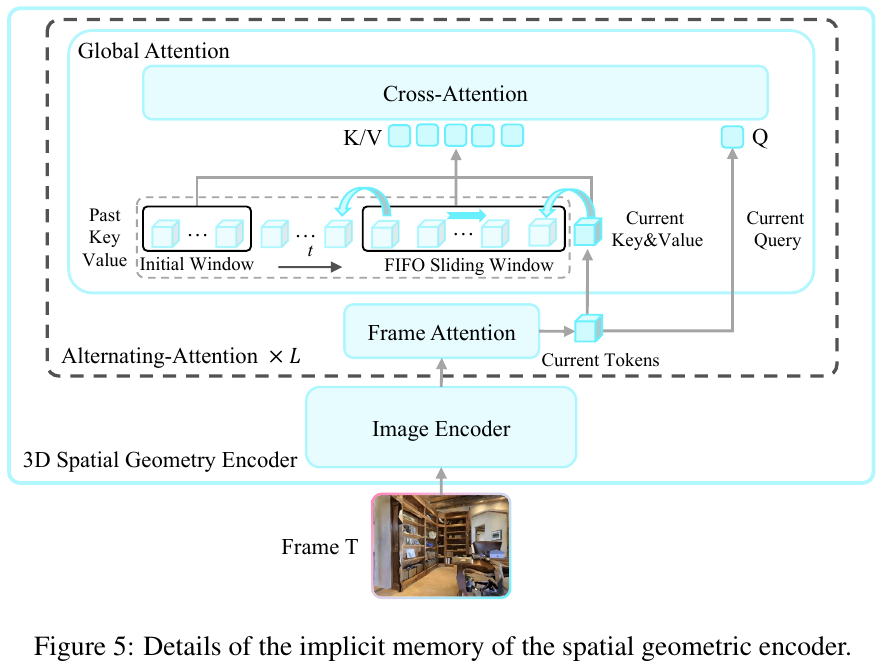
③ 双隐式神经内存 (Dual Implicit Neural Memory)
- 输入:历史帧在语义编码器与几何编码器内的 Key-Value (KV) 缓存。
- 处理:不再保存原始图像或冗余的多级地图,而是通过混合增量更新策略管理内存容量:
- 滑动窗口队列 $M_{\text{sliding}}$:一个固定容量为 $n$(如 48 帧)的先进先出(FIFO)队列,只保留最近 $n$ 帧的特征 KV 缓存。这保证了模型对近期局部环境细节的敏感性。
- 初始窗口 $M_{\text{initial}}$:永久保留导航任务开始前几帧的特征 KV 缓存。其充当“注意力汇(Attention Sinks)”,为长距离导航提供全局任务指引和恒定的地理起始锚点。 对于新的输入帧,编码器通过注意力交互融合 $M_{\text{sliding}}$ 和 $M_{\text{initial}}$ 内的历史信息: \(G_t = \text{Decoder}(\text{CrossAttn}(\text{Encoder}(x_t), \{ M_{\text{initial}}, M_{\text{sliding}} \}))\)
- 输出:更新后的当前帧几何 Token 和语义 Token。
- 设计动机:实现定长、紧凑的特征存储,彻底消除记忆空间随着时间无限拉长而膨胀的问题,且只增量计算当前帧,避免了 reprocess 历史所有图像造成的计算开销。
④ 空间感知特征融合 (Spatial-aware Feature Fusion)
- 输入:语义标记 $S’_t$ 与 3D 几何标记 $G_t$。
- 处理:
- 空间融合对齐:对 VGGT 提取的几何特征 $G_t$ 实施相同的空间合并(Spatial Merging)降采样,将其 $2 \times 2$ 的特征区域拼接对齐,产生 $G’_t \in \mathbb{R}^{\lfloor \frac{H}{2p} \rfloor \times \lfloor \frac{W}{2p} \rfloor \times C}$。
- 加权残差融合:利用轻量级的双层 MLP 投影层将两个域的特征融合成统一的、强空间感知的多模态视觉特征 $F_t$: \(F_t = S'_t + \lambda \cdot \text{MLP}(G'_t)\) 其中 $\lambda$ 为几何特征的权重,设定为 0.2。
- 输出:融合后的特征 $F_t$。
- 设计动机:在保证大模型主要关注语义指令对齐的前提下,将隐式 3D 几何特征低成本地无缝整合进大语言模型输入中。
训练目标与推理流程
- 训练目标:系统使用模仿学习(Behavior Cloning)对智能体进行端到端优化,优化过程中将 2D 视觉语义编码器(Qwen2.5-VL 视觉部分)和 3D 空间几何编码器(VGGT)的参数全部冻结(Frozen),仅微调 LLM 主干(7B)以及特征融合投影层(MLP)。使用 DAgger 算法在连续模拟环境中通过人类或专家轨迹对策略进行微调,显著减轻“漂移”带来的误差累积。
- 推理流程:每个时刻 $t$,智能体从 RGB 摄像头提取当前帧 $x_t$,通过双编码器与内存模块提取并更新隐式内存,融合成 $F_t$;接着将 $F_t$ 与自然语言指令嵌入 $\mathcal{I}$ 连接,直接由 LLM 的 KV cache 机制增量推理出下一个离散控制动作 $a_{t+1}$,直到输出
Stop。
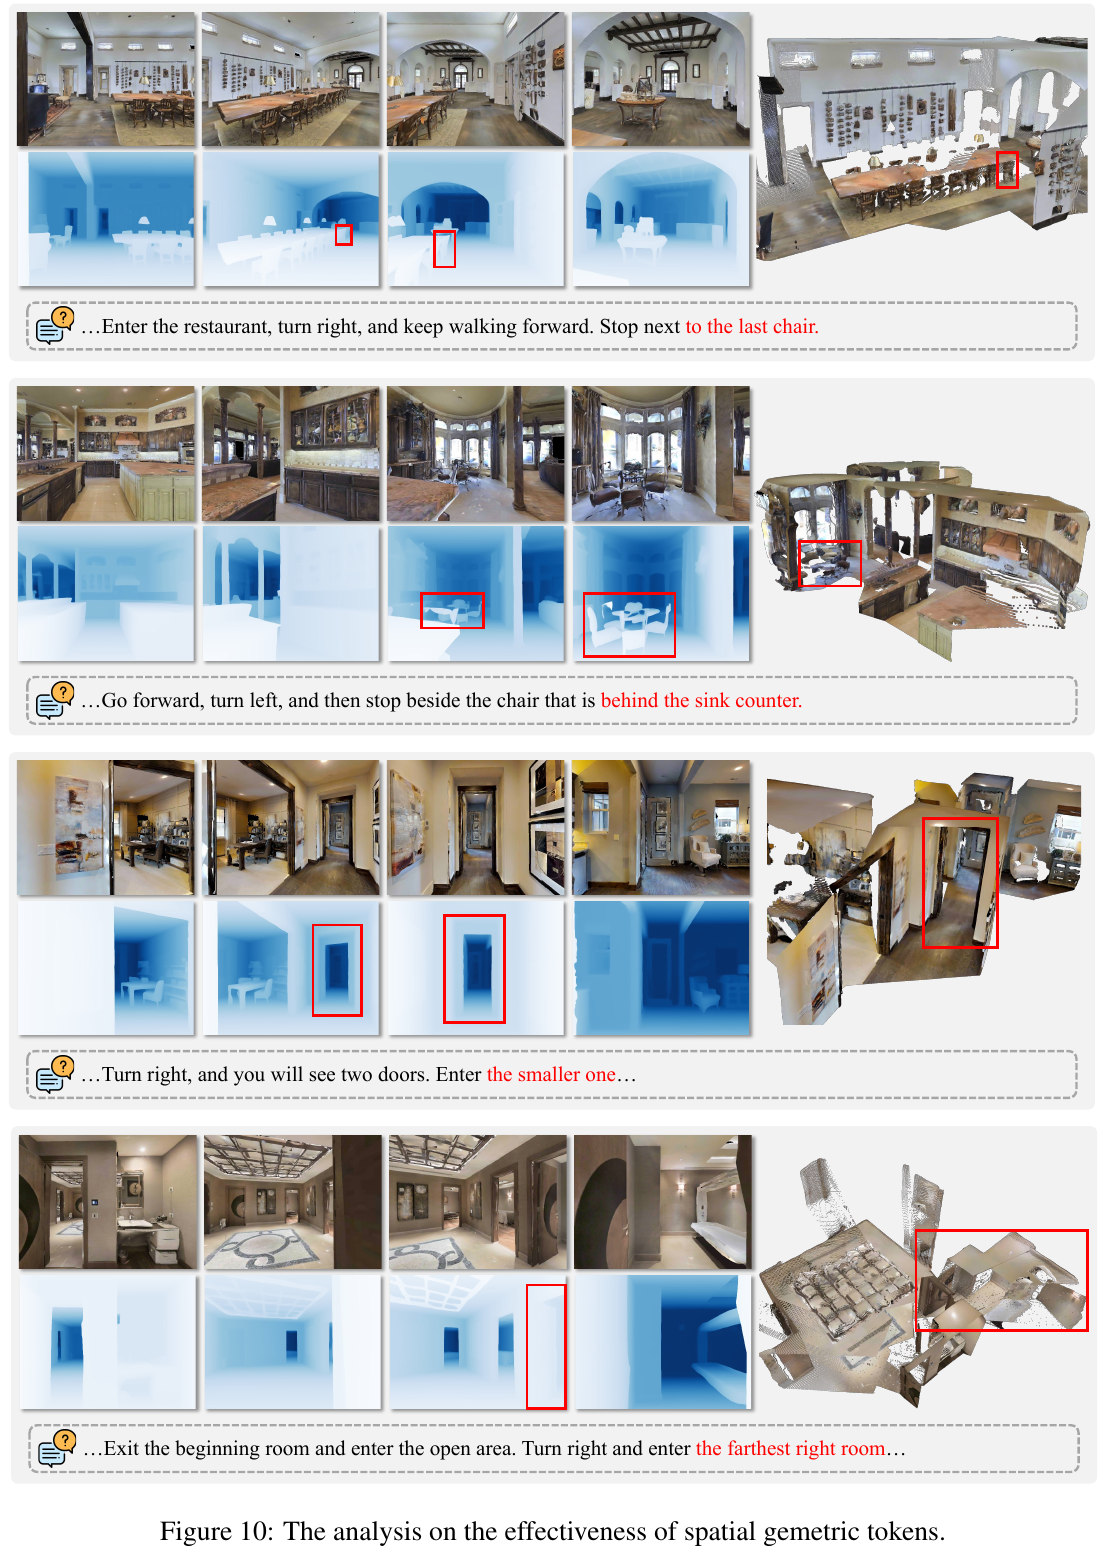
3. 核心结果/发现
- VLN-CE 基准表现(R2R-CE & RxR-CE):
- 在 R2R-CE 未见场景测试集(Val-Unseen)中,JanusVLN 刷新了 SOTA 成绩,取得了 成功率 (SR) 60.5% 和 路径长度加权成功率 (SPL) 56.8% 的杰出表现,相比此前最好的模型 StreamVLN,SR 提升了 3.6%,SPL 提升了 4.9%。
- 在不使用任何外部轨迹辅助训练的设置下(JanusVLN*),成功率依然达到 52.8%,超越了其他使用大量额外多模态数据的框架。
- 在 RxR-CE 基准中,其表现同样刷新 SOTA,取得了 SR 56.2% 和 SPL 47.5% 的优异成绩。
- HM3D-OVON 表现:
- 在面向开放词汇的目标导航测试(HM3D-OVON)中,JanusVLN 取得了 SR 44.9% 和 SPL 31.7%,遥遥领先于之前的算法(如 MTU3D 的 SR 40.8% 和 SPL 12.1%),展现出强劲的场景泛化力与指令理解力。
- 推理耗时对比:
- 引入了 Cached Memory 机制后,模型单帧的图像特征处理延迟(VGGT)被降至极低的 82ms(缓存 8 帧)与 195ms(缓存 48 帧),而如果不使用缓存、直接重计算全长序列特征,耗时则随着帧数呈指数级上升,很快会在 GPU 上发生内存溢出(OOM)。
- 消融实验关键结论:
- 3D 几何特征是路径规划的关键:去掉 3D 空间几何隐式内存后,模型在 R2R-CE 上的 SPL 表现从 49.2 急剧下滑至 40.9。
- 初始锚点不可或缺:若从内存中去除初始窗口(w/o initial’s KV),性能将下降近 2%,证明了 Attention Sinks 为导航任务提供全局参照的必要性。
4. 局限性
- 偏差自纠错能力仍然脆弱:统计表明,虽然系统利用 DAgger 算法收集了非最优路线数据进行微调,但当智能体在大范围、长程导航中严重偏离预设路线时,它依然很容易由于误差在时间上的逐步累积而彻底迷失,难以主动退回最优路径。
- 缺乏真实尺度引起的提前停止:由于 3D 几何编码器(VGGT)本身在没有真实物理标定的前提下仅提取隐式的相对几何特征,其输出在一定程度上缺乏真实的绝对尺度(Real-world Scale)。这导致智能体在距离目标物体还有一段距离(尚未到达 3 米判定半径)时,容易由于视觉上的“已看清目的地”而错误地提前停下来。
32. HSGM (2026)
——— 层级式语义-几何地图,填补 VLM 2D 视觉与 3D 空间推理及运动规划的鸿沟
📄 Paper: arXiv:2606.00095 · 🏛️ CVPR 2026 · Code
精华
- 针对大视觉语言模型(VLM)在连续环境导航(VLN-CE)中缺乏 3D 几何常识与底层运动规划能力(即语义-几何鸿沟)的问题,提出无须训练的层级式语义-几何地图(HSGM)。
- HSGM 在三维空间中维护层级场景表示,包含用于记录可通行性的几何地图、表征物体实例的语义地图以及用于采样航点与轨迹的决策地图。
- 通过将 3D 点云栅格化为 2D BEV 鸟瞰图,并在其上叠加可视化的离散航点标记,成功使 VLM 的 2D 视觉推理能够直接关联并操纵三维空间。
- 采用规划与控制解耦的设计,VLM 仅作为高层语义规划器选择离散的目标航点,而具体的无碰撞连续轨迹则交由经典的 A* 算法和底层 PID 控制器执行。
- 引入子任务管理机制将长程复杂指令解耦,并结合失败回溯(Backtracking)策略,显著降低了 VLM 的记忆与推理开销,大幅提升了导航的成功率。
1. 研究背景/问题
在连续三维环境中的视觉语言导航(VLN-CE)要求具身智能体基于第一人称视角(RGB-D)和相机位姿,按照复杂的自然语言指令运动并寻找目标物。尽管预训练的 VLM(如 GPT-5 等)具有强大的通用语义推理和 2D 视觉常识,但在将其应用于 VLN-CE 时,遇到了明显的 “语义-几何鸿沟” (Semantic-Geometric Gap):
- 三维几何理解贫瘠:VLM 虽然可以识别图像中的物体,但由于仅在 2D 图文对上进行训练,它们很难跨多视角重建全局 3D 拓扑布局,无法理解复杂的 3D 空间相对关系。
- 底层动作控制脱节:将语义级的目标描述(例如“穿过走廊,在沙发旁停下”)转化为精确的厘米级底层连续运动指令(如左转 $15^\circ$,前进 $0.5\text{ m}$)非常困难,容易导致避障失败和过度碰撞。
2. 主要方法/创新点
HSGM 通过显式地在三维空间中构建层级语义-几何表征,并将高层语义决策与低层控制解耦,彻底解决了上述鸿沟。
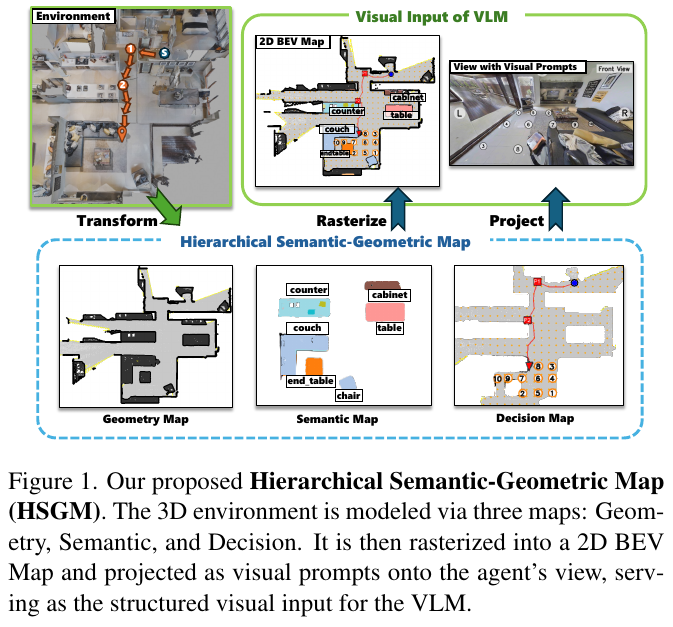
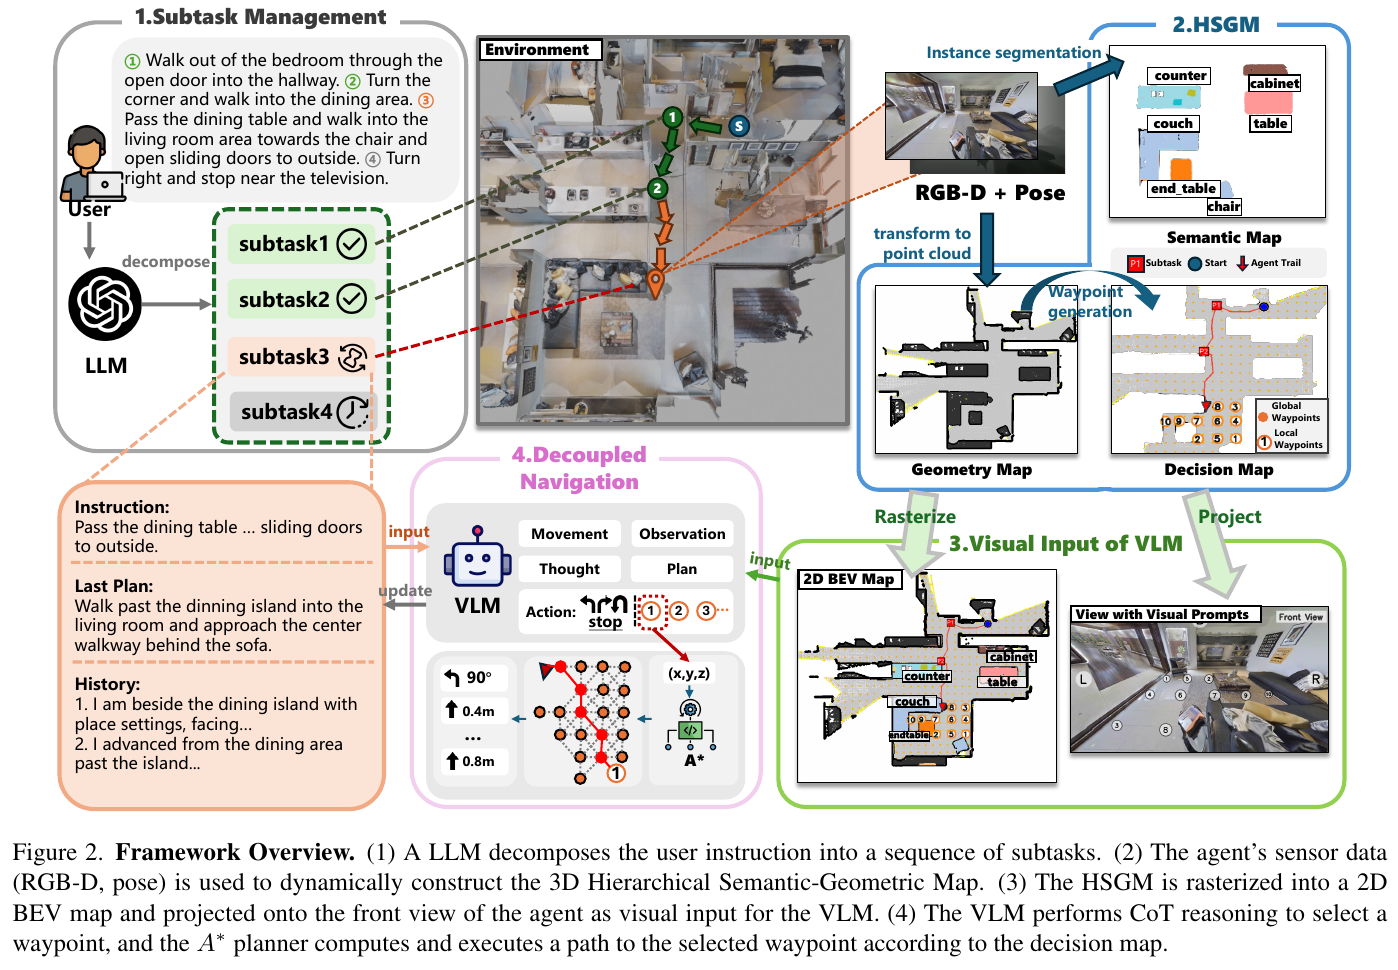
① 整体框架概述
如图 2 所示,HSGM 框架包含三大支柱:首先利用大模型对复杂的长句导航指令进行子任务解耦(Subtask Management);其次智能体在运行中动态构建层级语义-几何地图(HSGM);最后,系统基于该地图将 VLM 的高层语义航点选择(High-Level Planning)与 A* 经典路径规划算法的低层运动控制(Low-Level Control)进行完全解耦。
② 逐模块讲解
A. 动态层级建图 (Hierarchical Mapping) HSGM 包含三个并行的层级,以维持高精度、长期稳定的 3D 环境模型:
- 几何地图 (Geometry Map, $M_{geo}$):
- 输入:智能体采集的多视角 RGB-D 图像 $O_t$ 以及实时位姿 $\xi_t$。
- 处理:将图像像素通过对应的深度图与位姿反投影回 3D 空间,汇聚成场景点云 $P_{scene}$。点云中高于地面的部分识别为障碍物 $P_{obs}$,其余提取为初始可通行面 $P_{nav}^{init}$。针对可能遇到的跨楼层情况,通过法向量估计和倾斜面滤波专门提取楼梯区域点云 $P_{stair}$。
- 输出:最终的几何地图为两者并集: \(M_{geo} = P_{nav} \cup P_{obs}\) 其中 $P_{nav} = P_{nav}^{init} \cup P_{stair}$。
- 语义地图 (Semantic Map, $M_{sem}$):
- 输入:egocentric RGB 图像。
- 处理:利用 YOLO-E 进行 2D 目标检测与实例分割,提取物体的 2D Mask 和类别信息。随后利用深度图与相机位姿将 Mask 投影至 3D 空间生成物体点云。新生成的物体点云会根据 3D IoU 和类别标签的一致性,与已有物体特征相融合,并设定阈值剔除噪声点。
- 输出:包含 N 个语义物体的 3D 点云与标签集合: \(M_{sem} = \{(P_{obj, j}, c_j)\}_{j=1}^{N_{obj}}\)
- 决策地图 (Decision Map, $M_{dec}$):
- 输入:几何地图 $M_{geo}$、障碍点云 $P_{obs}$ 和智能体当前位置 $p_{agent}$。
- 处理:由两部分组成:全局航点图 $G = (V, E)$ 和局部航点集 $A_{curr}$。
- 全局图 $G$:对可通行点云进行下采样,通过柱状碰撞体检查(Cylindrical Occupancy Check,智能体高 $h$ 宽 $r$ 范围内无障碍点)确定安全节点。相邻节点如果在水平距离($\le 1.0\text{ m}$)和高度差($\le 0.3\text{ m}$,针对楼梯)内满足连通,则建立无碰撞边。
- 局部航点集 $A_{curr}$:在当前视野的可通行区域进行较粗粒度的采样,通过 cylindrical check 后,结合距离($0.3\text{ m} \sim 3.0\text{ m}$)及语义接近度进行筛选,并过滤掉在全局图上与当前位置不可达的悬空或隔离点。
- 输出:当前可用的决策图表示: \(M_{dec} = \{G, A_{curr}\}\)
B. 2D 栅格化与航点可视化投影 (2D Rasterization & Prompting)
- 输入:3D HSGM 各层信息。
- 处理:将三维点云进行高度投影并栅格化为 Top-down 的 2D BEV 图像(几何通道标记障碍和路,语义通道以特定标记代表各类物体,状态通道包含轨迹线与子任务终点等)。同时,将 $A_{curr}$ 的三维坐标转化为带有编号的彩色圆圈(未访问为灰色,已访问为红色),直接投影到 top-down BEV 图和 egocentric 第一人称前向视图上。
- 输出:直观的 2D 视觉提示图,将连续 3D 规划转化为 2D 离散的选择题。
C. 高低层解耦规划与控制 (Decoupled Navigation)
- 高层语义规划:VLM 作为决策核心,其输入包括当前的 2D BEV 图像、第一人称视角图(二者均叠加密集航点提示)以及系统提示和历史 Chain-of-Thought (CoT) 轨迹。VLM 运用 CoT 依次分析先前的进度、当前的环境、当前的子目标与接下来的路线,最后输出要跳转的航点序号 $a_t \in A_{curr}$,或原地转弯的姿态,或触发子任务完成的 STOP 信号。
- 低层控制执行:当 VLM 决策了目标航点后,经典的 A* 路径规划算法以欧几里得距离为代价函数,在全局航点图 $G$ 上检索出无碰撞的最短拓扑路径,再由 PID 控制器转化为一连串的“转弯 - 直行”物理动作指令驱使机器人移动。
③ 训练与推理细节
- 训练:本框架为 完全零样本(Zero-shot)、免训练 (Training-free) 架构。它不需要任何针对导航任务的大规模模仿学习或强化学习。
- 推理:VLM 使用了 GPT-5 的多模态 API。子任务管理模块通过大模型预先将用户输入分解为若干语义独立的阶段,并利用双重确认(两轮连续 STOP)防止过早停止。同时,如果在单一子任务上耗费步数过多,会自动回退至子任务的起点,实现路径纠偏与回溯(Automatic Backtracking)。
3. 核心结果/发现
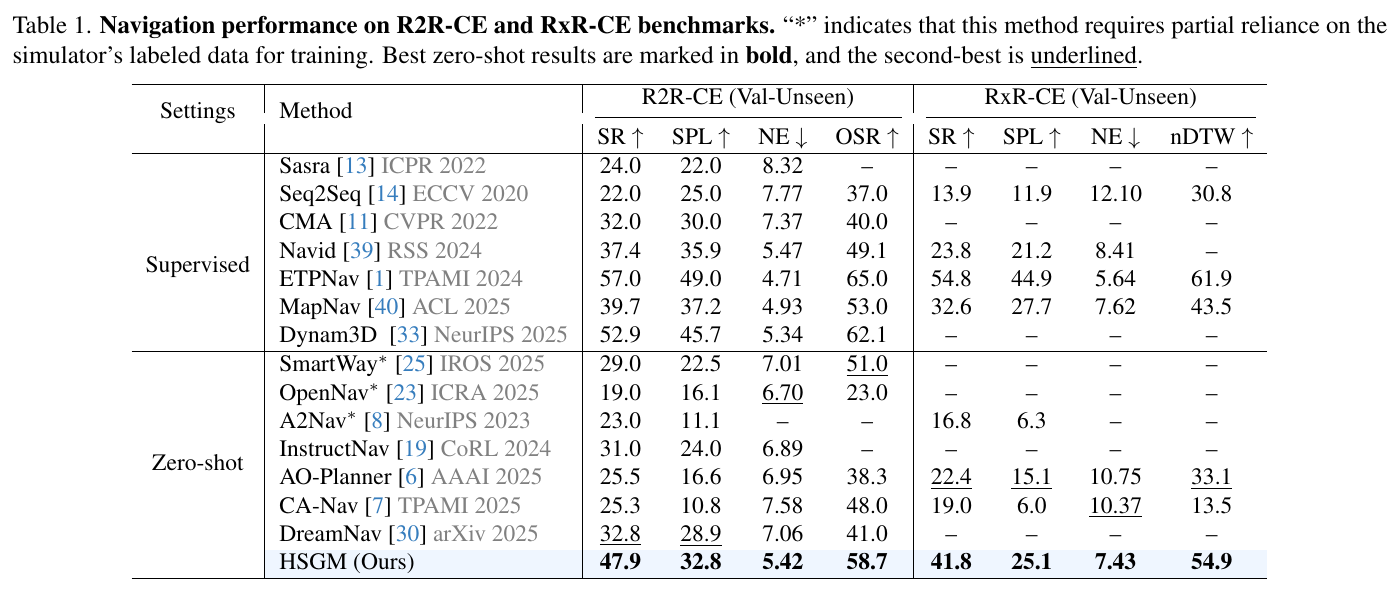
- 卓越的零样本性能: 在 R2R-CE(Val-Unseen)上,HSGM 取得了 47.9% 的成功率 (SR) 和 32.8% 的 SPL,优于当前最佳的零样本 baseline(DreamNav 32.8% SR,15.1% 领先)。更重要的是,它大幅打败了 CMA、NaVid (37.4% SR) 以及 MapNav (39.7% SR) 等使用了大量 Habitat 数据训练的监督学习模型。 在长程、多语言的 RxR-CE(Val-Unseen)上,其表现更为明显,SR 达到 41.8%,相较于先前最佳的零样本方法 AO-Planner (22.4% SR) 直接实现翻倍,且衡量路径逼真度的 nDTW 达到 54.9% (远高于 33.1%),这表明生成的轨迹极好地契合了人类指令。
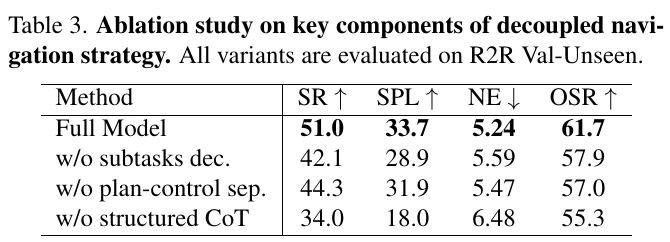
- 建图层级的增量消融: 如表 2 所示,在不提供 BEV 图的基线下成功率为 46.0%。逐步加入几何地图后,成功率提升至 47.3%;加入语义通道可辅助物体寻找,将成功率拉升至 49.2%;最后加入包含了历史轨迹和航点指示的决策层地图,使系统达到 51.0% (注:300 episode 子集)。证明了三层地图信息的互补性。
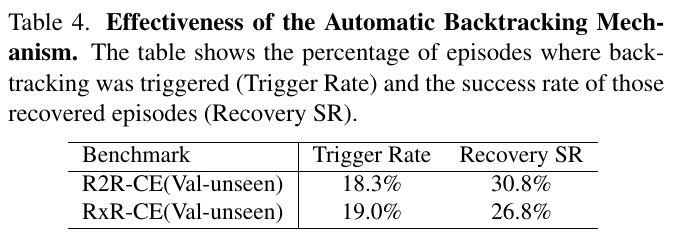
- 子任务与 CoT 推理的必要性:
- 去除子任务管理:SR 骤跌 8.9%。说明长任务中极易发生进度遗忘,而将其切分为离散目标可降低 VLM 的长上下文记忆负荷。
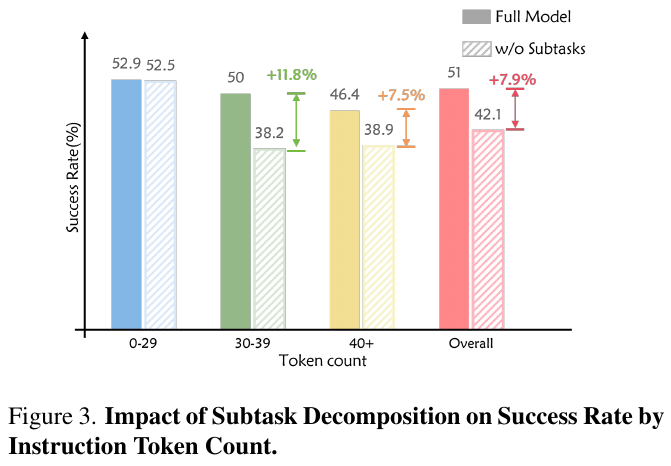
- 去除 A* 解耦规划(直线前进):SR 下降 6.7%。说明仅仅输出航点不够,若无经典几何规划避障,机器人在连续环境中极易因障碍物阻隔导致路线偏移或陷入局部极小。
-
去除 Chain-of-Thought:导航性能灾难性下滑(SR 下降 17%,跌至 34.0%),这表明长程三维导航是一个非常复杂的时空逻辑决策过程,需要显式的思维链过渡。
- 回溯机制的作用:
- 如表 4,在 R2R-CE 和 RxR-CE 中分别触发了 18.3% 与 19.0% 的自动回退,得益于此,分别挽救并纠正了其中 30.8% 和 26.8% 的失败回溯案例(Recovery SR),极大地提升了系统的运行鲁棒性。
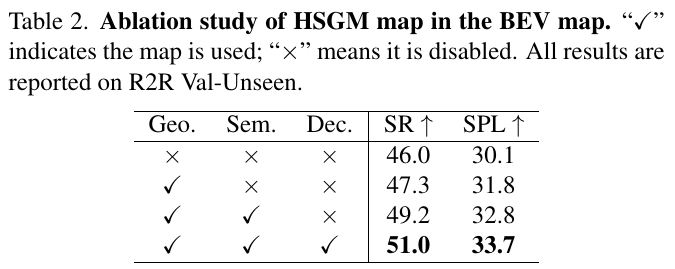
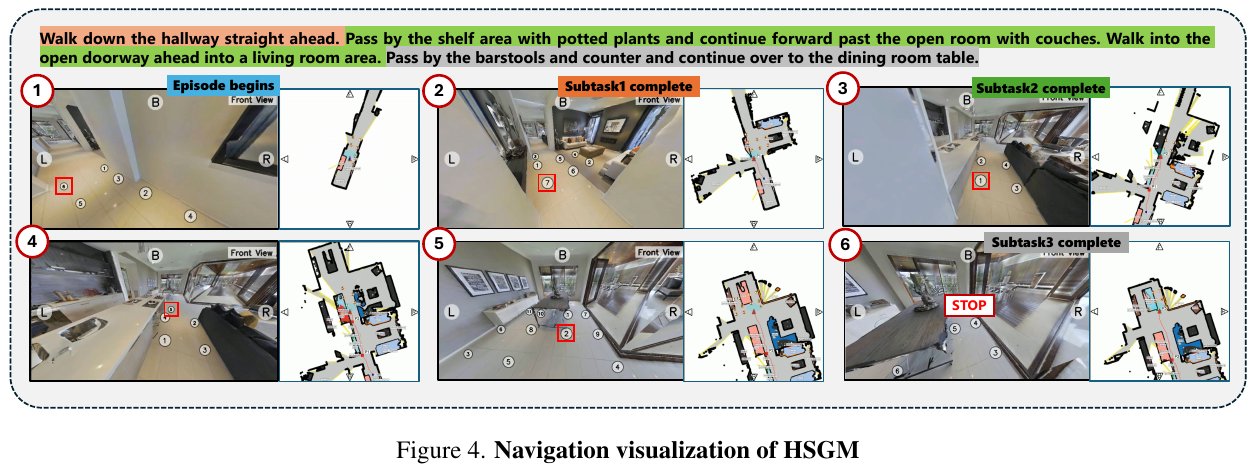
4. 局限性
- 传感器精度依赖度高:3D 点云建图严重依赖深度相机的精度以及位姿传感器的估计。如果发生相机遮挡、剧烈抖动或黑暗导致 2D 目标检测器失效,则生成的语义-几何地图会出现漂移或穿模。
- 高频推理与高昂延迟:采用强大的 GPT-5 等 VLM 进行高频 API 交互推理,在线推理开销和通信延迟十分明显,在对实时动态避障要求极高的超高速机器人任务上难以直接应用。
- 复杂动态场景适应性弱:当前航点生成与 A* 碰撞检测针对的是静态环境下的三维障碍,面对移动障碍物(如行人、宠物等)时,其建图更新机制和航点更新率可能无法及时应对。
33. OneVLA (2026)
OneVLA: A Unified Framework for Embodied Tasks ———首个在单一网络与动作头下统一具身导航和操作的 VLA 模型
📄 Paper: arXiv:2606.01241
精华
- 提出了 OneVLA,这是首个在单一网络架构与单个动作输出头(Action Head)下,同时解决具身导航(Navigation)与机械臂操作(Manipulation)任务的统一 VLA 框架,无需任何任务特定的模型变体。
- 核心创新在于设计了 11 维统一动作输出头,创造性地将离散的导航命令分布与连续的 7-DOF 机械臂末端控制量进行拼接,并通过任务特定维度掩码(task-specific weight masks)解决了不同动作空间带来的梯度干扰问题。
- 提出了多阶段渐进式混合训练策略(操作基础建立 $\rightarrow$ 导航能力融入 $\rightarrow$ 思维链 CoT 强化),使模型逐步掌握复杂的多模态知识,促进了跨任务域的表征学习和正向知识迁移。
- 仿真与实物实验表明,3B 参数 of OneVLA 在 VLN-CE 和 SimplerEnv 等多项导航和操作基准上均达到了 SOTA 性能,显著超越了现有的 7B 跨任务模型(如 UniVLA)和专门的单任务模型(如 StreamVLN、π0-Fast)。
- 提供了强有力的实证证据,证明导航与操作这两类截然不同的具身任务进行混合联合训练,可以实现性能上的互惠与相互增强(mutual reinforcement)。
1. 研究背景/问题
当前的具身智能机器人系统主要依赖专用的视觉-语言-动作(VLA)模型,通常局限于单一领域:
- 领域割裂:模型要么专注于导航(如 NaVid、MapNav),要么专注于机械臂操作(如 OpenVLA、π0),导致无法构建通用型的机器人智能体。
- 架构依赖变体:现有的跨任务 VLA 模型(如 UniVLA)虽然尝试同时处理两类任务,但仍需要为不同任务设计独立的动作头或特定任务的模型变体,无法实现真正的无缝切换。
本文旨在解决两个核心问题:
- 是否能设计一个完全统一的 VLA 架构,在没有任何任务特定变体的情况下,同时生成导航与操作动作?
- 导航和操作这两个根本不同的具身任务,在联合训练时能否实现知识的正向迁移与性能的相互增强?
2. 主要方法/创新点
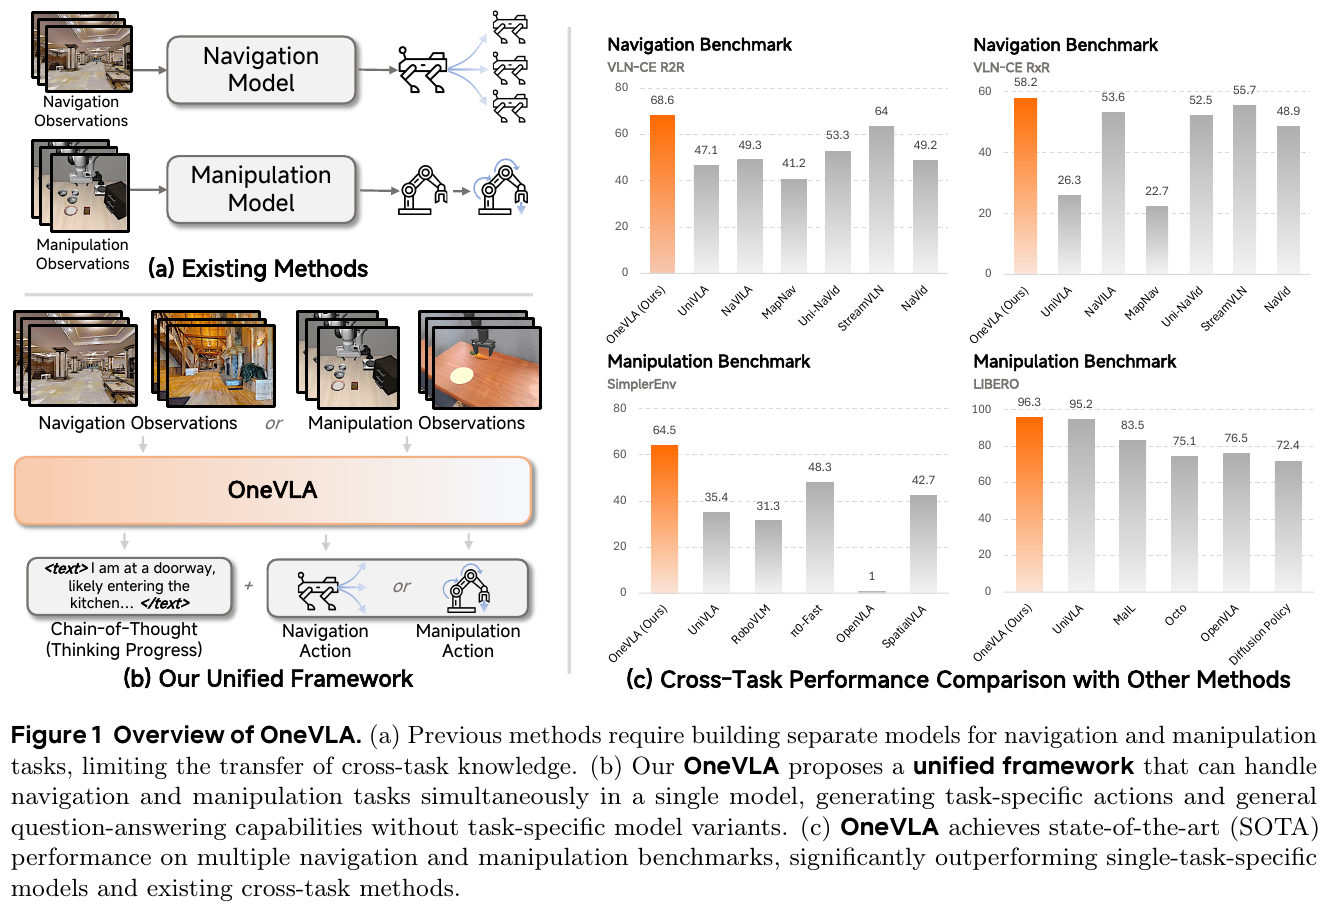
① 整体框架概述
OneVLA 在每个时间步 $t$ 接收包含多视角 RGB 图像($o_t$)、自然语言指令($l_t$)和可选的机器人状态($r_t$)在内的多模态输入。在单个 Forward Pass 中,模型先以文本自回归方式输出对指令的推理理解($y_t$),接着输出对应的动作序列($a_{t:t+T}$)。整体流程公式化表示为: \(OneVLA: (o_t, l_t, r_t) \rightarrow (y_t, a_{t:t+T})\) 动作输出会根据当前的任务自适应映射到离散导航命令或连续操作指令,而无需任何架构修改。
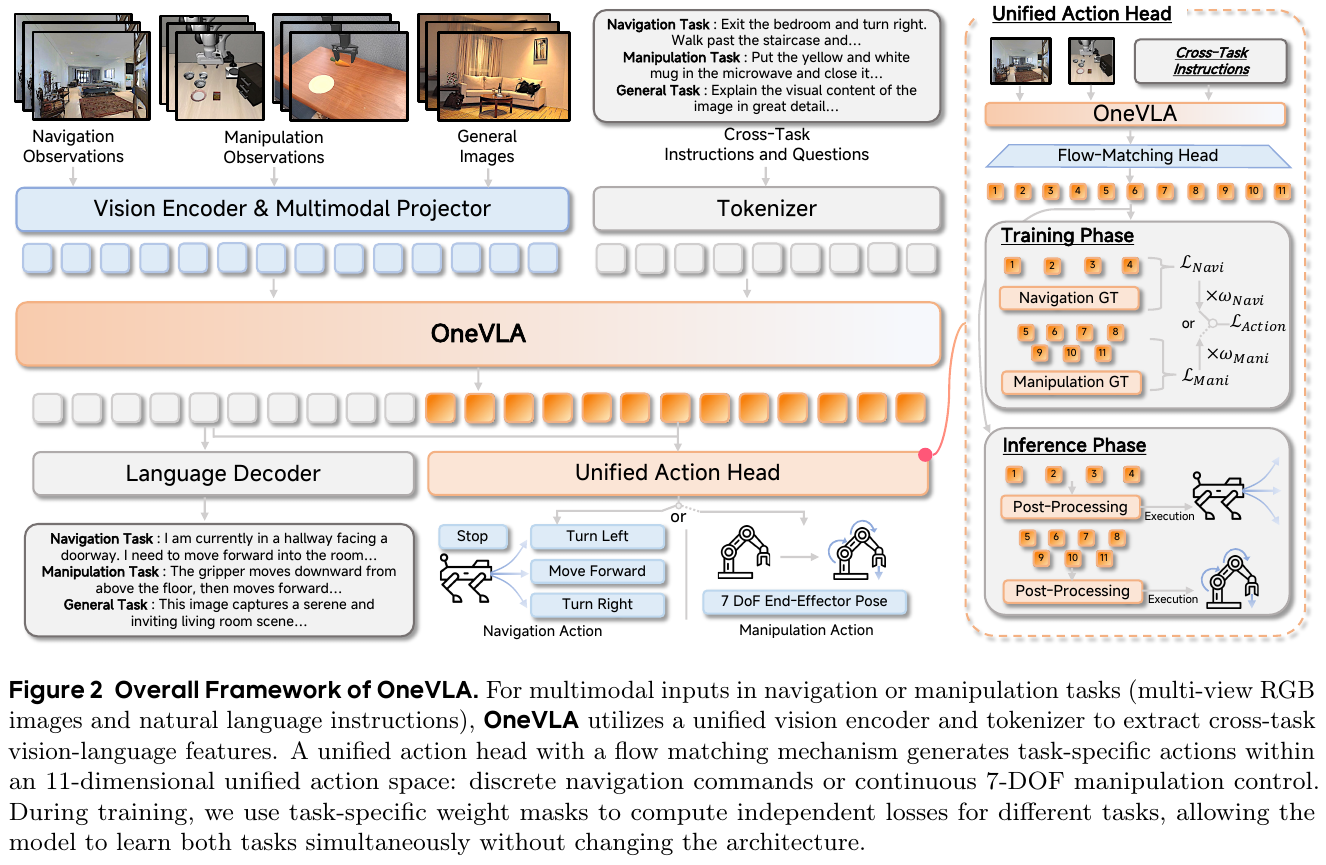
② 逐模块讲解
统一视觉-语言编码器(Unified Vision-Language Encoder)
- 输入:多视角观测 $o_t = {I_1, I_2, …, I_M}$($M$ 为摄像头视角数,如主相机与手眼相机)及文本指令 $l_t$。
- 处理:
- 每张图像 $I_i$ 被分割为 $14 \times 14$ 的图像块(Patches)。
- 通过 32 层的 Vision Transformer(隐藏维度 $d_v = 1280$)提取特征,并使用空间合并(merge size = 2)来捕获分层视觉特征。
- 通过线性投影层将提取的视觉特征映射到语言模型的隐藏空间($d_h = 2048$): \(V = \text{Proj}(\text{VisionEncoder}(o_t)) \in \mathbb{R}^{N_v \times d_h}\)
- 文本指令 $l_t$ 被 Tokenizer 编码到相同的 $d_h$ 空间。
- 将视觉 Token $V$ 与文本 Token $T$ 拼接后输入 36 层、具有 16 个注意力头的 Qwen2.5-VL-3B-Instruct 模型中进行深度跨模态融合。
- 输出:生成上下文感知的高维多模态表征 $H \in \mathbb{R}^{(N_v + N_t) \times d_h}$。
输出生成与 Token 解码(Output Generation)
- 核心机制:在词表中引入四种特殊 Token(
<text>,</text>,<action>,</action>),在单次前向传播中显式分离文本推理和动作生成两个阶段: \(\text{sequence} = \langle\text{text}\rangle y_t \langle/\text{text}\rangle \langle\text{action}\rangle \hat{a}_{t:t+T} \langle/\text{action}\rangle\) - 这种 Chain-of-Thought(CoT)式的设计允许模型先进行语言层面的物理推理与子目标规划,然后再条件化地生成执行动作,极大提升了多步任务下的可靠性与可解释性。
统一动作头与掩码流匹配(Unified Action Head)
- 11 维统一动作空间:拼接两个任务的动作输出:
\(a_{\text{unified}} = [a_{\text{navi}}, a_{\text{mani}}] \in \mathbb{R}^{11}\)
- $a_{\text{navi}} \in \mathbb{R}^4$:对应 discrete 导航指令的概率分布 $[p_{\text{forward}}, p_{\text{turn-left}}, p_{\text{turn-right}}, p_{\text{stop}}]$。
- $a_{\text{mani}} \in \mathbb{R}^7$:对应机械臂操作的 7-DOF 连续控制量 $[\Delta x, \Delta y, \Delta z, \Delta roll, \Delta pitch, \Delta yaw, g]$。
- 动作预测机制:采用基于 Transformer 的扩散模型(DiT-B)和流匹配(Flow Matching)。在去噪过程中,模型接收高维表征 $H$、时间步 sinusoidal 编码以及动作噪声 $a_t$,通过 Euler 积分迭代 $N$ 步预测速度场 $v_\theta$,最终生成连续的动作序列。
- 任务特定权重掩码(Loss Masking):为了消除离散导航概率与连续操作姿态之间的相互梯度干扰,对样本 $i$ 设计了掩码 $w_{\tau_i} \in {w_{\text{navi}}, w_{\text{mani}}}$。对于导航任务,操作相关的 7 维 loss 权重设为 0,反之亦然。关键维度(如 Stop 命令)被分配更高权重以缓解类别不平衡。 \(L_{\text{action}}^i = \text{mean}(w_{\tau_i} \odot (\hat{v}_{\theta}^i - v^i)^2)\)
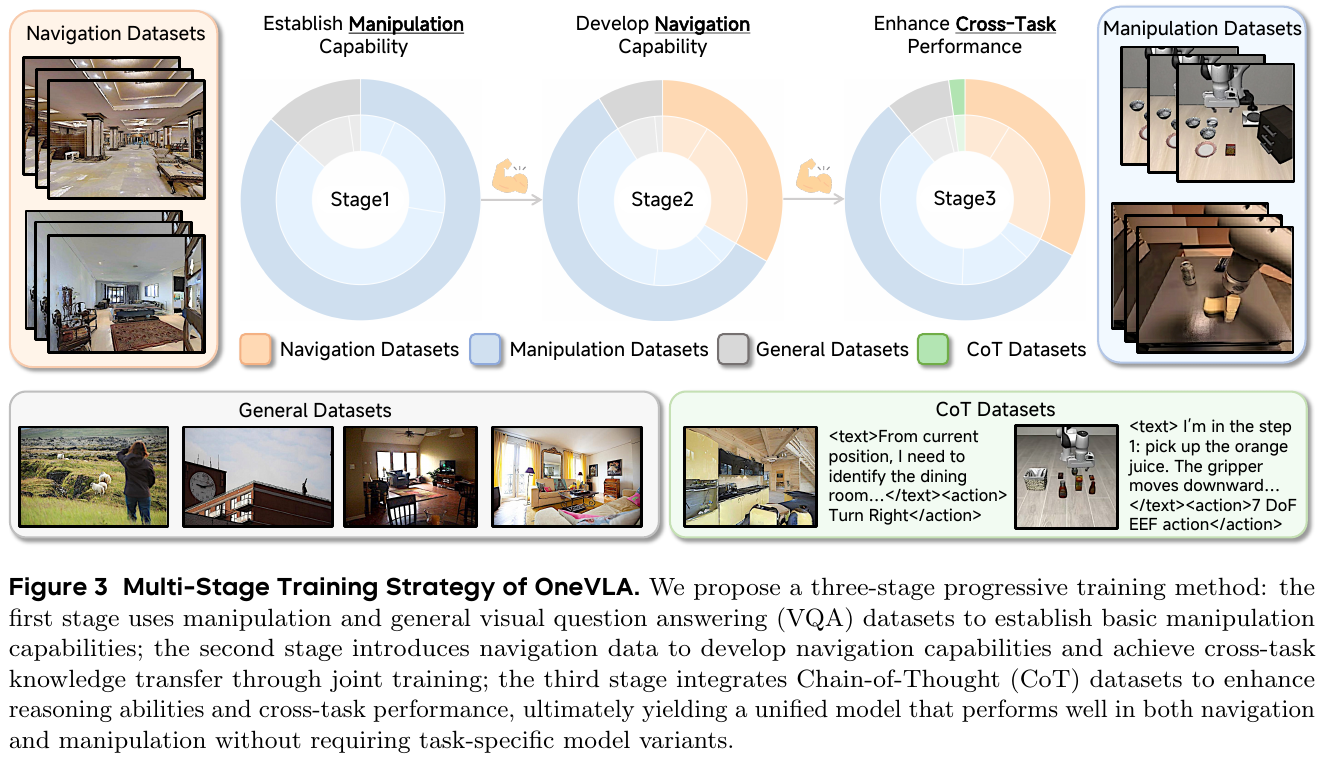
③ 多阶段渐进式训练策略
为了使单一模型平滑掌握如此异构的动作与理解空间,OneVLA 设计了三阶段训练方案:
- Stage 1 (操作基础建立):仅在机械臂操作数据集和通用视觉问答(VQA)数据集上进行预训练,只更新操作相关维度。
- Stage 2 (导航能力融入):引入 VLN 导航数据进行跨任务联合训练。此时两个通道的损失同时计算(使用各自的任务特定 Mask 隔离),使得 Vision-Language 骨干网开始学习融合两者的共享表示。
- Stage 3 (思维链 CoT 强化):最后阶段加入 Chain-of-Thought(CoT)推理数据,对语言和动作头进行端到端的联合微调,以极大强化模型在长程交互中的高层规划与理解能力。
3. 核心结果/发现
① 仿真基准对比(SOTA 性能)
OneVLA 在导航基准 VLN-CE (R2R & RxR) 以及操作基准 SimplerEnv 上均表现卓越:
| 类别 / 模型 | 统一架构 | R2R OSR ↑ | RxR OSR ↑ | SimplerEnv Avg. Success Rate ↑ |
|---|---|---|---|---|
| 导航专用 VLA | ||||
| NaVid (7B) | ❌ | 49.2% | 48.9% | - |
| Uni-NaVid (7B) | ❌ | 53.3% | 52.5% | - |
| StreamVLN (7B) | ❌ | 64.0% | 55.7% | - |
| 操作专用 VLA | ||||
| $\pi_0$-Fast (3B) | ❌ | - | - | 48.3% |
| OpenVLA-OFT (7B) | ❌ | - | - | 41.8% |
| 多任务跨域 VLA | ||||
| UniVLA (7B) | ❌ | 47.1% | 26.3% | 35.4% |
| OneVLA (Ours, 3B) | ✓ | 68.6% | 58.2% | 64.5% |
| 相比 UniVLA 提升 | - | +21.5% | +31.9% | +29.1% |
- 跨构型碾压:作为一个参数量仅 3B 的完全统一模型,OneVLA 击败了所有 7B 的专用单任务模型(如 StreamVLN 7B)和多任务模型(如 UniVLA 7B),且不需要为每个任务维护独立的动作头。
② 消融实验与互惠实证
- 渐进式训练的价值:多阶段训练相比单阶段混合训练,在导航和操作上的性能分别提升了 12.5%、15.3% 和 18.3%(见下表),证明了逐步引入任务复杂性的必要性。
| 训练策略 | R2R OSR | RxR OSR | SimplerEnv Avg |
|---|---|---|---|
| OneVLA (单阶段直接训练) | 56.1% | 42.9% | 46.2% |
| OneVLA (多阶段渐进训练) | 68.6% | 58.2% | 64.5% |
- 跨任务互惠效应(Mutual Reinforcement):将导航与操作进行联合训练后,相比于单独训练导航(Navi. Only)或单独训练操作(Mani. Only),模型在 R2R 导航上提升了 7.3%,在 RxR 导航上提升了 9.3%,在操作上提升了 5.5%(见下表)。这强有力地证实了:不同的具身任务在共享特征网络下,能学到更好的通用空间与多模态表征,从而互利共赢。
| 训练设置 | R2R OSR | RxR OSR | SimplerEnv Avg |
|---|---|---|---|
| OneVLA (单独任务训练) | 48.8% | 33.6% | 40.7% |
| OneVLA (跨任务联合训练) | 56.1% | 42.9% | 46.2% |
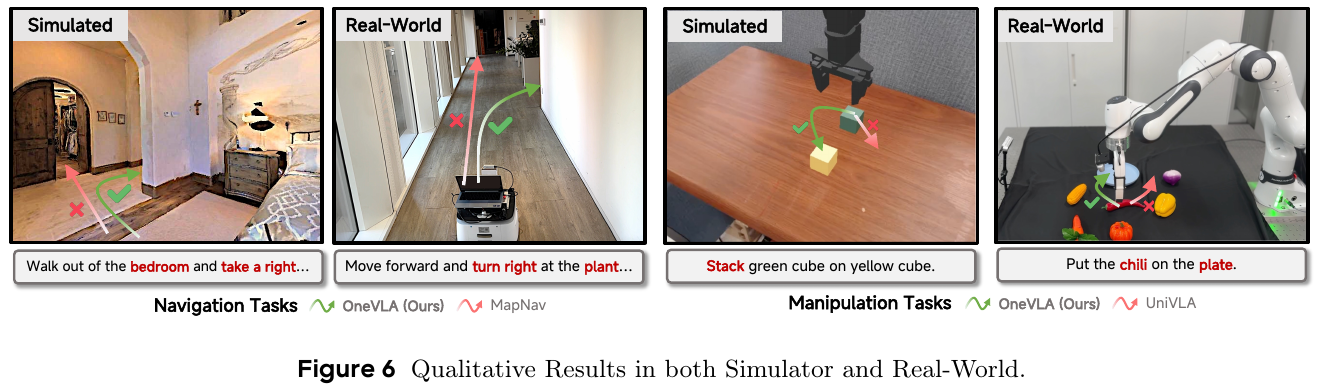
- 动作跨度(Action Horizon)消融:评估表明,预测步数 $T = 5$ 最优。过短的步数缺乏时序建模,过长的步数(如 8 步)由于累积误差,会导致操作性能急剧下降。
③ 真实世界实物评估
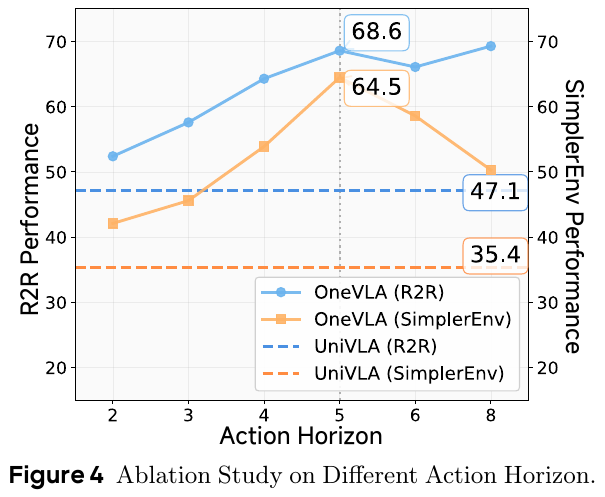
- 移动导航真机:四种典型场景中,导航成功率达 77.5%,相比 UniVLA 提升 35.0%。
- Franka 机械臂操作:四种代表性灵巧任务中,成功率达 78.8%,相比 UniVLA 提升 16.3%。证明了从仿真到现实(Sim-to-Real)的极强迁移与泛化能力。
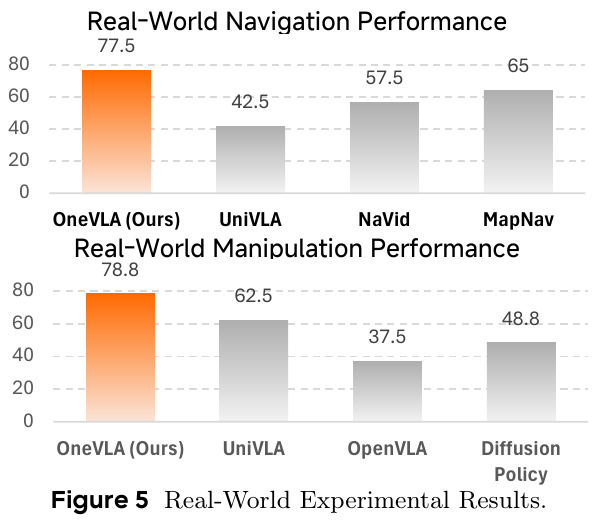
4. 局限性
- 真实世界极端长程任务的漂移:在极长程或多障碍物的复杂动态真机导航中,偶尔会出现因推理步数过多导致的动作偏差累积。
- 离散动作维度的稀疏性:统一动作空间中,虽然有 Loss Mask 屏蔽梯度,但在模型前向传播中导航动作依然以离散概率输出,无法直接表征更精细、连续的转弯控制。
- 计算延迟限制:自回归的 CoT 文本推理(
<text>...</text>)虽然能大幅增加准确率,本模型生成时间也随之增加,带来了额外的推理延迟,对于高频闭环机械臂控制(如 > 20Hz)具有一定的部署压力。
34. CA-VLN (2026)
——— 基于双智能体协作的多模态大模型具身导航框架
📄 Paper: Sensors 2026 · 🏛️ Sensors 2026
精华
- 双智能体协作机制:将高层常识认知与底层情景记忆解耦,通过知识推理智能体(Knowledge Agent)和分层历史智能体(History Agent)的协作,有效提升了具身导航智能体在未见环境(unseen environments)中的泛化与回溯能力。
- 渐进式在线知识生成:在推理时,智能体根据原始指令和实时视觉观测动态生成并检索 Top-K 相关的语义知识事实,降低了对静态离线知识库的依赖。
- 分层拓扑记忆设计:通过视角层与路径层的分层描述构建情景记忆拓扑图,既保留了时序连续性,又有效防止了徘徊或往复运动引起的记忆爆炸。
- 两阶段参数高效微调:利用 LoRA 约束可训练参数在 10M 以内,先后微调双智能体及多模态融合模块,实现了对大模型在具体导航任务中的低成本领域自适应。
- 解耦泛化的 Sim-to-Real 启示:将导航策略绑定在相对稳定的语义概念和连通关系上,而非脆弱的低层视觉纹理,这为克服 Sim-to-Real 的领域偏移提供了极佳的可迁移设计。
1. 研究背景/问题
视觉语言导航(VLN)要求智能体依据自然语言指令在复杂 3D 环境中寻路。然而,传统端到端方法在面临未见环境时泛化性能较差,且在大规模场景中由于缺乏长程历史语境而容易迷失或陷入循环。虽然近年来多模态大模型(MLLM)被引入具身导航,但大模型的庞大参数直接输出导航动作会带来巨大的“域差距”(Domain Gap)和极高的计算延迟,如何巧妙地将大模型的常识推理优势与精细的底层局部决策及空间拓扑记忆融合,依然是个亟待解决的难题。
2. 主要方法/创新点
① 整体框架概述
CA-VLN 提出了一个由知识推理智能体(Knowledge Reasoning Agent)和分层历史智能体(Hierarchical History Agent)组成的双智能体协作框架,并通过专门的多模态融合模块对视觉、文本、常识及记忆特征进行深度交互,最终输出动作决策。
② 逐模块讲解
- 知识推理智能体 (Knowledge Reasoning Agent)
- 输入:原始自然语言指令、当前视角下的实时多视角图像。
- 处理:训练期间,将原始指令与真值轨迹拼接,由 MLLM 生成精确的逐步指令并提取关键实体;推理期间,在无真值情况下,大模型采用逐步提示策略,从颜色、形状、尺寸识别场景中的可见物体属性,描述空间布局,并利用 CLIP 文本编码器在当前指令与预设事实之间进行检索,获取 Top-K 最相关的语义事实(如“Dining table is near the kitchen”)。
- 输出:提取的关键语义实体特征向量和检索到的 Top-K 语义事实特征向量。
- 设计动机:为了桥接 MLLM 与下游导航动作决策之间的语境鸿沟,将大模型作为“高级规划器与常识检索器”,用自然语言描述辅助多模态对齐。
- 分层历史智能体 (Hierarchical History Agent)
- 输入:当前时刻的图拓扑结构、历史遍历节点的局部场景描述以及图像的 CLIP 特征。
- 处理:维护两层分层结构:一是视角层(Viewpoint Hierarchy),利用 LLaVA 针对每一个新访问的观测点生成包含位置类型、显著视觉特征和连通区域关系的三元组描述;为了避免徘徊往复运动引起记忆爆炸,仅在智能体前进到新观测点时追加新节点。二是路径层(Path Hierarchy),按时间轴级联已访问视角的描述,利用 MLLM 进行全局路径的语义增强。
- 输出:分层历史特征向量 $H_{hist}$ 及拓扑节点的连接描述。
- 设计动机:克服了传统图神经网络在长距离依赖 and 长程回溯时因缺乏高层时序语义而迷失的缺点。
- 历史增强模块 (History Enhancement Module, HEM)
- 输入:未增强的局部节点特征向量 $V_t$、候选节点特征向量 $v_i$ 以及情景记忆中检索出的相关记忆向量 $m_s$。
- 处理:首先通过 MLP 对节点特征与记忆特征进行非线性融合: \(\tilde{V}_t = \text{MLP}([V_t; m_s]), \quad \tilde{v}_i = \text{MLP}([v_i; m_s])\) 随后通过图注意力网络(Graph-Aware Transformer, GAT)建立全局依赖关系。GAT 内部包含交叉注意力层(用于建模节点特征关系)和自注意力层(用于编码拓扑布局),计算公式为: \(\tilde{h}'_t = \text{GAT}(\tilde{h}_t) = \text{softmax}\left(\frac{(\tilde{h}_t W_q)(\tilde{h}_t W_k)^T}{\sqrt{d}} + M\right)\tilde{h}_t W_v\) 其中偏置矩阵 $M = D W_a + b_d$ 用于整合拓扑距离图,限制不可达节点间的影响。
- 输出:增强后的全局历史轨迹特征表示 \(\tilde{H}_t = \{\tilde{h}'_1, \tilde{h}'_2, \dots, \tilde{h}'_{t-1}\}\)。
- 设计动机:使历史表征既富有时序和语义信息,又兼备精确的几何结构约束,从而提升回溯决策的准确性。
- 多模态融合与动作预测模块
- 该模块包含指令引导特征融合 (IGFF) 和 知识感知视觉语义交互器 (KVSI) 两个子部分。
- IGFF 模块:提取指令
[CLS]Token 的全局语义特征,通过交叉注意力计算各视觉区域特征 $o_i$ 的响应权重,使智能体聚焦在指令相关的地标上: \(\eta_i = \text{softmax}\left(\frac{o_i W_q \hat{W}_0^T}{\sqrt{d}}\right), \quad \bar{o}_i = \eta_i o_i\) - KVSI 模块:融合视觉与知识特征。首先通过交叉注意力计算视觉查询与知识键之间的对齐分数 $a_{ij}$,并得到融合语义知识的局部特征: \(a_{ij} = \text{softmax}\left(\frac{Q K^T}{\sqrt{d}}\right), \quad o'_i = \sum_{j} a_{ij} \cdot V_j\) 此后通过自注意力精炼空间关系,并引入自适应视角加权机制(Adaptive View Weighting),结合历史语境为各候选视角计算重要性得分,最终通过 Softmax 归一化计算出加权后的上下文表征。
③ 端到端数据流
在每一个决策步骤 $t$:
- 智能体从当前环境获取全景视觉观测 $O_t$。
- 知识推理智能体结合当前指令与多模态模型在线生成的描述,检索出 Top-K 的语义事实知识 $K_{emb}$。
- 分层历史智能体更新图拓扑结构并利用 HEM 得到增强后的全局轨迹特征 \(\tilde{H}_t\)。
- 将提取的视觉特征、知识特征、指令特征和实体特征分别输入多模态融合模块,通过 KVSI 进行知识-视觉对齐,通过 IGFF 进行指令-视觉对齐,得到精炼的局部候选特征表示。
- 全局动作预测分支利用图注意力对全局拓扑图和指令交叉建模输出全局候选得分,局部动作预测分支则针对当前节点的相邻导航候选进行局部打分。
- 二者经过自适应加权融合,利用 Softmax 决策出概率最大的下一步动作(执行移动或停止),并更新下一时刻的历史和拓扑。
④ 训练目标 / 损失函数
模型采用两阶段微调。首先采用 LoRA 对 LLaVA-7B 进行指令微调,将可训练参数限制在 10M 以内,优化其生成 stepwise 指令与分层历史描述的能力。随后冻结智能体,联合微调融合与动作预测模块。动作预测分支使用行为克隆(Imitation Learning)与强化学习的混合损失进行优化。
3. 核心结果/发现
- R2R 数据集表现:在 unseen validation 集合上,CA-VLN 达到了 73.31% 的 Success Rate (SR)(相比基线 DUET 提升了 +1.79%)和 61.95% 的 SPL(提升 +1.53%);在 unseen test 集合上,SR 达到 70.27%,SPL 达到 60.31%,超越了 HAMT 和 KERM 等 SOTA 方法。
- REVERIE 与 SOON 表现:在包含丰富物体定位要求的 REVERIE 数据集上,未见场景下的 SR 达到 50.99%,物体定位指标 RGSR 提升了 +2.85%;在路径更长、空间结构更复杂的 SOON 数据集上,unseen validation 上的 SR 达到 37.32%(+1.02%),表明分层历史与知识增强对于大范围探索有明显增益。
- 消融实验与超参分析:分层历史、实体引导、大模型逐步指令等均提供了正向增益。对于 Top-K 的敏感度分析表明,知识检索的 Top-K 设定在 3 至 5 之间为最佳,过高(Top-K > 5)会因引入冗余或幻觉信息导致性能骤降。
4. 局限性
- 视觉稀疏场景敏感:在缺乏显著地标和物体纹理的视觉极简场景下,知识推理智能体由于无法捕捉丰富的实体属性,对导航指令的语义增强效果会有所下降。
- 计算与推理延迟:由于引入了在线 MLLM 的文本描述检索和图注意力计算,每步导航决策的推理耗时相比 baseline 增加了约 15%(但更优的路径规划即更高的 SPL 减少了总导航步数,在总耗时上提供了部分补偿)。
35. RynnBrain (2026)
———Open Spatiotemporal Foundation Model for Embodied Intelligence
📄 Paper: arXiv:2602.14979
精华
RynnBrain 最值得借鉴的核心思想包括:统一输出空间设计——将 bounding box、轨迹点、区域点等空间量编码为离散 coordinate token,与语言 token 共享同一 autoregressive 解码器,优雅地将定位任务转化为分类问题;Chain-of-Point (CoP) 推理——在文本推理链中交替插入显式空间定位步骤,使推理过程”扎根”于物理环境,避免幻觉;层级式 Plan-VLA 架构——高层 RynnBrain-Plan 生成带精确坐标的子任务计划,低层 RynnBrain-VLA 执行动作,两者分工明确;人模协作数据飞轮——仅在关键节点引入人工标注,结合模型辅助生成,以有限预算构建出 2000 万样本的高质量语料;多维度 Spatio-temporal Memory——将图像和视频统一为帧序列,用 temporal positional embedding 编码时序信息,赋予模型跨帧的全局空间感知能力。
1. 研究背景/问题
当前多模态基础模型在具身智能场景中存在三大缺口:自我中心认知范围狭窄(通常仅覆盖有限任务类别);空间推理局限于静态图像、缺乏时序一致的 spatio-temporal 表征;高层规划停留在纯文本空间、与物理约束脱节导致幻觉和执行失败。现有具身模型与通用 VLM 各有偏废,尚无统一框架同时具备宽泛语义泛化与精确物理定位能力。
2. 主要方法/创新点
RynnBrain 是阿里巴巴 DAMO Academy 提出的开源具身基础模型系列,基于 Qwen3-VL 构建,强化四大核心能力:
① 综合自我中心理解 (Egocentric Cognition) 涵盖物体理解、空间理解、计数、OCR、自我中心任务问答等,新增细粒度视频理解能力。
② 多样化时空定位 (Spatio-temporal Localization) 输出涵盖 Object Location(bounding box)、Area Location(区域点集)、Affordance Location(可交互热点)、Trajectory Location(最多 10 个轨迹航点)、Grasp Pose(4 角点抓取矩形),所有坐标归一化到 [0, 1000] 编码为整数 token。
③ 物理扎根推理 (Chain-of-Point Reasoning) RynnBrain-CoP 在推理链中交替生成文本步骤与空间定位 token,将抽象推理锚定到可观测的物理证据。训练数据由 Qwen3-VL-235B 生成初始推理链,再经人工标注关键帧精确空间实体。
④ 物理感知规划 (Physics-aware Planning) RynnBrain-Plan 输出的子任务计划直接嵌入 affordance/区域坐标,供下游 RynnBrain-VLA 执行;使用多轮对话数据微调,维持任务执行中的历史状态一致性。
模型规模:提供 RynnBrain-2B、8B(Dense)和 30B-A3B(MoE)三个尺度,预训练语料约 2000 万样本,涵盖 General MLLM、Cognition、Localization、Planning 四大类别。
训练优化:在线负载均衡流水线(按序列长度动态分配 DP worker),per-sample loss reduction 消除全局 token 计数同步开销,训练效率提升 2×。
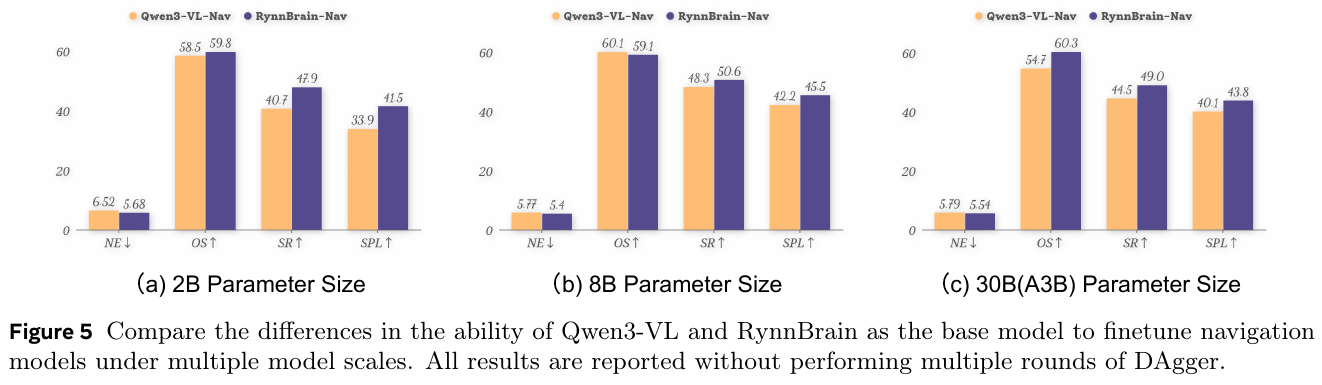
3. 核心结果/发现
- VLN 导航:RynnBrain-Nav-8B 在 R2R-CE 上 SR 58.6%、NE 4.92,RxR-CE 上 SR 56.1%、NE 6.20,在 R2R 和 RxR 上全面超越同尺度 Qwen3-VL 基线;2B 模型相比 Qwen3-VL-2B 提升 7.2% SR / 7.6% SPL;DAgger 迭代训练将 SR 从 50.6% 提升至 58.5%。
- 操作规划:RynnBrain-Plan-30B 在 OOD 任务 Table Bussing Hard 难度达到近 100% Task Progress,而 Qwen3-VL 30B < 10%、Gemini-3 Pro ~60%;多轮对话微调相比单轮基线在 Hard 任务提升显著(单轮几乎为 0)。
- VLA 抓取:RynnBrain-VLA 整体 SR 为 0.77,超越 π₀.₅(0.47)和 Qwen3-VL-Finetuned(0.60);RSR 0.97,体现出强的目标识别精度。
- 综合评测:在 28 个基准(20 个具身 + 8 个通用视觉理解)上,RynnBrain 全面超越现有开源具身基础模型,同时保留竞争力的通用 VLM 能力。
4. 局限性
MoE 架构(30B-A3B)在 VLN 任务上未能超越 8B Dense 模型,稀疏激活机制在此类任务中的潜力尚未充分释放,需要进一步探索专门的训练策略;DAgger 迭代在第 3 轮后呈现明显收益递减,导航策略收敛后的持续提升路径有待研究。
36. OmniNav (2026)
———用快慢双系统统一点目标、物体目标、指令目标导航与前沿探索
📄 Paper: arXiv:2509.25687 · 🏛️ ICLR 2026 (Poster)
精华
- 导航任务的瓶颈往往不在策略学习本身,而在于对通用指令和开放词汇物体的理解能力,这一发现指导了训练数据设计而非单纯堆叠导航算法。
- 用”快系统(连续路标点 + flow-matching)+ 慢系统(前沿探索 + 视觉记忆 + CoT 推理)”的双系统架构,把局部高频控制和全局长程规划解耦,二者通过 KV 缓存共享的中心记忆耦合。
- 用流匹配(flow matching)生成连续坐标路标点而非离散动作 token,避免了离散化带来的精度损失和误差累积,同时支持 5Hz 实时闭环控制。
- 把图像描述、OCR、grounding/referring 等通用视觉语言数据和导航数据联合训练,能显著提升指令理解和开放词汇物体识别能力,进而提升导航成功率——通用数据对导航任务的收益甚至超过任务本身数据。
- 前沿(frontier)+ 历史图像记忆的轻量记忆机制,比场景图或语义地图等复杂记忆结构更易实现,同样能支撑语义感知的探索决策。
1. 研究背景/问题
具身导航研究长期分裂为点目标、指令目标、物体目标三种范式,各自依赖任务定制数据,难以互相迁移;现有 VLM/VLA 方法普遍存在离散动作建模精度不足、长上下文管理困难、推理延迟高的问题,且实践中失败的主要原因往往是模型对通用指令和开放词汇物体理解不足,而非导航策略学习本身的缺陷。
2. 主要方法/创新点
OmniNav 整体由两个互补的子系统(快系统与慢系统)构成。快系统(System-1)负责基于短时视觉上下文和当前子任务,高频直接生成连续的三维路标点,用于局部敏捷控制;慢系统(System-2)负责基于全局探索地图(前沿点)和长时记忆进行审慎规划,做出高层探索决策。两者复用同一个微调后的多模态大模型(VLM)权重,但通过不同的前向和解码路径进行耦合,实现了“脑眼手协同”。
2.1 架构总览与工作流
OmniNav 包含三条推理管线(R2R/RxR 快系统、OVON 纯快系统、OVON 慢-快协同系统),其架构总览及闭环数据流如下:
flowchart TD
    CORE["改造版 Qwen2.5-VL-3B(核心策略)<br/>ViT视觉编码器 + Qwen2 LLM<br/>+ 航点头/到达头/角度头(query交叉注意)"]

    subgraph TRAIN["训练 (ms-swift 全参微调)"]
        T1["train_code: swift sft<br/>L1航点 + BCE到达 + 余弦角度"]
    end

    T1 -->|"输出 checkpoint"| CORE

    CORE -->|"推理 (torch.no_grad 闭环)"| P1
    CORE -->|"推理"| P2
    CORE -->|"推理"| P3

    subgraph PIPE["三条推理管线"]
        P1["① R2R / RxR<br/>快系统(视觉) waypoint_agent"]
        P2["② OVON<br/>快系统(视觉) waypoint_agent_ovon"]
        P3["③ OVON 慢-快协同<br/>慢系统(VLM前沿决策)+快系统(A*/航点)"]
    end

    P1 --> SIM
    P2 --> SIM
    P3 --> SIM

    SIM["Habitat-Sim 仿真器(闭环执行)<br/>观测(RGB三目/pose) → 模型 → 动作(航点/STOP) → 环境"]
    SIM -->|"观测反馈"| CORE
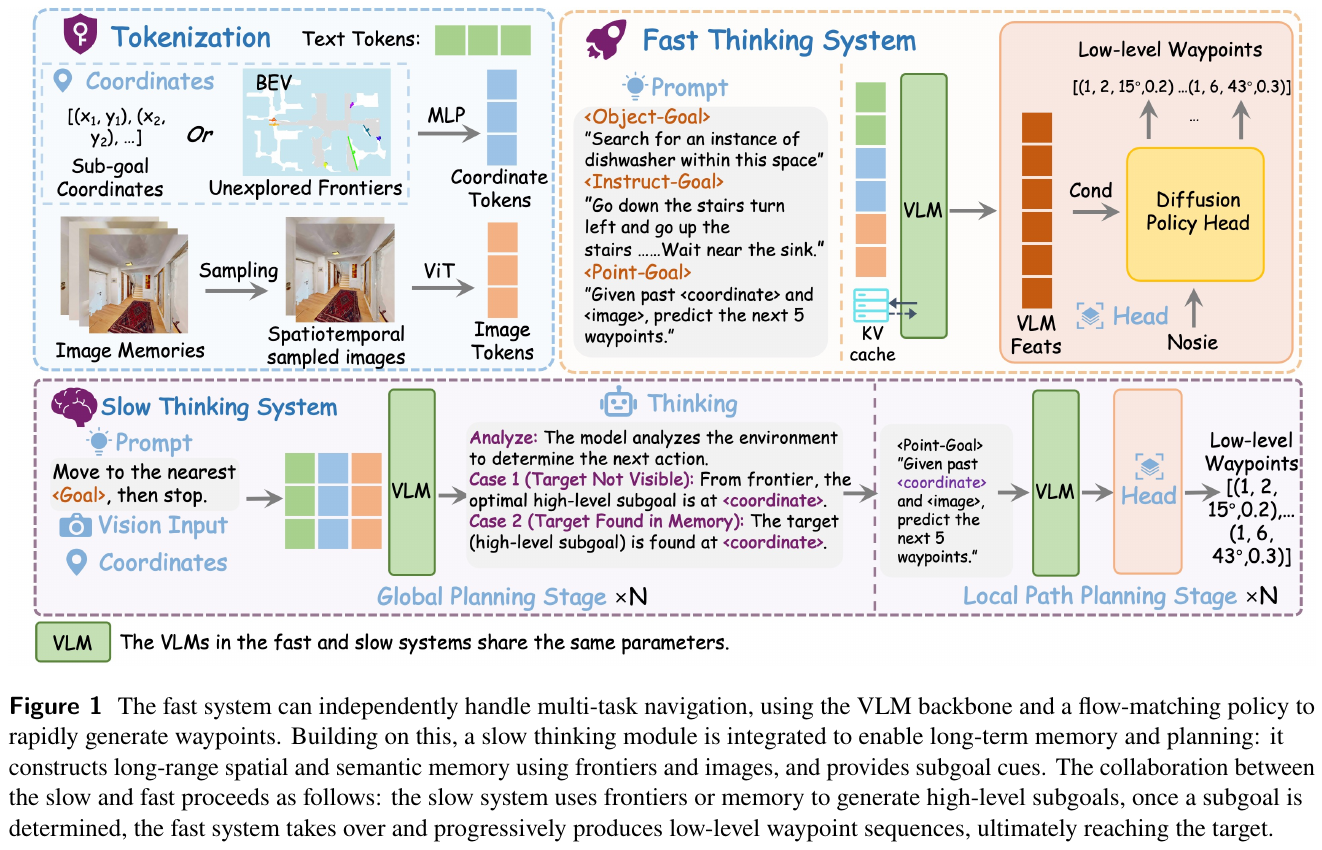
2.2 快系统(Fast Thinking System):端到端高频动作回归
快系统是一个纯视觉端到端的导航策略,其核心是对 Qwen2.5-VL-3B-Instruct 进行结构改造,在自回归语言模型主干后加挂了定制的航点回归头。其前向传播绕过了普通的语言生成 lm_head,直接回归输出物理空间的坐标和标志:
- 输入表示与特征提取:
- 当前三目观测:机器人当前的左、前、右三个方向的 RGB 图像(例如大小为
[640, 569, 3]),由 ViT 视觉编码器提取特征,通过smart_resize后每帧图像提取约 460 个 Token 的视觉表征。 - 低分辨率历史帧:为了在保留历史上下文的同时控制计算量,仅保留前向相机的历史帧(最大 20 帧,环形采样),并降采样至原分辨率的 1/4,经 ViT 提取后每帧约为 30 个 Token。
- 提示词与 NAV 特殊 Token:序列以特殊的动作标记
<|NAV|>结尾,以指示网络跳过生成头进入动作回归头。
- 当前三目观测:机器人当前的左、前、右三个方向的 RGB 图像(例如大小为
- 航点预测头 (Action Former):
- 提取 Qwen2 LLM 的输出特征
hidden_states(维度为[B, L, 2048],其中 2048 是 3B 模型的隐藏维度)。 - 使用一个可学习的
query_action参数(维度为[1, 1, 2048]),通过 4 头交叉注意力机制(Multihead Cross-Attention),以 query 为query_action,以 key/value 为hidden_states进行全局特征聚合,得到动作特征action_feature(维度为[B, 2048])。 - 航点回归:通过一个线性层预测未来 5 个路标点的相对位移增量,并在时间轴上累加(
cumsum),最后乘上缩放系数 0.3 还原为以米为单位的局部位移(x, y)。 - 角度预测:通过另一个独立的线性层结合
tanh激活函数,预测未来 5 个路标点的朝向角正弦与余弦值(sinθ, cosθ),通过atan2转化为实际偏航角。 - 到达预测:通过第三个线性层预测未来 5 个位置的到达概率(Logits)。只有当 5 个路标点的到达 Logits 均大于等于 0 时,才判定为已到达终端并下发
STOP动作;否则以第一个路标点(x, y)对应的极坐标(r, θ)下发移动控制指令。
- 提取 Qwen2 LLM 的输出特征
flowchart TD
    OBS["仿真器观测<br/>三目RGB left/front/right + pose"]
    M1["1. add_frame 历史帧管理<br/>(≤20历史帧, 1/4降采样)"]
    M2["2. 构建prompt + NAV特殊token"]
    M3["3. Qwen2.5-VL.forward(航点头)"]
    M4["4. 输出 5航点 + 5到达 + sin/cos"]
    D{"5个到达logit全 ≥0 ?"}
    STOP["STOP"]
    GO["GO_TOWARD_POINT(r=‖wp0‖, θ=atan2)"]
    STEP["env.step(action)"]

    OBS --> M1 --> M2 --> M3 --> M4 --> D
    D -->|"是"| STOP
    D -->|"否"| GO
    STOP --> STEP
    GO --> STEP
    STEP -->|"下一步观测"| OBS
2.3 慢系统(Slow Thinking System):基于前沿与 CoT 的审慎决策
慢系统负责长程探索规划。在诸如 ObjectNav 等探索任务中,机器人需要自主决定“去哪探索”。慢系统主要依赖普通的文本自回归生成(使用 Qwen2.5-VL.generate 分支,与快系统共享权重):
- 工作原理:
- 机器人原地旋转 360 度,拼合出 4 张全景图像,并利用 LiDAR 或深度数据更新一个简易的 3D 占据地图(Occupancy Grid Map)。
- 利用“战争迷雾”(Fog of War)机制检测出当前地图边缘的所有可探索前沿点(Frontier Points)。
- 将这 4 张全景图、机器人当前位姿、以及所有候选前沿点的相对坐标以纯文本形式拼入 Prompt,要求模型推理出目标的当前可见性并选择探索价值最高的前沿坐标。
- CoT 推理:模型首先输出一段思维链(例如分析历史帧中的语义线索:“浴帘通常在浴室,刚经过了走廊,所以我应该朝…前沿探索”),最后输出选定的相对坐标
[x, z],或在看到目标时输出found。
- 慢-快协同闭环:
- 慢系统定位高层前沿目标后,将坐标下发给快系统。
- 快系统作为低层执行器(“司机”),可以调用快系统航点预测策略,或者调用经典的 A* 测地路径跟随器(Geodesic Follower)把机器人带到选定的前沿点。
- 到达前沿点后,重新触发原地扫描和慢系统决策,循环往复。
flowchart TD
    START(["外层探索循环 total_steps < 4000"])
    SPIN["原地旋转扫描 12×turn_left<br/>采集360°全景 → 存入Bank"]
    FRONT["前沿检测<br/>fog-of-war揭示 + detect_frontier"]
    VLM["慢系统VLM决策 getresult()<br/>4全景图 + 前沿坐标 → 目标 + found?"]
    EXEC["快系统执行<br/>A*测地跟随 或 航点模型 → 走向目标"]
    DEC{"is_final_decision (found) ?"}
    MARK["标记已访问前沿"]
    FIN["结束本episode"]

    START --> SPIN --> FRONT --> VLM --> EXEC --> DEC
    DEC -->|"是"| FIN
    DEC -->|"否"| MARK --> SPIN
2.4 快系统与慢系统的核心对比
下表总结了快慢双系统在推理配置上的本质区别:
| 维度 | 慢系统(System-2 语义决策) | 快系统(System-1 动作执行) |
|---|---|---|
| 核心职责 | 动脑思考“去哪儿探索”(语义决策) | 手脚控制“怎么走过去”(低层执行) |
| 主要输入 | 4 张 360° 全景图 + 前沿点坐标(文本)+ 目标 | 短时历史帧 + 当前三目图像 + 特殊动作 Token |
| 解码方式 | generate 离散文本自回归生成 |
绕过 lm_head,通过动作查询头进行直接连续回归 |
| 输出形式 | CoT 推理文本与前沿坐标,看到物体时输出 found |
5 个路标点坐标 (x, y) + (sinθ, cosθ) + 到达 Logits |
| 调用频率 | 低频(通常在转弯、到达前沿或每 N 步决策时触发) | 高频(在 Habitat 中闭环以最高 5Hz 频率执行) |
2.5 数据构成与两阶段训练
- 混合数据集(9.2M+):
- 导航任务数据(4M):包含指令跟随(VLN-CE)、前沿探索等多任务数据。
- 视觉-语言通用数据(5.2M):包含图表、OCR、VQA、Referring & Grounding 等通用数据。实验表明,大模型强大的通用常识推理和 Referring 能力对于解决“开放词汇物体导航”的成功至关重要。
- 两阶段训练流程:
- Stage 1 (离散对齐):使用自回归语言建模目标(Autoregressive CE Loss)训练全连接层和主干,对齐语言、视觉与动作空间,使其初步理解指令和场景。
- Stage 2 (连续回归微调):在共享的 VLM 主干上接入
action_former交叉注意力回归头。使用 L1 航点回归损失、余弦角度回归损失和 BCE 到达分类损失进行联合优化,同时混入 20% 的 Stage 1 离散文本数据以防止微调破坏 VLM 的基座常识和语义理解能力。
⑤ 推理流程:在慢-快协同推理中,慢系统利用前沿或记忆生成高层子目标后,快系统接管并持续生成低层路标点序列逐步逼近目标;若直线路径被障碍物阻挡,快系统会依据实时视觉线索绕行调整,体现其并非单纯的预设坐标跟随器。
3. 核心结果/发现
- 指令目标导航(R2R-CE / RxR-CE Val-Unseen):仅用快系统和纯 RGB 输入即取得 SOTA,成功率分别比此前最优方法提升 4.4% 和 4.3%(SR 69.5% / 62.0% SPL)。
- 物体目标导航(HM3D-OVON):纯视觉输入下已超越此前最优方法 2.7%;加入慢系统(前沿推理 + CoT)后整体性能超过此前最强方法 18.4%(Val-Unseen SR 59.2%,SPL 33.2%)。
- 点目标导航(CityWalker 基准,开放集 MAOE 指标):OmniNav 11.53% 优于 CityWalker 的 15.23%。
- 消融研究:策略头(连续路标点 vs 离散动作块)、慢系统、通用数据、CoT 四个组件均带来稳定且可叠加的增益,全部启用时性能最佳;其中慢系统在长程探索任务上的提升最大。
- 真机部署:在四足机器人上以云端 RTX 3090 实现 5Hz 以上闸环控制,验证了零样本场景下物体目标、点目标(视觉避障)、指令目标三类任务的有效性。
4. 局限性
完整慢系统的真实物理部署仍需额外工程(如 LiDAR/深度估计的鲁棒实时集成),本文真机实验仅验证了快系统组件;复杂纹理物体(如毛毯、衣物)的识别在任何模型规模下仍不稳定,且模型规模(3B vs 7B)在数据充分时收益趋同,尚未进行系统性的 scaling law 研究。
37. Qwen-RobotNav (2026)
———首个统一的多任务、时空可重构具身导航大模型
📄 Paper: arxiv:2606.18112
精华
- 统一建模:Qwen-RobotNav 是首个将多任务导航(指令遵循、目标搜索、主动追踪、自动驾驶)统一为参数化观测上下文建模的通用导航底座大模型。
- 时空可重构:提出任务自适应观测编码(Task-Adaptive Observation Encoding),在推理时可通过调节 Token 预算、时间衰减和相机权重动态重新配置时空上下文策略。
- 架构零修改:采用自然语言标签对相机视角与时间戳进行交错标记,并使用具身前缀区分平台角色,无需修改预训练 Qwen3-VL 架构即可跨平台泛化。
- 联合训练:采用 15.6M 规模的混合数据集,将导航轨迹与 15% 的通用及导航特定视觉语言推理数据进行联合训练(Co-training),有效防止模型发生纯动作轨迹映射退化。
- 高效协同:在层次化 Agent 导航中,它与上层规划器通过“单回合证据+跨回合记忆本”的双层记忆机制无缝配合,在 EQA 等长程任务上实现显著的步数精简与 SOTA 表现。
1. 研究背景/问题
具身智能导航任务(如指令遵循、目标搜索、主动追踪和自动驾驶)多种多样,各自对视觉时空上下文的需求存在本质差异。例如,指令遵循需要长程的全局记忆来重定远期地标,而主动追踪则高度依赖最新几帧的近况画面进行实时反应。现有的统一导航模型大都使用固定的下采样或滑动窗口策略,无法在部署推理时因地制宜地调整,且在大大规模轨迹训练中极易丢失大模型的多模态通用理解与常识,退化为被动作的动作生成器。因此,如何在单一底座模型上暴露一个参数化、可重构的观测编码接口,并构建能与高层 Agent 协同运作的通用导航系统,是目前具身导航领域的核心挑战。
2. 主要方法/创新点
整体框架概述
Qwen-RobotNav 继承自 Qwen3-VL 多模态大模型,并在其基础上设计了一个极其轻量化的 4 层 MLP 动作预测头。该框架的核心思想是将多任务导航统一建模为回归预测 8 个未来路点的轨迹规划任务。在数据流的输入端,系统暴露出由 Token 预算 $B$、时间衰减系数 $\gamma$ 和相机权重 $w_c$ 组成的参数化接口,用以自适应控制输入图像的分辨率和时空 Token 占比,从而实现无缝的推理期策略重构。
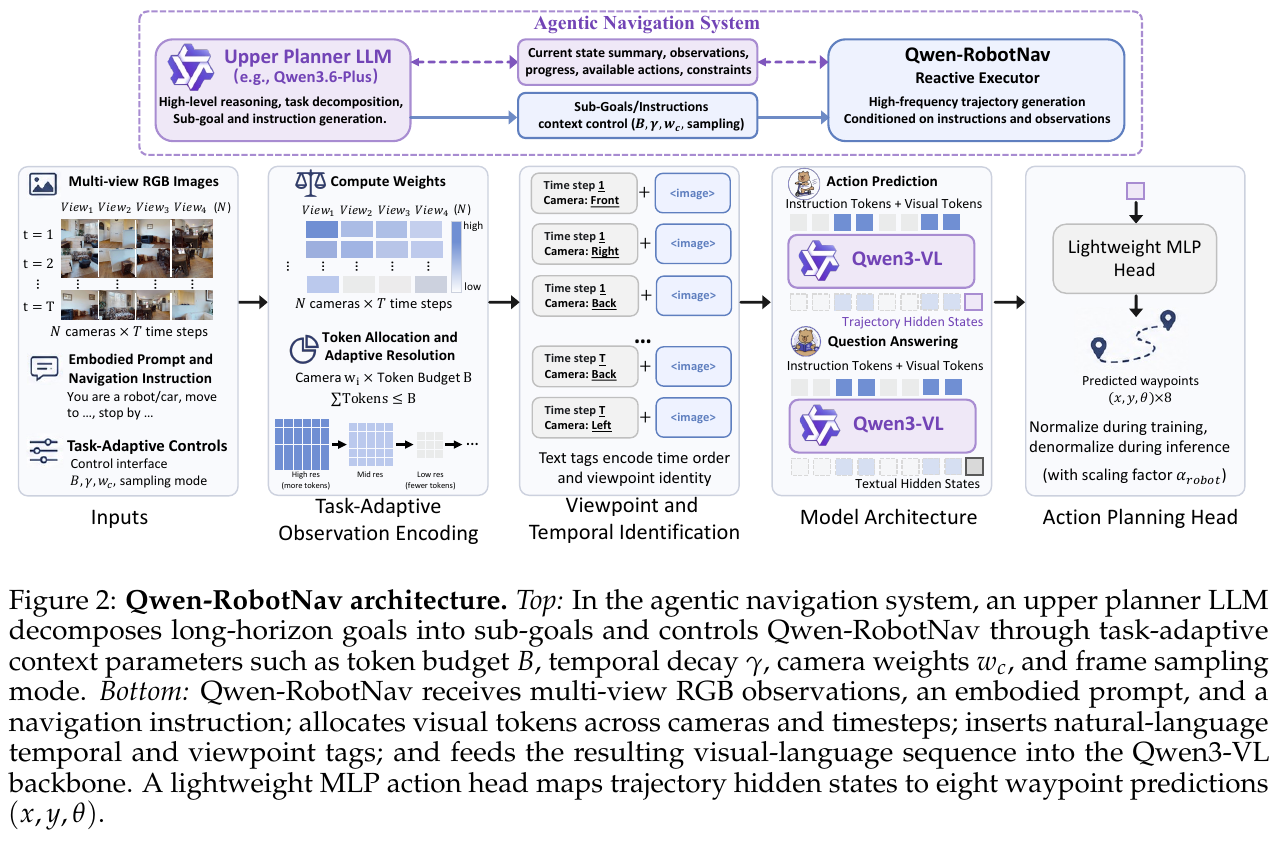
逐模块讲解
① 参数化观测编码与 Token 动态分配
- 输入:多视角图像序列 $I_{1:T}^{1:N}$(由 $N$ 个相机在 $T$ 个时间步捕获)、Token 预算 $B$、时间衰减因子 $\gamma$、相机权重向量 $w_c$。
- 处理:系统首先根据时间步 $t$ 计算每个保留帧的临时衰减权重: \(\omega_t = \exp\left(\gamma \cdot \frac{t}{T' - 1}\right)\) 其中 $\gamma=0$ 时退化为均匀分配,$\gamma > 0$ 时权重更偏向最新帧。随后,结合各视角的相机权重(如前向相机 $w_{\text{front}}=2.0$,后向相机 $w_{\text{rear}}=0.5$),生成联合时空权重矩阵 $W[t,c] = \omega_t \cdot w_c$。最后,通过受限分配算法(CONSTRAINEDALLOC),在满足单图 Token 上下限 $[b_{\min}, b_{\max}]$ 约束的前提下,将总 Token 预算 $B$ 分配给对应的画面。这些分配到的 Token 决定了输入图像的像素分辨率,以便使用 dynamic-resolution ViT 进行大小缩放与 patch 合并。
- 输出:经过动态分辨率缩放的图像序列特征 Token。
- 设计动机:实现推理时无需微调即可切换上下文倾向。例如,在局部的反应式追踪中,可以使用大 $\gamma$ 和小预算快速处理最新画面;在全局搜索中,则调小 $\gamma$ 并调大 $B$ 以保留更多的历史帧信息。
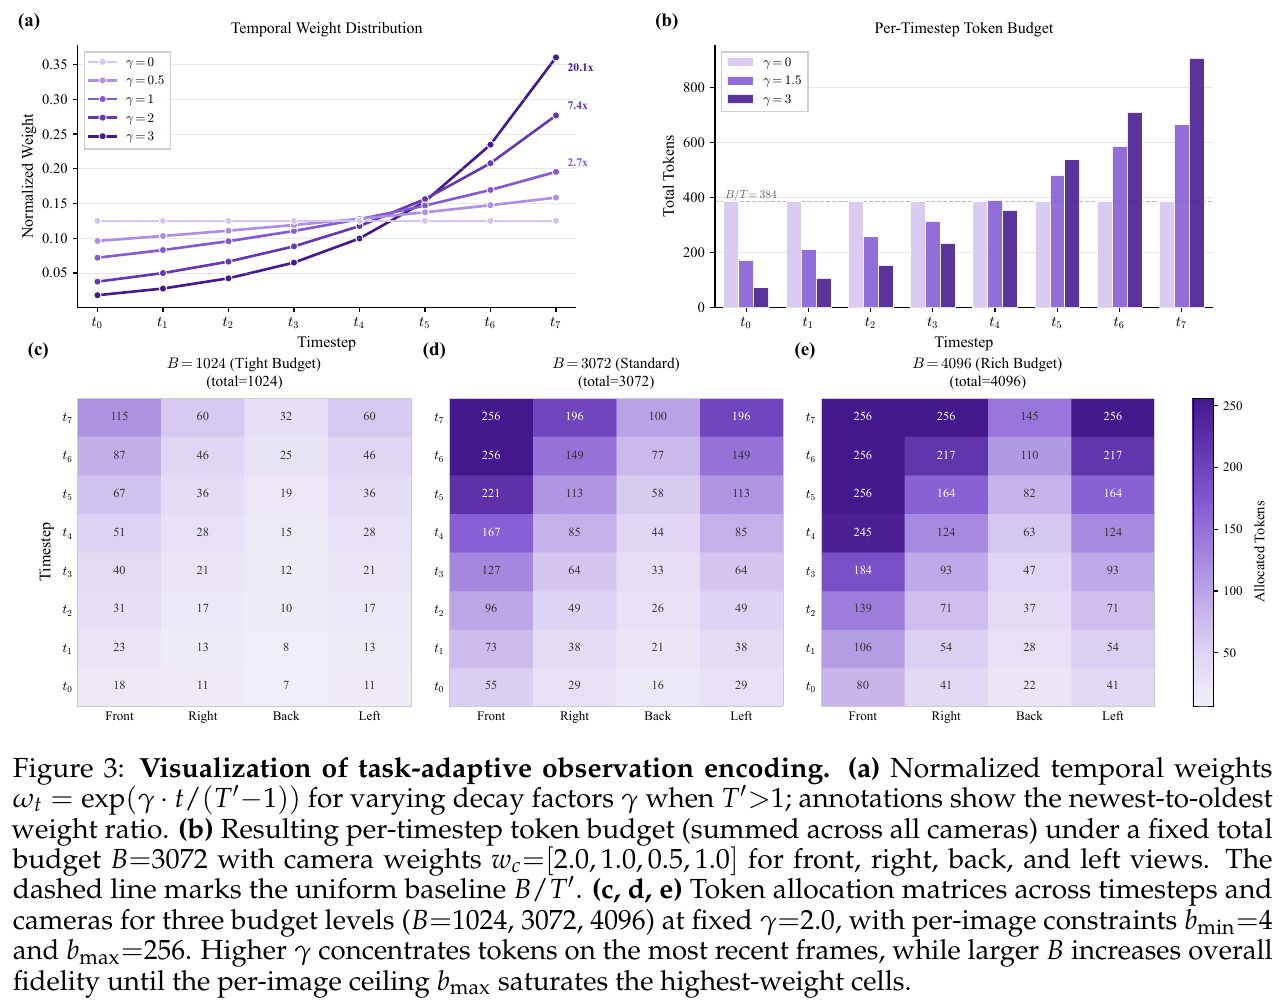
② 时空视图标识与具身提示
- 输入:动态分辨率的图像特征 Token、当前自然语言指令、具身提示前缀(如 “Imagine you are a robot…” 或 “Imagine you are a car…“)。
- 处理:系统将自然语言的相机视点标识(如 “Front View”、”Left View”)和时间步头(”Time step t”)直接交错拼插在对应的图像 Token 之前。同时,将具身类型置于 Prompt 的系统前缀中。
- 输出:输入给 Qwen3-VL 语言底座的统一图文交错 Token 序列。
- 设计动机:通过在普通的文本词表中插值时空标识,避免了引入额外的空间/时间位置编码层,最大程度保留了预训练大模型的语言 grounding 和空间推理能力,从而能够零样本支持新型机器人底盘或传感器配置。
③ 动作规划头与轨迹规划
- 输入:Qwen3-VL 在对应路点特征上的最后隐藏层状态 $E_A \in \mathbb{R}^d$。
- 处理:隐藏状态通过一个 4 层的高维 MLP(隐藏单元 512,使用 GELU 激活函数),在训练时使用每个数据集的第 99 百分位数作为尺度因子将真实路点坐标归一化到 $[-1, 1]$ 之间进行回归。
- 输出:$K=8$ 个带有航向角的未来 2D 轨迹路点 \(W = \{(x_k, y_k, \theta_k)\}_{k=1}^8\)。
- 设计动机:动作头被设计得尽可能轻量,确保几乎所有的时空建模与常识推理都在大语言底座内部进行,从而保证强大的跨场景泛化能力。
端到端数据流与 Agent 协作
当部署在多任务长程场景(如 EQA)中时,系统由上层规划器(如 Qwen3.6-Plus)和底层的 Qwen-RobotNav 共同构成。上层规划器根据全局目标进行高层推理与拆解,下发包含具体任务模式 $\tau_i$ 和观测参数 $\Phi_i$(如 $B$, $\gamma$)的导航 Tool 调用。Qwen-RobotNav 作为高频执行器输出轨迹并执行。每次执行完毕,导航 Harness 会自动将执行过程提炼为 compact 的轨迹证据(Trajectory Evidence)(记录关键的 landmark 和目标状态),并用来更新全局的证据笔记本(Evidence Notebook)。该机制实现了层次化的端到端闭环控制,成功避免了将 dense 视频流反复塞入大模型导致的上下文爆炸。
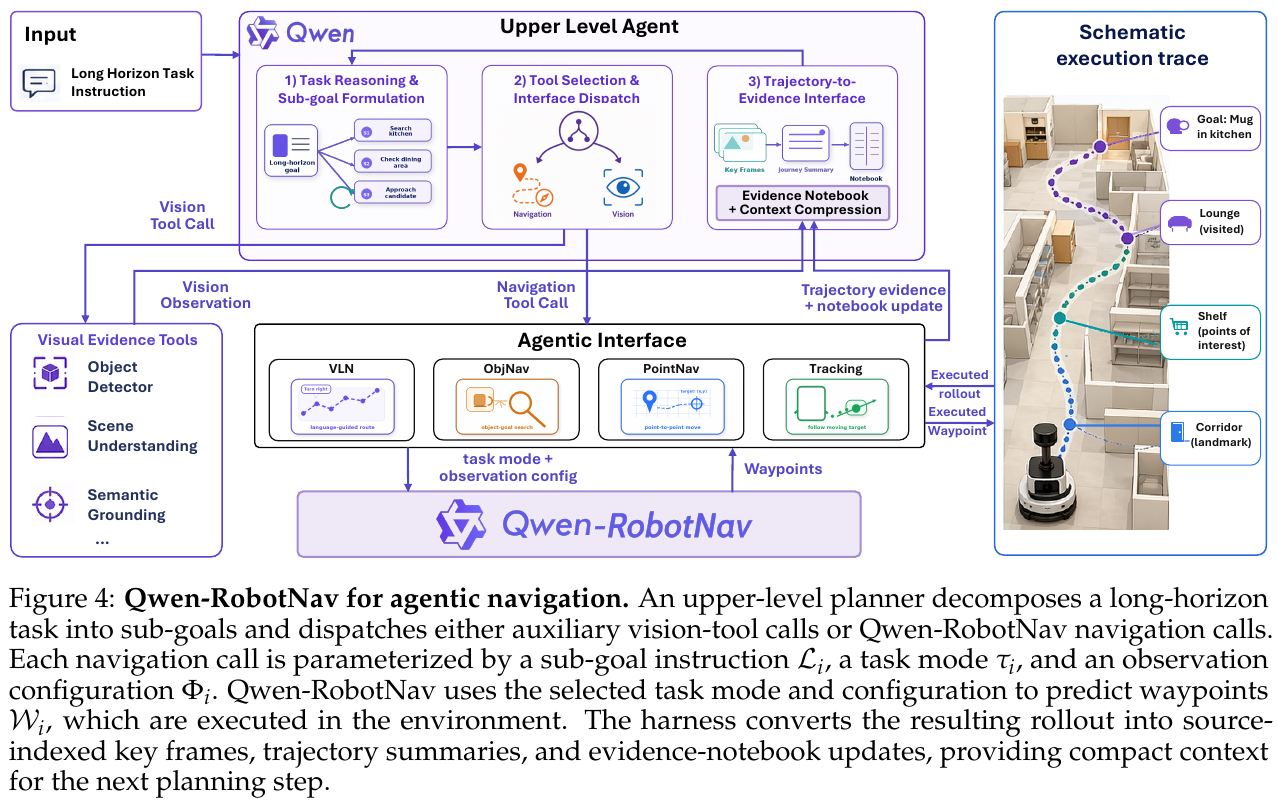
训练策略与联合训练
联合优化的损失函数定义为: \(L = L_{\text{traj}} + \lambda L_{\text{VL}}\) 其中 $L_{\text{traj}}$ 为预测轨迹相对于 ground-truth 的 MSE 损失;$L_{\text{VL}}$ 是基于 vision-language samples 的自回归 Next-Token 交叉熵损失,用于防止大模型的语言理解与开世界视觉感知能力在纯轨迹微调中发生退化崩溃。在训练过程中,所有观测配置($B$, $\gamma$, $w_c$, $b_{\min}$, $b_{\max}$)在每个 batch step 均会被进行独立随机采样,使模型自然适应任何推理时的配置变化。
3. 核心结果/发现
实验基准概览
Qwen-RobotNav-4B 和 8B 在多项基准测试中均展现出了 state-of-the-art(SOTA)的水平,覆盖了指令遵循、目标探索、主动追踪、自动驾驶等多个维度。
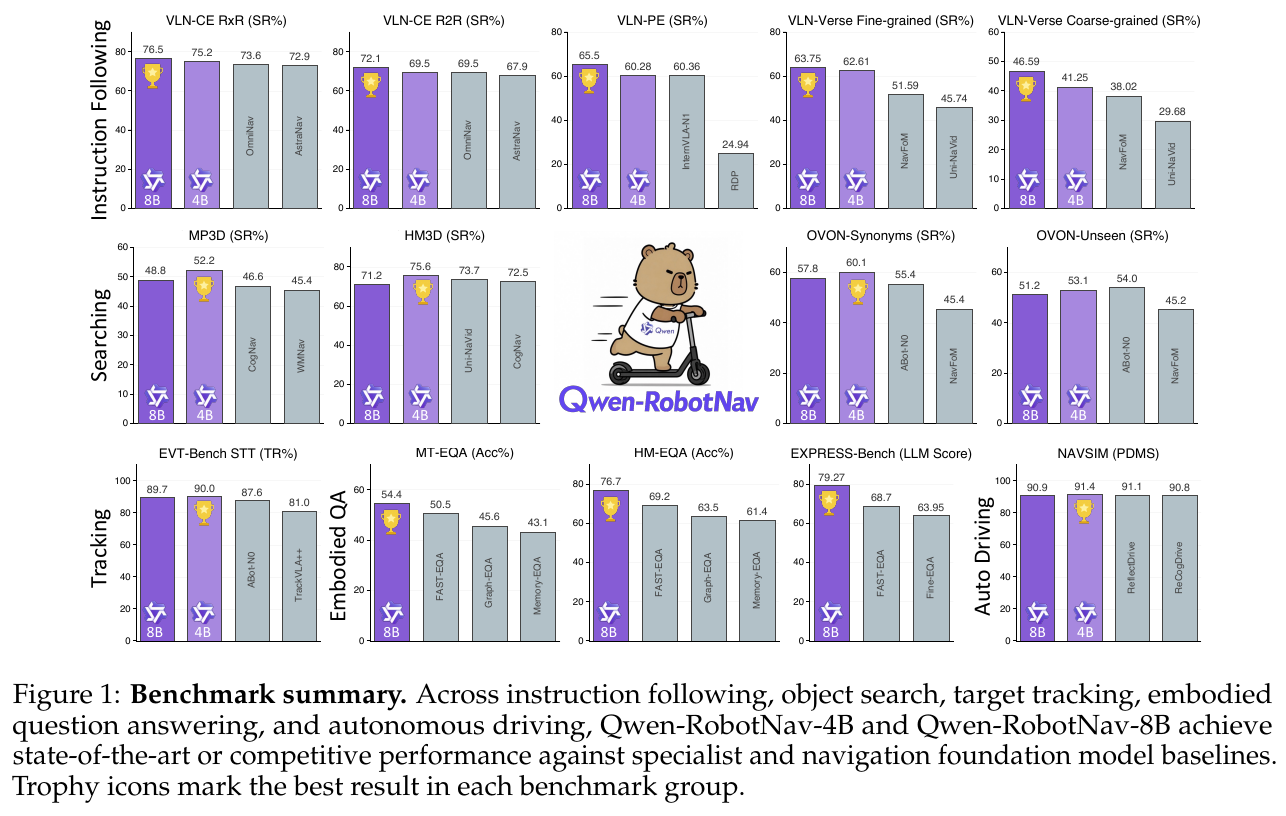
- 指令遵循 (VLN-CE): 在 R2R 基准上,Qwen-RobotNav-8B 达到 72.1% 的成功率(SR)和 66.6% 的 SPL;在长程的 RxR 基准上达到 76.5% 的 SR,超出强基线 NavFoM达 12.1% SR。在仅有单前向相机的 monocular 设定下,依然在 R2R 取得 66.9% SR,RxR 取得 73.4% SR,超越了专业的单目模型。
- 主动追踪 (EVT-Bench): 在 EVT-Bench 单目标追踪任务中,Qwen-RobotNav 取得了 90.0% 的追踪率(TR),是通用大模型及专用追踪模型(如 TrackVLA++)中的最高值,且碰撞率仅为 5.70%。
- 自动驾驶 (NAVSIM & AlpaSim): 在 NAVSIM 基准上,引入前三帧的历史自我状态(Ego-Status)后,Qwen-RobotNav-4B 取得了 91.4 PDMS(PDM Score),NC(导航合规率)高达 99.8%,超越了 WoTE、LAW 等专用多模态驾驶模型。此外,模型在 AlpaSim 上展现了出色的零样本跨领域闭环控制泛化能力。
- 具身问答 (EQA): 在与 Qwen3.6-Plus Agent 架构协同测试中,该系统在 HM-EQA 取得 76.7% SR,MT-EQA 取得 54.4% SR,而在导航所需的折算等效步数(Steps)上,比此前的 SOTA 方法(如 FAST-EQA)精简了 77%。
数据规模与接口控制消融
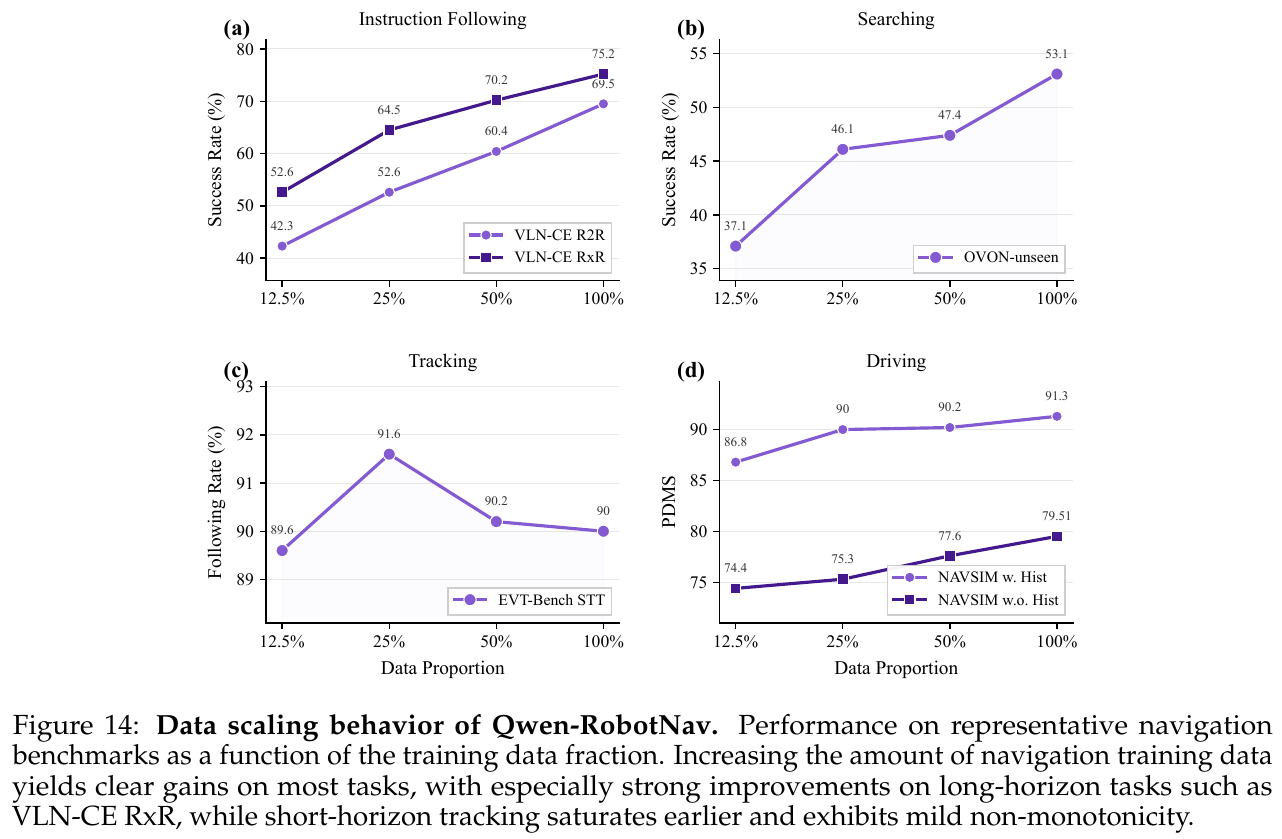
- 数据量消融:将导航轨迹数据占比从 12.5% 扩展到 100% 后,指令遵循(RxR)与自动驾驶(NAVSIM)的表现提升尤为显著,而短程追踪任务则在较少的数据下即快速饱和。
- 控制参数消融:
- Token 预算 $B$:预算从 2048 提升到 4608 时,R2R 的 SR 从 70.8% 攀升至 74.6%,但超过 3584 后 OSR 指标表现出边际效应递减,说明过量多余视觉特征可能引入负面噪声。
- 衰减系数 $\gamma$:$\gamma$ 从 0.5 提升到 3.5 的扫参中,SR 指标在 $\gamma=3.0$ 时达到峰值(72.5%),显示了对于局部导航,强化最新帧权重的 Recency Bias 非常重要,但过大的衰减会导致历史丢失,从而略微损害整体路径规划的高效性。
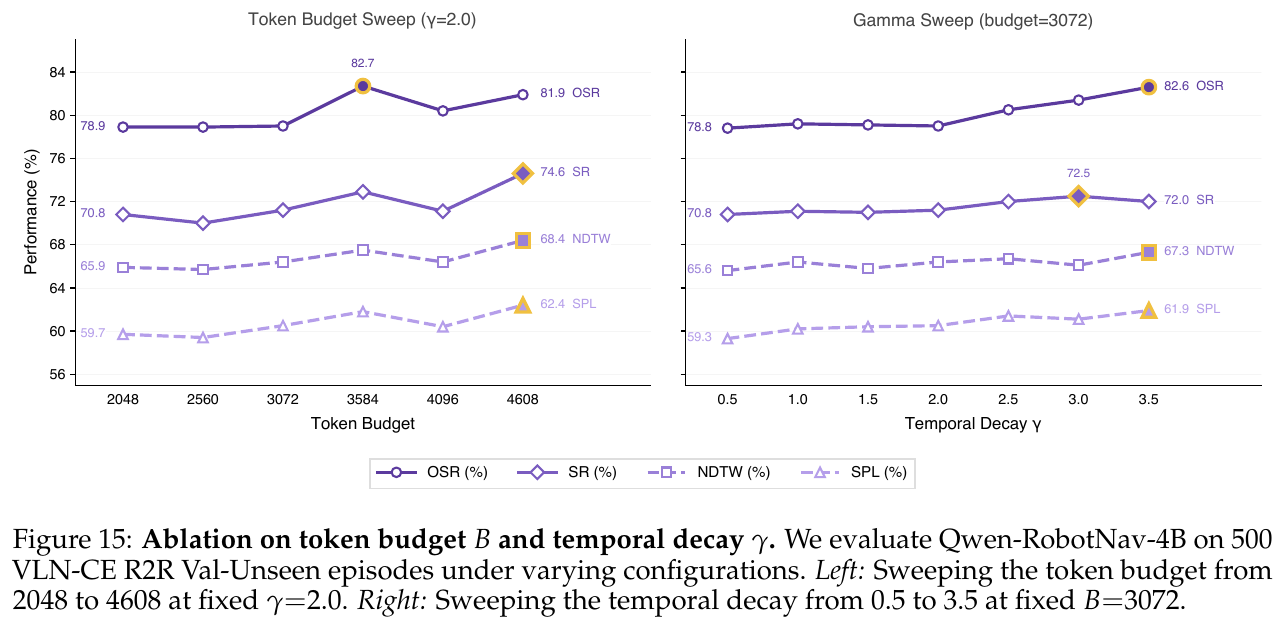
真实世界机器人部署
Qwen-RobotNav 部署在宇树 Unitree Go2 四足机器人以及移动底座上,在从未见过的展厅、复杂公寓等真实场景中展示了非凡的零样本落地能力。
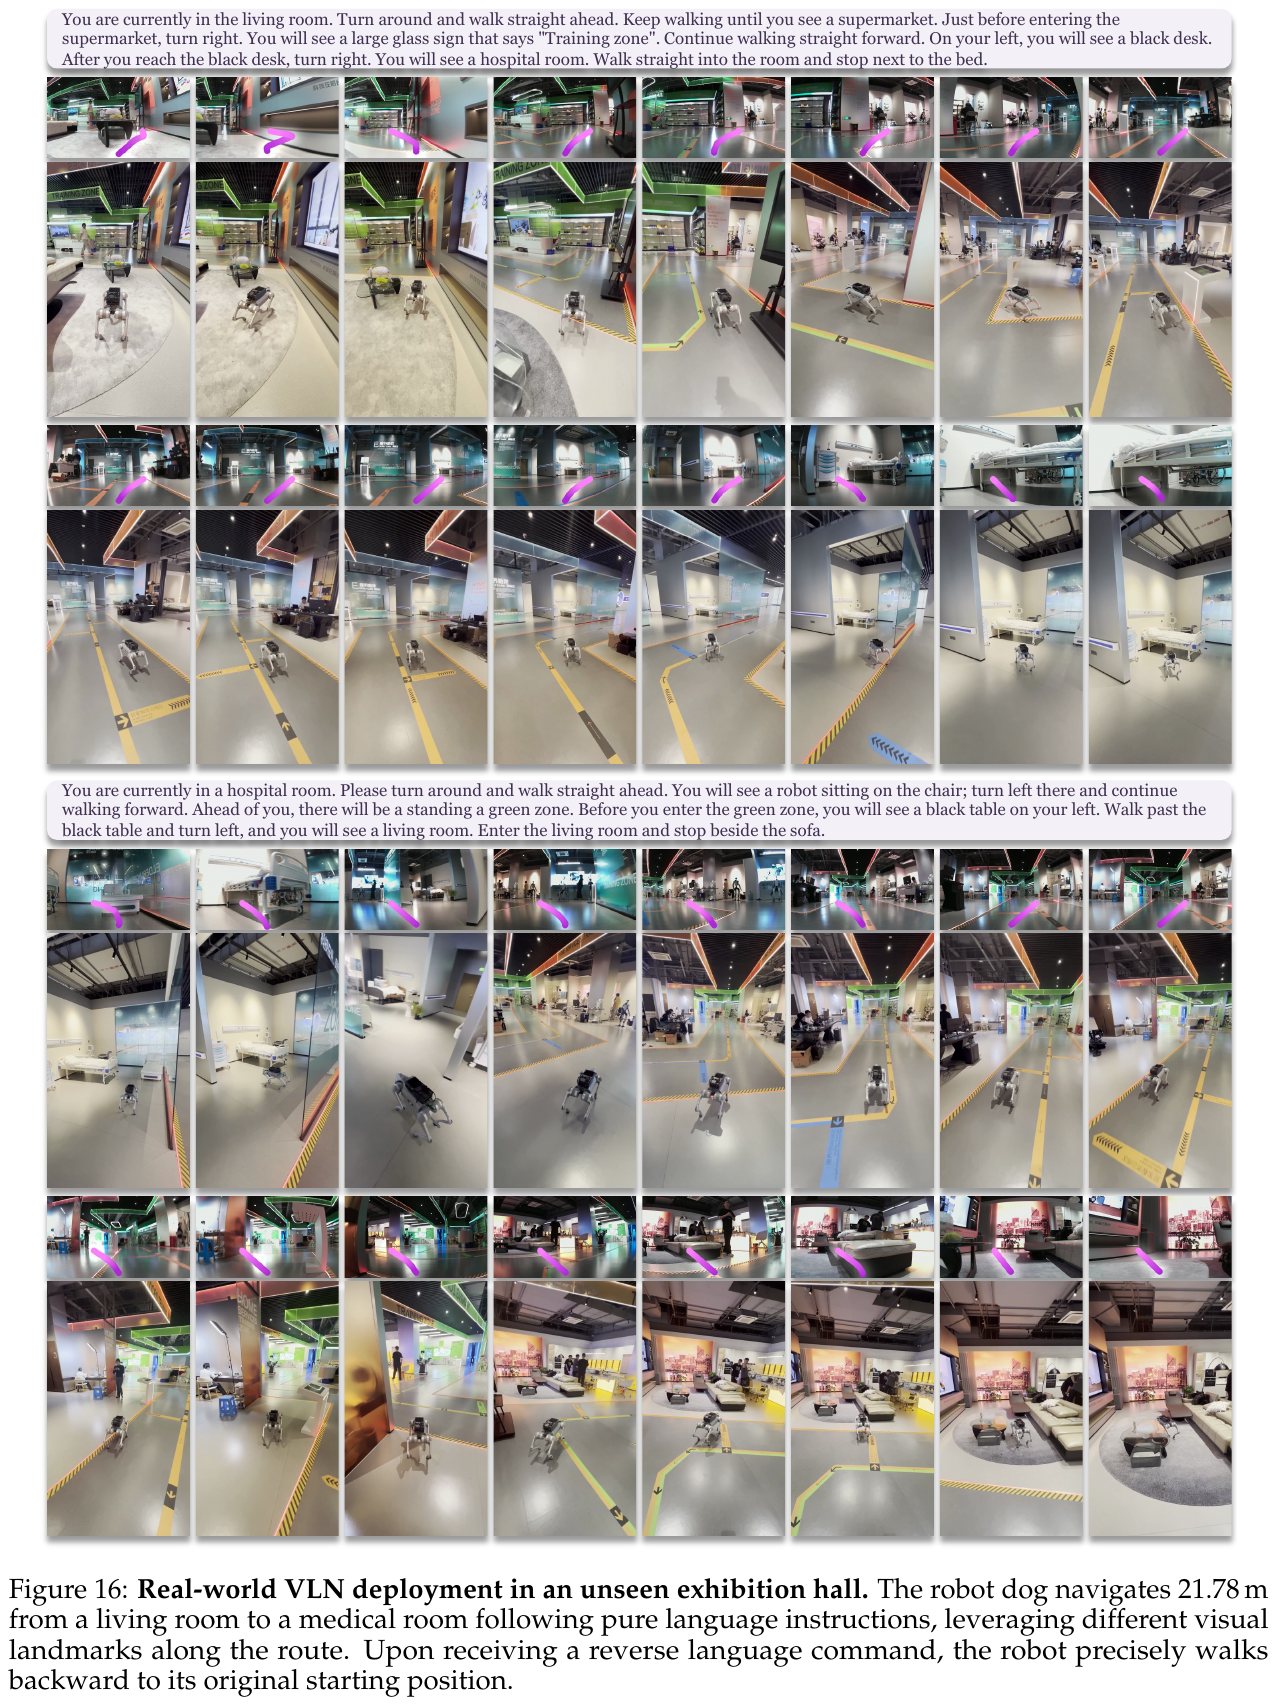
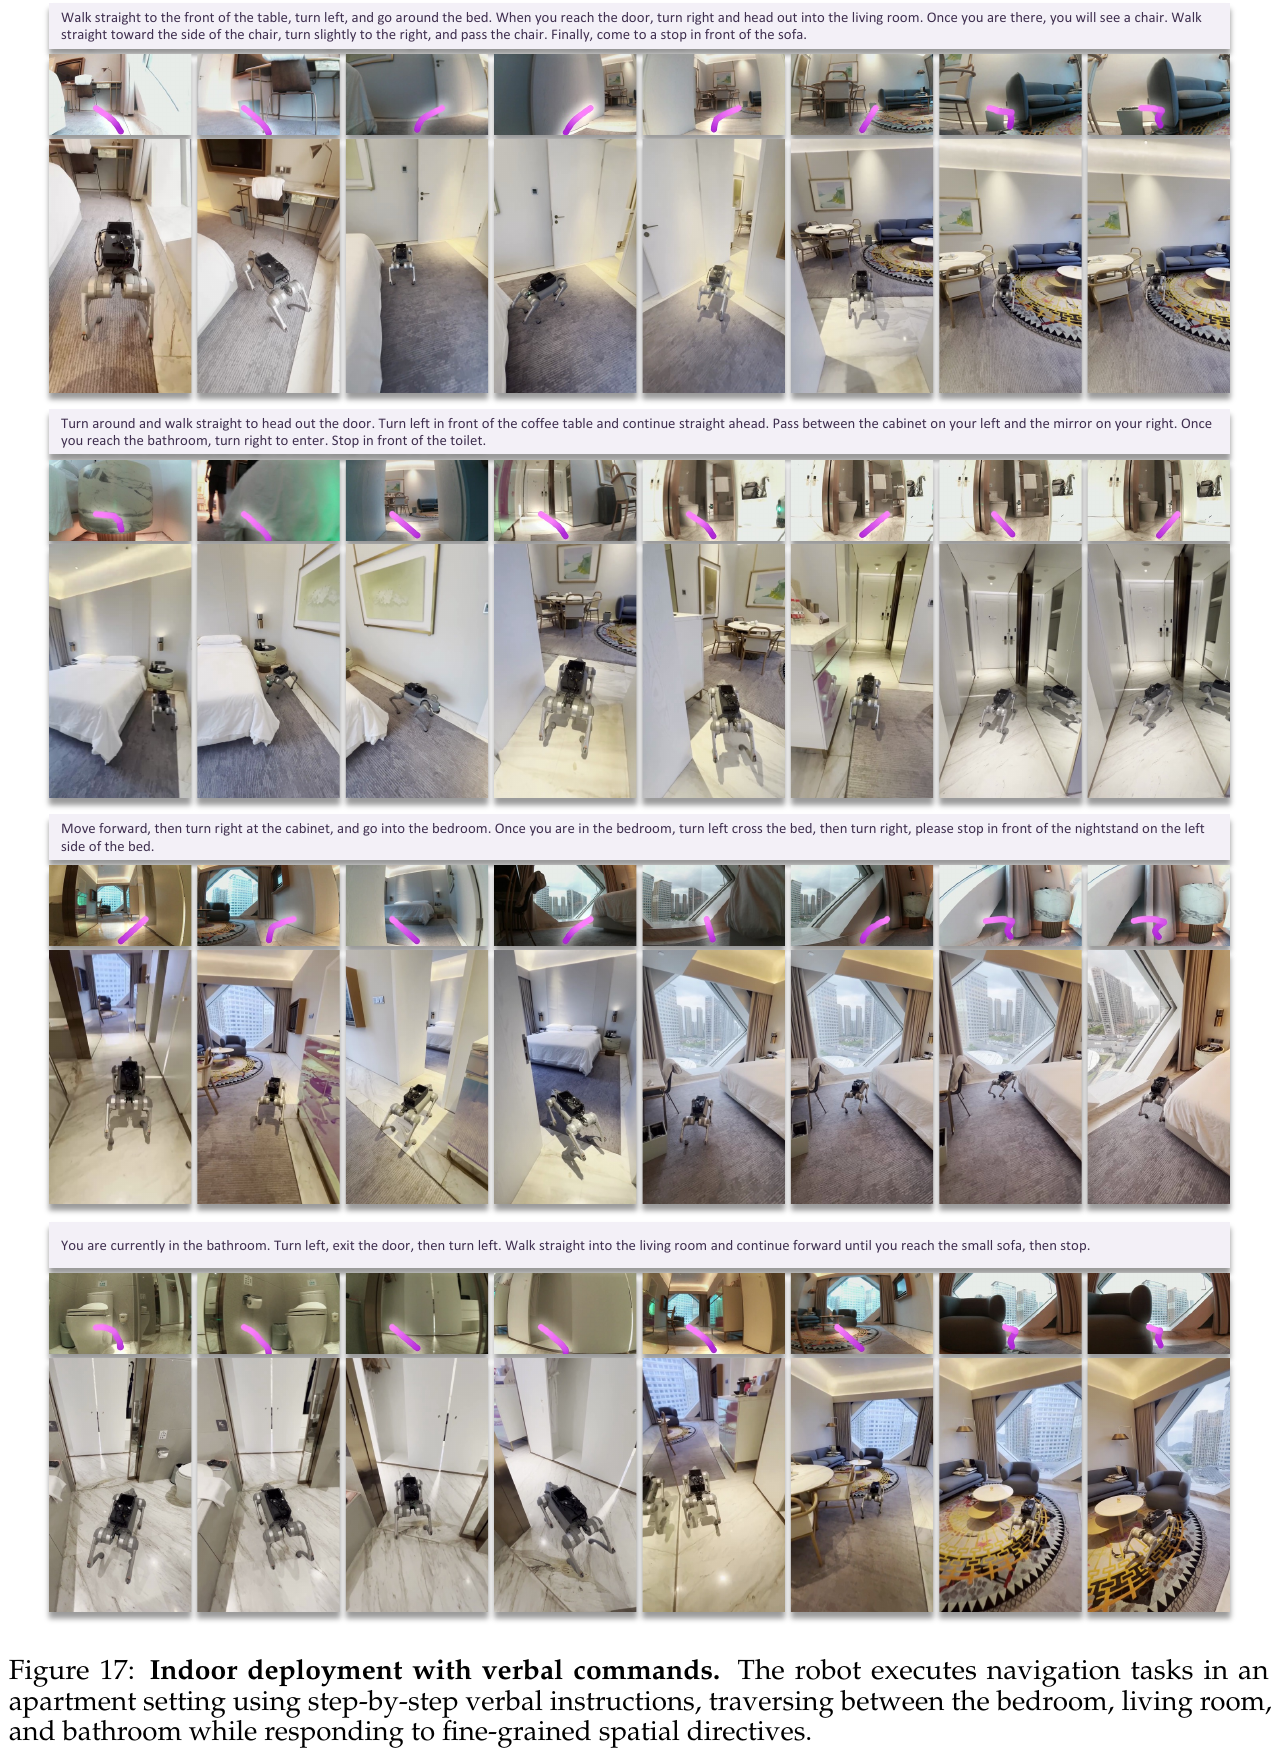
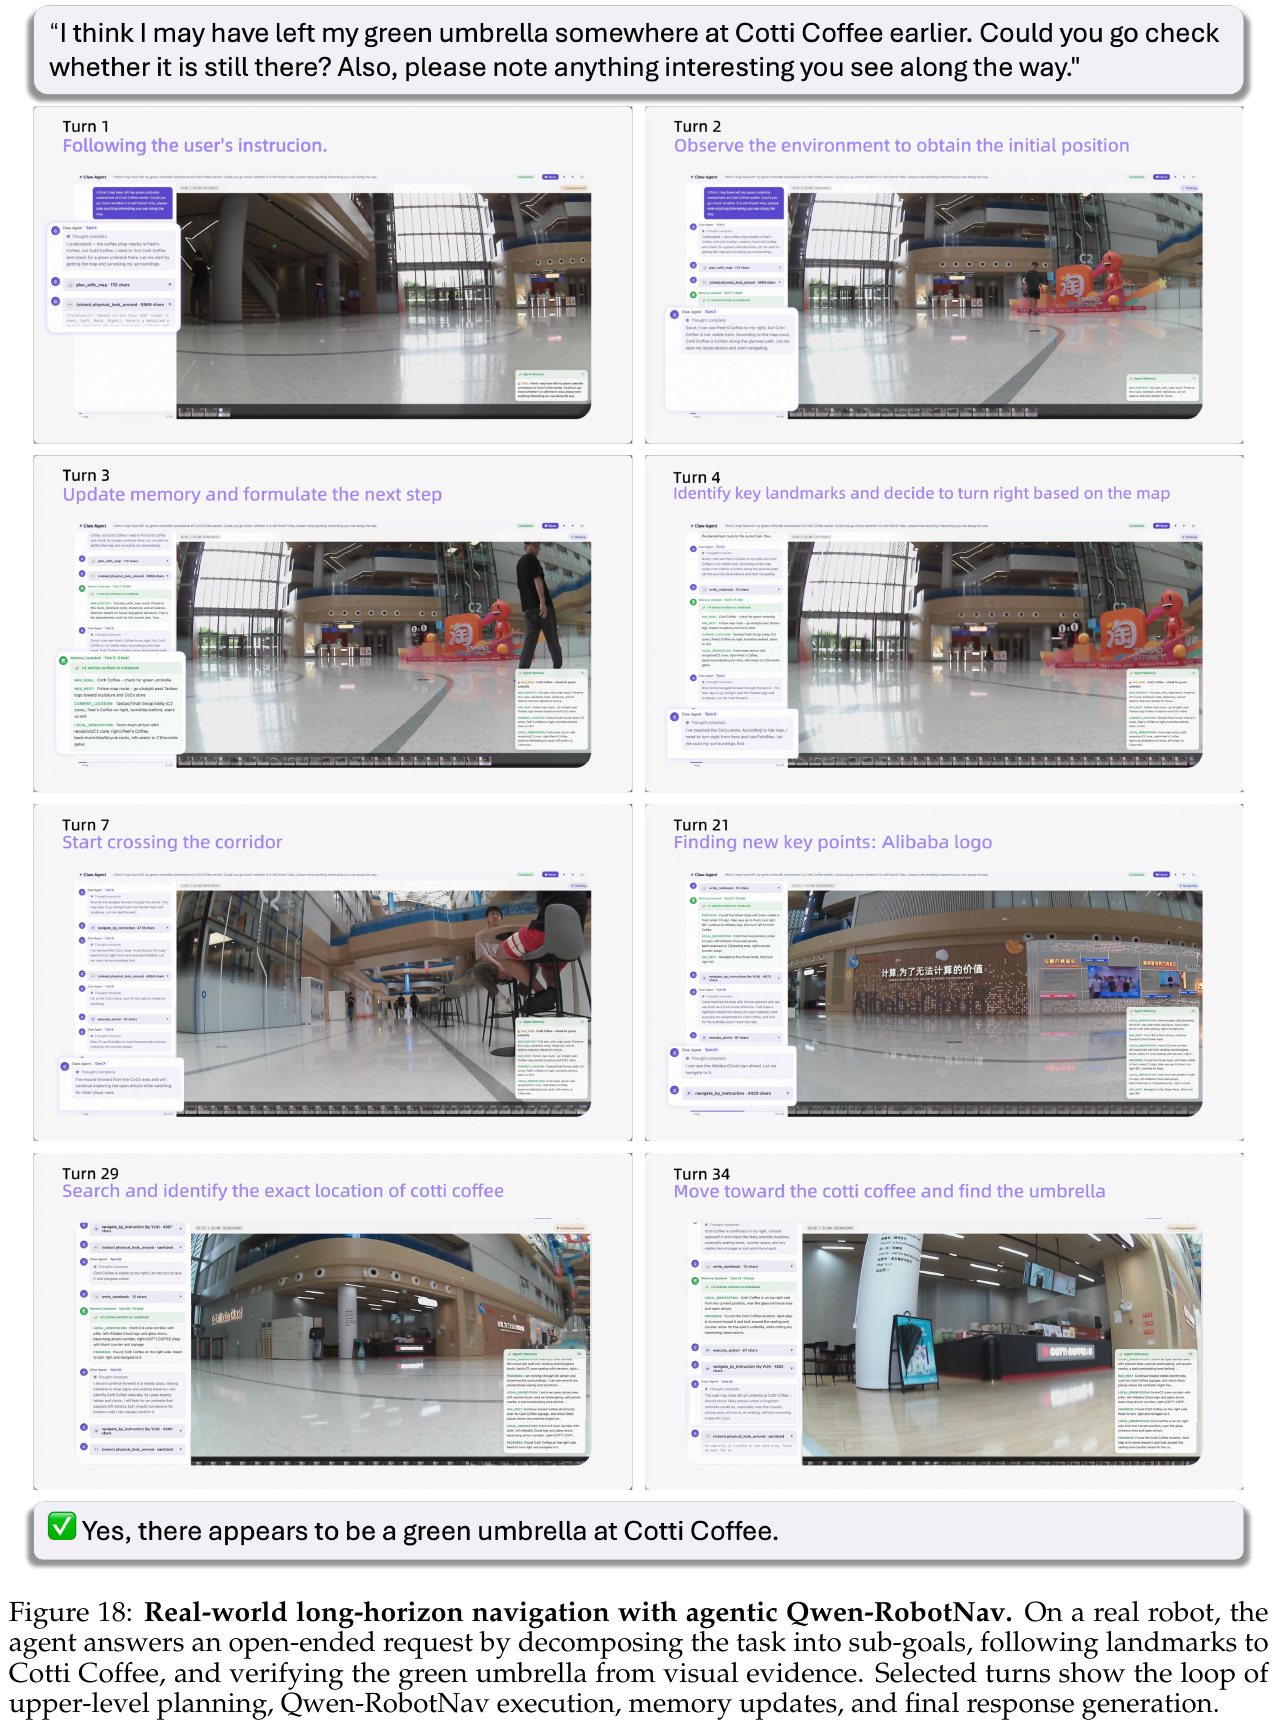
- 长程轨迹与运动原语:在长达 21.78 米的真实走廊中,四足机器人完全依靠自然语言指令成功穿越多个混合场景。令人瞩目的是,当接收到“向后退”的语言原语时,模型能够在完全没有里程计或目标图输入的情况下,以倒退姿态精准重走前行路线,验证了其在复杂物理环境下的精确空间闭环理解。
- 精细化控制与动态规划:在真实的公寓中,机器人精确地执行诸如“绕着床走”、“在夜视台的左侧停下”、“在出门前先转个身”等精细的空间细节逻辑。在更高级 of Agent 任务中,机器人可以自主探索寻找“Cotti Coffee”里落下的绿色雨伞,并在行进中自动汇报显著的路标标志。
4. 局限性
- 边缘部署的算力壁垒:虽然 remote-server 模式延迟表现优秀(196 ms, 5.1 Hz),但对网络稳定性和传输带宽存在天然的依赖,这在高速移动或网络信号死角中容易发生延迟突刺。而使用 NVIDIA Jetson Thor 进行 FP8 量化部署时,尽管延迟相对平稳(204 ms, 4.9 Hz),但其仍然受到端侧显存与计算带宽的严格物理限制,极大地约束了多视角和高频决策的上限。
- 基于 Skeleton 路径的效率损耗:由于在 ObjectNav 数据生成中广泛采用了基于 skeleton 的 medial-axis 探索算法,它虽然成功教会了模型如何在未知的场景中进行彻底的“房间-走廊-死角”回溯搜索,极大地提高了最终的寻物成功率(Reach-first),但这也导致模型在面对已知路径时,行为偏向于过分谨慎的安全避障与大范围搜寻,致使最终在某些特定路径上的 SPL 指标偏低。
38. GA-VLN (2026)
——— Geometry-Aware BEV Representation for Efficient Vision-Language Navigation
📄 Paper: arXiv:2605.22036 · 🏛️ CVPR 2026 · Code
精华
- 提出了一种面向连续环境视觉语言导航(VLN-CE)的新型几何感知鸟瞰图(GA-BEV)特征表示方法。
- GA-BEV 将显式的基于深度图的 3D 投影与来自 3D 基础模型(VGGT)的隐式 3D 几何先验相结合,构建出紧凑且富含空间结构的智能体中心 BEV 地图。
- 采用网格化 BEV 聚合(Grid-Based BEV Aggregation)大幅压缩了历史视觉 token 数量,在提升导航成功率的同时将每步推理的平均 token 数从约 4000 降至 514。
- 结合多模态大语言模型(MLLM,如 LLaVA-Video),设计了高效的双阶段对话式动作预测框架,实现 BEV 特征每 8 步仅更新一次的高效运行机制。
- 在 R2R-CE、RxR-CE 和 NavRAG-CE 等连续 VLN 基准上刷新了 SOTA,并且不依赖 labor-intensive 的 DAgger 增强或通用 VQA 混合训练,展现出极高的数据效率和零样本泛化能力。
1. 研究背景/问题
现有的视觉语言导航(VLN)方法在处理连续环境时,大多直接将密集历史 RGB 视频块(patch tokens)送入多模态大语言模型(MLLM)进行动作决策。这种做法存在两个核心局限:
- 高计算开销:随着时间步增长,密集的 RGB 视频块会产生极其庞大的 token 数量($t \times H_p \times W_p$ 级别的 token),带来巨大的推理延迟与计算负担。
- 缺乏显式空间结构:纯图像特征缺乏显式的 3D 几何和空间结构,导致智能体在多视角空间推理(如“左转并寻找身后的电视”)上面临严重挑战,导航表现受限。
2. 主要方法/创新点
为了克服上述局限,本文提出了 GA-VLN 框架,其核心是构建一个几何感知鸟瞰图(GA-BEV)表示,该表示融合了显式深度几何与隐式 3D 先验,并在 MLLM 导航决策中重用,极大地平衡了表现与效率。
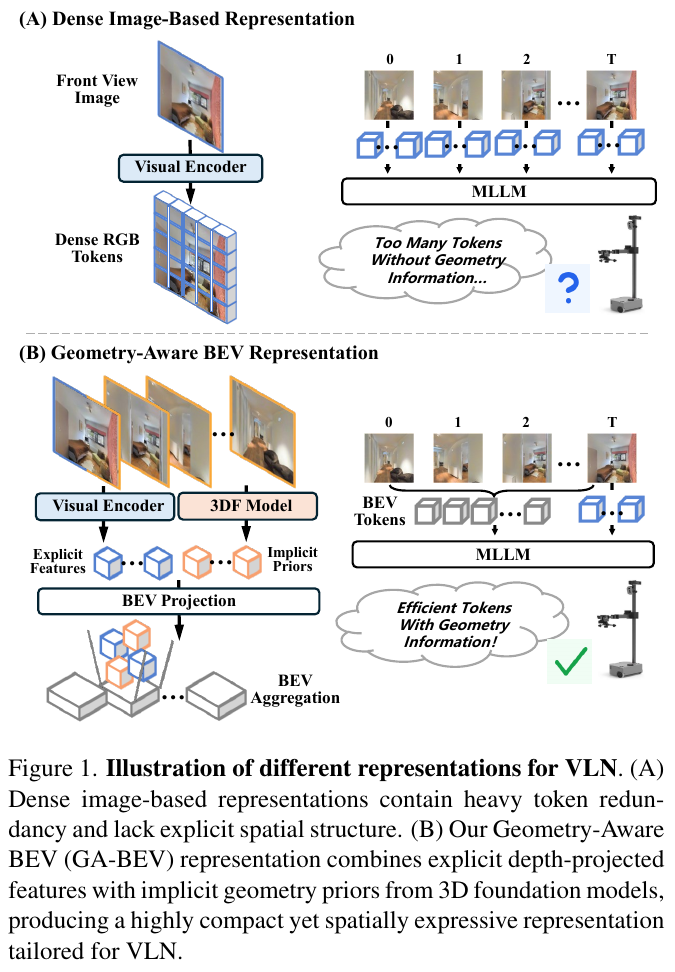
GA-BEV 表征构建流程
GA-BEV 的构建流程主要包含以下三个步骤:
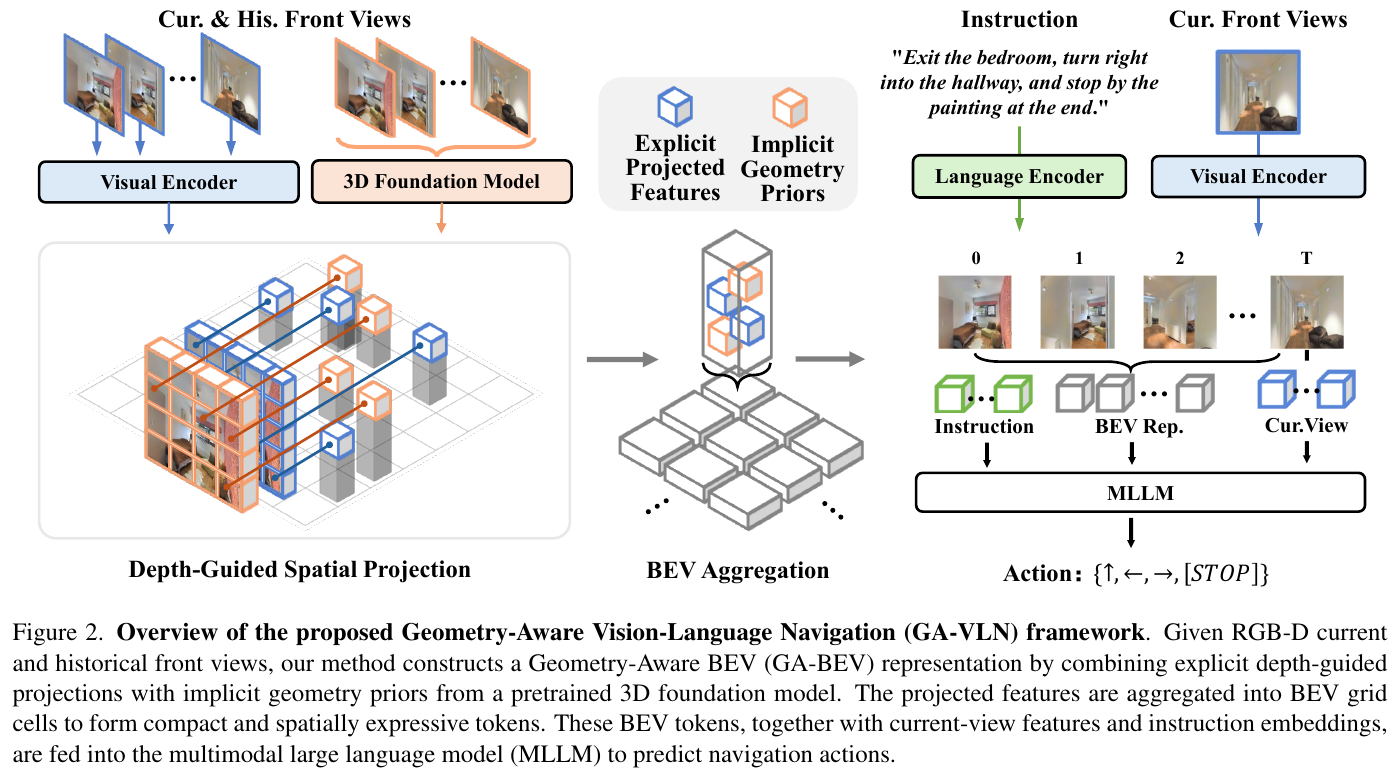
① 显式深度引导空间投影(Explicit Depth-Guided Spatial Projection)
- 输入:当前时间步的 RGB patch 特征 $V_t \in \mathbb{R}^{H_p \times W_p \times d_p}$,以及通过双三次插值(bicubic interpolation)缩放到相同分辨率的深度图 $D_t \in \mathbb{R}^{H_p \times W_p}$。
- 处理:利用当前时间步智能体的位置 $p_t$、相机旋转矩阵 $R_t$ 以及相机内参矩阵 $K$,根据针孔相机模型,将每个 2D 像素块中心反投影到 3D 世界坐标系中: \(\hat{p}_t(u, v) = R_t K^{-1} \begin{bmatrix} u \\ v \\ 1 \end{bmatrix} D_t(u, v) + p_t\)
- 输出:映射到 3D 空间的点云特征,这在输入阶段就为智能体显式注入了 3D 物理世界的空间几何一致性。
② 隐式 3D 几何先验融入(Implicit 3D Geometry Priors)
- 输入:智能体经历的历史图像序列 ${I_1, \dots, I_t}$。
- 处理:将历史序列输入 to 冻结参数的 3D 基础模型 $f_{3DFM}$(如 VGGT-1B)中,该模型经过大规模 3D 重建任务预训练,具备出色的多视角几何感知与形状先验: \(V^g = f_{3DFM}(\{I_1, \dots, I_t\}) \in \mathbb{R}^{t \times H_g \times W_g \times d_g}\) 通过一个 2 层 MLP(Linear-GeLU-Linear)投影层 $f_{project}$ 调整特征维度以匹配 SigLIP 特征: \(\tilde{V}^g = f_{project}(V^g) \in \mathbb{R}^{t \times H_g \times W_g \times d_p}\) 随后,使用与步骤 ① 相同的空间投影方式,将其投射到 3D 空间,得到对应的 3D 坐标 \(\hat{p}_g \in \mathbb{R}^{t \times H_g \times W_g \times 3}\)。
- 输出:富含隐式形状结构与多视角几何一致性的 3D 基础特征。
③ 网格化 BEV 聚合(Grid-Based BEV Aggregation)
- 输入:统一的 3D 空间特征集 $V = V \cup \tilde{V}^g$ 及其对应的 3D 物理位置 \(\hat{P} = \{\hat{p}\} \cup \{\hat{p}_g\}\)。
- 处理:由于室内空间物体在高度方向较矮,而智能体的动作主要约束在 2D 地面上,因此将所有 3D 特征投影到当前的以智能体为中心的 $(x, z)$ Bird’s-Eye-View (BEV) 平面上。
- 将 BEV 平面离散化为以智能体为中心、感知范围为 $[-R, R]$(取 $[-10\text{m}, 10\text{m}]$)、网格大小为 $\Delta \times \Delta$(取 $0.25\text{m} \times 0.25\text{m}$)的 $N \times N$ 网格。
- 对于每个非空网格 $(i, j)$,收集落入该网格的所有 3D 特征集 $S_{i, j}$。
- 对网格内的特征进行均值池化(mean pooling),并加上 2D 正弦位置编码(position embedding) $e_{i, j}$: \(B = \left\{ \frac{1}{\lvert S_{i,j} \rvert} \sum_{v \in S_{i,j}} v + e_{i,j} \;\middle|\; \lvert S_{i,j} \rvert > 0, i,j \in [1, N] \right\}\)
- 只保留非空网格,从而最大化地压缩冗余 token。
- 输出:高密度、紧凑的智能体中心 BEV 几何地图特征 $B$。
导航决策与推理流程:双阶段对话框架
为了最大化推理效率,GA-VLN 将动作决策表述为一个双阶段的对话式生成过程:
- 第一轮对话(Round 1):智能体接收语言指令 $L$、当前的正面视角图像 $IMAGE$(使用 SigLIP 编码)以及聚合了最近多达 32 个历史步观察的 GA-BEV 特征 $BEV$。MLLM(LLaVA-Video-7B)一次性预测 4 个动作(如
move forward,turn left,turn left,move forward)。 - 第二轮对话(Round 2):在执行完这 4 步后,智能体无需重新投影和更新 BEV 特征,仅获取新位置 of 正面视角图像 $IMAGE$,继续重用第一轮的 BEV 特征输入给 MLLM,再预测 4 个动作(如
turn left,turn right,move forward,STOP)。 - 更新周期:仅在每 8 步动作(即完成两轮对话)后,智能体才会重新构建并更新一次 BEV 特征。这样显著降低了 3D 基础模型前向传播和空间投影的调用频次。
3. 核心结果/发现
GA-VLN 在 Habitat 仿真环境中的多个连续导航数据集上进行了评估:
- 基准测试超越 SOTA(如 Table 1 所示):
- 在 R2R-CE 上,成功率(SR)达到 61.0%,SPL 达到 55.2%,均超过了此前最先进的 Image-based MLLM 智能体(如 StreamVLN: SR 56.9%, SPL 51.9%)。
- 在 RxR-CE 上,成功率(SR)达到 55.4%,SPL 达到 45.2%。
- 在 NavRAG-CE 上,成功率(SR)为 22.2%,SPL 为 18.2%。
- 重要特性:GA-VLN 在完全不使用 DAgger 数据增强与通用 VQA 数据联合训练的情况下,依靠高质数据集在少量 Epoch 下即取得了这些佳绩,验证了其极高的训练效率。
- 消融实验与效率分析:
- 显式深度投影与隐式 3D 先验的互补性(Table 2):
- 仅使用深度投影的 BEV 表征(w/o VGGT),SR 从 baseline 的 51.49% 提升至 59.21%,且 Latency 从 342.9ms 降至 212.9ms(归功于 token 的极度压缩)。
- 进一步融合 VGGT 的 3D 隐式先验后,成功率(SR)进一步攀升至 60.96%,虽然由于 3D Foundation Model 带来轻微的额外开销,但整体 Total Latency (258.7ms) 依然远低于 Baseline (342.9ms)。
- 最佳 BEV 超参数:网格分辨率设为 $0.25\text{m} \times 0.25\text{m}$ 最具性价比(Table 3);历史步长选为 32 最优,过长会引入累积误差与物理漂移。
- 抗噪稳健性强(Table 4):在模拟 Stretch 3 机器人的深度抖动($\sigma = 0.05\text{m}$)、位移漂移($\sigma = 0.05\text{m}$)和旋转偏差($\sigma = 5^{\circ}$)的传感器噪声测试下,GA-VLN 的 SR 下降均小于 2%,说明网格化均值池化和多视角 3D 特征的加入极大增强了鲁棒性。
- 显式深度投影与隐式 3D 先验的互补性(Table 2):
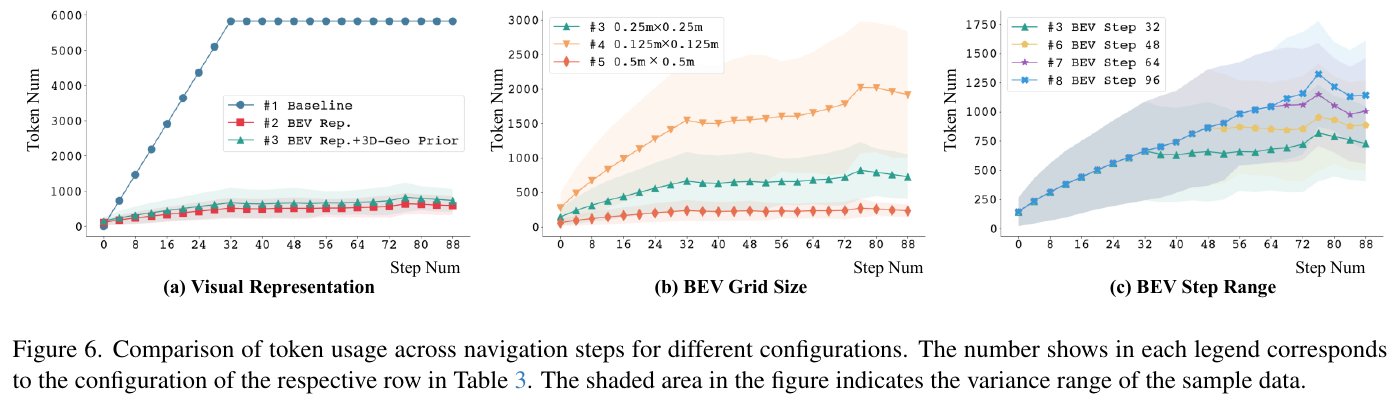
4. 局限性
- 实时深度图强依赖:显式投影环节非常依赖输入深度图的质量。在完全丢失深度或深度图质量极度恶化(例如镜面反射、强光直射)的情况下,三维重建的 BEV 地图可能会出现较大形变,进而影响导航性能。
- 历史滑窗限制:尽管 32 步的历史滑窗在大多数场景表现优秀,但当在超大规模或多楼层长程复杂场景中导航时,滑窗可能会丢弃较早前的关键地标,导致回溯困难。
5. 真实世界机器人部署
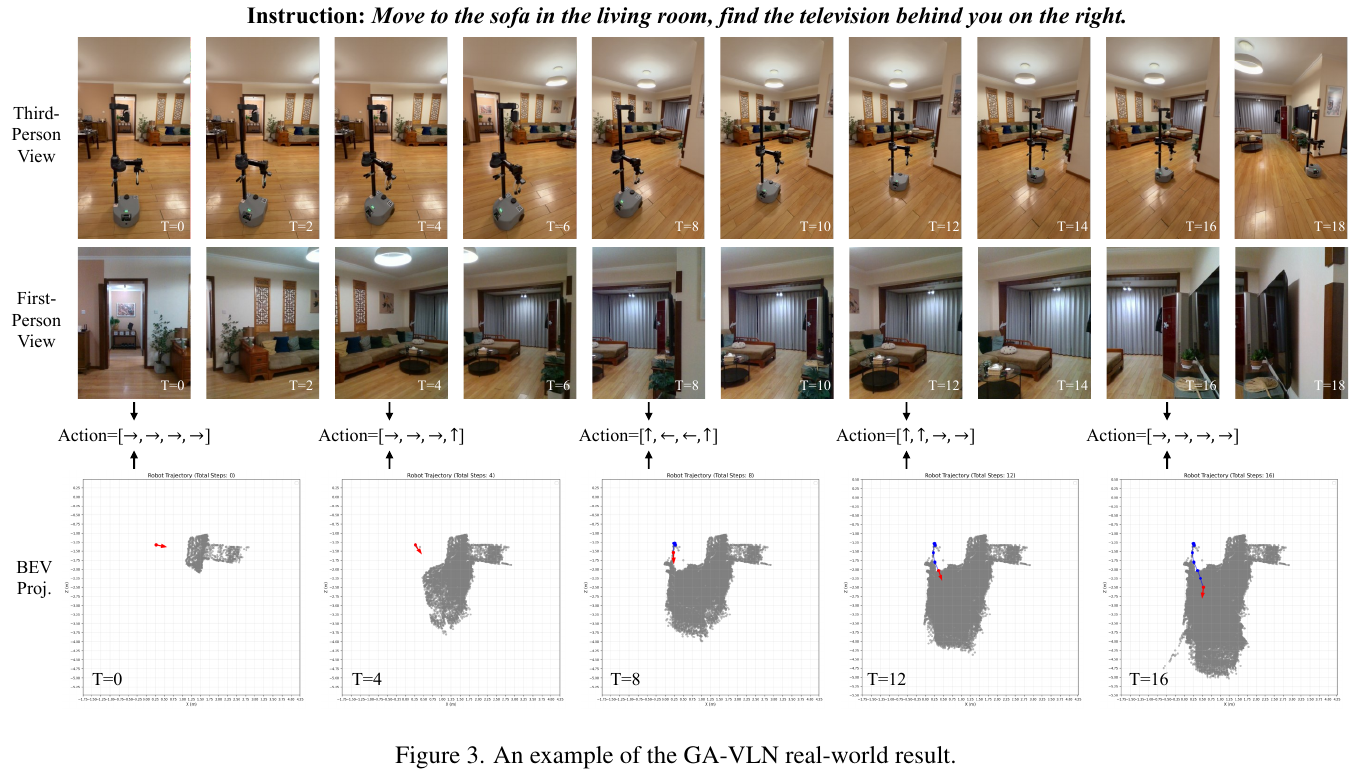
39. SEDualVLN (2026)
———空间增强的双系统连续环境视觉语言导航框架
📄 Paper: arXiv:2605.17249
精华
- 快慢协调决策:将导航任务分解为系统 1(轻量 VLM 原子动作预测器,高频)和系统 2(通用 MLLM 全局边界路径规划器,低频),兼顾了执行效率与全局规划能力。
- 多尺度空间增强:对系统 1 分别实施全局 3D 几何隐式监督和局部通道连通性显式提取,显著降低了 VLM 在岔路口走错方向的概率。
- 物理一致的 3D 路径渲染:系统 2 通过在线 3D 建图和沿路径插值渲染虚拟视图,为通用大模型提供高保真的空间感知,有效减少了纯文本或 2D 视角带来的空间幻觉。
- 性能新高度:在 continuous 视觉语言导航(VLN-CE)基准测试(R2R-CE 和 RxR-CE)上取得了最新的 State-of-the-Art 表现。
1. 研究背景/问题
现有的视觉语言导航(VLN)方法主要分为两类:一是基于轨迹数据微调的端到端视觉语言模型(VLM)策略,其动作执行快但缺乏动态推理能力,且在长距离导航中易因历史上下文累积而退化;二是零样本(Zero-Shot)模块化方案,其利用通用多模态大模型(MLLM)作为规划器,虽然泛化能力强,但由于缺乏精确的空间定位和几何推理能力,极易产生空间幻觉,且推理延迟巨大。
虽然最近有一些双系统(Dual-System)的尝试,但它们多是简单拼凑两种范式,未从根本上解决底层模型空间感知薄弱的问题。本论文提出 SEDualVLN,重点通过全局和局部等多尺度的空间增强(Spatial Enhancement)策略,赋予智能体极强的方向感,以提升其在连续未见环境(Unseen continuous environments)下的长周期导航鲁棒性。
2. 主要方法/创新点
① 双系统整体框架
SEDualVLN 由两个子系统以及一个协同调度器构成:
- 系统 1(快系统/动作生成器):高频运行,基于微调的 VLM 直接从当前第一视角 RGB 图像流和指令预测离散原子动作(前进、左转、右转、停止)。
- 系统 2(慢系统/路径规划器):低频运行,基于 3D 实时建图、路径插值渲染与通用 MLLM(如 GPT-4o),在全局地图上选择最佳的边界航点(waypoint)。
两个系统协同工作:系统 2 负责指引大方向,系统 1 负责执行到达航点所需的微观原子动作。通常,系统 1 执行约 20 步原子动作时,系统 2 才进行一次全局航点重新规划(频率比 20:1),这种“快慢协同”的设计不仅保证了实时响应,还兼顾了全局空间信息的整合。
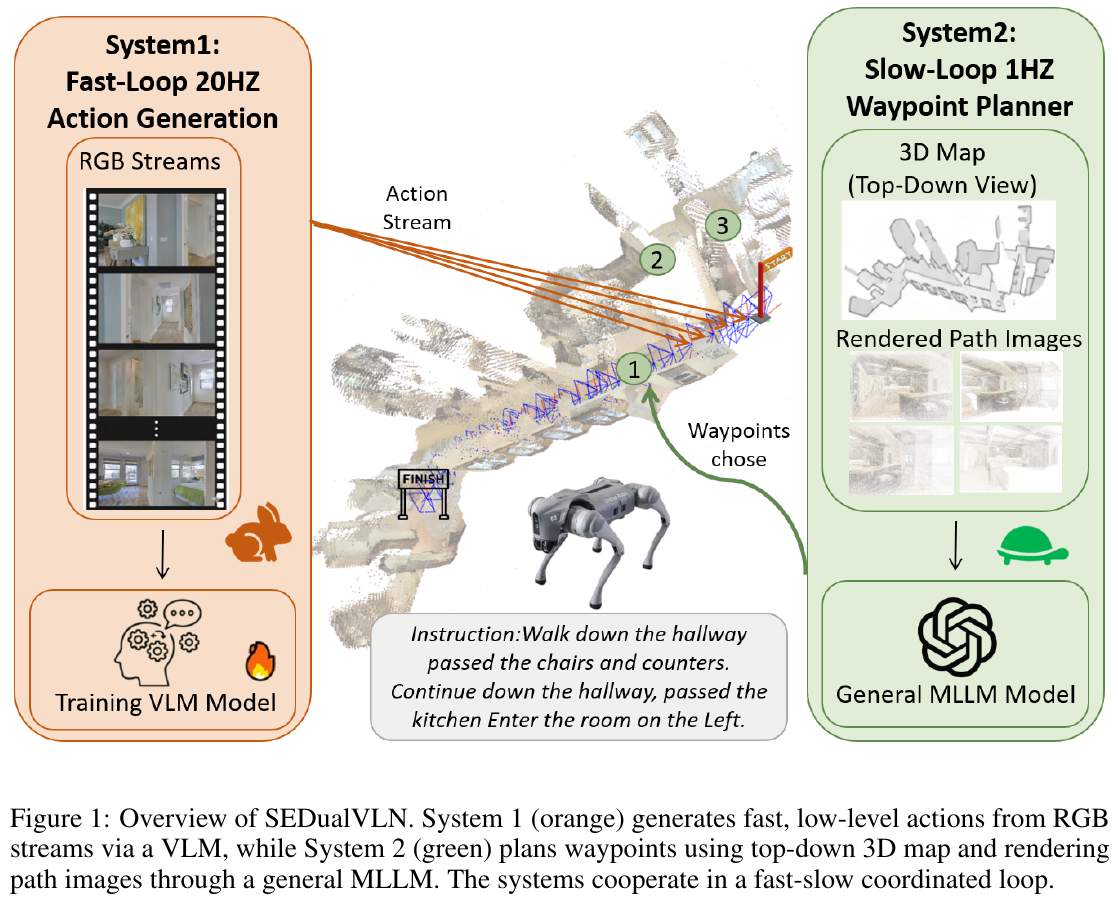
② 系统 1:空间增强的 VLM 模型
系统 1 基于 StreamVLN 骨干网络,通过多轮对话机制和 KV cache 实现高效推理。本论文引入了全局与局部双重空间增强策略来克服传统 VLM 空间表征隐式、易在长距离漂移的问题:
-
全局空间增强策略 (Global Spatial Enhancement Strategy): 不依赖额外的深度图传感器或显式 3D 重建模型,而是采用隐式对齐的策略。作者利用预训练的 3D 基础模型 VGGT 来提取当前帧 of 3D 空间结构特征。然后在 LLaVA-Video 中间的注意力融合层(第 24 层)上接入一个两层的 MLP,将 VLM 的视觉 Token 投影并与 VGGT 提取的 3D 空间特征进行对齐。
训练时,通过最小化两者的余弦距离来引导 VLM 隐式学习 3D 空间几何与结构信息。其联合训练损失函数 $L_{\text{SE}}$ 定义如下: \(L_{\text{SE}} = L_{\text{action}} + \alpha \cdot \frac{1}{N} \sum_{t=1}^{N} \left[ 1 - \cos\left(V_t, S_t + p_t\right) \right]\) 其中, $V_t$ 表示投影后的视觉 Token, $S_t$ 表示来自 VGGT 的 3D 空间表征, $p_t$ 为位置编码, $\alpha$ 是损失权重系数。
-
局部空间增强策略 (Local Spatial Enhancement Strategy): 在实际导航中,通道(如走廊、门口)是连接不同区域的关键拓扑结构,而 VLM 极易在这些决策岔路口选错分支。为此,作者设计了通道连通性提取模块(Channel Connectivity Extraction Module)。该模块首先使用开放词汇表目标检测模型 Grounding DINO 自动识别当前视野中的通道区域,随后利用 SAM 对这些区域进行分割以获取二值遮罩(通道区域像素设为 1,非通道设为 0),再经由 MLP 投影为与全局视觉 Token 维度相同的局部拓扑 Token 输入给 VLM。该策略使 VLM 能够显式地关注通道的连通性,显著减少了岔路口决策失误。
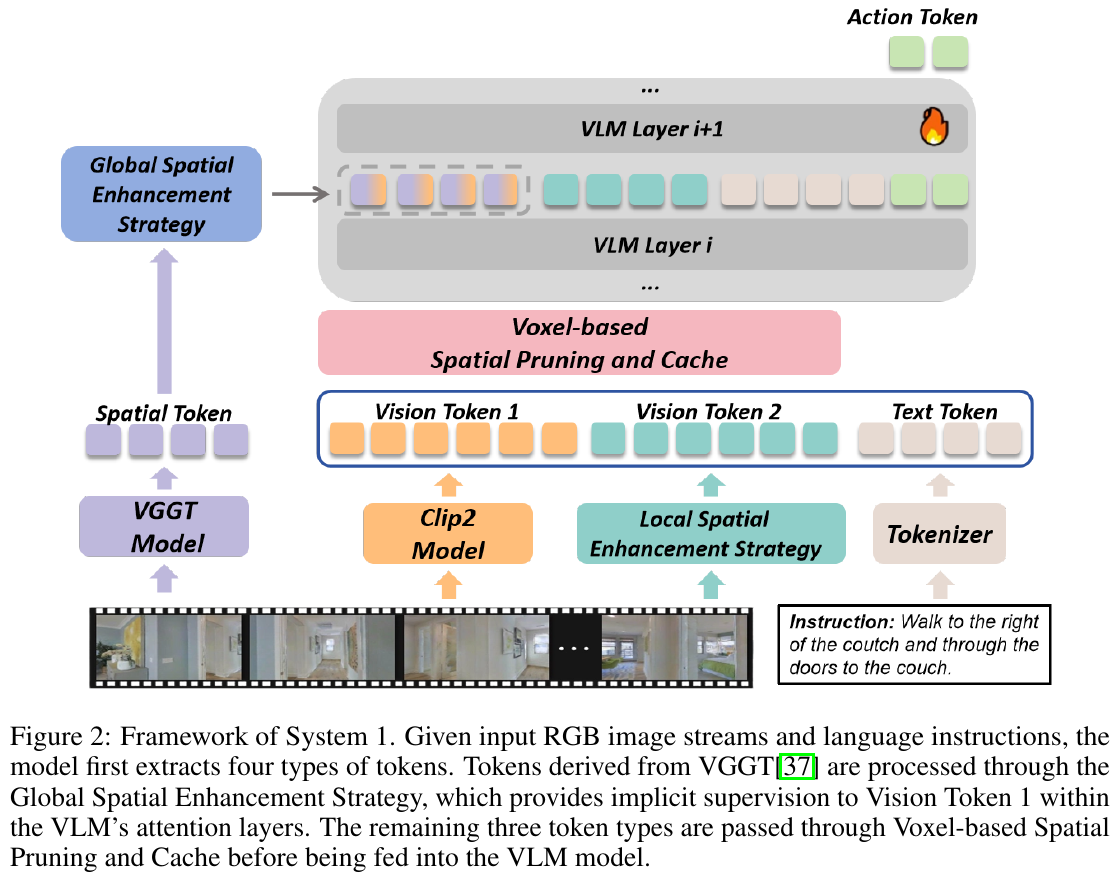
③ 系统 2:基于“建图-渲染-推理”的 MLLM 规划器
系统 2 旨在利用通用 MLLM(如 GPT-4o)强大的常识推理和零样本能力,并结合物理一致的 3D 地图克服其空间幻觉。其规划流程分为以下三步:
- 实时建图 (Mapping): 基于 LingBot-Map 算法,智能体在导航时实时在线构建轻量级的 3D 点云地图,并同时生成用以指引未探索区域的 2D 边界(frontier)地图。
- 路径虚拟渲染 (Rendering): 假设当前的候选边界点集合为 $F = {f_1, …, f_n}$。系统首先利用 A* 算法计算当前位置到各边界点在拓扑地图上的无碰撞路径: \(P_i = \text{A}^*(x_0, F_i)\) 为了向大模型直观呈现沿途视角,系统在路径的相邻节点间进行线性插值(若欧氏距离超过阈值 $d$ 则插入虚拟位姿点),并基于插值位姿渲染出虚拟的相机 RGB 视图。随后,为了减少大模型的输入 Token 消耗,使用 CLIP 编码器的余弦相似度进行冗余帧剪枝,仅保留场景变化明显的关键路径帧 ${I_1, …, I_m}$: \(s(I_k, I_{k+1}) = \frac{\langle \phi(I_k), \phi(I_{k+1}) \rangle}{\lVert \phi(I_k) \rVert \lVert \phi(I_{k+1}) \rVert} < \tau \implies \text{keep } I_{k+1}\)
- 两阶段多模态推理 (Reasoning):
- 第一阶段(环境自我感知增强):向 GPT-4o 输入 3D 自顶向下地图,令其总结和描述智能体当前所处位置和周遭环境(提取位置、空间关系与可行方向)。
- 第二阶段(模拟运动航点评估):向 GPT-4o 输入每个候选路径渲染出的视图序列,让其通过视觉与指令的契合度,评估并选择下一步的最佳边界航点 $F_i$。
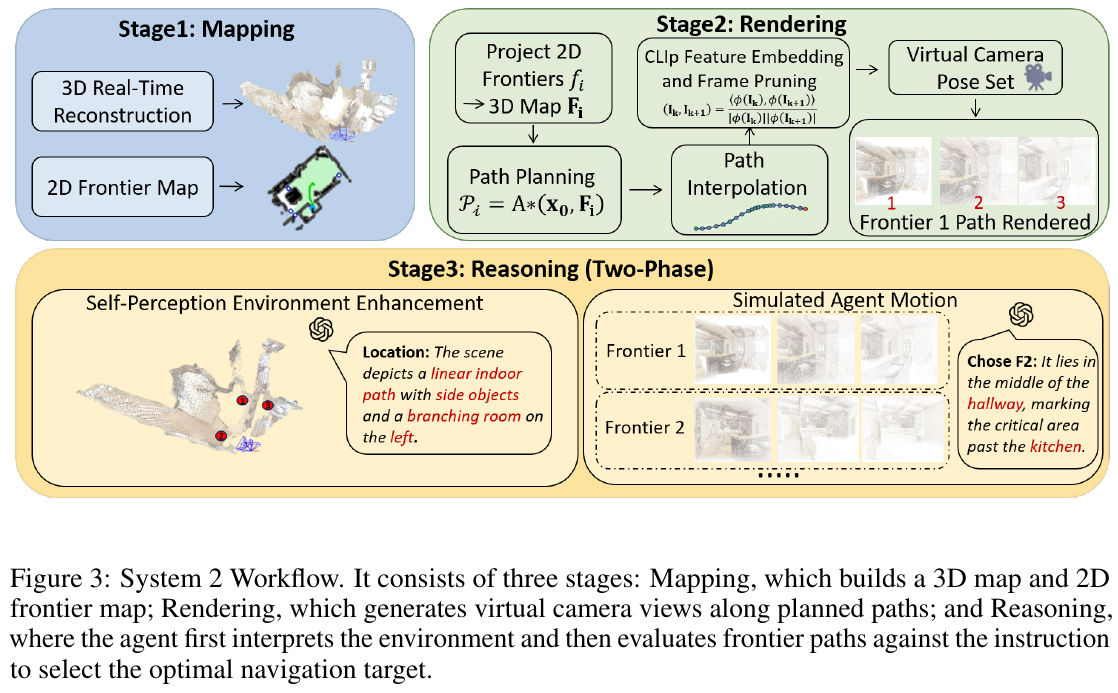
3. 核心结果/发现
-
SOTA 性能表现: 在连续视觉语言导航基准 R2R-CE 和 RxR-CE 的 Val-Unseen 验证集上,SEDualVLN 相比于之前最先进的双系统方法 DualVLN,在成功率(SR)上分别取得了 3% 和 2.5% 的绝对提升,且无需依赖任何额外的深度或全局传感器信息,仅用单目 RGB 输入即达到了新的基准高度。
-
岔路口避错能力: 消融实验与定性分析表明,在复杂的岔路口或房间交界处,引入通道连通性提取(LSES)能够极大地纠正智能体因视觉混淆引起的错误转向。
-
快慢协同的高效性: 单独运行系统 2 时,由于 GPT-4o 接口延迟和密集计算,单次导航的平均时间极其漫长(AT 接近 300秒)。而通过引入 20:1 的快慢频率比,双系统协同工作不仅使成功率高于单独的系统 1 或系统 2,更是将平均导航耗时(AT)降低了 5 倍以上,完美平衡了计算效率与决策准确度。
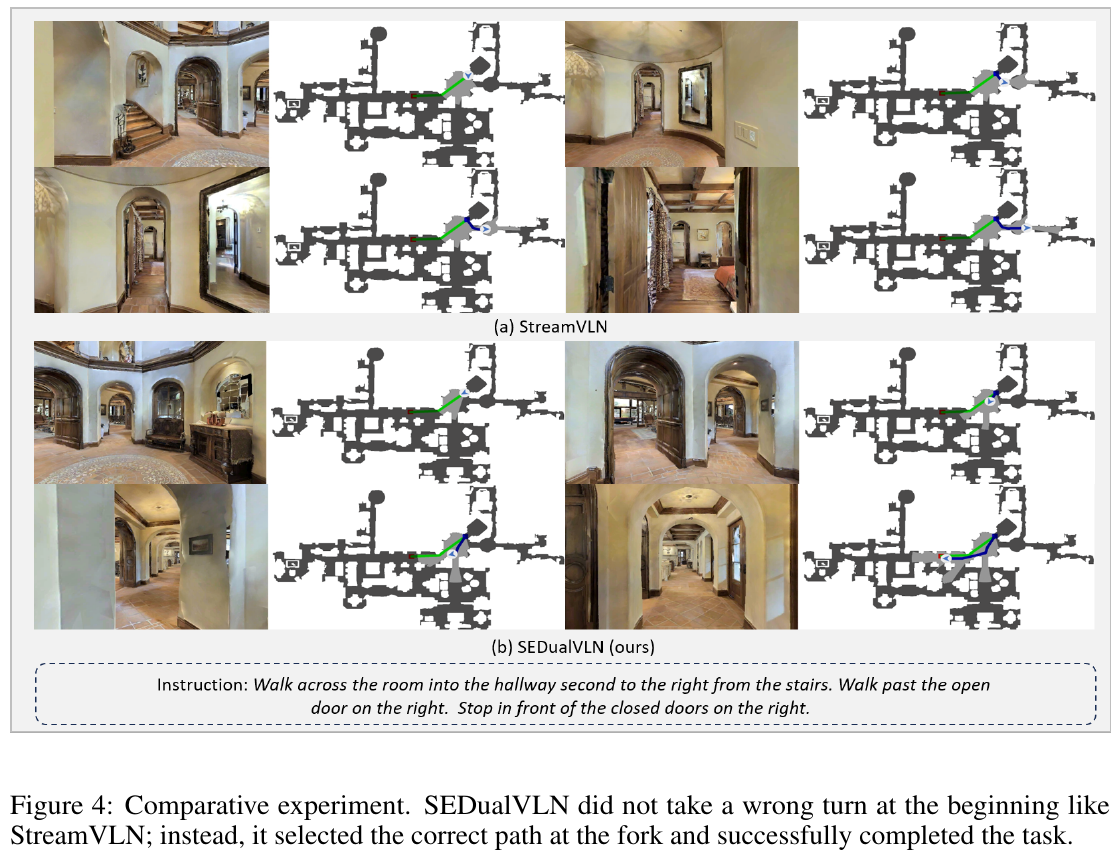
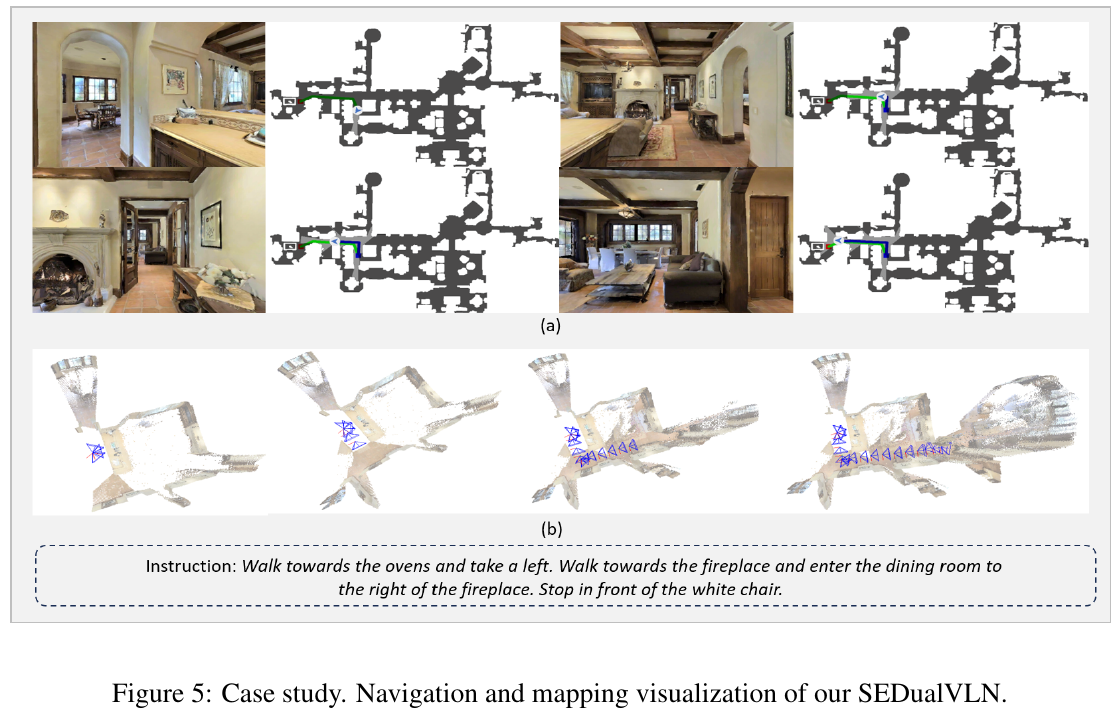
4. 局限性
- 真实物理设备部署难度:该框架严重依赖实时 3D 建图的表现。而在真实物理机器人设备上部署时,目前的实时三维重建特征提取仍存在较大的计算开销与噪声变形,建图的畸变可能会直接干扰系统 2 路径规划的准确度。
附录:系统 2 推理过程案例与 Prompt 模板
在系统 2 的推理机制中,GPT-4o 的决策包含两个阶段:
- 环境理解阶段:引导模型根据 3D 顶视图提取核心空间信息,输出当前 Location(位置环境)、Relationship(家具或障碍的空间关系)与 Possible directions(潜在的正确路径取向)。
- 规划决策阶段:输入各边界点路径的虚拟相机渲染流,评估 F1、F2、F3 等边界点中哪一个最符合导航指令,并生成具体原因。
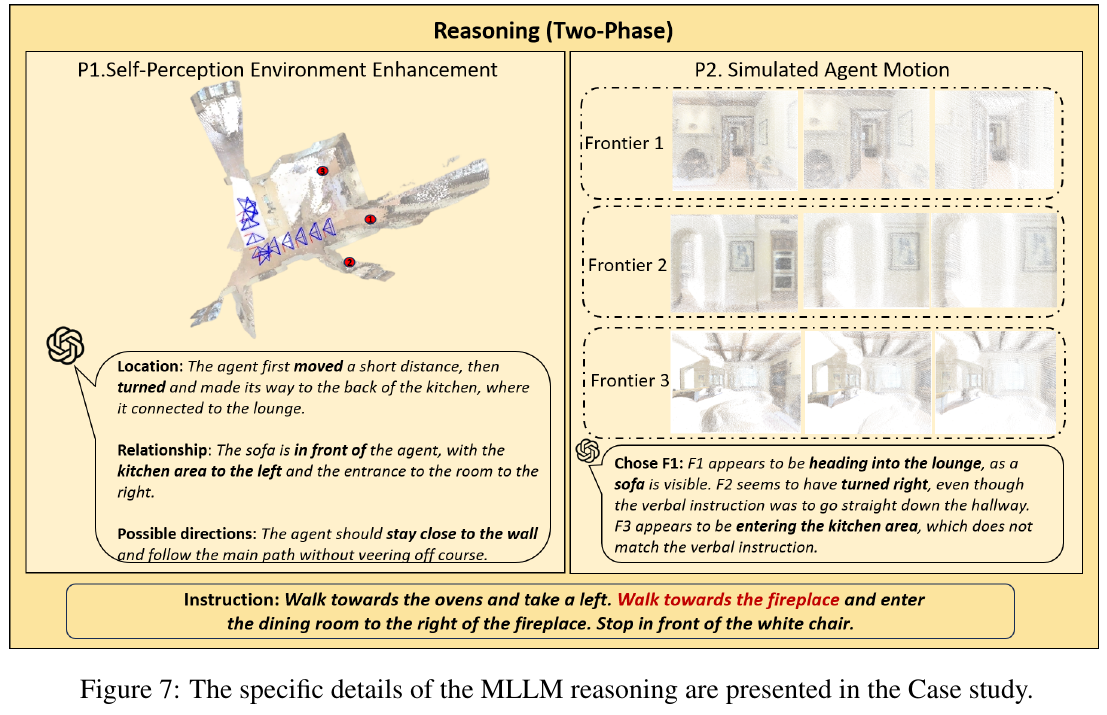
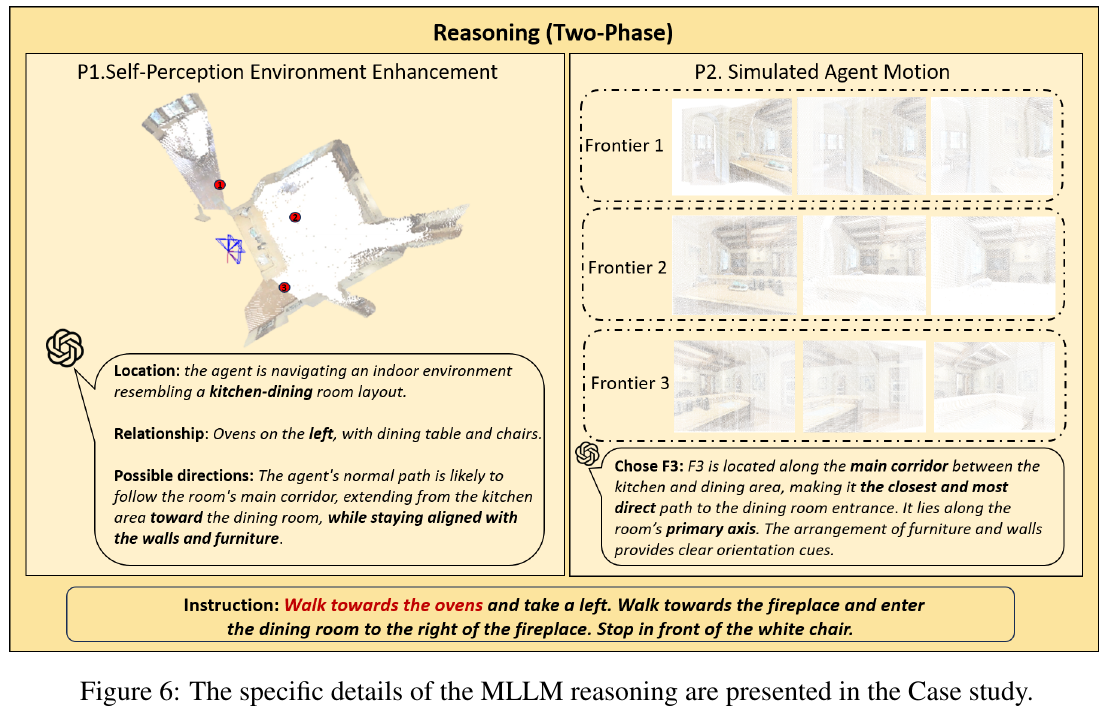
40. Robostral Navigate (2026)
———仅需单目 RGB 相机的 8B 视语言导航大模型:超高效仿真训练与在线强化学习
📄 Paper: arXiv:2607.20785 · Project Page
精华
- 单目 RGB 极简感知架构:Robostral Navigate 彻底打破对深度传感器(RGB-D)、LiDAR、多视角相机阵列或预建地图的依赖,仅以单目 RGB 图像流为输入,在图像空间直接预测 Pointing 坐标(像素坐标)与航向角变化,解耦物理几何与硬件内参约束,实现跨异构机器人的零样本迁移。
- 高低层解耦分级控制:采用“8B VLM 视语言推理(0.5 Hz 预测 Waypoint)+ 121M 扩散策略(10 Hz 生成动作块)+ 机器人底盘控制器(100 Hz 输出电机指令)”的分级控制管线,兼顾高层复杂语义规划与低层连续几何避障。
- Prefix-Tree 树状注意力加速 SFT (Tree Training):提出 Episode Packing 与前缀树 Attention Mask 机制,单 Forward Pass 计算整条轨迹损失,保留全量 action 监督信号的同时消除共享前缀的重复编码,将训练 Token 消耗降低 22 倍,训练时间从数月缩短至几天。
- 在线 RL (CISPO) 与 Hard Subsets 强化探索:基于 2.4M 仿真轨迹完成 SFT 后,利用 CISPO 算法在 35k 困难任务子集中进行在线强化学习,配合截断目标距离奖励 $- \max(2, \text{dist_to_goal})$,有效解决行为克隆的 Exposure Bias 与概率偏移,显著提振复杂场景探索与错误恢复能力。
- 单目 RGB 刷新 SOTA:在 R2R-CE Unseen 达到 77.4% SR / 74.2% SPL,RxR-CE Unseen 达到 75.1% SR / 68.7% SPL,不仅大幅碾压所有单相机方法,甚至全面超越了依赖深度相机及多视角全景的顶尖导航系统(如 Qwen-RobotNav-8B)。
1. 研究背景/问题
- 感知与硬件部署门槛:现有顶尖具身导航(VLN/VLA)系统普遍依赖深度相机(RGB-D)、LiDAR、多视角全景相机阵列或预先构建的环境地图。额外的传感器不仅大幅增加了单机制造成本与能耗,还需要复杂精密的传感器校准,严重限制了导航策略在轮式、足式及无人机等多元异构机器人上的快速部署与大规模泛化。
- 物理坐标强耦合的脆性:传统的端到端导航模型试图直接预测机器人在三维物理空间中的绝对度量坐标(Metric Displacement)。然而,这种度量控制高度依赖相机内参标定与确定的物理尺度。一旦相机安装仰角改变、透镜磨损或迁移到形态不同的机器人平台上,预测精度便会断崖式下降。
- 长轨迹训练的 Token 暴涨:在连续环境长行程导航任务中,传统行为克隆(SFT)训练将每个时间步作为独立样本输入,导致历史帧被重复前向编码。对于长度为 $T$ 的 Episode,Token 复杂度呈 $\mathcal O(T^2)$ 级数增长,造成巨大的算力浪费;且单靠 SFT 容易陷入 Exposure Bias 与 Covariate Shift,缺乏探索与死角复原能力。
- 核心动机:构建一种极简感知(单目 RGB)、可扩展(跨硬件形态零样本迁移)、高效训练(纯仿真数据 + 22x Token 压缩 + 在线 RL) 的通用具身导航 Recipe。
2. 主要方法/创新点
① 整体框架概述
Robostral Navigate 采用高层语义推理与低层几何控制解耦的双系统架构。系统由 8B 参数的 Vision-Language Model (VLM) 和 121M 参数的 Diffusion Policy 组合而成。
- 高层 8B VLM:以 0.5 Hz 运行,负责理解自然语言指令并基于历史 RGB 观察预测下一个 Waypoint;
- 低层 121M Diffusion Policy:以 10 Hz 运行,根据 Waypoint 与当前 RGB 观察生成局部动作块(Action Chunk,包含 30 步相对二维位移与旋转);
- 底盘控制器 (Motion Controller):以 100 Hz 运行,将动作块转换为特定硬件底盘的电机控制指令。
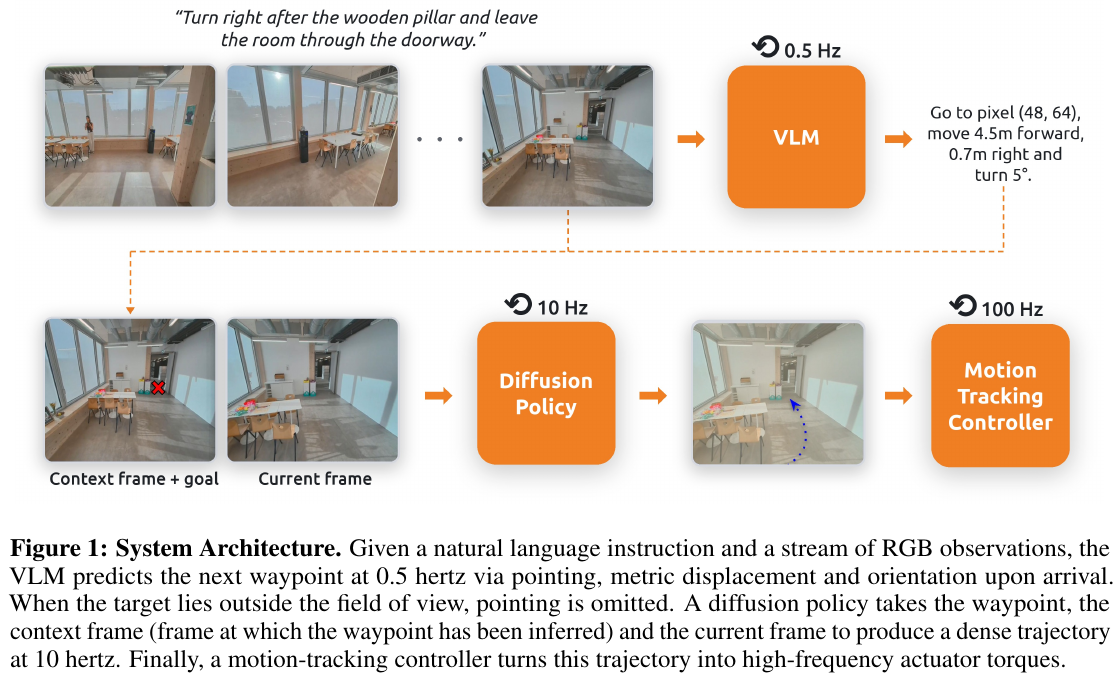
② 逐模块讲解
模块 1:基于图像空间 Pointing 与 Degree-of-Freedom 退化控制 (Robostral Navigate VLM)
- 输入:自然语言导航指令 + 历史单目 RGB 帧序列 $O_0, O_1, \dots, O_t$。
- 处理:基座模型初始化自一个 8B 密集的 Spatial Grounding VLM(具备指向、计数与目标定位能力)。在导航时,模型优先在图像空间预测当前视角下可见的最远轨迹点的像素坐标 $(u, v)$,以及到达该点时的航向角变化 $\Delta \theta$(相对当前帧的 Yaw 旋转)。
- 输出:
- 视野内指向控制 (Pointing Mode):预测 5 维元组 $a_{\mathrm{vis}} = (u, v, \Delta x, \Delta y, \Delta \theta)$,其中度量位移 $(\Delta x, \Delta y, \Delta \theta)$ 作为联合训练的辅任务。
- 视野外度量退化 (Displacement Fallback Mode):当目标不在当前视野内(如需大角度掉头或绕过墙角遮挡),模型省略图像坐标,降级预测 3 维局部位移 $a_{\mathrm{invis}} = (\Delta x, \Delta y, \Delta \theta)$。
- 终止控制:到达终点时输出 STOP 标记。
- 设计动机:在图像空间做 Pointing 指向天然解耦了相机的物理高度、倾角与内参差异,避免绑定特定的机器人几何尺寸。同时,利用 Grounding 专用基础模型强悍的语义理解与边界框预测能力实现冷启动——“理解物体在哪里”与“知道怎么走过去”在 VLM 内部多模态表征上实现了统一。
graph TD
    A["输入: 当前图像观测 RGB + 自然语言指令"] --> B["Robostral Navigate 8B VLM (0.5 Hz)"]
    B --> C{"目标路标是否在当前视野内?"}
    C -- "是" --> D["指向控制 Pointing Action"]
    D --> D1["预测 2D 图像像素坐标 (u, v)"]
    D --> D2["预测目标朝向变化 Δθ"]
    C -- "否" --> E["位移退化 Displacement Fallback"]
    E --> E1["预测局部坐标系偏移 (dx, dy, dθ)"]
    D1 --> F["121M Diffusion Policy (10 Hz)"]
    D2 --> F
    E1 --> F
    F --> G["100 Hz 电机控制器驱动硬件底盘"]
模块 2:低层扩散策略轨迹生成 (Diffusion Policy)
- 输入:VLM 输出的 Waypoint $a \in {a_{\mathrm{vis}}, a_{\mathrm{invis}}}$、机器人高度与半径先验、VLM 推理时的上下文帧 $o_{t_{\mathrm{vlm}}}$ 以及最新 RGB 帧 $o_t$(解决 VLM 延迟导致的推演滞后)。
- 处理:基于 121M 参数的 Lightweight Diffusion Transformer,预测未来 1 秒内 30 个连续步骤的相对二维位移与旋转量 $(\mathrm d x, \mathrm d y, \mathrm d \theta)$。
- 输出:10 Hz 的局部动作块(Action Chunk)。
- 设计动机:将连续避障与高频平滑轨迹控制剥离给小参数扩散模型,大幅减轻 8B VLM 的计算负担。
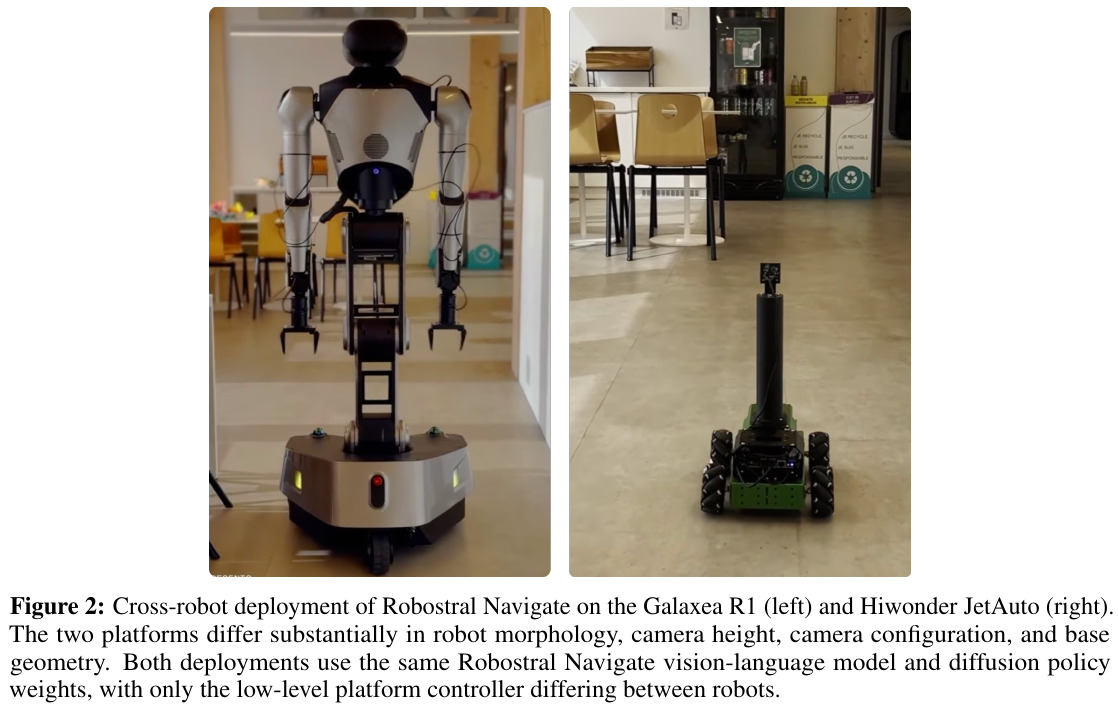
③ 训练算法创新:Prefix-Tree 树状注意力加速 SFT (Tree Training)
为了消除监督微调(SFT)阶段对历史帧的重复前向计算,团队将导航 Episode 建模为前缀树(Prefix Tree),并开发了高效的训练管线。
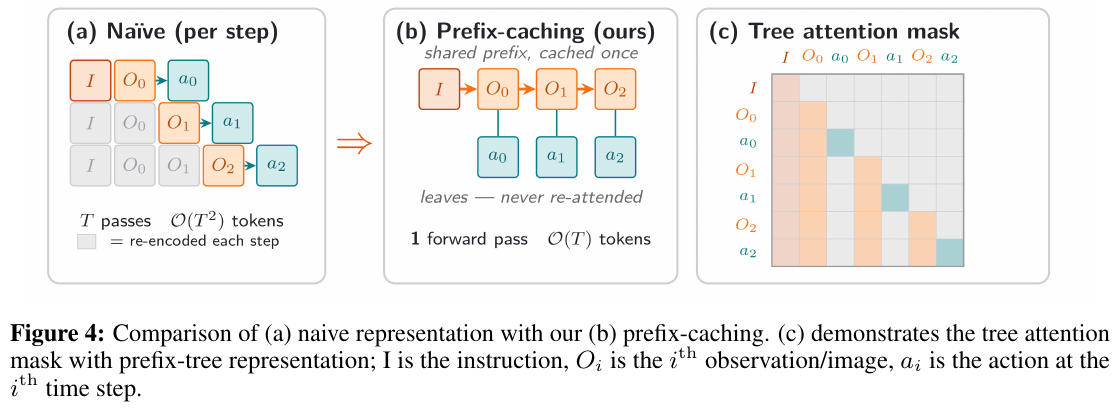
2.3.1 DFS 序列化与 Causal 序列打包 (Packing)
标准 SFT 将长度为 $T$ 的轨迹拆分为 $T$ 个独立样本,Token 复杂度呈 $\mathcal O(T^2)$。Robostral Navigate 将整个 Episode 的历史上下文拼装成一棵前缀树(根节点为静态指令 $I$,子节点为观察 $O_t$ 与动作 $a_t$),并通过深度优先搜索(DFS)遍历打包成单条序列: \(\text{Sequence}_{\text{packed}} = I | O_0 | a_0 | \dots | O_n | a_n\) 整条序列中每一个唯一的 token(包括图像视觉 Token)在单次 Forward 中仅计算一次,将 Token 复杂度降至 $\mathcal O(T)$。
2.3.2 树状注意力掩码 (Tree-based Attention Mask)
在单条打包序列中,为了防止 Causal Attention 导致模型在训练时“预知”未来步的 Ground-truth 动作(因为 Pointing 蕴含强方向信息),设计了树状注意力掩码。对于 Token $i$ 与 Token $j$,其可见性规则为: \(M_{ij} = \begin{cases} 0, & j < i \ \land \ (\text{token } j \text{ 在公共 Trunk} \ \lor \ \text{token } i, j \text{ 在同一 Branch}) \\ -\infty, & \text{otherwise} \end{cases}\) 此掩码不仅实现了因果遮蔽,更精确地阻断了兄弟分支与未来状态的信息泄露。
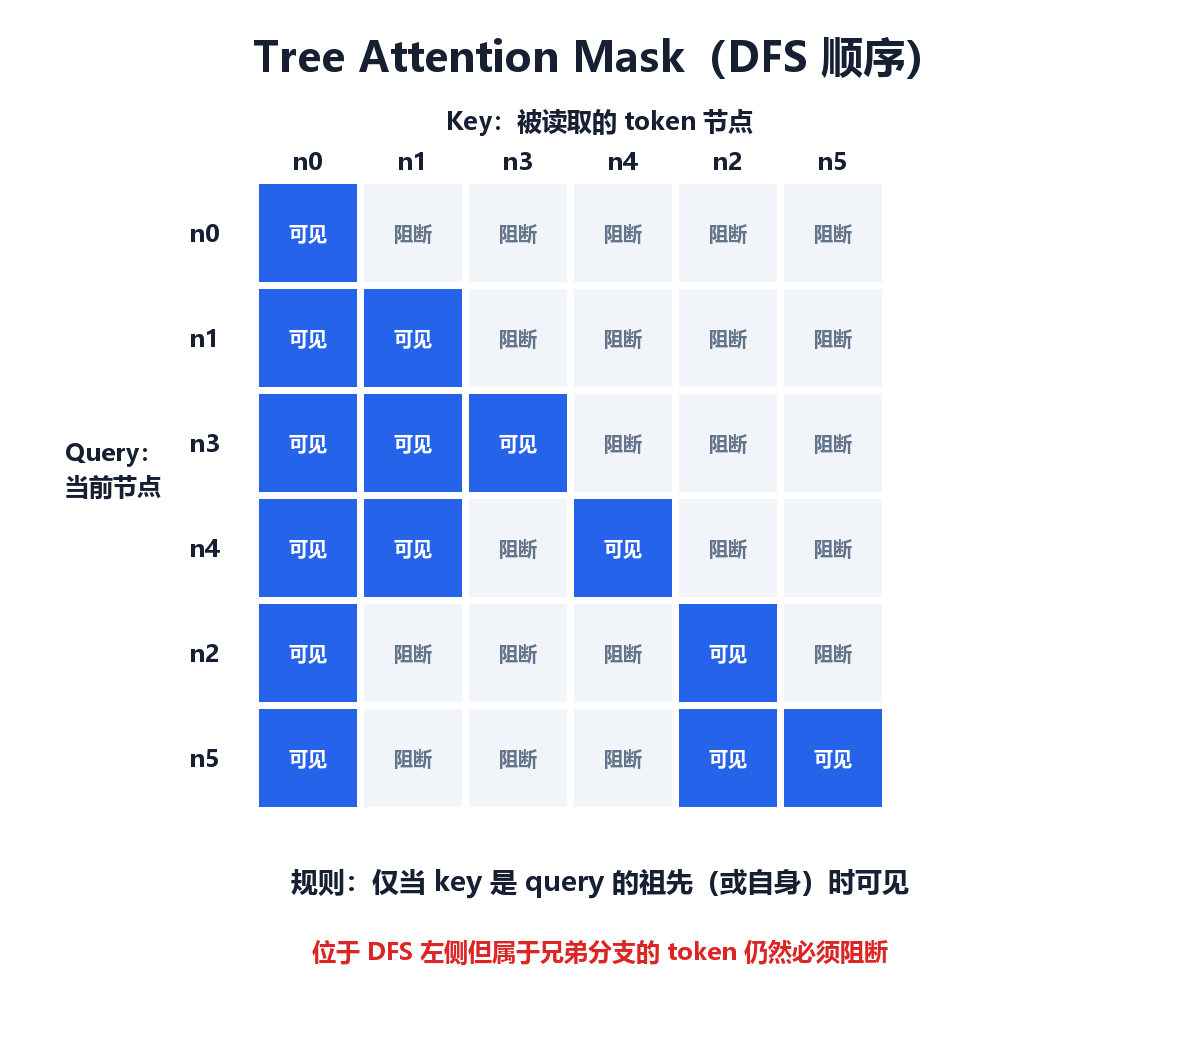
2.3.3 基于树深度的位置编码 (Depth-based RoPE)
RoPE 位置编码不能直接使用 DFS 序列中的物理下标,否则会导致错误的逻辑距离感。Robostral 根据 Token 在前缀树中的逻辑深度(Logical Depth)分配 RoPE 位置编码,保证位置编码与独立串行 Forward 时完全一致。
2.3.4 路径加权损失 (Path-Weighted Loss)
为保证单次 Forward 中的梯度大小与独立训练一致,对每个监督 Token 施加权重。若总共包含 $K$ 条根到叶的路径,第 $t$ 个 Token 属于 $g_t$ 条路径的前缀,则损失函数乘以权重 $g_t / K$: \(L_{\text{tree}} = \sum_t \frac{g_t}{K} \ell_t(\theta)\) 这一加权保证了共享前缀在 Backward 时累积的梯度方向与多个独立样本训练后的总平均梯度在数学上完全等价。在保留全部 action 监督信号的前提下,将训练 Token 消耗降低 22 倍,训练时间从数月缩短至几天。
④ 在线强化学习 (Online RL via CISPO)
在 2.4M 仿真轨迹的 SFT 之后,模型在面对未曾见过的死角或复杂干扰时仍可能产生漂移。Robostral 采用 CISPO (Clipped Importance Sampling Policy Optimization) 算法进行在线端到端微调。
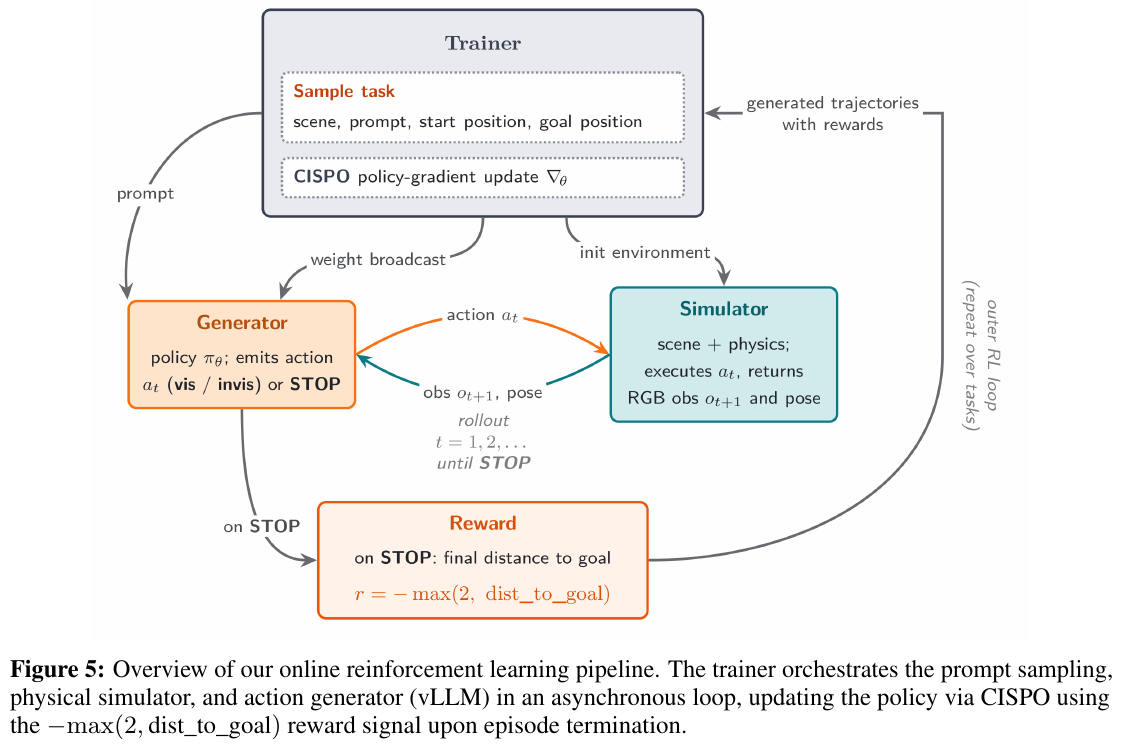
2.4.1 CISPO 算法机制与重要性采样截断
不同于 PPO 直接对目标损失函数进行 Clipped,CISPO 作用于重要性采样权重的梯度项上。新旧策略比率为: \(r_t(\theta) = \frac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{\text{old}}}(a_t|s_t)}\) CISPO 的梯度更新目标为: \(\nabla_\theta L_{\text{CISPO}} = \hat{\mathbb{E}}_t \left[ \min\left(r_t(\theta), \operatorname{clip}(r_t(\theta), 1-\epsilon, 1+\epsilon)\right) \nabla_\theta \log \pi_\theta(a_t|s_t) A_t \right]\) 这极大稳定了 8B 规模大模型在连续环境下的强化学习收敛性。
2.4.2 截断目标距离奖励函数
标量奖励函数定义为: \(R = - \max(2, \text{dist\_to\_goal})\) 其中 $\text{dist_to_goal}$ 为最终位置到目标的测地线距离(米)。将惩罚截断在 2 米以内,防止智能体在靠近目标后做无意义的微调晃动,激励模型在到达终点时精准触发 STOP 动作。
2.4.3 Hard Subsets 筛选与 场景连续 Curriculum
- Hard Subsets (35k 任务):从 SFT 模型推演中筛选出 35k 困难任务子集(仅保留 SFT 失败的复杂布局、歧义指令样本),将算力集中在难点突破;
- Visual Curriculum:数据采样时按 Scene 连续打包,使 Batch 内包含同一场景的多个 Episode,形成隐式视觉课程(Visual Curriculum)。
3. 核心结果/发现
Robostral Navigate 在 Room-to-Room in Continuous Environments (R2R-CE) 和 Room-Across-Room (RxR-CE) 两个最权威的真实连续运动视觉导航基准上均刷新了世界纪录。
3.1 权威基准性能对比表
| 模型类别 | 模型名称 | 感知模态 | R2R-CE Unseen SR ↑ | R2R-CE Unseen SPL ↑ | R2R-CE NE ↓ | RxR-CE Unseen SR ↑ | RxR-CE Unseen SPL ↑ | RxR-CE NE ↓ |
|---|---|---|---|---|---|---|---|---|
| 单目 RGB | Robostral Navigate (Ours) | 仅单目 RGB | 77.4% | 74.2% | 3.20m | 75.1% | 68.7% | 3.47m |
| 单目 RGB | Qwen-RobotNav-8B | 仅单目 RGB | 65.7% | 59.6% | 4.36m | 73.4% | 63.5% | 4.16m |
| 单目 RGB | Qwen-RobotNav-4B | 仅单目 RGB | 66.9% | 60.5% | 4.22m | 71.3% | 61.5% | 4.15m |
| 单目 RGB | Qwen-VLA-Instruct | 仅单目 RGB | 57.5% | 51.2% | 5.10m | 59.6% | 47.8% | 5.80m |
| 单目 RGB | StreamVLN | 仅单目 RGB | 56.9% | 51.9% | 4.98m | 52.9% | 46.0% | 6.22m |
| 单目 RGB | InternVLA-N1 | 仅单目 RGB | 55.4% | 52.1% | 4.89m | 49.5% | 41.8% | 6.41m |
| 单目 RGB | NaVILA | 仅单目 RGB | 54.0% | 49.0% | 5.22m | 49.3% | 44.0% | 6.77m |
| 深度/多相机 | Qwen-RobotNav-8B (Depth) | 深度 / 多相机 | 72.1% | 66.6% | 3.73m | 76.5% | 65.7% | 3.58m |
| 深度/多相机 | OmniNav | 深度 / 多相机 | 69.5% | 66.1% | 3.74m | 73.6% | 62.0% | 3.77m |
| 深度/多相机 | ABot-N0 | 深度 / 多相机 | 66.4% | 63.9% | 3.78m | 69.3% | 60.0% | 3.83m |
| 深度/多相机 | NavFoM | 深度 / 多相机 | 61.7% | 55.3% | 4.61m | 64.4% | 56.2% | 4.74m |
 3-1.svg)
3.2 关键结果分析
- 大幅碾压所有单目 RGB 基线: 在相同单目 RGB 条件下,Robostral Navigate 在 R2R-CE Unseen 上成功率达到 77.4%,领先之前最好的单目模型 Qwen-RobotNav-4B (66.9%) 达 +10.5%;在 RxR-CE 上领先 Qwen-RobotNav-8B +1.7% SR,且路径效率 SPL 提升 +5.2%。
- 超越深度与多视角传感器模型: 依靠单目 RGB 输入,Robostral Navigate 在 R2R-CE 上超越了搭载深度传感器与多相机的 Qwen-RobotNav-8B (72.1% SR) 达 +5.3%;在 RxR-CE 上 SPL (68.7% vs 65.7%) 与定位误差 (3.47m vs 3.58m) 均优于深度模型。
- 在线 RL 的性能跃升:
- R2R-CE Unseen 成功率从 SFT Baseline 的 73.4% 提升至 77.4% (+4.0%);
- RxR-CE Unseen 成功率从 71.2% 提升至 75.1% (+3.9%)。
- 跨构型零样本部署与鲁棒性: 同一套 VLM + Diffusion Policy 权重直接在 Galaxea R1(大底盘轮式)和 Hiwonder JetAuto(小巧四轮/四足)上部署成功。即便拉伸焦距、引入鱼眼畸变或改变相机安装高度,导航成功率波幅不超过 1.5%。
4. 局限性
- 盲区视场退化:在目标位于后方或盲区(> 90° 大角度转向)时,需要降级为度量位移(Metric Displacement Fallback)模式,在极度复杂迷宫或纹理极缺失环境中的探索效率仍有提升空间。
- 在线 RL 系统调度极度繁重:在线强化学习需要物理仿真渲染、vLLM 高并发推理以及分布式权重更新三方高并发协同调度,对 GPU 算力集群与工程管线要求极高。
41. ABot-N1 (2026)
———基于慢速认知与快速控制双系统架构的通用视觉语言导航基础模型
📄 Paper: arXiv:2607.10383 · Project Page · Benchmark(仅开源评测基准与数据集,模型权重与训练代码未公开)
精华
- 慢速-快速双系统解耦:将低频慢速的高维认知推理(System 2)与高频快速的低维反应性控制(System 1)进行时间尺度与计算资源解耦,消除了端到端黑盒模型的认知-控制动态错配。
- 统一的像素目标接口:通过输出可通行像素(Affordance Pixel)和目标像素(Target Pixel),将点导航、指令导航、物体导航、POI导航和行人跟随这五类异构任务统一为“在CoT解释下跟踪图像像素锚点”的问题,实现极佳的跨任务正向迁移。
- GRPO对齐与安全可达性:首次在导航基础模型中引入基于GRPO的强化学习对齐,设计了非对称指数安全边界惩罚与基于GSNR的平衡采样策略,将模型决策直接与任务完成度和可通行安全性挂钩。
- 精细的可解释性与安全性审计:人机可读的CoT文本链配合图像空间内的像素目标,使得导航决策的每一步都清晰透明,开发人员可以精准定位失败瓶颈是源于语义推理还是空间对齐。
- 城市级自主导航与新基准:展示了仅依赖低精度SD地图即可在复杂城市街区实现长程避障、路口选择、人行道和红绿灯遵从的鲁棒四足机器人导航,并开源了 ABotN-PointBench 与 ABotN-POIBench。
1. 研究背景/问题
传统的视觉语言导航(VLN)模型主要依赖端到端的多模态黑盒策略将观测直接映射到控制动作,但它们在向真实世界机器人部署时面临三大痛点:
- 去往点目标导航的偏移:在无高精地图导航时,由于地图路由或定位漂移,输入的本车局部坐标目标点常被偏移至车道、绿化带等物理不可达区域,导致常规模型停滞或违规。
- 去往目标物导航的语义遗忘与混淆:端到端微调容易侵蚀预训练VLM的通用语义先验,且将“搜索”和“接近”两阶段混为一谈,导致训练发散且难以进行失败归因。
- 缺乏可解释性与安全审计:黑盒端到端映射缺乏显式决策痕迹,开发人员难以断定失败是源于物理感知错误、逻辑推理还是底层控制。
2. 主要方法/创新点
① 整体框架概述
ABot-N1 提出了一个模块化的慢速-快速双系统架构(Slow-Fast Architecture)。慢速系统(System 2)是一个 4B 参数的高容量 VLM(Qwen-3.5-4B),负责低频 deliberative 逻辑推理,输出显式思维链(CoT)及投影到当前三相机视角(tri-view)上的像素目标(Pixel Goal)。快速系统(System 1)是一个 2B 参数的轻量级 VLM(Qwen-3.5-2B),作为高频动作专家(Action Expert),实时融合当前的相机输入与慢速系统输出的 CoT 及像素目标,解算出机器人底层的连续控制路点(Waypoints)。
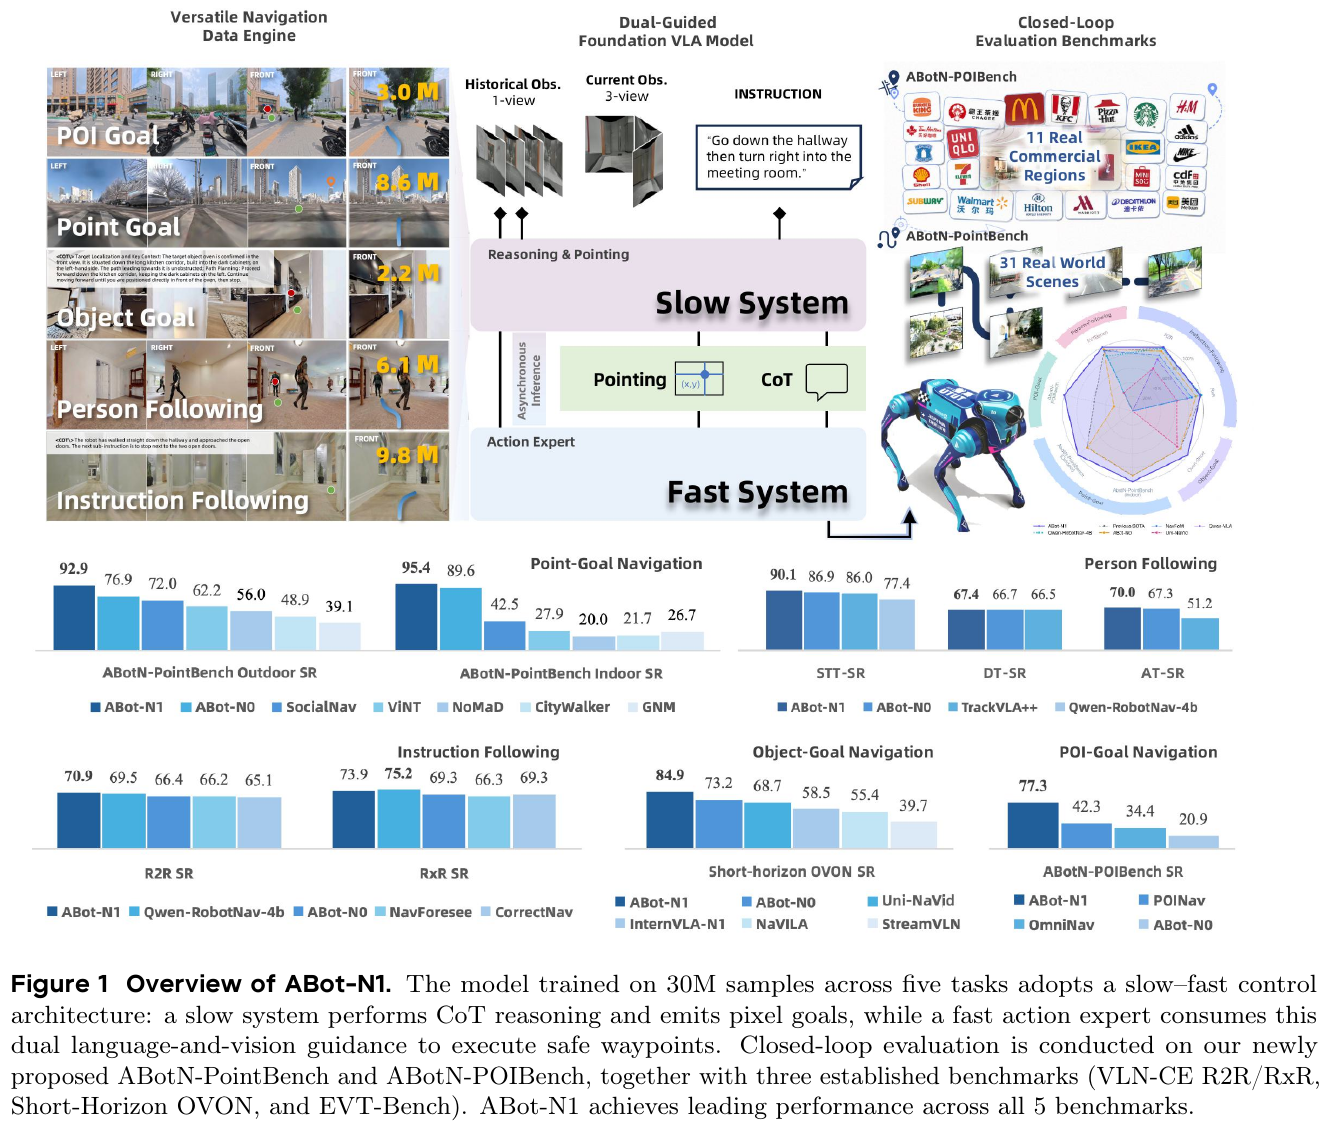
② 逐模块讲解
慢速系统(System 2 - 逻辑推理器)
- 输入:参考历史记忆帧(用 \(I_{1:K}^{\text{ref,mem}}\) 表示)、当前三相机观测视角 \(I_{\text{ref,tri}}\)(包含左、前、右三个相机的 RGB 图像)、当前的任务语言指令 $g = \ell$,以及上一决策周期的推理输出 $(C_{n-1}, p_{n-1})$,输入先前的决策有助于在长程任务中维持时序一致性。
- 处理过程:基于 Qwen-3.5-4B 强大的预训练多模态能力,执行显式的思维链(Chain-of-Thought)推理。该推理在语义复杂的任务(如指令导航和物体搜索)中激活,解析任务指令的当前进度(例如“已完成子指令A,正在执行B”),并结合视觉语义进行空间的可通行性分析。
- 输出:显式自然语言 CoT 推理轨迹 $C_n$ 和一组投影在 tri-view 视角中的像素目标(Pixel Goal)$p_n$。像素目标包含两种:
- 可通行像素(Affordance Pixel):图像中标记可安全通行区域的前方路点(在室内通常代表前方约3米,室外约5米的可达平整路面)。
- 目标像素(Target Pixel):指示具体任务目标的图像像素点(例如目标物件的质心、POI 商铺入口的底部中点或所追踪行人的底部中点),仅在目标可见或进入最终接近阶段时激活。
- 设计动机:将复杂的开放词表语义识别和社交规约推理从快速控制反馈中分离开来,使大模型的庞大语义先验可以在不阻塞高频底层的实时控制循环的前提下被充分利用。另外,可通行像素与目标像素作为统一桥梁,解耦了导航的拓扑语义决策和运动学轨迹执行。
快速系统(System 1 - 动作专家)
- 输入:高频实时的相机观测 \(I_{\text{cur,tri}}\)、高频局部记忆帧 \(I_{1:K}^{\text{cur,mem}}\)、慢速系统提供的最新 CoT 轨迹 $C_n$ 与像素目标 $p_n$、慢速系统决策时的参考视图 \(I_{\text{ref,tri}}\)(用于对齐像素空间)以及全局任务目标 $g$。
- 处理过程:首先通过 Qwen-3.5-2B 的多模态编码器提取融合状态 $h_t$,随后设计一组可学习的动作查询(Action Queries) $q_{\text{act}}$,利用类 QFormer 的交叉注意力机制从融合特征中蒸馏导航控制表征。最后由多层感知机(MLP)头解码该表征。
- 输出:预测未来 $H=5$ 个步骤的连续二维控制路点 $a_{t:t+H}$。每个路点包含相对于本车的 $SE(2)$ 位姿 $(x_i, y_i, \sin\theta_i, \cos\theta_i)$ 以及一个用于指示是否到达最终终点的二分类 Arriving 标志位 $c_i$。
- 设计动机:由于慢速系统已经通过思维链和图像坐标点将轨迹规划模式化(例如:左转避障或右转绕行),高频的 System 1 面临的动作空间回归分布基本上退化成了单峰(unimodal)问题。这使得 System 1 能够非常稳定高效地仅通过 Smooth-$L1$ 损失进行训练,无需复杂的扩散模型(Diffusion)或高斯混合(GMM)动作头。同时,高频控制能够动态避障,并在慢速推理周期之间通过持续追踪像素点来消除控制延迟。
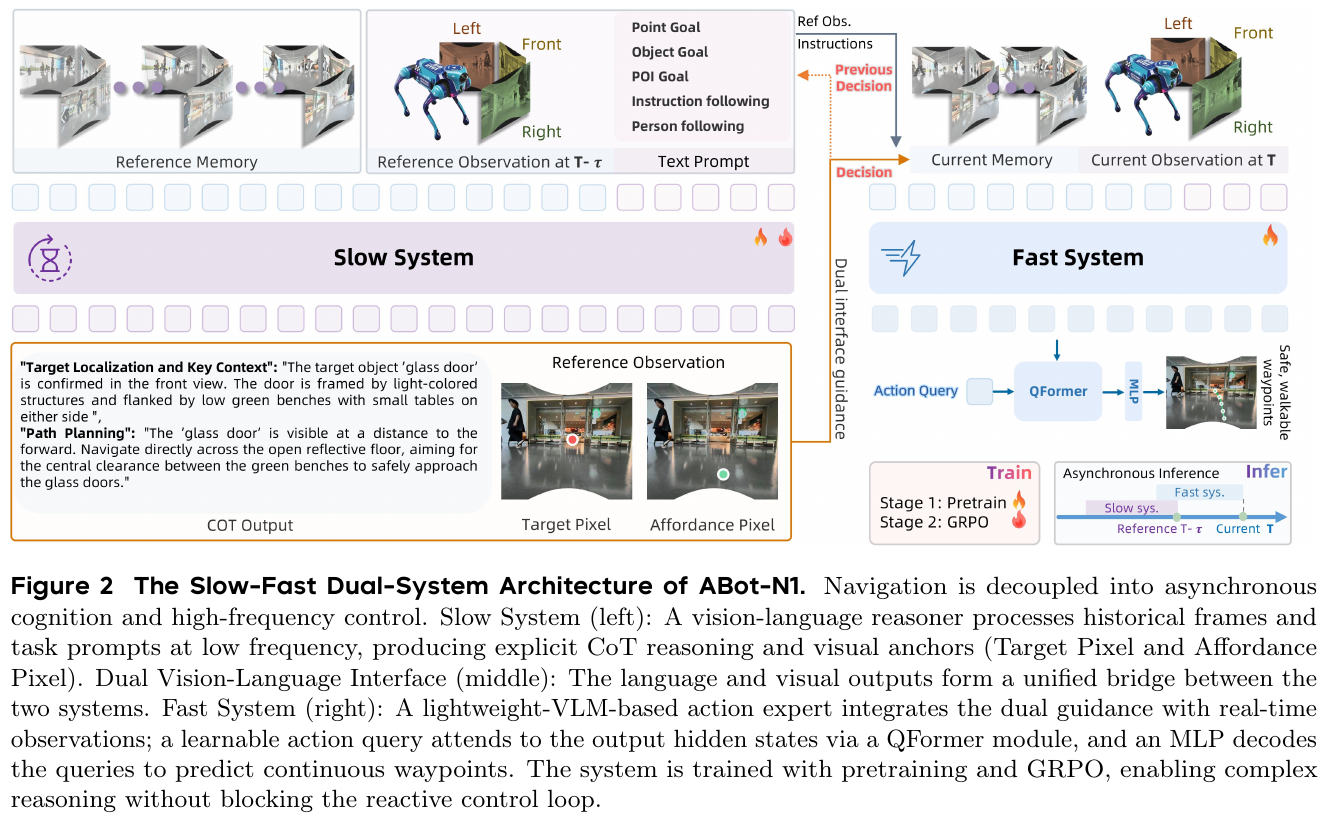
③ 端到端数据流
对于任意的具身任务,如“寻找最近的绿色垃圾桶”:
- 慢速系统接收当前环境的 tri-view 图像以及命令,开始执行 CoT 推理(定位垃圾桶并在画面中寻找一条绕开茶几的路线),并在 tri-view 的前置相机上输出 Affordance Pixel(指向绕行通路)和 Target Pixel(标注在检测到的垃圾桶上)。
- 快速系统在 10Hz 频率下闭环运行,利用最新的 Affordance/Target 像素在图像上的变化,连续解算输出路点。
- 机器人沿避障轨迹行进,直到 slow 系统评估抵达垃圾桶,发出 Target Pixel 并将 Arriving 标志 $c_i$ 设为 1,触发 Arrive 停止。
④ 训练目标与损失函数
- 模仿预训练阶段:
- 慢速系统损失:交叉熵语言建模损失 $L_{\text{CE}}$,对 CoT 文本 Token 以及像素目标坐标对应的 Token 序列进行监督。
- 快速系统损失:Smooth-$L1$ 位置回归损失、Smooth-$L1$ 航向角正余弦值回归损失,以及二分类交叉熵到达损失 $L_{\text{arrive}}$。
- GRPO 强化学习对齐阶段:
为了让慢速系统生成的像素目标直接符合可通行安全与真实任务成功率,使用 GRPO 算法优化慢速系统的参数:
\(L_{\text{GRPO}}(\theta) = \mathbb E \left[ \sum_{i,t} \min\left(\rho_t^{(i)} A^{(i)}, \text{clip}(\rho_t^{(i)}, 1\pm\epsilon)A^{(i)}\right) \right] - \beta \mathbb{D}_{\text{KL}}(\pi_\theta \parallel \pi_{\text{ref}})\)
奖励函数设计:$R = w_f R_{\text{format}} + w_t R_{\text{target}} + w_o R_{\text{safety}}$
- 格式奖励 $R_{\text{format}}$:指示输出是否符合规定的 JSON Schema,若不符合直接零分。
- 目标对齐奖励 $R_{\text{target}}$:使用指数核衡量预测像素 $\hat{p}$ 与地面真值 $p^\star$ 在三视图中的 L2 距离: \(R_{\text{target}} = \sum_{\text{frame}} \alpha_t \exp\left( - \frac{\lVert \hat{p} - p^\star \rVert^2}{\text{scale}} \right)\)
- 安全净空奖励 $R_{\text{safety}}$:将预测的 Affordance 像素反投影回 3D 空间,计算与最近非通行区域(如车道、花坛、障碍物)的真实距离 $d$:
\(R_{\text{safety}}(d) = \begin{cases} -\alpha_0, & d \ge d_{\text{safe}} \\ -\alpha_0 \exp\left( \beta(d_{\text{safe}} - d) \right), & d < d_{\text{safe}} \end{cases}\)
- 基于 GSNR 的平衡数据采样(Balanced Sampling): 由于安全奖励 $R_{\text{safety}}$ 在危险边缘的方差呈指数级增长,会导致梯度不稳定性。ABot-N1 通过求解 Var($R_{\text{safety}}$) 的阈值,过滤掉极度危险的 prompts,并将剩余训练样本按 GSNR(梯度信噪比)划分为 安全区(Safe Zone, 占比 50%)、临界区(Critical Zone, 占比 30%) 和 危险区(Danger Zone, 占比 20%) 进行 5:3:2 混合采样,以实现稳定的策略提升。
⑤ 推理流程与部署架构
在实际的四足机器人部署中,为克服 Jetson 边缘计算硬件的局限性,在推理时:
- 慢速系统模型进行了规模压缩(从 4B 压缩为 2B 参数的 Qwen-3.5-2B)。
- 快速系统进一步平替为带 306M 参数的扩散 Transformer (DiT),并用轻量的 DINOv2-Base 进行视觉编码。
- 两系统异步并行运行:慢速系统在 GPU 空闲时异步生成全局决策,快速系统则以 10Hz 稳定读取最新缓存并进行高频运动控制,极大地降低了端到端控制的时延。
3. 核心结果/发现
ABot-N1 在五项核心导航任务上均打破了先前的 SOTA 纪录,并且多任务联合训练模型匹配或超越了专门微调的单任务专家(Task Specialists),验证了正向跨任务迁移的优势:
- 指令导航 (Instruction-Following):在 Habitat R2R-CE 验证集上实现 70.89% 的成功率 (SR) 和 67.5% 的 SPL,大幅超越以往所有基于深度/里程计的强 baseline 模型;在 RxR-CE 上亦取得 SOTA 级别的 3.13米 平均导航误差 (NE)。
- 物体搜索 (Object-Goal):在短视距 OVON 测试中,将成功率提升至 84.9%,SPL 提升至 51.8%,且终点距目标物的平均距离 (DTG) 相比上一代 ABot-N0 缩减了一半 (0.82m vs 1.44m),展示了极高的最后阶段逼近精度。
- 点目标导航 (Point-Goal):在全新发布的城市级基准 ABotN-PointBench 户外 Split 上,ABot-N1 联合模型在最难的高阶难度下,成功率相比 ABot-N0 跃升了 +22.7% (达到 88.0%),在所有难度下均取得了最优的成功率(整体 92.9%)和社交合规度;室内 Split 下同样获得了 95.4% 的极高成功率。
- POI 导航 (POI-Goal):在商铺环境闭环基准 ABotN-POIBench 上,成功率相较于以往最强基准大幅跃升了 +35.0%,达到 77.3%,验证了利用 slow-fast 机制将商铺招牌语义识别与入口避障路径规划结合的高效性。
- 行人跟随 (Person-Following):在 EVT-Bench 上,在存在其他行人干扰 (DT split) 和遭遇频繁严重遮挡 (AT split) 的场景下,分别取得了 84.4% 和 87.8% 的卓越追踪率 (TR)。
4. 局限性
- 多任务联合下的碰撞率权衡:在行人追踪 (EVT-Bench) 场景的复杂遮挡 (AT) 及强干扰 (DT) 任务中,虽然追踪率 (TR) 与成功率 (SR) 达到最佳,但由于受混合预训练集中较激进的动作分布影响,碰撞率 (CR) 出现了轻微抬升 (17.9%)。未来有必要在 GRPO 阶段加入更显式的安全碰撞惩罚项来进行细化。
- 边缘部署时的性能-资源折衷:由于端侧算力限制,在真机部署时必须将慢速/快速模型分别进行参数压缩和架构置换(例如快速系统平替为 306M DiT)。这种异构硬件适配在一定程度上损失了原版 4B+2B Qwen 纯多模态大模型的完整表征能力。
42. ReflectVLN (2026)
———基于反思推理与双向交互机制的具身视觉语言导航
📄 Paper: arXiv:2607.12680 · 🏛️ IROS 2026
精华
- 将传统视觉语言导航(VLN)中”慢规划-快执行”的单向级联结构升级为意图 Agent 与执行 Agent 双向闭环交互架构。
- 引入触发 Token 机制(
<VLNBOA>,<VLNBOR>,<VLNBOC>),由执行 Agent 在导航过程中实时监测子目标完成度与偏航偏差,实现按需触发(On-demand)高层反思与重规划,避免了固定频率刷新的资源浪费与单向级联的语义脱节。 - 提出 Action-CoT(路径条件双重查询训练机制),在预测短期动作前先预测隐式粗粒度未来路线,为局部控制引入全局拓扑路径约束。
- 构建单轮反思驱动的数据生成流水线(Reflection-Driven Data Pipeline),收集策略 Rollout 失败样本并引入 Oracle 专家干预与 VLM 反思生成,经三方交叉验证生成高质纠错数据,无需大规模预训练或多轮迭代数据增强即可显著提升智能体在长程未知环境下的恢复能力。
1. 研究背景/问题
在连续环境视觉语言导航(VLN-CE)的长程执行过程中,机器人的微小控制误差容易不断累积导致偏航。现有高低层级解耦(Slow-Fast 或 Dual-System)方法大多采用单向通信:高层以固定频率输出语言子目标,低层单向执行,缺乏执行过程中的语义进度跟踪与故障诊断闭环。当机器人发生偏航时,高层无法及时接收偏差反馈,导致重规划滞后。此外,传统方法缺乏显式的反思(Reflection)机制来识别、诊断并修正导航失败。
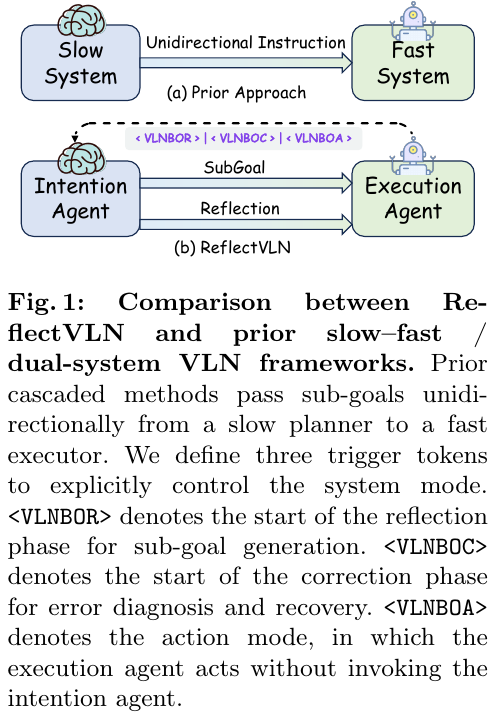
2. 主要方法/创新点
ReflectVLN 架构由两个独立参数化的 Agent 组成:意图 Agent(Intention Agent, $\theta_{int}$) 和 执行 Agent(Execution Agent, $\theta_{exe}$),均基于 Qwen2.5-VL-3B 模型初始化。
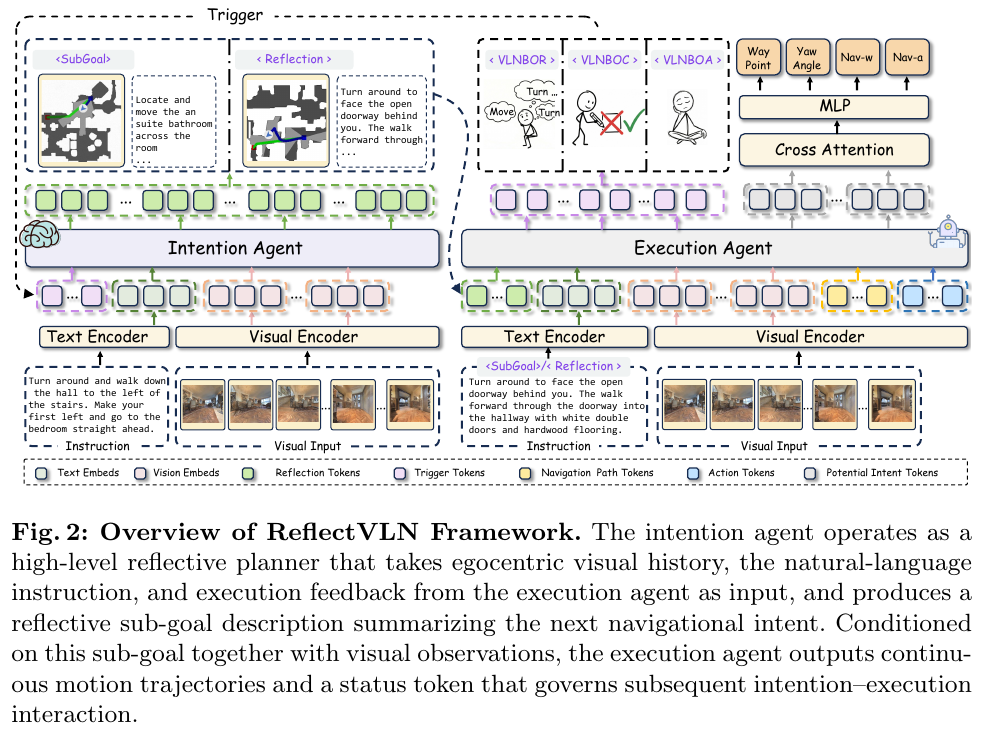
① 整体框架概述
系统由高层意图 Agent 与低层执行 Agent 构成。意图 Agent 负责全局长程指令的子任务分解与偏航反思;执行 Agent 负责在本地视场下将子目标落地为短期连续运动控制,并实时评估执行状态。两者通过显式的状态 Token 接口(Status Tokens)建立事件驱动的双向闭环通信,而非固定频次的单向指令下发。
② 逐模块讲解
- 意图 Agent(Intention Agent, $\theta_{int}$)
- 输入:全局自然语言指令 $\ell$、单目 RGB 历史观测 $I_{t-H:t}$ 以及执行 Agent 发送的状态触发信号 $z_t \in {R, C}$。
- 处理过程:基于 VLM 的多模态理解与生成能力,当接收到常规触发信号 $z_t = R$(
<VLNBOR>)时,结合路线进度生成下一个可执行子目标描述 $c_t$;当接收到纠错触发信号 $z_t = C$(<VLNBOC>)时,诊断偏航原因并输出带有矫正动作的子目标描述。 - 输出:结构化的自然语言子目标文本 $c_t$。
- 设计动机:直接利用 VLM 的语言推理能力完成高级语义规划,避免引入额外的目标检测器或复杂的像素级目标标定。
- 执行 Agent(Execution Agent with Action-CoT, $\theta_{exe}$)
- 输入:全局指令 $\ell$、当前语言子目标 $c_t$ 以及历史视觉观测 $I_{t-H:t}$。
- 处理过程(Action-CoT 路径条件双重查询):
- 首先利用可学习的导航查询(Navigation Queries, $Q_{nav}$)预测较长视界的隐式粗粒度未来路线 \(\hat{P}_t = \text{MLP}_{nav}(f_{\theta_{exe}}(X, Q_{nav}))\)。
- 将粗粒度路线特征 $E_{nav}$ 与动作查询(Action Queries, $Q_{act}$)拼接,预测短期控制动作 \(\hat{A}_t = \text{MLP}_{act}(f_{\theta_{exe}}(X, [E_{nav}; Q_{act}]))\)。
- 同时利用语言生成头自回归预测一个离散的状态 Token $z_t \in {A, R, C}$。
- 输出:连续运动控制量 \(\hat{A}_t\)(包含平面相对位移 $(\Delta x_t, \Delta y_t)$、朝向角 $(\cos\phi_t, \sin\phi_t)$ 和停止概率 logit $s_t$)以及交互状态 Token $z_t$。
- 设计动机:打破传统的纯文本 CoT 模式,将”思考(Thought)”建模为粗粒度未来路径约束,显式提升局部动作预测的路线时空一致性。
③ 闭环数据流与交互逻辑
- 初始时刻,意图 Agent 生成首个子目标 $c_1$。
- 每个时间步 $t$,执行 Agent 根据 $c_t$ 与视觉历史输出短程动作 \(\hat{A}_t\) 及状态 Token $z_t$。
- 若 $z_t = \langle \text{VLNBOA} \rangle$,执行 Agent 独立运行短期控制,不调用高层意图 Agent;
- 若 $z_t = \langle \text{VLNBOR} \rangle$,表明当前子目标已完成,触发意图 Agent 生成下一个常规子目标;
- 若 $z_t = \langle \text{VLNBOC} \rangle$,表明代理检测到严重偏航,触发意图 Agent 进行错误诊断并输出纠错子目标。
④ 训练目标与损失函数
-
Stage I: Action-CoT 预训练 定义单个控制点预测损失为位置损失、朝向损失和停止损失的组合: \(\mathcal{L}_{traj}(\hat{U}, U^*) = \lambda_{pos} \mathcal{L}_{pos} + \lambda_{ang} \mathcal{L}_{ang} + \lambda_{stop} \mathcal{L}_{stop}\) Action-CoT 预训练总损失结合了短期动作损失与粗粒度路线损失: \(\mathcal{L}_{WP} = \mathcal{L}_{traj}(\hat{A}, A^*) + \beta \mathcal{L}_{traj}(\hat{P}, P^*)\) 其中设置权重 $\lambda_{pos} = \lambda_{ang} = \lambda_{stop} = 1.0$,路线正则权重 $\beta = 0.1$。
-
Stage II: 状态感知联合微调
- 意图 Agent 目标:对常规请求与纠错请求进行自回归语言建模: \(\mathcal{L}_{int}^{(z)} = -\sum_{j=1}^{T} \log p_{\theta_{int}}(y_j^* \mid y_{<j}^*, \ell, I_{t-H:t}, z)\)
- 执行 Agent 目标:联合预测动作与状态 Token: \(\mathcal{L}_{exe} = \mathbf{1}[z_t^* = A] \mathcal{L}_{WP} + \lambda_{status} \mathcal{L}_{status}\) 其中 \(\mathcal{L}_{status} = -\log p_{\theta_{exe}}(z_t^* \mid \ell, c_t, I_{t-H:t})\)。
⑤ 反思驱动的数据构建流水线
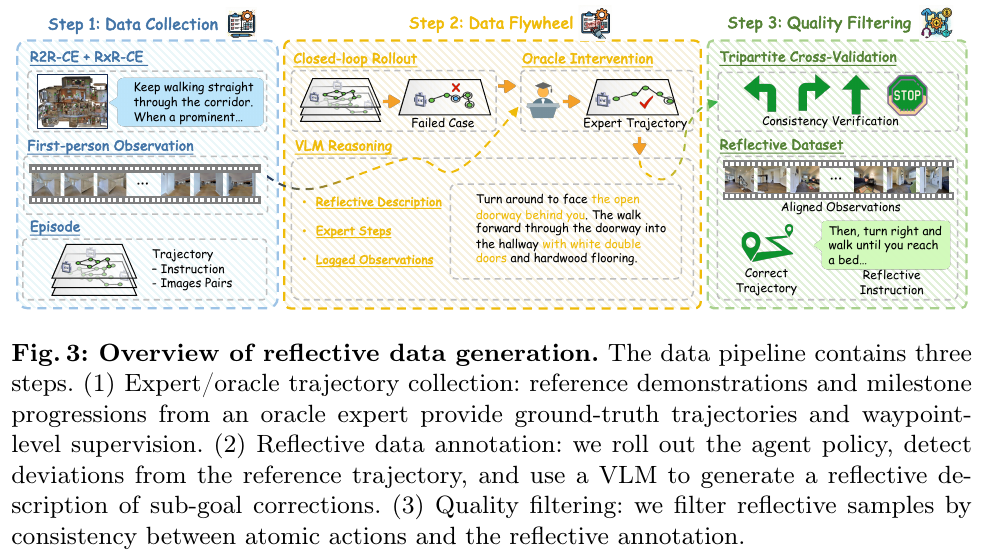
3. 核心结果/发现
在 Matterport3D 上的标准连续环境视觉语言导航基准(R2R-CE 与 RxR-CE Val-Unseen)上进行了全面评估:
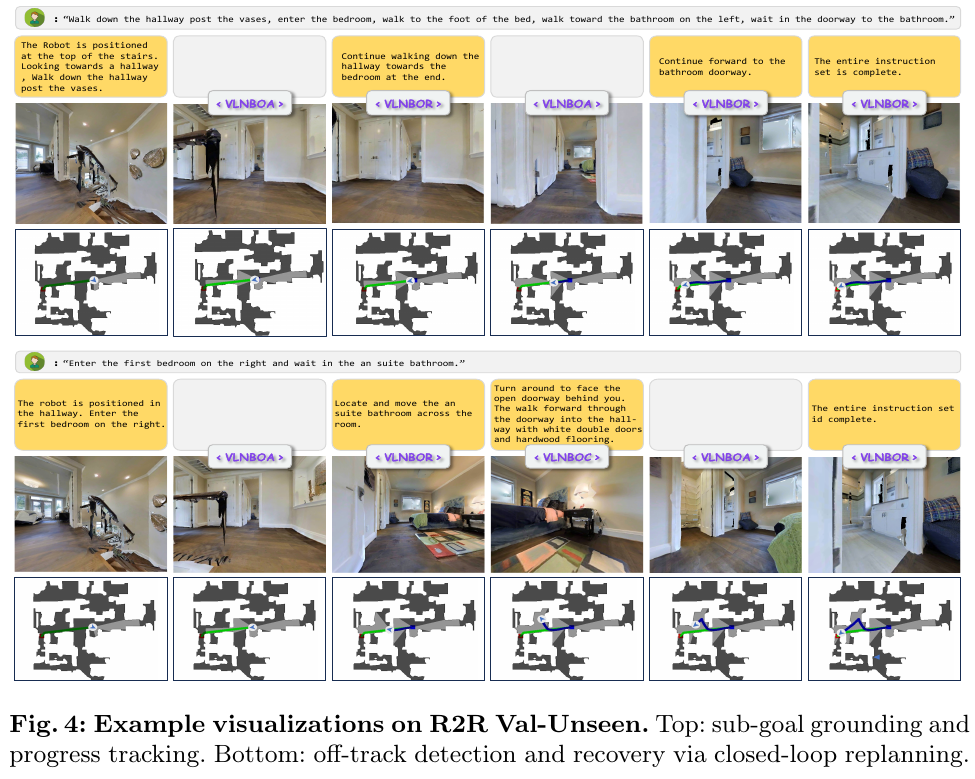
- SOTA 导航性能:
- R2R-CE 基准:在纯单目 RGB 条件下取得 62.8% 的成功率(SR) 和 58.5% 的 SPL(相比 StreamVLN 基线 SR 提升 5.9 个百分点,与 DualVLN 的 58.5% SPL 持平)。
- RxR-CE 基准:在长指令复杂的 RxR-CE 上取得 66.0% 的成功率(SR) 和 57.2% 的 SPL(相比 StreamVLN 基线 SR 提升 13.1 个百分点,超越了基于 7B 模型的 DualVLN 的 61.4% SR / 51.8% SPL)。
- 高数据与参数效率:
- 相比于 DualVLN(7B 模型、12M 训练样本、引入 ScaleVLN 额外数据)和 CorrectNav(7B 模型、多轮飞轮迭代),ReflectVLN 仅使用 2×3B 参数架构 和 1.5M 专家数据 + 100k 单轮反思数据,即取得了更优的整体表现。
- 消融实验与按需触发效率:
- Action-CoT 作用:引入路径条件粗粒度路线预测使 SR 从 52.8% 提升至 60.0%,SPL 从 50.1% 提升至 57.2%。
- 按需触发(On-demand)优势:相比于固定步长触发(如每 4 步或 12 步调用一次高层),按需触发取得了最高成功率(62.8% vs 61.8%/59.4%)。
- 高层调用频次:在推理阶段,意图 Agent 平均每 9.63 个执行步才被触发调用一次,显著降低了慢系统高层语言推理的计算负担。
4. 局限性
- 本文解耦双 Agent 架构独立使用 2 个 3B 模型(总参数量为 6B),与单体 7B 模型的消融对比未严格控制总参数量对齐;
- 评价指标主要侧重于按需触发的高层调用频次(Invocation frequency),未来仍需在实际硬件设备上进一步度量端到端延迟(Latency)与实际 FLOPs 功耗开销。
43. TuckerNav (2026)
———面向全天候多场景终身具身视觉语言导航的 Tucker 张量自适应
📄 Paper: arXiv:2603.14276 · 🏛️ ICLR 2026
精华
- 全新全天候终身导航范式 (AML-VLN):首次形式化提出全天候多场景终身视觉语言导航问题并构建 Benchmark,评估具身智能体在跨场景拓扑与多光照/恶劣环境(正常、低光、强光过曝、散射/雾天)下连续自适应与防忘能力。
- 高阶张量微调 (Tucker Adaptation, TuKA):突破经典 LoRA/MoE-LoRA 仅能表示二维双层知识(全局共享 + 任务特定)的结构瓶颈,将微调参数提升至高维张量空间,基于 Tucker 分解显式解耦出“通用导航技能 + 场景特定拓扑 + 环境特定物理”的多层级高维知识。
- 解耦知识增量学习 (DKIL):结合基于 Fisher 信息的弹性权重巩固(EWC)、已知专家一致性约束(Consistency Constraint)与新专家行空间正交优化(Orthogonal Optimization),有效防止新旧子空间领域的参数污染与灾难性遗忘。
- 测试期无 Task-ID 自适应检索:构建基于预训练 CLIP 视觉特征的场景与环境双层检索机制(Task-Specific Experts Search),测试阶段无需显式 Task ID 即可自动精准匹配当前视场的最优场景与环境专家。
- SOTA 性能与卓越泛化性:在包含 24 项连续任务的 Benchmark 上,AlldayWalker 智能体导航成功率 SR 达到 65%(显著超越 SD-LoRA 的 56% 与 BranchLoRA 的 44%),遗忘率 F-SR 降至 11%,并在 6 项全新未见任务中实现 55% 的零样本泛化 SR。
1. 研究背景/问题
传统的视觉语言导航(Vision-and-Language Navigation, VLN)研究通常假设智能体部署在静态且光照理想的单一场景中。然而在真实世界应用中,具身导航智能体必然需要面临全天候环境变化(昼夜正常光、夜间低光、强光过曝、恶劣散射/雾天)以及跨多场景持续迁移的挑战。当智能体按顺序连续学习多个场景与环境下的导航任务时,模型参数会被新任务急剧覆盖,导致对历史旧场景的严重灾难性遗忘(Catastrophic Forgetting)。
现有的参数高效微调方法(如 Vanilla LoRA,或基于 MoE 的 HydraLoRA、BranchLoRA、SD-LoRA 等)普遍通过低秩矩阵进行微调。这些方法本质上是在二维矩阵空间内建模,仅能将知识抽象为“共享矩阵 + 专属矩阵”的双层级结构(即全局通用知识与任务专属知识)。但是在 AML-VLN 任务中,导航知识跨越了多个不同层级:通用导航移动动作、场景特定拓扑结构、以及环境特定的物理成像规律。现有的低秩矩阵微调方法无法显式表示和解耦这种多层级的高维复杂知识,导致参数重用率低下、多领域特征严重交织混淆,难以兼顾增量自适应与跨场景/环境防忘。
2. 主要方法/创新点
① 整体框架概述
针对全天候多场景终身导航(AML-VLN)的挑战,本文提出了 Tucker Adaptation (TuKA) 架构与 Decoupled Knowledge Incremental Learning (DKIL) 增量学习机制,并构建了 AlldayWalker 终身导航智能体。系统将 Transformer 层的自适应权重映射至高维张量空间,通过 Tucker 分解(Tucker Decomposition)将高维张量显式拆解为捕捉全局通用导航能力的 Core Tensor、编解码维度投影矩阵,以及按场景和环境解耦的向量专家库。在连续学习阶段,DKIL 策略在共享与专属子空间上施行差异化约束;在推理阶段,智能体利用基于 CLIP 视觉特征的双层匹配检索,在无需 Task-ID 的情况下自动调取最优的场景与环境专家组合。
② 逐模块讲解
1. 高阶 Tucker 张量自适应 (Tucker Adaptation, TuKA)
- 输入/输出与张量升维:对于 Transformer 第 \(l\) 层的骨干权重 \(W_0^l \in \mathbb{R}^{a_l \times b_l}\),传统 LoRA 引入二维矩阵增量 \(\Delta W^l = B^l A^l\)。TuKA 将自适应升维至四阶高维张量 \(\mathcal{X}^l \in \mathbb{R}^{a_l \times b_l \times M \times N}\)(其中 \(M\) 为场景总数,\(N\) 为环境模式数)。
- Tucker 张量分解:将四阶张量 \(\mathcal{X}^l\) 进行 Tucker 分解: \(\mathcal{X}^l = \mathcal{G} \times_1 U_1 \times_2 U_2 \times_3 U_3 \times_4 U_4\)
- 子结构设计与功能:
- 核心张量 \(\mathcal{G} \in \mathbb{R}^{r_1 \times r_2 \times r_3 \times r_4}\):捕获所有特征维度与模式间的交叉交互信息,用于学习所有导航任务共享的核心通用导航技能(Task-Shared Knowledge)。
- 共享解码器 \(U_1 \in \mathbb{R}^{a_l \times r_1}\) 与编码器 \(U_2 \in \mathbb{R}^{b_l \times r_2}\):负责高维张量与底层 LLM 二维矩阵特征空间之间的维度转换与对齐。
- 场景专家矩阵 \(U_3 \in \mathbb{R}^{M \times r_3}\):包含 \(M\) 组场景专家,第 \(s\) 行 \(U_3[s, :]\) 显式表示第 \(s\) 个具体场景的特定拓扑与结构知识。
- 环境专家矩阵 \(U_4 \in \mathbb{R}^{N \times r_4}\):包含 \(N\) 组环境专家,第 \(e\) 行 \(U_4[e, :]\) 显式表示第 \(e\) 个退化环境(正常、低光、过曝、散射)的视觉物理感知知识。
- 任务增量权重切片导出:对于第 \(t\) 个场景 \(S_s\) 和环境 \(E_e\) 下的导航任务 \(T_t = \{S_s, E_e\}\),从高阶张量中抽取特定模式切片计算最终的增量权重: \(\Delta W_t = U_1 \cdot \left( \mathcal{G} \times_3 U_3[s, :] \times_4 U_4[e, :] \right) \cdot (U_2)^T\)
2. 解耦知识增量学习 (Decoupled Knowledge Incremental Learning, DKIL)
- 共享知识继承与 EWC 巩固:连续学习新任务 \(T_t\) 时,继承已更新的全局共享参数 \(\{\mathcal{G}, U_1, U_2\}\)。为了防止更新共享部分导致对早期任务的知识破坏,引入基于 Fisher 信息矩阵的弹性权重巩固(EWC Loss): \(\mathcal{L}_{\text{ewc}, t} = \lambda_1 \left( \|F_{\mathcal{G}, t-1} \odot (\mathcal{G} - \mathcal{G}')\|_F^2 + \|F_{U_1, t-1} \odot (U_1 - U_1')\|_F^2 + \|F_{U_2, t-1} \odot (U_2 - U_2')\|_F^2 \right)\) 其中 Fisher 矩阵使用滑动平均公式在连续学习中平滑更新:\(F_{\theta, t} = \omega \cdot F_{\theta, t-1} + (1-\omega) \cdot F_{\theta, t}\)。
- 已知专家一致性约束 (Consistency Loss):若新任务用到了此前已经学习过的场景 \(s\) 或环境 \(e\),对已有的专家行 \(U_3[s, :]\) 或 \(U_4[e, :]\) 施加一致性惩罚,防止重复训练破坏已有模式: \(\mathcal{L}_{\text{co}} = \lambda_2 \left( \alpha \|U_3[s, :] - U_3'[s, :]\|_F^2 + \beta \|U_4[e, :] - U_4'[e, :]\|_F^2 \right)\) 其中当场景或环境此前已学过时,对应指示变量 \(\alpha\) 或 \(\beta\) 设为 1。
- 未见新专家行空间正交优化 (Orthogonal Optimization):对于未见过的新场景或新环境,冻结其他无关专家,仅更新当前专属行 \(U_3[s, :]\) 或 \(U_4[e, :]\),并施加行空间正交约束,确保新旧专家子空间保持正交垂直,消除干涉: \(\mathcal{L}_{\text{es}} = \lambda_3 \left( (1-\alpha) \|\hat{U}_3 \hat{U}_3^T - I\|_F^2 + (1-\beta) \|\hat{U}_4 \hat{U}_4^T - I\|_F^2 \right)\)
3. 测试期任务专家自适应检索 (Task-Specific Experts Search)
- 特征库构建:训练阶段,利用预训练 CLIP 视觉编码器 \(V(\mathcal{O})\) 提取各个场景和环境下的观测图像特征,分别聚类构建场景特征库 \(\{F_{S_1}^e, \dots, F_{S_M}^e\}\) 和环境特征库 \(\{F_{E_1}^e, \dots, F_{E_N}^e\}\)。
- 无 Task-ID 两步余弦匹配:测试阶段,智能体面临未知导航环境 \(S_q\) 时,提取当前视野图特征 \(F_q^e = V(\mathcal{O}_q)\),通过余弦相似度检索匹配最佳场景专家与环境专家: \(s^* = \arg\max_s \text{Sim}(F_q^e, \{F_{S_m}^e\}), \quad e^* = \arg\max_e \text{Sim}(F_q^e, \{F_{E_n}^e\})\) 匹配到的专家向量输入 TuKA 张量生成公式,自动合成针对当前场景与光照的最佳微调权重,彻底摆脱对已知 Task-ID 的依赖。
4. Allday-Habitat 仿真平台与 AML-VLN Benchmark
- 3 种物理退化环境合成:
- 大气散射模型(雾/散射):\(I(x_i) = J(x_i) e^{-\beta d(x_i)} + A (1 - e^{-\beta d(x_i)})\),其中 \(d(x_i)\) 为深度,\(\beta\) 为散射系数,\(A\) 为大气光。
- 非线性低光模型(夜间低光):包含相机响应函数 (CRF)、增益曝光乘积及泊松-高斯混合噪声模型 \(N(x) = N_{\text{shot}}(x) + N_{\text{read}}(x)\)。
- 强光过曝模型:在相机感光前引入传感器动态范围上限饱和截断 \(\text{clip}(\cdot, 0, S_{\text{Sat}})\)。
- 24-Task 终身评估序列:包含 5 个仿真场景与 2 个真实世界场景,结合 4 种环境,构建 24 项连续学习任务序列。评估指标除了包含标准 SR、SPL、OSR 外,还引入遗忘率指标 F-SR、F-SPL、F-OSR。
③ 训练与损失函数
整体微调目标函数结合了自回归导航动作生成的交叉熵损失与三大增量正则化损失: \(\mathcal{L}_t = -\lambda \sum_{n=1}^N \log p_t(A_n, \hat{P}_n \mid I, \mathcal{O}_t) + \mathcal{L}_{\text{ewc}, t} + \mathcal{L}_{\text{co}} + \mathcal{L}_{\text{es}}\) 其中权重满足 \(\lambda = 1 - (\lambda_1 + \lambda_2 + \lambda_3)\)(实验设置 \(\lambda_1=0.2, \lambda_2=0.2, \lambda_3=0.1\))。
3. 核心结果/发现
- 24-Task AML-VLN Benchmark 综合评估:
- 在 24 项连续学习任务的完整序列测试中,基于 TuKA 的 AlldayWalker 取得了平均 65% 的成功率 (SR) 和 58% 的 SPL,大幅超越对比 baseline(包括 SD-LoRA 的 56%/50%、BranchLoRA 的 44%/39%、MoLA 的 33%/26% 以及 EWC-LoRA 的 15%/9%)。
- 在抗遗忘性能 (Forgetting Rate) 上,AlldayWalker 的 SR 遗忘率 F-SR 仅为 11%(相比之下 SD-LoRA 为 18%、BranchLoRA 为 36%、Sequential Fine-Tuning 为 87%),表现出极高的终身记忆稳定性。
- 高阶张量阶数消融 (3rd vs 4th vs 5th order Tensor):
- 对比将场景与环境耦合在一起的三阶张量 \(\mathcal{X} \in \mathbb{R}^{a \times b \times (M \times N)}\),四阶张量通过显式解耦场景模式与环境模式,在所有 20 项测试任务上取得全面超越的 SR 曲线。附录进一步验证了五阶张量在引入更细粒度任务模式时的良好扩展性。
- 共享组件的作用消融 (Core Tensor & En/Decoder Sharing):
- 去掉共享 Core Tensor \(\mathcal{G}\) 或共享编码器 \(U_2\) 会导致 SR 显著下降(由 65% 降至 53% 与 55%),证实共享张量和编码器成功学习到了跨任务通用的基础导航技能。共享解码器 \(U_1\) 则大幅降低了多任务存储开销(仅需 15.64M 参数)。
- 未知场景零样本泛化 (Zero-Shot Generalization on Unseen Scenarios):
- 在 6 个完全未见的全新场景与环境(G1-G6,包含仿真与真实世界低光/正常环境)上测试,AlldayWalker 依靠 CLIP 视觉检索匹配最相似专家,取得了 55% 的平均 SR,超越 SD-LoRA (39%) 达 16%,证明了高阶解耦表示具有优异的零样本泛化与泛化迁移能力。
4. 局限性
- 检索依赖 CLIP 特征质量:推理阶段的任务专家自适应匹配高度依赖预训练 CLIP 视觉编码器的表征能力;若遇到极其异常的极端成像降质(如强重度烟雾覆盖遮挡)导致视觉特征畸变,可能发生专家误匹配。
- 真实机械臂/移动机器人部署耗时:目前主要在仿真平台及有限的真实场景进行验证,在大规模复杂多楼层真实移动机器人终身在线部署中,仍需进一步优化高效在线索引与实时特征抽取推理耗时。
44. AgenticNav (2026)
———将零样本连续环境导航(VLN-CE)重构为 VLM 可调用的 Tool-Calling 架构
📄 Paper: arXiv:2606.10577
精华
- 范式重构:将零样本连续环境视觉语言导航(VLN-CE)重新定义为 VLM 与环境之间的 Tool-Calling 交互 Harness,打破对额外训练的航点预测器(Waypoint Predictor)的依赖。
- 像素级无航点动作控制:提出 Action Tool,允许 VLM 直接在 RGB 图像中点选目标像素 $(u,v)$,由后台 Harness 完成反投影、地平面转向/步长计算与 swept-corridor 扫掠安全碰撞检查。
- 按需深度感知:设计 Pixel-Depth Tool,VLM 可按需查询特定像素的真实物理深度与 $5\times 5$ 局部深度统计信息,无需全量深度图或隐式预测。
- 轻量化 Agentic 记忆:构建结合鸟瞰图 Map Image 与按需 Recall Tool 的 Memory 机制,仅在必要时调取历史节点 RGB 视图,彻底解决 Prompt 上下文过载与跨 Episode 依赖问题。
- SOTA 性能与实机泛化:在 R2R-CE 基准上,以 GPT-5.5 作为 VLM 核心实现 55% SR 与 48.41% SPL(大幅超越 SmartWay 的 44% SR / 35.04% SPL);在真实四轮机器人与复杂室内外场景中展现出极强的 Zero-Shot Sim-to-Real 泛化能力。
1. 研究背景/问题
零样本连续环境视觉语言导航(Zero-Shot VLN-CE)要求智能体在未见过的 3D 物理场景中,无需预定义导航图(Navigation Graph)和策略微调,仅凭自然语言指令和视觉/深度感知完成连续运动控制。大语言/视觉语言模型(VLM)的飞速发展使其成为高层决策核心,但现有方法存在三大严重瓶颈:
- 动作空间受限:Open-Nav、SmartWay 等 SOTA 方法普遍依赖额外训练的航点预测网络(Waypoint Predictor)来推荐候选动作点。若预测器未露出指令所需的关键方向/目标,VLM 将被局限在错误的候选集内,无法选出正确路径。
- 几何/深度感知缺失:现有架构将深度输入当作黑盒提供给航点预测器,或强制 VLM 直接解析复杂的密集深度图,导致 VLM 难以精准评估目标物体的物理距离与空间通达性。
- 记忆机制两难:传统方法通过不断向 Prompt 拼接历史文本/视觉帧来维护记忆,导致 Context 迅速过载并引入大量无关干扰;或者依赖跨 Episode(Cross-episode)经验检索(如 EvoNav),削弱了严格的零样本(Zero-shot)假设。
2. 主要方法/创新点
AgenticNav 将零样本 VLN-CE 重新构建为一种轻量级的 Tool-Calling Harness,将动作生成、深度感知与历史记忆解耦为 4 个可调用的工具接口(Action Tool, Depth Tool, Recall Tool, Stop Tool),在保留 VLM 语义推理与感知自由度的同时,将数值几何计算与安全检查交由确定性的物理 Harness 处理。
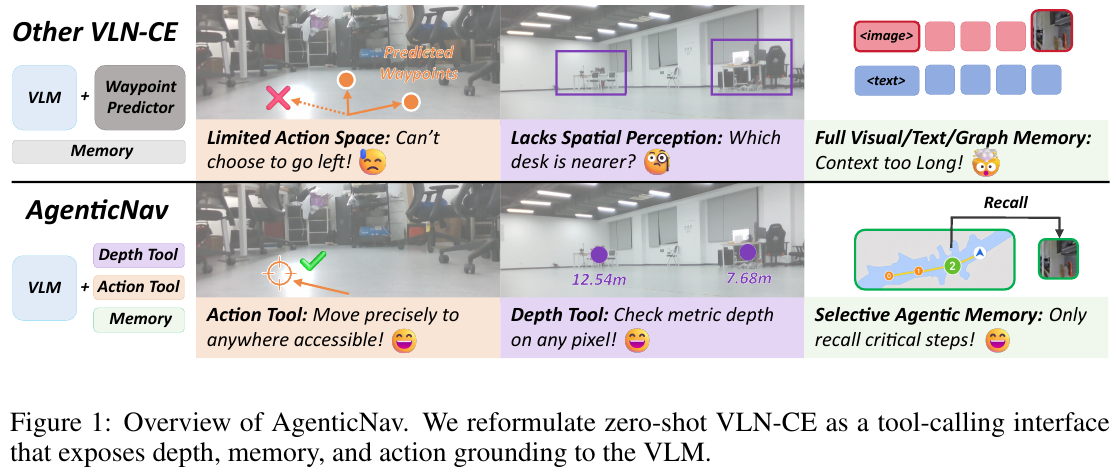
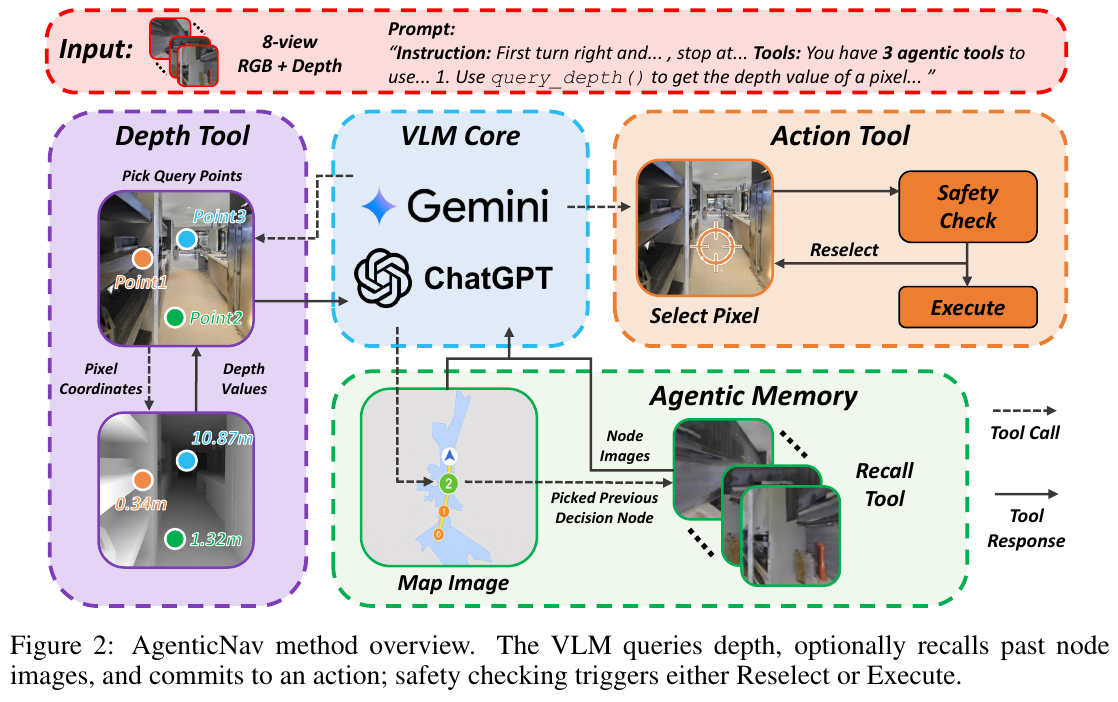
① 整体框架概述
AgenticNav 由 VLM 决策核心 与 四个确定性 Tool 接口 组成:
- Action Tool (
move_to):负责将 VLM 选中的图像像素转化为安全连续控制量。 - Depth Tool (
query_depth):负责向 VLM 提供特定像素的精准物理距离与局部表面特征。 - Agentic Memory (
Map Image+recall):负责维系全局轨迹感知与局部细节的按需检索。 - Stop Tool (
stop):负责判断导航终止。
② 逐模块讲解
1. Waypoint-Free Action Tool (move_to(k, u, v))
- 输入:VLM 选定的视角索引 $k$ 以及归一化像素坐标 $(u, v) \in [0,1]^2$。
- 处理过程:
- 几何反投影:结合相机内参 $K$、外参 $T_k$ 及深度值 $d = D_t^k(x, y)$,将像素 $(x, y)$ 反投影为机器人坐标系下的 3D 目标点: \(p_t = T_k \left( d K^{-1} [x, y, 1]^\top \right)\)
- 运动量计算:提取地平面方位角 $\theta = \text{bearing}(p_{t,xz})$,并根据最大步长限制 $\rho_{\max}$、停止边距 $m$ 及步长离散化间隔 $\Delta$ 计算实际前向距离: \(\rho = \Delta \left\lfloor \frac{\min\left(\rho_{\max}, \max(0, \|p_{t,xz}\| - m)\right)}{\Delta} \right\rfloor\)
- Swept-Corridor 扫掠安全检查:筛选出位于机器人身体高度区间 $[y_{\min}, y_{\max}]$ 内的所有障碍物点云集 $P_t$。沿着航向向量 $b_\theta = (-\sin\theta, \cos\theta)$ 与侧向向量 $\ell_\theta = (\cos\theta, \sin\theta)$ 检查机器人扫掠走廊内是否存在碰撞点:
\(\text{Safe}(\theta, \rho) = \mathbf{1} \left[ \nexists q \in P_t : 0 \lt q_{xz} \cdot b_\theta \lt \rho + r_a \land |q_{xz} \cdot \ell_\theta| \lt r_a \right]\)
其中 $r_a$ 为机器人半径。若检测到碰撞,返回
Reselect反馈提示 VLM 重选;若安全则输出Execute(θ, ρ)。
- 设计动机:摒弃有监督训练的航点预测器,赋予 VLM 直接选择视觉场景中任意可视可达位置(如特定门缝、走廊尽头、家具旁)的自由。
2. On-Demand Pixel-Depth Tool (query_depth(P))
- 输入:候选像素点批量集合 \(P = \{ p_i = (k_i, u_i, v_i) \}_{i=1}^m\)。
- 处理过程:对每个查询点采样相位的深度图,返回结构化信息: \(D(p_i) = \left( d_i, s_i^{5 \times 5}, \hat{\theta}_i, \hat{\rho}_i \right)\) 其中 $d_i$ 为物理深度(米),$s_i^{5 \times 5}$ 为以该像素为中心的 $5\times 5$ 窗口内的深度最小值、均值与中位数(用于判断是否落在边缘或平整表面),\(\hat{\theta}_i\) 与 \(\hat{\rho}_i\) 为预计算的动作预览。
- 设计动机:密集深度图对 VLM 而言极其难以定量解析。按需查询使 VLM 能够在决策前精准对比不同方向(如 “左侧通道是否畅通”、”前方开门处距离多远”),提供可靠的局部空间几何证据。
3. Agentic Memory 与 Visual Recall Tool
- 输入与结构:Episode 内记忆表示为 \(\mathcal{M}_t = (B_t, \mathcal{C}_t)\)。
- $B_t$ 为直接放入 Prompt 中的拓扑 Map Image,直观展示历史轨迹节点与当前方位。
- \(\mathcal{C}_t\) 为过去所有观察视图的缓存。
- Recall 机制:当 VLM 需要核对早期路标(如 “刚才路过路口看到的指示牌”)时,调用
recall(p, k),仅提取第 $p$ 步视角 $k$ 的单帧 RGB 图 \(R_t(p, k) = \mathcal{C}_t[p, k]\) 并追加到 Prompt 中。 - 设计动机:防止 Prompt 随导航步数暴增而溢出,避免无用视觉帧干扰 VLM 注意力,实现高效长程导航。
③ 推理与交互流程
- 初始时刻 VLM 接收语言指令、当前全景 RGB 图及初始 Map Image $B_t$。
- VLM 可根据需要多次调用
query_depth评估感兴趣目标点的距离,或调用recall回溯特定历史视图。 - VLM 调用
move_to输出目标像素;Harness 评估安全检查。若安全则驱动机器人移动并更新 Map Image;若不安全则反馈Reselect提示重新决策。 - 达到目标区域后,VLM 调用
stop()完成任务。
3. 核心结果/发现
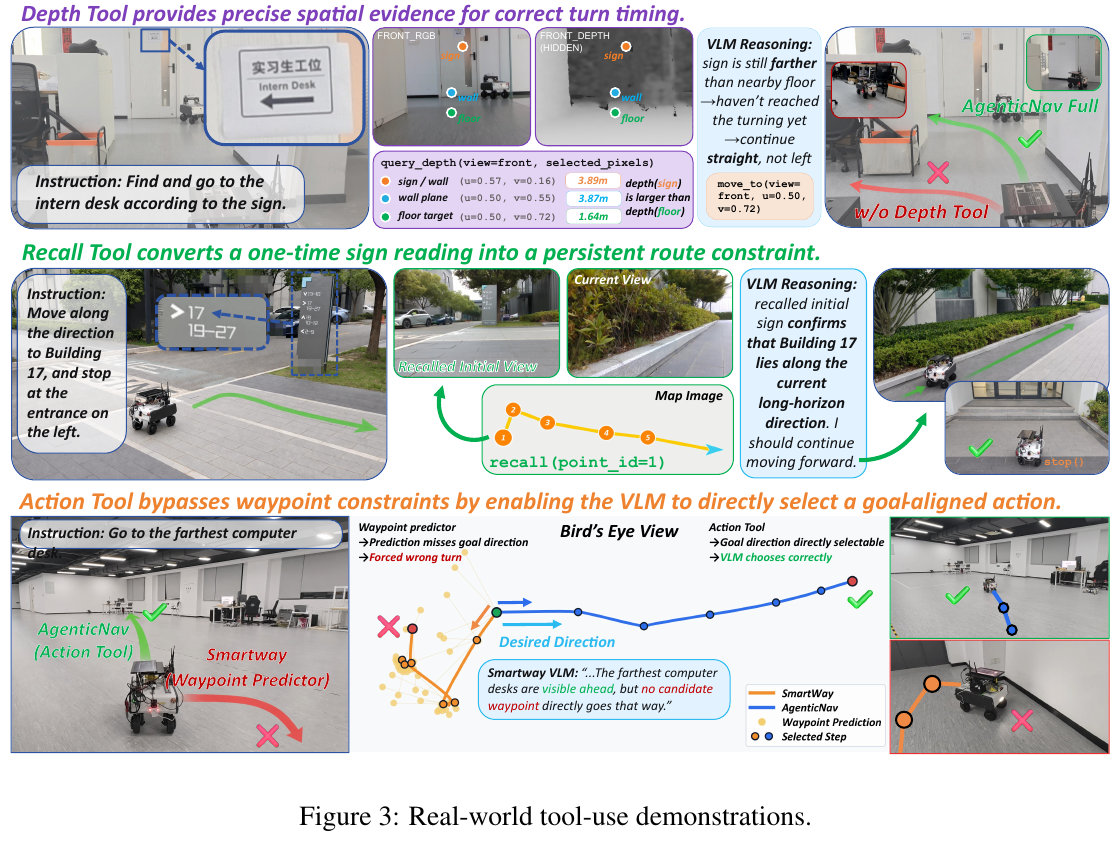
1. R2R-CE Simulation 评估(R2R-CEval Unseen 100 Episodes)
在严格相同 VLM Backbone(GPT-5.5 / Gemini-2.5-Pro)下,AgenticNav 刷新了 Zero-Shot VLN-CE 性能记录:
- AgenticNav-GPT-5.5 取得了 55% SR、48.41% SPL、65% OSR、63.41 nDTW 和 5.19 m NE,相较于同 Backbone 重现的 SOTA Baseline SmartWay-GPT-5.5(SR 44%, SPL 35.04%),SR 提升 11%,SPL 显著提升 13.37%。
- AgenticNav-Gemini-2.5-Pro 取得 49% SR,超越了 Open-Nav(23% SR)以及依赖跨 Episode 经验检索的 EvoNav(43% SR)。
2. 消融实验分析(Ablation Study)
在 R2R-CE 上对各个 Tool 模块进行剥离测试:
- 替换 Action Tool 为 Waypoint Predictor:SR 下降 5%(55% $\to$ 50%),SPL 下降 4.42%,证明自由选择视觉目标像素优于选择模型推荐的候选航点。
- 移除 Depth Tool:SR 骤降至 42%;若改为直接输入完整深度图,SR 恢复至 53%,但仍低于按需查询的 55%,证明结构化局部深度查询更契合 VLM 的推理模式。
- 移除 Agentic Memory:SR 跌至 41%;若仅保留 Map Image 而无 Recall Tool,SR 为 51%,证明 Visual Recall Tool 在长程/指示牌识别任务中不可或缺。
3. Real-World 实机测试
在包含实验室、办公区及户外庭院的 30 个复杂真实场景中部署于四轮全向机器人:
- 单视角模式(1-view):SR 达 33.3%,导航误差 NE 为 3.20m(SmartWay 为 23.3% / 3.57m)。
- 四视角模式(4-view):SR 提升至 46.7%,NE 降至 2.67m,对比 SmartWay 成功率翻倍(在户外庭院等广角场景优势尤为显著)。
4. 局限性
- 对基础 VLM 决策能力强依赖:失败分析表明,仿真中 88.9% 的失败及真实世界中 71.4% 的失败源自 VLM 本身的错误判断(如房间/分支选择错误或最终停靠偏离),硬件与控制失败仅占极小比例。
- 云端 API 延迟与网络依赖:依托云端大型 VLM API 带来了明显的推理时延与网络波动风险,限制了实时高频闭环控制能力。
- 环境假设依赖:依赖准确的局部定位与 RGB-D 传感器质量,在极端无特征或深度缺失区域表现受限。
45. MemVLN (2026)
———模拟人类双重记忆机制的高效连续环境视觉语言导航框架
📄 Paper: arXiv:2607.23504
精华
- 认知驱动的双记忆解耦:借鉴人类大脑的“情景记忆(Episodic Memory)”与“程序记忆(Procedural Memory)”,将连续环境视觉语言导航(VLN-CE)中的长时序视觉历史管理与低延迟动作决策解耦。
- 像素级金字塔分辨率(Pyramidal Resolution):基于观察注意力分布中“近强远弱”的先验,对不同时间跨度的历史帧进行像素级下采样,在保留完整拓扑感知与长程视角的前提下大幅压缩视觉 Token 序列长度。
- 架构无缝兼容性:相较于在隐空间破坏 2D 均匀网格的 Token Merging 方法,金字塔分辨率在原始像素空间保留了严格的 2D 拓扑结构,天然兼容 M-RoPE 和 DeepStack 等最新 LVLM 架构。
- 单次自回归避让(Fast Action):在程序记忆中构建扩充的原子中级动作词表($A_{aug}$),将多步/复合动作映射为单个 Token 预测,彻底消除了传统 LLM 多 Token 自回归解码带来的高延迟,实现 14 FPS 实时导航。
1. 研究背景/问题
- 核心问题:在连续环境视觉语言导航(VLN-CE)任务中,智能体既需要维持长时序的视觉历史以保证轨迹一致性、避免漂移,又需要在连续控制下具备极低的动作响应延迟(高 FPS)。
- 主要瓶颈:
- 长时序上下文爆炸:将所有历史高分辨率图像直接喂入 LVLM,会导致 Token 长度迅速膨胀,计算开销呈二次方增长;
- 自回归解码延迟:传统 LVLM 在预测动作时依赖多 Token 逐字自回归解码,首 Token 首帧 Prefill 与后续 Token 生成导致单步延迟超过 300ms,无法满足实时机器人控制要求。
2. 主要方法/创新点
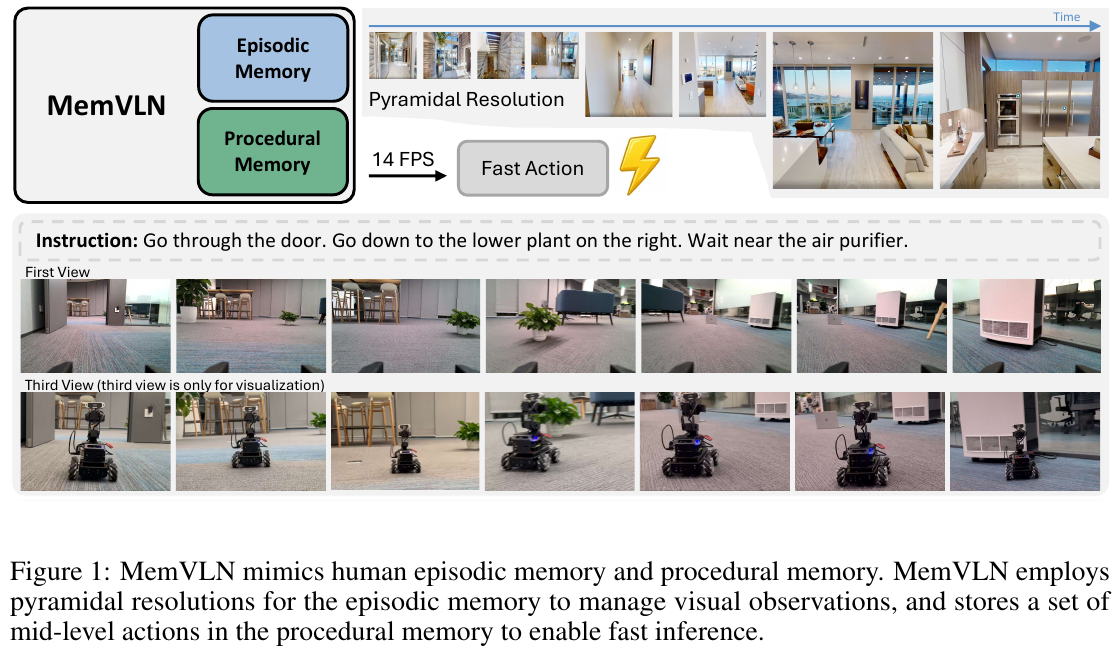
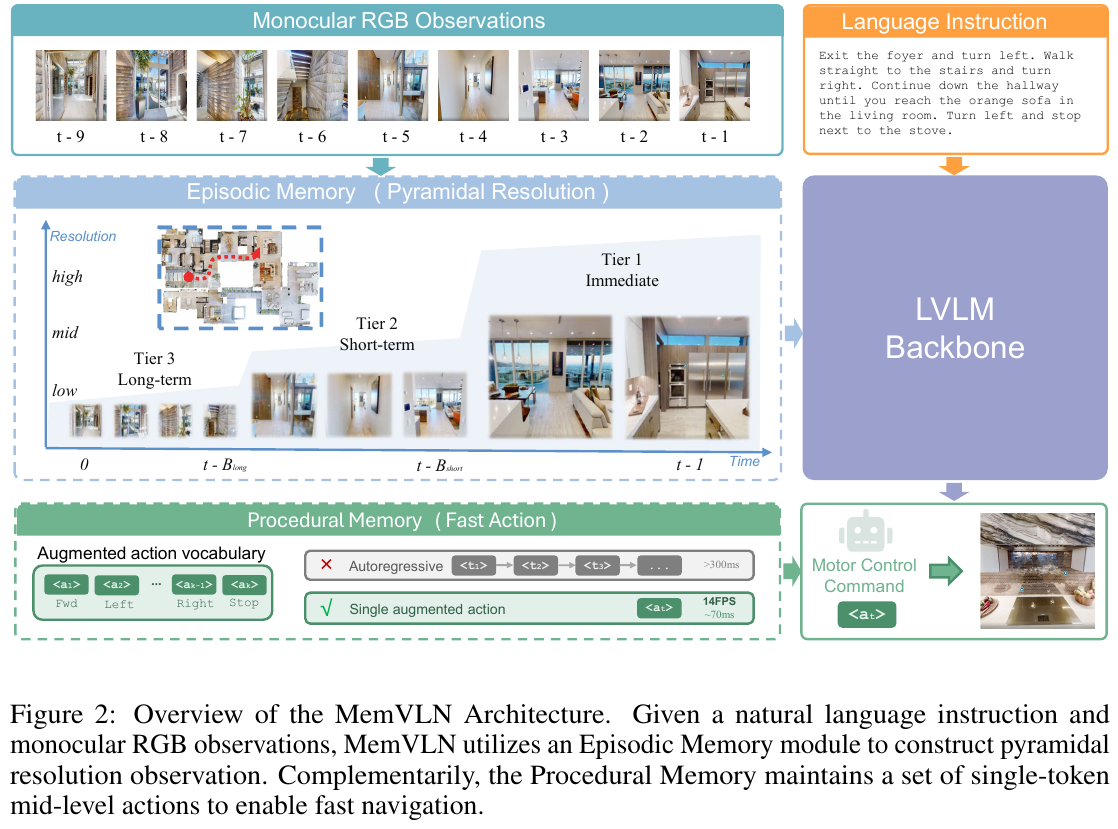
① 整体框架概述
MemVLN 框架由情景记忆模块(Episodic Memory)、视觉编码与多模态 LLM 主干(Visual Encoder & LVLM Backbone)以及程序记忆模块(Procedural Memory)三大核心组成。智能体在连续时间步接收单目 RGB 观察流与自然语言指令,通过情景记忆对历史帧进行金字塔分辨率重采样,拼接后经视觉编码器和 LLM 提取跨模态上下文,最终由程序记忆模块单次输出原子动作 Token,实现 14 FPS 的高效闭环控制。
② 逐模块讲解
A. 情景记忆模块:金字塔分辨率(Pyramidal Resolution)
- 输入:从起始步到当前步的完整单目 RGB 历史观察帧序列 $H_t = {v_0, v_1, \dots, v_{t-1}}$。
- 处理过程:
- 注意力先验分析:实测表明近期的 4 帧观察占据了超过 50% 的视觉注意力分配,且距离越近注意力权重呈指数级递增;
- 三级时间梯队划级:将历史帧按时间距离划分三个阶梯(即刻 Immediate、短期 Short-term、长期 Long-term),分别设置递减的分辨率 $r_{imm} > r_{short} > r_{long}$: \(v_t' = \begin{cases} \mathrm{Rescale}(v_t, r_{imm}), & T - B_{short} < t \le T - 1 \\ \mathrm{Rescale}(v_t, r_{short}), & T - B_{long} < t \le T - B_{short} \\ \mathrm{Rescale}(v_t, r_{long}), & 0 \le t \le T - B_{long} \end{cases}\)
- Token 预算分配:精细设置 $r_{long}$ 与 $r_{short}$,使得累计的长期历史 Token 总数不超过单个即刻高分辨率帧的 Token 量。
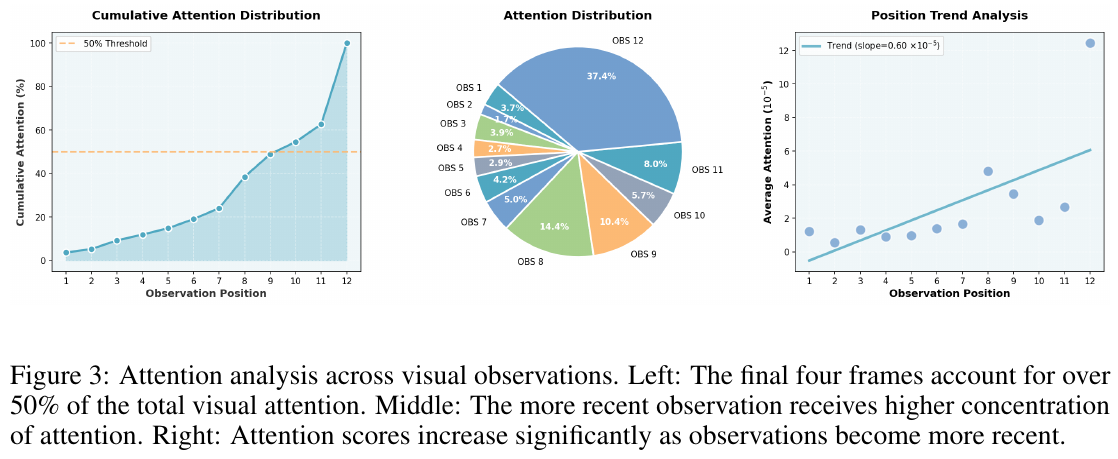
- 输出:经过像素级降采样的高效视觉帧集合 $S_t \subset H_t$ 及对应的视觉特征 $F_t = E_{vis}(S_t)$。
- 设计动机与优越性:对比 Uni-NaVid 或 StreamVLN 使用的 Token Merging(在隐空间按语义相似度聚类),Token Merging 会打乱 2D 像素阵列的规整网格,破坏现代 LVLM(如 Qwen2/3-VL)中的 M-RoPE 位置编码及 DeepStack 架构。而金字塔分辨率在原始像素空间下采样,保留了严格的 2D 拓扑物理结构,天然兼容最新的 3D/多模态位置编码。
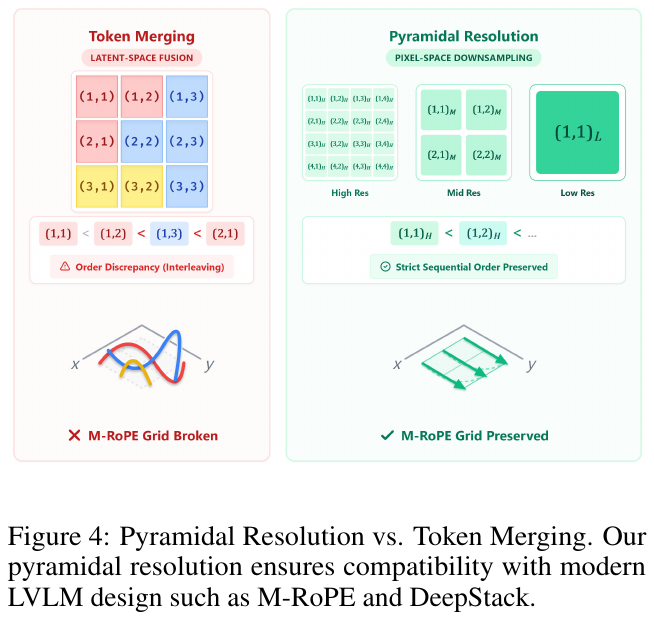
B. 程序记忆模块:单次快速动作生成(Fast Action)
- 输入:LVLM Backbone 融合后的跨模态隐层特征。
- 处理过程:
- 瓶颈分析:实验表明,LLM 解码首 Token 需 Prefill(约 70ms),后续逐 Token 自回归生成线性叠加延迟(10 个 Token 需 360ms)。
- 扩充中级动作词表($A_{aug}$):重用 LLM 词表中的单 Token 符号,重新映射为扩充的原子中级动作集(包含不同距离的前进 $25\text{cm}/50\text{cm}/75\text{cm}$、不同角度的转向 $15^\circ/30^\circ/45^\circ$ 以及 Stop)。
- 单次预测(One-shot Prediction):将复合动作预测转化为重用词表上的单 Token 分类任务,在单个 Forward Pass 内完成决策。
- 输出:单个中级动作 Token $a_t \in A_{aug}$,直接映射为底盘控制指令。
- 设计动机:借鉴人类程序记忆(自动化执行熟练动作技能的隐式记忆),绕过逐字自回归解码,将推理延迟从 >300ms 降低至 70ms(14 FPS)。
③ 端到端数据流
- 当前步 $t$ 获取单目 RGB 图像 $v_{t-1}$,与历史序列合并为 $H_t$;
- 经过情景记忆进行三级分辨率划分与 Rescale,得到像素级金字塔帧集合 $S_t$;
- 视觉编码器提取特征 $F_t = E_{vis}(S_t)$,与语言指令 $I$ 拼接;
- 送入 Qwen3-VL 4B/8B 主干,提取跨模态表示;
- 程序记忆 Head 输出单个动作 Token $a_t \in A_{aug}$ 并由 Habitat 仿真器/底盘执行。
④ 训练目标 / 损失函数
采用监督微调(SFT)训练策略,对于长度为 $T$ 的轨迹,最小化真值动作 \(a_t^*\) 的标准交叉熵损失(Cross-Entropy Loss):
\[L = -\frac{1}{T} \sum_{t=1}^{T} \log P(a_t^* \mid F_t, I; \theta)\]其中 $\theta$ 为 MemVLN 的可训练参数。
⑤ 推理流程
推理时无需任何迭代自回归循环,每时间步仅进行一次 Forward 传递,输出单个 Token 动作,实现实时闭环控制。
3. 核心结果/发现
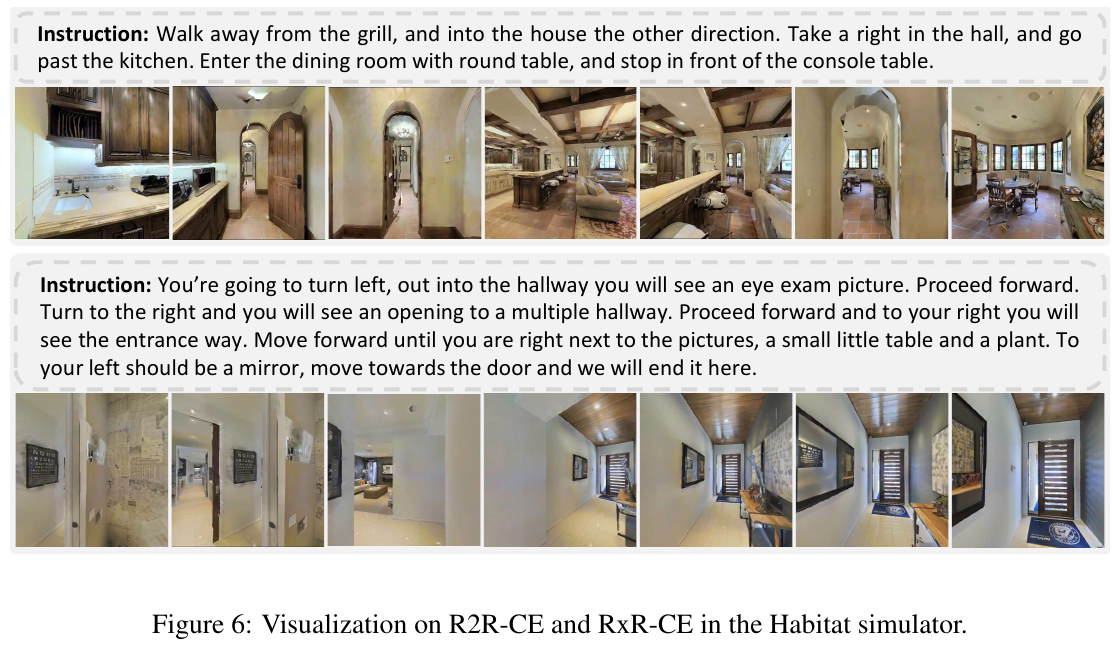
- R2R-CE Val Unseen 主结果:
- MemVLN-4B:NE 5.34、OS 63.2%、SR 56.6%、SPL 50.0%。
- MemVLN-8B:NE 4.98、OS 65.3%、SR 58.4%、SPL 51.2%。8B 版本取得 MemVLN 在 R2R-CE 上的最高 OS、SR 和 SPL;与 StreamVLN-7B(NE 4.98、OS 64.2%、SR 56.9%、SPL 51.9%)相比,SR 更高,但 SPL 略低。
- RxR-CE Val Unseen 主结果:
- MemVLN-4B:NE 4.22、SR 66.5%、SPL 57.4%。
- MemVLN-8B:NE 4.56、SR 66.0%、SPL 57.3%。4B 版本在 RxR-CE 的三项指标上均略优于 8B,并明显超过 StreamVLN-7B(NE 6.22、SR 52.9%、SPL 46.0%)和 NaVILA-8B(NE 6.77、SR 49.3%、SPL 44.0%)。该表未报告 RxR-CE 的 OS 指标。
- 总体发现:MemVLN 仅使用单目 RGB(sRGB)观测,不依赖全景图、里程计或深度输入;其中 8B 版本在 R2R-CE 上更强,而 4B 版本在更长、更复杂的 RxR-CE 上表现最佳,说明模型规模增大并未在两个基准上带来一致收益。
4. 局限性
- 端侧计算部署受限:虽然实现了 14 FPS 实时推理,但模型仍依赖高性能 GPU 显存(实验环境为 H200),在功耗受限的移动机器人边缘设备(如 Jetson Orin)上部署仍需进一步量化与轻量化剪枝。
- 极大参数规模扩展性:在千亿/万亿参数规模大模型的进一步扩展上,受到单卡显存与长时序训练开销的限制。
46. X-NavDP (2026)
———多构型机器人通用视觉导航的组内 Q 值重加权 Diffusion RL 强化学习微调框架
📄 Paper: arXiv:2607.28560 · 🏛️ CoRL 2026 · Code
💻 Code: InternRobotics/NavDP
精华
- 解决核心痛点:传统扩散导航策略依赖全局特权规划器模仿学习,缺乏局部视场下的自救探索与多构型适应能力,而常规 RL 算法在扩散策略微调中易面临似然计算不稳定或高斯探索破坏轨迹平滑性的难题。
- 自引导轨迹扰动:利用预训练模型内部的无目标(Goal-Agnostic)预测分支与坐标翻转组合,在保留扩散模型先验与时间平滑性的同时生成侧向、倒车与绕行等高多样性探索动作。
- 组内 Q 值重加权(GQRM):提出在同状态(Same-State)候选动作组内归一化 Q 值,解决了全局 Minibatch 归一化在困难低收益状态下梯度信号被掩盖的问题,实现高效稳健的扩散 actor 更新。
- 轻量化构型 FiLM 调制:通过在 Transformer 解码器输入与输出特征层注入构型 Embedding,用单套网络权重统一控制轮式、四足与人形(Dingo、Unitree Go2、G1)三种异构机器人。
- 大幅提升性能:在 40 个未见模拟场景中成功率由 61.20% 提升至 84.28%,并在真实世界死胡同自救等困难场景中将成功率由 10% 提升至 65%,仅需 12 小时并行 RL 训练。
1. 研究背景/问题
基于大规模数据预训练的扩散视觉导航策略(如 NavDP、NoMaD)具备极强的零样本泛化能力。然而,现有方法主要采用模仿学习(Imitation Learning),监督数据由全局全知规划器生成。这种训练范式存在两大天然缺陷:
- 决策歧义与无自救能力:真实部署时机器人仅能获取局部 Visual RGB-D 观测,全局最优轨迹与局部视觉的失配严重抑制了策略的自主探索,导致机器人面对死胡同(Dead-End)或长障碍物时无法后退或绕行自救。
- 构型盲目性(Embodiment-Blind):数据生成未考虑不同机器人的物理运动约束与动力学差异,难以直接跨机器人平台迁移。
虽然强化学习(RL)是解决交互试错与构型适用的有效途径,但扩散策略的 RL 微调存在极高的技术瓶颈:
- 基于策略梯度的微调方法(如 DPPO)需要穿透长扩散去噪链计算似然,导致训练极不稳定;
- 基于隐空间的微调方法(如 DSRL)冻结去噪核心参数,极大限制了探索能力;
- 基于重加权分段匹配的方法(如 DPMD)虽然稳定,但在全局 Minibatch 归一化下,困难状态的低绝对收益导致梯度失真。
2. 主要方法/创新点
X-NavDP 构建了一套高性能的扩散策略强化学习后训练框架。系统由三大核心模块构成:构型 FiLM 条件调制模块负责跨构型感知,自引导轨迹扰动模块生成兼具先验与多样性的探索候选,组内 Q 值重加权匹配(GQRM)在同状态组内精确计算策略改进方向,最后通过闭环时域引导(RTC)保障部署推演的连续平滑。
① 整体框架与分层控制
X-NavDP 采用分层控制架构:
- 高层导航策略:输入局部 RGB-D 图像与 PointGoal 目标坐标,扩散模型输出 $H$ 步未来航点轨迹 Chunk(如 3 秒轨迹);
- 低层控制栈:统一的 MPC 控制器将航点 Chunk 转化为底盘速度指令,再由机器人特定的低层足行/轮运动控制策略(25 Hz)执行。
- 并行训练环境:在 IsaacLab 中并行运行 500+ 个涉及轮式(Dingo)、四足(Unitree Go2)、人形(Unitree G1)机器人的仿真环境,高层策略按 3 秒宏观步(Macro-Step)收集 Replay Buffer。
② 自引导轨迹扰动(Self-Bootstrapped Perturbation)
直观上,直接给轨迹添加高斯噪声会破坏航点的时间连续性与动力学可行性。X-NavDP 发现:预训练策略在无目标(Goal-Agnostic)条件下的输出天然保持场景一致性且探索更激进。
因此,对同一视觉观测,算法同时采样有目标轨迹 \(\tilde{\tau}_{\text{pointgoal}}\) 与无目标轨迹 \(\tilde{\tau}_{\text{nogoal}}\),并进行带符号外推混合:
\[\tau_{\text{mixed}} = \mathbf{s} \odot \left( \tilde{\tau}_{\text{pointgoal}} + \lambda \tilde{\tau}_{\text{nogoal}} \right)\]其中 $\mathbf{s} = ((-1)^{B_1}, (-1)^{B_2})$ 是由伯努利分布生成的随机符号向量,对整体 Chunk 的 $x, y$ 坐标独立按概率 $\epsilon$ 进行翻转。这种设计能够原生地生成平滑的倒车、侧向避障与侧退自救轨迹。
举个例子(自引导扰动数据流): 假设机器人陷入死胡同,有目标预测 \(\tilde{\tau}_{\text{pointgoal}}\) 给出向前微动 $[+0.2, 0.0]$,单纯加高斯噪声可能得到 $[+0.2+\mathcal N, 0.0+\mathcal N]$(机器人剧烈抖动碰撞); 而无目标预测 \(\tilde{\tau}_{\text{nogoal}}\) 给出大范围探索航点 $[+0.5, +0.6]$。通过外推和符号翻转 $\mathbf s = (-1, -1)$,合成轨迹变为 $[-0.2, -0.6]$——产生了一条极其平滑且符合物理约束的倒车绕行轨迹!
③ 组内 Q 值重加权匹配(Group Q-Score Reweighted Matching, GQRM)
为解决标准 DPMD 在 Minibatch 全局归一化时“简单状态高收益掩盖困难状态低收益”的缺陷,GQRM 强制在同一状态下的候选动作组 $G(s)$ 内计算统计量:
组内均值与标准差公式: \(\bar{Q}_G(s) = \mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s)} [Q(s, a_0)], \quad \sigma_G(s) = \sqrt{\mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s)} [(Q(s, a_0) - \bar{Q}_G(s))^2]}\)
组内归一化优势值: \(\tilde{Q}_G(s, a_0) = \text{clip}\left( \frac{c (Q(s, a_0) - \bar{Q}_G(s))}{\sigma_G(s) + \varepsilon}, -h, h \right)\)
GQRM 的 Actor 优化目标: \(\mathcal L_{\text{GQRM}}(\theta; s, t) = \mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s), a_t \sim q_{t \mid 0}(\cdot \mid a_0)} \left[ \exp(\tilde{Q}_G(s, a_0) / \lambda) \left\lVert s_\theta(a_t; s, t) - \nabla_{a_t} \log q_{t \mid 0}(a_t \mid a_0) \right\rVert^2 \right]\)
在实践中,每次仅保留同状态候选组中优势值大于零前 $k$ 个候选动作(Top-$k$ Positive Advantage),既削减了低质量样本噪声,又大幅节省了计算开销。
| 维度 | 传统 DPMD 做法 | 本文 GQRM 做法 |
|---|---|---|
| 归一化范围 | 跨 Minibatch 内不同状态混合归一化 | 仅在同一状态采样的候选动作组内归一化 |
| 困境表现 | 简单状态的大 positive return 掩盖困难状态的相对优劣 | 即使绝对 return 全为负,也能区分出局部更优的倒车自救动作 |
| 梯度权重 | 困难状态样本权重接近于 0,无法学习自救 | 困难状态的局部相对优胜者获得指数级强化权重 |
④ 构型 FiLM 调制与闭环时域引导
- 构型 FiLM 调制(Embodiment Modulation):将机器人 ID 转换为 Embedding $\mathbf z_e = E_{\text{emb}}(e)$,一方面作为 Action Token 前的偏置 $\mathbf u_e = \mathbf u + f_\Delta(\mathbf z_e)$,另一方面通过 FiLM 生成缩放与偏移参数 $[\Delta \gamma_e, \Delta \beta_e] = f_{\text{FiLM}}(\mathbf z_e)$ 调制解码器输出特征 $\mathbf h_e = (1 + \Delta \gamma_e) \odot \mathbf h + \Delta \beta_e$,使得单套主干模型能感知不同机器人的宽度、转弯半径及推力特性。
- 闭环时域引导(RTC Guidance):推理部署时,在 DDPM 反向去噪步骤中引入前一预测轨迹的时域平滑梯度,更新公式为 \(\mathbf x_t^{(k-1)} = \boldsymbol \mu_k + \sigma_k \mathbf z + \sqrt{\bar{\alpha}_k} \eta_{\text{guide}} \mathbf g\),有效消除了滚动时域预测中的轨迹抖动。
graph TD
    A["输入: 局部 RGB-D + PointGoal + 机器人 ID"] --> B["构型 FiLM 模块注入 Robot Embedding"]
    B --> C["自引导扰动策略采样同状态候选组 G(s)"]
    C --> D["Twin Critics 评估候选组轨迹 Q(s, a0)"]
    D --> E["同状态组内归一化计算优势值 Q_tilde_G"]
    E --> F["保留 Top-k 正优势动作指数重加权"]
    F --> G["优化 Diffusion Score Network 去噪目标"]
    G --> H["MPC 追踪执行 + RTC 闭环平滑引导"]
3. 核心结果/发现
- 仿真基准全方位超越:在 IsaacLab 40 个未见测试场景中,X-NavDP 相比预训练基线 NavDP,平均成功率(SR)从 61.20% 提升至 84.28%,SPL 从 58.95% 提升至 77.19%。特别是在人形机器人(Unitree G1)上,Home 场景成功率从 50.70% 骤升至 84.50%。
- 真机硬核困境自救:在无真机微调(Zero-Shot Sim-to-Real)情况下部署于 Turtlebot、Unitree Go2 和 Unitree G1,在死胡同、长墙绕行等硬核测试集中,成功率从基线的 10% 飙升至 65%。
- 消融实验关键发现:
- 移除自引导扰动与轨迹反向会导致 RL 训练直接崩溃(SR 跌至 6.23%);
- 相比于 Soft-Prompt 拼接,FiLM 构型调制在多场景扩展时展现出更强的跨构型适应性;
- 相比于 DPPO 和 DSRL,GQRM 展现出极高的训练稳定性和数据效率(仅需 12 小时后训练)。
4. 局限性
- 短时域上下文依赖:策略当前主要依赖短时域视觉上下文,缺少长期拓扑记忆,在极长的墙体绕行中可能因记忆消退出现重复打转。
- 低层控制器依赖:跨构型泛化依赖于预先训练好的低层足行/轮式控制器,在非常规构型上的扩展需要先具备对应的基底控制器。
- 透明与空洞障碍物感知:对玻璃隔断、网格孔洞面板等透明/高穿透力障碍物的 RGB-D 深度测量易失效,需引入更强语义感知。
47. Image2Sim (2026)
———解耦 3D 空间锚定与超真实图像合成的实时神经仿真引擎
📄 Paper: arXiv:2607.05765 · Code
精华
- 打破几何与合成的博弈:Image2Sim 提出了“3D 空间锚定”与“超真实图像合成”解耦的神经仿真范式,利用前馈 3D 特征高斯(Feature Gaussian)提供显式度量几何约束,再由单步像素流(Pixel Flow)生成模型在 3D 几何 Alpha 掩码引导下补全未观测视野。
- 实时闭环高帧率仿真:采用连续时间 MeanFlow 单步速度估计与动量自蒸馏(Momentum-based Self-Distillation),将传统扩散/流匹配模型的多步迭代采样压缩为单步映射,在全景 RGB-D 渲染上达到 45.6 FPS,首次满足具身导航在线闭环交互与 DAgger/RL 训练的实时性要求。
- 自动化具身数据引擎:通过显式高斯体素化、GPU 平行光线步进碰撞查询与 collision-aware NavFn 规划,直接从无标注视频/图像构建近 2 万个交互式神经环境,并自动合成了超过 1000 万条跨视角、高保真的导航轨迹与多模态指令数据。
- 强跨域与 Scaling 律验证:基于纯 Image2Sim 神经环境训练的导航策略 Image2Nav,在完全不接触真实 Habitat 建模的情况下,跨模拟器 zero-shot 泛化至 R2R-CE(SR 70.3%)、RxR-CE 和 REVERIE-CE 刷新 SOTA,并在真实物理机器人(Hello Robot Stretch 3)上展现出卓越的零样本迁移能力。
1. 研究背景/问题
具身导航(Embodied Navigation)要求智能体在 3D 空间中准确理解多模态目标并执行物理动作。然而,构建大规模、高保真且具备物理接地(Physical Grounding)的交互式仿真环境长期存在矛盾:
- 真实扫描环境(如 Matterport3D、HM3D):视觉与几何真实度极高,但依赖昂贵的人工扫描与数字孪生重建,环境数量受限于数百到数千场景,无法支撑大规模策略预训练。
- 合成/程序化环境(如 AI2-THOR、ProcTHOR):极易大规模扩展,但包含大量人工 3D 资产与非真实渲染统计量,存在严重的 Sim-to-Real 跨域鸿沟。
- 传统生成式世界模型(World Models):能合成逼真视频,但缺乏显式持久的 3D 空间结构与物理碰撞面,无法支持智能体进行自由连贯的闭环导航动作交互。
为了兼具高真实度、无限扩展性与物理闭环性,Image2Sim 提出直接从无约束的姿态 RGB-D 图像/视频序列中构建可交互的实时神经仿真环境。
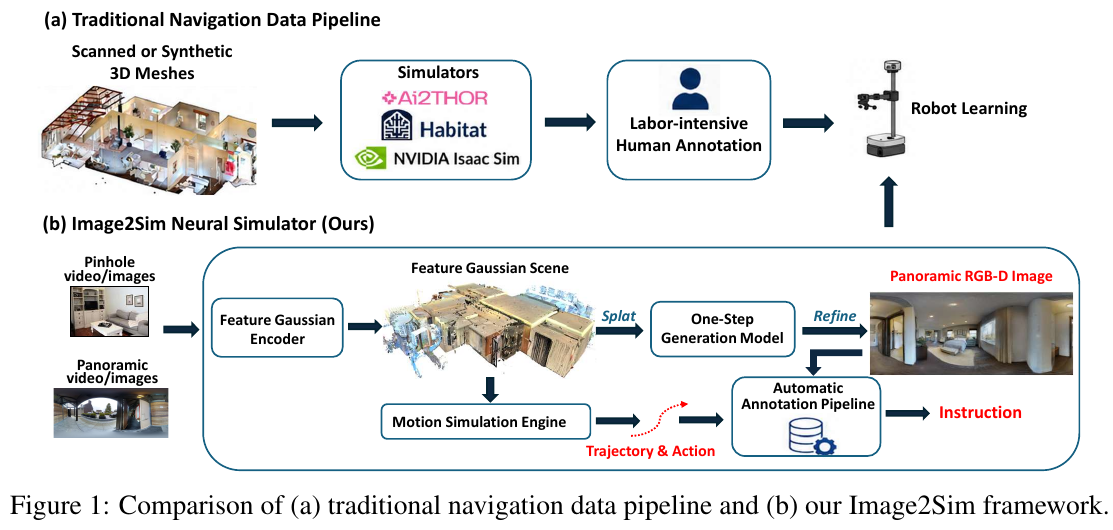
2. 主要方法/创新点
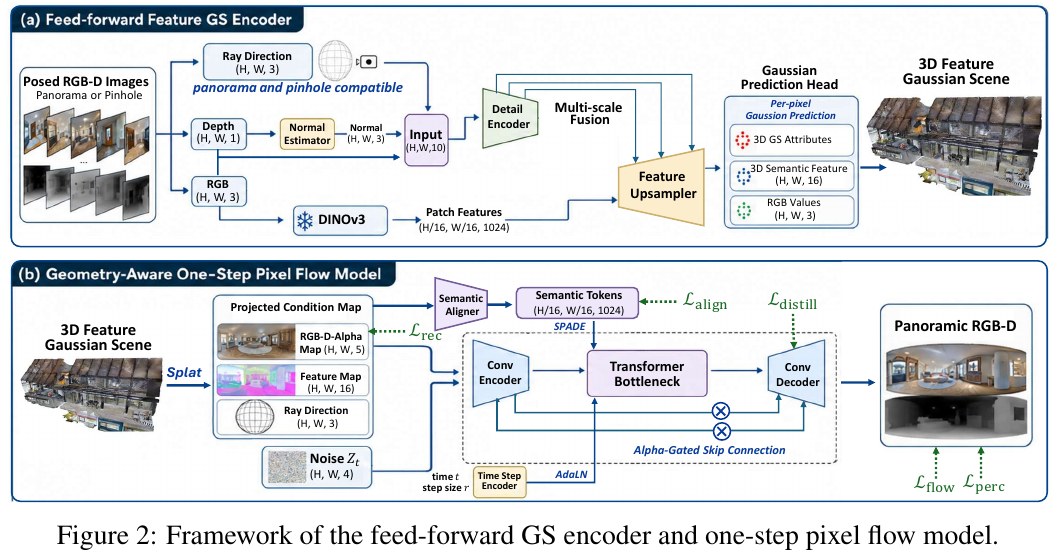
Image2Sim 的核心创新在于将神经环境建模拆分为两个解耦的模块:前馈 3D 特征高斯几何构建(提供持续 3D 空间锚定)与几何感知单步 Pixel Flow 渲染(负责未观测盲区的超真实生成补全)。
① 前馈 3D 特征高斯几何构建(Feed-Forward 3D Gaussian Encoder)
- 输入:任意姿态的 RGB-D 帧(支持针孔相机与全景相机),通过射线方向编码(Ray-Direction Encoding)统一表达。
- 处理:双流编码器提取特征——冻结的 DINOv3 主干捕捉高层语义特征,轻量级几何细节流保留 RGB、深度与法向量。特征融合后由预测头一次性反投影并生成 3D 特征高斯集合 \(\mathcal G = \{g_j\}_{j=1}^M\)。每个高斯元组包含中心 $\mathbf \mu_j \in \mathbb R^3$、缩放 $\mathbf s_j$、旋转 $\mathbf q_j$、不透明度 $\alpha_j$、颜色 $\mathbf c_j$ 及语义特征 $\mathbf f_j$。
- 输出:在目标位姿 $p$ 下投影得到的全景 RGB 图 \(\tilde{\mathbf I}_p\)、深度图 \(\tilde{\mathbf D}_p\)、透明度图 \(\tilde{\mathbf A}_p\) 和特征图 $\mathbf C_p$。
- 设计动机:摒弃传统 NeRF/3DGS 逐场景优化(Per-Scene Optimization)耗时数小时的缺点,实现单次前馈毫秒级构建 3D 场景。
② 几何感知单步 Pixel Flow 渲染器(Geometry-Aware One-Step Pixel Flow)
当智能体移动到未观测视角时,直接用 3DGS 飞溅渲染会产生大量破洞与伪影(黑洞盲区)。Image2Sim 设计了一个以概率流 ODE(Probability Flow ODE)为基础的 Pixel Flow 生成模型:
-
Alpha 门控源状态(Alpha-Gated Source State):利用 3DGS 渲染得到的透明度图 \(\tilde{\mathbf A}_p\) 衡量 3D 投影的几何可靠度。构造空间自适应噪声尺度: \(\Sigma(\tilde{\mathbf A}_p) = \tilde{\mathbf A}_p \odot \sigma_{\mathrm{small}} + (1 - \tilde{\mathbf A}_p) \odot \sigma_{\mathrm{large}}\) 由此生成 Alpha 门控源状态: \(\mathbf z_{\mathrm{src}} = \tilde{\mathbf A}_p \odot \tilde{\mathbf X}_p + \Sigma(\tilde{\mathbf A}_p) \odot \mathbf \epsilon, \quad \mathbf \epsilon \sim \mathcal N(\mathbf 0, \mathbf I)\) 在 3DGS 已观测的高 Alpha 区域保持原始投影细节;在低 Alpha 盲区输入较大噪声,引导生成模型进行合理补全。
-
网络结构:基于 UNet 架构,卷积编码器压缩源状态 $\mathbf z_{\mathrm{src}}$ 与几何条件 $\mathbf C_p$,Deep Transformer 瓶颈层引入 AdaLN 时间注入与 SPADE 式空间自适应归一化(注入 DINOv3 语义特征 $\Phi(\mathbf C_p)$)。上采样阶段采用 Alpha 金字塔门控跳跃连接(Alpha-Gated Skip Connections),保护高透明度区域的几何细节不被生成网络破坏。
举个例子(Alpha 门控手算推演): 假设智能体转头看向门后区域,全景图某像素在 3DGS 投影中透明度为 \(\tilde{A}_p = 0.95\)(已有已知几何),而旁边未被扫描到的墙角透明度为 \(\tilde{A}_p = 0.05\)(纯盲区)。 设 $\sigma_{\mathrm{small}}=0.01$,$\sigma_{\mathrm{large}}=1.0$。
- 已知区域噪声标准差仅为 $0.95 \times 0.01 + 0.05 \times 1.0 = 0.0595$,网络输入近乎纯净的投影 RGB-D 证据;
- 盲区像素噪声标准差达到 $0.05 \times 0.01 + 0.95 \times 1.0 = 0.9505$,网络收到强噪声信号,触发 generative 扩散/流匹配机制填充合理纹理与深度。
graph TD
    A["姿态 RGB-D 观测"] --> B["前馈 3D 特征高斯模型 (GS Encoder)"]
    B --> C["全景投影: 投影 RGB-D + 透明度 Alpha 图 A_p"]
    C --> D{"Alpha 门控分流"}
    D -- "高 Alpha (已知几何)" --> E["保留原始 3DGS 投影 + 小噪声"]
    D -- "低 Alpha (未观测盲区)" --> F["注入高斯噪声 Σ(A_p) ⊙ ε"]
    E --> G["Alpha 门控源状态 z_src"]
    F --> G
    G --> H["MeanFlow 单步 UNet/Transformer 瓶颈"]
    H --> I["速度场估计 V_θ (JVP 评估)"]
    I --> J["单步生成高保真全景 RGB-D (45.6 FPS)"]
    K["EMA TeacherPrivileged GT 条件"] -. "动量自蒸馏 L_distill" .-> H
③ Continuous-Time MeanFlow 与动量自蒸馏(Momentum Self-Distillation)
- MeanFlow 单步连续映射:传统 Flow Matching 需要 20–50 步 Euler 积分采样,速度极慢(<1 FPS)。Image2Sim 基于连续时间 MeanFlow 理论,直接预测从源状态 $\mathbf z_{\mathrm{src}}$ 到目标图像 $\mathbf X_p$ 的平均传输速度 $u_\theta = (\mathbf z_t - x_\theta)/\max(t, \varepsilon)$。结合前向 JVP(Jacobian-Vector Product)高效计算方向导数 $\frac{\mathrm d u_\theta}{\mathrm d t}$,一次 forward 即可完成生成,将渲染速度提升至 45.6 FPS。
- 动量自蒸馏损失:维持一个指数移动平均(EMA,衰减率 0.999)的 Teacher 网络,Teacher 接收特权 Ground-Truth 源状态 $\mathbf z_{\mathrm{gt}}$。Student 提取的解码器特征与 Teacher 强行对齐: \(\mathcal L_{\mathrm{distill}} = \sum_{k \in \mathcal K} \tilde{w}_k \left( 1 - \frac{\mathbf f_k^S \cdot \mathbf f_k^T}{\lVert \mathbf f_k^S \rVert_2 \lVert \mathbf f_k^T \rVert_2} + \beta \lVert \mathbf f_k^S - \mathbf f_k^T \rVert_2^2 \right)\) 极大增强了单步生成的稳定性,消除了光影抖动与幻觉伪影。
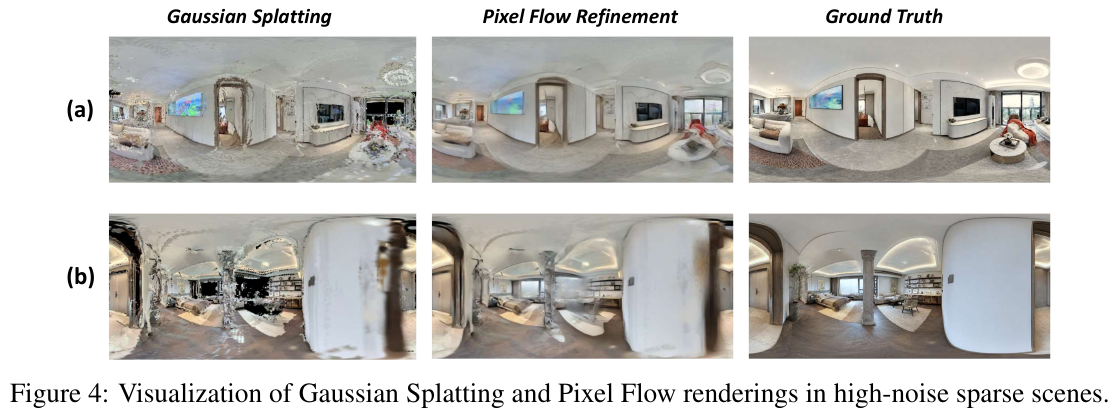
④ 物理运动仿真引擎与自动化数据流水线
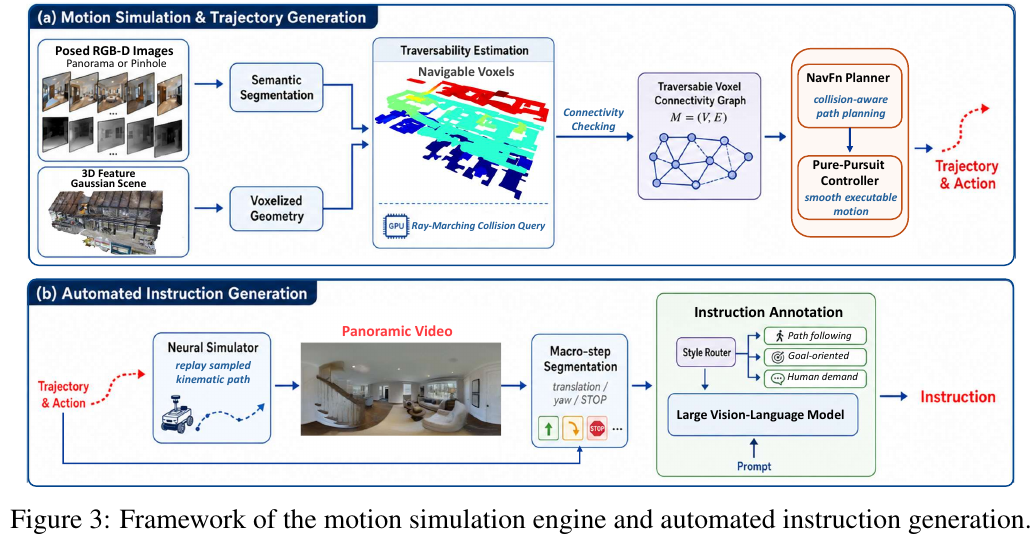
- 体素化与 GPU 光线步进碰撞查询:将 3D 高斯场景离散化为密集体素网格 $\mathcal V$,基于离地高度、表面连通性与障碍物安全间距判定可通行性。通过 GPU 并行光线步进(Ray Marching)查询机器人 Footprint 碰撞,构建可通行体素图 $\mathcal M = (\mathcal V, \mathcal E)$,支持贴墙滑动与碰撞拦截。
- 碰撞感知 NavFn 规划与纯追踪控制:在 Graph $\mathcal M$ 上运行结合安全代价的 NavFn 路径规划,利用 Pure-Pursuit 纯追踪控制器将离散节点转化为光滑的连续运动轨迹。
- VLM 自动化指令标注:重放物理轨迹渲染全景视频,利用 Large Vision-Language Model 自动生成路径追踪、目标导向与人类习惯等多多样化导航文本指令。
| 维度 | 传统扫描 3D Mesh (Habitat/Matterport3D) | 纯 3DGS 渲染 (AnySplat 等) | 纯生成式世界模型 (World Models) | Image2Sim 神经仿真器 (本文) |
|---|---|---|---|---|
| 场景扩展性 | 极低(依赖人工 3D 扫描) | 中(需逐场景优化或前馈预测) | 高(从视频/文本直接生成) | 极高(输入任意 RGB-D 视频/图像) |
| 未观测补全 | 不具备(依赖固定 Mesh 边界) | 极差(黑洞破洞、伪影重重) | 强(扩散/流匹配生成) | 极强(Alpha 门控 Pixel Flow 补全) |
| 交互渲染速度 | 极高(>100 FPS 传统渲染) | 极高(>115 FPS) | 极慢(<1 FPS 多步采样) | 实时高帧率(45.6 FPS 单步生成) |
| 物理闭环约束 | 具备(内置物理碰撞网格) | 缺乏(纯点云渲染无几何碰撞面) | 缺乏(无法精确阻挡机器人穿墙) | 具备(基于高斯体素与 GPU 光线步进) |
3. 核心结果/发现
① 视角合成渲染质量与速度对比
在 RealSee3D-Real(高噪声 LiDAR 深度)等挑战性数据集上,Image2Sim 展现出极其优异的鲁棒性与速度表现:
- 渲染质量:PSNR 达 17.43,SSIM 达 0.470,显著超越纯高斯前馈模型 AnySplat(PSNR 15.23, SSIM 0.415),有效弥补了结构缺失。
- 渲染帧率:全景 RGB-D 渲染速度达到 45.6 FPS,比传统扩散生成模型 DiT360(0.3 FPS)和 SE3DS(3.4 FPS)快一到两个数量级。
② 跨模拟器 Zero-Shot 具身导航性能 (R2R-CE, RxR-CE, REVERIE-CE)
基线导航模型 Image2Nav 仅在 Image2Sim 生成的神经数据集中训练,零样本直接在 Habitat 模拟器中评估(打破了所有 Baseline 在 Habitat 内部训练评估的习惯):
- R2R-CE 路径追踪导航:在 Val Unseen 划分上,Image2Nav(180° FOV)取得 SR 70.3%、SPL 65.6%、NE 3.71m 的 SOTA 成绩,大幅超越在 Habitat 内训练的顶级方法 EfficientVLN(SR 64.2%, SPL 55.9%)与 DualVLN(SR 64.3%, SPL 58.5%)。
- RxR-CE 多语言长指令导航:实现 SR 70.7%、SPL 59.1%、NE 3.74m、nDTW 71.8%。
- REVERIE-CE 目标导向导航:实现 SR 53.7%、SPL 42.7%。
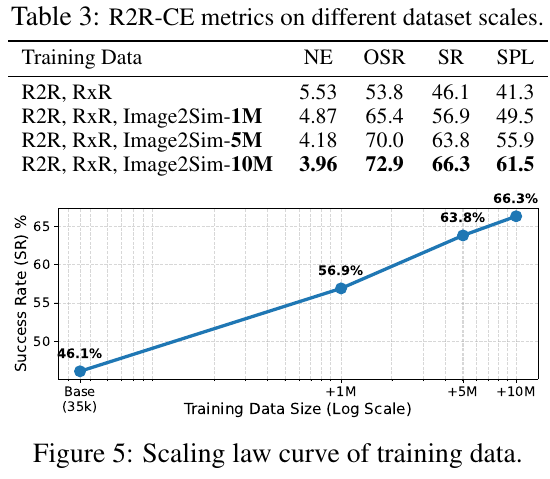
③ 导航数据的 Scaling Law 验证
如上图所示,当在 R2R/RxR 基础数据上逐步叠加 Image2Sim 产生的 1M、5M 到 10M 样本时,成功率(SR)呈现出清晰且未饱和的对数线性增长(SR 从 46.1% 飞跃至 66.3%,SPL 从 41.3% 提升至 61.5%)。这有力证明了当前具身导航性能仍受到数据量的强烈制约,而 Image2Sim 能够作为无尽的数据引擎持续赋能预训练。
④ 消融实验 (Ablation Study)
- 移除 Pixel Flow 生成模型:PSNR 暴跌至 17.75,SSIM 降至 0.438,证明单纯 3DGS 飞溅无法处理稀疏视角空洞。
- 移除语义特征注入:PSNR 降至 18.36,表明 DINOv3 语义指导对于生成合理的未观测墙体与家具至关重要。
- 移除 Alpha 门控融合:PSNR 降至 18.57,破坏了已知 3D 几何与生成补全的平衡。
- 移除动量自蒸馏:PSNR 降至 19.84,证明 EMA Teacher 成功抑制了单步生成中的闪烁伪影。
⑤ 真实物理机器人部署 (Real-World Deployment)
在 Hello Robot Stretch 3 移动机器人上的实机测试(20 次试练)表明:
- Path-following 任务:成功率达到 11/20(显著优于 JanusVLN 的 8/20 和 DualVLN 的 8/20)。
- Goal-oriented 任务:成功率达到 9/20(远高于 DualVLN 的 5/20)。
4. 局限性
- 轻量渲染器的容量权衡:为了支持 45+ FPS 实时在线闭环交互及 DAgger/RL 训练,轻量级渲染模型在极度复杂的超广角光影细节上略有容量牺牲。
- 物理交互动态有限:仿真器目前集中于导航层面的刚性碰撞与滑动约束,尚不支持复杂的接触力学、可移动物体与人机动态交互。
- 指令标注的语义偏差:完全自动化的大语言/视觉模型指令标注虽然实现了规模化,但偶尔可能引入天然的语言偏置或少量的图文不匹配。
48. DecoVLN (2026)
———Decoupling Observation, Reasoning, and Correction for Vision-and-Language Navigation
📄 Paper: arXiv:2603.13133 · 🏛️ CVPR 2026 · Project Page · Code(待发布)
精华
- 三维彻底解耦:打破传统流式导航“全量存内存、推理时均匀采样”的紧耦合低效模式,将观测流、推理流与纠错流在空间、时间与硬件显存上彻底分离。
- 自适应前置精炼(AMR):在流式观测进入阶段联合优化指令语义相关性、视觉多样性惩罚与时间跨度覆盖,在显存内常驻极紧凑的 $K=8$ 高信息密度记忆库。
- 信任域单步纠错微调(ECF):基于测地距离量化偏离度,仅在可控信任域内收集单步状态-动作对引导恢复,从根源杜绝长程累积复合误差与样本数据污染。
- 纯 RGB 单目超越多模态传感器:在 R2R-CE 与 RxR-CE 连续基准上分别取得 56.3% 与 54.2% 的成功率,在零额外大规模预训练数据下全面超越依赖深度图与 3D 体素投影的 SOTA 模型。
- 端云协同真机零样本迁移:将 4 步离散动作块(Action Chunk)端侧解析为连续相对目标位姿,在宇树 GO2 四足机器人上成功克服地面强反光与视觉混淆等真实环境扰动。
1. 研究背景/问题
视觉语言导航(Vision-and-Language Navigation, VLN)要求具身智能体仅依据自身的第一视角(Egocentric)视觉观测与长程自然语言指令,在未知的 3D 物理环境中自主规划连续移动路径并到达目标。现有方法主要面临三大瓶颈:
- “走走停停”(Stop-and-Think)造成的感知盲区:智能体执行一步后停顿感知再推理,动作不连贯且在运动过程中错失关键视觉地标。
- 传统流式导航的上下文污染与 I/O 拥堵:将所有历史观测帧无差别全量暂存到主机内存(RAM),推理时再被动均匀采样(Uniform Sampling)或依赖深度传感器构建 3D 体素剪枝,导致输入上下文充斥白墙、转角等无关噪声,且频繁在显存与内存之间搬运数据引发高推理延迟。
- 长程马尔可夫决策过程中的复合误差(Compounding Errors):开环自回归策略在早期产生微小漂移后会持续发散;而传统 DAgger 算法在整条轨迹严重偏离后仍强行收集修正动作,导致纠错样本严重偏离原始指令分布,造成训练数据污染。
2. 主要方法/创新点
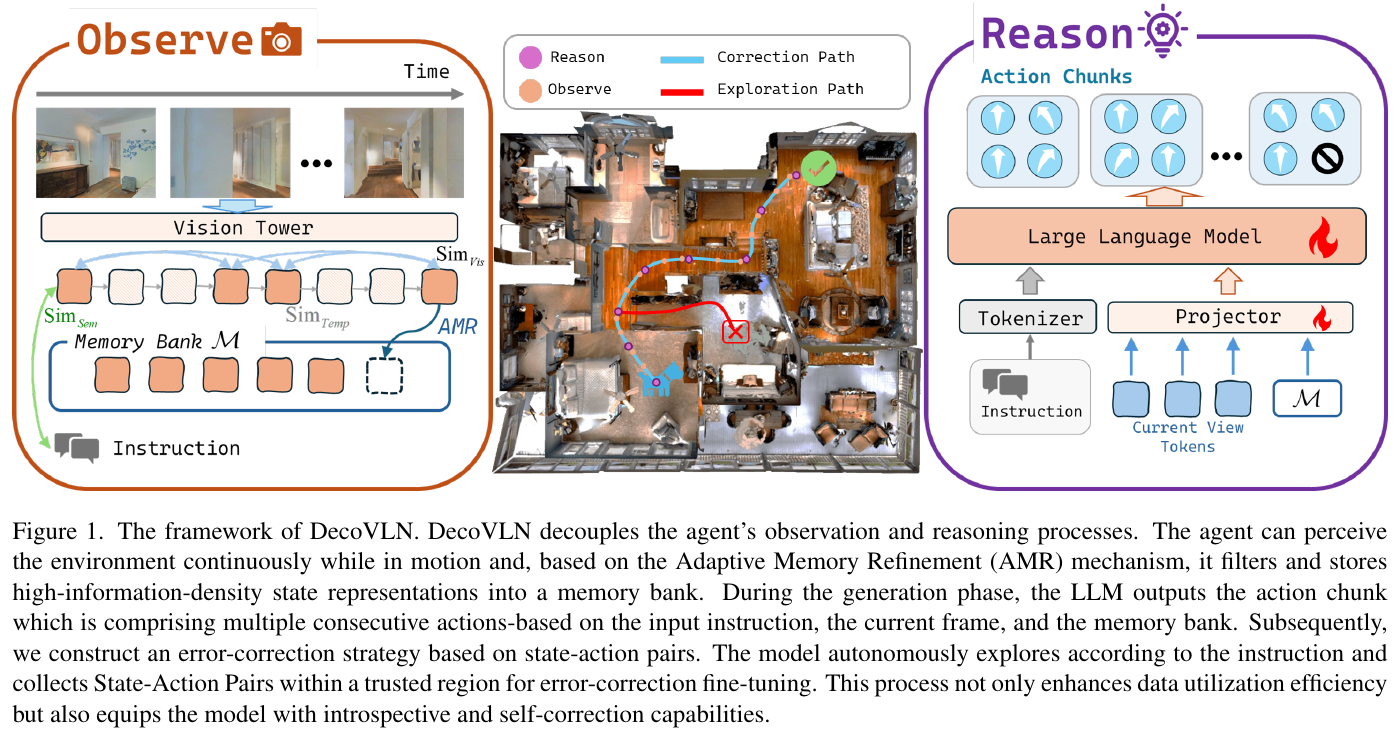
① 整体框架概述
DecoVLN 将视觉语言导航形式化为部分可观测马尔可夫决策过程(POMDP),通过三大解耦模块协同运行:
- 流式观测流(Observation Stream):在机器人运动过程中连续采集第一视角 RGB 图像,由自适应记忆精炼模块(AMR)在线评估每帧的多维价值,将最具信息量的特征常驻在显存 Memory Bank 中;
- 自回归推理流(Reasoning Stream):VLM(基于 LLaVA-Video-7B)仅接收当前指令、Memory Bank($K=8$ 帧)与最近 4 帧即时观测,自回归输出由 4 步连续动作组成的动作块(Action Chunk);
- 自纠错微调流(Correction Stream):在模拟器自主探索中,利用测地距离(Geodesic Distance)划分信任域(Trusted Region),动态捕获偏离轨迹下的单步纠偏状态-动作对,赋予模型闭环自愈能力。
② 观测与推理深度解耦:自适应记忆精炼(AMR)
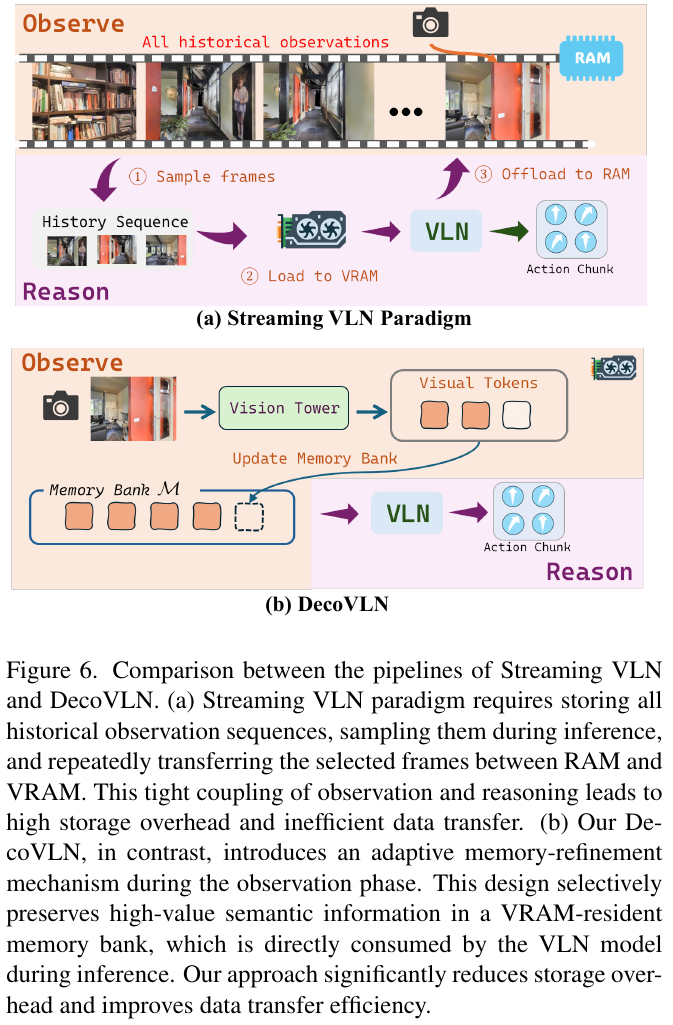
传统方法与 DecoVLN 在记忆维护逻辑上的本质差异如下:
| 维度 | 传统流式 VLN(如 StreamVLN) | 本文 DecoVLN |
|---|---|---|
| 记忆管理机制 | 后验剪枝(Post-hoc):先全量存入 RAM,推理时盲目均匀采样或依赖深度图 3D 体素去重 | 前置精炼(Pre-hoc):观测帧产生时即在线评估价值,只有高信息量关键帧进入 Memory Bank |
| 显存/内存 I/O | 每次推理都需在主机 RAM 与 GPU VRAM 间重复传输大量图像帧 | Memory Bank 全程常驻显存(VRAM),推理时零额外传输延迟 |
| 传感器依赖 | 依赖高精度深度传感器(RGB-D / 双目)计算点云与体素 | 仅需单目第一视角 RGB 图像,通用性强 |
| 指令相关性 | 采样过程与任务指令完全脱节,易混入大量白墙、地面等无效视野 | 动态计算图文语义相似度,紧密对齐指令涉及的地标 |
AMR 将长程记忆构建建模为显式多准则迭代优化问题。在导航过程中,智能体从候选帧池 $\mathcal C$ 中迭代选取 $K$ 帧加入精炼记忆库 $\mathcal M$,使得综合评分函数最大化:
\[f^* = \arg\max_{f \in \mathcal C \setminus \mathcal M} \left[ \lambda_R \cdot \mathrm{Sim}_{Sem}(f, I) - (1 - \lambda_R) \cdot \left( w_V \cdot \mathrm{Sim}_{Vis}(f, \mathcal M) + w_T \cdot \mathrm{Sim}_{Temp}(f, \mathcal M) \right) \right]\]其中各项物理意义如下:
- 语义相关性(\(\mathrm{Sim}_{Sem}\)):计算候选帧视觉嵌入 $e_f$ 与导航指令全局文本嵌入 $e_I$ 的余弦相似度: \(\mathrm{Sim}_{Sem}(f, I) = \frac{e_f \cdot e_I}{\lVert e_f \rVert \lVert e_I \rVert}\)
- 视觉多样性惩罚(\(\mathrm{Sim}_{Vis}\)):计算候选帧 $f$ 与当前记忆库 $\mathcal M$ 中所有已有帧的最大视觉余弦相似度,惩罚视场高度雷同的重复地标: \(\mathrm{Sim}_{Vis}(f, \mathcal M) = \max_{m \in \mathcal M} \frac{\mathrm{embed}(f) \cdot \mathrm{embed}(m)}{\lVert \mathrm{embed}(f) \rVert \lVert \mathrm{embed}(m) \rVert}\)
- 时间跨度覆盖惩罚(\(\mathrm{Sim}_{Temp}\)):惩罚时间戳过近的候选帧,鼓励记忆库在整条长轨迹上保持均匀的时间覆盖度($\epsilon$ 为防除零微小常数): \(\mathrm{Sim}_{Temp}(f, \mathcal M) = \frac{1}{\min_{m \in \mathcal M} \lvert t_f - t_m \rvert + \epsilon}\)
举个例子(AMR 权重平衡如何选出关键地标): 机器人执行一条 50 步的长指令:“穿过走廊,进入客厅并在黑色双人沙发旁停下”。 机器人在客厅停留了 15 步,如果只看语义相关性($\lambda_R = 1.0$),选出的 8 张记忆帧会全被客厅同一角度的沙发特写占满,导致前半段走廊的记忆完全丢失; 当引入视觉多样性与时间惩罚($\lambda_R = 0.5, w_V = 0.5, w_T = 0.5$)后,第二张客厅沙发帧因与已存沙发帧的 \(\mathrm{Sim}_{Vis} > 0.95\) 且时间差极小,得分被大幅扣减; 最终算法会自动保留:1 帧起始房间、2 帧走廊拐角、2 帧客厅入口、3 帧不同朝向的沙发地标,实现全时空高保真记忆。
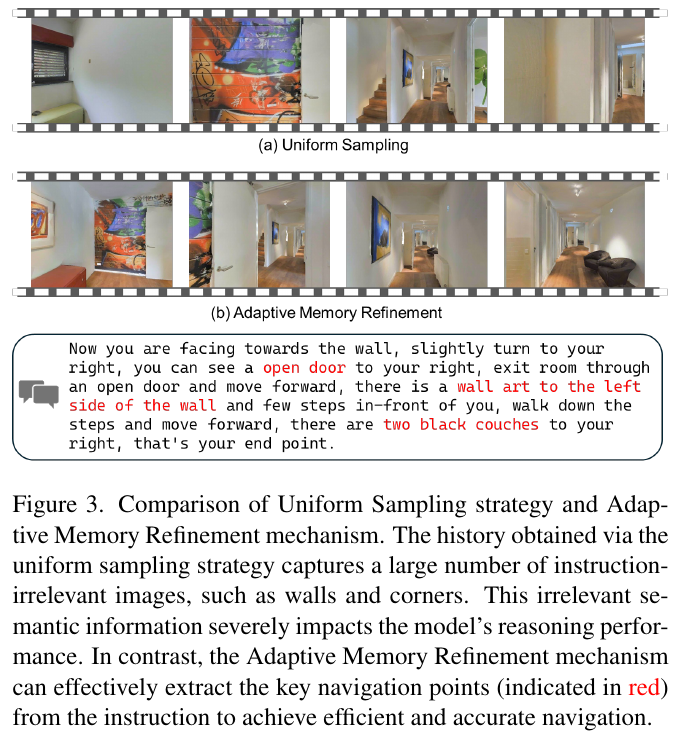
③ 信任域状态-动作对纠错微调(ECF)
长程导航中,微小的累积漂移常使智能体脱离专家轨迹。为解决这一难题,DecoVLN 提出基于步级状态-动作对(State-Action Pair)的信任域纠错微调策略:
graph TD
    A["智能体当前位姿 s_t + 即时观测 f_t"] --> B["计算相对专家轨迹的最小测地距离 DM(s_t)"]
    B --> C{"偏离度判定"}
    C -- "DM(s_t) == 0 (完美在轨)" --> D["正常推进策略采样"]
    C -- "0 < DM(s_t) <= tau (信任域内可控偏离)" --> E["查询最短路径专家策略 pi*(s_t) 得到纠偏动作 a_exp"]
    E --> F["存储单步样本 (s_t, a_exp, f_t) 入纠错集 D_c"]
    C -- "DM(s_t) > tau (严重越界污染区)" --> G["立即截断并终止当前 Episode (防止脏数据污染)"]
    F --> H["执行当前策略 a_t 推进至 s_t+1"]
    D --> H
    H --> I["AMR 在线精炼更新 Memory Bank H"]
具体算法细节如下:
- 偏离度度量:利用环境拓扑的测地距离(Geodesic Distance)定义偏离度 \(\mathrm{DM}(s_t) = \min_{s^* \in \mathcal P_{exp}} d_g(s_t, s^*)\)。
- 信任域阈值 $\tau$:设定信任域截断阈值 $\tau = 3\text{m}$。当 $0 < \mathrm{DM}(s_t) \le \tau$ 时,智能体偏离但仍处于可感知原始目标的有效上下文范围内,此时向最短路径专家策略(SPF)查询一步返回正轨的最优动作 \(a_t^{\mathrm{exp}} = \pi^*(s_t)\),存入微调数据集 $\mathcal D_c$;
- 越界截断:一旦 $\mathrm{DM}(s_t) > \tau$,说明已发生灾难性迷航,强行纠偏只会引入与语言指令脱节的奇异状态分布,算法立即中断该 Episode。
- 防灾难性遗忘混合训练:在纠错微调阶段,将 180K 导航纠错样本与 178K 的通用视频问答数据集(LLaVA-Video-178K)按比例混合,保证模型在获得闭环自愈能力的同时,维持基础多模态时空推理能力。
④ 动作块(Action Chunking)平滑解析与真机控制
在实际物理机器人(如 Unitree GO2)部署中,VLM 在远端服务器自回归生成 4 步离散符号动作块(例如:[forward 25cm, forward 25cm, turn left 15°, stop])。
举个例子(离散动作块向连续平滑轨迹的转换): 若四足机器人在真机上直接分步串行执行这 4 个离散指令,每走 25cm 就必须刹车减速一次,导致机身剧烈颠簸顿挫且航向极易漂移; DecoVLN 在 Jetson Orin 端侧控制器中将该动作序列合成为统一的局部相对目标位姿 $(\Delta x = 0.5\text{m}, \Delta y = 0, \Delta \theta = 15^\circ)$; 底层运动控制 API 基于该相对位姿规划出一条连续平滑的多项式轨迹曲线并直接下发电机力矩,实现流畅自然的连续步态。
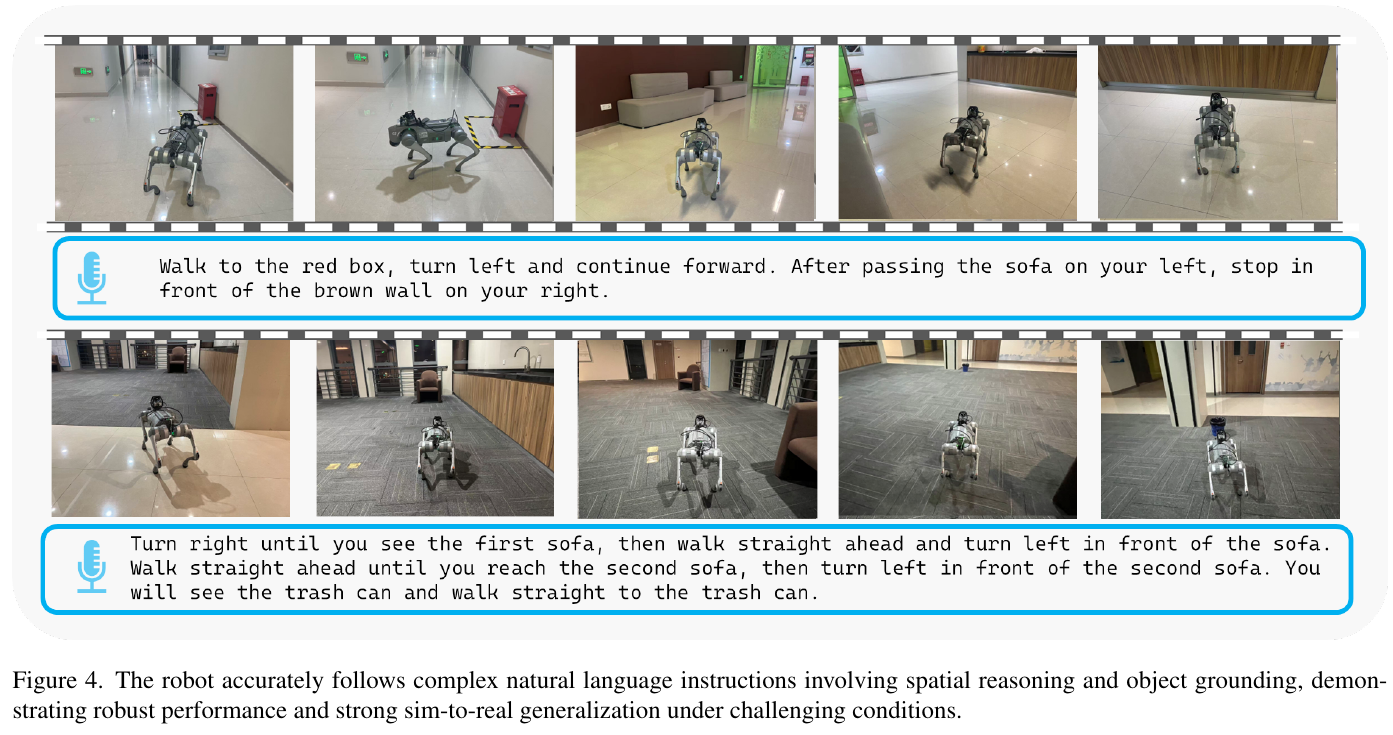
3. 核心结果/发现
- 基准性能全面领先:在 R2R-CE 和 RxR-CE Val-Unseen 连续基准上,DecoVLN 仅凭单目第一视角 RGB 输入分别斩获 56.3% 和 54.2% 的成功率(SR),SPL 分别达 50.5% 与 46.3%。
- 力压多模态传感器 SOTA:相比同样采用流式设计的 StreamVLN(SR: 52.8% / 48.6%),DecoVLN 在 RxR-CE 上的成功率提升高达 +5.6%,甚至大幅超越了使用 RGB+Depth 双模态输入的 StreamVLN 版本(SR: 52.9%)。
- 极高的数据与算力效率:无需在 ScaleVLN 等数百万级额外合成数据集上进行大规模预训练,仅在 Matterport3D 收集的 360K 样本上训练约 600 GPU-hours(8 张 A800),即可超越依赖大规模预训练的航路点与地图模型。
- 超长路径泛化力:在平均长度达 23 米的合成超长轨迹验证集(Long-Horizon Validation Set)上,DecoVLN 的成功率达到 36.9%,相比 StreamVLN 相对提升 +12.5%,证明了 AMR 记忆压缩对长时程抗遗忘的有效性。
- 真机涌现主动闭环对齐行为:在真机测试中,机器狗在行进中自发展现出横向微调与姿态补偿行为,主动确保关键路标和最终目标始终处于视野中心,具备真实的在线闭环抗干扰能力。
4. 局限性
- 依赖端云协同与无线网络带宽:模型基于 LLaVA-Video-7B 构建,7B 参数量难以直接在 Jetson Orin 等边缘计算平台实现全板载实时推理,对无线通信网络延迟和信号稳定性存在依赖。
- 极端地标丢失时的全局重定位能力有限:当遇到特征极其匮乏的完全对称走廊或严重视觉混淆导致彻底迷失时,当前系统缺少基于思维链(Chain-of-Thought)的主动回溯(Backtracking)与全局重新建图重规划机制。
49. TAMP-Nav (2026)
———Point, Think, Memorize, and Align for Efficient Navigation
📄 Paper: arXiv:2608.17512 · Code
精华
- 空间解耦(Point):提出 Pixel-to-3D 动作范式,让 2D 大视觉语言模型(VLM)仅作为“视觉指示器”在图像上点选 2D 像素航点,利用外置深度反投影交由传统 SLAM 控制器执行,彻底规避 2D VLM 回归连续 3D 坐标时的几何幻觉。
- 动态记忆(Think & Memorize):设计锚点-轨迹混合记忆(Anchor-Trajectory Memory),仅在关键拓扑决策点存储高保真视觉与思维链(CoT)语义锚点,中间过渡路径仅保留由多维旋转位置编码(RoPE)压缩的定长时空指示器(STI Token),极大减轻长程注意力稀释。
- 两级对齐(Align):提出融合退火引导采样的两级 GRPO 强化学习框架,将轨迹级全局成功/效率奖励与步级局部动作/推理价值奖励独立标准化后叠加,实现密集信号监督。
- 高效涌现:仅凭 90k 条合成轨迹冷启动与在线强化,便使模型自主涌现“直道快速通过、路口按需深思”的元认知能力,以 26.3% 的稀疏推理比例逼近 100% 密集推理上限,并在 R2R-CE(66.2% SR)与四足机器人真机零样本部署(60.0% SR)中取得 SOTA 表现。
1. 研究背景/问题
将通用大视觉语言模型(VLM)部署到连续环境具身导航(VLN-CE)中面临三大核心技术瓶颈:
- 动作空间的几何表征鸿沟(Geometric Gap):主流 VLM 预训练于 2D 图像-文本对,强行让其直接回归连续 3D 空间坐标或预测离散底层原子动作(如“左转 30 度”),极易引发严重的 3D 空间几何幻觉与极低的数据利用效率;
- 推理质量与计算延迟的权衡困境(Reasoning Dilemma):引入思维链(CoT)能强化高层规划,但固定步频或每步全量推理带来线性暴涨的计算延迟,缺乏根据场景复杂度动态决策的灵活性;
- 长程历史的记忆爆炸与时空感知缺失(Memory Bottleneck):全量保留历史视觉特征会导致多模态上下文溢出与注意力稀释,而启发式丢弃帧又会丢失关键拓扑线索,且缺乏显式的时空物理坐标来组织历史轨迹。
2. 主要方法/创新点
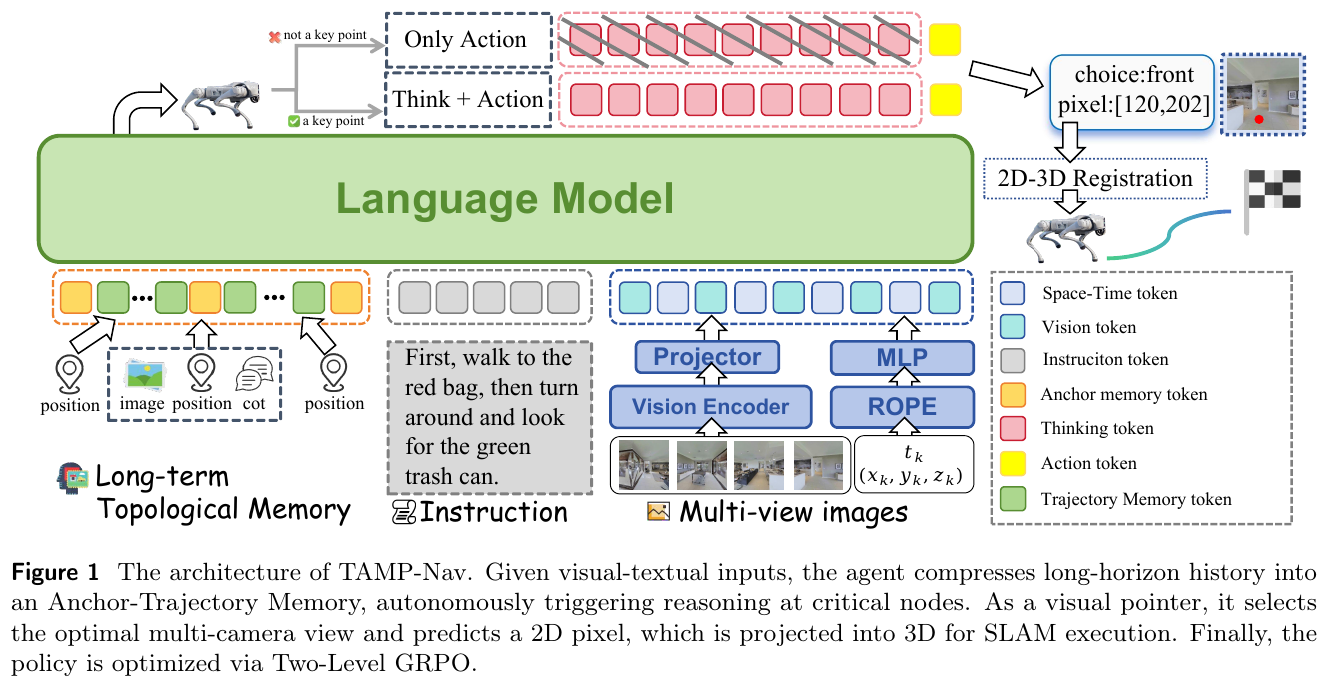
① 整体框架概述
TAMP-Nav 围绕“感知点选(Point)、按需思考(Think)、时空记忆(Memorize)、两级对齐(Align)”构建闭环交互系统。在每个导航步,智能体结合当前四视角环视图像与历史锚点-轨迹记忆维护长程空间认知;自主决定是否触发深层思维链分析;以 2D 像素指示器输出目标航点并反投影至 3D 空间交由底层 SLAM 控制器执行;整体策略通过两级 GRPO 强化学习完成认知规划与环境物理反馈的紧密对齐。
② Pixel-to-3D 动作空间(Point)
传统方法要求 VLM 隐式学习复杂的 3D 投影变换。TAMP-Nav 将高层语义决策与底层物理执行严格解耦:
- 视角选择与像素点选:在时间步 $t$,智能体接收 4 个环视相机视角 $V_t = {v_{t,1}, v_{t,2}, v_{t,3}, v_{t,4}}$ 实现 $360^\circ$ 全景感知。VLM 首先选定最优朝向视图 $v_{t,i}$,随后在图像平面上直接预测 2D 像素坐标 $a_t = (u, v)$ 作为目标航点。
- 3D 投影与局部执行:结合该视角的深度图 $D_{t,i}$ 与相机内参矩阵 $K$,直接计算局部 3D 空间坐标: \(P_t = D_{t,i}(u, v) \cdot K^{-1} [u, v, 1]^T\) 将 $P_t$ 转入全局世界坐标系后,直接分发给成熟的底层 SLAM 局部控制器(如 Fast-LIO2 里程计 + FAR Planner 局部规划器)自主完成运动控制与避障。这使得平均交互步数从传统原子动作的 30 余步大幅压缩至 9 步。
③ 锚点-轨迹混合记忆与时空指示器(Think & Memorize)
为解决长程导航中全量存储导致上下文爆炸、稀疏丢弃导致信息断裂的矛盾,TAMP-Nav 提出异构双轨记忆:
- 时空指示器(Space-Time Indicator, STI Token):
为了向上下文流中注入无歧义的物理绝对坐标 $(x, y)$、偏航角 $\text{yaw}$ 与时间步 $t$,通过多维旋转位置编码(RoPE)与多层感知机(MLP)构建定长特征向量:
\(E_{\text{STI}}(t, x, y, \text{yaw}) = \text{MLP}\left( \left[ \text{RoPE-2D}(x, y); \text{RoPE-1D}(t); \text{RoPE-2D}(\sin(\text{yaw}), \cos(\text{yaw})) \right] \right)\)
大白话直觉:偏航角如果在 $0^\circ$ 和 $360^\circ$ 边界直接用标量数值表示,机器人轻轻一转数值就会突变(如从 359 跳到 1);将其拆解为连续的三角函数对 $(\sin(\text{yaw}), \cos(\text{yaw}))$ 并映射到 2D 空间,能保证角度连续平滑旋转,消除几何不连续性。
降维装置 A —— 最小具体例子(存储压缩手算对比): 假设一段走廊导航包含 20 个时间步,其中只有第 1 步(起点)和第 12 步(T 型路口转弯)是关键决策点:
- 传统全量存储:每步保留多视角图像 patch,每步约 256 tokens,20 步将消耗 $20 \times 256 = 5120$ 个 tokens,迅速撑爆 4096 的上下文窗口并稀释注意力;
- TAMP-Nav 混合记忆:仅对第 1 和第 12 步存储高保真视觉与思维锚点(各占 1 组图像 tokens),其余 18 个非关键过渡步各仅压缩为 1 个定长 STI token(共 18 tokens);
- 效果:不仅将长程历史 token 消耗削减 90% 以上,而且机器人在每一步都能精确感知自己在第几步、位于世界坐标 $(x_t, y_t)$ 的哪个位置与朝向,彻底保留了连续运动轨迹的时空骨架。
- 显式锚点(Explicit Anchors)与轨迹流:
- 显式锚点 $A_k$:在触发深层 CoT 的拓扑关键点 $t_k$,以三元组形式保存: \(A_k = \langle M_{\text{STI}}^{(k)}, M_{\text{vis}}^{(k)}, M_{\text{state}}^{(k)} \rangle\) 其中 $M_{\text{STI}}^{(k)}$ 提供精确时空坐标,$M_{\text{vis}}^{(k)}$ 保留高保真原始视觉特征(支持像素级回环检测),$M_{\text{state}}^{(k)}$ 存储当步生成的 CoT 摘要,充当“阶段规划路标”;
- 轨迹流 $T_k$:在两个锚点之间的非关键直行或微调区间,完全剔除高开销的图像 token,仅保留轻量级 STI 序列: \(T_k = \left[ E_{\text{STI}}(t, x_t, y_t, \text{yaw}) \mid t \in \mathcal T \right]\)
- 工作记忆(Working Memory):当前步输入还会拼接当前 step 与最近一个锚点之间均匀采样的 2 帧最新图像,确保局部观察的连续性。
④ 核心机制降维对比
降维装置 C —— 具身导航核心架构对比表:
| 维度 | 传统原子动作 / 3D 回归范式 | 密集 CoT / 全量历史范式 | TAMP-Nav(本文方案) |
|---|---|---|---|
| 动作空间 | 预测离散底层动作(左转/前进)或直接回归 3D 空间坐标 | 启发式航点图搜索或扩散模型生成候选 | Pixel-to-3D:2D 像素点选 + 深度反投影 + SLAM 闭环控制器 |
| 推理机制 | 无 CoT 或每步无差别触发高开销 CoT | 固定步长间隔触发 CoT | 按需自发推理:RL 驱动,仅在路口/障碍物/目标附近深思 |
| 长程记忆 | 丢弃历史或单调均匀降采样(丢失拓扑连通性) | 全量保留视觉 tokens(上下文爆炸、注意力稀释) | 锚点-轨迹混合记忆:关键点留图文锚点,过渡步留定长 STI token |
| RL 优化 | 纯稀疏终点奖励(方差极大)或强行拟合专家动作 | 仅轨迹级结果奖励(难以归因单步动作) | 两级 GRPO:轨迹级全局优势 + 步级局部优势独立标准化后叠加 |
⑤ 两级 GRPO 强化学习对齐(Align)
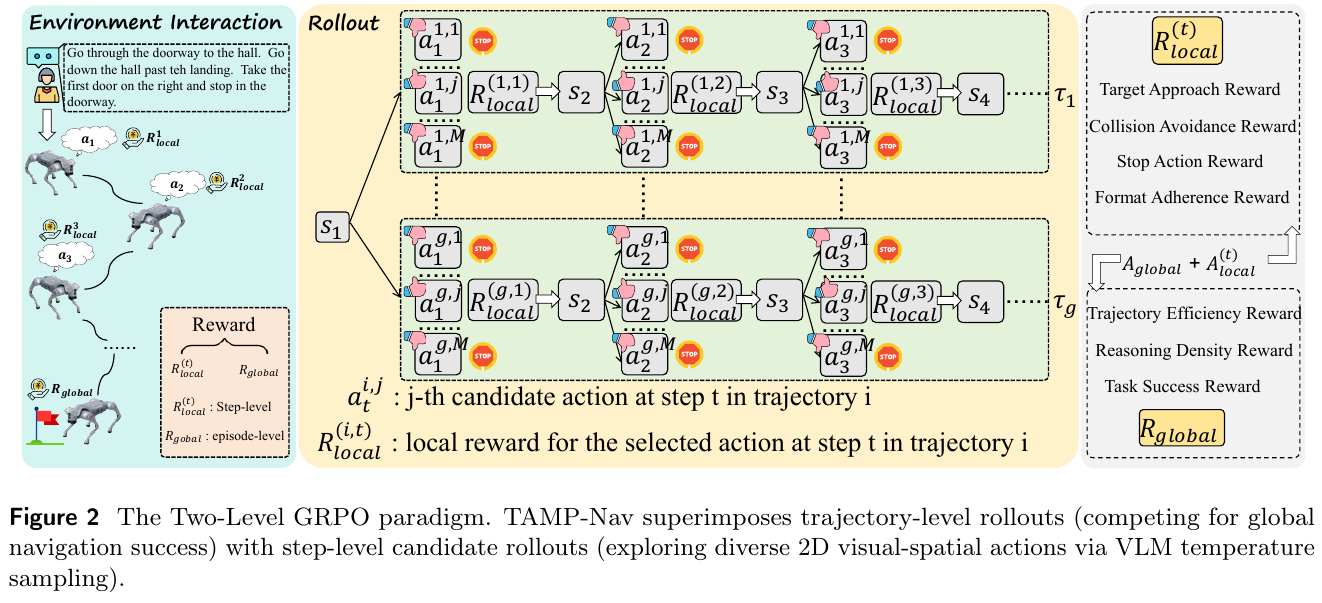
为了让智能体兼具微观避障精准度与宏观长程规划能力,TAMP-Nav 设计了两级 GRPO 框架与多分支采样:
降维装置 B —— 两级 GRPO 数据流与优势叠加机制(自制 Mermaid 图):
graph TD
    A["输入指令 q + 当前上下文 C_t"] --> B["生成 G=8 条完整探索轨迹 (轨迹级 Rollouts)"]
    B --> C["在每条轨迹各步 t, 温度采样 M=4 个候选动作 a_t^{i,j}"]
    C --> D["计算候选动作局部奖励 R_local(t)"]
    D --> E{"处于 RL 训练早期 (beta_k > 0)?"}
    E -- "是" --> F["按局部奖励权重执行退火引导采样 P_select"]
    E -- "否" --> G["均匀随机选取候选动作执行并推进环境"]
    F --> H["完成全部 G 条轨迹交互"]
    G --> H
    H --> I["轨迹级评估: 归纳 R_global (成功率/SPL/推理密度)"]
    H --> J["步级评估: 归纳 R_local (目标接近/避障/停止/推理价值/格式)"]
    I --> K["组内 Z-score 标准化 -> A_global"]
    J --> L["M 个候选内 Z-score 标准化 -> A_local(t)"]
    K --> M["双层优势直接叠加: A_S(t) = A_global + A_local(t)"]
    L --> M
    M --> N["广播到 Token 级别,执行 GRPO 策略裁剪更新"]
- 步级局部奖励(Local Step Rewards):
包含 5 项显式引导:
- 目标接近奖励 $r_{\text{app}}^{(t)}$:衡量测地线距离缩短量 $\Delta d = d_t - d_{t+1}$,通过双曲正切型有符号 Sigmoid 映射: \(r_{\text{app}}^{(t)} = \frac{2}{1 + \exp(-\Delta d)} - 1\)
- 碰撞避免奖励 $r_{\text{coll}}^{(t)}$:直接查询与最近障碍物的物理距离 $c_t$:$r_{\text{coll}}^{(t)} = \max(0, \min(c_t, 1.0))$;
- 停止动作奖励 $r_{\text{stop}}^{(t)}$:在目标点 1.5 米内停下奖励 $+1.0$,远离目标($>3.0$ 米)误停惩罚 $-1.0$;
- 推理价值奖励 $r_{\text{rea}}^{(t)}$:专门评估 CoT 是否真正带来了决策增益: \(r_{\text{rea}}^{(t)} = h_t \cdot \left( r_{\text{app}}^{(t)} - \bar r_{\text{app}}^{(t)} \right)\) 其中 $h_t \in {0, 1}$ 为是否触发思维链,$\bar r_{\text{app}}^{(t)}$ 为当前步 $M=4$ 个候选动作的平均接近得分。只有当产生思维链后的动作表现优于局部平均盲猜水平时,才给予正向奖励,严厉惩罚无意义的冗余推理;
- 格式规范奖励 $r_{\text{fmt}}^{(t)}$:确保严格遵循 JSON 结构且预测的像素落在合法的 $[0, 279]^2$ 图像视界内。
- 步级总奖励加权和: \(R_{\text{local}}^{(t)} = \lambda_1 r_{\text{app}}^{(t)} + \lambda_2 r_{\text{coll}}^{(t)} + \lambda_3 r_{\text{stop}}^{(t)} + \lambda_4 r_{\text{rea}}^{(t)} + \lambda_5 r_{\text{fmt}}^{(t)}\)
-
轨迹级全局奖励(Global Trajectory Rewards): \(R_{\text{global}} = \omega_1 r_{\text{suc}} + \omega_2 r_{\text{spl}} + \omega_3 r_{\text{den}}\) 其中 $r_{\text{suc}}$ 为最终任务成功奖励(严格成功给 1.0,Oracle 成功给 0.5),$r_{\text{spl}}$ 鼓励最短路径效率,$r_{\text{den}}$ 为推理密度奖励:当全轨迹推理步比例 $r \le 0.4$ 时维持高额奖励,超过 $0.4$ 开始陡峭衰减,超过 $0.6$ 归零,强制抑制“过度思考”。
-
退火引导采样(Annealed Guided Sampling): 在 RL 早期,纯随机探索难以在长程任务中遇到成功信号。TAMP-Nav 在训练步 $k$ 使用指数退火权重 $\beta_k = \beta_0 \cdot \alpha^k$($\beta_0=2.0, \alpha=0.99$)根据局部奖励加权采样候选动作: \(P_{\text{select}}(a_i) = \frac{\exp\left( \beta_k \cdot R_{\text{local}}^{(t)}(a_i) \right)}{\sum_{j=1}^M \exp\left( \beta_k \cdot R_{\text{local}}^{(t)}(a_j) \right)}\) 训练初期引导智能体探索高质量局部路径,随着训练推进 $\beta_k \to 0$,平滑过渡为均匀无偏探索。
- 双层优势叠加与 Token 级更新: 对 $G=8$ 条轨迹的 $R_{\text{global}}$ 计算组内 Z-score 得到 $A_{\text{global}}$;对当步选定动作在 $M=4$ 个候选中标准化得到 $A_{\text{local}}^{(t)}$。两者独立归一化后尺度一致,直接相加形成叠加优势: \(A_S^{(t)} = A_{\text{global}} + A_{\text{local}}^{(t)}\) 并将 $A_S^{(t)}$ 广播给当前步生成的全部 Token 执行 GRPO 策略梯度更新。
3. 核心结果/发现
① VLN-CE 连续环境基准全面 SOTA
- R2R-CE Val-Unseen:成功率(SR)达到 66.2%,SPL 达到 58.8%,导航误差(NE)降至 3.85m,相较于纯 SFT 模型(55.7% SR)提升 10.5 个百分点,全面超越 DualVLN(64.3% SR)、NavFoM(61.7% SR)和 StreamVLN(56.9% SR);
- RxR-CE Val-Unseen:成功率达到 65.7%,SPL 达到 56.9%,nDTW 达到 72.4%;
- 极致样本与推理效率:仅需 90k 条训练轨迹(700k 次交互),数据量远低于 DualVLN(763k 轨迹)与 NavFoM(337 万次交互);单任务平均推理时间仅 16.58 秒,相比 StreamVLN(37.47 秒)与 DualVLN(41.46 秒)提速一倍以上。
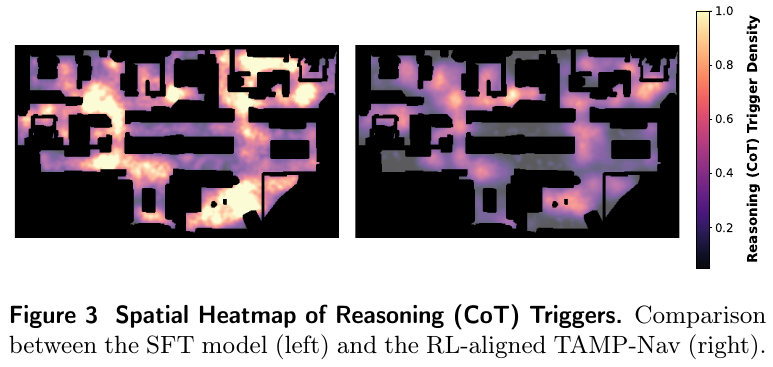
② 按需推理(Reasoning-on-Demand)的自发涌现
- 空间聚集性:如上图所示,RL 对齐后,模型在笔直走廊等平凡路径上的推理占比从 SFT 阶段的 38% 骤降至 11%,计算资源高度收敛于岔路口、房门出入口和目标物体附近;
- 极致性价比:在仅有 26.3% 推理比例(CoT Ratio)的情况下,取得了 66.2% SR,几乎完全追平了每步强制全量思考的 Dense CoT 上限(100% 推理比例,66.8% SR),大幅超越固定 1/3 间隔推理的基线(60.1% SR)。
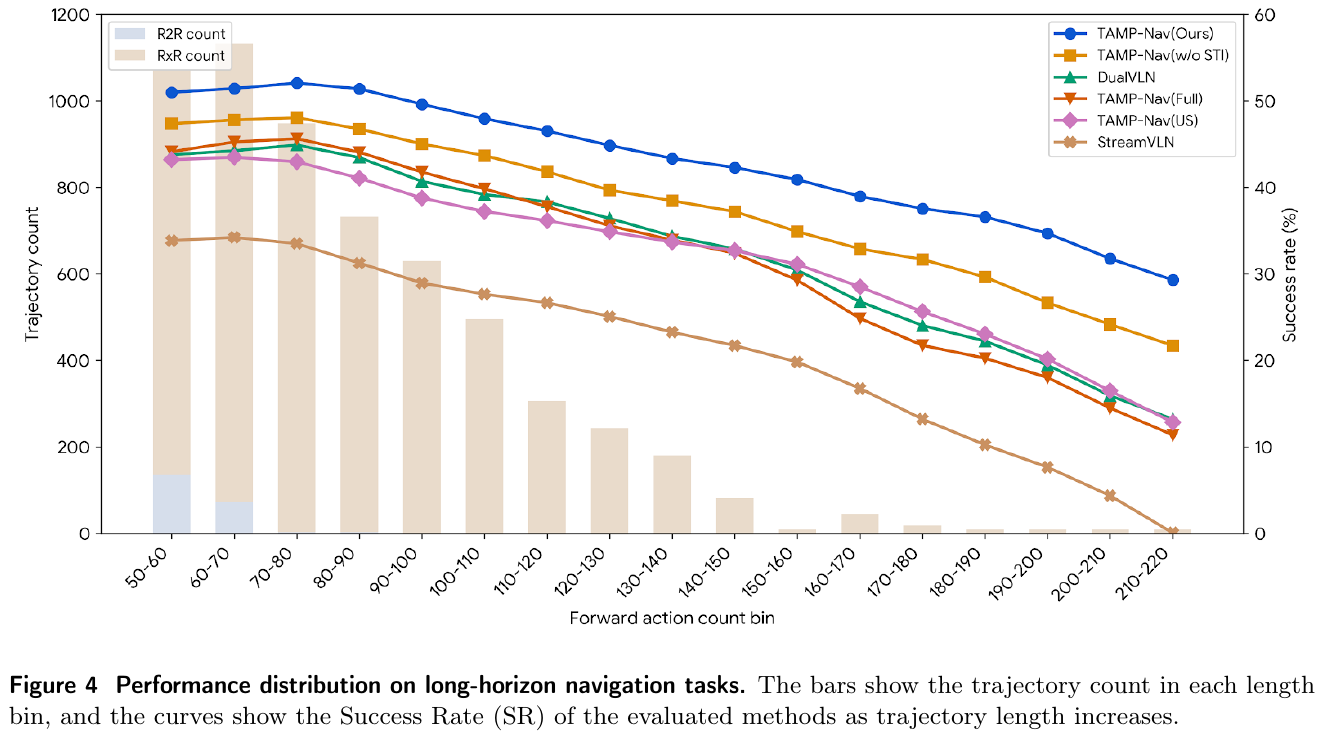
③ 超长程复杂任务的极佳稳定性
在路径长度超过 12.5 米(相当于 50 步以上连续原子动作)的 5927 条超长挑战子集上,TAMP-Nav 取得 49.8% SR,大幅领先 DualVLN(41.9%)与 StreamVLN(30.9%)。消融实验显示,去除 STI 时空指示器后长程性能骤降至 45.6%,证明定长时空表征对长程拓扑连通性的不可替代性。
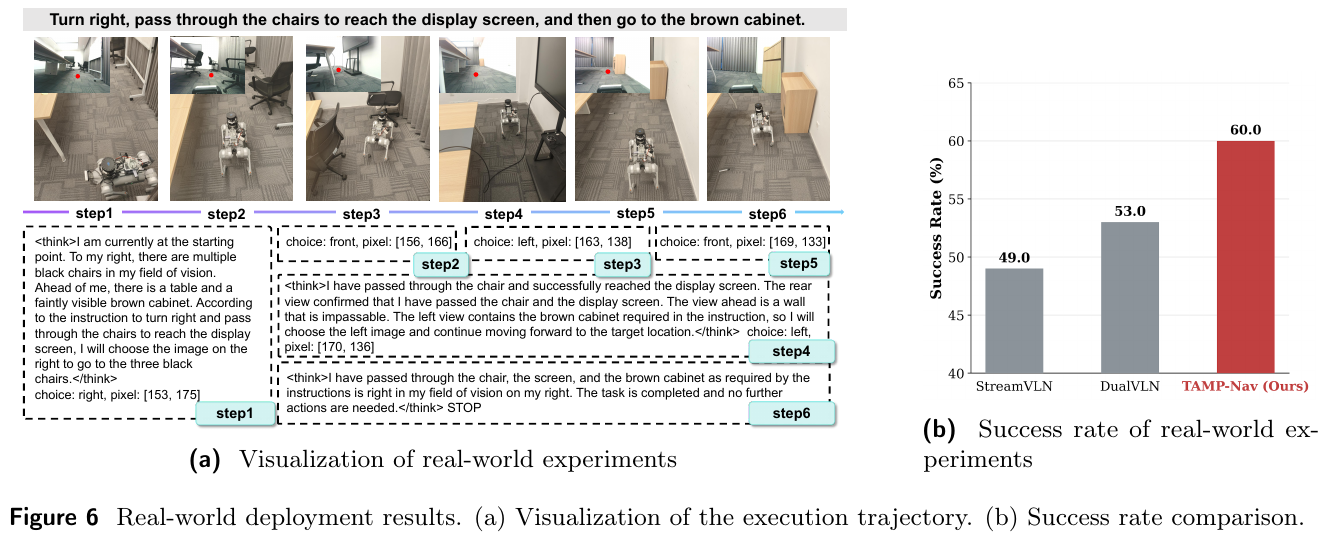
④ 四足机器人真实场景零样本部署
在未经过任何实机微调的情况下,直接部署于搭载 4 路环视 RGB-D 相机与 LiDAR 的 Unitree Go2 四足机器人上。在涵盖会议室、实验室、大厅、跨区域与室外的 100 次真实评测中,TAMP-Nav 取得 60.0% 的导航成功率,显著高于 StreamVLN(49.0%)与 DualVLN(53.0%),展现出强劲的 Sim-to-Real 零样本泛化能力。
4. 局限性
- 传感器与 SLAM 依赖:高度依赖深度相机与底层 SLAM 栈的局部建图与测距精度,在强光直射、大面积透明玻璃或 SLAM 严重漂移的极端场景下可能导致 3D 投影失效;
- 高度信息缺失:当前 STI token 仅编码平面二维坐标 $(x, y)$ 与朝向偏航角,尚未包含垂直高度 $z$,在跨楼层建筑和复杂三维阶梯场景中仍需拓展至完整的 3D 6-DoF 位姿表征;
- 强化学习仍局限于仿真环境:GRPO 训练依赖仿真器提供的特权全局奖励(真值距离与碰撞信息),尚无法直接在物理真机上开展在线强化学习探索。
50. LightNav-0 (2026)
———把 VLM 已有的空间智能”引出来”,而不是给它外挂一个导航模块
📄 Paper: arXiv:2608.30935 · Code
精华
- 全文的立场是”eliciting”而非”adding”:不加任何任务专用预测头、本体专家或航点预测器,只给 Qwen3-VL-4B 扩了词表,让导航能力从预训练 VLM 自己的空间先验里长出来。
- 双通道 pointing(affordance 点 + object 点)是整篇论文的枢纽——用图像平面上的一个栅格 token 同时表达”往哪走”与”目标在哪”,天然与任务、场景、机器人本体解耦,所以同一套监督能覆盖指令跟随、物体搜索、视觉跟踪三类任务。
- 残差向量量化(RVQ)把 10 步 SE(2) 轨迹压成 3 个 token,让”连续控制精度”与”语言模型 token 概率”第一次同时成立,这是它能原样套用 GRPO、而不必把扩散去噪重写成 MDP 的关键。
- 显式空间推理不一定要写成一长串文字 CoT:定长 2 个 token 的视觉 trace 既保住了可解释性,又躲开了变长解码的延迟。
- Scaling 实验给出一个反直觉却实用的结论——在这个量级上,扩环境多样性比扩数据量、也比把 backbone 从 4B 堆到 8B 更可靠。
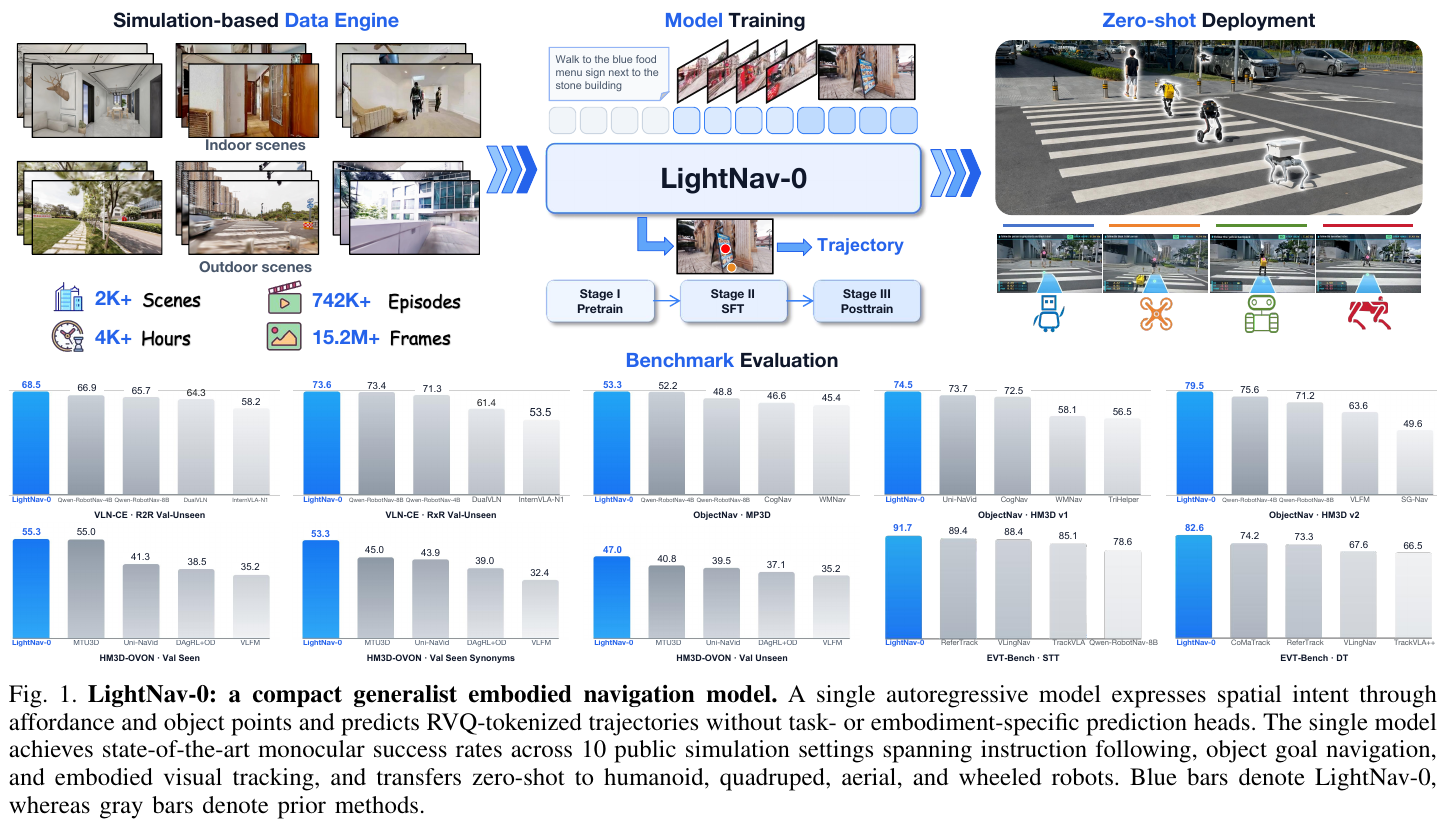
1. 研究背景/问题
具身导航要求同一个智能体把异构目标(一句自然语言指令、一个物体类别、一个移动的人)和视觉观测翻译成动作,并且要跨任务、跨场景、跨机器人本体。但现有系统几乎都为单一任务或单一 benchmark 优化,依赖航点预测器、拓扑地图、任务专用动作头这些”backbone 之外的结构”,把感知、推理、行动割裂开,一旦任务、传感器配置或机器人换掉就迁移不动。
与此同时,现代 VLM 其实已经编码了导航所需的大部分能力——开放词表识别、空间推理、指令理解、时序视频理解——只是这些能力很少被直接调用来做机器人控制。论文要回答的问题是:能不能让一个紧凑 VLM 直接充当通用具身导航的共享推理骨干?
2. 主要方法/创新点
① 整体框架概述
LightNav-0 把所有导航任务统一成”条件 token 生成”。在决策步 $t$,模型吃进语言指令 $I$ 和第一人称 RGB 历史 $O_{1:t}$,吐出一段固定格式的 token:先 2 个 pointing token(空间推理痕迹),紧跟 3 个 RVQ 动作 token(轨迹)。整个系统只有三个自研部件挂在一个冻结架构的 Qwen3-VL-4B-Instruct 上——慢快历史压缩器负责把无限增长的视觉历史塞进固定 token 预算,双通道 pointing 负责把”空间意图”表达成与本体无关的图像栅格坐标,RVQ 动作 tokenizer 负责把这个意图翻译成精确的、本体相关的轨迹。三者共用同一个原生自回归语言模型头,没有任何额外预测头。
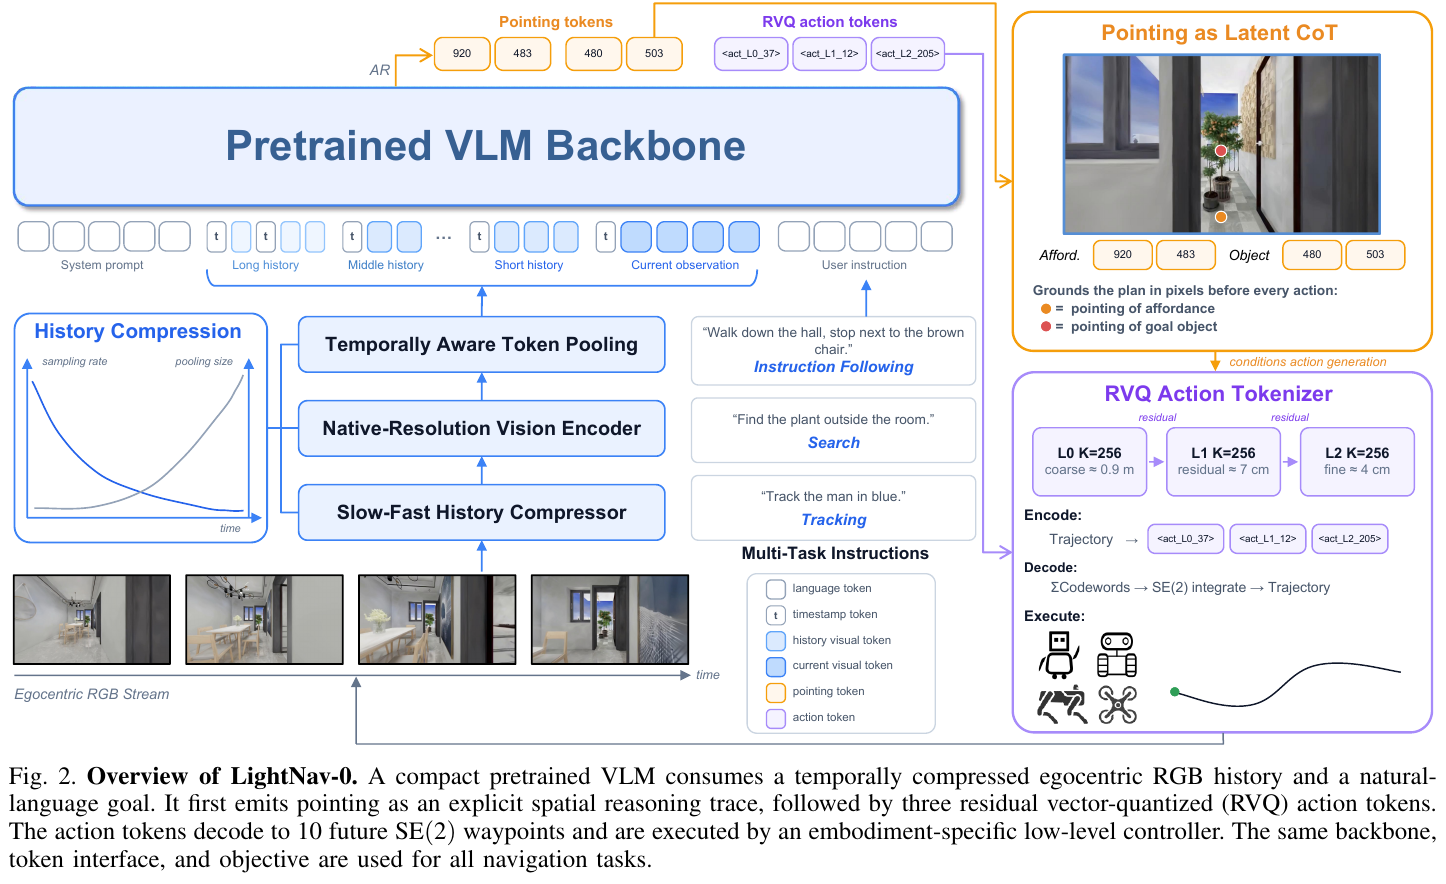
读者版的端到端数据流(论文原图是作者视角、信息密集,这张只讲一件事:一个决策步里数据怎么流):
graph TD
    A["单目 RGB 历史 O_1:t + 语言指令 I"] --> B["原生分辨率 ViT 逐帧编码"]
    B --> C["Slow-Fast 历史压缩:越老的帧采样越稀、池化越粗"]
    C --> D["拼成一条因果序列送进 Qwen3-VL-4B"]
    D --> E["Token 1:affordance 点(可走的自由空间栅格)"]
    E --> F["Token 2:object 点(目标物体 / 终点栅格)"]
    F --> G["Token 3-5:RVQ 的 L0 / L1 / L2 码字"]
    G --> H["码字求和 + SE(2) 积分 ⇒ 10 个未来航点"]
    H --> I["各本体共用的 Trajectory Follower"]
    I --> J["机器人自带的底层运动策略"]
② 时序感知的视觉历史压缩
- 输入:任意长度的第一人称 RGB 流。
- 处理:按”时间越久、记得越糊”来压——论文明说这是照着艾宾浩斯遗忘曲线的定性形状设计的。对时刻 $t_i$ 采集的历史帧,定义其”年龄” $\Delta T_i = t - t_i$,采样率随年龄指数衰减,空间池化步长随年龄指数增大:
被选中的帧各自过原生分辨率 ViT,再按 $s_i$ 做网格池化;池化后靠时间戳 token 保住先后顺序。
- 输出:一组”近处细、远处粗”的视觉 token,总量落在 256K / 576K / 1M 三档可配置像素预算内,按长期 / 中期 / 短期三层分配。
- 设计动机:导航既需要当前帧的几何细节(脚下能不能走),也需要长时程语境(我刚才是不是来过这儿)。全量原生分辨率编码会让 token 数无界增长;反过来把整段历史塌缩成一个定长表示又丢掉近处细节。分层分配是这两者之间的折中。
③ 双通道 pointing:把空间推理写成两个栅格 token
- 输入:当前视图 + 自动标注管线投影下来的两个目标点。
- 处理:把当前视图切成 $H_g$ 行 $W_g$ 列的栅格,一个归一化点 $p=(u,v)\in[0,1]^2$ 被拍平成一个整数索引:
affordance 点编码成 <apos_i>,object 点编码成 <opos_i>,两族 token 共享同一个栅格但索引空间独立。原地转向、停止、目标不可见这些”没有合法栅格”的情况,由各自 token 族里预留的索引表示。
- 输出:每步恰好 2 个 token,接在动作 token 前面。
- 设计动机:VLM 本来就把视觉证据摊在一个 2D token 阵列上,用一个栅格 token 表达一个点,正好踩在 backbone 预训练的 grounding 能力上;而且这个阵列定义在图像平面而非某个具体机器人的控制空间里,所以同一套表示能跨任务、跨本体复用。因果注意力让这段前缀自动变成一个条件化后续动作生成的显式空间痕迹。
举个例子(为什么是”一个 token”而不是”两个坐标 token”):假设栅格是 4 行 × 4 列,模型判断可走方向落在归一化坐标 $p = (u, v) = (0.6, 0.4)$。 列 $c = \lfloor 4 \times 0.6 \rfloor = 2$,行 $r = \lfloor 4 \times 0.4 \rfloor = 1$,拍平后 $i = 1 \times 4 + 2 = 6$ ——输出就是单个 token
<apos_6>。 换成”横坐标 token + 纵坐标 token”的写法,同一个点要花 2 个 token,模型还得自己学会这两个 token 是绑定的一对。栅格索引把这层耦合直接编进词表:每步的推理前缀恒定 2 个 token(一个 affordance、一个 object),不随场景复杂度变长,这正是它比自由文本 CoT 省的地方——文字 CoT 的解码长度是不可控的。
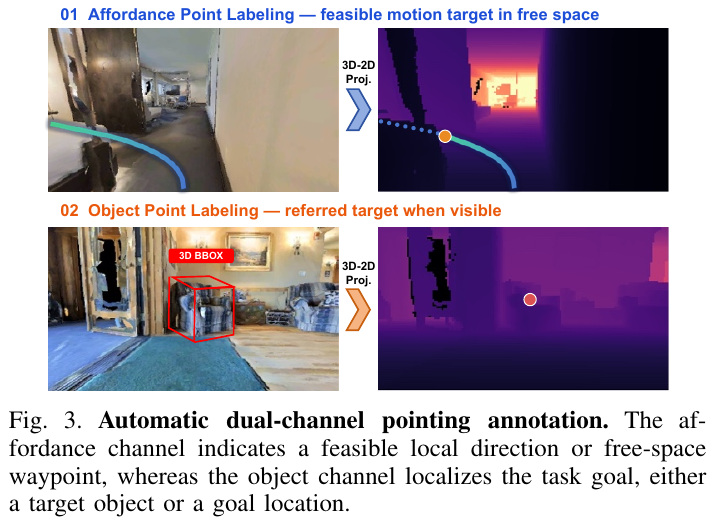
④ RVQ 动作 tokenizer:3 个 token 换 10 个航点
- 输入:一个动作块,即 10 个未来 SE(2) 航点拉平成的向量 $z_t \in \mathbb R^{10\times 3}$。
- 处理:三级残差量化,每级一个 256 词条的码本 $C^{(0)}, C^{(1)}, C^{(2)}$。第一级抓粗轨迹,后两级依次量化上一级留下的残差:
其中 $d_J$ 是拟合码本时用的 Jacobian 加权轨迹距离,在积分后的轨迹空间里加权,好让平移误差和朝向误差在量纲上平衡。指派轨迹时用的是
\[d_{traj}(z, \hat z) = \mathrm{ADE}(z, \hat z) + \lambda\,\lvert \Delta\theta(z) - \Delta\theta(\hat z)\rvert, \qquad \lambda = 0.3\]- 输出:三个层级化的动作 token
<act_L0_k><act_L1_k><act_L2_k>。解码时对任意非空前缀求和再做 SE(2) 积分:
- 设计动机:语言模型头直接吐连续控制量,会在”token 预测”和”几何精度”之间打架。RVQ 的巧妙之处在于任何非空前缀都能解码成一条可执行轨迹,而不是一个残缺的动作表示——所以算力或延迟吃紧时可以只生成 1 个或 2 个 token 执行粗轨迹,需要最高精度时才补齐第三级。
举个例子(为什么残差比”一次性大码本”划算):想象你要把一条轨迹口述给别人。 L0 相当于先说”大致朝这个方向走一段”——256 选 1,粒度约 0.9 m;L1 再补一句”比刚才那条再往左偏一点”,把残差压到约 7 cm;L2 最后微调到约 4 cm。 三句话(3 个 token)组合出 $256^3 \approx 1670$ 万条不同轨迹,最终平均位移误差 0.72 cm。 对照组是 VADv2 式的单层 $K=4096$ 规划词表——码本大了 16 倍、一次报完不做残差细化,误差反而是 2.48 cm(约 3.4 倍差)。省 token 的同时精度还更高,靠的正是”由粗到细”这个结构。
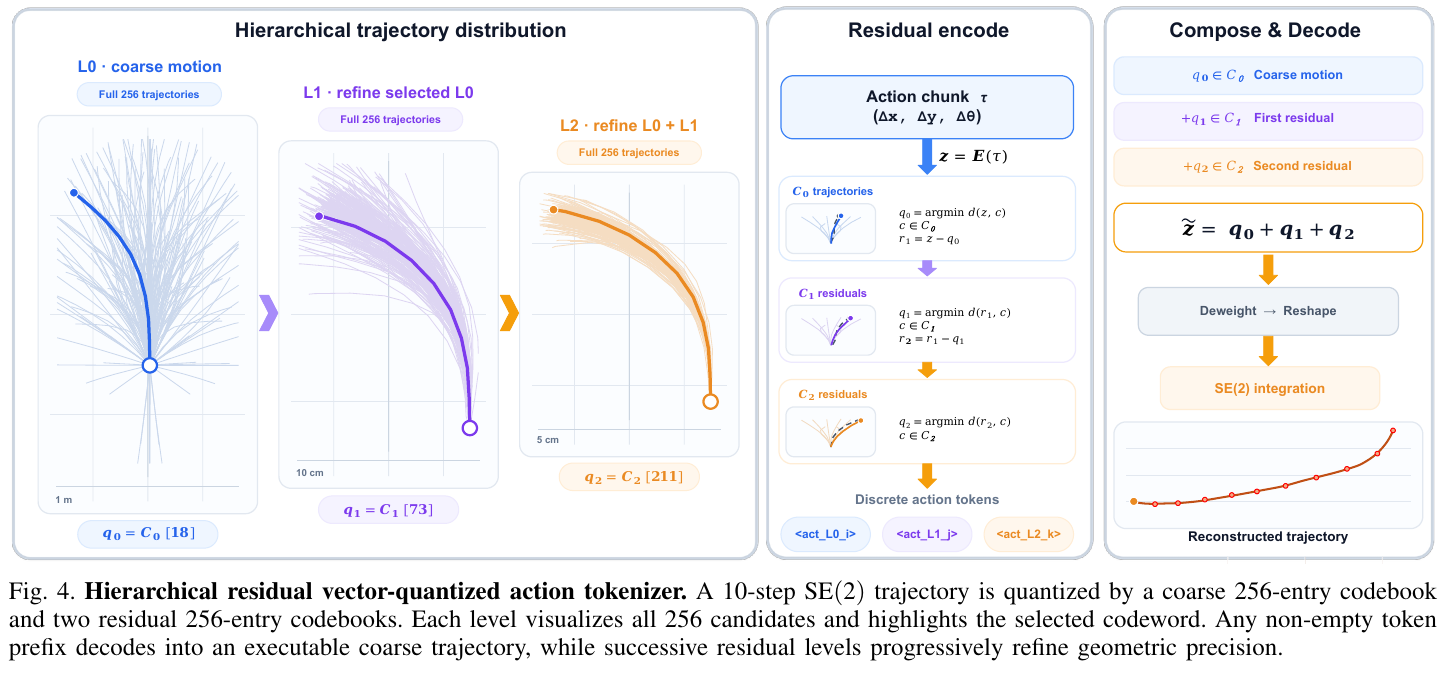
⑤ 统一的自回归训练目标
导航样本和辅助 VQA 样本走同一个因果语言模型损失,$M$ 是被监督的输出位置集合:
\[\mathcal L_{CE} = -\sum_{j \in M} \log p_\theta\!\left(y_j \mid x,\ y_{<j}\right)\]导航样本的监督序列就是 1 个 <apos_i> + 1 个 <opos_i> + 3 个 RVQ token;pointing 或空间 VQA 样本则是对应的索引 token 或语言回答。因为所有任务共享同一个 token 空间和同一个预测头,训练时不需要为导航损失单独配平衡权重,所有样本能挤进同一个打包的自回归训练循环——论文把约 8.6 个变长样本动态打包进每条 8,192 token 的训练序列。
⑥ 三阶段训练配方
Stage I — 具身推理(ER)中期训练。 先不碰动作,专门把 backbone 的空间能力调出来。从 36 个数据源构建 13.0M 样本的混合集,采样质量分配为 pointing 35.14%、单图 VQA 25.05%、视频推理 19.81%、通用视觉与抽象推理 20.00%。产出的 checkpoint 叫 LightNav-ER,用作后续导航对齐的初始化。约 170 H100 GPU-hours。
Stage II — 监督微调(SFT)。 把 LightNav-ER 对齐到统一导航 token 空间。任务平衡后的优化混合里,77.6% 的样本带导航动作监督,22.4% 是复习 ER 阶段能力的感知 / 推理样本——论文称之为”先特化、再保持”(specialize-then-retain)课程,防止专业化把 backbone 继承来的通用视觉语言能力挤没了。混合中含 DAgger 采集的样本,让策略见到自己动作诱导出的状态。约 950 H100 GPU-hours。
Stage III — 在线 RL 后训练。 DAgger 虽然补上了策略诱导状态,但目标仍是 token 级模仿,并不直接优化决定任务成败的闭环行为。于是用 GRPO 做在线优化,同一套 backbone、token 接口和 rollout 机制支撑三类任务,只有奖励函数不同:
\[A^{(g)} = \frac{R(\tau^{(g)}) - \mu_R}{\sigma_R + \epsilon_{num}}\]组内标准化把”场景难度”这个偏置消掉,只有同一起始状态下 $G$ 次尝试之间的排序才产生梯度。每个任务只给一个终局标量,并广播到轨迹的每个决策步($r_t = R(\tau)$ 对所有 $t$)——论文的理由很实在:要做逐步 reward shaping,就得在三种互不兼容的几何上手工设计三次势函数。超参为 $G=8$、每轮 $B=32$ 个种子(即每次更新 256 条 episode)、$\varepsilon=0.2$、$\beta=0.01$,单节点 8×H100。
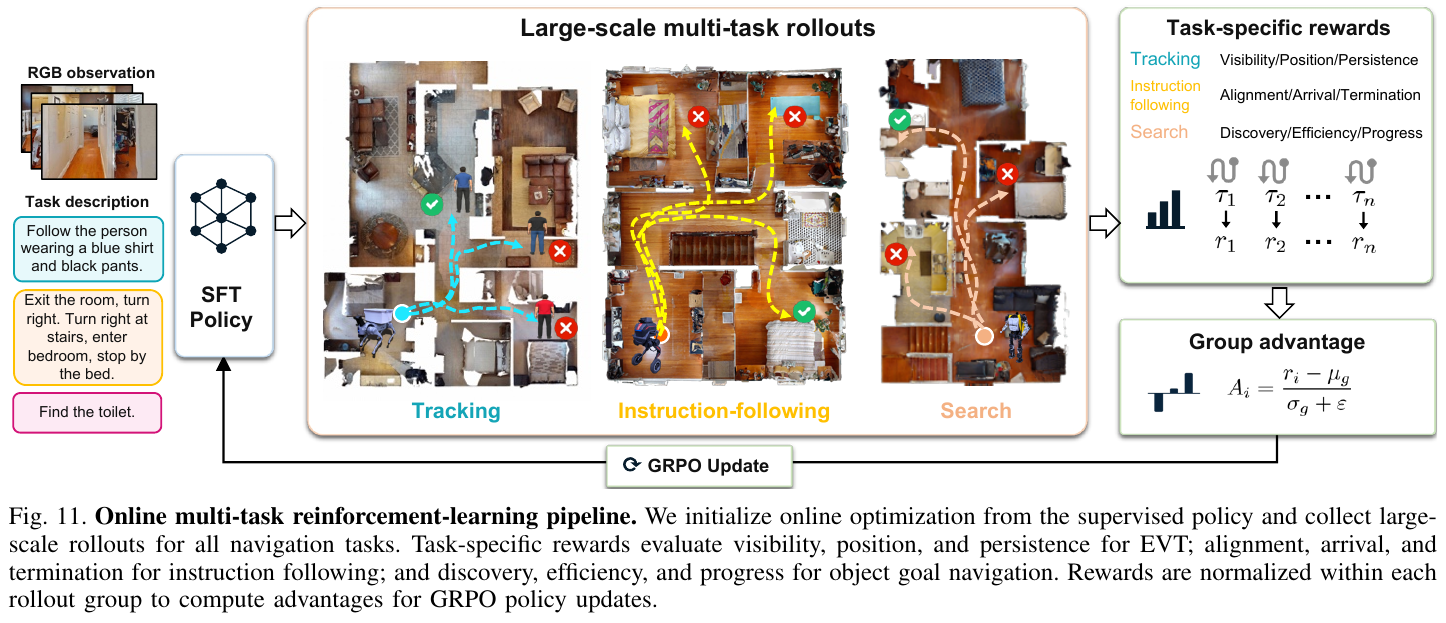
三个任务的终局奖励各自为政。指令跟随把路径保真度写进奖励,防止”抄近道到了终点但没按指令走”:
\[R_{VLN} = \left(1 + \mathrm{nDTW}\right)\mathbf 1[\text{success}] + \exp\!\left(-\frac{\max(d_T, d_{clip})^2}{\sigma_d^2}\right) - 0.25\cdot\mathbf 1[\text{timeout}]\]物体导航则换成路径效率 $PL = d_0 / \max(d_0, \tilde\ell)$(即 SPL 的逐 episode 版本),因为它只给类别不给路线,路径保真度无从谈起;那个高斯邻近项承担了全部失败样本的区分度——没有它,所有失败都是同一个奖励值,对组内方差毫无贡献。视觉跟踪最特殊:目标是移动的,没有终点可”到达”,于是奖励改成”逐步质量的时间平均”,且早停(跟丢或碰撞)时按固定时域 $T_0 = 300$ 步归一化,把没执行的步数记为零质量——不然一个早早撞墙的跟随者反而因为”平均值高”而占便宜。
举个例子(RL 训练集为什么要先筛一遍):一个 episode 种子要跑 $G=8$ 条 rollout。 若 8 条全成功,8 个奖励几乎相同,$\sigma_R \approx 0$,标准化后 8 个优势全是 0 —— 这 8 条仿真白跑,梯度贡献为零;全失败同理。 只有”8 条里成功 3 条”这种骑在决策边界上的 episode 才有非零方差。 所以论文先用 SFT checkpoint 对每个候选跑 $K$ 次,分箱成 always-solved / mixed / never-solved,只留 mixed。同理,采样保留哪些决策步也不能均匀抽——首末决策、以及带停止 / 卡住 / 碰撞 / 大角度转向这类离散事件的决策及其邻居必须保留,因为终局奖励恰恰是在这些稀有时刻挣到的,均匀抽样会按稀有度把它们丢掉。
⑦ 一张表看清”到底改了什么”
| 维度 | 主流导航 VLA | LightNav-0 |
|---|---|---|
| 空间中间表征 | 无,或自由文本 CoT,或独立航点预测器 | 双通道 pointing,定长 2 个图像栅格 token |
| 动作输出 | 离散原子指令,或外挂扩散 / 流匹配 / 回归动作头 | 原生 LM 头直出 3 个 RVQ token → 10 个 SE(2) 航点 |
| 任务与本体标识 | task identifier token、embodiment expert | 无,任务语义全由指令文本和监督格式指定 |
| 感知输入 | 常需全景 / 多相机 / 深度 / 里程计 | 仅单目前视 RGB |
| RL 可用性 | 连续动作头须先把去噪重写成 MDP 才能上 policy gradient | token 对数概率精确可得,GRPO 原样套用 |
⑧ 推理与部署
推理时 ViT 和语言模型跑在同一个进程里(避免视觉特征的跨进程传输),自回归解码由 vLLM 承接,在一张 RTX 4090 上每 token 约 4 ms。每个决策步只需 2 个 pointing token 加至多 3 个 RVQ token。真机侧则用一个共享的 Trajectory Follower 把轨迹翻译成各平台的里程计与速度指令,交给机器人自带的运动策略——高层 RGB-to-trajectory 策略本身完全不动。
⑨ 顺带产出:INSIGHT-Bench
论文还构建了一个新基准,把网格化仿真场景和 3D 高斯泼溅场景统一到同一套轨迹格式下:训练集 1,683 场景 / 53,090 episode,评测集 210 场景 / 1,097 episode。它按两个正交轴做诊断——场景轴(公寓 / 住宅 / 商业 / 机构 / 户外)和指令轴(Base / Direction / Relation / Extremum / Ordinal),后者对应解析目标所需的空间机制。标注管线用 Molmo2 做开集 pointing、靠度量深度抬升到 3D,并要求一个实例被至少两个不同视点的两次观测支持、3D 定位散度低于 0.6 m 才予保留。
3. 核心结果/发现
具身推理(LightNav-ER,8 个基准)。 4B 的 LightNav-ER 拿到 67.4 的完整集宏平均,4 项第一、4 项第二。相比自己的初始化 Qwen3-VL-4B(63.1)高 4.3 分,比 8B 的 Molmo2-ER(62.8)高 4.6 分且只用一半参数。增益最大的两项恰是最贴导航的能力——Where2Place +12.6、RefSpatial +11.9,分别对应自由空间 grounding 和多步空间指代。
指令跟随(VLN-CE val-unseen)。 R2R 上单目四项指标全线最优:SR 66.9 → 68.5,SPL 62.3 → 62.8,NE 4.05 → 3.91 m,OS 73.7。RxR 上 NE / SR / SPL 同为单目最佳(NE 4.09 → 3.66 m,降幅 10.5%;SR 73.6;SPL 64.5)。但 nDTW 只有 67.4,低于 DualVLN 的 70.0——论文自己点出:更高的成功率与终点精度并没有均匀地转化成轨迹保真度。
物体目标导航。 不用深度也不用里程计,三个闭集设置的单目 SR 与 SPL 全部最优:MP3D SR 46.6 → 53.3、SPL 17.5 → 21.2;HM3D v1 SR 74.5 / SPL 43.9;HM3D v2 SR 77.2 / SPL 41.5。这套纯 RGB 策略甚至越过了列出的多视角系统——HM3D v1 上比带深度和里程计的 WMNav 高 16.4 SR、12.7 SPL,等于排除了”视野更宽或几何信息更特权”这个解释。开放词表的 HM3D-OVON 上模式一致,且分布越偏增益越大:seen +0.3 SR,synonyms +9.6,unseen +6.2;SPL 分别 +7.6 / +7.8 / +4.4(以上为 arXiv v2 数字)。
具身视觉跟踪(EVT-Bench)。 STT 上 SR 91.7 / TR 87.7 / CR 1.87,DT 上 SR 82.6 / TR 80.1 / CR 4.62,单目设置下全面领先,DT 上比次优的 ReferTrack 还高 9.3 SR。
INSIGHT-Bench。 在统一部署协议下(同样 1,097 episode、120° 前视 480×270 RGB、300 步预算),SR 27.4 → 43.7、SPL 24.0 → 41.5、NE 4.25 → 3.88 m,全部聚合指标最优。指令轴上最大增益出现在 Direction(29.7 → 57.7),而且这是唯一一类 LightNav-0 超过自己 Base 分(45.1)的指令,6 个开源基线在加入第一人称方位词后分数一律低于各自的 Base——这与它的路线条件化监督(模板里显式写出第一人称方位并在改写中保留)直接对应。最难的仍是 Extremum(37.2),因为选”最左 / 第二个”必须先检出多个候选再比较位置。场景轴上公寓最强(61.1),户外相对增益最大(16.7 → 34.2,翻倍),机构类最弱(29.2)。
消融。 两个部件都被验证是必需的,而且双通道 pointing 的贡献远大于 ER 初始化:ER 初始化把 8 个设置的平均 SR 从 60.8 抬到 63.1、平均 SPL 从 39.0 抬到 40.0;而移除 pointing 监督后平均 SR 从 63.1 掉到 54.7、平均 SPL 从 40.0 掉到 34.3(约 3.7 倍于 ER 初始化的效果)。ER 初始化对 SR 的改善在 8 个设置上一致,但对 SPL 的改善小且不均匀,说明它主要改善语义与空间决策,路径效率更依赖下游导航对齐。
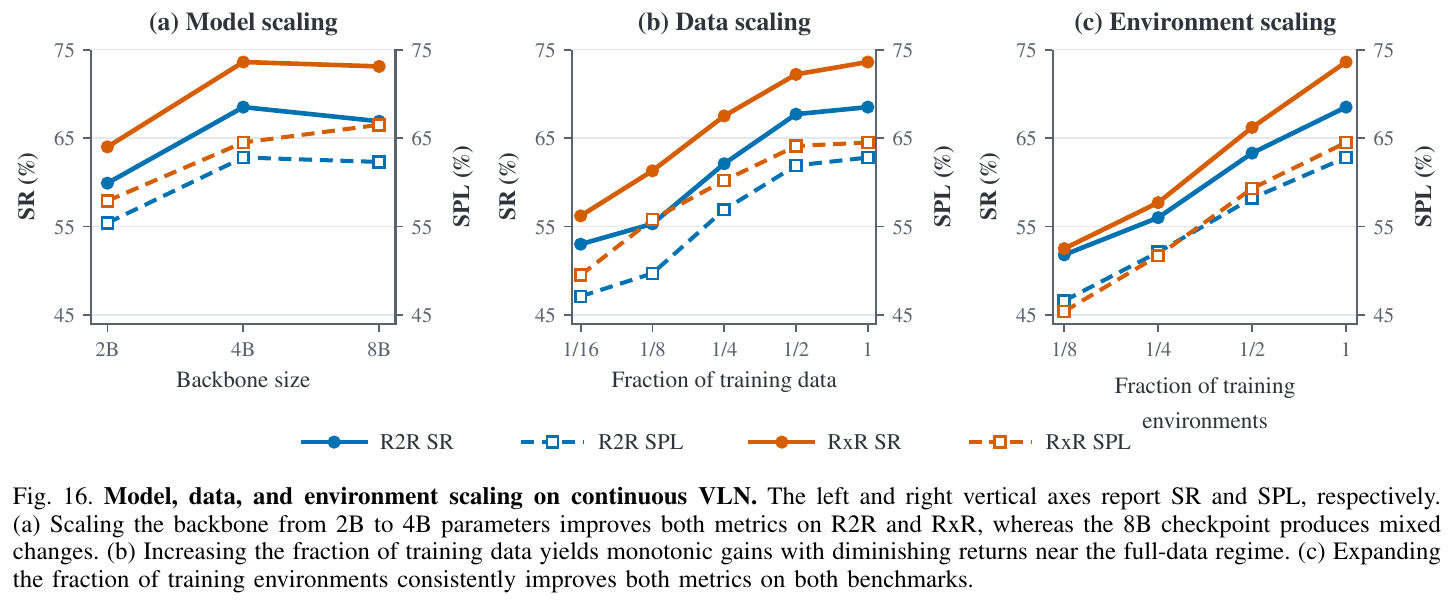
Scaling 的三条轴给出不同结论。 模型轴:2B → 4B 在 R2R / RxR 上涨 6.6–9.6 分,但 4B → 8B 不再一致有益(R2R SR/SPL 反降 1.6/0.5,RxR SR 降 0.5,仅 RxR SPL 升 2.0)——4B 是这批 checkpoint 里性价比最优的。数据轴:1/16 → 全量涨 15.0–17.4 分,但 1/2 → 全量只再添 0.4–1.4 分,收益明显递减。环境轴:1/8 → 全量在 R2R 上涨 16.7/16.2、RxR 上涨 21.1/19.1,且每个中间档都在改善全部四项指标;在对齐的 1/8-到-全量区间上,环境扩展的增益超过数据扩展。结论是扩环境多样性最可靠。
零样本迁移。 同一个 checkpoint 不做任何适配就迁到 Counter-Strike 1.6、VizDoom、Minecraft、Trigger Rally 四个游戏域,分别做指令跟随、目标跟踪和检查点驾驶——说明学到的 pointing-轨迹接口没有绑死在训练仿真器的外观统计或运动学上。
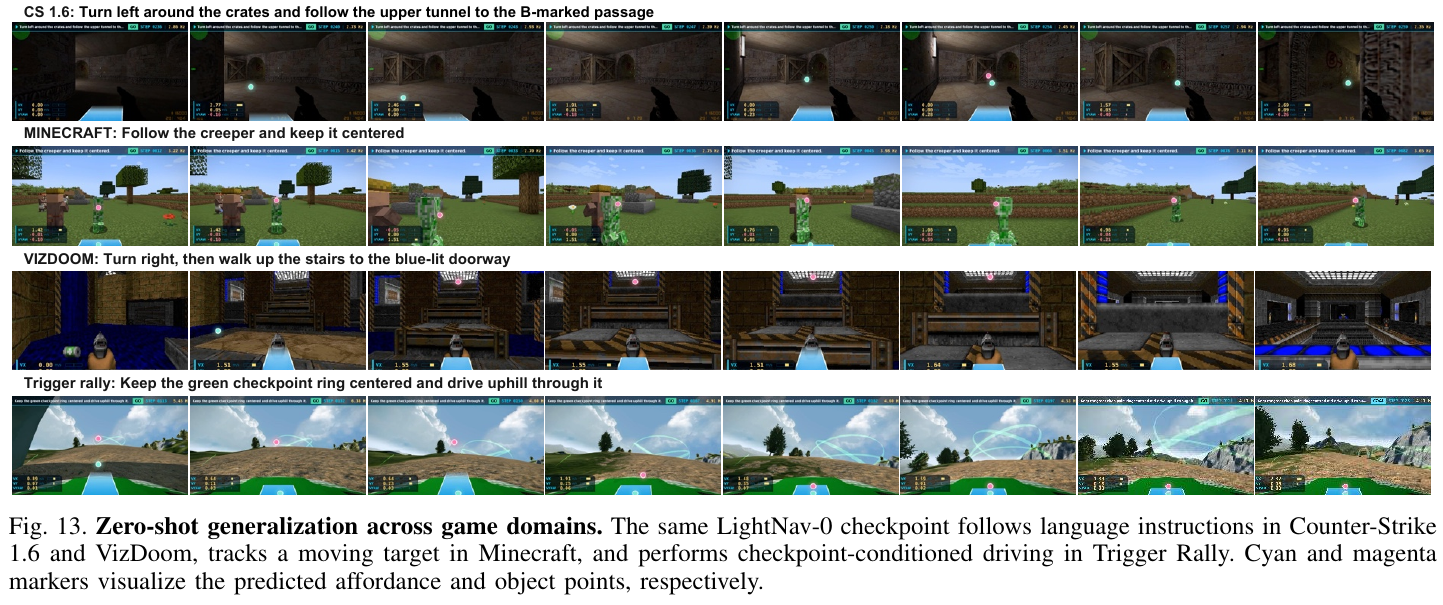
真机上同样零样本跨四种本体(人形 LightBot-0、四足 Unitree Go2、自研四旋翼、轮式 LIMX TRON 1)。最严苛的一项测试是跟踪:训练数据里的跟踪目标只有人,但模型能直接跟随从没见过的动态目标类别——人形机器人、轮式机器人、手推车——在视角、背景杂乱和光照变化下保持目标身份。
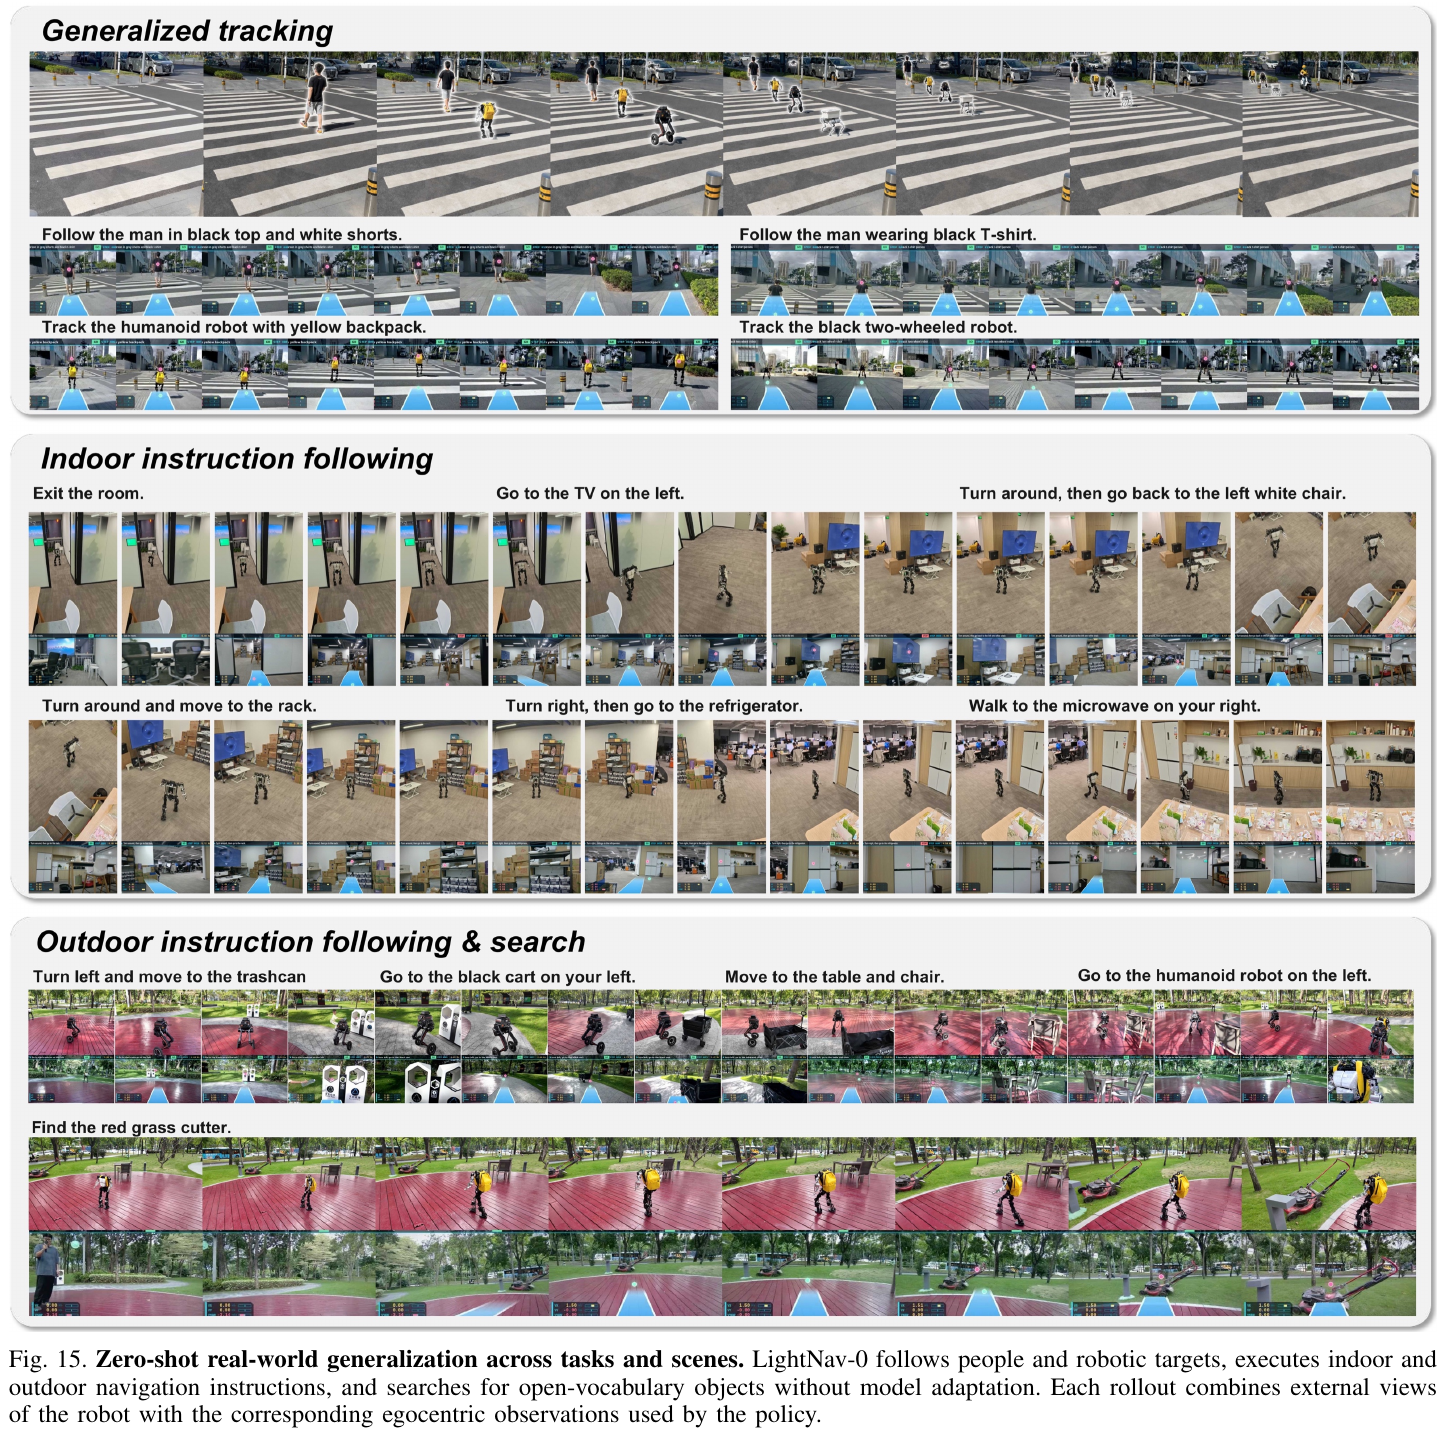
4. 局限性
作者自陈两点。其一,模型只有单一决策通路,没有把高频局部控制和慢速语义思考分开——理想形态应是一个轻量反应式策略负责避障与频繁轨迹修正,配一个慢速 VLM 规划器负责长时程推理。其二,预训练仍限于精选的具身数据集,若能在互联网规模视频上做更强预训练,可望覆盖更罕见的场景、交互与运动模式。
从实验本身还能读出两处未被作者列为局限的软肋:RxR 上的 nDTW(67.4)低于 DualVLN,说明成功率的提升没有同步转化为轨迹保真度;INSIGHT-Bench 的绝对成功率只有 43.7%,Extremum 类指令(37.2)和机构类场景(29.2)离可用还很远。
51. Uncertainty-Aware Gaussian Map for VLN (2026)
———三类感知不确定性 × Semantic Gaussian Map,赋予 VLN 智能体可靠决策能力
📄 Paper: arXiv:2607.13500 · 🏛️ ICLR 2026 · Code(待发布)
精华
- 将环境表征(3D Gaussian Map)与感知不确定性(几何/语义/外观)统一到同一空间,是比单纯 map-based 方法更稳健的设计范式。
- 几何不确定性用变分推断建模位置/尺度扰动,语义不确定性用语义属性扰动揭示歧义解释,外观不确定性用 Fisher Information 衡量渲染敏感度——三条路径正交互补,可迁移到其他 3DGS 场景表征任务。
- 用”3D Value Map”将不确定性从特征维度编码为可导航的 affordance / constraint,是将感知置信度转化为行动先验的优雅工程。
- 训练时让 SGM 的渲染损失和导航损失联合优化,使场景表征与决策策略协同提升,避免了两阶段分离设计的 representation gap。
- REVERIE RGS 提升 2.94%、R2R SR 提升 2% 的边际增益表明:当前 VLN 瓶颈已从”语言理解”转移到”感知可靠性”,不确定性建模是下一个值得深耕的方向。
1. 研究背景/问题
VLN 要求智能体在 3D 环境中依据自然语言指令导航。现有智能体在推理时普遍忽略感知不确定性(如相似门洞的视觉歧义、遮挡导致的路径可通行性不确定),训练目标迫使模型对每个 step 输出确定动作,无法表达”不确定”。这在遮挡多、结构重复的场景中易造成错误停止或路径偏移。
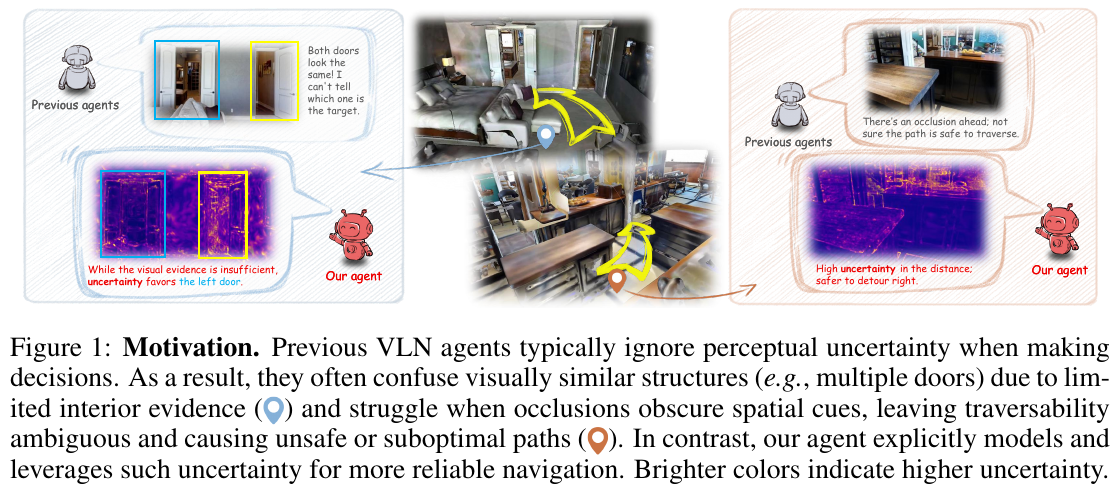
2. 主要方法/创新点
整体框架:SGM 构建 → 不确定性估计 → 3D Value Map → 多层 Transformer 预测动作。
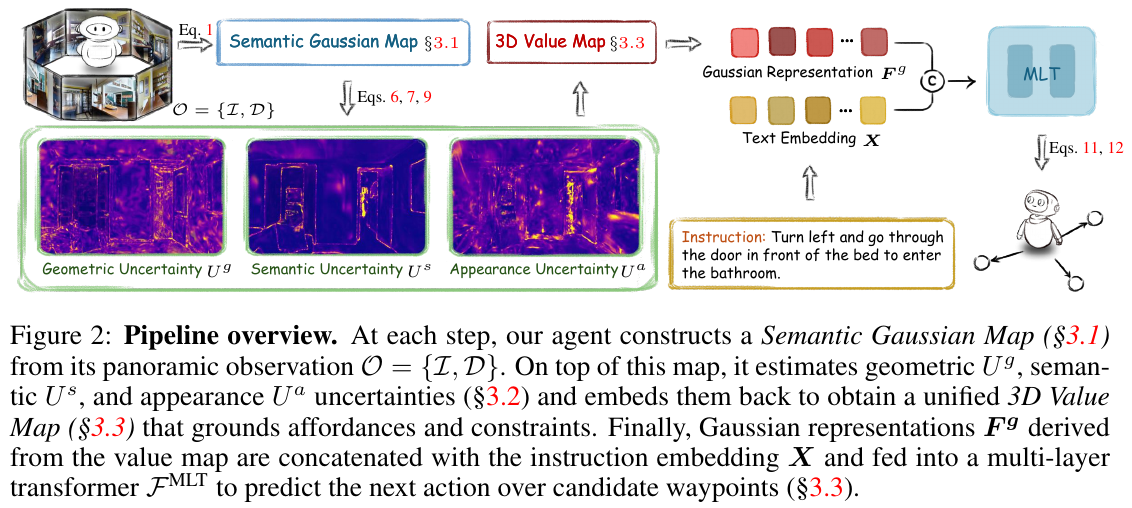
3.1 Semantic Gaussian Map (SGM)
每个导航点处,将多视角 RGB-D 观测反投影为稀疏伪激光点云,每个点初始化为一个可微 3D Gaussian primitive \(g_i\),包含:均值 \(\boldsymbol{\mu}_i \in \mathbb{R}^3\)(位置)、协方差 \(\boldsymbol{\Sigma}_i\)(形状/尺度)、不透明度 \(\alpha_i\)、颜色球谐系数 \(c_i\),以及语义属性 \(s_i\)(由 SAM2 分割区域 + CLIP 特征附加而来)。通过可微渲染优化使 SGM 与当前观测一致,并裁剪低尺度(\(\lVert e_i \rVert_2 < \tau_e\))和低不透明度(\(\alpha_i < \tau_\alpha\))的冗余 Gaussian。
3.2 不确定性估计(三类)
| 类型 | 建模方式 | 含义 |
|---|---|---|
| 几何不确定性 \(U^g\) | 对位置/尺度施加变分扰动,最小化 ELBO,提取变分分布标准差 | 结构可靠性:Gaussian 是否在多种几何假设下保持稳定 |
| 语义不确定性 \(U^s\) | 对语义属性施加可学习偏移,同样 ELBO 优化 | 语义歧义程度:同一区域的语义解释有多不稳定 |
| 外观不确定性 \(U^a\) | 用 Fisher Information(渲染 Jacobian 的 log-determinant)近似 Hessian | 外观敏感性:纹理复杂/遮挡/光照变化是否导致渲染剧变 |
3.3 3D Value Map 与动作预测
将 \((U^g, U^s, U^a)\) 附加到每个 Gaussian 的属性向量,扩展为 \(g_i \in \mathbb{R}^{20}\)。再通过非线性投影得到每个 Gaussian 的特征 \(F^{g_i} \in \mathbb{R}^{768}\),聚合后与语言嵌入 \(X\) 拼接,输入多层 Transformer \(\mathcal{F}^{\text{MLT}}\) 预测候选 waypoint 的导航概率。
3. 核心结果/发现
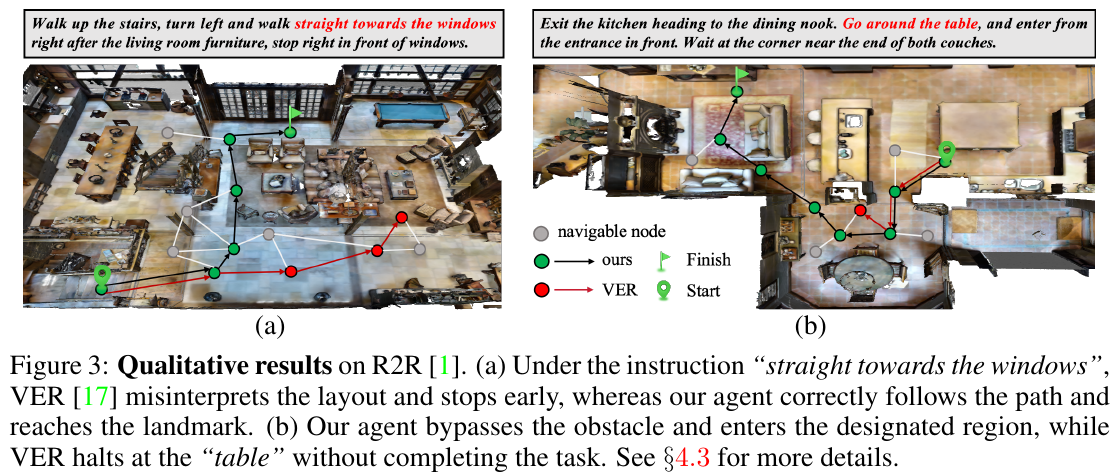
- R2R val unseen:SR 78%(vs VER 76%,+2%),SPL 66%(vs 65%,+1%)
- RxR val unseen:SR 65.2%(vs BEVBert 64.1%,+1.1%),nDTW 65.6%(vs 63.9%,+1.7%)
- REVERIE val unseen:RGS 37.65%(vs BEVBert 34.71%,+2.94%),RGSPL 27.01%(vs 24.44%,+2.57%)——远程目标定位能力显著提升
- 消融:SGM 单独带来结构理解增益(REVERIE RGS 32.15% → 35.48%),不确定性单独将 R2R SR 从 72.22% 提升至 74.20%,两者叠加达到最优 78.32%
- 三类不确定性均有独立贡献,全部使用时最优,几何+语义的提升幅度大于外观
4. 局限性
SGM 构建(尤其是 SAM2 语义抽取与不确定性估计)推理开销较大,训练阶段采用离线预计算缓解,但实时部署仍需轻量化替代(论文建议以轻量 SAM2 变体替换);此外,框架在 Matterport3D 室内场景验证,对室外或动态环境的泛化性未知。
52. HarnessVLN (2026)
———一套 Agent Harness,把”指令跟随”和”找物体”两类导航压进同一个工具调用协议
📄 Paper: arXiv:2609.15195 · Project Page
精华
训练无关导航真正的瓶颈不在于 planner 够不够聪明,而在于「语义上合理的提议」与「物理上能不能执行」之间缺一个仲裁层——HarnessVLN 就是把这个仲裁层显式做出来。做法是把 MLLM 从决策者降级为提议者:它输出的每一次工具调用,都要先过证据新鲜度、几何可达性、子目标一致性三道校验才允许派发,连 Stop 都只是「申请」而非「命令」。记忆被拆成互补的两套——事件记忆(任务中心,存完整失败轨迹)与时空图 ST Graph(环境中心,存可复用空间证据加轻量失败标注和回指事件的引用),既保住可追溯性,又让进入 MLLM 上下文的东西不随轨迹长度线性膨胀。协议保持不变、执行器可替换,于是同一套 Harness 同时吃下 VLN-CE R2R/RxR 与 HM3D-v2/OVON 四个基准,并直接迁到人形机器人上。可迁移的核心思想是:给 agent 加一层「派发前校验 + 结构化反馈回灌」的运行时,比继续调 prompt 更能把语义推理接回物理执行。
1. 研究背景/问题
指令跟随与目标物体导航这两类任务,都要求 agent 把语言接到部分可观测的环境上、边走边积累空间知识、并判断自己的动作是否真的推进了任务。训练式方法在目标任务上有效,但换任务形式或换环境就要重新采数据;MLLM 驱动的训练无关方法绕开了训练,却普遍把模型当成任务专用流水线里的一个 planner——证据怎么留存、提议怎么校验、失败如何影响后续决策,仍由外围流水线决定。于是老问题依旧:认出目标不等于走得到,发出动作不等于子目标完成;陈旧观测、不可达目标与执行失败会让后续规划与真实任务状态越走越偏,表现为反复尝试或错误终止。
2. 主要方法/创新点
整体框架:HarnessVLN 由四个部件构成——MLLM Planner 只负责提出语义操作,Agent Harness 负责组装上下文、校验提议、派发工具并回灌反馈,分层事件记忆负责记录任务进展与执行事件,持久化 ST Graph 负责沉淀可复用的空间证据。四者通过一套统一工具接口闭环:上下文组装 → 提议校验 → 工具派发 → 反馈整合 → 再组装。
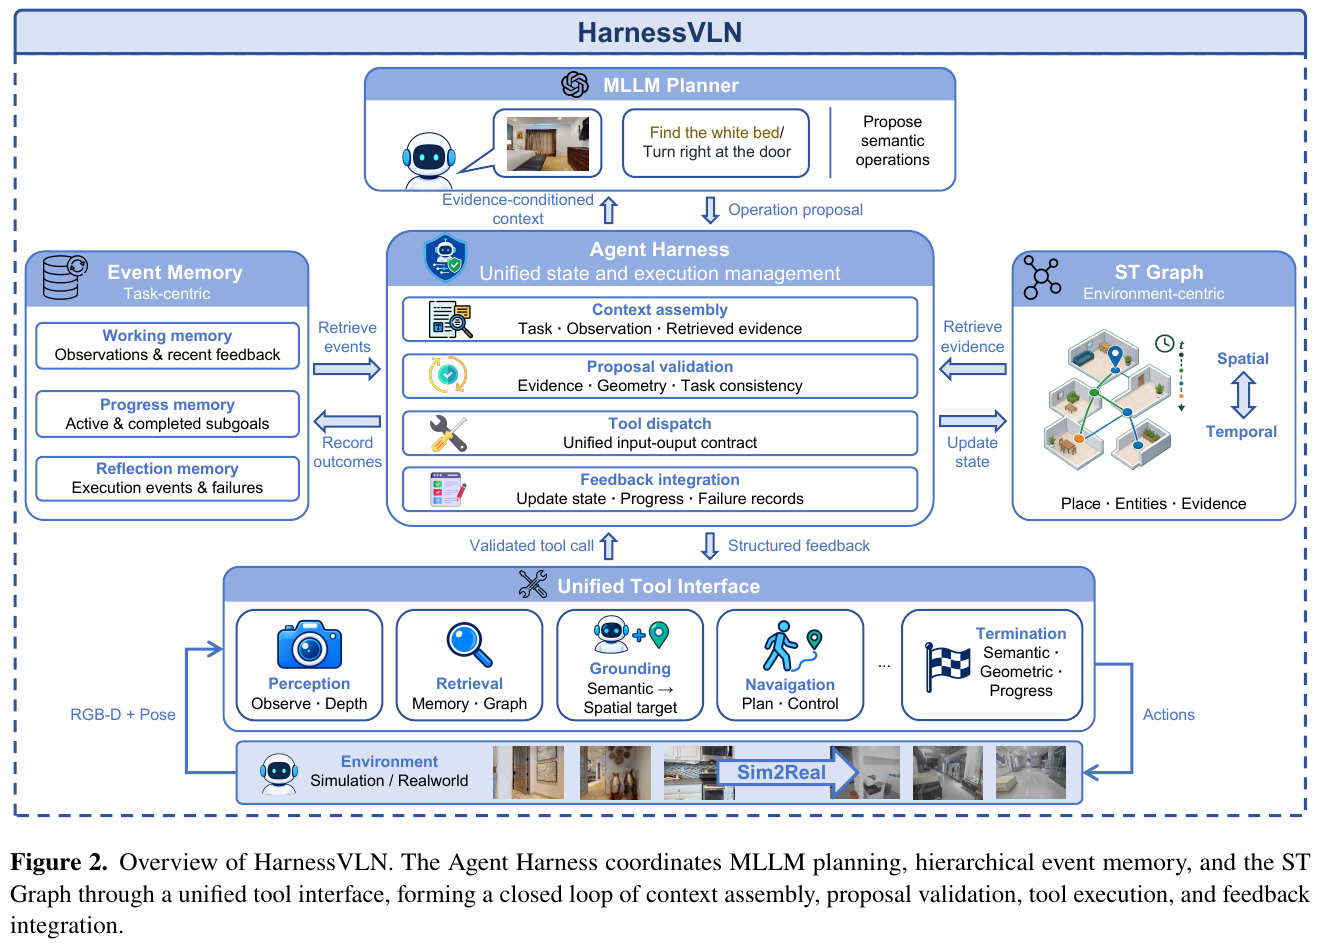
卡点一:说了半天,Harness 和普通的「MLLM 当 planner」流水线到底差在哪?
差别只有一句话:MLLM 说的话不再直接算数。传统流水线里模型输出什么就执行什么,Harness 则在模型和环境之间插了一道闸。
| 维度 | 传统 MLLM-as-planner 流水线 | HarnessVLN 的 Agent Harness |
|---|---|---|
| MLLM 的角色 | 决策者:输出的动作直接下发执行 | 提议者:输出的是”操作提议”,待审 |
| 提议怎么落地 | 下游模块尽力执行,成不成看运气 | 派发前查三件事:证据来源与新鲜度、目标几何可达性、与当前子目标是否一致 |
| 失败怎么用 | 只体现为”这步没成”,下一轮照样提同一个 | 写入 reflection memory,并在 ST Graph 对应地点挂轻量标注,压低下一轮检索得分 |
| 停不停 | 模型说 stop 就 stop | 模型只能”申请”,语义 ∧ 几何 ∧ 进度三重门控全过才真下发 |
画成运行时循环就是下面这张图。注意那条校验不通过的回边——它是整个框架区别于流水线的地方:被拒的提议不会消失,而是变成下一轮上下文里的一条负面证据。
graph TD
    A["观测 + 位姿 (RGB-D)"] --> B["上下文组装: 任务 · 当前观测 · 检索到的证据"]
    B --> C["MLLM Planner 提出一个语义操作"]
    C --> D{"Harness 三审: 证据够新吗 / 几何可达吗 / 与当前子目标一致吗"}
    D -- "不通过" --> E["写入 Reflection Memory 与 ST Graph 标注"]
    E --> B
    D -- "通过" --> F["派发工具调用 (统一输入输出契约)"]
    F --> G["结构化反馈: 到达 / 碰撞 / 不可达 / 无进展"]
    G --> H["更新 Harness 状态 · 任务进度 · ST Graph"]
    H --> B
2.1 Harness 的状态与决策循环
在决策步 $t$,Harness 维护状态
\[S_t = \langle x,\ \omega_t,\ p_t,\ z_t,\ M_t,\ G_t \rangle\]其中 $x$ 是任务规格(一条路线指令,或一个目标物体类别),$\omega_t$ 是位姿对齐的 RGB-D 观测与局部几何地图,$p_t$ 是 agent 位姿,$z_t$ 是任务进度,$M_t$ 是分层事件记忆,$G_t$ 是持久化 ST Graph。
两类任务共用同一份状态定义,差别只落在 $z_t$ 上:指令跟随时 $z_t$ 记录当前路线片段、已满足的运动约束与已观测到的地标;ObjectNav 时 $z_t$ 记录已探索区域、候选目标假设及其验证状态。任务变了,进度表示和完成判据变,但 Harness 协议本身一个字不改——这是它能同时覆盖两类任务的根本原因。
单步循环(论文 Algorithm 1):观测与位姿不一致就重新 Observe → 记录事件 → 合并图 → 取当前活跃子目标 → 按子目标检索经验 → 组装上下文 → MLLM 出提议 → Validate → 派发工具 → 用反馈更新状态。
2.2 统一工具接口
所有异构能力被包进一个共享的输入输出契约,因此换掉任何单个工具都不必改动 MLLM Planner 或 Harness 协议:
| 工具 | 角色 | 功能 |
|---|---|---|
observe |
感知 | 抓取当前 RGB-D 观测与 agent 位姿 |
observe_panorama |
感知 | 在预设朝向上抓取全景观测 |
retrieve_memory |
检索 | 从事件记忆与 ST Graph 取任务相关证据 |
ground_target |
接地 | 把子目标落到某个候选视角的图像区域 |
query_depth |
感知 | 估计已接地区域的深度及其不确定度 |
navigate_to |
导航 | 对已通过校验的目标调用 Navigation Executor |
backtrack |
恢复 | 回到此前访问过的位置并确认到达 |
request_stop |
终止 | 终止执行前验证任务是否真的完成 |
2.3 分层事件记忆 $M_t$(任务中心)
- Working memory(工作记忆):当前观测、有界的全景历史、活跃目标假设、近期工具反馈。只留下一步决策需要的短期上下文,因此不随轨迹长度无限增长。
- Progress memory(进度记忆):任务分解与完成状态。每个子目标有唯一 id 和四种状态之一——pending / active / completed / blocked;同一时刻至多一个 active,且标记 completed 必须有位姿对齐的观测或成功的工具结果作支撑,堵死了 planner「嘴上说完成了」就推进任务的路。
- Reflection memory(反思记忆):完整记录子目标级执行事件——不可达目标、接地不一致、碰撞、无进展、回溯失败、被拒的停止请求。每条含事件 id、任务上下文、位置、时间戳、工具反馈与支撑观测。
2.4 Harness 托管的时空图 $G_t$(环境中心)
\[G_t = \left( V_t^P \cup V_t^E,\ E_t,\ T_t \right)\]$V_t^P$ 为 place 节点,$V_t^E$ 为 entity 节点,$E_t$ 为带类型的空间关系,$T_t$ 存时间戳与轻量事件标注。
- Place 节点汇总已访问位置、支撑观测与可通行 waypoint;空间上相容的观测合并进已有 place,否则新建节点;相邻 place 用双向
NavigableTo边连接,形成可供前进与回溯复用的持久拓扑。 - Entity 节点表示 ObjectNav 目标与指令中提及的地标,带语义别名、空间假设、置信度与支撑视角;
ObservedFrom边保留「在何时、从哪个视角看到」的溯源信息,Contains边编码粗粒度的 place–entity 归属。正因为存了溯源,Harness 才能同时取回「目标假设」和「验证这个假设所需的证据」。 - 任务条件检索:每次 MLLM 决策前,按当前活跃子目标 $g_t$ 给 place 节点打分
其中 $R$ 为语义相关性(用局部 IDF 加权余弦相似度实现),$C$ 为新鲜度,$A$ 为空间显著性,$P$ 惩罚适用的历史失败。
卡点二:事件记忆和 ST Graph 看起来都在存历史,为什么要分两套?
因为它们回答的是两个不同的问题:事件记忆回答「这次任务我干了什么」,ST Graph 回答「这个房子长什么样」。前者随任务推进滚动、有界;后者跨子目标持久累积。
| 维度 | Event Memory(事件记忆) | ST Graph(时空图) |
|---|---|---|
| 视角与寿命 | 任务中心,随子目标滚动,working 部分有界 | 环境中心,跨子目标持久,整个 episode 累积 |
| 存什么 | 三层:working(当前观测与近期反馈)/ progress(子目标状态机)/ reflection(完整失败事件) | place 节点、entity 节点、带类型空间关系、时间戳 |
| 失败记录 | 权威全量:事件 id、任务上下文、位置、时间戳、工具反馈、支撑观测 | 只挂”此处在该子目标下栽过”的轻标注,外加一个指回原事件的引用 |
| 被谁读 | 组装当前决策上下文 | 按 $s(v_i \mid g_t)$ 打分选 top-K 地点,喂给 MLLM |
关键设计在最后两行:失败的完整轨迹只存一份(在 reflection memory),图里只放”指针加权重”。这样既能做失败感知的检索与恢复,又不用把执行历史在图里复制一遍。标注的相关性还会动态调整——子目标变了或新证据推翻了它,权重下降;同类失败反复出现,权重上升;同时惩罚有上限,避免某条支路因为失败过一次就被永久拉黑。
举个例子(检索打分怎么算):假设图里只有 3 个 place 节点,当前子目标是”去厨房找洗碗机”。按论文附录给的权重(新鲜度 0.3、显著性 0.3、每条适用失败扣 0.5、扣分上限 1.0):
- 节点 A(厨房,3 步前刚看过):$0.9 + 0.3 \times 1.0 + 0.3 \times 0.8 = 1.44$
- 节点 B(厨房另一侧,60 步前看过,且上次从这里导航过去撞墙失败过一次):$0.85 + 0.3 \times 0.2 + 0.3 \times 0.7 - 0.5 = 0.62$
- 节点 C(卧室):$0.1 + 0.3 \times 0.5 + 0.3 \times 0.3 = 0.34$
取分数最高的 3 个作种子、各向外扩一跳、最多返回 5 个 place —— 进入 MLLM 上下文的永远是这 5 个地点及其实体,图却可以随轨迹一直长下去。这就是「图增长但上下文不增长」的具体含义。
2.5 接地执行与基于证据的终止
MLLM 提出的是语义命令,物理执行需要接地的目标和可执行的控制量,所以 Navigation Executor 被做成一个可替换的 Harness 托管工具:Harness 负责接地与校验,Executor 只负责路径规划与局部控制。命令只有在「有证据支撑 + 几何可达 + 与活跃子目标和适用失败历史一致」时才派发;Executor 回传到达 / 碰撞 / 不可达 / 无进展等结构化反馈,用于更新状态、事件记忆与图。前进与回溯走的是同一条「校验—执行—更新」回路。
终止同样由 Harness 仲裁——MLLM 可以提议停止,但不能直接下发环境级 Stop 动作。请求被接受当且仅当
\[F_{stop} = F_{semantic} \wedge F_{geometric} \wedge F_{progress}\]三项分别校验目标身份、几何有效性与任务完成度。ObjectNav 要求目标在视觉上有支撑且落在停止半径内;指令跟随则要求当前证据支持最后一个路线片段、被引用的地标与接地的终点。被拒的请求会写进事件记忆,并触发进一步观测、目标细化、继续靠近或回溯。
举个例子(停止门控怎么救回一次失败):论文 Figure 8,HM3D-OVON 第 1297 集,目标类别是 picture。
第 216 步,agent 认为自己到了:按投影导航目标点算,距离只有 0.40 m,低于 1.0 m 的投影目标阈值,”看起来”该停了。 但 Harness 不信这个数——它优先抓一帧新鲜深度:在检测框锚点上取 5×5 邻域的中位数(要求 patch 标准差不超过 0.5 m),读到 4.65 m,远超 2.5 m 的深度阈值,于是 $F_{geometric}$ 不成立,停止申请被驳回,事件入库。 agent 继续靠近,第 429 步新深度读到 1.53 m,门通过;第 430 步真正停下,基准评测的终点距离是 0.13 m,成功。
一句话:投影目标点只能说明”我走到了我以为的地方”,新鲜深度才能说明”我真的挨着那个物体”。Harness 的价值就是在这两者冲突时,选择相信传感器而不是相信规划。
下面这张运行时面板把前面所有抽象状态一次性落地了——注意面板 ⑤ 里的 STOP GATE 计数(requested / gate pass / gate fail / rejected)、ST Graph 的节点边计数,以及面板 ⑦ 里每条 TODO 后面挂的 evidence id:“完成”这两个字在系统里始终绑着一条可回溯的观测。
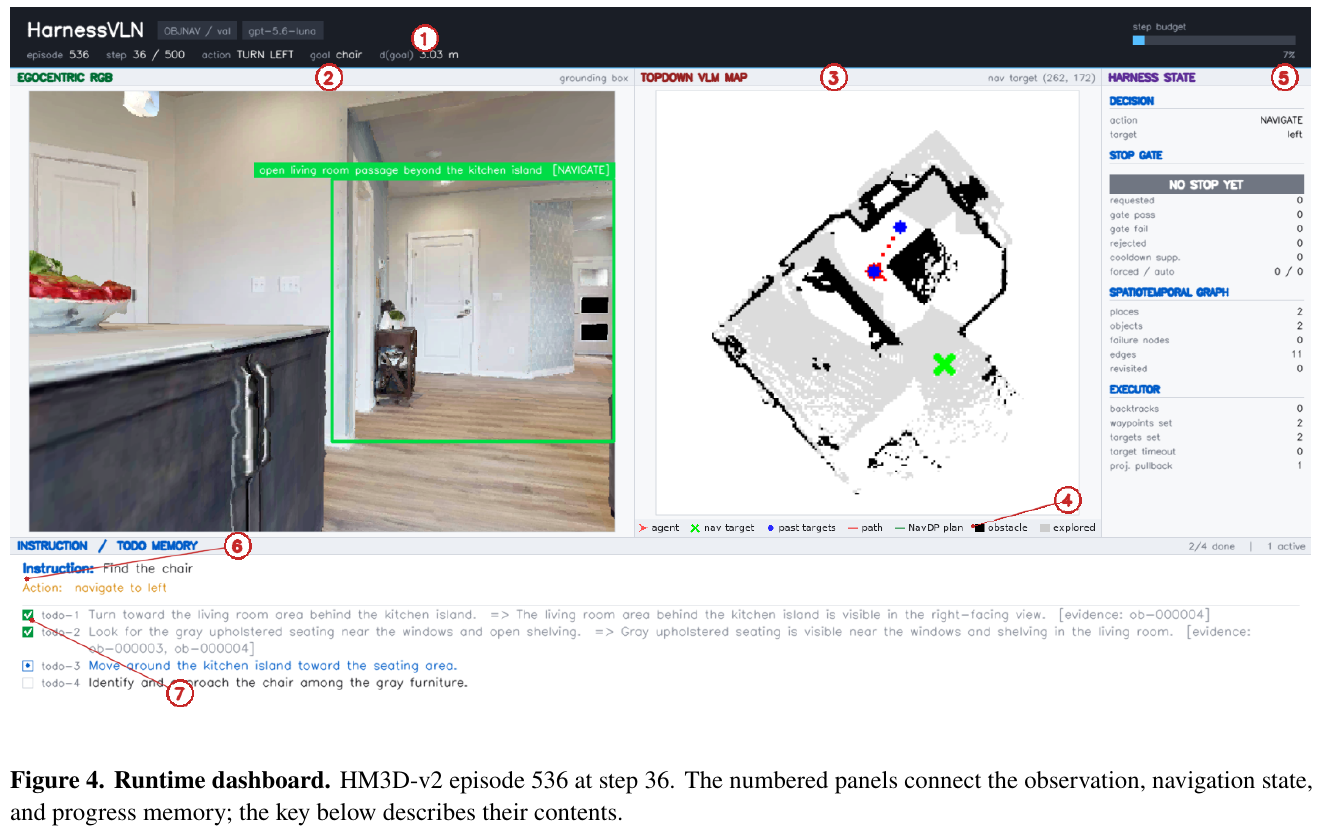
实现配置:640×480 同步 RGB-D、79° 水平视场;GroundingDINO 加 SAM 提供开放词表目标区域与分割掩码;Navigation Executor 平面运动用 FMM 规划器,需要上下楼梯时调用 NavDP。仿真主实验中,指令跟随用 GPT-5.5、ObjectNav 用 GPT-5.6-luna——同一个 episode 内所有推理功能(任务分解、导航规划、目标接地、停止验证、恢复)共用一个模型,只换 prompt。
3. 核心结果/发现
指令跟随(VLN-CE val-unseen):在训练无关方法中 R2R 与 RxR 的 SR 均为最高。相比同样用 GPT-5.5 的 AgenticNav,R2R 的 SR 高 5.8 分、OSR 高 7.7 分;相比 HSGM,RxR 的 SR 高 12.1 分、SPL 高 12.9 分,nDTW 相当。
| 方法 | R2R NE↓ | R2R OSR↑ | R2R SR↑ | R2R SPL↑ | RxR SR↑ | RxR SPL↑ | RxR nDTW↑ |
|---|---|---|---|---|---|---|---|
| NavFoM [ICLR26](有监督) | 3.78 | 70.8 | 61.7 | 55.3 | 64.4 | 56.2 | – |
| ABot-N0 [CVPR26](有监督) | 3.78 | 70.8 | 66.4 | 63.9 | 69.3 | 60.0 | – |
| GC-VLN [CoRL25] | 7.30 | 41.8 | 33.6 | 16.3 | 33.8 | 13.8 | – |
| HSGM [CVPR26] | 5.42 | 58.7 | 47.9 | 32.8 | 41.8 | 25.1 | 54.9 |
| AgenticNav-GPT-5.5 | 5.19 | 65.0 | 55.0 | 48.4 | – | – | – |
| HarnessVLN-GPT-5.5 | 4.01 | 72.7 | 60.8 | 43.5 | 53.9 | 38.0 | 54.8 |
目标物体导航:HM3D-v2 拿到训练无关方法中最高的 SR(76.0%);HM3D-OVON 上 SR 59.3%、SPL 36.6%,在所有列出方法中最高(含有监督方法),比 DRIVE-Nav 高 9.1 分与 4.0 分。
| 方法 | 需训练 | HM3D-v2 SR↑ | HM3D-v2 SPL↑ | OVON SR↑ | OVON SPL↑ |
|---|---|---|---|---|---|
| FiLM-Nav [arXiv25] | ✓ | 77.0 | 41.3 | 40.8 | 24.4 |
| ABot-N0 [CVPR26] | ✓ | – | – | 54.0 | 30.5 |
| DRIVE-Nav [arXiv26] | ✗ | 72.4 | 41.3 | 50.2 | 32.6 |
| MSGNav [CVPR26] | ✗ | 74.4 | 33.4 | 48.3 | 27.0 |
| HarnessVLN | ✗ | 76.0 | 37.9 | 59.3 | 36.6 |
消融(各 100 集固定子集,累积开启):事件记忆是最大单项增益,ST Graph 次之且同时改善 SPL,停止验证再补一刀。完整 Harness 相比基础 agent,R2R 与 OVON 的 SR 分别提升 18.0 与 10.0 分,OSR–SR 差距在两个任务上都收窄。
| Mem. | Graph | Stop | R2R SR↑ | R2R SPL↑ | R2R Gap↓ | OVON SR↑ | OVON SPL↑ | OVON Gap↓ |
|---|---|---|---|---|---|---|---|---|
| ✗ | ✗ | ✗ | 46.0 | 23.7 | 26.0 | 45.0 | 32.0 | 27.0 |
| ✓ | ✗ | ✗ | 54.0 | 33.0 | 19.0 | 52.0 | 32.4 | 20.0 |
| ✓ | ✓ | ✗ | 60.0 | 35.4 | 15.0 | 53.0 | 34.2 | 18.0 |
| ✓ | ✓ | ✓ | 64.0 | 35.8 | 13.0 | 55.0 | 33.0 | 19.0 |
一个诚实的反例:停止验证在 OVON 上把 SR 从 53.0 提到 55.0,却让 SPL 从 34.2 掉到 33.0、OSR–SR 差距从 18.0 涨到 19.0——更严的验证换来更高的完成率,代价是绕路和更谨慎的终止,两者并不同向。
模型敏感性(固定 100 集 OVON 子集):协议与工具不变只换基座,SR 在 51.0(Qwen3.8-flash)到 63.0(GPT-6-astra)之间摆动;而在同一基座 GPT-5.6-luna 下,HarnessVLN 的 55.0 对 MSGNav 的 37.0,说明增益主要来自 Harness 而非模型本身。
| 方法 | 基座模型 | SR↑ | SPL↑ | OSR↑ | Gap↓ |
|---|---|---|---|---|---|
| MSGNav | GPT-5.6-luna | 37.0 | 18.9 | 46.0 | 9.0 |
| HarnessVLN | GPT-5.6-luna | 55.0 | 33.0 | 74.0 | 19.0 |
| HarnessVLN | GPT-6-astra | 63.0 | 39.4 | 76.0 | 13.0 |
| HarnessVLN | Qwen3.8-flash | 51.0 | 32.8 | 75.0 | 24.0 |
真机部署:AgiBot A3U 全尺寸人形机器人(1.74 m,3D LiDAR 加多路 RGB-D 与鱼眼相机,NVIDIA Thor 板载算力),头部立体相机作主视觉传感器,Fast FoundationStereo 出稠密度量深度,规划模型换成本地的 Qwen-3.8-27B。三个场景:连续指令跟随(走到 806 室前路口、左转停在饮水机旁垃圾桶、再去冰箱)、开放词表物体搜索、以及「先停在门口指示牌再找自动售货机」的组合任务。ST Graph 在路线跟随与物体搜索之间保留了地标与目标证据,支撑了阶段之间的连续性。
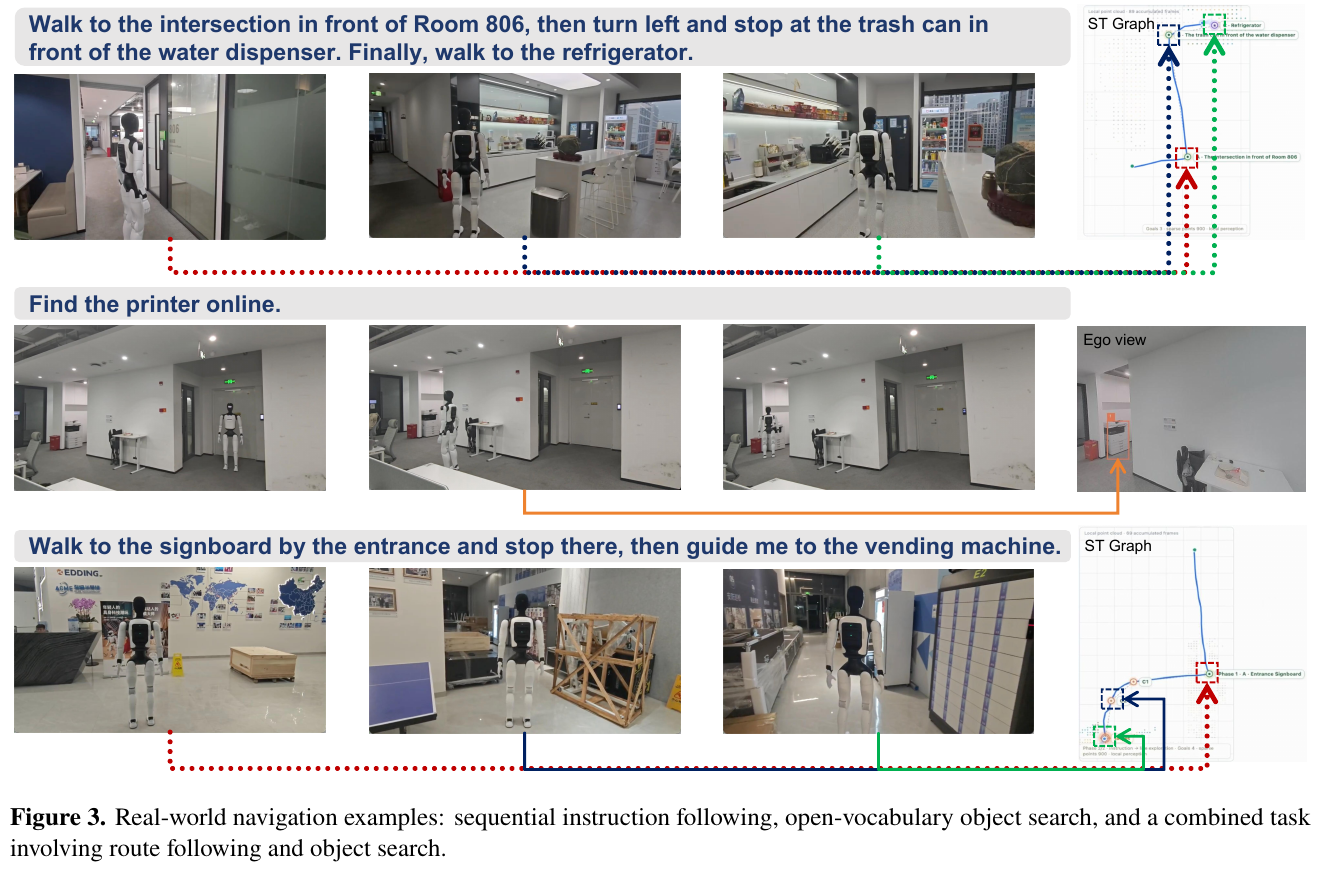
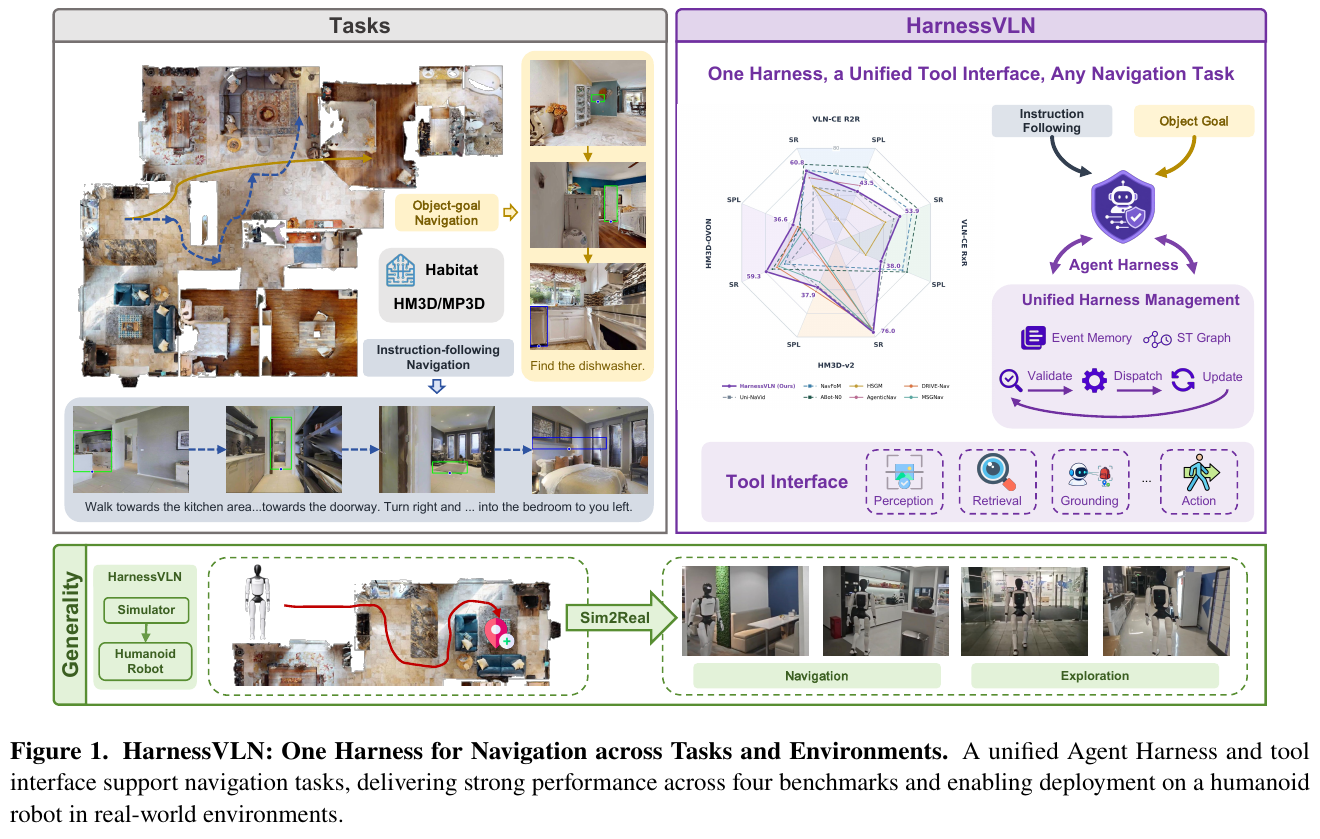
4. 局限性
论文自述:当前 Harness 的编排与校验规则是预先设定的,缺少在开放环境交互中自我演化的机制。从数据上看还有两点值得注意——更严的校验不免费,HarnessVLN 的 R2R SPL(43.5)低于同用 GPT-5.5 的 AgenticNav(48.4),HM3D-v2 SPL(37.9)也低于 FiLM-Nav 与 DRIVE-Nav 的 41.3,停止验证在 OVON 上甚至同时拉低 SPL 并拉大 OSR–SR 差距;对基座模型仍相当敏感,换成 Qwen3.8-flash 后 OVON 的 SR 掉 4 分、OSR–SR 差距从 19 扩到 24,说明”看见了却没能通过门走到”依然是主要失败模式。
53. GroundingVLN (2026)
———把视觉 grounding 做成”想”与”走”之间的共享接口
📄 Paper: arXiv:2609.18581
精华
VLN 里 VLM 的语义推理和机器人的空间执行之间一直缺一个可验证、可训练的接口:文本 CoT 说”我看到水槽”却说不清水槽在画面哪里,离散动作输出又没有任何显式目标。GroundingVLN 的做法是让 grounding 同时承担两件事——推理时把每条视觉断言绑定到像素坐标(<obj>标签|[x,y]</obj>),决策时输出一个与当前子任务进度对齐的像素目标,交给几何规划器反投影成 3D 路径。配套的两个关键设计是:数据引擎用 3D 世界标记加 SAM 3 跟踪解决”同一个物体跨视角改名换姓”的问题;GEAR 把像素目标反投影后按”真走过去能到哪”打分,而不是按 2D 像素距离打分。结果是只用 188K 样本(最强基线的 0.9%)拿到 R2R-CE 69.9% SR、RxR-CE 75.1% SR,且仅用 R2R 训练迁移到 RxR 仍有 59.9% SR,比最强基线高 20.1 个点。对方法论的启发是:当高层模型与低层执行器之间的接口本身带有可测量的几何量时,奖励设计就能从”对/错”升级为”差多少米”,样本效率随之量变到质变。
1. 研究背景/问题
连续环境 VLN 要求智能体把自然语言指令落到第一视角观测上,并持续跟踪进度、规划下一步。现有路线有三类缺口:直接输出离散动作(NaVid、StreamVLN)缺少显式空间目标,且需要海量轨迹数据重学”视觉到电机”的映射;文本 CoT 方法(NavCoT、AwareVLN)的中间结论无法与图像区域对应,说的话没法验证;航点方法(ETPNav、SmartWay)的动作空间被外部航点预测器的候选质量卡死。归根结底是两个耦合的缺口:推理过程没有空间锚点,高层决策没有几何精确的执行接口。
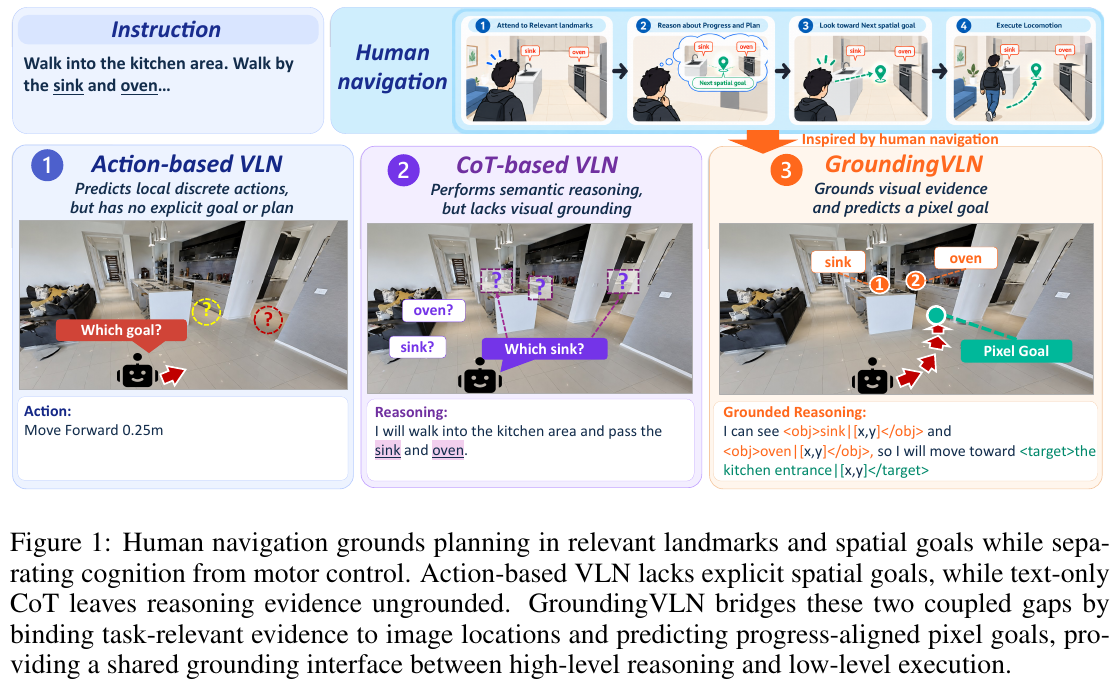
认知科学的证据是:人在决策点会选择性编码与导航相关的地标,并在迈步前主动把视线投向下一个落脚点。这直接启发了本文的设计——把 VLM 当作”高层认知系统”,只负责 grounding 推理与空间目标,运动执行交给低层规划器。
2. 主要方法/创新点
整体框架概述。 GroundingVLN 是一个解耦的闭环系统,由三部分构成:高层 VLM 负责结构化 grounded 推理并输出(当前子任务、高层动作、像素目标)三元组;低层执行模块把像素目标反投影成 3D 点、用 A* 规划路径并转成原始动作;GEAR 后训练用执行感知的奖励图把前两者对齐。指令在初始化时被一次性拆成有序子任务,之后每个决策步都在”当前子任务”这个语义刻度上推进。
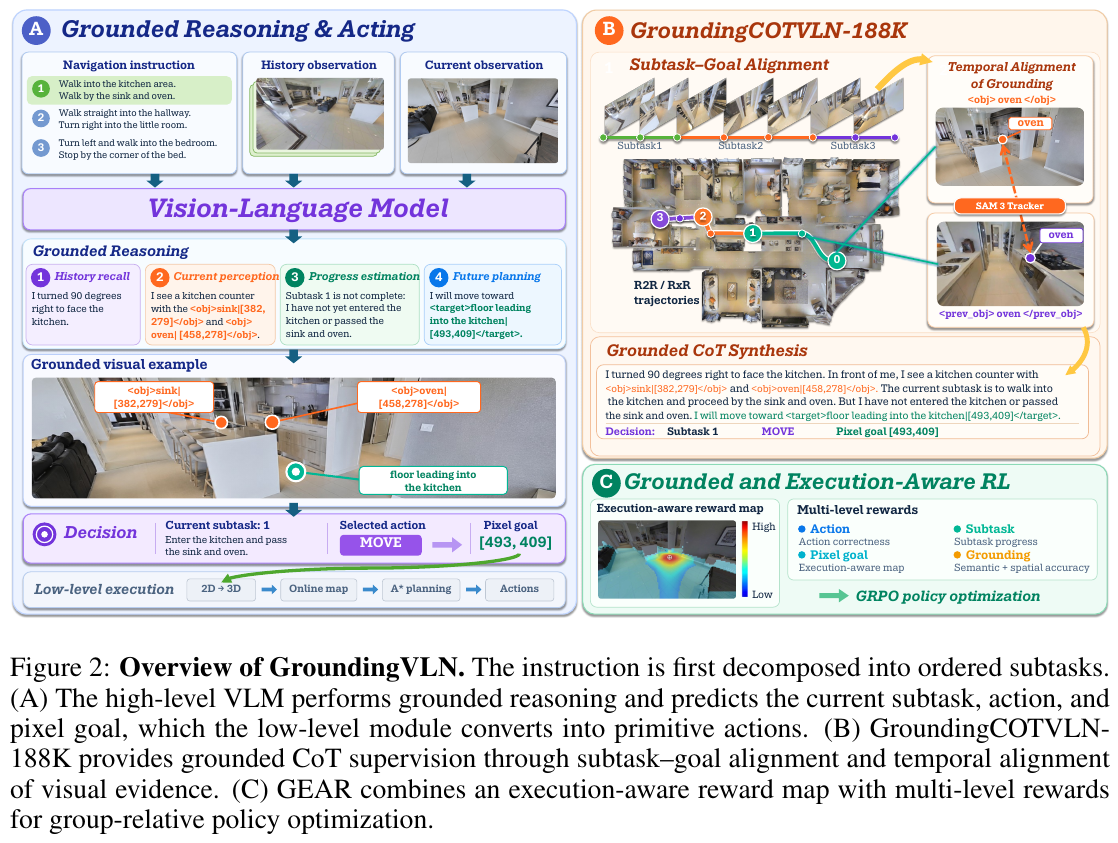
2.1 带 grounding 的结构化推理
输入:指令、历史交互 $H_t$、当前拼接的左-前-右 RGB 观测。
处理:VLM 按固定四阶段推理——① History Recall(回顾已走距离、朝向变化、看到过的地标)→ ② Current Perception(描述当前场景与朝向,识别指令相关证据)→ ③ Progress Estimation(哪些条件已满足、当前子任务是否完成)→ ④ Future Planning(按最早未完成的指令条件选下一个局部目标)。
输出:一段 CoT 文本,其中每个视觉断言都被标签包裹。
绑定规则很简单:新确认的实体写成 <obj>标签|[x,y]</obj>,之前已 grounding、这一帧又重新出现的实体写成 <prev_obj>标签|[x,y]</prev_obj>,坐标是当前视图下归一化的整数 $(x,y) \in [0,1000]^2$。
设计动机:这条规则让”我看到水槽”这句话变成可验证的——标注和 RL 阶段都能拿坐标去查那个位置到底是不是水槽;同时让历史证据能被显式复用到进度估计里,而不是淹没在自由文本中。
2.2 进度对齐的像素目标决策
推理完成后 VLM 输出高层动作 $a^h_t \in { \text{MOVE}, \text{TURN}, \text{STOP} }$。MOVE 必带一个像素目标 $g_t = (c_t, l_t, p_t)$——当前子任务 $c_t$、目标语义标签 $l_t$、像素位置 $p_t$,在 CoT 里以 <target>标签|[x,y]</target> 标出(与作为证据的 <obj> 区分开:<target> 是要走过去的可通行落点)。TURN 只执行原地 90° 或 180° 旋转,只有当转向后的目的地在当前视野中可见时才附带像素目标。STOP 仅在所有指令条件都满足时发出。
关键差异在于像素目标怎么选。DualVLN 监督的是”视野里最远的轨迹点”,本文则把候选点约束在当前子任务对应的轨迹段内:
\[q_t^* = \arg\max_{q} \ \mathrm{Prog}(q), \quad q \in T_{t:t+1} \cap S_{k_t}\]其中 $S_{k_t}$ 是当前子任务对齐的路径段,$T_{t:t+1}$ 是两个锚点之间实际执行过的轨迹,约束条件是该点在 $o_t$ 中连续可见(带深度遮挡校验)且可通行,最后用相机投影得到 $p_t = \Pi_t(q_t^*)$。
| 维度 | DualVLN 式”最远可见点” | GroundingVLN 的进度对齐像素目标 |
|---|---|---|
| 候选范围 | 整条参考轨迹上视野内最远的点 | 当前子任务段 ∩ 实际执行轨迹 |
| 终止边界 | 视野边界 | 该子任务的下一个决策边界 |
| 与语义的关系 | 无,纯几何最远 | 与预测的 current subtask 绑定,一起输出 |
| 执行器输入 | 扩散执行器吃 VLM 的潜在特征 | 显式像素坐标 → 反投影 → A* 规划 |
举个例子:指令”走进厨房,经过水槽和烤箱 → 直走进走廊 → 左转进卧室”被拆成 3 个 subtask。假设机器人此刻在客厅,subtask 1 还没完成。参考轨迹上视野里最远的可通行点是 12 m 外的走廊口——”最远可见点”策略会直接把它设成目标,一步跨过整个 subtask 1,水槽和烤箱压根没经过。GroundingVLN 把候选限制在 subtask 1 那一段里,段末就是 3 m 外的厨房入口,于是像素目标落在厨房门口地板的 [493, 409]。走到那里之后 subtask 1 才被判完成,再规划下一段。一句话:像素目标不是”能看多远走多远”,而是”这一小节任务该走到哪”。
2.3 低层规划与执行
输入:高层动作加像素目标。
处理:TURN 触发固定原地旋转,STOP 结束导航,只有 MOVE 会走完整几何链路——RTAB-Map 从 RGB-D 流在线估计相机位姿,累积点云构建包含地面支撑、障碍与高程变化(含楼梯)的地图;把归一化像素目标转成局部像素坐标,取对应深度、相机内参与估计位姿恢复 3D 世界位置;A* 在地图上搜无碰撞路径,路径跟随器把路径翻译成原始的前进与转向。
输出:一串低层动作。
端到端数据流(一个决策步的完整路径):
graph TD
    A["指令 + 历史观测 + 当前 RGB"] --> B["VLM: 四阶段 grounded reasoning"]
    B --> C{"高层动作"}
    C -- "STOP" --> D["结束导航"]
    C -- "TURN" --> E["原地旋转 90 度或 180 度"]
    C -- "MOVE" --> F["像素目标 x, y"]
    F --> G["深度反投影: 2D 像素转 3D 世界坐标"]
    G --> H["RTAB-Map 在线地图 + A star 规划"]
    H --> I["路径跟随器: 前进与转向序列"]
    I --> A
    E --> A
这里有个容易忽略的效率收益:VLM 平均每个 episode 只被调用 9.26 次,约占导航步数的 33.25%,其余步骤全由低层规划器接管——不必在每个原始动作上都跑一次大模型。
2.4 GroundingCOTVLN-188K:时序对齐的 grounding
数据集含 188K 条 grounded 图像与 CoT 样本,来自 21K 条 R2R / RxR 轨迹。构建分三步:
① 轨迹回放与锚点采样:在 Habitat 中回放参考路径,采三类决策锚点——到达锚点(参考点处)、转向锚点(大幅原地旋转附近)、中距锚点(走够距离后);大间隔处补采,近静止或冗余样本剔除。每个锚点存拼接的左-前-右 RGB-D、相机位姿、参考点索引、实际执行位置。
② 子任务与目标对齐:教师 VLM(Qwen3.5-397B-A17B)把指令拆成有序子任务 ${u_k}$ 并抽取地标与转向,每个 $u_k$ 对齐到一段连续路径 $S_k$,于是每个锚点都能拿到”当前进度段”和”已完成子任务集合”,再用 2.2 的公式选像素目标。
③ grounding 的时序对齐——这是与静态图像 grounding 最本质的区别。同一个物体在下一帧会移到别的像素位置,甚至被遮挡,带来两个风险:grounding 漂移到另一个相似实例(画面里有两个水槽,指的是哪个?),以及暂时看不见就被遗忘。解决办法是给每个 grounding 分配唯一的 3D 世界标记:
graph TD
    A["当前视角首次确认实体, 例如 oven"] --> B["打 obj 标签并记录像素坐标"]
    B --> C["反投影成唯一的 3D 世界标记"]
    C --> D["初始化 SAM 3 跟踪"]
    D --> E["到达下一个决策锚点"]
    E --> F{"3D 标记能重投影进当前视野吗"}
    F -- "能" --> G["直接得到新的像素位置"]
    F -- "不能" --> H["SAM 3 找回实例掩码, 用有效深度点更新 3D 位置"]
    H --> I{"新的 3D 估计与旧标记空间连续吗"}
    I -- "是" --> G
    I -- "否" --> J["拒绝该跟踪, 实体保留身份但标为不可见"]
    G --> K["以 prev_obj 标签重新绑定到当前像素"]
最后由确定性程序把”已执行运动 / 当前观测 / 进度状态 / 动作 / 像素目标”这些事实组装好,教师 VLM 只负责把它们口语化成结构化 CoT——这样 CoT 里的事实来自几何而非模型幻觉。样本还要过五道校验才保留:坐标可见性、深度遮挡、动作与推理一致性、格式完整性、标注泄漏检查。
消融里这一项的分量不小:关掉时序对齐重新标注并重训,SR 从 69.9% 掉到 62.2%,比去掉 <obj> / <prev_obj> 标签本身(66.1%)掉得更多——不一致的跨视角证据比没有证据更有害。
2.5 GEAR:执行感知的强化学习
像素目标的几何是连续可测的,这让后训练信号能比”动作对/错”细得多。GEAR 为每个锚点构造一张覆盖整个图像域的奖励图 $M_t$:候选像素 $p$ 先反投影得到执行端点 $P_t(p)$,落在墙面、家具等不可通行表面的直接用局部可通行图剔除;有效候选按下式打分:
\[Q_t(p) = \lambda_r \exp\left(-\frac{d_\perp(p)^2}{2\sigma_r^2}\right) + \lambda_p \exp\left(-\frac{(s(p)-s_t^*)^2}{2\sigma_p^2}\right) + \lambda_e \exp\left(-\frac{d_e(p)^2}{2\sigma_e^2}\right)\]三项分别管三件事:$d_\perp(p)$ 是到参考路线的横向偏离(管路线一致性);$s(p)-s_t^{\ast}$ 是与参考目标的路线进度差(管语义进度,走太少或冲太远都扣分);$d_e(p) = \lVert P_t(p) - P_t^{\ast} \rVert_2$ 是执行端点误差(管物理可执行性)。无效像素直接拿全图最低分。
举个例子:标注的参考目标在厨房门口地板上。模型给出两个候选像素——A 在门口地板上、离参考点 40 px;B 在紧挨门框的墙面上、离参考点同样 40 px。按 2D 像素距离,两者得分完全一样。但反投影到 3D 之后:A 落在可走地面上、离参考端点约 0.3 m,三项高斯都给高分;B 落在墙上,被可通行性掩膜直接判为无效、拿最低分。奖励图问的不是”你点得离标注近不近”,而是”照你点的走,机器人真能走到哪、离目标还差多远”。
在奖励图之外还叠了多级奖励:
\[R_y = \alpha_a R_{act} + \alpha_t R_{task} + \alpha_g R_{goal} + \lambda_g R_{grd} - P\]其中 $R_{goal}(p) = \phi(Q_t(p))$ 来自上面的奖励图;$R_{act}$ 是一张确定性的动作奖励矩阵(动作完全正确给 +1,TURN 方向错给 −0.5,该 TURN 却预测 MOVE、但目标落在与转向一致的画面外侧四分之一区给 −0.75,MOVE 与 TURN 互换给 −0.9,提前 STOP 或该 STOP 却做别的给 −1);$R_{task}$ 是子任务文本归一化后的精确匹配(对 +1 错 −1);$R_{grd}$ 评 grounding 的语义与空间正确性;$P$ 惩罚推理与决策之间的不一致。格式非法(<think> 块数量不对、JSON schema 不符、坐标越界、<target> 标签与决策不匹配等)直接给 $R = -1$。最后每个锚点采 G 个输出,用组内归一化奖励做 GRPO 裁剪目标优化。
训练配置:从 Qwen3.5-4B 初始化,先在 188K 样本上做 1 个 epoch SFT(8 张 H200 约 8 小时),再用 GEAR 在 16K 样本上跑 2000 步、学习率 1e-6(同硬件约 20 小时)。
3. 核心结果/发现
VLN-CE 主榜单全面 SOTA。 R2R-CE val_unseen:NE 3.66 / OS 74.8 / SR 69.9 / SPL 64.1;RxR-CE val_unseen:NE 3.54 / SR 75.1 / SPL 62.0 / nDTW 75.3。相比 ABot-N0 的 SR 绝对提升 3.5%(R2R)和 5.8%(RxR),且超过了 DualVLN(S2)+SPF——那个变体用 Habitat 的最短路径跟随器理想化执行其预测的像素目标,说明 GroundingVLN 的优势不是来自执行器,而是来自目标本身选得更对。
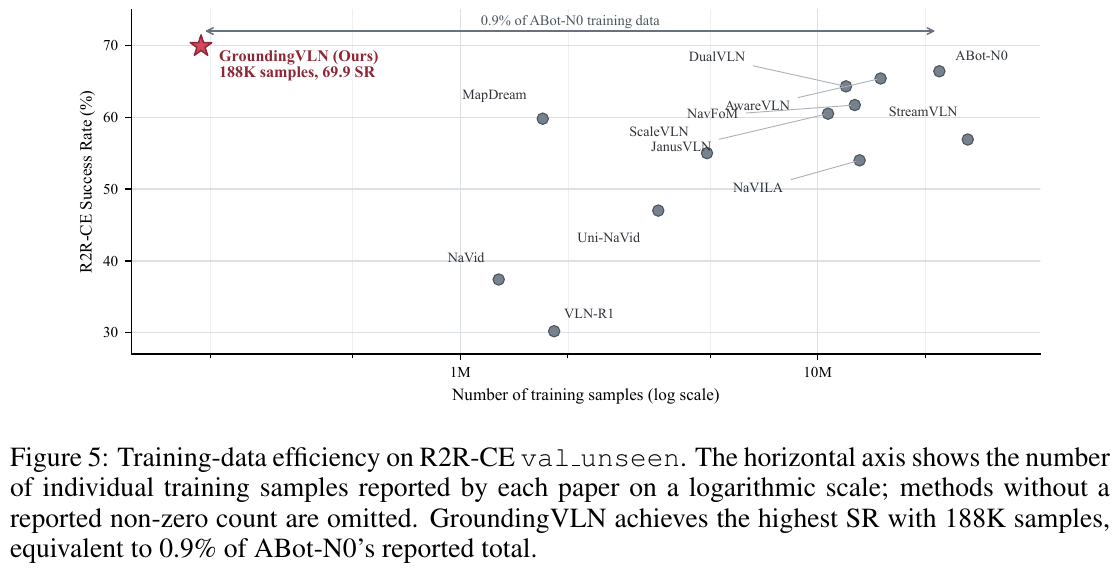
样本效率是最扎眼的一项。 188K 样本对比 ABot-N0 的 21.9M(16.9M 专家轨迹加 5.0M 推理样本),只用 0.9%。更严格的对照在附录 A.2:只用 R2R 与 RxR 数据(无额外导航语料)时,StreamVLN 的 SR 是 45.6%、JanusVLN Base 是 52.8%,GroundingVLN 是 69.9%;即使对上它们用全量语料的版本(26.3M / 10.69M),GroundingVLN 仍分别高 13.0% 和 9.4%。
跨数据集泛化的提升幅度更大。 只用 R2R 训练、零 RxR-CE 数据直接迁移到 RxR-CE val_unseen:SR 59.9% / SPL 48.2%,比最强基线 AwareVLN(39.8% / 36.0%)高 20.1 和 12.2 个绝对点。作者的解释是显式子任务进度、grounding 证据与像素目标接口共同构成了一种可迁移的导航表征,而不是记住了 R2R 的指令风格。
消融:GEAR 是第一功臣。 去掉 GEAR 掉 12.7 个点(69.9 → 57.2);把执行感知奖励图换成朴素 2D 像素距离掉到 66.2;去掉时序对齐掉到 62.2;去掉 <obj> / <prev_obj> 掉 3.8 点到 66.1;去掉子任务分解到 68.1(SPL 掉得更明显,到 62.2)。
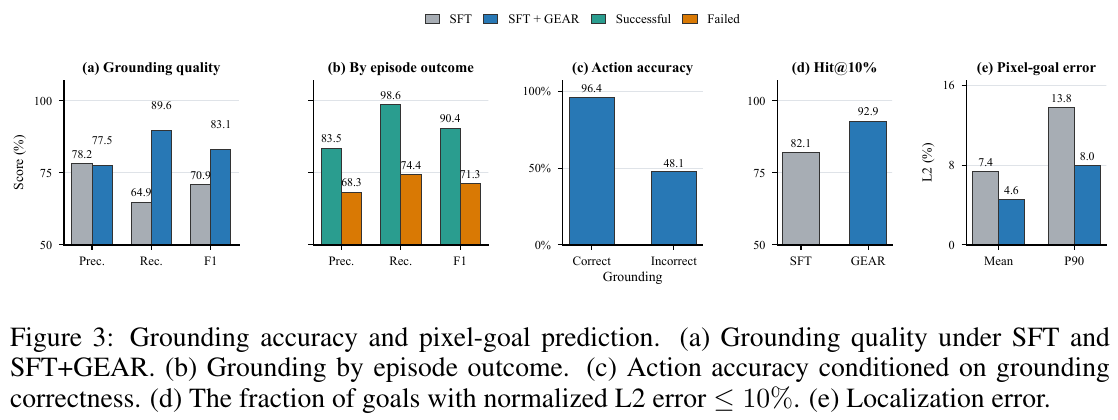
其中最有说服力的是 (c):grounding 正确的决策步,动作准确率几乎是 grounding 错误时的两倍(96.4% 对 48.1%)——这为”grounding 质量直接决定导航质量”提供了步级证据,而不只是端到端指标上的相关性。
没有灾难性遗忘。 导航微调后在 MMStar 上 57.20、MVBench 上 45.55,相比原始 Qwen3.5-4B(63.67 / 50.93)只掉 6.47 和 5.38 个点;而 AwareVLN 与 DualVLN System 2 在同样测试下几乎全零——前者继续吐导航协议,后者只返回方向动作或 STOP。有意思的是导航数据还带来了增益:Object Shuffle +27.5%、Scene Transition +5.0%、Egocentric Navigation +3.0%,集中在空间变化跟踪与自我中心运动推理上。
真机部署。 AgileX TRACER 2.0 轮式底盘配 Insta360 X5 与 RealSense D435(离地 1.2 m、下倾 30°),单张 RTX 4090 推理。每个难度 10 个 episode:Easy 100%、Medium 90%、Hard 60%、Overall 83.3%,三个基线全面落后(DualVLN 40%、AwareVLN 50%、StreamVLN 33.3%),在 Medium 与 Hard 上差距最大。
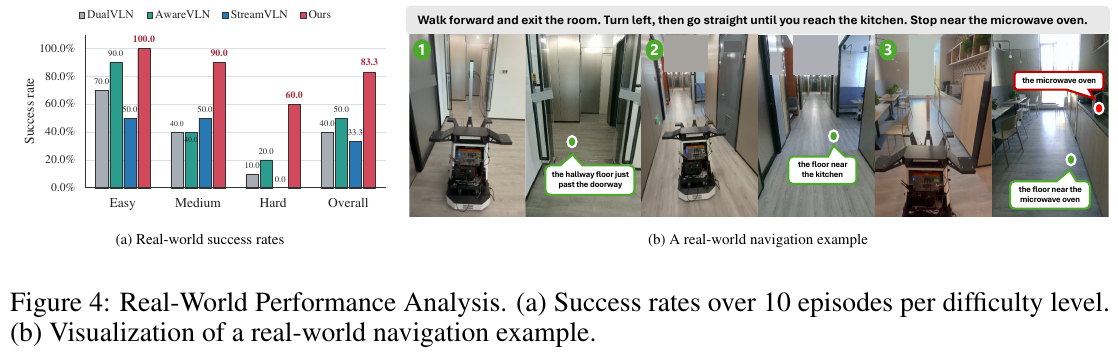
效率与鲁棒性。 平均每个 episode 推理 37.41 s,与最快的 Progress-Think(36.60 s)相当,比 NaVILA / Aux-Think / ActiveVLN 分别快 34.2% / 35.5% / 65.0%。深度噪声方面,按 D435 的立体基线(B = 0.05 m)与亚像素误差(0.08 px)建模视差域噪声后,SR 从 69.9% 降到 65.5%、SPL 从 64.1% 降到 59.7%,约 4.4 个点的降幅——一阶深度不确定度随距离平方增长,在 1 / 3 / 5 m 处分别约 0.58 / 5.20 / 14.43 cm。
4. 局限性
高层 VLM 只吃 RGB,但低层执行模块依赖传感器提供的度量深度才能把像素目标反投影成可靠的 3D 点,并支撑 RGB-D SLAM 的位姿与地图估计。这限制了在没有可靠深度传感的平台上部署,作者把”不依赖度量深度、又能保持几何精度的纯 RGB 低层规划器”列为后续工作。
54. GPT-6-Astra (2026)
———通用基础模型只凭单目 RGB 与原语动作,零样本跑通连续环境视觉语言导航
📄 Paper: arXiv:2609.29861 · Project Page
精华
- 把”看”也做成模型自己决定何时调用的工具——
observe()不耗步数,step()执行完不回传图像——接口只剩”看”和”动”两个动词,测出来的就是基础模型本身的导航能力,而不是外围模块的能力。 - 面对足够强的基础模型,航点预测器、全景、深度、预建图这些”脚手架”可能从助力变成上限:单目 RGB 加 0.25 m / 15° 的原语动作,在 R2R-CE-100 上拿到 79.0% SR、69.5% SPL,高于 Table 1 中所有零样本与训练式方法的报告值(评测子集不同,需谨慎看待)。
- 只看 SR 会漏掉三类问题:OSR 与 SR 之差(3 个 episode 进过目标圈却停错位置)、低 nDTW 的成功(EP42 绕了约 2.4 倍路程才到达)、像素不变的”空走”(EP176 连走 8 步画面没变),分别对应停止判断、路线遵循和执行确认。
- 推理强度从 medium 提到 ultra,SR 的 +3 个点是 9 个任务翻盘、6 个任务翻车相抵后的净值,另有 15 个任务两档都失败——多想一会儿改变的是个别 episode 的结局,没有系统性修好执行与终点验证。
- 对 VLN 研究的启发:导航专用的训练、记忆与动作控制,应该用”修好了基础模型哪一类剩余失败”来证明自身价值,而不是重复基础模型已有的能力。
1. 研究背景/问题
VLN-CE(连续环境视觉语言导航)要求 agent 在连续 3D 空间里按自然语言指令一步步转向、前进,并在正确位置停下,考验感知、推理、记忆与动作的长程配合。GPT-4、Gemini-2.5-Pro、Qwen2.5-VL 之后,零样本 VLN 的主流做法是给通用模型套上导航专用的”脚手架”——训练好的航点预测器、全景 RGB-D、人工设计的规划与记忆模块,甚至预探索建图——分数因而反映的是整套系统,而非模型本身。这份来自新加坡管理大学与澳大利亚机器学习研究院的报告不提出新方法,而是沿用 Embodied Agents Take Control(arXiv:2607.26148)的极简接口设定追问:把脚手架全部拿掉,OpenAI 的通用模型 GPT-6-Astra 自己能导航到什么程度,又会在哪里失败?
2. 主要方法/创新点
这是一篇评测报告,”方法”即三件事:一套极简的导航接口、一套与既有零样本工作对齐的评测协议,以及一套基于交互日志的行为分析框架。报告没有披露 GPT-6-Astra 的结构、训练数据或规模,只说明它是 OpenAI 的闭源通用模型,在 Codex 中提供 medium(默认)与 ultra 两档推理强度。
整体框架
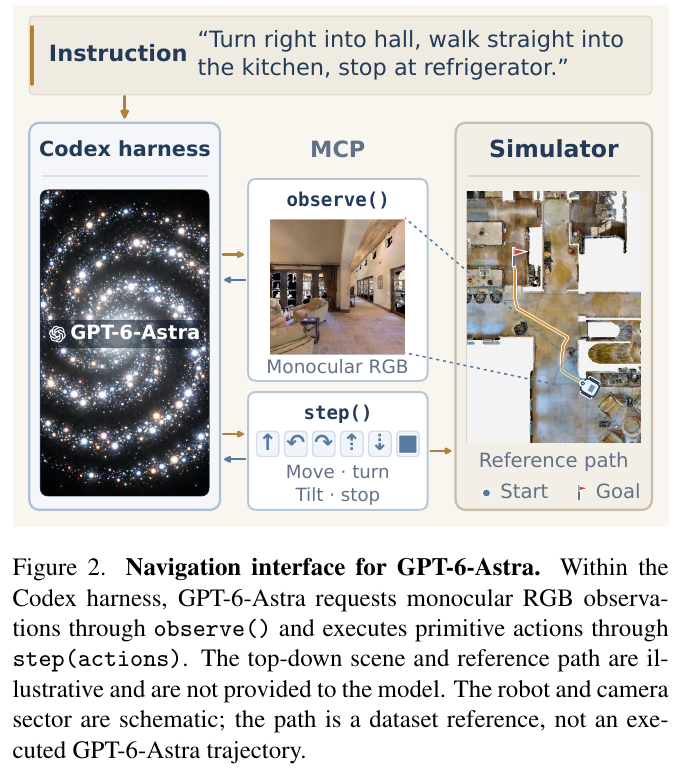
系统由三部分构成:Codex harness 只负责维持一个连续会话、不参与任何导航决策;MCP(Model Context Protocol,模型调用外部工具的标准协议)工具层只暴露 observe() 与 step(actions) 两个工具;VLN-CE 模拟器执行动作并判定成败。理解指令、何时观察、怎么移动、何时停下,全部由 GPT-6-Astra 在会话内自行决定。
与典型零样本 VLN-CE 系统相比,这个接口”极简”在以下几处:
| 维度 | 典型零样本 VLN-CE 方法 | 本报告的接口 |
|---|---|---|
| 观测 | 360° 全景,多数附带深度;部分方法预探索场景并重建(如 SpatialAnt) | 512×512 单目 RGB,要看就调 observe();无深度、无地图、无位姿 |
| 动作空间 | 训练好的航点预测器给出候选点,模型从中挑一个 | 原语动作序列:前进 0.25 m、左/右转 15°、相机俯仰 30°、STOP |
| 流程 | 人工设计的规划、记忆、动作选择模块 | 无导航专用模块,harness 只维持会话 |
| 导航训练 | 部分方法在导航数据上微调 | 不做任何导航微调 |
模块 1:观测工具 observe()
- 输入:无参数
- 处理:读取当前相机视角,不推进模拟器,也不消耗动作预算
- 输出:一张 512×512 单目 RGB。场景地图、参考轨迹、目标坐标、全局位姿与深度一律不提供
- 设计动机:把”看”变成模型主动选择的动作——看几次、什么时候看都由模型决定,从而检验它的主动感知能力,而不是由外部流程每步喂一张全景
模块 2:动作工具 step(actions)
- 输入:一个有序的原语动作序列,一次调用可以打包多个原语
- 处理:模拟器依次执行
- 输出:执行计数、剩余预算、是否终止——不返回图像,想看执行后的画面必须再调一次
observe() - 设计动机:动作粒度压到最低,不依赖任何训练好的航点预测器;”动完不给图”也意味着模型得自己判断动作是否真的生效,这正是后文执行失败分析的伏笔
举个例子:指令里的”右转进走廊”大约是 6 次右转(6 × 15° = 90°)。图 3 中 EP42 的一次调用”L × 6, F × 4”,就是在一次
step()里左转 90° 再前进 1 m(4 × 0.25 m)。打包多个原语只省调用次数,每个原语都照样计入 500 的动作预算——全部用来直走也只够约 125 m。
模块 3:Codex harness 与任务 prompt
任务 prompt 写明工具用法、预算与停止条件;harness 维持会话,让模型在同一上下文里持续积累已看到的画面与已执行的动作。GPT-6-Astra 以 medium 与 ultra 两档推理强度分别跑完全部 episode,两档共用同一份 prompt 与工具。
端到端数据流(读者版重画)
graph TD
    A["语言指令 + 任务 prompt(工具用法、预算、停止条件)"] --> B["GPT-6-Astra 推理:下一步做什么"]
    B -- "需要看" --> C["observe():返回单目 RGB,不耗预算"]
    C --> B
    B -- "决定移动" --> D["step(actions):执行一批原语动作"]
    D --> E["返回执行计数、剩余预算、终止状态(无图像)"]
    E --> B
    B -- "认为已到达" --> F["STOP"]
    F --> G{"终点距目标小于 3 m?"}
    G -- "是" --> H["成功"]
    G -- "否" --> I["失败"]
    E -- "500 个动作或 2400 s 用尽" --> I
评测协议
- 数据:R2R-CE-100,即 Open-Nav 引入的 100 个 val-unseen episode,覆盖 10 个场景,与 EvoNav、Open-Nav、SmartWay 等零样本工作采用同一协议;Table 1 中训练式方法的数字则来自全量 val-unseen
- 预算:每个 episode 最多 500 个原语动作、2,400 s,调用 STOP 或任一预算耗尽即结束
- 运行次数:每档推理强度、每个 episode 只跑一次
- 成功判定:显式调用 STOP,且终点到目标的测地距离小于 3 m
评测指标
报告同时用五个指标,因为它们回答的是不同问题:
- SR(成功率):STOP 时离目标小于 3 m 的比例——”到没到”
- NE(导航误差):终点到目标的测地距离,单位米——”差多远”
- OSR(oracle 成功率):轨迹上任意一点曾进入 3 m 圈即算——”路过没有”
- SPL:用路径长度加权的成功率——”到得是否高效”
其中 $S_i$ 为第 $i$ 个 episode 是否成功,$\ell_i$ 为最短路径长度,$p_i$ 为实际行走长度。
- nDTW(归一化动态时间规整):把实际轨迹 $Q$ 与参考路径 $R$ 逐点对齐后的累计距离压到 0–1——”是不是沿着指令描述的路线走”
其中 $d_{th}$ 取成功半径 3 m。
举个例子:ultra 设置下 100 个 episode 里,79 个成功,3 个轨迹曾进入 3 m 目标圈但最终停在圈外,18 个从未进过目标圈。于是 SR = 79%,OSR = (79 + 3) / 100 = 82%,正好对上 Table 1 的 82.0——OSR 与 SR 之间这 3 个点,就是”路过了却没停对”。再看成功的 EP42:终点误差只有 0.7 m,照样记为成功;但 SPL 41.2% 意味着实际路程约为最短路径的 1 / 0.412 ≈ 2.4 倍,nDTW 27.5% 说明轨迹和参考路线几乎不贴合——它先走进了卧室,发现顺序不对,又折回厨房重新出发。
行为分析框架
聚合指标之外,作者逐条检查 ultra 设置的交互日志(工具调用、实际执行的动作与对应的 RGB 画面),按两组问题组织分析:
- 能力侧:如何落地空间指代(4.1)、到达目标是否等于按路线走(4.2)、如何调整动作(4.3)
- 失败侧:路线遵循在哪里断掉(5.1)、能否从执行困难中恢复(5.2)、能否在正确位置停下(5.3)、提高推理强度能否解决失败(5.4)
作者也强调,日志只能支撑对”可观察行为”的分析,既不能确认单个语义判断是否正确,也看不到模型的内部推理。
3. 核心结果/发现
主结果:单目 RGB、零样本,SR 与 SPL 均为论文 Table 1 中最高
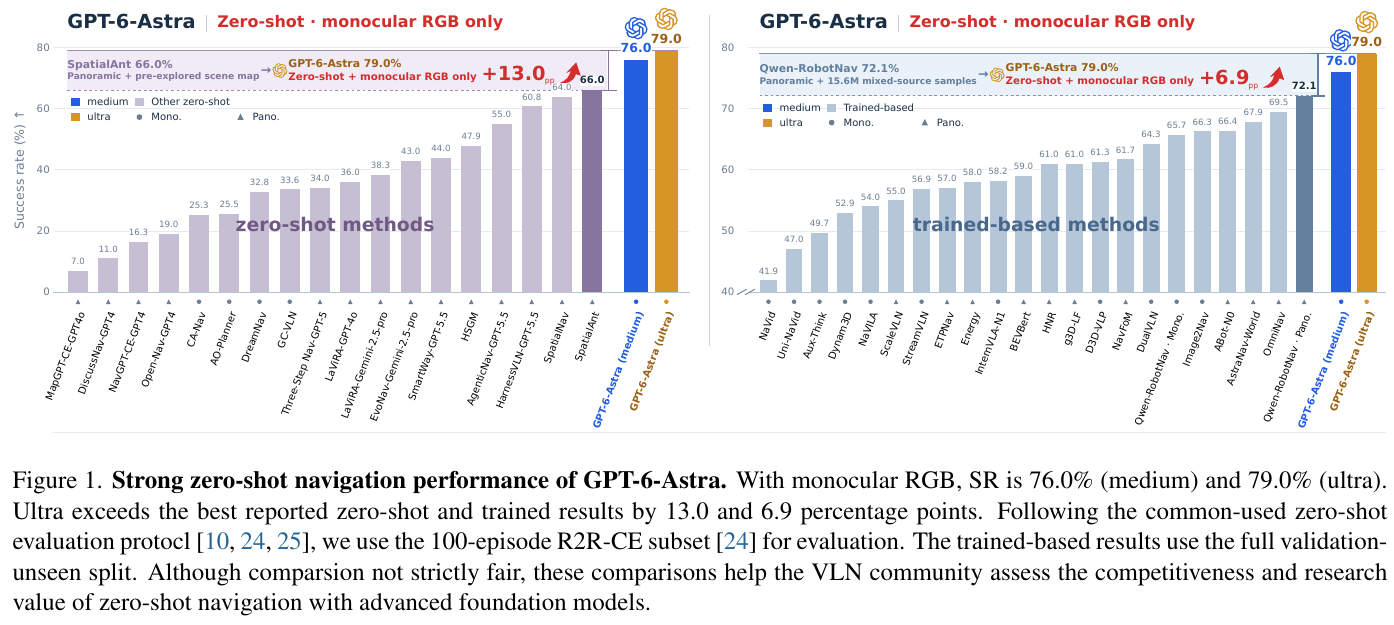
从 Table 1 摘取的代表性行(NE 单位为米,其余为百分比):
| 方法 | 类型 | 评测集 | 视角 | NE↓ | OSR↑ | SR↑ | SPL↑ |
|---|---|---|---|---|---|---|---|
| GC-VLN | 零样本 | Full | 单目 | 7.3 | 41.8 | 33.6 | 16.3 |
| AgenticNav-GPT-5.5 | 零样本 | R2R-CE-100 | 全景 | 5.2 | 65.0 | 55.0 | 48.4 |
| HarnessVLN-GPT-5.5 | 零样本 | – | 全景 | 4.0 | 72.7 | 60.8 | 43.5 |
| SpatialAnt | 零样本 | Author-sampled | 全景 | 4.4 | 76.0 | 66.0 | 54.4 |
| Image2Nav | 训练式 | Full | 单目 | 4.0 | 72.9 | 66.3 | 61.5 |
| Qwen-RobotNav-8B | 训练式 | Full | 单目 | 4.4 | 72.7 | 65.7 | 59.6 |
| OmniNav | 训练式 | Full | 全景 | 3.7 | 74.6 | 69.5 | 66.1 |
| Qwen-RobotNav-8B | 训练式 | Full | 全景 | 3.5 | 78.5 | 72.1 | 66.6 |
| GPT-6-Astra(medium) | 零样本 | R2R-CE-100 | 单目 | 2.7 | 83.0 | 76.0 | 67.9 |
| GPT-6-Astra(ultra) | 零样本 | R2R-CE-100 | 单目 | 3.0 | 82.0 | 79.0 | 69.5 |
- 在同为单目 RGB 的零样本方法中,此前最好的 GC-VLN 只有 33.6% SR / 16.3% SPL,GPT-6-Astra 的 SR 高出一倍以上
- NE 2.7–3.0 m 是 Table 1 中最低,比其中最强的训练式模型 Qwen-RobotNav-8B(全景,3.5 m)还低;SPL 69.5 同样高于 Table 1 中所有训练式方法。但 Table 1 未收录 Robostral Navigate:它在全量 val-unseen 上以单目 RGB 取得 77.4% SR、74.2 SPL,SPL 高于 GPT-6-Astra 的 69.5(NE 3.20 m 则不如 GPT-6-Astra 的 2.7–3.0 m)
- ultra 相比 medium 的 SR 与 SPL 更高,但 OSR 略低、NE 略高
- 作者反复提醒:训练式方法用全量 val-unseen,SpatialAnt 用作者自采样的 episode 并借助场景重建与模拟器深度,HarnessVLN 未注明子集,这些对比只说明竞争力,不构成同条件下的优劣结论
空间指代:序数式比地标相对式更稳
| 指令子集 | N | SR | SPL | nDTW |
|---|---|---|---|---|
| R2R-CE-100(全部) | 100 | 79.0 | 69.5 | 73.3 |
| 序数式选择(”第二个房间”“最右边的门”) | 14 | 85.7 | 68.6 | 73.4 |
| 地标相对式选择(”在……左边”“在……之间”“在……后面”) | 13 | 61.5 | 59.6 | 71.8 |
EP218 中模型离开卧室后,先在交互日志里把一间浴室认作”左手第一个房间”,再走向下一个门口;EP244 中它选中了”白色双开门左边”的门洞,两例都成功(NE 分别为 2.6 m、1.8 m)。作者注明这里是整条任务的成绩,不是单个空间关系判断的准确率,且两个子集的场景布局与难度也不同。
到达 ≠ 按路线走
- 79 个成功 episode 的 nDTW 中位数为 90.4%,多数紧贴参考路线;但有 8 个(10.1%)低于 50%。EP116 终点误差 0.1 m、nDTW 89.2%,是贴线的典型;EP42 则是大幅绕路后的成功
- 日志中有 16 个 episode 记录到明显的路线偏离或通行困难后的动作调整:10 个成功、6 个失败,成功者的 nDTW 与 SPL 中位数仅 44.3% 与 45.5%。这只统计了有记录的调整,不能说明调整本身对成败的因果作用
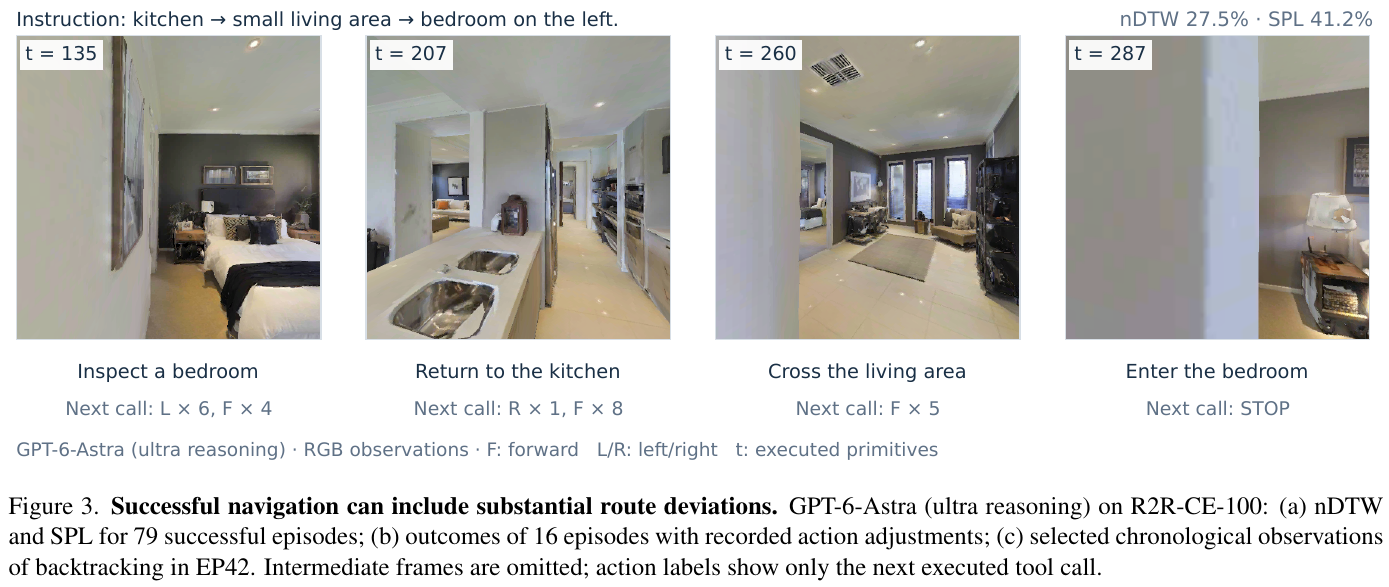
失败模式:路线、执行、停止三类
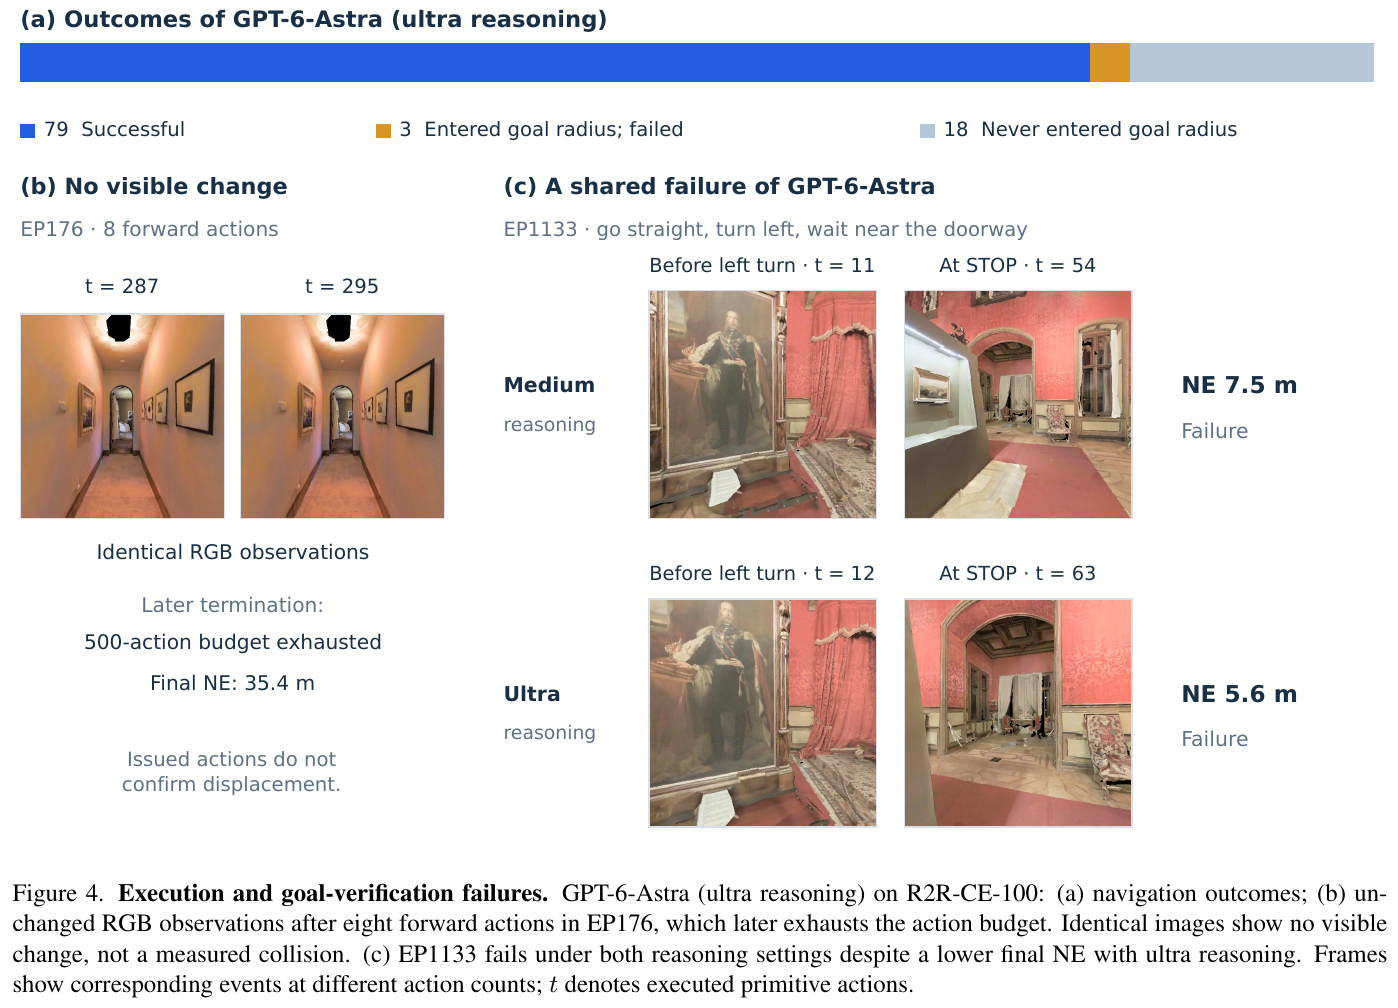
- 路线遵循断裂:ultra 的 21 个失败中,13 个终点离目标至少 5 m,其中 7 个超过 10 m。EP513 的指令提到壁炉客厅、两张白沙发和相邻餐厅入口,模型最后看到壁炉和浅色座椅就宣布到达,NE 却有 14.5 m——局部地标对上了,不代表到了指令说的那个地方,而日志也定位不到第一处走错的位置
- 执行困难与恢复:4 个 episode 里共有 5 批纯前进动作,执行前后的 RGB 逐像素相同(没有可见位移,但不等于测到了碰撞),其中 3 个 episode 最终仍然成功;EP70 在窄门附近经过转向与前进后进入下一个房间并成功;EP176 则在 8 次前进画面不变之后一直耗到 500 步预算,终点距目标 35.4 m。发出动作不等于真的动了,也不等于有效恢复
- 停止判断:99 个 episode 由模型主动 STOP,只有 EP176 触到动作上限;3 个失败 episode 的 OSR 为 1,即曾进入目标圈又离开。EP705 中模型报告在门口旁看到灭火器后停下,最终 NE 为 12.3 m
提高推理强度能解决多少失败?
把两档推理强度在同一批 100 个任务上的结局交叉起来(由正文数字推出:medium 失败 24 个,其中 9 个在 ultra 下成功、15 个仍失败;另有 6 个 medium 成功的任务在 ultra 下失败):
| ultra 成功 | ultra 失败 | 合计 | |
|---|---|---|---|
| medium 成功 | 70 | 6 | 76 |
| medium 失败 | 9 | 15 | 24 |
| 合计 | 79 | 21 | 100 |
怎么读这张表:SR 从 76 升到 79,不是”ultra 多修好 3 个任务”,而是 9 个翻盘减去 6 个翻车。只看这 15 个结局改变的任务,9 对 6 按精确二项检验(McNemar)的双侧 p 约为 0.61(笔者据表中计数计算,非论文报告),远谈不上显著。
- 15 个两档都失败的任务里,ultra 的 NE 更低的有 8 个、更高的有 7 个,没有一致的改善方向;EP1133 两档都在拱门附近停下,NE 从 7.5 m 降到 5.6 m,仍未进入 3 m 圈
- 两档运行所用的 Codex 版本也不同(medium 为 0.155.1,ultra 为 0.155.0),因此这组对比无法把差异单独归因于推理强度
作者对后续 VLN 研究的建议
- 通用模型经一个极简的”观察—动作”接口就能完成有竞争力的导航,说明这未必需要单独训练导航策略,但何时这条路线优于专门训练,还需在观测、动作预算与任务集都对齐的条件下比较
- 后续方法应优先补三块短板:地标重复出现时守住路线约束、识别无效运动并恢复、确认终点确实满足指令;评估时应把参考路径贴合度、执行反馈与停止结局和 SR 一起报告
4. 局限性
只在 R2R-CE-100(100 个 episode、10 个场景)上每档跑一次,与全量 val-unseen 上的训练式方法、Author-sampled 的 SpatialAnt 并非同条件对比;按二项分布粗算,100 个 episode 上 79% SR 的标准误约 4.1 个百分点,领先 Qwen-RobotNav 的 6.9 个点还不到两个标准误。GPT-6-Astra 是闭源模型,无法排除其训练数据含导航数据,推理成本与延迟目前也制约实际部署;作者计划补充多次运行的均值与标准差,并扩展到 RxR-CE、NavRAG-CE。
55. BudVLN (2026)
———Nipping the Drift in the Bud: Retrospective Rectification for Robust Vision-Language Navigation
📄 Paper: arXiv:2602.06356
精华
- 核心思想:通过“回顾式纠偏”(Retrospective Rectification)解决 Vision-Language Navigation (VLN) 中的指令-状态不一致问题。
- 训练范式:引入了 Adaptive Mutual Exclusion Strategy,将样本动态分流为效率路径和鲁棒性路径,实现了精准训练。
- 纠偏机制:利用“回锚”机制合成语义一致的修正轨迹,避免了传统方法中强制回归导致的语义冲突。
- 极致效率:采用 GRPO 算法(借鉴自 DeepSeek-R1),无需价值网络,训练成本仅为传统 DAgger 的约 25%。
- 性能卓越:在 R2R-CE 和 RxR-CE 基准测试上刷新 SOTA,尤其在处理偏差和鲁棒性方面表现突出。
1. 研究背景/问题
当前的视觉-语言导航(VLN)系统面临严重的曝光偏差(Exposure Bias)问题:推理时的细微偏差会导致严重的累积误差。虽然 DAgger 类方法尝试通过纠正错误状态来缓解这一问题,但论文指出这些方法存在指令-状态不一致(Instruction-State Misalignment)的致命局限。如图 1 所示,强制智能体从离群状态回归往往会生成与其原始语言指令相冲突的监督信号(例如:指令要求直行,但为回归正轨必须掉头),这会损害智能体的指令遵循能力。
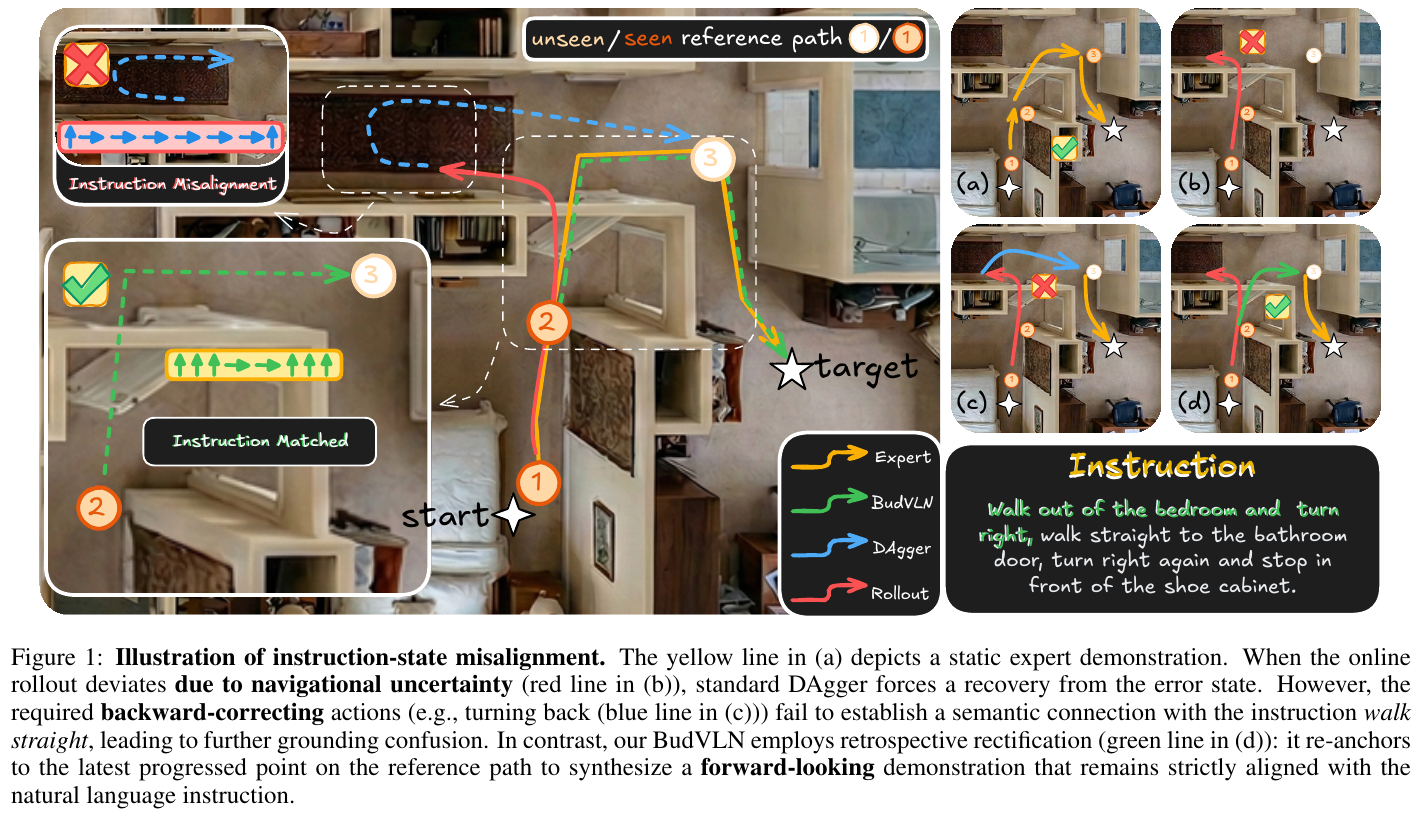
2. 主要方法/创新点
论文提出了 BudVLN,一个旨在通过统一的在线回顾式纠偏框架解决上述挑战的系统。
Adaptive Mutual Exclusion Strategy (自适应互斥策略)
BudVLN 并不对所有样本一视同仁,而是采用一种自适应策略进行动态路由:
- Proficiency Pathway (效率路径):通过 Greedy Probe 评估。若智能体已能熟练完成任务,则利用 GRPO (Group Relative Policy Optimization) 进行组内相对优势学习,进一步优化路径效率。
- Rectification Pathway (纠偏路径):若智能体在任务中失败,则触发回顾式纠偏。
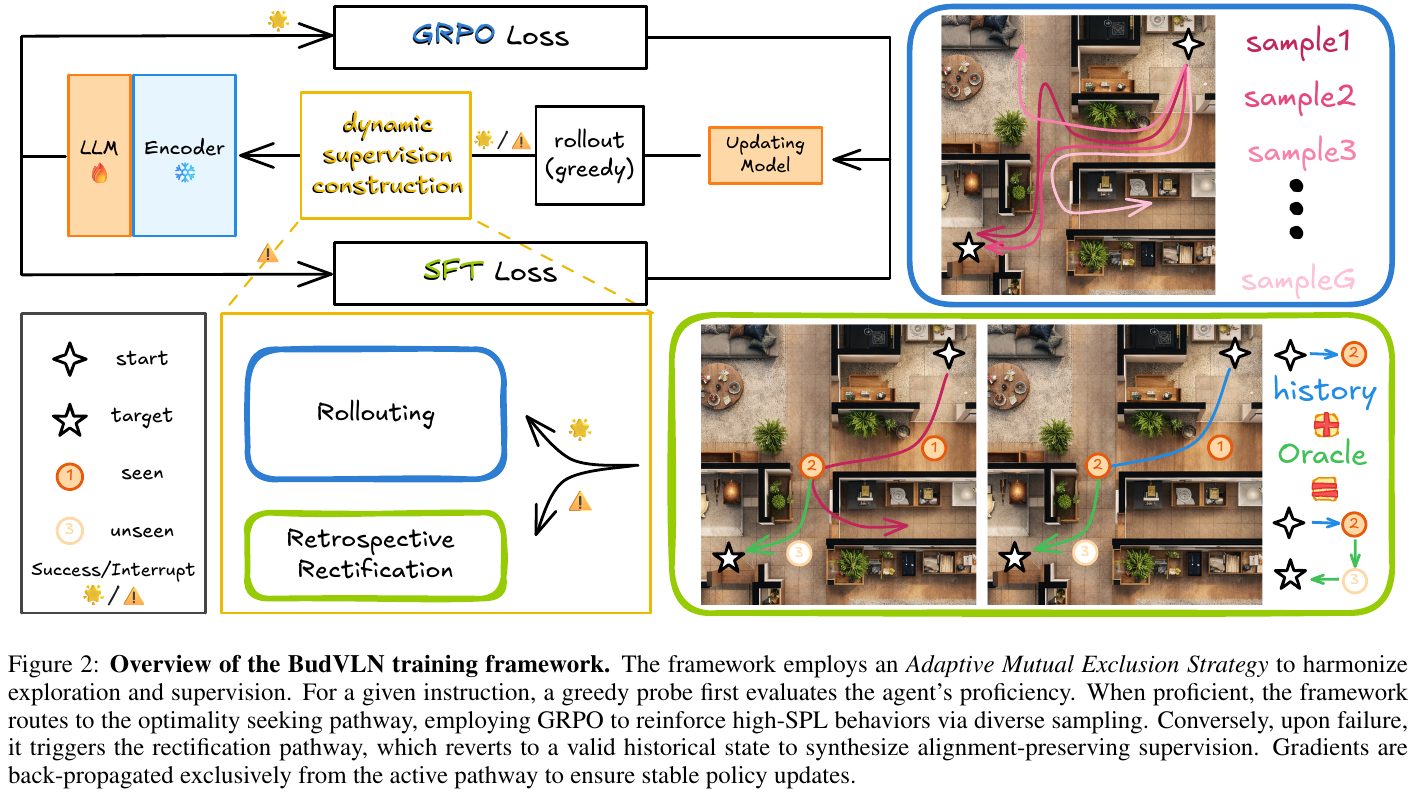
Retrospective Rectification (回顾式纠偏)
针对失败样本,BudVLN 执行以下操作:
- 回锚(Anchor Identification):将状态回溯到发生偏差前的最后一个有效路径点(Valid Anchor)。
- 语义一致性合成:利用 Oracle 合成从该锚点出发的正确轨迹,以此作为 SFT 的监督信号。 这种方法确保了监督信号与原始指令的语义一致性,彻底解决了 DAgger 的语义冲突问题。
GRPO 优化
受到大规模推理模型成功的启发,BudVLN 引入了 GRPO 算法。它通过在一个采样组内计算相对优势,摆脱了对昂贵价值网络(Value Network)的依赖,极大地降低了计算开销,同时提升了探索效率。
3. 核心结果/发现
- SOTA 性能:在 R2R-CE 和 RxR-CE 两个主流基准测试中,BudVLN 全面超越了现有模型。在 R2R-CE 上,成功率 (SR) 达到 57.6%,SPL 达到 51.1%。
- 训练效率:得益于 GRPO 算法和高效的纠偏机制,BudVLN 仅需 27 GPU 小时 即可完成训练,相比 DAgger 的 114 小时,效率提升了近 4 倍。
- 消融研究:实验证明,单独添加纠偏机制能显著提升 SR,而 GRPO 算法则对 SPL 的提升和训练效率的优化起到了关键作用。
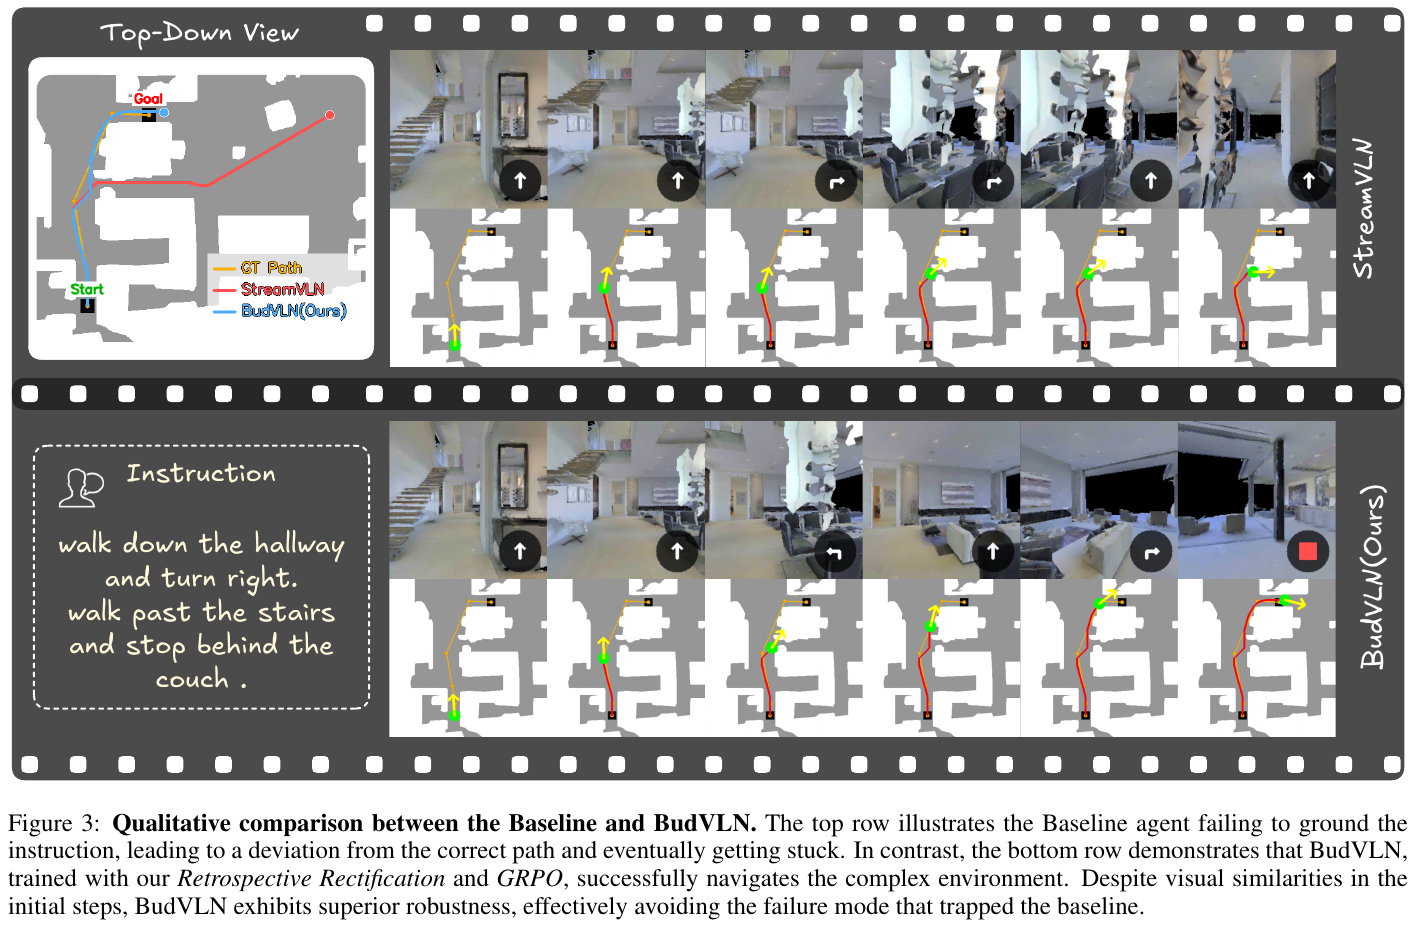
4. 局限性
虽然 BudVLN 在离散和连续环境中均表现出色,但其鲁棒性目前仍受限于预定义 Oracle 的质量。在极度复杂的极端环境下,如何自主生成更高质量的“回顾性”知识仍是未来研究的方向。
参考资料
已发表论文(会议 / 期刊)
下表汇总本文中已正式发表于会议或期刊的论文,其余条目为 arXiv 预印本:
| 会议 / 期刊 | 论文 |
|---|---|
| CVPR | VLN-Imagine (2025)、Slow4fast-VLN (2026)、AwareVLN (2026)、GA-VLN (2026)、HSGM (2026)、DecoVLN (2026)、R2R (2018, Spotlight)、DUET (2022) |
| ICLR | NavFoM (2026)、JanusVLN (2026)、OmniNav (2026, Poster)、TuckerNav (2026)、Uncertainty-Aware Gaussian Map (2026)、DualVLN (2026) |
| ICRA | NoMaD (2024)、VLFM (2024)、Open-Nav (2025)、NavDP (2026)、StreamVLN (2026) |
| ECCV | VLN-CE (2020)、NavGPT-2 (2024)、AgentVLN (2026) |
| AAAI | ODYSSEY (2026)、CorrectNav (2026)、R³ (2026)、PanoNav (2026, Poster) |
| ICCV | VLN-PE (2025) |
| ACL | MapNav (2025) |
| RSS | NaVid (2024) |
| IROS | ReflectVLN (2026) |
| CoRL | X-NavDP (2026) |
| RO-MAN | R2RIE-CE & IEDL (2024) |
| 期刊 | GaussNav (IEEE TPAMI 2025)、CausalNav (IEEE RA-L)、HumanoidVLN (IEEE RA-L)、Skill-Nav (Vicinagearth / Springer 2025)、CA-VLN (Sensors 2026) |
论文引用
- R2R (2018). 真实室内环境下的视觉-语言导航基准与序列到序列基线. arXiv: 1711.07280 · CVPR 2018 (Spotlight)
- VLN-CE (2020). Beyond the Nav-Graph: 在连续环境中的视觉-语言导航. arXiv: 2004.02857 · ECCV 2020
- DUET (2022). 基于双尺度图 Transformer 的离散拓扑视觉语言导航. arXiv: 2202.11742 · CVPR 2022 · Code: cshizhe/VLN-DUET
- NoMaD (2023). 目标掩码扩散策略实现统一导航. arXiv: 2310.07896 · ICRA 2024
- VLFM (2023). Vision-Language Frontier Maps for Zero-Shot Semantic Navigation. arXiv: 2312.03275 · ICRA 2024 · Code: rai-opensource/vlfm
- R2RIE-CE & IEDL (2024). 首个连续导航指令错误基准测试,以及结合指令-轨迹兼容性的多模态错误检测与定位框架. arXiv: 2403.10700 · ROMAN 2024
- NaVid (2024). 首个无需依赖地图、基于视频大模型的单目连续视觉语言导航模型. arXiv: 2402.15852 · RSS 2024 · Code: jzhzhang/NaVid-VLN-CE
- NavGPT-2 (2024). 释放大型视觉语言模型的导航推理能力. arXiv: 2407.12366 · ECCV 2024 · Code: GengzeZhou/NavGPT-2
- DualVLN/InternVLN (2025). Ground Slow, Move Fast: 具备世界模型与快慢双系统的端到端连续导航. arXiv: 2512.08186 · ICLR 2026 · Code: InternRobotics/InternNav
- ODYSSEY (2025). Open-World Quadrupeds Exploration and Manipulation for Long-Horizon Tasks. arXiv: 2508.08240 · AAAI 2026
- PanoNav (2025). Mapless Zero-Shot Object Navigation. arXiv: 2511.06840 · AAAI 2026 (Poster)
- VLN-R1 (2025). 基于GRPO与Time-Decayed Reward的端到端导航. arXiv: 2506.17221 · Data: Qi-Zhangyang/GPT4Scene-and-VLN-R1(仅开源训练数据与数据生成代码)
- StreamVLN (2025). 通过慢-快上下文建模实现流式视觉-语言导航. arXiv: 2507.05240 · ICRA 2026 · Code: OpenRobotLab/StreamVLN
- NavFoM (2025). Embodied Navigation Foundation Model. arXiv: 2509.12129 · ICLR 2026
- MapNav (2025). A Novel Memory Representation via Annotated Semantic Maps for Vision-and-Language Navigation. arXiv: 2502.13451 · ACL 2025 · Code: linglingxiansen/MapNav
- Open-Nav (2025). Zero-Shot VLN in Continuous Environment with Open-Source LLMs. arXiv: 2409.18794 · ICRA 2025
- Skill-Nav (2025). Enhanced Navigation with Versatile Quadrupedal Locomotion via Waypoint Interface. arXiv: 2506.21853 · Vicinagearth (Springer) 2025
- VLN-Imagine (2025). 用文本生成图像模型为导航智能体构建”视觉想象”. arXiv: 2503.16394 · CVPR 2025 · Code: akhilperincherry/VLN-Imagine
- VLN-PE (2025). 重新思考视觉-语言导航中的具身化差距:物理和视觉差异的全面研究. arXiv: 2507.13019v2 · ICCV 2025
- Goal2Pixel (2025). 将导航目标接地到图像像素,以像素预测统一 VLN-CE 的决策空间. arXiv: 2606.01621
- AstraNav-World (2025). 将”想象未来”与”规划未来”统一进同一个生成式概率框架. arXiv: 2512.21714 · Code: amap-cvlab/AstraNav-World
- CorrectNav (2025). 自纠错飞轮赋能的单目 RGB 视觉-语言-动作导航模型. arXiv: 2508.10416 · AAAI 2026 · Code: owlet914/CorrectNav
- Slow4fast-VLN (2026). General Vision-Language Navigation via Fast-Slow Interactive Reasoning. arXiv: 2601.09111v1 · CVPR 2026 · Code: yl6017339/Slow4Fast-VLN
- DGNav (2026). 动态拓扑感知:打破视觉-语言导航中的粒度刚性. arXiv: 2601.21751 · Code: shannanshouyin/DGNav
- CausalNav (2026). First Scene Graph-based Semantic Navigation for Dynamic Outdoor Environments. arXiv: 2601.01872 · IEEE RA-L
- AgentVLN (2026). Towards Agentic Vision-and-Language Navigation. arXiv: 2603.17670 · ECCV 2026 · Code: Allenxinn/AgentVLN
- VLN-Cache (2026). Enabling Token Caching for VLN Models with Visual/Semantic Dynamics Awareness. arXiv: 2603.07080
- R³: Run, Ruminate, and Regulate (2026). 一个面向视觉语言导航的双过程思考框架. arXiv: 2511.14131 · AAAI 2026 · Code(待发布): IAII-CAS/navigation_R3
- AwareVLN (2026). Reasoning with Self-awareness for Vision-Language Navigation. arXiv: 2605.22816 · CVPR 2026 · Code: GWxuan/AwareVLN
- Dual-Anchoring (2026). 用”指令进度”与”地标记忆”双重锚定,对抗 VLN 中的状态漂移(State Drift). arXiv: 2604.17473
- JanusVLN (2026). 解耦语义与空间:使用双隐式神经内存的视觉语言导航. arXiv: 2509.22548v2 · ICLR 2026 · Code: MIV-XJTU/JanusVLN
- HSGM (2026). 层级式语义-几何地图,填补 VLM 2D 视觉与 3D 空间推理及运动规划的鸿沟. arXiv: 2606.00095 · CVPR 2026 · Code: Teacher-Tom/HSGM_public
- OneVLA (2026). 首个在单一网络与动作头下统一具身导航和操作的 VLA 模型. arXiv: 2606.01241 · Code: linglingxiansen/OneVLA
- CA-VLN (2026). 基于双智能体协作的多模态大模型具身导航框架. DOI: 10.3390/s26041254 · Sensors 2026
- RynnBrain (2026). Open Spatiotemporal Foundation Model for Embodied Intelligence. arXiv: 2602.14979 · Code: alibaba-damo-academy/RynnBrain
- OmniNav (2026). 用快慢双系统统一点目标、物体目标、指令目标导航与前沿探索. arXiv: 2509.25687 · ICLR 2026 (Poster) · Code: amap-cvlab/OmniNav
- Qwen-RobotNav (2026). 首个统一的多任务、时空可重构具身导航大模型. arXiv: 2606.18112
- GA-VLN (2026). Geometry-Aware BEV Representation for Efficient Vision-Language Navigation. arXiv: 2605.22036 · CVPR 2026 · Code: jahhaoyang/GA-VLN
- SEDualVLN (2026). 空间增强的双系统连续环境视觉语言导航框架. arXiv: 2605.17249 · Project Page: kim-os.github.io/SEDualVLN
- Robostral Navigate (2026). 仅需单目 RGB 相机的 8B 视语言导航大模型:超高效仿真训练与在线强化学习. arXiv: 2607.20785
- ABot-N1 (2026). 基于慢速认知与快速控制双系统架构的通用视觉语言导航基础模型. arXiv: 2607.10383v2 · Benchmark: amap-cvlab/ABot-Navigation (ABotN-Bench)
- ReflectVLN (2026). 基于反思推理与双向交互机制的具身视觉语言导航. arXiv: 2607.12680 · IROS 2026
- TuckerNav (2026). 面向全天候多场景终身具身视觉语言导航的 Tucker 张量自适应. arXiv: 2603.14276 · ICLR 2026
- AgenticNav (2026). 将零样本连续环境导航(VLN-CE)重构为 VLM 可调用的 Tool-Calling 架构. arXiv: 2606.10577
- MemVLN (2026). 模拟人类双重记忆机制的高效连续环境视觉语言导航框架. arXiv: 2607.23504
- X-NavDP (2026). 多构型机器人通用视觉导航的组内 Q值重加权 Diffusion RL 强化学习微调框架. arXiv: 2607.28560 · CoRL 2026 · Code: InternRobotics/NavDP
- Image2Sim (2026). 解耦 3D 空间锚定与超真实图像合成的实时神经仿真引擎. arXiv: 2607.05765 · Code: MrZihan/Image2Sim
- DecoVLN (2026). Decoupling Observation, Reasoning, and Correction for Vision-and-Language Navigation. arXiv: 2603.13133 · CVPR 2026 · Code(待发布): Allenxinn/DecoVLN
- TAMP-Nav (2026). Point, Think, Memorize, and Align for Efficient Navigation. arXiv: 2608.17512 · Code: ZJU-OmniAI/Embodied-Omni
- LightNav-0 (2026). 把 VLM 已有的空间智能”引出来”,而不是给它外挂一个导航模块. arXiv: 2608.30935 · Code: lightorigins/LightNav-0
- Uncertainty-Aware Gaussian Map for VLN (2026). 三类感知不确定性 × Semantic Gaussian Map,赋予 VLN 智能体可靠决策能力. arXiv: 2607.13500 · ICLR 2026 · Code(待发布): Gaozzzz/Uncertainty-Aware-VLN
- HarnessVLN (2026). 一套 Agent Harness,把”指令跟随”和”找物体”两类导航压进同一个工具调用协议. arXiv: 2609.15195
- GroundingVLN (2026). 把视觉 grounding 做成”想”与”走”之间的共享接口. arXiv: 2609.18581
- GPT-6-Astra (2026). 通用基础模型只凭单目 RGB 与原语动作,零样本跑通连续环境视觉语言导航. arXiv: 2609.29861
- BudVLN (2026). Nipping the Drift in the Bud: Retrospective Rectification for Robust Vision-Language Navigation. arXiv: 2602.06356