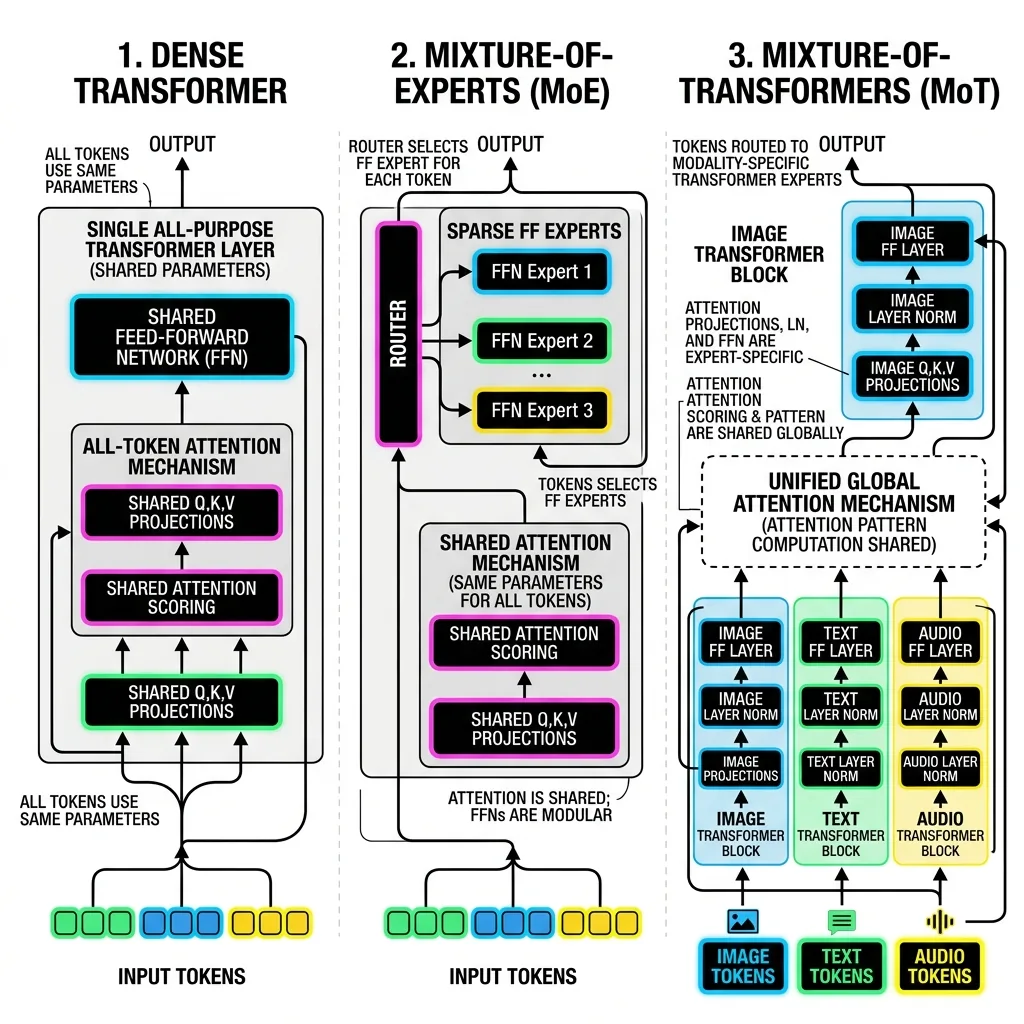
把文本、图像、语音 token 放进同一个 Dense Transformer,是统一多模态模型最直接的做法:所有 token 共用同一套 \(W_Q, W_K, W_V\)、FFN 和 LayerNorm。它的代价在于,分布差异很大的模态要在同一组参数上争夺容量,训练也随之变慢。
Meta 与斯坦福的 Liang 等人在 Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models(arXiv:2411.04996,TMLR 2025)中给出的方案很朴素:按模态复制所有非嵌入参数,只保留全局自注意力作为模态之间唯一的交汇点。由于每个 token 属于哪个模态是已知的,路由不需要学习。
本文先拆解 MoT 的计算流程,再逐条核对论文实验数字的含义,最后看 NVIDIA Cosmos 3 的双塔结构与原始 MoT 的异同。
1. 问题:模态互相拖累
在 Chameleon、Transfusion 这类早期融合(early-fusion)的多模态模型中,不同模态的 token 化方式不同(文本用 BPE,图像用 VQ 离散码或连续 latent),但进入 Transformer 之后,它们经过的是同一套投影矩阵、FFN 与 LayerNorm。
直觉上的担忧有两点:
- 分布差异:文本 token 离散、语义密集;图像 patch 冗余度高、空间相关性强。用同一组权重拟合两种统计结构,容量可能被互相挤占。
- 梯度干扰:不同模态的损失在同一组参数上产生的更新方向未必一致,一个模态的进步可能以另一个模态为代价。
这两点是 MoT 的动机,论文并没有直接测量梯度冲突。它给出的间接证据是第 4 节的留一(leave-one-out)实验:只把某一个模态单独拆出、其余模态继续共享参数时,各模态受益的程度并不对称。作者称之为非对称的模态竞争(non-reciprocal modality competition),比如单独拆出语音时,语音的收益保住了,但图像与文本的收益随之消失。
2. MoT 做了什么
2.1 与 MoE 的区别
稀疏化最常见的做法是 Mixture-of-Experts(MoE)。MoT 与 MoE 有三点不同:
- 拆分范围:MoE(如 Mixtral)通常只把 FFN 换成多个专家,注意力投影与 LayerNorm 仍然共享;MoT 把 FFN、\(W_Q, W_K, W_V, W_O\) 与 LayerNorm 全部按模态复制。
- 路由方式:MoE 用可学习的 router 给 token 分配专家,需要负载均衡损失等手段防止专家闲置;MoT 直接按模态标签分流,没有 router,也就没有路由塌缩和负载均衡损失的问题。
- 专家数量:MoE 的专家数 $E$ 可以很大;MoT 的“专家”数等于模态数 $K$,通常只有 2–3 个。
2.2 计算量不变,参数量变多
这是理解后文实验数字的关键:MoT 每个 token 的计算量与同宽度的 Dense 模型完全相同。每个 token 只经过自己模态那一套参数,论文称之为与 Dense 模型 “exact same computational structure and FLOP count”。变多的是总参数量,约为 Dense 的 $K$ 倍(嵌入层除外)。
因此,MoT 节省的不是单步计算,而是达到同等损失所需的训练步数。由于每步 FLOPs 相同,论文把“步数占比”直接写成“FLOPs 占比”。
3. 一个 MoT 层的计算流程
3.1 符号
设输入序列 $X = [x_1, \dots, x_N] \in \mathbb{R}^{N \times d}$,每个 token $x_i$ 带一个模态标签 $m_i \in \mathcal{M}$,例如 $\mathcal{M} = {\text{text}, \text{image}, \text{speech}}$。
对每个模态 $m$,MoT 维护一套专属参数:
- 两个 LayerNorm:\(\text{LN}_m\) 与 \(\text{LN}'_m\)
- 注意力投影:\(\mathbf{W}_{Q,m}, \mathbf{W}_{K,m}, \mathbf{W}_{V,m}, \mathbf{W}_{O,m} \in \mathbb{R}^{d \times d}\)
- 前馈网络:\(\text{FFN}_m\)
3.2 四个步骤
论文 Algorithm 1 的流程是:按模态分组 → 各自投影 → 恢复原序列顺序 → 全局注意力 → 再按模态分组做输出投影、LayerNorm 和 FFN。写成公式如下。
第一步:按模态投影出 Q、K、V。 每个 token 用自己模态的 LayerNorm 与投影矩阵:
\[\mathbf{q}_i = \text{LN}_{m_i}(x_i)\,\mathbf{W}_{Q,m_i},\quad \mathbf{k}_i = \text{LN}_{m_i}(x_i)\,\mathbf{W}_{K,m_i},\quad \mathbf{v}_i = \text{LN}_{m_i}(x_i)\,\mathbf{W}_{V,m_i}\]第二步:全局自注意力。 把所有 token 的 \(\mathbf{q}_i, \mathbf{k}_i, \mathbf{v}_i\) 按原序列顺序拼回 $\mathbf{Q}, \mathbf{K}, \mathbf{V}$,做一次标准(多头)注意力,因果掩码等与 Dense 模型一致:
\[\mathbf{H} = \text{Softmax}\left(\frac{\mathbf{Q}\mathbf{K}^\top}{\sqrt{d_k}}\right)\mathbf{V}\]这是各模态唯一交换信息的地方:投影空间是各自的,但文本 token 能直接注意到图像 token,反之亦然。
第三步:按模态做输出投影与残差。
\[y_i = x_i + \mathbf{h}_i\,\mathbf{W}_{O,m_i}\]第四步:按模态做 FFN。
\[z_i = y_i + \text{FFN}_{m_i}\big(\text{LN}'_{m_i}(y_i)\big)\]$Z = [z_1, \dots, z_N]$ 即该层输出。可以看出,如果把所有 $m_i$ 都设成同一个模态,这一层就退化回普通的 Pre-LN Transformer 层,这也是 MoT 每 token FLOPs 与 Dense 相同的原因。
4. Dense、MoE 与 MoT 对比
| 维度 | Dense | MoE | MoT |
|---|---|---|---|
| 注意力投影(QKV/O) | 共享 | 共享 | 按模态拆分 |
| LayerNorm | 共享 | 共享 | 按模态拆分 |
| FFN | 共享 | 稀疏专家 | 按模态拆分 |
| 路由 | 无 | 可学习 router | 按模态标签,确定性 |
| 每 token 计算量 | 基准 | 取决于激活专家数(top-1 时接近 Dense) | 与 Dense 相同 |
| 总参数(非嵌入) | 基准 | 约 $E$ 倍(FFN 部分) | 约 $K$ 倍(全部) |
| 额外训练机制 | 无 | 负载均衡损失等 | 无 |
论文还从通信角度比较了两者:每层新增参数,MoT 约为 $7(K-1)D^2$,MoE 约为 $3(E-1)D^2$ 以上。由于 $K$ 通常远小于 $E$,MoT 的“参数/FLOPs”比更低,分布式训练时的通信压力也更小。
5. 实验:每个数字各指什么
论文在三种设置下评测:Chameleon(文本与图像都做自回归)、Chameleon + 语音,以及 Transfusion(文本自回归、图像扩散)。下面逐条说明主要数字的含义。
5.1 达到同等损失的 FLOPs
- Chameleon,7B,文本 + 图像:MoT 用 Dense 模型 55.8% 的训练步数(等价于训练 FLOPs)就达到了 Dense 训练结束时的验证损失。
- Chameleon + 语音,7B:在语音模态上,MoT 用 37.2% 的 FLOPs 达到 Dense 的语音性能。语音实验覆盖 443M、880M、1.5B 和 7B 四个规模,37.2% 是 7B 的结果。
- Transfusion,7B:在图像指标上,MoT 用约 三分之一 的 FLOPs 达到 Dense 的水平;此外,760M 的 MoT 在关键图像生成指标上超过了 1.4B 的 Dense 模型。
需要注意的是:这些都是训练效率的数字,不是推理时“只激活了 55.8% 的参数”。另外,Transfusion 设置下文本模态的收益很小甚至没有,作者列出了几种可能的原因,但没有定论。
5.2 墙钟时间
FLOPs 节省不一定能换成实际的训练时间节省。论文在 AWS p4de.24xlarge(A100)上用 256 张卡做了 Chameleon 设置的测速:
- 图像:MoT 用 Dense 47.2% 的 GPU 时间达到 Dense 的图像训练损失;
- 文本:用 75.6% 的时间达到 Dense 的文本损失;
- 对照组 MoE-4x 在文本上没有加速,在图像上反而慢了 1.7 倍。
实现方式就是第 3 节的“按模态分组 → 投影 → 还原顺序”,配合 FSDP 与 PyTorch 2 编译,没有用到专门的融合算子。作者提到的主要开销来自两处:按模态分组带来的 CPU-GPU 同步,以及模态在 batch 和 GPU 之间分布不均造成的负载不平衡。这些开销在他们的设置下不在关键路径上;grouped GEMM、块稀疏矩阵乘等优化留作后续工作。
5.3 拆哪些参数最重要
论文的消融(Section 3.5)显示:
- 只拆 FFN 就能带来大部分收益,图像上尤其明显;
- 再拆 Q/K/V,还有显著的额外收益:在 Obelisc 数据上,相比只拆 FFN,图像节省约 33.3% 的 FLOPs,文本约 10%;
- 拆 LayerNorm 的影响可以忽略。
5.4 与 MoE-4x 的比较
MoE-4x 的稀疏参数比 MoT 更多,但整体表现不如 MoT,在图像和语音上差距更明显:其图像优势在 7B 规模消失,语音验证损失甚至不如 Dense。作者也提醒,评测中 Expert Choice 路由可能泄露未来 token 的信息,MoE-4x 的结果因此可能被高估,换到分布外数据时又可能被低估。
论文第 5 节还尝试在 MoT 的文本分支里再套一层 MoE-4x,文本有初步提升且不损害图像,作者明确称之为早期概念验证。
6. Cosmos 3:按角色拆分
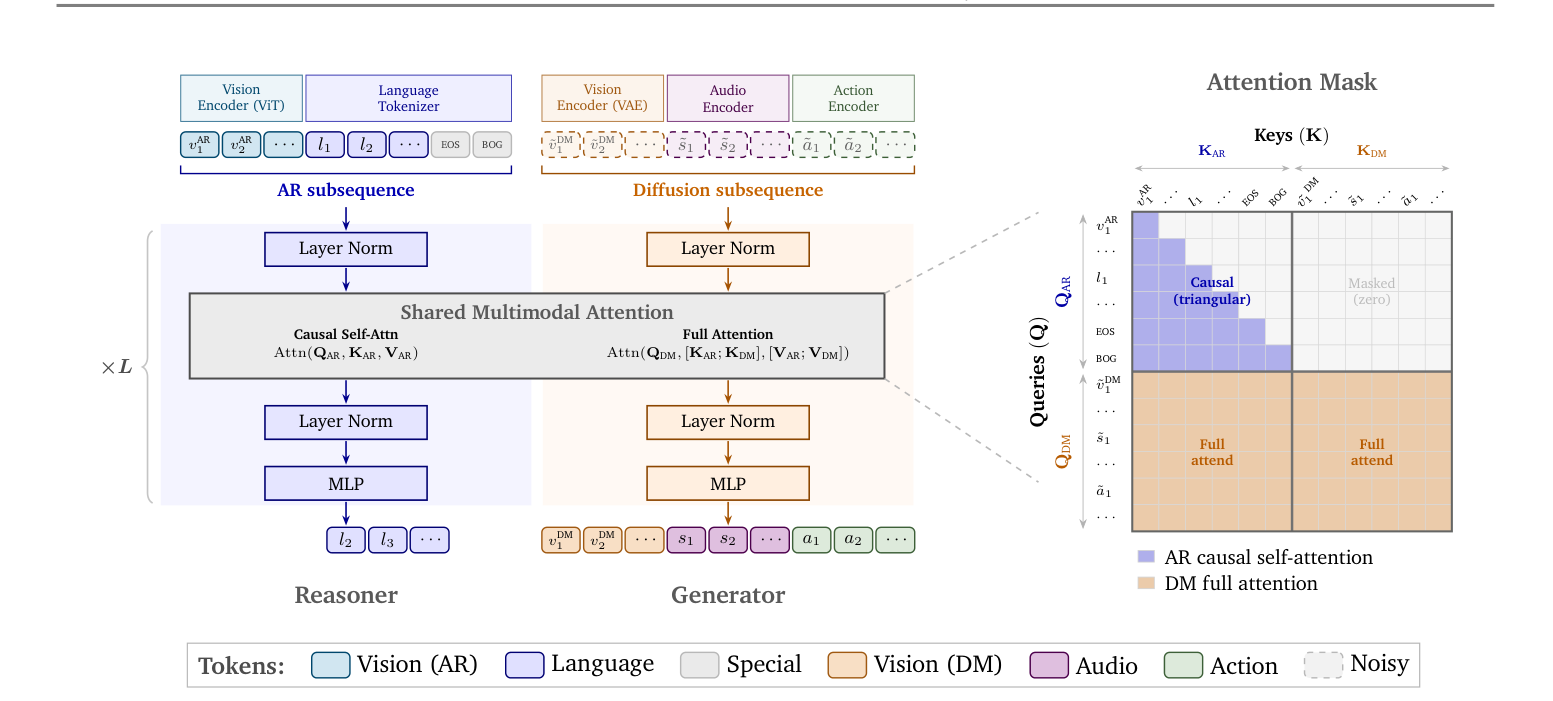
NVIDIA 在 2026 年 6 月发布的 Cosmos 3(arXiv:2606.02800)用一个模型同时覆盖理解、生成与动作,其骨干是双塔 MoT。但它拆分参数的依据和原始 MoT 不同,这一点容易被忽略。
6.1 两座塔分别是什么
序列被切成两段:
- AR 子序列(Reasoner 塔):语言 token 与 ViT 视觉 token,用因果注意力做下一个 token 预测,承担理解与推理;
- DM 子序列(Generator 塔):VAE 视觉 latent、音频和动作 token,训练时加噪,用 Flow Matching 去噪,承担生成。
每个解码层并行持有两套参数,二者都从预训练 VLM(Nano 与 Super 分别来自 Qwen3-VL 8B 与 32B)初始化。两段在注意力上的规则是:
- AR token 只看自身之前的 AR token;
- DM token 以 AR 与 DM token 的并集作为 Key/Value,双向注意;
- AR token 永远不会被 DM token 更新,生成过程不会反过来改写理解通路。
6.2 与原始 MoT 的异同
相同的是核心机制:参数按 token 类别拆开、分流规则固定、所有 token 在共享的自注意力里交汇。
不同的有两点:
- 分流依据:原始 MoT 按模态分流,一个模态一套参数;Cosmos 3 按角色分流,同为视觉信息,ViT token 进 Reasoner、VAE latent 进 Generator。
- 注意力掩码:原始 MoT 的掩码与 Dense 模型一致;Cosmos 3 的 AR 段用因果掩码、DM 段用全注意力,并且是单向的:DM 能读 AR,AR 不能读 DM。
6.3 规模
双塔意味着总参数约为同级 Dense 骨干的 2 倍:
| 变体 | 总参 / Dense 骨干 | 状态 |
|---|---|---|
| Cosmos3-Edge | 4B / 2B | 后续发布 |
| Cosmos3-Nano | 16B / 8B | 已发布 |
| Cosmos3-Super | 64B / 32B | 已发布 |
位置编码、动作表示、三种动作模式(前向动力学、逆动力学、策略)和各项评测结果,详见 世界模型综述 §7.3 Cosmos 3。
7. 互动沙盘
下面的沙盘演示 token 在 Dense、MoE、MoT 中分别经过哪些参数。它只是示意:MoE 一栏为了简化画成“每个模态一个 FFN 专家”,真实 MoE 的专家并不对应模态,而是由 router 动态分配。
多模态 Token 分流示意
切换架构模式,点击“开始分流”观察 Token 在各层权重(LN、QKV、Attention、FFN)中的流动轨迹。
8. 什么时候适合用 MoT
适合的场景:模态边界清晰、各模态数据量都不小、训练算力是主要瓶颈。MoT 不改变每 token 的计算量,也不需要调 router,从 Dense 改过来的工程量较小,论文在三种设置下都观察到了训练加速。
需要权衡的地方:
- 显存与存储:总参数约为 Dense 的 $K$ 倍,训练时的优化器状态和推理时的权重占用都会相应增加。
- 推理批处理:一个 batch 里各模态 token 的比例不固定,每个分支的矩阵乘可能吃不满。作者建议用动态或连续批处理,或者把较小的模态 padding 到与较大的模态等长后合并计算,代价是部分无效计算或更高的延迟。
- 结论的适用范围:墙钟时间的结果来自一套特定的 AWS 集群,作者明确表示换到其他硬件需要重新验证;Transfusion 设置下文本收益有限;7B Transfusion 模型只训练了 0.5T token,尚未饱和。
- 模态定义:MoT 依赖“每个 token 属于哪一类”事先已知。Cosmos 3 的做法说明,这个类别不一定是模态,也可以是理解与生成这样的角色。
一句话总结:MoT 用 $K$ 倍的参数换取更快的训练收敛,每 token 计算量不变;拆注意力投影和 FFN 有用,拆 LayerNorm 作用不大;全局自注意力是唯一不拆的部分。
参考文献:
- Liang, W., Yu, L., Luo, L., et al. Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models. TMLR, 2025. arXiv:2411.04996
- NVIDIA. Cosmos 3: Omnimodal World Models for Physical AI. 2026. arXiv:2606.02800
- Chameleon Team. Chameleon: Mixed-Modal Early-Fusion Foundation Models. 2024. arXiv:2405.09818
- Zhou, C., Yu, L., Babu, A., et al. Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model. 2024. arXiv:2408.11039