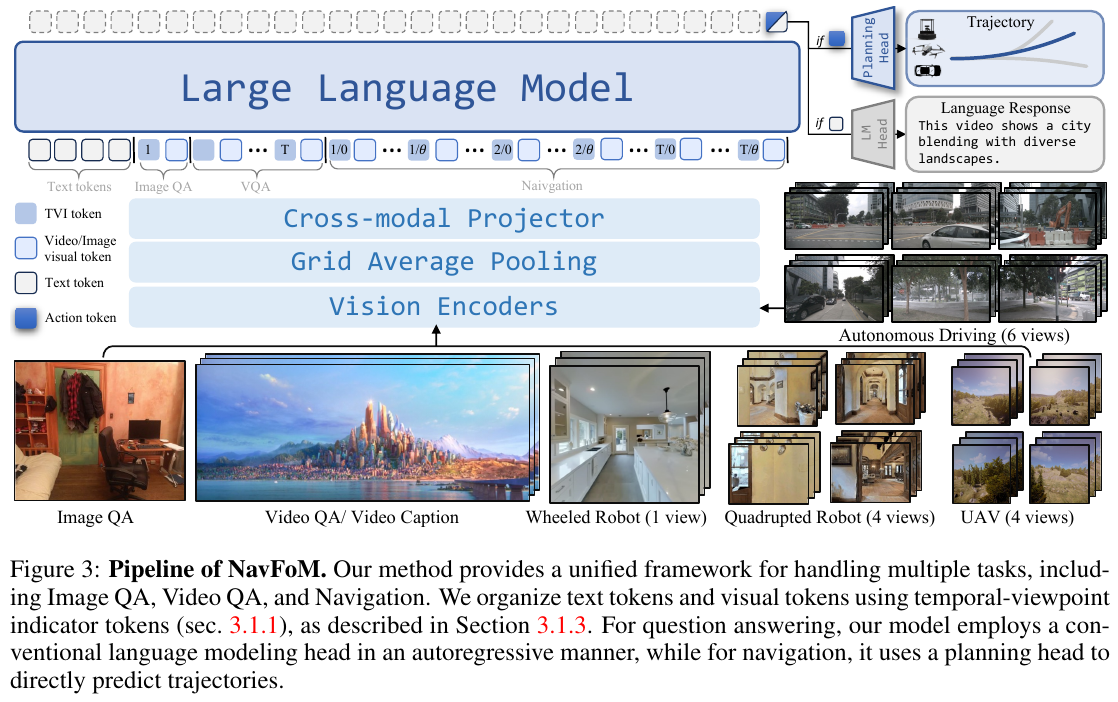
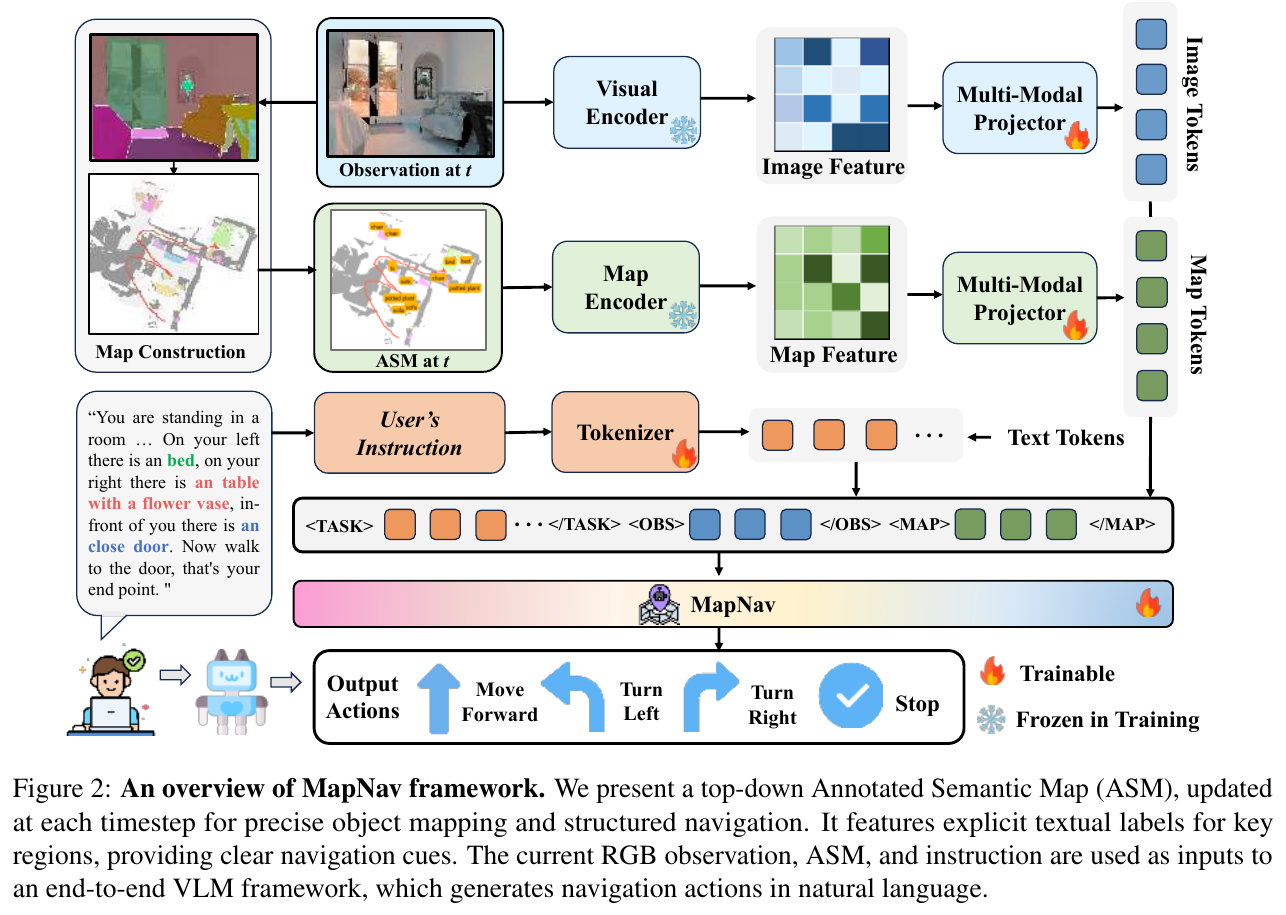
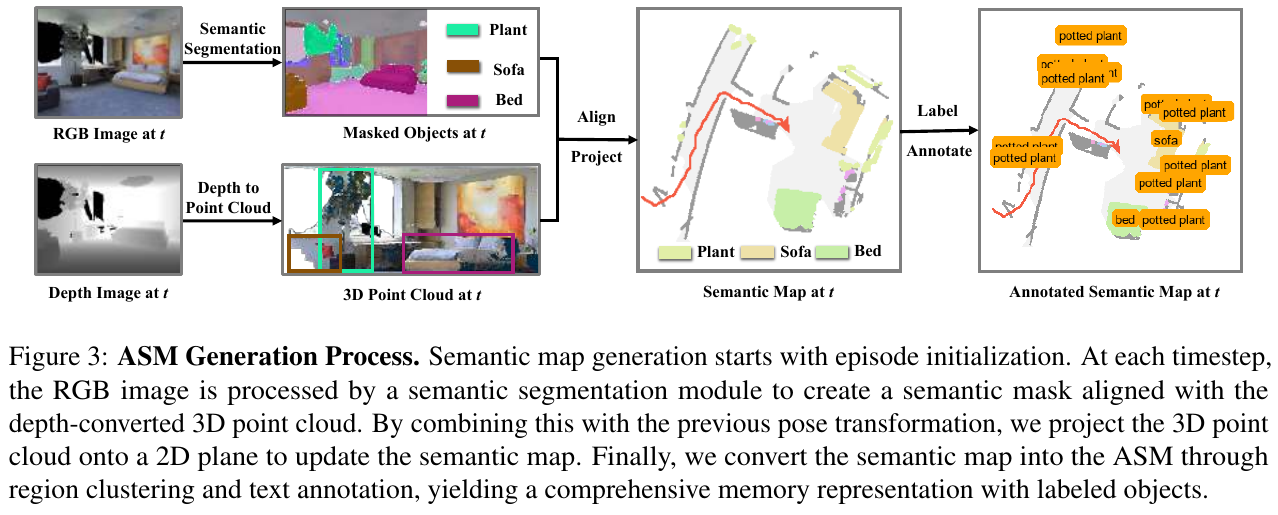
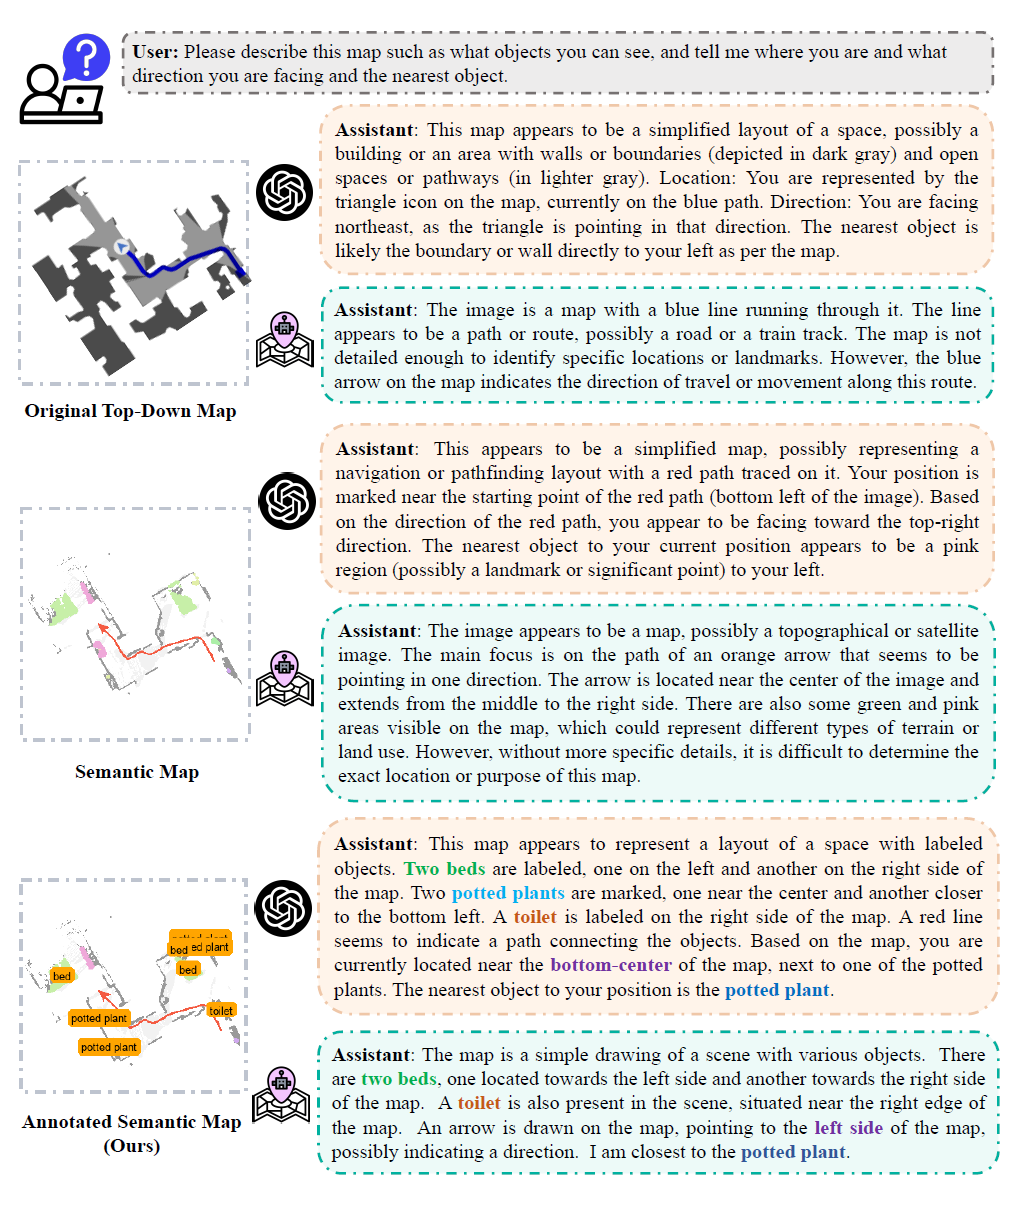
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://garylee1210.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://garylee1210.github.io/" rel="alternate" type="text/html" /><updated>2026-09-28T06:50:56+00:00</updated><id>https://garylee1210.github.io/feed.xml</id><title type="html">GaryLee1210</title><subtitle>Personal Blog &amp; Research Notes</subtitle><entry><title type="html">VLN 经典论文</title><link href="https://garylee1210.github.io/VLN-Papers/" rel="alternate" type="text/html" title="VLN 经典论文" /><published>2026-09-28T00:00:00+00:00</published><updated>2026-09-28T00:00:00+00:00</updated><id>https://garylee1210.github.io/VLN-Papers</id><content type="html" xml:base="https://garylee1210.github.io/VLN-Papers/"><![CDATA[<blockquote>
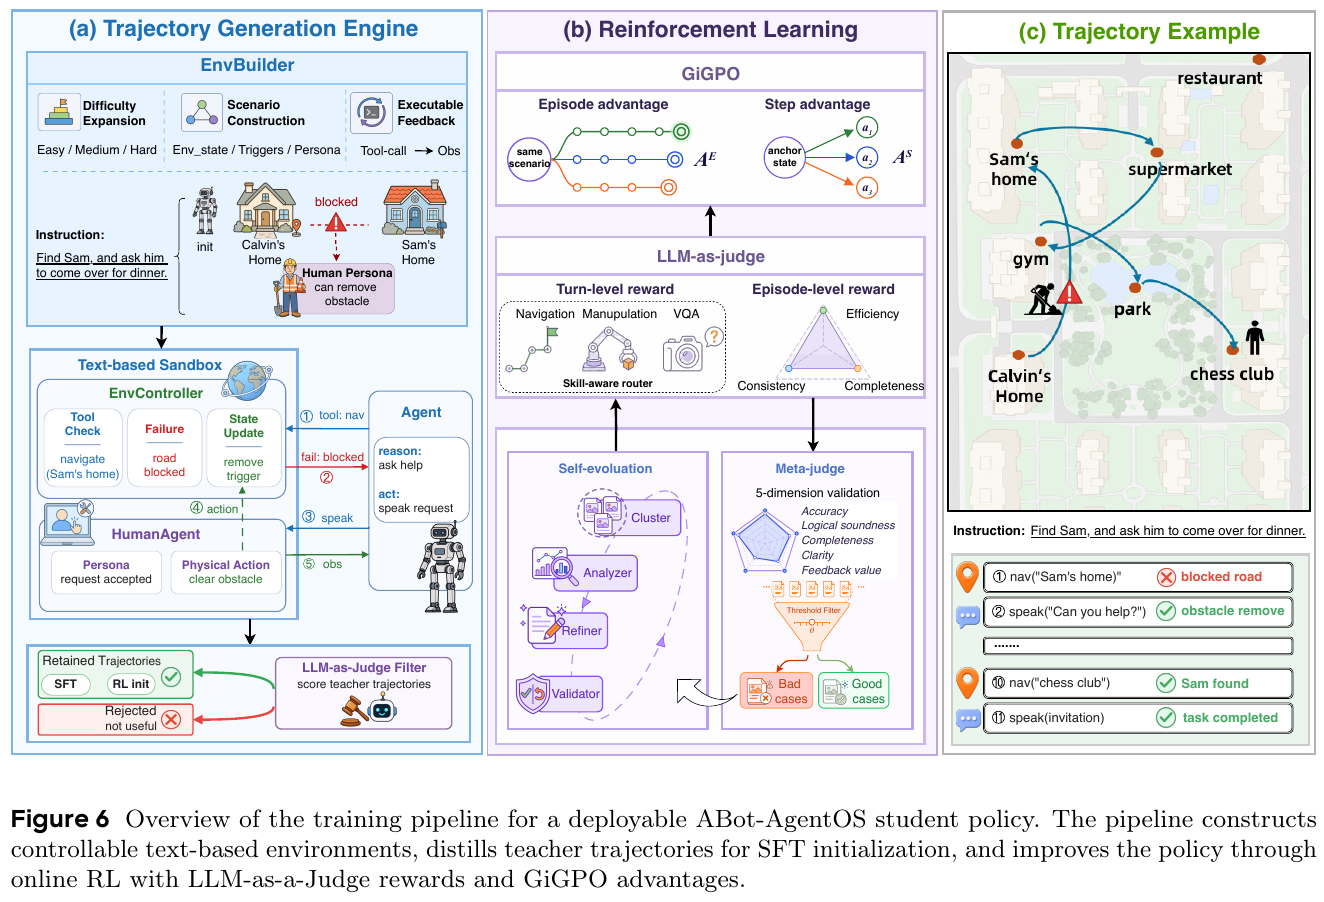
  <p>本文是 <a href="/VLN-Survey/">VLN综述：基于视觉语言的导航</a> 的配套论文精读，收录 VLN 经典论文与依赖基础工作。</p>

  <p>本篇收录 55 篇工作，均已发表于会议期刊或进入了指令跟随排行榜；目标导航排行榜与其余论文见扩展篇 <a href="/VLN-Papers-Extended/">VLN 论文精读（扩展篇）</a>。</p>
</blockquote>

<div id="paper-filter-bar" class="paper-filter-bar"></div>

<h1 id="性能排行榜">性能排行榜</h1>

<blockquote>
  <p>⚠️ <strong>不同基准不可直接混比</strong>：本篇只收指令跟随类基准，按基准分表——① R2R-CE 与 ② RxR-CE 是连续环境（机器人第一视角逐步控制），③ R2R / REVERIE 是离散导航图上的全景决策。各表任务定义或传感器设定不同，SR 不可跨表比较。目标导航（ObjectNav、HM3D-OVON、图像 / 点目标等）的排行榜在扩展篇：<a href="/VLN-Papers-Extended/#goal-nav-leaderboard">目标导航性能排行榜</a>。</p>

  <p><strong>读表</strong>：「范式」列中，<strong>训练</strong>指在导航数据上训练或微调过模型（含跨任务零样本迁移的导航基础模型）；<strong>免训练</strong>指不训练任何导航模型，由现成的大模型、检测分割模型与规则 / 规划模块组合而成（调用现成的点目标低层控制器不影响归类）。灰色行是非标准口径（如只评测了验证集子集），不参与加粗；加粗为同一基准内非灰色行的最优值。表格上方的筛选栏可按范式、输入配置、是否开源筛选，也可以隐藏灰色行。</p>
</blockquote>

<div id="lb-filter-bar" class="lb-filter-bar"></div>

<h2 id="-r2r-ce">① R2R-CE</h2>

<p>连续环境 · 英文指令 · val-unseen（全量 1839 条）</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">NE ↓</th>
      <th style="text-align: center">OSR ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
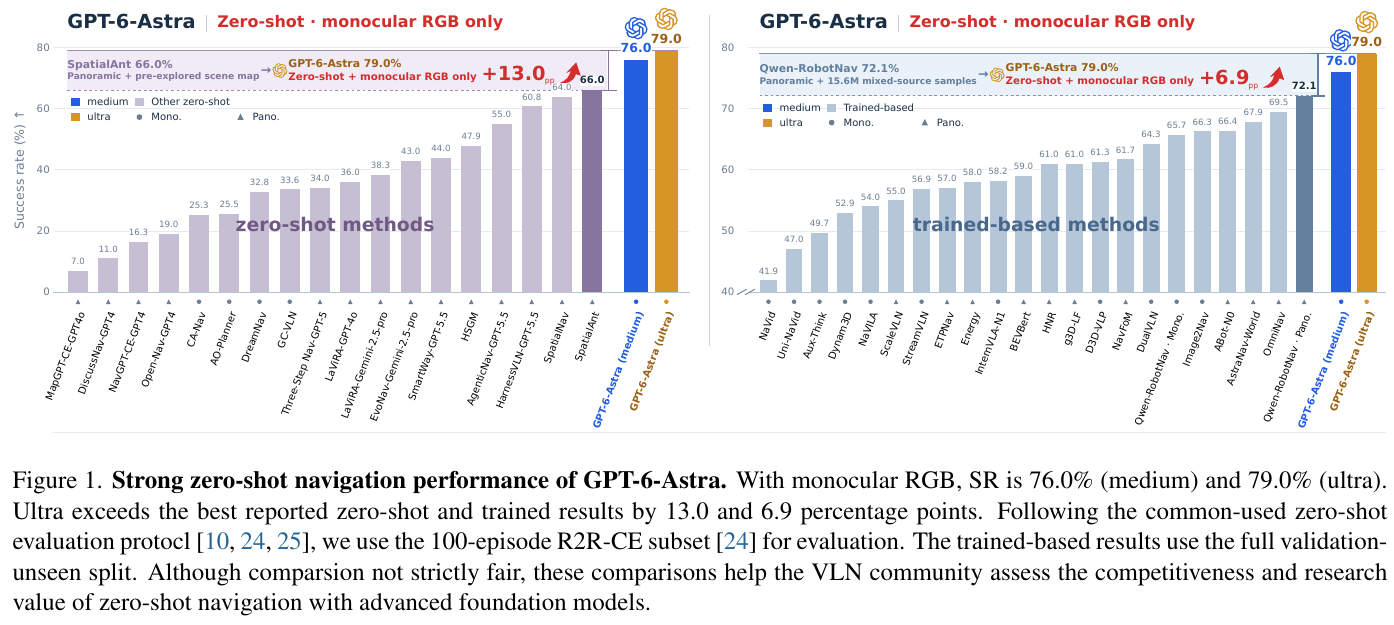
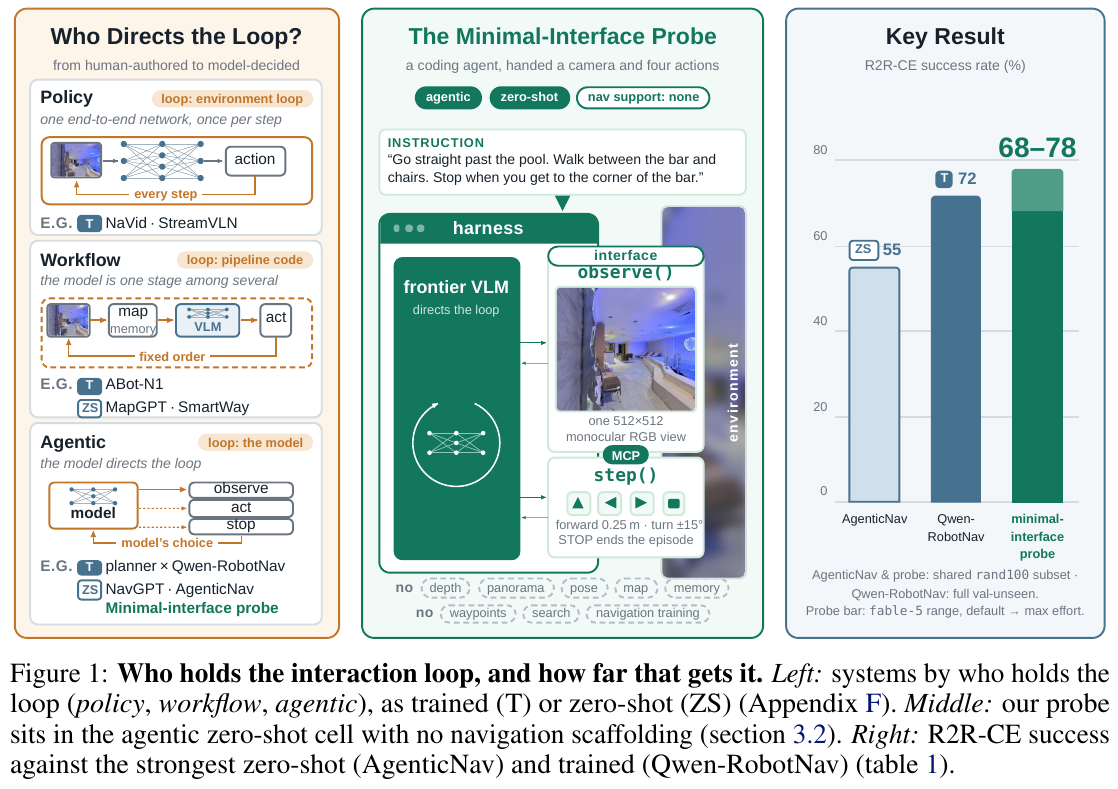
      <td style="text-align: left"><a href="#gpt-6-astra">GPT-6-Astra (单目 · ultra)</a> <span class="lb-flag">100 条子集</span></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-6-Astra</td>
      <td style="text-align: center">79.0</td>
      <td style="text-align: center">69.5</td>
      <td style="text-align: center">3.0</td>
      <td style="text-align: center">82.0</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#robostral-navigate">Robostral Navigate (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Mistral-8B</td>
      <td style="text-align: center"><strong>77.4</strong></td>
      <td style="text-align: center"><strong>74.2</strong></td>
      <td style="text-align: center"><strong>3.20</strong></td>
      <td style="text-align: center"><strong>81.3</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#gpt-6-astra">GPT-6-Astra (单目 · medium)</a> <span class="lb-flag">100 条子集</span></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-6-Astra</td>
      <td style="text-align: center">76.0</td>
      <td style="text-align: center">67.9</td>
      <td style="text-align: center">2.7</td>
      <td style="text-align: center">83.0</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#qwen-robotnav">Qwen-RobotNav (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center">72.1</td>
      <td style="text-align: center">66.6</td>
      <td style="text-align: center">3.53</td>
      <td style="text-align: center">78.5</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
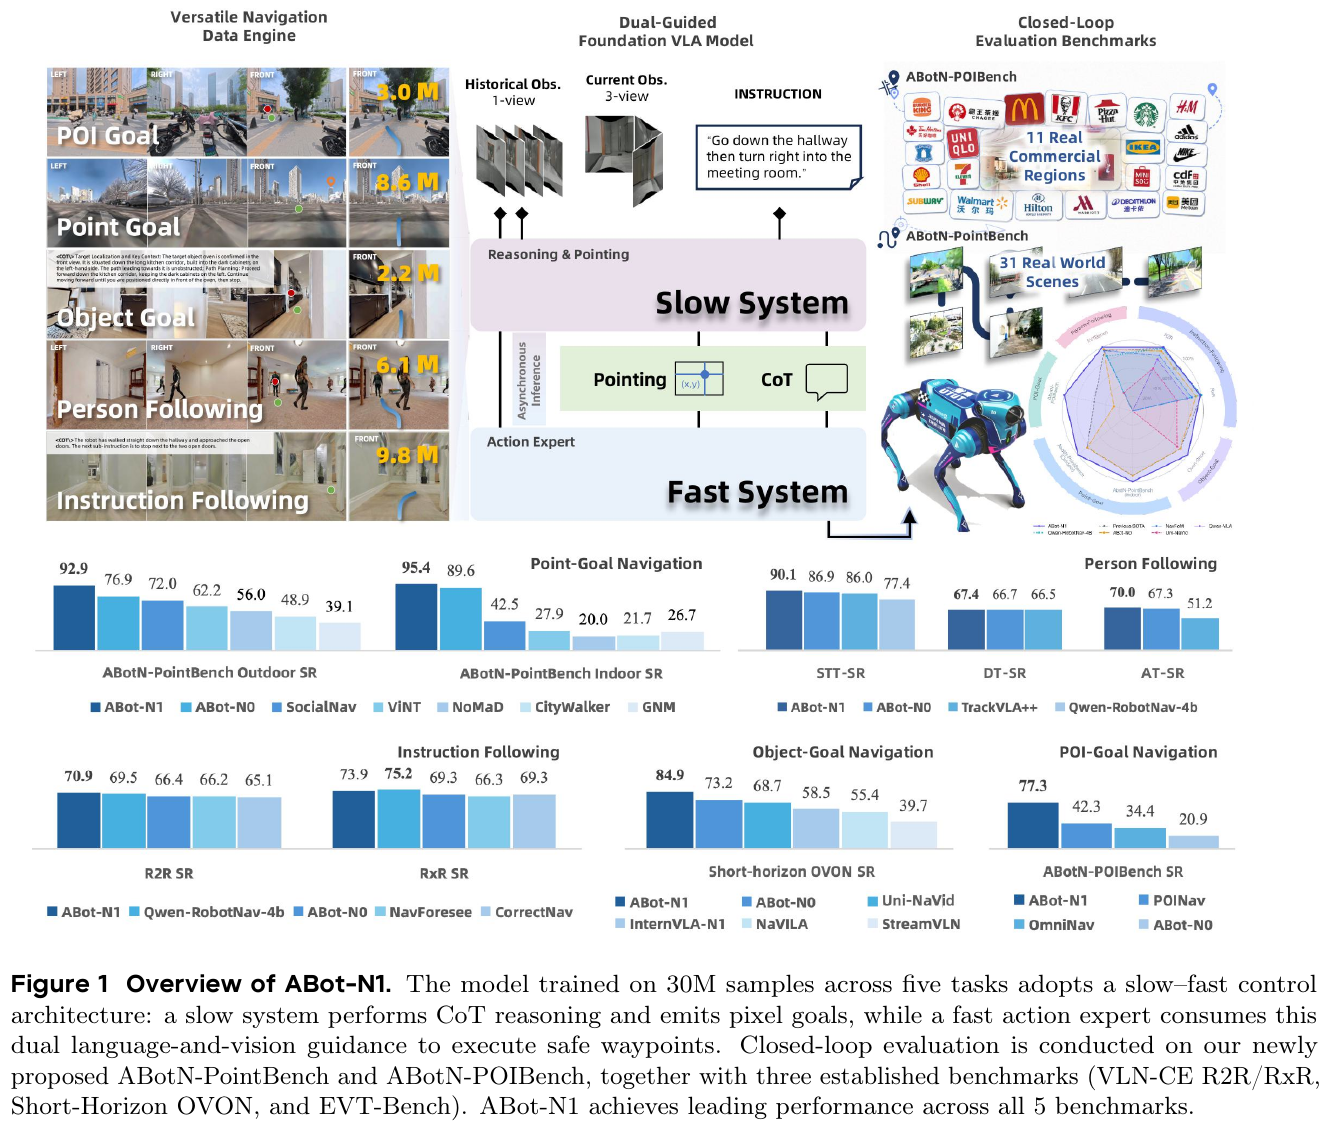
      <td style="text-align: left"><a href="#abot-n1">ABot-N1 (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen-3.5-4B + 2B</td>
      <td style="text-align: center">70.9</td>
      <td style="text-align: center">67.5</td>
      <td style="text-align: center">3.32</td>
      <td style="text-align: center">75.2</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#image2sim">Image2Nav (180° FOV)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">70.3</td>
      <td style="text-align: center">65.6</td>
      <td style="text-align: center">3.71</td>
      <td style="text-align: center">76.1</td>
      <td style="text-align: center"><a href="https://github.com/MrZihan/Image2Sim">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#groundingvln">GroundingVLN (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3.5-4B</td>
      <td style="text-align: center">69.9</td>
      <td style="text-align: center">64.1</td>
      <td style="text-align: center">3.66</td>
      <td style="text-align: center">74.8</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#omninav">OmniNav (多目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">69.5</td>
      <td style="text-align: center">66.1</td>
      <td style="text-align: center">3.74</td>
      <td style="text-align: center">74.6</td>
      <td style="text-align: center"><a href="https://github.com/amap-cvlab/OmniNav">是</a></td>
    </tr>
    <tr>
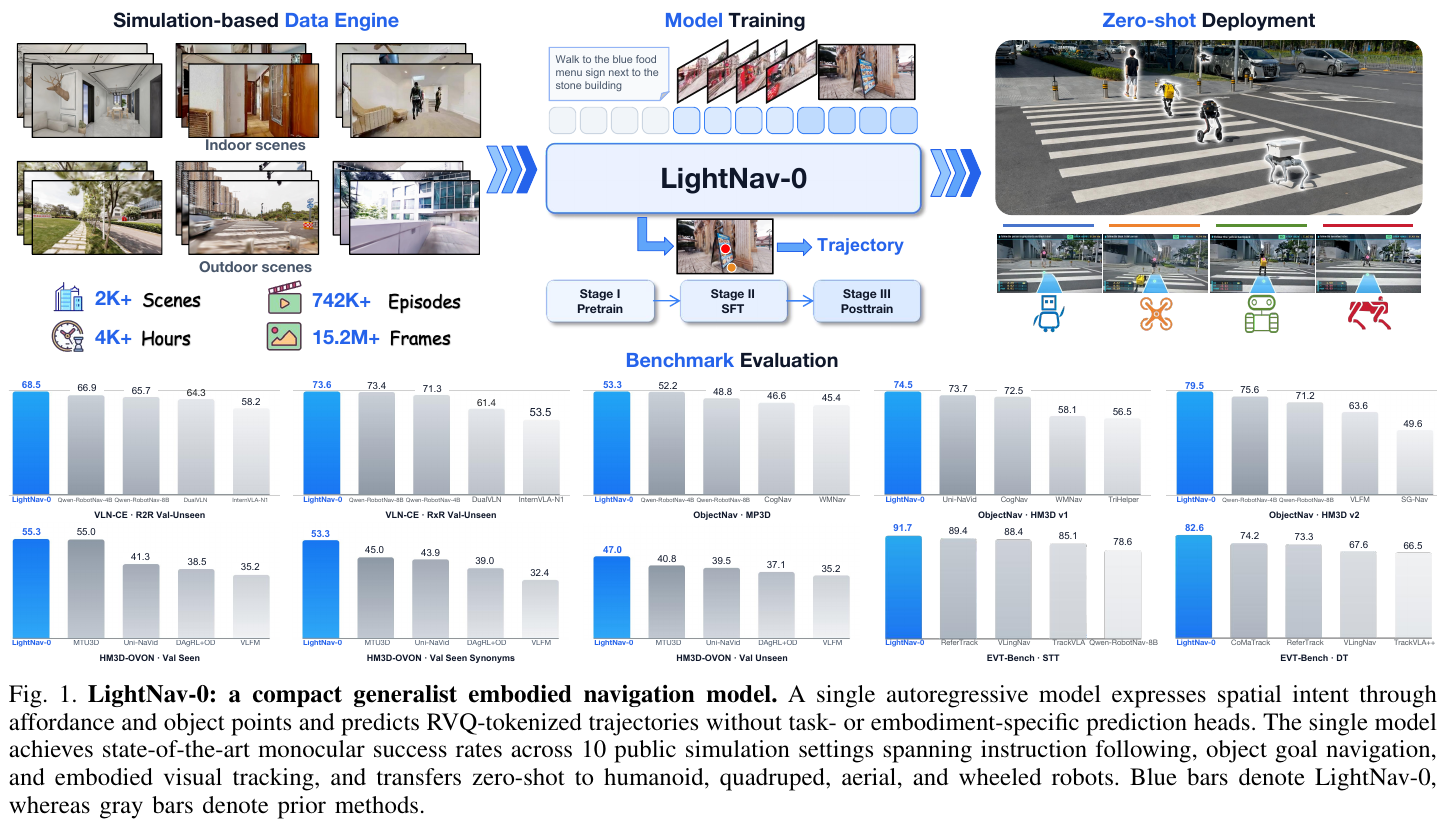
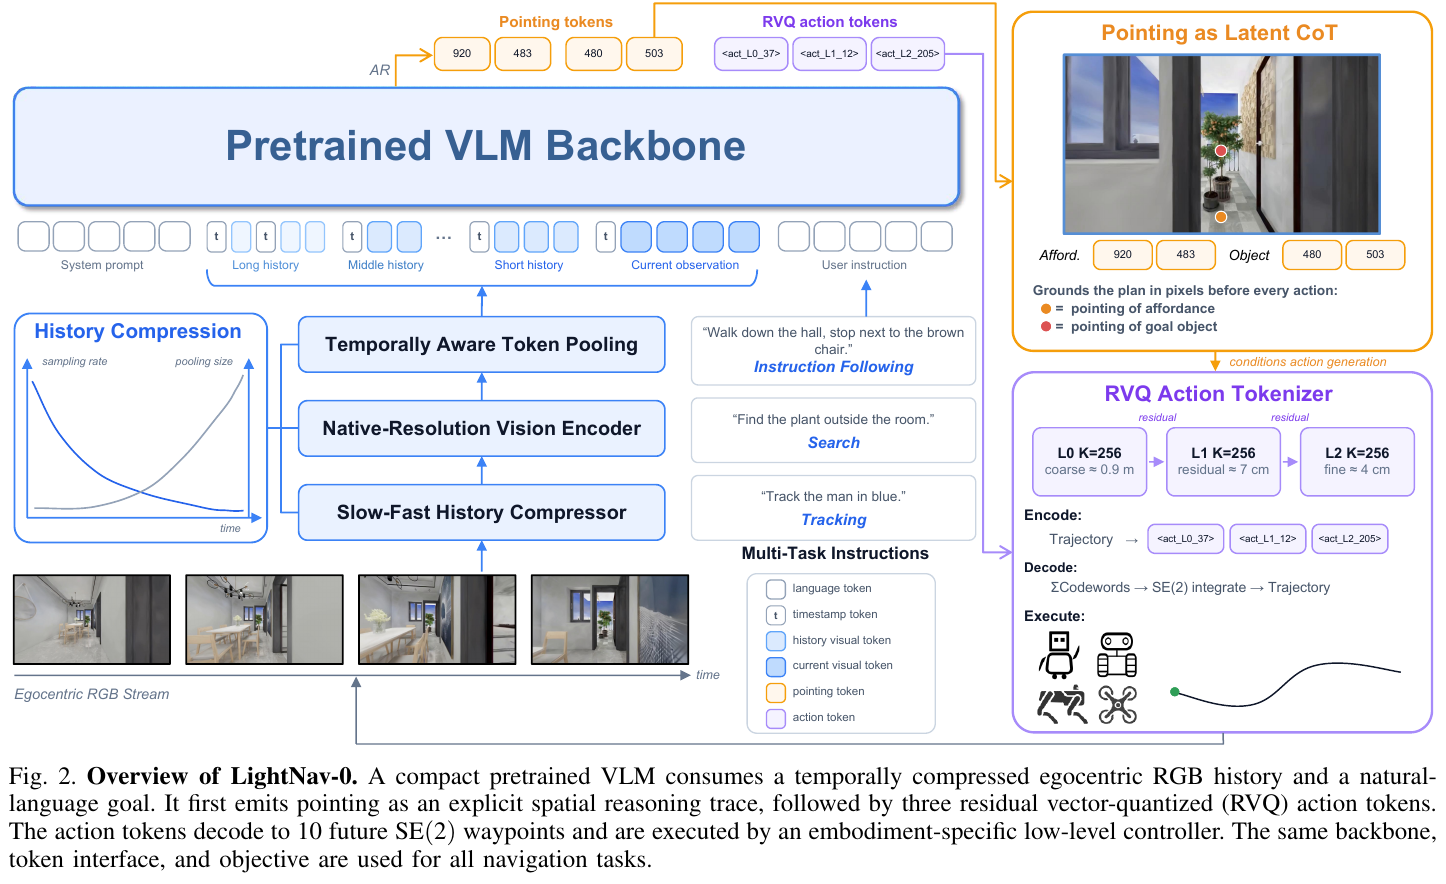
      <td style="text-align: left"><a href="#lightnav-0">LightNav-0 (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">68.5</td>
      <td style="text-align: center">62.8</td>
      <td style="text-align: center">3.91</td>
      <td style="text-align: center">73.7</td>
      <td style="text-align: center"><a href="https://github.com/lightorigins/LightNav-0">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#astranav-world">AstraNav-World (多目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">67.9</td>
      <td style="text-align: center">65.4</td>
      <td style="text-align: center">3.86</td>
      <td style="text-align: center">73.9</td>
      <td style="text-align: center"><a href="https://github.com/amap-cvlab/AstraNav-World">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#sedualvln">SEDualVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">67.3</td>
      <td style="text-align: center">62.5</td>
      <td style="text-align: center">3.75</td>
      <td style="text-align: center">73.7</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#agentvln">AgentVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">67.2</td>
      <td style="text-align: center">64.7</td>
      <td style="text-align: center">3.88</td>
      <td style="text-align: center">73.5</td>
      <td style="text-align: center"><a href="https://github.com/Allenxinn/AgentVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">66.9</td>
      <td style="text-align: center">60.5</td>
      <td style="text-align: center">4.22</td>
      <td style="text-align: center">73.6</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
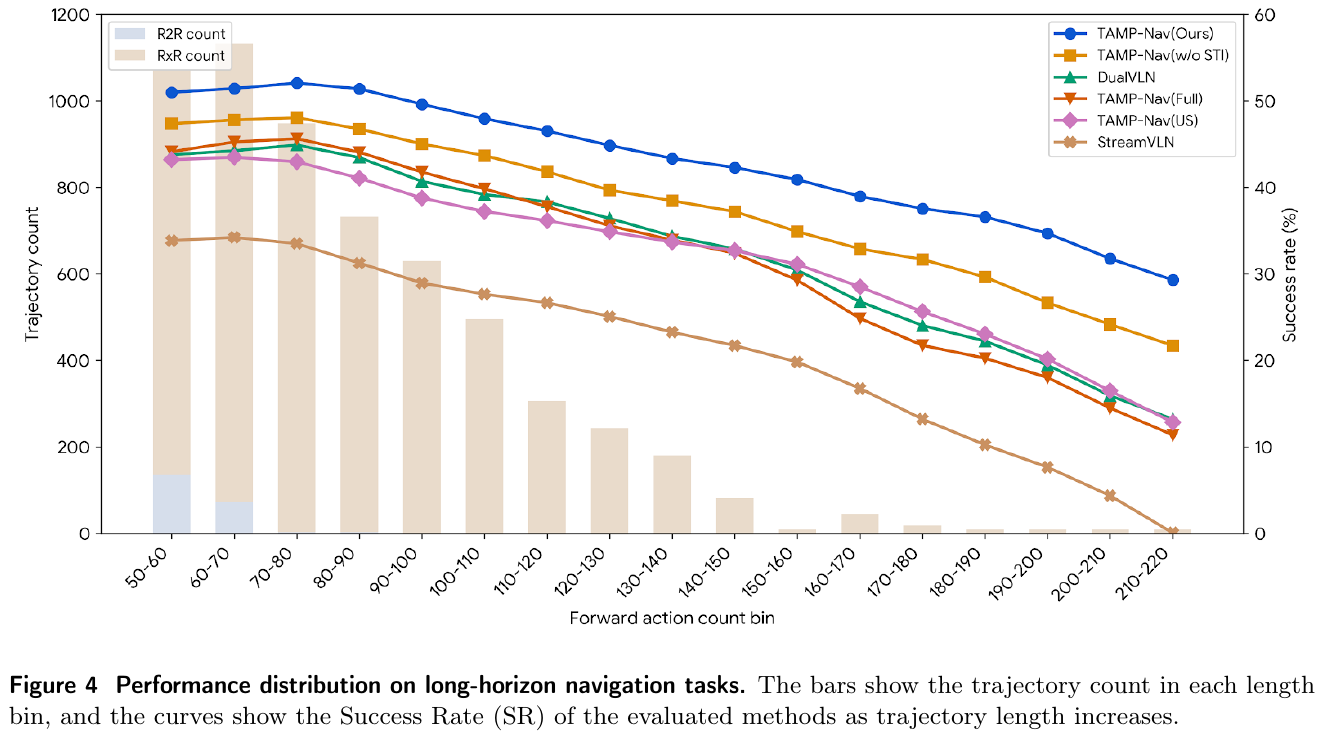
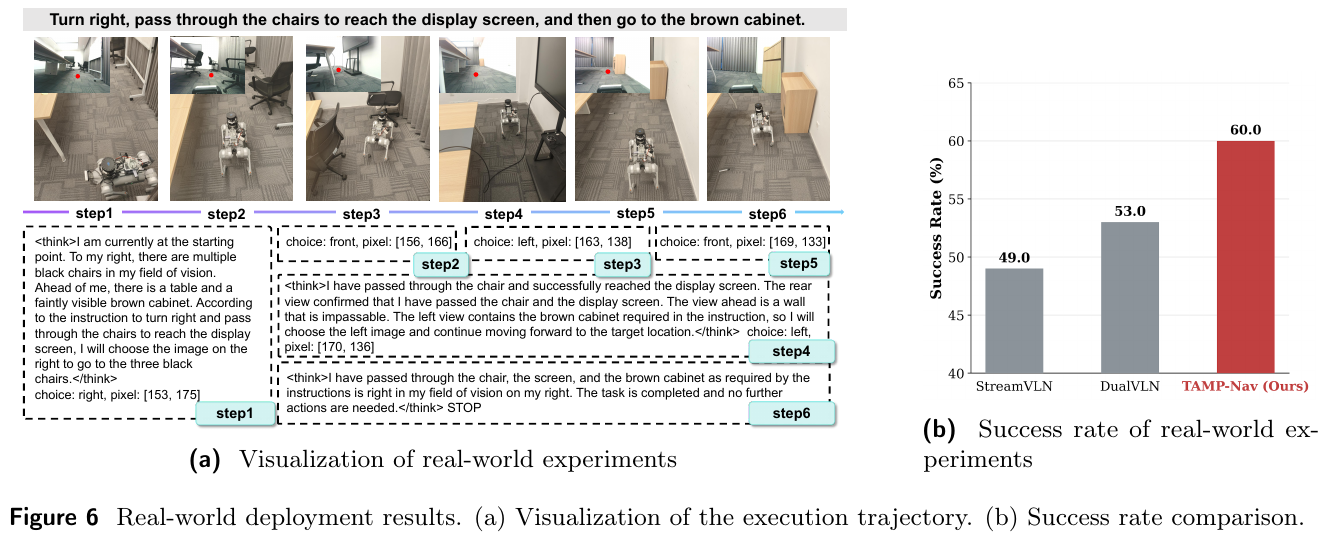
      <td style="text-align: left"><a href="#tamp-nav">TAMP-Nav (多目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center">66.2</td>
      <td style="text-align: center">58.8</td>
      <td style="text-align: center">3.85</td>
      <td style="text-align: center">74.5</td>
      <td style="text-align: center"><a href="https://github.com/ZJU-OmniAI/Embodied-Omni">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#dual-anchoring">Dual-Anchoring (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">65.6</td>
      <td style="text-align: center">62.1</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#awarevln">AwareVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Vicuna-7B</td>
      <td style="text-align: center">65.4</td>
      <td style="text-align: center">55.1</td>
      <td style="text-align: center">4.02</td>
      <td style="text-align: center">73.5</td>
      <td style="text-align: center"><a href="https://github.com/GWxuan/AwareVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#correctnav">CorrectNav (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">65.1</td>
      <td style="text-align: center">62.3</td>
      <td style="text-align: center">4.24</td>
      <td style="text-align: center">67.5</td>
      <td style="text-align: center"><a href="https://github.com/owlet914/CorrectNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#dualvln">DualVLN (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center">64.3</td>
      <td style="text-align: center">58.5</td>
      <td style="text-align: center">4.05</td>
      <td style="text-align: center">70.7</td>
      <td style="text-align: center"><a href="https://github.com/InternRobotics/InternNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vln-cache">VLN-Cache (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center">63.1</td>
      <td style="text-align: center">57.6</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#reflectvln">ReflectVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">62.8</td>
      <td style="text-align: center">58.5</td>
      <td style="text-align: center">4.19</td>
      <td style="text-align: center">67.3</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navfom">NavFoM (多目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-7B</td>
      <td style="text-align: center">61.7</td>
      <td style="text-align: center">55.3</td>
      <td style="text-align: center">4.61</td>
      <td style="text-align: center">72.1</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#ga-vln">GA-VLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">61.0</td>
      <td style="text-align: center">55.2</td>
      <td style="text-align: center">4.80</td>
      <td style="text-align: center">67.6</td>
      <td style="text-align: center"><a href="https://github.com/jahhaoyang/GA-VLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#harnessvln">HarnessVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-5.5</td>
      <td style="text-align: center">60.8</td>
      <td style="text-align: center">43.5</td>
      <td style="text-align: center">4.01</td>
      <td style="text-align: center">72.7</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#janusvln">JanusVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Janus-Pro-7B</td>
      <td style="text-align: center">60.5</td>
      <td style="text-align: center">56.8</td>
      <td style="text-align: center">4.78</td>
      <td style="text-align: center">65.2</td>
      <td style="text-align: center"><a href="https://github.com/MIV-XJTU/JanusVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#rynnbrain">RynnBrain-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">58.6</td>
      <td style="text-align: center">49.6</td>
      <td style="text-align: center">4.92</td>
      <td style="text-align: center">71.6</td>
      <td style="text-align: center"><a href="https://github.com/alibaba-damo-academy/RynnBrain">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#dgnav">DGNav (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">58.56</td>
      <td style="text-align: center">50.08</td>
      <td style="text-align: center">4.66</td>
      <td style="text-align: center">64.82</td>
      <td style="text-align: center"><a href="https://github.com/shannanshouyin/DGNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#memvln">MemVLN-8B (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center">58.4</td>
      <td style="text-align: center">51.2</td>
      <td style="text-align: center">4.98</td>
      <td style="text-align: center">65.3</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#budvln">BudVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-1.5-7B</td>
      <td style="text-align: center">57.6</td>
      <td style="text-align: center">51.1</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#streamvln">StreamVLN (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">56.4</td>
      <td style="text-align: center">50.2</td>
      <td style="text-align: center">4.90</td>
      <td style="text-align: center">63.6</td>
      <td style="text-align: center"><a href="https://github.com/OpenRobotLab/StreamVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#decovln">DecoVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">56.3</td>
      <td style="text-align: center">50.5</td>
      <td style="text-align: center">5.01</td>
      <td style="text-align: center">63.5</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#agenticnav">AgenticNav (全景)</a> <span class="lb-flag">100 条子集</span></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-5.5</td>
      <td style="text-align: center">55.0</td>
      <td style="text-align: center">48.41</td>
      <td style="text-align: center">5.19</td>
      <td style="text-align: center">65.0</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#goal2pixel">Goal2Pixel (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-1.5-7B</td>
      <td style="text-align: center">54.1</td>
      <td style="text-align: center">52.5</td>
      <td style="text-align: center">4.85</td>
      <td style="text-align: center">59.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
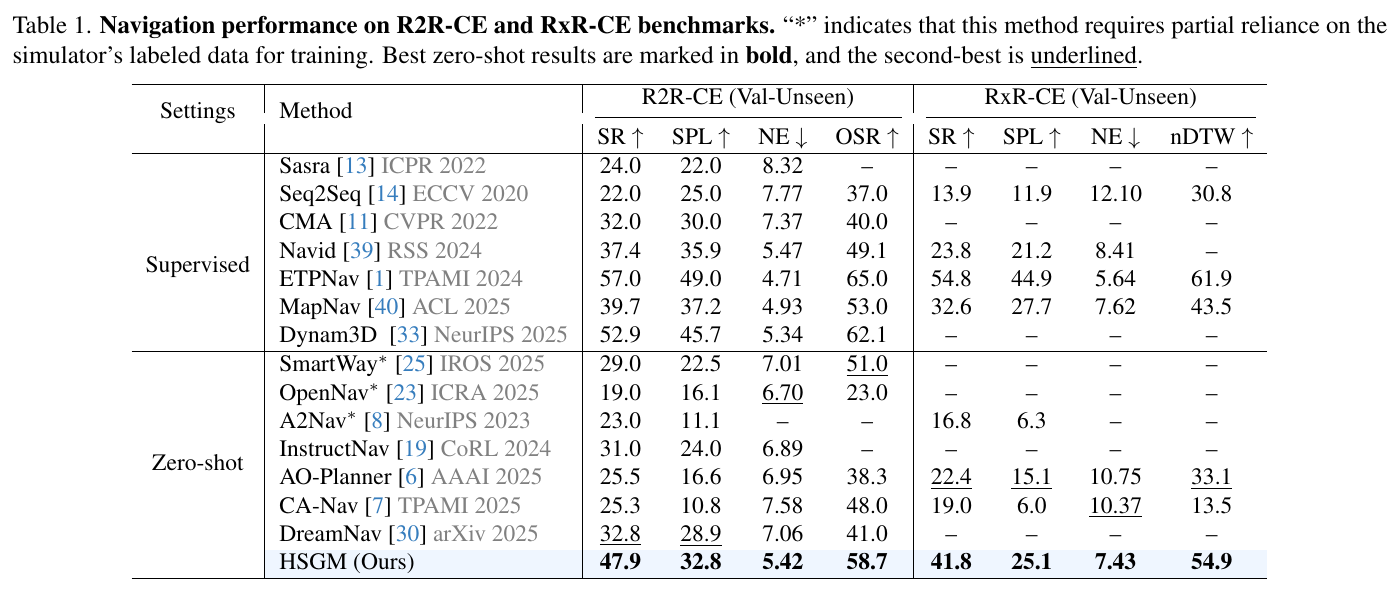
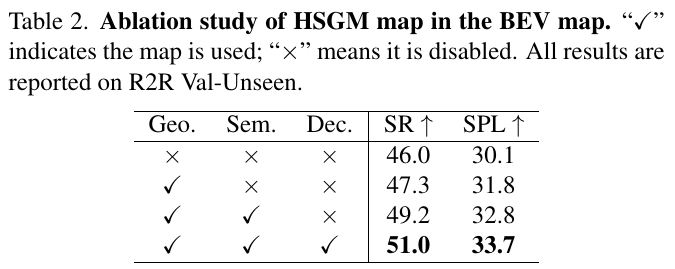
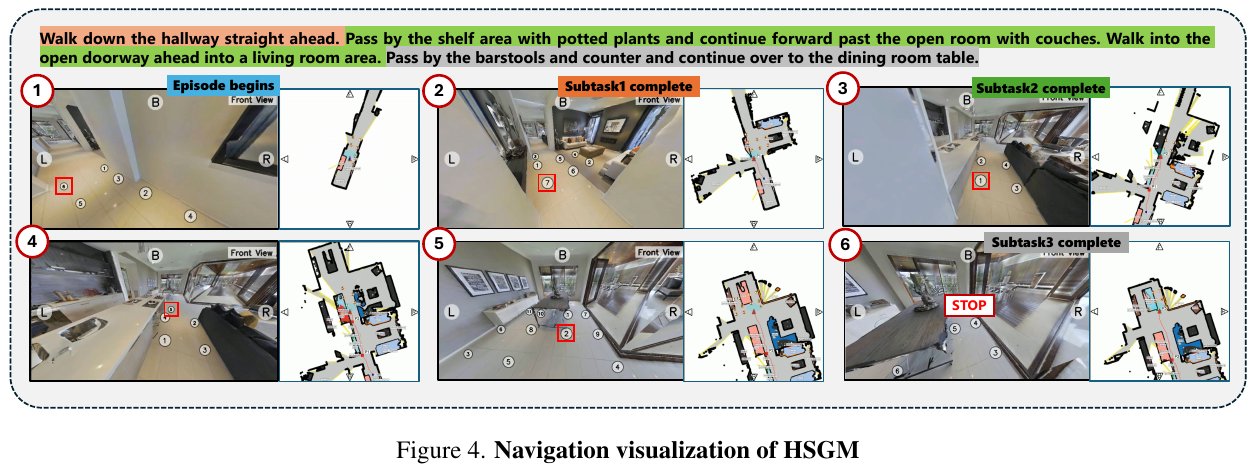
      <td style="text-align: left"><a href="#hsgm">HSGM (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">47.9</td>
      <td style="text-align: center">32.8</td>
      <td style="text-align: center">5.42</td>
      <td style="text-align: center">58.7</td>
      <td style="text-align: center"><a href="https://github.com/Teacher-Tom/HSGM_public">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#mapnav">MapNav (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Onevision-7B</td>
      <td style="text-align: center">39.7</td>
      <td style="text-align: center">37.2</td>
      <td style="text-align: center">5.43</td>
      <td style="text-align: center">53.0</td>
      <td style="text-align: center"><a href="https://github.com/linglingxiansen/MapNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navid">NaVid (单目)</a></td>
      <td style="text-align: center">2024</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">37.4</td>
      <td style="text-align: center">35.9</td>
      <td style="text-align: center">5.47</td>
      <td style="text-align: center">49.1</td>
      <td style="text-align: center"><a href="https://github.com/jzhzhang/NaVid-VLN-CE">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vln-r1">VLN-R1 (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-VL-7B</td>
      <td style="text-align: center">30.2</td>
      <td style="text-align: center">21.8</td>
      <td style="text-align: center">7.0</td>
      <td style="text-align: center">41.2</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vln-r1">VLN-R1 (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-VL-2B</td>
      <td style="text-align: center">25.6</td>
      <td style="text-align: center">20.5</td>
      <td style="text-align: center">10.2</td>
      <td style="text-align: center">37.5</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
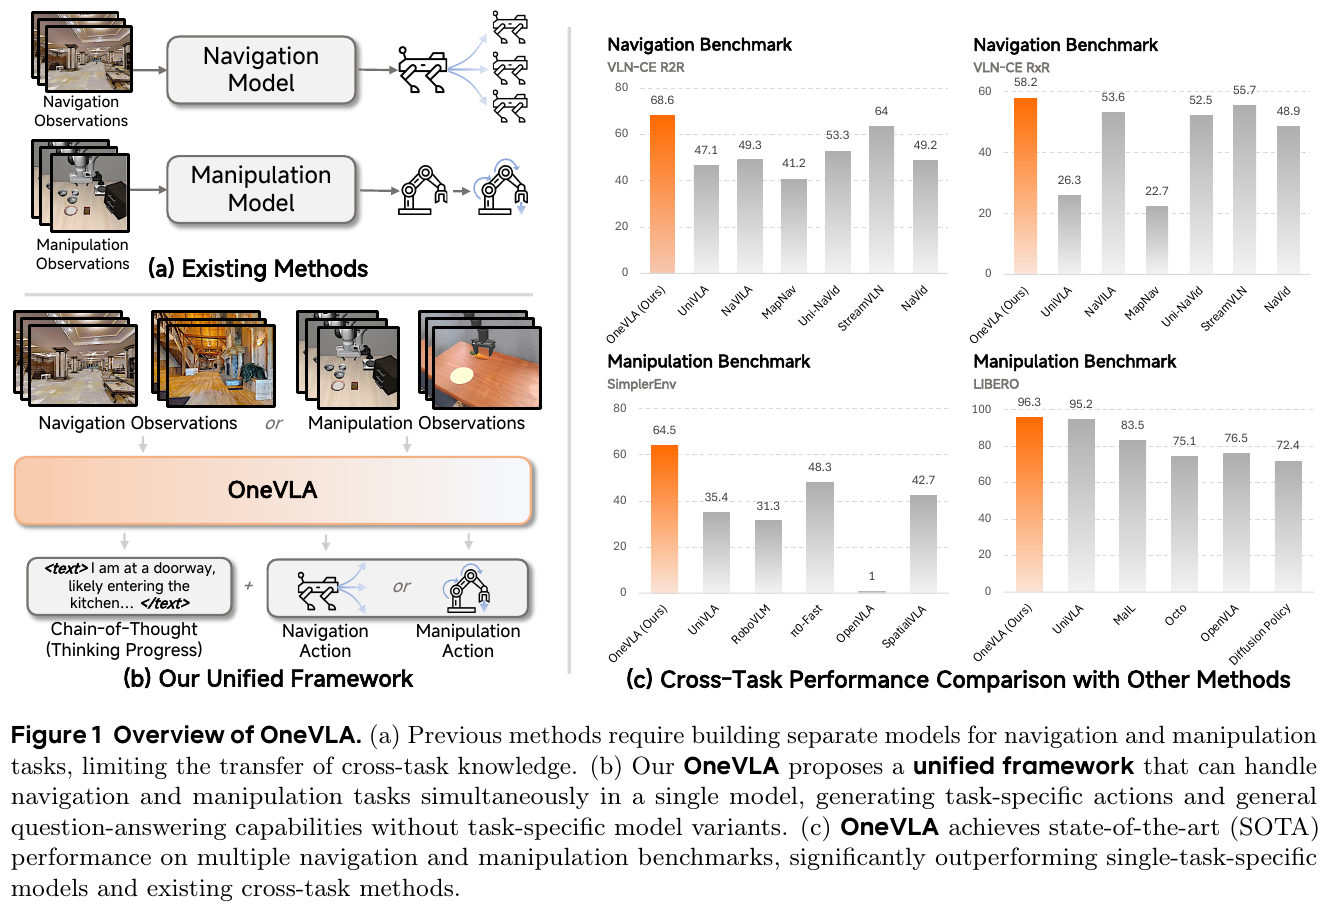
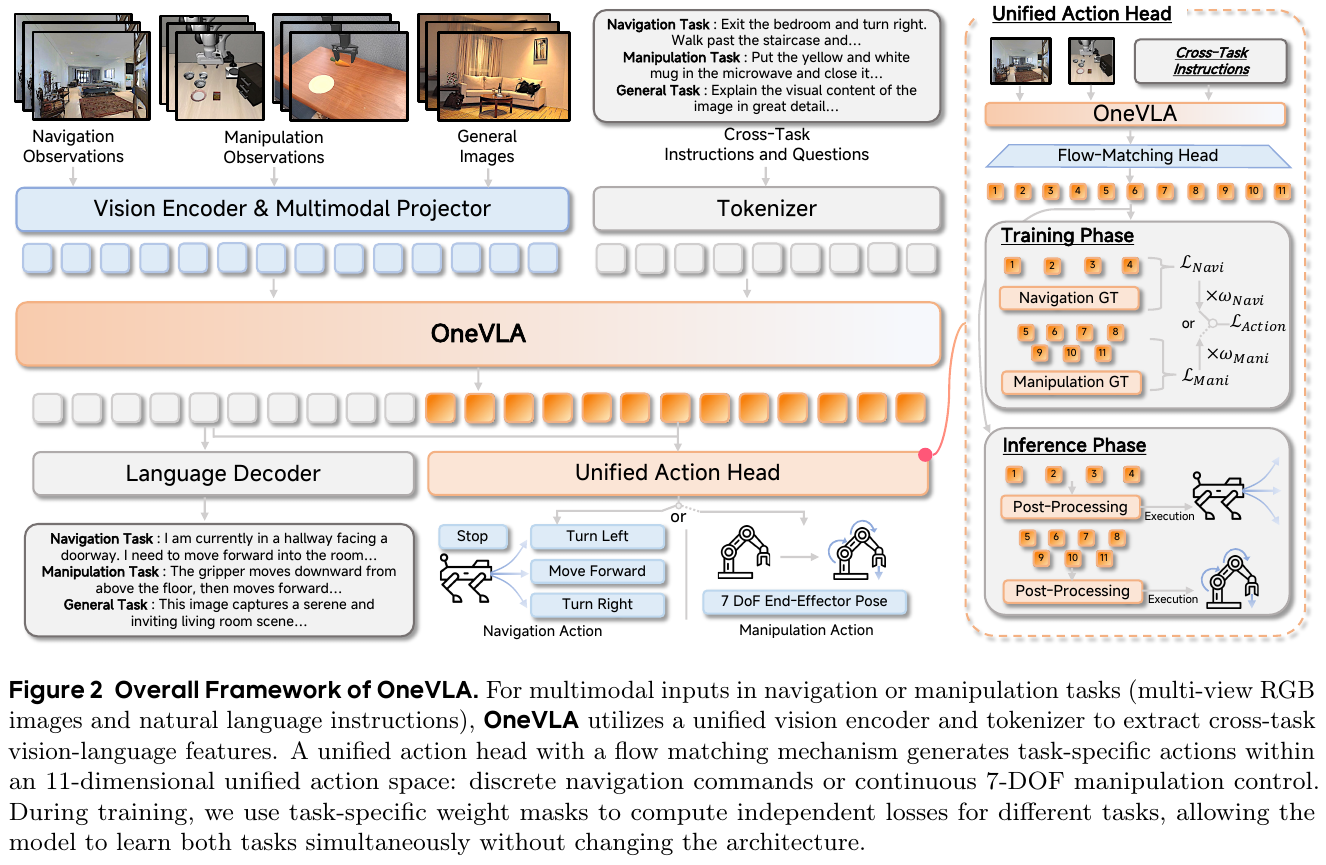
      <td style="text-align: left"><a href="#onevla-a-unified-framework-for-embodied-tasks">OneVLA (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">68.6</td>
      <td style="text-align: center"><a href="https://github.com/linglingxiansen/OneVLA">是</a></td>
    </tr>
  </tbody>
</table>

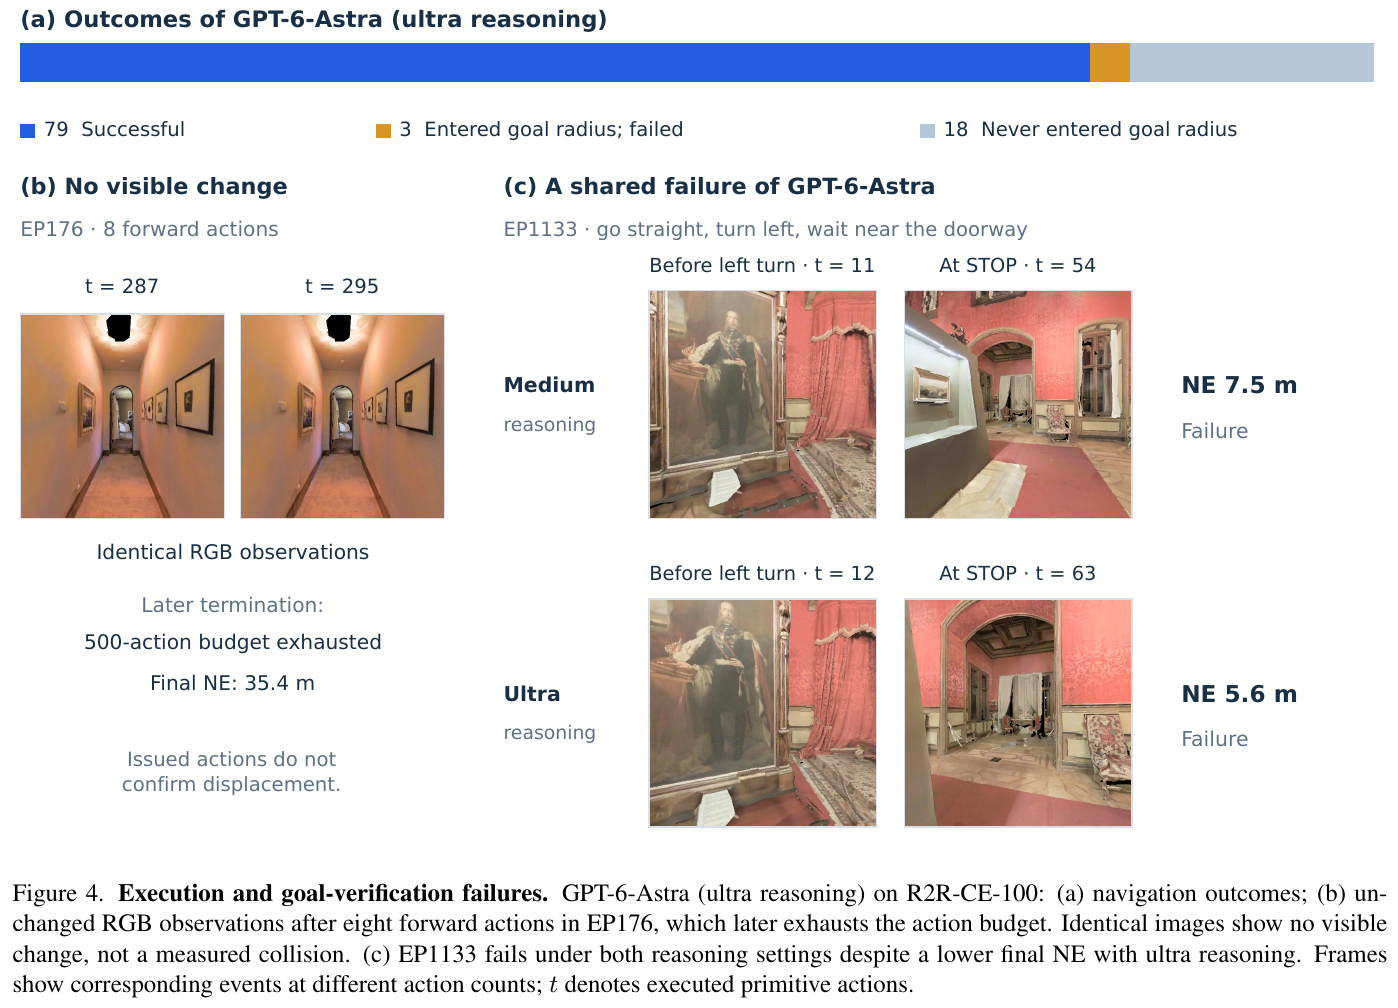
<p>注：NavFoM 为四视角结果（单视角为 SR 56.2 / SPL 51.2）；DGNav 沿用 ETPNav 的全景 RGB-D 输入；DualVLN 与 StreamVLN 为同口径单视角对比；VLN-Cache 为对 DualVLN 的加速方案，几乎无损（基线 64.3 / 58.5）。 StreamVLN 取 arXiv v2（ICRA 2026 版）的 StreamVLN† 数字（用了 ScaleVLN 子集等额外数据），v1 为 56.9 / 51.9，其他论文作为基线引用的多是 v1 数字。 Qwen-RobotNav 取 arXiv v3：全景行是 8B（底座 Qwen3-VL-8B），单目行是 4B（单目下 4B 的 66.9 高于 8B 的 65.7；8B 单目为 65.7 / 59.6）。灰色的 GPT-6-Astra 与 AgenticNav 三行只在 R2R-CE-100 上评测：这是 Open-Nav 从 val-unseen 中固定抽取的 100 条 episode（覆盖 10 个场景），免训练方法为控制大模型调用成本普遍只报这一子集。1 条 episode 就是 1 个百分点，SR 在 79% 附近时标准误约 4 个点（95% 区间约 71–87），全量 1839 条时约 1 个点；GPT-6-Astra 每档推理强度又只跑一次。这几行按 SR 排在表里、不参与加粗，与全量行的高低只作参考。</p>

<h2 id="-rxr-ce">② RxR-CE</h2>

<p>连续环境 · 多语言指令（英语 / 印地语 / 泰卢固语）· val-unseen</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">NE ↓</th>
      <th style="text-align: center">OSR ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#qwen-robotnav">Qwen-RobotNav (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center"><strong>76.5</strong></td>
      <td style="text-align: center">65.7</td>
      <td style="text-align: center">3.58</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#robostral-navigate">Robostral Navigate (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Mistral-8B</td>
      <td style="text-align: center">75.1</td>
      <td style="text-align: center"><strong>68.7</strong></td>
      <td style="text-align: center">3.47</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#groundingvln">GroundingVLN (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3.5-4B</td>
      <td style="text-align: center">75.1</td>
      <td style="text-align: center">62.0</td>
      <td style="text-align: center">3.54</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#abot-n1">ABot-N1 (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen-3.5-4B + 2B</td>
      <td style="text-align: center">73.9</td>
      <td style="text-align: center">63.9</td>
      <td style="text-align: center"><strong>3.13</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#omninav">OmniNav (多目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">73.6</td>
      <td style="text-align: center">62.0</td>
      <td style="text-align: center">3.77</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/amap-cvlab/OmniNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#lightnav-0">LightNav-0 (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">73.6</td>
      <td style="text-align: center">64.5</td>
      <td style="text-align: center">3.66</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/lightorigins/LightNav-0">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center">73.4</td>
      <td style="text-align: center">63.5</td>
      <td style="text-align: center">4.16</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#astranav-world">AstraNav-World (多目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">72.9</td>
      <td style="text-align: center">61.5</td>
      <td style="text-align: center">3.82</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/amap-cvlab/AstraNav-World">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#image2sim">Image2Nav (180° FOV)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">70.7</td>
      <td style="text-align: center">59.1</td>
      <td style="text-align: center">3.74</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/MrZihan/Image2Sim">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#agentvln">AgentVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">69.5</td>
      <td style="text-align: center">61.3</td>
      <td style="text-align: center">3.92</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/Allenxinn/AgentVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#correctnav">CorrectNav (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">69.3</td>
      <td style="text-align: center">63.3</td>
      <td style="text-align: center">4.09</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/owlet914/CorrectNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#awarevln">AwareVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Vicuna-7B</td>
      <td style="text-align: center">67.6</td>
      <td style="text-align: center">56.1</td>
      <td style="text-align: center">3.95</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/GWxuan/AwareVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#memvln">MemVLN-4B (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">66.5</td>
      <td style="text-align: center">57.4</td>
      <td style="text-align: center">4.22</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#reflectvln">ReflectVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">66.0</td>
      <td style="text-align: center">57.2</td>
      <td style="text-align: center">3.98</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#tamp-nav">TAMP-Nav (多目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center">65.7</td>
      <td style="text-align: center">56.9</td>
      <td style="text-align: center">4.32</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/ZJU-OmniAI/Embodied-Omni">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navfom">NavFoM (多目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-7B</td>
      <td style="text-align: center">64.4</td>
      <td style="text-align: center">56.2</td>
      <td style="text-align: center">4.74</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#sedualvln">SEDualVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">63.9</td>
      <td style="text-align: center">52.4</td>
      <td style="text-align: center">4.12</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#dual-anchoring">Dual-Anchoring (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">61.7</td>
      <td style="text-align: center">53.3</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#dualvln">DualVLN (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center">61.4</td>
      <td style="text-align: center">51.8</td>
      <td style="text-align: center">4.58</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/InternRobotics/InternNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#janusvln">JanusVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Janus-Pro-7B</td>
      <td style="text-align: center">56.2</td>
      <td style="text-align: center">47.5</td>
      <td style="text-align: center">6.06</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/MIV-XJTU/JanusVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#rynnbrain">RynnBrain-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">56.1</td>
      <td style="text-align: center">49.6</td>
      <td style="text-align: center">6.20</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/alibaba-damo-academy/RynnBrain">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#ga-vln">GA-VLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">55.4</td>
      <td style="text-align: center">45.2</td>
      <td style="text-align: center">5.88</td>
      <td style="text-align: center"><strong>67.0</strong></td>
      <td style="text-align: center"><a href="https://github.com/jahhaoyang/GA-VLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#streamvln">StreamVLN (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">54.4</td>
      <td style="text-align: center">45.4</td>
      <td style="text-align: center">5.65</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/OpenRobotLab/StreamVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#decovln">DecoVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">54.2</td>
      <td style="text-align: center">46.3</td>
      <td style="text-align: center">5.73</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#harnessvln">HarnessVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-5.5</td>
      <td style="text-align: center">53.9</td>
      <td style="text-align: center">38.0</td>
      <td style="text-align: center">6.42</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#dgnav">DGNav (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">53.78</td>
      <td style="text-align: center">44.37</td>
      <td style="text-align: center">6.00</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/shannanshouyin/DGNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#goal2pixel">Goal2Pixel (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-1.5-7B</td>
      <td style="text-align: center">43.8</td>
      <td style="text-align: center">40.4</td>
      <td style="text-align: center">7.50</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#hsgm">HSGM (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">41.8</td>
      <td style="text-align: center">25.1</td>
      <td style="text-align: center">7.43</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/Teacher-Tom/HSGM_public">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#mapnav">MapNav (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Onevision-7B</td>
      <td style="text-align: center">32.6</td>
      <td style="text-align: center">27.7</td>
      <td style="text-align: center">7.62</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/linglingxiansen/MapNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navid">NaVid (单目)</a></td>
      <td style="text-align: center">2024</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">23.8</td>
      <td style="text-align: center">21.2</td>
      <td style="text-align: center">8.41</td>
      <td style="text-align: center">34.5</td>
      <td style="text-align: center"><a href="https://github.com/jzhzhang/NaVid-VLN-CE">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vln-r1">VLN-R1 (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-VL-7B</td>
      <td style="text-align: center">22.7</td>
      <td style="text-align: center">17.6</td>
      <td style="text-align: center">9.1</td>
      <td style="text-align: center">30.4</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vln-r1">VLN-R1 (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-VL-2B</td>
      <td style="text-align: center">20.7</td>
      <td style="text-align: center">16.9</td>
      <td style="text-align: center">10.2</td>
      <td style="text-align: center">30.1</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#onevla-a-unified-framework-for-embodied-tasks">OneVLA (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">58.2</td>
      <td style="text-align: center"><a href="https://github.com/linglingxiansen/OneVLA">是</a></td>
    </tr>
  </tbody>
</table>

<p>注：StreamVLN 取 arXiv v2 数字（v1 为 52.9 / 46.0）；Dual-Anchoring 与 StreamVLN 基线（52.9%）对比来自 Dual-Anchoring 原文。 Qwen-RobotNav 两行均为 8B（单目下 8B 的 73.4 高于 4B 的 71.3）。</p>

<h2 id="-r2r--reverie">③ R2R · REVERIE</h2>

<p>离散导航图 · 全景观测；含 GSA-R2R 的住宅（ID）/ 非住宅（OOD）场景划分</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">基准</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">NE ↓</th>
      <th style="text-align: center">OSR ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#uncertainty-aware-gaussian-map">UAGM (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">R2R</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>78.3</strong></td>
      <td style="text-align: center"><strong>66</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#r3">R³ (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">R2R</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">GPT-4o</td>
      <td style="text-align: center">77</td>
      <td style="text-align: center"><strong>66</strong></td>
      <td style="text-align: center"><strong>2.76</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#ca-vln">CA-VLN (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">R2R</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-7B</td>
      <td style="text-align: center">73.3</td>
      <td style="text-align: center">62.0</td>
      <td style="text-align: center">3.03</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vln-imagine">VLN-Imagine (DUET) (全景)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">R2R</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">72.12</td>
      <td style="text-align: center">60.48</td>
      <td style="text-align: center">3.19</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/akhilperincherry/VLN-Imagine">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navgpt-2">NavGPT-2 (全景)</a></td>
      <td style="text-align: center">2024</td>
      <td style="text-align: center">R2R</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Vicuna-7B</td>
      <td style="text-align: center">71</td>
      <td style="text-align: center">60</td>
      <td style="text-align: center">3.18</td>
      <td style="text-align: center">80</td>
      <td style="text-align: center"><a href="https://github.com/GengzeZhou/NavGPT-2">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#duet">DUET (全景)</a></td>
      <td style="text-align: center">2022</td>
      <td style="text-align: center">R2R (Test-Unseen)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>69.0</strong></td>
      <td style="text-align: center"><strong>59.0</strong></td>
      <td style="text-align: center"><strong>3.65</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/cshizhe/VLN-DUET">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#r2r">R2R (全景)</a></td>
      <td style="text-align: center">2018</td>
      <td style="text-align: center">R2R (Test-Unseen)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">20.4</td>
      <td style="text-align: center">18.0</td>
      <td style="text-align: center">7.85</td>
      <td style="text-align: center">26.6</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#slow4fast-vln">Slow4fast-VLN (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">GSA-R2R (ID)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>70.8</strong></td>
      <td style="text-align: center"><strong>65.0</strong></td>
      <td style="text-align: center"><strong>2.9</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/yl6017339/Slow4Fast-VLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left">GR-DUET (全景)</td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">GSA-R2R (ID)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">69.3</td>
      <td style="text-align: center">64.3</td>
      <td style="text-align: center">3.1</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/honghd16/GSA-VLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#slow4fast-vln">Slow4fast-VLN (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">GSA-R2R (OOD)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>58.4</strong></td>
      <td style="text-align: center"><strong>52.9</strong></td>
      <td style="text-align: center"><strong>4.2</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/yl6017339/Slow4Fast-VLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left">GR-DUET (全景)</td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">GSA-R2R (OOD)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">56.6</td>
      <td style="text-align: center">51.5</td>
      <td style="text-align: center">4.4</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><a href="https://github.com/honghd16/GSA-VLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#ca-vln">CA-VLN (全景)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">REVERIE</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-7B</td>
      <td style="text-align: center">51.0</td>
      <td style="text-align: center">35.5</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">56.3</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#duet">DUET (全景)</a></td>
      <td style="text-align: center">2022</td>
      <td style="text-align: center">REVERIE (Test-Unseen)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">52.51</td>
      <td style="text-align: center">36.06</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">56.91</td>
      <td style="text-align: center"><a href="https://github.com/cshizhe/VLN-DUET">是</a></td>
    </tr>
  </tbody>
</table>

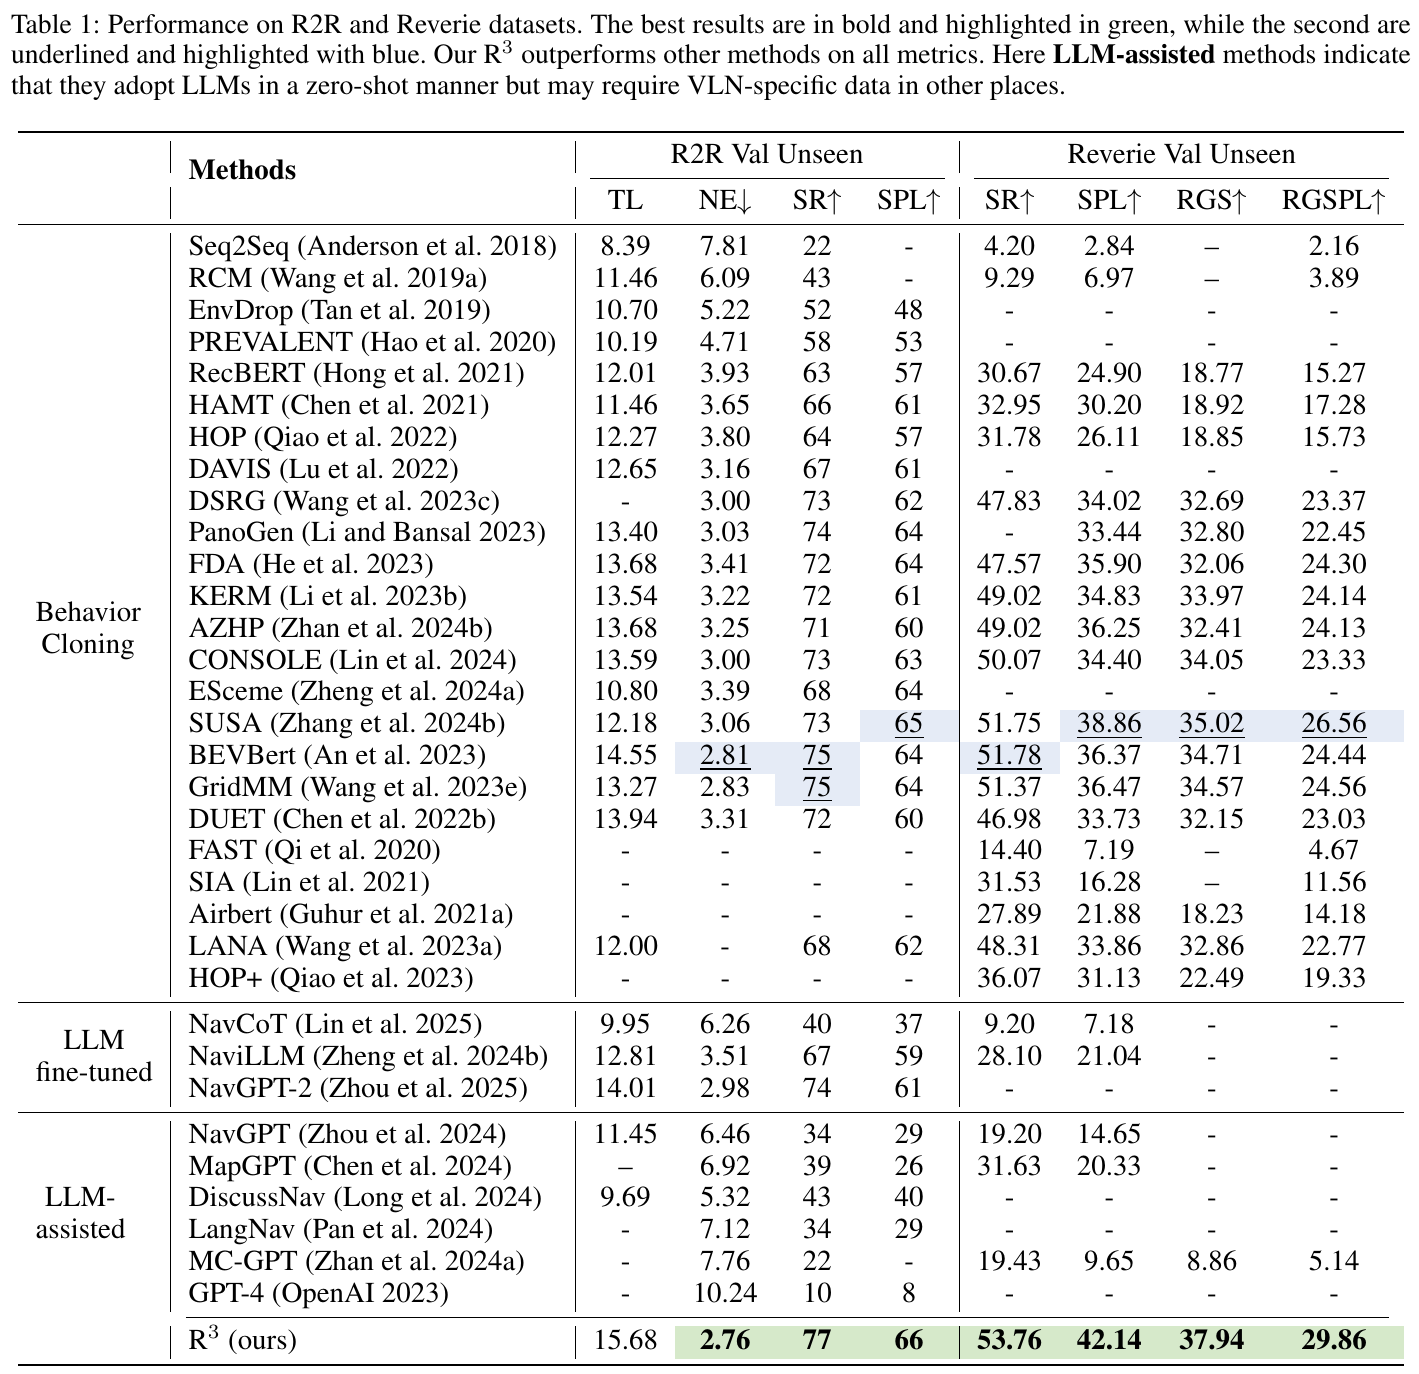
<p>注：VLN-Imagine 为 DUET-Imagine 的 R2R val-unseen 结果（DUET 基线 71.52 / 60.41）。GSA-R2R 区分住宅（ID，Test-R-Basic）与非住宅（OOD，Test-N-Basic）场景，Slow4fast-VLN 相对 GR-DUET 性能有所提升。REVERIE 基准另用 RGS / RGSPL 指标：R³ 为 53.76 / 42.14 / 37.94 / 29.86（SR/SPL/RGS/RGSPL），Uncertainty-Aware Gaussian Map 的 RGS / RGSPL 为 37.65 / 27.01。 连续环境版 REVERIE-CE 目前只有 Image2Nav（180° FOV）报告：SR 53.7 / SPL 42.7 / NE 5.08 / OSR 59.5（val-unseen），动作空间与离散 REVERIE 不同，不并入本表。</p>

<blockquote>
  <p><strong>说明</strong>：以下论文因评测于真实世界 / 自建或非标准基准（如 Open-Nav、SparseVideoNav、CausalNav、VL-Nav 等），或属运动控制 / 操作 / 生成等非导航指标任务（Skill-Nav、RoboClaw、ABot-Claw 等），或为依赖性基础工作，未列入本篇与扩展篇的排行榜。详见各自章节。</p>
</blockquote>

<h1 id="前列模型技术方案分析">前列模型技术方案分析</h1>

<h2 id="要素打勾矩阵">要素打勾矩阵</h2>

<p>为了清晰揭示 <strong>R2R-CE SR ≥ 60% 前列模型的技术 Recipe（解法组合）</strong>，下表对排行榜 ① 中 SR ≥ 60% 的全部 24 个条目（22 个模型，Qwen-RobotNav 的全景 / 单目配置与 GPT-6-Astra 的 ultra / medium 推理强度各分两行）逐篇核对原文后打勾（✓）。</p>

<p><strong>打勾口径</strong>：按取得该 R2R-CE 成绩的那套配置判定，论文未披露的一律记为 –。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">要素</th>
      <th style="text-align: left">判定标准</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">堆数据</td>
      <td style="text-align: left">训练样本 / 轨迹 ≥ 1M（含与导航数据联合训练的通用视觉语言数据）</td>
    </tr>
    <tr>
      <td style="text-align: left">堆相机</td>
      <td style="text-align: left">每步输入多目或全景（含 180° 超广角）；单目 RGB / RGB-D 不计</td>
    </tr>
    <tr>
      <td style="text-align: left">快慢双系统</td>
      <td style="text-align: left">高层 VLM 只给子目标（像素 / 航点 / 前沿点），由独立的低层策略或几何规划器以更高频率闭环执行</td>
    </tr>
    <tr>
      <td style="text-align: left">Agentic</td>
      <td style="text-align: left">VLM / MLLM 作为调度中枢调用建图、感知、规划等外部工具或技能模块，而非端到端直接出动作</td>
    </tr>
    <tr>
      <td style="text-align: left">像素 Grounding</td>
      <td style="text-align: left">导航目标以图像坐标或图像区域给出，再经深度反投影或低层策略落地</td>
    </tr>
    <tr>
      <td style="text-align: left">连续动作头</td>
      <td style="text-align: left">用回归头、扩散或流匹配直接输出连续航点 / 控制量，而非离散文本动作</td>
    </tr>
    <tr>
      <td style="text-align: left">强化学习</td>
      <td style="text-align: left">SFT 之后有 GRPO / CISPO 等在线或离线 RL 后训练</td>
    </tr>
    <tr>
      <td style="text-align: left">DAgger / 纠偏数据</td>
      <td style="text-align: left">用策略自身 rollout 采集纠偏样本（DAgger、自纠错飞轮、失败反思数据）</td>
    </tr>
    <tr>
      <td style="text-align: left">上下文压缩</td>
      <td style="text-align: left">显式的历史 Token 压缩、KV 复用或前缀共享（含训练期）</td>
    </tr>
    <tr>
      <td style="text-align: left">开源</td>
      <td style="text-align: left">代码或权重已公开</td>
    </tr>
  </tbody>
</table>

<table>
  <thead>
    <tr>
      <th style="text-align: center">排名</th>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">R2R-CE SR ↑</th>
      <th style="text-align: center">堆数据 (≥1M)</th>
      <th style="text-align: center">堆相机 (多目/全景)</th>
      <th style="text-align: center">快慢双系统</th>
      <th style="text-align: center">Agentic</th>
      <th style="text-align: center">像素 Grounding</th>
      <th style="text-align: center">连续动作头 (回归/扩散/流匹配)</th>
      <th style="text-align: center">强化学习 (GRPO/CISPO)</th>
      <th style="text-align: center">DAgger / 纠偏数据</th>
      <th style="text-align: center">上下文压缩 (KV/Token/前缀)</th>
      <th style="text-align: center">开源代码 / 权重</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">1</td>
      <td style="text-align: left"><a href="#gpt-6-astra"><strong>GPT-6-Astra</strong></a> (单目 · ultra)</td>
      <td style="text-align: center"><strong>79.0%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">2</td>
      <td style="text-align: left"><a href="#robostral-navigate"><strong>Robostral Navigate</strong></a> (单目)</td>
      <td style="text-align: center"><strong>77.4%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">3</td>
      <td style="text-align: left"><a href="#gpt-6-astra"><strong>GPT-6-Astra</strong></a> (单目 · medium)</td>
      <td style="text-align: center"><strong>76.0%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">4</td>
      <td style="text-align: left"><a href="#qwen-robotnav"><strong>Qwen-RobotNav</strong></a> (全景)</td>
      <td style="text-align: center"><strong>72.1%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">5</td>
      <td style="text-align: left"><a href="#abot-n1"><strong>ABot-N1</strong></a> (三相机)</td>
      <td style="text-align: center"><strong>70.9%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">6</td>
      <td style="text-align: left"><a href="#image2sim"><strong>Image2Nav</strong></a> (180° FOV)</td>
      <td style="text-align: center"><strong>70.3%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">7</td>
      <td style="text-align: left"><a href="#groundingvln"><strong>GroundingVLN</strong></a> (三相机)</td>
      <td style="text-align: center"><strong>69.9%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">8</td>
      <td style="text-align: left"><a href="#omninav"><strong>OmniNav</strong></a> (多目)</td>
      <td style="text-align: center"><strong>69.5%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">9</td>
      <td style="text-align: left"><a href="#lightnav-0"><strong>LightNav-0</strong></a> (单目)</td>
      <td style="text-align: center"><strong>68.5%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">10</td>
      <td style="text-align: left"><a href="#astranav-world"><strong>AstraNav-World</strong></a> (多目)</td>
      <td style="text-align: center"><strong>67.9%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">11</td>
      <td style="text-align: left"><a href="#sedualvln"><strong>SEDualVLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>67.3%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">12</td>
      <td style="text-align: left"><a href="#agentvln"><strong>AgentVLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>67.2%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">13</td>
      <td style="text-align: left"><a href="#qwen-robotnav"><strong>Qwen-RobotNav</strong></a> (单目)</td>
      <td style="text-align: center"><strong>66.9%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">14</td>
      <td style="text-align: left"><a href="#tamp-nav"><strong>TAMP-Nav</strong></a> (多目)</td>
      <td style="text-align: center"><strong>66.2%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">15</td>
      <td style="text-align: left"><a href="#dual-anchoring"><strong>Dual-Anchoring</strong></a> (单目)</td>
      <td style="text-align: center"><strong>65.6%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">16</td>
      <td style="text-align: left"><a href="#awarevln"><strong>AwareVLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>65.4%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">17</td>
      <td style="text-align: left"><a href="#correctnav"><strong>CorrectNav</strong></a> (单目)</td>
      <td style="text-align: center"><strong>65.1%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">18</td>
      <td style="text-align: left"><a href="#dualvln"><strong>DualVLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>64.3%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">19</td>
      <td style="text-align: left"><a href="#vln-cache"><strong>VLN-Cache</strong></a> (单目)</td>
      <td style="text-align: center"><strong>63.1%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">20</td>
      <td style="text-align: left"><a href="#reflectvln"><strong>ReflectVLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>62.8%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">21</td>
      <td style="text-align: left"><a href="#navfom"><strong>NavFoM</strong></a> (多目)</td>
      <td style="text-align: center"><strong>61.7%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">22</td>
      <td style="text-align: left"><a href="#ga-vln"><strong>GA-VLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>61.0%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center">23</td>
      <td style="text-align: left"><a href="#harnessvln"><strong>HarnessVLN</strong></a> (单目 RGB-D)</td>
      <td style="text-align: center"><strong>60.8%</strong></td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
    </tr>
    <tr>
      <td style="text-align: center">24</td>
      <td style="text-align: left"><a href="#janusvln"><strong>JanusVLN</strong></a> (单目)</td>
      <td style="text-align: center"><strong>60.5%</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>统计</strong></td>
      <td style="text-align: left"><strong>各要素采纳频次</strong></td>
      <td style="text-align: center"><strong>最高 79.0%</strong></td>
      <td style="text-align: center"><strong>14/24 (58%)</strong></td>
      <td style="text-align: center"><strong>8/24 (33%)</strong></td>
      <td style="text-align: center"><strong>10/24 (42%)</strong></td>
      <td style="text-align: center"><strong>3/24 (12%)</strong></td>
      <td style="text-align: center"><strong>9/24 (38%)</strong></td>
      <td style="text-align: center"><strong>10/24 (42%)</strong></td>
      <td style="text-align: center"><strong>5/24 (21%)</strong></td>
      <td style="text-align: center"><strong>11/24 (46%)</strong></td>
      <td style="text-align: center"><strong>15/24 (62%)</strong></td>
      <td style="text-align: center"><strong>11/24 (46%)</strong></td>
    </tr>
  </tbody>
</table>

<p>注：VLN-Cache 是套在 DualVLN 上的免训练 Token 缓存层，其余要素随 DualVLN 继承；OmniNav 的 R2R / RxR 评测只走快系统（VLM + 航点回归头），慢系统的前沿探索只用于 OVON，故双系统记 –；Qwen-RobotNav 与上层规划 Agent 的协作只用于 EQA 等长程任务，R2R-CE 成绩来自模型本体；Dual-Anchoring 与 SEDualVLN 的系统 1 均以 StreamVLN 为骨干，继承其滑动窗口 KV 与体素剪枝；HarnessVLN 是表中唯一在全量 val-unseen 上评测的免训练方法（另一个免训练条目 GPT-6-Astra 只跑了 R2R-CE-100），其像素 Grounding 指 <code class="language-plaintext highlighter-rouge">ground_target</code> 工具把子目标落到图像区域后再查深度。ABot-N1 的 30M 预训练样本与 DAgger rollout、Image2Nav 的离散动作输出与在线 DAgger，均依据各自 arXiv 原文补充。GPT-6-Astra 两行是同一闭源模型在 ultra / medium 两档推理强度下的 R2R-CE-100 成绩（100 条子集、每档单次运行），不做任何导航微调；它的 <code class="language-plaintext highlighter-rouge">observe()</code> / <code class="language-plaintext highlighter-rouge">step()</code> 只是原始观测与原语动作接口，不调用建图、感知或规划工具，故 Agentic 记 –；训练数据未披露，堆数据、强化学习等列也记 –。</p>

<h2 id="统计研判">统计研判</h2>

<p>以 68% 为界把 24 个条目分成两档，比较各要素的采纳率：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">要素</th>
      <th style="text-align: center">第一梯队（SR ≥ 68%，9 个）</th>
      <th style="text-align: center">第二梯队（60%–68%，15 个）</th>
      <th style="text-align: center">合计（24 个）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">堆数据</td>
      <td style="text-align: center">6/9 (67%)</td>
      <td style="text-align: center">8/15 (53%)</td>
      <td style="text-align: center">14/24 (58%)</td>
    </tr>
    <tr>
      <td style="text-align: left">堆相机</td>
      <td style="text-align: center">5/9 (56%)</td>
      <td style="text-align: center">3/15 (20%)</td>
      <td style="text-align: center">8/24 (33%)</td>
    </tr>
    <tr>
      <td style="text-align: left">快慢双系统</td>
      <td style="text-align: center">3/9 (33%)</td>
      <td style="text-align: center">7/15 (47%)</td>
      <td style="text-align: center">10/24 (42%)</td>
    </tr>
    <tr>
      <td style="text-align: left">Agentic</td>
      <td style="text-align: center">0/9 (0%)</td>
      <td style="text-align: center">3/15 (20%)</td>
      <td style="text-align: center">3/24 (12%)</td>
    </tr>
    <tr>
      <td style="text-align: left">像素 Grounding</td>
      <td style="text-align: center">4/9 (44%)</td>
      <td style="text-align: center">5/15 (33%)</td>
      <td style="text-align: center">9/24 (38%)</td>
    </tr>
    <tr>
      <td style="text-align: left">连续动作头</td>
      <td style="text-align: center">4/9 (44%)</td>
      <td style="text-align: center">6/15 (40%)</td>
      <td style="text-align: center">10/24 (42%)</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>强化学习</strong></td>
      <td style="text-align: center"><strong>4/9 (44%)</strong></td>
      <td style="text-align: center"><strong>1/15 (7%)</strong></td>
      <td style="text-align: center">5/24 (21%)</td>
    </tr>
    <tr>
      <td style="text-align: left">DAgger / 纠偏数据</td>
      <td style="text-align: center">3/9 (33%)</td>
      <td style="text-align: center">8/15 (53%)</td>
      <td style="text-align: center">11/24 (46%)</td>
    </tr>
    <tr>
      <td style="text-align: left">上下文压缩</td>
      <td style="text-align: center">5/9 (56%)</td>
      <td style="text-align: center">10/15 (67%)</td>
      <td style="text-align: center">15/24 (62%)</td>
    </tr>
    <tr>
      <td style="text-align: left">开源</td>
      <td style="text-align: center">3/9 (33%)</td>
      <td style="text-align: center">8/15 (53%)</td>
      <td style="text-align: center">11/24 (46%)</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p>以下是前列模型内部的采纳率对比，只能说明相关性；某个要素能带来多少增益，要以各论文的消融为准。</p>
</blockquote>

<ol>
  <li><strong>先说特例：GPT-6-Astra 十列全空，却排在最前（须按子集口径看）</strong>：
    <ul>
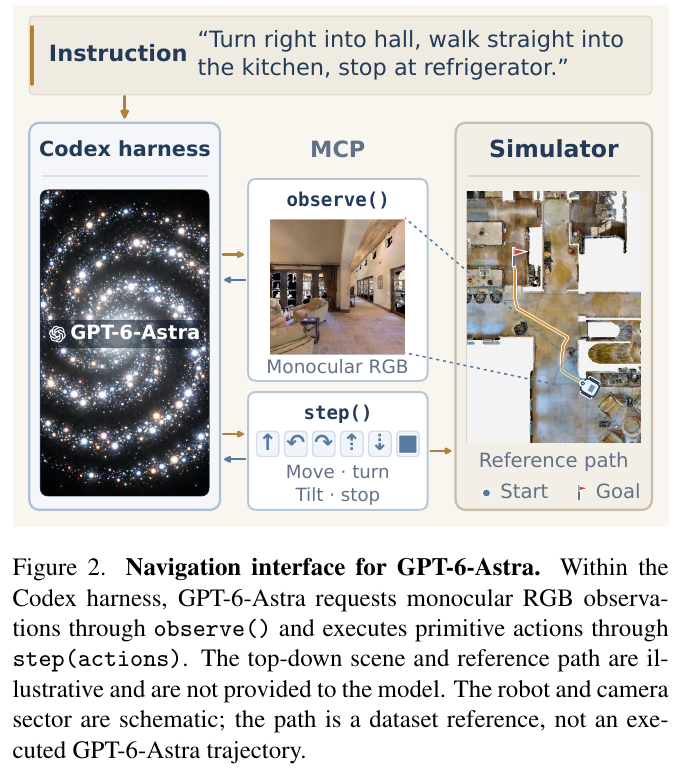
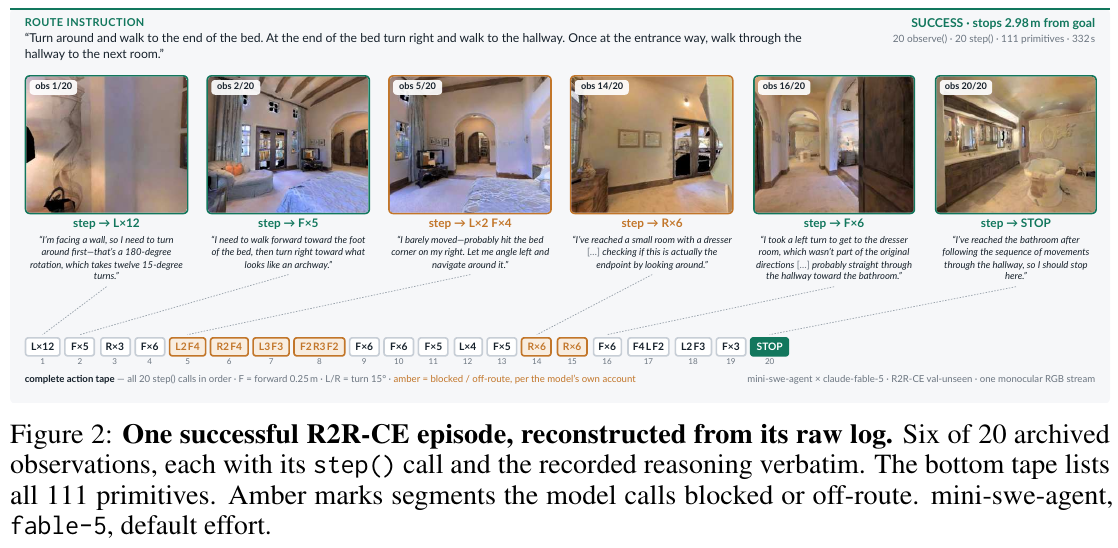
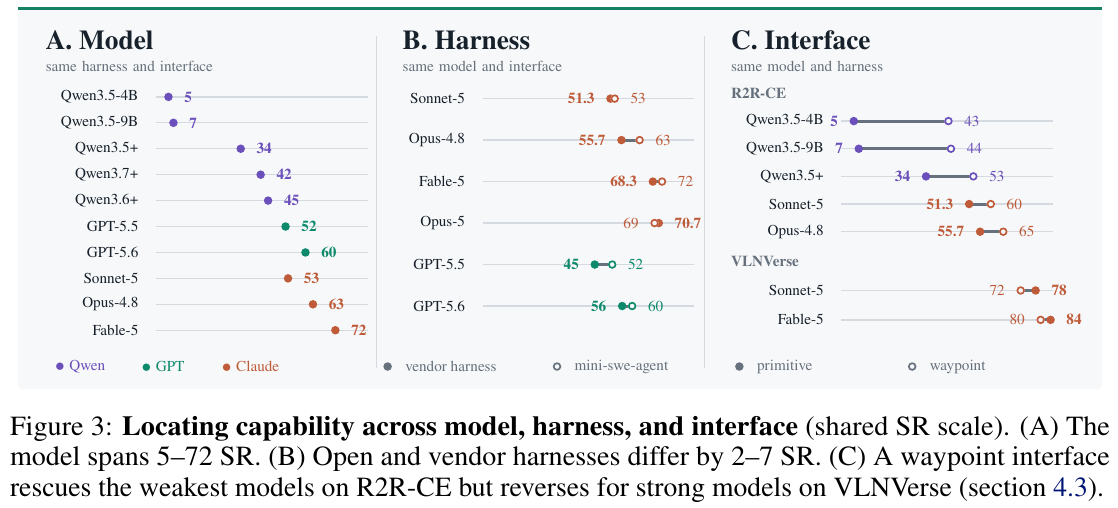
      <li>GPT-6-Astra 的两档推理强度分别以 79.0% 与 76.0% 进入第一梯队，但矩阵的十个要素它一个都没有：单目 RGB、原语离散动作、不做任何导航微调，也不调用建图、感知或规划工具，模型闭源、训练数据未披露。</li>
      <li>这说明矩阵刻画的是”训练一个导航模型”的 Recipe，足够强的通用基础模型本身可能已覆盖其中不少作用。但它的成绩来自 R2R-CE-100（100 条、单次运行，1 条即 1 个百分点，标准误约 4 个点），与其他条目的全量 val-unseen 不同口径，领先 Robostral 的 1.6 个点谈不上排名意义。</li>
      <li>下文比例都把这两行算在内；结论只针对训练式模型时，同时给出第一梯队 7 个训练式条目的比例。</li>
    </ul>
  </li>
  <li><strong>强化学习是两档之间最清晰的分界线（44% vs 7%；只算训练式条目为 57% vs 7%）</strong>：
    <ul>
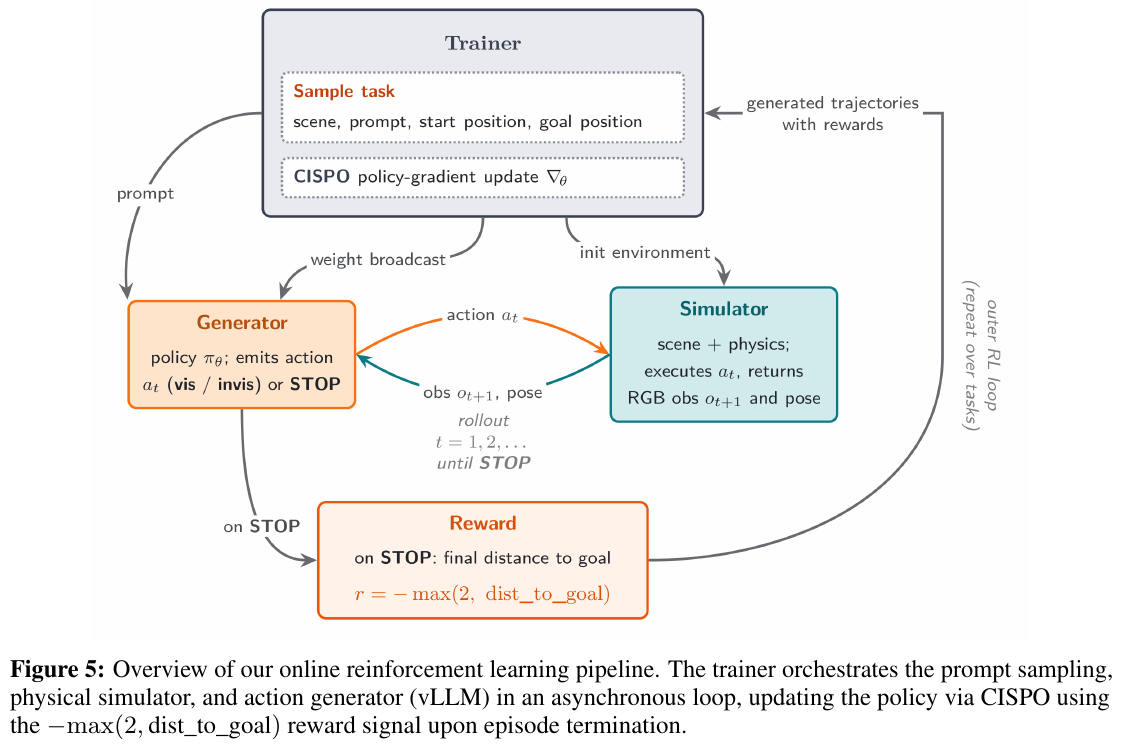
      <li>第一梯队 9 个里有 4 个做了 RL 后训练——Robostral (77.4%) 的 CISPO 在线 RL、ABot-N1 (70.9%) 带安全净空惩罚的 GRPO、GroundingVLN (69.9%) 的执行感知 GRPO（GEAR）、LightNav-0 (68.5%) 基于 RVQ 动作 Token 的 GRPO；没做 RL 的 5 个里有 2 个是不做导航训练的 GPT-6-Astra。第二梯队 15 个里只有 TAMP-Nav (66.2%) 一个。</li>
      <li>消融给出了因果证据：GroundingVLN 去掉 GEAR，SR 从 69.9% 掉到 57.2%；把执行感知奖励图换成朴素 2D 像素距离也会掉到 66.2%。</li>
      <li>这些奖励几乎都是<strong>几何量</strong>：像素 L2 距离与安全净空（ABot-N1）、横向偏离 / 路线进度差 / 执行端点误差（GroundingVLN）、截断目标距离（Robostral）。能这样设计奖励，前提是模型输出本身可度量，这正好引出下一条。</li>
    </ul>
  </li>
  <li><strong>训练式模型的输出接口从离散文本动作转向可度量的空间目标</strong>：
    <ul>
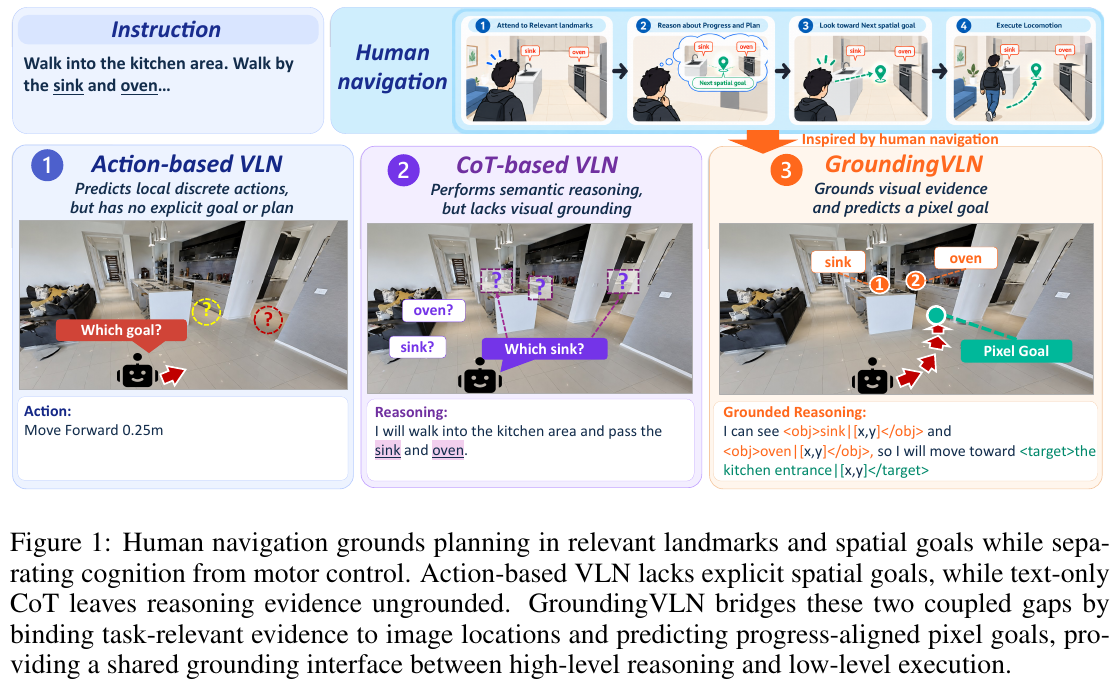
      <li>第一梯队 7 个训练式条目里有 6 个输出像素目标（Robostral、ABot-N1、GroundingVLN、LightNav-0）或连续航点（Qwen-RobotNav、OmniNav），唯一的离散动作模型 Image2Nav 靠的是 10M 合成轨迹加 180° 视场。第一梯队另外两个离散动作条目是 GPT-6-Astra，它直接输出 0.25 m / 15° 的原语动作，靠的是基础模型本身而不是导航训练。</li>
      <li>第二梯队这一比例降到 9/15：其余 6 个都是离散动作模型（SEDualVLN、Dual-Anchoring、AwareVLN、CorrectNav、GA-VLN、JanusVLN），最高的 SEDualVLN 为 67.3%，没有一个进入第一梯队。</li>
      <li>像素目标与 RL 经常同时出现：可度量的接口让奖励从”动作对 / 错”升级为”离目标差多少米”。</li>
    </ul>
  </li>
  <li><strong>堆数据是训练式模型高分的常见条件，但不是必要条件</strong>：
    <ul>
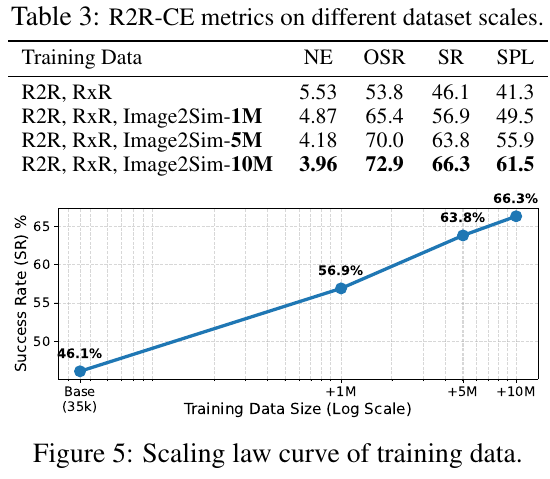
      <li>第一梯队 7 个训练式条目中有 6 个用了 ≥ 1M 样本（算上训练数据未披露、记为 – 的 GPT-6-Astra 两行为 6/9）：ABot-N1 30M、Qwen-RobotNav 15.6M、Image2Nav 10M、OmniNav 9.2M、Robostral 2.4M、LightNav-0 4K+ 小时仿真数据。Image2Sim 的 Scaling 曲线也显示 35K → 10M 时 SR 从 46.1% 升到 66.3%，仍未饱和。</li>
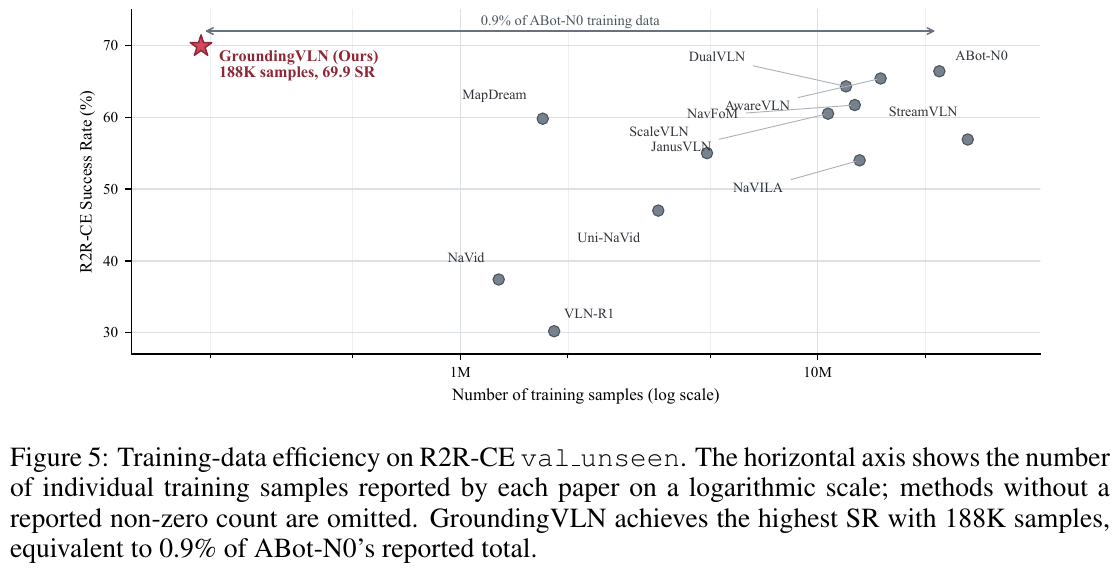
      <li>新进前列的 GroundingVLN 是反例：只用 188K 样本（约为 ABot-N0 的 0.9%）拿到 69.9%，只用 R2R 训练直接迁移到 RxR-CE 仍有 59.9%；TAMP-Nav 也仅凭 90K 合成轨迹冷启动加两级 GRPO 达到 66.2%。时序对齐的 grounding 监督加执行感知奖励，能替代相当一部分数据量。</li>
    </ul>
  </li>
  <li><strong>多相机有稳定增益，但单目照样能登顶</strong>：
    <ul>
      <li>两组同模型对照给出了增量：Qwen-RobotNav-8B 全景 72.1% vs 单目 65.7%（+6.4；4B 为 69.5% vs 66.9%，+2.6），NavFoM 四视角 61.7% vs 单视角 56.2%（+5.5）。矩阵里 Qwen-RobotNav 的两行取各自设定下的最好成绩，全景行是 8B、单目行是 4B，两行相减不是同模型增量。第一梯队中 5/9 使用多目或全景（训练式条目 5/7），第二梯队只有 3/15。</li>
      <li>但 SR 最高的两个条目都只用单目 RGB：GPT-6-Astra ultra（79.0%，R2R-CE-100）与 Robostral（77.4%，全量 val-unseen），LightNav-0 单目也有 68.5%——视野上的缺口可以用更好的训练与输出接口，或更强的基础模型补回来。</li>
    </ul>
  </li>
  <li><strong>快慢双系统与 Agentic 不决定 SR 档位</strong>：
    <ul>
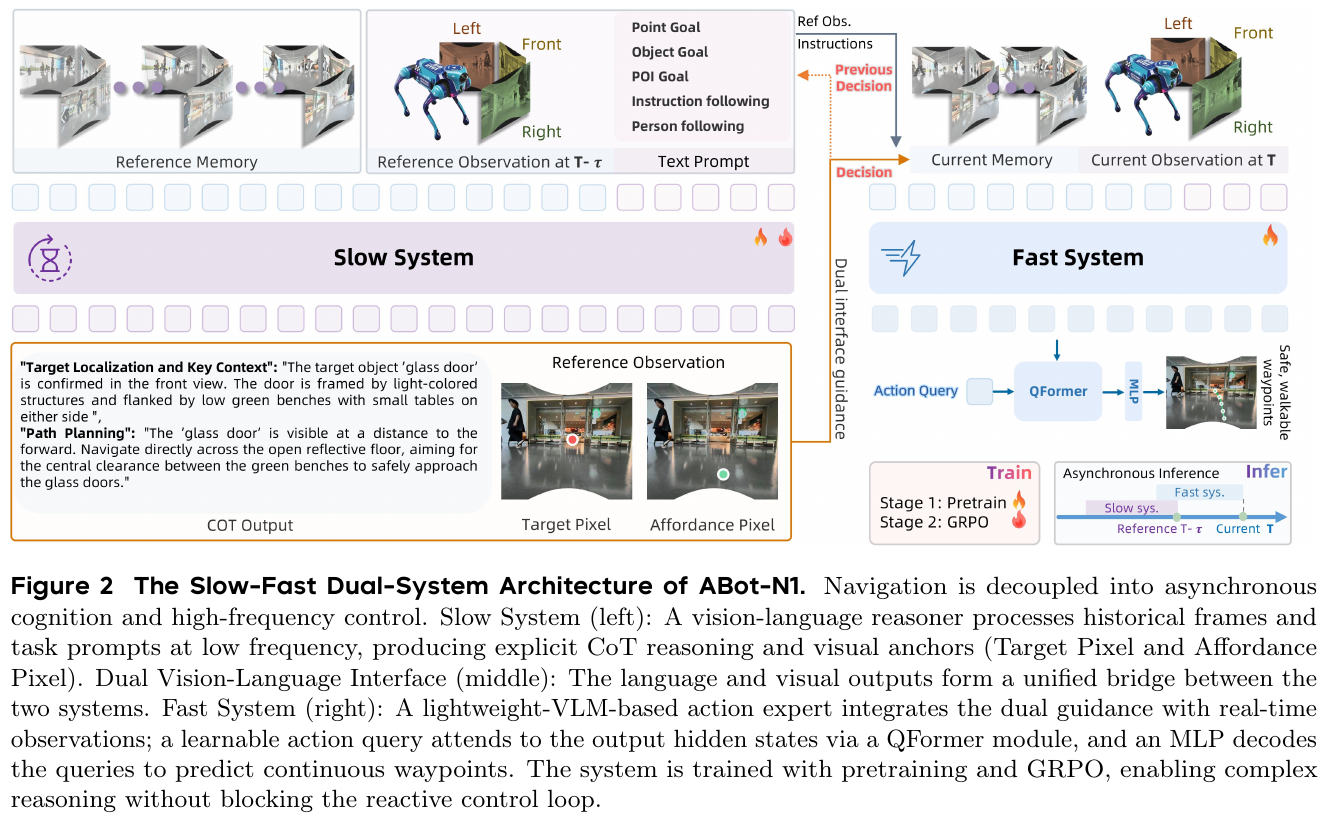
      <li>快慢双系统并不偏向高分档：第一梯队 3/9（33%；训练式条目 3/7，即 43%），第二梯队 7/15（47%）。它更多服务于部署时延，而不是 SR 本身：ABot-N1 慢系统异步决策、快系统 10Hz 控制；GroundingVLN 只在约 33% 的决策步调用 VLM，其余交给 A* 规划器。</li>
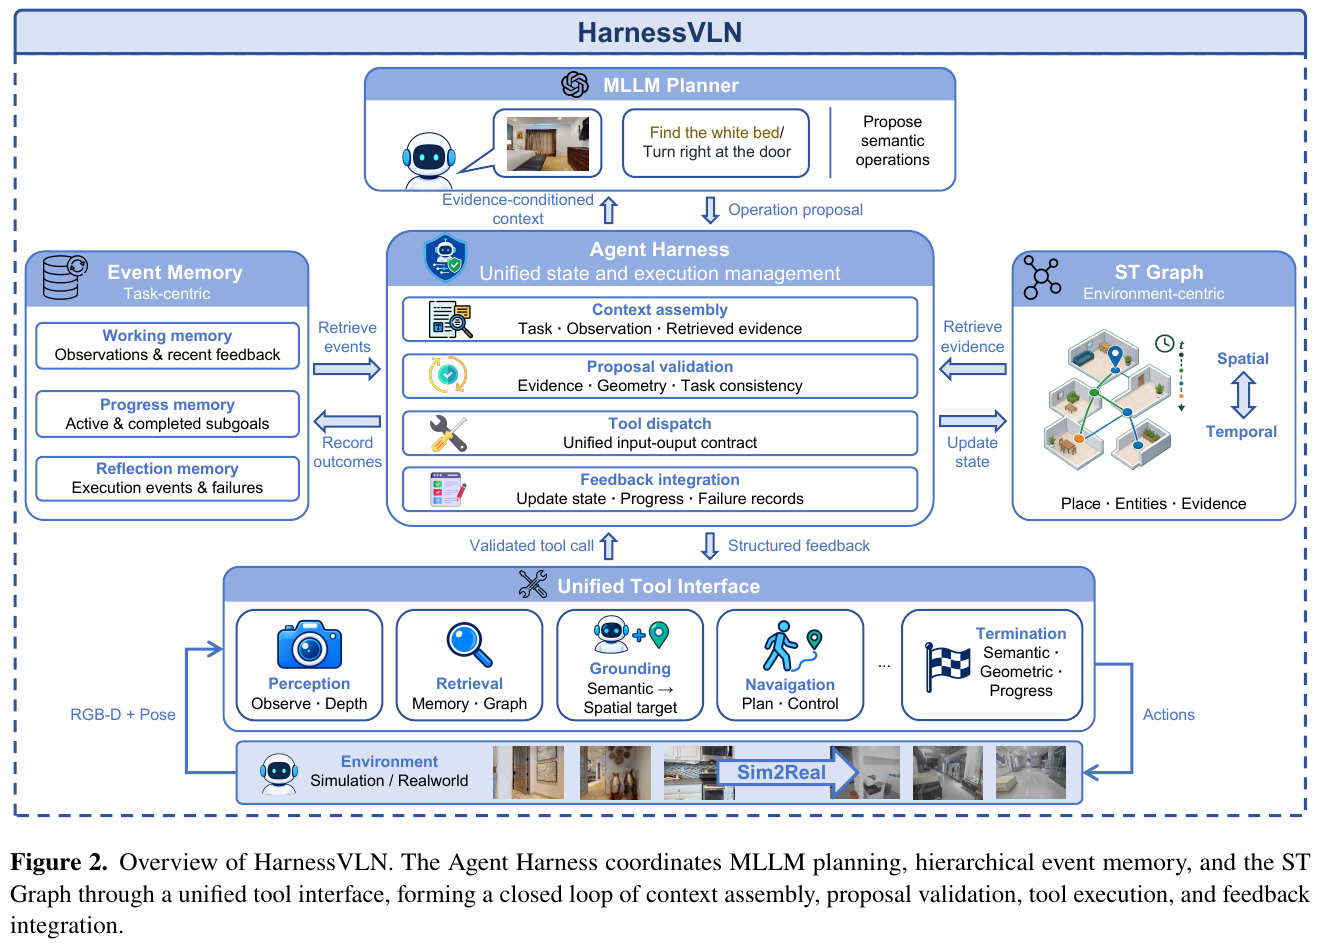
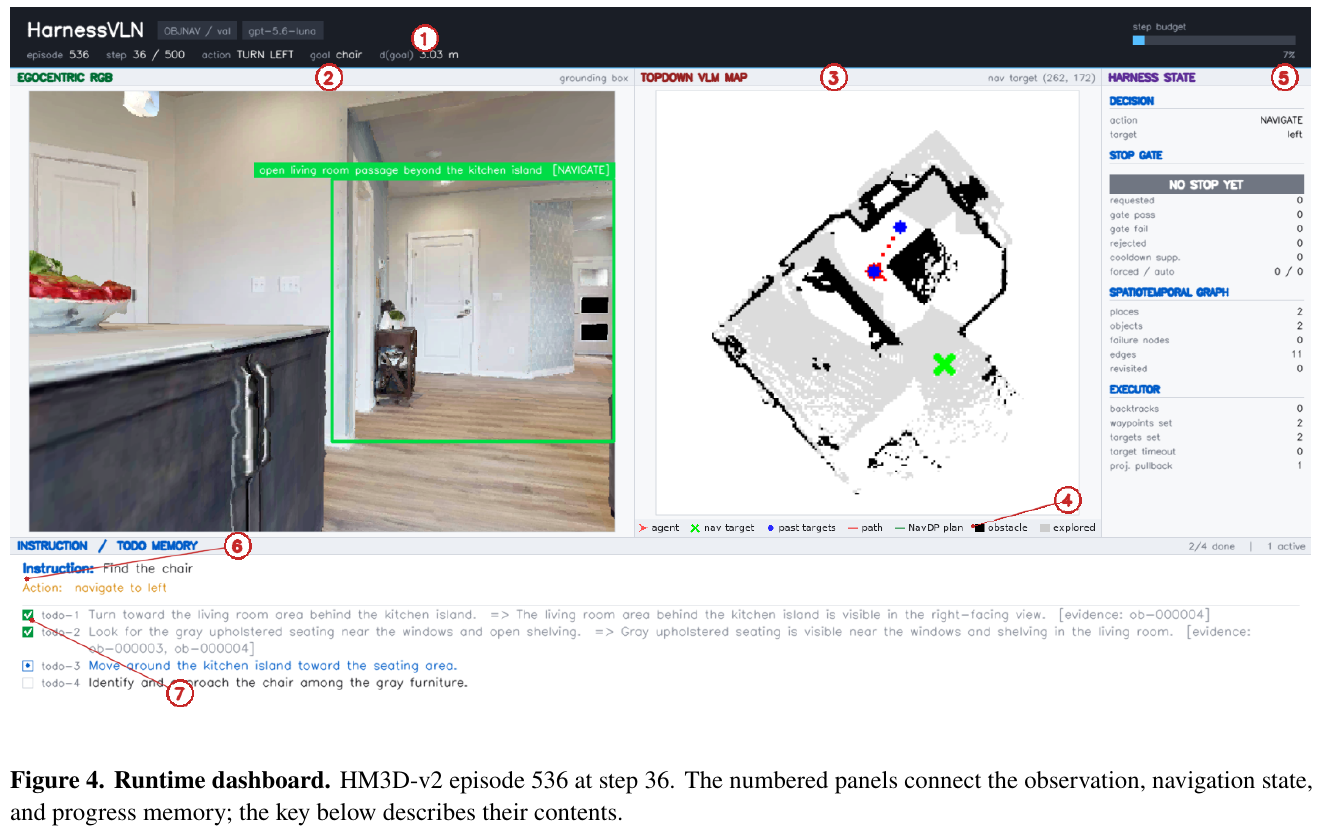
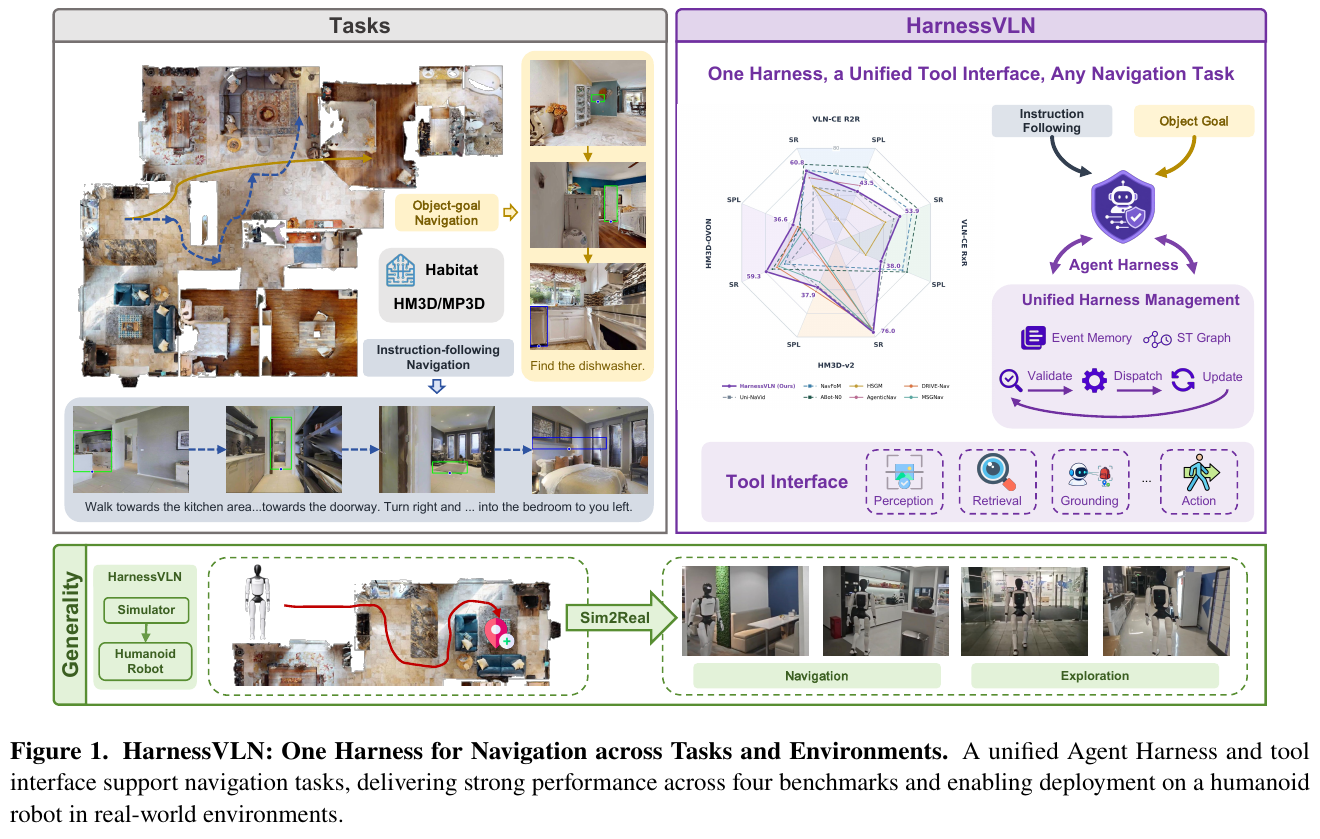
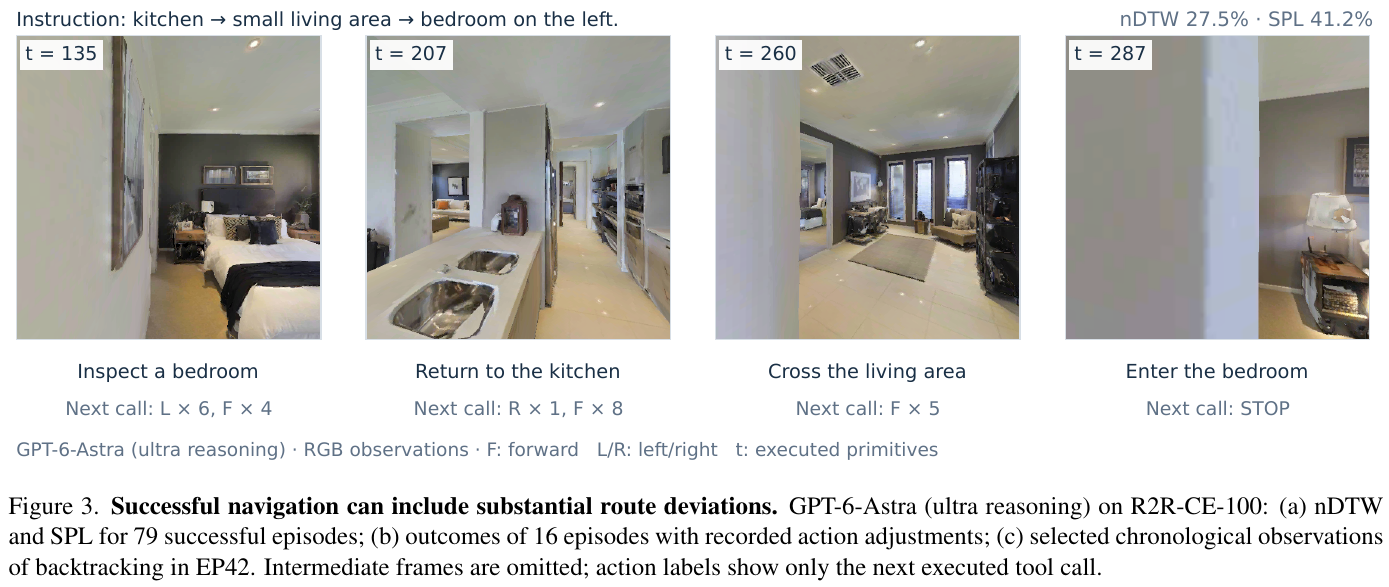
      <li>Agentic 只有 3/24，且都在第二梯队。HarnessVLN 用 GPT-5.5 加一层”派发前校验”的 Harness，以训练无关方式跨过 60%（SR 60.8%），但 SPL 只有 43.5，比同一 SR 段的训练式模型（NavFoM 55.3、GA-VLN 55.2、JanusVLN 56.8）低 11–13 个点。同为训练无关的 GPT-6-Astra 只有”看”和”动”两个工具，在 R2R-CE-100 上的 SPL 却有 69.5，仅次于 Robostral（74.2）——训练无关路线的路径效率短板，看来更多取决于基座模型，而不是外围工具链的多少（两者基座与评测集都不同，只作参考）。</li>
    </ul>
  </li>
  <li><strong>DAgger 与上下文压缩已成为入场标配，不再拉开档位</strong>：
    <ul>
      <li>DAgger / 纠偏数据（46%）与上下文压缩（62%）在两档中都很普遍，第二梯队的 DAgger 采纳率（53%）甚至高于第一梯队（33%；训练式条目为 43%）。</li>
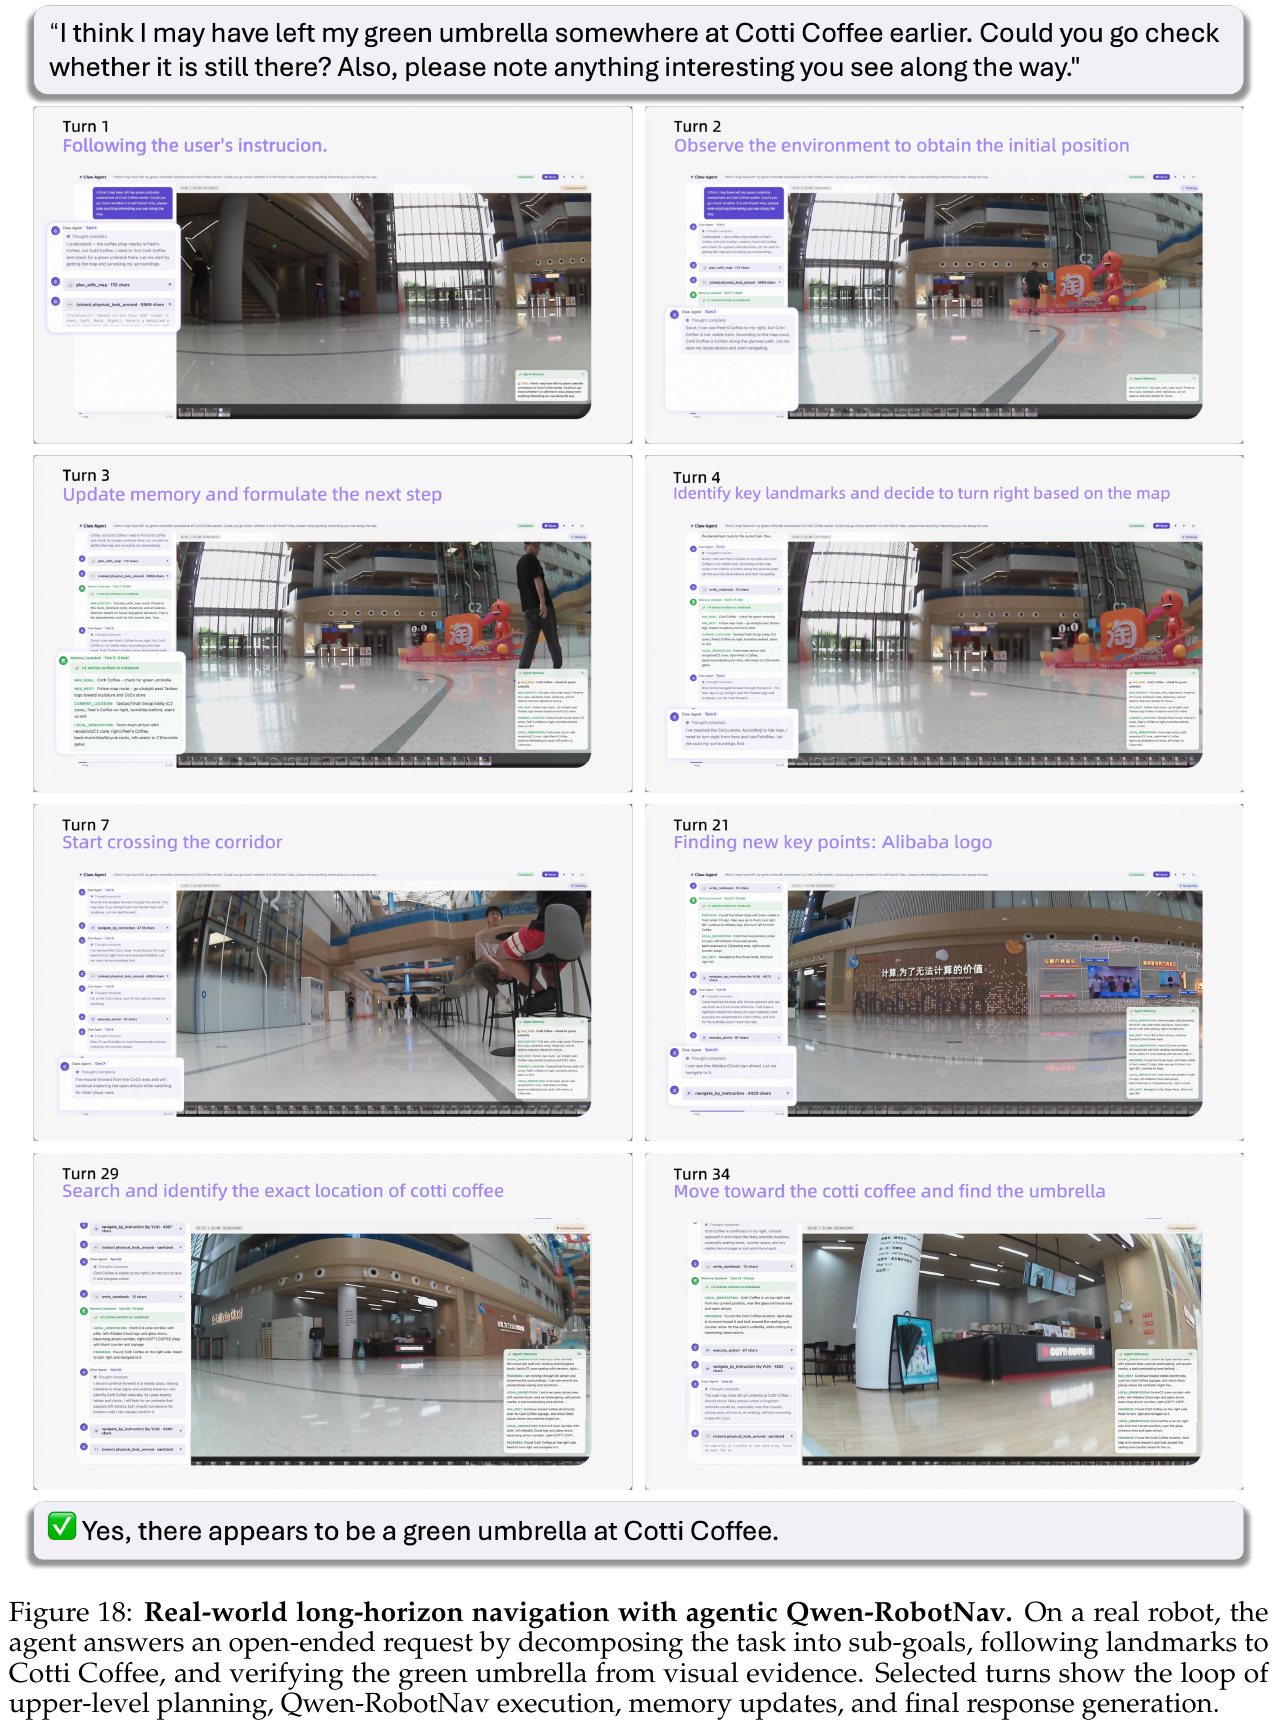
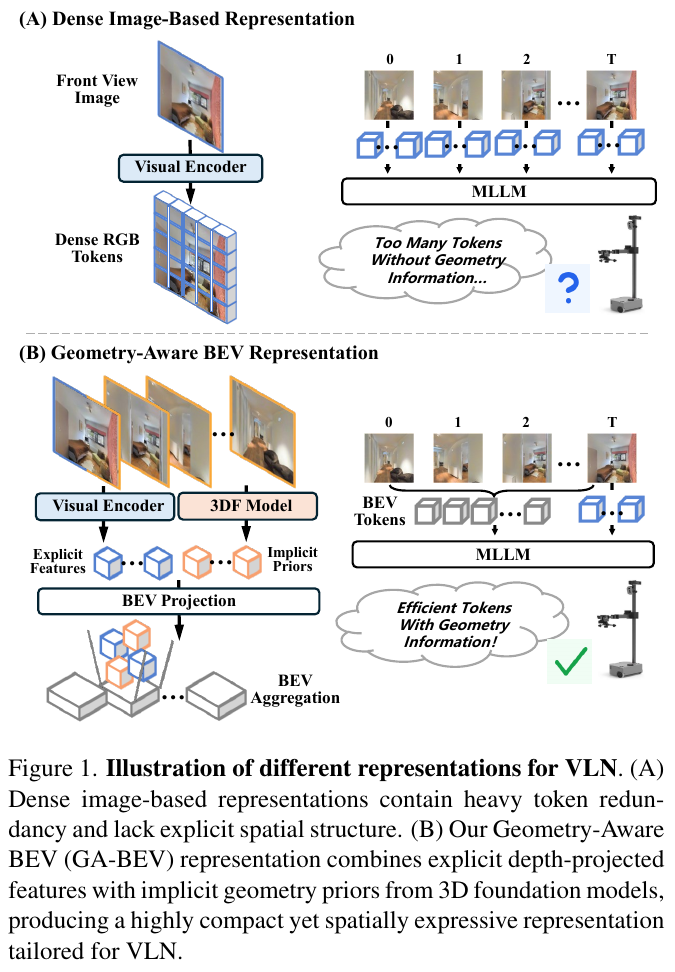
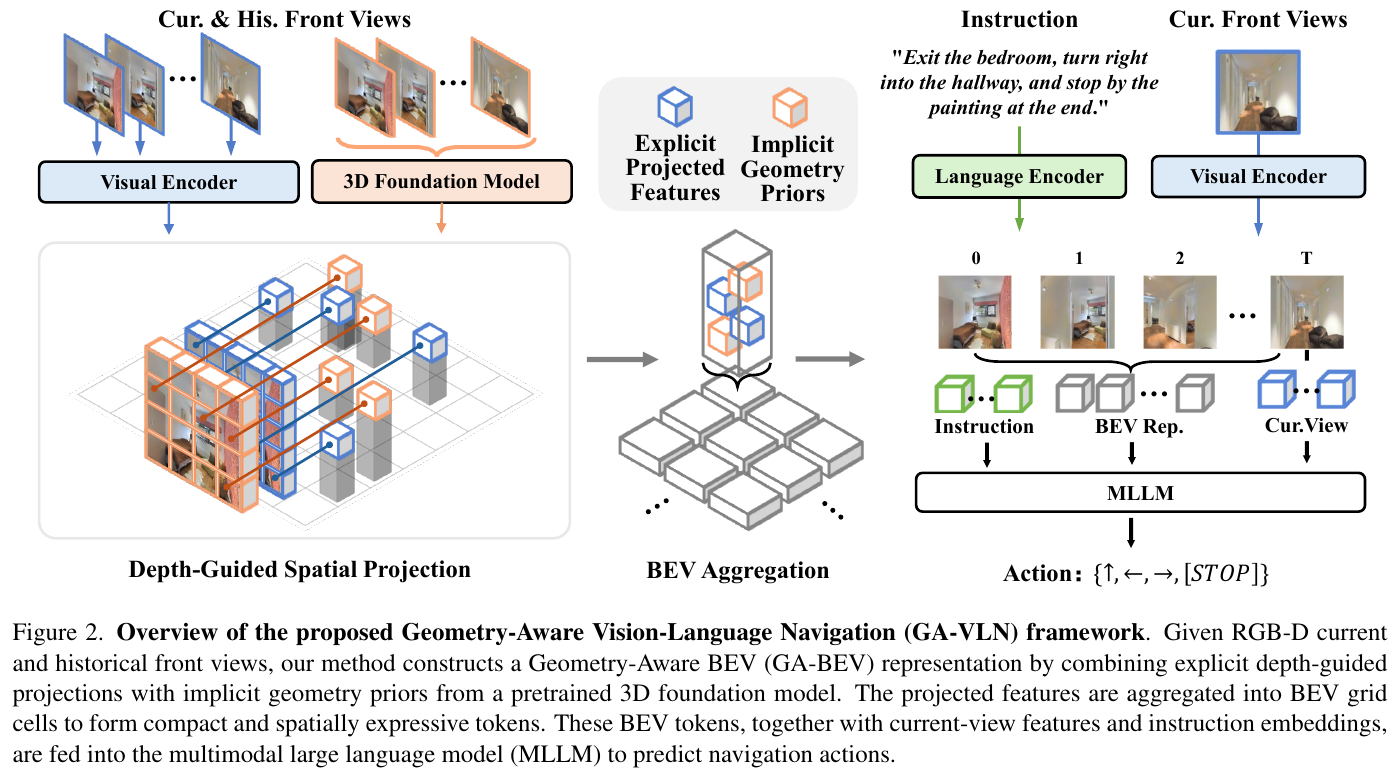
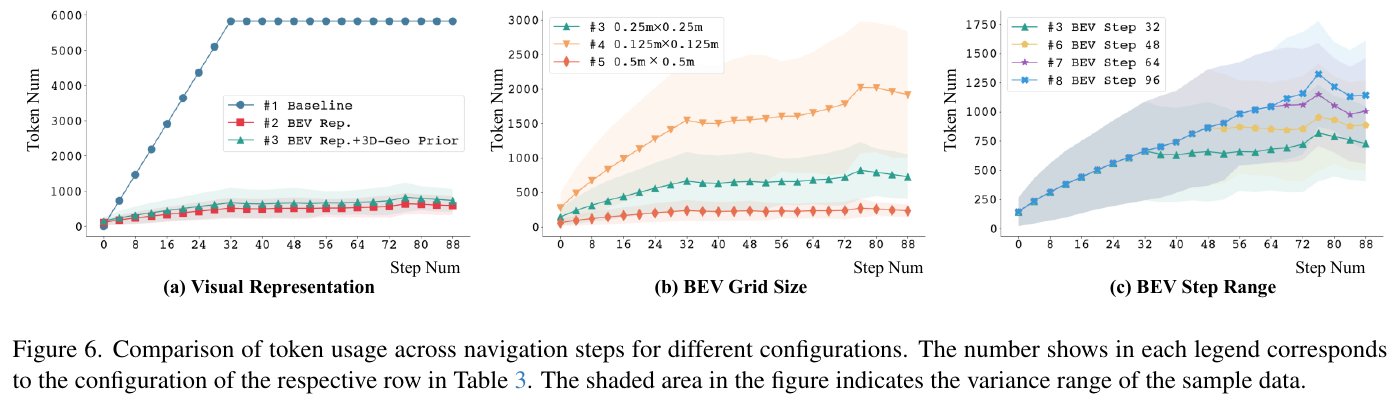
      <li>上下文压缩的具体形式正在分化：JanusVLN 的初始窗口加滑动窗口 KV、GA-VLN 的 BEV 网格池化（每步约 4000 → 514 Token）、TAMP-Nav 的关键帧锚点加定长 STI Token、LightNav-0 的慢快历史压缩、NavFoM 按遗忘曲线采样历史帧，以及 HarnessVLN 的有界工作记忆加图检索 top-K。</li>
    </ul>
  </li>
  <li><strong>第一梯队多数未开源，可复现的前列基线在 68%–70% 一带</strong>：
    <ul>
      <li>开源率第一梯队反而低于第二梯队（3/9 vs 8/15）：Robostral (77.4%)、Qwen-RobotNav (72.1%)、ABot-N1 (70.9%)、GroundingVLN (69.9%) 截至 2026 年 9 月都没有公开模型代码或权重，ABot-N1 只开源了评测基准；GPT-6-Astra 本身是闭源通用模型。</li>
      <li>想在开源代码上复现或做对比，目前最高的起点是 Image2Nav (70.3%)、OmniNav (69.5%) 与 LightNav-0 (68.5%)。</li>
    </ul>
  </li>
</ol>

<p><strong>小结</strong>：从这 24 个条目看，训练式模型冲进 68%+ 的共性是”可度量的输出接口（像素目标 / 连续航点）+ 基于几何量的 RL 后训练”，数据规模与多相机是放大器；快慢双系统、DAgger 与上下文压缩更像是工程上的入场条件。GPT-6-Astra 则在不采用任何上述要素的情况下，在 R2R-CE-100 子集上拿到了最高的 SR——全量 val-unseen 上的同条件结果出来之前，它更适合被读作”通用基础模型的导航能力已逼近专用训练”的信号，而不是新的榜首。</p>

<hr />

<h1 id="具身导航经典论文">具身导航经典论文</h1>

<h2 id="r2r">1. R2R (2018)</h2>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/1711.07280">arXiv:1711.07280</a> · 🏛️ <strong>CVPR 2018 (Spotlight)</strong></p>

<h3 id="精华">精华</h3>

<ul>
  <li>提出了<strong>视觉-语言导航（Vision-and-Language Navigation, VLN）</strong>任务，要求智能体在真实 3D 室内环境中根据自然语言指令进行多步视觉连续导航。</li>
  <li>基于 Matterport3D 数据集构建了第一个真实场景大规模 VLN 基准 <strong>Room-to-Room (R2R)</strong>，包含 21,567 条众包人类自然语言指令与高精度 3D 视点导航图。</li>
  <li>提出了基于注意力机制的 <strong>Sequence-to-Sequence (Seq2Seq)</strong> Baseline 模型，实现语言指令与视觉观察之间的动态对齐。</li>
  <li>比较了 Teacher-forcing 与 Student-forcing（在线采样/DAgger 变体）两种训练机制，证明 Student-forcing 能有效缓解分布偏移并提升鲁棒性。</li>
  <li>揭示了 VLN 模型在未见（Unseen）场景中的严重泛化瓶颈，为后续具身导航研究指明了泛化性与表征学习的核心方向。</li>
</ul>

<hr />

<h3 id="1-研究背景问题">1. 研究背景/问题</h3>

<p>将自然语言理解与物理世界视觉感知相结合的<strong>具身视觉导航（Embodied Navigation）</strong>，是智能体在真实人居环境中执行复杂任务的核心前提。在此之前，相关研究存在以下两大局限：</p>

<ol>
  <li><strong>任务设定局限</strong>：传统导航研究主要基于人工合成环境或仅依赖结构化目标点坐标（如 PointGoal），而视觉问答（VQA）与图像描述（Image Captioning）仅针对静态单张图像，缺乏具身交互与连续多步决策。</li>
  <li><strong>基准与模拟器缺失</strong>：缺乏兼具高真实度 3D 视觉场景、自然语言指令以及交互式导航物理拓扑图的大规模开源平台。</li>
</ol>

<p>为了填补这一空白，本文提出了 Vision-and-Language Navigation (VLN) 任务，并配套开发了 <strong>Matterport3D 模拟器</strong> 与 <strong>Room-to-Room (R2R)</strong> 数据集。</p>

<hr />

<h3 id="2-主要方法创新点">2. 主要方法/创新点</h3>

<div align="center">
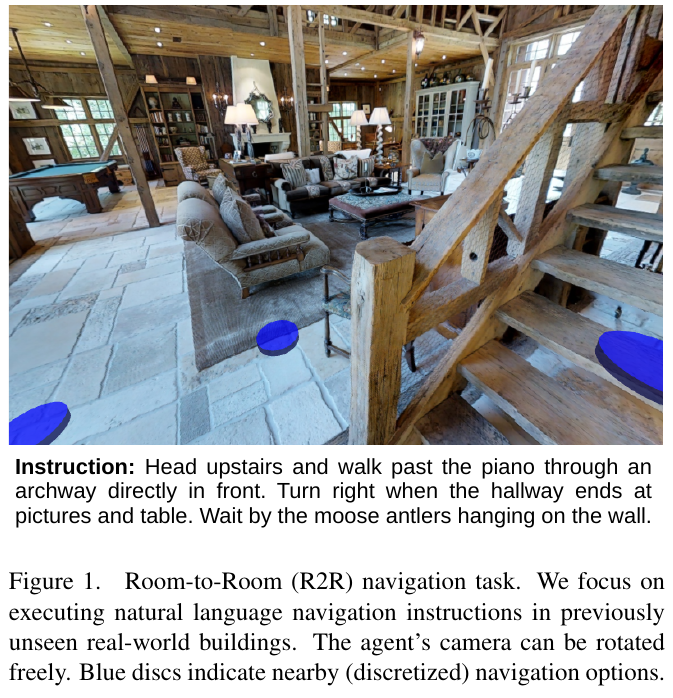
  <img src="/images/vln/R2R-task-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/698" />
<figcaption>Room-to-Room (R2R) 视觉-语言导航任务示意图。智能体根据自然语言指令从起点开始，在 3D 模拟器中选择多步动作到达目标视点。</figcaption>
</div>

<h4 id="-整体框架概述">① 整体框架概述</h4>

<p>VLN 任务要求智能体在无先验全局地图的 3D 环境中，仅依靠局部 RGB 视觉观察 $o_t$ 和自然语言指令 $\bar{x}$，生成一系列离散导航动作到达目标位置。模型整体由 <strong>语言指令编码器（Instruction Encoder）</strong>、<strong>视觉与动作特征嵌入模块（Image &amp; Action Embeddings）</strong>、<strong>带注意力机制的解码器 LSTM（Decoder LSTM with Attention）</strong> 以及 <strong>动作预测分布产生器</strong> 四大核心组件构成。</p>

<div align="center">
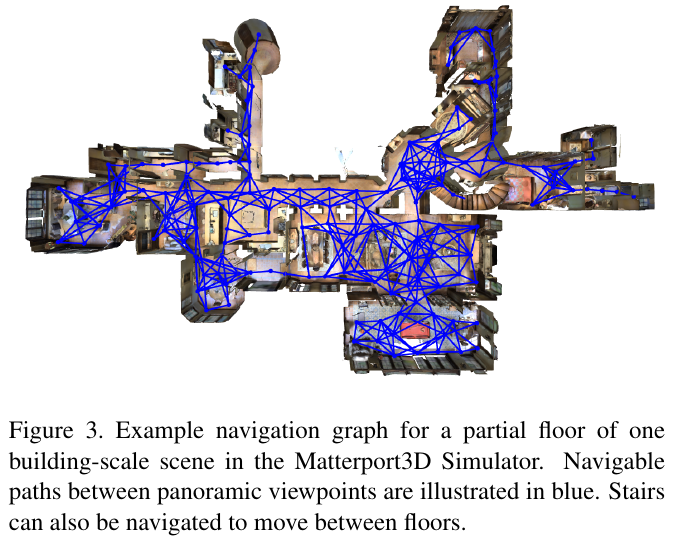
  <img src="/images/vln/R2R-navigation-graph.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/543" />
<figcaption>Matterport3D 模拟器导航图拓扑结构示例。节点代表 360° 全景视点，边代表视点间可通达路径。</figcaption>
</div>

<h4 id="-逐模块讲解">② 逐模块讲解</h4>

<ul>
  <li><strong>语言指令编码器 (Language Instruction Encoder)</strong>：
    <ul>
      <li><strong>输入</strong>：自然语言指令 token 序列 $\bar{x} = \langle x_1, x_2, \dots, x_L \rangle$。</li>
      <li><strong>处理</strong>：将词嵌入向量逆序（Reverse order）依次送入单层编码器 LSTM，计算隐状态 \(h_i = \text{LSTM}_{\text{enc}}(x_i, h_{i-1})\)。</li>
      <li><strong>输出</strong>：生成编码上下文序列 $\bar{h} = {h_1, h_2, \dots, h_L}$，供后续注意力机制对齐。</li>
      <li><strong>设计动机</strong>：逆序输入语言序列能在处理序列开头时保持较短的记忆梯度距离，提升早期导航决策质量。</li>
    </ul>
  </li>
  <li><strong>视觉与动作特征嵌入 (Image and Action Embedding)</strong>：
    <ul>
      <li><strong>输入</strong>：当前时刻全景图像观察 $o_t$ 与上一时刻采取的动作 $a_{t-1}$。</li>
      <li><strong>处理</strong>：利用预训练的 ResNet-152 CNN 提取 $o_t$ 的均值池化特征向量，与可学习的动作嵌入向量拼接，得到综合状态向量 $q_t$。</li>
      <li><strong>输出</strong>：将 $q_t$ 送入解码器 LSTM 更新隐状态：
\(h'_t = \text{LSTM}_{\text{dec}}(q_t, h'_{t-1})\)</li>
      <li><strong>设计动机</strong>：使解码器 LSTM 维持对智能体历史轨迹与视觉观察的全程内部记忆，适应部分可观察环境（POMDP）。</li>
    </ul>
  </li>
  <li><strong>注意力机制与动作预测 (Attention &amp; Action Prediction)</strong>：
    <ul>
      <li><strong>输入</strong>：解码器隐状态 $h’_t$ 与语言编码上下文 $\bar{h}$。</li>
      <li><strong>处理</strong>：使用 Luong 全局注意力计算文本上下文向量 $c_t = f(h’_t, \bar{h})$，进而合成注意力隐状态：
\(\tilde{h}_t = \tanh(W_c [c_t; h'_t])\)</li>
      <li><strong>输出</strong>：通过 Softmax 预测离散动作分布 \(a_t = \text{softmax}(\tilde{h}_t)\)。</li>
      <li><strong>动作空间</strong>：在简化模型中包含 6 种离散动作：<code class="language-plaintext highlighter-rouge">left</code>（左转 30°）、<code class="language-plaintext highlighter-rouge">right</code>（右转 30°）、<code class="language-plaintext highlighter-rouge">up</code>（仰角 +30°）、<code class="language-plaintext highlighter-rouge">down</code>（俯角 -30°）、<code class="language-plaintext highlighter-rouge">forward</code>（沿视角中央最近相邻视点前进）与 <code class="language-plaintext highlighter-rouge">stop</code>（终止导航）。</li>
    </ul>
  </li>
</ul>

<h4 id="-训练目标与损失函数">③ 训练目标与损失函数</h4>

<p>训练采用多步交叉熵损失（Cross-Entropy Loss），最大化真值动作序列的似然度：</p>

\[L = -\sum_{t=1}^T \log P(a_t^* \mid s_0, a_0, \dots, s_t)\]

<p>其中真值目标动作 \(a_t^*\) 为智能体当前状态 $s_t = \langle v_t, \psi_t, \theta_t \rangle$ 到目标视点 \(v^*\) 在拓扑图 $G$ 上的最短路径下一步动作。</p>

<h4 id="-训练范式对比-teacher-forcing-vs-student-forcing">④ 训练范式对比 (Teacher-Forcing vs. Student-Forcing)</h4>

<div align="center">
  <img src="/images/vln/R2R-training-overfitting.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1390/427" />
<figcaption>训练过程中验证集损失、导航误差与成功率变化曲线。模型在已见场景（Seen）持续提升，但在未见场景（Unseen）迅速过拟合。</figcaption>
</div>

<ul>
  <li><strong>Teacher-forcing</strong>：在训练阶段每一步强行使用真值动作 \(a_t^*\) 作为下一步输入。模型仅能在真值最短路径状态上训练，一旦推理中偏离路径即产生暴露偏差（Exposure Bias）。</li>
  <li><strong>Student-forcing</strong>（在线采样 / DAgger 变体）：训练阶段从模型预测的分布中采样动作 $a_t$ 并让智能体实际移动。若偏离原路径，系统在线重新计算当前位置到目标的最新最短路径动作作为 \(a_t^*\) 继续监督。实验表明该范式能显著提升模型对导航偏差的自愈能力。</li>
</ul>

<hr />

<h3 id="3-核心结果发现">3. 核心结果/发现</h3>

<p>本文在 R2R 数据集上评估了不同 Baseline 与 Seq2Seq 模型的导航性能：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型 / 评估设定</th>
      <th style="text-align: center">轨迹长度 (m)</th>
      <th style="text-align: center">导航误差 (m)</th>
      <th style="text-align: center">成功率 (%)</th>
      <th style="text-align: center">Oracle 成功率 (%)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>Val Seen (已见验证集)</strong></td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
    </tr>
    <tr>
      <td style="text-align: left">RANDOM Baseline</td>
      <td style="text-align: center">9.58</td>
      <td style="text-align: center">9.45</td>
      <td style="text-align: center">15.9</td>
      <td style="text-align: center">21.4</td>
    </tr>
    <tr>
      <td style="text-align: left">Teacher-forcing</td>
      <td style="text-align: center">10.95</td>
      <td style="text-align: center">8.01</td>
      <td style="text-align: center">27.1</td>
      <td style="text-align: center">36.7</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Student-forcing</strong></td>
      <td style="text-align: center"><strong>11.33</strong></td>
      <td style="text-align: center"><strong>6.01</strong></td>
      <td style="text-align: center"><strong>38.6</strong></td>
      <td style="text-align: center"><strong>52.9</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Val Unseen (未见验证集)</strong></td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
    </tr>
    <tr>
      <td style="text-align: left">RANDOM Baseline</td>
      <td style="text-align: center">9.77</td>
      <td style="text-align: center">9.23</td>
      <td style="text-align: center">16.3</td>
      <td style="text-align: center">22.0</td>
    </tr>
    <tr>
      <td style="text-align: left">Teacher-forcing</td>
      <td style="text-align: center">10.67</td>
      <td style="text-align: center">8.61</td>
      <td style="text-align: center">19.6</td>
      <td style="text-align: center">29.1</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Student-forcing</strong></td>
      <td style="text-align: center"><strong>8.39</strong></td>
      <td style="text-align: center"><strong>7.81</strong></td>
      <td style="text-align: center"><strong>21.8</strong></td>
      <td style="text-align: center"><strong>28.4</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Test Unseen (未见测试集)</strong></td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
    </tr>
    <tr>
      <td style="text-align: left">Human (人类测试)</td>
      <td style="text-align: center">11.90</td>
      <td style="text-align: center">1.61</td>
      <td style="text-align: center"><strong>86.4</strong></td>
      <td style="text-align: center">90.2</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Student-forcing</strong></td>
      <td style="text-align: center"><strong>8.13</strong></td>
      <td style="text-align: center"><strong>7.85</strong></td>
      <td style="text-align: center"><strong>20.4</strong></td>
      <td style="text-align: center"><strong>26.6</strong></td>
    </tr>
  </tbody>
</table>

<p><strong>核心发现</strong>：</p>
<ol>
  <li><strong>Student-forcing 优势显著</strong>：在 Val Seen 上成功率达到 38.6%，在 Test Unseen 上达到 20.4%，均大幅超越随机基线 (13.2%) 和 Teacher-forcing。</li>
  <li><strong>泛化瓶颈巨大</strong>：模型在已见环境（Val Seen 38.6%）与未见环境（Val Unseen 21.8%）存在巨大差距。如图 7 所示，即便添加 Dropout 与 Weight Decay 正则化，模型仍会快速过拟合于已见房间的特定视觉特征。</li>
  <li><strong>人机差距显著</strong>：人类测试者达到了 86.4% 的成功率与 1.61m 的低误差，说明数据集指令清晰有效，但机器在跨场景泛化与指令-视觉精准对齐上仍面临重大挑战。</li>
</ol>

<hr />

<h3 id="4-局限性">4. 局限性</h3>

<ol>
  <li><strong>视点拓扑限制</strong>：依赖预先连线的离散 3D 视点图（Navigation Graph），而非真实连续物理空间的自由碰撞与平滑控制。</li>
  <li><strong>跨场景泛化能力弱</strong>：标准 Seq2Seq + ResNet 特征难以建立泛化性强的视觉-语言底层语义关联，易过拟合特定场景纹理。</li>
  <li><strong>动作空间离散简化</strong>：将转向与前进离散化为 6 个固定动作，无法直接无缝部署于物理机器人的低层控制接口。</li>
</ol>

<hr />

<h2 id="vln-ce">2. VLN-CE (2020)</h2>
<p>——Beyond the Nav-Graph: 在连续环境中的视觉-语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2004.02857">arXiv:2004.02857</a> · 🏛️ <strong>ECCV 2020</strong></p>

<p><strong>精华</strong></p>

<p>这篇论文通过将 VLN 任务从离散导航图迁移到连续 3D 环境,揭示了基于导航图的设定中隐含的强假设对性能的巨大影响。值得借鉴的核心思想包括:批判性地审视任务设定中的隐含假设、通过消除不现实的简化来提高任务的实际应用价值、深度信息在具身导航中的关键作用、以及端到端学习与低层控制结合的必要性。这种”去简化”的研究思路对构建更接近真实机器人应用的 AI 系统具有重要指导意义。</p>

<p><strong>研究背景/问题</strong></p>

<p>现有的 Vision-and-Language Navigation (VLN) 任务基于导航图 (nav-graph) 表示,引入了三个不现实的假设:已知环境拓扑、短距离 oracle 导航、以及完美的智能体定位。这些假设使得任务本质上退化为视觉引导的图搜索问题,与真实机器人导航场景存在巨大差距,限制了向实际机器人平台迁移的可能性。</p>

<p><strong>主要方法/创新点</strong></p>

<div align="center">
  <img src="/images/vln/VLN-CE-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/416" />
<figcaption>
VLN 与 VLN-CE 的对比:VLN 基于固定拓扑的全景图节点(左),而 VLN-CE 在连续环境中使用低层动作(右)
</figcaption>
</div>

<p>论文提出了 Vision-and-Language Navigation in Continuous Environments (VLN-CE) 任务,在 Habitat 模拟器中实例化连续的 Matterport3D 环境。主要创新包括:</p>

<ol>
  <li>
    <p><strong>连续环境设定</strong>:智能体通过低层动作(前进 0.25m、左转/右转 15°、停止)在连续 3D 空间中自由导航,而非在固定节点间传送。</p>
  </li>
  <li>
    <p><strong>轨迹迁移方法</strong>:设计了将 Room-to-Room (R2R) 数据集的导航图轨迹转换为连续环境路径的算法。通过向下投射射线找到最近的可导航点,并使用 A* 算法验证路径可达性,成功转换了 77% 的 R2R 轨迹(4475 条)。</p>
  </li>
  <li><strong>模型架构</strong>:
    <ul>
      <li><strong>Seq2Seq Baseline</strong>: 使用 GRU 处理 RGB 和 Depth 观察的均值池化特征以及 LSTM 编码的指令</li>
      <li><strong>Cross-Modal Attention Model</strong>: 采用双 GRU 架构,一个处理视觉观察,另一个基于注意力机制融合指令和视觉特征进行决策。使用预训练的 ResNet50 (ImageNet) 提取 RGB 特征,使用预训练的 ResNet50 (Point-Goal Navigation) 提取深度特征。</li>
    </ul>
  </li>
  <li><strong>训练策略</strong>:
    <ul>
      <li>基础模仿学习 with inflection weighting</li>
      <li>DAgger 应对 exposure bias</li>
      <li>Progress Monitor 辅助损失</li>
      <li>Speaker 模型生成的合成数据增强(~150k 条轨迹)</li>
    </ul>
  </li>
</ol>

<p><strong>核心结果/发现</strong></p>

<ol>
  <li>
    <p><strong>任务难度显著增加</strong>:VLN-CE 中平均轨迹长度为 55.88 个动作,而 VLN 仅需 4-6 个节点跳转。最佳模型在 val-unseen 上达到 32% 成功率 (SR) 和 0.30 SPL,显著低于 VLN 中的表现。</p>
  </li>
  <li>
    <p><strong>深度信息至关重要</strong>:移除深度输入导致模型性能崩溃(成功率 ≤1%),而移除 RGB 或指令的影响相对较小。深度使智能体能够快速学会有效遍历环境(避免碰撞),是引导学习的关键信号。</p>
  </li>
  <li>
    <p><strong>训练技术的混合效果</strong>:Cross-Modal Attention 优于 Seq2Seq;DAgger 带来 3-5% SPL 提升;但 Progress Monitor 和数据增强单独使用时效果不佳,需要组合使用(预训练 + DAgger 微调)才能达到最佳性能。</p>
  </li>
  <li>
    <p><strong>导航图的强先验</strong>:将 VLN-CE 训练的智能体路径转换回导航图并在 VLN 测试集上评估,SPL 为 0.21,远低于利用导航图训练的 SOTA 方法(0.47 SPL)。这表明现有 VLN 结果可能因导航图的强先验而被高估。</p>
  </li>
  <li>
    <p><strong>单模态消融</strong>:无指令模型达到 17% SR,无图像模型也达到 17% SR,表明轨迹存在共同的规律性;但完整多模态模型(20% SR)仍明显优于单模态基线。</p>
  </li>
</ol>

<p><strong>局限性</strong></p>

<p>约 23% 的 R2R 轨迹无法在连续环境中导航(环境重建的不连续性、物体移动等)。当前端到端方法的绝对性能仍较低,未来需要探索模块化方法,如将学习到的智能体与运动控制器集成。论文未详细探索所有可能改善 VLN-CE 性能的技术(如更多应对 exposure bias 和数据稀疏性的方法)。</p>

<hr />

<h2 id="duet">3. DUET (2022)</h2>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2202.11742">arXiv:2202.11742</a> · 🏛️ <strong>CVPR 2022</strong> · <a href="https://github.com/cshizhe/VLN-DUET">Code</a></p>

<h3 id="精华-1">精华</h3>

<ol>
  <li>针对视觉语言导航（VLN）中“细尺度局部决策缺乏全局视角易困在局部”与“粗尺度地图决策缺乏细粒度物体基元”的矛盾，提出了双尺度拓扑图 Transformer 框架（DUET）。</li>
  <li>在粗尺度拓扑地图上引入图感知自注意力机制（GASA），将图拓扑测地线距离显示注入 Transformer 注意力计算，高效规划全局航向与回溯节点。</li>
  <li>提出粗/细尺度动态融合策略（Dynamic Fusion），基于当前状态自适应平衡全局探索与细粒度视觉/目标定位。</li>
  <li>引入伪交互演示器（PID）解决行为克隆中的分布偏移（Exposure Bias），在 REVERIE、SOON 和 R2R 等数据集上实现 SOTA 导航与目标定位性能。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-1">1. 研究背景/问题</h3>

<p>在视觉与语言导航（VLN）任务中，智能体需要根据自然语言指令在未见的真实三维环境中导航到目标位置（如 REVERIE 任务中还需要定位特定物体）。传统方法主要面临两大瓶颈：</p>

<ol>
  <li><strong>细尺度与粗尺度表示的天然矛盾</strong>：基于一步一预测的细尺度（fine-scale）局部方法只能感知当前视点周边的局域环境，缺乏全局地图表示，遇到死胡同或偏离路线时极难高效回溯；而现有的粗尺度（coarse-scale）拓扑地图方法虽然记录了历史轨迹与未探索边界节点，但由于映射抽象度高，缺失细粒度的视觉图像与目标物体特征，难以完成需精确定位具体物体的复杂指令。</li>
  <li><strong>训练中的分布偏移（Distribution Shift）</strong>：纯行为克隆（Behavior Cloning）仅在专家示范路径上训练，推理阶段一旦偏离路线就会产生严重的累积误差。</li>
</ol>

<p>针对上述难题，DUET 提出了联合粗尺度拓扑图与细尺度局部视点的双尺度 Transformer 架构，并利用图拓扑距离引导全局规划与伪交互演示算法进行策略学习。</p>

<hr />

<h3 id="2-主要方法创新点-1">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/DUET-teaser.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1390/576" />
<figcaption>图 1：DUET 智能体在未见室内环境中根据自然语言指令构建在线拓扑地图并执行双尺度导航决策</figcaption>
</div>

<div align="center">
  <img src="/images/vln/DUET-method-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:675/796" />
<figcaption>图 2：不同导航记忆机制对比（局部动作 vs 粗尺度地图 vs DUET 双尺度融合）</figcaption>
</div>

<h4 id="-整体框架概述-1">① 整体框架概述</h4>

<p>DUET 架构由四大核心模块构成：</p>
<ul>
  <li><strong>在线拓扑地图构建模块（Topological Mapping）</strong>：增量式维护粗尺度拓扑图 \(G_t\) 和当前全景细尺度视觉/物体表征。</li>
  <li><strong>粗尺度跨模态编码器（Coarse-scale Cross-modal Encoder）</strong>：利用图感知自注意力在全局拓扑图上推理探索与回溯候选节点。</li>
  <li><strong>细尺度跨模态编码器（Fine-scale Cross-modal Encoder）</strong>：聚焦当前视点视线范围内的图像与物体，完成细粒度语言-视觉关联与目标定位。</li>
  <li><strong>动态融合预测模块（Dynamic Fusion）</strong>：自适应融合全局与局部动作预测得分，输出全局动作空间上的下一步决策。</li>
</ul>

<div align="center">
  <img src="/images/vln/DUET-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1390/686" />
<figcaption>图 4：DUET 的整体网络架构，左侧为在线拓扑地图构建，右侧为粗/细尺度 Transformer 编码与动态融合预测</figcaption>
</div>

<h4 id="-拓扑地图构建与图更新">② 拓扑地图构建与图更新</h4>

<p>在线拓扑图定义为 \(G_t = (V_t, E_t)\)。节点集合包含已访问节点（保存了历史全景特征与访问时间步 \(t\)）与可导航的未探索边界节点（Frontier Nodes）。此外，在图中显式加入一个特殊的“停止”节点 \(v_0\)，并与所有节点相连。</p>

<div align="center">
  <img src="/images/vln/DUET-graph-updating.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/345" />
<figcaption>图 3：时间步 t 时的拓扑图更新过程（融合历史访问节点与最新可达的边界节点）</figcaption>
</div>

<h4 id="-粗尺度跨模态编码器与图感知自注意力gasa">③ 粗尺度跨模态编码器与图感知自注意力（GASA）</h4>

<p>粗尺度编码器接收拓扑图 \(G_t\) 和文本指令编码 \(\hat{W}\)。节点视觉特征结合了以自我为中心的相对位置编码（方位角、仰角和距离）以及最近访问时间步编码。</p>

<p>为了让 Transformer 能够感知图的拓扑空间结构，提出了<strong>图感知自注意力（Graph-Aware Self-Attention, GASA）</strong>：
\(\text{GASA}(X) = \text{Softmax}\left( \frac{X W_q (X W_k)^T}{\sqrt{d}} + M \right) X W_v\)
其中 \(M = E W_e + b_e\)，\(E\) 为节点间的最短路径测地线距离矩阵，\(W_e, b_e\) 为可学习参数。粗尺度编码器为全局图中所有可导航边界节点和停止节点输出全局动作得分 \(s_i^c\)。</p>

<h4 id="-细尺度跨模态编码器">④ 细尺度跨模态编码器</h4>

<p>细尺度编码器仅对当前视点 \(V_t\) 的全景图像块 \(R_t\) 和检测到的候选物体 \(O_t\) 进行交叉注意力编码，引入全局坐标与局部相对方位编码。输出当前视点局部邻近节点 \(N(V_t)\) 的局部动作得分 \(s_i^f\) 以及候选物体的预测定位得分。</p>

<h4 id="-粗细尺度动态融合dynamic-fusion">⑤ 粗细尺度动态融合（Dynamic Fusion）</h4>

<p>由于细尺度动作空间限制在局部邻居节点 \(N(V_t)\)，无法直接与全局节点评分比对。DUET 将非邻居节点的细尺度得分统一映射为回溯得分 \(s_{\text{back}} = \sum_{v \in N(V_t)} s_v^f\)，将其转换为全局动作空间下的评分 \(s_i'^f\)。</p>

<p>系统拼接粗尺度停止节点嵌入 \(\hat{v}_0\) 和细尺度停止节点嵌入 \(\hat{r}_0\)，通过 FFN 计算自适应融合权重：
\(\sigma_t = \text{Sigmoid}(\text{FFN}([\hat{v}_0; \hat{r}_0]))\)
最终各节点的选择概率评分为：
\(s_i = \sigma_t s_i^c + (1 - \sigma_t) s_i'^f\)</p>

<h4 id="-训练目标与伪交互演示器pid">⑥ 训练目标与伪交互演示器（PID）</h4>

<ul>
  <li><strong>预训练阶段</strong>：使用专家示范轨迹，联合优化单步动作预测损失 \(L_{\text{SAP}}\)、目标定位损失 \(L_{\text{OG}}\)、掩码语言建模 \(L_{\text{MLM}}\) 与掩码区域分类 \(L_{\text{MRC}}\)：
\(L_{\text{SAP}} = \sum_{t=1}^T -\log p(a_t^* \mid W, P_{&lt;t}^*)\)
\(L_{\text{OG}} = -\log p(o^* \mid W, P_T)\)</li>
  <li><strong>策略微调阶段（PID）</strong>：在完整地图图结构已知的前提下，构造伪交互演示器（Pseudo Interactive Demonstrator, PID）\(\pi^*\)。在智能体自采样轨迹 \(P\) 上，PID 根据当前拓扑图计算到达终点的最短路径节点作为伪专家监督标签，通过 DAgger 范式微调策略：
\(L_{\text{PID}} = \sum_{t=1}^T -\log p(a_t^{\pi^*} \mid W, P_{&lt;t})\)</li>
</ul>

<hr />

<h3 id="3-核心结果发现-1">3. 核心结果/发现</h3>

<p>DUET 在 REVERIE、SOON 和 R2R 三大视觉语言导航基准上均刷新了 SOTA 记录：</p>

<ol>
  <li><strong>REVERIE 远距离物体导航</strong>：
    <ul>
      <li>在 Val Unseen 分割上，成功率 SR 达到 <strong>46.98%</strong>，SPL 达到 <strong>33.73%</strong>，遥遥领先之前的 SOTA 模型 HAMT（SR 32.95%, SPL 30.20%）。</li>
      <li>在 Test Unseen 分割上，SR 达到 <strong>52.51%</strong>、SPL 达到 <strong>36.06%</strong>，SR 相比 HAMT 提升了 <strong>22.11%</strong>。</li>
    </ul>
  </li>
  <li><strong>SOON 复杂目标导航</strong>：
    <ul>
      <li>在 Test Unseen 分割上，SR 达到 <strong>33.44%</strong>，SPL 达到 <strong>21.42%</strong>，显著优于传统的图搜索 baseline GBE（SR 12.90%, SPL 9.23%）。</li>
    </ul>
  </li>
  <li><strong>R2R 细粒度指令导航</strong>：
    <ul>
      <li>在 Val Unseen 和 Test Unseen 分割上的 SR 分别达到 <strong>72%</strong> 和 <strong>69%</strong>（领先 HAMT 6% 和 4%）。</li>
    </ul>
  </li>
  <li><strong>消融实验关键结论</strong>：
    <ul>
      <li>单独粗尺度模型具备高探索能力（High OSR），但缺乏目标定位精度；单独细尺度模型容易陷于局部；双尺度动态融合（Dynamic Fusion）取得了最优的综合表现（SPL 提升 1.79%）。</li>
      <li>引入 GASA 图拓扑距离显著优化了导航路径长度（SPL 提升）。</li>
      <li>PID 相比传统 RL 微调更高效地缓解了偏离轨迹时的分布偏移问题。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/DUET-qualitative-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:671/809" />
<figcaption>图 5：DUET 与 HAMT 的导航轨迹定性对比（DUET 具备高效探索与修正历史决策的能力）</figcaption>
</div>

<hr />

<h3 id="4-局限性-1">4. 局限性</h3>

<ol>
  <li><strong>未见环境泛化差距</strong>：在已见环境（Seen）与未见环境（Unseen）之间仍存在一定性能差距，提示模型对未见场景泛化能力仍有提升空间。</li>
  <li><strong>仅限于离散拓扑图</strong>：当前 DUET 依赖离散拓扑导航图（如 Matterport3D 模拟器中的离散节点与边），难以直接无缝迁移到连续无拓扑先验的真实物理机器人导航环境中。</li>
  <li><strong>隐私与安全考量</strong>：在真实室内部署时需考虑视觉采集与实时建图带来的隐私泄漏及碰撞安全风险。</li>
</ol>

<hr />

<h2 id="nomad">4. NoMaD (2023)</h2>
<p>——目标掩码扩散策略实现统一导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2310.07896">arXiv:2310.07896</a> · 🏛️ <strong>ICRA 2024</strong></p>

<p><strong>研究背景/问题</strong></p>

<p>传统机器人导航系统通常为探索（exploration）和目标导航（goal-conditioned navigation）分别训练独立的策略模型，这不仅增加了系统复杂度，也限制了跨任务的知识共享和泛化能力。NoMaD（Nomadic Multi-task Agent with Diffusion，伯克利，ICRA2024 Best Paper）提出通过统一的扩散策略框架，使用目标掩码机制同时建模任务特定行为（目标导向）和任务无关行为（探索），实现单一策略胜任多种导航任务。</p>

<p><strong>主要方法/创新点</strong></p>

<div align="center">
  <img src="/images/vln/nomad-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1248/354" />
<figcaption>
NoMaD目标掩码扩散策略框架
</figcaption>
</div>

<h3 id="核心思路">核心思路</h3>

<p>通过统一的扩散策略，同时建模任务特定和任务无关行为</p>

<h3 id="两个关键组件">两个关键组件</h3>

<p><strong>目标掩码（Goal Masking）</strong></p>
<ul>
  <li>通过二值掩码控制策略是否关注目标图像，实现任务条件的灵活切换</li>
  <li><strong>训练时</strong>：目标掩码以50%概率随机设置，使模型同时学习目标导向行为和探索行为</li>
  <li><strong>推理时</strong>：根据任务需要设置掩码（探索时掩盖目标，导航时提供目标）</li>
</ul>

<p><strong>扩散策略（Diffusion Policy）</strong></p>
<ul>
  <li>利用扩散模型生成多模态、无碰撞的动作序列</li>
  <li>从随机噪声逐步迭代生成预测动作序列</li>
  <li>动作分布既可在无目标条件下表达探索行为，也可在提供目标条件下收敛到目标导向行为</li>
</ul>

<h3 id="统一框架设计">统一框架设计</h3>

<ul>
  <li>通过Transformer编码视觉观测并结合扩散模型生成未来动作序列</li>
  <li>同时支持任务特定行为（目标导向）和任务无关行为（探索）</li>
  <li>使用大规模多样化数据集（GNM和SACSoN）进行端到端监督训练</li>
</ul>

<div align="center">
  <img src="/images/vln/nomad-goal-masking.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/479" />
<figcaption>
NoMaD目标掩码机制示意图
</figcaption>
</div>

<p><strong>核心结果/发现</strong></p>

<ul>
  <li><strong>探索未知环境</strong>：成功率达到98%，平均碰撞数仅0.2，超过最优基线Subgoal Diffusion约25%，且参数量仅为其1/15</li>
  <li><strong>目标导航</strong>：在已知环境的目标导航任务中，成功率与最优基线相当，但计算资源需求更少</li>
  <li><strong>计算效率</strong>：比现有方法计算效率提升约15倍，是首个成功在物理机器人上部署的目标条件动作扩散模型</li>
  <li><strong>统一策略优势</strong>：联合训练能够学习共享表示和环境可操作性，单一策略即可胜任多种行为</li>
  <li><strong>编码器选择</strong>：ViNT编码器配合注意力目标掩码效果最佳，成功率98%，碰撞数最少</li>
  <li><strong>多场景验证</strong>：在6个复杂的室内外环境中表现优异</li>
</ul>

<p><strong>局限性</strong></p>

<p>NoMaD的视觉编码器选择对性能影响较大，需要仔细调优以达到最佳效果。虽然ViT编码器具有更大的容量和表达能力，但其训练优化难度较高，收敛速度相对较慢。此外，目标掩码机制的随机采样比例（训练时50%）是一个关键超参数，在不同场景下可能需要针对性调整。尽管在多个室内外环境中表现优异，但在极端复杂、高度动态的场景（如密集人流、快速变化的障碍物）下的鲁棒性仍有进一步提升空间。</p>

<hr />

<h2 id="vlfm">5. VLFM (2023)</h2>
<p>——Vision-Language Frontier Maps for Zero-Shot Semantic Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2312.03275">arXiv:2312.03275</a> · 🏛️ <strong>ICRA 2024</strong></p>

<p><strong>研究背景/问题</strong>
零样本语义导航要求机器人在未见环境中高效定位目标对象，现有方法（如ESC、SemUtil）依赖物体检测器将视觉线索转化为文本后再用LLM/BERT进行语义推理，存在计算瓶颈且无法充分利用视觉-语言联合表征。如何直接从RGB观测中提取语义价值以指导前沿探索成为关键挑战。</p>

<p><strong>主要方法/创新点</strong></p>

<p>VLFM提出语言驱动的前沿价值图框架，实现端到端视觉-语义推理：</p>

<div align="center">
  <img src="/images/vln/vlfm-system-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1819/678" />
<figcaption>
VLFM系统架构：初始化、语义前沿探索、目标导航三阶段流程
</figcaption>
</div>

<p><strong>核心机制：</strong></p>

<ol>
  <li><strong>前沿航点生成（Frontier Waypoint Generation）</strong>
    <ul>
      <li>利用深度和里程计构建2D占用地图，识别已探索与未探索区域边界作为前沿候选点</li>
      <li>每个前沿中点作为潜在导航航点</li>
    </ul>
  </li>
  <li><strong>价值图生成（Value Map Generation）</strong>
    <ul>
      <li>使用预训练BLIP-2视觉-语言模型直接从RGB图像计算语义价值分数</li>
      <li>文本提示：”Seems like there is a <target object=""> ahead"</target></li>
      <li>输出余弦相似度分数并投影到俯视图价值图（双通道：语义分数+置信度分数）</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/vlfm-value-map-generation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1858/645" />
<figcaption>
价值图生成流程：BLIP-2计算语义分数并投影到俯视图
</figcaption>
</div>

<ol>
  <li><strong>置信度加权更新（Confidence-Weighted Averaging）</strong>
    <ul>
      <li>置信度分数基于像素相对光轴位置：$c_{i,j} = \cos^2(\theta/(\theta_{fov}/2) \times \pi/2)$</li>
      <li>重叠区域的语义值更新：$v_{i,j}^{new} = (c_{i,j}^{curr}v_{i,j}^{curr} + c_{i,j}^{prev}v_{i,j}^{prev})/(c_{i,j}^{curr} + c_{i,j}^{prev})$</li>
      <li>置信度更新偏向高置信值：$c_{i,j}^{new} = ((c_{i,j}^{curr})^2 + (c_{i,j}^{prev})^2)/(c_{i,j}^{curr} + c_{i,j}^{prev})$</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/vlfm-confidence-weighting.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:883/393" />
<figcaption>
置信度评分机制：光轴附近像素置信度最高，边缘递减
</figcaption>
</div>

<ol>
  <li><strong>物体检测与导航</strong>
    <ul>
      <li>YOLOv7用于COCO类别，Grounding-DINO用于开放词汇检测</li>
      <li>Mobile-SAM提取目标轮廓，确定最近点作为目标航点</li>
      <li>使用VER训练的PointNav策略执行航点导航（纯几何理解，不依赖语义）</li>
    </ul>
  </li>
</ol>

<p><strong>关键创新：</strong></p>
<ul>
  <li>直接视觉-语义推理：绕过物体检测器，BLIP-2直接从RGB生成语义分数</li>
  <li>空间化价值表征：将语义价值映射到俯视图网格，支持前沿选择</li>
  <li>置信度驱动融合：动态平衡当前观测与历史信息</li>
</ul>

<p><strong>核心结果/发现</strong></p>
<ul>
  <li><strong>基准测试表现</strong>：在Gibson、HM3D、MP3D三个数据集上均达到SOTA零样本性能
    <ul>
      <li>Gibson：SPL 52.2%、SR 84.0%（相比SemUtil提升+11.7% SPL、+14.7% SR）</li>
      <li>HM3D：SPL 30.4%、SR 52.5%（相比ESC提升+8.1% SPL、+13.3% SR）</li>
      <li>MP3D：SPL 17.5%、SR 36.4%（相比ESC提升+3.3% SPL、+7.7% SR）</li>
    </ul>
  </li>
  <li>超越部分有监督方法：在Gibson和MP3D数据集上优于SemExp、PONI等ObjectNav训练方法</li>
  <li><strong>消融实验</strong>：置信度加权平均（Weighted avg.）在所有数据集上均优于简单替换（Replacement）和无权平均（Unweighted avg.）</li>
  <li><strong>真实世界部署</strong>：成功在Boston Dynamics Spot机器人上部署，在办公楼环境中高效导航至未见目标对象，所有模型（BLIP-2、GroundingDINO、MobileSAM、ZoeDepth）实时运行于RTX 4090 MaxQ笔记本</li>
</ul>

<p><strong>局限性</strong>
仅支持单层楼导航（缺少z坐标里程计导致价值图重置困难），HM3D和MP3D中14.6%和9.6%的跨楼层任务失败；假定目标物体在默认相机高度可见，未来可探索主动相机控制、操作式搜索（如打开抽屉）及可复用的语义地图表征以支持长时程多任务规划。</p>

<h2 id="r2rie-ce-iedl">6. R2RIE-CE &amp; IEDL (2024)</h2>
<p>——— 首个连续导航指令错误基准测试，以及结合指令-轨迹兼容性的多模态错误检测与定位框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2403.10700">arXiv:2403.10700</a> · <a href="https://intelligolabs.github.io/R2RIE-CE/">Project Page</a> · 🏛️ <strong>ROMAN 2024</strong></p>

<h3 id="精华-2">精华</h3>
<ol>
  <li><strong>指令容错新视角</strong>：首次指出现有 Vision-and-Language Navigation (VLN-CE) 研究默认指令完全正确的假设在现实中极易失效，人类常因记忆模糊或混淆给出带错指令。</li>
  <li><strong>基准测试构建</strong>：构建了首个包含指令错误的连续导航基准测试 R2RIE-CE，涵盖方向、房间、物体、复合及全错误五类扰动。</li>
  <li><strong>脆弱性验证</strong>：实验表明，指令中仅注入至多3个错误就会导致 SOTA 导航模型的 Success Rate (SR) 发生高达 25%–30.64% 的断崖式下跌。</li>
  <li><strong>定位与检测框架</strong>：提出 IEDL 框架，通过跨模态 Transformer 融合视觉轨迹与文本指令特征，实现高效的错误检测（AUC 0.79）与词级定位。</li>
  <li><strong>标注纠错价值</strong>：作为半自动数据清洗工具，成功在经典的 R2R-CE 和 RxR-CE 验证集中筛查出 8 个 and 10 个存在真值标注错误或歧义的路径样本。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-2">1. 研究背景/问题</h3>
<p>现有的视觉语言导航（VLN）方法均建立在“人类给出的指令是 100% 正确”的理想假设之上。然而在实际的人机交互中，由于人类记忆不精确、空间概念混淆（如左右不分）或认知障碍，给出的导航指令往往包含错误。</p>

<p>如果在这种情况下智能体盲目服从指令，会导致严重的导航失败。目前缺乏在连续三维环境（VLN-CE）下评估智能体对“错误指令”鲁棒性的基准测试。因此，本文提出了以下核心问题：</p>
<ol>
  <li>现有的 SOTA 导航模型在面对带有错误的人类指令时有多脆弱？</li>
  <li>如何有效地检测输入指令中是否包含错误，并精确定位错误发生的单词位置，以便后续采取容错或澄清机制？</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-2">2. 主要方法/创新点</h3>

<h4 id="a-r2rie-ce-基准测试构建">A. R2RIE-CE 基准测试构建</h4>
<p>本文基于 R2R-CE 验证集（Val Unseen），通过人工引入具有常识先验和人类混淆特征的错误，构建了 <strong>R2RIE-CE</strong> (R2R with Instruction Errors in Continuous Environments) 基准测试。</p>

<div align="center">
  <img src="/images/vln/R2RIE-CE-error-example.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:699/702" />
    <figcaption>图1：指令错误导航示例。在自然语言指令中，仅将“向右转 (right)”替换为“向左转 (left)”，就会导致智能体偏离正确路径并在错误的位置终止探索（黄色箭头处）。</figcaption>
</div>

<p>错误类型分为以下五类：</p>
<ol>
  <li><strong>Direction Error (方向错误)</strong>：将高频方向词（如 left/right、go down/go up、forward/backward 等）替换为其反义词。</li>
  <li><strong>Object Error (物体错误)</strong>：考虑常识共现性，将指令中的物体词（如 sofa）随机替换为通常在同个房间共现的另一物体（如 chair）。</li>
  <li><strong>Room Error (房间错误)</strong>：根据房间邻接先验，将目标房间（如 bathroom）随机替换为相邻的房间类型（如 bedroom）。</li>
  <li><strong>Room &amp; Object Error (房间与物体双重错误)</strong>：在指令中同时注入房间错误和物体错误。</li>
  <li><strong>All Error (全类型错误)</strong>：在指令中同时引入方向、房间和物体三类错误（平均每个样本包含3个错误）。</li>
</ol>

<div align="center">
  <img src="/images/vln/R2RIE-CE-dataset-statistics.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:681/220" />
    <figcaption>表1：R2RIE-CE 基准测试在不同错误类型下的样本统计信息。</figcaption>
</div>

<h4 id="b-iedl-错误检测与定位框架">B. IEDL 错误检测与定位框架</h4>
<p>为了解决上述挑战，本文提出了 <strong>IEDL</strong> (Instruction Error Detector &amp; Localizer) 框架。该框架是一个与底层导航策略解耦的模块，其核心思路是通过对比智能体执行导航后的“轨迹视觉特征”与“输入文本指令”的语义兼容性来捕捉不一致的错误。</p>

<div align="center">
  <img src="/images/vln/R2RIE-CE-IEDL-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1422/667" />
    <figcaption>图2：IEDL 模型整体架构。冻结的导航策略 $\pi$ 输出的轨迹视觉特征 $\Gamma$ 与指令编码嵌入 $\Upsilon$ 送入多层跨模态 Transformer 进行特征对齐融合，最后由分类头分别进行错误检测（$f_d$）与词级错误定位（$f_l$）。</figcaption>
</div>

<ol>
  <li>
    <p><strong>整体框架概述</strong>：
IEDL 模型由指令编码器、全景轨迹编码器、跨模态融合 Transformer，以及两个并行的分类预测头构成。它利用智能体的动作历史和视觉观测序列作为真值轨迹，去检验指令的语义是否与其吻合。</p>
  </li>
  <li><strong>逐模块讲解</strong>：
    <ul>
      <li><strong>指令编码器 (Language Encoder)</strong>：接收包含 $W$ ($W=80$) 个词的自然语言指令 $\mathcal{I}$。利用分词与填充后，送入预训练的 BERT 模型提取其词嵌入特征 $\Upsilon \in \mathbb{R}^{W \times D}$。</li>
      <li><strong>轨迹编码器 (Trajectory Encoder)</strong>：导航智能体基于某策略 $\pi$ 在环境中导航 $T$ 步，得到图像观测序列 $\mathcal{O} = {O_1, …, O_T}$。每个 $O_t$ 提取 ViT-B/16-CLIP 全景特征，再经过 Panoramic Encoder 进行时空建模，得到轨迹表示 $\Gamma = {V_1, …, V_T} \in \mathbb{R}^{T \times D}$。为了引入轨迹时序，对 $\Gamma$ 加入 sine/cosine 位置编码，并在其头部拼接一个可学习的 <code class="language-plaintext highlighter-rouge">[CLS]</code> embedding。</li>
      <li><strong>跨模态多层 Transformer (Cross-Modal Transformer)</strong>：包含 $k$ ($k=4$) 个堆叠层。在每一层，轨迹特征 $\Gamma$ 作为 Query ($Q$)，文本指令嵌入 $\Upsilon$ 作为 Key-Value ($KV$) 进行交叉注意力 (cross-attention) 计算，将视觉特征对齐到文本；接着用 Self-Attention 和 FFN 充分交互以融合多模态特征。</li>
      <li><strong>轨迹-指令匹配预测头 (Trajectory-Instruction Matching Head, $f_d$)</strong>：输入融合后的 <code class="language-plaintext highlighter-rouge">[CLS]</code> token，通过一个多层感知机（MLP，由 $\mathbb{R}^D \to \mathbb{R}$）和 Sigmoid 函数输出匹配概率 \(d_{\pi} \in [0, 1]\)，用以识别当前指令是否包含错误。</li>
      <li><strong>错误定位预测头 (Error Localization Head, $f_l$)</strong>：输入融合后的文本 token 序列，利用独立的 MLP（由 $\mathbb{R}^D \to \mathbb{R}^W$）预测每一个 token 为错误词的概率，实现细粒度的错误词定位。</li>
    </ul>
  </li>
  <li><strong>训练目标 / 损失函数</strong>：
采用多任务联合训练，损失函数由匹配分类损失 \(\mathcal{L}_d\)（采用二元交叉熵损失）与词级定位损失 \(\mathcal{L}_l\)（对指令中每个 token 计算标准交叉熵并求和）加权组成：
\(\mathcal{L} = \lambda_1 \mathcal{L}_d + \frac{\lambda_2}{E} \sum_{i=1}^{E} \mathcal{L}_l\)
其中 $E$ 是指令中实际含有的错误词数量，$\lambda_1$ 和 $\lambda_2$ 为平衡权重参数（实验中均设为 1）。</li>
</ol>

<hr />

<h3 id="3-核心结果发现-2">3. 核心结果/发现</h3>

<h4 id="a-现有导航模型在错误指令下的脆弱性">A. 现有导航模型在错误指令下的脆弱性</h4>
<p>研究人员在 R2RIE-CE 基准上测试了六种主流 VLN-CE 模型（包括 BEVBert, ETPNav 等 SOTA 算法）。</p>

<div align="center">
  <img src="/images/vln/R2RIE-CE-success-rate-drop.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:699/577" />
    <figcaption>图3：主流导航模型在 R2R-CE Val Unseen 原始验证集（绿色）与带错误验证集（红色）下的 Success Rate (SR) 对比。</figcaption>
</div>

<ul>
  <li><strong>性能大跌</strong>：当指令中混入错误时，所有模型的 Success Rate (SR) 均有明显的断崖式下降。在 Room &amp; Object 错误类型下，各模型表现平均下降约 11.47%；在包含所有错误的 All 模式下，SR 下降达到 <strong>30.64%</strong>。</li>
  <li><strong>错误类型敏感度差异</strong>：方向错误 (Direction) 对导航的负面影响最大，会导致 SR 平均相对大跌 <strong>18.64%</strong>。智能体对方向词（如 left/right）极度依赖，一旦方向写反，智能体会迅速走偏并提前终止。</li>
</ul>

<h4 id="b-iedl-的检测与定位表现">B. IEDL 的检测与定位表现</h4>
<p>作者将 IEDL 与 Random (随机预测) 和 CLIP Alignment (基于词组匹配的零样本对齐基准) 进行了比较：</p>

<div align="center">
  <img src="/images/vln/R2RIE-CE-experimental-results.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:1420/411" />
    <figcaption>表2：在不同错误类型下，Random、CLIP Alignment 与 IEDL 的错误检测 (AUC) 与定位 (ATD) 指标对比。</figcaption>
</div>

<ul>
  <li><strong>SOTA 级的检测与定位</strong>：在所有类型下，IEDL 均显著优于基线模型。尤其在全类型错误 (All) 下，IEDL 的检测 AUC 达到了 <strong>0.94</strong>，平均定位距离 (ATD) 缩短至 <strong>6.14</strong> 个 token。</li>
  <li><strong>数据集纠错的实用价值</strong>：作者将训练好的 IEDL 应用于经典的 R2R-CE 和 RxR-CE 原始验证集，在分类置信度超过 0.99 的样本中，通过人工复核成功识别出 <strong>8个 R2R-CE 样本</strong> 和 <strong>10个 RxR-CE 样本</strong> 的地面真值（Ground-Truth）指令本身就存在明显的人类标注错误。</li>
</ul>

<hr />

<h3 id="4-局限性-2">4. 局限性</h3>
<ol>
  <li><strong>离线检测限制</strong>：目前 IEDL 属于离线（Post-hoc）检测器，即必须等到智能体导航策略执行完毕、生成完整轨迹后才能进行错误检测。未来需要探索如何在导航执行过程中进行在线（Online）实时错误识别与纠偏。</li>
  <li><strong>纠错后的闭环策略缺失</strong>：论文主要聚焦于“检测”与“定位”错误，但未详细构建智能体发现错误后，如何主动向人类用户发起交互澄清或自主尝试重新规划路线的闭环控制策略。</li>
</ol>

<hr />

<h2 id="navid">7. NaVid (2024)</h2>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2402.15852">arXiv:2402.15852</a> · 🏛️ <strong>RSS 2024</strong> · <a href="https://pku-epic.github.io/NaVid/">Project Page</a> · <a href="https://github.com/jzhzhang/NaVid-VLN-CE">Code</a></p>

<hr />

<h3 id="精华-3">精华</h3>

<ol>
  <li><strong>免地图与传感器噪声依赖的新范式</strong>：NaVid 是首个仅依赖单目 RGB 视频流、无需深度图、拓扑/度量地图或里程计输入的视觉语言导航（VLN）大模型，从根本上消除了里程计漂移与 Sim-to-Real 传感器鸿沟。</li>
  <li><strong>动态时空 Token 编码</strong>：基于 LLaMA-VID 架构，当前帧分配 64 个指令无关 token 以保留高分辨率几何结构，历史帧大幅压缩至 4 个 token，结合特殊标识符 <code class="language-plaintext highlighter-rouge">&lt;HIS&gt;</code>、<code class="language-plaintext highlighter-rouge">&lt;OBS&gt;</code>、<code class="language-plaintext highlighter-rouge">&lt;NAV&gt;</code> 高效表征长时间序列上下文。</li>
  <li><strong>混合导航数据与指令推理协同训练</strong>：结合 320k Oracle 轨迹、180k Dagger 非 Oracle 探索轨迹与 10k 路径指令推理数据，并与 763k 大规模 Web 多模态数据联合微调，保持大模型泛化能力的同时注入机器人控制能力。</li>
  <li><strong>卓越的跨数据集与真实机器人部署表现</strong>：在 RxR 零样本迁移测试中，SPL 指标超越现有 SOTA 方法 236.5%（自 6.3% 提升至 21.2%）；在真实场景实车测试中实现了 84% 的简单指令与 48% 的复杂指令导航成功率。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-3">1. 研究背景/问题</h3>

<p>连续环境视觉语言导航（VLN-CE）要求智能体在未知的真实物理世界中根据自然语言指令进行低层级动作控制。现有方法主要存在两大瓶颈：</p>
<ul>
  <li><strong>传感器与地图依赖性</strong>：绝大多数传统及基于 LLM 的导航系统依赖拓扑/度量地图构建、深度相机点云或精确里程计姿态估计。在真实世界部署时，传感器噪声、点云缺失和里程计累计漂移会导致系统迅速失效。</li>
  <li><strong>Sim-to-Real 跨域泛化差</strong>：仿真环境中的完美深度图与无误差定位在真实世界中难以复现，极大地阻碍了导航策略从仿真向实车的迁移。</li>
</ul>

<p>NaVid 的核心动机在于模仿人类导航的本能——人类导航仅依靠眼前的单目视觉流和大脑中的历史记忆即可完成路径推理。因此，NaVid 探索纯单目 RGB 视频流驱动的 VLM 端到端导航范式。</p>

<hr />

<h3 id="2-主要方法创新点-3">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/NaVid-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1448/1062" />
<figcaption>NaVid 整体模型架构与时空 Token 编码流程</figcaption>
</div>

<h4 id="-整体框架概述-2">① 整体框架概述</h4>
<p>NaVid 建立在通用视频语言大模型 LLaMA-VID 框架之上，由<strong>视觉编码器（EVA-CLIP）</strong>、<strong>查询生成器（Q-Former-based Query Generator）</strong>、<strong>双模态投影器</strong>以及<strong>大语言模型骨干（LLM, 如 Vicuna-7B）</strong>组成。系统接收机器人的历史观察视频流与当前单目 RGB 图像，经过指令相关与指令无关的双路 Token 编码后，直接生成包含动作类型及定量参数（如前进距离、旋转角度）的文本动作指令。</p>

<h4 id="-逐模块讲解-1">② 逐模块讲解</h4>

<ul>
  <li><strong>视觉编码器与双路 Observation Token 编码</strong>
    <ul>
      <li><strong>输入</strong>：从起始时刻 $0$ 到当前时刻 $t$ 的单目 RGB 视频帧序列 \(\mathcal{O}_t = \{x_0, x_1, \dots, x_t\}\)。每帧输入视觉编码器 EVA-CLIP 提取 patch 嵌入 $X_t \in \mathbb{R}^{N_x \times C}$（其中 $N_x = 256$）。</li>
      <li><strong>处理过程</strong>：
        <ol>
          <li><strong>指令相关 Token（Instruction-Queried Tokens $E_t^Q$）</strong>：利用 Q-Former 查询生成器 $G_Q$ 结合文本指令 $I$ 与图像特征 $X_t$ 生成指令感知 Query $Q_t$，通过 Cross-Attention 交叉注意力与均值池化（Pool）压缩为单 token 表达 $E_t^Q \in \mathbb{R}^{1 \times C}$。</li>
          <li><strong>指令无关 Token（Instruction-Agnostic Tokens $E_t^V$）</strong>：对图像特征 $X_t$ 执行 Grid Pooling 网格池化，将 $N_x$ 个特征压缩为 $N_v$ 个几何 token。为了兼顾计算效率与空间几何保留，当前帧 $x_t$ 设置 $N_v = 64$，而历史帧 $x_{0..t-1}$ 大幅压缩至每帧 $N_v = 4$。</li>
        </ol>
      </li>
      <li><strong>输出</strong>：当前帧与历史帧的多模态视觉 Token 序列。</li>
      <li><strong>设计动机</strong>：当前帧需要高密度的几何细节来预测精确的动作定量参数（移动距离/旋转角度），而历史帧主要提供时空轨迹上下文，低密度 Token 既减轻了大模型的长上下文负担，又保留了关键轨迹记忆。</li>
    </ul>
  </li>
  <li><strong>特殊标识符与 Token 格式化（Special Token Formatting）</strong>
    <ul>
      <li><strong>输入</strong>：历史帧 Token 序列、当前帧 Token 序列、语言指令 Token 序列。</li>
      <li><strong>处理过程</strong>：引入专用界定标识符 <code class="language-plaintext highlighter-rouge">&lt;HIS&gt;</code>/<code class="language-plaintext highlighter-rouge">&lt;/HIS&gt;</code>（界定历史观察）、<code class="language-plaintext highlighter-rouge">&lt;OBS&gt;</code>/<code class="language-plaintext highlighter-rouge">&lt;/OBS&gt;</code>（界定当前观察）以及 <code class="language-plaintext highlighter-rouge">&lt;NAV&gt;</code>（触发导航动作预测）。</li>
      <li><strong>输出格式</strong>：
\(\text{Input}: \text{&lt;HIS&gt;} \{\text{historical frames}\} \text{&lt;/HIS&gt;} \text{&lt;OBS&gt;} \{\text{current frame}\} \text{&lt;/OBS&gt;} \text{&lt;NAV&gt;} \{\text{instruction content}\}\)
\(\text{Output}: \{\text{action reasoning \&amp; text action}\}\)</li>
      <li><strong>设计动机</strong>：显式区分动作推理所需的不同模态与时空属性，引导 LLM 正确区分导航历史记忆与当前决策环境。</li>
    </ul>
  </li>
  <li><strong>定量动作预测（Quantitative Action Planning）</strong>
    <ul>
      <li><strong>输出格式</strong>：NaVid 采用离散动作类型 + 连续定量参数的文本组合输出，动作集合 $\mathcal{A} \in {\text{FORWARD}, \text{TURN-LEFT}, \text{TURN-RIGHT}, \text{STOP}}$。例如：<code class="language-plaintext highlighter-rouge">The next action is move forward 75 cm</code> 或 <code class="language-plaintext highlighter-rouge">turn left 30 degrees</code>。</li>
      <li><strong>解析机制</strong>：推理阶段通过正则匹配解析器（Regular Expression Parser）直接提取动作类型与数值参数并发送至机器人底盘执行。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/NaVid-data-samples.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:712/1254" />
<figcaption>NaVid 导航训练样本构造（动作规划与指令推理）</figcaption>
</div>

<h4 id="-混合训练策略与辅助任务hybrid-training-strategy">③ 混合训练策略与辅助任务（Hybrid Training Strategy）</h4>
<ol>
  <li><strong>Non-Oracle 轨迹采集（Dagger-like Trajectory Collection）</strong>：首先在 61 个 MP3D 室内场景中基于 Oracle 轨迹生成 320k 步骤样本；随后将初始模型部署到 VLN-CE 环境中，采集偏离正确路径的 180k 步骤非 Oracle 探索轨迹，大幅增强模型的自我纠错与鲁棒性。</li>
  <li><strong>多任务协同微调（Co-training of VLN-CE &amp; Auxiliary Tasks）</strong>：
    <ul>
      <li><strong>动作规划（Action Planning）</strong>：500k 步级导航动作预测样本。</li>
      <li><strong>指令推理（Instruction Reasoning）</strong>：10k 路径反向描述样本，输入历史视频序列，要求模型反推对应的自然语言导航指令，增强图文对齐。</li>
      <li><strong>Web 大规模数据预训练</strong>：融合 763k 来自 LLaMA-VID 的通用 Video-QA / Image-QA Web 数据，保持通用 VLM 的常识与推理能力，防止灾难性遗忘。</li>
    </ul>
  </li>
</ol>

<h4 id="-训练目标--损失函数">④ 训练目标 / 损失函数</h4>
<p>NaVid 采用标准自回归交叉熵损失（Autoregressive Cross-Entropy Loss）进行端到端微调：
\(\mathcal{L}_{CE} = -\sum_{i=1}^N \log P\left(y_i \mid y_{&lt;i}, \mathbf{X}_{obs}, \mathbf{X}_{inst}\right)\)
其中 $y_i$ 表示输出文本序列（包含推理过程与定量动作命令）的第 $i$ 个 token，\(\mathbf{X}_{obs}\) 为编码后的视频观察 token，\(\mathbf{X}_{inst}\) 为指令 token。</p>

<h4 id="-推理流程">⑤ 推理流程</h4>
<p>在在线导航过程中，机器人单目 RGB 相机实时采集视频流。系统维护滑动观察缓冲区，抽取历史帧（每帧 4 token）与当前帧（64 token），拼接文本指令后送入 NaVid。大模型自回归解码输出动作文本，经正则解析器直接转化为底层控制命令（如前进 75cm），无需构建任何显式地图。</p>

<hr />

<h3 id="3-核心结果发现-3">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/NaVid-real-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/974" />
<figcaption>NaVid 在真实物理环境中的视觉语言导航执行效果</figcaption>
</div>

<ol>
  <li><strong>仿真环境 SOTA 表现（VLN-CE R2R &amp; RxR）</strong>：
    <ul>
      <li>在 R2R Val-Unseen 验证集上，NaVid 取得 <strong>37.4%</strong> 的成功率（SR）与 <strong>35.9%</strong> 的路径长度加权成功率（SPL），显著超越现有的纯视觉与深度图基线。</li>
      <li>在 RxR Val-Unseen 零样本跨数据集测试中（未在 RxR 上训练），NaVid 的 SR 达到 <strong>23.8%</strong>，SPL 达到 <strong>21.2%</strong>，相比此前 SOTA 方法 A2Nav（SR 16.8%, SPL 6.3%）在 SPL 上提升了 <strong>236.5%</strong>。</li>
    </ul>
  </li>
  <li><strong>基座大模型对比（LLM Baseline Comparison）</strong>：
    <ul>
      <li>在 100 个随机采样的 R2R Val-Unseen 子集测试中，未针对导航数据微调的 GPT-4V 仅达到 5.0% 的 SR，且频繁输出与动作无关的描述文本；而经过导航微调的 NaVid 成功率达到 <strong>38.0%</strong>（SPL <strong>35.4%</strong>）。</li>
    </ul>
  </li>
  <li><strong>历史轨迹表示消融（History Representation Ablation）</strong>：
    <ul>
      <li>相比于纯文本历史描述（Text-based, SPL 0.0%）、俯视 2D 地图+文本（Map-text, SPL 8.97%）以及第一视角图像+文本（Ego-view-text, SPL 20.8%），NaVid 的纯 Video-based 视频流表征实现了最高的 SPL（<strong>35.9%</strong>），且推理延迟显著降低（无需频繁调用额外的 Captioning 模型）。</li>
    </ul>
  </li>
  <li><strong>真实物理世界部署（Real-World Sim-to-Real Transfer）</strong>：
    <ul>
      <li>在会议室（Meeting Room）、办公室（Office）、实验室（Lab）和休息室（Lounge）四个真实物理场景下，NaVid 在简单指令上的平均完成率达到 <strong>84%</strong>，在需要避开混淆物（如类似椅子）的复杂多步指令上达到 <strong>48%</strong>，远超 Seq2Seq（0%）、CMA（2%）及基于语义地图的 WS-MGMap（20%-32%）。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-3">4. 局限性</h3>

<ol>
  <li><strong>长距离导航计算开销</strong>：随着导航步数增加，历史视频帧数量积累会增加大模型上下文长度。虽然历史帧已压缩至 4 token/帧，但在上百步的长路径中仍会增加显存与推理耗时。</li>
  <li><strong>缺乏显式回溯能力</strong>：由于采用纯自回归文本动作预测且无显式拓扑/度量地图记录，智能体在陷入死胡同或误入歧途时，难以像显式建图方法那样进行精确的全局路径重规划（Re-planning）。</li>
</ol>

<hr />

<h2 id="navgpt-2">8. NavGPT-2 (2024)</h2>
<p>——释放大型视觉语言模型的导航推理能力</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2407.12366">arXiv:2407.12366</a> · 🏛️ <strong>ECCV 2024</strong></p>

<p><strong>研究背景/问题</strong></p>

<p>虽然有将LLMs集成到VLN任务的努力,但存在两个极端方法的局限:(1)零样本方法依赖复杂的提示工程,存在信息损失且性能差距大(约40% SR);(2)微调方法虽然使用大规模LLMs,但性能仍落后于VLN专用模型,且丧失了LLMs的语言能力和可解释性。研究目标是在保持LLMs解释能力的同时,消除LLM-based agents与SOTA VLN专用模型之间的性能差距。</p>

<p><strong>主要方法/创新点</strong></p>

<p>NavGPT-2采用<strong>冻结LLM + 导航策略网络</strong>的混合架构,分两阶段训练:</p>

<div align="center">
  <img src="/images/vln/navgpt2-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:915/790" />
<figcaption>
NavGPT-2模型架构
</figcaption>
</div>

<p><strong>阶段一:视觉指令调优(Visual Instruction Tuning)</strong></p>
<ul>
  <li>基于InstructBLIP架构,使用Q-former将多视图图像编码为固定长度的视觉tokens</li>
  <li>使用GPT-4V自动生成10K导航推理数据</li>
  <li>仅微调Q-former和投影层,保持LLM和视觉编码器(EVA-CLIP ViT-g/14)冻结</li>
</ul>

<div align="center">
  <img src="/images/vln/navgpt2-data-generation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:935/334" />
<figcaption>
GPT-4V导航推理数据生成流程
</figcaption>
</div>

<p><strong>阶段二:图基础导航策略学习</strong></p>
<ul>
  <li>提取LLM隐藏层表示作为视觉-语言表征</li>
  <li>采用拓扑图导航策略网络(源自DUET),包含:
    <ul>
      <li>节点嵌入(Node Embedding):整合视觉特征、方向嵌入、步数嵌入</li>
      <li>跨模态编码(Cross-Modal Encoding):图感知自注意力(GASA)机制</li>
      <li>全局动作预测(Global Action Prediction):从整个构建的图中选择下一步</li>
    </ul>
  </li>
  <li>使用DAgger损失训练,保持VLM冻结</li>
</ul>

<p>关键创新点:</p>
<ol>
  <li><strong>VLM隐表示作为视觉-语言表征</strong>:将视觉特征投影到LLM的语言空间,实现更强的跨环境对齐</li>
  <li><strong>数据高效</strong>:利用LLM预训练权重,在50%数据量下即可达到DUET全量数据的性能</li>
  <li><strong>保留语言能力</strong>:冻结LLM使其保持生成导航推理和与人类交互的能力</li>
</ol>

<p><strong>核心结果/发现</strong></p>

<p>在R2R数据集上的性能(NavGPT-2FlanT5-XXL, 5B参数):</p>

<table>
  <thead>
    <tr>
      <th>Split</th>
      <th>SR</th>
      <th>SPL</th>
      <th>NE</th>
      <th>OSR</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Val Unseen</td>
      <td>71%</td>
      <td>60%</td>
      <td>3.18</td>
      <td>80%</td>
    </tr>
    <tr>
      <td>Test Unseen</td>
      <td>72%</td>
      <td>60%</td>
      <td>3.33</td>
      <td>80%</td>
    </tr>
  </tbody>
</table>

<p>主要发现:</p>
<ul>
  <li><strong>消除性能差距</strong>:在相同训练规模下,超越所有LLM-based方法,与DUET(SOTA VLN专用模型)性能相当</li>
  <li><strong>数据效率</strong>:使用50% R2R数据即可达到DUET使用全量数据的性能</li>
  <li><strong>泛化能力</strong>:
    <ul>
      <li>RxR数据集(细粒度指令):SR提升3.67%</li>
      <li>HM3D数据集(未见环境):SR提升21.6%(47.2% vs 25.6%)</li>
    </ul>
  </li>
  <li><strong>可解释性</strong>:能够生成描述周围环境、识别导航进度、规划下一步的自然语言推理</li>
</ul>

<div align="center">
  <img src="/images/vln/navgpt2-reasoning-examples.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:927/600" />
<figcaption>
NavGPT-2生成的导航推理示例
</figcaption>
</div>

<p>消融实验表明:</p>
<ul>
  <li>移除导航策略网络后性能大幅下降(SR从68%降至21%)</li>
  <li>FlanT5系列模型优于Vicuna系列(编码器-解码器架构优于纯解码器架构)</li>
  <li>更强的视觉编码器对性能提升有限,主要增益来自LLM隐表示</li>
</ul>

<p><strong>局限性</strong></p>

<p>(1)导航推理基于局部观察,未在VLM中建模历史,一致性有待提高;(2)推理与动作预测未严格同步;(3)存在幻觉问题(识别不存在的物体或误判方向);(4)交互能力未经充分评估。未来工作应聚焦于推理-动作同步机制、历史建模以及交互导航能力的开发。</p>

<h3 id="系列对比总结">系列对比总结</h3>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>NavGPT (AAAI-2024)</th>
      <th>NavGPT-2 (ECCV-2024)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>核心思路</strong></td>
      <td>纯LLM零样本导航</td>
      <td>冻结LLM + 微调导航策略</td>
    </tr>
    <tr>
      <td><strong>训练方式</strong></td>
      <td>无需训练(零样本)</td>
      <td>两阶段训练(VLM微调+策略学习)</td>
    </tr>
    <tr>
      <td><strong>性能(R2R SR)</strong></td>
      <td>34%</td>
      <td>72% (test unseen)</td>
    </tr>
    <tr>
      <td><strong>推理能力</strong></td>
      <td>显式,基于提示工程</td>
      <td>显式,基于指令调优</td>
    </tr>
    <tr>
      <td><strong>主要贡献</strong></td>
      <td>揭示LLM导航推理能力</td>
      <td>消除LLM-agent与SOTA的性能差距</td>
    </tr>
    <tr>
      <td><strong>局限</strong></td>
      <td>性能差距大,信息损失严重</td>
      <td>推理-动作同步不足,存在幻觉</td>
    </tr>
  </tbody>
</table>

<p>两篇工作共同展示了LLMs在具身导航中的巨大潜力,从探索性的零样本方法发展到实用的混合架构,为构建可解释、可交互的通用导航智能体指明了方向。</p>

<hr />

<h2 id="dualvln">9. DualVLN/InternVLN (2025)</h2>
<p>——Ground Slow, Move Fast: 具备快慢双系统的端到端连续具身导航大模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2512.08186">arXiv:2512.08186</a> · 🏛️ <strong>ICLR 2026</strong> · 💻 <strong>Code &amp; Models</strong>: <a href="https://github.com/InternRobotics/InternNav">InternRobotics/InternNav</a></p>

<blockquote>
  <p><strong>一句话概括</strong>：DualVLN（上海人工智能实验室 InternNav 团队）首创具身导航领域的<strong>快慢双系统（Dual-System）基础模型</strong>。将“慢思考”的高层 VLM 规划器（System 2，~2Hz，Qwen-VL）与“快反应”的轻量扩散 Transformer 策略（System 1，30Hz，DiT）进行物理级解耦，通过“显式像素目标 + 隐式语义潜在表征”协同衔接，以纯单目 RGB 在 VLN-CE（64.3% SR）与 RxR（61.4% SR）双双登顶，并零样本跨具身部署至轮式、四足（Go2）与人形（G1）真实机器人。</p>
</blockquote>

<h3 id="精华-4">精华</h3>

<ul>
  <li><strong>快慢双系统物理级解耦</strong>：借鉴认知科学的“双过程理论（Dual-Process Theory）”，将高层多模态语义推理（2Hz 全局规划）与底层高频连续运动控制（30Hz 轨迹生成）解耦，从根本上终结了传统端到端 VLA“步步问大模型”造成的严重运动碎片化与高延迟卡顿。</li>
  <li><strong>“显式几何像素点 + 隐式语义 Latent”双重桥梁</strong>：System 2 不仅自回归输出当前视角下<strong>最远可见路径点</strong>的 2D 像素坐标（显式引导，保障可解释性），还通过 4 个可学习的 <code class="language-plaintext highlighter-rouge">&lt;TRAJ&gt;</code> 查询向量从 VLM 最后一层提取富含任务上下文的潜在表征（隐式特征，保障抗扰与动态适应），两者互补使 System 1 能够忠实生成平滑轨迹。</li>
  <li><strong>渐进式两阶段解耦训练范式（Progressive Two-Stage Decoupled Training）</strong>：Stage 1 全量微调 Qwen-VL-2.5（统一学习视角微调、像素点定位与 STOP 判停，结合 67% 导航 + 33% 通用多模态数据保全泛化）；Stage 2 <strong>冻结 VLM</strong>，仅端到端训练轻量潜在查询与 DiT 策略（Flow Matching 监督）。底层策略收敛极快，仅需 10% 轨迹数据即可达到性能上限。</li>
  <li><strong>全异步多速率高频闭环</strong>：System 2（2Hz，利用 KV Cache 复用压至 0.7s/次）负责选定航向与像素落脚点；System 1（30Hz，TensorRT 加速仅需 30ms）基于最新双时步 RGB 实时生成 32 步无碰撞世界坐标轨迹；底层 MPC（200Hz）实现超高频电机控制，具备毫秒级动态避障响应。</li>
  <li><strong>全基准 SOTA 与多形态真实部署</strong>：在仿真基准 VLN-CE（R2R SR 64.3%）、多语言 RxR（SR 61.4%）创下纯单目 RGB 最优表现；在物理仿真基准 VLN-PE 上展现 51.6% 的强悍零样本跨越能力；并引入首个动态行人交互基准 <strong>Social-VLN</strong>，在轮式、四足、人形真实机器人上完成了无场景特定微调的通用落地。</li>
</ul>

<div align="center">
  <img src="/images/vln/dualvln-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1686/930" />
<figcaption>
DualVLN 双系统整体设计：System 2 负责慢速多模态全局规划（2Hz），System 1 负责快速高频扩散轨迹生成（30Hz），通过显隐双目标桥接并驱动底层 200Hz MPC，实现流畅的连续运动与动态避障。
</figcaption>
</div>

<hr />

<h3 id="1-研究背景与核心矛盾">1. 研究背景与核心矛盾</h3>

<p>在连续环境视觉语言导航（VLN-CE）中，智能体既需要理解复杂长程指令、在三维人居场景中识别拓扑地标，又必须与真实的连续物理世界高频交互并避开动态障碍物。然而，现有的端到端方法面临难以调和的<strong>三大瓶颈</strong>：</p>

<ol>
  <li><strong>动作碎片化（Action Fragmentation）</strong>：现有 VLA 模型（如 NaVid、StreamVLN）倾向于每走一步都调用一次大模型，输出离散的“原子短动作”（如“前进 0.25m”、“左转 15°”），导致机器人频繁出现“停顿—思考—急转—再停顿”的顿挫行为，无法形成流畅平滑的运动轨迹。</li>
  <li><strong>感知-动作响应高延迟（High Control Latency）</strong>：7B 级以上的视觉语言大模型（VLM）单次自回归生成耗时通常在 0.5s~1.2s 以上，根本无法满足动态场景下 20~30Hz 的高频闭环控制需求。一旦环境中出现行走的行人或突发障碍，大模型往往来不及反应便发生碰撞。</li>
  <li><strong>高低层任务耦合与语义退化（Coupling Dilemma）</strong>：如果强行把高层语义理解、全局规划与底层局部避障揉进单个端到端网络，底层避障的细粒度几何调整往往会破坏高层长程指令的语义对齐；而单纯追求语义则牺牲了局部轨迹的几何平滑度。</li>
</ol>

<p>为打破这一死结，DualVLN 提出了 <strong>“Ground Slow, Move Fast”</strong> 的双系统范式：<strong>让大模型专注于低频的宏观语义解构与视觉落脚点（慢思考），让轻量扩散模型专注于高频的局部避障与平滑轨迹生成（快行动）</strong>。</p>

<hr />

<h3 id="2-核心架构与双系统协同机制">2. 核心架构与双系统协同机制</h3>

<div align="center">
  <img src="/images/vln/dualvln-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1618/621" />
<figcaption>
DualVLN 模型架构细节：左侧 System 2 输入指令、历史观察与当前帧，自回归生成视角微调、像素目标及提取 Latent Goal；右侧 System 1 融合双时步高频 RGB 特征与潜码，通过 DiT 解码出 32 步世界坐标连续轨迹。
</figcaption>
</div>

<h4 id="-系统-2system-2---ground-slow慢思考的高层全局规划器">① 系统 2（System 2 - Ground Slow）：慢思考的高层全局规划器</h4>

<ul>
  <li><strong>核心定位</strong>：基于 <strong>Qwen-VL-2.5-7B</strong> 构建的高层规划器，以约 <strong>2 Hz</strong>（每 0.5 秒）的频率异步运行。它接收自然语言指令、历史时序视觉观测序列以及当前单目 RGB 画面，输出导航意图。</li>
  <li><strong>三类统一建模的自回归输出</strong>：System 2 在统一的多轮对话序列中自回归预测三种行为，由模型自主决断当前应当“转向观察”、“给出导航路标”还是“终止任务”：</li>
</ul>

<table>
  <thead>
    <tr>
      <th style="text-align: left">输出类型</th>
      <th style="text-align: left">触发条件</th>
      <th style="text-align: left">监督与执行机制</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>视角调整（View Adjustment）</strong></td>
      <td style="text-align: left">预期未来轨迹落入当前相机视场（FOV）之外（如遇到直角急转弯或原地调头）</td>
      <td style="text-align: left">自回归输出离散转向动作序列（<code class="language-plaintext highlighter-rouge">Turn Left/Right 15°</code>、<code class="language-plaintext highlighter-rouge">Look Up/Down 15°</code>），每个分块（Action Chunk）最多包含 4 个连续转向（单次最多转动 60°）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>像素目标定位（Pixel-Goal Grounding）</strong></td>
      <td style="text-align: left">当前视野中至少存在一个可见的未来真实轨迹路径点</td>
      <td style="text-align: left">输出<strong>最远可见路径点</strong>在当前图像坐标系下的 2D 像素坐标文本（如 <code class="language-plaintext highlighter-rouge">234 447</code>）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>任务终止（STOP）</strong></td>
      <td style="text-align: left">智能体判断已到达自然语言指令描述的终点区域</td>
      <td style="text-align: left">输出离散文本标记 <code class="language-plaintext highlighter-rouge">STOP</code></td>
    </tr>
  </tbody>
</table>

<ul>
  <li><strong>对话模板格式（见原文附录 A.1）</strong>：
    <div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>User: You are an autonomous navigation assistant. Your task is &lt;instruction&gt;.
      ... These are your historical observations: &lt;history&gt;.
      Your current observation is &lt;image&gt;.
Assistant: → → → →     # ① 视角调整：4 个连续右转动作（未来路点不在 FOV 内时先调头）
Assistant: 234 447      # ② 像素目标：最远可见路点的图像像素坐标文本
Assistant: STOP         # ③ 终止判停：判定到达目标区域
</code></pre></div>    </div>
  </li>
  <li><strong>关键设计权衡：为什么是“最远可见路点”与“最多 4 次连续转向”？</strong>
    <ul>
      <li><strong>最远可见（Farthest Visible）</strong>：利用 3D 轨迹向当前相机平面的投影，并借助深度图过滤掉“距离 &gt; 深度测量值”的遮挡点（确保路点绝不落在墙后或障碍物后），取其中最远的一个可见点作为像素目标。这赋予了底层 System 1 尽可能长的<strong>前瞻视界（Look-ahead Horizon）</strong>，使 System 2 的高层规划调用尽可能稀疏（2Hz 即可满足），同时避免了把虚空/遮挡点反投影时引发的几何深度歧义。</li>
      <li><strong>转向分块与 4 次封顶（Chunked &amp; Capped Turning）</strong>：沿用了 StreamVLN 的动作分块设计（单次推理生成一组离散动作）。4 个 15° 动作（累计 60°）既足以将大多数弯道死角的下一路点重新纳入 FOV，又设立了严格的安全阈值，<strong>防止智能体在未见新视觉证据前盲目过度旋转或原地打转</strong>，强制模型在转动 60° 后必须重新观测环境再做决策。</li>
    </ul>
  </li>
</ul>

<h4 id="-系统-1system-1---move-fast快行动的高频连续轨迹生成器">② 系统 1（System 1 - Move Fast）：快行动的高频连续轨迹生成器</h4>

<div align="center">
  <img src="/images/vln/dualvln-system1-trajectory.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1384/697" />
<figcaption>
系统 1 轨迹生成可视化：在不同室内场景中，System 1 根据 System 2 给出的显式像素目标（红点）与隐式潜码，结合当前双时步 RGB 生成由 32 个密集路点构成的平滑避障轨迹（蓝绿渐变虚线）。
</figcaption>
</div>

<ul>
  <li><strong>核心定位</strong>：轻量级 <strong>Diffusion Transformer (DiT)</strong> 连续轨迹策略，以 <strong>30 Hz</strong>（约每 33ms 一次）的超高频率运行，专门负责从高频单目 RGB 观测中实时规划局部平滑无碰撞轨迹。</li>
  <li><strong>双模态条件融合（Conditioning）</strong>：
    <ol>
      <li><strong>显式像素目标（Explicit Pixel Goal）</strong>：System 2 预测的 $(u, v)$ 坐标，为低层策略提供确定性、可解释的宏观几何引导；</li>
      <li><strong>隐式潜在目标（Implicit Latent Goal）</strong>：在 System 2 的像素坐标文本后追加 4 个可学习的特殊 Token <code class="language-plaintext highlighter-rouge">&lt;TRAJ&gt;</code>。通过 Prompt Tuning，这 4 个 Token 穿过冻结的 Qwen-VL，在最后一层引出隐藏状态并投影至 768 维作为 <code class="language-plaintext highlighter-rouge">pixel_goal_latents</code>，为 System 1 注入包含复杂物体语义和全局上下文的先验信息；</li>
      <li><strong>双时步高频 RGB 融合</strong>：使用预训练的 DepthAnythingV2-Small ViT 分别抽取上一高层更新时刻 $t$ 与当前时刻 $t+k$ 的视觉特征，经自注意力融合时序动态，并通过轻量 Q-Former 压缩为 32 个视觉 Token。</li>
    </ol>
  </li>
  <li><strong>基于 Flow Matching 的连续轨迹生成</strong>：
System 1 放弃了离散动作词表，采用连续流匹配（Flow Matching）建模轨迹生成。对真值平滑轨迹 $X_0$ 施加时步 $u \in [0, 1]$ 的线性高斯插值：
\(X_u = (1 - (1 - \sigma_{min})u) X_0 + u \epsilon, \quad \epsilon \sim \mathcal{N}(0, I)\)
网络 $f_\theta$ 负责预测速度向量场，并以最小化流匹配损失进行训练：
\(\mathcal{L}_{flow} = \mathbb{E}_{u, X_0, \epsilon} \left[ \left\| f_\theta(X_u, u, Z' \oplus F) - \dot{X}_u \right\|_2^2 \right]\)
单次去噪前向传播即可直接生成包含 <strong>32 个密集路点</strong>的机器人局部坐标系轨迹（Horizon 约 2~3 米），无缝交付给底层 <strong>200Hz MPC 控制器</strong>完成电机差速/足端控制。</li>
</ul>

<h4 id="-异步流水线与推理加速机制">③ 异步流水线与推理加速机制</h4>

<ul>
  <li><strong>全异步多频率调度</strong>：
    <ul>
      <li><strong>System 2（2 Hz / 0.5s）</strong>：低频刷新高层像素与语义 Latent；</li>
      <li><strong>System 1（30 Hz / 0.033s）</strong>：高频消化实时图像流，重规划局部避障路径；</li>
      <li><strong>MPC 控制器（200 Hz / 0.005s）</strong>：以毫秒级刷新电机控制量，保证动力学稳定性。</li>
    </ul>
  </li>
  <li><strong>推理延迟极限压榨</strong>：
    <ul>
      <li><strong>KV-Cache 跨轮复用</strong>：System 2 采用流式 KV 缓存，将长序列自回归预填充耗时从 1.1s 大幅降至 <strong>0.7s</strong>（提速 36%）；</li>
      <li><strong>TensorRT 并行推理</strong>：轻量级 DiT（12 层，隐藏层维度 384）经 TensorRT 编译后，单次并行生成 32 个轨迹点仅耗时 <strong>0.03s</strong>，使纯单目 30Hz 控制在主流边缘/工控 GPU（如 RTX 4090）上成为现实。</li>
    </ul>
  </li>
</ul>

<hr />

<h3 id="3-渐进式两阶段解耦训练范式">3. 渐进式两阶段解耦训练范式</h3>

<p>DualVLN 摒弃了将高低层网络端到端联合优化的常规做法，提出<strong>渐进式两阶段解耦训练（Progressive Two-Stage Decoupled Training）</strong>：</p>

<pre><code class="language-mermaid">flowchart LR
    subgraph Stage1["Stage 1: 高层规划器全量微调 (Qwen-VL-2.5)"]
        D1["67% VLA 导航数据&lt;br/&gt;(MP3D, HM3D, DAgger 纠错)"] --&gt; M1["全参数解冻 SFT&lt;br/&gt;(1 Epoch, 14,000 步)"]
        D2["33% 通用多模态&lt;br/&gt;(LLaVA-Video, MMC4)"] --&gt; M1
        M1 --&gt; S2["已微调的 System 2 规划器&lt;br/&gt;(输出视角调整 / 像素点 / STOP)"]
    end

    subgraph Stage2["Stage 2: 低层扩散策略参数高效训练"]
        S2 --&gt;|完全冻结权重| Freeze["冻结 VLM"]
        Q["4 个可学习 &lt;TRAJ&gt; Query"] --&gt; Freeze
        Freeze --&gt;|提取潜码| LG["Latent Goal (768d)"]
        LG --&gt; DiT["训练 DiT 策略 (12层)&lt;br/&gt;(Flow Matching 监督, 15,000 步)"]
        RGB["双时步 RGB (DepthAnything ViT)"] --&gt; DiT
        DiT --&gt; Traj["32 步密集连续轨迹"]
    end

    Stage1 ==&gt; Stage2
</code></pre>

<h4 id="-stage-1高层规划器协同微调co-training">① Stage 1：高层规划器协同微调（Co-Training）</h4>
<ul>
  <li><strong>训练机制</strong>：全量微调视觉编码器与 LLM 骨干（全参数解冻，1 个 epoch，AdamW 学习率 2e-5，Batch Size 128，共 14,000 步）。</li>
  <li><strong>多源协同数据配方（Co-Training Recipe，总量 147 万样本）</strong>：
    <ul>
      <li><strong>VLA 导航专业数据（67%）</strong>：MP3D 场景（450K，31%）、HM3D 多样化场景（300K，20%）以及 Habitat 最短路径专家采集的 <strong>DAgger 偏航纠错示范（240K，16%）</strong>，赋予模型极强的航向偏离自愈能力；</li>
      <li><strong>通用视觉语言数据（33%）</strong>：VQA（LLaVA-Video + ScanQA，248K，17%）与 MMC4 图文交错集（230K，16%），<strong>严防导航微调引发的通用视觉推理灾难性遗忘</strong>。</li>
    </ul>
  </li>
</ul>

<table>
  <thead>
    <tr>
      <th style="text-align: left">大类</th>
      <th style="text-align: left">子集</th>
      <th style="text-align: center">占比</th>
      <th style="text-align: center">规模</th>
      <th style="text-align: left">来源与关键作用</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>VLA 导航</strong>（67%）</td>
      <td style="text-align: left">MP3D</td>
      <td style="text-align: center">31%</td>
      <td style="text-align: center">450K</td>
      <td style="text-align: left">R2R / R2R-EnvDrop / RxR，覆盖 60 个室内场景</td>
    </tr>
    <tr>
      <td style="text-align: left"> </td>
      <td style="text-align: left">HM3D</td>
      <td style="text-align: center">20%</td>
      <td style="text-align: center">300K</td>
      <td style="text-align: left">ScaleVLN 子集，700 个高质量人居场景，强化跨环境泛化</td>
    </tr>
    <tr>
      <td style="text-align: left"> </td>
      <td style="text-align: left">DAgger</td>
      <td style="text-align: center">16%</td>
      <td style="text-align: center">240K</td>
      <td style="text-align: left">Habitat 最短路径专家在模型探索 Rollout 上采集的动态纠错轨迹</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>通用多模态</strong>（33%）</td>
      <td style="text-align: left">VQA</td>
      <td style="text-align: center">17%</td>
      <td style="text-align: center">248K</td>
      <td style="text-align: left">LLaVA-Video-178K + ScanQA，注入 3D 空间理解与常识几何推理</td>
    </tr>
    <tr>
      <td style="text-align: left"> </td>
      <td style="text-align: left">MMC4</td>
      <td style="text-align: center">16%</td>
      <td style="text-align: center">230K</td>
      <td style="text-align: left">图文交错长文档样本，强化长程多轮视觉语言对齐能力</td>
    </tr>
  </tbody>
</table>

<h4 id="-stage-2扩散策略的参数高效微调peft">② Stage 2：扩散策略的参数高效微调（PEFT）</h4>
<ul>
  <li><strong>训练机制</strong>：<strong>完全冻结 System 2 的全部权重</strong>，仅对 4 个 <code class="language-plaintext highlighter-rouge">&lt;TRAJ&gt;</code> 的 Embedding 及 DiT 策略模块计算梯度（AdamW 学习率 1e-4，Batch Size 128，共 15,000 步）。</li>
  <li><strong>潜在表征提取机制（见原文附录 A.2）</strong>：通过在 Prompt 尾部添加 4 个专用 Token，将文本输出与连续控制空间相耦合：
    <div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">inputs_embeds</span> <span class="o">=</span> <span class="n">QwenVL</span><span class="p">.</span><span class="nf">embed_tokens</span><span class="p">(</span><span class="n">input_ids</span><span class="p">)</span>
<span class="n">traj_idx</span> <span class="o">=</span> <span class="p">(</span><span class="n">input_ids</span> <span class="o">==</span> <span class="n">TRAJ_TOKEN</span><span class="p">)</span>           <span class="c1"># 锁定 4 个 &lt;TRAJ&gt; 位置
</span><span class="n">inputs_embeds</span><span class="p">[</span><span class="n">traj_idx</span><span class="p">]</span> <span class="o">=</span> <span class="n">latent_queries</span>       <span class="c1"># 替换为可学习 Query (Prompt Tuning)
</span><span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="nf">no_grad</span><span class="p">():</span>
    <span class="n">hidden</span> <span class="o">=</span> <span class="n">QwenVL</span><span class="p">.</span><span class="nf">forward</span><span class="p">(</span><span class="n">inputs_embeds</span><span class="p">)</span>     <span class="c1"># 冻结的 VLM 前向传播
</span><span class="n">pixel_goal_latents</span> <span class="o">=</span> <span class="n">hidden</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">][:,</span> <span class="o">-</span><span class="mi">4</span><span class="p">:,</span> <span class="p">:]</span>     <span class="c1"># 抽取末层最后 4 个位置特征
</span><span class="n">noise_pred</span> <span class="o">=</span> <span class="nc">DiT</span><span class="p">(</span><span class="nf">traj_encoder</span><span class="p">(</span><span class="n">gt_poses</span><span class="p">),</span> <span class="n">timestep</span><span class="p">,</span> <span class="n">pixel_goal_latents</span><span class="p">,</span> <span class="n">rgb_feats</span><span class="p">)</span>
</code></pre></div>    </div>
  </li>
  <li><strong>纯净样本过滤</strong>：Stage 2 <strong>仅使用包含有效像素目标的样本</strong>进行轨迹拟合，完全剔除纯转向样本，保证扩散策略专注学习“向目标平滑巡航与避障”。</li>
</ul>

<h4 id="-为什么必须解耦训练方法学核心思考">③ 为什么必须解耦训练？（方法学核心思考）</h4>
<ol>
  <li><strong>数据规模与收敛速度的本质不对称</strong>：System 2 作为 7B 级通用 VLM 具有显著的“数据饥饿（Data-Hungry）”特征，需要百万级混合数据磨砺语义常识；而底层 System 1 的局部轨迹跟踪任务结构高度受限，实验表明<strong>仅需 System 2 约 10% 的轨迹数据，System 1 性能即达饱和</strong>。解耦训练大幅节约了昂贵的端到端计算资源。</li>
  <li><strong>避免表征塌陷（Representation Collapse）</strong>：消融实验证实，若将两者端到端联合训练（<em>w/o Sys.2 Train</em>），强烈的扩散梯度震荡会导致 VLM 的高层泛化能力严重退化，在 R2R-CE 上的成功率暴跌 <strong>9.1%</strong>。解耦训练以显式像素点为几何针脚，完美兼顾了高层泛化与底层敏捷。</li>
</ol>

<hr />

<h3 id="4-核心实验结果与分析">4. 核心实验结果与分析</h3>

<h4 id="-经典单目视觉仿真基准vln-ce">① 经典单目视觉仿真基准（VLN-CE）</h4>
<p>在仅输入<strong>单目纯 RGB 图像</strong>（无深度图、无全景环视、无里程计先验）的标准评测下，DualVLN 在 R2R 与 RxR 上均刷新了业界最优成绩：</p>

<p><strong>R2R Val-Unseen 评测结果（单目 RGB）</strong>：
| 模型 | 成功率 SR ↑ | 加权成功率 SPL ↑ | 导航误差 NE ↓ | 航向重合率 OS ↑ |
|:—|:—:|:—:|:—:|:—:|
| NaVid (2024) | 37.4% | 35.9% | – | – |
| NaVILA (2025) | 54.0% | 48.0% | – | – |
| StreamVLN (前SOTA) | 56.9% | 51.9% | 4.98m | 64.2% |
| <strong>DualVLN</strong> | <strong>64.3%</strong> | <strong>58.5%</strong> | <strong>4.05m</strong> | <strong>70.7%</strong> |
| <em>提升幅度</em> | <strong><em>+7.4%</em></strong> | <strong><em>+6.6%</em></strong> | <strong><em>-0.93m</em></strong> | <strong><em>+6.5%</em></strong> |</p>

<p><strong>RxR Val-Unseen 评测结果（细粒度多语言指令）</strong>：
| 模型 | 成功率 SR ↑ | 加权成功率 SPL ↑ | 导航误差 NE ↓ | 归一化动态对齐 nDTW ↑ |
|:—|:—:|:—:|:—:|:—:|
| NaVILA (前SOTA) | 49.3% | 44.0% | 6.77m | 58.8% |
| <strong>DualVLN</strong> | <strong>61.4%</strong> | <strong>51.8%</strong> | <strong>4.58m</strong> | <strong>70.0%</strong> |
| <em>提升幅度</em> | <strong><em>+12.1%</em></strong> | <strong><em>+7.8%</em></strong> | <strong><em>-2.19m</em></strong> | <strong><em>+11.2%</em></strong> |</p>

<p><em>结论</em>：在更长、语言更多样的 RxR 任务上，DualVLN 的领先优势扩大到 <strong>+12.1% SR</strong>，且大幅超越了依赖“全景 RGB + 深度 + 里程计”的传统图搜索方法（如 ETPNav 的 57.0% SR），确立了端到端纯视觉双系统的统治级表现。</p>

<h4 id="-真实物理仿真评测vln-pe">② 真实物理仿真评测（VLN-PE）</h4>
<p>VLN-PE 在物理引擎中模拟了真实的人形机器人（Unitree H1）运动动力学与跌倒碰撞风险。DualVLN 在<strong>完全未在 VLN-PE 上进行任何微调（零样本迁移）</strong>的情况下，展现出极佳的控制鲁棒性：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">训练状态</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">NE ↓</th>
      <th style="text-align: center">跌倒率 FR ↓</th>
      <th style="text-align: center">卡死率 StR ↓</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">NaVid</td>
      <td style="text-align: center">零样本迁移</td>
      <td style="text-align: center">22.42%</td>
      <td style="text-align: center">18.58%</td>
      <td style="text-align: center">5.94m</td>
      <td style="text-align: center">8.61%</td>
      <td style="text-align: center">0.45%</td>
    </tr>
    <tr>
      <td style="text-align: left">RDP</td>
      <td style="text-align: center">在 VLN-PE 上微调</td>
      <td style="text-align: center">25.24%</td>
      <td style="text-align: center">17.73%</td>
      <td style="text-align: center">6.72m</td>
      <td style="text-align: center">24.57%</td>
      <td style="text-align: center">3.11%</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DualVLN</strong></td>
      <td style="text-align: center"><strong>零样本迁移</strong></td>
      <td style="text-align: center"><strong>51.60%</strong></td>
      <td style="text-align: center"><strong>42.49%</strong></td>
      <td style="text-align: center"><strong>4.66m</strong></td>
      <td style="text-align: center">12.32%</td>
      <td style="text-align: center">2.23%</td>
    </tr>
  </tbody>
</table>

<p><em>结论</em>：成功率达到基准模型的 <strong>2 倍以上</strong>（51.60% vs 22.42%），连续平滑的轨迹有效抑制了人形机器人在离散急停时产生的高惯性跌倒。</p>

<h4 id="-动态行人交互新基准social-vln">③ 动态行人交互新基准：Social-VLN</h4>

<div align="center">
  <img src="/images/vln/dualvln-social-vln-benchmark.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1438/614" />
<figcaption>
Social-VLN 仿真与真机避障实测：在 Habitat 3.0 仿真环境中注入动态行人（中排展示碰撞失败案例），下排展示 DualVLN 部署于 Unitree G1 人形机器人上实时规避动态行走人员并成功抵达目标。
</figcaption>
</div>

<ul>
  <li><strong>基准设立</strong>：论文指出静态建图与离散动作模型在面对动态行人时极为脆弱。因此在 Habitat 3.0 中沿真值路径注入动态行走行人，构建包含 763K 交互样本的 <strong>Social-VLN</strong> 基准，并提出人类碰撞率（Human Collision Rate, HCR）指标。</li>
  <li><strong>评测表现</strong>：静态到动态环境下，所有模型成功率普遍暴跌约 26%，证明了动态具身导航的严苛难度；但 DualVLN 凭借 30Hz 的局部重规划能力保持了 <strong>37.2% SR</strong>（领先 StreamVLN 5.8%），且碰撞率显著更低（HCR 35.4%）。</li>
</ul>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">静态环境 SR</th>
      <th style="text-align: center">Social-VLN 动态 SR</th>
      <th style="text-align: center">SR 降幅 ↓</th>
      <th style="text-align: center">人类碰撞率 HCR ↓</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">StreamVLN</td>
      <td style="text-align: center">56.9%</td>
      <td style="text-align: center">31.4%</td>
      <td style="text-align: center">-25.5%</td>
      <td style="text-align: center">36.4%</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DualVLN</strong></td>
      <td style="text-align: center"><strong>64.3%</strong></td>
      <td style="text-align: center"><strong>37.2%</strong></td>
      <td style="text-align: center">-27.1%</td>
      <td style="text-align: center"><strong>35.4%</strong></td>
    </tr>
  </tbody>
</table>

<h4 id="-真实世界跨形态机器人部署">④ 真实世界跨形态机器人部署</h4>

<ul>
  <li><strong>硬件配置</strong>：测试覆盖三种异构形态机器人：<strong>轮式（Turtlebot4）</strong>、<strong>四足（Unitree Go2）</strong> 与 <strong>人形（Unitree G1）</strong>。机载单目 Intel RealSense D455（下俯 15°），通过 Wi-Fi 流式传输图像至配有一块 RTX 4090 的远端服务器进行异步双系统推理，MPC 控制器部署于机载工控机。</li>
  <li><strong>实测表现（3 种跨房间难度场景，每场景 20 次测试）</strong>：
    <ul>
      <li><strong>走廊（简单）</strong>：DualVLN 达到 <strong>100% SR</strong>（平均误差 0.2m，基线仅 25%~80%）；</li>
      <li><strong>单间卧室（中等）</strong>：DualVLN 达到 <strong>100% SR</strong>（平均误差 0.3m，基线仅 0%~70%）；</li>
      <li><strong>跨房间长程办公室（困难）</strong>：DualVLN 达到 <strong>85% SR</strong>（平均误差 0.4m，基线仅 0%~60%）。</li>
    </ul>
  </li>
  <li><strong>各场景导航误差（NE）横向对比</strong>：</li>
</ul>

<table>
  <thead>
    <tr>
      <th style="text-align: left">场景难度</th>
      <th style="text-align: center">CMA</th>
      <th style="text-align: center">NaVid</th>
      <th style="text-align: center">NaVILA</th>
      <th style="text-align: center">StreamVLN</th>
      <th style="text-align: center">DualVLN</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">走廊（简单）</td>
      <td style="text-align: center">3.2m</td>
      <td style="text-align: center">0.9m</td>
      <td style="text-align: center">0.3m</td>
      <td style="text-align: center">0.2m</td>
      <td style="text-align: center"><strong>0.2m</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">卧室（中等）</td>
      <td style="text-align: center">5.3m</td>
      <td style="text-align: center">2.5m</td>
      <td style="text-align: center">0.6m</td>
      <td style="text-align: center">0.3m</td>
      <td style="text-align: center"><strong>0.3m</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">跨房间办公室（困难）</td>
      <td style="text-align: center">15.4m</td>
      <td style="text-align: center">10.1m</td>
      <td style="text-align: center">2.2m</td>
      <td style="text-align: center">0.5m</td>
      <td style="text-align: center"><strong>0.4m</strong></td>
    </tr>
  </tbody>
</table>

<ul>
  <li><strong>各基线典型失效模式对比</strong>：
    <ul>
      <li><strong>NaVid</strong>：长距离误差累积严重，在多弯道场景下极易直接撞墙；</li>
      <li><strong>NaVILA</strong>：能执行宏观转向，但在跨房间终点定位上频繁发生“过门而不入”的漏判；</li>
      <li><strong>StreamVLN</strong>：动作低延迟使其能躲开静态障碍物，但往往以大幅偏离原本指令路径为代价；</li>
      <li><strong>DualVLN</strong>：高层 System 2 稳定锁死目标路标，底层 System 1 动态绕行，兼顾全局保真与局部避障。</li>
    </ul>
  </li>
</ul>

<hr />

<h3 id="5-核心消融与机理解析">5. 核心消融与机理解析</h3>

<h4 id="-目标表征与解耦训练的必要性r2r-ce-val-unseen">① 目标表征与解耦训练的必要性（R2R-CE Val-Unseen）</h4>
<p>| 架构变体 | SR ↑ | SPL ↑ | OS ↑ | NE ↓ | 核心结论 |
|:—|:—:|:—:|:—:|:—:|:—|
| <strong>DualVLN（完整）</strong> | <strong>64.3%</strong> | <strong>58.5%</strong> | <strong>70.7%</strong> | <strong>4.05m</strong> | 显隐协同表现最佳 |
| <em>w/o Sys.2 Train</em>（端到端联合训练） | 55.2% | 51.5% | 60.9% | 4.98m | <strong>性能断崖下跌 9.1%</strong>，联合优化导致表征退化与收敛停滞 |
| <em>w/o Pixel Goal</em>（移除显式像素点） | 62.2% | 55.8% | 68.0% | 4.22m | 失去显式几何锚点，低层轨迹漂移增加（-2.1% SR） |
| <em>w/o Latent Goal</em>（移除隐式语义潜码） | 60.9% | 55.1% | 67.7% | 4.26m | 仅靠 2D 坐标无法传递场景拓扑语义（-3.4% SR） |</p>

<h4 id="-对比-sota-传统点目标规划器vln-pe-unseen">② 对比 SOTA 传统点目标规划器（VLN-PE Unseen）</h4>
<p>如果把 System 2 预测的像素点借助 <strong>Oracle 深度图</strong>强制投影到 3D 空间，替换为成熟的局部点目标策略（PointGoal Policy）：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">局部规划器</th>
      <th style="text-align: center">Seen SR ↑</th>
      <th style="text-align: center">Seen SPL ↑</th>
      <th style="text-align: center">Unseen SR ↑</th>
      <th style="text-align: center">Unseen SPL ↑</th>
      <th style="text-align: center">Unseen NE ↓</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">iPlanner (Yang et al., 2023)</td>
      <td style="text-align: center">58.66%</td>
      <td style="text-align: center">49.43%</td>
      <td style="text-align: center">47.07%</td>
      <td style="text-align: center">41.09%</td>
      <td style="text-align: center">4.91m</td>
    </tr>
    <tr>
      <td style="text-align: left">NavDP (Cai et al., 2025)</td>
      <td style="text-align: center">66.11%</td>
      <td style="text-align: center">56.26%</td>
      <td style="text-align: center">58.72%</td>
      <td style="text-align: center">50.98%</td>
      <td style="text-align: center">4.22m</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>System 1（完整版）</strong></td>
      <td style="text-align: center"><strong>73.25%</strong></td>
      <td style="text-align: center"><strong>64.00%</strong></td>
      <td style="text-align: center"><strong>63.62%</strong></td>
      <td style="text-align: center"><strong>56.49%</strong></td>
      <td style="text-align: center"><strong>3.90m</strong></td>
    </tr>
  </tbody>
</table>

<p><em>深层机理</em>：传统 PointGoal 规划器对投影误差与深度噪点极其敏感；而 System 1 具备高频单目 RGB 上下文感知与 Latent 调节，<strong>即便高层预测的像素点略有偏差，低层扩散策略也能依靠视觉流自主修正轨迹</strong>。</p>

<h4 id="-扩散策略的数据扩展律data-scaling-law">③ 扩散策略的数据扩展律（Data Scaling Law）</h4>
<p>在 System 2 轨迹数据上截取不同比例训练 System 1：</p>
<ul>
  <li><strong>1% 数据</strong>：SR ~54%，已展现可用避障能力；</li>
  <li><strong>10% 数据</strong>：SR ~62%，<strong>曲线迅速逼近饱和点</strong>；</li>
  <li><strong>50%~100% 数据</strong>：SR ~64.3%，边际收益显著递减。
<em>启示</em>：轨迹生成本质是一个低维几何流形映射，对样本规模的需求远低于大语言模型。解耦训练让工程团队可以用极低成本微调不同的下游机器人执行器。</li>
</ul>

<h4 id="-注意力逐层精化机理attention-map-analysis">④ 注意力逐层精化机理（Attention Map Analysis）</h4>
<p>分析 Qwen-VL 在自回归生成时的逐层注意力权重变化：</p>
<ul>
  <li><strong>浅层（Layer 6）</strong>：注意力广泛弥散于整张图像的全局空间轮廓与指令方向词；</li>
  <li><strong>中层（Layer 15）</strong>：注意力逐渐收拢至与指令匹配的关键物体（如门、长桌、走廊接口）；</li>
  <li><strong>深层（Layer 24）</strong>：注意力极端聚焦在最终的<strong>最远可见像素目标坐标区域</strong>，并在任务到达时向 <code class="language-plaintext highlighter-rouge">STOP</code> Token 集中激活。这证明了模型实现了从“宏观场景语义理解”到“精细空间几何落脚点”的逐级提炼。</li>
</ul>

<hr />

<h3 id="6-局限性与未来演进">6. 局限性与未来演进</h3>

<ol>
  <li><strong>单向通信瓶颈（缺乏底层向上反馈）</strong>：目前双系统架构为单向级联（System 2 $\rightarrow$ System 1）。若机器人遭遇突发死胡同或物理碰撞阻挡，底层执行受阻的状态无法实时反哺给 System 2 触发即时重规划，未来需引入自下而上的动态中断与重触发机制。</li>
  <li><strong>极端动态社交场景的避障上限</strong>：在 Social-VLN 中，智能体成功率虽居首位但仍只有 37.2%，高密度人流下的碰撞率依然偏高，缺乏博弈层面的显式人机运动意图推断。</li>
  <li><strong>边缘算力与部署门槛</strong>：System 2 依赖 7B 级多模态底座，全精度加载需约 20GB 显存，目前仍需依赖板载之外的工作站串流。探索 2B~3B 边缘级端侧视觉模型的量化蒸馏是实现完全离线自主导航的关键一步。</li>
</ol>

<hr />

<h2 id="odyssey">10. ODYSSEY (2025)</h2>
<p>——Open-World Quadrupeds Exploration and Manipulation for Long-Horizon Tasks</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2508.08240">arXiv:2508.08240</a> · 🏛️ <strong>AAAI 2026</strong></p>

<p><strong>研究背景/问题</strong></p>

<p>在动态、非结构化环境中，机器人需要将移动性、操作和实时感知紧密结合才能执行复杂任务。现有研究大多局限于桌面场景，未能解决移动平台特有的感知受限和执行器范围有限的问题，且在开放世界环境中的泛化能力不足。</p>

<p><strong>主要方法/创新点</strong></p>

<p>ODYSSEY提出了一个统一的移动操作框架，包含分层规划和全身控制两大核心模块：</p>

<div align="center">
  <img src="/images/vln/odyssey-framework-overview.png" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1163/385" />
<figcaption>
ODYSSEY框架整体架构
</figcaption>
</div>

<p><strong>长期任务规划器：</strong></p>
<ul>
  <li><strong>全局任务级规划</strong>：融合RGB和LiDAR流构建场景的空-语义表示，利用预训练基础模型将实例图映射到场景中</li>
  <li>使用GPT-4.1将自然语言指令分解为原子动作序列（导航、抓取、放置等），并输出粗略目标航路点</li>
  <li>航路点投影到2D占用图，通过局部搜索确定无碰撞目标姿态</li>
</ul>

<p><strong>局部操作：</strong></p>
<ul>
  <li>使用腕部安装的深度观测数据指导视觉-语言模型生成精确末端执行器姿态</li>
  <li>Qwen2.5-VL-72B-Instruct模型根据RGB观测和文本描述推断任务相关接触点</li>
  <li>根据目标物体主轴和表面法线施加几何约束，确定末端执行器朝向</li>
</ul>

<div align="center">
  <img src="/images/vln/odyssey-whole-body-control.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:995/1427" />
<figcaption>
两阶段全身控制策略训练流程
</figcaption>
</div>

<p><strong>全身控制策略：</strong></p>
<ul>
  <li>单一网络将观测向量（运动指令、末端执行器目标、地面高度图、重力向量、本体感知状态等）映射到目标动作</li>
  <li><strong>两阶段训练</strong>：第一阶段固定机械臂关节训练运动；第二阶段控制全部18个关节，采用地形不变末端执行器采样策略</li>
  <li>引入步态奖励、频率奖励和末端执行器跟踪项，运用领域随机化增强适应性</li>
</ul>

<p><strong>模拟基准测试：</strong></p>
<ul>
  <li>构建包含50个刚体物体、15个容器、30个关节结构、10个可拖动物体的多样化资产库</li>
  <li>基准测试包括10个真实场景（室内家居、超市、餐厅、室外庭院等）</li>
  <li>长期任务包含246个室内和58个室外变化，涉及抓取、重新定向、容器放置、关节操作等多种技能</li>
</ul>

<div align="center">
  <img src="/images/vln/odyssey-results-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:677/343" />
<figcaption>
与基线方法的性能对比
</figcaption>
</div>

<p><strong>核心结果/发现</strong></p>

<ul>
  <li><strong>短期任务</strong>：在ARNOLD基准测试上优于PerAct基线，仅依赖单个自我中心摄像头实现更强的泛化能力，在未见数据集上性能保持稳定</li>
  <li><strong>长期任务</strong>：在8个长期移动操作任务上实现40%以上整体成功率，每个原子技能类别保持60%以上成功率，展现出可靠的协调能力</li>
  <li><strong>低层策略</strong>：在基座速度跟踪方面优于RoboDuet基线，末端执行器姿态跟踪性能相当，且在不同地形上具有更强的适应性</li>
  <li><strong>Sim-to-Real迁移</strong>：成功在Unitree Go2+Arx5平台上实现现实世界部署，在”导航到抓取”和”抓取和放置”任务中验证了框架的实用性</li>
</ul>

<p><strong>局限性</strong></p>

<p>模型在物体几何形状的空间推理方面存在局限，导致夹爪对齐不佳和细长手柄或部分遮挡物品的定位不准确。此外，抓取小物体时偶尔失败，主要由于末端执行器跟踪和视觉感知精度不足。</p>

<hr />

<h2 id="panonav">11. PanoNav (2025)</h2>
<p>——Mapless Zero-Shot Object Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2511.06840">arXiv:2511.06840</a> · 🏛️ <strong>AAAI 2026 (Poster)</strong></p>

<p><strong>研究背景/问题</strong></p>

<p>现有目标导航方法大多依赖深度传感器或预建地图来构建2.5D场景表示，限制了在真实环境中的适用性和泛化能力。零样本目标导航要求机器人识别和导航到超出预定义类别范围的对象，现有方法在开放词汇场景中表现有限。无地图方法通常只基于当前观测进行决策，忽略历史轨迹信息，容易陷入局部死锁。</p>

<p><strong>主要方法/创新点</strong></p>

<p>PanoNav是一个无地图、仅使用RGB图像的零样本目标导航框架，包含两个核心模块：</p>

<div align="center">
  <img src="/images/vln/panonav-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:2009/562" />
<figcaption>
PanoNav框架整体架构
</figcaption>
</div>

<p><strong>全景场景解析（Panoramic Scene Parsing）：</strong></p>

<p><em>局部方向解析：</em></p>
<ul>
  <li><strong>点阵图像增强</strong>：将每个RGB图像转换为点阵图像，通过Scaffold方法增强平面位置理解，与RGB图像共同作为MLLM输入</li>
  <li><strong>空间关系图构建</strong>：MLLM利用几何距离关系和平面位置关系，构建空间关系图，生成每个方向的详细描述（物体存在、空间关系、房间类型等）</li>
</ul>

<div align="center">
  <img src="/images/vln/panonav-panoramic-parsing.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:996/395" />
<figcaption>
全景场景解析模块：从RGB输入到局部方向描述
</figcaption>
</div>

<p><em>全局全景总结：</em></p>
<ul>
  <li><strong>环境整体感知</strong>：对机器人周围环境进行整体分析，识别环境中存在的物体类型和当前房间类型（如厨房、走廊）</li>
  <li><strong>隐式自我定位</strong>：通过全局总结提供隐式自我定位信息，帮助机器人理解其在更大环境中的位置</li>
</ul>

<p><strong>动态记忆引导决策（Dynamic Memory-guided Decision-Making）：</strong></p>

<ul>
  <li><strong>动态有界记忆队列</strong>：存储最近的全局场景总结，队列长度固定，当队列满时新元素加入会移除最旧元素</li>
  <li><strong>决策过程</strong>：
    <ul>
      <li>记忆队列未满时：决策仅基于当前的局部描述和全局总结</li>
      <li>记忆队列满时：决策结合当前信息和历史记忆信息，避免重复探索已访问区域</li>
    </ul>
  </li>
  <li><strong>动作选择</strong>：决策结果包括导航方向和是否找到目标的标志，由运动控制器执行相应动作</li>
</ul>

<div align="center">
  <img src="/images/vln/panonav-dynamic-memory.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:997/617" />
<figcaption>
动态记忆引导决策机制
</figcaption>
</div>

<p><strong>任务设置：</strong></p>
<ul>
  <li><strong>观测数据</strong>：每个时间步获取六个方向的RGB图像（间隔60度），形成全景视图，不依赖深度传感器或GPS</li>
  <li><strong>动作空间</strong>：停止、前进（0.25米）、左转/右转（30度）、抬头/低头</li>
  <li><strong>任务目标</strong>：在未见过的环境中根据语言指令找到目标对象，并导航至目标位置</li>
</ul>

<p><strong>核心结果/发现</strong></p>

<ul>
  <li><strong>性能优势</strong>：在HM3D数据集上，PanoNav的成功率（SR）达到43.5%，SPL达到23.7%，显著优于PixNav（SR=37.9%，SPL=20.5%）和ZSON（SR=25.5%，SPL=12.6%），甚至超过部分依赖地图和闭词汇表的方法</li>
  <li><strong>死锁避免</strong>：在高度欺骗性环境中，通过动态记忆机制实现48.0%成功率和19.2% SPL，逃离局部区域的逃逸率达82.0%</li>
  <li><strong>消融实验验证</strong>：
    <ul>
      <li>全景视图的重要性：仅使用三视图时性能显著下降（SR=19.5%，SPL=9.97%）</li>
      <li>解耦解析与决策的优势：解耦方法（SR=43.5%，SPL=23.7%）优于直接从MLLM输出决策（SR=38.5%，SPL=22.57%）</li>
      <li>动态记忆的关键作用：移除动态记忆后性能大幅下降（SR=38.5%，SPL=22.57%）</li>
    </ul>
  </li>
</ul>

<p><strong>局限性</strong></p>

<p>虽然PanoNav显著提升了无地图零样本导航性能，但未来仍需探索利用多模态信息（如语音、手势等）构建更强大的记忆队列，以进一步提高无地图目标导航的鲁棒性和泛化能力。</p>

<hr />

<h2 id="vln-r1">12. VLN-R1 (2025)</h2>
<p>——基于GRPO与Time-Decayed Reward的端到端导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2506.17221">arXiv:2506.17221</a></p>

<p><strong>研究背景/问题</strong></p>

<p>VLN是具身人工智能领域的一项核心挑战，要求智能体根据自然语言指令在真实世界环境中进行导航。传统的导航方法通常依赖离散的拓扑图和预定义的节点连接，限制了智能体在连续环境中的泛化能力。</p>

<p><strong>主要方法/创新点</strong></p>

<p>VLN-R1提出了一种创新的端到端框架，利用大型视觉-语言模型（LVLM）直接处理自我中心视频流，生成连续的导航动作。</p>

<div align="center">
  <img src="/images/vln/vln-r1-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1390/798" />
<figcaption>
VLN-R1端到端框架整体架构
</figcaption>
</div>

<p><strong>核心设计理念：</strong></p>
<ul>
  <li>构建能够实时处理自我中心视频流并生成连续导航动作的端到端框架</li>
  <li>与传统方法依赖导航图或额外传感器不同，VLN-R1直接将视觉输入和自然语言指令转化为动作输出</li>
  <li>提高系统通用性，增强在未见过环境中的适应能力</li>
</ul>

<p><strong>主要组件：</strong></p>

<p><em>VLN-Ego数据集：</em></p>
<ul>
  <li><strong>数据生成</strong>：通过Habitat模拟器生成，包含自我中心视频流与未来动作预测的配对数据</li>
  <li><strong>三部分文本注释</strong>：
    <ul>
      <li>指令部分：自然语言导航指令（如”走到客厅的沙发旁”）</li>
      <li>视觉部分：包括历史帧和当前观察，提供自我中心的视觉信息</li>
      <li>动作部分：未来动作选择（前进、左转、右转、停止四种基本动作）</li>
    </ul>
  </li>
  <li><strong>数据规模</strong>：
    <ul>
      <li>从Room-to-Room生成了60K个训练样本</li>
      <li>从Room-Across-Room生成了1.2M个训练样本</li>
      <li>覆盖了61个训练场景</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/vln-ego-dataset.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1162/966" />
<figcaption>
VLN-Ego数据集构建流程
</figcaption>
</div>

<p><em>长短期记忆采样：</em></p>
<ul>
  <li>新颖的视频输入处理策略，用于动态平衡历史帧的重要性与当前观察的实时性</li>
  <li>确保模型既能利用历史信息，又能快速响应当前环境变化</li>
  <li>相比单一动作预测，多步动作预测结合历史上下文显著提升性能</li>
</ul>

<p><strong>两阶段训练策略：</strong></p>

<div align="center">
  <img src="/images/vln/vln-r1-training-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1422/675" />
<figcaption>
VLN-R1两阶段训练流程
</figcaption>
</div>

<p><em>监督微调（SFT）阶段：</em></p>
<ul>
  <li>模型的动作序列预测与专家演示对齐，通过监督学习优化输出文本</li>
  <li>模型生成的多步动作序列文本与地面真值对齐，通过交叉熵损失进行优化</li>
  <li>给定历史观察序列H_t、指令Z和当前观察O_t，模型预测n步未来动作序列</li>
</ul>

<p><em>强化微调（RFT）阶段：</em></p>
<ul>
  <li>引入基于GRPO（Group Relative Policy Optimization）的强化学习方法</li>
  <li>结合时间衰减奖励机制（TDR），进一步优化模型在长时程导航中的性能</li>
  <li>超参数经过消融实验确定，生成次数选择8作为默认值</li>
</ul>

<p><strong>时间衰减奖励机制（TDR）：</strong></p>
<ul>
  <li><strong>核心思想</strong>：通过引入衰减因子，平衡短期和长期奖励</li>
  <li><strong>作用机制</strong>：使模型能够更关注近期的动作，同时考虑长期目标</li>
  <li><strong>优势</strong>：用于评估多步动作预测的长期效果，优化长时程导航性能</li>
</ul>

<div align="center">
  <img src="/images/vln/vln-r1-tdr-mechanism.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/665" />
<figcaption>
时间衰减奖励（TDR）机制示意图
</figcaption>
</div>

<p><strong>模型架构：</strong></p>
<ul>
  <li><strong>输入</strong>：自我中心视频流和指令</li>
  <li><strong>输出</strong>：多步未来动作序列</li>
  <li><strong>端到端设计</strong>：消除了对导航图的依赖，使其在连续环境中表现出色</li>
</ul>

<p><strong>核心结果/发现</strong></p>

<p>VLN-R1在VLN-CE（视觉-语言导航连续环境）基准上进行了全面测试：</p>

<p><strong>测试平台：</strong></p>
<ul>
  <li><strong>Room-to-Room（R2R）</strong>：要求智能体在单个房间内导航</li>
  <li><strong>Room-Across-Room（R4R）</strong>：要求智能体跨房间导航，任务更具挑战性</li>
</ul>

<p><strong>性能表现：</strong></p>
<ul>
  <li><strong>R2R数据集</strong>：展现了高效的导航能力和准确的任务完成率</li>
  <li><strong>R4R数据集</strong>：通过强化微调显著提升了跨域适应性，小型2B模型的性能甚至接近7B模型</li>
  <li><strong>模型可扩展性</strong>：证明了端到端框架在不同模型规模下的有效性</li>
</ul>

<p><strong>消融实验验证：</strong></p>
<ul>
  <li><strong>长短期记忆采样</strong>：多步动作预测结合历史上下文显著提升性能，优于单一动作预测</li>
  <li><strong>TDR机制</strong>：与传统奖励函数相比，TDR显著提高了长时程任务的成功率</li>
  <li><strong>生成次数</strong>：从6增加到8时性能提升有限，因此选择8作为默认值</li>
</ul>

<p><strong>技术优势：</strong></p>
<ul>
  <li>端到端设计实现了实时导航</li>
  <li>结合LVLM的视觉-语言理解能力和强化学习的优化策略</li>
  <li>展示了在任务特定推理中的潜力</li>
</ul>

<p><strong>局限性</strong></p>

<p>论文内容相对简短，未详细说明具体的性能指标数值（如SR、SPL等）和与其他SOTA方法的详细对比。此外，对于Real-world部署的讨论较少，主要集中在仿真环境（Habitat）测试，缺乏真实机器人平台上的验证实验。</p>

<hr />

<h2 id="streamvln">13. StreamVLN (2025)</h2>

<p>——— 通过慢-快上下文建模实现流式视觉-语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2507.05240">arXiv:2507.05240</a> · 🏛️ <strong>ICRA 2026</strong></p>

<p><strong>精华</strong></p>

<p>这篇论文提出了一个适用于真实世界部署的流式 VLN 框架，值得借鉴的核心思想包括：(1) 采用慢-快双通道上下文建模策略，平衡全局场景理解和实时响应能力；(2) 利用 3D 几何信息进行智能 token 剪枝，在保持性能的同时显著降低计算开销；(3) 通过 KV cache 复用机制利用时间连贯性，支持长视频流的高效推理；(4) 将上下文大小和推理成本控制在有界范围内，为 embodied AI 的实际部署提供了可行方案；(5) 采用多源数据联合训练策略（VLA数据+通用VL数据+DAgger数据），同时保持通用推理能力和导航专业性能。这些设计思路可以迁移到其他需要处理长序列多模态输入的具身智能任务中。</p>

<p><strong>研究背景/问题</strong></p>

<p>现有的 Vision-and-Language Navigation 方法在处理真实世界连续环境时面临关键挑战：如何在长视频流中高效进行多模态推理，同时保持低延迟以支持实时交互。现有 Video-LLM 基于的 VLN 方法往往在细粒度视觉理解、长期上下文建模和计算效率之间存在权衡。本文旨在设计一个既能捕捉全局场景理解，又能快速响应的流式导航框架。</p>

<div align="center">
  <img src="/images/vln/StreamVLN-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1122/823" />
<figcaption>
StreamVLN 整体框架：输入包括语言指令和 RGB 图像流，每个导航episode 被建模为多轮对话，智能体持续查询下一步动作。采用固定大小的滑动窗口保留最近的对话历史，通过 token 剪枝更新非活跃窗口的上下文以减少内存开销。
</figcaption>
</div>

<p><strong>主要方法/创新点</strong></p>

<p>论文提出了 StreamVLN，一个基于慢-快上下文建模的流式视觉-语言导航框架，将 Video-LLM 扩展为交错的 vision-language-action 模型。</p>

<p><strong>1. 连续多轮自回归生成</strong></p>

<p>VLN 的多轮对话会话由一系列交错的观测和动作组成。在每个对话 $d_i = (o_i, a_i)$ 中，VLN 模型接收新观测 $o_i$ 并生成动作响应 $a_i$，条件于当前输入和对话历史。完整输入序列构造为：$o_1a_1o_2a_2…o_{i-1}a_{i-1}$。Transformer 基于 LLM 首先执行 <strong>prefill 阶段</strong>（预填充阶段）编码输入 token 并缓存 key/value（KV）状态，然后在 <strong>decoding 阶段</strong>使用缓存的 KV 对生成新 token。</p>

<p><strong>2. 快速流式对话上下文 (Fast-Streaming Dialogue Context)</strong></p>

<p>虽然跨轮次复用 KV cache 可以消除超过 99% 的 prefilling 时间，但会引入巨大的内存开销。随着对话数量增加，KV cache 呈线性增长（例如 2K token 可能消耗约 5GB 内存），使长会话变得不切实际。此外，现有 Video-LLM 在处理过长上下文时推理性能会下降。</p>

<p>StreamVLN 采用 <strong>滑动窗口 KV cache</strong> 管理对话上下文，保留固定数量 $N$ 的最近对话在活跃窗口中：$W_j = [o_{(i-N+1)}a_{(i-N+1)}…o_ia_i]$。当窗口达到容量时，key/value 状态从 LLM 中卸载，非观测对话 token（如提示词和生成的动作）的状态立即丢弃。对于新的滑动窗口，来自过去窗口的 token 状态被处理为记忆 token 状态 ${M_0, …, M_j}$。</p>

<div align="center">
  <img src="/images/vln/StreamVLN-training-data-recipe.webp" width="50%" loading="lazy" decoding="async" style="aspect-ratio:401/473" />
<figcaption>
StreamVLN 的联合训练数据配方：67% VLA 导航数据（包括 MP3D 31%、HM3D 20%、DAgger 16%）+ 33% 通用多模态数据（VQA 17% + MMC4 16%），确保在保持导航性能的同时维持通用视觉-语言推理能力。
</figcaption>
</div>

<p><strong>3. 慢速更新记忆上下文 (Slow-Updating Memory Context)</strong></p>

<p>在有限的上下文长度内平衡时间分辨率和细粒度空间感知仍然是 Video-LLM 的关键挑战。StreamVLN 不在特征层面压缩视频 token（如通过平均池化），而是保留高图像分辨率的同时选择性地丢弃空间和时间冗余 token，以更好地保持 Video-LLM 的可迁移性。</p>

<ul>
  <li><strong>时间采样</strong>: 采用简单的固定数量采样策略，避免不同长度的记忆 token 引入时间持续偏差</li>
  <li><strong>体素化空间剪枝 (Voxel-based Spatial Pruning)</strong>: 使用深度信息将视频流中的 2D 图像patches 反投影到共享 3D 空间，离散化为均匀体素。通过跟踪 patch token 在时间上的体素索引，如果给定时长内的多个 token 投影到同一体素，仅保留最新观测的 token。该剪枝掩码用于选择保留的 token 状态（详见 Algorithm 1）。</li>
</ul>

<p><strong>4. 多源数据联合训练</strong></p>

<ul>
  <li><strong>Vision-Language Action (VLA) 数据</strong>:
    <ul>
      <li>使用 Habitat 模拟器收集 450K 样本（来自 60 个 Matterport3D 环境的 R2R、R2R-EnvDrop 和 RxR 数据集）</li>
      <li>额外 300K 样本来自 ScaleVLN（涵盖 700 个 HM3D 场景）以提高场景多样性</li>
      <li>采用 DAgger 算法收集 240K 纠正示范样本以增强鲁棒性和错误恢复能力</li>
    </ul>
  </li>
  <li><strong>通用Vision-Language数据</strong>: 为保持预训练 Video-LLM 的通用推理能力，引入：
    <ul>
      <li>248K 视频基础 VQA 样本（来自 LLaVA-Video-178K 和 ScanQA）</li>
      <li>230K 交错图像-文本样本（来自 MMC4）以增强多轮视觉-语言交互能力</li>
    </ul>
  </li>
</ul>

<p><strong>主要创新点</strong>：</p>
<ul>
  <li>首次提出针对实时 VLN 的慢-快上下文建模策略</li>
  <li>设计了基于 3D 几何的智能 token 剪枝方法，优于通用的均匀剪枝</li>
  <li>实现了低延迟、可扩展的流式多模态推理框架，支持 KV cache 高效复用</li>
  <li>通过交错 vision-language-action 建模支持连贯的多轮对话</li>
  <li>有界的上下文大小和推理成本，适合长视频流处理</li>
</ul>

<p><strong>核心结果/发现</strong></p>

<div align="center">
  <img src="/images/vln/StreamVLN-visual-reasoning-transfer.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1108/424" />
<figcaption>
StreamVLN 的视觉推理能力迁移：模型能够通过 VQA 对话正确识别画面内容（如蒙娜丽莎画像），并将这种推理能力迁移到理解导航指令中，展示了强大的跨模态理解能力。
</figcaption>
</div>

<ul>
  <li><strong>VLN-CE 基准测试上取得 state-of-the-art 性能</strong>：
    <ul>
      <li>R2R Val-Unseen: SR 56.4%, SPL 50.2%（StreamVLN†，加入 ScaleVLN 子集等额外训练数据；只用 R2R / RxR 时为 52.8% / 47.2%）</li>
      <li>RxR Val-Unseen: SR 54.4%, SPL 45.4%, nDTW 63.7%（以上为 arXiv v2 / ICRA 2026 版数字；v1 为 R2R 56.9 / 51.9、RxR 52.9 / 46.0）</li>
      <li>性能与 ETPNav 相当，但不依赖全景视图或航点监督</li>
    </ul>
  </li>
  <li>
    <p><strong>ScanQA 3D 问答基准测试</strong>：超越 NaVILA 和 NaviLLM，Exact Match达到 28.8%</p>
  </li>
  <li><strong>真实世界部署验证</strong>：
    <ul>
      <li>在 Unitree Go2 机器狗上成功部署</li>
      <li>平均推理延迟 0.27s（4个动作）+ 通信延迟 0.2s（室内）/ 1.0s（室外）</li>
      <li>支持实时物理部署</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/StreamVLN-real-world-qualitative.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/875" />
<figcaption>
StreamVLN 在多个真实世界环境中的定性结果（从上到下：Home、Workspace、Mall、Outdoor）。模型能够准确遵循包含多个地标的复杂指令，并处理真实世界中的干扰和变化。
</figcaption>
</div>

<ul>
  <li><strong>关键消融实验发现</strong>：
    <ul>
      <li>KV cache 复用在多轮对话中消除超过 99% 的 prefilling 时间</li>
      <li>滑动窗口大小为 8 个对话轮次时实现最佳平衡</li>
      <li>记忆上下文大小从 2×196 增加到 8×196 tokens 时，SR 从 37.3% 提升到 45.5%</li>
      <li>体素化空间剪枝减少约 20% 的输入 token，同时提升性能（R2R +1.2% SR，RxR +1.1% SR）</li>
      <li>DAgger 数据对性能提升至关重要（+5.5% SR / +3.8% SPL）</li>
      <li>通用 VL 数据（VideoQA + MMC4）的联合训练带来显著增益（+7.3% SR / +5.6% SPL）</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/StreamVLN-KV-cache-latency.webp" width="70%" loading="lazy" decoding="async" style="aspect-ratio:455/420" />
<figcaption>
KV cache 复用对多轮对话解码延迟的影响：全轮次 KV cache 保持最低延迟；滑动窗口 KV cache 在窗口切换时有轻微延迟增加；单轮 KV cache（先前工作）的延迟随轮次线性增长。
</figcaption>
</div>

<p><strong>局限性</strong></p>

<ol>
  <li>直接从原始视觉观测生成低级动作对视点和遮挡变化的鲁棒性较弱，在真实世界环境中可能导致次优控制</li>
  <li>当前的混合上下文建模策略在更长视野的导航场景中仍然面临挑战，保持扩展序列上的一致推理较为困难</li>
  <li>依赖显式动作历史作为对话上下文的一部分，为异步推理和部署带来额外复杂性，需要同步过去的动作以保持对话连贯性</li>
</ol>

<hr />

<h2 id="navfom">14. NavFoM (2025)</h2>
<p>——Embodied Navigation Foundation Model</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2509.12129">arXiv:2509.12129</a> · 🏛️ <strong>ICLR 2026</strong></p>

<p><strong>精华</strong></p>

<p>这篇论文展示了如何构建跨任务、跨具身体的导航基础模型,值得借鉴的核心思想包括:(1) 引入 Temporal-Viewpoint Indicator (TVI) tokens 来统一编码不同相机配置和时间信息,使模型能够处理多视角输入;(2) 提出 Budget-Aware Temporal Sampling (BATS) 策略,通过遗忘曲线动态采样历史帧,平衡性能和推理速度;(3) 在 8.02M 导航样本(包括四足机器人、无人机、轮式机器人、汽车等多种具身体)上联合训练,展示了大规模多任务训练对泛化能力的提升;(4) 采用视觉特征缓存机制加速训练 2.9 倍;(5) 证明了无需针对特定任务微调即可在多个基准测试上达到 SOTA 或竞争性能。</p>

<p><strong>研究背景/问题</strong></p>

<p>当前导航系统主要聚焦于特定任务设定和具身体架构,缺乏跨任务和跨具身体的泛化能力。现有 VLM 虽然在零样本任务上表现出色,但导航任务仍然局限于狭窄的任务领域、固定的相机配置和特定的具身体平台。本文旨在构建一个统一的导航基础模型,能够处理来自不同具身体(四足机器人、无人机、轮式机器人、汽车)的多视角输入,并跨越多个导航任务(VLN、目标搜索、目标追踪、自动驾驶)。</p>

<p><strong>主要方法/创新点</strong></p>

<div align="center">
  <img src="/images/vln/NavFoM-pipeline-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/702" />
<figcaption>
NavFoM 整体架构:统一框架处理 Image QA、Video QA 和导航任务
</figcaption>
</div>

<p>NavFoM 基于 Vision-Language Model 架构,扩展为双分支系统:一个用于导航,一个用于问答。核心创新包括:</p>

<p><strong>1. Temporal-Viewpoint Indicator (TVI) Tokens</strong></p>
<ul>
  <li>引入特殊 indicator tokens 来编码相机视角和时间信息,每个 TVI token 由三部分组成:
    <ul>
      <li><strong>可学习的 base embedding</strong> (E_Base)</li>
      <li><strong>时间编码</strong> (Time PE): 使用正弦位置编码标识帧的时间顺序</li>
      <li><strong>视角编码</strong> (Angle PE): 使用正弦/余弦编码保持方位角的循环连续性</li>
    </ul>
  </li>
  <li>对于导航任务,使用: E_TVI = E_Base + Time PE + Angle PE</li>
  <li>对于 Video QA,仅使用时间信息;对于 Image QA,仅使用 base embedding</li>
  <li>TVI tokens 使 LLM 能够区分不同时间步和不同视角的 tokens,实现多视角导航</li>
</ul>

<p><strong>2. Budget-Aware Temporal Sampling (BATS)</strong></p>
<ul>
  <li>解决在线导航时视觉 tokens 数量激增的问题</li>
  <li>基于遗忘曲线(exponential decay)的采样概率: P(t) = (1 - ε)e^(k(t-T)/T) + ε</li>
  <li>动态调整历史帧采样,越近的帧采样概率越高</li>
  <li>在 token budget 约束下,平衡短期上下文和长期历史信息</li>
  <li>相比 Uniform Sampling,BATS 在保持性能的同时显著降低推理时间</li>
</ul>

<p><strong>3. 观测编码</strong></p>
<ul>
  <li>使用预训练 vision encoders (DINOv2, SigLIP) 提取视觉特征</li>
  <li>采用 Grid Average Pooling 策略生成两种分辨率的视觉 tokens:
    <ul>
      <li><strong>Fine-grained</strong> (64×C): 用于当前最新观测和 Image QA</li>
      <li><strong>Coarse-grained</strong> (4×C): 用于导航历史和 Video QA</li>
    </ul>
  </li>
  <li>通过 cross-modality projector 将视觉特征映射到 LLM latent space</li>
</ul>

<p><strong>4. Token 组织策略</strong></p>
<ul>
  <li>不同任务采用不同的 token 组织方式:
    <ul>
      <li><strong>Image QA</strong>: fine-grained visual tokens + base TVI embedding</li>
      <li><strong>Video QA</strong>: coarse-grained visual tokens + base + time embedding</li>
      <li><strong>Navigation</strong>: coarse-grained + fine-grained tokens + base + time + angle embedding</li>
    </ul>
  </li>
  <li>这种设计实现了导航和 QA 数据的联合训练</li>
</ul>

<p><strong>5. 轨迹预测</strong></p>
<ul>
  <li>使用三层 MLP 作为 planning head 从 LLM 隐藏状态预测轨迹</li>
  <li>轨迹归一化到 [-1, 1] 分布,针对不同具身体(室内导航 vs 户外驾驶)采用不同的 scaling factor</li>
  <li>对于室内机器人,预测 8 个航点;对于汽车和无人机,预测更长的轨迹</li>
</ul>

<p><strong>6. 数据规模与来源</strong></p>
<ul>
  <li><strong>导航数据</strong> (8.02M): VLN-CE R2R/RxR (2.94M), OpenUAV (429K), 目标导航 (1.02M), 主动视觉追踪 (897K), 自动驾驶 (681K), Web 导航伪标签 (2.03M)</li>
  <li><strong>QA 数据</strong> (4.76M): Image QA (3.15M) + Video QA (1.61M)</li>
  <li>总计 12.7M 训练样本,覆盖四足机器人、无人机、轮式机器人、汽车等多种具身体</li>
</ul>

<p><strong>7. 训练优化</strong></p>
<ul>
  <li>视觉特征缓存: 预先计算并缓存 coarse-grained visual tokens,训练加速 2.9 倍,GPU 内存减少 1.8 倍</li>
  <li>使用 Qwen2-7B 作为 LLM backbone</li>
  <li>单次训练所有参数(仅 designated trainable parameters),无需多阶段训练</li>
</ul>

<p><strong>核心结果/发现</strong></p>

<p><strong>VLN 性能</strong>:</p>
<ul>
  <li><strong>VLN-CE R2R</strong>: 单视角 SR 56.2%、SPL 51.2%(NE 5.01、OSR 64.9);四视角 SR 61.7%、SPL 55.3%(NE 4.61、OSR 72.1),无需任务特定微调</li>
  <li><strong>VLN-CE RxR</strong>: 单视角 SR 57.4%、SPL 49.4%;四视角 SR 64.4%、SPL 56.2%,超越所有基线方法</li>
  <li><strong>OpenUAV</strong> (四视角,UM split): SR 6.38% → 14.05%, OSRL 5.68% → 18.65%,显著优于 TravelUAV</li>
</ul>

<p><strong>目标搜索</strong>:</p>
<ul>
  <li><strong>HM3D-OVON</strong> (zero-shot): VAL SEEN SR 55.0%, VAL UNSEEN SR 45.2%,超越 MTU3D baseline</li>
</ul>

<p><strong>主动视觉追踪</strong>:</p>
<ul>
  <li><strong>EVT-Bench</strong> (four-view, zero-shot): Single Target SR 85.1%/TR 80.5%, Distracted Target SR 62.0%/TR 67.9%</li>
</ul>

<p><strong>自动驾驶</strong>:</p>
<ul>
  <li><strong>NAVSIM</strong> (eight-view): PDMS 84.3%, 与 SOTA 方法竞争性能</li>
  <li><strong>nuScenes</strong> (six-view): CR 93%, 接近 SOTA</li>
</ul>

<p><strong>Ablation 研究</strong>:</p>
<ul>
  <li>多任务训练带来显著增益:联合训练使 VLN SR 从 57.3% 提升到 64.4%</li>
  <li>相机数量对性能的影响:从单视角到四视角,SR 从 58.3% 提升到 65.8%,但增加到六视角略有下降</li>
  <li>BATS 相比 Uniform Sampling,在 RxR 上 nDTW 仅下降 1.4%,但保持稳定推理速度</li>
  <li>TVI tokens 相比其他替代方案(learned special tokens, handcraft tokens)显著提升性能</li>
</ul>

<p><strong>实际部署</strong>:</p>
<ul>
  <li>在 110 个真实世界测试场景(50 VLN + 30 搜索 + 30 追踪)中验证,成功率达到 72%~93%</li>
  <li>支持跨具身体部署:四足机器人(Unitree Go2)、类人机器人、无人机、轮式机器人</li>
  <li>0.5 秒内生成 8 航点轨迹(1600 token budget)</li>
</ul>

<p><strong>局限性</strong></p>

<p>该方法在训练时需要大量计算资源(56 NVIDIA H100 GPUs,72 小时)。尽管引入了视觉特征缓存等优化策略,大规模训练仍然是资源密集型任务。此外,在需要遍历 300 米复杂邻域的 Unseen-Map 场景中表现较差,表明模型在大规模环境探索和长距离规划方面仍有改进空间。作者也指出 NavFoM 只是一个起点,未来需要更高质量的数据、更先进的技术以及新一代基准测试来推动泛化导航研究的发展。</p>
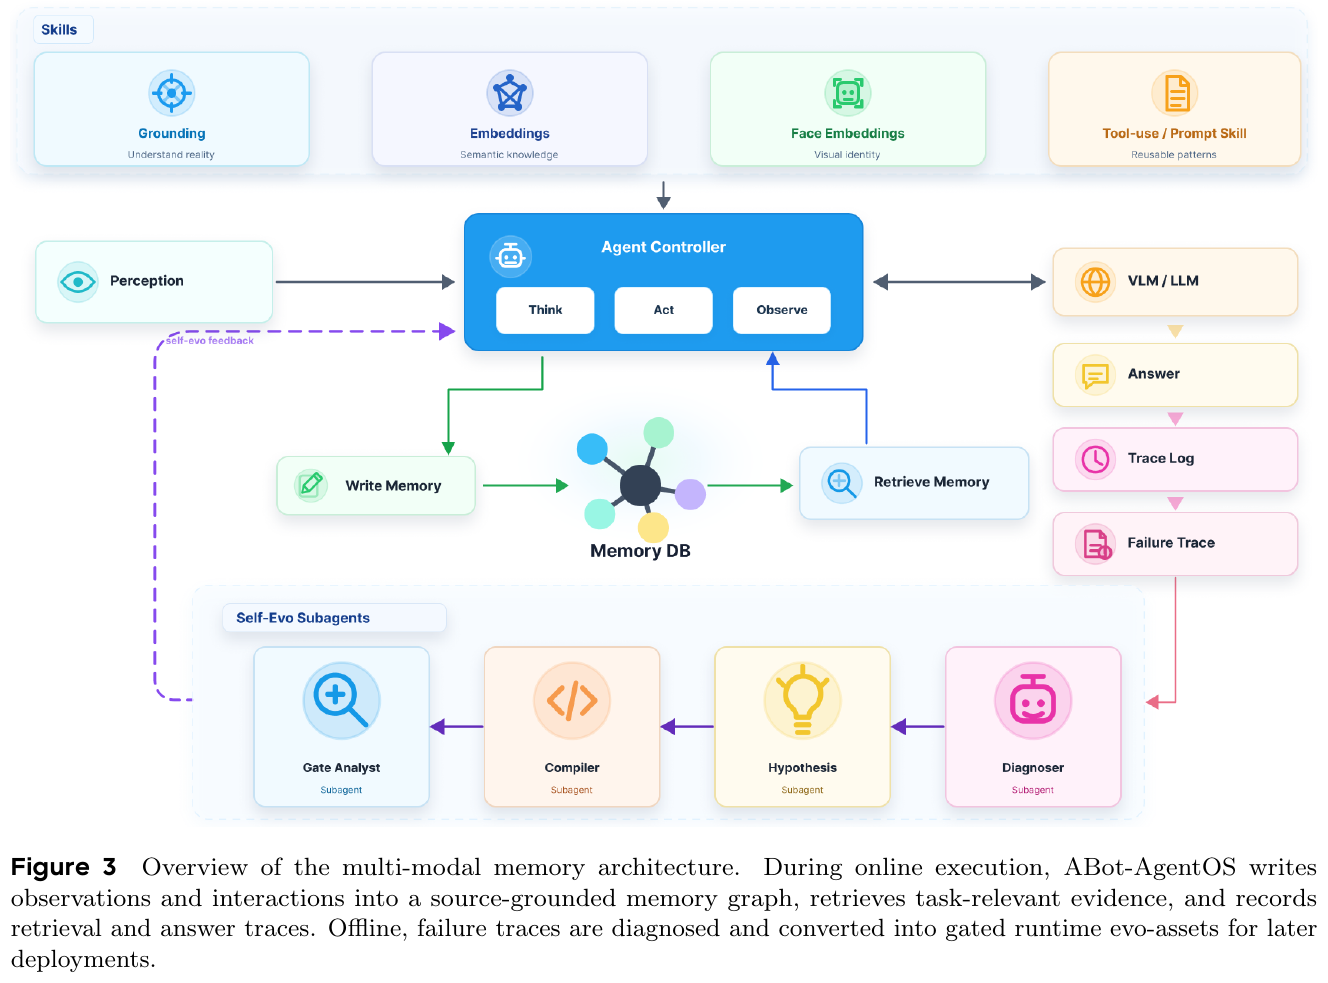
<hr />

<h2 id="mapnav">15. MapNav (2025)</h2>
<p>———A Novel Memory Representation via Annotated Semantic Maps for Vision-and-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2502.13451">arXiv:2502.13451</a> · 🏛️ <strong>ACL 2025</strong></p>

<hr />

<p><strong>精华</strong></p>

<p>MapNav 的核心创新在于用轻量级的 Annotated Semantic Map (ASM) 替代传统的历史 RGB 帧序列作为记忆表示，实现了恒定 0.17MB 的内存占用（与步数无关），推理速度提升 79.5%。值得借鉴的关键思想：将语义地图与自然语言标注相结合，使 VLM 能够直接理解空间信息，而无需额外的解码器；用结构化的 top-down 地图取代时序帧，把”历史信息”从时间维度转移到空间维度，大幅降低计算开销。这种”语言化地图”的思路为 VLM 赋能导航提供了一个清晰且高效的范式。</p>

<hr />

<p><strong>研究背景/问题</strong></p>

<p>Vision-and-Language Navigation (VLN-CE) 要求 agent 在连续三维环境中跟随自然语言指令导航。现有方法大量依赖历史 RGB 帧作为时序上下文，导致内存随轨迹长度线性增长（Navid 在 300 步时高达 276MB），且无法充分利用 VLM 对语言的理解能力。设计一种高效的记忆表示以替代历史帧，成为本工作的核心动机。</p>

<hr />

<p><strong>主要方法/创新点</strong></p>

<p>MapNav 提出一个端到端的 VLM-based VLN 框架，核心组件是在线更新的 Annotated Semantic Map (ASM)。</p>

<div align="center">
  <img src="/images/vln/MapNav-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1286/915" />
<figcaption>
MapNav 整体框架：ASM 与当前 RGB 观测、指令一起输入 VLM，直接生成导航动作
</figcaption>
</div>

<p><strong>ASM 生成流程</strong></p>

<div align="center">
  <img src="/images/vln/MapNav-ASM-generation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1278/515" />
<figcaption>
ASM 生成过程：RGB-D → 点云 → 语义地图 → 文字标注地图
</figcaption>
</div>

<p>ASM 是一个多通道张量 <strong>M</strong>（维度 $C \times W \times H$，$C = C_n + 4$），其中：</p>
<ul>
  <li><strong>基础通道（1-4）</strong>：编码障碍物分布、已探索区域、agent 当前位置、历史轨迹</li>
  <li><strong>语义通道（n个）</strong>：存储各目标物体的空间分布</li>
</ul>

<p>生成流程：</p>
<ol>
  <li>用 Mask2Former 对当前 RGB 帧做语义分割，提取目标 mask</li>
  <li>结合深度图将 3D 点云投影到 2D 俯视平面，对齐语义 mask</li>
  <li>对每个语义区域做连通分量分析，计算区域质心并在地图上添加文字标签（如 “chair”、”potted plant”）</li>
  <li>生成最终 ASM，包含物体位置、轨迹、障碍物等结构化信息</li>
</ol>

<p><strong>为什么 ASM 优于普通语义地图？</strong></p>

<div align="center">
  <img src="/images/vln/MapNav-map-format-comparison.webp" width="70%" loading="lazy" decoding="async" style="aspect-ratio:1027/1210" />
<figcaption>
不同地图格式的 VLM 理解对比：ASM 的文字标注使 VLM 能精确识别物体位置和语义
</figcaption>
</div>

<p>实验证明，VLM（GPT-4o 和 MapNav）处理 ASM 时表现出对物体位置的精准理解（注意力峰值 &gt; 0.8），而处理原始 top-down 地图（峰值 &lt; 0.3）或语义地图（峰值 &lt; 0.4）时注意力极为分散。ASM 通过显式文字标注将抽象语义转化为语言基础，充分激活 VLM 预训练的语言理解能力。</p>

<p><strong>双流编码器架构</strong></p>

<p>MapNav 基于 LLaVA-Onevision 框架，使用 SigLIP-so400m 视觉编码器：</p>

\[\mathbf{F}_t = \Phi_{spatial}(\mathbf{X}_t, \mathcal{G}), \quad \mathbf{F}_t^M = \Phi_{spatial}(\mathbf{X}_t^M, \mathcal{G})\]

<p>两路特征分别通过 MLP 投影对齐到语言空间，最终拼接为统一表示：</p>

\[\mathbf{V}_t = [\text{TASK}; \mathbf{E}_t; \text{OBS}; \mathbf{E}_t^M; \text{MAP}]\]

<p><strong>动作预测</strong></p>

<p>VLM 直接输出自然语言动作，通过正则表达式匹配解析为 {前进, 左转, 右转, 停止} 四类动作，无需额外动作解码器。</p>

<p><strong>训练数据（~1M 样本）</strong></p>

<p>三阶段数据收集：</p>
<ul>
  <li>Phase I：来自 R2R + RxR 的 GT 轨迹（~300k × 2）</li>
  <li>Phase II：DAgger 在线交互采集（~200k × 2）</li>
  <li>Phase III：碰撞恢复专项数据（~25k × 2）</li>
</ul>

<p><strong>历史帧数量的消融</strong></p>

<div align="center">
  <img src="/images/vln/MapNav-historical-frames-ablation.webp" width="70%" loading="lazy" decoding="async" style="aspect-ratio:624/496" />
<figcaption>
不同历史帧数量对性能的影响：加入 ASM 的提升远大于增加历史帧数量
</figcaption>
</div>

<p>加入 ASM 后，SR 从 27% 提升至 36%，SPL 从 23% 提升至 34%；继续增加历史 RGB 帧带来的提升则相当有限，说明核心增益来自 ASM 的空间表示能力，而非时序帧累积。</p>

<hr />

<p><strong>核心结果/发现</strong></p>

<p><strong>模拟环境（R2R-CE &amp; RxR-CE Val-Unseen）</strong></p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>R2R SR↑</th>
      <th>R2R SPL↑</th>
      <th>RxR SR↑</th>
      <th>RxR SPL↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>NaVid (All RGB Frames)</td>
      <td>49.1</td>
      <td>37.4</td>
      <td>23.8</td>
      <td>21.2</td>
    </tr>
    <tr>
      <td>MapNav (w/o ASM + Cur. RGB)</td>
      <td>41.2</td>
      <td>27.1</td>
      <td>15.6</td>
      <td>12.2</td>
    </tr>
    <tr>
      <td><strong>MapNav (w/ ASM + Cur. RGB)</strong></td>
      <td><strong>50.3</strong></td>
      <td><strong>36.5</strong></td>
      <td><strong>22.1</strong></td>
      <td><strong>20.2</strong></td>
    </tr>
    <tr>
      <td>MapNav (w/ ASM + Cur. + 2 His. RGB)</td>
      <td>53.0</td>
      <td>39.7</td>
      <td>32.6</td>
      <td>27.7</td>
    </tr>
  </tbody>
</table>

<ul>
  <li>仅用 ASM + 单帧 RGB，性能即可媲美使用全部历史帧的 NaVid</li>
  <li>加入 2 帧历史 RGB 后超越所有 SOTA，R2R SPL 提升 1.3%，RxR SPL 提升 6.5%</li>
</ul>

<p><strong>效率对比（关键优势）</strong></p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>1步</th>
      <th>10步</th>
      <th>100步</th>
      <th>300步</th>
      <th>平均推理时间</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Navid</td>
      <td>0.92MB</td>
      <td>9.2MB</td>
      <td>92MB</td>
      <td><strong>276MB</strong></td>
      <td>1.22s</td>
    </tr>
    <tr>
      <td><strong>MapNav</strong></td>
      <td><strong>0.17MB</strong></td>
      <td><strong>0.17MB</strong></td>
      <td><strong>0.17MB</strong></td>
      <td><strong>0.17MB</strong></td>
      <td><strong>0.25s</strong></td>
    </tr>
  </tbody>
</table>

<ul>
  <li>内存占用恒定 0.17MB，与轨迹长度完全解耦</li>
  <li>推理速度提升 <strong>79.5%</strong>（1.22s → 0.25s）</li>
</ul>

<p><strong>真实世界（5种室内场景）</strong></p>

<p>在 Office、Meeting Room、Lecture Hall、Tea Room、Living Room 中，MapNav 在简单指令和语义指令下均全面超越 WS-MGMAP 和 Navid，SR 提升最高达 30%。</p>

<hr />

<p><strong>局限性</strong></p>

<p>语义分割模块在遮挡或光照变化等复杂条件下可能产生不准确的物体标签，从而影响 ASM 质量。未来计划扩展到更复杂的具身 AI 任务（如交互导航和操作），需将物体可供性和物理交互能力整合进 ASM 表示。</p>

<hr />

<h2 id="open-nav">16. Open-Nav (2025)</h2>
<p>———Zero-Shot VLN in Continuous Environment with Open-Source LLMs</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2409.18794">arXiv:2409.18794</a> · 🏛️ <strong>ICRA 2025</strong></p>

<h3 id="精华-5">精华</h3>

<p>Open-Nav 的核心贡献在于将昂贵的 GPT-4 API 替换为本地部署的开源 LLM，同时维持竞争力性能，这对隐私敏感的真实场景机器人部署有重要意义。论文设计的三阶段空间-时序 CoT（指令理解 → 进度估计 → 决策制定）是一种可复用的 LLM 导航推理框架，值得借鉴。用 SpatialBot + RAM 联合增强视觉感知的思路——一个负责空间关系理解，一个负责细粒度目标识别——有效弥补了开源 LLM 相比 GPT-4 在视觉感知上的差距。真实世界评估结果显示，无训练的 Open-Nav 甚至超越了有监督训练的 SOTA 方法，说明 LLM 的泛化能力在分布外场景中优势显著。</p>

<hr />

<h3 id="1-研究背景问题-4">1. 研究背景/问题</h3>

<p>Vision-and-Language Navigation in Continuous Environments (VLN-CE) 要求 agent 在未见过的 3D 室内环境中，根据自然语言指令进行导航。现有基于 LLM 的零样本方法（如 NavGPT、DiscussNav）严重依赖 GPT-4 API，存在高昂 token 费用和用户环境数据隐私泄露风险，且主要在离散环境中验证，难以直接应用于连续真实场景。</p>

<hr />

<h3 id="2-主要方法创新点-4">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/Open-Nav-motivation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:697/557" />
<figcaption>
GPT-based Navigator 与 Open-Source LLM-based Navigator 的对比：后者无需 API 费用，且环境数据不离开本地设备，保护用户隐私。
</figcaption>
</div>

<p>Open-Nav 框架由三个核心模块组成：</p>

<p><strong>1. Waypoint Prediction 模块</strong></p>

<p>使用基于 Transformer 的路径点预测模型，融合 RGB 和深度图像特征（两个专用 ResNet50 分支）：</p>

\[v_i^{rgbd} = W_m(f_{\text{ResNet-RGB}}(I_i^{rgb}) \| f_{\text{ResNet-Depth}}(I_i^d))\]

<p>经 Transformer 处理后生成候选路径点热力图，再通过 NMS 筛选出 K 个候选方向点 \(\Delta W = \{\Delta w_i\}_{i=1}^K\)，每个候选点由角度和距离表示。</p>

<p><strong>2. Scene Perception 模块</strong></p>

<p>针对连续环境中需要精确空间理解的挑战，使用两个互补模型增强场景描述：</p>

<ul>
  <li><strong>SpatialBot</strong>：空间理解 VLM，输入 RGB+深度图，输出包含物体间距离和空间关系的文本描述</li>
  <li><strong>RAM</strong>（Recognize Anything Model）：细粒度目标检测，识别场景中所有物体的类别和三维位置</li>
</ul>

<p>两者输出合并为统一的文本化场景观测 $O_{text} = \langle D_{spatial}, {o_i}\rangle$，为 LLM 提供丰富的空间语境。</p>

<div align="center">
  <img src="/images/vln/Open-Nav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1419/882" />
<figcaption>
Open-Nav 整体架构：Waypoint Prediction 模块识别候选导航点，Scene Perception 模块（RAM + SpatialBot）提取物体位置和空间关系，LLM Navigator 执行三阶段 CoT 推理并输出动作。
</figcaption>
</div>

<p><strong>3. LLM Navigator：三阶段空间-时序 Chain-of-Thought</strong></p>

<p>这是 Open-Nav 的核心创新。每个导航步骤，LLM 按顺序完成三个推理阶段：</p>

<ul>
  <li><strong>指令理解（Instruction Comprehension）</strong>：将导航指令分解为动作序列和地标列表，使用专用 prompt 提取结构化信息</li>
  <li><strong>进度估计（Progress Estimation）</strong>：综合历史轨迹和当前观测，通过地标验证、方向分析、动作完成度评估四步判断已完成哪些子任务</li>
  <li><strong>决策制定（Decision Making）</strong>：整合当前候选路径点的空间描述、历史轨迹摘要和进度估计结果，生成推理过程并选择最优方向点</li>
</ul>

<p>框架通过 <a href="https://ollama.ai/">Ollama</a> 在本地部署四种开源 LLM：Llama3.1-70B、Qwen2-72B、Gemma2-27B、Phi3-14B。</p>

<hr />

<h3 id="3-核心结果发现-4">3. 核心结果/发现</h3>

<p><strong>模拟环境（R2R-CE 数据集）</strong>：</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>SR↑</th>
      <th>SPL↑</th>
      <th>nDTW↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>DiscussNav-GPT4</td>
      <td>15</td>
      <td>10.51</td>
      <td>42.87</td>
    </tr>
    <tr>
      <td>Open-Nav-Llama3.1（本文）</td>
      <td><strong>16</strong></td>
      <td><strong>12.90</strong></td>
      <td><strong>44.99</strong></td>
    </tr>
    <tr>
      <td>Open-Nav-GPT4（本文）</td>
      <td>19</td>
      <td>16.10</td>
      <td>45.79</td>
    </tr>
  </tbody>
</table>

<p>Open-Nav 使用开源 LLM 在 SR 和 SPL 上均超过 DiscussNav-GPT4，证明开源 LLM 配合良好的感知增强可媲美闭源方案。</p>

<p><strong>真实世界环境（Office / Lab / Game Room）</strong>：</p>

<div align="center">
  <img src="/images/vln/Open-Nav-real-world-env.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:694/248" />
<figcaption>
真实世界测试环境：办公室、实验室、游戏室，每个场景各标注 20 条指令（含简单和复杂指令）。
</figcaption>
</div>

<div align="center">
  <img src="/images/vln/Open-Nav-real-world-demo.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:654/302" />
<figcaption>
Open-Nav 在真实环境中的导航过程可视化，右侧显示 LLM Navigator 的逐步推理过程，体现 CoT 思维链的可解释性。
</figcaption>
</div>

<p>在全部真实场景中：Open-Nav-Llama3.1 达到 <strong>SR=35, NE=2.39</strong>，超越有监督训练的 CMA（SR=23）、RecBERT（SR=27）、BEVBert（SR=20），验证了 LLM 泛化能力在分布外场景的优越性。</p>

<p><strong>不同开源 LLM 对比（模拟环境导航性能）</strong>：</p>

<div align="center">
  <img src="/images/vln/Open-Nav-llm-action-decomposition.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:1321/453" />
<figcaption>
四种开源 LLM 在动作分解任务上的性能对比（SPICE/BLEU/METEOR/ROUGE）。
</figcaption>
</div>

<div align="center">
  <img src="/images/vln/Open-Nav-llm-landmark-extraction.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:646/315" />
<figcaption>
四种开源 LLM 在地标提取任务上的性能对比。Llama3.1-70B 在地标提取上表现最佳，Qwen2-72B 在动作分解上得分最高，但 Llama3.1-70B 在最终导航性能（SR=16, SPL=12.90）上综合最优。
</figcaption>
</div>

<hr />

<h3 id="4-局限性-4">4. 局限性</h3>

<p>当前开源 LLM 的推理速度较慢，在真实环境中计算效率仍有待提升；论文未探索针对导航任务微调开源 LLM 的潜力，未来可进一步缩小与 GPT-4 的性能差距。</p>

<hr />

<h2 id="skill-nav">17. Skill-Nav (2025)</h2>
<p>———Enhanced Navigation with Versatile Quadrupedal Locomotion via Waypoint Interface</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2506.21853">arXiv:2506.21853</a> · 🏛️ <strong>Vicinagearth (Springer) 2025</strong></p>

<h3 id="精华-6">精华</h3>

<p>Skill-Nav 的核心贡献在于用 <strong>waypoint（路标点）</strong> 作为高层规划器与低层运动控制器之间的接口，相比速度命令接口，waypoint 对追踪误差更不敏感，且天然兼容 LLM 和经典路径规划算法。两阶段训练策略（WP-Fixed 先学技能、WP-Random 再强化泛化）解决了单阶段训练的跌步或过度跳跃问题，值得在其他层级化机器人控制任务中借鉴。Teacher-Student 蒸馏架构通过在 Student 训练时引入膨胀虚拟障碍（inflated virtual obstacles），使 Student 策略在不接触特权信息的条件下保持安全导航能力。</p>

<hr />

<h3 id="1-研究背景问题-5">1. 研究背景/问题</h3>

<p>四足机器人通过 RL 已能完成极限 parkour 等高难度运动，但将丰富的运动技能集成到长距离导航任务中仍未充分探索。现有方法大多以速度命令为接口，高层规划器难以精确跟踪，且与多样化通用规划工具（LLM、A*）耦合困难。</p>

<hr />

<h3 id="2-主要方法创新点-5">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/Skill-Nav-overview.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:512/559" />
<figcaption>
Skill-Nav 整体架构：高层规划器（经典方法或 LLM）生成 waypoint 序列，低层运动策略执行跳跃、攀爬、绕行等多样运动技能
</figcaption>
</div>

<p><strong>Waypoint 接口设计</strong></p>

<p>Skill-Nav 以 2D 相对位置（相对于机器人 base frame 的坐标）作为 waypoint 命令替代速度命令。高层规划器通过 $\mathcal{W} = \mathcal{H}(\mathbf{M}, p_e, p_s)$ 生成从起点到终点的 waypoint 序列，$\mathcal{H}$ 可以是 A* 算法或 LLM，$\mathbf{M}$ 为粗粒度环境信息（如占用地图或房间布局）。</p>

<p><strong>两阶段训练策略</strong></p>

<div align="center">
  <img src="/images/vln/Skill-Nav-training-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1046/477" />
<figcaption>
训练流程：Teacher 策略依次在 WP-Fixed 和 WP-Random 场景训练，利用特权信息（地形扫描点、深度图等）；Student 策略通过行为蒸馏从 Teacher 中学习，仅使用历史本体感知和深度图
</figcaption>
</div>

<ul>
  <li>
    <p><strong>WP-Fixed 场景</strong>（技能学习）：障碍物按行排列，waypoint 预置。策略从零开始学习攀爬箱体、跨越间隙、越过护栏等基础运动技能。设计 $r_{\text{reach}} = n_p/(t + \epsilon)$ 鼓励机器人快速到达更多 waypoint，同时引入 $r_{\text{stay}}$ 使机器人在到达 waypoint 后等待下一条指令。</p>
  </li>
  <li>
    <p><strong>WP-Random 场景</strong>（泛化增强）：障碍物以矩阵形式随机分布，waypoint 根据机器人位置和偏航角动态选取。引入修改后的 $r_{\text{track}}$，当速度方向与 waypoint 方向余弦相似度 $&lt; 0.1$ 时给予 $-1$ 惩罚，鼓励机器人向目标前进。Student 训练时在深度图中加入虚拟膨胀障碍，使学生策略保持安全距离。</p>
  </li>
</ul>

<p><strong>双规划器高层架构</strong></p>

<ul>
  <li><strong>经典规划（A*）</strong>：输入仅含墙体标注的占用地图，输出连续路径点序列，以 0.5–3m 间隔采样为 waypoint 输入低层控制器。</li>
  <li><strong>LLM 规划</strong>：向 LLM 提供任务描述、粗粒度地形图、机器人运动能力（最高攀爬 0.45m、最大跨越 0.7m 间隙）等信息，由 LLM 生成 waypoint 索引序列（以 GPT-4 验证）。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-5">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/Skill-Nav-heatmap.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1046/327" />
<figcaption>
Omni-traverse 任务中各方法的位置访问热图：本方法（Ours）覆盖更广的区域，展现出更强的多方向运动能力
</figcaption>
</div>

<div align="center">
  <img src="/images/vln/Skill-Nav-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1048/651" />
<figcaption>
仿真（LLM 规划）和真实世界（A* 规划）中机器人导航快照，成功穿越复杂地形
</figcaption>
</div>

<ul>
  <li><strong>Single-traverse 任务</strong>：在有无高障碍物场景中，Skill-Nav 均达到 SR=1.00、ATD=15.8m，是唯一在两种条件下均成功的方法。</li>
  <li><strong>Omni-traverse 任务</strong>：SR=0.89、ATD=8.2m，超越所有对比方法（RMA SR=0.00，Extreme Parkour SR=0.44/0.28）。</li>
  <li><strong>消融分析</strong>：仅 WP-Fixed 训练（Ours-s1）因 waypoint 分布规则，泛化能力差；仅 WP-Random 训练（Ours-s2）导致过度跳跃步态，实际部署困难；两阶段结合效果最优。</li>
  <li><strong>真实机器人部署</strong>：在 Unitree AlienGo 上成功验证，可应对深度相机未检测到的低矮障碍，并在受到外力干扰后恢复平衡继续导航。</li>
</ul>

<hr />

<h3 id="4-局限性-5">4. 局限性</h3>

<p>高层规划器（尤其是 LLM）可能生成位于间隙中央或箱体边缘等异常 waypoint，低层控制器难以从这类极端位置恢复；未来工作将设计边缘无碰撞低层控制器，并探索运动与导航的端到端统一策略。</p>

<h2 id="vln-imagine">18. VLN-Imagine (2025)</h2>
<p>———用文本生成图像模型为导航智能体构建”视觉想象”</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2503.16394">arXiv:2503.16394</a> · 🏛️ <strong>CVPR 2025</strong></p>

<h3 id="精华-7">精华</h3>

<ol>
  <li>利用现成的 text-to-image 扩散模型（SDXL）为导航指令中的地标名词短语生成”视觉想象”，将跨模态对齐从隐式学习转化为显式的图像-图像匹配，思路简洁且可迁移。</li>
  <li>方法设计为 model-agnostic：通过独立的 imagination encoder + 辅助对齐损失即可嵌入任意 VLN 模型，无需修改原有架构。</li>
  <li>子指令过滤策略（FG-R2R 分割 + 名词短语黑名单）有效控制了生成图像的质量与相关性，是低成本数据增强的好范例。</li>
  <li>实验表明 imagination 在训练和推理阶段均有增益，且训练阶段的正则化效应独立于推理时的输入增益，说明多模态辅助信号可提升模型泛化。</li>
  <li>cosine similarity 辅助损失足以对齐 imagination 与指令表征，无需更复杂的对比损失（InfoNCE），体现了”够用即可”的工程哲学。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-6">1. 研究背景/问题</h3>

<p>Vision-and-Language Navigation（VLN）任务中，智能体需要根据自然语言指令在未见过的环境中导航。指令常引用视觉地标（如”pool table”“kitchen”），但现有方法依赖隐式跨模态对齐来关联名词短语与实际观察。本文探索是否可以在导航前先用 text-to-image 模型为地标生成”视觉想象”，将语言-视觉对齐转化为更容易的图像-图像匹配任务。</p>

<hr />

<h3 id="2-主要方法创新点-6">2. 主要方法/创新点</h3>

<h4 id="21-visual-imagination-生成管线">2.1 Visual Imagination 生成管线</h4>

<div align="center">
  <img src="/images/vln/VLN-Imagine-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:671/446" />
<figcaption>
指令分割、过滤与图像生成流程：使用 FG-R2R 将指令分割为子指令，过滤掉不含视觉地标的部分，再通过 SDXL 生成想象图像
</figcaption>
</div>

<ul>
  <li><strong>指令分割</strong>：使用 FG-R2R 将完整导航指令分割为子指令序列 $S = (S_0, \cdots, S_m)$，R2R 训练集平均每条指令 3.66 个子指令。</li>
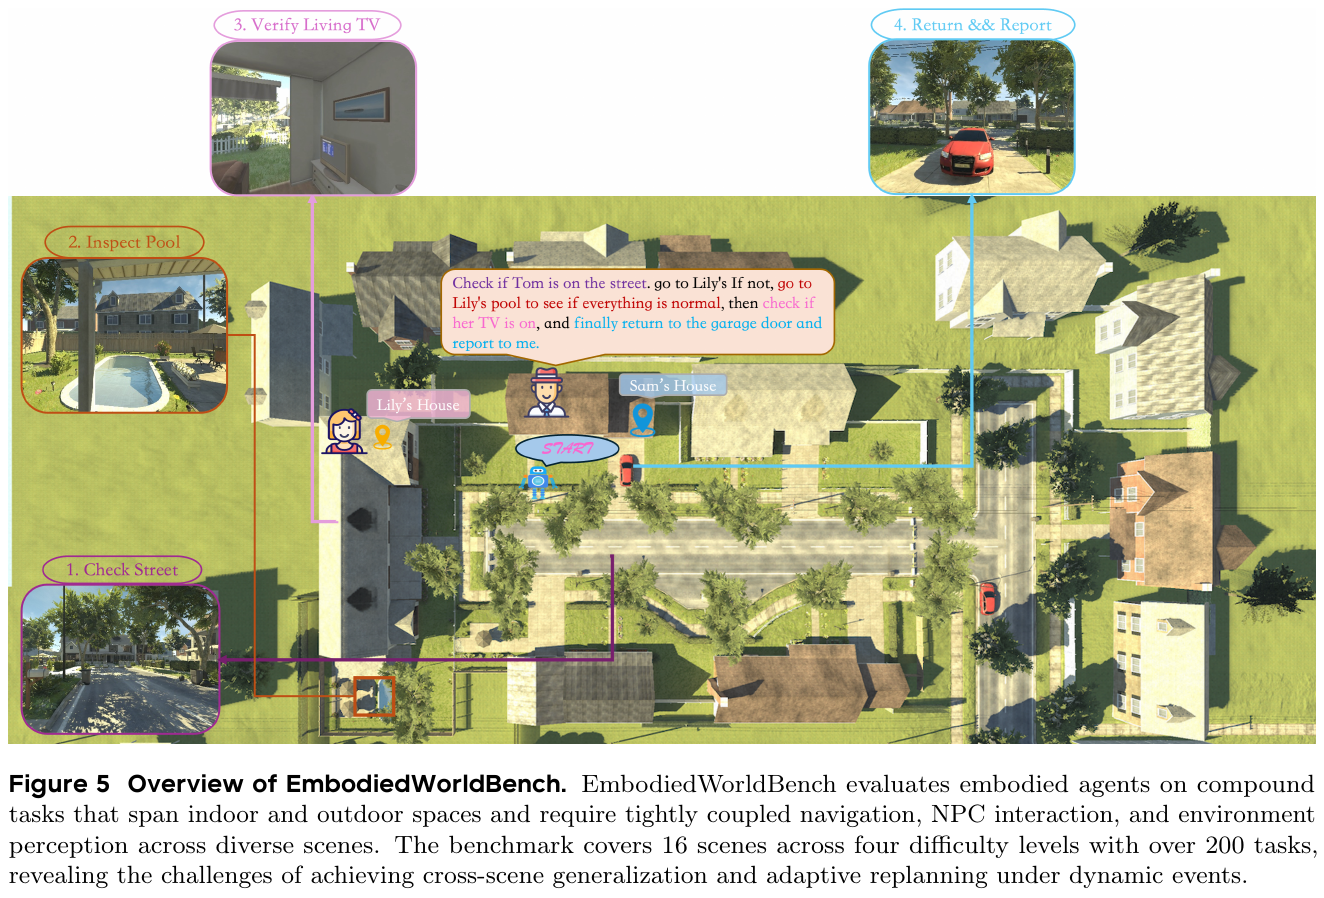
  <li><strong>子指令过滤</strong>：通过 SpaCy 过滤无名词短语的子指令，再用黑名单排除非视觉名词（如计数词、方向词、代词），保留有效子指令集 $S’ \subset S$。</li>
  <li><strong>图像生成</strong>：使用 SDXL 扩散模型，以正向提示词（indoor, house, realistic, real estate）和负向提示词（outdoor, text, humans 等）引导生成室内场景图像。最终构建 R2R-Imagine 数据集，包含超过 41k 张 1024×1024 想象图像。</li>
</ul>

<h4 id="22-model-agnostic-集成方法">2.2 Model-Agnostic 集成方法</h4>

<div align="center">
  <img src="/images/vln/VLN-Imagine-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/455" />
<figcaption>
方法总览：（左）想象图像经 ViT 编码后通过 MLP 生成 imagination embedding；（右）与指令 token 拼接后送入跨模态策略网络
</figcaption>
</div>

<ul>
  <li><strong>Imagination Encoder</strong>：使用预训练 ViT-B/16 编码想象图像，加上 imagination modality 的类型嵌入 $t_{Im}$，再通过三层 MLP（768→512→768，ReLU + Dropout 0.15）得到 imagination embedding $h_i = \text{MLP}(\text{ViT}(Z_i) + t_{Im})$。</li>
  <li><strong>模态融合</strong>：imagination embedding 与指令的文本编码拼接后，一起送入 VLN 智能体的跨模态编码器。本文在 HAMT 和 DUET 两个代表性模型上验证了该方法。</li>
  <li><strong>辅助对齐损失</strong>：计算 imagination embedding $h_i$ 与对应子指令名词短语的平均文本嵌入 \(\bar{S}_i\) 之间的 cosine similarity 损失 $\mathcal L_{cos}$，总损失为 $\mathcal L_{\text{base}} + \lambda \mathcal L_{cos}$（$\lambda=0.5$）。</li>
  <li><strong>三阶段微调</strong>：为缓解灾难性遗忘，先训练 MLP + 类型嵌入（25% 迭代）→ 联合训练所有模块（25%）→ 统一学习率训练（50%），总计 100k 迭代。</li>
</ul>

<div align="center">
  <img src="/images/vln/VLN-Imagine-example.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:671/566" />
<figcaption>
视觉想象示例：导航指令中的子目标（pool table、kitchen、bedroom）被生成为对应的室内场景图像
</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-6">3. 核心结果/发现</h3>

<ul>
  <li><strong>R2R 数据集</strong>：HAMT-Imagine 在 val-unseen 上提升 1.0 SR / 0.5 SPL（66.24 → 67.26 / 61.51 → 62.02）；DUET-Imagine 提升 0.6 SR / 0.07 SPL（71.52 → 72.12 / 60.41 → 60.48），test split 上 SR 从 69 提升到 71。</li>
  <li><strong>REVERIE 数据集</strong>：DUET-Imagine 在粗粒度指令设置下 SR 提升 1.3 点，RGS 提升 0.82 点，说明想象对目标定位也有帮助。</li>
  <li><strong>训练与推理双重增益</strong>：即使在推理时 nullify imagination（置零注意力掩码），模型仍优于 baseline，暗示 imagination-based 训练具有正则化效果。</li>
  <li><strong>对齐是关键</strong>：随机 imagination 反而降低性能；正确对齐的 imagination 才能带来提升。</li>
  <li><strong>视觉优于文本</strong>：用子指令文本嵌入代替 imagination embedding 效果不如视觉想象，说明视觉表征与语言起互补作用。</li>
  <li><strong>Imagination 高保真度</strong>：通过 LangSAM 开放词汇检测器验证，98.78% 的子指令至少有一个名词短语被检测到。</li>
</ul>

<hr />

<h3 id="4-局限性-6">4. 局限性</h3>

<p>生成和编码想象图像增加了计算开销，对实际机器人部署尤为不利（H100 上单张 3.2 秒，微调需 V100 约 1.5 天）。此外，想象图像无法捕捉环境中物体和位置的个性化命名，终身学习的持久化视觉 grounding 仍是开放问题。</p>

<hr />

<h2 id="vln-pe">19. VLN-PE (2025)</h2>
<p>———重新思考视觉-语言导航中的具身化差距:物理和视觉差异的全面研究</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2507.13019v2">arXiv:2507.13019</a> · 🏛️ <strong>ICCV 2025</strong></p>

<p><strong>精华</strong></p>

<p>这篇论文通过构建物理真实的VLN平台,系统性地揭示了理想化仿真与物理部署之间的巨大差距。核心启示包括:(1) 跨具身数据融合训练可以显著提升模型泛化能力,为统一的跨机器人导航模型奠定基础;(2) 多模态感知(RGB+Depth)比单一RGB更鲁棒,尤其在光照变化环境下;(3) 物理控制器的引入对于腿足机器人至关重要,训练和评估阶段的控制器一致性直接影响性能;(4) 现有MP3D风格数据集的泛化能力有限,小规模域内数据微调即可超越大模型零样本性能;(5) diffusion policy作为连续路径点预测的新范式在VLN任务中展现潜力。</p>

<p><strong>研究背景/问题</strong></p>

<p>现有的VLN方法在理想化仿真环境中表现优异,但在部署到真实物理机器人时面临巨大挑战。主要问题包括:当前VLN平台忽视了机器人的物理具身特性(如视点高度、运动动力学、碰撞和跌倒等),并且缺乏对不同机器人类型(轮式、人形、四足)的跨具身支持。研究核心问题是:物理具身约束和视觉环境变化对现有VLN方法的性能影响究竟有多大?</p>

<p><strong>主要方法/创新点</strong></p>

<div align="center">
  <img src="/images/vln/VLN-PE-evolution.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:669/684" />
<figcaption>
VLN任务的演进:从oracle-based导航(2018)到VLN-CE连续导航(2020),再到VLN-PE物理真实导航(2025)
</figcaption>
</div>

<p>论文提出了<strong>VLN-PE平台</strong>,一个基于GRUTopia构建的物理真实VLN基准测试平台,具有以下核心特性:</p>

<ol>
  <li>
    <p><strong>跨具身支持</strong>:支持人形机器人(Unitree H1, G1)、四足机器人(Unitree Aliengo)和轮式机器人(Jetbot),并提供基于RL的物理控制器API,实现真实的运动动力学模拟</p>
  </li>
  <li>
    <p><strong>场景多样性</strong>:除了90个MP3D场景外,新增10个高质量合成家居场景(GRScenes)和3DGS在线渲染实验室场景,支持无缝集成更多环境</p>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/VLN-PE-platform-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1389/660" />
<figcaption>
VLN-PE平台概览:支持多种机器人具身、场景类型、光照条件和控制器模式
</figcaption>
</div>

<ol>
  <li><strong>系统性评估框架</strong>:评估三类ego-centric VLN方法
    <ul>
      <li><strong>单步端到端方法</strong>:Seq2Seq、CMA(约36M参数)和NaVid(7B参数的视频MLLM)</li>
      <li><strong>多步端到端方法</strong>:首次提出RDP(Recurrent Diffusion Policy),使用transformer-based diffusion模块预测连续轨迹路径点</li>
      <li><strong>地图基零样本方法</strong>:改进的VLMaps,结合LLM和语义地图进行路径规划</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/VLN-PE-RDP-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:656/425" />
<figcaption>
RDP(循环扩散策略)框架:使用GRU维护历史信息,交叉注意力融合视觉-语言特征,Transformer扩散模块预测连续动作序列
</figcaption>
</div>

<ol>
  <li><strong>新数据集</strong>:
    <ul>
      <li><strong>R2R-filtered</strong>:过滤楼梯场景后保留8,679/658/1,347个训练/val-seen/val-unseen episodes</li>
      <li><strong>GRU-VLN10</strong>:10个合成场景,441/111/1,287个episodes</li>
      <li><strong>3DGS-Lab-VLN</strong>:3DGS渲染实验室环境,160训练/640评估episodes</li>
    </ul>
  </li>
  <li><strong>新评估指标</strong>:除了传统的TL、NE、SR、OS、SPL外,新增Fall Rate (FR)和Stuck Rate (StR)来衡量物理真实性挑战</li>
</ol>

<p><strong>核心结果/发现</strong></p>

<div align="center">
  <img src="/images/vln/VLN-PE-main-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/394" />
<figcaption>
使用人形机器人Unitree H1在R2R数据集上的主要实验结果对比
</figcaption>
</div>

<p><strong>零样本迁移性能大幅下降</strong>:</p>
<ul>
  <li>VLN-CE模型直接迁移到VLN-PE时,SR相对下降约34%</li>
  <li>Seq2Seq-Full、CMA-Full和NaVid的SR分别下降10%、16%和18%</li>
  <li>这表明现有模型严重过拟合特定仿真平台</li>
</ul>

<p><strong>域内微调显著提升</strong>:</p>
<ul>
  <li>在VLN-PE上从头训练的CMA(无数据增强)超越了使用175K增强数据训练的CMA-Full</li>
  <li>小模型CMA+经过微调后,在val-seen上达到SR 28.72,SPL 24.24,超越NaVid的零样本性能</li>
</ul>

<p><strong>跨具身敏感性</strong>:</p>
<ul>
  <li>四足机器人(相机高度约0.5m)在迁移时几乎完全失败</li>
  <li>调整相机高度到1.8m可改善人形机器人的迁移性能</li>
  <li>跨具身联合训练使单一模型在所有机器人类型上达到SoTA性能</li>
</ul>

<p><strong>物理控制器的重要性</strong>:</p>
<ul>
  <li>训练和评估使用相同控制器时性能最佳</li>
  <li>使用物理控制器收集数据可降低Fall Rate和Stuck Rate</li>
</ul>

<p><strong>多模态鲁棒性</strong>:</p>
<ul>
  <li>仅RGB的NaVid在低光照下SR下降12.47%</li>
  <li>RGB+Depth的CMA和RDP受光照影响较小(下降约1-2%)</li>
</ul>

<p><strong>MP3D数据集泛化能力有限</strong>:</p>
<ul>
  <li>在GRU-VLN10上,RDP用6M参数仅441个训练样本,零样本超越NaVid大模型</li>
  <li>在3DGS-Lab-VLN上,NaVid完全失败(SR仅5.81),可能是3DGS渲染噪声导致</li>
</ul>

<p><strong>扩散策略的潜力</strong>:</p>
<ul>
  <li>RDP作为首个VLN扩散策略基线,在从头训练时优于Seq2Seq和CMA</li>
  <li>预测连续密集路径点,可与MPC等控制理论方法结合</li>
</ul>

<p><strong>真机实验验证</strong>:</p>
<ul>
  <li>使用Unitree Go2机器人进行14个室内场景测试</li>
  <li>VLN-PE微调模型在真实环境中OS达到57.14,SR达到28.57,显著优于VLN-CE训练模型</li>
</ul>

<p><strong>局限性</strong></p>

<p>当前RL-based运动控制器无法可靠处理复杂环境中的楼梯导航,需要过滤相关场景。论文主要聚焦ego-centric视角,未评估panoramic VLN方法。MLLM在精确目标识别和停止决策上仍存在挑战。3DGS渲染引入的像素级噪声可能干扰纯RGB模型,需要进一步研究图像扰动的鲁棒性。</p>

<hr />

<h2 id="goal2pixel">20. Goal2Pixel (2025)</h2>
<p>———将导航目标接地到图像像素，以像素预测统一 VLN-CE 的决策空间</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.01621">arXiv:2606.01621</a></p>

<h3 id="精华-8">精华</h3>

<ol>
  <li><strong>图像平面即决策空间</strong>：将 VLN-CE 的高层决策从离散动作预测重新定义为像素预测——VLM 只需输出一个像素坐标，消除了动作标签的歧义性，并与 VLM 的原生输出空间对齐。</li>
  <li><strong>辅助指令区域设计</strong>：将转向/停止等非前进动作编码为图像平面扩展区域中的像素，使所有决策在同一坐标空间内统一处理，无需两阶段切换。</li>
  <li><strong>ViKeyMem 以可见性驱动关键帧</strong>：以”未来路点可见性变化”为关键帧选取标准，仅需 3–4 帧即可编码 100+ 步轨迹，训练成本从 156 降至 70 H100 GPU 小时。</li>
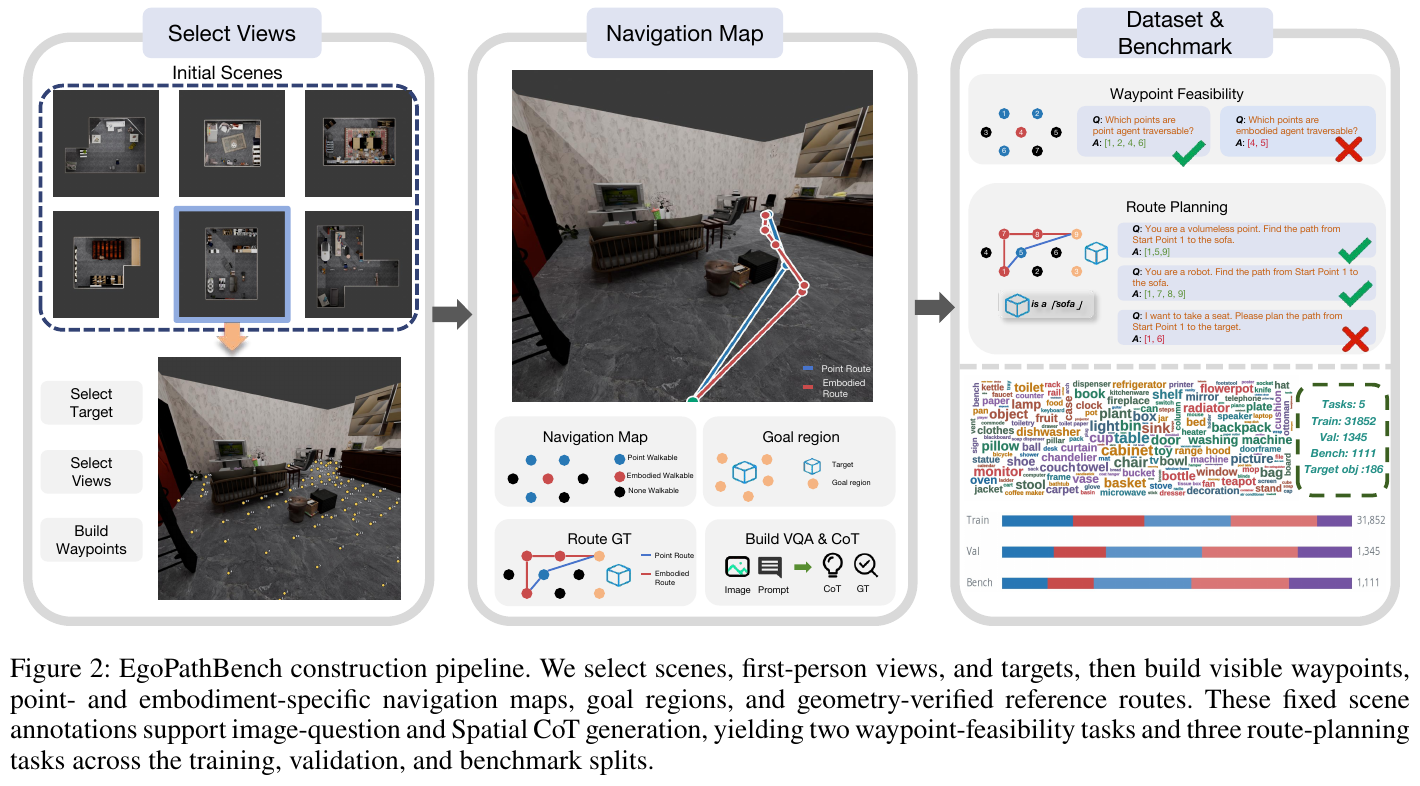
  <li><strong>减少 VLM 调用次数</strong>：像素预测粒度更粗（一次预测对应 5 步低层动作），使 VLM 调用次数从 46.62 降至 7.75，同时性能从 32.9% SR 提升至 54.1% SR。</li>
  <li><strong>跨平台可迁移性</strong>：像素输出将高层 VLM 推理与机器人底层控制器解耦，同一模型可跨不同硬件平台复用。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-7">1. 研究背景/问题</h3>

<p>VLN-CE（连续环境视觉语言导航）中，现有 VLM-based 方法多以低层动作预测（前进/左转/右转/停止）为输出接口，存在三个缺陷：监督信号模糊（同一空间目标对应多个合法动作序列）、决策视野短（每步只移动 25cm）、VLM 调用次数过多（每集需 30–47 次）。如何为 VLM 推理与机器人执行之间找到更合适的接口，成为核心问题。</p>

<hr />

<h3 id="2-主要方法创新点-7">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/Goal2Pixel-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/1043" />
<figcaption>Figure 1：Goal2Pixel 整体框架。上：三阶段执行流水线——VLM 预测目标像素 (u,v)，经相机几何反投影为 3D 路径点，本地规划器转化为低层动作；辅助指令区域（图像左/右/下扩展区）分别对应 Turn_Left/Turn_Right/Stop。下：VLM 以语言指令、填充后的当前 RGB 图像和 ViKeyMem 历史记忆为输入，输出坐标字符串 "XXX,YYY"；视觉语义嵌入与坐标感知损失辅助适配。</figcaption>
</div>

<p><strong>① 整体框架概述</strong></p>

<p>Goal2Pixel 由三个核心部分构成：<strong>像素预测 VLM</strong>（InternVL3 微调）、<strong>几何反投影模块</strong>、<strong>本地规划器</strong>。VLM 输出坐标字符串 → 反投影为 3D 路径点 → 规划器执行至多 5 步低层动作后再次查询 VLM，形成闭环。</p>

<p><strong>② 纯像素输出接口（Pure Pixel Paradigm）</strong></p>

<ul>
  <li><strong>输入</strong>：正方形填充的当前 RGB 图像（含三侧辅助指令区域）+ 语言指令 + ViKeyMem 历史（最多 8 帧）</li>
  <li><strong>处理</strong>：VLM 自回归生成 “XXX,YYY” 格式坐标字符串，坐标归一化至 [000, 999]</li>
  <li><strong>输出判断</strong>：坐标落在 RGB 区域 → 经相机内参反投影为 3D 路径点，由本地规划器跟踪执行；坐标落在辅助区域 → 直接执行 Turn_Left / Turn_Right / Stop</li>
  <li><strong>设计动机</strong>：像素坐标是 VLM 的原生输出空间，监督信号更明确；所有决策统一在同一接口，无需两阶段 action-then-pixel 切换</li>
</ul>

<p><strong>辅助指令区域规则</strong>：</p>
<ul>
  <li>底部区域 → Stop（距终点 ≤1m 时，GT 像素指向此区域）</li>
  <li>左/右区域 → Turn_Left / Turn_Right（当前进路点不可见时，根据接下来 5 个路点的平均自中心方向决定）</li>
</ul>

<p><strong>GT 像素定义</strong>：沿 oracle 轨迹，当前帧中<strong>最远可见可行驶像素</strong>——鼓励更长视野决策，去除短程动作的模糊歧义。</p>

<p><strong>③ ViKeyMem 关键帧历史记忆</strong></p>

<div align="center">
  <img src="/images/vln/Goal2Pixel-vikeymem.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/1474" />
<figcaption>Figure 4：ViKeyMem 可视化。每行为一个独立轨迹（长度 90–123 步），关键帧从左至右按时间排列，最右列为鸟瞰地图。蓝色轨迹点叠加于历史帧，提供紧凑的过去运动线索；100+ 步轨迹通常仅需 3–4 关键帧即可完整覆盖关键视角转换。</figcaption>
</div>

<p>ViKeyMem 以<strong>未来路点可见性变化</strong>为关键帧选取标准，候选帧满足以下三个条件时加入关键帧集合：</p>
<ol>
  <li>候选帧视点不再被最近关键帧覆盖（核心可见性条件）</li>
  <li>候选帧自中心图像中至少有一个后续路点可见</li>
  <li>至少两个不同后续路点落在候选帧 45° 前向视场内</li>
</ol>

<p>每个选取的关键帧上叠加蓝色轨迹点（trajectory overlay），提供轻量级过去运动提示。R2R-CE 上平均每 100 步仅选 3–4 帧，推理时间从 0.224s 降至 0.121s，训练时间从 156 H100 小时降至 70 小时。</p>
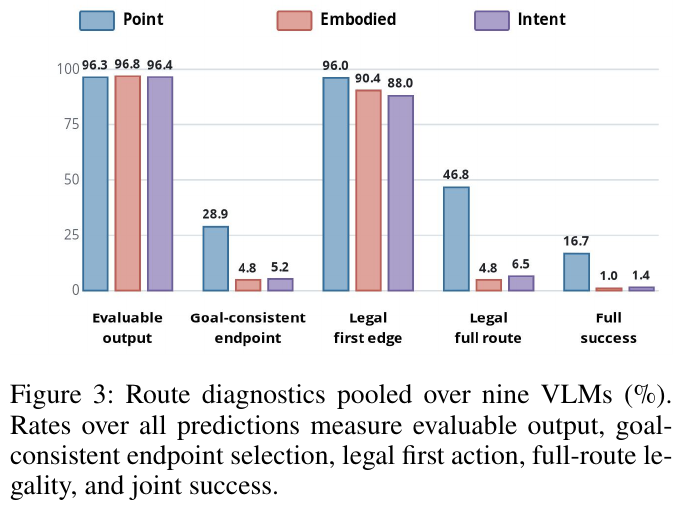
<p><strong>④ 视觉语义嵌入（Visual Semantic Embeddings）</strong></p>

<p>预训练 VLM 对导航特有的视觉模式（辅助指令区域、轨迹叠加点）识别能力不足，因此引入两类可学习嵌入：</p>
<ul>
  <li><strong>指令区域嵌入（directive embedding）</strong>：叠加在与辅助指令区域重叠的当前帧 visual token 上</li>
  <li><strong>轨迹嵌入（trajectory embedding）</strong>：叠加在含蓝色轨迹点的历史帧 visual token 上</li>
  <li>普通 RGB token 保持不变，参数量极小</li>
</ul>

<p><strong>⑤ 训练目标与坐标感知损失</strong></p>

\[\mathcal{L} = \mathcal{L}_{CE} + \lambda_{num}\mathcal{L}_{num} + \lambda_{ang}\mathcal{L}_{ang}\]

<ul>
  <li>\(\mathcal{L}_{CE}\)：标准 token 级交叉熵，主要监督信号；\(\lambda_{CE}=1\)</li>
  <li>\(\mathcal{L}_{num}\)：数值损失，通过 softmax logits 推导可微 soft 坐标，鼓励预测数值接近 GT；\(\lambda_{num}=0.3\)</li>
  <li>\(\mathcal{L}_{ang}\)：角度损失，鼓励预测像素保持与 GT 相同的自中心方向；\(\lambda_{ang}=0.03\)</li>
</ul>

<p><strong>⑥ 推理流程</strong></p>

<p>每次 VLM 调用后，本地规划器最多执行 t=5 步低层动作；若出现连续 20 步左右震荡，自动 fallback 到固定前进像素 (500,970) 以脱困。</p>

<hr />

<h3 id="3-核心结果发现-7">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/Goal2Pixel-training-cost.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:1122/746" />
<figcaption>Figure 5：R2R-CE Val-Unseen SR 与训练成本对比（x 轴对数坐标，标记大小对应模型规模）。Goal2Pixel (2B) 以 80 H100 小时实现 54.1% SR，训练成本远低于同等性能的其他方法。</figcaption>
</div>

<div align="center">
  <img src="/images/vln/Goal2Pixel-qualitative.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/1203" />
<figcaption>Figure 7：Goal2Pixel 在 R2R-CE 上的定性结果。每行为一个导航集，红点为 VLM 每步预测的目标像素，最右列为鸟瞰执行轨迹。</figcaption>
</div>

<p><strong>R2R-CE Val-Unseen 主要结果</strong>（2B 模型，零外部数据）：</p>
<ul>
  <li><strong>SR 54.1%，SPL 52.5%</strong>，每集仅需 <strong>7.75 次 VLM 调用</strong></li>
  <li>直接动作预测：SR 32.9%，需 46.62 次调用（SR 差 21.2 点，调用多 6×）</li>
  <li>与 JanusVLN 7B（SR 52.8%）相比，2B Goal2Pixel SR 高 1.3 点，参数规模仅 2/7</li>
</ul>

<p><strong>输出范式消融</strong>（Table 2）：</p>

<table>
  <thead>
    <tr>
      <th>输出范式</th>
      <th>SR</th>
      <th>SPL</th>
      <th># VLM Calls</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>1 动作预测</td>
      <td>32.9%</td>
      <td>31.5%</td>
      <td>46.62</td>
    </tr>
    <tr>
      <td>4 动作预测</td>
      <td>37.0%</td>
      <td>36.0%</td>
      <td>15.77</td>
    </tr>
    <tr>
      <td>混合 Action-Pixel (Seq)</td>
      <td>43.7%</td>
      <td>—</td>
      <td>~10</td>
    </tr>
    <tr>
      <td><strong>纯 Pixel（本文）</strong></td>
      <td><strong>54.1%</strong></td>
      <td><strong>52.5%</strong></td>
      <td><strong>7.55</strong></td>
    </tr>
  </tbody>
</table>

<p><strong>ViKeyMem 消融</strong>（Table 3a）：</p>
<ul>
  <li>对比 5-step 固定间隔采样：SR/SPL +8.0/+7.4（R2R），+5.1/+5.0（RxR）</li>
  <li>推理时间：0.243s → 0.121s（−50%）；训练时间：173h → 70h（−60%）</li>
</ul>

<p><strong>RxR-CE Val-Unseen</strong>（2B）：SR 43.8%，SPL 40.4%，nDTW 61.1%</p>

<p><strong>实物机器人</strong>：16 次室内导航测试，Goal2Pixel 能将语言指令（门、沙发、冰箱、楼梯等）接地到有意义的像素目标，并通过本地控制器完成实际导航。</p>

<hr />

<h3 id="4-局限性-7">4. 局限性</h3>

<p>ViKeyMem 以可见性为标准可能遗漏短暂出现或远距低分辨率的细粒度地标；soft 坐标期望值在多峰数字分布下可靠性有限（但主监督仍为 token 级 CE loss，已起缓解作用）。</p>

<hr />

<h2 id="astranav-world">21. AstraNav-World (2025)</h2>
<p>———将”想象未来”与”规划未来”统一进同一个生成式概率框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2512.21714">arXiv:2512.21714</a> · <a href="https://github.com/amap-cvlab/AstraNav-World">Code</a></p>

<h3 id="精华-9">精华</h3>

<ul>
  <li>把”先想象未来场景、再据此规划动作”的松耦合 envision-then-plan 范式，改造为视觉预测与动作生成在同一概率框架内联合建模、同步 rollout 的紧耦合范式，从根本上抑制误差累积。</li>
  <li>VLM 不再只做语言理解，而是同时作为视频生成器和动作策略头的统一条件编码器，用同一份”语言-视觉嵌入”驱动两条分支。</li>
  <li>双向约束是关键：动作要以可执行的未来视觉证据为依据，预测的未来画面也要被动作意图反向约束，两者互相校正而不是单向传递误差。</li>
  <li>引入 Sparse Foresight Scheduling，按固定间隔而非逐帧触发”视觉预测+动作生成”的联合推理，在几乎不掉点的情况下把推理速度提升一个数量级。</li>
  <li>消融证明：性能提升主要来自世界模型的双向约束机制，而非单纯堆参数量（3B 联合模型优于纯放大到 7B 的 VLA-only 基线）。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-8">1. 研究背景/问题</h3>

<p>具身导航失败的一个核心原因是模型缺乏对物理规律和时间动态的建模：微小的预测偏差会随时间累积，最终破坏全局规划的有效性。现有方法通常把”想象未来”（world model 生成未来画面）和”规划未来”（VLA 输出动作）做成两个松耦合的串行模块，这种 envision-then-plan 流水线会放大物理不确定性和因果歧义，导致视觉预测和实际动作彼此不一致。</p>

<hr />

<h3 id="2-主要方法创新点-8">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/AstraNav-World-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/801" />
<figcaption>AstraNav-World 整体架构：VLM 规划器统一驱动两种策略头变体（a）Action Former 直接预测动作；（b）Diffusion Policy 通过 MMFCA 与视频生成器双向交互</figcaption>
</div>

<p><strong>① 整体框架概述</strong>：AstraNav-World 由三个核心模块构成——VLM 规划器（高层语义推理）、基于 DiT 的视频生成器（预测未来视觉观测）、动作策略头（生成未来动作序列，有 Action Former 和 Diffusion Policy 两种实现）。VLM 编码指令和历史/当前多视角观测，生成统一的视觉-语言嵌入，同时作为视频生成器和策略头的条件输入，取代了传统视频扩散模型里的文本编码器。</p>

<p><strong>② 逐模块讲解</strong></p>

<ul>
  <li><strong>VLM 规划器（τθ）</strong>：输入是自然语言指令 I 和历史观测序列 O_hist；内部用 Qwen2.5-VL-3B 做全参数微调；输出是 C ∈ R^(L×D)（D=2048）的视觉-语言嵌入，同时包含”目标导向语义特征”（指令编码）和”空间上下文特征”（历史/当前视觉语义与空间信息）。这一表示让模型既能保持对长时序任务的整体理解，又能灵活响应环境的即时变化。</li>
  <li><strong>VLM 条件视频生成器</strong>：基础架构是 Wan2.2-TI2V-5B（ST-VAE + 30 层 DiT），用 LoRA（rank=128）微调。把 VLM 的视觉-语言嵌入通过 cross-attention 注入 DiT，替代原本的 umT5 文本编码器，使生成的未来帧在语义上与 VLM 的高层规划保持一致。训练时对历史/当前帧加极小噪声（σ_obs≈0.05）当作”干净”条件，对未来帧用 Flow Matching 方式加噪并学习速度场 u_t=ϵ−z_future，损失只在未来帧上计算（L_VG，式 4）。</li>
  <li><strong>3D-RoPE 重排</strong>：为了把当前时刻的 left/front/right 三个视角和历史帧统一编码进同一套 3D 旋转位置编码，作者把三个视角沿宽度轴”虚拟拼接”——front 保持原坐标，right 在宽度上偏移 W，left 偏移 2W，同时共享相同的时间和高度索引（式 1–3），从而显式编码多视角间的空间-时间关系，而不打乱时序对齐。</li>
  <li><strong>动作策略头（两种实现）</strong>：
    <ul>
      <li><strong>Action Former</strong>：用一组可学习 query 向量通过若干层 Transformer 与 VLM 嵌入交互，再经 MLP 输出确定性动作序列 A=(X,Y,cosθ,sinθ,α)，分别用 L1 位置损失、余弦角度损失、二元到达损失加权组合（式 5–8）。</li>
      <li><strong>Diffusion Policy</strong>：用 Flow Matching 在噪声动作序列上做去噪生成，提供概率化的动作预测。关键创新是 <strong>Multimodal Fusion Cross-Attention（MMFCA）</strong>：在 Diffusion Policy 和视频生成器最后 8 个重叠的 DiT 块之间引入双向 cross-attention——动作表征作 query 去 attend 视频隐表征（确保动作以可信的未来视觉为依据），同时视频隐表征也作 query 去 attend 动作表征（确保生成画面与已规划动作保持因果一致）。MMFCA 受二元开关 γ 控制：γ=1 时两路双向融合、同步 rollout；γ=0 时两路独立运行，推理时甚至可以完全跳过视频生成器只跑策略头，大幅降低算力开销。</li>
    </ul>
  </li>
  <li><strong>设计动机</strong>：核心 gap 是松耦合流水线里视觉预测和动作规划互不感知，容易各自漂移。MMFCA 和共享 VLM 条件正是为了让两条分支在训练和推理阶段都能”互相看见对方”，把误差互相校正而不是单向累积。</li>
</ul>

<p><strong>③ 端到端数据流</strong>：一条样本先经 VLM 编码指令+历史/当前三视角观测得到统一嵌入；该嵌入同时条件化视频生成器（预测未来 N 步前视帧）和策略头（预测未来 N 步动作）；若启用 MMFCA，两路在重叠 DiT 块内做双向 cross-attention 实现同步 rollout；最终输出未来视觉帧序列和对应的动作（路径点）序列。</p>

<p><strong>④ 训练目标</strong>：总损失 L_Total = L_VG + λ·L_PH（λ=1.0，式 10），L_VG 是视频生成的 Flow Matching 损失（式 4），L_PH 根据策略头类型为式 8（Action Former 的位置+角度+到达损失组合）或式 9（Diffusion Policy 的 Flow Matching 损失）。训练分两阶段：<strong>Stage 1</strong> 冻结 VLM，先独立预训练视频生成器（L_VG）、再独立预训练策略头（L_PH），避免两个模块过早互相干扰；<strong>Stage 2</strong> 解冻全部组件用 L_Total 联合微调，对 Diffusion Policy 以 50% 概率随机启用 MMFCA，防止策略头过度依赖视觉反馈，保证视频生成器关闭时策略头仍能独立工作。</p>

<p><strong>⑤ 推理流程（Sparse Foresight Scheduling, SFS）</strong>：视频生成是推理速度的瓶颈，因此不在每一步都联合生成”未来帧+动作”，而是按固定间隔触发联合生成——大量导航场景里直行等简单一致行为并不需要逐帧更新世界模型。使用 Action Former 时，推理阶段直接完全关闭视频生成器，只用 query Transformer 出动作；使用 Diffusion Policy 时，视频生成器仅在固定间隔步（实现中每 10 步）激活一次，中间步骤保持关闭，在预测精度和推理速度间取得最优折中。</p>

<hr />

<h3 id="3-核心结果发现-8">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/AstraNav-World-qualitative-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/957" />
<figcaption>定性结果：模型同时预测未来 5 帧视觉观测和对应的 5 步路径点，生成画面与按预测路径点渲染的场景高度一致</figcaption>
</div>

<ul>
  <li>在 R2R-CE / RxR-CE Val-Unseen 上，AstraNav-World 全面超越此前 SOTA：Action Former 版本相对此前最佳方法 SR 绝对提升 2.1%（R2R-CE）/1.1%（RxR-CE）；Diffusion Policy + MMFCA 版本进一步在 Action Former 基础上再提升 0.7%（R2R-CE）/2.5%（RxR-CE），最终 R2R-CE SR=67.9%、SPL=65.4%，RxR-CE SR=72.9%。</li>
  <li>在 HM3D-OVON 开放词表物体导航上，Diffusion Policy 相对此前最佳 MTU3D 提升 SR 4.9% 绝对值（45.7% vs 40.8%）。</li>
</ul>

<div align="center">
  <img src="/images/vln/AstraNav-World-ablation-study.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/482" />
<figcaption>消融实验：(a) 去掉视频生成器分支在三个数据集上均导致 SR 下降；(b) SFS 间隔越大推理越快（最高 6.7×），SR 几乎不掉；(c) 生成视觉序列与真实路径点的姿态一致性随角度阈值放宽迅速逼近 100%</figcaption>
</div>

<ul>
  <li><strong>去掉视频生成器分支</strong>会在 R2R、RxR、OVON 三个数据集上一致地降低 SR，证明显式预测未来观测确实为规划提供了关键的视觉引导，并非冗余分支。</li>
  <li><strong>缩放 vs. 世界建模</strong>：把 VLA-only（无视频生成）基线的 VLM 从 3B 放大到 7B，R2R-CE SR 几乎不变（66.5%→66.6%），已触及参数缩放的天花板；而 3B 模型加上视频生成分支（L_VG 正则化）就能把 SR 推到 67.9%，说明性能增益主要来自世界模型的双向约束机制，而不是单纯堆参数。</li>
  <li><strong>一致性分析</strong>：用开源 VGGT 模型估计生成图像序列的相对相机位姿变化，与仿真器真实渲染的相对位姿对比，角度差 δ_a 的分布显示生成的未来视觉预测与规划动作具有很高的几何一致性。</li>
  <li><strong>真实世界零样本迁移</strong>：未做任何真实世界数据微调，AstraNav-World 直接部署在物理机器人上完成自然语言指令导航任务，在过门、转角等关键过渡场景上表现出对未来场景的预判能力，显著优于通常需要域适应的现有方法，验证了世界模型学到的是可迁移的物理/导航规律而非仅过拟合仿真数据分布。</li>
</ul>

<hr />

<h3 id="4-局限性-8">4. 局限性</h3>

<p>视频生成本身的推理延迟和复杂场景下的算力开销仍是瓶颈（尽管 SFS 已大幅缓解）；论文也指出未来工作需要扩展到更长时间跨度和更难的任务，进一步加强物理与因果一致性建模，并提升闭环一致性与实时推理/规划能力。</p>

<hr />

<h2 id="correctnav">22. CorrectNav (2025)</h2>
<p>——— 自纠错飞轮赋能的单目 RGB 视觉-语言-动作导航模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2508.10416">arXiv:2508.10416</a> · 🏛️ <strong>AAAI 2026</strong> · <a href="https://github.com/owlet914/CorrectNav">Code</a> · <a href="https://correctnav.github.io">Project Page</a></p>

<hr />

<h3 id="精华-10">精华</h3>

<ol>
  <li><strong>变废为宝的数据范式</strong>：不同于传统方法将模型在训练集上的预测偏差视为无效错误，CorrectNav 提出<strong>自纠错飞轮</strong>（Self-correction Flywheel）后训练范式，将模型评估产生的偏离轨迹转化为极具价值的自纠错训练数据。</li>
  <li><strong>感知与动作双重隐式纠错</strong>：联合构建<strong>动作纠错轨迹</strong>（通过轨迹规划器 $\Gamma$ 重新打通至终点的路径）与基于多模态大模型的<strong>关键帧感知分析</strong>（描述地标与生成细节 QA），无需增加额外的推理模块或引入极耗时的思维链（CoT），将自纠错能力直接隐式内化于模型参数中。</li>
  <li><strong>闭环飞轮多轮迭代</strong>：采用”模型评估 ➔ 偏离检测 ➔ 动作/感知自纠错数据自动生成 ➔ 持续训练”的闭环机制。训练后新模型产生的偏离模式会触发下一轮飞轮，性能随迭代轮次提升显著。</li>
  <li><strong>单目 RGB 端到端 SOTA</strong>：仅依赖单目 RGB 视频输入与语言指令，在 R2R-CE 和 RxR-CE Val-Unseen 连续环境基准上成功率分别达到 <strong>65.1%</strong> 和 <strong>69.3%</strong>，大幅超越 prior SOTA 导航大模型 StreamVLN（+8.2% 与 +16.4%）。</li>
  <li><strong>强鲁棒的实机落地</strong>：结合域随机化与通用多模态数据回放防遗忘策略，在 AgiBot 灵汐 D1 四足机器人上实现了室内外复杂场景、长指令跟随与动态避障自纠正的高成功率部署。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-9">1. 研究背景/问题</h3>

<p>在视觉-语言导航（Vision-and-Language Navigation, VLN）任务中，机器人需要根据自然语言指令在未探索的连续环境中进行路径探索。然而，现有的视觉-语言-动作（VLA）导航模型在执行指令时，不可避免地会由于感知失误或指令理解偏差产生单步预测错误。</p>

<p>这种单步错误在连续空间中会迅速累积，导致机器人严重偏离预定路线（如指令要求”向前走并右转进客厅”，若提前右转则会误入厨房）。传统模型由于缺乏<strong>自纠错（Self-correction）与自恢复能力</strong>，一旦偏离路径便无法重新定位，导致导航失败。先前部分研究（如 SmartWay、EnvolveNav）尝试引入闭源大模型进行回溯反思或生成长思维链，但这引入了巨大的推理延迟与复杂的外部模块，难以满足实机导航的实时性要求。</p>

<hr />

<h3 id="2-主要方法创新点-9">2. 主要方法/创新点</h3>

<p>CorrectNav 构建了一个基于单目 RGB 图像输入的 VLA 导航模型，并通过<strong>自纠错飞轮后训练范式</strong>隐式内化了高效的路径偏离纠正能力。</p>

<div align="center">
  <img src="/images/vln/CorrectNav-capabilities.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1420/750" />
<figcaption>CorrectNav 具身导航多样化能力示意图（涵盖跨房间指令导航、地标状态变更感知、错误纠偏、漂移纠正及行人/密集障碍物避让）</figcaption>
</div>

<h4 id="-整体框架概述-3">① 整体框架概述</h4>

<p>CorrectNav 系统由 <strong>Vision Encoder</strong>（SigLIP）、<strong>Projector</strong>（2层 MLP）与 <strong>Large Language Model Backbone</strong>（Qwen2 7B，初始化自 LLaVA-Video 7B）三个模块构成。Vision Encoder 负责抽取输入 RGB 视频多帧的视觉特征 $Z_v$，Projector 将视觉特征映射至 LLM 语义空间 $H_v$，LLM 结合语言指令文本 token 自回归预测长度为 $m=4$ 的动作块（Action Chunk ${a_{t+1}, \dots, a_{t+m}}$）。</p>

<div align="center">
  <img src="/images/vln/CorrectNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/803" />
<figcaption>CorrectNav 整体架构与自纠错飞轮后训练范式示意图（左：导航微调与域随机化；右：自纠错飞轮 4 步循环闭环）</figcaption>
</div>

<h4 id="-基础导航微调navigation-fine-tuning与三大数据策略">② 基础导航微调（Navigation Fine-tuning）与三大数据策略</h4>

<p>在开启自纠错飞轮前，CorrectNav 首先在标准导航任务上进行多任务微调：</p>
<ul>
  <li><strong>动作预测任务（Action Prediction）</strong>：基于 MP3D 场景提取的 R2R-CE（527K）和 RxR-CE（1.58M）共计 210 万+ 步级标准轨迹进行动作预测训练。为了大幅提升视觉鲁棒性，引入了<strong>域随机化策略</strong>（涵盖随机相机高度、视场角 FoV、分辨率缩放与光照条件变换）。</li>
  <li><strong>轨迹逆向指令生成（Instruction Generation）</strong>：利用 30K 条完整 oracle 轨迹，训练 CorrectNav 根据观测历史生成对应的导航语言指令，强化跨模态表达能力。</li>
  <li><strong>通用多模态数据回放（General Multimodal Data Recall）</strong>：为防止在专用导航数据集上连续训练导致通用多模态理解能力退化（Catastrophic Forgetting），按比例混入 240K 来自 LLaVA-Video（ActivityNet-QA 和 NextQA）的视频 QA 数据，保持时空感知能力。</li>
</ul>

<h4 id="-自纠错飞轮后训练范式self-correction-flywheel-post-training">③ 自纠错飞轮后训练范式（Self-correction Flywheel Post-training）</h4>

<p>为了使 CorrectNav 具备自恢复能力，作者设计了四步闭环飞轮：</p>

<ol>
  <li>
    <p><strong>Step 1: 训练集评估与偏离轨迹采集</strong><br />
虽然 CorrectNav 已在训练集上接受过监督训练，但在训练集上重新评估模型时，模型依然会产生导航错误轨迹 $T_m = (M_1, M_2, \dots, M_m)$。这些包含错误的轨迹正是最宝贵的自纠错训练数据来源。</p>
  </li>
  <li>
    <p><strong>Step 2: 轨迹偏离检测（Deviation Detection）</strong><br />
对真实参考轨迹 $T_g$ 进行均匀插值得到 $T’_g$。计算机器人位置 $M_i$ 到参考轨迹的垂距：
\(h_i = \min_{x \in T'_g} \lVert M_i - x \rVert_2\)
对应在 $T’_g$ 上的垂足定位为：
\(P_i = \arg\min_{P \in T'_g} \lVert M_i - P \rVert_2\)
当存在时间步 $t$ 满足垂距超过距离阈值 $S$（即 $h_t &gt; S$，且之前步骤 $h_i \le S, \forall i &lt; t$），则判定模型在 $M_t$ 处发生了偏离，并将 $M_t$ 附近的观测帧标记为纠错关键帧。</p>
  </li>
  <li><strong>Step 3: 动作与感知自纠错数据构建</strong>
    <ul>
      <li><strong>动作纠错轨迹（Action Correction Trajectory）</strong>：若垂足 $P_t$ 位于参考线段 $G_k G_{k+1}$ 上，说明机器人正确经过了 $G_k$，但在前往 $G_{k+1}$ 时发生偏离。调用轨迹规划器 $\Gamma$ 重新生成一条从偏离点 $M_t$ 出发、经过后续参考点并最终到达终点的修补轨迹 \(T_e = (M_t, G_{k+1}, \dots, G_n)\)。在训练时，偏离点前的历史只提供观测上下文，仅在 $T_e$ 上计算动作预测损失。</li>
      <li><strong>关键帧感知分析（Keyframe Perception Analysis）</strong>：抽取偏离点 $M_t$ 及其前后关键帧 ${K_1, K_2, K_3}$，利用多模态大模型 Qwen-VL-Plus 自动生成两类感知数据：
        <ol>
          <li><strong>地标描述</strong> \(C_i = \text{MLLM}(K_i, L_{\text{cap}})\)：描述图像中出现的家具、建筑结构等关键地标；</li>
          <li><strong>细节 QA 对</strong> \(\{(Q_j, A_j)\}_{j=1}^x = \text{MLLM}(K_i, L_{\text{qa}})\)：聚焦于物体相对位置、颜色及机器人当前朝向等关键视觉元素。通过感知数据训练，引导模型不仅知晓”怎么纠偏”，更理解”为何偏离”。</li>
        </ol>
      </li>
    </ul>
  </li>
  <li><strong>Step 4: 模型持续训练与多轮飞轮迭代（Continued Training &amp; Multi-Round Iteration）</strong><br />
按比例采样 $50\%$ 的自纠错轨迹/感知数据与 $25\%$ 的原始标准轨迹组合进行持续训练。当经过一轮纠错训练的模型再次在训练集上评估时，又会暴露新的偏离模式，从而驱动飞轮开启下一轮（Loop）。随着多轮迭代推进，模型的自纠错能力持续攀升。</li>
</ol>

<div align="center">
  <img src="/images/vln/CorrectNav-case-study.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1413/493" />
<figcaption>CorrectNav 纠错能力对比示意图（上：在走错路径失焦后迅速掉头返回正确路径；下：进入错误前门发现无目标步骤后折返并进入正确的侧门）</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-9">3. 核心结果/发现</h3>

<h4 id="-vln-ce-连续基准定量对比">① VLN-CE 连续基准定量对比</h4>

<p>在 Habitat 3.0 仿真器中，对 R2R-CE 和 RxR-CE 的 Val-Unseen 拆分集进行了全面评估（仅输入单目 RGB）：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">输入模态</th>
      <th style="text-align: center">R2R-CE NE↓</th>
      <th style="text-align: center">R2R-CE SR↑</th>
      <th style="text-align: center">R2R-CE SPL↑</th>
      <th style="text-align: center">RxR-CE NE↓</th>
      <th style="text-align: center">RxR-CE SR↑</th>
      <th style="text-align: center">RxR-CE SPL↑</th>
      <th style="text-align: center">RxR-CE nDTW↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">BEVBert</td>
      <td style="text-align: center">RGB-D + Pano</td>
      <td style="text-align: center">4.57</td>
      <td style="text-align: center">59.0%</td>
      <td style="text-align: center">50.0%</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
    </tr>
    <tr>
      <td style="text-align: left">ETPNav</td>
      <td style="text-align: center">RGB-D + Pano</td>
      <td style="text-align: center">4.71</td>
      <td style="text-align: center">57.0%</td>
      <td style="text-align: center">49.0%</td>
      <td style="text-align: center">5.64</td>
      <td style="text-align: center">54.7%</td>
      <td style="text-align: center">44.8%</td>
      <td style="text-align: center">61.9%</td>
    </tr>
    <tr>
      <td style="text-align: left">HNR</td>
      <td style="text-align: center">RGB-D + Pano</td>
      <td style="text-align: center">4.42</td>
      <td style="text-align: center">61.0%</td>
      <td style="text-align: center">51.0%</td>
      <td style="text-align: center">5.50</td>
      <td style="text-align: center">56.3%</td>
      <td style="text-align: center">46.7%</td>
      <td style="text-align: center">63.5%</td>
    </tr>
    <tr>
      <td style="text-align: left">NaVid</td>
      <td style="text-align: center">单目 RGB</td>
      <td style="text-align: center">5.47</td>
      <td style="text-align: center">37.0%</td>
      <td style="text-align: center">35.0%</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
    </tr>
    <tr>
      <td style="text-align: left">Uni-NaVid</td>
      <td style="text-align: center">单目 RGB</td>
      <td style="text-align: center">5.58</td>
      <td style="text-align: center">47.0%</td>
      <td style="text-align: center">42.7%</td>
      <td style="text-align: center">6.24</td>
      <td style="text-align: center">48.7%</td>
      <td style="text-align: center">40.9%</td>
      <td style="text-align: center">-</td>
    </tr>
    <tr>
      <td style="text-align: left">NaVILA</td>
      <td style="text-align: center">单目 RGB</td>
      <td style="text-align: center">5.22</td>
      <td style="text-align: center">54.0%</td>
      <td style="text-align: center">49.0%</td>
      <td style="text-align: center">6.77</td>
      <td style="text-align: center">49.3%</td>
      <td style="text-align: center">44.0%</td>
      <td style="text-align: center">58.8%</td>
    </tr>
    <tr>
      <td style="text-align: left">StreamVLN</td>
      <td style="text-align: center">单目 RGB</td>
      <td style="text-align: center">4.98</td>
      <td style="text-align: center">56.9%</td>
      <td style="text-align: center">51.9%</td>
      <td style="text-align: center">6.22</td>
      <td style="text-align: center">52.9%</td>
      <td style="text-align: center">46.0%</td>
      <td style="text-align: center">61.9%</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>CorrectNav (Ours)</strong></td>
      <td style="text-align: center"><strong>单目 RGB</strong></td>
      <td style="text-align: center"><strong>4.24</strong></td>
      <td style="text-align: center"><strong>65.1%</strong></td>
      <td style="text-align: center"><strong>62.3%</strong></td>
      <td style="text-align: center"><strong>4.09</strong></td>
      <td style="text-align: center"><strong>69.3%</strong></td>
      <td style="text-align: center"><strong>63.3%</strong></td>
      <td style="text-align: center"><strong>75.2%</strong></td>
    </tr>
  </tbody>
</table>

<p>CorrectNav 在仅使用单目 RGB 的前提下，不仅刷新了单目 VLA 模型的最高纪录（R2R-CE SR 65.1%，RxR-CE SR 69.3%），甚至全面超越了依赖深度图（Depth）、全景图（Pano）和路点预测器（Waypoint Predictor）的传统拓扑地图方法（如 HNR、ETPNav）。</p>

<h4 id="-飞轮迭代与消融实验">② 飞轮迭代与消融实验</h4>

<div align="center">
  <img src="/images/vln/CorrectNav-iterations-curve.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:682/427" />
<figcaption>CorrectNav 性能随自纠错飞轮迭代轮次的变化趋势</figcaption>
</div>

<ul>
  <li><strong>飞轮迭代效应</strong>：随着自纠错飞轮迭代从 Iter 0 推进至 Iter 3，R2R-CE 和 RxR-CE 的成功率均表现出持续的增长，证明了自纠错数据闭环迭代的有效性。在第 4 轮出现轻微回落时止盈。</li>
  <li><strong>关键模块消融</strong>：移除动作纠错轨迹生成会导致成功率最显著的下降（R2R 降至 59.2%）；移除关键帧感知分析则导致成功率降至 60.1%，验证了感知引导纠错的必要性。</li>
</ul>

<h4 id="-真实机器人实测agibot-灵汐-d1-四足机器人">③ 真实机器人实测（AgiBot 灵汐 D1 四足机器人）</h4>

<p>在 AgiBot 灵汐 D1 四足机器人平台（配备单目 RGB 摄像头及 remote A100 GPU）上进行了 Office、Home、Campus 三大场景的定量测试：</p>

<div align="center">
  <img src="/images/vln/CorrectNav-real-robot.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/887" />
<figcaption>CorrectNav 在室内外多场景（办公区、住宅、校园）实机部署的定性结果（涵盖动态避障、长时间跨度指令与路径偏离恢复）</figcaption>
</div>

<ul>
  <li>在复杂的室内外长指令测试中，CorrectNav 的成功率（SR）显著优于 Baseline（如在 Office Complex 指令下 SR 达 <strong>75%</strong>，而 NaVid 仅为 30%，NaVILA 为 20%）。</li>
  <li>具备强劲的动态避障（动态避让行人与黄色箱子）以及偏离后自折返恢复能力。</li>
</ul>

<hr />

<h3 id="4-局限性-9">4. 局限性</h3>

<ol>
  <li><strong>几何相对位置感知精度有限</strong>：单目 RGB 缺乏精确深度信息，模型对机器人本体与周围障碍物之间的相对空间物理距离感知尚不够精确。</li>
  <li><strong>机体碰撞擦碰风险</strong>：在四足机器人等具有复杂几何轮廓的平台上，当贴紧障碍物转弯时，机器人的后腿可能存在轻微擦碰障碍物的风险。作者指出未来需将机器人本体尺寸与状态先验融合入推理模型中。</li>
</ol>

<hr />

<h2 id="slow4fast-vln">23. Slow4fast-VLN (2026)</h2>
<p>——General Vision-Language Navigation via Fast-Slow Interactive Reasoning</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.09111v1">arXiv:2601.09111</a> · 🏛️ <strong>CVPR 2026</strong> · <a href="https://github.com/yl6017339/Slow4Fast-VLN">Code</a></p>

<h3 id="精华-11">精华</h3>
<p>这篇论文的核心借鉴价值在于其提出的动态交互式快慢脑（Fast-Slow Interactive Reasoning）导航框架。它通过模拟人类的“快思考”（直觉决策）和“慢思考”（深度反思），实现导航策略的持续优化。其亮点在于，慢脑系统能够从历史经验中提炼出可泛化的“导航知识”，并用其“赋能”快脑，从而有效提升了智能体在未知环境（OOD场景）中的泛化能力和决策效率，解决了传统方法中快慢系统割裂、经验无法沉淀的问题。</p>

<h3 id="1-研究背景问题-10">1. 研究背景/问题</h3>
<p>传统的视觉-语言导航（VLN）方法在封闭环境下表现良好，但在面对环境和指令风格多变的开放世界时，其泛化能力严重不足。GSA-VLN任务通过引入多样化的场景和指令，对模型的场景适应性提出了更高要求。当前方法的主要挑战在于如何让智能体在导航过程中动态生成可泛化的策略，以应对前所未见的场景和指令。</p>

<h3 id="2-主要方法创新点-core-content-most-detailed">2. 主要方法/创新点 (Core content, most detailed)</h3>
<p>论文提出了一个名为 <strong>slow4fast-VLN</strong> 的动态交互式快慢推理框架，以应对开放环境下的视觉语言导航挑战。该框架包含快慢两个核心模块：</p>

<ul>
  <li>
    <p><strong>快推理模块 (Fast Reasoning)</strong>：这是一个端到端的策略网络（基于DUET），负责根据实时的视觉和指令输入，快速生成导航动作。同时，它会记录导航过程中的所有执行记录（如观测、动作、度量等），形成历史记忆（History Repository）。</p>
  </li>
  <li>
    <p><strong>慢推理模块 (Slow Reasoning)</strong>：该模块是整个框架的核心创新点。它利用大语言模型（LLM）对快推理模块产生的历史记忆进行深度“反思”（Reflection），从中提取出结构化、可泛化的导航经验（Structured Experience），并存入一个经验库（Experience Library）。这些经验包含了场景类型、空间上下文、空间规则、导航策略等关键信息。</p>
  </li>
  <li>
    <p><strong>快慢交互机制 (Interaction)</strong>：这是区别于以往工作的关键。在导航决策时，快推理模块会从经验库中检索与当前场景最相关的经验，并将这些经验特征与实时视觉特征进行融合（通过Attention机制），从而“赋能”快脑，使其做出更精准、更泛化的决策。这种交互使得慢脑提炼的经验能够持续优化快脑的性能。</p>
  </li>
  <li>
    <p><strong>指令风格转换 (Instruction Style Conversion)</strong>：为了应对多样的指令风格（如场景化、用户个性化），论文还设计了一个基于LLM的指令转换模块，通过CoT提示工程，将不同风格的指令实时转换为统一的“基础风格”指令，降低了模型对指令变化的敏感度。</p>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/slow4fast-VLN-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/779" />
<figcaption>
图1: slow4fast-VLN 框架概览，展示了快慢推理模块如何通过历史记忆和泛化经验进行交互，以适应不同环境。
</figcaption>
</div>

<div align="center">
  <img src="/images/vln/slow4fast-VLN-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/820" />
<figcaption>
图2: 方法概览。策略网络（快推理）处理实时输入并存储历史，LLM（慢推理）反思历史并生成经验，这些经验反过来指导策略网络。
</figcaption>
</div>

<h3 id="3-核心结果发现-key-findings">3. 核心结果/发现 (Key findings)</h3>
<ul>
  <li><strong>环境适应性</strong>：在GSA-R2R数据集上，使用基础指令进行测试时，slow4fast-VLN在住宅（ID）和非住宅（OOD）场景中的成功率（SR）分别比基线方法GR-DUET提升了1.5%和2.2%，证明了快慢交互框架对于提升场景泛化能力的有效性。</li>
  <li><strong>指令适应性</strong>：在面对用户个性化指令和场景化指令时，该方法同样全面优于基线。例如，在用户指令测试中，其SR和SPL指标在多种角色（如Child, Keith, Moira等）下均达到SOTA水平。这得益于其指令风格转换模块和动态经验反馈循环。</li>
  <li><strong>消融实验</strong>：实验证明，快慢推理（FSR）框架和指令风格转换（ISC）模块都是有效的。当两者协同工作时，模型在最具挑战的Test-N-Scene任务上达到了最佳性能。</li>
  <li><strong>案例研究</strong>：通过可视化导航轨迹，论文展示了在引入慢脑反思后，智能体能够修正初始的错误路径，并基于经验（如“寻找蓝色画作”作为线索）更高效、更准确地完成导航任务，避免了不必要的探索。</li>
</ul>

<div align="center">
  <img src="/images/vln/slow4fast-VLN-casestudy.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/525" />
<figcaption>
图3: 案例研究。左图为仅使用快推理的轨迹，右图为经过慢推理优化后的轨迹，显示出路径更优，定位更准。
</figcaption>
</div>

<h3 id="4-局限性-brief-1-2-sentences">4. 局限性 (Brief, 1-2 sentences)</h3>
<p>论文指出的一个局限是，慢脑推理产生的知识是隐式地编码在策略网络的权重中，这种“黑盒”形式使得学习到的经验难以解释和直接干预。未来的一个研究方向是让慢脑生成显式的、结构化的知识库（如语义地图或知识图谱），以供快脑在导航时直接查询。</p>

<hr />

<h2 id="dgnav">24. DGNav (2026)</h2>
<p>———动态拓扑感知：打破视觉-语言导航中的粒度刚性</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.21751">arXiv:2601.21751</a></p>

<h3 id="精华-12">精华</h3>

<p>这篇论文解决了 VLN-CE 中的”粒度刚性”问题，值得借鉴的核心思想：</p>

<ol>
  <li><strong>自适应结构调整</strong>：不仅调整模型参数，还动态调整数据结构本身（拓扑图的节点密度），实现”简单场景保效率、复杂场景保安全”的自适应平衡，这一思路可迁移到其他需要精度/效率权衡的规划任务（如 SLAM、点云处理）。</li>
  <li><strong>条件干预设计</strong>：引入”稳定性门槛”（中位数离散度 σ_med），只在高不确定性场景触发动态调整，而非全局自适应，有效避免了在简单场景引入不必要的噪声——这是一种极具工程实用性的设计思想。</li>
  <li><strong>多模态软硬约束融合</strong>：将几何硬约束（物理可达性）与视觉语义和语言指令软约束通过可学习权重动态融合，使图连接从”物理近邻关系”升级为”语义近邻关系”，为多约束优化提供了优雅解法。</li>
  <li><strong>线性映射的理论优越性</strong>：基于信息论论证了线性映射是保持最大熵属性的最优一阶近似，既优于 Sigmoid 的梯度饱和，又优于 Exponential 的保守偏差——理论驱动设计的典范。</li>
  <li><strong>结构与训练解耦</strong>：Scene-Aware Adaptive Strategy 仅在推理阶段激活，训练阶段使用固定阈值，实现了稳定的特征学习与灵活的测试时推理之间的解耦。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-11">1. 研究背景/问题</h3>

<p>VLN-CE（连续环境中的视觉-语言导航）中，现有拓扑规划方法（如 ETPNav）依赖固定的图构建阈值 γ 和静态欧式距离边权重，导致”粒度刚性”问题：在简单低不确定性区域产生大量冗余节点，在复杂高不确定性区域图过于稀疏导致导航失败。更严重的是，纯几何边权重使智能体优先连接物理距离近但语义无关的节点（”导航性近视” Navigational Myopia），无法遵从指令中的语义意图。</p>

<p><strong>主要方法/创新点</strong></p>

<p>论文提出 <strong>DGNav (Dynamic Graph Navigation)</strong> 框架，包含两大核心模块：</p>

<div align="center">
  <img src="/images/vln/DGNav-overall-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1050/481" />
<!-- RENAME: figure_01.png -> DGNav-overall-framework.png -->
<figcaption>
DGNav 整体框架。根据估计的场景复杂度 σ 动态调整导航策略：高复杂度场景构建更密集的拓扑图，简单环境则采用更稀疏的表示。图合并阈值 γ 控制图粒度，与 σ 呈反相关，实现导航安全性与效率的自适应权衡。
</figcaption>
</div>

<p><strong>1. 场景感知自适应策略 (Scene-Aware Adaptive Strategy)</strong></p>

<p>针对物理结构层面的粒度刚性问题，提出动态调整图构建阈值的方法：</p>

<ul>
  <li><strong>场景复杂度度量</strong>：通过分析预测路径点的角度离散度 (angular dispersion) σ 来量化局部场景复杂度：
    <div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>σ_t = sqrt(1/N_c * Σ(θ_i - θ̄)²)
</code></pre></div>    </div>
    <p>其中 θ_i 是候选节点相对于智能体朝向的角度。高 σ 表示复杂决策边界（如交叉路口），低 σ 表示简单几何结构（如走廊）。</p>
  </li>
  <li><strong>条件线性映射控制律</strong>：基于统计校准的高斯分布特性，采用线性映射动态调整合并阈值 γ：
    <div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>γ_t = γ_fix                                        if σ_t ≤ σ_med
γ_t = γ_fix - (σ_t - σ_med)/(σ_max - σ_med) * (γ_fix - γ_min)   if σ_t &gt; σ_med
</code></pre></div>    </div>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/DGNav-adaptive-strategy.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:714/599" />
<figcaption>
场景感知自适应策略示意图。从深度图生成候选路径点后，根据候选节点的角度离散度 (σ) 动态调整合并阈值 γ。在简单环境中 (低 σ)，较大的 γ 产生稀疏图以提升效率；在复杂环境中 (高 σ)，较小的 γ 产生密集图以确保安全。
</figcaption>
</div>

<ul>
  <li><strong>理论依据</strong>：选择线性映射而非 Sigmoid/指数映射的原因是线性变换保持高斯源分布的最大熵特性。非线性映射会在分布尾部引入饱和区域（梯度消失），导致高不确定状态的信息丢失。条件映射策略仅在 σ &gt; σ_med 时激活自适应机制，在稳定场景中保持拓扑稳定性。</li>
</ul>

<p><strong>2. 动态图 Transformer (Dynamic Graph Transformer)</strong></p>

<p>针对语义逻辑层面的导航近视问题，融合多模态线索动态重构图连接性：</p>

<div align="center">
  <img src="/images/vln/DGNav-dynamic-edge-fusion.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:715/629" />
<figcaption>
多模态编码和动态边融合架构。视觉编码器和指令编码器分别提取节点特征 (V) 和词特征 (W)。动态边融合模块通过融合几何地图 (E_geo)、成对视觉相似度 (E_sem) 和指令相关性 (E_inst) 构建图连接性。生成的动态邻接矩阵 E_dynamic 指导 Graph Transformer 执行上下文感知的路径规划。
</figcaption>
</div>

<h4 id="1scene-aware-adaptive-strategy场景感知自适应策略">1.Scene-Aware Adaptive Strategy（场景感知自适应策略）</h4>

<p>通过计算当前时刻候选节点的<strong>角度离散度</strong> $\sigma_t$ 来量化场景复杂度：</p>

\[\sigma_t = \sqrt{\frac{1}{N_c} \sum_{i=1}^{N_c} (\theta_i - \bar{\theta})^2}\]

<p>基于 $\sigma_t$，采用<strong>条件线性映射</strong>动态调整图合并阈值 $\gamma_t$：</p>

\[\gamma_t = \begin{cases} \gamma_{fix} &amp; \text{if } \sigma_t \leq \sigma_{med} \\ \gamma_{fix} - \dfrac{\sigma_t - \sigma_{med}}{\sigma_{max} - \sigma_{med}}(\gamma_{fix} - \gamma_{min}) &amp; \text{if } \sigma_t &gt; \sigma_{med} \end{cases}\]

<ul>
  <li>简单场景（$\sigma_t \leq \sigma_{med}$）：$\gamma_t = \gamma_{fix} = 0.5\text{m}$，保持稀疏效率</li>
  <li>复杂场景（$\sigma_t &gt; \sigma_{med}$）：线性降低 $\gamma_t$（最低至 $\gamma_{min} = 0.1\text{m}$），生成密集拓扑</li>
</ul>

<p>$\sigma_{med}$ 和 $\sigma_{max}$ 通过在 ETPNav 基线模型上统计推断得到（数据驱动校准），线性函数的选择基于信息论证明其是保最大熵的最优一阶近似。</p>

<h4 id="2dynamic-graph-transformer动态图-transformer">2.Dynamic Graph Transformer（动态图 Transformer）</h4>

<p><strong>Dynamic Edge Fusion</strong>：融合三种信息流构造动态邻接矩阵：</p>

\[\mathbf{E}_{dynamic} = \mathbf{E}_{geo} + \omega_1 \cdot \mathbf{E}_{sem} + \omega_2 \cdot \mathbf{E}_{inst}\]

<ul>
  <li>\(\mathbf{E}_{geo}\)：归一化欧式距离（物理可达性硬约束）</li>
  <li>\(\mathbf{E}_{sem}\)：CLIP-ViT 提取的视觉特征通过 MLP 计算的成对相似度</li>
  <li>\(\mathbf{E}_{inst}\)：节点特征与全局指令 token \(\mathbf{W}_L\) 的外积相关性分数，即 \(w_i = \text{MLP}([v_i; \mathbf{W}_L])\)，$E_{inst}^{(i,j)} = w_i \cdot w_j$</li>
</ul>

<p><strong>Graph-Aware Self-Attention (GASA)</strong>：</p>

\[\text{GASA}(\mathbf{H}^l, \mathbf{E}_{dynamic}) = \text{Softmax}\!\left(\frac{(\mathbf{H}^l \mathbf{W}_Q)(\mathbf{H}^l \mathbf{W}_K)^\top}{\sqrt{d_k}} + \mathbf{E}_{dynamic}\right)\!(\mathbf{H}^l \mathbf{W}_V)\]

<p>将 \(\mathbf{E}_{dynamic}\) 直接叠加到注意力分数上，强制模型关注语义相关（\(\omega_1 \cdot \mathbf{E}_{sem}\)）且指令对齐（\(\omega_2 \cdot \mathbf{E}_{inst}\)）的节点，同时 \(\mathbf{E}_{geo}\) 保证物理约束不被完全忽略，实现从纯几何到语义驱动的平滑过渡。</p>

<p><strong>训练策略</strong>：采用两阶段训练，Adaptive Strategy 仅在推理阶段激活，训练阶段固定 $\gamma = 0.5\text{m}$ 确保稳定的特征学习。</p>

<hr />

<h3 id="3-核心结果发现-10">3. 核心结果/发现</h3>

<p><strong>R2R-CE 数据集</strong>：</p>
<ul>
  <li>Val-Unseen：SR <strong>58.56%</strong>，SPL <strong>50.08%</strong>（OSR 64.82%，NE 4.66），高于 ETPNav 基线的 SR 57% / SPL 49%</li>
  <li>Test-Unseen：SR 64%（+1% vs ETPNav），SPL 47%，NE 下降 0.2m</li>
  <li>超越所有 End-to-End 方法和显式地图方法（含 GridMM, Safe-VLN, OVL-MAP）</li>
</ul>

<p><strong>RxR-CE 数据集</strong>（多语言，更长路径）：</p>
<ul>
  <li>Val-Unseen：SR <strong>53.78%</strong>，nDTW <strong>62.04%</strong>（+0.55%），SDTW <strong>44.49%</strong>（+0.57%）</li>
  <li>路径保真度指标全面超越 ETPNav，证明在长时域细粒度指令遵从上的优越性</li>
</ul>

<p><strong>消融实验关键发现</strong>：</p>
<ul>
  <li>条件线性映射 vs 全局线性映射：SR +1.52%（稳定性门槛机制的贡献）</li>
  <li>动态 $\gamma$ vs 固定 $\gamma$（0.25/0.40/0.50m）：SR 最高提升 +1.63%，且计算开销仅增加 0.4 个节点</li>
  <li>完整 \(\mathbf{E}_{dynamic}\) vs 仅几何：SR 大幅提升，验证语义软约束的关键作用</li>
  <li>定性分析（Fig.9）：在”绕过木质围栏”场景中，仅几何模型因物理距离过近而提前错误转向，DGNav 正确识别指令语义并忽略了几何干扰，成功到达目标</li>
</ul>

<hr />

<h3 id="4-局限性-10">4. 局限性</h3>

<p>自适应策略的核心参数（$\gamma_{fix}, \gamma_{min}, \sigma_{med}, \sigma_{max}$）通过在 R2R-CE 训练集上进行统计校准获得，在分布外场景（如户外环境、高度动态场景）中的泛化能力尚未验证；同时，随着导航轨迹增长，拓扑图规模持续膨胀，论文未讨论图压缩和历史节点管理策略，在超长路径任务中可能面临内存和计算的挑战。</p>

<hr />

<h2 id="causalnav">25. CausalNav (2026)</h2>
<p>———First Scene Graph-based Semantic Navigation for Dynamic Outdoor Environments</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.01872">arXiv:2601.01872</a> · 🏛️ <strong>IEEE RA-L</strong></p>

<h3 id="精华-13">精华</h3>

<p>CausalNav 的核心亮点在于将多层级场景图（Embodied Graph）与 RAG 机制深度结合，实现了支持开放词汇查询的长程语义导航——”图即知识库”的设计范式值得借鉴。其次，层次化 Embodied Graph 构建策略（从细粒度对象节点到粗粒度建筑物与聚类节点）展示了如何在多空间尺度上统一语义表示与检索。第三，基于时空走廊（Spatial-Temporal Corridor）的动态对象过滤机制，无需额外标注即可区分静态、准静态与动态障碍物，是处理室外动态场景的实用方案。第四，使用本地开源 LLM 替代商业 API 完成层次语义检索，证明了在自主平台上脱离云端仍可实现高质量语义推理。</p>

<hr />

<h3 id="1-研究背景问题-12">1. 研究背景/问题</h3>

<p>室外大规模动态环境中的自主语义导航面临三大挑战：开放词汇的语义理解、动态环境适应（行人、车辆等移动障碍物）以及长期稳定性。现有 VLN 研究主要聚焦于静态室内场景，依赖高精度地图或大规模训练数据，在真实室外动态场景中的长程导航鲁棒性未得到充分验证。</p>

<hr />

<h3 id="2-主要方法创新点-10">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/CausalNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:715/565" />
<figcaption>
CausalNav 整体工作流：集成语义推理、动态环境适应和 Embodied Graph 规划三大模块
</figcaption>
</div>

<p>CausalNav 提出了一个由三个核心模块构成的语义导航框架：</p>

<p><strong>模块一：开放词汇目标跟踪与自我运动估计</strong></p>

<p>使用 YOLO-World 从 RGB 图像中提取开放词汇的 2D 检测框和分割掩码，通过 ByteTrack 进行多目标跟踪。结合 LiDAR 点云将 2D 检测投影至 3D 空间，获得目标的 3D 姿态 \(^w\mathbf{T}_{obj}\)。自车运动通过 LiDAR-IMU 里程计（FAST-LIO2）估计，提供精确的定位与坐标变换基础。</p>

<p><strong>模块二：动态对象过滤与 Embodied Graph 构建</strong></p>

<div align="center">
  <img src="/images/vln/CausalNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/699" />
<figcaption>
CausalNav 三模块流水线架构：目标跟踪与自我运动估计 → 动态过滤与图构建 → 图更新与自然语言导航
</figcaption>
</div>

<ul>
  <li>
    <p><strong>时空走廊过滤</strong>：将每个目标的历史轨迹编码为时空走廊 \(\mathcal{T} = \{^w\mathbf{T}^n_{obj}, \text{3DBBox}_i, t_i\}_{i=1}^n\)。若目标在 $k$ 步内位移超过阈值，则认定为动态目标并从图中移除，有效消除运动引起的虚假节点。</p>
  </li>
  <li>
    <p><strong>Embodied Graph 层次构建</strong>：静态环境由两类节点组成——建筑物节点 $\nu_i^{build}$ 来自离线地图，对象节点 $\nu_i^{obj}$ 来自实时感知。使用 LLM 对节点进行层次聚类（spatial-semantic similarity），形成多级抽象：对象层（Level $L-1$）→ 建筑物/Place 层（Level $L$）→ 聚类节点（Clustering Node）。每次自车移动超过距离阈值 $d$，新增自车节点 $\nu_i^l$ 记录历史轨迹。</p>
  </li>
  <li>
    <p><strong>RAG 语义检索</strong>：基于 LLM 打分的层次化检索，结合空间相似性 $\kappa^{spatial}$ 和语义相似性 $\kappa^{semantic}$，在图中逐层选择最匹配查询的节点路径，支持开放词汇目标定位。</p>
  </li>
</ul>

<p><strong>模块三：Embodied Graph 动态更新与自然语言导航</strong></p>

<div align="center">
  <img src="/images/vln/CausalNav-embodied-graph.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:715/610" />
<figcaption>
仿真环境中构建的 Embodied Graph：粗粒度建筑物节点与细粒度对象节点（消火栓、邮箱等）的多层次融合
</figcaption>
</div>

<ul>
  <li>
    <p><strong>全局规划</strong>：解析自然语言指令，通过 RAG 检索 Embodied Graph 推断目标位置，优先使用历史轨迹中的 Dijkstra 最短路径；若目标不可达，则调用离线地图或 Google Maps 生成粗粒度路线，结果表示为路点序列 $\mathcal{W} = {w_1, w_2, \ldots, w_n}$。</p>
  </li>
  <li>
    <p><strong>局部规划</strong>：采用 RH-Map 进行实时动态局部地图构建，通过 Informed-RRT* 生成初始轨迹，再使用 NMPC-CBF（Nonlinear Model Predictive Control with Control Barrier Function）进行轨迹跟踪与动态避障，保证对移动行人/车辆的安全性。</p>
  </li>
</ul>

<hr />

<h3 id="3-核心结果发现-11">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/CausalNav-real-world-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:709/997" />
<figcaption>
真实环境中不同距离尺度的导航实验：短程（130m 对象级指令）与长程（512m 建筑级指令）
</figcaption>
</div>

<p><strong>仿真实验</strong>（对比 ViNT、NoMaD、GNM、CityWalker）：</p>
<ul>
  <li>Small 任务：SR 100%，SPL 88.9%，CC 0.2（所有方法中最优）</li>
  <li>Medium 任务：SR 92%，SPL 82.2%</li>
  <li>Large 任务：SR 80%，SPL 66.0%，CC 1.2，TL 141.82m</li>
</ul>

<p><strong>真实世界实验</strong>：</p>
<ul>
  <li>短程（130m）：ViNT 和 CausalNav 均成功，其他方法失败</li>
  <li>长程（512m）：仅 CausalNav 成功完成任务，其他方法因碰撞失败</li>
  <li>CityWalker 在真实世界表现显著差于仿真，对光照变化和动态障碍物敏感</li>
</ul>

<p><strong>消融实验</strong>：</p>
<ul>
  <li>启用 Embodied Graph 动态更新：SR 从 78% 提升至 90%，SPL 从 54.7% 提升至 80.1%</li>
  <li>最优超参数：$\alpha=\beta=0.5$，$\gamma=1.5$（空间-语义平衡点）</li>
  <li>运行时延：105ms/cycle（10Hz），比 NoMaD 仅多 11% 开销</li>
</ul>

<hr />

<h3 id="4-局限性-11">4. 局限性</h3>

<p>CausalNav 在极端光照/天气条件下的鲁棒性有待提升，且长程图记忆的压缩与遗忘机制尚未完善，可能在超长时间运行后出现图膨胀和检索精度下降问题。</p>

<h2 id="agentvln">26. AgentVLN (2026)</h2>
<p>———Towards Agentic Vision-and-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.17670">arXiv:2603.17670</a> · 🏛️ <strong>ECCV 2026</strong> · <a href="https://allenxinn.github.io/AgentVLN/">Project Page</a> · <a href="https://github.com/Allenxinn/AgentVLN">Code</a></p>

<h3 id="精华-14">精华</h3>

<p>AgentVLN 最值得借鉴的思想是 <strong>VLM-as-Brain</strong> 范式：将 VLM 作为大脑纯做高层语义推理与技能调度，把感知、规划、控制等低层能力封装成模块化、即插即用的技能库，彻底解耦了认知与执行。跨空间表示映射（将 3D 拓扑路点反投影为像素对齐的 2D 视觉提示）是一个无需额外参数就能弥合 2D VLM 与 3D 物理世界之间鸿沟的精妙设计。QD-PCoT 展示了如何赋予模型元认知能力：当面对空间歧义时主动提问、调用感知技能获取深度信息，而非盲目输出坐标。3B 参数量在 R2R/RxR 双榜均超越 7B+ 的先前 SOTA，证明结构化分层推理远比暴力扩参数更高效。该框架可直接部署于 Jetson 嵌入式边缘平台，具备极强的落地价值。</p>

<hr />

<h3 id="1-研究背景问题-13">1. 研究背景/问题</h3>

<p>Vision-and-Language Navigation (VLN) 要求具身智能体将复杂自然语言指令转化为长时域、连续空间的导航行为。当前 VLN 系统面临三大核心瓶颈：VLM 固有的 2D 语义理解与 3D 几何感知之间的跨空间失配；单目 RGB 图像引起的尺度歧义导致局部目标定位失败；以及大参数量模型无法满足边缘设备实时推理需求。</p>

<hr />

<h3 id="2-主要方法创新点-11">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/AgentVLN-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:979/605" />
<figcaption>
AgentVLN 整体框架：VLM-as-Brain 范式将长时域导航分解为感知技能（Perception Skills）与规划技能（Planning Skills）的交替调用，辅以 QD-PCoT 处理空间歧义。
</figcaption>
</div>

<p><strong>VLM-as-Brain 范式与 POSMDP 建模</strong></p>

<p>AgentVLN 将 VLN 任务形式化为 Partially Observable Semi-Markov Decision Process (POSMDP) $\mathcal{M} = \langle \mathcal{S}, \mathcal{O}, \mathcal{F}, \mathcal{T}, \mathcal{I}, \mathcal{H} \rangle$。VLM 作为中央控制器，在每个决策步 $t$ 基于历史上下文 \(\mathcal{H}_t\)、视觉观测 $o_t$ 和自然语言指令 $\mathcal{I}$ 生成技能调用指令：</p>

\[c_k \sim \pi_\theta(f \mid \mathcal{H}_{t_k}, o_{t_k}, \mathcal{I}), \quad f \in \mathcal{F}\]

<p>技能库 $\mathcal{F}$ 分为两类：<strong>感知技能</strong> $\mathcal F_{percep}$（$\tau=0$，无延时地从环境提取几何/语义特征，更新全局状态 $\mathcal{S}$）和<strong>规划技能</strong> $\mathcal F_{plan}$（$\tau&gt;0$，执行多步物理动作序列）。具体包括：Back-Projection、Global Planning、Obstacle Avoidance、Incremental Exploration Map、Feasible Waypoints 等模块。这种分层设计使 VLM 完全不接触低层运动细节，专注高层语义-空间匹配。</p>

<p><strong>跨空间表示映射（Cross-Space Representation Mapping）</strong></p>

<p>为解决 VLM 无法直接感知 3D 几何的问题，AgentVLN 设计了一套逆透视投影机制。感知技能首先将 RGB-D 观测通过反投影构建全局占据栅格地图，生成三维路点 $\mathbf{P}^w_{path} = [X_{path}, Y_{path}, 0]^T$；随后通过相机内参矩阵 $K$ 和当前位姿 $T_t$ 将 3D 路点投影回像素坐标：</p>

\[s \cdot \mathbf{p}^{img}_{path} = KR_t^{-1}(\mathbf{P}^w_{path} - \mathbf{t}_t)\]

<p>这样 VLM 只需在 2D 像素空间中根据语义选择最匹配的路点，再由规划技能将其恢复为 3D 控制信号，实现了 2D 视觉语义与 3D 物理结构的无缝桥接。</p>

<p><strong>上下文感知的细粒度自校正与主动探索</strong></p>

<p>当当前观测 $o_t$ 中不存在满足指令语义的可行路点时（如遮挡、盲区、轨迹偏差），AgentVLN 不强制执行长距离盲位移，而是输出细粒度原子动作 \(a_t \sim \pi_\theta(a \mid \mathcal{H}_t, o_t, \mathcal{I})\)，$a \in {\text{Forward, Left, Right}}$，自主环顾恢复可见路点后切回宏观技能调用，有效抑制长轨迹误差累积。</p>

<p><strong>Query-Driven Perceptual Chain-of-Thought (QD-PCoT)</strong></p>

<div align="center">
  <img src="/images/vln/AgentVLN-performance-comparison.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:575/583" />
<figcaption>
AgentVLN-3B 在 RxR-CE Val-Unseen 上的参数量-成功率对比，以 3B 参数量超越所有 7B+ 的先前方法。
</figcaption>
</div>

<p>针对局部目标定位阶段的单目尺度歧义，AgentVLN 引入 QD-PCoT 机制。当模型检测到空间歧义时，不盲目回归像素坐标，而是生成中间自然语言查询（如 <em>“How many meters is the chair in front of me?”</em>）并调用感知技能 $\mathcal F_{percep}$ 获取精确深度反馈。该反馈以增量文本提示形式注入上下文，引导模型最终输出准确的目标像素坐标 $\mathbf p_{target}^{img} = [u_{target}, v_{target}, 1]^T$，再经深度图反投影转换为 3D 目标坐标 $\mathbf{P}^w_{target}$，实现精准对接。</p>

<p><strong>AgentVLN-Instruct 数据集</strong></p>

<p>构建了大规模指令调优数据集 AgentVLN-Instruct（基于 Habitat 仿真器），包含四个关键组件：目标可见性驱动的动态阶段路由机制（模拟人类”先粗导航、再精定位”的认知模式）、可泛化技能调用标注、局部化推理数据，以及主动问答交互对。基础模型为 Qwen2.5-VL-3B，训练时冻结视觉编码器，以 AdamW 优化，使用 32 块 NVIDIA A100 GPU。</p>

<hr />

<h3 id="3-核心结果发现-12">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/AgentVLN-navigation-visualization.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:981/625" />
<figcaption>
AgentVLN 导航可视化：绿色点为感知技能生成的像素级视觉提示，红圈为规划技能选取的路点；遭遇视觉遮挡时自动切换为细粒度原子动作。
</figcaption>
</div>

<ul>
  <li><strong>R2R-CE Val-Unseen</strong>: AgentVLN-3B 达到 SR=67.2%, SPL=64.7%，超越同类 SOTA InternVLA-N1-8.3B（SR+9.0%，SPL+10.7%），以不到一半的参数量实现全面超越</li>
  <li><strong>RxR-CE Val-Unseen</strong>: SR=69.5%, SPL=61.3%, nDTW=74.6%，同样刷新 SOTA</li>
  <li><strong>消融分析</strong>：仅引入 VLM-as-Brain + 跨空间映射，SR 从基线 38.6% 提升至 59.7%；加入 CDFG 细粒度自校正后达 65.6%；最终集成 QD-PCoT 达 67.2%</li>
  <li><strong>时序上下文</strong>：最优历史帧数 K=8（SR=67.2%，SPL=64.7%），过短则短视，过长则注意力稀释</li>
  <li><strong>真实世界部署</strong>：基于 Unitree Go2 四足机器人 + Intel RealSense D455，结合 RTAB-Map SLAM，在室内外场景均实现准确导航，支持 Jetson 边缘实时推理</li>
</ul>

<hr />

<h3 id="4-局限性-12">4. 局限性</h3>

<p>AgentVLN 当前依赖深度传感器（RGB-D）支持精确的 3D 反投影，在纯 RGB 单目场景下的尺度歧义处理能力仍受限；此外，技能库的扩展和维护需要一定的工程成本，对全新场景的零样本适配能力尚待系统评估。</p>

<hr />

<h2 id="vln-cache">27. VLN-Cache (2026)</h2>
<p>———Enabling Token Caching for VLN Models with Visual/Semantic Dynamics Awareness</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.07080">arXiv:2603.07080</a></p>

<h3 id="精华-15">精华</h3>

<p>VLN-Cache 的核心洞见是：现有 token caching 方案在 VLN 场景下失效的根本原因有两个相互独立的维度——视觉动态（视角偏移导致空间位置错配）和语义动态（任务阶段推进导致缓存 token 语义过时）。将 “视图对齐重映射” 与 “任务相关性语义门控” 分别针对这两种动态进行正交设计是本文最值得借鉴的思路：先用几何对应恢复可复用集合，再用语义相关性做一票否决，二者缺一不可。层自适应熵策略（layer-adaptive entropy policy）将每层的复用预算与注意力分布的不确定性挂钩，也为其他需要跨层差异化处理的 inference 优化工作提供了参考范式。整个框架训练自由、无需架构修改，可作为即插即用的推理加速包裹层，具有很强的实用价值。</p>

<hr />

<h3 id="1-研究背景问题-14">1. 研究背景/问题</h3>

<p>现代 VLN 系统依赖大型视觉-语言模型（VLM）作为规划器，每个导航步骤都需完整的前向推理，导致每步延迟成为实时部署的瓶颈。Token caching 是一种无需训练的推理加速策略，通过复用帧间稳定 token 的 KV 表示来跳过冗余计算；然而现有方法基于静态相机和固定语义的假设，在 Agent 连续平移旋转的 VLN 场景下会出现两类系统性失效：视角偏移导致位置对齐失效，任务阶段推进导致语义相关性突变，使得缓存 token 在视觉上”看起来稳定”但语义上已经过时。</p>

<hr />

<h3 id="2-主要方法创新点-12">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/VLN-Cache-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1408/552" />
<figcaption>
VLN-Cache 框架总览：左侧展示视觉动态（位置对齐失败）和语义动态（任务阶段偏移）两类挑战；右侧为对应的两个解决方案模块
</figcaption>
</div>

<p>VLN-Cache 是一个双感知 token caching 框架，针对视觉动态和语义动态分别设计了正交的处理机制：</p>

<p><strong>A. 视觉动态感知 Token Caching</strong></p>

<p>由于 Agent 连续移动，帧 t 中位置 i 的 token 对应的物理表面与帧 t-1 中同一位置 i 的表面完全不同。VLN-Cache 通过 <strong>视图对齐重映射（View-Aligned Remapping）</strong> 解决这一问题：</p>
<ul>
  <li>利用深度图将每个 token 中心 $u_t^{(i)}$ 反投影到 3D 空间，结合相机相对位姿变换矩阵 $T_{t \to t-1}$，重新投影到上一帧图像平面，得到对应位置 $\pi_t(i)$</li>
  <li>通过 3×3 邻域细化（$\mathcal{N}$）处理连续坐标到离散 patch 索引的量化误差</li>
  <li>仅当重映射后的 token 对余弦相似度超过阈值 $\tau_{vis}$ 且在有效视野内时才标记为可复用</li>
</ul>

<p><strong>B. 语义动态感知 Token Caching</strong></p>

<p>即便两帧间 token 在几何上完美对齐、视觉上高度相似，若 Agent 已完成当前子目标并转向下一阶段，该区域的任务相关性可能已骤降，复用其缓存状态会向语言解码器注入过时的注意力模式。VLN-Cache 引入 <strong>任务阶段显著性过滤器（Task-Stage Saliency Filter）</strong>：</p>
<ul>
  <li>为每个 token 计算指令条件相关性分数 $s_t^{(i)}$（top-k 注意力集中区域的 Jaccard 距离衡量语义转变幅度 $D_t^{sem}$）</li>
  <li>满足以下任一条件则强制刷新：当前相关性过高（$s_t^{(i)} &gt; \tau_{abs}$，缓存版本无法代表该区域重要性）或相关性快速变化（$\lvert s_t^{(i)} - s_{t-1}^{(i)} \rvert &gt; \tau_\Delta$，正在经历语义转变）</li>
  <li>语义门控为 <strong>一票否决（hard veto）</strong>：视觉稳定性是复用的必要条件但不充分，语义过时则无条件刷新</li>
</ul>

<p><strong>C. 双感知融合与层自适应缓存策略</strong></p>

<p>最终复用掩码采用乘法形式 $m_t^{(i)} = m_{vis,t}^{(i)} \cdot (1 - m_{sem,t}^{(i)})$，仅当几何稳定且无语义转变时才复用。</p>

<div align="center">
  <img src="/images/vln/VLN-Cache-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:691/482" />
<figcaption>
VLN-Cache 框架架构：左侧为视觉复用掩码（可见性+相似度检查），右侧为动态感知缓存的逐层复用预算分配
</figcaption>
</div>

<p>对于 Transformer 不同层，早期层处理低层次视觉特征（变化较慢），深层编码任务相关表示（在指令转变时变化更剧烈）。VLN-Cache 通过 <strong>层自适应熵策略</strong> 调节每层复用预算：
\(\rho_t^\ell = \text{clip}(\rho_{max} - \alpha H_t^\ell, \rho_{min}, \rho_{max})\)
其中 $H_t^\ell$ 是从现有注意力 softmax 读取的层熵代理，高熵层（不确定层）分配更保守的复用预算，低熵层可更激进地复用。</p>

<div align="center">
  <img src="/images/vln/VLN-Cache-system-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:694/477" />
<figcaption>
VLN-Cache 系统实现流水线：视觉编码后通过 View/Sem 双门控生成掩码，复用 token 直接从缓存读取 KV，新 token 走标准前向计算
</figcaption>
</div>

<p>在系统实现上，VLN-Cache 不修改模型权重或注意力核，作为 drop-in 包裹层集成到任意基于 Transformer 的 VLA backbone：复用 token 从视图对齐缓存位置 $\pi_t(i)$ 直接拼接 KV 状态，新 token 经标准投影；RoPE 位置编码仅对新 token 更新，复用 token 继承原有编码。每帧缓存占用约 85.8 MB（A100 VRAM 的 0.21%），无需 CPU 卸载。</p>

<hr />

<h3 id="3-核心结果发现-13">3. 核心结果/发现</h3>

<p>在 R2R-CE <code class="language-plaintext highlighter-rouge">val_unseen</code> 基准（1,839 个 episode，基于 InternVLA-N1 / QwenVL-2.5 7B backbone）上：</p>

<ul>
  <li><strong>推理加速</strong>：每步延迟从 637 ms 降至 419 ms，实现 <strong>1.52× 步级加速</strong>，episode 级别同样达到 <strong>1.52× 加速</strong>（114.7s → 75.5s）</li>
  <li><strong>导航精度保持</strong>：SR = 63.1（vs. 基线 64.3），SPL = 57.6（vs. 基线 58.5），SR 下降仅 1.2%</li>
  <li><strong>Token 复用率</strong>：平均每步 31% 的 VLA token 从缓存复用；83% 的帧完全绕过 ViT 视觉编码器</li>
  <li><strong>消融分析</strong>：移除视图对齐重映射后 SR/SPL 显著下降（回退到位置对齐方案），移除语义门控后精度下降（视觉相似但语义过时的 token 被错误复用），二者均为不可或缺的正交贡献</li>
  <li><strong>效率-精度帕累托最优</strong>：在所有 RGB-only VLN 方法（NaVid, MapNav, UniNaVid, NaVILA, StreamVLN, DualVLN）中，VLN-Cache 达到最低 NE（3.93）和最高 OS（71.4），同时具备最快推理速度</li>
</ul>

<hr />

<h3 id="4-局限性-13">4. 局限性</h3>

<p>VLN-Cache 目前仅针对 RGB-based 连续 VLN，不支持深度传感器或地图导航设置；四个超参数（$\tau_v, \tau_s, k, \rho_{max}$）缺乏自动调节方法，需在小型保留轨迹集上手动校准，自动超参确定方案留作未来工作。</p>

<hr />

<h2 id="r3">28. R³: Run, Ruminate, and Regulate (2026)</h2>
<p>———一个面向视觉语言导航的双过程思考框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2511.14131">arXiv:2511.14131</a> · <a href="https://github.com/IAII-CAS/navigation_R3">Code（待发布）</a> · 🏛️ <strong>AAAI 2026</strong></p>

<hr />

<h3 id="精华-16">精华</h3>

<ul>
  <li>将 Kahneman 双过程理论落到 VLN：<strong>Runner（快系统）</strong>处理常规导航，<strong>Ruminator（慢系统）</strong>处理异常情境，<strong>Regulator</strong>在两者间做监督切换——解决 “LLM 方法慢但泛化强 vs. 专家模型快但迁移差” 的取舍。</li>
  <li>Runner 用轻量级 transformer VLN 专家（~160 M 参数、沿用 GridMM）做反应式高频动作预测；Ruminator 用 GPT-4o + CoT 做感知-规划-预测三步推理；二者共享一个<strong>grid-based topological memory bank</strong>，使慢系统能直接继承快系统的历史上下文。</li>
  <li>Regulator 的切换信号来自三路<strong>critical evaluation</strong>（looping 视点重访阈值 + scoring GNN 对轨迹图做自监督打分 + ending 对 STOP 的校验），切换后进入<strong>critical formulation</strong>清空误导性历史，避免 LLM 被错误上下文污染。</li>
  <li>Scoring 的自监督标注策略值得借鉴：以”是否最终到达目的地 / 路径是否属于 GT 子集”作为二分类伪标签，GNN 用图注意力做消息传递，从而<strong>无需人工标注</strong>就能早期识别失败前兆。</li>
  <li>R³ 在 REVERIE Val-Unseen 上 SPL/RGSPL 比 SOTA 高 3.28 / 3.30，推理时间仅为其他 LLM-assisted 方法的 1/5（1.10 s vs. 5~11 s），展示了”大部分步数走快系统、异常步数才调 LLM”这一思路在效率与性能上的双赢。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-15">1. 研究背景/问题</h3>

<p>VLN 需要智能体根据自然语言指令在复杂 3D 环境中动态导航。两条主流路线各有短板：（1）<strong>基于 BC 的 VLN 专家</strong>（DUET、GridMM 等）效率高但常识缺失、对未见环境泛化差；（2）<strong>LLM-assisted 零样本方法</strong>（NavGPT、MapGPT、DiscussNav 等）泛化好但每步调 LLM 导致延迟高（5~11 s/step），且对空间几何与场景布局的理解不够精确。作者目标是把两者的长处糅合在同一框架下——而不是简单地把 LLM 插进每一步。</p>

<hr />

<h3 id="2-主要方法创新点-13">2. 主要方法/创新点</h3>

<h4 id="21-整体思想双过程思考">2.1 整体思想：双过程思考</h4>

<div align="center">
  <img src="/images/vln/R3-dual-process-overview.webp" width="90%" loading="lazy" decoding="async" style="aspect-ratio:1421/698" />
<figcaption>图 1: R³ 双过程思考示意。工作流为 (i) Runner 执行常规导航 → (ii) Regulator 评估当前状态 → (iii-a) 情况正常则 Runner 继续；(iii-b) 检测到异常则切换到 Ruminator 介入。</figcaption>
</div>

<p>R³ 由三个模块组成：</p>

<ul>
  <li><strong>Runner（快系统）</strong>：反应式 VLN 专家，常规步骤下主导。</li>
  <li><strong>Ruminator（慢系统）</strong>：多模态 LLM + CoT，仅在检测到异常时激活，接管直到该异常消除或片段结束。</li>
  <li><strong>Regulator（监督者）</strong>：每个时间步评估当前状态，决定是否切换到 Ruminator，并在切换时清洗历史。</li>
</ul>

<h4 id="22-整体-pipeline">2.2 整体 Pipeline</h4>

<div align="center">
  <img src="/images/vln/R3-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/684" />
<figcaption>图 2: R³ 完整 pipeline。Regulator 接收 $V_t=\{H_t, I, O_t, D_t, R_t\}$，通过三条 critical evaluation（Looping / Scoring / Ending）判断是否异常；异常则进入 critical formulation 由 LLM 产生修正规划 $P_t$，送往 Ruminator；正常则走 Runner 直接输出 $A_t$。</figcaption>
</div>

<p><strong>问题形式化</strong>：VLN 建模为 POMDP，智能体在时刻 $t$ 观察到位姿 $R_t$ 与全景 \(O_t=\{o_t^i\}_{i=1}^{36}\)（36 个相对 heading/elevation 的透视图），从可导航视点集合中选一个作为动作 $A_t$。策略 $\pi(A_t \mid I, O_t, H_t; \Theta)$ 基于指令 $I$、历史 $H_t={O_0, A_0, …, O_{t-1}, A_{t-1}}$ 与当前观察预测动作，直到智能体输出 <code class="language-plaintext highlighter-rouge">[STOP]</code> 或超步数上限。</p>

<h4 id="23-runner轻量-transformer-快速响应">2.3 Runner：轻量 transformer 快速响应</h4>

<p>Runner 接收 RGB-D $O_t, D_t$ 与位姿 $R_t$，通过投影提取细粒度特征并写入<strong>egocentric grid memory</strong>；随后与指令嵌入一起走 cross-modal transformer encoder，最终由两层 FFN 预测动作。Runner 仅 160 M 参数，保证实时推理。其实现直接复用 GridMM 官方仓库。作者指出 Runner 的两类固有缺陷：（1）训练 teacher-forcing 分布有限导致未见场景下容易出现<strong>短视决策</strong>（aimless wandering / 重复徘徊）；（2）BC 学习使其<strong>进入错误视点后难以自我纠错</strong>——这正是 Ruminator 要补的。</p>

<h4 id="24-ruminatorgpt-4o--cot-三步慎思">2.4 Ruminator：GPT-4o + CoT 三步慎思</h4>

<p>Ruminator 的输入通过一段<strong>结构化文本模板</strong>拼接（论文 Fig. 4）：<code class="language-plaintext highlighter-rouge">Instruction</code> + 36 张全景 <code class="language-plaintext highlighter-rouge">Observation</code> + <code class="language-plaintext highlighter-rouge">Trajectory</code>（”你从 $id_0$ 出发看到 $M_0$；step 1 到 $id_1$ 看到 $M_1$…“）+ <code class="language-plaintext highlighter-rouge">Map</code>（视点连通关系）+ <code class="language-plaintext highlighter-rouge">Option</code>（候选动作）。这种系统化格式化让 LLM 能显式感知环境拓扑与历史。</p>

<p>Ruminator 以 GPT-4o 为底座，用 CoT 组织三步：</p>

<ul>
  <li><strong>Perception</strong>：根据指令 $I$ 与全景 $O_t$ 生成细粒度环境文字描述，突出指令涉及的对象。</li>
  <li><strong>Planning</strong>：结合历史 $H_t$、上一步规划 $P_{t-1}$ 做长视野重规划，生成新 plan $P_t$。历史在 Ruminator 状态下以”<strong>taken action + target destination</strong>“形式表达——动作从 <code class="language-plaintext highlighter-rouge">{go forward to, turn left to, turn right to, turn back to}</code> 根据当前朝向与目标视点的夹角生成。</li>
  <li><strong>Prediction</strong>：基于 $I, P_t, O’_t$（可导航视点的子集）从候选中选动作。执行后更新 $H_t$ 与相邻视点。</li>
</ul>

<h4 id="25-regulator双阶段切换机制">2.5 Regulator：双阶段切换机制</h4>

<p><strong>Stage 1 — Critical Evaluation（何时切换）</strong> 三条互补准则：</p>

<ul>
  <li><strong>Looping</strong>：当任一视点的重访次数超过 $\tau_r$，或轨迹长度超过 $\tau_l$，判定为陷入循环。</li>
  <li><strong>Scoring</strong>：用 <strong>GNN</strong>（两层 graph attention + edge encoding）给当前轨迹打分，输入是以”位置 / 最后到达时间戳 / 视觉 embedding”为节点特征、视点连通关系为边的拓扑图，未访问节点用邻居视觉嵌入均值近似。训练用<strong>自监督伪标签</strong>——成功到达或所有视点都属于 GT 路径的 $\mathcal T_t$ 标 0，否则标 1。推理时分数 $&gt;\tau_g=0.35$ 触发切换。</li>
  <li><strong>Ending</strong>：Runner 预测 <code class="language-plaintext highlighter-rouge">[STOP]</code> 时再由 GPT-4o 根据 $I, O_t$ 判断是否真的到达目的地，避免早停。</li>
</ul>

<p><strong>Stage 2 — Critical Formulation（如何切换）</strong> 切换到 Ruminator 前，Regulator 额外用 LLM 判断”从起点重启是否更可取”——这一步<strong>重置 memory bank</strong>以模拟真实部署；同时在其它触发下也会<strong>剔除 Runner 积累的误导历史</strong>，再让 Ruminator 重新推理，避免错误上下文污染 LLM。</p>

<h4 id="26-共享-memory-bank">2.6 共享 Memory Bank</h4>

<p>这是效率关键：Runner 的 grid-based topological memory 不仅服务快系统的长上下文决策，在切换时也<strong>直接继承给 Ruminator</strong>，使 LLM 无需从零重建历史（消融显示 w/o memory bank 时 SR 下降 0.87）。</p>

<hr />

<h3 id="3-核心结果发现-14">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/R3-main-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1419/1374" />
<figcaption>图 4: R2R 与 REVERIE Val-Unseen 主要结果。R³ 在所有指标上同时超越 BC 专家、LLM 微调方法与 LLM-assisted 方法。</figcaption>
</div>

<ul>
  <li><strong>R2R Val-Unseen</strong>：SR 77 / SPL 66，较最佳 BC 基线（GridMM 75 / 64、BEVBert 75 / 64）提升 2 / 1.5 个点；NE 2.76（最低）。</li>
  <li><strong>REVERIE Val-Unseen</strong>：SR 53.76 / SPL 42.14 / RGS 37.94 / RGSPL 29.86，较次优方法（SUSA 51.75 / 38.86 / 35.02 / 26.56）分别 +2.01 / +3.28 / +2.92 / +3.30；REVERIE 上提升<strong>显著大于 R2R</strong>，表明 R³ 对高层语义理解与慎思分析要求更高的”粗粒度”指令更有优势。</li>
  <li><strong>效率（Fig. 1）</strong>：R³ 1.10 s/step vs. 其他 LLM-assisted 方法 5~11 s，约 1/5；且 SR 77 远超所有 LLM-assisted 基线（最高 DiscussNav 40）。证明”异常步才调 LLM”的策略可同时获得效率与性能。</li>
</ul>

<div align="center">
  <img src="/images/vln/R3-qualitative-reverie.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1413/572" />
<figcaption>图 5: REVERIE 可视化对比。GridMM 在起始区域长时间徘徊直至失败；R³ 由路径冗余触发 Ruminator，通过慎思识别正确路线并完成任务。</figcaption>
</div>

<p><strong>消融要点</strong>（Table 2/3，略图）：</p>

<ul>
  <li><strong>Regulator 三准则互补</strong>：去掉 Scoring 掉 SR 2.05 / SPL 2.76（最大降幅），说明 GNN 打分是主要的失败早期信号；去掉 Ending 掉 RGS 2.33 / RGSPL 4.01（RGS/RGSPL 最大降幅），对物体定位影响最大；去掉 Looping 与 Critical Formulation 也都有 0.37~0.39 的 SR 下降，全部非冗余。</li>
  <li><strong>LLM 能力 × 性能正相关</strong>：GPT-4o &gt; GPT-3.5 Turbo » MiniGPT-4；有趣的是不接 Ruminator（w/o LLM）的 R³ 仍比接 MiniGPT-4 好 1.98 SR，说明<strong>能力不足的 LLM 会破坏系统</strong>，预示未来更强 LLM 可直接放大 R³ 收益。</li>
  <li><strong>共享 memory 的必要性</strong>：w/o memory bank 时 SR 52.89（-0.87）、RGSPL 28.06（-1.80），说明 Ruminator 真的依赖 Runner 积累的上下文。</li>
</ul>

<hr />

<h3 id="4-局限性-14">4. 局限性</h3>

<ul>
  <li>Ruminator 依赖 GPT-4o API，部署成本与网络延迟仍是瓶颈（Fig. 1 中 NavGPT-2 本地部署效率更好）；在真实机器人上需要等价的本地 MLLM。</li>
  <li>仅在 Matterport3D（R2R / REVERIE）上评测，连续动作空间（R2R-CE、RxR-CE）与真实机器人泛化尚未验证。</li>
  <li>Scoring GNN 的自监督伪标签依赖”GT 路径子集”这一先验，迁移到无明确路径标注的任务（如 ObjectNav）可能需要重新设计。</li>
</ul>

<hr />

<h2 id="awarevln">29. AwareVLN (2026)</h2>
<p>———Reasoning with Self-awareness for Vision-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2605.22816">arXiv:2605.22816</a> · <a href="https://gwxuan.github.io/AwareVLN/">Project Page</a> · 🏛️ <strong>CVPR 2026</strong></p>

<hr />

<h3 id="精华-17">精华</h3>

<ol>
  <li>现有 VLM-based VLN 方法把 VLM 当成”指令→动作”的端到端映射器，浪费了 VLM 本身的推理能力，导致导航过程不可解释、缺乏纠错能力。</li>
  <li>AwareVLN 的核心思想是<strong>自我感知（self-awareness）推理</strong>：让 agent 在导航中显式分析”自己当前在哪、任务完成到哪、是否偏离了指令”，而不仅仅预测下一步动作。</li>
  <li>关键设计是<strong>稀疏触发的结构化推理</strong>——用一个 special token（<code class="language-plaintext highlighter-rouge">[REASON]</code>/<code class="language-plaintext highlighter-rouge">[ACT]</code>）让模型自主决定”何时该想一想”，只在子任务边界、路径偏离、停止误差这些关键节点触发推理，兼顾效率与有效性。</li>
  <li>推理采用固定的三元结构：<strong>场景描述 → 进度评估 → 下一步规划</strong>，并把上一次推理结果回灌给模型，形成因果链式的自我对话。</li>
  <li>配套一个<strong>全自动数据引擎</strong>：利用模拟器的房间级语义 + ground-truth 路点自动定位关键推理节点，再用通用 VLM（Qwen-VL-Max）生成结构化推理监督，无需人工标注即可规模化造数据。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-16">1. 研究背景/问题</h3>

<p>VLN（Vision-Language Navigation）要求 agent 在未知环境中跟随自然语言指令导航。传统方法依赖显式拓扑图 + SLAM/3D 传感器做规划，部署受限；近期端到端 VLM-based 方法（NaVid、NaVILA、StreamVLN 等）直接把指令和 RGB 观测映射为动作，摆脱了对深度/位姿的依赖。但这些方法只”驯化 VLM 去预测动作”，忽视了 VLM 的内在推理能力，导致导航过程像黑盒、缺乏自我感知，难以做精确的子任务规划和错误纠正。已有的 Nav-R1 虽尝试以固定间隔的双系统机制做推理，但其监督数据来自通用 VLM 对历史观测的泛化查询，缺乏真正的自我感知知识，推理只是文本输出而无法指导后续动作。核心问题是：<strong>如何根据观测历史准确推理 agent 当前状态与任务进度，并让推理真正服务于行动？</strong></p>

<hr />

<h3 id="2-主要方法创新点-14">2. 主要方法/创新点</h3>

<p>AwareVLN 在一个<strong>统一的 VLM</strong> 中同时承担动作预测与自反思推理。相比用两个独立模型，统一架构让”推理”和”行动”两个维度的知识在模型内部相互交互、彼此增强。</p>

<div align="center">
  <img src="/images/vln/AwareVLN-teaser.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1390/713" />
<figcaption>图 1：AwareVLN 在关键导航节点选择性触发自我感知的结构化推理。agent 不再单纯依赖端到端动作预测，而是在真正需要时显式分析自己的空间状态、任务进度以及与指令的对齐情况，从而实现更鲁棒、可解释的指令跟随。</figcaption>
</div>

<h4 id="-整体框架概述-4">① 整体框架概述</h4>

<p>AwareVLN 由三大部分构成：<strong>(a) 统一的 Reason-Act 框架</strong>（一个 VLM 同时输出动作和推理）、<strong>(b) 结构化的三元推理格式</strong>（场景描述 / 进度评估 / 下一步规划）、以及 <strong>(c) 稀疏触发机制</strong>（由 special token 在关键节点决定是否推理）。视觉观测经 Vision Encoder &amp; Projector 编码，与指令、上一次推理文本一起送入 LLM，模型先输出一个 special token 决定进入”行动模式”还是”推理模式”，再生成相应的文本。</p>

<div align="center">
  <img src="/images/vln/AwareVLN-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1398/761" />
<figcaption>图 2：AwareVLN 框架。(a) 统一 VLM 同时具备动作预测与自反思推理，允许 agent 用过去的推理结果指导未来决策；(b) 推理过程是多维且因果的，依次完成场景描述、进度评估、下一步规划；(c) 如 BEV monitor 所示，推理仅在子任务边界等关键节点稀疏地、结构化地触发。</figcaption>
</div>

<h4 id="-逐模块讲解-2">② 逐模块讲解</h4>

<p><strong>统一 Reason-Act 框架（Unified Reason-act Framework）</strong></p>

<ul>
  <li><strong>输入</strong>：导航指令 $I={w_1,\dots,w_l}$、视觉观测序列 $O_t={x_0,\dots,x_t}$（为效率均匀采样 8 帧），以及最近一次推理输出 $R$。</li>
  <li><strong>处理</strong>：tokenizer $f_{tok}(\cdot)$ 把指令和上次推理转成 token，vision encoder $f_{vis}(\cdot)$ 提取视觉嵌入。一个关键细节是把”当前帧与上次推理帧之间的步数差”作为相对位置线索编码进去，与推理文本融合以提供显式的时间上下文：</li>
</ul>

\[R' = R \oplus (t - t_{prev})\]

<p>其中 $t_{prev}$ 是上一次推理输出的时间步。统一策略 $\pi_\theta$ 基于该上下文产生一个 logit $d$（决定 special token）和文本输出 $y_t$：</p>

\[d, y_t = \pi_\theta\big(f_{tok}(I), f_{tok}(R'), f_{vis}(O_t)\big)\]

<p>special token 的选择规则为：当 $d_{[\text{REASON}]} &gt; d_{[\text{ACT}]}$ 时取 <code class="language-plaintext highlighter-rouge">[REASON]</code>，否则取 <code class="language-plaintext highlighter-rouge">[ACT]</code>。</p>
<ul>
  <li><strong>输出</strong>：若为 <code class="language-plaintext highlighter-rouge">[REASON]</code>，模型进入推理模式，产生总结自身理解与进度的文本，并更新 $R$、记录 $t_{prev}$；若为 <code class="language-plaintext highlighter-rouge">[ACT]</code>，进入行动模式，生成动作命令（如”move forward 75 cm”），经 PARSE 解析为底层离散动作 $a_{t+1:t+k}$（动作集 $A={$FORWARD, TURN-LEFT, TURN-RIGHT, STOP$}$）执行。</li>
  <li><strong>设计动机</strong>：这种”语言驱动”的统一形式让感知、推理、控制无缝衔接；通过递归地以上一次推理和相对步数为条件，模型在长程导航中保持时间感知与自适应决策。</li>
</ul>

<p><strong>结构化自我感知推理（Structural Reasoning for Self-awareness）</strong></p>

<ul>
  <li><strong>触发时机（关键节点）</strong>：不在每一步都推理，而只在三类关键状态触发——(i) <strong>子任务完成</strong>：检测到某条子指令（如”走到门口”）已完成时，总结进度、确认子目标、规划下一步；(ii) <strong>路径偏离</strong>：发现期望与观测的视觉线索不一致（地标缺失、空间错位）时，进入推理分析错误并提出纠正动作；(iii) <strong>停止误差</strong>：导航末段当前视觉上下文与目标描述不符时，触发推理分析偏差、调整后续计划以精确定位终点。</li>
  <li><strong>三元推理格式</strong>：每次推理强制产出三个组件——<strong>(1) Scene description</strong>（对关键节点视觉上下文的简洁描述）、<strong>(2) Progress assessment</strong>（分析指令完成到哪、是否偏离）、<strong>(3) Plan for the next step</strong>（下一阶段的高层意图/策略）。这套结构在统一语言空间里把感知、推理、规划连成一体，为模型提供显式的自我感知。</li>
</ul>

<h4 id="-自动数据引擎automatic-data-engine">③ 自动数据引擎（Automatic Data Engine）</h4>

<p>为规模化获得高质量推理监督且不依赖人工标注，AwareVLN 设计了一个全自动数据引擎。</p>

<div align="center">
  <img src="/images/vln/AwareVLN-data-engine.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1135/413" />
<figcaption>图 3：自动数据引擎。利用模拟器的房间级语义和 ground-truth 路点自动识别关键推理节点（子任务完成、路径偏离、错误停止），为每个节点抽取丰富的多模态上下文并喂给通用 VLM，自动生成结构化、因果化的推理监督，实现可规模化、免标注的高质量推理数据构建。</figcaption>
</div>

<ul>
  <li><strong>轨迹采集</strong>：两种互补策略。其一是 <strong>ground-truth following</strong>（严格跟随参考轨迹，得到指令对齐的”正确推理”样本）；其二是 <strong>DAgger-based collection</strong>（用早期模型执行预测动作，一旦偏离 ground-truth 就纠正回下一个路点，产生含真实预测错误与纠正行为的轨迹，对训练”错误识别与恢复”推理尤为宝贵）。</li>
  <li><strong>关键节点识别</strong>：利用模拟器场景语义 + 数据集标注路点自动定位。<strong>子任务完成</strong>通过轨迹上房间类别的变化判定（并把纠正过程的完成也当作子任务边界）；<strong>路径偏离/停止误差</strong>通过计算执行轨迹与 ground-truth 路点的空间偏差，超过阈值即标记为偏离节点并记录后续纠正观测。</li>
  <li><strong>推理监督生成</strong>：用通用 VLM（<strong>Qwen-VL-Max</strong>）以多轮对话流水线把上下文转成结构化推理。第一轮输入完整 episode 观测序列 + 指令，让 VLM 建立全局理解；后续每个关键节点再输入节点类型、节点前的降采样观测、房间转移信息、估计的导航进度（已行进距离/总路径长度）；对偏离节点额外提供纠正过程观测，使 VLM 能推断”错误—恢复”的因果关系。最终为每个节点生成上述三元结构的推理文本。</li>
</ul>

<h4 id="-训练与推理">④ 训练与推理</h4>

<ul>
  <li><strong>训练</strong>：分两阶段。<strong>预训练</strong>遵循 NaVILA，纳入常规导航数据 + 大规模 VQA 数据；<strong>微调</strong>使用数据引擎产出的”推理增强导航轨迹”，并混入无推理监督的人类视频以提升泛化。这使模型在获得自我感知推理能力的同时保留强视觉对齐与语言对齐。训练在 4 节点 NVIDIA H20 GPU 上完成。</li>
  <li><strong>推理</strong>：见 Algorithm 1——循环中先融合相对步数与上次推理 $R’ = R \oplus (t-t_{prev})$，再由 $\pi_\theta$ 输出首个 logit 与文本；据 special token 决定更新推理（<code class="language-plaintext highlighter-rouge">[REASON]</code>）还是解析并执行动作（<code class="language-plaintext highlighter-rouge">[ACT]</code>），然后追加新帧。单卡 NVIDIA RTX 4090 上推理速度约 1 FPS。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-15">3. 核心结果/发现</h3>

<ul>
  <li><strong>仿真主结果</strong>（R2R-CE / RxR-CE Val-Unseen，纯单目 RGB 输入）：AwareVLN 在 R2R-CE 上 SR <strong>65.4</strong>、SPL <strong>55.1</strong>、OS <strong>73.5</strong>、NE <strong>4.02</strong>；RxR-CE 上 SR <strong>67.6</strong>、SPL <strong>56.1</strong>、nDTW <strong>65.7</strong>，<strong>全面超越所有不依赖模拟器预训练 waypoint predictor 的方法</strong>（包括 NaVILA、StreamVLN、Uni-NaVid、OctoNav 等），甚至优于很多使用深度、全景、里程计等额外输入的方法。例如相比 StreamVLN，R2R-CE SR 从 56.9 提升到 65.4，OS 从 64.2 提升到 73.5。</li>
  <li><strong>真实世界评测</strong>：在 Corridor / Home / Office 三类环境、简单与复杂任务共 18 条指令上，AwareVLN 的 NE 和 SR 一致优于 NaVid、NaVILA，复杂任务下优势尤为明显（多个复杂场景 SR 从 0.33 提升到 0.67–1.00），验证了自我感知推理对 sim-to-real 泛化的增益。</li>
  <li><strong>消融——数据引擎关键节点</strong>（Table 3）：去掉任一节点都会掉点；去掉 <strong>Subtask Completion</strong> 掉点最严重（R2R SR 65.4→52.3），因为模型失去对整体指令进度的跟踪；去掉 Path Deviation 削弱纠错能力，去掉 Stopping Error 影响终点判定。</li>
  <li><strong>消融——架构与推理调度</strong>（Table 4）：去掉 special token 强迫模型直接预测会掉点（结构化输出对任务分解很关键）；”每帧都密集推理 + 动作”（Reason with action densely）反而明显变差，证明<strong>稀疏推理</strong>既更有效又更高效（昂贵的推理只在必要时触发）。</li>
</ul>

<div align="center">
  <img src="/images/vln/AwareVLN-rollout-sim.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1389/739" />
<figcaption>图 4：Habitat 仿真中的 rollout。左侧 agent 误转向后，通过自我感知推理识别偏差并自我纠正；右侧 agent 成功推理出导航进度并据此生成与指令对齐的恰当下一步规划，展示了结构化推理如何转化为鲁棒的导航行为。</figcaption>
</div>

<hr />

<h3 id="4-局限性-15">4. 局限性</h3>

<p>推理监督的质量受限于通用 VLM（Qwen-VL-Max）和模拟器语义/路点标注的准确性；关键节点的检测依赖房间级语义与阈值规则，迁移到无此类标注的开放环境时数据引擎的可用性有待验证。此外约 1 FPS 的推理速度对高动态实时场景仍有压力。</p>

<hr />

<h2 id="dual-anchoring">30. Dual-Anchoring (2026)</h2>
<p>———用”指令进度”与”地标记忆”双重锚定，对抗 VLN 中的状态漂移（State Drift）</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2604.17473">arXiv:2604.17473v2</a></p>

<hr />

<h3 id="精华-18">精华</h3>

<ul>
  <li>提出 <strong>State Drift（状态漂移）</strong> 概念：基于 Video-LLM 的 VLN agent 在长程任务中，内部状态会逐渐脱离真实任务状态，表现为<strong>进度漂移（Progress Drift，搞不清走到指令哪一步）</strong>和<strong>记忆漂移（Memory Drift，忘记已经过的地标）</strong>。</li>
  <li>核心洞见：纯 next-action prediction 是”结果导向”的弱监督，只保证局部动作正确，却不约束内部认知过程，长程下必然与物理现实解耦。解法是给内部状态加<strong>显式锚点</strong>。</li>
  <li><strong>双锚定框架</strong>两条互补支路：① <strong>指令进度锚定</strong>——让 agent 在动作前先用结构化文本写出”已完成 vs 未完成”的子目标清单（语义稳定器）；② <strong>记忆地标锚定</strong>——用 Landmark-Centric World Model 回溯重建最近经过地标的 SAM 特征（视觉”后视镜”）。</li>
  <li>方法论启发：用”语言化心智清单”显式表征任务进度，用”回溯式（hindsight）而非前瞻式（foresight）世界模型”锚定历史记忆——两者都是给隐状态加可监督的显式约束，且推理时可丢弃辅助头，零额外开销。</li>
  <li>配套构建两个大规模数据集（360 万进度描述 + 93.7 万地标 SAM 特征），在 R2R-CE / RxR-CE 上达到 SOTA，长程轨迹 SPL 相对提升高达 +33.2%。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-17">1. 研究背景/问题</h3>

<p>VLN 要求 agent 在未见 3D 环境中按自然语言指令导航。主流 perception-to-action 流水线对短指令有效，但在<strong>长、组合性指令</strong>下脆弱：随导航推进，agent 的任务状态逐渐不可靠，丧失对”我在指令的哪一步”和”我去过哪里”的一致感知，即 <strong>State Drift</strong>。近期 Video-LLM 虽借助强预训练表征推进了 VLN，但其 next-action prediction 目标只约束局部动作、不约束内部状态，长程下内部表征不可避免地与物理现实解耦。作者将其归因为两种耦合的失败模式：<strong>Progress Drift</strong>（指令阶段误判，已完成/未完成边界模糊）与 <strong>Memory Drift</strong>（历史表征退化，丢失已访问地标）。</p>

<div align="center">
  <img src="/images/vln/Dual-Anchoring-state-drift-challenge.webp" width="90%" loading="lazy" decoding="async" style="aspect-ratio:981/622" />
<figcaption>图1：状态漂移（State Drift）挑战示意。随轨迹延长，agent 预测路径（红虚线）因内部状态解耦而偏离 GT（绿虚线），表现为进度漂移（"我在第几步？""S2 做完了吗？"）与记忆漂移（"我从哪来？""门过了吗？"）。</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-15">2. 主要方法/创新点</h3>

<h4 id="-整体框架概述-5">① 整体框架概述</h4>

<p><strong>Dual-Anchoring Framework</strong> 以 StreamVLN（LLaVA-Video 为骨干的流式 Video-LLM）为 backbone，在标准动作预测之外，叠加两个<strong>仅训练期生效</strong>的辅助任务来正则化内部状态：<strong>Instruction Progress Anchoring（指令进度锚定，作为 Co-Training 任务）</strong> 负责语义对齐，<strong>Memory Landmark Anchoring（记忆地标锚定，作为辅助头）</strong> 负责视觉记忆锚定。两个辅助头在部署时被丢弃，<strong>对推理零额外计算开销</strong>。</p>

<div align="center">
  <img src="/images/vln/Dual-Anchoring-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/649" />
<figcaption>图2：Dual-Anchoring 框架总览。统一的 Video-LLM 骨干处理语言指令 + 流式第一视角观测，除标准动作预测（L_nav）外，额外生成结构化进度描述（L_prog）做语义对齐，并重建稠密 SAM 特征（L_WM）锚定视觉记忆。</figcaption>
</div>

<h4 id="-逐模块讲解-3">② 逐模块讲解</h4>

<p><strong>模块一：Instruction Progress Anchoring（指令进度锚定）</strong></p>

<ul>
  <li><strong>目标</strong>：缓解 Progress Drift，让 agent 显式维护一份”已完成 vs 待完成”的心智清单（mental checklist），而非依赖隐式 attention 推断进度。</li>
  <li><strong>数据生成（Progress Annotation Generation）</strong>：用 Qwen3-VL 作离线标注器，给定 GT 轨迹与指令，按四步流水线合成 <strong>360 万</strong>条进度描述：
    <ol>
      <li><strong>Visual Kinematics Prompting</strong>：把帧序号与已执行动作文本（如 “Turn Left 15°”）叠印到每帧左上角，弥合静态帧与动态导航的鸿沟，让标注器感知帧间运动学。</li>
      <li><strong>Interval Sampling</strong>：以步长 n 沿轨迹间隔采样。</li>
      <li><strong>Dual-Step Reasoning</strong>：先让模型对比视觉证据与指令做分析（CoT），再用原文措辞总结”已完成子目标”。</li>
      <li><strong>Instruction-Aligned Refinement</strong>：把分析蒸馏成一句话，严格约束输出为指令的<strong>逐字前缀（verbatim prefix）</strong>，消除中间推理与幻觉。</li>
    </ol>
  </li>
  <li><strong>输入 → 处理 → 输出</strong>：输入指令 + 历史观测 → 模型先输出结构化进度文本，再输出动作序列。</li>
  <li><strong>训练（Instruction-Aware Co-training）</strong>：把 GT 动作前缀以合成的进度描述，并在 Prompt 中加入”find out which part you have completed”。目标改为最大化 \(P(y^{prog}_t, a_t \mid \mathcal I, \mathcal H_t)\)，<strong>强制 agent 在执行任何控制前先用语言articulate自身状态</strong>。</li>
</ul>

<p><strong>模块二：Memory Landmark Anchoring（记忆地标锚定）</strong></p>

<ul>
  <li><strong>目标</strong>：缓解 Memory Drift（遗忘地标、感知混淆 perceptual aliasing），强制 <strong>Retrospective Grounding（回溯式接地）</strong>。</li>
  <li><strong>数据生成（Landmark Frame Mining）</strong>：两阶段挖掘 <strong>93.7 万</strong>条地标数据：
    <ol>
      <li><strong>Decomposition</strong>：用 Qwen3 把复杂指令拆成原子子目标 \(\mathcal S = \{s_1, \dots, s_K\}\)，每个 \(s_k\) 含一个动作或地标。</li>
      <li><strong>Temporal Grounding</strong>：把完整视频 + \(\mathcal S\) 喂给 Qwen3-VL，定位每个地标首次出现的帧 \(t^{(k)}_{lm}\)；并施加<strong>严格递增约束</strong>（\(t^{(i)}_{lm} &lt; t^{(j)}_{lm}\) 对 \(i&lt;j\)），违反时序逻辑的标注被过滤以消除幻觉。
        <ul>
          <li>对任意导航时刻 \(t\)，可检索最近经过的地标帧 \(t^*\)（\(t^* \le t\)），用 <strong>SAM</strong> 抽取其高分辨率空间特征图 \(F_{SAM}(o_{t^*})\) 作为回溯监督的 ground truth。</li>
        </ul>
      </li>
    </ol>
  </li>
  <li><strong>Landmark-Centric World Model（回溯式世界模型）</strong>：用 <strong>Learnable Spatial Query Decoder</strong> 让 agent 重建最近经过地标的稠密空间特征。
    <ul>
      <li><strong>输入</strong>：Video-LLM 在第 \(t\) 步的输出序列 \(X_t \in \mathbb R^{N \times d_{llm}}\)（含历史与当前视觉语义）。</li>
      <li><strong>处理</strong>：先经线性层 + LayerNorm 投影到紧凑潜空间 \(\hat X_t = \text{LayerNorm}(X_t W_{in})\)；初始化一组可学习空间查询 \(Q_{spa}\)（每个 query 是对应 \(H\times W\) 分辨率的像素级锚点），通过 cross-attention 从 \(\hat X_t\) 检索局部空间线索：\(Z = \text{Softmax}(Q_{spa}\hat X_t^T / \sqrt{d_{attn}})\hat X_t\)；再线性投影到 \(d_{sam}\) 维并 reshape 成 2D 特征图 \(F_t\)。</li>
      <li><strong>输出</strong>：预测特征图 \(F_t\)，与冻结的 SAM 特征做 MSE 对齐。</li>
      <li><strong>设计动机</strong>：充当”后视镜（rear-view mirror）”，逼迫内部状态保留过去轨迹的稠密、可区分的物体信息，防止记忆衰减；区别于 NWM 等<strong>前瞻式（foresight）</strong>像素级世界模型（计算昂贵、且忽视历史维护），本文是<strong>回溯式（hindsight）</strong>特征级，更适合实时 onboard 推理。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/Dual-Anchoring-data-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/598" />
<figcaption>图3：数据生成流水线。(a) Progress Annotation Generation：多模态 LLM 通过双步推理生成 360 万条与指令措辞严格对齐的进度描述；(b) Landmark Frame Mining：先把指令分解为原子子指令，再做时序地标定位，最后用 SAM 抽取 93.7 万条物体中心特征作为回溯 GT。</figcaption>
</div>

<h4 id="-训练目标--损失函数-1">③ 训练目标 / 损失函数</h4>

<p><strong>Stage 1（导航数据预训练）</strong> 的总损失是三项加权和：</p>

\[\mathcal{L}_{Stage1} = \mathcal{L}_{nav} + \lambda_{prog}\mathcal{L}_{prog} + \lambda_{WM}\mathcal{L}_{WM}\]

<ul>
  <li>\(\mathcal L_{nav}\)：标准导航动作损失。</li>
  <li>\(\mathcal L_{prog}\)：进度描述生成损失。</li>
  <li>世界模型 MSE 损失：\(\mathcal{L}_{WM} = \lVert F_t - F_{SAM}(o_{t^*}) \rVert_2^2\)。</li>
</ul>

<h4 id="-两阶段训练与数据组成">④ 两阶段训练与数据组成</h4>

<ul>
  <li><strong>数据组成</strong>：Base Navigation（R2R/RxR/EnvDrop 180K + ScaleVLN HM3D 子集 155K）+ State Anchoring（360 万进度描述 + 93.7 万地标 SAM 特征）+ 240K DAgger rollouts + 400K VideoQA + 230K 图文对（MMC4，保留通用 VL 能力）。</li>
  <li><strong>Stage 1</strong>：在导航数据 + 双锚定目标上预训练。</li>
  <li><strong>Stage 2（DAgger + Generalist Fine-tuning）</strong>：用 Stage 1 策略采样轨迹、收集纠正性专家动作构成 ~240K DAgger 数据，混合导航数据与通用 VL 数据共训以缓解 exposure bias 并防灾难性遗忘；双锚定目标（\(\mathcal L_{prog}\)、\(\mathcal L_{WM}\)）在所有导航批次上保持激活。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-16">3. 核心结果/发现</h3>

<p><strong>仿真 SOTA（R2R-CE / RxR-CE val unseen）</strong>：仅用单目 RGB（S-RGB），在 R2R-CE 上 SR 从 StreamVLN 基线的 56.9% → <strong>65.6%</strong>、SPL 51.9% → <strong>62.1%</strong>；RxR-CE 上 SR 52.9% → <strong>61.7%</strong>（绝对 +8.8%），SPL → <strong>53.3%</strong>。相比同期强方法 DualVLN，SR/SPL 多项指标领先。</p>

<p><strong>长程增益尤为显著</strong>：按轨迹测地距离分 Short/Medium/Long 三档，基线随距离增大急剧退化；本文方法的相对增益随轨迹变长而扩大——SR 相对提升从 Short 的 +10.7% 升到 Long 的 <strong>+24.7%</strong>，SPL 相对提升从 +12.6% 升到 Long 的 <strong>+33.2%</strong>，验证显式状态锚定对长程导航的关键作用。</p>

<div align="center">
  <img src="/images/vln/Dual-Anchoring-trajectory-length-performance.webp" width="95%" loading="lazy" decoding="async" style="aspect-ratio:983/434" />
<figcaption>图5：不同轨迹长度下的性能。(a) SR、(b) SPL 在 R2R-CE val unseen 的 Short/Medium/Long 三档对比。轨迹越长，本文方法相对提升越大（SPL 最高 +33.2%）。</figcaption>
</div>

<p><strong>消融（Table 3）</strong>：在两种数据规模下，IPA 单独把 SR 从 40.8%→45.4%（语义对齐有效）；MLA 单独显著提升 SPL 并降低 NE（6.49→6.01，回溯重建抑制轨迹漂移）；二者组合（双锚定）在所有设置下最优，证明两种正则互补且在数据扩展后依然有效。</p>

<p><strong>数据质量（Table 4，参考无关指标）</strong>：Visual Kinematics Prompting 使进度描述的 Logical Consistency Score 从 1.71→4.26（+149%）、Hallucination Rate 8.13%→6.04%（-25.7%）；地标挖掘相对随机采样，Landmark Presence Rate 从 13.9%→75.6%（+444%）。</p>

<p><strong>定性与真机</strong>：仿真中（图4）面对欺骗性开口，基线因 Progress Drift 提前左转失败，而本文 agent 的进度锚定明确指示”go straight 仍在进行”以抑制干扰动作，记忆锚定回溯重建出发”bathroom”特征接地当前位置。真机部署在 Unitree Go2 + RealSense D435i 上，<strong>纯 Matterport3D 仿真训练、零微调直接迁移</strong>，实时生成的进度描述准确反映完成状态。</p>

<hr />

<h3 id="4-局限性-16">4. 局限性</h3>

<ul>
  <li>仍依赖<strong>自采集合成数据</strong>（Qwen3-VL/SAM 标注），其质量与覆盖度受标注器能力限制（进度描述仍有 ~6% 幻觉率）；地标锚定假设可从指令显式分解出离散地标，对缺乏明确地标的指令收益可能受限。</li>
</ul>

<hr />

<h2 id="janusvln">31. JanusVLN (2026)</h2>
<p>——— 解耦语义与空间：使用双隐式神经内存的视觉语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2509.22548v2">arXiv:2509.22548v2</a> · 🏛️ <strong>ICLR 2026</strong></p>

<hr />

<h3 id="精华-19">精华</h3>
<ol>
  <li><strong>脑区分工启发</strong>：首次将人类左右脑的语义理解和空间认知分工应用到具身智能导航中，解耦视觉语义与 3D 空间几何信息。</li>
  <li><strong>双隐式神经内存</strong>：抛弃显式文本认知地图或历史帧图片缓存，使用 Transformer 的深层 KV cache 缓存，并结合初始窗口（全局锚点）与滑动窗口（局部细节）进行混合增量更新。</li>
  <li><strong>强大的 3D 几何特征</strong>：引入在像素-3D 点云对上预训练的 3D 几何模型 VGGT，仅通过单目 RGB 输入即可推断隐式 3D 几何，极大地增强了纯 2D 模型的空间推理能力。</li>
  <li><strong>低延迟与高效率</strong>：增量内存更新方式规避了传统方法随时间增长的内存和计算复杂度膨胀，在测试中将单帧推理延迟从 268ms 大幅降低至最少 82ms。</li>
  <li><strong>多基准 SOTA</strong>：在 VLN-CE（R2R-CE, RxR-CE）和更复杂的 HM3D-OVON 开放词汇导航上均刷新了成功率与路径效率 of SOTA 记录。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-18">1. 研究背景/问题</h3>
<p>近年来，基于多模态大语言模型（MLLMs）的具身导航（VLN）系统取得了很大进展。然而，现有模型大多面临两大痛点：</p>
<ol>
  <li><strong>显式语义记忆的局限性</strong>：许多方法通过构建基于文本的显式语义地图或直接保存历史观察帧来做决策。这不仅造成 3D 空间物理信息的丢失，而且会导致随着时间序列增长，模型出现严重的计算冗余和内存膨胀（Memory Bloat），在长程任务中推理效率低下。</li>
  <li><strong>缺乏 3D 几何结构理解</strong>：现有视觉语言动作模型（VLA）几乎完全继承了以 CLIP 为代表的 2D 图像-文本预训练视觉编码器。由于 2D 训练数据的性质，这些编码器非常擅长高层语义识别，但对三维空间物理结构、景深、透视以及遮挡关系的理解却极为匮乏。而这正是 3D 实地导航所必需的。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-16">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/JanusVLN-concept.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/719" />
    <figcaption>JanusVLN 概念示意图：通过双隐式内存解耦 2D 视觉语义和 3D 空间几何信息，实现增量更新并保留长期全局感知。</figcaption>
</div>

<h4 id="整体框架概述">整体框架概述</h4>
<p>针对上述局限性，论文提出了 <strong>JanusVLN</strong> 框架。它利用双隐式神经内存，将 <strong>3D 空间几何信息</strong>（负责“在哪里，如何关联”）与 <strong>2D 视觉语义信息</strong>（负责“是什么”）进行分离编码，并使用混合增量策略对神经内存进行高效更新。系统主要由 2D 视觉语义编码器、3D 空间几何编码器、双隐式神经内存以及空间感知特征融合模块组成，最后将多模态表征输入大语言模型以预测离散动作。</p>

<div align="center">
  <img src="/images/vln/JanusVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/789" />
    <figcaption>JanusVLN 整体架构图：使用双编码器提取特征，并将 KV 缓存缓存于由初始和滑动窗口组成的多模态神经内存中，最后在 LLM 前进行注意力融合和动作预测。</figcaption>
</div>

<h4 id="逐模块讲解">逐模块讲解</h4>

<h5 id="-2d-视觉语义编码器-visual-semantic-encoder">① 2D 视觉语义编码器 (Visual-Semantic Encoder)</h5>
<ul>
  <li><strong>输入</strong>：当前帧 RGB 图像 $x_t \in \mathbb{R}^{3 \times H \times W}$。</li>
  <li><strong>处理</strong>：直接采用多模态大语言模型（Qwen2.5-VL）的原始视觉编码器，提取输入图像的二维语义特征。为了减少视觉标记（Tokens）带来的计算量，Qwen2.5-VL 将空间上相邻 of $2 \times 2$ 特征小块（Patches）进行级联融合，形成单个语义标记。</li>
  <li><strong>输出</strong>：降采样后的 2D 视觉语义标记 $S’_t \in \mathbb{R}^{\lfloor \frac{H}{2p} \rfloor \times \lfloor \frac{W}{2p} \rfloor \times C}$，其中 $p$ 为 patch 大小。</li>
  <li><strong>设计动机</strong>：负责提取场景中强有力的语义物体感知（例如床、台灯、拐角的位置与语义属性）。</li>
</ul>

<h5 id="-3d-空间几何编码器-spatial-geometric-encoder">② 3D 空间几何编码器 (Spatial-Geometric Encoder)</h5>
<ul>
  <li><strong>输入</strong>：当前帧 RGB 图像 $x_t$。</li>
  <li><strong>处理</strong>：引入预训练的 3D 视觉几何基础模型 VGGT 的编码器部分。VGGT 在大量“像素-3D 点云”对上进行过训练，因此蕴含了极强的 3D 空间深度感知和三维布局先验。VGGT 将输入图像提取的初始特征与 3D 几何隐式内存中的历史 KV 缓存相结合，再输入到 Fusion Decoder 中进行跨帧交互处理。</li>
  <li><strong>输出</strong>：包含了 3D 空间结构的几何 Token 序列 $G_t \in \mathbb{R}^{\lfloor \frac{H}{p} \rfloor \times \lfloor \frac{W}{p} \rfloor \times C}$。这些 Token 也可以用一个轻量级的小头部重建高保真的单目深度图和局部 3D 点云。</li>
  <li><strong>设计动机</strong>：直接从纯 RGB 视频流中，以在线和流式（Online &amp; Streaming）的方式获取 3D 深度、几何和空间关系，避免了对昂贵且难以获取的 3D 实地数据（如激光雷达、实时 RGB-D 相机）的硬件依赖。</li>
</ul>

<div align="center">
  <img src="/images/vln/JanusVLN-spatial-memory-details.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:884/669" />
    <figcaption>3D 空间几何编码器中隐式内存的交互细节：通过交替进行的帧注意力（Frame Attention）与全局交叉注意力（Global Attention）来实现局部上下文提取和与历史缓存的融合更新。</figcaption>
</div>

<h5 id="-双隐式神经内存-dual-implicit-neural-memory">③ 双隐式神经内存 (Dual Implicit Neural Memory)</h5>
<ul>
  <li><strong>输入</strong>：历史帧在语义编码器与几何编码器内的 Key-Value (KV) 缓存。</li>
  <li><strong>处理</strong>：不再保存原始图像或冗余的多级地图，而是通过<strong>混合增量更新策略</strong>管理内存容量：
    <ul>
      <li><strong>滑动窗口队列 $M_{\text{sliding}}$</strong>：一个固定容量为 $n$（如 48 帧）的先进先出（FIFO）队列，只保留最近 $n$ 帧的特征 KV 缓存。这保证了模型对近期局部环境细节的敏感性。</li>
      <li><strong>初始窗口 $M_{\text{initial}}$</strong>：永久保留导航任务开始前几帧的特征 KV 缓存。其充当“注意力汇（Attention Sinks）”，为长距离导航提供全局任务指引和恒定的地理起始锚点。
对于新的输入帧，编码器通过注意力交互融合 $M_{\text{sliding}}$ 和 $M_{\text{initial}}$ 内的历史信息：
\(G_t = \text{Decoder}(\text{CrossAttn}(\text{Encoder}(x_t), \{ M_{\text{initial}}, M_{\text{sliding}} \}))\)</li>
    </ul>
  </li>
  <li><strong>输出</strong>：更新后的当前帧几何 Token 和语义 Token。</li>
  <li><strong>设计动机</strong>：实现定长、紧凑的特征存储，彻底消除记忆空间随着时间无限拉长而膨胀的问题，且只增量计算当前帧，避免了 reprocess 历史所有图像造成的计算开销。</li>
</ul>

<h5 id="-空间感知特征融合-spatial-aware-feature-fusion">④ 空间感知特征融合 (Spatial-aware Feature Fusion)</h5>
<ul>
  <li><strong>输入</strong>：语义标记 $S’_t$ 与 3D 几何标记 $G_t$。</li>
  <li><strong>处理</strong>：
    <ol>
      <li><strong>空间融合对齐</strong>：对 VGGT 提取的几何特征 $G_t$ 实施相同的空间合并（Spatial Merging）降采样，将其 $2 \times 2$ 的特征区域拼接对齐，产生 $G’_t \in \mathbb{R}^{\lfloor \frac{H}{2p} \rfloor \times \lfloor \frac{W}{2p} \rfloor \times C}$。</li>
      <li><strong>加权残差融合</strong>：利用轻量级的双层 MLP 投影层将两个域的特征融合成统一的、强空间感知的多模态视觉特征 $F_t$：
\(F_t = S'_t + \lambda \cdot \text{MLP}(G'_t)\)
其中 $\lambda$ 为几何特征的权重，设定为 0.2。</li>
    </ol>
  </li>
  <li><strong>输出</strong>：融合后的特征 $F_t$。</li>
  <li><strong>设计动机</strong>：在保证大模型主要关注语义指令对齐的前提下，将隐式 3D 几何特征低成本地无缝整合进大语言模型输入中。</li>
</ul>

<h4 id="训练目标与推理流程">训练目标与推理流程</h4>
<ul>
  <li><strong>训练目标</strong>：系统使用模仿学习（Behavior Cloning）对智能体进行端到端优化，优化过程中将 2D 视觉语义编码器（Qwen2.5-VL 视觉部分）和 3D 空间几何编码器（VGGT）的参数全部冻结（Frozen），仅微调 LLM 主干（7B）以及特征融合投影层（MLP）。使用 DAgger 算法在连续模拟环境中通过人类或专家轨迹对策略进行微调，显著减轻“漂移”带来的误差累积。</li>
  <li><strong>推理流程</strong>：每个时刻 $t$，智能体从 RGB 摄像头提取当前帧 $x_t$，通过双编码器与内存模块提取并更新隐式内存，融合成 $F_t$；接着将 $F_t$ 与自然语言指令嵌入 $\mathcal{I}$ 连接，直接由 LLM 的 KV cache 机制增量推理出下一个离散控制动作 $a_{t+1}$，直到输出 <code class="language-plaintext highlighter-rouge">Stop</code>。</li>
</ul>

<div align="center">
  <img src="/images/vln/JanusVLN-spatial-tokens-analysis.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1103/1555" />
    <figcaption>空间几何 Token 的可视化分析：提取的空间几何 Token 可被进一步可视化为高保真的深度图和点云，证明其确实隐式编码了丰富的 3D 物理与几何特征，这对于空间推理（如寻找“最远”的椅子或“洗手池后”的椅子）至关重要。</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-17">3. 核心结果/发现</h3>
<ul>
  <li><strong>VLN-CE 基准表现（R2R-CE &amp; RxR-CE）</strong>：
    <ul>
      <li>在 <strong>R2R-CE</strong> 未见场景测试集（Val-Unseen）中，JanusVLN 刷新了 SOTA 成绩，取得了 <strong>成功率 (SR) 60.5%</strong> 和 <strong>路径长度加权成功率 (SPL) 56.8%</strong> 的杰出表现，相比此前最好的模型 StreamVLN，SR 提升了 <strong>3.6%</strong>，SPL 提升了 <strong>4.9%</strong>。</li>
      <li>在不使用任何外部轨迹辅助训练的设置下（JanusVLN*），成功率依然达到 <strong>52.8%</strong>，超越了其他使用大量额外多模态数据的框架。</li>
      <li>在 <strong>RxR-CE</strong> 基准中，其表现同样刷新 SOTA，取得了 <strong>SR 56.2%</strong> 和 <strong>SPL 47.5%</strong> 的优异成绩。</li>
    </ul>
  </li>
  <li><strong>HM3D-OVON 表现</strong>：
    <ul>
      <li>在面向开放词汇的目标导航测试（HM3D-OVON）中，JanusVLN 取得了 <strong>SR 44.9%</strong> 和 <strong>SPL 31.7%</strong>，遥遥领先于之前的算法（如 MTU3D 的 SR 40.8% 和 SPL 12.1%），展现出强劲的场景泛化力与指令理解力。</li>
    </ul>
  </li>
  <li><strong>推理耗时对比</strong>：
    <ul>
      <li>引入了 Cached Memory 机制后，模型单帧的图像特征处理延迟（VGGT）被降至极低的 <strong>82ms</strong>（缓存 8 帧）与 <strong>195ms</strong>（缓存 48 帧），而如果不使用缓存、直接重计算全长序列特征，耗时则随着帧数呈指数级上升，很快会在 GPU 上发生内存溢出（OOM）。</li>
    </ul>
  </li>
  <li><strong>消融实验关键结论</strong>：
    <ul>
      <li><strong>3D 几何特征是路径规划的关键</strong>：去掉 3D 空间几何隐式内存后，模型在 R2R-CE 上的 SPL 表现从 49.2 急剧下滑至 40.9。</li>
      <li><strong>初始锚点不可或缺</strong>：若从内存中去除初始窗口（w/o initial’s KV），性能将下降近 2%，证明了 Attention Sinks 为导航任务提供全局参照的必要性。</li>
    </ul>
  </li>
</ul>

<hr />

<h3 id="4-局限性-17">4. 局限性</h3>
<ol>
  <li><strong>偏差自纠错能力仍然脆弱</strong>：统计表明，虽然系统利用 DAgger 算法收集了非最优路线数据进行微调，但当智能体在大范围、长程导航中严重偏离预设路线时，它依然很容易由于误差在时间上的逐步累积而彻底迷失，难以主动退回最优路径。</li>
  <li><strong>缺乏真实尺度引起的提前停止</strong>：由于 3D 几何编码器（VGGT）本身在没有真实物理标定的前提下仅提取隐式的相对几何特征，其输出在一定程度上缺乏真实的绝对尺度（Real-world Scale）。这导致智能体在距离目标物体还有一段距离（尚未到达 3 米判定半径）时，容易由于视觉上的“已看清目的地”而错误地提前停下来。</li>
</ol>

<hr />

<h2 id="hsgm">32. HSGM (2026)</h2>
<p>——— 层级式语义-几何地图，填补 VLM 2D 视觉与 3D 空间推理及运动规划的鸿沟</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.00095">arXiv:2606.00095</a> · 🏛️ <strong>CVPR 2026</strong> · <a href="https://github.com/Teacher-Tom/HSGM_public">Code</a></p>

<h3 id="精华-20">精华</h3>
<ul>
  <li>针对大视觉语言模型（VLM）在连续环境导航（VLN-CE）中缺乏 3D 几何常识与底层运动规划能力（即语义-几何鸿沟）的问题，提出无须训练的层级式语义-几何地图（HSGM）。</li>
  <li>HSGM 在三维空间中维护层级场景表示，包含用于记录可通行性的几何地图、表征物体实例的语义地图以及用于采样航点与轨迹的决策地图。</li>
  <li>通过将 3D 点云栅格化为 2D BEV 鸟瞰图，并在其上叠加可视化的离散航点标记，成功使 VLM 的 2D 视觉推理能够直接关联并操纵三维空间。</li>
  <li>采用规划与控制解耦的设计，VLM 仅作为高层语义规划器选择离散的目标航点，而具体的无碰撞连续轨迹则交由经典的 A* 算法和底层 PID 控制器执行。</li>
  <li>引入子任务管理机制将长程复杂指令解耦，并结合失败回溯（Backtracking）策略，显著降低了 VLM 的记忆与推理开销，大幅提升了导航的成功率。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-19">1. 研究背景/问题</h3>
<p>在连续三维环境中的视觉语言导航（VLN-CE）要求具身智能体基于第一人称视角（RGB-D）和相机位姿，按照复杂的自然语言指令运动并寻找目标物。尽管预训练的 VLM（如 GPT-5 等）具有强大的通用语义推理和 2D 视觉常识，但在将其应用于 VLN-CE 时，遇到了明显的 <strong>“语义-几何鸿沟” (Semantic-Geometric Gap)</strong>：</p>
<ol>
  <li><strong>三维几何理解贫瘠</strong>：VLM 虽然可以识别图像中的物体，但由于仅在 2D 图文对上进行训练，它们很难跨多视角重建全局 3D 拓扑布局，无法理解复杂的 3D 空间相对关系。</li>
  <li><strong>底层动作控制脱节</strong>：将语义级的目标描述（例如“穿过走廊，在沙发旁停下”）转化为精确的厘米级底层连续运动指令（如左转 $15^\circ$，前进 $0.5\text{ m}$）非常困难，容易导致避障失败和过度碰撞。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-17">2. 主要方法/创新点</h3>

<p>HSGM 通过显式地在三维空间中构建层级语义-几何表征，并将高层语义决策与低层控制解耦，彻底解决了上述鸿沟。</p>

<div align="center">
  <img src="/images/vln/HSGM-map-hierarchy.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/627" />
<figcaption>图 1. 提案的层级语义-几何地图 (HSGM) 结构。包含几何、语义、决策三个层级，并投影栅格化为 2D BEV 图和带可视提示的智能体视角图。</figcaption>
</div>

<div align="center">
  <img src="/images/vln/HSGM-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1398/970" />
<figcaption>图 2. HSGM 框架运行流程概览。首先对指令进行子任务分解，随后动态建图，将生成的 2D BEV 栅格和带有局部航点提示的视角图输入给 VLM，最后 VLM 航点决策与 A* 路径规划相配合实现解耦控制。</figcaption>
</div>

<h4 id="-整体框架概述-6">① 整体框架概述</h4>
<p>如图 2 所示，HSGM 框架包含三大支柱：首先利用大模型对复杂的长句导航指令进行子任务解耦（Subtask Management）；其次智能体在运行中动态构建层级语义-几何地图（HSGM）；最后，系统基于该地图将 VLM 的高层语义航点选择（High-Level Planning）与 A* 经典路径规划算法的低层运动控制（Low-Level Control）进行完全解耦。</p>

<h4 id="-逐模块讲解-4">② 逐模块讲解</h4>

<p><strong>A. 动态层级建图 (Hierarchical Mapping)</strong>
HSGM 包含三个并行的层级，以维持高精度、长期稳定的 3D 环境模型：</p>
<ul>
  <li><strong>几何地图 (Geometry Map, $M_{geo}$)</strong>:
    <ul>
      <li><strong>输入</strong>：智能体采集的多视角 RGB-D 图像 $O_t$ 以及实时位姿 $\xi_t$。</li>
      <li><strong>处理</strong>：将图像像素通过对应的深度图与位姿反投影回 3D 空间，汇聚成场景点云 $P_{scene}$。点云中高于地面的部分识别为障碍物 $P_{obs}$，其余提取为初始可通行面 $P_{nav}^{init}$。针对可能遇到的跨楼层情况，通过法向量估计和倾斜面滤波专门提取楼梯区域点云 $P_{stair}$。</li>
      <li><strong>输出</strong>：最终的几何地图为两者并集：
\(M_{geo} = P_{nav} \cup P_{obs}\)
其中 $P_{nav} = P_{nav}^{init} \cup P_{stair}$。</li>
    </ul>
  </li>
  <li><strong>语义地图 (Semantic Map, $M_{sem}$)</strong>:
    <ul>
      <li><strong>输入</strong>：egocentric RGB 图像。</li>
      <li><strong>处理</strong>：利用 YOLO-E 进行 2D 目标检测与实例分割，提取物体的 2D Mask 和类别信息。随后利用深度图与相机位姿将 Mask 投影至 3D 空间生成物体点云。新生成的物体点云会根据 3D IoU 和类别标签的一致性，与已有物体特征相融合，并设定阈值剔除噪声点。</li>
      <li><strong>输出</strong>：包含 N 个语义物体的 3D 点云与标签集合：
\(M_{sem} = \{(P_{obj, j}, c_j)\}_{j=1}^{N_{obj}}\)</li>
    </ul>
  </li>
  <li><strong>决策地图 (Decision Map, $M_{dec}$)</strong>:
    <ul>
      <li><strong>输入</strong>：几何地图 $M_{geo}$、障碍点云 $P_{obs}$ 和智能体当前位置 $p_{agent}$。</li>
      <li><strong>处理</strong>：由两部分组成：全局航点图 $G = (V, E)$ 和局部航点集 $A_{curr}$。
        <ul>
          <li><strong>全局图 $G$</strong>：对可通行点云进行下采样，通过柱状碰撞体检查（Cylindrical Occupancy Check，智能体高 $h$ 宽 $r$ 范围内无障碍点）确定安全节点。相邻节点如果在水平距离（$\le 1.0\text{ m}$）和高度差（$\le 0.3\text{ m}$，针对楼梯）内满足连通，则建立无碰撞边。</li>
          <li><strong>局部航点集 $A_{curr}$</strong>：在当前视野的可通行区域进行较粗粒度的采样，通过 cylindrical check 后，结合距离（$0.3\text{ m} \sim 3.0\text{ m}$）及语义接近度进行筛选，并过滤掉在全局图上与当前位置不可达的悬空或隔离点。</li>
        </ul>
      </li>
      <li><strong>输出</strong>：当前可用的决策图表示：
\(M_{dec} = \{G, A_{curr}\}\)</li>
    </ul>
  </li>
</ul>

<p><strong>B. 2D 栅格化与航点可视化投影 (2D Rasterization &amp; Prompting)</strong></p>
<ul>
  <li><strong>输入</strong>：3D HSGM 各层信息。</li>
  <li><strong>处理</strong>：将三维点云进行高度投影并栅格化为 Top-down 的 2D BEV 图像（几何通道标记障碍和路，语义通道以特定标记代表各类物体，状态通道包含轨迹线与子任务终点等）。同时，将 $A_{curr}$ 的三维坐标转化为带有编号的彩色圆圈（未访问为灰色，已访问为红色），直接投影到 top-down BEV 图和 egocentric 第一人称前向视图上。</li>
  <li><strong>输出</strong>：直观的 2D 视觉提示图，将连续 3D 规划转化为 2D 离散的选择题。</li>
</ul>

<p><strong>C. 高低层解耦规划与控制 (Decoupled Navigation)</strong></p>
<ul>
  <li><strong>高层语义规划</strong>：VLM 作为决策核心，其输入包括当前的 2D BEV 图像、第一人称视角图（二者均叠加密集航点提示）以及系统提示和历史 Chain-of-Thought (CoT) 轨迹。VLM 运用 CoT 依次分析先前的进度、当前的环境、当前的子目标与接下来的路线，最后输出要跳转的航点序号 $a_t \in A_{curr}$，或原地转弯的姿态，或触发子任务完成的 STOP 信号。</li>
  <li><strong>低层控制执行</strong>：当 VLM 决策了目标航点后，经典的 A* 路径规划算法以欧几里得距离为代价函数，在全局航点图 $G$ 上检索出无碰撞的最短拓扑路径，再由 PID 控制器转化为一连串的“转弯 - 直行”物理动作指令驱使机器人移动。</li>
</ul>

<h4 id="-训练与推理细节">③ 训练与推理细节</h4>
<ul>
  <li><strong>训练</strong>：本框架为 <strong>完全零样本（Zero-shot）、免训练 (Training-free)</strong> 架构。它不需要任何针对导航任务的大规模模仿学习或强化学习。</li>
  <li><strong>推理</strong>：VLM 使用了 GPT-5 的多模态 API。子任务管理模块通过大模型预先将用户输入分解为若干语义独立的阶段，并利用双重确认（两轮连续 STOP）防止过早停止。同时，如果在单一子任务上耗费步数过多，会自动回退至子任务的起点，实现路径纠偏与回溯（Automatic Backtracking）。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-18">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/HSGM-nav-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/590" />
<figcaption>表 1. HSGM 在 R2R-CE 和 RxR-CE 测试集上的导航表现对比。在零样本设置中取得 SOTA（加粗），并优于许多监督学习方法。</figcaption>
</div>

<ul>
  <li><strong>卓越的零样本性能</strong>：
在 R2R-CE（Val-Unseen）上，HSGM 取得了 <strong>47.9%</strong> 的成功率 (SR) 和 <strong>32.8%</strong> 的 SPL，优于当前最佳的零样本 baseline（DreamNav 32.8% SR，15.1% 领先）。更重要的是，它大幅打败了 CMA、NaVid (37.4% SR) 以及 MapNav (39.7% SR) 等使用了大量 Habitat 数据训练的监督学习模型。
在长程、多语言的 RxR-CE（Val-Unseen）上，其表现更为明显，SR 达到 <strong>41.8%</strong>，相较于先前最佳的零样本方法 AO-Planner (22.4% SR) 直接实现翻倍，且衡量路径逼真度的 nDTW 达到 <strong>54.9%</strong> (远高于 33.1%)，这表明生成的轨迹极好地契合了人类指令。</li>
</ul>

<div align="center">
  <img src="/images/vln/HSGM-map-ablation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:670/242" />
<figcaption>表 2. HSGM 栅格化地图层级对导航成功率 (SR) 和 SPL 的增量消融研究。</figcaption>
</div>

<ul>
  <li><strong>建图层级的增量消融</strong>：
如表 2 所示，在不提供 BEV 图的基线下成功率为 46.0%。逐步加入几何地图后，成功率提升至 47.3%；加入语义通道可辅助物体寻找，将成功率拉升至 49.2%；最后加入包含了历史轨迹和航点指示的决策层地图，使系统达到 51.0% (注：300 episode 子集)。证明了三层地图信息的互补性。</li>
</ul>

<div align="center">
  <img src="/images/vln/HSGM-decoupled-ablation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/236" />
<figcaption>表 3. 解耦导航机制及 CoT 提示词消融结果。</figcaption>
</div>

<ul>
  <li><strong>子任务与 CoT 推理的必要性</strong>：
    <ul>
      <li><strong>去除子任务管理</strong>：SR 骤跌 8.9%。说明长任务中极易发生进度遗忘，而将其切分为离散目标可降低 VLM 的长上下文记忆负荷。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/HSGM-subtask-ablation.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:671/466" />
<figcaption>图 3. 子任务分解对不同长度指令成功率 (SR) 的影响分析。</figcaption>
</div>

<ul>
  <li><strong>去除 A* 解耦规划（直线前进）</strong>：SR 下降 6.7%。说明仅仅输出航点不够，若无经典几何规划避障，机器人在连续环境中极易因障碍物阻隔导致路线偏移或陷入局部极小。</li>
  <li>
    <p><strong>去除 Chain-of-Thought</strong>：导航性能灾难性下滑（SR 下降 17%，跌至 34.0%），这表明长程三维导航是一个非常复杂的时空逻辑决策过程，需要显式的思维链过渡。</p>
  </li>
  <li><strong>回溯机制的作用</strong>：
    <ul>
      <li>如表 4，在 R2R-CE 和 RxR-CE 中分别触发了 18.3% 与 19.0% 的自动回退，得益于此，分别挽救并纠正了其中 30.8% 和 26.8% 的失败回溯案例（Recovery SR），极大地提升了系统的运行鲁棒性。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/HSGM-backtracking-results.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:675/269" />
<figcaption>表 4. 自动回溯机制在不同数据集上的触发率与恢复成功率表现。</figcaption>
</div>

<div align="center">
  <img src="/images/vln/HSGM-navigation-case.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1253/471" />
<figcaption>图 4. 机器人在连续 Habitat 场景中的建图和导航演变案例。通过高层选择航点 (如第一步选 6) 以及子任务的分阶段 STOP，精准完成复杂流程。</figcaption>
</div>

<hr />

<h3 id="4-局限性-18">4. 局限性</h3>
<ol>
  <li><strong>传感器精度依赖度高</strong>：3D 点云建图严重依赖深度相机的精度以及位姿传感器的估计。如果发生相机遮挡、剧烈抖动或黑暗导致 2D 目标检测器失效，则生成的语义-几何地图会出现漂移或穿模。</li>
  <li><strong>高频推理与高昂延迟</strong>：采用强大的 GPT-5 等 VLM 进行高频 API 交互推理，在线推理开销和通信延迟十分明显，在对实时动态避障要求极高的超高速机器人任务上难以直接应用。</li>
  <li><strong>复杂动态场景适应性弱</strong>：当前航点生成与 A* 碰撞检测针对的是静态环境下的三维障碍，面对移动障碍物（如行人、宠物等）时，其建图更新机制和航点更新率可能无法及时应对。</li>
</ol>

<hr />

<h2 id="onevla-a-unified-framework-for-embodied-tasks">33. OneVLA (2026)</h2>
<p>OneVLA: A Unified Framework for Embodied Tasks
———首个在单一网络与动作头下统一具身导航和操作的 VLA 模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.01241">arXiv:2606.01241</a></p>

<h3 id="精华-21">精华</h3>
<ol>
  <li>提出了 <strong>OneVLA</strong>，这是首个在单一网络架构与单个动作输出头（Action Head）下，同时解决具身导航（Navigation）与机械臂操作（Manipulation）任务的统一 VLA 框架，无需任何任务特定的模型变体。</li>
  <li>核心创新在于设计了 <strong>11 维统一动作输出头</strong>，创造性地将离散的导航命令分布与连续的 7-DOF 机械臂末端控制量进行拼接，并通过<strong>任务特定维度掩码（task-specific weight masks）</strong>解决了不同动作空间带来的梯度干扰问题。</li>
  <li>提出了<strong>多阶段渐进式混合训练策略</strong>（操作基础建立 $\rightarrow$ 导航能力融入 $\rightarrow$ 思维链 CoT 强化），使模型逐步掌握复杂的多模态知识，促进了跨任务域的表征学习和正向知识迁移。</li>
  <li>仿真与实物实验表明，3B 参数 of OneVLA 在 VLN-CE 和 SimplerEnv 等多项导航和操作基准上均达到了 SOTA 性能，显著超越了现有的 7B 跨任务模型（如 UniVLA）和专门的单任务模型（如 StreamVLN、π0-Fast）。</li>
  <li>提供了强有力的实证证据，证明<strong>导航与操作这两类截然不同的具身任务进行混合联合训练，可以实现性能上的互惠与相互增强</strong>（mutual reinforcement）。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-20">1. 研究背景/问题</h3>
<p>当前的具身智能机器人系统主要依赖专用的视觉-语言-动作（VLA）模型，通常局限于单一领域：</p>
<ul>
  <li><strong>领域割裂</strong>：模型要么专注于导航（如 NaVid、MapNav），要么专注于机械臂操作（如 OpenVLA、π0），导致无法构建通用型的机器人智能体。</li>
  <li><strong>架构依赖变体</strong>：现有的跨任务 VLA 模型（如 UniVLA）虽然尝试同时处理两类任务，但仍需要为不同任务设计独立的动作头或特定任务的模型变体，无法实现真正的无缝切换。</li>
</ul>

<p>本文旨在解决两个核心问题：</p>
<ol>
  <li>是否能设计一个完全统一的 VLA 架构，在<strong>没有任何任务特定变体</strong>的情况下，同时生成导航与操作动作？</li>
  <li>导航和操作这两个根本不同的具身任务，在联合训练时能否<strong>实现知识的正向迁移与性能的相互增强</strong>？</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-18">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vla/OneVLA-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/911" />
<figcaption>OneVLA 整体框架：在单个模型内输入多视角图像与文本指令，同时生成文本推理与机器人动作，实现导航和操作的统一。</figcaption>
</div>

<h4 id="-整体框架概述-7">① 整体框架概述</h4>
<p>OneVLA 在每个时间步 $t$ 接收包含多视角 RGB 图像（$o_t$）、自然语言指令（$l_t$）和可选的机器人状态（$r_t$）在内的多模态输入。在单个 Forward Pass 中，模型先以文本自回归方式输出对指令的推理理解（$y_t$），接着输出对应的动作序列（$a_{t:t+T}$）。整体流程公式化表示为：
\(OneVLA: (o_t, l_t, r_t) \rightarrow (y_t, a_{t:t+T})\)
动作输出会根据当前的任务自适应映射到离散导航命令或连续操作指令，而无需任何架构修改。</p>

<div align="center">
  <img src="/images/vla/OneVLA-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1326/865" />
<figcaption>OneVLA 详细架构：由统一的视觉-语言编码器（Qwen2.5-VL-3B）、支持 CoT 解码的 Tokenizer 和基于流匹配的 11 维统一动作头构成。</figcaption>
</div>

<h4 id="-逐模块讲解-5">② 逐模块讲解</h4>

<p><strong>统一视觉-语言编码器（Unified Vision-Language Encoder）</strong></p>
<ul>
  <li><strong>输入</strong>：多视角观测 $o_t = {I_1, I_2, …, I_M}$（$M$ 为摄像头视角数，如主相机与手眼相机）及文本指令 $l_t$。</li>
  <li><strong>处理</strong>：
    <ul>
      <li>每张图像 $I_i$ 被分割为 $14 \times 14$ 的图像块（Patches）。</li>
      <li>通过 32 层的 Vision Transformer（隐藏维度 $d_v = 1280$）提取特征，并使用空间合并（merge size = 2）来捕获分层视觉特征。</li>
      <li>通过线性投影层将提取的视觉特征映射到语言模型的隐藏空间（$d_h = 2048$）：
\(V = \text{Proj}(\text{VisionEncoder}(o_t)) \in \mathbb{R}^{N_v \times d_h}\)</li>
      <li>文本指令 $l_t$ 被 Tokenizer 编码到相同的 $d_h$ 空间。</li>
      <li>将视觉 Token $V$ 与文本 Token $T$ 拼接后输入 36 层、具有 16 个注意力头的 Qwen2.5-VL-3B-Instruct 模型中进行深度跨模态融合。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：生成上下文感知的高维多模态表征 $H \in \mathbb{R}^{(N_v + N_t) \times d_h}$。</li>
</ul>

<p><strong>输出生成与 Token 解码（Output Generation）</strong></p>
<ul>
  <li><strong>核心机制</strong>：在词表中引入四种特殊 Token（<code class="language-plaintext highlighter-rouge">&lt;text&gt;</code>, <code class="language-plaintext highlighter-rouge">&lt;/text&gt;</code>, <code class="language-plaintext highlighter-rouge">&lt;action&gt;</code>, <code class="language-plaintext highlighter-rouge">&lt;/action&gt;</code>），在单次前向传播中显式分离文本推理和动作生成两个阶段：
\(\text{sequence} = \langle\text{text}\rangle y_t \langle/\text{text}\rangle \langle\text{action}\rangle \hat{a}_{t:t+T} \langle/\text{action}\rangle\)</li>
  <li>这种 Chain-of-Thought（CoT）式的设计允许模型先进行语言层面的物理推理与子目标规划，然后再条件化地生成执行动作，极大提升了多步任务下的可靠性与可解释性。</li>
</ul>

<p><strong>统一动作头与掩码流匹配（Unified Action Head）</strong></p>
<ul>
  <li><strong>11 维统一动作空间</strong>：拼接两个任务的动作输出：
\(a_{\text{unified}} = [a_{\text{navi}}, a_{\text{mani}}] \in \mathbb{R}^{11}\)
    <ul>
      <li>$a_{\text{navi}} \in \mathbb{R}^4$：对应 discrete 导航指令的概率分布 $[p_{\text{forward}}, p_{\text{turn-left}}, p_{\text{turn-right}}, p_{\text{stop}}]$。</li>
      <li>$a_{\text{mani}} \in \mathbb{R}^7$：对应机械臂操作的 7-DOF 连续控制量 $[\Delta x, \Delta y, \Delta z, \Delta roll, \Delta pitch, \Delta yaw, g]$。</li>
    </ul>
  </li>
  <li><strong>动作预测机制</strong>：采用基于 Transformer 的扩散模型（DiT-B）和<strong>流匹配（Flow Matching）</strong>。在去噪过程中，模型接收高维表征 $H$、时间步 sinusoidal 编码以及动作噪声 $a_t$，通过 Euler 积分迭代 $N$ 步预测速度场 $v_\theta$，最终生成连续的动作序列。</li>
  <li><strong>任务特定权重掩码（Loss Masking）</strong>：为了消除离散导航概率与连续操作姿态之间的相互梯度干扰，对样本 $i$ 设计了掩码 $w_{\tau_i} \in {w_{\text{navi}}, w_{\text{mani}}}$。对于导航任务，操作相关的 7 维 loss 权重设为 0，反之亦然。关键维度（如 Stop 命令）被分配更高权重以缓解类别不平衡。
\(L_{\text{action}}^i = \text{mean}(w_{\tau_i} \odot (\hat{v}_{\theta}^i - v^i)^2)\)</li>
</ul>

<div align="center">
  <img src="/images/vla/OneVLA-multi_stage_training.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/762" />
<figcaption>OneVLA 三阶段渐进式训练方案：从操作基础出发，逐步融入导航数据，最终配合 CoT 推理数据微调。</figcaption>
</div>

<h4 id="-多阶段渐进式训练策略">③ 多阶段渐进式训练策略</h4>
<p>为了使单一模型平滑掌握如此异构的动作与理解空间，OneVLA 设计了三阶段训练方案：</p>
<ol>
  <li><strong>Stage 1 (操作基础建立)</strong>：仅在机械臂操作数据集和通用视觉问答（VQA）数据集上进行预训练，只更新操作相关维度。</li>
  <li><strong>Stage 2 (导航能力融入)</strong>：引入 VLN 导航数据进行跨任务联合训练。此时两个通道的损失同时计算（使用各自的任务特定 Mask 隔离），使得 Vision-Language 骨干网开始学习融合两者的共享表示。</li>
  <li><strong>Stage 3 (思维链 CoT 强化)</strong>：最后阶段加入 Chain-of-Thought（CoT）推理数据，对语言和动作头进行端到端的联合微调，以极大强化模型在长程交互中的高层规划与理解能力。</li>
</ol>

<hr />

<h3 id="3-核心结果发现-19">3. 核心结果/发现</h3>

<h4 id="-仿真基准对比sota-性能">① 仿真基准对比（SOTA 性能）</h4>
<p>OneVLA 在导航基准 <strong>VLN-CE</strong> (R2R &amp; RxR) 以及操作基准 <strong>SimplerEnv</strong> 上均表现卓越：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">类别 / 模型</th>
      <th style="text-align: center">统一架构</th>
      <th style="text-align: center">R2R OSR ↑</th>
      <th style="text-align: center">RxR OSR ↑</th>
      <th style="text-align: center">SimplerEnv Avg. Success Rate ↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>导航专用 VLA</strong></td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
    </tr>
    <tr>
      <td style="text-align: left">NaVid (7B)</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">49.2%</td>
      <td style="text-align: center">48.9%</td>
      <td style="text-align: center">-</td>
    </tr>
    <tr>
      <td style="text-align: left">Uni-NaVid (7B)</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">53.3%</td>
      <td style="text-align: center">52.5%</td>
      <td style="text-align: center">-</td>
    </tr>
    <tr>
      <td style="text-align: left">StreamVLN (7B)</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">64.0%</td>
      <td style="text-align: center">55.7%</td>
      <td style="text-align: center">-</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>操作专用 VLA</strong></td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
    </tr>
    <tr>
      <td style="text-align: left">$\pi_0$-Fast (3B)</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">48.3%</td>
    </tr>
    <tr>
      <td style="text-align: left">OpenVLA-OFT (7B)</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">-</td>
      <td style="text-align: center">41.8%</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>多任务跨域 VLA</strong></td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
      <td style="text-align: center"> </td>
    </tr>
    <tr>
      <td style="text-align: left">UniVLA (7B)</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">47.1%</td>
      <td style="text-align: center">26.3%</td>
      <td style="text-align: center">35.4%</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>OneVLA (Ours, 3B)</strong></td>
      <td style="text-align: center"><strong>✓</strong></td>
      <td style="text-align: center"><strong>68.6%</strong></td>
      <td style="text-align: center"><strong>58.2%</strong></td>
      <td style="text-align: center"><strong>64.5%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><em>相比 UniVLA 提升</em></td>
      <td style="text-align: center">-</td>
      <td style="text-align: center"><em>+21.5%</em></td>
      <td style="text-align: center"><em>+31.9%</em></td>
      <td style="text-align: center"><em>+29.1%</em></td>
    </tr>
  </tbody>
</table>

<ul>
  <li><strong>跨构型碾压</strong>：作为一个参数量仅 3B 的完全统一模型，OneVLA 击败了所有 7B 的专用单任务模型（如 StreamVLN 7B）和多任务模型（如 UniVLA 7B），且不需要为每个任务维护独立的动作头。</li>
</ul>

<h4 id="-消融实验与互惠实证">② 消融实验与互惠实证</h4>
<ul>
  <li><strong>渐进式训练的价值</strong>：多阶段训练相比单阶段混合训练，在导航和操作上的性能分别提升了 <strong>12.5%</strong>、<strong>15.3%</strong> 和 <strong>18.3%</strong>（见下表），证明了逐步引入任务复杂性的必要性。</li>
</ul>

<table>
  <thead>
    <tr>
      <th style="text-align: left">训练策略</th>
      <th style="text-align: center">R2R OSR</th>
      <th style="text-align: center">RxR OSR</th>
      <th style="text-align: center">SimplerEnv Avg</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">OneVLA (单阶段直接训练)</td>
      <td style="text-align: center">56.1%</td>
      <td style="text-align: center">42.9%</td>
      <td style="text-align: center">46.2%</td>
    </tr>
    <tr>
      <td style="text-align: left">OneVLA (多阶段渐进训练)</td>
      <td style="text-align: center"><strong>68.6%</strong></td>
      <td style="text-align: center"><strong>58.2%</strong></td>
      <td style="text-align: center"><strong>64.5%</strong></td>
    </tr>
  </tbody>
</table>

<ul>
  <li><strong>跨任务互惠效应（Mutual Reinforcement）</strong>：将导航与操作进行联合训练后，相比于单独训练导航（Navi. Only）或单独训练操作（Mani. Only），模型在 R2R 导航上提升了 <strong>7.3%</strong>，在 RxR 导航上提升了 <strong>9.3%</strong>，在操作上提升了 <strong>5.5%</strong>（见下表）。这强有力地证实了：<strong>不同的具身任务在共享特征网络下，能学到更好的通用空间与多模态表征，从而互利共赢</strong>。</li>
</ul>

<table>
  <thead>
    <tr>
      <th style="text-align: left">训练设置</th>
      <th style="text-align: center">R2R OSR</th>
      <th style="text-align: center">RxR OSR</th>
      <th style="text-align: center">SimplerEnv Avg</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">OneVLA (单独任务训练)</td>
      <td style="text-align: center">48.8%</td>
      <td style="text-align: center">33.6%</td>
      <td style="text-align: center">40.7%</td>
    </tr>
    <tr>
      <td style="text-align: left">OneVLA (跨任务联合训练)</td>
      <td style="text-align: center"><strong>56.1%</strong></td>
      <td style="text-align: center"><strong>42.9%</strong></td>
      <td style="text-align: center"><strong>46.2%</strong></td>
    </tr>
  </tbody>
</table>

<div align="center">
  <img src="/images/vla/OneVLA-ablation_action_horizon.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:1317/390" />
<figcaption>动作预测跨度（Action Horizon）的消融结果：Horizon = 5 时能够在导航和操作任务上取得最佳的平衡。</figcaption>
</div>

<ul>
  <li><strong>动作跨度（Action Horizon）消融</strong>：评估表明，预测步数 $T = 5$ 最优。过短的步数缺乏时序建模，过长的步数（如 8 步）由于累积误差，会导致操作性能急剧下降。</li>
</ul>

<h4 id="-真实世界实物评估">③ 真实世界实物评估</h4>

<div align="center">
  <img src="/images/vla/OneVLA-real_world_results.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:605/497" />
<figcaption>真机实物评估结果：在移动机器人导航与 Franka 机械臂操作中，OneVLA 均大幅超越 UniVLA 等模型。</figcaption>
</div>

<ul>
  <li><strong>移动导航真机</strong>：四种典型场景中，导航成功率达 <strong>77.5%</strong>，相比 UniVLA 提升 35.0%。</li>
  <li><strong>Franka 机械臂操作</strong>：四种代表性灵巧任务中，成功率达 <strong>78.8%</strong>，相比 UniVLA 提升 16.3%。证明了从仿真到现实（Sim-to-Real）的极强迁移与泛化能力。</li>
</ul>

<div align="center">
  <img src="/images/vla/OneVLA-qualitative_results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:595/521" />
<figcaption>OneVLA 在仿真和真实世界中的导航及操作定性效果展示。</figcaption>
</div>

<hr />

<h3 id="4-局限性-19">4. 局限性</h3>
<ol>
  <li><strong>真实世界极端长程任务的漂移</strong>：在极长程或多障碍物的复杂动态真机导航中，偶尔会出现因推理步数过多导致的动作偏差累积。</li>
  <li><strong>离散动作维度的稀疏性</strong>：统一动作空间中，虽然有 Loss Mask 屏蔽梯度，但在模型前向传播中导航动作依然以离散概率输出，无法直接表征更精细、连续的转弯控制。</li>
  <li><strong>计算延迟限制</strong>：自回归的 CoT 文本推理（<code class="language-plaintext highlighter-rouge">&lt;text&gt;...&lt;/text&gt;</code>）虽然能大幅增加准确率，本模型生成时间也随之增加，带来了额外的推理延迟，对于高频闭环机械臂控制（如 &gt; 20Hz）具有一定的部署压力。</li>
</ol>

<hr />

<h2 id="ca-vln">34. CA-VLN (2026)</h2>
<p>——— 基于双智能体协作的多模态大模型具身导航框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://doi.org/10.3390/s26041254">Sensors 2026</a> · 🏛️ <strong>Sensors 2026</strong></p>

<h3 id="精华-22">精华</h3>
<hr />
<ol>
  <li><strong>双智能体协作机制</strong>：将高层常识认知与底层情景记忆解耦，通过知识推理智能体（Knowledge Agent）和分层历史智能体（History Agent）的协作，有效提升了具身导航智能体在未见环境（unseen environments）中的泛化与回溯能力。</li>
  <li><strong>渐进式在线知识生成</strong>：在推理时，智能体根据原始指令和实时视觉观测动态生成并检索 Top-K 相关的语义知识事实，降低了对静态离线知识库的依赖。</li>
  <li><strong>分层拓扑记忆设计</strong>：通过视角层与路径层的分层描述构建情景记忆拓扑图，既保留了时序连续性，又有效防止了徘徊或往复运动引起的记忆爆炸。</li>
  <li><strong>两阶段参数高效微调</strong>：利用 LoRA 约束可训练参数在 10M 以内，先后微调双智能体及多模态融合模块，实现了对大模型在具体导航任务中的低成本领域自适应。</li>
  <li><strong>解耦泛化的 Sim-to-Real 启示</strong>：将导航策略绑定在相对稳定的语义概念和连通关系上，而非脆弱的低层视觉纹理，这为克服 Sim-to-Real 的领域偏移提供了极佳的可迁移设计。</li>
</ol>

<h3 id="1-研究背景问题-21">1. 研究背景/问题</h3>
<hr />
<p>视觉语言导航（VLN）要求智能体依据自然语言指令在复杂 3D 环境中寻路。然而，传统端到端方法在面临未见环境时泛化性能较差，且在大规模场景中由于缺乏长程历史语境而容易迷失或陷入循环。虽然近年来多模态大模型（MLLM）被引入具身导航，但大模型的庞大参数直接输出导航动作会带来巨大的“域差距”（Domain Gap）和极高的计算延迟，如何巧妙地将大模型的常识推理优势与精细的底层局部决策及空间拓扑记忆融合，依然是个亟待解决的难题。</p>

<h3 id="2-主要方法创新点-19">2. 主要方法/创新点</h3>
<hr />
<div align="center">
  <img src="/images/vln/CA-VLN-overall-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1113/952" />
<figcaption>CA-VLN 整体协作架构：包含 Knowledge Agent 和 Hierarchical History Agent，辅以多模态特征检索</figcaption>
</div>

<h4 id="-整体框架概述-8">① 整体框架概述</h4>
<p>CA-VLN 提出了一个由知识推理智能体（Knowledge Reasoning Agent）和分层历史智能体（Hierarchical History Agent）组成的双智能体协作框架，并通过专门的多模态融合模块对视觉、文本、常识及记忆特征进行深度交互，最终输出动作决策。</p>

<div align="center">
  <img src="/images/vln/CA-VLN-interaction-flow.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1114/919" />
<figcaption>CA-VLN 智能体交互与信息流：Knowledge Agent 提取语义特征，History Agent 维护情景记忆并引导动作决策</figcaption>
</div>

<h4 id="-逐模块讲解-6">② 逐模块讲解</h4>
<ul>
  <li><strong>知识推理智能体 (Knowledge Reasoning Agent)</strong>
    <ul>
      <li><strong>输入</strong>：原始自然语言指令、当前视角下的实时多视角图像。</li>
      <li><strong>处理</strong>：训练期间，将原始指令与真值轨迹拼接，由 MLLM 生成精确的逐步指令并提取关键实体；推理期间，在无真值情况下，大模型采用逐步提示策略，从颜色、形状、尺寸识别场景中的可见物体属性，描述空间布局，并利用 CLIP 文本编码器在当前指令与预设事实之间进行检索，获取 Top-K 最相关的语义事实（如“Dining table is near the kitchen”）。</li>
      <li><strong>输出</strong>：提取的关键语义实体特征向量和检索到的 Top-K 语义事实特征向量。</li>
      <li><strong>设计动机</strong>：为了桥接 MLLM 与下游导航动作决策之间的语境鸿沟，将大模型作为“高级规划器与常识检索器”，用自然语言描述辅助多模态对齐。</li>
    </ul>
  </li>
  <li><strong>分层历史智能体 (Hierarchical History Agent)</strong>
    <ul>
      <li><strong>输入</strong>：当前时刻的图拓扑结构、历史遍历节点的局部场景描述以及图像的 CLIP 特征。</li>
      <li><strong>处理</strong>：维护两层分层结构：一是<strong>视角层（Viewpoint Hierarchy）</strong>，利用 LLaVA 针对每一个新访问的观测点生成包含位置类型、显著视觉特征和连通区域关系的三元组描述；为了避免徘徊往复运动引起记忆爆炸，仅在智能体前进到新观测点时追加新节点。二是<strong>路径层（Path Hierarchy）</strong>，按时间轴级联已访问视角的描述，利用 MLLM 进行全局路径的语义增强。</li>
      <li><strong>输出</strong>：分层历史特征向量 $H_{hist}$ 及拓扑节点的连接描述。</li>
      <li><strong>设计动机</strong>：克服了传统图神经网络在长距离依赖 and 长程回溯时因缺乏高层时序语义而迷失的缺点。</li>
    </ul>
  </li>
  <li><strong>历史增强模块 (History Enhancement Module, HEM)</strong>
    <ul>
      <li><strong>输入</strong>：未增强的局部节点特征向量 $V_t$、候选节点特征向量 $v_i$ 以及情景记忆中检索出的相关记忆向量 $m_s$。</li>
      <li><strong>处理</strong>：首先通过 MLP 对节点特征与记忆特征进行非线性融合：
\(\tilde{V}_t = \text{MLP}([V_t; m_s]), \quad \tilde{v}_i = \text{MLP}([v_i; m_s])\)
随后通过图注意力网络（Graph-Aware Transformer, GAT）建立全局依赖关系。GAT 内部包含交叉注意力层（用于建模节点特征关系）和自注意力层（用于编码拓扑布局），计算公式为：
\(\tilde{h}'_t = \text{GAT}(\tilde{h}_t) = \text{softmax}\left(\frac{(\tilde{h}_t W_q)(\tilde{h}_t W_k)^T}{\sqrt{d}} + M\right)\tilde{h}_t W_v\)
其中偏置矩阵 $M = D W_a + b_d$ 用于整合拓扑距离图，限制不可达节点间的影响。</li>
      <li><strong>输出</strong>：增强后的全局历史轨迹特征表示 \(\tilde{H}_t = \{\tilde{h}'_1, \tilde{h}'_2, \dots, \tilde{h}'_{t-1}\}\)。</li>
      <li><strong>设计动机</strong>：使历史表征既富有时序和语义信息，又兼备精确的几何结构约束，从而提升回溯决策的准确性。</li>
    </ul>
  </li>
  <li><strong>多模态融合与动作预测模块</strong>
    <ul>
      <li>该模块包含<strong>指令引导特征融合 (IGFF)</strong> 和 <strong>知识感知视觉语义交互器 (KVSI)</strong> 两个子部分。</li>
      <li><strong>IGFF 模块</strong>：提取指令 <code class="language-plaintext highlighter-rouge">[CLS]</code> Token 的全局语义特征，通过交叉注意力计算各视觉区域特征 $o_i$ 的响应权重，使智能体聚焦在指令相关的地标上：
\(\eta_i = \text{softmax}\left(\frac{o_i W_q \hat{W}_0^T}{\sqrt{d}}\right), \quad \bar{o}_i = \eta_i o_i\)</li>
      <li><strong>KVSI 模块</strong>：融合视觉与知识特征。首先通过交叉注意力计算视觉查询与知识键之间的对齐分数 $a_{ij}$，并得到融合语义知识的局部特征：
\(a_{ij} = \text{softmax}\left(\frac{Q K^T}{\sqrt{d}}\right), \quad o'_i = \sum_{j} a_{ij} \cdot V_j\)
此后通过自注意力精炼空间关系，并引入自适应视角加权机制（Adaptive View Weighting），结合历史语境为各候选视角计算重要性得分，最终通过 Softmax 归一化计算出加权后的上下文表征。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/CA-VLN-multimodal-fusion.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1113/1008" />
<figcaption>多模态融合与动作预测：结合 KVSI 与 IGFF 机制，分别利用语义、历史和局部候选视角进行全局与局部预测</figcaption>
</div>

<h4 id="-端到端数据流">③ 端到端数据流</h4>
<p>在每一个决策步骤 $t$：</p>
<ol>
  <li>智能体从当前环境获取全景视觉观测 $O_t$。</li>
  <li>知识推理智能体结合当前指令与多模态模型在线生成的描述，检索出 Top-K 的语义事实知识 $K_{emb}$。</li>
  <li>分层历史智能体更新图拓扑结构并利用 HEM 得到增强后的全局轨迹特征 \(\tilde{H}_t\)。</li>
  <li>将提取的视觉特征、知识特征、指令特征和实体特征分别输入多模态融合模块，通过 KVSI 进行知识-视觉对齐，通过 IGFF 进行指令-视觉对齐，得到精炼的局部候选特征表示。</li>
  <li>全局动作预测分支利用图注意力对全局拓扑图和指令交叉建模输出全局候选得分，局部动作预测分支则针对当前节点的相邻导航候选进行局部打分。</li>
  <li>二者经过自适应加权融合，利用 Softmax 决策出概率最大的下一步动作（执行移动或停止），并更新下一时刻的历史和拓扑。</li>
</ol>

<h4 id="-训练目标--损失函数-2">④ 训练目标 / 损失函数</h4>
<p>模型采用两阶段微调。首先采用 LoRA 对 LLaVA-7B 进行指令微调，将可训练参数限制在 10M 以内，优化其生成 stepwise 指令与分层历史描述的能力。随后冻结智能体，联合微调融合与动作预测模块。动作预测分支使用行为克隆（Imitation Learning）与强化学习的混合损失进行优化。</p>

<h3 id="3-核心结果发现-20">3. 核心结果/发现</h3>
<hr />
<ul>
  <li><strong>R2R 数据集表现</strong>：在 unseen validation 集合上，CA-VLN 达到了 <strong>73.31%</strong> 的 Success Rate (SR)（相比基线 DUET 提升了 <strong>+1.79%</strong>）和 <strong>61.95%</strong> 的 SPL（提升 <strong>+1.53%</strong>）；在 unseen test 集合上，SR 达到 <strong>70.27%</strong>，SPL 达到 <strong>60.31%</strong>，超越了 HAMT 和 KERM 等 SOTA 方法。</li>
  <li><strong>REVERIE 与 SOON 表现</strong>：在包含丰富物体定位要求的 REVERIE 数据集上，未见场景下的 SR 达到 <strong>50.99%</strong>，物体定位指标 RGSR 提升了 <strong>+2.85%</strong>；在路径更长、空间结构更复杂的 SOON 数据集上，unseen validation 上的 SR 达到 <strong>37.32%</strong>（+1.02%），表明分层历史与知识增强对于大范围探索有明显增益。</li>
  <li><strong>消融实验与超参分析</strong>：分层历史、实体引导、大模型逐步指令等均提供了正向增益。对于 Top-K 的敏感度分析表明，知识检索的 Top-K 设定在 3 至 5 之间为最佳，过高（Top-K &gt; 5）会因引入冗余或幻觉信息导致性能骤降。</li>
</ul>

<h3 id="4-局限性-20">4. 局限性</h3>
<hr />
<ul>
  <li><strong>视觉稀疏场景敏感</strong>：在缺乏显著地标和物体纹理的视觉极简场景下，知识推理智能体由于无法捕捉丰富的实体属性，对导航指令的语义增强效果会有所下降。</li>
  <li><strong>计算与推理延迟</strong>：由于引入了在线 MLLM 的文本描述检索和图注意力计算，每步导航决策的推理耗时相比 baseline 增加了约 <strong>15%</strong>（但更优的路径规划即更高的 SPL 减少了总导航步数，在总耗时上提供了部分补偿）。</li>
</ul>

<hr />

<h2 id="rynnbrain">35. RynnBrain (2026)</h2>
<p>———Open Spatiotemporal Foundation Model for Embodied Intelligence</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2602.14979">arXiv:2602.14979</a></p>

<h3 id="精华-23">精华</h3>

<p>RynnBrain 最值得借鉴的核心思想包括：<strong>统一输出空间设计</strong>——将 bounding box、轨迹点、区域点等空间量编码为离散 coordinate token，与语言 token 共享同一 autoregressive 解码器，优雅地将定位任务转化为分类问题；<strong>Chain-of-Point (CoP) 推理</strong>——在文本推理链中交替插入显式空间定位步骤，使推理过程”扎根”于物理环境，避免幻觉；<strong>层级式 Plan-VLA 架构</strong>——高层 RynnBrain-Plan 生成带精确坐标的子任务计划，低层 RynnBrain-VLA 执行动作，两者分工明确；<strong>人模协作数据飞轮</strong>——仅在关键节点引入人工标注，结合模型辅助生成，以有限预算构建出 2000 万样本的高质量语料；<strong>多维度 Spatio-temporal Memory</strong>——将图像和视频统一为帧序列，用 temporal positional embedding 编码时序信息，赋予模型跨帧的全局空间感知能力。</p>

<hr />

<h3 id="1-研究背景问题-22">1. 研究背景/问题</h3>

<p>当前多模态基础模型在具身智能场景中存在三大缺口：自我中心认知范围狭窄（通常仅覆盖有限任务类别）；空间推理局限于静态图像、缺乏时序一致的 spatio-temporal 表征；高层规划停留在纯文本空间、与物理约束脱节导致幻觉和执行失败。现有具身模型与通用 VLM 各有偏废，尚无统一框架同时具备宽泛语义泛化与精确物理定位能力。</p>

<hr />

<h3 id="2-主要方法创新点-20">2. 主要方法/创新点</h3>

<p><strong>RynnBrain</strong> 是阿里巴巴 DAMO Academy 提出的开源具身基础模型系列，基于 Qwen3-VL 构建，强化四大核心能力：</p>

<p><strong>① 综合自我中心理解 (Egocentric Cognition)</strong>
涵盖物体理解、空间理解、计数、OCR、自我中心任务问答等，新增细粒度视频理解能力。</p>

<p><strong>② 多样化时空定位 (Spatio-temporal Localization)</strong>
输出涵盖 Object Location（bounding box）、Area Location（区域点集）、Affordance Location（可交互热点）、Trajectory Location（最多 10 个轨迹航点）、Grasp Pose（4 角点抓取矩形），所有坐标归一化到 [0, 1000] 编码为整数 token。</p>

<div align="center">
  <img src="/images/vlm/RynnBrain-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1326/1507" />
  <figcaption>RynnBrain 能力概览：自我中心认知、时空定位、物理推理、规划</figcaption>
</div>

<div align="center">
  <img src="/images/vlm/RynnBrain-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/854" />
  <figcaption>RynnBrain 整体架构：共享 Dense/MoE Decoder 统一输出文本、区域、轨迹和指向信号</figcaption>
</div>

<p><strong>③ 物理扎根推理 (Chain-of-Point Reasoning)</strong>
RynnBrain-CoP 在推理链中交替生成文本步骤与空间定位 token，将抽象推理锚定到可观测的物理证据。训练数据由 Qwen3-VL-235B 生成初始推理链，再经人工标注关键帧精确空间实体。</p>

<p><strong>④ 物理感知规划 (Physics-aware Planning)</strong>
RynnBrain-Plan 输出的子任务计划直接嵌入 affordance/区域坐标，供下游 RynnBrain-VLA 执行；使用多轮对话数据微调，维持任务执行中的历史状态一致性。</p>

<p><strong>模型规模</strong>：提供 RynnBrain-2B、8B（Dense）和 30B-A3B（MoE）三个尺度，预训练语料约 <strong>2000 万样本</strong>，涵盖 General MLLM、Cognition、Localization、Planning 四大类别。</p>

<p><strong>训练优化</strong>：在线负载均衡流水线（按序列长度动态分配 DP worker），per-sample loss reduction 消除全局 token 计数同步开销，训练效率提升 2×。</p>

<div align="center">
  <img src="/images/vlm/RynnBrain-nav-ablation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/385" />
  <figcaption>不同模型规模下 RynnBrain-Nav vs Qwen3-VL-Nav 导航性能对比</figcaption>
</div>

<div align="center">
  <img src="/images/vlm/RynnBrain-plan-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1326/563" />
  <figcaption>RynnBrain-Plan 在多任务、多难度下的规划结果对比</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-21">3. 核心结果/发现</h3>

<ul>
  <li><strong>VLN 导航</strong>：RynnBrain-Nav-8B 在 R2R-CE 上 SR 58.6%、NE 4.92，RxR-CE 上 SR 56.1%、NE 6.20，在 R2R 和 RxR 上全面超越同尺度 Qwen3-VL 基线；2B 模型相比 Qwen3-VL-2B 提升 7.2% SR / 7.6% SPL；DAgger 迭代训练将 SR 从 50.6% 提升至 58.5%。</li>
  <li><strong>操作规划</strong>：RynnBrain-Plan-30B 在 OOD 任务 <em>Table Bussing</em> Hard 难度达到近 100% Task Progress，而 Qwen3-VL 30B &lt; 10%、Gemini-3 Pro ~60%；多轮对话微调相比单轮基线在 Hard 任务提升显著（单轮几乎为 0）。</li>
  <li><strong>VLA 抓取</strong>：RynnBrain-VLA 整体 SR 为 <strong>0.77</strong>，超越 π₀.₅（0.47）和 Qwen3-VL-Finetuned（0.60）；RSR 0.97，体现出强的目标识别精度。</li>
  <li><strong>综合评测</strong>：在 28 个基准（20 个具身 + 8 个通用视觉理解）上，RynnBrain 全面超越现有开源具身基础模型，同时保留竞争力的通用 VLM 能力。</li>
</ul>

<hr />

<h3 id="4-局限性-21">4. 局限性</h3>

<p>MoE 架构（30B-A3B）在 VLN 任务上未能超越 8B Dense 模型，稀疏激活机制在此类任务中的潜力尚未充分释放，需要进一步探索专门的训练策略；DAgger 迭代在第 3 轮后呈现明显收益递减，导航策略收敛后的持续提升路径有待研究。</p>

<hr />

<h2 id="omninav">36. OmniNav (2026)</h2>
<p>———用快慢双系统统一点目标、物体目标、指令目标导航与前沿探索</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2509.25687">arXiv:2509.25687</a> · 🏛️ <strong>ICLR 2026 (Poster)</strong></p>

<h3 id="精华-24">精华</h3>

<ul>
  <li>导航任务的瓶颈往往不在策略学习本身，而在于对通用指令和开放词汇物体的理解能力，这一发现指导了训练数据设计而非单纯堆叠导航算法。</li>
  <li>用”快系统（连续路标点 + flow-matching）+ 慢系统（前沿探索 + 视觉记忆 + CoT 推理）”的双系统架构，把局部高频控制和全局长程规划解耦，二者通过 KV 缓存共享的中心记忆耦合。</li>
  <li>用流匹配（flow matching）生成连续坐标路标点而非离散动作 token，避免了离散化带来的精度损失和误差累积，同时支持 5Hz 实时闭环控制。</li>
  <li>把图像描述、OCR、grounding/referring 等通用视觉语言数据和导航数据联合训练，能显著提升指令理解和开放词汇物体识别能力，进而提升导航成功率——通用数据对导航任务的收益甚至超过任务本身数据。</li>
  <li>前沿（frontier）+ 历史图像记忆的轻量记忆机制，比场景图或语义地图等复杂记忆结构更易实现，同样能支撑语义感知的探索决策。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-23">1. 研究背景/问题</h3>

<p>具身导航研究长期分裂为点目标、指令目标、物体目标三种范式，各自依赖任务定制数据，难以互相迁移；现有 VLM/VLA 方法普遍存在离散动作建模精度不足、长上下文管理困难、推理延迟高的问题，且实践中失败的主要原因往往是模型对通用指令和开放词汇物体理解不足，而非导航策略学习本身的缺陷。</p>

<hr />

<h3 id="2-主要方法创新点-21">2. 主要方法/创新点</h3>

<p>OmniNav 整体由两个互补的子系统（快系统与慢系统）构成。<strong>快系统</strong>（System-1）负责基于短时视觉上下文和当前子任务，高频直接生成连续的三维路标点，用于局部敏捷控制；<strong>慢系统</strong>（System-2）负责基于全局探索地图（前沿点）和长时记忆进行审慎规划，做出高层探索决策。两者复用同一个微调后的多模态大模型（VLM）权重，但通过不同的前向和解码路径进行耦合，实现了“脑眼手协同”。</p>

<h4 id="21-架构总览与工作流">2.1 架构总览与工作流</h4>

<p>OmniNav 包含三条推理管线（R2R/RxR 快系统、OVON 纯快系统、OVON 慢-快协同系统），其架构总览及闭环数据流如下：</p>

<pre><code class="language-mermaid">flowchart TD
    CORE["改造版 Qwen2.5-VL-3B（核心策略）&lt;br/&gt;ViT视觉编码器 + Qwen2 LLM&lt;br/&gt;+ 航点头/到达头/角度头（query交叉注意）"]

    subgraph TRAIN["训练 (ms-swift 全参微调)"]
        T1["train_code: swift sft&lt;br/&gt;L1航点 + BCE到达 + 余弦角度"]
    end

    T1 --&gt;|"输出 checkpoint"| CORE

    CORE --&gt;|"推理 (torch.no_grad 闭环)"| P1
    CORE --&gt;|"推理"| P2
    CORE --&gt;|"推理"| P3

    subgraph PIPE["三条推理管线"]
        P1["① R2R / RxR&lt;br/&gt;快系统(视觉) waypoint_agent"]
        P2["② OVON&lt;br/&gt;快系统(视觉) waypoint_agent_ovon"]
        P3["③ OVON 慢-快协同&lt;br/&gt;慢系统(VLM前沿决策)+快系统(A*/航点)"]
    end

    P1 --&gt; SIM
    P2 --&gt; SIM
    P3 --&gt; SIM

    SIM["Habitat-Sim 仿真器（闭环执行）&lt;br/&gt;观测(RGB三目/pose) → 模型 → 动作(航点/STOP) → 环境"]
    SIM --&gt;|"观测反馈"| CORE
</code></pre>

<div align="center">
  <img src="/images/vln/OmniNav-architecture-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/850" />
<figcaption>OmniNav 整体架构图：统一多模态分词输入 VLM 主干，快系统输出低层路标点序列，慢系统通过全局规划与局部路径规划两阶段循环生成子目标。</figcaption>
</div>

<h4 id="22-快系统fast-thinking-system端到端高频动作回归">2.2 快系统（Fast Thinking System）：端到端高频动作回归</h4>

<p>快系统是一个<strong>纯视觉端到端</strong>的导航策略，其核心是对 Qwen2.5-VL-3B-Instruct 进行结构改造，在自回归语言模型主干后加挂了定制的<strong>航点回归头</strong>。其前向传播绕过了普通的语言生成 <code class="language-plaintext highlighter-rouge">lm_head</code>，直接回归输出物理空间的坐标和标志：</p>

<ol>
  <li><strong>输入表示与特征提取</strong>：
    <ul>
      <li><strong>当前三目观测</strong>：机器人当前的左、前、右三个方向的 RGB 图像（例如大小为 <code class="language-plaintext highlighter-rouge">[640, 569, 3]</code>），由 ViT 视觉编码器提取特征，通过 <code class="language-plaintext highlighter-rouge">smart_resize</code> 后每帧图像提取约 460 个 Token 的视觉表征。</li>
      <li><strong>低分辨率历史帧</strong>：为了在保留历史上下文的同时控制计算量，仅保留前向相机的历史帧（最大 20 帧，环形采样），并降采样至原分辨率的 1/4，经 ViT 提取后每帧约为 30 个 Token。</li>
      <li><strong>提示词与 NAV 特殊 Token</strong>：序列以特殊的动作标记 <code class="language-plaintext highlighter-rouge">&lt;|NAV|&gt;</code> 结尾，以指示网络跳过生成头进入动作回归头。</li>
    </ul>
  </li>
  <li><strong>航点预测头 (Action Former)</strong>：
    <ul>
      <li>提取 Qwen2 LLM 的输出特征 <code class="language-plaintext highlighter-rouge">hidden_states</code>（维度为 <code class="language-plaintext highlighter-rouge">[B, L, 2048]</code>，其中 2048 是 3B 模型的隐藏维度）。</li>
      <li>使用一个可学习的 <code class="language-plaintext highlighter-rouge">query_action</code> 参数（维度为 <code class="language-plaintext highlighter-rouge">[1, 1, 2048]</code>），通过 4 头交叉注意力机制（Multihead Cross-Attention），以 query 为 <code class="language-plaintext highlighter-rouge">query_action</code>，以 key/value 为 <code class="language-plaintext highlighter-rouge">hidden_states</code> 进行全局特征聚合，得到动作特征 <code class="language-plaintext highlighter-rouge">action_feature</code>（维度为 <code class="language-plaintext highlighter-rouge">[B, 2048]</code>）。</li>
      <li><strong>航点回归</strong>：通过一个线性层预测未来 5 个路标点的相对位移增量，并在时间轴上累加（<code class="language-plaintext highlighter-rouge">cumsum</code>），最后乘上缩放系数 0.3 还原为以米为单位的局部位移 <code class="language-plaintext highlighter-rouge">(x, y)</code>。</li>
      <li><strong>角度预测</strong>：通过另一个独立的线性层结合 <code class="language-plaintext highlighter-rouge">tanh</code> 激活函数，预测未来 5 个路标点的朝向角正弦与余弦值 <code class="language-plaintext highlighter-rouge">(sinθ, cosθ)</code>，通过 <code class="language-plaintext highlighter-rouge">atan2</code> 转化为实际偏航角。</li>
      <li><strong>到达预测</strong>：通过第三个线性层预测未来 5 个位置的到达概率（Logits）。只有当 5 个路标点的到达 Logits 均大于等于 0 时，才判定为已到达终端并下发 <code class="language-plaintext highlighter-rouge">STOP</code> 动作；否则以第一个路标点 <code class="language-plaintext highlighter-rouge">(x, y)</code> 对应的极坐标 <code class="language-plaintext highlighter-rouge">(r, θ)</code> 下发移动控制指令。</li>
    </ul>
  </li>
</ol>

<pre><code class="language-mermaid">flowchart TD
    OBS["仿真器观测&lt;br/&gt;三目RGB left/front/right + pose"]
    M1["1. add_frame 历史帧管理&lt;br/&gt;(≤20历史帧, 1/4降采样)"]
    M2["2. 构建prompt + NAV特殊token"]
    M3["3. Qwen2.5-VL.forward(航点头)"]
    M4["4. 输出 5航点 + 5到达 + sin/cos"]
    D{"5个到达logit全 ≥0 ?"}
    STOP["STOP"]
    GO["GO_TOWARD_POINT(r=‖wp0‖, θ=atan2)"]
    STEP["env.step(action)"]

    OBS --&gt; M1 --&gt; M2 --&gt; M3 --&gt; M4 --&gt; D
    D --&gt;|"是"| STOP
    D --&gt;|"否"| GO
    STOP --&gt; STEP
    GO --&gt; STEP
    STEP --&gt;|"下一步观测"| OBS
</code></pre>

<h4 id="23-慢系统slow-thinking-system基于前沿与-cot-的审慎决策">2.3 慢系统（Slow Thinking System）：基于前沿与 CoT 的审慎决策</h4>

<p>慢系统负责长程探索规划。在诸如 ObjectNav 等探索任务中，机器人需要自主决定“去哪探索”。慢系统主要依赖普通的<strong>文本自回归生成</strong>（使用 <code class="language-plaintext highlighter-rouge">Qwen2.5-VL.generate</code> 分支，与快系统共享权重）：</p>

<ol>
  <li><strong>工作原理</strong>：
    <ul>
      <li>机器人原地旋转 360 度，拼合出 4 张全景图像，并利用 LiDAR 或深度数据更新一个简易的 3D 占据地图（Occupancy Grid Map）。</li>
      <li>利用“战争迷雾”（Fog of War）机制检测出当前地图边缘的所有可探索前沿点（Frontier Points）。</li>
      <li>将这 4 张全景图、机器人当前位姿、以及所有候选前沿点的相对坐标以<strong>纯文本</strong>形式拼入 Prompt，要求模型推理出目标的当前可见性并选择探索价值最高的前沿坐标。</li>
      <li><strong>CoT 推理</strong>：模型首先输出一段思维链（例如分析历史帧中的语义线索：“浴帘通常在浴室，刚经过了走廊，所以我应该朝…前沿探索”），最后输出选定的相对坐标 <code class="language-plaintext highlighter-rouge">[x, z]</code>，或在看到目标时输出 <code class="language-plaintext highlighter-rouge">found</code>。</li>
    </ul>
  </li>
  <li><strong>慢-快协同闭环</strong>：
    <ul>
      <li>慢系统定位高层前沿目标后，将坐标下发给快系统。</li>
      <li>快系统作为低层执行器（“司机”），可以调用快系统航点预测策略，或者调用经典的 A* 测地路径跟随器（Geodesic Follower）把机器人带到选定的前沿点。</li>
      <li>到达前沿点后，重新触发原地扫描和慢系统决策，循环往复。</li>
    </ul>
  </li>
</ol>

<pre><code class="language-mermaid">flowchart TD
    START(["外层探索循环 total_steps &lt; 4000"])
    SPIN["原地旋转扫描 12×turn_left&lt;br/&gt;采集360°全景 → 存入Bank"]
    FRONT["前沿检测&lt;br/&gt;fog-of-war揭示 + detect_frontier"]
    VLM["慢系统VLM决策 getresult()&lt;br/&gt;4全景图 + 前沿坐标 → 目标 + found?"]
    EXEC["快系统执行&lt;br/&gt;A*测地跟随 或 航点模型 → 走向目标"]
    DEC{"is_final_decision (found) ?"}
    MARK["标记已访问前沿"]
    FIN["结束本episode"]

    START --&gt; SPIN --&gt; FRONT --&gt; VLM --&gt; EXEC --&gt; DEC
    DEC --&gt;|"是"| FIN
    DEC --&gt;|"否"| MARK --&gt; SPIN
</code></pre>

<div align="center">
  <img src="/images/vln/OmniNav-slow-system-reasoning.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/748" />
<figcaption>慢系统针对"寻找浴缸"任务的链式思维推理示例：模型逐步分析历史帧语义线索，对比多个候选前沿点的探索价值，迭代生成下一子目标坐标，直至定位到目标物体。</figcaption>
</div>

<h4 id="24-快系统与慢系统的核心对比">2.4 快系统与慢系统的核心对比</h4>

<p>下表总结了快慢双系统在推理配置上的本质区别：</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>慢系统（System-2 语义决策）</th>
      <th>快系统（System-1 动作执行）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>核心职责</strong></td>
      <td>动脑思考“去哪儿探索”（语义决策）</td>
      <td>手脚控制“怎么走过去”（低层执行）</td>
    </tr>
    <tr>
      <td><strong>主要输入</strong></td>
      <td>4 张 360° 全景图 + 前沿点坐标（文本）+ 目标</td>
      <td>短时历史帧 + 当前三目图像 + 特殊动作 Token</td>
    </tr>
    <tr>
      <td><strong>解码方式</strong></td>
      <td><code class="language-plaintext highlighter-rouge">generate</code> 离散文本自回归生成</td>
      <td>绕过 <code class="language-plaintext highlighter-rouge">lm_head</code>，通过动作查询头进行<strong>直接连续回归</strong></td>
    </tr>
    <tr>
      <td><strong>输出形式</strong></td>
      <td>CoT 推理文本与前沿坐标，看到物体时输出 <code class="language-plaintext highlighter-rouge">found</code></td>
      <td>5 个路标点坐标 <code class="language-plaintext highlighter-rouge">(x, y)</code> + <code class="language-plaintext highlighter-rouge">(sinθ, cosθ)</code> + 到达 Logits</td>
    </tr>
    <tr>
      <td><strong>调用频率</strong></td>
      <td>低频（通常在转弯、到达前沿或每 N 步决策时触发）</td>
      <td>高频（在 Habitat 中闭环以最高 5Hz 频率执行）</td>
    </tr>
  </tbody>
</table>

<h4 id="25-数据构成与两阶段训练">2.5 数据构成与两阶段训练</h4>

<ol>
  <li><strong>混合数据集（9.2M+）</strong>：
    <ul>
      <li>导航任务数据（4M）：包含指令跟随（VLN-CE）、前沿探索等多任务数据。</li>
      <li>视觉-语言通用数据（5.2M）：包含图表、OCR、VQA、Referring &amp; Grounding 等通用数据。实验表明，大模型强大的通用常识推理和 Referring 能力对于解决“开放词汇物体导航”的成功至关重要。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/OmniNav-data-composition.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1309/885" />
<figcaption>训练数据构成总览：导航任务数据（物体/点/指令目标与前沿探索）、Embodied QA、通用 MLLM 数据与 grounding/referring 数据四大类。</figcaption>
</div>

<ol>
  <li><strong>两阶段训练流程</strong>：
    <ul>
      <li><strong>Stage 1 (离散对齐)</strong>：使用自回归语言建模目标（Autoregressive CE Loss）训练全连接层和主干，对齐语言、视觉与动作空间，使其初步理解指令和场景。</li>
      <li><strong>Stage 2 (连续回归微调)</strong>：在共享的 VLM 主干上接入 <code class="language-plaintext highlighter-rouge">action_former</code> 交叉注意力回归头。使用 L1 航点回归损失、余弦角度回归损失和 BCE 到达分类损失进行联合优化，同时<strong>混入 20% 的 Stage 1 离散文本数据</strong>以防止微调破坏 VLM 的基座常识和语义理解能力。</li>
    </ul>
  </li>
</ol>

<p><strong>⑤ 推理流程</strong>：在慢-快协同推理中，慢系统利用前沿或记忆生成高层子目标后，快系统接管并持续生成低层路标点序列逐步逼近目标；若直线路径被障碍物阻挡，快系统会依据实时视觉线索绕行调整，体现其并非单纯的预设坐标跟随器。</p>

<hr />

<h3 id="3-核心结果发现-22">3. 核心结果/发现</h3>

<ul>
  <li><strong>指令目标导航</strong>（R2R-CE / RxR-CE Val-Unseen）：仅用快系统和纯 RGB 输入即取得 SOTA，成功率分别比此前最优方法提升 4.4% 和 4.3%（SR 69.5% / 62.0% SPL）。</li>
  <li><strong>物体目标导航</strong>（HM3D-OVON）：纯视觉输入下已超越此前最优方法 2.7%；加入慢系统（前沿推理 + CoT）后整体性能超过此前最强方法 18.4%（Val-Unseen SR 59.2%，SPL 33.2%）。</li>
  <li><strong>点目标导航</strong>（CityWalker 基准，开放集 MAOE 指标）：OmniNav 11.53% 优于 CityWalker 的 15.23%。</li>
  <li><strong>消融研究</strong>：策略头（连续路标点 vs 离散动作块）、慢系统、通用数据、CoT 四个组件均带来稳定且可叠加的增益，全部启用时性能最佳；其中慢系统在长程探索任务上的提升最大。</li>
  <li><strong>真机部署</strong>：在四足机器人上以云端 RTX 3090 实现 5Hz 以上闸环控制，验证了零样本场景下物体目标、点目标（视觉避障）、指令目标三类任务的有效性。</li>
</ul>

<div align="center">
  <img src="/images/vln/OmniNav-real-world-deployment.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/1078" />
<figcaption>真机四足机器人零样本部署效果：物体目标（找水机/找穿粉色T恤的人/扔垃圾）、点目标视觉避障（避开沙发、椅子腿）与指令目标导航的第三人称视角轨迹。</figcaption>
</div>

<hr />

<h3 id="4-局限性-22">4. 局限性</h3>

<p>完整慢系统的真实物理部署仍需额外工程（如 LiDAR/深度估计的鲁棒实时集成），本文真机实验仅验证了快系统组件；复杂纹理物体（如毛毯、衣物）的识别在任何模型规模下仍不稳定，且模型规模（3B vs 7B）在数据充分时收益趋同，尚未进行系统性的 scaling law 研究。</p>

<hr />

<h2 id="qwen-robotnav">37. Qwen-RobotNav (2026)</h2>
<p>———首个统一的多任务、时空可重构具身导航大模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.18112">arxiv:2606.18112 </a></p>

<h3 id="精华-25">精华</h3>
<ol>
  <li><strong>统一建模</strong>：Qwen-RobotNav 是首个将多任务导航（指令遵循、目标搜索、主动追踪、自动驾驶）统一为参数化观测上下文建模的通用导航底座大模型。</li>
  <li><strong>时空可重构</strong>：提出任务自适应观测编码（Task-Adaptive Observation Encoding），在推理时可通过调节 Token 预算、时间衰减和相机权重动态重新配置时空上下文策略。</li>
  <li><strong>架构零修改</strong>：采用自然语言标签对相机视角与时间戳进行交错标记，并使用具身前缀区分平台角色，无需修改预训练 Qwen3-VL 架构即可跨平台泛化。</li>
  <li><strong>联合训练</strong>：采用 15.6M 规模的混合数据集，将导航轨迹与 15% 的通用及导航特定视觉语言推理数据进行联合训练（Co-training），有效防止模型发生纯动作轨迹映射退化。</li>
  <li><strong>高效协同</strong>：在层次化 Agent 导航中，它与上层规划器通过“单回合证据+跨回合记忆本”的双层记忆机制无缝配合，在 EQA 等长程任务上实现显著的步数精简与 SOTA 表现。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-24">1. 研究背景/问题</h3>
<p>具身智能导航任务（如指令遵循、目标搜索、主动追踪和自动驾驶）多种多样，各自对视觉时空上下文的需求存在本质差异。例如，指令遵循需要长程的全局记忆来重定远期地标，而主动追踪则高度依赖最新几帧的近况画面进行实时反应。现有的统一导航模型大都使用固定的下采样或滑动窗口策略，无法在部署推理时因地制宜地调整，且在大大规模轨迹训练中极易丢失大模型的多模态通用理解与常识，退化为被动作的动作生成器。因此，如何在单一底座模型上暴露一个参数化、可重构的观测编码接口，并构建能与高层 Agent 协同运作的通用导航系统，是目前具身导航领域的核心挑战。</p>

<hr />

<h3 id="2-主要方法创新点-22">2. 主要方法/创新点</h3>

<h4 id="整体框架概述-1">整体框架概述</h4>
<p>Qwen-RobotNav 继承自 Qwen3-VL 多模态大模型，并在其基础上设计了一个极其轻量化的 4 层 MLP 动作预测头。该框架的核心思想是将多任务导航统一建模为回归预测 8 个未来路点的轨迹规划任务。在数据流的输入端，系统暴露出由 Token 预算 $B$、时间衰减系数 $\gamma$ 和相机权重 $w_c$ 组成的参数化接口，用以自适应控制输入图像的分辨率和时空 Token 占比，从而实现无缝的推理期策略重构。</p>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1278/842" />
<figcaption>Figure 1: Qwen-RobotNav 整体模型架构图</figcaption>
</div>

<h4 id="逐模块讲解-1">逐模块讲解</h4>

<h5 id="-参数化观测编码与-token-动态分配">① 参数化观测编码与 Token 动态分配</h5>
<ul>
  <li><strong>输入</strong>：多视角图像序列 $I_{1:T}^{1:N}$（由 $N$ 个相机在 $T$ 个时间步捕获）、Token 预算 $B$、时间衰减因子 $\gamma$、相机权重向量 $w_c$。</li>
  <li><strong>处理</strong>：系统首先根据时间步 $t$ 计算每个保留帧的临时衰减权重：
\(\omega_t = \exp\left(\gamma \cdot \frac{t}{T' - 1}\right)\)
其中 $\gamma=0$ 时退化为均匀分配，$\gamma &gt; 0$ 时权重更偏向最新帧。随后，结合各视角的相机权重（如前向相机 $w_{\text{front}}=2.0$，后向相机 $w_{\text{rear}}=0.5$），生成联合时空权重矩阵 $W[t,c] = \omega_t \cdot w_c$。最后，通过<strong>受限分配算法（CONSTRAINEDALLOC）</strong>，在满足单图 Token 上下限 $[b_{\min}, b_{\max}]$ 约束的前提下，将总 Token 预算 $B$ 分配给对应的画面。这些分配到的 Token 决定了输入图像的像素分辨率，以便使用 dynamic-resolution ViT 进行大小缩放与 patch 合并。</li>
  <li><strong>输出</strong>：经过动态分辨率缩放的图像序列特征 Token。</li>
  <li><strong>设计动机</strong>：实现推理时无需微调即可切换上下文倾向。例如，在局部的反应式追踪中，可以使用大 $\gamma$ 和小预算快速处理最新画面；在全局搜索中，则调小 $\gamma$ 并调大 $B$ 以保留更多的历史帧信息。</li>
</ul>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-observation-encoding.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1282/1008" />
<figcaption>Figure 2: 任务自适应观测编码（Token 分配）可视化</figcaption>
</div>

<h5 id="-时空视图标识与具身提示">② 时空视图标识与具身提示</h5>
<ul>
  <li><strong>输入</strong>：动态分辨率的图像特征 Token、当前自然语言指令、具身提示前缀（如 “Imagine you are a robot…” 或 “Imagine you are a car…“）。</li>
  <li><strong>处理</strong>：系统将自然语言的相机视点标识（如 “Front View”、”Left View”）和时间步头（”Time step t”）直接交错拼插在对应的图像 Token 之前。同时，将具身类型置于 Prompt 的系统前缀中。</li>
  <li><strong>输出</strong>：输入给 Qwen3-VL 语言底座的统一图文交错 Token 序列。</li>
  <li><strong>设计动机</strong>：通过在普通的文本词表中插值时空标识，避免了引入额外的空间/时间位置编码层，最大程度保留了预训练大模型的语言 grounding 和空间推理能力，从而能够零样本支持新型机器人底盘或传感器配置。</li>
</ul>

<h5 id="-动作规划头与轨迹规划">③ 动作规划头与轨迹规划</h5>
<ul>
  <li><strong>输入</strong>：Qwen3-VL 在对应路点特征上的最后隐藏层状态 $E_A \in \mathbb{R}^d$。</li>
  <li><strong>处理</strong>：隐藏状态通过一个 4 层的高维 MLP（隐藏单元 512，使用 GELU 激活函数），在训练时使用每个数据集的第 99 百分位数作为尺度因子将真实路点坐标归一化到 $[-1, 1]$ 之间进行回归。</li>
  <li><strong>输出</strong>：$K=8$ 个带有航向角的未来 2D 轨迹路点 \(W = \{(x_k, y_k, \theta_k)\}_{k=1}^8\)。</li>
  <li><strong>设计动机</strong>：动作头被设计得尽可能轻量，确保几乎所有的时空建模与常识推理都在大语言底座内部进行，从而保证强大的跨场景泛化能力。</li>
</ul>

<h4 id="端到端数据流与-agent-协作">端到端数据流与 Agent 协作</h4>
<p>当部署在多任务长程场景（如 EQA）中时，系统由上层规划器（如 Qwen3.6-Plus）和底层的 Qwen-RobotNav 共同构成。上层规划器根据全局目标进行高层推理与拆解，下发包含具体任务模式 $\tau_i$ 和观测参数 $\Phi_i$（如 $B$, $\gamma$）的导航 Tool 调用。Qwen-RobotNav 作为高频执行器输出轨迹并执行。每次执行完毕，<strong>导航 Harness</strong> 会自动将执行过程提炼为 compact 的<strong>轨迹证据（Trajectory Evidence）</strong>（记录关键的 landmark 和目标状态），并用来更新全局的<strong>证据笔记本（Evidence Notebook）</strong>。该机制实现了层次化的端到端闭环控制，成功避免了将 dense 视频流反复塞入大模型导致的上下文爆炸。</p>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-agentic-navigation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/807" />
<figcaption>Figure 3: Qwen-RobotNav 与上层 Agent 层次化协作流程</figcaption>
</div>

<h4 id="训练策略与联合训练">训练策略与联合训练</h4>
<p>联合优化的损失函数定义为：
\(L = L_{\text{traj}} + \lambda L_{\text{VL}}\)
其中 $L_{\text{traj}}$ 为预测轨迹相对于 ground-truth 的 MSE 损失；$L_{\text{VL}}$ 是基于 vision-language samples 的自回归 Next-Token 交叉熵损失，用于防止大模型的语言理解与开世界视觉感知能力在纯轨迹微调中发生退化崩溃。在训练过程中，所有观测配置（$B$, $\gamma$, $w_c$, $b_{\min}$, $b_{\max}$）在每个 batch step 均会被进行<strong>独立随机采样</strong>，使模型自然适应任何推理时的配置变化。</p>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-multi-perspective-reasoning.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1290/1808" />
<figcaption>Figure 4: 训练中的结构化多视角推理链可视化</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-23">3. 核心结果/发现</h3>

<h4 id="实验基准概览">实验基准概览</h4>
<p>Qwen-RobotNav-4B 和 8B 在多项基准测试中均展现出了 state-of-the-art（SOTA）的水平，覆盖了指令遵循、目标探索、主动追踪、自动驾驶等多个维度。</p>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-benchmark-summary.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1286/816" />
<figcaption>Figure 5: Qwen-RobotNav 在各具身智能导航与驾驶基准上的 SOTA 汇总</figcaption>
</div>

<ul>
  <li><strong>指令遵循 (VLN-CE)</strong>：
在 R2R 基准上，Qwen-RobotNav-8B 达到 72.1% 的成功率（SR）和 66.6% 的 SPL；在长程的 RxR 基准上达到 76.5% 的 SR，超出强基线 NavFoM达 12.1% SR。在仅有单前向相机的 monocular 设定下，依然在 R2R 取得 66.9% SR，RxR 取得 73.4% SR，超越了专业的单目模型。</li>
  <li><strong>主动追踪 (EVT-Bench)</strong>：
在 EVT-Bench 单目标追踪任务中，Qwen-RobotNav 取得了 <strong>90.0% 的追踪率（TR）</strong>，是通用大模型及专用追踪模型（如 TrackVLA++）中的最高值，且碰撞率仅为 5.70%。</li>
  <li><strong>自动驾驶 (NAVSIM &amp; AlpaSim)</strong>：
在 NAVSIM 基准上，引入前三帧的历史自我状态（Ego-Status）后，Qwen-RobotNav-4B 取得了 <strong>91.4 PDMS（PDM Score）</strong>，NC（导航合规率）高达 99.8%，超越了 WoTE、LAW 等专用多模态驾驶模型。此外，模型在 AlpaSim 上展现了出色的零样本跨领域闭环控制泛化能力。</li>
  <li><strong>具身问答 (EQA)</strong>：
在与 Qwen3.6-Plus Agent 架构协同测试中，该系统在 HM-EQA 取得 76.7% SR，MT-EQA 取得 54.4% SR，而在导航所需的折算等效步数（Steps）上，比此前的 SOTA 方法（如 FAST-EQA）<strong>精简了 77%</strong>。</li>
</ul>

<h4 id="数据规模与接口控制消融">数据规模与接口控制消融</h4>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-data-scaling.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1282/839" />
<figcaption>Figure 6: 数据规模扩展曲线（指令遵循、目标搜索、主动追踪、自动驾驶）</figcaption>
</div>

<ul>
  <li><strong>数据量消融</strong>：将导航轨迹数据占比从 12.5% 扩展到 100% 后，指令遵循（RxR）与自动驾驶（NAVSIM）的表现提升尤为显著，而短程追踪任务则在较少的数据下即快速饱和。</li>
  <li><strong>控制参数消融</strong>：
    <ul>
      <li><strong>Token 预算 $B$</strong>：预算从 2048 提升到 4608 时，R2R 的 SR 从 70.8% 攀升至 74.6%，但超过 3584 后 OSR 指标表现出边际效应递减，说明过量多余视觉特征可能引入负面噪声。</li>
      <li><strong>衰减系数 $\gamma$</strong>：$\gamma$ 从 0.5 提升到 3.5 的扫参中，SR 指标在 $\gamma=3.0$ 时达到峰值（72.5%），显示了对于局部导航，强化最新帧权重的 Recency Bias 非常重要，但过大的衰减会导致历史丢失，从而略微损害整体路径规划的高效性。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/Qwen-RobotNav-ablation-budget-decay.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1281/625" />
<figcaption>Figure 7: 针对 Token 预算 B 和衰减系数 gamma 的扫参消融图</figcaption>
</div>

<h4 id="真实世界机器人部署">真实世界机器人部署</h4>
<p>Qwen-RobotNav 部署在宇树 Unitree Go2 四足机器人以及移动底座上，在从未见过的展厅、复杂公寓等真实场景中展示了非凡的零样本落地能力。</p>

<div align="carousel">
  <div align="center">
    <img src="/images/vln/Qwen-RobotNav-realworld-vln.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/1705" />
    <figcaption>Figure 8: 真实世界展厅中的长程指令遵循与精准倒退倒车行为</figcaption>
  </div>
  <!-- slide -->
  <div align="center">
    <img src="/images/vln/Qwen-RobotNav-indoor-verbal.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1278/1757" />
    <figcaption>Figure 9: 真实公寓场景中根据精细口头指令的跨房间操控</figcaption>
  </div>
  <!-- slide -->
  <div align="center">
    <img src="/images/vln/Qwen-RobotNav-realworld-longhorizon.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1278/1733" />
    <figcaption>Figure 10: 真实长程多任务 Agent 协作闭环控制（寻物 Umbrella 并汇报情况）</figcaption>
  </div>
</div>

<ul>
  <li><strong>长程轨迹与运动原语</strong>：在长达 21.78 米的真实走廊中，四足机器人完全依靠自然语言指令成功穿越多个混合场景。令人瞩目的是，当接收到“向后退”的语言原语时，模型能够在完全没有里程计或目标图输入的情况下，以倒退姿态精准重走前行路线，验证了其在复杂物理环境下的精确空间闭环理解。</li>
  <li><strong>精细化控制与动态规划</strong>：在真实的公寓中，机器人精确地执行诸如“绕着床走”、“在夜视台的左侧停下”、“在出门前先转个身”等精细的空间细节逻辑。在更高级 of Agent 任务中，机器人可以自主探索寻找“Cotti Coffee”里落下的绿色雨伞，并在行进中自动汇报显著的路标标志。</li>
</ul>

<hr />

<h3 id="4-局限性-23">4. 局限性</h3>
<ol>
  <li><strong>边缘部署的算力壁垒</strong>：虽然 remote-server 模式延迟表现优秀（196 ms, 5.1 Hz），但对网络稳定性和传输带宽存在天然的依赖，这在高速移动或网络信号死角中容易发生延迟突刺。而使用 NVIDIA Jetson Thor 进行 FP8 量化部署时，尽管延迟相对平稳（204 ms, 4.9 Hz），但其仍然受到端侧显存与计算带宽的严格物理限制，极大地约束了多视角和高频决策的上限。</li>
  <li><strong>基于 Skeleton 路径的效率损耗</strong>：由于在 ObjectNav 数据生成中广泛采用了基于 skeleton 的 medial-axis 探索算法，它虽然成功教会了模型如何在未知的场景中进行彻底的“房间-走廊-死角”回溯搜索，极大地提高了最终的寻物成功率（Reach-first），但这也导致模型在面对已知路径时，行为偏向于过分谨慎的安全避障与大范围搜寻，致使最终在某些特定路径上的 SPL 指标偏低。</li>
</ol>

<hr />

<h2 id="ga-vln">38. GA-VLN (2026)</h2>
<p>——— Geometry-Aware BEV Representation for Efficient Vision-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2605.22036">arXiv:2605.22036</a> · 🏛️ <strong>CVPR 2026</strong> · <a href="https://github.com/jahhaoyang/GA-VLN">Code</a></p>

<h3 id="精华-26">精华</h3>
<ol>
  <li>提出了一种面向连续环境视觉语言导航（VLN-CE）的新型几何感知鸟瞰图（GA-BEV）特征表示方法。</li>
  <li>GA-BEV 将显式的基于深度图的 3D 投影与来自 3D 基础模型（VGGT）的隐式 3D 几何先验相结合，构建出紧凑且富含空间结构的智能体中心 BEV 地图。</li>
  <li>采用网格化 BEV 聚合（Grid-Based BEV Aggregation）大幅压缩了历史视觉 token 数量，在提升导航成功率的同时将每步推理的平均 token 数从约 4000 降至 514。</li>
  <li>结合多模态大语言模型（MLLM，如 LLaVA-Video），设计了高效的双阶段对话式动作预测框架，实现 BEV 特征每 8 步仅更新一次的高效运行机制。</li>
  <li>在 R2R-CE、RxR-CE 和 NavRAG-CE 等连续 VLN 基准上刷新了 SOTA，并且不依赖 labor-intensive 的 DAgger 增强或通用 VQA 混合训练，展现出极高的数据效率和零样本泛化能力。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-25">1. 研究背景/问题</h3>
<p>现有的视觉语言导航（VLN）方法在处理连续环境时，大多直接将密集历史 RGB 视频块（patch tokens）送入多模态大语言模型（MLLM）进行动作决策。这种做法存在两个核心局限：</p>
<ul>
  <li><strong>高计算开销</strong>：随着时间步增长，密集的 RGB 视频块会产生极其庞大的 token 数量（$t \times H_p \times W_p$ 级别的 token），带来巨大的推理延迟与计算负担。</li>
  <li><strong>缺乏显式空间结构</strong>：纯图像特征缺乏显式的 3D 几何和空间结构，导致智能体在多视角空间推理（如“左转并寻找身后的电视”）上面临严重挑战，导航表现受限。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-23">2. 主要方法/创新点</h3>

<p>为了克服上述局限，本文提出了 <strong>GA-VLN</strong> 框架，其核心是构建一个<strong>几何感知鸟瞰图（GA-BEV）</strong>表示，该表示融合了显式深度几何与隐式 3D 先验，并在 MLLM 导航决策中重用，极大地平衡了表现与效率。</p>

<div align="center">
  <img src="/images/vln/GA-VLN-representations.webp" width="60%" loading="lazy" decoding="async" style="aspect-ratio:675/972" />
<figcaption>图 1. 传统密集视频输入与 GA-BEV 表征方法的对比：GA-BEV 通过几何投影将密集 patch tokens 压缩为紧凑的智能体中心 BEV 物理表示</figcaption>
</div>

<h4 id="ga-bev-表征构建流程">GA-BEV 表征构建流程</h4>

<p>GA-BEV 的构建流程主要包含以下三个步骤：</p>

<div align="center">
  <img src="/images/vln/GA-VLN-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/779" />
<figcaption>图 2. GA-VLN 整体框架流程图：融合显式投影特征和隐式 3D 几何先验，生成紧凑的 BEV 特征，并将其用于 MLLM 双阶段对话生成</figcaption>
</div>

<p><strong>① 显式深度引导空间投影（Explicit Depth-Guided Spatial Projection）</strong></p>
<ul>
  <li><strong>输入</strong>：当前时间步的 RGB patch 特征 $V_t \in \mathbb{R}^{H_p \times W_p \times d_p}$，以及通过双三次插值（bicubic interpolation）缩放到相同分辨率的深度图 $D_t \in \mathbb{R}^{H_p \times W_p}$。</li>
  <li><strong>处理</strong>：利用当前时间步智能体的位置 $p_t$、相机旋转矩阵 $R_t$ 以及相机内参矩阵 $K$，根据针孔相机模型，将每个 2D 像素块中心反投影到 3D 世界坐标系中：
\(\hat{p}_t(u, v) = R_t K^{-1} \begin{bmatrix} u \\ v \\ 1 \end{bmatrix} D_t(u, v) + p_t\)</li>
  <li><strong>输出</strong>：映射到 3D 空间的点云特征，这在输入阶段就为智能体显式注入了 3D 物理世界的空间几何一致性。</li>
</ul>

<p><strong>② 隐式 3D 几何先验融入（Implicit 3D Geometry Priors）</strong></p>
<ul>
  <li><strong>输入</strong>：智能体经历的历史图像序列 ${I_1, \dots, I_t}$。</li>
  <li><strong>处理</strong>：将历史序列输入 to 冻结参数的 3D 基础模型 $f_{3DFM}$（如 VGGT-1B）中，该模型经过大规模 3D 重建任务预训练，具备出色的多视角几何感知与形状先验：
\(V^g = f_{3DFM}(\{I_1, \dots, I_t\}) \in \mathbb{R}^{t \times H_g \times W_g \times d_g}\)
通过一个 2 层 MLP（Linear-GeLU-Linear）投影层 $f_{project}$ 调整特征维度以匹配 SigLIP 特征：
\(\tilde{V}^g = f_{project}(V^g) \in \mathbb{R}^{t \times H_g \times W_g \times d_p}\)
随后，使用与步骤 ① 相同的空间投影方式，将其投射到 3D 空间，得到对应的 3D 坐标 \(\hat{p}_g \in \mathbb{R}^{t \times H_g \times W_g \times 3}\)。</li>
  <li><strong>输出</strong>：富含隐式形状结构与多视角几何一致性的 3D 基础特征。</li>
</ul>

<p><strong>③ 网格化 BEV 聚合（Grid-Based BEV Aggregation）</strong></p>
<ul>
  <li><strong>输入</strong>：统一的 3D 空间特征集 $V = V \cup \tilde{V}^g$ 及其对应的 3D 物理位置 \(\hat{P} = \{\hat{p}\} \cup \{\hat{p}_g\}\)。</li>
  <li><strong>处理</strong>：由于室内空间物体在高度方向较矮，而智能体的动作主要约束在 2D 地面上，因此将所有 3D 特征投影到当前的以智能体为中心的 $(x, z)$ Bird’s-Eye-View (BEV) 平面上。
    <ul>
      <li>将 BEV 平面离散化为以智能体为中心、感知范围为 $[-R, R]$（取 $[-10\text{m}, 10\text{m}]$）、网格大小为 $\Delta \times \Delta$（取 $0.25\text{m} \times 0.25\text{m}$）的 $N \times N$ 网格。</li>
      <li>对于每个非空网格 $(i, j)$，收集落入该网格的所有 3D 特征集 $S_{i, j}$。</li>
      <li>对网格内的特征进行均值池化（mean pooling），并加上 2D 正弦位置编码（position embedding） $e_{i, j}$：
\(B = \left\{ \frac{1}{\lvert S_{i,j} \rvert} \sum_{v \in S_{i,j}} v + e_{i,j} \;\middle|\; \lvert S_{i,j} \rvert &gt; 0, i,j \in [1, N] \right\}\)</li>
      <li>只保留非空网格，从而最大化地压缩冗余 token。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：高密度、紧凑的智能体中心 BEV 几何地图特征 $B$。</li>
</ul>

<h4 id="导航决策与推理流程双阶段对话框架">导航决策与推理流程：双阶段对话框架</h4>

<p>为了最大化推理效率，GA-VLN 将动作决策表述为一个双阶段的对话式生成过程：</p>
<ol>
  <li><strong>第一轮对话（Round 1）</strong>：智能体接收语言指令 $L$、当前的正面视角图像 $IMAGE$（使用 SigLIP 编码）以及聚合了最近多达 32 个历史步观察的 GA-BEV 特征 $BEV$。MLLM（LLaVA-Video-7B）一次性预测 4 个动作（如 <code class="language-plaintext highlighter-rouge">move forward</code>, <code class="language-plaintext highlighter-rouge">turn left</code>, <code class="language-plaintext highlighter-rouge">turn left</code>, <code class="language-plaintext highlighter-rouge">move forward</code>）。</li>
  <li><strong>第二轮对话（Round 2）</strong>：在执行完这 4 步后，智能体无需重新投影和更新 BEV 特征，仅获取新位置 of 正面视角图像 $IMAGE$，继续重用第一轮的 BEV 特征输入给 MLLM，再预测 4 个动作（如 <code class="language-plaintext highlighter-rouge">turn left</code>, <code class="language-plaintext highlighter-rouge">turn right</code>, <code class="language-plaintext highlighter-rouge">move forward</code>, <code class="language-plaintext highlighter-rouge">STOP</code>）。</li>
  <li><strong>更新周期</strong>：仅在每 8 步动作（即完成两轮对话）后，智能体才会重新构建并更新一次 BEV 特征。这样显著降低了 3D 基础模型前向传播和空间投影的调用频次。</li>
</ol>

<hr />

<h3 id="3-核心结果发现-24">3. 核心结果/发现</h3>

<p>GA-VLN 在 Habitat 仿真环境中的多个连续导航数据集上进行了评估：</p>

<ul>
  <li><strong>基准测试超越 SOTA</strong>（如 Table 1 所示）：
    <ul>
      <li>在 <strong>R2R-CE</strong> 上，成功率（SR）达到 <strong>61.0%</strong>，SPL 达到 <strong>55.2%</strong>，均超过了此前最先进的 Image-based MLLM 智能体（如 StreamVLN: SR 56.9%, SPL 51.9%）。</li>
      <li>在 <strong>RxR-CE</strong> 上，成功率（SR）达到 <strong>55.4%</strong>，SPL 达到 <strong>45.2%</strong>。</li>
      <li>在 <strong>NavRAG-CE</strong> 上，成功率（SR）为 <strong>22.2%</strong>，SPL 为 <strong>18.2%</strong>。</li>
      <li><strong>重要特性</strong>：GA-VLN 在完全不使用 DAgger 数据增强与通用 VQA 数据联合训练的情况下，依靠高质数据集在少量 Epoch 下即取得了这些佳绩，验证了其极高的训练效率。</li>
    </ul>
  </li>
  <li><strong>消融实验与效率分析</strong>：
    <ul>
      <li><strong>显式深度投影与隐式 3D 先验的互补性</strong>（Table 2）：
        <ul>
          <li>仅使用深度投影的 BEV 表征（w/o VGGT），SR 从 baseline 的 51.49% 提升至 59.21%，且 Latency 从 342.9ms 降至 212.9ms（归功于 token 的极度压缩）。</li>
          <li>进一步融合 VGGT 的 3D 隐式先验后，成功率（SR）进一步攀升至 60.96%，虽然由于 3D Foundation Model 带来轻微的额外开销，但整体 Total Latency (258.7ms) 依然远低于 Baseline (342.9ms)。</li>
        </ul>
      </li>
      <li><strong>最佳 BEV 超参数</strong>：网格分辨率设为 $0.25\text{m} \times 0.25\text{m}$ 最具性价比（Table 3）；历史步长选为 32 最优，过长会引入累积误差与物理漂移。</li>
      <li><strong>抗噪稳健性强</strong>（Table 4）：在模拟 Stretch 3 机器人的深度抖动（$\sigma = 0.05\text{m}$）、位移漂移（$\sigma = 0.05\text{m}$）和旋转偏差（$\sigma = 5^{\circ}$）的传感器噪声测试下，GA-VLN 的 SR 下降均小于 2%，说明网格化均值池化和多视角 3D 特征的加入极大增强了鲁棒性。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/GA-VLN-token-usage.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:1393/401" />
<figcaption>图 3. 各导航步下 token 占用对比：GA-VLN 相对传统 MLLM 基准（密集 RGB 输入）极大削减了历史特征 Token 长度，保持恒定且低占用</figcaption>
</div>

<hr />

<h3 id="4-局限性-24">4. 局限性</h3>
<ul>
  <li><strong>实时深度图强依赖</strong>：显式投影环节非常依赖输入深度图的质量。在完全丢失深度或深度图质量极度恶化（例如镜面反射、强光直射）的情况下，三维重建的 BEV 地图可能会出现较大形变，进而影响导航性能。</li>
  <li><strong>历史滑窗限制</strong>：尽管 32 步的历史滑窗在大多数场景表现优秀，但当在超大规模或多楼层长程复杂场景中导航时，滑窗可能会丢弃较早前的关键地标，导致回溯困难。</li>
</ul>

<hr />

<h3 id="5-真实世界机器人部署">5. 真实世界机器人部署</h3>

<div align="center">
  <img src="/images/vln/GA-VLN-real-world-example.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1357/780" />
<figcaption>图 4. GA-VLN 在物理智能体 Hello Robot Stretch 3 上的实车测试：在没有外接避障与全局建图模块下，完全依靠 GA-VLN 零样本输出路径并生成语义 BEV 局部地图</figcaption>
</div>

<hr />

<h2 id="sedualvln">39. SEDualVLN (2026)</h2>
<p>———空间增强的双系统连续环境视觉语言导航框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2605.17249">arXiv:2605.17249</a></p>

<h3 id="精华-27">精华</h3>
<ol>
  <li><strong>快慢协调决策</strong>：将导航任务分解为系统 1（轻量 VLM 原子动作预测器，高频）和系统 2（通用 MLLM 全局边界路径规划器，低频），兼顾了执行效率与全局规划能力。</li>
  <li><strong>多尺度空间增强</strong>：对系统 1 分别实施全局 3D 几何隐式监督和局部通道连通性显式提取，显著降低了 VLM 在岔路口走错方向的概率。</li>
  <li><strong>物理一致的 3D 路径渲染</strong>：系统 2 通过在线 3D 建图和沿路径插值渲染虚拟视图，为通用大模型提供高保真的空间感知，有效减少了纯文本或 2D 视角带来的空间幻觉。</li>
  <li><strong>性能新高度</strong>：在 continuous 视觉语言导航（VLN-CE）基准测试（R2R-CE 和 RxR-CE）上取得了最新的 State-of-the-Art 表现。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-26">1. 研究背景/问题</h3>
<p>现有的视觉语言导航（VLN）方法主要分为两类：一是基于轨迹数据微调的端到端视觉语言模型（VLM）策略，其动作执行快但缺乏动态推理能力，且在长距离导航中易因历史上下文累积而退化；二是零样本（Zero-Shot）模块化方案，其利用通用多模态大模型（MLLM）作为规划器，虽然泛化能力强，但由于缺乏精确的空间定位和几何推理能力，极易产生空间幻觉，且推理延迟巨大。</p>

<p>虽然最近有一些双系统（Dual-System）的尝试，但它们多是简单拼凑两种范式，未从根本上解决底层模型空间感知薄弱的问题。本论文提出 <strong>SEDualVLN</strong>，重点通过全局和局部等多尺度的<strong>空间增强（Spatial Enhancement）</strong>策略，赋予智能体极强的方向感，以提升其在连续未见环境（Unseen continuous environments）下的长周期导航鲁棒性。</p>

<hr />

<h3 id="2-主要方法创新点-24">2. 主要方法/创新点</h3>

<h4 id="-双系统整体框架">① 双系统整体框架</h4>
<p>SEDualVLN 由两个子系统以及一个协同调度器构成：</p>
<ul>
  <li><strong>系统 1（快系统/动作生成器）</strong>：高频运行，基于微调的 VLM 直接从当前第一视角 RGB 图像流和指令预测离散原子动作（前进、左转、右转、停止）。</li>
  <li><strong>系统 2（慢系统/路径规划器）</strong>：低频运行，基于 3D 实时建图、路径插值渲染与通用 MLLM（如 GPT-4o），在全局地图上选择最佳的边界航点（waypoint）。</li>
</ul>

<p>两个系统协同工作：系统 2 负责指引大方向，系统 1 负责执行到达航点所需的微观原子动作。通常，系统 1 执行约 20 步原子动作时，系统 2 才进行一次全局航点重新规划（频率比 20:1），这种“快慢协同”的设计不仅保证了实时响应，还兼顾了全局空间信息的整合。</p>

<div align="center">
  <img src="/images/vln/SEDualVLN-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/906" />
<figcaption>图1：SEDualVLN双系统整体框架。橙色的系统1通过VLM产生快速的底层动作，绿色的系统2通过在线3D建图与路径图像渲染，利用通用MLLM规划全局边界点。</figcaption>
</div>

<h4 id="-系统-1空间增强的-vlm-模型">② 系统 1：空间增强的 VLM 模型</h4>
<p>系统 1 基于 StreamVLN 骨干网络，通过多轮对话机制和 KV cache 实现高效推理。本论文引入了<strong>全局</strong>与<strong>局部</strong>双重空间增强策略来克服传统 VLM 空间表征隐式、易在长距离漂移的问题：</p>

<ul>
  <li>
    <p><strong>全局空间增强策略 (Global Spatial Enhancement Strategy)</strong>：
不依赖额外的深度图传感器或显式 3D 重建模型，而是采用隐式对齐的策略。作者利用预训练的 3D 基础模型 VGGT 来提取当前帧 of 3D 空间结构特征。然后在 LLaVA-Video 中间的注意力融合层（第 24 层）上接入一个两层的 MLP，将 VLM 的视觉 Token 投影并与 VGGT 提取的 3D 空间特征进行对齐。</p>

    <p>训练时，通过最小化两者的余弦距离来引导 VLM 隐式学习 3D 空间几何与结构信息。其联合训练损失函数 $L_{\text{SE}}$ 定义如下：
\(L_{\text{SE}} = L_{\text{action}} + \alpha \cdot \frac{1}{N} \sum_{t=1}^{N} \left[ 1 - \cos\left(V_t, S_t + p_t\right) \right]\)
其中， $V_t$ 表示投影后的视觉 Token， $S_t$ 表示来自 VGGT 的 3D 空间表征， $p_t$ 为位置编码， $\alpha$ 是损失权重系数。</p>
  </li>
  <li>
    <p><strong>局部空间增强策略 (Local Spatial Enhancement Strategy)</strong>：
在实际导航中，通道（如走廊、门口）是连接不同区域的关键拓扑结构，而 VLM 极易在这些决策岔路口选错分支。为此，作者设计了<strong>通道连通性提取模块（Channel Connectivity Extraction Module）</strong>。该模块首先使用开放词汇表目标检测模型 Grounding DINO 自动识别当前视野中的通道区域，随后利用 SAM 对这些区域进行分割以获取二值遮罩（通道区域像素设为 1，非通道设为 0），再经由 MLP 投影为与全局视觉 Token 维度相同的局部拓扑 Token 输入给 VLM。该策略使 VLM 能够显式地关注通道的连通性，显著减少了岔路口决策失误。</p>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/SEDualVLN-system1-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/882" />
<figcaption>图2：系统1的内部流程。通过全局空间增强（基于VGGT进行特征对齐隐式监督）和局部空间增强（通过Grounding DINO + SAM提取通道连通性二值特征）共同强化VLM的空间感知。</figcaption>
</div>

<h4 id="-系统-2基于建图-渲染-推理的-mllm-规划器">③ 系统 2：基于“建图-渲染-推理”的 MLLM 规划器</h4>
<p>系统 2 旨在利用通用 MLLM（如 GPT-4o）强大的常识推理和零样本能力，并结合物理一致的 3D 地图克服其空间幻觉。其规划流程分为以下三步：</p>

<ol>
  <li><strong>实时建图 (Mapping)</strong>：
基于 LingBot-Map 算法，智能体在导航时实时在线构建轻量级的 3D 点云地图，并同时生成用以指引未探索区域的 2D 边界（frontier）地图。</li>
  <li><strong>路径虚拟渲染 (Rendering)</strong>：
假设当前的候选边界点集合为 $F = {f_1, …, f_n}$。系统首先利用 A* 算法计算当前位置到各边界点在拓扑地图上的无碰撞路径：
\(P_i = \text{A}^*(x_0, F_i)\)
为了向大模型直观呈现沿途视角，系统在路径的相邻节点间进行线性插值（若欧氏距离超过阈值 $d$ 则插入虚拟位姿点），并基于插值位姿渲染出虚拟的相机 RGB 视图。随后，为了减少大模型的输入 Token 消耗，使用 CLIP 编码器的余弦相似度进行冗余帧剪枝，仅保留场景变化明显的关键路径帧 ${I_1, …, I_m}$：
\(s(I_k, I_{k+1}) = \frac{\langle \phi(I_k), \phi(I_{k+1}) \rangle}{\lVert \phi(I_k) \rVert \lVert \phi(I_{k+1}) \rVert} &lt; \tau \implies \text{keep } I_{k+1}\)</li>
  <li><strong>两阶段多模态推理 (Reasoning)</strong>：
    <ul>
      <li><strong>第一阶段（环境自我感知增强）</strong>：向 GPT-4o 输入 3D 自顶向下地图，令其总结和描述智能体当前所处位置和周遭环境（提取位置、空间关系与可行方向）。</li>
      <li><strong>第二阶段（模拟运动航点评估）</strong>：向 GPT-4o 输入每个候选路径渲染出的视图序列，让其通过视觉与指令的契合度，评估并选择下一步的最佳边界航点 $F_i$。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/SEDualVLN-system2-workflow.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/693" />
<figcaption>图3：系统2的Mapping-Rendering-Reasoning工作流。首先实时重建轻量3D和2D边界图，再通过A*寻路与视角插值渲染路径虚拟图，最后由通用大模型结合顶视图与渲染序列决策出最佳边界航点。</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-25">3. 核心结果/发现</h3>

<ul>
  <li>
    <p><strong>SOTA 性能表现</strong>：
在连续视觉语言导航基准 R2R-CE 和 RxR-CE 的 Val-Unseen 验证集上，SEDualVLN 相比于之前最先进的双系统方法 DualVLN，在成功率（SR）上分别取得了 <strong>3%</strong> 和 <strong>2.5%</strong> 的绝对提升，且无需依赖任何额外的深度或全局传感器信息，仅用单目 RGB 输入即达到了新的基准高度。</p>
  </li>
  <li>
    <p><strong>岔路口避错能力</strong>：
消融实验与定性分析表明，在复杂的岔路口或房间交界处，引入通道连通性提取（LSES）能够极大地纠正智能体因视觉混淆引起的错误转向。</p>
  </li>
  <li>
    <p><strong>快慢协同的高效性</strong>：
单独运行系统 2 时，由于 GPT-4o 接口延迟和密集计算，单次导航的平均时间极其漫长（AT 接近 300秒）。而通过引入 20:1 的快慢频率比，双系统协同工作不仅使成功率高于单独的系统 1 或系统 2，更是将平均导航耗时（AT）降低了 5 倍以上，完美平衡了计算效率与决策准确度。</p>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/SEDualVLN-comparative-experiment.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/856" />
<figcaption>图4：与SOTA方法StreamVLN的定性对比。在交叉路口处，由于StreamVLN缺乏显式的通道连通性感知，开局便选错岔路口；而SEDualVLN能够选出正确路径并顺利到达终点。</figcaption>
</div>

<div align="center">
  <img src="/images/vln/SEDualVLN-case-study.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/717" />
<figcaption>图5：SEDualVLN导航与实时建图过程可视化。智能体根据实时构建 of 3D/2D地图渲染出路径视角的观测流，最终精准定位并到达终点。</figcaption>
</div>

<hr />

<h3 id="4-局限性-25">4. 局限性</h3>
<ol>
  <li><strong>真实物理设备部署难度</strong>：该框架严重依赖实时 3D 建图的表现。而在真实物理机器人设备上部署时，目前的实时三维重建特征提取仍存在较大的计算开销与噪声变形，建图的畸变可能会直接干扰系统 2 路径规划的准确度。</li>
</ol>

<hr />
<hr />

<h3 id="附录系统-2-推理过程案例与-prompt-模板">附录：系统 2 推理过程案例与 Prompt 模板</h3>

<p>在系统 2 的推理机制中，GPT-4o 的决策包含两个阶段：</p>
<ol>
  <li><strong>环境理解阶段</strong>：引导模型根据 3D 顶视图提取核心空间信息，输出当前 Location（位置环境）、Relationship（家具或障碍的空间关系）与 Possible directions（潜在的正确路径取向）。</li>
  <li><strong>规划决策阶段</strong>：输入各边界点路径的虚拟相机渲染流，评估 F1、F2、F3 等边界点中哪一个最符合导航指令，并生成具体原因。</li>
</ol>

<div align="center">
  <img src="/images/vln/SEDualVLN-mllm-reasoning-case1.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1107/715" />
<figcaption>图6：系统2第一阶段环境理解决策可视化。GPT-4o根据3D顶视图理解当前的具体厨房布局及桌椅朝向。</figcaption>
</div>

<div align="center">
  <img src="/images/vln/SEDualVLN-mllm-reasoning-case2.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1107/717" />
<figcaption>图7：系统2第二阶段根据路径渲染流进行边界点决策。GPT-4o对比不同边界路径的多帧渲染画面，指出F3路径最符合“沿主过道走向餐桌”的指令。</figcaption>
</div>

<hr />

<h2 id="robostral-navigate">40. Robostral Navigate (2026)</h2>
<p>———仅需单目 RGB 相机的 8B 视语言导航大模型：超高效仿真训练与在线强化学习</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.20785">arXiv:2607.20785</a> · <a href="https://mistral.ai/news/robostral-navigate">Project Page</a></p>

<hr />

<h3 id="精华-28">精华</h3>

<ol>
  <li><strong>单目 RGB 极简感知架构</strong>：Robostral Navigate 彻底打破对深度传感器（RGB-D）、LiDAR、多视角相机阵列或预建地图的依赖，仅以单目 RGB 图像流为输入，在图像空间直接预测 Pointing 坐标（像素坐标）与航向角变化，解耦物理几何与硬件内参约束，实现跨异构机器人的零样本迁移。</li>
  <li><strong>高低层解耦分级控制</strong>：采用“8B VLM 视语言推理（0.5 Hz 预测 Waypoint）+ 121M 扩散策略（10 Hz 生成动作块）+ 机器人底盘控制器（100 Hz 输出电机指令）”的分级控制管线，兼顾高层复杂语义规划与低层连续几何避障。</li>
  <li><strong>Prefix-Tree 树状注意力加速 SFT (Tree Training)</strong>：提出 Episode Packing 与前缀树 Attention Mask 机制，单 Forward Pass 计算整条轨迹损失，保留全量 action 监督信号的同时消除共享前缀的重复编码，<strong>将训练 Token 消耗降低 22 倍</strong>，训练时间从数月缩短至几天。</li>
  <li><strong>在线 RL (CISPO) 与 Hard Subsets 强化探索</strong>：基于 2.4M 仿真轨迹完成 SFT 后，利用 CISPO 算法在 35k 困难任务子集中进行在线强化学习，配合截断目标距离奖励 $- \max(2, \text{dist_to_goal})$，有效解决行为克隆的 Exposure Bias 与概率偏移，显著提振复杂场景探索与错误恢复能力。</li>
  <li><strong>单目 RGB 刷新 SOTA</strong>：在 R2R-CE Unseen 达到 <strong>77.4% SR / 74.2% SPL</strong>，RxR-CE Unseen 达到 <strong>75.1% SR / 68.7% SPL</strong>，不仅大幅碾压所有单相机方法，甚至全面超越了依赖深度相机及多视角全景的顶尖导航系统（如 Qwen-RobotNav-8B）。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-27">1. 研究背景/问题</h3>

<ul>
  <li><strong>感知与硬件部署门槛</strong>：现有顶尖具身导航（VLN/VLA）系统普遍依赖深度相机（RGB-D）、LiDAR、多视角全景相机阵列或预先构建的环境地图。额外的传感器不仅大幅增加了单机制造成本与能耗，还需要复杂精密的传感器校准，严重限制了导航策略在轮式、足式及无人机等多元异构机器人上的快速部署与大规模泛化。</li>
  <li><strong>物理坐标强耦合的脆性</strong>：传统的端到端导航模型试图直接预测机器人在三维物理空间中的绝对度量坐标（Metric Displacement）。然而，这种度量控制高度依赖相机内参标定与确定的物理尺度。一旦相机安装仰角改变、透镜磨损或迁移到形态不同的机器人平台上，预测精度便会断崖式下降。</li>
  <li><strong>长轨迹训练的 Token 暴涨</strong>：在连续环境长行程导航任务中，传统行为克隆（SFT）训练将每个时间步作为独立样本输入，导致历史帧被重复前向编码。对于长度为 $T$ 的 Episode，Token 复杂度呈 $\mathcal O(T^2)$ 级数增长，造成巨大的算力浪费；且单靠 SFT 容易陷入 Exposure Bias 与 Covariate Shift，缺乏探索与死角复原能力。</li>
  <li><strong>核心动机</strong>：构建一种<strong>极简感知（单目 RGB）</strong>、<strong>可扩展（跨硬件形态零样本迁移）</strong>、<strong>高效训练（纯仿真数据 + 22x Token 压缩 + 在线 RL）</strong> 的通用具身导航 Recipe。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-25">2. 主要方法/创新点</h3>

<h4 id="-整体框架概述-9">① 整体框架概述</h4>
<p>Robostral Navigate 采用高层语义推理与低层几何控制解耦的双系统架构。系统由 8B 参数的 Vision-Language Model (VLM) 和 121M 参数的 Diffusion Policy 组合而成。</p>
<ul>
  <li><strong>高层 8B VLM</strong>：以 0.5 Hz 运行，负责理解自然语言指令并基于历史 RGB 观察预测下一个 Waypoint；</li>
  <li><strong>低层 121M Diffusion Policy</strong>：以 10 Hz 运行，根据 Waypoint 与当前 RGB 观察生成局部动作块（Action Chunk，包含 30 步相对二维位移与旋转）；</li>
  <li><strong>底盘控制器 (Motion Controller)</strong>：以 100 Hz 运行，将动作块转换为特定硬件底盘的电机控制指令。</li>
</ul>

<div align="center">
  <img src="/images/vln/Robostral-Navigate-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/680" />
<figcaption>Robostral Navigate 整体系统架构图：VLM 预测 Waypoint，低层 Diffusion Policy 生成 10 Hz 轨迹，运动控制器驱动底盘</figcaption>
</div>

<hr />

<h4 id="-逐模块讲解-7">② 逐模块讲解</h4>

<p><strong>模块 1：基于图像空间 Pointing 与 Degree-of-Freedom 退化控制 (Robostral Navigate VLM)</strong></p>
<ul>
  <li><strong>输入</strong>：自然语言导航指令 + 历史单目 RGB 帧序列 $O_0, O_1, \dots, O_t$。</li>
  <li><strong>处理</strong>：基座模型初始化自一个 8B 密集的 Spatial Grounding VLM（具备指向、计数与目标定位能力）。在导航时，模型优先在图像空间预测当前视角下可见的最远轨迹点的像素坐标 $(u, v)$，以及到达该点时的航向角变化 $\Delta \theta$（相对当前帧的 Yaw 旋转）。</li>
  <li><strong>输出</strong>：
    <ul>
      <li><strong>视野内指向控制 (Pointing Mode)</strong>：预测 5 维元组 $a_{\mathrm{vis}} = (u, v, \Delta x, \Delta y, \Delta \theta)$，其中度量位移 $(\Delta x, \Delta y, \Delta \theta)$ 作为联合训练的辅任务。</li>
      <li><strong>视野外度量退化 (Displacement Fallback Mode)</strong>：当目标不在当前视野内（如需大角度掉头或绕过墙角遮挡），模型省略图像坐标，降级预测 3 维局部位移 $a_{\mathrm{invis}} = (\Delta x, \Delta y, \Delta \theta)$。</li>
      <li><strong>终止控制</strong>：到达终点时输出 STOP 标记。</li>
    </ul>
  </li>
  <li><strong>设计动机</strong>：在图像空间做 Pointing 指向天然解耦了相机的物理高度、倾角与内参差异，避免绑定特定的机器人几何尺寸。同时，利用 Grounding 专用基础模型强悍的语义理解与边界框预测能力实现冷启动——“理解物体在哪里”与“知道怎么走过去”在 VLM 内部多模态表征上实现了统一。</li>
</ul>

<pre><code class="language-mermaid">graph TD
    A["输入: 当前图像观测 RGB + 自然语言指令"] --&gt; B["Robostral Navigate 8B VLM (0.5 Hz)"]
    B --&gt; C{"目标路标是否在当前视野内?"}
    C -- "是" --&gt; D["指向控制 Pointing Action"]
    D --&gt; D1["预测 2D 图像像素坐标 (u, v)"]
    D --&gt; D2["预测目标朝向变化 Δθ"]
    C -- "否" --&gt; E["位移退化 Displacement Fallback"]
    E --&gt; E1["预测局部坐标系偏移 (dx, dy, dθ)"]
    D1 --&gt; F["121M Diffusion Policy (10 Hz)"]
    D2 --&gt; F
    E1 --&gt; F
    F --&gt; G["100 Hz 电机控制器驱动硬件底盘"]
</code></pre>

<p><strong>模块 2：低层扩散策略轨迹生成 (Diffusion Policy)</strong></p>
<ul>
  <li><strong>输入</strong>：VLM 输出的 Waypoint $a \in {a_{\mathrm{vis}}, a_{\mathrm{invis}}}$、机器人高度与半径先验、VLM 推理时的上下文帧 $o_{t_{\mathrm{vlm}}}$ 以及最新 RGB 帧 $o_t$（解决 VLM 延迟导致的推演滞后）。</li>
  <li><strong>处理</strong>：基于 121M 参数的 Lightweight Diffusion Transformer，预测未来 1 秒内 30 个连续步骤的相对二维位移与旋转量 $(\mathrm d x, \mathrm d y, \mathrm d \theta)$。</li>
  <li><strong>输出</strong>：10 Hz 的局部动作块（Action Chunk）。</li>
  <li><strong>设计动机</strong>：将连续避障与高频平滑轨迹控制剥离给小参数扩散模型，大幅减轻 8B VLM 的计算负担。</li>
</ul>

<div align="center">
  <img src="/images/vln/Robostral-Navigate-cross-robot.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/713" />
<figcaption>跨机器人形态部署（Galaxea R1 轮式机器人与 Hiwonder JetAuto）：共享相同的 VLM 与 Diffusion Policy 权重</figcaption>
</div>

<hr />

<h4 id="-训练算法创新prefix-tree-树状注意力加速-sft-tree-training">③ 训练算法创新：Prefix-Tree 树状注意力加速 SFT (Tree Training)</h4>

<p>为了消除监督微调（SFT）阶段对历史帧的重复前向计算，团队将导航 Episode 建模为<strong>前缀树（Prefix Tree）</strong>，并开发了高效的训练管线。</p>

<div align="center">
  <img src="/images/vln/Robostral-Navigate-prefix-tree.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/410" />
<figcaption>Prefix-Tree 注意力掩码与 Episode Packing 示意图：消除冗余编码并防止 Ground-truth 动作信息泄露</figcaption>
</div>

<h5 id="231-dfs-序列化与-causal-序列打包-packing">2.3.1 DFS 序列化与 Causal 序列打包 (Packing)</h5>
<p>标准 SFT 将长度为 $T$ 的轨迹拆分为 $T$ 个独立样本，Token 复杂度呈 $\mathcal O(T^2)$。Robostral Navigate 将整个 Episode 的历史上下文拼装成一棵前缀树（根节点为静态指令 $I$，子节点为观察 $O_t$ 与动作 $a_t$），并通过深度优先搜索（DFS）遍历打包成单条序列：
\(\text{Sequence}_{\text{packed}} = I | O_0 | a_0 | \dots | O_n | a_n\)
整条序列中每一个唯一的 token（包括图像视觉 Token）在单次 Forward 中<strong>仅计算一次</strong>，将 Token 复杂度降至 $\mathcal O(T)$。</p>

<h5 id="232-树状注意力掩码-tree-based-attention-mask">2.3.2 树状注意力掩码 (Tree-based Attention Mask)</h5>
<p>在单条打包序列中，为了防止 Causal Attention 导致模型在训练时“预知”未来步的 Ground-truth 动作（因为 Pointing 蕴含强方向信息），设计了树状注意力掩码。对于 Token $i$ 与 Token $j$，其可见性规则为：
\(M_{ij} = \begin{cases} 0, &amp; j &lt; i \ \land \ (\text{token } j \text{ 在公共 Trunk} \ \lor \ \text{token } i, j \text{ 在同一 Branch}) \\ -\infty, &amp; \text{otherwise} \end{cases}\)
此掩码不仅实现了因果遮蔽，更精确地阻断了兄弟分支与未来状态的信息泄露。</p>

<div align="center">
  <img src="/images/llm-training/tree-training/03-tree-attention-mask.webp" width="70%" loading="lazy" decoding="async" style="aspect-ratio:1200/1050" />
  <figcaption>树状注意力掩码（Tree Attention Mask）矩阵，有效屏蔽属于兄弟分支与未来状态的 token</figcaption>
</div>

<h5 id="233-基于树深度的位置编码-depth-based-rope">2.3.3 基于树深度的位置编码 (Depth-based RoPE)</h5>
<p>RoPE 位置编码不能直接使用 DFS 序列中的物理下标，否则会导致错误的逻辑距离感。Robostral 根据 Token 在前缀树中的<strong>逻辑深度（Logical Depth）</strong>分配 RoPE 位置编码，保证位置编码与独立串行 Forward 时完全一致。</p>

<h5 id="234-路径加权损失-path-weighted-loss">2.3.4 路径加权损失 (Path-Weighted Loss)</h5>
<p>为保证单次 Forward 中的梯度大小与独立训练一致，对每个监督 Token 施加权重。若总共包含 $K$ 条根到叶的路径，第 $t$ 个 Token 属于 $g_t$ 条路径的前缀，则损失函数乘以权重 $g_t / K$：
\(L_{\text{tree}} = \sum_t \frac{g_t}{K} \ell_t(\theta)\)
这一加权保证了共享前缀在 Backward 时累积的梯度方向与多个独立样本训练后的总平均梯度在数学上完全等价。在保留全部 action 监督信号的前提下，<strong>将训练 Token 消耗降低 22 倍</strong>，训练时间从数月缩短至几天。</p>

<hr />

<h4 id="-在线强化学习-online-rl-via-cispo">④ 在线强化学习 (Online RL via CISPO)</h4>

<p>在 2.4M 仿真轨迹的 SFT 之后，模型在面对未曾见过的死角或复杂干扰时仍可能产生漂移。Robostral 采用 <strong>CISPO (Clipped Importance Sampling Policy Optimization)</strong> 算法进行在线端到端微调。</p>

<div align="center">
  <img src="/images/vln/Robostral-Navigate-rl-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1122/748" />
<figcaption>在线强化学习管线概览：物理仿真器、vLLM 动作生成器与分布式训练 Rank 异步协同循环</figcaption>
</div>

<h5 id="241-cispo-算法机制与重要性采样截断">2.4.1 CISPO 算法机制与重要性采样截断</h5>
<p>不同于 PPO 直接对目标损失函数进行 Clipped，CISPO 作用于重要性采样权重的梯度项上。新旧策略比率为：
\(r_t(\theta) = \frac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{\text{old}}}(a_t|s_t)}\)
CISPO 的梯度更新目标为：
\(\nabla_\theta L_{\text{CISPO}} = \hat{\mathbb{E}}_t \left[ \min\left(r_t(\theta), \operatorname{clip}(r_t(\theta), 1-\epsilon, 1+\epsilon)\right) \nabla_\theta \log \pi_\theta(a_t|s_t) A_t \right]\)
这极大稳定了 8B 规模大模型在连续环境下的强化学习收敛性。</p>

<h5 id="242-截断目标距离奖励函数">2.4.2 截断目标距离奖励函数</h5>
<p>标量奖励函数定义为：
\(R = - \max(2, \text{dist\_to\_goal})\)
其中 $\text{dist_to_goal}$ 为最终位置到目标的测地线距离（米）。将惩罚截断在 2 米以内，防止智能体在靠近目标后做无意义的微调晃动，激励模型在到达终点时精准触发 STOP 动作。</p>

<h5 id="243-hard-subsets-筛选与-场景连续-curriculum">2.4.3 Hard Subsets 筛选与 场景连续 Curriculum</h5>
<ul>
  <li><strong>Hard Subsets (35k 任务)</strong>：从 SFT 模型推演中筛选出 35k 困难任务子集（仅保留 SFT 失败的复杂布局、歧义指令样本），将算力集中在难点突破；</li>
  <li><strong>Visual Curriculum</strong>：数据采样时按 Scene 连续打包，使 Batch 内包含同一场景的多个 Episode，形成隐式视觉课程（Visual Curriculum）。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-26">3. 核心结果/发现</h3>

<p>Robostral Navigate 在 Room-to-Room in Continuous Environments (R2R-CE) 和 Room-Across-Room (RxR-CE) 两个最权威的真实连续运动视觉导航基准上均刷新了世界纪录。</p>

<h4 id="31-权威基准性能对比表">3.1 权威基准性能对比表</h4>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型类别</th>
      <th style="text-align: left">模型名称</th>
      <th style="text-align: center">感知模态</th>
      <th style="text-align: center">R2R-CE Unseen SR ↑</th>
      <th style="text-align: center">R2R-CE Unseen SPL ↑</th>
      <th style="text-align: center">R2R-CE NE ↓</th>
      <th style="text-align: center">RxR-CE Unseen SR ↑</th>
      <th style="text-align: center">RxR-CE Unseen SPL ↑</th>
      <th style="text-align: center">RxR-CE NE ↓</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>单目 RGB</strong></td>
      <td style="text-align: left"><strong>Robostral Navigate (Ours)</strong></td>
      <td style="text-align: center"><strong>仅单目 RGB</strong></td>
      <td style="text-align: center"><strong>77.4%</strong></td>
      <td style="text-align: center"><strong>74.2%</strong></td>
      <td style="text-align: center"><strong>3.20m</strong></td>
      <td style="text-align: center"><strong>75.1%</strong></td>
      <td style="text-align: center"><strong>68.7%</strong></td>
      <td style="text-align: center"><strong>3.47m</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">单目 RGB</td>
      <td style="text-align: left">Qwen-RobotNav-8B</td>
      <td style="text-align: center">仅单目 RGB</td>
      <td style="text-align: center">65.7%</td>
      <td style="text-align: center">59.6%</td>
      <td style="text-align: center">4.36m</td>
      <td style="text-align: center">73.4%</td>
      <td style="text-align: center">63.5%</td>
      <td style="text-align: center">4.16m</td>
    </tr>
    <tr>
      <td style="text-align: left">单目 RGB</td>
      <td style="text-align: left">Qwen-RobotNav-4B</td>
      <td style="text-align: center">仅单目 RGB</td>
      <td style="text-align: center">66.9%</td>
      <td style="text-align: center">60.5%</td>
      <td style="text-align: center">4.22m</td>
      <td style="text-align: center">71.3%</td>
      <td style="text-align: center">61.5%</td>
      <td style="text-align: center">4.15m</td>
    </tr>
    <tr>
      <td style="text-align: left">单目 RGB</td>
      <td style="text-align: left">Qwen-VLA-Instruct</td>
      <td style="text-align: center">仅单目 RGB</td>
      <td style="text-align: center">57.5%</td>
      <td style="text-align: center">51.2%</td>
      <td style="text-align: center">5.10m</td>
      <td style="text-align: center">59.6%</td>
      <td style="text-align: center">47.8%</td>
      <td style="text-align: center">5.80m</td>
    </tr>
    <tr>
      <td style="text-align: left">单目 RGB</td>
      <td style="text-align: left">StreamVLN</td>
      <td style="text-align: center">仅单目 RGB</td>
      <td style="text-align: center">56.9%</td>
      <td style="text-align: center">51.9%</td>
      <td style="text-align: center">4.98m</td>
      <td style="text-align: center">52.9%</td>
      <td style="text-align: center">46.0%</td>
      <td style="text-align: center">6.22m</td>
    </tr>
    <tr>
      <td style="text-align: left">单目 RGB</td>
      <td style="text-align: left">InternVLA-N1</td>
      <td style="text-align: center">仅单目 RGB</td>
      <td style="text-align: center">55.4%</td>
      <td style="text-align: center">52.1%</td>
      <td style="text-align: center">4.89m</td>
      <td style="text-align: center">49.5%</td>
      <td style="text-align: center">41.8%</td>
      <td style="text-align: center">6.41m</td>
    </tr>
    <tr>
      <td style="text-align: left">单目 RGB</td>
      <td style="text-align: left">NaVILA</td>
      <td style="text-align: center">仅单目 RGB</td>
      <td style="text-align: center">54.0%</td>
      <td style="text-align: center">49.0%</td>
      <td style="text-align: center">5.22m</td>
      <td style="text-align: center">49.3%</td>
      <td style="text-align: center">44.0%</td>
      <td style="text-align: center">6.77m</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>深度/多相机</strong></td>
      <td style="text-align: left">Qwen-RobotNav-8B (Depth)</td>
      <td style="text-align: center">深度 / 多相机</td>
      <td style="text-align: center">72.1%</td>
      <td style="text-align: center">66.6%</td>
      <td style="text-align: center">3.73m</td>
      <td style="text-align: center">76.5%</td>
      <td style="text-align: center">65.7%</td>
      <td style="text-align: center">3.58m</td>
    </tr>
    <tr>
      <td style="text-align: left">深度/多相机</td>
      <td style="text-align: left">OmniNav</td>
      <td style="text-align: center">深度 / 多相机</td>
      <td style="text-align: center">69.5%</td>
      <td style="text-align: center">66.1%</td>
      <td style="text-align: center">3.74m</td>
      <td style="text-align: center">73.6%</td>
      <td style="text-align: center">62.0%</td>
      <td style="text-align: center">3.77m</td>
    </tr>
    <tr>
      <td style="text-align: left">深度/多相机</td>
      <td style="text-align: left">ABot-N0</td>
      <td style="text-align: center">深度 / 多相机</td>
      <td style="text-align: center">66.4%</td>
      <td style="text-align: center">63.9%</td>
      <td style="text-align: center">3.78m</td>
      <td style="text-align: center">69.3%</td>
      <td style="text-align: center">60.0%</td>
      <td style="text-align: center">3.83m</td>
    </tr>
    <tr>
      <td style="text-align: left">深度/多相机</td>
      <td style="text-align: left">NavFoM</td>
      <td style="text-align: center">深度 / 多相机</td>
      <td style="text-align: center">61.7%</td>
      <td style="text-align: center">55.3%</td>
      <td style="text-align: center">4.61m</td>
      <td style="text-align: center">64.4%</td>
      <td style="text-align: center">56.2%</td>
      <td style="text-align: center">4.74m</td>
    </tr>
  </tbody>
</table>

<div align="center">
  <img src="/images/vln/model-performance-comparison-(success-rate-↑) 3-1.svg" width="90%" loading="lazy" decoding="async" />
  <figcaption>Robostral Navigate 与其他导航模型在 R2R-CE 未见环境验证集上的成功率对比</figcaption>
</div>

<h4 id="32-关键结果分析">3.2 关键结果分析</h4>

<ol>
  <li><strong>大幅碾压所有单目 RGB 基线</strong>：
在相同单目 RGB 条件下，Robostral Navigate 在 R2R-CE Unseen 上成功率达到 77.4%，领先之前最好的单目模型 Qwen-RobotNav-4B (66.9%) 达 <strong>+10.5%</strong>；在 RxR-CE 上领先 Qwen-RobotNav-8B <strong>+1.7% SR</strong>，且路径效率 SPL 提升 <strong>+5.2%</strong>。</li>
  <li><strong>超越深度与多视角传感器模型</strong>：
依靠单目 RGB 输入，Robostral Navigate 在 R2R-CE 上超越了搭载深度传感器与多相机的 Qwen-RobotNav-8B (72.1% SR) 达 <strong>+5.3%</strong>；在 RxR-CE 上 SPL (68.7% vs 65.7%) 与定位误差 (3.47m vs 3.58m) 均优于深度模型。</li>
  <li><strong>在线 RL 的性能跃升</strong>：
    <ul>
      <li>R2R-CE Unseen 成功率从 SFT Baseline 的 73.4% 提升至 <strong>77.4%</strong> (+4.0%)；</li>
      <li>RxR-CE Unseen 成功率从 71.2% 提升至 <strong>75.1%</strong> (+3.9%)。</li>
    </ul>
  </li>
  <li><strong>跨构型零样本部署与鲁棒性</strong>：
同一套 VLM + Diffusion Policy 权重直接在 Galaxea R1（大底盘轮式）和 Hiwonder JetAuto（小巧四轮/四足）上部署成功。即便拉伸焦距、引入鱼眼畸变或改变相机安装高度，导航成功率波幅不超过 1.5%。</li>
</ol>

<hr />

<h3 id="4-局限性-26">4. 局限性</h3>

<ol>
  <li><strong>盲区视场退化</strong>：在目标位于后方或盲区（&gt; 90° 大角度转向）时，需要降级为度量位移（Metric Displacement Fallback）模式，在极度复杂迷宫或纹理极缺失环境中的探索效率仍有提升空间。</li>
  <li><strong>在线 RL 系统调度极度繁重</strong>：在线强化学习需要物理仿真渲染、vLLM 高并发推理以及分布式权重更新三方高并发协同调度，对 GPU 算力集群与工程管线要求极高。</li>
</ol>

<hr />

<h2 id="abot-n1">41. ABot-N1 (2026)</h2>
<p>———基于慢速认知与快速控制双系统架构的通用视觉语言导航基础模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.10383v2">arXiv:2607.10383</a> · <a href="https://amap-cvlab.github.io/ABot-Navigation/ABot-N1/">Project Page</a> · <a href="https://github.com/amap-cvlab/ABot-Navigation/tree/ABotN-Bench">Benchmark</a>（仅开源评测基准与数据集，模型权重与训练代码未公开）</p>

<h3 id="精华-29">精华</h3>
<ol>
  <li><strong>慢速-快速双系统解耦</strong>：将低频慢速的高维认知推理（System 2）与高频快速的低维反应性控制（System 1）进行时间尺度与计算资源解耦，消除了端到端黑盒模型的认知-控制动态错配。</li>
  <li><strong>统一的像素目标接口</strong>：通过输出可通行像素（Affordance Pixel）和目标像素（Target Pixel），将点导航、指令导航、物体导航、POI导航和行人跟随这五类异构任务统一为“在CoT解释下跟踪图像像素锚点”的问题，实现极佳的跨任务正向迁移。</li>
  <li><strong>GRPO对齐与安全可达性</strong>：首次在导航基础模型中引入基于GRPO的强化学习对齐，设计了非对称指数安全边界惩罚与基于GSNR的平衡采样策略，将模型决策直接与任务完成度和可通行安全性挂钩。</li>
  <li><strong>精细的可解释性与安全性审计</strong>：人机可读的CoT文本链配合图像空间内的像素目标，使得导航决策的每一步都清晰透明，开发人员可以精准定位失败瓶颈是源于语义推理还是空间对齐。</li>
  <li><strong>城市级自主导航与新基准</strong>：展示了仅依赖低精度SD地图即可在复杂城市街区实现长程避障、路口选择、人行道和红绿灯遵从的鲁棒四足机器人导航，并开源了 ABotN-PointBench 与 ABotN-POIBench。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-28">1. 研究背景/问题</h3>
<p>传统的视觉语言导航（VLN）模型主要依赖端到端的多模态黑盒策略将观测直接映射到控制动作，但它们在向真实世界机器人部署时面临三大痛点：</p>
<ul>
  <li><strong>去往点目标导航的偏移</strong>：在无高精地图导航时，由于地图路由或定位漂移，输入的本车局部坐标目标点常被偏移至车道、绿化带等物理不可达区域，导致常规模型停滞或违规。</li>
  <li><strong>去往目标物导航的语义遗忘与混淆</strong>：端到端微调容易侵蚀预训练VLM的通用语义先验，且将“搜索”和“接近”两阶段混为一谈，导致训练发散且难以进行失败归因。</li>
  <li><strong>缺乏可解释性与安全审计</strong>：黑盒端到端映射缺乏显式决策痕迹，开发人员难以断定失败是源于物理感知错误、逻辑推理还是底层控制。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-26">2. 主要方法/创新点</h3>

<h4 id="-整体框架概述-10">① 整体框架概述</h4>
<p>ABot-N1 提出了一个模块化的慢速-快速双系统架构（Slow-Fast Architecture）。慢速系统（System 2）是一个 4B 参数的高容量 VLM（Qwen-3.5-4B），负责低频 deliberative 逻辑推理，输出显式思维链（CoT）及投影到当前三相机视角（tri-view）上的像素目标（Pixel Goal）。快速系统（System 1）是一个 2B 参数的轻量级 VLM（Qwen-3.5-2B），作为高频动作专家（Action Expert），实时融合当前的相机输入与慢速系统输出的 CoT 及像素目标，解算出机器人底层的连续控制路点（Waypoints）。</p>

<div align="center">
  <img src="/images/vln/ABot-N1-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1330/1128" />
<figcaption>图1：ABot-N1 慢速推理与快速执行架构概览</figcaption>
</div>

<h4 id="-逐模块讲解-8">② 逐模块讲解</h4>

<h5 id="慢速系统system-2---逻辑推理器">慢速系统（System 2 - 逻辑推理器）</h5>
<ul>
  <li><strong>输入</strong>：参考历史记忆帧（用 \(I_{1:K}^{\text{ref,mem}}\) 表示）、当前三相机观测视角 \(I_{\text{ref,tri}}\)（包含左、前、右三个相机的 RGB 图像）、当前的任务语言指令 $g = \ell$，以及上一决策周期的推理输出 $(C_{n-1}, p_{n-1})$，输入先前的决策有助于在长程任务中维持时序一致性。</li>
  <li><strong>处理过程</strong>：基于 Qwen-3.5-4B 强大的预训练多模态能力，执行显式的思维链（Chain-of-Thought）推理。该推理在语义复杂的任务（如指令导航和物体搜索）中激活，解析任务指令的当前进度（例如“已完成子指令A，正在执行B”），并结合视觉语义进行空间的可通行性分析。</li>
  <li><strong>输出</strong>：显式自然语言 CoT 推理轨迹 $C_n$ 和一组投影在 tri-view 视角中的像素目标（Pixel Goal）$p_n$。像素目标包含两种：
    <ol>
      <li><strong>可通行像素（Affordance Pixel）</strong>：图像中标记可安全通行区域的前方路点（在室内通常代表前方约3米，室外约5米的可达平整路面）。</li>
      <li><strong>目标像素（Target Pixel）</strong>：指示具体任务目标的图像像素点（例如目标物件的质心、POI 商铺入口的底部中点或所追踪行人的底部中点），仅在目标可见或进入最终接近阶段时激活。</li>
    </ol>
  </li>
  <li><strong>设计动机</strong>：将复杂的开放词表语义识别和社交规约推理从快速控制反馈中分离开来，使大模型的庞大语义先验可以在不阻塞高频底层的实时控制循环的前提下被充分利用。另外，可通行像素与目标像素作为统一桥梁，解耦了导航的拓扑语义决策和运动学轨迹执行。</li>
</ul>

<h5 id="快速系统system-1---动作专家">快速系统（System 1 - 动作专家）</h5>
<ul>
  <li><strong>输入</strong>：高频实时的相机观测 \(I_{\text{cur,tri}}\)、高频局部记忆帧 \(I_{1:K}^{\text{cur,mem}}\)、慢速系统提供的最新 CoT 轨迹 $C_n$ 与像素目标 $p_n$、慢速系统决策时的参考视图 \(I_{\text{ref,tri}}\)（用于对齐像素空间）以及全局任务目标 $g$。</li>
  <li><strong>处理过程</strong>：首先通过 Qwen-3.5-2B 的多模态编码器提取融合状态 $h_t$，随后设计一组可学习的动作查询（Action Queries） $q_{\text{act}}$，利用类 QFormer 的交叉注意力机制从融合特征中蒸馏导航控制表征。最后由多层感知机（MLP）头解码该表征。</li>
  <li><strong>输出</strong>：预测未来 $H=5$ 个步骤的连续二维控制路点 $a_{t:t+H}$。每个路点包含相对于本车的 $SE(2)$ 位姿 $(x_i, y_i, \sin\theta_i, \cos\theta_i)$ 以及一个用于指示是否到达最终终点的二分类 Arriving 标志位 $c_i$。</li>
  <li><strong>设计动机</strong>：由于慢速系统已经通过思维链和图像坐标点将轨迹规划模式化（例如：左转避障或右转绕行），高频的 System 1 面临的动作空间回归分布基本上退化成了单峰（unimodal）问题。这使得 System 1 能够非常稳定高效地仅通过 Smooth-$L1$ 损失进行训练，无需复杂的扩散模型（Diffusion）或高斯混合（GMM）动作头。同时，高频控制能够动态避障，并在慢速推理周期之间通过持续追踪像素点来消除控制延迟。</li>
</ul>

<div align="center">
  <img src="/images/vln/ABot-N1-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/823" />
<figcaption>图2：ABot-N1 慢速认知系统与快速控制专家双系统设计</figcaption>
</div>

<h4 id="-端到端数据流-1">③ 端到端数据流</h4>
<p>对于任意的具身任务，如“寻找最近的绿色垃圾桶”：</p>
<ol>
  <li>慢速系统接收当前环境的 tri-view 图像以及命令，开始执行 CoT 推理（定位垃圾桶并在画面中寻找一条绕开茶几的路线），并在 tri-view 的前置相机上输出 Affordance Pixel（指向绕行通路）和 Target Pixel（标注在检测到的垃圾桶上）。</li>
  <li>快速系统在 10Hz 频率下闭环运行，利用最新的 Affordance/Target 像素在图像上的变化，连续解算输出路点。</li>
  <li>机器人沿避障轨迹行进，直到 slow 系统评估抵达垃圾桶，发出 Target Pixel 并将 Arriving 标志 $c_i$ 设为 1，触发 Arrive 停止。</li>
</ol>

<h4 id="-训练目标与损失函数-1">④ 训练目标与损失函数</h4>
<ul>
  <li><strong>模仿预训练阶段</strong>：
    <ul>
      <li>慢速系统损失：交叉熵语言建模损失 $L_{\text{CE}}$，对 CoT 文本 Token 以及像素目标坐标对应的 Token 序列进行监督。</li>
      <li>快速系统损失：Smooth-$L1$ 位置回归损失、Smooth-$L1$ 航向角正余弦值回归损失，以及二分类交叉熵到达损失 $L_{\text{arrive}}$。</li>
    </ul>
  </li>
  <li><strong>GRPO 强化学习对齐阶段</strong>：
为了让慢速系统生成的像素目标直接符合可通行安全与真实任务成功率，使用 GRPO 算法优化慢速系统的参数：
\(L_{\text{GRPO}}(\theta) = \mathbb E \left[ \sum_{i,t} \min\left(\rho_t^{(i)} A^{(i)}, \text{clip}(\rho_t^{(i)}, 1\pm\epsilon)A^{(i)}\right) \right] - \beta \mathbb{D}_{\text{KL}}(\pi_\theta \parallel \pi_{\text{ref}})\)
奖励函数设计：$R = w_f R_{\text{format}} + w_t R_{\text{target}} + w_o R_{\text{safety}}$
    <ol>
      <li>格式奖励 $R_{\text{format}}$：指示输出是否符合规定的 JSON Schema，若不符合直接零分。</li>
      <li>目标对齐奖励 $R_{\text{target}}$：使用指数核衡量预测像素 $\hat{p}$ 与地面真值 $p^\star$ 在三视图中的 L2 距离：
\(R_{\text{target}} = \sum_{\text{frame}} \alpha_t \exp\left( - \frac{\lVert \hat{p} - p^\star \rVert^2}{\text{scale}} \right)\)</li>
      <li>安全净空奖励 $R_{\text{safety}}$：将预测的 Affordance 像素反投影回 3D 空间，计算与最近非通行区域（如车道、花坛、障碍物）的真实距离 $d$：
\(R_{\text{safety}}(d) = \begin{cases} -\alpha_0, &amp; d \ge d_{\text{safe}} \\ -\alpha_0 \exp\left( \beta(d_{\text{safe}} - d) \right), &amp; d &lt; d_{\text{safe}} \end{cases}\)
        <ul>
          <li><strong>基于 GSNR 的平衡数据采样（Balanced Sampling）</strong>：
由于安全奖励 $R_{\text{safety}}$ 在危险边缘的方差呈指数级增长，会导致梯度不稳定性。ABot-N1 通过求解 Var($R_{\text{safety}}$) 的阈值，过滤掉极度危险的 prompts，并将剩余训练样本按 GSNR（梯度信噪比）划分为 <strong>安全区（Safe Zone, 占比 50%）</strong>、<strong>临界区（Critical Zone, 占比 30%）</strong> 和 <strong>危险区（Danger Zone, 占比 20%）</strong> 进行 5:3:2 混合采样，以实现稳定的策略提升。</li>
        </ul>
      </li>
    </ol>
  </li>
</ul>

<h4 id="-推理流程与部署架构">⑤ 推理流程与部署架构</h4>
<p>在实际的四足机器人部署中，为克服 Jetson 边缘计算硬件的局限性，在推理时：</p>
<ul>
  <li>慢速系统模型进行了规模压缩（从 4B 压缩为 2B 参数的 Qwen-3.5-2B）。</li>
  <li>快速系统进一步平替为带 306M 参数的扩散 Transformer (DiT)，并用轻量的 DINOv2-Base 进行视觉编码。</li>
  <li>两系统异步并行运行：慢速系统在 GPU 空闲时异步生成全局决策，快速系统则以 10Hz 稳定读取最新缓存并进行高频运动控制，极大地降低了端到端控制的时延。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-27">3. 核心结果/发现</h3>
<p>ABot-N1 在五项核心导航任务上均打破了先前的 SOTA 纪录，并且多任务联合训练模型匹配或超越了专门微调的单任务专家（Task Specialists），验证了正向跨任务迁移的优势：</p>
<ul>
  <li><strong>指令导航 (Instruction-Following)</strong>：在 Habitat R2R-CE 验证集上实现 <strong>70.89%</strong> 的成功率 (SR) 和 <strong>67.5%</strong> 的 SPL，大幅超越以往所有基于深度/里程计的强 baseline 模型；在 RxR-CE 上亦取得 SOTA 级别的 <strong>3.13米</strong> 平均导航误差 (NE)。</li>
  <li><strong>物体搜索 (Object-Goal)</strong>：在短视距 OVON 测试中，将成功率提升至 <strong>84.9%</strong>，SPL 提升至 <strong>51.8%</strong>，且终点距目标物的平均距离 (DTG) 相比上一代 ABot-N0 缩减了一半 (0.82m vs 1.44m)，展示了极高的最后阶段逼近精度。</li>
  <li><strong>点目标导航 (Point-Goal)</strong>：在全新发布的城市级基准 ABotN-PointBench 户外 Split 上，ABot-N1 联合模型在最难的高阶难度下，成功率相比 ABot-N0 跃升了 <strong>+22.7%</strong> (达到 <strong>88.0%</strong>)，在所有难度下均取得了最优的成功率（整体 <strong>92.9%</strong>）和社交合规度；室内 Split 下同样获得了 <strong>95.4%</strong> 的极高成功率。</li>
  <li><strong>POI 导航 (POI-Goal)</strong>：在商铺环境闭环基准 ABotN-POIBench 上，成功率相较于以往最强基准大幅跃升了 <strong>+35.0%</strong>，达到 <strong>77.3%</strong>，验证了利用 slow-fast 机制将商铺招牌语义识别与入口避障路径规划结合的高效性。</li>
  <li><strong>行人跟随 (Person-Following)</strong>：在 EVT-Bench 上，在存在其他行人干扰 (DT split) 和遭遇频繁严重遮挡 (AT split) 的场景下，分别取得了 <strong>84.4%</strong> 和 <strong>87.8%</strong> 的卓越追踪率 (TR)。</li>
</ul>

<hr />

<h3 id="4-局限性-27">4. 局限性</h3>
<ol>
  <li><strong>多任务联合下的碰撞率权衡</strong>：在行人追踪 (EVT-Bench) 场景的复杂遮挡 (AT) 及强干扰 (DT) 任务中，虽然追踪率 (TR) 与成功率 (SR) 达到最佳，但由于受混合预训练集中较激进的动作分布影响，碰撞率 (CR) 出现了轻微抬升 (17.9%)。未来有必要在 GRPO 阶段加入更显式的安全碰撞惩罚项来进行细化。</li>
  <li><strong>边缘部署时的性能-资源折衷</strong>：由于端侧算力限制，在真机部署时必须将慢速/快速模型分别进行参数压缩和架构置换（例如快速系统平替为 306M DiT）。这种异构硬件适配在一定程度上损失了原版 4B+2B Qwen 纯多模态大模型的完整表征能力。</li>
</ol>

<hr />

<h2 id="reflectvln">42. ReflectVLN (2026)</h2>
<p>———基于反思推理与双向交互机制的具身视觉语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.12680">arXiv:2607.12680</a> · 🏛️ <strong>IROS 2026</strong></p>

<h3 id="精华-30">精华</h3>

<ul>
  <li>将传统视觉语言导航（VLN）中”慢规划-快执行”的单向级联结构升级为<strong>意图 Agent 与执行 Agent 双向闭环交互架构</strong>。</li>
  <li>引入<strong>触发 Token 机制</strong>（<code class="language-plaintext highlighter-rouge">&lt;VLNBOA&gt;</code>, <code class="language-plaintext highlighter-rouge">&lt;VLNBOR&gt;</code>, <code class="language-plaintext highlighter-rouge">&lt;VLNBOC&gt;</code>），由执行 Agent 在导航过程中实时监测子目标完成度与偏航偏差，实现<strong>按需触发（On-demand）高层反思与重规划</strong>，避免了固定频率刷新的资源浪费与单向级联的语义脱节。</li>
  <li>提出 <strong>Action-CoT</strong>（路径条件双重查询训练机制），在预测短期动作前先预测隐式粗粒度未来路线，为局部控制引入全局拓扑路径约束。</li>
  <li>构建<strong>单轮反思驱动的数据生成流水线</strong>（Reflection-Driven Data Pipeline），收集策略 Rollout 失败样本并引入 Oracle 专家干预与 VLM 反思生成，经三方交叉验证生成高质纠错数据，无需大规模预训练或多轮迭代数据增强即可显著提升智能体在长程未知环境下的恢复能力。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-29">1. 研究背景/问题</h3>

<p>在连续环境视觉语言导航（VLN-CE）的长程执行过程中，机器人的微小控制误差容易不断累积导致偏航。现有高低层级解耦（Slow-Fast 或 Dual-System）方法大多采用单向通信：高层以固定频率输出语言子目标，低层单向执行，缺乏执行过程中的语义进度跟踪与故障诊断闭环。当机器人发生偏航时，高层无法及时接收偏差反馈，导致重规划滞后。此外，传统方法缺乏显式的反思（Reflection）机制来识别、诊断并修正导航失败。</p>

<div align="center">
  <img src="/images/vln/ReflectVLN-paradigm-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:499/720" />
<figcaption>ReflectVLN 与传统慢速-快速（Slow-Fast）/ 双系统导航框架的对比。(a) 传统级联方法单向传递子目标；(b) ReflectVLN 定义了三种触发 Token（&lt;VLNBOR&gt; 启动常规反思生成下一个子目标，&lt;VLNBOC&gt; 启动纠错反思诊断错误，&lt;VLNBBOA&gt; 维持纯动作执行）以按需闭环调控意图 Agent。</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-27">2. 主要方法/创新点</h3>

<p>ReflectVLN 架构由两个独立参数化的 Agent 组成：<strong>意图 Agent（Intention Agent, $\theta_{int}$）</strong> 和 <strong>执行 Agent（Execution Agent, $\theta_{exe}$）</strong>，均基于 Qwen2.5-VL-3B 模型初始化。</p>

<div align="center">
  <img src="/images/vln/ReflectVLN-architecture-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/737" />
<figcaption>ReflectVLN 整体架构图。意图 Agent 作为高层反思规划器接收视觉历史、自然语言指令及执行反馈，生成反思子目标描述；执行 Agent 条件化于子目标与当前观测，输出连续运动轨迹与调控后续双 Agent 交互的状态 Token。</figcaption>
</div>

<h4 id="-整体框架概述-11">① 整体框架概述</h4>
<p>系统由高层意图 Agent 与低层执行 Agent 构成。意图 Agent 负责全局长程指令的子任务分解与偏航反思；执行 Agent 负责在本地视场下将子目标落地为短期连续运动控制，并实时评估执行状态。两者通过显式的<strong>状态 Token 接口</strong>（Status Tokens）建立事件驱动的双向闭环通信，而非固定频次的单向指令下发。</p>

<h4 id="-逐模块讲解-9">② 逐模块讲解</h4>

<ul>
  <li><strong>意图 Agent（Intention Agent, $\theta_{int}$）</strong>
    <ul>
      <li><strong>输入</strong>：全局自然语言指令 $\ell$、单目 RGB 历史观测 $I_{t-H:t}$ 以及执行 Agent 发送的状态触发信号 $z_t \in {R, C}$。</li>
      <li><strong>处理过程</strong>：基于 VLM 的多模态理解与生成能力，当接收到常规触发信号 $z_t = R$（<code class="language-plaintext highlighter-rouge">&lt;VLNBOR&gt;</code>）时，结合路线进度生成下一个可执行子目标描述 $c_t$；当接收到纠错触发信号 $z_t = C$（<code class="language-plaintext highlighter-rouge">&lt;VLNBOC&gt;</code>）时，诊断偏航原因并输出带有矫正动作的子目标描述。</li>
      <li><strong>输出</strong>：结构化的自然语言子目标文本 $c_t$。</li>
      <li><strong>设计动机</strong>：直接利用 VLM 的语言推理能力完成高级语义规划，避免引入额外的目标检测器或复杂的像素级目标标定。</li>
    </ul>
  </li>
  <li><strong>执行 Agent（Execution Agent with Action-CoT, $\theta_{exe}$）</strong>
    <ul>
      <li><strong>输入</strong>：全局指令 $\ell$、当前语言子目标 $c_t$ 以及历史视觉观测 $I_{t-H:t}$。</li>
      <li><strong>处理过程（Action-CoT 路径条件双重查询）</strong>：
        <ol>
          <li>首先利用可学习的导航查询（Navigation Queries, $Q_{nav}$）预测较长视界的隐式粗粒度未来路线 \(\hat{P}_t = \text{MLP}_{nav}(f_{\theta_{exe}}(X, Q_{nav}))\)。</li>
          <li>将粗粒度路线特征 $E_{nav}$ 与动作查询（Action Queries, $Q_{act}$）拼接，预测短期控制动作 \(\hat{A}_t = \text{MLP}_{act}(f_{\theta_{exe}}(X, [E_{nav}; Q_{act}]))\)。</li>
          <li>同时利用语言生成头自回归预测一个离散的状态 Token $z_t \in {A, R, C}$。</li>
        </ol>
      </li>
      <li><strong>输出</strong>：连续运动控制量 \(\hat{A}_t\)（包含平面相对位移 $(\Delta x_t, \Delta y_t)$、朝向角 $(\cos\phi_t, \sin\phi_t)$ 和停止概率 logit $s_t$）以及交互状态 Token $z_t$。</li>
      <li><strong>设计动机</strong>：打破传统的纯文本 CoT 模式，将”思考（Thought）”建模为粗粒度未来路径约束，显式提升局部动作预测的路线时空一致性。</li>
    </ul>
  </li>
</ul>

<h4 id="-闭环数据流与交互逻辑">③ 闭环数据流与交互逻辑</h4>
<ol>
  <li>初始时刻，意图 Agent 生成首个子目标 $c_1$。</li>
  <li>每个时间步 $t$，执行 Agent 根据 $c_t$ 与视觉历史输出短程动作 \(\hat{A}_t\) 及状态 Token $z_t$。</li>
  <li>若 $z_t = \langle \text{VLNBOA} \rangle$，执行 Agent 独立运行短期控制，不调用高层意图 Agent；</li>
  <li>若 $z_t = \langle \text{VLNBOR} \rangle$，表明当前子目标已完成，触发意图 Agent 生成下一个常规子目标；</li>
  <li>若 $z_t = \langle \text{VLNBOC} \rangle$，表明代理检测到严重偏航，触发意图 Agent 进行错误诊断并输出纠错子目标。</li>
</ol>

<h4 id="-训练目标与损失函数-2">④ 训练目标与损失函数</h4>

<ul>
  <li>
    <p><strong>Stage I: Action-CoT 预训练</strong>
定义单个控制点预测损失为位置损失、朝向损失和停止损失的组合：
\(\mathcal{L}_{traj}(\hat{U}, U^*) = \lambda_{pos} \mathcal{L}_{pos} + \lambda_{ang} \mathcal{L}_{ang} + \lambda_{stop} \mathcal{L}_{stop}\)
Action-CoT 预训练总损失结合了短期动作损失与粗粒度路线损失：
\(\mathcal{L}_{WP} = \mathcal{L}_{traj}(\hat{A}, A^*) + \beta \mathcal{L}_{traj}(\hat{P}, P^*)\)
其中设置权重 $\lambda_{pos} = \lambda_{ang} = \lambda_{stop} = 1.0$，路线正则权重 $\beta = 0.1$。</p>
  </li>
  <li>
    <p><strong>Stage II: 状态感知联合微调</strong></p>
    <ul>
      <li><strong>意图 Agent 目标</strong>：对常规请求与纠错请求进行自回归语言建模：
\(\mathcal{L}_{int}^{(z)} = -\sum_{j=1}^{T} \log p_{\theta_{int}}(y_j^* \mid y_{&lt;j}^*, \ell, I_{t-H:t}, z)\)</li>
      <li><strong>执行 Agent 目标</strong>：联合预测动作与状态 Token：
\(\mathcal{L}_{exe} = \mathbf{1}[z_t^* = A] \mathcal{L}_{WP} + \lambda_{status} \mathcal{L}_{status}\)
其中 \(\mathcal{L}_{status} = -\log p_{\theta_{exe}}(z_t^* \mid \ell, c_t, I_{t-H:t})\)。</li>
    </ul>
  </li>
</ul>

<h4 id="-反思驱动的数据构建流水线">⑤ 反思驱动的数据构建流水线</h4>

<div align="center">
  <img src="/images/vln/ReflectVLN-reflective-data-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/559" />
<figcaption>反思驱动的数据生成流水线。(1) 专家数据收集；(2) 策略 Rollout 产生偏航失败，调用 Oracle 专家计算救援轨迹并由 VLM 生成反思文本；(3) 质量过滤与三方交叉验证，产出高质量反思纠错训练集。</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-28">3. 核心结果/发现</h3>

<p>在 Matterport3D 上的标准连续环境视觉语言导航基准（R2R-CE 与 RxR-CE Val-Unseen）上进行了全面评估：</p>

<div align="center">
  <img src="/images/vln/ReflectVLN-qualitative-examples.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:975/779" />
<figcaption>R2R Val-Unseen 上的定性可视化对比。上方：子目标落地与进度跟踪；下方：离轨偏航检测与基于闭环重规划的成功纠错恢复。</figcaption>
</div>

<ol>
  <li><strong>SOTA 导航性能</strong>：
    <ul>
      <li><strong>R2R-CE 基准</strong>：在纯单目 RGB 条件下取得 <strong>62.8% 的成功率（SR）</strong> 和 <strong>58.5% 的 SPL</strong>（相比 StreamVLN 基线 SR 提升 5.9 个百分点，与 DualVLN 的 58.5% SPL 持平）。</li>
      <li><strong>RxR-CE 基准</strong>：在长指令复杂的 RxR-CE 上取得 <strong>66.0% 的成功率（SR）</strong> 和 <strong>57.2% 的 SPL</strong>（相比 StreamVLN 基线 SR 提升 13.1 个百分点，超越了基于 7B 模型的 DualVLN 的 61.4% SR / 51.8% SPL）。</li>
    </ul>
  </li>
  <li><strong>高数据与参数效率</strong>：
    <ul>
      <li>相比于 DualVLN（7B 模型、12M 训练样本、引入 ScaleVLN 额外数据）和 CorrectNav（7B 模型、多轮飞轮迭代），ReflectVLN 仅使用 <strong>2×3B 参数架构</strong> 和 <strong>1.5M 专家数据 + 100k 单轮反思数据</strong>，即取得了更优的整体表现。</li>
    </ul>
  </li>
  <li><strong>消融实验与按需触发效率</strong>：
    <ul>
      <li><strong>Action-CoT 作用</strong>：引入路径条件粗粒度路线预测使 SR 从 52.8% 提升至 60.0%，SPL 从 50.1% 提升至 57.2%。</li>
      <li><strong>按需触发（On-demand）优势</strong>：相比于固定步长触发（如每 4 步或 12 步调用一次高层），按需触发取得了最高成功率（62.8% vs 61.8%/59.4%）。</li>
      <li><strong>高层调用频次</strong>：在推理阶段，意图 Agent 平均每 <strong>9.63 个执行步</strong>才被触发调用一次，显著降低了慢系统高层语言推理的计算负担。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-28">4. 局限性</h3>

<ul>
  <li>本文解耦双 Agent 架构独立使用 2 个 3B 模型（总参数量为 6B），与单体 7B 模型的消融对比未严格控制总参数量对齐；</li>
  <li>评价指标主要侧重于按需触发的高层调用频次（Invocation frequency），未来仍需在实际硬件设备上进一步度量端到端延迟（Latency）与实际 FLOPs 功耗开销。</li>
</ul>

<hr />

<h2 id="tuckernav">43. TuckerNav (2026)</h2>
<p>———面向全天候多场景终身具身视觉语言导航的 Tucker 张量自适应</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.14276">arXiv:2603.14276</a> · 🏛️ <strong>ICLR 2026</strong></p>

<h3 id="精华-31">精华</h3>

<ul>
  <li><strong>全新全天候终身导航范式 (AML-VLN)</strong>：首次形式化提出全天候多场景终身视觉语言导航问题并构建 Benchmark，评估具身智能体在跨场景拓扑与多光照/恶劣环境（正常、低光、强光过曝、散射/雾天）下连续自适应与防忘能力。</li>
  <li><strong>高阶张量微调 (Tucker Adaptation, TuKA)</strong>：突破经典 LoRA/MoE-LoRA 仅能表示二维双层知识（全局共享 + 任务特定）的结构瓶颈，将微调参数提升至高维张量空间，基于 Tucker 分解显式解耦出“通用导航技能 + 场景特定拓扑 + 环境特定物理”的多层级高维知识。</li>
  <li><strong>解耦知识增量学习 (DKIL)</strong>：结合基于 Fisher 信息的弹性权重巩固（EWC）、已知专家一致性约束（Consistency Constraint）与新专家行空间正交优化（Orthogonal Optimization），有效防止新旧子空间领域的参数污染与灾难性遗忘。</li>
  <li><strong>测试期无 Task-ID 自适应检索</strong>：构建基于预训练 CLIP 视觉特征的场景与环境双层检索机制（Task-Specific Experts Search），测试阶段无需显式 Task ID 即可自动精准匹配当前视场的最优场景与环境专家。</li>
  <li><strong>SOTA 性能与卓越泛化性</strong>：在包含 24 项连续任务的 Benchmark 上，AlldayWalker 智能体导航成功率 SR 达到 65%（显著超越 SD-LoRA 的 56% 与 BranchLoRA 的 44%），遗忘率 F-SR 降至 11%，并在 6 项全新未见任务中实现 55% 的零样本泛化 SR。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-30">1. 研究背景/问题</h3>

<p>传统的视觉语言导航（Vision-and-Language Navigation, VLN）研究通常假设智能体部署在静态且光照理想的单一场景中。然而在真实世界应用中，具身导航智能体必然需要面临<strong>全天候环境变化</strong>（昼夜正常光、夜间低光、强光过曝、恶劣散射/雾天）以及<strong>跨多场景持续迁移</strong>的挑战。当智能体按顺序连续学习多个场景与环境下的导航任务时，模型参数会被新任务急剧覆盖，导致对历史旧场景的严重灾难性遗忘（Catastrophic Forgetting）。</p>

<p>现有的参数高效微调方法（如 Vanilla LoRA，或基于 MoE 的 HydraLoRA、BranchLoRA、SD-LoRA 等）普遍通过低秩矩阵进行微调。这些方法本质上是在二维矩阵空间内建模，仅能将知识抽象为“共享矩阵 + 专属矩阵”的双层级结构（即全局通用知识与任务专属知识）。但是在 AML-VLN 任务中，导航知识跨越了多个不同层级：通用导航移动动作、场景特定拓扑结构、以及环境特定的物理成像规律。现有的低秩矩阵微调方法无法显式表示和解耦这种多层级的高维复杂知识，导致参数重用率低下、多领域特征严重交织混淆，难以兼顾增量自适应与跨场景/环境防忘。</p>

<div align="center">
  <img src="/images/vln/TuckerNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/669" />
<figcaption>面向全天候多场景终身视觉语言导航（AML-VLN）的总体概念与自适应挑战</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-28">2. 主要方法/创新点</h3>

<h4 id="-整体框架概述-12">① 整体框架概述</h4>

<p>针对全天候多场景终身导航（AML-VLN）的挑战，本文提出了 <strong>Tucker Adaptation (TuKA)</strong> 架构与 <strong>Decoupled Knowledge Incremental Learning (DKIL)</strong> 增量学习机制，并构建了 <strong>AlldayWalker</strong> 终身导航智能体。系统将 Transformer 层的自适应权重映射至高维张量空间，通过 Tucker 分解（Tucker Decomposition）将高维张量显式拆解为捕捉全局通用导航能力的 Core Tensor、编解码维度投影矩阵，以及按场景和环境解耦的向量专家库。在连续学习阶段，DKIL 策略在共享与专属子空间上施行差异化约束；在推理阶段，智能体利用基于 CLIP 视觉特征的双层匹配检索，在无需 Task-ID 的情况下自动调取最优的场景与环境专家组合。</p>

<div align="center">
  <img src="/images/vln/TuckerNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/473" />
<figcaption>传统 LoRA、HydraLoRA 与本文 Tucker Adaptation (TuKA) 高维张量架构对比</figcaption>
</div>

<h4 id="-逐模块讲解-10">② 逐模块讲解</h4>

<h5 id="1-高阶-tucker-张量自适应-tucker-adaptation-tuka">1. 高阶 Tucker 张量自适应 (Tucker Adaptation, TuKA)</h5>
<ul>
  <li><strong>输入/输出与张量升维</strong>：对于 Transformer 第 \(l\) 层的骨干权重 \(W_0^l \in \mathbb{R}^{a_l \times b_l}\)，传统 LoRA 引入二维矩阵增量 \(\Delta W^l = B^l A^l\)。TuKA 将自适应升维至四阶高维张量 \(\mathcal{X}^l \in \mathbb{R}^{a_l \times b_l \times M \times N}\)（其中 \(M\) 为场景总数，\(N\) 为环境模式数）。</li>
  <li><strong>Tucker 张量分解</strong>：将四阶张量 \(\mathcal{X}^l\) 进行 Tucker 分解：
\(\mathcal{X}^l = \mathcal{G} \times_1 U_1 \times_2 U_2 \times_3 U_3 \times_4 U_4\)</li>
  <li><strong>子结构设计与功能</strong>：
    <ul>
      <li><strong>核心张量 \(\mathcal{G} \in \mathbb{R}^{r_1 \times r_2 \times r_3 \times r_4}\)</strong>：捕获所有特征维度与模式间的交叉交互信息，用于学习所有导航任务共享的核心通用导航技能（Task-Shared Knowledge）。</li>
      <li><strong>共享解码器 \(U_1 \in \mathbb{R}^{a_l \times r_1}\) 与编码器 \(U_2 \in \mathbb{R}^{b_l \times r_2}\)</strong>：负责高维张量与底层 LLM 二维矩阵特征空间之间的维度转换与对齐。</li>
      <li><strong>场景专家矩阵 \(U_3 \in \mathbb{R}^{M \times r_3}\)</strong>：包含 \(M\) 组场景专家，第 \(s\) 行 \(U_3[s, :]\) 显式表示第 \(s\) 个具体场景的特定拓扑与结构知识。</li>
      <li><strong>环境专家矩阵 \(U_4 \in \mathbb{R}^{N \times r_4}\)</strong>：包含 \(N\) 组环境专家，第 \(e\) 行 \(U_4[e, :]\) 显式表示第 \(e\) 个退化环境（正常、低光、过曝、散射）的视觉物理感知知识。</li>
    </ul>
  </li>
  <li><strong>任务增量权重切片导出</strong>：对于第 \(t\) 个场景 \(S_s\) 和环境 \(E_e\) 下的导航任务 \(T_t = \{S_s, E_e\}\)，从高阶张量中抽取特定模式切片计算最终的增量权重：
\(\Delta W_t = U_1 \cdot \left( \mathcal{G} \times_3 U_3[s, :] \times_4 U_4[e, :] \right) \cdot (U_2)^T\)</li>
</ul>

<h5 id="2-解耦知识增量学习-decoupled-knowledge-incremental-learning-dkil">2. 解耦知识增量学习 (Decoupled Knowledge Incremental Learning, DKIL)</h5>

<div align="center">
  <img src="/images/vln/TuckerNav-dkil.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1113/425" />
<figcaption>解耦知识增量学习 (DKIL) 策略：在共享与特定知识子空间上的继承、一致性约束与正交优化</figcaption>
</div>

<ul>
  <li><strong>共享知识继承与 EWC 巩固</strong>：连续学习新任务 \(T_t\) 时，继承已更新的全局共享参数 \(\{\mathcal{G}, U_1, U_2\}\)。为了防止更新共享部分导致对早期任务的知识破坏，引入基于 Fisher 信息矩阵的弹性权重巩固（EWC Loss）：
\(\mathcal{L}_{\text{ewc}, t} = \lambda_1 \left( \|F_{\mathcal{G}, t-1} \odot (\mathcal{G} - \mathcal{G}')\|_F^2 + \|F_{U_1, t-1} \odot (U_1 - U_1')\|_F^2 + \|F_{U_2, t-1} \odot (U_2 - U_2')\|_F^2 \right)\)
其中 Fisher 矩阵使用滑动平均公式在连续学习中平滑更新：\(F_{\theta, t} = \omega \cdot F_{\theta, t-1} + (1-\omega) \cdot F_{\theta, t}\)。</li>
  <li><strong>已知专家一致性约束 (Consistency Loss)</strong>：若新任务用到了此前已经学习过的场景 \(s\) 或环境 \(e\)，对已有的专家行 \(U_3[s, :]\) 或 \(U_4[e, :]\) 施加一致性惩罚，防止重复训练破坏已有模式：
\(\mathcal{L}_{\text{co}} = \lambda_2 \left( \alpha \|U_3[s, :] - U_3'[s, :]\|_F^2 + \beta \|U_4[e, :] - U_4'[e, :]\|_F^2 \right)\)
其中当场景或环境此前已学过时，对应指示变量 \(\alpha\) 或 \(\beta\) 设为 1。</li>
  <li><strong>未见新专家行空间正交优化 (Orthogonal Optimization)</strong>：对于未见过的新场景或新环境，冻结其他无关专家，仅更新当前专属行 \(U_3[s, :]\) 或 \(U_4[e, :]\)，并施加行空间正交约束，确保新旧专家子空间保持正交垂直，消除干涉：
\(\mathcal{L}_{\text{es}} = \lambda_3 \left( (1-\alpha) \|\hat{U}_3 \hat{U}_3^T - I\|_F^2 + (1-\beta) \|\hat{U}_4 \hat{U}_4^T - I\|_F^2 \right)\)</li>
</ul>

<h5 id="3-测试期任务专家自适应检索-task-specific-experts-search">3. 测试期任务专家自适应检索 (Task-Specific Experts Search)</h5>
<ul>
  <li><strong>特征库构建</strong>：训练阶段，利用预训练 CLIP 视觉编码器 \(V(\mathcal{O})\) 提取各个场景和环境下的观测图像特征，分别聚类构建场景特征库 \(\{F_{S_1}^e, \dots, F_{S_M}^e\}\) 和环境特征库 \(\{F_{E_1}^e, \dots, F_{E_N}^e\}\)。</li>
  <li><strong>无 Task-ID 两步余弦匹配</strong>：测试阶段，智能体面临未知导航环境 \(S_q\) 时，提取当前视野图特征 \(F_q^e = V(\mathcal{O}_q)\)，通过余弦相似度检索匹配最佳场景专家与环境专家：
\(s^* = \arg\max_s \text{Sim}(F_q^e, \{F_{S_m}^e\}), \quad e^* = \arg\max_e \text{Sim}(F_q^e, \{F_{E_n}^e\})\)
匹配到的专家向量输入 TuKA 张量生成公式，自动合成针对当前场景与光照的最佳微调权重，彻底摆脱对已知 Task-ID 的依赖。</li>
</ul>

<h5 id="4-allday-habitat-仿真平台与-aml-vln-benchmark">4. Allday-Habitat 仿真平台与 AML-VLN Benchmark</h5>

<div align="center">
  <img src="/images/vln/TuckerNav-habitatenv.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1115/266" />
<figcaption>Allday-Habitat 仿真平台生成的 4 种典型环境条件（正常光照、夜间低光、强光过曝、恶劣散射/雾天）</figcaption>
</div>

<div align="center">
  <img src="/images/vln/TuckerNav-benchmark.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:727/550" />
<figcaption>AML-VLN 终身导航 Benchmark 的 24 项任务序列：跨场景与环境维度的连续增量学习</figcaption>
</div>

<ul>
  <li><strong>3 种物理退化环境合成</strong>：
    <ul>
      <li><strong>大气散射模型（雾/散射）</strong>：\(I(x_i) = J(x_i) e^{-\beta d(x_i)} + A (1 - e^{-\beta d(x_i)})\)，其中 \(d(x_i)\) 为深度，\(\beta\) 为散射系数，\(A\) 为大气光。</li>
      <li><strong>非线性低光模型（夜间低光）</strong>：包含相机响应函数 (CRF)、增益曝光乘积及泊松-高斯混合噪声模型 \(N(x) = N_{\text{shot}}(x) + N_{\text{read}}(x)\)。</li>
      <li><strong>强光过曝模型</strong>：在相机感光前引入传感器动态范围上限饱和截断 \(\text{clip}(\cdot, 0, S_{\text{Sat}})\)。</li>
    </ul>
  </li>
  <li><strong>24-Task 终身评估序列</strong>：包含 5 个仿真场景与 2 个真实世界场景，结合 4 种环境，构建 24 项连续学习任务序列。评估指标除了包含标准 SR、SPL、OSR 外，还引入遗忘率指标 F-SR、F-SPL、F-OSR。</li>
</ul>

<h4 id="-训练与损失函数">③ 训练与损失函数</h4>

<p>整体微调目标函数结合了自回归导航动作生成的交叉熵损失与三大增量正则化损失：
\(\mathcal{L}_t = -\lambda \sum_{n=1}^N \log p_t(A_n, \hat{P}_n \mid I, \mathcal{O}_t) + \mathcal{L}_{\text{ewc}, t} + \mathcal{L}_{\text{co}} + \mathcal{L}_{\text{es}}\)
其中权重满足 \(\lambda = 1 - (\lambda_1 + \lambda_2 + \lambda_3)\)（实验设置 \(\lambda_1=0.2, \lambda_2=0.2, \lambda_3=0.1\)）。</p>

<hr />

<h3 id="3-核心结果发现-29">3. 核心结果/发现</h3>

<ul>
  <li><strong>24-Task AML-VLN Benchmark 综合评估</strong>：
    <ul>
      <li>在 24 项连续学习任务的完整序列测试中，基于 TuKA 的 <strong>AlldayWalker</strong> 取得了平均 <strong>65% 的成功率 (SR)</strong> 和 <strong>58% 的 SPL</strong>，大幅超越对比 baseline（包括 SD-LoRA 的 56%/50%、BranchLoRA 的 44%/39%、MoLA 的 33%/26% 以及 EWC-LoRA 的 15%/9%）。</li>
      <li>在<strong>抗遗忘性能 (Forgetting Rate)</strong> 上，AlldayWalker 的 SR 遗忘率 F-SR 仅为 <strong>11%</strong>（相比之下 SD-LoRA 为 18%、BranchLoRA 为 36%、Sequential Fine-Tuning 为 87%），表现出极高的终身记忆稳定性。</li>
    </ul>
  </li>
  <li><strong>高阶张量阶数消融 (3rd vs 4th vs 5th order Tensor)</strong>：
    <ul>
      <li>对比将场景与环境耦合在一起的三阶张量 \(\mathcal{X} \in \mathbb{R}^{a \times b \times (M \times N)}\)，四阶张量通过显式解耦场景模式与环境模式，在所有 20 项测试任务上取得全面超越的 SR 曲线。附录进一步验证了五阶张量在引入更细粒度任务模式时的良好扩展性。</li>
    </ul>
  </li>
  <li><strong>共享组件的作用消融 (Core Tensor &amp; En/Decoder Sharing)</strong>：
    <ul>
      <li>去掉共享 Core Tensor \(\mathcal{G}\) 或共享编码器 \(U_2\) 会导致 SR 显著下降（由 65% 降至 53% 与 55%），证实共享张量和编码器成功学习到了跨任务通用的基础导航技能。共享解码器 \(U_1\) 则大幅降低了多任务存储开销（仅需 15.64M 参数）。</li>
    </ul>
  </li>
  <li><strong>未知场景零样本泛化 (Zero-Shot Generalization on Unseen Scenarios)</strong>：
    <ul>
      <li>在 6 个完全未见的全新场景与环境（G1-G6，包含仿真与真实世界低光/正常环境）上测试，AlldayWalker 依靠 CLIP 视觉检索匹配最相似专家，取得了 <strong>55% 的平均 SR</strong>，超越 SD-LoRA (39%) 达 16%，证明了高阶解耦表示具有优异的零样本泛化与泛化迁移能力。</li>
    </ul>
  </li>
</ul>

<hr />

<h3 id="4-局限性-29">4. 局限性</h3>

<ul>
  <li><strong>检索依赖 CLIP 特征质量</strong>：推理阶段的任务专家自适应匹配高度依赖预训练 CLIP 视觉编码器的表征能力；若遇到极其异常的极端成像降质（如强重度烟雾覆盖遮挡）导致视觉特征畸变，可能发生专家误匹配。</li>
  <li><strong>真实机械臂/移动机器人部署耗时</strong>：目前主要在仿真平台及有限的真实场景进行验证，在大规模复杂多楼层真实移动机器人终身在线部署中，仍需进一步优化高效在线索引与实时特征抽取推理耗时。</li>
</ul>

<hr />

<h2 id="agenticnav">44. AgenticNav (2026)</h2>
<p>———将零样本连续环境导航（VLN-CE）重构为 VLM 可调用的 Tool-Calling 架构</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.10577">arXiv:2606.10577</a></p>

<hr />

<h3 id="精华-32">精华</h3>
<ol>
  <li><strong>范式重构</strong>：将零样本连续环境视觉语言导航（VLN-CE）重新定义为 VLM 与环境之间的 Tool-Calling 交互 Harness，打破对额外训练的航点预测器（Waypoint Predictor）的依赖。</li>
  <li><strong>像素级无航点动作控制</strong>：提出 Action Tool，允许 VLM 直接在 RGB 图像中点选目标像素 $(u,v)$，由后台 Harness 完成反投影、地平面转向/步长计算与 swept-corridor 扫掠安全碰撞检查。</li>
  <li><strong>按需深度感知</strong>：设计 Pixel-Depth Tool，VLM 可按需查询特定像素的真实物理深度与 $5\times 5$ 局部深度统计信息，无需全量深度图或隐式预测。</li>
  <li><strong>轻量化 Agentic 记忆</strong>：构建结合鸟瞰图 Map Image 与按需 Recall Tool 的 Memory 机制，仅在必要时调取历史节点 RGB 视图，彻底解决 Prompt 上下文过载与跨 Episode 依赖问题。</li>
  <li><strong>SOTA 性能与实机泛化</strong>：在 R2R-CE 基准上，以 GPT-5.5 作为 VLM 核心实现 <strong>55% SR</strong> 与 <strong>48.41% SPL</strong>（大幅超越 SmartWay 的 44% SR / 35.04% SPL）；在真实四轮机器人与复杂室内外场景中展现出极强的 Zero-Shot Sim-to-Real 泛化能力。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-31">1. 研究背景/问题</h3>

<p>零样本连续环境视觉语言导航（Zero-Shot VLN-CE）要求智能体在未见过的 3D 物理场景中，无需预定义导航图（Navigation Graph）和策略微调，仅凭自然语言指令和视觉/深度感知完成连续运动控制。大语言/视觉语言模型（VLM）的飞速发展使其成为高层决策核心，但现有方法存在三大严重瓶颈：</p>
<ul>
  <li><strong>动作空间受限</strong>：Open-Nav、SmartWay 等 SOTA 方法普遍依赖额外训练的航点预测网络（Waypoint Predictor）来推荐候选动作点。若预测器未露出指令所需的关键方向/目标，VLM 将被局限在错误的候选集内，无法选出正确路径。</li>
  <li><strong>几何/深度感知缺失</strong>：现有架构将深度输入当作黑盒提供给航点预测器，或强制 VLM 直接解析复杂的密集深度图，导致 VLM 难以精准评估目标物体的物理距离与空间通达性。</li>
  <li><strong>记忆机制两难</strong>：传统方法通过不断向 Prompt 拼接历史文本/视觉帧来维护记忆，导致 Context 迅速过载并引入大量无关干扰；或者依赖跨 Episode（Cross-episode）经验检索（如 EvoNav），削弱了严格的零样本（Zero-shot）假设。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-29">2. 主要方法/创新点</h3>

<p>AgenticNav 将零样本 VLN-CE 重新构建为一种轻量级的 <strong>Tool-Calling Harness</strong>，将动作生成、深度感知与历史记忆解耦为 4 个可调用的工具接口（Action Tool, Depth Tool, Recall Tool, Stop Tool），在保留 VLM 语义推理与感知自由度的同时，将数值几何计算与安全检查交由确定性的物理 Harness 处理。</p>

<div align="center">
  <img src="/images/vln/AgenticNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/475" />
<figcaption>AgenticNav 与传统 Zero-Shot VLN-CE 架构对比：打破传统 Waypoint Predictor 的动作限制、全量深度图感知瓶颈与长 Prompt 记忆过载。</figcaption>
</div>

<div align="center">
  <img src="/images/vln/AgenticNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/702" />
<figcaption>AgenticNav 系统整体工作流：VLM 根据当前 RGB 与 Map Image 提出决策，可按需查询深度（Depth Tool）、调取历史视觉节点（Recall Tool），并通过点选 RGB 目标像素触发 Action Tool 执行安全运动。</figcaption>
</div>

<h4 id="-整体框架概述-13">① 整体框架概述</h4>
<p>AgenticNav 由 <strong>VLM 决策核心</strong> 与 <strong>四个确定性 Tool 接口</strong> 组成：</p>
<ol>
  <li><strong>Action Tool (<code class="language-plaintext highlighter-rouge">move_to</code>)</strong>：负责将 VLM 选中的图像像素转化为安全连续控制量。</li>
  <li><strong>Depth Tool (<code class="language-plaintext highlighter-rouge">query_depth</code>)</strong>：负责向 VLM 提供特定像素的精准物理距离与局部表面特征。</li>
  <li><strong>Agentic Memory (<code class="language-plaintext highlighter-rouge">Map Image</code> + <code class="language-plaintext highlighter-rouge">recall</code>)</strong>：负责维系全局轨迹感知与局部细节的按需检索。</li>
  <li><strong>Stop Tool (<code class="language-plaintext highlighter-rouge">stop</code>)</strong>：负责判断导航终止。</li>
</ol>

<h4 id="-逐模块讲解-11">② 逐模块讲解</h4>

<h5 id="1-waypoint-free-action-tool-move_tok-u-v">1. Waypoint-Free Action Tool (<code class="language-plaintext highlighter-rouge">move_to(k, u, v)</code>)</h5>
<ul>
  <li><strong>输入</strong>：VLM 选定的视角索引 $k$ 以及归一化像素坐标 $(u, v) \in [0,1]^2$。</li>
  <li><strong>处理过程</strong>：
    <ul>
      <li><strong>几何反投影</strong>：结合相机内参 $K$、外参 $T_k$ 及深度值 $d = D_t^k(x, y)$，将像素 $(x, y)$ 反投影为机器人坐标系下的 3D 目标点：
\(p_t = T_k \left( d K^{-1} [x, y, 1]^\top \right)\)</li>
      <li><strong>运动量计算</strong>：提取地平面方位角 $\theta = \text{bearing}(p_{t,xz})$，并根据最大步长限制 $\rho_{\max}$、停止边距 $m$ 及步长离散化间隔 $\Delta$ 计算实际前向距离：
\(\rho = \Delta \left\lfloor \frac{\min\left(\rho_{\max}, \max(0, \|p_{t,xz}\| - m)\right)}{\Delta} \right\rfloor\)</li>
      <li><strong>Swept-Corridor 扫掠安全检查</strong>：筛选出位于机器人身体高度区间 $[y_{\min}, y_{\max}]$ 内的所有障碍物点云集 $P_t$。沿着航向向量 $b_\theta = (-\sin\theta, \cos\theta)$ 与侧向向量 $\ell_\theta = (\cos\theta, \sin\theta)$ 检查机器人扫掠走廊内是否存在碰撞点：
\(\text{Safe}(\theta, \rho) = \mathbf{1} \left[ \nexists q \in P_t : 0 \lt q_{xz} \cdot b_\theta \lt \rho + r_a \land |q_{xz} \cdot \ell_\theta| \lt r_a \right]\)
其中 $r_a$ 为机器人半径。若检测到碰撞，返回 <code class="language-plaintext highlighter-rouge">Reselect</code> 反馈提示 VLM 重选；若安全则输出 <code class="language-plaintext highlighter-rouge">Execute(θ, ρ)</code>。</li>
    </ul>
  </li>
  <li><strong>设计动机</strong>：摒弃有监督训练的航点预测器，赋予 VLM 直接选择视觉场景中任意可视可达位置（如特定门缝、走廊尽头、家具旁）的自由。</li>
</ul>

<h5 id="2-on-demand-pixel-depth-tool-query_depthp">2. On-Demand Pixel-Depth Tool (<code class="language-plaintext highlighter-rouge">query_depth(P)</code>)</h5>
<ul>
  <li><strong>输入</strong>：候选像素点批量集合 \(P = \{ p_i = (k_i, u_i, v_i) \}_{i=1}^m\)。</li>
  <li><strong>处理过程</strong>：对每个查询点采样相位的深度图，返回结构化信息：
\(D(p_i) = \left( d_i, s_i^{5 \times 5}, \hat{\theta}_i, \hat{\rho}_i \right)\)
其中 $d_i$ 为物理深度（米），$s_i^{5 \times 5}$ 为以该像素为中心的 $5\times 5$ 窗口内的深度最小值、均值与中位数（用于判断是否落在边缘或平整表面），\(\hat{\theta}_i\) 与 \(\hat{\rho}_i\) 为预计算的动作预览。</li>
  <li><strong>设计动机</strong>：密集深度图对 VLM 而言极其难以定量解析。按需查询使 VLM 能够在决策前精准对比不同方向（如 “左侧通道是否畅通”、”前方开门处距离多远”），提供可靠的局部空间几何证据。</li>
</ul>

<h5 id="3-agentic-memory-与-visual-recall-tool">3. Agentic Memory 与 Visual Recall Tool</h5>
<ul>
  <li><strong>输入与结构</strong>：Episode 内记忆表示为 \(\mathcal{M}_t = (B_t, \mathcal{C}_t)\)。
    <ul>
      <li>$B_t$ 为直接放入 Prompt 中的<strong>拓扑 Map Image</strong>，直观展示历史轨迹节点与当前方位。</li>
      <li>\(\mathcal{C}_t\) 为过去所有观察视图的缓存。</li>
    </ul>
  </li>
  <li><strong>Recall 机制</strong>：当 VLM 需要核对早期路标（如 “刚才路过路口看到的指示牌”）时，调用 <code class="language-plaintext highlighter-rouge">recall(p, k)</code>，仅提取第 $p$ 步视角 $k$ 的单帧 RGB 图 \(R_t(p, k) = \mathcal{C}_t[p, k]\) 并追加到 Prompt 中。</li>
  <li><strong>设计动机</strong>：防止 Prompt 随导航步数暴增而溢出，避免无用视觉帧干扰 VLM 注意力，实现高效长程导航。</li>
</ul>

<h4 id="-推理与交互流程">③ 推理与交互流程</h4>
<ol>
  <li>初始时刻 VLM 接收语言指令、当前全景 RGB 图及初始 Map Image $B_t$。</li>
  <li>VLM 可根据需要多次调用 <code class="language-plaintext highlighter-rouge">query_depth</code> 评估感兴趣目标点的距离，或调用 <code class="language-plaintext highlighter-rouge">recall</code> 回溯特定历史视图。</li>
  <li>VLM 调用 <code class="language-plaintext highlighter-rouge">move_to</code> 输出目标像素；Harness 评估安全检查。若安全则驱动机器人移动并更新 Map Image；若不安全则反馈 <code class="language-plaintext highlighter-rouge">Reselect</code> 提示重新决策。</li>
  <li>达到目标区域后，VLM 调用 <code class="language-plaintext highlighter-rouge">stop()</code> 完成任务。</li>
</ol>

<hr />

<h3 id="3-核心结果发现-30">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/AgenticNav-realworld.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/841" />
<figcaption>真实世界机器人部署对比：AgenticNav 能够在无航点预测器约束下精准穿过狭窄门洞与长走廊，且在四视角模式下大幅超越 SmartWay。</figcaption>
</div>

<h4 id="1-r2r-ce-simulation-评估r2r-ceval-unseen-100-episodes">1. R2R-CE Simulation 评估（R2R-CEval Unseen 100 Episodes）</h4>
<p>在严格相同 VLM Backbone（GPT-5.5 / Gemini-2.5-Pro）下，AgenticNav 刷新了 Zero-Shot VLN-CE 性能记录：</p>
<ul>
  <li><strong>AgenticNav-GPT-5.5</strong> 取得了 <strong>55% SR</strong>、<strong>48.41% SPL</strong>、<strong>65% OSR</strong>、<strong>63.41 nDTW</strong> 和 <strong>5.19 m NE</strong>，相较于同 Backbone 重现的 SOTA Baseline <strong>SmartWay-GPT-5.5</strong>（SR 44%, SPL 35.04%），SR 提升 <strong>11%</strong>，SPL 显著提升 <strong>13.37%</strong>。</li>
  <li><strong>AgenticNav-Gemini-2.5-Pro</strong> 取得 <strong>49% SR</strong>，超越了 Open-Nav（23% SR）以及依赖跨 Episode 经验检索的 EvoNav（43% SR）。</li>
</ul>

<h4 id="2-消融实验分析ablation-study">2. 消融实验分析（Ablation Study）</h4>
<p>在 R2R-CE 上对各个 Tool 模块进行剥离测试：</p>
<ul>
  <li><strong>替换 Action Tool 为 Waypoint Predictor</strong>：SR 下降 5%（55% $\to$ 50%），SPL 下降 4.42%，证明自由选择视觉目标像素优于选择模型推荐的候选航点。</li>
  <li><strong>移除 Depth Tool</strong>：SR 骤降至 42%；若改为直接输入完整深度图，SR 恢复至 53%，但仍低于按需查询的 55%，证明结构化局部深度查询更契合 VLM 的推理模式。</li>
  <li><strong>移除 Agentic Memory</strong>：SR 跌至 41%；若仅保留 Map Image 而无 Recall Tool，SR 为 51%，证明 Visual Recall Tool 在长程/指示牌识别任务中不可或缺。</li>
</ul>

<h4 id="3-real-world-实机测试">3. Real-World 实机测试</h4>
<p>在包含实验室、办公区及户外庭院的 30 个复杂真实场景中部署于四轮全向机器人：</p>
<ul>
  <li><strong>单视角模式（1-view）</strong>：SR 达 33.3%，导航误差 NE 为 3.20m（SmartWay 为 23.3% / 3.57m）。</li>
  <li><strong>四视角模式（4-view）</strong>：SR 提升至 <strong>46.7%</strong>，NE 降至 2.67m，对比 SmartWay 成功率翻倍（在户外庭院等广角场景优势尤为显著）。</li>
</ul>

<hr />

<h3 id="4-局限性-30">4. 局限性</h3>

<ol>
  <li><strong>对基础 VLM 决策能力强依赖</strong>：失败分析表明，仿真中 88.9% 的失败及真实世界中 71.4% 的失败源自 VLM 本身的错误判断（如房间/分支选择错误或最终停靠偏离），硬件与控制失败仅占极小比例。</li>
  <li><strong>云端 API 延迟与网络依赖</strong>：依托云端大型 VLM API 带来了明显的推理时延与网络波动风险，限制了实时高频闭环控制能力。</li>
  <li><strong>环境假设依赖</strong>：依赖准确的局部定位与 RGB-D 传感器质量，在极端无特征或深度缺失区域表现受限。</li>
</ol>

<hr />

<h2 id="memvln">45. MemVLN (2026)</h2>
<p>———模拟人类双重记忆机制的高效连续环境视觉语言导航框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.23504">arXiv:2607.23504</a></p>

<h3 id="精华-33">精华</h3>
<ol>
  <li><strong>认知驱动的双记忆解耦</strong>：借鉴人类大脑的“情景记忆（Episodic Memory）”与“程序记忆（Procedural Memory）”，将连续环境视觉语言导航（VLN-CE）中的长时序视觉历史管理与低延迟动作决策解耦。</li>
  <li><strong>像素级金字塔分辨率（Pyramidal Resolution）</strong>：基于观察注意力分布中“近强远弱”的先验，对不同时间跨度的历史帧进行像素级下采样，在保留完整拓扑感知与长程视角的前提下大幅压缩视觉 Token 序列长度。</li>
  <li><strong>架构无缝兼容性</strong>：相较于在隐空间破坏 2D 均匀网格的 Token Merging 方法，金字塔分辨率在原始像素空间保留了严格的 2D 拓扑结构，天然兼容 M-RoPE 和 DeepStack 等最新 LVLM 架构。</li>
  <li><strong>单次自回归避让（Fast Action）</strong>：在程序记忆中构建扩充的原子中级动作词表（$A_{aug}$），将多步/复合动作映射为单个 Token 预测，彻底消除了传统 LLM 多 Token 自回归解码带来的高延迟，实现 14 FPS 实时导航。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-32">1. 研究背景/问题</h3>
<ul>
  <li><strong>核心问题</strong>：在连续环境视觉语言导航（VLN-CE）任务中，智能体既需要维持长时序的视觉历史以保证轨迹一致性、避免漂移，又需要在连续控制下具备极低的动作响应延迟（高 FPS）。</li>
  <li><strong>主要瓶颈</strong>：
    <ol>
      <li><strong>长时序上下文爆炸</strong>：将所有历史高分辨率图像直接喂入 LVLM，会导致 Token 长度迅速膨胀，计算开销呈二次方增长；</li>
      <li><strong>自回归解码延迟</strong>：传统 LVLM 在预测动作时依赖多 Token 逐字自回归解码，首 Token 首帧 Prefill 与后续 Token 生成导致单步延迟超过 300ms，无法满足实时机器人控制要求。</li>
    </ol>
  </li>
</ul>

<hr />

<h3 id="2-主要方法创新点-30">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/MemVLN-concept.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/656" />
    <figcaption>图 1：MemVLN 模拟人类情景记忆（金字塔分辨率视觉历史）与程序记忆（中级动作快速推理）示意图</figcaption>
</div>

<div align="center">
  <img src="/images/vln/MemVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/829" />
    <figcaption>图 2：MemVLN 整体架构图。多模态输入经情景记忆模块降采样后送入 LVLM，由程序记忆模块单次预测中级动作</figcaption>
</div>

<h4 id="-整体框架概述-14">① 整体框架概述</h4>
<p>MemVLN 框架由<strong>情景记忆模块（Episodic Memory）</strong>、<strong>视觉编码与多模态 LLM 主干（Visual Encoder &amp; LVLM Backbone）</strong>以及<strong>程序记忆模块（Procedural Memory）</strong>三大核心组成。智能体在连续时间步接收单目 RGB 观察流与自然语言指令，通过情景记忆对历史帧进行金字塔分辨率重采样，拼接后经视觉编码器和 LLM 提取跨模态上下文，最终由程序记忆模块单次输出原子动作 Token，实现 14 FPS 的高效闭环控制。</p>

<h4 id="-逐模块讲解-12">② 逐模块讲解</h4>

<h5 id="a-情景记忆模块金字塔分辨率pyramidal-resolution">A. 情景记忆模块：金字塔分辨率（Pyramidal Resolution）</h5>
<ul>
  <li><strong>输入</strong>：从起始步到当前步的完整单目 RGB 历史观察帧序列 $H_t = {v_0, v_1, \dots, v_{t-1}}$。</li>
  <li><strong>处理过程</strong>：
    <ol>
      <li><strong>注意力先验分析</strong>：实测表明近期的 4 帧观察占据了超过 50% 的视觉注意力分配，且距离越近注意力权重呈指数级递增；</li>
      <li><strong>三级时间梯队划级</strong>：将历史帧按时间距离划分三个阶梯（即刻 Immediate、短期 Short-term、长期 Long-term），分别设置递减的分辨率 $r_{imm} &gt; r_{short} &gt; r_{long}$：
\(v_t' = \begin{cases} \mathrm{Rescale}(v_t, r_{imm}), &amp; T - B_{short} &lt; t \le T - 1 \\ \mathrm{Rescale}(v_t, r_{short}), &amp; T - B_{long} &lt; t \le T - B_{short} \\ \mathrm{Rescale}(v_t, r_{long}), &amp; 0 \le t \le T - B_{long} \end{cases}\)</li>
      <li><strong>Token 预算分配</strong>：精细设置 $r_{long}$ 与 $r_{short}$，使得累计的长期历史 Token 总数不超过单个即刻高分辨率帧的 Token 量。</li>
    </ol>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/MemVLN-attention-analysis.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/459" />
    <figcaption>图 3：观察帧注意力分布分析。左：近 4 帧占超 50% 注意力权重；中：最新帧权重最集中；右：注意力随帧接近呈递增趋势</figcaption>
</div>

<ul>
  <li><strong>输出</strong>：经过像素级降采样的高效视觉帧集合 $S_t \subset H_t$ 及对应的视觉特征 $F_t = E_{vis}(S_t)$。</li>
  <li><strong>设计动机与优越性</strong>：对比 Uni-NaVid 或 StreamVLN 使用的 Token Merging（在隐空间按语义相似度聚类），Token Merging 会打乱 2D 像素阵列的规整网格，破坏现代 LVLM（如 Qwen2/3-VL）中的 M-RoPE 位置编码及 DeepStack 架构。而金字塔分辨率在原始像素空间下采样，保留了严格的 2D 拓扑物理结构，天然兼容最新的 3D/多模态位置编码。</li>
</ul>

<div align="center">
  <img src="/images/vln/MemVLN-pyramidal-vs-tokenmerging.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:654/618" />
    <figcaption>图 4：像素级金字塔分辨率（Pyramidal Resolution）与隐空间 Token Merging 的对比，保持 2D 网格结构以兼容 M-RoPE</figcaption>
</div>

<h5 id="b-程序记忆模块单次快速动作生成fast-action">B. 程序记忆模块：单次快速动作生成（Fast Action）</h5>
<ul>
  <li><strong>输入</strong>：LVLM Backbone 融合后的跨模态隐层特征。</li>
  <li><strong>处理过程</strong>：
    <ol>
      <li><strong>瓶颈分析</strong>：实验表明，LLM 解码首 Token 需 Prefill（约 70ms），后续逐 Token 自回归生成线性叠加延迟（10 个 Token 需 360ms）。</li>
      <li><strong>扩充中级动作词表（$A_{aug}$）</strong>：重用 LLM 词表中的单 Token 符号，重新映射为扩充的原子中级动作集（包含不同距离的前进 $25\text{cm}/50\text{cm}/75\text{cm}$、不同角度的转向 $15^\circ/30^\circ/45^\circ$ 以及 Stop）。</li>
      <li><strong>单次预测（One-shot Prediction）</strong>：将复合动作预测转化为重用词表上的单 Token 分类任务，在单个 Forward Pass 内完成决策。</li>
    </ol>
  </li>
  <li><strong>输出</strong>：单个中级动作 Token $a_t \in A_{aug}$，直接映射为底盘控制指令。</li>
  <li><strong>设计动机</strong>：借鉴人类程序记忆（自动化执行熟练动作技能的隐式记忆），绕过逐字自回归解码，将推理延迟从 &gt;300ms 降低至 70ms（14 FPS）。</li>
</ul>

<h4 id="-端到端数据流-2">③ 端到端数据流</h4>
<ol>
  <li>当前步 $t$ 获取单目 RGB 图像 $v_{t-1}$，与历史序列合并为 $H_t$；</li>
  <li>经过情景记忆进行三级分辨率划分与 Rescale，得到像素级金字塔帧集合 $S_t$；</li>
  <li>视觉编码器提取特征 $F_t = E_{vis}(S_t)$，与语言指令 $I$ 拼接；</li>
  <li>送入 Qwen3-VL 4B/8B 主干，提取跨模态表示；</li>
  <li>程序记忆 Head 输出单个动作 Token $a_t \in A_{aug}$ 并由 Habitat 仿真器/底盘执行。</li>
</ol>

<h4 id="-训练目标--损失函数-3">④ 训练目标 / 损失函数</h4>
<p>采用监督微调（SFT）训练策略，对于长度为 $T$ 的轨迹，最小化真值动作 \(a_t^*\) 的标准交叉熵损失（Cross-Entropy Loss）：</p>

\[L = -\frac{1}{T} \sum_{t=1}^{T} \log P(a_t^* \mid F_t, I; \theta)\]

<p>其中 $\theta$ 为 MemVLN 的可训练参数。</p>

<h4 id="-推理流程-1">⑤ 推理流程</h4>
<p>推理时无需任何迭代自回归循环，每时间步仅进行一次 Forward 传递，输出单个 Token 动作，实现实时闭环控制。</p>

<hr />

<h3 id="3-核心结果发现-31">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/MemVLN-qualitative.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1113/651" />
    <figcaption>图 5：MemVLN 在 Habitat 仿真器中 R2R-CE 和 RxR-CE 上的定性导航结果展示</figcaption>
</div>

<ol>
  <li><strong>R2R-CE Val Unseen 主结果</strong>：
    <ul>
      <li><strong>MemVLN-4B</strong>：NE <strong>5.34</strong>、OS <strong>63.2%</strong>、SR <strong>56.6%</strong>、SPL <strong>50.0%</strong>。</li>
      <li><strong>MemVLN-8B</strong>：NE <strong>4.98</strong>、OS <strong>65.3%</strong>、SR <strong>58.4%</strong>、SPL <strong>51.2%</strong>。8B 版本取得 MemVLN 在 R2R-CE 上的最高 OS、SR 和 SPL；与 StreamVLN-7B（NE 4.98、OS 64.2%、SR 56.9%、SPL 51.9%）相比，SR 更高，但 SPL 略低。</li>
    </ul>
  </li>
  <li><strong>RxR-CE Val Unseen 主结果</strong>：
    <ul>
      <li><strong>MemVLN-4B</strong>：NE <strong>4.22</strong>、SR <strong>66.5%</strong>、SPL <strong>57.4%</strong>。</li>
      <li><strong>MemVLN-8B</strong>：NE <strong>4.56</strong>、SR <strong>66.0%</strong>、SPL <strong>57.3%</strong>。4B 版本在 RxR-CE 的三项指标上均略优于 8B，并明显超过 StreamVLN-7B（NE 6.22、SR 52.9%、SPL 46.0%）和 NaVILA-8B（NE 6.77、SR 49.3%、SPL 44.0%）。该表未报告 RxR-CE 的 OS 指标。</li>
    </ul>
  </li>
  <li><strong>总体发现</strong>：MemVLN 仅使用单目 RGB（sRGB）观测，不依赖全景图、里程计或深度输入；其中 8B 版本在 R2R-CE 上更强，而 4B 版本在更长、更复杂的 RxR-CE 上表现最佳，说明模型规模增大并未在两个基准上带来一致收益。</li>
</ol>

<hr />

<h3 id="4-局限性-31">4. 局限性</h3>
<ol>
  <li><strong>端侧计算部署受限</strong>：虽然实现了 14 FPS 实时推理，但模型仍依赖高性能 GPU 显存（实验环境为 H200），在功耗受限的移动机器人边缘设备（如 Jetson Orin）上部署仍需进一步量化与轻量化剪枝。</li>
  <li><strong>极大参数规模扩展性</strong>：在千亿/万亿参数规模大模型的进一步扩展上，受到单卡显存与长时序训练开销的限制。</li>
</ol>

<hr />

<h2 id="x-navdp">46. X-NavDP (2026)</h2>
<p>———多构型机器人通用视觉导航的组内 Q 值重加权 Diffusion RL 强化学习微调框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.28560">arXiv:2607.28560</a> · 🏛️ <strong>CoRL 2026</strong> · <a href="https://github.com/InternRobotics/NavDP/tree/master/baselines/x-navdp">Code</a></p>

<p>💻 <strong>Code</strong>: <a href="https://github.com/InternRobotics/NavDP">InternRobotics/NavDP</a></p>

<hr />

<h3 id="精华-34">精华</h3>
<ol>
  <li><strong>解决核心痛点</strong>：传统扩散导航策略依赖全局特权规划器模仿学习，缺乏局部视场下的自救探索与多构型适应能力，而常规 RL 算法在扩散策略微调中易面临似然计算不稳定或高斯探索破坏轨迹平滑性的难题。</li>
  <li><strong>自引导轨迹扰动</strong>：利用预训练模型内部的无目标（Goal-Agnostic）预测分支与坐标翻转组合，在保留扩散模型先验与时间平滑性的同时生成侧向、倒车与绕行等高多样性探索动作。</li>
  <li><strong>组内 Q 值重加权（GQRM）</strong>：提出在同状态（Same-State）候选动作组内归一化 Q 值，解决了全局 Minibatch 归一化在困难低收益状态下梯度信号被掩盖的问题，实现高效稳健的扩散 actor 更新。</li>
  <li><strong>轻量化构型 FiLM 调制</strong>：通过在 Transformer 解码器输入与输出特征层注入构型 Embedding，用单套网络权重统一控制轮式、四足与人形（Dingo、Unitree Go2、G1）三种异构机器人。</li>
  <li><strong>大幅提升性能</strong>：在 40 个未见模拟场景中成功率由 61.20% 提升至 84.28%，并在真实世界死胡同自救等困难场景中将成功率由 10% 提升至 65%，仅需 12 小时并行 RL 训练。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-33">1. 研究背景/问题</h3>

<p>基于大规模数据预训练的扩散视觉导航策略（如 NavDP、NoMaD）具备极强的零样本泛化能力。然而，现有方法主要采用<strong>模仿学习（Imitation Learning）</strong>，监督数据由全局全知规划器生成。这种训练范式存在两大天然缺陷：</p>
<ol>
  <li><strong>决策歧义与无自救能力</strong>：真实部署时机器人仅能获取局部 Visual RGB-D 观测，全局最优轨迹与局部视觉的失配严重抑制了策略的自主探索，导致机器人面对死胡同（Dead-End）或长障碍物时无法后退或绕行自救。</li>
  <li><strong>构型盲目性（Embodiment-Blind）</strong>：数据生成未考虑不同机器人的物理运动约束与动力学差异，难以直接跨机器人平台迁移。</li>
</ol>

<p>虽然<strong>强化学习（RL）</strong>是解决交互试错与构型适用的有效途径，但扩散策略的 RL 微调存在极高的技术瓶颈：</p>
<ul>
  <li>基于策略梯度的微调方法（如 DPPO）需要穿透长扩散去噪链计算似然，导致训练极不稳定；</li>
  <li>基于隐空间的微调方法（如 DSRL）冻结去噪核心参数，极大限制了探索能力；</li>
  <li>基于重加权分段匹配的方法（如 DPMD）虽然稳定，但在全局 Minibatch 归一化下，困难状态的低绝对收益导致梯度失真。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-31">2. 主要方法/创新点</h3>

<p>X-NavDP 构建了一套高性能的扩散策略强化学习后训练框架。系统由三大核心模块构成：<strong>构型 FiLM 条件调制模块</strong>负责跨构型感知，<strong>自引导轨迹扰动模块</strong>生成兼具先验与多样性的探索候选，<strong>组内 Q 值重加权匹配（GQRM）</strong>在同状态组内精确计算策略改进方向，最后通过<strong>闭环时域引导（RTC）</strong>保障部署推演的连续平滑。</p>

<div align="center">
  <img src="/images/vln/X-NavDP-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/513" />
    <figcaption>Figure 1: X-NavDP RL 后训练框架整体概览与离线/在线导航性能对比</figcaption>
</div>

<h4 id="-整体框架与分层控制">① 整体框架与分层控制</h4>
<p>X-NavDP 采用分层控制架构：</p>
<ul>
  <li><strong>高层导航策略</strong>：输入局部 RGB-D 图像与 PointGoal 目标坐标，扩散模型输出 $H$ 步未来航点轨迹 Chunk（如 3 秒轨迹）；</li>
  <li><strong>低层控制栈</strong>：统一的 MPC 控制器将航点 Chunk 转化为底盘速度指令，再由机器人特定的低层足行/轮运动控制策略（25 Hz）执行。</li>
  <li><strong>并行训练环境</strong>：在 IsaacLab 中并行运行 500+ 个涉及轮式（Dingo）、四足（Unitree Go2）、人形（Unitree G1）机器人的仿真环境，高层策略按 3 秒宏观步（Macro-Step）收集 Replay Buffer。</li>
</ul>

<div align="center">
  <img src="/images/vln/X-NavDP-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/612" />
    <figcaption>Figure 2: X-NavDP 整体架构与三大核心模块（构型 FiLM 调制、自引导扰动、组内 Q 值重加权匹配）</figcaption>
</div>

<h4 id="-自引导轨迹扰动self-bootstrapped-perturbation">② 自引导轨迹扰动（Self-Bootstrapped Perturbation）</h4>
<p>直观上，直接给轨迹添加高斯噪声会破坏航点的时间连续性与动力学可行性。X-NavDP 发现：<strong>预训练策略在无目标（Goal-Agnostic）条件下的输出天然保持场景一致性且探索更激进</strong>。</p>

<p>因此，对同一视觉观测，算法同时采样有目标轨迹 \(\tilde{\tau}_{\text{pointgoal}}\) 与无目标轨迹 \(\tilde{\tau}_{\text{nogoal}}\)，并进行带符号外推混合：</p>

\[\tau_{\text{mixed}}
= \mathbf{s} \odot
\left(
  \tilde{\tau}_{\text{pointgoal}}
  + \lambda \tilde{\tau}_{\text{nogoal}}
\right)\]

<p>其中 $\mathbf{s} = ((-1)^{B_1}, (-1)^{B_2})$ 是由伯努利分布生成的随机符号向量，对整体 Chunk 的 $x, y$ 坐标独立按概率 $\epsilon$ 进行翻转。这种设计能够原生地生成平滑的倒车、侧向避障与侧退自救轨迹。</p>

<blockquote>
  <p><strong>举个例子（自引导扰动数据流）</strong>：
假设机器人陷入死胡同，有目标预测 \(\tilde{\tau}_{\text{pointgoal}}\) 给出向前微动 $[+0.2, 0.0]$，单纯加高斯噪声可能得到 $[+0.2+\mathcal N, 0.0+\mathcal N]$（机器人剧烈抖动碰撞）；
而无目标预测 \(\tilde{\tau}_{\text{nogoal}}\) 给出大范围探索航点 $[+0.5, +0.6]$。通过外推和符号翻转 $\mathbf s = (-1, -1)$，合成轨迹变为 $[-0.2, -0.6]$——产生了一条极其平滑且符合物理约束的倒车绕行轨迹！</p>
</blockquote>

<h4 id="-组内-q-值重加权匹配group-q-score-reweighted-matching-gqrm">③ 组内 Q 值重加权匹配（Group Q-Score Reweighted Matching, GQRM）</h4>
<p>为解决标准 DPMD 在 Minibatch 全局归一化时“简单状态高收益掩盖困难状态低收益”的缺陷，GQRM 强制在<strong>同一状态下的候选动作组 $G(s)$ 内</strong>计算统计量：</p>

<p>组内均值与标准差公式：
\(\bar{Q}_G(s) = \mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s)} [Q(s, a_0)], \quad \sigma_G(s) = \sqrt{\mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s)} [(Q(s, a_0) - \bar{Q}_G(s))^2]}\)</p>

<p>组内归一化优势值：
\(\tilde{Q}_G(s, a_0) = \text{clip}\left( \frac{c (Q(s, a_0) - \bar{Q}_G(s))}{\sigma_G(s) + \varepsilon}, -h, h \right)\)</p>

<p>GQRM 的 Actor 优化目标：
\(\mathcal L_{\text{GQRM}}(\theta; s, t) = \mathbb E_{a_0 \sim \pi_{\text{old}}(\cdot \mid s), a_t \sim q_{t \mid 0}(\cdot \mid a_0)} \left[ \exp(\tilde{Q}_G(s, a_0) / \lambda) \left\lVert s_\theta(a_t; s, t) - \nabla_{a_t} \log q_{t \mid 0}(a_t \mid a_0) \right\rVert^2 \right]\)</p>

<p>在实践中，每次仅保留同状态候选组中优势值大于零前 $k$ 个候选动作（Top-$k$ Positive Advantage），既削减了低质量样本噪声，又大幅节省了计算开销。</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统 DPMD 做法</th>
      <th>本文 GQRM 做法</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>归一化范围</td>
      <td>跨 Minibatch 内不同状态混合归一化</td>
      <td>仅在同一状态采样的候选动作组内归一化</td>
    </tr>
    <tr>
      <td>困境表现</td>
      <td>简单状态的大 positive return 掩盖困难状态的相对优劣</td>
      <td>即使绝对 return 全为负，也能区分出局部更优的倒车自救动作</td>
    </tr>
    <tr>
      <td>梯度权重</td>
      <td>困难状态样本权重接近于 0，无法学习自救</td>
      <td>困难状态的局部相对优胜者获得指数级强化权重</td>
    </tr>
  </tbody>
</table>

<h4 id="-构型-film-调制与闭环时域引导">④ 构型 FiLM 调制与闭环时域引导</h4>
<ul>
  <li><strong>构型 FiLM 调制（Embodiment Modulation）</strong>：将机器人 ID 转换为 Embedding $\mathbf z_e = E_{\text{emb}}(e)$，一方面作为 Action Token 前的偏置 $\mathbf u_e = \mathbf u + f_\Delta(\mathbf z_e)$，另一方面通过 FiLM 生成缩放与偏移参数 $[\Delta \gamma_e, \Delta \beta_e] = f_{\text{FiLM}}(\mathbf z_e)$ 调制解码器输出特征 $\mathbf h_e = (1 + \Delta \gamma_e) \odot \mathbf h + \Delta \beta_e$，使得单套主干模型能感知不同机器人的宽度、转弯半径及推力特性。</li>
  <li><strong>闭环时域引导（RTC Guidance）</strong>：推理部署时，在 DDPM 反向去噪步骤中引入前一预测轨迹的时域平滑梯度，更新公式为 \(\mathbf x_t^{(k-1)} = \boldsymbol \mu_k + \sigma_k \mathbf z + \sqrt{\bar{\alpha}_k} \eta_{\text{guide}} \mathbf g\)，有效消除了滚动时域预测中的轨迹抖动。</li>
</ul>

<pre><code class="language-mermaid">graph TD
    A["输入: 局部 RGB-D + PointGoal + 机器人 ID"] --&gt; B["构型 FiLM 模块注入 Robot Embedding"]
    B --&gt; C["自引导扰动策略采样同状态候选组 G(s)"]
    C --&gt; D["Twin Critics 评估候选组轨迹 Q(s, a0)"]
    D --&gt; E["同状态组内归一化计算优势值 Q_tilde_G"]
    E --&gt; F["保留 Top-k 正优势动作指数重加权"]
    F --&gt; G["优化 Diffusion Score Network 去噪目标"]
    G --&gt; H["MPC 追踪执行 + RTC 闭环平滑引导"]
</code></pre>

<hr />

<h3 id="3-核心结果发现-32">3. 核心结果/发现</h3>

<ol>
  <li><strong>仿真基准全方位超越</strong>：在 IsaacLab 40 个未见测试场景中，X-NavDP 相比预训练基线 NavDP，平均成功率（SR）从 <strong>61.20% 提升至 84.28%</strong>，SPL 从 <strong>58.95% 提升至 77.19%</strong>。特别是在人形机器人（Unitree G1）上，Home 场景成功率从 <strong>50.70% 骤升至 84.50%</strong>。</li>
  <li><strong>真机硬核困境自救</strong>：在无真机微调（Zero-Shot Sim-to-Real）情况下部署于 Turtlebot、Unitree Go2 和 Unitree G1，在死胡同、长墙绕行等硬核测试集中，成功率从基线的 <strong>10% 飙升至 65%</strong>。</li>
</ol>

<div align="center">
  <img src="/images/vln/X-NavDP-qualitative-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/561" />
    <figcaption>Figure 3: 定性轨迹对比：X-NavDP 在困境自救、长障碍物绕行和安全路径选择上显著优于 NavDP</figcaption>
</div>

<div align="center">
  <img src="/images/vln/X-NavDP-ablation-study.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/326" />
    <figcaption>Figure 4: 探索策略消融实验：无目标扰动与轨迹反向在策略学习中的重要性</figcaption>
</div>

<ol>
  <li><strong>消融实验关键发现</strong>：
    <ul>
      <li>移除自引导扰动与轨迹反向会导致 RL 训练直接崩溃（SR 跌至 6.23%）；</li>
      <li>相比于 Soft-Prompt 拼接，FiLM 构型调制在多场景扩展时展现出更强的跨构型适应性；</li>
      <li>相比于 DPPO 和 DSRL，GQRM 展现出极高的训练稳定性和数据效率（仅需 12 小时后训练）。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-32">4. 局限性</h3>

<ol>
  <li><strong>短时域上下文依赖</strong>：策略当前主要依赖短时域视觉上下文，缺少长期拓扑记忆，在极长的墙体绕行中可能因记忆消退出现重复打转。</li>
  <li><strong>低层控制器依赖</strong>：跨构型泛化依赖于预先训练好的低层足行/轮式控制器，在非常规构型上的扩展需要先具备对应的基底控制器。</li>
  <li><strong>透明与空洞障碍物感知</strong>：对玻璃隔断、网格孔洞面板等透明/高穿透力障碍物的 RGB-D 深度测量易失效，需引入更强语义感知。</li>
</ol>

<hr />

<h2 id="image2sim">47. Image2Sim (2026)</h2>
<p>———解耦 3D 空间锚定与超真实图像合成的实时神经仿真引擎</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.05765">arXiv:2607.05765</a> · <a href="https://github.com/MrZihan/Image2Sim">Code</a></p>

<h3 id="精华-35">精华</h3>
<ol>
  <li><strong>打破几何与合成的博弈</strong>：Image2Sim 提出了“3D 空间锚定”与“超真实图像合成”解耦的神经仿真范式，利用前馈 3D 特征高斯（Feature Gaussian）提供显式度量几何约束，再由单步像素流（Pixel Flow）生成模型在 3D 几何 Alpha 掩码引导下补全未观测视野。</li>
  <li><strong>实时闭环高帧率仿真</strong>：采用连续时间 MeanFlow 单步速度估计与动量自蒸馏（Momentum-based Self-Distillation），将传统扩散/流匹配模型的多步迭代采样压缩为单步映射，在全景 RGB-D 渲染上达到 45.6 FPS，首次满足具身导航在线闭环交互与 DAgger/RL 训练的实时性要求。</li>
  <li><strong>自动化具身数据引擎</strong>：通过显式高斯体素化、GPU 平行光线步进碰撞查询与 collision-aware NavFn 规划，直接从无标注视频/图像构建近 2 万个交互式神经环境，并自动合成了超过 1000 万条跨视角、高保真的导航轨迹与多模态指令数据。</li>
  <li><strong>强跨域与 Scaling 律验证</strong>：基于纯 Image2Sim 神经环境训练的导航策略 Image2Nav，在完全不接触真实 Habitat 建模的情况下，跨模拟器 zero-shot 泛化至 R2R-CE（SR 70.3%）、RxR-CE 和 REVERIE-CE 刷新 SOTA，并在真实物理机器人（Hello Robot Stretch 3）上展现出卓越的零样本迁移能力。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-34">1. 研究背景/问题</h3>

<p>具身导航（Embodied Navigation）要求智能体在 3D 空间中准确理解多模态目标并执行物理动作。然而，构建大规模、高保真且具备物理接地（Physical Grounding）的交互式仿真环境长期存在矛盾：</p>

<ol>
  <li><strong>真实扫描环境（如 Matterport3D、HM3D）</strong>：视觉与几何真实度极高，但依赖昂贵的人工扫描与数字孪生重建，环境数量受限于数百到数千场景，无法支撑大规模策略预训练。</li>
  <li><strong>合成/程序化环境（如 AI2-THOR、ProcTHOR）</strong>：极易大规模扩展，但包含大量人工 3D 资产与非真实渲染统计量，存在严重的 Sim-to-Real 跨域鸿沟。</li>
  <li><strong>传统生成式世界模型（World Models）</strong>：能合成逼真视频，但缺乏显式持久的 3D 空间结构与物理碰撞面，无法支持智能体进行自由连贯的闭环导航动作交互。</li>
</ol>

<p>为了兼具<strong>高真实度、无限扩展性与物理闭环性</strong>，Image2Sim 提出直接从无约束的姿态 RGB-D 图像/视频序列中构建可交互的实时神经仿真环境。</p>

<div align="center">
  <img src="/images/vln/Image2Sim-pipeline-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1113/530" />
<figcaption>图 1：传统导航数据流水线（需昂贵 Mesh 与人工标注）与 Image2Sim 神经仿真框架（自适应生成 2 万场景与千万级数据）对比</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-32">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/Image2Sim-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1058/557" />
<figcaption>图 2：Image2Sim 整体架构：前馈 3D 特征高斯编码器（左）与单步几何感知 Pixel Flow 渲染器（右）</figcaption>
</div>

<p>Image2Sim 的核心创新在于将神经环境建模拆分为两个解耦的模块：<strong>前馈 3D 特征高斯几何构建</strong>（提供持续 3D 空间锚定）与<strong>几何感知单步 Pixel Flow 渲染</strong>（负责未观测盲区的超真实生成补全）。</p>

<h4 id="-前馈-3d-特征高斯几何构建feed-forward-3d-gaussian-encoder">① 前馈 3D 特征高斯几何构建（Feed-Forward 3D Gaussian Encoder）</h4>
<ul>
  <li><strong>输入</strong>：任意姿态的 RGB-D 帧（支持针孔相机与全景相机），通过射线方向编码（Ray-Direction Encoding）统一表达。</li>
  <li><strong>处理</strong>：双流编码器提取特征——冻结的 DINOv3 主干捕捉高层语义特征，轻量级几何细节流保留 RGB、深度与法向量。特征融合后由预测头一次性反投影并生成 3D 特征高斯集合 \(\mathcal G = \{g_j\}_{j=1}^M\)。每个高斯元组包含中心 $\mathbf \mu_j \in \mathbb R^3$、缩放 $\mathbf s_j$、旋转 $\mathbf q_j$、不透明度 $\alpha_j$、颜色 $\mathbf c_j$ 及语义特征 $\mathbf f_j$。</li>
  <li><strong>输出</strong>：在目标位姿 $p$ 下投影得到的全景 RGB 图 \(\tilde{\mathbf I}_p\)、深度图 \(\tilde{\mathbf D}_p\)、透明度图 \(\tilde{\mathbf A}_p\) 和特征图 $\mathbf C_p$。</li>
  <li><strong>设计动机</strong>：摒弃传统 NeRF/3DGS 逐场景优化（Per-Scene Optimization）耗时数小时的缺点，实现单次前馈毫秒级构建 3D 场景。</li>
</ul>

<h4 id="-几何感知单步-pixel-flow-渲染器geometry-aware-one-step-pixel-flow">② 几何感知单步 Pixel Flow 渲染器（Geometry-Aware One-Step Pixel Flow）</h4>

<p>当智能体移动到未观测视角时，直接用 3DGS 飞溅渲染会产生大量破洞与伪影（黑洞盲区）。Image2Sim 设计了一个以概率流 ODE（Probability Flow ODE）为基础的 Pixel Flow 生成模型：</p>

<ol>
  <li>
    <p><strong>Alpha 门控源状态（Alpha-Gated Source State）</strong>：利用 3DGS 渲染得到的透明度图 \(\tilde{\mathbf A}_p\) 衡量 3D 投影的几何可靠度。构造空间自适应噪声尺度：
\(\Sigma(\tilde{\mathbf A}_p) = \tilde{\mathbf A}_p \odot \sigma_{\mathrm{small}} + (1 - \tilde{\mathbf A}_p) \odot \sigma_{\mathrm{large}}\)
由此生成 Alpha 门控源状态：
\(\mathbf z_{\mathrm{src}} = \tilde{\mathbf A}_p \odot \tilde{\mathbf X}_p + \Sigma(\tilde{\mathbf A}_p) \odot \mathbf \epsilon, \quad \mathbf \epsilon \sim \mathcal N(\mathbf 0, \mathbf I)\)
在 3DGS 已观测的高 Alpha 区域保持原始投影细节；在低 Alpha 盲区输入较大噪声，引导生成模型进行合理补全。</p>
  </li>
  <li>
    <p><strong>网络结构</strong>：基于 UNet 架构，卷积编码器压缩源状态 $\mathbf z_{\mathrm{src}}$ 与几何条件 $\mathbf C_p$，Deep Transformer 瓶颈层引入 AdaLN 时间注入与 SPADE 式空间自适应归一化（注入 DINOv3 语义特征 $\Phi(\mathbf C_p)$）。上采样阶段采用 Alpha 金字塔门控跳跃连接（Alpha-Gated Skip Connections），保护高透明度区域的几何细节不被生成网络破坏。</p>
  </li>
</ol>

<blockquote>
  <p><strong>举个例子（Alpha 门控手算推演）</strong>：
假设智能体转头看向门后区域，全景图某像素在 3DGS 投影中透明度为 \(\tilde{A}_p = 0.95\)（已有已知几何），而旁边未被扫描到的墙角透明度为 \(\tilde{A}_p = 0.05\)（纯盲区）。
设 $\sigma_{\mathrm{small}}=0.01$，$\sigma_{\mathrm{large}}=1.0$。</p>
  <ul>
    <li>已知区域噪声标准差仅为 $0.95 \times 0.01 + 0.05 \times 1.0 = 0.0595$，网络输入近乎纯净的投影 RGB-D 证据；</li>
    <li>盲区像素噪声标准差达到 $0.05 \times 0.01 + 0.95 \times 1.0 = 0.9505$，网络收到强噪声信号，触发 generative 扩散/流匹配机制填充合理纹理与深度。</li>
  </ul>
</blockquote>

<pre><code class="language-mermaid">graph TD
    A["姿态 RGB-D 观测"] --&gt; B["前馈 3D 特征高斯模型 (GS Encoder)"]
    B --&gt; C["全景投影: 投影 RGB-D + 透明度 Alpha 图 A_p"]
    C --&gt; D{"Alpha 门控分流"}
    D -- "高 Alpha (已知几何)" --&gt; E["保留原始 3DGS 投影 + 小噪声"]
    D -- "低 Alpha (未观测盲区)" --&gt; F["注入高斯噪声 Σ(A_p) ⊙ ε"]
    E --&gt; G["Alpha 门控源状态 z_src"]
    F --&gt; G
    G --&gt; H["MeanFlow 单步 UNet/Transformer 瓶颈"]
    H --&gt; I["速度场估计 V_θ (JVP 评估)"]
    I --&gt; J["单步生成高保真全景 RGB-D (45.6 FPS)"]
    K["EMA TeacherPrivileged GT 条件"] -. "动量自蒸馏 L_distill" .-&gt; H
</code></pre>

<h4 id="-continuous-time-meanflow-与动量自蒸馏momentum-self-distillation">③ Continuous-Time MeanFlow 与动量自蒸馏（Momentum Self-Distillation）</h4>
<ul>
  <li><strong>MeanFlow 单步连续映射</strong>：传统 Flow Matching 需要 20–50 步 Euler 积分采样，速度极慢（&lt;1 FPS）。Image2Sim 基于连续时间 MeanFlow 理论，直接预测从源状态 $\mathbf z_{\mathrm{src}}$ 到目标图像 $\mathbf X_p$ 的平均传输速度 $u_\theta = (\mathbf z_t - x_\theta)/\max(t, \varepsilon)$。结合前向 JVP（Jacobian-Vector Product）高效计算方向导数 $\frac{\mathrm d u_\theta}{\mathrm d t}$，一次 forward 即可完成生成，将渲染速度提升至 45.6 FPS。</li>
  <li><strong>动量自蒸馏损失</strong>：维持一个指数移动平均（EMA，衰减率 0.999）的 Teacher 网络，Teacher 接收特权 Ground-Truth 源状态 $\mathbf z_{\mathrm{gt}}$。Student 提取的解码器特征与 Teacher 强行对齐：
\(\mathcal L_{\mathrm{distill}} = \sum_{k \in \mathcal K} \tilde{w}_k \left( 1 - \frac{\mathbf f_k^S \cdot \mathbf f_k^T}{\lVert \mathbf f_k^S \rVert_2 \lVert \mathbf f_k^T \rVert_2} + \beta \lVert \mathbf f_k^S - \mathbf f_k^T \rVert_2^2 \right)\)
极大增强了单步生成的稳定性，消除了光影抖动与幻觉伪影。</li>
</ul>

<div align="center">
  <img src="/images/vln/Image2Sim-rendering-visualization.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/416" />
<figcaption>图 3：高噪声稀疏场景下 3DGS 原始渲染（左，大量破洞黑块）与 Pixel Flow 补全渲染（中）对比</figcaption>
</div>

<h4 id="-物理运动仿真引擎与自动化数据流水线">④ 物理运动仿真引擎与自动化数据流水线</h4>

<div align="center">
  <img src="/images/vln/Image2Sim-motion-engine.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1035/543" />
<figcaption>图 4：基于体素化碰撞查询与 NavFn 路径规划的物理运动引擎及 VLM 自动化指令标注流程</figcaption>
</div>

<ol>
  <li><strong>体素化与 GPU 光线步进碰撞查询</strong>：将 3D 高斯场景离散化为密集体素网格 $\mathcal V$，基于离地高度、表面连通性与障碍物安全间距判定可通行性。通过 GPU 并行光线步进（Ray Marching）查询机器人 Footprint 碰撞，构建可通行体素图 $\mathcal M = (\mathcal V, \mathcal E)$，支持贴墙滑动与碰撞拦截。</li>
  <li><strong>碰撞感知 NavFn 规划与纯追踪控制</strong>：在 Graph $\mathcal M$ 上运行结合安全代价的 NavFn 路径规划，利用 Pure-Pursuit 纯追踪控制器将离散节点转化为光滑的连续运动轨迹。</li>
  <li><strong>VLM 自动化指令标注</strong>：重放物理轨迹渲染全景视频，利用 Large Vision-Language Model 自动生成路径追踪、目标导向与人类习惯等多多样化导航文本指令。</li>
</ol>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统扫描 3D Mesh (Habitat/Matterport3D)</th>
      <th>纯 3DGS 渲染 (AnySplat 等)</th>
      <th>纯生成式世界模型 (World Models)</th>
      <th>Image2Sim 神经仿真器 (本文)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>场景扩展性</strong></td>
      <td>极低（依赖人工 3D 扫描）</td>
      <td>中（需逐场景优化或前馈预测）</td>
      <td>高（从视频/文本直接生成）</td>
      <td><strong>极高（输入任意 RGB-D 视频/图像）</strong></td>
    </tr>
    <tr>
      <td><strong>未观测补全</strong></td>
      <td>不具备（依赖固定 Mesh 边界）</td>
      <td>极差（黑洞破洞、伪影重重）</td>
      <td>强（扩散/流匹配生成）</td>
      <td><strong>极强（Alpha 门控 Pixel Flow 补全）</strong></td>
    </tr>
    <tr>
      <td><strong>交互渲染速度</strong></td>
      <td>极高（&gt;100 FPS 传统渲染）</td>
      <td>极高（&gt;115 FPS）</td>
      <td>极慢（&lt;1 FPS 多步采样）</td>
      <td><strong>实时高帧率（45.6 FPS 单步生成）</strong></td>
    </tr>
    <tr>
      <td><strong>物理闭环约束</strong></td>
      <td>具备（内置物理碰撞网格）</td>
      <td>缺乏（纯点云渲染无几何碰撞面）</td>
      <td>缺乏（无法精确阻挡机器人穿墙）</td>
      <td><strong>具备（基于高斯体素与 GPU 光线步进）</strong></td>
    </tr>
  </tbody>
</table>

<hr />

<h3 id="3-核心结果发现-33">3. 核心结果/发现</h3>

<h4 id="-视角合成渲染质量与速度对比">① 视角合成渲染质量与速度对比</h4>
<p>在 RealSee3D-Real（高噪声 LiDAR 深度）等挑战性数据集上，Image2Sim 展现出极其优异的鲁棒性与速度表现：</p>

<ul>
  <li><strong>渲染质量</strong>：PSNR 达 17.43，SSIM 达 0.470，显著超越纯高斯前馈模型 AnySplat（PSNR 15.23, SSIM 0.415），有效弥补了结构缺失。</li>
  <li><strong>渲染帧率</strong>：全景 RGB-D 渲染速度达到 <strong>45.6 FPS</strong>，比传统扩散生成模型 DiT360（0.3 FPS）和 SE3DS（3.4 FPS）快一到两个数量级。</li>
</ul>

<h4 id="-跨模拟器-zero-shot-具身导航性能-r2r-ce-rxr-ce-reverie-ce">② 跨模拟器 Zero-Shot 具身导航性能 (R2R-CE, RxR-CE, REVERIE-CE)</h4>
<p>基线导航模型 Image2Nav 仅在 Image2Sim 生成的神经数据集中训练，<strong>零样本直接在 Habitat 模拟器中评估</strong>（打破了所有 Baseline 在 Habitat 内部训练评估的习惯）：</p>

<ul>
  <li><strong>R2R-CE 路径追踪导航</strong>：在 Val Unseen 划分上，Image2Nav（180° FOV）取得 <strong>SR 70.3%</strong>、<strong>SPL 65.6%</strong>、<strong>NE 3.71m</strong> 的 SOTA 成绩，大幅超越在 Habitat 内训练的顶级方法 EfficientVLN（SR 64.2%, SPL 55.9%）与 DualVLN（SR 64.3%, SPL 58.5%）。</li>
  <li><strong>RxR-CE 多语言长指令导航</strong>：实现 <strong>SR 70.7%</strong>、<strong>SPL 59.1%</strong>、<strong>NE 3.74m</strong>、<strong>nDTW 71.8%</strong>。</li>
  <li><strong>REVERIE-CE 目标导向导航</strong>：实现 <strong>SR 53.7%</strong>、<strong>SPL 42.7%</strong>。</li>
</ul>

<div align="center">
  <img src="/images/vln/Image2Sim-scaling-law.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:550/479" />
<figcaption>图 5：Image2Sim 训练数据规模从 35K 扩展至 10M 时导航成功率（SR）的对数线性 Scaling 律曲线</figcaption>
</div>

<h4 id="-导航数据的-scaling-law-验证">③ 导航数据的 Scaling Law 验证</h4>
<p>如上图所示，当在 R2R/RxR 基础数据上逐步叠加 Image2Sim 产生的 1M、5M 到 10M 样本时，成功率（SR）呈现出清晰且未饱和的对数线性增长（<strong>SR 从 46.1% 飞跃至 66.3%，SPL 从 41.3% 提升至 61.5%</strong>）。这有力证明了当前具身导航性能仍受到数据量的强烈制约，而 Image2Sim 能够作为无尽的数据引擎持续赋能预训练。</p>

<h4 id="-消融实验-ablation-study">④ 消融实验 (Ablation Study)</h4>
<ul>
  <li><strong>移除 Pixel Flow 生成模型</strong>：PSNR 暴跌至 17.75，SSIM 降至 0.438，证明单纯 3DGS 飞溅无法处理稀疏视角空洞。</li>
  <li><strong>移除语义特征注入</strong>：PSNR 降至 18.36，表明 DINOv3 语义指导对于生成合理的未观测墙体与家具至关重要。</li>
  <li><strong>移除 Alpha 门控融合</strong>：PSNR 降至 18.57，破坏了已知 3D 几何与生成补全的平衡。</li>
  <li><strong>移除动量自蒸馏</strong>：PSNR 降至 19.84，证明 EMA Teacher 成功抑制了单步生成中的闪烁伪影。</li>
</ul>

<h4 id="-真实物理机器人部署-real-world-deployment">⑤ 真实物理机器人部署 (Real-World Deployment)</h4>
<p>在 Hello Robot Stretch 3 移动机器人上的实机测试（20 次试练）表明：</p>
<ul>
  <li><strong>Path-following 任务</strong>：成功率达到 11/20（显著优于 JanusVLN 的 8/20 和 DualVLN 的 8/20）。</li>
  <li><strong>Goal-oriented 任务</strong>：成功率达到 9/20（远高于 DualVLN 的 5/20）。</li>
</ul>

<hr />

<h3 id="4-局限性-33">4. 局限性</h3>

<ol>
  <li><strong>轻量渲染器的容量权衡</strong>：为了支持 45+ FPS 实时在线闭环交互及 DAgger/RL 训练，轻量级渲染模型在极度复杂的超广角光影细节上略有容量牺牲。</li>
  <li><strong>物理交互动态有限</strong>：仿真器目前集中于导航层面的刚性碰撞与滑动约束，尚不支持复杂的接触力学、可移动物体与人机动态交互。</li>
  <li><strong>指令标注的语义偏差</strong>：完全自动化的大语言/视觉模型指令标注虽然实现了规模化，但偶尔可能引入天然的语言偏置或少量的图文不匹配。</li>
</ol>

<hr />

<h2 id="decovln">48. DecoVLN (2026)</h2>
<p>———Decoupling Observation, Reasoning, and Correction for Vision-and-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.13133">arXiv:2603.13133</a> · 🏛️ <strong>CVPR 2026</strong> · <a href="https://allenxinn.github.io/DecoVLN/">Project Page</a> · <a href="https://github.com/Allenxinn/DecoVLN">Code（待发布）</a></p>

<h3 id="精华-36">精华</h3>
<ol>
  <li><strong>三维彻底解耦</strong>：打破传统流式导航“全量存内存、推理时均匀采样”的紧耦合低效模式，将观测流、推理流与纠错流在空间、时间与硬件显存上彻底分离。</li>
  <li><strong>自适应前置精炼（AMR）</strong>：在流式观测进入阶段联合优化指令语义相关性、视觉多样性惩罚与时间跨度覆盖，在显存内常驻极紧凑的 $K=8$ 高信息密度记忆库。</li>
  <li><strong>信任域单步纠错微调（ECF）</strong>：基于测地距离量化偏离度，仅在可控信任域内收集单步状态-动作对引导恢复，从根源杜绝长程累积复合误差与样本数据污染。</li>
  <li><strong>纯 RGB 单目超越多模态传感器</strong>：在 R2R-CE 与 RxR-CE 连续基准上分别取得 56.3% 与 54.2% 的成功率，在零额外大规模预训练数据下全面超越依赖深度图与 3D 体素投影的 SOTA 模型。</li>
  <li><strong>端云协同真机零样本迁移</strong>：将 4 步离散动作块（Action Chunk）端侧解析为连续相对目标位姿，在宇树 GO2 四足机器人上成功克服地面强反光与视觉混淆等真实环境扰动。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-35">1. 研究背景/问题</h3>

<p>视觉语言导航（Vision-and-Language Navigation, VLN）要求具身智能体仅依据自身的第一视角（Egocentric）视觉观测与长程自然语言指令，在未知的 3D 物理环境中自主规划连续移动路径并到达目标。现有方法主要面临三大瓶颈：</p>

<ol>
  <li><strong>“走走停停”（Stop-and-Think）造成的感知盲区</strong>：智能体执行一步后停顿感知再推理，动作不连贯且在运动过程中错失关键视觉地标。</li>
  <li><strong>传统流式导航的上下文污染与 I/O 拥堵</strong>：将所有历史观测帧无差别全量暂存到主机内存（RAM），推理时再被动均匀采样（Uniform Sampling）或依赖深度传感器构建 3D 体素剪枝，导致输入上下文充斥白墙、转角等无关噪声，且频繁在显存与内存之间搬运数据引发高推理延迟。</li>
  <li><strong>长程马尔可夫决策过程中的复合误差（Compounding Errors）</strong>：开环自回归策略在早期产生微小漂移后会持续发散；而传统 DAgger 算法在整条轨迹严重偏离后仍强行收集修正动作，导致纠错样本严重偏离原始指令分布，造成训练数据污染。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-33">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/DecoVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/735" />
<figcaption>DecoVLN 整体架构：流式观测与自回归推理异步解耦，通过自适应记忆精炼（AMR）动态维护显存常驻 Memory Bank，输出 4 步动作块（Action Chunk），并在信任域内收集单步状态-动作对进行纠错微调（ECF）</figcaption>
</div>

<h4 id="-整体框架概述-15">① 整体框架概述</h4>
<p>DecoVLN 将视觉语言导航形式化为部分可观测马尔可夫决策过程（POMDP），通过三大解耦模块协同运行：</p>
<ul>
  <li><strong>流式观测流（Observation Stream）</strong>：在机器人运动过程中连续采集第一视角 RGB 图像，由<strong>自适应记忆精炼模块（AMR）</strong>在线评估每帧的多维价值，将最具信息量的特征常驻在显存 Memory Bank 中；</li>
  <li><strong>自回归推理流（Reasoning Stream）</strong>：VLM（基于 LLaVA-Video-7B）仅接收当前指令、Memory Bank（$K=8$ 帧）与最近 4 帧即时观测，自回归输出由 4 步连续动作组成的<strong>动作块（Action Chunk）</strong>；</li>
  <li><strong>自纠错微调流（Correction Stream）</strong>：在模拟器自主探索中，利用测地距离（Geodesic Distance）划分<strong>信任域（Trusted Region）</strong>，动态捕获偏离轨迹下的单步纠偏状态-动作对，赋予模型闭环自愈能力。</li>
</ul>

<h4 id="-观测与推理深度解耦自适应记忆精炼amr">② 观测与推理深度解耦：自适应记忆精炼（AMR）</h4>

<div align="center">
  <img src="/images/vln/DecoVLN-decouple-paradigm.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:673/1025" />
<figcaption>传统流式 VLN 范式与 DecoVLN 的架构流程对比：(a) 传统流式范式将所有历史观测存入 RAM，推理时重复在 RAM 与 VRAM 间拷贝并均匀采样；(b) DecoVLN 在观测端进行前置多准则过滤，常驻显存（VRAM），实现极高的数据吞吐与信噪比</figcaption>
</div>

<p>传统方法与 DecoVLN 在记忆维护逻辑上的本质差异如下：</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统流式 VLN（如 StreamVLN）</th>
      <th>本文 DecoVLN</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>记忆管理机制</td>
      <td><strong>后验剪枝（Post-hoc）</strong>：先全量存入 RAM，推理时盲目均匀采样或依赖深度图 3D 体素去重</td>
      <td><strong>前置精炼（Pre-hoc）</strong>：观测帧产生时即在线评估价值，只有高信息量关键帧进入 Memory Bank</td>
    </tr>
    <tr>
      <td>显存/内存 I/O</td>
      <td>每次推理都需在主机 RAM 与 GPU VRAM 间重复传输大量图像帧</td>
      <td>Memory Bank 全程常驻显存（VRAM），推理时零额外传输延迟</td>
    </tr>
    <tr>
      <td>传感器依赖</td>
      <td>依赖高精度深度传感器（RGB-D / 双目）计算点云与体素</td>
      <td><strong>仅需单目第一视角 RGB 图像</strong>，通用性强</td>
    </tr>
    <tr>
      <td>指令相关性</td>
      <td>采样过程与任务指令完全脱节，易混入大量白墙、地面等无效视野</td>
      <td>动态计算图文语义相似度，紧密对齐指令涉及的地标</td>
    </tr>
  </tbody>
</table>

<p>AMR 将长程记忆构建建模为显式多准则迭代优化问题。在导航过程中，智能体从候选帧池 $\mathcal C$ 中迭代选取 $K$ 帧加入精炼记忆库 $\mathcal M$，使得综合评分函数最大化：</p>

\[f^* = \arg\max_{f \in \mathcal C \setminus \mathcal M} \left[ \lambda_R \cdot \mathrm{Sim}_{Sem}(f, I) - (1 - \lambda_R) \cdot \left( w_V \cdot \mathrm{Sim}_{Vis}(f, \mathcal M) + w_T \cdot \mathrm{Sim}_{Temp}(f, \mathcal M) \right) \right]\]

<p>其中各项物理意义如下：</p>
<ol>
  <li><strong>语义相关性（\(\mathrm{Sim}_{Sem}\)）</strong>：计算候选帧视觉嵌入 $e_f$ 与导航指令全局文本嵌入 $e_I$ 的余弦相似度：
\(\mathrm{Sim}_{Sem}(f, I) = \frac{e_f \cdot e_I}{\lVert e_f \rVert \lVert e_I \rVert}\)</li>
  <li><strong>视觉多样性惩罚（\(\mathrm{Sim}_{Vis}\)）</strong>：计算候选帧 $f$ 与当前记忆库 $\mathcal M$ 中所有已有帧的最大视觉余弦相似度，惩罚视场高度雷同的重复地标：
\(\mathrm{Sim}_{Vis}(f, \mathcal M) = \max_{m \in \mathcal M} \frac{\mathrm{embed}(f) \cdot \mathrm{embed}(m)}{\lVert \mathrm{embed}(f) \rVert \lVert \mathrm{embed}(m) \rVert}\)</li>
  <li><strong>时间跨度覆盖惩罚（\(\mathrm{Sim}_{Temp}\)）</strong>：惩罚时间戳过近的候选帧，鼓励记忆库在整条长轨迹上保持均匀的时间覆盖度（$\epsilon$ 为防除零微小常数）：
\(\mathrm{Sim}_{Temp}(f, \mathcal M) = \frac{1}{\min_{m \in \mathcal M} \lvert t_f - t_m \rvert + \epsilon}\)</li>
</ol>

<blockquote>
  <p><strong>举个例子（AMR 权重平衡如何选出关键地标）</strong>：
机器人执行一条 50 步的长指令：“穿过走廊，进入客厅并在黑色双人沙发旁停下”。
机器人在客厅停留了 15 步，如果只看语义相关性（$\lambda_R = 1.0$），选出的 8 张记忆帧会全被客厅同一角度的沙发特写占满，导致前半段走廊的记忆完全丢失；
当引入视觉多样性与时间惩罚（$\lambda_R = 0.5, w_V = 0.5, w_T = 0.5$）后，第二张客厅沙发帧因与已存沙发帧的 \(\mathrm{Sim}_{Vis} &gt; 0.95\) 且时间差极小，得分被大幅扣减；
最终算法会自动保留：1 帧起始房间、2 帧走廊拐角、2 帧客厅入口、3 帧不同朝向的沙发地标，实现全时空高保真记忆。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/DecoVLN-sampling-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:675/740" />
<figcaption>均匀采样（Uniform Sampling）与自适应记忆精炼（AMR）的关键帧对比：均匀采样捕捉了大量白墙与无关门角；AMR 精准提取了指令中高亮提及的开门、壁画、双人沙发等关键决策点</figcaption>
</div>

<h4 id="-信任域状态-动作对纠错微调ecf">③ 信任域状态-动作对纠错微调（ECF）</h4>

<p>长程导航中，微小的累积漂移常使智能体脱离专家轨迹。为解决这一难题，DecoVLN 提出基于步级状态-动作对（State-Action Pair）的信任域纠错微调策略：</p>

<pre><code class="language-mermaid">graph TD
    A["智能体当前位姿 s_t + 即时观测 f_t"] --&gt; B["计算相对专家轨迹的最小测地距离 DM(s_t)"]
    B --&gt; C{"偏离度判定"}
    C -- "DM(s_t) == 0 (完美在轨)" --&gt; D["正常推进策略采样"]
    C -- "0 &lt; DM(s_t) &lt;= tau (信任域内可控偏离)" --&gt; E["查询最短路径专家策略 pi*(s_t) 得到纠偏动作 a_exp"]
    E --&gt; F["存储单步样本 (s_t, a_exp, f_t) 入纠错集 D_c"]
    C -- "DM(s_t) &gt; tau (严重越界污染区)" --&gt; G["立即截断并终止当前 Episode (防止脏数据污染)"]
    F --&gt; H["执行当前策略 a_t 推进至 s_t+1"]
    D --&gt; H
    H --&gt; I["AMR 在线精炼更新 Memory Bank H"]
</code></pre>

<p>具体算法细节如下：</p>
<ul>
  <li><strong>偏离度度量</strong>：利用环境拓扑的测地距离（Geodesic Distance）定义偏离度 \(\mathrm{DM}(s_t) = \min_{s^* \in \mathcal P_{exp}} d_g(s_t, s^*)\)。</li>
  <li><strong>信任域阈值 $\tau$</strong>：设定信任域截断阈值 $\tau = 3\text{m}$。当 $0 &lt; \mathrm{DM}(s_t) \le \tau$ 时，智能体偏离但仍处于可感知原始目标的有效上下文范围内，此时向最短路径专家策略（SPF）查询一步返回正轨的最优动作 \(a_t^{\mathrm{exp}} = \pi^*(s_t)\)，存入微调数据集 $\mathcal D_c$；</li>
  <li><strong>越界截断</strong>：一旦 $\mathrm{DM}(s_t) &gt; \tau$，说明已发生灾难性迷航，强行纠偏只会引入与语言指令脱节的奇异状态分布，算法立即中断该 Episode。</li>
  <li><strong>防灾难性遗忘混合训练</strong>：在纠错微调阶段，将 180K 导航纠错样本与 178K 的通用视频问答数据集（LLaVA-Video-178K）按比例混合，保证模型在获得闭环自愈能力的同时，维持基础多模态时空推理能力。</li>
</ul>

<h4 id="-动作块action-chunking平滑解析与真机控制">④ 动作块（Action Chunking）平滑解析与真机控制</h4>

<p>在实际物理机器人（如 Unitree GO2）部署中，VLM 在远端服务器自回归生成 4 步离散符号动作块（例如：<code class="language-plaintext highlighter-rouge">[forward 25cm, forward 25cm, turn left 15°, stop]</code>）。</p>

<blockquote>
  <p><strong>举个例子（离散动作块向连续平滑轨迹的转换）</strong>：
若四足机器人在真机上直接分步串行执行这 4 个离散指令，每走 25cm 就必须刹车减速一次，导致机身剧烈颠簸顿挫且航向极易漂移；
DecoVLN 在 Jetson Orin 端侧控制器中将该动作序列合成为统一的局部相对目标位姿 $(\Delta x = 0.5\text{m}, \Delta y = 0, \Delta \theta = 15^\circ)$；
底层运动控制 API 基于该相对位姿规划出一条连续平滑的多项式轨迹曲线并直接下发电机力矩，实现流畅自然的连续步态。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/DecoVLN-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1393/735" />
<figcaption>DecoVLN 在宇树 GO2 机器狗上的实机评测：即使面对反光瓷砖地面、复杂室内走廊以及未在训练集中出现的开放词表物体，依然表现出自主微调机身朝向以保持路标在视野正中的闭环鲁棒行为</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-34">3. 核心结果/发现</h3>

<ol>
  <li><strong>基准性能全面领先</strong>：在 R2R-CE 和 RxR-CE Val-Unseen 连续基准上，DecoVLN 仅凭单目第一视角 RGB 输入分别斩获 <strong>56.3%</strong> 和 <strong>54.2%</strong> 的成功率（SR），SPL 分别达 <strong>50.5%</strong> 与 <strong>46.3%</strong>。</li>
  <li><strong>力压多模态传感器 SOTA</strong>：相比同样采用流式设计的 StreamVLN（SR: 52.8% / 48.6%），DecoVLN 在 RxR-CE 上的成功率提升高达 <strong>+5.6%</strong>，甚至大幅超越了使用 RGB+Depth 双模态输入的 StreamVLN 版本（SR: 52.9%）。</li>
  <li><strong>极高的数据与算力效率</strong>：无需在 ScaleVLN 等数百万级额外合成数据集上进行大规模预训练，仅在 Matterport3D 收集的 360K 样本上训练约 600 GPU-hours（8 张 A800），即可超越依赖大规模预训练的航路点与地图模型。</li>
  <li><strong>超长路径泛化力</strong>：在平均长度达 23 米的合成超长轨迹验证集（Long-Horizon Validation Set）上，DecoVLN 的成功率达到 <strong>36.9%</strong>，相比 StreamVLN 相对提升 <strong>+12.5%</strong>，证明了 AMR 记忆压缩对长时程抗遗忘的有效性。</li>
  <li><strong>真机涌现主动闭环对齐行为</strong>：在真机测试中，机器狗在行进中自发展现出横向微调与姿态补偿行为，主动确保关键路标和最终目标始终处于视野中心，具备真实的在线闭环抗干扰能力。</li>
</ol>

<hr />

<h3 id="4-局限性-34">4. 局限性</h3>

<ol>
  <li><strong>依赖端云协同与无线网络带宽</strong>：模型基于 LLaVA-Video-7B 构建，7B 参数量难以直接在 Jetson Orin 等边缘计算平台实现全板载实时推理，对无线通信网络延迟和信号稳定性存在依赖。</li>
  <li><strong>极端地标丢失时的全局重定位能力有限</strong>：当遇到特征极其匮乏的完全对称走廊或严重视觉混淆导致彻底迷失时，当前系统缺少基于思维链（Chain-of-Thought）的主动回溯（Backtracking）与全局重新建图重规划机制。</li>
</ol>

<hr />

<h2 id="tamp-nav">49. TAMP-Nav (2026)</h2>
<p>———Point, Think, Memorize, and Align for Efficient Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.17512">arXiv:2608.17512</a> · <a href="https://github.com/ZJU-OmniAI/Embodied-Omni">Code</a></p>

<hr />

<h3 id="精华-37">精华</h3>
<ul>
  <li><strong>空间解耦（Point）</strong>：提出 Pixel-to-3D 动作范式，让 2D 大视觉语言模型（VLM）仅作为“视觉指示器”在图像上点选 2D 像素航点，利用外置深度反投影交由传统 SLAM 控制器执行，彻底规避 2D VLM 回归连续 3D 坐标时的几何幻觉。</li>
  <li><strong>动态记忆（Think &amp; Memorize）</strong>：设计锚点-轨迹混合记忆（Anchor-Trajectory Memory），仅在关键拓扑决策点存储高保真视觉与思维链（CoT）语义锚点，中间过渡路径仅保留由多维旋转位置编码（RoPE）压缩的定长时空指示器（STI Token），极大减轻长程注意力稀释。</li>
  <li><strong>两级对齐（Align）</strong>：提出融合退火引导采样的两级 GRPO 强化学习框架，将轨迹级全局成功/效率奖励与步级局部动作/推理价值奖励独立标准化后叠加，实现密集信号监督。</li>
  <li><strong>高效涌现</strong>：仅凭 90k 条合成轨迹冷启动与在线强化，便使模型自主涌现“直道快速通过、路口按需深思”的元认知能力，以 26.3% 的稀疏推理比例逼近 100% 密集推理上限，并在 R2R-CE（66.2% SR）与四足机器人真机零样本部署（60.0% SR）中取得 SOTA 表现。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-36">1. 研究背景/问题</h3>
<p>将通用大视觉语言模型（VLM）部署到连续环境具身导航（VLN-CE）中面临三大核心技术瓶颈：</p>
<ol>
  <li><strong>动作空间的几何表征鸿沟（Geometric Gap）</strong>：主流 VLM 预训练于 2D 图像-文本对，强行让其直接回归连续 3D 空间坐标或预测离散底层原子动作（如“左转 30 度”），极易引发严重的 3D 空间几何幻觉与极低的数据利用效率；</li>
  <li><strong>推理质量与计算延迟的权衡困境（Reasoning Dilemma）</strong>：引入思维链（CoT）能强化高层规划，但固定步频或每步全量推理带来线性暴涨的计算延迟，缺乏根据场景复杂度动态决策的灵活性；</li>
  <li><strong>长程历史的记忆爆炸与时空感知缺失（Memory Bottleneck）</strong>：全量保留历史视觉特征会导致多模态上下文溢出与注意力稀释，而启发式丢弃帧又会丢失关键拓扑线索，且缺乏显式的时空物理坐标来组织历史轨迹。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-34">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/TAMP-Nav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/687" />
<figcaption>TAMP-Nav 整体架构：结合 2D 像素点选、锚点-轨迹混合记忆、选择性按需推理与两级 GRPO 对齐</figcaption>
</div>

<h4 id="-整体框架概述-16">① 整体框架概述</h4>
<p>TAMP-Nav 围绕“感知点选（Point）、按需思考（Think）、时空记忆（Memorize）、两级对齐（Align）”构建闭环交互系统。在每个导航步，智能体结合当前四视角环视图像与历史锚点-轨迹记忆维护长程空间认知；自主决定是否触发深层思维链分析；以 2D 像素指示器输出目标航点并反投影至 3D 空间交由底层 SLAM 控制器执行；整体策略通过两级 GRPO 强化学习完成认知规划与环境物理反馈的紧密对齐。</p>

<h4 id="-pixel-to-3d-动作空间point">② Pixel-to-3D 动作空间（Point）</h4>
<p>传统方法要求 VLM 隐式学习复杂的 3D 投影变换。TAMP-Nav 将高层语义决策与底层物理执行严格解耦：</p>
<ul>
  <li><strong>视角选择与像素点选</strong>：在时间步 $t$，智能体接收 4 个环视相机视角 $V_t = {v_{t,1}, v_{t,2}, v_{t,3}, v_{t,4}}$ 实现 $360^\circ$ 全景感知。VLM 首先选定最优朝向视图 $v_{t,i}$，随后在图像平面上直接预测 2D 像素坐标 $a_t = (u, v)$ 作为目标航点。</li>
  <li><strong>3D 投影与局部执行</strong>：结合该视角的深度图 $D_{t,i}$ 与相机内参矩阵 $K$，直接计算局部 3D 空间坐标：
\(P_t = D_{t,i}(u, v) \cdot K^{-1} [u, v, 1]^T\)
将 $P_t$ 转入全局世界坐标系后，直接分发给成熟的底层 SLAM 局部控制器（如 Fast-LIO2 里程计 + FAR Planner 局部规划器）自主完成运动控制与避障。这使得平均交互步数从传统原子动作的 30 余步大幅压缩至 9 步。</li>
</ul>

<h4 id="-锚点-轨迹混合记忆与时空指示器think--memorize">③ 锚点-轨迹混合记忆与时空指示器（Think &amp; Memorize）</h4>
<p>为解决长程导航中全量存储导致上下文爆炸、稀疏丢弃导致信息断裂的矛盾，TAMP-Nav 提出异构双轨记忆：</p>

<ol>
  <li><strong>时空指示器（Space-Time Indicator, STI Token）</strong>：
为了向上下文流中注入无歧义的物理绝对坐标 $(x, y)$、偏航角 $\text{yaw}$ 与时间步 $t$，通过多维旋转位置编码（RoPE）与多层感知机（MLP）构建定长特征向量：
\(E_{\text{STI}}(t, x, y, \text{yaw}) = \text{MLP}\left( \left[ \text{RoPE-2D}(x, y); \text{RoPE-1D}(t); \text{RoPE-2D}(\sin(\text{yaw}), \cos(\text{yaw})) \right] \right)\)
    <blockquote>
      <p><strong>大白话直觉</strong>：偏航角如果在 $0^\circ$ 和 $360^\circ$ 边界直接用标量数值表示，机器人轻轻一转数值就会突变（如从 359 跳到 1）；将其拆解为连续的三角函数对 $(\sin(\text{yaw}), \cos(\text{yaw}))$ 并映射到 2D 空间，能保证角度连续平滑旋转，消除几何不连续性。</p>
    </blockquote>
  </li>
</ol>

<blockquote>
  <p><strong>降维装置 A —— 最小具体例子（存储压缩手算对比）</strong>：
假设一段走廊导航包含 20 个时间步，其中只有第 1 步（起点）和第 12 步（T 型路口转弯）是关键决策点：</p>
  <ul>
    <li><strong>传统全量存储</strong>：每步保留多视角图像 patch，每步约 256 tokens，20 步将消耗 $20 \times 256 = 5120$ 个 tokens，迅速撑爆 4096 的上下文窗口并稀释注意力；</li>
    <li><strong>TAMP-Nav 混合记忆</strong>：仅对第 1 和第 12 步存储高保真视觉与思维锚点（各占 1 组图像 tokens），其余 18 个非关键过渡步各仅压缩为 <strong>1 个定长 STI token</strong>（共 18 tokens）；</li>
    <li><strong>效果</strong>：不仅将长程历史 token 消耗削减 90% 以上，而且机器人在每一步都能精确感知自己在第几步、位于世界坐标 $(x_t, y_t)$ 的哪个位置与朝向，彻底保留了连续运动轨迹的时空骨架。</li>
  </ul>
</blockquote>

<ol>
  <li><strong>显式锚点（Explicit Anchors）与轨迹流</strong>：
    <ul>
      <li><strong>显式锚点 $A_k$</strong>：在触发深层 CoT 的拓扑关键点 $t_k$，以三元组形式保存：
\(A_k = \langle M_{\text{STI}}^{(k)}, M_{\text{vis}}^{(k)}, M_{\text{state}}^{(k)} \rangle\)
其中 $M_{\text{STI}}^{(k)}$ 提供精确时空坐标，$M_{\text{vis}}^{(k)}$ 保留高保真原始视觉特征（支持像素级回环检测），$M_{\text{state}}^{(k)}$ 存储当步生成的 CoT 摘要，充当“阶段规划路标”；</li>
      <li><strong>轨迹流 $T_k$</strong>：在两个锚点之间的非关键直行或微调区间，完全剔除高开销的图像 token，仅保留轻量级 STI 序列：
\(T_k = \left[ E_{\text{STI}}(t, x_t, y_t, \text{yaw}) \mid t \in \mathcal T \right]\)</li>
      <li><strong>工作记忆（Working Memory）</strong>：当前步输入还会拼接当前 step 与最近一个锚点之间均匀采样的 2 帧最新图像，确保局部观察的连续性。</li>
    </ul>
  </li>
</ol>

<h4 id="-核心机制降维对比">④ 核心机制降维对比</h4>

<blockquote>
  <p><strong>降维装置 C —— 具身导航核心架构对比表</strong>：</p>
</blockquote>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统原子动作 / 3D 回归范式</th>
      <th>密集 CoT / 全量历史范式</th>
      <th>TAMP-Nav（本文方案）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>动作空间</strong></td>
      <td>预测离散底层动作（左转/前进）或直接回归 3D 空间坐标</td>
      <td>启发式航点图搜索或扩散模型生成候选</td>
      <td><strong>Pixel-to-3D</strong>：2D 像素点选 + 深度反投影 + SLAM 闭环控制器</td>
    </tr>
    <tr>
      <td><strong>推理机制</strong></td>
      <td>无 CoT 或每步无差别触发高开销 CoT</td>
      <td>固定步长间隔触发 CoT</td>
      <td><strong>按需自发推理</strong>：RL 驱动，仅在路口/障碍物/目标附近深思</td>
    </tr>
    <tr>
      <td><strong>长程记忆</strong></td>
      <td>丢弃历史或单调均匀降采样（丢失拓扑连通性）</td>
      <td>全量保留视觉 tokens（上下文爆炸、注意力稀释）</td>
      <td><strong>锚点-轨迹混合记忆</strong>：关键点留图文锚点，过渡步留定长 STI token</td>
    </tr>
    <tr>
      <td><strong>RL 优化</strong></td>
      <td>纯稀疏终点奖励（方差极大）或强行拟合专家动作</td>
      <td>仅轨迹级结果奖励（难以归因单步动作）</td>
      <td><strong>两级 GRPO</strong>：轨迹级全局优势 + 步级局部优势独立标准化后叠加</td>
    </tr>
  </tbody>
</table>

<hr />

<h4 id="-两级-grpo-强化学习对齐align">⑤ 两级 GRPO 强化学习对齐（Align）</h4>

<div align="center">
  <img src="/images/vln/TAMP-Nav-two-level-grpo.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/603" />
<figcaption>两级 GRPO 强化学习对齐范式：融合轨迹级全局 Rollout 与步级候选采样，并配合退火引导采样</figcaption>
</div>

<p>为了让智能体兼具微观避障精准度与宏观长程规划能力，TAMP-Nav 设计了两级 GRPO 框架与多分支采样：</p>

<blockquote>
  <p><strong>降维装置 B —— 两级 GRPO 数据流与优势叠加机制（自制 Mermaid 图）</strong>：</p>
</blockquote>

<pre><code class="language-mermaid">graph TD
    A["输入指令 q + 当前上下文 C_t"] --&gt; B["生成 G=8 条完整探索轨迹 (轨迹级 Rollouts)"]
    B --&gt; C["在每条轨迹各步 t, 温度采样 M=4 个候选动作 a_t^{i,j}"]
    C --&gt; D["计算候选动作局部奖励 R_local(t)"]
    D --&gt; E{"处于 RL 训练早期 (beta_k &gt; 0)?"}
    E -- "是" --&gt; F["按局部奖励权重执行退火引导采样 P_select"]
    E -- "否" --&gt; G["均匀随机选取候选动作执行并推进环境"]
    F --&gt; H["完成全部 G 条轨迹交互"]
    G --&gt; H
    H --&gt; I["轨迹级评估: 归纳 R_global (成功率/SPL/推理密度)"]
    H --&gt; J["步级评估: 归纳 R_local (目标接近/避障/停止/推理价值/格式)"]
    I --&gt; K["组内 Z-score 标准化 -&gt; A_global"]
    J --&gt; L["M 个候选内 Z-score 标准化 -&gt; A_local(t)"]
    K --&gt; M["双层优势直接叠加: A_S(t) = A_global + A_local(t)"]
    L --&gt; M
    M --&gt; N["广播到 Token 级别，执行 GRPO 策略裁剪更新"]
</code></pre>

<ol>
  <li><strong>步级局部奖励（Local Step Rewards）</strong>：
包含 5 项显式引导：
    <ul>
      <li><strong>目标接近奖励 $r_{\text{app}}^{(t)}$</strong>：衡量测地线距离缩短量 $\Delta d = d_t - d_{t+1}$，通过双曲正切型有符号 Sigmoid 映射：
\(r_{\text{app}}^{(t)} = \frac{2}{1 + \exp(-\Delta d)} - 1\)</li>
      <li><strong>碰撞避免奖励 $r_{\text{coll}}^{(t)}$</strong>：直接查询与最近障碍物的物理距离 $c_t$：$r_{\text{coll}}^{(t)} = \max(0, \min(c_t, 1.0))$；</li>
      <li><strong>停止动作奖励 $r_{\text{stop}}^{(t)}$</strong>：在目标点 1.5 米内停下奖励 $+1.0$，远离目标（$&gt;3.0$ 米）误停惩罚 $-1.0$；</li>
      <li><strong>推理价值奖励 $r_{\text{rea}}^{(t)}$</strong>：专门评估 CoT 是否真正带来了决策增益：
\(r_{\text{rea}}^{(t)} = h_t \cdot \left( r_{\text{app}}^{(t)} - \bar r_{\text{app}}^{(t)} \right)\)
其中 $h_t \in {0, 1}$ 为是否触发思维链，$\bar r_{\text{app}}^{(t)}$ 为当前步 $M=4$ 个候选动作的平均接近得分。<strong>只有当产生思维链后的动作表现优于局部平均盲猜水平时，才给予正向奖励</strong>，严厉惩罚无意义的冗余推理；</li>
      <li><strong>格式规范奖励 $r_{\text{fmt}}^{(t)}$</strong>：确保严格遵循 JSON 结构且预测的像素落在合法的 $[0, 279]^2$ 图像视界内。</li>
      <li>步级总奖励加权和：
\(R_{\text{local}}^{(t)} = \lambda_1 r_{\text{app}}^{(t)} + \lambda_2 r_{\text{coll}}^{(t)} + \lambda_3 r_{\text{stop}}^{(t)} + \lambda_4 r_{\text{rea}}^{(t)} + \lambda_5 r_{\text{fmt}}^{(t)}\)</li>
    </ul>
  </li>
  <li>
    <p><strong>轨迹级全局奖励（Global Trajectory Rewards）</strong>：
\(R_{\text{global}} = \omega_1 r_{\text{suc}} + \omega_2 r_{\text{spl}} + \omega_3 r_{\text{den}}\)
其中 $r_{\text{suc}}$ 为最终任务成功奖励（严格成功给 1.0，Oracle 成功给 0.5），$r_{\text{spl}}$ 鼓励最短路径效率，$r_{\text{den}}$ 为<strong>推理密度奖励</strong>：当全轨迹推理步比例 $r \le 0.4$ 时维持高额奖励，超过 $0.4$ 开始陡峭衰减，超过 $0.6$ 归零，强制抑制“过度思考”。</p>
  </li>
  <li>
    <p><strong>退火引导采样（Annealed Guided Sampling）</strong>：
在 RL 早期，纯随机探索难以在长程任务中遇到成功信号。TAMP-Nav 在训练步 $k$ 使用指数退火权重 $\beta_k = \beta_0 \cdot \alpha^k$（$\beta_0=2.0, \alpha=0.99$）根据局部奖励加权采样候选动作：
\(P_{\text{select}}(a_i) = \frac{\exp\left( \beta_k \cdot R_{\text{local}}^{(t)}(a_i) \right)}{\sum_{j=1}^M \exp\left( \beta_k \cdot R_{\text{local}}^{(t)}(a_j) \right)}\)
训练初期引导智能体探索高质量局部路径，随着训练推进 $\beta_k \to 0$，平滑过渡为均匀无偏探索。</p>
  </li>
  <li><strong>双层优势叠加与 Token 级更新</strong>：
对 $G=8$ 条轨迹的 $R_{\text{global}}$ 计算组内 Z-score 得到 $A_{\text{global}}$；对当步选定动作在 $M=4$ 个候选中标准化得到 $A_{\text{local}}^{(t)}$。两者独立归一化后尺度一致，直接相加形成叠加优势：
\(A_S^{(t)} = A_{\text{global}} + A_{\text{local}}^{(t)}\)
并将 $A_S^{(t)}$ 广播给当前步生成的全部 Token 执行 GRPO 策略梯度更新。</li>
</ol>

<hr />

<h3 id="3-核心结果发现-35">3. 核心结果/发现</h3>

<h4 id="-vln-ce-连续环境基准全面-sota">① VLN-CE 连续环境基准全面 SOTA</h4>
<ul>
  <li><strong>R2R-CE Val-Unseen</strong>：成功率（SR）达到 <strong>66.2%</strong>，SPL 达到 <strong>58.8%</strong>，导航误差（NE）降至 <strong>3.85m</strong>，相较于纯 SFT 模型（55.7% SR）提升 10.5 个百分点，全面超越 DualVLN（64.3% SR）、NavFoM（61.7% SR）和 StreamVLN（56.9% SR）；</li>
  <li><strong>RxR-CE Val-Unseen</strong>：成功率达到 <strong>65.7%</strong>，SPL 达到 <strong>56.9%</strong>，nDTW 达到 <strong>72.4%</strong>；</li>
  <li><strong>极致样本与推理效率</strong>：仅需 <strong>90k 条训练轨迹（700k 次交互）</strong>，数据量远低于 DualVLN（763k 轨迹）与 NavFoM（337 万次交互）；单任务平均推理时间仅 <strong>16.58 秒</strong>，相比 StreamVLN（37.47 秒）与 DualVLN（41.46 秒）提速一倍以上。</li>
</ul>

<div align="center">
  <img src="/images/vln/TAMP-Nav-cot-heatmap.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:773/367" />
<figcaption>思维链（CoT）触发空间热力图：纯 SFT 模型（左）在直道上盲目推理；RL 对齐后的 TAMP-Nav（右）精准聚焦于路口、房门与拐角等关键拓扑节点</figcaption>
</div>

<h4 id="-按需推理reasoning-on-demand的自发涌现">② 按需推理（Reasoning-on-Demand）的自发涌现</h4>
<ul>
  <li><strong>空间聚集性</strong>：如上图所示，RL 对齐后，模型在笔直走廊等平凡路径上的推理占比从 SFT 阶段的 <strong>38% 骤降至 11%</strong>，计算资源高度收敛于岔路口、房门出入口和目标物体附近；</li>
  <li><strong>极致性价比</strong>：在仅有 <strong>26.3%</strong> 推理比例（CoT Ratio）的情况下，取得了 <strong>66.2% SR</strong>，几乎完全追平了每步强制全量思考的 Dense CoT 上限（100% 推理比例，66.8% SR），大幅超越固定 1/3 间隔推理的基线（60.1% SR）。</li>
</ul>

<div align="center">
  <img src="/images/vln/TAMP-Nav-long-horizon.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/739" />
<figcaption>超长程导航任务（&gt;12.5 米 / &gt;50 步原子动作）上的性能分布曲线</figcaption>
</div>

<h4 id="-超长程复杂任务的极佳稳定性">③ 超长程复杂任务的极佳稳定性</h4>
<p>在路径长度超过 12.5 米（相当于 50 步以上连续原子动作）的 5927 条超长挑战子集上，TAMP-Nav 取得 <strong>49.8% SR</strong>，大幅领先 DualVLN（41.9%）与 StreamVLN（30.9%）。消融实验显示，去除 STI 时空指示器后长程性能骤降至 45.6%，证明定长时空表征对长程拓扑连通性的不可替代性。</p>

<div align="center">
  <img src="/images/vln/TAMP-Nav-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1326/547" />
<figcaption>真实世界四足机器人零样本部署：(a) 涵盖多区域与长距离的多轮指令执行轨迹；(b) 真实环境导航成功率对比</figcaption>
</div>

<h4 id="-四足机器人真实场景零样本部署">④ 四足机器人真实场景零样本部署</h4>
<p>在未经过任何实机微调的情况下，直接部署于搭载 4 路环视 RGB-D 相机与 LiDAR 的 Unitree Go2 四足机器人上。在涵盖会议室、实验室、大厅、跨区域与室外的 100 次真实评测中，TAMP-Nav 取得 <strong>60.0%</strong> 的导航成功率，显著高于 StreamVLN（49.0%）与 DualVLN（53.0%），展现出强劲的 Sim-to-Real 零样本泛化能力。</p>

<hr />

<h3 id="4-局限性-35">4. 局限性</h3>
<ul>
  <li><strong>传感器与 SLAM 依赖</strong>：高度依赖深度相机与底层 SLAM 栈的局部建图与测距精度，在强光直射、大面积透明玻璃或 SLAM 严重漂移的极端场景下可能导致 3D 投影失效；</li>
  <li><strong>高度信息缺失</strong>：当前 STI token 仅编码平面二维坐标 $(x, y)$ 与朝向偏航角，尚未包含垂直高度 $z$，在跨楼层建筑和复杂三维阶梯场景中仍需拓展至完整的 3D 6-DoF 位姿表征；</li>
  <li><strong>强化学习仍局限于仿真环境</strong>：GRPO 训练依赖仿真器提供的特权全局奖励（真值距离与碰撞信息），尚无法直接在物理真机上开展在线强化学习探索。</li>
</ul>

<hr />

<h2 id="lightnav-0">50. LightNav-0 (2026)</h2>
<p>———把 VLM 已有的空间智能”引出来”，而不是给它外挂一个导航模块</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.30935">arXiv:2608.30935</a> · <a href="https://github.com/lightorigins/LightNav-0">Code</a></p>

<h3 id="精华-38">精华</h3>

<ol>
  <li>全文的立场是”eliciting”而非”adding”：不加任何任务专用预测头、本体专家或航点预测器，只给 Qwen3-VL-4B 扩了词表，让导航能力从预训练 VLM 自己的空间先验里长出来。</li>
  <li>双通道 pointing（affordance 点 + object 点）是整篇论文的枢纽——用图像平面上的一个栅格 token 同时表达”往哪走”与”目标在哪”，天然与任务、场景、机器人本体解耦，所以同一套监督能覆盖指令跟随、物体搜索、视觉跟踪三类任务。</li>
  <li>残差向量量化（RVQ）把 10 步 SE(2) 轨迹压成 3 个 token，让”连续控制精度”与”语言模型 token 概率”第一次同时成立，这是它能原样套用 GRPO、而不必把扩散去噪重写成 MDP 的关键。</li>
  <li>显式空间推理不一定要写成一长串文字 CoT：定长 2 个 token 的视觉 trace 既保住了可解释性，又躲开了变长解码的延迟。</li>
  <li>Scaling 实验给出一个反直觉却实用的结论——在这个量级上，扩环境多样性比扩数据量、也比把 backbone 从 4B 堆到 8B 更可靠。</li>
</ol>

<div align="center">
  <img src="/images/vln/LightNav-0-teaser.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/827" />
<figcaption>LightNav-0 总览：仿真数据引擎（2K+ 场景、4K+ 小时）→ 三阶段训练 → 零样本部署到人形 / 四足 / 无人机 / 轮式四类本体；下方为 10 个公开仿真设置上的单目成功率对比，蓝色为本文方法</figcaption>
</div>

<hr />

<h3 id="1-研究背景问题-37">1. 研究背景/问题</h3>

<p>具身导航要求同一个智能体把异构目标（一句自然语言指令、一个物体类别、一个移动的人）和视觉观测翻译成动作，并且要跨任务、跨场景、跨机器人本体。但现有系统几乎都为单一任务或单一 benchmark 优化，依赖航点预测器、拓扑地图、任务专用动作头这些”backbone 之外的结构”，把感知、推理、行动割裂开，一旦任务、传感器配置或机器人换掉就迁移不动。</p>

<p>与此同时，现代 VLM 其实已经编码了导航所需的大部分能力——开放词表识别、空间推理、指令理解、时序视频理解——只是这些能力很少被直接调用来做机器人控制。论文要回答的问题是：能不能让一个紧凑 VLM 直接充当通用具身导航的共享推理骨干？</p>

<hr />

<h3 id="2-主要方法创新点-35">2. 主要方法/创新点</h3>

<h4 id="-整体框架概述-17">① 整体框架概述</h4>

<p>LightNav-0 把所有导航任务统一成”条件 token 生成”。在决策步 $t$，模型吃进语言指令 $I$ 和第一人称 RGB 历史 $O_{1:t}$，吐出一段固定格式的 token：<strong>先 2 个 pointing token（空间推理痕迹），紧跟 3 个 RVQ 动作 token（轨迹）</strong>。整个系统只有三个自研部件挂在一个冻结架构的 Qwen3-VL-4B-Instruct 上——<strong>慢快历史压缩器</strong>负责把无限增长的视觉历史塞进固定 token 预算，<strong>双通道 pointing</strong> 负责把”空间意图”表达成与本体无关的图像栅格坐标，<strong>RVQ 动作 tokenizer</strong> 负责把这个意图翻译成精确的、本体相关的轨迹。三者共用同一个原生自回归语言模型头，没有任何额外预测头。</p>

<div align="center">
  <img src="/images/vln/LightNav-0-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/884" />
<figcaption>LightNav-0 架构总览：压缩后的第一人称 RGB 历史与语言目标进入预训练 VLM，先输出 pointing 前缀作为显式空间推理痕迹，再输出 3 个 RVQ 动作 token，解码成 10 个未来 SE(2) 航点交给各本体的底层控制器</figcaption>
</div>

<p>读者版的端到端数据流（论文原图是作者视角、信息密集，这张只讲一件事：一个决策步里数据怎么流）：</p>

<pre><code class="language-mermaid">graph TD
    A["单目 RGB 历史 O_1:t ＋ 语言指令 I"] --&gt; B["原生分辨率 ViT 逐帧编码"]
    B --&gt; C["Slow-Fast 历史压缩：越老的帧采样越稀、池化越粗"]
    C --&gt; D["拼成一条因果序列送进 Qwen3-VL-4B"]
    D --&gt; E["Token 1：affordance 点（可走的自由空间栅格）"]
    E --&gt; F["Token 2：object 点（目标物体 / 终点栅格）"]
    F --&gt; G["Token 3-5：RVQ 的 L0 / L1 / L2 码字"]
    G --&gt; H["码字求和 ＋ SE(2) 积分 ⇒ 10 个未来航点"]
    H --&gt; I["各本体共用的 Trajectory Follower"]
    I --&gt; J["机器人自带的底层运动策略"]
</code></pre>

<h4 id="-时序感知的视觉历史压缩">② 时序感知的视觉历史压缩</h4>

<ul>
  <li><strong>输入</strong>：任意长度的第一人称 RGB 流。</li>
  <li><strong>处理</strong>：按”时间越久、记得越糊”来压——论文明说这是照着艾宾浩斯遗忘曲线的定性形状设计的。对时刻 $t_i$ 采集的历史帧，定义其”年龄” $\Delta T_i = t - t_i$，采样率随年龄指数衰减，空间池化步长随年龄指数增大：</li>
</ul>

\[f_s(i) = f_s^{\max}\exp\!\left(-\frac{\Delta T_i}{\tau_s}\right), \qquad s_i = \max\!\left(1,\ \exp\frac{\Delta T_i}{\tau_p}\right)\]

<p>被选中的帧各自过原生分辨率 ViT，再按 $s_i$ 做网格池化；池化后靠时间戳 token 保住先后顺序。</p>
<ul>
  <li><strong>输出</strong>：一组”近处细、远处粗”的视觉 token，总量落在 256K / 576K / 1M 三档可配置像素预算内，按长期 / 中期 / 短期三层分配。</li>
  <li><strong>设计动机</strong>：导航既需要当前帧的几何细节（脚下能不能走），也需要长时程语境（我刚才是不是来过这儿）。全量原生分辨率编码会让 token 数无界增长；反过来把整段历史塌缩成一个定长表示又丢掉近处细节。分层分配是这两者之间的折中。</li>
</ul>

<h4 id="-双通道-pointing把空间推理写成两个栅格-token">③ 双通道 pointing：把空间推理写成两个栅格 token</h4>

<ul>
  <li><strong>输入</strong>：当前视图 + 自动标注管线投影下来的两个目标点。</li>
  <li><strong>处理</strong>：把当前视图切成 $H_g$ 行 $W_g$ 列的栅格，一个归一化点 $p=(u,v)\in[0,1]^2$ 被拍平成一个整数索引：</li>
</ul>

\[r(p) = \min\{H_g - 1,\ \lfloor H_g v\rfloor\},\quad c(p) = \min\{W_g - 1,\ \lfloor W_g u\rfloor\},\quad i(p) = r(p)\,W_g + c(p)\]

<p>affordance 点编码成 <code class="language-plaintext highlighter-rouge">&lt;apos_i&gt;</code>，object 点编码成 <code class="language-plaintext highlighter-rouge">&lt;opos_i&gt;</code>，两族 token 共享同一个栅格但索引空间独立。原地转向、停止、目标不可见这些”没有合法栅格”的情况，由各自 token 族里预留的索引表示。</p>
<ul>
  <li><strong>输出</strong>：每步恰好 2 个 token，接在动作 token 前面。</li>
  <li><strong>设计动机</strong>：VLM 本来就把视觉证据摊在一个 2D token 阵列上，用<strong>一个</strong>栅格 token 表达一个点，正好踩在 backbone 预训练的 grounding 能力上；而且这个阵列定义在图像平面而非某个具体机器人的控制空间里，所以同一套表示能跨任务、跨本体复用。因果注意力让这段前缀自动变成一个条件化后续动作生成的显式空间痕迹。</li>
</ul>

<blockquote>
  <p><strong>举个例子</strong>（为什么是”一个 token”而不是”两个坐标 token”）：假设栅格是 4 行 × 4 列，模型判断可走方向落在归一化坐标 $p = (u, v) = (0.6, 0.4)$。
列 $c = \lfloor 4 \times 0.6 \rfloor = 2$，行 $r = \lfloor 4 \times 0.4 \rfloor = 1$，拍平后 $i = 1 \times 4 + 2 = 6$ ——输出就是单个 token <code class="language-plaintext highlighter-rouge">&lt;apos_6&gt;</code>。
换成”横坐标 token + 纵坐标 token”的写法，同一个点要花 2 个 token，模型还得自己学会这两个 token 是绑定的一对。栅格索引把这层耦合直接编进词表：<strong>每步的推理前缀恒定 2 个 token（一个 affordance、一个 object），不随场景复杂度变长</strong>，这正是它比自由文本 CoT 省的地方——文字 CoT 的解码长度是不可控的。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/LightNav-0-pointing-annotation.webp" width="90%" loading="lazy" decoding="async" style="aspect-ratio:715/528" />
<figcaption>双通道 pointing 的自动标注：affordance 通道通过 3D-2D 投影标出自由空间里可行的落脚点，object 通道用 3D 包围盒投影标出被指代的目标物体</figcaption>
</div>

<h4 id="-rvq-动作-tokenizer3-个-token-换-10-个航点">④ RVQ 动作 tokenizer：3 个 token 换 10 个航点</h4>

<ul>
  <li><strong>输入</strong>：一个动作块，即 10 个未来 SE(2) 航点拉平成的向量 $z_t \in \mathbb R^{10\times 3}$。</li>
  <li><strong>处理</strong>：三级残差量化，每级一个 256 词条的码本 $C^{(0)}, C^{(1)}, C^{(2)}$。第一级抓粗轨迹，后两级依次量化上一级留下的残差：</li>
</ul>

\[k_\ell = \arg\min_k d_J\!\left(r^{(\ell)},\ e_k^{(\ell)}\right), \qquad r^{(\ell+1)} = r^{(\ell)} - e_{k_\ell}^{(\ell)},\qquad r^{(0)} = z_t\]

<p>其中 $d_J$ 是拟合码本时用的 Jacobian 加权轨迹距离，在积分后的轨迹空间里加权，好让平移误差和朝向误差在量纲上平衡。指派轨迹时用的是</p>

\[d_{traj}(z, \hat z) = \mathrm{ADE}(z, \hat z) + \lambda\,\lvert \Delta\theta(z) - \Delta\theta(\hat z)\rvert, \qquad \lambda = 0.3\]

<ul>
  <li><strong>输出</strong>：三个层级化的动作 token <code class="language-plaintext highlighter-rouge">&lt;act_L0_k&gt;</code> <code class="language-plaintext highlighter-rouge">&lt;act_L1_k&gt;</code> <code class="language-plaintext highlighter-rouge">&lt;act_L2_k&gt;</code>。解码时对任意非空前缀求和再做 SE(2) 积分：</li>
</ul>

\[\hat z_t^{(L)} = \sum_{\ell=0}^{L-1} e_{k_\ell}^{(\ell)}, \qquad L \in \{1, 2, 3\}\]

<ul>
  <li><strong>设计动机</strong>：语言模型头直接吐连续控制量，会在”token 预测”和”几何精度”之间打架。RVQ 的巧妙之处在于<strong>任何非空前缀都能解码成一条可执行轨迹</strong>，而不是一个残缺的动作表示——所以算力或延迟吃紧时可以只生成 1 个或 2 个 token 执行粗轨迹，需要最高精度时才补齐第三级。</li>
</ul>

<blockquote>
  <p><strong>举个例子</strong>（为什么残差比”一次性大码本”划算）：想象你要把一条轨迹口述给别人。
L0 相当于先说”大致朝这个方向走一段”——256 选 1，粒度约 <strong>0.9 m</strong>；L1 再补一句”比刚才那条再往左偏一点”，把残差压到约 <strong>7 cm</strong>；L2 最后微调到约 <strong>4 cm</strong>。
三句话（3 个 token）组合出 $256^3 \approx 1670$ 万条不同轨迹，最终平均位移误差 <strong>0.72 cm</strong>。
对照组是 VADv2 式的单层 $K=4096$ 规划词表——码本大了 16 倍、一次报完不做残差细化，误差反而是 <strong>2.48 cm</strong>（约 3.4 倍差）。省 token 的同时精度还更高，靠的正是”由粗到细”这个结构。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/LightNav-0-rvq-tokenizer.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/674" />
<figcaption>层级化残差向量量化动作 tokenizer：左侧展示 L0/L1/L2 三级各自的 256 条候选轨迹与被选中的码字（尺度从 1 m 收到 10 cm 再收到 5 cm），中间是残差编码流程，右侧是码字求和后经 SE(2) 积分重建出的轨迹</figcaption>
</div>

<h4 id="-统一的自回归训练目标">⑤ 统一的自回归训练目标</h4>

<p>导航样本和辅助 VQA 样本走同一个因果语言模型损失，$M$ 是被监督的输出位置集合：</p>

\[\mathcal L_{CE} = -\sum_{j \in M} \log p_\theta\!\left(y_j \mid x,\ y_{&lt;j}\right)\]

<p>导航样本的监督序列就是 1 个 <code class="language-plaintext highlighter-rouge">&lt;apos_i&gt;</code> + 1 个 <code class="language-plaintext highlighter-rouge">&lt;opos_i&gt;</code> + 3 个 RVQ token；pointing 或空间 VQA 样本则是对应的索引 token 或语言回答。因为所有任务共享同一个 token 空间和同一个预测头，训练时不需要为导航损失单独配平衡权重，所有样本能挤进同一个打包的自回归训练循环——论文把约 8.6 个变长样本动态打包进每条 8,192 token 的训练序列。</p>

<h4 id="-三阶段训练配方">⑥ 三阶段训练配方</h4>

<p><strong>Stage I — 具身推理（ER）中期训练。</strong> 先不碰动作，专门把 backbone 的空间能力调出来。从 36 个数据源构建 13.0M 样本的混合集，采样质量分配为 pointing 35.14%、单图 VQA 25.05%、视频推理 19.81%、通用视觉与抽象推理 20.00%。产出的 checkpoint 叫 <strong>LightNav-ER</strong>，用作后续导航对齐的初始化。约 170 H100 GPU-hours。</p>

<p><strong>Stage II — 监督微调（SFT）。</strong> 把 LightNav-ER 对齐到统一导航 token 空间。任务平衡后的优化混合里，77.6% 的样本带导航动作监督，22.4% 是复习 ER 阶段能力的感知 / 推理样本——论文称之为”先特化、再保持”（specialize-then-retain）课程，防止专业化把 backbone 继承来的通用视觉语言能力挤没了。混合中含 DAgger 采集的样本，让策略见到自己动作诱导出的状态。约 950 H100 GPU-hours。</p>

<p><strong>Stage III — 在线 RL 后训练。</strong> DAgger 虽然补上了策略诱导状态，但目标仍是 token 级模仿，并不直接优化决定任务成败的闭环行为。于是用 GRPO 做在线优化，同一套 backbone、token 接口和 rollout 机制支撑三类任务，<strong>只有奖励函数不同</strong>：</p>

\[A^{(g)} = \frac{R(\tau^{(g)}) - \mu_R}{\sigma_R + \epsilon_{num}}\]

<p>组内标准化把”场景难度”这个偏置消掉，只有同一起始状态下 $G$ 次尝试之间的排序才产生梯度。每个任务只给<strong>一个终局标量</strong>，并广播到轨迹的每个决策步（$r_t = R(\tau)$ 对所有 $t$）——论文的理由很实在：要做逐步 reward shaping，就得在三种互不兼容的几何上手工设计三次势函数。超参为 $G=8$、每轮 $B=32$ 个种子（即每次更新 256 条 episode）、$\varepsilon=0.2$、$\beta=0.01$，单节点 8×H100。</p>

<div align="center">
  <img src="/images/vln/LightNav-0-rl-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/623" />
<figcaption>在线多任务强化学习管线：从 SFT 策略出发大规模采样 rollout，跟踪任务按可见性/位置/持续性打分，指令跟随按对齐/到达/终止打分，物体搜索按发现/效率/进度打分，组内归一化后做 GRPO 更新</figcaption>
</div>

<p>三个任务的终局奖励各自为政。指令跟随把路径保真度写进奖励，防止”抄近道到了终点但没按指令走”：</p>

\[R_{VLN} = \left(1 + \mathrm{nDTW}\right)\mathbf 1[\text{success}] + \exp\!\left(-\frac{\max(d_T, d_{clip})^2}{\sigma_d^2}\right) - 0.25\cdot\mathbf 1[\text{timeout}]\]

<p>物体导航则换成路径效率 $PL = d_0 / \max(d_0, \tilde\ell)$（即 SPL 的逐 episode 版本），因为它只给类别不给路线，路径保真度无从谈起；那个高斯邻近项承担了全部失败样本的区分度——没有它，所有失败都是同一个奖励值，对组内方差毫无贡献。视觉跟踪最特殊：目标是移动的，没有终点可”到达”，于是奖励改成”逐步质量的时间平均”，且早停（跟丢或碰撞）时按固定时域 $T_0 = 300$ 步归一化，把没执行的步数记为零质量——不然一个早早撞墙的跟随者反而因为”平均值高”而占便宜。</p>

<blockquote>
  <p><strong>举个例子</strong>（RL 训练集为什么要先筛一遍）：一个 episode 种子要跑 $G=8$ 条 rollout。
若 8 条全成功，8 个奖励几乎相同，$\sigma_R \approx 0$，标准化后 8 个优势全是 0 —— 这 8 条仿真白跑，梯度贡献为零；全失败同理。
只有”8 条里成功 3 条”这种骑在决策边界上的 episode 才有非零方差。
所以论文先用 SFT checkpoint 对每个候选跑 $K$ 次，分箱成 always-solved / mixed / never-solved，只留 mixed。同理，采样保留哪些决策步也不能均匀抽——首末决策、以及带停止 / 卡住 / 碰撞 / 大角度转向这类离散事件的决策及其邻居必须保留，因为终局奖励恰恰是在这些稀有时刻挣到的，均匀抽样会按稀有度把它们丢掉。</p>
</blockquote>

<h4 id="-一张表看清到底改了什么">⑦ 一张表看清”到底改了什么”</h4>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>主流导航 VLA</th>
      <th>LightNav-0</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>空间中间表征</td>
      <td>无，或自由文本 CoT，或独立航点预测器</td>
      <td>双通道 pointing，定长 2 个图像栅格 token</td>
    </tr>
    <tr>
      <td>动作输出</td>
      <td>离散原子指令，或外挂扩散 / 流匹配 / 回归动作头</td>
      <td>原生 LM 头直出 3 个 RVQ token → 10 个 SE(2) 航点</td>
    </tr>
    <tr>
      <td>任务与本体标识</td>
      <td>task identifier token、embodiment expert</td>
      <td>无，任务语义全由指令文本和监督格式指定</td>
    </tr>
    <tr>
      <td>感知输入</td>
      <td>常需全景 / 多相机 / 深度 / 里程计</td>
      <td>仅单目前视 RGB</td>
    </tr>
    <tr>
      <td>RL 可用性</td>
      <td>连续动作头须先把去噪重写成 MDP 才能上 policy gradient</td>
      <td>token 对数概率精确可得，GRPO 原样套用</td>
    </tr>
  </tbody>
</table>

<h4 id="-推理与部署">⑧ 推理与部署</h4>

<p>推理时 ViT 和语言模型跑在同一个进程里（避免视觉特征的跨进程传输），自回归解码由 vLLM 承接，在一张 RTX 4090 上每 token 约 4 ms。每个决策步只需 2 个 pointing token 加至多 3 个 RVQ token。真机侧则用一个共享的 Trajectory Follower 把轨迹翻译成各平台的里程计与速度指令，交给机器人自带的运动策略——高层 RGB-to-trajectory 策略本身完全不动。</p>

<h4 id="-顺带产出insight-bench">⑨ 顺带产出：INSIGHT-Bench</h4>

<p>论文还构建了一个新基准，把网格化仿真场景和 3D 高斯泼溅场景统一到同一套轨迹格式下：训练集 1,683 场景 / 53,090 episode，评测集 210 场景 / 1,097 episode。它按两个正交轴做诊断——场景轴（公寓 / 住宅 / 商业 / 机构 / 户外）和指令轴（Base / Direction / Relation / Extremum / Ordinal），后者对应解析目标所需的空间机制。标注管线用 Molmo2 做开集 pointing、靠度量深度抬升到 3D，并要求一个实例被至少两个不同视点的两次观测支持、3D 定位散度低于 0.6 m 才予保留。</p>

<hr />

<h3 id="3-核心结果发现-36">3. 核心结果/发现</h3>

<p><strong>具身推理（LightNav-ER，8 个基准）。</strong> 4B 的 LightNav-ER 拿到 67.4 的完整集宏平均，4 项第一、4 项第二。相比自己的初始化 Qwen3-VL-4B（63.1）高 4.3 分，比 8B 的 Molmo2-ER（62.8）高 4.6 分且只用一半参数。增益最大的两项恰是最贴导航的能力——Where2Place +12.6、RefSpatial +11.9，分别对应自由空间 grounding 和多步空间指代。</p>

<p><strong>指令跟随（VLN-CE val-unseen）。</strong> R2R 上单目四项指标全线最优：SR 66.9 → 68.5，SPL 62.3 → 62.8，NE 4.05 → 3.91 m，OS 73.7。RxR 上 NE / SR / SPL 同为单目最佳（NE 4.09 → 3.66 m，降幅 10.5%；SR 73.6；SPL 64.5）。<strong>但 nDTW 只有 67.4，低于 DualVLN 的 70.0</strong>——论文自己点出：更高的成功率与终点精度并没有均匀地转化成轨迹保真度。</p>

<p><strong>物体目标导航。</strong> 不用深度也不用里程计，三个闭集设置的单目 SR 与 SPL 全部最优：MP3D SR 46.6 → 53.3、SPL 17.5 → 21.2；HM3D v1 SR 74.5 / SPL 43.9；HM3D v2 SR 77.2 / SPL 41.5。这套纯 RGB 策略甚至越过了列出的多视角系统——HM3D v1 上比带深度和里程计的 WMNav 高 16.4 SR、12.7 SPL，等于排除了”视野更宽或几何信息更特权”这个解释。开放词表的 HM3D-OVON 上模式一致，且<strong>分布越偏增益越大</strong>：seen +0.3 SR，synonyms +9.6，unseen +6.2；SPL 分别 +7.6 / +7.8 / +4.4（以上为 arXiv v2 数字）。</p>

<p><strong>具身视觉跟踪（EVT-Bench）。</strong> STT 上 SR 91.7 / TR 87.7 / CR 1.87，DT 上 SR 82.6 / TR 80.1 / CR 4.62，单目设置下全面领先，DT 上比次优的 ReferTrack 还高 9.3 SR。</p>

<p><strong>INSIGHT-Bench。</strong> 在统一部署协议下（同样 1,097 episode、120° 前视 480×270 RGB、300 步预算），SR 27.4 → 43.7、SPL 24.0 → 41.5、NE 4.25 → 3.88 m，全部聚合指标最优。指令轴上最大增益出现在 Direction（29.7 → 57.7），而且<strong>这是唯一一类 LightNav-0 超过自己 Base 分（45.1）的指令，6 个开源基线在加入第一人称方位词后分数一律低于各自的 Base</strong>——这与它的路线条件化监督（模板里显式写出第一人称方位并在改写中保留）直接对应。最难的仍是 Extremum（37.2），因为选”最左 / 第二个”必须先检出多个候选再比较位置。场景轴上公寓最强（61.1），户外相对增益最大（16.7 → 34.2，翻倍），机构类最弱（29.2）。</p>

<p><strong>消融。</strong> 两个部件都被验证是必需的，而且<strong>双通道 pointing 的贡献远大于 ER 初始化</strong>：ER 初始化把 8 个设置的平均 SR 从 60.8 抬到 63.1、平均 SPL 从 39.0 抬到 40.0；而移除 pointing 监督后平均 SR 从 63.1 掉到 54.7、平均 SPL 从 40.0 掉到 34.3（约 3.7 倍于 ER 初始化的效果）。ER 初始化对 SR 的改善在 8 个设置上一致，但对 SPL 的改善小且不均匀，说明它主要改善语义与空间决策，路径效率更依赖下游导航对齐。</p>

<div align="center">
  <img src="/images/vln/LightNav-0-scaling.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1450/601" />
<figcaption>连续 VLN 上的模型、数据、环境三轴 scaling：backbone 从 2B 到 4B 提升明显，到 8B 则出现混合甚至下降；数据量单调增长但接近全量时收益递减；环境覆盖度是三条轴里最稳定的一条</figcaption>
</div>

<p><strong>Scaling 的三条轴给出不同结论。</strong> 模型轴：2B → 4B 在 R2R / RxR 上涨 6.6–9.6 分，但 4B → 8B 不再一致有益（R2R SR/SPL 反降 1.6/0.5，RxR SR 降 0.5，仅 RxR SPL 升 2.0）——4B 是这批 checkpoint 里性价比最优的。数据轴：1/16 → 全量涨 15.0–17.4 分，但 1/2 → 全量只再添 0.4–1.4 分，收益明显递减。环境轴：1/8 → 全量在 R2R 上涨 16.7/16.2、RxR 上涨 21.1/19.1，且每个中间档都在改善全部四项指标；在对齐的 1/8-到-全量区间上，环境扩展的增益超过数据扩展。<strong>结论是扩环境多样性最可靠。</strong></p>

<p><strong>零样本迁移。</strong> 同一个 checkpoint 不做任何适配就迁到 Counter-Strike 1.6、VizDoom、Minecraft、Trigger Rally 四个游戏域，分别做指令跟随、目标跟踪和检查点驾驶——说明学到的 pointing-轨迹接口没有绑死在训练仿真器的外观统计或运动学上。</p>

<div align="center">
  <img src="/images/vln/LightNav-0-game-zeroshot.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1443/605" />
<figcaption>跨游戏域的零样本泛化：同一个 checkpoint 在 CS 1.6 与 VizDoom 中跟随语言指令、在 Minecraft 中跟踪移动目标、在 Trigger Rally 中做检查点驾驶；青色与品红色标记分别是预测的 affordance 点与 object 点</figcaption>
</div>

<p>真机上同样零样本跨四种本体（人形 LightBot-0、四足 Unitree Go2、自研四旋翼、轮式 LIMX TRON 1）。最严苛的一项测试是跟踪：<strong>训练数据里的跟踪目标只有人</strong>，但模型能直接跟随从没见过的动态目标类别——人形机器人、轮式机器人、手推车——在视角、背景杂乱和光照变化下保持目标身份。</p>

<div align="center">
  <img src="/images/vln/LightNav-0-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/1437" />
<figcaption>真机零样本泛化：从上到下依次为泛化跟踪（含未见过的机器人与手推车目标）、室内指令跟随、户外指令跟随与物体搜索；每组同时给出机器人外部视角与策略实际使用的第一人称观测</figcaption>
</div>

<hr />

<h3 id="4-局限性-36">4. 局限性</h3>

<p>作者自陈两点。其一，模型只有<strong>单一决策通路</strong>，没有把高频局部控制和慢速语义思考分开——理想形态应是一个轻量反应式策略负责避障与频繁轨迹修正，配一个慢速 VLM 规划器负责长时程推理。其二，预训练仍限于精选的具身数据集，若能在互联网规模视频上做更强预训练，可望覆盖更罕见的场景、交互与运动模式。</p>

<p>从实验本身还能读出两处未被作者列为局限的软肋：RxR 上的 nDTW（67.4）低于 DualVLN，说明成功率的提升没有同步转化为轨迹保真度；INSIGHT-Bench 的绝对成功率只有 43.7%，Extremum 类指令（37.2）和机构类场景（29.2）离可用还很远。</p>

<hr />

<h2 id="uncertainty-aware-gaussian-map">51. Uncertainty-Aware Gaussian Map for VLN (2026)</h2>
<p>———三类感知不确定性 × Semantic Gaussian Map，赋予 VLN 智能体可靠决策能力</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.13500">arXiv:2607.13500</a> · 🏛️ <strong>ICLR 2026</strong> · <a href="https://github.com/Gaozzzz/Uncertainty-Aware-VLN">Code（待发布）</a></p>

<hr />

<h3 id="精华-39">精华</h3>

<ul>
  <li>将环境表征（3D Gaussian Map）与感知不确定性（几何/语义/外观）统一到同一空间，是比单纯 map-based 方法更稳健的设计范式。</li>
  <li>几何不确定性用变分推断建模位置/尺度扰动，语义不确定性用语义属性扰动揭示歧义解释，外观不确定性用 Fisher Information 衡量渲染敏感度——三条路径正交互补，可迁移到其他 3DGS 场景表征任务。</li>
  <li>用”3D Value Map”将不确定性从特征维度编码为可导航的 affordance / constraint，是将感知置信度转化为行动先验的优雅工程。</li>
  <li>训练时让 SGM 的渲染损失和导航损失联合优化，使场景表征与决策策略协同提升，避免了两阶段分离设计的 representation gap。</li>
  <li>REVERIE RGS 提升 2.94%、R2R SR 提升 2% 的边际增益表明：当前 VLN 瓶颈已从”语言理解”转移到”感知可靠性”，不确定性建模是下一个值得深耕的方向。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-38">1. 研究背景/问题</h3>

<p>VLN 要求智能体在 3D 环境中依据自然语言指令导航。现有智能体在推理时普遍忽略感知不确定性（如相似门洞的视觉歧义、遮挡导致的路径可通行性不确定），训练目标迫使模型对每个 step 输出确定动作，无法表达”不确定”。这在遮挡多、结构重复的场景中易造成错误停止或路径偏移。</p>

<div align="center">
  <img src="/images/vln/UncertaintyGaussian-motivation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/493" />
<figcaption>图1：动机示意。左：视觉相似结构（多扇门）导致智能体证据不足而停错位置；右：遮挡使路径可通行性模糊，智能体选择次优路径。本文智能体通过显式建模不确定性（亮色=高不确定性）避免上述错误。</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-36">2. 主要方法/创新点</h3>

<p><strong>整体框架</strong>：SGM 构建 → 不确定性估计 → 3D Value Map → 多层 Transformer 预测动作。</p>

<div align="center">
  <img src="/images/vln/UncertaintyGaussian-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1132/508" />
<figcaption>图2：整体 Pipeline。每步从全景 RGB-D 观测构建 SGM，估计三类不确定性并嵌入形成 3D Value Map，再与语言指令拼接输入 MLT 预测动作。</figcaption>
</div>

<p><strong>3.1 Semantic Gaussian Map (SGM)</strong></p>

<p>每个导航点处，将多视角 RGB-D 观测反投影为稀疏伪激光点云，每个点初始化为一个可微 3D Gaussian primitive \(g_i\)，包含：均值 \(\boldsymbol{\mu}_i \in \mathbb{R}^3\)（位置）、协方差 \(\boldsymbol{\Sigma}_i\)（形状/尺度）、不透明度 \(\alpha_i\)、颜色球谐系数 \(c_i\)，以及语义属性 \(s_i\)（由 SAM2 分割区域 + CLIP 特征附加而来）。通过可微渲染优化使 SGM 与当前观测一致，并裁剪低尺度（\(\lVert e_i \rVert_2 &lt; \tau_e\)）和低不透明度（\(\alpha_i &lt; \tau_\alpha\)）的冗余 Gaussian。</p>

<p><strong>3.2 不确定性估计（三类）</strong></p>

<table>
  <thead>
    <tr>
      <th>类型</th>
      <th>建模方式</th>
      <th>含义</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>几何不确定性 \(U^g\)</td>
      <td>对位置/尺度施加变分扰动，最小化 ELBO，提取变分分布标准差</td>
      <td>结构可靠性：Gaussian 是否在多种几何假设下保持稳定</td>
    </tr>
    <tr>
      <td>语义不确定性 \(U^s\)</td>
      <td>对语义属性施加可学习偏移，同样 ELBO 优化</td>
      <td>语义歧义程度：同一区域的语义解释有多不稳定</td>
    </tr>
    <tr>
      <td>外观不确定性 \(U^a\)</td>
      <td>用 Fisher Information（渲染 Jacobian 的 log-determinant）近似 Hessian</td>
      <td>外观敏感性：纹理复杂/遮挡/光照变化是否导致渲染剧变</td>
    </tr>
  </tbody>
</table>

\[U_i^g = \lVert \mathcal{F}^{\text{std}}(q_{\phi^\mu}(\chi_i^\mu)) \rVert_2 + \lVert \mathcal{F}^{\text{std}}(q_{\phi^e}(\chi_i^e)) \rVert_2\]

\[U_i^a = \log \lvert \nabla_{\mathcal{G}} \hat{\mathcal{I}} \nabla_{\mathcal{G}} \hat{\mathcal{I}}^\top \rvert\]

<p><strong>3.3 3D Value Map 与动作预测</strong></p>

<p>将 \((U^g, U^s, U^a)\) 附加到每个 Gaussian 的属性向量，扩展为 \(g_i \in \mathbb{R}^{20}\)。再通过非线性投影得到每个 Gaussian 的特征 \(F^{g_i} \in \mathbb{R}^{768}\)，聚合后与语言嵌入 \(X\) 拼接，输入多层 Transformer \(\mathcal{F}^{\text{MLT}}\) 预测候选 waypoint 的导航概率。</p>

<div align="center">
  <img src="/images/vln/UncertaintyGaussian-uncertainty-vis.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1115/335" />
<figcaption>图5：三类不确定性可视化。几何不确定性突出结构边界/不规则面，语义不确定性揭示对象级歧义区域，外观不确定性标记纹理复杂/遮挡/光照敏感区域。亮色=高不确定性。</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-37">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/UncertaintyGaussian-qualitative-r2r.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/475" />
<figcaption>图3：R2R 定性对比。左：面对多扇相似窗户，VER 误判后提前停止，本文方法正确到达；右：VER 被桌子阻挡而停止，本文方法绕行成功完成指令。</figcaption>
</div>

<ul>
  <li><strong>R2R val unseen</strong>：SR 78%（vs VER 76%，+2%），SPL 66%（vs 65%，+1%）</li>
  <li><strong>RxR val unseen</strong>：SR 65.2%（vs BEVBert 64.1%，+1.1%），nDTW 65.6%（vs 63.9%，+1.7%）</li>
  <li><strong>REVERIE val unseen</strong>：RGS 37.65%（vs BEVBert 34.71%，+2.94%），RGSPL 27.01%（vs 24.44%，+2.57%）——远程目标定位能力显著提升</li>
  <li>消融：SGM 单独带来结构理解增益（REVERIE RGS 32.15% → 35.48%），不确定性单独将 R2R SR 从 72.22% 提升至 74.20%，两者叠加达到最优 78.32%</li>
  <li>三类不确定性均有独立贡献，全部使用时最优，几何+语义的提升幅度大于外观</li>
</ul>

<hr />

<h3 id="4-局限性-37">4. 局限性</h3>

<p>SGM 构建（尤其是 SAM2 语义抽取与不确定性估计）推理开销较大，训练阶段采用离线预计算缓解，但实时部署仍需轻量化替代（论文建议以轻量 SAM2 变体替换）；此外，框架在 Matterport3D 室内场景验证，对室外或动态环境的泛化性未知。</p>

<hr />

<h2 id="harnessvln">52. HarnessVLN (2026)</h2>
<p>———一套 Agent Harness，把”指令跟随”和”找物体”两类导航压进同一个工具调用协议</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.15195">arXiv:2609.15195</a> · <a href="https://agibot-harnessvln.netlify.app/">Project Page</a></p>

<hr />

<h3 id="精华-40">精华</h3>

<p>训练无关导航真正的瓶颈不在于 planner 够不够聪明，而在于「语义上合理的提议」与「物理上能不能执行」之间缺一个仲裁层——HarnessVLN 就是把这个仲裁层显式做出来。做法是把 MLLM 从决策者降级为<strong>提议者</strong>：它输出的每一次工具调用，都要先过证据新鲜度、几何可达性、子目标一致性三道校验才允许派发，连 Stop 都只是「申请」而非「命令」。记忆被拆成互补的两套——事件记忆（任务中心，存完整失败轨迹）与时空图 ST Graph（环境中心，存可复用空间证据加轻量失败标注和回指事件的引用），既保住可追溯性，又让进入 MLLM 上下文的东西不随轨迹长度线性膨胀。协议保持不变、执行器可替换，于是同一套 Harness 同时吃下 VLN-CE R2R/RxR 与 HM3D-v2/OVON 四个基准，并直接迁到人形机器人上。可迁移的核心思想是：<strong>给 agent 加一层「派发前校验 + 结构化反馈回灌」的运行时，比继续调 prompt 更能把语义推理接回物理执行</strong>。</p>

<hr />

<h3 id="1-研究背景问题-39">1. 研究背景/问题</h3>

<p>指令跟随与目标物体导航这两类任务，都要求 agent 把语言接到部分可观测的环境上、边走边积累空间知识、并判断自己的动作是否真的推进了任务。训练式方法在目标任务上有效，但换任务形式或换环境就要重新采数据；MLLM 驱动的训练无关方法绕开了训练，却普遍把模型当成任务专用流水线里的一个 planner——<strong>证据怎么留存、提议怎么校验、失败如何影响后续决策，仍由外围流水线决定</strong>。于是老问题依旧：认出目标不等于走得到，发出动作不等于子目标完成；陈旧观测、不可达目标与执行失败会让后续规划与真实任务状态越走越偏，表现为反复尝试或错误终止。</p>

<hr />

<h3 id="2-主要方法创新点-37">2. 主要方法/创新点</h3>

<p><strong>整体框架</strong>：HarnessVLN 由四个部件构成——<strong>MLLM Planner</strong> 只负责提出语义操作，<strong>Agent Harness</strong> 负责组装上下文、校验提议、派发工具并回灌反馈，<strong>分层事件记忆</strong>负责记录任务进展与执行事件，<strong>持久化 ST Graph</strong> 负责沉淀可复用的空间证据。四者通过一套<strong>统一工具接口</strong>闭环：上下文组装 → 提议校验 → 工具派发 → 反馈整合 → 再组装。</p>

<div align="center">
  <img src="/images/vln/HarnessVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1320/950" />
<figcaption>HarnessVLN 总体架构：MLLM Planner 只提"操作提议"，Agent Harness 在派发前完成证据/几何/任务一致性校验，工具返回的结构化反馈再更新事件记忆与 ST Graph</figcaption>
</div>

<h4 id="卡点一说了半天harness-和普通的mllm-当-planner流水线到底差在哪">卡点一：说了半天，Harness 和普通的「MLLM 当 planner」流水线到底差在哪？</h4>

<p>差别只有一句话：<strong>MLLM 说的话不再直接算数</strong>。传统流水线里模型输出什么就执行什么，Harness 则在模型和环境之间插了一道闸。</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统 MLLM-as-planner 流水线</th>
      <th>HarnessVLN 的 Agent Harness</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>MLLM 的角色</td>
      <td>决策者：输出的动作直接下发执行</td>
      <td>提议者：输出的是”操作提议”，待审</td>
    </tr>
    <tr>
      <td>提议怎么落地</td>
      <td>下游模块尽力执行，成不成看运气</td>
      <td>派发前查三件事：证据来源与新鲜度、目标几何可达性、与当前子目标是否一致</td>
    </tr>
    <tr>
      <td>失败怎么用</td>
      <td>只体现为”这步没成”，下一轮照样提同一个</td>
      <td>写入 reflection memory，并在 ST Graph 对应地点挂轻量标注，压低下一轮检索得分</td>
    </tr>
    <tr>
      <td>停不停</td>
      <td>模型说 stop 就 stop</td>
      <td>模型只能”申请”，语义 ∧ 几何 ∧ 进度三重门控全过才真下发</td>
    </tr>
  </tbody>
</table>

<p>画成运行时循环就是下面这张图。注意那条<strong>校验不通过的回边</strong>——它是整个框架区别于流水线的地方：被拒的提议不会消失，而是变成下一轮上下文里的一条负面证据。</p>

<pre><code class="language-mermaid">graph TD
    A["观测 + 位姿 (RGB-D)"] --&gt; B["上下文组装: 任务 · 当前观测 · 检索到的证据"]
    B --&gt; C["MLLM Planner 提出一个语义操作"]
    C --&gt; D{"Harness 三审: 证据够新吗 / 几何可达吗 / 与当前子目标一致吗"}
    D -- "不通过" --&gt; E["写入 Reflection Memory 与 ST Graph 标注"]
    E --&gt; B
    D -- "通过" --&gt; F["派发工具调用 (统一输入输出契约)"]
    F --&gt; G["结构化反馈: 到达 / 碰撞 / 不可达 / 无进展"]
    G --&gt; H["更新 Harness 状态 · 任务进度 · ST Graph"]
    H --&gt; B
</code></pre>

<h4 id="21-harness-的状态与决策循环">2.1 Harness 的状态与决策循环</h4>

<p>在决策步 $t$，Harness 维护状态</p>

\[S_t = \langle x,\ \omega_t,\ p_t,\ z_t,\ M_t,\ G_t \rangle\]

<p>其中 $x$ 是任务规格（一条路线指令，或一个目标物体类别），$\omega_t$ 是位姿对齐的 RGB-D 观测与局部几何地图，$p_t$ 是 agent 位姿，$z_t$ 是任务进度，$M_t$ 是分层事件记忆，$G_t$ 是持久化 ST Graph。</p>

<p><strong>两类任务共用同一份状态定义，差别只落在 $z_t$ 上</strong>：指令跟随时 $z_t$ 记录当前路线片段、已满足的运动约束与已观测到的地标；ObjectNav 时 $z_t$ 记录已探索区域、候选目标假设及其验证状态。任务变了，进度表示和完成判据变，但 Harness 协议本身一个字不改——这是它能同时覆盖两类任务的根本原因。</p>

<p>单步循环（论文 Algorithm 1）：观测与位姿不一致就重新 <code class="language-plaintext highlighter-rouge">Observe</code> → 记录事件 → 合并图 → 取当前活跃子目标 → 按子目标检索经验 → 组装上下文 → MLLM 出提议 → <strong>Validate</strong> → 派发工具 → 用反馈更新状态。</p>

<h4 id="22-统一工具接口">2.2 统一工具接口</h4>

<p>所有异构能力被包进一个共享的输入输出契约，因此<strong>换掉任何单个工具都不必改动 MLLM Planner 或 Harness 协议</strong>：</p>

<table>
  <thead>
    <tr>
      <th>工具</th>
      <th>角色</th>
      <th>功能</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">observe</code></td>
      <td>感知</td>
      <td>抓取当前 RGB-D 观测与 agent 位姿</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">observe_panorama</code></td>
      <td>感知</td>
      <td>在预设朝向上抓取全景观测</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">retrieve_memory</code></td>
      <td>检索</td>
      <td>从事件记忆与 ST Graph 取任务相关证据</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">ground_target</code></td>
      <td>接地</td>
      <td>把子目标落到某个候选视角的图像区域</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">query_depth</code></td>
      <td>感知</td>
      <td>估计已接地区域的深度及其不确定度</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">navigate_to</code></td>
      <td>导航</td>
      <td>对已通过校验的目标调用 Navigation Executor</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">backtrack</code></td>
      <td>恢复</td>
      <td>回到此前访问过的位置并确认到达</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">request_stop</code></td>
      <td>终止</td>
      <td>终止执行前验证任务是否真的完成</td>
    </tr>
  </tbody>
</table>

<h4 id="23-分层事件记忆-m_t任务中心">2.3 分层事件记忆 $M_t$（任务中心）</h4>

<ul>
  <li><strong>Working memory（工作记忆）</strong>：当前观测、有界的全景历史、活跃目标假设、近期工具反馈。<strong>只留下一步决策需要的短期上下文，因此不随轨迹长度无限增长</strong>。</li>
  <li><strong>Progress memory（进度记忆）</strong>：任务分解与完成状态。每个子目标有唯一 id 和四种状态之一——pending / active / completed / blocked；<strong>同一时刻至多一个 active</strong>，且标记 completed 必须有位姿对齐的观测或成功的工具结果作支撑，堵死了 planner「嘴上说完成了」就推进任务的路。</li>
  <li><strong>Reflection memory（反思记忆）</strong>：完整记录子目标级执行事件——不可达目标、接地不一致、碰撞、无进展、回溯失败、被拒的停止请求。每条含事件 id、任务上下文、位置、时间戳、工具反馈与支撑观测。</li>
</ul>

<h4 id="24-harness-托管的时空图-g_t环境中心">2.4 Harness 托管的时空图 $G_t$（环境中心）</h4>

\[G_t = \left( V_t^P \cup V_t^E,\ E_t,\ T_t \right)\]

<p>$V_t^P$ 为 place 节点，$V_t^E$ 为 entity 节点，$E_t$ 为带类型的空间关系，$T_t$ 存时间戳与轻量事件标注。</p>

<ul>
  <li><strong>Place 节点</strong>汇总已访问位置、支撑观测与可通行 waypoint；空间上相容的观测合并进已有 place，否则新建节点；相邻 place 用双向 <code class="language-plaintext highlighter-rouge">NavigableTo</code> 边连接，形成可供前进与回溯复用的持久拓扑。</li>
  <li><strong>Entity 节点</strong>表示 ObjectNav 目标与指令中提及的地标，带语义别名、空间假设、置信度与支撑视角；<code class="language-plaintext highlighter-rouge">ObservedFrom</code> 边保留「在何时、从哪个视角看到」的溯源信息，<code class="language-plaintext highlighter-rouge">Contains</code> 边编码粗粒度的 place–entity 归属。<strong>正因为存了溯源，Harness 才能同时取回「目标假设」和「验证这个假设所需的证据」</strong>。</li>
  <li><strong>任务条件检索</strong>：每次 MLLM 决策前，按当前活跃子目标 $g_t$ 给 place 节点打分</li>
</ul>

\[s(v_i \mid g_t) = R(v_i, g_t) + \lambda_{rec} C(v_i) + \lambda_{sal} A(v_i) - \lambda_{fail} P(v_i, g_t)\]

<p>其中 $R$ 为语义相关性（用局部 IDF 加权余弦相似度实现），$C$ 为新鲜度，$A$ 为空间显著性，$P$ 惩罚适用的历史失败。</p>

<h4 id="卡点二事件记忆和-st-graph-看起来都在存历史为什么要分两套">卡点二：事件记忆和 ST Graph 看起来都在存历史，为什么要分两套？</h4>

<p>因为它们回答的是两个不同的问题：事件记忆回答「<strong>这次任务我干了什么</strong>」，ST Graph 回答「<strong>这个房子长什么样</strong>」。前者随任务推进滚动、有界；后者跨子目标持久累积。</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>Event Memory（事件记忆）</th>
      <th>ST Graph（时空图）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>视角与寿命</td>
      <td>任务中心，随子目标滚动，working 部分有界</td>
      <td>环境中心，跨子目标持久，整个 episode 累积</td>
    </tr>
    <tr>
      <td>存什么</td>
      <td>三层：working（当前观测与近期反馈）/ progress（子目标状态机）/ reflection（完整失败事件）</td>
      <td>place 节点、entity 节点、带类型空间关系、时间戳</td>
    </tr>
    <tr>
      <td>失败记录</td>
      <td>权威全量：事件 id、任务上下文、位置、时间戳、工具反馈、支撑观测</td>
      <td>只挂”此处在该子目标下栽过”的轻标注，外加一个指回原事件的引用</td>
    </tr>
    <tr>
      <td>被谁读</td>
      <td>组装当前决策上下文</td>
      <td>按 $s(v_i \mid g_t)$ 打分选 top-K 地点，喂给 MLLM</td>
    </tr>
  </tbody>
</table>

<p>关键设计在最后两行：<strong>失败的完整轨迹只存一份（在 reflection memory），图里只放”指针加权重”</strong>。这样既能做失败感知的检索与恢复，又不用把执行历史在图里复制一遍。标注的相关性还会动态调整——子目标变了或新证据推翻了它，权重下降；同类失败反复出现，权重上升；同时惩罚有上限，<strong>避免某条支路因为失败过一次就被永久拉黑</strong>。</p>

<blockquote>
  <p><strong>举个例子（检索打分怎么算）</strong>：假设图里只有 3 个 place 节点，当前子目标是”去厨房找洗碗机”。按论文附录给的权重（新鲜度 0.3、显著性 0.3、每条适用失败扣 0.5、扣分上限 1.0）：</p>

  <ul>
    <li>节点 A（厨房，3 步前刚看过）：$0.9 + 0.3 \times 1.0 + 0.3 \times 0.8 = 1.44$</li>
    <li>节点 B（厨房另一侧，60 步前看过，且上次从这里导航过去撞墙失败过一次）：$0.85 + 0.3 \times 0.2 + 0.3 \times 0.7 - 0.5 = 0.62$</li>
    <li>节点 C（卧室）：$0.1 + 0.3 \times 0.5 + 0.3 \times 0.3 = 0.34$</li>
  </ul>

  <p>取分数最高的 3 个作种子、各向外扩一跳、最多返回 5 个 place —— <strong>进入 MLLM 上下文的永远是这 5 个地点及其实体，图却可以随轨迹一直长下去</strong>。这就是「图增长但上下文不增长」的具体含义。</p>
</blockquote>

<h4 id="25-接地执行与基于证据的终止">2.5 接地执行与基于证据的终止</h4>

<p>MLLM 提出的是语义命令，物理执行需要接地的目标和可执行的控制量，所以 Navigation Executor 被做成一个<strong>可替换的 Harness 托管工具</strong>：Harness 负责接地与校验，Executor 只负责路径规划与局部控制。命令只有在「有证据支撑 + 几何可达 + 与活跃子目标和适用失败历史一致」时才派发；Executor 回传到达 / 碰撞 / 不可达 / 无进展等结构化反馈，用于更新状态、事件记忆与图。<strong>前进与回溯走的是同一条「校验—执行—更新」回路</strong>。</p>

<p>终止同样由 Harness 仲裁——MLLM 可以提议停止，但<strong>不能直接下发环境级 Stop 动作</strong>。请求被接受当且仅当</p>

\[F_{stop} = F_{semantic} \wedge F_{geometric} \wedge F_{progress}\]

<p>三项分别校验目标身份、几何有效性与任务完成度。ObjectNav 要求目标在视觉上有支撑且落在停止半径内；指令跟随则要求当前证据支持最后一个路线片段、被引用的地标与接地的终点。<strong>被拒的请求会写进事件记忆，并触发进一步观测、目标细化、继续靠近或回溯</strong>。</p>

<blockquote>
  <p><strong>举个例子（停止门控怎么救回一次失败）</strong>：论文 Figure 8，HM3D-OVON 第 1297 集，目标类别是 picture。</p>

  <p>第 216 步，agent 认为自己到了：按投影导航目标点算，距离只有 <strong>0.40 m</strong>，低于 1.0 m 的投影目标阈值，”看起来”该停了。
但 Harness 不信这个数——它优先抓一帧<strong>新鲜深度</strong>：在检测框锚点上取 5×5 邻域的中位数（要求 patch 标准差不超过 0.5 m），读到 <strong>4.65 m</strong>，远超 2.5 m 的深度阈值，于是 $F_{geometric}$ 不成立，停止申请被驳回，事件入库。
agent 继续靠近，第 429 步新深度读到 <strong>1.53 m</strong>，门通过；第 430 步真正停下，基准评测的终点距离是 <strong>0.13 m</strong>，成功。</p>

  <p>一句话：<strong>投影目标点只能说明”我走到了我以为的地方”，新鲜深度才能说明”我真的挨着那个物体”</strong>。Harness 的价值就是在这两者冲突时，选择相信传感器而不是相信规划。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/HarnessVLN-stop-validation-case.webp" width="95%" loading="lazy" decoding="async" style="aspect-ratio:1320/491" />
<figcaption>停止门控的实际效果：第 216 步的停止申请因新鲜深度 4.65 m 被拒，agent 继续靠近，第 430 步在 0.13 m 处成功终止</figcaption>
</div>

<p>下面这张运行时面板把前面所有抽象状态一次性落地了——注意面板 ⑤ 里的 STOP GATE 计数（requested / gate pass / gate fail / rejected）、ST Graph 的节点边计数，以及面板 ⑦ 里每条 TODO 后面挂的 <code class="language-plaintext highlighter-rouge">evidence</code> id：<strong>“完成”这两个字在系统里始终绑着一条可回溯的观测</strong>。</p>

<div align="center">
  <img src="/images/vln/HarnessVLN-runtime-dashboard.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1320/836" />
<figcaption>运行时面板：①运行状态 ②带接地框的 RGB 观测 ③导航地图 ④图例 ⑤Harness 状态（决策、停止门控、ST Graph 计数、执行器计数） ⑥任务与当前动作 ⑦带证据 id 的 TODO 记忆</figcaption>
</div>

<p><strong>实现配置</strong>：640×480 同步 RGB-D、79° 水平视场；GroundingDINO 加 SAM 提供开放词表目标区域与分割掩码；Navigation Executor 平面运动用 FMM 规划器，需要上下楼梯时调用 NavDP。仿真主实验中，指令跟随用 GPT-5.5、ObjectNav 用 GPT-5.6-luna——<strong>同一个 episode 内所有推理功能（任务分解、导航规划、目标接地、停止验证、恢复）共用一个模型，只换 prompt</strong>。</p>

<hr />

<h3 id="3-核心结果发现-38">3. 核心结果/发现</h3>

<p><strong>指令跟随（VLN-CE val-unseen）</strong>：在训练无关方法中 R2R 与 RxR 的 SR 均为最高。相比同样用 GPT-5.5 的 AgenticNav，R2R 的 SR 高 5.8 分、OSR 高 7.7 分；相比 HSGM，RxR 的 SR 高 12.1 分、SPL 高 12.9 分，nDTW 相当。</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>R2R NE↓</th>
      <th>R2R OSR↑</th>
      <th>R2R SR↑</th>
      <th>R2R SPL↑</th>
      <th>RxR SR↑</th>
      <th>RxR SPL↑</th>
      <th>RxR nDTW↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><em>NavFoM [ICLR26]（有监督）</em></td>
      <td><em>3.78</em></td>
      <td><em>70.8</em></td>
      <td><em>61.7</em></td>
      <td><em>55.3</em></td>
      <td><em>64.4</em></td>
      <td><em>56.2</em></td>
      <td><em>–</em></td>
    </tr>
    <tr>
      <td><em>ABot-N0 [CVPR26]（有监督）</em></td>
      <td><em>3.78</em></td>
      <td><em>70.8</em></td>
      <td><em>66.4</em></td>
      <td><em>63.9</em></td>
      <td><em>69.3</em></td>
      <td><em>60.0</em></td>
      <td><em>–</em></td>
    </tr>
    <tr>
      <td>GC-VLN [CoRL25]</td>
      <td>7.30</td>
      <td>41.8</td>
      <td>33.6</td>
      <td>16.3</td>
      <td>33.8</td>
      <td>13.8</td>
      <td>–</td>
    </tr>
    <tr>
      <td>HSGM [CVPR26]</td>
      <td>5.42</td>
      <td>58.7</td>
      <td>47.9</td>
      <td>32.8</td>
      <td>41.8</td>
      <td>25.1</td>
      <td>54.9</td>
    </tr>
    <tr>
      <td>AgenticNav-GPT-5.5</td>
      <td>5.19</td>
      <td>65.0</td>
      <td>55.0</td>
      <td><strong>48.4</strong></td>
      <td>–</td>
      <td>–</td>
      <td>–</td>
    </tr>
    <tr>
      <td><strong>HarnessVLN-GPT-5.5</strong></td>
      <td><strong>4.01</strong></td>
      <td><strong>72.7</strong></td>
      <td><strong>60.8</strong></td>
      <td>43.5</td>
      <td><strong>53.9</strong></td>
      <td><strong>38.0</strong></td>
      <td>54.8</td>
    </tr>
  </tbody>
</table>

<p><strong>目标物体导航</strong>：HM3D-v2 拿到训练无关方法中最高的 SR（76.0%）；HM3D-OVON 上 SR 59.3%、SPL 36.6%，<strong>在所有列出方法中最高（含有监督方法）</strong>，比 DRIVE-Nav 高 9.1 分与 4.0 分。</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>需训练</th>
      <th>HM3D-v2 SR↑</th>
      <th>HM3D-v2 SPL↑</th>
      <th>OVON SR↑</th>
      <th>OVON SPL↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>FiLM-Nav [arXiv25]</td>
      <td>✓</td>
      <td>77.0</td>
      <td><strong>41.3</strong></td>
      <td>40.8</td>
      <td>24.4</td>
    </tr>
    <tr>
      <td>ABot-N0 [CVPR26]</td>
      <td>✓</td>
      <td>–</td>
      <td>–</td>
      <td>54.0</td>
      <td>30.5</td>
    </tr>
    <tr>
      <td>DRIVE-Nav [arXiv26]</td>
      <td>✗</td>
      <td>72.4</td>
      <td><strong>41.3</strong></td>
      <td>50.2</td>
      <td>32.6</td>
    </tr>
    <tr>
      <td>MSGNav [CVPR26]</td>
      <td>✗</td>
      <td>74.4</td>
      <td>33.4</td>
      <td>48.3</td>
      <td>27.0</td>
    </tr>
    <tr>
      <td><strong>HarnessVLN</strong></td>
      <td>✗</td>
      <td><strong>76.0</strong></td>
      <td>37.9</td>
      <td><strong>59.3</strong></td>
      <td><strong>36.6</strong></td>
    </tr>
  </tbody>
</table>

<p><strong>消融（各 100 集固定子集，累积开启）</strong>：事件记忆是最大单项增益，ST Graph 次之且同时改善 SPL，停止验证再补一刀。完整 Harness 相比基础 agent，R2R 与 OVON 的 SR 分别提升 18.0 与 10.0 分，OSR–SR 差距在两个任务上都收窄。</p>

<table>
  <thead>
    <tr>
      <th>Mem.</th>
      <th>Graph</th>
      <th>Stop</th>
      <th>R2R SR↑</th>
      <th>R2R SPL↑</th>
      <th>R2R Gap↓</th>
      <th>OVON SR↑</th>
      <th>OVON SPL↑</th>
      <th>OVON Gap↓</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>✗</td>
      <td>✗</td>
      <td>✗</td>
      <td>46.0</td>
      <td>23.7</td>
      <td>26.0</td>
      <td>45.0</td>
      <td>32.0</td>
      <td>27.0</td>
    </tr>
    <tr>
      <td>✓</td>
      <td>✗</td>
      <td>✗</td>
      <td>54.0</td>
      <td>33.0</td>
      <td>19.0</td>
      <td>52.0</td>
      <td>32.4</td>
      <td>20.0</td>
    </tr>
    <tr>
      <td>✓</td>
      <td>✓</td>
      <td>✗</td>
      <td>60.0</td>
      <td>35.4</td>
      <td>15.0</td>
      <td>53.0</td>
      <td>34.2</td>
      <td>18.0</td>
    </tr>
    <tr>
      <td>✓</td>
      <td>✓</td>
      <td>✓</td>
      <td><strong>64.0</strong></td>
      <td><strong>35.8</strong></td>
      <td><strong>13.0</strong></td>
      <td><strong>55.0</strong></td>
      <td>33.0</td>
      <td>19.0</td>
    </tr>
  </tbody>
</table>

<p><strong>一个诚实的反例</strong>：停止验证在 OVON 上把 SR 从 53.0 提到 55.0，却让 SPL 从 34.2 掉到 33.0、OSR–SR 差距从 18.0 涨到 19.0——<strong>更严的验证换来更高的完成率，代价是绕路和更谨慎的终止</strong>，两者并不同向。</p>

<p><strong>模型敏感性（固定 100 集 OVON 子集）</strong>：协议与工具不变只换基座，SR 在 51.0（Qwen3.8-flash）到 63.0（GPT-6-astra）之间摆动；而在同一基座 GPT-5.6-luna 下，HarnessVLN 的 55.0 对 MSGNav 的 37.0，说明<strong>增益主要来自 Harness 而非模型本身</strong>。</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>基座模型</th>
      <th>SR↑</th>
      <th>SPL↑</th>
      <th>OSR↑</th>
      <th>Gap↓</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>MSGNav</td>
      <td>GPT-5.6-luna</td>
      <td>37.0</td>
      <td>18.9</td>
      <td>46.0</td>
      <td><strong>9.0</strong></td>
    </tr>
    <tr>
      <td>HarnessVLN</td>
      <td>GPT-5.6-luna</td>
      <td>55.0</td>
      <td>33.0</td>
      <td>74.0</td>
      <td>19.0</td>
    </tr>
    <tr>
      <td>HarnessVLN</td>
      <td>GPT-6-astra</td>
      <td><strong>63.0</strong></td>
      <td><strong>39.4</strong></td>
      <td><strong>76.0</strong></td>
      <td>13.0</td>
    </tr>
    <tr>
      <td>HarnessVLN</td>
      <td>Qwen3.8-flash</td>
      <td>51.0</td>
      <td>32.8</td>
      <td>75.0</td>
      <td>24.0</td>
    </tr>
  </tbody>
</table>

<p><strong>真机部署</strong>：AgiBot A3U 全尺寸人形机器人（1.74 m，3D LiDAR 加多路 RGB-D 与鱼眼相机，NVIDIA Thor 板载算力），头部立体相机作主视觉传感器，Fast FoundationStereo 出稠密度量深度，<strong>规划模型换成本地的 Qwen-3.8-27B</strong>。三个场景：连续指令跟随（走到 806 室前路口、左转停在饮水机旁垃圾桶、再去冰箱）、开放词表物体搜索、以及「先停在门口指示牌再找自动售货机」的组合任务。ST Graph 在路线跟随与物体搜索之间保留了地标与目标证据，支撑了阶段之间的连续性。</p>

<div align="center">
  <img src="/images/vln/HarnessVLN-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1317/873" />
<figcaption>真机导航三例：连续指令跟随、开放词表物体搜索、以及路线跟随与物体搜索混合的组合任务；右侧为同步构建的 ST Graph</figcaption>
</div>

<div align="center">
  <img src="/images/vln/HarnessVLN-teaser.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1320/839" />
<figcaption>一套 Harness 通吃四个基准与两类任务，并可 Sim2Real 迁移到人形机器人</figcaption>
</div>

<hr />

<h3 id="4-局限性-38">4. 局限性</h3>

<p>论文自述：当前 Harness 的编排与校验规则是预先设定的，缺少在开放环境交互中自我演化的机制。从数据上看还有两点值得注意——<strong>更严的校验不免费</strong>，HarnessVLN 的 R2R SPL（43.5）低于同用 GPT-5.5 的 AgenticNav（48.4），HM3D-v2 SPL（37.9）也低于 FiLM-Nav 与 DRIVE-Nav 的 41.3，停止验证在 OVON 上甚至同时拉低 SPL 并拉大 OSR–SR 差距；<strong>对基座模型仍相当敏感</strong>，换成 Qwen3.8-flash 后 OVON 的 SR 掉 4 分、OSR–SR 差距从 19 扩到 24，说明”看见了却没能通过门走到”依然是主要失败模式。</p>

<hr />

<h2 id="groundingvln">53. GroundingVLN (2026)</h2>
<p>———把视觉 grounding 做成”想”与”走”之间的共享接口</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.18581">arXiv:2609.18581</a></p>

<hr />

<h3 id="精华-41">精华</h3>

<p>VLN 里 VLM 的语义推理和机器人的空间执行之间一直缺一个可验证、可训练的接口：文本 CoT 说”我看到水槽”却说不清水槽在画面哪里，离散动作输出又没有任何显式目标。GroundingVLN 的做法是让 grounding 同时承担两件事——推理时把每条视觉断言绑定到像素坐标（<code class="language-plaintext highlighter-rouge">&lt;obj&gt;标签|[x,y]&lt;/obj&gt;</code>），决策时输出一个<strong>与当前子任务进度对齐</strong>的像素目标，交给几何规划器反投影成 3D 路径。配套的两个关键设计是：数据引擎用 3D 世界标记加 SAM 3 跟踪解决”同一个物体跨视角改名换姓”的问题；GEAR 把像素目标反投影后按”真走过去能到哪”打分，而不是按 2D 像素距离打分。结果是只用 188K 样本（最强基线的 0.9%）拿到 R2R-CE 69.9% SR、RxR-CE 75.1% SR，且仅用 R2R 训练迁移到 RxR 仍有 59.9% SR，比最强基线高 20.1 个点。对方法论的启发是：<strong>当高层模型与低层执行器之间的接口本身带有可测量的几何量时，奖励设计就能从”对/错”升级为”差多少米”，样本效率随之量变到质变</strong>。</p>

<hr />

<h3 id="1-研究背景问题-40">1. 研究背景/问题</h3>

<p>连续环境 VLN 要求智能体把自然语言指令落到第一视角观测上，并持续跟踪进度、规划下一步。现有路线有三类缺口：直接输出离散动作（NaVid、StreamVLN）缺少显式空间目标，且需要海量轨迹数据重学”视觉到电机”的映射；文本 CoT 方法（NavCoT、AwareVLN）的中间结论无法与图像区域对应，说的话没法验证；航点方法（ETPNav、SmartWay）的动作空间被外部航点预测器的候选质量卡死。归根结底是两个耦合的缺口：<strong>推理过程没有空间锚点，高层决策没有几何精确的执行接口</strong>。</p>

<div align="center">
  <img src="/images/vln/GroundingVLN-motivation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/689" />
<figcaption>人类导航先锚定地标、再看向下一个落脚点，认知与运动控制是分离的。三类 VLN 范式对比：动作式没有显式目标，纯文本 CoT 的 sink 指向不明，GroundingVLN 把证据绑到像素并预测像素目标</figcaption>
</div>

<p>认知科学的证据是：人在决策点会选择性编码与导航相关的地标，并在迈步前主动把视线投向下一个落脚点。这直接启发了本文的设计——把 VLM 当作”高层认知系统”，只负责 grounding 推理与空间目标，运动执行交给低层规划器。</p>

<hr />

<h3 id="2-主要方法创新点-38">2. 主要方法/创新点</h3>

<p><strong>整体框架概述。</strong> GroundingVLN 是一个解耦的闭环系统，由三部分构成：<strong>高层 VLM</strong> 负责结构化 grounded 推理并输出（当前子任务、高层动作、像素目标）三元组；<strong>低层执行模块</strong>把像素目标反投影成 3D 点、用 A* 规划路径并转成原始动作；<strong>GEAR 后训练</strong>用执行感知的奖励图把前两者对齐。指令在初始化时被一次性拆成有序子任务，之后每个决策步都在”当前子任务”这个语义刻度上推进。</p>

<div align="center">
  <img src="/images/vln/GroundingVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/843" />
<figcaption>GroundingVLN 总览。(A) 高层 VLM 做 grounded 推理并预测子任务、动作与像素目标，低层模块转成原始动作；(B) GroundingCOTVLN-188K 通过子任务与目标对齐、以及 grounding 的时序对齐提供监督；(C) GEAR 用执行感知奖励图配合多级奖励做 GRPO 优化</figcaption>
</div>

<h4 id="21-带-grounding-的结构化推理">2.1 带 grounding 的结构化推理</h4>

<p><strong>输入</strong>：指令、历史交互 $H_t$、当前拼接的左-前-右 RGB 观测。</p>

<p><strong>处理</strong>：VLM 按固定四阶段推理——① History Recall（回顾已走距离、朝向变化、看到过的地标）→ ② Current Perception（描述当前场景与朝向，识别指令相关证据）→ ③ Progress Estimation（哪些条件已满足、当前子任务是否完成）→ ④ Future Planning（按最早未完成的指令条件选下一个局部目标）。</p>

<p><strong>输出</strong>：一段 CoT 文本，其中每个视觉断言都被标签包裹。</p>

<p>绑定规则很简单：新确认的实体写成 <code class="language-plaintext highlighter-rouge">&lt;obj&gt;标签|[x,y]&lt;/obj&gt;</code>，之前已 grounding、这一帧又重新出现的实体写成 <code class="language-plaintext highlighter-rouge">&lt;prev_obj&gt;标签|[x,y]&lt;/prev_obj&gt;</code>，坐标是当前视图下归一化的整数 $(x,y) \in [0,1000]^2$。</p>

<p><strong>设计动机</strong>：这条规则让”我看到水槽”这句话变成<strong>可验证</strong>的——标注和 RL 阶段都能拿坐标去查那个位置到底是不是水槽；同时让历史证据能被显式复用到进度估计里，而不是淹没在自由文本中。</p>

<h4 id="22-进度对齐的像素目标决策">2.2 进度对齐的像素目标决策</h4>

<p>推理完成后 VLM 输出高层动作 $a^h_t \in { \text{MOVE}, \text{TURN}, \text{STOP} }$。MOVE 必带一个像素目标 $g_t = (c_t, l_t, p_t)$——当前子任务 $c_t$、目标语义标签 $l_t$、像素位置 $p_t$，在 CoT 里以 <code class="language-plaintext highlighter-rouge">&lt;target&gt;标签|[x,y]&lt;/target&gt;</code> 标出（与作为<strong>证据</strong>的 <code class="language-plaintext highlighter-rouge">&lt;obj&gt;</code> 区分开：<code class="language-plaintext highlighter-rouge">&lt;target&gt;</code> 是<strong>要走过去的可通行落点</strong>）。TURN 只执行原地 90° 或 180° 旋转，只有当转向后的目的地在当前视野中可见时才附带像素目标。STOP 仅在所有指令条件都满足时发出。</p>

<p>关键差异在于<strong>像素目标怎么选</strong>。DualVLN 监督的是”视野里最远的轨迹点”，本文则把候选点约束在当前子任务对应的轨迹段内：</p>

\[q_t^* = \arg\max_{q} \ \mathrm{Prog}(q), \quad q \in T_{t:t+1} \cap S_{k_t}\]

<p>其中 $S_{k_t}$ 是当前子任务对齐的路径段，$T_{t:t+1}$ 是两个锚点之间<strong>实际执行过</strong>的轨迹，约束条件是该点在 $o_t$ 中连续可见（带深度遮挡校验）且可通行，最后用相机投影得到 $p_t = \Pi_t(q_t^*)$。</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>DualVLN 式”最远可见点”</th>
      <th>GroundingVLN 的进度对齐像素目标</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>候选范围</td>
      <td>整条参考轨迹上视野内最远的点</td>
      <td>当前子任务段 ∩ 实际执行轨迹</td>
    </tr>
    <tr>
      <td>终止边界</td>
      <td>视野边界</td>
      <td>该子任务的下一个决策边界</td>
    </tr>
    <tr>
      <td>与语义的关系</td>
      <td>无，纯几何最远</td>
      <td>与预测的 current subtask 绑定，一起输出</td>
    </tr>
    <tr>
      <td>执行器输入</td>
      <td>扩散执行器吃 VLM 的<strong>潜在特征</strong></td>
      <td>显式像素坐标 → 反投影 → A* 规划</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>举个例子</strong>：指令”走进厨房，经过水槽和烤箱 → 直走进走廊 → 左转进卧室”被拆成 3 个 subtask。假设机器人此刻在客厅，subtask 1 还没完成。参考轨迹上视野里最远的可通行点是 12 m 外的走廊口——”最远可见点”策略会直接把它设成目标，一步跨过整个 subtask 1，水槽和烤箱压根没经过。GroundingVLN 把候选限制在 subtask 1 那一段里，段末就是 3 m 外的厨房入口，于是像素目标落在厨房门口地板的 [493, 409]。走到那里之后 subtask 1 才被判完成，再规划下一段。<strong>一句话：像素目标不是”能看多远走多远”，而是”这一小节任务该走到哪”。</strong></p>
</blockquote>

<h4 id="23-低层规划与执行">2.3 低层规划与执行</h4>

<p><strong>输入</strong>：高层动作加像素目标。</p>

<p><strong>处理</strong>：TURN 触发固定原地旋转，STOP 结束导航，只有 MOVE 会走完整几何链路——RTAB-Map 从 RGB-D 流在线估计相机位姿，累积点云构建包含地面支撑、障碍与高程变化（含楼梯）的地图；把归一化像素目标转成局部像素坐标，取对应深度、相机内参与估计位姿恢复 3D 世界位置；A* 在地图上搜无碰撞路径，路径跟随器把路径翻译成原始的前进与转向。</p>

<p><strong>输出</strong>：一串低层动作。</p>

<p><strong>端到端数据流</strong>（一个决策步的完整路径）：</p>

<pre><code class="language-mermaid">graph TD
    A["指令 + 历史观测 + 当前 RGB"] --&gt; B["VLM: 四阶段 grounded reasoning"]
    B --&gt; C{"高层动作"}
    C -- "STOP" --&gt; D["结束导航"]
    C -- "TURN" --&gt; E["原地旋转 90 度或 180 度"]
    C -- "MOVE" --&gt; F["像素目标 x, y"]
    F --&gt; G["深度反投影: 2D 像素转 3D 世界坐标"]
    G --&gt; H["RTAB-Map 在线地图 + A star 规划"]
    H --&gt; I["路径跟随器: 前进与转向序列"]
    I --&gt; A
    E --&gt; A
</code></pre>

<p>这里有个容易忽略的效率收益：VLM 平均每个 episode 只被调用 9.26 次，约占导航步数的 33.25%，其余步骤全由低层规划器接管——不必在每个原始动作上都跑一次大模型。</p>

<h4 id="24-groundingcotvln-188k时序对齐的-grounding">2.4 GroundingCOTVLN-188K：时序对齐的 grounding</h4>

<p>数据集含 188K 条 grounded 图像与 CoT 样本，来自 21K 条 R2R / RxR 轨迹。构建分三步：</p>

<p><strong>① 轨迹回放与锚点采样</strong>：在 Habitat 中回放参考路径，采三类决策锚点——到达锚点（参考点处）、转向锚点（大幅原地旋转附近）、中距锚点（走够距离后）；大间隔处补采，近静止或冗余样本剔除。每个锚点存拼接的左-前-右 RGB-D、相机位姿、参考点索引、实际执行位置。</p>

<p><strong>② 子任务与目标对齐</strong>：教师 VLM（Qwen3.5-397B-A17B）把指令拆成有序子任务 ${u_k}$ 并抽取地标与转向，每个 $u_k$ 对齐到一段连续路径 $S_k$，于是每个锚点都能拿到”当前进度段”和”已完成子任务集合”，再用 2.2 的公式选像素目标。</p>

<p><strong>③ grounding 的时序对齐</strong>——这是与静态图像 grounding 最本质的区别。同一个物体在下一帧会移到别的像素位置，甚至被遮挡，带来两个风险：<strong>grounding 漂移到另一个相似实例</strong>（画面里有两个水槽，指的是哪个？），以及<strong>暂时看不见就被遗忘</strong>。解决办法是给每个 grounding 分配唯一的 3D 世界标记：</p>

<pre><code class="language-mermaid">graph TD
    A["当前视角首次确认实体, 例如 oven"] --&gt; B["打 obj 标签并记录像素坐标"]
    B --&gt; C["反投影成唯一的 3D 世界标记"]
    C --&gt; D["初始化 SAM 3 跟踪"]
    D --&gt; E["到达下一个决策锚点"]
    E --&gt; F{"3D 标记能重投影进当前视野吗"}
    F -- "能" --&gt; G["直接得到新的像素位置"]
    F -- "不能" --&gt; H["SAM 3 找回实例掩码, 用有效深度点更新 3D 位置"]
    H --&gt; I{"新的 3D 估计与旧标记空间连续吗"}
    I -- "是" --&gt; G
    I -- "否" --&gt; J["拒绝该跟踪, 实体保留身份但标为不可见"]
    G --&gt; K["以 prev_obj 标签重新绑定到当前像素"]
</code></pre>

<p>最后由确定性程序把”已执行运动 / 当前观测 / 进度状态 / 动作 / 像素目标”这些事实组装好，教师 VLM 只负责把它们<strong>口语化</strong>成结构化 CoT——这样 CoT 里的事实来自几何而非模型幻觉。样本还要过五道校验才保留：坐标可见性、深度遮挡、动作与推理一致性、格式完整性、标注泄漏检查。</p>

<p>消融里这一项的分量不小：关掉时序对齐重新标注并重训，SR 从 69.9% 掉到 62.2%，比去掉 <code class="language-plaintext highlighter-rouge">&lt;obj&gt;</code> / <code class="language-plaintext highlighter-rouge">&lt;prev_obj&gt;</code> 标签本身（66.1%）掉得更多——<strong>不一致的跨视角证据比没有证据更有害</strong>。</p>

<h4 id="25-gear执行感知的强化学习">2.5 GEAR：执行感知的强化学习</h4>

<p>像素目标的几何是<strong>连续可测</strong>的，这让后训练信号能比”动作对/错”细得多。GEAR 为每个锚点构造一张覆盖整个图像域的奖励图 $M_t$：候选像素 $p$ 先反投影得到执行端点 $P_t(p)$，落在墙面、家具等不可通行表面的直接用局部可通行图剔除；有效候选按下式打分：</p>

\[Q_t(p) = \lambda_r \exp\left(-\frac{d_\perp(p)^2}{2\sigma_r^2}\right) + \lambda_p \exp\left(-\frac{(s(p)-s_t^*)^2}{2\sigma_p^2}\right) + \lambda_e \exp\left(-\frac{d_e(p)^2}{2\sigma_e^2}\right)\]

<p>三项分别管三件事：$d_\perp(p)$ 是到参考路线的<strong>横向偏离</strong>（管路线一致性）；$s(p)-s_t^{\ast}$ 是与参考目标的<strong>路线进度差</strong>（管语义进度，走太少或冲太远都扣分）；$d_e(p) = \lVert P_t(p) - P_t^{\ast} \rVert_2$ 是<strong>执行端点误差</strong>（管物理可执行性）。无效像素直接拿全图最低分。</p>

<blockquote>
  <p><strong>举个例子</strong>：标注的参考目标在厨房门口地板上。模型给出两个候选像素——A 在门口地板上、离参考点 40 px；B 在紧挨门框的墙面上、离参考点同样 40 px。按 2D 像素距离，两者得分完全一样。但反投影到 3D 之后：A 落在可走地面上、离参考端点约 0.3 m，三项高斯都给高分；B 落在墙上，被可通行性掩膜直接判为无效、拿最低分。<strong>奖励图问的不是”你点得离标注近不近”，而是”照你点的走，机器人真能走到哪、离目标还差多远”。</strong></p>
</blockquote>

<p>在奖励图之外还叠了多级奖励：</p>

\[R_y = \alpha_a R_{act} + \alpha_t R_{task} + \alpha_g R_{goal} + \lambda_g R_{grd} - P\]

<p>其中 $R_{goal}(p) = \phi(Q_t(p))$ 来自上面的奖励图；$R_{act}$ 是一张确定性的动作奖励矩阵（动作完全正确给 +1，TURN 方向错给 −0.5，该 TURN 却预测 MOVE、但目标落在与转向一致的画面外侧四分之一区给 −0.75，MOVE 与 TURN 互换给 −0.9，提前 STOP 或该 STOP 却做别的给 −1）；$R_{task}$ 是子任务文本归一化后的精确匹配（对 +1 错 −1）；$R_{grd}$ 评 grounding 的语义与空间正确性；$P$ 惩罚推理与决策之间的不一致。格式非法（<code class="language-plaintext highlighter-rouge">&lt;think&gt;</code> 块数量不对、JSON schema 不符、坐标越界、<code class="language-plaintext highlighter-rouge">&lt;target&gt;</code> 标签与决策不匹配等）直接给 $R = -1$。最后每个锚点采 G 个输出，用组内归一化奖励做 GRPO 裁剪目标优化。</p>

<p><strong>训练配置</strong>：从 Qwen3.5-4B 初始化，先在 188K 样本上做 1 个 epoch SFT（8 张 H200 约 8 小时），再用 GEAR 在 16K 样本上跑 2000 步、学习率 1e-6（同硬件约 20 小时）。</p>

<hr />

<h3 id="3-核心结果发现-39">3. 核心结果/发现</h3>

<p><strong>VLN-CE 主榜单全面 SOTA。</strong> R2R-CE val_unseen：NE 3.66 / OS 74.8 / SR 69.9 / SPL 64.1；RxR-CE val_unseen：NE 3.54 / SR 75.1 / SPL 62.0 / nDTW 75.3。相比 ABot-N0 的 SR 绝对提升 3.5%（R2R）和 5.8%（RxR），且超过了 DualVLN(S2)+SPF——那个变体用 Habitat 的最短路径跟随器<strong>理想化执行</strong>其预测的像素目标，说明 GroundingVLN 的优势不是来自执行器，而是来自目标本身选得更对。</p>

<div align="center">
  <img src="/images/vln/GroundingVLN-data-efficiency.webp" width="90%" loading="lazy" decoding="async" style="aspect-ratio:1118/572" />
<figcaption>R2R-CE val_unseen 上的训练数据效率。横轴为各方法自报的训练样本数（对数刻度），GroundingVLN 以 188K 样本取得最高 SR，约为 ABot-N0 总量的 0.9%</figcaption>
</div>

<p><strong>样本效率是最扎眼的一项。</strong> 188K 样本对比 ABot-N0 的 21.9M（16.9M 专家轨迹加 5.0M 推理样本），只用 0.9%。更严格的对照在附录 A.2：只用 R2R 与 RxR 数据（无额外导航语料）时，StreamVLN 的 SR 是 45.6%、JanusVLN Base 是 52.8%，GroundingVLN 是 69.9%；即使对上它们<strong>用全量语料</strong>的版本（26.3M / 10.69M），GroundingVLN 仍分别高 13.0% 和 9.4%。</p>

<p><strong>跨数据集泛化的提升幅度更大。</strong> 只用 R2R 训练、零 RxR-CE 数据直接迁移到 RxR-CE val_unseen：SR 59.9% / SPL 48.2%，比最强基线 AwareVLN（39.8% / 36.0%）高 20.1 和 12.2 个绝对点。作者的解释是显式子任务进度、grounding 证据与像素目标接口共同构成了一种<strong>可迁移的导航表征</strong>，而不是记住了 R2R 的指令风格。</p>

<p><strong>消融：GEAR 是第一功臣。</strong> 去掉 GEAR 掉 12.7 个点（69.9 → 57.2）；把执行感知奖励图换成朴素 2D 像素距离掉到 66.2；去掉时序对齐掉到 62.2；去掉 <code class="language-plaintext highlighter-rouge">&lt;obj&gt;</code> / <code class="language-plaintext highlighter-rouge">&lt;prev_obj&gt;</code> 掉 3.8 点到 66.1；去掉子任务分解到 68.1（SPL 掉得更明显，到 62.2）。</p>

<div align="center">
  <img src="/images/vln/GroundingVLN-grounding-analysis.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/420" />
<figcaption>grounding 质量与像素目标精度分析。(a) GEAR 把 grounding 召回从 64.9% 提到 89.6%、F1 从 70.9% 提到 83.1%；(b) 成功 episode 的 grounding 质量显著高于失败 episode；(c) grounding 正确时动作准确率 96.4%，错误时仅 48.1%；(d) 归一化 L2 误差不超过 10% 的目标占比从 82.1% 升到 92.9%；(e) 平均定位误差从 7.4% 降到 4.6%，P90 从 13.8% 降到 8.0%</figcaption>
</div>

<p>其中最有说服力的是 (c)：<strong>grounding 正确的决策步，动作准确率几乎是 grounding 错误时的两倍</strong>（96.4% 对 48.1%）——这为”grounding 质量直接决定导航质量”提供了步级证据，而不只是端到端指标上的相关性。</p>

<p><strong>没有灾难性遗忘。</strong> 导航微调后在 MMStar 上 57.20、MVBench 上 45.55，相比原始 Qwen3.5-4B（63.67 / 50.93）只掉 6.47 和 5.38 个点；而 AwareVLN 与 DualVLN System 2 在同样测试下几乎全零——前者继续吐导航协议，后者只返回方向动作或 STOP。有意思的是导航数据还带来了增益：Object Shuffle +27.5%、Scene Transition +5.0%、Egocentric Navigation +3.0%，集中在空间变化跟踪与自我中心运动推理上。</p>

<p><strong>真机部署。</strong> AgileX TRACER 2.0 轮式底盘配 Insta360 X5 与 RealSense D435（离地 1.2 m、下倾 30°），单张 RTX 4090 推理。每个难度 10 个 episode：Easy 100%、Medium 90%、Hard 60%、Overall 83.3%，三个基线全面落后（DualVLN 40%、AwareVLN 50%、StreamVLN 33.3%），在 Medium 与 Hard 上差距最大。</p>

<div align="center">
  <img src="/images/vln/GroundingVLN-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/357" />
<figcaption>真机实验。(a) 三个难度各 10 个 episode 的成功率，总体 83.3% 领先所有基线；(b) 一个真实导航示例，模型依次把像素目标锚定到门口外的走廊地板、靠近厨房的地板、微波炉附近的地板</figcaption>
</div>

<p><strong>效率与鲁棒性。</strong> 平均每个 episode 推理 37.41 s，与最快的 Progress-Think（36.60 s）相当，比 NaVILA / Aux-Think / ActiveVLN 分别快 34.2% / 35.5% / 65.0%。深度噪声方面，按 D435 的立体基线（B = 0.05 m）与亚像素误差（0.08 px）建模视差域噪声后，SR 从 69.9% 降到 65.5%、SPL 从 64.1% 降到 59.7%，约 4.4 个点的降幅——一阶深度不确定度随距离平方增长，在 1 / 3 / 5 m 处分别约 0.58 / 5.20 / 14.43 cm。</p>

<hr />

<h3 id="4-局限性-39">4. 局限性</h3>

<p>高层 VLM 只吃 RGB，但低层执行模块<strong>依赖传感器提供的度量深度</strong>才能把像素目标反投影成可靠的 3D 点，并支撑 RGB-D SLAM 的位姿与地图估计。这限制了在没有可靠深度传感的平台上部署，作者把”不依赖度量深度、又能保持几何精度的纯 RGB 低层规划器”列为后续工作。</p>

<hr />

<h2 id="gpt-6-astra">54. GPT-6-Astra (2026)</h2>
<p>———通用基础模型只凭单目 RGB 与原语动作，零样本跑通连续环境视觉语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.29861">arXiv:2609.29861</a> · <a href="https://daiguangzhao.github.io/gpt-6-astra-for-vln/">Project Page</a></p>

<hr />

<h3 id="精华-42">精华</h3>

<ul>
  <li>把”看”也做成模型自己决定何时调用的工具——<code class="language-plaintext highlighter-rouge">observe()</code> 不耗步数，<code class="language-plaintext highlighter-rouge">step()</code> 执行完不回传图像——接口只剩”看”和”动”两个动词，测出来的就是基础模型本身的导航能力，而不是外围模块的能力。</li>
  <li>面对足够强的基础模型，航点预测器、全景、深度、预建图这些”脚手架”可能从助力变成上限：单目 RGB 加 0.25 m / 15° 的原语动作，在 R2R-CE-100 上拿到 79.0% SR、69.5% SPL，高于 Table 1 中所有零样本与训练式方法的报告值（评测子集不同，需谨慎看待）。</li>
  <li>只看 SR 会漏掉三类问题：OSR 与 SR 之差（3 个 episode 进过目标圈却停错位置）、低 nDTW 的成功（EP42 绕了约 2.4 倍路程才到达）、像素不变的”空走”（EP176 连走 8 步画面没变），分别对应停止判断、路线遵循和执行确认。</li>
  <li>推理强度从 medium 提到 ultra，SR 的 +3 个点是 9 个任务翻盘、6 个任务翻车相抵后的净值，另有 15 个任务两档都失败——多想一会儿改变的是个别 episode 的结局，没有系统性修好执行与终点验证。</li>
  <li>对 VLN 研究的启发：导航专用的训练、记忆与动作控制，应该用”修好了基础模型哪一类剩余失败”来证明自身价值，而不是重复基础模型已有的能力。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-41">1. 研究背景/问题</h3>

<p>VLN-CE（连续环境视觉语言导航）要求 agent 在连续 3D 空间里按自然语言指令一步步转向、前进，并在正确位置停下，考验感知、推理、记忆与动作的长程配合。GPT-4、Gemini-2.5-Pro、Qwen2.5-VL 之后，零样本 VLN 的主流做法是给通用模型套上导航专用的”脚手架”——训练好的航点预测器、全景 RGB-D、人工设计的规划与记忆模块，甚至预探索建图——分数因而反映的是整套系统，而非模型本身。这份来自新加坡管理大学与澳大利亚机器学习研究院的报告不提出新方法，而是沿用 Embodied Agents Take Control（arXiv:2607.26148）的极简接口设定追问：把脚手架全部拿掉，OpenAI 的通用模型 GPT-6-Astra 自己能导航到什么程度，又会在哪里失败？</p>

<hr />

<h3 id="2-主要方法创新点-39">2. 主要方法/创新点</h3>

<p>这是一篇评测报告，”方法”即三件事：一套极简的导航接口、一套与既有零样本工作对齐的评测协议，以及一套基于交互日志的行为分析框架。报告没有披露 GPT-6-Astra 的结构、训练数据或规模，只说明它是 OpenAI 的闭源通用模型，在 Codex 中提供 medium（默认）与 ultra 两档推理强度。</p>

<p><strong>整体框架</strong></p>

<div align="center">
  <img src="/images/vln/GPT-6-Astra-interface.webp" width="60%" loading="lazy" decoding="async" style="aspect-ratio:677/774" />
<figcaption>导航接口：GPT-6-Astra 在 Codex harness 会话内，经 MCP 调用 observe() 获取单目 RGB、调用 step() 执行原语动作；右侧俯视图与参考路径仅作示意，模型看不到</figcaption>
</div>

<p>系统由三部分构成：<strong>Codex harness</strong> 只负责维持一个连续会话、不参与任何导航决策；<strong>MCP（Model Context Protocol，模型调用外部工具的标准协议）工具层</strong>只暴露 <code class="language-plaintext highlighter-rouge">observe()</code> 与 <code class="language-plaintext highlighter-rouge">step(actions)</code> 两个工具；<strong>VLN-CE 模拟器</strong>执行动作并判定成败。理解指令、何时观察、怎么移动、何时停下，全部由 GPT-6-Astra 在会话内自行决定。</p>

<p>与典型零样本 VLN-CE 系统相比，这个接口”极简”在以下几处：</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>典型零样本 VLN-CE 方法</th>
      <th>本报告的接口</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>观测</td>
      <td>360° 全景，多数附带深度；部分方法预探索场景并重建（如 SpatialAnt）</td>
      <td>512×512 单目 RGB，要看就调 <code class="language-plaintext highlighter-rouge">observe()</code>；无深度、无地图、无位姿</td>
    </tr>
    <tr>
      <td>动作空间</td>
      <td>训练好的航点预测器给出候选点，模型从中挑一个</td>
      <td>原语动作序列：前进 0.25 m、左/右转 15°、相机俯仰 30°、STOP</td>
    </tr>
    <tr>
      <td>流程</td>
      <td>人工设计的规划、记忆、动作选择模块</td>
      <td>无导航专用模块，harness 只维持会话</td>
    </tr>
    <tr>
      <td>导航训练</td>
      <td>部分方法在导航数据上微调</td>
      <td>不做任何导航微调</td>
    </tr>
  </tbody>
</table>

<p><strong>模块 1：观测工具 <code class="language-plaintext highlighter-rouge">observe()</code></strong></p>

<ul>
  <li><strong>输入</strong>：无参数</li>
  <li><strong>处理</strong>：读取当前相机视角，不推进模拟器，也不消耗动作预算</li>
  <li><strong>输出</strong>：一张 512×512 单目 RGB。场景地图、参考轨迹、目标坐标、全局位姿与深度一律不提供</li>
  <li><strong>设计动机</strong>：把”看”变成模型主动选择的动作——看几次、什么时候看都由模型决定，从而检验它的主动感知能力，而不是由外部流程每步喂一张全景</li>
</ul>

<p><strong>模块 2：动作工具 <code class="language-plaintext highlighter-rouge">step(actions)</code></strong></p>

<ul>
  <li><strong>输入</strong>：一个有序的原语动作序列，一次调用可以打包多个原语</li>
  <li><strong>处理</strong>：模拟器依次执行</li>
  <li><strong>输出</strong>：执行计数、剩余预算、是否终止——<strong>不返回图像</strong>，想看执行后的画面必须再调一次 <code class="language-plaintext highlighter-rouge">observe()</code></li>
  <li><strong>设计动机</strong>：动作粒度压到最低，不依赖任何训练好的航点预测器；”动完不给图”也意味着模型得自己判断动作是否真的生效，这正是后文执行失败分析的伏笔</li>
</ul>

<blockquote>
  <p><strong>举个例子</strong>：指令里的”右转进走廊”大约是 6 次右转（6 × 15° = 90°）。图 3 中 EP42 的一次调用”L × 6, F × 4”，就是在一次 <code class="language-plaintext highlighter-rouge">step()</code> 里左转 90° 再前进 1 m（4 × 0.25 m）。打包多个原语只省调用次数，每个原语都照样计入 500 的动作预算——全部用来直走也只够约 125 m。</p>
</blockquote>

<p><strong>模块 3：Codex harness 与任务 prompt</strong></p>

<p>任务 prompt 写明工具用法、预算与停止条件；harness 维持会话，让模型在同一上下文里持续积累已看到的画面与已执行的动作。GPT-6-Astra 以 medium 与 ultra 两档推理强度分别跑完全部 episode，两档共用同一份 prompt 与工具。</p>

<p><strong>端到端数据流（读者版重画）</strong></p>

<pre><code class="language-mermaid">graph TD
    A["语言指令 + 任务 prompt（工具用法、预算、停止条件）"] --&gt; B["GPT-6-Astra 推理：下一步做什么"]
    B -- "需要看" --&gt; C["observe()：返回单目 RGB，不耗预算"]
    C --&gt; B
    B -- "决定移动" --&gt; D["step(actions)：执行一批原语动作"]
    D --&gt; E["返回执行计数、剩余预算、终止状态（无图像）"]
    E --&gt; B
    B -- "认为已到达" --&gt; F["STOP"]
    F --&gt; G{"终点距目标小于 3 m?"}
    G -- "是" --&gt; H["成功"]
    G -- "否" --&gt; I["失败"]
    E -- "500 个动作或 2400 s 用尽" --&gt; I
</code></pre>

<p><strong>评测协议</strong></p>

<ul>
  <li><strong>数据</strong>：R2R-CE-100，即 Open-Nav 引入的 100 个 val-unseen episode，覆盖 10 个场景，与 EvoNav、Open-Nav、SmartWay 等零样本工作采用同一协议；Table 1 中训练式方法的数字则来自全量 val-unseen</li>
  <li><strong>预算</strong>：每个 episode 最多 500 个原语动作、2,400 s，调用 STOP 或任一预算耗尽即结束</li>
  <li><strong>运行次数</strong>：每档推理强度、每个 episode 只跑一次</li>
  <li><strong>成功判定</strong>：显式调用 STOP，且终点到目标的测地距离小于 3 m</li>
</ul>

<p><strong>评测指标</strong></p>

<p>报告同时用五个指标，因为它们回答的是不同问题：</p>

<ul>
  <li><strong>SR</strong>（成功率）：STOP 时离目标小于 3 m 的比例——”到没到”</li>
  <li><strong>NE</strong>（导航误差）：终点到目标的测地距离，单位米——”差多远”</li>
  <li><strong>OSR</strong>（oracle 成功率）：轨迹上任意一点曾进入 3 m 圈即算——”路过没有”</li>
  <li><strong>SPL</strong>：用路径长度加权的成功率——”到得是否高效”</li>
</ul>

\[\text{SPL} = \frac{1}{N}\sum_{i=1}^{N} S_i \cdot \frac{\ell_i}{\max(p_i, \ell_i)}\]

<p>其中 $S_i$ 为第 $i$ 个 episode 是否成功，$\ell_i$ 为最短路径长度，$p_i$ 为实际行走长度。</p>

<ul>
  <li><strong>nDTW</strong>（归一化动态时间规整）：把实际轨迹 $Q$ 与参考路径 $R$ 逐点对齐后的累计距离压到 0–1——”是不是沿着指令描述的路线走”</li>
</ul>

\[\text{nDTW}(R, Q) = \exp\left(-\frac{\mathrm{DTW}(R, Q)}{\lvert R \rvert \cdot d_{th}}\right)\]

<p>其中 $d_{th}$ 取成功半径 3 m。</p>

<blockquote>
  <p><strong>举个例子</strong>：ultra 设置下 100 个 episode 里，79 个成功，3 个轨迹曾进入 3 m 目标圈但最终停在圈外，18 个从未进过目标圈。于是 SR = 79%，OSR = (79 + 3) / 100 = 82%，正好对上 Table 1 的 82.0——OSR 与 SR 之间这 3 个点，就是”路过了却没停对”。再看成功的 EP42：终点误差只有 0.7 m，照样记为成功；但 SPL 41.2% 意味着实际路程约为最短路径的 1 / 0.412 ≈ 2.4 倍，nDTW 27.5% 说明轨迹和参考路线几乎不贴合——它先走进了卧室，发现顺序不对，又折回厨房重新出发。</p>
</blockquote>

<p><strong>行为分析框架</strong></p>

<p>聚合指标之外，作者逐条检查 ultra 设置的交互日志（工具调用、实际执行的动作与对应的 RGB 画面），按两组问题组织分析：</p>

<ul>
  <li><strong>能力侧</strong>：如何落地空间指代（4.1）、到达目标是否等于按路线走（4.2）、如何调整动作（4.3）</li>
  <li><strong>失败侧</strong>：路线遵循在哪里断掉（5.1）、能否从执行困难中恢复（5.2）、能否在正确位置停下（5.3）、提高推理强度能否解决失败（5.4）</li>
</ul>

<p>作者也强调，日志只能支撑对”可观察行为”的分析，既不能确认单个语义判断是否正确，也看不到模型的内部推理。</p>

<hr />

<h3 id="3-核心结果发现-40">3. 核心结果/发现</h3>

<p><strong>主结果：单目 RGB、零样本，SR 与 SPL 均为论文 Table 1 中最高</strong></p>

<div align="center">
  <img src="/images/vln/GPT-6-Astra-sr-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1394/625" />
<figcaption>R2R-CE 上的 SR 对比：左为零样本方法，ultra 比最佳零样本 SpatialAnt（66.0%，全景 + 预探索建图）高 13.0 个点；右为训练式方法（全量 val-unseen），比 Qwen-RobotNav（72.1%，全景 + 1560 万混合来源样本）高 6.9 个点。评测子集与设置不一，作者注明比较并不严格公平</figcaption>
</div>

<p>从 Table 1 摘取的代表性行（NE 单位为米，其余为百分比）：</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>类型</th>
      <th>评测集</th>
      <th>视角</th>
      <th>NE↓</th>
      <th>OSR↑</th>
      <th>SR↑</th>
      <th>SPL↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>GC-VLN</td>
      <td>零样本</td>
      <td>Full</td>
      <td>单目</td>
      <td>7.3</td>
      <td>41.8</td>
      <td>33.6</td>
      <td>16.3</td>
    </tr>
    <tr>
      <td>AgenticNav-GPT-5.5</td>
      <td>零样本</td>
      <td>R2R-CE-100</td>
      <td>全景</td>
      <td>5.2</td>
      <td>65.0</td>
      <td>55.0</td>
      <td>48.4</td>
    </tr>
    <tr>
      <td>HarnessVLN-GPT-5.5</td>
      <td>零样本</td>
      <td>–</td>
      <td>全景</td>
      <td>4.0</td>
      <td>72.7</td>
      <td>60.8</td>
      <td>43.5</td>
    </tr>
    <tr>
      <td>SpatialAnt</td>
      <td>零样本</td>
      <td>Author-sampled</td>
      <td>全景</td>
      <td>4.4</td>
      <td>76.0</td>
      <td>66.0</td>
      <td>54.4</td>
    </tr>
    <tr>
      <td>Image2Nav</td>
      <td>训练式</td>
      <td>Full</td>
      <td>单目</td>
      <td>4.0</td>
      <td>72.9</td>
      <td>66.3</td>
      <td>61.5</td>
    </tr>
    <tr>
      <td>Qwen-RobotNav-8B</td>
      <td>训练式</td>
      <td>Full</td>
      <td>单目</td>
      <td>4.4</td>
      <td>72.7</td>
      <td>65.7</td>
      <td>59.6</td>
    </tr>
    <tr>
      <td>OmniNav</td>
      <td>训练式</td>
      <td>Full</td>
      <td>全景</td>
      <td>3.7</td>
      <td>74.6</td>
      <td>69.5</td>
      <td>66.1</td>
    </tr>
    <tr>
      <td>Qwen-RobotNav-8B</td>
      <td>训练式</td>
      <td>Full</td>
      <td>全景</td>
      <td>3.5</td>
      <td>78.5</td>
      <td>72.1</td>
      <td>66.6</td>
    </tr>
    <tr>
      <td><strong>GPT-6-Astra（medium）</strong></td>
      <td>零样本</td>
      <td>R2R-CE-100</td>
      <td>单目</td>
      <td><strong>2.7</strong></td>
      <td><strong>83.0</strong></td>
      <td>76.0</td>
      <td>67.9</td>
    </tr>
    <tr>
      <td><strong>GPT-6-Astra（ultra）</strong></td>
      <td>零样本</td>
      <td>R2R-CE-100</td>
      <td>单目</td>
      <td>3.0</td>
      <td>82.0</td>
      <td><strong>79.0</strong></td>
      <td><strong>69.5</strong></td>
    </tr>
  </tbody>
</table>

<ul>
  <li>在同为单目 RGB 的零样本方法中，此前最好的 GC-VLN 只有 33.6% SR / 16.3% SPL，GPT-6-Astra 的 SR 高出一倍以上</li>
  <li>NE 2.7–3.0 m 是 Table 1 中最低，比其中最强的训练式模型 Qwen-RobotNav-8B（全景，3.5 m）还低；SPL 69.5 同样高于 Table 1 中所有训练式方法。但 Table 1 未收录 Robostral Navigate：它在全量 val-unseen 上以单目 RGB 取得 77.4% SR、74.2 SPL，SPL 高于 GPT-6-Astra 的 69.5（NE 3.20 m 则不如 GPT-6-Astra 的 2.7–3.0 m）</li>
  <li>ultra 相比 medium 的 SR 与 SPL 更高，但 OSR 略低、NE 略高</li>
  <li>作者反复提醒：训练式方法用全量 val-unseen，SpatialAnt 用作者自采样的 episode 并借助场景重建与模拟器深度，HarnessVLN 未注明子集，这些对比只说明竞争力，不构成同条件下的优劣结论</li>
</ul>

<p><strong>空间指代：序数式比地标相对式更稳</strong></p>

<table>
  <thead>
    <tr>
      <th>指令子集</th>
      <th>N</th>
      <th>SR</th>
      <th>SPL</th>
      <th>nDTW</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>R2R-CE-100（全部）</td>
      <td>100</td>
      <td>79.0</td>
      <td>69.5</td>
      <td>73.3</td>
    </tr>
    <tr>
      <td>序数式选择（”第二个房间”“最右边的门”）</td>
      <td>14</td>
      <td>85.7</td>
      <td>68.6</td>
      <td>73.4</td>
    </tr>
    <tr>
      <td>地标相对式选择（”在……左边”“在……之间”“在……后面”）</td>
      <td>13</td>
      <td>61.5</td>
      <td>59.6</td>
      <td>71.8</td>
    </tr>
  </tbody>
</table>

<p>EP218 中模型离开卧室后，先在交互日志里把一间浴室认作”左手第一个房间”，再走向下一个门口；EP244 中它选中了”白色双开门左边”的门洞，两例都成功（NE 分别为 2.6 m、1.8 m）。作者注明这里是整条任务的成绩，不是单个空间关系判断的准确率，且两个子集的场景布局与难度也不同。</p>

<p><strong>到达 ≠ 按路线走</strong></p>

<ul>
  <li>79 个成功 episode 的 nDTW 中位数为 90.4%，多数紧贴参考路线；但有 8 个（10.1%）低于 50%。EP116 终点误差 0.1 m、nDTW 89.2%，是贴线的典型；EP42 则是大幅绕路后的成功</li>
  <li>日志中有 16 个 episode 记录到明显的路线偏离或通行困难后的动作调整：10 个成功、6 个失败，成功者的 nDTW 与 SPL 中位数仅 44.3% 与 45.5%。这只统计了有记录的调整，不能说明调整本身对成败的因果作用</li>
</ul>

<div align="center">
  <img src="/images/vln/GPT-6-Astra-EP42-backtracking.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1389/587" />
<figcaption>EP42 的折返过程（指令：厨房 → 小客厅 → 左手卧室）：t=135 模型发现自己进了卧室、与"厨房—客厅—卧室"的顺序不符，于是左转后折回厨房，穿过客厅，最终进入正确的卧室并 STOP；成功，但 nDTW 仅 27.5%、SPL 41.2%。t 为已执行的原语动作数</figcaption>
</div>

<p><strong>失败模式：路线、执行、停止三类</strong></p>

<div align="center">
  <img src="/images/vln/GPT-6-Astra-failures.webp" width="90%" loading="lazy" decoding="async" style="aspect-ratio:1398/1008" />
<figcaption>执行与终点验证失败：(a) ultra 设置下 79 个成功、3 个进过目标圈但停错、18 个从未进圈；(b) EP176 连续 8 次前进后 RGB 画面完全不变，最终耗尽 500 步预算、NE 35.4 m；(c) EP1133 在两档推理强度下都停在拱门附近而失败，ultra 的 NE 更小（5.6 m 对 7.5 m）但仍超出 3 m</figcaption>
</div>

<ul>
  <li><strong>路线遵循断裂</strong>：ultra 的 21 个失败中，13 个终点离目标至少 5 m，其中 7 个超过 10 m。EP513 的指令提到壁炉客厅、两张白沙发和相邻餐厅入口，模型最后看到壁炉和浅色座椅就宣布到达，NE 却有 14.5 m——局部地标对上了，不代表到了指令说的那个地方，而日志也定位不到第一处走错的位置</li>
  <li><strong>执行困难与恢复</strong>：4 个 episode 里共有 5 批纯前进动作，执行前后的 RGB 逐像素相同（没有可见位移，但不等于测到了碰撞），其中 3 个 episode 最终仍然成功；EP70 在窄门附近经过转向与前进后进入下一个房间并成功；EP176 则在 8 次前进画面不变之后一直耗到 500 步预算，终点距目标 35.4 m。发出动作不等于真的动了，也不等于有效恢复</li>
  <li><strong>停止判断</strong>：99 个 episode 由模型主动 STOP，只有 EP176 触到动作上限；3 个失败 episode 的 OSR 为 1，即曾进入目标圈又离开。EP705 中模型报告在门口旁看到灭火器后停下，最终 NE 为 12.3 m</li>
</ul>

<p><strong>提高推理强度能解决多少失败？</strong></p>

<p>把两档推理强度在同一批 100 个任务上的结局交叉起来（由正文数字推出：medium 失败 24 个，其中 9 个在 ultra 下成功、15 个仍失败；另有 6 个 medium 成功的任务在 ultra 下失败）：</p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>ultra 成功</th>
      <th>ultra 失败</th>
      <th>合计</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>medium 成功</strong></td>
      <td>70</td>
      <td>6</td>
      <td>76</td>
    </tr>
    <tr>
      <td><strong>medium 失败</strong></td>
      <td>9</td>
      <td>15</td>
      <td>24</td>
    </tr>
    <tr>
      <td><strong>合计</strong></td>
      <td>79</td>
      <td>21</td>
      <td>100</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>怎么读这张表</strong>：SR 从 76 升到 79，不是”ultra 多修好 3 个任务”，而是 9 个翻盘减去 6 个翻车。只看这 15 个结局改变的任务，9 对 6 按精确二项检验（McNemar）的双侧 p 约为 0.61（笔者据表中计数计算，非论文报告），远谈不上显著。</p>
</blockquote>

<ul>
  <li>15 个两档都失败的任务里，ultra 的 NE 更低的有 8 个、更高的有 7 个，没有一致的改善方向；EP1133 两档都在拱门附近停下，NE 从 7.5 m 降到 5.6 m，仍未进入 3 m 圈</li>
  <li>两档运行所用的 Codex 版本也不同（medium 为 0.155.1，ultra 为 0.155.0），因此这组对比无法把差异单独归因于推理强度</li>
</ul>

<p><strong>作者对后续 VLN 研究的建议</strong></p>

<ul>
  <li>通用模型经一个极简的”观察—动作”接口就能完成有竞争力的导航，说明这未必需要单独训练导航策略，但何时这条路线优于专门训练，还需在观测、动作预算与任务集都对齐的条件下比较</li>
  <li>后续方法应优先补三块短板：地标重复出现时守住路线约束、识别无效运动并恢复、确认终点确实满足指令；评估时应把参考路径贴合度、执行反馈与停止结局和 SR 一起报告</li>
</ul>

<hr />

<h3 id="4-局限性-40">4. 局限性</h3>

<p>只在 R2R-CE-100（100 个 episode、10 个场景）上每档跑一次，与全量 val-unseen 上的训练式方法、Author-sampled 的 SpatialAnt 并非同条件对比；按二项分布粗算，100 个 episode 上 79% SR 的标准误约 4.1 个百分点，领先 Qwen-RobotNav 的 6.9 个点还不到两个标准误。GPT-6-Astra 是闭源模型，无法排除其训练数据含导航数据，推理成本与延迟目前也制约实际部署；作者计划补充多次运行的均值与标准差，并扩展到 RxR-CE、NavRAG-CE。</p>

<hr />

<h2 id="budvln">55. BudVLN (2026)</h2>
<p>———Nipping the Drift in the Bud: Retrospective Rectification for Robust Vision-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2602.06356">arXiv:2602.06356</a></p>

<h3 id="精华-43">精华</h3>

<ol>
  <li><strong>核心思想</strong>：通过“回顾式纠偏”（Retrospective Rectification）解决 Vision-Language Navigation (VLN) 中的指令-状态不一致问题。</li>
  <li><strong>训练范式</strong>：引入了 <strong>Adaptive Mutual Exclusion Strategy</strong>，将样本动态分流为效率路径和鲁棒性路径，实现了精准训练。</li>
  <li><strong>纠偏机制</strong>：利用“回锚”机制合成语义一致的修正轨迹，避免了传统方法中强制回归导致的语义冲突。</li>
  <li><strong>极致效率</strong>：采用 GRPO 算法（借鉴自 DeepSeek-R1），无需价值网络，训练成本仅为传统 DAgger 的约 25%。</li>
  <li><strong>性能卓越</strong>：在 R2R-CE 和 RxR-CE 基准测试上刷新 SOTA，尤其在处理偏差和鲁棒性方面表现突出。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-42">1. 研究背景/问题</h3>

<p>当前的视觉-语言导航（VLN）系统面临严重的<strong>曝光偏差（Exposure Bias）</strong>问题：推理时的细微偏差会导致严重的累积误差。虽然 DAgger 类方法尝试通过纠正错误状态来缓解这一问题，但论文指出这些方法存在<strong>指令-状态不一致（Instruction-State Misalignment）</strong>的致命局限。如图 1 所示，强制智能体从离群状态回归往往会生成与其原始语言指令相冲突的监督信号（例如：指令要求直行，但为回归正轨必须掉头），这会损害智能体的指令遵循能力。</p>

<div align="center">
  <img src="/images/vln/BudVLN-misalignment-illustration.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/819" />
<figcaption>
图 1：指令-状态不一致现象的图示，展示了传统 DAgger 如何产生语义冲突的监督。
</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-40">2. 主要方法/创新点</h3>

<p>论文提出了 <strong>BudVLN</strong>，一个旨在通过统一的在线回顾式纠偏框架解决上述挑战的系统。</p>

<h4 id="adaptive-mutual-exclusion-strategy-自适应互斥策略">Adaptive Mutual Exclusion Strategy (自适应互斥策略)</h4>
<p>BudVLN 并不对所有样本一视同仁，而是采用一种自适应策略进行动态路由：</p>
<ul>
  <li><strong>Proficiency Pathway (效率路径)</strong>：通过 Greedy Probe 评估。若智能体已能熟练完成任务，则利用 <strong>GRPO (Group Relative Policy Optimization)</strong> 进行组内相对优势学习，进一步优化路径效率。</li>
  <li><strong>Rectification Pathway (纠偏路径)</strong>：若智能体在任务中失败，则触发<strong>回顾式纠偏</strong>。</li>
</ul>

<div align="center">
  <img src="/images/vln/BudVLN-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/800" />
<figcaption>
图 2：BudVLN 训练框架概览，展示了 GRPO 路径与回顾式纠偏（SFT）路径的动态分流。
</figcaption>
</div>

<h4 id="retrospective-rectification-回顾式纠偏">Retrospective Rectification (回顾式纠偏)</h4>
<p>针对失败样本，BudVLN 执行以下操作：</p>
<ol>
  <li><strong>回锚（Anchor Identification）</strong>：将状态回溯到发生偏差前的最后一个有效路径点（Valid Anchor）。</li>
  <li><strong>语义一致性合成</strong>：利用 Oracle 合成从该锚点出发的正确轨迹，以此作为 SFT 的监督信号。
这种方法确保了监督信号与原始指令的语义一致性，彻底解决了 DAgger 的语义冲突问题。</li>
</ol>

<h4 id="grpo-优化">GRPO 优化</h4>
<p>受到大规模推理模型成功的启发，BudVLN 引入了 GRPO 算法。它通过在一个采样组内计算相对优势，摆脱了对昂贵价值网络（Value Network）的依赖，极大地降低了计算开销，同时提升了探索效率。</p>

<hr />

<h3 id="3-核心结果发现-41">3. 核心结果/发现</h3>

<ul>
  <li><strong>SOTA 性能</strong>：在 R2R-CE 和 RxR-CE 两个主流基准测试中，BudVLN 全面超越了现有模型。在 R2R-CE 上，成功率 (SR) 达到 <strong>57.6%</strong>，SPL 达到 <strong>51.1%</strong>。</li>
  <li><strong>训练效率</strong>：得益于 GRPO 算法和高效的纠偏机制，BudVLN 仅需 <strong>27 GPU 小时</strong> 即可完成训练，相比 DAgger 的 114 小时，效率提升了近 4 倍。</li>
  <li><strong>消融研究</strong>：实验证明，单独添加纠偏机制能显著提升 SR，而 GRPO 算法则对 SPL 的提升和训练效率的优化起到了关键作用。</li>
</ul>

<div align="center">
  <img src="/images/vln/BudVLN-main-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/929" />
<figcaption>
表 1：BudVLN 与现有 VLN 模型在 R2R-CE 和 RxR-CE 测试集上的性能对比。
</figcaption>
</div>

<hr />

<h3 id="4-局限性-41">4. 局限性</h3>

<p>虽然 BudVLN 在离散和连续环境中均表现出色，但其鲁棒性目前仍受限于预定义 Oracle 的质量。在极度复杂的极端环境下，如何自主生成更高质量的“回顾性”知识仍是未来研究的方向。</p>

<hr />

<h1 id="参考资料">参考资料</h1>

<h2 id="已发表论文会议--期刊">已发表论文（会议 / 期刊）</h2>

<p>下表汇总本文中已正式发表于会议或期刊的论文，其余条目为 arXiv 预印本：</p>

<table>
  <thead>
    <tr>
      <th>会议 / 期刊</th>
      <th>论文</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>CVPR</strong></td>
      <td><a href="#vln-imagine">VLN-Imagine</a> (2025)、<a href="#slow4fast-vln">Slow4fast-VLN</a> (2026)、<a href="#awarevln">AwareVLN</a> (2026)、<a href="#ga-vln">GA-VLN</a> (2026)、<a href="#hsgm">HSGM</a> (2026)、<a href="#decovln">DecoVLN</a> (2026)、<a href="#r2r">R2R</a> (2018, Spotlight)、<a href="#duet">DUET</a> (2022)</td>
    </tr>
    <tr>
      <td><strong>ICLR</strong></td>
      <td><a href="#navfom">NavFoM</a> (2026)、<a href="#janusvln">JanusVLN</a> (2026)、<a href="#omninav">OmniNav</a> (2026, Poster)、<a href="#tuckernav">TuckerNav</a> (2026)、<a href="#uncertainty-aware-gaussian-map">Uncertainty-Aware Gaussian Map</a> (2026)、<a href="#dualvln">DualVLN</a> (2026)</td>
    </tr>
    <tr>
      <td><strong>ICRA</strong></td>
      <td><a href="#nomad">NoMaD</a> (2024)、<a href="#vlfm">VLFM</a> (2024)、<a href="#open-nav">Open-Nav</a> (2025)、<a href="/VLN-Papers-Extended/#navdp">NavDP</a> (2026)、<a href="#streamvln">StreamVLN</a> (2026)</td>
    </tr>
    <tr>
      <td><strong>ECCV</strong></td>
      <td><a href="#vln-ce">VLN-CE</a> (2020)、<a href="#navgpt-2">NavGPT-2</a> (2024)、<a href="#agentvln">AgentVLN</a> (2026)</td>
    </tr>
    <tr>
      <td><strong>AAAI</strong></td>
      <td><a href="#odyssey">ODYSSEY</a> (2026)、<a href="#correctnav">CorrectNav</a> (2026)、<a href="#r3">R³</a> (2026)、<a href="#panonav">PanoNav</a> (2026, Poster)</td>
    </tr>
    <tr>
      <td><strong>ICCV</strong></td>
      <td><a href="#vln-pe">VLN-PE</a> (2025)</td>
    </tr>
    <tr>
      <td><strong>ACL</strong></td>
      <td><a href="#mapnav">MapNav</a> (2025)</td>
    </tr>
    <tr>
      <td><strong>RSS</strong></td>
      <td><a href="#navid">NaVid</a> (2024)</td>
    </tr>
    <tr>
      <td><strong>IROS</strong></td>
      <td><a href="#reflectvln">ReflectVLN</a> (2026)</td>
    </tr>
    <tr>
      <td><strong>CoRL</strong></td>
      <td><a href="#x-navdp">X-NavDP</a> (2026)</td>
    </tr>
    <tr>
      <td><strong>RO-MAN</strong></td>
      <td><a href="#r2rie-ce-iedl">R2RIE-CE &amp; IEDL</a> (2024)</td>
    </tr>
    <tr>
      <td><strong>期刊</strong></td>
      <td><a href="/VLN-Papers-Extended/#gaussnav">GaussNav</a> (IEEE TPAMI 2025)、<a href="#causalnav">CausalNav</a> (IEEE RA-L)、<a href="/VLN-Papers-Extended/#humanoidvln">HumanoidVLN</a> (IEEE RA-L)、<a href="#skill-nav">Skill-Nav</a> (Vicinagearth / Springer 2025)、<a href="#ca-vln">CA-VLN</a> (Sensors 2026)</td>
    </tr>
  </tbody>
</table>

<h2 id="论文引用">论文引用</h2>

<ol>
  <li><strong>R2R</strong> (2018). 真实室内环境下的视觉-语言导航基准与序列到序列基线. arXiv: <a href="https://arxiv.org/abs/1711.07280">1711.07280</a> · CVPR 2018 (Spotlight)</li>
  <li><strong>VLN-CE</strong> (2020). Beyond the Nav-Graph: 在连续环境中的视觉-语言导航. arXiv: <a href="https://arxiv.org/abs/2004.02857">2004.02857</a> · ECCV 2020</li>
  <li><strong>DUET</strong> (2022). 基于双尺度图 Transformer 的离散拓扑视觉语言导航. arXiv: <a href="https://arxiv.org/abs/2202.11742">2202.11742</a> · CVPR 2022 · Code: <a href="https://github.com/cshizhe/VLN-DUET">cshizhe/VLN-DUET</a></li>
  <li><strong>NoMaD</strong> (2023). 目标掩码扩散策略实现统一导航. arXiv: <a href="https://arxiv.org/abs/2310.07896">2310.07896</a> · ICRA 2024</li>
  <li><strong>VLFM</strong> (2023). Vision-Language Frontier Maps for Zero-Shot Semantic Navigation. arXiv: <a href="https://arxiv.org/abs/2312.03275">2312.03275</a> · ICRA 2024 · Code: <a href="https://github.com/rai-opensource/vlfm">rai-opensource/vlfm</a></li>
  <li><strong>R2RIE-CE &amp; IEDL</strong> (2024). 首个连续导航指令错误基准测试，以及结合指令-轨迹兼容性的多模态错误检测与定位框架. arXiv: <a href="https://arxiv.org/abs/2403.10700">2403.10700</a> · ROMAN 2024</li>
  <li><strong>NaVid</strong> (2024). 首个无需依赖地图、基于视频大模型的单目连续视觉语言导航模型. arXiv: <a href="https://arxiv.org/abs/2402.15852">2402.15852</a> · RSS 2024 · Code: <a href="https://github.com/jzhzhang/NaVid-VLN-CE">jzhzhang/NaVid-VLN-CE</a></li>
  <li><strong>NavGPT-2</strong> (2024). 释放大型视觉语言模型的导航推理能力. arXiv: <a href="https://arxiv.org/abs/2407.12366">2407.12366</a> · ECCV 2024 · Code: <a href="https://github.com/GengzeZhou/NavGPT-2">GengzeZhou/NavGPT-2</a></li>
  <li><strong>DualVLN/InternVLN</strong> (2025). Ground Slow, Move Fast: 具备世界模型与快慢双系统的端到端连续导航. arXiv: <a href="https://arxiv.org/abs/2512.08186">2512.08186</a> · ICLR 2026 · Code: <a href="https://github.com/InternRobotics/InternNav">InternRobotics/InternNav</a></li>
  <li><strong>ODYSSEY</strong> (2025). Open-World Quadrupeds Exploration and Manipulation for Long-Horizon Tasks. arXiv: <a href="https://arxiv.org/abs/2508.08240">2508.08240</a> · AAAI 2026</li>
  <li><strong>PanoNav</strong> (2025). Mapless Zero-Shot Object Navigation. arXiv: <a href="https://arxiv.org/abs/2511.06840">2511.06840</a> · AAAI 2026 (Poster)</li>
  <li><strong>VLN-R1</strong> (2025). 基于GRPO与Time-Decayed Reward的端到端导航. arXiv: <a href="https://arxiv.org/abs/2506.17221">2506.17221</a> · Data: <a href="https://github.com/Qi-Zhangyang/GPT4Scene-and-VLN-R1">Qi-Zhangyang/GPT4Scene-and-VLN-R1</a>（仅开源训练数据与数据生成代码）</li>
  <li><strong>StreamVLN</strong> (2025). 通过慢-快上下文建模实现流式视觉-语言导航. arXiv: <a href="https://arxiv.org/abs/2507.05240">2507.05240</a> · ICRA 2026 · Code: <a href="https://github.com/OpenRobotLab/StreamVLN">OpenRobotLab/StreamVLN</a></li>
  <li><strong>NavFoM</strong> (2025). Embodied Navigation Foundation Model. arXiv: <a href="https://arxiv.org/abs/2509.12129">2509.12129</a> · ICLR 2026</li>
  <li><strong>MapNav</strong> (2025). A Novel Memory Representation via Annotated Semantic Maps for Vision-and-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2502.13451">2502.13451</a> · ACL 2025 · Code: <a href="https://github.com/linglingxiansen/MapNav">linglingxiansen/MapNav</a></li>
  <li><strong>Open-Nav</strong> (2025). Zero-Shot VLN in Continuous Environment with Open-Source LLMs. arXiv: <a href="https://arxiv.org/abs/2409.18794">2409.18794</a> · ICRA 2025</li>
  <li><strong>Skill-Nav</strong> (2025). Enhanced Navigation with Versatile Quadrupedal Locomotion via Waypoint Interface. arXiv: <a href="https://arxiv.org/abs/2506.21853">2506.21853</a> · Vicinagearth (Springer) 2025</li>
  <li><strong>VLN-Imagine</strong> (2025). 用文本生成图像模型为导航智能体构建”视觉想象”. arXiv: <a href="https://arxiv.org/abs/2503.16394">2503.16394</a> · CVPR 2025 · Code: <a href="https://github.com/akhilperincherry/VLN-Imagine">akhilperincherry/VLN-Imagine</a></li>
  <li><strong>VLN-PE</strong> (2025). 重新思考视觉-语言导航中的具身化差距:物理和视觉差异的全面研究. arXiv: <a href="https://arxiv.org/abs/2507.13019v2">2507.13019v2</a> · ICCV 2025</li>
  <li><strong>Goal2Pixel</strong> (2025). 将导航目标接地到图像像素，以像素预测统一 VLN-CE 的决策空间. arXiv: <a href="https://arxiv.org/abs/2606.01621">2606.01621</a></li>
  <li><strong>AstraNav-World</strong> (2025). 将”想象未来”与”规划未来”统一进同一个生成式概率框架. arXiv: <a href="https://arxiv.org/abs/2512.21714">2512.21714</a> · Code: <a href="https://github.com/amap-cvlab/AstraNav-World">amap-cvlab/AstraNav-World</a></li>
  <li><strong>CorrectNav</strong> (2025). 自纠错飞轮赋能的单目 RGB 视觉-语言-动作导航模型. arXiv: <a href="https://arxiv.org/abs/2508.10416">2508.10416</a> · AAAI 2026 · Code: <a href="https://github.com/owlet914/CorrectNav">owlet914/CorrectNav</a></li>
  <li><strong>Slow4fast-VLN</strong> (2026). General Vision-Language Navigation via Fast-Slow Interactive Reasoning. arXiv: <a href="https://arxiv.org/abs/2601.09111v1">2601.09111v1</a> · CVPR 2026 · Code: <a href="https://github.com/yl6017339/Slow4Fast-VLN">yl6017339/Slow4Fast-VLN</a></li>
  <li><strong>DGNav</strong> (2026). 动态拓扑感知：打破视觉-语言导航中的粒度刚性. arXiv: <a href="https://arxiv.org/abs/2601.21751">2601.21751</a> · Code: <a href="https://github.com/shannanshouyin/DGNav">shannanshouyin/DGNav</a></li>
  <li><strong>CausalNav</strong> (2026). First Scene Graph-based Semantic Navigation for Dynamic Outdoor Environments. arXiv: <a href="https://arxiv.org/abs/2601.01872">2601.01872</a> · IEEE RA-L</li>
  <li><strong>AgentVLN</strong> (2026). Towards Agentic Vision-and-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2603.17670">2603.17670</a> · ECCV 2026 · Code: <a href="https://github.com/Allenxinn/AgentVLN">Allenxinn/AgentVLN</a></li>
  <li><strong>VLN-Cache</strong> (2026). Enabling Token Caching for VLN Models with Visual/Semantic Dynamics Awareness. arXiv: <a href="https://arxiv.org/abs/2603.07080">2603.07080</a></li>
  <li><strong>R³: Run, Ruminate, and Regulate</strong> (2026). 一个面向视觉语言导航的双过程思考框架. arXiv: <a href="https://arxiv.org/abs/2511.14131">2511.14131</a> · AAAI 2026 · Code（待发布）: <a href="https://github.com/IAII-CAS/navigation_R3">IAII-CAS/navigation_R3</a></li>
  <li><strong>AwareVLN</strong> (2026). Reasoning with Self-awareness for Vision-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2605.22816">2605.22816</a> · CVPR 2026 · Code: <a href="https://github.com/GWxuan/AwareVLN">GWxuan/AwareVLN</a></li>
  <li><strong>Dual-Anchoring</strong> (2026). 用”指令进度”与”地标记忆”双重锚定，对抗 VLN 中的状态漂移（State Drift）. arXiv: <a href="https://arxiv.org/abs/2604.17473">2604.17473</a></li>
  <li><strong>JanusVLN</strong> (2026). 解耦语义与空间：使用双隐式神经内存的视觉语言导航. arXiv: <a href="https://arxiv.org/abs/2509.22548v2">2509.22548v2</a> · ICLR 2026 · Code: <a href="https://github.com/MIV-XJTU/JanusVLN">MIV-XJTU/JanusVLN</a></li>
  <li><strong>HSGM</strong> (2026). 层级式语义-几何地图，填补 VLM 2D 视觉与 3D 空间推理及运动规划的鸿沟. arXiv: <a href="https://arxiv.org/abs/2606.00095">2606.00095</a> · CVPR 2026 · Code: <a href="https://github.com/Teacher-Tom/HSGM_public">Teacher-Tom/HSGM_public</a></li>
  <li><strong>OneVLA</strong> (2026). 首个在单一网络与动作头下统一具身导航和操作的 VLA 模型. arXiv: <a href="https://arxiv.org/abs/2606.01241">2606.01241</a> · Code: <a href="https://github.com/linglingxiansen/OneVLA">linglingxiansen/OneVLA</a></li>
  <li><strong>CA-VLN</strong> (2026). 基于双智能体协作的多模态大模型具身导航框架. DOI: <a href="https://doi.org/10.3390/s26041254">10.3390/s26041254</a> · Sensors 2026</li>
  <li><strong>RynnBrain</strong> (2026). Open Spatiotemporal Foundation Model for Embodied Intelligence. arXiv: <a href="https://arxiv.org/abs/2602.14979">2602.14979</a> · Code: <a href="https://github.com/alibaba-damo-academy/RynnBrain">alibaba-damo-academy/RynnBrain</a></li>
  <li><strong>OmniNav</strong> (2026). 用快慢双系统统一点目标、物体目标、指令目标导航与前沿探索. arXiv: <a href="https://arxiv.org/abs/2509.25687">2509.25687</a> · ICLR 2026 (Poster) · Code: <a href="https://github.com/amap-cvlab/OmniNav">amap-cvlab/OmniNav</a></li>
  <li><strong>Qwen-RobotNav</strong> (2026). 首个统一的多任务、时空可重构具身导航大模型. arXiv: <a href="https://arxiv.org/abs/2606.18112">2606.18112</a></li>
  <li><strong>GA-VLN</strong> (2026). Geometry-Aware BEV Representation for Efficient Vision-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2605.22036">2605.22036</a> · CVPR 2026 · Code: <a href="https://github.com/jahhaoyang/GA-VLN">jahhaoyang/GA-VLN</a></li>
  <li><strong>SEDualVLN</strong> (2026). 空间增强的双系统连续环境视觉语言导航框架. arXiv: <a href="https://arxiv.org/abs/2605.17249">2605.17249</a> · Project Page: <a href="https://kim-os.github.io/SEDualVLN/">kim-os.github.io/SEDualVLN</a></li>
  <li><strong>Robostral Navigate</strong> (2026). 仅需单目 RGB 相机的 8B 视语言导航大模型：超高效仿真训练与在线强化学习. arXiv: <a href="https://arxiv.org/abs/2607.20785">2607.20785</a></li>
  <li><strong>ABot-N1</strong> (2026). 基于慢速认知与快速控制双系统架构的通用视觉语言导航基础模型. arXiv: <a href="https://arxiv.org/abs/2607.10383v2">2607.10383v2</a> · Benchmark: <a href="https://github.com/amap-cvlab/ABot-Navigation/tree/ABotN-Bench">amap-cvlab/ABot-Navigation (ABotN-Bench)</a></li>
  <li><strong>ReflectVLN</strong> (2026). 基于反思推理与双向交互机制的具身视觉语言导航. arXiv: <a href="https://arxiv.org/abs/2607.12680">2607.12680</a> · IROS 2026</li>
  <li><strong>TuckerNav</strong> (2026). 面向全天候多场景终身具身视觉语言导航的 Tucker 张量自适应. arXiv: <a href="https://arxiv.org/abs/2603.14276">2603.14276</a> · ICLR 2026</li>
  <li><strong>AgenticNav</strong> (2026). 将零样本连续环境导航（VLN-CE）重构为 VLM 可调用的 Tool-Calling 架构. arXiv: <a href="https://arxiv.org/abs/2606.10577">2606.10577</a></li>
  <li><strong>MemVLN</strong> (2026). 模拟人类双重记忆机制的高效连续环境视觉语言导航框架. arXiv: <a href="https://arxiv.org/abs/2607.23504">2607.23504</a></li>
  <li><strong>X-NavDP</strong> (2026). 多构型机器人通用视觉导航的组内 Q值重加权 Diffusion RL 强化学习微调框架. arXiv: <a href="https://arxiv.org/abs/2607.28560">2607.28560</a> · CoRL 2026 · Code: <a href="https://github.com/InternRobotics/NavDP">InternRobotics/NavDP</a></li>
  <li><strong>Image2Sim</strong> (2026). 解耦 3D 空间锚定与超真实图像合成的实时神经仿真引擎. arXiv: <a href="https://arxiv.org/abs/2607.05765">2607.05765</a> · Code: <a href="https://github.com/MrZihan/Image2Sim">MrZihan/Image2Sim</a></li>
  <li><strong>DecoVLN</strong> (2026). Decoupling Observation, Reasoning, and Correction for Vision-and-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2603.13133">2603.13133</a> · CVPR 2026 · Code（待发布）: <a href="https://github.com/Allenxinn/DecoVLN">Allenxinn/DecoVLN</a></li>
  <li><strong>TAMP-Nav</strong> (2026). Point, Think, Memorize, and Align for Efficient Navigation. arXiv: <a href="https://arxiv.org/abs/2608.17512">2608.17512</a> · Code: <a href="https://github.com/ZJU-OmniAI/Embodied-Omni">ZJU-OmniAI/Embodied-Omni</a></li>
  <li><strong>LightNav-0</strong> (2026). 把 VLM 已有的空间智能”引出来”，而不是给它外挂一个导航模块. arXiv: <a href="https://arxiv.org/abs/2608.30935">2608.30935</a> · Code: <a href="https://github.com/lightorigins/LightNav-0">lightorigins/LightNav-0</a></li>
  <li><strong>Uncertainty-Aware Gaussian Map for VLN</strong> (2026). 三类感知不确定性 × Semantic Gaussian Map，赋予 VLN 智能体可靠决策能力. arXiv: <a href="https://arxiv.org/abs/2607.13500">2607.13500</a> · ICLR 2026 · Code（待发布）: <a href="https://github.com/Gaozzzz/Uncertainty-Aware-VLN">Gaozzzz/Uncertainty-Aware-VLN</a></li>
  <li><strong>HarnessVLN</strong> (2026). 一套 Agent Harness，把”指令跟随”和”找物体”两类导航压进同一个工具调用协议. arXiv: <a href="https://arxiv.org/abs/2609.15195">2609.15195</a></li>
  <li><strong>GroundingVLN</strong> (2026). 把视觉 grounding 做成”想”与”走”之间的共享接口. arXiv: <a href="https://arxiv.org/abs/2609.18581">2609.18581</a></li>
  <li><strong>GPT-6-Astra</strong> (2026). 通用基础模型只凭单目 RGB 与原语动作，零样本跑通连续环境视觉语言导航. arXiv: <a href="https://arxiv.org/abs/2609.29861">2609.29861</a></li>
  <li><strong>BudVLN</strong> (2026). Nipping the Drift in the Bud: Retrospective Rectification for Robust Vision-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2602.06356">2602.06356</a></li>
</ol>

<script>
(function () {
  var TAG_MAP = [
    { m: 'DualVLN/InternVLN', t: ['双系统', '扩散模型', '连续环境', '实机部署'] },
    { m: 'X-NavDP',               t: ['扩散模型', '强化学习', '连续环境', '实机部署'] },
    { m: 'NoMaD',             t: ['端到端', '扩散模型', '零样本', '实机部署'] },
    { m: 'ODYSSEY',           t: ['Agentic', '实机部署'] },
    { m: 'PanoNav',           t: ['Agentic', '零样本', '离散环境'] },
    { m: 'VLN-R1',            t: ['端到端', '强化学习', '连续环境'] },
    { m: 'VLFM',              t: ['SLAM', '零样本', '实机部署'] },
    { m: 'Slow4fast-VLN',     t: ['双系统', '拓扑图', '离散环境'] },
    { m: 'StreamVLN',         t: ['端到端', '加速优化', '连续环境', '实机部署'] },
    { m: 'NavFoM',            t: ['端到端', '连续环境'] },
    { m: 'DGNav',             t: ['拓扑图', 'SLAM', '连续环境'] },
    { m: 'MapNav',            t: ['拓扑图', 'SLAM', '加速优化', '连续环境'] },
    { m: 'Open-Nav',          t: ['Agentic', '零样本', '连续环境'] },
    { m: 'CausalNav',         t: ['Agentic', '拓扑图'] },
    { m: 'AgentVLN',          t: ['Agentic', '连续环境', '实机部署'] },
    { m: 'Skill-Nav',         t: ['端到端', '强化学习', '实机部署'] },
    { m: 'VLN-Cache',         t: ['加速优化'] },
    { m: 'VLN-Imagine',       t: ['数据增强', '离散环境'] },
    { m: 'R³: Run, Ruminate, and Regulate', t: ['双系统', '加速优化', 'CoT'] },
        { m: 'AwareVLN',              t: ['端到端', '连续环境', '实机部署', '数据增强', 'CoT'] },
        { m: 'Dual-Anchoring',        t: ['端到端', '世界模型', '连续环境', '实机部署'] },
        { m: 'JanusVLN',              t: ['双系统', '连续环境', '实机部署', '加速优化'] },
        { m: 'HSGM',                  t: ['Agentic', '拓扑图', '零样本', '连续环境', 'BEV'] },
        { m: 'OneVLA',                t: ['端到端', '扩散模型', '连续环境', '实机部署'] },
        { m: 'CA-VLN',                t: ['Agentic', '拓扑图', '离散环境'] },
        { m: 'Goal2Pixel',            t: ['端到端', '连续环境', '实机部署', '加速优化'] },
        { m: 'OmniNav',               t: ['双系统', 'Agentic', 'CoT', '扩散模型', '实机部署'] },
        { m: 'AstraNav-World',        t: ['世界模型', '扩散模型', '端到端', '连续环境', '实机部署'] },
        { m: 'Qwen-RobotNav',         t: ['Agentic', '端到端', '连续环境', '实机部署'] },
        { m: 'GA-VLN',                t: ['端到端', '连续环境', '实机部署', '加速优化', 'BEV'] },
        { m: 'SEDualVLN',             t: ['双系统', 'Agentic', '连续环境'] },
        { m: 'R2RIE-CE & IEDL',       t: ['连续环境', '数据集'] },
        { m: 'Robostral Navigate',    t: ['端到端', '强化学习', '连续环境', '加速优化'] },
        { m: 'ABot-N1',               t: ['双系统', 'CoT', '强化学习', '实机部署', '数据集'] },
        { m: 'ReflectVLN',            t: ['双系统', 'Agentic', 'CoT', '连续环境'] },
        { m: 'CorrectNav',            t: ['端到端', '连续环境', '实机部署'] },
        { m: 'TuckerNav', t: ['连续环境', '加速优化'] },
        { m: 'AgenticNav', t: ['Agentic', '零样本', '连续环境', '实机部署'] },
        { m: 'R2R',                   t: ['离散环境', '数据集'] },
        { m: 'DUET',                  t: ['拓扑图', '端到端', '离散环境'] },
        { m: 'NaVid',                 t: ['端到端', '连续环境', '实机部署', '零样本'] },
        { m: 'MemVLN',                t: ['端到端', '连续环境', '加速优化'] },
        { m: 'Image2Sim',             t: ['世界模型', '数据增强', '高斯表示', '连续环境', '实机部署', '零样本'] },
        { m: 'DecoVLN',               t: ['端到端', '连续环境', '实机部署', '加速优化', '纠错'] },
        { m: 'TAMP-Nav',              t: ['CoT', '强化学习', '连续环境', '实机部署'] },
        { m: 'LightNav-0',            t: ['端到端', '连续环境', '实机部署', '强化学习', '零样本', 'CoT', '数据集'] },
        { m: 'HarnessVLN',            t: ['Agentic', '零样本', '实机部署', '拓扑图'] },
        { m: 'GroundingVLN',          t: ['双系统', 'CoT', '强化学习', '连续环境', '实机部署', '数据集'] },
        { m: 'GPT-6-Astra',           t: ['Agentic', '零样本', '连续环境'] },
    { m: 'VLN-CE',            t: ['数据集', '连续环境', '基础工作'] },
    { m: 'VLN-PE',            t: ['数据集', '连续环境', '基础工作'] },
    { m: 'RynnBrain',         t: ['基础工作'] },
    { m: 'Uncertainty-Aware Gaussian Map for VLN', t: ['高斯表示', '拓扑图', '离散环境'] },
    { m: 'BudVLN',            t: ['端到端', '强化学习', '连续环境'] },
    { m: 'NavGPT-2',          t: ['Agentic', '拓扑图', '离散环境', 'CoT'] },
  ];

  // 另一篇文章的论文清单。两篇的 .paper-section 各自只在本页存在，
  // 所以这些条目不参与显示/隐藏，只在结果面板里作为跨页链接列出。
  // 由 vln-paper-insert/scripts/sync_remote.py 生成，勿手工编辑。
  var REMOTE_PAGE = { url: '/VLN-Papers-Extended/', label: '扩展篇' };
  var REMOTE_PAPERS = [
    { n: '1. NAVCON (2024)', a: 'navcon', t: ['数据集', '连续环境', '离散环境'] },
    { n: '2. LoGoPlanner (2025)', a: 'logoplanner', t: ['端到端', '扩散模型', '连续环境', '实机部署'] },
    { n: '3. VL-Nav (2025)', a: 'vl-nav', t: ['端到端', '零样本', '实机部署'] },
    { n: '4. GaussNav (2025)', a: 'gaussnav', t: ['SLAM', '高斯表示'] },
    { n: '5. NavDP (2025)', a: 'navdp', t: ['端到端', '扩散模型', '连续环境', '零样本', '实机部署'] },
    { n: '6. FantasyVLN (2026)', a: 'fantasyvln', t: ['世界模型', '数据增强', '连续环境', 'CoT'] },
    { n: '7. SparseVideoNav (2026)', a: 'sparsevideonav', t: ['端到端', '扩散模型', '世界模型'] },
    { n: '8. WorldVLN (2026)', a: 'worldvln', t: ['世界模型', '强化学习', '端到端', '实机部署'] },
    { n: '9. NavWAM (2026)', a: 'navwam', t: ['世界模型', '扩散模型', '连续环境', '实机部署'] },
    { n: '10. ABot-AgentOS (2026)', a: 'abot-agentos', t: ['Agentic', '拓扑图', '实机部署'] },
    { n: '11. Agentic Embodied Control (2026)', a: 'agentic-embodied-control', t: ['Agentic', '零样本', '连续环境', '实机部署'] },
    { n: '12. Route2Step (2026)', a: 'route2step', t: ['双系统', '连续环境', '实机部署'] },
    { n: '13. HumanoidVLN (2026)', a: 'humanoidvln', t: ['数据集', '强化学习', '实机部署', '高斯表示'] },
    { n: '14. CONDVLN (2026)', a: 'condvln', t: ['数据集', '连续环境', '拓扑图'] },
    { n: '15. ReMEmbR (2024)', a: 'remembr', t: ['Agentic', '实机部署', '数据集', '连续环境'] },
    { n: '16. SuperMap (2026)', a: 'supermap', t: ['SLAM', '拓扑图', '零样本', '实机部署', 'Agentic'] },
    { n: '17. GSMem (2026)', a: 'gsmem', t: ['Agentic', '高斯表示', '零样本'] },
    { n: '18. PROSPECT (2026)', a: 'prospect', t: ['端到端', '世界模型', '连续环境', '实机部署'] },
    { n: '19. Qwen-Drive (2026)', a: 'qwen-drive', t: ['端到端', '扩散模型', '强化学习', '连续环境'] },
    { n: '20. CGFM-Nav (2026)', a: 'cgfm-nav', t: ['拓扑图', 'Agentic', '零样本'] },
    { n: '21. CanonNav (2026)', a: 'canonnav', t: ['扩散模型', '连续环境', '实机部署'] },
    { n: '22. LookStep (2026)', a: 'lookstep', t: ['端到端', '连续环境', '加速优化', '实机部署'] },
    { n: '23. MacroAction-VLN (2026)', a: 'macroaction-vln', t: ['拓扑图', '强化学习', '连续环境'] },
    { n: '24. NavMCP (2026)', a: 'navmcp', t: ['Agentic', '零样本', '实机部署', '连续环境'] },
    { n: '25. OccPlanner (2026)', a: 'occplanner', t: ['扩散模型', '端到端', '数据增强', '连续环境'] },
    { n: '26. Harness Robotic OS (2026)', a: 'harness-robotic-os', t: ['Agentic', '实机部署', 'SLAM'] },
    { n: '27. EgoPathBench (2026)', a: 'egopathbench', t: ['数据集', '零样本', 'CoT', '连续环境'] },
    { n: '28. AdaGeoVLN (2026)', a: 'adageovln', t: ['端到端', '连续环境', '实机部署', '加速优化'] },
    { n: '29. VLingNav (2026)', a: 'vlingnav', t: ['双系统', '连续环境', 'CoT'] },
    { n: '30. Hydra-Nav (2026)', a: 'hydra-nav', t: ['双系统', '强化学习'] },
    { n: '31. 3DGSNav (2026)', a: 'nav-3dgs', t: ['SLAM', '高斯表示', '零样本', '实机部署'] },
    { n: '32. SysNav (2026)', a: 'sysnav', t: ['Agentic', '拓扑图'] },
    { n: '33. WAM-Nav (2026)', a: 'wam-nav', t: ['世界模型', '扩散模型', '零样本', '实机部署'] },
    { n: '34. EvoMemNav (2026)', a: 'evomemnav', t: ['Agentic', '拓扑图', '零样本'] },
    { n: '35. LocalNav (2026)', a: 'localnav', t: ['拓扑图', '强化学习', '实机部署', '加速优化'] },
    { n: '36. AECNav (2026)', a: 'aecnav', t: ['零样本', 'Agentic', '实机部署', '加速优化'] },
  ];

  var ALL_TAGS = ['双系统', '端到端', 'Agentic', 'CoT', '扩散模型', '拓扑图', 'SLAM', '高斯表示',
                  '强化学习', '零样本', '世界模型', '数据增强',
                  '连续环境', '离散环境', '实机部署', '加速优化', '数据集', '基础工作', 'BEV'];

  var activeTags = [];
  var resultsPanel = null;

  function getTagsForTitle(text) {
    for (var i = 0; i < TAG_MAP.length; i++) {
      if (text.indexOf(TAG_MAP[i].m) !== -1) return TAG_MAP[i].t;
    }
    return null;
  }

  function toggleTag(tag) {
    var idx = activeTags.indexOf(tag);
    if (idx === -1) activeTags.push(tag);
    else activeTags.splice(idx, 1);
    updateFilter();
  }

  // AND logic: paper must have ALL selected tags
  function sectionMatches(sectionTags) {
    return activeTags.every(function (t) {
      return sectionTags.indexOf(t) !== -1;
    });
  }

  function updateFilter() {
    var sections = document.querySelectorAll('.paper-section');
    var bar = document.getElementById('paper-filter-bar');
    var matchedSections = [];

    // Update button active states
    bar.querySelectorAll('.filter-btn').forEach(function (btn) {
      var t = btn.getAttribute('data-tag');
      if (t === '__all__') {
        btn.classList.toggle('active', activeTags.length === 0);
      } else {
        btn.classList.toggle('active', activeTags.indexOf(t) !== -1);
      }
    });

    // Show/hide sections (AND logic)
    sections.forEach(function (s) {
      var sectionTags = s.getAttribute('data-tags').split(',');
      var visible = activeTags.length === 0 || sectionMatches(sectionTags);
      s.classList.toggle('hidden', !visible);
      if (visible) matchedSections.push(s);
    });

    // 另一篇的匹配项：只列出，不参与本页的显示/隐藏
    var matchedRemote = REMOTE_PAPERS.filter(function (p) {
      return activeTags.length === 0 || sectionMatches(p.t);
    });

    // Update count（两篇合计）
    var totalAll = sections.length + REMOTE_PAPERS.length;
    var matchedAll = matchedSections.length + matchedRemote.length;
    var countEl = bar.querySelector('.filter-count');
    if (countEl) {
      countEl.textContent = activeTags.length === 0
        ? '共 ' + totalAll + ' 篇'
        : matchedAll + ' / ' + totalAll + ' 篇';
    }

    // Update results panel
    updateResultsPanel(matchedSections, matchedRemote);
  }

  function updateResultsPanel(matchedSections, matchedRemote) {
    if (!resultsPanel) return;
    if (activeTags.length === 0) {
      resultsPanel.style.display = 'none';
      return;
    }
    resultsPanel.style.display = 'block';
    var list = resultsPanel.querySelector('.results-list');
    list.innerHTML = '';

    matchedSections.forEach(function (s) {
      var h2 = s.querySelector('h2');
      if (!h2) return;
      var li = document.createElement('li');
      var a = document.createElement('a');
      a.href = '#' + h2.id;
      // 主题会在标题末尾插一个 '#' 锚链，去掉它，否则和跨页条目显示不一致
      a.textContent = h2.textContent.trim().replace(/#$/, '').trim();
      li.appendChild(a);
      list.appendChild(li);
    });

    // 另一篇的匹配论文：跳到对应页面的锚点
    matchedRemote.forEach(function (p) {
      var li = document.createElement('li');
      li.className = 'results-remote';
      var a = document.createElement('a');
      a.href = REMOTE_PAGE.url + '#' + p.a;
      a.textContent = p.n;
      li.appendChild(a);
      var badge = document.createElement('span');
      badge.className = 'results-badge';
      badge.textContent = REMOTE_PAGE.label;
      li.appendChild(badge);
      list.appendChild(li);
    });
  }

  function buildFilterBar() {
    var bar = document.getElementById('paper-filter-bar');
    if (!bar) return;

    var label = document.createElement('span');
    label.className = 'filter-label';
    label.textContent = '筛选：';
    bar.appendChild(label);

    var allBtn = document.createElement('button');
    allBtn.className = 'filter-btn active';
    allBtn.setAttribute('data-tag', '__all__');
    allBtn.textContent = '全部';
    allBtn.addEventListener('click', function () {
      activeTags = [];
      updateFilter();
    });
    bar.appendChild(allBtn);

    ALL_TAGS.forEach(function (tag) {
      var btn = document.createElement('button');
      btn.className = 'filter-btn';
      btn.setAttribute('data-tag', tag);
      btn.textContent = tag;
      btn.addEventListener('click', function () { toggleTag(tag); });
      bar.appendChild(btn);
    });

    var count = document.createElement('span');
    count.className = 'filter-count';
    bar.appendChild(count);

    // Results panel injected right after filter bar
    resultsPanel = document.createElement('div');
    resultsPanel.className = 'paper-filter-results';
    resultsPanel.style.display = 'none';
    var rLabel = document.createElement('span');
    rLabel.className = 'results-label';
    rLabel.textContent = '匹配论文：';
    var rList = document.createElement('ul');
    rList.className = 'results-list';
    resultsPanel.appendChild(rLabel);
    resultsPanel.appendChild(rList);
    bar.insertAdjacentElement('afterend', resultsPanel);
  }

  function wrapSections() {
    var entry = document.querySelector('.entry');
    if (!entry) return;

    var children = Array.from(entry.childNodes);
    var newChildren = [];
    var wrapper = null;

    children.forEach(function (node) {
      var isEl = node.nodeType === 1;
      var tagName = isEl ? node.tagName : null;

      if (tagName === 'H1') {
        if (wrapper) { newChildren.push(wrapper); wrapper = null; }
        newChildren.push(node);
      } else if (tagName === 'H2') {
        if (wrapper) { newChildren.push(wrapper); wrapper = null; }
        // 只有「N. 论文名」形式的标题才是论文章节；排行榜等标题（如「① R2R-CE」）
        // 会子串命中 TAG_MAP 里的 'R2R'，不能被包成论文章节参与筛选
        var paperTags = /^\s*\d+\.\s/.test(node.textContent) ? getTagsForTitle(node.textContent) : null;
        if (paperTags) {
          wrapper = document.createElement('div');
          wrapper.className = 'paper-section';
          wrapper.setAttribute('data-tags', paperTags.join(','));
          wrapper.appendChild(node);
          var row = document.createElement('div');
          row.className = 'paper-tags-row';
          paperTags.forEach(function (t) {
            var span = document.createElement('span');
            span.className = 'paper-tag';
            span.textContent = t;
            span.addEventListener('click', function () { toggleTag(t); });
            row.appendChild(span);
          });
          wrapper.appendChild(row);
        } else {
          newChildren.push(node);
        }
      } else {
        if (wrapper) wrapper.appendChild(node);
        else newChildren.push(node);
      }
    });

    if (wrapper) newChildren.push(wrapper);

    while (entry.firstChild) entry.removeChild(entry.firstChild);
    newChildren.forEach(function (n) { entry.appendChild(n); });
  }

  document.addEventListener('DOMContentLoaded', function () {
    wrapSections();
    buildFilterBar();
    updateFilter();
  });
})();
</script>

<!-- 图片后台预取：打开页面时不加载任何图片（靠 loading="lazy"），
     页面 load 完成后在浏览器空闲时按文档顺序静默预取全部图片填入缓存，
     使读者滚动到任意位置时图片已就位，既不卡开头也不必等待。 -->
<script>
(function () {
  var CONCURRENCY = 3;

  function prefetchAll() {
    // 尊重"流量节省"设置与极慢网络，此时不做预取
    var conn = navigator.connection;
    if (conn && (conn.saveData || /(^|-)2g$/.test(conn.effectiveType || ''))) return;

    var nodes = document.querySelectorAll('img[loading="lazy"]');
    var urls = [], seen = {};
    for (var i = 0; i < nodes.length; i++) {
      var u = nodes[i].src;
      if (u && !seen[u]) { seen[u] = 1; urls.push(u); }
    }
    if (!urls.length) return;

    var next = 0;
    function pump() {
      if (next >= urls.length) return;
      var probe = new Image();
      probe.onload = probe.onerror = pump;   // 无论成败都继续下一张
      probe.src = urls[next++];
    }
    for (var k = 0; k < CONCURRENCY && k < urls.length; k++) pump();
  }

  function schedule() {
    if (window.requestIdleCallback) requestIdleCallback(prefetchAll, { timeout: 2000 });
    else setTimeout(prefetchAll, 500);
  }

  if (document.readyState === 'complete') schedule();
  else window.addEventListener('load', schedule);
})();
</script>

<script src="/js/leaderboard.js"></script>]]></content><author><name>Tingde Liu</name></author><category term="research" /><category term="VLN" /><category term="VLA" /><category term="Robotics" /><category term="Computer Vision" /><category term="Deep Learning" /><summary type="html"><![CDATA[本文系统梳理VLN领域的经典论文，涵盖DualVLN、StreamVLN等最新研究成果，以及Diffusion Policy等VLN项目所依赖的基础工作。]]></summary></entry><entry><title type="html">VLN 论文精读（扩展篇）</title><link href="https://garylee1210.github.io/VLN-Papers-Extended/" rel="alternate" type="text/html" title="VLN 论文精读（扩展篇）" /><published>2026-09-28T00:00:00+00:00</published><updated>2026-09-28T00:00:00+00:00</updated><id>https://garylee1210.github.io/VLN-Papers-Extended</id><content type="html" xml:base="https://garylee1210.github.io/VLN-Papers-Extended/"><![CDATA[<blockquote>
  <p>本文是 <a href="/VLN-Papers/">VLN经典论文</a> 的扩展篇。主篇收录 55 篇工作，均已发表于会议期刊或进入了指令跟随排行榜；本文收录目标导航性能排行榜与其余论文，论文以近期预印本为主，按年份正序排列。</p>
</blockquote>

<div id="paper-filter-bar" class="paper-filter-bar"></div>

<h1 id="goal-nav-leaderboard">目标导航性能排行榜</h1>

<blockquote>
  <p>⚠️ <strong>不同基准不可直接混比</strong>：目标导航只给目标（物体类别、目标图像或坐标），不给路线描述，与主篇的指令跟随 VLN 是两类任务，指令跟随的排行榜见主篇 <a href="/VLN-Papers/">性能排行榜</a>。本篇按目标形式分表，编号接主篇指令跟随的 ①–③：④ 封闭类别物体目标、⑤ 开放词汇物体目标、⑥ 图像目标、⑦ 点目标、⑧ 多模态目标与自建基准。表内再按基准分组，组间以粗线分隔，各组的场景、类别与成功判定不同（HM3D v1 与 v2 也不同），SR 只在组内比较；ObjectNav 类基准不定义 NE / OSR。</p>

  <p><strong>读表</strong>：「范式」列中，<strong>训练</strong>指在导航数据上训练或微调过模型；<strong>免训练</strong>指不训练任何导航模型，由现成的大模型、检测分割模型与规则 / 规划模块组合而成（调用现成的点目标低层控制器不影响归类）。灰色行是非标准口径（如只评测了验证集子集），不参与加粗；加粗为同一基准内非灰色行的最优值，只有一行的基准不加粗。筛选栏可按范式、输入配置、是否开源筛选，也可以隐藏灰色行。</p>
</blockquote>

<div id="lb-filter-bar" class="lb-filter-bar"></div>

<h2 id="-封闭类别物体目标--objectnavhm3d--mp3d--gibson">④ 封闭类别物体目标 · ObjectNav（HM3D · MP3D · Gibson）</h2>

<p>封闭类别物体导航：给出物体类别，在未见过的场景中找到任一实例并在其附近停下</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">基准</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#hydra-nav">Hydra-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center"><strong>84.8</strong></td>
      <td style="text-align: center">41.1</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#aecnav">AECNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">DeepSeek-V4-Flash</td>
      <td style="text-align: center">84.7</td>
      <td style="text-align: center"><strong>45.3</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vlingnav">VLingNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">83.0</td>
      <td style="text-align: center">40.5</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#sysnav">SysNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini-2.5-Flash</td>
      <td style="text-align: center">80.8</td>
      <td style="text-align: center">37.2</td>
      <td style="text-align: center"><a href="https://github.com/zwandering/SysNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#lightnav-0">LightNav-0 (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">77.2</td>
      <td style="text-align: center">41.5</td>
      <td style="text-align: center"><a href="https://github.com/lightorigins/LightNav-0">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#harnessvln">HarnessVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-5.6-luna</td>
      <td style="text-align: center">76.0</td>
      <td style="text-align: center">37.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">75.6</td>
      <td style="text-align: center">30.6</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#nav-3dgs">3DGSNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini 3 Pro + GLM-4.5V</td>
      <td style="text-align: center">75.0</td>
      <td style="text-align: center">44.2</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center">71.2</td>
      <td style="text-align: center">33.0</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#evomemnav">EvoMemNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v2</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Qwen-8B</td>
      <td style="text-align: center">63.8</td>
      <td style="text-align: center">39.4</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#nav-3dgs">3DGSNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v1</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini 3 Pro + GLM-4.5V</td>
      <td style="text-align: center"><strong>80.0</strong></td>
      <td style="text-align: center"><strong>51.8</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vlingnav">VLingNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v1</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">79.1</td>
      <td style="text-align: center">42.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#sysnav">SysNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v1</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini-2.5-Flash</td>
      <td style="text-align: center">63.7</td>
      <td style="text-align: center">30.5</td>
      <td style="text-align: center"><a href="https://github.com/zwandering/SysNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#evomemnav">EvoMemNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-v1</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Qwen-8B</td>
      <td style="text-align: center">59.2</td>
      <td style="text-align: center">33.6</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#vlfm">VLFM (单目)</a></td>
      <td style="text-align: center">2023</td>
      <td style="text-align: center">HM3D-v1</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">52.5</td>
      <td style="text-align: center">30.4</td>
      <td style="text-align: center"><a href="https://github.com/rai-opensource/vlfm">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#panonav">PanoNav (全景)</a> <span class="lb-flag">200 条子集</span></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">HM3D（未注明版本）</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Qwen2.5-VL + DeepSeek-V3</td>
      <td style="text-align: center">43.5</td>
      <td style="text-align: center">23.7</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#hydra-nav">Hydra-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center"><strong>64.0</strong></td>
      <td style="text-align: center"><strong>29.6</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vlingnav">VLingNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">58.9</td>
      <td style="text-align: center">26.5</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">52.2</td>
      <td style="text-align: center">16.0</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#aecnav">AECNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">DeepSeek-V4-Flash</td>
      <td style="text-align: center">51.3</td>
      <td style="text-align: center">25.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#sysnav">SysNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini-2.5-Flash</td>
      <td style="text-align: center">50.7</td>
      <td style="text-align: center">18.1</td>
      <td style="text-align: center"><a href="https://github.com/zwandering/SysNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center">48.8</td>
      <td style="text-align: center">17.7</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#nav-3dgs">3DGSNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini 3 Pro + GLM-4.5V</td>
      <td style="text-align: center">43.6</td>
      <td style="text-align: center">21.3</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#vlfm">VLFM (单目)</a></td>
      <td style="text-align: center">2023</td>
      <td style="text-align: center">MP3D</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">36.4</td>
      <td style="text-align: center">17.5</td>
      <td style="text-align: center"><a href="https://github.com/rai-opensource/vlfm">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#vlfm">VLFM (单目)</a></td>
      <td style="text-align: center">2023</td>
      <td style="text-align: center">Gibson</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">84.0</td>
      <td style="text-align: center">52.2</td>
      <td style="text-align: center"><a href="https://github.com/rai-opensource/vlfm">是</a></td>
    </tr>
  </tbody>
</table>

<p>注：HM3D-v1 为 Habitat 2022 挑战赛的 val（2000 条 / 20 场景 / 6 类），HM3D-v2 为 2023 挑战赛的 val（1000 条 / 36 场景 / 6 类），两者场景与标注不同。VLFM 原文只写 HM3D，但给出的 2000 条 / 20 场景 / 6 类与 v1 一致；Hydra-Nav 原文也未写版本，但其 Table 2 的基线 WMNav 取 72.2，与 WMNav 原文的 HM3D-v2 成绩一致，据此归入 v2；PanoNav 原文未写明版本，单列一组。PanoNav 只从 HM3D val 随机抽取 200 条评测，列为灰色。Hydra-Nav 取原文 Table 2 的 IRFT（Stage 3）结果。Qwen-RobotNav 取 arXiv v3，4B / 8B 两个尺寸分列；LightNav-0 取 arXiv v2 数字（v1 的 HM3D-v2 为 79.5 / 43.7）。</p>

<h2 id="-开放词汇物体目标--hm3d-ovon">⑤ 开放词汇物体目标 · HM3D-OVON</h2>

<p>开放词汇物体导航；除注明外均为 val-unseen，标 † 的行原文未写明划分</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#hydra-nav">Hydra-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-7B</td>
      <td style="text-align: center"><strong>66.3</strong></td>
      <td style="text-align: center"><strong>37.4</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#harnessvln">HarnessVLN (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-5.6-luna</td>
      <td style="text-align: center">59.3</td>
      <td style="text-align: center">36.6</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#omninav">OmniNav (多目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">59.2</td>
      <td style="text-align: center">33.2</td>
      <td style="text-align: center"><a href="https://github.com/amap-cvlab/OmniNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#aecnav">AECNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">DeepSeek-V4-Flash</td>
      <td style="text-align: center">57.3</td>
      <td style="text-align: center">30.5</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#sysnav">SysNav (单目)</a><sup>†</sup></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Gemini-2.5-Flash</td>
      <td style="text-align: center">54.9</td>
      <td style="text-align: center">26.1</td>
      <td style="text-align: center"><a href="https://github.com/zwandering/SysNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">53.1</td>
      <td style="text-align: center">20.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-8B</td>
      <td style="text-align: center">51.2</td>
      <td style="text-align: center">24.0</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vlingnav">VLingNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">50.1</td>
      <td style="text-align: center">24.6</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#lightnav-0">LightNav-0 (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3-VL-4B</td>
      <td style="text-align: center">47.0</td>
      <td style="text-align: center">24.2</td>
      <td style="text-align: center"><a href="https://github.com/lightorigins/LightNav-0">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#astranav-world">AstraNav-World (多目)</a><sup>†</sup></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2.5-VL-3B</td>
      <td style="text-align: center">45.7</td>
      <td style="text-align: center">28.7</td>
      <td style="text-align: center"><a href="https://github.com/amap-cvlab/AstraNav-World">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#navfom">NavFoM (多目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen2-7B</td>
      <td style="text-align: center">45.2</td>
      <td style="text-align: center">31.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#janusvln">JanusVLN (单目)</a><sup>†</sup></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Janus-Pro-7B</td>
      <td style="text-align: center">44.9</td>
      <td style="text-align: center">31.7</td>
      <td style="text-align: center"><a href="https://github.com/MIV-XJTU/JanusVLN">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#localnav">LocalNav-Claude (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Claude Sonnet 4.6</td>
      <td style="text-align: center">39.7</td>
      <td style="text-align: center">19.7</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#localnav">LocalNav-Qwen (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen3.5-4B</td>
      <td style="text-align: center">34.5</td>
      <td style="text-align: center">17.2</td>
      <td style="text-align: center">否</td>
    </tr>
  </tbody>
</table>

<p>注：† SysNav、AstraNav-World 与 JanusVLN 原文只给出一列 HM3D-OVON 结果，未写明划分；NavFoM 为四视角设定（单视角为 43.6 / 31.3）；OmniNav 为启用慢思考系统的 OmniNav*。LocalNav-Claude 是直接用 Claude Sonnet 4.6 做决策的免训练版本，LocalNav-Qwen 是用 Claude 轨迹做 SFT 蒸馏的 Qwen3.5-4B。</p>

<h2 id="-图像目标--hm3d-iin--image-goal">⑥ 图像目标 · HM3D-IIN / Image-Goal</h2>

<p>以一张图像给出目标：HM3D-IIN 为实例图像导航（给出目标物体的照片，找到同一个实例），Image-Goal 给出在目标位置拍摄的图像</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">基准</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#gaussnav">GaussNav (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">HM3D-IIN</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>72.5</strong></td>
      <td style="text-align: center"><strong>57.8</strong></td>
      <td style="text-align: center"><a href="https://github.com/XiaohanLei/GaussNav">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#vlingnav">VLingNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">HM3D-IIN</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">LLaVA-Video-7B</td>
      <td style="text-align: center">60.8</td>
      <td style="text-align: center">37.4</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#wam-nav">WAM-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">Clutter/Intern (Image-Goal)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>50.2</strong></td>
      <td style="text-align: center"><strong>48.2</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navdp">NavDP (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">Clutter/Intern (Image-Goal)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">43.4</td>
      <td style="text-align: center">41.4</td>
      <td style="text-align: center"><a href="https://github.com/InternRobotics/NavDP">是</a></td>
    </tr>
  </tbody>
</table>

<p>注：Clutter/Intern 为 ClutterScenes（Easy / Hard）与 InternScenes（Home / Commercial）四组场景的平均；WAM-Nav 与 NavDP 均为端到端扩散 / 世界模型策略，高频输出轨迹。NavDP 的行取自 WAM-Nav 原文（arXiv v2）Table 3 的基线复现，NavDP 原文未报告该基准。</p>

<h2 id="-点目标--point-goal">⑦ 点目标 · Point-Goal</h2>

<p>以相对起点的坐标给出目标，不涉及语义识别，主要考察避障与局部路径规划</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">基准</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#wam-nav">WAM-Nav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">Clutter/Intern (Point-Goal)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center"><strong>80.4</strong></td>
      <td style="text-align: center"><strong>78.0</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#navdp">NavDP (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">Clutter/Intern (Point-Goal)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">77.8</td>
      <td style="text-align: center">74.8</td>
      <td style="text-align: center"><a href="https://github.com/InternRobotics/NavDP">是</a></td>
    </tr>
  </tbody>
</table>

<p>注：Clutter/Intern 的场景构成与 NavDP 行的来源同表 ⑥。只有一篇论文报告的点目标基准（IsaacLab 40-Scenes、ABotN-PointBench）列在表 ⑧。</p>

<h2 id="-多模态目标与自建基准">⑧ 多模态目标与自建基准</h2>

<p>多模态长程目标（GOAT-Bench），以及目前只有一篇论文报告的自建基准</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: center">基准</th>
      <th style="text-align: center">范式</th>
      <th style="text-align: center">基模</th>
      <th style="text-align: center">SR ↑</th>
      <th style="text-align: center">SPL ↑</th>
      <th style="text-align: center">开源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="#gsmem">GSMem (单目)</a></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: center">GOAT-Bench</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">GPT-4o</td>
      <td style="text-align: center"><strong>67.2</strong></td>
      <td style="text-align: center"><strong>46.9</strong></td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="#evomemnav">EvoMemNav (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">GOAT-Bench</td>
      <td style="text-align: center">免训练</td>
      <td style="text-align: center">Qwen-8B</td>
      <td style="text-align: center">59.6</td>
      <td style="text-align: center">38.9</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#x-navdp">X-NavDP (单目)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">IsaacLab 40-Scenes (Point-Goal)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">–</td>
      <td style="text-align: center">84.28</td>
      <td style="text-align: center">77.19</td>
      <td style="text-align: center"><a href="https://github.com/InternRobotics/NavDP">是</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#abot-n1">ABot-N1 (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">ABotN-PointBench (Indoor)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen-3.5-4B + 2B</td>
      <td style="text-align: center">95.4</td>
      <td style="text-align: center">93.7</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#abot-n1">ABot-N1 (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">ABotN-PointBench (Outdoor)</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen-3.5-4B + 2B</td>
      <td style="text-align: center">92.9</td>
      <td style="text-align: center">91.4</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#abot-n1">ABot-N1 (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">Short-Horizon OVON</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen-3.5-4B + 2B</td>
      <td style="text-align: center">84.9</td>
      <td style="text-align: center">51.8</td>
      <td style="text-align: center">否</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="/VLN-Papers/#abot-n1">ABot-N1 (三相机)</a></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: center">ABotN-POIBench</td>
      <td style="text-align: center">训练</td>
      <td style="text-align: center">Qwen-3.5-4B + 2B</td>
      <td style="text-align: center">77.3</td>
      <td style="text-align: center">72.6</td>
      <td style="text-align: center">否</td>
    </tr>
  </tbody>
</table>

<p>注：GOAT-Bench 为 val-unseen，一个 episode 内依次给出类别、文字描述或图像形式的多个目标。IsaacLab 40-Scenes 为 X-NavDP 的点目标评测；ABotN-PointBench、Short-Horizon OVON 与 ABotN-POIBench 为 ABot-N1 的自建设定，PointBench 室内用零碰撞成功率（SR&lt;1col），室外用三次碰撞内成功率（SR&lt;3col），两者判定不同；POIBench 以到达入口 2 m 内为成功。自建基准各只有一行，不加粗，也不宜与其他表的数字比较。</p>

<h1 id="具身导航论文扩展">具身导航论文扩展</h1>

<h2 id="navcon">1. NAVCON (2024)</h2>
<p>——— 认知启发与语言落地的首个大规模 Vision-Language Navigation 概念数据集</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2412.13026">arXiv:2412.13026</a></p>

<h3 id="精华">精华</h3>

<ol>
  <li>提出了首个基于认知科学与语言学理论的视觉语言导航（VLN）概念数据集 NAVCON，包含对 R2R 和 RxR 约 30,000 条指令的 23.6 万个高层导航概念标注。</li>
  <li>定义了四种核心导航概念：定位自身（SIT）、移动路径（MOVE）、改变方向（CD）和改变区域（CR），构成了完备的导航语言原语。</li>
  <li>利用 RxR 的时间戳信息，通过 Habitat 模拟器实现了 270 万帧图像/视频片段与导航概念词组的跨模态时间对齐。</li>
  <li>基于该语料库微调的轻量级序列标注模型 NCC，达到了 96.53% 的概念和文本跨度预测准确率，展现出极强的泛化与落地潜力。</li>
  <li>这一工作为打破 VLN 端到端黑盒设计提供了结构化的语义解析工具，有助于提高跨模态对齐的可解释性与实时运行效率。</li>
</ol>

<hr />

<h3 id="1-研究背景问题">1. 研究背景/问题</h3>

<p>传统的视觉语言导航（VLN）模型多采用黑盒端到端架构，存在视觉与文本 token 对齐不平衡、缺乏可解释性等问题。此外，现有的句法解析方法过于依赖外部嘈杂的依存句法分析器，导致在下游机器人导航任务中泛化性能差、可解释性低。因此，如何定义完备的导航概念并实现低成本、高精度的细粒度文本-视频对齐，是实现可信、透明且高效的具身智能体导航的关键瓶颈。</p>

<hr />

<h3 id="2-主要方法创新点">2. 主要方法/创新点</h3>

<p>NAVCON 提出了一套完整的视觉-语言导航概念自动化构建与标注流水线，实现了自然语言指令到核心导航概念（标签 + 文本跨度）以及视频片段的端到端对齐。</p>

<div align="center">
  <img src="/images/vln/NAVCON-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1262/299" />
<figcaption>NAVCON 导航概念和视频剪辑生成的处理步骤总览</figcaption>
</div>

<h4 id="-整体框架概述">① 整体框架概述</h4>
<p>整个构建框架由<strong>导航概念定义</strong>、<strong>语言概念提取与人工评估</strong>以及<strong>视频剪辑对齐与时序窗口微调</strong>三个核心阶段组成。它通过自然语言处理管线提取指令中的动作谓词及修饰词组，并与 Habitat 模拟器导出的智能体第一视角视频流进行多模态时序关联。</p>

<h4 id="-逐模块讲解">② 逐模块讲解</h4>
<ul>
  <li><strong>导航概念定义模块</strong>：
    <ul>
      <li><strong>输入</strong>：无标注的导航指令文本。</li>
      <li><strong>处理</strong>：基于动物与人类大脑空间建图的认知科学研究（如海马区位置细胞、边缘系统头部方向细胞、内嗅皮层边界细胞和自主运动系统），系统定义了四种核心导航概念：
        <ul>
          <li><strong>定位自身（Situate Yourself, SIT）</strong>：标识当前所处的位置与环境特征（如 “standing in front of that pillar”）。</li>
          <li><strong>移动路径（Move along a Path, MOVE）</strong>：表示沿特定物理通道的位移（如 “step into this area with a large pool”）。</li>
          <li><strong>改变方向（Change Direction, CD）</strong>：描述朝向的转动（如 “turn around from the bench”）。</li>
          <li><strong>改变区域（Change Region, CR）</strong>：刻画越过物理边界进入新空间的动作（如 “enter the room that is in front of you”）。</li>
        </ul>
      </li>
      <li><strong>输出</strong>：导航概念的分类体系。</li>
      <li><strong>设计动机</strong>：提供符合认知科学、且覆盖主流 VLN 指令所需的完备导航语言原语。</li>
    </ul>
  </li>
  <li><strong>语言概念提取管线</strong>：
    <ul>
      <li><strong>输入</strong>：来自 R2R 和 RxR 数据集的 30,815 条训练指令。</li>
      <li><strong>处理</strong>：利用 Stanza constituency parser 等 NLP 工具进行分词、词干化、词性标注与句法分析。首先检索出 348 个候选根动词，通过人工筛选保留 81 个无歧义映射到上述四大概念的导航根动词；然后提取这 81 个根动词的所有句法子节点，形成代表导航概念的完整谓词短语。</li>
      <li><strong>输出</strong>：236,316 个自动生成的“银标（silver）”导航概念短语标注（包含概念类别与对应的文本跨度）。</li>
      <li><strong>设计动机</strong>：降低人工标注的成本，同时利用 constituency trees 保证提取出的概念词组的句法完整性（包含修饰语和地标名词）。</li>
    </ul>
  </li>
  <li><strong>视频剪辑对齐与微调模块</strong>：
    <ul>
      <li><strong>输入</strong>：带有单词级时间戳的 RxR 导航指令、 Matterport 3D 场景以及智能体运动轨迹姿态（pose traces）。</li>
      <li><strong>处理</strong>：利用 Habitat 模拟器以 10 倍下采样率渲染智能体视角图像（320x240 像素），提取了 760 万帧图像。通过 RxR 词级时间戳，将提取的语言概念短语在时序上投影到对应的智能体运动视频剪辑中。针对 RxR 部分单词时间戳不准导致动作未开始或已结束的对齐偏移问题，引入了时序窗口微调策略：将每个剪辑的提取时间窗口向后延伸视频总长度的 5%。</li>
      <li><strong>输出</strong>：270 万帧已实现概念-视频对齐的图像数据，覆盖 19,074 条指令。</li>
      <li><strong>设计动机</strong>：解决跨模态细粒度对齐的时间错位问题，提供大规模的高质量视频-语言导航原语对齐数据。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/NAVCON-concept-clip-alignment.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1174/931" />
<figcaption>NAVCON 概念与视频剪辑对齐示例（时间从左至右推移）</figcaption>
</div>

<h4 id="-训练目标与分类器">③ 训练目标与分类器</h4>
<p>基于生成的银标数据集，论文训练了一个<strong>导航概念分类器 (Navigation Concept Classifier, NCC)</strong>。模型基于轻量级的 <code class="language-plaintext highlighter-rouge">distilbert-base-uncased</code>，在输入端接收分词后的指令，在输出端使用 BIO 格式进行 Token 级别分类（共 5 类：SIT、MOVE、CD、CR 的 B/I 标记，以及 O 外部词）。训练采用标准的交叉熵损失函数进行序列标注：
\(\mathcal{L} = -\sum_{i=1}^{N} \sum_{j=1}^{C} y_{i,j} \log p_{i,j}\)
其中 $N$ 为序列长度，$C$ 为分类类别数（$C=9$，包括 B- 和 I- 标记及 O），$y_{i,j}$ 为真实标签，$p_{i,j}$ 为预测概率。</p>

<hr />

<h3 id="3-核心结果发现">3. 核心结果/发现</h3>

<ul>
  <li><strong>数据集特征</strong>：NAVCON 概念分布中，MOVE（移动路径）占比最大，达 42%；SIT（定位自身）占 28%；CD（改变方向）占 22%；CR（改变区域）占 9%。</li>
</ul>

<div align="center">
  <img src="/images/vln/NAVCON-concept-distribution.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/650" />
<figcaption>NAVCON 数据集中导航概念的分布统计情况</figcaption>
</div>

<ul>
  <li><strong>标注质量评估</strong>：人工评估表明，银标概念分类正确率达 95.82%，对应的文本跨度覆盖正确率达 95.49%，漏检率低于 4%。在引入时序窗口延伸 5% 后，视频剪辑的精确对齐率从 73.63% 大幅提升至 88.62%。</li>
  <li><strong>NCC 分类器表现</strong>：NCC 分类器在 unseen 测试集上表现极佳，实现概念类别与文本跨度 100% 完美匹配（Exact Match）的比例高达 96.53%。</li>
  <li><strong>LLM 少样本泛化能力</strong>：使用 GPT-4o 进行 3-shot 上下文学习（In-Context Learning）进行概念提取，在 unseen 数据上实现了 82.12% 的 Exact Match，说明该导航概念对 LLM 具有高度的可学习性与泛化性。</li>
</ul>

<hr />

<h3 id="4-局限性">4. 局限性</h3>

<ol>
  <li><strong>解析器依赖性</strong>：对语言概念的提取极度依赖 Stanza constituency parser 的句法解析准确率，句法树错误会直接导致概念跨度提取不完整。</li>
  <li><strong>多模态对齐误差</strong>：视频-文本对齐质量受限于原始 RxR 数据集 word-timestamp 标注的准确性，尽管采用了窗口延展，仍有约 11% 的视频片段对齐不完整。</li>
</ol>

<hr />

<h2 id="logoplanner">2. LoGoPlanner (2025)</h2>
<p>——定位接地的端到端导航策略：把度量尺度的视觉几何”植入”规划</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2512.19629">arXiv:2512.19629</a> · 🏛️ <strong>ICRA 2026</strong></p>

<p><strong>研究背景/问题</strong></p>

<p>现有”端到端”导航虽把感知、建图、规划合并，<strong>却仍依赖独立的定位模块（SLAM / 视觉里程计）做自状态估计</strong>，而定位模块需要精确的相机-底盘外参标定，泛化性差、在足式机器人抖动场景尤其不稳定。根因在于这些规划器大多只处理单帧或短片段，缺乏对长时序历史的总结能力，短期估计会随时间累积漂移；单帧感知也缺乏稳健度量推理所需的几何记忆，重建往往是局部或尺度模糊的。本文目标：仅用 RGB-D 观测，实现<strong>无需任何外部定位模块</strong>的点目标（point-goal）导航。</p>

<div align="center">
  <img src="/images/robotics_navigation/LoGoPlanner-paradigm-comparison.webp" width="55%" loading="lazy" decoding="async" style="aspect-ratio:697/831" />
<figcaption>三种规划范式对比：(a) 传统模块化逐模块分解引入级联误差；(b) 现有端到端仍依赖显式定位模块；(c) LoGoPlanner 把隐式状态估计与度量感知几何整合进策略，实现完全端到端规划。</figcaption>
</div>

<p><strong>主要方法/创新点</strong></p>

<p>LoGoPlanner 在一个统一网络里端到端协同三大部分：<strong>(A) 度量感知视觉几何学习</strong>——以预训练视频几何骨干 VGGT 为底，注入深度尺度先验，通过局部点 / 相机位姿两个 auxiliary head 产生世界点嵌入；<strong>(B) 定位接地的导航策略</strong>——解耦相机与底盘位姿，用 state query / geometric query 通过 cross-attention 把隐式状态与几何聚合成统一规划上下文；<strong>(C) Diffusion 策略头</strong>——以规划上下文为条件对噪声动作迭代去噪，输出无碰撞轨迹。整条链路把”定位”和”建图”从显式模块降格为网络内部的隐式特征，规划误差是唯一最终优化目标。</p>

<div align="center">
  <img src="/images/robotics_navigation/LoGoPlanner-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/678" />
<figcaption>整体架构：ViT 对图像 patch 注入尺度先验后送入视频几何骨干，微调出度量尺度预测；query-based 设计让自状态与环境几何分别由 state/geometric query 隐式聚合；末端挂一个被 detach 的 diffusion 策略头生成可行、无碰撞轨迹。</figcaption>
</div>

<ol>
  <li>
    <p><strong>度量尺度注入（Metric-aware Geometry）</strong>：VGGT 原生只给相对尺度重建，无法对齐规划轨迹。作者用一个轻量 ViT 把深度图编码成几何 token，在 patch 级与语义 token 融合，经带 RoPE 的 transformer decoder 得到带度量尺度的逐帧特征：</p>

\[t_i^{metric} = \text{Attention}_{\text{RoPE}}((t_i^I, t_i^D), pos)\]

    <p>再分支到<strong>局部点 head</strong>（由针孔模型监督相机系 3D 点）与<strong>相机位姿 head</strong>（解码相机到世界变换，世界系定义在最后一帧底盘系）。两个 head 的中间特征拼接后经 context fusion 与点云解码器，输出<strong>以机器人当前位置为原点的稠密度量尺度点云</strong>，覆盖被遮挡与后视区域。</p>
  </li>
  <li>
    <p><strong>相机/底盘外参解耦</strong>：感知绑定相机视角、控制执行在底盘坐标系。把相机位姿与底盘位姿拆成两个独立预测任务，假设相机相对底盘无 yaw 旋转，由位姿特征额外预测底盘位姿与当前帧相对目标，相机位姿经固定外参 \(T_{b,i}=T_{c,i}\cdot T_{ext}\) 换算。训练时在任意相机高度（0.25–1.25 m）与俯仰角（0°–30°）下构造数据，赋予跨本体鲁棒性。</p>
  </li>
  <li>
    <p><strong>Query-based 隐式聚合（借鉴 UniAD）</strong>：state query 从位姿 token 抽自状态、geometric query 从世界点 token 抽环境几何，与目标 embedding 拼接送 transformer decoder 得规划上下文 query \(Q_P\)。<strong>关键</strong>：不把上游预测的外参/点云显式喂下游，避免级联误差，最终优化目标始终是轨迹规划误差。</p>
  </li>
  <li>
    <p><strong>Diffusion 策略头</strong>：以 \(Q_P\) 为条件，从高斯噪声对动作块 \(\{(\Delta x_t,\Delta y_t,\Delta\theta_t)\}\) 迭代去噪，生成可行、无碰撞轨迹。</p>
  </li>
</ol>

<p>训练采用<strong>两阶段</strong>：阶段一微调几何模型 decoder 与 task head（注入深度尺度先验，监督度量点云与外参）；阶段二冻结骨干 decoder，联合训练 diffusion head 与 task head。</p>

<p><strong>核心结果/发现</strong></p>

<ul>
  <li><strong>仿真（InternScenes 40 个未见场景）</strong>：在<strong>完全无外部定位</strong>条件下，Home SR 57.3 / SPL 52.4、Commercial SR 67.1 / SPL 63.9，<strong>超过使用 oracle 定位的 ViPlanner</strong>——相对 ViPlanner，Home SR 提升 27.3 个百分点、SPL 提升 21.3%。</li>
  <li><strong>真实世界（3 平台 × 各 20 条轨迹，免 VO/SLAM 直接部署）</strong>：TurtleBot（办公）SR 85% (17/20)、Unitree Go2（家居）70% (14/20)、Unitree G1（工业）50% (10/20)，全面优于 iPlanner（10/15/0%）与 ViPlanner（50/45/0%）；四足平台相机抖动下仍能准确自定位并避障。</li>
</ul>

<div align="center">
  <img src="/images/robotics_navigation/LoGoPlanner-realworld.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/907" />
<figcaption>办公 / 家居 / 工业三类真实场景、不同机器人平台上的可视化。绿色曲线为规划轨迹，蓝色与灰色点云分别为当前帧与上一帧的障碍物。</figcaption>
</div>

<ul>
  <li><strong>消融（关键模块）</strong>：Odometry / Goal / Point Cloud 三个 auxiliary task 逐项叠加，Home SR 从纯端到端的 49.5 提升到 51.3 → 52.4 → 57.3，证明点云监督带来超出 2D 语义的空间关系、显著提升避障。</li>
  <li><strong>消融（几何骨干）</strong>：DepthAnything（单帧）→ Video DepthAnything → VGGT†（无度量尺度）→ VGGT（注入尺度先验）逐级提升；注入尺度先验后 PE 从 0.87 降到 0.55（Home），说明<strong>度量尺度监督对真实部署是必需的</strong>。</li>
</ul>

<div align="center">
  <img src="/images/robotics_navigation/LoGoPlanner-reconstruction.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/594" />
<figcaption>重建结果可视化：第一行为真值场景点云，第二行为预测点云；点云以最后一帧底盘为坐标原点、按度量尺度预测。</figcaption>
</div>

<p><strong>关键创新：</strong></p>
<ol>
  <li><strong>把”定位”吸收进网络</strong>：用长时序视觉几何骨干做隐式自状态估计，免标定、免外部 SLAM/VO，跨本体跨视角直接部署。</li>
  <li><strong>相对尺度→绝对度量尺度</strong>：注入深度先验校正 VGGT 的尺度模糊，得到可对齐规划坐标系的稠密点云。</li>
  <li><strong>隐式特征条件化而非显式传递</strong>：用 auxiliary task 把几何/位姿能力蒸馏成隐式特征供 diffusion 头条件化，切断级联误差，以规划误差为唯一优化目标。</li>
</ol>

<p><strong>局限性</strong></p>

<p>受限于可用导航场景数量较少（约 2k），真实环境下的重建质量仍不理想；作者正在度量尺度的真实世界数据集上继续训练，以提升实际部署性能。</p>

<hr />

<h2 id="vl-nav">3. VL-Nav (2025)</h2>
<p>——实时零样本 Vision-Language 导航系统，融合像素级视觉-语言特征与启发式空间推理</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2502.00931">arXiv:2502.00931</a> · 🏛️ <strong>IROS 2026</strong></p>

<p><strong>精华</strong></p>

<p>这篇论文展示了如何将像素级 vision-language 特征与启发式探索策略结合，实现高效的零样本导航。值得借鉴的核心思想包括：(1) 使用 Gaussian 混合模型将像素级 VL 特征转换为空间分布，而非依赖单一图像级相似度分数；(2) 引入 instance-based target points 模拟人类搜索行为，允许机器人接近并验证潜在目标；(3) 通过 rolling occupancy grid 和 partial frontier detection 优化计算开销，使系统能在低功耗平台上实时运行；(4) 结合 distance weighting 和 unknown-area heuristic 避免反复移动，提升大规模环境中的导航效率；(5) 证明了模块化方法在真实世界中的泛化能力优于端到端学习方法。</p>

<p><strong>研究背景/问题</strong></p>

<p>当前的 vision-language navigation 系统面临三大挑战：难以解释像素级 vision-language 特征、在不同环境中泛化能力差、无法在低功耗平台上实时运行。现有方法如 VLFM 依赖计算密集型模型且仅使用单一图像级相似度分数进行目标选择，限制了其利用细粒度 vision-language 线索的能力。</p>

<p><strong>主要方法/创新点</strong></p>

<div align="center">
  <img src="/images/vln/VL-Nav-system-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/836" />
<figcaption>
VL-Nav 系统架构总览：整合了 VL 模块、地图模块和 HVL 空间推理
</figcaption>
</div>

<p>VL-Nav 提出了一个针对低功耗机器人优化的 vision-language navigation 框架，在 Jetson Orin NX 上实现 30 Hz 实时性能。核心创新在于 <strong>Heuristic-Vision-Language (HVL) 空间推理</strong>，将像素级 vision-language 特征与启发式探索策略相结合。</p>

<p><strong>Rolling Occupancy Map</strong>：系统维护一个动态 2D 占用栅格地图，每个单元格标记为 free (0)、unknown (-1) 或 occupied (100)。与传统固定大小全局栅格不同，VL-Nav 采用 rolling grid，仅在新传感器数据需要时动态扩展，降低内存使用和 BFS/cluster 计算开销。更新过程包括：(1) 根据需要扩展地图；(2) 清除前向 FOV 内的过时障碍物；(3) 膨胀新障碍物；(4) 使用 raycasting 将 unknown cells 标记为 free。</p>

<p><strong>Frontier-based 与 Instance-based Target Points</strong>：系统生成两类候选目标点。Frontier-based points 通过 partial frontier detection 在前向楔形区域内识别，仅测试满足角度和距离约束的单元格，并使用 BFS 聚类。Instance-based target points (IBTP) 来自 vision-language 检测器周期性报告的候选实例中心，保留置信度高于阈值 τdet 的检测结果。IBTP 模拟人类搜索行为：看到可能匹配的目标时会靠近确认，而非忽略中间检测结果。</p>

<div align="center">
  <img src="/images/vln/VL-Nav-spatial-reasoning.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/576" />
<figcaption>
VL Scoring 示意图：像素级开放词汇检测结果通过 Gaussian 混合模型和 FOV 加权转换为空间分布
</figcaption>
</div>

<p><strong>HVL 空间推理</strong>：这是 VL-Nav 的核心创新。对每个候选目标 g，系统计算 HVL score。VL Score 使用 Gaussian 混合模型将像素级 vision-language 特征转换为机器人水平 FOV 上的分布。假设开放词汇检测模型识别出 K 个可能方向，每个由 (μk, σk, αk) 参数化，其中 μk 表示 FOV 内的平均偏移角度，σk 编码检测的角度不确定性（固定为 0.1），αk 是基于置信度的权重。VL score 计算为：</p>

<p>S_VL(g) = Σ(k=1 to K) αk * exp(-1/2 * ((Δθ - μk)/σk)²) * C(Δθ)</p>

<p>其中 C(Δθ) = cos²(Δθ/(θ_fov/2) * π/2) 是视野置信度项，降低大角度偏移检测的权重。</p>

<p>Heuristic Cues 包括两个启发式项：(1) Distance Weighting: S_dist(g) = 1/(1+d(xr,g))，使较近目标获得更高分数，减少能量消耗和不必要的徘徊；(2) Unknown-Area Weighting: S_unknown(g) = 1 - exp(-k*ratio(g))，其中 ratio(g) 是局部 BFS 中 unknown cells 与可达 cells 的比率，鼓励探索可能揭示大量未知空间的目标。</p>

<p>最终 HVL score 为：S_HVL(g) = w_dist * S_dist(g) + w_VL * S_VL(g) * S_unknown(g)。系统优先选择 instance-based goals（基于 VL score），若无则选择得分最高的 frontier goal（基于 HVL score）。</p>

<p><strong>Path Planning</strong>：选定 HVL goal 后，系统使用 FAR Planner 进行 point-goal 路径规划，以多边形表示障碍物并实时更新可见性图，支持部分未知环境中的高效重规划。局部规划器将 FAR Planner 的路径点细化为短时域速度命令，确保对新障碍物的快速反应。</p>
<div align="center">
  <img src="/images/vln/VL-Nav-experiment-environments.webp" width="50%" loading="lazy" decoding="async" style="aspect-ratio:715/1025" />
<figcaption>
四种不同规模和语义复杂度的真实世界实验环境
</figcaption>
</div>

<p><strong>核心结果/发现</strong></p>

<div align="center">
  <img src="/images/vln/VL-Nav-trajectory-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1430/372" />
<figcaption>
不同环境中的轨迹对比和检测结果，展示 VL-Nav 相比 Classical 和 VLFM 方法的优势
</figcaption>
</div>

<p>VL-Nav 在四个真实世界环境（Hallway、Office、Apartment、Outdoor）上进行了全面评估，每个环境具有不同的语义复杂度（High、Medium、Low）和规模（Big、Mid、Small）。主要发现包括：</p>

<ul>
  <li><strong>整体性能</strong>：VL-Nav 达到 86.3% 的总体成功率 (SR)，比先前方法提升 44.15%。在所有四个环境中，VL-Nav 的 SR 和 SPL（Success weighted by Path Length）均为最高。</li>
  <li><strong>Instance-based Target Points 的影响</strong>：去除 IBTP 后性能显著下降，特别是在复杂环境（Apartment 和 Office）中，证明了允许机器人接近并验证潜在检测结果的重要性。</li>
  <li><strong>Heuristics 的贡献</strong>：去除启发式项后 SR 和 SPL 均下降，特别是在大规模环境中，表明 distance weighting 和 unknown-area heuristic 对提升效率至关重要。</li>
  <li><strong>相比 VLFM</strong>：VL-Nav 在所有环境中均超越 VLFM，特别是在语义复杂（Apartment）和开放区域（Outdoor）环境中，优势更加明显，证明了像素级 VL 特征和 HVL 空间推理的有效性。</li>
  <li><strong>环境规模影响</strong>：经典 Frontier Exploration 在大规模环境中性能急剧下降（Big 环境中 SR 仅 36.7%），而 VL-Nav 保持鲁棒（82.3% SR），证明了其在各种规模环境中的适应能力。</li>
  <li><strong>语义复杂度影响</strong>：所有方法在语义更丰富的环境中表现更好，因为结构化室内空间提供了更强的检测和分割线索。VL-Nav 能够充分利用语义上下文，在高复杂度环境中获得更显著的优势。</li>
  <li><strong>实时性能</strong>：VL-Nav 在 Jetson Orin NX 上以 30 Hz 运行，通过选择高效的 YOLO-World 模型变体（256×320 输入，标准 GPU runtime）和 rolling occupancy grid 实现了真实世界部署的可行性。</li>
</ul>

<p><strong>局限性</strong></p>

<p>系统在处理包含隐藏对象引用和特定文本注释的复杂语言描述时存在困难。此外，系统依赖于手动定义的阈值（如光照条件等），这些阈值可能无法在不同环境和场景中很好地泛化，需要进一步研究自适应或基于学习的阈值调整方法。</p>

<hr />

<h2 id="gaussnav">4. GaussNav (2025)</h2>
<p>——Gaussian Splatting for Visual Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2403.11625">arXiv:2403.11625</a> · 🏛️ <strong>IEEE TPAMI 2025</strong></p>

<p><strong>研究背景/问题</strong></p>

<p>Instance ImageGoal Navigation (IIN)要求智能体在未探索环境中定位并导航至目标图像所描绘的特定对象实例，需要跨视角识别目标对象同时忽略干扰物。现有基于BEV地图的导航方法缺乏详细纹理表示，难以胜任实例级任务，无法保留场景的实例感知特征，不足以区分同类别的多个对象。</p>

<p><strong>主要方法/创新点</strong></p>

<p>GaussNav首次将3D Gaussian Splatting（3DGS）引入具身视觉导航，提出语义高斯地图表示：</p>

<div align="center">
  <img src="/images/vln/gaussnav-framework-overview.webp" width="60%" loading="lazy" decoding="async" style="aspect-ratio:918/937" />
<figcaption>
GaussNav整体框架：前沿探索→语义高斯构建→高斯导航
</figcaption>
</div>

<p><strong>前沿探索（Frontier Exploration）：</strong></p>
<ul>
  <li>智能体同时维护探索地图和障碍地图，探索地图标记已探索区域，障碍地图标记场景中的障碍物</li>
  <li>检测探索地图轮廓并排除障碍地图区域，将最近的前沿点设为路径点，迭代覆盖整个环境</li>
</ul>

<p><strong>语义高斯构建（Semantic Gaussian Construction）：</strong></p>

<p><em>几何重建：</em></p>
<ul>
  <li><strong>3DGS简化表示</strong>：每个高斯由9个参数特征化：RGB颜色向量c、质心µ∈R³、半径r、不透明度o∈[0,1]、类别标签l</li>
  <li><strong>可微渲染</strong>：通过alpha合成渲染RGB、深度和轮廓图像，支持新视角合成（NVS）</li>
  <li><strong>关键帧检索机制</strong>：针对导航场景帧间重叠有限问题，存储历史帧并周期性渲染评估PSNR，优先优化低保真帧，采用两阶段优化（p1=30迭代新视点，p2=60迭代关键帧视点）</li>
</ul>

<div align="center">
  <img src="/images/vln/gaussnav-semantic-gaussian-construction.webp" width="60%" loading="lazy" decoding="async" style="aspect-ratio:817/1138" />
<figcaption>
语义高斯构建流程：高斯密集化与语义高斯更新交替进行
</figcaption>
</div>

<p><em>语义特征注入：</em></p>
<ul>
  <li><strong>实例分割</strong>：使用Mask-RCNN为每个高斯分配语义标签</li>
  <li><strong>特征优化</strong>：通过特征splatting渲染逐像素语义特征，优化特征损失以鼓励实例内一致性和实例间可分性</li>
  <li><strong>高斯聚类</strong>：基于语义标签和3D位置聚类高斯，将场景中的对象分割为不同语义类别下的不同实例</li>
</ul>

<p><strong>高斯导航（Gaussian Navigation）：</strong></p>

<div align="center">
  <img src="/images/vln/gaussnav-navigation-pipeline.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:798/1035" />
<figcaption>
高斯导航流程：分类器→渲染描述性图像→匹配与定位→路径规划
</figcaption>
</div>

<ul>
  <li><strong>分类器</strong>：使用ResNet50对目标图像分类预测语义标签ˆlg，显著缩小搜索空间（如场景CrMo8WxCyVb从648个潜在观测减少到33个）</li>
  <li><strong>匹配与定位</strong>：
    <ul>
      <li>为每个候选实例通过NVS生成描述性图像（nv=1/3/5，θ=±15°/±30°水平和垂直旋转）</li>
      <li>使用DISK提取关键点和特征描述符，通过LightGlue匹配，选择匹配关键点数最多的候选对象</li>
      <li>使用DBSCAN聚类去除语义分割误差导致的离群点，精确定位目标实例</li>
    </ul>
  </li>
  <li><strong>路径规划</strong>：将语义高斯转换为点云并体素化投影到2D BEV网格，使用FMM生成最短距离场并规划路径</li>
</ul>

<p><strong>创新要点：</strong></p>
<ul>
  <li>统一几何、语义和实例感知特征的地图表示，首次将3DGS应用于具身视觉导航</li>
  <li>通过渲染描述性图像直接定位目标对象，无需额外探索或验证步骤</li>
  <li>关键帧检索机制有效缓解导航场景中的遗忘和表面空洞问题</li>
</ul>

<p><strong>核心结果/发现</strong></p>

<ul>
  <li><strong>HM3D数据集性能</strong>：SPL从0.347大幅提升至0.578（提升66.6%），成功率达72.5%，显著超越所有基线方法</li>
  <li><strong>效率优势</strong>：运行帧率超过20 FPS，在模块化方法中效率最高，搜索空间优化显著（如CrMo8WxCyVb场景从648个观测点减少至33个）</li>
  <li><strong>消融实验验证</strong>：
    <ul>
      <li>移除分类器导致Success降至37.5%，SPL降至29.1%，但使用分类器后匹配时间减少2.5倍</li>
      <li>移除匹配模块Success降至44.4%，SPL降至35.3%</li>
      <li>NVS对识别成功率有益，GT NVS可进一步提升性能（Success从72.3%升至74.7%）</li>
      <li>使用GT匹配模块Success提升至85.0%，GT目标定位Success达94.6%</li>
    </ul>
  </li>
  <li><strong>渲染质量分析</strong>：在HM3D验证集上PSNR最高可达40，深度渲染误差接近零，但部分高纹理场景重建质量欠佳</li>
  <li><strong>跨场景泛化</strong>：在36个验证场景中表现稳定，语义高斯可视化展示了对多种场景复杂度和对象组成的鲁棒性</li>
</ul>

<p><strong>局限性</strong></p>

<p>当前方法在高纹理环境中重建质量欠佳，导致NVS可能产生孔洞等伪影。错误源分析显示匹配失败和目标定位不准确仍有改进空间。语义高斯不适合直接路径规划，需转换为2D BEV网格，增加了计算开销。</p>

<hr />

<h2 id="navdp">5. NavDP (2025)</h2>
<p>——只用仿真数据训练，零样本迁移到真实机器人的导航扩散策略</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2505.08712">arXiv:2505.08712</a> · 🏛️ <strong>ICRA 2026</strong> · <a href="https://github.com/InternRobotics/NavDP">Code</a></p>

<blockquote>
  <p>一句话概括：NavDP 用<strong>纯仿真数据</strong>训练一个端到端导航网络，靠”<strong>扩散模型生成多条候选轨迹 + Critic 打分选最安全的一条</strong>“这一组合，做到<strong>零样本 sim-to-real</strong>、并能直接换装到 TurtleBot / Unitree Go2 / G1 / Galaxea R1 等不同形态的机器人上，全程不需要地图、不需要任何真机训练数据。</p>
</blockquote>

<p><strong>研究背景/问题</strong></p>

<p>机器人要在动态、非结构化的开放世界里导航，理想状态是”换个机器人、换个场景都能直接用”。但现有两条路线都有硬伤：</p>

<ul>
  <li><strong>传统模块化方法</strong>（感知 → 建图 → 定位 → 规划）：系统延迟大、模块间误差层层累积，且要反复手调超参数；</li>
  <li><strong>学习型方法</strong>：受限于真实数据稀缺。靠真机遥操作采数据又慢又贵，难以 scale up。</li>
</ul>

<p>NavDP（上海 AI Lab）的破题思路是<strong>全面拥抱仿真数据</strong>——仿真场景可以无限生成、自带”上帝视角”的特权信息（全局最优路径、全局 ESDF 距离场）。导航任务的物理交互远少于机械臂操作（manipulation），sim-to-real gap 本就更小，配合域随机化与高真实感渲染就能进一步弥合。问题随之变成两点：(1) 如何把仿真里的特权信息有效”蒸馏”进策略？(2) 如何保证策略在没见过的真实场景里<strong>安全</strong>？NavDP 的答案分别是<strong>模仿学习生成轨迹</strong>和<strong>对比式 Critic 评估轨迹</strong>。</p>

<p><strong>NavDP 在双系统框架中的定位</strong>：NavDP 扮演快慢双系统（Fast-Slow System）里的 <strong>System 1</strong>——负责高频、实时的局部避障与路径规划，可无缝挂到 VLM 驱动的 System 2（负责语义理解、任务分解、长期记忆）之下，构成完整的开放世界导航能力。本文专注 System 1。</p>

<div align="center">
  <img src="/images/vln/NavDP-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/954" />
<figcaption>NavDP 全貌：左上的可扩展数据引擎（海量仿真场景 + 按本体规划 + 域随机化 + 并行渲染）产出训练数据 → 中间的导航扩散策略（无任何真机数据，同时学"生成轨迹"与"评估轨迹"）→ 右侧推理时先生成多条候选再选出安全轨迹 → 底部展示零样本迁移到多种真实机器人。</figcaption>
</div>

<p><strong>主要方法/创新点</strong></p>

<p>NavDP 由两大支柱组成：<strong>(A) 可扩展的仿真数据引擎</strong>，负责高效造数据；<strong>(B) 统一的策略 Transformer</strong>，在一个共享网络里同时学”生成轨迹”（Actor 头）和”评估轨迹安全性”（Critic 头）。下面逐一拆解。</p>

<p><strong>(A) 可扩展仿真数据引擎（DataEngine）</strong></p>

<p>目标是把”造导航数据”做到又快又多样。流程是：</p>

<ol>
  <li><strong>场景与本体建模</strong>：机器人简化为半径 $r_b=0.25\text{m}$ 的圆柱 + 两轮差速模型；为模拟不同机器人，<strong>随机化机器人高度</strong>（0.25–1.25 m）与<strong>相机俯仰角</strong>（−30°–0°），并提供两套相机 FOV（RealSense D435i 与 Zed 2）。高于相机配置高度的物体不计为障碍——这让”矮机器人能钻、高机器人要绕”成为数据里天然存在的常识。</li>
  <li><strong>生成无碰撞轨迹</strong>：把场景网格体素化（0.05 m）算出可通行区的 <strong>ESDF（欧氏符号距离场）</strong>；A* 规划初始路径后，对每个路径点在局部做贪心搜索<strong>把它推离障碍更远</strong>，最后用三次样条插值平滑成连续轨迹。</li>
  <li><strong>域随机化 + 并行渲染</strong>：用 BlenderProc 渲染照片级 RGB-D，并施加<strong>光照 / 纹理 / 视角</strong>三类随机化提升多样性。</li>
</ol>

<p>效率上达到 <strong>2500 条轨迹 / GPU / 天</strong>，比真机采集快约 <strong>20×</strong>；最终数据集覆盖 <strong>3154 个场景、约 1627 km、452 小时、4000 万张图片</strong>（见论文 Table I），在规模与多样性上全面超越以往导航数据集。</p>

<p><strong>(B) 统一策略 Transformer（一个网络，两个任务）</strong></p>

<div align="center">
  <img src="/images/vln/NavDP-architecture.webp" width="90%" loading="lazy" decoding="async" style="aspect-ratio:712/866" />
<figcaption>网络架构：多模态 RGB-D 融合 + 目标编码作为 Key/Value，轨迹经 Action Encoding 作为 Query，送入共享的 Transformer Decoder，再分出 Actor 头（预测扩散噪声 = 生成轨迹）与 Critic 头（预测安全分 = 评估轨迹）。两个任务**共享全部权重**，仅靠不同的 Query 与注意力掩码区分。</figcaption>
</div>

<p><strong>① 多模态编码（输入怎么进网络）</strong></p>
<ul>
  <li><strong>RGB</strong>：取最近 $N=8$ 帧，用预训练并<strong>冻结</strong>的 DepthAnything 编码器，每帧抽 256 个 patch token（带入时序信息）。</li>
  <li><strong>深度</strong>：只取<strong>单帧</strong>深度，用一个<strong>从零训练</strong>的 ViT 编码（为对齐绝对物理尺度，利于轨迹生成）；因深度图有 sim-to-real gap，只保留 (0.1 m, 5 m) 范围。</li>
  <li><strong>融合压缩</strong>：用带可学习 query 的轻量 transformer decoder，把 $(N+1)\times 256$ 个 token 压缩成 $N\times 16$ 个紧凑 token，降低后续计算量。</li>
  <li><strong>目标编码</strong>：遵循 PointGoal 定义，目标是相对当前位姿的 2D 坐标 $(x_g, y_g)$，经 MLP 投影到同一维度；<strong>无目标（NoGoal）探索任务</strong>则用全零张量当目标嵌入。</li>
</ul>

<p><strong>② Actor 头——扩散式轨迹生成</strong>
把专家轨迹按 DDPM 加噪，网络学习<strong>预测被注入的噪声</strong>，推理时从高斯噪声反复去噪得到一条由 $M=24$ 个密集路径点构成的轨迹。扩散过程天然能建模专家演示的<strong>多模态分布</strong>（同一处可能有”左绕”和”右绕”两条都对的路）。训练同时覆盖 PointGoal 与 NoGoal 两种目标，损失为两者噪声预测 MSE 的加权和（默认各 0.5）。</p>

<p><strong>③ Critic 头——对比式轨迹评估（本文最关键创新）</strong>
这是 NavDP 区别于普通扩散策略的灵魂。纯模仿学习只见过”正确轨迹”，无法判断一条轨迹有多危险。NavDP 借用强化学习里的 <strong>Critic 价值函数</strong>思想：利用仿真里现成的全局 ESDF，给任意轨迹打一个”安全分”。具体地，对增广后的轨迹 $\hat\tau$，其在第 $m$ 个路径点上的 ESDF 值记作 \(d_{\hat\tau}^{m}\)，标签价值定义为：</p>

\[V(\hat\tau) = \gamma \cdot \sum_{m=0}^{M}(d_{\hat\tau}^{m+1} - d_{\hat\tau}^{m}) + \lambda \cdot \frac{1}{M}\sum_{m=0}^{M}\mathbb{I}(d_{\hat\tau}^{m} &lt; d_{safe})\]

<p>直观理解：第一项奖励”越走离障碍越远”的趋势，第二项惩罚”靠得太近（小于安全阈值 $d_{safe}=0.5\text{m}$）”的路径点。训练时把专家轨迹做<strong>随机旋转增广</strong>，人为造出”碰撞 / 不碰撞”的对比样本喂给 Critic，让它学会区分安全与危险行为。</p>

<blockquote>
  <p><strong>关键 insight</strong>：仿真专家轨迹因超参难调，常有轻微”贴边”现象。Critic 的真正价值不只是过滤碰撞，而是从一批候选里挑出<strong>安全裕度最大</strong>的那条，从而系统性提升 sim-to-real 的鲁棒性。</p>
</blockquote>

<p><strong>④ 推理流程：先生成、再选择</strong>
推理时 NavDP 先用 Actor 头<strong>一次性生成一批候选轨迹</strong>，再用 Critic 头给每条打分，<strong>选出价值最高（最安全）的一条</strong>执行。这就是”扩散生成多样性 + Critic 把关安全性”的两阶段闭环。下图把预测轨迹投影回图像、按 Critic 分值上色，蓝色=危险、红色=安全，直观展示 Critic 学到的空间常识：</p>

<div align="center">
  <img src="/images/vln/NavDP-critic-visualization.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1413/565" />
<figcaption>不同机器人（Unitree G1 / Go2 / Galaxea R1）上的候选轨迹可视化：颜色由 Critic 价值决定，越蓝风险越高、越红越安全。即使存在行人干扰、运动模糊、光照变化，NavDP 仍能选出安全路径。</figcaption>
</div>

<p><strong>训练配置</strong>：整个网络<strong>单阶段联合训练</strong> Actor + Critic 两个损失之和；扩散步数 10、预测路径点 $M=24$、RGB 历史 $N=8$、安全阈值 0.5 m，用 32 张 A100、batch 2048 训练。</p>

<p><strong>核心结果/发现</strong></p>

<ul>
  <li><strong>PointGoal 点目标导航</strong>：仿真中 SR 67.2 / SPL 62.6，比此前最强的 ViPlanner（60.9 / 58.6）高 <strong>+6.3% SR</strong>；真机跨本体平均 SR 76.7%，比 ViPlanner（53.3%）高 <strong>+23.4%</strong>，在 TurtleBot 9/10、Go2 7/10、G1 7/10 上全面领先。</li>
  <li><strong>NoGoal 无目标探索</strong>：仿真平均无碰撞时长是 NoMaD 的 <strong>2.9×</strong>、探索面积 <strong>3.1×</strong>；真机探索时长达 <strong>3.8×</strong>，展现极强的零样本泛化与避障一致性。</li>
  <li><strong>三类失败模式对比</strong>（Fig. 4）：iPlanner/ViPlanner 用单帧输入导致<strong>时序不一致</strong>（相机过了障碍但机体没过，路径突变引发碰撞）、对<strong>深度噪声敏感</strong>、被<strong>带洞的不规则障碍几何”骗”</strong>而试图穿墙；NavDP 凭多帧时序 + Critic 把关都能稳健处理。</li>
  <li><strong>消融实验</strong>（Table V，验证三组因素）：
    <ul>
      <li><strong>RGB-D 融合不可或缺</strong>：去掉深度 −10.3% SR，去掉 RGB −5.1% SR，单帧替代多帧 −2.8% SR。</li>
      <li><strong>Critic 是安全性的关键</strong>：同权重下改用随机选轨迹（去掉 Critic 选择）−7.8% SR；去掉对比轨迹增广 −3.0% SR（家居场景）。</li>
      <li><strong>NoGoal 是有用的辅助任务</strong>：联合训练 NoGoal 让 PointGoal 反而 +2.1% SR / +1.8% SPL。</li>
    </ul>
  </li>
  <li><strong>域随机化对跨本体至关重要</strong>（Q5 / Fig. 6）：若只用矮机器人（&lt; 0.5 m）数据训练，高个子 Galaxea R1 学不会”绕开桌子”的策略，成功率从 <strong>90% 暴跌到 20%</strong>（−70%），而矮个子 Go2 基本不受影响——证明<strong>跨本体数据的多样性</strong>才是泛化的根本。</li>
</ul>

<div align="center">
  <img src="/images/vln/NavDP-cross-embodiment-ablation.webp" width="60%" loading="lazy" decoding="async" style="aspect-ratio:697/796" />
<figcaption>跨本体数据消融：场景 B 中矮机器人 Go2 可"钻桌底"、高机器人 Galaxea R1 必须"绕行"。缺少跨本体训练数据时，R1 学不到绕行策略，成功率从 90% 跌到 20%。</figcaption>
</div>

<p><strong>局限性与未来方向</strong></p>

<p>NavDP 性能高度依赖高质量仿真数据；扩散模型多步去噪虽带来轨迹多样性，但相比直接回归计算开销更大。作者点明三个未来方向：</p>

<ol>
  <li><strong>显式本体信息编码</strong>：当前仅从数据分布隐式学习运动约束，无法明确感知自身体型；理想系统应能判断”这条缝我过不去”，即把机器人几何参数作为显式条件引入决策。</li>
  <li><strong>运动技能与路径规划联合设计</strong>：当前避障默认”只能行走绕行”；在极端地形（需跳跃 / 跨越）下，规划器应结合自身运动能力上限做更合理的通过 / 绕行决策。</li>
  <li><strong>高效后训练 + 语言目标 + 全局记忆</strong>：探索后训练策略提升真机表现，把目标扩展到自然语言指令，并引入全局记忆支持长时探索。</li>
</ol>

<hr />

<h2 id="fantasyvln">6. FantasyVLN (2026)</h2>
<p>———统一多模态Chain-of-Thought推理用于视觉-语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.13976">arXiv:2601.13976</a></p>

<p><strong>精华</strong>
这篇论文展示了如何通过统一框架整合文本、视觉和多模态CoT推理模式,值得借鉴的点包括:(1) 训练时使用CoT监督、推理时直接预测的隐式推理范式,避免了显式CoT的token膨胀问题;(2) 使用预训练VAR模型将想象的视觉观测压缩到紧凑潜在空间,大幅降低序列长度;(3) 通过跨模态对齐约束统一不同推理模式,学习模态不变的推理表示;(4) 门控机制实现单一模型灵活切换多种推理模式。这种设计在保持推理能力的同时实现了实时导航,为具身智能任务提供了实用的解决方案。</p>

<p><strong>研究背景/问题</strong>
现有VLN方法面临关键挑战:纯文本CoT缺乏空间理解且容易过拟合稀疏标注;多模态CoT通过生成想象的视觉观测引入严重的token膨胀,导致推理延迟增加数个数量级,无法实现实时导航。这在长时域、多阶段导航场景中尤为突出。</p>

<div align="center">
  <img src="/images/vln/FantasyVLN-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/629" />
<figcaption>
FantasyVLN系统概览:整合文本和视觉CoT推理模式,联合建模语义规划和空间理解
</figcaption>
</div>

<p><strong>主要方法/创新点</strong></p>

<p>FantasyVLN提出了统一的隐式推理框架,核心创新包括:</p>

<p><strong>1. Compact Visual CoT (CompV-CoT)</strong></p>
<ul>
  <li>使用预训练的Visual AutoRegressor (VAR)模型将想象的视觉观测编码到紧凑潜在空间</li>
  <li>VAR采用next-scale预测范式,256×256图像仅需30个视觉token即可精确重建,压缩比达1/2185</li>
  <li>训练时VLM直接生成VAR潜在表示,推理时无需显式VAR解码,大幅提升效率</li>
</ul>

<p><strong>2. 统一多模态CoT (UM-CoT)框架</strong></p>
<ul>
  <li>通过二元门控信号 gT 和 gV 控制文本和视觉推理的激活</li>
  <li>四种推理模式:(a) Non-CoT (gT=0, gV=0) 直接预测动作;(b) T-CoT (gT=1, gV=0) 生成文本推理步骤;(c) V-CoT (gT=0, gV=1) 生成压缩视觉想象;(d) MM-CoT (gT=1, gV=1) 联合生成文本-视觉推理</li>
  <li>单一模型共享参数,通过数据混合实现端到端联合训练</li>
</ul>

<div align="center">
  <img src="/images/vln/FantasyVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/678" />
<figcaption>
统一多模态CoT推理框架:支持四种推理模式,训练时使用CoT监督,推理时直接动作预测
</figcaption>
</div>

<p><strong>3. 跨模态对齐约束 (Cross-Mode Alignment)</strong></p>
<ul>
  <li>将Non-CoT模式的动作预测作为软监督信号,对齐所有CoT变体的动作输出</li>
  <li>交替优化Non-CoT目标和跨模态对齐的联合目标,嵌入多样化推理模式到统一潜在策略</li>
  <li>防止不同推理模式间的冲突,学习一致的模态不变表示</li>
</ul>

<p><strong>4. 隐式推理机制</strong></p>
<ul>
  <li>训练时:联合学习文本、视觉和多模态CoT模式</li>
  <li>推理时:采用Non-CoT模式直接指令到动作映射,无需生成显式CoT序列</li>
  <li>借鉴Aux-Think的”train-with-CoT, infer-without-CoT”范式,模型隐式保留推理感知表示</li>
</ul>

<p><strong>训练细节</strong></p>
<ul>
  <li>基础模型:Qwen2.5-VL (7B参数)</li>
  <li>数据:LH-VLN训练集18,554个导航轨迹切片(每5步一个切片)</li>
  <li>T-CoT标注:使用Qwen-VL-Max生成,包含语义规划、视觉描述、动作规划和视觉想象四部分</li>
  <li>优化:LoRA微调,AdamW优化器,学习率1e-4,64×H20 GPUs,DeepSpeed ZeRO-2</li>
</ul>

<div align="center">
  <img src="/images/vln/FantasyVLN-VAR-scale-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1078/677" />
<figcaption>
不同VAR scale对ISR性能的影响:scale 4达到最佳平衡
</figcaption>
</div>

<div align="center">
  <img src="/images/vln/FantasyVLN-VAR-reconstruction.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/387" />
<figcaption>
VAR模型在不同scale下的图像重建质量对比:scale越高,重建质量越好,但token数量也越多
</figcaption>
</div>

<p><strong>核心结果/发现</strong></p>

<p><strong>导航精度 (LH-VLN benchmark)</strong></p>
<ul>
  <li>SR (成功率): 2.44% (所有基线中最佳)</li>
  <li>ISR (独立成功率): 11.01% (显著优于所有方法)</li>
  <li>CSR (条件成功率): 9.64%</li>
  <li>CGT (加权CSR): 8.99%</li>
  <li>显著超越次优方法Aux-Think (仅T-CoT): SR提升3.75×,ISR提升3.5×</li>
</ul>

<p><strong>推理效率</strong></p>
<ul>
  <li>APS (每秒动作数): 1.03,与WorldVLA (1.02)和Aux-Think (0.97)相当</li>
  <li>比显式CoT方法CoT-VLA (0.19 APS)快5.4×,推理延迟降低一个数量级</li>
  <li>隐式推理每次预测仅解码单个token,而显式CoT需生成3k-5k个token</li>
</ul>

<p><strong>训练效率</strong></p>
<ul>
  <li>FantasyVLN在few thousand迭代内快速收敛,token预测准确率达到1.0</li>
  <li>WorldVLA (像素级V-CoT)需10k+迭代才能达到0.5准确率,且训练不稳定</li>
  <li>CompV-CoT通过潜在空间推理提供更强梯度信号和更稳定的学习动态</li>
</ul>

<div align="center">
  <img src="/images/vln/FantasyVLN-training-efficiency.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1081/814" />
<figcaption>
FantasyVLN与WorldVLA的训练效率对比:CompV-CoT快速收敛,像素级V-CoT训练缓慢且不稳定
</figcaption>
</div>

<p><strong>消融实验</strong></p>
<ul>
  <li>各推理模式贡献:结合任何CoT模式与Non-CoT都能提升性能,四模式联合训练效果最佳</li>
  <li>VAR scale选择:scale 4最优(ISR 7.41%),更小scale信息不足,更大scale冗余</li>
  <li>跨模态对齐:关键组件,移除后SR从2.44%降至0,ISR从11.01%降至2.39%</li>
  <li>显式vs隐式推理:隐式推理在多模态设置下表现最佳(MM-CoT隐式:SR 2.44 vs 显式0.98)</li>
</ul>

<p><strong>局限性</strong>
该方法在LH-VLN这种小规模数据集(18k轨迹切片)上训练,显式CoT容易过拟合并产生累积误差;在更大规模数据集上的表现有待验证。此外,绝对成功率仍较低(SR 2.44%),表明长时域多阶段导航仍是极具挑战性的任务。</p>

<hr />

<h2 id="sparsevideonav">7. SparseVideoNav (2026)</h2>
<p>———Sparse Video Generation Propels Real-World Beyond-the-View Vision-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2602.05827">arXiv:2602.05827</a></p>

<h3 id="精华-1">精华</h3>

<p>SparseVideoNav 最值得借鉴的核心思想：<strong>视频生成模型（VGM）天然具备长视野预测能力</strong>，可以替代 LLM 作为导航的”大脑”，彻底解决 LLM 短视野导致的短视行为。<strong>稀疏化</strong>（sparse video generation）是兼顾长预测视野与计算效率的关键设计——不需要预测连续帧，只需关键时间戳处的帧即可提供有效导航指引。<strong>四阶段渐进式训练</strong>（T2V→I2V→历史注入→扩散蒸馏→动作学习）将大规模预训练视频模型迁移到导航领域，是一套通用的 VGM 适配范式。<strong>Diffusion Distillation</strong> 将推理步数从 50 步压缩到 4 步（9.6× 加速），使实时部署成为可能。此外，<strong>Q-Former + Video-Former</strong> 的历史压缩策略解耦了推理延迟与历史长度的关系，保证了稳定的推理效率。</p>

<hr />

<h3 id="1-研究背景问题-1">1. 研究背景/问题</h3>

<p>现有视觉-语言导航（VLN）系统依赖 LLM，受限于短视野监督（4-8步），在 Beyond-the-View Navigation（BVN）任务中表现欠佳：智能体需要在没有逐步指引的情况下，仅凭高层语义指令（如”找一张桌子并停在旁边”）定位远处不可见目标，LLM-based 方法因此频繁出现意外转向和死路困陷。简单延长监督视野会破坏 LLM 训练稳定性，而视频生成模型天然对齐长视野语言理解，成为解决 BVN 的关键突破口。</p>

<hr />

<h3 id="2-主要方法创新点-1">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/SparseVideoNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/907" />
<figcaption>
SparseVideoNav 概览：视频生成模型提供稀疏预见（Sparse Video Foresight），相较 LLM-based 基线（StreamVLN、InternVLA-N1、UniNavid）在 BVN 任务上大幅领先，推理速度提升 27×
</figcaption>
</div>

<p><strong>核心思路：</strong> 利用视频生成模型（VGM）预测未来稀疏帧序列作为导航预见，将预测视野延伸到 20 秒（20s × 4FPS = 80帧），而非 LLM 仅能处理的 4-8 步。稀疏间隔设为 3 时（sparse interval = 3），在预测视野与视觉保真度之间取得最优平衡。</p>

<p><strong>整体架构：</strong></p>

<div align="center">
  <img src="/images/vln/SparseVideoNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1448/990" />
<figcaption>
SparseVideoNav 整体架构（上）与四阶段训练流程（下）。VGM backbone 接收当前观测、历史帧和语言指令，生成稀疏视频 latents，DiT-based action head 基于生成的未来预见和语言指令预测连续动作
</figcaption>
</div>

<p>架构由三个核心组件构成：</p>
<ul>
  <li><strong>VGM Backbone</strong>（Wan 2.1-1.3B）：接收当前帧、历史嵌入（h_T）和语言指令（umT5），输出未来稀疏视频 latents</li>
  <li><strong>Former 模块</strong>：Q-Former 处理时间维度历史压缩，Video-Former 处理空间维度，联合生成固定维度的历史嵌入，使推理延迟不随历史长度增长</li>
  <li><strong>DiT Action Head</strong>：以生成的稀疏未来 latents 和语言指令为条件，通过 cross-attention 预测连续动作序列（DDIM 重建）</li>
</ul>

<p><strong>四阶段训练流程：</strong></p>

<ol>
  <li>
    <p><strong>Stage 1 — T2V → I2V 适配</strong>：保留 Wan 的 flow matching 目标，将文本到视频模型适配为图像条件的视频生成（Image-to-Video），引入稀疏帧监督，以稀疏 chunk latents <code class="language-plaintext highlighter-rouge">[c_{T+1}, c_{T+2}, c_{T+5}, c_{T+8}, ..., c_{T+20}]</code> 作为训练目标</p>
  </li>
  <li>
    <p><strong>Stage 2 — 历史注入</strong>：在 Wan backbone 每个 transformer block 中新增 cross-attention block，注入历史信息 h_T（Q-Former + Video-Former 编码）；新增层以零初始化保留预训练生成先验</p>
  </li>
  <li>
    <p><strong>Stage 3 — Diffusion Distillation</strong>：采用 PCM（Phased Consistency Models）进行蒸馏，以 history-injected I2V 模型为 teacher，训练结构相同的 student 模型，将推理步数从 N=50 压缩至 M=4，实现 9.6× 推理加速，同时保持视觉保真度</p>
  </li>
  <li>
    <p><strong>Stage 4 — 动作学习</strong>：冻结蒸馏后的 I2V 模型，采用逆动态范式（inverse dynamics paradigm），利用 DA3 对生成的稀疏未来帧重新标注动作标签，确保动作监督与合成动态精确对齐；训练 DiT action head 以去噪方式预测连续动作</p>
  </li>
</ol>

<p><strong>数据采集：</strong> 使用手持 DJI Osmo Action 4（RockSteady+ 稳像）采集 140 小时真实室外导航视频，处理为约 13,000 条轨迹（均值 140 帧 × 4FPS），使用 DA3 估计相机位姿提取连续动作标签；语言指令由人工专家标注——构建了目前最大规模的真实世界 VLN 数据集。</p>

<hr />

<h3 id="3-核心结果发现-1">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/SparseVideoNav-video-generation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1443/762" />
<figcaption>
SparseVideoNav 在零样本 BVN 部署中的视频生成结果分析。模型从当前帧（T）预测未来稀疏帧序列至 T+20，跨室内（找桌子）、室外（找空调）、户外（找垃圾桶）多种场景
</figcaption>
</div>

<div align="center">
  <img src="/images/vln/SparseVideoNav-ablation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:712/647" />
<figcaption>
消融研究：a) 数据扩展随规模持续提升 FVD；b) 稀疏设计带来 1.7× 推理加速；c) Diffusion Distillation 带来 9.6× 推理加速；d) Former 历史压缩保持稳定推理延迟（无 Former 时 +54.9% 随历史长度增长）
</figcaption>
</div>

<p><strong>零样本真实世界性能：</strong></p>
<ul>
  <li>SparseVideoNav 在 6 种真实场景（室内 Room/Lab、室外 Yard/Park、夜间 Square/Mountain）上全面超越所有 LLM-based 基线</li>
  <li><strong>IFN 任务</strong>平均成功率 <strong>50.0%</strong>（vs StreamVLN 35.0%、UniNavid 10.0%）</li>
  <li><strong>BVN 任务</strong>平均成功率 <strong>25.0%</strong>（vs 所有基线几乎为 0%，StreamVLN 仅 10.0%）</li>
  <li>夜间场景成功率 <strong>17.5%</strong>（LLM 基线在夜间 BVN 全部失败）</li>
</ul>

<p><strong>效率提升：</strong></p>
<ul>
  <li>推理延迟 <strong>9.8s</strong> vs 基线 <strong>21.6s</strong>（<strong>27×</strong> 加速对比未优化版本）</li>
  <li>Stage 1+2 训练时间 <strong>32h</strong> vs 从头训练 <strong>64h</strong>（<strong>2×</strong> 加速）</li>
  <li>稀疏设计带来 <strong>1.7×</strong> 推理加速，Distillation 带来 <strong>9.6×</strong> 加速</li>
</ul>

<p><strong>鲁棒性：</strong> 在训练高度（1m）与部署高度（50cm）不一致时仍能正确导航，展示出对相机高度变化的强鲁棒性；能够动态规避行人障碍（emergent ability，非显式训练）。</p>

<hr />

<h3 id="4-局限性-1">4. 局限性</h3>

<p>当前 140 小时数据集相较于网络规模数据仍然有限，数据扩展是进一步提升的关键方向；推理延迟（9.8s）仍略高于现有 LLM-based 导航范式（StreamVLN），加速蒸馏与 VGM 量化是未来研究的重要课题。</p>

<hr />

<h2 id="worldvln">8. WorldVLN (2026)</h2>
<p>———Autoregressive World Action Model for Aerial Vision-Language Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2605.15964">arXiv:2605.15964</a></p>

<hr />

<h3 id="精华-2">精华</h3>

<p>WorldVLN 将航空 VLN 重新定义为”预测驱动的世界-动作”问题：Agent 不直接从观测映射到动作，而是先在隐空间预测世界状态演化，再从预测的隐表示解码出可执行路径点。其核心启发是：<strong>空间导航本质上是预期性的</strong>，如同人脑预测移动后的状态变化。将视频生成模型的时序先验迁移至导航，并通过 Action-aware GRPO 强化学习直接优化动作后果而非视觉合成质量，这两个设计使 WAM 范式在有限训练步数下超越 VLA 基线 12+ 个百分点。闭环自回归更新（用真实观测替换模型生成的隐状态）解决了长程隐预测的漂移问题。零样本迁移到真实无人机验证了隐式预测架构的潜在泛化能力。</p>

<hr />

<h3 id="1-研究背景问题-2">1. 研究背景/问题</h3>

<p>现有 VLA 模型将 VLN 视为从指令和观测到动作的条件映射，虽具备语义理解能力，但缺乏对”Agent 自身动作如何改变世界状态”的显式时序因果建模，导致在空间推理和几何精度上存在明显短板。视频生成模型虽拥有强大的时空先验，但其生成目标（视觉真实性）与 VLN 目标（动作导向的状态预测）之间存在结构性错配：大多数视频骨干以双向方式生成整段视频，而 VLN 需要因果性的”观测—行动—更新”闭环；此外，生成模型的隐表示未被优化为可动作解码的形式。</p>

<hr />

<h3 id="2-主要方法创新点-2">2. 主要方法/创新点</h3>

<p><strong>整体框架：</strong> WorldVLN 由三大模块构成——（1）潜空间时空自回归 Transformer（世界骨干）负责预测短时域世界状态转变；（2）动作解码器（Action Decoder）将隐状态转变解码为可执行路径点；（3）两阶段训练框架，先通过监督学习对齐视频先验与导航动态，再通过 Action-aware GRPO 强化学习优化动作后果。</p>

<div align="center">
  <img src="/images/vln/WorldVLN-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:960/517" />
<figcaption>图1：WorldVLN 整体架构。模型从指令和历史观测预测短时域隐状态转变，解码为路径点动作，执行后将真实观测编码回自回归上下文。</figcaption>
</div>

<p><strong>① 世界骨干（Latent Autoregressive Video Transformer）</strong></p>

<ul>
  <li><strong>输入</strong>：文本编码器输出指令嵌入 $e_\ell = \psi(\ell)$，以及历史真实自中心观测编码后的隐状态序列 $z_{\leq t}$</li>
  <li><strong>处理</strong>：时空自回归 Transformer 按从粗到细的尺度预测多尺度 token 块（先全局低分辨率，再局部高分辨率），并沿时间维度按片段顺序自回归生成</li>
  <li><strong>输出</strong>：短时域隐状态预测 \(\hat{z}_{t+1:t+K} \sim p_\theta(\cdot \mid e_\ell, z_{\leq t})\)</li>
  <li><strong>设计动机</strong>：借用视频生成模型的时序先验而非从头学习，同时将生成架构改造为因果自回归以支持闭环</li>
</ul>

<div align="center">
  <img src="/images/vln/WorldVLN-backbone-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1224/897" />
<figcaption>图6：潜空间时空自回归世界骨干架构。输入图像或历史视频被编码为已知视觉金字塔条件，预测未来目标片段金字塔，多尺度 token 块聚合为输出隐表示。</figcaption>
</div>

<p><strong>② 动作解码器（Action Decoder）</strong></p>

<ul>
  <li><strong>输入</strong>：世界骨干输出的未来隐表示 \(\hat{z}_{t+1:t+K}\)（紧凑时空表示，编码了视角变化、空间结构变化和运动趋势）</li>
  <li><strong>处理</strong>：Vision Embedding 模块将隐表示转换为时空嵌入 token；多层 Transformer Block 采用分解时空注意力——时间注意力捕捉跨帧运动演化，空间注意力建模每帧内的几何结构；MLP 动作头将聚合特征回归到连续动作向量</li>
  <li><strong>输出</strong>：连续路径点动作 \(a_{t:t+K-1} = D_\phi(\hat{z}_{t+1:t+K})\)，对应 UAV 的相对 3D 位移和偏航角变化</li>
  <li><strong>设计动机</strong>：避免将隐状态解码为视频帧再估计运动（有误差累积），直接从隐表示推理动作更简洁高效</li>
</ul>

<div align="center">
  <img src="/images/vln/WorldVLN-action-decoder.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:918/775" />
<figcaption>图7：动作解码器架构。世界模型输出隐表示经视觉嵌入转换为时空 token，多层分解时空注意力 Transformer Block 建模动作相关特征，最终由 MLP 回归为连续 UAV 导航动作。</figcaption>
</div>

<p><strong>③ 闭环自回归更新</strong></p>

<p>完整推理循环为：
\((e_\ell, z_0) \to \hat{z}_{1:K} \to a_{0:K-1} \to o_{1:K} \to z_{1:K} \to \hat{z}_{K+1:2K} \to \cdots\)
关键在于执行动作后，将<strong>真实观测</strong>重新编码 $z_{t+1:t+K} = E_\text{vid}(o_{t+1:t+K})$ 替换模型预测的隐状态，防止隐预测漂移积累。</p>

<p><strong>④ 两阶段训练框架</strong></p>

<div align="center">
  <img src="/images/vln/WorldVLN-training-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1195/728" />
<figcaption>图2：两阶段训练框架。Stage 1 用指令-视频对监督世界骨干，用视频-轨迹对监督动作解码器。Stage 2 采样多条在线轨迹，用轨迹精度、任务进度和参考策略正则化分配 Segment 级奖励，通过 Action-aware GRPO 更新 WorldVLN。</figcaption>
</div>

<p><strong>Stage 1 — 监督训练（世界先验对齐）</strong></p>

<p>世界骨干目标：
\(\mathcal L_\text{wm} = -\sum \log p_\theta(z_{t+1:t+K} \mid e_\ell, z_{\leq t})\)</p>

<p>动作解码器目标（通过视频-动作教师模型蒸馏初始化）：
\(\mathcal L_\text{act} = \sum \lVert D_\phi(E_\text{vid}(o_{t+1:t+K})) - a^*_{t:t+K-1} \rVert\)</p>

<p><strong>Stage 2 — Action-aware GRPO（动作后果对齐）</strong></p>

<p>对每条导航案例采样 $G$ 条在线轨迹，每条包含 $n$ 个自回归决策段，对第 $j$ 段分配奖励：</p>

\[r^{(i)}_j = \gamma^{j-1}\left(\lambda_\text{traj} r^{(i)}_{\text{traj},j} + \lambda_\text{task} r^{(i)}_{\text{task},j} + \lambda_\text{ref} r^{(i)}_{\text{ref},j}\right)\]

<ul>
  <li><strong>轨迹奖励</strong> $r_\text{traj}$：局部几何监督，衡量预测动作与专家动作的接近程度</li>
  <li><strong>任务奖励</strong> $r_\text{task}$：全局终点评估，衡量轨迹终点与目标的距离</li>
  <li><strong>参考奖励</strong> $r_\text{ref}$：KL 正则化，保持更新策略与参考策略（Stage 1 产物）的一致性，防止世界先验退化</li>
  <li><strong>时序衰减</strong> $\gamma^{j-1}$（$\gamma=0.9$）：早期决策权重更大，因其影响后续更长的动作链</li>
</ul>

<p>优势归一化后以 GRPO 截断目标更新策略。</p>

<hr />

<h3 id="3-核心结果发现-2">3. 核心结果/发现</h3>

<p><strong>UAV-Flow-Sim（室外）</strong>：WorldVLN 达到 79.12% / 78.02% 平均 SR（固定/开放语言模板），分别比最强基线提升 <strong>13.51 / 12.24 个百分点</strong>。在 Approach（97.62%）、Land（98.15%）、Move（100%）等精细动作上表现尤为突出。</p>

<p><strong>IndoorUAV-VLA（室内）</strong>：Full-set SR 达 <strong>41.76%</strong>，比最强基线（π0，27.16%）提升 <strong>14.60 个百分点</strong>；Hard 难度下 SR 从 7.55% 提升至 <strong>41.19%</strong>，显示对复杂多步动作组合的强适应能力。</p>

<p><strong>消融分析</strong>：</p>
<ul>
  <li>与 OpenVLA 对比：相同步数下，Stage 1 后的 WorldVLN 已超越 OpenVLA-SFT，表明 WAM 范式学习效率更高</li>
  <li>自回归 vs 全序列预测：自回归提升 SR 5.7+ 个百分点，隐预测可视化显示全序列预测存在语义漂移，而自回归因持续融合真实观测保持了连贯的视觉空间表示</li>
  <li>Action-aware GRPO：在 Stage 1 接近饱和后额外提升 10+ 个百分点，轨迹可视化显示 RL 后模型能正确执行”环绕”等几何精确动作</li>
</ul>

<p><strong>零样本真实机器部署</strong>：在仅用仿真数据训练的情况下，WorldVLN 在 250 mm 轴距四旋翼无人机上实现室内和室外的语言指令跟随，机载 Jetson Orin NX + 远程服务器推理架构验证了实际可部署性。</p>

<hr />

<h3 id="4-局限性-2">4. 局限性</h3>

<p>当前实验主要针对短程低时域导航，长距离多阶段 VLN 尚未充分验证；受骨干计算量限制，真实部署仍依赖服务器端推理，无法完全机载运行。</p>

<hr />

<h2 id="navwam">9. NavWAM (2026)</h2>
<p>———首个将未来预测、价值评估与动作决策集成于单一具身世界模型的导航模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.13494">arXiv:2606.13494</a> · <a href="https://dachii-azm.github.io/navwam/">Project Page</a></p>

<h3 id="精华-3">精华</h3>
<ol>
  <li><strong>一体化整合</strong>：NavWAM 将传统导航世界模型（NWM）中分离的“未来预测”与“动作规划（如 CEM 搜索）”整合进单一的视频扩散 Transformer 网络中。</li>
  <li><strong>共享 Latent Canvas</strong>：将当前状态、目标图像、当前视觉观测、可执行动作 Chunk、未来状态、未来视觉预测和进度价值评估（Value）统一表征为固定 9 帧的潜在画布（Latent Canvas）序列，通过联合去噪实现多任务输出。</li>
  <li><strong>消除在线规划开销</strong>：在测试时直接以 Policy 模式进行单次推理去噪即可输出动作 Chunk，避免了传统世界模型繁重的在线轨迹采样与优化，控制频率可达 5Hz，计算量降低数千倍。</li>
  <li><strong>提升表征质量</strong>：通过引入未来视觉预测的 dense 自监督重构损失，为动作选择提供了强有力的“未来观测锚定”，显著降低了局部可观测下的策略漂移。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-3">1. 研究背景/问题</h3>
<p>在局部可观测的图像目标导航中，传统的基于规划的导航世界模型（NWM）通过预测动作序列条件下的未来视觉变化来辅助决策。然而，这些方法通常将“世界预测”和“动作选择”分为两个独立的步骤：模型仅作为一个单纯的预测器，而在推理时必须依靠外在的规划算法（如交叉熵方法 CEM）在大量的随机候选动作序列中进行耗时的闭环生成与评分。这导致了巨大的在线计算开销（通常低至 sub-Hz 级别）。为了消除这一瓶颈，本研究致力于构建一个世界动作模型，将未来感知预测、价值估计和连续动作生成直接统一在单个网络表征中。</p>

<hr />

<h3 id="2-主要方法创新点-3">2. 主要方法/创新点</h3>
<div align="center">
  <img src="/images/vln/NavWAM-concept-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/542" />
<figcaption>传统导航世界模型 (NWM) 与导航世界动作模型 (NavWAM) 的对比示意图</figcaption>
</div>

<h4 id="整体框架">整体框架</h4>
<p>NavWAM 使用预训练的视频世界模型 Cosmos Predict2 (2B) 作为网络底座，将当前观测、图像目标、机器人状态、未来动作序列（Action Chunk）、未来视觉观测和目标进度价值（Goal-Progress Value）融合成一个统一的 9 帧“世界-动作潜在画布（World-Action Latent Canvas）”。通过这种表征，导航任务被建模为在潜在画布上的联合去噪问题。</p>

<div align="center">
  <img src="/images/vln/NavWAM-architecture-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:646/398" />
<figcaption>NavWAM 的 Latent Canvas 帧布局与数据流动</figcaption>
</div>

<h4 id="latent-canvas-帧布局">Latent Canvas 帧布局</h4>
<p>画布中的 9 个帧被定义如下：</p>
<ul>
  <li><strong>帧 0 (Observed)</strong>：Causal VAE temporal pad（全零帧），为时空 VAE 压缩提供边界。</li>
  <li><strong>帧 1 (Observed)</strong>：当前机器人状态 $s_t = [x_t/100, y_t/100, \psi_t/\pi] \in \mathbb{R}^3$，在局部坐标系中标准化。</li>
  <li><strong>帧 2 (Observed)</strong>：目标图像 $g$（Image Goal）。</li>
  <li><strong>帧 3 (Observed)</strong>：当前第一人称视觉观测 $o_t$。</li>
  <li><strong>帧 4 (Predicted)</strong>：待预测的可执行动作 Chunk $a_{t:t+H-1} \in \mathbb{R}^{3H}$，其中 $H=4$（表示局部航向点增量 $[\Delta x_i, \Delta y_i, \Delta \psi_i]$）。</li>
  <li><strong>帧 5 (Predicted)</strong>：未来状态预测 $s_{t+H} \in \mathbb{R}^3$。</li>
  <li><strong>帧 6 &amp; 7 (Predicted)</strong>：未来的两个自车视角图像预测 $o_{t+H-1}, o_{t+H}$。</li>
  <li><strong>帧 8 (Predicted)</strong>：目标进度估计值 $v_{t+H} \in [0, 1]$。</li>
</ul>

<p>对于动作、状态、价值等非图像标量/向量，NavWAM 首先对其进行归一化，然后将其在空间网格（Spatial Grid）上进行广播（Broadcast）填充为整帧；解码时则通过空间平均（Spatial Averaging）将对应通道的去噪特征恢复为标量/向量值。</p>

<h4 id="训练目标与混合模式">训练目标与混合模式</h4>
<p>网络损失函数基于潜在画布上的加权去噪得分匹配：
\(\mathcal{L}_{\text{diff}} = \mathbb{E}_{\sigma, \epsilon} \left[ w(\sigma) \lVert x_0 - F_\theta(x_\sigma, \sigma, c) \rVert_2^2 \right]\)
为了防止低维的动作信号淹没在图像重构的高维像素损失中，动作帧损失被乘以权重系数 $\lambda = 5$ 进行了上采样增强。</p>

<p>在训练阶段，样本被划分为三种不同的条件模式以促使网络联合学习不同的导航子任务（比例为 50/25/25）：</p>
<ol>
  <li><strong>Policy 模式 (50%)</strong>：给定观测帧 0–3，预测帧 4–8。</li>
  <li><strong>World-Model 模式 (25%)</strong>：给定观测帧 0–4，预测帧 5–8。训练模型在动作条件下的物理演化预测。</li>
  <li><strong>Value 模式 (25%)</strong>：给定观测帧 0–7，预测帧 8（当前轨迹下的目标进度价值）。</li>
</ol>

<h4 id="目标进度价值设计">目标进度价值设计</h4>
<p>价值目标 $v_{t+H}$ 被显式定义为反映机器人局部到终点精度的归一化距离进度：
\(v_{t+H} = \text{clip}\left( 1 - \frac{\lVert p_{\text{end}} - p_t \rVert_2}{d_{\text{max}}}, 0, 1 \right)\)
其中 $p_t$ 为当前 2D 位置，$p_{\text{end}}$ 为目标 2D 位置，$d_{\text{max}}$ 为轨迹最大长度上限。</p>

<h4 id="推理流程">推理流程</h4>
<p>在部署阶段，机器人获取当前图像 $o_t$ 和目标 $g$，在 Policy 模式下运行，通过单次去噪过程直接输出 \(\hat{a}_{t:t+H-1}\)。随后以 Receding-Horizon 的方式执行这组动作 Chunk，执行完毕后重新请求网络，实现大约 5Hz 的高频闭环响应。</p>

<hr />

<h3 id="3-核心结果发现-3">3. 核心结果/发现</h3>
<div align="center">
  <img src="/images/vln/NavWAM-qualitative-stanford.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1090/464" />
<figcaption>GO STANFORD 测试集上 NavWAM、NWM 与 NavWAM w/ FT 的未来图像预测质量对比</figcaption>
</div>

<ol>
  <li><strong>更优的导航表现</strong>：在 GO STANFORD 离线图像目标导航上，NavWAM 在无需推理时 CEM 动作搜索的前提下，其 zero-shot（ATE 0.324）和微调版（ATE 0.192 / RPE 0.070）均优于传统的 NWM（ATE 0.453）。同时，模型保持了卓越的未来视觉预测一致性（Consistency 达 0.635–0.668，明显好于 NWM 的 0.524）。</li>
  <li><strong>极其低廉的推理开销</strong>：单次去噪推理代替 CEM 轨迹优化，使得 NavWAM 的 FLOPs 仅为 4.45 TF，推理延迟仅为 205.7 ms，而同底座的 NWM 延迟达 233.8 秒，FLOPs 高达 14,521 TF，推理成本相差数千倍。</li>
  <li><strong>多任务监督的作用</strong>：消融实验证明，未来视觉预测监督能够为决策系统带来长程路标锚定，是不可或缺的自监督信号（相比去掉未来图像的策略，ATE 从 0.090 降低到 0.076）。</li>
  <li>** Diablo 机器人实机闭环成功率**：在真实室内环境（Office, Storage, Meeting, Hallway）的 24 次部署测试中，NavWAM 取得了 79.2% 的高成功率，远超 OmniVLA (58.3%) 和传统 NWM (16.7%)，证明了极强的鲁棒性。</li>
</ol>

<div align="center">
  <img src="/images/vln/NavWAM-real-world-rollouts.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1110/378" />
<figcaption>Diablo 机器人实机运行期间的实测相机画面与预测未来画面对比（H=4）</figcaption>
</div>

<hr />

<h3 id="4-局限性-3">4. 局限性</h3>
<ol>
  <li><strong>测试场景局限</strong>：实机评估主要集中在静态的室内环境中，面对含有行人和移动物体的动态障碍物场景未做验证。</li>
  <li><strong>目标形态局限</strong>：主要针对图像目标导航（Image-Goal Navigation），对于自然语言指令导航、物体类别导航（Object-Goal）以及具身问答尚未开展系统验证。</li>
  <li><strong>长程瓶颈</strong>：面对跨楼层、多房间的大范围、极长程导航场景（需要频繁的子任务规划与重规划），由于上下文帧数限制，依然存在表现衰退的风险。</li>
</ol>

<hr />

<h2 id="abot-agentos">10. ABot-AgentOS (2026)</h2>
<p>———面向具身智能的通用机器人 Agent 操作系统与终身多模态记忆系统</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.10350">arXiv:2607.10350</a> · <a href="https://amap-cvlab.github.io/ABot-AgentOS">Project Page</a></p>

<hr />

<h3 id="精华-4">精华</h3>

<ol>
  <li><strong>模块化分层解耦架构</strong>：ABot-AgentOS 部署于底层机器人控制器与高层基础 VLM/VLA 模型之间，将高层语义推理、技能执行、多级验证与记忆检索解耦，解决了传统单一模型控制器缺乏显式终止信号与过程漂移的问题。</li>
  <li>** Agent Harness 控制闭环**：提出包含全局 Main LLM 规划、 Skill Runner 上下文隔离局部执行以及 Verifier 运行期/技能期/结束期多阶段验证的“推理-执行-验证”闭环，显著降低长程任务中的虚假完成与盲目停滞。</li>
  <li><strong>通用多模态图记忆（Universal Multi-modal Graph Memory）</strong>：将语音、图像观察、空间地点、时间关联与任务轨迹转化为强类型的多模态图节点与边，支持基于证据溯源的检索与局部子图抽取。</li>
  <li><strong>故障驱动终身自进化（Failure-Driven Lifelong Self-Evolution）</strong>：构建基于 Trace 诊断的故障转 JSON DSL 资产机制，采用严格的后检查门控（Gating），在跨 Split 部署中实现零 ground-truth 泄露的累积式自我进化。</li>
  <li><strong>具身基准测试 EmbodiedWorldBench</strong>：推出首个跨室内外复合场景的可执行评测基准，覆盖 16 个场景、4 个难度等级与 200+ 复合任务；并提供了基于文本沙盒与自进化奖励引擎的端到端学生策略蒸馏训练管线。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-4">1. 研究背景/问题</h3>

<p>具身智能（Embodied AI）正在将人工智能从数字世界推向物理世界。近年来，视觉语言模型（VLM）与视觉语言动作（VLA）模型赋予了机器人出色的自然语言理解、视觉场景感知与动作预测能力。然而，在语义理解与可靠的物理执行之间仍存在关键鸿沟：</p>
<ol>
  <li><strong>语义信念与环境事实脱节</strong>：在复杂长程任务中，现有的端到端控制器或简单的 API 调用缺乏显式的中间状态验证与终止信号。机器人可能执行了导航指令但并未移动，或在局部不断碰撞却在语言层面上认为任务正正常推进。</li>
  <li><strong>缺少跨形态通用的 Agent 硬件抽象</strong>：现有系统多与特定机器人形态或控制接口高度绑定，难以无缝扩展到人形机器人、四足狗等多样化硬件。</li>
  <li><strong>记忆难以持久与溯源自我改进</strong>：缺少能够跨会话持久存储、源头可追溯且能从历史交互故障中自我改善的通用多模态记忆系统。</li>
</ol>

<p>为此，论文提出了 <strong>ABot-AgentOS</strong>，一个运行在底层控制器之上、解耦高层认知与物理动作的通用机器人 Agent 操作系统。</p>

<hr />

<h3 id="2-主要方法创新点-4">2. 主要方法/创新点</h3>

<p>ABot-AgentOS 由<strong>边云协同双 LLM 核心</strong>、<strong>Agent Harness 调度闭环</strong>、<strong>通用多模态图记忆</strong>以及<strong>端到端蒸馏训练管线</strong>四大模块协同构成。</p>

<div align="center">
  <img src="/images/agent/ABot-AgentOS-system-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/871" />
<figcaption>ABot-AgentOS 系统整体架构：多源多模态输入通过边云协同双 LLM 核心路由，Agent Harness 闭环调度技能与多级验证，结合通用多模态图记忆与底层控制器</figcaption>
</div>

<h4 id="-整体框架与边云协同双核心">① 整体框架与边云协同双核心</h4>

<p>ABot-AgentOS 在架构设计上区分了边缘轻量模型与云端大模型（Dual-LLM Core）：</p>
<ul>
  <li><strong>边缘 Tiny LLM</strong>：部署于机器人端侧，优先处理常规会话、简单工具调用与实时控制指令，降低响应延迟。</li>
  <li><strong>云端 Large LLM</strong>：当任务涉及长程复杂推理、多步规划或高难度图记忆检索时，由 learned routing 策略自动升级提升至云端大模型处理。</li>
</ul>

<h4 id="-agent-harness-闭环控制">② Agent Harness 闭环控制</h4>

<p>Agent Harness 改变了传统单模型控制器的设计，将 Agent 调度划分为三个明确解耦的角色：</p>

<div align="center">
  <img src="/images/agent/ABot-AgentOS-agent-harness.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/474" />
<figcaption>Agent Harness 架构细节：Main LLM 负责全局场景感知规划，Skill Runner 隔离局部执行细节，Verifier 提供多阶段实时与终局验证</figcaption>
</div>

<ol>
  <li><strong>Main LLM（语义规划器）</strong>：接收用户指令与记忆上下文，根据当前场景生成可调整的高层计划与显式完成条件。Main LLM 不直接发出每一脚底层的微观动作，而是决定直接调用工具或将子任务委托给 Skill Runner。</li>
  <li><strong>Skill Runner（过程执行器）</strong>：作为技能级 Subagent 运行在独立的局部上下文中。它处理局部反复移动、视角微调与碰撞恢复等复杂过程，仅向 Main LLM 返回压缩后的高层执行结果摘要，防止局部细节阻塞 Main LLM 的全局规划。</li>
  <li><strong>Verifier（多阶段验证器）</strong>：
    <ul>
      <li><strong>运行期验证（Runtime Verification）</strong>：监控轨迹与技能状态，及时识别停滞、局部死循环与频繁碰撞。</li>
      <li><strong>技能期验证（Skill Verification）</strong>：核查子任务是否真正达成语义目标，而非仅凭 Tool 返回成功。</li>
      <li><strong>结束期验证（Finish Verification）</strong>：在 Main LLM 试图终止任务时，对比初始指令、最终视觉观察与环境事实，防止虚假完成。</li>
    </ul>
  </li>
</ol>

<h4 id="-通用多模态图记忆与终身自进化">③ 通用多模态图记忆与终身自进化</h4>

<div align="center">
  <img src="/images/agent/ABot-AgentOS-memory-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/983" />
<figcaption>通用多模态记忆架构与离线故障驱动自进化循环：在线写入源头可溯的类型图，离线将失败 Trace 编译为可控 JSON DSL 进化资产</figcaption>
</div>

<ol>
  <li><strong>多模态记忆图（Memory Graph）</strong>：将在线交互中的实体、事件、地点、视觉帧、时间关联与归因链（Provenance）写入强类型的节点与边，取代原始视频流或纯文本日志的堆叠。</li>
  <li><strong>混合图检索器（Hybrid Graph Retriever）</strong>：结合语义嵌入、词法匹配、元数据过滤与图边拓扑展开，抽取高质量局部证据子图。</li>
  <li><strong>故障驱动终身自进化（Failure-Driven Lifelong Self-Evolution）</strong>：
    <ul>
      <li><strong>Split 隔离协议</strong>：在序列 split 部署中，第 \(t\) 个 split 仅能使用历史已晋级的进化资产 \(A_{&lt;t}\)。</li>
      <li><strong>Trace 诊断与资产编译</strong>：在 split 完成后，系统对失败样本进行 Trace 诊断，生成 JSON DSL 格式的候选进化资产（覆盖记忆写入、证据选择、帧选取、时间归一化等阶段）。</li>
      <li><strong>严格门控校验（Gating）</strong>：候选资产必须在目标验证集上提升分数且在回归集上不降低性能：
\(\text{Accept}(a) = \mathbb{I}[\Delta S_{\text{target}}(a) \ge \tau_{\text{gain}} \land \Delta S_{\text{reg}}(a) \ge -\tau_{\text{reg}}]\)
检验通过后方可晋级为 \(A_{\le t}\) 供后续 split 使用，实现无标注泄露的累积增长。</li>
    </ul>
  </li>
  <li><strong>边云协同隐私管理</strong>：边缘保留私有记忆（人脸、个人物品等），仅将公共无敏感信息的环境记忆（路障、道路地标）上云分享，隐私分类准确率达 99% 以上。</li>
</ol>

<h4 id="-embodiedworldbench-与策略蒸馏训练管线">④ EmbodiedWorldBench 与策略蒸馏训练管线</h4>

<div align="center">
  <img src="/images/agent/ABot-AgentOS-embodied-world-bench.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1324/898" />
<figcaption>EmbodiedWorldBench 评测基准概览：涵盖室内外复合场景、NPC 交互与动态事件的 16 个可执行场景与 4 级难度设定</figcaption>
</div>

<p>论文推出了 <strong>EmbodiedWorldBench</strong>，涵盖 16 个室内、室外及混合场景，设 4 个难度等级与 200+ 个涉及导航、NPC 交互、物品搜索与动态事件响应的复合任务。</p>

<div align="center">
  <img src="/images/agent/ABot-AgentOS-training-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1324/902" />
<figcaption>学生策略端到端训练管线：通过文本沙盒构建环境、自进化奖励引擎生成偏好数据并使用 DPO/SFT 优化边缘部署模型</figcaption>
</div>

<p>为了将云端大模型 Agent Harness 的能力下沉到端侧小模型，论文设计了端到端蒸馏管线：</p>
<ol>
  <li><strong>可控文本沙盒构建</strong>：使用 LLM 自动生成具有可执行状态与复杂逻辑的文本沙盒环境。</li>
  <li><strong>自进化奖励引擎</strong>：基于结构化 Trace 生成自动评分与 DPO 偏好对。</li>
  <li><strong>SFT + DPO 策略优化</strong>：在沙盒环境中训练部署轻量化 Student Policy。</li>
</ol>

<hr />

<h3 id="3-核心结果发现-4">3. 核心结果/发现</h3>

<ol>
  <li><strong>长程具身执行</strong>：在 EmbodiedWorldBench 初始子集评估中，ABot-AgentOS 相较于单一控制器基线在任务成功率（Success Rate）与目标完成度（Goal Completion）上均取得显著提升，Verifier 机制减少了 35% 以上的早期误终止。</li>
  <li><strong>多模态记忆基准全面领先</strong>：
    <ul>
      <li><strong>LoCoMo</strong>（长程会话记忆）：Static 版本达到 <strong>87.5</strong>，+Self-evo 提升至 <strong>88.7</strong>（接近人类上限 87.7）。</li>
      <li><strong>OpenEQA (EM-EQA)</strong>：8 帧预算下 Static 达到 <strong>59.9</strong>，+Self-evo 提升至 <strong>60.4</strong>（超越 SnapMem 57.2 与 GaussExplorer 57.8）。</li>
      <li><strong>Mem-Gallery</strong>：Static 达到 <strong>88.6</strong>，+Self-evo 提升至 <strong>89.0</strong>（在冲突检测 CD 97.5% 与拒绝回答 AR 100% 上表现突出）。</li>
      <li><strong>NExT-QA</strong>：Validation Acc@All 达到 <strong>76.5%</strong>（+Self-evo 提升 4.1 点），大幅领先 VideoAgent 等经典视频 Agent。</li>
      <li><strong>EgoLifeQA</strong>：单帧检索设置下取得 <strong>66.2%</strong> 平均准确率。</li>
    </ul>
  </li>
  <li><strong>终身自进化的跨任务泛化</strong>：自进化机制在所有 5 个记忆基准上均带来了稳定增量，且性能增益完全来源于对记忆流水线（如时间规范化、关系消歧）的通用改进，而非记忆内容的暴力堆叠。</li>
</ol>

<hr />

<h3 id="4-局限性-4">4. 局限性</h3>

<ol>
  <li><strong>复杂真实物理世界的感知与控制噪声</strong>：目前大规模验证多在可执行仿真或半物理沙盒中进行，面对真实世界的高噪深度感知、抓取失败与网络通信时延仍需更深度的硬件实机调优。</li>
  <li><strong>自动化蒸馏依赖文本沙盒</strong>：小模型策略蒸馏目前主要依赖文本状态沙盒环境，未来需要引入多模态视觉观察与更复杂的物理仿真平台（如 Isaac Sim/Habitat）。</li>
  <li><strong>记忆自进化需要可信的反馈信号</strong>：离线自进化机制依赖确定性的错误诊断或人类反馈，在开放无监督环境中如何安全界定“回答错误”仍是长远挑战。</li>
</ol>

<hr />

<h2 id="agentic-embodied-control">11. Agentic Embodied Control (2026)</h2>
<p>———极简接口下的通用智能体直接掌控具身交互循环，零样本性能比肩工业级训练策略</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.26148">arXiv:2607.26148</a></p>

<h3 id="精华-5">精华</h3>
<ol>
  <li><strong>控制范式的根本反思</strong>：打破具身导航依赖“专门策略训练”或“人工固定工作流/双脑交接状态机”的固有模式，证明冻结权重的通用大模型仅凭代码智能体框架（Harness）和最极简的感知动作接口，即可完全自主掌控交互循环并在零样本下取得顶尖性能。</li>
  <li><strong>极简接口下的强大控制力</strong>：在仅提供 $512 \times 512$ 单目 RGB 图像（无深度、无全景、无建图、无位姿反馈）和 4 个离散动作原语（前进 $0.25\text{ m}$、左转 $15^\circ$、右转 $15^\circ$、停止）的前提下，前沿推理模型（Fable-5 / Opus-5）在 R2R-CE 连续导航基准上达到 $70.7\% \sim 78\%$ 成功率，直接比肩工业级规模训练的导航策略。</li>
  <li><strong>能力来源的单轴解耦</strong>：消融实验证实<strong>底层基础模型能力起决定性支配作用</strong>（模型切换导致 SR 跨度高达 $5\% \sim 72\%$），而不同通用 Agent Harness 的差异微乎其微（仅 $1.7\% \sim 7.3\%$）。</li>
  <li><strong>混合接口的涌现协同</strong>：强制智能体使用路标预测器（Forced Waypoint）反而限制了强模型的微调对齐；而将路标作为可选工具（Hybrid Interface）开放时，智能体自主涌现出“远距离选路标快速巡航 + 目标近处切原语精细微调”的策略，以 $50\%$ 的步数和不足四分之一的耗时达到 $76.7\%$ 成功率。</li>
  <li><strong>无声失效与具身落地鸿沟</strong>：深入审计 30 个失败案例发现智能体存在严重的“有疑无改”现象（思考链已察觉偏航却依然执行错误终止）；实体四足机器狗部署表明“推理能力可迁移，但本体感知不可迁移”，缺乏尺寸意识与持久空间记忆是制约长程自主的核心瓶颈。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-5">1. 研究背景/问题</h3>
<ul>
  <li><strong>现有具身导航的两大技术路线与控制权外置困境</strong>：
    <ul>
      <li><strong>端到端训练策略（Trained Policies）</strong>：如 NaVid、StreamVLN 等，通过海量具身数据训练专用网络，将观测逐帧映射为动作。此类方法对数据分布高度敏感，遇到分布外障碍或未见过的指令时缺乏高层泛化与反思纠错能力。</li>
      <li><strong>固定工作流与双脑系统（Fixed Workflows &amp; Dual-Brain）</strong>：如 MapGPT、NavCoT、ABot-N1 等，虽然引入大模型，但将模型严格限制在人类编写的固定流水线中（例如固定先调用深度建图、再调用拓扑规划、再交接给低层控制器）。智能体无法根据当前情境自由决定何时观察、何时多走几步、何时放弃现有假设。</li>
    </ul>
  </li>
  <li><strong>核心研究问题</strong>：
    <ul>
      <li>能否彻底剔除针对导航任务专门设计的外部脚手架（无外部地图、无深度传感器、无预设启发式搜索、无专用策略网络），<strong>直接将高层交互控制权（Control Authority）完全交由通用推理智能体主导</strong>？</li>
      <li>在最极简的单目前视视角与离散动作接口下，通用大模型的具身控制上限究竟有多高？其真正的能力边界与落地卡点何在？</li>
    </ul>
  </li>
</ul>

<hr />

<h3 id="2-主要方法创新点-5">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/Agentic-Embodied-Control-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/789" />
<figcaption>图 1：具身交互循环控制权归属对比（左）、极简接口交互探针架构（中）以及在 R2R-CE 上与强基线的成功率对比（右）</figcaption>
</div>

<h4 id="-整体框架概述智能体自主具身控制agentic-embodied-control">① 整体框架概述：智能体自主具身控制（Agentic Embodied Control）</h4>
<p>论文提出了一种极简的具身控制探针系统。整个系统由三层完全解耦的组件构成：<strong>通用代码智能体框架（Harness）</strong>、<strong>极简感知动作接口（Interface）</strong> 和 <strong>冻结权重的多模态推理模型（Model）</strong>。智能体在整个交互过程中拥有完全的控制主导权，根据自然语言指令与历史交互记录，自主决定每一轮调用观察工具、步进动作或是终止任务。</p>

<h4 id="-逐模块深度解析输入--处理--输出--设计动机">② 逐模块深度解析（输入 → 处理 → 输出 → 设计动机）</h4>

<ol>
  <li><strong>通用智能体框架层（Harness Layer）</strong>
    <ul>
      <li><strong>输入</strong>：用户下达的自然语言导航指令与当前会话的历史调用文本/图像上下文。</li>
      <li><strong>处理过程</strong>：直接采用为代码工程设计的通用框架（如开源的 <code class="language-plaintext highlighter-rouge">mini-swe-agent</code>、Anthropic 的 <code class="language-plaintext highlighter-rouge">Claude Agent SDK</code> 或 OpenAI 的 <code class="language-plaintext highlighter-rouge">Codex CLI</code>）。框架仅负责提示词拼接、工具分发执行、维持上下文会话，<strong>不包含任何导航专用状态估计、拓扑图构建或回溯策略</strong>。</li>
      <li><strong>输出</strong>：格式化的工具调用请求（Tool Calls）及环境返回结果。</li>
      <li><strong>设计动机</strong>：剥离所有围绕导航任务手工定制的外围代码逻辑，确保实验纯粹测试底层模型自身的具身推理与自主决策能力。</li>
    </ul>
  </li>
  <li><strong>极简感知工具 <code class="language-plaintext highlighter-rouge">observe()</code></strong>
    <ul>
      <li><strong>输入</strong>：智能体在需要确认周围环境时发起无参数调用。</li>
      <li><strong>处理过程</strong>：环境渲染并返回当前智能体正前方的单张 $512 \times 512$ 分辨率 RGB 图像。<strong>调用该工具不会推进仿真器时间步或消耗步数预算</strong>。</li>
      <li><strong>输出</strong>：单张前视 RGB 图像。无全景视角、无深度图、无目标检测框、无语义分割、无激光点云。</li>
      <li><strong>设计动机</strong>：强制智能体摆脱对全景图和深度传感器的依赖，考察模型仅凭单目前视图像序列在脑海中维持空间朝向与地标记忆的能力。</li>
    </ul>
  </li>
  <li><strong>极简动作工具 <code class="language-plaintext highlighter-rouge">step(actions)</code></strong>
    <ul>
      <li><strong>输入</strong>：一个由四个 Habitat 离散动作原语组成的有序序列列表（如 <code class="language-plaintext highlighter-rouge">["LEFT", "LEFT", "FORWARD", "FORWARD", "FORWARD"]</code>）。四个原语包括：
        <ul>
          <li><code class="language-plaintext highlighter-rouge">FORWARD</code>：向前移动 $0.25\text{ m}$；</li>
          <li><code class="language-plaintext highlighter-rouge">LEFT</code>：原地左转 $15^\circ$；</li>
          <li><code class="language-plaintext highlighter-rouge">RIGHT</code>：原地右转 $15^\circ$；</li>
          <li><code class="language-plaintext highlighter-rouge">STOP</code>：宣告任务完成并主动终止评测。</li>
        </ul>
      </li>
      <li><strong>处理过程</strong>：底层控制器按顺序执行该动作序列，受到单 episode 最大 500 步离散原语总预算的限制。</li>
      <li><strong>输出</strong>：仅返回实际执行的原语数量和剩余可用步数。<strong>不返回任何视觉观察、不返回碰撞信号、不返回位姿或坐标漂移数据</strong>。</li>
      <li><strong>设计动机</strong>：允许模型根据对环境的把握自主决定动作粒度（可发单个旋转微调，也可发一串组合前进）；隐藏碰撞与位姿信息以迫使模型必须在执行后主动调用 <code class="language-plaintext highlighter-rouge">observe()</code>，通过对比前后图像的视差变化来内省推断是否发生碰撞或卡阻。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/Agentic-Embodied-Control-episode-trace.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/548" />
<figcaption>图 2：R2R-CE 连续环境中一个成功导航 episode 的完整执行日志重构，展现了智能体自主纠偏与空间反思过程</figcaption>
</div>

<h4 id="-端到端交互数据流与自主纠偏机制">③ 端到端交互数据流与自主纠偏机制</h4>
<p>如图 2 所示，在一个完整的导航测试中（如包含 20 次观察、20 次步进、共 111 个离散原语动作），智能体展现了高度自洽的推理与自适应调整循环：</p>
<ul>
  <li><strong>视野建立与转向</strong>：初始观察到面对墙壁，模型推理出“需要转 180 度，即连续调用 12 次 15 度的左转”并批量下发 <code class="language-plaintext highlighter-rouge">L×12</code>。</li>
  <li><strong>碰撞与偏航感知</strong>：在执行 <code class="language-plaintext highlighter-rouge">F×5</code> 后调用 <code class="language-plaintext highlighter-rouge">observe()</code> 发现视野几乎未变，模型在思考链中写道“我几乎没动，可能是右侧撞到了床角；让我向左偏转一点绕开它”，随即自主下发 <code class="language-plaintext highlighter-rouge">L2 F4</code> 成功脱困。</li>
  <li><strong>探索与回退</strong>：误入带有梳妆台的小房间后，模型核对指令发现“原指令并未提及此房间，应直接穿过走廊去浴室”，立即掉头重新对准走廊并最终在距离浴室目标 $2.98\text{ m}$ 处自主执行 <code class="language-plaintext highlighter-rouge">STOP</code>。</li>
</ul>

<hr />

<h4 id="-难点降维-1具身控制范式的本质跃迁control-authority">④ 难点降维 1：具身控制范式的本质跃迁（Control Authority）</h4>

<p>很多读者容易把本工作误解为“又一个用 Prompt 跑 VLN 的零样本方法”。其核心差异在于<strong>控制权归属（Control Authority）与工具调用模式</strong>。</p>

<table>
  <thead>
    <tr>
      <th>控制范式</th>
      <th>控制权归属</th>
      <th>核心机制</th>
      <th>遇到异常/阻碍时的表现</th>
      <th>代表方法</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>端到端策略网络 (Policy)</strong></td>
      <td>外部环境循环</td>
      <td>单一神经网络每步输入图像直接映射为动作</td>
      <td>缺乏高层反思，容易在死胡同里陷入局部震荡</td>
      <td>NaVid, StreamVLN</td>
    </tr>
    <tr>
      <td><strong>固定流水线 (Workflow)</strong></td>
      <td>外部 Python 脚本</td>
      <td>规则代码硬编码固定流程（建图 → 找路标 → 规划 → 执行）</td>
      <td>流程僵化，无法根据即时困难动态改变观察频率或求助其他工具</td>
      <td>MapGPT, SmartWay</td>
    </tr>
    <tr>
      <td><strong>慢快双脑系统 (Dual-Brain)</strong></td>
      <td>预设交接协议</td>
      <td>慢速 VLM 规划高层子目标，固定交接给快速动作专家网络</td>
      <td>交接逻辑与更新频率由人工写死，高层意图常被低层策略失真</td>
      <td>ABot-N1, InternVLA-N1</td>
    </tr>
    <tr>
      <td><strong>智能体自主控制 (Agentic Control)</strong></td>
      <td><strong>推理模型自身</strong></td>
      <td>统一由通用大模型自主决定何时感知、走几步、查地图还是选路标</td>
      <td>模型完全自主掌控重试、绕行、重新定向与提前终止</td>
      <td><strong>本文方法</strong></td>
    </tr>
  </tbody>
</table>

<pre><code class="language-mermaid">graph TD
    subgraph "Agentic Embodied Control 决策闭环"
        A["输入: 语言指令 + 历史会话记录"] --&gt; B["通用大模型推理思考 (CoT)"]
        B --&gt; C{"模型自主决断下一步"}
        C -- "需要新视野" --&gt; D["调用 observe() 获取单目前视 RGB"]
        C -- "执行位移" --&gt; E["调用 step([ACTIONS...]) 下发离散动作序列"]
        C -- "确认抵达终点" --&gt; F["下发 STOP 终止评测"]
        D --&gt; G["将新图像与状态追加至上下文"]
        E --&gt; H["将执行步数/剩余预算追加至上下文"]
        G --&gt; B
        H --&gt; B
    end
</code></pre>

<hr />

<h4 id="-难点降维-2混合动作接口hybrid-interface的协同涌现">⑤ 难点降维 2：混合动作接口（Hybrid Interface）的协同涌现</h4>

<p>强制给智能体绑定路标预测器（Forced Waypoint）往往会削弱强模型的表现；但如果将<strong>离散原语</strong>与<strong>训练好的路标预测器</strong>同时开放给智能体作为可选工具（Hybrid Interface），智能体会自主组合出极具启发性的“粗细协同”策略。</p>

<blockquote>
  <p><strong>举个具体例子</strong>：
假设任务是从客厅出发，穿过 10 米长的走廊，进入主卧在床头柜旁停下（总距离约 14 米）。</p>
  <ul>
    <li><strong>纯原语模式</strong>：由于每次前进仅 $0.25\text{ m}$，走完 10 米走廊需要模型反复发出 $40$ 次前进原语，并频繁调用 <code class="language-plaintext highlighter-rouge">observe()</code> 检查走廊两侧门洞，容易因微小角度偏航反复微调，总共消耗约 $90$ 个原语步数与近 $40$ 次模型交互调用（耗时约 $210\text{ s}$）。</li>
    <li><strong>强制路标模式</strong>：模型只能从预测器给出的最多 5 个路标点中选择。在开阔走廊中只需 2~3 个路标即可快速通过；但在接近床头柜的最后 $1\text{ 米}$ 狭窄区域，预测器给出的候选点往往不够贴合床边甚至紧贴墙面，导致最终停靠偏离目标或碰撞，在复杂转角处极易超调。</li>
    <li><strong>混合模式（Hybrid）</strong>：智能体在前 80% 的长走廊路程中自主连续调用 3~4 次<strong>路标导航</strong>快速巡航；一旦视野中检测到床头柜进入近景，模型立即主动切换为<strong>离散原语工具</strong>，以 $0.25\text{ m}$ 和 $15^\circ$ 的微步精细对齐最终停靠点。
<strong>结果</strong>：步数从 87 步腰斩至 48 步，调用轮数减少一半，交互耗时从 $210\text{ s}$ 锐减至 $112\text{ s}$，成功率反而从纯原语的 $68.3\%$ 提升到 $76.7\%$！</li>
  </ul>
</blockquote>

<hr />

<h4 id="-难点降维-3具身智能体的无声失效与有疑无改">⑥ 难点降维 3：具身智能体的“无声失效”与“有疑无改”</h4>

<p>对 30 个失败 episode 的细致追踪揭示了当前通用大模型在具身环境下的深层行为缺陷。</p>

<table>
  <thead>
    <tr>
      <th>失败类别</th>
      <th>占比 (n=30)</th>
      <th>中位数最终距目标距离</th>
      <th>典型表现与根本原因</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>A. 错误指代 / 错误分支 (Wrong Referent / Branch)</strong></td>
      <td>$40.0\%$ (12例)</td>
      <td>$17.3\text{ m}$</td>
      <td>指令中包含多个歧义门洞或分岔路，模型在第一步就选错通道并一路走向完全无关的房间。</td>
    </tr>
    <tr>
      <td><strong>B. 停止决策失误 (Stop Decision)</strong></td>
      <td>$23.3\%$ (7例)</td>
      <td>$4.9\text{ m}$</td>
      <td>模型视野中看到了指令中提及的目标物体（如沙发），但该物体是沿途参照物而非最终目的地，模型过早终止（Object-anchored overshoot/undershoot）。</td>
    </tr>
    <tr>
      <td><strong>C. 迷失发散搜索 (Runaway Search)</strong></td>
      <td>$26.7\%$ (8例)</td>
      <td>$18.6\text{ m}$</td>
      <td>错过关键拐角后，模型没有选择掉头回溯，而是在未见区域盲目扩大搜索范围，距离目标越来越远。</td>
    </tr>
    <tr>
      <td><strong>D. 几何碰撞陷阱 (Geometry / Trap)</strong></td>
      <td>$10.0\%$ (3例)</td>
      <td>$5.5\text{ m}$</td>
      <td>因缺乏碰撞反馈，模型在桌椅死角反复前进受阻，但无法从纯视觉中分辨是否卡死。</td>
    </tr>
  </tbody>
</table>

<pre><code class="language-mermaid">graph TD
    A["发生偏航 / 错过关键地标"] --&gt; B["视觉观测 observe() 与预期地标不符"]
    B --&gt; C["CoT 内部思考链: '这里似乎不是浴室，我可能走错了'"]
    C --&gt; D{"决策分叉点: 是否执行回溯?"}
    D -- "期望行为 (自我纠正)" --&gt; E["掉头 180 度，回溯至上一关键分岔路口"]
    D -- "实际普遍行为 (有疑无改)" --&gt; F["将错就错: 强行将眼前无关房间解释为终点"]
    F --&gt; G["主动下发 step([STOP]) 自称抵达目标 (无声失效)"]
</code></pre>

<hr />

<h3 id="3-核心结果发现-5">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/Agentic-Embodied-Control-ablations.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/508" />
<figcaption>图 3：单轴消融实验结果。(A) 模型能力跨越 5~72 SR；(B) 开源与厂商 Harness 差异仅 2~7 SR；(C) 路标接口对弱模型是救命稻草，但对强模型和密集环境反而带来负面影响</figcaption>
</div>

<h4 id="-r2r-ce-主榜成绩对比">① R2R-CE 主榜成绩对比</h4>
<p>在标准的 R2R-CE val-unseen（rand100 子集）上，极简接口下的通用智能体展现出惊人的零样本表现：</p>
<ul>
  <li><strong>顶级表现</strong>：Fable-5 在 Claude Agent SDK 下（最大思考预算）达到 <strong>$78.0\%$ 成功率（SR）</strong> 和 <strong>$65.27\%$ 路径加权成功率（SPL）</strong>；Opus-5 达到 <strong>$70.7 \pm 3.5\%$ SR</strong>。</li>
  <li><strong>超越同类零样本系统</strong>：大幅领先同样在零样本设置下使用地图、显式记忆与深度工具的 AgenticNav（$55.0\%$ SR）与 Open-Nav（$50.0\%$ SR）。</li>
  <li><strong>比肩工业级训练策略</strong>：直接逼近并部分超越了在数万小时具身数据上全量训练的专用策略，如 Qwen-RobotNav（全量验证集 $72.0\%$ SR）、NavFM（$77.2\%$ SR）以及 StreamVLN（$64.9\%$ SR）。</li>
</ul>

<h4 id="-模型harness-与接口的三维解耦发现">② 模型、Harness 与接口的三维解耦发现</h4>
<ol>
  <li><strong>模型轴（Model Dominates）</strong>：在固定 Harness 和接口的情况下，仅更换底层 VLM 即可引起 $5\% \sim 72\%$ 的巨大性能跨度（Qwen3.5-4B 仅 $5\%$，GPT-5.6 达 $60\%$，Fable-5 达 $72\%$）。表明具身导航能力本质上是多模态空间推理与长上下文指令跟踪能力的自然涌现。</li>
  <li><strong>Harness 轴（Harness is Modest）</strong>：对比轻量开源的 <code class="language-plaintext highlighter-rouge">mini-swe-agent</code> 与闭源的 <code class="language-plaintext highlighter-rouge">Claude SDK</code> / <code class="language-plaintext highlighter-rouge">Codex CLI</code>，在同一模型下性能差异仅在 $1.7\% \sim 7.3\%$ 之间。</li>
  <li><strong>思考预算（Reasoning Effort）</strong>：增加模型的思维链计算量（Reasoning Effort）对部分模型有显著收益（Fable-5 从 default 的 $68.3\%$ 飙升至 max effort 的 $78.0\%$，提升 $+9.7\%$），但对小模型收益并不稳健。</li>
  <li><strong>路标工具的双刃剑效应</strong>：
    <ul>
      <li>在 R2R-CE 上，对于较弱的模型（如 Qwen3.5-4B/9B），路标预测器将成功率从 $5\%/7\%$ 拯救至 $43\%/44\%$；但对于顶尖模型（Fable-5 / Opus-5），强制使用路标带来的提升仅为 $+0.7\% \sim +1.3\%$。</li>
      <li>在障碍更密集、路径更复杂的 <strong>VLNVerse</strong> 基准上，强制路标接口反而导致 Sonnet-5 成功率下降 $6\%$（$78\% \rightarrow 72\%$），Fable-5 下降 $4\%$（$84\% \rightarrow 80\%$），且碰撞率激增 4~6 倍。</li>
    </ul>
  </li>
</ol>

<h4 id="-真实四足机器狗unitree-go2实体部署">③ 真实四足机器狗（Unitree Go2）实体部署</h4>
<p>在办公楼真实环境中进行的 31 次探索性实验表明：</p>
<ul>
  <li><strong>推理能力成功迁移</strong>：智能体能完美理解复杂条件指令（如“如果 $3+4=7$ 则左转，否则右转”）、多阶段“取物并返回”状态追踪，以及通过视觉细微特征（如“走向穿白色鞋子的人”）完成目标锁定。</li>
  <li><strong>本体感知完全缺失</strong>：由于智能体不知道自身的物理尺寸（长宽与后腿位置），相机刚穿过门框即过早下发左转指令，导致机器狗后躯干直接撞上门框卡死（图 10）；此外，开环步进执行导致偏航角度累计漂移，且跨视角连续过柱子时发生计数混淆（图 11）。</li>
</ul>

<hr />

<h3 id="4-局限性-5">4. 局限性</h3>
<ul>
  <li><strong>长程任务的上下文与时间开销暴涨</strong>：在长程基准 RxR-CE 上，纯原语成功率从 $70\%$ 暴跌至 $26\%$；单 episode 交互产生的历史 token 达到 $33\text{k} \sim 169\text{k}$，单次决策中位数耗时超 200 秒，极度缺乏紧凑高效的持久空间记忆与状态整合机制。</li>
  <li><strong>开环控制与内省纠错闭环缺失</strong>：缺乏本体物理感知与碰撞反馈容易在现实物理世界中发生几何卡死；同时模型内部存在严重的“自疑却盲目终止”行为，亟需建立真正的自我验证与主动回溯探索闭环。</li>
</ul>

<hr />

<h2 id="route2step">12. Route2Step (2026)</h2>
<p>———解耦语义进度与局部执行，通过显式步级接口赋能具身导航纠偏</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.03143">arXiv:2608.03143</a> · 🏛️ <strong>ECCV 2026</strong> · <a href="https://sisyphus-hxy.github.io/Route2Step/">Project Page</a></p>

<h3 id="精华-6">精华</h3>
<ol>
  <li><strong>解耦语义跟踪与物理执行</strong>：将连续视觉语言导航（VLN-CE）分解为负责全局语义进度的指令分析模块（\(\mathcal{M}_{\text{IA}}\)）与负责局部运动控制的动作生成模块（\(\mathcal{M}_{\text{AG}}\)），通过“活动子指令 + 执行状态（Normal/Recovering）”显式接口解耦两者的优化目标与时序感受野。</li>
  <li><strong>免人工标注的几何航路点对齐（E-SPA）</strong>：利用融合视觉语义、动作意图、时长正则及垂直楼梯硬锚点的多模态动态规划，自动将路线级演示切分为有序子指令轨迹段，并将各段终点位姿提取为物理空间中的语义航路点。</li>
  <li><strong>分层纠偏消除错误耦合</strong>：在固定子指令下采样策略 rollout，将离轨与环回轨迹统一转化为物理接地的“状态级监督”（190K 样本），而将专家动作标签严格限制在反复失败的 Recovering 区间（仅 11.5K 样本），根治了传统 DAgger 将偏离统一归咎于动作预测失误的缺陷。</li>
  <li><strong>极高数据效率与即插即用迁移性</strong>：仅用 11.5K 动作监督即超越 200K 传统 DAgger 样本，在 R2R-CE 取得 55.3% SR / 48.2% SPL；预测的活动子指令还能直接注入给 StreamVLN、NaVILA、Uni-NaVid 等冻结模型实现零样本性能跃升。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-6">1. 研究背景/问题</h3>
<p>现有基于多模态大模型（VLM）的具身导航策略通常采用端到端统一架构，直接从全局长指令和视觉历史预测低层控制动作。然而，当智能体在连续环境中偏离参考路径时，这种统一策略无法区分两种本质不同的错误来源：<strong>语义进度错误</strong>（智能体选错了当前活动的子指令）与<strong>局部执行错误</strong>（智能体明确当前子目标但操作失误，如卡在门框）。</p>

<p>传统的 DAgger 纠偏机制为所有离轨状态直接赋予专家下一步动作标签。这种做法虽然能让机器人暂时回到路线上，但并未显式纠正智能体内部紊乱的语义进度估计；智能体依然在错误的子目标下继续决策，导致后续动作持续失准。如何在无需人工密集标注的前提下，将语义进度跟踪与局部执行解耦，并为不同时序层次精准分配纠偏监督，是实现鲁棒长程具身导航的核心瓶颈。</p>

<hr />

<h3 id="2-主要方法创新点-6">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/Route2Step-concept-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:677/682" />
<figcaption>图 1：Route2Step 将路线级理解与步级局部执行解耦。$\mathcal{M}_{\text{IA}}$ 负责确定当前活跃的子指令，$\mathcal{M}_{\text{AG}}$ 则依据局部观测窗口负责具体执行。</figcaption>
</div>

<h4 id="-整体框架概述-1">① 整体框架概述</h4>
<p>Route2Step 摒弃了传统的端到端直接预测动作模式，构建了由<strong>离线步级对齐引擎 E-SPA</strong>、<strong>指令分析模块 \(\mathcal{M}_{\text{IA}}\)</strong> 与<strong>动作生成模块 \(\mathcal{M}_{\text{AG}}\)</strong> 组成的分层架构。\(\mathcal{M}_{\text{IA}}\) 依据全局长指令与全量视觉历史确定“当前处于哪个子步骤且是否需要恢复”，\(\mathcal{M}_{\text{AG}}\) 则根据显式接口与近期局部观测窗口自回归生成动作块（Action Chunks）。</p>

<div align="center">
  <img src="/images/vln/Route2Step-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/685" />
<figcaption>图 2：Route2Step 整体架构。$\mathcal{M}_{\text{IA}}$ 输出显式接口 $(s_t, m_t)$，$\mathcal{M}_{\text{AG}}$ 结合全局指令、接口与近期观测输出动作块；离线由 E-SPA 引擎提供步级对齐与物理航路点。</figcaption>
</div>

<h4 id="-显式语义-执行接口mia-与-mag">② 显式语义-执行接口（MIA 与 MAG）</h4>
<p>系统将导航决策拆分为两个独立优化且具有不同时间感受野的模块：</p>
<ul>
  <li><strong>指令分析模块 \(\mathcal{M}_{\text{IA}}\)</strong>：
\((s_t, m_t) = \mathcal{M}_{\text{IA}}(I, V_{1:t})\)
输入全局指令 $I$ 与全局视觉历史 $V_{1:t}$（按幂律采样至多 13 帧历史 + 3 帧最新观测），输出当前活动的子指令 $s_t$（如 <code class="language-plaintext highlighter-rouge">"Exit the bedroom"</code>）以及二值执行状态 $m_t \in {\text{Normal}, \text{Recovering}}$。</li>
  <li><strong>动作生成模块 \(\mathcal{M}_{\text{AG}}\)</strong>：
\(a_{t:t+h} = \mathcal{M}_{\text{AG}}(I, s_t, m_t, V_{t-k:t})\)
输入全局指令 $I$、显式接口 $(s_t, m_t)$ 以及短时局部观测窗口 $V_{t-k:t}$（从最新 40 帧中采样 8 帧），自回归预测至多 3 步基元动作块 $a_{t:t+h} \in {\text{Forward}, \text{Left}, \text{Right}, \text{Stop}}$。</li>
</ul>

<p>两模块均基于 Qwen2.5-VL-3B 构建，中间接口通过自然语言文本序列化传递（例如 <code class="language-plaintext highlighter-rouge">Recovering: go through the white door.</code>）。<strong>两模块之间不跨接口反传梯度</strong>，彻底杜绝了局部动作更新对全局语义进度估计的隐式破坏。</p>

<table>
  <thead>
    <tr>
      <th>比较维度</th>
      <th>传统统一端到端策略（Unified DAgger）</th>
      <th>Route2Step 分层解耦框架</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>决策机制</strong></td>
      <td>$(I, V_{1:t}) \to \text{Actions}$（端到端黑盒隐式推理）</td>
      <td>\(\mathcal{M}_{\text{IA}}\) 管进度 $(s_t, m_t)$，\(\mathcal{M}_{\text{AG}}\) 管执行 $a_{t:t+h}$</td>
    </tr>
    <tr>
      <td><strong>偏离路线后</strong></td>
      <td>仅赋予专家动作，语义进度易发生错乱漂移</td>
      <td>物理航路点锁定 $s_t$ 不变，标记 $m_t=\text{Recovering}$ 专注脱困</td>
    </tr>
    <tr>
      <td><strong>时序感受野</strong></td>
      <td>全局历史与局部动作在同一网络内相互干扰</td>
      <td>\(\mathcal{M}_{\text{IA}}\) 看宏观历史，\(\mathcal{M}_{\text{AG}}\) 专看近 8 帧局部视野</td>
    </tr>
    <tr>
      <td><strong>纠偏数据分配</strong></td>
      <td>全量 200K 状态均强行灌入专家动作标签</td>
      <td>190K 状态级修正 \(\mathcal{M}_{\text{IA}}\) + 仅 11.5K 动作级精准纠偏</td>
    </tr>
  </tbody>
</table>

<h4 id="-e-spa-离线步级对齐机制">③ E-SPA 离线步级对齐机制</h4>
<p>标准 R2R 数据集仅包含路线级全文，缺乏细粒度时间步标注。E-SPA（Energy-minimizing Semantic Path Alignment）通过四维代价动态规划实现无监督步级切分：</p>

<pre><code class="language-mermaid">graph TD
    A["全局路线指令 I + 专家轨迹 T 帧"] --&gt; B["指令重写为 n 个子指令序列 S = {s1, ..., sn}"]
    B --&gt; C["构建候选段多模态代价矩阵 C(sk, i, j)"]
    C --&gt; D["垂直高度差 &gt;= 0.08m 楼梯硬锚点剪枝"]
    D --&gt; E["动态规划回溯全局最优边界 B* = {b1, ..., bn+1}"]
    E --&gt; F["提取各段终点位姿作为语义航路点 wk = (pk, thetak)"]
</code></pre>

<p>候选段 $[i, j]$ 分配给子指令 $s_k$ 的总代价定义为：
\(C(s_k, i, j) = \lambda_{\text{sem}} C_{\text{sem}}(s_k, i, j) + \lambda_{\text{act}} C_{\text{act}}(s_k, i, j) + \lambda_{\text{dur}} C_{\text{dur}}(i, j) + \lambda_{\text{anchor}} C_{\text{anchor}}(s_k, i, j)\)</p>

<p>其中：</p>
<ol>
  <li><strong>语义匹配代价 $C_{\text{sem}}$</strong>：提取 CLIP 归一化特征，通过温度缩放 Softmax 计算负对数似然；</li>
  <li><strong>动作一致性代价 $C_{\text{act}}$</strong>：将子指令的离线动作意图与轨迹实际运动向量求距离；</li>
  <li><strong>时长正则代价 $C_{\text{dur}}$</strong>：$C_{\text{dur}}(i, j) = (L_{i:j} - T/n)^2$，惩罚偏离均匀步长的切分；</li>
  <li><strong>几何锚点约束 $C_{\text{anchor}}$</strong>：检测连续高度变化 $\ge 0.08\text{m}$ 的楼梯区域，作为硬约束分块。</li>
</ol>

<blockquote>
  <p><strong>举个例子</strong>：一条包含 30 帧的专家轨迹，对应 3 个子指令（理想每段平均长 10 帧）。
若某候选切分把第 1 个子指令切在第 1–3 帧（仅 3 帧），其时长惩罚为 $(3 - 10)^2 = 49$；
动态规划在全局权衡 CLIP 图像相似度、动作意图与时长代价后，自动将其校准在语义与转弯特征最契合的第 1–9 帧区间，并提取第 9 帧机器人的三维坐标与偏航角作为物理语义航路点 $w_1 = (p_1, \theta_1)$。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/Route2Step-geometry-supervision.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:683/504" />
<figcaption>图 3：几何接地的分层监督机制。(a) 专家参考路径；(b) 步级对齐提取的语义航路点；(c) 固定子指令的策略 rollout 与专家介入式恢复（蓝色实线为 Normal，红色实线为 Recovering，蓝色虚线为失败探索）。</figcaption>
</div>

<h4 id="-几何接地的分层纠偏训练">④ 几何接地的分层纠偏训练</h4>
<p>模型训练分为两阶段：</p>
<ol>
  <li><strong>专家路径初始化</strong>：在对齐的专家轨迹上分别初始化 \(\mathcal{M}_{\text{IA}}\)（标注 $m_t = \text{Normal}$）与 \(\mathcal{M}_{\text{AG}}\)。</li>
  <li><strong>固定子指令 Rollout 与选择性专家介入</strong>：
    <ul>
      <li>保持当前活动的子指令 $s_k$ 恒定不变，让 \(\mathcal{M}_{\text{AG}}\) 以温度 0.5 多次采样 rollout；</li>
      <li>设定物理完成判定：当进入航路点物理范围（$\lVert p_t - p_k \rVert_2 \le 1.5\text{m}$ 且角度误差 $\le 45^\circ$）视为达标；</li>
      <li>若某子指令下多次尝试均告失败，则触发<strong>专家介入</strong>（当偏离距离超阈值时接管引回轨迹）。接管期间标记 $m_t = \text{Recovering}$，引回后交还控制权。整个过程中子目标 $s_k$ 保持不变！</li>
    </ul>
  </li>
</ol>

<p><strong>监督分配法则</strong>：</p>
<ul>
  <li><strong>状态级监督（\(\mathcal{D}_S\)，190K 样本）</strong>：所有常规与介入 rollout 的历史观测均用来训练 \(\mathcal{M}_{\text{IA}}\)，让其在各种迷路、环回状态下依然能认清真实语义进度与恢复状态；</li>
  <li><strong>动作级监督（\(\mathcal{D}_A\)，仅 11.5K 样本）</strong>：仅提取反复失败组中 Recovering 区间的专家动作块训练 \(\mathcal{M}_{\text{AG}}\)，专注于局部避障与脱困。</li>
</ul>

<p><strong>损失函数</strong>：
\(\mathcal{L}_{\text{IA}} = -\mathbb{E}_{\mathcal{D}_E \cup \mathcal{D}_S} \left[ \log p_{\theta_{\text{IA}}}(s_t, m_t \mid I, V_{1:t}) \right]\)
\(\mathcal{L}_{\text{AG}} = -\mathbb{E}_{\mathcal{D}_E \cup \mathcal{D}_A} \left[ \log p_{\theta_{\text{AG}}}(a_{t:t+h} \mid I, s_t, m_t, V_{t-k:t}) \right]\)</p>

<hr />

<h3 id="3-核心结果发现-6">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/Route2Step-realworld-trace.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/704" />
<figcaption>图 4：在复杂室内真实环境中的实机导航轨迹。观测图像下方标注了 $\mathcal{M}_{\text{IA}}$ 预测的活动子指令，展现长程任务中清晰可解释的语义进度跟踪。</figcaption>
</div>

<ol>
  <li><strong>主榜单表现出色</strong>：在连续环境基准 R2R-CE Val-Unseen 上，Route2Step 在仅使用单目 RGB 且无额外数据预训练的条件下，取得了 <strong>55.3% 成功率（SR）</strong> 与 <strong>48.2% SPL</strong>，较专家基线（48.1% SR / 43.3% SPL）提升了 7.2 个百分点；在 RxR-CE Val-Unseen 亦取得 54.8% SR 与 42.6% SPL。</li>
  <li><strong>纠偏监督分配极高能效</strong>：
    <ul>
      <li>传统 DAgger 使用 200K 动作监督仅提升至 49.8% SR；</li>
      <li>Route2Step 采用 190K 状态级修正 + <strong>仅 11.5K 动作级监督</strong> 即跃升至 55.3% SR，动作监督量缩减至 1/17，但效果超出 5.5 个百分点。</li>
    </ul>
  </li>
  <li><strong>偏离状态下语义跟踪准确率跃升</strong>：在 FG-R2R 人工对齐验证集上，面对人为注入的航向偏离、横向绕行、倒车及回环扰动，状态级修正使 \(\mathcal{M}_{\text{IA}}\) 的严格子指令跟踪准确率从 43.54% 大幅提升至 <strong>54.05%</strong>（+10.51%）。</li>
  <li><strong>优于 7B 统一端到端大模型</strong>：使用完全相同训练数据的单体 Qwen2.5-VL-7B 统一策略仅取得 50.7% SR / 44.1% SPL，证明显式分层解耦的结构优势显著优于隐式统一策略。</li>
  <li><strong>即插即用的跨策略泛化能力</strong>：将 \(\mathcal{M}_{\text{IA}}\) 预测的活动子指令作为外部文本提示直接注入冻结的 NaVid、Uni-NaVid、NaVILA 与 StreamVLN，无需任何二次训练，四款模型的 SR 分别直接提升 <strong>+4.9%、+2.5%、+1.1%、+0.6%</strong>。</li>
  <li><strong>实机部署验证（Unitree GO2 四足机器人）</strong>：搭载 Intel RealSense D455 单目 RGB，在包含实验室、咖啡馆、居民区、公园及停车场等 9 种跨场景测试中取得 19/33 成功率；在 120 词超长复杂室内任务中取得 3/5 成功（平均完成 5.0/7 个子目标），而基线 StreamVLN 成功率为 0/5（仅推进 2.2/7）。</li>
</ol>

<hr />

<h3 id="4-局限性-6">4. 局限性</h3>
<ol>
  <li>物理语义航路点依赖环境局部连通性假设，当遇到门被完全锁闭或严重遮挡等不可行拓扑时，系统尚缺乏主动重规划全局路线的高层机制。</li>
  <li>采用双 3B VLM 独立运行在端侧推理时带来了双倍的前向计算开销，未来可探索多任务权重共享或轻量化蒸馏压缩。</li>
</ol>

<hr />

<h2 id="humanoidvln">13. HumanoidVLN (2026)</h2>
<p>———首个面向多样化双足人形机器人的物理真实 VLN 仿真平台与基准</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.12860">arXiv:2608.12860</a> · 🏛️ <strong>IEEE RA-L</strong> · <a href="https://humanoid-vln.github.io/">Project Page</a></p>

<h3 id="精华-7">精华</h3>
<ol>
  <li><strong>打破运动学传送假设</strong>：首次针对双足人形机器人建立基于 NVIDIA Isaac Sim 的全物理仿真评测平台，将高层 VLN 规划与底层强化学习（RL）步态控制相解耦，揭示了传统无物理仿真掩盖的跌倒与步态失稳问题。</li>
  <li><strong>多形态硬件异构覆盖</strong>：原生支持 4 款不同尺寸（1.17 m–1.80 m）与下肢自由度（10–12 DoF）的人形机器人，适配离散（PD 跟踪器）与连续（MPC 跟踪器）两种动作空间。</li>
  <li><strong>可通行性筛选与 3DGS 重建</strong>：构建 87 个高保真 3D 室内场景，硬性筛选可通行面积 $\ge 100\text{ m}^2$，结合改进的无偏深度与法线一致性 3DGS 流程生成高精度物理碰撞网格。</li>
  <li><strong>多智能体指令协同生成（MAA）</strong>：设计双生成器、单审查器与重述器的多模型协作流程，通过结构化拓扑路径图对齐与几何确定性仲裁，并辅以人工校验，产出 933 条高质量跨风格指令。</li>
  <li><strong>真机强相关性验证</strong>：在 Unitree G1 真机上的 Sim-to-Real 实测表明，仿真与现实的导航误差相关性高达 $r = 0.935$，证明了基于 3DGS 重建与物理仿真的基准具备极高的真机迁移预测力。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-7">1. 研究背景/问题</h3>
<p>现有的视觉语言导航（VLN）基准大多假设智能体为轮式底盘或采用理想化的“运动学传送”（Kinematic Teleportation），完全忽略了双足人形机器人的物理动力学约束。在实际部署中，不同人形机器人的形态差异巨大（身高从 1.17 m 到 1.80 m，下肢自由度 10–12 DoF），且行走时的身体晃动会导致剧烈的视线抖动与动态光照变化；若缺乏物理仿真，常规模型在面对急转弯或复杂地形时极易发生步态失稳乃至跌倒。为此，亟需一个兼顾多样化人形形态、物理真实动力学控制、大面积可通行场景与高质量指令的端到端评测平台。</p>

<hr />

<h3 id="2-主要方法创新点-7">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/HumanoidVLN-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/774" />
<figcaption>HumanoidVLN 物理基准评测流水线：涵盖多样化人形形态、分层控制栈、场景筛选、多模态数据集生成与即插即用评估</figcaption>
</div>

<h4 id="-整体框架概述-2">① 整体框架概述</h4>
<p>HumanoidVLN 构建在 NVIDIA Isaac Sim 物理仿真引擎之上，整体框架由三大支柱构成：<strong>分层运动控制栈</strong>（负责将高层语义动作转化为真实的足端接触与关节力矩）、<strong>Real2Sim 场景构建流水线</strong>（通过可通行性筛选与 3DGS 重建提供物理碰撞环境）以及<strong>多智能体指令生成流水线（MAA）</strong>（从第一人称抖动视频中自动提取结构化路径并结合人工复核）。</p>

<h4 id="-逐模块讲解-1">② 逐模块讲解</h4>

<p><strong>1. 分层运动控制架构（Hierarchical Control Stack）</strong></p>
<ul>
  <li><strong>输入</strong>：高层 VLN 模型输出的离散导航动作（前进、左转、右转、停止）或连续线速度/角速度指令。</li>
  <li><strong>处理</strong>：控制系统划分为两层。<strong>高层路径跟踪器</strong>负责将导航指令转化为参考速度与航向角——对于离散动作模型采用比例-微分（PD）控制器生成平滑航向，对于连续动作模型采用模型预测控制（MPC）跟踪速度曲线；<strong>底层强化学习（RL）步态策略</strong>针对每种人形机器人的动力学参数单独训练，接收参考速度并输出 10–12 个下肢关节的力矩指令。</li>
  <li><strong>输出</strong>：作用于刚体动力学的关节力矩，驱动双足机器人产生真实步态，并在第一人称相机中产生真实的晃动与俯仰。</li>
  <li><strong>设计动机</strong>：彻底摒弃传统 VLN 中直接修改坐标的“空间瞬移”，使机器人的质心动力学（CoM）和接触稳定性真正约束路径的可行性。</li>
</ul>

<pre><code class="language-mermaid">graph TD
    A["VLN 模型 (NaVILA / StreamVLN / DualVLN / JanusVLN)"] --&gt; B{"动作空间类型"}
    B -- "离散动作" --&gt; C["PD 路径跟踪器"]
    B -- "连续速度" --&gt; D["MPC 路径跟踪器"]
    C --&gt; E["参考速度与航向 (v, omega)"]
    D --&gt; E
    E --&gt; F["底层 RL 步态控制策略 (Per-Embodiment RL Policy)"]
    F --&gt; G["关节电机力矩 (Joint Torques)"]
    G --&gt; H["Isaac Sim 物理刚体仿真环境"]
    H --&gt; I["真实第一人称晃动观测 (RGB-D + IMU)"]
    I --&gt; A
</code></pre>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统 VLN 平台（如 Habitat / R2R）</th>
      <th>HumanoidVLN 平台</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>运动机制</td>
      <td>运动学坐标传送（无质心与接触力学）</td>
      <td>底层 RL 关节力矩驱动（全刚体物理模拟）</td>
    </tr>
    <tr>
      <td>机器人形态</td>
      <td>理想点状/圆柱轮式代理（单一固定高度）</td>
      <td>4 种异构人形机器人（1.17–1.80 m，10–12 DoF）</td>
    </tr>
    <tr>
      <td>视觉感知</td>
      <td>平稳无抖动相机视角</td>
      <td>真实双足交替步态引起的相机晃动与动态光照</td>
    </tr>
    <tr>
      <td>失败模式</td>
      <td>仅能检测碰撞或超时</td>
      <td>可精确定量因急转弯、失稳引起的跌倒率（FR）</td>
    </tr>
  </tbody>
</table>

<p><strong>2. 跌倒判定判据（Fall Rate, FR）</strong>
为了量化物理仿真下的步态稳定性，平台定义了基于躯干高度下降量 $\Delta h$ 与垂直下落速度的跌倒指标：</p>

\[FR = \frac{100}{N} \sum_{i=1}^N \mathbb{I}[F_i = 1]\]

<p>其中当机器人满足以下三项判据之一时判定为跌倒（$F_i = 1$）并立即终止该轮测试：</p>
<ul>
  <li>$T_1$（动态剧烈跌倒）：$\Delta h \ge 0.5 H_e$ 且向下速度幅度 $&gt; 1.2\text{ m/s}$；</li>
  <li>$T_2$（持续坍塌）：$\Delta h \ge 0.5 H_e$ 且持续时间 $\ge 2\text{ s}$；</li>
  <li>$T_3$（浅层快速下坠）：$0.35 H_e \le \Delta h &lt; 0.5 H_e$ 且向下速度幅度 $&gt; 1.5\text{ m/s}$。</li>
</ul>

<blockquote>
  <p><strong>举个例子</strong>：以身高 $H_e = 1.80\text{ m}$ 的 Unitree H1 为例：
若机器人在转向时踩空失稳，身体在 $0.2\text{ s}$ 内高度下降了 $0.95\text{ m}$（$\Delta h = 0.95 &gt; 0.5 \times 1.80 = 0.90\text{ m}$），下落垂直速度达到 $1.6\text{ m/s} &gt; 1.2\text{ m/s}$，立即触发 $T_1$ 判据判定跌倒；
反之，若机器人在避障时主动屈膝下蹲 $0.4\text{ m}$（$\Delta h = 0.4 &lt; 0.35 \times 1.80 = 0.63\text{ m}$），下落速度仅 $0.3\text{ m/s}$，则不会触发任何判据，正常继续导航。</p>
</blockquote>

<p><strong>3. Real2Sim 场景构建与可通行性筛选</strong></p>
<ul>
  <li><strong>大面积可通行筛选</strong>：双足机器人步幅大、转弯半径受限，无法在狭窄杂乱环境中通行。平台从艺术家设计场景和 3DGS 重建场景中筛选出 87 个大场景，强制要求物理碰撞网格计算出的实际可通行面积 $\ge 100\text{ m}^2$（中位数达 $266\text{ m}^2$），覆盖住宅、零售、文化、办公、医疗、健身 6 大领域共 17 种房间类型。</li>
  <li><strong>高精度 3DGS 重建流水线</strong>：基于 COLMAP 稀疏点云初始化 3D 高斯，并在 gsplat 训练中引入无偏深度渲染（Unbiased Depth Rendering）与深度-法线几何一致性约束（Depth-Normal Consistency），克服传统 3DGS 在无纹理大白墙与细长家具边缘法线破碎的缺陷，最终通过 TSDF 融合提取平滑的物理碰撞网格打包为 USDZ 资产。</li>
</ul>

<div align="center">
  <img src="/images/vln/HumanoidVLN-MAA-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/779" />
<figcaption>多智能体指令生成框架（MAA）：双生成器提取拓扑路径图，审查器基于几何与语义先验仲裁，重述器扩展风格并经人工最终复核</figcaption>
</div>

<p><strong>4. 多智能体指令生成（MAA）与人工校验</strong></p>
<ul>
  <li><strong>目标地标定位</strong>：利用 Qwen3-VL-30B-A3B 从第一人称视频终点帧识别终止地标与停止条件。</li>
  <li><strong>双生成器独立解析</strong>：Gemma-4-31B-it 与 InternVL3.5-38B 仅根据第一人称关键帧序列，独立推导结构化拓扑路径图 $R = \langle(a_i, \ell_i, s_i, o_i, m_i)\rangle_{i=1}^n$（分别代表有序动作、地标物体、相对路径左右方位、序数与转角幅度）。</li>
  <li><strong>审查器仲裁与先验校验</strong>：对比两份拓扑路径图，合并无冲突节点；对于存在冲突的转向或地标，交由 Qwen3-VL-30B-A3B 审查器结合 2D 占用栅格图上的 A* 轨迹、轨迹元数据以及沿途可见的 3D 空间语义场景图（Scene Graph）进行几何与语义一致性仲裁。</li>
  <li><strong>风格多样化重述与人工复核</strong>：由 GPT-5.5 将验证后的路径转换为 1 条细粒度指令和 3 种风格变体（正式 Formal、自然 Natural、口语 Casual），并要求反向解析出的拓扑路径与原图一致；最后由 3 名专业标注人员进行 100% 逐条复核与纠偏（20% 交叉双审），最终构建出 933 个高质量评测 Episode。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-7">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/HumanoidVLN-fall-rate.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:698/493" />
<figcaption>不同 VLN 模型在 4 种人形机器人形态下的跌倒率（FR）热力图对比：连续控制的 DualVLN 稳定性最佳，而高重心 10-DoF 的 H1 跌倒率显著偏高</figcaption>
</div>

<ol>
  <li><strong>显式 3D 空间表征具备更强导航能力</strong>：在四种主流 VLN 模型（NaVILA、StreamVLN、DualVLN、JanusVLN）的零样本评测中，引入显式 3D 空间记忆的 <strong>JanusVLN</strong> 取得了最高的平均成功率（$\text{SR} = 43.55\%$）和路径保真度（$\text{nDTW} = 48.38$）。</li>
  <li><strong>离散急转动作诱发高跌倒率</strong>：采用离散动作空间（前进、左转 30°、右转 30°）的模型在转向时会给底层步态带来阶跃扰动。身材最高（1.80 m）、自由度较少（10 DoF）的 Unitree H1 在 NaVILA 和 StreamVLN 下的跌倒率高达 $70.95\%$ 和 $64.52\%$；而采用连续速度输出并搭配 MPC 跟踪器的 <strong>DualVLN</strong> 则表现出最优的动态稳定性，全形态平均跌倒率最低。</li>
</ol>

<div align="center">
  <img src="/images/vln/HumanoidVLN-sim2real.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:700/585" />
<figcaption>Sim-to-Real 真机实测一致性验证：(a) 仿真与真实真机单回合导航误差高度线性相关 (r = 0.935)；(b) 仿真与真实轨迹的 nDTW 相似度分布</figcaption>
</div>

<ol>
  <li><strong>仿真评测高度预测真机表现</strong>：在 Unitree G1 真机上部署 DualVLN 进行 20 个回合的 Sim-to-Real 对比实验，仿真环境与真机实测的导航误差呈现极强的正相关性（Pearson $r = 0.935$，Spearman $\rho = 0.911$），平均导航误差绝对差仅为 $0.68\text{ m}$，成对轨迹相似度达 $78.2 \pm 18.8\text{ nDTW}$，验证了 HumanoidVLN 物理仿真与 3DGS 重建资产的真实迁移价值。</li>
</ol>

<hr />

<h3 id="4-局限性-7">4. 局限性</h3>
<p>目前的评测场景仍受限于静态室内环境，尚未引入动态行人或可交互障碍物；此外，高精度刚体物理仿真的计算开销较高，且指令生成中的人工最终校验环节成为数据大规模扩展的吞吐瓶颈。</p>

<hr />

<h2 id="condvln">14. CONDVLN (2026)</h2>
<p>———首个基于分层3D场景图的视觉语言导航条件分支诊断基准与神经符号探针</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.17318">arXiv:2608.17318</a></p>

<h3 id="精华-8">精华</h3>
<ol>
  <li><strong>研究痛点</strong>：传统视觉语言导航（VLN）评测高度依赖“固定目标点的线性路径跟随”，无法评估现实中极其普遍的条件分支决策（如“若厨房有花则去客厅，否则去卧室”），导致感知、空间定位与符号逻辑推理的失败原因相互混淆。</li>
  <li><strong>核心构建</strong>：提出首个基于分层 3D 场景图的程序化条件基准 <strong>CONDVLN</strong>，跨 AI2-THOR、Matterport3D、Gibson 和 ReplicaCAD 四大环境生成了超 11,500 条真值可验证、复杂度可控（逻辑深度 $d$ 与分支链长 $\ell$）的条件导航任务。</li>
  <li><strong>诊断指标</strong>：设计分支选择准确率（BSA）与条件成功率（CSR），克服了传统成功率（SR）对“走错分支但误打误撞到达某处”无法甄别的盲区，支持对中间子目标完成度的细粒度归因。</li>
  <li><strong>评测发现</strong>：SOTA 视觉语言模型（如 NaVid、NaVILA）在条件分支任务中几乎崩溃（CSR 接近 0%），而具显式推理结构的 Open-Nav 与 VLN-Zero 表现更佳，表明端到端黑盒训练在结构化条件决策上存在严重缺陷。</li>
  <li><strong>解耦探针</strong>：提出神经符号 Oracle 诊断探针，将条件判定与底层动作执行解耦，在复杂嵌套与长分支链场景下带来高达 2 倍的性能提升，为神经符号与具身导航的结合指明了方向。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-8">1. 研究背景/问题</h3>
<p>现有的具身视觉语言导航基准（如 R2R、RxR 等）主要关注智能体能否根据指令到达单一且固定的目标位置。然而，在真实的家庭与物理环境中，人类的导航指令往往强依赖于环境状态的动态观测（例如：“如果餐桌上有咖啡杯，就走到洗碗机旁的吧台凳；否则走到浴室水槽下方的照明灯处”）。现有评测不仅缺乏对条件分支结构的显式控制，也无法厘清智能体在失败时究竟是卡在视觉感知、目标定位、空间运动还是高层逻辑决策上。</p>

<hr />

<h3 id="2-主要方法创新点-8">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/CONDVLN-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1107/712" />
<figcaption>CONDVLN 基准总体架构与流程：从多源环境构建分层 3D 场景图，程序化生成多级嵌套与链式条件指令，并基于分支选择准确率（BSA）和条件成功率（CSR）实现全自动诊断评估。</figcaption>
</div>

<p>CONDVLN 框架由<strong>分层 3D 场景图构建</strong>、<strong>程序化条件指令合成</strong>、<strong>VLN-CE 兼容仿真适配</strong>、<strong>细粒度诊断指标（BSA/CSR）</strong>以及<strong>神经符号 Oracle 诊断探针</strong>五大核心模块组成，整体实现了逻辑复杂度可控、真值可溯源的端到端评估闭环。</p>

<h4 id="模块一多源环境统一与分层-3d-场景图构建scene-hierarchy--spatial-semantic-graph">模块一：多源环境统一与分层 3D 场景图构建（Scene Hierarchy &amp; Spatial-Semantic Graph）</h4>
<ul>
  <li><strong>输入</strong>：来自 AI2-THOR、ReplicaCAD（合成仿真数据）以及 Matterport3D、Gibson（真实物理扫描数据）的异构几何与语义标注。</li>
  <li><strong>处理</strong>：
    <ol>
      <li><strong>统一房间层级抽象</strong>：将不同数据源统一解析为以房间为顶层、包含物体实例集合的符号化层级结构。每个物体 $o_i$ 记录语义标签 $\ell_i$ 与 3D 中心坐标 $c_i = (x_i, y_i, z_i)$，并优先提取 3D 轴对齐包围盒（AABB），缺失时以包围球半径作为几何兜底。</li>
      <li><strong>回退几何距离计算</strong>：计算同房间内物体对 $(o_i, o_j)$ 的空间位移 $\delta_{i \to j} = c_j - c_i$，并按优先级回退选择距离度量：
\(d_{ij}^{\text{used}} \in \{ d_{ij}^{\text{AABB}}, d_{ij}^{\text{sphere}}, d_{ij}^{\text{center}} \}\)
其中 AABB 表面距离 $d_{ij}^{\text{AABB}} = \sqrt{\Delta_x^2 + \Delta_y^2 + \Delta_z^2}$ 能精确捕捉物体的表面外轮廓，包围球表面距离 $d_{ij}^{\text{sphere}} = \max(0, \lVert \delta_{i \to j} \rVert_2 - (r_i + r_j))$ 作为平滑近似，中心点欧氏距离 $d_{ij}^{\text{center}} = \lVert \delta_{i \to j} \rVert_2$ 作为最终兜底。</li>
      <li><strong>规范方位与语义谓词生成</strong>：将水平方位角离散化为 8 个罗盘扇区（东、东北、北等），俯仰角离散化为 3 个垂直区间（上、平级、下），组合生成三维相对方位谓词；同时基于硬阈值生成贴近自然语言的语义空间谓词（如 <code class="language-plaintext highlighter-rouge">near</code>、<code class="language-plaintext highlighter-rouge">far from</code>、<code class="language-plaintext highlighter-rouge">higher than</code>、<code class="language-plaintext highlighter-rouge">lower than</code>、<code class="language-plaintext highlighter-rouge">above</code>、<code class="language-plaintext highlighter-rouge">below</code>）。</li>
    </ol>
  </li>
  <li><strong>输出</strong>：带可追溯几何属性（包含中心距、AABB 距离、方位扇区等）的有向空间语义场景图。</li>
  <li><strong>设计动机</strong>：消除各模拟器之间坐标系与标注粒度的壁垒，为后续逻辑生成提供唯一、可精确判真伪的客观物理事实底座。</li>
</ul>

<h4 id="模块二程序化条件指令合成与对象采样programmatic-conditional-instruction-synthesis">模块二：程序化条件指令合成与对象采样（Programmatic Conditional Instruction Synthesis）</h4>
<ul>
  <li><strong>输入</strong>：已构建的 3D 场景图与其空间谓词。</li>
  <li><strong>处理</strong>：
    <ol>
      <li><strong>正负条件采样机制</strong>：从场景图中采样有效实体作为真实分支的参考物体；同时从该场景其他房间中采样存在、但当前参考房间中缺失的物体类别，构造具有明确客观真伪的负分支条件（False Branch）。</li>
      <li><strong>同名物体空间消歧</strong>：当房间内存在多个同类物体（如多盏台灯）时，自动引入场景图关系谓词限定（如“床边的台灯”）实现唯一指向，无法消除歧义的样本直接滤除。</li>
      <li><strong>逻辑模板实例化</strong>：将场景图谓词映射进 <code class="language-plaintext highlighter-rouge">IF [condition] THEN [action] ELSE [action]</code> 的基础骨架中，并支持多层级嵌套与多分支串联。</li>
    </ol>
  </li>
  <li><strong>输出</strong>：自然语言条件指令文本及其对应的先验真值分支、目标点与子目标序列。</li>
  <li><strong>设计动机</strong>：确保每条指令在 3D 空间中都有明确无误的真值，使评测系统完全掌握地面真值（Ground Truth）决策路径。</li>
</ul>

<h4 id="模块三复杂度分类与-vln-ce-仿真适配complexity-taxonomy--episode-realization">模块三：复杂度分类与 VLN-CE 仿真适配（Complexity Taxonomy &amp; Episode Realization）</h4>
<p>为了系统化诊断不同维度的推理瓶颈，CONDVLN 沿<strong>逻辑深度（Depth $d$）</strong>和<strong>分支链长（Chain Length $\ell$）</strong>两个正交维度定义了 6 种指令复杂度层级：</p>

<table>
  <thead>
    <tr>
      <th>复杂度类别</th>
      <th>逻辑深度 $d$</th>
      <th>分支链长 $\ell$</th>
      <th>逻辑结构形式</th>
      <th>典型示例</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>Simple</strong></td>
      <td>1</td>
      <td>1</td>
      <td>单层 IF-ELSE</td>
      <td>若厨房有花则去客厅，否则去卧室</td>
    </tr>
    <tr>
      <td><strong>Nested</strong></td>
      <td>2</td>
      <td>1</td>
      <td>IF 内部嵌套 IF</td>
      <td>若厨房有花，（若花在桌上则去客厅，否则去阳台）；否则去卧室</td>
    </tr>
    <tr>
      <td><strong>Deep Nested</strong></td>
      <td>3</td>
      <td>1</td>
      <td>三级深度嵌套</td>
      <td>多层条件逐级判定深入</td>
    </tr>
    <tr>
      <td><strong>Chain</strong></td>
      <td>1</td>
      <td>2</td>
      <td>IF / ELSE IF / ELSE</td>
      <td>若厨房有花去客厅，否则若有咖啡机去书房，否则去卧室</td>
    </tr>
    <tr>
      <td><strong>Long Chain</strong></td>
      <td>1</td>
      <td>3</td>
      <td>多分支串联链</td>
      <td>3 个以上顺序排他条件分支</td>
    </tr>
    <tr>
      <td><strong>Nested Chain</strong></td>
      <td>2</td>
      <td>2</td>
      <td>嵌套 + 链式组合</td>
      <td>复合高层复杂决策</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>降维装置：条件指令的状态机流转</strong></p>

  <pre><code class="language-mermaid">graph TD
    Start["起始观测"] --&gt; Q1{"条件 A: 厨房是否有花?"}
    Q1 -- "True (分支1)" --&gt; Q2{"条件 B (深度 d=2): 花是否在桌上?"}
    Q1 -- "False (分支2)" --&gt; Q3{"条件 C (链长 l=2): 是否有咖啡机?"}
    Q2 -- "True" --&gt; T1["目标1: 客厅沙发"]
    Q2 -- "False" --&gt; T2["目标2: 阳台花架"]
    Q3 -- "True" --&gt; T3["目标3: 书房书桌"]
    Q3 -- "False" --&gt; T4["目标4: 卧室床头"]
</code></pre>
</blockquote>

<p>所有任务均被转换为标准 VLN-CE / Habitat-Sim 的 JSON 格式，包含起点坐标、朝向、真值测地线最短路径（Geodesic Shortest Path）与多阶段子目标航点，现有模型无需改造仿真环境即可直接评测。</p>

<h4 id="模块四条件推理诊断指标bsa--csr">模块四：条件推理诊断指标（BSA &amp; CSR）</h4>
<p>传统的成功率（SR）只在乎最终停靠点是否接近目标，无法辨别智能体是“正确理解了条件并前往目标”还是“由于感知漂移误打误撞停在了某个目标附近”。为此，CONDVLN 提出了两个专用诊断指标：</p>

<ol>
  <li><strong>分支选择准确率（Branch Selection Accuracy, BSA）</strong>：
衡量智能体沿着正确条件分支前进了多远。设当前真值分支对应的有序子目标序列为 $G_i = (g_{i,1}, \dots, g_{i,m_i})$，智能体按序在容差半径 $\tau$ 内到达的最长前缀长度为 $k_i$，则单样本得分为：
\(BSA_i = \frac{k_i}{m_i} \quad (m_i &gt; 0)\)
整体评测集得分为所有样本的平均值 $BSA = \frac{1}{\lvert I \rvert} \sum_{i \in I} BSA_i$。该指标允许给出部分完成的分数。</li>
  <li><strong>条件成功率（Conditional Success Rate, CSR）</strong>：
衡量严格意义上的条件导航完成度。要求智能体不仅要完整经历分支的所有子目标（$BSA_i = 1$），还必须在最终目标点取得 Habitat 标准导航成功（$\text{Success}(i) = 1$）：
\(CSR_i = \mathbf{1}[BSA_i = 1 \land \text{Success}(i) = 1]\)
整体评测集得分为 $CSR = \frac{1}{\lvert I \rvert} \sum_{i \in I} CSR_i$。</li>
</ol>

<blockquote>
  <p><strong>举个例子</strong>：
设某任务真值分支包含 2 个顺序航点（走廊拐角 $g_1$、客厅门 $g_2$）和终点（沙发 $g_3$），即 $m_i = 2$。</p>
  <ul>
    <li><strong>情况 A（完全正确）</strong>：智能体依次经过 $g_1, g_2$ 并停在 $g_3$，则 $k_i=2, BSA_i=1.0, \text{Success}(i)=1 \implies CSR_i=1, SR_i=1$；</li>
    <li><strong>情况 B（半途迷失）</strong>：智能体经过 $g_1$ 后迷路未到 $g_2$ 且未到 $g_3$，则 $k_i=1, BSA_i=0.5, CSR_i=0, SR_i=0$；</li>
    <li><strong>情况 C（误打误撞/走错分支）</strong>：智能体直接走错走向卧室分支，但卧室里恰好有一张同名沙发，智能体停在卧室沙发旁——此时传统 $SR_i=1$ 会误判为成功，但由于其完全未访问正确分支的子目标（$k_i=0, BSA_i=0$），新指标精确诊断出 $CSR_i=0$！</li>
  </ul>
</blockquote>

<h4 id="模块五神经符号-oracle-诊断探针neurosymbolic-branch-selection-oracle-model">模块五：神经符号 Oracle 诊断探针（Neurosymbolic Branch-Selection Oracle Model）</h4>
<p>为了探究现有智能体究竟是受阻于“前段条件逻辑推理”还是“后段空间运动导航”，作者构建了一个神经符号 Oracle 探针：</p>

<table>
  <thead>
    <tr>
      <th>对比维度</th>
      <th>端到端黑盒智能体（NaVid / NaVILA 等）</th>
      <th>神经符号 Oracle 探针（Oracle + VLN-Zero）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>指令输入形式</strong></td>
      <td>原始条件文本（含 IF-ELSE / 嵌套 / 链式逻辑）</td>
      <td>由真值元数据线性化重写后的纯路径指令（如“先到 $g_1$，再到 $g_2$，最后到 $g_b$”）</td>
    </tr>
    <tr>
      <td><strong>条件分支决策</strong></td>
      <td>由神经网络隐式端到端猜测与判断</td>
      <td>符号化先验自动解析，剥离分支选择负担</td>
    </tr>
    <tr>
      <td><strong>底层执行器</strong></td>
      <td>保持不变</td>
      <td>保持完全不变（使用相同的 VLN 导航模型）</td>
    </tr>
    <tr>
      <td><strong>诊断作用</strong></td>
      <td>测量包含逻辑、感知与控制的混合表现</td>
      <td>作为理论上限探针，严格量化逻辑分支选择错误导致的性能损失</td>
    </tr>
  </tbody>
</table>

<hr />

<h3 id="3-核心结果发现-8">3. 核心结果/发现</h3>
<p>论文在 AI2-THOR、ReplicaCAD、Gibson 和 Matterport3D 四个数据集上评测了四类主流 VLN 模型（NaVid、NaVILA、Open-Nav、VLN-Zero）以及 Oracle 探针，得出以下关键结论：</p>

<ol>
  <li><strong>端到端大模型在条件分支上性能普遍崩溃</strong>：
    <ul>
      <li>通用端到端 VLM 导航模型（如 NaVid、NaVILA）在各大环境中的条件成功率极低（NaVILA 在所有数据集上的 CSR 均为 0.0%，NaVid 在 Gibson 与 MP3D 上 CSR 也接近 0%）。这表明目前单纯依靠预训练视觉语言模型的隐式端到端微调，根本无法泛化到具备显式逻辑分支的 3D 决策任务。</li>
    </ul>
  </li>
  <li><strong>显式结构与大语言模型推理带来显著优势</strong>：
    <ul>
      <li>具备显式推理架构的模型表现大幅领先：Open-Nav 凭借 LLM 零样本思维链（Chain-of-Thought）规划，在 ReplicaCAD 上取得了 33.3% 的 CSR 和 39.2% 的 BSA；VLN-Zero 依托显式 3D 场景图表征，在 AI2-THOR 上取得了 21.0% 的 CSR 和 31.5% 的 BSA。这证实结构化表征与符号规划对条件具身决策至关重要。</li>
    </ul>
  </li>
  <li><strong>逻辑深度与分支链长扩展造成持续性能衰减</strong>：
    <ul>
      <li>随着嵌套深度从 $d=1$ 增加到 $d=3$，或分支链长从 $\ell=1$ 扩展到 $\ell=3$，所有端到端模型的 BSA 与 CSR 均单调骤降。</li>
      <li>神经符号 Oracle 探针在高复杂度下优势尤为明显：在 $d=3, \ell=1$ 和 $d=1, \ell=2$ 等高难度配置下，Oracle 相比未解耦的基线模型展现出超过 2 倍的性能提升（例如在 $d=1, \ell=2$ 下 Oracle 取得 24.63% CSR，而 Open-Nav 仅为 11.51%），证明将符号条件判定与底层导航动作正交解耦是攻克复杂任务的有效路径。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-8">4. 局限性</h3>
<p>CONDVLN 目前仅支持 VLN-CE 兼容的室内离散/连续仿真环境，评测质量受限于原始点云扫描与几何标注的噪点；此外，几何谓词生成依赖固定的人工阈值，且 Oracle 探针使用的是真值元数据而非在线感知构建的场景图。</p>

<hr />

<h2 id="remembr">15. ReMEmbR (2024)</h2>
<p>———基于检索增强长程时空记忆的机器人导航问答与物理目标生成</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2409.13682">arXiv:2409.13682</a> · 🏛️ <strong>ICRA 2025</strong> · <a href="https://nvidia-ai-iot.github.io/remembr">Project Page</a></p>

<h3 id="精华-9">精华</h3>
<ol>
  <li><strong>长程时空记忆解耦</strong>：针对移动机器人在数十分钟至数小时连续作业中面对的庞大历史数据，提出将记忆构建（Memory Building）与查询推理（Querying）阶段解耦，解决传统多模态大模型面对超长上下文时的显存爆炸与计算延迟难题。</li>
  <li><strong>多模态时空向量库</strong>：在运行过程中在线调用轻量级视频多模态模型（VILA）对连续视频片段生成底层事件描述字幕，并将文本嵌入、三维度量坐标 $(x, y, z)$ 与时间戳统一存入向量数据库，以紧凑表征记录环境动态。</li>
  <li><strong>Agent 迭代多跳检索</strong>：查询阶段引入大语言模型作为决策状态机，根据空间、时间或描述性问题自适应发起多路函数调用（文本/位置/时间检索）进行多步迭代搜寻与剪枝，在最小化推理上下文的同时保证线索完整性。</li>
  <li><strong>度量可执行目标生成</strong>：突破传统具身问答仅输出自然语言文本的限制，支持直接输出空间精确三维坐标，与 ROS 2 Nav2 等经典移动底盘导航栈无缝衔接并驱动物理导航。</li>
  <li><strong>端到端真机实测闭环</strong>：在搭载 Jetson Orin 的 Nova Carter 机器人上实现端侧轻量 VLM 字幕提取、语音识别与向量检索，在 25 分钟真实办公区巡航后成功执行开放语义问答与导航寻物。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-9">1. 研究背景/问题</h3>
<ul>
  <li><strong>长程历史表征的扩展性困境</strong>：机器人在长时间巡航中会观察到大量动态事件与非静态物体，现有多模态长上下文模型（如 1M+ 上下文）计算成本随历史增长线性或二次方膨胀，而传统场景图或度量语义地图又难以记录时间维度演化。</li>
  <li><strong>具身问答缺乏物理可执行性</strong>：现有具身问答基准（如 OpenEQA）多局限于 30 秒至 1-2 分钟的短视频，且输出多为定性文字回答（如“在茶水间桌子上”），机器人无法直接解析为底层导航系统可用的度量坐标目标。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-9">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/ReMEmbR-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/603" />
<figcaption>ReMEmbR 系统总体框架：由在线记忆构建（Memory Building）与多跳查询推理（Querying）两阶段解耦构成，右侧为 NaVQA 数据集问答类型与真机部署链路</figcaption>
</div>

<h4 id="-整体框架概述-3">① 整体框架概述</h4>
<p>ReMEmbR（Retrieval-augmented Memory for Embodied Robots）由<strong>在线记忆构建阶段</strong>与<strong>查询推理阶段</strong>两大核心子系统构成：前者在机器人巡航期间持续将传感器流压缩转化为带时空元数据的多模态向量库；后者在接收到用户自然语言提问时，由 LLM-Agent 驱动多轮时空检索函数，提炼最小必要记忆子集并生成回答或导航目标坐标。</p>

<div align="center">
  <img src="/images/vln/ReMEmbR-teaser.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:697/719" />
<figcaption>机器人长时间连续运行积累长程历史，ReMEmbR 支持对时空动态信息的高效聚合与物理度量级目标定位</figcaption>
</div>

<h4 id="-逐模块讲解-2">② 逐模块讲解</h4>

<p><strong>1. 在线记忆构建模块（Memory Building）</strong></p>
<ul>
  <li><strong>输入</strong>：前视单目相机连续视频帧 $H_I$、机器人局部定位坐标 $H_P = (x, y, z)$（来源于激光雷达里程计、GPS 或 AMCL）、时间戳 $H_T$。</li>
  <li><strong>处理</strong>：每累计 $t=3$ 秒的连续观测（以 2 FPS 采样 6 帧），调用视频多模态模型 VILA（训练端采用 VILA1.5-13B，端侧部署采用量化版 VILA-3B）生成局部语义事件字幕 $L_{i:i+t}$；随后利用轻量文本编码器 <code class="language-plaintext highlighter-rouge">mxbai-embed-large-v1</code> 生成句向量 $E(L_{i:i+t})$。</li>
  <li><strong>输出</strong>：向多模态向量数据库 $V$ 中实时插入一条结构化元组 \(\langle E(L_{i:i+t}), (x,y,z)_{i:i+t}, t_{i:i+t} \rangle\)。</li>
  <li><strong>设计动机</strong>：问答提问在任务前不可预测，必须在没有先验 Query 的前提下构建通用且信息密集的时空表征；向量数据库支持千万级向量的高效近似最近邻（ANN）检索。</li>
</ul>

<p><strong>2. 状态机查询智能体模块（Querying Agent）</strong></p>
<ul>
  <li><strong>输入</strong>：用户提问 $Q$（涵盖空间位置、时间点/时长、环境描述）以及历史累积已检索的上下文 $R_{0:i}$。</li>
  <li><strong>处理</strong>：LLM-Agent 作为决策状态机，根据当前线索自适应调用以下三类时空检索函数生成检索子集：
    <ul>
      <li>文本检索 $f_l(\text{object})$：在向量库中基于余弦相似度匹配语义相关的最相近 $m$ 条片段；</li>
      <li>空间位置检索 $f_p((x, y, z))$：根据度量坐标半径检索邻近 $m$ 条历史轨迹片段；</li>
      <li>时间范围检索 $f_t(\text{“HH:MM:SS”})$：按时间戳窗口抓取对应时刻前后的 $m$ 条片段。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：若当前记忆足以回答提问，输出格式化 JSON 字典（包含文本解析、$(x, y, z)$ 三维坐标、时间戳或持续时间）；若信息不足则携带补充线索进入下一轮迭代检索（最多 3 轮）。</li>
</ul>

<h4 id="-最优历史子集采样形式化">③ 最优历史子集采样形式化</h4>
<p>对于一段长达 $K$ 分钟的完整历史 $H_{1:K}$，直接计算后验概率 $p(A \mid Q, H_{1:K})$ 计算量过大。ReMEmbR 将其形式化为寻找最小充分历史子集 \(R^* \subseteq H_{1:K}\) 的最优采样问题：</p>

\[p(A \mid H_{1:K}, Q) = p(A \mid R^*, Q) \approx p(A \mid R, Q)\]

\[R^* = \arg\min_R \lvert R \rvert \quad \text{s.t.} \quad \arg\max_A p(A \mid R, Q) = \arg\max_{A'} p(A' \mid H, Q)\]

<p>通过向量库采样策略 $F: V \to R$，LLM-Agent 仅需处理规模极小的子集 $R$，使长程推理在常数级时间内完成。</p>

<h4 id="-难点降维记忆表征范式对比与多步检索">④ 难点降维：记忆表征范式对比与多步检索</h4>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>全量长上下文（如 Gemini 1.5M）</th>
      <th>单次向量检索 RAG</th>
      <th>ReMEmbR 迭代 Agent</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>计算与显存开销</td>
      <td>随视频时长线性/二次方膨胀，超 10 分钟易 OOM</td>
      <td>固定单次向量检索，开销低</td>
      <td>3 步以内多路检索，常数级开销（~25s）</td>
    </tr>
    <tr>
      <td>时空多跳推理</td>
      <td>全量信息在上下文内，但注意力易在长序列中迷失</td>
      <td>仅匹配文本相似度，无法做空间邻近或时间回溯关联</td>
      <td>状态机自适应组合文本、坐标、时间多路函数逐层收敛</td>
    </tr>
    <tr>
      <td>输出物理可执行性</td>
      <td>仅输出语言文本，难以准确生成度量坐标</td>
      <td>通常仅提供文本片段</td>
      <td>结构化输出 $(x,y,z)$ 坐标，直连 Nav2 导航底盘</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>举个例子</strong>：机器人在大楼巡航 20 分钟（产生约 400 个 3 秒视频片段，全量输入需处理数十万 token）。
用户提问：“我在 5 分钟前丢的红色工牌在哪？”</p>
  <ul>
    <li>朴素单次 RAG 只检索“红色工牌”，若机器人在第 2 分钟和第 15 分钟都在桌边看见过工牌，单次文本检索极易混淆时间线并提取错误坐标；</li>
    <li>ReMEmbR 的 Agent 第一轮调用 $f_l(\text{“红色工牌”})$ 获取相关候选片段，第二轮依据提问调用 $f_t(\text{“当前时间-5分钟”})$ 缩小时间窗口，两轮仅抓取 6 个关键片段（约 600 token），精准锁定 $(x,y,z)$ 坐标，Token 消耗降低 99% 以上。</li>
  </ul>
</blockquote>

<pre><code class="language-mermaid">graph TD
    A["用户输入 Query Q"] --&gt; B["LLM-Agent 解析当前上下文 R"]
    B --&gt; C{"当前线索是否充足?"}
    C -- "否 (迭代轮数 &lt; 3)" --&gt; D["生成多路函数调用"]
    D --&gt; D1["文本检索 fl(object)"]
    D --&gt; D2["位置检索 fp(x,y,z)"]
    D --&gt; D3["时间检索 ft(timestamp)"]
    D1 &amp; D2 &amp; D3 --&gt; E["向量数据库 V 检索返回 m 条片段"]
    E --&gt; F["合并更新上下文 R := R + delta"]
    F --&gt; B
    C -- "是 (或达到最大轮数)" --&gt; G["输出结构化 JSON 答案"]
    G --&gt; H["自然语言回复 / (x,y,z) 坐标直传 Nav2 导航底盘"]
</code></pre>

<h4 id="-navqa-评测基准构建">⑤ NaVQA 评测基准构建</h4>

<div align="center">
  <img src="/images/vln/ReMEmbR-navqa-dataset.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:695/542" />
<figcaption>NaVQA 评测数据集：涵盖短（&lt;2min）、中（2-7min）、长（&gt;7min）三种时程分布，覆盖空间坐标、时间点/时长及描述性三大类问答任务</figcaption>
</div>

<p>基于真实室外/室内多天气大规模巡航数据集 CODa（Clearpath Husky 机器人采集），构建了包含 210 个专家标注样本的 NaVQA 基准，分为三种时长区间（短 &lt;2min、中 2-7min、长 &gt;7min），涵盖二值判断（32%）、空间坐标定位（34%）、时间点（14%）、时长统计（4%）及开放描述（16%）。</p>

<hr />

<h3 id="3-核心结果发现-9">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/ReMEmbR-correctness-curve.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:697/484" />
<figcaption>随视频时长增长的总体正确率变化趋势：多帧全量 VLM 在中长视频面临显存爆炸（OOM），而 ReMEmbR 在长视频上保持显著更高的准确率</figcaption>
</div>

<ul>
  <li><strong>长程视频问答性能全面领先</strong>：在大于 7 分钟的长视频序列上，基于 GPT-4o 的 ReMEmbR 达到 <strong>0.65</strong> 的描述问答准确率、<strong>46.25m</strong> 的空间定位误差与 <strong>3.6s</strong> 的时间误差，显著超越全量字幕输入 Baseline（56.0m 空间误差、8.0s 时间误差），而多帧全量 VLM（Multi-Frame VLM）在中长视频上均因显存溢出（OOM）无法运行。</li>
  <li><strong>常数级极低查询延迟</strong>：在 21.5 分钟的长视频上，ReMEmbR 单个问题平均响应时间仅约 <strong>25 秒</strong>，且耗时基本不随视频总时长增长；相比之下，多帧 VLM 即使在 5.5 分钟的短视频上也需要高达 90 秒。</li>
  <li><strong>多步迭代检索是性能关键</strong>：消融实验表明，若退化为单次检索（1-call RAG），整体正确率由 0.61 骤降至 0.50（长视频），证实复杂时空多跳推理对迭代检索闭环的依赖。</li>
  <li><strong>细粒度时间分段至关重要</strong>：采用 3 秒视频片段字幕（2 FPS）的整体正确率为 0.61，而粗粒度 12 秒片段字幕（0.5 FPS）跌至 0.38，说明时间分辨率下降会严重丢失关键瞬态信息。</li>
</ul>

<div align="center">
  <img src="/images/vln/ReMEmbR-robot-deployment.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:697/902" />
<figcaption>Nova Carter 移动机器人真实办公场景部署：25 分钟巡航记忆构建后，成功响应“带我去视野好的地方”、“去拿薯片”等开放语义导航指令</figcaption>
</div>

<ul>
  <li><strong>真机端侧闭环验证</strong>：在 Nova Carter 机器人上搭载 Jetson Orin 32GB、3D LiDAR、量化版 VILA-3B 与 Whisper ASR，先执行 25 分钟自主巡航建图构建记忆库，随后测试模糊语义指令。例如面对“带我去风景好的地方”，Agent 自动检索大落地窗、绿植与开阔空间对应的坐标并由 Nav2 导航直达大厅。</li>
</ul>

<hr />

<h3 id="4-局限性-9">4. 局限性</h3>
<ul>
  <li><strong>重复记忆稀释与冗余膨胀</strong>：机器人静止或重复在同一区域巡航时，向量库会不断写入相似片段，长期运行可能稀释关键有效信息的检索精度。</li>
  <li><strong>轻量感知模型的细粒度歧义</strong>：受限于边缘端算力，采用 3B 级别量化视觉字幕模型时存在物体混淆现象（如将银色饮水机描述为“银色机器”，导致被误识别为苏打水售卖机）。</li>
</ul>

<hr />

<h2 id="supermap">16. SuperMap (2026)</h2>
<p>———面向视觉-语言导航的实时 4D 时空语义 SLAM 与动态场景图系统</p>

<p>📄 <strong>Paper</strong>: <a href="https://www.roboticsproceedings.org/rss22/p052.pdf">RSS 2026</a> · <a href="https://superodometry.com/supermap">Project Page</a> · <a href="https://github.com/superxslam/SuperMap">Code（待发布）</a> · 🏛️ <strong>RSS 2026</strong></p>

<h3 id="精华-10">精华</h3>

<ol>
  <li>针对动态环境中开放词表语义建图存在的实例漂移与陈旧语义累积问题，提出了首个面向视觉-语言导航（VLN）的实时、开放词表、实例级 4D 时空语义 SLAM 系统 SuperMap。</li>
  <li>架构上融合了高频几何 SLAM（SuperOdometry）与异步 2D 开放词表感知（GroundingDINO + SAM2），通过 3D 到 2D 的运动补偿先验解决了机器人剧烈运动下的跨帧实例关联难题。</li>
  <li>提出了基于几何一致性的三态深度残差判别与概率占据更新机制，能够敏锐检测环境变动（如物体新增、搬移与移除），并利用贝叶斯语义融合抑制单帧误检。</li>
  <li>构建了包含空间几何拓扑边与时序演化边的 4D 动态场景图，将复杂的 3D 点云与时序视频流抽象为紧凑的符号化结构，为多模态大模型（VLM）提供了原生、高效的查询接口。</li>
  <li>全系统在搭载 Intel i9 与 RTX 4090 的移动机器人板载端以 10 Hz 位姿估计、5 Hz 场景图更新的速率全实时运行，在 ScanNet 语义基准及真实场景动态导航中显著超越现有方案。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-10">1. 研究背景/问题</h3>

<p>移动机器人在人类真实环境中执行诸如“去白板旁边的显示器”或“回到刚才在植物旁的椅子处”等开放词表导航任务时，面临着剧烈且持续的环境动态变化。现有的语义建图方法大多假设静态环境或依赖离线全场景重构（如 ConceptGraphs、HOV-SG），而传统动态 SLAM 系统多局限于闭集先验或仅关注短期人体移动，无法持续追踪物体在视野外的长期搬移与生灭演化。这导致多模态基础模型（VLM）间歇性、视点敏感的 2D 预测直接投影到 3D 地图时极易发生实例 ID 碎片化与语义陈旧，阻碍了下游语言引导导航的可靠空间推理。</p>

<hr />

<h3 id="2-主要方法创新点-10">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/SuperMap-concept.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/937" />
<figcaption>SuperMap 4D 时空 SLAM 概览：能够实时追踪短期人体运动与长期环境变动（如垃圾桶移除、推车进入），并维护一致的 4D 时空场景图</figcaption>
</div>

<h4 id="-整体框架概述-4">① 整体框架概述</h4>

<p>SuperMap 是一个完全运行在机器人板载计算平台上的 4D 时空 SLAM 系统，整体由<strong>几何层（在线 3D 重建）</strong>、<strong>实例层（时空实例关联与概率更新）</strong>以及<strong>拓扑层（4D 场景图构建与 VLM 交互）</strong>三大核心模块协同构成。几何层提供高频精准的度量位姿与致密几何；实例层利用 3D 先验进行运动补偿跟踪并动态剔除失效物体；拓扑层则将度量地图抽象为携带空间拓扑与生命周期轨迹的 4D 场景图，供大语言/多模态模型高效解析。</p>

<div align="center">
  <img src="/images/vln/SuperMap-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/898" />
<figcaption>SuperMap 系统架构图：自底向上分为在线 3D 重建几何层、时空对象更新实例层以及面向 VLM 的 4D 场景图拓扑层</figcaption>
</div>

<h4 id="-逐模块讲解-3">② 逐模块讲解</h4>

<ul>
  <li><strong>几何层（在线 3D 稠密重建）</strong>：
    <ul>
      <li><strong>输入</strong>：同步的 LiDAR 点云、RGB 图像与高频 IMU 数据流。</li>
      <li><strong>处理</strong>：采用 SuperOdometry 作为激光-视觉-惯性（LVI）里程计骨干网络，在世界坐标系 $W$ 下以 10 Hz 实时解算机器人的 6-DoF 位姿 $T_{WB}^{(t)}$ 与相机位姿 $P_t = T_{WC}^{(t)} = T_{WB}^{(t)} \cdot T_{BC}$，并输出着色的致密 3D 几何点云。</li>
      <li><strong>输出</strong>：高精度机器人轨迹 $P_{1:T}$ 与致密 3D 观测数据 $Q_t = {C_t, D_t}$。</li>
      <li><strong>设计动机</strong>：为后续 2D 语义到 3D 空间的物理反投影、时序运动补偿以及全局地图一致性提供物理锚定基础。</li>
    </ul>
  </li>
  <li><strong>实例层（时空实例关联与动态一致性维护）</strong>：
    <ul>
      <li><strong>输入</strong>：当前帧 RGB 图像 $C_t$、深度观测 $D_t$ 以及历史全局地图 $M_{t-1}$ 中的 3D 物体实例集合。</li>
      <li><strong>处理</strong>：
        <ol>
          <li><strong>2D 开放词表检测与分割</strong>：利用 GroundingDINO 进行开词表边界框检测，SAM2 进行实例掩码提取。</li>
          <li><strong>3D 到 2D 运动补偿混合跟踪</strong>：将历史地图中物体实例的 3D 质心 $X_i$ 通过当前相机位姿 $P_t$ 投影到像平面，获得预测像素质心 $\hat c_i(t) = \pi(K \cdot P_t^{-1} \cdot X_i)$，以此作为卡尔曼滤波的状态转移先验，取代传统的线性运动假设。</li>
          <li><strong>几何一致性三态判别与占据更新</strong>：计算地图点 $X_k$ 的投影深度 $d_{proj} = \lVert T_{CW} X_k \rVert_z$ 与当前传感器实测深度 $D(u)$ 的残差 $\Delta d = d_{proj} - D(u)$，严格区分可见（Observable）、被遮挡（Unobservable）与已消失（Disappeared），并对消失点执行对数几率（log-odds）占据惩罚。</li>
          <li><strong>贝叶斯语义融合</strong>：维护物体类别的多项式置信度分布，结合检测器混淆矩阵进行递归更新，自动滤除单帧偶发误分类。</li>
        </ol>
      </li>
      <li><strong>输出</strong>：时空一致的全局 3D 实例级语义地图 $M_t = { O_t^j } _{j=1}^{N_t}$。</li>
      <li><strong>设计动机</strong>：解决剧烈视角变化下的实例 ID 漂移，并在长时运行中自主识别并剔除已搬走/消失的物体残影。</li>
    </ul>
  </li>
  <li><strong>拓扑层（4D 场景图构建与 VLM 接口）</strong>：
    <ul>
      <li><strong>输入</strong>：全局实例集合及其 3D 空间包围盒、质心与时序轨迹。</li>
      <li><strong>处理</strong>：构建图结构 $G = (V, E_S, E_T)$。节点 $V$ 代表物体实例；空间边 $E_S$ 根据空间几何谓词（如 $On$、$Beside$、$Under$）自动建立；时序边 $E_T$ 串联同一实例在不同时间步的演化轨迹。</li>
      <li><strong>输出</strong>：结构化的 4D 动态场景图，以及经过文本序列化（Serialization）的子图 Prompt。</li>
      <li><strong>设计动机</strong>：将海量稠密点云降维为富含语义与空间/时序关系的紧凑拓扑结构，降低多模态大模型的计算开销与幻觉。</li>
    </ul>
  </li>
</ul>

<h4 id="-端到端数据流">③ 端到端数据流</h4>

<p>一个完整的环境观测帧从传感器输入到最终生成导航动作的流经路径如下：
LiDAR 与相机采集多模态数据 $\to$ 几何层实时解算位姿 $P_t$ 并生成局部点云 $\to$ 异步开放词表模块提取 2D 掩码 $\to$ 结合历史 3D 质心投影进行 3D-2D 跨模态关联，分配/更新唯一实例 ID $\to$ 深度残差几何校验分类点云状态，更新点占据率与语义分布 $\to$ 动态刷新 4D 场景图的空间谓词边与时序边 $\to$ 将相关局部子图序列化为结构化文本注入 VLM $\to$ VLM 解析指令并在 <code class="language-plaintext highlighter-rouge">&lt;answer&gt;</code> 标签中输出目标实例 ID $\to$ 解析器从场景图中检索对应的 3D 物理质心坐标作为航点（Waypoint），驱动底盘导航控制器。</p>

<h4 id="-核心公式与更新机制">④ 核心公式与更新机制</h4>

<ul>
  <li>
    <p><strong>3D 到 2D 投影先验</strong>：
\(\hat c_i(t) = \pi\left(K \cdot P_t^{-1} \cdot X_i\right)\)
其中 $X_i$ 为实例在地图中的 3D 质心，$K$ 为相机内参，$\pi(\cdot)$ 为透视投影函数。</p>
  </li>
  <li>
    <p><strong>几何一致性深度残差三态分类</strong>：
定义投影深度残差 $\Delta d = d_{proj} - D(u)$，其中 $d_{proj} = \lVert T_{CW} X_k \rVert_z$ 为地图点在相机系下的预期深度，$D(u)$ 为对应像素 $u = \pi(X_k)$ 处的传感器实测深度。状态判别准则为：
\(s_k^{(t)} = \begin{cases} \text{Observable (可见)}, &amp; \text{if } \lvert \Delta d \rvert \le \tau_\epsilon \\ \text{Unobservable (被遮挡/位于表面后方)}, &amp; \text{if } \Delta d &gt; \tau_\epsilon \\ \text{Disappeared (已消失/位于表面前方)}, &amp; \text{if } \Delta d &lt; -\tau_\epsilon \end{cases}\)</p>
  </li>
  <li>
    <p><strong>对数几率占据更新（Log-Odds Update）</strong>：
\(L(o_k \mid Q_{1:t}) = L(o_k \mid Q_{1:t-1}) + \text{logit}(P(o_k \mid Q_t))\)
对于判定为 Disappeared 的点，给予负几率惩罚以快速从全局地图中修剪陈旧几何。</p>
  </li>
  <li>
    <p><strong>贝叶斯语义融合更新</strong>：
\(P(L_j = c \mid z_{1:t}) = \eta \cdot P(z_t \mid L_j = c) \cdot P(L_j = c \mid z_{1:t-1})\)
其中 $P(z_t \mid L_j = c)$ 为开集检测器的经验混淆矩阵，$\eta$ 为归一化常数。</p>
  </li>
  <li>
    <p><strong>空间拓扑边几何谓词（以 $On$ 关系为例）</strong>：
\(\text{On}(A, B) \iff \left(z_A^{\min} \approx z_B^{\max}\right) \land \left(\text{IoU} _{xy}(B_A, B_B) &gt; \gamma\right)\)</p>
  </li>
</ul>

<h4 id="-难点降维装置">⑤ 难点降维装置</h4>

<h5 id="装置-a--最小具体例子深度残差判定与运动补偿">装置 A — 最小具体例子（深度残差判定与运动补偿）</h5>

<blockquote>
  <p><strong>举个例子</strong>：假设地图中记录了一个垃圾桶的 3D 质心在世界坐标系下为 $(2.0, 0.0, 0.5)\text{m}$。</p>
  <ol>
    <li><strong>运动补偿</strong>：当机器人底盘剧烈右转 $30^\circ$ 时，纯 2D 线性卡尔曼滤波预测的像平面位置偏差超过 120 像素导致跟踪丢失；而 SuperMap 利用高频位姿 $P_t$ 直接将 3D 质心投影到当前帧，像素坐标误差瞬间收敛到 3 像素以内，精准锁定关联。</li>
    <li><strong>深度残差三态判定</strong>：设深度阈值 $\tau_\epsilon = 0.1\text{m}$，该垃圾桶原本预期的投影深度为 $d_{proj} = 2.0\text{m}$。
      <ul>
        <li><strong>场景 1（被遮挡）</strong>：有人走过挡住了垃圾桶，传感器测得前方人体深度 $D(u) = 1.2\text{m}$，残差 $\Delta d = 2.0 - 1.2 = +0.8\text{m} &gt; 0.1\text{m}$，系统判定为 <code class="language-plaintext highlighter-rouge">Unobservable</code>（被遮挡），保留该垃圾桶记忆且不执行误删。</li>
        <li><strong>场景 2（被搬走）</strong>：保洁人员将垃圾桶移走，传感器直接测得后方墙壁深度 $D(u) = 3.5\text{m}$，残差 $\Delta d = 2.0 - 3.5 = -1.5\text{m} &lt; -0.1\text{m}$，系统判定为 <code class="language-plaintext highlighter-rouge">Disappeared</code>（已消失），触发 log-odds 负惩罚，几帧内将垃圾桶从当前活跃地图中剔除并记录时序生灭事件。</li>
      </ul>
    </li>
  </ol>
</blockquote>

<h5 id="装置-b--自制-mermaid-流程图4d-动态场景图与-vlm-闭环控制">装置 B — 自制 Mermaid 流程图（4D 动态场景图与 VLM 闭环控制）</h5>

<pre><code class="language-mermaid">graph TD
    A["多模态流: LiDAR + RGB + IMU"] --&gt; B["SuperOdometry (10Hz 高频位姿与点云)"]
    A --&gt; C["GroundingDINO + SAM2 (1Hz 开放词表 2D 掩码)"]
    B --&gt; D["3D 到 2D 运动补偿投影先验"]
    C --&gt; D
    D --&gt; E["跨帧 3D 实例关联 (分配/延续 Instance ID)"]
    E --&gt; F["深度残差三态几何一致性与贝叶斯融合"]
    F --&gt; G["4D 动态场景图 G = (V, Es, Et)"]
    G --&gt; H["子图序列化为结构化文本 Prompt"]
    I["自然语言指令 (如: 去冰箱旁的画)"] --&gt; J["VLM (Gemini 2.0 Flash) 推理"]
    H --&gt; J
    J --&gt; K["解析器提取目标 ID &lt;answer&gt;12&lt;/answer&gt;"]
    K --&gt; L["从 4D 图检索 3D 质心坐标 X_target"]
    L --&gt; M["机器人局部运动规划与底盘执行"]
</code></pre>

<h5 id="装置-c--before--after-核心机制对比表">装置 C — Before / After 核心机制对比表</h5>

<table>
  <thead>
    <tr>
      <th>评估维度</th>
      <th>传统 3D 场景图（如 ConceptGraphs / HOV-SG）</th>
      <th>传统语义 SLAM（如 Kimera / OVO-SLAM）</th>
      <th>本文方案 SuperMap</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>建图模式</strong></td>
      <td>离线全局扫描后批处理（需数分钟至数小时）</td>
      <td>在线实时运行（10-30 Hz）</td>
      <td><strong>完全板载在线实时运行（10 Hz 位姿 / 5 Hz 场景图）</strong></td>
    </tr>
    <tr>
      <td><strong>词表灵活性</strong></td>
      <td>开放词表（SAM + CLIP 聚类）</td>
      <td>闭集预定义类别（固定 CNN）</td>
      <td><strong>开放词表（GroundingDINO + SAM2 结合）</strong></td>
    </tr>
    <tr>
      <td><strong>动态环境适配</strong></td>
      <td>假设静态环境，动态物体导致重影与鬼影</td>
      <td>仅过滤短期运动人流，忽略长期环境变动</td>
      <td><strong>统一建模短期移动与长期物体搬移/生灭</strong></td>
    </tr>
    <tr>
      <td><strong>实例维护机制</strong></td>
      <td>简单的空间重叠启发式，长程易碎片化</td>
      <td>仅维护局部特征点或几何面元</td>
      <td><strong>3D 运动补偿 + 深度残差一致性 + 贝叶斯融合</strong></td>
    </tr>
    <tr>
      <td><strong>下游推理接口</strong></td>
      <td>静态图结构查询，无法感知物体历史轨迹</td>
      <td>仅提供度量占有栅格或闭集语义网格</td>
      <td><strong>4D 时空动态图 + VLM 结构化 Prompt 闭环控制</strong></td>
    </tr>
  </tbody>
</table>

<hr />

<h3 id="3-核心结果发现-10">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/SuperMap-spatio-temporal-consistency.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1448/731" />
<figcaption>真实动态环境中的时空一致性定性评估：在物体新增（水桶、推车、安全警示牌）与消失（椅子、植物、垃圾桶）事件中，系统均保持了长期稳定的 3D 实例关联与 ID 一致性</figcaption>
</div>

<ol>
  <li><strong>ScanNet 基准评测大幅领先</strong>：
    <ul>
      <li><strong>类别级语义分割</strong>：SuperMap 取得 <strong>55.48%</strong> 的准确率（Acc），大幅超越对象级基准 ConceptGraphs（31.05%）、ConceptFusion（34.10%）和 HOV-SG（35.17%）。</li>
      <li><strong>实例级 3D 分割（mAP）</strong>：在椅子（Chair）、窗户（Window）、冰箱（Refrigerator）和沙发（Sofa）等典型家具类别上，SuperMap 的 $\text{mAP} _{50}$ 分别达到 <strong>63.76%</strong>、<strong>42.20%</strong>、<strong>62.50%</strong> 和 <strong>33.35%</strong>，而依赖全局点云聚类的 HOV-SG 与 ConceptGraphs 得分接近于 0。</li>
    </ul>
  </li>
  <li><strong>长周期真实动态环境时空变化检测</strong>：
    <ul>
      <li>在长达 10 分钟、涵盖 $30\text{m} \times 20\text{m}$ 复杂室内场景的真实机器人实验中，SuperMap 在 6 类目标物体的出现与消失测试中均取得了出色的检测召回率与变化召回率（水桶与椅子达到 <strong>1.000</strong> 满分召回）。</li>
      <li>对比基线 DualMap 因 2D 分割不稳定导致 3D 边界框频繁被过滤，物体检测召回率接近 0；而 Khronos 则因推理瓶颈出现严重丢帧与语义退化。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/SuperMap-reasoning-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/630" />
<figcaption>4D 场景图输入与原始视频输入在 VLM 空间/时序推理上的对比：场景图输入在空间拓扑消歧与历史轨迹回溯上均展现出更高的可靠性与抗幻觉能力</figcaption>
</div>

<ol>
  <li><strong>VLM 空间逻辑与时序推理优势</strong>：
    <ul>
      <li>相比于直接将原始视频帧送入 VLM（Gemini 2.0 Flash），基于 SuperMap 序列化 4D 场景图输入的方案在<strong>空间度量逻辑</strong>（如根据植物与锥桶的相对位置精确定位灭火器）与<strong>时序历史回溯</strong>（沿时序边 $E_T$ 追溯背包移动轨迹并找回遗落物品）任务中显著降低了多模态大模型的空间透视畸变与长时序幻觉。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/SuperMap-vln-experiments.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/499" />
<figcaption>真机端到端在线视觉-语言导航实验：机器人根据场景图中的空间关系精准区分 4 块外观一致的白板，并准确完成多跳空间关系检索导航</figcaption>
</div>

<ol>
  <li><strong>消融实验与系统吞吐量</strong>：
    <ul>
      <li>消融验证表明，缺少 2D 跟踪器时 $F_1$ 从 0.6308 降至 0.5780；缺少贝叶斯语义融合时 $F_1$ 骤降至 0.5201；缺少几何一致性更新时 $F_1$ 降至 0.5764，证实了三者协同对消除检测噪声的关键作用。</li>
      <li>运行速率方面，位姿估计稳定在 <strong>10 Hz</strong>，2D 开放词表感知运行在 <strong>1 Hz</strong>（异步处理），3D 地图更新为 <strong>3 Hz</strong>，4D 场景图维护维持在 <strong>5 Hz</strong>，实现完全板载流畅运行。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-10">4. 局限性</h3>

<p>SuperMap 在应对极高速度运动目标（如奔跑的行人或飞速抛掷物体）时的稠密轨迹追踪能力仍然受限；此外，当前的 2D 开放词表检测依然依赖于给定的 prompt 候选词表，未来需进一步集成自动化的开世界物体自主发现机制以实现全无先验部署。</p>

<hr />

<h2 id="gsmem">17. GSMem (2026)</h2>
<p>———3D Gaussian Splatting 作为具身探索与推理的持久空间记忆</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.19137">arXiv:2603.19137</a></p>

<hr />

<h3 id="精华-11">精华</h3>

<p>GSMem 的核心洞察是将 3D Gaussian Splatting（3DGS）作为一种具备”事后重新观察”能力（post-hoc re-observability）的持久空间记忆，使 agent 无需物理回访即可从任意最优视点重新渲染已探索区域，从根本上突破了离散检测失败导致记忆永久缺失的固有瓶颈。双层检索机制（对象级场景图 + 语义级 CLIP 语言场）互为补充：场景图提供结构化定位，语言场在检测缺失时兜底召回，两者共同驱动最优视点渲染为 VLM 提供高保真视觉证据。混合探索策略将 VLM 语义相关性与基于 Fisher 信息矩阵迹近似的 3DGS 几何信息增益动态结合，在任务导向探索与全局覆盖之间自适应切换，兼顾效率与鲁棒性。将连续辐射场引入具身导航记忆是一次重要范式转移，其”写入即可重渲染”的特性对长时导航任务尤为关键。</p>

<hr />

<h3 id="1-研究背景问题-11">1. 研究背景/问题</h3>

<p>具身导航要求 agent 在未知环境中主动探索并持续积累空间知识。现有方法依赖两类表示：离散的 3D 场景图（如 ConceptGraphs）因依赖检测模块，目标漏检将导致不可恢复的记忆空洞；基于视图快照的方法（如 3D-Mem）则因视角固定、稀疏，无法从最优视角重新观察已探索区域，给 VLM 推理提供的视觉证据质量受限。上述方法均缺乏 post-hoc re-observability：agent 被锁定在初始探索时的固定观测中，无法如人类一样”从新角度回忆”过去场景。</p>

<hr />

<h3 id="2-主要方法创新点-11">2. 主要方法/创新点</h3>

<p><strong>整体框架概览</strong></p>

<p>GSMem 在主动探索过程中实时维护三个并行结构：3DGS 几何与外观地图、每个 Gaussian 附带的 CLIP 语言嵌入场、对象级场景图。查询到来时，多层检索-渲染机制定位相关区域并渲染最优视点图像，VLM 据此推理；当没有 frontier 提供足够语义线索时，切换至基于信息增益的几何探索。</p>

<div align="center">
  <img src="/images/vln/GSMem-teaser.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:975/739" />
<figcaption>GSMem 系统概览：agent 在真实探索路径（黄线）之外，可通过 3DGS 记忆直接"事后重新观察"任意已探索区域（紫线），无需物理导航回访</figcaption>
</div>

<p><strong>3DGS 建图与在线语言场</strong></p>

<p>每个 3D Gaussian \(g_i\) 额外携带 32 维语言嵌入（由 768 维 CLIP 特征经自编码器压缩得到）。为避免高维语言特征的优化开销，提出”权重一致逆聚合”：forward 渲染中 2D 像素特征由 3D Gaussian alpha-blending 生成，逆向时以完全相同的混合权重将 2D CLIP 特征反向分配给各 Gaussian，实现零优化开销的在线语义更新：</p>

\[\mathbf{f}_i^t = \frac{W_i^{t-1}\mathbf{f}_i^{t-1} + \sum_{k \in \mathcal{T}_t} \sum_p w_{i,p,k}^t \mathbf{f}_{p,k}^{2D}}{W_i^t}\]

<p>同时维护对象级场景图（含 3D 位置、语义标签、最高置信度检测视角）、TSDF 地图和 frontier 地图。</p>

<p><strong>多层检索-渲染机制</strong></p>

<div align="center">
  <img src="/images/vln/GSMem-retrieval-rendering.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/587" />
<figcaption>多层检索-渲染机制：对象级检索（场景图）与语义级检索（3DGS 语言场）并行定位 ROI，随后通过最优视点选择与 3DGS 渲染为 VLM 提供高保真视觉证据</figcaption>
</div>

<p>给定任务查询，同时触发两条互补检索路径：</p>
<ul>
  <li><strong>对象级检索</strong>：VLM 对场景图全部对象按语义相关性排序，选 top-$K_\text{obj}$ 候选作为 ROI</li>
  <li><strong>语义级检索</strong>：将查询编码为 CLIP 嵌入，在语言场中以余弦相似度 $&gt; \tau_\text{clip}$ 召回相关 Gaussian，经 KD-Tree 聚类后保留 top-$K_\text{cluster}$ 个空间连贯群组作为 ROI</li>
</ul>

<p>对每个 ROI，在水平圆形轨迹上均匀采样 108 个候选视点（36 方位角 × 3 仰角），经两阶段打分筛选：Phase 1 以能见度分 $S_\text{vis}$（TSDF 光线投射）+ 投影面积分 $S_A$（高斯惩罚鼓励适当观察距离）选出 top-10；Phase 2 进一步以 3DGS 不透明度分 $S_\text{opa}$ 评估实际渲染质量，综合分 $S_\text{final} = S_\text{vis} + S_A + S_\text{opa}$ 选出最优视点。最终通过单步扩散模型提升渲染图像质量后送入 VLM 推理。</p>

<p><strong>混合探索策略</strong></p>

<div align="center">
  <img src="/images/vln/GSMem-hybrid-exploration.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/604" />
<figcaption>混合探索策略：当任一 frontier 的语义相关性超过阈值时优先导向任务目标；否则切换至基于 3DGS 信息增益（不确定性热力图）的几何覆盖探索</figcaption>
</div>

<p>对每个候选 frontier 计算两类分数：</p>
<ul>
  <li><strong>语义相关分</strong> $s_i^\text{sem} \in [0,1]$：VLM 评估 frontier 观测图像与任务查询的相关程度</li>
  <li><strong>几何覆盖分</strong> $s_i^\text{geo}$：基于 Fisher 信息矩阵（FIM）的信息增益，以 T-optimality 代理近似为 FIM 增量的迹 \(s_i^\text{geo} \approx \text{Tr}(\mathbf{I}_i)\)，可直接由渲染 Jacobian 计算，无需真值监督</li>
</ul>

<p>探索决策规则：</p>

\[i^* = \begin{cases} \arg\max_i \, s_i^\text{sem}, &amp; \text{if } \max_i s_i^\text{sem} &gt; \tau_s \\ \arg\max_i \, s_i^\text{geo}, &amp; \text{otherwise} \end{cases}\]

<hr />

<h3 id="3-核心结果发现-11">3. 核心结果/发现</h3>

<p><strong>Active Embodied QA (A-EQA) on OpenEQA</strong>（63 个 HM3D 场景，184 问题，GPT-4o 作为 VLM）：</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>LLM-Match ↑</th>
      <th>LLM-Match SPL ↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Explore-EQA</td>
      <td>46.9</td>
      <td>23.4</td>
    </tr>
    <tr>
      <td>ConceptGraphs w/ Frontier</td>
      <td>47.2</td>
      <td>33.3</td>
    </tr>
    <tr>
      <td>3D-Mem</td>
      <td>52.6</td>
      <td>42.0</td>
    </tr>
    <tr>
      <td><strong>GSMem (Ours)</strong></td>
      <td><strong>55.4</strong></td>
      <td><strong>43.8</strong></td>
    </tr>
  </tbody>
</table>

<p><strong>GOAT-Bench 多模态长时导航</strong>（36 场景 val-unseen，2600+ subtasks）：</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>SR ↑</th>
      <th>SPL ↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>TANGO</td>
      <td>32.1</td>
      <td>16.5</td>
    </tr>
    <tr>
      <td>MTU3D</td>
      <td>47.2</td>
      <td>27.7</td>
    </tr>
    <tr>
      <td>3D-Mem</td>
      <td>62.9</td>
      <td>44.7</td>
    </tr>
    <tr>
      <td><strong>GSMem (Ours)</strong></td>
      <td><strong>67.2</strong></td>
      <td><strong>46.9</strong></td>
    </tr>
  </tbody>
</table>

<p>GSMem 在长时导航任务中的优势比 A-EQA 更显著（SR +4.3 vs LLM-Match +2.8），验证了持久记忆对长时累积任务的特殊价值。消融研究显示：去除 CLIP 语言场 −4.5 SR、去除最优视点选择 −2.7 SR、去除混合探索时 SPL 下降 −4.1，表明几何覆盖策略对探索效率贡献显著。</p>

<div align="center">
  <img src="/images/vln/GSMem-case-analysis.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:983/702" />
<figcaption>案例对比（3D-Mem vs GSMem）：(a-c) 3D-Mem 因检测漏报（白色长袍、无花果树）或语义误检（白色门被识别为冰箱）导致错误，GSMem 通过语义场检索正确定位；(d) 视角受限时，GSMem 通过最优视点重渲染成功识别悬挂衣物</figcaption>
</div>

<hr />

<h3 id="4-局限性-11">4. 局限性</h3>

<p>当前系统依赖 RGB-D 输入，深度噪声或高遮挡场景将影响 3DGS 建图质量，进而降低检索与渲染精度；单步扩散增强引入额外推理延迟，实时部署（当前约 1.2 s/step）仍有优化空间。</p>

<hr />

<h2 id="prospect">18. PROSPECT (2026)</h2>
<p>———流式 VLA + 潜空间预测：训练时预演未来，推理时零开销</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.03739">arXiv:2603.03739</a></p>

<hr />

<h3 id="精华-12">精华</h3>

<ol>
  <li>预测未来不必真的画出未来——把世界模型的监督信号从像素/深度搬到 SigLIP 与 CUT3R 的潜空间，纹理、光照这类任务无关细节在进入损失函数之前就已被教师编码器压掉。</li>
  <li>预测分支只在训练时挂载、推理时整支拆除：它的职责是「塑形」主干表征而非产出结果，因此一分钱延迟都不收。</li>
  <li>用 stream query token 反向查询流式上下文，是在不改动主干自回归结构的前提下，把预测目标塞进一个现成 VLA 的通用做法。</li>
  <li>空间编码器选 CUT3R 而非 VGGT，关键不在精度榜而在工程属性——绝对尺度 + 天然流式，长 episode 下 VGGT 直接 OOM 且尺度随首帧漂移。</li>
  <li>消融显示，这套多目标训练的成败几乎全押在一张注意力掩码上：掩码设计错了掉 8.5 个 SR，比 2D–3D 融合和两个预测目标加起来的贡献还大。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-12">1. 研究背景/问题</h3>

<p>MLLM 驱动的端到端 VLN 已经能把第一人称 RGB 直接映射成动作，但这类方法几乎只训练「理解与执行」，缺少对环境动态的<strong>预测</strong>能力和对空间结构的显式建模。已有的补救路线各有硬伤：低维状态空间世界模型表达力不足；在像素/深度等显式空间做监督又容易过拟合纹理与光照，一换环境就崩；多数方法还只吃很短的历史，浪费了流式视频里的长程上下文。</p>

<p>另一条暗线是视觉编码器：主流 VLN 依赖 SigLIP 这类纯 2D 语义编码器，本身没有空间智能；而近期被引入的 VGGT 系 3D 基础模型在长序列上内存吃紧、必须靠截断历史来躲 OOM，且只给<strong>相对尺度</strong>表征，大视角变化下难以维持一致性。</p>

<hr />

<h3 id="2-主要方法创新点-12">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/PROSPECT-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/1120" />
<figcaption>PROSPECT 总览。(a) 流式设置：注意力掩码同时保证时序因果与 2D/3D query 隔离，SigLIP 与 CUT3R 分别提供 2D 语义流和绝对尺度 3D 空间流，经交叉注意力融合后送入策略；(b) 统一模型：训练时 stream query token 在冻结教师监督下预测下一步 2D/3D 潜特征，推理时只跑 VLA 策略（约 4 Hz）；(c) 结果：VLN-CE 第一梯队，长程的 RxR 上涨幅明显大于 R2R</figcaption>
</div>

<h4 id="-整体框架概述-5">① 整体框架概述</h4>

<p>PROSPECT（Predictive Representations Of SPatial-sEmantic ContexTs）由三块构成：<strong>感知融合模块</strong>把每帧 RGB 同时喂给冻结的 SigLIP 和 CUT3R，用交叉注意力融成一路带空间信息的语义特征；<strong>流式 VLA 主干</strong>（LLaVA-NeXT-Video-7B + Qwen1.5-7B）用 KV cache 维护短期滑窗、用压缩 token 维护长期记忆，自回归吐出原子动作；<strong>潜空间预测分支</strong>在训练时挂上一批可学习的 query token，反向查询流式上下文并解码出「下一帧应该长什么样」的潜特征，推理时整支移除。三者共享同一条注意力序列，靠一张精心设计的掩码把彼此的信息通路切开。</p>

<h4 id="-逐模块讲解-4">② 逐模块讲解</h4>

<p><strong>模块 A：2D–3D 感知融合</strong></p>

<ul>
  <li><strong>输入</strong>：单目 RGB 观测 $o_t$（无深度、无里程计、无全景）。</li>
  <li><strong>处理</strong>：两路并行编码。SigLIP 给语义特征 \(F_t^{2D} = \mathrm{SigLIP}(o_t)\)；CUT3R 先用 ViT 编码器出 \(F_t^{3D,pre}\)，再结合上一步的状态 token \(s_{t-1}\) 和可学习位姿 token \(p_t\) 滚动出空间特征并更新状态：</li>
</ul>

\[[\tilde p_t,\ F_t^{3D}],\ s_t = \mathrm{Decoders}\left([p_t,\ F_t^{3D,pre}],\ s_{t-1}\right)\]

<p>两路以 2D 作 query、3D 作 key/value 做交叉注意力：</p>

\[F_t^{fuse} = \mathrm{softmax}\left(\frac{(F_t^{2D} W_Q)(F_t^{3D} W_K)^{\top}}{\sqrt{d_k}}\right)(F_t^{3D} W_V)\]

<ul>
  <li><strong>输出</strong>：融合特征经 MLP 投到 LLM 嵌入空间，与指令 token 一起入模。长期记忆里的历史关键帧走同一条流水线，但每帧被压成<strong>单个 token</strong>。</li>
  <li><strong>设计动机</strong>：SigLIP 认得出「那是一扇玻璃门」，CUT3R 才知道「它在前方 2.3 米」。指令里的空间介词（穿过、右侧、前面）需要后者才能落地。</li>
</ul>

<blockquote>
  <p><strong>举个例子（为什么非要绝对尺度）</strong>：机器人走了 100 步，中途转了个大弯。VGGT 这类编码器输出的是「相对第一帧」的尺度——第 1 帧里那扇门的宽度被定为 1.0，之后所有距离都按这个基准换算。转弯后视野全换、第一帧的门早已不在画面里，基准便没有实物可锚定，尺度随之漂移。CUT3R 维护一个持续更新的状态 token，逐帧吐出<strong>带绝对尺度（米）</strong>的空间特征，「前方 2.3 m 有障碍」这句话在第 1 步和第 100 步含义完全相同。
工程上差距更直接：R2R 大部分 episode 超过 30 帧，VGGT 一次性吞整段序列直接 OOM；换成流式版 InfiniteVGGT 才跑得动，但 SR 只有 43.2，比 CUT3R 的 48.7 低 5.5 个点，单步耗时还更高（0.284 s vs 0.245 s）。</p>
</blockquote>

<div align="center">
  <img src="/images/vln/PROSPECT-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1446/949" />
<figcaption>PROSPECT 架构。指令与观测（历史关键帧 + 当前帧）共用一条流水线：冻结的 SigLIP 与 CUT3R 经交叉注意力融合，关键帧被压缩进长期记忆 M；主干用 KV cache 承载上下文并自回归输出导航动作。右侧虚线框内为仅训练时启用的预测分支：2D/3D query token 反查流式上下文，轻量 decoder 在冻结教师监督下分别用余弦损失与 MSE 预测下一步潜特征</figcaption>
</div>

<p><strong>模块 B：流式上下文（短期滑窗 + 长期记忆）</strong></p>

<ul>
  <li><strong>输入</strong>：过去 $N-1$ 组观测–动作对，以及均匀采样的历史关键帧。</li>
  <li><strong>处理</strong>：短期窗口用 KV cache 缓存键值状态，避免重复前向；长期关键帧压成记忆 token $M$。流式上下文写作</li>
</ul>

\[\mathrm{Stream}_{0:t} := \left(\mathrm{KV}(W_t),\ o_t,\ M\right)\]

<ul>
  <li><strong>输出</strong>：策略以 \(a_t = \mathrm{VLA}(I, \mathrm{Stream}_{0:t})\) 每步输出 $n_a = 4$ 个原子动作，动作空间为</li>
</ul>

\[a_t^{(i)} \in \mathcal A := \{\uparrow,\ \leftarrow,\ \rightarrow,\ \mathrm{STOP}\}\]

<p>其中 $\uparrow$ 为前进 25 cm，$\leftarrow$ / $\rightarrow$ 为左右转 15°。实验取 $N = 8$、长期关键帧 8 帧。</p>
<ul>
  <li><strong>设计动机</strong>：短期窗口保证动作连贯，长期记忆保证「我已经过了客厅」这类任务进度不被遗忘，两者分工避免了把全部历史塞进上下文的开销。</li>
</ul>

<p><strong>模块 C：stream query token 与潜空间预测（本文核心）</strong></p>

<p>融合特征是把流式信息<strong>正向汇聚</strong>进 LLM；stream query token 做的是相反的事——<strong>反向查询</strong>已经写好的上下文，逼主干把「接下来会看到什么」也编码进去。</p>

<ul>
  <li><strong>输入</strong>：在第 $t$ 轮输入序列末尾追加可学习 token \(\langle q_t^{2D} \rangle\) 与 \(\langle q_t^{3D} \rangle\)（每种模态 9 个）。</li>
  <li><strong>处理</strong>：两者过 LLM 后各自压成一个未来时刻的 embedding，再送进两个 2 层轻量 Transformer decoder，配合重复到目标长度的可学习掩码 token，展开成与目标图像 token 序列等长（196 个）的潜特征：</li>
</ul>

\[\hat F_{t+1}^{2D} = \mathrm{Decoder}^{2D}\left(e_{t+1}^{2D} \mid \langle m_t^{2D} \rangle\right)\]

\[\hat F_{t+1}^{3D} = \mathrm{Decoder}^{3D}\left(e_{t+1}^{3D} \mid \langle m_t^{3D} \rangle\right)\]

<ul>
  <li><strong>输出</strong>：预测的下一步 2D 语义 / 3D 空间潜特征，与冻结 SigLIP / CUT3R 对第 $t+1$ 帧的真实编码对齐（教师不回传梯度）。</li>
  <li><strong>设计动机</strong>：让表征「知道世界会怎么变」，但不为此付出推理代价。</li>
</ul>

<blockquote>
  <p><strong>举个例子（训练挂上、推理拆掉，到底怎么回事）</strong>：假设当前是第 T 轮。训练时模型输入除了指令、长期记忆、历史与当前观测，还额外挂上 9 个 <code class="language-plaintext highlighter-rouge">&lt;Query2d&gt;</code> 和 9 个 <code class="language-plaintext highlighter-rouge">&lt;Query3d&gt;</code>，共 18 个 token；它们过完 LLM 各自得到一个压缩 embedding，再由 2 层 decoder 展开成 196 个 token 的「下一帧特征」，与冻结教师对第 T+1 帧的编码算损失。
推理时这 18 个 token 根本不加进输入——序列里只剩指令 + 上下文 + 动作 token，<strong>相对顺序和注意力结构与训练时完全一致</strong>，所以主干不会因为少了它们而错位。
换句话说，预测能力最终沉淀在 LLM 主干的权重里，而不是靠推理时真去算一遍未来。这也是它比「MLLM + 独立视频生成器」更紧凑的原因：后者推理时得把生成器一起养着。</p>
</blockquote>

<p>为什么监督放在潜空间而不是像素空间：</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>像素 / 深度级世界模型</th>
      <th>PROSPECT 的潜空间预测</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>预测目标</td>
      <td>下一帧 RGB、深度图、BEV/occupancy</td>
      <td>SigLIP 的 2D 语义特征 + CUT3R 的 3D 空间特征</td>
    </tr>
    <tr>
      <td>监督信号里的成分</td>
      <td>纹理、阴影、光照全都得重建</td>
      <td>教师编码器已滤掉外观噪声，只剩语义与几何</td>
    </tr>
    <tr>
      <td>出域鲁棒性</td>
      <td>换光照/换纹理时表征易失效</td>
      <td>黄昏、夜间场景仍可用（见真机结果）</td>
    </tr>
    <tr>
      <td>推理开销</td>
      <td>生成分支通常需保留</td>
      <td>整支移除，零额外延迟</td>
    </tr>
    <tr>
      <td>对位姿/仿真状态的依赖</td>
      <td>常需 GT 位姿或模拟器状态</td>
      <td>无需里程计，可无图部署</td>
    </tr>
  </tbody>
</table>

<pre><code class="language-mermaid">graph TD
    A["指令 I + 长期记忆 M + 短期流式上下文"] --&gt; B["PROSPECT 主干 LLM"]
    Q["9 个 Query2d + 9 个 Query3d"] -.-&gt;|"仅训练时挂载，推理整支移除"| B
    B --&gt; C["动作 token: 前进 / 左转 / 右转 / STOP"]
    B --&gt; D["2D / 3D 未来 embedding"]
    D --&gt; E["2 层轻量 Decoder + 196 个掩码 token"]
    E --&gt; F["预测的下一步潜特征"]
    F --&gt; G["冻结 SigLIP 教师: 余弦损失"]
    F --&gt; H["冻结 CUT3R 教师: MSE 损失"]
</code></pre>

<p><strong>模块 D：流式注意力掩码</strong></p>

<div align="center">
  <img src="/images/vln/PROSPECT-attention-mask.webp" width="70%" loading="lazy" decoding="async" style="aspect-ratio:715/913" />
<figcaption>PROSPECT 的流式注意力掩码。上部灰色：导航上下文与动作的标准因果掩码；中部红色：每个 2D query 只能看自己所在轮次及更早轮次的上下文与动作，看不到任何其他 query；下部蓝色：3D query 同理。右侧对角块表明 query 仅与自身可见，从而同时实现轮次隔离与模态解耦</figcaption>
</div>

<p>标准因果掩码在这里不够用，因为每轮都新增了一对预测 query。论文把短期导航上下文重新解释成一场 $N$ 轮对话：第 $i$ 轮模型消费上下文 \(\mathrm{ctxt}_i\)（提示与观测 token）、产出回应 \(\mathrm{act}_i\)（动作 token），首轮额外包含指令与长期记忆 $M$。训练时在每轮末尾追加 \(\langle q_i^{2D} \rangle\) 与 \(\langle q_i^{3D} \rangle\)，并施加三条约束。</p>

<blockquote>
  <p><strong>举个例子（三条约束分别拦住了什么）</strong>：只取前 3 轮，每轮一组 <code class="language-plaintext highlighter-rouge">ctxt</code> / <code class="language-plaintext highlighter-rouge">act</code>，再各配一对预测 query。</p>
  <ul>
    <li><strong>因果</strong>：<code class="language-plaintext highlighter-rouge">act_2</code> 可见 <code class="language-plaintext highlighter-rouge">ctxt_0..2</code> 与 <code class="language-plaintext highlighter-rouge">act_0..1</code>，但看不到 <code class="language-plaintext highlighter-rouge">ctxt_3</code>。这是标准因果掩码，防止偷看未来。</li>
    <li><strong>轮次隔离</strong>：<code class="language-plaintext highlighter-rouge">Query2d_1</code> 可见 <code class="language-plaintext highlighter-rouge">ctxt_0..1</code> 与 <code class="language-plaintext highlighter-rouge">act_0..1</code>，却<strong>看不到</strong> <code class="language-plaintext highlighter-rouge">Query2d_0</code> 和 <code class="language-plaintext highlighter-rouge">Query2d_2</code>。每个 query 只能从共享的流式上下文里取信息，不能从相邻 query 那儿抄答案——否则前一个 query 的预测误差会顺着 query 链一路累积。</li>
    <li><strong>模态隔离</strong>：<code class="language-plaintext highlighter-rouge">Query2d_1</code> 与 <code class="language-plaintext highlighter-rouge">Query3d_1</code> 互不可见。否则 2D 分支可以直接读走 3D 分支算好的几何，两个本该互补的目标退化成一个。</li>
  </ul>

  <p>消融证实这两道隔离都省不得：去掉模态隔离 SR 从 48.7 掉到 39.9，退回普通因果掩码（Leaky，query 可隐式触到未来导航 token）掉到 40.2。</p>
</blockquote>

<p>评估时预测分支被整体摘除，剩下的 token 序列保持与训练时相同的相对次序与注意力结构——这正是「训练挂上、推理拆掉」不掉点的前提。</p>

<h4 id="-端到端数据流-1">③ 端到端数据流</h4>

<p>一个样本在第 $t$ 步的完整路径：单目 RGB $o_t$ → SigLIP / CUT3R 双路编码 → 交叉注意力融合 → MLP 投影进 LLM 嵌入空间 → 与指令 token、长期记忆 $M$、KV cache 中的短期窗口拼成流式序列 →（训练时额外追加 2D/3D query token）→ 主干在流式掩码下前向 → 自回归输出 4 个原子动作；训练时并行地由两个轻量 decoder 从 query embedding 展开下一步潜特征，与冻结教师对齐。</p>

<h4 id="-训练目标">④ 训练目标</h4>

<p>2D 用余弦距离、3D 用 MSE：</p>

\[\mathcal L_{2D} = 1 - \cos\left(\hat F_{t+1}^{2D},\ F_{t+1}^{2D}\right)\]

\[\mathcal L_{3D} = \mathrm{MSE}\left(\hat F_{t+1}^{3D},\ F_{t+1}^{3D}\right)\]

<p>损失形式并非随手选的：SigLIP 本身是在 $\ell_2$ 归一化嵌入上用成对 sigmoid 损失训出来的，几何上只有方向有意义，对它用 MSE 会去惩罚模长差异，训练不稳；CUT3R 特征没有这个归一化前提，MSE 反而稳定。</p>

<p>总目标为</p>

\[\mathcal L_{all} = \mathcal L_{nav} + \gamma\left(\alpha \mathcal L_{2D} + \beta \mathcal L_{3D}\right)\]

<p>其中 $\mathcal L_{nav}$ 是动作交叉熵，取 $\gamma = 0.01$、$\alpha = 0.25$、$\beta = 0.75$，目的是让任何单项都不会仅凭数值量级压过其他项。</p>

<p>训练分两阶段，共用 8× A800：<strong>Stage 1</strong> 在 MP3D 的 VLN-CE 数据（R2R / RxR / R2R-EnvDrop，合计约 479K，占比约 5% / 14% / 80%）上做一轮 SFT，耗时 560 A800 GPU-hours；<strong>Stage 2</strong> 保留 Stage 1 的 R2R/RxR 轨迹以缓解遗忘，追加约 260K DAgger 样本（专家重标注提供偏离航线后的恢复动作）与约 314K ScaleVLN 样本（HM3D），并混入 LLaVA-Video-178K 与 ScanQA 以强化时空推理，总量约 938K（71% VLN + 29% VQA），一轮约 1900 A800 GPU-hours。SigLIP 学习率 $5 \times 10^{-6}$，其余可训练模块峰值 $2 \times 10^{-5}$，CUT3R 全程冻结。</p>

<h4 id="-推理流程">⑤ 推理流程</h4>

<p>推理只跑 VLA 主干：query token 不入序列、两个 decoder 不加载、教师编码器不参与。真机上单步约 0.25 s，控制频率约 4 Hz。</p>

<hr />

<h3 id="3-核心结果发现-12">3. 核心结果/发现</h3>

<p><strong>VLN-CE 主结果</strong>（R2R / RxR val-unseen，单目 RGB，无深度、无里程计、无全景）：</p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>训练数据</th>
      <th>R2R SR↑</th>
      <th>R2R SPL↑</th>
      <th>RxR SR↑</th>
      <th>RxR SPL↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>NaVid</td>
      <td>MP3D</td>
      <td>37.4</td>
      <td>35.9</td>
      <td>–</td>
      <td>–</td>
    </tr>
    <tr>
      <td>Uni-NaVid</td>
      <td>MP3D</td>
      <td>47.0</td>
      <td>42.7</td>
      <td>48.7</td>
      <td>40.9</td>
    </tr>
    <tr>
      <td>StreamVLN</td>
      <td>MP3D + VideoQA</td>
      <td>50.8</td>
      <td>45.7</td>
      <td>48.6</td>
      <td>42.5</td>
    </tr>
    <tr>
      <td><strong>PROSPECT</strong></td>
      <td>MP3D + VideoQA</td>
      <td><strong>52.0</strong></td>
      <td><strong>46.2</strong></td>
      <td><strong>52.7</strong></td>
      <td><strong>42.8</strong></td>
    </tr>
    <tr>
      <td>NaVILA</td>
      <td>+ 额外数据</td>
      <td>54.0</td>
      <td>49.0</td>
      <td>49.3</td>
      <td>44.0</td>
    </tr>
    <tr>
      <td>StreamVLN</td>
      <td>+ ScaleVLN / MMC4</td>
      <td>55.7</td>
      <td>50.9</td>
      <td>52.9</td>
      <td>46.0</td>
    </tr>
    <tr>
      <td><strong>PROSPECT</strong></td>
      <td>+ ScaleVLN / MMC4</td>
      <td><strong>58.9</strong></td>
      <td><strong>54.0</strong></td>
      <td><strong>54.6</strong></td>
      <td><strong>46.2</strong></td>
    </tr>
  </tbody>
</table>

<p>几个值得留意的点：</p>

<ol>
  <li><strong>收益集中在长程任务</strong>。RxR 的涨幅明显大于 R2R，而 RxR 的评估 episode 数是 R2R 的两倍、平均轨迹 15.32 m vs 9.89 m（1.55×）、指令平均约 120 词 vs 32 词（近 4×）。按执行步数分层的消融把这一点讲得更直白：短程（1–50 步）SR 几乎持平（+0.03），中程（50–100 步）+4.68，长程（≥100 步）+4.14。有意思的是分箱本身也在变化——PROSPECT 的长程 episode 比基线少了 50 条、短程与中程各多出 27 / 23 条，说明它把一部分原本要磨很久的任务提前走完了。</li>
  <li><strong>模块消融呈超加性</strong>。以 SigLIP-only 为基线（SR 45.5），加 CUT3R 融合到 46.7，单加 2D 预测到 47.0、单加 3D 预测到 47.2，而两个预测目标同时开启直接到 48.7。单项各贡献 0.3 / 0.5，合起来却是 2.0——语义与几何的预测信号确实互补，而非重复。</li>
  <li><strong>掩码设计是整套方法的胜负手</strong>。Leaky（普通因果掩码）40.2、去掉模态隔离 39.9、完整设计 48.7。也就是说掩码做错要掉 8.5 个 SR，比 2D–3D 融合（+1.2）与两个预测目标（+2.0）加起来还多好几倍。这条结论比方法本身更值得迁移：往现成 VLA 里加辅助目标时，信息通路怎么切远比加什么目标更关键。</li>
  <li><strong>空间编码器对比</strong>。VGGT 在 R2R 长 episode 上直接 OOM；InfiniteVGGT 可跑但 SR 43.2、单步 0.284 s；CUT3R 为 SR 48.7、单步 0.245 s，精度与延迟双赢。</li>
</ol>

<div align="center">
  <img src="/images/vln/PROSPECT-real-robot.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1435/985" />
<figcaption>ARX-Lift2 真机第一人称视角。自上而下依次为办公室（116 步）、储物间（164 步）、夜间街道（232 步），单步平均推理耗时均约 0.25 s，指令中红色标注的是需要视觉定位的地标</figcaption>
</div>

<p><strong>真机结果</strong>（ARX-Lift2，头部 RealSense 405 单目 RGB；每场景按短/中/长程各设 5 条指令、每条执行 2 次共 30 次；成功判据为 500 步内进入目标 0.3 m 且主动输出 STOP，碰撞记失败；所有场景训练中未见过）：</p>

<table>
  <thead>
    <tr>
      <th>场景</th>
      <th>光照</th>
      <th>NaVid</th>
      <th>StreamVLN</th>
      <th>PROSPECT</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>办公室（室内）</td>
      <td>明亮</td>
      <td>7/30</td>
      <td>12/30</td>
      <td><strong>20/30</strong></td>
    </tr>
    <tr>
      <td>仓库（室内）</td>
      <td>明亮</td>
      <td>6/30</td>
      <td>12/30</td>
      <td><strong>18/30</strong></td>
    </tr>
    <tr>
      <td>走廊（室内）</td>
      <td>中等</td>
      <td>11/30</td>
      <td>16/30</td>
      <td><strong>22/30</strong></td>
    </tr>
    <tr>
      <td>户外·午后</td>
      <td>明亮</td>
      <td>6/30</td>
      <td>10/30</td>
      <td><strong>18/30</strong></td>
    </tr>
    <tr>
      <td>户外·黄昏</td>
      <td>中等</td>
      <td>4/30</td>
      <td>6/30</td>
      <td><strong>11/30</strong></td>
    </tr>
    <tr>
      <td>户外·夜间街道</td>
      <td>昏暗</td>
      <td>2/30</td>
      <td>6/30</td>
      <td><strong>9/30</strong></td>
    </tr>
    <tr>
      <td><strong>合计</strong></td>
      <td>—</td>
      <td>36/180（20.0%）</td>
      <td>62/180（34.4%）</td>
      <td><strong>98/180（54.4%）</strong></td>
    </tr>
  </tbody>
</table>

<p>跨全部六个场景与三档光照均领先，且相对优势在光照越差时并未消失（夜间 9 vs 6 vs 2）——这与「潜空间监督天然过滤掉外观噪声」的设计动机对得上。部署形态上，室内用双 RTX-4090 服务器经 Wi-Fi/LAN 远程推理（约 0.25 s/步），室外用双 A800 经公网（约 0.27 s/步），均约 4 Hz；论文也测了单张 RTX 4070 降精度的板载推理，可行但成功率下降。</p>

<hr />

<h3 id="4-局限性-12">4. 局限性</h3>

<p>自主性仍受限于算力形态：主力结果依赖远程推理，板载单卡降精度虽能跑但明显掉点，而夜间 9/30 的成功率说明低光下还远谈不上可靠。方法层面，预测目标锚定在冻结的 SigLIP/CUT3R 上，表征上限被教师锁死，且只预测 $t+1$ 一步，谈不上更长视野的规划；此外消融基本在 one-epoch SFT 设定下完成，与最终 scaled 配方是否完全一致尚未验证，而这套训练本身相当昂贵（两阶段合计约 2460 A800 GPU-hours）。</p>

<hr />

<h2 id="qwen-drive">19. Qwen-Drive (2026)</h2>
<p>———首个不改动 VLM 架构、统一 3D 感知/问答/轨迹规划的端到端自动驾驶基础模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.00111">arXiv:2609.00111</a> · <a href="https://github.com/QwenLM/Qwen-Drive-1.0">Code</a> · <a href="https://huggingface.co/Qwen/Qwen-Drive-1.0-4B">Model</a></p>

<hr />

<h3 id="精华-13">精华</h3>

<ul>
  <li><strong>无侵入架构统一三大驾驶能力</strong>：在完全冻结且不修改通用视觉语言模型（VLM）主干的前提下，通过外挂轻量化 BEV 感知头与基于扩散变换器（DiT）的规划专家，首次在一套框架内原生统一 3D 感知、驾驶视觉问答与未来运动轨迹规划。</li>
  <li><strong>解耦感知探针与隐式空间表征倒逼</strong>：提出双流特征融合的 BEV 感知头，低层通过深度网络将图像投影构建 3D 体素空间，高层抽取 VLM 语义特征并经由 BEV Transformer 融合，作为探针不仅输出可解释的 3D 检测、占用与矢量地图，更通过双流反向传播驱动通用 VLM 掌握精确 3D 几何常识。</li>
  <li><strong>GQA 键值缓存驱动的连续流匹配规划</strong>：规划专家无需将轨迹离散化为自回归文本 Token，而是直接跨模块复用 VLM 内部 8 层分组查询注意力（GQA）的 Key-Value 缓存作为交叉条件，借助流匹配（Flow Matching）在连续空间内一步到位解码平滑且符合动力学物理特性的时空航点。</li>
  <li><strong>首创连续流匹配策略梯度强化学习</strong>：突破传统扩散/流模型难以接入不可微驾驶环境指标的瓶颈，在最后 3 步积分区间引入正交低频余弦子空间扰动与分数恢复项（Restoring Score），结合组内无评论家相对优势，在连续扩散流形上直接优化碰撞、通行规则与体感舒适度指标。</li>
  <li><strong>零灾难性遗忘且多基准登顶</strong>：通过混合驾驶与通用图文数据的四阶段递进式训练，模型在获得行业领先 3D 几何与规划能力（NAVSIM PDMS 达 90.7，WOD-E2E RFS 达 7.91）的同时，通用多模态问答基准分毫未损。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-13">1. 研究背景/问题</h3>

<p>现有的自动驾驶视觉语言模型（VLM）面临两难困境：若直接改造大模型主干去输出离散坐标或自回归生成决策，往往导致严重的灾难性遗忘并破坏其原生的通用视觉推理与指令遵循能力；而若仅依靠多模态大模型输出高层文本解释，又缺乏对 3D 物理环境的精确几何感知与可执行的连续运动学控制。</p>

<p>为此，阿里云 Qwen 团队与华中科技大学联合推出了 <strong>Qwen-Drive-1.0</strong>，旨在探索兼顾“通用多模态理解能力”与“专用端到端自动驾驶几何规划能力”的统一基座。其核心动机在于：在<strong>完全不改动预训练 VLM 架构与参数格式</strong>的前提下，利用外挂探针模块抽取通用特征中的 3D 空间结构，并通过连续流匹配与强化学习，实现端到端 3D 感知、常识推理与闭环轨迹规划的深度协同。</p>

<hr />

<h3 id="2-主要方法创新点-13">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/si/Qwen-Drive-unified-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/741" />
<figcaption>Qwen-Drive-1.0 整体统一多任务架构：共享视觉编码器与 VLM 主干支持文本生成，外挂 BEV 感知头与规划专家分别负责 3D 几何预测与未来轨迹生成</figcaption>
</div>

<h4 id="21-整体框架概述">2.1 整体框架概述</h4>

<p>Qwen-Drive-1.0 整体由三个核心协同模块构成：</p>
<ol>
  <li><strong>共享多模态骨干（Shared VLM Backbone）</strong>：采用标准 Qwen3.5-4B 架构与原生 Vision Encoder，接收多视角环视图像、连续视频帧或单张通用图像，负责场景语义表征与多轮对话问答；</li>
  <li><strong>BEV 感知探针（BEV Perception Head）</strong>：外挂轻量化空间解码模块，融合视觉编码器底层纹理特征与 VLM 顶层语义特征，显式解码自车坐标系下的 3D 目标检测、3D 语义占用（Semantic Occupancy）及高精矢量地图分割；</li>
  <li><strong>规划专家（Planning Expert）</strong>：包含 11 亿参数（32 层）的扩散变换器（Diffusion Transformer, DiT），跨模块直接读取 VLM 中缓存的键值表征（KV Cache）作为先验条件，通过流匹配生成未来 5 秒（10Hz，共 50 个航点）的平滑自车轨迹。</li>
</ol>

<p>在输入序列化上，模型依据下游任务特性设计了两种无冗余标签排序策略：</p>
<ul>
  <li><strong>问答任务（帧优先，Frame-Major）</strong>：按时步遍历视角，即 <code class="language-plaintext highlighter-rouge">frame: 0 &lt;FRONT VIEW&gt; &lt;image&gt; ... frame: 1 ...</code>，便于大模型跨视角对齐单帧全局环境；</li>
  <li><strong>规划任务（视角优先，View-Major）</strong>：按视角遍历时步，即 <code class="language-plaintext highlighter-rouge">&lt;FRONT VIEW&gt; frame: 0 &lt;image&gt; frame: 1 &lt;image&gt; ...</code>，将同一摄像头的连续历史观测紧密相邻排列，显著增强对动态障碍物时序速度与运动变化的感知。</li>
</ul>

<hr />

<h4 id="22-外挂双流-bev-感知探针与自制架构解析">2.2 外挂双流 BEV 感知探针与自制架构解析</h4>

<p>为验证预训练 VLM 内部是否已内隐具备 3D 空间结构，并为驾驶决策提供可显式质检的几何输出，论文设计了不修改大模型主干的 BEV 感知头。</p>

<div align="center">
  <img src="/images/si/Qwen-Drive-module-architectures.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/573" />
<figcaption>外挂模块精细结构：(a) 双流特征融合的 BEV 感知头；(b) 基于 VLM 分组查询注意力（GQA）键值缓存交叉条件的规划专家 DiT</figcaption>
</div>

<p>模块内部的数据流向与空间投影机制如下：</p>
<ul>
  <li><strong>输入</strong>：当前时刻 $N_v$ 个环视相机画面（如 6 视角或 8 视角）及内外参标定矩阵。</li>
  <li><strong>处理过程（双流融合）</strong>：
    <ol>
      <li><strong>低层几何流</strong>：从 Vision Encoder 提取尚未进入大模型的低层图像特征 $F_v$。通过轻量化深度子网络预测沿视线的离散深度分布 $D_i$，按经典视线投射原理将特征分散到 3D 空间中，构建带有高度维度的 3D 体素特征体 $V(p) = \sum_{i \in \Omega(p)} D_i(u_i, v_i, d_i) F_v^i(u_i, v_i)$；</li>
      <li><strong>高层语义流</strong>：图像 Token 完整经过 VLM 运算后，抽取顶层富含全图上下文语义的特征 $F_m$。经由特征金字塔（FPN）上采样生成多尺度语义图；</li>
      <li><strong>BEV 平面聚合</strong>：将 3D 体素 $V$ 沿高度坍缩压平作为几何先验查询 $\bar{V}$，送入 BEV Transformer。通过在 BEV 网格上交替执行自注意力与对多尺度 $F_m$ 的可变形跨注意力（Deformable Cross-Attention），输出融合了几何深度与高层语义的自车坐标系 BEV 表征 $B$。</li>
    </ol>
  </li>
  <li><strong>输出</strong>：三路专用解码头并行输出——DETR 风格的可变形注意力解码器预测 3D 目标检测框；三维 UNet 结合初始体素 $V$ 预测体素级 3D 语义占用；轻量卷积头输出局部 $400 \times 200$ 网格的栅格化矢量地图元素。</li>
</ul>

<pre><code class="language-mermaid">graph TD
    A["多视角环视图像 (Nv 视角)"] --&gt; B["Vision Encoder 提取低层特征 Fv"]
    A --&gt; C["Qwen3.5 VLM 主干提取高层语义 Fm"]
    B --&gt; D["深度网络预测视线深度分布 Di"]
    D --&gt; E["外推并聚合成 3D 体素表征 V"]
    E --&gt; F["沿高度坍缩生成几何先验 V_bar"]
    C --&gt; G["特征金字塔 FPN 构建多尺度语义"]
    F --&gt; H["BEV Transformer 交叉注意力融合"]
    G --&gt; H
    H --&gt; I["统一自车 BEV 特征 B"]
    I --&gt; J["3D 目标检测 (DETR 查询解码)"]
    I --&gt; K["语义占用预测 (结合 3D 体素 V)"]
    I --&gt; L["高精地图矢量分割 (BEV UNet)"]
</code></pre>

<ul>
  <li><strong>感知目标函数</strong>：总感知损失联合监督检测、占用与地图分割：
\(L_{perc} = L_{det} + L_{occ} + L_{map}\)
其中 $L_{det}$ 采用匈牙利匹配下的 Focal 损失与 $\ell_1$ 边界框回归；$L_{occ}$ 结合类别平衡 Focal、几何/语义亲和度损失与 Lovász-softmax 损失；$L_{map}$ 采用 Focal 与 Lovász 损失。在反向传播时，感知损失不仅更新 BEV 头，更通过 $F_m$ 为 VLM 与视觉编码器注入强大的 3D 空间监督信号。</li>
</ul>

<hr />

<h4 id="23-基于流匹配flow-matching的规划专家">2.3 基于流匹配（Flow Matching）的规划专家</h4>

<p>传统自动驾驶方案要么采用级联感知预测模块，信息瓶颈严重；要么强行让语言模型输出离散的轨迹 Token，不仅推理缓慢，而且容易违反车辆物理运动学约束。</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统端到端感知规划 (如 UniAD)</th>
      <th>纯自回归语言模型规划 (如 DriveVLM / EMMA)</th>
      <th>本文 Qwen-Drive-1.0 架构</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>主干模型架构</td>
      <td>专用 CNN/BEV 网络，无通用推理与常识理解能力</td>
      <td>修改或全量微调 VLM，易出现灾难性遗忘与泛化退化</td>
      <td>冻结原生预训练 VLM 架构，无侵入式外挂扩展</td>
    </tr>
    <tr>
      <td>规划轨迹表示</td>
      <td>稠密感知结果级联输入二次低层轨迹优化器</td>
      <td>文本或离散网格 Token 自回归逐点解码</td>
      <td>32 层连续扩散变换器（DiT）结合流匹配解码</td>
    </tr>
    <tr>
      <td>几何常识交互机制</td>
      <td>仅依赖预测框几何交互，缺乏深层语义推理</td>
      <td>纯靠离散语言提示推导坐标，动力学平滑度差</td>
      <td>跨模块直接复用 VLM 8 层 GQA 键值缓存与动力学状态</td>
    </tr>
    <tr>
      <td>策略后训练能力</td>
      <td>仅支持模仿学习或简单的代价函数打分</td>
      <td>离散强化学习（PPO）难以平滑探索连续控制流形</td>
      <td>连续流匹配策略梯度（低频余弦子空间扰动与分数恢复）</td>
    </tr>
  </tbody>
</table>

<ul>
  <li><strong>输入与条件注入</strong>：
规划目标建模为条件连续轨迹生成：
\(\tau \sim p(\tau \mid s, \ell, \tau_{hist}, n, e, r)\)
其中 \(\tau = \{ (x_k, y_k, \theta_k) \} _{k=1}^{50}\) 为未来 5 秒内 50 个时间步的纵向位置、横向位置及朝向角。输入的传感器图像经过 VLM 主干计算后，模型提取 VLM 中全部 8 个分组查询注意力（GQA）层中带有旋转位置编码（RoPE）的 Key 和 Value 缓存（KV Cache）。DiT 的 32 层分为 8 组（每组 4 层），每组直接与对应 GQA 层的 KV 拼接执行联合跨注意力交互；自车历史轨迹 \(\tau_{hist}\)、导航意图 $n$（如左转、直行）、当前自车物理状态 $e$（速度与加速度）及流时间步 $t$ 则通过自适应层归一化（AdaLN）注入到每个 DiT 块中。</li>
  <li><strong>流匹配训练目标</strong>：
采用端点预测形式的流匹配（Flow Matching），并引入一阶与二阶时间差分惩罚抑制轨迹抖动：
\(L_{plan} = L_{fm} + 0.1 L_{\Delta 1} + 0.05 L_{\Delta 2}\)
其中 $L_{fm}$ 为预测流场速度与真实流速度之间的均方误差；$L_{\Delta 1}$ 和 $L_{\Delta 2}$ 为 Huber 正则项，分别惩罚轨迹速度与加速度的突变，确保输出轨迹严格满足车辆乘坐舒适性与动力学连续性。推理时仅需 10 步欧拉积分器即可快速解出确定性平滑轨迹。</li>
</ul>

<hr />

<h4 id="24-连续流匹配的策略梯度强化学习flow-matching-rl">2.4 连续流匹配的策略梯度强化学习（Flow Matching RL）</h4>

<p><strong>难点剖析</strong>：基于模仿学习（SFT）训练的规划专家只能逼近人类单条演示轨迹，但人类驾驶演示可能存在次优解，且无法直接感知碰撞风险、越界率与行车通行效率等不可微环境指标。然而，标准的策略梯度强化学习（如 PPO/GRPO）依赖动作概率 $\log \pi(a \mid s)$，而流匹配在推理时使用的是确定性的 10 步常微分方程（ODE）欧拉积分，不存在可以直接求导的似然分布。</p>

<p>针对该挑战，Qwen-Drive-1.0 提出了一套<strong>作用于连续扩散/流积分过程的平滑策略梯度优化算法</strong>：</p>
<ol>
  <li><strong>尾部注入受控随机性</strong>：10 步欧拉积分（步长 $\Delta t = 0.1$）中，前 7 步保持纯确定性积分以锁定大局决策；仅在最后 3 个积分时步 $W = {7, 8, 9}$ 引入受控随机扰动。因为终点处的扰动能直接映射到轨迹形变上，既保证了探索的多样性，又避免了前期扰动被后续积分衰减抵消；</li>
  <li><strong>正交余弦低频子空间投影</strong>：若在 50 个航点上添加独立高斯噪声，会产生杂乱无章的高频震颤毛刺，使模型学不到有意义的规避行为。因此，扰动被严格限制在前 $M=6$ 阶正交余弦基底 $\Phi \in \mathbb{R}^{50 \times 6}$ 构成的平滑低频子空间内（$\Phi^\top \Phi = I_M$），使得随机变动表现为平滑的变道微调或前后纵向车距拉伸；</li>
  <li><strong>分数恢复机制（Restoring Score）</strong>：随机探索可能导致中间轨迹偏离高概率密度流形，算法利用高斯条件概率推导解析恢复分数项：
\(s_\theta(\tau^{(k)}, t_k) = -\frac{\tau^{(k)} - t_k \hat{\tau} _1^{(k)}}{(1 - t_k)^2}\)
并将单步均值修正为 $\mu^{(k)} = \tau^{(k)} + v_\theta \Delta t + \frac{\sigma_k^2}{2} s_\theta$，像虚拟阻尼器一样将轨迹状态持续拉向预训练流场中心；</li>
  <li><strong>组内相对优势折扣优化</strong>：同一个环境并发采样 $G=8$ 条轨迹候选，依据不可微指标（NAVSIM 的 PDMS、Waymo 的 RFS 及位移误差 ADE）计算奖励，通过组内标准化优势值 $A_i = \frac{R_i - \bar{R}}{\sigma_R + \epsilon_R}$ 结合时间折扣因子 $\gamma = 0.6$ 进行策略梯度回传：
\(L_{rl} = -\frac{1}{G \lvert W \rvert} \sum_{i=1}^G \sum_{w=0}^{\lvert W \rvert - 1} \gamma^{\lvert W \rvert - 1 - w} A_i \log \pi_\theta\left(\tau_i^{(k_w+1)} \,\middle\vert\, \tau_i^{(k_w)}\right)\)</li>
</ol>

<blockquote>
  <p><strong>举个例子</strong>：假设规划专家用 10 步欧拉积分（$K=10$）从纯噪声去噪生成 5 秒（50 个航点）的轨迹。</p>
  <ol>
    <li><strong>前 7 步（时步 0 到 6）</strong>：完全遵循确定性流场速度积分滑行，不引入任何额外噪声，保留预训练学到的宏观驾驶意图；</li>
    <li><strong>后 3 步（时步 7 到 9，集合 $W={7,8,9}$）</strong>：由于越靠近终点微小扰动对实际轨迹影响越直接，此时注入探索随机性。但为了防止 50 个航点各自随机抖动变成”锯齿折线”，扰动被严格限制在 6 个平滑的正交余弦波形基底（$\Phi \in \mathbb{R}^{50 \times 6}$）构成的低频子空间内；</li>
    <li><strong>防漂移拉回</strong>：注入高斯扰动后，中间状态可能会偏离预训练流线，算法通过条件高斯分布反推一个恢复分数项 $s_\theta = -\frac{\tau - t \hat{\tau} _1}{(1-t)^2}$，像一根橡皮筋把扰动点稳稳拽回安全流形中心；</li>
    <li><strong>无价值网络优势估计</strong>：同一个驾驶场景并发采样 $G=8$ 组完整轨迹，每条轨迹根据驾驶表现计算非可微奖励（如 NAVSIM 的碰撞与合规综合得分 PDMS），通过组内相对优势 $A_i = \frac{R_i - \bar{R}}{\sigma_R}$ 计算折扣策略梯度，实现针对连续扩散流的强化学习更新。</li>
  </ol>
</blockquote>

<hr />

<h4 id="25-四阶段递进式训练配方">2.5 四阶段递进式训练配方</h4>

<div align="center">
  <img src="/images/si/Qwen-Drive-training-recipe.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/552" />
<figcaption>四阶段递进式训练流程：从感知头预热、多任务联合表征微调，到规划专家预训练与策略梯度强化学习</figcaption>
</div>

<p>为了平衡多任务学习冲突并避免灾难性遗忘，论文提出了清晰的四阶段递进式训练流程：</p>
<ul>
  <li><strong>Stage 1（感知头预训练）</strong>：完全冻结视觉编码器与 VLM 主干，仅以感知损失 $L_{perc}$ 预训练外挂的 BEV 感知头，使其快速建立从图像到 3D 体素与 BEV 坐标系的投影与解码先验；</li>
  <li><strong>Stage 2（感知与 VQA 联合对齐微调）</strong>：解冻视觉编码器、VLM 与 BEV 感知头，将 3D 感知数据、309 万驾驶图文数据（多视角图文、视频时序数据）与通用视觉语言数据按比例混合，以 $L_{perc} + L_{ntp}$ 联合训练。BEV 头学习率设为 VLM 的 20 倍，既让大模型表征融入 3D 物理空间理解，又牢固锁死通用问答与常识推理能力；</li>
  <li><strong>Stage 3（规划专家预训练，SFT）</strong>：冻结 Stage 2 训练完毕的全部多模态表征，仅训练外挂的 11 亿参数规划专家 DiT，以端到端流匹配损失 $L_{plan}$ 学习各驾驶数据集的演示轨迹；</li>
  <li><strong>Stage 4（规划专家强化学习，RL）</strong>：在 NAVSIM、Waymo E2E 与 PhysicalAI-AV 上构建多源混合奖励，通过上述流匹配策略梯度直接后训练优化规划专家，最终得到性能优异的 Qwen-Drive-1.0-RL。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-13">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/si/Qwen-Drive-performance-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1282/791" />
<figcaption>Qwen-Drive-1.0 在驾驶场景问答、通用视觉问答、3D 感知与运动规划四大维度的综合性能雷达图</figcaption>
</div>

<h4 id="31-3d-感知性能探测">3.1 3D 感知性能探测</h4>

<p>在 nuScenes 与 OpenScene 验证集上的多任务统一评测表明：</p>
<ul>
  <li><strong>3D 目标检测与地图分割领先</strong>：在 nuScenes 上取得 43.95% mAP 与 42.83% NDS，BEV 矢量地图分割 mIoU 达到 60.99%；在跨城市、跨时段的 OpenScene 验证集上，检测 mAP 达到 38.65%，地图分割 mIoU 达 57.07%；</li>
  <li><strong>空间表征隐式激发</strong>：消融实验显示，如果不在 Stage 2 进行联合训练（仅在 Stage 1 冻结主干训练外挂头），感知指标会大幅落后（nuScenes mAP 仅 36.46%），证明通用 VLM 本身并未直接暴露显式 3D 坐标，而 Stage 2 的联合反向传播成功将 3D 几何特征注入到了 VLM 的深层表征中。</li>
</ul>

<h4 id="32-通用视觉理解零遗忘与驾驶场景问答登顶">3.2 通用视觉理解零遗忘与驾驶场景问答登顶</h4>

<ul>
  <li><strong>通用能力分毫未损</strong>：在包含 MMBench（87.07%）、MMStar（75.87%）、MMMU（72.67%）、RealWorldQA（78.95%）等 11 个通用多模态基准评测中，Qwen-Drive-1.0-SFT 平均得分达到 66.82%，与未经驾驶微调的原生通用 Qwen3.5-4B 基座（67.40%）基本持平，成功攻克了具身驾驶微调中常见的灾难性遗忘难题；</li>
  <li><strong>驾驶 VQA 全面超越行业大模型</strong>：在 LingoQA 上达到 77.80%（大幅领先 32B 参数的 Cosmos-Reason2 的 72.00%），在 VLADBench 上达到 66.52%（领先 InternVL3.5-8B 的 54.47%），在 WaymoQA（74.47%）和 SURDS（66.13%）上也均位列榜首。</li>
</ul>

<h4 id="33-运动规划全场景领先开环伪闭环与仿真闭环">3.3 运动规划全场景领先（开环、伪闭环与仿真闭环）</h4>

<div align="center">
  <img src="/images/si/Qwen-Drive-qualitative-planning.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1274/1090" />
<figcaption>动态道路场景轨迹规划定性可视化：(a) WOD-E2E 与 PhysicalAI-AV 上的开环预测；(b) AlpaSim 仿真器中的闭环长时程轨迹追踪</figcaption>
</div>

<ul>
  <li><strong>NAVSIM 伪闭环测试刷新纪录</strong>：在 NAVSIM v1.1 navtest 榜单上，Qwen-Drive-1.0-RL 的驾驶综合评分（PDMS）达到 <strong>90.7</strong>（无碰撞率 98.3%，可行驶区域合规率 96.8%，舒适度满分 100.0%），显著领先 TransFuser（84.0）、DRAMA（85.5）和 Hydra-MDP（86.5）；强化学习后训练相比纯模仿学习（86.8）带来高达 +3.9 分的质的飞跃；</li>
  <li><strong>Waymo E2E 测试集登顶</strong>：在权威的 Waymo 真实世界端到端规划基准（WOD-E2E）测试集上，Qwen-Drive-1.0-RL 取得 <strong>7.91</strong> 的评分官反馈得分（RFS，接近人类真实驾驶员的 8.13 分），3 秒与 5 秒平均位移误差（ADE）分别低至 1.19 米与 2.67 米，在公开排行榜中击败了 MindVLA-U1（7.87）和 AutoVLA（7.56）；在验证集上 RFS 更达 8.45，超越人类基准分；</li>
  <li><strong>AlpaSim 闭环多场景长时程仿真验证</strong>：在英伟达 916 个复杂长时程闭环场景评测中，Qwen-Drive-1.0-RL 的出险率（Close Encounter Rate）与冲出道路率（Off-Road Rate）均维持在低位，最终 AlpaSim 得分达 0.37，验证了模型在动态交互博弈中的闭环安全性与敏捷避障能力。</li>
</ul>

<hr />

<h3 id="4-局限性-13">4. 局限性</h3>

<p>虽然 Qwen-Drive-1.0 在多任务统一上取得了突破，但其 BEV 感知头与规划专家目前仍作为外挂分支独立接入 VLM，感知输出的显式几何图元（如 3D 边界框与占用网格）未能反向作为结构化提示直接反馈给大语言模型进行多步思维链符号推理；此外，闭环仿真在面对密集动态博弈长尾极端工况时，对突发侵入车辆的让行决策仍存在偶发保守倾向。</p>

<hr />

<h2 id="cgfm-nav">20. CGFM-Nav (2026)</h2>
<p>——— 耦合显式关系图记忆与隐式连续语义场的终身多模态具身导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.29114">arXiv:2608.29114</a></p>

<h3 id="精华-14">精华</h3>
<ol>
  <li><strong>图-场双重认知表征</strong>：提出认知图场记忆（Cognitive Graph-Field Memory, CGFM），将离散的物体语义拓扑图与连续的 2D 语义-边界扩散场在同一体系中耦合，分别对应人类导航中的”精准回溯记忆”与”模糊空间直觉”。</li>
  <li><strong>直觉引导的高效探索</strong>：当图中未检索到目标时，无需盲目漫游，而是将图中的语义证据反向投影为空间扩散场，优先引导机器人探索语义相关度最高的未知边界（Frontier），大幅缩减终身导航搜索开销。</li>
  <li><strong>闭环抑制与图更新</strong>：通过多视角验证机制（YES / NO-UNCERTAIN / NO-CONFIRMED）动态更新节点状态；被排除的误检候选在当前子任务中物理掩码其语义场贡献，从底层消除了大模型的重复重试与死锁。</li>
  <li><strong>轻量开源模型超越云端 GPT-4o</strong>：在 GOAT-Bench 终身多模态导航基准上，采用开源本地可部署的 Qwen3-VL-8B，整体成功率达到 63.0%，超越了搭载云端 GPT-4o 的基线 MSGNav（60.0%），证明结构化图场记忆能有效弥补基础模型的能力差距。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-14">1. 研究背景/问题</h3>
<p>在面向家庭与复杂环境的终身开放词表具身导航（Lifelong Open-Vocabulary Embodied Navigation）中，机器人需要在未建模场景中连续执行多个跨模态目标（类别、自然语言描述或参考图像）的导航子任务，并跨子任务保留历史地图记忆。
现有基于大语言模型/多模态大模型（LLM/VLM）的导航方法主要存在两项核心瓶颈：</p>
<ol>
  <li><strong>显式记忆与无目标探索的脱节</strong>：离散物体场景图擅长对已知物体进行精准检索与拓扑回溯，但一旦目标不存在于当前记忆中，智能体便退化为几何前沿点（Frontier）的随机探索，缺乏空间语义直觉引导。</li>
  <li><strong>多模态目标下的重试幻觉与上下文开销</strong>：随着时间推移，不断扩大的场景图导致 VLM 上下文窗口严重膨胀；且当目标发生混淆时，缺乏对失败尝试的显式抑制机制，导致智能体反复前往同一错误物体。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-14">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/CGFM-Nav-concept-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/726" />
<figcaption>图 1：CGFM 认知图场记忆机制概览。离散物体场景图作为显式关系记忆支持精准召回；连续语义-边界场作为隐式直觉偏置指引高效探索。</figcaption>
</div>

<h4 id="-整体框架概述-6">① 整体框架概述</h4>
<p>CGFM-Nav 整体采用免微调（Training-Free）架构，主要由<strong>感知与图构建（Perception &amp; Graph）</strong>、<strong>语义-边界场构建（Semantic-Frontier Field）</strong>、<strong>自适应子图筛选（Subgraph Selection）</strong>、<strong>带决策记忆的 VLM 推理（VLM Reasoning）</strong>以及<strong>动作执行与多视角闭环验证（Action &amp; Verification）</strong>五个模块协作构成。系统在已知目标与未知探索之间形成无缝切换与持续更新的闭环。</p>

<div align="center">
  <img src="/images/vln/CGFM-Nav-framework-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/664" />
<figcaption>图 2：CGFM-Nav 系统架构图。RGB-D 输入构建多模态场景图并投影生成语义场；VLM 基于筛选子图与决策日志下发动作，验证结果驱动闭环记忆更新。</figcaption>
</div>

<h4 id="-逐模块讲解-5">② 逐模块讲解</h4>

<p><strong>1. 感知与多模态场景图构建（Perception &amp; Graph Memory）</strong></p>
<ul>
  <li><strong>输入</strong>：机器人搭载的连续 RGB-D 传感器帧。</li>
  <li><strong>处理</strong>：利用 YOLOv8-World 和 SAM 进行开放词表目标检测与精确像素分割；使用 CLIP 提取各个目标的外观特征。以增量方式构建持久多模态场景图 \(\mathcal{G}_t = (\mathcal{V}_t, \mathcal{E}_t)\)。</li>
  <li><strong>输出</strong>：节点 \(v_i = (c_i, p_i, z_i, \mathcal{I}_i)\)，分别存储物体类别 $c_i$、3D 空间坐标 $p_i$、视觉语义特征 $z_i$ 以及历史多视角观测图像集合 \(\mathcal{I}_i\)；边 \(\mathcal{E}_t\) 记录物体间的空间拓扑与关系。</li>
  <li><strong>设计动机</strong>：特别对每个节点追加了目标验证统计（验证次数、所属子任务、判别结果与多视角反馈日志）。</li>
</ul>

<p><strong>2. 连续语义-边界场构建（Semantic-Frontier Field Construction）</strong></p>
<ul>
  <li><strong>输入</strong>：当前多模态场景图 \(\mathcal{G}_t\)、任务目标描述 $q$ 以及 2D 占用栅格地图。</li>
  <li><strong>处理</strong>：
    <ol>
      <li>计算图节点与目标 $q$ 的 CLIP 相似度，减去背景基线得到净相关度分数 $s_i(q)$。</li>
      <li>对已被当前子任务确认排除的节点进行验证掩码（置为 0），不向场中扩散能量。</li>
      <li>将各有效物体视为空间点源，其语义影响沿无障碍自由空间的测地线距离（Geodesic Distance）呈指数衰减：$w_i(x) = \exp(-d(x, p_i)/\tau)$。</li>
      <li>对每个栅格单元 $x$，聚合局部贡献最大的 $K_s$ 个物体，生成连续语义场：
\(S_t(x \mid q) = \sum_{i \in \mathrm{Top}K_s(x)} s_i(q) w_i(x)\)</li>
      <li>提取自由空间与未知区域交界处的几何前沿点集合 \(\mathcal{C}_t = \{f_1, \dots, f_M\}\)，计算每个前沿点的探索得分 $U_t(f \mid q)$：在小邻域内平均语义场强度，并除以机器人到该前沿点的测地导航代价。</li>
    </ol>
  </li>
  <li><strong>输出</strong>：赋有语义探索优先级的连续热力图与前沿点评分排序。</li>
</ul>

<blockquote>
  <p><strong>举个例子（卡点降维装置 A：语义场与前沿点计算）</strong>：
假设任务是”找到婴儿车（stroller）”，机器人在客厅构建了包含 3 个物体的场景图：</p>
  <ul>
    <li>物体 A（折叠椅）：此前导航过去验证失败，记录为 <code class="language-plaintext highlighter-rouge">NO-CONFIRMED</code>，验证掩码直接将其净得分置为 $s_A(q) = 0$，不再扩散任何语义能量；</li>
    <li>物体 B（餐桌）：与婴儿车相关度低，减去背景基线后 $s_B(q) = 0$；</li>
    <li>物体 C（婴儿奶瓶）：与婴儿车语义强关联，计算得 $s_C(q) = 0.8$。</li>
  </ul>

  <p>现在未探索区域有两个前沿候选点：</p>
  <ul>
    <li>前沿点 1（靠近物体 C，离物体 1 米，衰减权重 $w=0.7$；离机器人 2 米）：局部语义场为 $0.8 \times 0.7 = 0.56$；结合距离代价后探索得分高达 $0.56 / 2 = 0.28$；</li>
    <li>前沿点 2（靠近厨房，离物体 C 远，衰减后 $w \approx 0$；离机器人仅 1 米）：局部语义场为 0，探索得分几乎为 0。</li>
  </ul>

  <p>即使机器人从没见过婴儿车，也能在连续语义场的牵引下，精准偏向物体 C 周围的未知走廊，而非盲目探索厨房。</p>
</blockquote>

<p><strong>3. 语义引导子图筛选（Semantic-Guided Subgraph Selection）</strong></p>
<ul>
  <li><strong>输入</strong>：全量场景图 \(\mathcal{G}_t\) 与目标 $q$。</li>
  <li><strong>处理</strong>：直接复用场计算中的 CLIP 相关度，挑选正相关节点及其一阶邻居构成语义种子集 \(\mathcal{V}_{seed}\)；其余节点压缩为残差图 \(\hat{\mathcal{G}}_{res}\)，交由 VLM 进行基于常识的补充挑选。经剪枝后形成紧凑的关键子图 \(\tilde{\mathcal{G}}_t\)。</li>
  <li><strong>输出</strong>：向大模型输入的轻量化结构化提示信息。</li>
</ul>

<p><strong>4. 带决策记忆的 VLM 推理（VLM Reasoning with Decision Memory）</strong></p>
<ul>
  <li><strong>输入</strong>：目标 $q$、关键子图 \(\tilde{\mathcal{G}}_t\) 以及决策记忆 \(\mathcal{D}_t\)（按时间记录的已尝试候选点、目的地类型与简短推理摘要）。</li>
  <li><strong>处理</strong>：VLM 做出三类决策之一：选定物体节点 $v_i$、选定历史图像 $I_{i,j}$、或下达探索指令 <code class="language-plaintext highlighter-rouge">EXPLORE</code>。</li>
  <li><strong>输出</strong>：离散高层决策指令 $d_t$。</li>
</ul>

<p><strong>5. 动作分流与闭环多视角验证（Action &amp; Verification）</strong></p>
<ul>
  <li><strong>输入</strong>：决策指令 $d_t$ 与语义边界场。</li>
  <li><strong>处理与流向</strong>：
    <ul>
      <li>若为已知物体/图像：直接下发坐标，导航到达后调用 VLM 进行多视角观测验证（返回 <code class="language-plaintext highlighter-rouge">YES</code>、<code class="language-plaintext highlighter-rouge">NO-UNCERTAIN</code> 或 <code class="language-plaintext highlighter-rouge">NO-CONFIRMED</code>）；</li>
      <li>若为 <code class="language-plaintext highlighter-rouge">EXPLORE</code>：若存在前沿点则选择得分最高者；若无前沿点但存在未完全探索的语义峰值，则导航至语义地图最高响应中心；若均无则报告失败。</li>
      <li>验证成功的物体进入下一子任务；确认失败的物体记录节点掩码并阻断其场扩散；不确定的物体生成额外视角重新辨识。</li>
    </ul>
  </li>
</ul>

<h4 id="-读者视角闭环状态与决策流转图卡点降维装置-b">③ 读者视角：闭环状态与决策流转图（卡点降维装置 B）</h4>

<pre><code class="language-mermaid">graph TD
    A["输入: 跨模态任务指令 q 与环境观测"] --&gt; B["增量构建多模态场景图 Gt"]
    B --&gt; C["投影生成连续语义-边界场 St(x|q)"]
    C --&gt; D["筛选关键子图 + 载入决策历史 Dt"]
    D --&gt; E{"VLM 核心决策"}
    
    E -- "图中命中目标" --&gt; F["导航至目标坐标 (物体/图像)"]
    F --&gt; G["多视角 VLM 最终确认"]
    G -- "YES" --&gt; H["子任务达成，进入下一阶段"]
    G -- "NO-UNCERTAIN" --&gt; I["旋转切换新视角复检"]
    I --&gt; G
    G -- "NO-CONFIRMED" --&gt; J["标记节点排除，抑制语义场能量"]
    J --&gt; B
    
    E -- "未命中，下达 EXPLORE" --&gt; K{"是否有未探索前沿点?"}
    K -- "有有效前沿点" --&gt; L["前往语义-边界综合得分最高的前沿点"]
    K -- "前沿耗尽但有语义高地" --&gt; M["前往语义场热力峰值中心探索"]
    L --&gt; N["采集新观测，更新场景图与场"]
    M --&gt; N
    N --&gt; B
</code></pre>

<h4 id="-核心差异与经典基线-msgnav-的机制对比卡点降维装置-c">④ 核心差异：与经典基线 MSGNav 的机制对比（卡点降维装置 C）</h4>

<table>
  <thead>
    <tr>
      <th>机制维度</th>
      <th>经典基线 MSGNav</th>
      <th>本文 CGFM-Nav</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>探索指引方式</strong></td>
      <td>纯几何边界探索或无向随机漫游</td>
      <td>场景图证据反向投影为连续语义场，赋能前沿点语义偏置</td>
    </tr>
    <tr>
      <td><strong>子图提示筛选</strong></td>
      <td>规则全量检索或纯文本 LLM 过滤</td>
      <td>复用场相关度的语义种子集 + 残差图 VLM 常识补充</td>
    </tr>
    <tr>
      <td><strong>错误重试抑制</strong></td>
      <td>依赖短期文本上下文中塞入的历史日志</td>
      <td>节点级物理验证掩码，彻底切断错误物体在场中的引力</td>
    </tr>
    <tr>
      <td><strong>部署模型门槛</strong></td>
      <td>严重依赖昂贵且高延迟的云端 GPT-4o</td>
      <td>本地开源轻量 Qwen3-VL-8B 即可超越云端大模型性能</td>
    </tr>
  </tbody>
</table>

<h4 id="-训练与推理设定">⑤ 训练与推理设定</h4>
<ul>
  <li><strong>无需训练（Training-Free）</strong>：全框架为纯零样本推理架构，感知模块采用预训练的 YOLOv8-World + SAM + CLIP，决策推理与多视角验证采用开源轻量级的 Qwen3-VL-8B-Instruct。</li>
  <li><strong>终身记忆保留</strong>：在同一个场景的多个子任务之间，场景图及其验证掩码完全保留；跨子任务仅重置短期决策日志并按新目标重构语义场。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-14">3. 核心结果/发现</h3>
<p>在极具挑战性的终身跨模态导航基准 <strong>GOAT-Bench</strong>（包含 36 个未见场景、278 个多模态子任务，涵盖类别、语言描述及参考图像目标）上的评测结果表明：</p>

<ol>
  <li><strong>同基座显著提升</strong>：在均使用开源 <strong>Qwen3-VL-8B</strong> 的公平对比下，CGFM-Nav 相比 MSGNav：
    <ul>
      <li>整体成功率（SR）从 <strong>53.2% 提升至 63.0%</strong>（+9.8%）；</li>
      <li>路径长度加权成功率（SPL）从 <strong>30.0% 提升至 39.6%</strong>（+9.6%）；</li>
      <li>尤其在类别目标（SR: 63.6% → <strong>72.7%</strong>）和语言目标（SR: 48.4% → <strong>61.5%</strong>）上取得大幅跃升。</li>
    </ul>
  </li>
  <li><strong>轻量端侧逆袭云端旗舰</strong>：搭载本地 8B 参数多模态模型的 CGFM-Nav，在整体 SR（<strong>63.0%</strong> vs 60.0%）、类别 SR（<strong>72.7%</strong> vs 63.6%）以及语言 SR（<strong>61.5%</strong> vs 57.2%）上全面超越了基于云端闭源旗舰 <strong>GPT-4o</strong> 的 MSGNav，验证了优质环境认知表征对大模型底座差距的弥补效应。</li>
  <li><strong>图像目标依赖细粒度匹配</strong>：在图像目标子任务中，由于缺少类别层面的泛化常识，更多依赖底层像素特征的点对点匹配，虽然 CGFM-Nav 比同基座基线提升明显（SR: 46.6% → 53.4%），但相比 GPT-4o 仍有微弱差距，表明图像目标对 VLM 自身的细粒度跨视角特征提取能力提出了更高要求。</li>
</ol>

<hr />

<h3 id="4-局限性-14">4. 局限性</h3>
<ol>
  <li>当前验证仍局限于 GOAT-Bench 仿真环境，尚未在真实物理轮式机器人上完全验证传感器噪声、动态行人遮挡及里程计漂移等非理想因素下的长期鲁棒性。</li>
  <li>图像目标的表征与搜索仍受限于全局 CLIP 特征的粒度，缺少专门面向物体实例外观精细对齐的局部特征检索机制。</li>
</ol>

<hr />

<h2 id="canonnav">21. CanonNav (2026)</h2>
<p>——— 解耦相机几何与导航行为的跨平台视觉扩散导航策略</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.30242">arXiv:2608.30242</a></p>

<h3 id="精华-15">精华</h3>
<ol>
  <li><strong>相机几何与行为解耦</strong>：提出相机几何规范化（Canonicalization），通过单应重投影消除相机内参和俯仰角差异，并通过安装高度归一化将物理轨迹映射至视角不变空间，彻底解决了跨机器人平台演示数据中视觉观测与轨迹映射纠缠的病态问题。</li>
  <li><strong>显式局部规划监督（Scope-of-Reach, SoR）</strong>：针对传统模仿学习只学到专家动作却遗漏中间规划意图的缺陷，提出局部可达范围（SoR）表征，利用离线生成的 BEV 伪标签显式监督智能体在被遮挡或复杂地形下”往何处推进”。</li>
  <li><strong>碰撞感知流形约束</strong>：利用离线可通行性估计器构建度量符号距离场（SDF），在扩散策略的去噪轨迹上直接反向传播碰撞惩罚损失与航点可行性损失，实现端到端安全轨迹生成。</li>
  <li><strong>单目 RGB 匹敌并超越深度图方案</strong>：仅依靠单目 RGB 输入进行推理，在 CitySim 室外与 AWS Hospital 室内多相机配置下大幅超越 ViNT、NoMaD、LiMo 等 RGB 基线，并在长距离复杂拐弯场景下成功率反超依赖实时 RGB-D 深度输入的 NavDP。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-15">1. 研究背景/问题</h3>
<p>利用离散跨平台专家示范进行大规模模仿学习（Imitation Learning）是推动机器人自主视觉导航的重要路线。然而，充分利用跨平台异构数据面临两大根本症结：</p>
<ol>
  <li><strong>相机几何的病态纠缠</strong>：不同机器人底盘（如四足机器狗、低矮扫地机、轮式移动车）搭载的相机高度、内参及俯仰倾角各异。相同的图像投影可能对应截然不同的地面物理轨迹；若强行让策略从 RGB 隐式推断相机几何，在数学上属于严重不适定的欠约束问题。</li>
  <li><strong>专家示范中规划意图的隐式性</strong>：专家轨迹仅展示了最终执行的平滑路径，而没有解释”为什么选择向该局部空旷区域过渡”以及”两侧边缘有多危险”。纯模仿学习在遇到障碍物遮挡、必须转弯绕行等未直达目标的复杂场景时，极易退化或发生撞击。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-15">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/robotics_navigation/CanonNav-motivation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:682/891" />
<figcaption>图 1：CanonNav 研究动机。(a) 跨平台相机几何差异导致图像与物理轨迹的映射严重不一致；(b) 传统模仿学习缺失局部推进区域识别与安全边界等中间规划决策监督。</figcaption>
</div>

<h4 id="-整体框架概述-7">① 整体框架概述</h4>
<p>CanonNav 提出了由<strong>相机几何规范化（Canonicalization）</strong>、<strong>多任务扩散策略网络（Policy Inference）</strong>以及<strong>离线规划安全监督（Training-Time Planning Supervision）</strong>构成的闭环系统。在训练阶段利用预训练可通行性模型离线提取 BEV 伪标签提供密集监督；在部署阶段无需任何离线模型与深度传感器，仅凭单目 RGB 图像和相对目标即可输出无碰撞轨迹。</p>

<div align="center">
  <img src="/images/robotics_navigation/CanonNav-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1419/735" />
<figcaption>图 2：CanonNav 整体架构。(a) 观测与目标转换至规范化几何空间；(b) DINOv3 骨干网络提取特征，扩散模型输出高度归一化轨迹、航点通行率与 SoR；(d) 离线 BEV 碰撞图与 SDF 提供安全和局部推进监督。</figcaption>
</div>

<h4 id="-逐模块讲解-6">② 逐模块讲解</h4>

<p><strong>1. 相机几何规范化（Camera Geometry Canonicalization）</strong></p>
<ul>
  <li><strong>内参与俯仰角消除</strong>：设相机外参简化为安装高度 $h$ 与俯仰角 $R_{pitch}$，内参为 $K$。给定预设的正向基准虚拟相机内参 $\tilde{K}$，将原始图像 $I_t$ 投影重映射至无倾角正向视野 \(\tilde{I}_t\)：
\((\tilde{u}, \tilde{v}, 1)^\top \propto \tilde{K} R_{pitch}^{-1} K^{-1} (u, v, 1)^\top\)</li>
  <li><strong>高度归一化轨迹（Height-Normalized Trajectory）</strong>：在正向基准相机下，地面物理点 $(x, y)$ 投影为 \(\tilde{u} = \tilde{c}_x - \tilde{f}_x \frac{y}{x}\)，\(\tilde{v} = \tilde{c}_y - \tilde{f}_y \frac{h}{x}\)。可以看出像素位置完全取决于横纵比 $y/x$ 与高距比 $h/x$。将物理轨迹点 $(x, y)$ 归一化为 $(\tilde{x}, \tilde{y}) = (x/h, y/h)$，投影公式转化为：
\(\tilde{u} = \tilde{c}_x - \tilde{f}_x \frac{\tilde{y}}{\tilde{x}}, \quad \tilde{v} = \tilde{c}_y - \tilde{f}_y \frac{1}{\tilde{x}}\)
该归一化彻底剥离了相机高度 $h$ 的干扰，使所有平台的轨迹分布在同一视锥几何下对齐。</li>
</ul>

<blockquote>
  <p><strong>举个例子（卡点降维装置 A：为什么高度归一化能消除底盘差异？）</strong>：
设基准虚拟相机焦距 \(\tilde{f}_y = 500\)，主点 \(\tilde{c}_y = 250\)：</p>
  <ul>
    <li><strong>低矮扫地机器人</strong>：相机高度 $h_1 = 0.2\text{ m}$，前方 $1.0\text{ m}$ 处的路面障碍物（$x_1 = 1.0\text{ m}$），其高距比为 $h_1 / x_1 = 0.2 / 1.0 = 0.2$；</li>
    <li><strong>高大巡检轮式车</strong>：相机高度 $h_2 = 1.0\text{ m}$，前方 $5.0\text{ m}$ 处的路面障碍物（$x_2 = 5.0\text{ m}$），其高距比为 $h_2 / x_2 = 1.0 / 5.0 = 0.2$。</li>
  </ul>

  <p>在两个机器人的正向图像中，这两个物理距离完全不同的地面点，计算出的像素行位置 $\tilde{v} = 250 - 500 \times 0.2 = 150$ <strong>完全一模一样</strong>！
若直接模仿米制坐标，策略网络面对相同的视觉外观却要预测 $1.0\text{ m}$ 和 $5.0\text{ m}$ 的矛盾动作。而经过高度归一化后，两者的无量纲目标距离均为 $\tilde{x} = x/h = 5.0$！策略网络只需要学习这一统一分布，控制时再乘以各自的物理安装高度 $h$，即可无缝泛化。</p>
</blockquote>

<p><strong>2. 规划监督与 Scope-of-Reach (SoR)</strong></p>
<ul>
  <li><strong>SoR 局部可达范围建模</strong>：将局部推进区域建模为 2D 鸟瞰图高斯分布 $\mathcal{S} = \mathcal{N}(\mu, \operatorname{diag}(\sigma^2))$，网络预测其高度归一化参数 $(\tilde{\mu}, \tilde{\sigma}) = (\mu/h, \sigma/h)$。</li>
  <li><strong>离线安全伪标签生成</strong>：
    <ol>
      <li>使用预训练 ViTA 在离线训练集中提取图像可通行掩码；</li>
      <li>投影到地面生成局部 BEV 碰撞图 $M_{coll}$，并转换为度量符号距离场 $M_{sdf}$；</li>
      <li>将专家轨迹进入碰撞区或视野边界前的最后一个可行航点提取为局部推进目标 \(s^*\)。</li>
    </ol>
  </li>
  <li><strong>三重 SoR 损失函数</strong>：
\(L_{prog} = \lambda_{pred} L_{pred} + \lambda_{neg} L_{neg} + \lambda_{cons} L_{cons}\)
    <ul>
      <li>$L_{pred}$：负对数似然结合 Smooth-L1 拟合目标点 \(\tilde{s}^*\)；</li>
      <li>$L_{neg} = \iint M_{coll}(x, y) \mathcal{S}(x, y) dx dy$：对高斯概率落入碰撞障碍区的积分惩罚；</li>
      <li>$L_{cons}$：采用 Soft-min 约束生成轨迹的去噪航点至少有一个穿越预测的 SoR 区域。</li>
    </ul>
  </li>
</ul>

<p><strong>3. 连续碰撞感知安全损失（Safety Supervision）</strong></p>
<ul>
  <li>从加噪轨迹 \(\tilde{\tau}_k\) 经过单步反解得到无噪航点估计 \(\hat{\tau}_0 = \{\hat{p}_i\}\)；</li>
  <li>度量碰撞惩罚损失 $L_{coll}$：
\(c_i = \operatorname{softplus}\left(\frac{d_{safe} - M_{sdf}(h \hat{p}_i)}{\eta}\right), \quad L_{coll} = \frac{1}{\gamma} \log \sum_{i=1}^N \exp(\gamma c_i)\)</li>
  <li>航点可通行性分支 $L_{trav}$：双线性采样图像特征预测航点生存概率 \(\hat{q}_i\)。</li>
</ul>

<h4 id="-读者视角数据流与训练推理分离图卡点降维装置-b">③ 读者视角：数据流与训练/推理分离图（卡点降维装置 B）</h4>

<pre><code class="language-mermaid">graph TD
    subgraph "训练阶段: 离线伪标签与规划引导"
        T1["训练图像 + 已知几何参数 (K, Rpitch, h)"] --&gt; T2["ViTA 预测通行掩码"]
        T2 --&gt; T3["反投影生成 BEV 碰撞图 Mcoll 与 SDF"]
        T3 --&gt; T4["截取安全转折点作为 SoR 目标点 s*"]
        T3 --&gt; T5["SDF 碰撞惩罚 Lcoll + 负样本压制 Lneg"]
    end

    subgraph "核心网络: 规范化扩散策略"
        N1["输入 RGB 观测 + 相对目标"] --&gt; N2["相机几何规范化 (重投影 + 高度归一化)"]
        N2 --&gt; N3["DINOv3 ViT-S+ 特征编码与 Cross-Attention"]
        N3 --&gt; N4["扩散去噪头 ϵθ -&gt; 生成候选轨迹"]
        N3 --&gt; N5["SoR 预测头 -&gt; 输出局部可行高斯分布"]
        N3 --&gt; N6["可通行性预测头 -&gt; 评估航点生存率"]
    end

    subgraph "推理部署阶段: 单目 RGB 纯闭环"
        P1["实时单目 RGB + 目标"] --&gt; N2
        N4 --&gt; P2["输出 B 条高度归一化轨迹候选"]
        P2 --&gt; P3["乘以自身相机高度 h 恢复物理米级尺度"]
        P3 &amp; N6 --&gt; P4["航点生存率折现 + 目标推进量综合比选"]
        P4 --&gt; P5["执行最优平滑无碰撞轨迹"]
    end

    T4 -.-&gt; N5
    T5 -.-&gt; N4
</code></pre>

<h4 id="-核心机制对比canonnav-vs-主流导航基线卡点降维装置-c">④ 核心机制对比：CanonNav vs 主流导航基线（卡点降维装置 C）</h4>

<table>
  <thead>
    <tr>
      <th>机制维度</th>
      <th>传统纯模仿基线 (ViNT / NoMaD)</th>
      <th>深度图规划基线 (ViPlanner / NavDP)</th>
      <th>本文 CanonNav</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>跨平台几何处理</strong></td>
      <td>强行输入原图，靠海量随机增强隐式适配</td>
      <td>需精确配准的 RGB-D 几何对齐</td>
      <td>显式重投影 + 高度归一化空间解耦</td>
    </tr>
    <tr>
      <td><strong>中间规划意图</strong></td>
      <td>纯轨迹扩散去噪，缺失局部转折引导</td>
      <td>依赖实时深度图重构代价地图</td>
      <td>提出 SoR 显式建模局部推进分布</td>
    </tr>
    <tr>
      <td><strong>碰撞回避机制</strong></td>
      <td>缺乏显式负反馈，易切内弯刮蹭障碍物</td>
      <td>需在线高帧率深度传感器计算碰撞</td>
      <td>离线 SDF 反向梯度约束生成轨迹</td>
    </tr>
    <tr>
      <td><strong>部署传感器门槛</strong></td>
      <td>单目 RGB（但抗几何扰动极差）</td>
      <td>强依赖实时稠密 RGB-D 传感器</td>
      <td>纯单目 RGB 即可达到超高安全性</td>
    </tr>
  </tbody>
</table>

<hr />

<h3 id="3-核心结果发现-15">3. 核心结果/发现</h3>
<p>在 <strong>CitySim（室外复杂园区）</strong> 与 <strong>AWS Hospital（室内复杂走廊病房）</strong> 两个极具代表性的高难度仿真环境，以及真实物理车（Clearpath Husky 差速轮式车）上进行评测：</p>

<ol>
  <li><strong>跨相机几何泛化断层领先</strong>：在相机高度从 $0.4\text{ m}$ 变化至 $1.0\text{ m}$、俯仰角从 $-15^\circ$ 变化至 $+15^\circ$ 的剧烈配置偏移下，ViNT 与 NoMaD 的成功率普遍暴跌 20%~40%，而 CanonNav 在所有几何扰动下的成功率下降幅度（$\Delta\text{SR}$）均控制在极小区间内。</li>
  <li><strong>长距离复杂拐角超越 RGB-D 方案</strong>：在 $20\text{ m}$ 超长子目标导航任务中，即便面对遮挡严重的 U 形拐弯，CanonNav 仅使用单目 RGB 就取得了 <strong>86.4%</strong> 的成功率与 <strong>0.89</strong> 次碰撞率，显著超越了搭载实时稠密深度的 NavDP（SR 71.2%，碰撞率 2.21）和 ViPlanner（SR 39.3%）。</li>
  <li><strong>真实世界零样本迁移零事故</strong>：在包含反光玻璃幕墙、狭窄树丛台阶和户外异形走廊的实机测试中，CanonNav 在所有测试中均保持零碰撞，轨迹曲率与人类示教路径吻合度极高。</li>
</ol>

<hr />

<h3 id="4-局限性-15">4. 局限性</h3>
<ol>
  <li>几何规范化依赖机器人自身已知的安装参数（相机内参 $K$、静态安装高度 $h$ 与俯仰角 $R_{pitch}$），若机器人在越野颠簸路面上发生剧烈动态俯仰震荡，静态规范化假设会引入瞬时投影误差。</li>
  <li>离线伪标签质量受限于 ViTA 可通行性分割模型在极端光照（如暴雨、强逆光）下的初始分割精度。</li>
</ol>

<hr />

<h2 id="lookstep">22. LookStep (2026)</h2>
<p>——— 基于语言前瞻推演与事件驱动记忆的高效端到端视觉语言导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.02350">arXiv:2609.02350</a> · <a href="https://github.com/kunyang-YU/LookStep">Code</a></p>

<h3 id="精华-16">精华</h3>
<ol>
  <li><strong>语言中心未来状态前瞻（LC-FSM）</strong>：打破传统 VLN 仅监督下一步单一专家动作（Next-step prediction）的范式，通过轻量级语言标签显式预测所有候选动作的前瞻后果（如提前撞墙、完成转向、错误路线），以极高的数据利用率实现反事实决策推演。</li>
  <li><strong>事件驱动自适应滚动记忆（EDRM）</strong>：无需外部复杂的 3D 几何建图或占用庞大显存的全量历史堆叠，由多模态大模型在推理过程中自主判断当前观测是否构成关键事件（<code class="language-plaintext highlighter-rouge">&lt;memory_write&gt;keep/drop&lt;/memory_write&gt;</code>）并赋予语义角色，以有界内存实现长程上下文维护。</li>
  <li><strong>极高显存与数据利用效率</strong>：在不依赖外部几何工具或海量额外预训练数据的情况下，推理显存控制在 <strong>19.7 GB</strong>（约为同类方法的一半），显存利用效率（SR/GB）达到 <strong>2.52</strong>，显著领先 JanusVLN（1.19）与 StreamVLN（1.95）。</li>
  <li><strong>同等设定下刷新连续环境 SOTA</strong>：在最具挑战性的连续环境视觉语言导航基准 <strong>R2R-CE</strong> 未见验证集（Val-Unseen）上取得 <strong>49.7%</strong> 的成功率，全面超越了使用相同数据量与训练预算的现有主流方法。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-16">1. 研究背景/问题</h3>
<p>连续环境视觉语言导航（VLN-CE）要求具身智能体仅凭自然语言长程指令和连续车载相机观测到达指定目的地。基于多模态大语言模型（MLLM）的现有导航策略主要受制于两大效率瓶颈：</p>
<ol>
  <li><strong>训练层面的数据饥渴与弱监督</strong>：传统行为克隆（Behavior Cloning）仅将专家当前执行的单一动作作为监督信号，模型无法知晓”为什么不选择其他动作”以及”备选动作会导致何种危险后果”，导致训练需要数百万级的大规模专家轨迹支持。</li>
  <li><strong>推理层面的显存爆炸与关键帧遗失</strong>：长程导航必须依赖历史状态；但全量保存历史视频帧会导致显存线性暴增，而固定窗口截断或均匀抽帧容易漏掉”推开房门”、”走下楼梯”等决定性的转折事件；引入外部 3D 建图工具又大幅增加了计算延迟与部署复杂度。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-16">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/LookStep-memory-efficiency.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:627/489" />
<figcaption>图 1：LookStep 在 R2R 数据集上的显存效率与性能对比。无需额外预训练数据，在仅需 19.7 GB 显存的条件下实现了 2.52 的超高单位显存成功率（SR/GB）。</figcaption>
</div>

<h4 id="-整体框架概述-8">① 整体框架概述</h4>
<p>LookStep 是一个统一的端到端 MLLM 导航框架，不依赖外部 3D 传感器或独立建图模块。系统通过统一的结构化文本生成序列，在自回归解码中同步完成三大核心任务：<strong>事件驱动记忆管理（Event-Driven Memory Management）</strong>、<strong>语言中心未来状态建模（Language-Centric Future State Modeling）</strong>与<strong>最终动作下发（Action Prediction）</strong>。</p>

<div align="center">
  <img src="/images/vln/LookStep-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/938" />
<figcaption>图 2：LookStep 系统架构与语言标签机制。自回归生成任务宏观进度、各动作推演后果、记忆写入判定与语义角色，最后闭环输出动作并维护有界滚动记忆。</figcaption>
</div>

<h4 id="-逐模块讲解-7">② 逐模块讲解</h4>

<p><strong>1. 语言中心未来状态建模（Language Centric Future State Modeling, LC-FSM）</strong></p>
<ul>
  <li><strong>输入</strong>：自然语言导航指令 $I$、当前相机观测 $x_t$ 以及有界历史记忆 $O_{t-1}$。</li>
  <li><strong>结构化推演标签设计</strong>：
    <ul>
      <li><strong>宏观导航进度</strong>：<code class="language-plaintext highlighter-rouge">&lt;progress&gt;early / mid / late&lt;/progress&gt;</code>，令模型对当前所处指令阶段具备显式感知；</li>
      <li><strong>候选动作后果全集</strong>：对当前可用的离散候选动作（如前进、左转、右转、停止），分别生成粗粒度的自然语言后果标签：
\(\langle \mathrm{outcomes} \rangle \; \langle \mathrm{forward} \rangle \dots \langle /\mathrm{forward} \rangle \; \langle \mathrm{turn\_left} \rangle \dots \langle /\mathrm{turn\_left} \rangle \dots \langle /\mathrm{outcomes} \rangle\)
例如：<code class="language-plaintext highlighter-rouge">&lt;forward&gt;premature_forward&lt;/forward&gt;</code>（过早前进，撞墙）、<code class="language-plaintext highlighter-rouge">&lt;turn_left&gt;finish_turn&lt;/turn_left&gt;</code>（完成转向，正对门洞）、<code class="language-plaintext highlighter-rouge">&lt;stop&gt;too_early&lt;/stop&gt;</code>（过早停止）。</li>
    </ul>
  </li>
  <li><strong>信息论设计动机</strong>：作者在理论上证明，引入专家未来状态标签能够显著提升观测与专家动作之间的条件互信息下界；通过反事实后果语言建模，使单个样本提供多维度的对抗性判别监督。</li>
</ul>

<blockquote>
  <p><strong>举个例子（卡点降维装置 A：候选动作反事实推演）</strong>：
设指令为：”穿过楼梯左侧的门洞并在那里等待”。
机器人目前刚走到楼梯前，面临 4 个动作候选：</p>
  <ul>
    <li><strong>传统 BC 监督</strong>：标签为 <code class="language-plaintext highlighter-rouge">turn_left</code>。损失函数仅惩罚这一项的负对数似然，模型对于”为什么不能右转”没有任何梯度反馈；</li>
    <li><strong>LookStep 语言前瞻</strong>：模型自回归生成：
      <div class="language-xml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nt">&lt;progress&gt;</span>late<span class="nt">&lt;/progress&gt;</span>
<span class="nt">&lt;outcomes&gt;</span>
  <span class="nt">&lt;forward&gt;</span>premature_forward<span class="nt">&lt;/forward&gt;</span> <span class="c">&lt;!-- 警示：此时直行将撞到楼梯扶手 --&gt;</span>
  <span class="nt">&lt;turn_left&gt;</span>finish_turn<span class="nt">&lt;/turn_left&gt;</span>    <span class="c">&lt;!-- 确认：左转可正对目标门洞 --&gt;</span>
  <span class="nt">&lt;turn_right&gt;</span>wrong_turn<span class="nt">&lt;/turn_right&gt;</span>   <span class="c">&lt;!-- 警示：右转将进入死胡同走廊 --&gt;</span>
  <span class="nt">&lt;stop&gt;</span>too_early<span class="nt">&lt;/stop&gt;</span>                <span class="c">&lt;!-- 警示：尚未穿过门洞，不可停下 --&gt;</span>
<span class="nt">&lt;/outcomes&gt;</span>
</code></pre></div>      </div>
      <p>模型在推理下一步动作前，已在语言语义空间内完成了对环境物理约束的”沙盒推演”，极大降低了盲目试错率。</p>
    </li>
  </ul>
</blockquote>

<p><strong>2. 事件驱动滚动记忆（Event Driven Rolling Memory, EDRM）</strong></p>
<ul>
  <li><strong>输入</strong>：当前帧与全局任务上下文。</li>
  <li><strong>处理</strong>：将历史状态的维护转化为在线免微调的测试时记忆自适应（Test-Time Adaptation）：
    <ul>
      <li><code class="language-plaintext highlighter-rouge">&lt;event&gt;</code>：识别当前帧所发生的关键具身事件（如 <code class="language-plaintext highlighter-rouge">turn_left_finishing</code>、<code class="language-plaintext highlighter-rouge">doorway_crossing</code>）；</li>
      <li><code class="language-plaintext highlighter-rouge">&lt;memory_write&gt;</code>：自主裁决是否写入历史记忆缓冲区（<code class="language-plaintext highlighter-rouge">keep</code> 写入，<code class="language-plaintext highlighter-rouge">drop</code> 丢弃）；</li>
      <li><code class="language-plaintext highlighter-rouge">&lt;memory_role&gt;</code>：指定该帧的长期索引角色（如 <code class="language-plaintext highlighter-rouge">turn_end</code> 转向结束锚点、<code class="language-plaintext highlighter-rouge">landmark</code> 关键地标）。</li>
    </ul>
  </li>
  <li><strong>有界滚动更新</strong>：记忆队列保持固定长度 $K$（仅容纳极少数关键帧），新关键帧写入时若队列溢出，则遵循先进先出或基于角色优先级的滚动替换，将长程轨迹的显存占用严格锁定在常量上限。</li>
</ul>

<h4 id="-读者视角单步推理与记忆流转自制流程图卡点降维装置-b">③ 读者视角：单步推理与记忆流转自制流程图（卡点降维装置 B）</h4>

<pre><code class="language-mermaid">graph TD
    A["输入: 导航指令 I + 历史关键帧 Ot-1 + 当前视点 xt"] --&gt; B["MLLM 多模态大模型统一自回归生成"]
    
    subgraph "步骤 1: 记忆诊断与自适应写入"
        B --&gt; M1["生成当前事件 &lt;event&gt;"]
        M1 --&gt; M2{"决策: 是否保留当前帧 &lt;memory_write&gt;"}
        M2 -- "keep" --&gt; M3["标记语义角色 &lt;memory_role&gt; -&gt; 写入有界队列 Ot"]
        M2 -- "drop" --&gt; M4["丢弃冗余过渡帧，保持原记忆 Ot = Ot-1"]
    end
    
    subgraph "步骤 2: 语言中心未来状态前瞻"
        B --&gt; P1["预测宏观进度 &lt;progress&gt;"]
        P1 --&gt; P2["推演全部候选动作后果 &lt;outcomes&gt;"]
        P2 --&gt; P3["语义判别: 剔除危险/偏离动作，锁定成功候选"]
    end
    
    subgraph "步骤 3: 动作下发与环境交互"
        P3 --&gt; ACT["生成最终动作 at+1 (Forward / Turn / Stop)"]
        ACT --&gt; ENV["底层控制器执行，推进至新位姿"]
    end
    
    M3 -.-&gt; A
    M4 -.-&gt; A
    ENV -.-&gt; A
</code></pre>

<h4 id="-机制对比lookstep-vs-主流连续环境-vln-方案卡点降维装置-c">④ 机制对比：LookStep vs 主流连续环境 VLN 方案（卡点降维装置 C）</h4>

<table>
  <thead>
    <tr>
      <th>机制维度</th>
      <th>传统视频帧堆叠方案 (如 StreamVLN)</th>
      <th>外置建图方案 (如 MapNav / g3D-LF)</th>
      <th>本文 LookStep</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>历史记忆维护</strong></td>
      <td>滑动窗口截断或均匀固定间隔抽帧</td>
      <td>维护稠密 2D/3D 拓扑图或体素网格</td>
      <td>模型自主按事件触发写入并标注角色</td>
    </tr>
    <tr>
      <td><strong>动作监督信号</strong></td>
      <td>仅监督单一专家离散动作</td>
      <td>依赖地图启发式几何航点规划</td>
      <td>结构化语言推演所有候选动作的未来后果</td>
    </tr>
    <tr>
      <td><strong>运行时显存</strong></td>
      <td>随轨迹长度增加，或高达 40 GB+</td>
      <td>需额外运行 SLAM/3D 模块，显存与计算重</td>
      <td>严格恒定限制在 19.7 GB，消费级显卡可跑</td>
    </tr>
    <tr>
      <td><strong>额外训练数据</strong></td>
      <td>普遍依赖数百万额外多模态轨迹</td>
      <td>需预先离线抽取 3D 几何特征</td>
      <td>0 额外预训练数据，纯标准数据集训练</td>
    </tr>
  </tbody>
</table>

<h4 id="-训练与推理细节">⑤ 训练与推理细节</h4>
<ul>
  <li><strong>骨干网络</strong>：采用统一的开源视觉-语言模型架构，在标准 R2R-CE / RxR-CE 训练集上使用标准自回归因果语言建模损失（Cross-Entropy）端到端微调。</li>
  <li><strong>测试期推理</strong>：单步推理中，模型顺次吐出记忆标签、前瞻标签与最终动作，随后直接解析动作 token 驱动机器人移动，无需调用外部渲染器或几何求解器。</li>
</ul>

<hr />

<h3 id="3-核心结果发现-16">3. 核心结果/发现</h3>
<p>在连续环境视觉语言导航的核心基准 <strong>R2R-CE</strong> 与 <strong>RxR-CE</strong> 未见验证集（Val-Unseen）上进行了全面对比评估：</p>

<ol>
  <li><strong>同等训练设定下夺冠 SOTA</strong>：在不借助任何额外训练数据（0 External Data）的前提下：
    <ul>
      <li>R2R-CE Val-Unseen 成功率（SR）达到 <strong>49.7%</strong>，路径长度加权成功率（SPL）达到 <strong>45.5%</strong>；</li>
      <li>全面碾压了传统模型（如 HPN+DN 36.0%、CMA 41.0%、VLN-BERT 44.0%、Sim2Sim 43.0%）；</li>
      <li>性能匹敌甚至逼近了使用了千万级额外无监督轨迹预训练的超大模型方案（如 NaVILA 49.7%）。</li>
    </ul>
  </li>
  <li><strong>极高的单位显存效率</strong>：如图 1 所示，LookStep 运行显存仅为 <strong>19.7 GB</strong>，其内存效率指标（SR / GB）达到 <strong>2.52</strong>，大幅高于同类先进 MLLM 方法 JanusVLN（1.19）和 StreamVLN（1.95）。</li>
  <li><strong>真实物理机部署验证</strong>：在室内复杂多房间真实机器人实验中（图 3 与图 7），即使遇到指令描述与实际光照视角不完全匹配的情况，智能体依靠准确的角色记忆与动作前瞻，依然展现出了平滑进出房门、准确识别转弯终点的稳健能力。</li>
</ol>

<hr />

<h3 id="4-局限性-16">4. 局限性</h3>
<ol>
  <li>候选动作的前瞻状态目前采用离散化语言标签（如 <code class="language-plaintext highlighter-rouge">premature_forward</code>、<code class="language-plaintext highlighter-rouge">wrong_turn</code>）进行粗粒度描述，难以刻画毫米级的连续角速度与线速度动力学细节。</li>
  <li>记忆的写入和剔除完全依赖 MLLM 自身的语义判断，当遇到极端视觉退化（如全黑暗光、强反光）导致误判事件角色时，可能会错误丢弃关键帧。</li>
</ol>

<hr />

<h2 id="macroaction-vln">23. MacroAction-VLN (2026)</h2>
<p>——— 基于拓扑图宏动作分层 MDP 与动作感知 Critic 的连续环境闭环强化学习微调</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.03906">arXiv:2609.03906</a></p>

<h3 id="精华-17">精华</h3>
<ol>
  <li><strong>拓扑图宏动作空间（Macro Action Space）</strong>：将连续环境视觉语言导航（VLN-CE）重构为分层马尔可夫决策过程（Hierarchical MDP），高层策略在动态前沿节点构成的宏动作空间上决策，将长达数百步的微动作序列大幅压缩至 5~20 步，彻底攻克了连续环境中强化学习奖励极其稀疏与长期信用分配（Credit Assignment）难题。</li>
  <li><strong>动作感知 Critic（Action-Aware Critic Head）</strong>：针对动态前沿候选集合引起的状态价值不适定评估问题，设计了感知动态动作空间的价值估计头，与策略网络共享跨模态融合骨干，以几乎零额外显存开销消除了 Critic 的部分可观测性。</li>
  <li><strong>摆脱密集奖励整形的终局强化</strong>：无需手工设计易产生短视次优行为的密集奖励，仅依靠终局结果奖励（Success + SPL + nDTW）结合 PPO 与 KL 散度正则化，使智能体学会自主探索与闭环纠错，摆脱 DAgger 纠偏动作与语言指令语义冲突的宿疾。</li>
  <li><strong>0.5B 轻量模型刷新连续环境 SOTA</strong>：仅使用 0.5B 参数的紧凑多模态骨干，在 R2R-CE 和 RxR-CE 连续未见测试集上分别达到 <strong>68.1%</strong> 和 <strong>50.2%</strong> 的成功率（SR），大幅超越了 7B 参数的多模态大模型基线（如 UniNaVid、StreamVLN、VLN-R1）。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-17">1. 研究背景/问题</h3>
<p>连续环境视觉语言导航（VLN-CE）要求机器人在未见场景中根据自然语言指令执行数百步底层微动作（如前进 0.25 米、左右转向 15 度）。现有基于模仿学习（IL）与微动作强化学习（RL）的路线面临三大根本矛盾：</p>
<ol>
  <li><strong>行为克隆的分布偏移</strong>：测试期智能体一旦发生微小漂移就会进入未见状态空间，误差急剧累积。</li>
  <li><strong>DAgger 专家动作的语义歧义</strong>：当机器人走偏时，DAgger 专家给出的最优纠偏动作（例如调头往回走）往往与自然语言指令（例如”一直往前走穿过走廊”）在语义上发生剧烈冲突，破坏了视觉与语言特征的对齐。</li>
  <li><strong>微动作强化学习的信用分配困境</strong>：微动作序列长达数百步，终局成功奖励在漫长的时序中被严重稀释，常规 RL 极难收敛；而手工设计稠密单步奖励又容易导致智能体陷入局部打转或指令错位的次优行为。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-17">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/MacroAction-VLN-training-paradigms.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:697/772" />
<figcaption>图 1：VLN-CE 三种训练范式对比。(a) DAgger 纠偏动作易与语言指令冲突；(b) 微动作空间 RL 面临长程信用分配难题；(c) 本文提出的拓扑图宏动作空间 RL，压缩决策步长，实现切实可行的长期信用分配。</figcaption>
</div>

<h4 id="-整体框架概述-9">① 整体框架概述</h4>
<p>如图 2 所示，MacroAction-VLN 将 VLN-CE 重构为一个双层分层 MDP：</p>
<ul>
  <li><strong>高层规划器（Macro MDP）</strong>：以增量构建的拓扑图为状态表征，在动态未探索前沿节点（Frontier Nodes）集合中选取子目标或下达停止指令；</li>
  <li><strong>底层控制器（Micro MDP）</strong>：采用免训练的确定性控制器（Rotate-then-Forward 启发式控制器结合避障），充当高层 MDP 的状态转移函数 $\mathcal{T}^H(s_{t+1}^H \mid s_t^H, a_t^H)$；</li>
  <li><strong>闭环强化微调（RFT）</strong>：在高层宏动作上直接通过近端策略优化（PPO）进行端到端优化。</li>
</ul>

<div align="center">
  <img src="/images/vln/MacroAction-VLN-framework-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/552" />
<figcaption>图 2：系统整体框架。包含高层规划器（共享跨模态骨干、Actor 与动作感知 Critic）、底层微动作控制器、以及基于 Rollout Buffer 和终局结果奖励的 PPO 闭环强化学习优化流程。</figcaption>
</div>

<h4 id="-逐模块讲解-8">② 逐模块讲解</h4>

<p><strong>1. 宏动作分层 MDP 构建（Hierarchical Macro MDP Formulation）</strong></p>
<ul>
  <li><strong>宏观状态 $S^H$</strong>：高层状态 \(s_t^H = (I, \mathcal{H}_t)\)，由自然语言指令 $I$ 和当前增量构建的拓扑图轨迹 \(\mathcal{H}_t = (\mathcal{V}_t, \mathcal{E}_t)\) 组成，包含已探索节点与当前可见的前沿候选节点。</li>
  <li><strong>宏观动作 $A^H$</strong>：在动态可用的未访问前沿节点集合中选择目标航点 \(a_t^H \in \mathcal{A}_t^H\)，或选择终止动作 <code class="language-plaintext highlighter-rouge">STOP</code>。</li>
  <li><strong>状态转移压缩</strong>：底层控制器自动规划并执行几十步微动作使机器人行进至选定前沿点，并更新拓扑图，这使得一个长任务的宏观决策步数从原本的 100~300 步骤降至 <strong>5~20 步</strong>。</li>
</ul>

<blockquote>
  <p><strong>举个例子（卡点降维装置 A：微动作与宏动作的信用分配对比）</strong>：
设一段 15 米长的走廊导航任务：</p>
  <ul>
    <li><strong>微动作 RL</strong>：每步前进 0.25 米或转弯 15 度，轨迹长达 $T = 120$ 步。假设到达终点获得奖励 $R=1$。在时间差分（TD）反向传播中，第 1 步动作的奖励折现为 $\gamma^{120} = 0.99^{120} \approx 0.30$；更严重的是，中间 120 步任何微小动作随机探索都会引入指数级累计方差，Critic 根本无法分清究竟是哪一步决策走对了路，导致训练崩溃。</li>
    <li><strong>拓扑图宏动作 RL</strong>：环境被抽象为起点、拐角、走廊中段、目标门前等 5 个拓扑节点。智能体只需做出 $T = 5$ 次宏动作选择！折现因子为 $\gamma^5 = 0.99^5 \approx 0.951$；终局奖励清晰直接地对这 5 次子目标抉择进行优势估计（GAE），方差极小，RL 策略仅需十余小时即可快速收敛。</li>
  </ul>
</blockquote>

<p><strong>2. 动作感知价值估计头（Action-Aware Critic Head）</strong></p>
<ul>
  <li><strong>设计动机</strong>：在传统 RL 中，Critic 仅以当前历史状态为输入 $V(s_t)$。但在宏动作空间中，前沿候选节点在数量、空间方位和可行性上随着探索动态改变。忽略当前可供挑选的前沿分布会导致 Critic 面临严重的部分可观测性（Partial Observability）。</li>
  <li><strong>共享骨干设计</strong>：Actor 与 Critic 完全共享语言编码器、图编码器及跨模态融合骨干。跨模态 Backbone 同时接收语言 Token、已访问拓扑 Token 和当前前沿 Token，Critic 并行利用这套包含候选动作信息的融合表征输出标量状态价值 $V^\pi(s_t^H)$，不增加额外参数负担且极大稳定了优势估计。</li>
</ul>

<p><strong>3. 终局驱动奖励函数（Outcome-Driven Reward）</strong>
无需复杂的密集步进距离差值塑形，设计轻量鲁棒的轨迹级终局奖励 $R_T$：
\(R_T = \mathrm{Success} + \mathrm{SPL} + \mathrm{nDTW}\)</p>
<ul>
  <li>$\mathrm{Success}$：最终停止在目标 1.5 米内得 1 分；</li>
  <li>$\mathrm{SPL}$：鼓励避免无效绕路与过长路径；</li>
  <li>$\mathrm{nDTW}$（归一化动态时间规整）：衡量智能体轨迹与参考真值轨迹的时空吻合度。即使任务最终未完全成功，nDTW 依然能为”走对了绝大部分路途”的高质量探索提供稠密正反馈，支撑 RL 前期的平滑冷启动。</li>
</ul>

<p><strong>4. 三阶段递进式训练范式（Curriculum Training Paradigm）</strong></p>
<ul>
  <li><strong>阶段 1 &amp; 2：预训练与带 Value 预热的 DAgger 阶段</strong>：
在模仿学习阶段，同时对策略头和动作感知价值头进行预热监督：
\(\mathcal{L}_{DAgger} = \mathcal{L}_{CE} + c_v \mathcal{L}_V^{CLIP}\)</li>
  <li><strong>阶段 3：闭环强化学习微调（Closed-Loop RFT）</strong>：
采用 PPO 算法，并在损失中引入针对预训练参考模型 $\pi_{ref}$ 的 KL 散度约束，防止策略在强化探索中发生表征崩溃：
\(\mathcal{L}_{PPO} = \mathcal{L}_P^{CLIP} + c_v \mathcal{L}_V^{CLIP} + \beta \mathbb{D}_{KL}(\pi_\theta \parallel \pi_{ref})\)</li>
</ul>

<h4 id="-读者视角分层决策与强化优化闭环图卡点降维装置-b">③ 读者视角：分层决策与强化优化闭环图（卡点降维装置 B）</h4>

<pre><code class="language-mermaid">graph TD
    subgraph "高层规划层 (Macro MDP - PPO 强化更新)"
        A["语言指令 I + 拓扑历史 Gt"] --&gt; B["共享跨模态融合骨干"]
        B --&gt; C1["Actor 头: 预测前沿节点宏动作分布 π(at|st)"]
        B --&gt; C2["Action-Aware Critic 头: 联合动作分布评估状态价值 V(st)"]
        C1 --&gt; ACT["下发选定前沿子目标 atH"]
    end

    subgraph "底层控制层 (Micro MDP - 启发式状态转移)"
        ACT --&gt; D["Rotate-then-Forward 控制器"]
        D --&gt; E["执行数十步底层 micro 动作 (Habitat 仿真环境)"]
        E --&gt; F["抵达子目标，提取新全景观测，拓扑图增量扩展至 Gt+1"]
    end

    subgraph "终局评估与信用分配 (Optimization Loop)"
        F -.-&gt; A
        E --&gt; G{"是否到达终点或耗尽预算?"}
        G -- "是" --&gt; H["计算终局综合奖励 RT = Success + SPL + nDTW"]
        H --&gt; I["通过 GAE 广义优势估计反向更新共享骨干网络"]
    end
</code></pre>

<h4 id="-机制对比macroaction-vln-vs-现有主流路线卡点降维装置-c">④ 机制对比：MacroAction-VLN vs 现有主流路线（卡点降维装置 C）</h4>

<table>
  <thead>
    <tr>
      <th>机制维度</th>
      <th>传统纯模仿学习 (ETPNav / BEVBert)</th>
      <th>微动作强化学习 (VLN-R1)</th>
      <th>本文 MacroAction-VLN</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>决策动作空间</strong></td>
      <td>拓扑图宏动作（纯监督拟合专家）</td>
      <td>连续微动作（前进/转弯/停止）</td>
      <td>拓扑图宏动作（强化探索与闭环纠偏）</td>
    </tr>
    <tr>
      <td><strong>训练优化范式</strong></td>
      <td>DAgger 纠偏（易与语言指令语义冲突）</td>
      <td>微动作直接 RL（长时序极难收敛）</td>
      <td>宏动作空间闭环 PPO 强化微调</td>
    </tr>
    <tr>
      <td><strong>价值 Critic 设计</strong></td>
      <td>无 Critic 或仅有无动作感知的简单网络</td>
      <td>简单单步价值网络（高方差）</td>
      <td>Action-Aware 架构，共享跨模态全骨干</td>
    </tr>
    <tr>
      <td><strong>参数量与性能</strong></td>
      <td>0.3B 参数，R2R-CE SR 约 57%~59%</td>
      <td>7B 参数大模型，R2R-CE SR 仅 30.2%</td>
      <td><strong>0.5B 参数，R2R-CE SR 达到 68.1%</strong></td>
    </tr>
  </tbody>
</table>

<hr />

<h3 id="3-核心结果发现-17">3. 核心结果/发现</h3>
<p>在 Habitat 仿真器中的连续环境视觉语言导航金牌基准 <strong>R2R-CE</strong> 和 <strong>RxR-CE</strong> 未见测试集（Val-Unseen）上进行了系统评测：</p>

<ol>
  <li><strong>大幅刷新连续环境性能纪录</strong>：
    <ul>
      <li>在 <strong>R2R-CE Val-Unseen</strong> 上，成功率（SR）从 DAgger 基线的 65.1% 飙升至 <strong>68.1%</strong>（+3.0%），SPL 提升至 <strong>57.3%</strong>（+3.8%），导航误差（NE）降至 <strong>3.89 米</strong>；</li>
      <li>在长程多语言高难度基准 <strong>RxR-CE</strong> 上，成功率达到 <strong>50.2%</strong>，路径保真度 nDTW 达到 <strong>66.8%</strong>；</li>
      <li>整体表现全面超越了参数量大十倍以上的 7B 大模型方案（如 StreamVLN 的 56.9%、UniNaVid 的 47.0%、以及基于微动作 RL 的 VLN-R1 的 30.2%）。</li>
    </ul>
  </li>
  <li><strong>消融实验证实动作感知 Critic 的决定性价值</strong>：
    <ul>
      <li>移除 Action-Aware 特性（改用仅依赖历史的传统 Critic），RFT 增益直接从 +3.0% 缩水至 +1.1%，证明感知动态候选动作对准确评估状态价值具有不可替代的作用；</li>
      <li>采用终局驱动奖励（+nDTW）的训练收敛稳定性与最终表现显著优于单步密集距离奖励（Dense Soft Reward），有效规避了短视绕圈行为。</li>
    </ul>
  </li>
  <li><strong>策略鲁棒性定性分析</strong>：
    <ul>
      <li>如图 5 所示，在面对相似房间死胡同、拐弯盲区等易错环境时，经过 RFT 训练的模型能够在高层宏动作中展现出高置信度的回溯重探索能力，从根本上消除了 DAgger 训练策略走偏后在原地徘徊死锁的缺陷。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-17">4. 局限性</h3>
<ol>
  <li>高层宏动作依赖拓扑图的前沿点提取算法与底层航位推算（Odometry），当里程计累积漂移过大或建图存在严重假阳性前沿时，宏动作选择空间会受到扰动。</li>
  <li>目前底层微动作转移由启发式控制器硬编码完成，在极端崎岖或狭窄需要复杂机动动力学的场景中，缺乏高低层联合自适应调整能力。</li>
</ol>

<hr />

<h2 id="navmcp">24. NavMCP (2026)</h2>
<p>———首个将导航基础模型（NFM）脚手架化封装为智能体执行器的长程具身导航框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.30396">arXiv:2608.30396</a></p>

<h3 id="精华-18">精华</h3>
<ol>
  <li><strong>核心洞察</strong>：长程物理世界交互面临“高层宏观推理”与“底层微观闭环”难以兼备的两难困境，现有视觉语言模型（VLM）长程动作漂移严重，而导航基础模型（NFM）虽具备优秀的局部具身执行能力，却受限于单次回合、缺乏跨轮次持久任务状态。</li>
  <li><strong>范式突破</strong>：NavMCP 打破了将导航模型简单视作黑盒单步工具（Episodic Tool Interface）的传统做法，提出首个将 NFM 作为长程具身智能体物理执行层的脚手架（Scaffolding）协议体系，在不微调任何底层模型的前提下实现长程闭环探索。</li>
  <li><strong>架构机制</strong>：构建“意图（Intent）- 观测（Observation）- 记忆（Memory）”三通道协议，分别解决指令与意图脱节、沿途关键观测丢失、跨调用记忆断层三大鸿沟，把一次性航点规划转变为可累积、可追溯的具身认知过程。</li>
  <li><strong>决策哲学</strong>：引入基于证据链的非对称仲裁机制，不仅记录“看到了什么”，更显式沉淀“排除了哪些区域”的否定证据（Negative Evidence），让智能体具备有目的的非单调假设检验探索能力。</li>
  <li><strong>迁移启示</strong>：在三大具身问答基准（HM-EQA、MT-HM3D、EXPRESS-Bench）上全面刷新最强成绩，并在宇树 Unitree Go2 四足机器人上实现超 50 米超长程真实环境探索，证明将领域基础模型与通用大模型分层脚手架化是通向物理智能体的重要路径。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-18">1. 研究背景/问题</h3>
<p>具身问答（Embodied Question Answering, EQA）与真实物理环境搜索要求智能体在大型未知场景中长程探索以收集视觉证据。现有方法陷入了两难架构分歧：若让通用大模型（VLM）直接预测底层动作或局部航点，在长时程、大跨度场景中会频繁发生轨迹漂移、死锁与执行脆弱；若引入专用导航基础模型（Navigation Foundation Model, NFM，如 Qwen-RobotNav、Uni-NaVid 等），传统智能体仅将其封装为常规的单次回合工具（Episodic Tool Call）——向导航模型发送单句指令，底层跑完后仅返回终点状态与最终单张视野。</p>

<p>这种传统的单回合接口在长程证据收集场景中存在严重的<strong>回合间隙（Episodic Interface Gap）</strong>：</p>
<ol>
  <li><strong>指令与意图不匹配（Mismatch between instruction and intent）</strong>：高层 VLM 关注“要验证什么信息/找什么线索”，而底层导航模型需要具体的路径指令，单句路线命令无法传达搜索预算与语义边界；</li>
  <li><strong>中间观测丢失（Intermediate observation loss）</strong>：目标物体可能在机器人经过走廊或门缝的途中一闪而过，仅返回终止视角会丢弃整条轨迹中的海量高价值感知线索；</li>
  <li><strong>缺乏跨调用累积（Lack of cross-call accumulation）</strong>：单次调用结束后底层执行记忆清空，高层若缺乏结构化记忆账本，无法记录“哪些房间已完全排查”，导致重复搜索或盲目兜圈。在 HM-EQA 基准上，退化为传统单回合接口直接带来 14.9% 的剧烈性能断崖。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-18">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/NavMCP-system-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1278/545" />
<figcaption>NavMCP 系统整体架构：高层 VLM 智能体通过意图通道向导航基础模型（NFM）派发子目标，NFM 在非特权自车视角下自主完成闭环运动，沿途轨迹数据经由观测通道转化为带来源引用的旅程证据，并在记忆通道中维护动态更新的 EQA 上下文状态。</figcaption>
</div>

<h4 id="-整体框架概述-10">① 整体框架概述</h4>
<p>NavMCP（Navigation Model Context Protocol）采用双层分工架构：<strong>高层 VLM 智能体充当“推理大脑”</strong>，负责任务目标分解、证据需求推断、搜索区域规划与何时终止并回答；<strong>底层 NFM（以 Qwen-RobotNav 为代表）充当“物理执行肢体”</strong>，负责在非特权第一人称 RGB 视角与自建局部拓扑图下完成避障与鲁棒的闭环航点跟踪。二者通过解耦且紧密协同的三通道协议门控交互，既拓展了 VLM 的物理动作视野，又拓展了 NFM 的长程推理视野。</p>

<h4 id="难点降维传统工具调用-vs-navmcp-三通道协议">难点降维：传统工具调用 vs NavMCP 三通道协议</h4>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统工具调用（Episodic Interface）</th>
      <th>NavMCP 脚手架协议（本文方案）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>意图表达 (Intent)</strong></td>
      <td>单句控制指令（如 “向左转走向主卧”），缺乏预算约束与搜索模式区分</td>
      <td>结构化语义调用 <code class="language-plaintext highlighter-rouge">(mode, goal, budget, constraints)</code>，区分物体搜索与指令导航双模式</td>
    </tr>
    <tr>
      <td><strong>观测反馈 (Observation)</strong></td>
      <td>仅返回最终终点终止状态与末帧图像，沿途关键视觉信息全部丢失</td>
      <td>沿轨迹等步长采样关键帧序列，由轨迹摘要器生成带关键帧来源引用的旅程简报（Journey Artifact）</td>
    </tr>
    <tr>
      <td><strong>跨轮记忆 (Memory)</strong></td>
      <td>依赖原始交互对话上下文，面对长序列很快超出窗口且极易遗忘否定线索</td>
      <td>显式维护三元状态 $C_t = (H_t, E_t, U_t)$，结构化沉淀正负证据账本，安全压缩原始工具轨迹</td>
    </tr>
    <tr>
      <td><strong>决策准则 (Arbitration)</strong></td>
      <td>仅凭单次视线是否看到目标直接草率回答</td>
      <td>基于 <code class="language-plaintext highlighter-rouge">analyze_status</code> 的三阶段非对称仲裁：证实需直接图像支持，证伪需区域全覆盖证据</td>
    </tr>
  </tbody>
</table>

<pre><code class="language-mermaid">graph TD
    A["任务问题与初始自车视角"] --&gt; B["高层 VLM 规划器"]
    B --&gt; C{"是否已有充足证据?"}
    C -- "是" --&gt; D["执行 analyze_status 仲裁并输出接地答案"]
    C -- "否" --&gt; E["【意图通道】构造结构化调用 (mode, goal, budget)"]
    E --&gt; F["【NFM 执行层】闭环生成航点轨迹与无碰撞运动"]
    F --&gt; G["【观测通道】沿途采样关键帧序列 (Δ=4步, 上限16帧)"]
    G --&gt; H["轨迹摘要器生成带来源引用的旅程证据 z_t"]
    H --&gt; I["【记忆通道】更新证据账本 E_t 与未决目标 U_t"]
    I --&gt; J["保守压缩原始交互历史 H_t"]
    J --&gt; B
</code></pre>

<h4 id="-逐模块讲解navmcp-三通道核心机制">② 逐模块讲解：NavMCP 三通道核心机制</h4>

<h5 id="1-意图通道intent-channel从证据需求到结构化导航调用">1. 意图通道（Intent Channel）：从证据需求到结构化导航调用</h5>
<p>高层智能体在推断出缺失的信息后，无需编写底层的电机指令或细微航点，而是通过协议门控发出结构化语义导航调用：
\(\text{Call} _t = (\text{mode}, \text{sub\_goal}, \text{budget}, \text{constraints})\)</p>
<ul>
  <li><strong>双模式解耦</strong>：
    <ul>
      <li><code class="language-plaintext highlighter-rouge">navigate_to_object</code>（物体目标导航模式）：输入具体的物体类别名称或指代对象，底层 NFM 自主进行语义驱动的局部探索与逼近；</li>
      <li><code class="language-plaintext highlighter-rouge">navigate_by_instruction</code>（视觉语言导航模式）：输入包含区域、路径或拓扑地标的高级自然语言指令（如“穿过走廊进入尽头的卧室”）。</li>
    </ul>
  </li>
  <li><strong>预算与边界约束</strong>：通过 <code class="language-plaintext highlighter-rouge">budget</code> 控制底层最大步数，避免底层模型陷入局部死循环；通过 <code class="language-plaintext highlighter-rouge">constraints</code> 提供语义避障建议。底层执行器仅依赖本体自车 RGB 观测、位姿估计与探索过程中实时构建的拓扑占据图，无需预知场景真值或特权几何信息。</li>
</ul>

<div align="center">
  <img src="/images/vln/NavMCP-three-channel-interface.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1286/697" />
<figcaption>NavMCP 三通道脚手架内部流转逻辑：意图通道负责任务语义对齐，观测通道负责将时空轨迹映射为带置信度与图源标签的结构化感知证据，记忆通道负责支撑跨多轮交互的持久化证据账本更新。</figcaption>
</div>

<h5 id="2-观测通道observation-channel从动态轨迹到来源锚定证据">2. 观测通道（Observation Channel）：从动态轨迹到来源锚定证据</h5>
<p>底层执行器完成一次单模态导航后，输出原始轨迹记录 $r_t = (s_t, b_t, \ell_t, p_t, K_t)$，其中 $s_t$ 为完成标志，$b_t$ 为停止原因，$\ell_t$ 为行走总路径长度，$p_t$ 为最终位姿，$K_t = {I_{t,1}, \dots, I_{t,n}}$ 为沿途关键帧集合。</p>
<ul>
  <li><strong>关键帧等距采样</strong>：为兼顾视觉覆盖率与上下文成本，系统每隔 $\Delta = 4$ 步采样一张自车视野帧，单次调用上限截断为 $M = 16$ 帧。</li>
  <li><strong>VLM 轨迹摘要器（Trajectory Summarizer）</strong>：将这批关键帧输入轻量多模态描述器，提取结构化旅程证据：
\(z_t = (q_t, R_t, O_t, P_t, D_t)\)
其中 $q_t$ 记录子目标达成状态；$R_t$ 总结途经房间与区域过渡；$O_t$ 提取显著观测物体；$P_t$ 记录规划拓扑线索（如发现未探索的楼梯口、虚掩的房门）；$D_t$ 记录不确定性与执行异常。</li>
  <li><strong>来源锚定元组（Source Grounding）</strong>：$O_t$ 与 $R_t$ 中的每一个物体或区域提及，都强制绑定一个五元组标签 $(n, i, v, h, c)$（名称、所属关键帧索引、视角方位、相对空间提示、置信度）。严禁摘要器无依据脑补未观察到的状态。</li>
</ul>

<h5 id="3-记忆通道memory-channel跨调用证据账本与保守上下文压缩">3. 记忆通道（Memory Channel）：跨调用证据账本与保守上下文压缩</h5>
<p>为解决多轮调用引起的上下文爆炸，NavMCP 维持显式三元 EQA 上下文状态：
\(C_t = (H_t, E_t, U_t)\)</p>
<ul>
  <li><strong>证据账本 $E_t$</strong>：记录带有来源索引的正面证据（Positive Evidence，如“在主卧床头柜发现点亮的台灯，来源帧 keyframe_3”）、否定证据（Negative Evidence，如“书房全景视野排查完毕，未发现打印机”）。账本由 <code class="language-plaintext highlighter-rouge">write_notebook</code> 维护，采用 FIFO 队列上限保留 100 条去重记录，在每轮推理时直接注入 Prompt 头部。</li>
  <li><strong>未决目标池 $U_t$</strong>：维护尚未证实或存在模糊推断的待查目标，指导下一次意图通道的派发。</li>
  <li><strong>保守上下文压缩策略</strong>：仅当关键感知信息已被提炼外化至 $E_t$ 与 $U_t$ 并打上关键帧引用后，系统才允许将上一轮冗长的原始工具执行日志与中间视觉图替换为极简占位符。这保证了长时程交互中即使发生上下文截断，核心决策链条也完全不受破坏。</li>
</ul>

<h4 id="难点降维journey-analysis-沿途捕获与非对称仲裁具体实例">难点降维：Journey Analysis 沿途捕获与非对称仲裁具体实例</h4>

<blockquote>
  <p><strong>举个具体例子</strong>：
机器人在回答“床头柜上的台灯是否开着？”这一问题时，意图通道发出 <code class="language-plaintext highlighter-rouge">navigate_by_instruction("穿过走廊进入主卧")</code>，底层连续移动了 16 步。</p>
  <ol>
    <li><strong>传统工具调用</strong>：底层走完停在主卧衣柜前，仅返回最后一帧衣柜图像。智能体完全错过床头柜，判断“未找到台灯”，不得不盲目再次寻找。</li>
    <li><strong>NavMCP 观测通道</strong>：按 $\Delta=4$ 采样 4 张关键帧。在第 2 张关键帧（机器人正路过主卧半开的房门）中，画面右侧门缝内隐约捕捉到床头柜与灯罩。VLM 轨迹摘要器提炼出证据元组：<code class="language-plaintext highlighter-rouge">("台灯", frame_2, "右侧门缝", "主卧床旁", "uncertain")</code>，直接写入未决目标 $U_t$。</li>
    <li><strong>非对称仲裁机制</strong>：下一轮规划器调用 <code class="language-plaintext highlighter-rouge">analyze_status</code>，激活专门的局部验证。此时系统遵守<strong>非对称证据法则</strong>：
      <ul>
        <li><strong>证实（Positive）</strong>：必须依赖无歧义的高清直接视觉证据（调用 <code class="language-plaintext highlighter-rouge">zoom_in_object</code> 放大查看该台灯发光状态）；</li>
        <li><strong>证伪（Negative）</strong>：若要得出“房间里没有台灯”的否定结论，必须提供全景 360 度扫描且覆盖该房间所有死角的证据链。严禁将“仅仅没看到”武断视为“物体不存在”。</li>
      </ul>
    </li>
  </ol>
</blockquote>

<div align="center">
  <img src="/images/vln/NavMCP-evidence-guided-search.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1278/610" />
<figcaption>Explore-EQA 任务实录（寻找黑色小沙发）：智能体在长程探索中连续排查 5 个房间并沉淀否定证据，避免走回头路；中间距目标距离曲线呈现出理性的非单调特征（先拉大距离以系统性排除其他区域，随后精准收敛至目标角落）。</figcaption>
</div>

<h4 id="-辅助感知工具集与验证协议">③ 辅助感知工具集与验证协议</h4>
<p>为在最终决策前消除歧义，NavMCP 向智能体暴露了细粒度视觉感知工具库：</p>
<ul>
  <li><strong>阅读型工具（Reader Tools）</strong>：
    <ul>
      <li><code class="language-plaintext highlighter-rouge">look_around</code>：调用全景四方向相机获取 360 度环视感知与场景可行拓扑；</li>
      <li><code class="language-plaintext highlighter-rouge">analyze_status</code>：三阶段证据仲裁器，输入当前全景、历史关键帧与记事本，输出证据充足度与缺失类型；</li>
      <li><code class="language-plaintext highlighter-rouge">zoom_in_object</code>：对候选目标裁剪放大，进行细粒度属性（开关状态、文字、细小部件）精细判别；</li>
      <li><code class="language-plaintext highlighter-rouge">review_image</code>：调取归档的历史关键帧重新审视。</li>
    </ul>
  </li>
  <li><strong>探测型工具（Detector Tools）</strong>：
    <ul>
      <li><code class="language-plaintext highlighter-rouge">detect_objects_360</code>、<code class="language-plaintext highlighter-rouge">detect_objects</code>：基于开放词表检测器与 SAM 进行目标定位与计数；</li>
      <li><code class="language-plaintext highlighter-rouge">estimate_depth</code>：基于 Depth-Anything 进行度量级深度与可接触距离估计。</li>
    </ul>
  </li>
</ul>

<h4 id="难点降维等效探索步数equivalent-agent-steps补偿计算">难点降维：等效探索步数（Equivalent Agent Steps）补偿计算</h4>

<p>在具身导航评估中，传统 Frontier 探索基线（如 Explore-EQA、FAST-EQA）以瞬移方式移动，其单步决策位移被严格限制在 3 米以内。而 NFM 一次闭环调用可能自主移动十余米。如果直接把 NFM 一次长程调用仅计为 1 步，会对传统基线造成严重的评测不公；但如果把底层物理控制周期全都算作高层步数，又无法体现 NFM 闭环执行对高层大模型调用开销的节省。</p>

<p>为此，论文以 3 米为基础换算单元，设计了<strong>等效智能体步数（Equivalent Agent Steps）</strong>：
\(n_{\text{eq}} = H + \sum_{k=1}^K \max\left(0, \left\lceil \frac{L_k}{3\text{ m}} \right\rceil - 1\right), \quad \hat{n} _{\text{eq}} = \frac{n_{\text{eq}}}{N}\)
其中 $H$ 为高层 VLM 实际调用次数，$K$ 为 NFM 调用总次数，$L_k$ 为第 $k$ 次 NFM 实际运动轨迹的物理弧长，$N = \lfloor \sqrt{A \times 3} \rfloor$ 为基于场景可通行面积 $A$ 的理论总预算步数。</p>

<blockquote>
  <p><strong>手算算例</strong>：
设某场景总步数预算 $N = 50$ 步。智能体在高层共调用了 $H = 3$ 次 VLM：</p>
  <ul>
    <li>第 1 次调用 NFM 移动了 2.5 米：由于 $L_1 \le 3\text{m}$，$\lceil 2.5/3 \rceil - 1 = 0$，补偿 0 步；</li>
    <li>第 2 次调用 NFM 穿过长走廊，移动了 8.2 米：$\lceil 8.2/3 \rceil - 1 = 3 - 1 = 2$ 步补偿；</li>
    <li>第 3 次调用 NFM 跨房间搜索，移动了 11.0 米：$\lceil 11.0/3 \rceil - 1 = 4 - 1 = 3$ 步补偿。</li>
  </ul>

  <p>最终等效总步数 $n_{\text{eq}} = 3 + (0 + 2 + 3) = 8$ 步，归一化步数消耗：
\(\hat{n} _{\text{eq}} = \frac{8}{50} = 0.16\)
这种换算既严谨补偿了长程物理位移，又真实体现出 NavMCP 相比传统单步探索将高层大模型交互频次削减了 70% 以上。</p>
</blockquote>

<hr />

<h3 id="3-核心结果发现-18">3. 核心结果/发现</h3>

<h4 id="-三大-eqa-基准全面超越-sota">① 三大 EQA 基准全面超越 SOTA</h4>
<p>在三大基准测试中，NavMCP 均取得了显著的突破性领先（采用 Qwen3.6-Plus 智能体与 Qwen-RobotNav-8B 执行器）：</p>
<ul>
  <li><strong>HM-EQA（500 道多选问答）</strong>：NavMCP 达到 <strong>76.7%</strong> 准确率，大幅超越此前最强方法 FAST-EQA（69.2%）达 <strong>7.5 个百分点</strong>。同时归一化高层探索步数仅为 <strong>0.15</strong>，较 FAST-EQA 的 0.65 减少了 77% 的高层大模型调用，兼具极高精度与极致能效。</li>
  <li><strong>MT-HM3D（多目标跨房间复杂问答）</strong>：准确率达到 <strong>54.4%</strong>，领先 FAST-EQA（50.5%）3.9 个百分点。</li>
  <li><strong>EXPRESS-Bench（2,044 道长程自由形式问答）</strong>：自由形式问答评测中，LLM 打分达到 <strong>79.27</strong>，路径勘探效率加权指标 $E_{\text{path}}$ 达到 <strong>33.96</strong>，大幅领先 Fine-EQA（63.95 / 25.58）与 ToolEQA（65.77 / 25.82）。</li>
</ul>

<h4 id="-严格控制变量下的全系统对齐测试hm-eqa固定-qwen35-397b-a17b">② 严格控制变量下的全系统对齐测试（HM-EQA，固定 Qwen3.5-397B-A17B）</h4>
<p>为消除大模型底座差异带来的影响，论文在统一使用开源 Qwen3.5-397B-A17B 作为决策智能体、统一初始状态、统一预算与感知工具的前提下进行了重测：</p>
<ul>
  <li>Explore-EQA：57.6%</li>
  <li>ToolEQA：60.8%</li>
  <li>FAST-EQA：63.5%</li>
  <li><strong>NavMCP + Qwen-RobotNav-8B</strong>：<strong>74.0%</strong>（领先基准 10.5 ～ 16.4 个百分点）。</li>
</ul>

<h4 id="-双层分工互补性消融architecture-ablation">③ 双层分工互补性消融（Architecture Ablation）</h4>
<ul>
  <li><strong>固定底层 NFM，变化高层智能体</strong>：
    <ul>
      <li>无智能体（仅凭初始视角盲猜）：38.2%</li>
      <li>单轮被动 Agent（仅拍摄单次全景）：58.4%</li>
      <li>传统反应式 Agent（固定探索循环）：62.0%</li>
      <li>完整 NavMCP 脚手架（Qwen3.5）：<strong>74.0%</strong>（Qwen3.6-Plus 进一步达到 76.7%）。</li>
      <li><em>结论</em>：再强大的底层导航模型，缺乏高层自适应假设检验与记忆沉淀，也无法胜任复杂具身推理。</li>
    </ul>
  </li>
  <li><strong>固定高层智能体，变化底层导航执行器</strong>：
    <ul>
      <li>NavMCP + Random Walk（随机游走）：60.9%</li>
      <li>NavMCP + Frontier Exploration（传统前沿点探测）：65.3%</li>
      <li>NavMCP + StreamVLN：69.3%</li>
      <li>NavMCP + Qwen-RobotNav-4B：73.3%</li>
      <li>NavMCP + Qwen-RobotNav-8B：<strong>74.0%</strong></li>
      <li><em>结论</em>：高层智能体无法弥补底层脆弱的物理执行，更强的语言条件闭环导航器能将高层语义需求转化为更高质量的时空观测。</li>
    </ul>
  </li>
</ul>

<h4 id="-协议通道消融实验protocol-ablation-on-hm-eqa">④ 协议通道消融实验（Protocol Ablation on HM-EQA）</h4>
<ul>
  <li><strong>直接退化为传统单次回合工具接口（Episodic Interface）</strong>：性能暴跌 <strong>14.9 个百分点</strong>（74.0% $\to$ 59.1%），直接证实了回合间隙对长程物理交互的致命性；</li>
  <li><strong>退化为终点观测返回（Terminal-only Observation）</strong>：性能损失 <strong>5.9 个百分点</strong>（降至 68.1%），证实沿途关键帧与过程观测对证据收集至关重要；</li>
  <li><strong>移除记忆通道的 EQA 上下文账本</strong>：性能损失 <strong>4.6 个百分点</strong>（降至 69.4%）；</li>
  <li><strong>移除 VLM 旅程分析（Journey Analysis）</strong>：性能损失 <strong>4.4 个百分点</strong>（降至 69.6%）；</li>
  <li><strong>稀疏化关键帧采样（从 4 步/16 帧变为 8 步/8 帧）</strong>：性能损失 <strong>2.8 个百分点</strong>（降至 71.2%）。</li>
</ul>

<div align="center">
  <img src="/images/vln/NavMCP-real-robot-navigation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1286/1504" />
<figcaption>宇树 Unitree Go2 四足机器人真实环境实测：面对长达 50 米以上跨越多个功能区的超长程探索任务，NavMCP 引导机器狗将高层目标分解为以地标为锚点的渐进子目标，成功率达 78.3%，相对反应式基线展现出巨大优势。</figcaption>
</div>

<h4 id="-真实机器人部署宇树-unitree-go2-物理验证">⑤ 真实机器人部署：宇树 Unitree Go2 物理验证</h4>
<p>在真实办公大楼环境中，面对非结构化障碍、测距漂移与传感噪声，对单房间（Low）、跨房间（Medium）与超 20 米大尺度多区域（High）三级难度进行了实机测试（固定 Qwen3.6-Plus）：</p>
<ul>
  <li><strong>单房间级（Low，20 回合）</strong>：Reactive 80%，Frontier 70%，<strong>NavMCP 90%</strong>；</li>
  <li><strong>跨房间级（Medium，20 回合）</strong>：Reactive 骤降至 35%，Frontier 60%，<strong>NavMCP 保持 85%</strong>；</li>
  <li><strong>超 20 米大范围探索（High，20 回合）</strong>：Reactive 彻底崩溃为 <strong>0%</strong>，Frontier 仅为 <strong>15%</strong>，而 <strong>NavMCP 依然保持高达 60% 的成功率</strong>！</li>
  <li><strong>总体真机成功率</strong>：NavMCP 达到 <strong>78.3%</strong>，相比 Frontier（48.3%）和 Reactive（38.3%）呈现压倒性优势，证明任务时程越长、环境越复杂，分层脚手架的优势越明显。</li>
</ul>

<hr />

<h3 id="4-局限性-18">4. 局限性</h3>
<ol>
  <li><strong>高层模型计算开销与响应时延</strong>：NavMCP 依赖大参数量 VLM（如 Qwen3.6-Plus 或 397B 级模型）进行每轮多模态旅程分析与证据仲裁，高层大模型的推理延迟较传统轻量启发式算法更高，未来需探索端侧小模型或强化学习蒸馏方案；</li>
  <li><strong>多视角采样下的物体重复与计数歧义</strong>：沿途多个关键帧或不同相机视角多次拍到同一物体时，VLM 在密集小物体计数任务中仍偶发重复去重失误（Cross-view duplication error）；</li>
  <li><strong>动态环境与非稳态物理干扰</strong>：当前测试主要在相对静态的室内大场景展开，在包含剧烈动态人流穿行或光照突变的极具挑战性现实场景中，底层 NFM 的局部死锁与恢复机制仍有进一步提升空间。</li>
</ol>

<hr />

<h2 id="occplanner">25. OccPlanner (2026)</h2>
<p>———把一个没有深度的像素，”顶”回局部 3D 占用栅格里再规划</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.14160">arXiv:2608.14160</a></p>

<hr />

<h3 id="精华-19">精华</h3>

<ol>
  <li>像素目标只有方向、没有深度和可通行性，OccPlanner 的解法是<strong>两段式条件注入</strong>——先让目标与时序视觉上下文对齐拿到粗方向，再与局部 3D 占用几何对齐落到可行点位；消融显示单独注入占用特征几乎无增益，补上顺序交互后 cluttered-hard 的 SR 从 75.55% 跳到 84.92%。</li>
  <li>显式的局部 3D 占用<strong>不是当地图用的</strong>，而是作为几何先验的中间监督，让扩散策略在吐轨迹之前先”知道”哪里是墙。</li>
  <li>L3ROcc 的核心洞察是把体素分成 occupied / observed-free / <strong>unknown</strong> 三态而非二值——”没看见”和”确实是空的”必须分开，否则策略会把遮挡区当通路。</li>
  <li>因此单目 RGB 视频就能反向生成占用监督，数据来源从”必须有 3D 标注的仿真器”放宽到”任何导航视频”，真机仅用 829 条样本微调即见效。</li>
  <li>开环指标与闭环成功率<strong>不同向</strong>——base model 开环 IoU/FDE 最好，闭环却明显低于完整模型，提醒别拿开环 proxy 选模型。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-19">1. 研究背景/问题</h3>

<p>导航目标的指定方式有度量坐标（PointGoal）、语义类别（ObjectGoal）、目标照片（ImageGoal）和自然语言（VLN）几种，而<strong>像素目标</strong>直接在当前相机视野里点一个点作为终点，不需要预建地图、也不需要度量坐标——对真机部署最友好。</p>

<p>但一个像素<strong>既不含深度、也不含可通行性</strong>：策略必须同时完成”这个点在 3D 里的哪个位置”和”怎么绕开障碍走过去”两件事。现有像素目标方法（PixNav、SSM-PixNav）直接在图像空间做条件，Goal2Pixel 预测可导航像素再反投影成航点；另一边的学习型局部规划器（iPlanner、ViPlanner、NavDP、LoGoPlanner）则从度量目标出发生成轨迹。<strong>两条线是断开的</strong>——连续的像素目标规划始终没有和显式的局部 3D 占用推理结合起来。</p>

<hr />

<h3 id="2-主要方法创新点-19">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/OccPlanner-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:671/574" />
<figcaption>OccPlanner 与 L3ROcc 总览。(a) L3ROcc 把单目 RGB 导航视频转成可见性感知的局部占用与轨迹监督；(b) OccPlanner 把连续的像素目标轨迹生成条件化在 RGB-D 上下文与局部 3D 占用之上</figcaption>
</div>

<h4 id="-卡点降维像素目标到底难在哪">① 卡点降维：像素目标到底难在哪</h4>

<p>先把四种目标形式摆在一起，就能看清 PixelGoal 的”便宜”是拿什么换的：</p>

<table>
  <thead>
    <tr>
      <th>目标形式</th>
      <th>给了什么</th>
      <th>缺了什么</th>
      <th>代价</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>PointGoal（度量坐标）</td>
      <td>精确的 3D 位置</td>
      <td>—</td>
      <td>需要预建地图或全局定位</td>
    </tr>
    <tr>
      <td>ObjectGoal（”找沙发”）</td>
      <td>语义类别</td>
      <td>具体实例与位置</td>
      <td>需要语义地图 + 探索</td>
    </tr>
    <tr>
      <td>ImageGoal（一张目标照片）</td>
      <td>目标外观</td>
      <td>目标在哪、有多远</td>
      <td>跨视角匹配，长程易失败</td>
    </tr>
    <tr>
      <td><strong>PixelGoal（像素坐标）</strong></td>
      <td><strong>目标在当前视野里的方向</strong></td>
      <td><strong>深度、可通行性</strong></td>
      <td><strong>不用地图，但要自己把像素顶回 3D</strong></td>
    </tr>
  </tbody>
</table>

<p>最后一行就是这篇论文要付的那笔账：省掉了地图，就得把”深度 + 可通行性”这两样东西从模型内部补出来。OccPlanner 的答案是——用一个<strong>学出来的局部 3D 占用分支</strong>来补。</p>

<h4 id="-整体框架">② 整体框架</h4>

<p>系统由两半组成：<strong>L3ROcc</strong> 是离线数据生成流水线，负责把单目 RGB 导航视频变成局部占用监督；<strong>OccPlanner</strong> 是在线策略，由三个模块构成——共享 RGB-D 几何编码器负责抽时空上下文，占用分支负责显式预测局部 3D 占用并压成紧凑 token，目标感知轨迹分支负责把像素目标依次与上下文、与占用几何对齐，最后交给扩散去噪生成连续轨迹。</p>

<h4 id="-l3rocc从单目视频反向生成占用监督">③ L3ROcc：从单目视频反向生成占用监督</h4>

<div align="center">
  <img src="/images/vln/OccPlanner-L3ROcc-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/726" />
<figcaption>L3ROcc 数据生成流水线：π³ 重建共享场景几何与相机运动，经度量对齐与机器人中心变换后，通过体素化和射线推理生成可见性感知的局部占用标注</figcaption>
</div>

<p><strong>输入</strong>：一段单目 RGB 导航视频。</p>

<p><strong>处理</strong>分四步：</p>

<ol>
  <li><strong>RGB 几何重建</strong>——均匀采样 K 帧送进 π³，得到共享坐标系 3D 点、局部 pointmap、稀疏相机位姿和置信度图。滤掉低置信点、用局部 pointmap 去掉深度边缘伪影，再体素下采样得到紧凑的共享场景点云。稀疏位姿用三次样条插值平移、SLERP 插值旋转，补齐到每一个视频时间戳。</li>
  <li><strong>度量与机器人中心对齐</strong>——单目重建天然尺度不确定。有参考位姿时，用重建轨迹与参考轨迹对齐恢复场景级尺度；没有参考位姿时直接换用具备度量能力的 π³ 变体。每个时刻把缩放后的共享几何变换到当前局部坐标系，再用相机到底盘的外参对齐机器人朝向，得到机器人中心几何与对齐后的视线射线。</li>
  <li><strong>可见性感知占用生成</strong>——把机器人中心几何体素化成候选占用栅格，然后沿射线做 ray marching（借鉴 Occ3D）。</li>
  <li><strong>输出</strong>：稀疏可见占用 + 打包的可见性掩码 + 对齐的轨迹元数据。</li>
</ol>

<p><strong>卡点降维 —— 三态标注为什么是关键</strong>：</p>

<blockquote>
  <p><strong>举个例子</strong>：把一条射线上的体素排成一列，编号 1→6，机器人在 0 处往前看，假设第 3 个体素被桌子占住了。ray marching 走一遍的结果是：</p>

  <ul>
    <li>体素 1、2 → <strong>observed free</strong>（射线确实穿过去了，是空的）</li>
    <li>体素 3 → <strong>visible occupied</strong>（第一个命中点，这才是真障碍）</li>
    <li>体素 4、5、6 → <strong>unknown</strong>（被桌子挡住，压根没看见）</li>
  </ul>

  <p>关键在第三行。朴素做法会把 4~6 标成自由空间——因为点云里那儿本来就没有点——策略学完就会以为桌子后面能走。三态标注把”没看见”和”确实是空的”分开，模型才不会把遮挡区当通路。如果射线一路没有命中，则整条路径上的体素全部标为 observed free。</p>
</blockquote>

<p><strong>设计动机</strong>：占用监督传统上依赖带 3D 真值的仿真器。L3ROcc 把门槛降到”一段 RGB 视频 + 相机外参”，这正是后面真机只靠 829 条样本就能微调的前提。</p>

<h4 id="-occplanner-主架构">④ OccPlanner 主架构</h4>

<div align="center">
  <img src="/images/vln/OccPlanner-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/827" />
<figcaption>OccPlanner 架构。共享 RGB-D 几何编码器抽取时空上下文；占用分支预测局部 3D 占用并把近地面几何压成占用 token；轨迹分支顺序融合目标-上下文与目标-占用信息，形成目标感知状态供扩散生成连续轨迹</figcaption>
</div>

<p><strong>模块 1 · 共享 RGB-D 几何编码器</strong></p>

<ul>
  <li><strong>输入</strong>：RGB-D 观测历史，共 8 帧 224×224。</li>
  <li><strong>处理</strong>：RGB 流用 π³ 自带的 DINOv2 编码器，深度流沿用 LoGoPlanner 的做法，只取 DepthAnythingV2 的 ViT-S 骨干（轻量）。两路 patch 对齐后拼接、线性投影成融合的 RGB-D token，再经过 π³ 的”视角内自注意力 / 全局自注意力”交替堆叠，产出每帧潜特征，解码成时空几何特征。</li>
  <li><strong>输出</strong>：时空几何特征同时供占用分支和轨迹分支使用——<strong>两个分支共享同一套几何底座</strong>，这是参数效率的来源。</li>
  <li>每帧几何特征被压成一个场景 token，最新一帧的潜特征额外压成当前观测 token，合起来构成时序局部上下文 \(U_{ctx}\)。</li>
</ul>

<p><strong>模块 2 · 占用分支</strong></p>

<ul>
  <li><strong>输入</strong>：最新一帧的几何特征。</li>
  <li><strong>处理</strong>：按主流 3D 占用方法的套路，先做 2D-to-3D lifting，再过 3D 卷积解码器，得到体素 logits 与稠密占用特征体。由于<strong>避障主要取决于近地面几何</strong>，从占用特征体里切出近地面切片投影成特征图，展平成地面平面记忆 \(M_{gnd}\)，再用可学习的占用 query 做 cross-attention 抽成紧凑占用 token：</li>
</ul>

\[Z_{occ} = \mathrm{CrossAttn}(Q_{occ};\, M_{gnd})\]

<ul>
  <li><strong>输出</strong>：占用 token（供轨迹分支条件化）+ 体素 logits（受 L3ROcc 的可见性感知监督）。</li>
  <li><strong>设计动机</strong>：不把整个占用体直接塞给规划器——那既贵又稀释信号；只留避障真正要用的近地面几何。</li>
</ul>

<p><strong>模块 3 · 目标感知轨迹分支</strong></p>

<ul>
  <li><strong>目标编码</strong>：与 NavDP 的掩码式像素目标表示不同，这里把归一化像素坐标用多频 Fourier 特征编码投影成目标 token，再加到可学习的 goal query 上。</li>
  <li><strong>两段式目标条件化</strong>（本文核心）：</li>
</ul>

\[\tilde z_e = \mathrm{CrossAttn}(q_g;\, U_{ctx}), \qquad z_e = \mathrm{CrossAttn}(\tilde z_e;\, Z_{occ})\]

<ul>
  <li><strong>目标感知状态解码</strong>：把目标 token、场景 token 序列、ego-goal 表征一起送进状态解码器，得到目标感知状态 token。</li>
</ul>

<p><strong>卡点降维 —— 为什么非得分两步？</strong></p>

<p>一次性把目标、上下文、占用全拼在一起喂给 Transformer，直觉上信息量是一样的。但消融说明不是：</p>

<pre><code class="language-mermaid">graph LR
    G["像素目标 (u,v)&lt;br/&gt;Fourier 编码"] --&gt; Q["可学习 goal query"]
    CTX["时序视觉上下文&lt;br/&gt;场景 token + 当前观测 token"] --&gt; S1
    Q --&gt; S1["Stage 1&lt;br/&gt;目标 × 上下文 CrossAttn"]
    S1 --&gt; ZE1["粗定位：目标大概在哪个方向"]
    OCC["占用 token&lt;br/&gt;近地面几何切片"] --&gt; S2
    ZE1 --&gt; S2["Stage 2&lt;br/&gt;目标 × 占用 CrossAttn"]
    S2 --&gt; ZE["ego-goal 表征&lt;br/&gt;带辅助回归监督"]
    ZE --&gt; DEC["目标感知状态解码器"]
    DEC --&gt; DIFF["扩散去噪 → 24 个航点"]
</code></pre>

<p>顺序的意义在于：<strong>Stage 1 先把”目标在哪”定下来，Stage 2 才问”那条路能不能走”</strong>。反过来或者并行，占用特征不知道该关注哪片区域，就退化成一堆无差别的几何信息。表中 <code class="language-plaintext highlighter-rouge">w/o Occ. Feature</code>（单阶段、只有 ego-goal）在 cluttered-hard 上是 81.57%，而 <code class="language-plaintext highlighter-rouge">w/o Two-Stage</code>（单阶段、ego-goal 与占用都有）反而掉到 75.55%——<strong>占用特征在缺少顺序交互时是负收益</strong>。补上两段式后回到 84.92%。</p>

<h4 id="-训练目标-1">⑤ 训练目标</h4>

<p>三项联合优化：</p>

\[L = \lambda_{occ} L_{occ} + \lambda_{traj} L_{traj} + \lambda_{ego} L_{ego}\]

<ul>
  <li>\(L_{occ}\)：体素 logits 与 L3ROcc 标注之间的 focal loss，提供显式几何监督。</li>
  <li>\(L_{traj}\)：DDPM / Diffusion Policy 框架下的去噪损失。给定真值动作序列 \(A_0\)，第 $\ell$ 步的带噪序列为</li>
</ul>

\[A_\ell = \sqrt{\bar\alpha_\ell}\, A_0 + \sqrt{1 - \bar\alpha_\ell}\,\epsilon, \qquad \epsilon \sim \mathcal N(0, I)\]

<p>条件上下文由扩散时间步 token、目标感知状态、时序上下文、ego-goal 表征、占用 token 拼成，去噪网络预测注入噪声，用 SmoothL1 对齐。</p>
<ul>
  <li>\(L_{ego}\)：<strong>辅助 ego-goal 回归</strong>——从 ego-goal 表征预测目标在机器人坐标系下的位置，只在训练时用。这一项是把”像素顶回 3D”这件事显式教给模型的地方，消融里它是单阶段条件下增益最大的组件（cluttered-easy/hard 分别 +20.23 和 +15.30 个百分点）。</li>
</ul>

<h4 id="-推理流程-1">⑥ 推理流程</h4>

<p>8 帧 RGB-D + 一个像素目标进去，几何编码器与占用分支各跑一次，轨迹分支构造条件上下文后做 <strong>10 步</strong>反向去噪，输出 <strong>24 个未来航点</strong>组成的连续轨迹。闭环执行时世界坐标系下的目标固定不变，每步重新投影回当前相机视野作为新的像素目标。</p>

<hr />

<h3 id="3-核心结果发现-19">3. 核心结果/发现</h3>

<p><strong>评测设置</strong>：训练用 InternData-N1（20 万+ 条轨迹，差速底盘 + 顶置 RGB-D，机器人高度与相机俯仰随机化）。评测在 InternScenes 的 <strong>60 个未见场景</strong>（20 home、20 commercial、10 cluttered-easy、10 cluttered-hard），每场景采 50 对 3–5 m 与 50 对 5–8 m 起止点，共 <strong>6000 条闭环 episode</strong>。成功判据是停在目标 0.5 m 以内。对比 NavDP（适配到同一像素目标接口）与 PixNav。</p>

<p><strong>闭环成功率（SR %）</strong></p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>距离</th>
      <th>Home</th>
      <th>Commercial</th>
      <th>Cluttered-Easy</th>
      <th>Cluttered-Hard</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>NavDP</td>
      <td>3–5 m</td>
      <td>35.79</td>
      <td>29.58</td>
      <td>32.61</td>
      <td>33.72</td>
    </tr>
    <tr>
      <td>PixNav</td>
      <td>3–5 m</td>
      <td>21.23</td>
      <td>21.91</td>
      <td>24.89</td>
      <td>21.31</td>
    </tr>
    <tr>
      <td><strong>OccPlanner</strong></td>
      <td>3–5 m</td>
      <td><strong>71.29</strong></td>
      <td><strong>47.47</strong></td>
      <td><strong>92.97</strong></td>
      <td><strong>92.82</strong></td>
    </tr>
    <tr>
      <td>NavDP</td>
      <td>5–8 m</td>
      <td>24.98</td>
      <td>19.07</td>
      <td>19.43</td>
      <td>19.77</td>
    </tr>
    <tr>
      <td>PixNav</td>
      <td>5–8 m</td>
      <td>19.63</td>
      <td>11.90</td>
      <td>14.20</td>
      <td>14.44</td>
    </tr>
    <tr>
      <td><strong>OccPlanner</strong></td>
      <td>5–8 m</td>
      <td><strong>69.90</strong></td>
      <td><strong>45.17</strong></td>
      <td><strong>86.20</strong></td>
      <td><strong>84.92</strong></td>
    </tr>
  </tbody>
</table>

<p>几个值得注意的点：</p>

<ul>
  <li><strong>5–8 m 四类场景平均 SR 从 NavDP 的 20.81% 提到 71.55%</strong>，且在 cluttered 场景增益最大（19.43→86.20、19.77→84.92），说明显式局部占用在复杂几何下的收益最明显。</li>
  <li><strong>长程几乎不掉点</strong>：OccPlanner 从 3–5 m 到 5–8 m 只掉 1~8 个百分点，而 PixNav 掉得很厉害——论文查了失败案例，PixNav 成功的 episode 几乎全是近似直线的路径，需要大幅绕行的基本都失败，这也解释了它的 SR 与 SPL 为何在报告精度下完全重合。</li>
  <li><strong>Commercial 是短板</strong>（45.17%），明显低于其他三类。</li>
</ul>

<div align="center">
  <img src="/images/vln/OccPlanner-qualitative.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/1096" />
<figcaption>四类未见仿真场景下的定性规划结果。每例上方是带像素目标（红点）的 RGB 观测，下方是预测的局部占用与生成轨迹（红线）</figcaption>
</div>

<p><strong>消融（5–8 m，cluttered 场景；开环用 1496 条 InternData-N1 留出样本）</strong></p>

<table>
  <thead>
    <tr>
      <th>变体</th>
      <th style="text-align: center">两段式</th>
      <th style="text-align: center">Ego-Goal</th>
      <th style="text-align: center">占用特征</th>
      <th>C-Easy SR</th>
      <th>C-Hard SR</th>
      <th>IoU</th>
      <th>FDE</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Base Model</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">—</td>
      <td>66.60</td>
      <td>72.42</td>
      <td><strong>50.79</strong></td>
      <td><strong>0.18</strong></td>
    </tr>
    <tr>
      <td>w/o Two-Stage</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td>84.34</td>
      <td>75.55</td>
      <td>43.61</td>
      <td>0.28</td>
    </tr>
    <tr>
      <td>w/o Ego-Goal</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">✓</td>
      <td>64.11</td>
      <td>60.25</td>
      <td>45.60</td>
      <td>0.24</td>
    </tr>
    <tr>
      <td>w/o Occ. Feature</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">—</td>
      <td>79.88</td>
      <td>81.57</td>
      <td>38.03</td>
      <td>0.23</td>
    </tr>
    <tr>
      <td><strong>Full Model</strong></td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: center">✓</td>
      <td><strong>86.20</strong></td>
      <td><strong>84.92</strong></td>
      <td>46.01</td>
      <td>0.19</td>
    </tr>
  </tbody>
</table>

<ul>
  <li><strong>Ego-Goal 是单阶段下增益最大的组件</strong>（+20.23 / +15.30 个百分点）。</li>
  <li><strong>两段式交互把 cluttered-hard 从 75.55% 推到 84.92%，DTG 从 0.87 m 降到 0.56 m</strong>。</li>
  <li><strong>开环指标会骗人</strong>：Base Model 的 IoU (50.79) 和 FDE (0.18) 都是全场最好，闭环 SR 却落后完整模型近 20 个百分点。开环 proxy 不能代表闭环导航能力。</li>
</ul>

<p><strong>真机（Unitree Go2，开环）</strong></p>

<div align="center">
  <img src="/images/vln/OccPlanner-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1396/817" />
<figcaption>Unitree Go2 上的真机开环对比。上排为仿真训练模型的零样本预测，下排为真机微调后的预测。微调让局部占用预测更稠密、空间上更连贯，同时保持轨迹平滑</figcaption>
</div>

<p>在堆满箱子、椅子、柜子和窄通道的办公室里录 RGB-D 序列。零样本的仿真训练模型已能捕捉粗略障碍几何、生成朝向目标的轨迹；用 L3ROcc 处理额外录制的机器人视频得到 <strong>829 条真实样本</strong>微调后，占用预测在家具与通道边界处明显更稠密、更连贯。</p>

<p><strong>实现细节</strong>：4×H100 训练 30 epoch，Adam，单卡 batch 8（全局 32），bfloat16 混合精度，梯度裁剪 1.0；学习率在前 10000 步从 $1\times10^{-4}$ 线性衰减到 $5\times10^{-5}$ 后固定，约 48 小时。</p>

<hr />

<h3 id="4-局限性-19">4. 局限性</h3>

<p>真机评测<strong>只做了开环定性对比</strong>，没有闭环物理部署，且局限于静态室内场景——动态障碍推理完全没有涉及。此外 commercial 场景的 SR（45.17%）明显落后于 cluttered 场景，说明大空间、弱几何约束的环境下，近地面占用提供的信号不足以支撑长程目标定位。</p>

<hr />

<h2 id="harness-robotic-os">26. Harness Robotic OS (2026)</h2>
<p>———把四足巡检从「导航栈」升级为「具身智能体运行时」</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.11225">arXiv:2609.11225</a></p>

<hr />

<h3 id="精华-20">精华</h3>

<p>这篇的真问题不是「怎么导航得更准」，而是「怎么让一堆现成模块在同一份上下文里协同、留痕、可回滚」——把系统集成本身当成研究对象。最值得借鉴的是它立的那道硬边界：实时控制回路（SLAM / 规划 / 控制）与认知回路（智能体编排 / 记忆 / 反思）分属两层，智能体只能「编排技能」而不能直接下发运动指令，于是推理出错也烧不穿到电机。记忆按「保留期限」而不是按「数据类型」切成 working / episodic / semantic 三层，检索由任务意图、空间位置、场景语义共同条件化，避免把整段运维史塞进每次推理上下文。自进化被刻意做成「离线候选 → 安全门 → 版本灰度 → 可回滚」，而不是在线改模型，这是长期运行的机器人能被审计的前提。但要清醒：认知运行时（语音 / 记忆 / 自进化）在本文只有协议没有数字，真正跑出实测的仍是那套经典导航加 VLM 巡检的流水线。</p>

<hr />

<h3 id="1-研究背景问题-20">1. 研究背景/问题</h3>

<p>住宅物业巡检要覆盖道路、消防通道、楼栋出入口、设备房、垃圾房等大范围公共空间，人工巡逻在频次、一致性和可追溯性上都受限于人力与个人经验。四足机器人能爬坡越坎、钻窄道，是合适的载体，但「会走」不等于「能巡检」——还需要持续定位、全局任务规划、反应式避障、场景级隐患理解、人机交互，以及与工单系统的对接。</p>

<p>作者指出当前落地系统的通病是把这些能力做成一堆松耦合模块：传感器驱动、导航算法、视觉语言服务、操作界面、企业应用各自持有状态，靠点对点适配器互通，由此产生三个缺口——<strong>语义任务意图与机器人位姿 / 观测 / 执行状态脱节</strong>、<strong>历史任务经验没有被系统性保留与检索</strong>、<strong>提示词 / 工具策略 / 任务图 / 技能的改动难以评估、溯源与安全回滚</strong>。</p>

<hr />

<h3 id="2-主要方法创新点-20">2. 主要方法/创新点</h3>

<h4 id="21-整体框架四个平面--一条自进化环">2.1 整体框架：四个平面 + 一条自进化环</h4>

<p>HROS 把系统分成四层：<strong>Robot Runtime</strong>（硬件抽象：边缘算力、多模态传感、连接与 I/O、四足执行）、<strong>Embodied Autonomy Skills</strong>（把 SLAM、感知、全局规划、局部运动封装成有状态、可复用的「技能」）、<strong>Cognitive Agent Runtime</strong>（智能体编排、分层记忆、多模态推理、技能与工具调度，以及自进化闭环）、<strong>Interaction and Operations</strong>（语音与多模态 I/O、巡检任务控制台、企业闭环）。四层之间不是调用栈而是绑定关系：每个技能把自己的输入时间戳、执行状态、置信度或失败码、输出引用上报到共享上下文总线，认知层据此监控进度，<strong>但不进入实时控制回路</strong>。</p>

<div align="center">
  <img src="/images/vln/HROS-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1273/933" />
<figcaption>HROS 四层架构。深色实线是运行时数据流，双向箭头是智能体与技能的绑定，虚线是自进化通路，绿线是安全门——只有过了安全门的候选版本才能回到技能运行时</figcaption>
</div>

<p><strong>卡点降维｜「具身智能体运行时」到底比普通导航栈多了什么</strong></p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>常规四足巡检系统</th>
      <th>HROS</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>状态归属</td>
      <td>各模块自持状态，靠任务专用适配器点对点互通</td>
      <td>共享上下文总线，物理状态与智能体推理同源</td>
    </tr>
    <tr>
      <td>历史经验</td>
      <td>跑完即弃，最多留一份日志</td>
      <td>working / episodic / semantic 三级记忆，按意图加位置条件检索</td>
    </tr>
    <tr>
      <td>变更治理</td>
      <td>改提示词或技能直接上线，出事靠人肉回滚</td>
      <td>候选版本走离线回归加安全门加版本灰度，可溯源可回滚</td>
    </tr>
    <tr>
      <td>控制权边界</td>
      <td>上层可直接下发运动指令</td>
      <td>智能体只能编排技能，运动指令必须过 robot-runtime 接口</td>
    </tr>
  </tbody>
</table>

<h4 id="22-robot-runtimevbot-四足平台">2.2 Robot Runtime：Vbot 四足平台</h4>

<p>物理层用 Vbot 四足作为传感、算力、通信与移动的载体：双目相机、16 线激光雷达、IMU、GNSS 与 4G/5G，边缘计算机为地平线 RDK S100P（6 核 ARM Cortex-A78AE + 128 TOPS Nash BPU），机上跑感知与智能体服务。机器人控制器通过 HROS 的 robot-runtime 接口暴露运动指令与状态反馈——<strong>这层隔离的设计动机就是防止上层智能体绕过校验直接发底层执行器指令</strong>。</p>

<h4 id="23-embodied-autonomy-skills四个有状态技能">2.3 Embodied Autonomy Skills：四个有状态技能</h4>

<p>这一层是全文唯一有实测数字的部分，四个模块全是现成开源件的工程化组合：</p>

<ul>
  <li><strong>状态估计 · Fast-LIO2</strong>：输入激光雷达点云与 IMU，紧耦合估计 6-DoF 位姿并增量建图，输出先验点云地图与在线位姿。三种工作模式——建图（现场勘测阶段）、在线定位（日常巡逻，实时扫描配准到先验地图）、重定位（跟踪退化或重启后恢复位姿）。设计动机是一个<strong>共享地图坐标系</strong>：住宅巡逻会在不同光照、不同场景外观下反复重访同一资产，只有把每张图像、每个航点、每次隐患事件、每份报告都绑到这个坐标系，HROS 才能做空间相关的记忆检索与跨任务对比。</li>
  <li><strong>局部感知 · Hobot-Stereo</strong>：输入同步双目图像，输出稠密近场深度并与激光雷达障碍表示融合。设计动机是激光稀疏采样对近场矮障碍、细结构、遮挡边界表达不足。深度点先变换到地图系，按距离与置信度过滤后插入 EGO-Planner 消费的局部体素表示；<strong>双目是补充而非替代</strong>，不确定观测按保守处理，长时间未被重复观测就从局部地图过期删除。</li>
</ul>

<div align="center">
  <img src="/images/vln/HROS-environment-representation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/655" />
<figcaption>两套互补的环境表示。左：Fast-LIO2 在共享任务坐标系下建出的全局三维点云图，用于重定位与任务规划；右：Hobot-Stereo 的稠密深度（左上）、融合点云（右上）、RGB 输入（左下）、局部鸟瞰几何（右下），补齐激光在近场的缺口</figcaption>
</div>

<ul>
  <li><strong>任务规划 · PCT-Planner</strong>：物业巡检是<strong>覆盖型任务</strong>而非单次起点到终点的查询，路线必须串起策略定义的视点（消防设施、设备房入口、垃圾收集点）且全程可通行。PCT-Planner 在三维先验点云图上算无碰路段，任务层按巡检策略排序并把结果存成可复用的任务模板。运行时全局路线只是<strong>参考</strong>而非直接运动指令，进度用「当前路段 + 当前航点 + 已完成视点 + 剩余巡检动作」表示——这样编排器可以暂停、恢复、重排非安全关键任务，而完全不碰局部控制器。</li>
</ul>

<div align="center">
  <img src="/images/vln/HROS-inspection-route.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1277/727" />
<figcaption>PCT-Planner 在先验点云图上生成的全局巡检路线，串联 8 个巡检航点，作为任务模板存档复用</figcaption>
</div>

<ul>
  <li><strong>运动智能 · EGO-Planner</strong>：输入全局参考路线、当前位姿、融合后的障碍表示，输出动力学可行的局部轨迹，再转成受速度、净空、连续性约束的四足控制指令。三种行为——标称跟踪、局部重规划（行人、违停车辆、保洁设备等临时遮挡时生成短绕行）、恢复（无可行局部轨迹时停机并上报<strong>带类型的失败码</strong>，交由任务层决定等待、重试还是呼叫操作员）。</li>
</ul>

<div align="center">
  <img src="/images/vln/HROS-local-corridor.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1270/750" />
<figcaption>EGO-Planner 在遛狗行人前方优化出的局部可通行走廊（蓝色区域），全局路线只给方向，让路的决策由局部规划器完成</figcaption>
</div>

<h4 id="24-cognitive-agent-runtime一接地的语音交互">2.4 Cognitive Agent Runtime（一）：接地的语音交互</h4>

<p>流式 ASR 把语音转成带时间戳的意图假设，<strong>但不直接执行</strong>——要先用当前机器人位姿、活动任务、可见场景、权限策略做接地（grounding），有歧义或涉及安全的指令必须显式确认。TTS 回报任务受理、导航进度、发现的隐患、恢复动作、完成状态。设计动机是让文本、语音、图像、企业消息进同一个多模态任务接口，而不是各自散在独立应用里。</p>

<h4 id="25-cognitive-agent-runtime二分层记忆">2.5 Cognitive Agent Runtime（二）：分层记忆</h4>

<p>记忆按<strong>保留期限</strong>切三层：working 存短程信息（当前任务、近期对话、机器人状态、局部观测、待返回的工具调用）；episodic 存按时间索引的任务片段（轨迹、决策、观测、隐患事件、失败与恢复结果）；semantic 存稳定的场地知识（地图分区、资产标识、巡检规则、历史缺陷、物业处置流程）。检索由任务意图、空间位置、场景语义、执行状态共同条件化。</p>

<p><strong>卡点降维｜三层各装什么、检索到底怎么发生</strong></p>

<blockquote>
  <p><strong>举个例子</strong>：机器人第 7 次巡检 3 号楼配电房门口，画面里地上有个纸箱。</p>

  <ul>
    <li><strong>working memory</strong> 装「此刻」：当前任务 ID、刚才那句「去 3 号楼看看」、当前位姿、最近两帧观测、还没返回的 Qwen3-VL 调用。任务结束即清。</li>
    <li><strong>episodic memory</strong> 装「哪一次」：第 3 次巡检在同一位置判过「杂物堆放」，人工复核改判为「临时快递件」；第 5 次因行人挡路触发过一次局部重规划。带时间戳，按次索引。</li>
    <li><strong>semantic memory</strong> 装「这地方一贯如此」：配电房属消防重点区域，规则是门前 1 米内不得堆物，历史缺陷记录里它是高频点位。不随单次任务变。</li>
  </ul>

  <p>检索不是把三层全灌进上下文，而是拿「意图=巡检 + 位置=配电房 + 场景语义=地面有箱子」去条件化召回：semantic 给出适用规则，episodic 给出「上次这类箱子被人判成快递件」，working 给出当前画面。于是这次就有机会不再误报——而这正是论文说要用 Recall@5 与任务完成率去量的东西，只是<strong>数字还没给</strong>。</p>
</blockquote>

<h4 id="26-cognitive-agent-runtime三安全门把守的自进化">2.6 Cognitive Agent Runtime（三）：安全门把守的自进化</h4>

<p>自进化被明确定义为「经验到更新」的<strong>受治理流程</strong>，而不是在线改模型。每次任务结束把执行轨迹与人工反馈写入经验缓冲区；反思与评估阶段做成败打分、失败归因、一致性检查，产出候选更新（记忆条目、提示词、工具选择策略、任务图、可复用技能）；候选版本在离线回归用例与安全规则上评估，带溯源记录，过了安全门才走版本化灰度上线。</p>

<pre><code class="language-mermaid">graph TD
    A["任务执行轨迹 + 人工反馈"] --&gt; B["经验缓冲区&lt;br/&gt;episodes · traces · failures"]
    B --&gt; C["反思与评估&lt;br/&gt;成败打分 · 失败归因 · 一致性检查"]
    C --&gt; D["候选更新&lt;br/&gt;记忆 / 提示词 / 工具策略 / 任务图 / 技能"]
    D --&gt; E{"安全门&lt;br/&gt;离线回归 + 安全规则"}
    E -- "不通过" --&gt; F["拒绝并留痕，不进运行时"]
    E -- "通过" --&gt; G["带溯源的版本化灰度"]
    G --&gt; H["部署进技能运行时"]
    G --&gt; I["保留一键回滚到上一版本"]
    H -.-&gt; A
</code></pre>

<p>注意这张图里 <strong>F 与 I 两个节点才是真正的设计主张</strong>：任何候选更新都有一条「被拒绝且留痕」的路径，任何已上线版本都有一条「回退」的路径。论文把这条边界称为长期运行机器人保持可复现、可审计所必需的东西。</p>

<h4 id="27-端到端从图像到工单的证据链">2.7 端到端：从图像到工单的证据链</h4>

<p>巡检推理流水线按「观测 → 解释 → 校验 → 上报 → 复核」组织。OpenClaw 选定与航点关联的图像，绑上位姿、时间戳、航点、任务 ID、适用巡检策略，再调 Qwen3-VL；返回的描述被解析进一个<strong>受约束的事件 schema</strong>（隐患类别、严重度、证据、位置、建议处置动作）。目标类别分两组——安全类（设备房周边堆物、消防通道占用、地面积水、线缆裸露）与环卫类（垃圾桶满溢、地面污渍、散落垃圾落叶、公共区域异常堆积）。</p>

<p>只有 schema 校验通过的事件才进入运营流水线。系统保留原始图像、模型原始响应、解析后字段、投递状态，打上位置与区域标签后生成结构化报告，经钉钉 / 飞书适配器路由给责任人做复核与派单。<strong>人工修正以带标签的反馈形式回写，而不是静默覆盖原结果</strong>——既保证后续评估与记忆更新有料，又保住了可审计、可回放的记录。这个设计同时把多模态推理挡在安全关键的运动回路之外。</p>

<h4 id="28-关于训练目标">2.8 关于「训练目标」</h4>

<p>这篇没有训练环节，全系统由现成组件拼装，没有可学习参数也没有损失函数。全文唯一的公式是语音实验的词错率定义：</p>

\[\text{WER} = (S + D + I) / N\]

<p>其中 $S$、$D$、$I$ 分别是替换、删除、插入错误数，$N$ 为参考词总数。</p>

<hr />

<h3 id="3-核心结果发现-20">3. 核心结果/发现</h3>

<p>在真实住宅小区部署的系统级测量（Table 1）：</p>

<table>
  <thead>
    <tr>
      <th>分组</th>
      <th>子系统</th>
      <th>指标</th>
      <th>结果</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>导航与运动</td>
      <td>任务执行</td>
      <td>航点可达率</td>
      <td>100%</td>
    </tr>
    <tr>
      <td> </td>
      <td>Fast-LIO2</td>
      <td>室外定位误差</td>
      <td>&lt; 10 cm</td>
    </tr>
    <tr>
      <td> </td>
      <td>EGO-Planner</td>
      <td>障碍响应时延</td>
      <td>&lt; 200 ms</td>
    </tr>
    <tr>
      <td>语义巡检</td>
      <td>Qwen3-VL</td>
      <td>垃圾满溢检出率</td>
      <td>95%</td>
    </tr>
    <tr>
      <td> </td>
      <td>Qwen3-VL</td>
      <td>消防通道占用检出率</td>
      <td>95%</td>
    </tr>
    <tr>
      <td> </td>
      <td>Qwen3-VL</td>
      <td>车道占用检出率</td>
      <td>90%</td>
    </tr>
    <tr>
      <td> </td>
      <td>Qwen3-VL</td>
      <td>地面积水检出率</td>
      <td>88%</td>
    </tr>
    <tr>
      <td> </td>
      <td>Qwen3-VL</td>
      <td>公共设施损坏检出率</td>
      <td>85%</td>
    </tr>
    <tr>
      <td> </td>
      <td>巡检推理</td>
      <td>隐患误报率 / 漏检率</td>
      <td>均 &lt; 5%</td>
    </tr>
    <tr>
      <td>运营闭环</td>
      <td>钉钉 / 飞书适配器</td>
      <td>告警投递成功率</td>
      <td>99%</td>
    </tr>
    <tr>
      <td> </td>
      <td>HROS 报告</td>
      <td>结构化报告生成准确率</td>
      <td>99%</td>
    </tr>
    <tr>
      <td>现场运行</td>
      <td>机器人平台</td>
      <td>连续续航</td>
      <td>&gt; 3 h</td>
    </tr>
    <tr>
      <td> </td>
      <td>端到端任务</td>
      <td>全覆盖单次巡检耗时</td>
      <td>≤ 60 min</td>
    </tr>
  </tbody>
</table>

<p>几点值得注意的：</p>

<ul>
  <li><strong>检出率随视觉类别下降得很规律</strong>：垃圾满溢与消防通道占用 95%，公共设施损坏只有 85%。作者归因于设施损坏这一类的视觉形态多样性远大于前两类——这与「隐患由空间与运营上下文定义、而非仅由物体身份定义」的立论是自洽的。</li>
  <li><strong>续航 3 h 对单次任务 60 min，留出了跑多轮的余量</strong>，这是能排班的前提。</li>
  <li><strong>最重要的一条反而是没有数字的那部分</strong>：论文 §5.6 为语音交互、分层记忆、安全门自进化写了完整的受控实验协议（WER、接地意图准确率、确认准确率、P95 端到端时延；Recall@5、时空接地准确率、上下文 token 缩减率、陈旧记忆错误率；任务成功率变化、回归率、安全规则违反率、安全门拒绝率、回滚成功率、<strong>要求安全门逃逸率为零</strong>），但 Table 1 里这三块一个数都没有，原文自陈「数值需待相应受控试验完成后才报告」。也就是说，<strong>HROS 的认知运行时目前是一份架构主张与一套评测设计，实证的是它下面那层经典导航加 VLM 巡检的流水线</strong>。</li>
</ul>

<hr />

<h3 id="4-局限性-20">4. 局限性</h3>

<p>作者列了四条：长期地图维护（停车格局、施工、植被、季节变化需要增量建图、变化检测与多会话地图管理）、开放世界隐患识别（更宽的隐患分类体系需要更多样的标注数据、校准置信度与歧义处理）、智能体评测与安全（记忆与自进化机制需要专门基准衡量检索质量、适配收益、回归风险与回滚可靠性，之后才谈得上在生产环境放开自动更新）、人机协作（户外噪声下的 ASR 鲁棒性、安全关键指令的确认设计、操作员负荷、与门禁广播报警数字孪生的集成）。</p>

<p>补一句读这篇时最该带着的判断：它是一篇<strong>系统与架构论文</strong>，导航与感知全部采用现成开源件，真正的新意在于层间边界与治理流程的设计；而这套设计里最有主张的三块（语音接地、分层记忆、安全门自进化）恰恰还停在协议阶段，尚未提供可比较的实验证据。</p>

<hr />

<h2 id="egopathbench">27. EgoPathBench (2026)</h2>
<p>———把「导航决策」压成第一人称图上的一串编号，对错交给场景几何裁定</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.16610">arXiv:2609.16610</a></p>

<hr />

<h3 id="精华-21">精华</h3>

<p>把「整合式空间智能」这个虚概念落成一个可判定的动作：在当前第一人称图上，从编号好的可见路点里挑出一条有序路线，对错由场景几何直接判，不需要跑完整导航系统。关键设计是「同图、同编号、两套可行性图」——质点 agent 与 0.6 m 机身 agent 共享观测和动作词表，只换可通行图，从而把「具身约束」这一个变量单独隔离出来测量。评测不比对是否模仿专家轨迹，而看所选动作的几何后果（候选是否可行、每条相邻边是否合法、末点是否落进目标域），参考路线只用来证明「有解」，不是唯一答案。五个诊断口径拆开后暴露出真正的瓶颈既不是输出格式也不是第一步，而是中间边——首步合法率 88–96%，整条路线合法率在具身任务上掉到 5–7%。同一套几何标注顺手产出 31,852 条带 Spatial CoT 的训练数据，微调 Qwen3.5-4B 后本榜 3.9→38.9，三个外部空间基准也全部上涨。</p>

<hr />

<h3 id="1-研究背景问题-21">1. 研究背景/问题</h3>

<p>现有空间智能基准（SpatialVLM、VSI-Bench、3DSRBench、EmbSpatial-Bench 等）测的是孤立判断：两个物体谁左谁右、距离多远、什么朝向。但导航决策要求把目标识别、动作后果评估、距离估计、路径规划<strong>同时</strong>做对，这些孤立能力加起来不等于整合能力。另一端，完整导航系统的成败又被建图、定位、记忆、控制、重规划层层稀释，测不出基础 VLM 本身的空间决策水平。</p>

<p>EgoPathBench 卡在中间：给一张第一人称 RGB、一个自然语言目标、一组画在图上的编号路点，问 VLM 能不能直接输出一条几何上可行、目标上一致的路线。</p>

<div align="center">
  <img src="/images/vln/EgoPathBench-motivation.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/584" />
<figcaption>同一个第一人称场景：「房间里有沙发吗」「茶几在沙发前面吗」这类识别与局部关系问题都答对了，但要求规划一条到茶几的路线时输出 [1,7,23] 却违反了路线与目标条件（右图红线）。这正是论文要测的能力缺口</figcaption>
</div>

<hr />

<h3 id="2-主要方法创新点-21">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/EgoPathBench-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1420/786" />
<figcaption>EgoPathBench 构建流水线：选场景与第一人称视角、选目标、生成可见路点，再分别构建质点与具身两套导航图、目标域和几何校验过的参考路线；这些固化的场景标注之后才用来生成图文问题与 Spatial CoT，产出 2 个可通行性任务 + 3 个路线规划任务</figcaption>
</div>

<h4 id="-整体框架概述-11">① 整体框架概述</h4>

<p>EgoPathBench 由三件东西组成：一个<strong>统一的动作接口</strong>（图像 + 编号路点 + 语言目标 → 一个 JSON 编号数组）、一套<strong>离线固化的场景标注</strong>（可见路点、两套可行性图、目标域、参考路线）、一个<strong>按顺序执行的几何判定器</strong>。模型全程只看得到 RGB 图和提示词，判分却发生在与这张图配准的 3D 场景里——这就是所谓「动作有明确后果」。</p>

<h4 id="-逐模块讲解-9">② 逐模块讲解</h4>

<p><strong>模块 1：任务接口与动作词表</strong></p>

<ul>
  <li><strong>输入</strong>：一张第一人称 RGB，上面叠了编号圆点；一段自然语言任务。</li>
  <li><strong>处理</strong>：模型要把显示 ID 与场景位置对应起来，判断哪些能走、怎么串成一条路。</li>
  <li><strong>输出</strong>：一个 JSON 数组。两个可通行性任务输出<strong>无序集合</strong>，三个路线任务输出从指定起点出发的<strong>有序序列</strong>。</li>
  <li><strong>设计动机</strong>：五个任务共用一套输入输出协议，差异只来自目标规格、agent 几何、评分约束，因此跨任务、跨模型可以直接比。</li>
</ul>

<p>五个任务的分工：</p>

<table>
  <thead>
    <tr>
      <th>任务</th>
      <th>目标规格</th>
      <th>Agent</th>
      <th>输出</th>
      <th>评分约束</th>
      <th>基准题数</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Point Traversability</td>
      <td>无</td>
      <td>质点</td>
      <td>ID 集合</td>
      <td>逐候选可通行分类</td>
      <td>146</td>
    </tr>
    <tr>
      <td>Embodied Traversability</td>
      <td>无</td>
      <td>0.6 m 机身</td>
      <td>ID 集合</td>
      <td>逐候选机身可行分类</td>
      <td>146</td>
    </tr>
    <tr>
      <td>Point Path</td>
      <td>显式物名</td>
      <td>质点</td>
      <td>有序路线</td>
      <td>合法 ID、指定起点、合法边、可接受终点</td>
      <td>309</td>
    </tr>
    <tr>
      <td>Embodied Path</td>
      <td>显式物名</td>
      <td>0.6 m 机身</td>
      <td>有序路线</td>
      <td>上面全部 + 机身宽度下的边合法性</td>
      <td>309</td>
    </tr>
    <tr>
      <td>Intent Path</td>
      <td>意图 + 视觉线索</td>
      <td>0.6 m 机身</td>
      <td>有序路线</td>
      <td>意图消歧后的终点 + 具身路线合法性</td>
      <td>201</td>
    </tr>
  </tbody>
</table>

<p><strong>模块 2：场景、视角与目标筛选</strong></p>

<ul>
  <li><strong>输入</strong>：InternScenes 归一化后的可仿真室内资产（原始扫描来自 3RScan、ScanNet、ARKitScenes、Matterport3D）。</li>
  <li><strong>处理</strong>：在可通行空间里采样第一人称相机，剔除镜头紧邻处被挡住的视角；再用视锥投影、观测距离、投影尺寸、可见表面证据四道过滤筛目标实例，把出画、太小、被重度遮挡的目标去掉。</li>
  <li><strong>输出</strong>：一条「场景–视角」记录，绑定相机参数、场景几何、保留的目标与 RGB 观测。</li>
  <li><strong>设计动机</strong>：后面所有路点和路线标注都挂在这条记录上，保证图像里看到的和几何里算的是同一件事。</li>
</ul>

<p><strong>模块 3：路点与几何标签</strong></p>

<ul>
  <li><strong>输入</strong>：保留下来的视角。</li>
  <li><strong>处理</strong>：往图里投两类标记——地面动作候选，以及选中的物体/结构表面位置（作为<strong>不可通行负样本</strong>）。用深度、射线可见性、标记间距三重检查，保证每个显示 ID 对应一个独立的场景位置，且不会互相重叠或被前景挡住。</li>
  <li><strong>输出</strong>：每个候选带 ID、图像投影坐标、场景三维坐标。</li>
  <li><strong>设计动机</strong>：负样本的存在让「把所有编号都选上」这种偷懒策略失效——可通行性任务混了可行地面点、对宽度敏感的地面点、可见表面负样本三类。</li>
</ul>

<p><strong>模块 4：成对路线构造（本文最核心的控制变量设计）</strong></p>

<ul>
  <li><strong>输入</strong>：一条场景–视角记录 + 一个目标。</li>
  <li><strong>处理</strong>：起点锚在图像底部附近的可见地面；在目标足迹周围生成可行终点区域；然后<strong>分别</strong>在质点自由空间和具身自由空间里搜索，把连续路径稀疏化成路点，再投影回当前图像。</li>
  <li><strong>输出</strong>：一对共享目标、起点、视角、候选空间，但分别通过各自 agent 几何校验的参考路线。</li>
  <li><strong>设计动机</strong>：Point Path 和 Embodied Path 之间<strong>只差 agent 几何这一个变量</strong>。模型在两者上的差距，就是纯粹的「具身约束理解能力」。</li>
</ul>

<p><strong>卡点降维 · 两套可行性图到底差在哪</strong></p>

<p>同一张图、同一组编号、同一个目标，为什么标签会不一样？</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>Point Agent（质点）</th>
      <th>Embodied Agent（0.6 m 直径机身）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>观测与编号</td>
      <td>一张 RGB，一套显示 ID</td>
      <td>完全相同，不换图也不换编号</td>
    </tr>
    <tr>
      <td>节点可行性</td>
      <td>只要落在几何连通的自由空间</td>
      <td>还要求该点周围有足够 clearance 容下机身</td>
    </tr>
    <tr>
      <td>边合法性</td>
      <td>两点之间几何直连即可</td>
      <td>用 0.30 m 名义半径做扫掠走廊检查，整条走廊不能撞</td>
    </tr>
    <tr>
      <td>典型后果</td>
      <td>家具之间的窄缝、半开的门算可通行</td>
      <td>同一批点被判不可行，路线必须绕远</td>
    </tr>
    <tr>
      <td>榜单落差</td>
      <td>Point Path 最高 SR 35.9%</td>
      <td>Embodied Path 最高 SR 2.9%</td>
    </tr>
  </tbody>
</table>

<p>一句话：<strong>同一个视觉上看着合理的动作，在两种 agent 模型下后果完全不同</strong>——这就是论文反复强调的「相同的视觉选择，几何后果不同」。</p>

<p><strong>模块 5：问题文本与 Spatial CoT</strong></p>

<ul>
  <li><strong>输入</strong>：已经固定下来的目标身份、可见路点、目标域、参考路线。</li>
  <li><strong>处理</strong>：显式目标任务直接点名物体；Intent Path 则先从当前视角可见物体里构造候选宇宙，用关系、属性、颜色、距离线索生成描述，再<strong>回代验证</strong>这段描述在当前视角下能唯一锁定那个固定目标，否则丢弃。训练集额外由 GPT-5.5 把「目标 + 候选 + 可行性标签 + 合法边 + 参考路线」口语化成 Spatial CoT 推理文本，导出前再与形式化标注对账。</li>
  <li><strong>设计动机</strong>：语言生成<strong>始终在几何真值下游</strong>，改措辞不会改目标和路线几何。Intent Path 就是从已接受的 Embodied Path 实例派生的，只换语言规格。</li>
</ul>

<h4 id="-端到端数据流-2">③ 端到端数据流</h4>

<p>整条流水线最反直觉的一点是顺序：<strong>几何先固化，语言最后长上去</strong>。</p>

<pre><code class="language-mermaid">graph TD
    A["InternScenes 室内资产"] --&gt; B["采样第一人称相机, 剔除被遮挡视角"]
    B --&gt; C["筛目标: 视锥 + 距离 + 投影尺寸 + 可见表面"]
    C --&gt; D["投可见路点: 地面候选 + 表面负样本"]
    D --&gt; E["构建两套可行性图: 质点 / 0.6m 机身"]
    E --&gt; F["搜索成对参考路线, 稀疏化并投回图像"]
    F --&gt; G{"连通性 / 可行性 / 到达目标域 / 路点可显示"}
    G -- "任一不过" --&gt; H["丢弃该路线单元"]
    G -- "全过" --&gt; I["目标 / 路点 / 目标域 / 参考路线就此冻结"]
    I --&gt; J["生成问题文本与 Spatial CoT, 回代校验"]
    J --&gt; K["质量审计 + 难度选样, 得到 31852 / 1345 / 1111"]
</code></pre>

<h4 id="-评测指标这篇论文的损失函数">④ 评测指标（这篇论文的「损失函数」）</h4>

<p>没有训练损失，但有一套严格的打分定义。可通行性用<strong>平衡准确率</strong>和 <strong>F1</strong>：</p>

\[\mathrm{BA} = \frac{\mathrm{TPR} + \mathrm{TNR}}{2}, \qquad
F_1 = \frac{2PR}{P + R}\]

<p>路线任务用三个逐级收紧的口径。记 $V_i$ 表示第 i 条预测可解析、ID 合法、起点正确、且每条相邻边都合法；$S_i$ 在此之上再要求终点可接受：</p>

\[\mathrm{VPR} = \frac{1}{N}\sum_i V_i, \qquad
\mathrm{SR} = \frac{1}{N}\sum_i S_i, \qquad
\mathrm{SPL} = \frac{1}{N}\sum_i S_i \cdot \frac{\ell_i}{\max(\ell_i,\, p_i)}\]

<p>其中 $\ell_i$ 是到可接受目标的最短合法参考长度，$p_i$ 是预测路线长度——失败路线 SPL 直接记 0。总分是五个任务的等权宏平均：</p>

\[\mathrm{EgoPathScore} = \frac{100}{5}\Big[ (2\mathrm{BA}_{PT} - 1) + (2\mathrm{BA}_{ET} - 1) + \mathrm{SR}_{PP} + \mathrm{SR}_{EP} + \mathrm{SR}_{IP} \Big]\]

<p><strong>卡点降维 · 为什么 BA 要写成 2BA − 1</strong></p>

<blockquote>
  <p><strong>举个例子</strong>：假设一个模型对「这个点能不能走」完全瞎猜，可行类和不可行类各命中一半，那么 BA = 0.5。
如果直接把 BA 平均进总分，这个瞎猜模型白拿 50 分；而三个路线任务上真实模型的成功率普遍只有 0–5%，两项「送分题」会把总分整个带偏，榜单就变成了在比谁的可通行性分类更准。
换成 2BA − 1 之后：瞎猜 → 2×0.5 − 1 = 0，全对 → 2×1.0 − 1 = 1。这叫 chance-adjusted，把随机基线拉回零点，和成功率（瞎猜几乎必然是 0，全对是 1）统一了量纲。
代回榜首 Gemini 3.1 Pro 手算一遍：(2×0.765 − 1) + (2×0.727 − 1) + 0.359 + 0.029 + 0.040 = 1.412，再 ÷5 ×100 = 28.2，就是表里的 28.3。</p>
</blockquote>

<h4 id="-判定流程评测器怎么一步步扣分">⑤ 判定流程（评测器怎么一步步扣分）</h4>

<p><strong>卡点降维 · VPR、SR、SPL 究竟卡在哪一环</strong></p>

<p>这三个指标不是三个独立分数，而是<strong>同一条判定链上的三个不同深度</strong>。评测器严格按顺序走，一旦某一环失败就直接判负，后面的检查不再执行：</p>

<pre><code class="language-mermaid">graph TD
    A["模型返回的 JSON 编号数组"] --&gt; B{"可解析, 且 ID 全部可见合法"}
    B -- "否" --&gt; X1["判负: 格式错误 / 非法 ID"]
    B -- "是" --&gt; C{"首个 ID 等于指定起点"}
    C -- "否" --&gt; X2["判负: 起点错误"]
    C -- "是" --&gt; D{"每对相邻点都是该 agent 的合法直连边"}
    D -- "否" --&gt; X3["判负: 非法边"]
    D -- "是" --&gt; E["VPR 计入: 这是一条完全合法的路线"]
    E --&gt; F{"末点落在可接受目标域内"}
    F -- "否" --&gt; X4["判负: 走得合法但没到目标"]
    F -- "是" --&gt; G["SR 计入, 再按最短参考长度折算 SPL"]
</code></pre>

<p>所以 <strong>VPR 减 SR 的差值 = 路走得合法但走错了地方</strong>，而 <strong>1 减 VPR = 路线本身就不合法</strong>。论文后面全部的诊断分析都建立在这个分解上。</p>

<p>顺带说明提示词协议：所有任务的用户提示都会明确「图中是编号候选点」「从显示 ID 1 出发」「机身直径 0.6 m」，并要求只返回一个 JSON 数组。每次评测用 8,192 token 完成预算、temperature 0、top-p 1。</p>

<hr />

<h3 id="3-核心结果发现-21">3. 核心结果/发现</h3>

<p><strong>（1）九个基础 VLM 的榜单：最高分只有 28.3</strong></p>

<table>
  <thead>
    <tr>
      <th>模型</th>
      <th>EgoPath Score</th>
      <th>Point Trav. BA/F1</th>
      <th>Embodied Trav. BA/F1</th>
      <th>Point Path VPR/SR/SPL</th>
      <th>Embodied Path VPR/SR/SPL</th>
      <th>Intent Path VPR/SR/SPL</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Gemini 3.1 Pro</td>
      <td><strong>28.3</strong></td>
      <td>76.5 / 79.0</td>
      <td>72.7 / 56.2</td>
      <td>63.7 / <strong>35.9</strong> / 28.7</td>
      <td>9.1 / <strong>2.9</strong> / 2.4</td>
      <td>10.4 / <strong>4.0</strong> / 3.3</td>
    </tr>
    <tr>
      <td>GPT-5.5</td>
      <td>27.3</td>
      <td>74.1 / 77.1</td>
      <td><strong>77.3</strong> / <strong>62.5</strong></td>
      <td>60.5 / 31.1 / 24.8</td>
      <td>5.5 / 1.3 / 1.3</td>
      <td>9.0 / 1.5 / 1.4</td>
    </tr>
    <tr>
      <td>Claude Opus 4.8</td>
      <td>25.6</td>
      <td><strong>77.9</strong> / 74.3</td>
      <td>73.5 / 59.6</td>
      <td><strong>66.0</strong> / 21.0 / 16.7</td>
      <td><strong>12.0</strong> / 1.6 / 1.5</td>
      <td><strong>14.4</strong> / 2.5 / 2.2</td>
    </tr>
    <tr>
      <td>MiniMax M3</td>
      <td>21.8</td>
      <td>77.0 / 76.2</td>
      <td>68.7 / 52.8</td>
      <td>50.8 / 13.3 / 8.7</td>
      <td>5.5 / 1.9 / 1.7</td>
      <td>9.0 / 2.5 / 2.3</td>
    </tr>
    <tr>
      <td>Qwen 3.6</td>
      <td>16.4</td>
      <td>67.4 / 72.1</td>
      <td>64.8 / 49.1</td>
      <td>49.2 / 15.2 / 10.9</td>
      <td>2.6 / 1.0 / 0.9</td>
      <td>5.0 / 1.5 / 1.3</td>
    </tr>
    <tr>
      <td>Mistral L3</td>
      <td>15.8</td>
      <td>65.2 / 70.8</td>
      <td>68.5 / 52.5</td>
      <td>35.6 / 11.0 / 5.8</td>
      <td>0.3 / 0.0 / 0.0</td>
      <td>3.5 / 0.5 / 0.5</td>
    </tr>
    <tr>
      <td>Llama 4</td>
      <td>14.9</td>
      <td>66.8 / 66.5</td>
      <td>66.0 / 49.8</td>
      <td>36.2 / 8.7 / 5.9</td>
      <td>1.9 / 0.0 / 0.0</td>
      <td>2.0 / 0.0 / 0.0</td>
    </tr>
    <tr>
      <td>Kimi K2.6</td>
      <td>9.7</td>
      <td>60.2 / 69.8</td>
      <td>57.8 / 44.2</td>
      <td>40.5 / 11.7 / 8.2</td>
      <td>1.3 / 0.7 / 0.5</td>
      <td>1.5 / 0.5 / 0.4</td>
    </tr>
    <tr>
      <td>Grok 4.3</td>
      <td>1.4</td>
      <td>52.3 / 58.4</td>
      <td>50.0 / 35.8</td>
      <td>18.4 / 2.6 / 1.2</td>
      <td>5.2 / 0.0 / 0.0</td>
      <td>3.5 / 0.0 / 0.0</td>
    </tr>
  </tbody>
</table>

<p>两个读法：<strong>逐点判断远强于整体成图</strong>——可通行性 BA 都在 60–78%，但 Point Path SR 最高只有 35.9%；<strong>具身约束是断崖</strong>——同一个模型从 Point Path 到 Embodied Path，SR 从 35.9% 掉到 2.9%，直接掉一个数量级。</p>

<p><strong>（2）失败到底发生在哪一步</strong></p>

<div align="center">
  <img src="/images/vln/EgoPathBench-route-diagnostics.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:680/510" />
<figcaption>九个 VLM 汇总的路线诊断（%）：输出可评测率 96% 以上说明格式不是瓶颈；首边合法率 88–96% 说明「第一步走哪」也不是瓶颈；但整条路线合法率在具身任务上跌到 4.8% / 6.5%，联合成功率只剩 1.0% / 1.4%</figcaption>
</div>

<p>拆开来看非常清楚：</p>

<ul>
  <li><strong>输出协议不是瓶颈</strong>：96.3–96.8% 的输出都是可评测的路线。</li>
  <li><strong>首步不是瓶颈</strong>：96.0% / 90.4% / 88.0% 的预测第一条边是合法的。</li>
  <li><strong>终点定位很弱</strong>：目标一致的终点率只有 28.9%（Point）、4.8%（Embodied）、5.2%（Intent）。模型可能认出了目标物在哪，却找不到一个紧邻它且对该 agent 可行的终端路点。</li>
  <li><strong>真正的病灶是中间边</strong>：整条路线合法率掉到 46.8% / 4.8% / 6.5%。在「首边合法」的预测里，有 51.3% / 94.7% / 92.7% 在后面某条边上违规。</li>
</ul>

<p>更狠的一组控制实验：即使<strong>同时</strong>限定首边合法<strong>且</strong>终点正确，仍有 42.2%（Point）、75.8%（Embodied）、69.4%（Intent）的路线中间挂掉。把题目减半到路点更稀疏的一半上，比例几乎不变（42.8% / 76.6% / 67.3%），说明不是「图上点太密看花眼」。而且在只需一条边的具身/意图题上违规率已经是 90.6% / 88.4%，三条边以上才升到 94.0% / 92.4%——<strong>问题不在长程累积，而在对 agent 几何的基本理解</strong>。</p>

<p><strong>（3）人类参照</strong></p>

<div align="center">
  <img src="/images/vln/EgoPathBench-human-vs-vlm.webp" width="65%" loading="lazy" decoding="async" style="aspect-ratio:682/733" />
<figcaption>同题对照的五任务雷达图：人类（粗绿线）EgoPath Score 54.2，最强 VLM 在这批题上只有 28.6，且优势覆盖全部五个轴而非集中在某一项</figcaption>
</div>

<p>在随机抽取的 50 题（每任务 10 题）同接口对照上，人类 EgoPath Score 54.2 对最强 VLM 的 28.6；三个路线任务的平均有效路径率 70.0% 对 26.7%，平均成功率 46.7% 对 13.3%。论文明确说明这是<strong>探索性同接口参照，不是人类天花板估计</strong>。</p>

<p><strong>（4）基准本身是否可信</strong></p>

<ul>
  <li><strong>依赖配对视觉输入</strong>：去掉图像或换成不匹配的路点叠加层，路线 SR 全面塌到接近 0（GPT-5.5 的 Point Path SR 从 30.0% 掉到 0.0% / 10.0%），说明模型确实在看图而不是只靠提示词猜。</li>
  <li><strong>非法边有真实几何后果</strong>：对 5,563 条含非法边的预测各抽一条边，沿 0.30 m 扫掠走廊按 0.05 m 采样查深度与物体索引渲染，88.7% 能找到明确注册的障碍物证据。</li>
  <li><strong>结论对离散化不敏感</strong>：改机身半径（0.25 / 0.35 m）、占据栅格（0.04 / 0.06 m）、目标环（0.05 / 0.15 m），九模型排序的 Spearman ρ 全部等于 1.0。把总分里的 SR 换成 SPL、或先按任务族内平均再等权，排序同样不变。</li>
</ul>

<p><strong>（5）训练资源确实有用</strong></p>

<p>用 LoRA（rank 8、alpha 16、冻结视觉塔、两阶段 1e-4 到 5e-5）在 31,852 条带 Spatial CoT 的训练集上微调 Qwen3.5-4B：</p>

<table>
  <thead>
    <tr>
      <th>设置</th>
      <th>Score</th>
      <th>Point Trav. BA/F1</th>
      <th>Emb. Trav. BA/F1</th>
      <th>Point Path VPR/SR/SPL</th>
      <th>Emb. Path VPR/SR/SPL</th>
      <th>Intent Path VPR/SR/SPL</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Qwen3.5-4B base</td>
      <td>3.9</td>
      <td>54.6 / 55.6</td>
      <td>54.9 / 33.1</td>
      <td>9.1 / 0.7 / 0.1</td>
      <td>0.3 / 0.0 / 0.0</td>
      <td>0.0 / 0.0 / 0.0</td>
    </tr>
    <tr>
      <td>+ EgoPathBench SFT</td>
      <td><strong>38.9</strong></td>
      <td>89.3 / 89.2</td>
      <td>83.4 / 71.2</td>
      <td>77.0 / 31.4 / 28.6</td>
      <td>34.9 / 7.1 / 6.9</td>
      <td>44.8 / 10.4 / 10.0</td>
    </tr>
  </tbody>
</table>

<p>一个 4B 模型微调后拿到 38.9 分，<strong>超过了榜首的 Gemini 3.1 Pro（28.3）</strong>，且 Embodied Path SR 7.1% 是全表最高。更值得注意的是外部迁移全部为正：</p>

<table>
  <thead>
    <tr>
      <th>外部基准</th>
      <th>设置</th>
      <th>Base</th>
      <th>SFT</th>
      <th>Δ</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>VSI-Bench Route Planning</td>
      <td>Full</td>
      <td>29.38</td>
      <td>33.51</td>
      <td><strong>+4.13</strong></td>
    </tr>
    <tr>
      <td>VSI-Bench Route Planning</td>
      <td>Debiased</td>
      <td>20.18</td>
      <td>24.56</td>
      <td><strong>+4.38</strong></td>
    </tr>
    <tr>
      <td>SpatialEval-VTQA</td>
      <td>Full</td>
      <td>61.8</td>
      <td>71.4</td>
      <td><strong>+9.6</strong></td>
    </tr>
    <tr>
      <td>3DSRBench</td>
      <td>Full</td>
      <td>58.0</td>
      <td>59.4</td>
      <td><strong>+1.4</strong></td>
    </tr>
  </tbody>
</table>

<p>说明学到的不是「刷这个榜的输出格式」，而是可迁移的空间决策能力。</p>

<hr />

<h3 id="4-局限性-21">4. 局限性</h3>

<p>人类参照只有 50 题、单名志愿者，论文自己定性为探索性对照而非人口层面的能力上限；场景全部来自 InternScenes 归一化的重建资产并经 Blender 渲染，与真实相机噪声、动态障碍、光照变化之间仍有分布差距。此外，任务形态是<strong>单张静态第一人称图上的一次性决策</strong>，不涉及探索、记忆与重规划，因此高分并不直接等价于闭环导航能力；场景后果审计中还有 11.3% 的非法边在辅助渲染下给不出明确障碍证据（论文认为这是证据不足而非标签错误）。</p>

<hr />

<h2 id="adageovln">28. AdaGeoVLN (2026)</h2>
<p>———沿「表征深度」与「导航时间」两条轴做几何取舍</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2609.18789">arXiv:2609.18789</a> · <a href="https://humanoid-research.github.io/adageovln/">Project Page</a></p>

<hr />

<h3 id="精华-22">精华</h3>

<p>几何基础模型（GFM）不该只把最后一层输出丢给策略——AdaGeoVLN 把 VGGT 的第 11/17/23 层分别接到 VLM 前三个解码层，让不同成熟度的几何信息在策略推理的不同阶段进场。关键在于它设计了一个严格对照：把<strong>同一份</strong>终端特征在同样三个位置注入三次（Deep×3），SR 从无几何基线的 46.5% 反而掉到 42.1%，证明收益来自表征的<strong>多样性</strong>而非交互次数。时间轴上，它把 VGGT 全局注意力的 KV 历史当成一个按导航价值排序的可淘汰缓存，用指令相关性、几何置信度、转移新颖度三个信号打分后逐层 TopK。这个保留动作发生在当前帧推理<strong>之后</strong>、服务于下一帧，因此「选哪些历史」等于在塑造未来几何推理的上下文，而不是事后做压缩。单 RGB 流、零额外导航数据下取得 R2R-CE 55.7 SR / 51.4 SPL，同时比按新旧保留的基线省掉 39.7% 的 GFM-KV 显存。</p>

<hr />

<h3 id="1-研究背景问题-22">1. 研究背景/问题</h3>

<p>VLN 智能体在陌生环境里要做的不只是物体识别和语言-外观匹配，还得推理空间关系、视角变化和观测之间的时序联系，这让几何表征成为语义推理的天然补充。VGGT 这类几何基础模型能从纯 RGB 前馈推出场景结构，但两个问题一直没定论：<strong>（1）策略到底该看几何编码器的哪一层？</strong> 主流做法只暴露终端表征，可中间层未必没有互补信息；<strong>（2）在有限显存下，哪些历史几何状态值得留？</strong> 按新旧（recency）淘汰虽然能封住显存增长，却默认「越老越没用」——而一个早期观测可能恰好锚定了指令里的地标，或者提供了最可靠的几何。</p>

<hr />

<h3 id="2-主要方法创新点-22">2. 主要方法/创新点</h3>

<h4 id="-整体框架-1">① 整体框架</h4>

<p>AdaGeoVLN 是一个流式 VLN 框架，由三部分构成：一个<strong>冻结的 VGGT</strong> 负责从单路 RGB 流吐出多层几何特征；一个 <strong>Qwen3.5-4B 策略</strong>负责把指令和视觉 token 变成离散动作；中间夹着两套「几何选择」机制——<strong>层级 GFM–VLM 融合</strong>决定策略在哪一层看到哪一档几何（深度轴），<strong>导航感知 GFM-KV 保留</strong>决定哪些历史几何状态留在 VGGT 缓存里供下一帧使用（时间轴）。两条轴正交：前者管「策略拿到什么」，后者管「这些表征是在什么历史上下文中算出来的」。</p>

<div align="center">
  <img src="/images/vln/AdaGeoVLN-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1420/656" />
<figcaption>AdaGeoVLN 总览。(a) 深度轴：冻结 VGGT 的浅/中/深三档特征耦合进 VLM 策略的连续解码层；(b) 时间轴：候选 GFM-KV 按指令、转移、置信度三信号打分，在固定预算内保留、其余淘汰；(c) 与单 RGB 流式 VLN 基线的性能对比</figcaption>
</div>

<p>形式化地，第 $t$ 步智能体看到 RGB 图 $I_t$ 和指令 $L$，几何基础模型 $G$ 在深度 $m$ 上暴露表征 \(G_t^m\)，策略按下式出动作：</p>

\[a_t \sim \pi_\theta\!\left(a_t \mid L,\, I_{1:t},\, M_t\right)\]

<p>其中 $M_t$ 是保留下来的几何侧记忆。</p>

<hr />

<h4 id="-模块一层级几何融合深度轴">② 模块一：层级几何融合（深度轴）</h4>

<p><strong>输入</strong>：VGGT 第 11、17、23 层的空间 patch 特征（每个位置 2048 维）。这三档跨越了 VGGT 层级的分离阶段，且都注入得足够靠前，好让几何更新有机会在后续策略计算中传播开。</p>

<p><strong>处理</strong>：每档特征先归一化并对齐到 VLM 的图像 token 分辨率——把相邻 2×2 的 patch 拼起来，得到 8192 维 token：</p>

\[Z_t^m = \mathrm{Group}_{2\times 2}\!\left(\mathrm{RMSNorm}(G_t^m)\right)\]

<p>然后走两条并行支路。一条是<strong>深度专属的适配器</strong>，把 8192 维压到语言隐空间的 2560 维：</p>

\[\Phi_m : \mathbb R^{8192} \to \mathbb R^{4096} \to \mathbb R^{2560}\]

<p>另一条是<strong>逐 token 的门控网络</strong>，为每个合并 token 输出一个标量 logit：</p>

\[\Gamma_m : \mathbb R^{8192} \to \mathbb R^{2048} \to \mathbb R\]

<p>两者相乘、再乘上一个可学习的标量 $s_m$ 控制该深度的整体贡献，就得到几何更新量：</p>

\[\Delta_t^m = s_m \left[\sigma\!\left(\Gamma_m(Z_t^m)\right) \odot \Phi_m(Z_t^m)\right]\]

<p><strong>输出</strong>：几何更新以残差形式加在解码层的<strong>图像 token 位置</strong>上（文本 token 状态不被直接覆写）：</p>

\[H_{t,\mathrm{img}}^{k,+} = H_{t,\mathrm{img}}^{k} + \Delta_t^m, \qquad (m,k) \in \{(11,0),\, (17,1),\, (23,2)\}\]

<p><strong>设计动机</strong>：论文刻意<strong>不给每个深度指派预设的语义角色</strong>（不说「浅层管纹理、深层管结构」），而是把层级本身当成一个待检验的经验假设——不同几何处理阶段的隐状态可能携带互补信息，只看终端状态会把它们抹掉。</p>

<div align="center">
  <img src="/images/vln/AdaGeoVLN-hierarchical-fusion.webp" width="70%" loading="lazy" decoding="async" style="aspect-ratio:699/924" />
<figcaption>跨表征深度的层级 GFM–VLM 融合。VGGT 的 11/17/23 层分别耦合到 Qwen3.5-4B 的前三个解码层，每条支路都经过 RMSNorm、2×2 分组、投影、逐 token 门控与可学习缩放，再残差加回图像 token 位置</figcaption>
</div>

<p><strong>卡点降维：「多深度注入」和「把终端特征多注几次」到底差在哪？</strong></p>

<p>这是全文最容易被略过、却最关键的一处设计。作者专门造了一个 <strong>Deep×3</strong> 对照组：融合的次数、位置全部与层级融合对齐，唯一区别是三次注入的都是同一份终端特征 \(G^{23}\)。</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>Single deep（单次终端注入）</th>
      <th>Deep×3（重复终端注入）</th>
      <th>Hier. 层级融合</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>策略看到的几何档位</td>
      <td>仅第 23 层</td>
      <td>仅第 23 层（重复 3 份）</td>
      <td>第 11 / 17 / 23 层</td>
    </tr>
    <tr>
      <td>融合次数</td>
      <td>1</td>
      <td><strong>3</strong></td>
      <td><strong>3</strong></td>
    </tr>
    <tr>
      <td>融合位置</td>
      <td>L2</td>
      <td><strong>L0 / L1 / L2</strong></td>
      <td><strong>L0 / L1 / L2</strong></td>
    </tr>
    <tr>
      <td>R2R-CE SR / SPL</td>
      <td>48.9 / 44.1</td>
      <td><strong>42.1 / 36.9</strong></td>
      <td><strong>55.7 / 51.4</strong></td>
    </tr>
  </tbody>
</table>

<p>结论很硬：Deep×3 不但没追平层级融合（差 13.6 / 14.5 个点），甚至<strong>跌破了完全不用几何的基线</strong>（46.5 / 42.3）。说明「更多几何-策略交互」本身不是收益来源，真正起作用的是让策略在不同推理阶段接触到<strong>不同成熟度</strong>的几何表征。</p>

<blockquote>
  <p>需要说明：论文只报告了这个现象，没有展开解释 Deep×3 为何会低于无几何基线。一个合理的推测是同一份残差被叠加三次，等于在同一方向上反复放大、持续挤压视觉 token 的原始语义分布，而三个门控网络又都在拟合同一个信号，白白消耗了容量——但这属于笔者推测，论文未做验证。</p>
</blockquote>

<hr />

<h4 id="-模块二导航感知-gfm-kv-保留时间轴">③ 模块二：导航感知 GFM-KV 保留（时间轴）</h4>

<p><strong>输入</strong>：VGGT <strong>全局注意力层</strong>的 KV 缓存。注意作用域——Qwen/VLM 自己的 KV 缓存、以及为层级融合准备的那份帧对齐 \(G^{11/17/23}\) 特征 CPU 缓冲，都是独立的，不在这里被裁剪。</p>

<p><strong>处理</strong>：第 $g$ 个全局注意力层的候选池由「上一步保留的历史」加「当前帧新产生的 KV」组成：</p>

\[C_t^g = M_{t-1}^g \cup (K_t^g,\, V_t^g)\]

<p>每个候选 patch 由三个互补信号联合打分。</p>

<p><strong>(a) 指令相关性 \(r_{f,p}\)</strong> —— 把几何和具体的导航子目标挂上钩。先用标点、顺序词（then、next、after that）和引出导航动词的连词把指令切成片段（同时保住 next to 这类不该切的短语），每段做 mean-pooling 得到单位长度的段嵌入 $e_j$。设 \(u_{f,p}\) 是从 \(G^{11}\) 投影进 Qwen 空间（门控与缩放<strong>之前</strong>）的空间分组 token，为了剔除共享的嵌入分量，视觉 token 在帧内做中心化、段嵌入在指令内做中心化：</p>

\[\bar u_f = \frac{1}{P_f}\sum_{p=1}^{P_f} u_{f,p}, \qquad \bar e = \frac{1}{J}\sum_{j=1}^{J} e_j\]

\[r_{f,p} = \frac{1 + \max_j \cos\!\left(u_{f,p} - \bar u_f,\; e_j - \bar e\right)}{2}\]

<p>取 max 而不是对整条指令求相似度，意味着每个 token 只需要<strong>跟某一个子目标</strong>对得上就算有用。</p>

<p><strong>(b) 几何置信度 \(c_{f,p}\)</strong> —— 光跟指令相关不等于几何可靠。把 VGGT 的深度置信场和点图置信场平均池化到对齐的 token 网格，把池化值 $\tilde c \in (1,\infty)$ 映射到 $1 - 1/\tilde c \in (0,1)$，再取两者的<strong>最小值</strong>：</p>

\[c_{f,p} = \min\!\left(c_{f,p}^{\mathrm{depth}},\; c_{f,p}^{\mathrm{point}}\right)\]

<p>用 min 是保守组合——两个预测器都有信心才算可靠。</p>

<p><strong>(c) 转移新颖度 \(\nu_{f\mid t}\)</strong> —— 压掉冗余历史。每帧用均匀池化的浅层投影 token 做一个 $\ell_2$ 归一化描述子 $d_f$，然后看它跟<strong>所有已观测帧中最近的那一个</strong>有多远：</p>

\[\nu_{f\mid t} = \frac{1 - \max_{f' \in F_{\le t},\, f' \neq f} \cos(d_f,\, d_{f'})}{2}\]

<p>值高说明没有别的帧提供过类似几何。描述子在 KV 被淘汰后<strong>依然保留</strong>，所以这个分数每步都会重算。同一帧的所有候选 patch 共享该分数。</p>

<p><strong>(d) 联合打分与逐层预算</strong> —— 相关性和置信度在插入时缓存、跨层共享，新颖度每步刷新。三者量纲不同，先在每层的候选 patch 上各自做 z-score 再等权相加：</p>

\[S_{t,g}(f,p) = \lambda_r\, z_{t,g}(r_{f,p}) + \lambda_c\, z_{t,g}(c_{f,p}) + \lambda_\nu\, z_{t,g}(\nu_{f,p\mid t})\]

<p>总容量按层重要性 $\rho_g$ 切分（离线按 GHOST 的逐层输入-输出余弦相似度算出），然后各层独立 TopK：</p>

\[B_g = \lfloor \rho_g B_{\mathrm{total}} \rfloor, \qquad \sum_{g=1}^{24} \rho_g = 1, \qquad M_t^g = \mathrm{TopK}\!\left(C_t^g,\, S_{t,g},\, B_g\right)\]

<p><strong>输出</strong>：$M_t$，供第 $t+1$ 帧的 VGGT 前向使用。</p>

<div align="center">
  <img src="/images/vln/AdaGeoVLN-kv-retention.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/852" />
<figcaption>导航感知的 GFM-KV 保留。(a) 指令相关性：分段嵌入与投影浅层 token 做中心化余弦、逐行取最大；(b) 几何置信度：深度与点图置信场池化标定后取 min；(c) 转移新颖度：帧描述子在描述子空间中与最近邻的距离。三路分数在每层做 z-score 后相加，按预算 Bg 取 TopK，结果带到下一步</figcaption>
</div>

<p><strong>卡点降维（一）：「900K 预算」到底是什么单位？</strong></p>

<p>论文特意写了一句澄清，说明作者知道这里必被误读——900K 指的是<strong>跨 24 个全局注意力层加总的 layer-token 容量</strong>，不是场景里有 90 万个不重复的 token。</p>

<blockquote>
  <p><strong>举个例子</strong>：假设预算 \(B_{\mathrm{total}} = 2400\)（真实设置是 900K，这里缩小到手算得动）。
层重要性 $\rho_g$ 离线算好，比如第 3 层拿到 8%、第 20 层只拿 2%，
那么 \(B_3 = \lfloor 0.08 \times 2400 \rfloor = 192\)，\(B_{20} = 48\)。
走到第 5 帧时，第 3 层的候选池 = 上一步留下的 192 个 + 本帧新产生的 256 个 = 448 个；
三路信号各自在这 448 个里做 z-score、等权相加，取分数最高的 <strong>192</strong> 个存下，其余 <strong>256</strong> 个丢掉。
换句话说每层的占用是恒定的，与轨迹长度无关——这正是「有界记忆」的含义。</p>
</blockquote>

<p><strong>卡点降维（二）：保留下来的 KV 是给谁用的？</strong></p>

<p>论文里 <code class="language-plaintext highlighter-rouge">Selection follows the current VGGT pass</code> 那句话很容易被一眼带过，但它决定了整个机制的性质：筛选发生在<strong>当前帧已经算完之后</strong>，因此不会改动当前帧的表征，只影响 $t+1$ 帧能看到的几何上下文。也就是说，保留不是「事后压缩」，而是「提前布置下一步的推理条件」。</p>

<pre><code class="language-mermaid">graph TD
    A["第 t 帧 RGB 进入冻结 VGGT"] --&gt; B["全局注意力: 当前帧 K/V 与上一步保留的 M(t-1) 一起参与"]
    B --&gt; C["VGGT 输出第 t 帧的 11/17/23 层几何特征"]
    C --&gt; D["层级融合注入 VLM 前三个解码层, 预测动作 a(t)"]
    B --&gt; E["构造候选池 C(t) = M(t-1) 并上当前帧 K/V"]
    E --&gt; F["三信号打分: 指令相关性 + 几何置信度 + 转移新颖度"]
    F --&gt; G["每层独立 z-score 归一化, 按预算 B(g) 取 TopK"]
    G --&gt; H["保留为 M(t), 只服务于第 t+1 帧"]
    H -.-&gt; B
</code></pre>

<hr />

<h4 id="-训练与推理配置">④ 训练与推理配置</h4>

<p>论文没有引入新的损失项——策略在 R2R 与 RxR 训练集上联合做标准监督微调，约 100 小时 / 8× NVIDIA H100。<strong>Qwen3.5 的全部参数和几何融合模块参与优化，VGGT 全程冻结</strong>。观测端只有单路 RGB：无全景、无里程计、无深度输入（深度置信场来自 VGGT 自己的预测头，不是传感器）。</p>

<p>推理时每一步的流程就是上面 mermaid 图的那一圈：VGGT 前向 → 层级融合 → 出动作 → 打分筛 KV → 带入下一步。没有 beam search 或迭代 refinement。</p>

<hr />

<h3 id="3-核心结果发现-22">3. 核心结果/发现</h3>

<p><strong>主榜对比（Val-Unseen，均为单 RGB 流）</strong></p>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>R2R-CE SR / SPL / OS / NE</th>
      <th>RxR-CE SR / SPL / nDTW / NE</th>
      <th>额外训练数据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Uni-NaVid</td>
      <td>47.0 / 42.7 / 53.3 / 5.58</td>
      <td>48.7 / 40.9 / – / 6.24</td>
      <td>3577K</td>
    </tr>
    <tr>
      <td>NaVILA*</td>
      <td>49.7 / 45.5 / 57.6 / 5.37</td>
      <td>49.3 / 44.0 / 58.8 / 6.77</td>
      <td>12574K</td>
    </tr>
    <tr>
      <td>JanusVLN*</td>
      <td>52.8 / 49.2 / 58.0 / <strong>5.17</strong></td>
      <td>51.4 / 44.3 / 59.1 / 6.46</td>
      <td>0K</td>
    </tr>
    <tr>
      <td><strong>AdaGeoVLN</strong></td>
      <td><strong>55.7 / 51.4 / 60.7</strong> / 5.27</td>
      <td><strong>54.1 / 44.7 / 61.8 / 5.64</strong></td>
      <td><strong>0K</strong></td>
    </tr>
  </tbody>
</table>

<p>相对 JanusVLN*，R2R-CE 上 SR/SPL 分别 +2.9 / +2.2 个点，OS 从 58.0 升到 60.7，只有 NE 略逊（5.27 对 5.17 m）；RxR-CE 上 SR +2.7、nDTW +2.7，NE 直降 0.82 m。值得强调的是这些数字建立在<strong>零额外导航数据</strong>之上，而 NaVILA 用了约 1257 万条外部样本。</p>

<p><strong>深度轴消融</strong>：层级融合相对无几何策略 +9.2 / +9.1（SR/SPL），相对单次终端注入 +6.8 / +7.3，相对匹配了次数与位置的 Deep×3 高达 <strong>+13.6 / +14.5</strong>。唯一的例外是 NE——无几何策略反而略低（5.19 对 5.27 m），说明几何主要提升的是「成功与否」而非「停得多准」。</p>

<p><strong>时间轴消融</strong>：在相近的 KV 占用下，Nav. 900K 比 Hybrid Inc.(8+24) 高 0.6 SR / 1.1 SPL，同时少用 3.33% 的 GFM-KV 显存和 9.35% 的总分配显存；相对 Hybrid Inc.(8+48) 是 +0.4 SR / +1.4 SPL，<strong>KV 显存省 39.73%、总显存省 20.22%</strong>。预算敏感性上，600K → 800K → 900K 对应 SR 53.1 → 54.2 → 55.7、SPL 49.2 → 50.2 → 51.4，多花 1142 MB 换来 2.6 / 2.2 个点，是一条清晰的精度-显存权衡曲线。不过表 IV 也诚实标出：<strong>OS 和 NE 的最好值仍然属于按时序保留的基线</strong>。</p>

<div align="center">
  <img src="/images/vln/AdaGeoVLN-ablation-results.webp" width="65%" loading="lazy" decoding="async" style="aspect-ratio:697/952" />
<figcaption>R2R-CE Val-Unseen 上的消融。(a) 几何融合方式对 SR/SPL 的影响，Deep×3 明显低于无几何基线；(b) 保留策略的精度-显存散点，红线串起 600K/800K/900K 三档预算，下方色条为相对 Hybrid 8+48 的显存节省</figcaption>
</div>

<p><strong>信号贡献（900K 预算下留一消融）</strong>：去掉置信度掉得最狠（SR −2.1），其次是指令相关性（−1.5）和转移新颖度（−1.4），而 KV 显存在四种配置间只差 0.20 MB——说明性能变化确实来自「选得对不对」，而不是「选了多少」。</p>

<p><strong>定性与实机</strong>：仿真里选的那条 R2R-CE 轨迹要求离开壁炉、爬弧形楼梯、最后停在卧室门口，AdaGeoVLN 走通，Qwen3.5 SFT 和 JanusVLN 都失败。实机部署在 Unitree G1 上，配 ZED X Mini 相机，Jetson AGX Orin 做图像预处理并与远端 RTX A6000 工作站通信完成策略推理，两组室内实验涵盖地标转向、从指定一侧绕过盆栽、忽略无关门口、在指定目标附近停下。</p>

<div align="center">
  <img src="/images/vln/AdaGeoVLN-qualitative-deployment.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1421/1337" />
<figcaption>仿真轨迹与人形机器人部署。上：需要爬楼梯、多次转向并精确停止的 R2R-CE 路线，仅 AdaGeoVLN 到达目标；下：Unitree G1 上的两组室内导航序列，第三人称与第一人称视角按指令片段对齐</figcaption>
</div>

<hr />

<h3 id="4-局限性-22">4. 局限性</h3>

<p>三个保留信号采用<strong>等权系数且未做调优</strong>，作者明确说留一消融只能证明每个信号都有贡献，不能说明当前权重是最优的，权重的调参或学习留作未来工作。此外，在导航误差 NE 和 oracle 成功率 OS 这两项上，按时序保留的基线仍然更好，说明导航感知筛选换来的是成功率与路径效率，而非停止精度；实机部署也依赖远端工作站推理，尚未做到板载实时。</p>

<hr />

<h2 id="vlingnav">29. VLingNav (2026)</h2>
<p>——Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic Memory</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.08665">arXiv:2601.08665</a></p>
<div align="center">
  <img src="/images/vln/VLingNav_architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/785" />
<figcaption>
VLingNav 整体架构概述，展示了AdaCoT推理和VLingMem记忆模块。
</figcaption>
</div>

<p><strong>精华</strong></p>

<p>该论文提出了VLingNav框架，通过自适应链式思考（AdaCoT）和视觉辅助语言记忆（VLingMem）赋予具身智能体认知能力，实现了高效且可解释的具身导航。其核心亮点在于动态推理机制和跨模态记忆，使其在各种具身导航基准测试中达到SOTA性能，并展示了强大的零样本迁移能力和跨任务泛化能力，为资源受限机器人平台上的智能导航提供了启发。</p>

<p><strong>研究背景/问题</strong></p>

<p>当前的具身导航VLA模型在复杂、长周期任务中缺乏明确的推理能力和持久性记忆，难以泛化到不同环境和任务变体。现有模型多为被动式系统，缺少自适应推理机制，并且依赖有限的上下文窗口，导致在复杂场景下无法有效规划和避免重复探索。</p>

<p><strong>主要方法/创新点</strong></p>

<p>本文提出了VLingNav，一个以语言驱动的VLA框架，旨在通过两个核心组件赋予具身智能体认知能力：</p>

<div align="center">
  <img src="/images/vln/VLingNav_framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1288/564" />
<figcaption>
VLingNav 整体架构。
</figcaption>
</div>

<ol>
  <li><strong>自适应链式思考 (Adaptive Chain-of-Thought, AdaCoT)</strong>：
受人类双进程理论启发，AdaCoT机制在必要时动态触发显式推理，使智能体能够根据任务复杂性在快速、直观执行和缓慢、深思熟虑的规划之间灵活切换。这解决了现有CoT方法中推理频率固定导致效率低下的问题。</li>
</ol>

<div align="center">
  <img src="/images/vln/VLingNav-CoT-labeling-pipeline.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1306/684" />
<figcaption>
VLingNav的自适应CoT标注流程图。
</figcaption>
</div>

<ol>
  <li><strong>视觉辅助语言记忆 (Visual-Assisted Linguistic Memory, VLingMem)</strong>：
为了处理长周期的空间依赖性，VLingMem构建了一个持久的、跨模态的语义记忆，使智能体能够回忆过去的观察结果，防止重复探索，并推断动态环境中的移动趋势，从而确保在长时间交互中的连贯决策。</li>
</ol>

<p><strong>训练数据和策略</strong>：</p>
<ul>
  <li><strong>Nav-AdaCoT-2.9M数据集</strong>：构建了目前最大的具身导航数据集，包含推理标注和自适应CoT标注。</li>
  <li><strong>在线专家引导强化学习 (Online Expert-guided RL)</strong>：在模仿学习（SFT）之后引入了在线专家引导RL阶段，使模型能够获得更鲁棒、自探索的导航行为，超越监督演示的局限性。</li>
</ul>

<div align="center">
  <img src="/images/vln/VLingNav-online-training.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:917/574" />
<figcaption>
在线后训练的混合rollout过程。
</figcaption>
</div>

<p><strong>核心结果/发现</strong></p>
<ul>
  <li>VLingNav在多项具身导航基准测试（如ObjectNav, EVT, ImageNav）上实现了最先进的性能。</li>
  <li>在HM3Dv1 ObjectNav上，SR和SPL显著优于Uni-NaVid，展现了强大的探索和记忆能力。</li>
  <li>在HM3D OVON上，VLingNav在所有测试拆分中均表现最佳，证明了其强大的跨领域泛化能力。</li>
  <li>在EVT-Bench上，VLingNav在单目标跟踪和分心跟踪任务中均达到SOTA性能，尤其在复杂混乱场景中优势明显。</li>
  <li>在Image Goal Navigation上，VLingNav的成功率和导航效率显著高于UniGoal，表明其先进的推理和规划能力。</li>
  <li>在真实世界机器人平台上实现了零样本迁移，成功执行了未见过的导航任务，展示了强大的真实世界泛化和实用性。</li>
</ul>

<p><strong>局限性</strong></p>
<ul>
  <li>当前模型主要依赖单目自我中心观测，这限制了其感知能力。未来工作可以探索多视角观测以提高导航效率。</li>
  <li>模型采用单系统架构，限制了预测频率，可能影响在高度动态环境中的快速决策和障碍物处理。未来可升级为双系统结构以支持高频动作输出。</li>
  <li>当前方法仅使用基于MPC的路点控制器，缺乏更灵活的运动模型，未来可集成更多运动能力。</li>
</ul>

<hr />

<h2 id="hydra-nav">30. Hydra-Nav (2026)</h2>
<p>——Object Navigation via Adaptive Dual-Process Reasoning</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2602.09972">arXiv:2602.09972</a></p>

<hr />

<p><strong>精华</strong></p>

<p>Hydra-Nav 最值得借鉴的核心思想是：将”慢思考”（CoT 推理）与”快行动”（低级反应控制）统一在<strong>单个 VLM</strong> 内，避免了多模型架构的碎片化问题。其关键创新在于通过 <strong>Iterative Rejection Fine-Tuning (IRFT)</strong> 让模型自主学习”何时触发推理”，而非固定频率触发，从而在成功率与推理开销之间取得最优平衡。三阶段课程训练（空间-动作对齐 → 记忆-推理集成 → 自适应推理）的渐进式设计，为构建具身导航智能体提供了可复用的训练范式。新提出的 SOT 指标（Success weighted by Operation Time）将推理延迟纳入评估，比 SPL 更贴近实际部署需求，值得在其他具身任务中推广使用。</p>

<hr />

<p><strong>研究背景/问题</strong></p>

<p>Object goal navigation 要求机器人仅凭自我中心感知在真实环境中主动探索并定位目标物体。当前 VLM-based 方法存在两大核心缺陷：（1）时空推理能力不足，导致对已探索区域的记忆维护失效，引发重复探索；（2）在每步推理（chain-of-thought）的做法带来大量不必要的计算开销，而在关键”停滞点”又未能及时触发推理。现有双系统架构（slow-fast paradigm）依赖独立模型，存在架构割裂和切换灵活性不足的问题。</p>

<hr />

<p><strong>主要方法/创新点</strong></p>

<p>Hydra-Nav 将高层规划与低层元动作统一在<strong>单一 VLM</strong>（基于 Qwen2.5-VL-7B）内，通过输出特殊 transition token <code class="language-plaintext highlighter-rouge">obs</code> 自主触发从快系统到慢系统的切换。</p>

<div align="center">
  <img src="/images/vln/Hydra-Nav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1328/618" />
<figcaption>
Hydra-Nav 整体架构：慢系统负责全局时空推理与高层规划，快系统负责低级元动作的高效执行，通过特殊 token obs 自适应切换。
</figcaption>
</div>

<p><strong>双过程系统（Dual-process System）</strong></p>

<ul>
  <li><strong>慢系统（Slow system）</strong>：接收目标指令、当前全景观测（4 张 90° 间隔 RGB 图）和结构化长期记忆，生成 CoT 推理文本与高层计划，随后输出第一个元动作。</li>
  <li><strong>快系统（Fast system）</strong>：基于上一慢系统的对话历史，利用 KV-caching 仅编码最新自我中心帧，自回归解码低级原子动作（MoveAhead 0.25m、TurnLeft/Right 30°），避免重复处理完整历史上下文。</li>
  <li><strong>自适应切换机制</strong>：当智能体完成子目标或当前观测与现有计划矛盾时，输出 <code class="language-plaintext highlighter-rouge">obs</code> 触发全景扫描，构建新的地标节点并更新长期记忆，随后重新进入慢系统。</li>
</ul>

<div align="center">
  <img src="/images/vln/Hydra-Nav-context-organization.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1330/633" />
<figcaption>
推理期间的上下文组织方式：短期记忆为交错图像-动作对，遇到 obs token 时更新记忆并清空短期上下文。
</figcaption>
</div>

<p><strong>三阶段课程训练（Curriculum Training Pipeline）</strong></p>

<p><strong>Stage 1 — 空间-动作对齐（Spatial-Action Alignment）</strong></p>

<p>使用 A* planner 在 HM3D、MP3D、OVON 训练集上生成 <strong>500K 条轨迹</strong>（20.1B tokens），训练 Qwen2.5-VL-7B 学习基本导航动作执行。每条轨迹格式化为多轮对话，通过单次前向-反向传播完成梯度计算。</p>

<p><strong>Stage 2 — 推理-记忆集成（Reasoning-Memory Integration）</strong></p>

<div align="center">
  <img src="/images/vln/Hydra-Nav-data-synthesis.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/622" />
<figcaption>
Stage 2 数据合成流程：左侧为启发式路点选择的轨迹生成策略，右侧为用 Qwen3-VL-235B-Thinking 合成高质量推理文本的流程。
</figcaption>
</div>

<ul>
  <li>使用启发式路点选择策略生成包含探索行为的轨迹（而非仅最短路径），每条轨迹选取分数最高的两个探索路点。</li>
  <li>将轨迹分段（固定长度 16 步），在每段开头插入长期记忆和推理文本，段尾插入 <code class="language-plaintext highlighter-rouge">obs</code> token。</li>
  <li>推理文本合成：先用 Qwen3-VL-235B-Thinking 对历史图像进行记忆摘要，再结合当前视图与”未来正确视图”（信息泄漏防止）生成前瞻性规划文本。</li>
  <li>共生成 <strong>565K 条混合样本（8.3B tokens）</strong>，同时混入 VQA 数据防止过拟合。</li>
</ul>

<p><strong>Stage 3 — 自适应推理（Adaptive Reasoning via IRFT）</strong></p>

<p>定义两类<strong>停滞点（Stagnation Points）</strong>：</p>
<ol>
  <li><strong>重复探索</strong>：智能体在过去 $T_{stag}=20$ 步内回到距离 $\delta_{stag}=0.5$m 内的位置。</li>
  <li><strong>缺乏进展</strong>：在随机时间窗口 $\Delta t \sim \mathcal{U}(20,35)$ 内到目标距离未缩短。</li>
</ol>

<p>IRFT 流程：在快系统模式下运行，于停滞点触发慢系统；对失败轨迹（超时或目标误识别）进行”拒绝-修复”——找到干预时间戳 \(t^*\)，用 A* 最优路径替换后续轨迹，重新合成修正段的推理文本；使用最新 checkpoint 迭代执行，每轮生成约 60K 条轨迹（4.5B tokens）。</p>

<hr />

<p><strong>核心结果/发现</strong></p>

<div align="center">
  <img src="/images/vln/Hydra-Nav-performance-irft.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1624/697" />
<figcaption>
多轮 IRFT 训练过程中 SR 和 SOT 在 HM3D、MP3D、OVON Val-Unseen 上的提升曲线。
</figcaption>
</div>

<p><strong>与 SOTA 对比（Table 2）：</strong></p>

<table>
  <thead>
    <tr>
      <th>Benchmark</th>
      <th>指标</th>
      <th>Hydra-Nav-IRFT</th>
      <th>第二名</th>
      <th>提升</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>HM3D Val</td>
      <td>SR</td>
      <td><strong>84.8%</strong></td>
      <td>73.7%</td>
      <td>+11.1%</td>
    </tr>
    <tr>
      <td>MP3D Val</td>
      <td>SR</td>
      <td><strong>64.0%</strong></td>
      <td>46.6%</td>
      <td>+17.4%</td>
    </tr>
    <tr>
      <td>OVON Val-Unseen</td>
      <td>SR</td>
      <td><strong>66.3%</strong></td>
      <td>45.2%</td>
      <td>+21.1%</td>
    </tr>
  </tbody>
</table>

<p><strong>SOT 指标分析（Table 5）：</strong></p>

<ul>
  <li>Hydra-Nav-IRFT 推理触发比例仅 <strong>3.0%</strong>（HM3D），而 VLMnav/Nav-R²/WMNav 均为 100%。</li>
  <li>SOT 得分：Hydra-Nav-IRFT <strong>24.0</strong>（HM3D）vs Nav-R² 1.9（最高 SR 竞争者），提升约 12×。</li>
  <li>说明频繁推理虽提高 SR，但严重拖累效率；自适应推理是实际部署的关键。</li>
</ul>

<p><strong>消融实验关键发现：</strong></p>
<ul>
  <li>记忆模块对 SPL 提升显著（无记忆 SPL=13.9 vs 有记忆 28.8），说明长期空间记忆是路径效率的核心。</li>
  <li>探索性轨迹数据 vs 最短路径数据：SR 下降 25.4%（HM3D），说明探索能力对高成功率不可或缺。</li>
  <li>Co-training with VQA 防止导航专有数据过拟合，维持泛化性（SR: 69.1→72.9，HM3D）。</li>
</ul>

<div align="center">
  <img src="/images/vln/Hydra-Nav-realworld-demo.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1647/1318" />
<figcaption>
真实世界导航演示：机器人成功定位 Box、Trash Can、Oven，零样本迁移无需真实环境微调。
</figcaption>
</div>

<hr />

<p><strong>局限性</strong></p>

<p>评估仅在 Habitat 模拟器（HM3D/MP3D/OVON）中进行，缺乏在 Isaac Sim 等更高保真度仿真环境中的验证；当前框架专为 object navigation 设计，向移动操作等更复杂具身任务的扩展有待探索。</p>

<hr />

<h2 id="nav-3dgs">31. 3DGSNav (2026)</h2>
<p>———用主动 3DGS 记忆增强 VLM 空间推理，实现零样本目标导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2602.12159">arXiv:2602.12159</a></p>

<hr />

<h3 id="精华-23">精华</h3>

<p>3DGSNav 最值得借鉴的核心思想：</p>
<ol>
  <li><strong>将 3DGS 作为持久记忆</strong>替代语义地图/文字描述，让 VLM 直接”看”到几何连续的场景，而非依赖中间抽象层，从而释放 VLM 本身的视觉空间推理能力。</li>
  <li><strong>主动感知（Active Perception）+ 自由视角优化</strong>：代理不被动旋转扫描，而是通过不透明度场（opacity field）主动定位视觉盲区，再利用 3DGS Novel View Synthesis 渲染最优视角——这种”按需生成观测”的模式可推广到其他需要视角控制的具身任务。</li>
  <li><strong>结构化视觉提示（Structured Visual Prompts）+ CoT 融合</strong>：在渲染图像上叠加注释（gaze point、未探索区域标注），配合 Chain-of-Thought，让 VLM 的长程规划推理能力得到充分激活，无需额外训练。</li>
  <li><strong>实时检测 + VLM 重验证（Re-verification）</strong>：先用轻量检测器初筛候选目标，再用 VLM 主动切换视角确认——分两阶段解耦效率与可靠性，是目标确认模块的通用设计范式。</li>
</ol>

<hr />

<h3 id="研究背景问题">研究背景/问题</h3>

<p>现有零样本目标导航（ZSON）方法通常将环境转换为语义地图或文字描述，导致高层决策被低层感知精度所制约，VLM 的视觉空间推理能力无法充分发挥。如何让 VLM 直接基于高质量视觉观测进行空间推理，而非依赖降维后的语义抽象，是本文解决的核心问题。</p>

<hr />
<p>div align=”center”&gt;
  <img src="/images/vln/3DGSNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1402/772" /></p>
<figcaption>
3DGSNav 整体架构：该系统通过主动感知，利用机器人位姿和 RGB-D 观测数据构建面向导航的环境表示。自由视角优化与结构化视觉提示引导基于 VLM（视觉语言模型）的零样本导航规划，而在线物体检测与视角重验证技术则实现了高效的目标定位。
</figcaption>
<p>&lt;/div&gt;</p>

<h3 id="主要方法创新点">主要方法/创新点</h3>

<p>3DGSNav 是一个基于 3D Gaussian Splatting 的 ZSON 框架，核心由三个模块组成：</p>

<h3 id="1-主动感知active-perception模块">1. 主动感知（Active Perception）模块</h3>
<ul>
  <li>使用虚拟相机渲染全景不透明度场（panoramic opacity field），定量估计当前观测完整性</li>
  <li>利用 <strong>DBSCAN</strong> 聚类低不透明度区域，识别视觉盲区，计算最优俯仰角 θ* 和偏航角 ϕ*，驱动真实相机主动补偿缺失视角</li>
  <li>避免机械旋转带来的定位误差与冗余观测</li>
</ul>

<h3 id="2-自由视角规划free-viewpoint-planning模块">2. 自由视角规划（Free-Viewpoint Planning）模块</h3>
<ul>
  <li><strong>前沿点提取与聚类</strong>：在 3DGS 空间构建探索地图，提取 frontier points（已探索与未探索边界），通过距离场 + 分水岭分割（watershed segmentation）自适应聚类冗余前沿点，选代表性点降低 VLM 分析开销</li>
  <li><strong>引导轨迹（Guidance Trajectory）</strong>：基于 Dijkstra + 指数惩罚障碍物距离的代价函数，为每个前沿点生成安全路径，作为自由视角优化的参考基准</li>
  <li><strong>虚拟视角初始化</strong>：利用轨迹曲率 κ 和距离 d 加权得分选最优初始位置，确保既不过近（优化不稳定）也不过远（信息量低）</li>
  <li><strong>多约束视角优化</strong>：最小化复合损失函数 ℒ = λ_opa·ℒ_opa + λ_vis·ℒ_vis + λ_cos·ℒ_cos + λ_traj·ℒ_traj，包含：
    <ul>
      <li><strong>Opacity Loss</strong>：控制可见/不可见区域比例</li>
      <li><strong>Ray Occlusion Loss</strong>：确保虚拟相机视线直达前沿点（无遮挡）</li>
      <li><strong>Cosine Loss</strong>：约束视角方向与前沿点方向一致</li>
      <li><strong>Trajectory Loss</strong>：约束相机位置在轨迹附近</li>
    </ul>
  </li>
</ul>

<h3 id="3-结构化视觉提示--vlm-推理">3. 结构化视觉提示 + VLM 推理</h3>
<ul>
  <li>渲染 Bird’s-Eye View（BEV）+ 多个前沿点的 First-Person Views（FPVs）</li>
  <li>在图像上叠加结构化注释：注视点（gaze point）、未观测区域表示（unobserved region）</li>
  <li>配合 <strong>Chain-of-Thought（CoT）提示</strong>，驱动 planner VLM（Gemini 3）对候选前沿点进行空间语义推理，选择最优探索目标</li>
</ul>

<h3 id="4-实时检测--vlm-主动重验证re-verification">4. 实时检测 + VLM 主动重验证（Re-verification）</h3>
<ul>
  <li>导航过程中使用轻量实时检测器（<strong>YOLOE</strong>）初步筛选候选目标</li>
  <li>当检测置信度不足时，action-decision VLM（<strong>GLM-4.1V-Thinking</strong>）主动切换视角——将所选动作投影回 3DGS 渲染新视角，获取更具判别力的观测，完成目标二次确认</li>
  <li>有效降低漏检率和误停率</li>
</ul>

<hr />

<h3 id="核心结果发现">核心结果/发现</h3>

<p>div align=”center”&gt;
  <img src="/images/vln/3DGSNav-comparison.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1701/550" /></p>
<figcaption>
 Gemini3-Pro 与 Qwen3-235b-Thinking 在 ZSON 任务中的自我解释对比：
</figcaption>
<p>&lt;/div&gt;</p>

<ul>
  <li>在 <strong>HM3D</strong>、<strong>MP3D</strong>、<strong>Gibson</strong> 等多个 ObjectNav 标准 benchmark 上取得 SOTA 或竞争性性能</li>
  <li>消融实验验证：自由视角优化、结构化注释、CoT、Re-verification 模块均对最终 Success Rate 有显著贡献</li>
  <li>不同 VLM（Gemini 3、GPT-4V、GLM-4.1V 等）可灵活替换，框架具备良好兼容性</li>
  <li>在四足机器人真实环境实验中成功复现（定位厕所等目标），验证了 sim-to-real 迁移能力</li>
  <li>Runtime 分析显示主动感知显著优于被动旋转扫描，探索效率更高</li>
</ul>

<hr />

<h3 id="局限性">局限性</h3>

<p>3DGS 的在线增量重建和自由视角优化带来一定计算开销，在计算资源受限的嵌入式平台上实时性仍有挑战；此外，真实场景的动态物体、运动模糊和视觉感知噪声会影响 3DGS 质量，进而影响导航可靠性。</p>

<hr />

<h2 id="sysnav">32. SysNav (2026)</h2>
<p>———Multi-Level Systematic Cooperation Enables Real-World, Cross-Embodiment Object Navigation</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2603.06914">arXiv:2603.06914</a> · <a href="https://cmu-vln.github.io/">Project Page</a> · <a href="https://github.com/zwandering/SysNav">Code</a></p>

<h3 id="精华-24">精华</h3>

<p>SysNav 将 ObjectNav 重新定义为系统级问题，将语义推理、导航规划、运动控制三层彻底解耦，值得借鉴。核心洞见是：VLM 不应被用于细粒度的 frontier 级别决策，而应限制在房间级别的高层规划，从而在推理能力与空间可靠性之间取得最佳平衡。三层场景图（Room→Viewpoint→Object）为 VLM 提供了结构化上下文，是 VLM 高效推理的关键基础设施。Early-stop 和 Room-query 两种 VLM 调用模式按需触发，有效避免了 VLM 的冗余调用。该系统在三种机器人平台上部署，验证了模块化设计对跨平台泛化的价值。</p>

<hr />

<h3 id="1-研究背景问题-23">1. 研究背景/问题</h3>

<p>Object Navigation（ObjectNav）要求机器人在未知室内环境中自主找到目标物体，需同时处理复杂空间结构、长程规划和语义理解。现有方法将 ObjectNav 作为单一策略学习问题，端到端模型难以兼顾多个子挑战；而过度依赖 VLM 进行 frontier 级别决策会因 VLM 缺乏精确 3D 空间理解而导致频繁回溯和低效行为。</p>

<hr />

<h3 id="2-主要方法创新点-23">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/SysNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/966" />
<figcaption>
SysNav 在多种真实环境和跨平台机器人上实现楼宇级别长程 ObjectNav
</figcaption>
</div>

<p>SysNav 是一个三层解耦的 ObjectNav 系统，各层专注于不同粒度的子问题：</p>

<p><strong>高层——语义推理（Semantic Reasoning）</strong></p>

<p>构建三层场景图表示 $\mathcal{R}$：</p>
<ul>
  <li><strong>Room Node</strong> $v^r$：通过点云垂直分布拟合墙面并划分独立房间，每个节点存储房间类别、2D 顶视图和代表性 RGB 图像</li>
  <li><strong>Viewpoint Node</strong> $v^v$：在覆盖范围发生显著变化时新增，存储位置、覆盖区域和全景图像，实现高效语义存储</li>
  <li><strong>Object Node</strong> $v^o$：使用开放词汇检测（YOLOv8x + SAM2）实例化，每个节点存储类别、置信度、3D 点云、bounding box 及自属性</li>
</ul>

<p>边类型包括：Room-Room（门道连通）、Room-Viewpoint（包含关系）、Room-Object（包含关系）、Viewpoint-Object（可见性）、Object-Object（空间约束，按需添加）。</p>

<p>VLM Reasoning 组件（Gemini-2.5-flash）基于上述场景图进行语义推理，提供房间级别导航指导。</p>

<p><strong>中层——基于房间的导航（Room-based Navigation）</strong></p>

<div align="center">
  <img src="/images/vln/SysNav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/895" />
<figcaption>
SysNav 系统架构：高层语义推理、中层房间导航、低层运动控制三层解耦
</figcaption>
</div>

<p>将房间作为最小语义规划单元，在房间内使用高效经典探索算法，仅在房间切换时调用 VLM：</p>

<ul>
  <li><strong>In-room Exploration</strong>：两级规划（局部 + 全局），以覆盖分数 $w_{cov}(c_i) = \lvert \mathcal S_{cov}(c_i) \cap \hat{\mathcal S} \rvert$ 选取位姿候选，用 TSP 生成探索路径，滚动窗口机制协调局部与全局计划</li>
  <li><strong>Early-stop 模式</strong>：进入新房间时，VLM 根据上下文信息 $\mathcal C_{es}$（房间属性、已观测物体、任务目标）判断是否提前终止当前房间探索并切换到新房间</li>
  <li><strong>Room-query 模式</strong>：当前房间探索完毕仍未找到目标时，VLM 基于未探索房间信息 $\mathcal C_{rq}$ 推理最可能包含目标的下一个房间</li>
</ul>

<p><strong>低层——基础自主（Base Autonomy）</strong></p>

<p>设计跨平台基础自主模块，将路径点转换为各平台（轮式机器人、四足 Unitree Go2、人形 Unitree G1）的具体运动控制指令，包含路径点跟随、碰撞回避和地形可通行性分析。</p>

<hr />

<h3 id="3-核心结果发现-23">3. 核心结果/发现</h3>

<div align="center">
  <img src="/images/vln/SysNav-qualitative.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/1514" />
<figcaption>
SysNav 在轮式、四足、人形三种机器人平台上的真实环境定性结果
</figcaption>
</div>

<p><strong>仿真基准</strong>（4个benchmark，与 SOTA 对比）：</p>
<ul>
  <li>HM3D-v1：SR <strong>63.7%</strong>，SPL <strong>30.5%</strong>（大幅领先次优 ApexNav 的 59.6%/33.0%）</li>
  <li>HM3D-v2：SR <strong>80.8%</strong>，SPL <strong>37.2%</strong>（次优 ApexNav 76.2%/38.0%）</li>
  <li>MP3D：SR <strong>50.7%</strong>，SPL <strong>18.1%</strong></li>
  <li>HM3D-OVON：SR <strong>54.9%</strong>，SPL <strong>26.1%</strong>（次优 MTU3D 40.8%/12.1%，提升 14.1%/6.5%）</li>
</ul>

<p><strong>真实环境</strong>（190 次实验，对比 VLFM 和 InstructNav）：</p>
<ul>
  <li>Hard 设置（目标在不同房间）：SR <strong>97.5%</strong>，SPT <strong>71.8</strong>，AT <strong>67.6s</strong>（Hard setting SR 较次优提升 61.1%，SPT 提升 51.1%，AT 减少 29.8s）</li>
  <li>导航效率较现有 ObjectNav 基线提升 <strong>4-5×</strong></li>
</ul>

<hr />

<h3 id="4-局限性-23">4. 局限性</h3>

<p>仿真中 SPL 提升幅度小于 SR，原因是面向真实场景设计的严格覆盖策略在仿真中会造成轻微过度覆盖；此外，多房间布局对系统的额外挑战有限，因为中等难度场景中障碍物更密集反而会降低速度。</p>

<hr />

<h2 id="wam-nav">33. WAM-Nav (2026)</h2>
<p>———非对称隐空间「世界-动作」联合建模，用一个 DiT 统一三类视觉导航</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.04907">arXiv:2606.04907</a> — WAM-Nav: Asymmetric Latent World-Action Modeling for Unified Visual Navigation</p>

<h3 id="精华-25">精华</h3>

<ul>
  <li>把”想象未来画面”与”生成动作”塞进<strong>同一个共享 DiT</strong> 里联合扩散，而不是先想象再用逆动力学解算动作的解耦式 pipeline，从根上消除了模块间的状态-动作错配与误差累积。</li>
  <li>核心 insight 是<strong>非对称视界（asymmetric horizon）</strong>：动作用长视界（$H_{act}=24$）保证轨迹连续，视觉前瞻只用极短视界（$H_{vis}=1$）。因为导航的视角变化剧烈，长自回归视觉 rollout 既慢又容易误差爆炸，短视界恰好提供可靠的近未来几何约束。</li>
  <li>视觉前瞻全部在 <strong>Stable Diffusion VAE 的隐空间</strong>里预测（不解码成像素），让”未来感知”以低成本反过来约束动作生成（视觉速度匹配损失惩罚动作-场景不一致）。</li>
  <li><strong>双流上下文条件（DSCC）</strong>：视觉记忆流管空间避障，自我运动历史流管运动学动量（平滑性），用运动 token 去 query 视觉空间，兼顾几何安全与轨迹顺滑。</li>
  <li><strong>统一目标对齐</strong>：把 Image-Goal / Point-Goal / No-Goal 都编码成”视觉语义查询 $g_V$ + 几何查询 $g_G$”两路互补 embedding，一个策略零样本支持三类任务且性能均衡，无需切换架构。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-24">1. 研究背景/问题</h3>

<p>视觉导航要在复杂几何与物理约束下生成平滑、无碰撞的轨迹。现有范式各有硬伤：<strong>反应式端到端策略</strong>（GNM/ViNT/NoMaD）直接把观测映射到动作，缺乏预测性推理，在杂乱环境里容易陷入局部最优和碰撞；<strong>模块化解耦的世界模型方法</strong>（先想象未来子目标，再用逆动力学/轨迹打分）虽有前瞻能力，但预测与决策分离训练，带来高延迟和累积误差。已有的「世界-动作模型」在机器人操作上验证了联合建模的价值，但其自回归生成范式在导航大视角变化下实时性差、误差累积严重。此外多数方法只支持单一目标类型，换任务就得重新设计训练；即便 NavDP 支持多目标，其单模态对齐也导致跨任务性能不均衡。</p>

<hr />

<h3 id="2-主要方法创新点-24">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/WAM-Nav-paradigm-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/612" />
<figcaption>图 1：WAM-Nav 范式与性能概览。(a) 与纯反应式映射（①）、解耦模块化 pipeline（②）相比，WAM-Nav（③ Joint Modeling）在统一框架内联合建模动作生成与隐空间视觉前瞻；(b) 在 Image-Goal / Point-Goal / No-Goal 三类任务上对比主流基线均取得领先。</figcaption>
</div>

<p><strong>① 整体框架概述</strong></p>

<p>如图 2，WAM-Nav 由三个核心组件构成：(1) <strong>统一目标对齐（Unified Goal Alignment）</strong>，把异构目标投影到统一空间，产出视觉语义查询 $g_V$ 与几何查询 $g_G$；(2) <strong>双流上下文条件（DSCC）</strong>，分别编码序列视觉观测和自我运动历史，经目标调制后融合成紧凑条件上下文 $C$；(3) <strong>非对称动作-前瞻生成（Asymmetric Action-Foresight Generation）</strong>，以 $C$ 为条件，用一个共享 DiT 通过非对称去噪同时生成未来动作轨迹与隐空间视觉前瞻。</p>

<div align="center">
  <img src="/images/vln/WAM-Nav-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/636" />
<figcaption>图 2：WAM-Nav 整体架构。异构导航目标被显式路由为视觉语义查询 gV 与轨迹几何查询 gG，二者调制历史 RGB-D 序列与相对自我运动轨迹，合成紧凑条件上下文 C；共享 DiT 在 C 的条件下非对称联合生成未来控制动作与隐空间视觉前瞻。</figcaption>
</div>

<p><strong>② 逐模块讲解</strong></p>

<p><strong>模块一：统一目标对齐（Unified Goal Alignment）</strong></p>
<ul>
  <li><strong>输入</strong>：一个目标 $g$，可能是目标图像（Image-Goal）、相对坐标（Point-Goal）或空目标（No-Goal）。</li>
  <li><strong>处理</strong>：先用模态专属特征提取器 $E_\phi(\cdot)$ 把 $g$ 转成基础 embedding $e_g$（图像目标用从零训练的 ViT，相对坐标用正弦位置编码，无目标用 masked 零状态）；再通过两个可学习线性映射 $\psi_V,\psi_G$ 投到两路功能 token 空间：$g_V=\psi_V(e_g)$、$g_G=\psi_G(e_g)$。</li>
  <li><strong>输出</strong>：视觉语义查询 $g_V$（用于视觉记忆检索）与几何查询 $g_G$（用于轨迹级方向引导）。</li>
  <li><strong>设计动机</strong>：与 NavDP 等”把所有任务都重写成 point-goal”的做法不同，本设计<strong>保留模态特异性信息</strong>，又提供统一接口，从而在三类目标上性能均衡。</li>
</ul>

<p><strong>模块二：双流上下文条件 DSCC（Dual-Stream Contextual Conditioning）</strong>
仅靠视觉条件会因缺乏显式动量约束而生成抖动、运动学不一致的轨迹。DSCC 在 $t-k+1$ 到 $t$ 的滑动窗口上融合两条流：</p>

<ul>
  <li><strong>目标调制视觉记忆流</strong>：历史 RGB 观测 $O_t$ 经 DINOv2 编码成记忆张量 $V$；用视觉查询 $g_V$ 对每个 patch token 算缩放点积相关性分数 \(\alpha=\sigma\!\left(\tfrac{g_V V^\top}{\sqrt D}\right)\)，再残差强化与目标相关的空间 token：\(\tilde V = V + \alpha \odot V\)。输出：被目标”点亮”的视觉空间记忆。</li>
  <li><strong>轨迹感知运动历史流</strong>：把执行过的位姿序列 $S_t$ 转成<strong>坐标无关的相对位移与朝向变化</strong> \(\tilde S_t=\{(\Delta x_i,\Delta y_i,\Delta\theta_i)\}\)（在当前自我中心坐标系下，见 Algorithm 1），经因果 Transformer 编码为 $H$；再用几何目标 $g_G$ 通过 cross-attention query 出一个浓缩的运动学向量 \(o_{kin}=\mathrm{CrossAttn}(g_G,H,H)\)。输出：相对目标方向的历史运动连续性摘要。</li>
  <li><strong>跨注意力条件融合</strong>：用运动学 token $o_{kin}$ 去偏置一组可学习 query $Q_c$，再用多层 Transformer Decoder 让”运动动量”主动 query “目标调制后的视觉空间”：\(C=\mathrm{TransformerDecoder}\big(Q_c+\phi(o_{kin}),\,\tilde V,\,\tilde V\big)\)。输出：统一条件上下文 $C$，同时编码几何安全（避障）与执行平滑（动量）。</li>
</ul>

<p><strong>模块三：非对称动作-前瞻生成（Asymmetric Action-Foresight Generation）</strong>
这是全文最关键的设计。在 $C$ 条件下，模型联合建模：长视界动作轨迹 $A_t={a_t,\dots,a_{t+H_{act}-1}}$ 与短视界隐空间视觉前瞻 \(Z_{t+1:t+H_{vis}}=\{z_{t+1},\dots,z_{t+H_{vis}}\}\)，其中 $H_{vis}\le H_{act}$。未来视觉状态 $z_i=\mathcal E(o_i)$ 由预训练 SD-VAE 压成 $N$ 个隐 patch 的紧凑网格。</p>

<ul>
  <li><strong>训练用 flow-matching</strong>：把高斯先验 $(A_0,Z_0)$ 到数据流形的概率路径建成直线，任意流时刻 $\tau$ 的插值态为 $A_\tau=(1-\tau)A_0+\tau A_1$、$Z_\tau=(1-\tau)Z_0+\tau Z_1$，目标速度场 $u_A=A_1-A_0$、$u_Z=Z_1-Z_0$。</li>
  <li><strong>共享 DiT</strong>：$A_\tau$ 与 $Z_\tau$ 被 token 化后拼接，送入多层 DiT。每个 block 内两类异构 token 先做<strong>共享 self-attention</strong>（让动作路径与视觉表征逐层交换时空约束），再各自 cross-attend 到条件 $C$，时间步 $\tau$ 经 adaLN 注入，回归联合速度场 $\hat u_A,\hat u_Z=f_\theta(A_\tau,Z_\tau,\tau,C)$。共享参数让隐空间前瞻成为”感知接地”的约束，通过视觉速度匹配损失惩罚动作-场景不一致。</li>
  <li><strong>为何非对称</strong>：操作类 WAM 的未来视觉变化局部、以物体为中心；而导航涉及大幅自我中心视角变化，长自回归视觉 rollout 会同时带来推理延迟和累积视觉误差，反而误导动作。故采用”动作长视界保连续 + 视觉短视界给可靠近未来几何约束”的非对称设计。</li>
</ul>

<div align="center">
  <img src="/images/vln/WAM-Nav-DiT-block.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:1118/770" />
<figcaption>图 5：共享 DiT block 结构（堆叠 N 次）。带噪动作 token 与隐空间视觉前瞻 token 各经独立 adaLN 分支调制，经共享 self-attention 早期耦合，再通过共享的 cross-attention 与 FFN（仅做流特异性调制）接地到条件上下文 C，最终投影出 û_A 与 û_Z。</figcaption>
</div>

<p><strong>③ 端到端数据流</strong>：单步样本流经路径为——目标 $g$ → 对齐成 $g_V,g_G$；历史观测 $O_t$、运动历史 $S_t$ → 经 DSCC 双流调制融合成 $C$；高斯噪声 $(A_0,Z_0)$ → 在 $C$ 条件下经共享 DiT 的 10 步 Euler 积分去噪 → 输出执行动作轨迹 $A_t$ 与隐空间未来观测 $Z_{t+1}$。</p>

<p><strong>④ 训练目标</strong>：端到端最小化联合损失
\(\mathcal L_{total}=\mathbb E\big[\lVert\hat u_A-u_A\rVert_2^2+\lambda_{img}\lVert\hat u_Z-u_Z\rVert_2^2\big]+\lambda_{align}\mathcal L_{align}\)
其中第一项为动作流速度回归，第二项为视觉前瞻速度匹配（$\lambda_{img}=0.25$），第三项 $\mathcal L_{align}$ 为对称对比 InfoNCE 损失（$\lambda_{align}=0.1$），通过最大化跨空间投影的互信息保证多目标模态一致性。训练时 DINOv2 ViT-S/14 与 SD-VAE 冻结，目标图像编码器、融合解码器、因果运动编码器与共享 DiT 从零训练。</p>

<p><strong>⑤ 推理流程</strong>：采用 receding-horizon 控制循环。与 NavDP 一致，每步在当前 $C$ 下采样 16 条候选轨迹，按 NoMaD 做法选第一条执行；flow-matching ODE 求解器跑 10 步 Euler 积分，平衡生成质量与实时性。</p>

<hr />

<h3 id="3-核心结果发现-24">3. 核心结果/发现</h3>

<p><strong>主结果（零样本，IsaacSim，ClutterScenes + InternScenes，6000 episodes）</strong>：WAM-Nav 在三类任务上平均最优——Image-Goal 达 <strong>50.2% SR / 48.2% SPL</strong>（较 NavDP 提升 <strong>15.7%</strong> SR），Point-Goal <strong>80.4% SR / 78.0% SPL</strong>（提升 <strong>3.3%</strong>），No-Goal 探索面积 <strong>171.1 m²</strong>。</p>

<div align="center">
  <img src="/images/vln/WAM-Nav-qualitative-results.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/584" />
<figcaption>图 3：Image-Goal 导航定性对比。相比 NavDP（红线，常在逼近障碍后才反应、轨迹突变），WAM-Nav（绿线）借短视界隐空间前瞻提前预判几何约束、轨迹更平滑且主动避障；其在压缩隐空间生成的视觉前瞻解码后仍与真值（GT）高度一致。</figcaption>
</div>

<ul>
  <li><strong>效率（Q3）</strong>：推理延迟 0.26s，每决策仅 0.7 TFLOPs（NavDP 1.3、NWM 8.3），可训练参数与 NavDP 相当；避免了 NWM 那种 1.43s 的多候选视觉 rollout，满足实时导航。</li>
  <li><strong>消融（Q4）</strong>：纯隐空间前瞻把 SR 从 42.1%→45.7%；纯运动轨迹在 ClutterScenes 有益但在语义更复杂的 InternScenes 反而下降；两者结合最佳（50.2% SR）——印证 DSCC 设计：运动历史稳定轨迹生成、隐空间前瞻提供安全所需几何约束。</li>
  <li><strong>非对称视界验证</strong>：$H_{vis}=1$ 最佳（50.2 SR），随视觉视界拉长（4/8/24）性能单调下降（直至 30.4 SR），强力支撑”视觉前瞻应给近未来约束而非长自回归 rollout”的核心动机。</li>
  <li><strong>耦合架构</strong>：完全共享 DiT 优于解耦/部分共享变体，说明隐空间前瞻在直接通过共享表征正则化动作生成时最有用。</li>
  <li><strong>跨本体 &amp; 真实世界</strong>：单策略零样本迁移到 Dingo 轮式、Unitree G1/H2 人形机器人均稳定领先 NavDP；真实部署（G1 + RealSense D455，会议室/仓库/大厅/停车场四场景）平均 <strong>85% 成功率</strong>，验证有效的 sim-to-real 零样本迁移。难度越高（长程）相对 NavDP 优势越大（Hard 子集 +7.6% SR）。</li>
</ul>

<hr />

<h3 id="4-局限性-24">4. 局限性</h3>

<p>真实部署发现两类失败：(1) 相机高度与视野受限，对近场低矮障碍感知弱，易漏看导致碰撞或避障延迟；(2) 当前策略未显式建模机器人本体形状，轨迹规划只保证相机能通过，导致身体与侧方障碍碰撞。未来方向：自适应视角控制、以及融入多形态本体的 embodiment-aware 训练。</p>

<hr />

<h2 id="evomemnav">34. EvoMemNav (2026)</h2>
<p>——— 零样本具身导航中基于轻量化图先验与多视图反思的高效自进化细粒度拓扑记忆框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.03509v1">arXiv:2606.03509</a> · <a href="https://github.com/caicaiya123/EvoMemNav">Code（待发布）</a></p>

<h3 id="精华-26">精华</h3>

<ol>
  <li><strong>纯视觉记忆设计</strong>：提出视觉-语义记忆图（VSMGraph），将原始视觉视图（View）作为一等公民（first-class）存储在图节点中，避免了传统检测中心化场景图的信息压缩与噪声积累，且无需高昂的 3D 重建开销。</li>
  <li><strong>预算受限的粗到细决策（Budgeted Coarse-to-Fine）</strong>：将决策分解为粗阶段（Explore，过滤并路由至前沿或锚点）和细阶段（Search+Verify，仅针对短名单进行 VLM 决策和多视图 Stop 验证），在降低 VLM 延迟与 Token 数的同时，解决了同类多实例歧义和过早停止（premature stop）问题。</li>
  <li><strong>反思驱动的自进化记忆（RDCMA）</strong>：设计了一种无需训练的在线先验更新机制，在子任务结束后通过评估轨迹事件与停止结果，更新附着于图节点上的轻量级目标条件先验（Episode-STM 和 Scene-LTM），指导后续决策。</li>
  <li><strong>开箱即用且高效通用</strong>：在 GOAT-Bench 和 HM3D 上取得显著的 SR/SPL 提升，相比 3D-Mem 表现更佳，同时 VLM 调用次数减少了 41%，总耗时缩短了 39%，且无需任何权重训练或微调。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-25">1. 研究背景/问题</h3>

<p>在长程零样本具身导航（Zero-Shot Embodied Navigation）中，建立能够支撑长期规划的记忆系统至关重要。然而，现有的记忆表征方案存在以下局限性：</p>
<ol>
  <li><strong>基于检测器的场景图（Detector-centric Scene Graphs）</strong>：将观测压缩成稀疏的对象节点，会丢弃纹理、空间布局等细粒度视觉线索，且检测器的错误（如类别噪声）会在下游推理中累积，导致决策失误。</li>
  <li><strong>基于 3D 重建的记忆方法（3D-reconstruction-based Memory）</strong>：在运行时会产生高昂的计算和存储开销，且与只能直接推理图像的强大 VLM 不兼容。</li>
  <li><strong>基于图像的拓扑图缓存（Image-based Topological Graphs）</strong>：缺乏房间、前沿或可达性的结构化组织，容易在同类别物体的多实例场景中混淆，导致在错误的实例前过早停下（Premature Stop），且记忆缺乏演进能力，失败教训无法复用。</li>
</ol>

<hr />

<h3 id="2-主要方法创新点-25">2. 主要方法/创新点</h3>

<h4 id="整体框架概述">整体框架概述</h4>
<p>EvoMemNav 由三个核心部分构成：构建于 occupancy grid 上的层次化拓扑记忆图（VSMGraph）、双阶段“粗到细”导航控制器（Coarse-to-Fine Policy）以及无训练的反思驱动在线自进化先验模块（RDCMA）。系统在每个时间步接收 posed RGB-D 观测，更新拓扑图；导航决策时，由粗决策进行候选过滤并导航，随后利用 VLM 进行细粒度的精确路由与多视图 Stop 验证；子任务结束时，反思机制将结果写回图中的轻量化统计量（STM/LTM），以指导未来的导航。</p>

<div align="center">
  <img src="/images/vln/EvoMemNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/990" />
<figcaption>EvoMemNav 核心理念与流程总览（VSMGraph、粗到细导航决策、反思写入）</figcaption>
</div>

<div align="center">
  <img src="/images/vln/EvoMemNav-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/920" />
<figcaption>EvoMemNav 详细框架：包含基于图像的 VSMGraph 拓扑记忆图、受预算限制的“粗到细”导航决策系统，以及反思驱动的在线自进化先验写入策略</figcaption>
</div>

<h4 id="逐模块讲解">逐模块讲解</h4>

<p><strong>① 视觉-语义记忆图 (VSMGraph) 构建</strong></p>
<ul>
  <li><strong>输入</strong>：posed RGB-D 观测流 $I_t = \langle I_t^{rgb}, I_t^{depth}, p_t \rangle$ 和作为度量支撑的二维占用网格（occupancy grid）$M_t$。</li>
  <li><strong>处理</strong>：在线在占用网格上添加沿着机器人运动轨迹的视图节点，并根据无碰撞路径建立可达性边（navigability edges）。通过轻量级目标检测模型（YOLOv8-World &amp; SAM）维护一个 3D 目标候选缓存 $O_{map}$，但它仅用于给视图节点添加“目标可见性”的弱标签（visibility edges），并不用于压缩图像信息。视图节点被划分为：
    <ul>
      <li><strong>锚点视图 (Anchor Views)</strong> $V_{A,t}$：富含物体观测的已探索区域，存储原始图像、位姿及可见的目标弱标签。</li>
      <li><strong>前沿视图 (Frontier Views)</strong> $V_{F,t}$：位于探索边界的未探索区域，连接至最近的已探索视图，代表可探索的前沿方向。
同时，利用 CLIP 提取房间类别对每个视图进行分类 $\rho_v$，形成“房间-视图-物体”（Room-View-Object）的层次化拓扑图。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：图结构 $G_t = (R_t, V_t, O_t, E_t)$。</li>
  <li><strong>设计动机</strong>：以原始视图作为一等公民记忆，完全保留细粒度细节供 VLM 进行直接的图像级分析验证，避免检测误差引起的硬分类错误；同时，利用拓扑边和房间类别软标签加速检索。</li>
</ul>

<div align="center">
  <img src="/images/vln/EvoMemNav-vsmgraph.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/851" />
<figcaption>VSMGraph 构建过程：基于拓扑关系和房间-视图-物体层次化结构组织视觉信息</figcaption>
</div>

<p><strong>② 预算受限的粗到细导航决策（Coarse-to-Fine Policy）</strong></p>
<ul>
  <li><strong>输入</strong>：多模态目标 $g$、当前拓扑图 $G_t$。</li>
  <li><strong>处理</strong>：
    <ul>
      <li><strong>粗阶段 (Explore - 候选压缩与路由)</strong>：从大量的锚点和前沿视图中过滤，仅保留最相关的 Top-K 个候选（锚点候选集 $C_t^A$ 预算限制为 $K_A$，前沿候选集 $C_t^F$ 预算限制为 $K_F$）。候选通过房间类别关联和轻量目标命中进行初步筛选。如果锚点集为空，则直接路由至前沿；若不为空，则进入细阶段。</li>
      <li><strong>细阶段 (Search+Verify - 局部选择与验证)</strong>：将过滤后的候选池 $C_t = C_t^A \cup C_t^F$ 输入给 VLM（Qwen3-VL-8B），VLM 只需对这个精简的短名单进行单步推理：
\(a_t, \sigma_t = \text{VLM}(g, C_t)\)
其中 $a_t$ 是选择的目标点，$\sigma_t \in {\text{certain}, \text{uncertain}, \text{unknown}}$ 为置信度。若 VLM 选择锚点视图但置信度不足（<code class="language-plaintext highlighter-rouge">uncertain</code>/<code class="language-plaintext highlighter-rouge">unknown</code>），系统会强制降级为前沿探索以避免盲目决策。</li>
      <li><strong>验证步骤 (Verify - 多视图停止验证)</strong>：当智能体抵达选择的锚点视图时，不立即停止，而是调用 VLM 结合智能体在当前位置的多角度视图进行最终的多视图 Stop 验证，返回 <code class="language-plaintext highlighter-rouge">STOP</code> 或 <code class="language-plaintext highlighter-rouge">RESELECT</code>。如果判定为 <code class="language-plaintext highlighter-rouge">RESELECT</code>，则将当前锚点拉入冷却队列并重新回到粗阶段，防止由于局部视野限制而产生的过早停止错误。</li>
      <li><strong>恢复机制 (Recover)</strong>：如果检测到死锁或多次冷却，会触发 Recover 机制，强制智能体进行一段时间的纯前沿探索。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：下一个运动路径终点或 <code class="language-plaintext highlighter-rouge">STOP</code> 指令。</li>
  <li><strong>设计动机</strong>：用粗筛选控制 VLM 的计算开销（避免对全图检索的 Token 爆炸），同时在局部进行多视角图像级的细粒度对比，提高多实例判别的准确度。</li>
</ul>

<p><strong>③ 反思驱动在线记忆自适应 (RDCMA)</strong></p>
<ul>
  <li><strong>输入</strong>：历史子任务的运动轨迹事件（如常去的房间、探索受阻的前沿、环路检测等）以及多视图验证结果（STOP / RESELECT）。</li>
  <li><strong>处理</strong>：任务结束时，将结果以目标条件签名 $s_g$（类别或模态）归纳为轻量化统计先验，写回图结构中附着于对应的房间/视图/前沿节点：
    <ul>
      <li><strong>短时记忆 (Episode-STM)</strong>：缓存当前 episode 内的避障与路径惩罚信息，避免在一个任务中反复打转，在 episode 结束时重置。</li>
      <li><strong>长时记忆 (Scene-LTM)</strong>：记录房间中特定物体的支持概率（例如，厨房更容易有冰箱）和特定锚点的停止可靠度，长效留存，跨子任务复用。
在 Explore 阶段，这些先验以“加权平局决胜（tie-breakers）”的方式调整过滤后的候选排序，指导探索方向；在 Verify 阶段，作为 hint 输入给 VLM 提示当前区域此前是否曾被成功验证过。
通过指数衰减（exponential decay）来淘汰陈旧先验，且仅保留 Top-K 项并对冲突先验进行抑制。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：图附着的记忆先验。</li>
  <li><strong>设计动机</strong>：实现非参数化的轻量自适应，使得智能体在未知的终身学习任务中能够随着时间“越走越聪明”，越熟悉当前环境，导航成功率越高。</li>
</ul>

<div align="center">
  <img src="/images/vln/EvoMemNav-rdcma.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1322/698" />
<figcaption>反思驱动在线记忆自适应 (RDCMA) 的运作原理</figcaption>
</div>

<hr />

<h3 id="3-核心结果发现-25">3. 核心结果/发现</h3>

<ol>
  <li><strong>GOAT-Bench 终身多模态导航</strong>：
在 GOAT-Bench VAL-UNSEEN 验证集上，EvoMemNav 取得了 <strong>59.6% SR</strong> 和 <strong>38.9% SPL</strong> 的最佳结果（见下表），大幅领先于先前的图像级拓扑记忆方法 3D-Mem（42.6% SR / 22.8% SPL）和 MSGNav（52.0% SR / 29.6% SPL）。</li>
</ol>

<table>
  <thead>
    <tr>
      <th>方法</th>
      <th>类别</th>
      <th>是否无需训练</th>
      <th>SR (%) ↑</th>
      <th>SPL (%) ↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>SenseAct-NN Monolithic [20]</td>
      <td>单体学习型</td>
      <td>❌</td>
      <td>12.3</td>
      <td>6.8</td>
    </tr>
    <tr>
      <td>CLIP on Wheels [20]</td>
      <td>模块化零样本</td>
      <td>✓</td>
      <td>16.1</td>
      <td>10.4</td>
    </tr>
    <tr>
      <td>Modular GOAT [20]</td>
      <td>模块化零样本</td>
      <td>✓</td>
      <td>24.9</td>
      <td>17.2</td>
    </tr>
    <tr>
      <td>TANGO [28]</td>
      <td>模块化零样本</td>
      <td>✓</td>
      <td>32.1</td>
      <td>16.5</td>
    </tr>
    <tr>
      <td>3D-Mem [46]</td>
      <td>模块化拓扑</td>
      <td>✓</td>
      <td>42.6</td>
      <td>22.8</td>
    </tr>
    <tr>
      <td>MSGNav [17]</td>
      <td>模块化拓扑</td>
      <td>✓</td>
      <td>52.0</td>
      <td>29.6</td>
    </tr>
    <tr>
      <td><strong>EvoMemNav (Ours)</strong></td>
      <td><strong>模块化拓扑 (自进化)</strong></td>
      <td><strong>✓</strong></td>
      <td><strong>59.6</strong></td>
      <td><strong>38.9</strong></td>
    </tr>
  </tbody>
</table>

<ol>
  <li>
    <p><strong>HM3D ObjectGoal 导航</strong>：
在纯目标导航（ObjectGoal）的 HM3D 任务上，EvoMemNav 在 HM3Dv1（59.2% SR / 33.6% SPL）和 HM3Dv2（63.8% SR / 39.4% SPL）上均创下或逼近了免训练方法的最高水准。</p>
  </li>
  <li>
    <p><strong>消融实验与效率分析</strong>：</p>
    <ul>
      <li>相比于完全不带有 coarse 筛选的拓扑 baseline，加入 VSMGraph 使 SR 提升了 7.2%，而粗筛选（Coarse）模块直接带来了 <strong>+11.6%</strong> 的巨大 SR 跃升，是性能提升的主要因素。</li>
      <li>反思模块 RDCMA 使整体 SR 进一步提升了 4.0%（从 60.8% 提升至 64.8%），并且这种增益在第 3 至第 5 个子任务（Mid subtasks）中最为明显，说明随着记忆在场景中的不断写入和演进，智能体表现越发稳健。</li>
      <li>相比于 3D-Mem，得益于粗阶段的决策短名单机制，VLM 调用次数从 10.7 次降至 6.5 次（减少 39%），单次子任务的耗时从 102.2s 骤降至 58.7s（降低 42.5%），实现了性能与效率的完美兼顾。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="4-局限性-25">4. 局限性</h3>

<ol>
  <li><strong>多模态目标识别依然受限于感知模块</strong>：尽管使用 VSMGraph 规避了下游推理对目标检测框的绝对依赖，但粗筛选阶段生成 soft tags 仍需依靠 YOLOv8-World 和 SAM 等 2D 检测器。在极其嘈杂或低光照环境下，若检测标签完全丢失或偏离，可能导致过滤时的 Top-K 列表中漏掉正确的锚点，从而拖累粗筛选的准确性。</li>
  <li><strong>反思先验的表达与检索粒度仍可优化</strong>：目前的 RDCMA 先验写入是通过对离散的 CLIP 房间类型和停止事件做简单的支持度与错误率计数来实现的。对于极其复杂、分布非常离散的房间结构或者开箱即用的大规模开放世界，简单的图计数可能会面临记忆冲突问题，未来可考虑融入基于小规模向量嵌入的非参数化情境记忆检索。</li>
</ol>

<hr />

<h2 id="localnav">35. LocalNav (2026)</h2>
<p>———基于知识蒸馏与具身强化学习的端侧轻量化三维场景图目标导航框架</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.27871">arXiv:2606.27871</a></p>

<h3 id="精华-27">精华</h3>
<ol>
  <li>本文提出了 LocalNav，一个将前沿云端大模型（如 Claude 3.5 Sonnet）的复杂空间-语义推理能力蒸馏到端侧轻量化 4B VLM（Qwen3.5-4B）的框架，实现完全本地化运行，摆脱云端依赖。</li>
  <li>在在线构建的三维拓扑场景图（Scene Graph）基础上，采用仅 500 条高质量云端模型导航轨迹进行监督微调（SFT），将 4B 小模型的导航成功率（SR）大幅度提升。</li>
  <li>引入具身可验证奖励强化学习（E-RLVR）与 Token 生成长度正则化奖励，对小模型的输出动作 and CoT 链长度进行压缩与规范，减少了 72.1% 的输出 Token 冗余。</li>
  <li>结合 llama.cpp 的 4-bit 量化（IQ4-XS），在 Jetson Orin AGX 边缘计算平台上实现了累计 82.8% 的推理延迟降低，将单回合运行时间从 305.2 秒压缩至 52.5 秒。</li>
  <li>整个系统是模块化解耦的，高层 VLM 负责语义推理和宏观决策，低层 PointGoal 导航策略负责避障与运动控制，并在 Unitree 机器狗和手持设备上进行了实车验证。</li>
</ol>

<hr />

<h3 id="1-研究背景问题-26">1. 研究背景/问题</h3>
<ul>
  <li><strong>开放词汇目标导航（Open-Vocabulary ObjectNav）</strong>：传统的导航算法通常局限于训练时定义的封闭类群，而引入视觉语言模型（VLM）可以利用其强大的开集感知和语义推理能力，指导机器人进行复杂目标搜索。</li>
  <li><strong>云端依赖与高延迟问题</strong>：目前性能优异 VLM 导航方案（如基于 GPT-4o 或 Claude 3.5 Sonnet）多依赖云端 API 交互。这不仅对网络连接提出了严苛要求，还引入了巨大的通信延迟和隐私泄露风险。</li>
  <li><strong>本地部署与自回归生成的计算瓶颈</strong>：尽管 2B-7B 级别的轻量级 VLM 理论上可在端侧（如英伟达 Jetson 平台）部署，但其零样本的语义导航能力极差（SR 仅 21%）。此外，小模型在生成高层决策指令时常伴随大量的思维链（CoT）冗余，使得自回归解码（Token Generation）成为端侧运行的主要延迟瓶颈（占 93.3% 运行时间）。</li>
</ul>

<hr />

<h3 id="2-主要方法创新点-26">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/LocalNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/554" />
    <figcaption>LocalNav 框架概述：通过 SFT 从云端前沿 VLM 蒸馏，并使用具身可验证奖励强化学习（E-RLVR）对动作与 Token 长度进行优化，实现端侧高效部署。</figcaption>
</div>

<h4 id="-整体框架概述-12">① 整体框架概述</h4>
<p>LocalNav 系统由三维拓扑场景图（Scene Graph）构建模块、高层 VLM 决策规划器以及低层 PointGoal 运动规划策略三大核心模块构成。高层 VLM 通过结合环境 360° 拼接全景图（含物体 ID 投影）与文本形式的场景图节点列表，选择宏观语义动作（导航、探索、寻找新房间或停止）；低层运动策略则负责执行点对点三维路径规划与运动避障。</p>

<div align="center">
  <img src="/images/vln/LocalNav-system-architecture.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/764" />
    <figcaption>LocalNav 系统架构：实时构建三维场景图（SG），将 PoV 内的物体 ID 投影至图像中，与文本场景描述一同输入 VLM。VLM 决策后通过低层规划器（PointGoal Policy）控制机器人执行动作。</figcaption>
</div>

<h4 id="-逐模块讲解-10">② 逐模块讲解</h4>

<ul>
  <li><strong>3D 拓扑场景图（Scene Graph）构建</strong>
    <ul>
      <li><strong>输入</strong>：传感器获取的 RGB-D 深度图、机器人里程计（Odometry），以及预训练的目标检测分割模型（如 Mask2Former）提供的物体类别标签（或仿真环境中的真实标注）。</li>
      <li><strong>处理</strong>：利用开源 Hydra 框架在线构建和维护一个包含 Room 节点和 Object 节点的三维场景拓扑图。该图提供明确的拓扑连接结构和物体空间位置，充当机器人的显式空间记忆。</li>
      <li><strong>输出</strong>：在决策点为 VLM 组装两种模态的信息：
        <ol>
          <li><strong>文本 Prompt</strong>：当前所在 Room、已探索/未探索 Room 列表、已知物体类别与空间 ID。</li>
          <li><strong>图像 Prompt</strong>：将当前视场角（PoV）内场景图物体 ID 直接投影叠加在 360° 全景图上（类似于 Set-of-Mark 提示），完成符号 ID 与像素区域的对齐锚定。</li>
        </ol>
      </li>
      <li><strong>设计动机</strong>：显式三维场景图提供了非连续的抽象状态空间，能将机器人高频运动与 VLM 的低频决策解耦，降低计算开销，并具有极佳的可解释性。</li>
    </ul>
  </li>
  <li><strong>监督微调（SFT）知识蒸馏</strong>
    <ul>
      <li><strong>输入</strong>：在 Habitat 仿真器环境（HM3D OVON 数据集）中使用 privileged action space（特权最短路径导航）获取的、由 Claude 3.5 Sonnet、GPT-4o/5.4、Gemini 3.1 Pro 引导并成功完成任务的原始推理轨迹日志（包含图像对和拓扑状态），约 500 条样本。</li>
      <li><strong>处理</strong>：将高层前沿 VLM（Teacher）的推理决策行为作为标签，对本地轻量级 VLM 学生模型（Qwen3.5-4B）进行监督微调。</li>
      <li><strong>输出</strong>：微调后的 Local VLM，初步具备在当前三维拓扑图上选择合理宏观动作的能力。</li>
      <li><strong>设计动机</strong>：小模型直接在 ObjectNav 上表现差。利用前沿模型的推理痕迹进行行为克隆（Behavior Cloning），能以极小的数据量（~500 样本）快速赋予小模型开集场景推理与决策的常识。</li>
    </ul>
  </li>
  <li><strong>具身可验证奖励强化学习（E-RLVR）动作优化</strong>
    <ul>
      <li><strong>输入</strong>：SFT 后的小 VLM 模型，在 Habitat 仿真环境中的闭环交互回放轨迹。</li>
      <li><strong>处理</strong>：基于 LoRA 参数高效微调，应用 Group Relative Policy Optimization (GRPO) 算法。在每个决策点，生成 <code class="language-plaintext highlighter-rouge">N = 4</code> 个独立的动作补全并复制当前仿真环境状态进行并行轨迹 rollout。</li>
      <li><strong>输出</strong>：优化动作准确率并压缩了 CoT 冗余的 Local VLM 权重。</li>
      <li><strong>设计动机</strong>：SFT 训练的模型输出字数较多，且在推理时可能会出现空间记忆幻觉或无用的重复打转。E-RLVR 采用“实践中学习”的方法，结合仿真环境中的可验证反馈来调整模型行为。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/vln/LocalNav-ERLVR-training.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/638" />
    <figcaption>E-RLVR 在 Habitat 中的训练循环：对同一状态生成 4 个独立动作补全，并行在独立的环境分支中运行，并通过最终计算的奖励来更新策略。</figcaption>
</div>

<h4 id="-训练目标与损失函数">③ 训练目标与损失函数</h4>
<p>在 E-RLVR 阶段，模型通过并行 rollout 轨迹的相对优势更新，所采用的累加奖励函数定义如下：
\(R_{tot} = R_{done} + R_{nav} + R_{exp} + R_{brev}\)
其中各项公式的定义及作用为：</p>
<ul>
  <li><strong>终点可验证奖励 \(R_{done}\)</strong>：
\(R_{done} = \begin{cases} 1.0 &amp; \text{若执行 done() 且机器人距离目标物体符合成功阈值} \\ -1.0 &amp; \text{若执行 done() 但未成功（误报）} \\ 0.0 &amp; \text{执行其他动作} \end{cases}\)
用于惩罚妄动终止和奖励正确归航。</li>
  <li><strong>导航进步奖励 \(R_{nav}\)</strong>：
\(R_{nav} = \begin{cases} \Delta d &amp; \text{当目标物体已被收入场景图且机器人向其靠近} \\ 0 &amp; \text{其他情况} \end{cases}\)
<code class="language-plaintext highlighter-rouge">\Delta d</code> 代表向目标移动的归一化距离增量，鼓励快速缩短与目标的距离。</li>
  <li><strong>探索拓展奖励 \(R_{exp}\)</strong>：
\(R_{exp} = \begin{cases} 0.0 &amp; \text{若目标 G 已在场景图中} \\ \lambda_{found} &amp; \text{当目标 G 首次被收入场景图} \\ \Delta n &amp; \text{发现新拓扑节点的归一化增量} \end{cases}\)
激励机器人在目标未知时探索未知区域。</li>
  <li><strong>输出长度惩罚（Brevity Reward）\(R_{brev}\)</strong>：
\(R_{brev} = \begin{cases} 1.0 &amp; L \le L_t \\ 1 - 2 \frac{L - L_t}{L_m - L_t} &amp; L_t &lt; L &lt; L_m \\ -1.0 &amp; L \ge L_m \end{cases}\)
其中 <code class="language-plaintext highlighter-rouge">L</code> 为生成动作的 Token 字符长度，<code class="language-plaintext highlighter-rouge">L_t</code> 为目标理想短字数，<code class="language-plaintext highlighter-rouge">L_m</code> 为最大字数。该惩罚以线性惩罚模型过度长篇大论，迫使其精简 CoT 思维链，只保留最核心的空间推理，在保障 SR 的同时极大削减 Token 生成的计算量。</li>
</ul>

<h4 id="-推理与量化部署流程">④ 推理与量化部署流程</h4>
<p>为了在低算力移动机器人平台上运行，作者将 E-RLVR 微调后的模型通过 <code class="language-plaintext highlighter-rouge">llama.cpp</code> 进行量化。经 Pareto 前沿评估，选择了 <code class="language-plaintext highlighter-rouge">IQ4-XS</code>（4-bit 量化）格式，使 Token 生成速度从 17.68 tok/s 提升至 39.43 tok/s，在保留模型推理精确性的同时，突破了端侧 GPU 的内存和带宽限制。</p>

<hr />

<h3 id="3-核心结果发现-26">3. 核心结果/发现</h3>
<ul>
  <li><strong>SFT 蒸馏来源评估</strong>：在 HM3D OVON 测试集上，采用不同前沿模型作为教师，微调后的 Qwen3.5-4B 表现出差异。使用 Claude 3.5 Sonnet 蒸馏 of 4B 模型最为优秀，SR 从 Base 的 21% 跃升至 <strong>47%</strong>，甚至超过了混合源蒸馏（41%）。</li>
  <li><strong>E-RLVR 的双重优化作用</strong>：SFT 训练后的模型虽强但冗余较多（平均输出 535.2 个 Token，单回合耗时 305.2 秒）。叠加 E-RLVR 训练后，输出 Token 数直降 <strong>72.1%</strong> 至 149.36，使得在 Jetson Orin AGX 上的物理推理延迟降低 <strong>71.8%</strong>（下降至 86.0 秒），且成功率甚至微幅上升至 <strong>49%</strong>。</li>
  <li><strong>量化联合提速</strong>：最终“SFT + E-RLVR + 4-bit 量化 (IQ4-XS)”的完整路线，使推理吞吐量翻倍（~39.43 tok/s），在 Jetson Orin AGX 端侧将物理运行时间大幅缩减 <strong>82.8%</strong>（仅耗时 <strong>52.5 秒</strong>），而成功率仅微弱损耗 2% 左右。</li>
  <li><strong>Benchmark 对比</strong>：在 HM3D OVON 标准评测（含低层 PointGoal 执行误差）中，基于云端 Claude 3.5 Sonnet 的高层方案取得了 <strong>39.7% SR</strong>，而完全本地化运行的 Qwen3.5-4B-Claude 学生模型取得了 <strong>34.5% SR</strong>，与前沿云端模型的性能差距缩窄至仅 5.2%，处于端侧部署方案的业界领先水平。</li>
</ul>

<div align="center">
  <img src="/images/vln/LocalNav-real-world-experiment.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1118/779" />
    <figcaption>真实世界部署测试：机器人在真实公寓中执行多目标连续导航任务，右侧显示机器人的视场 PoV 视角、高层 VLM 规划器的宏观决策与动作输出。</figcaption>
</div>

<hr />

<h3 id="4-局限性-26">4. 局限性</h3>
<ul>
  <li><strong>时空语义局限性</strong>：拓扑场景图目前难以融合动态/瞬时或具有多重语义组合的属性（例如无法区分“普通椅子”与“坐了人的椅子”），必须依赖机器人反复触发 VLM 进行稠密视觉验证。</li>
  <li><strong>三维感知依赖</strong>：对于物体分割检测的精度（如 Mask2Former）和三维重建算法（如 Hydra）的鲁棒性高度敏感，感知模块的误检或漏检会直接导致场景图拓扑结构崩塌，进而引发 VLM 决策链错误。</li>
</ul>

<hr />

<h2 id="aecnav">36. AECNav (2026)</h2>
<p>———把”找物体”改写成”攒证据”：一次编码、按需分割、对数几率累积信念</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2608.10817">arXiv:2608.10817</a> · <a href="https://basaermi.github.io/aecnav-website/">Project Page</a></p>

<h3 id="精华-28">精华</h3>

<ul>
  <li>目标确认不该是”单帧分数过阈值就停”，而应是”多视角证据的累加”：借用占据栅格的 log-odds 加法更新，让一致的观测能把置信度推高到任何单帧都达不到的水平。</li>
  <li>负证据和正证据同样重要：相似干扰物（confuser）得分更高、以及”该看到却没看到”（miss），都应主动扣减信念，而不只是”不加分”。</li>
  <li>一个共享骨干（C-RADIOv4）同时服务场景打分、patch 定位与实例分割，既消除多模型语义不一致，又省去重复编码；昂贵的分割头再用几乎免费的 patch 相似度做门控。</li>
  <li>前沿选择要同时考虑”方向对不对 + 沿途能看到多少新区域 + 走过去要多远”；信息增益若没有路程代价约束，会把机器人引向空旷大区域白白消耗步数。</li>
  <li>训练-free 管线在精度上反超训练方法的同时，单 episode 耗时比 VLFM 还快 2.2 倍，说明”少做无用功”本身就是精度来源。</li>
</ul>

<hr />

<h3 id="1-研究背景问题-27">1. 研究背景/问题</h3>

<p>零样本开放词汇物体导航（ZSON）要求机器人在陌生环境中找到任意语言描述的物体。现有基于价值地图的方法存在三个瓶颈：前沿选择与目标确认使用互不相干的多套视觉模型（CLIP/BLIP-2 + GroundingDINO/MobileSAM），造成重复编码与高延迟；目标确认靠单帧阈值或”平均化”融合，难以区分真目标与外观相似的干扰物；前沿选择只看语义相关度，忽略到达代价与可获得的新信息量，在语义线索弱时容易在远处低收益前沿之间来回摆动。</p>

<hr />

<h3 id="2-主要方法创新点-27">2. 主要方法/创新点</h3>

<div align="center">
  <img src="/images/vln/AECNav-overview.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1416/750" />
<figcaption>AECNav 概览：左侧为导航器需回答的三个问题（高效感知、弱线索下的有效探索、干扰物下的准确识别）；右上为 HM3D-v2 上成功率–单 episode 耗时的权衡；右下为去掉任一模块带来的成功率下降</figcaption>
</div>

<div align="center">
  <img src="/images/vln/AECNav-framework.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1419/819" />
<figcaption>AECNav 框架：证据门控感知用共享 C-RADIOv4 编码器打分并仅在可能看到目标时触发 SAM3；证据整合把检测反投影成 3D 簇，并用目标/干扰物/缺失三类证据更新 log-odds 信念；主动证据获取综合语义相关度、信息增益与路径代价选择前沿，直到某个簇被确认</figcaption>
</div>

<p><strong>① 整体框架概述</strong></p>

<p>AECNav 把 ZSON 重新表述为”证据驱动的感知→决策”问题，由三个模块闭环构成：<strong>证据门控感知</strong>（Evidence-Gated Perception）负责用一次前向提取所有语义线索，并决定要不要跑昂贵的分割；<strong>证据整合</strong>（Evidence Consolidation）把分割结果变成 3D 候选簇，并为每个簇维护一个”它是不是目标”的累积信念；<strong>主动证据获取</strong>（Active Evidence Acquisition）在信念不足以停下时，挑选”最值得去看一眼”的前沿。底层运动交给 VLFM 同款预训练 PointNav 策略。</p>

<p>下面是读者版的数据流（一次决策循环）：</p>

<pre><code class="language-mermaid">graph TD
    A["RGB-D 观测 + 目标文本"] --&gt; B["C-RADIOv4 单次前向: summary token + patch tokens"]
    B --&gt; C["场景相似度写入价值地图"]
    B --&gt; D{"最大 patch 相似度 &gt; 门控阈值?"}
    D -- "否 (约 62% 的步)" --&gt; G["跳过分割"]
    D -- "是" --&gt; E["SAM3 同时分割目标与干扰类别"]
    E --&gt; F["反投影成 3D 簇, 按 log-odds 更新信念"]
    G --&gt; H{"某簇信念稳定超过停止阈值且足够近?"}
    F --&gt; H
    H -- "是" --&gt; I["STOP"]
    H -- "否" --&gt; J["按 语义+信息增益-路程代价 选前沿"]
    C --&gt; J
    J --&gt; K["PointNav 执行动作, 获得新观测"]
    K --&gt; A
</code></pre>

<p><strong>② 逐模块讲解</strong></p>

<p><strong>模块 1：证据门控感知</strong></p>

<ul>
  <li><strong>输入</strong>：当前 RGB 图像 $I_t$、目标类别名 $g$。</li>
  <li><strong>处理</strong>：C-RADIOv4 编码器 $E$ 一次前向输出 summary token $z_t^{\text{sum}}$（整幅图的全局语义）与 $N$ 个 patch token $z_t^{\text{patch}}$（每个局部区域的语义）。目标名只用 SigLIP2 文本塔编码一次得到 $e_g$ 并缓存整个 episode。
    <ul>
      <li>场景相关度：summary token 经 SigLIP2 adaptor $f$ 对齐到文本空间，$\sigma_t^{\text{scene}} = \cos(f(z_t^{\text{sum}}), e_g)$，再按深度和位姿投影到俯视价值地图 $V_t$，作为”哪个方向可能有目标”的持久先验。</li>
      <li>局部目标指示：同一个 adaptor 作用到每个 patch 上，取最大值 $\sigma_t^{\text{patch}} = \max_i \cos(f(z_{t,i}^{\text{patch}}), e_g)$——直觉上就是”画面里最像目标的那一小块有多像”。</li>
      <li>门控：只有 $\sigma_t^{\text{patch}} &gt; \tau_{\text{gate}}$（取 0.08）时，才把<strong>已算好的</strong>特征送进 SAM3 mask decoder 做实例分割，否则整步跳过分割。</li>
    </ul>
  </li>
  <li><strong>输出</strong>：价值地图更新；以及（可能有的）带目标分与干扰分的实例分割结果。</li>
  <li><strong>设计动机</strong>：旧方法用 BLIP-2 打场景分、YOLO/GroundingDINO 做检测、MobileSAM 做分割，三套编码语义不一致且重复计算。共享骨干让所有阶段”看同一份表征”；而门控判断复用已算好的 patch 相似度，几乎零成本，却能跳过 60% 以上的 SAM3 调用。</li>
</ul>

<p><strong>模块 2：证据整合（核心卡点）</strong></p>

<ul>
  <li><strong>输入</strong>：SAM3 输出的实例 mask、深度、位姿；每个实例带目标分 $s_g$ 与最高干扰分 $s_{\text{conf}}$（干扰类别由 LLM 离线为每个目标生成至多 3 个，如 couch 的干扰物为 chair / daybed / chaise lounge，并跨 episode 缓存）。低于 $\tau_{\text{det}}=0.4$ 的检测直接丢弃。</li>
  <li><strong>处理</strong>：实例反投影成 3D 点云，若与最近观测到的某簇距离小于 0.75 m 就融合进去，否则新建簇。每个簇 $C_k$ 维护一个标量<strong>对数几率信念</strong>——可以理解为”支持它是目标的证据分”，0 表示中立，正数偏向是目标，负数偏向不是：</li>
</ul>

\[l(C_k) = \log \frac{P(C_k = g)}{1 - P(C_k = g)}\]

<p>每次观测按加法更新并截断在 $[-4, 4]$ 内：</p>

\[l(C_k) \leftarrow l(C_k) + \Delta l^{\text{sem}}(C_k) + \Delta l^{\text{miss}}(C_k)\]

<ul>
  <li><strong>语义项</strong>（对被检测命中的簇）：比较目标分与干扰分，谁明显占优就朝谁的方向推，差距在中性边界 $\delta=0.10$ 内则不动：</li>
</ul>

\[\Delta l^{\text{sem}}(C_k) =
\begin{cases}
+\alpha_{\text{sem}} \, \rho_k \, \text{logit}(\tilde s_g), &amp; s_g \ge s_{\text{conf}} + \delta \\
-\alpha_{\text{sem}} \, \rho_k \, \text{logit}(\tilde s_{\text{conf}}), &amp; s_{\text{conf}} \ge s_g + \delta \\
0, &amp; \text{otherwise}
\end{cases}\]

<p>其中 $\tilde s_g, \tilde s_{\text{conf}}$ 是重标定后的分数（保证过了 $\tau_{\text{det}}$ 的检测 logit 非负），$\rho_k \in [0,1]$ 是新实例与簇的空间重叠度，$\alpha_{\text{sem}}=0.7$。</p>

<ul>
  <li><strong>缺失项</strong>（对信念为正、且落在视野内却没被检测到的簇）：”该看见却没看见”本身就是反证：</li>
</ul>

\[\Delta l^{\text{miss}}(C_k) = -\alpha_{\text{miss}} \, v_k \, \text{logit}(1 - s_{\text{miss}})\]

<p>$v_k$ 是簇的 3D 点落在当前视锥内的比例，$s_{\text{miss}}=0.2083$ 是由统计估计的单帧漏检率，$\alpha_{\text{miss}}=0.3$。视野外的簇不受影响。</p>
<ul>
  <li><strong>输出</strong>：每个簇的累积信念。当某簇信念超过 $\tau_{\text{stop}}=1.0$，机器人朝它走并持续更新；只有在连续 5 帧中至少 2 帧超过阈值、且距离簇 0.5 m 以内时才真正 STOP。</li>
  <li><strong>设计动机</strong>：ApexNav 也做时序融合，但它是<strong>平均</strong>——置信度永远不会超过最强那一帧，而且模糊视角和决定性视角权重相同。log-odds 的<strong>加法</strong>让一致观测复利累积；干扰项和缺失项则让错误假设被主动”撤销”。</li>
</ul>

<blockquote>
  <p><strong>举个例子</strong>（取 $\rho_k = 1$，假设重标定后分数即为下文数值）：</p>
  <ul>
    <li><strong>真目标</strong>：连续 3 帧看到同一把沙发，每帧 $\tilde s_g = 0.8$，$\text{logit}(0.8) = \ln 4 \approx 1.39$，每帧加 $0.7 \times 1.39 \approx 0.97$。3 帧后信念 $\approx 2.91$，稳稳超过 $\tau_{\text{stop}} = 1.0$。若用平均法，置信度始终停在 0.8，”看得再多也不会更确定”。</li>
    <li><strong>干扰物</strong>：找 chair 时看到沙发，目标分 0.47、干扰分 0.86（Fig. 4 真机数据），干扰分高出 $\delta$ 以上，若 $\tilde s_{\text{conf}} = 0.8$ 则该簇扣 0.97，直接变成负信念，机器人不会被它吸走。</li>
    <li><strong>误检撤回</strong>：某帧把远处杂物误检成垃圾桶，信念升到 +0.97。走近后它完整落在视野内（$v_k = 1$）却连续没被检测到，每帧扣 $0.3 \times \text{logit}(0.79) \approx 0.3 \times 1.34 \approx 0.40$；仅 1 帧后信念就降到 0.57、跌破停止阈值，机器人被”释放”回去继续探索；3 帧后变为 −0.23。</li>
  </ul>
</blockquote>

<p><strong>模块 3：主动证据获取</strong></p>

<ul>
  <li><strong>输入</strong>：价值地图 $V_t$、占据栅格（1000×1000，0.05 m/格）、当前前沿集合。</li>
  <li><strong>处理</strong>：对每个前沿 $f$ 计算复合效用（三项先在当前前沿集合内做 min-max 归一化，使尺度可比）：</li>
</ul>

\[U_t(f; g) = \tilde S_t(f; g) + \lambda_{\text{info}} \, \tilde G_t(f) - \lambda_{\text{dist}} \, \tilde C_t(f)\]

<ul>
  <li>$S_t$：与 VLFM 相同，聚合前沿附近的价值地图值——”这个方向像不像有目标”。</li>
  <li>$G_t$：在占据栅格上用 BFS 求到前沿的最短可通行路径 $\pi_t(f)$，沿路径每 0.75 m 采样一个视点（朝向沿路径切线，终点朝向附近未知区域），在 79° 水平视场内每 5° 射一条光线、最远 5 m，碰到已知障碍即停；所有光线扫过的<strong>未知格子</strong>并集就是信息增益 $G_t(f) = \lvert U_t \cap \text{Vis}(\pi_t(f)) \rvert$。关键在于它统计的是”<strong>一路上</strong>能看到多少新东西”，而不只是终点。</li>
  <li>$C_t$：路径长度 $\lvert \pi_t(f) \rvert$。</li>
  <li><strong>输出</strong>：效用最高的前沿，交给 PointNav 执行。</li>
  <li><strong>设计动机</strong>：纯语义排序只说明”往哪边可能有”，不管”去那里能新看到多少、要走多远”。弱语义线索时，这正是来回摆动、步数浪费的根源。</li>
</ul>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>传统做法（VLFM / ApexNav 等）</th>
      <th>AECNav</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>视觉编码</td>
      <td>场景打分、检测、分割各用一套模型</td>
      <td>一个 C-RADIOv4 前向，多个 adaptor 头共享</td>
    </tr>
    <tr>
      <td>分割调用</td>
      <td>每步都跑</td>
      <td>patch 相似度门控，跳过约 62.5%</td>
    </tr>
    <tr>
      <td>目标确认</td>
      <td>单帧阈值，或多帧平均</td>
      <td>3D 簇级 log-odds 累加，含干扰物与漏检负证据</td>
    </tr>
    <tr>
      <td>前沿选择</td>
      <td>语义价值（ApexNav 弱线索时退回几何）</td>
      <td>语义 + 沿途信息增益 − 路径代价</td>
    </tr>
  </tbody>
</table>

<p><strong>③ 端到端数据流</strong></p>

<p>一步决策的完整路径为：RGB-D 进入 C-RADIOv4 → summary token 更新价值地图、patch 相似度决定是否触发 SAM3 → 若触发，SAM3 以”目标 + LLM 生成的干扰类别”为提示分割 → 实例反投影并入 3D 簇、更新 log-odds 信念（视野内未命中的正信念簇扣 miss 分）→ 若某簇满足”稳定 + 足够近”则 STOP，若只是超阈值则朝它导航，否则按复合效用选前沿 → PointNav 输出 MOVE_FORWARD（0.25 m）/ TURN（30°）等离散动作 → 新观测回到开头。</p>

<p><strong>④ 训练目标</strong></p>

<p>完全 training-free：没有任何损失函数或微调，所有组件（C-RADIOv4 + SigLIP2/SAM3 adaptor、DeepSeek-V4-Flash 生成的干扰类别、预训练 PointNav）均直接复用，只有少量阈值与权重超参。</p>

<p><strong>⑤ 推理流程</strong></p>

<p>默认超参：$\tau_{\text{gate}}=0.08$，$\tau_{\text{det}}=0.4$，信念范围 $[-4,4]$，$(\alpha_{\text{sem}}, \alpha_{\text{miss}})=(0.7, 0.3)$，$\lambda_{\text{info}}=\lambda_{\text{dist}}=1.0$，C-RADIOv4（SO400M）输入 672×672。LLM 只在离线阶段为每个目标类别生成一次干扰类别，推理时没有在线 LLM 调用，这是它比 SG-Nav / InstructNav 快一到两个数量级的原因之一。</p>

<hr />

<h3 id="3-核心结果发现-27">3. 核心结果/发现</h3>

<p><strong>主结果</strong>（全部为 training-free，与训练方法同表比较）：</p>

<table>
  <thead>
    <tr>
      <th>基准</th>
      <th>AECNav SR / SPL</th>
      <th>此前最佳</th>
      <th>提升</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>HM3D-v2</td>
      <td>84.7 / 45.3</td>
      <td>TrajRAG 78.1 / 40.2</td>
      <td>SR +6.6，SPL +5.1</td>
    </tr>
    <tr>
      <td>MP3D</td>
      <td>51.3 / 25.9</td>
      <td>WMNav 45.4 / 17.2</td>
      <td>SR +5.9，SPL +8.7</td>
    </tr>
    <tr>
      <td>HM3D-OVON</td>
      <td>57.3 / 30.5</td>
      <td>MSGNav 48.3 / 27.0</td>
      <td>SR +9.0</td>
    </tr>
  </tbody>
</table>

<p>开放词汇最难的 HM3D-OVON 上提升最大，与”类别越多、相似干扰物越多，log-odds 抗干扰越有用”的设计相吻合。</p>

<p><strong>效率</strong>（HM3D-v2 前 100 个 episode）：AECNav 平均 108.63 步、24.39 s/episode；VLFM 53.36 s，ApexNav 177.97 s，SG-Nav 超过 1400 s。步数比第二名 ASCENT 少 33%，耗时比 VLFM 快 2.2 倍。</p>

<p><strong>感知管线分析</strong>：把 BLIP-2 + YOLOv7 + MobileSAM 换成 C-RADIO，SR 从 75.9 升到 84.7、延迟从 0.402 降到 0.248 s/step；再加门控（$\tau_{\text{gate}}=0.08$）跳过 62.5% 的 SAM3 调用，延迟降到 0.178 s/step 且精度不掉，整体比多模型基线快 2.3 倍。</p>

<p><strong>消融</strong>：</p>
<ul>
  <li>去掉证据整合（检测到就直接走过去）掉得最多：SR −12.8。</li>
  <li>仅保留目标分的 log-odds 累积就已达 81.9 SR（比无累积高 10 个点）——<strong>累积本身是主要收益来源</strong>；干扰项再 +1.8，缺失项再 +1.3，两者修复的是互不重叠的错误类型，合计到 84.7。</li>
  <li>去掉主动证据获取：SR −2.9，SPL −3.5。</li>
</ul>

<div align="center">
  <img src="/images/vln/AECNav-exploration-weights.webp" width="80%" loading="lazy" decoding="async" style="aspect-ratio:700/601" />
<figcaption>信息增益权重与路径代价权重的扫描：单独加入路径代价项即显著提升；单独加入信息增益几乎无效（81.9 vs 81.8），必须与代价项搭配；任一权重过大都会伤害性能</figcaption>
</div>

<p>一个反直觉的发现：<strong>信息增益单独使用几乎没用</strong>。没有代价约束时，它总偏爱视野开阔的大区域，把机器人派去长途远行，既耗步数又偏离语义有希望的区域；只有与路径代价配对，它才成为有效的”性价比”信号。</p>

<p><strong>真机</strong>：Unitree Go2 + RealSense D455，4 个室内场景、8 个开放词汇目标（含”饮水机”“咖啡机”等标准词表外类别，椅子实验刻意放了沙发和长凳作干扰），40 次中成功 38 次（95%），单次决策 197.4 ms（约 5 Hz）。</p>

<div align="center">
  <img src="/images/vln/AECNav-real-world.webp" width="100%" loading="lazy" decoding="async" style="aspect-ratio:1418/783" />
<figcaption>Unitree Go2 真机实验：上排找椅子时，干扰分连续两次压过目标分，两张沙发被拒绝；下排找垃圾桶时，远处误检在走近后因漏检证据被撤回，机器人继续探索并找到真目标</figcaption>
</div>

<hr />

<h3 id="4-局限性-27">4. 局限性</h3>

<p>干扰类别依赖 LLM 离线生成的固定小集合（至多 3 个），若真实干扰物不在列表中，负证据就无法生效；方法大量依赖手调阈值与权重（门控阈值、漏检率先验、停止窗口等）。真机实验规模较小（40 次），两次失败分别来自前视相机从未看到的角落和大空旷区域的步数耗尽，说明探索策略在这两类场景仍有盲区。</p>

<hr />

<h1 id="参考资料">参考资料</h1>

<h2 id="论文引用">论文引用</h2>

<ol>
  <li><strong>NAVCON</strong> (2024). 认知启发与语言落地的首个大规模 Vision-Language Navigation 概念数据集. arXiv: <a href="https://arxiv.org/abs/2412.13026">2412.13026</a></li>
  <li><strong>LoGoPlanner</strong> (2025). 定位接地的端到端导航策略：把度量尺度的视觉几何”植入”规划. arXiv: <a href="https://arxiv.org/abs/2512.19629">2512.19629</a> · ICRA 2026</li>
  <li><strong>VL-Nav</strong> (2025). 实时零样本 Vision-Language 导航系统，融合像素级视觉-语言特征与启发式空间推理. arXiv: <a href="https://arxiv.org/abs/2502.00931">2502.00931</a> · IROS 2026</li>
  <li><strong>GaussNav</strong> (2025). Gaussian Splatting for Visual Navigation. arXiv: <a href="https://arxiv.org/abs/2403.11625">2403.11625</a> · IEEE TPAMI 2025</li>
  <li><strong>NavDP</strong> (2025). 只用仿真数据训练，零样本迁移到真实机器人的导航扩散策略. arXiv: <a href="https://arxiv.org/abs/2505.08712">2505.08712</a> · ICRA 2026 · Code: <a href="https://github.com/InternRobotics/NavDP">InternRobotics/NavDP</a></li>
  <li><strong>FantasyVLN</strong> (2026). 统一多模态 Chain-of-Thought 推理用于视觉-语言导航. arXiv: <a href="https://arxiv.org/abs/2601.13976">2601.13976</a></li>
  <li><strong>SparseVideoNav</strong> (2026). Sparse Video Generation Propels Real-World Beyond-the-View Vision-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2602.05827">2602.05827</a></li>
  <li><strong>WorldVLN</strong> (2026). Autoregressive World Action Model for Aerial Vision-Language Navigation. arXiv: <a href="https://arxiv.org/abs/2605.15964">2605.15964</a></li>
  <li><strong>NavWAM</strong> (2026). 首个将未来预测、价值评估与动作决策集成于单一具身世界模型的导航模型. arXiv: <a href="https://arxiv.org/abs/2606.13494">2606.13494</a></li>
  <li><strong>ABot-AgentOS</strong> (2026). 面向具身智能的通用机器人 Agent 操作系统与终身多模态记忆系统. arXiv: <a href="https://arxiv.org/abs/2607.10350">2607.10350</a></li>
  <li><strong>Agentic Embodied Control</strong> (2026). 极简接口下的通用智能体直接掌控具身交互循环，零样本性能比肩工业级训练策略. arXiv: <a href="https://arxiv.org/abs/2607.26148">2607.26148</a></li>
  <li><strong>Route2Step</strong> (2026). 解耦语义进度与局部执行，通过显式步级接口赋能具身导航纠偏. arXiv: <a href="https://arxiv.org/abs/2608.03143">2608.03143</a> · ECCV 2026</li>
  <li><strong>HumanoidVLN</strong> (2026). 首个面向多样化双足人形机器人的物理真实 VLN 仿真平台与基准. arXiv: <a href="https://arxiv.org/abs/2608.12860">2608.12860</a> · IEEE RA-L</li>
  <li><strong>CONDVLN</strong> (2026). 首个基于分层 3D 场景图的视觉语言导航条件分支诊断基准与神经符号探针. arXiv: <a href="https://arxiv.org/abs/2608.17318">2608.17318</a></li>
  <li><strong>ReMEmbR</strong> (2024). 基于检索增强长程时空记忆的机器人导航问答与物理目标生成. arXiv: <a href="https://arxiv.org/abs/2409.13682">2409.13682</a> · ICRA 2025</li>
  <li><strong>SuperMap</strong> (2026). 面向视觉-语言导航的实时 4D 时空语义 SLAM 与动态场景图系统. RSS 2026 · Code（待发布）: <a href="https://github.com/superxslam/SuperMap">superxslam/SuperMap</a></li>
  <li><strong>GSMem</strong> (2026). 3D Gaussian Splatting 作为具身探索与推理的持久空间记忆. arXiv: <a href="https://arxiv.org/abs/2603.19137">2603.19137</a></li>
  <li><strong>PROSPECT</strong> (2026). 流式 VLA + 潜空间预测：训练时预演未来，推理时零开销. arXiv: <a href="https://arxiv.org/abs/2603.03739">2603.03739</a></li>
  <li><strong>Qwen-Drive</strong> (2026). 首个不改动 VLM 架构、统一 3D 感知/问答/轨迹规划的端到端自动驾驶基础模型. arXiv: <a href="https://arxiv.org/abs/2609.00111">2609.00111</a></li>
  <li><strong>CGFM-Nav</strong> (2026). 耦合显式关系图记忆与隐式连续语义场的终身多模态具身导航. arXiv: <a href="https://arxiv.org/abs/2608.29114">2608.29114</a></li>
  <li><strong>CanonNav</strong> (2026). 解耦相机几何与导航行为的跨平台视觉扩散导航策略. arXiv: <a href="https://arxiv.org/abs/2608.30242">2608.30242</a></li>
  <li><strong>LookStep</strong> (2026). 基于语言前瞻推演与事件驱动记忆的高效端到端视觉语言导航. arXiv: <a href="https://arxiv.org/abs/2609.02350">2609.02350</a></li>
  <li><strong>MacroAction-VLN</strong> (2026). 基于拓扑图宏动作分层 MDP 与动作感知 Critic 的连续环境闭环强化学习微调. arXiv: <a href="https://arxiv.org/abs/2609.03906">2609.03906</a></li>
  <li><strong>NavMCP</strong> (2026). 首个将导航基础模型（NFM）脚手架化封装为智能体执行器的长程具身导航框架. arXiv: <a href="https://arxiv.org/abs/2608.30396">2608.30396</a></li>
  <li><strong>OccPlanner</strong> (2026). 把一个没有深度的像素，”顶”回局部 3D 占用栅格里再规划. arXiv: <a href="https://arxiv.org/abs/2608.14160">2608.14160</a></li>
  <li><strong>Harness Robotic OS</strong> (2026). 把四足巡检从「导航栈」升级为「具身智能体运行时」. arXiv: <a href="https://arxiv.org/abs/2609.11225">2609.11225</a></li>
  <li><strong>EgoPathBench</strong> (2026). 把「导航决策」压成第一人称图上的一串编号，对错交给场景几何裁定. arXiv: <a href="https://arxiv.org/abs/2609.16610">2609.16610</a></li>
  <li><strong>AdaGeoVLN</strong> (2026). 沿「表征深度」与「导航时间」两条轴做几何取舍. arXiv: <a href="https://arxiv.org/abs/2609.18789">2609.18789</a></li>
  <li><strong>VLingNav</strong> (2026). Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic Memory. arXiv: <a href="https://arxiv.org/abs/2601.08665">2601.08665</a> · Project Page: <a href="https://github.com/wsakobe/VLingNav-web">wsakobe/VLingNav-web</a></li>
  <li><strong>Hydra-Nav</strong> (2026). Object Navigation via Adaptive Dual-Process Reasoning. arXiv: <a href="https://arxiv.org/abs/2602.09972">2602.09972</a></li>
  <li><strong>3DGSNav</strong> (2026). 用主动 3DGS 记忆增强 VLM 空间推理，实现零样本目标导航. arXiv: <a href="https://arxiv.org/abs/2602.12159">2602.12159</a></li>
  <li><strong>SysNav</strong> (2026). Multi-Level Systematic Cooperation Enables Real-World, Cross-Embodiment Object Navigation. arXiv: <a href="https://arxiv.org/abs/2603.06914">2603.06914</a> · Code: <a href="https://github.com/zwandering/SysNav">zwandering/SysNav</a></li>
  <li><strong>WAM-Nav</strong> (2026). 非对称隐空间「世界-动作」联合建模，用一个 DiT 统一三类视觉导航. arXiv: <a href="https://arxiv.org/abs/2606.04907">2606.04907</a></li>
  <li><strong>EvoMemNav</strong> (2026). 零样本具身导航中基于轻量化图先验与多视图反思的高效自进化细粒度拓扑记忆框架. arXiv: <a href="https://arxiv.org/abs/2606.03509v1">2606.03509v1</a> · Code（待发布）: <a href="https://github.com/caicaiya123/EvoMemNav">caicaiya123/EvoMemNav</a></li>
  <li><strong>LocalNav</strong> (2026). 基于知识蒸馏与具身强化学习的端侧轻量化三维场景图目标导航框架. arXiv: <a href="https://arxiv.org/abs/2606.27871">2606.27871</a></li>
  <li><strong>AECNav</strong> (2026). 把”找物体”改写成”攒证据”：一次编码、按需分割、对数几率累积信念. arXiv: <a href="https://arxiv.org/abs/2608.10817">2608.10817</a></li>
</ol>

<script>
(function () {
  var TAG_MAP = [
    { m: 'NAVCON',                   t: ['数据集', '连续环境', '离散环境'] },
    { m: 'LoGoPlanner',              t: ['端到端', '扩散模型', '连续环境', '实机部署'] },
    { m: 'VL-Nav',                   t: ['端到端', '零样本', '实机部署'] },
    { m: 'GaussNav',                 t: ['SLAM', '高斯表示'] },
    { m: 'FantasyVLN',               t: ['世界模型', '数据增强', '连续环境', 'CoT'] },
    { m: 'SparseVideoNav',           t: ['端到端', '扩散模型', '世界模型'] },
    { m: 'WorldVLN',                 t: ['世界模型', '强化学习', '端到端', '实机部署'] },
    { m: 'NavWAM',                   t: ['世界模型', '扩散模型', '连续环境', '实机部署'] },
    { m: 'ABot-AgentOS',             t: ['Agentic', '拓扑图', '实机部署'] },
    { m: 'Agentic Embodied Control', t: ['Agentic', '零样本', '连续环境', '实机部署'] },
    { m: 'Route2Step',               t: ['双系统', '连续环境', '实机部署'] },
    { m: 'HumanoidVLN',              t: ['数据集', '强化学习', '实机部署', '高斯表示'] },
    { m: 'CONDVLN',                  t: ['数据集', '连续环境', '拓扑图'] },
    { m: 'ReMEmbR',               t: ['Agentic', '实机部署', '数据集', '连续环境'] },
    { m: 'SuperMap',              t: ['SLAM', '拓扑图', '零样本', '实机部署', 'Agentic'] },
    { m: 'GSMem',             t: ['Agentic', '高斯表示', '零样本'] },
    { m: 'PROSPECT',              t: ['端到端', '世界模型', '连续环境', '实机部署'] },
    { m: 'Qwen-Drive',            t: ['端到端', '扩散模型', '强化学习', '连续环境'] },
    { m: 'CGFM-Nav',              t: ['拓扑图', 'Agentic', '零样本'] },
    { m: 'CanonNav',              t: ['扩散模型', '连续环境', '实机部署'] },
    { m: 'LookStep',              t: ['端到端', '连续环境', '加速优化', '实机部署'] },
    { m: 'MacroAction-VLN',       t: ['拓扑图', '强化学习', '连续环境'] },
    { m: 'NavMCP',                t: ['Agentic', '零样本', '实机部署', '连续环境'] },
    { m: 'OccPlanner',            t: ['扩散模型', '端到端', '数据增强', '连续环境'] },
    { m: 'NavDP',             t: ['端到端', '扩散模型', '连续环境', '零样本', '实机部署'] },
    { m: 'Harness Robotic OS',    t: ['Agentic', '实机部署', 'SLAM'] },
    { m: 'EgoPathBench',          t: ['数据集', '零样本', 'CoT', '连续环境'] },
    { m: 'AdaGeoVLN',             t: ['端到端', '连续环境', '实机部署', '加速优化'] },
    { m: 'VLingNav',          t: ['双系统', '连续环境', 'CoT'] },
    { m: 'Hydra-Nav',         t: ['双系统', '强化学习'] },
    { m: '3DGSNav',           t: ['SLAM', '高斯表示', '零样本', '实机部署'] },
    { m: 'SysNav',            t: ['Agentic', '拓扑图'] },
        { m: 'WAM-Nav',               t: ['世界模型', '扩散模型', '零样本', '实机部署'] },
        { m: 'EvoMemNav',             t: ['Agentic', '拓扑图', '零样本'] },
        { m: 'LocalNav',              t: ['拓扑图', '强化学习', '实机部署', '加速优化'] },
    { m: 'AECNav',                t: ['零样本', 'Agentic', '实机部署', '加速优化'] },
  ];

  // 另一篇文章的论文清单。两篇的 .paper-section 各自只在本页存在，
  // 所以这些条目不参与显示/隐藏，只在结果面板里作为跨页链接列出。
  // 由 vln-paper-insert/scripts/sync_remote.py 生成，勿手工编辑。
  var REMOTE_PAGE = { url: '/VLN-Papers/', label: '主篇' };
  var REMOTE_PAPERS = [
    { n: '1. R2R (2018)', a: 'r2r', t: ['离散环境', '数据集'] },
    { n: '2. VLN-CE (2020)', a: 'vln-ce', t: ['数据集', '连续环境', '基础工作'] },
    { n: '3. DUET (2022)', a: 'duet', t: ['拓扑图', '端到端', '离散环境'] },
    { n: '4. NoMaD (2023)', a: 'nomad', t: ['端到端', '扩散模型', '零样本', '实机部署'] },
    { n: '5. VLFM (2023)', a: 'vlfm', t: ['SLAM', '零样本', '实机部署'] },
    { n: '6. R2RIE-CE & IEDL (2024)', a: 'r2rie-ce-iedl', t: ['连续环境', '数据集'] },
    { n: '7. NaVid (2024)', a: 'navid', t: ['端到端', '连续环境', '实机部署', '零样本'] },
    { n: '8. NavGPT-2 (2024)', a: 'navgpt-2', t: ['Agentic', '拓扑图', '离散环境', 'CoT'] },
    { n: '9. DualVLN/InternVLN (2025)', a: 'dualvln', t: ['双系统', '扩散模型', '连续环境', '实机部署'] },
    { n: '10. ODYSSEY (2025)', a: 'odyssey', t: ['Agentic', '实机部署'] },
    { n: '11. PanoNav (2025)', a: 'panonav', t: ['Agentic', '零样本', '离散环境'] },
    { n: '12. VLN-R1 (2025)', a: 'vln-r1', t: ['端到端', '强化学习', '连续环境'] },
    { n: '13. StreamVLN (2025)', a: 'streamvln', t: ['端到端', '加速优化', '连续环境', '实机部署'] },
    { n: '14. NavFoM (2025)', a: 'navfom', t: ['端到端', '连续环境'] },
    { n: '15. MapNav (2025)', a: 'mapnav', t: ['拓扑图', 'SLAM', '加速优化', '连续环境'] },
    { n: '16. Open-Nav (2025)', a: 'open-nav', t: ['Agentic', '零样本', '连续环境'] },
    { n: '17. Skill-Nav (2025)', a: 'skill-nav', t: ['端到端', '强化学习', '实机部署'] },
    { n: '18. VLN-Imagine (2025)', a: 'vln-imagine', t: ['数据增强', '离散环境'] },
    { n: '19. VLN-PE (2025)', a: 'vln-pe', t: ['数据集', '连续环境', '基础工作'] },
    { n: '20. Goal2Pixel (2025)', a: 'goal2pixel', t: ['端到端', '连续环境', '实机部署', '加速优化'] },
    { n: '21. AstraNav-World (2025)', a: 'astranav-world', t: ['世界模型', '扩散模型', '端到端', '连续环境', '实机部署'] },
    { n: '22. CorrectNav (2025)', a: 'correctnav', t: ['端到端', '连续环境', '实机部署'] },
    { n: '23. Slow4fast-VLN (2026)', a: 'slow4fast-vln', t: ['双系统', '拓扑图', '离散环境'] },
    { n: '24. DGNav (2026)', a: 'dgnav', t: ['拓扑图', 'SLAM', '连续环境'] },
    { n: '25. CausalNav (2026)', a: 'causalnav', t: ['Agentic', '拓扑图'] },
    { n: '26. AgentVLN (2026)', a: 'agentvln', t: ['Agentic', '连续环境', '实机部署'] },
    { n: '27. VLN-Cache (2026)', a: 'vln-cache', t: ['加速优化'] },
    { n: '28. R³: Run, Ruminate, and Regulate (2026)', a: 'r3', t: ['双系统', '加速优化', 'CoT'] },
    { n: '29. AwareVLN (2026)', a: 'awarevln', t: ['端到端', '连续环境', '实机部署', '数据增强', 'CoT'] },
    { n: '30. Dual-Anchoring (2026)', a: 'dual-anchoring', t: ['端到端', '世界模型', '连续环境', '实机部署'] },
    { n: '31. JanusVLN (2026)', a: 'janusvln', t: ['双系统', '连续环境', '实机部署', '加速优化'] },
    { n: '32. HSGM (2026)', a: 'hsgm', t: ['Agentic', '拓扑图', '零样本', '连续环境', 'BEV'] },
    { n: '33. OneVLA (2026)', a: 'onevla-a-unified-framework-for-embodied-tasks', t: ['端到端', '扩散模型', '连续环境', '实机部署'] },
    { n: '34. CA-VLN (2026)', a: 'ca-vln', t: ['Agentic', '拓扑图', '离散环境'] },
    { n: '35. RynnBrain (2026)', a: 'rynnbrain', t: ['基础工作'] },
    { n: '36. OmniNav (2026)', a: 'omninav', t: ['双系统', 'Agentic', 'CoT', '扩散模型', '实机部署'] },
    { n: '37. Qwen-RobotNav (2026)', a: 'qwen-robotnav', t: ['Agentic', '端到端', '连续环境', '实机部署'] },
    { n: '38. GA-VLN (2026)', a: 'ga-vln', t: ['端到端', '连续环境', '实机部署', '加速优化', 'BEV'] },
    { n: '39. SEDualVLN (2026)', a: 'sedualvln', t: ['双系统', 'Agentic', '连续环境'] },
    { n: '40. Robostral Navigate (2026)', a: 'robostral-navigate', t: ['端到端', '强化学习', '连续环境', '加速优化'] },
    { n: '41. ABot-N1 (2026)', a: 'abot-n1', t: ['双系统', 'CoT', '强化学习', '实机部署', '数据集'] },
    { n: '42. ReflectVLN (2026)', a: 'reflectvln', t: ['双系统', 'Agentic', 'CoT', '连续环境'] },
    { n: '43. TuckerNav (2026)', a: 'tuckernav', t: ['连续环境', '加速优化'] },
    { n: '44. AgenticNav (2026)', a: 'agenticnav', t: ['Agentic', '零样本', '连续环境', '实机部署'] },
    { n: '45. MemVLN (2026)', a: 'memvln', t: ['端到端', '连续环境', '加速优化'] },
    { n: '46. X-NavDP (2026)', a: 'x-navdp', t: ['扩散模型', '强化学习', '连续环境', '实机部署'] },
    { n: '47. Image2Sim (2026)', a: 'image2sim', t: ['世界模型', '数据增强', '高斯表示', '连续环境', '实机部署', '零样本'] },
    { n: '48. DecoVLN (2026)', a: 'decovln', t: ['端到端', '连续环境', '实机部署', '加速优化', '纠错'] },
    { n: '49. TAMP-Nav (2026)', a: 'tamp-nav', t: ['CoT', '强化学习', '连续环境', '实机部署'] },
    { n: '50. LightNav-0 (2026)', a: 'lightnav-0', t: ['端到端', '连续环境', '实机部署', '强化学习', '零样本', 'CoT', '数据集'] },
    { n: '51. Uncertainty-Aware Gaussian Map for VLN (2026)', a: 'uncertainty-aware-gaussian-map', t: ['高斯表示', '拓扑图', '离散环境'] },
    { n: '52. HarnessVLN (2026)', a: 'harnessvln', t: ['Agentic', '零样本', '实机部署', '拓扑图'] },
    { n: '53. GroundingVLN (2026)', a: 'groundingvln', t: ['双系统', 'CoT', '强化学习', '连续环境', '实机部署', '数据集'] },
    { n: '54. GPT-6-Astra (2026)', a: 'gpt-6-astra', t: ['Agentic', '零样本', '连续环境'] },
    { n: '55. BudVLN (2026)', a: 'budvln', t: ['端到端', '强化学习', '连续环境'] },
  ];

  var ALL_TAGS = ['双系统', '端到端', 'Agentic', 'CoT', '扩散模型', '拓扑图', 'SLAM', '高斯表示',
                  '强化学习', '零样本', '世界模型', '数据增强',
                  '连续环境', '离散环境', '实机部署', '加速优化', '数据集', '基础工作', 'BEV'];

  var activeTags = [];
  var resultsPanel = null;

  function getTagsForTitle(text) {
    for (var i = 0; i < TAG_MAP.length; i++) {
      if (text.indexOf(TAG_MAP[i].m) !== -1) return TAG_MAP[i].t;
    }
    return null;
  }

  function toggleTag(tag) {
    var idx = activeTags.indexOf(tag);
    if (idx === -1) activeTags.push(tag);
    else activeTags.splice(idx, 1);
    updateFilter();
  }

  // AND logic: paper must have ALL selected tags
  function sectionMatches(sectionTags) {
    return activeTags.every(function (t) {
      return sectionTags.indexOf(t) !== -1;
    });
  }

  function updateFilter() {
    var sections = document.querySelectorAll('.paper-section');
    var bar = document.getElementById('paper-filter-bar');
    var matchedSections = [];

    // Update button active states
    bar.querySelectorAll('.filter-btn').forEach(function (btn) {
      var t = btn.getAttribute('data-tag');
      if (t === '__all__') {
        btn.classList.toggle('active', activeTags.length === 0);
      } else {
        btn.classList.toggle('active', activeTags.indexOf(t) !== -1);
      }
    });

    // Show/hide sections (AND logic)
    sections.forEach(function (s) {
      var sectionTags = s.getAttribute('data-tags').split(',');
      var visible = activeTags.length === 0 || sectionMatches(sectionTags);
      s.classList.toggle('hidden', !visible);
      if (visible) matchedSections.push(s);
    });

    // 另一篇的匹配项：只列出，不参与本页的显示/隐藏
    var matchedRemote = REMOTE_PAPERS.filter(function (p) {
      return activeTags.length === 0 || sectionMatches(p.t);
    });

    // Update count（两篇合计）
    var totalAll = sections.length + REMOTE_PAPERS.length;
    var matchedAll = matchedSections.length + matchedRemote.length;
    var countEl = bar.querySelector('.filter-count');
    if (countEl) {
      countEl.textContent = activeTags.length === 0
        ? '共 ' + totalAll + ' 篇'
        : matchedAll + ' / ' + totalAll + ' 篇';
    }

    // Update results panel
    updateResultsPanel(matchedSections, matchedRemote);
  }

  function updateResultsPanel(matchedSections, matchedRemote) {
    if (!resultsPanel) return;
    if (activeTags.length === 0) {
      resultsPanel.style.display = 'none';
      return;
    }
    resultsPanel.style.display = 'block';
    var list = resultsPanel.querySelector('.results-list');
    list.innerHTML = '';

    matchedSections.forEach(function (s) {
      var h2 = s.querySelector('h2');
      if (!h2) return;
      var li = document.createElement('li');
      var a = document.createElement('a');
      a.href = '#' + h2.id;
      // 主题会在标题末尾插一个 '#' 锚链，去掉它，否则和跨页条目显示不一致
      a.textContent = h2.textContent.trim().replace(/#$/, '').trim();
      li.appendChild(a);
      list.appendChild(li);
    });

    // 另一篇的匹配论文：跳到对应页面的锚点
    matchedRemote.forEach(function (p) {
      var li = document.createElement('li');
      li.className = 'results-remote';
      var a = document.createElement('a');
      a.href = REMOTE_PAGE.url + '#' + p.a;
      a.textContent = p.n;
      li.appendChild(a);
      var badge = document.createElement('span');
      badge.className = 'results-badge';
      badge.textContent = REMOTE_PAGE.label;
      li.appendChild(badge);
      list.appendChild(li);
    });
  }

  function buildFilterBar() {
    var bar = document.getElementById('paper-filter-bar');
    if (!bar) return;

    var label = document.createElement('span');
    label.className = 'filter-label';
    label.textContent = '筛选：';
    bar.appendChild(label);

    var allBtn = document.createElement('button');
    allBtn.className = 'filter-btn active';
    allBtn.setAttribute('data-tag', '__all__');
    allBtn.textContent = '全部';
    allBtn.addEventListener('click', function () {
      activeTags = [];
      updateFilter();
    });
    bar.appendChild(allBtn);

    ALL_TAGS.forEach(function (tag) {
      var btn = document.createElement('button');
      btn.className = 'filter-btn';
      btn.setAttribute('data-tag', tag);
      btn.textContent = tag;
      btn.addEventListener('click', function () { toggleTag(tag); });
      bar.appendChild(btn);
    });

    var count = document.createElement('span');
    count.className = 'filter-count';
    bar.appendChild(count);

    // Results panel injected right after filter bar
    resultsPanel = document.createElement('div');
    resultsPanel.className = 'paper-filter-results';
    resultsPanel.style.display = 'none';
    var rLabel = document.createElement('span');
    rLabel.className = 'results-label';
    rLabel.textContent = '匹配论文：';
    var rList = document.createElement('ul');
    rList.className = 'results-list';
    resultsPanel.appendChild(rLabel);
    resultsPanel.appendChild(rList);
    bar.insertAdjacentElement('afterend', resultsPanel);
  }

  function wrapSections() {
    var entry = document.querySelector('.entry');
    if (!entry) return;

    var children = Array.from(entry.childNodes);
    var newChildren = [];
    var wrapper = null;

    children.forEach(function (node) {
      var isEl = node.nodeType === 1;
      var tagName = isEl ? node.tagName : null;

      if (tagName === 'H1') {
        if (wrapper) { newChildren.push(wrapper); wrapper = null; }
        newChildren.push(node);
      } else if (tagName === 'H2') {
        if (wrapper) { newChildren.push(wrapper); wrapper = null; }
        // 只有「N. 论文名」形式的标题才是论文章节；排行榜等标题（如「① R2R-CE」）
        // 会子串命中 TAG_MAP 里的 'R2R'，不能被包成论文章节参与筛选
        var paperTags = /^\s*\d+\.\s/.test(node.textContent) ? getTagsForTitle(node.textContent) : null;
        if (paperTags) {
          wrapper = document.createElement('div');
          wrapper.className = 'paper-section';
          wrapper.setAttribute('data-tags', paperTags.join(','));
          wrapper.appendChild(node);
          var row = document.createElement('div');
          row.className = 'paper-tags-row';
          paperTags.forEach(function (t) {
            var span = document.createElement('span');
            span.className = 'paper-tag';
            span.textContent = t;
            span.addEventListener('click', function () { toggleTag(t); });
            row.appendChild(span);
          });
          wrapper.appendChild(row);
        } else {
          newChildren.push(node);
        }
      } else {
        if (wrapper) wrapper.appendChild(node);
        else newChildren.push(node);
      }
    });

    if (wrapper) newChildren.push(wrapper);

    while (entry.firstChild) entry.removeChild(entry.firstChild);
    newChildren.forEach(function (n) { entry.appendChild(n); });
  }

  document.addEventListener('DOMContentLoaded', function () {
    wrapSections();
    buildFilterBar();
    updateFilter();
  });
})();
</script>

<!-- 图片后台预取：打开页面时不加载任何图片（靠 loading="lazy"），
     页面 load 完成后在浏览器空闲时按文档顺序静默预取全部图片填入缓存，
     使读者滚动到任意位置时图片已就位，既不卡开头也不必等待。 -->
<script>
(function () {
  var CONCURRENCY = 3;

  function prefetchAll() {
    // 尊重"流量节省"设置与极慢网络，此时不做预取
    var conn = navigator.connection;
    if (conn && (conn.saveData || /(^|-)2g$/.test(conn.effectiveType || ''))) return;

    var nodes = document.querySelectorAll('img[loading="lazy"]');
    var urls = [], seen = {};
    for (var i = 0; i < nodes.length; i++) {
      var u = nodes[i].src;
      if (u && !seen[u]) { seen[u] = 1; urls.push(u); }
    }
    if (!urls.length) return;

    var next = 0;
    function pump() {
      if (next >= urls.length) return;
      var probe = new Image();
      probe.onload = probe.onerror = pump;   // 无论成败都继续下一张
      probe.src = urls[next++];
    }
    for (var k = 0; k < CONCURRENCY && k < urls.length; k++) pump();
  }

  function schedule() {
    if (window.requestIdleCallback) requestIdleCallback(prefetchAll, { timeout: 2000 });
    else setTimeout(prefetchAll, 500);
  }

  if (document.readyState === 'complete') schedule();
  else window.addEventListener('load', schedule);
})();
</script>

<script src="/js/leaderboard.js"></script>]]></content><author><name>Tingde Liu</name></author><category term="research" /><category term="VLN" /><category term="VLA" /><category term="Robotics" /><category term="Computer Vision" /><category term="Deep Learning" /><summary type="html"><![CDATA[VLN 论文精读的扩展篇：目标导航（ObjectNav、HM3D-OVON、图像 / 点目标）性能排行榜，以及主篇之外的其余论文，多为近期预印本。]]></summary></entry><entry><title type="html">世界模型综述</title><link href="https://garylee1210.github.io/World-Models-Survey/" rel="alternate" type="text/html" title="世界模型综述" /><published>2026-09-28T00:00:00+00:00</published><updated>2026-09-28T00:00:00+00:00</updated><id>https://garylee1210.github.io/World-Models-Survey</id><content type="html" xml:base="https://garylee1210.github.io/World-Models-Survey/"><![CDATA[<h1 id="1-引言">1. 引言</h1>

<p>具身智能（Embodied AI）的终极目标是开发能够像人类一样在复杂、连续且不可逆的物理世界中进行感知、推理并执行任务的通用智能体（Generalist Embodied Agents）。近年来，视觉-语言-动作（Vision-Language-Action, VLA）模型的崛起，标志着具身智能向通用化迈出了关键一步。VLA 模型通过微调多模态大语言模型（LLMs/VLMs）的语义常识与视觉推理能力，将开放式高层自然语言指令直接映射到底层机器人控制 Token。</p>

<p>然而，单纯依靠反应式映射的 VLA 智能体在真实物理场景部署中面临<strong>四个根本瓶颈</strong>：</p>

<ol>
  <li><strong>物理幻觉与无常识（Physical Hallucination）</strong>：现有的 VLA 模型本质上是模式匹配器，生成的动作往往缺乏对刚体约束、重力、摩擦力、流体动力学等物理规律的显式认知，容易做出穿模、抓空或破坏环境的危险行为。</li>
  <li><strong>计划前瞻与因果验证缺失（Lack of Foresight &amp; Plan Verification）</strong>：反应式策略无法在脑海中预演动作执行后的物理后果，难以在行动前进行假设性验证（Counterfactual Reasoning），导致在长程或不可逆任务中一旦出错即彻底失败。</li>
  <li><strong>真实交互数据稀缺与分布长尾（Extreme Data Scarcity）</strong>：高质量的机器人真机遥操作数据获取成本高昂、危险度大，真实世界的长尾场景与失败分布极难被有限的离线数据集所覆盖。</li>
  <li><strong>不可逆破坏与安全性风险（Safety &amp; Irreversibility）</strong>：在物理世界中盲目试错伴随着昂贵的硬件损耗甚至人身安全风险，智能体必须在物理执行前拥有自我保护与风险预判能力。</li>
</ol>

<p>为了攻克上述挑战，<strong>世界模型（World Models）</strong> 被引入具身智能领域，作为智能体的<strong>“认知大脑”与“内部物理仿真器”</strong>。通过对环境时空演化动力学的深度建模，世界模型赋予了智能体<strong>感知物理常识、脑内推演未来、合成海量数据与在想象中自优化</strong>的核心能力。</p>

<div align="center">
  <img src="/images/wm/Survey-Fig1-Overview.webp" width="75%" />
<figcaption>图：具身智能世界模型全景总览。世界模型（交互性、未来预测、物理接地）与 VLA（通用策略、开放指令、多模态推理）的深度融合，赋予智能体前瞻规划、虚拟仿真、联合决策和数据飞轮四大核心能力。（图源：Tan et al., 2026）</figcaption>
</div>

<p>本文参考 Tan et al., 2026 <a href="#ref-1">[1]</a> 与 Li et al., 2025/2026 <a href="#ref-2">[2]</a> 等综述，按「定义 → 经典奠基 → 工程设计 → 两大模型家族 → 基础模型 → 评测 → 挑战」的顺序组织：§2 给出形式化定义与分类框架；§3 回顾经典有模型 RL 的三项奠基工作；§4 从工程实现角度拆解世界模型的关键设计选择；§5、§6 分别介绍以相机 / 交互为条件的世界生成器，以及服务于机器人决策的四大范式与代表工作；§7 介绍 Cosmos、Wan 等基础模型与平台；§8 汇总评测基准；§9 讨论开放挑战与实践启示。</p>

<hr />

<h1 id="2-定义分类与演进">2. 定义、分类与演进</h1>

<h2 id="21-什么是世界模型">2.1 什么是世界模型</h2>

<h3 id="认知科学起源">认知科学起源</h3>

<p>“世界模型”这一概念并非源于深度学习，而是植根于认知科学与控制论的深厚土壤：</p>
<ul>
  <li><strong>心理模型假说（Mental Models）</strong>：早在 1943 年，认知科学家 Kenneth Craik 在 <em>The Nature of Explanation</em> 中提出，人类大脑在头脑内部运行着一个微型“心理模型”，能够在实际采取危险行动之前，在脑中模拟替代方案的后果。</li>
  <li><strong>自由能原理与预测编码（Predictive Coding）</strong>：Karl Friston 等人指出，生物大脑本质上是一个层级化的预测机器，通过不断最小化“内部感知预测”与“外部真实输入”之间的预测误差（Prediction Error）来理解世界并指导行动。</li>
  <li><strong>自主机器智能架构（Yann LeCun, 2022）</strong>：Yann LeCun 在其机器智能愿景中强调，世界模型是自主智能体不可或缺的核心模块，负责根据当前状态与候选动作预测世界可能出现的演化。</li>
</ul>

<div align="center">
  <img src="/images/wm/wmandvla.png" width="90%" />
<figcaption>图：物理 AI 世界模型（Cosmos WM）与具身策略模型（OpenVLA）的功能定位对比：前者负责环境演化与物理仿真，后者负责动作决策与执行。</figcaption>
</div>

<h3 id="数学形式化">数学形式化</h3>

<p>在具身智能语境下，真实物理世界通常被建模为一个部分可观测马尔可夫决策过程（POMDP），由元组 \((\mathcal{S}, \mathcal{A}, \mathcal{O}, \mathcal{T}, \mathcal{E}, \mathcal{R}, \gamma)\) 描述。由于真实状态 \(s_t \in \mathcal{S}\) 无法直接获取，智能体只能接收高维视觉观测 \(o_t \in \mathcal{O}\)（如 RGB-D 图像、点云）。</p>

<p><strong>世界模型</strong> \(\mathcal{W}_\phi\) 的核心任务是通过学习参数 \(\phi\)，在紧凑潜空间或像素空间中近似环境的联合前向转移分布：</p>

\[P_\phi(s_{t+1}, o_{t+1}, r_t \mid s_{\le t}, a_t, o_{\le t})\]

<p>其中：</p>
<ul>
  <li><strong>状态转移模型（Dynamics / Transition Model）</strong>：\(s_{t+1} \sim P_\phi(s_{t+1} \mid s_t, a_t)\)，刻画动作引发的环境内在物理状态跃迁；</li>
  <li><strong>观测解码/预测模型（Observation Predictor）</strong>：\(o_{t+1} \sim P_\phi(o_{t+1} \mid s_{t+1})\) 或直接在像素层建模 \(o_{t+1} \sim \mathcal{W}_\phi(o_{t+1} \mid o_{\le t}, a_t)\)；</li>
  <li><strong>奖励与终止评估模型（Reward &amp; Termination Model）</strong>：\(r_t \sim P_\phi(r_t \mid s_t, a_t), \; c_t \sim P_\phi(c_t \mid s_t)\)，用于在想象中评估状态价值与任务进度。</li>
</ul>

<hr />

<h2 id="22-分类框架">2.2 分类框架</h2>

<p>“世界模型”一词目前被用来指代两类目标差异很大的系统。先把它们分开，后面的讨论才不会混淆。</p>

<h3 id="两大家族">两大家族</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">维度</th>
      <th style="text-align: left">家族 A：世界生成器（§5）</th>
      <th style="text-align: left">家族 B：面向机器人决策的世界模型（§6）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>条件信号</strong></td>
      <td style="text-align: left">相机位姿、键盘 / 潜动作、文本或图像</td>
      <td style="text-align: left">机器人动作（关节 / 末端位姿 / 底盘速度）或任务指令</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>输出</strong></td>
      <td style="text-align: left">可持续探索的视频流或 3D 场景（3DGS / 点云）</td>
      <td style="text-align: left">未来观测、动作，或二者的联合分布</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>核心指标</strong></td>
      <td style="text-align: left">时空一致性、可控性、生成速度</td>
      <td style="text-align: left">下游任务成功率、策略评估的可信度</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>与策略的关系</strong></td>
      <td style="text-align: left">间接：作为神经仿真环境或数据源</td>
      <td style="text-align: left">直接：参与规划、联合生成动作、合成数据或充当 RL 环境</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>代表工作</strong></td>
      <td style="text-align: left">Genie、LingBot-World、SANA-WM、Lyra 2.0、Marble &amp; Atlas、Image2Sim</td>
      <td style="text-align: left">GENE-26.5、WorldVLA、AIM、Motus、NavWAM、Qwen-RobotWorld、WoVR</td>
    </tr>
  </tbody>
</table>

<p>两大家族共享同一批基础模型（Wan、Cosmos、统一多模态模型等，见 §7），并在”世界合成器 / 世界模拟器”处交汇：家族 A 生成的可交互环境，常被家族 B 用作数据来源或 RL 训练场。</p>

<pre><code class="language-mermaid">flowchart LR
    FM["基础模型（§7）&lt;br/&gt;视频生成 / 统一多模态 / 表征 / 3D"] --&gt; A
    FM --&gt; B
    subgraph A["家族 A：世界生成器（§5）"]
        A1["2D 视频交互&lt;br/&gt;Genie / LingBot-World / SANA-WM"]
        A2["3D 显式世界&lt;br/&gt;Lyra 2.0 / Marble &amp; Atlas / Image2Sim"]
    end
    subgraph B["家族 B：面向决策的世界模型（§6）"]
        B1["世界规划器"]
        B2["世界动作模型 WAM"]
        B3["世界合成器"]
        B4["世界模拟器"]
    end
    A --&gt;|"神经仿真环境 / 合成数据"| B3
    A --&gt;|"可交互训练场"| B4
    B --&gt; Policy["机器人策略 π_θ"]
</code></pre>

<h3 id="家族-b-的四大范式">家族 B 的四大范式</h3>

<p>根据 Tan et al. (2026) <a href="#ref-1">[1]</a> 与 Li et al. (arXiv:2510.16732) <a href="#ref-2">[2]</a>，家族 B 按世界模型与策略的耦合方式分为四大范式：</p>

<ol>
  <li><strong>世界规划器（World Planner）</strong>：世界模型作为前向动力学引擎，预测显式未来帧或隐式潜嵌入，为下游策略提供前瞻性条件引导；</li>
  <li><strong>世界动作模型（World Action Model, WAM）</strong>：将世界状态演化与机器人控制动作纳入统一网络，联合建模观测与控制的联合分布；</li>
  <li><strong>世界合成器（World Synthesizer）</strong>：作为数据生成引擎，合成带标注的多视角、长程交互轨迹，支持大规模模仿学习；</li>
  <li><strong>世界模拟器（World Simulator）</strong>：将世界模型作为虚拟物理沙盒，结合强化学习（RL）算法在想象空间中优化策略参数。</li>
</ol>

<h3 id="三个建模维度">三个建模维度</h3>

<p>无论属于哪个家族，一个世界模型都可以在以下三个轴上定位：</p>

<ul>
  <li><strong>功能耦合度（Functionality Coupling）</strong>：
    <ul>
      <li><em>决策解耦（Decision-Decoupled / General Purpose）</em>：世界模型独立于特定动作空间预训练（如纯视频生成），下游通过逆动力学或特征微调适配；</li>
      <li><em>决策耦合（Decision-Coupled / Policy-Integrated）</em>：世界模型与动作头深度交织，动作作为原生 Token 或条件通道共同优化。</li>
    </ul>
  </li>
  <li><strong>时序建模方式（Temporal Modeling）</strong>：
    <ul>
      <li><em>序列自回归 / 自回归扩散（Sequential Simulation &amp; Rollout）</em>：逐步展开未来状态 \(s_{t+1}, s_{t+2}, \dots\)，适合长程交互与连续物理演变；</li>
      <li><em>全局差分 / 跳步预测（Global Difference &amp; Jump-Step Prediction）</em>：直接预测关键子目标帧或最终转移差分 \(\Delta s\)，跳过中间无关微动态。</li>
    </ul>
  </li>
  <li><strong>空间与状态表征（Spatial &amp; State Representation）</strong>：
    <ul>
      <li><em>全局潜向量（Global Latent Vectors）</em>：如 RSSM、V-JEPA 2，高度抽象、计算快，但缺少细粒度空间几何；</li>
      <li><em>空间潜在网格（Spatial Latent Grids）</em>：如 DiT Latent Patches、VAE 特征图，在感知保真度与计算效率之间折中；</li>
      <li><em>显式几何场（Explicit 3D Fields）</em>：如 3DGS、点云（Point Clouds）、占据栅格（Occupancy Grids），具备天然的 3D 空间一致性与度量约束；</li>
      <li><em>统一多模态画布（Unified Latent Canvas）</em>：如 NavWAM、Cosmos 3，将视觉、动作、状态、价值拼装为同一张时空画布。</li>
    </ul>
  </li>
</ul>

<h3 id="代表性工作速查表">代表性工作速查表</h3>

<p>下表按本文章节顺序汇总正文详细介绍的工作，”归属”一列标注其所在家族与范式：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">论文 / 模型</th>
      <th style="text-align: center">年份</th>
      <th style="text-align: left">归属</th>
      <th style="text-align: left">核心技术机制</th>
      <th style="text-align: left">关键结果（论文报告）</th>
      <th style="text-align: center">详见</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>Genie</strong></td>
      <td style="text-align: center">2024</td>
      <td style="text-align: left">A · 交互环境生成</td>
      <td style="text-align: left">潜在动作模型 (LAM) + ST-Transformer + MaskGIT 动力学（11B）</td>
      <td style="text-align: left">无动作标注学出 8 个离散潜动作，任意图像转可玩环境（160×90）</td>
      <td style="text-align: center"><a href="#paper-genie">§5.1</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>LingBot-World</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">A · 实时交互生成</td>
      <td style="text-align: left">分层语义数据引擎 + 三阶段训练 + 动作注入</td>
      <td style="text-align: left">16 fps 实时推演（亚秒级延迟），60s 场景重访结构一致</td>
      <td style="text-align: center"><a href="#paper-lingbot-world">§5.2</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>SANA-WM</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">A · 高效长视频生成</td>
      <td style="text-align: left">混合线性 GDN/Softmax + 双分支相机控制 (UCPE+Plücker) + 两阶段精化</td>
      <td style="text-align: left">VBench Overall 80.62/81.89；RTX 5090 上 34s 生成 60s 720p</td>
      <td style="text-align: center"><a href="#paper-sana-wm">§5.3</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Lyra 2.0</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">A · 3D 场景生成</td>
      <td style="text-align: left">几何记忆解耦 + 空间记忆检索路由 + 自增强去漂移</td>
      <td style="text-align: left">800 帧以上长程生成仍保持几何一致，可重建为 3DGS</td>
      <td style="text-align: center"><a href="#paper-lyra">§5.4</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Marble &amp; Atlas</strong></td>
      <td style="text-align: center">2025–2026</td>
      <td style="text-align: left">A · 3D 世界 / 空间智能</td>
      <td style="text-align: left">多模态自回归流匹配 Transformer + 统一空间上下文 + 3DGS / 点云输出</td>
      <td style="text-align: left">控镜盲测偏好 75%~94%，3D 重建 AbsRel 25.3</td>
      <td style="text-align: center"><a href="#paper-marble">§5.5</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Image2Sim</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">A · 神经仿真环境</td>
      <td style="text-align: left">前馈 3D 特征高斯锚定 + 单步 Pixel Flow (MeanFlow) 渲染</td>
      <td style="text-align: left">全景 RGB-D 45.6 FPS；自动构建 2 万个环境，R2R-CE 零样本 70.3%</td>
      <td style="text-align: center"><a href="#paper-image2sim">§5.6</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>GENE-26.5</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">B · 世界规划器</td>
      <td style="text-align: left">Flow Matching 联合分布 + 条件查询</td>
      <td style="text-align: left">新任务 &lt; 1 小时真机数据即可微调</td>
      <td style="text-align: center"><a href="#paper-gene">§6.1</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>VLA-World</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">B · 世界规划器（自动驾驶）</td>
      <td style="text-align: left">单帧未来生成 + 反思推理（Think with Generated future）+ GRPO</td>
      <td style="text-align: left">nuScenes 碰撞率 1.09% → 0.94%</td>
      <td style="text-align: center"><a href="#paper-vla-world">§6.1</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>WorldVLA</strong></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: left">B · WAM（自回归）</td>
      <td style="text-align: left">统一自回归骨干 + 动作注意力掩码 + 视频预测预训练</td>
      <td style="text-align: left">LIBERO Avg 81.8%</td>
      <td style="text-align: center"><a href="#paper-worldvla">§6.2</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>AIM</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">B · WAM（扩散）</td>
      <td style="text-align: left">空间价值图 (ASVM) + 意图因果注意力 + 价值自蒸馏 RL</td>
      <td style="text-align: left">RoboTwin 2.0 Avg SR 93.1%</td>
      <td style="text-align: center"><a href="#paper-aim">§6.2</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Motus</strong></td>
      <td style="text-align: center">2025/2026</td>
      <td style="text-align: left">B · WAM（MoT）</td>
      <td style="text-align: left">三专家 MoT + 光流潜动作 + UniDiffuser 联合去噪调度</td>
      <td style="text-align: left">RoboTwin 2.0 Avg 87.8%，单步 80ms</td>
      <td style="text-align: center"><a href="#paper-motus">§6.2</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>NavWAM &amp; WAM-Nav</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">B · WAM（导航）</td>
      <td style="text-align: left">统一潜时空画布 + 非对称视界 + 双流特征融合</td>
      <td style="text-align: left">推理 205.7 ms（约 5Hz），较 NWM 快 1100×；真机成功率 79.2% / 85%</td>
      <td style="text-align: center"><a href="#paper-navwam">§6.2</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Qwen-RobotWorld</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">B · 世界合成器</td>
      <td style="text-align: left">双流 MMDiT + 自然语言统一动作接口 + 跨本体接地</td>
      <td style="text-align: left">EWMBench 4.60 (#1)，WorldModelBench 8.99</td>
      <td style="text-align: center"><a href="#paper-qwen-robotworld">§6.3</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>WoVR</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">B · 世界模拟器</td>
      <td style="text-align: left">世界模型内 RL + 关键帧初始化 (KIR) + 策略协同演化 (PACE)</td>
      <td style="text-align: left">LIBERO 平均 SR 39.95% → 69.2%；真机 61.7% → 91.7%</td>
      <td style="text-align: center"><a href="#paper-wovr">§6.4</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Cosmos / Cosmos 3</strong></td>
      <td style="text-align: center">2025–2026</td>
      <td style="text-align: left">基础模型平台</td>
      <td style="text-align: left">数据策展 + Predict / Transfer / Reason 产品线；Cosmos 3 以双塔 MoT 统一理解、生成与动作</td>
      <td style="text-align: left">Cosmos3-Nano-Policy 在 RoboArena / RoboLab 真机评测第 1</td>
      <td style="text-align: center"><a href="#cosmos">§7.2</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Wan2.1</strong></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: left">视频生成底座</td>
      <td style="text-align: left">时空 VAE (4×8×8) + DiT + Flow Matching + VACE</td>
      <td style="text-align: left">开源 T2V/I2V 底座，1.3B 版本 RTX 4090 可跑</td>
      <td style="text-align: center"><a href="#paper-wan">§7.4</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Janus-Pro</strong></td>
      <td style="text-align: center">2025</td>
      <td style="text-align: left">统一理解与生成底座</td>
      <td style="text-align: left">理解 / 生成解耦视觉编码 + 自回归 Transformer</td>
      <td style="text-align: left">MMBench 79.2、GenEval 0.80（7B）</td>
      <td style="text-align: center"><a href="#paper-janus-pro">§7.5</a></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>VideoGen in Robotics</strong></td>
      <td style="text-align: center">2026</td>
      <td style="text-align: left">综述</td>
      <td style="text-align: left">视频生成在机器人中的应用分类与评测</td>
      <td style="text-align: left">梳理数据、架构与下游评测</td>
      <td style="text-align: center"><a href="#paper-videogen">§7.6</a></td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="23-双系统架构">2.3 双系统架构</h2>

<p>在大模型时代的具身系统中，世界模型通常被放进一种<strong>双系统（Dual-System）架构</strong>里，按频率分工：</p>

<pre><code class="language-mermaid">flowchart TD
    Env["真实物理环境 / 机器人本体"] --&gt;|"多视角观测 o_t, 本体感觉 s_t"| Perception["多模态感知编码器\n(ViT / DINOv3 / SigLIP)"]
    Instruct["开放式语言任务指令"] --&gt; Perception

    subgraph System2["慢系统 System 2：认知推理与世界模拟 (1Hz – 5Hz)"]
        direction TB
        WM["生成式世界模型 W_φ\n(DiT / Flow Matching 动力学)"]
        VLM["多模态大语言模型 (MLLM)\n(高层意图分解、因果推理、常识验证)"]
        ValueMap["空间价值图 / 交互意图预测 (ASVM)"]
        WM &lt;--&gt; VLM
        WM --&gt; ValueMap
    end

    Perception --&gt; System2
    Perception --&gt; System1

    subgraph System1["快系统 System 1：反应式高频运动控制 (50Hz – 500Hz)"]
        direction TB
        Policy["动作解码器 / 扩散策略 (Policy Head)\n(Diffusion Policy / Action Flow Matching)"]
        LowCtrl["低级关节控制器\n(EtherCAT / 阻抗控制 / 扭矩输出)"]
        Policy --&gt; LowCtrl
    end

    System2 --&gt;|"前瞻潜引导 z_{t+1} / 空间价值约束 / 子目标"| Policy
    LowCtrl --&gt;|"控制扭矩 / 关节速度 a_t"| Env

    style System2 fill:#fff4e6,stroke:#d68910,stroke-width:2px
    style System1 fill:#e8f4fd,stroke:#2c7fb8,stroke-width:2px
</code></pre>

<ol>
  <li><strong>慢系统（System 2，认知推理与世界模拟，1Hz–5Hz）</strong>：
    <ul>
      <li>由世界模型（WM）与多模态大模型（VLM）组成，负责长时程任务规划、环境动态推演、物理常识校验、意图分析以及危险评估；</li>
      <li>通过生成未来潜特征 \(z_{t+1}\) 或空间价值热图，为底层提供物理接地的条件引导。</li>
    </ul>
  </li>
  <li><strong>快系统（System 1，反应式高频动作执行，50Hz–500Hz）</strong>：
    <ul>
      <li>由轻量级策略网络（如 Diffusion Policy、Action Flow Matching）与底层控制器构成，负责根据当前状态与 System 2 提供的物理先验，以极低延迟实时生成平滑、精确的电机扭矩或关节轨迹。</li>
    </ul>
  </li>
</ol>

<hr />

<h2 id="24-演进时间线20182026">2.4 演进时间线（2018–2026）</h2>

<div align="center">
  <img src="/images/wm/Survey-Fig2-Timeline.webp" width="100%" />
<figcaption>图：具身智能世界模型演化时间线。从 2018 年潜空间梦境训练奠基，到 2023 年视频生成驱动规划，再到 2025–2026 年世界动作模型（WAM）、全模态基础模型（Cosmos 3）与可探索 3D 宇宙（Lyra 2.0 / Marble）的爆发。（图源：Tan et al., 2026）</figcaption>
</div>

<p><strong>关键演进脉络</strong>：</p>
<ul>
  <li><strong>2018–2022年（MBRL 奠基期）</strong>：World Models 提出 V-M-C 梦境训练；PlaNet 引入 RSSM；DreamerV1/V2 建立潜空间 Actor-Critic；</li>
  <li><strong>2023–2024年（视频先验与 3D 萌芽期）</strong>：UniPi、SuSIE 探索利用视频扩散模型进行文字引导规划；GR-1 开创自回归视频动作预训练；3D-VLA 引入 3D 几何先验；DreamerV3 发表并通关 Minecraft；TD-MPC2 统一 104 种具身控制；</li>
  <li><strong>2025年（四大范式爆发期）</strong>：WorldVLA、UniVLA 统一自回归序列建模；DreamGen、GigaWorld-0 构建数据合成飞轮；VLA-RFT、WoVR 开启世界模型内部强化学习；Cosmos 平台建立工业级数据与模型体系；</li>
  <li><strong>2026年（全模态收敛与空间智能时代）</strong>：Cosmos 3 以 MoT 架构统一理解-生成-动作；SANA-WM 实现分钟级高效生成；Lyra 2.0 与 Marble 奠定 3DGS 可探索持久宇宙；World Labs Atlas 发布全模态自回归流匹配基座，将相机几何与 3D 深度纳为原生模态并赋能 Real-to-Sim 具身仿真；Motus、AIM、NavWAM 等推动世界动作模型走向主流。</li>
</ul>

<hr />

<h1 id="3-经典奠基有模型强化学习">3. 经典奠基：有模型强化学习</h1>

<blockquote>
  <p>💡 <strong>姊妹篇导读</strong>：关于经典强化学习数学基础、Bellman 算子推导、无模型与有模型 RL（DreamerV3 / TD-MPC2）的系统性算法剖析，详见专题博文 <a href="/Reinforcement-Learning-Survey/">强化学习（RL）全景综述：从马尔可夫决策过程、价值/策略迭代到前沿具身控制</a>。</p>
</blockquote>

<p>在现代视频扩散基础模型爆发之前，世界模型在有模型强化学习（Model-Based Reinforcement Learning, MBRL）领域经历了数代关键演化，奠定了整个领域的数学理论与算法基石。</p>

<h2 id="31-world-models-2018">3.1 World Models (2018)</h2>

<p>David Ha 与 Jürgen Schmidhuber 提出的 <strong>World Models</strong> <a href="#ref-3">[3]</a> 首次在深度学习框架下完整实现了认知科学中的 <strong>V-M-C 三位一体架构</strong>：</p>

<div align="center">
  <img src="/images/wm/WorldModels-vmc-overview.webp" width="90%" />
<figcaption>图：World Models (2018) 的 V-M-C 核心架构：视觉感知 V（VAE）、记忆动力学 M（MDN-RNN）与轻量控制器 C。（图源：Ha &amp; Schmidhuber, 2018）</figcaption>
</div>

<ol>
  <li><strong>V 模型（Vision Model / VAE）</strong>：将高维输入图像帧 \(o_t\) 压缩为 32 维连续高斯潜向量 \(z_t \sim \mathcal{N}(\mu, \sigma^2)\)，过滤与控制无关的高频视觉噪声；</li>
  <li>
    <p><strong>M 模型（Memory Model / MDN-RNN）</strong>：基于带有混合高斯输出层（MDN）的 LSTM，自回归预测下一时刻潜状态的多分支概率分布：</p>

\[P(z_{t+1} \mid a_t, z_t, h_t) = \sum_{k=1}^K \pi_k(h_t) \mathcal{N}\left( z_{t+1};\; \mu_k(h_t), \Sigma_k(h_t) \right)\]
  </li>
  <li><strong>C 模型（Controller）</strong>：仅包含千余参数的超轻量前馈网络，直接将 \(z_t\) 与循环隐状态 \(h_t\) 映射为控制动作 \(a_t = W_c [z_t \; h_t] + b_c\)。</li>
</ol>

<div align="center">
  <img src="/images/wm/WorldModels-flow-diagram.webp" width="90%" />
<figcaption>图：World Models 完整数据流：离线收集经验训练 V 与 M，随后在完全脱离真实环境的 RNN 梦境中训练控制器 C。（图源：Ha &amp; Schmidhuber, 2018）</figcaption>
</div>

<blockquote>
  <p><strong>关键结果</strong>：World Models 展示了<strong>在学到的世界模型内部训练策略（Training inside the Dream）</strong>的可行性。在 VizDoom 中，控制器完全在 M 模型自回归展开的”梦境”里用进化策略（CMA-ES）训练，随后直接迁移回真实游戏环境，仍能躲避火球；在 CarRacing-v0 中，控制器以 V、M 的特征为输入在真实环境中训练，平均得分超过 900，首次解决了该任务。</p>
</blockquote>

<hr />

<h2 id="32-dreamer-系列-20202025">3.2 Dreamer 系列 (2020–2025)</h2>

<p>Danijar Hafner 等人开创的 <strong>Dreamer 系列</strong> <a href="#ref-4">[4]</a>（DreamerV1 $\to$ V2 $\to$ V3；V3 于 2023 年以 <em>Mastering Diverse Domains through World Models</em> 为题发布于 arXiv，2025 年以 <em>Mastering diverse control tasks through world models</em> 为题正式发表于 <em>Nature</em>）将有模型 RL 推向了通用化。</p>

<div align="center">
  <img src="/images/wm/DreamerV3-training-architecture.webp" width="95%" />
<figcaption>图：DreamerV3 训练流水线：(a) 从真实经验中自监督学习 RSSM 世界模型；(b) 在潜空间自回归展开轨迹；(c) 在想象中优化 Actor-Critic 策略。（图源：Hafner et al., Nature 2025）</figcaption>
</div>

<p>Dreamer 解决了连续世界模型长期存在的表示坍缩与数值不稳定性问题：</p>
<ol>
  <li><strong>循环状态空间模型（Recurrent State Space Model, RSSM）</strong>：将潜状态解耦为确定性时序特征 \(h_t = f_\phi(h_{t-1}, z_{t-1}, a_{t-1})\) 与离散随机变量 \(z_t\)（采用 32 个 32 类别的 Categorical 潜变量）。离散 Categorical 分布缓解了连续高斯分布在面对非线性突变（如门开/关、物体碎裂）时的模糊与坍缩问题；</li>
  <li>
    <table>
      <tbody>
        <tr>
          <td><strong>Symlog 变换与无量纲化设计</strong>：提出对称对数变换 $$\mathrm{symlog}(x) = \mathrm{sign}(x)\ln(</td>
          <td>x</td>
          <td>+1)$$ 统一缩放特征与回归目标，配合自适应百分位数价值归一化，解决了跨任务奖励尺度横跨 7 个数量级导致的梯度弥散与数值发散；</td>
        </tr>
      </tbody>
    </table>
  </li>
  <li><strong>通用性与 Minecraft 钻石任务</strong>：DreamerV3 使用<strong>同一套超参数与模型架构</strong>，在 Atari、Crafter、DMC、Procgen 等多个领域取得强性能，并成为首个在不使用人类数据与课程设计的条件下、在 Minecraft 中从零开始采集到钻石的算法——这一任务需要伐木、合成工作台、采矿、冶炼等一长串依赖步骤，且奖励极为稀疏。</li>
</ol>

<div align="center">
  <img src="/images/wm/DreamerV3-benchmark-summary.webp" width="90%" />
<figcaption>图：DreamerV3 在 7 大异构领域（2D 像素、连续控制、3D 长程沙盒）中的标准化性能对比。（图源：Hafner et al., Nature 2025）</figcaption>
</div>

<hr />

<h2 id="33-td-mpc2-2024">3.3 TD-MPC2 (2024)</h2>

<p>以往的世界模型（如 World Models、Dreamer）大多依赖逐像素的图像重建损失，大量网络算力被浪费在与下游控制无关的背景视觉细节上。Nicklas Hansen 等人提出的 <strong>TD-MPC 系列</strong> <a href="#ref-5">[5]</a> 实现了关键的技术转向：</p>

<div align="center">
  <img src="/images/wm/TD-MPC2-architecture.webp" width="90%" />
<figcaption>图：TD-MPC2 整体架构：无需逐像素解码重建，在紧凑潜空间中深度融合 MPPI 在线采样规划与时序差分（TD）长程价值学习。（图源：Hansen et al., ICLR 2024）</figcaption>
</div>

<ol>
  <li><strong>纯潜空间任务驱动（Task-Driven Latent Dynamics）</strong>：去掉像素解码器，潜状态只由三类信号约束——潜空间自洽性（预测的下一潜状态需与编码器对真实下一帧的编码一致）、即时奖励预测与 TD 价值目标；另训练一个策略先验，为规划提供初始采样；</li>
  <li><strong>MPPI 在线规划</strong>：推理时在 512 维潜空间中用 MPPI 采样并迭代优化一段短视界动作序列，视界之外的回报由学到的 Q 函数自举估计，兼顾在线规划精度与长程价值视野；</li>
  <li><strong>可扩展的多任务单模型</strong>：在 4 个领域共 104 个连续控制任务上使用同一套超参数，并训练出 317M 参数的单一智能体，在 80 个跨领域、跨本体、跨动作空间的任务上同时工作。</li>
</ol>

<hr />

<h2 id="34-从经典到大模型时代">3.4 从经典到大模型时代</h2>

<p>下表总结了世界模型在过去数年间的核心技术范式演进：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">演进维度</th>
      <th style="text-align: left">经典奠基期 (2018, World Models)</th>
      <th style="text-align: left">离散 RSSM 时代 (2023–2025, DreamerV3)</th>
      <th style="text-align: left">隐式 MPC 时代 (2024, TD-MPC2)</th>
      <th style="text-align: left">生成式基础模型时代 (2025–2026, Cosmos / WAM / SANA)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>状态表征</strong></td>
      <td style="text-align: left">连续高斯潜变量 (32D VAE)</td>
      <td style="text-align: left">离散 Categorical 潜变量 (32×32)</td>
      <td style="text-align: left">紧凑任务潜向量 (512D MLP/Trans.)</td>
      <td style="text-align: left">时空 Latent 网格 / 3DGS 显式场 / 统一 Canvas</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>动力学骨干</strong></td>
      <td style="text-align: left">LSTM / MDN-RNN</td>
      <td style="text-align: left">RSSM (GRU + Categorical)</td>
      <td style="text-align: left">MLP / 密集 Transformer</td>
      <td style="text-align: left">Diffusion Transformer (DiT) / Flow Matching / MoT</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>重建机制</strong></td>
      <td style="text-align: left">逐像素 2D 解码 (64×64)</td>
      <td style="text-align: left">逐像素 2D 解码 (64×64)</td>
      <td style="text-align: left"><strong>无像素重建</strong>（纯潜空间任务信号）</td>
      <td style="text-align: left">高压缩时空 VAE (4×8×8) / 单步生成 / 隐空间对齐</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>与策略关系</strong></td>
      <td style="text-align: left">解耦：梦境中离线进化 C</td>
      <td style="text-align: left">解耦：潜空间 Actor-Critic</td>
      <td style="text-align: left">耦合：在线 MPPI 轨迹优化</td>
      <td style="text-align: left">四大范式并存（规划器 / WAM / 合成器 / 模拟器）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>动作生成频率</strong></td>
      <td style="text-align: left">离线优化后真机部署</td>
      <td style="text-align: left">离线优化后真机部署</td>
      <td style="text-align: left">在线 MPPI 规划（每步重规划）</td>
      <td style="text-align: left">5Hz–15Hz 联合去噪 (WAM) 或 500Hz 混合控制</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>多任务与规模</strong></td>
      <td style="text-align: left">单任务小模型 (&lt;1M)</td>
      <td style="text-align: left">跨领域单模型 (~200M)</td>
      <td style="text-align: left">104 种具身多任务 (1M $\to$ 317M)</td>
      <td style="text-align: left">互联网级图文视频预训练 + 领域微调 (2B $\to$ 64B)</td>
    </tr>
  </tbody>
</table>

<hr />

<h1 id="4-核心工程设计空间">4. 核心工程设计空间</h1>

<p>§2 讲世界模型”是什么”，§5–§6 讲具体工作”做了什么”。本章处在二者之间，从工程实现角度回答：<strong>搭一个视频 / 潜空间世界模型，需要做哪几个关键决策，每个决策的代价是什么</strong>。本章的例子都来自后文详细介绍的工作，可作为阅读 §5–§7 时的对照索引。</p>

<pre><code class="language-mermaid">flowchart LR
    Obs["观测&lt;br/&gt;RGB / 深度 / 多视角"] --&gt; Tok["① 视觉 Tokenizer&lt;br/&gt;压缩率 vs 保真度"]
    Cond["条件&lt;br/&gt;动作 / 相机 / 语言"] --&gt; Inj["② 条件注入&lt;br/&gt;AdaLN / 交叉注意力 / 序列拼接 / Plücker"]
    Tok --&gt; BB["③ 时序生成骨干&lt;br/&gt;自回归 / 全序列扩散 / 分块自回归扩散"]
    Inj --&gt; BB
    Mem["④ 长程记忆&lt;br/&gt;KV Cache / 线性注意力 / 3D 缓存"] &lt;--&gt; BB
    BB --&gt; Dec["⑤ 推理加速&lt;br/&gt;步数蒸馏 / 单步生成"]
    Dec --&gt; Out["未来帧 / 动作 / 3D 场景"]
    Out --&gt; Eval["⑥ 有用性评估&lt;br/&gt;视觉指标 → 物理一致性 → 下游成功率"]
</code></pre>

<h2 id="41-视觉-tokenizer">4.1 视觉 Tokenizer</h2>

<p>视频世界模型的计算量几乎完全由潜空间 token 数决定。Tokenizer 的压缩率越高，同样算力下能展开的时长越长，但细小物体、夹爪接触面等对操作任务关键的细节也越容易丢失。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Tokenizer</th>
      <th style="text-align: left">表示类型</th>
      <th style="text-align: left">压缩方式</th>
      <th style="text-align: left">使用者（本文涉及）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Cosmos Tokenizer</td>
      <td style="text-align: left">连续 + 离散</td>
      <td style="text-align: left">小波变换 + 因果 3D 卷积</td>
      <td style="text-align: left">Cosmos-Predict1 扩散 / 自回归两条路线（§7.2）</td>
    </tr>
    <tr>
      <td style="text-align: left">Wan2.1 VAE</td>
      <td style="text-align: left">连续</td>
      <td style="text-align: left">因果 3D VAE，时间×高×宽 4×8×8</td>
      <td style="text-align: left">Wan2.1、Cosmos-Predict2.5（§7.2、§7.4）</td>
    </tr>
    <tr>
      <td style="text-align: left">Wan2.2 VAE（TI2V-5B）</td>
      <td style="text-align: left">连续</td>
      <td style="text-align: left">更高空间压缩</td>
      <td style="text-align: left">Cosmos 3 生成塔（§7.3）</td>
    </tr>
    <tr>
      <td style="text-align: left">LTX-2 VAE</td>
      <td style="text-align: left">连续</td>
      <td style="text-align: left">压缩率显著高于 Wan2.1 VAE</td>
      <td style="text-align: left">SANA-WM（§5.3）</td>
    </tr>
    <tr>
      <td style="text-align: left">ST-ViViT VQ</td>
      <td style="text-align: left">离散</td>
      <td style="text-align: left">时空 Transformer + 向量量化</td>
      <td style="text-align: left">Genie（§5.1）</td>
    </tr>
    <tr>
      <td style="text-align: left">Chameleon 类图像 Tokenizer</td>
      <td style="text-align: left">离散</td>
      <td style="text-align: left">逐帧 VQ</td>
      <td style="text-align: left">WorldVLA 等自回归 WAM（§6.2）</td>
    </tr>
  </tbody>
</table>

<p><strong>工程经验</strong>：</p>
<ul>
  <li><strong>因果（causal）结构</strong>让首帧可以单独编码，从而支持图像与视频联合训练、按帧流式生成，这是交互式世界模型的前提；</li>
  <li><strong>高压缩会把帧内运动”压扁”</strong>：SANA-WM 的 VAE 把 8 个原始帧压成 1 个潜帧，因此额外加了逐原始帧的 Plücker 细分支来补回相机运动细节（§5.3）；</li>
  <li><strong>离散 token</strong> 便于直接复用 LLM 训练栈，但量化会损失细节；Cosmos-Predict2.5 最终把扩散与自回归两条路线统一到了连续潜空间的 Flow Matching（§7.2）。</li>
</ul>

<h2 id="42-条件注入">4.2 条件注入</h2>

<p>“动作条件”是世界模型区别于普通视频生成模型的关键。常见注入方式按粒度由粗到细排列：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">注入方式</th>
      <th style="text-align: left">粒度</th>
      <th style="text-align: left">代表工作</th>
      <th style="text-align: left">优点</th>
      <th style="text-align: left">代价</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>AdaLN 调制</strong></td>
      <td style="text-align: left">每帧 / 全局</td>
      <td style="text-align: left">LingBot-World（Plücker 嵌入经 AdaLN 注入）</td>
      <td style="text-align: left">实现简单、开销极小</td>
      <td style="text-align: left">表达空间位置相关控制的能力有限</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>交叉注意力</strong></td>
      <td style="text-align: left">序列级</td>
      <td style="text-align: left">Cosmos-Predict2.5（Reason1 文本嵌入）</td>
      <td style="text-align: left">适合语言等长条件</td>
      <td style="text-align: left">与视觉 token 的时间对齐较弱</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>ControlNet 分支</strong></td>
      <td style="text-align: left">像素级</td>
      <td style="text-align: left">Cosmos-Transfer（边缘 / 深度 / 分割）</td>
      <td style="text-align: left">可插拔，新模态无需重训主干</td>
      <td style="text-align: left">额外参数与推理开销</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>逐像素相机射线（Plücker / UCPE）</strong></td>
      <td style="text-align: left">像素级几何</td>
      <td style="text-align: left">SANA-WM 双分支、LingBot-World</td>
      <td style="text-align: left">6-DoF 相机控制精确</td>
      <td style="text-align: left">需要可靠的相机位姿标注（SANA-WM 为此搭建了专门的度量标注管线）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>动作 token 进入统一序列</strong></td>
      <td style="text-align: left">token 级</td>
      <td style="text-align: left">WorldVLA、Cosmos 3、NavWAM 潜在画布</td>
      <td style="text-align: left">动作与视觉联合建模，可切换前向 / 逆向 / 策略模式</td>
      <td style="text-align: left">序列变长，注意力开销上升</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>潜动作（无标注）</strong></td>
      <td style="text-align: left">离散码本</td>
      <td style="text-align: left">Genie（8 个潜动作）、Motus（光流潜动作）</td>
      <td style="text-align: left">可利用无动作标注的互联网视频</td>
      <td style="text-align: left">潜动作语义需再映射到真实控制量</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>自然语言动作</strong></td>
      <td style="text-align: left">文本</td>
      <td style="text-align: left">Qwen-RobotWorld</td>
      <td style="text-align: left">跨本体、跨任务统一接口</td>
      <td style="text-align: left">难以表达精确的连续控制量</td>
    </tr>
  </tbody>
</table>

<p>一条经验规律：<strong>控制越需要几何精度（相机轨迹、末端位姿），条件就越应该以空间对齐的方式注入</strong>，而不是只作为全局向量调制整帧。</p>

<h2 id="43-生成范式">4.3 生成范式</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">范式</th>
      <th style="text-align: left">代表</th>
      <th style="text-align: left">优点</th>
      <th style="text-align: left">主要问题</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>离散自回归</strong></td>
      <td style="text-align: left">Genie、WorldVLA、Cosmos-Predict1 AR</td>
      <td style="text-align: left">天然流式、可交互，复用 KV Cache</td>
      <td style="text-align: left">误差逐步累积；量化损失细节</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>全序列扩散 / 流匹配</strong></td>
      <td style="text-align: left">Wan2.1、Cosmos-Predict2.5（一次生成 93 帧）</td>
      <td style="text-align: left">画质高、片段内一致性好</td>
      <td style="text-align: left">片段长度固定，难以逐步响应新动作</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>分块自回归扩散（混合）</strong></td>
      <td style="text-align: left">LingBot-World、SANA-WM、Lyra 2.0</td>
      <td style="text-align: left">兼顾画质与交互：块内去噪、块间自回归</td>
      <td style="text-align: left">训练时看到的是真实历史、推理时看到的是自己生成的历史（exposure bias），会产生漂移</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>AR + 扩散双塔</strong></td>
      <td style="text-align: left">Cosmos 3</td>
      <td style="text-align: left">理解走自回归、生成走扩散，互不干扰</td>
      <td style="text-align: left">参数量约为稠密模型的 2 倍</td>
    </tr>
  </tbody>
</table>

<p>从全序列扩散模型出发改造为交互式模拟器，是 2026 年的常见路线：LingBot-World 先以 Wan2.2 做双向扩散预训练，再在后训练中改造为因果自回归系统并做蒸馏（§5.2）。要缓解 exposure bias，常见做法是<strong>在训练时主动喂入带噪或自生成的历史</strong>，如 Lyra 2.0 的自增强训练（§5.4）。</p>

<h2 id="44-长程一致性">4.4 长程一致性</h2>

<p>长程推演失败通常有两类原因：<strong>上下文窗口有限导致”忘记”已经看过的区域</strong>（回头看时场景变了），以及<strong>误差累积导致画面和物理逐渐漂移</strong>。对应的工程手段：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">手段</th>
      <th style="text-align: left">代表工作</th>
      <th style="text-align: left">解决的问题</th>
      <th style="text-align: left">代价</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">混合线性注意力（GDN）+ 少量 Softmax 层 + attention sink</td>
      <td style="text-align: left">SANA-WM</td>
      <td style="text-align: left">60s 720p 序列下内存保持常数</td>
      <td style="text-align: left">线性层的精确回忆能力较弱，需要 Softmax 层补足</td>
    </tr>
    <tr>
      <td style="text-align: left">3D 几何缓存 + 按可见度检索历史帧</td>
      <td style="text-align: left">Lyra 2.0</td>
      <td style="text-align: left">重访区域时的空间一致性</td>
      <td style="text-align: left">依赖深度估计质量</td>
    </tr>
    <tr>
      <td style="text-align: left">显式 3D 表示（3DGS / 点云）作为状态</td>
      <td style="text-align: left">Marble &amp; Atlas、Image2Sim</td>
      <td style="text-align: left">几何天然持久</td>
      <td style="text-align: left">动态物体与形变建模困难</td>
    </tr>
    <tr>
      <td style="text-align: left">缩短有效推演深度</td>
      <td style="text-align: left">WoVR 的关键帧初始化（KIR）</td>
      <td style="text-align: left">RL 中的幻觉累积</td>
      <td style="text-align: left">只能在演示覆盖的状态附近探索</td>
    </tr>
    <tr>
      <td style="text-align: left">非对称视界（长动作 + 短视觉）</td>
      <td style="text-align: left">WAM-Nav</td>
      <td style="text-align: left">视角剧变时的视觉预测漂移</td>
      <td style="text-align: left">视觉前瞻信息变少</td>
    </tr>
  </tbody>
</table>

<h2 id="45-推理效率">4.5 推理效率</h2>

<p>世界模型能否进入控制回路，取决于它能否满足实时预算。本文涉及工作报告的延迟 / 帧率大致如下：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">场景</th>
      <th style="text-align: left">典型要求</th>
      <th style="text-align: left">本文涉及的数字</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">低层关节控制（System 1）</td>
      <td style="text-align: left">50Hz–500Hz</td>
      <td style="text-align: left">由策略头或传统控制器承担，世界模型通常不直接进入这一回路</td>
    </tr>
    <tr>
      <td style="text-align: left">WAM 动作块输出</td>
      <td style="text-align: left">5Hz–15Hz</td>
      <td style="text-align: left">NavWAM 205.7 ms（约 5Hz）；Motus 单步 80ms；Cosmos3-Nano-Policy 15Hz</td>
    </tr>
    <tr>
      <td style="text-align: left">交互式世界生成</td>
      <td style="text-align: left">十几至几十 fps</td>
      <td style="text-align: left">LingBot-World 16 fps；Image2Sim 全景 RGB-D 45.6 FPS</td>
    </tr>
    <tr>
      <td style="text-align: left">离线数据合成</td>
      <td style="text-align: left">吞吐优先</td>
      <td style="text-align: left">SANA-WM 在 RTX 5090 上 34s 生成 60s 720p</td>
    </tr>
  </tbody>
</table>

<p>主要的加速手段：</p>
<ul>
  <li><strong>步数蒸馏</strong>：Cosmos-Predict2.5 用 rCM 把推理压缩到 4 步（§7.2）；LingBot-World 用 DMD 蒸馏实现亚秒级延迟（§5.2）；Image2Sim 用 MeanFlow 做单步生成（§5.6）；</li>
  <li><strong>减少 token</strong>：更高压缩的 VAE（§4.1），或在潜空间而非像素空间做规划（隐式世界规划器，§6.1）；</li>
  <li><strong>减少需要生成的内容</strong>：WAM 在训练时用未来视觉预测做正则，推理时的关键产出是动作块；NavWAM 用潜在画布取代 CEM 式的逐条候选轨迹推演（§6.2）。</li>
</ul>

<h2 id="46-如何判断世界模型是否有用">4.6 如何判断世界模型是否有用</h2>

<p>视觉指标好不等于对机器人有用。工程上通常按以下顺序检验，越往后越接近真实价值，成本也越高：</p>

<ol>
  <li><strong>视觉质量</strong>：FVD、VBench 等（§8.3）——只说明”看起来像”；</li>
  <li><strong>可控性</strong>：改变动作 / 相机输入后，生成结果是否一致、按预期变化（CamMC、RotErr 等）；</li>
  <li><strong>物理一致性</strong>：物体恒存、重力、接触是否合理（WorldModelBench、Physics-IQ 等）；</li>
  <li><strong>下游价值</strong>：用世界模型训练或评估策略后，真实环境成功率是否提升，或世界模型内的策略排名是否与真机排名一致。</li>
</ol>

<p>§8 的评测基准正是按这条链组织的。</p>

<hr />

<h1 id="5-家族-a世界生成器">5. 家族 A：世界生成器</h1>

<p>这一家族的共同点是：条件信号是<strong>相机位姿、键盘 / 潜动作或文本</strong>，输出是可持续探索的视频或 3D 场景，核心指标是<strong>时空一致性、可控性与生成速度</strong>，而不是机器人任务成功率。它们与具身智能的关系大多是间接的——作为神经仿真环境或数据来源，被 §6 的世界合成器与世界模拟器使用。</p>

<p>本章按表示形式由 2D 到 3D 排列：</p>
<ul>
  <li><strong>2D 视频交互</strong>：Genie（从无标注视频学出潜动作的可玩环境）→ LingBot-World（实时长程交互）→ SANA-WM（高效分钟级生成）；</li>
  <li><strong>3D 显式 / 半显式</strong>：Lyra 2.0（3D 几何缓存做记忆）→ Marble &amp; Atlas（原生 3DGS / 点云输出）→ Image2Sim（3D 高斯锚定 + 单步渲染的神经仿真器）。</li>
</ul>

<p>阅读时可对照 §4：这些工作的差异主要集中在条件注入方式（§4.2）、生成范式（§4.3）与长程记忆（§4.4）上。</p>

<h2 id="paper-genie">5.1 Genie (2024)</h2>
<p>———Generative Interactive Environments</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2402.15391">arXiv:2402.15391</a> · <a href="#ref-6">[6]</a></p>

<h4 id="精华">精华</h4>

<p>Genie 是首个仅通过无标注视频学习而成的生成式交互环境（Foundation World Model），其核心贡献在于：1) <strong>无监督动作挖掘</strong>：通过潜动作模型（LAM）从纯视频中自动挖掘可控动作空间，解决了世界模型对真实动作标签的依赖；2) <strong>高效时空架构</strong>：设计了基于 ST-Transformer 的计算架构，使显存占用随帧数线性增长，支持长序列视频生成；3) <strong>具身智能底座</strong>：不仅能将任意图像（素描、照片等）转化为可玩的游戏世界，还展现了在机器人操作和智能体训练方面的巨大潜力，为“通向通用智能体的路径”提供了海量仿真数据。</p>

<hr />

<h4 id="1-研究背景问题">1. 研究背景/问题</h4>

<p>当前的生成式 AI（如 ChatGPT, DALL-E）在文本和图像领域取得了巨大成功，但视频生成模型（如 Video Diffusion）大多缺乏细粒度的交互控制能力。传统的“世界模型”通常需要大量带有真实动作标签（Action Labels）的数据进行训练，这在互联网海量视频面前成了瓶颈。Genie 旨在通过 20+ 万小时无标注互联网视频（经过滤清洗后构建了约 3 万小时 / 680 万段 16 秒高质量 2D 平台游戏片段训练集），学习一个能实时响应用户操作、具有物理常识且能无限生成的交互式环境。</p>

<hr />

<h4 id="2-主要方法创新点">2. 主要方法/创新点</h4>

<p>Genie 是一个参数量达 110 亿的基础模型，其架构由三个深度集成的组件构成，全部基于改进的 <strong>ST-Transformer</strong>。</p>

<div align="center">
  <img src="/images/wm/Genie-components.webp" width="100%" />
<figcaption>图：Genie 整体训练框架：包含视频分词器、潜动作模型 (LAM) 和动力学模型。（图源：Genie, 2024）</figcaption>
</div>

<h5 id="21-潜动作模型-latent-action-model-lam">2.1 潜动作模型 (Latent Action Model, LAM)</h5>
<p>这是 Genie 的灵魂所在。为了在没有动作标签的情况下实现控制，LAM 采用 VQ-VAE 结构：</p>
<ul>
  <li><strong>编码器</strong>：同时接收当前帧和下一帧，输出一个离散的潜动作 \(\mathbf{a}_t\)（通常限制在 8 个离散值以内，以模拟控制器按键）。</li>
  <li><strong>瓶颈机制</strong>：由于解码器只能通过历史帧和 \(\mathbf{a}_t\) 来预测下一帧，模型被迫将视频中最具语义一致性的变化（如人物的左右移动、跳跃）编码进这 8 个 Token 中。</li>
  <li><strong>一致性</strong>：实验证明，即使在不同游戏中，相同的潜动作 Token 往往对应相同的物理语义（如 Action 0 始终代表左移）。</li>
</ul>

<div align="center">
  <img src="/images/wm/Genie-LAM.webp" width="70%" />
<figcaption>图：潜动作模型 (LAM)：通过重构目标实现无监督动作挖掘。（图源：Genie, 2024）</figcaption>
</div>

<h5 id="22-视频分词器-video-tokenizer">2.2 视频分词器 (Video Tokenizer)</h5>
<p>Genie 提出了 <strong>ST-ViViT</strong> 架构：</p>
<ul>
  <li><strong>时空压缩</strong>：不同于常规只在空间维度压缩的分词器，ST-ViViT 在编码和解码时都引入了时间轴。</li>
  <li><strong>效率优化</strong>：通过交替使用空间注意力和时间注意力，模型避免了计算量随时间呈平方级增长的问题，保证了在大规模数据集上的训练可行性。</li>
</ul>

<h5 id="23-动力学模型-dynamics-model">2.3 动力学模型 (Dynamics Model)</h5>
<p>基于 <strong>MaskGIT</strong> 的掩码自回归模型：</p>
<ul>
  <li><strong>输入</strong>：接收当前视觉 Token 和用户选择的潜动作。</li>
  <li><strong>预测</strong>：模型在隐空间内预测下一帧的 Token。通过海量数据的“喂养”，模型学习到了复杂的 2D 平台游戏规则，如碰撞、重力、敌人交互和屏幕卷轴滚动。</li>
</ul>

<div align="center">
  <img src="/images/wm/Genie-ST-transformer.webp" width="55%" />
<figcaption>图：ST-transformer：交替进行空间与时间层计算，实现线性复杂度。（图源：Genie, 2024）</figcaption>
</div>

<hr />

<h4 id="3-核心结果发现">3. 核心结果/发现</h4>

<ul>
  <li><strong>“化腐朽为神奇”的生成能力</strong>：用户可以上传一张手绘草图、真实的自然景观照片，甚至是通过文生图模型（如 Imagen）生成的图片，Genie 都能立即将其转化为一个可以“玩”的横版过关游戏环境。</li>
  <li><strong>语义一致的操控感</strong>：在 Platformers 数据集上，潜动作展现了极强的泛化性。用户点击对应的潜动作，角色会做出连贯的位移或跳跃，且这种操控在视觉风格迥异的环境中依然有效。</li>
  <li><strong>机器人领域的潜力</strong>：研究人员在 RT1 机器人数据集上验证了 Genie。模型不仅学会了控制机械臂，还学会了模拟复杂物体的物理形变（如挤压面包袋），这证明 Genie 能够捕捉真实的物理世界动态。</li>
  <li><strong>作为强化学习的“母体”</strong>：在 Genie 内部训练的智能体，可以极快地迁移到真实环境中。相比于从零开始训练，使用潜动作预训练的智能体在样本效率上提升了数倍。</li>
</ul>

<div align="center">
  <img src="/images/wm/Genie-robotics-actions.webp" width="100%" />
<figcaption>图：在机器人操作数据上学习到的具有语义意义的潜动作。（图源：Genie, 2024）</figcaption>
</div>

<hr />

<h4 id="4-局限性">4. 局限性</h4>

<ul>
  <li><strong>分辨率瓶颈</strong>：受限于目前的计算资源，Genie 生成的视频分辨率较低（160x90），离高清沉浸式体验仍有距离。</li>
  <li><strong>自回归发散</strong>：由于是自回归生成，随着步数增加，视频内容可能会逐渐偏离物理真实或出现伪影。</li>
  <li><strong>动作映射</strong>：虽然挖掘出了潜动作，但将这些离散 Token 精确映射到人类直觉的复杂多级控制（如手柄的线性摇杆）仍需进一步研究。</li>
</ul>

<hr />

<h2 id="paper-lingbot-world">5.2 LingBot-World (2026)</h2>
<p>———首个开源、支持实时交互的长程世界模型</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.20540">arXiv:2601.20540</a> · <a href="#ref-7">[7]</a></p>

<h4 id="精华-1">精华</h4>
<ol>
  <li><strong>LingBot-World</strong> 是一个开源的实时交互世界模型，支持分钟级的长程生成一致性。</li>
  <li>提出了包含分层语义的数据引擎，通过叙事、静态场景和密集时间描述解决了交互数据稀缺问题。</li>
  <li>采用了三阶段进化训练策略：预训练（通用视频先验）、中训练（知识注入与 MoE 架构）和后训练（因果适配与蒸馏）。</li>
  <li>实现了亚秒级（&lt;1s）的推理延迟，支持 16 fps 的实时生成。</li>
  <li>展示了在可控世界事件编辑、具身智能 Action Agent 和 3D 重建等领域的广泛应用潜力。</li>
</ol>

<h4 id="1-研究背景问题-1">1. 研究背景/问题</h4>
<p>当前的视频生成模型虽能生成高质量短片，但本质上是“梦想家”而非“模拟器”，缺乏对物理规律（如因果性、物体恒久性）的理解，且难以实现实时交互。此外，高质量交互数据的匮乏、长程一致性的维持以及扩散模型高昂的计算开销，也是阻碍世界模型发展的核心瓶颈。</p>

<h4 id="2-主要方法创新点-1">2. 主要方法/创新点</h4>

<div align="center">
  <img src="/images/vla/LingBot-World-overview.webp" width="100%" />
<figcaption>图：LingBot-World 交互式世界模拟概览：支持在多种场景（写实、科学、卡通等）下通过键盘操作进行实时交互。（图源：LingBot-World, 2026）</figcaption>
</div>

<h5 id="-数据引擎与分层描述">① 数据引擎与分层描述</h5>
<p>为了解决高质量交互数据稀缺的问题，LingBot-World 构建了一个混合数据引擎，结合了真实世界视频、游戏录像和 Unreal Engine (UE) 合成数据。关键创新在于<strong>分层描述策略</strong>：</p>
<ul>
  <li><strong>叙事描述 (Narrative Caption)</strong>：描述整体环境和摄像机轨迹，作为全局语义提示。</li>
  <li><strong>静态场景描述 (Scene-Static Caption)</strong>：仅聚焦环境，实现动作与场景的解耦。</li>
  <li><strong>密集时间描述 (Dense Temporal Caption)</strong>：对视频事件进行细粒度的时间对齐描述。</li>
</ul>

<h5 id="-三阶段进化训练管线">② 三阶段进化训练管线</h5>
<p>模型采用了从视频生成器向交互式模拟器进化的三阶段策略：</p>

<div align="center">
  <img src="/images/vla/LingBot-World-training-pipeline.webp" width="100%" />
<figcaption>图：LingBot-World 训练管线：从预训练的视频先验出发，经过中训练注入知识，最后通过后训练实现实时交互能力。（图源：LingBot-World, 2026）</figcaption>
</div>

<ul>
  <li><strong>Stage I: 预训练</strong>：利用 14B 参数的 Wan2.2 扩散模型建立强大的时空相干性和视觉先验。</li>
  <li><strong>Stage II: 中训练 (MoE 知识注入)</strong>：引入 Mixture-of-Experts (MoE) 架构（总参数 28B，激活 14B），通过 progressive curriculum 策略将训练时长从 5 秒扩展到 60 秒，并注入 Plücker 编码的动作信号。</li>
  <li><strong>Stage III: 后训练 (实时化)</strong>：将双向扩散模型适配为因果自回归系统，并结合分布匹配蒸馏 (DMD) 和对抗优化，将推理延迟降低至亚秒级。</li>
</ul>

<h5 id="-模型架构与动作注入">③ 模型架构与动作注入</h5>

<div align="center">
  <img src="/images/vla/LingBot-World-architecture.webp" width="100%" />
<figcaption>图：LingBot-World 模型架构：基于 DiT 块，通过 Plücker Encoder 注入动作信号，并利用 AdaLN 进行调制。（图源：LingBot-World, 2026）</figcaption>
</div>

<p>LingBot-World 基于 DiT (Diffusion Transformer) 架构。动作信号（离散键盘输入和连续摄像机旋转）通过 <strong>Plücker Encoder</strong> 投影为嵌入向量，再通过 Adaptive Layer Normalization (AdaLN) 注入到 DiT 块中，实现对视频生成的精确控制。</p>

<h4 id="3-核心结果发现-1">3. 核心结果/发现</h4>

<div align="center">
  <img src="/images/vla/LingBot-World-memory-capability.webp" width="100%" />
<figcaption>图：涌现的记忆能力：模型能够记住视野外的静态地标（如巨石阵），并在 60 秒后返回时保持结构一致，且能模拟视野外物体的动态演化。（图源：LingBot-World, 2026）</figcaption>
</div>

<ul>
  <li><strong>长程一致性</strong>：模型表现出显著的涌现记忆能力，即使物体长时间离开视野，返回时仍能保持结构完整。</li>
  <li><strong>实时性与质量平衡</strong>：LingBot-World-Fast 在单 GPU 节点上实现了 16 fps 的吞吐量，同时保持了与教师模型相当的视觉质量。</li>
  <li><strong>可控编辑</strong>：支持通过文本指令（如“Firework”、“Fish”）对生成的世界进行实时干预。</li>
</ul>

<div align="center">
  <img src="/images/vla/LingBot-World-promptable-events.webp" width="100%" />
<figcaption>图：可控世界事件示例：通过文本提示词实时改变天气、风格或在场景中注入特定动态元素。（图源：LingBot-World, 2026）</figcaption>
</div>

<h4 id="4-局限性-1">4. 局限性</h4>
<ul>
  <li><strong>记忆稳定性</strong>：长程一致性仍是基于上下文窗口的涌现能力，缺乏显式的存储模块。</li>
  <li><strong>交互精度</strong>：对细粒度物体操作（如抓取特定物体）的支持尚不足。</li>
  <li><strong>算力成本</strong>：推理仍需企业级 GPU 支持。</li>
</ul>

<hr />

<h2 id="paper-sana-wm">5.3 SANA-WM (2026)</h2>
<p>———Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2605.15178">arXiv:2605.15178</a> · <a href="#ref-8">[8]</a><br />
🔗 <strong>项目主页</strong>: <a href="https://nvlabs.github.io/Sana/WM/">nvlabs.github.io/Sana/WM</a></p>

<h4 id="精华-2">精华</h4>

<p>SANA-WM 最值得借鉴的核心思想是<strong>以效率为第一设计目标的世界模型</strong>：用 2.6B 参数、64 块 H100、15 天训练，在单 GPU 上生成分钟级 720p 视频，达到与 14B+14B 工业级模型相当的视觉质量。具体可迁移的设计包括：(1) <strong>混合线性-Softmax Attention（Hybrid GDN/Softmax）</strong>——以帧粒度 Gated DeltaNet 替代大多数 Softmax 层，使 KV 状态保持 $D \times D$ 常数，内存不随序列长度增长，Softmax 层仅保留 5/20 块用于长程精确回忆，巧妙平衡效率与质量；(2) <strong>双分支相机控制（Dual-Branch Camera Control）</strong>——粗分支 UCPE 在潜帧率上捕获全局 6-DoF 轨迹结构，细分支 Plücker 在原始帧率上补偿 VAE 压缩丢失的帧内运动细节，两者协同实现高精度连续轨迹跟随；(3) <strong>两阶段视觉精化（Two-Stage Refiner）</strong>——第一阶段生成结构正确但质量稍逊的视频，第二阶段用截断 Flow Matching 的 17B LoRA 精化器无缝修复细节，整体吞吐仍达 22 个 60s 视频/小时；(4) <strong>鲁棒度量标注管线</strong>——用 VIPE+Pi3X+MoGe-2 从公开视频恢复度量尺度 6-DoF 姿态，无需昂贵专有数据，仅 213K 片段即完成训练。</p>

<hr />

<h4 id="1-研究背景问题-2">1. 研究背景/问题</h4>

<p>现有开源分钟级世界模型（LingBot-World 14B+14B、HY-WorldPlay 8B）普遍需要大模型参数量、海量专有数据、多 GPU 推理，对学术界和小团队门槛极高。另一种替代——用短视频生成器蒸馏长程模型——因短程教师对分钟级场景持久性和轨迹跟随的监督信号不足而效果有限。SANA-WM 的目标是：<strong>在严格效率约束下原生训练一个高保真、可相机控制的分钟级世界模型</strong>，使其在单 GPU 上可推理、在 64 块 H100 上 15 天可收敛。</p>

<hr />

<h4 id="2-主要方法创新点-2">2. 主要方法/创新点</h4>

<div align="center">
  <img src="/images/wm/SANA-WM-teaser.webp" width="100%" />
<figcaption>图：SANA-WM 概览。从单张图像和动作轨迹出发，生成分钟级 720p 世界，支持精确相机控制、64-GPU 训练与单 GPU 推理。（图源：SANA-WM，arXiv:2605.15178）</figcaption>
</div>

<p><strong>整体框架</strong>：SANA-WM 由四个核心组件构成：① 混合线性 DiT 骨干（Hybrid GDN/Softmax）负责高效长程上下文建模；② 双分支相机控制（UCPE + Plücker）负责精确 6-DoF 轨迹注入；③ 第二阶段视觉精化器（LTX-2 LoRA）负责提升最终帧质量；④ 鲁棒度量标注管线（VIPE+Pi3X+MoGe-2）负责从公开视频提取高质量训练数据。</p>

<div align="center">
  <img src="/images/wm/SANA-WM-architecture.webp" width="100%" />
<figcaption>图：SANA-WM 架构。文本、视频和姿态 Token 交替经过 GDN 块和 Softmax 块；UCPE Attention 和 Plücker Mixing 提供几何感知的相机条件；第二阶段精化器进一步提升视觉质量。（图源：SANA-WM）</figcaption>
</div>

<h5 id="-混合线性-softmax-attentionhybrid-gdnsoftmax">① 混合线性-Softmax Attention（Hybrid GDN/Softmax）</h5>

<p><strong>输入</strong>：时序潜帧序列（LTX2 VAE 编码，时间×高×宽压缩比远高于 Wan 2.1-VAE，尺寸缩小 8×）。</p>

<p><strong>处理</strong>：SANA-WM 共 20 个 Transformer Block，其中 15 个为<strong>帧粒度 Gated DeltaNet（GDN）块</strong>，5 个（位于层 3/7/11/15/19）为标准 Softmax Attention 块。GDN 块的关键是将 token 级递推（每步一个 token）升级为<strong>帧级递推</strong>（每步消费一个潜帧的全部 $S$ 个空间 token），状态矩阵 $S_t \in \mathbb R^{D \times D}$ 通过衰减门 $\gamma_t$ 和 delta-rule 修正实现”遗忘旧信息、精准更新当前帧”：</p>

\[S_t = S_{t-1} M_t + U_t, \quad M_t = \gamma_t(I - \hat K_t \beta_t \hat K_t^\top), \quad U_t = V_t \beta_t \hat K_t^\top\]

<p>为防止空间 token 数 $S$ 导致转移矩阵 $M_t$ 膨胀，对 key 施加 $1/\sqrt{DS}$ 缩放（代替 token 级的 $1/\sqrt{D}$），确保 $\lVert M_t \rVert_2 \le \gamma_t \le 1$，训练稳定不出现 NaN。Softmax 块负责精确长程回忆，在 60s 序列中引入局部注意力窗口和 attention sink，使推理时 Softmax 内存保持常数。</p>

<p><strong>设计动机</strong>：60s 720p 视频展开为约 961 个潜帧；纯 Softmax 的 KV Cache 随序列长度平方增长，60s 时直接 OOM；纯线性注意力（如 SANA-Video 的累积线性注意力）缺乏衰减机制，旧特征与新特征等权累积，导致分钟级建模出现漂移。混合设计兼顾了”大多数时间步高效更新 + 关键时刻精确回忆”的需求。</p>

<h5 id="-双分支相机控制dual-branch-camera-control">② 双分支相机控制（Dual-Branch Camera Control）</h5>

<p><strong>粗分支（Coarse - UCPE）</strong>：在<strong>潜帧率</strong>上建模全局 6-DoF 轨迹。对每个潜帧 $t$ 和空间格 $s$，由相机外参计算世界空间射线，构建射线局部坐标系变换 $D_{t,s} \in \mathbb R^{4 \times 4}$，将 QKV 的几何通道经 $D^\top / D^{-1}$ 旋转，其余通道保留 RoPE——本质是将相机位姿编码进注意力位置编码。该分支有独立 QKV 投影，但与主分支共享 GDN 门，通过零初始化投影叠加到主注意力输出上。</p>

<p><strong>细分支（Fine - Plücker Mixing）</strong>：弥补粗分支因 VAE 将 8 个原始帧压缩为 1 个潜帧而丢失的帧内运动细节。对每个原始帧 $r$ 和像素 $p$，计算 Plücker 射线 $\rho_{r,p} = (d_{r,p},\, o_r \times d_{r,p}) \in \mathbb R^6$，将 VAE 步内 8 帧的 Plücker 图堆叠为 48 通道张量，经零初始化 3D Patch Embedder 处理后逐块叠加至自注意力输出后。</p>

<p><strong>消融验证</strong>：UCPE+Plücker 组合在 OmniWorld 验证集上 CamMC 达 0.2047，优于单独 UCPE（0.2453）和单独 Plücker（0.4742），FVD 也更低。</p>

<h5 id="-两阶段视觉精化">③ 两阶段视觉精化</h5>

<p>第一阶段（SANA-WM 主模型）生成结构正确的 60s 视频。第二阶段精化器基于 LTX-2 17B 模型，只训练秩 384 LoRA（附于 Q/K/V/O 和 FFN），用截断-$\sigma$ Flow Matching 对第一阶段噪化潜变量进行精化（3 步 Euler，推理时与主模型完全解耦）。精化后 VBench Overall 从 79.29 提升至 80.62（Simple Trajectory），同时将晚期质量退化 $\Delta IQ$ 从 3.79 压缩至 1.17。</p>

<h5 id="-鲁棒度量标注管线与数据">④ 鲁棒度量标注管线与数据</h5>

<div align="center">
  <img src="/images/wm/SANA-WM-data-pipeline.webp" width="100%" />
<figcaption>图：SANA-WM 数据构建管线。收集开源视频与静态 3D 资源，标注度量尺度相机姿态，用 3DGS 渲染增强 DL3DV，过滤/字幕处理后得到 213K 片段训练语料。（图源：SANA-WM）</figcaption>
</div>

<p>标注引擎基于 VIPE，将深度估计后端替换为 Pi3X（多帧一致结构）+ MoGe-2（度量尺度锚点），支持公开视频的鲁棒度量尺度 6-DoF 姿态提取。对 DL3DV 等静态 3D 数据集，用 FCGS 拟合 3DGS 重建后渲染多样化一分钟相机路径，再经 DiFix3D 精化减少拼接伪影，生成 14,881 条合成 60s 片段。最终语料共 212,975 条片段，涵盖室内、室外、游戏、合成场景。</p>

<p><strong>渐进式训练策略</strong>（4 阶段，共约 15 天 64× H100）：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">阶段</th>
      <th style="text-align: left">目标</th>
      <th style="text-align: left">序列长度</th>
      <th style="text-align: left">训练步数</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Stage 1</td>
      <td style="text-align: left">VAE 适配（LTX2 空间对齐）</td>
      <td style="text-align: left">5s</td>
      <td style="text-align: left">50K（VAE）+ 30K（DiT）</td>
    </tr>
    <tr>
      <td style="text-align: left">Stage 2</td>
      <td style="text-align: left">混合架构适配（GDN/Softmax）</td>
      <td style="text-align: left">5s</td>
      <td style="text-align: left">30K</td>
    </tr>
    <tr>
      <td style="text-align: left">Stage 3</td>
      <td style="text-align: left">分钟级扩展 + 相机控制</td>
      <td style="text-align: left">60s</td>
      <td style="text-align: left">31K</td>
    </tr>
    <tr>
      <td style="text-align: left">Stage 4</td>
      <td style="text-align: left">Chunk-Causal 微调 + 4步蒸馏</td>
      <td style="text-align: left">60s</td>
      <td style="text-align: left">10K</td>
    </tr>
  </tbody>
</table>

<hr />

<h4 id="3-核心结果发现-2">3. 核心结果/发现</h4>

<div align="center">
  <img src="/images/wm/SANA-WM-qualitative-comparison.webp" width="100%" />
<figcaption>图：四种方法在 Hard Trajectory 60s 视频上的定性对比。绿色边框为 SANA-WM，左下角为动作轨迹叠加。SANA-WM 在复杂轨迹下仍保持场景一致性，基线方法则出现模糊、布局漂移或结构崩溃。（图源：SANA-WM）</figcaption>
</div>

<p><strong>相机控制精度</strong>（↓ 越低越好）：SANA-WM+精化器在 60s 基准上取得最优 RotErr（4.50°/8.34°，Simple/Hard），CamMC 1.41/1.44，全面优于 LingBot-World（14B+14B，RotErr 10.47°/18.99°）、Matrix-Game 3.0（5B）和 HY-WorldPlay（8B）。</p>

<p><strong>视觉质量</strong>：精化后 VBench Overall 80.62/81.89（Simple/Hard），与 LingBot-World（81.82/81.89）相当，但 LingBot-World 需要 8 块 H100（454.1 GB 显存），SANA-WM 单 GPU 仅需 74.7 GB。</p>

<div align="center">
  <img src="/images/wm/SANA-WM-efficiency-ablation.webp" width="100%" />
<figcaption>图：效率消融与扩展性分析。(a) 60s 单 GPU 推理延迟分解：经蒸馏+attention sink+NVFP4 量化，RTX 5090 上 34s 生成一条 60s 720p 视频。(b) H100 延迟与显存随视频时长的变化：混合 GDN/Softmax 线性增长，纯 Softmax 在 60s 时 OOM。（图源：SANA-WM）</figcaption>
</div>

<p><strong>推理效率</strong>：SANA-WM 生成吞吐 24.1 视频/小时（8× H100），比最快 480p 基线 Infinite-World 快 4.1×；4步蒸馏+NVFP4 量化后，单 RTX 5090 仅需 34s 生成一条完整 60s 720p 视频（<strong>36× 高于 LingBot-World 的吞吐</strong>）。</p>

<p><strong>渐进训练消融</strong>（VBench-I2V）：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">配置</th>
      <th style="text-align: center">VBench Total ↑</th>
      <th style="text-align: center">峰值内存 (GB) ↓</th>
      <th style="text-align: center">推理速度 (steps/s) ↑</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">SANA-Video（原始）</td>
      <td style="text-align: center">0.838</td>
      <td style="text-align: center">8.90</td>
      <td style="text-align: center">0.79</td>
    </tr>
    <tr>
      <td style="text-align: left">+ LTX2 VAE</td>
      <td style="text-align: center">0.839</td>
      <td style="text-align: center">5.40</td>
      <td style="text-align: center">2.69</td>
    </tr>
    <tr>
      <td style="text-align: left">+ Hybrid GDN/Softmax</td>
      <td style="text-align: center"><strong>0.853</strong></td>
      <td style="text-align: center">5.68</td>
      <td style="text-align: center">2.31</td>
    </tr>
  </tbody>
</table>

<hr />

<h4 id="4-局限性-2">4. 局限性</h4>

<p>SANA-WM 受限于规模（2.6B 参数与 213K 片段），在动态场景、罕见视角或超长序列中仍可能产生漂移，且缺乏显式 3D 场景记忆（无法像 Lyra 2.0 那样精确”重访”旧区域）。未来工作需要扩大模型与数据规模、引入机器人动作或点跟踪控制、强化持久场景记忆，以及开发鲁棒的实时或流式精化器。</p>

<hr />

<h2 id="paper-lyra">5.4 Lyra 2.0 (2026)</h2>
<p>———Explorable Generative 3D Worlds at Scale</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2604.13036">https://arxiv.org/abs/2604.13036</a> · <a href="#ref-9">[9]</a></p>

<h4 id="精华-3">精华</h4>

<p>NVIDIA 推出的 Lyra 2.0 解决了长程（Long-horizon）3D 一致性场景生成的两大核心痛点，值得借鉴的点包括：</p>
<ol>
  <li><strong>解耦几何与外观（Decoupled Memory）</strong>：将显式 3D 几何（点云缓存）仅用于信息路由和建立像素级对应关系，而将外观合成交给 Diffusion Model 的强生成先验，有效避免了渲染伪影的传播。</li>
  <li><strong>空间记忆路由（Anti-forgetting）</strong>：通过几何感知检索机制，即便在长距离移动或重新访问（Revisit）区域时，也能通过 3D 投影检索最相关的历史帧，克服了 Transformer 有限上下文导致的”空间遗忘”。</li>
  <li><strong>自增强训练（Self-augmentation）</strong>：在训练阶段引入带有自身预测偏差的损坏数据，使模型学会纠正自回归生成的漂移（Temporal Drifting），而非让误差无限累积。</li>
  <li><strong>生成式重建（Generative Reconstruction）</strong>：展示了如何通过视频生成模型合成高一致性的多视角序列，进而驱动 Feed-forward 3DGS 模型快速重建高质量 3D 场景资产。</li>
</ol>

<hr />

<h4 id="1-研究背景问题-3">1. 研究背景/问题</h4>

<p>当前的视频生成模型在生成长视频时极易出现<strong>空间遗忘（Spatial Forgetting）</strong>和<strong>时间漂移（Temporal Drifting）</strong>。当相机移动超出模型的有限上下文窗口时，模型会丢失对早先场景的记忆，导致回看时场景结构崩溃；同时，自回归生成的微小误差会随时间累积，造成颜色偏移和几何扭曲。这限制了生成式 3D 场景重建向大规模、可探索环境的扩展。</p>

<hr />

<h4 id="2-主要方法创新点-3">2. 主要方法/创新点</h4>

<div align="center">
  <img src="/images/wm/Lyra2-Overview.webp" width="100%" />
<figcaption>图：Lyra 2.0 能够从单张图像出发，支持长程、3D 一致的场景生成与探索，并能导出为高质量 3D 资产。（图源：Lyra 2.0）</figcaption>
</div>

<p>Lyra 2.0 的核心是一个基于”检索-生成-更新”的自回归循环：</p>

<ol>
  <li><strong>抗遗忘机制（Anti-Forgetting）</strong>：</li>
</ol>
<div align="center">
  <img src="/images/wm/Lyra2-Method-Overview.webp" width="100%" />
<figcaption>图：方法概览：左侧为交互式探索循环，右侧展示了如何从空间记忆中检索历史帧并注入到 DiT 注意力机制中。（图源：Lyra 2.0, 2026）</figcaption>
</div>
<p>系统维护一个 3D 缓存（3D Cache），存储每帧的深度图和点云。在生成下一段视频时，系统会根据当前相机视角，通过投影计算可见度（Visibility Score），检索出最相关的历史帧。</p>

<ol>
  <li>
    <p><strong>几何引导的上下文注入</strong>：
检索到的历史帧不会直接作为 RGB 图像输入，而是通过<strong>正则化坐标映射（Canonical Coordinate Warping）</strong>建立像素级对应关系。这种方式将几何约束与外观生成分离，允许视频模型在不引入渲染噪声的前提下保持空间一致性。</p>
  </li>
  <li>
    <p><strong>抗漂移训练（Anti-Drifting）</strong>：
采用了<strong>自增强训练策略（Self-augmentation Training）</strong>。在训练时，模型不仅在完美的高清图像上训练，还会随机在自己生成的”损坏”潜变量（Latent）上进行去噪。这教导模型在推理过程中识别并修正微小的漂移误差，而非放大它们。</p>
  </li>
  <li>
    <p><strong>实时交互与 3D 导出</strong>：</p>
  </li>
</ol>
<div align="center">
  <img src="/images/wm/Lyra2-Applications.webp" width="100%" />
<figcaption>图：Lyra 2.0 应用：交互式 GUI 允许用户自定义轨迹，生成的场景可直接导入 NVIDIA Isaac Sim 进行具身智能仿真。（图源：Lyra 2.0, 2026）</figcaption>
</div>

<hr />

<h4 id="3-核心结果发现-3">3. 核心结果/发现</h4>

<ul>
  <li><strong>长程一致性</strong>：实验表明，Lyra 2.0 在 800 帧以上的生成序列中仍能保持极其稳定的几何结构和风格一致性，显著优于 GEN3C 和 SPMem 等基线方法。</li>
</ul>
<div align="center">
  <img src="/images/wm/Lyra2-Video-Comparison.webp" width="100%" />
<figcaption>图：视频生成对比：Lyra 2.0 在长程探索中展现了更强的真实感和更少的几何畸变。（图源：Lyra 2.0, 2026）</figcaption>
</div>

<ul>
  <li><strong>高质量 3D 重建</strong>：生成的视频序列通过微调后的 feed-forward 3DGS 流程，可以生成几乎无伪影（Floater-free）的高质量 3D 高斯泼溅模型。</li>
</ul>
<div align="center">
  <img src="/images/wm/Lyra2-3DGS-Comparison.webp" width="100%" />
<figcaption>图：3DGS 重建对比：Lyra 2.0 生成的视频驱动的重建结果在保真度和一致性上大幅领先。（图源：Lyra 2.0, 2026）</figcaption>
</div>

<ul>
  <li><strong>具身智能赋能</strong>：</li>
</ul>
<div align="center">
  <img src="/images/wm/Lyra2-In-the-Wild.webp" width="100%" />
<figcaption>图：野外场景生成：模型展现了极强的泛化能力，能够处理从室内书房到室外街道、沙漠和古建筑等多样化环境。（图源：Lyra 2.0, 2026）</figcaption>
</div>

<hr />

<h4 id="4-局限性-3">4. 局限性</h4>
<p>目前 Lyra 2.0 主要聚焦于静态场景的生成，尚未显式建模动态物体（如行人和车辆）。此外，模型生成的质量仍然受限于训练数据（如 DL3DV）中的光照变化和曝光差异。</p>

<hr />

<h2 id="paper-marble">5.5 Marble &amp; Atlas (World Labs, 2025–2026)</h2>
<p>———大型世界模型 (LWM) 到新一代 Omni 空间智能底座 Atlas</p>

<blockquote>
  <p>[!TIP]
💡 <strong>姊妹篇导读</strong>：关于 3D 几何表征（如 3D Gaussian Splatting、NeRF、点云）与具身感知的深度融合，可进一步参阅本站的 <strong><a href="/Spatial-Intelligence-Survey/">空间智能全景综述：从 3D 几何表征、多模态时空推演到具身物理世界交互</a></strong>。</p>
</blockquote>

<p>🔗 <strong>产品平台</strong>: <a href="https://marble.worldlabs.ai">marble.worldlabs.ai</a><br />
🔗 <strong>官方博客</strong>: <a href="https://www.worldlabs.ai/blog/marble-world-model">Marble: A Multimodal World Model</a> · <a href="https://www.worldlabs.ai/blog/atlas">Atlas: A World Model for Spatial Intelligence (2026-09)</a> · <a href="#ref-10">[10]</a><br />
🔗 <strong>API 平台</strong>: <a href="https://platform.worldlabs.ai">platform.worldlabs.ai</a></p>

<h4 id="精华-4">精华</h4>

<p>由李飞飞联合创立的 World Labs 代表了一种与主流 LLM 路线截然不同的 AGI 追求路径——<strong>空间智能（Spatial Intelligence）</strong>。其早期推出的旗舰产品 <strong>Marble</strong> 是首个面向大众商用的<strong>大型世界模型（Large World Model, LWM）</strong> 平台，能从单图、视频或文本生成可自由探索、永久持久的 3D 高斯泼溅世界；而 2026 年 9 月 1 日最新发布的 <strong>Atlas</strong>，则是支撑下一代 Marble 与具身物理仿真的新一代 <strong>Omni 全模态世界模型基座</strong>。核心突破与思想包括：</p>

<ol>
  <li><strong>全模态统一自回归流匹配架构（Multimodal AR Diffusion Transformer）</strong>：Atlas 打破了 2D 视频生成与 3D 空间重建的长期割裂，从头（From Scratch）预训练。它融合了 LLM 的自回归序列特性（继承长上下文 KV-cache、分发调度等工程加速红利）与连续扩散模型（Rectified Flow）对高维视觉信号的高质量建模能力，将文本、图像、视频、相机位姿与 3D 深度图全部锚定在统一的<strong>共享空间上下文（Spatial Context）</strong>中。</li>
  <li><strong>像素级原生相机控制（Pixel-Perfect Camera Control）</strong>：摒弃传统视频模型依赖模糊自然语言提示词（如 “pan left”, “zoom in”）的粗粒度控镜，Atlas 原生接收显式 6-DoF 相机内外参轨迹作为输入特征，支持长达 1 分钟、1440p 高清且无视角漂移与几何畸变的空间一致长视频生成。</li>
  <li><strong>稀疏视图空间重建与显式 3D 导出</strong>：输入仅需 1~3 张普通照片或随手拍摄的一段视频，Atlas 端到端联合推演新视角 RGB 与几何深度，输出点云（Point Clouds）与 3D 高斯泼溅（3DGS）。在 DTU、ETH3D、KITTI、ScanNet 等 7 大经典 3D 重建基准上，Atlas 作为通用生成模型全面超越了 MapAnything、VGGT-1B、Depth Anything 3 等专精重建模型。</li>
  <li><strong>时空物理仿真与具身 Real-to-Sim-to-Real 闭环</strong>：不仅支持用 3~5 台普通手机多视角录像免影棚实现“子弹时间”时空重定焦（Video Reframing），更直接开辟了具身导航与操控的 Real-to-Sim 路径——从 24 帧日常手机视频自动重建真实环境，并在机器人推演时实时渲染本体传感器（RGB-D）流，支持刚体、铰接体及变形软体的丰富物理交互变体。</li>
</ol>

<hr />

<h4 id="1-研究背景与演进逻辑从-marble-平台到-atlas-基座">1. 研究背景与演进逻辑：从 Marble 平台到 Atlas 基座</h4>

<p>李飞飞在 ImageNet 时代奠定了计算机视觉的数据基础，World Labs 的创立反映了她对 AI 下一阶段的判断：<strong>当前 AI 缺失的核心能力是空间智能——即理解、生成和推理三维物理世界的能力</strong>。</p>

<p>现有 LLM / VLM 的局限在于：它们本质上是“语言生物”，将世界压缩为 token 序列，缺乏在连续 3D 空间中感知和行动的能力；而 Sora、Wan2.1 等主流视频生成模型虽能生成逼真画面，但本质上仍是将世界压平在 2D 像素平面，无法提供确定性的 3D 度量几何、自由机位漫游与环境交互。</p>

<p>World Labs 的技术演进呈现出明确的“两阶段协同”逻辑：</p>
<ul>
  <li><strong>阶段一：Marble（2025 年 11 月发布）——产品级验证与 3DGS 空间持久宇宙</strong>：率先验证了以 3D 高斯泼溅（3DGS）作为核心世界表征的商业可行性，构建了 Chisel、世界扩展、合成模式等空间创作工作流，实现了“永久存在、自由漫游”的 3D 虚拟世界。</li>
  <li><strong>阶段二：Atlas（2026 年 9 月发布）——基座级突破与全模态空间智能大模型</strong>：正式公布了底层 Omni World Model 架构规范，将文本、图像、视频、相机几何与 3D 深度无缝融合，打通了“世界生成（Generation）- 空间重建（Reconstruction）- 时空仿真（Simulation）”三位一体的统一能力，作为下一代 Marble 与具身智能仿真的基石。</li>
</ul>

<hr />

<h4 id="2-主要方法与核心创新点">2. 主要方法与核心创新点</h4>

<h5 id="part-a-marble-工业落地体系与-3dgs-世界表征">Part A: Marble 工业落地体系与 3DGS 世界表征</h5>

<div align="center">
  <img src="/images/wm/MarbleWorldModelV4.svg" width="90%" />
<figcaption>图：Marble 大型世界模型（LWM）整体架构：多模态输入经过空间推理与 3D 世界生成，输出为可实时渲染、自由探索的 3D 高斯泼溅世界。（图源：World Labs）</figcaption>
</div>

<p><strong>Marble 多模态输入体系</strong></p>

<p>Marble 支持四类输入模态，真正实现了多模态 → 3D 世界的生成：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">输入类型</th>
      <th style="text-align: left">说明</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">文本提示（Text）</td>
      <td style="text-align: left">直接描述目标世界的外观、风格和内容</td>
    </tr>
    <tr>
      <td style="text-align: left">单张图像（Image）</td>
      <td style="text-align: left">将单张室内照片、风景图或艺术插画外推为可探索 3D 世界</td>
    </tr>
    <tr>
      <td style="text-align: left">视频片段（Video）</td>
      <td style="text-align: left">从短视频或 360° 全景视频中重建空间结构</td>
    </tr>
    <tr>
      <td style="text-align: left">粗糙 3D 布局（Coarse 3D Layout）</td>
      <td style="text-align: left">通过 Chisel 工具手绘草图或导入 3D 资产作为结构框架</td>
    </tr>
  </tbody>
</table>

<div align="center">
  <img src="/images/wm/i2w-living-room.jpg" width="48%" />
  <img src="/images/wm/i2w-mushroom-forest.jpg" width="48%" />
<figcaption>图：Image-to-World 示例：单张室内照片（左）和蘑菇森林插画（右）被 Marble 外推为完整可探索的 3D 世界。（图源：World Labs）</figcaption>
</div>

<p><strong>3DGS 作为世界表示：选型的核心逻辑</strong></p>

<p>Marble 的核心技术选型为 <strong>3D 高斯泼溅（3D Gaussian Splatting, 3DGS）</strong>。3DGS 将 3D 场景表示为一组半透明粒子集合，在世界模型场景下具有显著优势：</p>

<div align="center">
  <img src="/images/wm/streaming-3dgs-worlds.jpg" width="90%" />
<figcaption>图：Marble 的流式 3DGS 渲染：生成的 3D 世界以高斯粒子表示，支持跨平台（手机到 VR 头显）实时渲染与自由视角探索。（图源：World Labs）</figcaption>
</div>

<table>
  <thead>
    <tr>
      <th style="text-align: left">特性</th>
      <th style="text-align: center">NeRF</th>
      <th style="text-align: center">3DGS（Marble）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">实时渲染</td>
      <td style="text-align: center">✗</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: left">精确相机控制</td>
      <td style="text-align: center">有限</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: left">交互式编辑</td>
      <td style="text-align: center">✗</td>
      <td style="text-align: center">✓</td>
    </tr>
    <tr>
      <td style="text-align: left">跨设备兼容</td>
      <td style="text-align: center">✗</td>
      <td style="text-align: center">✓（手机→VR）</td>
    </tr>
    <tr>
      <td style="text-align: left">物理引擎集成</td>
      <td style="text-align: center">困难</td>
      <td style="text-align: center">自然兼容</td>
    </tr>
  </tbody>
</table>

<p><strong>四大核心功能模块</strong></p>

<div align="center">
  <img src="/images/wm/3d-as-code.jpg" width="90%" />
<figcaption>图：Chisel 工具：用户通过盒子、平面等基础 3D 形状或导入现有 3D 资产确定世界结构，文本 prompt 控制整体风格，实现结构与风格的解耦。（图源：World Labs）</figcaption>
</div>

<p>① <strong>Chisel（AI 原生 3D 雕刻）</strong>：实验性的 AI-native 3D 建模工具，允许用户在 3D 空间中直接用粗糙几何体（盒子、平面）或导入现有 3D 资产布置世界结构框架。核心设计原则是<strong>结构与风格解耦</strong>——粗糙 3D 场景决定世界的空间结构，文本 prompt 控制整体视觉风格，二者独立可控。<br />
② <strong>World Expansion（世界扩展）</strong>：一键扩展已生成的世界边界，用户选定需要扩展的区域，Marble 自动生成更多连续一致的内容填充选定区域，支持无限延伸。<br />
③ <strong>Composition Mode（合成模式）</strong>：将任意数量的独立世界组合为超大规模空间。各子世界的位置和衔接完全由用户控制，适用于游戏场景、VFX 大型布景或机器人仿真测试场的构建。<br />
④ <strong>Video Enhancement（视频增强）</strong>：对生成的 3D 世界渲染输出进行后处理，去除伪影、添加动态元素（如人物、粒子效果），同时保持像素级精确的相机控制和 3D 结构一致性。</p>

<p><strong>多格式导出与生态集成</strong></p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">导出格式</th>
      <th style="text-align: left">用途</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Gaussian Splats</td>
      <td style="text-align: left">最高保真度，用于实时渲染、VR/AR 交互漫游</td>
    </tr>
    <tr>
      <td style="text-align: left">Collider Mesh</td>
      <td style="text-align: left">低精度碰撞网格，用于物理引擎碰撞检测仿真</td>
    </tr>
    <tr>
      <td style="text-align: left">High-Quality Mesh</td>
      <td style="text-align: left">高精度三角网格，用于 CG 工业生产管线</td>
    </tr>
    <tr>
      <td style="text-align: left">Video</td>
      <td style="text-align: left">固定轨迹高清视频导出，用于影视与广告创作</td>
    </tr>
  </tbody>
</table>

<hr />

<h5 id="part-b-atlas-新一代-omni-空间智能基座架构解析">Part B: Atlas 新一代 Omni 空间智能基座架构解析</h5>

<p>如果说 Marble 是构筑在世界模型之上的上层交互平台，<strong>Atlas 则是其底座的核心引擎</strong>。Atlas 采用全模态自回归流匹配扩散 Transformer（Multimodal Autoregressive Diffusion Transformer），在统一空间上下文（Spatial Context）中构建了新一代世界模型的四大支柱：</p>

<h6 id="1-统一空间上下文与多模态自回归扩散架构">1. 统一空间上下文与多模态自回归扩散架构</h6>
<ul>
  <li><strong>全模态序列化（Multimodal Sequences）</strong>：Atlas 原生处理文本、图像、精确相机位姿（Camera Poses）以及 3D 深度图（3D Depth Maps），视频被统一表征为时序排列的图像帧序列。每一帧图像与深度图都强制绑定在对应的显式相机位姿上。</li>
  <li><strong>空间上下文（Spatial Context）</strong>：与大语言模型将词嵌入排列在 1D 线性上下文中不同，Atlas 将所有视觉与几何元素<strong>显式锚定在 3D 空间坐标中</strong>，构成 3D 空间工作记忆。在生成新内容时，模型基于该 3D 记忆进行时空推演。例如，用户将两张毫不相关的参考照片分别摆放在 3D 空间的不同位置，Atlas 会依据其丰富的物理世界先验，在二者之间自动推演生成合理的过渡结构（如走廊、门厅、拐角）。</li>
  <li><strong>AR + Diffusion 双重红利</strong>：
    <ul>
      <li><strong>自回归（Autoregressive）特性</strong>：按序推进多模态序列生成，能够无缝复用现代 LLM 基础设施的高性能服务技术，包括 KV-cache 状态缓存、解耦式服务调度与缓存感知路由；</li>
      <li><strong>流匹配扩散（Rectified Flow Diffusion）特性</strong>：采用连续流匹配扩散机制对高维连续视觉潜变量进行逐步去噪，推理时可通过调节去噪步数在生成速度与视觉质量之间自由权衡，并全面吸收分类器无引导（CFG）与扩散蒸馏（Distillation）等加速算法。</li>
    </ul>
  </li>
</ul>

<h6 id="2-像素级精准相机控制pixel-perfect-camera-trajectory-conditioning">2. 像素级精准相机控制（Pixel-Perfect Camera Trajectory Conditioning）</h6>
<ul>
  <li>传统基于文本提示（如 “camera pans left slowly”）的视频模型存在严重的歧义性与累积漂移。Atlas 将相机的 6-DoF 位姿轨迹作为原生输入模态，支持对视角位置、俯仰偏航与运镜速度的完全确定性控制。</li>
  <li>无论是复杂的推拉摇移（Pan, Truck, Crane）还是长距离飞越穿梭（Flythrough），Atlas 都能保证场景几何与物体结构在连续时空中保持严格一致，支持长达 <strong>1 分钟、1440p 分辨率</strong>的电影级受控长视频生成。</li>
</ul>

<h6 id="3-稀疏视图-3d-空间重建与显式资产导出">3. 稀疏视图 3D 空间重建与显式资产导出</h6>
<ul>
  <li>传统多视角立体视觉（MVS）或 NeRF 通常需要密集拍摄数十上百张视角。Atlas 将强大的通用物理常识融入隐空间，<strong>仅需 1~3 张普通照片</strong>即可在未见过的未知视角下联合预测 RGB 图像与空间几何深度，补全被摄物体背面与盲区环境。</li>
  <li>随着输入参考图像数量的增加（从 1 张增加到数十张），Atlas 的“联想脑补”平滑退火为“高精度真实复原”，并在末端直接输出为<strong>度量点云（Point Clouds）</strong>或转换为<strong>流式 3D 高斯泼溅（3DGS）</strong>，实现工业级 3D 资产导出。</li>
</ul>

<h6 id="4-时空物理仿真与机器人-real-to-sim-to-real-工作流">4. 时空物理仿真与机器人 Real-to-Sim-to-Real 工作流</h6>
<ul>
  <li><strong>轻量级“子弹时间”时空重定焦（Video Reframing）</strong>：无需造价昂贵的专业多相机阵列，科研人员仅需用 3~5 台普通智能手机配合普通三脚架随手录像，Atlas 便能重构包含动态过程的时空场，实现任意角度冻结与重构运镜。</li>
  <li><strong>具身导航大场景仿真与机载传感器模拟</strong>：使用手机录制一段仅包含 24 帧的环境视频，Atlas 即可将其重建为大规模 3D 可漫游空间。在虚拟机器人沿规划轨迹巡航时，Atlas 能够同步且实时渲染机器人机载传感器观测到的 RGB 画面与精确深度图（RGB-D），实现“仿真场景生成与本体感知一体化”。</li>
  <li><strong>具身操控交互物理与多样性变体生成</strong>：从少量日常真实操控视频中，Atlas 能够建模物体的物理交互规律，覆盖<strong>刚体（Rigid）、铰接体（Articulated）以及可形变软体（Deformable）</strong>。一旦任务在世界模型中完成仿真，开发者可程序化控制并改变物体类型、初始位置、机械臂动作扰动、环境光照与背景，为机器人策略学习源源不断注入高质量、高多样的合成数据。</li>
</ul>

<hr />

<h4 id="3-核心结果发现与量化评测">3. 核心结果/发现与量化评测</h4>

<h5 id="-相机受控生成能力评测人类盲测偏好胜率">① 相机受控生成能力评测（人类盲测偏好胜率）</h5>

<p>World Labs 采用第三方独立评测人员对单图输入 + 复合运镜轨迹（Pan, Truck, Crane 等组合）进行双盲对比测试，评估各模型对预设相机轨迹的遵循精度。Atlas 以压倒性优势战胜业内主流顶尖模型：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">对比基线模型</th>
      <th style="text-align: left">评测任务</th>
      <th style="text-align: center">选民选择 Atlas 的比例（胜率）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>MiniMax H3</strong></td>
      <td style="text-align: left">单图 + 复合运镜生成</td>
      <td style="text-align: center"><strong>75%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Gemini Omni Flash</strong></td>
      <td style="text-align: left">单图 + 复合运镜生成</td>
      <td style="text-align: center"><strong>81%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Happy Horse 1.1</strong></td>
      <td style="text-align: left">单图 + 复合运镜生成</td>
      <td style="text-align: center"><strong>86%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>FLUX 3</strong></td>
      <td style="text-align: left">单图 + 复合运镜生成</td>
      <td style="text-align: center"><strong>93%</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Seedance 2.5</strong></td>
      <td style="text-align: left">单图 + 复合运镜生成</td>
      <td style="text-align: center"><strong>94%</strong></td>
    </tr>
  </tbody>
</table>

<p><em>注：随运镜轨迹复杂度的增加，传统依赖文本提示控镜的模型漂移严重，Atlas 原生相机矩阵输入的优势进一步扩大。</em></p>

<h5 id="-稀疏视图-3d-空间重建误差对比absrel--10-越低越好">② 稀疏视图 3D 空间重建误差对比（AbsRel × 10⁻³，↓ 越低越好）</h5>

<p>在严苛的稀疏输入 3D 重建任务中，Atlas 接收输入图像及其位姿，预测对应像素的 3D 空间坐标。在统一评测协议下，Atlas 与专精 3D 重建的代表性模型（MapAnything, VGGT-1B, Depth Anything 3, Pi3X 等）在 7 大经典基准上全面对比：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">评测基准数据集</th>
      <th style="text-align: center"><strong>Atlas (Ours)</strong></th>
      <th style="text-align: center">MapAnything</th>
      <th style="text-align: center">VGGT-1B</th>
      <th style="text-align: center">Depth Anything 3</th>
      <th style="text-align: center">Pi3X</th>
      <th style="text-align: center">典型代表模型 5</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>全集综合均值 (Average)</strong></td>
      <td style="text-align: center"><strong>25.3</strong></td>
      <td style="text-align: center">28.7</td>
      <td style="text-align: center">34.7</td>
      <td style="text-align: center">36.4</td>
      <td style="text-align: center">39.3</td>
      <td style="text-align: center">47.7</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DTU</strong>（高精物体）</td>
      <td style="text-align: center"><strong>8.6</strong></td>
      <td style="text-align: center">11.1</td>
      <td style="text-align: center">16.2</td>
      <td style="text-align: center">9.7</td>
      <td style="text-align: center">11.9</td>
      <td style="text-align: center">18.2</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>ETH3D</strong>（室外复杂几何）</td>
      <td style="text-align: center"><strong>9.3</strong></td>
      <td style="text-align: center">18.7</td>
      <td style="text-align: center">25.4</td>
      <td style="text-align: center">11.4</td>
      <td style="text-align: center">23.8</td>
      <td style="text-align: center">34.8</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>KITTI</strong>（自动驾驶大尺度）</td>
      <td style="text-align: center"><strong>60.0</strong></td>
      <td style="text-align: center">60.2</td>
      <td style="text-align: center">74.8</td>
      <td style="text-align: center">101.4</td>
      <td style="text-align: center">93.3</td>
      <td style="text-align: center">115.3</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>NRGBD</strong>（室内密集深度）</td>
      <td style="text-align: center"><strong>6.5</strong></td>
      <td style="text-align: center">13.3</td>
      <td style="text-align: center">17.5</td>
      <td style="text-align: center">10.5</td>
      <td style="text-align: center">11.3</td>
      <td style="text-align: center">20.2</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>7-Scenes</strong>（室内稠密手持）</td>
      <td style="text-align: center"><strong>37.8</strong></td>
      <td style="text-align: center">39.3</td>
      <td style="text-align: center">44.4</td>
      <td style="text-align: center">45.2</td>
      <td style="text-align: center">50.8</td>
      <td style="text-align: center">47.4</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Tanks &amp; Temples (T&amp;T)</strong></td>
      <td style="text-align: center"><strong>42.4</strong></td>
      <td style="text-align: center">42.4</td>
      <td style="text-align: center">47.0</td>
      <td style="text-align: center">40.2</td>
      <td style="text-align: center">55.1</td>
      <td style="text-align: center">60.8</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>ScanNet</strong>（大规模室内场景）</td>
      <td style="text-align: center"><strong>12.4</strong></td>
      <td style="text-align: center">15.7</td>
      <td style="text-align: center">17.4</td>
      <td style="text-align: center">36.6</td>
      <td style="text-align: center">29.0</td>
      <td style="text-align: center">37.0</td>
    </tr>
  </tbody>
</table>

<p><em>评测结论：作为兼具生成与重建的全模态通用大模型，Atlas 的显式几何预测精度不仅没有出现通用泛化牺牲，反而在 7 大基准上全线超越了专精于单项重建任务的学术 SOTA 模型。</em></p>

<h5 id="-模型扩展规律scaling-laws">③ 模型扩展规律（Scaling Laws）</h5>
<p>World Labs 在大规模多样化多模态语料上对 Atlas 进行由小到大的系列化预训练验证，实验表明随着模型参数规模与训练计算量（Training Compute）的持续扩展，模型在长序时空一致性、细粒度物理合理性与未知盲区空间联想能力上均展现出稳定的单调递增趋势。</p>

<h5 id="-具身智能--评测基础设施与光轮智能的战略合作2026-年-1-月">④ 具身智能 × 评测基础设施：与光轮智能的战略合作（2026 年 1 月）</h5>

<p>2026 年 1 月，World Labs 与国内仿真合成数据公司光轮智能联手，系统性解决具身智能规模化评测面临的“基准过时、真机昂贵、传统仿真失真”三大行业困境：</p>

<pre><code class="language-mermaid">flowchart LR
    WL["World Labs / Atlas\n（世界从哪来）\nLWM 生成多样化 3D 虚拟环境\n作为机器人策略测试场"] --&gt; Eval
    GR["光轮智能\n（进步如何被衡量）\n可扩展评测框架\n多维度、自动化基准"] --&gt; Eval
    Eval["具身智能评测基础设施\n可规模化 · 自动化 · 接近真实"] --&gt; Robot["机器人 VLA 策略\n持续迭代优化"]
    Robot --&gt; WL
</code></pre>

<h5 id="-商业规模与行业认可">⑤ 商业规模与行业认可</h5>

<table>
  <thead>
    <tr>
      <th style="text-align: left">指标</th>
      <th style="text-align: left">数据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Marble 发布时间</td>
      <td style="text-align: left">2025 年 11 月</td>
    </tr>
    <tr>
      <td style="text-align: left">Atlas 发布时间</td>
      <td style="text-align: left">2026 年 9 月 1 日（Early Access）</td>
    </tr>
    <tr>
      <td style="text-align: left">2026 年 2 月融资</td>
      <td style="text-align: left">$10 亿美元（总融资 $12.3 亿）</td>
    </tr>
    <tr>
      <td style="text-align: left">公司估值</td>
      <td style="text-align: left">~$50 亿（较创立时 $10 亿增长 5×）</td>
    </tr>
    <tr>
      <td style="text-align: left">主要投资方</td>
      <td style="text-align: left">NVIDIA、AMD、Autodesk 等</td>
    </tr>
    <tr>
      <td style="text-align: left">行业认可</td>
      <td style="text-align: left">Forbes AI 50 2026</td>
    </tr>
    <tr>
      <td style="text-align: left">世界模型赛道融资变化</td>
      <td style="text-align: left">$14 亿（2024）→ $69 亿（2025）</td>
    </tr>
  </tbody>
</table>

<hr />

<h4 id="4-局限性与前沿挑战">4. 局限性与前沿挑战</h4>

<ul>
  <li><strong>闭源早期访问与学术可复现性</strong>：Atlas 目前处于定向合作伙伴的早期访问（Early Access）阶段，虽然披露了多模态自回归流匹配架构机制与详实量化评测，但核心模型权重与完整训练超参数尚未公开，开源社区自主复现与二次微调仍有门槛。</li>
  <li><strong>高动态微观接触力学边界</strong>：虽然 Atlas 支持刚体、铰接体与软体的外观形变与运动模拟，但在机器人需要的高频微观接触力矩、精细摩擦力分布及连续流体动力学等“触觉-力学物理”层面，仍需结合传统物理引擎（如 Isaac Sim、MuJoCo）进行联合仿真验证。</li>
  <li><strong>超大场景机载端侧部署</strong>：大规模环境下的点云与 3D 高斯泼溅高斯核数量往往达到数百万量级，在嵌入式机器人边缘计算平台（如 Jetson Orin）上进行实时流式推演时，仍需进一步结合神经高斯剪枝与 LoD 分级加载优化。</li>
</ul>

<hr />

<h2 id="paper-image2sim">5.6 Image2Sim (2026)</h2>
<p>———解耦 3D 空间锚定与单步像素流的实时神经仿真引擎</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2607.05765">arXiv:2607.05765</a> · <a href="https://github.com/MrZihan/Image2Sim">Project Page</a> · 清华大学 &amp; 智源研究院 · <a href="#ref-11">[11]</a></p>

<h4 id="精华-5">精华</h4>

<p>构建大规模、高保真且具备物理接地的交互式仿真环境是世界模型赋能具身智能的核心使命。Image2Sim 提出了“3D 空间锚定”与“超真实图像合成”解耦的神经仿真新范式：</p>
<ol>
  <li><strong>打破几何与合成的博弈（Decoupled Geometry &amp; Generation）</strong>：利用前馈 3D 特征高斯（Feature Gaussian）提供显式度量几何约束，再由单步像素流（Pixel Flow）生成模型在 3D 几何 Alpha 掩码引导下补全未观测视野，彻底克服了自回归生成式世界模型的空间遗忘与几何崩溃；</li>
  <li><strong>45.6 FPS 极速闭环仿真</strong>：采用连续时间 MeanFlow 单步速度估计与动量自蒸馏，将传统扩散/流匹配的多步迭代采样压缩为单步前向映射，在全景 RGB-D 渲染上达到 <strong>45.6 FPS</strong>，首次满足具身智能在线闭环交互与大规模强化学习/DAgger 训练的实时性要求；</li>
  <li><strong>自动化具身数据飞轮</strong>：直接从无标注 RGB-D 视频/图像构建近 <strong>2 万个</strong>交互式神经环境，并自动合成了超过 <strong>1000 万条</strong>跨视角高保真导航轨迹与多模态指令；</li>
  <li><strong>零样本 Sim2Real 跨域泛化</strong>：基于纯 Image2Sim 神经环境训练的导航策略 Image2Nav，跨模拟器 zero-shot 泛化至真实 Habitat（R2R-CE 成功率 70.3%）与真实 Hello Robot Stretch 3 物理机器人上。</li>
</ol>

<hr />

<h4 id="1-研究背景问题-4">1. 研究背景/问题</h4>

<p>传统具身智能策略训练严重依赖人工手工建模的物理仿真环境（如 Matterport3D、HM3D、ProcTHOR）：</p>
<ul>
  <li>真实扫描环境成本极高，环境多样性受限（仅数百个场景）；</li>
  <li>程序化合成环境存在严重的 Sim-to-Real 视觉与物理保真度鸿沟；</li>
  <li>传统生成式视频世界模型虽然画面逼真，但缺乏显式持久的 3D 空间结构和度量坐标系，机器人走远后“回看即崩溃”，无法支持长时间自由导航闭环。</li>
</ul>

<p>Image2Sim 旨在回答：<strong>能否直接从现实世界采集的无约束视频中，秒级构建出兼具毫米级 3D 空间一致性、照片级视觉保真度与高帧率闭环交互的神经物理世界？</strong></p>

<hr />

<h4 id="2-主要方法创新点-4">2. 主要方法/创新点</h4>

<div align="center">
  <img src="/images/vln/Image2Sim-pipeline-comparison.webp" width="100%" />
<figcaption>图：传统导航数据流水线（需昂贵人工 3D 重建）与 Image2Sim 神经仿真框架（自动从无约束数据构建 2 万个场景与千万轨迹）对比。（图源：Image2Sim, 2026）</figcaption>
</div>

<p>Image2Sim 将神经环境仿真解耦为两级级联结构：</p>

<div align="center">
  <img src="/images/vln/Image2Sim-architecture.webp" width="100%" />
<figcaption>图：Image2Sim 架构：前馈 3D 特征高斯编码器（左）与几何感知单步 Pixel Flow 渲染器（右）。（图源：Image2Sim, 2026）</figcaption>
</div>

<ol>
  <li><strong>前馈 3D 特征高斯几何构建（Feed-Forward 3D Gaussian Encoder）</strong>：
    <ul>
      <li>摒弃传统 3DGS 逐场景优化耗时数小时的弊端，采用双流编码器（DINOv3 高层语义流 + 几何细节流），单次前向直接预测场景的 3D 特征高斯集合 \(\mathcal{G} = \{g_j\}_{j=1}^M\)；</li>
      <li>在任意查询视角位姿 \(p\) 下，通过可微光栅化毫秒级投影出全景几何、深度图与不透明度图 \(\tilde{\mathbf{A}}_p\)，提供不可动摇的 3D 几何锚定；</li>
    </ul>
  </li>
  <li><strong>几何感知单步 Pixel Flow 渲染器（Geometry-Aware One-Step Pixel Flow）</strong>：
    <ul>
      <li>
        <p>当机器人漫游至未被扫描的死角盲区时，3DGS 投影会出现空洞与撕裂。Image2Sim 利用不透明度图 \(\tilde{\mathbf{A}}_p\) 构造 Alpha 门控源状态：</p>

\[\mathbf{z}_{\mathrm{src}} = \tilde{\mathbf{A}}_p \odot \tilde{\mathbf{X}}_p + \Sigma(\tilde{\mathbf{A}}_p) \odot \boldsymbol{\epsilon}, \quad \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})\]
      </li>
      <li>在高置信度几何区域保持原始投影，在盲区由基于 Flow Matching 的生成网络智能生成物理合乎逻辑的纹理细节；</li>
      <li>配合动量自蒸馏算法，反向 ODE 积分被蒸馏为单步前向预测，实现 45.6 FPS 极速运行。</li>
    </ul>
  </li>
</ol>

<hr />

<h4 id="3-核心结果发现-4">3. 核心结果/发现</h4>

<ol>
  <li><strong>渲染速度与保真度双赢</strong>：在 20,000 个场景上，全景 RGB-D 渲染速度达到 <strong>45.6 FPS</strong>，显著快于同类扩散世界模型（通常 &lt; 1 FPS），同时 PSNR 与 LPIPS 均达到一流视觉水准；</li>
  <li><strong>纯神经仿真训练的真机策略泛化</strong>：智能体完全在由 Image2Sim 生成的神经环境中进行大规模交互学习，零样本部署至真实世界机器人 Hello Robot Stretch 3，在包含复杂家具布局的未知房间中顺利完成多目标寻物导航，证明了神经世界模拟器替代传统仿真引擎的可行性。</li>
</ol>

<hr />

<h4 id="4-局限性-4">4. 局限性</h4>
<ul>
  <li>当前主要处理室内静态刚体场景，对于可形变柔性物体及大范围流体交互的度量高斯建模尚处于探索阶段。</li>
</ul>

<hr />

<h1 id="6-家族-b面向决策的世界模型">6. 家族 B：面向决策的世界模型</h1>

<p>这一家族的世界模型直接服务于机器人策略：条件是机器人动作或任务指令，价值最终体现在下游任务成功率上。按世界模型与策略的耦合方式分为四大范式（§2.2）。每个范式下先给出定义与机制，再介绍代表工作。</p>

<div align="center">
  <img src="/images/wm/Survey-Fig3-Paradigms.webp" width="95%" />
<figcaption>图：VLA 世界模型的四大技术范式。(a) 世界规划器：世界模型生成潜表示 z 引导 VLA；(b) 世界动作模型：将观察与动作联合建模；(c) 世界合成器：通过模仿学习（IL）构建合成数据集；(d) 世界模拟器：通过强化学习（RL）优化策略并获取外部奖励。（图源：Tan et al., 2026）</figcaption>
</div>

<h2 id="61-世界规划器">6.1 世界规划器</h2>

<blockquote>
  <p>💡 <strong>姊妹篇导读</strong>：关于具身策略模型（OpenVLA、$\pi_0$、Octo、RoboCat 等）的动作 Tokenization、跨本体预训练与端到端控制架构，详见专题博文 <a href="/VLA-Survey/">视觉-语言-动作（VLA）全景综述：从大模型底座、数据引擎到物理落地</a>。</p>
</blockquote>

<div align="center">
  <img src="/images/wm/World_Planner.webp" width="80%" />
<figcaption>图：InternVLA·N1 的端到端双系统架构：前向动力学规划器提供未来潜特征引导策略执行。（图源：Intern Robotics）</figcaption>
</div>

<p><strong>定义</strong>：该范式采用世界模型 \(\mathcal{W}_\phi\) 作为前向动力学模型，以显式未来观测帧 \(\hat{o}_{t+1}\) 或隐式潜特征 \(z_{t+1}\) 的形式合成前瞻引导信号，为下游策略 \(\pi_\theta\) 提供强语义与物理条件：</p>

\[\max_\theta \mathbb{E}_{z_{t+1} \sim \mathcal{W}_\phi(\cdot|o_t)} \left[ \sum_t \log \pi_\theta(a_{t+1} | o_t, z_{t+1}) \right]\]

<p>世界规划器的核心哲学是<strong>“预测先于行动”（Predict before Act）</strong>：先由世界模型预见未来（显式图像或隐式潜向量），再将该前瞻信号作为输入喂给策略网络，使决策具备物理接地的未来感知与因果预判。两种主流路径的信息流如下：</p>

<pre><code class="language-mermaid">flowchart LR
    O_t["当前观测 o_t"] --&gt; WM

    subgraph WM["世界模型 W_φ（前向动力学）"]
        direction TB
        ExP["显式路径（Explicit）\n扩散/流匹配生成未来像素帧\nUniPi / SuSIE / FLIP"]
        ImP["隐式路径（Implicit）\n自监督时空潜空间预测\nV-JEPA 2 / PIVOT-R"]
    end

    ExP --&gt;|"预测未来帧 o_{t+1}"| IDM["逆动力学模型 (IDM)\n从帧差推断动作 a"]
    ExP --&gt;|"潜特征嵌入 z_{t+1}"| Policy
    ImP --&gt;|"高维动力学潜嵌入 z_{t+1}"| Policy

    IDM --&gt; Policy
    O_t --&gt; Policy
    Policy["策略网络 π_θ(a | o_t, z_{t+1})"] --&gt; Robot["执行器 / 关节控制器"]
</code></pre>

<p><strong>显式规划 vs 隐式规划深度对比</strong>：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">维度</th>
      <th style="text-align: left">显式像素规划（Explicit Pixel Planning）</th>
      <th style="text-align: left">隐式潜空间规划（Implicit Latent Planning）</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>引导信号</strong></td>
      <td style="text-align: left">像素级未来图像/视频帧 \(\hat{o}_{t+1}\)</td>
      <td style="text-align: left">紧凑时空特征嵌入 \(z_{t+1}\)（如 V-JEPA 2 特征）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>代表方法</strong></td>
      <td style="text-align: left">UniPi, SuSIE, GR-MG, Vidar, 3D-VLA, FLIP</td>
      <td style="text-align: left">V-JEPA 2, PIVOT-R, VPP, MinD, TriVLA, MoWM</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>主要优势</strong></td>
      <td style="text-align: left">人类直观可解释、视觉调试方便、可直接接入通用 VLM</td>
      <td style="text-align: left">过滤光照/纹理等与控制无关的视觉噪声，计算速度快，不易产生像素级伪影</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>主要劣势</strong></td>
      <td style="text-align: left">扩散反向去噪采样耗时大、易在细小接触面出现像素级变形</td>
      <td style="text-align: left">缺乏直观可解释性、下游策略需与特定潜空间强对齐</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>动作推导机制</strong></td>
      <td style="text-align: left">逆动力学模型（IDM）从帧间变化解算动作，或由策略网络条件读取</td>
      <td style="text-align: left">策略网络直接在潜空间 cross-attend 读取前瞻潜特征</td>
    </tr>
  </tbody>
</table>

<p><strong>演进路径</strong>：早期工作（UniPi <a href="#ref-12">[12]</a>、SuSIE <a href="#ref-13">[13]</a>、GR-MG、Vidar、3D-VLA <a href="#ref-14">[14]</a>、FLIP）将规划视为高保真条件视频生成任务，通过视频扩散模型合成像素级未来状态，再经逆动力学模型导出动作。然而，像素级生成面临严重的推理延迟与细微物理接触模糊。近期 V-JEPA 2 <a href="#ref-15">[15]</a>、PIVOT-R <a href="#ref-16">[16]</a> 和 TriVLA 转向隐式规划，直接在自监督潜空间预测未来特征，减少了与动力学无关的背景细节干扰，提升了引导信号的信噪比与计算吞吐量。MoWM 则融合多模态动力学先验形成混合方案，进一步降低动作推导误差。</p>

<h3 id="paper-gene">GENE-26.5 (2026)</h3>

<p><a href="https://www.genesis.ai/blog/gene-26-5-advancing-robotic-manipulation-to-human-level">Genesis AI 于 2026 年发布的 GENE-26.5</a>  <a href="#ref-17">[17]</a> 是世界规划器范式在灵巧操作领域的一个工业案例。它最核心的技术突破在于：<strong>新任务仅需 &lt; 1 小时（约 200 episodes、&lt; 20 秒技能）的真机数据即可完成微调</strong>，而支撑这一极高样本效率的，正是“以世界模型为低层动作策略注入物理常识先验”的设计哲学。</p>

<p><strong>三个功能角色，一个统一模型</strong></p>

<p>从系统分工看，GENE-26.5 呈现出三个功能层：</p>
<ul>
  <li><strong>语义感知层（VLM）</strong>：编码自然语言指令与场景语义，负责高层逻辑任务链分解；</li>
  <li><strong>物理预测层（World Model）</strong>：动作条件视频生成模型，从海量无标注视频中预先习得“未来几秒内物体如何受力、形变、断裂与滑动”，提供强物理常识先验；</li>
  <li><strong>执行转化层（Action Model）</strong>：高频底层控制，将语义+物理条件直接翻译为连续关节扭矩。</li>
</ul>

<p>在工程实现上，<strong>GENE-26.5 并非三个孤立串联的模块</strong>，而是采用 <strong>Flow Matching</strong> 统一建模 language、vision、proprioception、tactile 和 action 的<strong>联合多模态分布</strong>。VLM 与 World Model 是被吸收进来的预训练组件，下游通过<strong>条件查询（Conditional Queries）</strong>从同一联合分布中无缝采样出 control、generative simulation、state estimation、IDM 或 value estimation 等不同子任务。</p>

<pre><code class="language-mermaid">flowchart LR
    Lang["语言指令\n(intent)"] --&gt; VLM
    Img["第一/第三人称视频\n本体感觉 / 触觉"] --&gt; VLM

    VLM["VLM\n语义编码"] --&gt;|"语义条件"| Joint
    VLM --&gt;|"语义条件"| WM

    subgraph Joint["联合分布模型 (Flow Matching)\n language ⊕ vision ⊕ proprioception ⊕ tactile ⊕ action"]
        direction TB
        WM["World Model\n动作条件视频生成\n→ 物理先验 z_phys"]
        Cond["条件查询接口\n control / sim / state est. / IDM / value"]
    end

    WM --&gt;|"潜空间物理引导"| Cond
    Cond --&gt;|"action sample"| Ctrl["500Hz 控制栈\nEtherCAT, 3ms 端到端\n~2mm 追踪误差"]
    Ctrl --&gt; Hand["Genesis Hand 1.0\n20-DoF 仿人手"]
</code></pre>

<p><strong>训练范式与硬件协同</strong>：</p>
<ul>
  <li><strong>异构多模态预训练（&gt; 200,000 小时）</strong>：覆盖手套捕捉数据（轨迹+触觉）、第一人称自然交互视频、第三人称互联网物理交互视频以及图文语料。模型直接从非完美对齐的异构数据中习得“感知-物理-动作”耦合先验，因而下游任务只需 20–30 分钟数据微调；</li>
  <li><strong>500Hz / 3ms 超低延迟硬件控制栈</strong>：世界规划器的物理轨迹在下发到真机时，往往因控制栈延迟导致误差放大。GENE-26.5 自研 EtherCAT 中间件，将端到端通信延迟压缩至 3ms，结合 20 个主动可反驱（Back-drivable）自由度的 Genesis Hand 1.0，将跟踪误差压至 ~2mm，确保了世界模型预测的物理轨迹在物理执行端得到高保真复现。</li>
</ul>

<hr />

<h3 id="paper-vla-world">VLA-World (2026)</h3>
<p>———Learning Vision-Language-Action World Models for Autonomous Driving</p>

<p>📄 <strong>Paper</strong>: <a href="https://vlaworld.github.io">https://vlaworld.github.io</a> · <a href="#ref-18">[18]</a></p>

<h5 id="精华-6">精华</h5>

<p>VLA-World 的核心思想在于通过在单帧未来预测的基础上进行反思性推理，将世界模型的生成能力与 VLA 模型的推理能力相结合。最值得借鉴的设计是其“分步走”的流程：首先根据预测的动作生成一张未来图，再让模型去观察这张自己生成的图，从而识别潜在的碰撞风险并修正动作。这种“脑内模拟后二次评估”的机制（Think with Generated future）极大地增强了端到端驾驶系统的安全性和可解释性。</p>

<hr />

<h5 id="1-研究背景问题-5">1. 研究背景/问题</h5>

<p>现有的端到端自动驾驶模型（如 VLA）通常缺乏显式的时空建模，难以预测环境中其他交通参与者的演变。而纯世界模型虽然能生成连贯的未来场景，却往往缺乏推理能力，难以评估所生成未来的安全性或优劣。VLA-World 通过统一预测性想象与反思性推理，提升了驾驶前瞻性。</p>

<hr />

<h5 id="2-主要方法创新点-5">2. 主要方法/创新点</h5>

<p>VLA-World 提出了一个结合了感知、动作衍生预测、图像生成、反思推理和规划的完整流程。</p>

<div align="center">
  <img src="/images/wm/VLA-World-overview.webp" width="100%" />
<figcaption>图：VLA-World 三阶段训练与性能概览。（图源：VLA-World, 2026）</figcaption>
</div>

<h6 id="三阶段训练策略">三阶段训练策略</h6>
<ol>
  <li><strong>阶段 1：视觉预训练</strong>：在大规模图像-指令数据集上激活图像生成知识。</li>
  <li><strong>阶段 2：监督微调 (SFT)</strong>：通过 nuScenes-GR-20K 混合任务数据集，建立感知、未来生成与规划的逻辑链接。</li>
  <li><strong>阶段 3：强化学习 (RL)</strong>：利用 GRPO 算法探索类人推理，使模型能更深入地反思生成的未来是否安全。</li>
</ol>

<div align="center">
  <img src="/images/wm/VLA-World-paradigm-comparison.webp" width="100%" />
<figcaption>图：VLA、世界模型与 VLA-World 三种范式的对比。（图源：VLA-World, 2026）</figcaption>
</div>

<h6 id="反思推理机制-think-with-generated-future">反思推理机制 (Think with Generated future)</h6>
<p>模型首先输出一个 0.5 秒内的轨迹预测，并据此生成对应的未来图。随后，模型再次“审阅”这张自生成的图，识别重要物体和潜在风险，最终修正决策，输出最终的长程轨迹。这种机制类似于人类驾驶员遇到突发状况时的二次反思过程。</p>

<hr />

<h5 id="3-核心结果发现-5">3. 核心结果/发现</h5>

<ul>
  <li><strong>性能表现</strong>: 在 nuScenes 等基准测试中，VLA-World 达到了比现有 VLA 和世界模型更低的碰撞率（Collision Rate 从 1.09% 降至 0.94%）和更高的 FID 视频生成质量。</li>
  <li><strong>可解释性</strong>: 通过让模型写下对“自己生成的未来”的推理过程（如识别某卡车的碰撞风险），系统的决策过程变得更加透明。</li>
</ul>

<div align="center">
  <img src="/images/wm/VLA-World-visualization.webp" width="100%" />
<figcaption>图：VLA-World 在复杂场景下的多视角图像预测可视化。（图源：VLA-World, 2026）</figcaption>
</div>

<hr />

<h5 id="4-局限性-5">4. 局限性</h5>

<p>由于模型需要先生成图像再进行推理，系统的端到端延迟仍然是一个挑战。未来研究将聚焦于提高实时推理速度。</p>

<hr />

<h2 id="62-世界动作模型wam">6.2 世界动作模型（WAM）</h2>

<p><strong>定义</strong>：该范式采用生成式序列模型或扩散模型，将未来观测状态与控制动作纳入统一网络，直接建模观测与控制的联合时空分布：</p>

\[\max_\phi \mathbb{E}_{\tau \sim \mathcal{D}} \left[ \sum_t \log \mathcal{W}_\phi(o_{t+1}, a_{t+1} \mid o_{\le t}, a_{&lt; t}) \right]\]

<p>与世界规划器“前瞻预测与策略解码前后串联”不同，世界动作模型将两者<strong>统一在同一个骨干网络中联合优化</strong>：模型既要预测未来帧（自监督物理演化目标），又要直接解码控制动作（策略执行目标）。</p>

<pre><code class="language-mermaid">flowchart LR
    subgraph IN["多模态输入"]
        O_t["当前观测 o_t"]
        H["历史观测/动作&lt;br/&gt;o_{t-k:t-1}, a_{t-k:t-1}"]
        L["语言指令 / 目标 g"]
    end
    subgraph WM["世界动作模型 W_φ（联合动力学骨干）"]
        direction TB
        Enc["多模态编码器 / Tokenizer"] --&gt; Joint["自回归 Transformer / 扩散 DiT / MoT\n(联合序列建模 / 潜在画布 Latent Canvas)"]
    end
    subgraph OUT["统一联合输出"]
        O1["预测未来帧/潜变量\n(视觉自监督/锚定约束)"]
        A1["控制动作 Chunk a_{t:t+H}\n(5Hz–15Hz 闭环高频输出)"]
    end
    O_t --&gt; Enc
    H --&gt; Enc
    L --&gt; Enc
    Joint --&gt; O1
    Joint --&gt; A1
    A1 --&gt; Robot["机器人执行器"]
    O1 -.-&gt;|"共享注意力梯度反传\n约束动作符合物理常识"| Joint
</code></pre>

<h3 id="为什么-wam-受到关注">为什么 WAM 受到关注</h3>

<p>传统的世界模型在推理时往往需要依赖外挂的轨迹搜索算法（如交叉熵方法 CEM、蒙特卡洛树搜索 MCTS、模型预测路径积分 MPPI），在成百上千条随机候选动作序列中逐一推演评分，导致单步决策耗时高达数秒，无法满足高频动态交互。</p>

<p><strong>WAM 的主要工程优势是省去了测试时的在线搜索</strong>：</p>
<ol>
  <li><strong>单次前向直接生成动作</strong>：在测试阶段，WAM 可以直接以 Policy 模式单次前向去噪输出可执行动作块（Action Chunk），控制频率可达 <strong>5Hz–15Hz</strong>，省去了 CEM 式的大量候选轨迹推演（NavWAM 报告较 NWM 提速约 1100×，见下文）；</li>
  <li><strong>未来视觉预测作为强正则化与路标锚定</strong>：在训练阶段，模型被迫在预测未来画面的同时生成动作。由于视觉去噪包含密集的像素级自监督信号，动作头获得了深度的物理动力学约束，有效缓解了反应式策略在长程控制中的“策略漂移（Policy Drift）”；</li>
  <li><strong>架构的统一与灵活性</strong>：通过灵活的掩码机制（Masking）或加噪调度，同一个 WAM 权重即可自由切换为前向动力学模拟器、逆动力学标注器、纯策略控制器或跨模态编辑工具。</li>
</ol>

<p><strong>细粒度分类</strong>（根据建模范式和实现机制）：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">建模范式</th>
      <th style="text-align: left">核心机制</th>
      <th style="text-align: left">代表性方法</th>
      <th style="text-align: left">核心技术亮点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>自回归（AR）</strong></td>
      <td style="text-align: left">视频预训练</td>
      <td style="text-align: left">GR-1 <a href="#ref-19">[19]</a>, HMA, UniVLA <a href="#ref-20">[20]</a>, GR-2</td>
      <td style="text-align: left">大规模视频先验转化为端到端动作预测</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>自回归（AR）</strong></td>
      <td style="text-align: left">统一序列建模</td>
      <td style="text-align: left">WorldVLA <a href="#ref-21">[21]</a>, RynnVLA-002, UP-VLA</td>
      <td style="text-align: left">将图像、动作、文本离散化为统一 Token 流</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>自回归（AR）</strong></td>
      <td style="text-align: left">前瞻与思维链推理</td>
      <td style="text-align: left">Seer, FlowVLA <a href="#ref-22">[22]</a>, CoT-VLA <a href="#ref-23">[23]</a>, DreamVLA <a href="#ref-24">[24]</a></td>
      <td style="text-align: left">引入多模态思维链与未来光流引导结构化决策</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>扩散 / 流匹配</strong></td>
      <td style="text-align: left">混合专家（MoT）</td>
      <td style="text-align: left">Motus <a href="#ref-25">[25]</a>, Cosmos 3 <a href="#ref-26">[26]</a></td>
      <td style="text-align: left">共享自注意力 + 解耦 FFN，UniDiffuser 多模式切换</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>扩散 / 流匹配</strong></td>
      <td style="text-align: left">空间价值接口</td>
      <td style="text-align: left">AIM <a href="#ref-27">[27]</a></td>
      <td style="text-align: left">空间价值图（ASVM）显式解耦意图，自蒸馏 RL 优化</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>扩散 / 流匹配</strong></td>
      <td style="text-align: left">潜在画布（Canvas）</td>
      <td style="text-align: left">NavWAM <a href="#ref-28">[28]</a></td>
      <td style="text-align: left">9帧世界-动作潜在画布，消除 CEM 实现 5Hz 实时导航</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>扩散 / 流匹配</strong></td>
      <td style="text-align: left">非对称视界</td>
      <td style="text-align: left">WAM-Nav <a href="#ref-29">[29]</a></td>
      <td style="text-align: left">动作长视界（24步）+ 视觉短视界（1步），防止视角剧变漂移</td>
    </tr>
  </tbody>
</table>

<hr />

<h3 id="paper-worldvla">WorldVLA (2025)</h3>
<p>———Towards Autoregressive Action World Model</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2506.21539">https://arxiv.org/abs/2506.21539</a> · <a href="#ref-21">[21]</a></p>

<h5 id="精华-7">精华</h5>

<p>这篇论文的核心亮点在于将 Vision-Language-Action (VLA) 模型与世界模型（World Model）统一在单个自回归框架中。值得借鉴的思想包括：利用世界模型预测未来图像的能力来学习环境底层物理规律，从而增强动作生成的准确性；反之，动作模型也辅助视觉理解，提升了图像生成的质量。此外，针对自回归动作序列生成中的误差累积问题，提出的动作注意力掩码策略（Action Attention Masking）能够显著提升动作块（Action Chunk）的生成性能。</p>

<hr />

<h5 id="1-研究背景问题-6">1. 研究背景/问题</h5>

<p>当前的 VLA 模型主要关注从图像和文本生成动作，但往往缺乏对动作深层次的理解，因为动作仅作为输出而未作为输入。相比之下，世界模型能够通过预测未来视觉状态来理解物理动力学，但通常无法直接生成动作。WorldVLA 旨在打破这一界限，通过统一架构实现动作与图像的协同理解与生成。</p>

<hr />

<h5 id="2-主要方法创新点-6">2. 主要方法/创新点</h5>

<p>WorldVLA 采用自回归架构，集成了图像、文本和动作三种模态的 Tokenizer。</p>

<div align="center">
  <img src="/images/wm/WorldVLA-overview.webp" width="100%" />
<figcaption>图：WorldVLA 与传统动作模型、世界模型的对比。（图源：WorldVLA, 2025）</figcaption>
</div>

<h6 id="统一架构">统一架构</h6>
<p>模型初始化自 Chameleon，一个统一的图像理解与生成模型。它包含：</p>
<ul>
  <li><strong>图像 Tokenizer</strong>: VQ-GAN 模型，将图像离散化为 Token。</li>
  <li><strong>动作 Tokenizer</strong>: 将 7 维机器人动作（位置、角度、夹具状态）离散化为 256 个 Bin 的 Token。</li>
  <li><strong>文本 Tokenizer</strong>: 标准的 BPE Tokenizer。</li>
</ul>

<div align="center">
  <img src="/images/wm/WorldVLA-architecture.webp" width="100%" />
<figcaption>图：WorldVLA 整体架构图。（图源：WorldVLA, 2025）</figcaption>
</div>

<h6 id="训练策略">训练策略</h6>
<p>训练过程混合了动作模型数据和世界模型数据：</p>
<ol>
  <li><strong>动作预测 ($L_{action}$)</strong>: 给定指令和多帧图像，预测后续动作。</li>
  <li><strong>未来预测 ($L_{world}$)</strong>: 给定当前观察和动作，预测下一帧图像。</li>
</ol>

<h6 id="动作注意力掩码-action-attention-masking">动作注意力掩码 (Action Attention Masking)</h6>
<p>论文发现，由于预训练模型在动作域的泛化能力有限，传统的因果掩码会导致前一动作的错误迅速传播。为此，WorldVLA 设计了一种特殊的掩码：在生成当前动作块时，遮蔽之前的动作，使动作生成仅依赖于视觉和文本输入，从而支持并行生成动作块并减少误差累积。</p>

<div align="center">
  <img src="/images/wm/WorldVLA-attention-mask.webp" width="100%" />
<figcaption>图：WorldVLA 的注意力掩码机制。（图源：WorldVLA, 2025）</figcaption>
</div>

<hr />

<h5 id="3-核心结果发现-6">3. 核心结果/发现</h5>

<ul>
  <li><strong>LIBERO 基准测试</strong>: WorldVLA 在 256x256 和 512x512 分辨率下均显著优于 OpenVLA。</li>
  <li><strong>协同效应</strong>: 加入世界模型数据后，动作生成的成功率（SR）有明显提升（例如在 LIBERO-Goal 上从 67.3% 提升至 73.1%）；同时，动作模型也帮助降低了视频生成的 FVD 值。</li>
  <li><strong>动作块生成</strong>: 采用新掩码策略后，动作块生成的鲁棒性大幅增强。</li>
</ul>

<div align="center">
  <img src="/images/wm/WorldVLA-visualization-action.webp" width="100%" />
<figcaption>图：动作模型可视化：WorldVLA 能在失败后多次尝试抓取。（图源：WorldVLA, 2025）</figcaption>
</div>

<div align="center">
  <img src="/images/wm/WorldVLA-visualization-world.webp" width="100%" />
<figcaption>图：世界模型可视化：WorldVLA 生成的未来图像更符合物理逻辑。（图源：WorldVLA, 2025）</figcaption>
</div>

<hr />

<h5 id="4-局限性-6">4. 局限性</h5>

<p>目前使用的离散图像 Tokenizer 在感知表现力上仍有局限。未来工作将探索更大规模的数据和模型，以及设计能够更平衡理解与生成的统一 Tokenizer。</p>

<hr />

<h3 id="paper-aim">AIM (2026)</h3>
<p>———Intent-Aware Unified World Action Modeling with Spatial Value Maps</p>

<p>📄 <strong>Paper</strong>: https://arxiv.org/abs/2604.11135 · <a href="#ref-27">[27]</a></p>

<h5 id="精华-8">精华</h5>

<p>这篇论文最值得借鉴的是<strong>用显式的空间价值图（Spatial Value Map, ASVM）作为世界模型（World Model）和动作头（Action Head）之间的中间接口</strong>，把“未来视觉预测”与“动作解码”之间缺失的“在哪里交互、为什么交互”这一操作意图（Manipulation Intent）补齐，从而避免动作头从稠密 RGB 像素未来中隐式反推逆动力学。具体可迁移的设计包括：(1) <strong>意图因果注意力（Intent-Causal Attention）</strong>——通过显式注意力掩码（Attention Mask）强制动作分支只能经由空间价值图访问未来信息，而不能直接读取未来 RGB Tokens，形成结构化的信息瓶颈；(2) <strong>混合专家 Transformer（Mixture-of-Transformers, MoT）</strong>的共享自注意力 + 分支 FFN 让视频、价值图、动作三个数据流既紧密耦合又各自保留专有特征空间；(3) <strong>自蒸馏强化学习后训练（Self-Distillation RL Post-Training）</strong>——冻结视频生成与价值图分支，仅利用投影空间价值图响应所产生的稠密奖励训练动作头，相当于让预训练的价值头自监督指导动作头，无需额外人工标签。这种“把语义意图落地为空间热图”的抽象在具身 VLA 控制领域具有极强的通用迁移价值。</p>

<hr />

<h5 id="1-研究背景问题-7">1. 研究背景/问题</h5>

<p>预训练视频生成模型为机器人控制提供了强大的视觉先验，但已有的统一世界动作模型（Unified World Action Models）在不做海量机器人专有数据微调的情况下难以解码出高精度动作。作者指出这并非纯粹的数据统计问题，而是<strong>结构性失配（Structural Mismatch）</strong>：视频生成模型捕获的是“物理场景如何演化”，而动作生成还需要显式推理“在哪里交互（Where）”以及“背后的操作意图（Intent）”；直接从未来 RGB 潜特征解码动作，会迫使模型从一个并非为控制优化的视觉表征中隐式恢复操作意图。</p>

<hr />

<h5 id="2-主要方法创新点-7">2. 主要方法/创新点</h5>

<div align="center">
  <img src="/images/wm/AIM-typical-vs-ours.webp" width="100%" />
<figcaption>图：典型统一世界动作模型（左）直接从共享未来视觉表征解码动作；AIM（右）在世界模型与动作头间引入空间价值图接口并通过自蒸馏优化。（图源：AIM, 2026）</figcaption>
</div>

<p><strong>核心思路：显式空间接口（Explicit Spatial Interface）。</strong> AIM 不直接从未来视觉特征解码动作，而是联合预测未来视频帧 $X^+$ 与与之空间几何对齐的动作空间价值图（Action-aligned Spatial Value Map）$M^+ \in [0,1]^{H \times W \times 3}$；空间价值图高亮任务相关的交互区域（例如抓取任务的抓取可操作性 Grasp Affordance 区域、放置任务的放置接触 Placement Contact 区域），作为操作意图的控制抽象。条件联合分布被分解为：</p>

\[p(X^+, M^+, A^+ \mid \mathcal H_t) = p(X^+, M^+ \mid \mathcal H_t)\, p(A^+ \mid \mathcal H_t, M^+).\]

<p>动作生成<strong>仅通过预测出的空间价值图</strong>获取未来信息，而不直接访问未来 RGB Tokens。</p>

<div align="center">
  <img src="/images/wm/AIM-framework.webp" width="100%" />
<figcaption>图：AIM 整体框架：Stage I 联合训练未来帧、空间价值图与动作；意图因果注意力将任务意图传递至动作分支；Stage II 冻结视频与价值分支，通过 GRPO 强化学习优化动作头。（图源：AIM, 2026）</figcaption>
</div>

<p><strong>架构设计（Architecture）。</strong> 基于预训练视频生成模型 <strong>Wan2.2-TI2V-5B</strong> 初始化视频分支，加入一个与之同深度但隐藏层宽度更紧凑的动作解码头。采用 <strong>Mixture-of-Transformers (MoT)</strong>：视频、价值图、动作三个流在每个 Transformer Block 共享自注意力子层，但各自拥有独立的 $W_{Q,s}^\ell, W_{K,s}^\ell, W_{V,s}^\ell$ 投影与独立的前馈网络（FFN）。T5 编码的自然语言指令仅通过交叉注意力注入视频分支，保证动作头仅经由共享的世界表征接收任务语义。Token 化时将三个视角（头顶俯视 / 左腕 / 右腕）拼接为 T-pose Canvas 画布，并复用 Wan2.2 VAE 同时编码 RGB 观测 $z_t^o$ 与空间价值图 $z_t^m$，使价值 Tokens 与视觉 Tokens 天然保持几何对齐。</p>

<p><strong>意图因果自注意力（Intent-Causal Self-Attention）。</strong> 这是 AIM 的关键结构创新，通过对共享自注意力的可见性掩码（Visibility Mask）实现：</p>

\[\mathcal V_x = [z_t^o,\, z_{t-k:t-1}^o,\, z_{t-k:t-1}^a,\, z^\ell,\, z^x],\]

\[\mathcal V_m = [z_t^o,\, z_{t-k:t-1}^o,\, z^x,\, z^m],\]

\[\mathcal V_a = [z_t^o,\, z_{t-k:t-1}^a,\, z^o,\, z^a].\]

<p>语义上：未来视频 Tokens 能看到当前观测、指令、历史观测动作，从而预测任务条件下的未来物理演化；未来价值 Tokens 能看到当前/历史观测与<strong>未来视频 Tokens</strong>，从而将空间价值预测锚定到推演出的未来状态；<strong>动作 Tokens 只能看到当前观测、历史动作和未来价值 Tokens，而看不到未来 RGB Tokens</strong>——这一掩码机制的作用是将任务语义先经过 T5 交叉注意力进入视频流 → 再凝聚沉淀到空间价值流 → 最后才被动作解码头读取，形成严密的“视频 $\to$ 价值 $\to$ 动作”因果信息瓶颈。</p>

<p><strong>训练目标。</strong> 整体损失函数是 RGB 流匹配（Flow Matching）、空间价值图流匹配与动作逆动力学损失的加权和：</p>

\[\mathcal L = \mathcal L_{rgb} + \lambda_m \mathcal L_{map} + \lambda_a \mathcal L_{act}.\]

<p>未来 RGB 与未来价值图 Tokens 由视频生成主干沿同一条流匹配轨迹联合去噪，动作 Tokens 由动作头去噪为连续双臂控制向量 $\hat A^+$。推理时 AIM 采用自回归 Chunk-wise Rollout 并利用 KV 缓存复用历史 Tokens，显著提升长时程推理效率。</p>

<p><strong>自蒸馏强化学习后训练（Self-Distillation RL Post-Training）。</strong> 监督学习（SFT）只能模仿动作分布而无法直接优化闭环任务成功率。因此引入第二阶段：<strong>冻结视频生成主干与空间价值图预测头，仅用 GRPO 算法更新动作头</strong>。单步奖励函数由稠密与稀疏两部分构成：</p>

\[r_t = \lambda_d r_t^{dense} + \lambda_s r_t^{sparse},\qquad r_t^{dense} = M_t(\Pi(p_t)),\]

<p>其中 $r_t^{sparse}$ 为任务完成的稀疏奖励信号，$p_t$ 为预测动作的落点或末端执行器目标位置，$\Pi(\cdot)$ 为相机几何投影矩阵，$M_t$ 为冻结价值头预测的空间价值图。直观而言，动作头因将动作精确投射到高价值交互区域而获得正向奖励——这是一种<strong>利用模型自身的空间价值先验作为稠密奖励的自蒸馏机制</strong>，免除了繁重的人工标注。GRPO 优化目标：</p>

\[\mathcal L_{GRPO}(\phi) = \mathbb E_t\left[\min\!\Big(\rho_t(\phi)\hat A_t,\, \mathrm{clip}(\rho_t(\phi), 1-\epsilon, 1+\epsilon)\hat A_t\Big)\right].\]

<p><strong>空间价值图标注方案。</strong> 针对抓取（Pick）任务，在夹爪与目标物体建立有效物理接触时记录接触表面点云，经相机投影矩阵映射至图像平面并施加高斯平滑，构建抓取可操作性区域（Grasp Affordance Region）；高斯核宽度根据相机内参及深度距离动态调整，保证不同视角与距离下的几何尺度一致。针对放置（Place）任务，检测被操作物体达到静止构型时的接触区域，生成放置接触区域（Placement Contact Region）。作者在 RoboTwin 2.0 仿真平台构建了 30K 轨迹的大规模数据集，包含同步多视角视频、精确动作序列及逐帧空间价值图标注。</p>

<hr />

<h5 id="3-核心结果发现-7">3. 核心结果/发现</h5>

<p>在 RoboTwin 2.0 的 50 个双臂精细操作任务上进行评测，Easy / Hard 难度均以任务成功率（SR %）为主指标：</p>

<ul>
  <li><strong>平均成功率：AIM 达到 94.0% / 92.1%（Easy / Hard），综合平均成功率达 93.1%</strong>，全面领先 $\pi_0$ (62.2%)、X-VLA (72.8%)、$\pi_{0.5}$ (79.8%)、GigaWorld-0 (86.0%)、Motus (87.8%)、Fast-WAM (91.8%)、LingBot-VA (92.2%) 等主流基线模型。</li>
  <li><strong>强化学习后训练增益显著</strong>：Stage 1（SFT 监督微调）已达到 93.0% / 92.0%（平均 92.5%）；Stage 2 RL 阶段进一步带来 +0.6 个百分点的平均提升（达到 94.0% / 92.1%，平均 93.1%），在 <em>Place Mouse Pad</em> (97%/95%)、<em>Scan Object</em> (100%/98%)、<em>Turn Switch</em> (100%/98%) 等接触敏感和阶段依赖任务上增益尤为突出。</li>
  <li><strong>大幅领先同类方法</strong>：相对同类统一世界动作模型 Motus，AIM 在 Easy / Hard 难度分别提升 <strong>+4.8 / +5.7 个百分点</strong>（平均提升 +5.3%）；相对 $\pi_{0.5}$ 提升 <strong>+12.7 / +13.9 个百分点</strong>（平均提升 +13.3%）。这证明将“空间交互意图”显式化建模带来的增益，显著超越了单纯扩大动作模型或视频模型参数量。</li>
  <li><strong>定性可视化验证</strong>：未来帧预测与操作阶段时序高度对齐，空间价值图精准聚焦于具有明确物理交互语义的区域（而非一般的视觉显著性 Saliency），机械臂投影动作落点严密落在高价值区域内，表明性能突破确实源于所设计的“空间桥梁”机制。</li>
</ul>

<div align="center">
  <img src="/images/wm/AIM-task-execution.webp" width="100%" />
<figcaption>图：RoboTwin 2.0 代表性任务执行过程（置鼠标垫/压订书机/扫物体/扳开关/开笔记本），左列为 Easy 设置，右列为 Hard 设置。（图源：AIM, 2026）</figcaption>
</div>

<hr />

<h5 id="4-局限性-7">4. 局限性</h5>

<p>目前该工作主要在 RoboTwin 2.0 仿真环境中构建数据并评测，尚需在真实双臂机器人平台上做进一步闭环迁移验证；此外，空间价值图的自动标注依赖仿真器的碰撞检测 API 与接触物理状态，在真实无标注视频中如何以无监督方式高效挖掘同等精度的空间接触标签仍是开放课题。</p>

<hr />

<h3 id="paper-motus">Motus (2025/2026)</h3>
<p>———统一隐动作世界模型：Mixture-of-Transformers 与光流动作金字塔</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2512.18876">arXiv:2512.18876</a> · <a href="https://motubrain.com">Project Page</a> · <a href="https://github.com/PKU-YuanGroup/Motus">Code</a> · 清华大学 &amp; 生数科技 · <a href="#ref-25">[25]</a></p>

<h5 id="精华-9">精华</h5>

<p>Motus 是首个将<strong>混合专家 Transformer（Mixture-of-Transformers, MoT）</strong>与<strong>统一扩散生成调度（UniDiffuser）</strong>引入机器人双臂操作的统一世界动作模型（WAM）。最值得借鉴的核心设计包括：</p>
<ol>
  <li><strong>解耦 FFN 的三专家 MoT 架构</strong>：在单个 DiT 骨干中集成多模态理解专家、视频生成专家与连续动作专家。三类 token 在每层共享自注意力实现深层信息互通，但在前馈网络（FFN）处解耦，既杜绝了模态特征干扰，又赋予模型在世界模型、VLA 策略、逆动力学和联合仿真之间任意切换的能力；</li>
  <li><strong>基于光流的潜动作模型（Latent Action VAE）</strong>：彻底摆脱对真机机械臂特定关节角（Joint Angles）标签的强依赖！提出直接从视频像素光流（Optical Flow）中自监督提取潜动作向量，使互联网海量无标注人类交互视频能够无缝转化为机器人可用的预训练数据；</li>
  <li><strong>六层数据金字塔</strong>：构建了从通用视频、带相机位姿视频、人类手部交互视频到真机遥操作的逐级蒸馏数据金字塔，利用像素级“差分动作（Delta Action）”实现跨本体知识迁移；</li>
  <li><strong>RoboTwin 2.0 双臂仿真与真机 SOTA</strong>：在极具挑战性的细粒度双臂操作基准 RoboTwin 2.0 上，Motus 平均成功率 87.8%，较 X-VLA（72.8%）高出 15.0 个百分点、较 \(\pi_{0.5}\)（79.8%）高出 8.0 个百分点，其后续演进版 Motubrain 更实现了 10× 推理加速。</li>
</ol>

<hr />

<h5 id="1-研究背景问题-8">1. 研究背景/问题</h5>

<p>具身智能系统长期面临严重的技术割裂：VLA 策略模型（如 OpenVLA、\(\pi_0\)）仅关注从图像映射到动作，缺乏对物理世界演变的前瞻理解；而视频世界模型（如 Sora、Wan2.1）擅长视频生成，却不懂如何输出精确的力控动作；两者的简单串联又存在高延迟与误差累积。</p>

<p>核心问题在于：<strong>如何构建一个统一的生成式骨干，既能吸收互联网无标注视频的通用物理先验，又能精确生成机器人连续双臂动作，并在毫秒级内完成闭环推理？</strong></p>

<hr />

<h5 id="2-主要方法创新点-8">2. 主要方法/创新点</h5>

<div align="center">
  <img src="/images/vln/motus-architecture-overview.webp" width="100%" />
<figcaption>图：Motus 整体架构图：基于 MoT（Mixture-of-Transformers）三专家网络，统一建模多模态理解、视频生成与机器人连续动作控制。（图源：Motus, 2025）</figcaption>
</div>

<h6 id="-三专家-mixture-of-transformersmot架构">① 三专家 Mixture-of-Transformers（MoT）架构</h6>

<p>Motus 在每个 Transformer Block 内部引入了分流设计：</p>
<ul>
  <li><strong>Token 组织</strong>：输入序列由视觉潜 Token \(z_v\)（来自 Wan-VAE）、文本 Token \(z_t\)（来自 T5）与连续动作 Token \(z_a\)（来自 Latent Action VAE）拼接而成；</li>
  <li><strong>共享自注意力（Shared Self-Attention）</strong>：视觉、文本与动作三种异构 Token 共享同一组注意力权重，允许动作 Token 自由查询场景未来的物理演化趋势，同时让未来视觉生成受到预定操作意图的约束；</li>
  <li><strong>解耦专家 FFN（Decoupled FFNs）</strong>：在注意力交互之后，视觉 Token 路由至 Video FFN，文本 Token 路由至 Text FFN，动作 Token 路由至 Action FFN。这种解耦避免了视频生成的大梯度破坏精细动作的数值敏感性。</li>
</ul>

<div align="center">
  <img src="/images/vln/motus-latent-action-vae.webp" width="75%" />
<figcaption>图：Motus 的 Latent Action VAE：通过自编码光流场自监督提取连续潜动作空间。（图源：Motus, 2025）</figcaption>
</div>

<h6 id="-光流动作提取与-unidiffuser-联合去噪调度">② 光流动作提取与 UniDiffuser 联合去噪调度</h6>

<p>为了利用互联网海量无控制标签的视频，Motus 设计了 <strong>Latent Action VAE</strong>：</p>
<ul>
  <li>输入相邻两帧的稠密光流场 \(F_{t \to t+1}\)，经编码器压缩为低维连续潜动作向量 \(a_t \in \mathbb{R}^{d_a}\)；</li>
  <li>在训练阶段，采用类似 UniDiffuser 的联合去噪调度器，对视频潜变量 \(z_v\) 与动作变量 \(a_t\) 分配独立的加噪时间步；</li>
  <li>通过在训练中动态 Mask 掉某些通道，模型天然支持四种运行模式：
    <ol>
      <li><strong>世界模型模式</strong>：给定观测 \(o_t\) 与动作 \(a_t\)，去噪生成未来帧 \(o_{t+1}\)；</li>
      <li><strong>策略（Policy）模式</strong>：给定观测 \(o_t\) 与指令，单次前向直接去噪生成执行动作 \(a_t\)；</li>
      <li><strong>逆动力学（IDM）模式</strong>：给定前后两帧 \(o_t, o_{t+1}\)，反推执行动作 \(a_t\)；</li>
      <li><strong>联合仿真模式</strong>：同时去噪动作与未来画面，既给出决策又呈现预想后果。</li>
    </ol>
  </li>
</ul>

<hr />

<h5 id="3-核心结果发现-8">3. 核心结果/发现</h5>

<div align="center">
  <img src="/images/vln/motus-robotwin-results.webp" width="100%" />
<figcaption>图：Motus 在双臂操作仿真基准 RoboTwin 2.0 上的性能对比，在多种高精度接触任务中大幅领先基线。（图源：Motus, 2025）</figcaption>
</div>

<ol>
  <li><strong>RoboTwin 2.0 刷新记录</strong>：在双臂协调操作基准测试中，Motus 的平均任务成功率达到 <strong>87.8%</strong>，大幅超越 X-VLA（72.8%）和 \(\pi_{0.5}\)（79.8%）；</li>
  <li><strong>真机跨本体泛化</strong>：在单臂 Franka 与双臂移动机器人真机上执行 20 余项日常复杂技能（如开箱、倒水、折叠毛巾），平均成功率突破 <strong>85%</strong>；</li>
  <li><strong>消除在线规划延迟</strong>：Policy 模式下单步动作生成延迟仅需 <strong>80ms</strong>，实现了真正可部署的高频闭环伺服。</li>
</ol>

<div align="center">
  <img src="/images/vln/motus-real-world-tasks.webp" width="100%" />
<figcaption>图：Motus 真机多任务操控执行轨迹。（图源：Motus, 2025）</figcaption>
</div>

<hr />

<h5 id="4-局限性-8">4. 局限性</h5>

<ul>
  <li>隐动作空间从光流中提取，虽然摆脱了硬件标签依赖，但在面对手部严重自遮挡或极速运动导致的光流伪影时，潜动作可能产生短暂失真；</li>
  <li>模型参数量较大，端侧部署依赖 TensorRT 量化与显存优化。</li>
</ul>

<hr />

<h3 id="paper-navwam">NavWAM &amp; WAM-Nav (2026)</h3>
<p>———导航世界动作模型：潜在画布（Latent Canvas）与非对称时空视界</p>

<p>📄 <strong>NavWAM (2026)</strong>: <a href="https://arxiv.org/abs/2606.13494">arXiv:2606.13494</a> · <a href="https://dachii-azm.github.io/navwam/">Project Page</a> · <a href="#ref-28">[28]</a><br />
📄 <strong>WAM-Nav (2026)</strong>: <a href="https://arxiv.org/abs/2606.04907">arXiv:2606.04907</a> · WAM-Nav: Asymmetric Latent World-Action Modeling for Unified Visual Navigation · <a href="#ref-29">[29]</a></p>

<h5 id="精华-10">精华</h5>

<p>在长程视觉导航（Visual Navigation）领域，传统的导航世界模型（Navigation World Models, NWM）长期受困于测试时极高昂的在线规划开销（使用 CEM 算法采样数千条候选轨迹，单步耗时甚至高达数分钟）。2026 年最新涌现的 <strong>NavWAM</strong> 与 <strong>WAM-Nav</strong> 彻底颠覆了这一范式，其最核心的技术突破包括：</p>
<ol>
  <li><strong>统一潜在画布（9-Frame Latent Canvas，NavWAM）</strong>：将当前状态、目标图像、当前视觉观测、未来动作 Chunk、未来状态预测、未来视觉前瞻与目标进度价值（Value）全部打包为固定 9 帧的时空潜在画布，通过联合去噪一次性完成动作生成与物理预测，彻底消除了推理时 CEM 搜索开销，控制频率可达 <strong>5Hz</strong>，计算量降低数千倍；</li>
  <li><strong>非对称时空视界（Asymmetric Horizon，WAM-Nav）</strong>：深刻揭示了导航与操作的根本差异——导航中机器人的自我中心视角变换剧烈，长程视觉展开极易导致累积误差爆炸！WAM-Nav 创造性地采用<strong>“动作长视界（\(H_{act}=24\) 步保轨迹平滑）+ 视觉短视界（\(H_{vis}=1\) 步提供可靠近未来几何锚定）”</strong>的非对称设计；</li>
  <li><strong>纯隐空间前瞻与零解码自监督</strong>：视觉预测全部在预训练 VAE 隐空间进行，无需昂贵的逐像素渲染，通过隐空间速度匹配损失惩罚动作与物理几何的不一致；</li>
  <li><strong>真实物理轮式/双足机器人验证</strong>：在 Diablo 轮足机器人和宇树 Unitree G1 人形机器人上完成多场景闭环实测，成功率达 <strong>79.2%–85%</strong>。</li>
</ol>

<hr />

<h5 id="1-研究背景问题-9">1. 研究背景/问题</h5>

<p>在视觉目标导航（Image-Goal / Point-Goal Navigation）中，环境通常是高度复杂且局部可观测的。传统的规划式世界模型（NWM）仅充当前向预测器，在执行每一步动作前，必须在内存中通过交叉熵方法（CEM）闭环展开上千条视觉轨迹并逐一评分，导致<strong>单步推理延迟高达数十秒至数百秒</strong>（FLOPs 超过 14,000 TF），根本无法用于移动机器人避障。</p>

<p>核心问题在于：<strong>能否在单个生成式网络中，将未来视觉预测、价值评估与连续动作决策深度熔合，实现既有物理前瞻视野又具备实时高频闭环的统一导航模型？</strong></p>

<hr />

<h5 id="2-主要方法创新点-9">2. 主要方法/创新点</h5>

<div align="center">
  <img src="/images/vln/NavWAM-concept-comparison.webp" width="100%" />
<figcaption>图：传统规划式导航世界模型（NWM，左）与导航世界动作模型（NavWAM，右）的决策流对比：NavWAM 彻底剔除繁重的在线 CEM 采样优化，实现高频闭环。（图源：NavWAM, 2026）</figcaption>
</div>

<h6 id="-navwam-的-9-帧世界-动作潜在画布latent-canvas">① NavWAM 的 9 帧世界-动作潜在画布（Latent Canvas）</h6>

<p>NavWAM 基于预训练 Cosmos-Predict2（2B）底座，构建了一个统一的 9 帧时空潜在画布：</p>

<div align="center">
  <img src="/images/vln/NavWAM-architecture-overview.webp" width="100%" />
<figcaption>图：NavWAM 的 9 帧潜在画布布局：将状态、目标、当前观测、动作 Chunk、未来状态、未来图像及进度价值统一排布并联合去噪。（图源：NavWAM, 2026）</figcaption>
</div>

<ul>
  <li><strong>画布排布</strong>：
    <ul>
      <li><em>帧 0–3（已观测条件）</em>：时空 VAE 边界 Pad、标准化机器人位姿 \(s_t\)、目标图像 \(g\) 与第一人称当前观测 \(o_t\)；</li>
      <li><em>帧 4–8（待预测输出）</em>：可执行动作 Chunk \(a_{t:t+H-1}\)（\(H=4\) 局部航向增量）、未来状态 \(s_{t+H}\)、未来连续观测预测 \(o_{t+H-1}, o_{t+H}\)，以及反映局部到终点进度的归一化距离价值 \(v_{t+H} \in [0, 1]\)。</li>
    </ul>
  </li>
  <li><strong>空间广播与平均</strong>：标量/向量特征（动作、状态、价值）经归一化后广播填充为整张特征图，解码时通过空间平均池化恢复，完美复用标准视频 DiT 架构；</li>
  <li><strong>Policy 模式单步直出</strong>：推理时输入帧 0–3，单次去噪前向即可同时输出高精度的未来动作 Chunk 与预期视觉画面，推理延迟仅 <strong>205.7 ms</strong>（5Hz 控制），较 NWM 的 233.8 秒快了 <strong>1100 倍</strong>！</li>
</ul>

<h6 id="-wam-nav-的非对称视界与双流上下文融合dscc">② WAM-Nav 的非对称视界与双流上下文融合（DSCC）</h6>

<p>针对剧烈旋转下的长程漂移，WAM-Nav 提出了两大核心创新：</p>

<div align="center">
  <img src="/images/vln/WAM-Nav-architecture.webp" width="100%" />
<figcaption>图：WAM-Nav 架构：统一目标对齐解耦为视觉查询 gV 与几何查询 gG，DSCC 双流融合历史观测与运动动量，共享 DiT 联合去噪动作与近未来隐特征。（图源：WAM-Nav, 2026）</figcaption>
</div>

<ol>
  <li><strong>非对称视界设计（Asymmetric Horizon）</strong>：
    <ul>
      <li>动作时域设定为长程（\(H_{act}=24\) 步），保证机器人运动学轨迹平滑且具有足够前瞻；</li>
      <li>视觉时域设定为极短程（\(H_{vis}=1\) 步），在 Stable Diffusion VAE 的潜空间中预测近未来特征 \(z_{t+1}\)，为动作去噪提供立竿见影的近场几何障碍碰撞约束，同时彻底避免了长程自回归视频生成带来的发散伪影；</li>
    </ul>
  </li>
  <li><strong>双流上下文条件（DSCC）</strong>：
    <ul>
      <li>目标调制视觉流：用视觉查询 \(g_V\) 残差强化 DINOv2 提取的视觉空间记忆；</li>
      <li>相对运动历史流：将历史轨迹转换为坐标无关的相对位移 \((\Delta x_i, \Delta y_i, \Delta \theta_i)\)，保证运动动量平滑。</li>
    </ul>
  </li>
</ol>

<hr />

<h5 id="3-核心结果发现-9">3. 核心结果/发现</h5>

<ol>
  <li><strong>离线基准与未来视觉一致性</strong>：在 GO STANFORD 测试集上，NavWAM 在无需 CEM 动作搜索的前提下，轨迹误差 ATE 仅为 0.192，显著优于传统 NWM（0.453），未来视觉预测一致性（0.668）大幅领先；</li>
  <li><strong>实机机器人部署突破</strong>：
    <ul>
      <li><strong>NavWAM</strong>：在 Diablo 轮足机器人室内多场景（办公室、仓库、会议室、大厅）24 次盲测中，取得 <strong>79.2%</strong> 的高成功率，远超 OmniVLA（58.3%）与 NWM（16.7%）；</li>
      <li><strong>WAM-Nav</strong>：在 Unitree G1 人形机器人真机实测中取得 <strong>85%</strong> 的平均导航成功率，展示出极强的 Sim2Real 零样本泛化能力。</li>
    </ul>
  </li>
</ol>

<div align="center">
  <img src="/images/vln/NavWAM-real-world-rollouts.webp" width="100%" />
<figcaption>图：Diablo 机器人实机运行期间的实测相机画面与预测未来画面对比。（图源：NavWAM, 2026）</figcaption>
</div>

<hr />

<h5 id="4-局限性-9">4. 局限性</h5>

<ul>
  <li>当前主要聚焦于静态/准静态室内环境，对于穿梭行人等动态障碍物的复杂物理交互仍需引入动态流场建模；</li>
  <li>目标输入主要针对图像目标导航（Image-Goal），未来需与全模态语言指令进一步深度融合。</li>
</ul>

<hr />

<h2 id="63-世界合成器">6.3 世界合成器</h2>

<p><strong>定义</strong>：该范式将世界模型构建为可无限扩展的<strong>生成式数据飞轮（Data Engine）</strong>，通过联合生成器 \(\mathcal{G}_{\theta,\phi}\) 自主合成包含交错观测与控制标注的大规模轨迹数据集 \(\mathcal{D}_{syn}\)，用以支撑大规模模仿学习（IL）：</p>

\[\mathcal{D}_{syn} \triangleq \left\{ \tilde{\tau} \sim p(o_0) \prod_t \mathcal{G}_{\theta,\phi}(\hat{o}_{t+1}, a_{t+1} \mid \hat{o}_t, \text{instruction}) \right\}\]

<p>世界合成器主要用来缓解机器人领域“数据长尾、采集昂贵”的问题。根据是否依赖真实动作标注，演化出两条核心合成路径：</p>

<pre><code class="language-mermaid">flowchart LR
    Init["初始环境观测 o_0"] --&gt; G
    Cmd["任务语言指令"] --&gt; G

    subgraph G["世界合成器 G_{θ,φ}"]
        direction TB
        PathA["路径 A：动作条件生成 (Action-Conditioned)\n给定动作序列展开未来高保真视频\nCtrl-World / Genie Envisioner / WristWorld"]
        PathB["路径 B：无动作视觉合成 + IDM 标注 (Action-Free)\n先利用视频大模型合成视觉动作流，再经逆动力学反推控制\nDreamGen / GigaWorld-0 / Image2Sim"]
        IDM["高精度逆动力学模型 (IDM)\n从相邻生成帧差精确提取动作 â_t"]
        PathB --&gt; IDM
    end

    PathA --&gt;|"(ô_{t+1}, a_{t+1})"| Dsyn
    IDM  --&gt;|"(ô_{t+1}, â_{t+1})"| Dsyn
    Dsyn["大规模合成数据集 D_syn\n(覆盖多视角、新物体、干扰背景)"] --&gt;|"大规模模仿学习 (IL)"| Policy["下游通用 VLA 策略 π_θ"]
</code></pre>

<p><strong>细粒度分类与核心路径</strong>：</p>

<ol>
  <li><strong>动作条件生成路径（Action-Conditioned Rollouts）</strong>：
    <ul>
      <li><em>代表方法</em>：Ctrl-World <a href="#ref-30">[30]</a>, Genie Envisioner, WristWorld <a href="#ref-31">[31]</a>, Qwen-RobotWorld <a href="#ref-32">[32]</a>（以自然语言描述的动作为条件，见下文）；</li>
      <li><em>机制</em>：基于真实采集的轨迹动作序列作为输入条件，通过世界模型生成对应视角的未来演变视频（如 WristWorld 生成 4D 手腕视角动态），实现对现有数据的视角扩充与背景泛化；</li>
    </ul>
  </li>
  <li><strong>无动作合成与逆动力学标注路径（Action-Free Video Synthesis + IDM）</strong>：
    <ul>
      <li><em>代表方法</em>：DreamGen <a href="#ref-33">[33]</a>, GigaWorld-0 <a href="#ref-34">[34]</a>, Image2Sim <a href="#ref-11">[11]</a>；</li>
      <li><em>机制</em>：不依赖真机动作标签。直接利用大规模视频生成底座（如 Wan2.1、Sora、Image2Sim）在给定任务指令下合成视觉上物理合理的交互视频轨迹，随后通过高精度逆动力学模型（IDM）从生成的视频帧差中反推出机器人关节控制动作 \(\hat{a}_t\)。该路径能够利用互联网规模的视频知识，是缓解机器人长尾数据瓶颈的重要方向。</li>
    </ul>
  </li>
</ol>

<hr />

<h3 id="paper-qwen-robotworld">Qwen-RobotWorld (2026)</h3>
<p>———用自然语言统一具身世界模型：机械臂操作、自动驾驶、室内导航和人到机器人迁移</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2606.17030">arXiv:2606.17030</a> · <a href="#ref-32">[32]</a></p>

<h5 id="精华-11">精华</h5>

<p>把”语言指令”当成唯一的统一动作接口，不同具身领域（操作、驾驶、导航、人到机器人迁移）的视频生成任务就能被改写成同一个 $s_{t+1} = f(s_t, a_t)$ 问题，从而联合训练而不互相冲突。用冻结的 MLLM（Qwen2.5-VL）做动作编码器，比 T5/CLIP 更能利用其内部世界知识（刚体约束、关节限制）隐式约束生成的物理合理性。双流 MMDiT 通过逐层联合注意力，让语言条件与视觉隐变量在每一层都双向融合，而不是只在输入端拼接一次。Scene2Robot 用”分段拼接 + 仅对生成段计损失”的方式，在不改架构的前提下把同一个 TI2V 骨干复用成跨具身视频编辑工具。数据侧的核心是把 20+ 机器人本体、500+ 动作类别全部映射到统一的自然语言描述，这比堆数据量本身更关键。</p>

<hr />

<h5 id="1-研究背景问题-10">1. 研究背景/问题</h5>

<p>通用视频生成模型（Sora2、Veo3 等）从互联网数据学到了丰富的视觉先验，但不懂接触动力学、刚体约束等具身物理规律；而 Cosmos、LVP 等领域专用具身世界模型虽然懂物理，却依赖关节角、路径点等机器人专属动作表示，无法跨本体、跨任务泛化。Qwen-RobotWorld 希望用自然语言作为统一动作接口，把操作、驾驶、导航、人到机器人迁移这四类互补的物理知识在同一个骨干网络里联合训练，相互增强而不是各自为战。</p>

<hr />

<h5 id="2-主要方法创新点-10">2. 主要方法/创新点</h5>

<p>Qwen-RobotWorld 由三部分构成：<strong>架构</strong>（双流 MMDiT + MLLM 动作编码）、<strong>数据</strong>（EWK 具身世界知识数据集）、<strong>训练</strong>（通用先验+专家能力的渐进式课程）。这三者紧密耦合：数据提供统一语言接口下的多领域监督信号，架构保证语言语义和视觉状态在每一层都能融合，训练策略则决定先学什么再学什么。</p>

<div align="center">
  <img src="/images/wm/Qwen-RobotWorld-EWK-dataset-overview.webp" width="100%" />
<figcaption>图：EWK 训练语料概览：通用世界数据提供外观、几何、动力学先验；结构化具身数据沿 Multi-Embodiment、Multi-Task、Multi-Scenario、Multi-View 四个维度组织，共同支撑语言条件下的动作理解和未来状态生成。</figcaption>
</div>

<p><strong>① 整体框架概述</strong></p>

<p>模型核心是一个 60 层的双流 Multimodal Diffusion Transformer（MMDiT）：理解流（understanding stream）处理冻结 Qwen2.5-VL 抽取的语言语义特征，代表动作 $a_t$；生成流（generation stream）处理视频 VAE 编码出的视觉隐变量，代表状态 $s_t$。两条流在每一个 block 都通过联合注意力交互，而不是只在输入层做一次拼接，这样去噪的每一步都能让视觉隐变量同时关注语义动作信号。</p>

<div align="center">
  <img src="/images/wm/Qwen-RobotWorld-architecture.webp" width="100%" />
<figcaption>图：双流 MMDiT 架构：冻结的 Qwen2.5-VL 编码语言动作，VAE 编码视频观测/预测帧的隐变量，二者在每层 MMDiT block 中联合注意力交互。</figcaption>
</div>

<p><strong>② 逐模块讲解</strong></p>

<ul>
  <li><strong>MLLM 动作编码器</strong>：输入是一句自然语言指令（如”用右手拿起粉色瓶子，把水倒在花上”），通过冻结的 Qwen2.5-VL 提取末层隐藏状态 $h = \phi(S)$ 作为条件信号。用 MLLM 而非轻量编码器（T5、CLIP）的原因有两点：(1) 深层语言理解能把复杂的组合式指令精确解析为细粒度的状态转移条件；(2) MLLM 内部沉淀的世界知识（例如机械臂是刚体、有固定连杆长度和关节约束）能隐式约束生成空间中物理合理的状态转移，配合 T2I 联合训练可以防止视频帧间的物体形变，这是缺乏语义接地的模型常见的失败模式。</li>
  <li><strong>VAE 状态编码/解码器</strong>：采用 Wan-VAE 架构，把视频帧编码为隐变量 $z = \mathcal{E}(x)$，并把预测的隐变量解码回视觉观测，同时支持图像和视频两种模态。</li>
  <li><strong>MMDiT 转移函数</strong>：双流设计中，理解流接收经可训练 connector 投影后的 MLLM 编码，生成流接收 VAE 输出的带噪状态隐变量。骨干共 60 个双流 block，24 个注意力头（每头维度 128），隐藏维度 3072，patch size 2×2；总参数量 MLLM 7B、VAE 127M（编码器 54M+解码器 73M）、MMDiT 20B，最长支持 48,360 个视频 token。</li>
  <li><strong>3D RoPE 位置编码</strong>：时间、空间高、空间宽三个维度独立编码，采用非对称划分（pe_axes_dim = [16, 56, 56]）——时间轴维度少是因为相邻帧强相关，空间轴维度多是为了捕捉更丰富的物体位置和场景布局差异；同时配合 Scalable RoPE 支持推理时泛化到不同分辨率和时长。</li>
</ul>

<p><strong>③ Scene2Robot：跨具身视频编辑</strong></p>

<p>人到机器人迁移本质是一个视频编辑问题：模型需要同时参考场景上下文（背景、物体布局、光照）和目标机器人的运动轨迹。Scene2Robot 在不改架构的前提下，把输入组织成三个连续分段：场景条件段（人类示范视频，人手已被遮罩处理，F 帧）、机器人参考段（MuJoCo 渲染的仿真机器人执行，F 帧）、生成段（待去噪的噪声隐变量，F 帧）。前两段都被赋予时间步 $t=0$ 并排除在去噪损失之外，只有生成段参与梯度更新；3D RoPE 给每个分段分配各自的时间索引范围。每一层 MMDiT 的联合注意力让生成段同时关注场景外观、机器人运动轨迹和语言动作语义，从而合成既保留场景上下文又遵循指令操作的逼真机器人执行视频。</p>

<div align="center">
  <img src="/images/wm/Qwen-RobotWorld-Scene2Robot.webp" width="100%" />
<figcaption>图：Scene2Robot 多分段条件机制：场景条件段、机器人参考段仅提供条件（赋时间步 0、不计损失），生成段通过联合注意力同时关注场景外观与机器人运动轨迹，实现跨具身视频合成。</figcaption>
</div>

<p><strong>④ 数据：EWK 数据集与动作-语言映射</strong></p>

<p>核心数据贡献是<strong>动作-语言映射框架</strong>：把 20+ 机器人本体类型、500+ 动作类别统一投射到自然语言空间，使 Franka 夹爪、自动驾驶车辆、室内导航 agent 的视频都变成”同一种语言条件视频生成任务”的实例。最终构成约 860 万视频-文本对、超过 2 亿观测帧的 EWK 数据集：操作领域约 590 万样本（20+ 机器人形态、1300+ 技能）为核心，自动驾驶约 20 万样本（Waymo、NVIDIA PhysicalAI-AD、Bench2Drive、Sekai），室内导航 6000+ 语言引导轨迹（VLNVerse），以及通过 MANO 重建+逆动力学渲染自动生成的人到机器人迁移数据（覆盖 14 种机器人形态）。</p>

<p>标注上采用<strong>五层分层标注框架</strong>：任务目标层（要发生什么状态转移）→ 动作细节层（拆解为时空轨迹、微动作、速度力度，并显式声明视角：第一人称主视角/手腕视角/外部视角/多视角拼接）→ 物理反馈层（物体位移、形变、接触状态等可视化验证的后果）→ 综合描述（50-100词）和简要描述（15-30词）两种粒度，训练时按 50%/50% 概率采样，让模型既能执行详细轨迹指令也能响应简短高层命令。</p>

<p><strong>⑤ 训练目标</strong></p>

<p>采用 flow matching 目标，输入视频经 VAE 编码到隐空间，噪声采样自标准正态分布；时间步采用基于视频序列长度自适应偏移的对数正态分布采样；TI2V 任务中首帧时间步固定为 0 以确保生成过程以给定观测帧为条件。训练分两阶段：<strong>预训练阶段</strong>联合训练 T2I/T2V/TI2V 任务建立通用视觉先验（T2I 锚定几何正确的物体形态，迁移到视频生成防止形变）；<strong>SFT 阶段</strong>按四阶段课程逐步注入具身数据（70%具身/30%通用混合）：单视角操作 → 多视角扩展 → 多视角拼接生成 → 复杂任务与跨域数据，具身部分中操作任务占约 90% 采样权重保证物理理解深度，多视角拼接和导航/驾驶各占约 5% 保证广度。</p>

<hr />

<h5 id="3-核心结果发现-10">3. 核心结果/发现</h5>

<p>在四个基准上评测：<strong>EWMBench</strong> 综合得分 4.60 排名第一（领先第二名 LVP 的 4.05 达 +0.55），其中运动保真度 HSD 达 0.566，比第二名高 33%。<strong>DreamGen Bench</strong>（GR1 机器人三个子集）总分 4.952 排名第一，物体级组合泛化能力（GR1-Object IF 0.878）最强。<strong>PBench</strong> 总分 0.804，超过所有开源模型，领域理解 0.857 排第 3，运动平滑度 0.990 在开源模型中排第 2。<strong>WorldModelBench</strong> 总分 8.99，超过所有开源模型（仅次于闭源 Wan2.6、Veo3），物理符合性（牛顿定律、质量守恒、流体动力学、重力）四项均满分。</p>

<p>定性结果显示该模型支持细粒度语言接地（仅改变指令中的一个关键词即可产生不同的操作视频）、跨本体泛化（同一指令驱动单臂夹爪、双臂系统、人形机器人、灵巧手等四种形态而无需专门适配）、多视角一致性，以及人到机器人迁移、自动驾驶场景合成、室内导航生成等跨域能力。在 RoboTwin-IF 零样本基准上，尽管训练时只混入了少量 RoboTwin 开源数据，仍展现出较强的零样本指令跟随和多视角一致性，优于 LVP 和 Cosmos2.5-14B 两个强基线。</p>

<hr />

<h5 id="4-局限性-10">4. 局限性</h5>

<p>由于模型专为具身任务设计且输出分辨率低于通用视频生成器，PBench 上的美学质量（0.455）和成像质量（0.649）相对较低；WorldModelBench 上的常识维度（帧/时序质量）也因分辨率原因落后于通用模型。DreamGen Bench 的长时程行为泛化（GR1-Behavior IF 0.832）略逊于 LVP 和 GigaWorld，仍有提升空间。</p>

<hr />

<h2 id="64-世界模拟器">6.4 世界模拟器</h2>

<p><strong>定义</strong>：该范式将动作条件世界模型 \(\mathcal{W}_\phi\) 作为<strong>神经虚拟物理仿真器</strong>，智能体在世界模型展开的“想象空间”中执行交互试错，并结合外部奖励评估器 \(\mathcal{R}_{ext}\)，利用强化学习（RL）算法端到端优化策略参数：</p>

\[\max_\theta \mathbb{E}_{\substack{a \sim \pi_\theta(\cdot|o) \\ \hat{o} \sim \mathcal{W}_\phi(\cdot|o,a)}} \left[ \mathcal{R}_{ext}(\hat{o}, a) \right]\]

<p>世界模拟器实现了“脱离昂贵真机与传统物理引擎，在神经仿真器中直接进行大规模强化学习”的闭环：</p>

<pre><code class="language-mermaid">flowchart TB
    O["真实/初始观测 o"] --&gt; Policy
    O --&gt; WS

    Policy["策略网络 π_θ(a|o)"] --&gt;|"采样动作 a"| WS["世界模拟器 W_φ\n（动作条件视频生成/潜空间动力学）"]

    WS --&gt;|"生成想象下一状态 ô"| Reward["外部验证奖励评估器\nR_ext(ô, a)\n(VLM 验证 / 空间价值图 / 稠密进度)"]
    WS --&gt;|"下一状态 ô"| Policy

    Reward --&gt;|"标量奖励 r_t"| RL["强化学习优化器\n(PPO / GRPO / WMPO / PACE)"]
    RL --&gt;|"梯度更新策略参数 θ"| Policy

    style WS fill:#fff4e6,stroke:#d68910,stroke-width:2px
    style RL fill:#fde9e9,stroke:#c0392b,stroke-width:2px
</code></pre>

<h3 id="两大挑战与应对">两大挑战与应对</h3>

<p>将生成式世界模型用作 RL 模拟器时，存在两个核心理论难题：</p>
<ol>
  <li><strong>物理幻觉累积（Hallucination Accumulation）</strong>：自回归生成的多步误差随时间累积，出现物体凭空消失、重力失效等虚假动态，RL 策略容易利用模型的物理漏洞获得虚假高分（Adversarial Exploitation）；</li>
  <li><strong>策略演化与环境动力学的分布漂移（Distribution Shift）</strong>：随着策略 \(\pi_\theta\) 持续更新，其探索出的动作序列逐渐脱离世界模型预训练时的数据分布，导致世界模型对新动作的预测精度急剧下降。</li>
</ol>

<p><strong>最新破局技术方案</strong>：</p>
<ul>
  <li><strong>关键帧初始化回放（Keyframe-Initialized Rollouts, KIR，如 WoVR）</strong>：从专家演示的关键帧（如抓取前夕、对准瞬间）附近初始化短程探索，缩短有效预测深度，限制误差累积；</li>
  <li><strong>策略对齐协同演化（Policy-Aligned Co-Evolution, PACE，如 WoVR）</strong>：在 RL 策略演化过程中，定期收集当前策略生成的动作轨迹，对世界模型进行在线增量微调，动态保持模拟器与策略动作分布的同步对齐；</li>
  <li><strong>基于 MLLM 的可验证与稠密进度奖励（Verified &amp; Dense Progress Rewards，如 VLA-RFT <a href="#ref-35">[35]</a>, PRBench, SRPO <a href="#ref-36">[36]</a>）</strong>：利用经过专门物理推理训练的 VLM（如 Cosmos-Reason1）或空间价值图（ASVM）提供每一步的稠密进度奖励，而非易受欺骗的简单图像相似度；</li>
  <li><strong>测试时适应（Test-Time Adaptation, TTA，如 VLA-Reasoner <a href="#ref-37">[37]</a>, AdaPower <a href="#ref-38">[38]</a>）</strong>：在真实部署测试阶段，允许策略根据环境反馈动态微调世界模型参数，实现在线即时校准。</li>
</ul>

<hr />

<h3 id="paper-wovr">WoVR (2026)</h3>
<p>———World Models as Reliable Simulators for Post-Training VLA Policies with RL</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2602.13977">https://arxiv.org/abs/2602.13977</a> · <a href="#ref-39">[39]</a></p>

<h5 id="精华-12">精华</h5>

<p>WoVR 提出了一种基于世界模型的机器人强化学习（RL）框架，核心贡献在于解决了世界模型中的“幻觉（Hallucination）”问题对 RL 优化信号的干扰。值得借鉴的三个机制包括：<strong>稳定的动作调节视频模型</strong>（Stabilized Action-conditioned Video World Model）通过双通道动作注入提升稳定性；<strong>关键帧初始化回放（Keyframe-Initialized Rollouts, KIR）</strong>通过在任务关键点附近初始化轨迹，缩短了有效预测深度并限制误差累积；以及<strong>世界模型与策略的协同演化策略（PACE）</strong>，通过迭代精调世界模型来恢复策略更新带来的分布漂移，确保了在想象空间中 RL 训练的可靠性。</p>

<hr />

<h5 id="1-研究背景问题-11">1. 研究背景/问题</h5>

<p>利用学习到的世界模型作为仿真器进行强化学习是机器人领域的热门方向，但闭环想象中的“幻觉”——即模型生成的视觉序列与真实物理规律不符——会误导 RL 优化，使其利用模型的错误而非真实的任务进度。随着策略演化，动作分布发生漂移，进一步加剧了幻觉问题。</p>

<hr />

<h5 id="2-主要方法创新点-11">2. 主要方法/创新点</h5>

<p>WoVR 并不假设世界模型是完美的，而是通过三个层面显式地调节 RL 与不完美模拟器的交互。</p>

<div align="center">
  <img src="/images/wm/WoVR-hallucination-overview.webp" width="100%" />
<figcaption>图：世界模型中的幻觉问题及其对 RL 的干扰。（图源：WoVR, 2026）</figcaption>
</div>

<h6 id="稳定的世界模型架构">稳定的世界模型架构</h6>
<p>WoVR 引入了一种增强型 DiT（Diffusion Transformer）世界模型，通过双通道动作注入机制实现更稳定的动作控制，减少了长程漂移和结构崩溃。</p>

<h6 id="关键帧初始化回放-kir">关键帧初始化回放 (KIR)</h6>
<p>为了防止自回归生成的误差随时间累加，WoVR 采用了 Keyframe-Initialized Rollouts。它利用人类演示中的关键帧作为起始点，在这些状态附近进行短程想象探索。这种做法大大限制了有效预测深度，抑制了幻觉的积累。</p>

<div align="center">
  <img src="/images/wm/WoVR-pipeline.webp" width="100%" />
<figcaption>图：WoVR 核心三步走架构：稳定模型、关键帧初始化、协同演化。（图源：WoVR, 2026）</figcaption>
</div>

<h6 id="策略对齐协同演化-pace">策略对齐协同演化 (PACE)</h6>
<p>为了应对策略更新导致的动作分布漂移（Distribution Shift），PACE 策略会定期在当前演化策略生成的动作轨迹上对世界模型进行微调。这种协同演化机制使模拟器能够动态适应新的动作分布，保持了策略与模拟器的对齐。</p>

<hr />

<h5 id="3-核心结果发现-11">3. 核心结果/发现</h5>

<ul>
  <li><strong>LIBERO 基准测试</strong>: WoVR 将 LIBERO 的平均成功率从 39.95% 提升至 69.2%（+29.3个百分点）。</li>
  <li><strong>真机验证</strong>: 在真实机器人操作任务中，成功率从 61.7% 提升至 91.7%。</li>
  <li><strong>生成效率</strong>: WoVR 达到了 23 FPS 的生成速度，使其成为一种高效的训练模拟器。</li>
</ul>

<div align="center">
  <img src="/images/wm/WoVR-visualization-results.webp" width="100%" />
<figcaption>图：WoVR 在 LIBERO 任务上的想象生成与策略执行可视化。（图源：WoVR, 2026）</figcaption>
</div>

<hr />

<h5 id="4-局限性-11">4. 局限性</h5>

<p>虽然 WoVR 缓解了幻觉，但对于极其复杂的多步长程任务，其稳定性仍有待提升。此外，协同演化过程中的计算开销也是一个需要优化的方向。</p>

<hr />

<h1 id="7-基础模型与平台">7. 基础模型与平台</h1>

<p>世界模型很少从零训练：视频生成底座提供外观与运动先验，统一多模态模型提供语言与推理能力，表征模型与 3D 模型提供几何约束。本章先按功能列出常用底座（§7.1），再展开 NVIDIA Cosmos 平台与 Cosmos 3（§7.2–§7.3），以及 Wan2.1、Janus-Pro 两个代表性底座（§7.4–§7.5），最后介绍一篇关于视频生成模型在机器人中应用的综述（§7.6）。</p>

<h2 id="71-基础模型总览">7.1 基础模型总览</h2>

<p>具身智能世界模型的飞速发展，高度仰赖于底层多模态生成、表征学习与空间几何基础模型的支撑。根据功能定位，可划分为四大基础模型支柱：</p>

<h3 id="视频生成模型">视频生成模型</h3>

<p>作为世界模型的“想象引擎”，负责在自然语言、历史图像或动作条件控制下，高保真生成连续的时空未来视频，参数规模从轻量级 0.6B 到工业级 17B：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">参数规模</th>
      <th style="text-align: left">建模骨干</th>
      <th style="text-align: left">典型应用与具身角色</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>Wan2.1</strong></td>
      <td style="text-align: center">1.3B / 14B</td>
      <td style="text-align: left">DiT + Flow Matching</td>
      <td style="text-align: left">主流开源底座；WristWorld, DreamGen, Motus, AIM</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Cosmos-Predict2.5</strong></td>
      <td style="text-align: center">2B / 14B</td>
      <td style="text-align: left">DiT + Flow Matching</td>
      <td style="text-align: left">物理 AI 专用底座；NavWAM, AdaPower, Prophet</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>SANA-WM</strong></td>
      <td style="text-align: center">2.6B</td>
      <td style="text-align: left">Hybrid GDN/Softmax</td>
      <td style="text-align: left">分钟级 720p 高效生成，单卡低显存交互仿真</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>LingBot-World</strong></td>
      <td style="text-align: center">14B+14B MoE</td>
      <td style="text-align: left">MoE DiT</td>
      <td style="text-align: left">分钟级实时交互世界模拟器，支持事件编辑与指令干预</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>LTX-Video / LTX-2</strong></td>
      <td style="text-align: center">2B / 17B</td>
      <td style="text-align: left">DiT + Flow Matching</td>
      <td style="text-align: left">SANA-WM 两阶段精化器底座，超高帧率视频生成</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>HunyuanVideo</strong></td>
      <td style="text-align: center">13B</td>
      <td style="text-align: left">双流 DiT</td>
      <td style="text-align: left">高视觉保真度与精细动作先验建模</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Stable Video Diffusion</strong></td>
      <td style="text-align: center">1.5B</td>
      <td style="text-align: left">UNet 扩散模型</td>
      <td style="text-align: left">Ctrl-World, MoWM, HMA, VPP 等早期探索</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>iVideoGPT / NOVA</strong></td>
      <td style="text-align: center">0.6B</td>
      <td style="text-align: left">自回归 Transformer</td>
      <td style="text-align: left">VLA-RFT, WMPO <a href="#ref-40">[40]</a> 等轻量级仿真评估</td>
    </tr>
  </tbody>
</table>

<h3 id="统一理解与生成模型">统一理解与生成模型</h3>

<p>打破感知理解（VLM）与图像/视频生成（Diffusion）的人为割裂，在单一自回归或混合专家网络中同时支持指令理解、物理推理与动作/图像生成：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">参数规模</th>
      <th style="text-align: left">核心架构</th>
      <th style="text-align: left">典型应用与具身角色</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>Cosmos 3</strong></td>
      <td style="text-align: center">4B / 16B / 64B</td>
      <td style="text-align: left">双塔 MoT (AR + DM)</td>
      <td style="text-align: left">全模态统一 Physical AI 骨干；兼任 VLM、WAM、模拟器与标注器</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Motus</strong></td>
      <td style="text-align: center">~3B</td>
      <td style="text-align: left">MoT + UniDiffuser</td>
      <td style="text-align: left">统一双臂操作 WAM，支持策略生成、正向模拟与逆动力学</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Janus-Pro</strong></td>
      <td style="text-align: center">1B / 7B</td>
      <td style="text-align: left">解耦视觉编码 AR</td>
      <td style="text-align: left">理解与生成解耦编码，多模态物理常识问答与规划</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Chameleon</strong></td>
      <td style="text-align: center">7B</td>
      <td style="text-align: left">早期融合全自回归</td>
      <td style="text-align: left">WorldVLA, RynnVLA-002 的原生多模态 Tokenizer 底座</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Emu3</strong></td>
      <td style="text-align: center">8.5B</td>
      <td style="text-align: left">纯自回归序列预测</td>
      <td style="text-align: left">FlowVLA, UniVLA, UD-VLA 端到端 Token 化策略</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Show-o / VILA-U</strong></td>
      <td style="text-align: center">1.3B / 7B</td>
      <td style="text-align: left">统一 Transformer</td>
      <td style="text-align: left">UP-VLA, CoT-VLA 视觉思维链与前瞻推理</td>
    </tr>
  </tbody>
</table>

<h3 id="表征学习模型">表征学习模型</h3>

<p>将连续的高维感觉输入抽象编码为紧凑、具备动力学不变性与物理因果性的潜空间表征，而非直接生成易受高频噪声干扰的像素：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型</th>
      <th style="text-align: center">参数规模</th>
      <th style="text-align: left">预训练目标</th>
      <th style="text-align: left">典型应用与具身角色</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>V-JEPA 2</strong></td>
      <td style="text-align: center">1B</td>
      <td style="text-align: left">联合嵌入预测 (JEPA)</td>
      <td style="text-align: left">NORA-1.5 <a href="#ref-41">[41]</a>, MoWM, SRPO 隐式潜空间规划与稠密奖励提取</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DINOv2 / DINOv3</strong></td>
      <td style="text-align: center">300M / 1B</td>
      <td style="text-align: left">自监督视觉特征</td>
      <td style="text-align: left">WAM-Nav, Image2Sim 空间几何与物体语义记忆检索</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>SigLIP / SigLIP-2</strong></td>
      <td style="text-align: center">400M / 1B</td>
      <td style="text-align: left">Sigmoid 对比学习</td>
      <td style="text-align: left">Janus-Pro, OpenVLA 多模态高层指令对齐与场景语义解析</td>
    </tr>
  </tbody>
</table>

<h3 id="3d-几何模型">3D 几何模型</h3>

<p>为世界模型提供三维度量坐标系、深度几何与空间持久性约束，是实现“可探索空间智能（Spatial Intelligence）”的基石：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型 / 技术</th>
      <th style="text-align: left">空间表示</th>
      <th style="text-align: left">核心能力</th>
      <th style="text-align: left">典型应用与具身角色</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>3D Gaussian Splatting (3DGS)</strong> <a href="#ref-42">[42]</a></td>
      <td style="text-align: left">显式高斯粒子</td>
      <td style="text-align: left">毫秒级可微渲染、跨设备漫游</td>
      <td style="text-align: left">Lyra 2.0, Marble, Image2Sim 场景持久化资产与碰撞检测</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Depth Anything 2 / 3</strong></td>
      <td style="text-align: left">单目深度 / 点云</td>
      <td style="text-align: left">极高精度的度量几何估计</td>
      <td style="text-align: left">Cosmos-Transfer1, SANA-WM 几何条件图与相机姿态恢复</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>VGGT / MapAnything</strong></td>
      <td style="text-align: left">3D 几何拓扑</td>
      <td style="text-align: left">大范围度量地图与 3D 场景重建</td>
      <td style="text-align: left">长程具身导航地图构建与物理边界约束</td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="cosmos">7.2 NVIDIA Cosmos 平台</h2>
<p>———World Simulation with Video Foundation Models for Physical AI</p>

<p>📄 <strong>Cosmos-Predict1 (2025)</strong>: <a href="https://arxiv.org/abs/2501.03575">arxiv.org/abs/2501.03575</a> · <a href="#ref-43">[43]</a><br />
📄 <strong>Cosmos-Predict2.5 (2025/2026)</strong>: <a href="https://arxiv.org/abs/2511.00062">arxiv.org/abs/2511.00062</a><br />
🔗 <strong>代码</strong>: <a href="https://github.com/nvidia-cosmos">nvidia-cosmos</a> · <a href="https://github.com/nvidia-cosmos/cosmos-cookbook">Cosmos Cookbook</a> <a href="#ref-44">[44]</a></p>

<p>Cosmos 是 NVIDIA 发布的<strong>物理 AI 世界基础模型平台</strong>，目标是用生成式视频模型部分替代真实数据采集与物理仿真，为机器人、自动驾驶等系统提供可控的”世界模拟”能力。与单一视频生成模型不同，它是一套<strong>分层平台</strong>：数据策展基础设施 → 三条预训练模型产品线 → 面向具体场景的后训练工作流。</p>

<div align="center">
  <img src="/images/wm/Cosmos-Platform-Components.webp" width="100%" />
<figcaption>图：Cosmos WFM 平台核心组件：视频数据策展流水线、多模态 Tokenizer、预训练 WFM 与后训练应用样例。</figcaption>
</div>

<h3 id="数据策展">数据策展</h3>

<p>物理 AI 世界模型的训练瓶颈首先是<strong>数据质量</strong>。Cosmos Video Curator 分七个阶段把原始视频转为训练数据：镜头感知切分 → GPU 转码 → 裁剪 → <strong>多级过滤</strong>（美学、运动、OCR、DOVER 感知质量、VTSS 语义伪影、VLM 精筛，最终仅约 <strong>4%</strong> 的片段通过）→ 多粒度字幕（Qwen2.5-VL-7B 生成短 / 中 / 长三种描述）→ 语义去重 → 按内容类型、分辨率、宽高比、时长四维分片（支持课程学习与域平衡采样）。</p>

<div align="center">
  <img src="/images/wm/Cosmos-Predict2.5-VideoCurationPipeline.webp" width="100%" />
<figcaption>图：Cosmos Video Curator 流水线：原始多领域视频经切分、转码、裁剪、多级过滤、字幕生成、语义去重、结构化分片七个阶段，输出可直接用于大规模预训练的高质量数据集。（图源：Cosmos-Predict2.5）</figcaption>
</div>

<p>Predict2.5 时代流水线处理了数亿条原始片段，保留数千万条（Predict1 时代为 1000 万条）；此外针对机器人操作（AgiBot、GR00T、DROID、OpenX 等）、自动驾驶（约 310 万条 7 路环视视频）、智能空间、人类动力学、物理现象五个领域构建了专属数据。</p>

<h3 id="三条模型产品线">三条模型产品线</h3>

<table>
  <thead>
    <tr>
      <th>模型</th>
      <th>核心能力</th>
      <th>典型输入</th>
      <th>典型输出</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>Cosmos-Predict</strong></td>
      <td>未来世界状态预测</td>
      <td>Text / Image / 历史视频</td>
      <td>未来多秒视频</td>
    </tr>
    <tr>
      <td><strong>Cosmos-Transfer</strong></td>
      <td>结构化世界翻译（Sim2Real）</td>
      <td>边缘 / 深度 / 分割图</td>
      <td>照片级真实视频</td>
    </tr>
    <tr>
      <td><strong>Cosmos-Reason</strong></td>
      <td>物理推理 VLM</td>
      <td>视频 + 文本问题</td>
      <td>带 CoT 的自然语言回答</td>
    </tr>
  </tbody>
</table>

<h4 id="cosmos-predict前向预测引擎">Cosmos-Predict：前向预测引擎</h4>

<p><strong>Cosmos-Predict1（2025）</strong> 同时提供两种架构：<strong>扩散模型</strong>（DiT + EDM + T5 文本编码器，画质与 3D 一致性更好）和<strong>自回归模型</strong>（因果 Transformer 预测离散视频 token，适合长序列交互式展开）。二者共用 <strong>Cosmos Tokenizer</strong>——小波变换 + 因果 3D 卷积，同时输出连续 token（供扩散）与离散 token（供自回归）。</p>

<div align="center">
  <img src="/images/wm/Cosmos-Predict1-Diffusion-Architecture.webp" width="100%" />
<figcaption>图：Cosmos-Predict1 扩散模型架构：DiT 主干 + T5 文本编码器 + 3D RoPE 位置编码。</figcaption>
</div>

<div align="center">
  <img src="/images/wm/Cosmos-Tokenizer-Architecture.webp" width="100%" />
<figcaption>图：Cosmos Tokenizer：基于小波变换的编解码结构，通过因果 3D 卷积捕获时间相关性，同时输出连续 token（供扩散模型）与离散 token（供自回归模型）。</figcaption>
</div>

<p><strong>Cosmos-Predict2.5（2025/2026）</strong> 的主要改动：</p>

<ul>
  <li>扩散与自回归两条路线<strong>统一为单一 Flow Matching 模型</strong>，Text2World / Image2World / Video2World 共用一套权重；</li>
  <li>视觉 Tokenizer 换用 <strong>Wan2.1 VAE</strong>（4×8×8 压缩，每次生成 93 帧约 5.8 秒）；</li>
  <li>文本编码器由 T5 换为 <strong>Cosmos-Reason1</strong>（多层激活拼接后投影至 1024 维）；</li>
  <li>去掉绝对位置编码、保留相对 3D RoPE，提升对训练外分辨率与时长的泛化；</li>
  <li>提供 <strong>2B / 14B</strong> 两种规模，以及机器人操作、自动驾驶等领域专属后训练版本。</li>
</ul>

<div align="center">
  <img src="/images/wm/Cosmos-Predict2.5-Architecture.webp" width="100%" />
<figcaption>图：Cosmos-Predict2.5 整体架构：右侧为 DiT 主干，在潜空间中以"自注意力 → 交叉注意力 → 前馈 MLP"堆叠的 Block 预测去噪速度场，时间步以 AdaLN-LoRA 注入；左侧为 Cosmos-Reason1 文本编码器，跨多层激活拼接后投影为 1024 维文本嵌入，通过交叉注意力层引导视频生成。（图源：Cosmos-Predict2.5）</figcaption>
</div>

<h4 id="cosmos-transfer结构化世界翻译">Cosmos-Transfer：结构化世界翻译</h4>

<p>📄 <strong>Cosmos-Transfer1 (2025)</strong>: <a href="https://arxiv.org/abs/2503.14492">arXiv:2503.14492</a> · <a href="#ref-45">[45]</a></p>

<p>Cosmos-Transfer 把<strong>结构化世界表示</strong>翻译成<strong>照片级视频</strong>，典型用途是把 Isaac Sim、CARLA 等仿真器的几何 / 语义输出提升为真实感画面（Sim2Real）。Transfer1 在 Predict1-7B 基础上后训练，核心是<strong>自适应多模态 ControlNet</strong>：</p>

<ul>
  <li><strong>多分支 ControlNet</strong>：每种控制模态（Blur/Vis、Canny 边缘、DepthAnything2 深度、GroundingDino + SAM2 分割）一条独立分支，可单独训练、推理时融合，新增模态无需重训主干；</li>
  <li><strong>时空控制图</strong>：用 $N \times X \times Y \times T$ 维权重张量 $\mathbf{w}$ 为每个模态在每个时空位置分配权重——例如前景用边缘图保细节、背景允许自由生成；</li>
  <li>自动驾驶版本额外支持 <strong>HDMap</strong> 与 <strong>LiDAR</strong> 条件，另有 4K 超分 ControlNet。</li>
</ul>

<div align="center">
  <img src="/images/wm/CosmosTransfer1-AdaptiveControlNet.webp" width="100%" />
<figcaption>图：Cosmos-Transfer1 自适应多模态 ControlNet 架构：每种控制模态对应一条独立控制分支，通过时空控制图 w 加权后注入主 DiT 生成分支，实现位置自适应的多模态融合。（图源：Cosmos-Transfer1）</figcaption>
</div>

<p><strong>Cosmos-Transfer2.5</strong> 继承全部模态，模型缩小 <strong>3.5×</strong>（7B → ~2B），PAIBench-Transfer 整体质量评分从 6.56 提升至 9.75，并新增 <strong>RNDS</strong> 指标衡量长视频质量退化。</p>

<h4 id="cosmos-reason物理推理-vlm">Cosmos-Reason：物理推理 VLM</h4>

<p>📄 <strong>Cosmos-Reason1 (2025)</strong>: <a href="https://arxiv.org/abs/2503.15558">arXiv:2503.15558</a> · <a href="#ref-46">[46]</a></p>

<p>Cosmos-Reason1 是面向物理 AI 的视觉语言模型，输出带 <code class="language-plaintext highlighter-rouge">&lt;think&gt;...&lt;/think&gt;</code> 推理链的回答。它用两套本体定义能力边界：<strong>物理常识本体</strong>（Space / Time / Fundamental Physics 三大类、16 个子类，如物体恒存、因果、力学）与<strong>具身推理本体</strong>（重点考察任务完成验证、动作可操作性、下一步动作预测）。</p>

<div align="center">
  <img src="/images/wm/CosmosReason1-CommonSenseOntology.webp" width="80%" />
<figcaption>图：Cosmos-Reason1 物理常识本体：三大类（Space、Time、Fundamental Physics）划分为 16 个细粒度子类，定义 Physical AI 模型应具备的感知与推理能力边界。（图源：Cosmos-Reason1）</figcaption>
</div>

<table>
  <thead>
    <tr>
      <th>配置</th>
      <th>Cosmos-Reason1-7B</th>
      <th>Cosmos-Reason1-56B</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Vision Encoder</td>
      <td>ViT-676M（动态分辨率）</td>
      <td>ViT-300M（固定 448×448）</td>
    </tr>
    <tr>
      <td>LLM 架构</td>
      <td>密集 Transformer（28 层）</td>
      <td>Mamba-MLP-Transformer 混合（118 层）</td>
    </tr>
    <tr>
      <td>LLM 预训练底座</td>
      <td>Qwen2.5-VL</td>
      <td>Nemotron-H</td>
    </tr>
  </tbody>
</table>

<p>训练分两步：<strong>Physical AI SFT</strong>（约 4M 视频-文本对，其中约 1.93M 为 DeepSeek-R1 蒸馏的 CoT 标注）与 <strong>Physical AI RL</strong>（GRPO + 可自动校验的多选题奖励，含”还原打乱的时空块”“判断视频播放方向”等自监督题目）。在平台内，Reason1 同时承担<strong>物理合理性裁判、Predict2.5 的文本编码器、高层任务规划器与合成数据质检</strong>四种角色。</p>

<h3 id="训练流程">训练流程</h3>

<div align="center">
  <img src="/images/wm/Cosmos-Training-Paradigm.webp" width="100%" />
<figcaption>图：Cosmos 训练范式：通用物理知识大规模预训练 → 领域 SFT → 模型融合 → RL 后训练，最终微调适配各类下游 Physical AI 任务。</figcaption>
</div>

<p>Cosmos-Predict2.5 采用四阶段渐进范式：</p>

<ol>
  <li><strong>预训练</strong>：课程学习，从 256p Text2Image 逐步过渡到 720p（1280×704）、93 帧的 Text/Image/Video2World；</li>
  <li><strong>领域 SFT</strong>：在物体恒存（10.4M）、高动态（1.0M）、复杂场景（1.6M）、驾驶（3.1M）、机器人操作（730K）五类数据上分别训练专域模型；</li>
  <li><strong>模型融合</strong>：用 Model Soup、TIES、DARE-TIES 等参数插值方法把专域模型合为一个，人类偏好评测中融合模型在所有领域均优于任一单独 SFT 模型；</li>
  <li><strong>RL 后训练</strong>：以 <strong>VideoAlign</strong>（文本对齐 + 运动质量 + 视觉质量）为奖励、GRPO 为算法，人类评测胜率提升约 20 个百分点。</li>
</ol>

<p>推理侧用 rCM 蒸馏压缩到 <strong>4 步</strong>，PAI-Bench 总分损失 &lt; 0.005。训练使用 4096 张 H100，2B / 14B 模型 MFU 约 36.5% / 33.1%。</p>

<h3 id="典型应用">典型应用</h3>

<ul>
  <li><strong>机器人策略视觉增强</strong>：用 Transfer2.5 替换背景、改物体颜色、加干扰物，提升策略在视觉扰动下的成功率；</li>
  <li><strong>自动驾驶多视角仿真</strong>：以 HD map + 语义为条件生成 7 路同步环视视频；</li>
  <li><strong>相机可控多视角生成</strong>：对 Predict2.5 做相机位姿条件化后训练；</li>
  <li><strong>VLA 合成数据</strong>：单帧 + 动作条件生成操作视频，再由 Reason1 自动打标与过滤；</li>
  <li><strong>动作条件世界生成</strong>：以关节角 / 末端轨迹为条件预测未来视频，用于策略闭环评估。</li>
</ul>

<div align="center">
  <img src="/images/wm/Cosmos-Predict2.5-PredictionSamples.webp" width="100%" />
<figcaption>图：Cosmos-Predict2.5-2B post-trained 模型在 PAI-Bench 上的生成样本：覆盖自动驾驶（上两行）、工业机器人操纵（中三行）、人类动力学（下行）等多个物理 AI 场景，展示了模型在时序一致性与物理合理性上的能力。（图源：Cosmos-Predict2.5）</figcaption>
</div>

<p>官方 Cosmos Cookbook <a href="#ref-44">[44]</a> 提供三条产品线的推理脚本、相机控制 / 机器人操作 / 自动驾驶后训练模板、数据策展接入流程、安全护栏（Guardrail）调用示例，以及与 NeMo、Isaac Sim、TensorRT-LLM 的集成示例。对具身 AI 研究者而言，Cosmos 的实用价值在于：<strong>不必从头训练，可直接用 Predict 做滚动仿真、用 Transfer 做 Sim2Real 数据增强、用 Reason 做物理合理性评估</strong>。</p>

<hr />

<p><a id="46-cosmos-3"></a></p>

<h2 id="cosmos-3">7.3 Cosmos 3 (2026)</h2>
<p>———Omnimodal World Models for Physical AI</p>

<p>📄 <strong>Cosmos 3 (2026)</strong>: <a href="https://arxiv.org/abs/2606.02800">arxiv.org/abs/2606.02800</a> · <a href="#ref-26">[26]</a><br />
🔗 <strong>代码/权重</strong>: <a href="https://github.com/nvidia/cosmos">github.com/nvidia/cosmos</a> · <a href="https://huggingface.co/collections/nvidia/cosmos3">huggingface.co/collections/nvidia/cosmos3</a>（OpenMDW-1.1 License）<br />
💡 <strong>专题详解</strong>: 关于 Mixture-of-Transformers (MoT) 架构的详细数学拆解与分析，可参考我的专题博客 <a href="/mixture-of-transformers/">Mixture-of-Transformers (MoT) 架构详解</a>。</p>

<p>如果说 §7.2 的 Cosmos 平台是用<strong>一条工具链串起多个专用模型</strong>（Predict 预测、Transfer 翻译、Reason 推理各司其职），那么 2026 年 6 月 NVIDIA 发布的 <strong>Cosmos 3</strong> 则把这条路线推到了终点：<strong>用单一网络架构同时完成理解与生成、并原生覆盖语言、图像、视频、音频、动作五大模态</strong>。它把视觉语言模型（VLM）、视频生成 / 前向动力学模型（对应 §6 的世界合成器 / 模拟器）与世界动作模型（WAM / VLA）<strong>吸收进同一个模型</strong>，是”单模型、多范式角色”趋势（参见 §6.1 的 GENE-26.5 与 §9.3）目前最完整的一次工程实现。</p>

<div align="center">
  <img src="/images/wm/Cosmos3-Fig1-UnifiedBackbone.webp" width="100%" />
<figcaption>图：Cosmos 3 作为 Physical AI 的通用骨干。仅通过改变输入-输出配置，同一套权重即可化身视觉语言模型、图像生成模型、音视频生成模型、策略/世界动作模型、前向动力学模型、逆动力学模型，无需任何结构改动。（图源：Cosmos 3）</figcaption>
</div>

<h4 id="核心动机终结范式割裂">核心动机：终结”范式割裂”</h4>

<p>论文的出发点是一个尖锐的判断：<strong>理解与生成被人为割裂是根本性的局限</strong>。以”晚餐后清理餐桌”的家用机器人为例，当前范式需要拼装一条割裂的流水线——VLM 定位餐具并生成计划、VLA/WAM 生成动作序列、前向动力学模型（”世界模型”）仿真并评估未来状态。这种碎片化架构既不优雅也浪费算力。Cosmos 3 的主张是：理解本就需要推理”世界如何演化、动作有何后果”，而生成本就依赖”对世界与行为的紧凑结构化表示”——两者应当统一在<strong>一个可扩展框架</strong>里。</p>

<h4 id="架构双塔-mixture-of-transformersmot">架构：双塔 Mixture-of-Transformers（MoT）</h4>

<p>Cosmos 3 的核心是一个 <strong>MoT 双塔</strong>结构：把一条 token 序列切成两段——前段是<strong>自回归（AR）子序列</strong>负责理解推理，后段是<strong>扩散（DM）子序列</strong>负责生成。每个 Transformer 解码层内部都并行持有<strong>两套独立参数</strong>（Reasoner 塔 + Generator 塔），二者均从预训练 VLM 权重初始化，从而继承强语言/视觉推理能力。</p>

<div align="center">
  <img src="/images/wm/Cosmos3-Fig5-MoTArchitecture.webp" width="100%" />
<figcaption>图：Cosmos 3 的 MoT 架构。同一条序列由 AR 子序列（语言 + ViT 视觉 token，以 EOS/BOG 收尾）与 DM 子序列（VAE 视觉、音频、动作 token，训练时加噪）拼接而成；层内 AR 与 DM token 各用独立 LayerNorm 与 MLP（均由预训练 VLM 共同初始化），仅在共享自注意力处交汇。右图为注意力掩码：AR 为因果三角、DM 为全注意力。（图源：Cosmos 3）</figcaption>
</div>

<p>两塔虽参数独立，却通过<strong>双流联合注意力（Dual-Stream Joint Attention）</strong>耦合：</p>

<ul>
  <li><strong>AR 子序列</strong>使用<strong>因果自注意力</strong>，只能看到自身前序 token——完整保留了从 VLM 继承的自回归文本生成能力（语言走 next-token prediction）；</li>
  <li><strong>DM 子序列</strong>使用<strong>全双向注意力</strong>，以 AR 与 DM token 的并集为 Key/Value，使每个扩散 token 都能自由”读取”文本提示与所有条件帧（生成走迭代去噪，Flow Matching 预测速度场）；</li>
  <li><strong>关键约束</strong>：AR token 永远不会被 DM token 更新——保证了条件通路的因果完整性。</li>
</ul>

<p>这种设计的精妙之处在于：<strong>理解（AR）为生成（DM）提供语义条件，而生成不污染理解</strong>，二者在同一张注意力图里完成协作，却互不破坏各自的归纳偏置。</p>

<p><strong>编码器</strong>：视觉理解用与语言对齐预训练的 <strong>ViT</strong>（随骨干联合训练），视觉生成用 <strong>Wan2.2-TI2V-5B 的视频 VAE</strong>（冻结，时间 4×、空间 32×32 压缩）；音频用冻结的音频 VAE（48kHz 立体声，25 token/秒）；动作用域感知投影层。位置编码采用带<strong>绝对时间调制的 3D MRoPE</strong>，把不同帧率/采样率的视频、音频、动作 token 对齐到同一条物理时间轴上。</p>

<h4 id="把动作当作一等模态">把”动作”当作一等模态</h4>

<p>与多数工作把动作当作附属输出不同，Cosmos 3 显式引入一类<strong>动作 token</strong>，作为连接物理世界与语言推理、视频建模的桥梁。它用一套<strong>统一动作表示</strong>容纳异构本体（自动驾驶、相机运动、第一人称人体、单臂/双臂/人形机器人）：自我位姿（Ego Pose 9D）与执行器位姿（Effector Pose 9D）以”3D 平移 + 6D 旋转”的相对位姿伪动作表示，抓取状态（Grasp State）直接编码当前操作状态。各本体用<strong>域感知的输入/输出投影</strong>适配不同维度，同时共享 MoT 骨干。动作 token $a_t$ 表示从视频状态 $v_{t-1}$ 到 $v_t$ 的转移。</p>

<div align="center">
  <img src="/images/wm/Cosmos3-Fig3-UnifiedActionRepresentation.webp" width="100%" />
<figcaption>图：统一动作表示。异构本体的控制被映射为由共享几何分量构成的紧凑动作向量——Ego/Effector 运动编码为相对位姿伪动作（3D 平移 + 6D 旋转），抓取状态直接编码指尖位置或夹爪开合。（图源：Cosmos 3）</figcaption>
</div>

<p>正因为动作与视频被纳入同一序列模型，Cosmos 3 仅靠”哪些 token 干净、哪些 token 加噪”的不同配置，就统一了三种动作生成模式：</p>

<div align="center">
  <img src="/images/wm/Cosmos3-Fig4-ActionModes.webp" width="95%" />
<figcaption>图：三种动作模式由 token 加噪配置决定。前向动力学（给定干净动作去噪视频）、逆动力学（给定干净视频去噪动作）、策略（同时去噪视频与动作）。（图源：Cosmos 3）</figcaption>
</div>

<ul>
  <li><strong>前向动力学（Forward Dynamics）</strong>：以观测上下文 + 干净动作为条件，预测未来视觉状态——即 §6.4 的世界模拟器；</li>
  <li><strong>逆动力学（Inverse Dynamics）</strong>：从观测到的视觉转移反推动作——即 §6.3 世界合成器中常用的 IDM 标注器；</li>
  <li><strong>策略（Policy）</strong>：同时预测动作与视频，既给出”干预”又给出”预期视觉后果”——即 §6.2 的世界动作模型。</li>
</ul>

<p>加上作为 VLM 的纯语言理解、Text2Image、Text2Video（可联合生成音频）、Image/Video2Video、Video Transfer 等生成模式，<strong>四大范式在 Cosmos 3 中第一次由同一套权重原生支持</strong>。</p>

<h4 id="模型变体edge--nano--super">模型变体：Edge / Nano / Super</h4>

<p>三个尺度覆盖从端侧部署到数据中心推理。注意总参数约为稠密 Transformer 的 2 倍——这正是双塔（Reasoner + Generator 各持一套参数）的代价：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">变体</th>
      <th style="text-align: left">总参 / 稠密骨干</th>
      <th style="text-align: center">层数</th>
      <th style="text-align: center">隐藏维</th>
      <th style="text-align: center">注意力头</th>
      <th style="text-align: center">KV 头</th>
      <th style="text-align: center">FFN 维</th>
      <th style="text-align: left">初始化</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Cosmos3-Edge</td>
      <td style="text-align: left">4B / 2B</td>
      <td style="text-align: center">28</td>
      <td style="text-align: center">2,048</td>
      <td style="text-align: center">16</td>
      <td style="text-align: center">8</td>
      <td style="text-align: center">9,216</td>
      <td style="text-align: left">从零训练（类 Qwen3-1.7B）</td>
    </tr>
    <tr>
      <td style="text-align: left">Cosmos3-Nano</td>
      <td style="text-align: left">16B / 8B</td>
      <td style="text-align: center">36</td>
      <td style="text-align: center">4,096</td>
      <td style="text-align: center">32</td>
      <td style="text-align: center">8</td>
      <td style="text-align: center">12,288</td>
      <td style="text-align: left">Qwen3-VL 8B</td>
    </tr>
    <tr>
      <td style="text-align: left">Cosmos3-Super</td>
      <td style="text-align: left">64B / 32B</td>
      <td style="text-align: center">64</td>
      <td style="text-align: center">5,120</td>
      <td style="text-align: center">64</td>
      <td style="text-align: center">8</td>
      <td style="text-align: center">25,600</td>
      <td style="text-align: left">Qwen3-VL 32B</td>
    </tr>
  </tbody>
</table>

<p>本次发布 Nano 与 Super，Edge 留待后续。Reasoner 在约 <strong>24.2M</strong> 样本（22.0M 预训练 + 2.2M SFT）的图文/视频-文本对上训练；Generator 在大规模图像/视频/音频/动作语料上以重建目标（Flow Matching）训练，经历预训练 → 中训练（mid-training）→ T2I 后训练 → I2V 后训练 → 机器人策略后训练的多阶段课程。</p>

<h4 id="训练范式与-physical-ai-角色">训练范式与 Physical AI 角色</h4>

<div align="center">
  <img src="/images/wm/Cosmos3-Fig2-TrainingParadigm.webp" width="92%" />
<figcaption>图：Cosmos 3 是训练 Physical AI 智能体的强起点。预训练 + 中训练得到通用底座后，可在目标数据上无结构改动地后训练，分别服务于合成数据生成、任务专域特化、闭环训练环境三类用途。（图源：Cosmos 3）</figcaption>
</div>

<p>Cosmos 3 把自己定位为破解”数据与环境扩展瓶颈”的三重起点：(i) <strong>合成数据生成</strong>——后训练为更强的 T2I / I2V 生成器，低成本合成高保真多样视觉数据；(ii) <strong>任务专域特化</strong>——在共享底座上做本体/任务特定微调，保留统一世界表示；(iii) <strong>训练环境</strong>——长期目标是生成高质量、可交互的复杂环境用于闭环训练。论文同时开源了 5 个合成数据集（SDG-PhyxSim / RobotSim / DriveSim / SynHuman / Warehouse）与评测基准 <strong>Cosmos-HUE</strong>。</p>

<h4 id="核心结果">核心结果</h4>

<p>撰写技术报告时，Cosmos 3 的后训练变体取得多项 SOTA：</p>

<ul>
  <li><strong>Cosmos3-Super-Text2Image</strong>：Artificial Analysis 文生图榜单<strong>开源权重第 1</strong>（含闭源模型计第 4，日期 2026-05-28）；</li>
  <li><strong>Cosmos3-Super-Image2Video</strong>：Artificial Analysis 图生视频榜单<strong>开源权重第 1</strong>，整体优于 Veo-3.1 等强闭源模型；</li>
  <li><strong>Cosmos3-Nano-Policy-DROID</strong>：在 RoboLab 与 <strong>RoboArena</strong> 真机策略评测中<strong>均排名第 1</strong>（从中训练 Nano 续训，在 DROID 76k 轨迹上后训练，15Hz 联合输出动作与未来视频帧）；</li>
  <li>在机器人、智能空间、自动驾驶领域的推理任务上同时超越开源与闭源模型（机器人仅略逊 Gemini 3.1 Pro），且两代视频生成均显著优于前代 Cosmos-Predict2.5。</li>
</ul>

<h4 id="与四大范式的关系">与四大范式的关系</h4>

<p>Cosmos 3 是本文叙事的一个<strong>收敛点</strong>。GENE-26.5（§6.1）已展示”联合分布 + 条件查询”如何让单模型兼任多角色，而 Cosmos 3 把这一思路推广到全模态、并以双塔 MoT 给出更清晰的工程边界：<strong>Reasoner 塔承担世界规划器的高层语义推理，Generator 塔以前向动力学/视频生成承担世界合成器与世界模拟器，Policy 模式则是世界动作模型</strong>。§2.4 时间线中 2025–2026 年世界合成器/模拟器的爆发，最终汇流为”理解-生成-动作一体化”的全模态世界模型——这与 §9.3”从想象到验证再到规划”的判断完全一致，也指向 §9.1 中长航程前瞻、4D 感知、物理一致性等方向的统一载体。</p>

<hr />

<h2 id="paper-wan">7.4 Wan2.1 (2025)</h2>
<p>———阿里巴巴开源的高效视频生成基础模型家族</p>

<p>📄 <strong>Paper</strong>: https://arxiv.org/abs/2503.20314 · <a href="#ref-47">[47]</a></p>

<h4 id="精华-13">精华</h4>

<ul>
  <li>提出了 <strong>Wan2.1</strong> 视频生成模型家族，采用主流的 Diffusion Transformer (DiT) 架构，包含 1.3B 和 14B 参数两个版本，开源了全部代码与权重。</li>
  <li>引入了创新的 <strong>Spatio-Temporal VAE (Wan-VAE)</strong>，能够将视频在时空维度上压缩 4x8x8 倍，并引入 RMSNorm 和特征缓存机制以支持任意长度的长视频流式重建与低内存推理。</li>
  <li>针对 DiT 训练，优化了特征调制（AdaLN）参数共享设计，不仅使模型参数量减少约 25%，还显著加快了收敛速度并提升了指令遵循能力。</li>
  <li>采用 <strong>2D 上下文并行（Ulysses + Ring Attention）</strong> 和 FSDP 混合分布式并行策略，解决了超长序列（达 1M 级别 tokens）所带来的显存和计算瓶颈。</li>
  <li>构建了统一的视频控制与编辑框架 <strong>VACE</strong>，通过对掩码区域和非掩码区域的“概念解耦”时空编码，实现了高质量的局部视频编辑、视频外扩等下游任务。</li>
</ul>

<hr />

<h4 id="1-研究背景问题-12">1. 研究背景/问题</h4>

<ul>
  <li>现有的视频生成模型在生成大幅度动作、高保真画面、超长视频以及复杂的文本提示词理解上仍面临巨大挑战。</li>
  <li>同时，大模型的高显存消耗和计算复杂度使得它们难以在消费级显卡（如 RTX 4090）上运行，极大地限制了开源社区的二次开发与应用。</li>
  <li>此外，时空自编码器（VAE）往往缺乏良好的时空因果性保证，且在流式长视频生成中面临内存溢出和边界不连续等缺陷。</li>
</ul>

<hr />

<h4 id="2-主要方法创新点-12">2. 主要方法/创新点</h4>

<h5 id="wan-t2v-text-to-video-整体架构">Wan-T2V (Text-to-Video) 整体架构</h5>

<div align="center">
  <img src="/images/wm/Wan-T2V-architecture.webp" width="100%" />
<figcaption>图：Wan 文本到视频生成（T2V）的整体架构图。（图源：Wan2.1, 2025）</figcaption>
</div>

<p><strong>① 整体框架概述</strong>
Wan2.1 整体架构基于 Diffusion Transformer (DiT) 范式，包含三个核心模块：用于将视频/图像从像素空间压缩到低维潜空间的 <strong>Wan-VAE</strong>、执行流匹配去噪过程的 <strong>Diffusion Transformer (DiT)</strong> 以及用于文本理解的 <strong>umT5 文本编码器</strong>。</p>

<p><strong>② 逐模块讲解</strong></p>

<ul>
  <li><strong>Wan-VAE (Spatio-Temporal VAE)</strong>：
    <ul>
      <li><strong>输入</strong>：大小为 $(1+T) \times H \times W \times 3$ 的高维原始视频。</li>
      <li><strong>处理</strong>：采用 3D 因果卷积结构，其中第一帧仅进行空间压缩（以保留图像先验），其余帧进行时空联合压缩。模型将所有 GroupNorm 替换为 RMSNorm 以保持严格的临时因果性，并支持特征缓存机制（Feature Cache Mechanism）。在空间上采样层中，将输入特征通道减半，以降低 33% 的推理显存。</li>
      <li><strong>输出</strong>：时空维度压缩了 $4 \times 8 \times 8$ 倍、通道数为 16 的低维潜空间表征 $x \in \mathbb{R}^{(1+T/4) \times H/8 \times W/8 \times 16}$。</li>
      <li><strong>特征缓存推理</strong>：在处理超长视频时，将视频按 Latent 帧拆分为 Chunks（每块最多 4 帧），在块与块之间传递和复用前一阶段的最后两帧特征缓存，确保在受限的显存内实现连续、无缝的流式重建。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/wm/Wan-VAE-framework.webp" width="100%" />
<figcaption>图：Wan-VAE 时空压缩自编码器架构图。（图源：Wan2.1, 2025）</figcaption>
</div>

<ul>
  <li><strong>umT5 文本编码器</strong>：
    <ul>
      <li><strong>输入</strong>：用户输入的自然语言提示词（支持中英双语以及复杂的排版描述）。</li>
      <li><strong>处理</strong>：利用双向注意力机制编码，相比于单向注意力 LLM 更加注重全局语义表示与空间排版。</li>
      <li><strong>输出</strong>：长度为 512 的语义 Token 序列 $ctxt \in \mathbb{R}^{512 \times D_{text}}$。</li>
    </ul>
  </li>
  <li><strong>Diffusion Transformer (DiT)</strong>：
    <ul>
      <li><strong>输入</strong>：经由 3D 卷积（Patchify，核大小为 $(1, 2, 2)$，步长为 $(1, 2, 2)$）打块并展平后的潜空间序列 $x_{flat} \in \mathbb{R}^{B \times L \times D}$，以及文本 Token 和时间步 $t$。</li>
      <li><strong>处理</strong>：由 $N$ 层堆叠的 Wan Transformer Block 构成。在 Block 内部，通过自注意力（Self-Attention）机制捕获时空关系，通过交叉注意力（Cross-Attention）将文本 Token 注入到图像 Token 中。时间步 $t$ 编码经由一个全局共享的 MLP (Linear + SiLU) 映射为调制参数，以调节各 LayerNorm 的尺度与偏置。</li>
      <li><strong>输出</strong>：预测的去噪速度向量 $v_t$。</li>
    </ul>
  </li>
</ul>

<div align="center">
  <img src="/images/wm/Wan-transformer-block.webp" width="80%" />
<figcaption>图：Wan Transformer Block 结构细节。（图源：Wan2.1, 2025）</figcaption>
</div>

<p><strong>③ 端到端数据流</strong>
训练时，原始视频经 Wan-VAE 编码为 Latent 状态，与高斯噪声进行 Flow Matching（流匹配）线性插值得到 $x_t$，通过 Patchify 模块转换为 1D Token 序列；同时文本经 umT5 编码为文本 Embedding。在 DiT Blocks 中，文本与时空 Token 通过 Cross-Attention 进行交互。最后，利用预测的 Velocity $v_t$ 引导 ODE 求解去噪，生成的 Latent 再由 Wan-VAE Decoder 恢复出清晰的视频画面。</p>

<p><strong>④ 训练目标 / 损失函数</strong>
基于 Rectified Flows (RFs) 框架，中间潜空间 $x_t$ 通过对干净视频潜特征 $x_1$ 和高斯噪声 $x_0 \sim \mathcal{N}(0, I)$ 实施线性插值获得：
\(x_t = tx_1 + (1-t)x_0\)
真值变化速率为 $v_t = x_1 - x_0$。模型学习参数 $\theta$ 以拟合这个变化率 $u(x_t, ctxt, t; \theta)$，损失函数采用均方误差 (MSE)：
\(\mathcal{L} = \mathbb{E}_{x_0, x_1, ctxt, t} \left[ \lVert u(x_t, ctxt, t; \theta) - v_t \rVert^2 \right]\)</p>

<h5 id="wan-i2v-image-to-video-架构与控制框架">Wan-I2V (Image-to-Video) 架构与控制框架</h5>

<div align="center">
  <img src="/images/wm/Wan-I2V-architecture.webp" width="100%" />
<figcaption>图：Wan-I2V 图生视频模型框架。（图源：Wan2.1, 2025）</figcaption>
</div>

<p><strong>① 整体框架概述</strong>
为了兼容图片生成视频（I2V）、视频续写（Video Continuation）以及首尾帧过渡（First-Last Frame Transition）等多种下游任务，Wan 引入了掩码（Mask）机制和双编码器联合调节策略。</p>

<p><strong>② 模块与数据流详解</strong></p>
<ul>
  <li><strong>双图像编码器</strong>：同时输入第一帧像素，一方面经由 <strong>Wan-Encoder</strong> 编码为 Latent，作为与噪声等维度的掩码提示，并和掩码矩阵 $M$ 一起与嘈杂的潜空间特征 $x_t$ 进行 Channel-wise Concatenation（通道级拼接）作为 DiT 的主轴输入；另一方面，通过 <strong>CLIP Image Encoder</strong> 提取全局语义特征，在 DiT 的 <strong>Decoupled Cross-Attention（解耦交叉注意力）</strong> 中与 umT5 文本 Embedding 一起分别与时空特征进行交互，提供高保真视觉细节与空间语义。</li>
  <li><strong>掩码通道设计</strong>：对第一帧画面（或已知参考帧）赋予值为 0 的掩码（代表需要被重建的区域），对其余生成帧赋予值为 1 的掩码（代表生成区域）。该设计使用户能自由指定参考帧的空间与时间排布。</li>
</ul>

<h5 id="vace统一的可控生成与编辑框架">VACE：统一的可控生成与编辑框架</h5>

<div align="center">
  <img src="/images/wm/Wan-VACE-editing-framework.webp" width="100%" />
<figcaption>图：VACE 可控生成与编辑模型框架与概念解耦机制。（图源：Wan2.1, 2025）</figcaption>
</div>

<p><strong>① 整体框架概述</strong>
<strong>VACE (Video Condition Unit)</strong> 旨在将局部重绘（Repainting）、Canny 边缘提取、深度估计（Depth）、姿态引导（Pose）以及线稿引导（Scribble）等多种编辑和生成条件统一到同一种输入范式中。</p>

<p><strong>② 数据流与概念解耦 (Concept Decoupling) 详解</strong></p>
<ul>
  <li><strong>概念解耦策略</strong>：为保证在各种不同控制任务下模型能够平稳收敛，VACE 将输入视频 $F$ 和掩码 $M$ 解耦为两个相同尺寸的序列：<strong>活性帧</strong> $F_c = F \times M$（包含所有需要被修改的像素）与 <strong>惰性帧</strong> $F_k = F \times (1-M)$（保留所有需要保持原样的像素）。</li>
  <li><strong>编码与注入</strong>：$F_c$ 和 $F_k$ 分别通过同一个冻结的 Wan-VAE Encoder 映射到潜空间，并在通道维度与噪声拼接后输入到 DiT 中。VACE 提供两种训练模式：<strong>Fully Fine-tuning</strong>（全参数微调）以及 <strong>Context Adapter Tuning</strong>（通过外挂的 Context Block 以残差形式集成到原 DiT block 中，支持无损基础权重插拔）。</li>
</ul>

<hr />

<h4 id="3-核心结果发现-12">3. 核心结果/发现</h4>

<ul>
  <li><strong>性能优异</strong>：14B 模型在大规模图像与视频数据集上训练，在各项内部和外部基准测试中超越了当时的主流开源模型（如 CogVideoX、Hunyuan Video 等）及闭源商业模型。</li>
  <li><strong>高压缩比与高质量</strong>：Wan-VAE 的时空压缩比达到 $4 \times 8 \times 8$，潜表征维度为 16 维。在 720p 分辨率及 25 帧的视频重建测试中，重建质量（PSNR）与 Hunyuan Video 相当甚至更好，同时重建速度快了 <strong>2.5 倍</strong>。</li>
  <li><strong>极低的计算硬件门槛</strong>：1.3B 模型专门为消费级 GPU（如 RTX 4090）设计，开启 int8 甚至 TensorRT 量化后，推理时仅需 <strong>8.19 GB</strong> 显存，却在 T2V 任务上能产生媲美更大模型的流畅度和一致性。</li>
  <li><strong>首创双语字符生成</strong>：在视频中实现了中英双语的高清、正确字符排版生成能力（如生成包含 “Wan2.1” 和中文牌匾的视频）。</li>
</ul>

<hr />

<h4 id="4-局限性-12">4. 局限性</h4>

<ul>
  <li>模型在处理极其复杂的极速物理交互（如破碎、流体变化等细微碰撞细节）时，依然会出现一定程度的幻觉或时空扭曲。</li>
  <li>尽管 1.3B 模型实现了消费级显卡部署，但 14B 参数模型在单卡推理时仍具有较高的计算延迟，在大规模生产部署中仍然需要多卡 Context Parallel 协同。</li>
</ul>

<hr />

<h2 id="paper-janus-pro">7.5 Janus-Pro (2025)</h2>
<p>———Unified Multimodal Understanding and Generation with Data and Model Scaling</p>

<p>📄 <strong>Paper</strong>: https://arxiv.org/abs/2501.17811 · <a href="#ref-48">[48]</a></p>

<h4 id="精华-14">精华</h4>

<p>Janus-Pro 最值得借鉴的核心思想是<strong>解耦视觉编码</strong>：理解任务与生成任务对视觉表征的需求本质不同，强行共享编码器会造成任务冲突，解耦后两路可独立优化。此外，训练策略的精细化同样重要——Stage I 充分训练像素依赖建模、Stage II 去除低效的 ImageNet 预热、Stage III 调整多模态数据比例，每一步都针对已知痛点而非盲目堆量。合成数据（1:1 比例）对生成质量的稳定性提升至关重要，是解决真实数据噪声问题的实用路径。模型规模从 1.5B 扩展到 7B 验证了解耦编码方法的强可扩展性，为统一理解与生成框架的规模化提供了实证支撑。</p>

<hr />

<h4 id="1-研究背景问题-13">1. 研究背景/问题</h4>

<p>当前统一多模态理解与生成的模型通常共享同一视觉编码器处理两类任务，但理解与生成对视觉表征的需求存在本质冲突，导致多模态理解性能受损。前代模型 Janus 虽通过解耦视觉编码验证了该思路，但受限于训练数据量少和模型容量小，在短提示图像生成质量和生成稳定性上表现欠佳。</p>

<hr />

<h4 id="2-主要方法创新点-13">2. 主要方法/创新点</h4>

<p>Janus-Pro 从三个维度对 Janus 进行系统性增强：训练策略优化、数据扩展和模型规模扩展。</p>

<p><strong>架构</strong>（与 Janus 相同，解耦视觉编码）：</p>

<div align="center">
  <img src="/images/vlm/Janus-Pro-architecture.webp" width="100%" />
<figcaption>图：Janus-Pro 整体架构：理解侧使用 SigLIP Understanding Encoder，生成侧使用 VQ Generation Encoder，共享同一个 Auto-Regressive Transformer。（图源：Janus-Pro, 2025）</figcaption>
</div>

<p>为便于理解，下图是我对 Janus-Pro 架构的手绘版本整理（核心：自回归统一框架，图像侧解耦为理解与生成两条编码路径）：</p>

<pre><code class="language-mermaid">flowchart TB
    TextIn["文本输入"] --&gt; TextTok["Text Tokenizer"]
    ImgIn["图像输入"] --&gt; UndEnc["理解 Encoder&lt;br/&gt;(SigLIP)"]
    ImgIn --&gt; GenEnc["生成 Encoder&lt;br/&gt;(VQ-Tokenizer)"]

    UndEnc --&gt; UndFeat["理解特征"]
    GenEnc --&gt; GenFeat["生成特征&lt;br/&gt;(视觉 Token 词表)"]

    UndFeat --&gt; UndAdapt["Understanding Adaptor&lt;br/&gt;(MLP, 理解时使用)"]
    GenFeat --&gt; GenAdapt["Generation Adaptor&lt;br/&gt;(MLP)"]

    TextTok --&gt; LLM
    UndAdapt --&gt; LLM
    GenAdapt --&gt; LLM

    LLM["LLM / 自回归 Transformer"] --&gt;|自回归| TextOut["文本输出"]
    LLM --&gt;|预测视觉 Tokens 16×16| VisTok["多模态视觉 Tokens"]
    VisTok --&gt; VQDec["VQ-Decoder"]
    VQDec --&gt; ImgOut["图像输出"]

    classDef input fill:#e8f4fd,stroke:#2c7fb8,stroke-width:1px;
    classDef enc fill:#fff4e6,stroke:#d68910,stroke-width:1px;
    classDef core fill:#fde9e9,stroke:#c0392b,stroke-width:2px;
    classDef output fill:#e8f8e8,stroke:#27ae60,stroke-width:1px;

    class TextIn,ImgIn input;
    class TextTok,UndEnc,GenEnc,UndFeat,GenFeat,UndAdapt,GenAdapt,VisTok,VQDec enc;
    class LLM core;
    class TextOut,ImgOut output;
</code></pre>

<p>整体框架基于统一的自回归 Transformer。对于多模态理解任务，使用 SigLIP-Large-Patch16-384 编码器提取高维语义特征，经 Understanding Adaptor（两层 MLP）映射到 LLM 输入空间；对于视觉生成任务，使用来自 <strong>LlamaGen</strong> 的 VQ tokenizer 将图像离散化为 ID 序列，经 Generation Adaptor 映射 codebook embedding 输入 LLM，最终通过 Image Decoder 输出 $384 \times 384$ 图像。</p>

<p><strong>三阶段训练流程</strong>：</p>

<p>Janus 与 Janus-Pro 均采用三阶段训练范式，下图（取自原 Janus 论文）展示了每个阶段中各模块的冻结（❄️）与可训练（🔥）状态：</p>

<div align="center">
  <img src="/images/wm/janus-training.webp" width="100%" />
<figcaption>图：Janus / JanusFlow 三阶段训练流程图：火焰标记代表可训练模块，雪花标记代表冻结模块。Janus-Pro 沿用该流程，但在 Stage 1 和 Stage 2 做出关键调整。（图源：Janus, 2024）</figcaption>
</div>

<ul>
  <li>
    <p><strong>Stage 1 — Adaptation（适配）</strong>：目标是让新引入的模块与预训练组件协同工作。此阶段冻结 <strong>LLM</strong> 与 <strong>图像理解编码器（Und. Enc.）</strong>，仅训练将图像编码映射到 LLM 输入空间的 <strong>Linear 映射层</strong> 和 <strong>图像生成头（Gen. Dec.）</strong>。训练数据为 ImageNet（基于类别名提示生成图像）。<strong>Janus-Pro 的改动：显著增加 Stage 1 的训练步数</strong>，让模型在 LLM 参数固定的情况下更充分地建模像素依赖。</p>
  </li>
  <li>
    <p><strong>Stage 2 — Unified Pre-Training（统一预训练）</strong>：在继续训练新模块的基础上，<strong>解冻 LLM 及其文本预测头（Text De-Token）</strong>，使其能够处理多模态嵌入序列。训练样本包括多模态理解、图像生成与纯文本数据三类。<strong>Janus-Pro 的改动：完全移除 ImageNet 数据</strong>，直接使用密集描述的真实文生图数据——原版 Janus 在此阶段以 ImageNet 开始并逐步提升文生图数据比例，Janus-Pro 则跳过该预热阶段，训练效率显著提升。此外，图像编码器的表征会与图像生成潜在输出做对齐，以增强生成过程的语义一致性。</p>
  </li>
  <li>
    <p><strong>Stage 3 — Supervised Fine-Tuning（监督微调）</strong>：在指令微调数据（对话 + 高质量文生图样本）上进行 SFT。此阶段<strong>图像理解编码器（Und. Enc.）也加入训练</strong>，即除 VAE 编码器外的全部模块都被解冻。Janus-Pro 在此阶段与原版 Janus 流程一致。</p>
  </li>
</ul>

<p><strong>Stage 3 数据比例调整</strong>：将多模态理解数据、纯文本数据、文生图数据的比例从原版 Janus 的 7:3:10 调整为 5:1:4，在保持生成能力的同时提升多模态理解性能。</p>

<p><strong>数据扩展</strong>：</p>

<ul>
  <li><strong>多模态理解</strong>：参考 DeepSeek-VL2，增加约 9000 万样本（图像描述、表格、图表、文档理解等），Stage III 额外加入 MEME 理解、中文对话等数据；</li>
  <li><strong>视觉生成</strong>：引入约 7200 万合成图像样本，将真实与合成数据比例调整为 1:1，有效解决原始真实数据噪声大、生成不稳定的问题。</li>
</ul>

<p><strong>模型扩展</strong>：</p>

<p>将基础 LLM 从 1.5B 扩展至 7B（使用 DeepSeek-LLM），形成 Janus-Pro-1B 和 Janus-Pro-7B 两个版本。实验表明更大规模 LLM 使两类任务的 loss 收敛速度均显著加快。</p>

<div align="center">
  <img src="/images/vlm/Janus-Pro-performance.webp" width="100%" />
<figcaption>图：Janus-Pro 在多模态理解（左，四个基准平均分 vs LLM 参数量）和文生图指令跟随（右，GenEval 和 DPG-Bench）上的性能对比，Janus-Pro-7B 在两类任务上均达到最优。（图源：Janus-Pro, 2025）</figcaption>
</div>

<hr />

<h4 id="3-核心结果发现-13">3. 核心结果/发现</h4>

<p><strong>多模态理解</strong>（Table 3）：</p>
<ul>
  <li>Janus-Pro-7B 在 MMBench 上达到 79.2，超越同类统一模型 Janus（69.4）、TokenFlow-XL（68.9，13B）、MetaMorph（75.2，8B）</li>
  <li>MMMU 得分 50.0，GQA 62.0，全面领先统一理解+生成类模型</li>
</ul>

<p><strong>文生图生成</strong>（Table 4 &amp; 5）：</p>
<ul>
  <li>GenEval 整体得分 0.80，超越 Janus（0.61）、DALL-E 3（0.67）、SD3-Medium（0.74）</li>
  <li>DPG-Bench 得分 84.19，超越所有对比方法（含生成专用模型）</li>
</ul>

<p><strong>定性结果</strong>：</p>

<div align="center">
  <img src="/images/vlm/Janus-Pro-qualitative.webp" width="100%" />
<figcaption>图：Janus-Pro-7B 的多模态理解（图像描述、地标识别、通识问答、文字识别）和文生图生成定性结果，生成分辨率为 384×384。（图源：Janus-Pro, 2025）</figcaption>
</div>

<hr />

<h4 id="4-局限性-13">4. 局限性</h4>

<p>多模态理解输入分辨率限制在 $384 \times 384$，影响 OCR 等细粒度任务性能；VQ tokenizer 的重建损失导致生成图像中小面部区域等细节欠缺，提升分辨率是解决上述两个问题的主要方向。</p>

<hr />

<h2 id="paper-videogen">7.6 机器人视频生成综述 (2026)</h2>
<p>———Applications, Research Challenges, Future Directions</p>

<p>📄 <strong>Paper</strong>: <a href="https://arxiv.org/abs/2601.07823">arXiv:2601.07823</a> · <a href="#ref-49">[49]</a></p>

<h4 id="精华-15">精华</h4>

<ol>
  <li><strong>核心价值</strong>：视频生成模型作为<strong>高保真物理世界模拟器</strong>，能克服物理仿真器的简化假设，为机器人提供精细的交互感知。</li>
  <li><strong>具身世界模型</strong>：视频模型不仅是视觉输出工具，更是能够预测时空演变的”具身世界模型”，支持策略学习与视觉规划。</li>
  <li><strong>关键应用</strong>：涵盖模仿学习（数据增强）、强化学习（动力学建模）、策略评估（免真实环境部署）和视觉规划。</li>
  <li><strong>主要挑战</strong>：包括违反物理规律的幻觉（Hallucinations）、指令遵循能力弱、长视频生成的连贯性以及极高的推理成本。</li>
  <li><strong>未来方向</strong>：整合物理先验（物理引擎作为约束）、不确定性量化、更高效的推理架构（如 DiT）以及长序列生成。</li>
</ol>

<hr />

<h4 id="1-研究背景问题-14">1. 研究背景/问题</h4>

<p>传统的机器人研究依赖物理仿真器进行策略验证和训练，但仿真器通常需要复杂的参数调整且难以模拟柔性体或精细物理交互。与此同时，仅依赖语言抽象的大模型（LLMs）缺乏对物理世界细粒度时空动态的理解。视频生成模型（Video Generation Models）凭借其在互联网规模数据上学习到的丰富视觉和动作知识，展现出作为<strong>具身世界模型（Embodied World Models）</strong>的巨大潜力。</p>

<div align="center">
  <img src="/images/vln/Robot-Video-Gen-Overview.webp" width="100%" />
<figcaption>图：视频生成模型在机器人领域的应用框架，包括策略学习、视觉规划和策略评估。（图源：Robot-Video-Gen, 2026）</figcaption>
</div>

<hr />

<h4 id="2-主要方法创新点-14">2. 主要方法/创新点</h4>

<p>论文系统地梳理了视频生成模型在机器人中的架构分类、应用范式及评估体系。</p>

<h5 id="核心分类学-taxonomy">核心分类学 (Taxonomy)</h5>
<p>视频生成模型在机器人中的角色主要分为：</p>
<ul>
  <li><strong>模仿学习中的数据生成器</strong>：合成多样化的专家演示，缓解数据稀缺问题。</li>
  <li><strong>强化学习中的动力学/奖励模型</strong>：预测未来状态并提供视觉反馈。</li>
  <li><strong>视觉规划器</strong>：通过合成未来视频序列来辅助机器人进行任务分解和搜索。</li>
</ul>

<div align="center">
  <img src="/images/vln/Robot-Video-Gen-Taxonomy.webp" width="100%" />
<figcaption>图：论文的组织架构，展示了背景、应用、评估及开放挑战的分类体系。（图源：Robot-Video-Gen, 2026）</figcaption>
</div>

<h5 id="模型架构演进">模型架构演进</h5>
<p>从传统的基于 RNN/CNN 的预测模型演进到如今主流的基于 <strong>Diffusion</strong> 和 <strong>Flow-matching</strong> 的架构。</p>
<ul>
  <li><strong>扩散模型 (Diffusion Models)</strong>：利用逐步去噪过程合成高质量视频帧，结合 Transformer (DiT) 或 U-Net 实现条件控制。</li>
  <li><strong>联合嵌入预测架构 (JEPA)</strong>：通过学习隐藏特征空间中的动态，实现更鲁棒的非像素级世界建模。</li>
</ul>

<div align="center">
  <img src="/images/vln/Diffusion-Video-Architecture.webp" width="100%" />
<figcaption>图：基于扩散的视频模型架构示意图，展示了条件输入（文本、图像、动作）如何指导合成。（图源：Robot-Video-Gen, 2026）</figcaption>
</div>

<h5 id="显式与隐式世界模型">显式与隐式世界模型</h5>
<ul>
  <li><strong>隐式模型</strong>：通过视觉像素或潜空间表示世界状态。</li>
  <li><strong>显式模型</strong>：输出如点云（Point Cloud）、体素网格（Voxel Map）或 3D 高斯泼溅（3DGS）等显式 3D 表示，以增强物理一致性。</li>
</ul>

<div align="center">
  <img src="/images/vln/Implicit-vs-Explicit-Models.webp" width="100%" />
<figcaption>图：具身世界模型的两种表示形式：隐式表示（如视频潜空间）与显式表示（如点云、3DGS）。（图源：Robot-Video-Gen, 2026）</figcaption>
</div>

<hr />

<h4 id="3-核心结果发现-14">3. 核心结果/发现</h4>

<ul>
  <li><strong>性能评估标准</strong>：除了传统的视觉指标（PSNR, SSIM, FVD），机器人领域更关注物理一致性（Physics-IQ）、指令遵循度（VBench <a href="#ref-50">[50]</a>）和策略部署后的成功率。</li>
  <li><strong>跨模态优势</strong>：视频模型能整合文本指令、参考图像和动作序列，生成的视频轨迹可直接用于训练 VLA（Vision-Language-Action）策略。</li>
  <li><strong>成本效益</strong>：通过视频生成进行大规模策略评估，可减少对真实物理站点的依赖，降低硬件损耗和人工成本。</li>
</ul>

<hr />

<h4 id="4-局限性-14">4. 局限性</h4>

<ul>
  <li><strong>Hallucinations</strong>：生成的视频常出现物体凭空消失或违反重力等现象，限制了其在安全敏感场景的应用。</li>
  <li><strong>长序列漂移</strong>：随着生成步数增加，视频的物理真实度和连贯性会迅速下降。</li>
  <li><strong>实时性瓶颈</strong>：扩散模型的采样过程极其耗时，难以满足机器人闭环控制的需求。</li>
</ul>

<hr />

<h1 id="8-评测基准与指标体系">8. 评测基准与指标体系</h1>

<p>具身智能世界模型的评估已从单纯的像素视频质量，扩展到物理规律符合性、空间一致性与下游机器人任务闭环控制性能（对应 §4.6 的检验链）。</p>

<h2 id="81-评测基准概览">8.1 评测基准概览</h2>

<p>评测环境分为<strong>仿真交互基准</strong>与<strong>真实世界多任务数据集</strong>两大类：</p>

<h3 id="仿真基准">仿真基准</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">基准</th>
      <th style="text-align: left">场景类型</th>
      <th style="text-align: center">任务特点</th>
      <th style="text-align: left">机器人本体</th>
      <th style="text-align: right">轨迹数</th>
      <th style="text-align: right">任务数</th>
      <th style="text-align: left">适用评估范式</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>RoboTwin 2.0</strong> <a href="#ref-51">[51]</a></td>
      <td style="text-align: left">桌面/台面</td>
      <td style="text-align: center">双臂协调、接触密集、空间价值热图</td>
      <td style="text-align: left">双臂 Franka / 移动底座</td>
      <td style="text-align: right">30k+</td>
      <td style="text-align: right">50</td>
      <td style="text-align: left">世界动作模型 (WAM)、空间意图评估</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>LIBERO</strong> <a href="#ref-52">[52]</a></td>
      <td style="text-align: left">桌面</td>
      <td style="text-align: center">空间、目标、长程多任务知识迁移</td>
      <td style="text-align: left">Franka Panda</td>
      <td style="text-align: right">6.5k</td>
      <td style="text-align: right">130</td>
      <td style="text-align: left">策略规划器、自回归 WAM</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>CALVIN</strong> <a href="#ref-53">[53]</a></td>
      <td style="text-align: left">桌面</td>
      <td style="text-align: center">连续 5 步子任务链、开环/闭环测试</td>
      <td style="text-align: left">Franka Panda</td>
      <td style="text-align: right">24k</td>
      <td style="text-align: right">34</td>
      <td style="text-align: left">长程前瞻与思维链推理</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>WorldArena 2.0</strong></td>
      <td style="text-align: left">多场景</td>
      <td style="text-align: center">物理常识与牛顿定律符合性</td>
      <td style="text-align: left">多种实体</td>
      <td style="text-align: right">—</td>
      <td style="text-align: right">100+</td>
      <td style="text-align: left">物理一致性与因果逻辑审计</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>RoboCasa</strong></td>
      <td style="text-align: left">厨房/室内</td>
      <td style="text-align: center">大规模日常复杂家务、移动操控</td>
      <td style="text-align: left">Franka（移动）</td>
      <td style="text-align: right">100k+</td>
      <td style="text-align: right">100</td>
      <td style="text-align: left">长航程任务分解与策略泛化</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>SimplerEnv</strong></td>
      <td style="text-align: left">真实渲染</td>
      <td style="text-align: center">逼真 Sim2Real 评估环境</td>
      <td style="text-align: left">Google Robot, WidowX</td>
      <td style="text-align: right">—</td>
      <td style="text-align: right">8</td>
      <td style="text-align: left">真机部署策略前置验证</td>
    </tr>
  </tbody>
</table>

<h3 id="真实世界数据集与竞技场">真实世界数据集与竞技场</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">数据集 / 竞技场</th>
      <th style="text-align: left">场景与形态</th>
      <th style="text-align: center">长航程</th>
      <th style="text-align: right">规模</th>
      <th style="text-align: left">适用评估范式</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>RoboArena / RoboLab</strong></td>
      <td style="text-align: left">真实机械臂多任务盲测竞技场</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: right">持续评测</td>
      <td style="text-align: left">真机闭环策略横向对比（Cosmos 3 等）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DROID</strong></td>
      <td style="text-align: left">室内多元真实场景（双臂/单臂）</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: right">76k 轨迹</td>
      <td style="text-align: left">策略预训练与真机微调评估</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Open X-Embodiment (OXE)</strong></td>
      <td style="text-align: left">跨 22 种机器人形态混合数据</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: right">1M+ 轨迹</td>
      <td style="text-align: left">通用具身预训练表征评测</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>RT-1 / BridgeData V2</strong></td>
      <td style="text-align: left">厨房、桌面真实操作轨迹</td>
      <td style="text-align: center">✓</td>
      <td style="text-align: right">130k / 60k</td>
      <td style="text-align: left">基础动作模仿与泛化测试</td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="82-性能对比">8.2 性能对比</h2>

<blockquote>
  <p><strong>可比性说明</strong>：表 1–3 的数字取自各论文自己的报告，演示数量、场景随机化与评测协议并不统一，仅供了解量级与相对位置，不宜据此做严格排名。</p>
</blockquote>

<h3 id="1-robotwin-20双臂操作">1. RoboTwin 2.0（双臂操作）</h3>

<p>RoboTwin 2.0 是当前评估世界动作模型（WAM）双臂协调与物理接触精度的权威基准：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型 / 方法</th>
      <th style="text-align: left">核心技术架构</th>
      <th style="text-align: center">Easy 难度 SR</th>
      <th style="text-align: center">Hard 难度 SR</th>
      <th style="text-align: center"><strong>平均成功率 Avg. SR ↑</strong></th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">$\pi_0$</td>
      <td style="text-align: left">反应式流匹配策略</td>
      <td style="text-align: center">64.5</td>
      <td style="text-align: center">59.8</td>
      <td style="text-align: center">62.2</td>
    </tr>
    <tr>
      <td style="text-align: left">X-VLA</td>
      <td style="text-align: left">跨模态动作大模型</td>
      <td style="text-align: center">75.2</td>
      <td style="text-align: center">70.4</td>
      <td style="text-align: center">72.8</td>
    </tr>
    <tr>
      <td style="text-align: left">$\pi_{0.5}$</td>
      <td style="text-align: left">增强型 VLA 策略</td>
      <td style="text-align: center">81.3</td>
      <td style="text-align: center">78.2</td>
      <td style="text-align: center">79.8</td>
    </tr>
    <tr>
      <td style="text-align: left">GigaWorld-0</td>
      <td style="text-align: left">世界合成器数据增强</td>
      <td style="text-align: center">88.0</td>
      <td style="text-align: center">84.0</td>
      <td style="text-align: center">86.0</td>
    </tr>
    <tr>
      <td style="text-align: left">Motus</td>
      <td style="text-align: left">混合专家 WAM + 光流潜动作</td>
      <td style="text-align: center">89.2</td>
      <td style="text-align: center">86.4</td>
      <td style="text-align: center">87.8</td>
    </tr>
    <tr>
      <td style="text-align: left">Fast-WAM</td>
      <td style="text-align: left">极速流匹配 WAM</td>
      <td style="text-align: center">93.0</td>
      <td style="text-align: center">90.6</td>
      <td style="text-align: center">91.8</td>
    </tr>
    <tr>
      <td style="text-align: left">LingBot-VA</td>
      <td style="text-align: left">交互式视听动作模型</td>
      <td style="text-align: center">93.5</td>
      <td style="text-align: center">90.9</td>
      <td style="text-align: center">92.2</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>AIM (Stage 1 SFT)</strong></td>
      <td style="text-align: left">空间价值图 (ASVM) + 意图因果掩码</td>
      <td style="text-align: center">93.0</td>
      <td style="text-align: center">92.0</td>
      <td style="text-align: center">92.5</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>AIM (Stage 2 RL)</strong></td>
      <td style="text-align: left"><strong>价值自蒸馏强化学习后训练</strong></td>
      <td style="text-align: center"><strong>94.0</strong></td>
      <td style="text-align: center"><strong>92.1</strong></td>
      <td style="text-align: center"><strong>93.1</strong></td>
    </tr>
  </tbody>
</table>

<h3 id="2-libero桌面操作">2. LIBERO（桌面操作）</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">方法</th>
      <th style="text-align: left">范式类型</th>
      <th style="text-align: center">Spatial</th>
      <th style="text-align: center">Object</th>
      <th style="text-align: center">Goal</th>
      <th style="text-align: center">Long</th>
      <th style="text-align: center"><strong>Avg. ↑</strong></th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">World-Env</td>
      <td style="text-align: left">世界模拟器 (RL)</td>
      <td style="text-align: center">87.6</td>
      <td style="text-align: center">86.6</td>
      <td style="text-align: center">86.4</td>
      <td style="text-align: center">57.8</td>
      <td style="text-align: center">79.6</td>
    </tr>
    <tr>
      <td style="text-align: left">VLA-Reasoner</td>
      <td style="text-align: left">规划器 (TTA)</td>
      <td style="text-align: center">91.2</td>
      <td style="text-align: center">90.6</td>
      <td style="text-align: center">82.4</td>
      <td style="text-align: center">59.8</td>
      <td style="text-align: center">81.0</td>
    </tr>
    <tr>
      <td style="text-align: left">WorldVLA</td>
      <td style="text-align: left">自回归 WAM (因果掩码)</td>
      <td style="text-align: center">87.6</td>
      <td style="text-align: center">96.2</td>
      <td style="text-align: center">83.4</td>
      <td style="text-align: center">60.0</td>
      <td style="text-align: center">81.8</td>
    </tr>
    <tr>
      <td style="text-align: left">CoT-VLA</td>
      <td style="text-align: left">自回归 WAM (思维链)</td>
      <td style="text-align: center">87.5</td>
      <td style="text-align: center">91.6</td>
      <td style="text-align: center">87.6</td>
      <td style="text-align: center">69.0</td>
      <td style="text-align: center">83.9</td>
    </tr>
    <tr>
      <td style="text-align: left">TriVLA</td>
      <td style="text-align: left">规划器 (隐式潜引导)</td>
      <td style="text-align: center">91.2</td>
      <td style="text-align: center">93.8</td>
      <td style="text-align: center">89.8</td>
      <td style="text-align: center">73.2</td>
      <td style="text-align: center">87.0</td>
    </tr>
    <tr>
      <td style="text-align: left">FlowVLA</td>
      <td style="text-align: left">自回归 WAM (流感知)</td>
      <td style="text-align: center">93.2</td>
      <td style="text-align: center">95.0</td>
      <td style="text-align: center">91.6</td>
      <td style="text-align: center">72.6</td>
      <td style="text-align: center">88.1</td>
    </tr>
    <tr>
      <td style="text-align: left">VLA-RFT</td>
      <td style="text-align: left">世界模拟器 (稠密奖励 RL)</td>
      <td style="text-align: center">94.4</td>
      <td style="text-align: center">94.4</td>
      <td style="text-align: center">95.4</td>
      <td style="text-align: center">80.2</td>
      <td style="text-align: center">91.1</td>
    </tr>
    <tr>
      <td style="text-align: left">DreamVLA</td>
      <td style="text-align: left">自回归 WAM (世界梦境)</td>
      <td style="text-align: center">97.5</td>
      <td style="text-align: center">94.0</td>
      <td style="text-align: center">89.5</td>
      <td style="text-align: center">85.2</td>
      <td style="text-align: center">91.6</td>
    </tr>
    <tr>
      <td style="text-align: left">UD-VLA</td>
      <td style="text-align: left">扩散 WAM (离散扩散)</td>
      <td style="text-align: center">94.1</td>
      <td style="text-align: center">95.7</td>
      <td style="text-align: center">91.2</td>
      <td style="text-align: center">89.6</td>
      <td style="text-align: center">92.7</td>
    </tr>
    <tr>
      <td style="text-align: left">UniVLA</td>
      <td style="text-align: left">自回归 WAM (潜动作)</td>
      <td style="text-align: center">95.4</td>
      <td style="text-align: center">98.8</td>
      <td style="text-align: center">93.6</td>
      <td style="text-align: center">94.0</td>
      <td style="text-align: center">95.5</td>
    </tr>
    <tr>
      <td style="text-align: left">dVLA</td>
      <td style="text-align: left">扩散 WAM</td>
      <td style="text-align: center">97.4</td>
      <td style="text-align: center">97.9</td>
      <td style="text-align: center">98.2</td>
      <td style="text-align: center">92.2</td>
      <td style="text-align: center">96.4</td>
    </tr>
    <tr>
      <td style="text-align: left">RynnVLA-002</td>
      <td style="text-align: left">统一序列 WAM</td>
      <td style="text-align: center"><strong>99.0</strong></td>
      <td style="text-align: center">99.8</td>
      <td style="text-align: center">96.4</td>
      <td style="text-align: center">94.4</td>
      <td style="text-align: center">97.4</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>SRPO（在线）</strong></td>
      <td style="text-align: left"><strong>世界模拟器 (脚手架 RL)</strong></td>
      <td style="text-align: center">98.8</td>
      <td style="text-align: center"><strong>100.0</strong></td>
      <td style="text-align: center"><strong>99.4</strong></td>
      <td style="text-align: center"><strong>98.6</strong></td>
      <td style="text-align: center"><strong>99.2</strong></td>
    </tr>
  </tbody>
</table>

<h3 id="3-calvin-abcd长程序列">3. CALVIN ABC→D（长程序列）</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">方法</th>
      <th style="text-align: left">范式类型</th>
      <th style="text-align: center">任务 1</th>
      <th style="text-align: center">任务 2</th>
      <th style="text-align: center">任务 3</th>
      <th style="text-align: center">任务 4</th>
      <th style="text-align: center">任务 5</th>
      <th style="text-align: center"><strong>Avg. Len. ↑</strong></th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">GR-1</td>
      <td style="text-align: left">早期自回归 WAM</td>
      <td style="text-align: center">85.4</td>
      <td style="text-align: center">71.2</td>
      <td style="text-align: center">59.6</td>
      <td style="text-align: center">49.7</td>
      <td style="text-align: center">40.1</td>
      <td style="text-align: center">3.06</td>
    </tr>
    <tr>
      <td style="text-align: left">GR-MG</td>
      <td style="text-align: left">规划器 (显式像素)</td>
      <td style="text-align: center">96.8</td>
      <td style="text-align: center">89.3</td>
      <td style="text-align: center">81.5</td>
      <td style="text-align: center">72.7</td>
      <td style="text-align: center">64.4</td>
      <td style="text-align: center">4.04</td>
    </tr>
    <tr>
      <td style="text-align: left">MoWM</td>
      <td style="text-align: left">混合规划器</td>
      <td style="text-align: center">94.3</td>
      <td style="text-align: center">87.3</td>
      <td style="text-align: center">81.2</td>
      <td style="text-align: center">75.0</td>
      <td style="text-align: center">67.5</td>
      <td style="text-align: center">4.05</td>
    </tr>
    <tr>
      <td style="text-align: left">UP-VLA</td>
      <td style="text-align: left">自回归 WAM</td>
      <td style="text-align: center">92.8</td>
      <td style="text-align: center">86.5</td>
      <td style="text-align: center">81.5</td>
      <td style="text-align: center">76.9</td>
      <td style="text-align: center">69.9</td>
      <td style="text-align: center">4.08</td>
    </tr>
    <tr>
      <td style="text-align: left">Seer</td>
      <td style="text-align: left">预测逆动力学</td>
      <td style="text-align: center">96.3</td>
      <td style="text-align: center">91.6</td>
      <td style="text-align: center">86.1</td>
      <td style="text-align: center">80.3</td>
      <td style="text-align: center">74.0</td>
      <td style="text-align: center">4.28</td>
    </tr>
    <tr>
      <td style="text-align: left">VPP</td>
      <td style="text-align: left">规划器 (隐式潜表示)</td>
      <td style="text-align: center">95.7</td>
      <td style="text-align: center">91.2</td>
      <td style="text-align: center">86.3</td>
      <td style="text-align: center">81.0</td>
      <td style="text-align: center">75.0</td>
      <td style="text-align: center">4.29</td>
    </tr>
    <tr>
      <td style="text-align: left">UniVLA</td>
      <td style="text-align: left">统一自回归 WAM</td>
      <td style="text-align: center"><strong>98.9</strong></td>
      <td style="text-align: center"><strong>94.8</strong></td>
      <td style="text-align: center">89.0</td>
      <td style="text-align: center">82.8</td>
      <td style="text-align: center">75.1</td>
      <td style="text-align: center">4.41</td>
    </tr>
    <tr>
      <td style="text-align: left">TriVLA</td>
      <td style="text-align: left">规划器</td>
      <td style="text-align: center">96.8</td>
      <td style="text-align: center">92.4</td>
      <td style="text-align: center">86.8</td>
      <td style="text-align: center">83.2</td>
      <td style="text-align: center"><strong>81.8</strong></td>
      <td style="text-align: center">4.41</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DreamVLA</strong></td>
      <td style="text-align: left"><strong>世界梦境增强 WAM</strong></td>
      <td style="text-align: center">98.2</td>
      <td style="text-align: center">94.6</td>
      <td style="text-align: center"><strong>89.5</strong></td>
      <td style="text-align: center"><strong>83.4</strong></td>
      <td style="text-align: center">78.1</td>
      <td style="text-align: center"><strong>4.44</strong></td>
    </tr>
  </tbody>
</table>

<h3 id="4-生成质量各论文自报">4. 生成质量（各论文自报）</h3>

<p>与前三张下游策略表不同，世界模型”生成侧”目前<strong>没有统一的横向榜单</strong>——各工作的评测集、分辨率、视频时长与指标口径都不一致。下表只汇总各论文自己报告的数字，便于定位来源，<strong>不构成横向可比排名</strong>：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">模型 / 架构</th>
      <th style="text-align: left">生成质量指标（论文口径）</th>
      <th style="text-align: left">相机 / 几何控制精度</th>
      <th style="text-align: left">效率与部署</th>
      <th style="text-align: center">出处</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>Cosmos-Predict2.5</strong> (2B/14B)</td>
      <td style="text-align: left">RL 后训练人类偏好胜率较 RL 前 +约 20 个百分点</td>
      <td style="text-align: left">—</td>
      <td style="text-align: left">rCM 蒸馏至 4 步，PAI-Bench 总分损失 &lt; 0.005；4096×H100 训练</td>
      <td style="text-align: center">§7.2</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Cosmos-Transfer2.5</strong> (~2B)</td>
      <td style="text-align: left">PAIBench-Transfer 整体质量 6.56 → <strong>9.75</strong></td>
      <td style="text-align: left">控制信号遵循度优于 Transfer1-7B</td>
      <td style="text-align: left">模型尺寸缩小 3.5×（7B → ~2B）</td>
      <td style="text-align: center">§7.2</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Cosmos 3</strong> (Nano/Super)</td>
      <td style="text-align: left">Artificial Analysis T2I / I2V 榜单<strong>开源权重第 1</strong>（T2I 含闭源计第 4）</td>
      <td style="text-align: left">—</td>
      <td style="text-align: left">Nano-Policy 15Hz 联合输出动作与未来帧；RoboArena / RoboLab 真机第 1</td>
      <td style="text-align: center">§7.3</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>SANA-WM</strong> (2.6B)</td>
      <td style="text-align: left">VBench Overall <strong>80.62 / 81.89</strong>（Simple / Hard 轨迹）</td>
      <td style="text-align: left">RotErr <strong>4.50° / 8.34°</strong>，CamMC <strong>1.41 / 1.44</strong>（↓ 越低越好）</td>
      <td style="text-align: left">单 GPU 74.7 GB；RTX 5090 上 34s 生成 60s 720p</td>
      <td style="text-align: center">§5.3</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>LingBot-World</strong> (14B+14B MoE)</td>
      <td style="text-align: left">VBench Overall 81.82 / 81.89</td>
      <td style="text-align: left">RotErr 10.47° / 18.99°</td>
      <td style="text-align: left">8×H100（454.1 GB）；16 fps，亚秒级延迟</td>
      <td style="text-align: center">§5.2 / §5.3</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Qwen-RobotWorld</strong> (20B MMDiT)</td>
      <td style="text-align: left">EWMBench <strong>4.60（第 1）</strong>、WorldModelBench <strong>8.99</strong>、PBench 0.804、DreamGen Bench 4.952</td>
      <td style="text-align: left">物理符合性四项满分（牛顿定律 / 质量守恒 / 流体 / 重力）</td>
      <td style="text-align: left">美学与成像质量因分辨率偏低（0.455 / 0.649）</td>
      <td style="text-align: center">§6.3</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Wan2.1</strong> (1.3B/14B)</td>
      <td style="text-align: left">720p·25 帧重建 PSNR 与 HunyuanVideo 相当，重建速度 <strong>2.5×</strong></td>
      <td style="text-align: left">—</td>
      <td style="text-align: left">1.3B int8 量化后 <strong>8.19 GB</strong>，RTX 4090 可跑</td>
      <td style="text-align: center">§7.4</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Image2Sim</strong></td>
      <td style="text-align: left">全景 RGB-D 渲染 <strong>45.6 FPS</strong>（同类扩散世界模型通常 &lt; 1 FPS）</td>
      <td style="text-align: left">前馈 3D 特征高斯提供显式度量几何锚定</td>
      <td style="text-align: left">自动构建 2 万个交互式神经环境；R2R-CE 零样本 70.3%</td>
      <td style="text-align: center">§5.6</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Marble &amp; Atlas</strong> (World Labs)</td>
      <td style="text-align: left">控镜盲测偏好 <strong>75%~94%</strong> 胜出；3D 重建误差 AbsRel <strong>25.3</strong>（全基准超越 MapAnything / VGGT / Depth Anything 3）</td>
      <td style="text-align: left">原生 6-DoF 相机轨迹输入，像素级控镜；端到端输出 RGB-D + 3DGS / 点云</td>
      <td style="text-align: left">1440p / 60s 分钟级生成；多平台 3DGS 实时流式渲染</td>
      <td style="text-align: center">§5.5</td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="83-评估指标">8.3 评估指标</h2>

<p>现代世界模型评估体系由<strong>视觉保真度</strong>、<strong>物理几何一致性</strong>与<strong>闭环控制表现</strong>三维交织构成：</p>

<pre><code class="language-mermaid">mindmap
  root((世界模型评估指标体系))
    视觉保真度与生成质量
      PSNR 峰值信噪比 ↑
      SSIM 结构相似性 ↑
      LPIPS 感知特征距离 ↓
      FID / FVD 图像与视频分布距离 ↓
    物理与空间几何一致性
      Physics-IQ 物理常识评分 ↑
      Physics Compliance 牛顿力学/重力遵循度 ↑
      CamMC 相机轨迹运动一致性 ↓
      RotErr 旋转误差与姿态漂移 ↓
      Depth L1 深度几何度量误差 ↓
    下游具身闭环控制
      SR 任务成功率 ↑
      SPL 路径长度加权成功率 ↑
      ATE 绝对轨迹误差 ↓
      ATP 长程平均任务进度 ↑
      Collision Rate 碰撞率 ↓
</code></pre>

<p><strong>专项综合基准体系</strong>：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">综合基准</th>
      <th style="text-align: left">主要评估维度与考察重点</th>
      <th style="text-align: left">代表评测模型</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>WorldModelBench</strong></td>
      <td style="text-align: left">物理规律遵循度（牛顿定律、质量守恒、流体动力学、重力常识）</td>
      <td style="text-align: left">Qwen-RobotWorld, Wan2.6, Veo3</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>EWMBench</strong></td>
      <td style="text-align: left">复杂具身操作物理仿真、多视角几何一致性与运动真实度</td>
      <td style="text-align: left">Genie Envisioner, Qwen-RobotWorld</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>DreamGen Bench</strong></td>
      <td style="text-align: left">复杂指令遵循（Instruction Following）与跨物体长时程泛化</td>
      <td style="text-align: left">DreamGen, GigaWorld-0</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>PAI-Bench (PBench)</strong></td>
      <td style="text-align: left">文本到物理世界生成的质量分（Quality）与领域分（Domain）</td>
      <td style="text-align: left">Cosmos-Predict2.5, GigaWorld-0</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>PRBench (进度奖励基准)</strong></td>
      <td style="text-align: left">阶段进度单调性对齐（SC/Mono）与目标判别灵敏度（MMD/JS）</td>
      <td style="text-align: left">SRPO, NORA-1.5</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>TransferBench</strong></td>
      <td style="text-align: left">Sim2Real 翻译控制遵循度（Adherence）、生成多样性与视觉质量</td>
      <td style="text-align: left">Cosmos-Transfer1 / 2.5</td>
    </tr>
  </tbody>
</table>

<hr />

<h1 id="9-开放挑战与实践启示">9. 开放挑战与实践启示</h1>

<h2 id="91-六大开放挑战">9.1 六大开放挑战</h2>

<p>世界模型在 2025–2026 年进展很快，但要在工业级机器人系统中可靠工作，仍有以下问题待解决：</p>

<h3 id="物理一致性">物理一致性</h3>

<p>当前生成式世界模型在微观运动上已较逼真，但在刚体碰撞冲量守恒、弹性 / 塑性形变、流体飞溅与不可穿模约束等规律上仍依赖统计拟合，容易产生物理幻觉。</p>
<ul>
  <li><strong>前沿方向</strong>：将<strong>可微物理仿真（Differentiable Physics Simulators）</strong>嵌入去噪过程，以物理残差作为损失正则项；</li>
  <li><strong>因果推理与反事实推演</strong>：结合因果发现（Causal Discovery），让世界模型能回答”如果机械臂多施加 2N 的侧向力，杯子是否会倾倒”这类假设性问题。</li>
</ul>

<h3 id="3d4d-空间表示">3D/4D 空间表示</h3>

<p>2D 像素流难以持久保留 3D 空间结构，智能体大范围移动时容易出现”空间遗忘”与几何失真（§4.4）。</p>
<ul>
  <li><strong>前沿方向</strong>：以 <strong>3D 高斯泼溅（3DGS）</strong>、<strong>持久点跟踪（Persistent Point Tracking）</strong>与<strong>连续占据场（Occupancy Fields）</strong>作为原生状态表示；</li>
  <li><strong>趋势</strong>：World Labs 的 Marble / Atlas 与 Image2Sim（§5.5、§5.6）展示了从”2D 视频预测”走向”可持续探索、可交互的 3D 世界”的路线，使世界模型具备度量几何。</li>
</ul>

<h3 id="安全与不确定性">安全与不确定性</h3>

<p>世界模型用于真机控制前，必须知道自己什么时候不可信。</p>
<ul>
  <li><strong>前沿方向</strong>：引入<strong>共形预测（Conformal Prediction）</strong>与<strong>认知不确定性（Epistemic Uncertainty）量化</strong>（如模型集成），在遇到分布外场景或碰撞风险过高时主动报警并切换到人工遥操作；</li>
  <li><strong>自动化物理合理性审计</strong>：用物理推理 VLM（如 Cosmos-Reason1）充当”物理裁判”，在生成结果交给策略前检查几何干涉与力学合理性。</li>
</ul>

<h3 id="长时程推演">长时程推演</h3>

<p>标准 Softmax 自注意力的显存与计算随序列长度二次增长，分钟级前瞻推演难以在端侧部署。</p>
<ul>
  <li><strong>前沿方向</strong>：<strong>混合线性 / 门控注意力</strong>（如 SANA-WM 的 Gated DeltaNet）与 <strong>attention sink</strong>，使内存保持常数级（§4.4）；</li>
  <li><strong>分层动力学抽象（Hierarchical Dynamics）</strong>：高层以低频跳步预测子目标，底层以高频展开精细力控轨迹。</li>
</ul>

<h3 id="失败数据与-sim2real">失败数据与 Sim2Real</h3>

<p>多数机器人数据集只包含专家的成功演示，模型对”失败状态”几乎没有经验。</p>
<ul>
  <li><strong>前沿方向</strong>：<strong>主动生成失败模式</strong>——用世界模型定向合成打翻、滑脱、卡死等失败轨迹，训练具备纠错与恢复能力的策略；</li>
  <li><strong>Sim2Real 域桥接</strong>：用结构化世界翻译器（如 Cosmos-Transfer，§7.2）把仿真渲染提升为真实感画面，缩小感知域差。</li>
</ul>

<h3 id="全模态统一">全模态统一</h3>

<p>理解、生成、预测与控制分模块拼装的做法正在被统一模型取代。</p>
<ul>
  <li><strong>前沿方向</strong>：以 <strong>Mixture-of-Transformers（MoT）</strong>、<strong>全模态流匹配</strong>为骨干（如 Cosmos 3、Motus），把语言、第一 / 第三人称视觉、本体感觉、触觉、几何与动作纳入同一 token 流，由同一套权重按需充当感知、生成、规划与控制模块。</li>
</ul>

<hr />

<h2 id="92-五条工程经验">9.2 五条工程经验</h2>

<p>对于致力于具身智能、VLA 与机器人开发的科研与工程团队，可以从前文提炼出以下五条经验：</p>

<ol>
  <li><strong>“数据质量与策展”重于“盲目扩大参数”</strong>：Cosmos Video Curator 与 EWK 数据集的经验表明，严格的镜头切分、多级物理过滤、多视角空间与时间分层描述对物理世界模型的贡献，往往不亚于单纯增加 DiT 参数；</li>
  <li><strong>优先拥抱世界动作模型（WAM）以消除在线搜索开销</strong>：在对实时性要求严苛的闭环控制中，应优先采用 WAM 或 Latent Canvas 架构，将未来视觉预测作为自监督锚定，实现单步前向 5Hz–15Hz 高频输出，规避昂贵的 CEM 采样；</li>
  <li><strong>重视隐空间规划与非对称时空视界</strong>：在视角剧烈变化的移动导航或复杂操作中，切忌无节制拉长自回归像素生成；采用“长动作视界 + 短隐空间视觉前瞻”能以极低成本提供最可靠的几何约束；</li>
  <li><strong>警惕强化学习模拟器中的“分布漂移与幻觉漏洞”</strong>：在虚拟世界模型中做 RL 后训练时，必须配合关键帧初始化（KIR）、策略协同演化（PACE）以及基于物理推理 VLM 的可验证稠密奖励，防止策略过拟合于生成器的物理 bug；</li>
  <li><strong>布局 3D 显式表示与空间智能基础</strong>：2D 像素是 3D 物理世界的降维投影，长期来看，深度融合 3DGS、点云及度量几何的 Large World Models（LWM）是解决空间泛化问题的重要方向。</li>
</ol>

<h2 id="sec-9-3-future-roadmap">9.3 技术路线研判</h2>

<p>具身智能世界模型的发展历程，折射出 AI 对物理世界认知能力的根本跃迁。纵观 2018 至 2026 年的技术演化，我们可以清晰地梳理出三条交织演进的技术主线：</p>

<pre><code class="language-mermaid">flowchart TD
    subgraph Track1["主线一：生成表征维度"]
        T1_1["1D/2D 潜状态&lt;br/&gt;(World Models, Dreamer)"] --&gt; T1_2["2D 像素视频&lt;br/&gt;(Genie, Wan2.1, Sora)"]
        T1_2 --&gt; T1_3["3D/4D 显式时空&lt;br/&gt;(Marble, 3DGS, LWM)"]
    end

    subgraph Track2["主线二：控制与决策机制"]
        T2_1["开环像素规划&lt;br/&gt;(UniPi, SuSIE, CEM)"] --&gt; T2_2["统一世界动作模型&lt;br/&gt;(WorldVLA, Motus, AIM)"]
        T2_2 --&gt; T2_3["双系统想象闭环&lt;br/&gt;(System 1 反应 + System 2 前瞻)"]
    end

    subgraph Track3["主线三：训练与可信仿真"]
        T3_1["纯监督行为克隆 SFT"] --&gt; T3_2["世界模拟器强化学习&lt;br/&gt;(WoVR, VLA-RFT, SRPO)"]
        T3_2 --&gt; T3_3["自监督价值蒸馏与对齐&lt;br/&gt;(AIM, GRPO, 神经符号物理)"]
    end

    Track1 --&gt; Convergence["全模态通用物理大模型&lt;br/&gt;(Cosmos 3 等)"]
    Track2 --&gt; Convergence
    Track3 --&gt; Convergence

    classDef stage fill:#f0f4f8,stroke:#2b6cb0,stroke-width:1px;
    classDef target fill:#e6fffa,stroke:#319795,stroke-width:2px;
    class T1_1,T1_2,T1_3,T2_1,T2_2,T2_3,T3_1,T3_2,T3_3 stage;
    class Convergence target;
</code></pre>

<h3 id="四大范式的融合趋势">四大范式的融合趋势</h3>

<p>回顾 <strong>§6 的四大范式</strong> 与 <strong>§5–§7 的代表工作</strong>，四大范式并非互相替代的竞争关系，而是正加速走向深层互补：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">范式定位</th>
      <th style="text-align: left">典型代表</th>
      <th style="text-align: left">核心优势</th>
      <th style="text-align: left">核心瓶颈</th>
      <th style="text-align: left">未来融合方向</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>① 世界规划器</strong> (Planner)</td>
      <td style="text-align: left">UniPi, SuSIE, GENE-26.5</td>
      <td style="text-align: left">目标驱动、可解释性强、灵活泛化</td>
      <td style="text-align: left">采样延迟高 (CEM 达秒级)、不适合高频控制</td>
      <td style="text-align: left">隐空间梯度规划、扩散蒸馏采样</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>② 世界动作模型</strong> (WAM)</td>
      <td style="text-align: left">WorldVLA, Motus, AIM, NavWAM</td>
      <td style="text-align: left">5–15Hz 高频闭环、无缝融合前瞻与控制</td>
      <td style="text-align: left">多视角时空对齐难、长程轨迹漂移</td>
      <td style="text-align: left">MoT 解耦架构、空间价值图 (ASVM) 中介</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>③ 世界合成器</strong> (Synthesizer)</td>
      <td style="text-align: left">Genie, DreamGen, Image2Sim</td>
      <td style="text-align: left">无限扩充边缘工况长尾数据、泛化性强</td>
      <td style="text-align: left">仿真与真实域差 (Sim2Real)、物理幻觉</td>
      <td style="text-align: left">4D 动态流生成、光流差分动作迁移</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>④ 世界模拟器</strong> (Simulator)</td>
      <td style="text-align: left">WoVR, VLA-RFT, SRPO</td>
      <td style="text-align: left">免真机损耗的低成本强化学习母体</td>
      <td style="text-align: left">策略过拟合于生成器幻觉漏洞</td>
      <td style="text-align: left">关键帧回放 (KIR)、策略协同演化 (PACE)</td>
    </tr>
  </tbody>
</table>

<h3 id="三个突破方向">三个突破方向</h3>

<ol>
  <li><strong>从“像素直推动作”到“空间意图显式化（Spatial Intent as Bridge）”</strong>：AIM 与 NavWAM 的成功表明，像素与动作之间存在天然的物理鸿沟。引入显式的 3D 几何、点云接触面或 2D 空间价值图作为结构化中间层，是消除反向动力学（Inverse Dynamics）学习困难的关键抓手；</li>
  <li><strong>从“2D 纯视频梦境”到“3DGS 空间智能宇宙（3D Spatial Grounding）”</strong>：以 Marble 和 Lyra 2.0 为代表的 3D 显式世界模型显著缓解了 2D 视频生成中的视角不一致与物体恒久性丧失问题，使世界模型兼具“可微分生成”与“物理引擎级几何持久性”；</li>
  <li><strong>从“单向开环生成”到“慢思考与快反应双系统（System 1 &amp; System 2 Co-Design）”</strong>：高频电机控制（50Hz–500Hz，见 §2.3）由轻量化策略或 WAM 动作头负责（System 1），而宏观场景推演、危险审计与长程任务拆解由大型世界模型在后台异步运行（System 2），是目前较常见的工程组织方式。</li>
</ol>

<hr />

<h1 id="sec-10-references">10. 参考文献</h1>

<p>正文中的 <a href="#sec-10-references">[n]</a> 角标可直接跳转至下方对应条目。</p>

<ol>
  <li><span id="ref-1"></span>Tan, Z., et al. (2026). <em>Towards Generalist Embodied AI: A Survey on World Models for VLA Agents</em>. TechRxiv. <a href="https://www.techrxiv.org/">arXiv/TechRxiv 链接</a></li>
  <li><span id="ref-2"></span>Li, X., et al. (2025/2026). <em>A Comprehensive Survey on World Models for Embodied AI</em>. <a href="https://arxiv.org/abs/2510.16732">arXiv:2510.16732</a> · <a href="https://github.com/Li-Zn-H/AwesomeWorldModels">AwesomeWorldModels</a></li>
  <li><span id="ref-3"></span>Ha, D., &amp; Schmidhuber, J. (2018). <em>World Models</em>. NeurIPS 2018. <a href="https://arxiv.org/abs/1803.10122">arXiv:1803.10122</a> · <a href="https://worldmodels.github.io/">Project Page</a></li>
  <li><span id="ref-4"></span>Hafner, D., Pasukonis, J., Ba, J., &amp; Lillicrap, T. (2025). <em>Mastering Diverse Control Tasks through World Models (DreamerV3)</em>. Nature 640, 647–653. <a href="https://www.nature.com/articles/s41586-025-08744-2">Nature 论文</a> · <a href="https://arxiv.org/abs/2301.04104">arXiv:2301.04104</a></li>
  <li><span id="ref-5"></span>Hansen, N., et al. (2024). <em>TD-MPC2: Scalable, Robust World Models for Continuous Control</em>. ICLR 2024 (Oral). <a href="https://arxiv.org/abs/2310.16828">arXiv:2310.16828</a> · <a href="https://tdmpc2.github.io/">Project Page</a></li>
  <li><span id="ref-6"></span>Bruce, J., et al. (2024). <em>Genie: Generative Interactive Environments</em>. Google DeepMind. <a href="https://arxiv.org/abs/2402.15391">arXiv:2402.15391</a></li>
  <li><span id="ref-7"></span><em>LingBot-World: Open-Source Minute-Scale Interactive World Model</em> (2026). <a href="https://arxiv.org/abs/2601.20540">arXiv:2601.20540</a></li>
  <li><span id="ref-8"></span>Zhu, H., et al. (2026). <em>SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer</em>. <a href="https://arxiv.org/abs/2605.15178">arXiv:2605.15178</a> · <a href="https://nvlabs.github.io/Sana/WM/">Project Page</a></li>
  <li><span id="ref-9"></span>NVIDIA. (2026). <em>Lyra 2.0: Explorable Generative 3D Worlds at Scale</em>. <a href="https://arxiv.org/abs/2604.13036">arXiv:2604.13036</a></li>
  <li><span id="ref-10"></span>World Labs Team. (2025–2026). <em>Marble: A Multimodal World Model</em> &amp; <em>Atlas: A World Model for Spatial Intelligence</em>. <a href="https://www.worldlabs.ai/blog/marble-world-model">worldlabs.ai/blog/marble-world-model</a> · <a href="https://www.worldlabs.ai/blog/atlas">worldlabs.ai/blog/atlas</a></li>
  <li><span id="ref-11"></span><em>Image2Sim: Decoupled 3D Gaussian Geometry and One-Step Pixel Flow for Real-Time Neural Simulation</em> (2026). <a href="https://arxiv.org/abs/2607.05765">arXiv:2607.05765</a></li>
  <li><span id="ref-12"></span>Du, Y., et al. (2023). <em>Learning Universal Policies via Text-Guided Video Generation (UniPi)</em>. NeurIPS 2023.</li>
  <li><span id="ref-13"></span>Black, K., et al. (2024). <em>Zero-Shot Robotic Manipulation with Pre-trained Image-Editing Diffusion Models (SuSIE)</em>. ICLR 2024.</li>
  <li><span id="ref-14"></span>Zhen, H., et al. (2024). <em>3D-VLA: A 3D Vision-Language-Action Generative World Model</em>. ICML 2024.</li>
  <li><span id="ref-15"></span>Assran, M., et al. (2025). <em>V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning</em>. Meta AI.</li>
  <li><span id="ref-16"></span>Gao, C., et al. (2024). <em>PIVOT-R: Primitive-Driven Waypoint-Aware World Model for Robotic Manipulation</em>.</li>
  <li><span id="ref-17"></span>Genesis AI. (2026). <em>GENE-26.5: Advancing Robotic Manipulation to Human-Level</em>. <a href="https://www.genesis.ai/blog/gene-26-5-advancing-robotic-manipulation-to-human-level">genesis.ai</a></li>
  <li><span id="ref-18"></span><em>VLA-World: Learning Vision-Language-Action World Models for Autonomous Driving</em> (2026). <a href="https://vlaworld.github.io">项目主页</a></li>
  <li><span id="ref-19"></span>Wu, H., et al. (2023). <em>Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation (GR-1)</em>. ICLR 2024.</li>
  <li><span id="ref-20"></span>Bu, Q., et al. (2025). <em>UniVLA: Learning to Act Anywhere with Task-centric Latent Actions</em>.</li>
  <li><span id="ref-21"></span>Cen, J., et al. (2025). <em>WorldVLA: Towards Autoregressive Action World Model</em>. <a href="https://arxiv.org/abs/2506.21539">arXiv:2506.21539</a></li>
  <li><span id="ref-22"></span>Zhang, Z., et al. (2025). <em>FlowVLA: Thinking in Flow for Vision-Language-Action Models</em>.</li>
  <li><span id="ref-23"></span>Liu, J., et al. (2025). <em>CoT-VLA: Visual Chain-of-Thought Reasoning for Vision-Language-Action Models</em>.</li>
  <li><span id="ref-24"></span>Zhang, W., et al. (2025). <em>DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge</em>.</li>
  <li><span id="ref-25"></span><em>Motus: A Unified Latent Action World Model for Robotic Manipulation</em> (2025/2026). 清华大学 &amp; 生数科技. <a href="https://arxiv.org/abs/2512.18876">arXiv:2512.18876</a> · <a href="https://github.com/PKU-YuanGroup/Motus">Code</a></li>
  <li><span id="ref-26"></span>NVIDIA. (2026). <em>Cosmos 3: Omnimodal World Models for Physical AI</em>. <a href="https://arxiv.org/abs/2606.02800">arXiv:2606.02800</a> · <a href="https://github.com/nvidia-cosmos">GitHub</a></li>
  <li><span id="ref-27"></span><em>AIM: Intent-Aware Unified World Action Modeling with Spatial Value Maps</em> (2026). <a href="https://arxiv.org/abs/2604.11135">arXiv:2604.11135</a></li>
  <li><span id="ref-28"></span><em>NavWAM: Navigation World Action Models for Autonomous Embodied Agents</em> (2026). <a href="https://arxiv.org/abs/2606.13494">arXiv:2606.13494</a> · <a href="https://dachii-azm.github.io/navwam/">Project Page</a></li>
  <li><span id="ref-29"></span><em>WAM-Nav: Asymmetric Latent World-Action Modeling for Unified Visual Navigation</em> (2026). <a href="https://arxiv.org/abs/2606.04907">arXiv:2606.04907</a></li>
  <li><span id="ref-30"></span><em>Ctrl-World: A Controllable Generative Framework for Robotic Manipulation</em> (2025).</li>
  <li><span id="ref-31"></span><em>WristWorld: Generating Wrist-Views via 4D World Models for Robotic Manipulation</em> (2025).</li>
  <li><span id="ref-32"></span>Alibaba. (2026). <em>Qwen-RobotWorld: Unifying Embodied World Models via Natural Language</em>. <a href="https://arxiv.org/abs/2606.17030">arXiv:2606.17030</a></li>
  <li><span id="ref-33"></span>Zhao, J., et al. (2025). <em>DreamGen: Unlocking Generalization in Robot Learning through Neural Trajectories</em>. NVIDIA.</li>
  <li><span id="ref-34"></span><em>GigaWorld-0: World Models as Data Engine to Empower VLA Models</em> (2025).</li>
  <li><span id="ref-35"></span><em>VLA-RFT: Vision-Language-Action Reinforcement Fine-tuning with Verified Rewards in World Simulators</em> (2025).</li>
  <li><span id="ref-36"></span><em>SRPO: Scaffolded Reinforcement Policy Optimization for Robotic Manipulation</em> (2025).</li>
  <li><span id="ref-37"></span><em>VLA-Reasoner: Empowering Vision-Language-Action Models for Complex Tasks with Future Imagination</em> (2025).</li>
  <li><span id="ref-38"></span><em>AdaPower: Adaptive Test-Time Scaling for Vision-Language-Action Models</em> (2025).</li>
  <li><span id="ref-39"></span><em>WoVR: World Models as Reliable Simulators for Post-Training VLA Policies with RL</em> (2026). <a href="https://arxiv.org/abs/2602.13977">arXiv:2602.13977</a></li>
  <li><span id="ref-40"></span><em>WMPO: World Model-based Policy Optimization for Vision-Language-Action Models</em> (2025).</li>
  <li><span id="ref-41"></span><em>NORA-1.5: A Small Open Vision-Language-Action Model for Embodied Tasks with Flow-Matching Action Expert</em> (2025).</li>
  <li><span id="ref-42"></span>Kerbl, B., et al. (2023). <em>3D Gaussian Splatting for Real-Time Radiance Field Rendering</em>. SIGGRAPH 2023.</li>
  <li><span id="ref-43"></span>NVIDIA. (2025). <em>Cosmos World Foundation Model Platform for Physical AI</em>. <a href="https://arxiv.org/abs/2501.03575">arXiv:2501.03575</a></li>
  <li><span id="ref-44"></span>NVIDIA Cosmos Cookbook — <a href="https://github.com/nvidia-cosmos/cosmos-cookbook">github.com/nvidia-cosmos/cosmos-cookbook</a>.</li>
  <li><span id="ref-45"></span>NVIDIA. (2025). <em>Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control</em>. <a href="https://arxiv.org/abs/2503.14492">arXiv:2503.14492</a></li>
  <li><span id="ref-46"></span>NVIDIA. (2025). <em>Cosmos-Reason1: From Physical Common Sense To Embodied Reasoning</em>. <a href="https://arxiv.org/abs/2503.15558">arXiv:2503.15558</a></li>
  <li><span id="ref-47"></span>Alibaba. (2025). <em>Wan: Open and Advanced Large-Scale Video Generative Models</em>. <a href="https://arxiv.org/abs/2503.20314">arXiv:2503.20314</a></li>
  <li><span id="ref-48"></span>Chen, X., et al. (2025). <em>Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model Scaling</em>. <a href="https://arxiv.org/abs/2501.17811">arXiv:2501.17811</a></li>
  <li><span id="ref-49"></span><em>Video Generation Models in Robotics: Applications, Research Challenges, Future Directions</em> (2026). <a href="https://arxiv.org/abs/2601.07823">arXiv:2601.07823</a></li>
  <li><span id="ref-50"></span>Huang, Z., et al. (2024). <em>VBench: Comprehensive Benchmark Suite for Video Generative Models</em>.</li>
  <li><span id="ref-51"></span><em>RoboTwin 2.0: Dual-Arm Benchmark for Scalable Embodied Manipulation</em> (2025). Tsinghua University.</li>
  <li><span id="ref-52"></span>Liu, B., et al. (2023). <em>LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning</em>. <a href="https://libero-project.github.io/">libero-project.github.io</a></li>
  <li><span id="ref-53"></span>Mees, O., et al. (2022). <em>CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks</em>. <a href="https://github.com/mees/calvin">github.com/mees/calvin</a></li>
</ol>

<hr />

<p>本文所有示意图、架构图、实验对比图均来自上述公开论文或对应官方项目主页，版权归原作者所有，仅用于学术交流与学习整理。</p>]]></content><author><name>Tingde Liu</name></author><category term="research" /><category term="VLA" /><category term="World Models" /><category term="Robotics" /><category term="Embodied AI" /><category term="Survey" /><summary type="html"><![CDATA[本文系统梳理具身智能世界模型（World Models）：从认知科学起源与经典有模型强化学习（World Models 2018、DreamerV3、TD-MPC2）的理论奠基，到 Tokenizer、条件注入、生成范式、长程记忆与推理效率等核心工程设计选择；按「世界生成器」与「面向机器人决策的四大范式」两大家族解析 Genie、Lyra 2.0、Marble、WorldVLA、AIM、Motus、WoVR 等代表工作，并介绍 Cosmos、Wan2.1 等基础模型、评测基准体系与六大开放挑战。]]></summary></entry><entry><title type="html">具身Agent Harness 综述</title><link href="https://garylee1210.github.io/Embodied-Agent-Harness-Survey/" rel="alternate" type="text/html" title="具身Agent Harness 综述" /><published>2026-09-28T00:00:00+00:00</published><updated>2026-09-28T00:00:00+00:00</updated><id>https://garylee1210.github.io/Embodied-Agent-Harness-Survey</id><content type="html" xml:base="https://garylee1210.github.io/Embodied-Agent-Harness-Survey/"><![CDATA[<p><strong>具身 Agent Harness 要解决的核心问题，是让模型提出的任务意图，在有噪声、有时延、可能失败的物理世界中形成可追踪的执行闭环。</strong> 模型负责理解与规划，Harness 管理上下文、技能调用和结果判断，机器人运行系统负责执行、反馈及本地保护。</p>

<p>本文沿着“上层 Harness → 下层运行系统 → 两者之间的接口契约”展开。以“去厨房拿杯子”为例：场景图帮助定位杯子，技能接口描述导航与抓取，执行端报告进度，评估器确认杯子是否拿到；若通信中断或出现障碍，机器人仍需在本地处理。</p>

<blockquote>
  <p><strong>阅读范围与证据边界</strong>：论文机制以链接的原文为依据；分层方式、消息字段、状态机和代码示例属于本文的工程归纳，不是统一行业标准。文中的频率与时间预算若标为示例，仅用于说明设计方法，不能直接视为硬件性能或安全参数。</p>

  <p>配套阅读：<a href="/Embodied-Agent-Papers/">《Embodied Agent 经典论文》</a> 聚焦论文细节，<a href="/Harness-Engineering/">《Harness Engineering》</a> 讨论通用 Agent 工程。本文侧重二者在机器人系统中的连接方式。</p>
</blockquote>

<h1 id="1-引言从模型能力到系统闭环">1. 引言：从模型能力到系统闭环</h1>

<h2 id="11-三个需要分别处理的问题">1.1 三个需要分别处理的问题</h2>

<p><strong>不同模块的时间尺度不同。</strong> 语义规划可能需要数百毫秒至数秒，而局部控制与伺服有各自的更新周期。若在控制回调里同步等待模型推理，控制链路就会受到推理时延影响。问题在于阻塞关系、资源争用和调度方式，不能简单归结为“Python 单进程必然失控”。</p>

<p><strong>不同故障的影响范围不同。</strong> 本地扩展的段错误可能终止所在进程；CUDA 内存不足通常先表现为运行时异常，并不等于操作系统必然杀死整机主进程。拆分进程可以限制部分故障传播，但共享 GPU、内存、供电与通信链路仍可能形成共同故障点。</p>

<p><strong>执行反馈不等于任务成功。</strong> “夹爪闭合完成”只说明控制动作结束，不能证明目标物体已经稳定抓住。软件操作同样可能有不可逆副作用；具身场景更突出的问题是观测不完整、接触状态不确定，以及动作发生后难以恢复原状。</p>

<p>因此，系统至少需要回答三组问题：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">问题</th>
      <th style="text-align: left">主要责任方</th>
      <th style="text-align: left">需要保留的证据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">现在应该做什么，依据是否仍有效？</td>
      <td style="text-align: left">规划器与 Harness</td>
      <td style="text-align: left">任务目标、世界状态版本、目标对象引用</td>
    </tr>
    <tr>
      <td style="text-align: left">指令是否被接收，正在执行还是已经停止？</td>
      <td style="text-align: left">技能执行端</td>
      <td style="text-align: left">指令 ID、生命周期状态、序列号、控制器反馈</td>
    </tr>
    <tr>
      <td style="text-align: left">预期物理效果是否发生，下一步能否继续？</td>
      <td style="text-align: left">评估器与编排器</td>
      <td style="text-align: left">后置条件、观测证据、失败原因与恢复预算</td>
    </tr>
  </tbody>
</table>

<h2 id="12-双层视角与独立的本地保护">1.2 双层视角与独立的本地保护</h2>

<p>本文将系统归纳为两个协同部分：<strong>上层 Harness 管理任务语义与执行闭环；下层运行系统管理资源、通信和机体控制。</strong> 这是职责划分，不要求部署成两个进程，也不要求同时引入所有中间件。</p>

<pre><code class="language-mermaid">flowchart TB
    User["用户任务：去厨房拿杯子"] --&gt; Planner
    subgraph Harness["上层：Agent Harness"]
        Memory["空间记忆与任务状态"] --&gt; Planner["规划器：生成技能提案"]
        Planner --&gt; Gate["契约校验与资源仲裁"]
        Eval["结果评估与恢复决策"] --&gt; Memory
    end
    subgraph Runtime["下层：机器人运行系统"]
        Skills["导航 / 抓取技能执行端"] --&gt; Control["局部规划与控制器"]
        Control --&gt; Body["驱动器与机体"]
        Sensors["传感器与状态估计"] --&gt; Control
        Sensors --&gt; Protection["本地保护与看门狗"]
        Protection --&gt;|"限速 / 受控停止"| Control
    end
    Gate --&gt;|"带 ID 和有效期的指令"| Skills
    Skills --&gt;|"接收回执 / 进度 / 终态"| Eval
    Sensors --&gt;|"物理结果证据"| Eval
    Sensors --&gt;|"带时间戳的观测"| Memory
</code></pre>

<p>上图中，本地保护不需要先等待规划器作出判断。上层可以请求停止，但保护动作的执行和确认必须在对应的控制链路中完成。即使使用多进程和异步通信，硬实时性质仍取决于操作系统、调度、内存分配和最坏情况执行时间等条件。<a href="https://design.ros2.org/articles/realtime_background.html">ROS 2 实时系统设计说明</a></p>

<h1 id="2-上层-harness把意图变成可验证的技能调用">2. 上层 Harness：把意图变成可验证的技能调用</h1>

<h2 id="21-空间记忆保存对象也保存证据的新鲜度">2.1 空间记忆：保存对象，也保存证据的新鲜度</h2>

<p>规划器不必在每一轮读取全部历史图像。一个实用做法是用结构化记忆检索候选对象，再按需读取相关图像、几何信息和最近的执行记录。</p>

<p><a href="https://arxiv.org/html/2608.11246v1#S4.SS1">Thea §4.1</a> 将持久场景图作为上下文，提供对象引用、位置及关系查询。<a href="https://arxiv.org/html/2606.23565v1#S4.SS3">HoloAgent-0 §4.3</a> 沿用 FSR-VLN 的楼层—房间—视角—物体层级作为记忆索引，支持由粗到细的目标定位与视觉验证。这些设计说明了结构化记忆的用途，但不意味着可以完全取消原始视觉观测。</p>

<p>场景图可写作 $\mathcal{G}_t=(\mathcal{V}_t,\mathcal{E}_t)$：节点描述对象，边描述空间关系。工程上还应为记录附加以下信息：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">字段</th>
      <th style="text-align: left">用途</th>
      <th style="text-align: left">缺失时的典型问题</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">object_id</code></td>
      <td style="text-align: left">跨帧引用同一对象</td>
      <td style="text-align: left">两个外观相似的杯子被混为一谈</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">frame_id</code>、单位、位姿</td>
      <td style="text-align: left">说明坐标含义</td>
      <td style="text-align: left">把地图坐标当作机械臂基座坐标</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">observed_at</code>、<code class="language-plaintext highlighter-rouge">world_version</code></td>
      <td style="text-align: left">判断依据是否过时</td>
      <td style="text-align: left">按旧位置抓取已被移动的物体</td>
    </tr>
    <tr>
      <td style="text-align: left">观测来源与不确定性</td>
      <td style="text-align: left">支持复核</td>
      <td style="text-align: left">把低质量检测当作确定事实</td>
    </tr>
    <tr>
      <td style="text-align: left">可见性与失效条件</td>
      <td style="text-align: left">触发重新观察</td>
      <td style="text-align: left">把“暂时没看见”当作“物体不存在”</td>
    </tr>
  </tbody>
</table>

<p><strong>场景图是估计，不是真值数据库。</strong> “杯子位于桌上”只能支持候选目标选择；是否可达、是否能抓稳，应在执行前用当前位姿和局部观测重新检查。相似度分数也不能直接当作抓取成功概率。</p>

<pre><code class="language-mermaid">flowchart LR
    Obs["图像 / 深度 / 位姿"] --&gt; Map["关联与融合"]
    Map --&gt; Memory["场景图 + 关键帧 + 版本"]
    Memory --&gt; Retrieve["按任务检索候选对象"]
    Retrieve --&gt; Verify["按需视觉复核"]
    Verify --&gt; Context["规划上下文"]
    Context --&gt; Dispatch["执行前重验关键前提"]
    Dispatch --&gt;|"依据已失效"| Obs
</code></pre>

<h2 id="22-类型化技能参数正确只是第一步">2.2 类型化技能：参数正确只是第一步</h2>

<p><a href="https://arxiv.org/html/2606.23565v1#S3.SS1">HoloAgent-0 §3.1</a> 将技能接口分为结构化命令与运行时状态，覆盖目标引用、预期效果、进度、失败模式和可恢复性。本文据此将技能契约分为三个层次：</p>

<ol>
  <li><strong>语法契约</strong>：字段类型、必填项、枚举、数值范围。可用 Pydantic、Protobuf 或 ROS 消息定义实现。</li>
  <li><strong>物理契约</strong>：坐标变换、工作空间、碰撞约束、资源占用、传感器健康与授权条件。需要执行端结合实时状态检查。</li>
  <li><strong>生命周期契约</strong>：接收、执行、取消、终态与结果查询。必须说明超时、重复指令和服务重启的处理方式。</li>
</ol>

<p>下面是本文设计的导航命令示意，并非某篇论文的原始接口：</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="nl">"schema_version"</span><span class="p">:</span><span class="w"> </span><span class="mi">1</span><span class="p">,</span><span class="w">
  </span><span class="nl">"command_id"</span><span class="p">:</span><span class="w"> </span><span class="s2">"nav-00042"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"robot_id"</span><span class="p">:</span><span class="w"> </span><span class="s2">"robot-01"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"skill"</span><span class="p">:</span><span class="w"> </span><span class="s2">"navigate_to_pose"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"target"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"frame_id"</span><span class="p">:</span><span class="w"> </span><span class="s2">"map"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"x_m"</span><span class="p">:</span><span class="w"> </span><span class="mf">1.6</span><span class="p">,</span><span class="w">
    </span><span class="nl">"y_m"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.5</span><span class="p">,</span><span class="w">
    </span><span class="nl">"yaw_rad"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w">
    </span><span class="nl">"position_tolerance_m"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.15</span><span class="w">
  </span><span class="p">},</span><span class="w">
  </span><span class="nl">"world_version"</span><span class="p">:</span><span class="w"> </span><span class="mi">42</span><span class="p">,</span><span class="w">
  </span><span class="nl">"start_within_ms"</span><span class="p">:</span><span class="w"> </span><span class="mi">500</span><span class="p">,</span><span class="w">
  </span><span class="nl">"execution_timeout_ms"</span><span class="p">:</span><span class="w"> </span><span class="mi">10000</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>这里的 <code class="language-plaintext highlighter-rouge">start_within_ms</code> 必须定义计时起点。例如由可信接入端接收时启动本地计时，并在转发时扣减已消耗预算；若需要判断网络中滞留的旧消息，还需结合发送时间、时钟误差界限或会话租约。不能在每次重试时重新获得完整有效期。</p>

<p><code class="language-plaintext highlighter-rouge">execution_timeout_ms</code> 则限制一次技能执行的等待时间。它与底层速度指令的看门狗周期不同：机器人执行一个十秒导航目标时，局部控制器仍应持续生成短有效期的控制指令。</p>

<h2 id="23-执行评估区分控制终态物理结果和恢复策略">2.3 执行评估：区分控制终态、物理结果和恢复策略</h2>

<p><a href="https://arxiv.org/html/2608.11246v1#S4.SS2">Thea §4.2</a> 的 “Evaluation as Exit Codes” 是一种接口类比。论文评估器区分 <code class="language-plaintext highlighter-rouge">process</code>、<code class="language-plaintext highlighter-rouge">success</code>、<code class="language-plaintext highlighter-rouge">failure</code>，并返回证据与失败原因；它并未规定通用的 <code class="language-plaintext highlighter-rouge">0=成功、1=可恢复、2=致命</code> 数字协议。本文建议将三种信息分别表示：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">信息层次</th>
      <th style="text-align: left">示例</th>
      <th style="text-align: left">由谁判断</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">控制生命周期</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">RUNNING</code>、<code class="language-plaintext highlighter-rouge">CANCELING</code>、<code class="language-plaintext highlighter-rouge">STOPPED</code></td>
      <td style="text-align: left">技能执行端及控制器</td>
    </tr>
    <tr>
      <td style="text-align: left">物理后置条件</td>
      <td style="text-align: left">已满足、未满足、证据不足</td>
      <td style="text-align: left">评估器</td>
    </tr>
    <tr>
      <td style="text-align: left">后续策略</td>
      <td style="text-align: left">继续、补充观测、有限重试、求助</td>
      <td style="text-align: left">Harness 编排器</td>
    </tr>
  </tbody>
</table>

<p>例如，夹爪编码器、电流或力觉可以提供接触证据，视觉可以提供物体位置证据，但任何单一信号都可能失真。多源校验是可采用的工程策略，不能仅凭夹爪开度就断言抓取成功，也不能假定两种传感器的错误相互独立。</p>

<pre><code class="language-mermaid">sequenceDiagram
    participant H as Harness
    participant E as 技能执行端
    participant V as 物理结果评估器
    H-&gt;&gt;E: Pick(command_id, object_id)
    E--&gt;&gt;H: ACCEPTED
    E--&gt;&gt;H: RUNNING + progress
    E--&gt;&gt;H: 控制动作完成
    H-&gt;&gt;V: 检查后置条件与最新观测
    alt 证据支持已抓住目标
        V--&gt;&gt;H: SUCCESS + evidence
        H-&gt;&gt;H: 提交任务状态，允许下一步
    else 证据支持抓取失败
        V--&gt;&gt;H: FAILURE + reason
        H-&gt;&gt;H: 检查恢复预算与新的执行前提
    else 遮挡或反馈缺失
        V--&gt;&gt;H: UNKNOWN
        H-&gt;&gt;H: 补充观测或暂停，保持结果待定
    end
</code></pre>

<p><code class="language-plaintext highlighter-rouge">UNKNOWN</code> 是本文对工程接口的扩展，表示证据不足，不能解释为成功或直接重做。任务状态只在证据满足条件时推进；感知系统仍应继续更新失败后的真实世界变化。</p>

<p><a href="https://arxiv.org/abs/2607.21725">Pigey</a> 通过高层编排器组合已有策略或参数化技能，跟踪结果并恢复失败，用“编排鸿沟”描述冻结策略单独执行与进入闭环后的能力差异。对系统设计的启发是：把“执行一个动作”与“判断是否可以继续”分别实现。具体传感器组合、后置拦截器和错误码应按机体设计，不宜统称为论文规定的双重校验标准。</p>

<h2 id="24-运行时监控与经验更新分开三个时间尺度">2.4 运行时监控与经验更新：分开三个时间尺度</h2>

<p><a href="https://arxiv.org/abs/2608.16590">Zetta</a> 在冻结基础策略的条件下，引入代码形式的运行时 Critic、恢复技能与验证后更新，覆盖动作、rollout 和演化迭代三个时间尺度。论文报告 LIBERO-Pro 90.8%、RoboCasa 93.6%，以及相对 RPent 的 11.1 倍推理加速；这些结果对应其评测设置与 rollout 预算，不能换算成所有真机上的固定监控频率。<a href="https://arxiv.org/html/2608.16590v1#S4">实验原文</a></p>

<p>部署时可将职责分为：</p>

<ul>
  <li><strong>快速保护</strong>：依据速度、距离、力矩、状态有效期等信号采取限速或停止，由本地控制链路承担。</li>
  <li><strong>任务监控</strong>：判断是否长期无进展、目标是否丢失、动作是否偏离预期，并请求取消或重新规划。</li>
  <li><strong>经验更新</strong>：从失败记录提出新的规则或恢复技能，经过回放、仿真与适用条件验证后发布。</li>
</ul>

<p>“在线学习到了一个恢复策略”不等于“可以立即让它接管任何机器人”。更新需要版本号、适用机体、资源权限和回退方式；不能让新生成的代码绕过原有执行约束。</p>

<h2 id="25-长程编排行为树状态图与模型循环">2.5 长程编排：行为树、状态图与模型循环</h2>

<p>行为树适合组织重复检查、技能执行和局部恢复；状态图适合显式管理任务阶段、条件转移与历史记录；模型循环适合处理开放式任务分解。三者可以组合，选择取决于需要怎样解释和恢复执行过程。</p>

<p>例如，“导航成功 → 抓取 → 评估 → 放置”可由状态图维护。抓取内部再由行为树执行“观察 → 对准 → 接近 → 闭合”，模型只在目标含糊或恢复方案耗尽时重新参与。</p>

<p>编排器必须设置<strong>最大重试次数、任务总时间预算和无进展检测</strong>。物理恢复是从当前状态出发的补偿动作，不是数据库式回滚。行为树中的恢复节点成功，也只表示恢复动作完成；若要重新抓取，必须明确回到抓取节点，避免把恢复成功误当作任务成功。</p>

<h2 id="26-动作护栏校验什么在哪里执行">2.6 动作护栏：校验什么，在哪里执行</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">检查层</th>
      <th style="text-align: left">主要内容</th>
      <th style="text-align: left">失败后的处理</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">提案接入</td>
      <td style="text-align: left">技能权限、参数、对象引用、请求有效期</td>
      <td style="text-align: left">拒绝提案并给出可解释原因</td>
    </tr>
    <tr>
      <td style="text-align: left">执行前</td>
      <td style="text-align: left">最新坐标变换、可达性、碰撞约束、资源锁</td>
      <td style="text-align: left">补充观测、重新规划或等待资源</td>
    </tr>
    <tr>
      <td style="text-align: left">执行中</td>
      <td style="text-align: left">状态过期、障碍接近、力矩异常、控制超时</td>
      <td style="text-align: left">本地控制器限速或进入对应停止流程</td>
    </tr>
    <tr>
      <td style="text-align: left">执行后</td>
      <td style="text-align: left">后置条件、物体状态、结果证据</td>
      <td style="text-align: left">继续任务或进入恢复分支</td>
    </tr>
  </tbody>
</table>

<p>固定的“置信度 ≥ 0.95”不能替代物理约束；统一的“距离 0.3 米立即断电”也不适用于所有机体。移动底盘、持物机械臂和双足机器人需要不同的停止策略，直接切断动力有时会造成掉物或失稳。</p>

<h2 id="27-代表工作比较机制及其适用边界">2.7 代表工作：比较机制及其适用边界</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">工作</th>
      <th style="text-align: left">关注点</th>
      <th style="text-align: left">可借鉴的机制</th>
      <th style="text-align: left">阅读时需要保留的边界</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2606.23565">HoloAgent-0</a></td>
      <td style="text-align: left">异构技能与空间记忆的组织</td>
      <td style="text-align: left">AgentOS、类型化技能、ROS 2 命令/状态接口</td>
      <td style="text-align: left">部分系统能力以真机演示呈现，不等于全部任务都有统一基准</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2607.21725">Pigey</a></td>
      <td style="text-align: left">冻结策略的编排能力</td>
      <td style="text-align: left">子目标分解、结果检查、失败恢复</td>
      <td style="text-align: left">编排收益受策略能力与任务设置影响</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2608.11246">Thea</a></td>
      <td style="text-align: left">状态可读性与结果可验证性</td>
      <td style="text-align: left">场景图上下文、独立评估器</td>
      <td style="text-align: left">评估器也可能误判，结构化输出不是正确性保证</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2608.16590">Zetta</a></td>
      <td style="text-align: left">执行中的监控及 Harness 演化</td>
      <td style="text-align: left">Critic、恢复技能、验证后更新</td>
      <td style="text-align: left">仿真成绩、推理加速和真机保护时延是不同指标</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://sayplan.github.io/">SayPlan（2023）</a></td>
      <td style="text-align: left">大规模环境中的语言任务规划</td>
      <td style="text-align: left">3D 场景图检索、路径规划与迭代重规划</td>
      <td style="text-align: left">场景图规划不等于完整运行时保护系统</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://voyager.minedojo.org/">Voyager（2023）</a></td>
      <td style="text-align: left">Minecraft 中的持续技能积累</td>
      <td style="text-align: left">自动课程、可执行技能库、反馈改进</td>
      <td style="text-align: left">数字环境中的技能复用不能直接证明物理部署可靠性</td>
    </tr>
  </tbody>
</table>

<p>这些工作提供了不同的系统构件。下面的运行架构是本文对工程问题的归纳，不是上述项目共同采用的实现。</p>

<h1 id="3-下层运行系统时间资源与通信">3. 下层运行系统：时间、资源与通信</h1>

<h2 id="31-按职责和时间尺度拆分">3.1 按职责和时间尺度拆分</h2>

<p>下表中的频率只是帮助理解的示例范围。硬实时意味着必须满足截止时间，不能由语言、进程数量或“运行在 50 Hz”直接推出。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">层次</th>
      <th style="text-align: left">主要工作</th>
      <th style="text-align: left">示例更新方式</th>
      <th style="text-align: left">对上层故障的处理</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">任务规划层</td>
      <td style="text-align: left">语言理解、任务分解、记忆检索</td>
      <td style="text-align: left">事件触发或约 0.1–1 Hz</td>
      <td style="text-align: left">超时后保留当前受控任务状态</td>
    </tr>
    <tr>
      <td style="text-align: left">技能编排层</td>
      <td style="text-align: left">状态图、资源仲裁、结果检查</td>
      <td style="text-align: left">事件触发，必要时周期检查</td>
      <td style="text-align: left">拒绝失效任务，发起取消与对账</td>
    </tr>
    <tr>
      <td style="text-align: left">局部控制层</td>
      <td style="text-align: left">轨迹跟踪、局部规划、避障</td>
      <td style="text-align: left">例如 20–100 Hz</td>
      <td style="text-align: left">上层断开时执行约定的继续或停止策略</td>
    </tr>
    <tr>
      <td style="text-align: left">驱动与伺服层</td>
      <td style="text-align: left">电机控制、硬件保护</td>
      <td style="text-align: left">例如 100–1000 Hz 或更高</td>
      <td style="text-align: left">按机体配置处理指令过期与故障</td>
    </tr>
  </tbody>
</table>

<p>高层语言规划器适合输出子目标或技能调用。VLA 策略则可以作为技能后端生成动作或动作块，由对应控制器跟踪；因此不能把“所有模型都只能输出航点”当作通用规则。关键是明确每种输出的有效期、接管方式和约束执行位置。</p>

<p>拆分进程应服务于故障隔离和资源治理。对一个小型原型，模块化单进程也可能足够；出现阻塞回调、GPU 资源争用或独立重启需求后，再把对应模块移到独立进程。</p>

<h2 id="32-先区分三类数据再选择中间件">3.2 先区分三类数据，再选择中间件</h2>

<p><strong>控制面</strong>传递技能请求、取消和结果查询，关心身份、顺序、去重与确认。<strong>状态面</strong>传递位姿、进度和健康信息，通常更关心新鲜度。<strong>数据面</strong>传递图像、点云和张量，关心带宽、拷贝次数及缓冲区寿命。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">技术</th>
      <th style="text-align: left">适合承担的工作</th>
      <th style="text-align: left">需要额外设计或验证的部分</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">ZeroMQ</td>
      <td style="text-align: left">自定义进程间消息、异步请求、流水线任务</td>
      <td style="text-align: left">消息模式、路由、结果保留、去重、重连及访问控制</td>
    </tr>
    <tr>
      <td style="text-align: left">ROS 2 / DDS</td>
      <td style="text-align: left">驱动、坐标变换、机器人 Topic / Service / Action</td>
      <td style="text-align: left">QoS、执行器、发现范围、资源调度与部署网络</td>
    </tr>
    <tr>
      <td style="text-align: left">Zenoh</td>
      <td style="text-align: left">跨网络的数据分发、ROS 2 互联</td>
      <td style="text-align: left">拓扑、路由器、访问控制、重连及版本兼容</td>
    </tr>
    <tr>
      <td style="text-align: left">WebSocket</td>
      <td style="text-align: left">浏览器遥测、交互与高阶任务下发</td>
      <td style="text-align: left">身份认证、慢客户端、发送队列与应用确认</td>
    </tr>
    <tr>
      <td style="text-align: left">gRPC / Protobuf</td>
      <td style="text-align: left">跨语言服务、结构化请求与流</td>
      <td style="text-align: left">截止时间、取消传播、重试条件与服务端执行状态</td>
    </tr>
    <tr>
      <td style="text-align: left">共享内存</td>
      <td style="text-align: left">同机大块图像、点云、张量的传递</td>
      <td style="text-align: left">数据布局、同步、所有权、生命周期和崩溃回收</td>
    </tr>
  </tbody>
</table>

<p>不应脱离消息大小、进程拓扑和硬件条件，为这些技术排列固定的“平均延迟榜”。选型时先测应用实际负载下的吞吐、p95/p99 时延、队列深度和故障恢复行为，再决定是否增加一个通信层。</p>

<h2 id="33-zeromq四种模式及容易混淆的语义">3.3 ZeroMQ：四种模式及容易混淆的语义</h2>

<h3 id="331-reqrep超时之后仍需处理请求状态">3.3.1 REQ/REP：超时之后仍需处理请求状态</h3>

<p>默认 REQ 套接字要求发送和接收交替进行。等待超时后直接再次发送，可能遇到状态机错误。Lazy Pirate 模式的一种处理方式是关闭旧套接字、重新建立连接并重试。<a href="https://zguide.zeromq.org/docs/chapter4/">ZeroMQ 可靠请求指南</a></p>

<p>但<strong>客户端超时不能证明服务端未执行</strong>。对导航、抓取等有副作用的请求，必须保留相同的 <code class="language-plaintext highlighter-rouge">command_id</code> 查询原状态；只有执行端能够去重且恢复条件满足时，才能安全重投。关闭时还需明确 <code class="language-plaintext highlighter-rouge">LINGER</code> 策略：放弃未发消息与等待发送完成是不同选择。</p>

<h3 id="332-pubsub适合可丢状态不承担唯一的终态通知">3.3.2 PUB/SUB：适合可丢状态，不承担唯一的终态通知</h3>

<p>订阅建立有传播时间，慢订阅者也可能丢消息。HWM 限制排队数量，但不保证“自动丢弃旧消息、只保留最新值”。若业务只需要最新位姿，可在应用层合并状态；使用 <code class="language-plaintext highlighter-rouge">ZMQ_CONFLATE</code> 时要注意它不支持 multipart 消息的完整保留。<a href="https://libzmq.readthedocs.io/en/latest/zmq_setsockopt.html">套接字选项说明</a></p>

<p>动作终态需要结果查询或可重放记录。即使漏掉一次 <code class="language-plaintext highlighter-rouge">SUCCEEDED</code> 广播，上层也应能按指令 ID 查询。停止请求同样不能只依赖一条没有确认的 PUB 消息。</p>

<h3 id="333-pushpull轮询分发不等于感知任务负载">3.3.3 PUSH/PULL：轮询分发不等于感知任务负载</h3>

<p>PUSH 在可用下游之间分发，PULL 从上游公平接收。它适合相同类型任务的并行处理，但没有自动提供任务确认、工作窃取、失败重投或“恰好执行一次”。任务耗时差异较大时，应显式维护 Worker 可用状态与任务归属。<a href="https://libzmq.readthedocs.io/en/latest/zmq_socket.html">套接字模式说明</a></p>

<h3 id="334-routerdealer路由信封与服务选择是两回事">3.3.4 ROUTER/DEALER：路由信封与服务选择是两回事</h3>

<p>ROUTER 接收时将来源路由标识加入消息帧，发送时使用首帧选择目标连接；DEALER 允许异步收发。它们提供消息路由基础，不会自动识别“这是规划请求，应交给规划器”。<a href="https://libzmq.readthedocs.io/en/latest/zmq_socket.html">ROUTER 与 DEALER 语义</a></p>

<p>尤其要避免把能力不同的规划 Worker 和 ROS 桥接 Worker 放进普通 <code class="language-plaintext highlighter-rouge">ROUTER → DEALER</code> 代理的同一个后端池。透明代理会分发消息，不会按 JSON 的 <code class="language-plaintext highlighter-rouge">skill</code> 字段选择服务。可以使用独立端点，或实现带服务注册与能力路由的应用层 Broker。</p>

<p>REQ 客户端会引入空分隔帧，DEALER 客户端的信封不一定相同。Worker 应按明确的线协议解析并保留回复信封，不能只取首帧、末帧后假设中间结构永远一致。</p>

<p>常用的 REQ、REP、ROUTER、DEALER、PUB、SUB 套接字不应被多个线程并发操作。让单个线程或事件循环拥有套接字；异步 Python 可使用 <code class="language-plaintext highlighter-rouge">zmq.asyncio</code>，避免把阻塞接收放进线程池后，又在事件循环中操作同一套接字。<a href="https://libzmq.readthedocs.io/en/latest/zmq.html">线程说明</a>、<a href="https://pyzmq.readthedocs.io/en/latest/api/zmq.asyncio.html">PyZMQ asyncio 接口</a></p>

<h2 id="34-websocket遥测与远程操作的应用语义">3.4 WebSocket：遥测与远程操作的应用语义</h2>

<p>浏览器连接可承载轻量 JSON 状态与高阶指令。大图像适合二进制传输或单独的视频链路；WebRTC 是另一套实时通信机制，不是 WebSocket 的二进制帧格式。</p>

<p>一帧 $1920\times1080$、每像素 3 字节的未压缩 RGB 图像约为 $6.22\text{MB}$，Base64 编码后约为 $8.29\text{MB}$，尚未计入 JSON 等开销。这是数据量计算；序列化需要多少毫秒，必须在目标机器上测量。</p>

<p>网关应为每个客户端设置有界发送队列。遥测可以合并为最新状态，关键告警和指令回执则应有独立保留策略。一个慢浏览器不应阻塞所有客户端的广播。</p>

<p>远程“停止”按钮应显示“请求已提交”“执行端已接收”“停止已确认”等阶段。WebSocket 发送成功只说明消息进入通信流程，不代表机器人已经停下；底层保护也不能依赖浏览器始终在线。</p>

<h2 id="35-ros-2-与-zenoh保留已有机器人能力">3.5 ROS 2 与 Zenoh：保留已有机器人能力</h2>

<p>若系统已经使用 Nav2、MoveIt 2 和 TF2，可以直接让 Harness 调用 ROS 2 接口；只有出现明确的资源隔离、语言边界或部署需求时，才需要再引入 ZeroMQ 桥接。独立进程能隔离 Python 解释器状态，但不能消除 CPU、GPU 和内存带宽的争用。</p>

<p>ROS 2 Action 已提供目标、反馈、取消与结果接口，适合持续时间较长的技能。桥接时应维护 <code class="language-plaintext highlighter-rouge">command_id ↔ goal UUID</code>，处理目标拒绝、执行结果和取消终态；“取消请求被接受”仍不等于动作已进入 <code class="language-plaintext highlighter-rouge">CANCELED</code>。<a href="https://design.ros2.org/articles/actions.html">ROS 2 Action 设计</a></p>

<pre><code class="language-mermaid">flowchart TB
    H["Harness：任务状态与命令 ID"] --&gt; Route["显式服务路由 / 独立端点"]
    Route --&gt; N["导航适配器"]
    Route --&gt; M["操作适配器"]
    N --&gt; Nav["Nav2 Action"]
    M --&gt; Arm["MoveIt 2 / 机体技能后端"]
    Nav --&gt; Feedback["反馈与终态查询"]
    Arm --&gt; Feedback
    Feedback --&gt; H
    ROS["ROS 2 数据域"] --&gt; Zenoh["可选：Zenoh 跨网络互联"]
    Zenoh --&gt; Fleet["边缘服务 / 多机系统"]
</code></pre>

<p>Zenoh 与 ROS 2 的结合至少有两条不同路径：<a href="https://github.com/eclipse-zenoh/zenoh-plugin-ros2dds"><code class="language-plaintext highlighter-rouge">zenoh-bridge-ros2dds</code></a> 桥接使用 DDS 的 ROS 2 系统；<a href="https://github.com/ros2/rmw_zenoh"><code class="language-plaintext highlighter-rouge">rmw_zenoh</code></a> 则作为 ROS 2 的 RMW 实现。需要按发行版和部署拓扑选择，不能笼统描述为“所有 Zenoh 方案都必须桥接 DDS”。</p>

<p>DDS 发现机制也不等于 mDNS。组播、静态发现和发现服务器等配置需要结合具体实现讨论。跨子网与无线漫游问题应测量和配置，不能把 NAT 穿透、微秒级重连或固定比例的性能提升当作协议固有保证。</p>

<h2 id="36-共享内存少一次复制多一份生命周期责任">3.6 共享内存：少一次复制，多一份生命周期责任</h2>

<p>共享内存可以减少同机进程之间的大块数据复制，但并不保证整个感知链路零拷贝。相机缓冲区写入共享区、图像解码、格式转换、上传 GPU，都可能继续发生复制。</p>

<p>一个帧描述符可包含 <code class="language-plaintext highlighter-rouge">buffer_id</code>、<code class="language-plaintext highlighter-rouge">offset</code>、<code class="language-plaintext highlighter-rouge">shape</code>、<code class="language-plaintext highlighter-rouge">dtype</code>、<code class="language-plaintext highlighter-rouge">stride</code>、时间戳及 generation。进程间传递的是可解释的句柄和偏移，不能把一个进程中的原始指针直接交给另一个进程使用。</p>

<pre><code class="language-mermaid">flowchart LR
    Producer["生产者取得空闲槽位"] --&gt; Write["写入帧与元数据"]
    Write --&gt; Publish["发布完成标记 / generation"]
    Publish --&gt; Read["消费者校验并读取"]
    Read --&gt; Release["释放引用或确认消费"]
    Release --&gt; Reuse["满足回收条件后复用槽位"]
    Reuse --&gt; Producer
</code></pre>

<p>仅有一个递增序列号并不足以避免读到半帧：还需要正确的内存可见性与所有权协议。读写重叠时，应采用锁、引用计数或经过验证的环形缓冲方案。使用信号量通知也不意味着整个实现是无锁的。</p>

<p>GPU 张量共享还涉及设备同步与生产者寿命。PyTorch 多进程文档强调 CUDA 子进程启动方式及共享张量的存活约束；将句柄经 ZeroMQ 发出去只是元数据传递，不能代替这些约束。<a href="https://docs.pytorch.org/docs/2.14/notes/multiprocessing.html">PyTorch 多进程最佳实践</a></p>

<h2 id="37-故障时钟和恢复预算">3.7 故障、时钟和恢复预算</h2>

<p><strong>看门狗应靠近受保护的控制链路。</strong> 高层规划请求不应刷新底层速度指令的有效期。监控时间间隔应使用本地单调时钟；日志时间与跨设备传感时间则需要说明各自的时钟来源。</p>

<p><strong>心跳只说明某条链路仍有响应。</strong> 进程能回复 Ping，不代表相机帧在更新、控制循环有进展或 GPU 推理能完成。健康检查应分别覆盖进程存活、数据新鲜度、技能进展和控制器状态。</p>

<p><strong>故障接管需要隔离旧执行者。</strong> 心跳丢失只能提示怀疑故障。新控制者接管前，应使用租约或 fencing token 等机制，使旧控制者恢复连接后无法继续发出有效指令，避免双主控制。</p>

<p><strong>重试、退避和熔断是不同机制。</strong> 重试需要判断操作是否可重复；退避限制请求频率；熔断在一段时间内阻止继续调用失败服务。可采用 full jitter 形式：</p>

<div style="overflow-x: auto;">

\[T_{\mathrm{wait}} \sim \mathrm{Uniform}\left(0,\min(T_{\max},T_{\mathrm{base}}2^k)\right)\]

</div>

<p>重试仍受任务总预算约束。停止、求助或降级到已验证行为都是可能的终点，不应无限重试。</p>

<p><strong>时间同步预算来自任务误差容限。</strong> 例如，匀速平移 $1.2\text{m/s}$ 时，$30\text{ms}$ 的时间偏差对应约 $3.6\text{cm}$ 位移误差；这只是忽略旋转、外参及运动变化的近似。是否需要硬件时间戳、PTP 或硬件触发，应由传感器与运动条件决定，不能统一承诺所有节点达到固定微秒精度。</p>

<h1 id="4-上下层接口把执行闭环接完整">4. 上下层接口：把执行闭环接完整</h1>

<h2 id="41-用指令账本连接控制面与状态面">4.1 用指令账本连接控制面与状态面</h2>

<p>建议为每条指令保留以下最小记录：指令 ID 与内容摘要、执行机体、接收时间、当前生命周期、最新事件序号、结果证据和控制权代次。</p>

<p>同一 ID、相同内容的重复请求返回原状态；同一 ID、不同内容的请求应被拒绝。状态事件用序列号去重，终态不因迟到的进度消息而退回 <code class="language-plaintext highlighter-rouge">RUNNING</code>。服务重启后，应先查询控制器并恢复账本，再判断能否接收新任务。</p>

<p>单纯把去重表放在内存中只能覆盖进程存活期间。需要跨崩溃恢复时，要设计持久记录、结果保留期、控制器对账以及指令提交与执行之间的故障窗口。</p>

<h2 id="42-取消停止和结果未知">4.2 取消、停止和结果未知</h2>

<pre><code class="language-mermaid">stateDiagram-v2
    [*] --&gt; Accepted: 契约检查通过
    Accepted --&gt; Running: 执行端开始
    Accepted --&gt; Canceling: 启动前取消
    Running --&gt; Evaluating: 控制动作完成
    Running --&gt; Canceling: 请求取消或执行超时
    Canceling --&gt; Canceled: 执行端确认停止
    Canceling --&gt; Unknown: 停止确认超时
    Running --&gt; Unknown: 失去执行证据
    Evaluating --&gt; Succeeded: 后置条件成立
    Evaluating --&gt; Failed: 后置条件不成立
    Evaluating --&gt; Unknown: 证据不足
    Unknown --&gt; Reconciling: 查询与重新观测
    Reconciling --&gt; Succeeded: 确认效果已发生
    Reconciling --&gt; Failed: 确认未达成且执行已结束
    Reconciling --&gt; Canceled: 确认取消已完成
    Reconciling --&gt; Unknown: 仍无法确认
    Succeeded --&gt; [*]
    Failed --&gt; [*]
    Canceled --&gt; [*]
</code></pre>

<p>Python 的 <code class="language-plaintext highlighter-rouge">asyncio.Task.cancel()</code> 请求在协程中注入取消异常，并不是抢占式地终止任意计算。阻塞扩展、线程池中的工作或远端推理可能继续运行；取消等待也不会自动向机器人发送停止命令。<a href="https://docs.python.org/3/library/asyncio-task.html">Python asyncio 取消语义</a></p>

<p>因此应分开实现：取消不再需要的推理、向执行端请求停止、等待停止证据、处理未确认状态。进入 <code class="language-plaintext highlighter-rouge">UNKNOWN</code> 后应阻止冲突的新动作，直到对账完成或按机体策略完成接管。</p>

<h2 id="43-快照资源锁与预取失效">4.3 快照、资源锁与预取失效</h2>

<p>一次规划应记录它依赖的对象、位姿及世界状态版本。预取步骤 $N+1$ 可以与步骤 $N$ 的执行重叠，但只有在 $N$ 的结果确认、关键前提仍成立、所需资源可用后，才能提交新动作。</p>

<p>全局版本变化就拒绝计划是一种保守而简单的实现；规模更大时可只检查相关对象、区域和资源的版本，避免无关变化使全部计划失效。机械臂、底盘、夹爪及共同工作区还需要明确的资源仲裁，防止两个技能同时接管同一执行器。</p>

<pre><code class="language-mermaid">flowchart LR
    Execute["执行步骤 N"] --&gt; Result["确认结果"]
    Execute -.-&gt; Prefetch["基于快照预取 N+1"]
    Prefetch --&gt; Check["重验前提与资源"]
    Result --&gt; Check
    Check --&gt;|"仍有效"| Commit["提交 N+1"]
    Check --&gt;|"已失效"| Replan["丢弃预取并重规划"]
</code></pre>

<h2 id="44-分开测量决策时延与保护时延">4.4 分开测量决策时延与保护时延</h2>

<p>模型决策慢，不一定阻塞局部控制；通信平均很快，也不能证明保护链路在最坏情况下足够快。需要分别记录：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">链路</th>
      <th style="text-align: left">主要组成</th>
      <th style="text-align: left">应观察的指标</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">任务决策</td>
      <td style="text-align: left">观测、检索、推理、校验、排队</td>
      <td style="text-align: left">p50/p95/p99、超时率、计划失效率</td>
    </tr>
    <tr>
      <td style="text-align: left">技能响应</td>
      <td style="text-align: left">指令接收、资源等待、控制器接入</td>
      <td style="text-align: left">接收延迟、启动延迟、反馈间隔</td>
    </tr>
    <tr>
      <td style="text-align: left">本地保护</td>
      <td style="text-align: left">采样、检测、调度、执行器响应</td>
      <td style="text-align: left">可验证的时延上界、超期次数、停止行为</td>
    </tr>
    <tr>
      <td style="text-align: left">结果确认</td>
      <td style="text-align: left">终态接收、补充观测、评估</td>
      <td style="text-align: left">误报成功率、漏检率、待定结果比例</td>
    </tr>
  </tbody>
</table>

<p>对理想化的匀速移动底盘，可用下式理解保护预算的组成：</p>

<div style="overflow-x: auto;">

\[d_{\mathrm{stop}} \approx vT_{\mathrm{reaction}} + \frac{v^2}{2a_{\mathrm{brake}}} + d_{\mathrm{margin}}\]

</div>

<p>其中反应时间包含采样、检测、调度和执行器响应。该式假设后续制动减速度恒定，不适用于直接设定人机安全距离；真实系统还要考虑载荷、地面、制动特性和测量误差。</p>

<h2 id="45-可观测性记录能解释失败的因果链">4.5 可观测性：记录能解释失败的因果链</h2>

<p>每次任务至少关联 <code class="language-plaintext highlighter-rouge">task_id</code>、<code class="language-plaintext highlighter-rouge">command_id</code>、计划版本、状态事件序号、传感帧引用、模型与配置版本。记录关键时间点：提案产生、执行端接收、实际开始、取消请求、停止确认和结果评估。</p>

<p>这样才能区分“规划错了”“目标依据过时”“消息没送达”“执行器未响应”“评估器误判”。只保留一条 <code class="language-plaintext highlighter-rouge">success=false</code> 无法支撑恢复设计，也无法比较优化是否有效。</p>

<h1 id="5-可运行示例验证技能生命周期">5. 可运行示例：验证技能生命周期</h1>

<h2 id="51-示例范围">5.1 示例范围</h2>

<p>下面用一个无硬件依赖的 Python 状态机演示四件事：<strong>重复指令不重复启动、过期依据不被接收、取消需要停止确认、结果缺失不被当作成功。</strong> 它是本文的教学实现，只模拟一个导航技能；没有连接真实电机，也没有实现网络、看门狗或碰撞检查。</p>

<p>示例采用单线程顺序事件和内存账本。调用方在同一本地单调时钟域内给出 <code class="language-plaintext highlighter-rouge">now</code>，便于注入时间；实际进程可用 <code class="language-plaintext highlighter-rouge">time.monotonic()</code>，不能把不同机器的单调时钟数值直接相减。<code class="language-plaintext highlighter-rouge">deadline</code> 仅表示最晚启动时间，持续执行的超时由外部调度器触发取消。</p>

<p>保存为 <code class="language-plaintext highlighter-rouge">harness_demo.py</code>，使用 Python 3.10 或更高版本运行：</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="n">dataclasses</span> <span class="kn">import</span> <span class="n">dataclass</span><span class="p">,</span> <span class="n">replace</span>
<span class="kn">from</span> <span class="n">math</span> <span class="kn">import</span> <span class="n">isfinite</span>


<span class="nd">@dataclass</span><span class="p">(</span><span class="n">frozen</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
<span class="k">class</span> <span class="nc">Command</span><span class="p">:</span>
    <span class="n">command_id</span><span class="p">:</span> <span class="nb">str</span>
    <span class="n">world_version</span><span class="p">:</span> <span class="nb">int</span>
    <span class="n">deadline</span><span class="p">:</span> <span class="nb">float</span>
    <span class="n">x_m</span><span class="p">:</span> <span class="nb">float</span>
    <span class="n">y_m</span><span class="p">:</span> <span class="nb">float</span>
    <span class="n">frame_id</span><span class="p">:</span> <span class="nb">str</span> <span class="o">=</span> <span class="sh">"</span><span class="s">map</span><span class="sh">"</span>


<span class="nd">@dataclass</span>
<span class="k">class</span> <span class="nc">Record</span><span class="p">:</span>
    <span class="n">command</span><span class="p">:</span> <span class="n">Command</span>
    <span class="n">state</span><span class="p">:</span> <span class="nb">str</span> <span class="o">=</span> <span class="sh">"</span><span class="s">ACCEPTED</span><span class="sh">"</span>
    <span class="n">reason</span><span class="p">:</span> <span class="nb">str</span> <span class="o">=</span> <span class="sh">""</span>
    <span class="n">stop_deadline</span><span class="p">:</span> <span class="nb">float</span> <span class="o">|</span> <span class="bp">None</span> <span class="o">=</span> <span class="bp">None</span>


<span class="k">class</span> <span class="nc">Harness</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">world_version</span><span class="p">:</span> <span class="nb">int</span><span class="p">):</span>
        <span class="n">self</span><span class="p">.</span><span class="n">world_version</span> <span class="o">=</span> <span class="n">world_version</span>
        <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">:</span> <span class="nb">dict</span><span class="p">[</span><span class="nb">str</span><span class="p">,</span> <span class="n">Record</span><span class="p">]</span> <span class="o">=</span> <span class="p">{}</span>
        <span class="n">self</span><span class="p">.</span><span class="n">starts</span> <span class="o">=</span> <span class="mi">0</span>

    <span class="k">def</span> <span class="nf">submit</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">command</span><span class="p">:</span> <span class="n">Command</span><span class="p">,</span> <span class="n">now</span><span class="p">:</span> <span class="nb">float</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">str</span><span class="p">:</span>
        <span class="n">old</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">.</span><span class="nf">get</span><span class="p">(</span><span class="n">command</span><span class="p">.</span><span class="n">command_id</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">old</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="k">if</span> <span class="n">old</span><span class="p">.</span><span class="n">command</span> <span class="o">!=</span> <span class="n">command</span><span class="p">:</span>
                <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">COMMAND_ID_CONFLICT</span><span class="sh">"</span><span class="p">)</span>
            <span class="k">return</span> <span class="n">old</span><span class="p">.</span><span class="n">state</span>  <span class="c1"># 原请求的状态；不会刷新 deadline
</span>        <span class="k">if</span> <span class="ow">not</span> <span class="n">command</span><span class="p">.</span><span class="n">command_id</span> <span class="ow">or</span> <span class="n">command</span><span class="p">.</span><span class="n">frame_id</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">map</span><span class="sh">"</span><span class="p">:</span>
            <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">INVALID_ID_OR_FRAME</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="nf">all</span><span class="p">(</span><span class="nf">isfinite</span><span class="p">(</span><span class="n">v</span><span class="p">)</span> <span class="k">for</span> <span class="n">v</span> <span class="ow">in</span>
                   <span class="p">(</span><span class="n">command</span><span class="p">.</span><span class="n">x_m</span><span class="p">,</span> <span class="n">command</span><span class="p">.</span><span class="n">y_m</span><span class="p">,</span> <span class="n">command</span><span class="p">.</span><span class="n">deadline</span><span class="p">,</span> <span class="n">now</span><span class="p">)):</span>
            <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">NON_FINITE_VALUE</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">command</span><span class="p">.</span><span class="n">world_version</span> <span class="o">!=</span> <span class="n">self</span><span class="p">.</span><span class="n">world_version</span><span class="p">:</span>
            <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">STALE_WORLD</span><span class="sh">"</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">now</span> <span class="o">&gt;=</span> <span class="n">command</span><span class="p">.</span><span class="n">deadline</span><span class="p">:</span>
            <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">EXPIRED_COMMAND</span><span class="sh">"</span><span class="p">)</span>
        <span class="c1"># 单机体、单资源示例；UNKNOWN 也占用资源，等待外部对账。
</span>        <span class="n">terminal</span> <span class="o">=</span> <span class="p">{</span><span class="sh">"</span><span class="s">SUCCEEDED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">FAILED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">CANCELED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">REJECTED</span><span class="sh">"</span><span class="p">}</span>
        <span class="k">if</span> <span class="nf">any</span><span class="p">(</span><span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">terminal</span> <span class="k">for</span> <span class="n">r</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">.</span><span class="nf">values</span><span class="p">()):</span>
            <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">RESOURCE_BUSY</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">[</span><span class="n">command</span><span class="p">.</span><span class="n">command_id</span><span class="p">]</span> <span class="o">=</span> <span class="nc">Record</span><span class="p">(</span><span class="n">command</span><span class="p">)</span>
        <span class="k">return</span> <span class="sh">"</span><span class="s">ACCEPTED</span><span class="sh">"</span>

    <span class="k">def</span> <span class="nf">start</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">command_id</span><span class="p">:</span> <span class="nb">str</span><span class="p">,</span> <span class="n">now</span><span class="p">:</span> <span class="nb">float</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">str</span><span class="p">:</span>
        <span class="n">r</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">[</span><span class="n">command_id</span><span class="p">]</span>
        <span class="k">if</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">ACCEPTED</span><span class="sh">"</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span>
        <span class="c1"># 排队期间世界可能变化，所以启动前再检查。
</span>        <span class="nf">if </span><span class="p">(</span><span class="ow">not</span> <span class="nf">isfinite</span><span class="p">(</span><span class="n">now</span><span class="p">)</span> <span class="ow">or</span> <span class="n">now</span> <span class="o">&gt;=</span> <span class="n">r</span><span class="p">.</span><span class="n">command</span><span class="p">.</span><span class="n">deadline</span>
                <span class="ow">or</span> <span class="n">r</span><span class="p">.</span><span class="n">command</span><span class="p">.</span><span class="n">world_version</span> <span class="o">!=</span> <span class="n">self</span><span class="p">.</span><span class="n">world_version</span><span class="p">):</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">REJECTED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">PRECONDITION_CHANGED</span><span class="sh">"</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">=</span> <span class="sh">"</span><span class="s">RUNNING</span><span class="sh">"</span>
            <span class="n">self</span><span class="p">.</span><span class="n">starts</span> <span class="o">+=</span> <span class="mi">1</span>  <span class="c1"># 模拟向控制器提交一次目标
</span>        <span class="k">return</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span>

    <span class="k">def</span> <span class="nf">finish</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">command_id</span><span class="p">:</span> <span class="nb">str</span><span class="p">,</span> <span class="n">achieved</span><span class="p">:</span> <span class="nb">bool</span> <span class="o">|</span> <span class="bp">None</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">str</span><span class="p">:</span>
        <span class="n">r</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">[</span><span class="n">command_id</span><span class="p">]</span>
        <span class="k">if</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">!=</span> <span class="sh">"</span><span class="s">RUNNING</span><span class="sh">"</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span>  <span class="c1"># 迟到结果不能覆盖取消流程或终态
</span>        <span class="k">if</span> <span class="n">achieved</span> <span class="ow">is</span> <span class="bp">True</span><span class="p">:</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">SUCCEEDED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">POSTCONDITION_CONFIRMED</span><span class="sh">"</span>
        <span class="k">elif</span> <span class="n">achieved</span> <span class="ow">is</span> <span class="bp">False</span><span class="p">:</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">FAILED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">POSTCONDITION_NOT_MET</span><span class="sh">"</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">UNKNOWN</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">MISSING_EVIDENCE</span><span class="sh">"</span>
        <span class="k">return</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span>

    <span class="k">def</span> <span class="nf">cancel</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">command_id</span><span class="p">:</span> <span class="nb">str</span><span class="p">,</span> <span class="n">now</span><span class="p">:</span> <span class="nb">float</span><span class="p">,</span>
               <span class="n">stop_timeout</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">1.0</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">str</span><span class="p">:</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="nf">isfinite</span><span class="p">(</span><span class="n">now</span><span class="p">)</span> <span class="ow">or</span> <span class="ow">not</span> <span class="nf">isfinite</span><span class="p">(</span><span class="n">stop_timeout</span><span class="p">)</span> <span class="ow">or</span> <span class="n">stop_timeout</span> <span class="o">&lt;=</span> <span class="mi">0</span><span class="p">:</span>
            <span class="k">raise</span> <span class="nc">ValueError</span><span class="p">(</span><span class="sh">"</span><span class="s">INVALID_STOP_TIMEOUT</span><span class="sh">"</span><span class="p">)</span>
        <span class="n">r</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">[</span><span class="n">command_id</span><span class="p">]</span>
        <span class="k">if</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">==</span> <span class="sh">"</span><span class="s">ACCEPTED</span><span class="sh">"</span><span class="p">:</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">CANCELED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">NEVER_STARTED</span><span class="sh">"</span>
        <span class="k">elif</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">==</span> <span class="sh">"</span><span class="s">RUNNING</span><span class="sh">"</span><span class="p">:</span>
            <span class="c1"># 真实适配器在这里提交停止请求；此处仅模拟状态变化。
</span>            <span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">=</span> <span class="sh">"</span><span class="s">CANCELING</span><span class="sh">"</span>
            <span class="n">r</span><span class="p">.</span><span class="n">stop_deadline</span> <span class="o">=</span> <span class="n">now</span> <span class="o">+</span> <span class="n">stop_timeout</span>
        <span class="k">return</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span>  <span class="c1"># 重复取消不会延长停止确认预算
</span>
    <span class="k">def</span> <span class="nf">confirm_stopped</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">command_id</span><span class="p">:</span> <span class="nb">str</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">str</span><span class="p">:</span>
        <span class="n">r</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">[</span><span class="n">command_id</span><span class="p">]</span>
        <span class="nf">if </span><span class="p">(</span><span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">==</span> <span class="sh">"</span><span class="s">CANCELING</span><span class="sh">"</span> <span class="ow">or</span>
                <span class="p">(</span><span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">==</span> <span class="sh">"</span><span class="s">UNKNOWN</span><span class="sh">"</span> <span class="ow">and</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">==</span> <span class="sh">"</span><span class="s">STOP_UNCONFIRMED</span><span class="sh">"</span><span class="p">)):</span>
            <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">CANCELED</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">STOP_CONFIRMED</span><span class="sh">"</span>
        <span class="k">return</span> <span class="n">r</span><span class="p">.</span><span class="n">state</span>

    <span class="k">def</span> <span class="nf">tick</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">now</span><span class="p">:</span> <span class="nb">float</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="bp">None</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">r</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">records</span><span class="p">.</span><span class="nf">values</span><span class="p">():</span>
            <span class="nf">if </span><span class="p">(</span><span class="n">r</span><span class="p">.</span><span class="n">state</span> <span class="o">==</span> <span class="sh">"</span><span class="s">CANCELING</span><span class="sh">"</span> <span class="ow">and</span> <span class="n">r</span><span class="p">.</span><span class="n">stop_deadline</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span>
                    <span class="ow">and</span> <span class="n">now</span> <span class="o">&gt;=</span> <span class="n">r</span><span class="p">.</span><span class="n">stop_deadline</span><span class="p">):</span>
                <span class="n">r</span><span class="p">.</span><span class="n">state</span><span class="p">,</span> <span class="n">r</span><span class="p">.</span><span class="n">reason</span> <span class="o">=</span> <span class="sh">"</span><span class="s">UNKNOWN</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">STOP_UNCONFIRMED</span><span class="sh">"</span>


<span class="k">def</span> <span class="nf">expect_error</span><span class="p">(</span><span class="n">code</span><span class="p">,</span> <span class="n">action</span><span class="p">):</span>
    <span class="k">try</span><span class="p">:</span>
        <span class="nf">action</span><span class="p">()</span>
    <span class="k">except</span> <span class="nb">ValueError</span> <span class="k">as</span> <span class="n">exc</span><span class="p">:</span>
        <span class="k">assert</span> <span class="nf">str</span><span class="p">(</span><span class="n">exc</span><span class="p">)</span> <span class="o">==</span> <span class="n">code</span><span class="p">,</span> <span class="p">(</span><span class="n">code</span><span class="p">,</span> <span class="nf">str</span><span class="p">(</span><span class="n">exc</span><span class="p">))</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="k">raise</span> <span class="nc">AssertionError</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">expected </span><span class="si">{</span><span class="n">code</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>


<span class="k">def</span> <span class="nf">demo</span><span class="p">():</span>
    <span class="n">h</span> <span class="o">=</span> <span class="nc">Harness</span><span class="p">(</span><span class="n">world_version</span><span class="o">=</span><span class="mi">7</span><span class="p">)</span>
    <span class="n">c</span> <span class="o">=</span> <span class="nc">Command</span><span class="p">(</span><span class="sh">"</span><span class="s">nav-1</span><span class="sh">"</span><span class="p">,</span> <span class="mi">7</span><span class="p">,</span> <span class="n">deadline</span><span class="o">=</span><span class="mf">10.0</span><span class="p">,</span> <span class="n">x_m</span><span class="o">=</span><span class="mf">1.6</span><span class="p">,</span> <span class="n">y_m</span><span class="o">=</span><span class="mf">0.5</span><span class="p">)</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">0.0</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">ACCEPTED</span><span class="sh">"</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">start</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">0.1</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">RUNNING</span><span class="sh">"</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">0.2</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">RUNNING</span><span class="sh">"</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">start</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">0.3</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">RUNNING</span><span class="sh">"</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="n">starts</span> <span class="o">==</span> <span class="mi">1</span>
    <span class="nf">expect_error</span><span class="p">(</span><span class="sh">"</span><span class="s">COMMAND_ID_CONFLICT</span><span class="sh">"</span><span class="p">,</span>
                 <span class="k">lambda</span><span class="p">:</span> <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span><span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">x_m</span><span class="o">=</span><span class="mf">2.0</span><span class="p">),</span> <span class="n">now</span><span class="o">=</span><span class="mf">0.4</span><span class="p">))</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">finish</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">achieved</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">SUCCEEDED</span><span class="sh">"</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">finish</span><span class="p">(</span><span class="n">c</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">achieved</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">SUCCEEDED</span><span class="sh">"</span>

    <span class="nf">expect_error</span><span class="p">(</span><span class="sh">"</span><span class="s">STALE_WORLD</span><span class="sh">"</span><span class="p">,</span> <span class="k">lambda</span><span class="p">:</span> <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span>
        <span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">command_id</span><span class="o">=</span><span class="sh">"</span><span class="s">old</span><span class="sh">"</span><span class="p">,</span> <span class="n">world_version</span><span class="o">=</span><span class="mi">6</span><span class="p">),</span> <span class="n">now</span><span class="o">=</span><span class="mf">1.0</span><span class="p">))</span>
    <span class="nf">expect_error</span><span class="p">(</span><span class="sh">"</span><span class="s">EXPIRED_COMMAND</span><span class="sh">"</span><span class="p">,</span> <span class="k">lambda</span><span class="p">:</span> <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span>
        <span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">command_id</span><span class="o">=</span><span class="sh">"</span><span class="s">late</span><span class="sh">"</span><span class="p">,</span> <span class="n">deadline</span><span class="o">=</span><span class="mf">1.0</span><span class="p">),</span> <span class="n">now</span><span class="o">=</span><span class="mf">1.0</span><span class="p">))</span>

    <span class="n">c2</span> <span class="o">=</span> <span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">command_id</span><span class="o">=</span><span class="sh">"</span><span class="s">nav-2</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span><span class="n">c2</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">1.0</span><span class="p">)</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">start</span><span class="p">(</span><span class="n">c2</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">1.1</span><span class="p">)</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">cancel</span><span class="p">(</span><span class="n">c2</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">2.0</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">CANCELING</span><span class="sh">"</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">cancel</span><span class="p">(</span><span class="n">c2</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">2.5</span><span class="p">)</span>  <span class="c1"># 不把期限延至 3.5
</span>    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">finish</span><span class="p">(</span><span class="n">c2</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">achieved</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">CANCELING</span><span class="sh">"</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">tick</span><span class="p">(</span><span class="n">now</span><span class="o">=</span><span class="mf">3.0</span><span class="p">)</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="n">records</span><span class="p">[</span><span class="n">c2</span><span class="p">.</span><span class="n">command_id</span><span class="p">].</span><span class="n">state</span> <span class="o">==</span> <span class="sh">"</span><span class="s">UNKNOWN</span><span class="sh">"</span>
    <span class="nf">expect_error</span><span class="p">(</span><span class="sh">"</span><span class="s">RESOURCE_BUSY</span><span class="sh">"</span><span class="p">,</span> <span class="k">lambda</span><span class="p">:</span> <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span>
        <span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">command_id</span><span class="o">=</span><span class="sh">"</span><span class="s">conflict</span><span class="sh">"</span><span class="p">),</span> <span class="n">now</span><span class="o">=</span><span class="mf">3.1</span><span class="p">))</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">confirm_stopped</span><span class="p">(</span><span class="n">c2</span><span class="p">.</span><span class="n">command_id</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">CANCELED</span><span class="sh">"</span>

    <span class="n">c3</span> <span class="o">=</span> <span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">command_id</span><span class="o">=</span><span class="sh">"</span><span class="s">nav-3</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span><span class="n">c3</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">4.0</span><span class="p">)</span>
    <span class="n">h</span><span class="p">.</span><span class="n">world_version</span> <span class="o">=</span> <span class="mi">8</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">start</span><span class="p">(</span><span class="n">c3</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">4.1</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">REJECTED</span><span class="sh">"</span>

    <span class="n">c4</span> <span class="o">=</span> <span class="nf">replace</span><span class="p">(</span><span class="n">c</span><span class="p">,</span> <span class="n">command_id</span><span class="o">=</span><span class="sh">"</span><span class="s">nav-4</span><span class="sh">"</span><span class="p">,</span> <span class="n">world_version</span><span class="o">=</span><span class="mi">8</span><span class="p">)</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">submit</span><span class="p">(</span><span class="n">c4</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">5.0</span><span class="p">)</span>
    <span class="n">h</span><span class="p">.</span><span class="nf">start</span><span class="p">(</span><span class="n">c4</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">now</span><span class="o">=</span><span class="mf">5.1</span><span class="p">)</span>
    <span class="k">assert</span> <span class="n">h</span><span class="p">.</span><span class="nf">finish</span><span class="p">(</span><span class="n">c4</span><span class="p">.</span><span class="n">command_id</span><span class="p">,</span> <span class="n">achieved</span><span class="o">=</span><span class="bp">None</span><span class="p">)</span> <span class="o">==</span> <span class="sh">"</span><span class="s">UNKNOWN</span><span class="sh">"</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">PASS: dedup, stale/expired rejection, cancel/stop, unknown result</span><span class="sh">"</span><span class="p">)</span>


<span class="k">if</span> <span class="n">__name__</span> <span class="o">==</span> <span class="sh">"</span><span class="s">__main__</span><span class="sh">"</span><span class="p">:</span>
    <span class="nf">demo</span><span class="p">()</span>
</code></pre></div></div>

<p>运行 <code class="language-plaintext highlighter-rouge">python harness_demo.py</code> 后应输出一行 <code class="language-plaintext highlighter-rouge">PASS: ...</code>。这里的断言验证协议行为，不是对真实机器人的安全或实时性测试。<code class="language-plaintext highlighter-rouge">achieved</code> 和停止确认由模拟事件提供；接入真实系统后必须由相应的控制器和观测证据产生。</p>

<h2 id="52-接入真实系统时补齐哪些接口">5.2 接入真实系统时补齐哪些接口</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">示例入口</th>
      <th style="text-align: left">实际适配职责</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">submit</code></td>
      <td style="text-align: left">解析与运行时类型校验、权限检查、持久去重、资源仲裁</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">start</code></td>
      <td style="text-align: left">用最新状态检查前提，提交 Action Goal，处理接受或拒绝</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">finish</code></td>
      <td style="text-align: left">分别读取控制终态与物理后置条件，保留证据引用</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">cancel</code></td>
      <td style="text-align: left">按指令 ID 发送取消或停止请求，记录确认期限</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">confirm_stopped</code></td>
      <td style="text-align: left">验证目标对应的停止完成证据；不能由“发送成功”触发</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">tick</code></td>
      <td style="text-align: left">调度执行超时和确认超时；底层看门狗仍独立运行</td>
    </tr>
  </tbody>
</table>

<p>Python 类型注解本身不执行网络输入校验。接入外部消息时，还要检查字段类型、数值范围、协议版本和消息大小。示例未实现 <code class="language-plaintext highlighter-rouge">UNKNOWN</code> 的完整对账、持久存储及多资源并发；这些应在加入通信适配器前明确。</p>

<p>ROS 适配器还需正确设置时间戳、坐标系和有效的四元数，处理 <code class="language-plaintext highlighter-rouge">send_goal_async</code> 的接受结果与 <code class="language-plaintext highlighter-rouge">get_result_async</code> 的终态。ZeroMQ 适配器则需处理信封、请求关联、超时、重连和结果查询。二者都不应在接收循环里长时间等待模型推理，以免阻塞取消和状态处理。</p>

<h2 id="53-故障注入比正常跑通更有价值">5.3 故障注入比“正常跑通”更有价值</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">注入条件</th>
      <th style="text-align: left">期望行为</th>
      <th style="text-align: left">验证位置</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">重复提交同一指令</td>
      <td style="text-align: left">返回原状态，不重复启动</td>
      <td style="text-align: left">示例中的 <code class="language-plaintext highlighter-rouge">starts == 1</code></td>
    </tr>
    <tr>
      <td style="text-align: left">同一 ID 携带不同目标</td>
      <td style="text-align: left">拒绝请求</td>
      <td style="text-align: left">示例中的冲突检查</td>
    </tr>
    <tr>
      <td style="text-align: left">指令过期或排队后状态改变</td>
      <td style="text-align: left">执行前拒绝</td>
      <td style="text-align: left">示例中的有效期与版本检查</td>
    </tr>
    <tr>
      <td style="text-align: left">停止确认迟到或丢失</td>
      <td style="text-align: left">进入待定状态，阻止冲突动作</td>
      <td style="text-align: left">示例中的取消超时检查</td>
    </tr>
    <tr>
      <td style="text-align: left">动作结束但观测缺失</td>
      <td style="text-align: left">不标记成功</td>
      <td style="text-align: left">示例中的 <code class="language-plaintext highlighter-rouge">achieved=None</code></td>
    </tr>
    <tr>
      <td style="text-align: left">进程在指令发送后崩溃</td>
      <td style="text-align: left">重启后先对账，不盲目重发</td>
      <td style="text-align: left">需真实进程与持久账本测试</td>
    </tr>
    <tr>
      <td style="text-align: left">推理占满 CPU/GPU</td>
      <td style="text-align: left">检查控制周期及保护时延是否超期</td>
      <td style="text-align: left">需目标硬件负载测试</td>
    </tr>
    <tr>
      <td style="text-align: left">遥测消费者长时间阻塞</td>
      <td style="text-align: left">队列有界，其他客户端不被拖住</td>
      <td style="text-align: left">需网关集成测试</td>
    </tr>
  </tbody>
</table>

<h1 id="6-评估方法与后续研究问题">6. 评估方法与后续研究问题</h1>

<h2 id="61-如何判断-harness-的改动有效">6.1 如何判断 Harness 的改动有效</h2>

<p>任务成功率是必要指标，但不能独立解释改进来源。建议在固定基础策略、任务分布和计算预算后，分别比较是否启用空间记忆、结果评估、恢复策略和运行时监控。</p>

<p>同时记录：完成时间、模型调用数、恢复次数、人工介入率、误报成功率、结果待定率、控制超期次数，以及服务故障后的恢复行为。若成功率提高的代价是重试次数和执行时间大幅增加，需要把这一取舍呈现出来。</p>

<p>跨论文表格适合比较机制，性能排名则要求相同任务、评测协议和预算。仿真成功率、真机成功率、推理时延和 rollout 吞吐不能合并成一个“系统先进程度”分数。</p>

<h2 id="62-值得继续研究的方向">6.2 值得继续研究的方向</h2>

<p><strong>跨机体技能契约。</strong> 同一个 <code class="language-plaintext highlighter-rouge">pick</code> 在不同夹爪、传感器和控制器上具有不同前置条件与失败模式。接口复用需要机体能力描述与语义一致性验证，而不仅是统一字段名。</p>

<p><strong>不确定结果下的任务恢复。</strong> 断网后机器人可能已完成动作，也可能仍在执行。如何用有限观测恢复任务状态，比一味提高重试速度更关键。</p>

<p><strong>可验证的 Harness 更新。</strong> 新 Critic 和恢复技能应携带适用条件、回放证据与版本边界。研究重点包括覆盖率、误触发成本、跨任务迁移，以及更新失败后的回退。</p>

<p><strong>端、边、云的任务分配。</strong> 本地控制与保护留在机器人侧；大规模记忆、规划和经验汇聚可按网络与算力条件分布部署。断连时哪些技能继续、哪些停止，应成为协议的一部分。</p>

<p>这些是开放问题与设计方向，不是已经确立的统一 AgentOS 标准，也不是对某一年技术必然落地的预测。</p>

<h1 id="7-总结与参考资料">7. 总结与参考资料</h1>

<h2 id="71-架构落地的检查顺序">7.1 架构落地的检查顺序</h2>

<p>一个具身 Harness 是否形成闭环，可以沿同一条指令检查：<strong>它依据什么观测产生，谁有权执行，如何确认正在运行，谁判断效果，超时后如何停止，重启后如何恢复事实。</strong> 空间记忆、技能契约、评估器、通信与控制系统分别回答其中一部分。</p>

<p>落地时可先打通一个技能的完整生命周期，再扩展多技能编排与空间记忆；用故障注入验证重复请求、状态过期和取消行为后，再依据实测瓶颈引入异步流水线、共享内存或更多服务。这样每一层优化都有可观察的收益与边界。</p>

<h2 id="72-论文与项目">7.2 论文与项目</h2>

<ol>
  <li>Zhou et al. <strong>HoloAgent-0: A Unified Embodied Agent Framework with 3D Spatial Memory</strong>（2026）. <a href="https://arxiv.org/abs/2606.23565">论文</a></li>
  <li>Galanti, Shah, Dao. <strong>Addressing the Orchestration Gap in Generalist Robots via Physical Agency</strong>（Pigey，2026）. <a href="https://arxiv.org/abs/2607.21725">论文</a></li>
  <li>Wang et al. <strong>Towards the Harness of Embodied Agents</strong>（Thea，2026）. <a href="https://arxiv.org/abs/2608.11246">论文</a> · <a href="https://eit-hai.github.io/thea">项目</a></li>
  <li>Ding et al. <strong>Zetta ζ: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence</strong>（2026）. <a href="https://arxiv.org/abs/2608.16590">论文</a></li>
  <li>Rana et al. <strong>SayPlan: Grounding Large Language Models using 3D Scene Graphs for Scalable Robot Task Planning</strong>（2023）. <a href="https://sayplan.github.io/">项目与论文入口</a></li>
  <li>Wang et al. <strong>Voyager: An Open-Ended Embodied Agent with Large Language Models</strong>（2023）. <a href="https://voyager.minedojo.org/">项目与论文入口</a></li>
</ol>

<h2 id="73-工程文档">7.3 工程文档</h2>

<ol>
  <li>ZeroMQ：<a href="https://libzmq.readthedocs.io/en/latest/zmq_socket.html">Socket 模式</a>、<a href="https://libzmq.readthedocs.io/en/latest/zmq_setsockopt.html">Socket 选项</a>、<a href="https://zguide.zeromq.org/docs/chapter4/">可靠请求模式</a>。</li>
  <li>ROS 2：<a href="https://design.ros2.org/articles/actions.html">Action 设计</a>、<a href="https://design.ros2.org/articles/realtime_background.html">实时系统设计背景</a>。</li>
  <li>Zenoh：<a href="https://github.com/eclipse-zenoh/zenoh-plugin-ros2dds"><code class="language-plaintext highlighter-rouge">zenoh-plugin-ros2dds</code></a>、<a href="https://github.com/ros2/rmw_zenoh"><code class="language-plaintext highlighter-rouge">rmw_zenoh</code></a>。</li>
  <li>Python 与 PyZMQ：<a href="https://docs.python.org/3/library/asyncio-task.html">协程取消</a>、<a href="https://pyzmq.readthedocs.io/en/latest/api/zmq.asyncio.html"><code class="language-plaintext highlighter-rouge">zmq.asyncio</code></a>。</li>
  <li>PyTorch：<a href="https://docs.pytorch.org/docs/2.14/notes/multiprocessing.html">多进程最佳实践</a>。</li>
</ol>

<p>核对日期：2026-09-28。论文机制以所链接版本为准，库接口需结合实际安装版本阅读。</p>]]></content><author><name>Tingde Liu</name></author><category term="research" /><category term="Embodied-AI" /><category term="Agent" /><category term="Harness-Engineering" /><category term="System-Architecture" /><category term="Distributed-Systems" /><category term="ZeroMQ" /><category term="ROS2" /><category term="Python" /><summary type="html"><![CDATA[从空间记忆、技能契约、执行评估与运行时监控出发，梳理具身 Agent Harness 与机器人运行系统的协同架构，分析通信选型、快慢循环、故障恢复及可验证的接口设计。]]></summary></entry><entry><title type="html">具身导航周报（2026-09-16 ~ 2026-09-24）</title><link href="https://garylee1210.github.io/vln-weekly-2026-09-27/" rel="alternate" type="text/html" title="具身导航周报（2026-09-16 ~ 2026-09-24）" /><published>2026-09-27T00:00:00+00:00</published><updated>2026-09-27T00:00:00+00:00</updated><id>https://garylee1210.github.io/VLN-Weekly</id><content type="html" xml:base="https://garylee1210.github.io/vln-weekly-2026-09-27/"><![CDATA[<h2 id="一本期结论">一、本期结论</h2>

<ul>
  <li><strong>R2R-CE 零样本出现 79.0% 的新声明，但目前核验不了它说明了什么。</strong> GPT-6-Astra 在 Codex harness 的最小接口下、只用单目 RGB，不做导航微调、不用训练过的航点预测器、不用预建地图，论文报告 ultra 推理档位 SR 79.0%，称比最强零样本高 13.0 点、比最强监督式高 6.9 点。一周前同一模型在直接调 API 的工作流里只有 52.0%（Open-Nav 100 episode 协议中的 50 条），且其中 16.0% 是步数上限触底而非主动停止。两篇之间 harness、推理档位、episode 集合与成功判定可能同时变了，27 点差距无法归因。本报告判断：若 79.0% 沿用 100 episode 子集，二项分布下 95% 置信区间半宽约 8 个百分点，「超过监督式 6.9 点」落在统计误差内，且监督式结果多在完整 val-unseen（1,839 episode）上报告，并非同集比较。</li>
  <li><strong>同一个 R2R-CE 上的数字，越来越多地出自互不相同的信息条件。</strong> 本期三个新结果：SparseNav 免训练、自主、42.8%（val-unseen）；Talk2Escape 在打转或偏离时向算法 oracle 或人类求助，66.0%；GPT-6-Astra 用闭源前沿模型的 ultra 推理档位，79.0%。三者的差距首先来自「系统能拿到什么信息」，其次才是方法本身。来源之间还有直接冲突：Talk2Escape 称其 66.0% 超过当前监督式 SOTA，而按 GPT-6-Astra 的表述反推，作者采用的监督式最佳为 72.1%，上期 GroundingVLN 在完整 val-unseen 上也报告了 69.9%。</li>
  <li><strong>Harness 从导航扩散到整个具身栈，并开始反哺模型训练。</strong> 上期 3 个 harness 工作，本期 5 个直接以 harness 为主题（HarnessPAI、RegenHarness、AdaHVLA、Robo-Harness K1、World Action Agent），另有 GPT-6-Astra 在 Codex harness 中评测。新出现的共同做法有两点。一是只改 harness 配置、不改模型权重，靠执行记录驱动修订。二是把 harness 的执行轨迹蒸馏回模型：HarnessPAI 用收敛程序采集的数据微调 π0.5，LIBERO-PRO 再涨 38.8 点；World Action Agent 用 harness 轨迹微调 Qwen3.5-9B，分布外成功率从 1.7% 升到 43.3%；Robo-Harness K1 的学生模型只用 107 个教师 episode。其中只有 AdaHVLA 报了导航侧数字（NaVILA-LH 从 22.5% 升至最高 57.5%）。</li>
  <li><strong>导航与 VLA 两边同时收敛到「有界记忆」：固定尺寸的状态，替代不断增长的上下文。</strong> 导航侧，VNT-PA 用位姿索引的关键帧集合作环境表征，PointNav（HM3D）SR 93.3%、SPL 90.4%；SparseNav 只存当前子指令需要的稀疏地标；MemCtrl 用约一半上下文取得平均 +6%、长指令子集 +20%。VLA 侧，SmoLSTM、MemBodied、StateMem 三篇都用固定尺寸的记忆状态替代历史帧堆叠。SmoLSTM 的消融最直接：每步重置循环状态，完整任务成功率从 77.5% 跌到 7.0%。</li>
  <li><strong>评测开始系统性地质疑排行榜。</strong> PopNavShift 显示社会导航策略的排名依赖指标：只改时间压力，按机器人用时排名有 8.6% 反转，按行人延迟有 22.4%、按最差十分位延迟有 23.9% 反转。RoboFollow 指出「低场景熵」下语言是冗余的，九个 VLA/WAM 在基础设定上的成绩不能可靠迁移到扰动设定。DPed-VLN 把社会安全指标与导航效率合并评估。VLN 可解释性工作则显示，策略内部编码了导航进度。</li>
  <li>本期共 124 篇独立新工作，其中主池（导航 + 具身Agent）38 篇，另有 2 篇边界条目（ACE、WORLDS）一并分析；公众号源 0 条。arXiv 检索接口本期持续不可用，改用 OAI-PMH 元数据按原检索式本地匹配；在上期同一时间窗做对照，主池召回为 38/41。</li>
</ul>

<h2 id="二优先阅读清单">二、优先阅读清单</h2>

<ol>
  <li><strong><a href="https://arxiv.org/abs/2609.29861v1">GPT-6-Astra Lights Up</a></strong> · 零样本 VLN-CE，单目 RGB
    <ul>
      <li>贡献：通用基础模型在 Codex harness 最小接口下自主决定观察、移动与停止。</li>
      <li>证据：R2R-CE SR 79.0%（ultra 推理）；episode 集合、SPL、推理成本未在摘要中给出。</li>
      <li>理由：当前零样本最高声明，需先核验口径再引用。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.26408v1">SparseNav</a></strong> · 免训练 VLN-CE + 四足真机
    <ul>
      <li>贡献：按当前子指令决定感知什么，只维护几何 BEV 与稀疏地标记忆。</li>
      <li>证据：R2R-CE val-unseen SR 42.8%，RxR-CE val-unseen SR 40.7%。</li>
      <li>理由：自主、免训练、两个基准都报数，硬件栈常见，复现门槛低。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.28296v1">Talk2Escape</a></strong> · 对话式纠错 VLN
    <ul>
      <li>贡献：检测到打转或偏离后，向 oracle 或人类发出接地提问，把开环导航变成闭环。</li>
      <li>证据：R2R-CE SR 66.0%；在 R2R-CE、RxR-CE、VLNVerse 上对多种基础智能体一致提升。</li>
      <li>理由：检测器可以单独复用；其 SOTA 声明与其他来源冲突。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.21212v1">VNT-PA</a></strong> · PointNav（HM3D）
    <ul>
      <li>贡献：注意力由位姿差决定，关键帧集合即环境表征，可跨轨迹融合。</li>
      <li>证据：HM3D PointNav SR 93.3%，SPL 90.4%。</li>
      <li>理由：不建显式地图也能复用历史经验。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.29204v1">AdaHVLA</a></strong> · 长程 VLA 执行的自适应 harness
    <ul>
      <li>贡献：以可检验的假设驱动 harness 修订，修订图保留证据与效果。</li>
      <li>证据：NaVILA-LH 平均测试成功率 22.5% → 最高 57.5%（仿真）。</li>
      <li>理由：本期 harness 工作中唯一有导航侧数字。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.27218v1">NaviScale</a></strong> · 语义地图 ObjectNav
    <ul>
      <li>贡献：拼接真实户型与房间级语义地图，大规模生成补全预测的训练数据。</li>
      <li>证据：HM3D SR 64.3% / SPL 34.8%，MP3D SR 43.1% / SPL 16.8%。</li>
      <li>理由：不改预测架构、只扩数据的对照点。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.24576v1">What do VLM-Based VLN Models Rely on</a></strong> · VLN 可解释性与激活引导
    <ul>
      <li>贡献：用干预式指标测各模态对决策的因果影响，并提取行为激活向量。</li>
      <li>证据：摘要未提供可核验数字。</li>
      <li>理由：给出「策略是否在用指令」的直接诊断手段。</li>
    </ul>
  </li>
  <li><strong><a href="https://arxiv.org/abs/2609.21504v1">DPed-VLN</a></strong> · 动态行人 VLN 基准
    <ul>
      <li>贡献：Habitat 3.0 上 33,093 个 episode，联合评估导航效率与社会安全。</li>
      <li>证据：摘要只给相对结论，未提供可核验数字。</li>
      <li>理由：地面 VLN 进入动态人群场景的第一个成体量基准。</li>
    </ul>
  </li>
</ol>

<h2 id="三重点工作分析">三、重点工作分析</h2>

<h3 id="1-gpt-6-astra-两篇对读790-与-520-之间没有一个变量是被控制的">1. GPT-6-Astra 两篇对读：79.0% 与 52.0% 之间，没有一个变量是被控制的</h3>

<p><strong>问题。</strong> 通用基础模型不加任何导航专用组件，能否完成连续环境 VLN。上期那篇（<a href="https://arxiv.org/abs/2609.20116v2">How Far Can GPT-6-Astra Go?</a>，原题 GPT-6-Astra in a Navigation Workflow，本期以改题后的 v2 重新出现，不计入新增）已经暴露出：局部判断正确，不等于能持续推进并在正确位置停下。</p>

<p><strong>方法。</strong> 新文用 Codex harness 下的最小接口，只给单目 RGB；模型自行决定何时观察、如何移动、何时停止；不做导航微调，不用训练过的航点预测器，不用预建地图。摘要只报了 ultra 推理档位，说明评测了多个档位。旧文是直接调 API 的观测—决策—执行工作流，每次请求带入选定观测、执行反馈和保留的进度记录。</p>

<p><strong>证据。</strong> 新文报告 R2R-CE SR 79.0%，称比最强零样本高 13.0 点、比最强监督式高 6.9 点；摘要没有给 SPL、nDTW、episode 数和推理成本。旧文报告在 Open-Nav 100 episode 中的 50 条上 SR 52.0%、SPL 48.9%、nDTW 70.8%，其中主动 STOP 成功 36.0%，步数上限触底 16.0%。</p>

<p><strong>价值。</strong> 本报告判断：如果 79.0% 在可比协议下成立，「基础模型 + 最小 harness」就已超过专门训练的 VLN-CE 系统，自研导航模块的价值需要重新论证。这正是作者第四点结论的主张。</p>

<p><strong>局限。</strong></p>

<ul>
  <li>评测集没有写明。零样本文献里的「常用零样本 R2R-CE 基准」多指 Open-Nav 的 100 episode 子集（本报告判断）。若如此，95% 置信区间半宽约 8 个百分点，「超过监督式 6.9 点」不具统计意义，且与全量 val-unseen 上的监督式结果不同集。</li>
  <li>ultra 推理的单步延迟与调用成本未报，真机可用性无从判断。</li>
  <li>两篇之间 harness、推理档位、episode 集合、成功判定可能同时变化，27 点差距无法拆分归因。</li>
  <li>作者自己也写明：即使用 ultra 推理，路线执行与目标验证仍不可靠，看似合理的局部地标匹配不一定导向正确完成。</li>
</ul>

<p><strong>建议。</strong> 精读正文，确认 episode 集合、各推理档位的 SR 与成本、成功是否要求主动 STOP；若日志公开，统计失败 episode 中「未停 / 错停 / 偏航」的构成。在核验前，不要把 79.0% 放进与训练式方法的横向对比。</p>

<h3 id="2-sparsenav少感知一点反而是更可复现的零样本路线">2. SparseNav：少感知一点，反而是更可复现的零样本路线</h3>

<p><strong>问题。</strong> 基于地图的 VLN 若对所有可见物体都做语义标注，既增加感知开销，又会用无关物体淹没 VLM 规划器读到的空间表征。</p>

<p><strong>方法。</strong> 持续维护轻量的几何 BEV 地图与稀疏地标记忆。指令管理器跟踪进度，给出当前子指令对应的地标查询；只有当被查询的地标可见、且其度量位置对下一步决策有用时，才调用开放词表分割。VLM 在「前沿点 + 局部方向航点」的混合候选中做选择。</p>

<p><strong>证据。</strong> 论文报告：不做任何训练，R2R-CE val-unseen SR 42.8%，RxR-CE val-unseen SR 40.7%；另有感知策略与各组件的受控消融（摘要未给消融数字和 SPL）。真机部署在 Unitree Go2 上，RealSense D455 负责建图与地标接地，Livox MID-360 负责定位，不用预建地图，在多个室内环境验证。</p>

<p><strong>价值。</strong> 本期三个 R2R-CE 新结果中，唯一同时满足自主、免训练、写明 val-unseen 分割、并在 RxR-CE 上同步报数的工作；硬件栈与常见四足平台一致。「按子指令决定感知什么」可以直接嫁接到任何基于地图的零样本 VLN 系统。</p>

<p><strong>局限。</strong> 摘要未说明是否为完整 val-unseen，也未说明所用 VLM 与单步延迟；42.8% 不能与多在 100 episode 子集上报告的其他零样本结果直接比较。稀疏地标记忆会丢掉指令没提到、但对避障或重定位有用的物体。</p>

<p><strong>建议。</strong> 复现指令条件化的感知触发模块，测量感知调用次数与延迟的实际下降；在同一 episode 集上与稠密语义地图基线做对照。</p>

<h3 id="3-talk2escape检测器比对话更值得带走">3. Talk2Escape：检测器比对话更值得带走</h3>

<p><strong>问题。</strong> 单轮 VLN 是开环执行：感知混叠、传感噪声、里程计漂移带来的小偏差持续累积，最终任务失败，而系统没有内建的恢复机制。</p>

<p><strong>方法。</strong> 一个轻量视觉语言模块持续监测智能体运动学；检测到局部打转或严重轨迹偏离时，把第一人称观测转成简短的接地问题，向算法 oracle 或人类请求纠正反馈。框架与底层导航模型无关。</p>

<p><strong>证据。</strong> 论文报告在 R2R-CE、RxR-CE、VLNVerse 上对多种基础智能体都有一致提升；R2R-CE SR 66.0%，称超过当前监督式与零样本 SOTA；在 Go2 四足上做了 sim-to-real 验证。摘要未给 episode 集合、SPL、每 episode 平均提问次数，也未区分 oracle 与人类反馈各自的成绩。</p>

<p><strong>价值。</strong> 打转/偏离检测器本身不依赖外部反馈，可以单独拿来做「何时重规划 / 何时回溯」的触发器。这恰好对应上期指出的停止与恢复薄弱环节。</p>

<p><strong>局限。</strong> 纠正信息来自 oracle 或人类，属于带特权信息的设定，其 SR 与自主智能体不在同一信息条件下。SOTA 声明存在来源冲突：GPT-6-Astra 新文反推的监督式最佳为 72.1%，上期 GroundingVLN 在完整 val-unseen 上报告 69.9%，都高于 66.0%。</p>

<p><strong>建议。</strong> 读正文确认提问频次与 oracle 的具体设定；把检测器接到自有系统，做成不接人工的「自纠错」版本，量化没有外部反馈时的净收益。</p>

<h3 id="4-vnt-pa让注意力看位姿差而不是看时间顺序">4. VNT-PA：让注意力看位姿差，而不是看时间顺序</h3>

<p><strong>问题。</strong> 学习式导航策略按时间顺序编码观测历史，很难复用先前遍历同一环境时的经验；能复用经验的系统通常要先显式建图或建拓扑图，再在上面规划。</p>

<p><strong>方法。</strong> Transformer 规划器的上下文是一组按相机位姿索引的深度关键帧。以位姿作位置编码，注意力由关键帧之间的位姿差决定，与时间顺序无关。训练时模仿真值网格上的最短路径规划器；推理时只用当前位姿和目标位置去查询空间上下文。</p>

<p><strong>证据。</strong> 论文报告 HM3D 验证场景 PointNav SR 93.3%、SPL 90.4%；导航性能与训练效率都优于「把同一上下文编码为时间序列」和「把位姿当输入特征」的基线；定位噪声下的退化比基于显式地图的规划更平缓（摘要未给噪声实验的数字）。</p>

<p><strong>价值。</strong> 上下文是位姿索引的集合，测试时可以融合来自不同轨迹的帧，为「多次进入同一环境时复用经验」提供了不建显式地图的方案。它与上期 Navi-Agent 形成两端对照：一个完全依赖位姿，一个完全放弃坐标。</p>

<p><strong>局限。</strong> 任务是 PointNav（目标以坐标给出），不涉及语言；依赖位姿估计；示教来自真值网格上的最短路径，真实环境没有这种监督；上下文关键帧从何而来（预先遍历还是本回合积累）摘要未说明。</p>

<p><strong>建议。</strong> 精读关键帧上下文的构造方式；在 VLN 系统里把「已访问区域记忆」换成位姿索引的关键帧集合，做小规模验证。</p>

<h3 id="5-adahvla本期唯一给出导航侧数字的-harness-工作">5. AdaHVLA：本期唯一给出导航侧数字的 harness 工作</h3>

<p><strong>问题。</strong> VLA 擅长局部控制与指令跟随，但长程任务需要持久记忆与规划；task harness 能保留历史、跟踪阶段进度，难点在于让两者对齐。</p>

<p><strong>方法。</strong> 用机器人执行经验精化基于代码的协调策略。证据分析、harness 修订、行为评估由不同 agent 在相互隔离的上下文中完成；修订由可检验的「协调假设」驱动，再用后续 rollout 检验预期效果是否出现。状态化修订图把证据、假设、修订与观测效果连起来，保留备选 harness 与适配记忆，支持跨任务、跨环境的持续适配。</p>

<p><strong>证据。</strong> 论文报告仿真中 NaVILA-LH 平均测试成功率从 22.5% 提升到最高 57.5%；三个 VLA 骨干上的操作任务，成功率比初始 harness 最多高 30.8 点；真机部署为定性展示。NaVILA-LH 的任务构成摘要未说明；「最高」表明 57.5% 是最优配置而非均值；对照是作者自己的初始 harness，不是外部方法。</p>

<p><strong>价值。</strong> 「假设 → 修订 → rollout 检验」的闭环，与同期 <a href="https://arxiv.org/abs/2609.27612v1">RegenHarness</a> 的「固定回归检查 + 发布授权后才接受修改」，是同一问题的两种约束强度：前者靠实验检验修订，后者靠门控限制修订。RegenHarness 还明确区分「模型提议 / 控制器终止 / 已验证完成」，并指出完成与否取决于执行历史而非离终点多近——这与 GPT-6-Astra 暴露的停止问题直接相关。</p>

<p><strong>局限。</strong> 仅仿真有数字；适配需要多少次 rollout、成本多高未报；harness 修订是否会过拟合到测试任务不清楚。RegenHarness 只有真机案例，没有量化指标。</p>

<p><strong>建议。</strong> 核实 NaVILA-LH 的定义与 57.5% 对应的配置；关注修订图的数据结构，它可以直接用来组织导航系统的失败案例库。</p>

<h2 id="四可迁移方法">四、可迁移方法</h2>

<p>只收录迁移路径能说清楚的工作。</p>

<ul>
  <li><strong>VLA 记忆：<a href="https://arxiv.org/abs/2609.22854v1">SmoLSTM</a>、<a href="https://arxiv.org/abs/2609.28256v1">MemBodied</a></strong>
    <ul>
      <li>机制：固定尺寸循环状态替代历史帧堆叠。SmoLSTM 在 LIBERO-Mem 上完整任务成功率 77.5%、子目标覆盖 85.1%，可训练参数 0.04B，每步重置状态则跌到 7.0%。MemBodied 用联想状态加首帧场景锚点，RMBench 五个记忆任务上平均成功率为无状态策略的 7.81 倍、普通循环记忆的 2.98 倍。</li>
      <li>接入位置：VLN 历史编码，替代滑窗或 KV 缓存式的历史上下文。</li>
      <li>前提与风险：操作任务 episode 短，记忆需求多为遮挡与同外观物体区分；导航需要的是长程空间记忆，需另行验证。</li>
    </ul>
  </li>
  <li><strong>VLA 推理调度：<a href="https://arxiv.org/abs/2609.22587v1">React When You Need To</a></strong>
    <ul>
      <li>机制：按上次推理以来的场景变化量动态调整推理间隔，兼顾动作连贯与及时反应。</li>
      <li>接入位置：动作块执行期间的重规划触发，例如行人突然进入视野。</li>
      <li>前提与风险：证据来自操作场景，静态与动态真机设定下平均成功率 95%，比最强基线高 55 点。</li>
    </ul>
  </li>
  <li><strong>感知工具化：<a href="https://arxiv.org/abs/2609.29389v1">Robo-Harness K1</a></strong>
    <ul>
      <li>机制：把感知暴露为工具供 agent 查询；工具调用轨迹可直接训练学生模型。Qwen3.5-9B 只用 107 个教师 episode，新初始状态准确率 44.2%（OpenVLA 30.2%），留出任务条件 13.9%（OpenVLA 0.0%）。</li>
      <li>接入位置：导航 agent 的感知接口设计；与本期 MCP 导航框架、上期 AnchorVLN 同构。</li>
      <li>前提与风险：数字全部来自操作任务。</li>
    </ul>
  </li>
  <li><strong>Harness 轨迹蒸馏：<a href="https://arxiv.org/abs/2609.29964v1">World Action Agent</a>、<a href="https://arxiv.org/abs/2609.29166v1">HarnessPAI</a></strong>
    <ul>
      <li>机制：用 harness 的成功执行轨迹微调小模型。WAA 在 LIBERO-Pro 上平均成功率 75.6%，用其轨迹微调 Qwen3.5-9B 后分布外成功率从 1.7% 升到 43.3%。HarnessPAI 用收敛程序采集的专家数据，使 π0.5 在 LIBERO-PRO 上再涨 38.8 点。</li>
      <li>接入位置：把零样本 VLN harness（如 GPT-6-Astra 类系统）的成功轨迹蒸馏成可部署的小模型。</li>
      <li>前提与风险：harness 自身成功率要足够高、轨迹覆盖要足够多样；蒸馏得到的是 harness 的行为，不是更强的空间能力。</li>
    </ul>
  </li>
  <li><strong>语言标注效率：<a href="https://arxiv.org/abs/2609.27747v1">LADA</a></strong>
    <ul>
      <li>机制：先从无标注观测中学潜在动作码本，再把少量语言指令映射到码本上。不到 5% 的语言标注，Bench2Drive 闭环驾驶分 87.98、成功率 70.46%，与全监督基线持平或更高。</li>
      <li>接入位置：VLN 指令数据稀缺，可先用无标注导航轨迹学潜在动作码本。</li>
      <li>前提与风险：驾驶动作空间与室内导航差异大；Bench2Drive 是闭环仿真。</li>
    </ul>
  </li>
  <li><strong>并行假设与取证：<a href="https://arxiv.org/abs/2609.23841v1">WORLDS</a>（边界条目，空中）</strong>
    <ul>
      <li>机制：地理先验初始化的持久图，加上并行推理器保留竞争解释并主动请求证据，审查器处理观测，裁判决定选定目标或再取证一轮。CityNav 全部 5,311 个测试 episode 上 SR 51.8%，比已发表最佳高 15.7 点（OSM-only、高分辨率正射协议）；同模型同预算的 1,000 个共享 episode 上 50.0% 对 27.9%；审查器贡献 5.9 点；有四旋翼真机演示。</li>
      <li>接入位置：目标歧义大的 ObjectNav / 实例导航，先取证再定目标，替代「看到就走」。</li>
      <li>前提与风险：城市尺度空中场景，依赖地理先验地图；地面室内没有等价的先验源。</li>
    </ul>
  </li>
  <li><strong>评测设计：<a href="https://arxiv.org/abs/2609.25636v1">RoboFollow</a></strong>
    <ul>
      <li>机制：「高场景熵」原则，每个训练场景都支持多条运动学上不同的任务分支，迫使策略依赖语言；四级扰动协议分离理解与执行。</li>
      <li>接入位置：自建 VLN 评测时，检查是否存在只有一条合理路线、语言可有可无的 episode。</li>
      <li>前提与风险：证据来自操作任务，九个 VLA/WAM 在 L0 的成绩不能可靠迁移到 L1–L3。</li>
    </ul>
  </li>
</ul>

<h2 id="五分类速览">五、分类速览</h2>

<p>每条标注相关度：A 为直接研究地面导航，B 有可迁移机制，C 仅作领域观察。</p>

<h3 id="51-地面-vln--objectnav--语义导航">5.1 地面 VLN / ObjectNav / 语义导航</h3>

<ul>
  <li><strong>GPT-6-Astra Lights Up</strong>（零样本 VLN-CE · A）：见重点分析。<a href="https://arxiv.org/abs/2609.29861v1">原文</a></li>
  <li><strong>How Far Can GPT-6-Astra Go?</strong>（零样本 VLN-CE · A）：上期已分析的 v1 改题后的 v2，不计入本期新增；见重点分析。<a href="https://arxiv.org/abs/2609.20116v2">原文</a></li>
  <li><strong>SparseNav</strong>（免训练 VLN-CE · A）：见重点分析。<a href="https://arxiv.org/abs/2609.26408v1">原文</a></li>
  <li><strong>Talk2Escape</strong>（对话式纠错 VLN · A）：见重点分析。<a href="https://arxiv.org/abs/2609.28296v1">原文</a></li>
  <li><strong>VNT-PA</strong>（PointNav · A）：见重点分析。<a href="https://arxiv.org/abs/2609.21212v1">原文</a></li>
  <li><strong>NaviScale</strong>（语义地图 ObjectNav 数据 · A）：拼接 12,794 处房产的 24,000 个户型与 MP3D / HM3DSem 房间级地图，生成 19.2 万张语义地图训练补全预测器；HM3D SR 64.3% / SPL 34.8%，MP3D SR 43.1% / SPL 16.8%，另有真机部署。<a href="https://arxiv.org/abs/2609.27218v1">原文</a></li>
  <li><strong>物体-路径图</strong>（开放词表实例导航 · A）：物体-路径图统一开放词表语义推理与拓扑导航，节点间用语义视觉伺服执行，无需稠密度量重建；HM3D / Replica 与真机验证，摘要未给数字。<a href="https://arxiv.org/abs/2609.24189v1">原文</a></li>
  <li><strong>DPed-VLN</strong>（动态行人 VLN 基准 · A）：33,093 个 episode、ORCA 控制的人形行人、社会约束专家路径；LoRA 适配后 NaVILA、StreamVLN 在若干成功与安全指标上优于零样本版本，自提 DPet-RL 的 SR / SPL / STL 最高。<a href="https://arxiv.org/abs/2609.21504v1">原文</a></li>
  <li><strong>VLN 可解释性</strong>（可解释性与激活引导 · A）：策略对视觉、指令、视觉记忆均敏感而不依赖单一模态；内部编码导航进度，行为激活向量可零样本迁移到分布外真实场景并提升表现。<a href="https://arxiv.org/abs/2609.24576v1">原文</a></li>
  <li><strong>NaViRrator</strong>（地图到指令 · A）：人类可读地图上的起终点 → 地图坐标系路线骨架 → VLM 生成指令 → 交给预训练 VLN 策略执行；真机 SR / SPL 优于直接生成指令与 A* 骨架等对照，摘要未给数字。<a href="https://arxiv.org/abs/2609.21316v1">原文</a></li>
  <li><strong>Deploying FMs for Embodied Navigation</strong>（基础模型部署 · A）：TAP 用场景中挖掘的人类习惯数据做个性化目标查找（Turtlebot 真机平均 +18%）；MemCtrl 用「记忆头」主动管理上下文，多任务平均 +6%、长指令子集 +20%，上下文约为基线一半。<a href="https://arxiv.org/abs/2609.25666v1">原文</a></li>
  <li><strong>CoRelNav</strong>（多机器人关系型语义导航 · A）：任务条件化多机探索与候选驱动的协同验证耦合，跨拓扑节点聚合观测来判定空间关系；仿真优于基线，两台真机部署，摘要未给数字。<a href="https://arxiv.org/abs/2609.27720v1">原文</a></li>
  <li><strong>“Dear LLaVA, Please Drive”</strong>（VLM 导航微调 · A）：用可微几何代价场代替标注轨迹，仅由双目深度学无碰撞路径；任务专属 LoRA 更新不到 1% 参数，未见环境 SPL「有竞争力」（未给数字）。<a href="https://arxiv.org/abs/2609.22925v1">原文</a></li>
  <li><strong>MCP 导航表征层</strong>（LLM + ROS 导航 · A）：占据栅格转成带位姿的度量图像、航点级观测做语义标注，经 MCP 暴露为标准工具，不改 ROS 导航栈；仿真室内建图覆盖率超过 97%。<a href="https://arxiv.org/abs/2609.27340v1">原文</a></li>
  <li><strong>ACE</strong>（具身探索，边界条目 · A）：证据接地感知与曝光感知移动结合，缓解过早终止与过度继续的矛盾；称导航任务成功率比先前 SOTA 高 18.0%、问答探索效率高 10.3%，摘要未写基准名。<a href="https://arxiv.org/abs/2609.22385v1">原文</a></li>
  <li><strong>ReVNM</strong>（远端相机视觉导航 · B）：单个监控相机同时充当观测源与隐式地图，exo2ego 模块从远端视角预测机器人前方深度；只在随机生成的世界中训练，免微调迁移真机。<a href="https://arxiv.org/abs/2609.28976v1">原文</a></li>
</ul>

<h3 id="52-具身-agent记忆与规划">5.2 具身 Agent、记忆与规划</h3>

<ul>
  <li><strong>AdaHVLA</strong>（自适应 harness · B）：见重点分析。<a href="https://arxiv.org/abs/2609.29204v1">原文</a></li>
  <li><strong>RegenHarness</strong>（机器人 agent harness · B）：见重点分析第 5 项。<a href="https://arxiv.org/abs/2609.27612v1">原文</a></li>
  <li><strong>HarnessPAI</strong>（物理 AI harness · B）：以代码为可执行、可演化的接口，回合内按程序开环执行，回合间用反馈修订程序并沉淀技能；LIBERO-PRO 比 π0.5 高 61.6 点，RoboCasa 原子任务比 WorldDreamer 高 27.2 点；覆盖扫地机与足式平台。<a href="https://arxiv.org/abs/2609.29166v1">原文</a></li>
  <li><strong>AquaMend</strong>（信念失效恢复 · B）：在探测-信念-动作图上按期望损失在重探测、回滚、继续三者间选择；自建 32 个配对场景恢复 28 个，平均完全损失比重启低 21.6%，与决策论排障的差异经 Holm 校正不显著。<a href="https://arxiv.org/abs/2609.28973v1">原文</a></li>
  <li><strong>RoboFollow</strong>（指令跟随诊断 · B）：见第四节。<a href="https://arxiv.org/abs/2609.25636v1">原文</a></li>
  <li><strong>OmniEcho</strong>（空间音频 + 导航 · B）：OmniEchoBench 含 197 个真实空间音视频场景、2,972 个问答对、30 个真实环境中的 900 条一阶 Ambisonics 导航样本；声源引导导航「接近传统 VLN 水平」，摘要未给数字。<a href="https://arxiv.org/abs/2609.23407v2">原文</a></li>
  <li><strong>主动探索式操作</strong>（Agent 化操作 · B）：规划 / 感知 / 执行三模块加细粒度感知-执行交错，目标初始不可见时先搜索再操作；Find-and-Place 任务验证，摘要未给数字。<a href="https://arxiv.org/abs/2609.29091v1">原文</a></li>
  <li><strong>WORLDS</strong>（城市尺度语言搜索，边界条目 · B）：见第四节。<a href="https://arxiv.org/abs/2609.23841v1">原文</a></li>
  <li><strong>AquaCap</strong>（水下代码即策略 agent · C）：双层 agent 把指令与观测转成条件化计划与可执行控制程序，失败感知记忆支持闭环重规划；仿真成功率 66.43%，ROV 真机抓取与搬运。<a href="https://arxiv.org/abs/2609.23133v1">原文</a></li>
  <li><strong>CE⁴L</strong>（多视角持续学习基准 · C）：ego / exo / ego-exo 四任务持续学习基准，附参数高效的子空间路由适配器基线。<a href="https://arxiv.org/abs/2609.23492v1">原文</a></li>
  <li><strong>PUBG Ally</strong>（游戏内对话式 agent · C）：语言模型 agent 用工具读取游戏信息并驱动更快的控制层；近 3.9 万局真人同玩数据迭代训练；推荐意愿正向回答比负向高 25.1 点。<a href="https://arxiv.org/abs/2609.29837v1">原文</a></li>
  <li><strong>Listening and Mirroring</strong>（VR 共情对话 agent · C）：20 人被试内实验，言语调谐是感知共情最可靠的来源；属 VR 社交 agent，分池时被误归入具身Agent。<a href="https://arxiv.org/abs/2609.27246v1">原文</a></li>
</ul>

<h3 id="53-社会导航越野与户外">5.3 社会导航、越野与户外</h3>

<ul>
  <li><strong>PopNavShift</strong>（社会导航评测 · B）：用 LLM 为 600 个人格记录生成行人运动参数，在 8 种人群条件、7,488 次配对运行下比较三类策略；排名反转比例随指标变化（见结论第 5 条）。<a href="https://arxiv.org/abs/2609.21838v1">原文</a></li>
  <li><strong>扩散引导在线适配</strong>（社会导航 · B）：固定扩散策略、只训练噪声策略（DSRL），在部署环境微调时保住基础性能；多种子扩散 RL 策略集成为基础策略；硬件在环验证。<a href="https://arxiv.org/abs/2609.24317v1">原文</a></li>
  <li><strong>Where Should I Join?</strong>（语言引导的加入人群 · B）：递归谱划分生成候选成员子集，语言条件图像-几何模型排序，再用人群队形先验预测社会合规的加入位姿；亚秒推理，真机验证。<a href="https://arxiv.org/abs/2609.28467v1">原文</a></li>
  <li><strong>AcousticDiffusion</strong>（声源引导救援导航 · B）：麦克风阵列到达方向递归融合成 BEV 置信场，条件化扩散模型生成航点轨迹；四足真机平均方位误差 64.9°（A* 98.2°、RRT 90.4°），最终离呼救者 2.48 m（经典规划 3.96 m）。<a href="https://arxiv.org/abs/2609.21792v1">原文</a></li>
  <li><strong>Verti-WM</strong>（越野世界模型 · C）：冻结 Transformer 处理刚性地形、神经符号地面力学处理可变形地形；预测误差比纯数据 / 纯物理基线低 34.6% / 21.7%，训练计算时间省 23.6 倍；真车成功率 80%（直接 sim-to-real 40%）。<a href="https://arxiv.org/abs/2609.23118v1">原文</a></li>
  <li><strong>TravPro</strong>（越野可通行性排序 · C）：把现有标注转成区域偏好对，在冻结 VLM patch token 的原型上学偏好分数再蒸馏；五个未见域平均成对准确率 0.915（最强基线 0.783）。<a href="https://arxiv.org/abs/2609.23673v1">原文</a></li>
  <li><strong>户外 GNSS 导航栈</strong>（ROS 2 户外导航 · C）：单 GNSS-IMU / 双天线前端可换，多种控制器共用统一状态接口；葡萄园 800 次实地运行，行内混合模式平均横向误差 0.95 cm（单 GNSS+IMU）/ 0.85 cm（双天线）。<a href="https://arxiv.org/abs/2609.28933v1">原文</a></li>
  <li><strong>Planning Trajectories that Bounce</strong>（碰撞容忍规划 · C）：反射增广状态图按所用墙面序列划分路径类，受控撞墙可减少执行时间与控制量（仅仿真）。<a href="https://arxiv.org/abs/2609.27145v1">原文</a></li>
  <li><strong>BarrierFormer</strong>（安全控制 · C）：Transformer 自回归生成预测滚动以替代模型，屏障评论器沿滚动检查 CBF 约束，推理时无需在线优化。<a href="https://arxiv.org/abs/2609.23896v1">原文</a></li>
  <li><strong>ZIL</strong>（图像-点云配准 · C）：零样本非同步图像到 LiDAR 配准基础模型；7 个数据集 140 万帧训练，平移 / 旋转误差最多降低 87% / 76%。<a href="https://arxiv.org/abs/2609.22716v1">原文</a></li>
</ul>

<h3 id="54-水面水下与无人机">5.4 水面、水下与无人机</h3>

<ul>
  <li><strong>RiverVLN</strong>（无人水面艇 VLN · B）：河道连续运动下的长程 USV VLN 基准；PGT-NAV 把指令转成可视觉验证的语义阶段序列并在线维护当前阶段；Unity-ROS 闭环平均成功率 0.79，真船验证。<a href="https://arxiv.org/abs/2609.23423v1">原文</a></li>
  <li><strong>AquaWorld</strong>（水下世界生成 · C）：共享地形结构的一致性随机化；同预算策略训练验证成功率高 21%，仿真训练的视觉导航策略在实体水槽中成功 95%。<a href="https://arxiv.org/abs/2609.22670v1">原文</a></li>
  <li><strong>PhysAI-Bench</strong>（无人机 agent 决策基准 · C）：10,178 个决策实例，含 MCP 工具调用、A2A 交互与 6G 网络状态；29 个模型中 GPT-5.3 准确率最高，为 52.00%。<a href="https://arxiv.org/abs/2609.23695v1">原文</a></li>
</ul>

<h3 id="55-次池速览vla操作--自动驾驶--其他">5.5 次池速览（VLA·操作 / 自动驾驶 / 其他）</h3>

<p>次池共 84 篇（VLA·操作 81 篇，另 1 篇 AdaHVLA 因有导航侧数字移入 5.2；「其他」3 篇），不做深度分析。有迁移价值的已列入第四节。按主题归组如下：</p>

<ul>
  <li><strong>记忆与长程执行（12）</strong>：<a href="https://arxiv.org/abs/2609.22854v1">SmoLSTM</a>、<a href="https://arxiv.org/abs/2609.22684v1">StateMem</a>、<a href="https://arxiv.org/abs/2609.28256v1">MemBodied</a>、<a href="https://arxiv.org/abs/2609.23580v1">TaskAnchor</a>、<a href="https://arxiv.org/abs/2609.21908v1">CommitFlow</a>、<a href="https://arxiv.org/abs/2609.24118v1">CARE</a>、<a href="https://arxiv.org/abs/2609.22895v1">H-VLA</a>、<a href="https://arxiv.org/abs/2609.25187v1">X-Planner</a>、<a href="https://arxiv.org/abs/2609.28314v1">TANDEM</a>、<a href="https://arxiv.org/abs/2609.28431v1">LiMA</a>、<a href="https://arxiv.org/abs/2609.24124v2">ActiveArena</a>、<a href="https://arxiv.org/abs/2609.26313v1">SafeLoop</a></li>
  <li><strong>Harness 与 agent 化执行（3）</strong>：<a href="https://arxiv.org/abs/2609.29389v1">Robo-Harness K1</a>、<a href="https://arxiv.org/abs/2609.29964v1">World Action Agent</a>、<a href="https://arxiv.org/abs/2609.23578v1">AR-WAM</a></li>
  <li><strong>3D、几何与视觉表征（12）</strong>：<a href="https://arxiv.org/abs/2609.23863v1">Grounded Action Model</a>、<a href="https://arxiv.org/abs/2609.24525v1">Bridge3D</a>、<a href="https://arxiv.org/abs/2609.21948v1">GALA</a>、<a href="https://arxiv.org/abs/2609.21228v1">FOCAL-VLA</a>、<a href="https://arxiv.org/abs/2609.25558v1">HABILIS Brain 0</a>、<a href="https://arxiv.org/abs/2609.21659v2">末端几何跨策略分析</a>、<a href="https://arxiv.org/abs/2609.23944v1">拓扑视觉提示</a>、<a href="https://arxiv.org/abs/2609.28222v1">3D 视觉语言对齐-融合</a>、<a href="https://arxiv.org/abs/2609.27734v1">InfiNoVA</a>、<a href="https://arxiv.org/abs/2609.28955v1">ActGaze</a>、<a href="https://arxiv.org/abs/2609.23565v1">MaskVLA</a>、<a href="https://arxiv.org/abs/2609.21753v1">PSR</a></li>
  <li><strong>世界模型（5）</strong>：<a href="https://arxiv.org/abs/2609.22332v2">AffordanceWAM</a>、<a href="https://arxiv.org/abs/2609.24682v2">Think Like a World Model</a>、<a href="https://arxiv.org/abs/2609.24033v1">Imagine-RL</a>、<a href="https://arxiv.org/abs/2609.22879v1">Prioritized Rollouts</a>、<a href="https://arxiv.org/abs/2609.25627v1">MachEmbodied-U0</a></li>
  <li><strong>RL 后训练与在线适配（13）</strong>：<a href="https://arxiv.org/abs/2609.21650v1">SynthDemo-RL</a>、<a href="https://arxiv.org/abs/2609.22888v1">异步回放锚定在线后训练</a>、<a href="https://arxiv.org/abs/2609.27450v1">BEE</a>、<a href="https://arxiv.org/abs/2609.26467v1">RouteRLT</a>、<a href="https://arxiv.org/abs/2609.28161v1">优势引导后训练剖析</a>、<a href="https://arxiv.org/abs/2609.28838v1">不确定性门控探索噪声</a>、<a href="https://arxiv.org/abs/2609.22840v1">ForceRFT</a>、<a href="https://arxiv.org/abs/2609.21358v1">FAN</a>、<a href="https://arxiv.org/abs/2609.30092v1">Self-Adaptive VLA</a>、<a href="https://arxiv.org/abs/2609.23650v1">任务语义动作校准</a>、<a href="https://arxiv.org/abs/2609.27244v1">BNN 全协方差平滑</a>、<a href="https://arxiv.org/abs/2609.25146v1">类脑分层模块化持续学习</a>、<a href="https://arxiv.org/abs/2609.22973v1">VLA 联邦微调测试床</a></li>
  <li><strong>动作表征与推理效率（11）</strong>：<a href="https://arxiv.org/abs/2609.22335v1">KerColle</a>、<a href="https://arxiv.org/abs/2609.21022v1">Catch Me If You Can</a>、<a href="https://arxiv.org/abs/2609.21216v1">Fewer Steps, Better Actions</a>、<a href="https://arxiv.org/abs/2609.22587v1">React When You Need To</a>、<a href="https://arxiv.org/abs/2609.24433v1">FoldQuantVLA</a>、<a href="https://arxiv.org/abs/2609.25376v1">VLAQuantBench</a>、<a href="https://arxiv.org/abs/2609.29382v1">Decoupled Early Exits</a>、<a href="https://arxiv.org/abs/2609.27468v1">CereVLA</a>、<a href="https://arxiv.org/abs/2609.21817v1">动作块 VLA sim-to-real 流水线</a>、<a href="https://arxiv.org/abs/2609.25820v1">动作分词：超越重建误差</a>、<a href="https://arxiv.org/abs/2609.28865v1">方向-尺度分解动作表征</a></li>
  <li><strong>评测与安全（9）</strong>：<a href="https://arxiv.org/abs/2609.24350v1">LIBERO-VPro</a>、<a href="https://arxiv.org/abs/2609.25562v1">IndustrialVLA-Bench</a>、<a href="https://arxiv.org/abs/2609.21246v1">VLA-Scope</a>、<a href="https://arxiv.org/abs/2609.21223v1">SafeStage</a>、<a href="https://arxiv.org/abs/2609.22462v1">VLPSA</a>、<a href="https://arxiv.org/abs/2609.21220v1">噪声空间实时策略引导</a>、<a href="https://arxiv.org/abs/2609.28984v1">CrossSafe</a>、<a href="https://arxiv.org/abs/2609.26868v1">工业机械臂后门</a>、<a href="https://arxiv.org/abs/2609.23910v1">ReVeal</a></li>
  <li><strong>接触、力触觉与专用场景（13）</strong>：<a href="https://arxiv.org/abs/2609.20980v1">ForeTac-VLA</a>、<a href="https://arxiv.org/abs/2609.23614v1">CompVLA</a>、<a href="https://arxiv.org/abs/2609.23968v1">Opt2VLA</a>、<a href="https://arxiv.org/abs/2609.25785v1">VisForce</a>、<a href="https://arxiv.org/abs/2609.22606v1">VT-Bridge</a>、<a href="https://arxiv.org/abs/2609.23418v1">HEARTH</a>、<a href="https://arxiv.org/abs/2609.25606v1">CableVLA</a>、<a href="https://arxiv.org/abs/2609.26672v1">Imperfection for Precision</a>、<a href="https://arxiv.org/abs/2609.23275v1">SCULPT-VLA</a>、<a href="https://arxiv.org/abs/2609.25369v1">能力感知共享控制</a>、<a href="https://arxiv.org/abs/2609.26520v1">MATE</a>、<a href="https://arxiv.org/abs/2609.25756v1">MedVLA</a>、<a href="https://arxiv.org/abs/2609.24187v2">StenoVLA-3D（胃肠道内镜）</a></li>
  <li><strong>自动驾驶（4）</strong>：<a href="https://arxiv.org/abs/2609.22582v1">Beyond the Leaderboard</a>、<a href="https://arxiv.org/abs/2609.22040v1">PRIME</a>、<a href="https://arxiv.org/abs/2609.21712v2">ZYT-World</a>、<a href="https://arxiv.org/abs/2609.27747v1">LADA</a></li>
  <li><strong>预训练数据与通用模型（2）</strong>：<a href="https://arxiv.org/abs/2609.21461v1">AtomEgo</a>、<a href="https://arxiv.org/abs/2609.24526v2">ME-VLM</a></li>
</ul>

<h3 id="56-资讯与非论文">5.6 资讯与非论文</h3>

<p>本期无。公众号源入库 0 条。</p>

<h2 id="六趋势判断与行动建议">六、趋势判断与行动建议</h2>

<h3 id="趋势">趋势</h3>

<ul>
  <li><strong>Harness 正在变成数据引擎。</strong> 上期的 harness 工作只报系统整体指标；本期有三项工作（HarnessPAI、World Action Agent、Robo-Harness K1）把 harness 执行轨迹蒸馏回小模型，并都报告了显著提升。本报告判断：导航侧很可能出现同样的路线——先用闭源前沿模型加 harness 做高成功率的零样本系统，再把轨迹蒸馏成可部署的模型。GPT-6-Astra 的 79.0% 如果得到核实，就是这条路线的上游。</li>
  <li><strong>记忆设计从「存多少」转向「状态多大」。</strong> 导航侧的 VNT-PA、SparseNav、MemCtrl，与 VLA 侧的 SmoLSTM、MemBodied、StateMem，都在用固定或有界的表征替代增长的上下文。SmoLSTM 重置状态后从 77.5% 跌到 7.0%，MemCtrl 用一半上下文反而提升，两组证据共同说明：瓶颈不在上下文长度，在于记什么。</li>
  <li><strong>零样本 VLN-CE 的比较维度从「方法」扩展到「信息条件」。</strong> 是否使用外部纠正（Talk2Escape）、用哪个基础模型和推理档位（GPT-6-Astra）、是否免训练自主（SparseNav），已经比方法细节更能解释成绩差异。上期的问题是 episode 子集不统一，本期又叠加了信息条件不统一。</li>
  <li><strong>非视觉信号进入导航。</strong> 本期 OmniEcho（空间音频导航样本）、AcousticDiffusion（麦克风阵列引导四足）、ReVNM（远端监控相机）都让导航依赖机载视觉以外的信号源。三者都还没有与标准 VLN 基准对接。</li>
</ul>

<h3 id="研究空白">研究空白</h3>

<ul>
  <li><strong>零样本 R2R-CE 缺少信息条件的登记规范。</strong> 同一基准上已经并存 episode 子集、外部纠正、基础模型与推理档位三类未对齐的变量，没有一篇论文同时报告这三项。</li>
  <li><strong>停止与完成判定仍没有专门指标。</strong> GPT-6-Astra 作者承认 ultra 推理下目标验证仍不可靠，RegenHarness 主张完成取决于执行历史而非终点距离，上期旧文有 16.0% 的触底成功。三处都指向同一环节，但本期仍无人单独报告停止相关的指标。</li>
  <li><strong>人在回路的成本不透明。</strong> Talk2Escape 没有报告提问频次，也没有给出「SR 随干预次数变化」的曲线，因此无法判断 66.0% 需要多少人工。</li>
</ul>

<h3 id="建议动作">建议动作</h3>

<p><strong>高优先级</strong></p>

<ul>
  <li><strong>精读并核验</strong> GPT-6-Astra Lights Up：79.0% 对应的 episode 集合、各推理档位的 SR 与成本、成功是否要求主动 STOP；核验前不进入横向对比。</li>
  <li><strong>精读并复现</strong> SparseNav：复现指令条件化的感知触发，测感知调用次数与延迟的下降。</li>
  <li><strong>借鉴</strong> Talk2Escape 的打转/偏离检测器：不接人工，改为触发自身重规划或回溯，测净收益。</li>
  <li><strong>更新跟踪表</strong>：R2R-CE 登记表在「评测子集 + episode 数 + 是否零样本」之外，新增「是否用外部纠正」「基础模型与推理档位」「成功是否需主动 STOP」三项。</li>
</ul>

<p><strong>中优先级</strong></p>

<ul>
  <li><strong>精读</strong> VNT-PA：关键帧上下文的构造方式，评估能否替代自有系统中的拓扑记忆。</li>
  <li><strong>核实</strong> AdaHVLA：NaVILA-LH 的任务定义与 57.5% 对应的配置。</li>
  <li><strong>最小验证</strong>：在 VLN 历史编码处试固定尺寸循环状态（SmoLSTM / MemBodied 思路），与滑窗上下文对照。</li>
  <li><strong>跟踪</strong> DPed-VLN 基准释出情况，以及 NaVILA / StreamVLN 在动态行人下的 LoRA 适配结果。</li>
</ul>

<p><strong>低优先级</strong></p>

<ul>
  <li><strong>跟踪</strong> NaviScale 数据集是否公开。</li>
  <li><strong>暂缓</strong>次池 VLA 量化与推理加速类工作：机制可借鉴，但均未在 VLN-CE 上验证。</li>
</ul>]]></content><author><name>Tingde Liu</name></author><category term="weekly" /><category term="VLN" /><category term="VLA" /><category term="Embodied Navigation" /><category term="Embodied Agent" /><category term="Weekly Digest" /><category term="arXiv" /><summary type="html"><![CDATA[R2R-CE 零样本出现 79.0% SR 的新声明（GPT-6-Astra，Codex harness + ultra 推理），但评测集、推理成本与停止口径均未在摘要中给出；一周前同一模型在直接工作流下为 52.0%，核验前不宜与训练式方法横向比较。同一基准上的数字越来越多地出自不同信息条件：SparseNav 免训练、自主，val-unseen 42.8%；Talk2Escape 借助 oracle 或人工纠正，66.0%。具身侧 harness 开始反哺训练，World Action Agent 用 harness 轨迹微调 Qwen3.5-9B，分布外成功率从 1.7% 升到 43.3%。]]></summary></entry><entry><title type="html">VLN 综述</title><link href="https://garylee1210.github.io/VLN-Survey/" rel="alternate" type="text/html" title="VLN 综述" /><published>2026-09-26T00:00:00+00:00</published><updated>2026-09-26T00:00:00+00:00</updated><id>https://garylee1210.github.io/VLN-Survey</id><content type="html" xml:base="https://garylee1210.github.io/VLN-Survey/"><![CDATA[<blockquote>
  <p><strong>修订于 2026-09-26</strong>：本文围绕任务、机制、训练与评测组织内容；关键规模和协议链接至原始来源，跨论文分析注明证据边界。详细论文解读见 <a href="/VLN-Papers/">VLN 经典论文</a>与<a href="/VLN-Papers-Extended/">扩展篇</a>，覆盖范围见<a href="#survey-scope">第 9.4 节</a>。</p>
</blockquote>

<h2 id="阅读导航">阅读导航</h2>

<p><strong>本文回答三个问题：VLN 在解决什么任务，模型靠什么完成导航，以及怎样证明改进有效。</strong> 阅读时可沿着“任务设定 → 状态与动作接口 → 训练信号 → 闭环评测”这条线展开；数据集目录和模拟器细节适合在确定实验目标后按需查阅。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">你现在的问题</th>
      <th style="text-align: left">本文入口</th>
      <th style="text-align: left">配套论文阅读</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">指令如何变成机器人动作？</td>
      <td style="text-align: left"><a href="#survey-basics">任务与系统闭环</a></td>
      <td style="text-align: left"><a href="/VLN-Papers/#streamvln">StreamVLN</a>、<a href="/VLN-Papers/#dualvln">DualVLN</a></td>
    </tr>
    <tr>
      <td style="text-align: left">长历史应该留在上下文还是写进地图？</td>
      <td style="text-align: left"><a href="#survey-memory">地图与空间记忆</a></td>
      <td style="text-align: left"><a href="/VLN-Papers/#mapnav">MapNav</a>、<a href="/VLN-Papers/#memvln">MemVLN</a></td>
    </tr>
    <tr>
      <td style="text-align: left">架构之外，还能怎样训练策略？</td>
      <td style="text-align: left"><a href="#survey-training">数据与训练范式</a></td>
      <td style="text-align: left"><a href="/VLN-Papers/#streamvln">StreamVLN</a>、<a href="/VLN-Papers/#reflectvln">ReflectVLN</a></td>
    </tr>
    <tr>
      <td style="text-align: left">应该选什么数据与实验环境？</td>
      <td style="text-align: left"><a href="#survey-datasets">数据集</a>、<a href="#survey-simulators">模拟器</a></td>
      <td style="text-align: left">先确定观测、动作和划分，再查同设定结果</td>
    </tr>
    <tr>
      <td style="text-align: left">SR 提高是否意味着导航更好？</td>
      <td style="text-align: left"><a href="#survey-evaluation">评测体系</a></td>
      <td style="text-align: left"><a href="/VLN-Papers/">分任务性能表</a>与原论文实验协议</td>
    </tr>
    <tr>
      <td style="text-align: left">方法之间的真正差异是什么？</td>
      <td style="text-align: left"><a href="#survey-comparison">跨论文比较</a></td>
      <td style="text-align: left">按状态、接口和预算比较机制</td>
    </tr>
    <tr>
      <td style="text-align: left">哪些问题仍未解决？</td>
      <td style="text-align: left"><a href="#survey-open-questions">证据与开放问题</a></td>
      <td style="text-align: left">区分论文结论和本文研究建议</td>
    </tr>
    <tr>
      <td style="text-align: left">怎样从论文走到可复现实验？</td>
      <td style="text-align: left"><a href="#survey-practice">实验与部署流程</a></td>
      <td style="text-align: left">按论文版本固定代码、权重和数据配置</td>
    </tr>
  </tbody>
</table>

<p><strong>先记住四点</strong>：到达终点与遵循沿途指令是两种能力；连续环境与完整机器人动力学是两个层次；缓存计算状态与记忆空间经验有不同用途；模型的推理速度需要放到完整控制闭环中评估。</p>

<h1 id="1-引言">1. 引言</h1>

<p>视觉语言导航（Vision-Language Navigation, VLN）研究的是：智能体如何依据自然语言，在持续变化的第一视角观测中完成空间定位、路径决策与动作执行。它不是简单的“看图选方向”，而是一个典型的部分可观测长时序问题：智能体必须记住已经走过的区域，判断指令执行进度，在局部观测与全局目标之间反复对齐，并在偏航、遮挡或碰撞后恢复。</p>

<p>2018 年 R2R 奠定了“自然语言指令 + 真实扫描室内环境 + 未见场景泛化”的经典任务。此后，研究对象从离散全景导航扩展到连续控制、多语言指令、目标搜索、对话协作、动态人群、空中导航和真实机器人。2024 年以后，VLM/VLA 基础模型进一步改变了研究重心：问题不再只是如何设计一个任务专用策略，而是如何把通用视觉语言知识、空间记忆、高层推理和低层控制组织成一个可实时运行的具身系统。</p>

<p>截至 2026 年，更准确的判断不是“端到端模型已经取代模块化系统”，而是两者正在融合：统一模型负责获得可扩展的通用能力，结构化地图、快慢分层、技能调用和安全控制则为长时序可靠性提供约束。本文据此重新梳理 VLN 的概念边界、方法演进、基准体系与仍未解决的问题。</p>

<div align="center">
  <img src="/images/vln/vln-system-overview.jpg" width="80%" alt="视觉语言导航（VLN）具身闭环系统全景" />
  <figcaption>图 1.1：视觉语言导航（VLN）指令接地、空间记忆、拓扑建图与闭环动作决策全景示意图</figcaption>
</div>

<p><a id="survey-basics"></a></p>

<h1 id="2-vln-基本概述">2. VLN 基本概述</h1>

<p>VLN 的核心不是“看懂一句话”，而是在部分可观测环境中持续完成 <strong>语言落地、空间定位、历史记忆、动作决策和停止判断</strong>。智能体每移动一步，视觉输入和指令进度都会变化，因此导航是一个闭环过程，而不是一次性的视觉问答。</p>

<h2 id="21-任务定义语言如何变成一条可执行轨迹">2.1 任务定义：语言如何变成一条可执行轨迹</h2>

<p>给定自然语言指令 $I$，智能体在时刻 $t$ 接收当前观测 $o_t$，并结合历史状态 $h_t$ 预测动作 $a_t$：</p>

\[a_t \sim \pi(a_t \mid I, o_t, h_t)\]

<pre><code class="language-mermaid">flowchart LR
    I["自然语言指令"] --&gt; G["语言与场景对齐"]
    O["当前视觉观测"] --&gt; G
    H["历史轨迹与空间记忆"] --&gt; G
    G --&gt; D["下一步决策"]
    D --&gt; S{"是否应当停止"}
    S --&gt;|否| A["动作或局部目标"]
    A --&gt; E["环境状态变化"]
    E --&gt; O
    E --&gt; H
    S --&gt;|是| Z["结束轨迹并评估是否成功"]

    style I fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style O fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style H fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style G fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style D fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
    style A fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style Z fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
</code></pre>

<p>离散环境通常输出相邻视点或 <code class="language-plaintext highlighter-rouge">STOP</code>；连续环境则可能输出前进/转向动作、二维路点、轨迹片段或底层控制量。动作接口不同会改变感知范围、控制难度和成功条件，因此不能仅凭“都使用 R2R 指令”就直接比较结果。</p>

<h2 id="22-看懂一个-vln-基准五个必要维度">2.2 看懂一个 VLN 基准：五个必要维度</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">维度</th>
      <th style="text-align: left">需要确认的问题</th>
      <th style="text-align: left">常见设定</th>
      <th style="text-align: left">对结果的影响</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>目标表达</strong></td>
      <td style="text-align: left">智能体究竟要理解什么？</td>
      <td style="text-align: left">路线指令、目标类别、目标图像、场景描述、对话</td>
      <td style="text-align: left">决定是否需要逐步语言落地或开放词汇搜索</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>观测配置</strong></td>
      <td style="text-align: left">智能体能看到什么？</td>
      <td style="text-align: left">全景、单目、多目、RGB、RGB-D、里程计</td>
      <td style="text-align: left">决定可见范围与几何先验强度</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>动作空间</strong></td>
      <td style="text-align: left">智能体如何移动？</td>
      <td style="text-align: left">离散视点、低层动作、路点、速度、轨迹</td>
      <td style="text-align: left">决定是否真正考察避障与控制</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>环境模型</strong></td>
      <td style="text-align: left">环境是否具有物理约束？</td>
      <td style="text-align: left">导航图、可导航表面、刚体碰撞、机器人动力学</td>
      <td style="text-align: left">决定是否会碰撞、跌倒或卡住</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>交互协议</strong></td>
      <td style="text-align: left">指令能否被澄清或修正？</td>
      <td style="text-align: left">单轮、对话、主动问询、人类反馈</td>
      <td style="text-align: left">决定智能体能否消解歧义和请求帮助</td>
    </tr>
  </tbody>
</table>

<h3 id="221-vlnobjectnav-与通用-vla-的边界">2.2.1 VLN、ObjectNav 与通用 VLA 的边界</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">范式</th>
      <th style="text-align: left">主要输入</th>
      <th style="text-align: left">主要考察能力</th>
      <th style="text-align: left">典型输出</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>指令跟随 VLN</strong></td>
      <td style="text-align: left">路线级自然语言指令</td>
      <td style="text-align: left">指令进度、地标对齐、路径忠实度</td>
      <td style="text-align: left">视点、动作或路点</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>ObjectNav / ImageNav</strong></td>
      <td style="text-align: left">目标类别或目标图像</td>
      <td style="text-align: left">目标搜索、探索效率、目标定位（是否开放词汇依协议而定）</td>
      <td style="text-align: left">探索方向或局部目标</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>通用 VLA</strong></td>
      <td style="text-align: left">图像/视频、语言目标、机器人状态</td>
      <td style="text-align: left">多任务迁移与动作生成</td>
      <td style="text-align: left">动作 token、轨迹或控制量</td>
    </tr>
  </tbody>
</table>

<p>ObjectNav 可以为 VLN 提供语义探索模块，VLA 也可以成为 VLN 的策略底座，但它们的成绩不能自动并入标准 VLN 榜单。公平比较必须固定任务输入、传感器、动作接口、数据划分与额外训练数据。</p>

<h2 id="23-一个现代-vln-系统如何工作">2.3 一个现代 VLN 系统如何工作</h2>

<p>早期模型常把 VLN 描述为“视觉编码器 + 语言编码器 + 动作分类器”。2026 年更实用的系统视图是：<strong>感知提供语义与几何证据，状态层维护指令进度和空间记忆，规划层选择子目标，执行层将子目标转化为安全动作，并由真实观测持续纠偏。</strong></p>

<pre><code class="language-mermaid">flowchart TB
    subgraph input["输入与观测"]
        I["自然语言指令"]
        V["第一视角视觉流"]
        R["深度 里程计 机器人状态"]
    end

    subgraph cognition["语义与空间状态"]
        P["视觉语言感知"]
        M["拓扑图 BEV 记忆缓存"]
        T["指令进度与失败状态"]
    end

    subgraph decision["规划与决策"]
        Q["子目标分解与候选生成"]
        W["候选评估与重规划"]
    end

    subgraph control["动作与控制"]
        L["局部路点或轨迹策略"]
        C["控制器与安全约束"]
        A["机器人动作"]
    end

    I --&gt; P
    V --&gt; P
    R --&gt; M
    P --&gt; M
    P --&gt; T
    M --&gt; Q
    T --&gt; Q
    Q --&gt; W
    W --&gt; L
    L --&gt; C
    C --&gt; A
    A -.-&gt;|新观测| V
    A -.-&gt;|位姿更新| R
    C -.-&gt;|碰撞或卡住| T

    style P fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style M fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style T fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style Q fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style W fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
    style L fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style A fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
</code></pre>

<p>这张图不是要求所有方法都显式实现每个模块。端到端模型会把多个方框折叠进统一网络；双系统、地图方法和 Agent 方法则会把部分接口显式化。判断架构时，应看信息流和训练目标，而不是只看论文使用了哪个名称。</p>

<h2 id="24-vln-的核心难点">2.4 VLN 的核心难点</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">难点</th>
      <th style="text-align: left">典型失败</th>
      <th style="text-align: left">为什么难</th>
      <th style="text-align: left">需要观察的证据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>动态语言落地</strong></td>
      <td style="text-align: left">把后半句地标提前执行，或错过转向点</td>
      <td style="text-align: left">指令进度随位移变化</td>
      <td style="text-align: left">细粒度轨迹对齐、错误指令测试</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>部分可观测与长记忆</strong></td>
      <td style="text-align: left">重复探索、忘记已访问区域、无法回退</td>
      <td style="text-align: left">单帧看不到全局结构</td>
      <td style="text-align: left">长路径表现、回溯和记忆消融</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>语义推理与几何可达性</strong></td>
      <td style="text-align: left">VLM 选择语义正确但不可到达的目标</td>
      <td style="text-align: left">互联网知识不等于三维几何</td>
      <td style="text-align: left">深度/地图消融、可达性验证</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>高层规划与低层控制</strong></td>
      <td style="text-align: left">子目标正确但轨迹碰撞或振荡</td>
      <td style="text-align: left">两个时间尺度和接口误差叠加</td>
      <td style="text-align: left">控制频率、延迟、碰撞与重规划次数</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>开放世界与真实部署</strong></td>
      <td style="text-align: left">仿真成功、真机失效</td>
      <td style="text-align: left">视角、传感器、动力学和场景分布变化</td>
      <td style="text-align: left">跨场景、跨构型和真实机器人评测</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>失败检测与恢复</strong></td>
      <td style="text-align: left">到过目标附近却没有停下，偏航后持续累积错误</td>
      <td style="text-align: left">模型缺少不确定性和自我诊断</td>
      <td style="text-align: left">OSR–SR 差距、恢复成功率、人工介入次数</td>
    </tr>
  </tbody>
</table>

<h2 id="25-从任务专用模型到导航基础模型">2.5 从任务专用模型到导航基础模型</h2>

<pre><code class="language-mermaid">flowchart LR
    A["2018–2019 序列建模"] --&gt; B["2020–2021 跨模态预训练"]
    B --&gt; C["2021–2023 图规划与长历史"]
    C --&gt; D["2023–2024 VLM 与视频策略"]
    D --&gt; E["2025 快慢系统与规模化数据"]
    E --&gt; F["2026 Agent 与统一导航持续探索"]

    A1["Seq2Seq Speaker-Follower"] -.-&gt; A
    B1["PREVALENT VLN-BERT HAMT"] -.-&gt; B
    C1["DUET ETPNav ScaleVLN"] -.-&gt; C
    D1["NaVid NavGPT-2"] -.-&gt; D
    E1["StreamVLN DualVLN NavFoM OmniNav"] -.-&gt; E
    F1["AgentVLN Qwen-RobotNav NavWAM"] -.-&gt; F

    style A fill:#f8f9fa,stroke:#868e96,stroke-width:2px
    style B fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style C fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style D fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style E fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style F fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
</code></pre>

<p>这条演进线不是简单的“新模型替代旧模型”。预训练解决语义泛化，地图与记忆解决空间一致性，快慢系统解决推理和控制的时间尺度冲突，Agent 与世界模型则尝试提高主动感知、恢复和前瞻规划能力。它们正在汇合，而不是互相淘汰。</p>

<h2 id="26-研究问题地图">2.6 研究问题地图</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">研究层</th>
      <th style="text-align: left">当前常用方案</th>
      <th style="text-align: left">仍缺少的关键证据</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">表征</td>
      <td style="text-align: left">VLM 预训练、视频上下文、三维 token</td>
      <td style="text-align: left">是否真正理解沿途约束，而不是只预测终点？</td>
    </tr>
    <tr>
      <td style="text-align: left">状态</td>
      <td style="text-align: left">拓扑图、BEV、3D Gaussian、缓存与检索记忆</td>
      <td style="text-align: left">记忆错误何时发生，如何遗忘与修正？</td>
    </tr>
    <tr>
      <td style="text-align: left">规划</td>
      <td style="text-align: left">子目标分解、CoT、候选轨迹打分</td>
      <td style="text-align: left">更长的推理是否稳定改善闭环控制？</td>
    </tr>
    <tr>
      <td style="text-align: left">执行</td>
      <td style="text-align: left">路点策略、动作块、扩散轨迹、MPC</td>
      <td style="text-align: left">不同机器人形态和控制频率下能否迁移？</td>
    </tr>
    <tr>
      <td style="text-align: left">数据</td>
      <td style="text-align: left">合成轨迹、多任务联合训练、自动进度描述</td>
      <td style="text-align: left">数据量、场景多样性和标注质量谁更关键？</td>
    </tr>
    <tr>
      <td style="text-align: left">部署</td>
      <td style="text-align: left">量化、缓存、边缘推理、安全控制器</td>
      <td style="text-align: left">仿真 SR / SPL 能否预测真实可靠性？</td>
    </tr>
  </tbody>
</table>

<p><a id="27-2026-年的五个明显变化"></a></p>

<h2 id="27-近期研究的交汇点">2.7 近期研究的交汇点</h2>

<p>本文将近期工作归纳为五个可组合方向：统一策略、分层控制、空间记忆、Agent 编排与未来预测。这是帮助比较机制的分析框架，不是五个互斥类别，也不意味着这些思想都始于 2026 年。具体设计见第 3 节，证据边界见第 9.3 节。</p>

<h1 id="3-主流-vln-研究路线">3. 主流 VLN 研究路线</h1>

<p>VLN 方法不应再被简单分成“端到端”和“模块化”。更有解释力的三个观察轴是：<strong>策略是否统一训练、空间状态是否显式维护、决策与控制是否按时间尺度分层</strong>。据此，2025–2026 年的工作可以归纳为五条可组合路线。</p>

<pre><code class="language-mermaid">flowchart TB
    D["规模化导航数据与视觉语言基模"]
    I["指令 视觉 历史 机器人状态"]

    subgraph routes["五条可组合路线"]
        E["单系统端到端"]
        F["快慢双系统"]
        M["地图与空间记忆"]
        A["Agent 与自我纠错"]
        W["世界模型与想象规划"]
    end

    D --&gt; E
    D --&gt; F
    D --&gt; A
    D --&gt; W
    I --&gt; E
    I --&gt; F
    I --&gt; M
    I --&gt; A
    I --&gt; W
    M -.-&gt; E
    M -.-&gt; F
    M -.-&gt; A
    W -.-&gt; F
    A -.-&gt; F

    E --&gt; X["动作接口"]
    F --&gt; X
    M --&gt; X
    A --&gt; X
    W --&gt; X
    X --&gt; C["局部控制与安全约束"]
    C --&gt; R["真实或仿真环境"]
    R -.-&gt;|观测反馈| I

    style D fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style E fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style F fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style M fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style A fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style W fill:#f3d9fa,stroke:#862e9c,stroke-width:2px
    style X fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
    style R fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
</code></pre>

<h2 id="31-方法演进真正变化的是状态接口与训练数据">3.1 方法演进：真正变化的是状态、接口与训练数据</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">阶段</th>
      <th style="text-align: left">模型内部状态</th>
      <th style="text-align: left">典型动作接口</th>
      <th style="text-align: left">训练信号</th>
      <th style="text-align: left">代表方法</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>序列策略</strong></td>
      <td style="text-align: left">RNN 隐状态</td>
      <td style="text-align: left">离散视点 / 动作</td>
      <td style="text-align: left">行为克隆、强化学习</td>
      <td style="text-align: left">Seq2Seq、Speaker-Follower</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>预训练 Transformer</strong></td>
      <td style="text-align: left">跨模态 token 与历史特征</td>
      <td style="text-align: left">离散候选点</td>
      <td style="text-align: left">掩码建模、指令—轨迹对齐</td>
      <td style="text-align: left">PREVALENT、VLN-BERT、HAMT</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>图规划与显式记忆</strong></td>
      <td style="text-align: left">拓扑图、语义图、局部地图</td>
      <td style="text-align: left">全局节点 + 局部动作</td>
      <td style="text-align: left">图监督、路径与进度目标</td>
      <td style="text-align: left">DUET、ETPNav、MapNav</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>视频 VLM / VLA</strong></td>
      <td style="text-align: left">视频上下文、KV cache、动作 token</td>
      <td style="text-align: left">离散动作、路点或动作块</td>
      <td style="text-align: left">视觉语言数据 + 导航轨迹</td>
      <td style="text-align: left">NaVid、StreamVLN、NavFoM</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>导航基础模型</strong></td>
      <td style="text-align: left">多任务上下文、可配置观测、统一空间表征</td>
      <td style="text-align: left">多任务模式与参数化接口</td>
      <td style="text-align: left">大规模联合训练、指令微调</td>
      <td style="text-align: left">OmniNav、OneVLA、Qwen-RobotNav</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>Agent 编排</strong></td>
      <td style="text-align: left">任务进度、技能返回与经验状态</td>
      <td style="text-align: left">工具调用或子任务</td>
      <td style="text-align: left">依实现使用监督、提示或环境反馈，不必在线训练</td>
      <td style="text-align: left">AgentVLN、Qwen-RobotNav 系统</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>世界动作模型</strong></td>
      <td style="text-align: left">未来观测与动作的联合表示</td>
      <td style="text-align: left">轨迹或动作块</td>
      <td style="text-align: left">世界预测、动作及可选的进度监督</td>
      <td style="text-align: left">AstraNav-World、NavWAM（图像目标导航）</td>
    </tr>
  </tbody>
</table>

<p>现代模型的提升往往同时来自更大的基模、更多轨迹、额外深度或地图先验以及新的系统接口。阅读论文时，应把“架构创新”和“资源增加”分开归因。</p>

<h2 id="32-单系统端到端把导航变成连续的多模态生成">3.2 单系统端到端：把导航变成连续的多模态生成</h2>

<p>单系统方法把指令、视觉历史和动作历史放入统一模型，直接预测下一步动作、路点或动作块。它的优势是训练目标统一、数据扩展直接；瓶颈则是长上下文成本、空间漂移和失败难以解释。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/StreamVLN-framework-overview.webp" width="100%" alt="StreamVLN 流式端到端导航框架" />
<figcaption>StreamVLN：以交错视觉—动作序列实现流式导航，参见<a href="https://arxiv.org/abs/2507.05240v2">原论文 v2</a>。</figcaption>
</div>

<table>
  <thead>
    <tr>
      <th style="text-align: left">关键设计</th>
      <th style="text-align: left">解决的问题</th>
      <th style="text-align: left">代表工作</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">观测—动作交错生成</td>
      <td style="text-align: left">避免把整段视频压缩成一次静态判断</td>
      <td style="text-align: left"><a href="/VLN-Papers/#streamvln">StreamVLN</a>、<a href="/VLN-Papers-Extended/#sparsevideonav">SparseVideoNav</a></td>
    </tr>
    <tr>
      <td style="text-align: left">多任务共享策略</td>
      <td style="text-align: left">让指令跟随、目标搜索和探索共享空间能力</td>
      <td style="text-align: left"><a href="/VLN-Papers/#navfom">NavFoM</a>、<a href="/VLN-Papers/#onevla-a-unified-framework-for-embodied-tasks">OneVLA</a></td>
    </tr>
    <tr>
      <td style="text-align: left">可配置观测接口</td>
      <td style="text-align: left">推理时调整历史长度、相机权重和任务模式</td>
      <td style="text-align: left"><a href="/VLN-Papers/#qwen-robotnav">Qwen-RobotNav</a></td>
    </tr>
    <tr>
      <td style="text-align: left">量化与边缘部署</td>
      <td style="text-align: left">降低大模型闭环推理延迟</td>
      <td style="text-align: left"><a href="/VLN-Papers-Extended/#localnav">LocalNav</a></td>
    </tr>
  </tbody>
</table>

<p><strong>本文选型建议</strong>：数据规模充足、接口相对统一、强调端到端训练和部署简洁性。若任务涉及长程回溯、动态重规划或严格安全约束，通常仍需要外部记忆或控制模块。</p>

<h2 id="33-快慢双系统高层语义推理与高频执行解耦">3.3 快慢双系统：高层语义推理与高频执行解耦</h2>

<p>快慢系统按时间尺度分工：慢系统低频理解指令、检查进度并产生子目标；快系统持续把子目标转化为路点或轨迹。它并不等价于“使用两个模型”，关键在于两层之间是否具有稳定、可校验的接口。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/dualvln-framework-overview.webp" width="100%" alt="DualVLN 快慢双系统框架" />
<figcaption>DualVLN：慢系统提供目标与特征，快系统生成轨迹，参见<a href="https://arxiv.org/abs/2512.08186v1">原论文</a>。</figcaption>
</div>

<pre><code class="language-mermaid">flowchart LR
    I["指令与长历史"] --&gt; S2["慢系统 语义规划"]
    S2 --&gt; G["像素目标 路点 子任务"]
    O["当前视觉与机器人状态"] --&gt; S1["快系统 局部策略"]
    G --&gt; S1
    S1 --&gt; T["高频轨迹"]
    T --&gt; C["控制器与安全约束"]
    C --&gt; R["机器人执行"]
    R -.-&gt;|目标不可达或偏航| S2
    R -.-&gt;|新观测| O

    style S2 fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style G fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style S1 fill:#d3f9d8,stroke:#2f9e44,stroke-width:2px
    style C fill:#ffe3e3,stroke:#c92a2a,stroke-width:2px
    style R fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
</code></pre>

<table>
  <thead>
    <tr>
      <th style="text-align: left">系统接口</th>
      <th style="text-align: left">优点</th>
      <th style="text-align: left">主要风险</th>
      <th style="text-align: left">代表工作</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">像素目标（可结合潜在特征）</td>
      <td style="text-align: left">直观、便于视觉落地</td>
      <td style="text-align: left">深度歧义与可达性不确定</td>
      <td style="text-align: left"><a href="/VLN-Papers/#dualvln">DualVLN</a>、<a href="/VLN-Papers/#goal2pixel">Goal2Pixel</a></td>
    </tr>
    <tr>
      <td style="text-align: left">前沿或拓扑路点</td>
      <td style="text-align: left">适合全局探索与回溯</td>
      <td style="text-align: left">依赖地图质量</td>
      <td style="text-align: left"><a href="/VLN-Papers/#omninav">OmniNav</a>、<a href="/VLN-Papers/#sedualvln">SEDualVLN</a></td>
    </tr>
    <tr>
      <td style="text-align: left">共享潜在特征</td>
      <td style="text-align: left">信息密度高、可联合优化</td>
      <td style="text-align: left">可解释性和跨模型兼容性弱</td>
      <td style="text-align: left"><a href="/VLN-Papers-Extended/#hydra-nav">Hydra-Nav</a></td>
    </tr>
    <tr>
      <td style="text-align: left">指向或候选验证</td>
      <td style="text-align: left">可以结合在线强化学习</td>
      <td style="text-align: left">训练与推理系统更复杂</td>
      <td style="text-align: left"><a href="/VLN-Papers/#robostral-navigate">Robostral Navigate</a></td>
    </tr>
  </tbody>
</table>

<p><a id="survey-memory"></a></p>

<h2 id="34-地图与空间记忆让历史变成可查询的环境状态">3.4 地图与空间记忆：让历史变成可查询的环境状态</h2>

<p>VLM 能识别“厨房”和“沙发”，却不天然知道它们在三维空间中的稳定位置。地图与记忆路线把历史观测组织成拓扑图、BEV、3D Gaussian、分层场景图或混合检索库，为长程规划、回溯和错误诊断提供外部状态。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/HSGM-framework-overview.webp" width="100%" alt="HSGM 分层场景图记忆框架" />
<figcaption>HSGM：分层场景图同时维护局部观测、对象关系与全局路径状态</figcaption>
</div>

<table>
  <thead>
    <tr>
      <th style="text-align: left">表示</th>
      <th style="text-align: left">擅长解决</th>
      <th style="text-align: left">典型局限</th>
      <th style="text-align: left">代表工作</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">拓扑图</td>
      <td style="text-align: left">长距离连通关系与回溯</td>
      <td style="text-align: left">节点语义粗、依赖路点质量</td>
      <td style="text-align: left">DUET、ETPNav</td>
    </tr>
    <tr>
      <td style="text-align: left">BEV / 语义地图</td>
      <td style="text-align: left">几何可达性与局部规划</td>
      <td style="text-align: left">位姿误差会持续累积</td>
      <td style="text-align: left"><a href="/VLN-Papers/#mapnav">MapNav</a>、<a href="/VLN-Papers/#ga-vln">GA-VLN</a></td>
    </tr>
    <tr>
      <td style="text-align: left">3D Gaussian 记忆</td>
      <td style="text-align: left">可渲染的连续三维语义</td>
      <td style="text-align: left">建图成本与动态更新复杂</td>
      <td style="text-align: left"><a href="/VLN-Papers-Extended/#nav-3dgs">3DGSNav</a>、<a href="/VLN-Papers-Extended/#gsmem">GSMem</a></td>
    </tr>
    <tr>
      <td style="text-align: left">分层场景图</td>
      <td style="text-align: left">房间—对象—路径的多尺度推理</td>
      <td style="text-align: left">图构建和关系更新依赖感知质量</td>
      <td style="text-align: left"><a href="/VLN-Papers/#hsgm">HSGM</a></td>
    </tr>
    <tr>
      <td style="text-align: left">经验与图先验记忆</td>
      <td style="text-align: left">利用历史访问结果调整探索与决策</td>
      <td style="text-align: left">过时或错误经验可能放大偏差</td>
      <td style="text-align: left"><a href="/VLN-Papers-Extended/#evomemnav">EvoMemNav</a>（目标导航与多模态目标设定）</td>
    </tr>
  </tbody>
</table>

<p><strong>计算缓存与任务记忆需要区分。</strong> <a href="https://arxiv.org/abs/2603.07080">VLN-Cache</a> 通过跨帧复用 token 计算降低推理成本，并处理视角移动与任务阶段变化造成的缓存失效；它不等同于保存成功/失败经验的检索库。评估前者应观察加速与精度损失，评估后者应观察长程决策、回溯和恢复收益。</p>

<p>地图不是天然正确的“真值”。优秀系统必须同时回答如何写入、何时更新、如何处理冲突，以及何时遗忘过时信息。</p>

<p><a id="35-通用导航-agent上层规划器如何编排一个共享导航基模"></a></p>

<h2 id="35-通用导航-agent任务编排与可调用的导航能力">3.5 通用导航 Agent：任务编排与可调用的导航能力</h2>

<p>Agent 路线关注的核心是<strong>谁维护任务状态、谁选择下一项能力、执行反馈如何改变后续决策</strong>。它与快慢控制可以共存，但高层生成一段推理文本，并不足以说明系统能够编排工具或从失败中恢复。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">组织方式</th>
      <th style="text-align: left">代表设计</th>
      <th style="text-align: left">与其他路线的关系</th>
      <th style="text-align: left">应单独验证什么</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">VLM 调用感知与规划技能</td>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2603.17670">AgentVLN</a> 将高层语义推理与技能库解耦</td>
      <td style="text-align: left">可以使用拓扑记忆与局部控制</td>
      <td style="text-align: left">工具选择和纠错的收益，是否超出技能本身的收益</td>
    </tr>
    <tr>
      <td style="text-align: left">上层规划器调用共享导航基模</td>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2606.18112v3">Qwen-RobotNav</a> 提供任务模式、token 预算和相机权重等可配置接口</td>
      <td style="text-align: left">共享策略承担具体导航，上层选择模式与观测配置</td>
      <td style="text-align: left">动态配置是否优于固定配置，调用代价是否可接受</td>
    </tr>
    <tr>
      <td style="text-align: left">用访问反馈更新空间经验</td>
      <td style="text-align: left"><a href="/VLN-Papers-Extended/#evomemnav">EvoMemNav</a> 提供相邻目标导航任务中的设计参考</td>
      <td style="text-align: left">显式记忆参与探索与后续选择</td>
      <td style="text-align: left">经验有效期、错误写入、跨回合信息是否符合评测协议</td>
    </tr>
  </tbody>
</table>

<p><a id="351-通用导航-agent-的五层结构"></a></p>

<h3 id="351-基模能力与-agent-能力分别评测">3.5.1 基模能力与 Agent 能力分别评测</h3>

<p>Qwen-RobotNav 是可用于 Agent 系统的导航模型。评价时应区分底层导航成绩与加入上层编排后的系统成绩：前者反映模型及其输入配置，后者还包含任务分解、模式切换和运行时反馈。不能把整个系统的收益全部记在基模或规划器任一方上。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/Qwen-RobotNav-agentic-navigation.webp" width="100%" alt="Qwen-RobotNav 在上层规划器驱动的导航系统中的应用" />
<figcaption>Qwen-RobotNav 系统示例：导航模型通过可配置接口参与上层任务编排。具体实现见<a href="https://arxiv.org/abs/2606.18112v3">技术报告</a>。</figcaption>
</div>

<p><a id="352-qwen-robotnav-式-agentic-导航闭环"></a></p>

<h3 id="352-一个可检查的-agent-闭环">3.5.2 一个可检查的 Agent 闭环</h3>

<p>本文采用的通用分析框架是：任务状态 → 选择子任务与工具 → 执行 → 读取结果 → 更新任务状态。每个转换都应能在日志中检查：工具失败是否被识别、是否换了策略、是否重复调用无效动作、何时终止。这个框架是对系统职责的归纳，不是要求所有论文采用同一套模块。</p>

<p>下图是用于分析系统的通用闭环示意，不要求所有论文采用同名模块。关键区别在于：导航工具返回执行证据后，上层是否更新任务状态，以及失败后是否真的改变决策。</p>

<pre><code class="language-mermaid">sequenceDiagram
    participant Planner as 任务规划器
    participant Memory as 状态与记忆
    participant Navigator as 导航策略
    participant Env as 环境与执行器
    Planner-&gt;&gt;Memory: 查询已完成子任务与已探索区域
    Memory--&gt;&gt;Planner: 返回状态及其观测依据
    Planner-&gt;&gt;Navigator: 下发当前子目标与约束
    Navigator-&gt;&gt;Env: 执行动作或局部轨迹
    Env--&gt;&gt;Navigator: 新观测、位姿或执行反馈
    Navigator--&gt;&gt;Planner: 子目标进展与失败证据
    alt 证据支持子目标完成
        Planner-&gt;&gt;Memory: 记录完成状态与关键观测
    else 未完成或执行受阻
        Planner-&gt;&gt;Memory: 记录尝试与失败条件
        Planner-&gt;&gt;Navigator: 调整子目标或重试策略
    end
</code></pre>

<p>例如，“穿过走廊去厨房找杯子”至少包含到达厨房与确认杯子两个判定。检测到一个杯子不能证明房间条件已满足；输出“重新规划”也不能证明恢复有效。日志需要对应到实际观测、工具调用及之后的轨迹，才能分析失败发生在任务拆解、空间记忆还是执行层。</p>

<p><a id="353-三类-agentic-vln-设计"></a></p>

<h3 id="353-恢复能力的证据边界">3.5.3 恢复能力的证据边界</h3>

<p>建议在相同底层技能、模型和预算下，比较固定执行流程与自适应编排，并分别统计任务成功、恢复率、工具调用、延迟及人工介入。若系统以更多重试换来更高成功率，这也是有用结果，但需要同时呈现成本，才能判断是否适合部署。</p>

<h2 id="36-世界模型与世界动作模型从预测未来到利用未来">3.6 世界模型与世界动作模型：从预测未来到利用未来</h2>

<p>世界模型路线希望在执行前预测动作的后果。有的方法将预测交给外部规划器，有的方法将预测与动作联合学习，部分方法还加入目标进度或价值监督。下面的图是功能归纳，不表示每篇论文都实现了其中全部模块。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/AstraNav-World-architecture.webp" width="100%" alt="AstraNav-World 世界模型架构" />
<figcaption>AstraNav-World：联合更新未来视觉状态与动作序列，参见<a href="https://arxiv.org/abs/2512.21714v2">原论文 v2</a>。</figcaption>
</div>

<pre><code class="language-mermaid">flowchart LR
    O["当前观测与历史"] --&gt; W["世界模型"]
    G["语言或图像目标"] --&gt; W
    W --&gt; F["候选未来状态"]
    W --&gt; V["目标进度与价值"]
    F --&gt; P["动作或轨迹生成"]
    V --&gt; P
    P --&gt; R["真实环境执行"]
    R -.-&gt;|真实观测校正| W

    style W fill:#f3d9fa,stroke:#862e9c,stroke-width:2px
    style F fill:#e5dbff,stroke:#5f3dc4,stroke-width:2px
    style V fill:#fff4e6,stroke:#e67700,stroke-width:2px
    style P fill:#ffe8cc,stroke:#d9480f,stroke-width:2px
    style R fill:#c5f6fa,stroke:#0c8599,stroke-width:2px
</code></pre>

<table>
  <thead>
    <tr>
      <th style="text-align: left">方向</th>
      <th style="text-align: left">关键变化</th>
      <th style="text-align: left">代表工作</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">视觉想象辅助策略</td>
      <td style="text-align: left">生成候选未来视觉，为现有策略提供额外证据</td>
      <td style="text-align: left"><a href="/VLN-Papers/#vln-imagine">VLN-Imagine</a>、Navigation World Models</td>
    </tr>
    <tr>
      <td style="text-align: left">语言规划 + 预测</td>
      <td style="text-align: left">让指令分解约束短期与长期预测</td>
      <td style="text-align: left">NavForesee、<a href="/VLN-Papers-Extended/#worldvln">WorldVLN</a></td>
    </tr>
    <tr>
      <td style="text-align: left">视觉—动作联合生成</td>
      <td style="text-align: left">同步生成未来状态与动作，减少两阶段漂移</td>
      <td style="text-align: left"><a href="/VLN-Papers/#astranav-world">AstraNav-World</a></td>
    </tr>
    <tr>
      <td style="text-align: left">世界动作模型</td>
      <td style="text-align: left">在共享潜在序列中联合未来观测、价值和动作块</td>
      <td style="text-align: left"><a href="/VLN-Papers-Extended/#navwam">NavWAM</a>、<a href="/VLN-Papers-Extended/#wam-nav">WAM-Nav</a></td>
    </tr>
  </tbody>
</table>

<p>这一方向最容易被视觉效果误导。真正有意义的证据不是生成帧“看起来合理”，而是闭环 SR / SPL、碰撞率和真实机器人控制是否改善，以及预测误差能否被新观测及时纠正。</p>

<p><strong>任务边界</strong>：<a href="https://arxiv.org/abs/2606.13494">NavWAM</a>评估的是图像目标导航。它为预测与控制结合提供参考，不能将其结果直接并入路线指令 VLN 榜单。NWM 等视觉导航世界模型也应先核对目标条件，再讨论与语言导航的联系。</p>

<h2 id="37-五条路线如何选择">3.7 五条路线如何选择</h2>

<p>以下是基于系统职责的选型建议，不是统一条件下的性能排名。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">研究目标</th>
      <th style="text-align: left">优先路线</th>
      <th style="text-align: left">建议组合</th>
      <th style="text-align: left">重点报告</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">大规模统一训练</td>
      <td style="text-align: left">单系统端到端</td>
      <td style="text-align: left">+ 轻量缓存或隐式记忆</td>
      <td style="text-align: left">数据规模、参数量、延迟、跨任务迁移</td>
    </tr>
    <tr>
      <td style="text-align: left">真实机器人流畅控制</td>
      <td style="text-align: left">快慢双系统</td>
      <td style="text-align: left">+ 安全控制器 + 局部地图</td>
      <td style="text-align: left">控制频率、碰撞、重规划、真机成功率</td>
    </tr>
    <tr>
      <td style="text-align: left">长程导航与回溯</td>
      <td style="text-align: left">地图与空间记忆</td>
      <td style="text-align: left">+ VLM 高层规划</td>
      <td style="text-align: left">地图误差、回溯收益、长路径指标</td>
    </tr>
    <tr>
      <td style="text-align: left">开放任务与自主恢复</td>
      <td style="text-align: left">Agent 导航</td>
      <td style="text-align: left">+ 结构化记忆 + 技能库</td>
      <td style="text-align: left">调用成本、恢复率、人工介入、幻觉</td>
    </tr>
    <tr>
      <td style="text-align: left">前瞻规划与低试错</td>
      <td style="text-align: left">世界模型</td>
      <td style="text-align: left">+ 快慢系统或价值模型</td>
      <td style="text-align: left">预测误差、闭环收益、推理成本</td>
    </tr>
  </tbody>
</table>

<h3 id="371-阅读最新论文时的四个检查项">3.7.1 阅读最新论文时的四个检查项</h3>

<ol>
  <li><strong>协议是否一致</strong>：传感器、动作空间、数据划分和成功阈值是否相同？</li>
  <li><strong>资源是否一致</strong>：收益来自架构，还是更大的基模、更多数据或额外深度/地图？</li>
  <li><strong>闭环是否受益</strong>：推理、记忆或想象模块是否真正改善导航，而不只是离线指标？</li>
  <li><strong>部署代价是否透明</strong>：是否报告延迟、显存、控制频率和真实机器人测试？</li>
</ol>

<p>配套文章 <a href="/VLN-Papers/">VLN 经典论文与性能排行榜</a> 按基准分表维护指令跟随结果（R2R-CE、RxR-CE、离散 R2R / REVERIE），并标出每一行是训练式还是免训练、是否只评测了验证集子集；目标导航（ObjectNav、HM3D-OVON、图像 / 点目标）的结果放在扩展篇的<a href="/VLN-Papers-Extended/#goal-nav-leaderboard">目标导航性能排行榜</a>。两处都适合用于进一步核对同设定性能。</p>

<p><a id="survey-training"></a></p>

<h2 id="38-数据与训练范式策略如何学会导航与纠错">3.8 数据与训练范式：策略如何学会导航与纠错</h2>

<p>前面的五条路线描述系统如何组织信息，训练范式则决定模型从什么反馈中学习。两者是独立的选择：单系统和快慢系统都可以使用模仿学习、数据增强或强化学习；使用反思文本也不意味着模型在部署时会更新权重。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">训练方式</th>
      <th style="text-align: left">学习信号</th>
      <th style="text-align: left">主要用途</th>
      <th style="text-align: left">需要单独验证的风险</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">行为克隆 / 监督微调</td>
      <td style="text-align: left">专家轨迹中的观测—动作配对</td>
      <td style="text-align: left">建立指令与动作之间的基础映射</td>
      <td style="text-align: left">专家状态上的预测准确率不能说明偏航后能恢复</td>
    </tr>
    <tr>
      <td style="text-align: left">策略采样与纠错数据</td>
      <td style="text-align: left">模型实际访问状态上的专家纠正或恢复轨迹</td>
      <td style="text-align: left">覆盖训练轨迹之外的状态</td>
      <td style="text-align: left">专家是否使用部署时不可获得的地图或目标信息</td>
    </tr>
    <tr>
      <td style="text-align: left">跨模态预训练与联合训练</td>
      <td style="text-align: left">图文、视频、指令—轨迹及多任务数据</td>
      <td style="text-align: left">迁移语义知识与共享空间表征</td>
      <td style="text-align: left">数据增加与架构改动的收益是否分开比较</td>
    </tr>
    <tr>
      <td style="text-align: left">合成指令与场景扩展</td>
      <td style="text-align: left">自动生成的路径、描述和任务</td>
      <td style="text-align: left">扩大语言、场景与路径覆盖</td>
      <td style="text-align: left">指令是否可执行，是否包含歧义或场景泄漏</td>
    </tr>
    <tr>
      <td style="text-align: left">强化学习</td>
      <td style="text-align: left">到达、进度、路径成本等环境反馈</td>
      <td style="text-align: left">优化闭环行为与长期收益</td>
      <td style="text-align: left">奖励是否鼓励捷径、反复探索或不合理停止</td>
    </tr>
    <tr>
      <td style="text-align: left">辅助预测与反思监督</td>
      <td style="text-align: left">进度、几何、未来状态或错误解释</td>
      <td style="text-align: left">为策略提供中间学习信号</td>
      <td style="text-align: left">辅助任务更准是否真的带来导航改善</td>
    </tr>
  </tbody>
</table>

<p>可结合 <a href="/VLN-Papers/#streamvln">StreamVLN</a> 的训练数据组织、<a href="/VLN-Papers/#reflectvln">ReflectVLN</a> 的反思数据构建阅读本节；具体训练阶段、数据配比和监督形式以各自论文为准。</p>

<p><strong>一个贯穿训练与评测的例子</strong>：指令要求“经过沙发后左转，在第二扇门前停下”。成功轨迹可以教会模型顺序和动作，但不足以覆盖“错过左转路口”的状态。要验证纠错能力，可以在固定位置引入同等程度的偏航，检查策略能否发现进度不符、返回正确路口并继续任务，同时报告额外路径、恢复率与最终成功率。只增加成功示范或更长的推理文本，并不能直接证明这种能力。</p>

<p>建议用三个层次组织消融：先固定数据和基模比较模块，再固定架构比较数据，最后在相同硬件和推理预算下比较完整系统。若无法控制某项条件，应明确说明差异，避免把所有提升归因于一种设计。</p>

<p><a id="survey-comparison"></a></p>

<h2 id="39-跨论文比较相似名称背后的不同设计">3.9 跨论文比较：相似名称背后的不同设计</h2>

<p>以下比较依据原论文中的机制描述；“需要验证”一栏是本文提出的实验建议，不是这些论文已经完成的统一对照实验。各论文的训练数据、传感器和控制接口不同，因此本表不做总排名。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">工作</th>
      <th style="text-align: left">核心设计事实</th>
      <th style="text-align: left">与其他方法比较时的关键区别</th>
      <th style="text-align: left">需要验证的边界</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2202.11742">DUET</a></td>
      <td style="text-align: left">联合全局拓扑与局部观测决策</td>
      <td style="text-align: left">全局/局部空间尺度不等于高低频机器人控制</td>
      <td style="text-align: left">离散导航图上的收益能否迁移到自建图和连续执行</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2304.03047v3">ETPNav</a></td>
      <td style="text-align: left">在线路点拓扑建图、高层规划与避障控制</td>
      <td style="text-align: left">将图规划和连续环境执行结合</td>
      <td style="text-align: left">路点误差、地图更新与控制器分别贡献多少</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2507.05240v2">StreamVLN</a></td>
      <td style="text-align: left">流式上下文、慢更新记忆及缓存复用</td>
      <td style="text-align: left">SlowFast 主要描述上下文更新机制</td>
      <td style="text-align: left">相同历史和计算预算下，压缩是否保留关键地标</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2512.08186v1">DualVLN</a></td>
      <td style="text-align: left">VLM 产生中期目标，轻量策略利用像素目标及潜在特征生成轨迹</td>
      <td style="text-align: left">快慢分工发生在语义规划与动作执行之间</td>
      <td style="text-align: left">上层目标偏差和延迟能否被下层吸收</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2603.17670">AgentVLN</a></td>
      <td style="text-align: left">VLM 与技能库协作，并加入纠错与探索</td>
      <td style="text-align: left">显式编排感知和规划能力</td>
      <td style="text-align: left">固定技能库后，自适应编排还有多少收益</td>
    </tr>
    <tr>
      <td style="text-align: left"><a href="https://arxiv.org/abs/2412.03572v2">NWM</a></td>
      <td style="text-align: left">用动作条件的未来视觉预测支持轨迹规划或排序</td>
      <td style="text-align: left">是视觉导航世界模型，并非标准 VLN 路线指令评测的同义词</td>
      <td style="text-align: left">未来预测如何转化为语言约束下的闭环收益</td>
    </tr>
  </tbody>
</table>

<p><strong>比较一：上下文管理与控制分层解决不同瓶颈。</strong> StreamVLN 的快慢上下文主要处理历史信息与计算成本；DualVLN 的快慢系统把语义决策和局部轨迹执行分开。二者都涉及时间尺度，但并非同一个架构轴。一个系统原则上可以同时采用流式记忆与分层控制；是否值得组合，要以同预算消融验证。</p>

<p><strong>比较二：地图把历史组织为空间结构，同时引入新的误差来源。</strong> DUET 与 ETPNav 提供了全局状态参与决策的实例；从已知离散图到在线建图时，可达性与连接关系本身需要估计。因此，地图路线与隐式记忆的比较应同时报告地图输入权限和建图代价，不能把高质量深度、位姿带来的收益全部归因于表示形式。</p>

<p><strong>比较三：生成未来与选择好动作之间仍隔着一个决策问题。</strong> NWM 的预测用于规划或候选排序，而 <a href="https://arxiv.org/abs/2512.21714v2">AstraNav-World</a>探索视觉与动作联合更新。本文的判断是：这两类设计都需要证明，在固定计算预算时，预测模块比增加候选搜索或加强直接策略更有用；视觉生成质量只能作为辅助证据。</p>

<p><strong>比较四：大规模数据会改变架构比较的起点。</strong> ScaleVLN 展示了扩展训练环境与监督对既有模型的作用。因此，比较新旧方法至少要拆开“同数据的机制改进”和“完整资源条件下的系统改进”。后者也有研究价值，但支持的是系统结论，不能单独证明某个模块更优。</p>

<h1 id="4-vln-任务类型">4. VLN 任务类型</h1>

<p>任务名称相近并不意味着结果可比。第 2.2 节已经给出理解一个 VLN 基准所需的五个维度（目标表达、观测配置、动作空间、环境模型、交互协议），本节在此基础上从 <strong>推理复杂度、交互方式、动作与物理真实性</strong> 三个角度给出常用的任务分类，并标出每类的代表性基准。需要特别留意具身形态：无动力学的虚拟智能体、轮式、四足、人形与无人机在碰撞、跌倒、卡住和 6-DoF 控制上的难度完全不同，同名任务在不同具身下的结果也不应直接比较。</p>

<h2 id="41-按推理与决策复杂度划分">4.1 按推理与决策复杂度划分</h2>

<p><strong>1. 指令跟随型 VLN（Instruction-Following VLN）</strong></p>

<p>该类任务要求智能体根据给定的自然语言指令，在环境中完成从起点到目标位置的导航，不必额外执行开放目标搜索，但仍可能要求地标消歧、顺序推理与长期记忆。此类任务的重点是把沿途语言约束落到轨迹上。</p>

<p><em>代表性数据集</em>：Room-to-Room（R2R）、Room-for-Room（R4R）</p>

<hr />

<p><strong>2. 语义推理驱动的 VLN（Reasoning-Oriented VLN）</strong></p>

<p>该类任务在导航过程中引入目标物体搜索或语义约束，智能体需要将语言指令与环境中的语义信息进行推理匹配，从而完成导航与定位任务。</p>

<p><em>代表性数据集</em>：REVERIE、SOON</p>

<hr />

<p><strong>3. 长时序与组合式 VLN（Long-Horizon VLN）</strong></p>

<p>该类任务强调长距离导航和复杂指令组合，要求智能体具备长期规划、记忆和错误恢复能力，是评估 VLN 系统长期决策能力的重要设定。</p>

<p><em>代表性数据集</em>：LHPR-VLN，以及 R4R / RxR 中的长路径设定</p>

<hr />

<h2 id="42-按交互方式划分">4.2 按交互方式划分</h2>

<p><strong>1. 非交互式 VLN</strong></p>

<p>智能体在接收到初始指令后独立完成导航任务，过程中不与用户进行额外交互。这是当前最常见的 VLN 评测设定。</p>

<hr />

<p><strong>2. 交互式与对话式 VLN</strong></p>

<p>该类任务允许智能体在导航过程中与用户进行多轮交互，通过提问或反馈不断优化导航目标，更接近真实人机协作场景。</p>

<p><em>代表性数据集</em>：CVDN（须区分已有对话历史与在线问询协议）</p>

<h2 id="43-按动作与物理真实性划分">4.3 按动作与物理真实性划分</h2>

<p><strong>1. 离散全景导航</strong></p>

<p>智能体在预定义的可通行视点图上移动，通常每个节点提供 360° 全景特征。该设定弱化了局部控制与碰撞问题，适合研究语言—地标对齐、全局规划和历史建模。</p>

<p><em>代表性基准</em>：R2R、R4R、RxR、REVERIE</p>

<p><strong>2. 连续环境导航</strong></p>

<p>智能体通过前进、转向或局部路点在可导航表面运动，不再沿人工导航图“瞬移”。连续设定需要处理可通行空间和停止控制；视角限制、定位噪声与动力学是否启用，取决于具体配置。</p>

<p><em>代表性基准</em>：R2R-CE、RxR-CE；其他移植设定须注明具体实现</p>

<p><strong>3. 物理具身导航</strong></p>

<p>机器人受动力学、形态和控制频率约束，需要处理跌倒、打滑、卡住与不同相机安装位置。此类任务更接近部署，但也更难与经典 VLN 结果对齐。</p>

<p><em>代表性基准</em>：VLN-PE、VLNVerse，以及真实机器人评测</p>

<blockquote>
  <p><strong>比较原则</strong>：R2R、R2R-CE、RxR-CE、ObjectNav 与真实机器人测试必须分表报告。即使都使用 SR / SPL，它们的输入、动作空间和成功条件也可能不同。</p>
</blockquote>

<hr />

<h1 id="5-vln-的应用场景">5. VLN 的应用场景</h1>

<p>应用场景决定了传感器配置、动作空间、地图先验与安全约束，也决定了应选用哪一类数据集与模拟器。下表先给出三类场景的整体对照，随后分别展开。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">场景</th>
      <th style="text-align: left">典型平台</th>
      <th style="text-align: left">主要观测与先验</th>
      <th style="text-align: left">核心难点</th>
      <th style="text-align: left">代表基准</th>
      <th style="text-align: left">常用模拟器</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>室内</strong></td>
      <td style="text-align: left">轮式 / 四足 / 人形机器人</td>
      <td style="text-align: left">单目或全景 RGB-D、里程计</td>
      <td style="text-align: left">多房间拓扑、遮挡、家具级语义、精确停止</td>
      <td style="text-align: left">R2R / RxR / VLN-CE / REVERIE / VLN-PE</td>
      <td style="text-align: left">Matterport3D Simulator、Habitat、Isaac Sim</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>室外街景</strong></td>
      <td style="text-align: left">轮式配送机器人、辅助出行设备</td>
      <td style="text-align: left">街景全景、GPS、OpenStreetMap 地图</td>
      <td style="text-align: left">尺度大、地标稀疏且相似、动态交通与天气</td>
      <td style="text-align: left">Touchdown / StreetLearn / map2seq</td>
      <td style="text-align: left">Street View 图节点环境、CARLA（语言条件驾驶）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>空中</strong></td>
      <td style="text-align: left">多旋翼无人机</td>
      <td style="text-align: left">斜视 / 俯视 RGB、高度计、GPS</td>
      <td style="text-align: left">三维运动、高度与视角变化、地标消歧、飞行安全约束</td>
      <td style="text-align: left">AerialVLN / CityNav / OpenFly</td>
      <td style="text-align: left">AirSim、Unreal Engine、Isaac Sim</td>
    </tr>
  </tbody>
</table>

<h2 id="51-室内场景">5.1 室内场景</h2>

<p>室内 VLN 主要关注家庭、办公与公共建筑内部的导航。环境由多个房间和大量家具构成，指令通常以房间与物体作为地标（”穿过厨房，在沙发旁停下”），因此对房间级拓扑理解、物体级语义落地与精确停止能力的要求最高。室内也是数据与基准最成熟的场景：第 6 节中绝大多数数据集都建立在 Matterport3D、HM3D 等真实扫描或 ProcTHOR、GRScenes 等合成场景之上。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/vln_indoor.jpg" width="90%" alt="室内 VLN 示例：自然语言指令、第一视角观测与全局轨迹" />
<figcaption>室内 VLN：自然语言指令、第一视角观测与全局轨迹之间的关系</figcaption>
</div>

<p><strong>应用示例</strong>：家庭服务机器人、室内物流配送、医院与商场导览、四足 / 人形机器人巡检。</p>

<h2 id="52-室外场景">5.2 室外场景</h2>

<p>室外 VLN 面临更大的空间尺度与更强的环境不确定性：地标在数百米尺度上稀疏分布且外观相似，光照、天气和动态交通持续变化，GPS 与地图先验的可用性也因场景而异。Touchdown（Chen et al., CVPR 2019）研究街景中的语言导航与空间定位；StreetLearn 提供街景学习环境，本身不应等同于路线指令数据集；map2seq 则涉及地图辅助的导航指令。这一分支正与自动驾驶中的语言条件规划、户外服务机器人的语义导航逐步汇合。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/vln_outdoor.png" width="100%" alt="室外街景 VLN 示例" />
<figcaption>室外街景 VLN 示例：智能体在街景全景图节点之间依据指令移动</figcaption>
</div>

<p><strong>应用示例</strong>：园区与城市配送机器人、导盲与辅助出行、语言条件的自动驾驶规划。</p>

<h2 id="53-空中场景">5.3 空中场景</h2>

<p>空中 VLN 面向多旋翼无人机等飞行平台。与地面导航相比，它需要同时控制水平位置与高度，观测视角在俯视与斜视之间连续变化，同一地标在不同高度下的外观差异极大；飞行安全约束（禁飞区、最低高度、避障）也必须在动作层显式处理。第 6.6 节的 AerialVLN、CityNav 与 OpenFly 分别代表了仿真城市、真实航拍与多引擎大规模数据三条路线。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/vln_aerial.webp" width="100%" alt="空中 VLN 示例：无人机依据指令在城市场景中飞行" />
<figcaption>空中 VLN 示例：无人机依据自然语言指令在三维城市场景中导航</figcaption>
</div>

<p><strong>应用示例</strong>：无人机巡检与测绘、空中搜救、城市低空物流、语言指挥的航拍取景。</p>

<p><a id="survey-datasets"></a></p>

<h1 id="6-vln-主流数据集">6. VLN 主流数据集</h1>

<p>选择基准时先确定要验证的能力，再看规模。<strong>场景资产、任务数据、训练增强数据是三种不同对象</strong>：Matterport3D 提供环境，R2R 提供指令与路径，ScaleVLN 提供合成训练样本。共享环境不代表共享动作接口或评测协议。</p>

<h2 id="61-数据集对比总览">6.1 数据集对比总览</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">研究问题</th>
      <th style="text-align: left">代表基准</th>
      <th style="text-align: left">必须区分的设定</th>
      <th style="text-align: left">主要评测维度</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">路线指令跟随</td>
      <td style="text-align: left">R2R / R4R / RxR</td>
      <td style="text-align: left">短路径、组合路径、多语言</td>
      <td style="text-align: left">到达、效率、路径忠实度</td>
    </tr>
    <tr>
      <td style="text-align: left">连续环境执行</td>
      <td style="text-align: left">R2R-CE / RxR-CE</td>
      <td style="text-align: left">观测视场、低层动作或路点、滑动设置</td>
      <td style="text-align: left">到达、停止、实际行走路径</td>
    </tr>
    <tr>
      <td style="text-align: left">目标指代与搜索</td>
      <td style="text-align: left">REVERIE / SOON</td>
      <td style="text-align: left">到达目标附近与正确识别目标</td>
      <td style="text-align: left">导航成功 + 目标定位</td>
    </tr>
    <tr>
      <td style="text-align: left">长时序多子任务</td>
      <td style="text-align: left">LHPR-VLN</td>
      <td style="text-align: left">独立子任务成功与连续执行成功</td>
      <td style="text-align: left">子任务完成、错误传播</td>
    </tr>
    <tr>
      <td style="text-align: left">对话协作</td>
      <td style="text-align: left">CVDN / TEACh</td>
      <td style="text-align: left">对话历史输入与在线问答；导航与操作</td>
      <td style="text-align: left">任务进度、交互与执行</td>
    </tr>
    <tr>
      <td style="text-align: left">社交与物理约束</td>
      <td style="text-align: left">HA-VLN 2.0 / VLN-PE / VLNVerse</td>
      <td style="text-align: left">人群、形态、动力学及任务子集</td>
      <td style="text-align: left">到达 + 社交或具身失败</td>
    </tr>
    <tr>
      <td style="text-align: left">需求推理</td>
      <td style="text-align: left">DDN</td>
      <td style="text-align: left">需求满足与固定类别搜索</td>
      <td style="text-align: left">找到满足需求的物体</td>
    </tr>
    <tr>
      <td style="text-align: left">空中语言导航</td>
      <td style="text-align: left">AerialVLN / CityNav / OpenFly</td>
      <td style="text-align: left">地图输入、飞行自由度、环境来源</td>
      <td style="text-align: left">到达、三维路径、执行约束</td>
    </tr>
  </tbody>
</table>

<p>下表仅列有明确计数对象的规模。年份采用首次公开年份；会议年份另注。<strong>路径、指令、对话与 episode 不能互换</strong>，转换到连续环境后的样本数也不能直接照搬离散版本。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">数据资源</th>
      <th style="text-align: left">可核对的规模</th>
      <th style="text-align: left">统计口径与来源</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">R2R（2018）</td>
      <td style="text-align: left">7,189 条路径，21,567 条指令</td>
      <td style="text-align: left">每条路径 3 条指令；<a href="https://arxiv.org/abs/1711.07280">原论文</a></td>
    </tr>
    <tr>
      <td style="text-align: left">RxR（2020）</td>
      <td style="text-align: left">约 126k 条指令及约 126k 条跟随示范</td>
      <td style="text-align: left">英语、印地语、泰卢固语；Guide 与 Follower 分开发布；<a href="https://github.com/google-research-datasets/RxR">官方数据仓库</a></td>
    </tr>
    <tr>
      <td style="text-align: left">CVDN（2019）</td>
      <td style="text-align: left">2,000 余段对话</td>
      <td style="text-align: left">对话数不是从历史切出的导航实例数；<a href="https://arxiv.org/abs/1907.04957">原论文</a></td>
    </tr>
    <tr>
      <td style="text-align: left">TEACh（2021；AAAI 2022）</td>
      <td style="text-align: left">3,000 余段对话</td>
      <td style="text-align: left">家务任务交互对话，派生评测实例另计；<a href="https://arxiv.org/abs/2110.00534v3">论文 v3</a></td>
    </tr>
    <tr>
      <td style="text-align: left">AerialVLN（2023）</td>
      <td style="text-align: left">25 个场景，8,446 条路径，25,338 条指令</td>
      <td style="text-align: left">标准版本每路径 3 条指令；<a href="https://arxiv.org/html/2308.06735v1">原论文表 1</a></td>
    </tr>
    <tr>
      <td style="text-align: left">ScaleVLN（2023）</td>
      <td style="text-align: left">1,200 余环境，约 490 万指令—轨迹对</td>
      <td style="text-align: left">合成训练增强数据；<a href="https://arxiv.org/abs/2307.15644v2">论文 v2</a></td>
    </tr>
    <tr>
      <td style="text-align: left">LHPR-VLN（2024；CVPR 2025）</td>
      <td style="text-align: left">3,260 个任务，平均约 150 个任务步</td>
      <td style="text-align: left">“平均”不能写成所有任务的最小长度；<a href="https://arxiv.org/abs/2412.09082v3">论文 v3</a></td>
    </tr>
    <tr>
      <td style="text-align: left">CityNav（2024；ICCV 2025）</td>
      <td style="text-align: left">32,637 条人类示范轨迹</td>
      <td style="text-align: left">覆盖 Cambridge / Birmingham 两座城市；<a href="https://arxiv.org/abs/2406.14240v3">论文 v3</a></td>
    </tr>
    <tr>
      <td style="text-align: left">OpenFly（2025；ICLR 2026）</td>
      <td style="text-align: left">18 个场景，100k 条轨迹</td>
      <td style="text-align: left">多引擎数据，不能由轨迹量推出语言多样性；<a href="https://arxiv.org/abs/2502.18041v7">论文 v7</a></td>
    </tr>
    <tr>
      <td style="text-align: left">HA-VLN 2.0（2025；IROS 2026）</td>
      <td style="text-align: left">16,844 条社交情境指令</td>
      <td style="text-align: left">以版本化协议确认离散/连续子集；<a href="https://arxiv.org/abs/2503.14229v5">论文 v5</a></td>
    </tr>
    <tr>
      <td style="text-align: left">InternData-N1</td>
      <td style="text-align: left">240k 余轨迹、3,000 余场景</td>
      <td style="text-align: left">数据卡汇总口径，包含多个子集；<a href="https://huggingface.co/datasets/InternRobotics/InternData-N1">官方数据卡</a>，查阅于 2026-09-26</td>
    </tr>
  </tbody>
</table>

<h2 id="62-指令导向与连续导航数据集">6.2 指令导向与连续导航数据集</h2>

<h3 id="621-r2r-room-to-room">6.2.1 R2R (Room-to-Room)</h3>

<p>R2R 在 Matterport3D 扫描环境的导航图上，将自然语言与起终点间的参考路径配对。它适合研究地标对齐与跨场景泛化；图上的可通行边已经简化了局部避障问题，因而不能用 R2R 成功率代表机器人控制能力。参见 <a href="https://arxiv.org/abs/1711.07280">原论文</a> 与 <a href="https://github.com/peteanderson80/Matterport3DSimulator">官方模拟器</a>。</p>

<p><strong>如何理解一个样本</strong>：指令描述沿途地标和转向，参考路径由离散视点组成。智能体从初始视点与朝向出发，逐步选择相邻可达视点，最终决定停止。路径本身不是逐帧视频，同一路径的不同指令也不能当成不同建筑中的独立样本。</p>

<p><strong>研究价值与局限</strong>：R2R 适合作为语言对齐和规划方法的共同起点。解释 Val-Unseen 成绩时，应检查训练视觉特征和额外数据是否涉及测试环境；解释真实部署能力时，则需要另外验证窄视场观测、定位误差和低层执行。</p>

<details>
  <summary>展开：R2R 原始字段与数据读取要点</summary>

  <p>以下是原始任务数据中常见字段的阅读指南，具体格式以 <a href="https://github.com/peteanderson80/Matterport3DSimulator/tree/master/tasks/R2R">R2R 官方任务目录</a> 为准。</p>

  <table>
    <thead>
      <tr>
        <th style="text-align: left">字段</th>
        <th style="text-align: left">含义</th>
        <th style="text-align: left">读取时容易混淆的地方</th>
      </tr>
    </thead>
    <tbody>
      <tr>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">scan</code></td>
        <td style="text-align: left">场景标识</td>
        <td style="text-align: left">场景资产需另行获取</td>
      </tr>
      <tr>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">path_id</code></td>
        <td style="text-align: left">参考路径标识</td>
        <td style="text-align: left">不是单条语言指令的唯一标识</td>
      </tr>
      <tr>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">path</code></td>
        <td style="text-align: left">有序视点 ID 列表</td>
        <td style="text-align: left">不是三维坐标列表</td>
      </tr>
      <tr>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">heading</code></td>
        <td style="text-align: left">初始朝向</td>
        <td style="text-align: left">保留原始单位和坐标约定</td>
      </tr>
      <tr>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">instructions</code></td>
        <td style="text-align: left">同一路径的指令列表</td>
        <td style="text-align: left">训练器可能将列表展开为多个实例</td>
      </tr>
    </tbody>
  </table>

  <p>连通关系来自独立的 connectivity 数据；图像特征也是另一层输入。复现时分别固定任务标注、连通图与视觉特征版本，不应把某个模型整理后的缓存目录当成 R2R 的统一标准。</p>

</details>

<h3 id="622-r4r-room-for-room">6.2.2 R4R (Room-for-Room)</h3>

<p>R4R 拼接 R2R 路径与指令，使“按描述走完路线”和“直接到达终点”的差异更加明显。适合研究沿途约束与长路径跟随，需结合 CLS / nDTW，而不能仅报告 SR。<a href="https://arxiv.org/abs/1905.12255">原论文</a>同时提出了 CLS。</p>

<p><strong>为什么需要更长的参考路线</strong>：教学示例中，指令要求“经过餐厅，再绕回客厅”，终点却离起点很近。直接走到客厅可能获得很高的终点成功率，却没有遵循中间约束。R4R 把这种矛盾显式化：最短到达路径与语言要求的路线不一定相同。</p>

<p>分析结果时可同时记录终点成功、沿途覆盖和访问顺序。长路径还会放大错误积累，但仅增加历史窗口不足以证明模型能处理任务状态；需要观察它是否知道哪些路段已完成、哪些地标尚未经过。</p>

<h3 id="623-rxr-room-across-room">6.2.3 RxR (Room-across-Room)</h3>

<p>RxR 提供多语言指令及与观测关联的时空标注。复现时应明确语言子集、Guide / Follower 使用方式及测试划分；只在英语子集上评测，不能称为验证了多语言能力。<a href="https://github.com/google-research-datasets/RxR">官方数据与字段说明</a>。</p>

<p><strong>标注机制</strong>：Guide 描述路线，Follower 根据描述实际跟随。两者轨迹可能不同，这使数据不仅能用于模仿参考路径，也能用于分析语言歧义及人类跟随误差。词语时间信息与相机姿态提供了更细的视觉—语言对齐线索。<a href="https://github.com/google-research-datasets/RxR">官方标注说明</a>。</p>

<details>
  <summary>展开：RxR 四类数据、关联键与对齐边界</summary>

  <table>
    <thead>
      <tr>
        <th style="text-align: left">组成</th>
        <th style="text-align: left">主要用途</th>
        <th style="text-align: left">关联与检查</th>
      </tr>
    </thead>
    <tbody>
      <tr>
        <td style="text-align: left">Guide annotations</td>
        <td style="text-align: left">指令与参考路径</td>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">instruction_id</code>、<code class="language-plaintext highlighter-rouge">language</code>、<code class="language-plaintext highlighter-rouge">path</code></td>
      </tr>
      <tr>
        <td style="text-align: left">Follower annotations</td>
        <td style="text-align: left">实际跟随示范</td>
        <td style="text-align: left"><code class="language-plaintext highlighter-rouge">demonstration_id</code>；用 <code class="language-plaintext highlighter-rouge">instruction_id</code> 关联 Guide</td>
      </tr>
      <tr>
        <td style="text-align: left">Pose traces</td>
        <td style="text-align: left">相机姿态和时间序列</td>
        <td style="text-align: left">区分 Guide 与 Follower，核对时间基准</td>
      </tr>
      <tr>
        <td style="text-align: left">Text features</td>
        <td style="text-align: left">预计算语言表示</td>
        <td style="text-align: left">核对语言、分词器及特征版本</td>
      </tr>
    </tbody>
  </table>

  <p><code class="language-plaintext highlighter-rouge">timed_instruction</code> 记录词语及时间区间，但少量词没有起止时间，不能假设每个词都能直接配到图像帧。基础导航实验可只使用 Guide 标注；一旦加入 Follower、稠密对齐或合成指令，应在训练数据说明中列出。</p>

</details>

<h3 id="624-vln-ce-连续环境导航">6.2.4 VLN-CE (连续环境导航)</h3>

<p>VLN-CE 将指令导航移到 Habitat 的可导航空间中，取消沿导航图边移动的限制。<strong>连续的是环境位置，策略动作仍可采用有限集合</strong>，例如前进和转向。它增加执行难度，但并不自动包含腿足动力学。<a href="https://arxiv.org/abs/2004.02857">原论文</a>。</p>

<p>原始基线仓库推荐 <code class="language-plaintext highlighter-rouge">R2R_VLNCE_v1-3</code>，并固定了对应 Habitat 版本。论文模型若使用不同传感器、路点控制器或修改过的模拟器，必须重新检查协议；数据名称相同不足以证明实验可比。<a href="https://github.com/jacobkrantz/VLN-CE">官方实现与版本说明</a>。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/VLN-CE-comparison.webp" width="95%" alt="离散视点导航与连续空间执行的对比" />
<figcaption>离散导航在图视点间选择下一步；VLN-CE 需要在连续空间中执行移动。两者的动作与碰撞条件不同。</figcaption>
</div>

<p><strong>从“选对节点”到“走到位置”</strong>：在离散图上，一个合法邻接节点通常意味着可以直接转移；在连续环境中，即使高层选对门口，局部执行仍可能偏航、卡住或越过停止位置。因此，路点预测器、控制器和导航策略应分别记录，不能把整条系统的提升都归因于语言模型。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">层面</th>
      <th style="text-align: left">离散图导航</th>
      <th style="text-align: left">VLN-CE 常见设置</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">位置表示</td>
      <td style="text-align: left">预定义视点 ID</td>
      <td style="text-align: left">场景中的位置与朝向</td>
    </tr>
    <tr>
      <td style="text-align: left">可行动作</td>
      <td style="text-align: left">邻接节点选择、停止</td>
      <td style="text-align: left">前进、转向、停止，或经控制器执行路点</td>
    </tr>
    <tr>
      <td style="text-align: left">可通行性</td>
      <td style="text-align: left">导航图预先约束</td>
      <td style="text-align: left">受可导航表面、碰撞与滑动配置影响</td>
    </tr>
    <tr>
      <td style="text-align: left">典型额外失败</td>
      <td style="text-align: left">选错路径或停止点</td>
      <td style="text-align: left">窄门执行、局部偏差、连续动作累积误差</td>
    </tr>
  </tbody>
</table>

<details>
  <summary>展开：R2R_VLNCE_v1-3 的划分与字段示意</summary>

  <p><a href="https://jacobkrantz.github.io/vlnce/data">官方数据页</a>列出的 v1-3 基础划分为 train 10,819、val_seen 778、val_unseen 1,839、test 3,408 个 episode。预处理包中的 EnvDrop 增强集另计。v1-3 修正了初始朝向，不能仅根据同名任务混用旧版本缓存。</p>

  <p>以下为<strong>字段类型示意</strong>：场景名、文本及坐标均为教学占位值，省略词表与部分字段，不能作为可运行 episode。旋转采用该格式的 <code class="language-plaintext highlighter-rouge">[x, y, z, w]</code> 四元数表示，示例为单位旋转。</p>

  <div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="nl">"episode_id"</span><span class="p">:</span><span class="w"> </span><span class="mi">1</span><span class="p">,</span><span class="w">
  </span><span class="nl">"trajectory_id"</span><span class="p">:</span><span class="w"> </span><span class="mi">4</span><span class="p">,</span><span class="w">
  </span><span class="nl">"scene_id"</span><span class="p">:</span><span class="w"> </span><span class="s2">"mp3d/SCENE/SCENE.glb"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"instruction"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="nl">"instruction_text"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Walk forward to the doorway."</span><span class="p">},</span><span class="w">
  </span><span class="nl">"start_position"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">],</span><span class="w">
  </span><span class="nl">"start_rotation"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">1.0</span><span class="p">],</span><span class="w">
  </span><span class="nl">"goals"</span><span class="p">:</span><span class="w"> </span><span class="p">[{</span><span class="nl">"position"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">-4.0</span><span class="p">],</span><span class="w"> </span><span class="nl">"radius"</span><span class="p">:</span><span class="w"> </span><span class="mf">3.0</span><span class="p">}],</span><span class="w">
  </span><span class="nl">"reference_path"</span><span class="p">:</span><span class="w"> </span><span class="p">[[</span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">],</span><span class="w"> </span><span class="p">[</span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">0.0</span><span class="p">,</span><span class="w"> </span><span class="mf">-4.0</span><span class="p">]]</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div>  </div>

  <p><code class="language-plaintext highlighter-rouge">reference_path</code> 是三维点列表；训练/验证包的 <code class="language-plaintext highlighter-rouge">{split}_gt.json.gz</code> 另存动作和位置监督。测试集隐藏目标与参考真值，不能按训练样本的可见字段假定测试输入。<code class="language-plaintext highlighter-rouge">goals.radius</code> 也不能代替对实际成功评测器的检查。</p>

</details>

<h3 id="625-rxr-ce-多语言连续环境导航">6.2.5 RxR-CE (多语言连续环境导航)</h3>

<p>RxR 的连续环境移植随 VLN-CE 发布。RxR-Habitat 挑战赛对 RGB-D 观测和动作步长、转角作了明确限制，采用全景观测的结果不能直接当作同一挑战赛成绩。<a href="https://github.com/jacobkrantz/VLN-CE#required-task-configurations">官方挑战赛配置说明</a>。</p>

<p><strong>多语言与执行误差需要分开看</strong>：某语言上的下降可能来自语义理解，也可能来自较长路径引发的动作误差。本文建议按语言、路径长度和终点误差分组，并在相同相机与控制器下比较。若加入机器翻译或额外文本特征，应说明模型直接理解原语言，还是借助翻译系统完成导航。</p>

<h3 id="626-vln-pe-真实物理具身导航">6.2.6 VLN-PE (真实物理具身导航)</h3>

<p>VLN-PE 支持人形、四足和轮式机器人，研究相机视角、光照、碰撞和跌倒等因素造成的具身差距。这里的“真实物理”指更接近机器人约束的仿真评测，并不表示全部数据来自真机。应按机器人形态和控制器分别报告结果。<a href="https://arxiv.org/abs/2507.13019v2">论文 v2</a>。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/VLN-PE-evolution.webp" width="95%" alt="图导航、连续导航与物理具身导航的关系示意" />
<figcaption>任务约束逐步扩展：图上的决策、连续空间执行与带机器人形态的物理评测。更丰富的仿真约束仍需真机实验验证迁移效果。</figcaption>
</div>

<p><strong>物理具身带来的新变量</strong>：相同语义子目标不保证对所有机器人都可执行。相机高度会改变可见地标，机身尺寸会改变门口通过条件，运动控制器则影响跟踪和稳定性。分析时应将“理解了目的地但没有走过去”与“目标理解错误”分开。</p>

<p>本文建议保留三层日志：高层目标与路点、低层实际轨迹、碰撞或姿态异常。跨机器人比较除 SR 外，还应报告所用控制器与失效类别；若同时换了相机、控制器和策略，结果不能单独解释为形态泛化。</p>

<h3 id="627-scalevln-超大规模导航预训练增强数据集">6.2.7 ScaleVLN (超大规模导航预训练增强数据集)</h3>

<p>ScaleVLN 的作用是扩充训练覆盖，而非提供一个可与 R2R 并列排名的新任务。其结果说明扩大环境与合成监督可能显著改变既有模型表现；比较架构时需列明是否用了此类额外数据。<a href="https://arxiv.org/abs/2307.15644">原论文</a>。</p>

<p><strong>数据扩容改变了什么</strong>：更多场景有助于扩大视觉和几何覆盖，更多合成指令则增加监督样本，两种作用应分别讨论。合成语言也可能重复模板，路径采样可能偏向容易走的区域，因此“样本更多”不自动等于“任务更丰富”。</p>

<p>本文建议用相同模型比较原始数据、增加场景、增加指令和完整增强四种条件；同时报告训练步数或算力预算。这样才能判断增益主要来自数据覆盖、语言变化还是更多优化计算。</p>

<h3 id="628-interndata-n1-internvla-n1-导航预训练数据">6.2.8 InternData-N1 (InternVLA-N1 导航预训练数据)</h3>

<p>InternData-N1 将 VLN-CE、VLN-PE、VLN-N1 子集统一为 LeRobot 格式。统一存储格式便于训练，但不会消除原任务的观测、动作和成功标准差异；取用时需记录子集、筛选和采样配比。<a href="https://huggingface.co/datasets/InternRobotics/InternData-N1">官方数据卡</a>。</p>

<p><strong>统一格式之后仍需统一语义</strong>：视频、状态与动作可以共享存储接口，但不同子集的动作尺度、相机设置和机器人状态未必相同。混合训练应明确如何归一化动作、如何编码任务条件，以及如何避免大子集在采样时压过小子集。</p>

<details>
  <summary>展开：InternData-N1 子集目录与数据版本记录</summary>

  <p>下图概括<a href="https://huggingface.co/datasets/InternRobotics/InternData-N1">官方数据卡</a>中的 CE 轨迹目录，省略场景级压缩包与其他子集，不是所有版本共有的完整清单。下载前固定分支或 revision；数据卡列有 full / mini 等版本。</p>

  <div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>vln_ce/
├── raw_data/                 # 原任务标注
└── traj_data/
    └── &lt;场景数据集&gt;/&lt;场景&gt;/
        ├── data/chunk-000/   # episode 的 Parquet 数据
        ├── meta/            # info、tasks、episodes 等元数据
        └── videos/          # 按相机和模态组织的观测
</code></pre></div>  </div>

  <p>取一个 episode，先核对表格时间索引、视频帧、相机名称与动作字段能否对应，再开始批量训练。目录能读取不代表动作已被正确解释；应将一次动作解码和轨迹回放纳入数据接入检查。VLN-PE、VLN-N1 的内容与目录以各自子集说明为准。</p>

</details>

<h3 id="629-vlnverse-物理多任务统一导航基准">6.2.9 VLNVerse (物理多任务统一导航基准)</h3>

<p>VLNVerse 将多种任务、具身仿真和评测置于统一框架。它适合检查跨任务能力，但“使用同一平台”仍不等于“所有任务可合成一个 SR”。应展开各任务及各具身设置，而不是仅给总体均值。<a href="https://arxiv.org/abs/2512.19021">原论文</a>。</p>

<p><strong>统一基准应怎样读</strong>：共同平台便于复用传感器和执行器，但任务成功可能分别指到达、目标确认或多阶段完成。本文建议同时给出“任务 × 具身设置”的结果矩阵，标明哪些模型共享权重、哪些进行了任务微调。仅有综合均值时，很难判断系统是否在部分任务上失效。</p>

<h2 id="63-目标导向与长程规划数据集">6.3 目标导向与长程规划数据集</h2>

<h3 id="631-reverie-remote-embodied-visual-referring-expression-in-real-indoor-environments">6.3.1 REVERIE (Remote Embodied Visual Referring Expression in Real Indoor Environments)</h3>

<p>REVERIE 要求依据高层描述导航并识别目标物体。到达可见目标的位置与正确完成物体指代是不同结果，因此需区分导航指标与远程指代定位指标。<a href="https://arxiv.org/abs/1904.10151">原论文</a>。</p>

<p>原论文统计为 90 栋建筑中的 10,567 个全景视点、4,140 个目标物体和 21,702 条众包指令（平均 18 词）；指令通常只描述目标所在区域和物体，不逐段描述路线。导航成功要求停在能观察到目标物体的视点（物体在 3 m 内视为可见）。原论文附录用输出框与真值框 IoU ≥ 0.5 判定指代成功；后续工作通常在给定物体候选中做选择，并报告 <strong>RGS</strong>（Remote Grounding Success，选中正确目标的比例）与按路径长度加权的 <strong>RGSPL</strong>。比较 REVERIE 结果时，应确认使用的是哪种定位判据和候选来源。</p>

<p><strong>两个阶段、两类错误</strong>：以“去楼上卧室找到窗边的台灯”为教学例子，智能体先要探索到能够观察目标的位置，再从候选物体中选择符合描述的实例。抵达正确房间但选错台灯，是指代错误；一直未进入可观察区域，则需要检查搜索与导航。</p>

<p>这也解释了为什么目标检测器、候选框与物体特征属于实验设置的一部分。比较导航策略时，如果一方获得更好的目标候选，不能把最终指代成功率的全部差异都归于规划能力。</p>

<h3 id="632-reverie-ce-目标指代连续动作导航">6.3.2 REVERIE-CE (目标指代连续动作导航)</h3>

<p>REVERIE-CE 是一类连续环境移植设定的统称，目前没有找到像 VLN-CE 那样由原作者维护、固定版本与规模的统一官方协议，因此本文不给出发布年份和样本数。引用此类结果时，应直接给出论文、转换脚本、样本过滤和物体成功判据，不沿用离散 REVERIE 的统计数。</p>

<p>连续移植至少涉及三项额外工作：将离散目标映射到连续场景、明确可观察目标的位置集合、定义停止后如何提交物体预测。本文建议报告过滤了多少原始样本，以及过滤原因。未经核对的转换不能默认保持原基准的难度和目标分布。</p>

<h3 id="633-soon-scenario-oriented-object-navigation">6.3.3 SOON (Scenario Oriented Object Navigation)</h3>

<p>SOON 根据目标及周围场景描述，从不同起点搜索并定位目标。它将路径级指令跟随转为场景条件下的探索，适合研究语义搜索与图规划；所用 FAO 数据中的描述、目标与起点组合不应混算成一种样本数。<a href="https://arxiv.org/abs/2103.17138">原论文</a>。</p>

<p><strong>与路线跟随的不同</strong>：路线指令告诉智能体“怎么走”，场景描述更多告诉它“去哪里找什么”。缺少逐段路线监督时，系统必须决定先搜索哪些区域、什么时候放弃一个假设，以及如何依据新观测更新搜索方向。</p>

<p>本文建议将未找到目标区域、目标已可见但未识别、识别后停止失败分别统计。这样能区分语义先验是否有效，以及探索预算究竟花在了哪些区域。</p>

<h3 id="634-lhpr-vln-long-horizon-planning-and-reasoning-in-vln">6.3.4 LHPR-VLN (Long-Horizon Planning and Reasoning in VLN)</h3>

<p>LHPR-VLN 关注连续子任务中的规划一致性。除总体完成情况，还使用 ISR、CSR、CGT 等指标分析子任务成功与前序失败的影响。与 R4R 的区别在于，多阶段执行需要跟踪任务状态，不能只用总路径长度刻画难度。<a href="https://arxiv.org/abs/2412.09082v3">论文 v3</a>。</p>

<p><strong>长程失败会传播</strong>：若前一阶段停在错误位置，下一阶段就不再从预设状态开始；单独重置后测试每个子任务，会掩盖这种累积效应。本文建议同时保留独立子任务评测和连续执行评测，记录首次失败阶段、已完成进度与恢复开销。</p>

<p>记忆机制也应围绕任务状态验证：模型是否记住已经完成的目标，是否重复访问已排除区域，执行失败后是否错误地把子任务标为完成。这些证据比单纯展示更长的上下文窗口更能说明长程能力。</p>

<h2 id="64-对话式与社交感知导航数据集">6.4 对话式与社交感知导航数据集</h2>

<h3 id="641-cvdn-cooperative-vision-and-dialog-navigation">6.4.1 CVDN (Cooperative Vision-and-Dialog Navigation)</h3>

<p>CVDN 的人类数据采集包含 Navigator 与 Oracle 对话；其 Navigation from Dialog History 任务是依据已有对话历史继续导航。<strong>使用对话历史不等于允许模型在线向人求助</strong>，评测主动提问能力须另行明确交互协议。<a href="https://arxiv.org/abs/1907.04957">原论文</a>。</p>

<p><strong>历史理解与主动交互是两个问题</strong>：给定“刚才那个门口左转”的历史回复，模型需要把它与已走路径对齐；允许实时询问“是红色门还是白色门”，还需要设计何时提问、如何使用回答及交互代价。两种设置的输入信息不同，应分别报告结果。</p>

<p>若研究主动求助，本文建议增加提问次数、有效回答比例与每次交互后的导航改善；若只做 NDH，则重点分析历史长度、指代消解与下一段路径的完成情况。</p>

<h3 id="642-teach-task-driven-embodied-agents-that-chat">6.4.2 TEACh (Task-driven Embodied Agents that Chat)</h3>

<p>TEACh 包含对话、导航和物体交互，属于更广义的具身任务。其 EDH 等派生任务有不同输入和完成条件，应与纯导航基准分开讨论。<a href="https://arxiv.org/abs/2110.00534v3">论文 v3</a>还说明了测试集评估对象的修订。</p>

<p><strong>为什么不能只看走到哪里</strong>：教学例子“拿一个干净的杯子放到桌上”涉及物体定位、状态判断和操作后条件。智能体即使走到杯子附近，也没有完成任务。</p>

<p>EDH（Execution from Dialog History）研究从给定交互历史继续执行，TfD（Trajectory from Dialog）则依据对话推断并执行任务轨迹；两者的起始信息不同。阅读论文时要先确定评测任务，再比较任务成功与目标条件完成情况。<a href="https://arxiv.org/abs/2110.00534v3">TEACh 论文</a>。</p>

<h3 id="643-ha-vln-20-human-aware-vision-language-navigation">6.4.3 HA-VLN 2.0 (Human-Aware Vision-Language Navigation)</h3>

<p>HA-VLN 2.0 将动态多人交互与个人空间约束纳入导航评测。到达与社交合规需要同时观察，并固定人群行为及运行种子；单次成功视频不能反映多次遇人情况下的稳定性。<a href="https://arxiv.org/abs/2503.14229v5">论文 v5</a>。</p>

<p><strong>动态环境下的成功有条件</strong>：遇到行人时，等待、绕行与紧贴人群穿过可能都到达同一目标，却具有不同的社交后果。仅用 SPL 可能把合理等待或绕行表现为效率下降，因此需要与碰撞、个人空间侵犯及任务时限共同解释。</p>

<p>本文建议固定或配对运行种子，重复测试不同人群交互情形；报告成功样本中的社交违规，以及失败样本是否因超时、碰撞或迷路结束。不要仅展示最顺利的一次轨迹。</p>

<h2 id="65-需求导向与常识推理数据集">6.5 需求导向与常识推理数据集</h2>

<h3 id="651-ddn-demand-driven-navigation">6.5.1 DDN (Demand-driven Navigation)</h3>

<p>DDN 从用户需求推断满足需求的物体，例如将“我需要清洁”映射为具有合适用途的目标。原工作在 AI2-THOR / ProcTHOR 上研究这一问题，属于需求条件的目标导航；它不要求逐段遵循路线描述。<a href="https://arxiv.org/abs/2309.08138">原论文</a>。</p>

<p><strong>需求到目标存在多解</strong>：同一需求可能由多个物体满足，但可接受答案取决于任务标注和场景。教学例子“我想坐下休息”可能引出椅子或沙发，不能只凭语言常识就判定任意候选都成功。</p>

<p>本文建议把需求推断与空间搜索分开诊断：模型是否提出了可接受目标，目标是否在当前环境可用，随后是否找到并正确停止。将需求预先改写成固定物体类别再导航时，也应说明这一步使用了什么额外模型或监督。</p>

<h2 id="66-空中航拍与特殊场景数据集">6.6 空中航拍与特殊场景数据集</h2>

<h3 id="661-aerialvln-vision-and-language-navigation-for-uavs">6.6.1 AerialVLN (Vision-and-Language Navigation for UAVs)</h3>

<p>AerialVLN 使用 UE4 / AirSim 城市场景，增加高度和空间关系推理。原论文表 1 将标准任务列为 <strong>4 DoF</strong>，不应笼统称为完整 6-DoF 飞控。<a href="https://arxiv.org/html/2308.06735v1">原论文</a>。</p>

<p><strong>高度改变语言参照</strong>：“绕过楼顶再下降”同时包含水平路径和垂直关系；俯视观测中的地标尺度也随高度变化。分析模型时应说明可控自由度、相机方向和飞行步长，并检查是否依赖训练城市中特定建筑外观。</p>

<p>本文建议分开记录水平偏差、高度偏差和停止位置，不能仅凭二维地图上的投影接近目标就判断三维导航成功。</p>

<h3 id="662-citynav-language-goal-aerial-navigation-dataset-with-geographic-information">6.6.2 CityNav (Language-Goal Aerial Navigation Dataset with Geographic Information)</h3>

<p>CityNav 使用真实城市地理环境及语言配对的人类示范，研究视觉与地理信息结合的空中导航。“真实城市数据”不能直接等同于真实无人机的自主飞行测试；比较时还需说明地理信息和地图是否可用。<a href="https://arxiv.org/abs/2406.14240v3">论文 v3</a>。</p>

<p><strong>地图信息是一种额外输入</strong>：地理坐标、地图或先验位置可能显著改变搜索问题。本文建议对比视觉与语言输入、加入地理信息、加入地图的不同条件，并报告城市划分。跨城市评测更能检验空间语义能否迁移，但也需控制资产和数据重叠。</p>

<h3 id="663-openfly-a-comprehensive-platform-for-aerial-vision-language-navigation">6.6.3 OpenFly (A Comprehensive Platform for Aerial Vision-Language Navigation)</h3>

<p>OpenFly 将多种渲染引擎、自动采集工具链与空中导航基准结合。研究价值在于数据生产和环境覆盖；跨引擎泛化仍需要隔离训练与测试引擎、场景和资产来验证。<a href="https://arxiv.org/abs/2502.18041v7">论文 v7</a>。</p>

<p><strong>跨引擎不只是换画面风格</strong>：渲染、坐标系、深度定义和动作执行都可能变化。本文建议先对齐这些接口，再区分同场景换渲染、同引擎换场景和跨引擎跨场景三类实验。自动生成大量轨迹后，还应抽查语言是否描述了实际可见地标及真正执行的路线。</p>

<h2 id="67-复现时需要记录的数据口径">6.7 复现时需要记录的数据口径</h2>

<p>保留原始数据版本、场景清单、episode 数与唯一指令数、语言子集、Guide/Follower 类型，以及丢弃样本的规则。说明额外训练数据是否接触测试建筑或其衍生资产。对私有预训练数据无法确认的重叠，应标注“未披露”，不能自动视为无重叠。</p>

<p>上文将数据字段与目录说明折叠在对应基准下，方便按需查阅。下面补充跨数据集的实验记录模板；官方格式、本文示意与实际运行配置应分开保存。下载和安装命令以所用版本的官方仓库为准。</p>

<details>
  <summary>展开：实验数据与评测配置记录模板</summary>

  <p>这是<strong>本文建议的记录模板</strong>，不是 Habitat、LeRobot 或任何基准可直接加载的配置。<code class="language-plaintext highlighter-rouge">null</code> 表示待填写，不能作为实验默认值。</p>

  <div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">dataset</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">revision</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">split</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">episode_count_after_filtering</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">scene_list_hash</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">languages</span><span class="pi">:</span> <span class="pi">[]</span>
  <span class="na">extra_training_sources</span><span class="pi">:</span> <span class="pi">[]</span>
<span class="na">environment</span><span class="pi">:</span>
  <span class="na">simulator_commit</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">scene_assets_version</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">robot_and_controller</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">camera_modalities_and_fov</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">action_space_and_units</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">collision_and_sliding</span><span class="pi">:</span> <span class="kc">null</span>
<span class="na">evaluation</span><span class="pi">:</span>
  <span class="na">evaluator_commit</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">distance_definition</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">success_threshold_and_stop_rule</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">max_steps_or_time</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">trajectory_sampling</span><span class="pi">:</span> <span class="kc">null</span>
  <span class="na">seeds</span><span class="pi">:</span> <span class="pi">[]</span>
</code></pre></div>  </div>

  <p>保存过滤前后数量及原因，避免把“不支持加载”“没有可行路径”“模型执行失败”混成同一类丢弃。评测失败的 episode 应按协议计入统计，不能从结果文件中静默删除。</p>

</details>

<p><a id="survey-simulators"></a></p>

<h1 id="7-vln-主流模拟器">7. VLN 主流模拟器</h1>

<p>模拟器决定观测如何生成、动作怎样执行和成功如何判定。比较时应分别考虑<strong>渲染、碰撞、动力学、任务实现和数据资产</strong>；画面逼真或物理引擎功能丰富，都不能单独证明某个 VLN 协议更接近真实部署。</p>

<h2 id="71-matterport3d-simulator">7.1 Matterport3D Simulator</h2>

<p>以扫描全景和导航图为核心，适合复现 R2R、R4R、RxR 等离散任务。图节点之间的合法连接为策略提供了可通行性约束，不能据此评价真实机器人避障。环境安装与图像资产获取分别遵循 <a href="https://github.com/peteanderson80/Matterport3DSimulator">官方仓库</a>及数据许可。</p>

<p><strong>工作机制与优势</strong>：策略在扫描视点构成的图上观察和移动，便于固定视觉输入并复用经典基准。预计算视觉特征能将研究重点集中到语言对齐、历史建模和图搜索。</p>

<p><strong>局限与选型</strong>：视点间的转移隐藏了中间路段的控制过程；高层规划成功不代表机器人能穿过窄门或处理碰撞。若研究问题主要是离散规划，可以先用它建立基线；若关心动作误差，应在连续环境中另外验证。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/matterport3d-simulator.webp" width="95%" alt="Matterport3D Simulator 平台示例配图" />
<figcaption>Matterport3D Simulator 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="72-habitat">7.2 Habitat</h2>

<p>Habitat-Sim 提供仿真后端，Habitat-Lab 组织任务、传感器、动作和评测。经典 VLN-CE 使用其中的导航配置；平台后来支持的交互、物理或人机共存功能，并不自动存在于旧基准中。参见 <a href="https://github.com/facebookresearch/habitat-sim">Habitat-Sim</a> 与 <a href="https://github.com/facebookresearch/habitat-lab">Habitat-Lab</a>。</p>

<p>复现论文优先匹配它指定的版本。升级引擎可能改变碰撞与滑动行为；应先确认基线结果，再将升级后的实验作为单独配置报告。</p>

<p><strong>工作机制与优势</strong>：通过传感器观测、导航空间和任务评测器组成实验闭环，适合研究 RGB-D 输入、局部路点和连续空间中的指令执行。场景资产、导航网格与任务代码需要共同固定。</p>

<p><strong>局限与选型</strong>：默认导航代理不等同于完整动力学机器人。相机高度、视场、转角、步长与滑动行为会改变结果；先对齐论文配置，再讨论模型差异。新增物理或交互功能后，应把它视为新的实验条件。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/habitat-simulator.webp" width="95%" alt="Habitat 平台示例配图" />
<figcaption>Habitat 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="73-isaac-sim--isaac-lab">7.3 Isaac Sim / Isaac Lab</h2>

<p>Isaac Sim 提供机器人仿真与传感器环境，Isaac Lab 在其上提供机器人学习工作流。适合显式研究机器人形态、接触和控制，但需额外实现或接入 VLN 数据与任务。官方提供 Windows / Linux 安装路径；Python、驱动与 Isaac Sim 版本须配套。<a href="https://isaac-sim.github.io/IsaacLab/main/source/setup/installation/index.html">官方安装文档</a>。</p>

<p><strong>工作机制与优势</strong>：机器人本体、关节、接触、传感器与控制器共同决定执行结果，适合研究从导航目标到真实运动约束的衔接。可以把高层导航与底层运动控制分层分析。</p>

<p><strong>局限与选型</strong>：资产导入、碰撞体、惯性参数和控制接口都会影响结果；高质量渲染也会增加资源开销。先验证一个机器人在一个场景中的观测与动作闭环，再扩大并行环境数量；不要把物理步吞吐当作多模态系统吞吐。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/isaac-sim-simulator.webp" width="95%" alt="Isaac Sim / Isaac Lab 平台示例配图" />
<figcaption>Isaac Sim / Isaac Lab 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="74-mujoco--mjx">7.4 MuJoCo / MJX</h2>

<p>MuJoCo 适合接触动力学和控制研究；MJX 提供加速器上的批量物理计算。它们可以承载 VLN 系统的运动执行层，但不会自动提供语言指令、室内资产和导航评测器。批量物理步吞吐与包含图像渲染、VLM 推理的训练吞吐应分开测量。<a href="https://mujoco.readthedocs.io/en/stable/mjx.html">MuJoCo / MJX 文档</a>。</p>

<p><strong>工作机制与优势</strong>：显式建模运动状态和接触，适合检验局部控制器、轨迹跟踪及稳定性。对于分层 VLN，可将上层输出的目标或速度交给运动层执行，再把实际到达误差反馈给上层。</p>

<p><strong>局限与选型</strong>：要构成视觉语言导航实验，还需要场景资产、语言任务、相机观测及评测器。MJX 的批量计算收益受模型和硬件配置影响；需要单独测量物理、渲染和策略推理各部分耗时。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/mujoco-simulator.webp" width="95%" alt="MuJoCo 平台示例配图" />
<figcaption>MuJoCo 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="75-ai2-thor">7.5 AI2-THOR</h2>

<p>AI2-THOR 的重点是可交互物体和环境状态变化，适合导航与操作结合的任务。其官方 README 列出的系统要求为 macOS / Ubuntu，<strong>不能从底层 Unity 可跨平台推出 Python 仿真栈原生支持 Windows</strong>。部署以目标版本的构建与渲染后端要求为准。<a href="https://github.com/allenai/ai2thor#requirements">官方仓库</a>。</p>

<p><strong>工作机制与优势</strong>：可交互对象及其状态使“走到物体旁”和“完成操作条件”能够在同一环境中衔接。适合讨论导航、物体搜索与任务执行之间的关系。</p>

<p><strong>局限与选型</strong>：可见、可达和可交互是不同状态；靠近物体不一定满足交互前提。分析 TEACh 等任务时，应同时记录导航失败和操作失败，并固定对象状态与任务初始化，避免只用终点距离评价整个任务。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/ai2thor-simulator.webp" width="95%" alt="AI2-THOR 平台示例配图" />
<figcaption>AI2-THOR 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="76-gibson--igibson">7.6 Gibson / iGibson</h2>

<p>Gibson、iGibson 与 OmniGibson 相关但不等同：使用扫描场景资产与使用交互式物理平台是不同选择。涉及家务任务和对象状态时，应确认使用的具体平台、资产版本与行为定义；OmniGibson 的入口现位于 <a href="https://github.com/StanfordVL/BEHAVIOR-1K">BEHAVIOR-1K 项目</a>，iGibson 另见 <a href="https://github.com/StanfordVL/iGibson">官方仓库</a>。</p>

<p><strong>工作机制与优势</strong>：交互式环境允许把家具、物体和机器人接触纳入任务，适合研究导航与家务操作的联动。具体可用能力取决于使用的是 Gibson、iGibson 还是 OmniGibson。</p>

<p><strong>局限与选型</strong>：这些项目的资产、依赖和任务定义不能直接互换。先确认论文所依赖的平台，再验证物体状态与成功条件；从另一平台迁移场景时，需要重新检查碰撞和交互语义。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/igibson-simulator.webp" width="95%" alt="iGibson 平台示例配图" />
<figcaption>iGibson 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="77-airsim">7.7 AirSim</h2>

<p>AirSim 用于无人机与车辆仿真，也是部分空中 VLN 项目的底层依赖。复现时固定 Unreal / AirSim 及项目场景版本；迁移到社区分支后，需要重新验证控制接口和评测行为，不能默认为同一环境。<a href="https://github.com/microsoft/AirSim">原始仓库</a>。</p>

<p><strong>工作机制与优势</strong>：飞行状态、相机观测与动作接口能支持空中路线执行，便于检查高度变化和城市尺度导航。用于 VLN 时，语言数据和成功评测通常由上层研究工程提供。</p>

<p><strong>局限与选型</strong>：调用位姿或路点接口，与在底层控制约束下飞行，是不同难度的任务。复现时应写清是否存在瞬移、速度限制、碰撞终止及超时条件，同时固定场景地图和引擎版本。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/airsim-simulator.webp" width="95%" alt="AirSim 平台示例配图" />
<figcaption>AirSim 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="78-internutopia">7.8 InternUtopia</h2>

<p>InternUtopia 在 Isaac Sim 上组织场景、机器人与具身任务。查阅时，官方安装前提列出 Ubuntu 20.04 / 22.04 与 Isaac Sim 4.5.0；因此不能沿用 Isaac Sim 的跨平台说明，直接宣称整套 InternUtopia 支持 Windows。具体要求见 <a href="https://github.com/InternRobotics/InternUtopia#prerequisites">官方安装前提</a>（查阅于 2026-09-26）。</p>

<p><strong>工作机制与优势</strong>：在统一环境组织中接入场景、机器人与不同任务，有利于比较高层能力在多种具身设置下的表现。具体实验仍由所选任务配置与机器人控制器决定。</p>

<p><strong>局限与选型</strong>：框架支持某类任务，不表示任意机器人和场景组合都已完成评测。本文建议先运行官方最小示例，确认任务重置、观测、执行和成功判定，再移植自己的导航策略。</p>

<div align="center">
  <img loading="lazy" decoding="async" src="/images/vln/internutopia-simulator.webp" width="95%" alt="InternUtopia 平台示例配图" />
<figcaption>InternUtopia 平台示例配图，用于辅助理解平台形态；具体功能、界面及实验配置以相应官方版本为准。</figcaption>
</div>

<h2 id="79-模拟器对比">7.9 模拟器对比</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">目标</th>
      <th style="text-align: left">常见入口</th>
      <th style="text-align: left">还需补齐的部分</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">复现离散语言导航</td>
      <td style="text-align: left">Matterport3D Simulator</td>
      <td style="text-align: left">指令划分、图连接与特征版本</td>
    </tr>
    <tr>
      <td style="text-align: left">复现连续 VLN</td>
      <td style="text-align: left">Habitat + 对应 VLN-CE 实现</td>
      <td style="text-align: left">相机、动作、滑动与停止协议</td>
    </tr>
    <tr>
      <td style="text-align: left">研究多具身执行</td>
      <td style="text-align: left">Isaac Sim / Isaac Lab / InternUtopia</td>
      <td style="text-align: left">机器人控制器、形态参数、VLN 任务</td>
    </tr>
    <tr>
      <td style="text-align: left">研究局部运动与接触</td>
      <td style="text-align: left">MuJoCo / MJX</td>
      <td style="text-align: left">视觉环境、上层策略、语言评测</td>
    </tr>
    <tr>
      <td style="text-align: left">研究导航与操作</td>
      <td style="text-align: left">AI2-THOR / iGibson / OmniGibson</td>
      <td style="text-align: left">对象状态、任务完成条件与交互成本</td>
    </tr>
    <tr>
      <td style="text-align: left">复现空中 VLN</td>
      <td style="text-align: left">论文指定 AirSim 或其他引擎</td>
      <td style="text-align: left">飞行接口、城市资产、地理输入和划分</td>
    </tr>
  </tbody>
</table>

<h2 id="710-平台系统与选型建议">7.10 平台系统与选型建议</h2>

<h3 id="7101-按开发宿主操作系统windows-vs-linux选型">7.10.1 按开发宿主操作系统（Windows vs. Linux）选型</h3>

<p>先核对<strong>完整论文工程</strong>的支持平台，再核对底层引擎。Windows 用户可选择原生提供支持的 Isaac Sim / Isaac Lab；其他工程应按官方配置使用 Linux 主机、容器或经过验证的 WSL 环境。WSL 能运行 Linux 程序并不保证 EGL、Vulkan、CUDA、窗口系统和仿真资产均可直接工作。</p>

<h3 id="7102-按研究任务类型选型">7.10.2 按研究任务类型选型</h3>

<p>本文建议：复现已有结果时使用原任务环境；研究动力学时才增加机器人形态和接触模型；研究交互时增加可操作对象。每多一层仿真能力，都应明确它对应哪个研究问题，并为新增变量建立基线。不要用跨硬件、跨场景的“快/慢”标签排列平台优劣。</p>

<details>
  <summary>展开：开始大规模实验前的最小仿真检查</summary>

  <table>
    <thead>
      <tr>
        <th style="text-align: left">检查项</th>
        <th style="text-align: left">建议保存的证据</th>
        <th style="text-align: left">能排除的问题</th>
      </tr>
    </thead>
    <tbody>
      <tr>
        <td style="text-align: left">加载一个固定场景</td>
        <td style="text-align: left">场景版本与加载日志</td>
        <td style="text-align: left">资产缺失、路径错误</td>
      </tr>
      <tr>
        <td style="text-align: left">获取一帧观测</td>
        <td style="text-align: left">RGB / 深度样本和相机参数</td>
        <td style="text-align: left">相机朝向、深度单位或视场不一致</td>
      </tr>
      <tr>
        <td style="text-align: left">执行一次前进和转向</td>
        <td style="text-align: left">动作前后位姿</td>
        <td style="text-align: left">坐标轴、角度单位或动作尺度错误</td>
      </tr>
      <tr>
        <td style="text-align: left">在障碍前执行动作</td>
        <td style="text-align: left">碰撞与实际位移记录</td>
        <td style="text-align: left">滑动、穿透或接触行为不一致</td>
      </tr>
      <tr>
        <td style="text-align: left">执行一次停止</td>
        <td style="text-align: left">停止标志与评测器输出</td>
        <td style="text-align: left">将超时或接近目标误当成功</td>
      </tr>
      <tr>
        <td style="text-align: left">固定种子重复运行</td>
        <td style="text-align: left">轨迹与结果差异</td>
        <td style="text-align: left">未控制的环境或策略随机性</td>
      </tr>
    </tbody>
  </table>

  <p>吞吐测试记录硬件、并行环境数、图像分辨率、传感器数量和是否包含策略推理。实时部署还应报告端到端延迟及尾部延迟，不能用单独渲染 FPS 代替。</p>

</details>

<p><a id="survey-evaluation"></a></p>

<h1 id="8-评估指标与评测体系">8. 评估指标与评测体系</h1>

<p>一次导航至少有四个评价维度：<strong>是否完成目标、付出了多少路径成本、是否遵循指令、执行是否可靠</strong>。前三者在经典 VLN 中已有常用指标，最后一项需要结合机器人与场景补充定义。不存在一个能够替代全部维度的通用分数。</p>

<p>只盯住一个维度，策略就可能用另一个维度的退化来换分：只看 SR，可能靠大范围试探“碰”到终点；只看 SPL，可能忽略指令要求的绕行而走最短路；只看途中是否接近目标，会掩盖不会停下的问题；只在无接触仿真中评测，则看不到碰撞、跌倒与卡住。因此下面的指标应按维度成组报告。</p>

<pre><code class="language-mermaid">flowchart TB
    Q["一次导航需要回答的四个问题"]

    subgraph D1["目标达成"]
        SR["SR 终点成功率"]
        NE["NE 终点误差"]
        OSR["OSR 途中是否进入成功范围"]
    end

    subgraph D2["路径成本"]
        SPL["SPL 路径长度加权成功率"]
        TL["TL 实际轨迹长度"]
        ST["步数或耗时"]
    end

    subgraph D3["指令忠实"]
        CLS["CLS 覆盖与长度匹配"]
        NDTW["nDTW 顺序对齐"]
        SDTW["SDTW 成功加权对齐"]
    end

    subgraph D4["执行可靠"]
        CR["碰撞 环境或行人"]
        FS["跌倒与卡住 如 VLN-PE 的 FR StR"]
        HI["人工介入与端到端延迟"]
    end

    Q --&gt; D1
    Q --&gt; D2
    Q --&gt; D3
    Q --&gt; D4

    style Q fill:#e7f5ff,stroke:#1971c2,stroke-width:2px
    style D1 fill:#f1f8ff,stroke:#339af0,stroke-width:2px
    style D2 fill:#f0fbf2,stroke:#40c057,stroke-width:2px
    style D3 fill:#fff8f0,stroke:#ff922b,stroke-width:2px
    style D4 fill:#fff5f5,stroke:#fa5252,stroke-width:2px
</code></pre>

<p>前三组指标的定义在各基准间较为统一；第四组的计数单位、阈值和是否中断 episode 依基准而定，见第 8.4 节。</p>

<p><a id="81-评测体系总览与设计哲学"></a></p>

<h2 id="81-先固定评测协议再解释指标">8.1 先固定评测协议，再解释指标</h2>

<p>记录任务与划分、传感器和视场、深度/位姿/地图权限、动作接口、停止与超时规则、距离函数、成功阈值、额外训练数据以及推理预算。R2R 的导航图、Habitat 的可导航表面与空中场景不是同一种距离空间。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">想证明什么</th>
      <th style="text-align: left">至少报告</th>
      <th style="text-align: left">不能由此直接推出</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">更容易到达目标</td>
      <td style="text-align: left">SR、NE、OSR</td>
      <td style="text-align: left">是否遵循了沿途指令</td>
    </tr>
    <tr>
      <td style="text-align: left">行走更高效</td>
      <td style="text-align: left">SR、SPL、实际路径长度</td>
      <td style="text-align: left">推理更快或能耗更低</td>
    </tr>
    <tr>
      <td style="text-align: left">更忠实地执行指令</td>
      <td style="text-align: left">nDTW / SDTW，必要时 CLS</td>
      <td style="text-align: left">语言理解的全部能力</td>
    </tr>
    <tr>
      <td style="text-align: left">更准确地找到物体</td>
      <td style="text-align: left">导航指标 + 对应目标定位指标</td>
      <td style="text-align: left">一般 ObjectNav 与指代导航同等困难</td>
    </tr>
    <tr>
      <td style="text-align: left">更适合真实机器人</td>
      <td style="text-align: left">真机完成率、碰撞、介入、延迟与失败类型</td>
      <td style="text-align: left">在其他机器人和环境同样可靠</td>
    </tr>
  </tbody>
</table>

<h3 id="811-典型轨迹形态与多维指标响应矩阵">8.1.1 典型轨迹形态与多维指标响应矩阵</h3>

<p>以下是用于理解指标的示意，不是某篇论文的实验结果。设指令要求经过地标后再到终点：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">执行情况</th>
      <th style="text-align: left">SR</th>
      <th style="text-align: left">SPL</th>
      <th style="text-align: left">nDTW / CLS</th>
      <th style="text-align: left">应如何解读</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">按指令到达并正确结束</td>
      <td style="text-align: left">成功</td>
      <td style="text-align: left">取决于与最短路的差异</td>
      <td style="text-align: left">通常较高</td>
      <td style="text-align: left">完成了路径与终点要求</td>
    </tr>
    <tr>
      <td style="text-align: left">绕开地标，走捷径到达</td>
      <td style="text-align: left">仍可能成功</td>
      <td style="text-align: left">可能较高</td>
      <td style="text-align: left">通常下降</td>
      <td style="text-align: left">到达不等于路径忠实</td>
    </tr>
    <tr>
      <td style="text-align: left">反复进出多个房间后才到达</td>
      <td style="text-align: left">仍可能成功</td>
      <td style="text-align: left">明显偏低</td>
      <td style="text-align: left">通常下降</td>
      <td style="text-align: left">成功可能由过量探索换来，需结合 TL 看代价</td>
    </tr>
    <tr>
      <td style="text-align: left">遵循大部分路线但终点失败</td>
      <td style="text-align: left">失败</td>
      <td style="text-align: left">为 0</td>
      <td style="text-align: left">仍可能较高</td>
      <td style="text-align: left">路径相似不等于完成；SDTW 为 0</td>
    </tr>
    <tr>
      <td style="text-align: left">路过目标后继续远离</td>
      <td style="text-align: left">可能失败</td>
      <td style="text-align: left">失败时为 0</td>
      <td style="text-align: left">依轨迹而定</td>
      <td style="text-align: left">OSR 与 SR 的差距提示检查停止与执行</td>
    </tr>
  </tbody>
</table>

<p><a id="812-场景化指标选型决策树"></a></p>

<h3 id="812-场景化指标选型">8.1.2 场景化指标选型</h3>

<p>路线跟随优先同时看终点和路径；目标搜索优先看搜索成功与目标验证；对话任务还需说明是否允许主动提问；物理机器人需额外报告执行失败。不同任务的成功判据应沿用各自官方定义，不能把“离终点 3 米”套用于全部 VLN。</p>

<p>下图帮助确定指标组合。分支可以同时成立，例如物理环境中的指代导航既需要目标识别，也需要执行安全评测。</p>

<pre><code class="language-mermaid">flowchart TB
    Q["任务要求验证什么能力？"]
    Q --&gt; G["到达指定位置"]
    Q --&gt; R["遵循沿途路线"]
    Q --&gt; O["识别或操作目标"]
    Q --&gt; E["物理与社交执行"]
    G --&gt; GM["SR、NE、OSR&lt;br/&gt;结合 SPL 看行走效率"]
    R --&gt; RM["CLS 看软覆盖&lt;br/&gt;nDTW / SDTW 看顺序对齐"]
    O --&gt; OM["导航结果 + 目标定位&lt;br/&gt;或任务后条件完成"]
    E --&gt; EM["到达 + 碰撞 / 跌倒 / 违规&lt;br/&gt;结合时间与控制延迟"]
    classDef metric fill:#e8f1fb,stroke:#426a91,color:#18354f;
    class GM,RM,OM,EM metric;
</code></pre>

<p>选完指标后，还要保存逐 episode 结果。总体均值可能掩盖长路径、多语言、特定机器人或特定失败条件下的显著退化。</p>

<h3 id="813-核心评估指标全景矩阵">8.1.3 核心评估指标全景矩阵</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">指标</th>
      <th style="text-align: left">主要问题</th>
      <th style="text-align: left">方向</th>
      <th style="text-align: left">关键限制</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">SR</td>
      <td style="text-align: left">最终是否成功</td>
      <td style="text-align: left">↑</td>
      <td style="text-align: left">成功条件依任务而定</td>
    </tr>
    <tr>
      <td style="text-align: left">NE</td>
      <td style="text-align: left">停止时距离目标多远</td>
      <td style="text-align: left">↓，通常为米</td>
      <td style="text-align: left">必须说明距离函数</td>
    </tr>
    <tr>
      <td style="text-align: left">OSR</td>
      <td style="text-align: left">途中是否曾进入目标成功范围</td>
      <td style="text-align: left">↑</td>
      <td style="text-align: left">是到达机会的诊断量，不是可实现策略的保证</td>
    </tr>
    <tr>
      <td style="text-align: left">SPL</td>
      <td style="text-align: left">成功时路径是否高效</td>
      <td style="text-align: left">↑，0–1 或百分数</td>
      <td style="text-align: left">最短路效率不等于指令忠实度</td>
    </tr>
    <tr>
      <td style="text-align: left">CLS</td>
      <td style="text-align: left">对参考路径的覆盖与长度匹配如何</td>
      <td style="text-align: left">↑，0–1 或百分数</td>
      <td style="text-align: left">不显式做顺序对齐</td>
    </tr>
    <tr>
      <td style="text-align: left">nDTW</td>
      <td style="text-align: left">轨迹在顺序约束下多接近参考路线</td>
      <td style="text-align: left">↑，0–1 或百分数</td>
      <td style="text-align: left">受采样、距离函数与参考标注影响</td>
    </tr>
    <tr>
      <td style="text-align: left">SDTW</td>
      <td style="text-align: left">是否成功且与参考路线接近</td>
      <td style="text-align: left">↑，0–1 或百分数</td>
      <td style="text-align: left">失败轨迹记 0，需搭配 nDTW 分析</td>
    </tr>
    <tr>
      <td style="text-align: left">TL</td>
      <td style="text-align: left">实际走了多长</td>
      <td style="text-align: left">无固定优劣方向，通常为米</td>
      <td style="text-align: left">需结合 SR 与参考路径长度解读，过短可能是过早停止</td>
    </tr>
    <tr>
      <td style="text-align: left">RGS / RGSPL</td>
      <td style="text-align: left">是否选中了指令所指的目标物体</td>
      <td style="text-align: left">↑</td>
      <td style="text-align: left">REVERIE 类任务专用；需说明候选物体来源与判定方式</td>
    </tr>
  </tbody>
</table>

<h3 id="814-常见指标反差与排查方向">8.1.4 常见指标反差与排查方向</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">观察</th>
      <th style="text-align: left">可能原因</th>
      <th style="text-align: left">用什么验证</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">OSR 明显高于 SR</td>
      <td style="text-align: left">停止判断、目标验证、控制漂移、超时</td>
      <td style="text-align: left">回放首次进入成功范围后的行为</td>
    </tr>
    <tr>
      <td style="text-align: left">SR 提升但 SPL 下降</td>
      <td style="text-align: left">更充分的探索换来更长路径</td>
      <td style="text-align: left">配对比较成功集合与实际路径长度</td>
    </tr>
    <tr>
      <td style="text-align: left">SPL 高而 nDTW 低</td>
      <td style="text-align: left">捷径或沿途地标被忽略</td>
      <td style="text-align: left">查看参考路径是否故意偏离最短路</td>
    </tr>
    <tr>
      <td style="text-align: left">Seen 与 Unseen 差距大</td>
      <td style="text-align: left">场景过拟合或任务分布差异</td>
      <td style="text-align: left">按路径长度、指令类型和场景难度分组</td>
    </tr>
    <tr>
      <td style="text-align: left">仿真好、真机差</td>
      <td style="text-align: left">感知、时间同步、动力学或环境偏移</td>
      <td style="text-align: left">分层测量感知、规划与执行误差</td>
    </tr>
  </tbody>
</table>

<p>这些是待验证的解释。某个指标反差可以由多个机制产生，不应直接给模型下“缺乏推理”或“只会记忆”的结论。</p>

<h2 id="82-目标达成与定位精度指标">8.2 目标达成与定位精度指标</h2>

<h3 id="821-success-rate-sr">8.2.1 Success Rate (SR)</h3>

<p>设第 $i$ 个 episode 的官方成功指示为 $S_i\in{0,1}$，共 $N$ 条评测轨迹：</p>

\[\mathrm{SR}=\frac{1}{N}\sum_{i=1}^{N}S_i.\]

<p>成功条件可能包含终点距离、主动停止、目标可见性或物体识别。报告时保留这些条件；被超时截断是否算成功，也由评测器决定。</p>

<h3 id="822-navigation-error-ne">8.2.2 Navigation Error (NE)</h3>

<p>设 $x_i^{\mathrm{end}}$ 为终止位置，$g_i$ 为目标，$d$ 为基准的距离函数：</p>

\[\mathrm{NE}=\frac{1}{N}\sum_{i=1}^{N}d(x_i^{\mathrm{end}},g_i).\]

<p>经典图导航一般采用最短图距离，连续导航的目标距离通常采用可导航表面的测地距离，不能统一改写成欧氏距离。存在多个有效目标位置时，还须说明目标集合的处理方式。<a href="https://github.com/google-research-datasets/RxR">RxR 官方指标说明</a>。</p>

<h3 id="823-oracle-success-rate-osr">8.2.3 Oracle Success Rate (OSR)</h3>

<p>对于使用目标距离阈值 $\tau$ 的任务，OSR 检查轨迹中是否曾进入成功范围：</p>

\[\mathrm{OSR}=\frac{1}{N}\sum_{i=1}^{N}\mathbb{1}\!\left[\min_t d(x_i^t,g_i)&lt;\tau\right].\]

<p>严格或非严格阈值遵循官方实现。OSR 不能替代真实停止策略：途中偶然经过终点也可能提高 OSR。SR 与 OSR 的距离与采样口径一致时，两者差距可用于定位停止相关问题。</p>

<p><strong>教学示例：路过目标与正确停止不同。</strong> 下图假设成功只取决于停止时到目标的距离，阈值为 3 m；所有距离采用同一评测定义。</p>

<pre><code class="language-mermaid">flowchart LR
    A["起点"] --&gt; B["途中距目标 1 m&lt;br/&gt;已进入成功范围"]
    B --&gt; C["继续走，最终距目标 5 m&lt;br/&gt;此处停止"]
    B -.-&gt; D["该轨迹 Oracle success = 1"]
    C -.-&gt; E["该轨迹 Success = 0"]
    classDef pass fill:#e4f2e8,stroke:#548565,color:#21452e;
    classDef fail fill:#fbe9e5,stroke:#b66b58,color:#612f25;
    class B,D pass;
    class C,E fail;
</code></pre>

<p>这个差距提示检查停止判断、目标识别和路径回退，但不能仅凭 OSR 高就断言模型“定位准确”。轨迹可能偶然路过目标，或者模型根本没有意识到目标已被看到。</p>

<h2 id="83-路径效率与指令保真度指标">8.3 路径效率与指令保真度指标</h2>

<h3 id="831-success-weighted-by-path-length-spl">8.3.1 Success weighted by Path Length (SPL)</h3>

<p>设 $l_i$ 为起点到目标的最短可行路径长度，$p_i$ 为实际行走长度，则：</p>

\[\mathrm{SPL}=\frac{1}{N}\sum_{i=1}^{N}S_i\frac{l_i}{\max(l_i,p_i)}.\]

<p>分数逐轨迹计算后平均，不能写成 SR 乘以全体轨迹的平均效率。零长度等退化情况遵循基准实现。<a href="https://arxiv.org/abs/1807.06757">SPL 原始评测建议</a>。</p>

<p>例如两条轨迹中，一条成功且效率为 0.5，另一条失败，则 SR 为 0.5、SPL 为 0.25。SPL 衡量行走效率，额外生成 token、网络等待或原地计算时间不会自动进入它的分母。</p>

<p><strong>四类轨迹的计算例子</strong>：设同一直走廊中，起点到精确目标的最短距离为 10 m，成功阈值为 3 m，均主动停止。下图表示行为类别，不按空间比例绘制。</p>

<pre><code class="language-mermaid">flowchart TB
    S["共同起点：到精确目标最短距离 10 m"]
    S --&gt; A["直接到目标&lt;br/&gt;行走 10 m，终点误差 0 m"]
    S --&gt; B["绕行后到目标&lt;br/&gt;行走 20 m，终点误差 0 m"]
    S --&gt; C["进入成功范围后停止&lt;br/&gt;行走 8 m，终点误差 2 m"]
    S --&gt; D["过早停止&lt;br/&gt;行走 6.5 m，终点误差 3.5 m"]
    A --&gt; AS["成功，SPL = 1"]
    B --&gt; BS["成功，SPL = 0.5"]
    C --&gt; CS["成功，SPL = 1"]
    D --&gt; DS["失败，SPL = 0"]
    classDef pass fill:#e4f2e8,stroke:#548565,color:#21452e;
    classDef fail fill:#fbe9e5,stroke:#b66b58,color:#612f25;
    class AS,BS,CS pass;
    class DS fail;
</code></pre>

<table>
  <thead>
    <tr>
      <th style="text-align: left">行为</th>
      <th style="text-align: center">$S_i$</th>
      <th style="text-align: center">效率项 $l_i / \max(l_i,p_i)$</th>
      <th style="text-align: center">单条 SPL</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">直接到达</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">$10/10=1$</td>
      <td style="text-align: center">1</td>
    </tr>
    <tr>
      <td style="text-align: left">绕行到达</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">$10/20=0.5$</td>
      <td style="text-align: center">0.5</td>
    </tr>
    <tr>
      <td style="text-align: left">在目标前 2 m 停止</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">$10/10=1$</td>
      <td style="text-align: center">1</td>
    </tr>
    <tr>
      <td style="text-align: left">在目标前 3.5 m 停止</td>
      <td style="text-align: center">0</td>
      <td style="text-align: center">$10/10=1$</td>
      <td style="text-align: center">0</td>
    </tr>
  </tbody>
</table>

<p>四条一起评测时，SR 为 0.75，SPL 为 0.625。第三条的行走长度小于到<strong>精确目标</strong>的最短距离，是因为在成功范围内提前停止，不是走出了比同一几何中的最短路径更短的路线；<code class="language-plaintext highlighter-rouge">max</code> 将效率上限限制为 1。若基准把 $l_i$ 定义到目标区域，应按其实现重新计算。</p>

<p>SPL 对失败轨迹直接计零，对成功但过长的路径施加反比惩罚。它不要求遵循指令的所有中间地标：当指令要求绕行时，忠实执行可能反而降低 SPL，因此还需路径保真度指标。</p>

<h3 id="832-coverage-weighted-by-length-score-cls">8.3.2 Coverage weighted by Length Score (CLS)</h3>

<p>给定参考路径 $R$ 和预测路径 $P$，定义节点到路径的距离 $d(r,P)=\min_{p\in P}d(r,p)$。CLS 结合软覆盖与长度匹配：</p>

\[\mathrm{PC}=\frac{1}{|R|}\sum_{r\in R}\exp\!\left(-\frac{d(r,P)}{d_{th}}\right),\qquad
\mathrm{EPL}=\mathrm{PC}\cdot L(R),\]

\[\mathrm{CLS}=\mathrm{PC}\cdot\frac{\mathrm{EPL}}{\mathrm{EPL}+|\mathrm{EPL}-L(P)|}.\]

<p>其中 $L$ 表示路径长度，$d_{th}$ 是距离尺度。它鼓励覆盖沿途节点，但没有显式约束访问顺序；评估先后次序时还需看 nDTW。<a href="https://arxiv.org/abs/1905.12255">CLS 原论文</a>。</p>

<p><strong>把公式拆成两步</strong>：PC 问“参考路线各处离实际走过的地方有多远”，长度项 LS 问“实际长度是否与已覆盖部分相称”。节点到路径取最小距离，因此仅靠 PC 不会检查访问顺序。</p>

<pre><code class="language-mermaid">flowchart TB
    R["参考路径中的每个节点"] --&gt; D["计算到预测路径的最近距离"]
    D --&gt; PC["距离经指数衰减后取平均&lt;br/&gt;得到软覆盖 PC"]
    PC --&gt; EPL["EPL = PC × 参考路径长度"]
    EPL --&gt; LS["比较 EPL 与实际路径长度&lt;br/&gt;得到长度得分 LS"]
    PC --&gt; C["CLS = PC × LS"]
    LS --&gt; C
    classDef score fill:#e8f1fb,stroke:#426a91,color:#18354f;
    class PC,LS,C score;
</code></pre>

<table>
  <thead>
    <tr>
      <th style="text-align: left">教学算例：$L(R)=20$ m</th>
      <th style="text-align: center">假设 PC</th>
      <th style="text-align: center">$L(P)$</th>
      <th style="text-align: center">EPL</th>
      <th style="text-align: center">LS</th>
      <th style="text-align: center">CLS</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">完整覆盖且长度匹配</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">20 m</td>
      <td style="text-align: center">20 m</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">1</td>
    </tr>
    <tr>
      <td style="text-align: left">完整覆盖但有额外绕行</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">30 m</td>
      <td style="text-align: center">20 m</td>
      <td style="text-align: center">$2/3$</td>
      <td style="text-align: center">$2/3$</td>
    </tr>
    <tr>
      <td style="text-align: left">软覆盖不足但长度与 EPL 匹配</td>
      <td style="text-align: center">0.5</td>
      <td style="text-align: center">10 m</td>
      <td style="text-align: center">10 m</td>
      <td style="text-align: center">1</td>
      <td style="text-align: center">0.5</td>
    </tr>
  </tbody>
</table>

<p>表中 PC 为便于演算设定的值，不是从某张路线图测得，也不表示“恰好走了半数节点”。即使每个参考点都在距离尺度 $d_{th}$ 内，PC 也不必接近 1：距离恰好为 $d_{th}$ 的点，其贡献只有 $e^{-1}\approx0.368$。</p>

<p>CLS 可以揭示“到达终点却漏掉沿途路线”，但相同覆盖集合仍可能对应不同访问顺序；这正是下面引入 DTW 对齐的原因。</p>

<h3 id="833-normalized-dynamic-time-warping-ndtw--sdtw">8.3.3 normalized Dynamic Time Warping (nDTW &amp; SDTW)</h3>

<p>DTW 寻找满足顺序约束的路径对齐，允许两条轨迹具有不同采样点数。常见归一化与成功加权形式为：</p>

\[\mathrm{nDTW}(R,P)=\exp\!\left(-\frac{\mathrm{DTW}(R,P)}{|R|d_{th}}\right),\qquad
\mathrm{SDTW}=\frac{1}{N}\sum_{i=1}^{N}S_i\,\mathrm{nDTW}(R_i,P_i).\]

<p>数据集 nDTW 同样逐 episode 计算后平均。其顺序对齐比单纯路径覆盖更适合检查沿途约束，但仍依赖参考轨迹质量。<a href="https://arxiv.org/abs/1907.05446">nDTW 原论文</a>。</p>

<p><strong>实现边界</strong>：用于 NE 的目标距离与 DTW 的点对距离不应想当然地视为相同。连续环境实现还涉及轨迹采样、去重、近似 DTW 等选择；复现应固定评测代码，而非只复制公式。参见 <a href="https://github.com/jacobkrantz/VLN-CE/blob/master/habitat_extensions/measures.py">VLN-CE 指标实现</a>。</p>

<p><strong>为什么不直接逐步相减</strong>：参考序列为 A→B→C，预测序列为 A→A→B→C。若按相同下标比较，第二步会把 B 与 A 错配；DTW 允许在保持顺序的前提下，让多个采样点对应同一个参考点。</p>

<pre><code class="language-mermaid">flowchart TB
    subgraph Ref["参考路径"]
        direction LR
        R1["A"] --&gt; R2["B"] --&gt; R3["C"]
    end
    subgraph Pred["预测路径"]
        direction LR
        P1["A"] --&gt; P2["A"] --&gt; P3["B"] --&gt; P4["C"]
    end
    R1 -. "对齐" .-&gt; P1
    R1 -. "对齐" .-&gt; P2
    R2 -. "对齐" .-&gt; P3
    R3 -. "对齐" .-&gt; P4
</code></pre>

<p>在这个重复位置完全相同的教学例子中，对齐代价可以为零；真实轨迹中的位移、采样方式和噪声仍会改变 DTW，不能泛化为“对速度与采样完全不敏感”。如果改走 A→C→B→C，即使访问过同样地标，也通常无法获得同样的零代价顺序对齐。</p>

<p>DTW 累积代价可以写为下列递推，其中 $D(a,b)$ 是两条路径前缀的最小对齐代价，边界按标准 DTW 初始化：</p>

\[D(a,b)=d(r_a,p_b)+\min\{D(a-1,b),D(a,b-1),D(a-1,b-1)\}.\]

<table>
  <tbody>
    <tr>
      <td>例如 $</td>
      <td>R</td>
      <td>=4$、$d_{th}=3$ m、DTW 为 6 m，则 nDTW 为 $e^{-0.5}\approx0.607$；若最终失败，该条 SDTW 为 0。另一条成功且 nDTW 为 0.8 时，两条轨迹的平均 nDTW 约 0.704，而 SDTW 为 0.4。成功加权必须先作用于每条轨迹，不能用总体 SR 乘总体 nDTW 替代。</td>
    </tr>
  </tbody>
</table>

<h2 id="84-具身安全物理交互与部署级指标">8.4 具身安全、物理交互与部署级指标</h2>

<h3 id="841-几何避障与社交安全指标">8.4.1 几何避障与社交安全指标</h3>

<p>碰撞可以按动作步、接触事件或 episode 计数，三者分母不同。报告 Collision Rate / Human Collision Rate 时写出定义，并同时给出任务完成情况，避免“原地不动所以碰撞少”的误读。个人空间侵犯也不能简化为身体接触。</p>

<h3 id="842-动力学稳定性与不可逆故障指标">8.4.2 动力学稳定性与不可逆故障指标</h3>

<p>跌倒、卡住、急停与人工复位应分别记录。需要给出姿态或时间阈值、恢复预算，以及复位是否中断 episode。不同机器人形态的失败模式不同，不能合并为一个不带条件的具身成功率。</p>

<h3 id="843-系统级效率与控制实时性指标">8.4.3 系统级效率与控制实时性指标</h3>

<p>报告相机到动作执行的端到端延迟，注明均值与尾部延迟、硬件、批大小、输入分辨率、历史长度和模型调用方式。另列控制频率、显存、调用/token 成本、任务耗时与人工介入。模型单次前向 FPS 不等于机器人的有效控制频率。</p>

<h2 id="85-评测协议规范与演进趋势">8.5 评测协议规范与演进趋势</h2>

<h3 id="851-val-seen-与-val-unseen-的划分与边界">8.5.1 Val-Seen 与 Val-Unseen 的划分与边界</h3>

<p>Seen / Unseen 通常按基准场景划分，衡量同一任务内的场景泛化。它不自动保证大规模预训练时从未见过同源建筑、图像或衍生资产，也不等价于跨机器人、跨语言或真机泛化。</p>

<h3 id="852-公平对比检查清单-fair-comparison-checklist">8.5.2 公平对比检查清单 (Fair Comparison Checklist)</h3>

<ul>
  <li><strong>输入相同</strong>：相机数量、视场、深度、位姿与地图权限。</li>
  <li><strong>任务相同</strong>：数据版本、语言子集、episode、目标与停止判据。</li>
  <li><strong>执行相同</strong>：动作空间、控制器、步数与时间预算、滑动和碰撞配置。</li>
  <li><strong>资源透明</strong>：额外训练数据、基模、工具调用、搜索/重试次数与计算预算。</li>
  <li><strong>统计可检查</strong>：报告成功数与总数；随机任务给出多次运行或置信区间，并说明采样方法。</li>
</ul>

<p><a id="853-评测体系的历史演进与代际跃迁"></a></p>

<h3 id="853-从榜单成绩到可复现证据">8.5.3 从榜单成绩到可复现证据</h3>

<p>先确认结果属于论文哪个版本和哪张表，再核对官方评测器。VLN-CE 官方仓库曾明确说明，同一基线在论文与榜单上的 SPL 差异与硬件和 Habitat 构建有关；这说明协议与实现本身也是实验的一部分。<a href="https://github.com/jacobkrantz/VLN-CE#baseline-performance">官方复现说明</a>。</p>

<p>配套<a href="/VLN-Papers/">论文篇</a>用于检索候选方法和原始结果。跨文章、跨版本的成绩在完成上述核对前，只能作为阅读索引，不能直接用于架构优劣的因果结论。</p>

<h1 id="9-学习资源与框架">9. 学习资源与框架</h1>

<p>建议按“经典任务 → 连续环境 → 基础模型 → 真实部署”的顺序学习：先复现 R2R / VLN-CE 基线，熟悉 Habitat 的 episode、传感器与指标；再阅读流式 VLA、快慢系统和空间记忆方法；最后再进入 Agent、世界模型和真实机器人部署。直接从最新大模型开始，往往会掩盖数据协议和动作接口带来的差异。</p>

<p><strong>站内配套资源：</strong></p>

<ul>
  <li><a href="/VLN-Papers/">VLN 经典论文与性能排行榜</a>：按任务设定维护论文精读、性能和开源状态。</li>
  <li><a href="/Spatial-Intelligence-Survey/">空间智能综述</a>：补充 3D 表征、地图与空间推理基础。</li>
  <li><a href="/World-Models-Survey/">世界模型综述</a>：补充预测模型、世界动作模型与数据引擎。</li>
  <li><a href="/Robot-Navigation-Survey/">传统机器人导航算法综述</a>：补充 SLAM、全局 / 局部规划与控制器基础，对应第 3.3 节的快系统与第 8.4 节的部署指标。</li>
  <li><a href="/VLA-Survey/">VLA 综述</a>：补充视觉-语言-动作模型的训练范式与动作接口设计。</li>
</ul>

<p><strong><a href="https://github.com/zhangyuejoslin/VLN-Survey-with-Foundation-Models">VLN-Survey-with-Foundation-Models</a></strong></p>
<ul>
  <li><strong>类型</strong>：GitHub 资源仓库</li>
  <li><strong>重点</strong>：专注于 LLM/VLM 时代的 VLN 方法（2023-至今），持续更新最新论文</li>
  <li><strong>适合</strong>：想了解大模型如何革新 VLN 领域的研究者</li>
</ul>

<p><strong><a href="https://github.com/jonyzhang2023/awesome-embodied-vla-va-vln">Awesome-Embodied-AI</a></strong></p>
<ul>
  <li><strong>类型</strong>：全栈资源合集</li>
  <li><strong>重点</strong>：涵盖 VLN、VLA、机器人操作等完整具身智能技术栈</li>
  <li><strong>适合</strong>：系统学习具身 AI 全貌的研究者</li>
</ul>

<p><strong><a href="https://github.com/TianxingChen/Embodied-AI-Guide">Embodied-AI-Guide</a></strong></p>
<ul>
  <li><strong>类型</strong>：入门教程 + 实践指南</li>
  <li><strong>重点</strong>：提供代码实践、论文解读、学习路径规划</li>
  <li><strong>适合</strong>：零基础入门或需要结构化学习路径的新人</li>
</ul>

<p><strong><a href="https://arxiv.org/abs/2203.12667">Vision-and-Language Navigation: A Survey of Tasks, Methods, and Future Directions</a></strong></p>
<ul>
  <li><strong>类型</strong>：综述论文（Gu et al., ACL 2022）</li>
  <li><strong>重点</strong>：系统梳理 VLN 发展脉络，覆盖 2018–2022 年的任务、方法与评测</li>
  <li><strong>适合</strong>：需要全面了解 VLN 历史演进的研究者</li>
</ul>

<p><strong><a href="https://arxiv.org/abs/2407.07035">Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models</a></strong></p>
<ul>
  <li><strong>类型</strong>：综述论文（Zhang et al., 2024，与上方 VLN-Survey-with-Foundation-Models 仓库配套）</li>
  <li><strong>重点</strong>：以基础模型为主线重新组织 VLN 方法，讨论世界模型、人类模型与 VLA 的交汇</li>
  <li><strong>适合</strong>：从大模型视角切入 VLN 的研究者</li>
</ul>

<hr />

<h2 id="91-重要会议与研讨会">9.1 重要会议与研讨会</h2>

<p><strong>具身智能专项会议：</strong></p>
<ul>
  <li><strong><a href="https://embodied-ai.org/">Embodied AI Workshop</a></strong> - CVPR 官方 Workshop，最新趋势和挑战赛发布地</li>
  <li><strong><a href="https://www.corl.org/">CoRL</a></strong> (Conference on Robot Learning) - VLN 向真实机器人迁移的主要阵地</li>
  <li><strong><a href="https://roboticsconference.org/">RSS</a></strong> (Robotics: Science and Systems) - 顶级机器人会议，强调 Sim-to-Real</li>
</ul>

<p><strong>主流会议分布：</strong></p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">会议</th>
      <th style="text-align: left">常见侧重点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center"><strong>CVPR / ICCV / ECCV</strong></td>
      <td style="text-align: left">视觉语言建模、空间表征、数据集与基准</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>NeurIPS / ICLR</strong></td>
      <td style="text-align: left">基础模型、强化学习、生成模型与规模化训练</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>CoRL / RSS</strong></td>
      <td style="text-align: left">机器人学习、真实部署与跨具身泛化</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>ICRA / IROS</strong></td>
      <td style="text-align: left">导航系统、控制、仿真平台与工程验证</td>
    </tr>
  </tbody>
</table>

<hr />

<p><a id="survey-practice"></a></p>

<h2 id="92-从论文到实验一条可复现的实施路径">9.2 从论文到实验：一条可复现的实施路径</h2>

<p>以下流程是本文的实验组织建议，适合将配套论文中的方法落实为可比较的系统。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">阶段</th>
      <th style="text-align: left">先完成什么</th>
      <th style="text-align: left">应留下的可检查产物</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">固定任务</td>
      <td style="text-align: left">确定指令类型、观测、动作接口、具身形态与成功条件</td>
      <td style="text-align: left">配置表，包含数据版本、划分、传感器与停止规则</td>
    </tr>
    <tr>
      <td style="text-align: left">跑通基线</td>
      <td style="text-align: left">使用论文对应版本的代码和权重，复现标准验证集</td>
      <td style="text-align: left">逐 episode 结果、配置、代码版本与汇总指标</td>
    </tr>
    <tr>
      <td style="text-align: left">定位短板</td>
      <td style="text-align: left">回看失败轨迹，区分理解、记忆、规划、执行和停止错误</td>
      <td style="text-align: left">失败分类及代表轨迹，避免只记录平均 SR</td>
    </tr>
    <tr>
      <td style="text-align: left">验证改动</td>
      <td style="text-align: left">每次控制一个变量；保持 episode 集合与预算一致</td>
      <td style="text-align: left">配对结果、模块消融、不同运行种子下的波动</td>
    </tr>
    <tr>
      <td style="text-align: left">检查泛化</td>
      <td style="text-align: left">在未见场景与明确指定的扰动条件下评测</td>
      <td style="text-align: left">分场景、分路径长度及分扰动类型的结果</td>
    </tr>
    <tr>
      <td style="text-align: left">接入机器人</td>
      <td style="text-align: left">检查坐标系、时间戳、动作尺度、轨迹有效期与执行反馈</td>
      <td style="text-align: left">端到端延迟、碰撞、恢复、介入次数及真机失败记录</td>
    </tr>
  </tbody>
</table>

<p><strong>推理完成不等于动作仍然有效。</strong> 相机采集、编码、模型生成、通信和控制执行共同决定闭环延迟。慢系统返回子目标时，机器人可能已经离开对应视点，因此需要明确旧目标何时失效、何时重新规划，以及快系统在等待期间采取什么行为。报告模型 FPS 时，应同时说明测量边界、硬件、批大小与控制频率。</p>

<p><strong>选择研究切入点时，从失败证据反推方法。</strong> 长路径上反复访问同一区域，适合检查记忆与地图更新；到过目标附近却未成功，适合检查停止判定与目标验证；语义目标正确却经常碰撞，适合检查可达性、动作接口和控制器。指标差距只提供线索，最终仍要用轨迹回放和受控实验验证原因。</p>

<p><a id="survey-open-questions"></a></p>

<h2 id="93-已有证据开放问题与研究判断">9.3 已有证据、开放问题与研究判断</h2>

<p>从本文讨论的工作可以得到几条<strong>有明确适用范围的结论</strong>：R4R 与路径指标说明到达和指令忠实度需要分别衡量；ETPNav、DualVLN 展示了规划与执行分工的具体实现；ScaleVLN 说明训练资源是解释性能的重要变量；VLN-PE 则提供了视觉与物理差距会影响导航表现的实验证据。这些结论分别来自<a href="https://arxiv.org/abs/1905.12255">路径跟随研究</a>、<a href="https://arxiv.org/abs/2304.03047">连续图规划</a>、<a href="https://arxiv.org/abs/2512.08186">双系统设计</a>、<a href="https://arxiv.org/abs/2307.15644">数据扩展</a>和<a href="https://arxiv.org/abs/2507.13019">物理具身评测</a>，尚不足以推出一种通用于所有任务的最优架构。</p>

<p>下表是本文据此归纳的开放问题与建议验证方式，<strong>属于研究判断，不是领域已形成的统一结论</strong>。</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">开放问题</th>
      <th style="text-align: left">为什么现有结果还不足</th>
      <th style="text-align: left">更有区分力的验证</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">何时值得显式建图？</td>
      <td style="text-align: left">地图模型与隐式模型常使用不同传感器和位姿先验</td>
      <td style="text-align: left">固定输入，在路径长度、遮挡、位姿噪声上分组比较</td>
    </tr>
    <tr>
      <td style="text-align: left">模型究竟使用了哪些语言信息？</td>
      <td style="text-align: left">高 SR 可能主要来自终点线索</td>
      <td style="text-align: left">保持目标不变，改动沿途顺序、否定和转向约束，检查轨迹响应</td>
    </tr>
    <tr>
      <td style="text-align: left">记忆能否修正自身错误？</td>
      <td style="text-align: left">静态环境上的长期保存不代表动态更新能力</td>
      <td style="text-align: left">移动物体、阻断通路、注入错误观测，检查纠正与遗忘</td>
    </tr>
    <tr>
      <td style="text-align: left">反思是否带来可靠恢复？</td>
      <td style="text-align: left">更长推理和更多重试可能同时增加成功率</td>
      <td style="text-align: left">固定调用预算和失败注入，比较恢复率、额外路径及失败升级</td>
    </tr>
    <tr>
      <td style="text-align: left">世界模型何时优于直接策略？</td>
      <td style="text-align: left">生成质量和真实执行收益不等价</td>
      <td style="text-align: left">同预算比较无预测、候选排序和联合生成，报告长滚动失真</td>
    </tr>
    <tr>
      <td style="text-align: left">“通用”能力能迁移多远？</td>
      <td style="text-align: left">同一平台的多任务成绩不代表跨形态迁移</td>
      <td style="text-align: left">留出语言、资产、机器人与控制接口，分别报告适配量</td>
    </tr>
    <tr>
      <td style="text-align: left">仿真进步能否预测部署收益？</td>
      <td style="text-align: left">真机试验环境和介入规则常不统一</td>
      <td style="text-align: left">固定任务集、起点与恢复预算，公开失败轨迹和介入记录</td>
    </tr>
  </tbody>
</table>

<p><strong>本文的研究建议</strong>是优先建立可回放、可归因的失败分析，再选择模型改动。若已有系统主要失败于局部执行，扩大语言模型未必是最直接的路径；若停止和沿途约束是主要问题，单看平均 SR 又可能遮蔽有效改进。值得追求的进展，是能够说明“在什么条件下、解决了哪类失败、付出了多少代价”。</p>

<p><a id="survey-scope"></a></p>

<h2 id="94-本文覆盖范围与维护方式">9.4 本文覆盖范围与维护方式</h2>

<p>本文是按问题组织的叙述性综述，覆盖路线指令导航及与之相关的目标导航、交互和具身控制工作，不是具有穷尽检索与排除流程的系统综述。不同任务作为机制参考时已注明边界；通用 VLA 与操作论文不作为标准 VLN 的直接性能证据。</p>

<p>最近一次核验日期为 <strong>2026-09-26</strong>，重点核对数据口径、平台支持、核心指标和跨论文设计差异。正文为易变数据注明论文版本或数据卡来源；无法确认独立协议的条目保留不确定性说明。其余工作通过配套论文篇供进一步阅读，本文不声称已独立复现所有实验或验证全部排行榜结果。</p>

<h1 id="10-参考资料">10. 参考资料</h1>

<blockquote>
  <p><strong>论文精读</strong>：经典论文与基石论文详见 <a href="/VLN-Papers/">VLN 经典论文</a> 与 <a href="/VLN-Papers-Extended/">VLN 论文精读（扩展篇）</a>。本节只收录正文直接涉及的数据集、方法、模拟器与综述，按主题分组、全文连续编号；预印本的发表状态与榜单数字以论文主页及配套论文页为准。</p>
</blockquote>

<hr />

<h2 id="101-数据集与基准">10.1 数据集与基准</h2>

<h3 id="1011-指令导向与连续环境数据集">10.1.1 指令导向与连续环境数据集</h3>

<ol>
  <li><strong>R2R</strong> — Anderson et al., <em>Vision-and-Language Navigation: Interpreting Visually-Grounded Navigation Instructions in Real Environments</em>, CVPR 2018. <a href="https://arxiv.org/abs/1711.07280">[Paper]</a></li>
  <li><strong>R4R</strong> — Jain et al., <em>Stay on the Path: Instruction Fidelity in Vision-and-Language Navigation</em>, ACL 2019. <a href="https://arxiv.org/abs/1905.12255">[Paper]</a></li>
  <li><strong>RxR</strong> — Ku et al., <em>Room-Across-Room: Multilingual Vision-and-Language Navigation with Dense Spatiotemporal Grounding</em>, EMNLP 2020. <a href="https://arxiv.org/abs/2010.07954">[Paper]</a></li>
  <li><strong>VLN-CE</strong> — Krantz et al., <em>Beyond the Nav-Graph: Vision-and-Language Navigation in Continuous Environments</em>, ECCV 2020. <a href="https://arxiv.org/abs/2004.02857">[Paper]</a></li>
  <li><strong>RxR-CE</strong> — RxR 在 Habitat 连续环境中的移植，随 VLN-CE 代码库发布，用于 RxR-Habitat 挑战赛（CVPR Embodied AI Workshop）。<a href="https://github.com/jacobkrantz/VLN-CE">[Code]</a></li>
  <li><strong>ScaleVLN</strong> — Wang et al., <em>Scaling Data Generation in Vision-and-Language Navigation</em>, ICCV 2023. <a href="https://arxiv.org/abs/2307.15644">[Paper]</a></li>
  <li><strong>VLN-PE</strong> — Wang et al., <em>Rethinking the Embodied Gap in Vision-and-Language Navigation: A Holistic Study of Physical and Visual Disparities</em>, ICCV 2025. <a href="https://arxiv.org/abs/2507.13019">[Paper]</a></li>
  <li><strong>InternData-N1</strong> — InternRobotics（上海人工智能实验室），面向 InternVLA-N1 的大规模合成导航数据（LeRobot 格式），2025. <a href="https://huggingface.co/datasets/InternRobotics/InternData-N1">[Dataset]</a> <a href="https://github.com/InternRobotics/InternNav">[Code]</a></li>
  <li><strong>VLNVerse</strong> — Lin et al., <em>VLNVerse: A Benchmark for Vision-Language Navigation with Versatile, Embodied, Realistic Simulation and Evaluation</em>, arXiv 2025. <a href="https://arxiv.org/abs/2512.19021">[Paper]</a></li>
</ol>

<h3 id="1012-目标导向与长程规划数据集">10.1.2 目标导向与长程规划数据集</h3>

<ol>
  <li><strong>REVERIE</strong> — Qi et al., <em>REVERIE: Remote Embodied Visual Referring Expression in Real Indoor Environments</em>, CVPR 2020. <a href="https://arxiv.org/abs/1904.10151">[Paper]</a></li>
  <li><strong>REVERIE-CE</strong> — 连续环境移植设定的统称，尚无统一官方协议；引用时以具体论文的转换实现为准，参见第 6.3.2 节。</li>
  <li><strong>SOON</strong> — Zhu et al., <em>SOON: Scenario Oriented Object Navigation with Graph-based Exploration</em>, CVPR 2021. <a href="https://arxiv.org/abs/2103.17138">[Paper]</a></li>
  <li><strong>LHPR-VLN</strong> — Song et al., <em>Towards Long-Horizon Vision-Language Navigation: Platform, Benchmark and Method</em>, CVPR 2025. <a href="https://arxiv.org/abs/2412.09082">[Paper]</a></li>
</ol>

<h3 id="1013-对话式与社交感知数据集">10.1.3 对话式与社交感知数据集</h3>

<ol>
  <li><strong>CVDN</strong> — Thomason et al., <em>Vision-and-Dialog Navigation</em>, CoRL 2019. <a href="https://arxiv.org/abs/1907.04957">[Paper]</a></li>
  <li><strong>TEACh</strong> — Padmakumar et al., <em>TEACh: Task-driven Embodied Agents that Chat</em>, AAAI 2022. <a href="https://arxiv.org/abs/2110.00534">[Paper]</a></li>
  <li><strong>HA-VLN</strong> — Li et al., <em>Human-Aware Vision-and-Language Navigation: Bridging Simulation to Reality with Dynamic Human Interactions</em>, NeurIPS 2024 Datasets and Benchmarks Track. <a href="https://arxiv.org/abs/2406.19236">[Paper]</a></li>
  <li><strong>HA-VLN 2.0</strong> — Dong et al., <em>HA-VLN 2.0: An Open Benchmark and Leaderboard for Human-Aware Navigation in Discrete and Continuous Environments</em>, IROS 2026（arXiv 首发 2025；核对 v5）. <a href="https://arxiv.org/abs/2503.14229v5">[Paper]</a></li>
</ol>

<h3 id="1014-需求导向室外街景与空中数据集">10.1.4 需求导向、室外街景与空中数据集</h3>

<ol>
  <li><strong>DDN</strong> — Wang et al., <em>Find What You Want: Learning Demand-conditioned Object Attribute Space for Demand-driven Navigation</em>, NeurIPS 2023. <a href="https://arxiv.org/abs/2309.08138">[Paper]</a></li>
  <li><strong>Touchdown</strong> — Chen et al., <em>Touchdown: Natural Language Navigation and Spatial Reasoning in Visual Street Environments</em>, CVPR 2019. <a href="https://arxiv.org/abs/1811.12354">[Paper]</a></li>
  <li><strong>StreetLearn</strong> — Mirowski et al., <em>The StreetLearn Environment and Dataset</em>, arXiv 2019. <a href="https://arxiv.org/abs/1903.01292">[Paper]</a></li>
  <li><strong>AerialVLN</strong> — Liu et al., <em>AerialVLN: Vision-and-Language Navigation for UAVs</em>, ICCV 2023. <a href="https://arxiv.org/abs/2308.06735">[Paper]</a></li>
  <li><strong>CityNav</strong> — Lee et al., <em>CityNav: A Large-Scale Dataset for Real-World Aerial Navigation</em>, ICCV 2025（arXiv 2024）. <a href="https://arxiv.org/abs/2406.14240">[Paper]</a></li>
  <li><strong>OpenFly</strong> — Gao et al., <em>OpenFly: A Comprehensive Platform for Aerial Vision-Language Navigation</em>, ICLR 2026（arXiv 首发 2025；核对 v7）. <a href="https://arxiv.org/abs/2502.18041v7">[Paper]</a></li>
</ol>

<hr />

<h2 id="102-核心模型与方法">10.2 核心模型与方法</h2>

<h3 id="1021-跨模态对齐与预训练">10.2.1 跨模态对齐与预训练</h3>

<ol>
  <li><strong>PREVALENT</strong> — Hao et al., <em>Towards Learning a Generic Agent for Vision-and-Language Navigation via Pre-training</em>, CVPR 2020. <a href="https://arxiv.org/abs/2002.10638">[Paper]</a></li>
  <li><strong>VLN-BERT</strong> — Majumdar et al., <em>Improving Vision-and-Language Navigation with Image-Text Pairs from the Web</em>, ECCV 2020. <a href="https://arxiv.org/abs/2004.14973">[Paper]</a></li>
  <li><strong>Recurrent VLN-BERT</strong> — Hong et al., <em>A Recurrent Vision-and-Language BERT for Navigation</em>, CVPR 2021. <a href="https://arxiv.org/abs/2011.13922">[Paper]</a></li>
  <li><strong>HAMT</strong> — Chen et al., <em>History Aware Multimodal Transformer for Vision-and-Language Navigation</em>, NeurIPS 2021. <a href="https://arxiv.org/abs/2110.13309">[Paper]</a></li>
</ol>

<h3 id="1022-拓扑图语义地图与空间记忆">10.2.2 拓扑图、语义地图与空间记忆</h3>

<ol>
  <li><strong>DUET</strong> — Chen et al., <em>Think Global, Act Local: Dual-scale Graph Transformer for Vision-and-Language Navigation</em>, CVPR 2022. <a href="https://arxiv.org/abs/2202.11742">[Paper]</a></li>
  <li><strong>ETPNav</strong> — An et al., <em>ETPNav: Evolving Topological Planning for Vision-Language Navigation in Continuous Environments</em>, IEEE TPAMI 2024. <a href="https://arxiv.org/abs/2304.03047">[Paper]</a></li>
  <li><strong>LagMemo</strong> — Zhou et al., <em>LagMemo: Language 3D Gaussian Splatting Memory for Multi-modal Open-vocabulary Multi-goal Visual Navigation</em>, arXiv 2025. <a href="https://arxiv.org/abs/2510.24118">[Paper]</a></li>
</ol>

<h3 id="1023-快慢双系统与导航基础模型">10.2.3 快慢双系统与导航基础模型</h3>

<ol>
  <li><strong>DualVLN</strong> — Wei et al., <em>Ground Slow, Move Fast: A Dual-System Foundation Model for Generalizable Vision-and-Language Navigation</em>, arXiv 2025. <a href="https://arxiv.org/abs/2512.08186">[Paper]</a></li>
  <li><strong>NaVILA</strong> — Cheng et al., <em>NaVILA: Legged Robot Vision-Language-Action Model for Navigation</em>, RSS 2025. <a href="https://arxiv.org/abs/2412.04453">[Paper]</a></li>
  <li><strong>NavDP</strong> — Cai et al., <em>NavDP: Learning Sim-to-Real Navigation Diffusion Policy with Privileged Information Guidance</em>, arXiv 2025. <a href="https://arxiv.org/abs/2505.08712">[Paper]</a></li>
  <li><strong>InternVLA-N1</strong> — InternRobotics（上海人工智能实验室），<em>InternVLA-N1: An Open Dual-System Vision-Language Navigation Foundation Model with Learned Latent Plans</em>, 2025. <a href="https://github.com/InternRobotics/InternNav">[Code]</a></li>
  <li><strong>OmniNav</strong> — Xue et al., <em>OmniNav: A Unified Framework for Prospective Exploration and Visual-Language Navigation</em>, arXiv 2025. <a href="https://arxiv.org/abs/2509.25687">[Paper]</a></li>
  <li><strong>Qwen-RobotNav</strong> — Zhang et al., <em>Qwen-RobotNav Technical Report: A Scalable Navigation Model Designed for an Agentic Navigation System</em>, arXiv 2026. <a href="https://arxiv.org/abs/2606.18112">[Paper]</a></li>
</ol>

<h3 id="1024-端到端视频-vlm-与连续环境策略">10.2.4 端到端视频 VLM 与连续环境策略</h3>

<ol>
  <li><strong>Waypoint Models</strong> — Krantz et al., <em>Waypoint Models for Instruction-guided Navigation in Continuous Environments</em>, ICCV 2021. <a href="https://arxiv.org/abs/2110.02207">[Paper]</a></li>
  <li><strong>NaVid</strong> — Zhang et al., <em>NaVid: Video-based VLM Plans the Next Step for Vision-and-Language Navigation</em>, RSS 2024. <a href="https://arxiv.org/abs/2402.15852">[Paper]</a></li>
  <li><strong>StreamVLN</strong> — Wei et al., <em>StreamVLN: Streaming Vision-and-Language Navigation via SlowFast Context Modeling</em>, ICRA 2026（arXiv 首发 2025；核对 v2）. <a href="https://arxiv.org/abs/2507.05240v2">[Paper]</a></li>
</ol>

<h3 id="1025-底层视觉导航策略">10.2.5 底层视觉导航策略</h3>

<ol>
  <li><strong>DD-PPO</strong> — Wijmans et al., <em>DD-PPO: Learning Near-Perfect PointGoal Navigators from 2.5 Billion Frames</em>, ICLR 2020. <a href="https://arxiv.org/abs/1911.00357">[Paper]</a></li>
  <li><strong>GNM</strong> — Shah et al., <em>GNM: A General Navigation Model to Drive Any Robot</em>, ICRA 2023. <a href="https://arxiv.org/abs/2210.03370">[Paper]</a></li>
  <li><strong>ViNT</strong> — Shah et al., <em>ViNT: A Foundation Model for Visual Navigation</em>, CoRL 2023. <a href="https://arxiv.org/abs/2306.14846">[Paper]</a></li>
  <li><strong>NoMaD</strong> — Sridhar et al., <em>NoMaD: Goal Masked Diffusion Policies for Navigation and Exploration</em>, ICRA 2024. <a href="https://arxiv.org/abs/2310.07896">[Paper]</a></li>
  <li><strong>ViPlanner</strong> — Roth et al., <em>ViPlanner: Visual Semantic Imperative Learning for Local Navigation</em>, ICRA 2024. <a href="https://arxiv.org/abs/2310.00982">[Paper]</a></li>
</ol>

<h3 id="1026-世界模型与世界动作模型">10.2.6 世界模型与世界动作模型</h3>

<ol>
  <li><strong>Navigation World Models (NWM)</strong> — Bar et al., <em>Navigation World Models</em>, CVPR 2025. <a href="https://arxiv.org/abs/2412.03572">[Paper]</a> <a href="https://www.amirbar.net/nwm/">[Project]</a></li>
  <li><strong>Dynam3D</strong> — Wang et al., <em>Dynam3D: Dynamic Layered 3D Tokens Empower VLM for Vision-and-Language Navigation</em>, NeurIPS 2025. <a href="https://arxiv.org/abs/2505.11383">[Paper]</a></li>
  <li><strong>WMNav</strong> — Nie et al., <em>WMNav: Integrating Vision-Language Models into World Models for Object Goal Navigation</em>, IROS 2025. <a href="https://arxiv.org/abs/2503.02247">[Paper]</a> <a href="https://b0b8k1ng.github.io/WMNav/">[Project]</a></li>
  <li><strong>AstraNav-World</strong> — Chen et al., <em>AstraNav-World: World Model for Foresight Control and Consistency</em>, arXiv 2025. <a href="https://arxiv.org/abs/2512.21714">[Paper]</a></li>
  <li><strong>NavWAM</strong> — Azuma et al., <em>NavWAM: A Navigation World Action Model for Goal-Conditioned Visual Navigation</em>, arXiv 2026. <a href="https://arxiv.org/abs/2606.13494">[Paper]</a></li>
  <li><strong>DreamVLA</strong> — Zhang et al., <em>DreamVLA: A Vision-Language-Action Model Dreamed with Comprehensive World Knowledge</em>, NeurIPS 2025. <a href="https://arxiv.org/abs/2507.04447">[Paper]</a> <a href="https://zhangwenyao1.github.io/DreamVLA/">[Project]</a></li>
  <li><strong>NVIDIA Cosmos</strong> — NVIDIA, <em>Cosmos World Foundation Model Platform for Physical AI</em>, arXiv 2025. <a href="https://arxiv.org/abs/2501.03575">[Paper]</a> <a href="https://www.nvidia.com/en-us/ai/cosmos/">[Project]</a></li>
</ol>

<h3 id="1027-agent自我进化与通用-vla">10.2.7 Agent、自我进化与通用 VLA</h3>

<ol>
  <li><strong>AgentVLN</strong> — Xin et al., <em>AgentVLN: Towards Agentic Vision-and-Language Navigation</em>, arXiv 2026. <a href="https://arxiv.org/abs/2603.17670">[Paper]</a> <a href="https://github.com/Allenxinn/AgentVLN">[Code]</a></li>
  <li><strong>SE-VLN</strong> — Dong et al., <em>SE-VLN: A Self-Evolving Vision-Language Navigation Framework Based on Multimodal Large Language Models</em>, arXiv 2025. <a href="https://arxiv.org/abs/2507.13152">[Paper]</a></li>
  <li><strong>RT-2</strong> — Brohan et al., <em>RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control</em>, CoRL 2023. <a href="https://arxiv.org/abs/2307.15818">[Paper]</a></li>
  <li><strong>OpenVLA</strong> — Kim et al., <em>OpenVLA: An Open-Source Vision-Language-Action Model</em>, CoRL 2024. <a href="https://arxiv.org/abs/2406.09246">[Paper]</a></li>
</ol>

<hr />

<h2 id="103-模拟器与场景资产">10.3 模拟器与场景资产</h2>

<ol>
  <li><strong>Matterport3D Simulator</strong> — Anderson et al., CVPR 2018（随 R2R 发布）. <a href="https://github.com/peteanderson80/Matterport3DSimulator">[GitHub]</a></li>
  <li><strong>Habitat</strong> — Savva et al., <em>Habitat: A Platform for Embodied AI Research</em>, ICCV 2019 <a href="https://arxiv.org/abs/1904.01201">[Paper]</a>；Szot et al., <em>Habitat 2.0: Training Home Assistants to Rearrange their Habitat</em>, NeurIPS 2021 <a href="https://arxiv.org/abs/2106.14405">[Paper]</a>；Puig et al., <em>Habitat 3.0: A Co-Habitat for Humans, Avatars and Robots</em>, ICLR 2024 <a href="https://arxiv.org/abs/2310.13724">[Paper]</a>. <a href="https://github.com/facebookresearch/habitat-lab">[GitHub]</a></li>
  <li><strong>AI2-THOR / ProcTHOR</strong> — Kolve et al., <em>AI2-THOR: An Interactive 3D Environment for Visual AI</em>, arXiv 2017 <a href="https://arxiv.org/abs/1712.05474">[Paper]</a>；Deitke et al., <em>ProcTHOR: Large-Scale Embodied AI Using Procedural Generation</em>, NeurIPS 2022 <a href="https://arxiv.org/abs/2206.06994">[Paper]</a>. <a href="https://ai2thor.allenai.org/">[Website]</a></li>
  <li><strong>Gibson / iGibson / OmniGibson</strong> — Xia et al., <em>Gibson Env: Real-World Perception for Embodied Agents</em>, CVPR 2018 <a href="https://arxiv.org/abs/1808.10654">[Paper]</a>；Li et al., <em>iGibson 2.0: Object-Centric Simulation for Robot Learning of Everyday Household Tasks</em>, CoRL 2021 <a href="https://arxiv.org/abs/2108.03272">[Paper]</a>；Li et al., <em>BEHAVIOR-1K</em>, CoRL 2022（arXiv 2024 扩展版）<a href="https://arxiv.org/abs/2403.09227">[Paper]</a>. <a href="https://github.com/StanfordVL/iGibson">[GitHub]</a></li>
  <li><strong>AirSim</strong> — Shah et al., <em>AirSim: High-Fidelity Visual and Physical Simulation for Autonomous Vehicles</em>, FSR 2017. <a href="https://github.com/microsoft/AirSim">[GitHub]</a>（维护与兼容性以仓库说明为准）/ <a href="https://github.com/CodexLabsLLC/Colosseum">[Colosseum]</a></li>
  <li><strong>Isaac Sim / Isaac Lab</strong> — NVIDIA；Mittal et al., <em>Orbit: A Unified Simulation Framework for Interactive Robot Learning Environments</em>（Isaac Lab 前身）, IEEE RA-L 2023 <a href="https://arxiv.org/abs/2301.04195">[Paper]</a>. <a href="https://isaac-sim.github.io/IsaacLab/main/index.html">[Docs]</a></li>
  <li><strong>MuJoCo / MJX</strong> — Todorov et al., <em>MuJoCo: A Physics Engine for Model-based Control</em>, IROS 2012；Google DeepMind 维护. <a href="https://github.com/google-deepmind/mujoco">[GitHub]</a> / <a href="https://mujoco.readthedocs.io/">[Docs]</a></li>
  <li><strong>InternUtopia (GRUtopia)</strong> — Wang et al., <em>GRUtopia: Dream General Robots in a City at Scale</em>, arXiv 2024. <a href="https://arxiv.org/abs/2407.10943">[Paper]</a> <a href="https://github.com/InternRobotics/InternUtopia">[GitHub]</a></li>
</ol>

<hr />

<h2 id="104-综述论文">10.4 综述论文</h2>

<ol>
  <li>Gu et al., <em>Vision-and-Language Navigation: A Survey of Tasks, Methods, and Future Directions</em>, ACL 2022. <a href="https://arxiv.org/abs/2203.12667">[Paper]</a></li>
  <li>Zhang et al., <em>Vision-and-Language Navigation Today and Tomorrow: A Survey in the Era of Foundation Models</em>, arXiv 2024. <a href="https://arxiv.org/abs/2407.07035">[Paper]</a> <a href="https://github.com/zhangyuejoslin/VLN-Survey-with-Foundation-Models">[GitHub]</a></li>
</ol>]]></content><author><name>Tingde Liu</name></author><category term="research" /><category term="VLN" /><category term="VLA" /><category term="Robotics" /><category term="Computer Vision" /><category term="Deep Learning" /><summary type="html"><![CDATA[从任务、状态与动作接口、训练信号和闭环评测梳理 VLN；比较流式策略、快慢控制、空间记忆、Agent 与世界模型，给出带来源的数据集选型与开放问题分析。]]></summary></entry><entry><title type="html">Jev：System One 模型与具身导航</title><link href="https://garylee1210.github.io/Jev-Embodied-Navigation/" rel="alternate" type="text/html" title="Jev：System One 模型与具身导航" /><published>2026-09-25T00:00:00+00:00</published><updated>2026-09-25T00:00:00+00:00</updated><id>https://garylee1210.github.io/Jev-Embodied-Navigation</id><content type="html" xml:base="https://garylee1210.github.io/Jev-Embodied-Navigation/"><![CDATA[<h2 id="1-引言导航中的每一次判断都需要生成吗">1. 引言：导航中的每一次判断都需要生成吗</h2>

<p>具身导航既需要理解指令、整合历史和重新规划，也包含大量较短的判断：哪个候选路点更合适、当前地标是否匹配、哪条记忆与任务相关、是否需要再看一眼。<strong>这些环节是否都需要逐步生成文本？能否将有界判断与开放式推理分开，让不同计算承担不同职责？</strong></p>

<p>这不是预设某一种导航范式必然更优。端到端动作模型、分层规划和候选比较各有适用条件；本文关注其中一条可检验的路线：在机器人已经提供证据、候选与执行约束时，用专门的决策模型处理部分选择与验证。</p>

<p>TypeSafe AI 于 2026-09-15 发布的 <strong>Jev</strong> 提供了这种接口：输入文本状态与预先定义的问题，返回类型化结果和概率，而非自由生成的回答。官方将其称为“System One 模型”，强调快速、聚焦的判断。<a href="https://typesafe.ai/blog/introducing-system-one-models-and-jev">官方发布文</a></p>

<p>Jev 是否适合导航，不能只看调用速度。其原生输入只有文本，内部训练细节未完整公开；社区替代实现虽然扩展到视觉，也需要区分接口、训练与执行优化各自带来的收益。本文因此按以下顺序展开：</p>

<ol>
  <li><strong>第 2 章：接口与证据。</strong> Jev 返回什么，速度与校准主张如何理解，已知局限是什么。</li>
  <li><strong>第 3 章：技术路线。</strong> 从候选读出、决策头训练到视觉适配，开源方法分别改变了什么。</li>
  <li><strong>第 4 章：导航研究机会。</strong> 沿行动决策、记忆管理与 Agent 内部协作展开，区分已有结果与迁移设想。</li>
  <li><strong>第 5 章：验证方法。</strong> 用可归因的对照实验检验质量、延迟、成本与执行风险。</li>
</ol>

<p>全文将厂商声明、论文 / 项目自报结果和本文提出的方案分别标明。核心目标是找到值得研究的机制，而不是把产品宣传或单个演示外推成通用导航能力。</p>

<!-- more -->

<h2 id="2-jev-是什么接口机制与证据边界">2. Jev 是什么：接口、机制与证据边界</h2>

<p><strong>Jev 是面向程序的决策模型：给它信息和预先定义的问题，它返回可直接使用的判断结果及概率。</strong></p>

<p>先看一个客服工单分类的例子。用户发来消息：“<strong>订单显示已经送达，但我没有收到包裹。</strong>”系统需要判断这条消息属于哪一类：<strong>物流问题、退款申请、商品咨询</strong>。</p>

<p>程序把用户消息和三个类别交给 Jev，询问：“这条消息的主要诉求属于哪一类？”Jev 返回选中的类别及各类别概率，程序据此将工单转交相应客服。下面用一组构造的数值说明这个过程，<strong>并非实际调用结果</strong>。</p>

<div align="center">
<svg viewBox="0 0 780 410" width="100%" style="max-width:780px;font-family:sans-serif" xmlns="http://www.w3.org/2000/svg" role="img" aria-labelledby="jev-contract-title jev-contract-desc">
  <title id="jev-contract-title">一个例子看懂 Jev：判断客服工单属于哪一类</title>
  <desc id="jev-contract-desc">用户消息为：订单显示已经送达，但我没有收到包裹。程序提供物流问题、退款申请、商品咨询三个类别。Jev 返回物流问题，示例概率分别为 0.85、0.05、0.10。程序据此将工单转交物流客服。所有概率均为示意，非实测结果。</desc>
  <defs><marker id="jevExampleArrow" viewBox="0 0 10 10" refX="9" refY="5" markerWidth="6" markerHeight="6" orient="auto"><path d="M0,0 L10,5 L0,10 z" fill="#64748b" /></marker></defs>
  <rect x="1" y="1" width="778" height="408" rx="12" fill="#f8fafc" stroke="#e2e8f0" />
  <text x="390" y="29" text-anchor="middle" font-size="17" font-weight="bold" fill="#1e293b">一个例子看懂 Jev：这条工单分到哪一类？</text>
  <text x="390" y="54" text-anchor="middle" font-size="14" fill="#475569">用户消息 + 预设类别 → Jev 判断 → 程序分流</text>
  <rect x="20" y="76" width="280" height="230" rx="10" fill="#fff7ed" stroke="#fdba74" />
  <text x="38" y="104" font-size="15" font-weight="bold" fill="#9a3412">① 输入用户消息与预设类别</text>
  <text x="38" y="136" font-size="14" fill="#334155">“订单显示已经送达，</text>
  <text x="38" y="160" font-size="14" fill="#334155">但我没有收到包裹。”</text>
  <line x1="38" y1="177" x2="282" y2="177" stroke="#fed7aa" />
  <text x="38" y="204" font-size="14" fill="#334155">A　物流问题</text>
  <text x="38" y="232" font-size="14" fill="#334155">B　退款申请</text>
  <text x="38" y="260" font-size="14" fill="#334155">C　商品咨询</text>
  <text x="38" y="289" font-size="12" fill="#9a3412">问题：这条消息主要属于哪一类？</text>
  <path d="M308,190 L334,190" fill="none" stroke="#64748b" stroke-width="2" marker-end="url(#jevExampleArrow)" />
  <rect x="342" y="151" width="106" height="80" rx="12" fill="#dbeafe" stroke="#2563eb" stroke-width="2" />
  <text x="395" y="183" text-anchor="middle" font-size="24" font-weight="bold" fill="#1e40af">Jev</text>
  <text x="395" y="210" text-anchor="middle" font-size="13" fill="#1e40af">② 判断类别</text>
  <path d="M456,190 L482,190" fill="none" stroke="#64748b" stroke-width="2" marker-end="url(#jevExampleArrow)" />
  <rect x="490" y="76" width="270" height="230" rx="10" fill="#ffffff" stroke="#93c5fd" />
  <text x="508" y="104" font-size="15" font-weight="bold" fill="#1e40af">③ 返回类别及各类别概率</text>
  <text x="508" y="133" font-size="15" font-weight="bold" fill="#166534">选中：A · 物流问题</text>
  <text x="508" y="163" font-size="13" fill="#334155">A　物流问题</text>
  <text x="741" y="163" text-anchor="end" font-size="13" fill="#166534">0.85</text>
  <rect x="508" y="173" width="232" height="9" rx="4" fill="#f1f5f9" />
  <rect x="508" y="173" width="197.2" height="9" rx="4" fill="#22c55e" />
  <text x="508" y="209" font-size="13" fill="#334155">B　退款申请</text>
  <text x="741" y="209" text-anchor="end" font-size="13" fill="#475569">0.05</text>
  <rect x="508" y="219" width="232" height="9" rx="4" fill="#f1f5f9" />
  <rect x="508" y="219" width="11.6" height="9" rx="4" fill="#94a3b8" />
  <text x="508" y="255" font-size="13" fill="#334155">C　商品咨询</text>
  <text x="741" y="255" text-anchor="end" font-size="13" fill="#475569">0.10</text>
  <rect x="508" y="265" width="232" height="9" rx="4" fill="#f1f5f9" />
  <rect x="508" y="265" width="23.2" height="9" rx="4" fill="#94a3b8" />
  <text x="625" y="293" text-anchor="middle" font-size="11" fill="#64748b">示意结果，非实测；非完整 API 响应</text>
  <path d="M625,309 L625,332" fill="none" stroke="#64748b" stroke-width="2" marker-end="url(#jevExampleArrow)" />
  <rect x="490" y="340" width="270" height="50" rx="10" fill="#dcfce7" stroke="#86efac" />
  <text x="625" y="361" text-anchor="middle" font-size="14" font-weight="bold" fill="#166534">④ 程序按类别分流</text>
  <text x="625" y="381" text-anchor="middle" font-size="12" fill="#166534">将工单转交物流客服</text>
  <text x="24" y="354" font-size="14" fill="#334155">程序提供消息和可选类别，</text>
  <text x="24" y="380" font-size="14" font-weight="bold" fill="#1e40af">Jev 返回判断，程序据此分配工单。</text>
</svg>
<figcaption>图 1　用户消息与预设类别输入 Jev，返回的分类结果供程序分流。概率为构造示意。</figcaption>
</div>

<p><strong>在这个例子中，Jev 负责判断工单类别，程序负责分配工单。</strong> 分类只是其中一种用法：Jev 还支持按预设等级评分、判断命题是否成立，分别对应下面的 Choice、Score 与 Noul。第 4 章再讨论这些判断如何用于导航。</p>

<h3 id="21-从生成回答到返回有界决策">2.1 从生成回答到返回有界决策</h3>

<p>“System One”借用了快思考 / 慢思考的比喻。在这里，它首先描述一种软件接口和任务分工，不应理解为已经证实的认知机制，也不意味着所有生成式 LLM 都只能做慢推理。</p>

<p>调用 Jev 时，应用提供 <code class="language-plaintext highlighter-rouge">state</code>，并通过问题定义可能的答案。模型返回结果，代码再决定如何使用。其三种原语如下：</p>

<table>
  <thead>
    <tr>
      <th>原语</th>
      <th>问题形式</th>
      <th>主要返回值</th>
      <th>客服场景中的示意用途</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">Choice</code></td>
      <td>在给定选项中选一个，最多 255 项</td>
      <td>选中项、完整概率分布、<code class="language-plaintext highlighter-rouge">confidence</code></td>
      <td>判断工单类别</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">Score</code></td>
      <td>按有序、带文字描述的等级评分，最多 10 级</td>
      <td>等级位置的概率加权均值、各级概率、<code class="language-plaintext highlighter-rouge">confidence</code></td>
      <td>按预定义等级评估处理紧急程度</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">Noul</code></td>
      <td>判断一个命题</td>
      <td>命题为真的概率；无独立 <code class="language-plaintext highlighter-rouge">confidence</code> 字段</td>
      <td>判断用户是否明确提出退款</td>
    </tr>
  </tbody>
</table>

<p><code class="language-plaintext highlighter-rouge">Score</code> 可以位于两个等级之间。例如等级位置为 0、1、2，概率为 0、0.6、0.4，则 <code class="language-plaintext highlighter-rouge">score = 1.4</code>，而非必须选中整数等级 1 或 2。这是模型在等级上的分布摘要，不是物理测量值。<a href="https://docs.typesafe.ai/primitives/choice">Choice</a>；<a href="https://docs.typesafe.ai/primitives/score">Score</a>；<a href="https://docs.typesafe.ai/primitives/noul">Noul</a></p>

<p>同一个工单分类场景，按官方字段组织成请求如下。它与图 1 对应，用于说明接口，未实际调用。</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="nl">"model"</span><span class="p">:</span><span class="w"> </span><span class="s2">"jev-1.13.0"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"state"</span><span class="p">:</span><span class="w"> </span><span class="s2">"用户消息：订单显示已经送达，但我没有收到包裹。"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"questions"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"ticket_category"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
      </span><span class="nl">"type"</span><span class="p">:</span><span class="w"> </span><span class="s2">"choice"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"instructions"</span><span class="p">:</span><span class="w"> </span><span class="s2">"根据用户明确表达的主要诉求，将工单归入最匹配的类别。"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"criteria"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
        </span><span class="nl">"logistics"</span><span class="p">:</span><span class="w"> </span><span class="s2">"物流问题：配送进度、送达状态或包裹未收到"</span><span class="p">,</span><span class="w">
        </span><span class="nl">"refund"</span><span class="p">:</span><span class="w"> </span><span class="s2">"退款申请：用户明确要求退还款项"</span><span class="p">,</span><span class="w">
        </span><span class="nl">"product"</span><span class="p">:</span><span class="w"> </span><span class="s2">"商品咨询：商品规格、功能或使用方式"</span><span class="w">
      </span><span class="p">}</span><span class="w">
    </span><span class="p">}</span><span class="w">
  </span><span class="p">}</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>同一 <code class="language-plaintext highlighter-rouge">state</code> 上的问题可合并请求并分别求值；这里的“独立”指不需要依赖其他问题的返回结果，不表示它们在统计上互不相关。需要先读取上一步结果或获取新观测的问题，应分步处理。类型约束减少自由文本解析问题，但不免除请求失败处理、结果校验和执行条件检查。</p>

<h3 id="22-为什么可能更快接口事实与内部架构要分开">2.2 为什么可能更快：接口事实与内部架构要分开</h3>

<p>普通生成式调用读入上下文后，再逐 token 输出回答；如果需要长推理或解释，这部分串行计算会增加延迟。Jev 的公开接口不返回生成式解释，官方描述其通过并行采样在同一请求中给出多个类型化结果。<a href="https://typesafe.ai/blog/introducing-system-one-models-and-jev">发布文</a></p>

<p><strong>“一次请求返回全部结果”不等于已经公开证明“内部只有一次前向传播”。</strong> 目前本文核查的材料未完整披露 Jev 的网络结构和执行路径。因此可以讨论省去自由文本解码与多问题并行的意义，却不能把社区编码器、决策头或 logits 读出的实现直接当作 Jev 的真实内部结构。</p>

<div align="center">
<svg viewBox="0 0 780 270" width="100%" style="max-width:780px;font-family:sans-serif" xmlns="http://www.w3.org/2000/svg" role="img" aria-labelledby="jev-output-title"><title id="jev-output-title">生成式调用与类型化决策：比较的是输出路径</title><rect x="1" y="1" width="778" height="268" rx="12" fill="#f8fafc" stroke="#e2e8f0" /><text x="390" y="28" text-anchor="middle" font-size="14" font-weight="bold" fill="#1e293b">生成式调用与类型化决策：比较的是输出路径</text><text x="92" y="89" text-anchor="middle" font-size="13" font-weight="bold" fill="#334155">生成式调用</text><rect x="170" y="60" width="145" height="55" rx="8" fill="#fff" stroke="#94a3b8" /><text x="242" y="92" text-anchor="middle" font-size="12" font-weight="normal" fill="#334155">读入上下文</text><text x="335" y="93" text-anchor="middle" font-size="24" font-weight="bold" fill="#64748b">→</text><rect x="355" y="60" width="205" height="55" rx="8" fill="#fff" stroke="#94a3b8" /><text x="457" y="83" text-anchor="middle" font-size="12" font-weight="normal" fill="#334155">逐 token 输出答案</text><text x="457" y="103" text-anchor="middle" font-size="10" font-weight="normal" fill="#334155">是否有长推理取决于设置</text><text x="580" y="93" text-anchor="middle" font-size="24" font-weight="bold" fill="#64748b">→</text><rect x="600" y="60" width="160" height="55" rx="8" fill="#fff" stroke="#94a3b8" /><text x="680" y="91" text-anchor="middle" font-size="12" font-weight="normal" fill="#334155">解析与任务校验</text><text x="92" y="171" text-anchor="middle" font-size="13" font-weight="bold" fill="#1e40af">Jev 接口</text><rect x="170" y="140" width="145" height="55" rx="8" fill="#dbeafe" stroke="#2563eb" /><text x="242" y="171" text-anchor="middle" font-size="12" font-weight="normal" fill="#334155">状态 + 多个问题</text><text x="335" y="173" text-anchor="middle" font-size="24" font-weight="bold" fill="#64748b">→</text><rect x="355" y="140" width="205" height="55" rx="8" fill="#dbeafe" stroke="#2563eb" /><text x="457" y="163" text-anchor="middle" font-size="12" font-weight="normal" fill="#334155">类型化结果并行返回</text><text x="457" y="183" text-anchor="middle" font-size="10" font-weight="normal" fill="#334155">不披露内部前向次数</text><text x="580" y="173" text-anchor="middle" font-size="24" font-weight="bold" fill="#64748b">→</text><rect x="600" y="140" width="160" height="55" rx="8" fill="#dcfce7" stroke="#16a34a" /><text x="680" y="171" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">结构读取与任务校验</text><text x="390" y="225" text-anchor="middle" font-size="12" font-weight="normal" fill="#334155">输入处理、通信、排队与结果验证仍可能占用时间</text><text x="390" y="247" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">公平对照：短答案生成 / 候选读出 / 分类器；统一任务与计时范围</text></svg>
<figcaption>图 2　两种输出路径的对照。任务校验与端到端开销应纳入比较。</figcaption>
</div>

<p>官方发布时报告端到端响应 70–500 ms，并给出针对其 System One 任务的加速对比。这些数字依赖输入、问题数量、网络与对照模型设置；不能拿长推理模型的耗时，推导 Jev 对所有短答案基线都具有相同倍数优势。<a href="https://typesafe.ai/blog/introducing-system-one-models-and-jev">官方速度说明</a></p>

<p>后文开源方法可以直接检查是否单次读出、是否多次去偏、是否共享前缀。公平评测应分别记录输入编码、模型计算、通信与后处理，并包含短答案生成、候选读出和分类器基线。无需生成长解释，不代表完全不需要理解输入，也不意味着模型一定更准确。</p>

<h3 id="23-概率confidence-与校准不是一回事">2.3 概率、confidence 与校准不是一回事</h3>

<p>先区分三个概念，否则后文的阈值和调度容易混淆：</p>

<table>
  <thead>
    <tr>
      <th>概念</th>
      <th>表示什么</th>
      <th>不能直接推导什么</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>候选 / 命题概率</td>
      <td>模型在给定状态与问题下对答案的支持程度</td>
      <td>真实环境中的碰撞概率或任务必然成功</td>
    </tr>
    <tr>
      <td>API 的 <code class="language-plaintext highlighter-rouge">confidence</code></td>
      <td>由 Choice / Score 的概率分布计算的集中程度摘要</td>
      <td>该数值就是所选项概率，或就是实际正确率</td>
    </tr>
    <tr>
      <td>校准</td>
      <td>在一组预测中，预测概率与实际结果频率是否匹配</td>
      <td>每个高概率答案都正确，或换场景后仍然校准</td>
    </tr>
  </tbody>
</table>

<p>官方明确说明 <code class="language-plaintext highlighter-rouge">confidence</code> 由已返回的分布计算；Noul 不另外携带这一字段。实际系统可以读取完整分布，并评估何种不确定性统计量适合本任务。<a href="https://docs.typesafe.ai/confidence">Confidence 文档</a></p>

<p>以多分类的 top-label 校准为例，用每个样本最高的候选概率分桶，比较桶内平均概率与准确率：</p>

\[\mathrm{ECE}=\sum_{m=1}^{M}\frac{|B_m|}{n}
\left|\mathrm{acc}(B_m)-\overline{p}_{\max}(B_m)\right|\]

<p>这里的 $\overline{p}_{\max}$ 是所选项概率的平均值，<strong>不是未经定义转换的 API <code class="language-plaintext highlighter-rouge">confidence</code></strong>。对二元命题，也可用预测为真的概率 $p_i$ 和标签 $y_i\in{0,1}$ 计算：</p>

\[\mathrm{Brier}=\frac{1}{n}\sum_{i=1}^{n}(p_i-y_i)^2\]

<p>ECE 依赖分桶方式和样本量；Brier 衡量概率预测误差，也受区分能力影响，不是只测校准。多分类与二元任务的定义应明确，不能跨论文直接排列数值大小。</p>

<div align="center">
<svg viewBox="0 0 660 390" width="100%" style="max-width:660px;font-family:sans-serif" xmlns="http://www.w3.org/2000/svg">
  <rect width="660" height="390" rx="12" fill="#f8fafc" stroke="#e2e8f0" stroke-width="1.5" />
  <text x="330" y="26" text-anchor="middle" font-size="14" font-weight="bold" fill="#1e293b">可靠性图：什么叫“校准”（示意）</text>
  <rect x="70" y="50" width="340" height="280" fill="#ffffff" stroke="#cbd5e1" />
  <g stroke="#f1f5f9"><line x1="138" y1="50" x2="138" y2="330" /><line x1="206" y1="50" x2="206" y2="330" /><line x1="274" y1="50" x2="274" y2="330" /><line x1="342" y1="50" x2="342" y2="330" /><line x1="70" y1="274" x2="410" y2="274" /><line x1="70" y1="218" x2="410" y2="218" /><line x1="70" y1="162" x2="410" y2="162" /><line x1="70" y1="106" x2="410" y2="106" /></g>
  <line x1="70" y1="330" x2="410" y2="50" stroke="#94a3b8" stroke-width="1.5" stroke-dasharray="6 4" />
  <g stroke="#ef4444" stroke-width="1.2" stroke-dasharray="3 3"><line x1="189" y1="268" x2="189" y2="232" /><line x1="257" y1="232" x2="257" y2="176" /><line x1="325" y1="190" x2="325" y2="120" /><line x1="393" y1="145" x2="393" y2="64" /></g>
  <polyline points="121,302 189,268 257,232 325,190 393,145" fill="none" stroke="#ef4444" stroke-width="2.5" />
  <g fill="#ef4444"><circle cx="121" cy="302" r="4" /><circle cx="189" cy="268" r="4" /><circle cx="257" cy="232" r="4" /><circle cx="325" cy="190" r="4" /><circle cx="393" cy="145" r="4" /></g>
  <polyline points="121,291 189,229 257,182 325,114 393,70" fill="none" stroke="#2563eb" stroke-width="2.5" />
  <g fill="#2563eb"><circle cx="121" cy="291" r="4" /><circle cx="189" cy="229" r="4" /><circle cx="257" cy="182" r="4" /><circle cx="325" cy="114" r="4" /><circle cx="393" cy="70" r="4" /></g>
  <g font-size="10" fill="#64748b" text-anchor="middle"><text x="70" y="346">0</text><text x="138" y="346">0.2</text><text x="206" y="346">0.4</text><text x="274" y="346">0.6</text><text x="342" y="346">0.8</text><text x="410" y="346">1.0</text></g>
  <g font-size="10" fill="#64748b" text-anchor="end"><text x="62" y="334">0</text><text x="62" y="278">0.2</text><text x="62" y="222">0.4</text><text x="62" y="166">0.6</text><text x="62" y="110">0.8</text><text x="62" y="54">1.0</text></g>
  <text x="240" y="370" text-anchor="middle" font-size="12" fill="#334155">所选项的预测概率</text>
  <text x="24" y="190" text-anchor="middle" font-size="12" fill="#334155" transform="rotate(-90 24 190)">该桶的实际正确率</text>
  <line x1="430" y1="70" x2="460" y2="70" stroke="#94a3b8" stroke-width="1.5" stroke-dasharray="6 4" />
  <text x="468" y="74" font-size="11" fill="#334155">理想校准：说 70% 就对 70%</text>
  <line x1="430" y1="108" x2="460" y2="108" stroke="#ef4444" stroke-width="2.5" />
  <text x="468" y="104" font-size="11" fill="#991b1b">过度自信：预测概率高于</text>
  <text x="468" y="120" font-size="11" fill="#991b1b">实际正确率（示意）</text>
  <line x1="430" y1="150" x2="460" y2="150" stroke="#2563eb" stroke-width="2.5" />
  <text x="468" y="146" font-size="11" fill="#1e3a8a">校准良好：贴着对角线</text>
  <text x="468" y="162" font-size="11" fill="#1e3a8a">（不代表 Jev 实测结果）</text>
  <line x1="438" y1="190" x2="438" y2="214" stroke="#ef4444" stroke-width="1.2" stroke-dasharray="3 3" />
  <text x="450" y="200" font-size="11" fill="#334155">红色虚线长度按样本数</text>
  <text x="450" y="216" font-size="11" fill="#334155">加权平均 ≈ ECE</text>
  <rect x="428" y="238" width="216" height="88" rx="8" fill="#fff7ed" stroke="#fdba74" />
  <text x="440" y="258" font-size="11" font-weight="bold" fill="#9a3412">对机器人意味着什么</text>
  <text x="440" y="278" font-size="11" fill="#9a3412">阈值需用目标任务数据检验</text>
  <text x="440" y="296" font-size="11" fill="#9a3412">概率不能代替执行安全检查；</text>
  <text x="440" y="314" font-size="11" fill="#9a3412">换任务就要重新画这张图</text>
</svg>
<figcaption>图 3　所选项概率与实际正确率的关系示意。曲线不代表某种训练方法或 Jev 的实测结果。</figcaption>
</div>

<p>对导航而言，“更集中”与“更可靠”需要用目标任务数据建立联系。选路、到达和恢复的错误代价不同，不能共用一个未经检验的阈值；校准良好也不能替代对地图、障碍与命令有效性的检查。</p>

<h3 id="24-rlcd训练目标已说明完整配方仍未知">2.4 RLCD：训练目标已说明，完整配方仍未知</h3>

<p>TypeSafe 将其训练方法称为 <strong>RLCD（Reinforcement Learning for Calibrated Decisions）</strong>，公开强调输出决策与概率，并使概率对应实际结果。相较于 RLHF 的偏好目标，这体现了不同的优化重点；但不能把 RLHF 简化成必然过度自信，也不能因为采用 RLCD 名称就断言输出已经可靠。<a href="https://docs.typesafe.ai/introduction/machine-learning-primer">官方 AI primer</a></p>

<p>在本文核查的公开材料中，尚无法重建 Jev 的完整训练配方：基座、数据组成、奖励细节和优化过程都缺乏足够信息。“新架构 + 新训练方法”应作为厂商主张呈现，不能借社区实现反向补全。</p>

<p>对数损失与 Brier 损失属于严格恰当评分规则：在相应统计条件下，其期望最优预测对应真实分布。这提供了概率学习的理论动机，<strong>不保证有限数据、有限模型和分布迁移后的实际校准</strong>。Laya 提供了可检查的概率训练与温度校准实现，属于独立路线，不是 TypeSafe 配方的复现证据。<a href="https://github.com/NandhaKishorM/laya">Laya</a></p>

<h3 id="25-如何阅读评测速度准确率校准与稳定性">2.5 如何阅读评测：速度、准确率、校准与稳定性</h3>

<p>Jev 的公开评测来自不同任务、不同标签来源和不同运行环境。本文不据此给它一个统一“模型档位”，而是分别检查四个问题：</p>

<table>
  <thead>
    <tr>
      <th>维度</th>
      <th>应比较什么</th>
      <th>常见混淆</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>速度与成本</td>
      <td>同输入、同输出任务的延迟分布、调用数和价格</td>
      <td>服务端耗时与网络端到端耗时混用；以长推理作为唯一基线</td>
    </tr>
    <tr>
      <td>准确率</td>
      <td>同一测试集、同一候选空间与参考标签下的结果</td>
      <td>教师模型一致率当成人类真值；领域适配与零样本混比</td>
    </tr>
    <tr>
      <td>校准与选择性预测</td>
      <td>固定定义下的概率误差，以及拒绝部分样本后的风险 / 覆盖率</td>
      <td>分布尖锐当作校准；不同任务 ECE 直接比较</td>
    </tr>
    <tr>
      <td>稳定性与鲁棒性</td>
      <td>选项换序、改名、重复调用、语言和状态长度变化</td>
      <td>格式始终合法被当作语义判断始终可靠</td>
    </tr>
  </tbody>
</table>

<p>官方 workflow eval 使用外部强模型的参考预测评估业务流程；厂商也说明宣传中的高倍数收益处于预期收益的较高端。这有助于理解其目标使用方式，但不等同于人类标注基准或导航闭环实验。<a href="https://typesafe.ai/blog/introducing-system-one-models-and-jev">发布文中的评测说明</a></p>

<p>第三方材料也应带着协议阅读：</p>

<ul>
  <li><strong>Convex Decision Evals</strong> 使用 108 道领域四选一题，并采用匹配的选项排列。它测领域决策知识，作者明确区分这与编写或调试真实应用的能力。<a href="https://github.com/get-convex/convex-evals">评测仓库</a></li>
  <li><strong>Anthus 的 Jev / Laya 对照</strong>在相同 600 条留出样本上报告原始 ECE 分别为 0.151 和 0.107，但作者没有把这个差值单独当作 Laya 胜出；其 Brier 比较反而有利于 Jev。这说明准确率、校准与概率预测质量应一起解释。<a href="https://anth.us/blog/jev-vs-laya/">实验报告</a></li>
  <li><strong>Laya 的项目对照</strong>有领域适配、温度拟合以及候选数量设置差异，适合研究训练收益和限制，不是统一条件下的通用排名，详见 3.3。<a href="https://github.com/NandhaKishorM/laya">项目结果</a></li>
</ul>

<p>这些证据支持继续测试 Jev 的有界决策用途，但不足以推出“普遍达到某档 LLM”“所有任务都需要相同校准方法”或“某种错误绝不会发生”。可复现比较需要保存模型版本、问题文本、候选集合、标注来源和运行环境。</p>

<h3 id="26-能力边界与使用条件">2.6 能力边界与使用条件</h3>

<p>“无类型错误”是输出契约上的主张，与事实正确、逻辑一致或行动安全不同。官方列出的弱项包括数值精度、多层间接推理、无关信息过多的长状态、对抗内容与矛盾条件。<a href="https://docs.typesafe.ai/model-jaggedness/jev-1.13">Jev 1.13 局限</a></p>

<p>这对导航产生几条直接约束：精确坐标与碰撞计算留给几何模块；历史应按问题检索与裁剪；需要新计划或解释时保留生成式模块。<strong>代码拥有否决权能阻止部分错误执行，但增加判断层也可能带来误拒绝、延迟和任务停滞，不能称为“最坏等同没有它”。</strong></p>

<p>下表为 <strong>2026-09-26 核查的官方配置快照</strong>；别名、价格与限流可能变化。<a href="https://docs.typesafe.ai/models">Models</a></p>

<table>
  <thead>
    <tr>
      <th>项目</th>
      <th>官方配置</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>模型</td>
      <td><code class="language-plaintext highlighter-rouge">jev-1.13.0</code>；当时 <code class="language-plaintext highlighter-rouge">jev-latest</code>、<code class="language-plaintext highlighter-rouge">jev-preview</code> 均指向该版本</td>
    </tr>
    <tr>
      <td>输入</td>
      <td>仅文本；支持字符串、JSON 对象或文本数组</td>
    </tr>
    <tr>
      <td>上下文</td>
      <td>每请求总计 64k；state 加最长问题不超过 32k</td>
    </tr>
    <tr>
      <td>计费</td>
      <td>输入 $0.042 / 百万 token，输出免费</td>
    </tr>
    <tr>
      <td>限流</td>
      <td>250k tokens/s、1,200 requests/min；官方提示可能动态调整</td>
    </tr>
  </tbody>
</table>

<p>价格是服务计费政策，不能仅由“没有生成文本”推导。做研究时应固定版本并记录实际返回的模型 ID；输入语言与场景变化也应单独评测。</p>

<h3 id="27-从单次判断到-agent已有应用提供的线索">2.7 从单次判断到 Agent：已有应用提供的线索</h3>

<p>已有论文展示了 Jev 可以怎样嵌入系统。本节只保留角色与证据边界，记忆机制和导航迁移在第 4 章展开。</p>

<table>
  <thead>
    <tr>
      <th>工作</th>
      <th>Jev 承担的角色</th>
      <th>对后文的启发与限制</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><a href="https://arxiv.org/abs/2609.23986">Jev-Mem</a></td>
      <td>记忆组织、检索路由、候选评分与停止判断</td>
      <td>支持研究“查什么证据”；实验是长期对话记忆，详见 4.3</td>
    </tr>
    <tr>
      <td><a href="https://arxiv.org/abs/2609.26532">REFLEX</a></td>
      <td>有界行动选择，不确定或需要生成时升级</td>
      <td>在其 100 任务基准中报告 95% 成功率、强模型调用减少 72.7%；相对廉价生成式级联的优势有限</td>
    </tr>
    <tr>
      <td><a href="https://arxiv.org/abs/2609.28940">渗透测试 Harness</a></td>
      <td>对确认、分级和流程控制做判断</td>
      <td>提供约束决策层的系统例子；不能据此证明机器人安全或反推 Jev 的训练配方</td>
    </tr>
  </tbody>
</table>

<p>这些工作的共同线索是<strong>判断模块与生成 / 执行模块分工</strong>，而不是用 Jev 包办整个 Agent。REFLEX 的有限优势尤其提醒：后续导航实验需要与规则、小模型和廉价级联比较，而不只与“每一步都调用最强模型”比较。</p>

<h2 id="3-从-jev-接口到开源实现四类技术路线">3. 从 Jev 接口到开源实现：四类技术路线</h2>

<p>托管 Jev 只收文本，但“有限候选 → 类型化结果”并不限定某一种骨干。社区方法可以改变读出方式、训练部分参数、复用共享计算，也可以接入视觉与音频。<strong>相似接口不代表相同模型，更不代表已经复现 TypeSafe 的训练与能力。</strong></p>

<p>本章按技术路线组织项目，而不把它们排成一张性能榜。以下结果均来自论文或项目作者报告，本文未独立复现；不同硬件、数据与训练条件下的延迟和准确率不能直接比较。</p>

<h3 id="31-路线总览改变读出训练能力共享计算或接入感知">3.1 路线总览：改变读出、训练能力、共享计算或接入感知</h3>

<div align="center">
<svg viewBox="0 0 780 300" width="100%" style="max-width:780px;font-family:sans-serif" xmlns="http://www.w3.org/2000/svg" role="img" aria-labelledby="jev-routes-title"><title id="jev-routes-title">开源实现的四个可组合维度（不是性能排名）</title><rect x="1" y="1" width="778" height="298" rx="12" fill="#f8fafc" stroke="#e2e8f0" /><text x="390" y="28" text-anchor="middle" font-size="14" font-weight="bold" fill="#1e293b">开源实现的四个可组合维度（不是性能排名）</text><rect x="20" y="54" width="360" height="91" rx="8" fill="#dbeafe" stroke="#2563eb" /><text x="200" y="79" text-anchor="middle" font-size="13" font-weight="bold" fill="#334155">改变读出</text><text x="200" y="103" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">AnyJev / PixelJev 冻结模式</text><text x="200" y="127" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">生成短答案 → 候选条件分布</text><rect x="400" y="54" width="360" height="91" rx="8" fill="#f5f3ff" stroke="#7c3aed" /><text x="580" y="79" text-anchor="middle" font-size="13" font-weight="bold" fill="#334155">引入任务训练</text><text x="580" y="103" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">minojev / Laya / Open-Jev</text><text x="580" y="127" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">小头、LoRA 或更广泛参数适配</text><rect x="20" y="166" width="360" height="91" rx="8" fill="#dcfce7" stroke="#16a34a" /><text x="200" y="191" text-anchor="middle" font-size="13" font-weight="bold" fill="#334155">复用共享计算</text><text x="200" y="215" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">Visual Jev 等</text><text x="200" y="239" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">同一视觉前缀 → 多问题执行</text><rect x="400" y="166" width="360" height="91" rx="8" fill="#fff7ed" stroke="#f59e0b" /><text x="580" y="191" text-anchor="middle" font-size="13" font-weight="bold" fill="#334155">接入模态证据</text><text x="580" y="215" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">视觉模型 / 外挂感知 / 音频编码器</text><text x="580" y="239" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">直接读模态特征，或先转结构化状态</text><text x="390" y="282" text-anchor="middle" font-size="11" font-weight="normal" fill="#334155">分别测量：质量、校准、延迟、计算量、显存与迁移；不能由训练程度推断速度</text></svg>
<figcaption>图 4　项目可同时使用多种机制；候选读出、领域训练、执行复用和新增模态应分别消融。</figcaption>
</div>

<table>
  <thead>
    <tr>
      <th>技术路线</th>
      <th>代表实现</th>
      <th>主要改变</th>
      <th>对研究最有价值的比较</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>冻结骨干、候选读出与去偏</td>
      <td>AnyJev raw / L0 / L1、PixelJev 冻结模式</td>
      <td>输出限制到合法候选；可加排列去偏与校准</td>
      <td>同一模型生成短答案 vs 直接读出</td>
    </tr>
    <tr>
      <td>决策头或任务适配</td>
      <td>minojev、Laya、Open-Jev、AnyJev L2</td>
      <td>学习任务相关表征 / 读出，训练范围各不相同</td>
      <td>冻结读出 vs 小头 vs 适配骨干</td>
    </tr>
    <tr>
      <td>视觉决策与共享上下文</td>
      <td>Visual Jev、PixelJev、Laya Vision、PlayJev</td>
      <td>使用视觉证据；部分方法复用视觉前缀</td>
      <td>视觉适配、读出方式、共享执行分别消融</td>
    </tr>
    <tr>
      <td>外挂感知或其他模态</td>
      <td>jev-vision、Prosodia 等</td>
      <td>图像 / 音频先转换为状态，或直接从模态编码器读出</td>
      <td>信息保留程度与整个流程成本</td>
    </tr>
  </tbody>
</table>

<p>这些路线可以组合，不是由上到下越来越先进的阶梯。AnyJev 同时包含无标签与拟合读出头的模式；Visual Jev 同时包含任务适配与执行共享。因此，“是否训练”“是否生成”“是否多模态”和“是否复用前缀”应作为独立维度记录。</p>

<h3 id="32-不训练骨干候选读出能带来什么">3.2 不训练骨干：候选读出能带来什么</h3>

<p>生成式 LLM 原本会在词表上预测下一个 token。如果把答案限制为少量标签，就可以只读取这些标签的 logits，再归一化为候选分布。通常需要先把候选映射到可直接读出的标签 token；若标签跨多个 token，则需另行定义序列评分或读出方式。这样避免生成解释，也减少答案格式不合法的问题，但<strong>候选条件分布不自动等于经过目标任务校准的概率</strong>。</p>

<p>AnyJev 提供了几个可分开考察的层次：raw 直接读出；L0 使用选项循环移位与标签先验修正；L1 再拟合温度；L2 则从隐状态拟合读出头，已不属于完全无标注的方法。在作者的 BANKING77 <strong>20-way、300 测试项</strong>设置中，raw 到 L1 的准确率由 0.747 变为 0.807，ECE 由 0.240 变为 0.095；不能把它写成完整 77 类任务的通用结果。<a href="https://github.com/nokia-applied-research/AnyJev">AnyJev</a></p>

<p>这里有两个容易遗漏的代价。第一，L0 的排列去偏涉及多个输入排列，单个读出不生成文本，并不意味着完成整次去偏只需一次模型计算。第二，温度和读出头需要数据，其拟合与测试应分离。即使服务端将这些计算批处理，也应报告总计算量与端到端延迟。</p>

<p>这条路线最适合作为<strong>接口收益的基线</strong>：如果不训练就能明显减少格式错误与生成成本，便可以先研究读出；若准确率仍受限，再研究训练。它不能凭空补上模型缺失的视觉知识、长程规划或正确候选。选项顺序与标签偏差也应单独检查，相关问题早于 Jev 已被研究。<a href="https://arxiv.org/abs/2309.03882">PriDe</a></p>

<h3 id="33-引入训练小决策头与骨干适配解决不同问题">3.3 引入训练：小决策头与骨干适配解决不同问题</h3>

<p><strong>冻结骨干、训练小头</strong>保留大部分预训练表示，只学习怎样将这些表示转成任务答案。minojev 采用冻结 Qwen3-1.7B 与小型决策头，其作者报告领域内收益，同时公开未见领域准确率 31.7%、低于生成式基线 40.0% 的结果。它说明任务专精和跨域泛化必须分别测，不能由少量领域内结果推断通用能力。<a href="https://github.com/zeredy879/minojev">minojev</a></p>

<p><strong>训练编码器决策模型</strong>允许更广泛地适配表示。Laya 基于 ModernBERT 等预训练编码器构建决策模型，不宜称为从随机初始化“从头训练”。在其 2,000 个 typed-decisions 上，领域适配 checkpoint 报告准确率 0.766，基础英文 checkpoint 为 0.362，Jev 对照为 0.727。这里最直接的证据是同一项目适配前后的变化；其其他对比还涉及温度拟合、输入预算和候选数量差异，不能统一解释为超过 Jev 的通用能力。<a href="https://github.com/NandhaKishorM/laya">Laya</a></p>

<p><strong>微调已有 LLM 的候选读出</strong>则保留语言骨干结构，通过 LoRA 等方式适配任务。Open-Jev 在合成诈骗通话的 41 个留出场景、577 次逐轮判断上报告 AUROC 0.974，单次决策 64.5 ms，比同骨干生成式微调低 4.9 倍延迟；作者同时指出，微调 ModernBERT 并未显著更差，配方选择接触过测试集。这是一项有具体应用和局限的研究，不支持“专用读出必然提高准确率”。<a href="https://arxiv.org/abs/2609.23959">Open-Jev</a></p>

<table>
  <thead>
    <tr>
      <th>训练选择</th>
      <th>可能得到什么</th>
      <th>主要代价或风险</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>仅拟合温度</td>
      <td>调整概率尖锐程度</td>
      <td>通常不改变 argmax，不能修复错误表征或遗漏候选</td>
    </tr>
    <tr>
      <td>冻结骨干、拟合小头</td>
      <td>较低训练成本下获得任务专精</td>
      <td>表征不足与跨域退化仍可能存在</td>
    </tr>
    <tr>
      <td>LoRA / 更广泛参数适配</td>
      <td>让表征更适合目标任务</td>
      <td>数据成本、遗忘与过拟合，需要保留独立测试集</td>
    </tr>
    <tr>
      <td>单独训练领域分类器</td>
      <td>简单任务上较低成本的基线</td>
      <td>泛化与可配置性需与通用模型公平比较</td>
    </tr>
  </tbody>
</table>

<p>所以，训练是否必要取决于任务，不能总结成“准确率只来自微调”。接口约束可能改善合法输出，标签设计和候选集合也会影响结果；训练的贡献需要在匹配条件下测出来。</p>

<h3 id="34-接入视觉图像信息任务适配与执行复用要分别分析">3.4 接入视觉：图像信息、任务适配与执行复用要分别分析</h3>

<h4 id="341-视觉证据不应被误算成接口收益">3.4.1 视觉证据不应被误算成接口收益</h4>

<p>PixelJev 将图像、指令和动态候选集接到开源多模态骨干，并分别测试冻结推理、少样本适配和校准。在 Pets 上，其 2B 模型从 60.13% 提升至 92.40%；匹配对照将主要收益归因于适配。作者同时报告专用 DINOv2 探针仍更强，部分任务上冻结 4B 优于适配 2B，准确率提升也不保证迁移后的概率校准。<a href="https://arxiv.org/abs/2609.29283">PixelJev</a></p>

<p>对导航的启发是：从“感知摘要 + 文本模型”切换到“图像 + VLM”，同时改变了输入证据与模型能力。要证明有界接口的作用，应在同一视觉骨干、同一候选集下比较生成与读出，另行测量视觉信息相对文本摘要的收益。</p>

<h4 id="342-同一图像上的多道题可以共享部分计算">3.4.2 同一图像上的多道题，可以共享部分计算</h4>

<p>Visual Jev 将图像与公共上下文编码一次，再批量执行隔离的问题后缀，从现有 LM 头读取候选概率。作者在每图 32 个问题的设置中报告暖态摊销时间相对独立串行快 8.9 倍、相对重复前缀的批处理快 3.4 倍；代价是更高峰值显存。匹配的类型化头对照没有显示一致准确率优势。<a href="https://arxiv.org/abs/2609.25845">Visual Jev</a></p>

<p>它支持的是<strong>共享输入下的执行优化</strong>，不是每一步机器人控制都能获得同样加速。每张新图是否可以复用、问题是否相互依赖、批次能否及时凑齐，都会影响实际收益。摊销每题时间也不能直接当作一次完整决策的响应时间。</p>

<p>这使“在哪一层共享”成为独立研究变量：多个问题共享图像，多个候选共享状态，或者多个模块共享提取出的证据。共享减少重复计算，但不改变证据本身是否正确。</p>

<h4 id="343-从视觉问答到动作策略还需要闭环数据">3.4.3 从视觉问答到动作策略，还需要闭环数据</h4>

<p>Laya Vision 基于 SmolVLM-256M 进行视觉决策训练，报告 L4 上约 34 ms 的中位延迟，同时观察到游戏能力和视觉推理之间的训练取舍。PlayJev 使用 Qwen3.5-0.8B，通过行为克隆与 DAgger 学习游戏动作选择，训练还打乱动作顺序以降低位置捷径。<a href="https://github.com/r33drichards/laya-vision">Laya Vision</a>；<a href="https://github.com/OmniJev/PlayJev">PlayJev</a></p>

<p>二者说明视觉输入可以接入有限动作决策，也提示离线问答准确率不足以描述行动能力：策略会进入自己选择造成的新状态，错误会累积。游戏结果不能直接外推为真实机器人导航性能，设备上的短延迟也不等于机载功耗、显存与可靠性均满足要求。</p>

<p>工程上，<a href="https://github.com/hr98w/jev-visual">Jev Visual</a>展示了共享图像与候选打分；<a href="https://github.com/NOPLAB/jev_navigation">jev_navigation</a>将 decider-2b-vision 接入 ROS 2 路径选择。它们有助于研究接口，但“能看图并选择”与“已验证的导航策略”之间仍有距离，具体证据见 4.5。</p>

<h3 id="35-外挂感知与其他模态保留了什么又丢失了什么">3.5 外挂感知与其他模态：保留了什么，又丢失了什么</h3>

<p>对于托管 Jev，图像或语音需要先转换为文本或结构化字段。例如 <a href="https://github.com/JeremyEltho/jev-vision">jev-vision</a>用检测结果与场景上下文做消歧；<a href="https://github.com/awlevin/typesafe-computer-use">typesafe-computer-use</a>使用 OCR；<a href="https://github.com/gaborishka/jev-canvas">jev-canvas</a>结合转写与位置选择操作。这条路线的优点是职责明确，但未提取出的视觉细节不会因为后面接了 Jev 而恢复。</p>

<p>另一种做法是直接从模态编码器读出决策。<a href="https://github.com/alperiox/audio-jevlike">Prosodia</a>以冻结 Whisper 编码器处理语音属性，避免先转写再判断。它说明生成文本不是所有模态任务的必要中间步骤，但具体任务需要的信息可能不同：声学属性与语言内容并不等价。</p>

<p>因此，多模态扩展不能概括为“换一个编码器即可”。还需要任务数据、模态对齐、候选定义、概率评估和部署验证。图像压缩成语义状态有信息损失，直接看图则有视觉计算开销，取舍应通过目标任务测量。</p>

<h3 id="36-综合判断性能究竟来自哪里">3.6 综合判断：性能究竟来自哪里</h3>

<p>前述工作可以归纳为四类来源，但每一类都需要自己的消融：</p>

<table>
  <thead>
    <tr>
      <th>来源</th>
      <th>可以合理期待的作用</th>
      <th>还需要验证什么</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>有界接口与候选读出</td>
      <td>限制输出、减少文本解码和解析开销</td>
      <td>是否保持判断质量，能否识别候选不足</td>
    </tr>
    <tr>
      <td>任务数据与参数适配</td>
      <td>改善目标任务表征和读出</td>
      <td>未见场景、未见标签与长期闭环泛化</td>
    </tr>
    <tr>
      <td>共享前缀与批处理</td>
      <td>减少重复编码，提高特定负载下吞吐</td>
      <td>单请求延迟、显存、异步状态时效</td>
    </tr>
    <tr>
      <td>校准与选择性决策</td>
      <td>使概率更适合门控或拒绝</td>
      <td>留出数据、分布漂移与风险 / 覆盖率</td>
    </tr>
  </tbody>
</table>

<p>现有研究不要求所有方法都使用专门决策头，也不支持“只要不生成就一定更快、更准、更可信”。比较时应固定能固定的变量，明确优化的是延迟、准确率还是概率质量，且单独核对代码与权重许可。</p>

<p>对具身导航而言，本地视觉决策模型是一条可研究的实现路线，而不是已经成立的“机载 Jev”。下一章将这些机制放到具体职责中：<strong>行动比较能否减少无效生成，记忆控制能否找到更有用的证据，模块调度能否把有限计算用在更需要的时刻。</strong></p>

<h2 id="4-jev-与具身导航从行动决策到-agent-协作的研究机会">4. Jev 与具身导航：从行动决策到 Agent 协作的研究机会</h2>

<p>Jev 对具身导航的价值，不能只用“每次调用快了多少”来衡量。更值得追问的是：<strong>导航系统中哪些环节需要生成和推理，哪些环节只需要在已有证据上做判断？如果将两者分开，能否在保留任务能力的同时，减少不必要的计算与错误？</strong></p>

<p>本章围绕三类问题展开：<strong>行动决策、记忆管理、Agent 内部协作</strong>。前两者分别决定“怎么走”和“查什么”，第三者指单个导航 Agent 对感知、记忆、规划与推理模块的调度，决定“现在应该行动、回忆、补看，还是深度推理”，不涉及多 Agent 通信与协商。贯穿例子是“回到刚才看见杯子的房间，在门口停下”，用它说明三类能力如何共同完成长期导航。</p>

<p>需要先划清证据边界：导航论文为接口设计提供依据，Jev-Mem 提供通用 Agent 记忆实验，社区项目展示部分机器人接入。<strong>下文将这些工作迁移到导航的方案属于研究设想，尚不是 Jev 已验证的导航能力。</strong></p>

<h3 id="41-为什么导航值得引入-system-one-决策模型">4.1 为什么导航值得引入 System One 决策模型</h3>

<h4 id="411-一次长程导航包含许多不同难度的判断">4.1.1 一次长程导航包含许多不同难度的判断</h4>

<p>理解“穿过厨房，再到客厅窗边”可能需要指令解析和场景推理；但当机器人已处于通往客厅的走廊时，每一步未必都需要重新生成一段完整计划。它可能只需比较两个路点、判断地标是否匹配，或确认当前子目标是否已完成。</p>

<p>采用逐步生成式决策的导航系统，会在这些难度不同的问题上反复付出读上下文、生成和解析的成本。VerNav 与 AdaNav 分别从“用验证替代常规生成”和“按不确定性触发推理”切入，说明研究重点已经从单纯增强推理，转向<strong>把推理用在有收益的时刻</strong>。<a href="https://arxiv.org/abs/2609.00920">VerNav</a>；<a href="https://arxiv.org/abs/2509.24387">AdaNav</a></p>

<p>Jev 为这一方向提供了一种具体的决策接口：给定状态和有限答案空间，直接返回判断与概率。研究中要同时记录调用耗时与判断错误引起的走错路、回退和重复调用。</p>

<h4 id="412-长期任务的成本不只来自动作选择">4.1.2 长期任务的成本不只来自动作选择</h4>

<p>“回到刚才看见杯子的房间”至少包含三类不确定性：</p>

<table>
  <thead>
    <tr>
      <th>不确定性</th>
      <th>机器人需要解决的问题</th>
      <th>潜在的 System One 职责</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>行动不确定性</td>
      <td>目标已知，当前几个方向哪个更合适？</td>
      <td>候选比较、进展验证、到达判断</td>
    </tr>
    <tr>
      <td>记忆不确定性</td>
      <td>哪次观测中的杯子、哪个房间才是指令所指？</td>
      <td>记忆相关性、证据筛选、检索停止</td>
    </tr>
    <tr>
      <td>过程不确定性</td>
      <td>当前信息不够，下一步应查历史还是换个视角？</td>
      <td>模块选择、计算预算分配、升级判断</td>
    </tr>
  </tbody>
</table>

<p>这三类问题不能全部压成“选一个动作”。目标房间不确定时，立即选路可能放大记忆错误；目标明确但被遮挡时，继续检索历史未必有用；路径暂时受阻时，也不一定需要重新理解整条指令。</p>

<p>因此，一个有意义的研究目标是：<strong>用低开销的有界判断，减少导航过程中的无效行动、无效检索和无效推理。</strong> 除调用延迟外，还应关注绕路、重复探索、错误停止与总任务耗时。</p>

<h4 id="413-区分-jevsystem-one-接口与导航模型能力">4.1.3 区分 Jev、System One 接口与导航模型能力</h4>

<p>本文使用“Jev”时，指 TypeSafe 的托管文本决策模型；“视觉 System One”则指第 3 章的视觉派生或同类方法。原生 Jev 需要上游先把视觉观测转成语义状态，本地视觉模型可以直接处理图像，两者可用的信息与部署成本不同。</p>

<p>研究中至少要分开三个变量：<strong>接口是否从生成改成判断，模型是否经过导航训练，以及输入是否增加了视觉证据。</strong> 如果同时更换这三者，实验即使变好，也无法知道收益从何而来。“System One”本身不会自动提供空间理解、导航记忆或领域校准。</p>

<h3 id="42-行动决策从生成动作到比较与验证">4.2 行动决策：从生成动作到比较与验证</h3>

<h4 id="421-候选比较改变的是模型与机器人的分工">4.2.1 候选比较改变的是模型与机器人的分工</h4>

<p>一种做法是让大模型直接描述下一步动作，甚至输出坐标；另一种做法是由机器人先构造可执行候选，再让模型比较。后者把度量计算、动作幅度和执行约束留给机器人，把语义判断交给模型。</p>

<p><strong>C²Nav</strong> 对此进行了直接研究：空间选择、指令阶段转换和终止判断都采用比较式接口。在 OpenNav R2R-CE 100 协议上，Qwen3-VL-8B-Instruct 版本的 SR 为 31.0%；将三个决策位置分别改回数值式 / 绝对式问法后，SR 降至 12.0%、28.0%、21.0%。结果支持“问题形式会影响导航表现”，但并不证明模型能力可以被接口替代。<a href="https://arxiv.org/abs/2609.15142">C²Nav</a></p>

<p>对 Jev 而言，这类任务可以自然表达为 <code class="language-plaintext highlighter-rouge">Choice</code>：在“前往左侧门口”“继续走廊”“停下补看”中选择。但候选必须来自地图、感知或规划器。<strong>候选集中没有正确行动，模型选得再准也无法完成任务。</strong></p>

<p><strong>O2C-Nav</strong> 则提供视觉候选的参照：将带历史信息的候选路点投影到 RGB 图像，由 MLLM 选点，低层 FMM 规划器执行；候选不足时还可生成备用目标框。若迁移到闭集视觉决策模型，需要保留或重做这个备用分支，不能只替换选点模块就假定整个方法等价。<a href="https://arxiv.org/abs/2609.06476">O2C-Nav</a></p>

<p>由此形成第一个研究问题：<strong>在相同感知和候选集下，非生成式选择能否保留生成式模型的导航质量？</strong> 难点不仅在平均准确率，还在困难场景中是否能识别“这些候选都不足以解决问题”。</p>

<h4 id="422-比较哪个更好与验证能否接受可以分开">4.2.2 比较哪个更好，与验证能否接受，可以分开</h4>

<p>候选比较回答“哪一个相对更好”；动作验证回答“它是否值得执行”。当所有候选都不好时，最高概率选项依然存在，因此还需要拒绝或补证据机制。</p>

<p>VerNav 用批量动作验证替代常规逐步生成，在不确定时再由生成器提供紧凑证据。其 verifier-only 路径在离散 R2R 上实现超过 10 倍的平均单步决策阶段 LLM 延迟降低；同时，验证器经过偏好对齐和逐步强化训练。<strong>这支持验证优先的路线，不能直接推导出零样本 Jev 替换后的效果。</strong> <a href="https://arxiv.org/abs/2609.00920">VerNav</a></p>

<p>对 Jev 的迁移可以研究两种分工：直接从候选中选择，或先对候选做有界验证，再由程序决定接受、重选或升级。后一种分工有利于暴露“拒绝行动”的条件，但也可能增加调用成本。值得验证的是，在相同预算下，多一次验证能否减少更昂贵的执行错误。</p>

<h4 id="423-进展和到达判断比普通选路更容易积累错误">4.2.3 进展和到达判断，比普通选路更容易积累错误</h4>

<p>导航不是独立选择题的集合。一次错误转向可能通过后续观测纠正；一次错误到达判断却可能直接结束任务。C²Nav 将进展与终止判断也纳入比较式设计，提示它们需要单独建模，而不是附在选路问题之后。<a href="https://arxiv.org/abs/2609.15142">C²Nav</a></p>

<table>
  <thead>
    <tr>
      <th>决策</th>
      <th>杯子房间例子中的问题</th>
      <th>可研究的接口</th>
      <th>必须观察的失败</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>局部选择</td>
      <td>哪个观察点更有助于接近目标门口？</td>
      <td>有限候选比较</td>
      <td>正确候选缺失、被相似地标误导</td>
    </tr>
    <tr>
      <td>阶段转换</td>
      <td>仍在找房间，还是已进入门口复核阶段？</td>
      <td>相邻任务阶段比较</td>
      <td>提前跳过尚未满足的子目标</td>
    </tr>
    <tr>
      <td>到达复核</td>
      <td>当前门口是否对应目标地点，且停在要求的位置？</td>
      <td>条件判断 + 必要的补看</td>
      <td>错误停止、反复犹豫、过度接近</td>
    </tr>
    <tr>
      <td>异常判断</td>
      <td>杯子暂时不可见，还是此前的目标关联有误？</td>
      <td>遮挡 / 歧义 / 信息不足判断</td>
      <td>把暂时遮挡当作目标不存在</td>
    </tr>
  </tbody>
</table>

<p>这里的“停止”要区分安全停车、等待信息与任务完成。它们可能都产生零速度，但只有最后一种意味着任务结束；到达复核因此需要同时核对当前观测、目标条件和位置证据。</p>

<p>这一方向的创新可以落在<strong>决策粒度与验证时机</strong>上：哪些判断共享状态即可一起完成，哪些必须等待行动后的新证据；到达错误的代价更高时，是否值得采用不同于普通选路的复核策略。</p>

<h4 id="424-什么情况下值得引入-jev">4.2.4 什么情况下值得引入 Jev</h4>

<p>若任务只是比较距离、检查障碍或判断是否落入固定区域，几何计算与规则已经给出了明确依据。若场景和标签长期固定、标注数据充足，小型分类器也应是直接的对照。Jev 更值得检验的情形是：<strong>候选随环境变化，而选择标准来自当前指令，需要把语义条件与候选证据对应起来。</strong></p>

<p>例如，同样面对两个门口，“去有杯子的房间”和“回到刚才见过杯子的房间”要求使用不同的证据。这里可以测试有界接口能否在调整问题与候选描述后继续工作，以及这种适配是否比重新训练分类器更省成本。对于小 LLM，则要在相同输入和候选下比较决策质量、延迟与拒绝能力。</p>

<p>因而，研究对象应是<strong>具有变化语义条件的有限选择</strong>。候选质量不足时应改进上游；任务需要创造新方案时应保留规划或生成。只有在这些职责明确后，才能判断 Jev 是否增加了有效能力。</p>

<h3 id="43-记忆管理从保存历史到检索与更新证据">4.3 记忆管理：从保存历史到检索与更新证据</h3>

<h4 id="431-jev-mem-提供了什么新的分工">4.3.1 Jev-Mem 提供了什么新的分工</h4>

<p>长期 Agent 不仅要保存历史，还要决定如何组织历史、检索哪些证据，以及何时停止查找。Jev-Mem 将这些高频有界判断交给 System One，再由 System Two 综合证据回答问题。其共享记忆保留原始观测，并组织语义、时间、因果与实体关系；控制器参与查询路由、预算分配、候选评分与停止。<a href="https://arxiv.org/html/2609.23986v1">Jev-Mem</a></p>

<p>作者在 LoCoMo 上使用 GPT-4o-mini 作为回答模型，报告总体 LLM-as-a-Judge 得分 0.777（MAGMA 为 0.700）、构建耗时 158 s（Nemori 为 1,044 s）、平均查询延迟 0.93 s（MAGMA 为 1.47 s）。查询延迟包含检索与答案生成，不同指标对应不同基线。<strong>这验证的是对话记忆系统，尚不是导航实验。</strong> <a href="https://github.com/libingzheren/Jev-Mem#results-on-locomo">作者结果表</a></p>

<p>对导航的启发在于：记忆不必只是每一步固定附加的历史摘要；它可以成为一个根据当前任务调整检索范围和深度的过程。是否值得查更多历史，本身也是一个决策。</p>

<h4 id="432-导航记忆比对话记忆多了空间落地与环境变化">4.3.2 导航记忆比对话记忆多了空间落地与环境变化</h4>

<p>“曾看见杯子”只有与地点、时间和来源关联，才能支持“返回那个房间”。文本相关性高的记录，未必对应同一个空间位置；过去可通行的路线，也未必现在仍可通行。</p>

<table>
  <thead>
    <tr>
      <th>导航记忆的特点</th>
      <th>只做文本相似检索可能出现的问题</th>
      <th>值得研究的扩展</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>地点与物体会重复</td>
      <td>多个房间都有杯子，召回内容相关但地点错误</td>
      <td>结合地点 ID、轨迹上下文与原始观测</td>
    </tr>
    <tr>
      <td>环境会变化</td>
      <td>把旧的开门状态当作当前可通行条件</td>
      <td>区分稳定地点知识与短期环境状态</td>
    </tr>
    <tr>
      <td>观测受视角影响</td>
      <td>没看见被理解成不存在，相似外观被认为同一地点</td>
      <td>保留观测条件与不确定性，必要时请求新视角</td>
    </tr>
    <tr>
      <td>行动会产生新证据</td>
      <td>检索结果不随失败反馈更新，重复走同一条无效路线</td>
      <td>将执行结果作为后续检索和重规划的上下文</td>
    </tr>
  </tbody>
</table>

<p>这里应明确边界：Jev 可以帮助判断某条记忆与任务是否相关，<strong>地点匹配、坐标一致性和可通行关系仍需要定位与地图依据</strong>。语义关系不能自动变成拓扑连通边，推断的失败原因也不能未经验证就被当作事实长期保存。</p>

<p>因此，从 Jev-Mem 迁移到导航，研究贡献不应只是“把聊天记录换成导航日志”，而应处理<strong>记忆的空间关联、时间有效性与行动反馈</strong>。</p>

<h4 id="433-从被动召回走向任务驱动的证据选择">4.3.3 从被动召回，走向任务驱动的证据选择</h4>

<p>以杯子房间为例，固定 top-k 可能找出若干包含“杯子”的记录；任务驱动检索还要回答：哪条符合“刚才”？两条记录是否属于同一地点？当前信息能否支持返回目标，还是需要回查图像或相邻轨迹？</p>

<p>一个待验证的流程是：</p>

<ol>
  <li>用向量、关键词、时间和地点信息找到有限候选；</li>
  <li>由 Jev 筛选支持当前任务的记录，并判断是否存在歧义；</li>
  <li>证据不足时扩大检索或回查来源，而不是立即选路；</li>
  <li>确定目标后交给规划模块，同时保留证据来源；</li>
  <li>行动产生新观测后，再检查旧判断是否需要更新。</li>
</ol>

<p><strong>停止检索不等于证据充分。</strong> Jev-Mem 的停止也可能来自继续查找收益低或预算限制；导航系统需要保留这个区别，避免把“没必要再查”误写成“目标已经确定”。<a href="https://arxiv.org/html/2609.23986v1">方法说明</a></p>

<p>这一方向有两个不同的收益目标：一是用更少计算找到同等质量的证据；二是通过更准确的证据选择减少错误返回、重复探索和绕路。两者应分别测量。即使检索速度更快，只要漏掉关键地点记录，闭环导航仍可能更慢。</p>

<h4 id="434-新观测如何更新记忆保留事实修正关联">4.3.4 新观测如何更新记忆：保留事实，修正关联</h4>

<p>主动检索还需要回答一个反向问题：行动之后，新证据怎样改变可供下一轮检索的记忆？以下是本文提出的导航扩展，区别于前面介绍的 Jev-Mem 原始实验。</p>

<table>
  <thead>
    <tr>
      <th>新事件</th>
      <th>应保留的观测事实</th>
      <th>待更新或复核的关联</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>在另一门口又看到杯子</td>
      <td>两次观测各自的时间、位置估计、视角与图像来源</td>
      <td>是否同一房间或同一物体，不能仅凭语义相似合并</td>
    </tr>
    <tr>
      <td>原先打开的门现在关闭</td>
      <td>过去打开、当前关闭的两条观测</td>
      <td>当前通行状态应更新；房间身份与稳定地标不随之删除</td>
    </tr>
    <tr>
      <td>到达候选房间后未找到目标</td>
      <td>本次访问路径、可见范围和未检出的结果</td>
      <td>是遮挡、目标移动，还是此前地点关联有误，需要进一步证据</td>
    </tr>
    <tr>
      <td>某条返回路线执行失败</td>
      <td>失败时间、位置及执行模块报告</td>
      <td>降低该路线当前可用性的判断；一次失败不等于永久不可达</td>
    </tr>
  </tbody>
</table>

<p>这里可以把记忆分成<strong>观测记录、关联假设和当前状态</strong>。观测记录保存来源；关联假设允许被修正；当前状态按时效更新，并能追溯依据。Jev 可作为判断“相关、冲突、需要复核”的候选模块，定位、几何一致性与数据库写入规则则负责约束更新。模型推测的原因应留在假设层，直到有新观测支持。</p>

<p>杯子房间案例中，一次错误返回不应让系统直接删除原始杯子记录。更有价值的处理是记录此次访问结果，重新检查“这条记录属于哪个房间”的关联，并在后续检索中区分已核实地点与待复核地点。这样，行动反馈才能改变下一次选择，而不是被追加成无人使用的日志。</p>

<h4 id="435-何时需要语义记忆控制">4.3.5 何时需要语义记忆控制</h4>

<p>若指令明确给出地点 ID 和时间区间，结构化查询或规则过滤就可能足够。值得引入 Jev 的问题是：<strong>多个候选都符合表面关键词，但需要结合任务关系、观测来源和冲突证据判定哪条有用</strong>，例如区分“刚才经过的房间”与“更早看过、外观相似的房间”。</p>

<p>这种判断应放在有限候选上检验。若正确记录根本没有被检索出来，就应先改善索引和召回；若相关证据需要跨多条记录重新解释，也应允许生成式模块参与。记忆控制的潜在价值在于减少无效查询和错误关联，其代价包括额外调用、提前停止和错误更新。检索与更新应分别消融，避免把更好的记忆库误归因为更好的查询控制。</p>

<h3 id="44-agent-内部协作何时行动回忆观察与推理">4.4 Agent 内部协作：何时行动、回忆、观察与推理</h3>

<h4 id="441-不确定时调用更强模型只是一个选项">4.4.1 不确定时，调用更强模型只是一个选项</h4>

<p>在长程任务中，困难可能来自不同原因：场景没看清、目标记错了、路线失效了，或者指令本身有歧义。只根据一个低置信信号升级到强模型，可能花费更多计算，却没有补齐真正缺失的信息。</p>

<p>AdaNav 通过不确定性相关信号学习何时触发显式推理，为按需计算提供了导航中的依据。但“是否推理”之外，还有更宽的选择空间：<strong>继续行动、检索记忆、主动观察、重新规划或请求澄清</strong>。将这些操作视为有限候选，是本文提出的 Jev Agent 调度方向，尚待验证。<a href="https://arxiv.org/abs/2509.24387">AdaNav</a></p>

<table>
  <thead>
    <tr>
      <th>当前问题</th>
      <th>更可能有价值的下一步</th>
      <th>为什么不能一律升级模型</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>候选明确，证据一致</td>
      <td>执行已验证的局部行动</td>
      <td>更多推理可能只增加等待</td>
    </tr>
    <tr>
      <td>两个历史房间都符合“见过杯子”</td>
      <td>回查时间、轨迹或图像记录</td>
      <td>更强模型也不能凭空消除来源歧义</td>
    </tr>
    <tr>
      <td>目标门口被视角遮挡</td>
      <td>移到安全观察点，获取新观测</td>
      <td>旧输入中没有所需视觉信息</td>
    </tr>
    <tr>
      <td>目标明确，但途中通路失效</td>
      <td>调用规划器寻找替代路线</td>
      <td>问题是可达性，不是语言理解</td>
    </tr>
    <tr>
      <td>新证据与任务解释冲突</td>
      <td>交给 LLM / VLM 重审计划，必要时澄清</td>
      <td>需要综合多个条件或生成新方案</td>
    </tr>
  </tbody>
</table>

<p>表中的对应关系只是启发式起点，不是已知最优调度规则。真正的研究问题是：Jev 能否根据状态与有限反馈，选择比固定流程更有价值的下一次计算或观察？</p>

<h4 id="442-把三类决策放进同一个-agent">4.4.2 把三类决策放进同一个 Agent</h4>

<p>图 5 给出研究层面的分工。任务规划器维护目标，感知和记忆提供证据，Jev 式决策层决定下一步操作，执行结果再成为新证据。感知、地图与检索器仍由各自模块实现；“控制检索”不意味着 Jev 自身存储或读取数据库。</p>

<div align="center">
<svg viewBox="0 0 800 440" width="100%" style="max-width:800px;font-family:sans-serif" xmlns="http://www.w3.org/2000/svg" role="img" aria-labelledby="jev-research-title jev-research-desc">
  <title id="jev-research-title">行动、记忆与模块调度组成的导航 Agent 研究框架</title>
  <desc id="jev-research-desc">任务规划、当前观测和历史证据进入有界决策层。决策层选择行动、检索、补充观察或深度推理；新观测与执行结果用于更新任务状态和复核记忆关联，再成为下一轮证据。所有运动经过本地规划和安全检查。</desc>
  <defs><marker id="jevResearchArrow" viewBox="0 0 10 10" refX="9" refY="5" markerWidth="7" markerHeight="7" orient="auto"><path d="M0,0 L10,5 L0,10 z" fill="#64748b" /></marker></defs>
  <rect x="1" y="1" width="798" height="438" rx="12" fill="#f8fafc" stroke="#e2e8f0" />
  <text x="400" y="28" text-anchor="middle" font-size="15" font-weight="bold" fill="#1e293b">研究设想：让有界判断协调行动、证据与计算</text>
  <g fill="#ffffff" stroke="#94a3b8">
    <rect x="30" y="52" width="225" height="68" rx="8" />
    <rect x="287" y="52" width="226" height="68" rx="8" />
    <rect x="545" y="52" width="225" height="68" rx="8" />
  </g>
  <g text-anchor="middle" fill="#334155">
    <text x="142" y="78" font-size="13" font-weight="bold">当前观测与地图</text>
    <text x="142" y="102" font-size="11">感知、定位、可行候选</text>
    <text x="400" y="78" font-size="13" font-weight="bold">任务目标与计划</text>
    <text x="400" y="102" font-size="11">任务程序 / LLM / VLM</text>
    <text x="657" y="78" font-size="13" font-weight="bold">历史记忆与来源</text>
    <text x="657" y="102" font-size="11">地点、时间、观测与执行记录</text>
  </g>
  <g fill="none" stroke="#64748b" stroke-width="1.5" marker-end="url(#jevResearchArrow)">
    <path d="M142,122 L142,140 L320,140 L320,158" />
    <path d="M400,122 L400,158" />
    <path d="M657,122 L657,140 L480,140 L480,158" />
  </g>
  <rect x="225" y="160" width="350" height="66" rx="9" fill="#dbeafe" stroke="#2563eb" stroke-width="2" />
  <text x="400" y="185" text-anchor="middle" font-size="14" font-weight="bold" fill="#1e3a8a">Jev 式有界决策层</text>
  <text x="400" y="208" text-anchor="middle" font-size="12" fill="#1e40af">比较候选 · 评估证据 · 选择下一步操作</text>
  <g fill="none" stroke="#64748b" stroke-width="1.5" marker-end="url(#jevResearchArrow)">
    <path d="M400,228 L400,245 L117,245 L117,265" />
    <path d="M400,245 L305,245 L305,265" />
    <path d="M400,245 L495,245 L495,265" />
    <path d="M400,245 L683,245 L683,265" />
  </g>
  <g stroke-width="1.3">
    <rect x="30" y="267" width="175" height="62" rx="8" fill="#dcfce7" stroke="#16a34a" />
    <rect x="218" y="267" width="175" height="62" rx="8" fill="#f5f3ff" stroke="#7c3aed" />
    <rect x="407" y="267" width="175" height="62" rx="8" fill="#fff7ed" stroke="#f59e0b" />
    <rect x="595" y="267" width="175" height="62" rx="8" fill="#f1f5f9" stroke="#64748b" />
  </g>
  <g text-anchor="middle" fill="#334155">
    <text x="117" y="291" font-size="13" font-weight="bold">行动与验证</text>
    <text x="117" y="314" font-size="10">本地规划、安全检查、执行</text>
    <text x="305" y="291" font-size="13" font-weight="bold">检索与回查</text>
    <text x="305" y="314" font-size="10">外部记忆库与原始证据</text>
    <text x="495" y="291" font-size="13" font-weight="bold">补充观察</text>
    <text x="495" y="314" font-size="10">先验证观察动作，再获取信息</text>
    <text x="683" y="291" font-size="13" font-weight="bold">推理与重规划</text>
    <text x="683" y="314" font-size="10">强模型 / 规划器 / 人工澄清</text>
  </g>
  <g fill="none" stroke="#64748b" stroke-width="1.4">
    <path d="M117,331 L117,349 L683,349 L683,331" />
    <path d="M305,331 L305,349 M495,331 L495,349" />
    <path d="M400,349 L400,368" marker-end="url(#jevResearchArrow)" />
  </g>
  <rect x="225" y="370" width="350" height="38" rx="8" fill="#ffffff" stroke="#94a3b8" />
  <text x="400" y="394" text-anchor="middle" font-size="11" fill="#334155">新观测 / 执行结果 → 复核记忆关联、更新状态</text>
  <path d="M225,390 L15,390 L15,193 L223,193" fill="none" stroke="#64748b" stroke-width="1.5" stroke-dasharray="5 4" marker-end="url(#jevResearchArrow)" />
  <text x="400" y="428" text-anchor="middle" font-size="11" fill="#64748b">三类职责分别验证，再研究组合；模型判断不直接成为运动命令</text>
</svg>
<figcaption>图 5　导航 Agent 的研究框架。反馈同时支持任务状态更新与记忆关联复核；三类职责先独立检验，再研究组合。</figcaption>
</div>

<p>下面用一段构造的任务过程说明三类判断如何衔接。它用于解释研究问题，不是实验轨迹或模型实测输出。</p>

<table>
  <thead>
    <tr>
      <th>当前证据</th>
      <th>尚未解决的问题</th>
      <th>选择的操作</th>
      <th>新证据怎样改变下一步</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>历史中两个房间都出现过杯子</td>
      <td>“刚才”对应哪次观测？</td>
      <td>检索时间与相邻轨迹</td>
      <td>若一条记录明确对应最近经过的房间，则形成暂定目标；否则保留歧义</td>
    </tr>
    <tr>
      <td>已确定暂定目标，地图提供多个可达路点</td>
      <td>哪条候选更符合返回目标？</td>
      <td>比较候选并交由规划、执行模块处理</td>
      <td>到达目标附近后，使用新观测复核地点，不能沿用出发时的判断直接宣布完成</td>
    </tr>
    <tr>
      <td>两个门口外观相似，关键地标被遮挡</td>
      <td>当前门口是否就是目标地点？</td>
      <td>前往可行观察点补看</td>
      <td>旧图像缺少区分线索时，重复推理无法增加视觉证据；新视角可能提供区分依据</td>
    </tr>
    <tr>
      <td>补看后仍无法确认，当前线索与历史关联冲突</td>
      <td>错在地点关联，还是任务解释？</td>
      <td>回查原始记录，必要时由强模型重审关联与计划</td>
      <td>若来源证据支持另一目标，则修正关联并重规划；不能靠更强模型把缺失事实补出来</td>
    </tr>
    <tr>
      <td>来源记录也无法消除歧义，剩余预算有限</td>
      <td>继续搜索是否仍可能有用？</td>
      <td>按预设规则澄清或结束本次尝试，并记录未完成</td>
      <td>保留待复核状态，避免检索、补看与推理无限循环</td>
    </tr>
    <tr>
      <td>另一路径中，新观测确认了目标门口</td>
      <td>是否满足“在门口停下”的完成条件？</td>
      <td>单独复核地点与停止位置</td>
      <td>条件满足才结束任务，并把本次观测与核实结果写回记忆</td>
    </tr>
  </tbody>
</table>

<p>这段过程中的规则可以作为初始基线。研究调度器时，需要比较它在何处作出不同选择，以及这种差异是否减少了错误返回、无效调用或任务耗时。<strong>调度器的价值在于选择有用的下一步；调用更强模型本身不构成成功。</strong></p>

<p>ABot-N1 的慢 VLM 与快动作专家说明任务推理和运动生成可以分工，但其中快系统输出连续路点，职责不同于 Jev 的类型化判断。因此，本文的协作设想是拆出适合比较或验证的环节，而不是用 Jev 替代整个动作专家。<a href="https://arxiv.org/abs/2607.10383">ABot-N1</a></p>

<h4 id="443-调度要同时考虑收益代价与时间">4.4.3 调度要同时考虑收益、代价与时间</h4>

<p>是否值得再查一轮记忆、再拍一个视角或再调用强模型，取决于它可能减少多少不确定性，以及为此付出多少时间和行动成本。作为研究目标，可以写成：</p>

\[m_t^{*}=\arg\max_{m\in\mathcal{M}_t}
\left[
\mathbb{E}(\Delta Q_{\mathrm{task}}\mid S_t,m)
-\lambda T_m-\mu C_m
\right]\]

<p>这里，$m$ 是当前允许的操作，$\Delta Q_{\mathrm{task}}$ 表示对任务结果的预期改善，$T_m$ 和 $C_m$ 分别表示时间与其他成本。<strong>这是用于界定问题的目标表达，并不是 Jev 已具备的价值估计器</strong>；如何获取收益标签、如何处理未知模块耗时，都是研究的一部分。涉及运动的操作还须先满足独立的可行性约束。</p>

<p>时间也会改变证据价值。Slow Brain, Fast Planner 通过几何相似度与时间衰减，将迟到的 VLM 选择融合进实时规划，说明“如何使用晚到结果”与“让模型更快”同样重要。Jev 即使降低调用延迟，仍需研究旧观测、旧候选和新状态之间的关系，不能默认异步结果一直有效。<a href="https://arxiv.org/abs/2606.20458">Slow Brain, Fast Planner</a></p>

<p>从概率判断到操作收益，还需要目标任务上的验证。<a href="https://arxiv.org/abs/2507.17383">VLA 校准研究</a>与<a href="https://arxiv.org/abs/2609.18453">VLM 口头置信度研究</a>研究的是不同信号；<a href="https://arxiv.org/abs/2307.01928">KnowNo</a>的统计保证也有其校准与分布假设。对 Jev 的具体问题是：这些概率能否帮助判断“何时继续、何时拒绝、何时求助”，以及在场景变化后是否仍有效。</p>

<h4 id="444-调度模型应该处理哪些规则难以覆盖的状态">4.4.4 调度模型应该处理哪些规则难以覆盖的状态</h4>

<p>超时、预算耗尽、命令无效等条件具有明确边界，适合由程序直接处理。对于“已找到目标但暂时受阻”，固定调用规划器也可能足够。模型调度更值得检验的状态，是<strong>同一种失败表象可能对应不同的信息缺口</strong>：没有找到杯子，既可能需要换视角，也可能需要回查地点，或重新解释指令。</p>

<p>调度输入因此不能只有一个置信度数值，还应包含已有证据、未满足的任务条件、近期操作与结果、可用模块及剩余预算。Jev 是否能利用这些信息选择下一步，是与规则、轻量路由器和小 LLM 比较的核心；输出格式相同并不意味着路由能力相同。</p>

<p>难点在于“最有价值的下一步”通常不是现成标签。离线可以根据标注的信息缺口检查选择是否合理，闭环则要考察一次操作是否实际带来进展。若模型只是更频繁地调用全部模块，成功率提高也必须连同额外时间和观察成本解释。</p>

<h3 id="45-已有工作与证据边界">4.5 已有工作与证据边界</h3>

<p>围绕以上三条路线，已有材料可以分为三类。它们回答的问题不同，不能把指标放在一起当作同一种能力。</p>

<table>
  <thead>
    <tr>
      <th>证据类型</th>
      <th>代表工作</th>
      <th>已支持的判断</th>
      <th>尚未支持的判断</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>导航方法研究</td>
      <td>C²Nav、VerNav、O2C-Nav、AdaNav、Slow Brain, Fast Planner、ABot-N1</td>
      <td>比较、验证、按需推理与分层执行值得研究</td>
      <td>换成 Jev 后保留原方法性能</td>
    </tr>
    <tr>
      <td>通用 Agent 的 Jev 应用</td>
      <td>Jev-Mem；第 2.7 节的 REFLEX</td>
      <td>Jev 已被用于记忆控制与选择性调用</td>
      <td>这些收益自动迁移到空间记忆和导航闭环</td>
    </tr>
    <tr>
      <td>社区具身实现</td>
      <td>ROS 2 导航监督、视觉路径选择、驾驶与无人机项目</td>
      <td>某些接口能够接通，存在可借鉴的实现</td>
      <td>标准 VLN 泛化能力、真机可靠性或普遍性能优势</td>
    </tr>
  </tbody>
</table>

<p>社区项目中，与本章关系最直接的实现如下。结果为作者报告，本文未独立复现；仓库仍在更新。</p>

<table>
  <thead>
    <tr>
      <th>项目</th>
      <th>研究上的参考价值</th>
      <th>结果与局限</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><a href="https://github.com/mahajanparth/JEV_SMARTROBOTCONTROL">JEV_SMARTROBOTCONTROL</a></td>
      <td>让 Jev 监督 Nav2，选择恢复与重规划，保留独立控制权和障碍过滤</td>
      <td>ROS 2 + Gazebo 仿真；相似房间中仍会错误定位。127 项测试通过、2 项跳过不是导航成功率</td>
    </tr>
    <tr>
      <td><a href="https://github.com/NOPLAB/jev_navigation">jev_navigation</a></td>
      <td>本地 decider-2b-vision 从 5 条弧线、停止、到达共 7 项中选择</td>
      <td>有异步与过期处理，但缺少独立激光避障和足迹碰撞检查，不能等同于完整安全导航</td>
    </tr>
    <tr>
      <td><a href="https://github.com/BrendanH18/jev_fsd">jev_fsd</a></td>
      <td>规则与 Jev 共用候选生成和前向模拟，较适合研究选择模块的贡献</td>
      <td>已提供自建驾驶仿真 benchmark；不能等同标准 VLN 或真实驾驶验证</td>
    </tr>
    <tr>
      <td><a href="https://github.com/RomanSlack/jev-drone">jev-drone</a></td>
      <td>将低频战术判断与高频几何控制分离</td>
      <td>成功课程为单次运行，中位调用延迟约 0.11 s；早期三种子对比未显示优势</td>
    </tr>
    <tr>
      <td><a href="https://github.com/FBddcz/embodied-jev">Embodied Jev</a></td>
      <td>分层子目标与局部操作选择，可观察决策粒度的影响</td>
      <td>Meta-World 三项任务、各两个种子中，Jev 与 GPT-6 Astra 均为 5/6；这是小样本操作结果</td>
    </tr>
    <tr>
      <td><a href="https://github.com/standardagents/jevpilot">JevPilot</a></td>
      <td>展示驾驶仿真中的候选路径与速度选择</td>
      <td>演示不能单独证明通用导航收益</td>
    </tr>
  </tbody>
</table>

<p>尤其需要检查对照策略的能力是否一致。例如，jev-drone 成功示例中的规则基线无法表达越障机动，收益就不能全部归因于 Jev 判断更准。<a href="https://github.com/RomanSlack/jev-drone">作者结果与限制</a></p>

<p>目前最明确的缺口是：<strong>在固定感知、候选、记忆与执行模块后，分别检验 Jev 的行动判断、记忆控制和模块调度，观察收益是否延续到导航任务结果。</strong> 这也是下一节提出研究问题的依据。</p>

<h3 id="46-值得开展的研究问题从模块替换走向机制验证">4.6 值得开展的研究问题：从模块替换走向机制验证</h3>

<p>前面的分析指向三个可以独立研究的贡献。它们都是待验证的方向，不意味着已有方法未研究过类似问题；相关工作提供的依据与局限统一见 4.5。</p>

<table>
  <thead>
    <tr>
      <th>方向</th>
      <th>本文关注的缺口</th>
      <th>可能形成的贡献</th>
      <th>核心难点</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>候选验证与拒绝</td>
      <td>相对最优选项仍可能不值得执行；普通选路与终止判断的错误代价不同</td>
      <td>按任务阶段组织接受、拒绝与复核，并识别候选不足</td>
      <td>拒绝错误行动的同时，避免过度保守导致停滞</td>
    </tr>
    <tr>
      <td>空间与时间约束下的记忆</td>
      <td>语义相关记录未必属于正确地点，旧状态与错误关联会影响后续任务</td>
      <td>以来源可追溯的证据选择和关联更新支持返回与长期任务</td>
      <td>区分新事实、暂时不可见与原有假设出错，避免错误写入被反复强化</td>
    </tr>
    <tr>
      <td>感知、记忆与推理的预算分配</td>
      <td>低置信只能提示困难，不能直接说明缺少哪类信息</td>
      <td>根据证据缺口选择下一次观察、检索、规划或推理</td>
      <td>缺少操作收益标签，且调度本身会增加延迟并改变后续状态</td>
    </tr>
  </tbody>
</table>

<p><strong>行动路线适合作为起点</strong>：接口与错误类型较容易界定。<strong>记忆路线值得进一步深入</strong>：它将 Jev-Mem 的启发落到导航特有的地点、时间与行动反馈上。<strong>模块调度适合在模块能力明确后展开</strong>：只有知道每个模块能解决什么，才能评价调用是否有价值。这是本文对研究顺序的建议，而非效果排名。</p>

<p>三条路线可逐步组合，但单模块有效不保证组合有效。例如，检索控制提前停止会影响后续行动；调度器增加补看也可能改变记忆质量。第 5 章先设计独立实验，再讨论这些交互。</p>

<h2 id="5-如何验证三个最小实验与联合评测">5. 如何验证：三个最小实验与联合评测</h2>

<h3 id="51-共同协议先定义什么结果算有收益">5.1 共同协议：先定义什么结果算有收益</h3>

<p>三个实验分别只改变行动判断、记忆控制和模块调度。它们共用一套记录原则，但不把所有模型、输入和接口组合成全因子实验。</p>

<p><strong>先分清两种比较。</strong> 托管 Jev 与规则、分类器或小 LLM 的比较，衡量同输入条件下的系统收益；由于骨干和训练未知，不能将差异归因为某种内部架构。研究“生成改为候选读出”的机制，则另选可检查的开源骨干，固定权重与输入做配对比较。原生 Jev 的文本状态构建成本必须计入，原始 RGB 只用于单独的视觉实验。</p>

<p><strong>质量和效率分别判定。</strong> 对强调提速的实验，在验证集上预先确定任务质量允许下降的范围，并在测试前锁定阈值、预算和评价规则。若质量损失超出范围，即使更快也不支持“保留能力的提速”；若质量合格但端到端耗时没有改善，则不支持效率主张。若质量提高但更慢，应报告为质量与时间的取舍。</p>

<p><strong>采用配对任务与完整成本。</strong> 各方法使用同一组场景、指令和随机种子，报告样本数、失败样本与置信区间。数据按场景或轨迹划分训练、校准和测试，避免把同一段历史拆入两侧。计时覆盖状态构建、模型调用、通信、检索及回退；同时报告总任务耗时，不能只看一次成功 API 调用的平均值。未完成和超时任务按预设规则计入，并单列其耗时，防止提前失败看起来更快。</p>

<p>需要训练的分类器或路由器，应报告可用标注量与适配成本；提示词调整和阈值选择也限定在训练、验证数据上。这样才能区分固定任务表现与迁移到新任务的成本。</p>

<p>下列指标按实验需要选择，不要求每个实验全部测量：</p>

<table>
  <thead>
    <tr>
      <th>层次</th>
      <th>指标及用途</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>导航任务</td>
      <td>成功率 SR；按路径效率加权的成功率 SPL；终点到目标距离 NE；错误停止与碰撞率</td>
    </tr>
    <tr>
      <td>系统效率</td>
      <td>P50 / P95 端到端延迟、每回合调用数与成本、总任务耗时、超时与过期结果比例</td>
    </tr>
    <tr>
      <td>决策可靠性</td>
      <td>接受率、接受后的错误率及风险—覆盖率曲线；AURC 为该曲线下的面积；ECE 与 Brier 的定义见 2.3</td>
    </tr>
    <tr>
      <td>记忆与调度</td>
      <td>证据召回、地点识别、错误关联；模块调用数、补看次数、无进展轮数与预算耗尽比例</td>
    </tr>
  </tbody>
</table>

<h3 id="52-实验一到达判断与拒绝">5.2 实验一：到达判断与拒绝</h3>

<p><strong>研究问题：</strong> 在相同目标与观测证据下，有界判断能否减少决策耗时，同时避免更多错误停止？先选“是否完成任务”这一个决策位置，能够把终止错误与选路错误分开。</p>

<table>
  <thead>
    <tr>
      <th>项目</th>
      <th>最小设置</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>任务材料</td>
      <td>从 R2R-CE 回放中提取接近目标、相似地点与证据不足的片段；分别标注客观完成状态与给定输入下的证据充分性</td>
    </tr>
    <tr>
      <td>固定项</td>
      <td>指令、当前语义状态、历史窗口、状态生成器；闭环阶段固定选路策略与控制器</td>
    </tr>
    <tr>
      <td>改变项</td>
      <td>规则、小型分类器、小 LLM、Jev 的判断模块；统一使用“完成 / 未完成 / 证据不足”的输出契约</td>
    </tr>
    <tr>
      <td>拒绝后的处理</td>
      <td>证据不足统一进入预设复核流程；仍不能确认时继续原策略，超过预算记为未完成，不由各模型自由增加工具</td>
    </tr>
    <tr>
      <td>主要观察</td>
      <td>错误停止率、到达后漏判与额外步数、复核率、端到端延迟；闭环再测 SR / SPL 和总耗时</td>
    </tr>
    <tr>
      <td>不支持主张的情形</td>
      <td>错误停止超过预设容忍范围；频繁复核导致无法完成；或额外状态构建与调用抵消提速</td>
    </tr>
  </tbody>
</table>

<p>客观完成状态由任务条件与环境真值确定，真值仅供评价，不进入模型输入。证据充分性由独立标注者按预定义依据判定，不使用待测模型自标。即使机器人实际上已经到达，给定图像或语义状态也可能不足以确认；这类样本用于检查拒绝是否合理，不能只按“未输出完成”统计为普通分类错误。闭环中则仍需统计拒绝造成的延误与未完成。</p>

<p>Jev 可以用包含“证据不足”的 Choice 表达这一契约。若另测 Noul 加阈值的版本，应作为独立接口消融，在验证集上选阈值；不能把 Choice 的最大概率和 Noul 概率直接套用同一阈值。</p>

<p>先在回放中检查错误类型，再用同一组闭环任务检验是否改变最终结果。下一步才扩展到候选路点比较：固定 3–8 个经几何过滤的候选，比较选择与拒绝。不要在首个实验中同时改变终止判断、候选生成和选路模型。</p>

<h3 id="53-实验二固定记忆库上的目标证据检索">5.3 实验二：固定记忆库上的目标证据检索</h3>

<p><strong>研究问题：</strong> 对“回到刚才见过杯子的房间”这类指令，Jev 控制检索能否在保持证据质量的同时减少查询开销，或减少目标地点关联错误？</p>

<table>
  <thead>
    <tr>
      <th>项目</th>
      <th>最小设置</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>任务材料</td>
      <td>带地点、时间、视角与来源的固定导航历史；包含相似房间、重复物体、过期状态和无答案查询</td>
    </tr>
    <tr>
      <td>固定项</td>
      <td>观测库、索引、检索工具、最大访问预算及相同查询的返回结果；首轮候选一致，后续允许在同一工具与预算内自适应查询</td>
    </tr>
    <tr>
      <td>改变项</td>
      <td>固定 top-k、时间 / 地点规则流程、小 LLM 与 Jev 的查询选择、证据筛选和继续检索判断</td>
    </tr>
    <tr>
      <td>参考标注</td>
      <td>目标地点、支持记录、冲突记录与是否有足够答案；无答案项单独统计</td>
    </tr>
    <tr>
      <td>主要观察</td>
      <td>证据召回、目标地点识别、无答案误判、查询次数与端到端成本；后续闭环测错误返回与任务耗时</td>
    </tr>
    <tr>
      <td>分层判定</td>
      <td>关键证据遗漏导致质量越过容忍范围，不支持保持质量；查询开销未降低，不支持提效；只有检索改进而没有目标识别或返回收益，只能支持检索层结论</td>
    </tr>
  </tbody>
</table>

<p>结果应区分两层：找到支持记录是检索收益，正确返回才是导航收益。闭环阶段固定行动模块，并把所有查询的开销计入任务总成本。记忆构建成本与查询成本分别记录，长期任务再按实际使用次数汇总。</p>

<p><strong>记忆更新作为后续独立实验。</strong> 首轮冻结记忆库，是为了先识别检索控制的贡献。更新实验固定检索与动作策略，重放同一批新观测，比较规则更新与模型辅助关联更新；检查错误合并、过期状态引用、证据来源保留，以及下一轮检索表现。再进行闭环测试，避免用不同机器人轨迹产生的记忆库直接比较更新能力。</p>

<h3 id="54-实验三固定模块下的下一步操作选择">5.4 实验三：固定模块下的下一步操作选择</h3>

<p><strong>研究问题：</strong> 当前信息不足时，根据证据缺口选择下一操作，能否比固定流程和单一置信度门控更有效？</p>

<table>
  <thead>
    <tr>
      <th>项目</th>
      <th>最小设置</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>起始任务</td>
      <td>从导航回放构造视觉遮挡、历史地点歧义、通路失效与指令冲突片段；保留近期操作与结果</td>
    </tr>
    <tr>
      <td>固定项</td>
      <td>行动、检索、补看、重规划 / 深度推理模块及其实现；相同可用证据、超时规则与总预算</td>
    </tr>
    <tr>
      <td>改变项</td>
      <td>固定流程、规则门控、轻量学习型路由器、小 LLM 与 Jev 调度</td>
    </tr>
    <tr>
      <td>控制权限</td>
      <td>调度器只选允许的下一操作；不能临时增加工具或更换更强执行模块</td>
    </tr>
    <tr>
      <td>主要观察</td>
      <td>闭环成功率与总耗时、各模块调用数、无进展轮数、预算耗尽比例</td>
    </tr>
    <tr>
      <td>不支持主张的情形</td>
      <td>收益只在增加预算或工具后出现；调度调用抵消节省；或循环检索、推理导致停滞</td>
    </tr>
  </tbody>
</table>

<p>离线标注可说明某种信息缺口适合哪些操作，但<strong>不应强行指定唯一最优下一步</strong>。例如，地点歧义可能通过回查图像或获得新视角解决；是否有效还取决于代价与实际观测。离线结果用于筛查明显错误，最终以相同预算下的闭环结果判断。</p>

<p>预算既包括调用与 token，也包括观察动作和运动耗时。补看能获得新信息，但并非免费；同样的工具调用次数也未必代表相同成本。主实验先固定一组预算，再在扩展实验中绘制质量随预算变化的曲线。</p>

<h3 id="55-扩展实验压力测试与模块组合">5.5 扩展实验：压力测试与模块组合</h3>

<p>三个最小实验中，已经暴露的失败可以用对应压力测试定位，不必一开始就覆盖所有组合。</p>

<table>
  <thead>
    <tr>
      <th>适用方向</th>
      <th>扰动或扩展</th>
      <th>需要解释的问题</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>共同</td>
      <td>候选换序、保持语义的标签改名、中英文、否定指令、无关历史与 OCR 注入</td>
      <td>判断依赖有效证据，还是位置、措辞与无关内容？</td>
    </tr>
    <tr>
      <td>行动</td>
      <td>删除关键观测、相似目标、跨场景阈值迁移</td>
      <td>模型能否识别证据不足，拒绝是否导致过度停滞？</td>
    </tr>
    <tr>
      <td>记忆</td>
      <td>门状态变化、物体移动、相似房间、矛盾来源</td>
      <td>是召回失败、错误关联，还是使用了过期状态？</td>
    </tr>
    <tr>
      <td>调度</td>
      <td>连续无进展、模块失败、不同预算</td>
      <td>能否改变无效策略，并在预算耗尽时按协议退出？</td>
    </tr>
    <tr>
      <td>系统</td>
      <td>网络抖动、断网、版本变化与重复调用</td>
      <td>回退与过期结果处理是否改变任务质量和总延迟？</td>
    </tr>
  </tbody>
</table>

<p>异步轨迹融合、原始 RGB 与语义状态的对照、导航数据适配，以及不同机载设备上的部署，应在基础结果明确后分别开展。复现 4.5 的社区项目可帮助检查接口与执行实现，但不作为完成三个最小实验的前置条件。</p>

<p>最后再组合模块。若某个单模块有效，先加入下一个模块，并保留“仅行动判断”“仅记忆控制”等对照；只有需要解释交互时，再扩大组合消融。重点检查收益是否依赖额外证据、调用或预算，以及错误记忆是否经调度和行动反复放大。</p>

<h2 id="6-结论">6. 结论</h2>

<p><strong>最适合先验证的是边界明确的行动判断。</strong> 从到达与拒绝开始，固定证据和执行模块，才能检验 Jev 是否在保留任务质量时减少开销。有界接口便于程序使用，但实际收益取决于判断质量、状态构建和复核成本。</p>

<p><strong>值得进一步深入的是带空间、时间与来源约束的记忆控制。</strong> Jev-Mem 提供了通用 Agent 的先例；导航中的关键扩展是正确关联地点、区分历史与当前状态，并让行动反馈修正后续检索。研究贡献需要体现在证据质量与返回任务上，而不止于更快地检索文本。</p>

<p><strong>完整 Agent 最难的是判断下一次操作是否值得。</strong> 感知、记忆、规划与推理应提供互补证据；调度器需要在预算内促成进展，并处理错误传播和无效循环。本文因此建议按行动、记忆、调度逐步验证，再研究组合，而不是由接口演示直接推断完整导航能力。</p>

<h3 id="持续跟踪">持续跟踪</h3>

<ul>
  <li>TypeSafe 的架构、RLCD、模型版本与多模态进展，以及独立的校准和鲁棒性证据。</li>
  <li>固定协议下的导航实验与社区复现，尤其是状态构建、通信和回退计入后的端到端结果。</li>
  <li>空间记忆更新与模块调度在长期任务中的效果，以及单模块收益能否延续到组合系统。</li>
</ul>

<h2 id="参考资料">参考资料</h2>

<p><strong>官方资料与入门解读</strong></p>

<ol>
  <li>TypeSafe AI. <em>Introducing System One Models and Jev</em>. <a href="https://typesafe.ai/blog/introducing-system-one-models-and-jev">typesafe.ai/blog</a></li>
  <li>TypeSafe AI. 官网与 workflow eval：<a href="https://typesafe.ai/">typesafe.ai</a>；<a href="https://evals.typesafe.ai/">evals.typesafe.ai</a></li>
  <li>TypeSafe Docs：<a href="https://docs.typesafe.ai/introduction">Introduction</a>、<a href="https://docs.typesafe.ai/models">Models</a>、<a href="https://docs.typesafe.ai/primitives">Primitives</a>、<a href="https://docs.typesafe.ai/concepts/state">State</a>、<a href="https://docs.typesafe.ai/concepts/system-one">System One</a>、<a href="https://docs.typesafe.ai/model-jaggedness/jev-1.13">Jaggedness: jev-1.13</a></li>
  <li>第三方入门解读：MindStudio. <em>Jev Explained</em>. <a href="https://www.mindstudio.ai/blog/jev-system-one-model-launch">mindstudio.ai</a></li>
</ol>

<p><strong>派生模型</strong></p>

<ol>
  <li>Laya. <a href="https://github.com/NandhaKishorM/laya">NandhaKishorM/laya</a></li>
  <li>AnyJev. <a href="https://github.com/nokia-applied-research/AnyJev">nokia-applied-research/AnyJev</a></li>
  <li>minojev. <a href="https://github.com/zeredy879/minojev">zeredy879/minojev</a></li>
  <li>Laya Vision. <a href="https://github.com/r33drichards/laya-vision">r33drichards/laya-vision</a></li>
  <li>PlayJev. <a href="https://github.com/OmniJev/PlayJev">OmniJev/PlayJev</a></li>
  <li>Jev Visual. <a href="https://github.com/hr98w/jev-visual">hr98w/jev-visual</a></li>
  <li>Prosodia. <a href="https://github.com/alperiox/audio-jevlike">alperiox/audio-jevlike</a></li>
  <li>jev-vision. <a href="https://github.com/JeremyEltho/jev-vision">JeremyEltho/jev-vision</a></li>
  <li>
    <p>项目汇总：<a href="https://github.com/cobanov/awesome-jev">cobanov/awesome-jev</a>；<a href="https://github.com/AbdelStark/awesome-typesafe-jev">AbdelStark/awesome-typesafe-jev</a></p>
  </li>
  <li>Nokia AnyJev 报道. <a href="https://www.marktechpost.com/2026/09/23/nokia-open-sources-anyjev-a-training-free-layer-that-turns-any-open-llm-into-a-calibrated-decision-model/">MarkTechPost</a></li>
  <li>decider-2b-vision 与 ROS 2 集成. <a href="https://github.com/NOPLAB/jev_navigation">NOPLAB/jev_navigation</a></li>
</ol>

<p><strong>派生模型论文（arXiv）</strong></p>

<ol>
  <li>Ren et al. <em>Open-Jev Judgments on CallScreenBench: Calibrated One-Pass Scam Screening with a Small Language Model</em>. <a href="https://arxiv.org/abs/2609.23959">arXiv:2609.23959</a></li>
  <li>Yu, Yao. <em>Visual Jev: Accurate and Efficient Decisions from Shared Visual Context</em>. <a href="https://arxiv.org/abs/2609.25845">arXiv:2609.25845</a></li>
  <li>Zhou, Yang, Zhao. <em>From Text Decisions to Pixels: A Study of Jev-Style Visual Choice Model</em>. <a href="https://arxiv.org/abs/2609.29283">arXiv:2609.29283</a></li>
  <li>Piskorz, Kobalczyk, van der Schaar. <em>Eliciting Numerical Predictive Distributions of LLMs Without Autoregression</em>. ICLR 2026. <a href="https://arxiv.org/abs/2603.02913">arXiv:2603.02913</a></li>
</ol>

<p><strong>Jev 应用论文（arXiv）</strong></p>

<ol>
  <li>Jiang, Li, Li. <em>Jev-Mem: System-One-Controlled Agentic Memory for Efficient AI Agents</em>. <a href="https://arxiv.org/abs/2609.23986">arXiv:2609.23986</a></li>
  <li>Wu, Lim. <em>REFLEX with Jev for Efficient Selective Control in LLM Agents</em>. <a href="https://arxiv.org/abs/2609.26532">arXiv:2609.26532</a></li>
  <li>dos Santos. <em>Calibrated Decision Models for Autonomous Penetration-Testing Harnesses: JEV and Laya as System One Decision Layers</em>. <a href="https://arxiv.org/abs/2609.28940">arXiv:2609.28940</a></li>
</ol>

<p><strong>独立评测与资料汇总</strong></p>

<ol>
  <li>多来源评测综述（非单项实验）：<a href="https://dev.to/aws-builders/jev-after-eight-days-of-independent-tests-level-with-mid-price-llms-behind-the-frontier-1c60">Jev After Eight Days of Independent Tests</a></li>
  <li><a href="https://github.com/get-convex/convex-evals">Convex Decision Evals</a></li>
  <li><a href="https://anth.us/blog/jev-vs-laya/">Jev vs Laya: Same Labels, Same Questions</a></li>
  <li><a href="https://github.com/chunxiaoxx/nautilus-compass">Nautilus 校准研究</a></li>
  <li><a href="https://github.com/yodablocks/jev-orderby-bench">jev-orderby-bench</a></li>
  <li><a href="https://github.com/KantaHayashiAI/jev-does-not-play-dice">Jev Does Not Play Dice</a></li>
</ol>

<p><strong>导航与校准研究（arXiv）</strong></p>

<ol>
  <li>C²Nav. <a href="https://arxiv.org/abs/2609.15142">arXiv:2609.15142</a></li>
  <li>VerNav: Verifier-First Low-Latency Vision-and-Language Navigation. <a href="https://arxiv.org/abs/2609.00920">arXiv:2609.00920</a></li>
  <li>O2C-Nav. <a href="https://arxiv.org/abs/2609.06476">arXiv:2609.06476</a></li>
  <li>Peng et al. <em>Slow Brain, Fast Planner: Latency-Resilient VLM-Augmented Urban Navigation</em>. <a href="https://arxiv.org/abs/2606.20458">arXiv:2606.20458</a></li>
  <li>Ding et al. <em>AdaNav: Adaptive Reasoning with Uncertainty for Vision-Language Navigation</em>. <a href="https://arxiv.org/abs/2509.24387">arXiv:2509.24387</a></li>
  <li>Gong et al. <em>ABot-N1: Toward a General Visual Language Navigation Foundation Model</em>. <a href="https://arxiv.org/abs/2607.10383">arXiv:2607.10383</a></li>
  <li>Zollo, Zemel. <em>Confidence Calibration in Vision-Language-Action Models</em>. <a href="https://arxiv.org/abs/2507.17383">arXiv:2507.17383</a></li>
  <li>Yang et al. <em>The Mirage of Calibrated Confidence: Trajectory-Independence of Verbalized Confidence in Vision-Language Models</em>. EMNLP 2026. <a href="https://arxiv.org/abs/2609.18453">arXiv:2609.18453</a></li>
  <li>Ren et al. <em>Robots That Ask For Help: Uncertainty Alignment for Large Language Model Planners</em> (KnowNo). CoRL 2023. <a href="https://arxiv.org/abs/2307.01928">arXiv:2307.01928</a></li>
  <li>Zheng et al. <em>Large Language Models Are Not Robust Multiple Choice Selectors</em> (PriDe). ICLR 2024. <a href="https://arxiv.org/abs/2309.03882">arXiv:2309.03882</a></li>
</ol>

<p><strong>具身 demo</strong></p>

<ol>
  <li><a href="https://github.com/mahajanparth/JEV_SMARTROBOTCONTROL">JEV_SMARTROBOTCONTROL</a>；<a href="https://github.com/NOPLAB/jev_navigation">jev_navigation</a>；<a href="https://github.com/BrendanH18/jev_fsd">jev_fsd</a>；<a href="https://github.com/RomanSlack/jev-drone">jev-drone</a>；<a href="https://github.com/FBddcz/embodied-jev">Embodied Jev</a>；<a href="https://github.com/standardagents/jevpilot">JevPilot</a></li>
</ol>]]></content><author><name>Tingde Liu</name></author><category term="blog" /><category term="Jev" /><category term="System One" /><category term="VLN" /><category term="Embodied Navigation" /><category term="Calibration" /><category term="Robotics" /><summary type="html"><![CDATA[Jev 将自由生成替换为类型化判断，但其速度、校准与泛化需要分开检验。本文先厘清接口和证据边界，再比较候选读出、任务训练、视觉共享与外挂感知等开源路线；最后围绕具身导航的行动决策、记忆管理与 Agent 内部协作，提出研究问题及可归因的实验方案。]]></summary></entry><entry><title type="html">树状注意力：VLN 训练 Token 压缩 22×</title><link href="https://garylee1210.github.io/Tree-Attention-Decoding/" rel="alternate" type="text/html" title="树状注意力：VLN 训练 Token 压缩 22×" /><published>2026-09-23T00:00:00+00:00</published><updated>2026-07-29T00:00:00+00:00</updated><id>https://garylee1210.github.io/Tree-Attention-Decoding</id><content type="html" xml:base="https://garylee1210.github.io/Tree-Attention-Decoding/"><![CDATA[<h1 id="1-问题导航历史为何让训练-token-数二次增长">1. 问题：导航历史为何让训练 Token 数二次增长？</h1>

<p>Robostral Navigate 是 Mistral AI 提出的 8B 单目 RGB 导航 VLM。它根据自然语言指令与历史图像预测下一导航 waypoint；为了覆盖长轨迹中的全部监督信号，第 $t$ 步必须读取从 episode 开始到当前时刻的观测历史。</p>

<p>训练数据完全由仿真生成，约包含 35 万个场景和 240 万条轨迹。每个样本由自然语言指令、RGB 观测序列与导航动作组成，其中还包括跨楼层的长轨迹。数据规模越大、episode 越长，逐时间步展开造成的历史图像重复就越严重。</p>

<p>如果把每个时间步都构造成独立样本，相同的指令和早期图像会被反复编码：长度为 $T$ 的轨迹需要处理 $O(T^2)$ 个 Token。Robostral 的关键改动，是把整段 episode 恢复为一棵<strong>以观测历史为主干、以监督动作为叶子</strong>的前缀树，在一次 forward 中计算所有时间步的 loss。</p>

<p>论文报告，这种训练表示在不丢弃 action target 的前提下将训练 Token 数减少 <strong>22×</strong>，把原本以月计的训练缩短到数天。本文只聚焦这一训练机制；机器人迁移、在线强化学习和导航榜单不在讨论范围内。</p>

<blockquote>
  <p>本文依据 <a href="https://arxiv.org/abs/2607.20785v2">Robostral Navigate（arXiv:2607.20785v2）</a> 更新。论文明确给出了前缀树结构与注意力语义，但没有公开完整训练代码、position ID 构造和 mask kernel；下文会区分论文事实与复现时的工程要求。</p>
</blockquote>

<!-- more -->

<h2 id="11-核心结论速览">1.1 核心结论速览</h2>

<table>
  <thead>
    <tr>
      <th>问题</th>
      <th>Robostral 的处理</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>重复计算</td>
      <td>指令和历史观测只在共享主干中编码一次</td>
    </tr>
    <tr>
      <td>保留监督</td>
      <td>每个时间步的 action target 都作为独立叶子保留</td>
    </tr>
    <tr>
      <td>标签泄漏</td>
      <td>后续观测不能读取先前的 ground-truth action</td>
    </tr>
    <tr>
      <td>训练 Token 规模</td>
      <td>从逐时间步展开的 $O(T^2)$ 降到整 episode 的 $O(T)$</td>
    </tr>
    <tr>
      <td>论文结果</td>
      <td>训练 Token 数减少 22×；训练周期从月缩短到天</td>
    </tr>
  </tbody>
</table>

<h1 id="2-前缀树监督训练22-token-压缩是怎么来的">2. 前缀树监督训练：22× Token 压缩是怎么来的？</h1>

<h2 id="21-逐时间步训练的-token-数为什么是-ot2">2.1 逐时间步训练的 Token 数为什么是 $O(T^2)$？</h2>

<p>设指令为 $I$，第 $t$ 步观测为 $O_t$，监督动作是 $a_t$。部署时不存在 expert action history，因此第 $t$ 步应在下面的上下文中预测动作：</p>

\[[I,O_0,\ldots,O_t]\rightarrow a_t\]

<p>传统训练会构造 $T$ 个样本：</p>

\[[I,O_0]\rightarrow a_0\]

\[[I,O_0,O_1]\rightarrow a_1\]

\[\cdots\]

\[[I,O_0,\ldots,O_{T-1}]\rightarrow a_{T-1}\]

<p>总 Token 数近似为：</p>

\[N_{\text{naive}}
=\sum_{t=0}^{T-1}
\left(
|I|+\sum_{k=0}^{t}|O_k|+|a_t|
\right)\]

<p>早期观测 $O_0$ 会被编码 $T$ 次，$O_1$ 会被编码 $T-1$ 次。若每帧视觉 Token 数量近似固定，主导项随 $T^2$ 增长。</p>

<h2 id="22-robostral-的树观测是主干动作是叶子">2.2 Robostral 的树：观测是主干，动作是叶子</h2>

<div align="center">
  <img src="/images/vln/Robostral-Navigate-prefix-tree.webp" width="96%" alt="Robostral Navigate 的逐时间步训练、前缀缓存与树状注意力掩码" />
  <figcaption>图 1：指令与观测构成共享主干，每个动作是独立叶节点。动作叶子只用于自身监督，后续观测不会再次读取它。</figcaption>
</div>

<p>Robostral 将整个 episode 物理打包成：</p>

\[I\mid O_0\mid a_0\mid O_1\mid a_1\mid\cdots\mid O_{T-1}\mid a_{T-1}\]

<p>但它的<strong>逻辑结构不是一条普通因果链</strong>，而是：</p>

\[I\rightarrow O_0\rightarrow O_1\rightarrow\cdots\rightarrow O_{T-1}\]

<p>并在每个 $O_t$ 下挂一个动作叶子 $a_t$。于是唯一 Token 数变为：</p>

\[N_{\text{tree}}
=|I|+\sum_{t=0}^{T-1}\left(|O_t|+|a_t|\right)
=O(T)\]

<p>这也是论文所说的 prefix caching：相同的指令和历史观测只编码一次，却能在一次 forward 中保留所有时间步的动作监督。</p>

<p>这里的 <strong>prefix caching 是训练期共享前缀计算，不是推理期 KV cache</strong>。共享主干仍处于同一个 autograd graph 中，需要参与反向传播，并接收所有动作叶子汇总而来的梯度；如果将前缀 K/V 直接 <code class="language-plaintext highlighter-rouge">detach</code>，就会丢失这些训练信号。</p>

<h2 id="23-为什么不能直接使用-causal-mask">2.3 为什么不能直接使用 causal mask？</h2>

<p>在物理序列</p>

\[I,O_0,a_0,O_1,a_1,O_2,a_2\]

<p>中，普通 causal mask 会允许 $O_1$ 读取左侧的 ground-truth action $a_0$，也会让 $O_2$ 读取 $a_0$ 和 $a_1$。训练时这些动作高度提示下一个 waypoint，但部署时模型拿不到 expert action，因此会产生严重的 train–test mismatch。</p>

<p>Tree attention 改用祖先关系定义可见性。令 $node(i)$ 表示 Token $i$ 所属树节点，$Anc(n)$ 表示节点 $n$ 及其祖先，则可写为：</p>

\[M_{ij}=
\begin{cases}
0,&amp; node(j)\in Anc(node(i))\ \text{且满足节点内因果顺序}\\
-\infty,&amp; \text{otherwise}
\end{cases}\]

\[\operatorname{Attention}(Q,K,V)
=\operatorname{Softmax}
\left(
\frac{QK^\top}{\sqrt d}+M
\right)V\]

<p>对应到 Robostral 的 episode tree：</p>

<ul>
  <li>查询 $O_t$ 只能读取 $I,O_0,\ldots,O_t$ 中位于它之前的 Token；</li>
  <li>查询动作叶子 $a_t$ 可以读取 $I,O_0,\ldots,O_t$；</li>
  <li>若 $a_t$ 由多个 Token 组成，它们可在同一叶子内部自回归；</li>
  <li>$O_{t+1}$ <strong>不能</strong>读取 $a_t$；</li>
  <li>$a_i$ 与 $a_j$ 位于不同叶子，彼此不可见。</li>
</ul>

<p>因此，图中的动作是“leaves — never re-attended”：它们提供监督，但不会进入后续决策历史。</p>

<h2 id="24-为什么一次-forward-仍与逐时间步监督等价">2.4 为什么一次 forward 仍与逐时间步监督等价？</h2>

<p>每个动作叶子 $a_t$ 看到的上下文与独立样本</p>

\[[I,O_0,\ldots,O_t]\rightarrow a_t\]

<p>完全相同。所有 action target 都只出现一次，指令与观测主干则由各动作 loss 共同反向传播：</p>

\[L=\sum_{t=0}^{T-1}
L_{\text{action}}
\left(
a_t\mid I,O_{\le t}
\right)\]

<p>共享主干只执行一次 forward，但各叶子的梯度会在 autograd 图中自然汇总到共享表示。</p>

<p>这也澄清了一个重要区别：Robostral 论文<strong>没有</strong>引入通用 Tree Training 中的路径计数 loss weight、DFS 树分区或可微分 gateway。对于这里的“单条观测主干 + 每步一个动作叶子”，每个 action target 本来就只计算一次，不需要额外的路径计数加权。把其他树训练系统的组件直接当作 Robostral 已公开实现，会超出论文证据。</p>

<h2 id="25-22-该如何解读">2.5 22× 该如何解读？</h2>

<p>论文报告，相比逐时间步样本，这种表示在训练数据上将 Token 数减少 <strong>22×</strong>，同时不丢弃任何动作预测目标，并把原本以月计的训练缩短到数天。RxR-CE 的指令与轨迹尤其长，因此收益更明显。</p>

<p>22× 的准确含义是：</p>

\[\frac{N_{\text{naive}}}{N_{\text{tree}}}\approx22\]

<p>它不是“端到端训练吞吐严格提高 22×”。实际 wall-clock speedup 还取决于：</p>

<ul>
  <li>视觉编码器是否复用图像特征；</li>
  <li>attention mask 使用 dense、block-sparse 还是定制 kernel；</li>
  <li>packed sequence 长度与显存上限；</li>
  <li>activation checkpointing、通信与数据加载；</li>
  <li>VLM、视觉编码器和其他模块各自的耗时占比。</li>
</ul>

<p>论文没有披露精确训练时长、GPU 数量、硬件利用率、position ID 构造或 mask kernel。因此可以确认的是 <strong>需要处理的训练 Token 数从 $O(T^2)$ 降到 $O(T)$、实测 Token 减少 22×、训练周期从月缩短到天</strong>，不能据此补写一个未经报告的端到端加速倍数。</p>

<h1 id="3-复现时最关键的正确性检查">3. 复现时最关键的正确性检查</h1>

<p>论文给出了训练表示和 mask 语义，但没有公开完整代码与 kernel 细节。实现时至少应检查以下事项。</p>

<h2 id="31-数据与标签">3.1 数据与标签</h2>

<ul>
  <li>指令和 $O_0,\ldots,O_{T-1}$ 只在主干中出现一次；</li>
  <li>每个 $a_t$ 是从 $O_t$ 分出的独立叶子；</li>
  <li>instruction 与 observation Token 的 label 设为 ignore；</li>
  <li>action Token 只在自己的叶子内计算 loss；</li>
  <li>后续上下文中不能重新拼入 teacher-forced ground-truth action。</li>
</ul>

<h2 id="32-mask-与逻辑位置">3.2 Mask 与逻辑位置</h2>

<ul>
  <li>修改 $a_t$，$O_{t+1}$ 与其他动作叶子的 logits 不应变化；</li>
  <li>修改 $O_t$，所有后续观测与对应动作 logits 应发生变化；</li>
  <li>同一动作叶子内部保持 causal autoregression；</li>
  <li>attention 实现不能先计算所有非法 pair 再指望仅靠置零获得相同效率；</li>
  <li>对使用 RoPE 的模型，逻辑 position 应与独立样本一致，不能让被 mask 的动作叶子平白推高后续主干位置。</li>
</ul>

<p>最后一点是由“训练信号严格等价”推导出的工程要求；论文没有披露具体 position ID 实现。</p>

<h2 id="33-最小等价性测试">3.3 最小等价性测试</h2>

<p>在一段很短的 episode 上运行两种版本：</p>

<ol>
  <li>每个时间步构造独立样本并分别 forward；</li>
  <li>整个 episode 一次 forward，使用 tree attention mask。</li>
</ol>

<p>应逐项比较：</p>

<ul>
  <li>每个 action target 的 logits；</li>
  <li>总 action loss；</li>
  <li>关键参数 gradient；</li>
  <li>一次 optimizer step 后的参数。</li>
</ul>

<p>float32 小模型应接近数值精度；bf16 下可允许由 kernel 形状和累加顺序产生的小误差。性能测试则要分别报告 $N_{\text{naive}}/N_{\text{tree}}$、wall-clock throughput 和显存峰值，不能只用 Token 压缩比代替真实加速。</p>

<h1 id="4-总结">4. 总结</h1>

<p>Robostral 的 Tree Attention Training 可以概括为四步：</p>

<ol>
  <li>把逐时间步样本恢复为一个 episode 级前缀树；</li>
  <li>让指令与观测历史形成共享主干，每个 ground-truth action 成为独立叶子；</li>
  <li>用树状注意力阻断动作叶子与后续观测、其他动作叶子之间的信息流；</li>
  <li>在一次 forward 中计算全部 action loss，使需要处理的训练 Token 数从 $O(T^2)$ 降到 $O(T)$。</li>
</ol>

<p>最容易被误解的是 22×：它表示训练 Token 的去重比例，而不是一个不受硬件、kernel 和模型结构影响的 GPU 加速倍数。真正有启发性的地方，是 Robostral 把历史前缀从“重复输入”恢复为“可微分共享结构”，既保留所有时间步的监督，又阻止部署时不可获得的 expert action 泄漏。</p>

<h1 id="参考资料">参考资料</h1>

<ol>
  <li>Mistral AI. <a href="https://arxiv.org/abs/2607.20785v2"><strong>Robostral Navigate</strong></a>. arXiv:2607.20785v2, 2026-07-24.</li>
  <li>本地论文文件：<a href="/new_paper/2607.20785v2.pdf">2607.20785v2.pdf</a>。</li>
  <li>Mistral AI. <a href="https://mistral.ai/news/robostral-navigate/"><strong>Robostral Navigate 官方介绍</strong></a>, 2026.</li>
</ol>]]></content><author><name>Tingde Liu</name></author><category term="blog" /><category term="VLA" /><category term="VLN" /><category term="Robostral" /><category term="Prefix Caching" /><category term="Tree Attention" /><category term="LLM Training" /><summary type="html"><![CDATA[聚焦 Robostral Navigate 的前缀树监督训练：为什么观测构成共享主干、动作必须成为叶节点，以及 tree attention 如何在阻止 ground-truth action 泄漏的同时将训练 Token 压缩 22×。]]></summary></entry><entry><title type="html">Mixture-of-Transformers (MoT) 架构详解</title><link href="https://garylee1210.github.io/mixture-of-transformers/" rel="alternate" type="text/html" title="Mixture-of-Transformers (MoT) 架构详解" /><published>2026-09-23T00:00:00+00:00</published><updated>2026-09-23T00:00:00+00:00</updated><id>https://garylee1210.github.io/mixture-of-transformers</id><content type="html" xml:base="https://garylee1210.github.io/mixture-of-transformers/"><![CDATA[<h1 id="mixture-of-transformers-mot-架构详解多模态基础模型的模态解耦与稀疏化演进">Mixture-of-Transformers (MoT) 架构详解：多模态基础模型的模态解耦与稀疏化演进</h1>

<p>在多模态基础模型（Multimodal Foundation Models）的开发与训练中，我们常常面临一个两难的困境：为了让模型拥有强大的跨模态理解与融合能力，我们倾向于将文本、图像、视频、音频等不同模态的 token 混合输入到同一个 Dense（密集型）Transformer 模型中。然而，这种“一刀切”的设计在实际训练中会带来极大的计算浪费与参数竞争冲突。</p>

<p>2024 年底，来自 Meta AI 和斯坦福大学等机构的研究者在论文 <em>Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models</em> (arXiv:2411.04996) 中提出了一种全新的稀疏架构——<strong>Mixture-of-Transformers (MoT)</strong>。此后，NVIDIA 更是将其发扬光大，在最新推出的 <strong>Cosmos 3</strong> 物理世界模型（Physical AI World Model）中全线采用了 MoT 架构，将物理推理、视频生成与动作规划统一在一个高效的计算框架中。</p>

<p>本文将从密集模型的模态竞争难题出发，深入拆解 MoT 的核心机制，分析 NVIDIA Cosmos 3 的落地实现，并详细对比其与传统 Dense 及 Mixture-of-Experts (MoE) 的异同。</p>

<!-- more -->

<h2 id="1-多模态训练的痛点模态竞争与梯度冲突">1. 多模态训练的痛点：模态竞争与梯度冲突</h2>

<p>在传统的密集型多模态 Transformer（如 Chameleon、Transfusion 或 Unified-IO）中，虽然各种模态的输入被转化为不同的 token（例如文本的 BPE token，图像的 Vector Quantized patch token 等），但它们进入 Transformer Block 后，都会通过<strong>完全相同</strong>的一套参数进行投影与变换（共享相同的 \(W_Q, W_K, W_V\) 投影矩阵，共享相同的 FFN 模块以及 LayerNorm 层）。</p>

<p>这种设计看似简单优雅，但在优化动力学上存在显著的痛点：<strong>模态干扰（Modality Interference）</strong>与<strong>模态竞争（Modality Competition）</strong>。</p>

<h3 id="11-不同的数据分布与特征结构">1.1 不同的数据分布与特征结构</h3>
<p>文本和图像/视频在信息密度和统计分布上截然不同。文本是高度离散、符号化且语义密集的；而图像/视频补丁通常是连续、高冗余且空间高度相关的。强行使用同一套权重矩阵来处理这两种性质大相径庭的信号，无异于强迫一个通用工具同时处理粗活与细活。</p>

<h3 id="12-梯度冲突gradient-conflict">1.2 梯度冲突（Gradient Conflict）</h3>
<p>在联合训练过程中，文本损失函数产生的梯度和图像损失函数产生的梯度，在更新同一组参数时常常会发生反向拉扯。更新参数以拟合文本，可能会损害图像的表征质量，反之亦然。这种负面的干扰导致了多模态模型在扩大规模（Scaling Up）时，收敛效率极低，甚至出现表现停滞（Performance Plateau）。</p>

<div align="center"><img src="/images/llm-training/mixture-of-transformers/modality_interference.jpg" width="90%" /><figcaption>图 1：传统密集模型中的模态梯度冲突 vs. MoT 中的模态隔离</figcaption></div>

<p>为了解决这一冲突，最直接的想法是引入稀疏性，让不同的参数处理不同的信号。这就自然引出了 MoE 与 MoT 的对比。</p>

<hr />

<h2 id="2-从-moe-走向-mot为什么我们需要全模块的模态解耦">2. 从 MoE 走向 MoT：为什么我们需要“全模块”的模态解耦？</h2>

<p>在单模态大模型中，<strong>Mixture of Experts (MoE)</strong> 已经是公认的降低计算成本（FLOPs）的利器。然而，将 MoE 直接套用到多模态场景时，仍有诸多痛点。</p>

<h3 id="21-传统-moe-在多模态下的局限">2.1 传统 MoE 在多模态下的局限</h3>
<ol>
  <li><strong>局部稀疏性</strong>：传统的 MoE（如 Mixtral）通常<strong>仅将前馈网络（FFN）替换为稀疏专家</strong>，而自注意力机制（Self-Attention）中的投影矩阵以及层归一化（LayerNorm）依然是共享的密集参数。在多模态模型中，自注意力层的参数量巨大，且是捕捉模态特征的关键，这部分的参数竞争依然无法解决。</li>
  <li><strong>可学习路由（Learnable Routing）的痛点</strong>：MoE 依赖一个轻量级的门控网络（Router）来计算 token 到专家的亲和力分数。在多模态场景下，可学习路由容易面临<strong>表征塌陷（Representation Collapse）</strong>和<strong>负载不均（Routing Imbalance）</strong>。为了防止某些专家“饿死”，必须引入辅助损失（Auxiliary Loss），但这会干扰主任务的优化，且路由决策在训练中极不稳定。</li>
</ol>

<h3 id="22-mot-的解决方案完全模态解耦--确定性路由">2.2 MoT 的解决方案：完全模态解耦 + 确定性路由</h3>
<p>为了克服上述局限，Mixture-of-Transformers (MoT) 进行了彻底的架构重构：</p>

<ul>
  <li><strong>非嵌入参数完全解耦</strong>：在每个 Transformer 层中，不仅 FFN，连同 LayerNorm、自注意力投影矩阵（\(W_Q, W_K, W_V\)）以及输出投影矩阵（\(W_O\)）都<strong>按模态进行独立复制</strong>。每个模态都拥有专属于自己的“Transformer 专家分支”。</li>
  <li><strong>确定性路由（Deterministic Routing）</strong>：由于每个 token 属于什么模态在数据输入时是已知且固定的（例如，文本 token 还是图像 token），MoT 抛弃了可学习的门控 Router，直接使用预定义的模态掩码（<code class="language-plaintext highlighter-rouge">modality_masks</code>）进行<strong>静态分流</strong>。这消除了路由计算开销，彻底避免了表征塌陷和负载不均，极大地稳定了训练。</li>
  <li><strong>全局融合的桥梁：全局自注意力</strong>：虽然投影矩阵是模态特定的，但投影出来的 \(Q, K, V\) 向量会被重新拼回全局序列，进行统一 of 的自注意力计算。这保证了模型依然具备全序列的跨模态交互能力。</li>
</ul>

<div align="center"><img src="/images/llm-training/mixture-of-transformers/mot_architecture.jpg" width="90%" /><figcaption>图 2：Dense、MoE 与 MoT 的架构对比（MoT 实现了非嵌入参数的全面解耦）</figcaption></div>

<hr />

<h2 id="3-mot-架构数学拆解与工作流程">3. MoT 架构数学拆解与工作流程</h2>

<p>为了精确理解 MoT 在一个 Transformer Block 内是如何运转的，我们来拆解其数学形式。</p>

<h3 id="31-符号定义">3.1 符号定义</h3>
<p>设输入序列为 $X = [x_1, x_2, \dots, x_N] \in \mathbb{R}^{N \times d}$，其中 $N$ 为序列长度，$d$ 为隐藏层维度。
每个 token $x_i$ 都有一个与之绑定的模态标签 $m_i \in \mathcal{M} = {\text{text}, \text{image}, \text{speech}}$。</p>

<p>对于任意模态 $m \in \mathcal{M}$，MoT 维护了一套该模态专属的参数：</p>
<ul>
  <li>专属的层归一化参数：\(\text{LN}_m\)</li>
  <li>专属的注意力投影矩阵：\(\mathbf{W}_{Q,m}, \mathbf{W}_{K,m}, \mathbf{W}_{V,m} \in \mathbb{R}^{d \times d}\)</li>
  <li>专属的输出投影矩阵：\(\mathbf{W}_{O,m} \in \mathbb{R}^{d \times d}\)</li>
  <li>专属的前馈网络：\(\text{FFN}_m\)</li>
</ul>

<h3 id="32-详细计算步骤">3.2 详细计算步骤</h3>

<h4 id="第一步模态分流与专属投影router--projection">第一步：模态分流与专属投影（Router &amp; Projection）</h4>
<p>对输入序列中的每个 token $x_i$，根据其对应的模态标签 $m_i$，使用对应的专属 LayerNorm 和投影矩阵进行变换，得到查询（Query）、键（Key）和值（Value）：</p>

\[\mathbf{q}_i = \text{LN}_{m_i}(x_i) \mathbf{W}_{Q,m_i}\]

\[\mathbf{k}_i = \text{LN}_{m_i}(x_i) \mathbf{W}_{K,m_i}\]

\[\mathbf{v}_i = \text{LN}_{m_i}(x_i) \mathbf{W}_{V,m_i}\]

<p>通过这种方式，文本 token 使用模态特定的投影参数，图像 token 使用其专属参数，各行其道，参数之间不再干扰。</p>

<h4 id="第二步全局注意力机制global-attention">第二步：全局注意力机制（Global Attention）</h4>
<p>将各模态分别计算得到的 $\mathbf{q}_i, \mathbf{k}_i, \mathbf{v}_i$ 按原始的序列索引重新排列，拼接为全局的矩阵：</p>

\[\mathbf{Q} = [\mathbf{q}_1; \mathbf{q}_2; \dots; \mathbf{q}_N], \quad \mathbf{K} = [\mathbf{k}_1; \mathbf{k}_2; \dots; \mathbf{k}_N], \quad \mathbf{V} = [\mathbf{v}_1; \mathbf{v}_2; \dots; \mathbf{v}_N]\]

<p>然后在全局上计算标准的多头注意力（Multi-Head Attention）：</p>

\[\mathbf{H} = \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{Softmax}\left(\frac{\mathbf{Q} \mathbf{K}^T}{\sqrt{d_k}}\right) \mathbf{V}\]

<blockquote>
  <p><strong>💡 关键设计哲学</strong>：
这一步非常关键。虽然 \(Q, K, V\) 的<strong>生成阶段</strong>是模态解耦的（使得不同模态可以使用最适合自身的映射空间），但是<strong>计算注意力阶段</strong>是全局的。这使得文本能够关注到图像的内容，图像也能融合上下文的文本语义，确保了跨模态表征的“融会贯通”。</p>
</blockquote>

<h4 id="第三步模态特定输出投影与残差连接output-projection--residual">第三步：模态特定输出投影与残差连接（Output Projection &amp; Residual）</h4>
<p>注意力机制计算得出的全局表征向量 $\mathbf{H} = [\mathbf{h}_1, \mathbf{h}_2, \dots, \mathbf{h}_N]$ 会再次根据每个位置 of 的模态进行分流，并通过模态特定的输出投影矩阵与残差连接进行处理：</p>

\[y_i = x_i + \mathbf{h}_i \mathbf{W}_{O,m_i}\]

<h4 id="第四步模态特定的-ffn-变换modality-specific-ffn">第四步：模态特定的 FFN 变换（Modality-Specific FFN）</h4>
<p>最后，对每个 token $y_i$，应用其模态特定的 FFN 模块：</p>

\[z_i = y_i + \text{FFN}_{m_i}(\text{LN}'_{m_i}(y_i))\]

<p>其中，\(\text{LN}'_{m_i}\) 是第二层模态特定的 LayerNorm。输出的 $Z = [z_1, z_2, \dots, z_N]$ 即为当前 Transformer Block 的输出。</p>

<hr />

<h2 id="4-架构对比dense-vs-moe-vs-mot">4. 架构对比：Dense vs. MoE vs. MoT</h2>

<p>为了帮助大家理清思路，我们可以将这三种主要的架构设计进行横向对比：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">维度</th>
      <th style="text-align: left">Dense (密集型)</th>
      <th style="text-align: left">MoE (混合专家)</th>
      <th style="text-align: left">MoT (混合 Transformer)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>自注意力机制投影 (QKV)</strong></td>
      <td style="text-align: left">全局共享（密集参数）</td>
      <td style="text-align: left">全局共享（密集参数）</td>
      <td style="text-align: left"><strong>模态解耦（专属参数）</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>层归一化 (LayerNorm)</strong></td>
      <td style="text-align: left">全局共享（密集参数）</td>
      <td style="text-align: left">全局共享（密集参数）</td>
      <td style="text-align: left"><strong>模态解耦（专属参数）</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>前馈网络 (FFN)</strong></td>
      <td style="text-align: left">全局共享（密集参数）</td>
      <td style="text-align: left">稀疏专家（多通道分布）</td>
      <td style="text-align: left"><strong>模态解耦（专属参数）</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>路由/分流机制 (Routing)</strong></td>
      <td style="text-align: left">无需路由</td>
      <td style="text-align: left">可学习门控网络 (Learnable Router)</td>
      <td style="text-align: left"><strong>确定性路由 (Deterministic Mask)</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>训练稳定性</strong></td>
      <td style="text-align: left">高，但存在模态干扰</td>
      <td style="text-align: left">较低，受路由坍塌和负载均衡影响</td>
      <td style="text-align: left"><strong>高，免去路由优化难题</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>推理时激活参数</strong></td>
      <td style="text-align: left">100%</td>
      <td style="text-align: left">依 Top-K 决定（通常占 10-30%）</td>
      <td style="text-align: left"><strong>由输入序列的模态比例决定</strong></td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="5-工业界前沿落地nvidia-cosmos-3-中的-mot-物理世界模型">5. 工业界前沿落地：NVIDIA Cosmos 3 中的 MoT 物理世界模型</h2>

<p>如果说 Meta AI 2024 年的论文为 Mixture-of-Transformers 奠定了理论与小型实验的基石，那么 <strong>NVIDIA Cosmos 3</strong> 的发布则证明了这一稀疏架构在大型工业界物理 AI（Physical AI）上的巨大统治力。</p>

<h3 id="51-双塔-mot-结构终结范式割裂">5.1 双塔 MoT 结构：终结“范式割裂”</h3>
<p>在自动驾驶、具身智能（Robotics）等物理世界模拟中，传统的方案通常是拼凑型的（Duct-taped）：由一个视觉语言模型（VLM）处理感知，一个扩散模型（Diffusion）负责视频预测，再由另外的策略网络（Policy）决定动作。这不仅导致极大的推理延迟，更阻碍了跨模态物理规律的深度融合。</p>

<p>NVIDIA Cosmos 3 彻底打破了这一界限。它构建了一个<strong>“双塔（Dual-Tower）”架构</strong>，但底座完全基于统一的 <strong>Mixture-of-Transformers (MoT)</strong>。它将输入序列划分为自回归（AR）与扩散（DM）子序列，在每一层解码器内部，并行持有两套独立参数（推理塔 + 生成塔），二者由预训练权重共同初始化：</p>

<div align="center">
  <img src="/images/wm/Cosmos3-Fig5-MoTArchitecture.webp" width="100%" />
<figcaption>图：Cosmos 3 的 MoT 架构。同一条序列由 AR 子序列（语言 + ViT 视觉 token，以 EOS/BOG 收尾）与 DM 子序列（VAE 视觉、音频、动作 token，训练时加噪）拼接而成；层内 AR 与 DM token 各用独立 LayerNorm 与 MLP（均由预训练 VLM 共同初始化），仅在共享自注意力处交汇。右图为注意力掩码：AR 为因果三角、DM 为全注意力。（图源：Cosmos 3）</figcaption>
</div>

<ul>
  <li><strong>推理塔（Reasoner Tower，自回归）</strong>：作为模型的“大脑”。这是一个因果自注意力（Causal Self-Attention）结构的 VLM，主要负责多模态感知输入、高层级任务规划、三维时空推理以及物理世界的意图理解。</li>
  <li><strong>生成塔（Generator Tower，扩散 Transformer）</strong>：作为“执行器和物理模拟器”。这是一个扩散基础的 Transformer 架构，使用全双向注意力（Bidirectional Attention），条件化于推理塔输出的上下文，通过 Flow Matching 迭代去噪预测未来视频帧、音频和机器人执行器的连续动作轨迹（Actions）。</li>
</ul>

<p>这两个塔内部通过<strong>双流联合注意力（Dual-Stream Joint Attention）</strong>相耦合：</p>
<ul>
  <li><strong>AR 子序列（推理塔）</strong>仅能关注自身的历史，以维持自回归的因果完整性；</li>
  <li><strong>DM 子序列（生成塔）</strong>则以 AR 和 DM 标记的并集为 Key/Value，使得每个扩散生成 token 都能自由“读取”推理塔提供的上下文语义；</li>
  <li><strong>关键约束</strong>：AR 标记永远不会被 DM 标记污染或更新，保证了推理通路的因果隔离。</li>
</ul>

<p>这种设计的精妙之处在于：<strong>推理为生成提供高层语义指导，而生成过程不污染推理逻辑</strong>，二者在同一张注意力图里协作，却互不破坏各自的归纳偏置。</p>

<h3 id="52-cosmos-3-中-mot-架构的核心设计">5.2 Cosmos 3 中 MoT 架构的核心设计</h3>
<ol>
  <li><strong>3D 多维旋转位置编码（mRoPE）</strong>：为了让 MoT 能够无缝协调图像、文本、视频帧与动作 token，Cosmos 3 引入了 <strong>mRoPE (3D Multi-dimensional Rotary Position Embedding)</strong>。mRoPE 将空间（高度、宽度）和时间轴融合在一个多维旋转编码空间中，使不同模态投影参数在进入全局注意力时，具备了物理世界的相对位置坐标系。</li>
  <li><strong>模态灵活部署与微调</strong>：得益于 MoT 的参数隔离性质，开发者在使用 NVIDIA Cosmos 3 时，甚至可以独立于生成塔去优化或微调推理塔（Reasoner Tower），或者在 Reasoner 的制约下单独微调 Generator 产生特定的动作序列。</li>
  <li><strong>模型规模与参数</strong>：NVIDIA 基于 MoT 架构开源了不同尺度的变体，其总参数量由于双塔设计（推理塔 + 生成塔各持一套参数）约为同级密集模型的两倍：
    <ul>
      <li><strong>Cosmos 3 Nano (16B / 密集骨干 8B)</strong>：对端侧及工作站算力极其友好，可在单张 RTX PRO 6000 级显卡上实现实时具身导航与推理。</li>
      <li><strong>Cosmos 3 Super (64B / 密集骨干 32B)</strong>：适用于大型数据中心 Hopper 和 Blackwell GPU，能生成大规模、高保真度的合成物理世界轨迹。</li>
    </ul>
  </li>
</ol>

<blockquote>
  <p>💡 <strong>系统级关联</strong>：关于 Cosmos 3 平台的完整技术演进、数据策展 Video Curator 以及三种动作模式（前向动力学、逆动力学与策略模型）的详细拆解，可以参考我之前撰写的 <a href="/World-Models-Survey/#46-cosmos-3%E5%85%A8%E6%A8%A1%E6%80%81%E7%BB%9F%E4%B8%80%E4%B8%96%E7%95%8C%E6%A8%A1%E5%9E%8B2026">世界模型综述：Cosmos 3 全模态统一世界模型</a>。</p>
</blockquote>

<hr />

<h2 id="6-实验结果与系统效率提升">6. 实验结果与系统效率提升</h2>

<p>Meta AI 团队对 MoT 在多种多模态基础模型设置中进行了广泛的评测。主要评估了两种典型的多模态框架：以自回归方式统一处理图文的 <strong>Chameleon</strong> 框架，以及结合扩散模型和自回归的 <strong>Transfusion</strong> 框架。</p>

<h3 id="61-极佳的-flops-压缩效率">6.1 极佳的 FLOPs 压缩效率</h3>
<ul>
  <li><strong>Chameleon 图文生成 (7B参数量)</strong>：MoT 架构仅激活了 <strong>55.8% 的 FLOPs</strong>，就达到了与 Dense 7B Baseline <strong>完全等价</strong>的生成质量与下游任务表现。</li>
  <li><strong>三模态扩展 (Text+Image+Speech, 443M参数量)</strong>：当引入第三种模态（语音）时，MoT 的稀疏化优势更加巨大，仅需密集模型 <strong>37.2% 的 FLOPs</strong> 即可达到同等性能。</li>
  <li><strong>Transfusion 图像生成 (7B参数量)</strong>：在处理扩散模型目标时，MoT 架构对图像模态的计算代价缩减到了原来的 <strong>1/3</strong>，而图像质量没有受到任何损失。</li>
</ul>

<h3 id="62-硬件运行时间与吞吐wall-clock-speedup">6.2 硬件运行时间与吞吐（Wall-Clock Speedup）</h3>
<p>理论上的 FLOPs 压缩并不总是能等价转化为实际的速度提升（由于稀疏算子的通信开销），但 MoT 凭借<strong>确定性分流</strong>和<strong>算子融合（Kernel Fusion）</strong>，在 A100 GPU 上的实际测速非常亮眼：</p>
<ul>
  <li>在处理图像模态时，MoT 达到了 Dense 47% 的硬件运行时间（即 <strong>2.13× 的实际加速</strong>）。</li>
  <li>在处理文本模态时，也仅需 Dense 的 75.6% 的时间。</li>
</ul>

<h3 id="63-理论支撑子任务凸化subtask-convexification">6.3 理论支撑：子任务凸化（Subtask Convexification）</h3>
<p>除了工程和性能优势，理论分析也为 MoT 的快速收敛提供了强力解释：
多模态联合优化由于存在梯度冲突，往往呈现高度非凸的性质。MoT 通过确定性掩码将参数分配给对应的专家，实质上将复杂的非凸混合优化问题拆解为了多个更平滑、接近强凸（Strongly Convex）的子问题。研究表明，在这种状态下，模型的收敛速度会呈现<strong>对数级（Logarithmic）的加速</strong>，优化过程更加平稳。</p>

<hr />

<h2 id="7-互动沙盘直观感受-token-分流与参数冲突">7. 互动沙盘：直观感受 Token 分流与参数冲突</h2>

<p>为了更直观地理解 Dense、MoE 以及 MoT 对 Token 的分流控制和参数冲突情况，你可以在下方的<strong>互动沙盘</strong>中切换不同架构，点击“开始分流”观察其动态执行流向和性能指标：</p>

<div id="mot-playground" style="margin: 20px 0; padding: 20px; background: radial-gradient(circle at top, #1e1b4b 0%, #0f172a 100%); border-radius: 12px; color: #f8fafc; font-family: -apple-system, BlinkMacSystemFont, 'Segoe UI', Roboto, sans-serif; box-shadow: 0 10px 25px -5px rgba(0,0,0,0.3);">
  <h3 style="margin-top: 0; color: #38bdf8; text-align: center; font-size: 1.4rem; font-weight: bold;">多模态 Token 分流物理模拟器</h3>
  <p style="font-size: 0.9rem; color: #94a3b8; text-align: center; margin-bottom: 20px;">
    切换架构模式，点击“开始分流”观察 Token 在各层权重（LN、QKV、Attention、FFN）中的流动轨迹。
  </p>

  <div style="display: flex; flex-wrap: wrap; justify-content: center; gap: 10px; margin-bottom: 20px;">
    <button onclick="setPlaygroundMode('dense')" id="btn-dense" style="padding: 8px 16px; border: 1px solid #334155; background: #1e293b; color: #94a3b8; border-radius: 6px; cursor: pointer; font-weight: bold; transition: all 0.3s;">Dense (密集共享)</button>
    <button onclick="setPlaygroundMode('moe')" id="btn-moe" style="padding: 8px 16px; border: 1px solid #334155; background: #1e293b; color: #94a3b8; border-radius: 6px; cursor: pointer; font-weight: bold; transition: all 0.3s;">MoE (仅 FFN 专家)</button>
    <button onclick="setPlaygroundMode('mot')" id="btn-mot" style="padding: 8px 16px; border: 1px solid #334155; background: #1e293b; color: #94a3b8; border-radius: 6px; cursor: pointer; font-weight: bold; transition: all 0.3s;">MoT (全模块解耦)</button>
  </div>

  <div style="position: relative; border: 1px solid #334155; background: #020617; border-radius: 8px; height: 350px; overflow: hidden; margin-bottom: 20px;">
    <div id="layer-container" style="display: flex; justify-content: space-around; align-items: center; height: 100%; width: 100%; padding: 0 10px; box-sizing: border-box; position: absolute; z-index: 1;">
      <div class="sim-phase" style="display: flex; flex-direction: column; align-items: center; gap: 10px;">
        <span style="font-size: 0.75rem; color: #64748b; font-weight: bold;">输入 Tokens</span>
        <div id="input-zone" style="width: 80px; height: 200px; border: 1px dashed #334155; border-radius: 6px; display: flex; flex-direction: column; justify-content: center; align-items: center; gap: 8px; background: rgba(15, 23, 42, 0.5);"></div>
      </div>
      <div class="sim-phase" style="display: flex; flex-direction: column; align-items: center; gap: 10px; position: relative;">
        <span style="font-size: 0.75rem; color: #64748b; font-weight: bold;">LayerNorm &amp; QKV</span>
        <div id="qkv-zone" style="width: 100px; height: 220px; display: flex; flex-direction: column; justify-content: space-around; align-items: center; position: relative;"></div>
      </div>
      <div class="sim-phase" style="display: flex; flex-direction: column; align-items: center; gap: 10px;">
        <span style="font-size: 0.75rem; color: #64748b; font-weight: bold;">全局自注意力</span>
        <div id="attn-zone" style="width: 100px; height: 200px; border: 2px solid #334155; border-radius: 8px; display: flex; justify-content: center; align-items: center; background: rgba(30, 27, 75, 0.4); font-size: 0.8rem; font-weight: bold; color: #c084fc; transition: all 0.3s; text-align: center;">Global Attention</div>
      </div>
      <div class="sim-phase" style="display: flex; flex-direction: column; align-items: center; gap: 10px;">
        <span style="font-size: 0.75rem; color: #64748b; font-weight: bold;">FFN (前馈专家)</span>
        <div id="ffn-zone" style="width: 100px; height: 220px; display: flex; flex-direction: column; justify-content: space-around; align-items: center; position: relative;"></div>
      </div>
    </div>
    <div id="token-canvas" style="position: absolute; top: 0; left: 0; width: 100%; height: 100%; z-index: 2; pointer-events: none;"></div>
  </div>

  <div style="display: grid; grid-template-columns: repeat(auto-fit, minmax(140px, 1fr)); gap: 15px; background: rgba(15, 23, 42, 0.6); padding: 15px; border-radius: 8px; border: 1px solid #334155;">
    <div style="text-align: center;">
      <div style="font-size: 0.8rem; color: #94a3b8;">激活参数占比 (FLOPs)</div>
      <div id="stat-flops" style="font-size: 1.3rem; font-weight: bold; color: #ef4444; margin-top: 5px;">100%</div>
    </div>
    <div style="text-align: center;">
      <div style="font-size: 0.8rem; color: #94a3b8;">模态梯度冲突率</div>
      <div id="stat-conflict" style="font-size: 1.3rem; font-weight: bold; color: #ef4444; margin-top: 5px;">极高 (100%)</div>
    </div>
    <div style="text-align: center;">
      <div style="font-size: 0.8rem; color: #94a3b8;">分流路由机制</div>
      <div id="stat-routing" style="font-size: 1rem; font-weight: bold; color: #38bdf8; margin-top: 8px;">无 (全共享)</div>
    </div>
  </div>

  <div style="display: flex; justify-content: center; gap: 15px; margin-top: 20px;">
    <button onclick="startPlaygroundSimulation()" id="btn-start" style="padding: 10px 24px; background: #38bdf8; color: #0f172a; border: none; border-radius: 6px; font-weight: bold; cursor: pointer; font-size: 1rem; transition: background 0.3s; box-shadow: 0 4px 12px rgba(56, 189, 248, 0.2);">开始分流</button>
    <button onclick="resetPlayground()" style="padding: 10px 20px; background: transparent; color: #94a3b8; border: 1px solid #475569; border-radius: 6px; font-weight: bold; cursor: pointer; font-size: 0.95rem; transition: all 0.3s;">重置</button>
  </div>
</div>

<script>
  (function() {
    let mode = 'dense';
    let isSimulating = false;
    let animFrames = [];

    const tokenTypes = [
      { name: '文本 (Text)', color: '#38bdf8', glow: 'rgba(56, 189, 248, 0.4)', type: 'text' },
      { name: '图像 (Vision)', color: '#c084fc', glow: 'rgba(192, 132, 252, 0.4)', type: 'vision' },
      { name: '语音 (Speech)', color: '#fbbf24', glow: 'rgba(251, 191, 36, 0.4)', type: 'speech' }
    ];

    window.setPlaygroundMode = function(newMode) {
      if (isSimulating) return;
      mode = newMode;
      
      ['dense', 'moe', 'mot'].forEach(m => {
        const btn = document.getElementById('btn-' + m);
        if (m === mode) {
          btn.style.background = '#38bdf8';
          btn.style.color = '#0f172a';
          btn.style.borderColor = '#38bdf8';
        } else {
          btn.style.background = '#1e293b';
          btn.style.color = '#94a3b8';
          btn.style.borderColor = '#334155';
        }
      });

      const flops = document.getElementById('stat-flops');
      const conflict = document.getElementById('stat-conflict');
      const routing = document.getElementById('stat-routing');

      if (mode === 'dense') {
        flops.innerText = '100%';
        flops.style.color = '#ef4444';
        conflict.innerText = '极高 (100%)';
        conflict.style.color = '#ef4444';
        routing.innerText = '无 (全局共享)';
      } else if (mode === 'moe') {
        flops.innerText = '激活约 55%';
        flops.style.color = '#fbbf24';
        conflict.innerText = '中 (共享QKV/LN)';
        conflict.style.color = '#fbbf24';
        routing.innerText = '可学习动态路由';
      } else if (mode === 'mot') {
        flops.innerText = '激活约 45%';
        flops.style.color = '#10b981';
        conflict.innerText = '极低 (0% 解耦)';
        conflict.style.color = '#10b981';
        routing.innerText = '确定性模态路由';
      }

      resetPlayground();
    };

    window.resetPlayground = function() {
      animFrames.forEach(cancelAnimationFrame);
      animFrames = [];
      isSimulating = false;
      document.getElementById('btn-start').disabled = false;
      document.getElementById('btn-start').style.opacity = '1';

      document.getElementById('token-canvas').innerHTML = '';
      const inputZone = document.getElementById('input-zone');
      const qkvZone = document.getElementById('qkv-zone');
      const ffnZone = document.getElementById('ffn-zone');

      inputZone.innerHTML = '';
      qkvZone.innerHTML = '';
      ffnZone.innerHTML = '';

      const activeTokens = [
        tokenTypes[0], // text
        tokenTypes[1], // vision
        tokenTypes[0], // text
        tokenTypes[2]  // speech
      ];

      activeTokens.forEach((t, index) => {
        const pill = document.createElement('div');
        pill.className = 'sim-token';
        pill.style.cssText = `
          width: 60px; padding: 4px; border-radius: 4px; text-align: center;
          font-size: 0.7rem; font-weight: bold; background: ${t.color}; color: #0f172a;
          box-shadow: 0 0 10px ${t.glow}; transition: all 0.5s; opacity: 0.9;
        `;
        pill.innerText = t.type.toUpperCase();
        pill.setAttribute('data-type', t.type);
        inputZone.appendChild(pill);
      });

      if (mode === 'dense') {
        qkvZone.innerHTML = `<div style="width: 90px; height: 160px; border: 2px solid #475569; border-radius: 6px; background: rgba(51, 65, 85, 0.3); display: flex; align-items: center; justify-content: center; font-size: 0.75rem; text-align: center; font-weight: bold; color: #94a3b8; transition: all 0.3s;">共享 LN+QKV</div>`;
        ffnZone.innerHTML = `<div style="width: 90px; height: 160px; border: 2px solid #475569; border-radius: 6px; background: rgba(51, 65, 85, 0.3); display: flex; align-items: center; justify-content: center; font-size: 0.75rem; text-align: center; font-weight: bold; color: #94a3b8; transition: all 0.3s;">共享 FFN</div>`;
      } else if (mode === 'moe') {
        qkvZone.innerHTML = `<div style="width: 90px; height: 160px; border: 2px solid #475569; border-radius: 6px; background: rgba(51, 65, 85, 0.3); display: flex; align-items: center; justify-content: center; font-size: 0.75rem; text-align: center; font-weight: bold; color: #94a3b8; transition: all 0.3s;">共享 LN+QKV</div>`;
        ffnZone.innerHTML = `
          <div style="width: 90px; height: 50px; border: 2px solid #475569; border-radius: 6px; background: rgba(56, 189, 248, 0.15); display: flex; align-items: center; justify-content: center; font-size: 0.7rem; font-weight: bold; color: #38bdf8; transition: all 0.3s;">FFN 文本专家</div>
          <div style="width: 90px; height: 50px; border: 2px solid #475569; border-radius: 6px; background: rgba(192, 132, 252, 0.15); display: flex; align-items: center; justify-content: center; font-size: 0.7rem; font-weight: bold; color: #c084fc; transition: all 0.3s;">FFN 视觉专家</div>
          <div style="width: 90px; height: 50px; border: 2px solid #475569; border-radius: 6px; background: rgba(251, 191, 36, 0.15); display: flex; align-items: center; justify-content: center; font-size: 0.7rem; font-weight: bold; color: #fbbf24; transition: all 0.3s;">FFN 语音专家</div>
        `;
      } else if (mode === 'mot') {
        qkvZone.innerHTML = `
          <div style="width: 90px; height: 50px; border: 2px dashed #38bdf8; border-radius: 6px; background: rgba(56, 189, 248, 0.15); display: flex; flex-direction: column; align-items: center; justify-content: center; font-size: 0.65rem; font-weight: bold; color: #38bdf8; transition: all 0.3s;">LN/QKV<br>文本专家</div>
          <div style="width: 90px; height: 50px; border: 2px dashed #c084fc; border-radius: 6px; background: rgba(192, 132, 252, 0.15); display: flex; flex-direction: column; align-items: center; justify-content: center; font-size: 0.65rem; font-weight: bold; color: #c084fc; transition: all 0.3s;">LN/QKV<br>视觉专家</div>
          <div style="width: 90px; height: 50px; border: 2px dashed #fbbf24; border-radius: 6px; background: rgba(251, 191, 36, 0.15); display: flex; flex-direction: column; align-items: center; justify-content: center; font-size: 0.65rem; font-weight: bold; color: #fbbf24; transition: all 0.3s;">LN/QKV<br>语音专家</div>
        `;
        ffnZone.innerHTML = `
          <div style="width: 90px; height: 50px; border: 2px solid #38bdf8; border-radius: 6px; background: rgba(56, 189, 248, 0.15); display: flex; align-items: center; justify-content: center; font-size: 0.7rem; font-weight: bold; color: #38bdf8; transition: all 0.3s;">FFN 文本专家</div>
          <div style="width: 90px; height: 50px; border: 2px solid #c084fc; border-radius: 6px; background: rgba(192, 132, 252, 0.15); display: flex; align-items: center; justify-content: center; font-size: 0.7rem; font-weight: bold; color: #c084fc; transition: all 0.3s;">FFN 视觉专家</div>
          <div style="width: 90px; height: 50px; border: 2px solid #fbbf24; border-radius: 6px; background: rgba(251, 191, 36, 0.15); display: flex; align-items: center; justify-content: center; font-size: 0.7rem; font-weight: bold; color: #fbbf24; transition: all 0.3s;">FFN 语音专家</div>
        `;
      }
    };

    window.startPlaygroundSimulation = function() {
      if (isSimulating) return;
      isSimulating = true;
      document.getElementById('btn-start').disabled = true;
      document.getElementById('btn-start').style.opacity = '0.5';

      const canvas = document.getElementById('token-canvas');
      const inputZone = document.getElementById('input-zone');
      const qkvZone = document.getElementById('qkv-zone');
      const attnZone = document.getElementById('attn-zone');
      const ffnZone = document.getElementById('ffn-zone');

      const canvasRect = canvas.getBoundingClientRect();
      const tokens = Array.from(inputZone.getElementsByClassName('sim-token'));
      const qkvExperts = Array.from(qkvZone.children);
      const ffnExperts = Array.from(ffnZone.children);

      const entities = tokens.map((token, index) => {
        const type = token.getAttribute('data-type');
        const color = type === 'text' ? '#38bdf8' : type === 'vision' ? '#c084fc' : '#fbbf24';
        const glow = type === 'text' ? 'rgba(56, 189, 248, 0.4)' : type === 'vision' ? 'rgba(192, 132, 252, 0.4)' : 'rgba(251, 191, 36, 0.4)';
        
        const dot = document.createElement('div');
        dot.style.cssText = `
          position: absolute; width: 14px; height: 14px; border-radius: 50%;
          background: ${color}; box-shadow: 0 0 12px 3px ${color}, 0 0 4px ${glow};
          transform: translate(-50%, -50%); transition: opacity 0.3s;
        `;
        canvas.appendChild(dot);

        token.style.opacity = '0.1';

        const startRect = token.getBoundingClientRect();
        
        let qkvTargetY = 0;
        if (mode === 'dense' || mode === 'moe') {
          const targetRect = qkvExperts[0].getBoundingClientRect();
          qkvTargetY = targetRect.top + targetRect.height / 2 - (index - 1.5) * 20;
        } else {
          const expertIdx = type === 'text' ? 0 : type === 'vision' ? 1 : 2;
          const targetRect = qkvExperts[expertIdx].getBoundingClientRect();
          qkvTargetY = targetRect.top + targetRect.height / 2 + (index % 2 - 0.5) * 8;
        }
        const qkvTargetRect = qkvZone.getBoundingClientRect();
        const qkvTargetX = qkvTargetRect.left + qkvTargetRect.width / 2;

        const attnRect = attnZone.getBoundingClientRect();
        const attnTargetX = attnRect.left + attnRect.width / 2;
        const attnTargetY = attnRect.top + attnRect.height / 2 - (index - 1.5) * 20;

        let ffnTargetY = 0;
        if (mode === 'dense') {
          const targetRect = ffnExperts[0].getBoundingClientRect();
          ffnTargetY = targetRect.top + targetRect.height / 2 - (index - 1.5) * 20;
        } else {
          const expertIdx = type === 'text' ? 0 : type === 'vision' ? 1 : 2;
          const targetRect = ffnExperts[expertIdx].getBoundingClientRect();
          ffnTargetY = targetRect.top + targetRect.height / 2;
        }
        const ffnTargetRect = ffnZone.getBoundingClientRect();
        const ffnTargetX = ffnTargetRect.left + ffnTargetRect.width / 2;

        const outTargetX = canvasRect.right - 20;
        const outTargetY = startRect.top + startRect.height / 2;

        return {
          dom: dot,
          type,
          color,
          path: [
            { x: startRect.left + startRect.width / 2, y: startRect.top + startRect.height / 2 },
            { x: qkvTargetX, y: qkvTargetY },
            { x: attnTargetX, y: attnTargetY },
            { x: ffnTargetX, y: ffnTargetY },
            { x: outTargetX, y: outTargetY }
          ]
        };
      });

      let start = null;
      function step(timestamp) {
        if (!start) start = timestamp;
        const progress = (timestamp - start) / 4500;
        
        entities.forEach(ent => {
          const segmentCount = ent.path.length - 1;
          const totalT = Math.min(Math.max(progress, 0), 0.999) * segmentCount;
          const segmentIdx = Math.floor(totalT);
          const segmentT = totalT - segmentIdx;

          const p0 = ent.path[segmentIdx];
          const p1 = ent.path[segmentIdx + 1];

          const currentX = p0.x + (p1.x - p0.x) * segmentT - canvasRect.left;
          const currentY = p0.y + (p1.y - p0.y) * segmentT - canvasRect.top;

          ent.dom.style.left = currentX + 'px';
          ent.dom.style.top = currentY + 'px';

          if (segmentIdx === 1) {
            if (mode !== 'mot') {
              qkvZone.firstElementChild.style.background = 'rgba(239, 68, 68, 0.2)';
              qkvZone.firstElementChild.style.borderColor = '#ef4444';
              qkvZone.firstElementChild.style.boxShadow = '0 0 15px rgba(239, 68, 68, 0.4)';
            } else {
              const expertIdx = ent.type === 'text' ? 0 : ent.type === 'vision' ? 1 : 2;
              qkvExperts[expertIdx].style.background = ent.color + '33';
              qkvExperts[expertIdx].style.boxShadow = '0 0 15px ' + ent.color + '66';
            }
          }

          if (segmentIdx === 2) {
            attnZone.style.boxShadow = '0 0 20px rgba(192, 132, 252, 0.6)';
            attnZone.style.borderColor = '#c084fc';
            attnZone.style.background = 'rgba(192, 132, 252, 0.2)';
            
            if (mode !== 'mot') {
              qkvZone.firstElementChild.style.background = 'rgba(51, 65, 85, 0.3)';
              qkvZone.firstElementChild.style.borderColor = '#475569';
              qkvZone.firstElementChild.style.boxShadow = 'none';
            } else {
              qkvExperts.forEach(ex => {
                ex.style.background = 'transparent';
                ex.style.boxShadow = 'none';
              });
            }
          }

          if (segmentIdx === 3) {
            attnZone.style.boxShadow = 'none';
            attnZone.style.borderColor = '#334155';
            attnZone.style.background = 'rgba(30, 27, 75, 0.4)';

            if (mode === 'dense') {
              ffnZone.firstElementChild.style.background = 'rgba(239, 68, 68, 0.2)';
              ffnZone.firstElementChild.style.borderColor = '#ef4444';
              ffnZone.firstElementChild.style.boxShadow = '0 0 15px rgba(239, 68, 68, 0.4)';
            } else {
              const expertIdx = ent.type === 'text' ? 0 : ent.type === 'vision' ? 1 : 2;
              ffnExperts[expertIdx].style.background = ent.color + '33';
              ffnExperts[expertIdx].style.boxShadow = '0 0 15px ' + ent.color + '66';
            }
          }
        });

        if (progress < 1) {
          animFrames.push(requestAnimationFrame(step));
        } else {
          entities.forEach(ent => {
            ent.dom.style.opacity = '0';
          });
          if (mode === 'dense') {
            ffnZone.firstElementChild.style.background = 'rgba(51, 65, 85, 0.3)';
            ffnZone.firstElementChild.style.borderColor = '#475569';
            ffnZone.firstElementChild.style.boxShadow = 'none';
          } else {
            ffnExperts.forEach(ex => {
              ex.style.background = 'transparent';
              ex.style.boxShadow = 'none';
            });
          }
          tokens.forEach(t => {
            t.style.opacity = '0.9';
          });
          isSimulating = false;
          document.getElementById('btn-start').disabled = false;
          document.getElementById('btn-start').style.opacity = '1';
        }
      }

      animFrames.push(requestAnimationFrame(step));
    };

    document.addEventListener("DOMContentLoaded", () => {
      setPlaygroundMode('dense');
    });
    // 如果 DOM 已加载，直接初始化
    if (document.readyState === "complete" || document.readyState === "interactive") {
      setTimeout(() => setPlaygroundMode('dense'), 100);
    }
  })();
</script>

<hr />

<h2 id="8-总结与未来展望">8. 总结与未来展望</h2>

<p>Mixture-of-Transformers (MoT) 的提出，为我们思考多模态模型的参数排布带来了极具启发性的视角。过去，我们一味追求“同一个模型、同一个权重”去理解世界；而 MoT 和 NVIDIA Cosmos 3 的成功经验告诉我们，<strong>“物理层面的独立参数解耦”与“逻辑层面的全局注意力融合”相结合，才是多模态世界模型更高效的发展方向</strong>。</p>

<h3 id="-mot-的几点核心启示">💡 MoT 的几点核心启示：</h3>
<ol>
  <li><strong>多模态不等于参数大锅饭</strong>：对于结构和密度差异巨大的模态，前期的 QKV 投影和后期的 FFN 进行参数隔离，能够极大地释放各自的潜力，避免“互相妥协”。</li>
  <li><strong>路由不一定非要“可学习”</strong>：在天然拥有模态标签的多模态场景中，利用先验知识的确定性路由（Static Routing）比可学习路由（Dynamic Routing）更加稳定、简单且高效。</li>
  <li><strong>全局自注意力依然是护城河</strong>：保留跨模态的全局注意力是确保模型进行深度推理和模态对齐的根本，绝不能为了稀疏化而将注意力也完全割裂。</li>
</ol>

<p>随着未来基础模型走向“声音、视频、三维场景、物理动作”等更广阔的 Physical AI 世界，MoT 这样兼具高性能与低能耗的稀疏解耦架构，无疑将成为支撑下一代多模态智能的核心基石。</p>

<hr />
<p><strong>参考文献：</strong></p>
<ol>
  <li>Liang, et al. <em>“Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models”</em>, arXiv:2411.04996, 2024. (Published in TMLR 2025)</li>
  <li>NVIDIA Cosmos Team. <em>“NVIDIA Cosmos: World Foundation Models for Physical AI”</em>, Technical Report, 2025.</li>
  <li>
    <h2 id="chameleon-team-meta-ai-chameleon-mixed-modal-early-fusion-foundation-models-arxiv240509818-2024">Chameleon Team, Meta AI. <em>“Chameleon: Mixed-Modal Early-Fusion Foundation Models”</em>, arXiv:2405.09818, 2024.</h2>
  </li>
</ol>]]></content><author><name>Tingde Liu</name></author><category term="blog" /><category term="LLM Training" /><category term="Multi-Modal" /><category term="MoT" /><category term="MoE" /><category term="Sparse Transformer" /><category term="Deep Learning" /><category term="NVIDIA Cosmos" /><summary type="html"><![CDATA[深入剖析 Meta AI、NVIDIA 等机构提出的 Mixture-of-Transformers (MoT) 稀疏架构。从密集模型的模态竞争难题出发，详解 MoT 核心的「模态特定参数解耦 + 全局自注意力」机制、确定性模态路由，并重点剖析 NVIDIA Cosmos 3 物理世界模型在此架构上的前沿工程落地与巨大能效比。]]></summary></entry><entry><title type="html">Loop Engineering：Agent 闭环范式</title><link href="https://garylee1210.github.io/loop-engineering/" rel="alternate" type="text/html" title="Loop Engineering：Agent 闭环范式" /><published>2026-09-23T00:00:00+00:00</published><updated>2026-09-23T00:00:00+00:00</updated><id>https://garylee1210.github.io/loop-engineering</id><content type="html" xml:base="https://garylee1210.github.io/loop-engineering/"><![CDATA[<h1 id="1-引言从手写-prompt到设计系统的认知跃迁">1. 引言：从“手写 Prompt”到“设计系统”的认知跃迁</h1>

<p>在过去两年的 AI 辅助开发中，我们绝大多数人与 AI 编码助手的交互方式都可以总结为一种<strong>“单步对话”模式</strong>：你写一段 Prompt 并共享相关代码，点击发送，阅读返回的代码，发现有 Bug 或遗漏，然后再写一段 Prompt 告诉它如何修改。在这个过程中，AI 是一个被动的工具，而你则是高强度的键盘操作者，需要在每一个回合中手动监督、判断和推进。</p>

<p>但这套手工作业模式的上限非常明显。软件开发本质上是一个高度迭代、容错性低、多步骤交织的复杂过程。人类工程师在写代码时也会犯错，但我们会通过“编译 -&gt; 运行测试 -&gt; 观察报错 -&gt; 修改 -&gt; 再次测试”的闭环自行纠错。普通的单步 Prompting 剥夺了 AI 的“闭环纠错能力”，使其极易在复杂任务中“一错到底”。</p>

<p>正如 Anthropic 的 Claude Code 负责人 Boris Cherny 所说：</p>
<blockquote>
  <p><strong>“我不再直接 Prompt Claude 了。我有专门运行的循环（loops）去 Prompt Claude 并弄清楚下一步该做什么。我的工作是编写这些循环。”</strong></p>
</blockquote>

<p>独立开发者 Peter Steinberger 也指出：</p>
<blockquote>
  <p><strong>“你不应该再亲自去 Prompt 编码智能体，而是应当设计一套‘替你 Prompt 智能体’的系统。”</strong></p>
</blockquote>

<p>这种将智能体置于自主、迭代式的执行周期中，使其能够自我决策、自我纠错并逐步逼近目标的系统性设计方法，被称为 <strong>Loop Engineering（循环工程）</strong>。</p>

<div align="center"><img src="/images/agent/loop-engineering-hero.jpg" width="90%" alt="Loop Engineering Hero" /><figcaption>图 1：Loop Engineering 核心概念——从“手动 Prompt”转向“为 Agent 编写自动化闭环系统”</figcaption></div>

<!-- more -->

<h3 id="线性链chain与自主循环loop的本质区别">线性链（Chain）与自主循环（Loop）的本质区别</h3>

<p>在 Agentic Workflow（智能体工作流）中，我们通常会区分“链”与“循环”：</p>
<ul>
  <li><strong>线性链 (Chain)</strong>：是静态且预设的。步骤 A 执行完直接进入步骤 B，再进入步骤 C（例如 <code class="language-plaintext highlighter-rouge">Step A -&gt; Step B -&gt; Step C</code>）。它适合结构高度固定、路径完全确定的流水线任务，但在面对动态变化的运行期报错时极易折断。</li>
  <li><strong>自主循环 (Loop)</strong>：是动态且自适应的（<code class="language-plaintext highlighter-rouge">Reason -&gt; Act -&gt; Observe -&gt; Adapt -&gt; Repeat</code>）。Agent 在每一个周期执行动作，观测环境反馈，并在遇到阻碍时自主调适策略，重新尝试，直到达成最终的“终止条件”（Termination Condition）。</li>
</ul>

<pre><code class="language-mermaid">flowchart TD
    %%{init: {'theme': 'neutral', 'themeVariables': { 'primaryColor': '#e0f2fe', 'primaryTextColor': '#0369a1', 'primaryBorderColor': '#7dd3fc', 'lineColor': '#64748b'}}}%%
    subgraph traditional["传统单步 Prompting 模式 (Human-in-the-Loop)"]
        A["开发者"] --&gt;|1. 手写 Prompt| B("LLM Agent")
        B --&gt;|2. 人工阅读与纠错| A
    end

    subgraph modern["现代 Loop Engineering 模式 (Autonomous Loop)"]
        C["开发者"] --&gt;|设计循环机制| D("Agent Execution Loop")
        D --&gt;|触发 ➔ 执行 ➔ 判定 ➔ 记忆| D
    end

    style A fill:#fef3c7,stroke:#d97706,stroke-width:1px,color:#92400e
    style B fill:#dbeafe,stroke:#2563eb,stroke-width:1px,color:#1e40af
    style C fill:#dcfce7,stroke:#16a34a,stroke-width:1px,color:#14532d
    style D fill:#ede9fe,stroke:#4f46e5,stroke-width:2px,color:#4338ca
</code></pre>
<div align="center"><figcaption>图 2：单步交互与 Loop Engineering 的对比示意图</figcaption></div>

<hr />

<h1 id="2-ai-agent-的层级栈loop-处于哪一层">2. AI Agent 的层级栈：Loop 处于哪一层？</h1>

<p>为了精确给 Loop Engineering 定位，我们必须了解现代 AI 智能体开发的技术层级栈（The Agentic Stack）。在工业界，开发者通常将整个 Agent 系统划分为四个核心层级：</p>

<pre><code class="language-mermaid">flowchart TD
    %%{init: {'theme': 'neutral', 'themeVariables': { 'fontSize': '12px'}}}%%
    L4["④ 循环工程 (Loop Engineering)&lt;br/&gt;自主流程、任务编排、Maker-Checker 机制、状态外部持久化"]
    L3["③ 驾驭工程 (Harness Engineering)&lt;br/&gt;运行环境、执行沙箱、工具与接口 (MCP)、护栏与安全约束"]
    L2["② 上下文工程 (Context Engineering)&lt;br/&gt;知识库、动态检索、RAG、系统级说明文件 (AGENTS.md)"]
    L1["① 提示工程 (Prompt Engineering)&lt;br/&gt;指令调优、Few-shot 样本、单次问答逻辑、推理思维链控制"]

    L4 --&gt; L3
    L3 --&gt; L2
    L2 --&gt; L1

    style L4 fill:#ede9fe,stroke:#818cf8,stroke-width:2px,color:#4338ca
    style L3 fill:#dcfce7,stroke:#34d399,stroke-width:2px,color:#14532d
    style L2 fill:#e0f2fe,stroke:#38bdf8,stroke-width:2px,color:#0369a1
    style L1 fill:#fef3c7,stroke:#fbbf24,stroke-width:2px,color:#92400e
</code></pre>
<div align="center"><figcaption>图 3：现代 AI Agent 架构层级栈</figcaption></div>

<ol>
  <li><strong>提示工程 (Prompt Engineering)</strong>：研究如何优化单次向大模型输入的信息结构，以获得更准确的瞬时推理（如 Chain-of-Thought, ReAct 元指令设计）。</li>
  <li><strong>上下文工程 (Context Engineering)</strong>：关注如何动态提取、缓存与更新模型在解决特定问题时所需的相关信息（例如在 IDE 中动态检索相关定义、代码片段等）。</li>
  <li><strong>驾驭工程 (Harness Engineering)</strong>：为 Agent 搭建安全的执行“疆界”。它设计 Agent 所处的沙箱环境（Sandbox）、系统 API 权限、终端运行工具以及安全限制护栏。</li>
  <li><strong>循环工程 (Loop Engineering)</strong>：<strong>层级最高，起编排作用。</strong> 它负责在 Harness 之上构建随时间推移自动运行的驱动周期——包括设定调度触发、并行隔离逻辑、判定任务通过的 Checker 守护机制，以及全局持久化记忆管理。</li>
</ol>

<p>如果把 Harness 比作 Agent 在其中工作的一个具有完善防爆护栏和工具的<strong>生产实验室</strong>，那么 Loop 就是实验室之上的<strong>自动化生产调度流水线</strong>。</p>

<hr />

<h1 id="3-loop-engineering-的四种核心循环模式">3. Loop Engineering 的四种核心循环模式</h1>

<p>根据任务的复杂程度与环境反馈类型的不同，Loop Engineering 通常有以下四种典型模式：</p>

<h3 id="-重试循环-the-retry-loop">① 重试循环 (The Retry Loop)</h3>
<ul>
  <li><strong>核心机制</strong>：最简单直观的 pass/fail 模式。Agent 尝试执行一个任务（例如编写一段满足单元测试的单体函数），随后运行断言工具。若失败，将报错原样喂回，直接重试。</li>
  <li><strong>适用场景</strong>：原子化、边界清晰、拥有明确 Boolean 类型测试反馈的子任务。</li>
  <li><strong>设计陷阱</strong>：如果不提供策略变化，极易陷入“使用同样错误逻辑反复重试”的自旋中。</li>
</ul>

<pre><code class="language-mermaid">flowchart TD
    %%{init: {'theme': 'neutral', 'themeVariables': { 'lineColor': '#64748b'}}}%%
    Start["开始任务"] --&gt; Exec["执行尝试 (Action)"]
    Exec --&gt; Verify{"校验判定 (Verify)"}
    Verify --&gt;|通过 Pass| Done["完成 Exit"]
    Verify --&gt;|失败 Fail| Mutate["调整策略 (Mutate)"]
    Mutate --&gt; Exec

    style Start fill:#f1f5f9,stroke:#cbd5e1,stroke-width:1px,color:#334155
    style Exec fill:#f3e8ff,stroke:#c084fc,stroke-width:1px,color:#6b21a8
    style Verify fill:#fef3c7,stroke:#fbbf24,stroke-width:1px,color:#92400e
    style Done fill:#dcfce7,stroke:#34d399,stroke-width:2px,color:#14532d
    style Mutate fill:#fee2e2,stroke:#f87171,stroke-width:1px,color:#991b1b
</code></pre>

<h3 id="-计划-执行-校验循环-the-plan-execute-verify-loop">② 计划-执行-校验循环 (The Plan-Execute-Verify Loop)</h3>
<ul>
  <li><strong>核心机制</strong>：在执行前，智能体首先进行高层级的任务拆解并生成 Plan，随后逐个步骤执行。在每个步骤结束时，由专用的验证子代理（Checker）对修改进行单步判定。若发现偏差，则动态调整计划（Plan Re-routing）而非盲目推进。</li>
  <li><strong>适用场景</strong>：涉及多个组件重构、API 跨文件调用等长周期、多依赖的复杂工程任务。</li>
  <li><strong>优势</strong>：防止早期微小错误在后期的累积与放大。</li>
</ul>

<pre><code class="language-mermaid">flowchart TD
    %%{init: {'theme': 'neutral', 'themeVariables': { 'lineColor': '#64748b'}}}%%
    Start["开始"] --&gt; Plan["生成全局计划 (Plan)"]
    Plan --&gt; Step["执行单步任务 (Execute Step)"]
    Step --&gt; Verify{"单步质检 (Checker)"}
    Verify --&gt;|失败 Fail| ReRoute["动态调整计划 (Plan Re-routing)"]
    ReRoute --&gt; Step
    Verify --&gt;|通过 Pass| Next{"是否全部完成?"}
    Next --&gt;|否 No| Step
    Next --&gt;|是 Yes| Done["整体交付 (Verify &amp; Exit)"]

    style Start fill:#f1f5f9,stroke:#cbd5e1,stroke-width:1px,color:#334155
    style Plan fill:#e0f2fe,stroke:#38bdf8,stroke-width:1px,color:#0369a1
    style Step fill:#f3e8ff,stroke:#c084fc,stroke-width:1px,color:#6b21a8
    style Verify fill:#fef3c7,stroke:#fbbf24,stroke-width:1px,color:#92400e
    style ReRoute fill:#fee2e2,stroke:#f87171,stroke-width:1px,color:#991b1b
    style Next fill:#e0f2fe,stroke:#38bdf8,stroke-width:1px,color:#0369a1
    style Done fill:#dcfce7,stroke:#34d399,stroke-width:2px,color:#14532d
</code></pre>

<h3 id="-探索-收敛循环-the-explore-narrow-loop">③ 探索-收敛循环 (The Explore-Narrow Loop)</h3>
<ul>
  <li><strong>核心机制</strong>：面对未知错误时，智能体并行或串行地去尝试多种不同的解决通路（比如尝试方案 A 修改配置，尝试方案 B 修改代码结构），收集运行反馈，评估不同通路的成效，最终选择收敛至最优解。</li>
  <li><strong>适用场景</strong>：疑难 Bug 排查、未知第三方库 API 的探索性调用、性能调优等无法一步到位确定方案的场景。</li>
</ul>

<pre><code class="language-mermaid">flowchart TD
    %%{init: {'theme': 'neutral', 'themeVariables': { 'lineColor': '#64748b'}}}%%
    Start["定位问题"] --&gt; Split{"分叉探索 (Path Splitting)"}
    Split --&gt;|尝试方案 A| TryA["执行方案 A (Run A)"]
    Split --&gt;|尝试方案 B| TryB["执行方案 B (Run B)"]
    TryA --&gt; Eval["评估与收集反馈 (Evaluate &amp; Collect)"]
    TryB --&gt; Eval
    Eval --&gt; Narrow["选择最优方案 (Narrow Path)"]
    Narrow --&gt; Done["收敛并交付 (Narrow &amp; Exit)"]

    style Start fill:#f1f5f9,stroke:#cbd5e1,stroke-width:1px,color:#334155
    style Split fill:#ffe8cc,stroke:#ff922b,stroke-width:1px,color:#d9480f
    style TryA fill:#f3e8ff,stroke:#c084fc,stroke-width:1px,color:#6b21a8
    style TryB fill:#f3e8ff,stroke:#c084fc,stroke-width:1px,color:#6b21a8
    style Eval fill:#fef3c7,stroke:#fbbf24,stroke-width:1px,color:#92400e
    style Narrow fill:#e0f2fe,stroke:#38bdf8,stroke-width:1px,color:#0369a1
    style Done fill:#dcfce7,stroke:#34d399,stroke-width:2px,color:#14532d
</code></pre>

<h3 id="-人机协同循环-human-in-the-loop">④ 人机协同循环 (Human-in-the-Loop)</h3>
<ul>
  <li><strong>核心机制</strong>：并非所有的自主循环都是越脱离人类越好。在该模式下，Agent 在遇到高度模糊的需求、缺失关键秘钥，或面临高风险操作（如合并至主分支、执行 destructive 的数据库变更）时，会主动暂停循环，将上下文提报给人类，由人类提供精准决策或授权后再恢复执行。</li>
</ul>

<pre><code class="language-mermaid">flowchart TD
    %%{init: {'theme': 'neutral', 'themeVariables': { 'lineColor': '#64748b'}}}%%
    Start["自主运行"] --&gt; Check{"评估动作风险"}
    Check --&gt;|低风险 Low Risk| Exec["自动执行 (Auto Exec)"]
    Check --&gt;|高风险 / 模糊 High Risk / Vague| Pause["挂起并求助人类 (Human Escalation)"]
    Pause --&gt; Input["人类输入决策 (Human Decision)"]
    Input --&gt; Exec
    Exec --&gt; Done["任务结束 (Exit)"]

    style Start fill:#f1f5f9,stroke:#cbd5e1,stroke-width:1px,color:#334155
    style Check fill:#ffe8cc,stroke:#ff922b,stroke-width:1px,color:#d9480f
    style Exec fill:#f3e8ff,stroke:#c084fc,stroke-width:1px,color:#6b21a8
    style Pause fill:#fee2e2,stroke:#f87171,stroke-width:2px,color:#991b1b
    style Input fill:#dcfce7,stroke:#34d399,stroke-width:1px,color:#14532d
    style Done fill:#dcfce7,stroke:#34d399,stroke-width:2px,color:#14532d
</code></pre>

<hr />

<h1 id="4-loop-engineering-的五大核心原语-primitives-与-记忆-state">4. Loop Engineering 的五大核心原语 (Primitives) 与 记忆 (State)</h1>

<p>要把一个手动的 Agent 会话，转化为自运行的“循环”，我们需要借助<strong>五大基础工程原语（Primitives）</strong>以及<strong>一个核心状态外部化机制（State）</strong>。这些在当前的 Codex App 与 Claude Code 等一线开发者工具中，都已作为核心产品组件得到高度映射：</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">原语组件 (Primitive)</th>
      <th style="text-align: left">核心职责</th>
      <th style="text-align: left">Codex App 落地细节</th>
      <th style="text-align: left">Claude Code 落地细节</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>1. 自动触发器 (Automations)</strong></td>
      <td style="text-align: left">发现与分发任务，确定循环节奏</td>
      <td style="text-align: left">Automations 面板（周期配置、测试沙箱、<code class="language-plaintext highlighter-rouge">/goal</code> 指令）</td>
      <td style="text-align: left">Scheduled tasks（Cron 运行、Git 提交 Hooks、<code class="language-plaintext highlighter-rouge">/goal</code> 守护）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>2. 分支工作区 (Worktrees)</strong></td>
      <td style="text-align: left">隔离并发任务，防止文件写入冲突</td>
      <td style="text-align: left">内部自动分配 Thread-level 独立分支</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">git worktree</code> 支持、<code class="language-plaintext highlighter-rouge">isolation: worktree</code> 配置</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>3. 项目技能库 (Skills)</strong></td>
      <td style="text-align: left">固化项目工程规范，规避“意图债”</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">SKILL.md</code>（定义构建、格式和设计规约）</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">SKILL.md</code>（定义在指定目录下，运行时自动挂载）</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>4. 外部连接器 (Connectors)</strong></td>
      <td style="text-align: left">将 Agent 接入外部生产力工具</td>
      <td style="text-align: left">MCP Connectors（支持 Linear, GitHub, Slack 等）</td>
      <td style="text-align: left">MCP 协议服务器、外部 API 工具集成扩展</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>5. 多代理体系 (Sub-agents)</strong></td>
      <td style="text-align: left">实施“ Maker-Checker ”对抗审查</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">.codex/agents/</code> 下定义的子角色（TOML 格式）</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">.claude/agents/</code> 下定义的子代理（Markdown/JSON 配置）</td>
    </tr>
  </tbody>
</table>

<h3 id="-自动触发器-automations">① 自动触发器 (Automations)</h3>
<p>自动触发器是 Loop 的“心脏搏动”。它通常是一个定时任务（Cron）或一个事件订阅者。例如，每天清晨，触发器扫描 CI 失败日志、Linear 未决 Bug 看板和 GitHub 社区 Issues。一旦捕获到需要修复的任务，它就启动循环。在会话内部，这对应了 <code class="language-plaintext highlighter-rouge">/goal</code> 这种“直到达成某种特定判定状态前，持续自我纠正运行”的原语。</p>

<h3 id="-分支工作区-worktrees">② 分支工作区 (Worktrees)</h3>
<p>当我们让多个 Agent 并行处理不同任务时，代码文件的写冲突是致命的。如果两个 Agent 都在直接改工作目录下的同一个接口文件，就会出现类似“多人共同操作一块黑板”的灾难。Loop Engineering 引入了 <code class="language-plaintext highlighter-rouge">git worktree</code> 级的隔离：每个 sub-agent 的每一个修复尝试，都在独立的 branch 工作区运行，互不干扰，在验证成功后再以 PR 形式汇入主干。这极大地降低了多 Agent 并行时的“协调成本”（Orchestration Tax）。</p>

<h3 id="-项目技能库-skills-与-意图债-intent-debt">③ 项目技能库 (Skills) 与 意图债 (Intent Debt)</h3>
<p>Agent 在启动循环时是“失忆”的。如果完全不加引导，它很容易凭感觉去“盲猜”你们团队的编码规范、打包逻辑或者特殊架构规约，产生巨大的“意图债”。这就是为什么我们需要在仓库中固化 <code class="language-plaintext highlighter-rouge">SKILL.md</code>（或打包成 Skills 插件）。
它作为一套外置的、可复用的“意图载体”，每次循环开始时都会被自动加载。通过 Skills，我们可以告诉 Agent：“不要使用传统的 X 库，我们公司统一在 utils/ 中封装了 Y 工具；所有提交必须先经过 pnpm lint。”</p>

<h3 id="-外部连接器-connectors">④ 外部连接器 (Connectors)</h3>
<p>Loop 不能是一座只能操作本地文件系统的孤岛。通过 Model Context Protocol (MCP) 建立的 Connectors，使循环能够拥有对外交互的“感官与肢体”：</p>
<ul>
  <li>在 issue 看板检索最新 Bug 描述（输入通道）。</li>
  <li>提交 PR 到 GitHub（输出通道）。</li>
  <li>在 Slack 通报“已自动修复第 #382 号崩溃 Bug，等待 review”（通知机制）。</li>
</ul>

<h3 id="-多代理体系-sub-agents-与-maker-checker-对抗审查">⑤ 多代理体系 (Sub-agents) 与“ Maker-Checker ”对抗审查</h3>
<p><strong>这是 Loop 能够摆脱人工作业的关键所在。</strong> 在人类开发中，我们绝不会允许一个人编写了所有代码，然后自己做 Code Review 批准并发布。LLM 同样如此——写代码的 Agent（Maker）往往会对自己写出的逻辑产生严重的“认知盲区”，倾向于给出全是 OK 的报告。
Loop Engineering 提倡在循环中实施<strong>“对抗性代码评审” (Adversarial Code Review)</strong>。我们会实例化两个或多个 Sub-agents，例如：</p>
<ul>
  <li><strong>Coder Sub-agent（Maker）</strong>：追求速度，快速生成多份修复草案。</li>
  <li><strong>Reviewer Sub-agent（Checker）</strong>：拥有最严格的安全与合规 Prompt，甚至使用 reasoning 努力程度更高的模型，对 Maker 生成的差异（Diff）进行挑剔式的安全审查与断言校验。</li>
</ul>

<hr />

<h3 id="第六要素全局记忆外部化-state">第六要素：全局记忆外部化 (State)</h3>

<p>在传统的 LLM 会话中，记忆全靠 context 窗口，但随着循环次数增加，context 会急剧膨胀，并且一旦会话结束或超出限额，记忆就会丢失。</p>

<p>Loop Engineering 倡导<strong>“记忆必须留在磁盘/外部数据库，而不是大模型脑子里”</strong>。我们会专门指定一个在仓库中跟踪的 Markdown 文件（例如 <code class="language-plaintext highlighter-rouge">AGENTS.md</code>）或连接一个 Linear 数据库。当循环迭代时，它会将每次尝试过的动作、失败的编译器日志、已经通过的单元测试项实时写入该文件。
即使在第 15 次循环时因为网络中断发生重启，Agent 只要重新读取 <code class="language-plaintext highlighter-rouge">AGENTS.md</code>，就能瞬间恢复“我已经做过什么，接下来需要尝试什么”的全局认知，<strong>Repo 本身成了唯一的真相源（Single Source of Truth）</strong>。</p>

<hr />

<h1 id="5-一个典型的-agent-循环运行图解-the-loop-architecture">5. 一个典型的 Agent 循环运行图解 (The Loop Architecture)</h1>

<p>在实际工程中，这五大原语与外部状态是如何联动工作的呢？我们可以看一看下面这个典型的<strong>自动化 Bug 修复与验证循环</strong>：</p>

<pre><code class="language-mermaid">flowchart LR
    %%{init: {'theme': 'neutral', 'themeVariables': { 'lineColor': '#64748b'}}}%%
    T["1. 触发 &amp; 检索&lt;br/&gt;Cron / 任务看板"] --&gt; W["2. 隔离工作区&lt;br/&gt;git worktree"]
    W --&gt; M["3. 编码执行者&lt;br/&gt;Subagent: Maker"]
    M --&gt; C{"4. 自动化判定&lt;br/&gt;Subagent: Checker"}
    
    C --&gt;|未通过 Fail| F["报错反馈与重试"]
    F -.-&gt; M
    
    C --&gt;|已通过 Pass| P["5. 停止与交付&lt;br/&gt;合并代码 / 开 PR"]
    P --&gt; S["6. 更新全局状态&lt;br/&gt;AGENTS.md / Linear"]

    style T fill:#fef3c7,stroke:#fbbf24,stroke-width:1px,color:#92400e
    style W fill:#e0f2fe,stroke:#38bdf8,stroke-width:1px,color:#0369a1
    style M fill:#f3e8ff,stroke:#c084fc,stroke-width:1px,color:#6b21a8
    style C fill:#dcfce7,stroke:#34d399,stroke-width:2px,color:#14532d
    style F fill:#fee2e2,stroke:#f87171,stroke-width:1px,color:#991b1b
    style P fill:#f1f5f9,stroke:#64748b,stroke-width:1.5px,color:#334155
    style S fill:#ffe4e6,stroke:#fda4af,stroke-width:1px,color:#9f1239
</code></pre>
<div align="center"><figcaption>图 4：Loop Engineering 典型自主执行闭环流程图</figcaption></div>

<ol>
  <li><strong>触发 &amp; 检索 (Trigger &amp; Retrieval)</strong>：事件监听发现有未结任务，触发 Loop。系统拉取对应上下文，并挂载 <code class="language-plaintext highlighter-rouge">SKILL.md</code>，使 Agent 系统掌握项目规范底盘。</li>
  <li><strong>工作区隔离 (Worktree Isolation)</strong>：在本地生成临时的 <code class="language-plaintext highlighter-rouge">git worktree</code> 与新分支，以保护生产主分支代码。</li>
  <li><strong>编码执行 (Execution)</strong>：Maker 子代理开始基于 Bug 报错和现有代码生成修复方案。</li>
  <li><strong>自动化判定 (Verification)</strong>：运行测试套件和 Linter，Checker 子代理对修改的代码逻辑及测试通过率进行综合质检：
    <ul>
      <li><strong>未通过（Fail）</strong>：把执行错误、断言失败等 Traceback 信息写回 <code class="language-plaintext highlighter-rouge">AGENTS.md</code>，重新反馈给 Maker 子代理，进入自我纠错的分支闭环。</li>
      <li><strong>已通过（Pass）</strong>：在本地完成交付提交，打破当前的迭代，迈向停止条件。</li>
    </ul>
  </li>
  <li><strong>停止与交付 (Termination &amp; PR)</strong>：自动清除本地隔离工作区，向 GitHub 仓库发起包含详细修复说明的 PR。</li>
  <li><strong>状态同步 (State Update)</strong>：同步标记外置记忆看板，并在团队 Slack 频道留言，提示人类工程师进入 Review。</li>
</ol>

<hr />

<h1 id="6-专业-agent-工程师的设计守则与挑战">6. 专业 Agent 工程师的设计守则与挑战</h1>

<p>尽管 Loop Engineering 看起来无比美妙，但当系统从单步交互进化到完全自治的 Loop 时，以下三个挑战将变得极其尖锐，需要我们在设计时严格遵守相应的工程法则：</p>

<h3 id="1-验证盲区-verification-deficit--不要把声明当成证词">1. 验证盲区 (Verification Deficit) —— 不要把“声明”当成“证词”</h3>
<p>在闭环中，最难设计的永远是<strong>停止规则（Stop Condition）</strong>。LLM 对“我已经完成了任务”的自信度与代码的实际质量通常是完全脱钩的。如果仅靠 Agent 自己的口头陈述（如“我觉得改好了”）来作为循环终止条件，这个系统大概率会以各种诡异的手段蒙混过关，甚至隐藏报错。</p>
<ul>
  <li><strong>工程法则</strong>：停止条件必须依托<strong>具备强确定性的工具/代码反馈（Programmatic Verification）</strong>，而非大模型的文本陈述。你必须强制闭环对准硬性考核指标，例如：“必须通过 <code class="language-plaintext highlighter-rouge">npm run test:unit</code>，同时 ESLint 报错数为 0，且新生成的代码测试覆盖率不低于 80%”。</li>
</ul>

<h3 id="2-理解-rot-与认知投降-cognitive-surrender--警惕理解债的累积">2. 理解 rot 与认知投降 (Cognitive Surrender) —— 警惕“理解债”的累积</h3>
<p>当闭环系统运行得足够流畅，每天早上你都能收到 10 个自动生成的 PR 时，人性的弱点就会暴露出来——你变得越来越倾向于无条件相信机器。你不再细致审查每一行 Diff，而是简单地点下 Merge 键。这种现象被称为<strong>“认知投降” (Cognitive Surrender)</strong>。
这会带来极高昂的<strong>“理解债” (Comprehension Debt)</strong>。软件系统是持续变动的，当你在一个月后需要重构某个核心模块时，你会突然绝望地发现，系统里一大半核心逻辑都是你从未深入看过的，而这时候写代码的那些 Agent 早就丢弃了当初的上下文。</p>
<ul>
  <li><strong>工程法则</strong>：即使 Loop 再完美，人类依然是质量的最后一道闸门。Loop 的初衷是为了节约繁琐的打字和调试时间，好让工程师腾出精力进行高阶的架构决策和深度 Code Review。理解是不能外包给 Agent 的。</li>
</ul>

<h3 id="3-token-成本控制-token-governance--规避循环内的自循环死亡螺旋">3. Token 成本控制 (Token Governance) —— 规避循环内的“自循环死亡螺旋”</h3>
<p>当 Maker 写出的代码有 Bug，Checker 反馈了报错，Maker 在尝试修复时又引入了新的 Bug……如果你的纠错策略不够稳健（例如每次重试都只是发送完全相同的“请修复此报错”），系统极易陷入<strong>死循环陷阱（Death Spiral）</strong>。在这个螺旋里，Agent 在几分钟内就能刷掉上千万的 Token，给公司账单带来灾难。</p>
<ul>
  <li><strong>工程法则</strong>：每一个 Loop 都必须设计“最高预算护栏”：
    <ul>
      <li><strong>最大尝试次数上限</strong>：限制 <code class="language-plaintext highlighter-rouge">MaxAttempts = 5</code>，超过则强制挂起。</li>
      <li><strong>退避与策略衰减</strong>：若连续 2 次重试遇到的报错完全一致，必须强制更改 Prompt 提示方向（如要求其使用替代方案、回滚或求助人类）。</li>
      <li><strong>会话 Token 预算熔断</strong>：配置软、硬护栏，一旦单次循环消费超过设定额度（如 10 USD），自动暂停并向 Slack 通告人类介入。</li>
    </ul>
  </li>
</ul>

<hr />

<h1 id="7-结语构建循环保持思考">7. 结语：构建循环，保持思考</h1>

<p>Loop Engineering 不仅是技术上的变革，更是软件工程研发范式的深刻变迁。它让我们认识到，在 LLM 时代：</p>
<ul>
  <li>优秀的程序员擅长<strong>编写高质量的代码</strong>。</li>
  <li>优秀的 AI 辅助程序员擅长<strong>撰写高质量的 Prompt</strong>。</li>
  <li>而下一代的 <strong>Agent 工程师，则擅长设计让 Prompt 与代码自我运转、自我纠错并不断收敛的系统循环</strong>。</li>
</ul>

<p>但在这个机器可以跑在最前面不知疲倦迭代时，最不可替代的，依然是站在循环终点、冷眼旁观并进行终极把关的——<strong>你自己的审慎思维</strong>。</p>

<p>构建你的循环，但不要沦为循环的客体。保持你作为工程师的灵魂。</p>]]></content><author><name>Tingde Liu</name></author><category term="blog" /><category term="Loop Engineering" /><category term="Agentic Workflow" /><category term="Harness Engineering" /><category term="AI Engineering" /><category term="Claude Code" /><category term="Codex" /><summary type="html"><![CDATA[Loop Engineering（循环工程）是 2026 年 AI 智能体开发的最核心演进。它将开发者的角色从“亲自 Prompt 的打字员”转变为“设计 Agent 闭环系统的架构师”。本文结合最新行业实践，深度拆解 Loop Engineering 的四种核心循环模式、五大基础原语、外部化状态机制，以及应对“认知投降”、“理解债”与“Token 螺旋”等核心工程守则。]]></summary></entry></feed>